Índices e Tabelas Organizadas por Índices
Índices são objetos de esquema que podem acelerar o acesso às linhas da tabela. Tabelas organizadas por índice são tabelas armazenadas em uma estrutura de índice.
-
Introdução a Índices Um índice é uma estrutura opcional, associada a uma tabela ou a um cluster de tabelas, que às vezes pode acelerar o acesso aos dados.
-
Visão Geral de Índices de Árvore B As árvores B, abreviadas para árvores balanceadas, são o tipo mais comum de índice de banco de dados. Um índice de árvore B é uma lista ordenada de valores divididos em intervalos. Ao associar uma chave a uma linha ou a um intervalo de linhas, as árvores B fornecem excelente desempenho de recuperação para uma ampla gama de consultas, incluindo correspondências exatas e pesquisas de intervalo.
-
Visão Geral de Índices de Bitmap Em um índice de bitmap, o banco de dados armazena um bitmap para cada chave de índice. Em um índice de árvore B convencional, uma entrada de índice aponta para uma única linha. Em um índice de bitmap, cada chave de índice armazena ponteiros para várias linhas.
-
Visão Geral de Índices Baseados em Funções Um índice baseado em funções calcula o valor de uma função ou expressão que envolve uma ou mais colunas e o armazena em um índice. Um índice baseado em função pode ser um índice B-tree ou um bitmap.
-
Visão Geral de Índices de Domínio de Aplicativo Um índice de domínio de aplicativo é um índice personalizado específico de um aplicativo.
-
Visão Geral dos Índices HNSW Quantizados Escalares Os índices HNSW (Hierarchical Navigable Small World) quantizados escalares podem ser usados para reduzir os requisitos de memória e acelerar a pesquisa de similaridade.
-
Visão Geral de Tabelas Organizadas por Índice Uma tabela organizada por índice é uma tabela armazenada em uma variação de uma estrutura de índice de árvore B. Por outro lado, uma tabela organizada por heap insere linhas onde elas cabem.
Introdução a Índices
Um índice é uma estrutura opcional, associada a uma tabela ou a um cluster de tabelas, que às vezes pode acelerar o acesso aos dados.
Os índices são objetos de esquema que são lógica e fisicamente independentes dos dados nos objetos aos quais estão associados. Dessa forma, você pode eliminar ou criar um índice sem afetar fisicamente a tabela indexada.
Observação: Se você eliminar um índice, os aplicativos ainda funcionarão. No entanto, o acesso a dados previamente indexados pode ser mais lento.
Para uma analogia, suponha que um gerente de RH tenha uma prateleira de caixas de papelão. As pastas que contêm informações do funcionário são inseridas aleatoriamente nas caixas. A pasta para o funcionário Whalen (ID 200) é 10 pastas acima da parte inferior da caixa 1, enquanto a pasta para King (ID 100) está na parte inferior da caixa 3. Para localizar uma pasta, o gerente procura cada pasta na caixa 1 de baixo para cima e, em seguida, move-se de caixa para caixa até que a pasta seja encontrada. Para acelerar o acesso, o gerente pode criar um índice que liste sequencialmente todos os IDs de funcionários com seu local de pasta:
ID 100: Box 3, position 1 (bottom)
ID 101: Box 7, position 8
ID 200: Box 1, position 10
.
.
.
Da mesma forma, o gerente poderia criar índices separados para sobrenomes de funcionários, IDs de departamento, etc.
Essa seção contém os seguintes tópicos:
-
Vantagens e Desvantagens de Índices A ausência ou a presença de um índice não requer uma alteração na redação de nenhuma instrução SQL.
-
Os Índices de Usabilidade e Visibilidade do Índice são utilizáveis (padrão) ou inutilizáveis, visíveis (padrão) ou invisíveis.
-
Chaves e Colunas Uma chave é um conjunto de colunas ou expressões nas quais você pode criar um índice.
-
Índices Compostos Um índice composto, também chamado de índice concatenado, é um índice em várias colunas de uma tabela.
-
Os Índices Exclusivos e Não Exclusivos podem ser exclusivos ou não exclusivos. Os índices exclusivos garantem que duas linhas de uma tabela não tenham valores duplicados na coluna ou nas colunas de chave.
-
Tipos de Índices O Oracle AI Database fornece vários esquemas de indexação, que fornecem funcionalidade de desempenho complementar.
-
Como o Banco de Dados Mantém Índices O banco de dados mantém e usa índices automaticamente após sua criação.
-
Armazenamento de Índice O Oracle AI Database armazena dados de índice em um segmento de índice.
Vantagens e desvantagens dos índices
A ausência ou a presença de um índice não requer uma alteração na redação de qualquer instrução SQL.
Índice é um caminho de acesso rápido a uma única linha de dados. Isso afeta apenas a velocidade da execução. Dado um valor de dados que foi indexado, o índice aponta diretamente para o local das linhas que contêm esse valor.
Quando existe um índice em uma ou mais colunas de uma tabela, o banco de dados pode, em alguns casos, recuperar um pequeno conjunto de linhas distribuídas aleatoriamente da tabela. Os índices são um dos muitos meios de reduzir a E/S do disco. Se uma tabela organizada por heap não tiver índices, o banco de dados deverá executar uma verificação completa da tabela para encontrar um valor. Por exemplo, uma consulta do local 2700 na tabela hr.departments não indexada requer que o banco de dados pesquise cada linha em cada bloco. Essa abordagem não se dimensiona bem e os volumes de dados aumentam.
As desvantagens dos índices incluem o seguinte:
-
A criação manual de índices geralmente requer conhecimento profundo do modelo, aplicativo e distribuição de dados.
-
À medida que os dados mudam, você deve rever as decisões anteriores sobre índices. Um índice pode deixar de ser útil ou novos índices podem ser necessários.
-
Os índices ocupam espaço em disco.
-
O banco de dados deve atualizar o índice quando ocorrer DML nos dados indexados, o que cria uma sobrecarga de desempenho. Observação: A partir do Oracle Database 19c, o banco de dados Oracle pode monitorar constantemente a carga de trabalho do aplicativo, criando e gerenciando índices automaticamente. A indexação automatizada é implementada como uma tarefa de banco de dados executada em um intervalo fixo.
Considere criar um índice nas seguintes situações:
-
As colunas indexadas forem consultadas com frequência e retornarem uma pequena porcentagem do número total de linhas na tabela.
-
Uma constraint referencial de integridade existe na(s) coluna(s) indexada(s). O índice é um meio de evitar um bloqueio completo da tabela, que, de outra forma, seria necessário se você atualizasse a tabela pai chave primária, mesclasse na tabela pai ou excluísse dela.
-
Uma constraint de chave exclusiva será colocada na tabela e você deseja especificar manualmente o índice e todas as opções de índice.
Consulte Também:
-
Oracle AI Database Administrator's Guide para saber mais sobre indexação automatizada
-
Manual do Usuário de Informações de Licenciamento do Oracle AI Database para obter detalhes sobre quais recursos são suportados para diferentes edições e serviços
Usabilidade e Visibilidade do Índice
Os índices são utilizáveis (padrão) ou inutilizáveis, visíveis (padrão) ou invisíveis.
Estas propriedades são definidas da seguinte forma:
-
Usabilidade
Um índice inutilizável, que é ignorado pelo otimizador, não é mantido pelas operações DML. Um índice inutilizável pode melhorar o desempenho de cargas em massa. Em vez de eliminar um índice e depois recriá-lo, você pode tornar o índice inutilizável e, em seguida, recriá-lo. Os índices e as partições de índice não utilizáveis não consomem espaço. Quando você torna um índice utilizável inutilizável, o banco de dados elimina seu segmento de índice.
-
Visibilidade
Um índice invisível é mantido pelas operações DML, mas não é usado por padrão pelo otimizador. Tornar um índice invisível é uma alternativa para torná-lo inutilizável ou eliminá-lo. Os índices invisíveis são especialmente úteis para testar a remoção de um índice antes de eliminá-lo ou usar índices temporariamente sem afetar a aplicação geral.
Consulte Também: "Visão Geral do Otimizador" para saber como o otimizador seleciona planos de execução
Chaves e Colunas
Chave é um conjunto de colunas ou expressões nas quais você pode criar um índice.
Embora os termos sejam frequentemente usados de forma intercambiável, os índices e as chaves são diferentes. Índices são estruturas armazenadas no banco de dados que os usuários gerenciam usando instruções SQL. As chaves são estritamente um conceito lógico.
A instrução a seguir cria um índice na coluna customer_id da tabela de amostra oe.orders:
CREATE INDEX ord_customer_ix ON orders (customer_id);Na instrução anterior, a coluna customer_id é a chave de índice. O próprio índice é chamado ord_customer_ix.
Observação: as chaves primárias e exclusivas têm índices automaticamente, mas talvez você queira criar um índice em uma chave estrangeira.
Consulte Também:
-
Oracle AI Database SQL Language Reference
CREATE INDEXsintaxe e semântica
Índices Compostos
Um índice composto, também chamado de índice concatenado, é um índice em várias colunas de uma tabela.
Coloque as colunas em um índice composto na ordem que faça mais sentido para as consultas que recuperarão os dados. As colunas não precisam ser adjacentes na tabela.
Os índices compostos podem agilizar a recuperação de dados para instruções SELECT nas quais a cláusula WHERE faz referência a todas as colunas ou à parte inicial do índice composto. Portanto, a ordem das colunas usadas na definição é importante. Em geral, as colunas mais acessadas são as primeiras.
Por exemplo, suponha que um aplicativo consulta frequentemente as colunas last_name, job_id e salary na tabela employees. Suponha também que last_name tenha uma cardinalidade alta, o que significa que o número de valores distintos é grande em comparação com o número de linhas da tabela. Você cria um índice com a seguinte ordem de coluna:
CREATE INDEX employees_ix
   ON employees (last_name, job_id, salary);
As consultas que acessam todas as três colunas, somente a coluna last_name ou apenas as colunas last_name e job_id usam esse índice. Neste exemplo, as consultas que não acessam a coluna last_name não usam o índice.
Observação: Em alguns casos, como quando a coluna principal tem cardinalidade muito baixa, o banco de dados pode usar uma verificação ignorada desse índice (consulte "Ignorar Verificação de Índice").
Podem existir vários índices na mesma tabela com a mesma ordem de coluna quando atenderem a qualquer uma das seguintes condições:
-
Os índices são de tipos diferentes.
Por exemplo, você pode criar índices de bitmap e B nas mesmas colunas.
-
Os índices usam esquemas de particionamento diferentes.
Por exemplo, você pode criar índices que são particionados localmente e índices que são particionados globalmente.
-
Os índices têm diferentes propriedades de exclusividade.
Por exemplo, você pode criar um índice exclusivo e um não exclusivo no mesmo conjunto de colunas.
Por exemplo, um índice não particionado, um índice particionado global e um índice particionado localmente podem existir para as mesmas colunas de tabela na mesma ordem. Somente um índice com o mesmo número de colunas na mesma ordem pode ser visível de cada vez.
Esse recurso permite migrar aplicativos sem a necessidade de eliminar um índice existente e recriá-lo com atributos diferentes. Além disso, esse recurso é útil em um banco de dados OLTP quando uma chave de índice continua aumentando, fazendo com que o banco de dados insira novas entradas no mesmo conjunto de blocos de índice. Para aliviar esses "pontos quentes", você pode evoluir o índice de um índice não particionado para um índice particionado global.
Se os índices no mesmo conjunto de colunas não diferirem no tipo ou esquema de particionamento, esses índices deverão usar permutações de coluna diferentes. Por exemplo, as seguintes instruções SQL especificam permutações de coluna válidas:
CREATE INDEX employee_idx1 ON employees (last_name, job_id);
CREATE INDEX employee_idx2 ON employees (job_id, last_name);
Consulte Também: Oracle AI Database SQL Tuning Guide para saber mais sobre a criação de vários índices no mesmo conjunto de colunas
Índices Exclusivos e Não Exclusivos
Os índices podem ser exclusivos ou não exclusivos. Os índices exclusivos garantem que duas linhas de uma tabela não tenham valores duplicados na coluna ou nas colunas de chave.
Por exemplo, seu aplicativo pode exigir que dois funcionários não tenham o mesmo ID. Em um índice exclusivo, existe um id de linha para cada valor de dados. Os dados nos blocos de folha são classificados apenas por chave.
Índices não exclusivos permitem valores duplicados na(s) coluna(s) indexada(s). Por exemplo, a coluna first_name da tabela employees pode conter vários valores Mike. Para um índice não exclusivo, o rowid é incluído na chave em ordem classificada, de modo que os índices não exclusivos são classificados pela chave de índice e rowid (crescente).
O Oracle AI Database não indexa linhas de tabela nas quais todas as colunas-chave são nulas, exceto para índices de bitmap ou quando o valor da coluna-chave do cluster é nulo.
Tipos de Índices
O Oracle AI Database fornece vários esquemas de indexação, que fornecem funcionalidade de desempenho complementar.
Os índices de árvore B são o tipo de índice padrão. São excelentes para índices altamente seletivos (poucas linhas correspondem a cada entrada de índice) e índices de chave primária. Usado como índices concatenados, um índice de árvore B pode recuperar dados classificados pelas colunas indexadas. Os índices de árvore B têm os subtipos mostrados na tabela a seguir.
Tabela 1 Subtipos de Índice de Árvore B
| Subtipo de Índice de Árvore B | Descrição | Para Saber Mais |
|---|---|---|
| Tabelas organizadas por índice | Uma tabela organizada por índice difere de uma tabela organizada por heap porque os dados são, em si, o índice. | "Visão Geral de Tabelas Organizadas por Índice" |
| Reverter índices de chaves | Neste tipo de índice, os bytes da chave de índice são invertidos, por exemplo, 103 é armazenado como 301. A reversão de bytes se espalha para fora insere no índice ao longo de muitos blocos. | "Reverter Índices de Chaves" |
| índices decrescentes | Esse tipo de índice armazena dados em uma ou mais colunas específicas em ordem decrescente. | "Índices Ascendentes e Descendentes" |
| Índices de cluster de árvore B | Esse tipo de índice armazena dados em uma ou mais colunas específicas em ordem decrescente. | "Índices Ascendentes e Descendentes" |
A tabela a seguir mostra tipos de índices que não usam uma estrutura de árvore B.
Tabela 2 Índices Não Usando uma Estrutura de Árvore B
| Tipo | Descrição | Para Saber Mais |
|---|---|---|
| Índices de junção de bitmap e bitmap | Em um índice de bitmap, uma entrada de índice usa um bitmap para apontar para várias linhas. Por outro lado, uma entrada de índice de árvore B aponta para uma única linha. Um índice de junção de bitmap é um índice de bitmap para a junção de duas ou mais tabelas. | "Visão Geral de Índices de Bitmap" |
| Índices baseados em função | Esse tipo de índice inclui colunas que são transformadas por uma função, como a função UPPER, ou incluídas em uma expressão. Os índices de bitmap ou de árvore B podem ser baseados em função. |
"Visão Geral de Índices Baseados em Funções" |
| Índices de domínio do aplicativo | Um usuário cria esse tipo de índice para dados em um domínio específico do aplicativo. O índice físico não precisa usar uma estrutura de índice tradicional e pode ser armazenado no banco de dados Oracle como tabelas ou externamente como um arquivo. | "Visão Geral dos Índices de Domínio de Aplicativo" |
Consulte Também:
-
Oracle AI Database Administrator's Guide para aprender a gerenciar índices
-
Guia de Ajuste do Oracle AI Database SQL para saber mais sobre diferentes caminhos de acesso ao índice
Como o Banco de Dados Mantém Índices
O banco de dados mantém e usa índices automaticamente após sua criação.
Os índices refletem automaticamente as mudanças nos dados nas tabelas subjacentes. Exemplos de alterações incluem adicionar, atualizar e excluir linhas. Nenhuma ação do usuário é necessária.
O desempenho de recuperação dos dados indexados permanece quase constante, mesmo quando as linhas são inseridas. No entanto, a presença de muitos índices em uma tabela degrada o desempenho da DML porque o banco de dados também deve atualizar os índices.
Consulte Também:
-
Oracle AI Database Administrator's Guide para saber mais sobre indexação automatizada
-
Manual do Usuário de Informações de Licenciamento do Oracle AI Database para obter detalhes sobre quais recursos são suportados para diferentes edições e serviços
Armazenamento de Índice
O Oracle AI Database armazena dados de índice em um segmento de índice.
O espaço disponível para dados de índice em um bloco de dados é o tamanho do bloco de dados menos a sobrecarga do bloco, a sobrecarga de entrada, o id da linha e um byte de comprimento para cada valor indexado.
O tablespace de um segmento de índice é o tablespace padrão do proprietário ou um tablespace especificamente nomeado na instrução CREATE INDEX. Para facilitar a administração, você pode armazenar um índice em um tablespace separado de sua tabela. Por exemplo, você pode optar por não fazer backup de tablespaces que contêm apenas índices, que podem ser recriados e, portanto, diminuir o tempo e o armazenamento necessários para backups.
Consulte Também: "Visão Geral de Blocos de Índice" para saber mais sobre os tipos de bloco de índice (raiz, ramificação e folha) e como as entradas de índice são armazenadas em um bloco
Visão Geral de Índices de Árvore B
As árvores B, abreviadas para árvores balanceadas, são o tipo mais comum de índice de banco de dados. Um índice de árvore B é uma lista ordenada de valores divididos em intervalos. Ao associar uma chave a uma linha ou a um intervalo de linhas, as árvores B fornecem excelente desempenho de recuperação para uma ampla gama de consultas, incluindo correspondências exatas e pesquisas de intervalo.
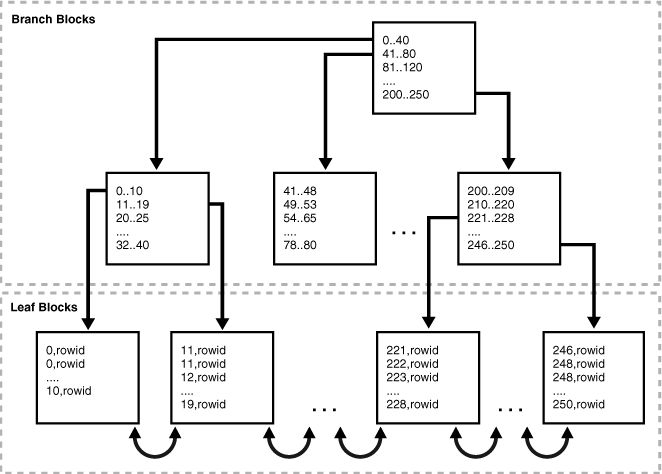
A figura a seguir ilustra a estrutura de um índice de árvore B. O exemplo mostra um índice na coluna department_id, que é uma coluna de chave estrangeira na tabela employees.
Figura 1: Estrutura interna de um índice de árvore B
Descrição da ilustração cncpt244.gif
Essa seção contém os seguintes tópicos:
-
Blocos de Ramificação e Blocos de Folha Um índice de árvore B tem dois tipos de blocos: o bloco de ramificação para pesquisa e o bloco de folha para armazenar valores de chave. Os blocos de ramificação de nível superior de um índice de árvore B contêm dados de índice que apontam para blocos de índice de nível inferior.
-
Verificações de Índice Em uma verificação de índice, o banco de dados recupera uma linha percorrendo o índice, usando os valores de coluna indexados especificados pela instrução. Se o banco de dados procurar um valor no índice, ele encontrará esse valor em n E/Ss em que n é a altura do índice da árvore B. Este é o princípio básico por trás dos índices do Oracle AI Database.
-
Inverter Índices de Chave Um índice de chave reversa é um tipo de índice de árvore B que inverte fisicamente os bytes de cada chave de índice, mantendo a ordem da coluna.
-
Índices Decrescentes e Decrescentes Em um índice crescente, o Oracle AI Database armazena dados em ordem crescente. Por padrão, os dados de caracteres são ordenados pelos valores binários contidos em cada byte do valor, dados numéricos do menor para o maior número e data do mais antigo para o mais recente.
-
Compactação de Índice Para reduzir o espaço em índices, o Oracle AI Database pode empregar diferentes algoritmos de compactação.
Blocos de ramos e blocos de folhas
Um índice de árvore B tem dois tipos de blocos: o bloco de ramificação para pesquisa e o bloco de folha para armazenar valores de chave. Os blocos de ramificação de nível superior de um índice de árvore B contêm dados de índice que apontam para blocos de índice de nível inferior.
Na Figura 5-1, o bloco de ramificação raiz tem uma entrada 0-40, que aponta para o bloco mais à esquerda no próximo nível de ramificação. Este bloco de ramificação contém entradas como 0-10 e 11-19. Cada uma dessas entradas aponta para um bloco de folha que contém valores de chave que se enquadram no intervalo.
Um índice de árvore B é equilibrado porque todos os blocos de folhas permanecem automaticamente na mesma profundidade. Assim, a recuperação de qualquer registro de qualquer lugar no índice leva aproximadamente a mesma quantidade de tempo. A altura do índice é o número de blocos necessários para ir do bloco raiz para um bloco de folhas. O nível da ramificação é a altura menos 1. Na Figura 5-1, o índice tem uma altura de 3 e um nível de ramificação de 2.
Os blocos de ramificação armazenam o prefixo de chave mínimo necessário para tomar uma decisão de ramificação entre duas chaves. Essa técnica permite que o banco de dados ajuste o máximo de dados possível em cada bloco de ramificação. Os blocos de ramificação contêm um ponteiro para o bloco filho que contém a chave. O número de teclas e ponteiros é limitado pelo tamanho do bloco.
Os blocos de folha contêm todos os valores de dados indexados e um id de linha correspondente usado para localizar a linha real. Cada entrada é classificada por (chave, rowid). Dentro de um bloco de folhas, uma chave e um id de linha são vinculados às suas entradas de irmãos à esquerda e à direita. Os próprios blocos de folhas também estão duplamente ligados. Na Figura 5-1 o bloco de folha mais à esquerda (0-10) é vinculado ao segundo bloco de folha (11-19). Observação: Os índices em colunas com dados de caracteres são baseados nos valores binários dos caracteres no conjunto de caracteres do banco de dados.
Varreduras de Índice
Em uma verificação de índice, o banco de dados recupera uma linha percorrendo o índice, usando os valores de coluna indexados especificados pela instrução. Se o banco de dados procurar um valor no índice, ele encontrará esse valor em n E/Ss em que n é a altura do índice da árvore B. Este é o princípio básico por trás dos índices do Oracle AI Database.
Se uma instrução SQL acessar apenas colunas indexadas, o banco de dados lerá valores diretamente do índice, em vez de da tabela. Se a instrução acessar colunas não indexadas além das colunas indexadas, o banco de dados usará rowids para localizar as linhas na tabela. Normalmente, o banco de dados recupera dados da tabela lendo alternadamente um bloco de índice e, em seguida, um bloco de tabela.
-
Verificação Completa de Índice Em uma verificação completa de índice, o banco de dados lê todo o índice em ordem. Uma verificação completa do índice estará disponível se um predicado (cláusula
WHERE) na instrução SQL fizer referência a uma coluna no índice e, em algumas circunstâncias, quando nenhum predicado for especificado. Uma verificação completa pode eliminar a classificação porque os dados são ordenados por chave de índice. -
Verificação Rápida de Índice Completo Uma verificação rápida de índice completo é uma verificação completa de índice na qual o banco de dados acessa os dados no próprio índice sem acessar a tabela e o banco de dados lê os blocos de índice sem nenhuma ordem específica.
-
Verificação de Intervalo de Índices Uma verificação de intervalo de índices é uma verificação ordenada de um índice no qual uma ou mais colunas iniciais de um índice são especificadas em condições, e são possíveis 0, 1 ou mais valores para uma chave de índice.
-
Verificação Exclusiva de Índice Ao contrário de uma verificação de intervalo de índice, uma verificação exclusiva de índice deve ter 0 ou 1 id de linha associado a uma chave de índice.
-
Ignorar Verificação de Índice Uma verificação de ignorar índice usa subíndices lógicos de um índice composto. O banco de dados "ignora" um único índice como se estivesse pesquisando índices separados.
-
Fator de Clusterização de Índice O fator de clusterização de índice mede a ordem das linhas em relação a um valor indexado, como sobrenome do funcionário. À medida que o grau de ordem aumenta, o fator de agrupamento diminui. Consulte Também: Guia de Ajuste do Oracle AI Database SQL para obter informações detalhadas sobre verificações de índice
Verificação Completa do Índice
Em uma verificação completa do índice, o banco de dados lê o índice inteiro em ordem. Uma verificação completa do índice estará disponível se um predicado (cláusula WHERE) na instrução SQL fizer referência a uma coluna no índice e, em algumas circunstâncias, quando nenhum predicado for especificado. Uma verificação completa pode eliminar a classificação porque os dados são ordenados por chave de índice.
Exemplo 5-1 Verificação Completa do Índice
Suponha que um aplicativo execute a seguinte consulta:
SELECT department_id, last_name, salary
FROM   employees
WHERE  salary > 5000
ORDER BY department_id, last_name;
Neste exemplo, o department_id, o last_name e o salary são uma chave composta em um índice. O Oracle AI Database executa uma verificação completa do índice, lendo-o em ordem classificada (ordenada por ID e sobrenome do departamento) e filtrando no atributo de salário. Dessa forma, o banco de dados verifica um conjunto de dados menor que a tabela employees, que contém mais colunas do que as incluídas na consulta e evita a classificação dos dados.
A varredura completa poderia ler as entradas de índice da seguinte forma:
50,Atkinson,2800,rowid
60,Austin,4800,rowid
70,Baer,10000,rowid
80,Abel,11000,rowid
80,Ande,6400,rowid
110,Austin,7200,rowid
.
.
.
Verificação Rápida de Índice Completo
Uma verificação de índice completa rápida é uma verificação de índice completa na qual o banco de dados acessa os dados no próprio índice sem acessar a tabela e o banco de dados lê os blocos de índice sem nenhuma ordem específica.
Varreduras completas rápidas de índice são uma alternativa para uma varredura completa de tabela quando ambas as condições são atendidas:
-
O índice deve conter todas as colunas necessárias para a consulta.
-
Uma linha que contenha todos os nulos não deve aparecer no conjunto de resultados da consulta. Para que esse resultado seja garantido, pelo menos uma coluna no índice deve ter:
-
Uma restrição
NOT NULL -
Um predicado aplicado à coluna que impede que nulos sejam considerados no conjunto de resultados da consulta
-
Exemplo 5-2 Verificação Rápida de Índice Completo
Suponha que um aplicativo emita a seguinte consulta, que não inclui uma cláusula ORDER BY:
SELECT last_name, salary
FROM   employees;
A coluna last_name tem uma restrição não nula. Se o sobrenome e o salário forem uma chave composta em um índice, uma rápida verificação completa do índice poderá ler as entradas de índice para obter as informações solicitadas:
Baida,2900,rowid
Atkinson,2800,rowid
Zlotkey,10500,rowid
Austin,7200,rowid
Baer,10000,rowid
Austin,4800,rowid
.
.
.
Varredura do Intervalo de Índice
Uma verificação de intervalo de índices é uma verificação ordenada de um índice no qual uma ou mais colunas iniciais de um índice são especificadas em condições, e são possíveis 0, 1 ou mais valores para uma chave de índice.
Uma condição especifica uma combinação de uma ou mais expressões e operadores lógicos (Boolianos). Ela retorna um valor de TRUE, FALSE ou UNKNOWN.
O banco de dados geralmente usa uma varredura de intervalo de índice para acessar dados seletivos. A seletividade é a porcentagem de linhas na tabela que a consulta seleciona, com 0 significando nenhuma linha e 1 significando todas as linhas. A seletividade é vinculada a um predicado de consulta, como WHERE last_name LIKE 'A%', ou a uma combinação de predicados. Um predicado se torna mais seletivo à medida que o valor se aproxima de 0 e menos seletivo (ou mais não seletivo) à medida que o valor se aproxima de 1.
Por exemplo, um usuário consulta funcionários cujos sobrenomes começam com A. Suponha que a coluna last_name seja indexada, com as seguintes entradas:
Abel,rowid
Ande,rowid
Atkinson,rowid
Austin,rowid
Austin,rowid
Baer,rowid
.
.
.
O banco de dados pode usar uma verificação de intervalo porque a coluna last_name é especificada no predicado e vários rowids são possíveis para cada chave de índice. Por exemplo, dois funcionários são chamados Austin, portanto, dois rowids estão associados à chave Austin.
Uma varredura de intervalo de índice pode ser delimitada em ambos os lados, como em uma consulta para departamentos com IDs entre 10 e 40, ou limitada em apenas um lado, como em uma consulta para IDs acima de 40. Para verificar o índice, o banco de dados se move para trás ou para frente através dos blocos de folha. Por exemplo, uma varredura para IDs entre 10 e 40 localiza o primeiro bloco de folha de índice que contém o valor de chave mais baixo que é 10 ou maior. A varredura prossegue horizontalmente através da lista vinculada de nós folha até que localize um valor maior que 40.
Verificação Exclusiva do Índice
Ao contrário de uma varredura de intervalo de índice, uma varredura exclusiva de índice deve ter 0 ou 1 ID de linha associado a uma chave de índice.
O banco de dados executa uma varredura exclusiva quando um predicado faz referência a todas as colunas na chave de um índice UNIQUE usando um operador de igualdade. Uma varredura exclusiva de índice interrompe o processamento assim que encontra o primeiro registro porque nenhum segundo registro é possível.
Como ilustração, suponha que um usuário execute a seguinte consulta:
SELECT *
FROM   employees
WHERE  employee_id = 5;
Suponha que a coluna employee_id seja a chave primária e seja indexada com entradas da seguinte forma:
1,rowid
2,rowid
4,rowid
5,rowid
6,rowid
.
.
.
Nesse caso, o banco de dados pode usar uma verificação exclusiva de índice para localizar o ID da linha do funcionário cujo ID é 5.
Ignorar Verificação de Índice
Uma verificação de ignorar índice usa subíndices lógicos de um índice composto. O banco de dados "ignora" um único índice como se estivesse pesquisando índices separados.
Ignorar a verificação será benéfico se houver poucos valores distintos na coluna principal de um índice composto e muitos valores distintos na chave não líder do índice. O banco de dados pode escolher uma varredura de ignorar índice quando a coluna principal do índice composto não for especificada em um predicado de consulta.
Exemplo 5-3 Ignorar Verificação de um Índice Composto
Suponha que você execute a seguinte consulta para um cliente na tabela sh.customers:
SELECT * FROM sh.customers WHERE cust_email = 'Abbey@company.example.com';A tabela customers tem uma coluna cust_gender cujos valores são M ou F. Suponha que exista um índice composto nas colunas (cust_gender, cust_email). O exemplo a seguir mostra uma parte das entradas de índice:
F,Wolf@company.example.com,rowid
F,Wolsey@company.example.com,rowid
F,Wood@company.example.com,rowid
F,Woodman@company.example.com,rowid
F,Yang@company.example.com,rowid
F,Zimmerman@company.example.com,rowid
M,Abbassi@company.example.com,rowid
M,Abbey@company.example.com,rowid
O banco de dados pode usar uma verificação ignorada deste índice, mesmo que cust_gender não esteja especificado na cláusula WHERE.
Em uma varredura ignorada, o número de subíndices lógicos é determinado pelo número de valores distintos na coluna à esquerda. No exemplo anterior, a coluna anterior possui dois valores possíveis. O banco de dados divide logicamente o índice em um subíndice com a chave F e um segundo subíndice com a chave M.
Ao procurar o registro do cliente cujo e-mail é Abbey@company.example.com, o banco de dados pesquisa o subíndice com o valor F primeiro e, em seguida, pesquisa o subíndice com o valor M. Conceitualmente, o banco de dados processa a consulta da seguinte forma:
SELECT * FROM sh.customers WHERE cust_gender = 'F'
  AND cust_email = 'Abbey@company.example.com'
UNION ALL
SELECT * FROM sh.customers WHERE cust_gender = 'M'
  AND cust_email = 'Abbey@company.example.com';
Consulte Também: Guia de Ajuste do Oracle AI Database SQL para saber mais sobre ignorar verificações
Fator de Clusterização de Índice
O fator de clusterização de índice mede a ordem das linhas em relação a um valor indexado, como sobrenome do funcionário. À medida que o grau de ordem aumenta, o fator de agrupamento diminui.
O fator de agrupamento é útil como uma medida aproximada do número de E/Ss necessárias para ler uma tabela inteira usando um índice:
-
Se o fator de clustering for alto, o Oracle AI Database executará um número relativamente alto de E/Ss durante uma varredura de intervalo de índice grande. As entradas de índice apontam para blocos de tabela aleatórios, então o banco de dados pode ter que ler e reler os mesmos blocos uma e outra vez para recuperar os dados apontados pelo índice.
-
Se o fator de clustering for baixo, o Oracle AI Database executará um número relativamente baixo de E/Ss durante uma varredura de intervalo de índice grande. As chaves de índice em um intervalo tendem a apontar para o mesmo bloco de dados, de modo que o banco de dados não precisa ler e reler os mesmos blocos repetidamente.
O fator de clustering é relevante para verificações de índice porque ele pode mostrar:
-
Se o banco de dados usará um índice para varreduras de grande intervalo
-
O grau de organização da tabela em relação à chave de índice
-
Se você deve considerar o uso de uma tabela, particionamento ou cluster de tabelas organizados por índice se as linhas tiverem que ser ordenadas pela chave de índice
Exemplo 5-4 Fator de Clusterização
Suponha que a tabela employees se encaixe em dois blocos de dados. Tabela 5-3 descreve as linhas nos dois blocos de dados (as reticências indicam dados que não são mostrados).
Conteúdo da Tabela 3 de Dois Blocos de Dados na Tabela EMPLOYEES
| Bloco de Dados 1 | Bloco de Dados 2 |
|---|---|
|
|
As linhas são armazenadas nos blocos em ordem de sobrenome (mostrado em negrito). Por exemplo, a linha inferior no bloco de dados 1 descreve Abel, a linha seguinte acima descreve Ande, e assim por diante em ordem alfabética até a linha superior no bloco 1 para Steven King. A linha inferior no bloco 2 descreve Kochar, a próxima linha para cima descreve Kumar, e assim por diante em ordem alfabética até a última linha no bloco para Zlotkey.
Suponha que exista um índice na coluna de sobrenome. Cada entrada de nome corresponde a um id de linha. Conceitualmente, as entradas de índice teriam a seguinte aparência:
Abel,block1row1
Ande,block1row2
Atkinson,block1row3
Austin,block1row4
Baer,block1row5
.
.
.
Suponha que exista um índice separado na coluna ID funcionário. Conceitualmente, as entradas de índice podem ter a seguinte aparência, com IDs de funcionário distribuídos em locais quase aleatórios nos dois blocos:
100,block1row50
101,block2row1
102,block1row9
103,block2row19
104,block2row39
105,block1row4
.
.
.
A instrução a seguir consulta a view ALL_INDEXES para o fator de clusterização desses dois índices:
SQL> SELECT INDEX_NAME, CLUSTERING_FACTOR
  2  FROM ALL_INDEXES
  3  WHERE INDEX_NAME IN ('EMP_NAME_IX','EMP_EMP_ID_PK');

INDEX_NAME           CLUSTERING_FACTOR
-------------------- -----------------
EMP_EMP_ID_PK                       19
EMP_NAME_IX                          2
O fator de cluster para EMP_NAME_IX é baixo, o que significa que as entradas de índice adjacentes em um único bloco de folha tendem a apontar para linhas nos mesmos blocos de dados. O fator de cluster para EMP_EMP_ID_PK é alto, o que significa que as entradas de índice adjacentes no mesmo bloco de folha têm muito menos probabilidade de apontar para linhas nos mesmos blocos de dados.
Consulte Também: Oracle AI Database Reference para saber mais sobre a ALL_INDEXES
Reverter Índices de Chave
Um índice de chave reversa é um tipo de índice de árvore B que inverte fisicamente os bytes de cada chave de índice, mantendo a ordem da coluna.
Por exemplo, se a chave de índice for 20 e os dois bytes armazenados para essa chave em hexadecimal forem C1,15 em um índice de árvore B padrão, um índice de chave reversa armazenará os bytes como 15,C1.
Inverter a chave resolve o problema de contenção para blocos de folhas no lado direito de um índice de árvore B. Esse problema pode ser especialmente agudo em um banco de dados Oracle Real Application Clusters (Oracle RAC) no qual várias instâncias modificam repetidamente o mesmo bloco. Por exemplo, em uma tabela orders, as chaves primárias das ordens são sequenciais. Uma instância do cluster adiciona a ordem 20, enquanto outra adiciona 21, com cada instância gravando sua chave no mesmo bloco de folhas no lado direito do índice.
Em um índice de chave reversa, a reversão da ordem de byte distribui as inserções em todas as chaves de folha no índice. Por exemplo, chaves como 20 e 21 que teriam sido adjacentes em um índice de chaves padrão agora são armazenadas distantes em blocos separados. Assim, a E/S para inserções de chaves sequenciais é mais uniformemente distribuída.
Como os dados no índice não são classificados por chave de coluna quando são armazenados, a organização de chave reversa elimina a capacidade de executar uma consulta de varredura de intervalo de índice em alguns casos. Por exemplo, se um usuário emitir uma consulta para IDs de prescrição maiores que 20, o banco de dados não poderá começar com o bloco que contém esse ID e prosseguir horizontalmente pelos blocos de folha.
Índices Crescente e Decrescente
Em um índice em ordem crescente, o Oracle AI Database armazena dados em ordem crescente. Por padrão, os dados de caracteres são ordenados pelos valores binários contidos em cada byte do valor, dados numéricos do menor para o maior número e data do mais antigo para o mais recente.
Para obter um exemplo de índice crescente, considere a seguinte instrução SQL:
CREATE INDEX emp_deptid_ix ON hr.employees(department_id);O Oracle AI Database classifica a tabela hr.employees na coluna department_id. Ele carrega o índice crescente com os valores de id de linha department_id e correspondentes em ordem crescente, começando com 0. Quando usa o índice, o Oracle AI Database pesquisa os valores department_id classificados e usa os rowids associados para localizar linhas que tenham o valor department_id solicitado.
Ao especificar a palavra-chave DESC na instrução CREATE INDEX, é possível criar um índice decrescente. Nesse caso, o índice armazena dados em uma ou mais colunas especificadas em ordem decrescente. Se o índice na Tabela 5-3 na coluna employees.department_id fosse decrescente, o bloqueio de folha contendo 250 estaria no lado esquerdo da árvore e o bloco com 0 à direita. A pesquisa padrão por meio de um índice decrescente é do valor mais alto para o mais baixo.
Os índices decrescentes são úteis quando uma consulta classifica algumas colunas em ordem crescente e outras em ordem decrescente. Para obter um exemplo, suponha que você crie um índice composto nas colunas last_name e department_id da seguinte forma:
CREATE INDEX emp_name_dpt_ix ON hr.employees(last_name ASC, department_id DESC);Se um usuário consultar hr.employees para obter os sobrenomes em ordem crescente (A a Z) e os IDs de departamento em ordem decrescente (alta para baixa), o banco de dados poderá usar esse índice para recuperar os dados e evitar a etapa extra de classificação.
Consulte Também:
-
Guia de Ajuste do Oracle AI Database SQL para saber mais sobre pesquisas de índice crescente e decrescente
-
Oracle AI Database SQL Language Reference para obter descrições das opções
ASCeDESCdoCREATE INDEX
Compactação de Índice
Para reduzir o espaço em índices, o Oracle AI Database pode empregar diferentes algoritmos de compactação.
-
Compressão de Prefixo O Oracle AI Database pode usar a compressão de prefixo, também conhecida como compressão de chave, para compactar partes dos valores da coluna de chave primária em um índice de árvore B ou em uma tabela organizada por índice. A compactação do prefixo pode reduzir bastante o espaço consumido pelo índice.
-
Compactação Avançada de Índice A partir do Oracle Database 12c Release 1 (12.1.0.2), a compactação avançada de índice melhora a compactação de prefixo tradicional para índices suportados em tabelas organizadas por heap.
Compactação de Prefixo
O Oracle AI Database pode usar a compactação de prefixo, também conhecida como compactação de chave, para compactar partes dos valores da coluna de chave primária em um índice de árvore B ou em uma tabela organizada por índice. A compactação do prefixo pode reduzir bastante o espaço consumido pelo índice.
Uma entrada de índice descompactada tem uma parte. Uma entrada de índice usando compressão de prefixo tem duas partes: uma entrada de prefixo, que é a peça de agrupamento, e uma entrada de sufixo, que é a peça única ou quase única. O banco de dados alcança a compactação compartilhando as entradas de prefixo entre as entradas de sufixo em um bloco de índice. Observação: Se uma chave não for definida para ter uma parte exclusiva, o banco de dados fornecerá uma, anexando um id de linha à parte de agrupamento.
Por padrão, o prefixo de um índice exclusivo consiste em todas as colunas de chave, excluindo a última, enquanto o prefixo de um índice não exclusivo consiste em todas as colunas de chave. Suponha que você crie um índice composto exclusivo em duas colunas da tabela oe.orders da seguinte forma:
CREATE UNIQUE INDEX orders_mod_stat_ix ON orders ( order_mode, order_status );No exemplo anterior, uma chave de índice pode ser online,0. O id da linha é armazenado na parte de dados chave da entrada e não faz parte da chave em si.
Observação: Se você criar um índice exclusivo em uma única coluna, o Oracle AI Database não poderá usar a compactação de chave de prefixo porque não existem prefixos comuns.
Como alternativa, suponha que você crie um índice não exclusivo nas mesmas colunas:
CREATE INDEX orders_mod_stat_ix ON orders ( order_mode, order_status );Suponha também que valores repetidos ocorram nas colunas order_mode e order_status. Um bloco de índice pode ter entradas conforme mostrado no exemplo a seguir:
online,0,AAAPvCAAFAAAAFaAAa
online,0,AAAPvCAAFAAAAFaAAg
online,0,AAAPvCAAFAAAAFaAAl
online,2,AAAPvCAAFAAAAFaAAm
online,3,AAAPvCAAFAAAAFaAAq
online,3,AAAPvCAAFAAAAFaAAt
No exemplo anterior, o prefixo de chave consistiria em uma concatenação dos valores order_mode e order_status, como em online,0. O sufixo consiste no id da linha, como em AAAPvCAAFAAAAFaAAa. O id da linha torna a entrada de índice inteira exclusiva porque um id da linha é exclusivo no próprio banco de dados.
Se o índice no exemplo anterior fosse criado com a compactação de prefixo padrão (especificada pela palavra-chave COMPRESS), os prefixos de chave duplicados, como online,0 e online,3 seriam compactados. Conceitualmente, o banco de dados atinge a compactação da seguinte forma:
online,0
AAAPvCAAFAAAAFaAAa
AAAPvCAAFAAAAFaAAg
AAAPvCAAFAAAAFaAAl
online,2
AAAPvCAAFAAAAFaAAm
online,3
AAAPvCAAFAAAAFaAAq
AAAPvCAAFAAAAFaAAt
As entradas de sufixo (os rowids) formam a versão compactada das linhas de índice. Cada entrada de sufixo faz referência a uma entrada de prefixo, que é armazenada no mesmo bloco de índice que o sufixo.
Como alternativa, você pode especificar um comprimento de prefixo ao criar um índice que usa compactação de prefixo. Por exemplo, se você especificou COMPRESS 1, o prefixo seria order_mode e o sufixo seria order_status,rowid. Para os valores no exemplo de bloco de índice, o índice consideraria ocorrências duplicadas do prefixo online, que pode ser representado conceitualmente da seguinte forma:
online
0,AAAPvCAAFAAAAFaAAa
0,AAAPvCAAFAAAAFaAAg
0,AAAPvCAAFAAAAFaAAl
2,AAAPvCAAFAAAAFaAAm
3,AAAPvCAAFAAAAFaAAq
3,AAAPvCAAFAAAAFaAAt
O índice armazena um prefixo específico uma vez por bloco de folha no máximo. Apenas as chaves nos blocos de folhas de um índice de árvore B são compactadas. Nos blocos de ramificação, o sufixo da chave pode ser truncado, mas a chave não é compactada.
Consulte Também:
-
Oracle AI Database Administrator's Guide para aprender a usar índices compactados
-
Oracle AI Database VLDB and Partitioning Guide para saber como usar compactação de prefixo para índices particionados
-
Oracle AI Database SQL Language Reference para obter descrições da cláusula key_compression da
CREATE INDEX
Compactação de Índice Avançada
A partir do Oracle Database 12c Release 1 ( 12.1.0.2), a compactação avançada de índice melhora a compactação de prefixo tradicional para índices suportados em tabelas organizadas por heap.
Benefícios da compactação avançada de índice
A compactação de prefixo tem limitações para tipos de índices suportados, taxa de compactação e facilidade de uso. Ao contrário da compactação de prefixo, que usa a eliminação de chave duplicada fixa para cada bloco, a compactação de índice avançada usa a eliminação de chave duplicada adaptável por bloco. As principais vantagens da compressão de índice avançada são:
-
O banco de dados escolhe automaticamente a melhor compactação para cada bloco, usando vários algoritmos internos, como prefixos de nível intra-coluna, eliminação de chave duplicada e compactação de id de linha. Ao contrário da compactação de prefixo, a compactação de índice avançada não exige que o usuário conheça as características dos dados.
-
A compactação avançada funciona em índices exclusivos e não exclusivos. A compactação de prefixos funciona bem em alguns índices não exclusivos, mas os índices são menores em índices cujas colunas iniciais não têm muitas repetições.
-
O índice comprimido é utilizável da mesma forma que um índice descompactado. O índice suporta os mesmos caminhos de acesso: pesquisas de chave exclusivas, varreduras de intervalo e varreduras completas rápidas.
-
Os índices podem herdar a compactação avançada de uma tabela pai ou contendo tablespace.
-
Tabelas organizadas por índices e índices baseados em funções suportam compactação avançada de índices. Tabelas organizadas por índice suportam baixa compactação. Os índices baseados em funções suportam compactação baixa e alta.
Como funciona a compactação avançada de índices
A compactação avançada de índice funciona no nível do bloco para fornecer a melhor compactação para cada bloco. O banco de dados usa a seguinte técnica:
-
Durante a criação do índice, à medida que um bloco de folha se torna cheio, o banco de dados compacta automaticamente o bloco para o nível ideal.
-
Ao reorganizar um bloco de índice como resultado de DML, se o banco de dados puder criar espaço suficiente para a entrada de índice de entrada, não ocorrerá uma divisão de bloco. Durante a DML sem compactação avançada de índice, no entanto, uma divisão de bloco de índice sempre ocorre quando o bloco se torna cheio.
Compactação avançada de índice ALTA
Nas versões anteriores ao Oracle Database 12c Release 2 (12.2), a única forma de compactação de índice avançada era a baixa compactação (COMPRESS ADVANCED LOW). Agora você também pode especificar a compactação alta (COMPRESS ADVANCED HIGH), que é o padrão. A compactação avançada de índice com a opção HIGH oferece as seguintes vantagens:
-
Oferece taxas de compactação mais altas na maioria dos casos, além de melhorar o desempenho das consultas que acessam o índice
-
Emprega algoritmos de compactação mais complexos do que avançados baixos
-
Armazena dados em uma unidade de compactação, que é um formato especial em disco Observação: Quando você aplica a compactação
HIGH, todos os blocos têm compactação. Quando você aplica a compactaçãoLOW, o banco de dados pode deixar alguns blocos descompactados. Você pode usar estatísticas para determinar quantos blocos ficaram descompactados.
Exemplo 5-5 Criando um Índice com Alta Compactação Avançada
Este exemplo ativa a compactação avançada de índice para um índice na tabela hr.employees:
CREATE INDEX hr.emp_mndp_ix
  ON hr.employees(manager_id, department_id)
  COMPRESS ADVANCED;
A consulta a seguir mostra o tipo de compactação:
SELECT COMPRESSION FROM DBA_INDEXES WHERE INDEX_NAME ='EMP_MNDP_IX';

COMPRESSION
-------------
ADVANCED HIGH
Consulte Também:
-
Oracle AI Database Administrator's Guide para saber como ativar a compactação avançada de índices
-
Oracle AI Database SQL Language Reference para obter descrições da cláusula key_compression do
CREATE INDEX -
Oracle AI Database Reference para saber mais sobre a
ALL_INDEXES
Visão Geral de Índices de Bitmap
Em um índice bitmap, o banco de dados armazena um bitmap para cada chave de índice. Em um índice de árvore B convencional, uma entrada de índice aponta para uma única linha. Em um índice de bitmap, cada chave de índice armazena ponteiros para várias linhas.
Os índices de bitmap são projetados principalmente para data warehousing ou ambientes nos quais as consultas fazem referência a muitas colunas de forma ad hoc. Situações que podem exigir um índice de bitmap incluem:
-
As colunas indexadas têm baixa cardinalidade, ou seja, o número de valores distintos é pequeno em comparação com o número de linhas da tabela.
-
A tabela indexada for somente leitura ou não estiver sujeita a modificações significativas por instruções DML.
Para um exemplo de data warehouse, a tabela sh.customers tem uma coluna cust_gender com apenas dois valores possíveis: M e F. Suponhamos que as consultas para o número de clientes de um determinado sexo sejam comuns. Nesse caso, a coluna customers.cust_gender seria candidata a um índice de bitmap.
Cada bit no bitmap corresponde a um possível rowid. Se o bit estiver definido, a linha com o id de linha correspondente conterá o valor da chave. Uma função de mapeamento converte a posição do bit em um rowid real, de modo que o índice bitmap fornece a mesma funcionalidade que um índice B-tree, embora use uma representação interna diferente.
Se a coluna indexada em uma única linha for atualizada, o banco de dados bloqueará a entrada da chave de índice (por exemplo, M ou F) e não o bit individual mapeado para a linha atualizada. Como uma chave aponta para muitas linhas, a DML nos dados indexados normalmente bloqueia todas essas linhas. Por esse motivo, os índices de bitmap não são apropriados para muitos aplicativos OLTP.
-
Exemplo: Índices de Bitmap em uma Única Tabela Neste exemplo, algumas colunas da tabela
sh.customerssão candidatas a um índice de bitmap. -
Índices de Junção de Bitmap Um índice de junção de bitmap é um índice de bitmap para a junção de duas ou mais tabelas.
-
Estrutura de Armazenamento de Bitmap O Oracle AI Database usa uma estrutura de índice de árvore B para armazenar bitmaps para cada chave indexada.
Consulte Também:
-
Guia de Ajuste do Oracle AI Database SQL para saber mais sobre índices de bitmap
-
Guia do Oracle AI Database Data Warehousing para aprender a usar índices de bitmap em um data warehouse
Exemplo: Índices de Bitmap em uma Única Tabela
Neste exemplo, algumas colunas da tabela sh.customers são candidatas a um índice de bitmap.
Considere a seguinte consulta:
SQL> SELECT cust_id, cust_last_name, cust_marital_status, cust_gender
  2  FROM   sh.customers
  3  WHERE  ROWNUM < 8 ORDER BY cust_id;

   CUST_ID CUST_LAST_ CUST_MAR C
---------- ---------- -------- -
         1 Kessel              M
         2 Koch                F
         3 Emmerson            M
         4 Hardy               M
         5 Gowen               M
         6 Charles    single   F
         7 Ingram     single   F

7 rows selected.
As colunas cust_marital_status e cust_gender têm baixa cardinalidade, enquanto cust_id e cust_last_name não. Assim, os índices de bitmap podem ser apropriados em cust_marital_status e cust_gender. Um índice de bitmap provavelmente não é útil para as outras colunas. Em vez disso, um índice de árvore B exclusivo nessas colunas provavelmente forneceria a representação e a recuperação mais eficientes. Tabela 5-4 ilustra o índice de bitmap para a saída da coluna cust_gender mostrada no exemplo anterior. Consiste em dois bitmaps separados, um para cada gênero.
Bitmap de Amostra da Tabela 4 para Uma Coluna
| Valor | Linha 1 | Linha 2 | Linha 3 | Linha 4 | Linha 5 | Linha 6 | Linha 7 |
|---|---|---|---|---|---|---|---|
M |
1 | 0 | 1 | 1 | 1 | 0 | 0 |
F |
0 | 1 | 0 | 0 | 0 | 1 | 1 |
Uma função de mapeamento converte cada bit no bitmap em um id de linha da tabela customers. Cada valor de bit depende dos valores da linha correspondente na tabela. Por exemplo, o bitmap do valor M contém um 1 como seu primeiro bit porque o gênero é M na primeira linha da tabela customers. O bitmap cust_gender='M' tem um 0 para os bits nas linhas 2, 6 e 7 porque essas linhas não contêm M como seu valor.
Observação: Os índices de bitmap podem incluir chaves que consistem inteiramente em valores nulos, ao contrário dos índices de árvore B. A indexação de nulos pode ser útil para algumas instruções SQL, como consultas com a função de agregação COUNT.
Um analista que investiga as tendências demográficas dos clientes pode perguntar: "Quantas de nossas clientes do sexo feminino são solteiras ou divorciadas?" Esta pergunta corresponde à seguinte consulta SQL:
SELECT COUNT(*)
FROM   customers
WHERE  cust_gender = 'F'
AND    cust_marital_status IN ('single', 'divorced');
Os índices de bitmap podem processar essa consulta de forma eficiente contando o número de valores 1 no bitmap resultante, conforme ilustrado na Tabela 5-5. Para identificar os clientes que atendem aos critérios, o Oracle AI Database pode usar o bitmap resultante para acessar a tabela.
Tabela 5 Exemplo de Bitmap para Duas Colunas
| Valor | Linha 1 | Linha 2 | Linha 3 | Linha 4 | Linha 5 | Linha 6 | Linha 7 |
|---|---|---|---|---|---|---|---|
M |
1 | 0 | 1 | 1 | 1 | 0 | 0 |
F |
0 | 1 | 0 | 0 | 0 | 1 | 1 |
single |
0 | 0 | 0 | 0 | 0 | 1 | 1 |
divorced |
0 | 0 | 0 | 0 | 0 | 0 | 0 |
single ou divorced e F |
0 | 0 | 0 | 0 | 0 | 1 | 1 |
A indexação de bitmap mescla de forma eficiente índices que correspondem a várias condições em uma cláusula WHERE. Linhas que satisfazem algumas condições, mas não todas, são filtradas antes de a própria tabela ser acessada. Esta técnica melhora o tempo de resposta, muitas vezes dramaticamente.
Índices de Junção de Bitmap
Um índice de junção bitmap é um índice de bitmap para a junção de duas ou mais tabelas.
Para cada valor em uma coluna de tabela, o índice armazena o id da linha correspondente na tabela indexada. Por outro lado, um índice de bitmap padrão é criado em uma única tabela.
Um índice de junção de bitmap é um meio eficiente de reduzir o volume de dados que devem ser unidos, executando restrições com antecedência. Para um exemplo de quando um índice de junção de bitmap seria útil, suponha que os usuários frequentemente consultem o número de funcionários com um tipo de cargo específico. Uma consulta típica pode ter a seguinte aparência:
SELECT COUNT(*)
FROM   employees, jobs
WHERE  employees.job_id = jobs.job_id
AND    jobs.job_title = 'Accountant';
A consulta anterior normalmente usaria um índice em jobs.job_title para recuperar as linhas de Accountant e, em seguida, o ID do job e um índice em employees.job_id para localizar as linhas correspondentes. Para recuperar os dados do próprio índice em vez de uma varredura das tabelas, você pode criar um índice de junção de bitmap da seguinte forma:
CREATE BITMAP INDEX employees_bm_idx
ON     employees (jobs.job_title)
FROM   employees, jobs
WHERE  employees.job_id = jobs.job_id;
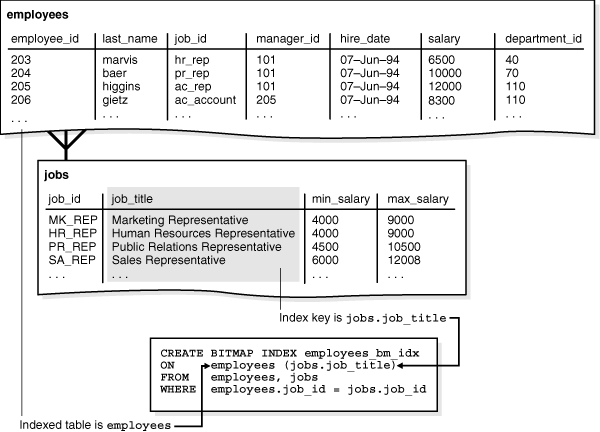
Conforme ilustrado na figura a seguir, a chave de índice é jobs.job_title e a tabela indexada é employees.
Figura 2: Índice de junção de bitmap
Descrição da ilustração cncpt239.gif
Conceitualmente, employees_bm_idx é um índice da coluna jobs.title na consulta SQL mostrada na consulta a seguir (saída de amostra incluída). A chave job_title no índice aponta para linhas na tabela employees. Uma consulta do número de contadores pode usar o índice para evitar o acesso às tabelas employees e jobs porque o próprio índice contém as informações solicitadas.
SELECT jobs.job_title AS "jobs.job_title", employees.rowid AS "employees.rowid"
FROM   employees, jobs
WHERE  employees.job_id = jobs.job_id
ORDER BY job_title;

jobs.job_title                      employees.rowid
----------------------------------- ------------------
Accountant                          AAAQNKAAFAAAABSAAL
Accountant                          AAAQNKAAFAAAABSAAN
Accountant                          AAAQNKAAFAAAABSAAM
Accountant                          AAAQNKAAFAAAABSAAJ
Accountant                          AAAQNKAAFAAAABSAAK
Accounting Manager                  AAAQNKAAFAAAABTAAH
Administration Assistant            AAAQNKAAFAAAABTAAC
Administration Vice President       AAAQNKAAFAAAABSAAC
Administration Vice President       AAAQNKAAFAAAABSAAB
.
.
.
Em um data warehouse, a condição de junção é uma equijunção (ele usa o operador de igualdade) entre as colunas de chave primária das tabelas de dimensões e as colunas de chave estrangeira da tabela de fatos. Os índices de junção de bitmap às vezes são muito mais eficientes no armazenamento do que as views de junção materializadas, uma alternativa para materializar junções com antecedência.
Consulte Também: Guia do Oracle AI Database Data Warehousing para obter mais informações sobre índices de junção de bitmap
Estrutura de armazenamento de bitmap
O Oracle AI Database usa uma estrutura de índice de árvore B para armazenar bitmaps para cada chave indexada.
Por exemplo, se jobs.job_title for a coluna de chave de um índice de bitmap, uma árvore B armazenará os dados do índice. Os blocos de folhas armazenam os bitmaps individuais.
Exemplo de Armazenamento de 5-6 Bitmap
Suponha que a coluna jobs.job_title tenha valores exclusivos Shipping Clerk, Stock Clerk e vários outros. Uma entrada de índice bitmap para este índice tem os seguintes componentes:
-
O título do cargo como chave de índice
-
Um rowid baixo e um rowid alto para uma faixa de rowids
-
Um bitmap para rowids específicos no intervalo
Conceitualmente, um bloco de folha de índice neste índice poderia conter entradas da seguinte forma:
Shipping Clerk,AAAPzRAAFAAAABSABQ,AAAPzRAAFAAAABSABZ,0010000100
Shipping Clerk,AAAPzRAAFAAAABSABa,AAAPzRAAFAAAABSABh,010010
Stock Clerk,AAAPzRAAFAAAABSAAa,AAAPzRAAFAAAABSAAc,1001001100
Stock Clerk,AAAPzRAAFAAAABSAAd,AAAPzRAAFAAAABSAAt,0101001001
Stock Clerk,AAAPzRAAFAAAABSAAu,AAAPzRAAFAAAABSABz,100001
.
.
.
O mesmo cargo aparece em várias entradas porque o intervalo de id da linha difere.
Uma sessão atualiza o ID do cargo de um funcionário de Shipping Clerk para Stock Clerk. Nesse caso, a sessão requer acesso exclusivo à entrada de chave de índice para o valor antigo (Shipping Clerk) e o novo (Stock Clerk). O Oracle AI Database bloqueia as linhas apontadas por essas duas entradas, mas não as linhas apontadas por Accountant ou qualquer outra chave até que o UPDATE seja confirmado.
Os dados de um índice de bitmap são armazenados em um segmento. O Oracle AI Database armazena cada bitmap em uma ou mais partes. Cada peça ocupa parte de um único bloco de dados.
Consulte Também: "Segmentos de Usuário" explica os diferentes tipos de segmentos e como os segmentos são criados
Visão Geral de Índices Baseados em Funções
Um índice baseado em função calcula o valor de uma função ou expressão que envolve uma ou mais colunas e a armazena em um índice. Um índice baseado em função pode ser um índice B-tree ou um bitmap.
A função indexada pode ser uma expressão aritmética ou uma expressão que contenha uma função SQL, uma função PL/SQL definida pelo usuário, uma função de pacote ou uma chamada C. Por exemplo, uma função pode adicionar os valores em duas colunas.
-
Uso de Índices Baseados em Funções Os índices baseados em funções são eficientes para avaliar instruções que contêm funções em suas cláusulas
WHERE. O banco de dados só usa o índice baseado em função quando a função é incluída em uma consulta. No entanto, quando o banco de dados processa as instruçõesINSERTeUPDATE, ele ainda deve avaliar a função para processar a instrução. -
Otimização com Índices Baseados em Funções Para consultas com expressões em uma cláusula
WHERE, o otimizador pode usar uma varredura de faixa de índices em um índice baseado em funções.
Consulte Também:
-
Oracle AI Database Administrator's Guide para aprender a criar índices baseados em funções
-
Oracle AI Database Development Guide para obter mais informações sobre o uso de índices baseados em funções
-
Oracle AI Database SQL Language Reference para obter restrições e observações de uso para índices baseados em funções
Usos de Índices Baseados em Funções
Os índices baseados em funções são eficientes para avaliar instruções que contêm funções em suas cláusulas WHERE. O banco de dados só usa o índice baseado em função quando a função é incluída em uma consulta. No entanto, quando o banco de dados processa as instruções INSERT e UPDATE, ele ainda deve avaliar a função para processar a instrução.
Exemplo 5-7 Índice Baseado em Expressão Aritmética
Por exemplo, suponha que você crie o seguinte índice baseado em funções:
CREATE INDEX emp_total_sal_idx
  ON employees (12 * salary * commission_pct, salary, commission_pct);
O banco de dados pode usar o índice anterior ao processar consultas como as seguintes (saída de amostra parcial incluída):
SELECT   employee_id, last_name, first_name,
         12*salary*commission_pct AS "ANNUAL SAL"
FROM     employees
WHERE    (12 * salary * commission_pct) < 30000
ORDER BY "ANNUAL SAL" DESC;

EMPLOYEE_ID LAST_NAME                 FIRST_NAME           ANNUAL SAL
----------- ------------------------- -------------------- ----------
        159 Smith                     Lindsey                   28800
        151 Bernstein                 David                     28500
        152 Hall                      Peter                     27000
        160 Doran                     Louise                    27000
        175 Hutton                    Alyssa                    26400
        149 Zlotkey                   Eleni                     25200
        169 Bloom                     Harrison                  24000
Exemplo 5-8 Índice Baseado em uma Função UPPER
Os índices baseados em função definidos nas funções SQL UPPER(column_name) ou LOWER(column_name) facilitam pesquisas sem distinção entre maiúsculas e minúsculas. Por exemplo, suponha que a coluna first_name em employees contenha caracteres em maiúsculas e minúsculas. Você cria o seguinte índice baseado em função na tabela hr.employees:
CREATE INDEX emp_fname_uppercase_idx
ON employees ( UPPER(first_name) );
O índice emp_fname_uppercase_idx pode facilitar consultas como as seguintes:
SELECT *
FROM   employees
WHERE  UPPER(first_name) = 'AUDREY';
Exemplo 5-9 Indexando Linhas Específicas em uma Tabela
Um índice baseado em funções também é útil para indexar somente linhas específicas de uma tabela. Por exemplo, a coluna cust_valid na tabela sh.customers tem I ou A como valor. Para indexar somente as linhas A, você pode gravar uma função que retorne um valor nulo para qualquer linha diferente das linhas A. Você poderia criar o índice da seguinte forma:
CREATE INDEX cust_valid_idx
ON customers ( CASE cust_valid WHEN 'A' THEN 'A' END );
Consulte Também:
-
Guia de Suporte à Globalização do Oracle AI Database para obter informações sobre índices linguísticos
-
Oracle AI Database SQL Language Reference para saber mais sobre funções SQL
Otimização com Índices Baseados em Funções
Para consultas com expressões em uma cláusula WHERE, o otimizador pode usar uma varredura de intervalo de índice em um índice baseado em função.
O caminho de acesso da varredura de intervalo é especialmente benéfico quando o predicado é altamente seletivo, ou seja, quando escolhe relativamente poucas linhas. No Exemplo 5-7, se um índice for criado na expressão 12*salary*commission_pct, o otimizador poderá usar uma varredura de intervalo de índice.
Uma coluna virtual também é útil para acelerar o acesso a dados derivados de expressões. Por exemplo, você pode definir a coluna virtual annual_sal como 12*salary*commission_pct e criar um índice baseado em função no annual_sal.
O otimizador executa a correspondência de expressão fazendo parse da expressão em uma instrução SQL e, em seguida, comparando as árvores de expressão da instrução e o índice baseado em função. Essa comparação não faz distinção entre maiúsculas e minúsculas e ignora espaços em branco.
Consultas diferentes podem usar tipos diferentes de varreduras de índice.
Consulte Também:
-
Guia de Ajuste do Oracle AI Database SQL para saber mais sobre como coletar estatísticas
-
Oracle AI Database Administrator's Guide para aprender a adicionar colunas virtuais a uma tabela
Visão Geral dos Índices de Domínio do Aplicativo
Um índice de domínio de aplicativo é um índice personalizado específico de um aplicativo.
A indexação extensa pode:
-
Acomoda índices em tipos de dados personalizados e complexos, como documentos, dados espaciais, imagens e videoclipes (consulte )
-
Utilizar técnicas de indexação especializadas
Você pode encapsular rotinas de gerenciamento de índice específicas do aplicativo como um objeto de esquema de tipo de índice e, em seguida, definir um índice de domínio em colunas de tabela ou atributos de um tipo de objeto. A indexação extensível pode processar com eficiência operadores específicos do aplicativo.
O software aplicativo, chamado de cartucho, controla a estrutura e o conteúdo de um índice de domínio. O banco de dados interage com o aplicativo para criar, manter e pesquisar o índice do domínio. A própria estrutura de índice pode ser armazenada no banco de dados como uma tabela organizada por índice ou externamente como um arquivo.
Consulte Também:
-
Guia de Desenvolvimento do Oracle AI Database para saber mais sobre tipos de dados complexos
-
Oracle AI Database Data Cartridge Developer's Guide para obter informações sobre o uso de cartuchos de dados na arquitetura de extensibilidade do Oracle AI Database
Visão Geral de Índices HNSW Quantizados Escalares
Índices escalares quantizados de Hierarchical Navigable Small World (HNSW) podem ser usados para reduzir os requisitos de memória e acelerar a pesquisa de similaridade.
No contexto de bancos de dados vetoriais, a quantização escalar é um método de compressão ou aproximação de vetores de dados de alta dimensão, quantificando independentemente cada dimensão (ou componente escalar) do vetor. Esta abordagem é usada para reduzir os requisitos de armazenamento de um banco de dados vetorial, preservando a estrutura essencial dos dados para tarefas como pesquisa de similaridade. A quantização escalar pode ser particularmente benéfica quando a simplicidade e os baixos requisitos de armazenamento são prioridades altas.
Os vetores de alta dimensão armazenados como números de ponto flutuante requerem um espaço de armazenamento significativo. A quantização escalar economiza memória compactando os vetores. Por exemplo, um vetor de 128 dimensões armazenado em 8 bits (INT8) por dimensão requer apenas 128 bytes de memória, enquanto o armazenamento de ponto flutuante de 32 bits (Float32) exigiria 512 bytes e o armazenamento duplo de 64 bits (Float64) exigiria 1024 bytes. Devido a esse requisito de armazenamento reduzido, a quantização escalar pode permitir que bancos de dados vetoriais manipulem conjuntos de dados muito grandes, compostos por até bilhões de vetores, que de outra forma seriam impraticáveis devido a restrições de armazenamento.
Outro benefício da quantização escalar é a velocidade de pesquisa aprimorada. Os métodos de pesquisa aproximados do vizinho (ANN) podem aproveitar dados quantizados para comparações mais rápidas, pois as operações em inteiros ou códigos binários são mais rápidas do que os cálculos de ponto flutuante.
Com o Oracle AI Database, a quantização escalar uniforme é o método de compactação implementado, o que significa que o intervalo de entrada é dividido em intervalos de tamanho igual. Cada intervalo é representado por um único nível de quantização, geralmente seu ponto médio. O intervalo de cada dimensão é dividido em intervalos iguais de 2b, em que b é o número de bits (por exemplo, 8 bits para int8). Cada valor flutuante é mapeado para o nível de quantização mais próximo.
Consulte Também:
-
Oracle AI Database AI Vector Search User's Guide para sintaxe e parâmetros de índice HNSW
-
Oracle AI Database SQL Language Reference para a instrução
CREATE VECTOR INDEX
Visão Geral de Tabelas Organizadas por Índice
Uma tabela organizada por índice é uma tabela armazenada em uma variação de uma estrutura de índice de árvore B. Por outro lado, uma tabela organizada por heap insere linhas onde elas cabem.
Em uma tabela organizada por índice, as linhas são armazenadas em um índice definido na chave primária da tabela. Cada entrada de índice na árvore B também armazena os valores de coluna que não são de chave. Assim, o índice são os dados e os dados são o índice. Os aplicativos manipulam tabelas organizadas por índice, assim como as tabelas organizadas por heap, usando instruções SQL.
Para uma analogia de uma tabela organizada por índice, suponha que um gerente de recursos humanos tenha uma caixa de papelão. Cada caixa é rotulada com um número-1, 2, 3, 4, e assim por diante-mas as caixas não se sentam nas prateleiras em ordem sequencial. Em vez disso, cada caixa contém um ponteiro para o local da prateleira da próxima caixa na sequência.
As pastas que contêm registros de funcionários são armazenadas em cada caixa. As pastas são classificadas por ID de funcionário. O funcionário King tem o ID 100, que é o ID mais baixo. Portanto, sua pasta fica na parte inferior da caixa 1. A pasta do funcionário 101 está no topo de 100, 102 está no topo de 101 e assim por diante até que a caixa 1 esteja cheia. A próxima pasta na sequência está na parte inferior da caixa 2.
Nessa analogia, a ordenação de pastas por ID de funcionário possibilita a pesquisa eficiente de pastas sem a necessidade de manter um índice separado. Suponhamos que um usuário solicite os registros dos funcionários 107, 120 e 122. Em vez de pesquisar um índice em uma etapa e recuperar as pastas em uma etapa separada, o gerente pode pesquisar as pastas em ordem sequencial e recuperar cada pasta conforme encontrado.
As tabelas organizadas por índice fornecem acesso mais rápido às linhas da tabela por chave principal ou um prefixo válido da chave. A presença de colunas não-chave de uma linha no bloco de folhas evita uma E/S de bloco de dados adicional. Por exemplo, o salário do funcionário 100 é armazenado na própria linha de índice. Além disso, como as linhas são armazenadas em ordem de chave primária, o acesso ao intervalo pela chave primária ou prefixo envolve entradas/saídas mínimas de bloco. Outro benefício é evitar a sobrecarga de espaço de um índice de chave primária separado.
Tabelas organizadas por índice são úteis quando partes relacionadas de dados devem ser armazenadas juntas ou os dados devem ser armazenados fisicamente em uma ordem específica. Um uso típico desse tipo de tabela é para recuperação de informações, dados espaciais e aplicativos OLAP.
-
Características da Tabela Organizada por Índice O sistema de banco de dados executa todas as operações em tabelas organizadas por índice manipulando a estrutura de índice da árvore B.
-
Tabelas Organizadas por Índice com Área de Overflow de Linha Ao criar uma tabela organizada por índice, você pode especificar um segmento separado como uma área de overflow de linha.
-
Índices Secundários em Tabelas Organizadas por Índice Um índice secundário é um índice de uma tabela organizada por índice.
Consulte Também:
-
Oracle Spatial Developer's Guide para obter uma visão geral do Oracle Spatial and Graph
-
Oracle AI Database Administrator's Guide para aprender a gerenciar tabelas organizadas por índice
-
Oracle AI Database SQL Language Reference para sintaxe e semântica do
CREATE TABLE ... ORGANIZATION INDEX
Características da Tabela Organizada por Índice
O sistema de banco de dados executa todas as operações em tabelas organizadas por índice manipulando a estrutura do índice da árvore B.
A tabela a seguir resume as diferenças entre tabelas organizadas por índice e tabelas organizadas por heap.
Tabela 6 Comparação de Tabelas Organizadas por Heap com Tabelas Organizadas por Índice
| Tabela Organizada por Heap | Tabela Organizada por Índice |
|---|---|
| O id da linha identifica exclusivamente uma linha. Opcionalmente, a restrição de chave primária pode ser definida. | A chave primária identifica exclusivamente uma linha. A restrição de chave primária deve ser definida. |
O rowid físico na pseudocoluna ROWID permite a criação de índices secundários. |
O id de linha lógico na pseudocoluna ROWID permite a criação de índices secundários. |
| Linhas individuais podem ser acessadas diretamente por rowid. | O acesso a linhas individuais pode ser alcançado indiretamente por chave primária. |
| A verificação completa da tabela sequencial retorna todas as linhas em alguma ordem. | Uma varredura completa do índice ou uma varredura completa rápida do índice retorna todas as linhas em alguma ordem. |
| Pode ser armazenado em um cluster de tabela com outras tabelas. | Não pode ser armazenado em um cluster de tabelas. |
Pode conter uma coluna do tipo de dados LONG e colunas de tipos de dados LOB. |
Pode conter colunas LOB, mas não colunas LONG. |
| Pode conter colunas virtuais (somente tabelas de heap relacional são suportadas). | Não pode conter colunas virtuais. |
As Tabelas Organizadas por Índice podem ser compactadas usando a compactação Baixa Avançada, adicionando a cláusula COMPRESS ADVANCED LOW à instrução CREATE TABLE. Advanced Low Compression é uma forma adaptativa de compressão de prefixo que calcula autonomamente o número ideal de colunas de prefixo para cada bloco de folha, levando a uma compressão ideal no nível do bloco sem qualquer intervenção do usuário. Isso inclui a possibilidade de não compactar, se apropriado. Isso garante que a compressão negativa não é possível. Maiores taxas de compressão são observadas com sobrecarga geral insignificante.
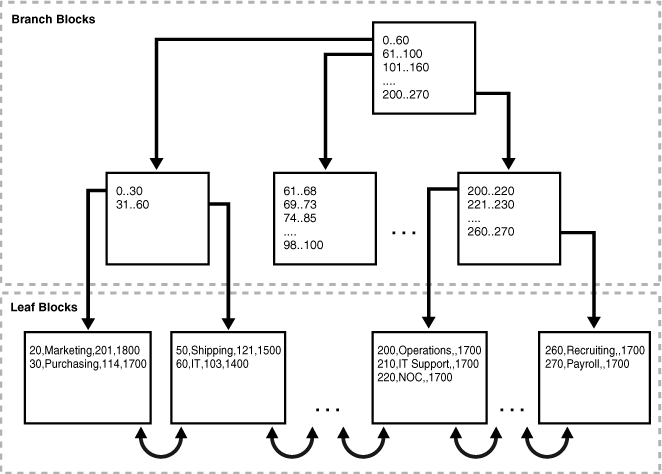
As verificações em tabelas organizadas por índice podem ser descarregadas para o Exadata Smart Scan, em que o otimizador considerou que a consulta pode ser executada como uma verificação completa rápida. Isso não requer nenhuma intervenção do usuário. O processamento completo do lado da célula será suportado em blocos de folha de tabela organizados por índice, onde todas as colunas de interesse residem no bloco de folha. Para casos em que algumas colunas residem no segmento de estouro, a verificação inteligente não processará essas colunas e o banco de dados concluirá a verificação. A Figura 5-3 ilustra a estrutura de uma tabela departments organizada por índice. Os blocos de folhas contêm as linhas da tabela, ordenadas sequencialmente por chave primária. Por exemplo, o primeiro valor no primeiro bloco de folha mostra um ID de departamento 20, o nome do departamento Marketing, o ID de gerente 201 e o ID de local 1800.
Figura 3: Tabela organizada por índice
Descrição da ilustração cncpt272.gif
Exemplo 5-10 Verificação da Tabela Organizada por Índice
Uma tabela organizada por índice armazena todos os dados na mesma estrutura e não precisa armazenar o id da linha. Conforme mostrado na Figura 5-3, o bloco de folhas 1 em uma tabela organizada por índice pode conter entradas da seguinte forma, ordenadas por chave primária:
20,Marketing,201,1800
30,Purchasing,114,1700
O bloco de folha 2 em uma tabela organizada por índice pode conter entradas da seguinte forma:
50,Shipping,121,1500
60,IT,103,1400
Uma varredura das linhas da tabela organizada por índice em ordem de chave primária lê os blocos na seguinte sequência:
-
Bloco 1
-
Bloco 2
Exemplo 5-11 Varredura de Tabela Organizada por Heap
Para contrastar o acesso aos dados em uma tabela organizada por heap com uma tabela organizada por índice, suponha que o bloco 1 de um segmento de tabela departments organizado por heap contenha linhas da seguinte forma:
50,Shipping,121,1500
20,Marketing,201,1800
O bloco 2 contém linhas para a mesma tabela da seguinte forma:
30,Purchasing,114,1700
60,IT,103,1400
Um bloco de folha de índice de árvore B para esta tabela heap-organizada contém as seguintes entradas, onde o primeiro valor é a chave primária e o segundo é o rowid:
20,AAAPeXAAFAAAAAyAAD
30,AAAPeXAAFAAAAAyAAA
50,AAAPeXAAFAAAAAyAAC
60,AAAPeXAAFAAAAAyAAB
Uma varredura das linhas da tabela em ordem de chave primária lê os blocos de segmentos da tabela na seguinte sequência:
-
Bloco 1
-
Bloco 2
-
Bloco 1
-
Bloco 2
Assim, o número de E/Ss de bloco neste exemplo é o dobro do número no exemplo organizado por índice.
Consulte Também:
para saber mais sobre tabelas organizadas por heap
para saber mais sobre a relação entre segmentos e blocos de dados
Tabelas Organizadas por Índice com Área de Overflow de Linha
Ao criar uma tabela organizada por índice, você pode especificar um segmento separado como uma área de estouro de linha.
Em tabelas organizadas por índice, as entradas de índice de árvore B podem ser grandes porque contêm uma linha inteira, portanto, um segmento separado para conter as entradas é útil. Em contraste, as entradas da árvore B são geralmente pequenas porque consistem na chave e no rowid.
Se uma área de estouro de linha for especificada, o banco de dados poderá dividir uma linha em uma tabela organizada por índice nas seguintes partes:
-
A entrada do índice
Essa parte contém valores de coluna para todas as colunas de chave primária, um rowid físico que aponta para a parte de overflow da linha e, opcionalmente, algumas das colunas que não são de chave. Essa parte é armazenada no segmento de índice.
-
A parte do overflow
Esta parte contém valores de coluna para as colunas que não são de chave restantes. Esta parte é armazenada no segmento de área de armazenamento de overflow.
Consulte Também:
-
Oracle AI Database Administrator's Guide para aprender a usar a cláusula
OVERFLOWdoCREATE TABLEpara definir uma área de overflow de linha -
Oracle AI Database SQL Language Reference para sintaxe e semântica do
CREATE TABLE ... OVERFLOW
Índices Secundários em Tabelas Organizadas por Índice
Um índice secundário é um índice de uma tabela organizada por índice.
Em certo sentido, um índice secundário é um índice em um índice. É um objeto de esquema independente e é armazenado separadamente da tabela organizada por índice.
O Oracle AI Database usa identificadores de linha chamados rowids lógicos para tabelas organizadas por índice. Uma id de linha lógica é uma representação codificada em base64 da chave primária da tabela. O tamanho do ID de linha lógico depende do tamanho da chave primária.
Linhas em blocos de folha de índice podem se mover dentro ou entre blocos por causa de inserções. As linhas em tabelas organizadas por índice não migram como as linhas organizadas por heap fazem. Como as linhas nas tabelas organizadas pelo índice não têm endereços físicos permanentes, o banco de dados usa rowids lógicos com base na chave primária.
Por exemplo, suponha que a tabela departments seja organizada por índice. A coluna location_id armazena o ID de cada departamento. A tabela armazena linhas da seguinte forma, com o último valor como o ID local:
10,Administration,200,1700
20,Marketing,201,1800
30,Purchasing,114,1700
40,Human Resources,203,2400
Um índice secundário na coluna location_id pode ter entradas de índice da seguinte forma, em que o valor após a vírgula é o rowid lógico:
1700,*BAFAJqoCwR/+
1700,*BAFAJqoCwQv+
1800,*BAFAJqoCwRX+
2400,*BAFAJqoCwSn+
Os índices secundários fornecem acesso rápido e eficiente a tabelas organizadas por índice usando colunas que não são nem a chave primária nem um prefixo da chave primária. Por exemplo, uma consulta dos nomes dos departamentos cujo ID seja maior que 1700 poderia usar o índice secundário para acelerar o acesso aos dados.
-
Os índices secundários Rowids Lógicos e Adivinhações Físicas usam rowids lógicos para localizar linhas da tabela.
-
Índices de Bitmap em Tabelas Organizadas por Índice Um índice secundário em uma tabela organizada por índice pode ser um índice bitmap. Um índice de bitmap armazena um bitmap para cada chave de índice.
Consulte Também:
-
"Tipos de Dados de Linhas" para saber mais sobre o uso de rowids e a pseudocoluna
ROWID -
"Linhas Encadeadas e Migradas" para saber por que as linhas migram e por que a migração aumenta o número de E/Ss
-
Oracle AI Database Administrator's Guide para aprender a criar índices secundários em uma tabela organizada por índice
-
Oracle AI Database VLDB and Partitioning Guide para saber mais sobre a criação de índices secundários em partições de tabelas organizadas por índice
Rowids lógicos e suposições físicas
Os índices secundários usam rowids lógicos para localizar linhas da tabela.
Um id de linha lógico inclui uma suposição física, que é o id de linha físico da entrada de índice quando foi feita pela primeira vez. O Oracle AI Database pode usar suposições físicas para sondar diretamente o bloco da folha da tabela organizada por índice, ignorando a pesquisa de chave primária. Quando a localização física de uma linha é alterada, o id da linha lógica permanece válido mesmo que contenha uma suposição física obsoleta.
Para uma tabela organizada por heap, o acesso por um índice secundário envolve uma varredura do índice secundário e uma E/S adicional para extrair o bloco de dados que contém a linha. Para tabelas organizadas por índice, o acesso por um índice secundário varia, dependendo do uso e da precisão das suposições físicas:
-
Sem suposições físicas, o acesso envolve duas varreduras de índice: uma varredura do índice secundário seguido por uma varredura do índice de chave primária.
-
Com suposições físicas, o acesso depende de sua precisão:
-
Com suposições físicas precisas, o acesso envolve uma verificação de índice secundária e uma E/S adicional para extrair o bloco de dados que contém a linha.
-
Com suposições físicas imprecisas, o acesso envolve uma varredura de índice secundário e uma E/S para buscar o bloco de dados errado (conforme indicado pelo palpite), seguido por uma varredura exclusiva de índice da tabela organizada por índice por valor de chave primária.
-
Índices de Bitmap em Tabelas Organizadas por Índice
Um índice secundário em uma tabela organizada por índice pode ser um índice bitmap. Um índice de bitmap armazena um bitmap para cada chave de índice.
Quando existem índices de bitmap em uma tabela organizada por índice, todos os índices de bitmap usam uma tabela de mapeamento organizada por heap. A tabela de mapeamento armazena os rowids lógicos da tabela organizada por índice. Cada linha da tabela de mapeamento armazena um id de linha lógico para a linha da tabela organizada por índice correspondente.
O banco de dados acessa um índice de bitmap usando uma chave de pesquisa. Se o banco de dados encontrar a chave, a entrada de bitmap será convertida em um rowid físico. Com tabelas organizadas por heap, o banco de dados usa o id da linha física para acessar a tabela base. Com tabelas organizadas por índice, o banco de dados usa o id de linha físico para acessar a tabela de mapeamento, o que, por sua vez, gera um id de linha lógico que o banco de dados usa para acessar a tabela organizada por índice. A figura a seguir ilustra o acesso ao índice para uma consulta da tabela departments_iot.
Figura 4: Índice de bitmap em tabela organizada por índice
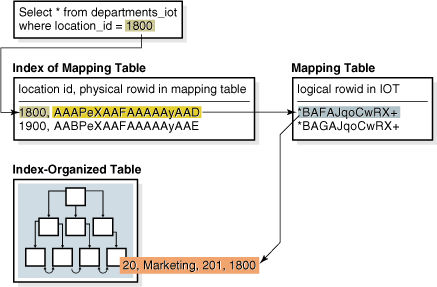
Descrição da ilustração cncpt330.gif
Observação: A movimentação de linhas em uma tabela organizada por índice não deixa os índices de bitmap criados nessa tabela organizada por índice inutilizáveis.
Consulte Também: "Rowids of Row Pieces" para aprender sobre as diferenças entre rowids físicos e lógicos