Tabelas e Clusters de Tabelas
Este capítulo apresenta uma introdução aos objetos de esquema e descreve tabelas, que são os tipos mais comuns de objetos de esquema.
-
Introdução a Objetos de Esquema Um esquema de banco de dados é um contêiner lógico para estruturas de dados, chamadas objetos de esquema. Exemplos de objetos de esquema são tabelas e índices. Você cria e manipula objetos de esquema com SQL.
-
Visão Geral das Tabelas Uma tabela é a unidade básica de organização de dados em um banco de dados Oracle.
-
Visão Geral de Clusters de Tabelas Um cluster de tabelas é um grupo de tabelas que compartilham colunas comuns e armazenam dados relacionados nos mesmos blocos.
-
Visão Geral de Tabelas Clusterizadas por Atributos Uma tabela clusterizada por atributos é uma tabela organizada por heap que armazena dados próximos ao disco com base nas diretivas de cluster especificadas pelo usuário. As diretivas especificam colunas em tabelas únicas ou múltiplas.
-
Visão Geral de Tabelas Temporárias Uma tabela temporária contém dados que só existem durante a duração de uma transação ou sessão.
-
Visão Geral de Tabelas Externas Uma tabela externa acessa dados em origens externas como se esses dados estivessem em uma tabela no banco de dados.
-
Visão Geral das Tabelas Blockchain Uma tabela blockchain é uma tabela somente para anexos projetada para aplicativos blockchain centralizados.
-
Visão Geral das Tabelas Imutáveis As tabela imutáveis são tabelas somente anexadas que impedem modificações não autorizadas dos dados por insiders e modificações acidentais dos dados resultantes de erros humanos.
-
Visão Geral das Tabelas de Objetos Uma tabela de objetos é um tipo especial de tabela em que cada linha representa um objeto.
Introdução a Objetos de Esquema
Um esquema de banco de dados é um contêiner lógico para estruturas de dados, chamadas de objetos de esquema. Exemplos de objetos de esquema são tabelas e índices. Você cria e manipula objetos de esquema com SQL.
Essa seção contém os seguintes tópicos:
-
Sobre Contas de Usuários Comuns e Locais Uma conta de usuário de banco de dados tem uma senha e privilégios de banco de dados específicos.
-
Objetos Comuns e Locais Um objeto comum é definido na raiz do CDB ou em uma raiz do aplicativo e pode ser referenciado usando links de metadados ou links de objeto. Um objeto local é todo objeto que não é um objeto comum.
-
Tipos de Objeto de Esquema O Oracle SQL permite criar e manipular muitos outros tipos de objetos de esquema.
-
Armazenamento de Objetos de Esquema Alguns objetos de esquema armazenam dados em um tipo de estrutura de armazenamento lógico chamado segmento. Por exemplo, uma tabela organizada por heap não particionada ou um índice cria um segmento.
-
Dependências do Objeto do Esquema Alguns objetos do esquema se referem a outros objetos, criando uma dependência do objeto do esquema.
-
Esquemas de Amostra Um banco de dados Oracle pode incluir esquemas de amostra, que são um conjunto de esquemas interligados que permitem que a documentação da Oracle e os materiais de instrução da Oracle ilustrem tarefas comuns do banco de dados. Consulte Também: Guia de Segurança do Oracle AI Database para saber mais sobre usuários e privilégios
Sobre Contas de Usuário Comuns e Locais
Uma conta de usuário do banco de dados tem uma senha e privilégios de banco de dados específicos.
Contas de Usuário e Esquemas
Cada conta de usuário possui um único esquema, que tem o mesmo nome que o usuário. O esquema contém os dados do usuário que possui o esquema. Por exemplo, a conta de usuário hr possui o esquema hr, que contém objetos de esquema, como a tabela employees. Em um banco de dados de produção, o proprietário do esquema geralmente representa um aplicativo de banco de dados em vez de uma pessoa.
Em um esquema, cada objeto de esquema de um tipo específico tem um nome exclusivo. Por exemplo, hr.employees se refere à tabela employees no esquema hr. A figura a seguir descreve um proprietário de esquema chamado hr e objetos de esquema dentro do esquema hr.
Figura 1: Esquema HR
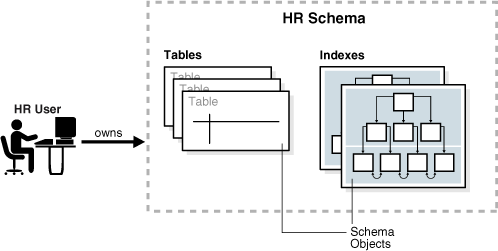
Descrição da ilustração cncpt230.gif
Contas de Usuário Comuns e Locais
Se uma conta de usuário possuir objetos que definem o banco de dados, essa conta de usuário será comum. As contas de usuário não fornecidas pelo Oracle são locais ou comuns. Um usuário comum do CDB é um usuário comum criado na raiz do CDB. Um usuário comum de aplicativo é um usuário criado em uma raiz de aplicativo e é comum somente dentro desse contêiner de aplicativos.
O gráfico a seguir mostra os possíveis tipos de conta de usuário em um CDB.
Figura 2: Contas de usuário em um CDB
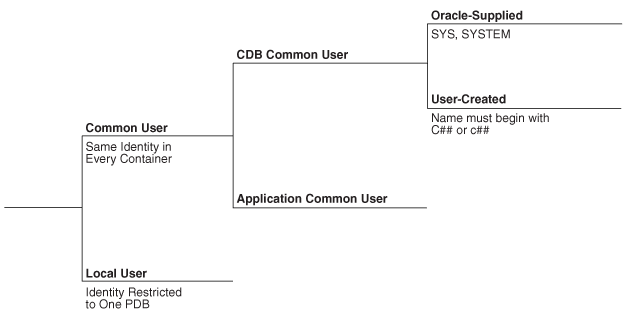
Descrição da ilustração cncpt370.png
Um usuário comum do CDB pode se conectar a qualquer contêiner no CDB ao qual ele tenha privilégios suficientes. Por outro lado, um usuário comum do aplicativo só pode se conectar à raiz do aplicativo em que foi criado ou a um PDB conectado a essa raiz do aplicativo, dependendo de seus privilégios.
-
Contas de Usuário Comuns No contexto do contêiner do sistema (CDB) ou de um contêiner de aplicativos, um usuário comum é um usuário do banco de dados que tem a mesma identidade na raiz e em cada PDB existente e futuro dentro desse contêiner.
-
Contas de Usuários Locais Um usuário local é um usuário de banco de dados que não é comum e só pode operar em um único PDB.
Contas de Usuário Comuns
No contexto do contêiner do sistema (CDB) ou de um contêiner de aplicativos, um usuário comum é um usuário do banco de dados que tem a mesma identidade na raiz e em cada PDB existente e futuro nesse contêiner.
Cada usuário comum pode se conectar e executar operações na raiz de seu contêiner e em qualquer PDB no qual ele tenha privilégios suficientes. Algumas tarefas administrativas devem ser executadas por um usuário comum. Exemplos incluem criar um PDB e desconectar um PDB.
Por exemplo, SYSTEM é um usuário comum do CDB com privilégios de DBA. Assim, o SYSTEM pode estabelecer conexão com a raiz do CDB e qualquer PDB no banco de dados. Você pode criar um usuário comum saas_sales_admin no contêiner de aplicativos saas_sales. Nesse caso, o usuário saas_sales_admin só poderia se conectar à raiz do aplicativo saas_sales ou a um PDB de aplicativo no contêiner de aplicativos saas_sales.
Cada usuário comum é fornecido pelo Oracle ou criado pelo usuário. Exemplos de usuários comuns fornecidos pelo sistema Oracle são SYS e SYSTEM. Cada usuário comum criado pelo usuário é um usuário comum do CDB ou um usuário comum do aplicativo.
A figura a seguir mostra exemplos de usuários e esquemas em dois PDBs: hrpdb e salespdb. SYS e c##dba são usuários comuns do CDB que têm esquemas nos arquivos CDB$ROOT, hrpdb e salespdb. Os usuários locais hr e rep existem no hrpdb. Os usuários locais hr e rep também existem no salespdb.
Figura 3: Usuários e Esquemas em um CDB
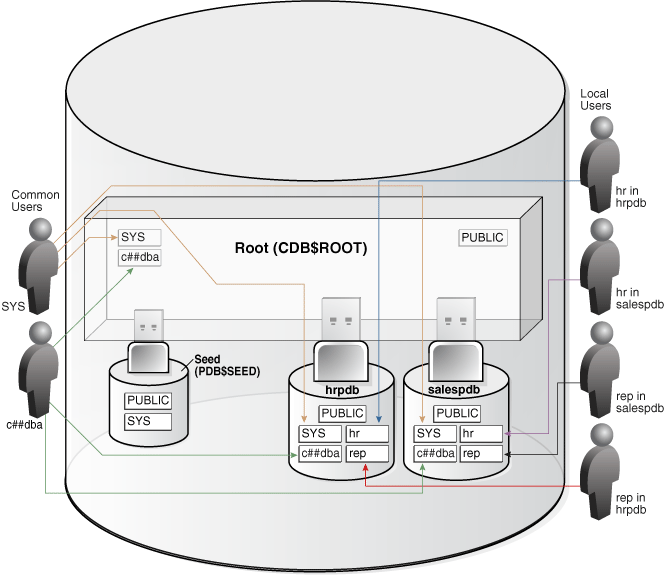
Descrição da ilustração cncpt340.png
Os usuários comuns têm as seguintes características:
-
Um usuário comum pode fazer log-in em qualquer contêiner (incluindo
CDB$ROOT) no qual ele tenha o privilégioCREATE SESSION.Um usuário comum não precisa ter os mesmos privilégios em cada contêiner. Por exemplo, o usuário
c##dbapode ter o privilégio de criar uma sessão emhrpdbe na raiz, mas não de criar uma sessão emsalespdb. Como um usuário comum com os privilégios apropriados pode alternar entre contêineres, um usuário comum na raiz pode administrar PDBs -
Um usuário comum de aplicativo não tem o privilégio
CREATE SESSIONem nenhum contêiner fora de seu próprio contêiner de aplicativos.Assim, um usuário comum do aplicativo é restrito ao seu próprio contêiner de aplicativos. Por exemplo, o usuário comum do aplicativo criado no aplicativo
saas_salessó pode se conectar à raiz do aplicativo e aos PDBs no contêiner de aplicativossaas_sales. -
Os nomes de usuários comuns do CDB criados pelo usuário devem seguir as regras de nomenclatura para outros usuários do banco de dados. Além disso, os nomes devem começar com os caracteres especificados pelo parâmetro de inicialização do
COMMON_USER_PREFIX, que sãoc##ouC##por padrão. Os nomes de usuário comuns fornecidos pelo Oracle e os nomes de usuário comuns de aplicativos criados pelo usuário não têm essa restrição.Nenhum nome de usuário local pode começar com os caracteres
c##ouC##. -
Cada usuário comum é nomeado exclusivamente entre todos os PDBs no contêiner (o contêiner do sistema ou um contêiner de aplicativo específico) no qual foi criado.
Um usuário comum do CDB é definido na raiz do CDB, mas deve ser capaz de estabelecer conexão com cada PDB com a mesma identidade. Um usuário comum do aplicativo reside na raiz do aplicativo e pode se conectar a cada PDB do aplicativo em seu contêiner com a mesma identidade.
-
Características de Usuários Comuns Cada usuário comum é fornecido pela Oracle ou criado pelo usuário.
-
Contas SYS e SYSTEM Todos os bancos de dados Oracle incluem contas de usuário comuns padrão com privilégios administrativos.
Características dos Usuários Comuns
Cada usuário comum é fornecido pelo Oracle ou criado pelo usuário.
As contas de usuário comuns têm as seguintes características:
-
Um usuário comum pode fazer log-in em qualquer contêiner (incluindo
CDB$ROOT) no qual ele tenha o privilégioCREATE SESSION.Um usuário comum não precisa ter os mesmos privilégios em cada contêiner. Por exemplo, o usuário
c##dbapode ter o privilégio de criar uma sessão nohrpdbe na raiz, mas não para criar uma sessão nosalespdb. Como um usuário comum com os privilégios apropriados pode alternar entre contêineres, um usuário comum na raiz pode administrar PDBs. -
Um usuário comum de aplicativo não tem o privilégio
CREATE SESSIONem nenhum contêiner fora de seu próprio contêiner de aplicativos.Assim, um usuário comum do aplicativo é restrito ao seu próprio contêiner de aplicativos. Por exemplo, o usuário comum do aplicativo criado no aplicativo
saas_salessó pode se conectar à raiz do aplicativo e aos PDBs no contêiner de aplicativossaas_sales. -
Os nomes de usuários comuns do CDB criados pelo usuário devem seguir as regras de nomenclatura para outros usuários do banco de dados. Além disso, os nomes devem começar com os caracteres especificados pelo parâmetro de inicialização do
COMMON_USER_PREFIX, que sãoc##ouC##por padrão. Os nomes de usuário comuns fornecidos pelo Oracle e os nomes de usuário comuns de aplicativos criados pelo usuário não têm essa restrição.Nenhum nome de usuário local pode começar com os caracteres
c##ouC##. -
Cada usuário comum é nomeado exclusivamente entre todos os PDBs no contêiner (o contêiner do sistema ou um contêiner de aplicativo específico) no qual foi criado.
Um usuário comum do CDB é definido na raiz do CDB, mas deve ser capaz de estabelecer conexão com cada PDB com a mesma identidade. Um usuário comum do aplicativo reside na raiz do aplicativo e pode se conectar a cada PDB do aplicativo em seu contêiner com a mesma identidade.
A figura a seguir mostra exemplos de usuários e esquemas em dois PDBs: hrpdb e salespdb. SYS e c##dba são usuários comuns do CDB que têm esquemas nos arquivos CDB$ROOT, hrpdb e salespdb. Os usuários locais hr e rep existem no hrpdb. Os usuários locais hr e rep também existem no salespdb.
Figura 4: Usuários e Esquemas em um CDB
Descrição da ilustração cncpt340.png
Consulte Também:
-
Oracle AI Database Security Guide para saber mais sobre contas de usuário comuns
-
Oracle AI Database Reference para saber mais sobre a
COMMON_USER_PREFIX
Contas SYS e SYSTEM
Todos os bancos de dados Oracle incluem contas de usuário comuns padrão com privilégios administrativos.
As contas administrativas são altamente privilegiadas e destinam-se apenas a DBAs autorizados a executar tarefas, como iniciar e interromper o banco de dados, gerenciar memória e armazenamento, criar e gerenciar usuários de banco de dados, entre outras.
A conta de usuário comum SYS é criada automaticamente quando um banco de dados é criado. Esta conta pode executar todas as funções administrativas do banco de dados. O esquema SYS armazena as tabelas base e as views do dicionário de dados. Essas tabelas base e views são críticas para a operação do Oracle AI Database. As tabelas no esquema SYS são manipuladas somente pelo banco de dados e nunca devem ser modificadas por nenhum usuário.
A conta administrativa SYSTEM também é criada automaticamente quando um banco de dados é criado. O esquema SYSTEM armazena tabelas e exibições adicionais que exibem informações administrativas e tabelas e exibições internas usadas por várias opções e ferramentas de Oracle AI Database. Nunca use o esquema SYSTEM para armazenar tabelas de interesse para usuários não administrativos.
Consulte Também:
-
Oracle AI Database Security Guide para saber mais sobre contas de usuário
-
Oracle AI Database Administrator's Guide para saber mais sobre as contas administrativas
SYS,SYSTEMe outras
Contas de Usuário Locais
Um usuário local é um usuário de banco de dados que não é comum e só pode operar em um único PDB.
Os usuários locais têm as seguintes características:
-
Um usuário local é específico de um PDB e pode ter um esquema nesse PDB.
No exemplo mostrado em "Características de Usuários Comuns", o usuário local
hrnohrpdbpossui o esquemahr. Nosalespdb, o usuário localreppossui o esquemarepe o usuário localhrpossui o esquemahr. -
Um usuário local pode administrar um PDB, incluindo abri-lo e fechá-lo.
Um usuário comum com privilégios
SYSDBApode conceder privilégiosSYSDBAa um usuário local. Nesse caso, o usuário privilegiado permanece local. -
Um usuário local em um PDB não pode fazer log-in em outro PDB ou na raiz do CDB.
Por exemplo, quando o usuário local
hrse conecta aohrpdb, ohrnão pode acessar objetos no esquemashque residem no banco de dadossalespdbsem usar um link de banco de dados. Da mesma forma, quando o usuário localshse conecta ao PDBsalespdb, oshnão pode acessar objetos no esquemahrque reside nohrpdbsem usar um link de banco de dados. -
O nome de um usuário local não deve começar com os caracteres
c##ouC##. -
O nome de um usuário local só deve ser exclusivo em seu PDB.
O nome de usuário e o PDB no qual esse esquema de usuário está contido determinam um usuário local exclusivo. "Características de Usuários Comuns" mostra que existe um usuário local e um esquema chamado
repemhrpdb. Existe um usuário local e um esquema completamente independentes com o nomerepno PDBsalespdb.
A tabela a seguir descreve um cenário que envolve o CDB em "Características dos Usuários Comuns". Cada linha descreve uma ação que ocorre após a ação na linha anterior. O usuário comum SYSTEM cria usuários locais em dois PDBs.
Tabela 1 Usuários Locais em um CDB
| Operação | Descrição |
|---|---|
|
O SYSTEM se conecta ao contêiner hrpdb usando o nome do serviço hrpdb. |
|
SYSTEM agora cria um usuário local rep e concede o privilégio CREATE SESSION neste PDB a esse usuário. O usuário é local porque usuários comuns só podem ser criados por um usuário comum conectado à raiz. |
|
O usuário rep, que é local para hrpdb, tenta se conectar ao salespdb. A tentativa falha porque o rep não existe no PDB salespdb. |
|
O SYSTEM se conecta ao contêiner salespdb usando o nome do serviço salespdb. |
|
SYSTEM cria um usuário local rep em salespdb e concede o privilégio CREATE SESSION neste PDB a esse usuário. Como o nome de um usuário local só deve ser exclusivo em seu PDB, um usuário chamado rep pode existir em salespdb e hrpdb. |
|
O usuário rep efetua log-in com sucesso no salespdb. |
Consulte Também: Guia de Segurança do Oracle AI Database para saber mais sobre contas de usuários locais
Objetos Comuns e Locais
Um objeto comum é definido na raiz do CDB ou em uma raiz do aplicativo e pode ser referenciado usando links de metadados ou links de objeto. Um objeto local é todo objeto que não é um objeto comum.
Os objetos comuns fornecidos pelo banco de dados são definidos no CDB$ROOT e não podem ser alterados. O Oracle Database não suporta a criação de objetos comuns no CDB$ROOT.
Você pode criar a maioria dos objetos de esquema, como tabelas, views, unidades de programa PL/SQL e Java, sequências, etc., como objetos comuns em uma raiz de aplicativo. Se o objeto existir em uma raiz de aplicativo, ele será chamado de objeto comum de aplicativo.
Um usuário local pode possuir um objeto comum. Além disso, um usuário comum pode possuir um objeto local, mas somente quando o objeto não é vinculado a dados ou a metadados, e também não é nem um link de metadados nem um link de dados.
Consulte Também: Oracle AI Database Security Guide para saber mais sobre o gerenciamento de privilégios para objetos comuns
Tipos do Objeto do Esquema
O Oracle SQL permite criar e manipular muitos outros tipos de objetos de esquema.
Os principais tipos de objetos de esquema são mostrados na tabela a seguir.
Objetos de Esquema da Tabela 2
| Objeto | Descrição | Para Saber Mais |
|---|---|---|
| Tabela | Uma tabela armazena dados em linhas. As tabelas são os objetos de esquema mais importantes de um banco de dados relacional. | "Visão Geral de Tabelas" |
| Índices | Índices são objetos de esquema que contêm uma entrada para cada linha indexada da tabela ou do cluster de tabelas e fornecem acesso rápido e direto às linhas. O Oracle AI Database suporta vários tipos de índice. Uma tabela organizada por índice é uma tabela na qual os dados são armazenados em uma estrutura de índice. | "Índices e Tabelas Organizadas por Índice" |
| Partições | As partições são pedaços de tabelas e índices grandes. Cada partição tem seu próprio nome e pode opcionalmente ter suas próprias características de armazenamento. | "Visão Geral de Partições" |
| Exibições | As views são apresentações personalizadas de dados em uma ou mais tabelas ou outras views. Elas podem ser vistas como consultas armazenadas. As views não contêm dados. | "Visão Geral das Views" |
| Sequências | Uma sequência é um objeto criado pelo usuário que pode ser compartilhado por vários usuários para gerar números inteiros. Normalmente, você usa sequências para gerar valores de chave primária. | "Visão Geral de Sequências" |
| Dimensões | Uma dimensão define um relacionamento pai-filho entre pares de conjuntos de colunas, em que todas as colunas de um conjunto de colunas devem vir da mesma tabela. As dimensões geralmente são usadas para categorizar dados, como clientes, produtos e tempo. | "Visão Geral de Dimensões" |
| Sinônimos | Um sinônimo é um alias para outro objeto do esquema. Como um sinônimo é simplesmente um alias, ele não requer outro armazenamento além de sua definição no dicionário de dados. | "Visão Geral de Sinônimos" |
| Pacotes e subprogramas PL/SQL | PL/SQL é a extensão procedural da SQL da Oracle. Um subprograma PL/SQL é um bloco PL/SQL nomeado que pode ser chamado com um conjunto de parâmetros. Um pacote PL/SQL agrupa tipos, variáveis e subprogramas PL/SQL logicamente relacionados. | "Subprogramas PL/SQL" |
Outros tipos de objetos também são armazenados no banco de dados e podem ser criados e manipulados com instruções SQL, mas não estão contidos em um esquema. Esses objetos incluem conta de usuário do banco de dados, atribuições, contextos e objetos de dicionário.
Consulte Também:
-
Oracle AI Database Administrator's Guide para aprender a gerenciar objetos de esquema
-
Oracle AI Database SQL Language Reference para obter mais informações sobre objetos de esquema e objetos de banco de dados
Armazenamento de Objetos do Esquema
Alguns objetos de esquema armazenam dados em um tipo de estrutura de armazenamento lógico chamado segmento. Por exemplo, uma tabela organizada por heap não particionada ou um índice cria um segmento.
Outros objetos de esquema, como views e sequências, consistem apenas em metadados. Este tópico descreve somente objetos de esquema que têm segmentos.
O Oracle AI Database armazena um objeto de esquema logicamente em um tablespace. Não há relacionamento entre esquemas e tablespaces: um tablespace pode conter objetos de diferentes esquemas e os objetos de um esquema podem estar contidos em diferentes tablespaces. Os dados de cada objeto estão fisicamente contidos em um ou mais arquivos de dados.
A figura a seguir mostra uma possível configuração de segmentos de tabela e índice, tablespaces e arquivos de dados. O segmento de dados de uma tabela abrange dois arquivos de dados, que fazem parte do mesmo tablespace. Um segmento não pode abranger vários tablespaces.
Figura 5: Segmentos, Tablespaces e Arquivos de Dados
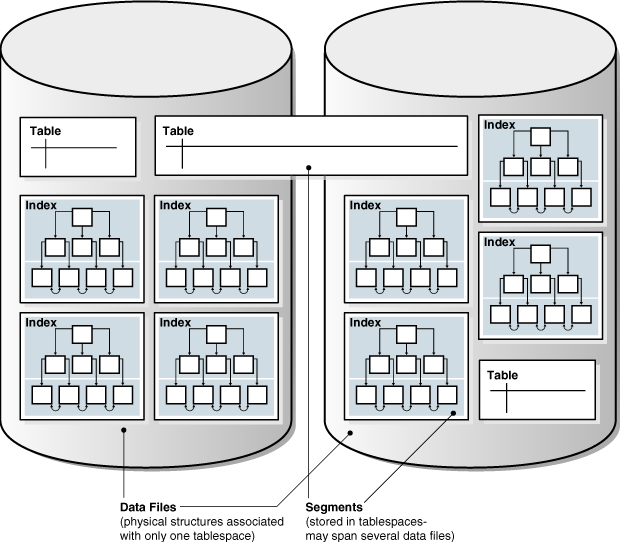
Descrição da ilustração cncpt284.gif
Consulte Também:
-
"Estruturas de Armazenamento Lógico" para saber mais sobre tablespaces e segmentos
-
Oracle AI Database Administrator's Guide para aprender a gerenciar o armazenamento para objetos de esquema
Dependências do Objeto do Esquema
Alguns objetos de esquema se referem a outros objetos, criando uma dependência de objeto de esquema.
Por exemplo, uma view contém uma consulta que faz referência a tabelas ou views, enquanto um subprograma PL/SQL chama outros subprogramas. Se a definição do objeto A fizer referência ao objeto B, A será um objeto dependente em B, e B será um objeto referenciado para A.
O Oracle AI Database fornece um mecanismo automático para garantir que um objeto dependente esteja sempre atualizado em relação aos seus objetos referenciados. Quando você cria um objeto dependente, o banco de dados rastreia as dependências entre o objeto dependente e seus objetos referenciados. Quando um objeto referenciado muda de uma forma que pode afetar um objeto dependente, o banco de dados marca o objeto dependente inválido. Por exemplo, se um usuário eliminar uma tabela, nenhuma view baseada na tabela eliminada poderá ser usada.
Um objeto dependente inválido deve ser recompilado em relação à nova definição de um objeto referenciado antes de o objeto dependente ser utilizável. A recompilação ocorre automaticamente quando o objeto dependente inválido é referenciado.
Como ilustração de como os objetos de esquema podem criar dependências, a seguinte amostra de script cria uma tabela test_table e, em seguida, um procedimento que consulta esta tabela:
CREATE TABLE test_table ( col1 INTEGER, col2 INTEGER );

CREATE OR REPLACE PROCEDURE test_proc
AS
BEGIN
 FOR x IN ( SELECT col1, col2 FROM test_table )
 LOOP
   -- process data
   NULL;
 END LOOP;
END;
/
A seguinte consulta do status do procedimento test_proc mostra que ele é válido:
SQL> SELECT OBJECT_NAME, STATUS FROM USER_OBJECTS WHERE OBJECT_NAME = 'TEST_PROC';

OBJECT_NAME STATUS
----------- -------
TEST_PROC   VALID
Depois de adicionar a coluna col3 a test_table, o procedimento ainda será válido porque o procedimento não tem dependências nessa coluna:
SQL> ALTER TABLE test_table ADD col3 NUMBER;

Table altered.

SQL> SELECT OBJECT_NAME, STATUS FROM USER_OBJECTS WHERE OBJECT_NAME = 'TEST_PROC';

OBJECT_NAME STATUS
----------- -------
TEST_PROC   VALID
No entanto, a alteração do tipo de dados da coluna col1, do qual depende o procedimento test_proc, invalida o procedimento:
SQL> ALTER TABLE test_table MODIFY col1 VARCHAR2(20);

Table altered.

SQL> SELECT OBJECT_NAME, STATUS FROM USER_OBJECTS WHERE OBJECT_NAME = 'TEST_PROC';

OBJECT_NAME STATUS
----------- -------
TEST_PROC   INVALID
A execução ou recompilação do procedimento o torna válido novamente, conforme mostrado no exemplo a seguir:
SQL> EXECUTE test_proc

PL/SQL procedure successfully completed.

SQL> SELECT OBJECT_NAME, STATUS FROM USER_OBJECTS WHERE OBJECT_NAME = 'TEST_PROC';

OBJECT_NAME STATUS
----------- -------
TEST_PROC   VALID
Consulte Também: Oracle AI Database Administrator's Guide e Oracle AI Database Development Guide para saber como gerenciar dependências de objetos de esquema
Exemplos de Esquemas
Um banco de dados Oracle pode incluir esquemas de amostra, que são um conjunto de esquemas interligados que permitem que a documentação da Oracle e os materiais de instrução da Oracle ilustrem tarefas comuns do banco de dados.
O esquema de amostra hr contém informações sobre funcionários, departamentos e locais, históricos de trabalho e assim por diante. A ilustração a seguir ilustra um diagrama de entidade-relacionamento das tabelas em hr. A maioria dos exemplos neste manual usa objetos deste esquema.
Figura 6: Esquema HR
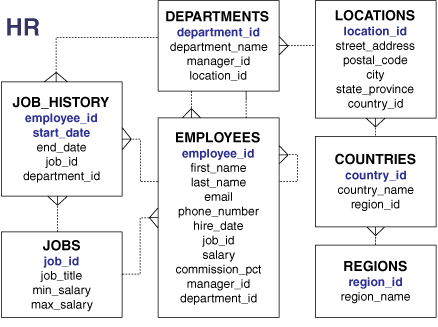
Descrição da ilustração cncpt292.gif
Consulte Também: Esquemas de Amostra do Oracle AI Database para saber como instalar os esquemas de amostra
Visão Geral de Tabelas
table é a unidade básica de organização de dados em um banco de dados Oracle.
Uma tabela descreve uma entidade, que é algo importante sobre a qual as informações devem ser registradas. Por exemplo, um funcionário pode ser uma entidade.
As tabelas do Oracle AI Database se enquadram nas seguintes categorias básicas:
-
Tabelas relacionais
As tabelas relacionais têm colunas simples e são o tipo de tabela mais comum. Exemplo 4-1 mostra uma instrução
CREATE TABLEpara uma tabela relacional. -
Tabelas de objeto
As colunas correspondem aos atributos de nível superior de um tipo de objeto. Consulte "Visão Geral das Tabelas de Objetos".
Você pode criar uma tabela relacional com as seguintes características organizacionais:
-
Uma tabela organizada por heap não armazena linhas em nenhuma ordem específica. Por padrão, a instrução
CREATE TABLEcria uma tabela organizada por heap. -
Uma tabela organizada por índice ordena linhas de acordo com os valores de chave primária. Para alguns aplicativos, as tabelas organizadas por índice melhoram o desempenho e usam o espaço em disco com mais eficiência. Consulte "Visão Geral de Tabelas Organizadas por Índice".
-
Uma tabela externa é uma tabela somente leitura cujos metadados são armazenados no banco de dados, mas cujos dados são armazenados fora do banco de dados. Consulte "Visão Geral de Tabelas Externas".
Uma tabela é permanente ou temporária. Uma definição de tabela permanente e dados persistem entre as sessões. Uma definição de tabela temporária persiste da mesma forma que uma definição de tabela permanente, mas os dados existem apenas durante uma transação ou sessão. As tabelas temporárias são úteis em aplicativos em que um conjunto de resultados deve ser mantido temporariamente, talvez porque o resultado seja construído por meio da execução de várias operações.
-
Colunas Uma definição de tabela inclui um nome de tabela e um conjunto de colunas.
-
Linhas Uma linha é um conjunto de informações da coluna correspondente a um registro em uma tabela.
-
Exemplo: Instruções CREATE TABLE e ALTER TABLE A instrução Oracle SQL para criar uma tabela é
CREATE TABLE. -
Tipos de Dados Oracle Cada coluna tem um tipo de dados, que é associado a um formato de armazenamento específico, restrições e intervalo válido de valores. O Tipo de dados de um Valor associa um conjunto fixo de propriedades ao Valor.
-
Constraints de Integridade Uma constraint de integridade é uma regra nomeada que restringe os valores de uma ou mais colunas de uma tabela.
-
O Armazenamento em Tabela Oracle AI Database usa um segmento de dados em um tablespace para armazenar dados de tabela.
-
Compactação de Tabela O banco de dados pode usar a compactação de tabela para reduzir a quantidade de armazenamento necessária para a tabela. Consulte Também: Oracle AI Database Administrator's Guide para saber como gerenciar tabelas
Colunas
Uma definição de tabela inclui o nome de uma tabela e o conjunto de colunas.
Uma coluna identifica um atributo da entidade descrita pela tabela. Por exemplo, a coluna employee_id na tabela employees refere-se ao atributo ID de funcionário de uma entidade de funcionário.
Em geral, você atribui a cada coluna um nome de coluna, um tipo de dados e uma largura ao criar uma tabela. Por exemplo, o tipo de dados para employee_id é NUMBER(6), indicando que essa coluna só pode conter dados numéricos de até 6 dígitos de largura. A largura pode ser predeterminada pelo tipo de dados, como acontece com DATE.
-
Colunas Virtuais Uma tabela pode conter uma coluna virtual, também chamada de coluna de expressão. As colunas de expressão podem ser virtuais, ou seja, não armazenadas em disco, ou materializadas, ou significados armazenados em disco.
-
Colunas Invisíveis Uma coluna invisível é uma coluna especificada pelo usuário cujos valores só são visíveis quando a coluna é explicitamente especificada por nome. Você pode adicionar uma coluna invisível a uma tabela sem afetar os aplicativos existentes e tornar a coluna visível, se necessário.
-
Reserva sem Bloqueio Uma Reserva sem Bloqueio permite que várias atualizações simultâneas em um valor de coluna numérico prossigam sem serem bloqueadas por atualizações não confirmadas ao adicionar ou subtrair do valor da coluna.
Colunas Virtuais
Uma tabela pode conter uma coluna virtual, também chamada de coluna de expressão. As colunas de expressão podem ser virtuais, ou seja, não armazenadas em disco, ou materializadas, ou significados armazenados em disco.
As colunas virtuais, também conhecidas como colunas de expressão, derivam os valores computando um conjunto de expressões ou funções especificadas pelo usuário. Uma tabela pode conter uma das várias colunas desse tipo, mas sempre deve ter uma coluna regular. Por exemplo, a definição da tabela EMP abaixo contém o valor por hora calculado com base no salário do funcionário dividido por 2080 horas por ano.
CREATE TABLE emp
(
   emp_id           NUMBER(9)     CONSTRAINT emp_pk PRIMARY KEY,
   emp_last_name    VARCHAR2(30)  CONSTRAINT emp_last_name_nn NOT NULL,
   emp_first_name   VARCHAR2(30)  CONSTRAINT emp_first_name_nn NOT NULL,
   emp_salary       NUMBER(9,2),
   emp_hourly_rate  NUMBER(7,2)   GENERATED ALWAYS AS (emp_salary/2080) VIRTUAL,
   emp_phone_no     VARCHAR2(10)
);
Em seguida, insira valores nas colunas não virtuais.
INSERT INTO emp (emp_id, emp_last_name, emp_first_name, emp_salary, emp_phone_no)
VALUES (8291, 'Patel', 'Siddharth', 60000, '6505551234');
Ao consultar a tabela, agora você vê o valor calculado retornado como uma coluna de expressão.
SELECT * FROM emp;

 EMP_ID EMP_LAST_NAME  EMP_FIRST_NAME     EMP_SALARY  EMP_HOURLY_RATE EMP_PHONE_NO
_______ ______________ _______________ _____________ ________________ _____________
   8291 Patel          Siddharth               60000            28.85 6505551234
Essas colunas de expressão podem ser virtuais ou materializadas em disco. No caso de colunas virtuais (expressão) puras, os valores de coluna não consomem espaço em disco e são calculados sob demanda no momento do acesso. No caso de colunas de expressão materializadas, os valores serão calculados no momento da DML e armazenados no disco.
Consulte Também: Oracle AI Database Administrator's Guide para aprender a gerenciar colunas virtuais
Colunas Invisíveis
Uma coluna invisível é uma coluna especificada pelo usuário cujos valores só são visíveis quando a coluna é explicitamente especificada por nome. Você pode adicionar uma coluna invisível a uma tabela sem afetar os aplicativos existentes e tornar a coluna visível, se necessário.
Em geral, as colunas invisíveis ajudam a migrar e evoluir aplicativos on-line. Um caso de uso pode ser um aplicativo que consulta uma tabela de três colunas com uma instrução SELECT *. A adição de uma quarta coluna à tabela interromperia o aplicativo, que espera três colunas de dados. Adicionar uma quarta coluna invisível faz com que o aplicativo funcione normalmente. Um desenvolvedor pode então alterar o aplicativo para tratar uma quarta coluna e tornar a coluna visível quando o aplicativo entrar em operação.
O exemplo a seguir cria uma tabela products com uma coluna invisível count e, em seguida, torna a coluna invisível visível:
CREATE TABLE products ( prod_id INT, count INT INVISIBLE );
ALTER TABLE products MODIFY ( count VISIBLE );
Consulte Também:
-
Oracle AI Database Administrator's Guide para aprender a gerenciar colunas invisíveis
-
Oracle AI Database SQL Language Reference para obter mais informações sobre colunas invisíveis
Reserva sem Bloqueio
Uma Reserva sem Bloqueio permite que várias atualizações simultâneas em um valor de coluna numérica continuem sem serem bloqueadas por atualizações não confirmadas ao adicionar ou subtrair do valor da coluna.
Ao evitar o mecanismo de bloqueio tradicional durante as atualizações, esse recurso permite que você melhore bastante a experiência do usuário com bloqueio reduzido na presença de atualizações simultâneas frequentes em colunas reserváveis. Em versões anteriores, quando um valor de coluna de uma linha é atualizado adicionando ou subtraindo dela, todas as outras atualizações dessa linha são bloqueadas até que a transação seja confirmada. Com a introdução do recurso Reserva sem Bloqueio no Oracle AI Database 26ai, você pode permitir que as transações adicionem ou subtraiam simultaneamente da coluna reservável da mesma linha sem bloquear umas às outras, especificando as condições para as quais as atualizações podem continuar. Isso é feito especificando que a coluna numérica é uma coluna RESERVABLE e criando uma constraint CHECK para a coluna. A melhoria adicional do throughput também pode ser obtida porque as atualizações da coluna reservável não bloqueiam as linhas e, portanto, não impedem que outra transação atualize colunas não reserváveis da mesma linha simultaneamente.
Por exemplo, você pode permitir que operações de adição e subtração em uma quantidade de estoque sejam bem-sucedidas se a quantidade em estoque for suficiente para a solicitação e não exceder nosso espaço de prateleira para 100 itens. Qualquer atualização desse tipo do valor de quantidade poderá continuar sem ser bloqueada por atualizações não confirmadas, desde que o valor da quantidade seja maior que zero e menor ou igual a 100. O valor adicionado ou subtraído é reservado e garantido por meio de um mecanismo de reserva interno para que a transação possa prosseguir sem aguardar outras transações que tenham feito reservas anteriores na coluna reservável da mesma linha a serem confirmadas.
As restrições CHECK no nível da tabela podem incluir colunas reserváveis e não reserváveis. Uma reserva sem bloqueio pendente que foi aprovada no momento em que uma atualização é emitida pode violar essa restrição no momento da confirmação da transação. Isso poderá acontecer se as colunas não reserváveis da constraint tiverem sido atualizadas de modo que seus valores atuais possam violar a constraint CHECK. A transação deverá ser encerrada se a restrição for violada. No entanto, as colunas não reserváveis em uma restrição no nível da tabela são geralmente limites que são modificados com muita frequência. O espaço de prateleira, o saldo necessário em uma conta e os limites de gastos são exemplos desses limites.
O exemplo a seguir cria uma tabela inventory com uma coluna reservável qty_on_hand. A restrição CHECK em qty_on_hand especifica que deve haver zero ou mais itens em estoque e não mais do que a capacidade de prateleira para esse item para uma atualização em qty_on_hand para continuar sem bloquear outras atualizações. No exemplo abaixo, a tabela inventory é criada com as restrições apropriadas, várias linhas de dados são inseridas e o dicionário de dados da tabela inventory é consultado.
CREATE TABLE inventory
( item_id            NUMBER          CONSTRAINT inv_pk PRIMARY KEY,
  item_display_name  VARCHAR2(100)   NOT NULL,
  item_desc          VARCHAR2(2000),
  qty_on_hand        NUMBER          RESERVABLE CONSTRAINT qty_ck CHECK
                                        (qty_on_hand >= 0) NOT NULL,
  shelf_capacity     NUMBER          NOT NULL,
    CONSTRAINT shelf_ck CHECK (qty_on_hand <= shelf_capacity)
);

-- Insert a few rows in the inventory table
INSERT INTO inventory VALUES (123, 'Milk', 'Lowfat 2%', 100, 120);
INSERT INTO inventory VALUES (456, 'Bread', 'Multigrain', 50, 100);
INSERT INTO inventory VALUES (789, 'Eggs', 'Organic', 50, 75);

COMMIT;

SELECT * FROM inventory;

-- Check views user_tab_cols and user_tables to check
-- if the table is a reservable table and the names of the reservable columns

SELECT table_name, has_reservable_column
FROM   user_tables
WHERE  table_name = 'INVENTORY';

SELECT column_name, reservable_column
FROM   user_tab_cols
WHERE  table_name = 'INVENTORY'
  AND  reservable_column = 'YES';
Um exemplo de várias atualizações simultâneas na coluna reservável:
-
Transação 1:
UPDATE inventory SET qty_on_hand = qty_on_hand - 10 WHERE item_id = 123; -
Transação 2:
UPDATE inventory SET qty_on_hand = qty_on_hand + 20 WHERE item_id = 123; -
Transação 3:
UPDATE inventory SET qty_on_hand = qty_on_hand - 30 WHERE item_id = 123; -
Transação 2:
commit; -
Transação 3:
commit; -
Transação 1:
commit;
Uma coluna reservável pode ser adicionada a uma tabela usando o comando ALTER TABLE especificando uma restrição de CHECK opcional. Por Exemplo:
ALTER TABLE inventory ADD
(qty_on_hold NUMBER RESERVABLE DEFAULT 0
 CONSTRAINT qty_hold CHECK (qty_on_hold >= 0 and qty_on_hold <= 25));
Uma coluna reservável pode ser convertida em uma coluna não reservável usando o seguinte comando ALTER TABLE. Os aplicativos podem optar por impor as restrições, embora as reservas reserváveis estejam desativadas; portanto, a restrição não é eliminada automaticamente quando uma coluna é convertida em uma coluna não reservável. A eliminação da restrição é opcional, dependendo dos seus requisitos. Por exemplo:
ALTER TABLE inventory MODIFY (qty_on_hand NOT RESERVABLE);
ALTER TABLE inventory DROP CONSTRAINT qty_ck;
Uma coluna não reservável pode ser convertida em uma coluna reservável usando o comando ALTER TABLE. Por Exemplo:
ALTER TABLE inventory MODIFY
(qty_on_hand RESERVABLE
 CONSTRAINT qty_ck CHECK (qty_on_hand >= 0 and qty_on_hand <= 100));
Linhas
Uma linha é um conjunto de informações da coluna correspondente a um registro em uma tabela.
Por exemplo, uma linha na tabela employees descreve os atributos de um funcionário específico: ID, sobrenome, nome, etc. do funcionário. Depois de criar uma tabela, você pode inserir, consultar, excluir e atualizar linhas usando SQL.
Exemplo: Instruções CREATE TABLE e ALTER TABLE
A instrução SQL da Oracle para criar uma tabela é CREATE TABLE.
Exemplo 4-1 CREATE TABLE funcionários
O exemplo a seguir mostra a instrução CREATE TABLE da tabela employees no esquema de amostra hr. A instrução especifica colunas como employee_id, first_name, etc., especificando um tipo de dados como NUMBER ou DATE para cada coluna.
CREATE TABLE employees
    ( employee_id    NUMBER(6),
      first_name     VARCHAR2(20),
      last_name      VARCHAR2(25)   CONSTRAINT emp_last_name_nn  NOT NULL,
      email          VARCHAR2(25)   CONSTRAINT emp_email_nn      NOT NULL,
      phone_number   VARCHAR2(20),
      hire_date      DATE           CONSTRAINT emp_hire_date_nn  NOT NULL,
      job_id         VARCHAR2(10)   CONSTRAINT emp_job_nn        NOT NULL,
      salary         NUMBER(8,2),
      commission_pct NUMBER(2,2),
      manager_id     NUMBER(6),
      department_id  NUMBER(4),
      CONSTRAINT     emp_salary_min CHECK (salary > 0),
      CONSTRAINT     emp_email_uk   UNIQUE (email)
    ) ;
Exemplo 4-2 funcionários de ALTER TABLE
O exemplo a seguir mostra uma instrução ALTER TABLE que adiciona restrições de integridade à tabela employees. As constraints de integridade impõem as regras de negócios e impedem a entrada de informações inválidas em tabelas.
ALTER TABLE employees
ADD ( CONSTRAINT emp_emp_id_pk   PRIMARY KEY (employee_id),
      CONSTRAINT emp_dept_fk     FOREIGN KEY (department_id)
                                   REFERENCES departments,
      CONSTRAINT emp_job_fk      FOREIGN KEY (job_id)
                                   REFERENCES jobs (job_id),
      CONSTRAINT emp_manager_fk  FOREIGN KEY (manager_id)
                                   REFERENCES employees
    ) ;
Exemplo 4-3 Linhas na Tabela de funcionários
A saída de amostra a seguir mostra 8 linhas e 6 colunas da tabela hr.employees.
EMPLOYEE_ID FIRST_NAME  LAST_NAME      SALARY COMMISSION_PCT DEPARTMENT_ID
----------- ----------- ------------- ------- -------------- -------------
        100 Steven      King            24000                           90
        101 Neena       Kochhar         17000                           90
        102 Lex         De Haan         17000                           90
        103 Alexander   Hunold           9000                           60
        107 Diana       Lorentz          4200                           60
        149 Eleni       Zlotkey         10500             .2            80
        174 Ellen       Abel            11000             .3            80
        178 Kimberely   Grant            7000            .15
A saída anterior ilustra algumas das seguintes características importantes de tabelas, colunas e linhas:
-
Uma linha da tabela descreve os atributos de um funcionário: nome, salário, departamento, etc. Por exemplo, a primeira linha da saída mostra o registro do funcionário chamado Steven King.
-
Uma coluna descreve um atributo do funcionário. No exemplo, a coluna
employee_idé a chave principal, o que significa que cada funcionário é identificado exclusivamente pelo ID do funcionário. É garantido que dois funcionários não tenham o mesmo ID. -
Uma coluna que não seja de chave pode conter linhas com valores idênticos. No exemplo, o valor do salário para os funcionários 101 e 102 é o mesmo:
17000. -
Uma coluna chave estrangeira refere-se a uma chave primária ou exclusiva na mesma ou em outra tabela. Neste exemplo, o valor de
90nodepartment_idcorresponde à colunadepartment_idda tabeladepartments. -
Campo é a interseção de uma linha e coluna. Ela pode conter apenas um valor. Por exemplo, o campo do ID departamento do funcionário 103 contém o valor
60. -
Um campo pode não ter um valor. Nesse caso, o campo contém um valor nulo. O valor da coluna
commission_pctpara o funcionário 100 é nulo, enquanto o valor no campo para o funcionário 149 é.2. Uma coluna permite nulos, a menos que uma restrição de integridade de chave primária ouNOTNULLtenha sido definida nesta coluna. Nesse caso, nenhuma linha pode ser inserida sem um valor para essa coluna.
Consulte Também: Referência de Linguagem SQL do Oracle AI Database para sintaxe e semântica do CREATE TABLE
Tipos de Dados Oracle
Cada coluna tem um tipo de dados, que é associado a um formato de armazenamento específico, restrições e intervalo válido de valores. O Tipo de dados de um Valor associa um conjunto fixo de propriedades ao Valor.
Essas propriedades fazem com que o Oracle AI Database trate valores de um tipo de dado de forma diferente dos valores de outro. Por exemplo, você pode multiplicar valores do tipo de dados NUMBER, mas não valores do tipo de dados RAW.
Ao criar uma tabela, você deve especificar um tipo de dados para cada coluna. Cada valor inserido subsequentemente em uma coluna assume o tipo de dados da coluna.
O Oracle AI Database fornece vários tipos de dados integrados. Os tipos de dados mais usados se enquadram nas categorias detalhadas nesta seção.
Outras categorias importantes de tipos incorporados incluem objetos brutos, grandes (LOBs) e coleções. O código PL/SQL tem tipos de dados para constantes e variáveis, que incluem BOOLEAN, tipos de referência, tipos compostos (registros) e tipos definidos pelo usuário.
-
Os tipos de dados de Tipos de Dados de Caracteres armazenam dados alfanuméricos em strings. O tipo de dados de caractere mais comum é
VARCHAR2, que é a opção mais eficiente para armazenar dados de caracteres. -
Tipos de Dados Numéricos Os tipos de dados numéricos do Oracle AI Database armazenam números fixos e de ponto flutuante, zero e infinito. Alguns tipos numéricos também armazenam valores que são o resultado indefinido de uma operação, conhecida como "não é um número" ou
NaN. -
Tipos de Dados de Data/Hora Os tipos de dados datetime são
DATEeTIMESTAMP. O Oracle AI Database fornece suporte abrangente a fusos horários para carimbos de data/hora. -
Tipos de Dados de Linhas Cada linha armazenada no banco de dados tem um endereço - uma representação interna para localizar essa linha no banco de dados. O Oracle AI Database usa um tipo de dados
ROWIDpara armazenar o endereço (rowid) de cada linha no banco de dados. -
Tipo de Dados Booliano O tipo de dados BOOLEAN compreende os valores de verdade distintos
TrueeFalse. -
Modelos de Formato e Tipos de Dados Um modelo de formato é uma literal de caractere que descreve o formato de dados numéricos ou de datetime armazenados em uma string. O modelo de formato não altera a representação interna do valor no banco de dados.
Consulte Também:
-
Guia do Desenvolvedor do Oracle AI Database SecureFiles and Large Objects
-
Oracle AI Database SQL Language Reference para saber mais sobre tipos de dados SQL integrados
-
Referência de Tipos e Pacotes PL/SQL do Oracle AI Database para saber mais sobre os tipos de dados PL/SQL
-
Guia de Desenvolvimento do Oracle AI Database para aprender a usar os tipos de dados integrados
Tipos de dados de caractere
Os tipos de dados de caracteres armazenam dados alfanuméricos em strings. O tipo de dados de caractere mais comum é VARCHAR2, que é a opção mais eficiente para armazenar dados de caracteres.
Os valores de byte correspondem ao esquema de codificação de caracteres, geralmente chamado de conjunto de caracteres. O conjunto de caracteres do banco de dados é estabelecido na criação do banco de dados. Exemplos de conjuntos de caracteres são ASCII de 7 bits, EBCDIC e Unicode UTF-8.
A semântica de tamanho dos tipos de dados de caracteres é mensurável em bytes ou caracteres. O tratamento das strings como uma sequência de bytes é chamado de semântica de bytes. Este é o padrão para tipos de dados de caracteres. O tratamento das strings como uma sequência de caracteres é chamado de semântica de caracteres. Caractere é um ponto de código do conjunto de caracteres do banco de dados.
-
VARCHAR2 e Tipos de Dados CHAR O tipo de dados
VARCHAR2armazena literais de caracteres de tamanho variável. Um literal é um valor de dados fixo. -
Tipos de Dados NCHAR e NVARCHAR2 Os tipos de dados
NCHAReNVARCHAR2armazenam dados de caracteres Unicode.
Consulte Também:
-
Guia de Suporte à Globalização do Oracle AI Database para saber mais sobre conjuntos de caracteres
-
Oracle AI Database Get Started with Oracle AI Database Development para obter uma breve introdução aos tipos de dados
-
Guia de Desenvolvimento do Oracle AI Database para aprender a escolher um tipo de dados de caracteres
VARCHAR2 e Tipos de Dados CHAR
O tipo de dados VARCHAR2 armazena literais de caracteres de tamanho variável. Um literal é um valor de dados fixo.
Por exemplo, 'LILA', 'St. George Island' e '101' são todos literais de caracteres; 5001 é um literal numérico. Literais de caracteres são colocados entre aspas simples para que o banco de dados possa distingui-los dos nomes de objeto de esquema. Observação: Este manual usa os termos literal de texto, literal de caracteres e string de forma intercambiável.
Ao criar uma tabela com uma coluna VARCHAR2, você especifica um tamanho máximo de string. No Exemplo 4-1, a coluna last_name tem um tipo de dados VARCHAR2(25), o que significa que qualquer nome armazenado na coluna tem no máximo 25 bytes.
Para cada linha, o Oracle AI Database armazena cada valor na coluna como um campo de tamanho variável, a menos que um valor exceda o tamanho máximo. Nesse caso, o banco de dados retorna um erro. Por exemplo, em um conjunto de caracteres de byte único, se você informar 10 caracteres para o valor da coluna last_name em uma linha, a coluna na parte da linha armazenará apenas 10 caracteres (10 bytes), não 25. O uso de VARCHAR2 reduz o consumo de espaço.
Em contraste com VARCHAR2, CHAR armazena strings de caracteres de tamanho fixo. Quando você cria uma tabela com uma coluna CHAR, a coluna requer um tamanho de string. O padrão é 1 byte. O banco de dados usa espaços em branco para preencher o valor com o tamanho especificado.
O Oracle AI Database compara valores VARCHAR2 usando semântica de comparação não preenchida e compara valores CHAR usando semântica de comparação preenchida em branco.
Consulte Também: Referência de Linguagem SQL do Oracle AI Database para obter detalhes sobre semânticas de comparação preenchidas em branco e não preenchidas
Tipos de Dados NCHAR e NVARCHAR2
Os tipos de dados NCHAR e NVARCHAR2 armazenam dados de caracteres Unicode.
Unicode é um conjunto de caracteres codificado universal que pode armazenar informações em qualquer idioma usando um único conjunto de caracteres. NCHAR armazena strings de caracteres de tamanho fixo que correspondem ao conjunto de caracteres nacionais, enquanto NVARCHAR2 armazena strings de caracteres de tamanho variável.
Você especifica um conjunto de caracteres nacionais ao criar um banco de dados. O conjunto de caracteres dos tipos de dados NCHAR e NVARCHAR2 deve ser AL16UTF16 ou UTF8. Ambos os conjuntos de caracteres usam codificação Unicode.
Quando você cria uma tabela com uma coluna NCHAR ou NVARCHAR2, o tamanho máximo é sempre em semântica de tamanho de caractere. A semântica de tamanho de caractere é a semântica de tamanho padrão e única para NCHAR ou NVARCHAR2.
Consulte Também: Oracle AI Database Globalization Support Guide para obter informações sobre o recurso de suporte à globalização da Oracle
Tipos de Dados Numéricos
Os tipos de dados numéricos do Oracle AI Database armazenam números fixos e de ponto flutuante, zero e infinito. Alguns tipos numéricos também armazenam valores que são o resultado indefinido de uma operação, conhecida como "não é um número" ou NaN.
O Oracle AI Database armazena dados numéricos em formato de tamanho variável. Cada valor é armazenado em notação científica, com 1 byte usado para armazenar o expoente. O banco de dados usa até 20 bytes para armazenar a mantissa, que é a parte de um número de ponto flutuante que contém seus dígitos significativos. O Oracle AI Database não armazena zeros à esquerda e à direita.
-
Tipo de Dados NÚMERO O tipo de dados
NUMBERarmazena números fixos e de ponto flutuante. O banco de dados pode armazenar números de praticamente qualquer magnitude. É garantido que esses dados sejam portáveis entre diferentes sistemas operacionais que executam o Oracle AI Database. O tipo de dadosNUMBERé recomendado para a maioria dos casos em que você deve armazenar dados numéricos. -
Números de Ponto Flutuante O Oracle AI Database fornece dois tipos de dados numéricos exclusivamente para números de ponto flutuante:
BINARY_FLOATeBINARY_DOUBLE.
Tipo de Dados NUMBER
O tipo de dados NUMBER armazena números fixos e de ponto flutuante. O banco de dados pode armazenar números de praticamente qualquer magnitude. É garantido que esses dados sejam portáveis entre diferentes sistemas operacionais que executam o Oracle AI Database. O tipo de dados NUMBER é recomendado para a maioria dos casos em que você deve armazenar dados numéricos.
Você especifica um número de ponto fixo no formato NUMBER(p,s), no qual p e s se referem às seguintes características:
-
Precisão
A precisão especifica o número total de dígitos. Se uma precisão não for especificada, a coluna armazenará os valores exatamente como fornecido pelo aplicativo sem nenhum arredondamento.
-
Dimensionar
A escala especifica o número de dígitos da casa decimal até o dígito menos significativo. A escala positiva conta dígitos à direita do ponto decimal até e incluindo o dígito menos significativo. A escala negativa conta dígitos à esquerda do ponto decimal até, mas não incluindo, o dígito menos significativo. Se você especificar uma precisão sem uma escala, como em
NUMBER(6), a escala será 0.
No Exemplo 4-1, a coluna salary é do tipo NUMBER(8,2), portanto, a precisão é 8 e a escala é 2. Portanto, o banco de dados armazena um salário de 100.000 como 100000.00.
Números de Ponto Flutuante
O Oracle AI Database fornece dois tipos de dados numéricos exclusivamente para números de ponto flutuante: BINARY_FLOAT e BINARY_DOUBLE.
Esses tipos suportam todas as funcionalidades básicas fornecidas pelo tipo de dados NUMBER. No entanto, enquanto NUMBER usa precisão decimal, BINARY_FLOAT e BINARY_DOUBLE usam precisão binária, o que permite cálculos aritméticos mais rápidos e geralmente reduz os requisitos de armazenamento.
BINARY_FLOAT e BINARY_DOUBLE são tipos de dados numéricos aproximados. Eles armazenam representações aproximadas de valores decimais, em vez de representações exatas. Por exemplo, o valor 0,1 não pode ser representado exatamente por BINARY_DOUBLE ou BINARY_FLOAT. Eles são frequentemente utilizados para cálculos científicos. Seu comportamento é semelhante aos tipos de dados FLOAT e DOUBLE no Java e XMLSchema.
Consulte Também: Oracle AI Database SQL Language Reference para aprender sobre precisão, escala e outras características de tipos numéricos
Tipos de Dados de Data/Hora
Os tipos de dados datetime são DATE e TIMESTAMP. O Oracle AI Database fornece suporte abrangente a fusos horários para carimbos de data/hora.
-
Tipo de Dados da Data O tipo de dados
DATEarmazena data e hora. Embora datetimes possam ser representados em tipos de dados de caracteres ou números,DATEtem propriedades associadas especiais. -
Tipo de Dados TIMESTAMP O tipo de dados
TIMESTAMPé uma extensão do tipo de dadosDATE.
Tipo de Dados DATE
O tipo de dados DATE armazena data e hora. Embora datetimes possam ser representados em tipos de dados de caracteres ou números, DATE tem propriedades associadas especiais.
O banco de dados armazena datas internamente como números. As datas são armazenadas em campos de tamanho fixo de 7 bytes cada, correspondendo a século, ano, mês, dia, hora, minuto e segundo. Observação: As datas suportam totalmente operações aritméticas, portanto, você adiciona e subtrai as datas de acordo com o que puder com números.
O banco de dados exibe datas de acordo com o modelo de formato especificado. Modelo de formato é uma literal de caractere que descreve o formato de uma data/hora em uma string. O formato de data padrão é DD-MON-RR, que exibe datas no formato 01-JAN-11.
RR é semelhante a YY (os dois últimos dígitos do ano), mas o século do valor de retorno varia de acordo com o ano de dois dígitos especificado e os dois últimos dígitos do ano atual. Suponha que em 1999 o banco de dados exiba 01-JAN-11. Se o formato de data usar RR, 11 especificará 2011, enquanto se o formato usar YY, 11 especificará 1911. Você pode alterar o formato de data padrão no nível da instância e da sessão do banco de dados.
O Oracle AI Database armazena o tempo no formato 24 horas-HH:MI:SS. Se nenhuma parte do tempo for informada, a hora em um campo de data será 00:00:00 A.M por padrão. Em uma entrada somente hora, a parte da data assume como padrão o primeiro dia do mês atual.
Consulte Também:
-
Guia de Desenvolvimento do Oracle AI Database para obter mais informações sobre séculos e máscaras de formato de data
-
Oracle AI Database SQL Language Reference para obter informações sobre códigos de formato de data e hora
-
Oracle AI Database Development Guide para aprender a executar operações aritméticas com tipos de dados de data e hora
TIMESTAMP - Tipo de Dados
O tipo de dados TIMESTAMP é uma extensão do tipo de dados DATE.
TIMESTAMP armazena segundos fracionais além das informações armazenadas no tipo de dados DATE. O tipo de dados TIMESTAMP é útil para armazenar valores de tempo precisos, como em aplicativos que devem rastrear a ordem do evento.
Os tipos de dados DATETIME TIMESTAMP WITH TIME ZONE e TIMESTAMP WITH LOCAL TIME ZONE reconhecem o fuso horário. Quando um usuário seleciona os dados, o valor é ajustado para o fuso horário da sessão do usuário. Esse tipo de dados é útil para coletar e avaliar informações de data entre regiões geográficas.
Consulte Também: Referência de Linguagem SQL do Oracle AI Database para obter detalhes sobre a sintaxe de criação e inserção de dados em colunas de timestamp
Tipos de Dados Rowid
Cada linha armazenada no banco de dados tem um endereço - uma representação interna para localizar essa linha no banco de dados. O Oracle AI Database usa um tipo de dados ROWID para armazenar o endereço (rowid) de cada linha no banco de dados.
Os Rowids se enquadram nas seguintes categorias:
-
Os rowids físicos armazenam os endereços de linhas em tabelas organizadas por heap, clusters de tabelas e partições de tabelas e índices.
-
Os rowids lógicos armazenam os endereços das linhas em tabelas organizadas por índice.
-
Rowids estrangeiros são identificadores em tabelas estrangeiras, como tabelas DB2 acessadas por meio de um gateway. Eles não são rowids padrão do Oracle AI Database.
Um tipo de dados chamado idlinha universal, ou idlinha, suporta todos os tipos de idlinha.
-
Uso de Rowids O Oracle AI Database usa rowids internamente para a construção de índices.
-
Pseudocoluna ROWID Cada tabela em um banco de dados Oracle tem uma pseudocoluna chamada
ROWID.
Uso de Rowids
O Oracle AI Database usa rowids internamente para a construção de índices.
Um índice de árvore B, que é o tipo mais comum, contém uma lista ordenada de chaves divididas em intervalos. Cada chave é associada a um id de linha que aponta para o endereço da linha associada para acesso rápido.
Os usuários finais e os desenvolvedores de aplicativos também podem usar rowids para várias funções importantes:
-
Os ids de linha são um meio rápido de acessar novamente uma linha se seu
rowidtiver sido recuperado anteriormente com uma instrução SELECT. -
Os ids de linha permitem ver como uma tabela é organizada.
Embora você possa criar tabelas com colunas definidas usando o tipo de dados ROWID, não deve armazenar rowids com a intenção de usá-las para acessar dados em um estágio posterior. O uso de rowids dessa maneira pode gerar resultados imprevisíveis ou incorretos. O rowid de uma linha pode ser alterado por vários motivos que podem ser iniciados pelo usuário ou internamente pelo mecanismo do banco de dados. Não é possível depender do rowid para apontar para a mesma linha ou para uma linha válida depois que qualquer uma dessas operações tiver ocorrido.
Pseudocoluna ROWID
Todas as tabelas em um banco de dados Oracle têm uma pseudocoluna chamada ROWID.
Uma pseudocoluna se comporta como uma coluna de tabela, mas não está realmente armazenada na tabela. Você pode selecionar pseudocolunas, mas não pode inserir, atualizar ou excluir seus valores. Uma pseudocoluna também é semelhante a uma função SQL sem argumentos. As funções sem argumentos geralmente retornam o mesmo valor para cada linha do conjunto de resultado, enquanto as pseudocolunas geralmente retornam um valor diferente para cada linha.
Os valores da pseudocoluna ROWID são strings que representam o endereço de cada linha. Essas strings têm o tipo de dados ROWID. Essa pseudocoluna não é evidente ao listar a estrutura de uma tabela executando SELECT ou DESCRIBE, nem a pseudocoluna consome espaço. No entanto, o id da linha de cada linha pode ser recuperado com uma consulta SQL usando a palavra reservada ROWID como nome de coluna.
O exemplo a seguir consulta a pseudocoluna ROWID para mostrar o rowid da linha na tabela employees para o funcionário 100:
SQL> SELECT ROWID FROM employees WHERE employee_id = 100;

ROWID
------------------
AAAPecAAFAAAABSAAA
Consulte Também:
-
Guia de Desenvolvimento do Oracle AI Database para aprender a identificar linhas por endereço
-
Oracle AI Database SQL Language Reference para saber mais sobre tipos de rowid
Tipo de Dados Boolianos
O tipo de dados BOOLEAN compreende os valores de verdade distintos True e False.
A menos que proibido por uma restrição NOT NULL, o tipo de dados Booliano também suporta o valor de verdade UNKNOWN como o valor nulo. Você pode usar o tipo de dados Booliano sempre que o tipo de dados aparecer na sintaxe Oracle SQL.
Consulte Também:
- Referência Rápida da Linguagem SQL do Oracle AI Database para obter informações sobre o tipo de dados booliano.
Formatar Modelos e Tipos de Dados
Um modelo de formato é uma literal de caractere que descreve o formato de data/hora ou de dados numéricos armazenados em uma string. O modelo de formato não altera a representação interna do valor no banco de dados.
Quando você converte uma string de caracteres em uma data ou um número, um modelo de formato determina como o banco de dados interpreta a string. Em SQL, você pode usar um modelo de formato como argumento das funções TO_CHAR e TO_DATE para formatar um valor a ser retornado do banco de dados ou para formatar um valor a ser armazenado no banco de dados.
A instrução a seguir seleciona os salários dos funcionários do Departamento 80 e usa a função TO_CHAR para converter esses salários em valores de caractere com o formato especificado pelo modelo de formato de número '$99,990.99':
SQL> SELECT last_name employee, TO_CHAR(salary, '$99,990.99') AS "SALARY"
  2  FROM   employees
  3  WHERE  department_id = 80 AND last_name = 'Russell';

EMPLOYEE                  SALARY
------------------------- -----------
Russell                    $14,000.00
O exemplo a seguir atualiza uma data de admissão usando a função TO_DATE com a máscara de formato 'YYYY MM DD' para converter a string '1998 05 20' em um valor DATE:
SQL> UPDATE employees
  2  SET hire_date = TO_DATE('1998 05 20','YYYY MM DD')
  3  WHERE last_name = 'Hunold';
Consulte Também: Referência de Linguagem SQL do Oracle AI Database para saber mais sobre modelos de formato
Constraints de Integridade
Uma constraint de integridade é uma regra nomeada que restringe os valores de uma ou mais colunas de uma tabela.
As regras de integridade de dados impedem a entrada de dados inválidos em tabelas. Além disso, as constraints podem impedir a exclusão de uma tabela quando existem certas dependências.
Se uma constraint for ativada, o banco de dados verificará os dados à medida que são inseridos ou atualizados. O Oracle AI Database impede que dados que não estejam em conformidade com a restrição sejam inseridos. Se uma restrição estiver desativada, o Oracle AI Database permitirá que dados que não estejam em conformidade com a restrição entrem no banco de dados.
Em Exemplo 4-1, a instrução CREATE TABLE especifica as restrições NOT NULL para as colunas last_name, email, hire_date e job_id. As cláusulas de restrição identificam as colunas e as condições da restrição. Essas restrições garantem que as colunas especificadas não contenham valores nulos. Por exemplo, uma tentativa de inserir um novo funcionário sem um ID cargo gera um erro.
Você pode criar uma constraint quando ou depois de criar uma tabela. Você pode desativar temporariamente as restrições, se necessário. O banco de dados armazena restrições no dicionário de dados.
Consulte Também:
-
"Integridade de Dados" para saber mais sobre restrições de integridade
-
"Visão Geral do Dicionário de Dados" para saber mais sobre o dicionário de dados
-
Oracle AI Database SQL Language Reference para saber mais sobre as cláusulas de restrição SQL
Armazenamento de Tabelas
O Oracle AI Database usa um segmento de dados em um tablespace para armazenar dados de tabela.
Um segmento contém extensões compostas por blocos de dados. O segmento de dados de uma tabela (ou segmento de dados do cluster, para um cluster de tabela) está localizado no tablespace padrão do proprietário da tabela ou em um tablespace chamado na instrução CREATE TABLE.
-
Organização da Tabela Por padrão, uma tabela é organizada como um heap, o que significa que o banco de dados coloca linhas onde melhor se encaixam, em vez de em uma ordem especificada pelo usuário. Assim, uma tabela organizada por heap é um conjunto não ordenado de linhas.
-
Armazenamento em Linhas O banco de dados armazena linhas em blocos de dados. Cada linha de uma tabela que contém dados com menos de 256 colunas está contida em uma ou mais linhas.
-
Rowids of Row Pieces Um rowid é efetivamente um endereço físico de 10 bytes de uma linha.
-
Armazenamento de Valores Nulos Um nulo é a ausência de um valor em uma coluna. Nulos indicam dados ausentes, desconhecidos ou inaplicáveis. Consulte Também: "Segmentos de Usuário" para saber mais sobre os tipos de segmentos e como eles são criados
Organização da Tabela
Por padrão, uma tabela é organizada como um heap, o que significa que o banco de dados coloca as linhas onde melhor se encaixam, em vez de em ordem especificada pelo usuário. Assim, uma tabela organizada por heap é um conjunto não ordenado de linhas. Observação: as tabelas organizadas por índice usam um princípio de organização diferente.
À medida que os usuários adicionam linhas, o banco de dados as coloca no primeiro espaço livre disponível no segmento de dados. As linhas não são garantidas para serem recuperadas na ordem em que foram inseridas.
A tabela hr.departments é uma tabela organizada por heap. Ela tem colunas para ID do departamento, nome, ID de gerente e ID de local. À medida que as linhas são inseridas, o banco de dados as armazena em qualquer lugar. Um bloco de dados no segmento de tabela pode conter as linhas não ordenadas mostradas no seguinte exemplo:
50,Shipping,121,1500
120,Treasury,,1700
70,Public Relations,204,2700
30,Purchasing,114,1700
130,Corporate Tax,,1700
10,Administration,200,1700
110,Accounting,205,1700
A ordem das colunas é a mesma para todas as linhas de uma tabela. O banco de dados geralmente armazena colunas na ordem em que foram listadas na instrução CREATE TABLE, mas essa ordem não é garantida. Por exemplo, se uma tabela tiver uma coluna do tipo LONG, o Oracle AI Database sempre armazenará essa coluna pela última vez na linha. Além disso, se você adicionar uma nova coluna a uma tabela, a nova coluna se tornará a última armazenada.
Uma tabela pode conter uma coluna virtual, que, diferentemente das colunas normais, não consomem espaço no disco. O banco de dados deriva os valores em uma coluna virtual sob demanda, calculando um conjunto de expressões ou funções especificadas pelo usuário. Você pode indexar colunas virtuais, coletar estatísticas sobre elas e criar restrições de integridade. Assim, as colunas virtuais são muito parecidas com as colunas não virtuais.
Consulte Também:
-
Oracle AI Database SQL Language Reference para saber mais sobre colunas virtuais
Armazenamento de Linhas
O banco de dados armazena linhas em blocos de dados. Cada linha de uma tabela que contém dados com menos de 256 colunas está contida em uma ou mais linhas.
Se possível, o Oracle AI Database armazena cada linha como uma peça de linha. No entanto, se todos os dados da linha não puderem ser inseridos em um único bloco de dados ou se uma atualização em uma linha existente fizer com que a linha ultrapasse seu bloco de dados, o banco de dados armazenará a linha usando várias partes de linha.
As linhas em um cluster de tabelas contêm as mesmas informações das linhas em tabelas não agrupadas. Além disso, as linhas de um cluster de tabelas contêm informações que fazem referência à chave do cluster à qual pertencem.
Consulte Também: "Formato de Bloco de Dados" para saber mais sobre os componentes de um bloco de dados
Rowids de peças de linha
Um rowid (id de linha) é efetivamente um endereço físico de 10 bytes de uma linha.
Cada linha em uma tabela organizada por heap tem um id de linha exclusivo para essa tabela que corresponde ao endereço físico de uma parte da linha. Para clusters de tabelas, as linhas em tabelas diferentes que estão no mesmo bloco de dados podem ter o mesmo id de linha.
O Oracle AI Database usa rowids internamente para a construção de índices. Por exemplo, cada chave em um índice de árvore B é associada a um id de linha que aponta para o endereço da linha associada para acesso rápido. Os rowids físicos fornecem o acesso mais rápido possível a uma linha de tabela, permitindo que o banco de dados recupere uma linha em até uma única Entrada/Saída.
Consulte Também:
-
"Formato de Rowid" para aprender sobre a estrutura de um rowid
-
"Visão Geral de Índices de Árvore B" para saber mais sobre os tipos e a estrutura de índices de árvore B
Armazenamento de Valores Nulos
Um nulo é a ausência de um valor em uma coluna. Nulos indicam dados ausentes, desconhecidos ou inaplicáveis.
Os nulos serão armazenados no banco de dados se estiverem entre colunas com valores de dados. Nesses casos, eles exigem 1 byte para armazenar o comprimento da coluna (zero). Os nulos finais em uma linha não exigem armazenamento porque um novo cabeçalho de linha sinaliza que as colunas restantes na linha anterior são nulas. Por exemplo, se as três últimas colunas de uma tabela forem nulas, nenhum dado será armazenado para essas colunas.
Consulte Também: Referência de Linguagem SQL do Oracle AI Database para saber mais sobre valores nulos
Compactação da Tabela
O banco de dados pode usar a compactação de tabela para reduzir a quantidade de armazenamento necessária para a tabela.
A compactação economiza espaço em disco, reduz o uso de memória no cache de buffer do banco de dados e, em alguns casos, acelera a execução da consulta. A compactação de tabelas é transparente para os aplicativos de banco de dados.
-
A compactação de tabela baseada em Dicionário Basic Table Compression and Advanced Row Compression fornece boas taxas de compactação para tabelas organizadas por heap.
-
Compressão Colunar Híbrida Com a Compactação Colunar Híbrida, o banco de dados armazena a mesma coluna para um grupo de linhas juntas. O bloco de dados não armazena dados em formato principal de linha, mas usa uma combinação de métodos de linha e colunar.
-
Memory Speed Hybrid Columnar Compression Memory Speed Hybrid Columnar Compression introduces on-disk compression unit formats that can be processed at memory speed.
Compactação Básica de Tabelas e Compactação Avançada de Linhas
A compactação de tabela baseada em dicionário fornece boas taxas de compactação para tabelas organizadas por heap.
O Oracle AI Database suporta os seguintes tipos de compactação de tabela baseada em dicionário:
-
Compactação básica de tabelas
Este tipo de compactação destina-se a operações de carga em massa. O banco de dados não compacta os dados modificados usando DML convencional. Você deve usar operações INSERT de caminho direto, operações
ALTER TABLE . . . MOVEou redefinição de tabela on-line para obter a compactação básica da tabela. -
Compactação avançada de linhas
Esse tipo de compactação é destinado a aplicativos OLTP e compacta dados manipulados por qualquer operação SQL. O banco de dados obtém uma taxa de compactação competitiva enquanto permite que o aplicativo execute DML em aproximadamente o mesmo período de tempo que o DML em uma tabela descompactada.
Para os tipos anteriores de compactação, o banco de dados armazena linhas compactadas no formato principal de linha. Todas as colunas de uma linha são armazenadas juntas, seguidas por todas as colunas da próxima linha e assim por diante. O banco de dados substitui valores duplicados por uma breve referência a uma tabela de símbolos armazenada no início do bloco. Assim, as informações que o banco de dados precisa para recriar os dados descompactados são armazenadas no próprio bloco de dados.
Blocos de dados compactados se parecem muito com blocos de dados normais. A maioria dos recursos e funções de banco de dados que funcionam em blocos de dados regulares também funcionam em blocos compactados.
Você pode declarar a compactação no nível de tablespace, tabela, partição ou subpartição. Se for especificado no nível do tablespace, todas as tabelas criadas no tablespace serão compactadas por padrão.
Exemplo 4-4 Compactação no Nível da Tabela
A instrução a seguir aplica a compactação avançada de linha à tabela orders:
ALTER TABLE oe.orders ROW STORE COMPRESS ADVANCED;Exemplo 4-5 Compactação no Nível de Partição
O exemplo a seguir de uma instrução CREATE TABLE parcial especifica a compactação avançada de linha para uma partição e a compactação básica de tabela para a outra partição:
CREATE TABLE sales (
    prod_id     NUMBER     NOT NULL,
    cust_id     NUMBER     NOT NULL, ... )
 PCTFREE 5 NOLOGGING NOCOMPRESS
 PARTITION BY RANGE (time_id)
 ( partition sales_2013 VALUES LESS THAN(TO_DATE(...)) ROW STORE COMPRESS BASIC,
   partition sales_2014 VALUES LESS THAN (MAXVALUE) ROW STORE COMPRESS ADVANCED );
Consulte Também:
-
"Formato de Linha" para saber como os valores são armazenados em uma linha
-
"Compactação do Bloco de Dados" para saber mais sobre o formato dos blocos de dados compactados
-
Oracle AI Database Utilities para aprender a usar o SQL*Loader para carregamentos diretos de caminho
-
Oracle AI Database Administrator's Guide e Oracle AI Database Performance Tuning Guide para saber mais sobre compactação de tabelas
Compactação de Hybrid Columnar
Com a compactação HCC (Hybrid Columnar Compression), o banco de dados armazena a mesma coluna para um grupo de linhas. O bloco de dados não armazena dados em formato principal de linha, mas usa uma combinação de métodos de linha e colunar.
O armazenamento de dados da coluna, com o mesmo tipo de dados e características semelhantes, aumenta drasticamente a economia de armazenamento obtida com a compactação. O banco de dados compacta dados manipulados por qualquer operação SQL, embora os níveis de compactação sejam maiores para cargas de caminho direto. As operações do banco de dados funcionam de forma transparente contra objetos compactados, portanto, não são necessárias alterações no aplicativo.
Observação: a Compactação de Colunas Híbridas e o Armazenamento de Colunas na Memória (armazenamento de colunas IM) estão intimamente relacionados. A principal diferença é que a compactação HCC (Hybrid Column Compression) otimiza o armazenamento em disco, enquanto o armazenamento da coluna IM otimiza o armazenamento da memória.
-
Tipos de HCC (Hybrid Columnar Compression) Se o armazenamento subjacente suportar HCC (Hybrid Columnar Compression), você poderá especificar diferentes tipos de compactação, dependendo das suas necessidades.
-
A compactação HCC (Compression Units), usa uma construção lógica denominada compression unit para armazenar um conjunto de linhas.
-
DML e Compactação Colunar Híbrida A compactação HCC (Hybrid Columnar Compression) tem implicações para o bloqueio de linhas em diferentes tipos de operações DML. Consulte Também: "Área na Memória" para saber mais sobre o armazenamento de colunas de IM
Tipos de Compactação Colunar Híbrida
Se o armazenamento subjacente for compatível com a compactação HCC (Hybrid Columnar Compression), você poderá especificar os diferentes tipos de compactação, dependendo das suas necessidades.
As opções de compactação são:
-
Compactação do depósito
Esse tipo de compactação é otimizado para economizar espaço de armazenamento e destina-se a aplicativos de data warehouse.
-
Compactação de arquivos
Este tipo de compressão é otimizado para níveis máximos de compressão, e destina-se a dados históricos e dados que não mudam.
O Hybrid Columnar Compression é otimizado para aplicações de data warehousing e suporte a decisões no armazenamento do Oracle Exadata. O Oracle Exadata maximiza o desempenho de consultas em tabelas compactadas usando o Hybrid Columnar Compression, aproveitando a potência de processamento, a memória e a largura de banda da rede Infiniband que são integrantes do servidor de armazenamento do Oracle Exadata.
Outros sistemas de armazenamento da Oracle suportam o Hybrid Columnar Compression e oferecem a mesma economia de espaço do armazenamento do Oracle Exadata, mas não oferecem o mesmo nível de desempenho de consulta. Para esses sistemas de armazenamento, a compactação HCC (Hybrid Columnar Compression) é ideal para o arquivamento no banco de dados de dados antigos que não são acessados com frequência.
Unidades de compressão
A compactação HCC (Hybrid Columnar Compression) usa uma construção lógica denominada unidade de compactação para armazenar um conjunto de linhas.
Quando você carrega dados em uma tabela, o banco de dados armazena grupos de linhas em formato colunar, com os valores de cada coluna armazenados e compactados juntos. Depois que o banco de dados compacta os dados da coluna para um conjunto de linhas, o banco de dados ajusta os dados na unidade de compactação.
Por exemplo, você aplica a Compactação Colunar Híbrida a uma tabela daily_sales. Ao final de cada dia, você preenche a tabela com itens e o número vendido, com o ID do item e a data formando uma chave primária composta. A tabela a seguir mostra um subconjunto das linhas no daily_sales.
Tabela 3 Exemplo de Tabela daily_sales
| Item_ID | Data | Num_Sold | Shipped_From | Reabastecer |
|---|---|---|---|---|
| 1.000 | 01-JUN-18 | 2 | WAREHOUSE1 | S |
| 1.001 | 01-JUN-18 | 0 | WAREHOUSE3 | N |
| 1.002 | 01-JUN-18 | 1 | WAREHOUSE3 | N |
| 1.003 | 01-JUN-14 | 0 | WAREHOUSE2 | N |
| 1.004 | 01-JUN-18 | 2 | WAREHOUSE1 | N |
| 1.005 | 01-JUN-18 | 1 | WAREHOUSE2 | N |
Suponha que este subconjunto de linhas seja armazenado em uma unidade de compactação. A compactação colunar híbrida armazena os valores de cada coluna e, em seguida, usa vários algoritmos para compactar cada coluna. O banco de dados escolhe os algoritmos com base em uma variedade de fatores, incluindo o tipo de dados da coluna, a cardinalidade dos valores reais na coluna e o nível de compactação escolhido pelo usuário.
Conforme mostrado no gráfico a seguir, cada unidade de compactação pode abranger vários blocos de dados. Os valores de uma determinada coluna podem ou não abranger vários blocos.
Figura 7: Unidade de compressão
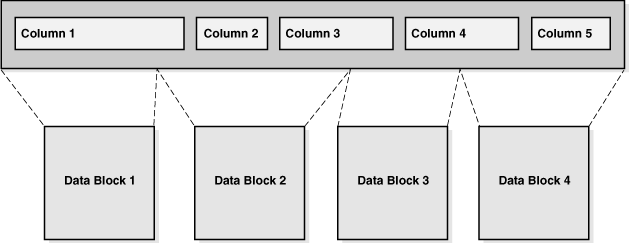
Descrição da ilustração sagug004.gif
Se a Compactação Colunar Híbrida não resultar em economia de espaço, o banco de dados armazenará os dados no formato DBMS_COMPRESSION.COMP_BLOCK. Nesse caso, o banco de dados aplica a compactação OLTP aos blocos, que residem em um segmento Hybrid Columnar Compression.
Consulte Também:
-
Manual do Usuário de Informações de Licenciamento do Oracle AI Database para saber mais sobre os requisitos de licenciamento do Hybrid Columnar Compression
-
Oracle AI Database Administrator's Guide para aprender a usar a compactação colunar híbrida
-
Oracle AI Database SQL Language Reference para sintaxe e semântica do
CREATE TABLE -
Referência de Tipos e Pacotes PL/SQL do Oracle AI Database para saber mais sobre o pacote
DBMS_COMPRESSION
DML e Compactação Colunar Híbrida
A compactação HCC (Hybrid Columnar Compression) tem implicações para o bloqueio de linhas em diferentes tipos de operações DML.
Cargas de Caminho Direto e Inserções Convencionais
Ao carregar dados em uma tabela que usa a compactação HCC (Hybrid Columnar Compression), você pode usar as inserções convencionais ou cargas de caminho direto. Cargas de caminho direto bloqueiam toda a tabela, o que reduz a simultaneidade.
A partir do Oracle Database 12c release 2 (12.2), é adicionado suporte para inserções de array convencionais no formato Hybrid Columnar Compression. As vantagens das inserções de array convencionais são:
-
As linhas inseridas usam bloqueios no nível da linha, o que aumenta a simultaneidade.
-
A Otimização Automática de Dados (ADO) e o Mapa de Calor suportam a Compressão Colunar Híbrida para políticas de nível de linha. Dessa forma, o banco de dados pode usar a compactação HCC (Hybrid Columnar Compression) para blocos elegíveis mesmo quando a atividade DML ocorre em outras partes do segmento.
Quando o aplicativo usa inserções de array convencionais, o Oracle AI Database armazena as linhas em unidades de compactação quando as seguintes condições são atendidas:
-
A tabela é armazenada em um tablespace ASSM.
-
O nível de compatibilidade é 12.2.0.1 ou posterior.
-
A definição da tabela satisfaz as restrições existentes da tabela Hybrid Columnar Compression, incluindo nenhuma coluna do tipo
LONGe nenhuma dependência de linha.
As inserções convencionais geram redo e undo. Dessa forma, as unidades de compactação criadas pela instrução DML convencional são submetidas a rollback ou a commit junto com a DML. O banco de dados executa automaticamente a manutenção do índice, assim como para as linhas que são armazenadas em blocos de dados convencionais.
A partir do Oracle AI Database 26ai, o Automatic Storage Compression permite que o Oracle AI Database direcione os dados de carregamento para um formato descompactado inicialmente e, em seguida, mova gradualmente as linhas para o formato Hybrid Columnar Compression em segundo plano. Isso é transparente para os usuários, ao mesmo tempo em que melhora o desempenho de ETL e mantém um desempenho de consulta rápido.
Atualizações e Exclusões
Por padrão, o banco de dados bloqueia todas as linhas na unidade de compactação se uma atualização ou exclusão for aplicada a qualquer linha na unidade. Para evitar esse problema, você pode optar por ativar o bloqueio no nível da linha para uma tabela. Nesse caso, o banco de dados só bloqueia linhas afetadas pela operação de atualização ou exclusão.
Consulte Também:
-
Oracle AI Database Administrator's Guide para aprender a executar inserções convencionais
-
Oracle AI Database SQL Language Reference para saber mais sobre a instrução
INSERT -
Referência de Linguagem SQL do Oracle AI Database para obter informações sobre como usar a dica
COMPRESS_IMMEDIATE -
Oracle AI Database VLDB and Partitioning Guide para obter informações sobre como usar a compactação automática de armazenamento
Compactação Colunar Híbrida de Velocidade de Memória
A compactação HCC (Memory Speed Hybrid Columnar Compression) introduz formatos de unidade de compactação em disco que podem ser processados na velocidade da memória.
Semelhante à compactação colunar híbrida, a compactação colunar híbrida de velocidade de memória é adequada para ambientes de data warehousing. Ele transforma os dados em um formato orientado por coluna e os compacta durante o carregamento de dados. A principal diferença é que o Memory Speed Hybrid Columnar Compression utiliza o mesmo formato colunar especial que o armazenamento de colunas na memória e o CELLMEMORY no cache flash do Exadata, obtendo assim varreduras colunares de alta velocidade e armazenamento em cache colunar eficiente em todas as camadas de armazenamento. Além disso, as unidades de Compressão Colunar Híbrida de Velocidade de Memória são significativamente maiores do que as unidades de compressão colunar híbridas, o que permite o uso efetivo do formato colunar na memória no disco.
A compactação HCC (Memory Speed Hybrid Columnar Compression) está ativada como uma extensão da compactação HCC (Hybrid Columnar Compression) usando o comando CREATE TABLE adicionando a palavra-chave MEMSPEED.
Exemplo 4-6 Compactação Colunar Híbrida de Velocidade de Memória
O exemplo a seguir cria a tabela orders com a compactação colunar híbrida de velocidade da memória ativada:
CREATE TABLE orders COLUMN STORE COMPRESS FOR MEMSPEED QUERY;Observação: Consulte Referência de Linguagem SQL do Oracle AI Database para obter mais informações.
Visão Geral de Clusters de Tabelas
Um cluster de tabelas é um grupo de tabelas que compartilham colunas comuns e armazenam dados relacionados nos mesmos blocos.
Quando as tabelas são agrupadas, um único bloco de dados pode conter linhas de várias tabelas. Por exemplo, um bloco pode armazenar linhas de ambas as tabelas employees e departments em vez de apenas uma tabela.
A chave de cluster é a coluna ou colunas que as tabelas clusterizadas têm em comum. Por exemplo, as tabelas employees e departments compartilham a coluna department_id. Você especifica a chave do cluster ao criar o cluster de tabelas e ao criar cada tabela adicionada ao cluster de tabelas.
O valor da chave do cluster é o valor das colunas da chave do cluster para um determinado conjunto de linhas. Todos os dados que contêm o mesmo valor de chave do cluster, como department_id=20, são armazenados fisicamente juntos. Cada valor de chave do cluster é armazenado apenas uma vez no cluster e no índice do cluster, não importa quantas linhas de tabelas diferentes contenham o valor.
Para uma analogia, suponha que um gerente de RH tenha dois casos de livro: um com caixas de pastas de funcionários e o outro com caixas de pastas de departamentos. Os usuários geralmente solicitam as pastas de todos os funcionários de um departamento específico. Para facilitar a recuperação, o gerente reorganiza todas as caixas em um único estojo de livro. Ela divide as caixas por ID departamento. Assim, todas as pastas para funcionários no departamento 20 e a pasta para o departamento 20 em si estão em uma caixa; as pastas para funcionários no departamento 100 e a pasta para o departamento 100 estão em outra caixa e assim por diante.
Considere agrupar tabelas quando elas forem principalmente consultadas (mas não modificadas) e os registros das tabelas forem frequentemente consultados juntos ou unidos. Como os clusters de tabelas armazenam linhas relacionadas de diferentes tabelas nos mesmos blocos de dados, os clusters de tabelas usados adequadamente oferecem os seguintes benefícios em relação às tabelas não agrupadas:
-
A Entrada/Saída do Disco foi reduzida para junções de tabelas clusterizadas.
-
O tempo de acesso melhora para junções de tabelas agrupadas.
-
É necessário menos armazenamento para armazenar dados relacionados de tabela e índice porque o valor da chave do cluster não é armazenado repetidamente para cada linha.
Normalmente, as tabelas de cluster não são apropriadas nas seguintes situações:
-
As tabelas são atualizadas com frequência.
-
As tabelas frequentemente exigem uma verificação completa da tabela.
-
As tabelas exigem truncamento.
-
Visão Geral de Clusters Indexados Um cluster de índice é um cluster de tabela que usa um índice para localizar dados. O índice do cluster é um índice de árvore B na chave do cluster. Um índice de cluster deve ser criado para que qualquer linha possa ser inserida em tabelas agrupadas.
-
Visão Geral de Clusters de Hash Um cluster hash é como um cluster indexado, exceto que a chave de índice é substituída por uma função hash. Não existe índice de cluster separado. Em um cluster hash, os dados são o índice.
Visão Geral de Clusters Indexados
Um cluster de índice é um cluster de tabelas que usa um índice para localizar dados. O índice do cluster é um índice de árvore B na chave do cluster. Um índice de cluster deve ser criado para que qualquer linha possa ser inserida em tabelas agrupadas.
Exemplo 4-7 Criando um Cluster de Tabelas e um Índice Associado
Suponha que você crie o cluster employees_departments_cluster com a chave de cluster department_id, conforme mostrado no seguinte exemplo:
CREATE CLUSTER employees_departments_cluster
   (department_id NUMBER(4))
SIZE 512;

CREATE INDEX idx_emp_dept_cluster
   ON CLUSTER employees_departments_cluster;
Como a cláusula HASHKEYS não está especificada, o employees_departments_cluster é um cluster indexado. O exemplo anterior cria um índice chamado idx_emp_dept_cluster na chave de cluster department_id.
Exemplo 4-8 Criando Tabelas em um Cluster Indexado
Você cria as tabelas employees e departments no cluster, especificando a coluna department_id como a chave do cluster, da seguinte forma (as reticências marcam o local onde a especificação da coluna vai):
CREATE TABLE employees ( ... )
   CLUSTER employees_departments_cluster (department_id);

CREATE TABLE departments ( ... )
   CLUSTER employees_departments_cluster (department_id);
Suponha que você adicione linhas às tabelas employees e departments. O banco de dados armazena fisicamente todas as linhas de cada departamento das tabelas employees e departments nos mesmos blocos de dados. O banco de dados armazena as linhas em um heap e as localiza com o índice. A Figura 4-8 mostra o cluster de tabelas employees_departments_cluster, que contém employees e departments. O banco de dados armazena linhas para os funcionários no departamento 20, departamento 110 juntos e assim por diante. Se as tabelas não forem agrupadas em clusters, o banco de dados não garantirá que as linhas relacionadas sejam armazenadas juntas.
Figura 8: Dados de tabela em cluster
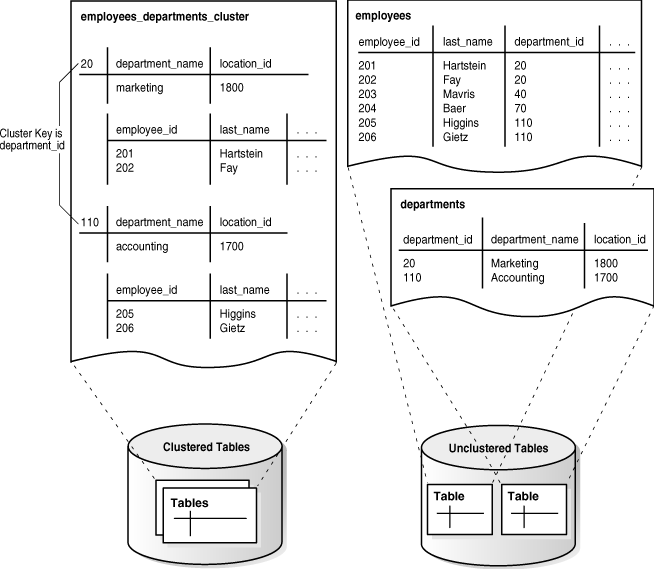
Descrição da ilustração cncpt023.gif
O índice do cluster da árvore B associa o valor da chave do cluster ao endereço do bloco do banco de dados (DBA) do bloco que contém os dados. Por exemplo, a entrada de índice para a chave 20 mostra o endereço do bloco que contém dados para funcionários no departamento 20:
20,AADAAAA9dO índice de cluster é gerenciado separadamente, assim como um índice em uma tabela não clusterizada, e pode existir em um tablespace separado do cluster de tabelas.
Consulte Também:
-
Oracle AI Database Administrator's Guide para aprender a criar e gerenciar clusters indexados
-
Oracle AI Database SQL Language Reference para sintaxe e semântica do
CREATE CLUSTER
Visão Geral de Clusters de Hash
Um cluster hash é como um cluster indexado, exceto que a chave de índice é substituída por uma função hash. Não existe índice de cluster separado. Em um cluster hash, os dados são o índice.
Com uma tabela indexada ou cluster indexado, o Oracle AI Database localiza linhas de tabela usando valores de chave armazenados em um índice separado. Para localizar ou armazenar uma linha em uma tabela indexada ou cluster de tabelas, o banco de dados deve executar pelo menos duas E/Ss:
-
Uma ou mais E/Ss para localizar ou armazenar o valor da chave no índice
-
Outra E/S para ler ou gravar a linha na tabela ou no cluster de tabelas
Para localizar ou armazenar uma linha em um cluster de hash, o Oracle AI Database aplica a função de hash ao valor da chave de cluster da linha. O valor de hash resultante corresponde a um bloco de dados no cluster, que o banco de dados lê ou grava em nome da instrução emitida.
Hashing é uma forma opcional de armazenar dados de tabelas para melhorar o desempenho da recuperação de dados. Os clusters de hash podem ser benéficos quando as seguintes condições são atendidas:
-
Uma tabela é consultada com muito mais frequência do que a modificada.
-
A coluna de chave de hash é consultada com frequência com condições de igualdade, por exemplo,
WHERE department_id=20. Para tais consultas, o valor da chave do cluster é hash. O valor da chave de hash aponta diretamente para a área do disco que armazena as linhas. -
Você pode razoavelmente adivinhar o número de chaves de hash e o tamanho dos dados armazenados com cada valor de chave.
-
Criação de Cluster de Hash Para criar um cluster de hash, use a mesma instrução
CREATE CLUSTERde um cluster indexado, com a adição de uma chave de hash. O número de valores de hash do cluster depende da chave de hash. -
Consultas de Clusters de Hash Em consultas de um cluster de hash, o banco de dados determina como fazer hash dos valores de chave inseridos pelo usuário.
-
Variações de Cluster de Hash Um cluster de hash de tabela única é uma versão otimizada de um cluster de hash que suporta apenas uma tabela por vez. Existe um mapeamento um a um entre chaves de hash e linhas.
-
Armazenamento de Cluster de Hash O Oracle AI Database aloca espaço para um cluster de hash de forma diferente de um cluster indexado.
Criação de Cluster de Hash
Para criar um cluster de hash, use a mesma instrução CREATE CLUSTER de um cluster indexado, com a adição de uma chave de hash. O número de valores de hash do cluster depende da chave de hash.
A chave do cluster, como a chave de um cluster indexado, é uma única coluna ou chave composta compartilhada pelas tabelas do cluster. Um valor de chave de hash é um valor real ou possível inserido na coluna de chave do cluster. Por exemplo, se a chave do cluster for department_id, os valores da chave de hash poderão ser 10, 20, 30 e assim por diante.
O Oracle AI Database usa uma função de hash que aceita um número infinito de valores de chave de hash como entrada e os classifica em um número finito de buckets. Cada bloco tem um ID numérico exclusivo conhecido como valor de hash. Cada valor de hash é mapeado para o endereço do bloco do banco de dados que armazena as linhas correspondentes ao valor da chave de hash (departamento 10, 20, 30, e assim por diante).
No exemplo a seguir, o número de departamentos que provavelmente existem é 100, portanto, HASHKEYS é definido como 100:
CREATE CLUSTER employees_departments_cluster
   (department_id NUMBER(4))
SIZE 8192 HASHKEYS 100;
Depois de criar o employees_departments_cluster, você poderá criar as tabelas employees e departments no cluster. Em seguida, você pode carregar dados no cluster de hash da mesma forma que no cluster indexado.
Consulte Também:
-
Oracle AI Database Administrator's Guide para aprender a criar e gerenciar clusters de hash
Consultas de Cluster de Hash
Nas consultas de um cluster de hash, o banco de dados determina como fazer hash dos valores de chave inseridos pelo usuário.
Por exemplo, os usuários frequentemente executam consultas como as seguintes, inserindo diferentes números de ID de departamento para p_id:
SELECT *
FROM   employees
WHERE  department_id = :p_id;

SELECT *
FROM   departments
WHERE  department_id = :p_id;

SELECT *
FROM   employees e, departments d
WHERE  e.department_id = d.department_id
AND    d.department_id = :p_id;
Se um usuário consultar funcionários em department_id=20, o banco de dados poderá fazer hash desse valor para o bucket 77. Se um usuário consultar funcionários em department_id=10, o banco de dados poderá fazer hash desse valor para o bucket 15. O banco de dados usa o valor de hash gerado internamente para localizar o bloco que contém as linhas do funcionário para o departamento solicitado.
A ilustração a seguir mostra um segmento de cluster de hash como uma linha horizontal de blocos. Conforme mostrado no gráfico, uma consulta pode recuperar dados em uma única E/S.
Figura 9: Recuperando Dados de um Cluster de Hash
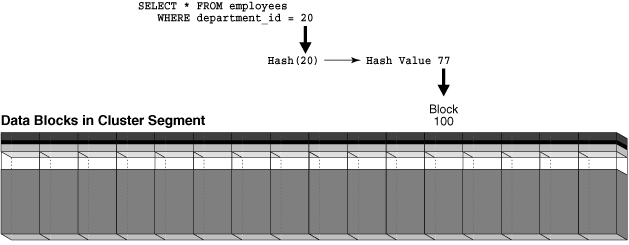
Descrição da ilustração cncpt329.gif
Uma limitação de clusters de hash é a indisponibilidade de varreduras de intervalo em chaves de cluster não indexadas. Suponha que não exista um índice separado para o cluster de hash criado em Criação de Cluster de Hash. Uma consulta para departamentos com IDs entre 20 e 100 não pode usar o algoritmo de hash porque ele não pode fazer hash de todos os valores possíveis entre 20 e 100. Como não existe índice, o banco de dados deve executar uma verificação completa.
Consulte Também: "Verificação de Faixa de Índices"
Variações de Cluster de Hash
Um cluster de hash de tabela única é uma versão otimizada de um cluster de hash que suporta apenas uma tabela por vez. Existe um mapeamento um a um entre chaves de hash e linhas.
Um cluster de hash de tabela única pode ser benéfico quando os usuários precisam de acesso rápido a uma tabela por chave primária. Por exemplo, os usuários geralmente pesquisam um registro de funcionário na tabela employees por employee_id.
Um cluster de hash classificado armazena as linhas correspondentes a cada valor da função de hash de forma que o banco de dados possa retorná-las eficientemente em ordem classificada. O banco de dados executa a classificação otimizada internamente. Para aplicativos que sempre consomem dados em ordem classificada, essa técnica pode significar uma recuperação mais rápida dos dados. Por exemplo, um aplicativo sempre pode ser classificado na coluna order_date da tabela orders.
Consulte Também: Oracle AI Database Administrator's Guide para saber como criar clusters de hash de tabela única e classificados
Armazenamento de Clusters Hash
O Oracle AI Database aloca espaço para um cluster de hash de forma diferente de um cluster indexado.
No exemplo em Criação de Cluster de Hash, HASHKEYS especifica o número de departamentos que provavelmente existirão, enquanto SIZE especifica o tamanho dos dados associados a cada departamento. O banco de dados calcula um valor de espaço de armazenamento com base na seguinte fórmula:
HASHKEYS * SIZE / database_block_sizeAssim, se o tamanho do bloco for 4096 bytes no exemplo mostrado em Criação de Cluster de Hash, o banco de dados alocará pelo menos 200 blocos para o cluster de hash.
O Oracle AI Database não limita o número de valores de chave de hash que você pode inserir no cluster. Por exemplo, mesmo que HASHKEYS seja 100, nada o impede de inserir 200 departamentos exclusivos na tabela departments. No entanto, a eficiência da recuperação do cluster de hash diminui quando o número de valores de hash excede o número de chaves de hash.
Para ilustrar os problemas de recuperação, suponha que o bloco 100 na Figura 4-9 esteja completamente cheio com linhas para o departamento 20. Um usuário insere um novo departamento com o department_id 43 na tabela departments. O número de departamentos excede o valor HASHKEYS; portanto, o banco de dados tem department_id 43 como valor de hash 77, que é o mesmo valor de hash usado para department_id 20. O hash de vários valores de entrada para o mesmo valor de saída denomina-se colisão de hash.
Quando os usuários inserem linhas no cluster para o departamento 43, o banco de dados não pode armazenar essas linhas no bloco 100, que está cheio. O banco de dados vincula o bloco 100 a um novo bloco de overflow, digamos, o bloco 200, e armazena as linhas inseridas no novo bloco. Os blocos 100 e 200 agora são elegíveis para armazenar dados de qualquer um dos departamentos. Conforme mostrado na Figura 4-10, uma consulta de qualquer departamento 20 ou 43 agora requer duas E/Ss para recuperar os dados: bloco 100 e seu bloco associado 200. Você pode resolver esse problema recriando o cluster com outro valor HASHKEYS.
Figura 10: Recuperando dados de um cluster de hash quando ocorre uma colisão de hash
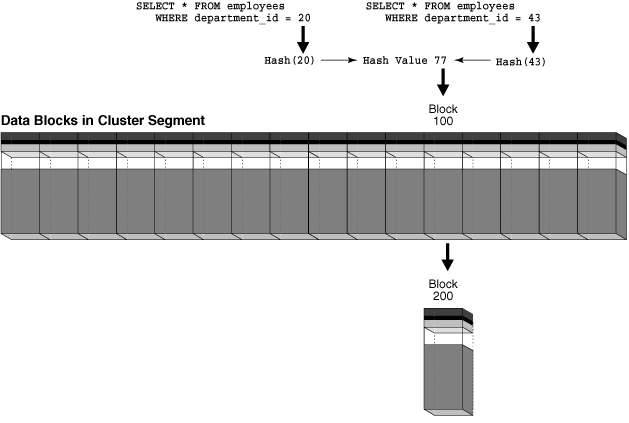
Descrição da ilustração cncpt331.gif
Consulte Também: Oracle AI Database Administrator's Guide para saber como gerenciar espaço em clusters de hash
Visão Geral de Tabelas Clusterizadas por Atributos
Uma tabela clusterizada de atributos é uma tabela organizada por heap que armazena dados próximos ao disco com base nas diretivas de cluster especificadas pelo usuário. As diretivas especificam colunas em tabelas únicas ou múltiplas.
As directivas são as seguintes:
-
A diretiva
CLUSTERING ... BY LINEAR ORDERordena dados em uma tabela de acordo com colunas especificadas.Considere o uso da clusterização
BY LINEAR ORDER, que é o padrão, quando as consultas qualificam o prefixo das colunas especificadas na cláusula de cluster. Por exemplo, se as consultas desh.salesgeralmente especificarem um ID de cliente ou um ID de cliente e um ID de produto, você poderá agrupar dados na tabela usando a ordem de coluna linearcust_id,prod_id. -
A diretiva
CLUSTERING ... BY INTERLEAVED ORDERordena dados em uma ou mais tabelas usando um algoritmo especial, semelhante a uma função de ordem Z, que permite a redução de E/S de várias colunas.Considere o uso da clusterização
BY INTERLEAVED ORDERquando as consultas especificarem uma variedade de combinações de colunas. Por exemplo, se as consultas desh.salesespecificarem diferentes dimensões em diferentes ordens, você poderá agrupar dados na tabelasalesde acordo com as colunas nessas dimensões.
A clusterização de atributos só está disponível para operações INSERT de caminho direto. É ignorado para DML convencional.
Essa seção contém os seguintes tópicos:
-
Vantagens de Tabelas Agrupadas por Atributos O principal benefício das tabelas agrupadas por atributos é a redução de E/S, que pode reduzir significativamente o custo de E/S e o custo de CPU das varreduras de tabelas. A redução de E/S ocorre com zonas ou reduzindo a E/S física por meio de uma proximidade física mais próxima no disco para os valores agrupados.
-
Unir Tabelas Clusterizadas de Atributos A clusterização de atributos baseada em colunas unidas é chamada unir clusterização de atributos. Ao contrário dos clusters de tabelas, as tabelas agrupadas por atributos de junção não armazenam dados de um grupo de tabelas nos mesmos blocos de banco de dados.
-
Redução de E/S usando regiões Uma zona é um conjunto de blocos de dados contíguos que armazena os valores mínimo e máximo das colunas relevantes.
-
Tabelas Agrupadas por Atributos com Ordenação Linear Um esquema de ordenação linear para uma tabela divide linhas em intervalos com base em atributos especificados pelo usuário em uma ordem específica. O Oracle AI Database suporta ordenação linear em tabelas únicas ou múltiplas conectadas por meio de um relacionamento de chave primária e estrangeira.
-
Tabelas Agrupadas por Atributos com Ordenação Entrelaçada A ordenação entrelaçada usa uma técnica semelhante a uma ordem Z.
Vantagens das Tabelas Agrupadas por Atributos
O principal benefício das tabelas agrupadas por atributos é a redução de E/S, que pode reduzir significativamente o custo de E/S e o custo de CPU das varreduras de tabelas. A redução de E/S ocorre com zonas ou reduzindo a E/S física por meio de uma proximidade física mais próxima no disco para os valores agrupados.
Uma tabela clusterizada de atributos tem as seguintes vantagens:
-
Você pode agrupar tabelas de fatos com base em colunas de dimensão em esquemas em estrela.
Nos esquemas em estrela, a maioria das consultas qualifica tabelas de dimensão e não tabelas de fatos, portanto, o agrupamento por colunas de tabela de fatos não é efetivo. O Oracle AI Database suporta clusterização em colunas em tabelas de dimensões.
-
A redução de E/S pode ocorrer em vários cenários diferentes:
-
Quando usado com Índices de Armazenamento do Oracle Exadata, poda mínima/máxima do Oracle In-Memory ou mapas de zona
-
Em aplicativos OLTP para consultas que qualificam um prefixo e usam clustering de atributos com ordem linear
-
Em um subconjunto das colunas de clusterização para clusterização
BY INTERLEAVED ORDER
-
-
A clusterização de atributos pode melhorar a compactação de dados e, dessa forma, melhorar indiretamente os custos de varredura de tabela.
Quando os mesmos valores estão próximos uns dos outros no disco, o banco de dados pode compactá-los com mais facilidade.
-
O Oracle AI Database não incorpora o custo de armazenamento e manutenção de um índice.
Consulte Também: Guia do Oracle AI Database Data Warehousing para obter mais vantagens de tabelas clusterizadas de atributos
Unir Tabelas Agrupadas de Atributos
A clusterização de atributos baseada em colunas unidas é chamada de agrupamento de atributos de junção. Ao contrário dos clusters de tabelas, as tabelas agrupadas por atributos de junção não armazenam dados de um grupo de tabelas nos mesmos blocos de banco de dados.
Por exemplo, considere uma tabela clusterizada por atributos, sales, associada a uma tabela de dimensões, products. A tabela sales contém somente linhas da tabela sales, mas a ordenação das linhas é baseada nos valores das colunas unidas da tabela products. A junção apropriada é executada durante as operações de movimentação de dados, inserção direta de caminho e CREATE TABLE AS SELECT. Por outro lado, se sales e products estivessem em um cluster de tabelas padrão, os blocos de dados conteriam linhas de ambas as tabelas.
Consulte Também: Guia do Oracle AI Database Data Warehousing para saber mais sobre clusterização de atributos de junção
Redução de E/S usando zonas
zona é um conjunto de blocos de dados contíguos que armazena os valores mínimo e máximo de colunas relevantes.
Quando uma instrução SQL contém predicados em colunas armazenadas em uma zona, o banco de dados compara os valores de predicado com o mínimo e o máximo armazenados na zona. Desta forma, o banco de dados determina quais zonas ler durante a execução SQL.
Redução de E/S é a capacidade de ignorar blocos de tabelas ou índices que não contêm dados que o banco de dados precisa para atender a uma consulta. Essa redução pode reduzir significativamente o custo de E/S e CPU das varreduras de tabela.
-
Finalidade de regiões Para uma analogia frouxa de regiões, considere um gerente de vendas que usa uma estante de pombos, que é análoga aos blocos de dados.
-
Mapas de Zonas Um mapa de zonas é uma estrutura de acesso independente que divide blocos de dados em zonas. O Oracle AI Database implementa cada mapa de zonas como um tipo de view materializada.
-
Criação de Mapa de Zona Os mapas de zona básicos são criados manual ou automaticamente.
-
Como um Mapa de Zona Funciona: Exemplo Este exemplo ilustra como um mapa de zona pode remover dados em uma consulta cujo predicado contém uma constante.
Finalidade das Zonas
Para uma analogia frouxa de zonas, considere um gerente de vendas que usa uma estante de pombos, que são análogos aos blocos de dados.
Cada pombo tem recibos (linhas) descrevendo camisas vendidas a um cliente, encomendadas por data de envio. Nesta analogia, um mapa de zonas é como uma pilha de cartões de índice. Cada cartão corresponde a uma "zona" (intervalo contíguo) de furos de pombos, como furos de pombo 1-10. Para cada zona, o cartão lista as datas mínimas e máximas de remessa para os recebimentos armazenados na zona.
Quando alguém quer saber quais camisas foram enviadas em uma determinada data, o gerente vira os cartões até que ela chegue ao intervalo de datas que contém a data solicitada, observa a zona do pombo e, em seguida, procura apenas pombos nesta zona para os recibos solicitados. Dessa forma, o gerente evita procurar os recibos em todas as fendas da estante.
Mapas de zona
Um mapa de zonas é uma estrutura de acesso independente que divide blocos de dados em zonas. O Oracle AI Database implementa cada mapa de zonas como um tipo de view materializada.
Assim como os índices, os mapas de zonas podem reduzir os custos de E/S e CPU das verificações de tabelas. Quando uma instrução SQL contém predicados em colunas em um mapa de zonas, o banco de dados compara os valores de predicados com os valores mínimos e máximos da coluna da tabela armazenada em cada zona para determinar quais zonas ler durante a execução de SQL.
Um mapa de zonas básicas é definido em uma única tabela e mantém os valores mínimo e máximo de algumas colunas desta tabela. Um mapa de zonas de junção é definido em uma tabela que tem uma junção externa com uma ou mais outras tabelas e mantém os valores mínimo e máximo de algumas colunas nas outras tabelas. O Oracle AI Database mantém os dois tipos de mapa de zonas automaticamente.
No máximo um mapa de zona pode existir em uma tabela. No caso de uma tabela particionada, existe um mapa de zonas para todas as partições e subpartições. Um mapa de zonas de uma tabela particionada também rastreia os valores mínimo e máximo por zona, por partição e por subpartição. As definições de mapa de zona podem incluir valores mínimos e máximos de colunas de dimensão, desde que a tabela tenha uma junção externa com as tabelas de dimensão. Observação: Você pode criar um mapa de zonas contendo apenas a zona no nível da partição ou da subpartição. A criação desse mapa de zonas expande os recursos de remoção de partição além dos metadados da partição.
Consulte Também: Guia do Oracle AI Database Data Warehousing para obter uma visão geral dos mapas de zonas
Criação de mapa de zonas
Os mapas de zonas básicas são criados manual ou automaticamente.
-
Mapas Manuais de Zonas Você pode criar, eliminar e manter mapas de zonas usando instruções DDL.
-
Mapas Automáticos de Zonas O Oracle AI Database pode criar mapas básicos de zonas automaticamente. Elas são conhecidas como mapas de zonas automáticas.
Mapas de Zona Manuais
Você pode criar, eliminar e manter mapas de zonas usando instruções DDL.
Sempre que você especificar a cláusula CLUSTERING em uma instrução CREATE TABLE ou ALTER TABLE, o banco de dados criará automaticamente um mapa de zona nas colunas de cluster especificadas. O mapa de zonas correlaciona valores mínimos e máximos de colunas com blocos de dados consecutivos na tabela clusterizada de atributos. As tabelas agrupadas por atributos usam mapas de zonas para executar a redução de E/S.
Você também pode criar mapas de zona explicitamente usando a instrução CREATE MATERIALIZED ZONEMAP. Nesse caso, você pode criar mapas de zona para uso com ou sem cluster de atributos. Por exemplo, você pode criar um mapa de zonas em uma tabela cujas linhas são naturalmente ordenadas em um conjunto de colunas, como uma tabela de negociação de ações cujas negociações são ordenadas por tempo.
Consulte Também:
-
Guia do Oracle AI Database Data Warehousing para saber mais como criar mapas de zonas
Mapas automáticos de zonas
O Oracle AI Database pode criar mapas de zonas básicos automaticamente. Elas são conhecidas como mapas de zonas automáticas.
O Oracle AI Database pode criar mapas de zonas básicos automaticamente para tabelas particionadas e não particionadas. Um processo em segundo plano mantém automaticamente mapas de zonas criados desta forma.
Use o procedimento DBMS_AUTO_ZONEMAP para ativar mapas automáticos de zonas:
EXEC DBMS_AUTO_ZONEMAP.CONFIGURE('AUTO_ZONEMAP_MODE','ON')Consulte Também:
-
Guia do Oracle AI Database Data Warehousing para saber mais sobre o gerenciamento de mapas de zonas automáticas usando o pacote
DBMS_AUTO_ZONEMAP -
Referência de Tipos e Pacotes PL/SQL do Oracle AI Database para saber mais sobre o pacote
DBMS_AUTO_ZONEMAP -
Manual do Usuário de Informações de Licenciamento do Oracle AI Database para obter detalhes sobre quais recursos são suportados para diferentes edições e serviços
Como funciona um mapa de região: exemplo
Este exemplo ilustra como um mapa de zonas pode podar dados em uma consulta cujo predicado contém uma constante.
Suponha que você crie a seguinte tabela lineitem:
CREATE TABLE lineitem
  ( orderkey      NUMBER        ,
    shipdate      DATE          ,
    receiptdate   DATE          ,
    destination   VARCHAR2(50)  ,
    quantity      NUMBER        );
A tabela lineitem contém 4 blocos de dados com 2 linhas por bloco. A Tabela 4-4 mostra as 8 linhas da tabela.
Tabela 4 Blocos de Dados para Tabela de item de linha
| Bloquear | chave de pedido | data da remessa | data de recebimento | destino | quantidade |
|---|---|---|---|---|---|
| 1 | 1 | 1-1-2014 | 1-10-2014 | San_Fran | 100 |
| 1 | 2 | 1-2-2014 | 1-10-2014 | San_Fran | 200 |
| 2 | 3 | 1-3-2014 | 1-9-2014 | San_Fran | 100 |
| 2 | 4 | 1-5-2014 | 1-10-2014 | San_Diego | 100 |
| 3 | 5 | 1-10-2014 | 1-15-2014 | San_Fran | 100 |
| 3 | 6 | 1-12-2014 | 1-16-2014 | San_Fran | 200 |
| 4 | 7 | 1-13-2014 | 1-20-2014 | San_Fran | 100 |
| 4 | 8 | 1-15-2014 | 1-30-2014 | San_Jose | 100 |
Você pode usar a instrução CREATE MATERIALIZED ZONEMAP para criar um mapa de zonas na tabela lineitem. Cada zona contém 2 blocos e armazena o mínimo e o máximo das colunas orderkey, shipdate e receiptdate. A Tabela 4-5 mostra o mapa de zonas.
Tabela 5 Mapa de Zona para Tabela de item de linha
| Intervalo do Bloco | chave de ordem mínima | max orderkey | data de remessa mínima | data máxima da remessa | data de recebimento mínima | data máxima de recebimento |
|---|---|---|---|---|---|---|
| 1-2 | 1 | 4 | 1-1-2014 | 1-5-2014 | 1-9-2014 | 1-10-2014 |
| 3-4 | 5 | 8 | 1-10-2014 | 1-15-2014 | 1-15-2014 | 1-30-2014 |
Quando você executa a consulta a seguir, o banco de dados pode ler o mapa de zonas e, em seguida, verificar somente os blocos 1 e 2 e, portanto, ignorar os blocos 3 e 4, porque a data 1-3-2014 está entre as datas mínima e máxima:
SELECT * FROM lineitem WHERE shipdate = '1-3-2014';Consulte Também:
-
Guia do Oracle AI Database Data Warehousing para aprender a usar mapas de zonas
-
Oracle AI Database SQL Language Reference para obter a sintaxe e a semântica da instrução
CREATE MATERIALIZED ZONEMAP
Tabelas Agrupadas por Atributos com Ordenação Linear
Um esquema de ordenação linear para uma tabela divide linhas em intervalos com base em atributos especificados pelo usuário em uma ordem específica. O Oracle AI Database suporta ordenação linear em tabelas únicas ou múltiplas conectadas por meio de um relacionamento de chave primária e estrangeira.
Por exemplo, a tabela sales divide as colunas cust_id e prod_id em intervalos e, em seguida, agrupa esses intervalos em disco. Quando você especifica a diretiva BY LINEAR ORDER para uma tabela, uma redução significativa de E/S pode ocorrer quando um predicado especifica a coluna de prefixo ou todas as colunas da diretiva.
Suponha que as consultas de sales geralmente especifiquem um ID de cliente ou uma combinação de um ID de cliente e um ID de produto. Você pode criar uma tabela clusterizada por atributos para que essas consultas se beneficiem da redução de E/S:
CREATE TABLE sales
(
   prod_id     NOT NULL NUMBER
,  cust_id     NOT NULL NUMBER
,  amount_sold NUMBER(10,2) ...
)
CLUSTERING
  BY LINEAR ORDER (cust_id, prod_id)
  YES ON LOAD YES ON DATA MOVEMENT
  WITH MATERIALIZED ZONEMAP;
As consultas que qualificam as colunas cust_id e prod_id ou o prefixo cust_id experimentam redução de E/S. As consultas que qualificam o prod_id só não apresentam redução significativa de E/S porque prod_id é o sufixo da cláusula BY LINEAR ORDER. Os exemplos a seguir mostram como o banco de dados pode reduzir a E/S durante as verificações de tabelas.
Exemplo 4-9 Especificando Somente cust_id
Um aplicativo emite a seguinte consulta:
SELECT * FROM sales WHERE cust_id = 100;Como a tabela sales é um cluster BY LINEAR ORDER, o banco de dados só deve ler as zonas que incluem o valor cust_id de 100.
Exemplo 4-10 Especificando prod_id e cust_id
Um aplicativo emite a seguinte consulta:
SELECT * FROM sales WHERE cust_id = 100 AND prod_id = 2300;Como a tabela sales é um cluster BY LINEAR ORDER, o banco de dados só deve ler as zonas que incluem o valor cust_id de 100 e o valor prod_id de 2300.
Consulte Também:
-
Guia do Oracle AI Database Data Warehousing para aprender a agrupar tabelas usando ordenação linear
-
Oracle AI Database SQL Language Reference para obter sintaxe e semântica da cláusula
BY LINEAR ORDER
Tabelas agrupadas por atributos com ordenação intercalada
A ordenação intercalada usa uma técnica semelhante a uma ordem Z.
A ordenação intercalada permite que o banco de dados remova a E/S com base em qualquer subconjunto de predicados nas colunas de cluster. A ordenação intercalada é útil para hierarquias dimensionais em um data warehouse.
Assim como as tabelas agrupadas por atributos com ordenação linear, o Oracle AI Database oferece suporte à ordenação intercalada em tabelas únicas ou múltiplas conectadas por meio de um relacionamento de chave primária e estrangeira. As colunas em tabelas diferentes da tabela clusterizada por atributos devem ser vinculadas por chave estrangeira e unidas à tabela clusterizada por atributos.
Grandes data warehouses frequentemente organizam dados em um esquema de estrela. Uma tabela de dimensões usa uma hierarquia pai-filho e é conectada a uma tabela de fatos por uma chave estrangeira. Agrupar em cluster uma tabela de fatos por ordem intercalada permite que o banco de dados use uma função especial para ignorar valores em colunas de dimensão durante as verificações de tabela.
Exemplo 4-11 Prescrição intercalada
Suponha que seu data warehouse contenha uma tabela de fatos sales e suas duas tabelas de dimensões: customers e products. A maioria das consultas tem predicados na hierarquia de tabelas customers (cust_state_province, cust_city) e na hierarquia de produtos (prod_category, prod_subcategory). Você pode usar a ordenação intercalada para a tabela sales, conforme mostrado na instrução parcial no seguinte exemplo:
CREATE TABLE sales
(
   prod_id NUMBER NOT NULL
,  cust_id NUMBER NOT NULL
,  amount_sold NUMBER(10,2) ...
)
CLUSTERING sales
   JOIN products ON (sales.prod_id = products.prod_id)
   JOIN customers ON (sales.cust_id = customers.cust_id)
   BY INTERLEAVED ORDER
   (
     (  products.prod_category
     ,  products.prod_subcategory
     ),
     (  customers.cust_state_province
     ,  customers.cust_city
     )
   )
WITH MATERIALIZED ZONEMAP;
Observação: As colunas especificadas na cláusula BY INTERLEAVED ORDER não precisam estar em tabelas de dimensão reais, mas devem estar conectadas por meio de um relacionamento de chave estrangeira principal.
Suponha que um aplicativo consulte as tabelas sales, products e customers em uma junção. A consulta especifica as colunas customers.prod_category e customers_cust_state_province no predicado da seguinte forma:
SELECT cust_city, prod_sub_category, SUM(amount_sold)
FROM   sales, products, customers
WHERE  sales.prod_id = products.prod_id
AND    sales.cust_id = customers.cust_id
AND    customers.prod_category = 'Boys'
AND    customers.cust_state_province = 'England - Norfolk'
GROUP BY cust_city, prod_sub_category;
Na consulta anterior, as colunas prod_category e cust_state_province fazem parte da definição de cluster mostrada no exemplo CREATE TABLE. Durante a verificação da tabela sales, o banco de dados pode consultar o mapa de zonas e acessar somente os rowids nessa zona.
Consulte Também:
-
Guia do Oracle AI Database Data Warehousing para aprender a agrupar tabelas usando pedidos intercalados
-
Oracle AI Database SQL Language Reference para obter sintaxe e semântica da cláusula
BY INTERLEAVED ORDER
Visão Geral de Tabelas Temporárias
Uma tabela temporária contém dados que só existem durante uma transação ou sessão.
Os dados em uma tabela temporária são privados para a sessão. Cada sessão só pode ver e modificar seus próprios dados.
É possível criar uma tabela temporária global ou uma tabela temporária privada. A tabela a seguir mostra as diferenças essenciais entre eles.
Tabela 6 Características da Tabela Temporária
| Característica | Global | Privado |
|---|---|---|
| Regras de nomeação | Igual às tabelas permanentes | Deve ser prefixado com ORA$PTT_ |
| Visibilidade da definição da tabela | Todas as sessões | Somente a sessão que criou a tabela |
| Armazenamento da definição da tabela | Disco | Somente memória |
| Tipos | Específico da transação (ON COMMIT DELETE ROWS) ou específico da sessão (ON COMMIT PRESERVE ROWS) |
Específico da transação (ON COMMIT DROP DEFINITION) ou específico da sessão (ON COMMIT PRESERVE DEFINITION) |
Um terceiro tipo de tabela temporária, conhecido como tabela temporária de duração de cursor, é criado pelo banco de dados automaticamente para determinados tipos de consultas.
-
Finalidade das Tabelas Temporárias As tabelas temporárias são úteis em aplicativos em que um conjunto de resultados deve ser armazenado em buffer.
-
Alocação de Segmento em Tabelas Temporárias Assim como as tabelas permanentes, as tabelas temporárias globais são objetos persistentes que são definidos estaticamente no dicionário de dados. Para tabelas temporárias privadas, os metadados só existem na memória, mas podem residir no tablespace temporário no disco.
-
Criação de Tabela Temporária A instrução
CREATE ... TEMPORARY TABLEcria uma tabela temporária. Consulte Também: Guia de Ajuste do Oracle AI Database SQL para saber mais sobre tabelas temporárias de duração do cursor
Finalidade das Tabelas Temporárias
As tabelas temporárias são úteis em aplicativos em que um conjunto de resultados deve ser armazenado em buffer.
Por exemplo, um aplicativo de programação permite que os alunos da faculdade criem cronogramas de curso semestrais opcionais. Uma linha em uma tabela temporária global representa cada cronograma. Durante a sessão, os dados da programação são privados. Quando o aluno escolhe um cronograma, o aplicativo move a linha do cronograma escolhido para uma tabela permanente. No final da sessão, o banco de dados elimina automaticamente os dados do cronograma que estavam na tabela temporária global.
As tabelas temporárias privadas são úteis para aplicativos de geração de relatórios dinâmicos. Por exemplo, um aplicativo CRM (Customer Resource Management) pode se conectar como o mesmo usuário indefinidamente, com várias sessões ativas ao mesmo tempo. Cada sessão cria uma tabela temporária privada chamada ORA$PTT_crm para cada nova transação. O aplicativo pode usar o mesmo nome de tabela para cada sessão, mas alterar a definição. Os dados e a definição são visíveis apenas para a sessão. A definição da tabela persiste até o fim da transação ou a eliminação manual da tabela.
Alocação de segmento em tabelas temporárias
Assim como as tabelas permanentes, as tabelas temporárias globais são objetos persistentes definidos estaticamente no dicionário de dados. Para tabelas temporárias privadas, os metadados só existem na memória, mas podem residir no tablespace temporário no disco.
Para tabelas temporárias globais e privadas, o banco de dados aloca segmentos temporários quando uma sessão insere dados pela primeira vez. Até que os dados sejam carregados em uma sessão, a tabela aparecerá vazia. Para tabelas temporárias específicas da transação, o banco de dados desaloca segmentos temporários no final da transação. Para tabelas temporárias específicas da sessão, o banco de dados desaloca segmentos temporários no final da sessão.
Consulte Também: "Segmentos Temporários"
Criação de Tabela Temporária
A instrução CREATE ... TEMPORARY TABLE cria uma tabela temporária.
Especifique GLOBAL TEMPORARY TABLE ou PRIVATE TEMPORARY TABLE. Em ambos os casos, a cláusula ON COMMIT especifica se os dados da tabela são específicos da transação (padrão) ou específicos da sessão. Você cria uma tabela temporária para o próprio banco de dados, não para cada procedimento armazenado PL/SQL.
Você pode criar índices para tabelas temporárias globais (não privadas) com a instrução CREATE INDEX. Esses índices também são temporários. Os dados no índice têm a mesma sessão ou escopo de transação que os dados na tabela temporária. Você também pode criar uma view ou um trigger em uma tabela temporária global.
Consulte Também:
-
Oracle AI Database Administrator's Guide para aprender a criar e gerenciar tabelas temporárias
-
Oracle AI Database SQL Language Reference para sintaxe e semântica do
CREATE ... TEMPORARY TABLE
Visão Geral de Tabelas Externas
Uma tabela externa acessa dados em origens externas como se esses dados estivessem em uma tabela no banco de dados.
Os dados podem estar em qualquer formato para o qual um driver de acesso seja fornecido. Você pode usar SQL (série ou paralelo), PL/SQL e Java para consultar tabelas externas.
-
As tabelas externas Finalidade das Tabelas Externas são úteis quando um aplicativo de banco de dados Oracle deve acessar dados não relacionais.
-
As tabelas externas Dados nos Armazenamentos de Objetos podem ser usadas para acessar dados nos armazenamentos de objetos.
-
Drivers de Acesso à Tabela Externa Um driver de acesso é uma API que interpreta os dados externos do banco de dados. O driver de acesso é executado dentro do banco de dados, que usa o driver para ler os dados na tabela externa. O driver de acesso e a camada de tabela externa são responsáveis por executar as transformações necessárias nos dados do arquivo de dados para que ele corresponda à definição da tabela externa.
-
Criação de Tabela Externa Internamente, criar uma tabela externa significa criar metadados no dicionário de dados. Diferentemente de uma tabela comum, uma tabela externa não descreve os dados armazenados no banco de dados nem como eles são armazenados externamente. Em vez disso, os metadados da tabela externa descrevem como a camada da tabela externa deve apresentar dados ao banco de dados.
-
Armazenamento Automático em Cache de Dados de Tabela Externa Os dados de tabelas externas são armazenados em cache de forma transparente para melhorar o desempenho da consulta.
Finalidade das Tabelas Externas
As tabelas externas são úteis quando um aplicativo de banco de dados Oracle deve acessar dados não relacionais.
Por exemplo, um aplicativo baseado em SQL pode precisar acessar um arquivo de texto cujos registros estão no seguinte formato:
100,Steven,King,SKING,515.123.4567,17-JUN-03,AD_PRES,31944,150,90
101,Neena,Kochhar,NKOCHHAR,515.123.4568,21-SEP-05,AD_VP,17000,100,90
102,Lex,De Haan,LDEHAAN,515.123.4569,13-JAN-01,AD_VP,17000,100,90
Você poderia criar uma tabela externa, copiar o arquivo de texto para o local especificado na definição da tabela externa e, em seguida, usar o SQL para consultar os registros no arquivo de texto. Da mesma forma, você pode usar tabelas externas para conceder acesso somente leitura a documentos JSON ou LOBs.
Em ambientes de data warehouse, as tabelas externas são valiosas para executar tarefas de extração, transformação e carregamento (ETL). Por exemplo, as tabelas externas permitem que você gaste a fase de carregamento de dados com a fase de transformação. Essa técnica elimina a necessidade de preparar dados dentro do banco de dados para processamento posterior dentro dele.
Você pode particionar tabelas externas em colunas virtuais ou não virtuais. Além disso, você pode criar uma tabela particionada híbrida, na qual algumas partições são internas e algumas externas. Assim como as partições internas, as partições externas se beneficiam de aprimoramentos de desempenho, como poda de partição e junções no sentido de partição. Por exemplo, você pode usar tabelas externas particionadas para analisar grandes volumes de dados não relacionais armazenados no HDFS (Hadoop Distributed File System) ou em um banco de dados NoSQL.
Consulte Também: "Tabelas Particionadas"
Dados em Armazenamentos de Objetos
As tabelas externas podem ser usadas para acessar dados em armazenamentos de objetos.
Além de dar suporte ao acesso a dados externos que residem em arquivos do sistema operacional e origens de Big Data, a Oracle oferece suporte ao acesso a dados externos no armazenamento de objetos. O armazenamento de objetos é comum na Nuvem e fornece uma arquitetura simples para gerenciar objetos individuais, qualquer tipo de dados não estruturados com metadados, agrupando-os em contêineres simples. Embora o armazenamento de objetos seja predominantemente uma arquitetura de armazenamento de dados na Nuvem, ele também está disponível como hardware de armazenamento on-premises.
Você pode acessar dados em armazenamentos de objetos usando o pacote DBMS_CLOUD ou definindo manualmente tabelas externas. A Oracle recomenda expressamente o uso do pacote DBMS_CLOUD porque ele fornece funcionalidade adicional e é totalmente compatível com o Oracle Autonomous Database.
Drivers de Acesso da Tabela Externa
Um driver de acesso é uma API que interpreta os dados externos do banco de dados. O driver de acesso é executado dentro do banco de dados, que usa o driver para ler os dados na tabela externa. O driver de acesso e a camada de tabela externa são responsáveis por executar as transformações necessárias nos dados do arquivo de dados para que ele corresponda à definição da tabela externa.
A figura a seguir representa o acesso SQL de dados externos.
Figura 11: Tabelas Externas
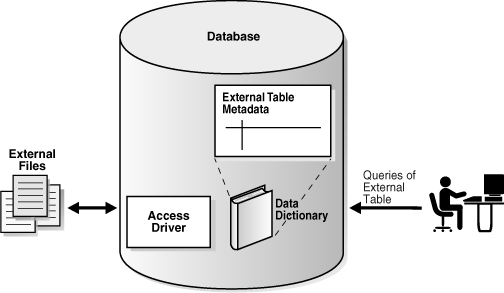
Descrição da ilustração cncpt231.gif
O Oracle fornece os seguintes drivers de acesso para tabelas externas:
-
ORACLE_LOADER(padrão)Permite o acesso a arquivos externos usando a maioria dos formatos suportados pelo SQL*Loader. Não é possível criar, atualizar ou anexar a um arquivo externo usando o driver
ORACLE_LOADER. -
ORACLE_DATAPUMPPermite descarregar ou carregar dados externos. Uma operação de descarregamento lê dados do banco de dados e os insere em uma tabela externa, representada por um ou mais arquivos externos. Depois que os arquivos externos são criados, o banco de dados não pode atualizar ou anexar dados a eles. Uma operação de carregamento lê uma tabela externa e carrega seus dados em um banco de dados.
-
ORACLE_HDFSPermite a extração de dados armazenados em um HDFS (Hadoop Distributed File System).
-
ORACLE_HIVEPermite acesso aos dados armazenados em um banco de dados Apache Hive. Os dados de origem podem ser armazenados em HDFS, HBase, Cassandra ou outros sistemas. Diferentemente dos outros drivers de acesso, você não pode especificar um local porque o
ORACLE_HIVEobtém informações de local de um armazenamento de metadados externo. -
ORACLE_BIGDATAPermite acesso somente leitura a dados armazenados em formatos estruturados e não estruturados, incluindo Apache Parquet, Apache Avro, Apache ORC, Apache Iceberg, o protocolo Linux Open Project Delta Sharing e formatos de texto. Você também pode usar esse driver para consultar dados locais, o que é útil para testes e conjuntos de dados menores.
Criação de Tabela Externa
Internamente, criar uma tabela externa significa criar metadados no dicionário de dados. Diferentemente de uma tabela comum, uma tabela externa não descreve os dados armazenados no banco de dados nem como eles são armazenados externamente. Em vez disso, os metadados da tabela externa descrevem como a camada da tabela externa deve apresentar dados ao banco de dados.
Uma instrução CREATE TABLE ... ORGANIZATION EXTERNAL tem duas partes. A definição da tabela externa descreve os tipos de coluna. Essa definição é como uma visualização que permite ao SQL consultar dados externos sem carregá-los no banco de dados. A segunda parte da instrução mapeia os dados externos para as colunas.
As tabelas externas são somente leitura, a menos que sejam criadas com CREATE TABLE AS SELECT com o driver de acesso ORACLE_DATAPUMP. As restrições para tabelas externas não incluem suporte para colunas indexadas e objetos de coluna.
Consulte Também:
-
Utilitários do Oracle AI Database para aprender sobre tabelas externas
-
Oracle AI Database Administrator's Guide para aprender sobre o gerenciamento de tabelas externas, conexões externas e objetos de diretório
-
Oracle AI Database SQL Language Reference para obter informações sobre como criar e consultar tabelas externas
Armazenamento Automático em Cache de Dados de Tabela Externa
Os dados de tabelas externas são armazenados em cache de forma transparente para melhorar o desempenho da consulta.
Os dados acessados com frequência de tabelas externas, que residem total ou parcialmente no armazenamento de objetos, são automaticamente armazenados em cache para aumentar o desempenho. O armazenamento em cache dos dados da tabela externa não requer alterações do aplicativo porque é tratado automaticamente pelo banco de dados Oracle.
Visão Geral das Tabelas Blockchain
Uma tabela blockchain é uma tabela somente para apêndice projetada para aplicativos blockchain centralizados.
No Oracle Blockchain Table, os colegas são usuários do banco de dados que confiam no banco de dados para manter um razão resistente a adulterações. O ledger é implementado como uma tabela blockchain, que é definida e gerenciada pelo aplicativo. Os aplicativos existentes podem se proteger contra fraudes sem exigir uma nova infraestrutura ou modelo de programação. Embora a taxa de transferência de transações seja menor do que para uma tabela padrão, o desempenho de uma tabela blockchain é melhor do que para uma blockchain descentralizada.
Uma tabela blockchain é somente anexada porque a única DML permitida são os comandos INSERT. A tabela não permite carregamentos de caminho direto com UPDATE, DELETE, MERGE, TRUNCATE. As transações de banco de dados podem abranger tabelas blockchain e tabelas padrão. Por exemplo, uma única transação pode inserir linhas em uma tabela padrão e duas tabelas de blockchain diferentes.
As tabelas Blockchain podem ser usadas para proteger o conteúdo do Flashback Data Archive. Isso permite determinar se alguém adulterou o conteúdo de uma tabela. Uma tabela de histórico de log de blockchain pode ser considerada como mantendo um redo log lógico criptograficamente seguro para alterações em uma tabela de usuário rastreada.
Você pode adicionar ou eliminar colunas de usuário de tabelas de blockchain começando com tabelas de blockchain versão 2. Não é permitido adicionar ou eliminar colunas de usuário das tabelas de blockchain da versão 1. As colunas físicas e os dados não são realmente eliminados, mas marcados como invisíveis.
-
Cadeias de Linhas Em uma tabela de blockchain, uma cadeia de linhas é uma série de linhas vinculadas a um esquema de hash.
-
Conteúdo da Linha O conteúdo da linha é uma sequência contígua de bytes que contém os dados da coluna da linha e o valor de hash da linha anterior na cadeia.
-
Interface do Usuário para Tabelas Blockchain Como uma tabela padrão, uma tabela blockchain é criada por SQL e suporta tipos de dados escalares, LOBs, JSON e partições. Você também pode criar índices e acionadores para tabelas blockchain.
Cadeias de Linhas
Em uma tabela de blockchain, uma cadeia de linhas é uma série de linhas vinculadas a um esquema de hash.
Uma cadeia de linhas do sistema é identificada por uma combinação exclusiva de ID da instância do banco de dados e ID da cadeia em uma tabela blockchain versão 1. A partir das tabelas blockchain da versão 2, o identificador exclusivo global do banco de dados que inseriu a linha é necessário, além desses dois identificadores. Uma cadeia de linhas do sistema é identificada por uma combinação exclusiva de ID exclusivo global do banco de dados plugável, ID da instância do banco de dados e ID da cadeia em uma tabela blockchain versão 2. Uma linha em uma tabela blockchain pertence exatamente a uma cadeia de linhas do sistema. Uma única tabela suporta várias cadeias de linhas do sistema. Observação: Uma linha encadeada em uma tabela padrão é ortogonal a uma cadeia de linhas em uma tabela blockchain. Apenas a palavra "cadeia" é a mesma.
Cada linha de uma cadeia tem um número de sequência exclusivo. O banco de dados sequencia as linhas usando um cálculo de hash SHA2-512 nas linhas de cada cadeia. O hash para cada linha inserida é derivado do conteúdo da linha inserida, que inclui o valor de hash da linha inserida anteriormente na cadeia.
Embora cada linha em uma tabela blockchain pertença exatamente a uma cadeia de sistema, ela também pode pertencer a uma cadeia de usuários com base em valores de um conjunto de colunas de usuário especificadas quando a tabela blockchain é criada.
Conteúdo da Linha
O conteúdo da linha é uma sequência contígua de bytes que contém os dados da coluna da linha e o valor de hash da linha anterior na cadeia.
Quando você cria uma tabela blockchain, o banco de dados cria várias colunas ocultas. Por exemplo, você pode criar a tabela de blockchain bank_ledger com as colunas bank e deposit:
CREATE BLOCKCHAIN TABLE bank_ledger (bank VARCHAR2 (128), deposit NUMBER)
  NO DROP UNTIL 31 DAYS IDLE
  NO DELETE UNTIL 31 DAYS AFTER INSERT
  HASHING USING "SHA2_512" VERSION "v1";
O banco de dados cria automaticamente colunas ocultas com o prefixo ORABCTAB: ORABCTAB_INST_ID$, ORABCTAB_CHAIN_ID$, ORABCTAB_SEQ_NUM$ e outros. Essas colunas ocultas, a maioria das quais você não pode alterar ou gerenciar, implementam o algoritmo anti-adulteração. Este algoritmo evita deadlocks adquirindo bloqueios de cadeia exclusivos em nível de tabela em uma ordem específica no momento do commit.
Observação: O conteúdo da linha para tabelas de blockchain é armazenado em blocos de dados padrão. Nesta release do Oracle AI Database, as tabelas de blockchain não suportam clusters de tabelas.
O ID ocorrência, o ID cadeia e o número de sequência identificam exclusivamente uma linha. A partir das tabelas blockchain da versão 2, o identificador exclusivo global do banco de dados que inseriu a linha é necessário, além desses três valores. Cada linha tem um hash SHA2-512 independente de plataforma que é armazenado na coluna oculta ORABCTAB_HASH$. O hash é baseado no conteúdo da linha inserida e no hash da linha anterior na cadeia.
O formato de dados para o valor da coluna de uma linha consiste em bytes dos metadados e do conteúdo da coluna. Os metadados da coluna são uma estrutura de 20 bytes que descreve características como posição na tabela, tipo de dados, status nulo e tamanho do byte. O conteúdo da coluna é o conjunto de bytes que representa o valor em uma linha. Por exemplo, a representação ASCII do valor Chase é 43 68 61 73 65. Você pode usar a função DUMP no SQL para obter metadados e conteúdo da coluna.
O conteúdo da linha para um cálculo de hash inclui os formatos de dados da coluna de várias colunas: o valor de hash na linha anterior da cadeia, as colunas definidas pelo usuário e um número fixo de colunas ocultas.
A ordem em que as linhas relacionadas são inseridas, chamadas de versões de linha, pode ser rastreada pelo sistema e registrada especificando um conjunto de colunas sobre as quais as versões de linha são definidas. Além disso, se as versões da linha forem especificadas, uma view será criada e mantida automaticamente, mostrando a última linha inserida para cada combinação de valores no conjunto de colunas especificado pelo usuário. O nome da view usa a convenção de nomenclatura Blockchain_Table_Name_LAST$.
Há muitos casos em que as linhas precisam ser assinadas adicional ou alternativamente por um delegado do usuário final. Um exemplo é um gerente bancário que assina uma linha inserida por um usuário final. Um assinante delegado é outro usuário do banco de dados que pode adicionar sua assinatura em uma linha que é calculada sobre o hash criptográfico do sistema da linha. Uma linha pode ser assinada por um usuário final, um delegado ou ambos. A assinatura de um delegado só é aceita se a assinatura puder ser verificada usando o certificado do delegado e o certificado do delegado for registrado em uma tabela de dicionário de banco de dados.
Quando uma linha é assinada por um usuário final ou delegado, o usuário pode querer adquirir uma contraassinatura para a linha. Uma contraassinatura pode ser considerada uma compilação de tabela de blockchain especificamente para a linha que já foi assinada por um usuário final ou delegado. Quando uma linha é contraassinada, a contraassinatura é retornada para o assinante da linha e também salva nessa linha. O usuário que solicita a contraassinatura na linha pode salvar essas informações para fins de não repúdio em um armazenamento de dados separado.
Interface do Usuário para Tabelas Blockchain
Como uma tabela padrão, uma tabela de blockchain é criada pelo SQL e suporta tipos de dados escalares, LOBs, JSON e partições. Você também pode criar índices e acionadores para tabelas blockchain.
Para criar uma tabela de blockchain, use uma instrução CREATE BLOCKCHAIN TABLE. Uma tabela de blockchain tem um período de retenção especificado pela cláusula NO DROP UNTIL n DAYS IDLE. Você pode remover a tabela usando DROP TABLE.
O Oracle Blockchain Table suporta as seguintes interfaces:
-
O pacote
DBMS_BLOCKCHAIN_TABLEpermite que você execute várias operações nas linhas da tabela. Por exemplo, para aplicar uma assinatura ao conteúdo de uma linha inserida anteriormente, use o procedimentoSIGN_ROW. Para verificar se as linhas não foram adulteradas, useVERIFY_ROWS. Para remover linhas após o período de retenção (especificado pela cláusulaNO DELETE) ter passado, useDELETE_EXPIRED_ROWS. -
A view
DBA_BLOCKCHAIN_TABLESmostra metadados de tabela, como o período de retenção de linhas, o período de inatividade antes de uma eliminação de tabela ser permitida e o algoritmo de hash.
Observação:
-
Oracle AI Database Administrator's Guide para aprender a gerenciar tabelas de blockchain
-
Referência de Tipos e Pacotes PL/SQL do Oracle AI Database para saber mais sobre o pacote
DBMS_BLOCKCHAIN_TABLE -
Oracle AI Database Reference para saber mais sobre a view
DBA_BLOCKCHAIN_TABLES
Visão geral de Tabelas imutáveis
Tabelas imutáveis são tabelas somente anexadas que impedem modificações não autorizadas dos dados por insiders e modificações acidentais dos dados resultantes dos erros humanos.
Modificações não autorizadas podem ser tentadas por funcionários comprometidos ou desonestos que têm acesso a credenciais internas.
É possível adicionar novas linhas a uma tabela imutável, mas não é possível modificar as linhas existentes. Você deve especificar um período de retenção para a tabela imutável e para linhas dentro da tabela imutável. As linhas se tornam obsoletas após o período de retenção de linha especificado. Somente linhas obsoletas podem ser excluídas da tabela imutável.
As tabelas imutáveis contêm colunas ocultas geradas pelo sistema. As colunas são as mesmas das tabelas blockchain. Quando uma linha é inserida, um valor não NULO é definido para as colunas ORABCTAB_CREATION_TIME$ e ORABCTAB_USER_NUMBER$. Exceto para tabelas imutáveis V1, um valor não NULO é definido para a coluna ORABCTAB_PDB_GUID$. Se a tabela imutável tiver sido criada com versões de linha, um valor não NULL será definido para as colunas ORABCTAB_ROW_VERSION$ e ORABCTAB_LAST_ROW_VERSION_NUMBER$. O valor das colunas ocultas restantes geradas pelo sistema é definido como NULL.
O uso de tabelas imutáveis não requer alterações nos aplicativos existentes.
Visão Geral de Tabelas de Objetos
Uma tabela de objetos é um tipo especial de tabela em que cada linha representa um objeto.
Um tipo de objeto do sistema Oracle é um tipo definido pelo usuário com nome, atributos e métodos. Tipos de objetos permitem modelar entidades do mundo real, como clientes e pedidos de compra, como objetos no banco de dados.
Um tipo de objeto define uma estrutura lógica, mas não cria armazenamento. O exemplo a seguir cria um tipo de objeto chamado department_typ:
CREATE TYPE department_typ AS OBJECT
   ( d_name     VARCHAR2(100),
     d_address  VARCHAR2(200) );
/
O exemplo a seguir cria uma tabela de objetos chamada departments_obj_t do tipo de objeto department_typ e, em seguida, insere uma linha na tabela. Os atributos (colunas) da tabela departments_obj_t são derivados da definição do tipo de objeto.
CREATE TABLE departments_obj_t OF department_typ;
INSERT INTO departments_obj_t VALUES ('hr', '10 Main St, Sometown, CA');
Assim como uma coluna relacional, uma tabela de objetos pode conter linhas de apenas um tipo de coisa, ou seja, instâncias de objetos do mesmo tipo declarado que a tabela. Por padrão, cada objeto de linha em uma tabela de objetos tem um identificador de objeto lógico (OID) associado que o identifica exclusivamente em uma tabela de objetos. A coluna OID de uma tabela de objetos é uma coluna oculta.
Consulte Também:
-
Oracle AI Database Object-Relational Developer's Guide para aprender sobre recursos objeto-relacionais no Oracle AI Database
-
Oracle AI Database SQL Language Reference para sintaxe e semântica do
CREATE TYPE