Partições, Views e Outros Objetos de Esquema
Embora tabelas e índices sejam os objetos de esquema mais importantes e comumente usados, o banco de dados suporta muitos outros tipos de objetos de esquema, os mais comuns dos quais são abordados neste capítulo.
-
Visão Geral de Partições Em um banco de dados Oracle, o particionamento permite decompor tabelas e índices muito grandes em partes menores e mais gerenciáveis chamadas partições. Cada partição é um objeto independente com seu próprio nome e, opcionalmente, suas próprias características de armazenamento.
-
Visão Geral de Tabelas com Sharding Em um banco de dados Oracle, o recurso Globally Distributed Database permite dividir qualquer tabela em partes chamadas shards que podem ser armazenadas em vários bancos de dados.
-
Visão Geral das Views Uma view é uma representação lógica de uma ou mais tabelas. Em essência, uma view é uma consulta armazenada.
-
Visão Geral de Views Materializadas Uma view materializada é um resultado de consulta que foi armazenado ou "materializado" antecipadamente como um objeto de esquema. A cláusula
FROMda consulta pode nomear tabelas, views ou views materializadas. -
Visão Geral de Sequências Uma sequência é um objeto de esquema a partir do qual vários usuários podem gerar números inteiros exclusivos. Um gerador de sequência fornece um método altamente escalável e de bom desempenho para gerar chaves substitutas para um tipo de dados de número.
-
Visão Geral de Dimensões Um data warehouse típico tem dois componentes importantes: dimensões e fatos.
-
Visão Geral de Sinônimos Um sinônimo é um alias para um objeto de esquema. Por exemplo, é possível criar um sinônimo para uma tabela ou view, sequência, unidade do programa PL/SQL, tipo de objeto definido pelo usuário ou outro sinônimo. Como um sinônimo é simplesmente um alias, ele não requer outro armazenamento além de sua definição no dicionário de dados.
Visão Geral de Partições
Em um banco de dados Oracle, o particionamento permite decompor tabelas e índices muito grandes em partes menores e mais gerenciáveis chamadas partições. Cada partição é um objeto independente com seu próprio nome e, opcionalmente, suas próprias características de armazenamento.
Para uma analogia que ilustra o particionamento, suponha que um gerente de RH tenha uma caixa grande que contenha pastas de funcionários. Cada pasta lista a data de admissão dos funcionários. Muitas vezes, são feitas consultas para funcionários contratados em um determinado mês. Uma abordagem para satisfazer essas solicitações é criar um índice na data de admissão do funcionário que especifique os locais das pastas espalhadas pela caixa. Por outro lado, uma estratégia de particionamento usa muitas caixas menores, com cada caixa contendo pastas para funcionários contratados em um determinado mês.
Usar caixas menores tem várias vantagens. Quando solicitado a recuperar as pastas dos funcionários contratados em junho, o gerente de RH pode recuperar a caixa Junho. Além disso, se qualquer caixa pequena estiver temporariamente danificada, as outras caixas pequenas permanecem disponíveis. Mudar de escritório também se torna mais fácil porque, em vez de mover uma única caixa pesada, o gerente pode mover várias caixas pequenas.
Do ponto de vista de um aplicativo, existe apenas um objeto de esquema. As instruções SQL não exigem modificação para acessar tabelas particionadas. O particionamento é útil para muitos tipos diferentes de aplicativos de banco de dados, particularmente aqueles que gerenciam grandes volumes de dados. Os benefícios incluem:
-
Maior disponibilidade
A indisponibilidade de uma partição não implica a indisponibilidade do objeto. O otimizador de consulta remove automaticamente partições não referenciadas do plano de consulta para que as consultas não sejam afetadas quando as partições estiverem indisponíveis.
-
Administração mais fácil de objetos de esquema
Um objeto particionado tem partes que podem ser gerenciadas coletivamente ou individualmente. As instruções DDL podem manipular partições em vez de tabelas ou índices inteiros. Assim, você pode dividir tarefas que consomem muitos recursos, como recriar um índice ou uma tabela. Por exemplo, você pode mover uma partição de tabela por vez. Se ocorrer um problema, somente a movimentação da partição deverá ser refeita, não a movimentação da tabela. Além disso, a eliminação de uma partição evita a execução de várias instruções
DELETE. -
Contenção reduzida para recursos compartilhados em sistemas OLTP
Em alguns sistemas OLTP, as partições podem diminuir a contenção de um recurso compartilhado. Por exemplo, DML é distribuído em muitos segmentos em vez de um segmento.
-
Desempenho de consulta aprimorado em data warehouses
Em um data warehouse, o particionamento pode acelerar o processamento de consultas ad hoc. Por exemplo, uma tabela de vendas contendo um milhão de linhas pode ser particionada por trimestre.
-
Características da Partição Cada partição de uma tabela ou índice deve ter os mesmos atributos lógicos, como nomes de colunas, tipos de dados e restrições.
-
Tabelas Particionadas Uma tabela particionada consiste em uma ou mais partições, que são gerenciadas individualmente e podem operar independentemente das outras partições.
-
Índices Particionados Um índice particionado é um índice que, como uma tabela particionada, foi dividido em partes menores e mais gerenciáveis.
-
Índices Parciais para Tabelas Particionadas Um índice parcial é um índice que está correlacionado com as propriedades de indexação de uma tabela particionada associada.
-
Usando o Object Store para Partições Mais Antigas Para partições somente para leitura, você pode usar armazenamento de baixo custo, como armazenamento de objetos na nuvem. Consulte Também: Oracle AI Database VLDB and Partitioning Guide para obter uma introdução ao particionamento
Características da Partição
Cada partição de uma tabela ou índice deve ter os mesmos atributos lógicos, como nomes de colunas, tipos de dados e restrições.
Por exemplo, todas as partições de uma tabela compartilham as mesmas definições de constraint e coluna. No entanto, cada partição pode ter atributos físicos separados, como o tablespace ao qual ela pertence.
-
Chave da Partição A chave da partição é um conjunto de uma ou mais colunas que determina a partição na qual cada linha de uma tabela particionada deve ir. Cada linha é designada inequivocamente a uma única partição.
-
Estratégias de Particionamento O Oracle Partitioning oferece várias estratégias de particionamento que controlam como o banco de dados coloca dados em partições. As estratégias básicas são intervalo, lista e particionamento de hash.
Chave de Partição
A chave de partição é um conjunto de uma ou mais colunas que determina a partição na qual cada linha de uma tabela particionada deve ir. Cada linha é designada inequivocamente a uma única partição.
Na tabela sales, você pode especificar a coluna time_id como a chave de uma partição de intervalo. O banco de dados atribui linhas a partições com base no fato de a data nesta coluna estar em um intervalo especificado. O Oracle AI Database direciona automaticamente as operações de inserção, atualização e exclusão para a partição apropriada usando a chave de partição.
Estratégias de Particionamento
O Oracle Partitioning oferece várias estratégias de particionamento que controlam como o banco de dados coloca dados em partições. As estratégias básicas são intervalo, lista e particionamento de hash.
Um particionamento de nível único usa apenas um método de distribuição de dados, por exemplo, apenas particionamento de lista ou apenas particionamento de intervalo. Em particionamento composto, uma tabela é particionada por um método de distribuição de dados e, em seguida, cada partição é dividida em subpartições usando um segundo método de distribuição de dados. Por exemplo, você pode usar uma partição de lista para channel_id e uma subpartição de intervalo para time_id.
Exemplo 6-1 Conjunto de Linhas de Amostra para Tabela Particionada
Este exemplo de particionamento pressupõe que você deseja preencher uma tabela particionada sales com as seguintes linhas:
  PROD_ID    CUST_ID TIME_ID   CHANNEL_ID   PROMO_ID QUANTITY_SOLD AMOUNT_SOLD
---------- ---------- --------- ---------- ---------- ------------- -----------
      116      11393 05-JUN-99          2        999             1
12.18
       40     100530 30-NOV-98          9         33             1       44.99
      118        133 06-JUN-01          2        999             1       17.12
      133       9450 01-DEC-00          2        999             1       31.28
       36       4523 27-JAN-99          3        999             1       53.89
      125       9417 04-FEB-98          3        999             1       16.86
       30        170 23-FEB-01          2        999             1         8.8
       24      11899 26-JUN-99          4        999             1       43.04
       35       2606 17-FEB-00          3        999             1       54.94
45 9491 28-AUG-98 4 350 1 47.45-
Particionamento de Intervalo No particionamento de intervalo, o banco de dados mapeia linhas para partições com base em intervalos de valores da chave de particionamento. Particionamento de intervalo é o tipo mais comum de particionamento e é frequentemente usado com datas.
-
Particionamento de intervalo é uma extensão do particionamento de intervalo.
-
Listar Particionamento No particionamento de lista, o banco de dados usa uma lista de valores discretos como a chave de partição para cada partição. A chave de particionamento consiste em uma ou mais colunas.
-
Particionamento de hash No particionamento de hash, o banco de dados mapeia linhas para partições com base em um algoritmo de hash que o banco de dados aplica à chave de particionamento especificada pelo usuário.
-
Particionamento de Referência Em particionamento de referência, a estratégia de particionamento de uma tabela filho é definida exclusivamente por meio do relacionamento de chave estrangeira com uma tabela pai. Para cada partição na tabela pai, existe exatamente uma partição correspondente na tabela filho. A tabela pai armazena os registros pais em uma partição específica, e a tabela filho armazena os registros filhos na partição correspondente.
-
Particionamento Composto No particionamento composto, uma tabela é particionada por um método de distribuição de dados e, em seguida, cada partição é subdividida em subpartições usando um segundo método de distribuição de dados. Assim, o particionamento composto combina os métodos básicos de distribuição de dados. Todas as subpartições de uma determinada partição representam um subconjunto lógico dos dados.
Particionamento de Faixa
No particionamento de intervalo, o banco de dados mapeia linhas para partições com base em intervalos de valores da chave de particionamento. Particionamento de intervalo é o tipo mais comum de particionamento e é frequentemente usado com datas.
Suponha que você crie time_range_sales como uma tabela particionada usando a seguinte instrução SQL, com a coluna time_id como chave de partição:
CREATE TABLE time_range_sales
   ( prod_id        NUMBER(6)
   , cust_id        NUMBER
   , time_id        DATE
   , channel_id     CHAR(1)
   , promo_id       NUMBER(6)
   , quantity_sold  NUMBER(3)
   , amount_sold    NUMBER(10,2)
   )
PARTITION BY RANGE (time_id)
 (PARTITION SALES_1998 VALUES LESS THAN (TO_DATE('01-JAN-1999','DD-MON-YYYY')),
  PARTITION SALES_1999 VALUES LESS THAN (TO_DATE('01-JAN-2000','DD-MON-YYYY')),
  PARTITION SALES_2000 VALUES LESS THAN (TO_DATE('01-JAN-2001','DD-MON-YYYY')),
  PARTITION SALES_2001 VALUES LESS THAN (MAXVALUE)
 );
Depois, você carrega time_range_sales com as linhas do Exemplo 6-1. O código mostra as distribuições de linha nas quatro partições. O banco de dados escolhe a partição para cada linha com base no valor time_id de acordo com as regras especificadas na cláusula PARTITION BY RANGE. O valor da chave de partição do intervalo determina o limite máximo não incluído para uma partição especificada.
Particionamento de Intervalo
Particionamento de intervalo é uma extensão do particionamento de intervalo.
Se você inserir dados que excedam as partições de intervalo existentes, o Oracle AI Database criará automaticamente partições de um intervalo especificado. Por exemplo, você pode criar uma tabela de histórico de vendas que armazena dados para cada mês em uma partição separada.
As partições de intervalo permitem que você evite criar partições de intervalo explicitamente. Você pode usar o particionamento de intervalo para quase todas as tabelas que são particionadas por intervalo e usam intervalos fixos para novas partições. A menos que você crie partições de intervalo com intervalos diferentes, ou a menos que você sempre defina atributos de partição específicos, considere o uso de partições de intervalo.
Ao particionar por intervalo, você deve especificar pelo menos uma partição de intervalo. O valor da chave de particionamento do intervalo determina o valor alto das partições do intervalo, que é chamado de ponto de transição. O banco de dados cria automaticamente partições de intervalo para dados com valores que estão além do ponto de transição. O limite inferior de cada partição de intervalo é o limite superior inclusivo do intervalo anterior ou da partição de intervalo. Assim, no Exemplo 6-2, o valor 01-JAN-2011 está na partição p2.
O banco de dados cria partições de intervalo para dados além do ponto de transição. Uma partição de intervalo estende o particionamento de intervalo instruindo o banco de dados a criar partições do intervalo ou intervalo especificado. O banco de dados cria automaticamente as partições quando os dados inseridos na tabela excedem todas as partições de intervalo existentes. Em Exemplo 6-2, a partição p3 contém linhas com valores de chave de particionamento time_id maiores ou iguais a 01-JAN-2013.
Exemplo 6-2 Particionamento de Intervalo
Suponha que você crie uma tabela de vendas com quatro partições de larguras variadas. Você especifica que acima do ponto de transição de 1º de janeiro de 2013, o banco de dados deve criar partições em intervalos de um mês. O limite superior da partição p3 representa o ponto de transição. A partição p3 e todas as partições abaixo dela estão na seção de intervalo, enquanto todas as partições acima dela se enquadram na seção de intervalo.
CREATE TABLE interval_sales
    ( prod_id        NUMBER(6)
    , cust_id        NUMBER
    , time_id        DATE
    , channel_id     CHAR(1)
    , promo_id       NUMBER(6)
    , quantity_sold  NUMBER(3)
    , amount_sold    NUMBER(10,2)
    )
  PARTITION BY RANGE (time_id)
  INTERVAL(NUMTOYMINTERVAL(1, 'MONTH'))
    ( PARTITION p0 VALUES LESS THAN (TO_DATE('1-1-2010', 'DD-MM-YYYY'))
    , PARTITION p1 VALUES LESS THAN (TO_DATE('1-1-2011', 'DD-MM-YYYY'))
    , PARTITION p2 VALUES LESS THAN (TO_DATE('1-7-2012', 'DD-MM-YYYY'))
    , PARTITION p3 VALUES LESS THAN (TO_DATE('1-1-2013', 'DD-MM-YYYY')) );
Você insere uma venda feita em 10 de outubro de 2014:
SQL> INSERT INTO interval_sales VALUES (39,7602,'10-OCT-14',9,null,1,11.79);

1 row created.
Uma consulta de USER_TAB_PARTITIONS mostra que o banco de dados criou uma nova partição para a venda em 10 de outubro porque a data da venda era posterior ao ponto de transição:
SQL> COL PNAME FORMAT a9
SQL> COL HIGH_VALUE FORMAT a40
SQL> SELECT PARTITION_NAME AS PNAME, HIGH_VALUE
  2  FROM USER_TAB_PARTITIONS WHERE TABLE_NAME = 'INTERVAL_SALES';

PNAME     HIGH_VALUE
--------- ----------------------------------------
P0        TO_DATE(' 2007-01-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
P1        TO_DATE(' 2008-01-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
P2        TO_DATE(' 2009-07-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
P3        TO_DATE(' 2010-01-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
SYS_P1598 TO_DATE(' 2014-11-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
Consulte Também: Oracle AI Database VLDB and Partitioning Guide para saber mais sobre partições de intervalo
Particionamento de Lista
No particionamento de lista, o banco de dados usa uma lista de valores discretos como a chave de partição para cada partição. A chave de particionamento consiste em uma ou mais colunas.
Você pode usar o particionamento de lista para controlar como linhas individuais são mapeadas para partições específicas. Usando listas, você pode agrupar e organizar conjuntos de dados relacionados quando a chave usada para identificá-los não for convenientemente ordenada.
Exemplo 6-3 Particionamento de Lista
Suponha que você crie list_sales como uma tabela particionada por lista usando a seguinte instrução, em que a coluna channel_id é a chave de partição:
CREATE TABLE list_sales
   ( prod_id        NUMBER(6)
   , cust_id        NUMBER
   , time_id        DATE
   , channel_id     CHAR(1)
   , promo_id       NUMBER(6)
   , quantity_sold  NUMBER(3)
   , amount_sold    NUMBER(10,2)
   )
PARTITION BY LIST (channel_id)
 ( PARTITION even_channels VALUES ('2','4'),
   PARTITION odd_channels VALUES ('3','9')
 );
Depois, você carrega a tabela com as linhas do Exemplo 6-1. O código mostra a distribuição da linha nas duas partições. O banco de dados escolhe a partição para cada linha com base no valor channel_id de acordo com as regras especificadas na cláusula PARTITION BY LIST. As linhas com um valor channel_id 2 ou 4 são armazenadas nas partições EVEN_CHANNELS, enquanto as linhas com um valor channel_id 3 ou 9 são armazenadas na partição ODD_CHANNELS.
Particionamento de Hash
No particionamento de hash, o banco de dados mapeia linhas para partições com base em um algoritmo de hash que o banco de dados aplica à chave de particionamento especificada pelo usuário.
O destino de uma linha é determinado pela função de hash interna aplicada à linha pelo banco de dados. Quando o número de partições é uma potência de 2, o algoritmo de hash cria uma distribuição aproximadamente uniforme de linhas em todas as partições.
O particionamento de hash é útil para dividir tabelas grandes para aumentar a capacidade de gerenciamento. Em vez de uma mesa grande para gerenciar, você tem várias peças menores. A perda de uma única partição de hash não afeta as partições restantes e pode ser recuperada de forma independente. O particionamento de hash também é útil em sistemas OLTP com alta contenção de atualização. Por exemplo, um segmento é dividido em várias partes, cada uma das quais é atualizada, em vez de um único segmento que experimenta contenção.
Suponha que você crie a tabela hash_sales particionada usando a seguinte instrução, com a coluna prod_id como chave de partição:
CREATE TABLE hash_sales
   ( prod_id        NUMBER(6)
   , cust_id        NUMBER
   , time_id        DATE
   , channel_id     CHAR(1)
   , promo_id       NUMBER(6)
   , quantity_sold  NUMBER(3)
   , amount_sold    NUMBER(10,2)
   )
PARTITION BY HASH (prod_id)
PARTITIONS 2;
Depois, você carrega a tabela com as linhas do Exemplo 6-1. O código mostra uma possível distribuição de linhas nas duas partições. Os nomes dessas partições são gerados pelo sistema.
À medida que você insere linhas, o banco de dados tenta distribuí-las aleatoriamente e uniformemente entre as partições. Não é possível especificar a partição na qual uma linha é colocada. O banco de dados aplica a função de hash, cujo resultado determina qual partição contém a linha.
Consulte Também:
-
Oracle AI Database VLDB and Partitioning Guide para saber como criar partições
-
Oracle AI Database SQL Language Reference para obter exemplos de
CREATE TABLE ... PARTITION BY
Particionamento de Referência
Em particionamento de referência, a estratégia de particionamento de uma tabela filho é definida exclusivamente por meio do relacionamento de chave estrangeira com uma tabela pai. Para cada partição na tabela pai, existe exatamente uma partição correspondente na tabela filho. A tabela pai armazena os registros pais em uma partição específica, e a tabela filho armazena os registros filhos na partição correspondente.
Por exemplo, uma tabela orders é o pai da tabela line_items, com uma chave primária e uma chave estrangeira definidas em order_id. As tabelas são particionadas por referência. Por exemplo, se o banco de dados armazenar a ordem 233 na partição Q3_2015 de orders, o banco de dados armazenará todos os itens de linha para a ordem 233 na partição Q3_2015 de line_items. Se a partição Q4_2015 for adicionada à orders, o banco de dados adicionará automaticamente Q4_2015 à line_items.
As vantagens do particionamento de referência são:
-
Ao usar a mesma estratégia de particionamento para as tabelas pai e filho, você evita duplicar todas as colunas de chave de particionamento. Essa estratégia reduz a sobrecarga manual de desnormalização e economiza espaço.
-
As operações de manutenção em uma tabela pai ocorrem na tabela filho automaticamente. Por exemplo, quando você adiciona uma partição à tabela primária, o banco de dados propaga automaticamente essa adição aos seus descendentes.
-
O banco de dados usa automaticamente junções por partição das partições na tabela pai e filho, melhorando o desempenho.
Você pode usar o particionamento de referência com todas as estratégias básicas de particionamento, incluindo o particionamento de intervalo. Você também pode criar tabelas particionadas de referência como tabelas particionadas compostas.
Exemplo 6-4 Criando Tabelas Particionadas por Referência
Este exemplo cria ordens de tabela pai que são particionadas por intervalo em order_date. A tabela filha particionada por referência order_items é criada com quatro partições, Q1_2015, Q2_2015, Q3_2015 e Q4_2015, em que cada partição contém as linhas order_items correspondentes às ordens na respectiva partição pai.
CREATE TABLE orders
    ( order_id           NUMBER(12),
      order_date         DATE,
      order_mode         VARCHAR2(8),
      customer_id        NUMBER(6),
      order_status       NUMBER(2),
      order_total        NUMBER(8,2),
      sales_rep_id       NUMBER(6),
      promotion_id       NUMBER(6),
      CONSTRAINT orders_pk PRIMARY KEY(order_id)
    )
  PARTITION BY RANGE(order_date)
    ( PARTITION Q1_2015 VALUES LESS THAN (TO_DATE('01-APR-2015','DD-MON-YYYY')),
      PARTITION Q2_2015 VALUES LESS THAN (TO_DATE('01-JUL-2015','DD-MON-YYYY')),
      PARTITION Q3_2015 VALUES LESS THAN (TO_DATE('01-OCT-2015','DD-MON-YYYY')),
      PARTITION Q4_2015 VALUES LESS THAN (TO_DATE('01-JAN-2006','DD-MON-YYYY'))
    );

CREATE TABLE order_items
    ( order_id           NUMBER(12) NOT NULL,
      line_item_id       NUMBER(3)  NOT NULL,
      product_id         NUMBER(6)  NOT NULL,
      unit_price         NUMBER(8,2),
      quantity           NUMBER(8),
      CONSTRAINT order_items_fk
      FOREIGN KEY(order_id) REFERENCES orders(order_id)
    )
    PARTITION BY REFERENCE(order_items_fk);
Consulte Também: Oracle AI Database VLDB and Partitioning Guide para obter uma visão geral do particionamento de referência
Particionamento do Composto
Em particionamento composto, uma tabela é particionada por um método de distribuição de dados e, em seguida, cada partição é subdividida em subpartições usando um segundo método de distribuição de dados. Assim, o particionamento composto combina os métodos básicos de distribuição de dados. Todas as subpartições de uma determinada partição representam um subconjunto lógico dos dados.
O particionamento composto oferece várias vantagens:
-
Dependendo da instrução SQL, a remoção de partição em uma ou duas dimensões pode melhorar o desempenho.
-
As consultas podem usar junções particionadas completas ou parciais em qualquer dimensão.
-
Você pode executar backup e recuperação paralelos de uma única tabela.
-
O número de partições é maior que no particionamento de nível único, o que pode ser benéfico para a execução paralela.
-
Você pode implementar uma janela incremental para suportar dados históricos e ainda particionar em outra dimensão se muitas instruções puderem se beneficiar de poda de partição ou junções no sentido de partição.
-
Você pode armazenar dados de forma diferente com base na identificação por uma chave de particionamento. Por exemplo, você pode decidir armazenar dados de um tipo de produto específico em um formato compactado e somente leitura e manter os dados de outro tipo de produto descompactados.
Intervalo, lista e particionamento de hash são elegíveis como estratégias de subparticionamento para tabelas particionadas compostas. A figura a seguir oferece uma exibição gráfica do particionamento composto range-hash e range-list.
Figura 1: Particionamento de Lista de Intervalos Compostos
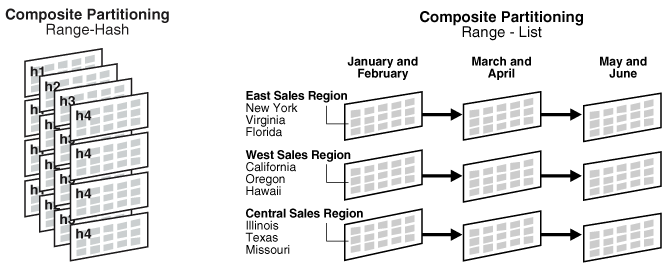
Descrição da ilustração vldbg009.gif
O banco de dados armazena cada subpartição em uma tabela particionada composta como um segmento separado. Assim, as propriedades da subpartição podem diferir das propriedades da tabela ou da partição à qual as subpartições pertencem.
Consulte Também: Oracle AI Database VLDB and Partitioning Guide para saber mais sobre particionamento de compostos
Tabelas Particionadas
Uma tabela particionada consiste em uma ou mais partições, que são gerenciadas individualmente e podem operar independentemente das outras partições.
Uma tabela é particionada ou não particionada. Mesmo que uma tabela particionada consiste em apenas uma partição, esta tabela é diferente de uma tabela não particionada, que não pode ter partições adicionadas a ela.
-
Segmentos para Tabelas Particionadas Uma tabela particionada é composta por um ou mais segmentos de partição de tabela.
-
Compressão para Tabelas Particionadas Algumas ou todas as partições de uma tabela organizada por heap podem ser armazenadas em um formato compactado.
Consulte Também:
"Características da Partição" para exemplos de tabelas particionadas
"Visão Geral de Tabelas Organizadas por Índice" para saber mais sobre a finalidade e as características das Tabelas Organizadas por Índice, que também podem se beneficiar do particionamento que fornece melhor capacidade de gerenciamento, disponibilidade e desempenho.
Segmentos para Tabelas Particionadas
Uma tabela particionada é composta por um ou mais segmentos de partição de tabela.
Se você criar uma tabela particionada chamada hash_products, nenhum segmento de tabela será alocado para essa tabela. Em vez disso, o banco de dados armazena dados para cada partição de tabela em seu próprio segmento de partição. Cada segmento de partição de tabela contém uma parte dos dados da tabela.
Quando uma tabela externa é particionada, todas as partições residem fora do banco de dados. Em uma tabela híbrida particionada, algumas partições são armazenadas em segmentos, enquanto outras são armazenadas externamente. Por exemplo, algumas partições da tabela sales podem ser armazenadas em arquivos de dados e outras em planilhas.
Consulte Também:
para saber mais sobre o relacionamento entre objetos e segmentos
Compactação para Tabelas Particionadas
Algumas ou todas as partições de uma tabela organizada por heap podem ser armazenadas em um formato compactado.
A compactação economiza espaço e pode acelerar a execução da consulta. Por esse motivo, a compactação pode ser útil em ambientes como data warehouses, em que a quantidade de operações de inserção e atualização é pequena e em ambientes OLTP.
Você pode declarar os atributos para compactação de tabela para um tablespace, tabela ou partição de tabela. Se declaradas no nível do tablespace, as tabelas criadas no tablespace serão compactadas por padrão. Você pode alterar o atributo de compactação de uma tabela. Nesse caso, a alteração só se aplica a novos dados que entram nessa tabela. Consequentemente, uma única tabela ou partição pode conter blocos compactados e descompactados, o que garante que o tamanho dos dados não aumentará devido à compactação. Se a compactação puder aumentar o tamanho de um bloco, o banco de dados não o aplicará ao bloco.
Consulte Também:
-
"Compressão de Tabela" para aprender sobre os tipos de compactação de tabela, incluindo compactação básica, avançada e HCC (Hybrid Columnar Compression)
-
Guia do Oracle AI Database Data Warehousing para saber mais sobre compactação de tabelas em um data warehouse
Índices Particionados
Um índice particionado é um índice que, como uma tabela particionada, foi dividido em partes menores e mais gerenciáveis.
Os índices globais são particionados independentemente da tabela na qual são criados, enquanto os índices locais são automaticamente vinculados ao método de particionamento de uma tabela. Assim como tabelas particionadas, os índices particionadas melhoram a capacidade de gerenciamento, a disponibilidade, o desempenho e o dimensionamento.
O gráfico a seguir mostra as opções de particionamento de índice.
Figura 2: Opções de Particionamento de Índice
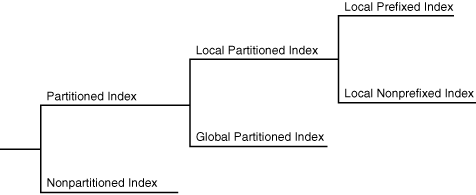
Descrição da ilustração cncpt301.gif
-
Índices Particionados Locais Em um índice particionado local, o índice é particionado nas mesmas colunas, com o mesmo número de partições e os mesmos limites de partição da tabela.
-
Índices Particionados Globais Um índice particionado global é um índice de árvore B que é particionado independentemente da tabela subjacente na qual é criado. Uma única partição de índice pode apontar para qualquer ou todas as partições de tabela, enquanto em um índice particionado localmente, existe uma paridade de um para um entre as partições de índice e as partições de tabela.
Consulte Também:
-
"Introduction to Indexes" para aprender sobre a diferença entre índices exclusivos e não exclusivos, e os diferentes tipos de índice
-
Oracle AI Database VLDB and Partitioning Guide para obter mais informações sobre índices particionados e como decidir qual tipo usar
Índices Particionados Locais
Em um índice particionado local, o índice é particionado nas mesmas colunas, com o mesmo número de partições e os mesmos limites de partição da tabela.
Cada partição de índice é associada a exatamente uma partição da tabela subjacente, de modo que todas as chaves em uma partição de índice se refiram apenas a linhas armazenadas em uma única partição de tabela. Dessa forma, o banco de dados sincroniza automaticamente as partições de índice com suas partições de tabela associadas, tornando cada par de índice de tabela independente.
Índices particionados locais são comuns em ambientes de data warehousing. Os índices locais oferecem as seguintes vantagens:
-
A disponibilidade é aumentada porque as ações que tornam os dados inválidos ou indisponíveis em uma partição afetam somente essa partição.
-
A manutenção da partição é simplificada. Ao mover uma partição de tabela, ou quando os dados envelhecem fora de uma partição, somente a partição de índice local associada deve ser reconstruída ou mantida. Em um índice global, todas as partições de índice devem ser recriadas ou mantidas.
-
Se ocorrer recuperação pontual de uma partição, os índices poderão ser recuperados até o tempo de recuperação (consulte o Oracle AI Database Backup and Recovery User's Guide). Todo o índice não precisa ser reconstruído.
O exemplo em Particionamento de Hash mostra a instrução de criação da tabela hash_sales particionada, usando a coluna prod_id como chave de partição. O exemplo a seguir cria um índice particionado local na coluna time_id da tabela hash_sales:
CREATE INDEX hash_sales_idx ON hash_sales(time_id) LOCAL;Na Figura 6-3, a tabela hash_products tem duas partições, portanto, hash_sales_idx tem duas partições. Cada partição de índice está associada a uma partição de tabela diferente. A partição de índice SYS_P38 indexa linhas na partição de tabela SYS_P33, enquanto a partição de índice SYS_P39 indexa linhas na partição de tabela SYS_P34.
Figura 3: Partições de Índice Local
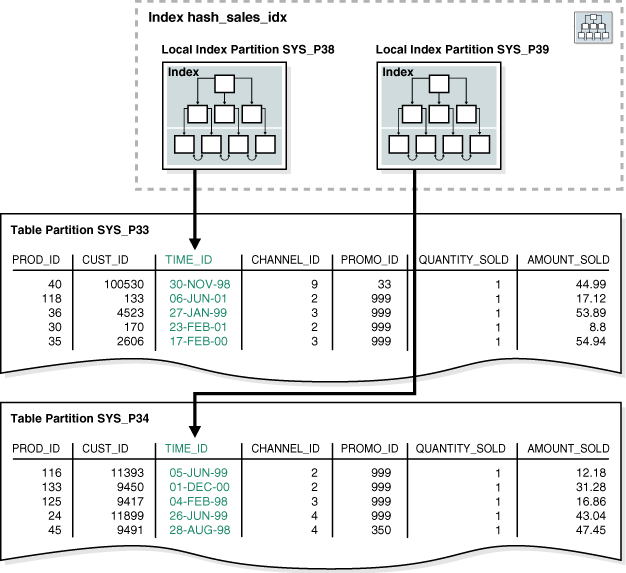
Descrição da ilustração cncpt302.gif
Não é possível adicionar explicitamente uma partição a um índice local. Em vez disso, novas partições são adicionadas aos índices locais somente quando você adiciona uma partição à tabela subjacente. Da mesma forma, não é possível eliminar explicitamente uma partição de um índice local. Em vez disso, as partições de índice local só são eliminadas quando você elimina uma partição da tabela subjacente.
Como outros índices, você pode criar um índice bitmap em tabelas particionadas. A única restrição é que os índices bitmap devem ser locais para a tabela particionada - eles não podem ser índices globais. Os índices de bitmap globais são suportados somente em tabelas não particionadas.
-
Índices Locais Prefixados e Não Fixados Os índices particionados locais são prefixados ou não prefixados.
-
Armazenamento de Índice Particionado Local Como uma partição de tabela, uma partição de índice local é armazenada em seu próprio segmento. Cada segmento contém uma parte do total de dados do índice. Assim, um índice local composto por quatro partições não é armazenado em um único segmento de índice, mas em quatro segmentos separados.
Índices Prefixos Locais e Não Fixos
Os índices particionados locais são prefixados ou não prefixados.
Os subtipos de índice são definidos da seguinte maneira:
-
Índices prefixados locais
Nesse caso, as chaves de partição estão na extremidade inicial da definição do índice. No exemplo
time_range_salesem Particionamento de Faixa, a tabela é particionada por faixa emtime_id. Um índice prefixado local nesta tabela teriatime_idcomo a primeira coluna em sua lista. -
Índices não fixos locais
Nesse caso, as chaves de partição não estão na borda inicial da lista de colunas indexadas e não precisam estar na lista. No exemplo
hash_sales_idxem Índices Particionados Locais, o índice é local não prefixado porque a chave de partiçãoproduct_idnão está na borda inicial.
Ambos os tipos de índices podem aproveitar a eliminação de partição (também chamada de eliminação de partição), que ocorre quando o otimizador acelera o acesso aos dados, excluindo partições da consideração. A possibilidade de uma consulta eliminar partições depende da consulta predicar. Uma consulta que usa um índice prefixado local sempre permite a eliminação da partição de índice, enquanto uma consulta que usa um índice não prefixado local pode não ser.
Consulte Também: Oracle AI Database VLDB and Partitioning Guide para saber como usar índices prefixados e não prefixados
Armazenamento de Índice Particionado Local
Como uma partição de tabela, uma partição de índice local é armazenada em seu próprio segmento. Cada segmento contém uma parte do total de dados do índice. Assim, um índice local composto por quatro partições não é armazenado em um único segmento de índice, mas em quatro segmentos separados.
Consulte Também: Referência de Linguagem SQL do Oracle AI Database para obter exemplos do CREATE INDEX ... LOCAL
Índices Particionados Globais
Um índice particionado global é um índice de árvore B que é particionado independentemente da tabela subjacente na qual foi criado. Uma única partição de índice pode apontar para qualquer ou todas as partições de tabela, enquanto em um índice particionado localmente, existe uma paridade de um para um entre as partições de índice e as partições de tabela.
Em geral, os índices globais são úteis para aplicativos OLTP, nos quais o acesso rápido, a integridade dos dados e a disponibilidade são importantes. Em um sistema OLTP, uma tabela pode ser particionada por uma chave, por exemplo, a coluna employees.department_id, mas um aplicativo pode precisar acessar os dados com muitas chaves diferentes, por exemplo, por employee_id ou job_id. Índices globais podem ser úteis neste cenário.
Como ilustração, suponha que você crie um índice particionado global na tabela time_range_sales com base no "Particionamento de Faixa". Nesta tabela, as linhas de vendas de 1998 são armazenadas em uma partição, as linhas de vendas de 1999 estão em outra e assim por diante. O exemplo a seguir cria um índice global particionado por intervalo na coluna channel_id:
CREATE INDEX time_channel_sales_idx ON time_range_sales (channel_id)
   GLOBAL PARTITION BY RANGE (channel_id)
      (PARTITION p1 VALUES LESS THAN (3),
       PARTITION p2 VALUES LESS THAN (4),
       PARTITION p3 VALUES LESS THAN (MAXVALUE));
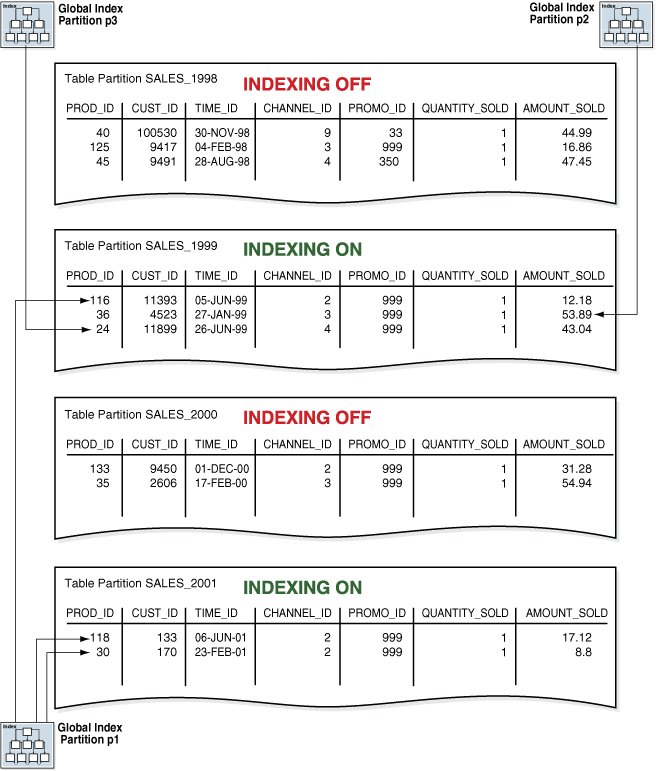
Conforme mostrado na Figura 6-4, uma partição de índice global pode conter entradas que apontam para várias partições de tabela. A partição de índice p1 aponta para as linhas com uma channel_id de 2, a partição de índice p2 aponta para as linhas com uma channel_id de 3 e a partição de índice p3 aponta para as linhas com uma channel_id de 4 ou 9.
Figura 4: Índice Particionado Global
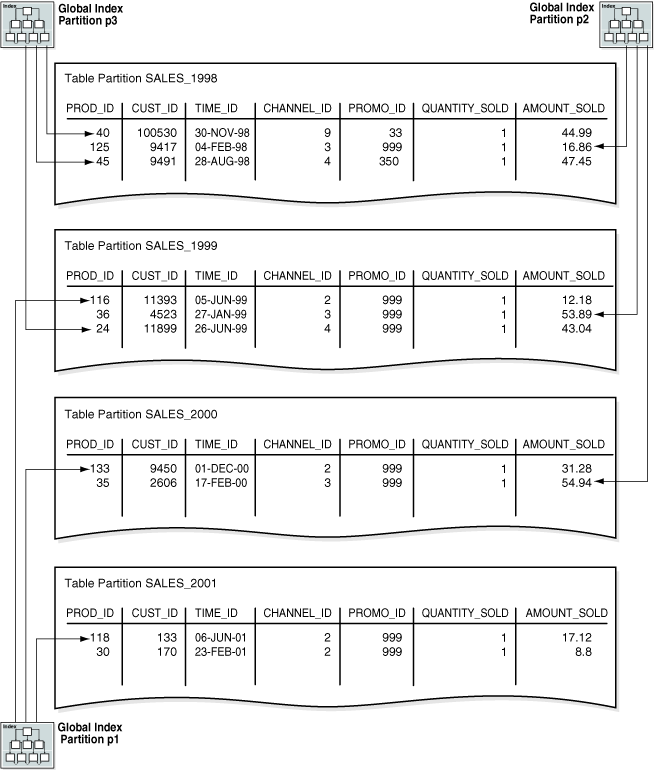
Descrição da ilustração cncpt300.gif
Consulte Também:
-
Oracle AI Database VLDB and Partitioning Guide para saber como gerenciar índices particionados globais
-
Referência de Linguagem SQL do Oracle AI Database para saber mais sobre a cláusula
GLOBAL PARTITIONdoCREATE INDEX
Índices Parciais para Tabelas Particionadas
Um índice parcial é um índice que está correlacionado com as propriedades de indexação de uma tabela particionada associada.
A correlação permite que você especifique quais partições de tabela serão indexadas. Os índices parciais oferecem as seguintes vantagens:
-
As partições de tabela que não são indexadas evitam consumir espaço de armazenamento de índice desnecessário.
-
O desempenho de cargas e consultas pode melhorar.
Antes do Oracle Database 12c, uma operação de partição de intercâmbio exigia uma atualização física de um índice global associado para mantê-lo utilizável. A partir do Oracle Database 12c, se as partições envolvidas em uma operação de manutenção de partição não fizerem parte de um índice global parcial, o índice permanecerá utilizável sem exigir qualquer manutenção de índice global.
-
Se você indexar apenas algumas partições de tabela na criação do índice e, posteriormente, indexar outras partições, poderá reduzir o espaço de classificação exigido pela criação do índice.
Você pode ativar ou desativar a indexação para as partições individuais de uma tabela. Um índice local parcial não tem partições de índice utilizáveis para todas as partições de tabela que têm a indexação desativada. Um índice global, particionado ou não, exclui os dados de todas as partições que têm indexação desativada. O banco de dados não suporta índices parciais para índices que impõem restrições exclusivas. A Figura 6-5 mostra o mesmo índice global da Figura 6-4, exceto que o índice global é parcial. As partições de tabela SALES_1998 e SALES_2000 têm a propriedade de indexação definida como OFF, portanto, o índice global parcial não as indexa.
Figura 5: Índice Particionado Global Parcial
Descrição da ilustração cncpt342.png
Usando o Object Store para Partições Mais Antigas
Para partições somente leitura, você pode usar armazenamento de baixo custo, como armazenamento de objetos na nuvem.
Os volumes de dados cresceram enormemente na última década. Além disso, os regulamentos e políticas governamentais exigiram a retenção de dados por períodos de tempo muito grandes em muitos casos. Os clientes de banco de dados Oracle usam várias estratégias de gerenciamento de dados para bancos de dados muito grandes. Os clientes têm os seguintes objetivos principais que estão tentando satisfazer.
Para armazenar grandes quantidades de dados com o menor custo possível Para atender aos novos requisitos regulatórios de retenção e proteção de dados Para melhorar as oportunidades de negócios por uma melhor análise com base em uma maior quantidade de dados.
Os clientes locais têm várias soluções para atingir os objetivos acima. O Oracle AI Database agora fornece esse recurso que permite desenvolver estratégias de gerenciamento de dados semelhantes para seus bancos de dados na nuvem, aproveitando camadas de armazenamento de baixo custo, como armazenamento de objetos na nuvem.
Os clientes de banco de dados Oracle criaram várias estratégias de gerenciamento de dados à medida que seus conjuntos de dados evoluíram e cresceram. Todas essas estratégias se enquadram no Information Lifecycle Management (ILM). Alguns dos recursos de banco de dados que ajudam na implementação de uma solução ILM incluem Particionamento de Dados, Compactação Avançada de Linhas, Compactação Híbrida Colunar, Otimização Automática de Dados e outros.
Um dos aspectos de uma solução ILM é definir uma camada de armazenamento de baixo custo. Isso permite que você mantenha grandes quantidades de dados pelo menor custo possível. A estratégia do Oracle ILM permite a compactação automática de dados e a movimentação de dados para uma camada de armazenamento de custo menor. Os clientes de banco de dados Oracle local usam soluções de armazenamento Oracle, como Oracle ZFS Storage Appliance ou Oracle Exadata Extended (XT) Storage Server como uma opção de armazenamento de baixo custo para dados mais antigos ou regulatórios, acessados com pouca frequência. Você também pode escolher opções de armazenamento de baixo custo semelhantes de fornecedores terceirizados.
O uso do armazenamento de objetos permite:
-
Armazene partições mais antigas e tablespaces somente para leitura no armazenamento de objetos.
-
Consulte os dados de arquivos de armazenamento de objetos on-line.
-
Impedir o acesso não autorizado a arquivos de armazenamento de objetos de propriedade de um PDB de outro PDB.
-
Mova os dados de volta do armazenamento de objetos para o armazenamento regular, caso você queira fazer alterações nos dados somente leitura.
-
Excluir tablespaces com arquivos de dados no armazenamento de objetos.
-
Movendo Partições Mais Antigas e Tablespaces Somente para Leitura para o Armazenamento de Objetos Você pode criar uma estratégia de particionamento baseada em tempo e mover os arquivos de dados de um tablespace somente para leitura para uma camada de armazenamento de custo mais baixo, como o armazenamento de objetos.
-
Acessando Objetos no Serviço Object Storage O acesso a dados de tabelas e partições no serviço Object Storage será completamente transparente para usuários e clientes SQL.
-
Gerenciamento de Credenciais para Arquivos do Serviço Object Store O acesso a arquivos no serviço Object Storage requer uma credencial.
-
Movendo Arquivos de Dados de Volta do Serviço Object Storage para o Armazenamento Tradicional Se os dados do armazenamento de objetos tiverem que ser atualizados, os dados deverão primeiro ser movidos de volta para o armazenamento tradicional.
-
Excluindo Arquivos de Dados do Serviço Object Store Você pode excluir tablespaces com arquivos de dados usando o comando padrão
DROP TABLESPACE.
Movendo Partições Mais Antigas e Tablespaces Somente para Leitura para o Object Store
Você pode criar uma estratégia de particionamento baseada em tempo e mover os arquivos de dados de um tablespace somente para leitura para uma camada de armazenamento de custo mais baixo, como o armazenamento de objetos.
Suponha que você tenha uma tabela chamada 'ordens' que seja um intervalo particionado na coluna DATE. Cada partição contém linhas para um ano específico e há partições existentes para 2022 e 2023. À medida que um novo ano se aproxima, o administrador do banco de dados decide adicionar uma nova partição para o ano de 2024. Ao mesmo tempo, o administrador do banco de dados decide que deseja mover a partição mais antiga para uma camada de armazenamento de baixo custo.
O exemplo de workflow abaixo representa um cenário em que o espaço de tabela tem uma única partição para uma única tabela. Isso não é uma restrição. O tablespace somente para leitura pode ter partições para uma ou mais tabelas. Você também tem a opção de tornar a partição somente leitura, além de tornar o tablespace somente leitura. Como prática recomendada, você pode tornar o tablespace somente para leitura e aguardar um período bem definido antes de mover os arquivos para o armazenamento de objetos. Isso garantirá que todas as tentativas de atualizar os dados somente leitura sejam capturadas e um erro seja retornado. É muito mais rápido mover dados em mutação para outro tablespace enquanto os dados ainda estão no Exadata ou em outro armazenamento tradicional. Será muito mais lento se esses dados precisarem ser copiados do armazenamento de objetos.
create tablespace orders_2022 DATAFILE '+DATA_DG/orders_2022.dbf' size 100g;
create tablespace orders_2023 DATAFILE '+DATA_DG/orders_2023.dbf' size 100g;

create table orders
( prod_id         NUMBER NOT NULL,
  time_id         DATE NOT NULL,
  quantity_sold   NUMBER(10,2) NOT NULL,
  amount_sold     NUMBER(10,2) NOT NULL)
    partition by range (time_id)
    ( partition orders_2022 VALUES LESS THAN (TO_DATE('2023-01-01 00:00:00', 'SYYYY-MM-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIAN'))
        TABLESPACE orders_2022,
      partition orders_2023 VALUES LESS THAN (TO_DATE('2024-01-01 00:00:00', 'SYYYY-MM-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIAN'))
        TABLESPACE orders_2023)
  ENABLE ROW MOVEMENT;

create tablespace orders_2024 DATAFILE '+DATA_DG/orders_2024.dbf' size 100g;

alter table orders
  ADD partition orders_2024
  values less than (TO_DATE('2024-01-01 00:00:00', 'SYYYY-MM-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIAN'))
  TABLESPACE orders_2024;

alter tablespace orders_2022 read only;

alter database property set default_credential = 'ADM.DEF_CRED_NAME';

alter database
  move datafile '+DATA_DG/orders_2022.dbf' to
  'https://objectstorage.example.com/oracle/orders_2022.dbf';
Acessando Objetos no Serviço Object Storage
Acessar dados de tabelas e partições no armazenamento de objetos será completamente transparente para usuários e clientes SQL.
O subsistema de entrada/saída do banco de dados consultará e servirá internamente blocos de arquivos armazenados no armazenamento de objetos. O SQL a seguir consultará as linhas da partição somente leitura orders_2022 que foi movida para o armazenamento de objetos no exemplo anterior.
select prod_id
from   orders
where  time_id < TO_DATE('2020-01-01 00:00:00', 'SYYYY-MM-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIAN');
Os índices existentes, tanto globais quanto locais, funcionam de forma transparente. A consulta de dados de compactação colunar híbridos e dados criptografados de TDE funcionam de forma transparente também da perspectiva do cliente.
Gerenciamento de Credenciais para Arquivos do Object Store
O acesso a arquivos no armazenamento de objetos requer uma credencial.
Uma credencial é um objeto de banco de dados que armazena um nome de usuário e uma senha. Os dados da credencial são criptografados e armazenados com segurança no esquema do PDB em que são criados.
Quando você planeja mover arquivos de dados para o armazenamento de objetos, deve definir uma credencial padrão. Essa credencial padrão é usada para acessar arquivos de dados no armazenamento de objetos.
Escolha a credencial padrão com os privilégios mínimos necessários. Depois que a credencial padrão permite o acesso ao armazenamento de objetos, a autenticação e a autorização do banco de dados padrão determinam quais usuários do banco de dados podem consultar ou operar nesses arquivos de dados.
alter database property set default_credential = 'ADM.DEF_CRED_NAME';

alter database move datafile '+DATA_DG/orders_2022.dbf' to
  'https://objectstorage.example.com/oracle/orders_2022.dbf';
Movendo Arquivos de Dados de Volta do Serviço Object Storage para o Armazenamento Tradicional
Se os dados do armazenamento de objetos precisarem ser atualizados, os dados deverão primeiro ser movidos de volta para o armazenamento tradicional.
No caso raro de você precisar modificar os dados somente leitura que já estão no armazenamento de objetos, a única opção é mover os dados de volta do armazenamento de objetos para o armazenamento tradicional. O workflow a seguir mostra como o arquivo de dados pode ser movido do armazenamento de objetos de volta para o sistema de arquivos ASM. Copiar um arquivo de volta do armazenamento de objetos terá implicações no desempenho.
alter database move datafile
  'https://objectstorage.example.com/oracle/orders_2022.dbf' to
  '+DATA_DG/orders_2022.dbf';

alter tablespace orders_2022 read write;
Excluindo Arquivos de Dados do Armazenamento de Objetos
Você pode excluir tablespaces com arquivos de dados usando o comando padrão DROP TABLESPACE.
A cláusula AND DATAFILES é usada para excluir os arquivos de dados do armazenamento de backend. Isso excluirá os arquivos do armazenamento de objetos. Se o arquivo de armazenamento de objetos tiver vários chunks no armazenamento de objetos, todos os chunks serão excluídos, bem como o manifesto.
drop tablespace orders_2022 including contents and datafiles;Visão Geral de Tabelas com Sharding
Em um banco de dados Oracle, o recurso Globally Distributed Database permite dividir qualquer tabela em partes chamadas shards que podem ser armazenadas em vários bancos de dados.
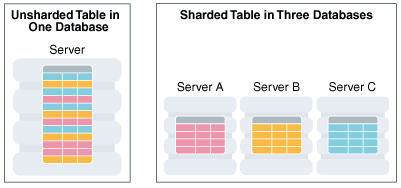
O particionamento horizontal envolve a divisão de uma tabela de banco de dados entre shards para que cada shard contenha a tabela com as mesmas colunas, mas com um subconjunto diferente de linhas. Uma divisão de tabela dessa maneira também é conhecida como tabela particionada.
A figura a seguir mostra uma tabela particionada horizontalmente em três shards.
Figura 6: Particionamento horizontal de uma tabela entre fragmentos
Descrição da ilustração admin_3v_134a.png
- Tabelas Partilhadas Uma tabela de banco de dados é dividida entre os shards, de modo que cada shard contenha a tabela com as mesmas colunas, mas com um subconjunto diferente de linhas. Uma divisão de tabela dessa maneira é chamada de tabela fragmentada. Consulte Também: Oracle Globally Distributed AI Database
Tabelas com Shards
Uma tabela de banco de dados é dividida entre os shards, de modo que cada shard contenha a tabela com as mesmas colunas, mas um subconjunto diferente de linhas. Uma divisão de tabela dessa maneira é chamada de tabela fragmentada.
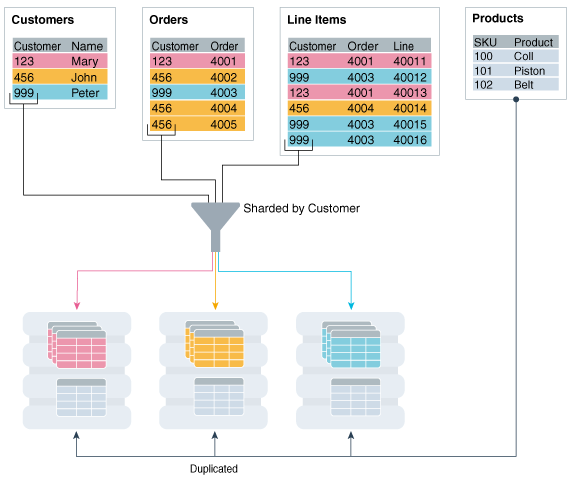
A figura a seguir mostra como um conjunto de tabelas (chamado de família de tabelas) pode ser particionado horizontalmente em um conjunto de PDBs de shard, de modo que cada shard contenha um subconjunto dos dados, indicado com linhas vermelhas, amarelas e azuis.
Figura 7: Particionamento horizontal de uma tabela entre fragmentos
Descrição da ilustração admin_3v_138e.png
As partições são distribuídas entre shards no nível do tablespace, com base em uma chave de sharding. Exemplos de chaves incluem ID do cliente, número da conta e ID do país.
Cada partição de uma tabela com sharding reside em um tablespace separado e cada tablespace é associado a um shard específico. Dependendo do método de sharding, a associação pode ser estabelecida automaticamente ou definida pelo administrador.
Embora as partições de uma tabela com sharding residam em vários shards, para o aplicativo, a tabela parece e se comporta exatamente da mesma forma que uma tabela particionada em um único banco de dados. As instruções SQL emitidas por um aplicativo nunca precisam se referir a shards ou depender do número de shards e de sua configuração.
A sintaxe SQL familiar para particionamento de tabela especifica como as linhas devem ser particionadas entre shards. Por exemplo, a instrução SQL a seguir cria uma tabela com sharding, particionando horizontalmente a tabela entre shards com base na chave de sharding cust_id.
CREATE SHARDED TABLE customers
( cust_id     NUMBER NOT NULL,
  name        VARCHAR2(50),
  address     VARCHAR2(250),
  region      VARCHAR2(20),
  class       VARCHAR2(3),
  signup      DATE,
  CONSTRAINT cust_pk PRIMARY KEY(cust_id)
)
PARTITION BY CONSISTENT HASH (cust_id)
PARTITIONS AUTO
TABLESPACE SET ts1;
A tabela com sharding no exemplo acima é particionada por hash consistente, um tipo especial de particionamento de hash comumente usado em sistemas distribuídos escaláveis. Essa técnica distribui automaticamente tablespaces entre shards para fornecer uma distribuição uniforme de dados e carga de trabalho. Observação: Não há suporte para índices globais em tabelas particionadas, mas há suporte para índices locais.
Visão Geral de Views
View é uma representação lógica de uma ou mais tabelas. Em essência, uma view é uma consulta armazenada.
Uma view deriva seus dados das tabelas nas quais ela se baseia, chamadas de tabelas básicas. As tabelas-base podem ser tabelas ou outras views. Todas as operações executadas em uma view realmente afetam as tabelas básicas. Você pode usar views na maioria dos lugares onde as tabelas são usadas.
Observação: as views materializadas usam uma estrutura de dados diferente das views padrão.
As exibições permitem que você personalize a apresentação de dados para diferentes tipos de usuários. Em geral, as views são usadas para:
-
Forneça um nível adicional de Segurança de Tabela restringindo o acesso a um conjunto predeterminado de linhas ou colunas de uma tabela
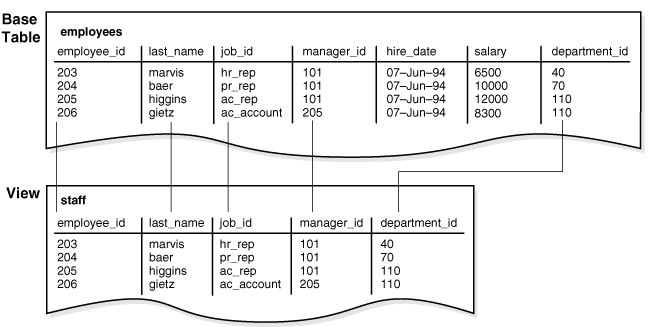
Por exemplo, a Figura 6-8 mostra como a view
staffnão mostra as colunassalaryoucommission_pctda tabela baseemployees. -
Ocultar complexidade de dados
Por exemplo, uma única view pode ser definida com uma junção, que é um conjunto de colunas ou linhas relacionadas em várias tabelas. No entanto, a view oculta o fato de que essas informações realmente se originam de várias tabelas. Uma consulta também pode realizar cálculos extensivos com informações da tabela. Dessa forma, os usuários podem consultar uma view sem saber como fazer uma junção ou cálculos.
-
Apresente os dados em uma perspectiva diferente da da tabela base
Por exemplo, as colunas de uma view podem ser renomeadas sem afetar as tabelas nas quais a view se baseia.
-
Isolar aplicativos de alterações em definições de tabelas-base
Por exemplo, se a consulta de definição de uma view fizer referência a três colunas de uma tabela de quatro colunas e uma quinta coluna for adicionada à tabela, a definição da view não será afetada, e todos os aplicativos que usam a view não serão afetados.
Para obter um exemplo do uso de views, considere a tabela hr.employees, que tem várias colunas e várias linhas. Para permitir que os usuários vejam apenas cinco dessas colunas ou apenas linhas específicas, você pode criar uma view da seguinte forma:
CREATE VIEW staff AS
  SELECT employee_id, last_name, job_id, manager_id, department_id
  FROM   employees;
Assim como acontece com todas as subconsultas, a consulta que define uma view não pode conter a cláusula FOR UPDATE. O gráfico a seguir ilustra a view chamada staff. Observe que a view mostra apenas cinco das colunas na tabela básica.
Figura 8: View
Descrição da ilustração cncpt045.gif
-
Características de Views Ao contrário de uma tabela, uma view não tem espaço de armazenamento alocado nem uma view contém dados. Em vez disso, uma view é definida por uma consulta que extrai ou deriva dados das tabelas básicas referenciadas pela view. Como uma view se baseia em outros objetos, não é necessário outro armazenamento além do armazenamento para a consulta que define a view no dicionário de dados.
-
Views de Junção Atualizáveis Uma view de junção tem várias tabelas ou views em sua cláusula
FROM. -
Views de Objeto Assim como uma view é uma tabela virtual, uma view de objeto é uma tabela de objeto virtual. Cada linha na view é um objeto, que é uma instância de um tipo de objeto. Um tipo de objeto é um tipo de dados definido pelo usuário.
Consulte Também:
-
Oracle AI Database Administrator's Guide para aprender a gerenciar views
-
Oracle AI Database SQL Language Reference para sintaxe e semântica do
CREATE VIEW
Características das Views
Diferentemente de uma tabela, uma view não tem espaço de armazenamento alocado nem uma view contém dados. Em vez disso, uma view é definida por uma consulta que extrai ou deriva dados das tabelas básicas referenciadas pela view. Como uma view se baseia em outros objetos, não é necessário outro armazenamento além do armazenamento para a consulta que define a view no dicionário de dados.
Uma view tem dependências de seus objetos referenciados, que são automaticamente tratados pelo banco de dados. Por exemplo, se você eliminar e recriar uma tabela base de uma view, o banco de dados determinará se a nova tabela base é aceitável para a definição da view.
-
Manipulação de Dados em Views Como as views são derivadas de tabelas, elas têm muitas semelhanças. Os usuários podem consultar views e, com algumas restrições, podem executar DML em views. As operações executadas em uma view afetam os dados em alguma tabela básica da view e estão sujeitas às restrições de integridade e acionadores das tabelas básicas.
-
Como os Dados São Acessados nas Views O Oracle AI Database armazena uma definição de view no dicionário de dados como o texto da consulta que define a view.
Manipulação de Dados em Views
Como as views são derivadas de tabelas, elas têm muitas semelhanças. Os usuários podem consultar views e, com algumas restrições, podem executar DML em views. As operações executadas em uma view afetam os dados em alguma tabela básica da view e estão sujeitas às restrições de integridade e acionadores das tabelas básicas.
O exemplo a seguir cria uma view da tabela hr.employees:
CREATE VIEW staff_dept_10 AS
SELECT employee_id, last_name, job_id,
       manager_id, department_id
FROM   employees
WHERE  department_id = 10
WITH CHECK OPTION CONSTRAINT staff_dept_10_cnst;
A consulta de definição faz referência somente às linhas do departamento 10. O CHECK OPTION cria a view com uma restrição para que as instruções INSERT e UPDATE emitidas na view não possam resultar em linhas que a view não possa selecionar. Portanto, é possível inserir linhas para funcionários no departamento 10, mas não linhas para o departamento 30.
Consulte Também: Referência de Linguagem SQL do Oracle AI Database para saber mais sobre restrições de subconsultas em instruções CREATE VIEW
Como os Dados São Acessados nas Views
O Oracle AI Database armazena uma definição de view no dicionário de dados como o texto da consulta que define a view.
Quando você faz referência a uma view em uma instrução SQL, o Oracle AI Database executa as seguintes tarefas:
-
Mescla uma consulta (sempre que possível) em uma view com as consultas que definem a view e quaisquer views subjacentes
O Oracle AI Database otimiza a consulta mesclada como se você tivesse emitido a consulta sem fazer referência às views. Portanto, o Oracle AI Database pode usar índices em qualquer coluna de tabela base referenciada, independentemente de as colunas serem referenciadas na definição da view ou na consulta do usuário na view.
Às vezes, o Oracle AI Database não pode mesclar a definição de view com a consulta do usuário. Nesses casos, o Oracle AI Database não pode usar todos os índices em colunas referenciadas.
-
Analisa a instrução mesclada em uma área SQL compartilhada
O Oracle AI Database analisa uma instrução que faz referência a uma view em uma nova área SQL compartilhada somente se nenhuma área SQL compartilhada existente contiver uma instrução semelhante. Assim, as views fornecem o benefício do uso reduzido de memória associado ao SQL compartilhado.
-
Executa a instrução SQL
O exemplo a seguir ilustra o acesso aos dados quando uma view é consultada. Suponha que você crie employees_view com base nas tabelas employees e departments:
CREATE VIEW employees_view AS
  SELECT employee_id, last_name, salary, location_id
  FROM   employees JOIN departments USING (department_id)
  WHERE  department_id = 10;
Um usuário executa a seguinte consulta de employees_view:
SELECT last_name
FROM   employees_view
WHERE  employee_id = 200;
O Oracle AI Database mescla a view e a consulta do usuário para construir a seguinte consulta, que é executada para recuperar os dados:
SELECT last_name
FROM   employees, departments
WHERE  employees.department_id = departments.department_id
AND    departments.department_id = 10
AND    employees.employee_id = 200;
Consulte Também:
-
Guia de Ajuste do Oracle AI Database SQL para aprender sobre otimização de consultas
Views de Junção Atualizáveis
Uma view de junção tem várias tabelas ou views em sua cláusula FROM.
No exemplo a seguir, a view staff_dept_10_30 une as tabelas employees e departments, incluindo apenas funcionários nos departamentos 10 ou 30:
CREATE VIEW staff_dept_10_30 AS
SELECT employee_id, last_name, job_id, e.department_id
FROM   employees e, departments d
WHERE  e.department_id IN (10, 30)
AND    e.department_id = d.department_id;
Uma view de junção atualizável, também chamada de view de junção modificável, envolve duas ou mais tabelas ou views básicas e permite operações DML. Uma view atualizável contém várias tabelas na cláusula FROM de nível superior da instrução SELECT e não é restrita pela cláusula WITH READ ONLY.
Para ser inerentemente atualizável, uma view deve atender a vários critérios. Por exemplo, uma regra geral é que uma operação INSERT, UPDATE ou DELETE em uma view de junção só pode modificar uma tabela base por vez. A seguinte consulta da view do dicionário de dados USER_UPDATABLE_COLUMNS mostra que a view staff_dept_10_30 é atualizável:
SQL> SELECT TABLE_NAME, COLUMN_NAME, UPDATABLE
  2  FROM   USER_UPDATABLE_COLUMNS
  3  WHERE  TABLE_NAME = 'STAFF_DEPT_10_30';

TABLE_NAME                     COLUMN_NAME                    UPD
------------------------------ ------------------------------ ---
STAFF_DEPT_10_30               EMPLOYEE_ID                    YES
STAFF_DEPT_10_30               LAST_NAME                      YES
STAFF_DEPT_10_30               JOB_ID                         YES
STAFF_DEPT_10_30               DEPARTMENT_ID                  YES
A partir do Oracle Database Release 21c, não é obrigatório que todas as colunas atualizáveis em uma view de junção sejam mapeadas para colunas de uma tabela preservada por chave. A tabela preservada por chave é uma tabela na qual cada linha da tabela subjacente aparece, no máximo, uma vez na saída da consulta. Na view staff_dept_10_30, department_id é a chave primária da tabela departments, de modo que cada linha da tabela employees aparece no máximo uma vez no conjunto de resultados, tornando a chave da tabela employees preservada. A tabela departments não é preservada por chave porque cada uma de suas linhas pode aparecer muitas vezes no conjunto de resultados. As colunas em uma tabela não preservada por chave poderão ser atualizadas se a operação UPDATE atualizar somente colunas de uma única tabela e a atualização for determinística, ou seja, ela atualizará cada linha apenas uma vez.
Consulte Também: Oracle AI Database Administrator's Guide para saber como atualizar views de join
Views de Objeto
Assim como uma view é uma tabela virtual, uma view de objeto é uma tabela de objeto virtual. Cada linha na view é um objeto, que é uma instância de um tipo de objeto. Um tipo de objeto é um tipo de dados definido pelo usuário.
Você pode recuperar, atualizar, inserir e excluir dados relacionais como se fossem armazenados como um tipo de objeto. Você também pode definir views com colunas que são tipos de dados, como objetos, REFs e coleções (tabelas aninhadas e VARRAYs).
Assim como as views relacionais, as views de objetos podem apresentar apenas os dados que os administradores de banco de dados querem que os usuários vejam. Por exemplo, uma view de objeto poderia apresentar dados sobre programadores de TI, mas omitir dados confidenciais sobre salários. O exemplo a seguir cria um objeto employee_type e, em seguida, a view it_prog_view com base nesse objeto:
CREATE TYPE employee_type AS OBJECT
(
  employee_id  NUMBER (6),
  last_name    VARCHAR2 (25),
  job_id       VARCHAR2 (10)
);
/

CREATE VIEW it_prog_view OF employee_type
  WITH OBJECT IDENTIFIER (employee_id) AS
SELECT  e.employee_id, e.last_name, e.job_id
FROM    employees e
WHERE   job_id = 'IT_PROG';
As views de objetos são úteis na criação de protótipos ou na transição para aplicações orientadas a objetos porque os dados na view podem ser obtidos de tabelas relacionais e acessados como se a tabela fosse definida como uma tabela de objetos. É possível executar aplicativos orientados a objetos sem converter tabelas existentes em uma estrutura física diferente.
Consulte Também:
-
Oracle AI Database Object-Relational Developer's Guide para aprender sobre tipos de objeto e views de objetos
-
Oracle AI Database SQL Language Reference para saber mais sobre a instrução
CREATE TYPE
Visão Geral das Views Materializadas
Uma view materializada é um resultado de consulta que foi armazenado ou "materializado" antecipadamente como um objeto de esquema. A cláusula FROM da consulta pode nomear tabelas, views ou views materializadas.
Uma view materializada geralmente serve como uma tabela mestra na replicação e uma tabela de fatos no data warehousing. Views materializadas resumem, computam, replicam e distribuem dados. Eles são adequados em vários ambientes de computação, como os seguintes:
-
Em data warehouses, as views materializadas podem calcular e armazenar dados gerados a partir de funções agregadas, como somas e médias.
Um resumo é uma view agregada que reduz o tempo de consulta pré-calculando junções e operações de agregação e armazenando os resultados em uma tabela. Views materializadas são equivalentes a resumos. Você também pode usar views materializadas para calcular junções com ou sem agregações.
-
Na replicação de view materializada, que é obtida usando XStream e Oracle GoldenGate, a view contém uma cópia completa ou parcial de uma tabela de um único ponto no tempo. Views materializadas replicam dados em sites distribuídos e sincronizam atualizações realizadas em vários sites. Esta forma de replicação é adequada para ambientes como vendas em campo quando os bancos de dados nem sempre estão conectados à rede.
-
Em ambientes de computação móvel, views materializadas podem baixar um subconjunto de dados de servidores centrais para clientes móveis, com atualizações periódicas dos servidores centrais e propagação de atualizações por clientes para os servidores centrais.
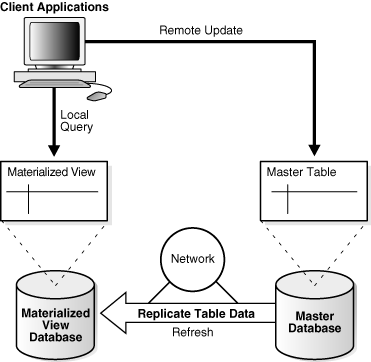
Em um ambiente de replicação, uma view materializada compartilha dados com uma tabela em outro banco de dados, chamada de banco de dados mestre. A tabela associada à view materializada no site mestre é a tabela mestra. A Figura 6-9 ilustra uma view materializada em um banco de dados com base em uma tabela mestre em outro banco de dados. Atualizações na replicação da tabela mestre para o banco de dados de view materializada.
Figura 9: View Materializada
Descrição da ilustração cncpt260.gif
-
Características das Views Materializadas As views materializadas compartilham algumas características de índices e views não materializadas.
-
Métodos de Atualização para Views Materializadas O banco de dados mantém dados em views materializadas, atualizando-os após alterações nas tabelas base. O método de atualização pode ser incremental ou uma atualização completa.
-
Views Materializadas Automáticas A partir do Oracle Database Release 21c, as views materializadas podem ser criadas e mantidas automaticamente.
-
Reescrita de consultas transforma uma solicitação de usuário gravada em tabelas-mestre em uma solicitação semanticamente equivalente que inclui views materializadas.
Consulte Também:
-
Guia do Oracle AI Database Data Warehousing para saber mais sobre resumos
-
Oracle AI Database XStream Guide para uma introdução ao XStream
-
http://www.oracle.com/technetwork/middleware/goldengate/documentation/index.html para saber mais sobre o Oracle GoldenGate
-
Oracle AI Database SQL Language Reference para saber mais sobre a instrução
CREATE MATERIALIZED VIEW
Características das Views Materializadas
Views materializadas compartilham algumas características de índices e views não materializadas.
As views materializadas são semelhantes aos índices das seguintes maneiras:
-
Eles contêm dados reais e consomem espaço de armazenamento.
-
Eles podem ser atualizados quando os dados em suas tabelas principais forem alterados.
-
Eles podem melhorar o desempenho da execução de SQL quando usados para operações de regravação de consulta.
-
Sua existência é transparente para aplicativos e usuários SQL.
Uma view materializada é semelhante a uma view não materializada porque representa dados em outras tabelas e views. Ao contrário dos índices, os usuários podem consultar views materializadas diretamente usando instruções SELECT. Dependendo dos tipos de atualização necessários, as views também podem ser atualizadas com instruções DML.
O exemplo a seguir cria e preenche uma view agregada materializada com base em três tabelas-mestre no esquema de amostra sh:
CREATE MATERIALIZED VIEW sales_mv AS
  SELECT t.calendar_year, p.prod_id, SUM(s.amount_sold) AS sum_sales
  FROM   times t, products p, sales s
  WHERE  t.time_id = s.time_id
  AND    p.prod_id = s.prod_id
  GROUP BY t.calendar_year, p.prod_id;
O exemplo a seguir elimina a tabela sales, que é uma tabela mestre para sales_mv e, em seguida, consulta sales_mv. A consulta seleciona dados porque as linhas são armazenadas (materializadas) separadamente dos dados nas tabelas principais.
SQL> DROP TABLE sales;

Table dropped.

SQL> SELECT * FROM sales_mv WHERE ROWNUM < 4;

CALENDAR_YEAR    PROD_ID  SUM_SALES
------------- ---------- ----------
         1998         13  936197.53
         1998         26  567533.83
         1998         27  107968.24
Uma view materializada pode ser particionada. Você pode definir uma view materializada em uma tabela particionada e um ou mais índices nela.
Consulte Também: Guia do Oracle AI Database Data Warehousing para aprender a usar views materializadas em um data warehouse
Atualizar Métodos para Views Materializadas
O banco de dados mantém dados em views materializadas, atualizando-os após alterações nas tabelas base. O método de atualização pode ser incremental ou uma atualização completa.
-
Concluir Atualização Uma atualização concluída executa a consulta que define a view materializada. Uma atualização completa ocorre quando você cria inicialmente a view materializada, a menos que a view materializada faça referência a uma tabela pré-criada ou defina a tabela como
BUILD DEFERRED. -
Atualização Incremental Uma atualização incremental, também chamada de atualização rápida, processa apenas as alterações nos dados existentes. Esse método elimina a necessidade de reconstruir views materializadas desde o início. O processamento apenas das alterações pode resultar em um tempo de atualização muito rápido.
-
Atualização no Local e Fora do Local Para os métodos completos e incrementais, o banco de dados pode atualizar a view materializada no local, que atualiza as instruções diretamente na view ou fora do local.
Atualização Completa
Uma atualização completa executa a consulta que define a view materializada. Uma atualização completa ocorre quando você cria inicialmente a view materializada, a menos que a view materializada faça referência a uma tabela pré-criada ou defina a tabela como BUILD DEFERRED.
Uma atualização completa pode ser lenta, especialmente se o banco de dados tiver que ler e processar grandes quantidades de dados. Você pode executar uma atualização completa a qualquer momento após a criação da view materializada.
Atualização Incremental
Uma atualização incremental, também chamada de atualização rápida, processa apenas as alterações nos dados existentes. Esse método elimina a necessidade de reconstruir views materializadas desde o início. O processamento apenas das alterações pode resultar em um tempo de atualização muito rápido.
Você pode atualizar views materializadas sob demanda ou em intervalos de tempo regulares. Como alternativa, você pode configurar views materializadas no mesmo banco de dados que suas tabelas base para atualizar sempre que uma transação fizer commit das alterações nas tabelas base.
A atualização rápida vem em um dos seguintes formulários:
-
Atualização Baseada em Log
Nesse tipo de atualização, um log de view materializada ou um log de carregador direto mantém um registro de alterações nas tabelas base. Um log de view materializada é um objeto de esquema que registra alterações em uma tabela-base para que uma view materializada definida na tabela-base possa ser atualizada de forma incremental. Cada log de view materializada é associado a uma única tabela base.
-
Atualização de controle de alteração de partição (PCT)
A atualização PCT é válida somente quando as tabelas base são particionadas. A atualização do PCT remove todos os dados nas partições de view materializada afetadas ou partes de dados afetadas e, em seguida, recalcula-os. O banco de dados usa as partições de tabela base modificadas para identificar as partições ou partes de dados afetadas na view. Quando ocorrem operações de manutenção de partição nas tabelas base, a atualização PCT é o único método de atualização incremental utilizável.
Atualização no Local e Fora do Local
Para os métodos completos e incrementais, o banco de dados pode atualizar a view materializada no local, que atualiza as instruções diretamente na view ou fora do local.
Uma atualização fora do local cria uma ou mais tabelas externas, executa as instruções de atualização e, em seguida, alterna a view materializada ou as partições afetadas com as tabelas externas. Essa técnica alcança alta disponibilidade durante a atualização, especialmente quando as instruções de atualização levam muito tempo para serem concluídas.
A atualização síncrona é um tipo de atualização fora do local. Uma atualização síncrona não modifica o conteúdo das tabelas base, mas usa as APIs no pacote de atualização síncrona, o que garante a consistência aplicando essas alterações às tabelas base e às views materializadas ao mesmo tempo. Essa abordagem permite que um conjunto de tabelas e as views materializadas definidas nelas sejam sempre sincronizadas. Em um data warehouse, o método de atualização síncrona é adequado pelos seguintes motivos:
-
O carregamento de dados incrementais é rigidamente controlado e ocorre em intervalos periódicos.
-
Tabelas e suas views materializadas são frequentemente particionadas da mesma forma, ou suas partições estão relacionadas por uma dependência funcional.
Consulte Também: Guia do Oracle AI Database Data Warehousing para saber como atualizar views materializadas
Views Materializadas Automáticas
A partir do Oracle Database Release 21c, as views materializadas podem ser criadas e mantidas automaticamente.
O Oracle AI Database pode criar e gerenciar automaticamente views materializadas para otimizar o desempenho da consulta. Com pouca ou nenhuma interação com o DBA, as tarefas em segundo plano monitoram e analisam as características da carga de trabalho e identificam onde as views materializadas melhorarão o desempenho do SQL. O benefício de desempenho das views materializadas do candidato é medido em segundo plano (usando consultas de carga de trabalho) antes de serem visíveis para a carga de trabalho.
Consulte Também:
-
Guia do Oracle AI Database Data Warehousing para obter informações adicionais
-
Referência de Tipos e Pacotes PL/SQL do Oracle AI Database para aprender a usar o pacote
DBMS_AUTO_MVpara implementar views materializadas automáticas
Regravação de Consulta
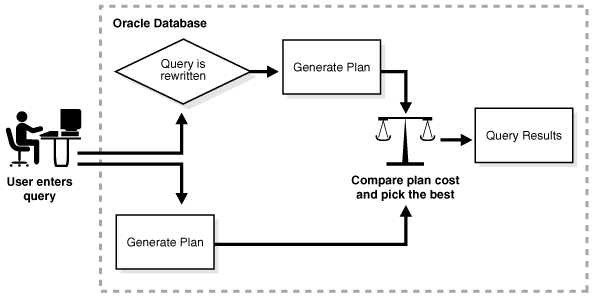
A reescrita de consulta transforma uma solicitação de usuário gravada em tabelas-mestre em uma solicitação semanticamente equivalente que inclui views materializadas.
Quando as tabelas de base contêm grandes quantidades de dados, a computação de um agregado ou junção é cara e demorada. Como as views materializadas contêm agregados e junções pré-calculadas, a regravação de consultas pode responder rapidamente a consultas usando views materializadas.
O transformador de consulta reescreve de forma transparente a solicitação para usar a view materializada, sem necessidade de intervenção do usuário e sem referência à view materializada na instrução SQL. Como a regravação da consulta é transparente, as views materializadas podem ser adicionadas ou eliminadas sem invalidar a SQL no código da aplicação.
Em geral, reescrever consultas para usar views materializadas em vez de tabelas de detalhes melhora o tempo de resposta. A figura a seguir mostra o banco de dados que está gerando um plano de execução para a consulta original e reescrita e escolhendo o plano de menor custo.
Figura 10: Regravação de Consulta
Descrição da ilustração cncpt334.gif
Consulte Também:
-
"Visão Geral do Otimizador" para saber mais sobre a transformação de consultas
-
Guia do Oracle AI Database Data Warehousing para aprender a usar a reescrita de consultas
Visão Geral de Sequências
sequência é um objeto de esquema a partir do qual vários usuários podem gerar números inteiros exclusivos. Um gerador de sequência fornece um método altamente escalável e de bom desempenho para gerar chaves substitutas para um tipo de dados de número.
-
Características da Sequência Uma definição de sequência indica informações gerais sobre a sequência, incluindo seu nome e se a sequência ascende ou descende.
-
Acesso Concorrente a Sequências O mesmo gerador de sequência pode gerar números para várias tabelas.
Características da Sequência
Uma definição de sequência indica informações gerais sobre a sequência, incluindo seu nome e se a sequência ascende ou descende.
Uma definição de sequência também indica:
-
O intervalo entre os números
-
Se o banco de dados deve armazenar em cache conjuntos de números de sequência gerados na memória
-
Se a sequência deve ser reiniciada quando um limite é atingido
O exemplo a seguir cria a sequência customers_seq no esquema de amostra oe. Um aplicativo pode usar essa sequência para fornecer números de ID do cliente quando linhas são adicionadas à tabela customers.
CREATE SEQUENCE customers_seq
START WITH      1000
INCREMENT BY    1
NOCACHE
NOCYCLE;
A primeira referência a customers_seq.nextval retorna 1000. A segunda retorna 1001. Cada referência subsequente retorna um valor 1 maior que a referência anterior.
Consulte Também:
-
Oracle AI Database Conceitos Básicos do Oracle AI Database Development para um tutorial que mostra como criar uma sequência
-
Oracle AI Database Administrator's Guide para saber como fazer referência a uma sequência em uma instrução SQL
-
Oracle AI Database SQL Language Reference para sintaxe e semântica do
CREATE SEQUENCE
Acesso Concorrente a Sequências
O mesmo gerador de sequência pode gerar números para várias tabelas.
O gerador pode criar chaves primárias automaticamente e coordenar chaves em várias linhas ou tabelas. Por exemplo, uma sequência pode gerar chaves primárias para uma tabela orders e uma tabela customers.
O gerador de sequência é útil em ambientes multiusuários para gerar números exclusivos sem a sobrecarga de Entrada/Saída de disco ou bloqueio de transação. Por exemplo, dois usuários inserem simultaneamente novas linhas na tabela orders. Ao usar uma sequência para gerar números exclusivos para a coluna order_id, nenhum usuário precisa aguardar que o outro informe o próximo número de pedido disponível. A sequência gera automaticamente os valores corretos para cada usuário.
Cada usuário que faz referência a uma sequência tem acesso ao número de sequência atual, que é a última sequência gerada na sessão. Um usuário pode emitir uma instrução para gerar um novo número de sequência ou usar o número atual gerado pela última vez pela sessão. Depois que uma instrução em uma sessão gera um número de sequência, ela fica disponível apenas para essa sessão. Os números de sequência individuais poderão ser ignorados se tiverem sido gerados e usados em uma transação que foi finalmente submetida a rollback.
Aviso: Se o seu aplicativo exigir um conjunto de números sem lacunas, você não poderá usar sequências Oracle. Você deve serializar atividades no banco de dados usando seu próprio código desenvolvido.
Consulte Também: "Concorrência e Consistência de Dados" para saber como as sessões acessam dados ao mesmo tempo
Visão Geral de Dimensões
Um data warehouse típico tem dois componentes importantes: dimensões e fatos.
Uma dimensão é qualquer categoria usada na especificação de perguntas de negócios, por exemplo, tempo, geografia, produto, departamento e canal de distribuição. Um fato é um evento ou entidade associada a um determinado conjunto de valores de dimensão, por exemplo, unidades vendidas ou lucros.
Exemplos de solicitações multidimensionais incluem o seguinte:
-
Mostre o total de vendas de todos os produtos em níveis crescentes de agregação para uma dimensão geográfica, de estado a país, para 2013 e 2014.
-
Criar uma análise tabular cruzada de nossas operações mostrando despesas por território na América do Sul para 2013 e 2014. Inclua todos os subtotais possíveis.
-
Liste os 10 principais representantes de vendas da Ásia de acordo com a receita de vendas de 2014 para produtos automotivos e classifique suas comissões.
Muitas perguntas multidimensionais exigem dados agregados e comparações de conjuntos de dados, muitas vezes ao longo do tempo, geografia ou orçamentos.
A criação de uma dimensão permite o uso mais amplo do recurso de regravação de consulta. Ao reescrever consultas de forma transparente para usar views materializadas, o banco de dados pode melhorar o desempenho da consulta.
-
Estrutura Hierárquica de uma Dimensão Uma tabela de dimensões é uma estrutura lógica que define relacionamentos hierárquicos (pai/filho) entre pares de colunas ou conjuntos de colunas.
-
Criação de Dimensões Você cria dimensões com a instrução SQL
CREATE DIMENSION. Consulte Também: Guia do Oracle AI Database Data Warehousing para saber mais sobre dimensões
Estrutura Hierárquica de uma Dimensão
Uma tabela de dimensões é uma estrutura lógica que define relacionamentos hierárquicos (pai/filho) entre pares de Colunas ou Conjuntos de Colunas.
Por exemplo, uma dimensão pode indicar que dentro de uma linha a coluna city implica o valor da coluna state e a coluna state implica o valor da coluna country.
Dentro de uma dimensão de cliente, os clientes podem rolar para cidade, estado, país, sub-região e região. A análise de dados geralmente começa em níveis mais altos na hierarquia dimensional e gradualmente se aprofunda se a situação justificar tal análise.
Cada valor no nível filho é associado a apenas um valor no nível pai. Um relacionamento hierárquico é uma dependência funcional de um nível de uma hierarquia em relação ao próximo nível da hierarquia.
Uma dimensão não tem armazenamento de dados designado a ela. As informações dimensionais são armazenadas em tabelas de dimensões, enquanto as informações de fatos são armazenadas em uma tabela de fatos.
Consulte Também:
- Guia do Oracle AI Database Data Warehousing para saber mais sobre dimensões
Criação de Dimensões
Você cria dimensões com a instrução SQL CREATE DIMENSION.
Esta instrução especifica:
-
Várias cláusulas
LEVEL, cada uma das quais identifica uma coluna ou conjunto de colunas na dimensão -
Uma ou mais cláusulas
HIERARCHYque especificam os relacionamentos pai/filho entre os níveis adjacentes -
Cláusulas
ATTRIBUTEopcionais, cada uma das quais identifica uma coluna adicional ou um conjunto de colunas associado a um nível individual
A seguinte instrução foi usada para criar a dimensão customers_dim no esquema de amostra sh:
CREATE DIMENSION customers_dim
   LEVEL customer   IS (customers.cust_id)
   LEVEL city       IS (customers.cust_city)
   LEVEL state      IS (customers.cust_state_province)
   LEVEL country    IS (countries.country_id)
   LEVEL subregion  IS (countries.country_subregion)
   LEVEL region     IS (countries.country_region)
   HIERARCHY geog_rollup (
      customer      CHILD OF
      city          CHILD OF
      state         CHILD OF
      country       CHILD OF
      subregion     CHILD OF
      region
   JOIN KEY (customers.country_id) REFERENCES country )
   ATTRIBUTE customer DETERMINES
   (cust_first_name, cust_last_name, cust_gender,
    cust_marital_status, cust_year_of_birth,
    cust_income_level, cust_credit_limit)
   ATTRIBUTE country DETERMINES (countries.country_name);
As colunas de uma dimensão podem vir da mesma tabela (desnormalizada) ou de várias tabelas (total ou parcialmente normalizadas). Por exemplo, uma dimensão normalizada de tempo pode incluir uma tabela de data, uma tabela de mês e uma tabela de ano, com condições da junção que conectam cada linha de data a uma linha de mês e cada linha de mês a uma linha de ano. Em uma dimensão de tempo totalmente desnormalizada, as colunas de data, mês e ano estão na mesma tabela. Se normalizadas ou desnormalizadas, as relações hierárquicas entre as colunas devem ser especificadas na instrução CREATE DIMENSION.
Consulte Também: Referência de Linguagem SQL do Oracle AI Database para sintaxe e semântica do CREATE DIMENSION
Visão geral de sinônimos
sinônimo é um alias para um objeto do esquema. Por exemplo, você pode criar um sinônimo para uma tabela ou view, sequência, unidade do programa PL/SQL, tipo de objeto definido pelo usuário ou outro sinônimo. Como um sinônimo é simplesmente um alias, ele não requer outro armazenamento além de sua definição no dicionário de dados.
Os sinônimos podem simplificar instruções SQL para usuários do banco de dados. Os sinônimos também são úteis para ocultar a identidade e a localização de um objeto de esquema subjacente. Se o objeto subjacente tiver que ser renomeado ou movido, somente o sinônimo deverá ser redefinido. Os aplicativos baseados no sinônimo continuam funcionando sem modificação.
É possível criar sinônimos privados e públicos. Um sinônimo privado está no esquema de um usuário específico que tem controle sobre sua disponibilidade para outros. Um sinônimo público pertence ao grupo de usuários chamado PUBLIC e pode ser acessado por cada usuário do banco de dados.
Exemplo 6-5 Sinônimo Público
Suponha que um administrador de banco de dados crie um sinônimo público chamado people para a tabela hr.employees. Em seguida, o usuário se conecta ao esquema oe e conta o número de linhas na tabela referenciada pelo sinônimo.
SQL> CREATE PUBLIC SYNONYM people FOR hr.employees;

Synonym created.

SQL> CONNECT oe
Enter password: password
Connected.

SQL> SELECT COUNT(*) FROM people;

  COUNT(*)
----------
       107
Use sinônimos públicos com moderação porque eles dificultam a consolidação do banco de dados. Conforme mostrado no exemplo a seguir, se outro administrador tentar criar o sinônimo público people, a criação falhará porque somente um sinônimo público people pode existir no banco de dados. O uso excessivo de sinônimos públicos causa conflitos de namespace entre aplicativos.
SQL> CREATE PUBLIC SYNONYM people FOR oe.customers;
CREATE PUBLIC SYNONYM people FOR oe.customers
                      *
ERROR at line 1:
ORA-00955: name is already used by an existing object

SQL> SELECT OWNER, SYNONYM_NAME, TABLE_OWNER, TABLE_NAME
  2  FROM DBA_SYNONYMS
  3  WHERE SYNONYM_NAME = 'PEOPLE';

OWNER      SYNONYM_NAME TABLE_OWNER TABLE_NAME
---------- ------------ ----------- ----------
PUBLIC     PEOPLE       HR          EMPLOYEES
Sinônimos em si não são seguros. Quando você concede privilégios de objeto em um sinônimo, você está realmente concedendo privilégios no objeto subjacente. O sinônimo está atuando apenas como um alias para o objeto na instrução GRANT.
Consulte Também:
-
Oracle AI Database Administrator's Guide para aprender a gerenciar sinônimos
-
Oracle AI Database SQL Language Reference para sintaxe e semântica do
CREATE SYNONYM