管理计算
本节介绍在 Oracle AI Data Platform 中创建、更改或删除计算集群的基本功能。
关于计算集群
借助通用计算集群,您可以在 Oracle AI Data Platform 实例中处理工作负载。
您可以从 AI 数据平台中的计算页面管理计算集群。
计算的类型
AI 数据平台中存在两种类型的计算:全用途计算集群和默认主目录计算集群。
您只能在 AI 数据平台中创建全功能计算集群。全功能计算集群适用于多种工作负载,可以附加到您的笔记本并用于工作流。除非另有说明,文档中对“计算集群”或“集群”的任何引用都引用了所有用途的计算集群。
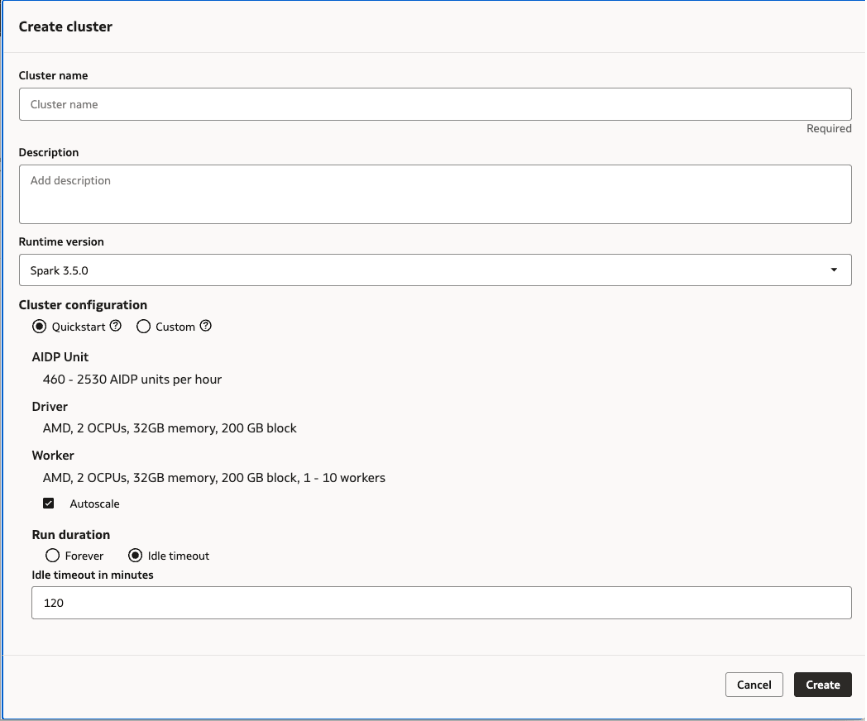
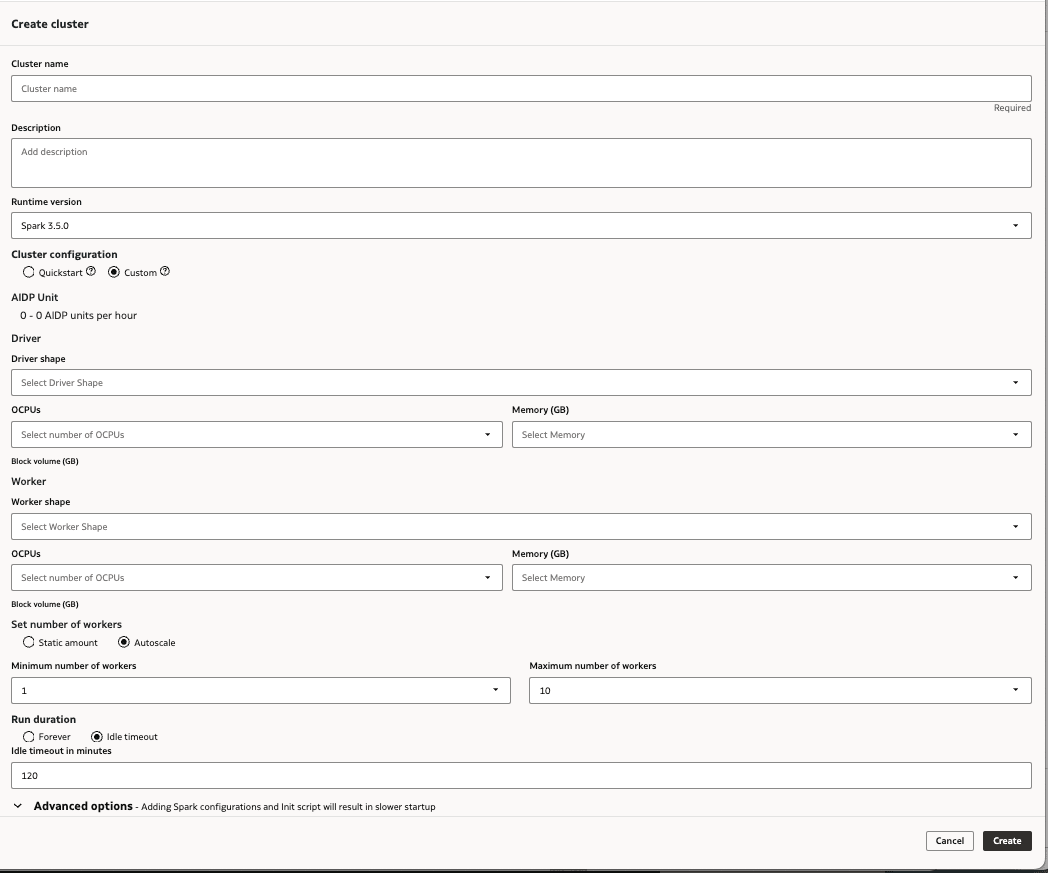
创建新的全用途计算集群时,可以选择快速入门或定制配置。快速入门配置经过优化,可以提供快速启动,而自定义配置允许您微调所有用途的计算集群,以适应您需要处理的特定工作负载。在“快速入门”和“自定义”配置选项中,您可以查看成本预测并修改空闲超时选项。
注意:
将定制库安装到配置了 Quickstart 的所有专用计算集群会自动将其更改为定制配置。这可能会影响启动性能。所有 AI 数据平台实例中都存在默认主目录计算集群。此集群负责基本的 AI 数据平台功能,例如搜索搜索、刷新目录对象、创建、编辑和删除对象以及测试连接。
集群运行时
可使用 Apache Spark 3.5 运行时创建全用途计算集群。运行时环境与以下各项兼容:
- Spark 3.5.0
- Delta 3.2.0(预先包含)
- Python 3.11
- Scala 2.12
- Hadoop 3.3.4
- Java 17
计算配置导出和导入
创建计算集群后,可以将为该集群配置的设置导出到工作区或目录中的卷,以再次用于其他集群。您可以将保存的配置导入到其他创建的群集,或者在创建过程中导入这些配置。
您的配置可供有权访问您保存配置的工作区或卷的其他用户使用,从而可以轻松地跨团队共享配置。
创建快速入门集群
您可以选择创建具有预配置设置的全功能计算集群,以便在 Oracle AI Data Platform 中处理数据和 AI 工作负载。
创建后,您可以随时编辑集群。
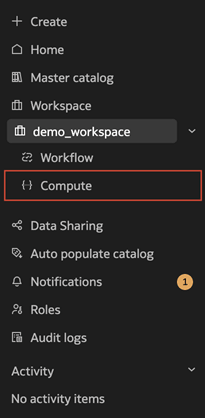
- 单击左侧导航面板中的创建,然后单击计算。您还可以导航到工作区,然后单击计算,然后单击
 创建集群。
创建定制集群
您可以在 Oracle AI Data Platform 中使用您自己选择处理数据和 AI 工作负载的配置设置创建全功能计算集群。
创建后,您可以随时编辑集群。
- 单击左侧导航面板中的创建,然后单击计算。您还可以导航到工作区,然后单击计算,然后单击 创建集群。
使用导入的配置创建群集
您可以使用从 Oracle AI Data Platform 中的现有计算集群导出的配置设置来创建全功能计算集群。
创建后,您可以随时编辑集群。
- 单击左侧导航面板中的创建,然后单击计算。您还可以导航到工作区,然后单击计算,然后单击 创建集群。
- 对于创建方法,请选择使用导出的配置。
- 从配置文件下拉菜单中,选择要用于新群集的已导出配置。导入的文件会预填充运行时、磁带库和环境设置。
- 提供名称和说明以标识您的集群。
- 根据需要修改其余设置。
- 单击创建。
创建 NVIDIA GPU 集群
您可以选择在全用途计算集群中使用 NVIDIA GPU 来加速统一 AI 和数据管道中的任何负载。
NVIDIA GPU 配置使用以下配置:
表 9-1 NVIDIA GPU 配置
| GPU 计数 | OCPU | 块存储 (GB) | GPU 内存 (GB) | CPU 内存 (GB) |
|---|---|---|---|---|
| 1 | 15 | 1500 | 24 | 240 |
| 2 | 30 | 3000 | 48 | 480 |
注意:
使用 NVIDIA GPU 配置时,驱动程序和 Worker 配置必须是 NVIDIA GPU。当前不支持为同一集群混合 CPU 和 GPU 配置。- 单击左侧导航面板中的创建,然后单击计算。您还可以导航到工作区,然后单击计算,然后单击 创建集群。
针对 Apache Spark 优化 NVIDIA GPU 集群
您可以通过使用 GPU 提供程序的建议和安装可选库来优化 NVIDIA GPU 集群,以优化其性能。
当 Oracle AI Data Platform 中的作业调用这些集群时,优化 GPU 集群有助于优化其性能。
对于基于 NVIDIA GPU 的集群,您可以按照 NVIDIA 的调优指南来获取优化性能的建议和步骤。
您还可以选择为 Apache Spark 库安装 NVIDIA cuDF 和 cuML 插件,以协助优化:
- cuDF Plugin for Apache Spark 库是 Apache Spark 的加速器,提供了一组利用 GPU 加速处理的插件。
- 适用于 Apache Spark 的 cuML 插件库支持基于 Apache Spark 的 GPU 加速分布式机器学习,并提供由 cuML 库提供支持的多种 PySpark ML 兼容算法。
cuDF 插件库通常首先用于功能工程和数据清理,然后使用 cuML 插件库大规模执行交叉验证。您可以将这些库用于欺诈检测(时间序列)、Web 点击流和 A/B 实验等用例。
表 9-2 建议的 Spark 配置
| 设置 | 值 | 注释 |
|---|---|---|
| spark.task.resource.gpu.amount | 0.0625 | 1 个 / spark.executor.cores |
| spark.rapids.sql.concurrentGpu 任务 | 3 | GPU 内存 / 8GB,最多 4 个 |
| spark.rapids.shuffle.multiThreaded.writer.threads | 32 | 每个工作进程的 CPU 核心数/GPU 计数 |
| spark.rapids.shuffle.multiThreaded.reader.threads | 32 | 每个工作进程的 CPU 核心数/GPU 计数 |
| spark.shuffle.manager | com.nvidia.spark.rapids.spark350.RapidsShuffleManager | - |
| spark.rapids.shuffle.mode | 多路径 | - |
| 火花插件 | com.nvidia.spark.SQLPlugin | - |
| spark.executor.resource.gpu.amount | 1 | - |
| spark.sql.files.maxPartitionBytes | 2 GB | 可选,建议用于大型数据集 |
| spark.rapids.sql.batchSizeBytes | 2 GB | 可选,建议用于大型数据集 |
| spark.rapids.memory.host.spillStorageSize | 32 G | 可选,建议用于大型数据集 |
| spark.rapids.memory.pinnedPool.size | 8 G | 可选,建议用于大型数据集 |
| spark.sql.adaptive.coalescePartitions.minPartitionSize | 32 MB | 可选,建议用于大型数据集 |
| spark.sql.adaptive.advisoryPartitionSizeInBytes | 160 MB | 可选,建议用于大型数据集 |
| spark.rapids.filecache.enabled | 真 | 可选,建议在工作负载将重用数据集时使用 |
导出计算配置
您可以将计算集群配置和相关项导出到工作区中的某个位置,以便将其导入到其他计算集群。
- 导航到工作区并单击计算。
- 在要为其导出设置的计算集群旁边,单击
 操作,然后单击导出计算配置。您还可以单击群集名称,单击右上角的操作,然后单击导出计算配置。
- 验证依赖项,例如库和环境变量。取消选择不应导出的任何内容。
- 选择工作区或卷中的保存位置。
- 单击导出。