添加提取
了解添加提取的先决条件和注意事项。
在开始添加提取之前,请确保已配置以下设置:
现在,您已准备好为您的部署添加提取。
存在以前的提取线索文件时创建提取的注意事项
-
如果在以前的配置中已存在孤立线索文件时创建提取,则该过程可能会失败。例如,如果
north/ea00000000仍然来自以前的配置且尚未删除,则创建提取可能会失败。 -
如果重新添加以较高序号开头的提取,并且存在以前的线索序号,则提取配置可能不同步或不正确。例如,如果存在
north/ea00002261并且您从north/ea00002262开始重新创建提取,则提取配置可能不正确。在这些情况下,应删除现有线索文件或将其移至未引用的位置。
提取信息屏幕
登录到微服务主页后,单击“创建”列中的 + 符号以打开添加提取向导。
在提取信息屏幕上,选择提取的类型。根据数据库平台,可用的提取类型可以是集成提取、更改数据捕获提取和初始加载提取。
如果需要为 Oracle AI Database 设置 Downstream Extract ,请启用 Downstream Extract 切换开关。
选择要创建的提取类型,并指定以下内容:
-
流程名称:提取流程的名称。“提取”处理的名称最多可为 8 个字符。
-
说明:正在创建的提取流程的说明
注:要了解如何创建初始加载提取,请参阅实例化。
单击下一步。
注册提取屏幕 - PostgreSQL 和 Yugabyte 数据库
注:需要注册 Oracle GoldenGate Extract for Oracle、不同的 PostgreSQL 风格和 Yugabyte 数据库。但是,在添加提取时,用于注册提取的配置选项将显示在不同的屏幕上。
注:另请参阅 PGOUTPUT 插件类型的准则和限制。
在注册提取屏幕上,配置以下选项,然后单击注册:
-
源身份证明:为数据库指定域。
-
别名:指定用作源登录的数据库连接的用户 ID 别名,或者从显示的选项中进行选择。
-
(所有 PostgreSQL 风格)插件类型:选择逻辑解码插件类型 pgoutput 。pgoutput 是所有 PostgreSQL 风格的缺省值。
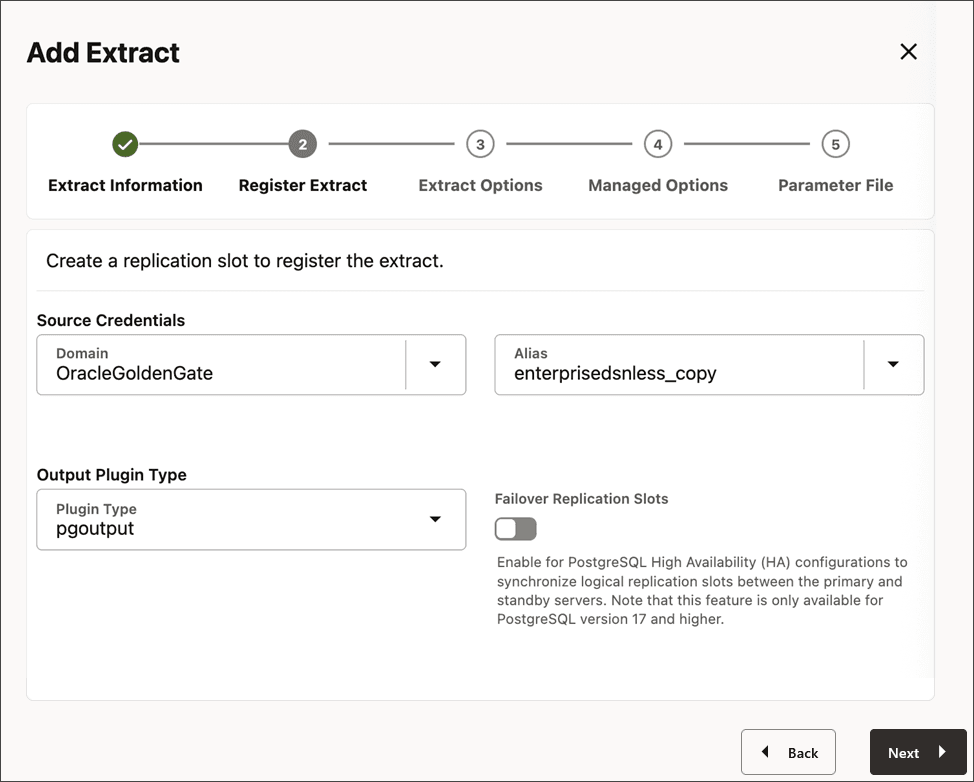
有关 PostgreSQL 17 及更高版本的故障转移复制插槽配置的详细信息,请参见 Failover Support for Oracle GoldenGate with PostgreSQL 17 and higher 。
-
(仅限 Yugabyte 数据库)插件类型:选择逻辑解码插件类型 yboutput 。YBOUTPUT 是 Yugabyte 数据库的默认值。
成功注册提取后,单击下一步。
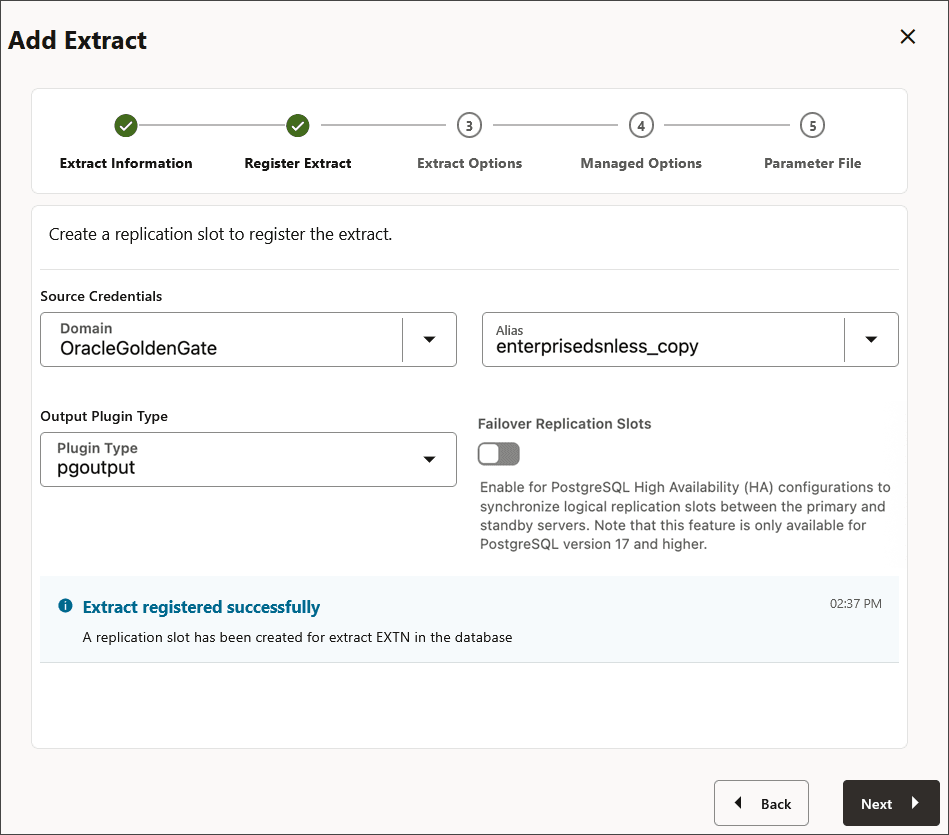
单击下一步。
从管理客户端注册 PostgreSQL 和 Yugabyte 数据库的提取
PostgreSQL 的提取必须注册到数据库并被授予保留的复制插槽。复制插槽通过数据库配置设置 max_replication_slots 进行分配,并且可以按照 Database Configuration 中所述进行配置。
按照以下说明注册提取。必须在创建提取之前完成提取注册。有关更多信息,请参见 Command Line Interface Reference for Oracle GoldenGate 中的 REGISTER EXTRACT 。
-
连接到部署,然后连接到源数据库的身份证明别名。
CONNECT http*s*://*remotehost*:*srvmgrport* DEPLOYMENT

          *deployment_name* AS *deployment_user* PASSWORD *deployment_password*
OGG (https://*remotehost*:*16000**postgresql_source*)> DBLOGIN USERIDALIAS *alias* -
注册提取,该提取在内部为提取创建复制插槽。提取名称不能超过 8 个字母数字字符。
REGISTER EXTRACT *extname*要使用
pgoutput插件显式注册 Extract,必须指定pgoutput插件类型:REGISTER EXTRACT *extname* PGPLUGINTYPE pgoutput;
您还可以从 Oracle GoldenGate MA Web 界面注册提取。请参阅添加提取。
PGOUTPUT 插件类型的准则和限制
配置 PGOUTPUT 插件类型的准则
设置 PostgreSQL 的插件类型时,请遵循以下准则:
-
必须在注册“提取”处理之前创建发布。
-
发布名称不能包含特殊字符:逗号 (,)、单引号(‘)和双引号(“)。
-
可以将多个发布名称指定为
publication_names中的逗号分隔列表。例如:TRANLOGOPTIONS STREAMINGOPTIONS (publication_names="my*123,my_publication2,123 pub,my_publication";)有关详细信息,请参见
TRANLOGOPTIONS STREAMINGOPTIONS参数。 -
列表中的最终发布名称必须以分号 (;) 结尾。
限制
为 PostgreSQL 选择插件类型时适用以下限制:
-
时区 (TZ) 环境变量:
WAL发送方进程始终在 UTC.If 中传输提交时间戳,OGG 会话时区与 UTC 不同,在 CDC 提取进程中按时间戳进行定位时可能会出现差异。要防止出现此问题,用户必须在部署层设置环境变量TZ=UTC。此限制专门适用于pgoutput插件。 -
多个截断:仅在
pgoutput插件中支持多个截断操作。test_decoding插件类型不允许多个截断。 -
具有唯一索引但没有主键的表:如果表没有主键但包含唯一索引,则副本标识必须使用索引,或者必须将其设置为
FULL。 -
发布删除对 CDC 提取的影响:如果在 CDC 提取仍在运行时删除发布,则存在复制插槽损坏的风险,导致其停止运行。在这种情况下,受影响的复制插槽不可用,重新创建同一发布将无法解决该问题。建议的解决方案是创建新的发布并将其与新的复制插槽关联以恢复 CDC 功能。
-
符合发布条件的表:发布中只能包括持久性基表和分区表。以下对象类型不能是发布的一部分:
-
临时表数
-
未记录的表
-
外部表
-
实体化视图
-
常规视图
-
-
使用 pgoutput 插件支持双向复制:使用
pgoutput插件进行双向复制时,必须先创建检查点表并将其包含在发布列表中,然后才能启动 CDC 提取进程。此外,仅应在创建检查点表并将其添加到发布后创建复制插槽。 -
列级发布限制:CDC 复制不支持为发布中的表指定部分列。必须在出版物中包括整个表。尝试仅添加部分列可能会导致 CDC 流中出现错误或数据差异。
提取选项屏幕
注:此屏幕提供了用于为 Oracle AI Database 注册提取的选项。如果要为 PostgreSQL 添加提取,则将在“注册提取”屏幕上完成提取注册。
在 Extract Options 屏幕上配置以下设置:
-
提取线索:
-
名称:提取线索文件的名称。线索文件的名称最多可为 2 个字符。
-
子目录:存储提取线索的子目录的目录名称。
-
线索序号:线索的序号。
-
线索大小:线索文件的最大大小。
-
加密配置文件:加密配置文件的说明。如果您尚未创建加密配置文件,则默认情况下将选择本地 Wallet 配置文件。要了解有关创建和应用加密配置文件的更多信息,请参见 Apply the OKV Encryption Profile 。
-
加密算法:提取线索文件可用的加密算法列表。
注:有关线索文件加密的更多信息,请参见 Trail File Encryption 和 Encrypting Trail Files 。
-
(仅限 Oracle)注册选项:指定以下选项为 Oracle AI Database 注册提取。
CSN :提交序号 (Commit Sequence Number,CSN) 值。
-
共享:此下拉列表用于定义如何共享 LogMiner 数据字典。可用选项包括“自动”、“无”和“提取名称”。Automatic 表示系统决定要共享哪个提取。无表示不共享 LogMiner 数据字典。提取名称表示 LogMiner 数据字典与指定的提取共享。
-
已优化:启用此选项可优化提取注册。
-
从管理客户端注册 Oracle 提取
按照以下说明注册提取。必须在创建提取之前完成提取注册。
确保已使用 DBLOGIN 命令与数据库连接。
有关更多信息,请参见 Command Line Interface Reference for Oracle GoldenGate 中的 [REGISTER EXTRACT](/pls/topic/lookup?ctx=en/database/goldengate/core/26/coredoc&id=GCLIR-GUID-5E42DB9E-EFDF-40C0-89D7-88413496B8A3)。
-
使用管理客户机连接到部署,然后连接到源数据库的身份证明别名。
OGG> CONNECT https://*remotehost*:*srvmgrport* DEPLOYMENT *deployment_name* AS *deployment_user* PASSWORD *deployment_password*运行
CONNECT命令时,命令提示符从 "not connected"(未连接)更改为 "https://servername:port deployment_name",如以下示例所示:OGG (https://*pdbeast.vcn.oracle.com*:*16000**depl_east*)> -
使用
DBLOGIN命令连接到数据库:OGG (https://*remotehost*:*port**oracle_source*)> DBLOGIN USERIDALIAS *alias* -
注册提取。提取名称不能超过 8 个字母数字字符。
OGG (https://*remotehost*:*port**oracle_source*)> REGISTER EXTRACT *extname* DATABASE
您还可以在后台注册提取,同时从 Oracle GoldenGate MA Web 界面创建提取。有关详细信息,请参阅添加提取。
下游捕获屏幕
仅对 Oracle 有效。
如果在 Extract Information 屏幕上选择了 Downstream Capture ,则会显示 Downstream Capture 选项屏幕。使用此屏幕为下游提取配置下游挖掘数据库连接。
-
挖掘身份证明:在域和别名框中指定域和用户 ID 别名值。
-
无用户 ID/无源数据库连接:启用此切换开关以使用活动数据卫士 (ADG) 设置挖掘数据库连接。此时将显示用于输入 ADG 提取身份证明的选项:
-
域:ADG 提取数据库的域名。
-
别名:ADG 提取数据库的域别名。
-
注:具有 ADG 的下游捕获不支持按 PDB 提取。
单击下一步。
“托管选项”屏幕
在 Managed Options(托管选项)屏幕上,配置提取流程的自动启动和自动重新启动选项。下表提供了以下选项:
下表提供了以下选项:
| 选项 | 说明 |
|---|---|
| 概要文件名 | 提供自动启动和自动启动配置文件的名称。您可以选择默认或自定义选项。 如果已创建配置文件,则还可以选择该配置文件。如果选择“定制”选项,则可以从此部分本身设置新概要。 |
| 对于部署的健康状况至关重要 | (仅限 Oracle)如果概要信息对部署健康状况至关重要,请启用此选项。
注意: 此选项仅在创建“提取”或“复制”时显示,在“概要”页面中设置受管理处理时不显示。 |
| 自动启动 | 为流程启用自动启动。 |
| 启动延迟 | 启动进程之前等待的时间,以秒为单位 |
| 自动重新启动 | 配置在进程终止时如何重新启动进程 |
| 最大重试数 | 指定尝试启动进程的最大重试次数 |
| 重试延迟 | 延迟尝试启动进程的时间 |
| 重试窗口 | 尝试启动流程的持续时间间隔 |
| 仅在失败时重新启动 | 如果为 true,则任务仅在失败后才重新启动。 |
| 在重试次数用完后禁用任务 | 如果为 true,则在用尽重新启动进程的所有尝试后,任务将被禁用。 |
单击下一步。
提取参数文件屏幕
在参数文件屏幕上,您可以编辑文本区域中的参数文件,以列出您感兴趣的捕获表详细信息。下面是一个提取参数文件示例:
EXTRACT exte
USERIDALIAS ggeast DOMAIN OracleGoldenGate
EXTTRAIL east/ea
DDL INCLUDE MAPPED
TABLE hr.*;单击创建并运行以创建并启动提取。如果选择创建,则会创建提取,但您需要使用“提取”选项启动提取。
返回到“管理服务”主页或“提取”页面,其中列出了所有创建的提取。
创建要提取的参数文件
请按照以下说明为提取创建参数文件。
-
(仅限 MySQL)在 Windows 服务器和 Linux 服务器(OGG 版本低于 23.10.x)上运行 Oracle GoldenGate for MySQL 时,该服务器位于远程主机上数据库服务器,确保其时区相同,如果不同,请使用提取中的
SETENV(TZ)参数并将其设置为数据库服务器的时区。有关 TZ 格式和更多详细信息,请参阅参数和函数参考指南中的 SETENV 参数。
请参阅以下链接以获得参考:
https://learn.microsoft.com/en-us/cpp/c-runtime-library/reference/tzset?view=msvc-170#remarks
https://www.gnu.org/software/libc/manual/html_node/TZ-Variable.html
-
在源系统上,发出以下命令:
EDIT PARAMS extract_name其中:
extract_name是您使用ADD EXTRACT命令创建的提取的名称,或者是参数文件的全限定名称(如果您在创建组时定义了备用位置)。 -
按下表中显示的顺序输入参数,为每个参数语句开始一个新行。某些参数仅适用于某些配置。
参数 说明 EXTRACT group- group 是使用
ADD EXTRACT命令创建的 Extract 组的名称。
将提取配置为具有检查点的联机流程。 [, USERIDALIAS alias options ]要指定数据库身份证明,请参见 [USERIDALIAS](/pls/topic/lookup?ctx=en/database/goldengate/core/26/coredoc&id=GWURF-GUID-530D7773-B66D-4499-A509-EF5BB9CE9B05)。ENCRYPTTRAIL algorithm对在此条目之后指定的所有线索进行加密。 SOURCECATALOG指定 Oracle 多租户容器数据库或 SEQUENCE语句中的默认容器。允许使用两部分名称 (schema.object),否则这些数据库需要三部分名称。可以使用此参数的多个实例为不同的TABLE或SEQUENCE参数集指定不同的默认容器或目录。TABLE [container. \| catalog.]owner.object \| schema.object \| library/file \| library/file(member);为多个对象指定对象的全限定名称或全限定通配符指定。如果数据库是 Oracle 多租户容器数据库,则对象名称必须包括容器或目录的名称,除非使用
SOURCECATALOG。schema是方案名称或一组通配符的方案。object是表名或通配符的表集合。library是 IBM i 库名称或通配符的库集。file是 IBM i 物理文件名或通配符的物理文件集。member是 IBM i 物理文件成员名称或通配符成员名称集。使用 IBM i 本机名称格式(带有可选成员的库/文件)时,唯一有效的通配符是具有至少一个有效字符的名称,后跟与任何名称匹配的尾随星号 (*) 或*ALL。
注意:
成员名称是可选的,如果成员名称必须作为对象名称的一部分写入线索,则必须提供该名称。如果不指定成员名称,则物理文件中的所有成员将隐式合并为线索中的单个对象。请参阅在 Oracle GoldenGate 输入中指定对象名称准则,以指定参数文件中的对象名称。
SCHEMAEXCLUDETABLEEXCLUDEEXCLUDEWILDCARDOBJECTSONLY可相互结合使用的参数,用于从关联的 TABLE语句中的通配符规范中排除特定对象。 - group 是使用
-
输入 Oracle GoldenGate 参数中列出的任何适当的可选提取参数。
-
保存并关闭参数文件。
以下提取参数文件样例说明了提取的各种配置参数和选项:
ADD EXTRACT *extract_name*
{, datasource}
{, BEGIN start_point} | {position_point}
[, PARAMS pathname]
[, REPORT pathname]
[, DESC 'description']-
extract_name是提取组的名称。需要提供组名称。 -
要指定要提取的数据源,需要
datasource。使用以下项之一:-
TRANLOG将事务处理日志指定为数据源。将此选项用于 Oracle Enterprise Edition 时,必须先以提取数据库用户(或具有相同权限的用户)的身份发出DBLOGIN命令,然后才能使用ADD EXTRACT(以及发出DELETE EXTRACT以删除提取组)。使用 Db2 z/OS 的 bsds 选项指定事务日志的 Bootstrap 数据集文件名。
-
INTEGRATED TRANLOG指定此提取将在集成捕获模式下运行,以便从 Oracle AI Database 日志挖掘服务器接收逻辑更改记录 (logical change record,LCR)。此参数仅适用于 Oracle 数据库。 -
EXTTRAILSOURCE trail_name,指定本地线索的相对或全限定名称。
-
-
BEGIN start_point通过建立初始检查点和处理起点来定义联机提取组。放弃在此点之前启动的事务处理。使用以下项之一: -
NOW 开始提取在执行
ADD EXTRACT命令以创建组时的时间戳的更改,或者在集成模式下提取,从组注册到REGISTER EXTRACT命令时开始提取更改。提取需要仅为 Oracle 和 PostgreSQL 数据库注册。时间戳:指定确切时间戳作为开始点的格式。使用比启用复制或日志记录的时间晚的开始点。
以下示例显示了使用特定时间戳重新定位提取:
<pre class="copy"><code>OGG (http://localhost:11000 ggeast as pdb1@east.oracle.com) 95> dblogin useridalias ggma Successfully logged into database PDB1.</code></pre> <pre class="copy"><code>OGG (http://localhost:11000 ggeast as ggma@ggeast/PDB1) 96> alter extract exte , begin 2024-05-03T03:48:00Z 2024-05-03T03:50:49Z INFO OGG-08100 Extract exte I/O position is altered and reposition to older date and time position 2024-05-03 03:48:00.000000 current date and time position 2024-05-03 03:49:04.000000. Duplicate transactions are filtered out. Perform output trail ETROLLOVER if duplicate transaction output is desired, or Extract configuration was updated. 2024-05-03T03:50:49Z INFO OGG-08100 Extract altered.</code></pre> -
position_point指定要在其中开始处理的特定事务处理日志文件中的特定位置。用于数据库的特定语法。 -
如果此组的参数文件将存储在 Oracle GoldenGate 目录的 dirprm 子目录以外的位置,则需要
PARAMS路径名。指定全限定名称。建议使用默认位置。 -
如果此组的进程报告将存储在 Oracle GoldenGate 目录的
dirrpt子目录以外的位置,则需要REPORT pathname。指定全限定名称。建议使用默认位置。 -
DESC 'description'指定组的说明。
提取的其他参数选项
了解提取配置可能需要的其他参数。
提取使用挖掘数据库中的数据库日志挖掘服务器来挖掘源数据库的重做流。通过将 TRANLOGOPTIONS 参数与提取参数文件中的 INTEGRATEDPARAMS 选项结合使用,可以设置特定于日志挖掘服务器的参数。
注:有关这些参数的详细信息和使用指南,请参阅 Oracle AI Database PL/SQL Packages and Types Reference 中的 "DBMS_CAPTURE_ADM" 部分。
可使用 INTEGRATEDPARAMS 设置以下参数:
-
CAPTURE_IDKEY_OBJECTS:控制FETCH可以支持的对象的捕获。Oracle GoldenGate 的默认值为Y(捕获 ID 密钥逻辑更改记录)。 -
DOWNSTREAM_REAL_TIME_MINE:控制日志挖掘服务器是作为实时下游捕获进程,还是作为归档日志下游捕获进程运行。缺省值为N(归档日志模式)。指定此参数以在下游日志挖掘服务器配置中使用实时捕获。有关建立下游挖掘配置的更多信息,请参阅 Downstream Extract for Oracle GoldenGate Deployment 。 -
INLINE_LOB_OPTIMIZATION:控制可内联处理的 LOB(例如小型 LOB)是否直接包含在 LCR 中,而不是发送 LOB 块 LCR。对于 Oracle GoldenGate,默认值为Y(是)。 -
MAX_SGA_SIZE:控制日志挖掘服务器使用的共享内存量。共享内存从 SGA 的流池中获取。默认值为 1 GB。 -
PARALLELISM:控制日志挖掘服务器使用的进程数。默认值为 2。对于 Oracle Standard Edition,必须将其设置为1。 -
TRACE_LEVEL:控制提取日志挖掘服务器的跟踪级别。仅在 Oracle 支持人员的指导下使用。Oracle GoldenGate 的默认值为0(无跟踪)。 -
WRITE_ALERT_LOG:控制提取日志挖掘服务器是否将消息写入 Oracle 预警日志。对于 Oracle GoldenGate,默认值为Y(是)。