Tabelle
Utilizzare le tabelle per definire la struttura dei dati.
È possibile caricare nuovi dati nelle tabelle o dati di riferimento in una posizione esistente. È possibile definire autorizzazioni di controllo dell'accesso con filtro per le tabelle creando autorizzazioni per le tabelle. Per ulteriori informazioni, vedere Autorizzazioni di tabella.
Per condividere una tabella, vedere Condividi dati.
Le tabelle possono essere gestite o esterne.
Tabelle gestite
Una tabella gestita definisce una struttura per i dati memorizzati in AI Data Platform e a cui possono accedere solo gli utenti di AI Data Platform.
Quando si elimina una tabella gestita, la definizione della tabella e i dati della tabella vengono eliminati.
Tabelle esterne
Una tabella esterna definisce una struttura per i dati memorizzati in una posizione non gestita da Oracle AI Data Platform. Quando si crea una tabella esterna in AI Data Platform, il ciclo di vita dei metadati viene gestito da AI Data Platform. Quando si elimina una tabella esterna, viene eliminata solo la definizione della tabella. I dati a cui fa riferimento la tabella esterna non sono stati eliminati.
Assicurarsi che gli utenti dispongano dei criteri IAM seguenti necessari per creare tabelle esterne:
allow group <GroupName> to read buckets in compartment id <external-data-CompartmentId>
allow group <GroupName> to inspect objects in compartment id <external-data-CompartmentId>
Per le tabelle esterne sono necessari criteri IAM aggiuntivi. Per ulteriori informazioni, vedere Policy IAM per Oracle AI Data Platform.
Formati tabella supportati
Le tabelle possono utilizzare formati basati su file come CSV, JSON, Avro, Parquet e ORC o formati di tabelle transazionali come Delta e Apache Iceberg. Le tabelle Iceberg utilizzano l'implementazione del catalogo Hadoop per gestire i metadati delle tabelle in Oracle Cloud Infrastructure Object Storage.
| Formato | Descrizione | Utilizzo |
|---|---|---|
| valori separati da virgole (CSV); | I dati vengono memorizzati come file di testo con un formato file basato su righe specificato per strutturare i dati. In genere, la prima riga del file è una riga di intestazione che contiene i nomi delle colonne per i dati. | Utilizzato per scambiare dati tabulari tra sistemi. Ogni riga del file è una riga di una tabella. |
| JavaScript Object Notation (JSON) | I dati vengono memorizzati in un formato standard basato su testo per rappresentare i dati strutturati in base alla sintassi dell'oggetto JavaScript. JSON supporta liste di oggetti o strutture gerarchiche. | Utilizzato nelle applicazioni di flusso. JSON semplifica lo storage dei dati correlati con relazioni complesse in un singolo documento ed evita la conversione caotica degli elenchi in un modello di dati relazionale. Si noti che JSON non è frazionabile. |
| Avro | I dati vengono memorizzati in un formato binario basato su righe mentre lo schema viene memorizzato in formato JSON per ridurre al minimo le dimensioni dei file e massimizzare l'efficienza. Avro ha un supporto affidabile per l'evoluzione dello schema gestendo i campi aggiunti, mancanti e modificati. Ciò consente al vecchio software di leggere i nuovi dati e al nuovo software di leggere i vecchi dati. Conosciuto anche come sistema di serializzazione dei dati. | Utilizzato per l'archiviazione dei dati in quanto i file Avro sono divisibili e comprimibili. Lo storage serializzato basato su righe è la soluzione ideale per transazioni di scrittura complesse, come l'inserimento di dati in AI Data Platform. Avro è anche una buona scelta quando l'evoluzione dello schema è critica durante le scritture ad alta velocità. |
| Parquet | I dati vengono memorizzati in un formato di dati colonnari ed è altamente comprimibile e divisibile. Parquet è ottimizzato per il paradigma Write Once Read Many (WORM). Scrive lentamente ma legge incredibilmente rapidamente, soprattutto quando si accede solo a un sottoinsieme di colonne. | Utilizzato per risolvere i problemi dei Big Data poiché gli algoritmi di compressione funzionano meglio con il formato dei dati colonnari. È possibile memorizzare i Big Data in vari formati, ad esempio immagini, video, documenti e tabelle di dati strutturati. Parquet è una buona scelta per carichi di lavoro pesanti durante la lettura di porzioni di dati. Ad esempio, quando il set di dati contiene molte colonne, ma si desidera accedere solo a un subset di colonne. Ideale quando si è dipendenti da Spark o quando si desidera che più servizi accedano agli stessi dati memorizzati nello storage degli oggetti. |
| ORC (Optimized Row Columnar) | I dati vengono memorizzati in raccolte di righe in un singolo file in formato colonnare. | Utilizzato per l'elaborazione parallela delle raccolte di righe in un cluster. Ideale quando le transazioni di lettura sono più di transazioni di scrittura o quando la compressione è la priorità. |
| Lago delta | I dati vengono memorizzati in un formato a colonne che estende i file di dati Parquet con un log delle transazioni basato su file JSON per le transazioni ACID e la gestione scalabile dei metadati. | Utilizzato per il supporto delle transazioni. |
| Iceberg | Formato di tabella aperta che gestisce i file di dati Parquet tramite metadati con controllo delle versioni, file manifesto e snapshot. AI Data Platform utilizza l'implementazione del catalogo Hadoop di Iceberg. | Da utilizzare per le transazioni ACID, le operazioni di lettura e scrittura concorrenti, l'evoluzione di schemi e partizioni, le query sui viaggi temporali, gli aggiornamenti a livello di riga, gli upsert e la gestione degli snapshot. |
Tipi di dati supportati
| Tipo di dati | Descrizione |
|---|---|
| Tipo di byte | Rappresenta i numeri interi firmati a 1 byte. L'intervallo di numeri è compreso tra -128 e 127. |
| Tipo breve | Rappresenta i numeri interi firmati a 2 byte. L'intervallo di numeri è compreso tra -32768 e 32767. |
| Tipo intero | Rappresenta i numeri interi firmati a 4 byte. L'intervallo di numeri è compreso tra -2147483648 e 2147483647. |
| LongType | Rappresenta numeri interi firmati a 8 byte. L'intervallo dei numeri è compreso tra -9223372036854775808 e 9223372036854775807. |
| Tipo float | Rappresenta i numeri a virgola mobile a precisione singola a 4 byte. |
| Doppio tipo | Rappresenta i numeri a virgola mobile a doppia precisione a 8 byte. |
| Tipo decimale | Rappresenta numeri decimali firmati con precisione arbitraria. Sostenuto internamente da java.math.BigDecimal. Un valore BigDecimal è costituito da un numero intero di precisione arbitrario senza scala e da una scala intera a 32 bit. |
| Tipo stringa | Rappresenta i valori della stringa di caratteri. |
| VarcharType(lunghezza) | Variante di StringType con limite di lunghezza. La scrittura dei dati non riuscirà se la stringa di input supera il limite di lunghezza. |
| CharType(lunghezza) | Una variante di VarcharType(lunghezza) che è lunghezza fissa. La colonna di lettura di tipo CharType(n) restituisce sempre i valori stringa di lunghezza n. Il confronto delle colonne del tipo di carattere comprimerà la lunghezza più breve a quella più lunga. |
| Tipo binario | Rappresenta i valori della sequenza in byte. |
| Tipo booleano | Rappresenta i valori booleani. |
| Tipo data | Rappresenta i valori dei campi anno, mese e giorno, senza un fuso orario. |
| Tipo indicatore orario | Indicatore data/ora con fuso orario locale (TIMESTAMP_LTZ). Rappresenta valori che comprendono i valori dei campi anno, mese, giorno, ora, minuto e secondo, con il fuso orario locale della sessione. Il valore dell'indicatore orario rappresenta un point in time assoluto. |
| Tipo indicatore orarioNTZ | Un indicatore orario senza fuso orario (TIMESTAMP_NTZ). Rappresenta i valori dei campi anno, mese, giorno, ora, minuto e secondo. Tutte le operazioni vengono eseguite senza tenere conto del fuso orario. |
| YearMonthIntervalType(startField, endField) | Rappresenta un intervallo di un anno-mese costituito da un sottoinsieme contiguo di MESE, mesi entro gli anni [0..11] e ANNO, anni nell'intervallo [0..178956970]. |
| DayTimeIntervalType(startField, endField) | Rappresenta un intervallo diurno costituito da un sottoinsieme contiguo di SECONDO, secondi in minuti ed eventualmente frazioni di secondo [0..59.999999], MINUTO, minuti in ore [0..59], ORA, ore in giorni [0..23] e GIORNO, giorni nell'intervallo [0..106751991]. |
| ArrayType(elementType, containsNull) | Rappresenta i valori che comprendono una sequenza di elementi con il tipo di elementType. containsNull viene utilizzato per indicare se gli elementi di un valore ArrayType possono avere valori nulli. |
| MapType(keyType, valueType, valueContainsNull) | Rappresenta i valori che comprendono un set di coppie chiave-valore. Il tipo di dati delle chiavi è descritto da keyType e il tipo di dati dei valori è descritto da valueType. Per un valore MapType, le chiavi non possono avere valori nulli. valueContainsNull viene utilizzato per indicare se i valori di un valore MapType possono avere valori nulli. |
| StructType(campi) | Rappresenta i valori con la struttura descritta da una sequenza di StructFields (campi). |
| StructField(nome, dataType, annullabile) | Rappresenta un campo in StructType. Il nome di un campo è indicato dal nome. Il tipo di dati di un campo è indicato da dataType. Nullable viene utilizzato per indicare se i valori di questi campi possono avere valori nulli. |
Limitazioni
Le seguenti limitazioni si applicano alle tabelle di AI Data Platform:
- Non è possibile definire una tabella esterna in file di dati o directory all'interno o su un volume.
- Impossibile definire una tabella esterna in un bucket o nella relativa directory già utilizzata per un'altra tabella esterna o volume esterno
- Impossibile visualizzare o elencare le viste nel catalogo principale.
Evoluzione degli schemi
L'evoluzione dello schema in Oracle AI Data Platform consente agli utenti con le autorizzazioni necessarie di aggiornare una tabella gestita utilizzando SQL in un notebook.
Ciò è utile quando una definizione di tabella viene modificata nel tempo per supportare nuove colonne, colonne rimosse, colonne rinominate, modifiche alle partizioni o ridenominazioni di tabelle senza ricreare il set di dati da zero. I formati supportati sono Parquet, Avro, Delta e Iceberg.
Operazioni supportate
Per le tabelle gestite sono state analizzate le seguenti operazioni di evoluzione dello schema:
| Operazione | Delta | Parquet | Avro | Iceberg |
|---|---|---|---|---|
| Rinomina tabella | Supportato | Supportato | Supportato | Supportato |
| Aggiungi colonna | Supportato | Supportato | Supportato | Supportato |
| Elimina colonne | Supportato | Non supportate | Non supportate | Supportato |
| Modifica o rinomina colonne | Supportato | Non supportate | Non supportate | Supportato |
| Sostituisci colonne | Supportato | Non supportate | Non supportate | Supportato |
| Aggiungi partizioni | Le partizioni vengono create automaticamente durante la scrittura dei dati. Impossibile aggiungere singole partizioni tramite DDL. | Supportato tramite DDL | Supportato tramite DDL | Le partizioni vengono create automaticamente durante la scrittura dei dati. Impossibile aggiungere singole partizioni tramite DDL. È possibile aggiungere campi alla specifica della partizione utilizzando ALTER TABLE ... ADD PARTITION FIELD.
|
| Elimina partizioni | Rimuovere i dati pertinenti ed eseguire VACUUM.
|
Supportato | Supportato | Non è possibile eliminare singole partizioni tramite DDL. Eliminare invece le righe pertinenti. È possibile rimuovere i campi dalla specifica della partizione utilizzando ALTER TABLE ... DROP PARTITION FIELD.
|
| Modifica tipo di dati | Può richiedere una soluzione CTAS o uno schema di sovrascrittura. | Non supportate | Non supportate | Supportato solo per promozioni di tipo compatibile, ad esempio da INT a BIGINT, FLOAT to DOUBLE e aumento della precisione decimale tramite ALTER TABLE. Conversioni restrittive e incompatibili non sono supportate.
|
Creare una tabella gestita
È possibile creare una tabella gestita in cui memorizzare i dati strutturati per lo schema gestito.
- Aprire la finestra di dialogo Crea tabella.
- Dal riquadro di navigazione di sinistra effettuare le operazioni riportate di seguito.
- Fare clic su
 Crea, quindi selezionare Tabella.
- Nella finestra di dialogo Seleziona posizione tabella selezionare il catalogo e lo schema per cui si desidera creare la tabella, quindi fare clic su Seleziona.
- Fare clic su
- Da
 Catalogo principale:
- Nella struttura del catalogo principale o nella scheda Cataloghi fare clic sul catalogo che si desidera creare per aprire la tabella.
- Nella scheda Schemi fare clic sullo schema che si desidera creare per aprire la tabella.
- Fare clic su Aggiungi a schema e selezionare Tabella.
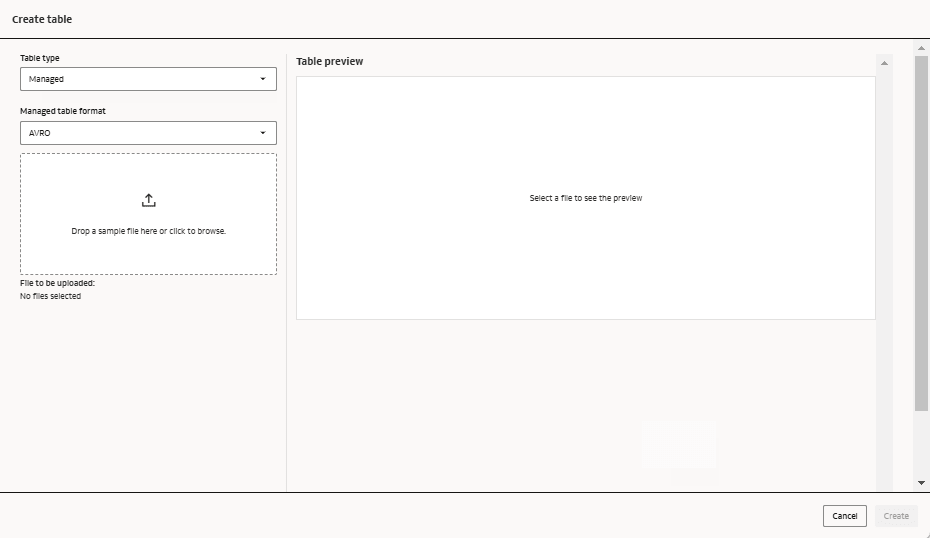
- Dal riquadro di navigazione di sinistra effettuare le operazioni riportate di seguito.
Crea tabella esterna
Puoi creare una tabella esterna per eseguire query sui dati direttamente nello storage degli oggetti OCI senza spostare o duplicare i dati in Oracle AI Data Platform.
- Aprire la finestra di dialogo Crea tabella.
- Dal riquadro di navigazione di sinistra effettuare le operazioni riportate di seguito.
- Fare clic su Crea, quindi selezionare Tabella.
- Nella finestra di dialogo Seleziona posizione tabella selezionare il catalogo e lo schema per cui si desidera creare la tabella, quindi fare clic su Seleziona.
- Fare clic su
- Da Catalogo principale:
- Nella struttura del catalogo principale o nella scheda Cataloghi fare clic sul catalogo che si desidera creare per aprire la tabella.
- Nella scheda Schemi fare clic sullo schema che si desidera creare per aprire la tabella.
- Fare clic su Aggiungi a schema e selezionare Tabella.
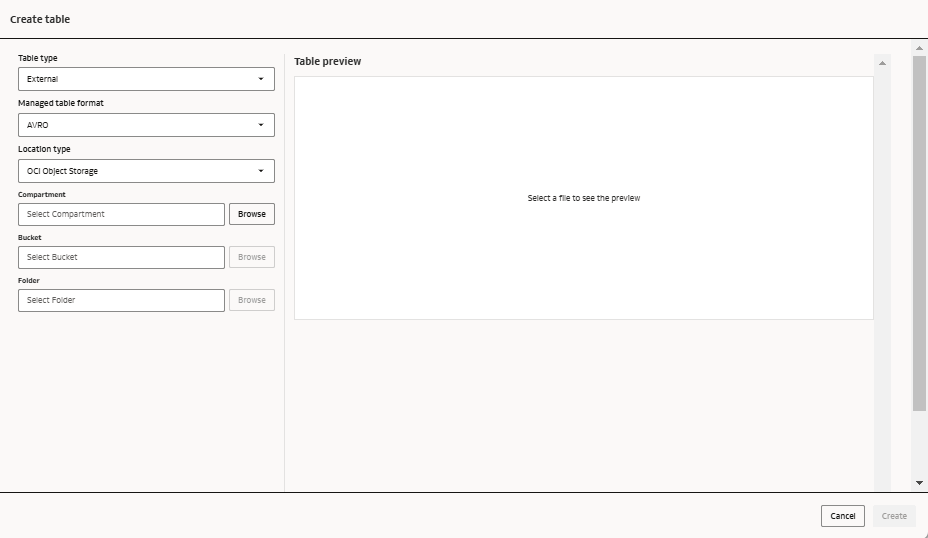
- Dal riquadro di navigazione di sinistra effettuare le operazioni riportate di seguito.
Visualizza dettagli tabella
È possibile visualizzare i dettagli di una tabella per esaminarne la configurazione e i metadati.
Nella scheda Dettagli di una tabella vengono visualizzati la chiave, il tipo e il formato della tabella, nonché la data e l'ora di creazione e l'ultimo aggiornamento della tabella. Vengono inoltre visualizzate le proprietà della tabella.
- Nel riquadro di navigazione a sinistra, fare clic su Catalogo principale.
- Nella struttura del catalogo principale espandere il catalogo e lo schema che contengono la tabella che si desidera visualizzare, quindi fare clic su Tabelle.
- Nella scheda Tabelle individuare la tabella e fare clic su
 Azioni, quindi fare clic su Visualizza.
- Fare clic su Dettagli.
Rinomina tabella
È possibile rinominare una tabella gestita se il relativo contenuto o scopo è stato modificato.
Nota
Le modifiche apportate alle tabelle esterne in Oracle AI Data Platform non vengono trasferite al catalogo remoto nello storage degli oggetti OCI.- Nel riquadro di navigazione a sinistra, fare clic su Catalogo principale.
- Nella struttura del catalogo principale espandere il catalogo e lo schema che contengono la tabella che si desidera modificare, quindi fare clic su Tabelle.
- Nella scheda Tabelle individuare la tabella e fare clic su Azioni, quindi fare clic su Rinomina.
- Modificare il nome della tabella e premere Invio.
Modifica descrizione tabella
È possibile modificare la descrizione di una tabella gestita se il relativo contenuto o scopo è stato modificato.
Nota
Le modifiche apportate alle tabelle esterne in Oracle AI Data Platform non vengono trasferite al catalogo remoto nello storage degli oggetti OCI.- Nel riquadro di navigazione a sinistra, fare clic su Catalogo principale.
- Nella struttura del catalogo principale espandere il catalogo e lo schema che contengono la tabella che si desidera modificare, quindi fare clic su Tabelle.
- Nella scheda Tabelle individuare la tabella e fare clic su Azioni, quindi fare clic su Modifica descrizione.
- Modificare la descrizione della tabella e fare clic su Salva.
Elimina una tabella
È possibile eliminare una tabella da uno schema gestito quando non è più necessaria.
Nota
I dati nello storage degli oggetti OCI a cui fa riferimento una tabella esterna non vengono eliminati.- Nel riquadro di navigazione a sinistra, fare clic su Catalogo principale.
- Nella struttura del catalogo principale espandere il catalogo e lo schema che contengono la tabella che si desidera eliminare, quindi fare clic su Tabelle.
- Nella scheda Tabelle individuare la tabella e fare clic su Azioni, quindi fare clic su Elimina.
- Fare clic su Elimina.