Adicionar um processo de Extract
Saiba mais sobre os pré-requisitos e as considerações para adicionar um Extract.
Antes de começar a adicionar um Extract, certifique-se de que as seguintes configurações estejam configuradas:
Agora, você está pronto para adicionar um Extract para sua implantação.
Considerações para criar um Extract quando existirem arquivos de trilha do Extract anteriores
-
Se você criar um Extract quando já existirem arquivos de trilha órfãos de uma configuração anterior, o processo poderá falhar. Por exemplo, se
north/ea00000000permanecer de uma configuração anterior e não tiver sido removido, a criação de um Extract poderá falhar. -
Se você adicionar novamente um Extract iniciando em um número de sequência maior, enquanto a sequência de trilha anterior existir, a configuração Extract poderá estar fora de sincronia ou incorreta. Por exemplo, se
north/ea00002261existir e você recriar o Extract começando emnorth/ea00002262, a configuração do Extract poderá estar incorreta. Nesses casos, os arquivos de trilha existentes devem ser removidos ou movidos para um local não referenciado.
Tela Extrair Informações
Depois de fazer log-in na home page de Microsserviços, clique no sinal + na coluna Criar para abrir o assistente Adicionar Extratos.
Na tela Informações da Extração, selecione o tipo de Extração. Dependendo da plataforma de banco de dados, os tipos de Extrações disponíveis podem ser Extração Integrada, Extração de Captura de Dados de Alteração e Extração de Carga Inicial.
Se você precisar configurar o Downstream Extract para o Oracle AI Database, ative a chave de alternância Downstream Extract.
Selecione o tipo de Extract a ser criado e especifique o seguinte:
-
Nome do Processo: Nome do processo de Extração. O nome do processo de Extract pode ter até 8 caracteres.
-
Descrição: Descrição do processo de Extract que está sendo criado
Observação: Para saber mais sobre como criar o Extract de carga inicial, consulte Instanciar.
Clique em Próximo.
Tela de Extração de Registro - PostgreSQL e Bancos de Dados Yugabyte
Observação: é necessário registrar o Oracle GoldenGate Extract for Oracle, diferentes sabores PostgreSQL e o Banco de Dados Yugabyte. No entanto, as opções de configuração para registrar o Extract são exibidas em telas diferentes ao adicionar o Extract.
Observação: consulte também Guidelines and Limitations for PGOUTPUT Plugin Type.
Na tela Registrar Extração, configure as seguintes opções e clique em Registrar:
-
Credenciais de Origem: Especifique um domínio para o banco de dados.
-
Alias: Especifique o alias do ID do usuário usado como a conexão do banco de dados para o log-in de origem ou selecione entre as opções exibidas.
-
(Todos os sabores PostgreSQL) Tipo de Plug-in: Selecione o tipo de plug-in de decodificação lógica pgoutput. O pgoutput é padrão para todos os sabores PostgreSQL.

Para obter detalhes sobre a configuração do slot de replicação de failover para PostgreSQL 17 e superior, consulteSuporte a Failover para Oracle GoldenGate com PostgreSQL 17 e superior.
-
(Somente Banco de Dados Yugabyte) Tipo de Plug-in: Selecione o tipo de plug-in de decodificação lógica yboutput. O YBOUTPUT é padrão para o Banco de Dados Yugabyte.
Clique em Próximo depois que o registro do Extract for bem-sucedido.
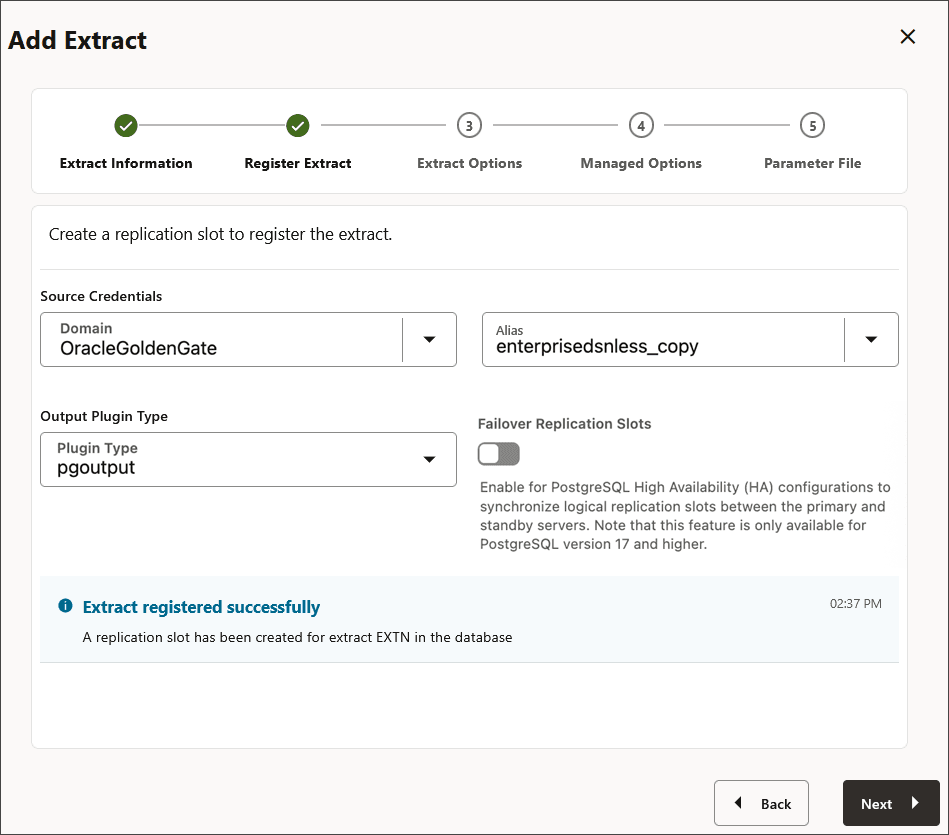
Clique em Próximo.
Registrar Extract para Bancos de Dados PostgreSQL e Yugabyte no Admin Client
Um Extract para PostgreSQL deve ser registrado no banco de dados e ter um slot de replicação reservado. Os slots de replicação são alocados por meio da definição de configuração do banco de dados max_replication_slots e podem ser configurados conforme discutido em Configuração do Banco de Dados.
Siga estas instruções para registrar um Extract. O registro de extração deve ser feito antes da criação de um Extract. Consulte REGISTER EXTRACT na Referência de Interface de Linha de Comando do Oracle GoldenGate para obter mais informações.
-
Conecte-se à implantação e, em seguida, conecte-se ao alias de credencial do banco de dados de origem.
CONNECT http*s*://*remotehost*:*srvmgrport* DEPLOYMENT

          *deployment_name* AS *deployment_user* PASSWORD *deployment_password*
OGG (https://*remotehost*:*16000**postgresql_source*)> DBLOGIN USERIDALIAS *alias* -
Registre o Extract, que cria internamente um slot de replicação para o Extract. Os nomes de extração não podem ter mais de 8 caracteres alfanuméricos.
REGISTER EXTRACT *extname*Para registrar explicitamente o Extract no plug-in
pgoutput, especifique o tipo de plug-inpgoutput:REGISTER EXTRACT *extname* PGPLUGINTYPE pgoutput;
Você também pode registrar um Extract na interface Web do Oracle GoldenGate MA. Consulte Adicionar um Extract.
Diretrizes e limitações para o tipo de plug-in PGOUTPUT
Diretrizes ao configurar o tipo de plug-in PGOUTPUT
Siga estas diretrizes ao definir o tipo de plug-in para PostgreSQL:
-
A(s) publicação(ões) deve(m) ser criada(s) antes de registrar o processo Extract.
-
Os nomes de publicação não devem conter caracteres especiais: vírgula (,), aspas simples (') e aspas duplas (").
-
Vários nomes de publicação podem ser especificados como uma lista separada por vírgulas no
publication_names. Por exemplo:TRANLOGOPTIONS STREAMINGOPTIONS (publication_names="my*123,my_publication2,123 pub,my_publication";)Para obter detalhes, consulte o parâmetro
TRANLOGOPTIONS STREAMINGOPTIONS. -
O nome da publicação final na lista deve terminar com um ponto e vírgula (;).
Limitações
As seguintes restrições se aplicam ao selecionar um tipo de plug-in para PostgreSQL:
-
Variável de ambiente TZ (Timezone): O processo do remetente
WALsempre transmite timestamps de commit em UTC.If; o fuso horário da sessão OGG difere do UTC; podem ocorrer discrepâncias ao posicionar por timestamp no processo de Extração CDC. Para evitar esse problema, os usuários devem definir a variável de ambienteTZ=UTCna camada de implantação. Essa limitação se aplica especificamente ao plug-inpgoutput. -
Vários truncamentos: Só há suporte para várias operações de truncamento no plug-in
pgoutput. O tipo de plug-intest_decodingnão permite vários troncos. -
Tabelas com índices exclusivos, mas sem Chave Primária: Se uma tabela não tiver chaves primárias, mas contiver índices exclusivos, a identidade da réplica deverá usar índices ou deverá ser definida como
FULL. -
Impacto na Exclusão da Publicação no Extrato do CDC: Se uma publicação for excluída enquanto o Extrato do CDC ainda estiver em execução, haverá um risco de corrupção do slot de replicação, fazendo com que ele pare de funcionar. Nesses casos, o slot de replicação afetado não é utilizável e recriar a mesma publicação não resolverá o problema. A solução recomendada é criar uma nova publicação e associá-la a um novo slot de replicação para restaurar a funcionalidade CDC.
-
Tabelas elegíveis para publicação: Somente tabelas base persistentes e tabelas particionadas podem ser incluídas em uma publicação. Os seguintes tipos de objeto não podem fazer parte de uma publicação:
-
Tabelas temporárias
-
Tabelas não conectadas
-
Tabelas estrangeiras
-
Views materializadas
-
Visualizações regulares
-
-
Suporte à Replicação Bidirecional com o Plug-in pgoutput: Ao usar o plug-in
pgoutputpara replicação bidirecional, a tabela de checkpoint deve ser criada e incluída na lista de publicações antes de iniciar o processo de Extração CDC. Além disso, o slot de replicação deve ser criado somente após a criação e a adição da tabela de checkpoint à publicação. -
Limitação de publicação no nível da coluna: A especificação de um subconjunto de colunas para uma tabela em uma publicação não é suportada para replicação de CDC. Você deve incluir a tabela inteira na publicação. A tentativa de adicionar apenas colunas parciais pode levar a erros ou discrepâncias de dados no fluxo CDC.
Tela Opções de Extração
Observação: esta tela fornece opções para registrar o processo Extract para o Oracle AI Database. Se você estiver adicionando um Extract para PostgreSQL, o registro do Extract será concluído na Tela de Extract do Registro.
Na tela Opções de Extração, defina as seguintes configurações:
-
Extrair Trilha:
-
Nome: Nome do arquivo de trilha Extract. O nome do arquivo de trilha pode ter até 2 caracteres.
-
Subdiretório: Nome do diretório do subdiretório no qual a trilha de Extract está armazenada.
-
Sequência da Trilha: Número de sequência da trilha.
-
Tamanho da Trilha: Tamanho máximo do arquivo da trilha.
-
Perfil de Criptografia: Descrição do perfil de criptografia. Se você não tiver criado um perfil de criptografia, o perfil da Wallet Local será selecionado, por padrão. Para saber mais sobre como criar e aplicar perfis de criptografia, consulte Aplicar o Perfil de Criptografia do OKV.
-
Algoritmo de Criptografia: Lista de algoritmos de criptografia disponíveis para o arquivo de trilha de Extração.
Observação: Para obter mais informações sobre a criptografia do arquivo de trilha, consulte Criptografia do Arquivo de Trilha e Criptografando Arquivos de Trilha.
-
(Somente Oracle)Opções de Registro: Especifique as seguintes opções para registrar um Extract para o Oracle AI Database.
CSN: valor do Número de Sequência de Commits (CSN).
-
Compartilhar: Esta lista drop-down é usada para definir como compartilhar o dicionário de dados LogMiner. As opções disponíveis são Automático, Nenhum e Nome da Extração. Automático significa que o sistema decide qual Extract compartilhar. Nenhum significa que o dicionário de dados LogMiner não é compartilhado. Nome da Extração significa que o dicionário de dados LogMiner é compartilhado com a Extração especificada.
-
Otimizado: Ative essa opção para otimizar o registro de Extração.
-
Registrar Extract para Oracle do Admin Client
Siga estas instruções para registrar um Extract. O registro de extração deve ser feito antes da criação de um Extract.
Certifique-se de estar conectado ao banco de dados usando o comando DBLOGIN.
Consulte [REGISTER EXTRACT](/pls/topic/lookup?ctx=en/database/goldengate/core/26/coredoc&id=GCLIR-GUID-5E42DB9E-EFDF-40C0-89D7-88413496B8A3) na Referência de Interface de Linha de Comando do Oracle GoldenGate para obter mais informações.
-
Usando o Admin Client, conecte-se à implantação e, em seguida, conecte-se ao alias de credencial do banco de dados de origem.
OGG> CONNECT https://*remotehost*:*srvmgrport* DEPLOYMENT *deployment_name* AS *deployment_user* PASSWORD *deployment_password*Ao executar o comando
CONNECT, o prompt de comando é alterado de "não conectado" para "https://servername:port deployment_name", conforme mostrado no seguinte exemplo:OGG (https://*pdbeast.vcn.oracle.com*:*16000**depl_east*)> -
Conecte-se ao banco de dados usando o comando
DBLOGIN:OGG (https://*remotehost*:*port**oracle_source*)> DBLOGIN USERIDALIAS *alias* -
Registre o processo Extract. Os nomes do Extract não podem ter mais de 8 caracteres alfanuméricos.
OGG (https://*remotehost*:*port**oracle_source*)> REGISTER EXTRACT *extname* DATABASE
Você também pode registrar um Extract em segundo plano ao criar um Extract na interface Web do Oracle GoldenGate MA. Consulte Adicionar um Extract para obter detalhes.
Tela de Captura Downstream
Válido apenas para o sistema Oracle.
Se você tiver selecionado a Captura de Downstream na tela Informações de Extração, a tela de opções Captura de Downstream será exibida. Configure a conexão do banco de dados de mineração downstream para o Extract downstream usando esta tela.
-
Mineração de Credenciais: Especifique o domínio e o valor do alias do ID do usuário nas caixas Domínio e Apelido.
-
Nenhum UserID/Nenhuma Conexão do Banco de Dados de Origem: Ative essa chave de alternância para configurar a conexão do banco de dados de mineração usando o Active Data Guard (ADG). As opções para informar a Credencial de Extração do ADG são exibidas:
-
Domínio: Nome do domínio para o banco do dados de extração do ADG.
-
Alias: Alias de domínio para o banco de dados da extração do ADG.
-
Observação: A Captura Downstream com ADG não suporta a Extração por PDB.
Clique em Próximo.
Tela Opções Gerenciadas
Na tela Opções Gerenciadas, configure as opções de início automático e reinicialização automática para o processo Extract. A tabela a seguir fornece estas opções:
A tabela a seguir fornece estas opções:
| Opção | Descrição |
|---|---|
| Nome do Perfil | Fornece o nome do perfil de inicialização automática e de reinicialização automática. Você pode selecionar as opções padrão ou personalizadas. Se já tiver criado um perfil, você também poderá selecioná-lo. Se você selecionar a opção Personalizado, poderá configurar um novo perfil nessa própria seção. |
| Crítico para a integridade da implantação | (Somente Oracle) Ative essa opção se o perfil for crítico para a integridade da implantação.
Observação: Essa opção só aparece durante a criação do processo Extract ou Replicat, e não quando você configura os processos gerenciados na página Perfis. |
| Iniciar Automaticamente | Ativa a inicialização automática do processo. |
| Atraso na Inicialização | Tempo de espera em segundos antes de iniciar o processo |
| Reinício Automático | Configura como reiniciar o processo se ele terminar |
| Máximo de Novas Tentativas | Especifique o número máximo de novas tentativas para tentar iniciar o processo |
| Atraso na Repetição | Atraso na tentativa de iniciar o processo |
| Janela de Novas Tentativas | O intervalo de duração para tentar iniciar o processo |
| Reiniciar somente na Falha | Se for verdadeiro, a tarefa só será reiniciada se ela falhar. |
| Desativar Tarefa após Novas Tentativas Esgotadas | Se for verdadeiro, a tarefa será desativada depois de esgotar todas as tentativas de reiniciar o processo. |
Clique em Próximo.
Tela Extrair Arquivo de Parâmetros
Na tela Arquivo de Parâmetro, você pode editar o arquivo de parâmetro na área de texto para listar os detalhes da tabela que está interessado em capturar. Veja a seguir um exemplo de arquivo de parâmetros do Extract:
EXTRACT exte
USERIDALIAS ggeast DOMAIN OracleGoldenGate
EXTTRAIL east/ea
DDL INCLUDE MAPPED
TABLE hr.*;
Clique em Criar e Executar para criar e iniciar o processo de Extract. Se você selecionar Criar, a Extração será criada, mas você precisará iniciá-la usando as opções da Extração.
Você retorna à home page do Serviço de Administração ou à página Extrair, na qual todas as Extrações criadas são listadas.
Criar um Arquivo de Parâmetros para Extração
Siga estas instruções para criar um arquivo de parâmetros para um processo de Extract.
-
(Somente MySQL) Ao executar o Oracle GoldenGate for MySQL em um servidor Windows e em um servidor Linux (para a versão do OGG inferior a 23.10.x), que está em um host remoto do o servidor de banco de dados, certifique-se de que seus fusos horários sejam os mesmos e, caso contrário, use o parâmetro
SETENV(TZ)dentro do Extract e defina-o como o fuso horário do servidor de banco de dados.Para obter mais detalhes sobre o formato TZ, consulte o parâmetro SETENV no Guia de Referência de Parâmetros e Funções.
Consulte os seguintes links para referência:
https://learn.microsoft.com/en-us/cpp/c-runtime-library/reference/tzset?view=msvc-170#remarks
https://www.gnu.org/software/libc/manual/html_node/TZ-Variable.html
-
No sistema de origem, execute o seguinte comando:
EDIT PARAMS extract_nameOnde:
extract_nameé o nome do processo Extract criado com o comandoADD EXTRACTou o nome totalmente qualificado do arquivo de parâmetros se você tiver definido um local alternativo quando criou o grupo. -
Informe os parâmetros na ordem mostrada na tabela a seguir, iniciando uma nova linha para cada instrução de parâmetro. Alguns parâmetros se aplicam apenas a determinadas configurações.
Parâmetro Descrição EXTRACT group- group é o nome do grupo de Extract criado com o comando
ADD EXTRACT.
Configura a Extração como um processo on-line com checkpoints. [, USERIDALIAS alias options ]Consulte [USERIDALIAS](/pls/topic/lookup?ctx=en/database/goldengate/core/26/coredoc&id=GWURF-GUID-530D7773-B66D-4499-A509-EF5BB9CE9B05)para especificar credenciais do banco de dados.ENCRYPTTRAIL algorithmCriptografa todas as trilhas que são especificadas após esta entrada. SOURCECATALOGEspecifica um contêiner padrão em um banco de dados contêiner multitenant Oracle ou em instruções SEQUENCE. Permite o uso dos nomes de duas partes (schema.object) nos quais, caso contrário, os nomes de três partes seriam necessários para esses bancos de dados. Você pode usar várias instâncias desse parâmetro para especificar diferentes contêineres ou catálogos padrão para diferentes conjuntos de parâmetrosTABLEouSEQUENCE.TABLE [container. \| catalog.]owner.object \| schema.object \| library/file \| library/file(member);Especifica o nome totalmente qualificado de um objeto ou uma especificação com curinga totalmente qualificada para vários objetos. Se o banco de dados for um banco de dados contêiner multitenant da Oracle, o nome do objeto deverá incluir o nome do contêiner ou catálogo, a menos que
SOURCECATALOGseja usado.schemaé o nome do esquema ou um conjunto de esquemas com curinga.objecté o nome da tabela ou um conjunto de tabelas com curingas.libraryé o nome da biblioteca IBM i ou um conjunto de bibliotecas com curinga.fileé o nome do arquivo físico IBM i ou um conjunto de arquivos físicos com curinga.memberé o nome do membro do arquivo físico IBM i ou um conjunto de nomes de membro com curinga. Ao usar o formato de nome nativo IBM i (biblioteca/arquivo com membro opcional), os únicos curingas válidos são um nome com pelo menos um caractere válido seguido por um asterisco à direita (*) ou*ALLque corresponde a qualquer nome.
Observação:
O nome do membro é opcional e deve ser fornecido se for necessário que os nomes do membro sejam gravados na trilha como parte do nome do objeto. Sem nomes de membros, todos os membros de um arquivo físico serão implicitamente mesclados como um único objeto na trilha.Consulte Especificando Nomes de Objetos na Entrada do Oracle GoldenGate para especificar nomes de objetos em arquivos de parâmetros.
SCHEMAEXCLUDETABLEEXCLUDEEXCLUDEWILDCARDOBJECTSONLYParâmetros que podem ser usados em conjunto para excluir objetos específicos de uma especificação de curinga na instrução TABLEassociada. - group é o nome do grupo de Extract criado com o comando
-
Informe quaisquer parâmetros de Extract opcionais apropriados listados nos Parâmetros do Oracle GoldenGate.
-
Salve e feche o arquivo de parâmetros.
O arquivo de parâmetros Extract de amostra a seguir explica vários parâmetros e opções de configuração para Extract:
ADD EXTRACT *extract_name*
{, datasource}
{, BEGIN start_point} | {position_point}
[, PARAMS pathname]
[, REPORT pathname]
[, DESC 'description']-
extract_nameé o nome do grupo de Extract. Um nome de grupo é necessário. -
datasourceé necessário para especificar a origem dos dados a serem extraídos. Use uma das seguintes opções:-
TRANLOGespecifica o log de transação como a origem de dados. Ao usar essa opção para o Oracle Enterprise Edition, você deve emitir o comandoDBLOGINcomo o usuário do banco de dados Extract (ou um usuário com os mesmos privilégios) antes de usarADD EXTRACT(e também antes de emitirDELETE EXTRACTpara remover um grupo Extract).Use a opção bsds para Db2 z/OS para especificar o nome do arquivo Bootstrap Data Set do log de transação.
-
INTEGRATED TRANLOGespecifica que este Extract operará no modo de captura integrada para receber LCR (Logical Change Records, Registros de alteração lógica) de um servidor de logmining do Oracle AI Database. Esse parâmetro só se aplica a bancos de dados Oracle. -
EXTTRAILSOURCE trail_namepara especificar o nome relativo ou totalmente qualificado de uma trilha local.
-
-
BEGIN start_pointdefine um grupo Extract on-line estabelecendo um checkpoint inicial e um ponto inicial para processamento. As transações iniciadas antes deste ponto são descartadas. Use uma das seguintes opções: -
AGORA para começar a extrair as alterações que são marcadas pelo tempo no ponto em que o comando
ADD EXTRACTé executado para criar o grupo ou, para Extract no modo integrado, a partir do momento em que o grupo é registrado com o comandoREGISTER EXTRACT. A extração precisa ser registrada somente para bancos de dados Oracle e PostgreSQL.Timestamp: O formato para especificar um timestamp exato como ponto inicial. Use um ponto inicial que seja posterior ao momento em que a replicação ou o log foi ativado.
O exemplo a seguir mostra o reposicionamento do Extract usando um timestamp específico:
<pre class="copy"><code>OGG (http://localhost:11000 ggeast as pdb1@east.oracle.com) 95> dblogin useridalias ggma Successfully logged into database PDB1.</code></pre> <pre class="copy"><code>OGG (http://localhost:11000 ggeast as ggma@ggeast/PDB1) 96> alter extract exte , begin 2024-05-03T03:48:00Z 2024-05-03T03:50:49Z INFO OGG-08100 Extract exte I/O position is altered and reposition to older date and time position 2024-05-03 03:48:00.000000 current date and time position 2024-05-03 03:49:04.000000. Duplicate transactions are filtered out. Perform output trail ETROLLOVER if duplicate transaction output is desired, or Extract configuration was updated. 2024-05-03T03:50:49Z INFO OGG-08100 Extract altered.</code></pre> -
position_pointespecifica uma posição específica dentro de um arquivo de log de transação específico no qual o processamento será iniciado. Para a sintaxe específica a ser usada no banco de dados. -
O nome do caminho
PARAMSserá obrigatório se o arquivo de parâmetros deste grupo for armazenado em um local diferente do subdiretório dirprm do diretório do Oracle GoldenGate. Especifique o nome totalmente qualificado. O local padrão é recomendado. -
REPORT pathnameserá necessário se o relatório de processo deste grupo for armazenado em um local diferente do subdiretóriodirrptdo diretório do Oracle GoldenGate. Especifique o nome totalmente qualificado. O local padrão é recomendado. -
DESC 'description'especifica uma descrição do grupo.
Opções de Parâmetro Adicionais para Extração
Saiba mais sobre parâmetros adicionais que podem ser necessários para sua configuração do Extract.
O Extract usa um servidor de logmining de banco de dados no banco de dados de mining para minerar o fluxo de redo do banco de dados de origem. Você pode definir parâmetros específicos do servidor de logmining usando o parâmetro TRANLOGOPTIONS com a opção INTEGRATEDPARAMS no arquivo de parâmetros de Extract.
Observação: Para obter informações detalhadas e orientação de uso desses parâmetros, consulte a seção "DBMS_CAPTURE_ADM" em Referência de Tipos e Pacotes PL/SQL do Oracle AI Database.
Os seguintes parâmetros podem ser definidos com INTEGRATEDPARAMS:
-
CAPTURE_IDKEY_OBJECTS: Controla a captura de objetos que podem ser suportados peloFETCH. O padrão do Oracle GoldenGate éY(registros de alteração lógica da chave do ID de captura). -
DOWNSTREAM_REAL_TIME_MINE: Controla se o servidor de logmining opera como um processo de captura downstream de tempo real ou como um processo de captura downstream de log arquivado. O padrão éN(modo de log arquivado). Especifique este parâmetro para usar a captura em tempo real em uma configuração de servidor de logmining downstream. Para obter mais informações sobre como estabelecer uma configuração de mineração downstream, consulte Extração Downstream para Implantação do Oracle GoldenGate. -
INLINE_LOB_OPTIMIZATION: Controla se os LOBs que podem ser processados em linha (como LOBs pequenos) são incluídos no LCR diretamente, em vez de enviar LCRs de bloco LOB. O padrão do Oracle GoldenGate éY(Sim). -
MAX_SGA_SIZE: Controla a quantidade de memória compartilhada usada pelo servidor de logmining. A memória compartilhada é obtida do pool de streams da SGA. O padrão é 1 GB. -
PARALLELISM: Controla o número de processos usados pelo servidor de logmining. O padrão é 2. Para o Oracle Standard Edition, isso deve ser definido como1. -
TRACE_LEVEL: Controla o nível de rastreamento do servidor de logmining Extract. Para uso apenas com orientação do Oracle Support. O padrão do Oracle GoldenGate é0(sem rastreamento). -
WRITE_ALERT_LOG: Controla se o servidor de logmining Extract grava mensagens no log de alerta do sistema Oracle. O padrão do Oracle GoldenGate éY(Sim).
Consulte Gerenciando Recursos do Servidor.