18 关于代理工具
Oracle AI Data Platform 支持可配置为访问数据并满足使用场景需求的工具模板。
代理支持由单个代理组成的配置,该代理可以与一个或多个工具进行交互。AI Data Platform 提供了三个工具模板,这些模板可以配置为通过可视化流或代码使用:
- 定制代码:定制代码工具允许 AI 开发人员使用 Python 实施其工具。开发人员将其工具打包到 ZIP 中,将其上载到其工作区,并将其配置为代理中的节点。自定义代码工具适用于内置工具无法提供所需集成的情况。
- HTTP 请求:通过 HTTP 请求工具,开发人员可以利用 AI 数据平台 API 及其提供的功能,在其代理中使用支持的 REST API 调用。代理可以使用 REST API 创建工作区对象、检查详细信息、拉式列表或修改现有对象。有关可用 API 的完整列表,请参阅 REST API for Oracle AI Data Platform 。
- 提示:通过提示工具,AI 开发人员可以定义可向 LLM 发出的参数化提示供他们选择。提示工具的常见用例包括电子邮件起草任务、翻译任务、样式转换、git 提交消息和代码说明。
- RAG :借助 RAG 工具,座席可以在生成响应之前提取相关的外部知识。在 AI Data Platform 中,RAG 工具查询知识库 (26ai Vector Search),并检索语义相关的文档块。然后将这些块传递给代理以生成响应。
- SQL :使用 SQL 工具,代理可以对通过外部目录(例如 Oracle Autonomous AI Lakehouse 、Oracle Autonomous AI Transaction Processing 或 Oracle Autonomous AI Database )注册的结构化数据源执行 SQL 查询。该工具适用于预定义 SQL 查询并可以进行参数化的情况。目标是让代理为参数分配值。此工具不是基于自然语言提示生成 SQL 查询的 NL2SQL 工具。
注意:
SQL 工具仅对外部目录中的数据执行查询。它不支持存储在标准目录中的数据。
通过可视化流管理代理工具
通过可视化流向座席添加工具时,您可以在座席的工具模板下找到工具。通过将工具拖放到可视化流画布中,可以向座席添加工具。在画布上拖动工具节点后,该节点会自动与代理连接。
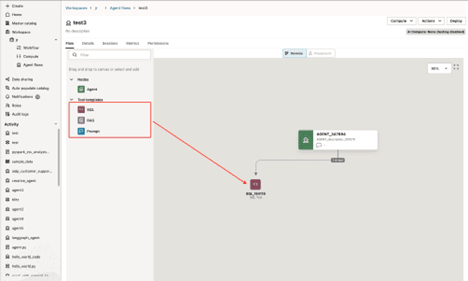
可以在“参数”选项卡中配置每个工具,并通过单击“测试”选项卡独立于代理进行测试。
注意:
必须先将 AI 计算附加到代理,然后才能测试系统工具。如果未附加计算,则禁用“Test(测试)”选项卡。代理工具通过 LangGraph 代码
您可以通过 AIDPToolConf() 类的实例向 LangGraph 编码的代理添加工具。
from aidputils.agents.toolkit.configs import AIDPToolConf
aidp_tool =  AIDPToolConf(name, description, tool_class, conf, params)
- 名称:用于帮助用户和 LLM 了解工具用途的描述性名称。
- 说明:为用户和 LLM 提供足够信息以了解工具的作用的全面汇总。
- tool_class:支持的工具类型:
PromptTool、SQLTool、RAGTool、HTTPTool和MCPTool。 - conf:工具配置。此信息在 LLM 中隐藏。
- params:暴露给 LLM 的参数。
定制工具
通过定制代码工具,座席开发人员可以使用自己的 Python 代码扩展 Oracle AI Data Platform 。
将工具实施打包为 ZIP 文件,将其上载到工作区,并将其配置为代理中的定制代码工具节点。代理使用 LLM 在运行时提供的参数将代码调用为工具。
定制代码工具适用于内置工具(HTTP、SQL、RAG、MCP)未涵盖所需的集成的情况,例如,当您需要执行本地计算、解析特定于域的格式或编写多个步骤时,这些步骤应以单个工具调用的形式显示在代理中。
在为定制代码工具上载 ZIP 文件时, AI 数据平台具有以下限制:
| 约束条件 | 限制 |
|---|---|
| 最大 ZIP 大小 | 10 MB |
| ZIP 中的最大文件大小 | 每个文件 10 MB |
| 最大未压缩总大小 | 500 MB |
| 遍历路径 | 已阻止(。。/已拒绝) |
注意:
定制代码工具在连接到代理的 AI 计算上运行。根据工作区网络配置,代码可以访问计算环境和出站网络访问。仅上传您信任的来源的代码。自定义代码工具参数
在“参数”选项卡上,为程序包中的每个工具类配置静态设置。使用“工具类”下拉列表可以在软件包中搜索到的工具之间切换。
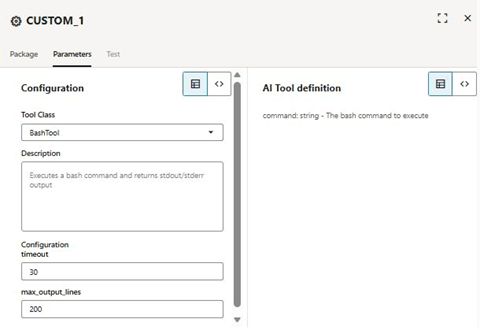
- 工具类:选择要配置的工具类。下拉列表从
tool_implementation.py中注册的类中填充。 - 说明:对工具的作用进行清晰简洁的说明。该说明将提供给代理,并帮助 LLM 决定何时调用该工具。缺省描述是从 tool_config.json 读取的,可以在此处覆盖。
- 配置:工具在运行时所需的静态设置。这些是在
tool_config.json的 conf 对象中定义的密钥。示例包括 timeout、base_dir、max_output_lines 和身份证明引用。配置值支持{{variable}}运行时参数引用。会话变量当前不会替换为定制工具配置;如果需要会话值,请将其作为代理的运行时参数传递。 - AI 工具定义:向代理公开的方案,包括代理可以传递的工具名称、说明和运行时参数。将从
tool_config.json中的方案数组自动呈现方案。
定制代码工具编写
定制代码工具包是具有以下结构的 ZIP 文件:
my_tool.zip
├── tool_implementation.py    # Required. Contains the tool class(es).
├── tool_config.json          # Required. Tool metadata and schema.
├── requirements.txt          # Optional. Python dependencies.
├── utils/                    # Optional. Helper modules.
│   ├── __init__.py
│   └── helpers.py
├── config/                   # Optional. Static configuration files.
│   └── settings.yaml
└── wheels/                   # Optional. Bundled wheel files for offline install.
    └── humanize-4.15.0-py3-none-any.whl
tool_implementation.py
每个工具类都扩展了 CustomToolBase,并使用 @BaseTool.register 进行装饰。该类必须实现 _execute_tool 类方法,该方法接收工具配置、代理的运行时参数和系统上下文变量,并返回一个值,如 dict、str 或 list。
下面是 tool_implementation.py 的空白示例模板:
"""Custom Code tool implementation."""
from aidputils.agents.tools.custom_tools.base import CustomToolBase


@BaseTool.register
class MyTool(CustomToolBase):
    """Brief description of what the tool does."""

    @classmethod
    def _validate_config(cls, conf, runtime_params, **context_vars):
        """Optional. Validate configuration before execution.
        Raise ValueError to abort the call.
        """
        # Example: require an api_key in the tool configuration
        if not conf.get("conf", {}).get("api_key"):
            raise ValueError("api_key is required")

    @classmethod
    def _execute_tool(cls, conf, runtime_params, **context_vars):
        """Required. Implement the tool logic.

        Args:
            conf: the AIDPToolConf dict. User configuration values
                live under conf["conf"] when the tool is invoked from
                a deployed agent. During a Test run the tool may
                receive a flat conf dict; the Developer Toolkit example
                below uses a small _get_cfg helper that tolerates both
                shapes.
            runtime_params: the runtime parameters passed by the
                agent at invocation time.
            context_vars: system context (such as datalake_id).

        Returns:
            Any value (dict, str, list, ...). It will be wrapped into
            the MCP response by the framework.

            To signal a failure, raise an exception:
              - ValueError -> INVALID_CONFIG
              - any other exception -> TOOL_EXECUTION_ERROR
            Do NOT return {"error": "..."}; the framework wraps a
            successful return in {"response": ..., "success": True},
            so a returned error dict is treated as a normal payload
            and the agent will not see it as a failure.
        """
        tool_conf = conf.get("conf", conf)
        param_value = runtime_params.get("my_param", "")
        # Tool logic here
        return {"output": f"Processed: {param_value}"}

    @classmethod
    def _transform_response(cls, response):
        """Optional. Transform the response before MCP formatting."""
        return response
tool_config.json
tool_config.json 文件描述了程序包中的工具—其显示名称、说明、版本、运行时参数模式和默认配置值。在 tool_implementation.py 中注册的每个工具必须在 tools 数组中有一个对应的条目。
tool_config.json 的空白示例模板:{
"displayName": "My Tool Package",
"description": "Brief description of the tool package.",
"tools": [
{
"toolClassName": "MyTool",
"displayName": "My Tool",
"description": "Clear description of when the agent should call this tool.",
"version": "1.0.0",
"schema": [
{
"name": "my_param",
"type": "string",
"description": "What this parameter is for."
}
],
"conf": {
"timeout": 30
}
}
]
}
模式字段类型
可视生成器中的“参数”选项卡接受字符串、数字和布尔值。运行时在手动编写 tool_config.json 时接受更宽的集合:int,integer,float,double,number,numeric,bytes,list,array,sequence,dict,map,mapping,set,tuple,none,null,plus general forms like list[int]。这些更广泛的类型可以从 JSON 中使用,但不会显示在 UI 下拉列表中。
要求 .txt
requirements.txt 文件列出了您的工具所需的 Python 依赖项。支持标准 pip 语法,包括版本说明符和注释。该文件是可选的—如果您的工具仅使用 Python 标准库或预安装的软件包,则不需要 requirements.txt。
以下是 requirements.txt 的空白示例:
# List third-party dependencies one per line.
# Examples:
# humanize>=4.0
# python-dateutil>=2.8,<3.0
# beautifulsoup4==4.12.3
AI Data Platform 可在将依赖项安装到 AI 计算上之前过滤 requirements.txt 中的依赖项,以防止运行时与平台本身发生冲突。筛选规则如下:
| Category | 范例 | 操作 |
|---|---|---|
| 平台包 | langgraph, langchain-core, langchain-oci, langchain_mcp_adapters, pyyaml | 已放弃(将中断代理运行时)。 |
| 预安装的软件包 | oci, requests, request-toolbelt, websocket, cryptography, certifi, pyopenssl, urllib3, pydantic, pydantic-core, pydantic-settings, numpy, oracledb, sqlalchemy, aiohttp, httpx, httpx-sse, anyio, jsonschema, orjson | 已跳过(已可用,无需声明)。 |
| URL 或 VCS 安装 | git+https://...,-e./local_pkg | 已拦截(安全)。 |
| 其他所有内容 | 人性化,美味汤 4,jmespath | 已安装。 |
注意:
在requirements.txt 中声明的依赖项在代理的完全部署期间安装。在从配置面板运行单个测试期间,不会安装相关项。如果您的工具依赖于第三方软件包,请先部署代理,然后从 Playground 练习该工具。
对于需要未预安装的依赖项且确定性(脱机安装很重要)的工具,可以将 .whl 文件捆绑在 ZIP 根目录下的轮子/目录中。该平台首先从本地轮目录安装,仅在需要时回退到软件包索引。这是针对生产工具的建议方法。
用于脱机安装的捆绑轮
pip download \
  --dest wheels/ \
  --platform manylinux_2_28_x86_64 \
  --python-version 3.11 \
  --only-binary=:all: \
  -r requirements.txt
工具生命周期挂钩
定制代码工具支持三种生命周期方法。仅需要 _execute_tool。
| 方法 | 调用时 | 用途 |
|---|---|---|
| _validate_config | 执行前 _tool | 验证配置。引发 ValueError 以在调用运行之前中止调用。 |
| 执行工具 (_E) | 在每次工具调用时 | 必需。实现工具的行为。返回任何值 (dict,str,list),并引发异常以指示失败(ValueError → INVALID_CONFIG,任何其他异常→ TOOL_EXECUTION_ERROR)。不要使用返回的 {"error":"..."} 指令,因为它被视为正常的有效负载。 |
| _transform_response | 执行后 _execute_tool | 转换响应,然后将其包装为 MCP 格式并返回给代理。 |
| 提示 _ 模板 | string | LLM 使用的提示模板,变量采用 {{variable}} 格式进行动态插入 |
配置值与运行时参数
自定义代码工具有两种不同的输入来源,很容易混淆。配置值来自“参数”选项卡的“配置”部分,在部署代理时会被烘焙到工具中。运行时参数在调用时来自代理,在每次调用时都不同。
- 配置值通过 conf.get("conf",conf) 访问。将它们用于在调用之间不发生更改的事情 - 基本 URL、身份证明引用、超时和输出限制。
- 运行时参数可通过 runtime_params.get("name") 访问。使用它们表示代理在呼叫时实际决定的值 - 查询、文件路径和请求正文。
注意:
配置值可以传递模板替代,即使您将其定义为数字,也可以作为字符串到达。始终以防御方式强制执行数字配置值,例如:int(tool_conf.get("timeout", 30))。
每个程序包多个工具
一个 ZIP 可以包含多个工具类。在 @CustomToolBase.register 中注册的每个类都将成为代理中的单独工具。"Package"(程序包)选项卡上的 "Tools"(工具)面板列出了搜索到的所有工具,并允许您单独启用每个工具。每个工具都通过“工具类”下拉列表在“参数”选项卡上单独配置。
代码工具通过 LangGraph 代码
在代码构建器中,通过 helppUtils Python 库注册定制代码工具,方法是引用上载的软件包并选择其工具类之一。
from aidputils.agents.toolkit.tool_helper import create_langgraph_tool
 from aidputils.agents.toolkit.configs import AIDPToolConf

hello_tool_conf = AIDPToolConf(
     name="hello_tool",
     description="Returns a hello world greeting.",
     tool_class="HelloTool",  # the class registered with @BaseTool.register
     conf={},                  # values from tool_config.json "conf"; supports {{variable}} substitution
     params=[
         {"name": "name", "type": "string",
          "description": "Name to greet."}
     ],
 )

hello_tool = create_langgraph_tool(hello_tool_conf.model_dump())
tool_class 必须是通过 @BaseTool.register 在 tool_implementation.py 中注册的确切类名。框架在 BaseTool.tool_class_registry[tool_class] 中查找类。conf 镜像了 tool_config.json 中匹配项的 conf 对象。
注意:
请勿将package_path 或 tool_class_name 放在 conf 中,因为不会使用它们。
测试代理自定义代码工具
通过测试选项卡,您可以在不运行完整代理的情况下执行工具。为配置中引用的任何运行时参数和任何会话变量提供值,然后单击“Run(运行)”以调用工具并查看响应。
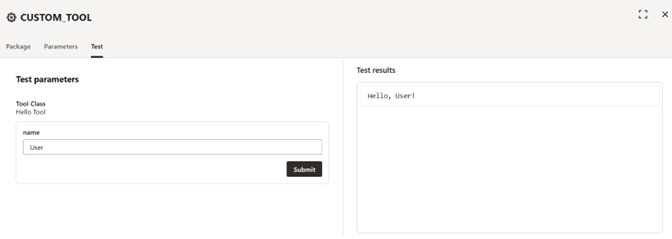
注意:
如果您的工具依赖于requirements.txt 中声明的第三方软件包,则依赖项会在代理的完全部署期间安装,而不是在单个测试运行期间安装。要测试依赖于其他软件包的代码,请先部署代理,然后从 Playground 调用该工具。
将定制工具添加到代理
您可以向代理添加定制工具,以允许您使用自己的 Python 代码扩展 Oracle AI Data Platform 。
注意:
在添加定制代码工具之前,必须将 AI 计算附加到代理。需要使用 AI 计算来安装依赖项并运行该工具。- 在程序包选项卡中,单击以选择包含定制代码的 ZIP 文件,或者将其拖放到屏幕上。等待上载完成。
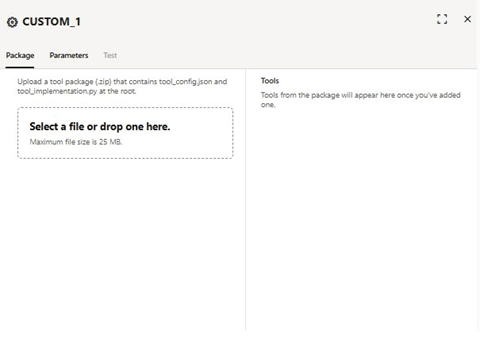
- 在 "Package"(软件包)选项卡的 Tools(工具)部分中查看搜索到的工具列表。将列出在
tool_implementation.py中找到的每个工具类及其类名称、说明和版本。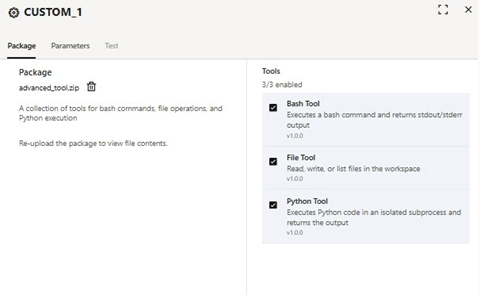
- 可选:单击测试选项卡。提供测试参数,然后单击提交。在测试结果窗格中查看测试结果。
远程 MCP 服务器工具
代理开发人员可以使用远程 MCP 服务器工具将其代理流连接到远程模型上下文协议 (MCP) 服务器。
MCP 工具既可用于可视化构建器,也可用于代码构建器体验。在代码构建器体验中,可以通过 helppUtils Python 库配置 MCP 连接。在本部分中,我们将介绍可视化构建器和代码构建器的体验。
注意:
此功能支持具有 HTTP 可流传输(远程服务器)的 MCP 服务器。不支持本地 stdio-transport MCP 服务器。Oracle AI Data Platform 身份证明存储中的 MCP 身份证明
配置 MCP 服务器时,需要选择远程 MCP 服务器是需要 No Authentication 还是需要 Bearer token 。如果您的 MCP 服务器需要验证令牌,则需要将该令牌添加到您的身份证明存储中,然后 MCP 服务器才能引用该令牌。
创建 MCP 服务器凭证时,为凭证类型选择秘密令牌选项,然后提供标识符密钥,例如 API 密钥和令牌值。有关详细信息,请参阅创建身份证明(预览)。
注意:
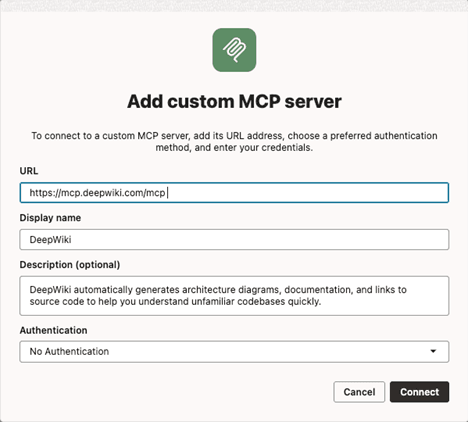
一个凭证可以存储多个密钥。公开可用的 MCP 服务器不需要额外的验证。例如,连接到 https://mcp.deepwiki.com/mcp 将如下所示:
如何向代理公开 MCP 工具
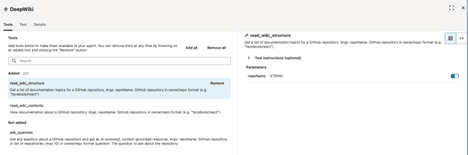
与远程 MCP 服务器建立成功连接后,您可以开始配置要向代理公开的服务器上托管的工具。对于 DeepWiki MCP 服务器,MCP 服务器配置面板如下所示。
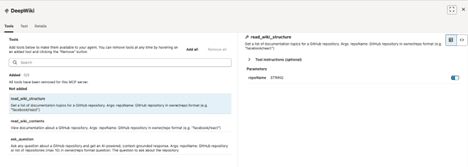
在左侧,"Tools"(工具)选项卡显示 MCP 服务器中可用的工具列表。您必须添加工具才能将其公开给代理。您可以通过单击全部添加选项一次公开所有工具或通过单击每个工具添加选项单独选择工具的子集来执行此操作。
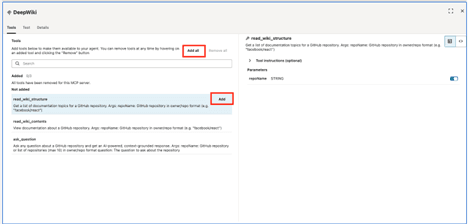
在下面的示例中,我们添加了两个工具(read_wiki_structure、read_wiki_structure)。您可以通过单击删除来删除工具。
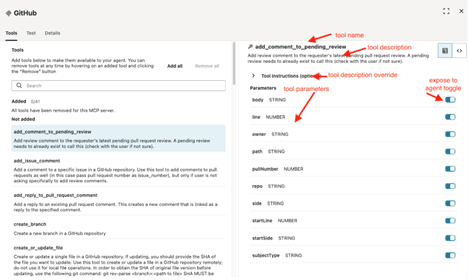
“工具”选项卡的右侧面板提供有关每个工具的文档,包括工具名称、工具说明以及工具参数。在下面的屏幕截图中,我显示了 GitHub MCP 服务器工具 add_comment_to_pending_review 的示例。
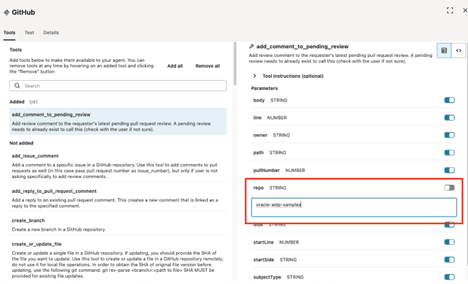
AI Data Platform 为每个工具提供了几个额外的控制措施。您可以从代理中隐藏参数并为这些参数分配值。例如,在 GitHub 中,您可以选择让代理仅对一个预先确定的存储库(例如 oracle-aidp-samples)进行注释。要实现此目的,请禁用 repo 参数并在文本框中指定默认值:
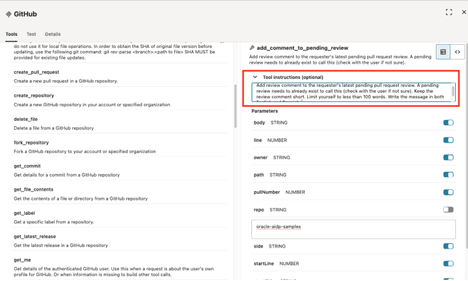
在工具说明字段中,您还可以覆盖工具说明并提供其他说明的替代说明。对于大多数用例,我们建议您采用 MCP 服务器提供的说明。
通过 LangGraph 代码远程 MCP 服务器工具
aidpUtils Python 库为开发人员提供了选择远程 MCP 服务器并将其工具的子集暴露给使用 LangGraph 构建的代理的功能。有关 helpputils API 的参考信息,请参阅 Aidp-utils API for Oracle AI Data Platform 。
您可以通过创建 build_structured_tools_from_allowed_mcp_tools 的实例来构建允许的工具集合:
from aidputils.agents.toolkit.tool_helper import build_structured_tools_from_allowed_mcp_tools

TOOLS = build_structured_tools_from_allowed_mcp_tools(
allowed_tools=<ALLOWED_MCP_TOOLS>,
	server_name=<MCP_SERVER_NAME>,
	endpoint=<MCP_ENDPOINT>,
	transport="streamable_http",
	auth=<MCP_AUTH>,
	headers={}
)- <MCP_SERVER_NAME> 是您要提供给 MCP 服务器的显示名称。这用于文档记录,不会向代理公开。
- <MCP_ENDPOINT> 是 MCP 服务器的端点(例如 https://api.githubcopilot.com/mcp/)
- <MCP_AUTH> 是包含关键字 "authType" 的字典。此键可以采用两个值:
NO_AUTH或BEARER_TOKEN。对于BEARER_TOKEN,需要使用另一个密钥:具有 Bearer 令牌值的“令牌”。 - <ALLOWED_MCP_TOOLS> 是要向代理公开的 MCP 服务器中的工具的列表。每个工具都需要遵循 MCP 协议的完整 JSON 工具定义。
示例如下:
MCP_SERVER_NAME = "test_mcp"
MCP_ENDPOINT = "http://144.25.36.217:9301/mcp"
MCP_AUTH = { "authType": "BEARER_TOKEN", "token": "valid-123" }

{
  "ALLOWED_TOOLS": [
    {
      "tool": {
        "name": "get_current_weather",
        "description": "Get current weather for a given city with advanced options.",
        "inputSchema": {
          "type": "object",
          "properties": {
            "city": {
              "type": "string"
            },
            "unit": {
              "type": "string",
              "default": "metric"
            },
            "include_historical": {
              "type": "boolean",
              "default": false
            },
            "detailed": {
              "type": "boolean",
              "default": true
            },
            "timeout": {
              "type": "integer",
              "default": 30
            }
          },
          "required": [
            "city"
          ]
        }
      },
      "instruction": "",
      "argOverrides": {}
    },
    {
      "tool": {
        "name": "get_forecast",
        "description": "Get forecast for a given city with customizable options.",
        "inputSchema": {
          "type": "object",
          "properties": {
            "city": {
              "type": "string"
            },
            "days": {
              "type": "integer",
              "default": 5
            },
            "unit": {
              "type": "string",
              "default": "metric"
            },
            "include_alerts": {
              "type": "boolean",
              "default": false
            },
            "detailed": {
              "type": "boolean",
              "default": true
            },
            "hourly": {
              "type": "boolean",
              "default": false
            }
          },
          "required": [
            "city"
          ]
        }
      },
      "instruction": "",
      "argOverrides": {}
    }
  ]
}

MCP_HEADERS = {}
TOOLS = build_structured_tools_from_allowed_mcp_tools( allowed_tools=ALLOWED_TOOLS,
	server_name=MCP_SERVER_NAME,
	endpoint=MCP_ENDPOINT,
	transport="streamable_http",
	auth=MCP_AUTH,
	headers=MCP_HEADERS,
)
然后,在类代理定义的 setup() 方法中使用 langchain.agent create_agent 创建代理实例时,可以使用 TOOLS 对象:
def setup(self):
    logger.info("Initializing TestMcpAgent")

    oci_llm = init_oci_llm(llm_conf)

    system_prompt = textwrap.dedent(
        """
        You're a weather agent. Append 12345 to every response.
        """
    ).strip()

    self.agent = create_agent(
        name="test_mcp_high_code",
        model=oci_llm,
        tools=TOOLS,
        system_prompt=system_prompt,
        debug=True,
    )

    logger.info("Agent ready.")
或者,如果使用会话变量来存储 Bearer 令牌的值,则可以将对以前创建的会话变量的引用分配给 auth 配置字典的令牌密钥。例如:
test_mcp_auth_config = { "authType": "BEARER_TOKEN", "token" : "{{sessionvariables.cred.mcp.test_mcp.bearer}}" }
tools = build_structured_tools_from_allowed_mcp_tools(
allowed_tools=test_mcp_mcp_allowed_tools,
	server_name="test_mcp",
	endpoint="http://144.25.36.217:9301/mcp",
	transport="streamable_http",
	auth=test_mcp_mcp_auth_config,
	headers={}
)
远程 MCP 服务器工具的代码示例
我们为 AI Data Platform Samples GitHub Repository 中的多个 MCP 场景提供端到端代码示例。
测试远程 MCP 服务器工具
选择工具后,下一步通常是测试单个工具,以确保它们按预期运行。这可以通过 MCP 工具节点的 "Test"(测试)选项卡完成。
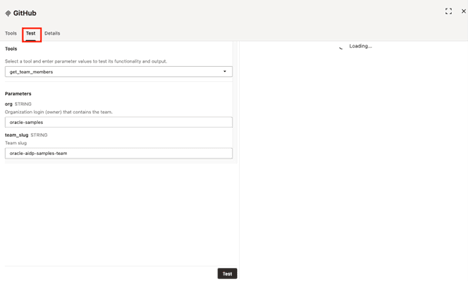
选择在“Tools(工具)”选项卡中添加的工具之一,提供参数值并单击“Test(测试)”按钮。
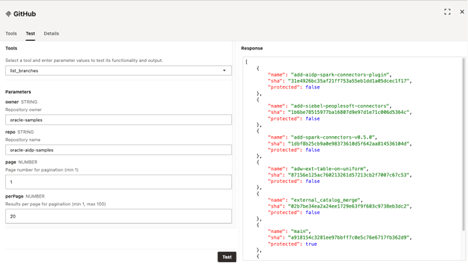
工具的输出将显示在右侧面板中。
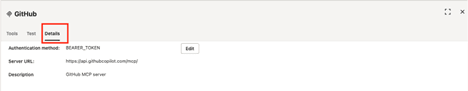
“详细信息”选项卡提供有关验证方法、MCP 服务器 URL 和说明的信息。
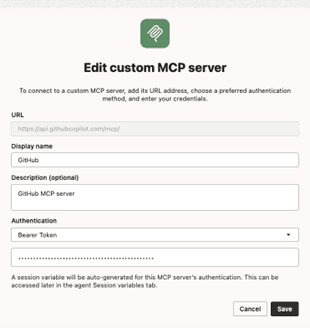
通过验证方法旁边的“Edit(编辑)”按钮,可以修改远程 MCP 工具节点的配置。您可以更改在建立连接时使用的显示名称、说明和 Bearer 标记:
将代理从 Visual Builder 连接到远程 MCP 服务器
通过将定制 MCP 服务器工具节点拖动到画布中,可以向代理添加对远程 MCP 服务器的访问权限。
注意:
托管代理的 AI 计算将继承其工作区的网络设置。如果为托管 AI 计算的工作区启用专用网络访问,则代理只能访问托管在所选专用 VCN 和子网中的 MCP 服务器。您的代理可能无法访问公共互联网上可用的远程 HTTP 服务器。- 导航到您的代理。
- 在流选项卡的工具模板下,单击 Custom MCP server(定制 MCP 服务器)并将其拖到画布上。
- 提供 MCP 服务器的服务器 URL。
- 为 MCP 服务器提供显示名称。这是可视化构建器画布中显示的节点的名称。
- 可选:为 MCP 服务器提供说明。未向代理提供说明字段。
- 从 Authentication(验证)下拉菜单中,选择一个验证方法。
- 无验证:如果远程 MCP 服务器公开可用并且不需要验证,则使用此选项。
- Bearer 标记:如果远程 MCP 服务器需要验证标记,则使用此选项。必须将 API 密钥存储在 Oracle AI Data Platform 身份证明存储中并提供对身份证明存储条目的引用。
- 单击连接。AI Data Platform 测试连接并报告结果。
HTTP 请求工具
通过 HTTP 请求工具,您的代理可以调用任何 HTTPS REST API。
您可以配置请求,包括方法、URL、标头、查询参数、请求正文、验证以及(可选)响应优化步骤。然后,代理在运行时调用端点。HTTP 请求工具在可视化构建器和代码构建器中都可用。在代码构建器中,该工具通过 helppUtils Python 库进行配置。
注意:
HTTP 请求工具仅支持 https:// 和 HTTP:// 请求。不支持 WebSocket 连接 (ws/wss)、二进制文件上载和自签名证书。注意:
托管代理的 AI 计算将继承其工作区的网络设置。如果为托管 AI 计算的工作区启用专用网络访问,则代理将仅访问所选专用 VCN 和子网中的 HTTP 端点。您的代理无法访问公共 Internet 上可用的端点。配置 HTTP 请求工具时必须提供以下设置:
| 配置 | 说明 |
|---|---|
| HTTP 方法 | 要使用的 HTTP 动词。支持的方法包括 GET、POST、PUT、PATCH 和 DELETE。 |
| URL | 目标端点的完整 URL。URL 支持 {{sessionVariables.variable_name}} 会话变量引用和 {{variable}} 运行时参数引用。例如:https://api.example.com/users/{{user_id}}/orders。
|
| 超时 | 工具等待来自远程端点的响应的最长时间。默认值为 30 秒,最大值为 300 秒。 |
| 验证类型 | 调用端点时要使用的验证方法。有关支持的验证方法的列表,请参见下面的 "Authentication"(验证)部分。 |
注意:
定制代码工具在连接到代理的 AI 计算上运行。根据工作区网络配置,代码可以访问计算环境和出站网络访问。仅上传您信任的来源的代码。标头
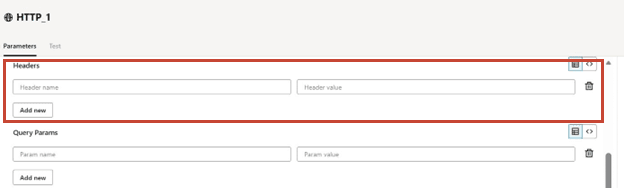
标头是随 HTTP 请求发送的键 - 值对。您可以根据需要单击“Add new(添加新)”按钮来添加任意多个标题。标头值可以使用 {{variable_name}} 语法引用会话变量和运行时参数。
注意:
对于敏感标头,应使用 "Authentication type"(验证类型)字段来确保从身份证明存储安全地注入身份证明。授权、Cookie 和 X-API-Key 是敏感标头,无法通过标头部分进行设置。查询参数
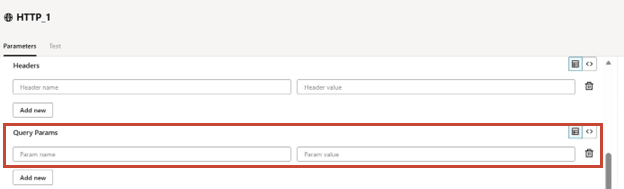
查询参数作为查询字符串附加到 URL。您可以根据需要单击“添加新”按钮来添加任意数量的查询参数。与标题一样,查询参数值可以引用会话变量和运行时参数。
说明
描述字段描述工具的作用、应该何时使用以及它产生的输出或效果。该说明将提供给代理,并帮助 LLM 决定何时调用该工具。
- • 目的:用一个清晰的句子说明工具的设计目的。示例:“此工具从知识库中检索客户支持请求单,并按优先级进行汇总。”
- 何时使用它:描述代理应调用此工具与调用其他工具的条件。
- 输入和输出:简要描述工具所需的参数及其返回内容的形状。
HTTP 请求验证
HTTP 请求工具支持多种验证方法。从 "Authentication type"(验证类型)下拉列表中选择相应的方法。
| 验证类型 | 说明 |
|---|---|
| 无验证 | 未向请求添加验证。可将其用于可公开访问的端点。 |
| OCI 资源主体 | 该请求使用 AI 计算的 OCI 资源主用户进行签名。调用 OCI 服务(例如对象存储或 OCI Generative AI 服务)时使用此功能。访问受 OCI IAM 策略监管。 |
| 基本验证 | 用户名和密码在 Authorization 标头中编码和发送。身份证明必须存储在身份证明存储中。 |
| Bearer 令牌 | 在 Authorization 标头中发送一个 Bearer 标记。标记必须存储在身份证明存储中。 |
| 标头验证 | API 密钥在定制标头(例如 X-API-Key)中发送。标头名称是可配置的,密钥值必须存储在身份证明存储中。 |
选择需要密钥的验证方法时,配置面板将显示凭证选择器。单击身份证明选择器以选择以前存储的身份证明,或者从身份证明存储创建新身份证明。有关分步过程,请参见 MCP 服务器文档的 "Credential Store"(身份证明存储)部分中的 "Storing a credential"(存储身份证明)。
会话变量和运行时参数
可以使用 {{sessionVariables.variable_name}} 语法在 URL、标题值、查询参数值和请求正文中引用会话变量。可以使用 {{variable_name}} 语法引用代理在调用时传递的运行时参数。
https://objectstorage.{{sessionVariables.region}}.oraclecloud.com/n/my-namespace/b/{{bucket}}/o该工具运行时,{{sessionVariables.region}} 将替换为当前会话的区域会话变量的值,{{bucket}} 将替换为调用时传递的代理值。
注意:
模板值在替换为 URL 或查询参数时会自动编码 URL。您不需要自己对它们进行 URL 编码。AI 工具定义
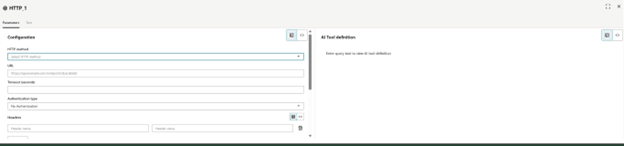
配置面板的右侧显示了 AI 工具定义。这是向代理公开的方案,它包括工具名称、说明和代理在调用工具时可以传递的运行时参数列表。AI 工具定义是从 "Description"(说明)字段和 URL、标题、查询参数和正文中检测到的 {{variable}} 占位符自动生成的。
AI 工具定义窗格是本文档前面显示的 HTTP 工具配置面板右侧的面板。在您提供说明并定义至少一个运行时参数之前,AI 工具定义窗格会显示占位符消息。在 URL、标题、查询参数或正文中填写说明并引用至少一个 {{variable}} 后,将在窗格中呈现方案。
优化代理的响应
许多 API 返回大量响应,其中包含代理不需要的字段。将整个响应发送回代理会使用令牌,并且可能会降低代理推理的质量。HTTP 请求工具提供了一个响应优化部分,允许您在将响应有效负载返回到代理之前减少响应有效负载。
- JSON 字段选择:从 JSON 响应中选择字段的子集。您可以使用点表示法(例如 data.results)和要包括或排除的字段列表来指定嵌套对象的路径。
- HTML CSS 选择器:使用 CSS 选择器(例如 article.content)提取 HTML 响应的子集。(可选)条带化 HTML 标记以仅返回文本。
- 文本截断:将响应上限设置为最大字符数,以防止文本响应过大。
错误处理和错误代码
HTTP 请求失败时,该工具将向代理返回结构化错误响应。该错误包括错误代码、用户可读消息以及有关失败的详细信息。代理可以使用此信息来决定是重试、回退到其他工具,还是向用户报告故障。
| 错误代码 | Category | 含义 | 可重试 |
|---|---|---|---|
| CONNECTION_TIMEOUT | 网络图 | 远程端点在配置的超时内未响应。 | 是 |
| DNS 失败 | 网络图 | 无法解析 URL 中的主机名。 | 是 |
| CONNECTION_REFUSED | 网络图 | 远程端点拒绝了连接。 | 是 |
| SSL_CERTIFICATE_ERROR | TLS | 无法验证远程端点的 TLS 证书。 | 无 |
| 未授权 | HTTP 401 | 远程端点拒绝了凭证。验证身份证明引用是否有效且未过期。对于 OCI 资源主用户,请确认 AI 计算在此环境中具有活动的资源主用户。 | 无 |
| 禁止 | HTTP 403 | 身份证明已成功验证,但缺少所请求资源的权限。验证附加到资源的 API 范围、权限或 IAM 策略。 | 无 |
| 未找到 | HTTP 404 | 远程端点找不到请求的资源。 | 无 |
| RATE_LIMITED | HTTP 429 | 远程端点限制调用者的速率。在 Retry-After 标头指示的延迟之后重试。 | 是 |
| 服务器出错 | HTTP 5xx | 远程端点返回了服务器错误。通常是一个短暂的问题。 | 是 |
| 服务 - 不可用 | HTTP 503 | 远程端点暂时不可用。 | 是 |
| INVALID_TEMPLATE | 验证 | 无法解析 {{variable}} 引用。验证每个引用的会话变量和运行时参数是否已定义并在调用时具有值。
|
无 |
| 无效 _URL | 验证 | URL 格式错误,使用不受支持的协议,或解析为阻止的地址(例如专用 IP 地址或云元数据端点)。 | 无 |
| 响应太大 | 验证 | 响应超过了最大响应大小 10 MB。 | 无 |
| 超出速率限制 | 平台 | 代理已超过平台的每代理请求速率限制(每分钟 60 个请求)或并发限制(10 个并发请求)。 | 是 |
每个错误响应都包括一个包含建议下一步的指导字段,以及一个包含所用时间和任何特定于错误的上下文(例如 HTTP 状态代码)的详细信息字段。
通过 LangGraph 代码发送 HTTP 请求工具
从代码构建器中,通过 helppUtils Python 库配置 HTTP 请求工具。定义 AIDPToolConf,将 tool_class 设置为 HttpEndpointTool ,并在 conf 字段中传递配置字典。
from aidputils.agents.toolkit.tool_helper import create_langgraph_tool
from aidputils.agents.toolkit.configs import AIDPToolConf

weather_http_tool_def = {
    "method": "GET",
    "url": "https://api.openweathermap.org/data/2.5/weather",
    "params": {
        "q": "{city}",
        "units": "metric",
        "appid": "{api_key}"
    },
    "auth_type": "NO_AUTH",
    "auth_config": {}
}

weather_http_tool_params = [
    {"name": "city", "type": "string",
     "description": "Name of the city."},
    {"name": "api_key", "type": "string",
     "description": "OpenWeather API key."}
]

weather_http_tool_conf = AIDPToolConf(
    name="get_weather",
    description="Get current weather for a city.",
    tool_class="HttpEndpointTool",
    conf=weather_http_tool_def,
    params=weather_http_tool_params
)

weather_tool = create_langgraph_tool(weather_http_tool_conf.model_dump())
conf 字典支持与可视化构建器相同的字段:method,url,headers,params,body,auth_type,auth_config 和 response_optimization。参数列表定义代理可以传递的运行时参数。
| auth_type | auth_config 字段 |
|---|---|
| NO_AUTH | {}(空)
|
| RESOURCE_PRINCIPAL | {}(空)
|
| BASIC_AUTH | 用户名、密码(或用于 OCI Vault 中身份证明的用户名 _vault_id、密码 _vault_id) |
| BEARER_AUTH | bearer_token(或 bearer_token_vault_id) |
| API_KEY_AUTH | api_key(或 api_key_vault_id),header_name(默认的 X-API-Key) |
| OAUTH2_CLIENT_CREDENTIALS | token_endpoint,scope,client_id,client_secret(或 client_id_vault_id,client_secret_vault_id) |
测试代理自定义代码工具
通过测试选项卡,您可以在不运行完整代理的情况下执行工具。为配置中引用的任何运行时参数和任何会话变量提供值,然后单击“Run(运行)”以调用工具并查看响应。
响应面板显示 HTTP 状态代码、响应标头、响应主体和用时(以毫秒为单位)。如果启用了响应优化,则优化响应也会与原始响应一起显示。
将 HTTP 请求工具添加到代理
您可以向代理添加 HTTP 请求工具,以允许您调用 HTTPS REST API。
注意:
在添加定制代码工具之前,必须将 AI 计算附加到代理。需要使用 AI 计算来安装依赖项并运行该工具。- 从工具模板中,将 HTTP 请求工具拖放到画布中。
- 为 HTTP 请求提供标头。单击添加新项以添加其他标题。
- 为 HTTP 请求提供任何查询参数。单击添加新参数以添加其他参数。
- 可选:单击测试选项卡。提供测试参数,然后单击提交。在测试结果窗格中查看测试结果。
提示工具
提示工具允许您使用模板化提示在 AI 代理中调用 LLM,并将 LLM 响应返回给代理。
您提供给 LLM 的提示可以包含由双括号标识的参数,例如 {{PARAMETER_NAME}}。调用工具时,代理会分配参数值。
注意:
提示模板仅替换双括号占位符:{{param_name}}表示runtime_params中的值{{sessionvariables.<name>}}表示会话变量
{name} 将以文字文本形式发送到模型,不会引发错误。这是有意的,因此提示中的文字大括号(例如,在 JSON 示例中)会被保留。
何时使用提示工具
- 您的提示很长,需要包含多个 100 个令牌的详细格式说明。
- 在代理指令中加入提示将增加上下文使用并显着增加成本,特别是如果一个为代理采用 SOTA LLM。
- 人们希望最大限度地减少给代理的指令的大小,以降低成本。
- 提示工具定义的任务可以由比使用代理的推理模型更小、更快的 LLM 来处理。较小的模型通常具有成本效益,在某些情况下,可以专门用于以特定方式或格式生成数据。
- 提示工具允许结构化输入参数来控制输出生成。如果您的用例可以进行参数化,并且生成会因会话而异,则将生成封装在提示工具中是有意义的。
此外,在提示工具中封装生成指令遵循许多现代代理架构优秀实践,包括工具可重用性、可维护性、模式、输出一致性、可扩展性和治理。一些示例用例包括:
- 在可作为模板的预定义、批准的结构之后生成电子邮件、报表、摘要、文章等
- 生成复杂的 JSON 输出
- 摘要、关键句子提取、文档解释任务
- 查询生成
- 针对特定模型优化的特定模式生成(例如图像、视频、音频、点云数据等)
通过可视化流提示工具
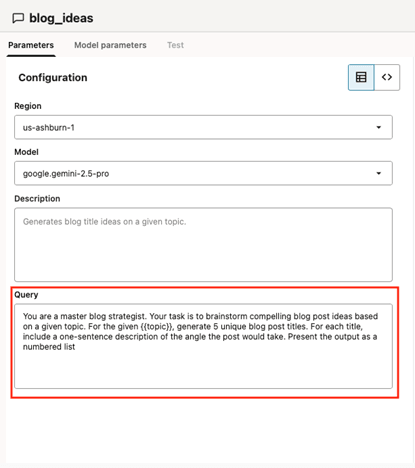
以下是通过可视化流构建的提示工具的示例,该工具要求 LLM 根据代理分配的主题生成博客帖子标题:
您是一位博客策略师。你的任务是基于一个给定的主题进行头脑风暴引人注目的博客文章的想法。对于给定的 {{topic}},生成 5 个唯一的博客文章标题。对于每个标题,包括对帖子将采用的角度的一句话描述。以编号列表形式显示输出。
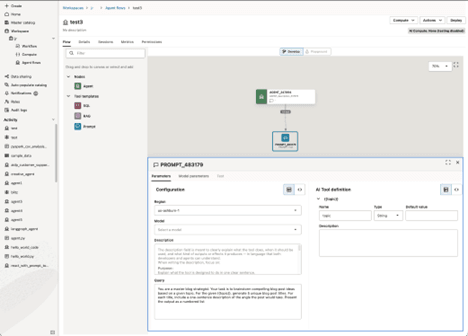
- 工具名称:使用工具的说明性名称来帮助指导代理。在本示例中,我们建议使用
blog_ideas。避免使用工具 123 等无益的名称。
- 工具说明:提供工具执行的操作的全面说明。如果工具存在限制,或者存在不应使用该工具的情况,请在说明字段中列出这些限制。
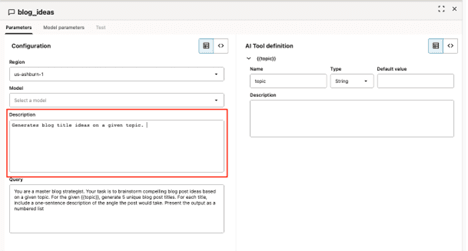
- OCI 区域和生成式 AI 服务 LLM:选择 OCI 区域以填充该区域中可用的 LLM 列表,然后选择您的 LLM。
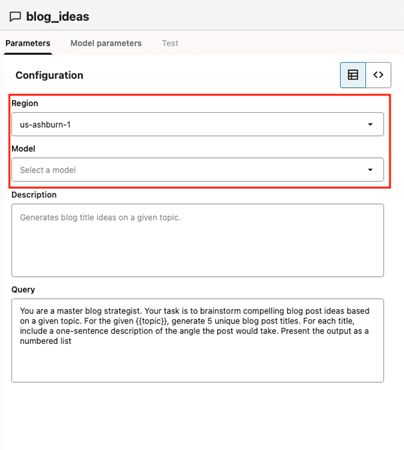
- LLM 参数:在 Model Parameters 选项卡中配置了最大输出标记、温度和顶部 p 等参数。如果未分配值,则使用 OCI Generative AI 服务的默认值。
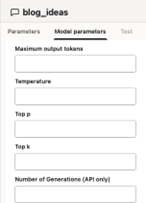
- 查询:用于定义工具用途的提示在查询字段中定义。
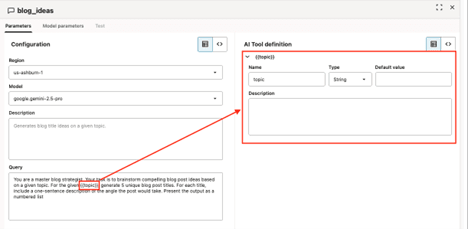
在提示中定义的参数会自动填充 AI Tool 定义面板。向代理提供每个参数的说明,以及参数类型和默认值(如果适用)。
通过 LangGraph 代码提示工具
如果要通过代码构建代理,则可以在可视流示例中配置相同的提示工具,如下所示:
prompt_config = {
  "llm": {
    "model_id" : "xai.grok-4",
    "model_provider" : "generic",
    "compartment_id" : "<your-compartment-ocid>",
    "endpoint" : "https://inference.generativeai.<oci-region>.oci.oraclecloud.com"
  }, "prompt_template": """
You are a master blog strategist. Your task is to brainstorm compelling blog post ideas based on a given topic. For the given {{topic}}, generate 5 unique blog post titles. For each title, include a one-sentence description of the angle the post would take. Present the output as a numbered list"
"""
}
prompt_params = [ {
  "name" : "topic",
  "type" : "string",
  "description" : "Blog topic",
  "defaultValue" : "golf"
} ]
然后,按如下方式实例化 AIDPToolConf:
blogger_tool = AIDPToolConf(name="blog_posts_topics",
                                  description= "Write blog posts ideas about a particular topic. ",
                                  tool_class = "PromptTool", conf=prompt_config params=prompt_params)
最后,使用辅助工具中的 create_langgraph_tool() 实用程序函数创建 LangGraph 兼容工具:
from aidputils.agents.toolkit.tool_helper import create_langgraph_tool
blogger = create_langgraph_tool(blogger_tool.model_dump())
将新创建的工具添加到 ReAct 代理。在 LangGraph 中,代码如下所示:
tools_agent1 = [blogger_tool]
self.agent = create_react_agent(model=<oci_llm>,
				     tools=tools_agent1,
				     prompt=<system_prompt>,
				     debug=True, checkpointer= checkpointer)
表 18-1 提示工具配置属性
| 属性 | 类型 | 说明 |
|---|---|---|
| LLM | 对象 | LLM 连接详细信息和参数 |
| model_id | string | 要使用的模型的标识符(例如 "xai.grok-4") |
| model_provider | string | LLM 模型的提供程序名称(例如,“通用”) |
| compartment_id | string | Oracle Cloud Infrastructure (OCI) 区间 OCID |
| endpoint | string | 模型的端点 URL |
| 提示 _ 模板 | string | LLM 使用的提示模板,变量采用 {{variable}} 格式进行动态插入 |
测试代理提示工具
通过单击测试选项卡并填写每个参数的值,可以独立于代理测试工具。提示将提交到您选择的 LLM。
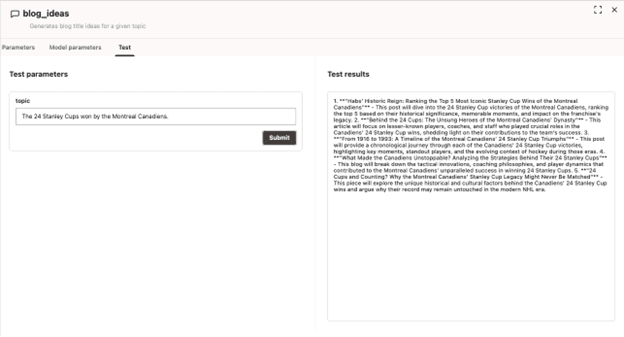
确保您的提示工具定义良好,并记录在文档中,以改进座席的结果。
向代理添加提示工具
您可以向代理添加提示工具,以允许您定义向所选 LLM 发出的参数化提示。
- 导航到您的代理。
- 从工具模板中,将提示工具拖放到画布中。
- 在 "Configuration"(配置)选项卡中,选择要使用的 LLM 并提供 LLM 的提示。单击代码
 以将配置作为 JSON 代码提供。
- 以介于 0.0 和 1.0 之间的值提供响应的温度,其中 0.0 提供严格的事实响应,1.0 提供最有创意的响应。
- 单击应用
 。
- 为在配置中建立的任何参数提供定义。单击代码 以将配置作为 JSON 代码提供。
- 单击
 应用。
- 可选:单击测试选项卡。提供测试参数,然后单击提交。在测试结果窗格中查看测试结果。
RAG 工具
RAG 工具向向量存储发出自然语言查询,并根据查询与存储文档之间的语义相似性检索文档。
注意:
知识库是创建 RAG 工具的先决条件。有关更多信息,请参阅知识库。通过可视化流进行 RAG 工具
RAG 工具要求您作为代理开发人员为以下参数提供值:
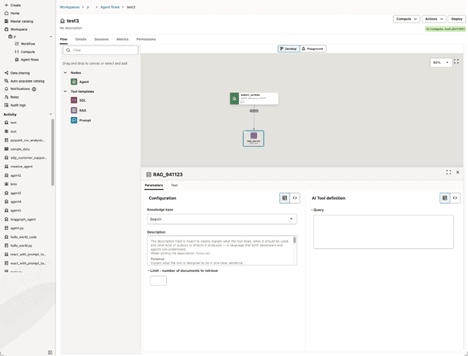
- 面向代理:
- 工具名称:工具的描述性名称,可帮助您和其他用户标识其功能。
- 工具说明:提供工具概述的简短摘要。
- 工具配置:
- 知识库:一个存储在 Oracle AI Data Platform 目录中的知识库。
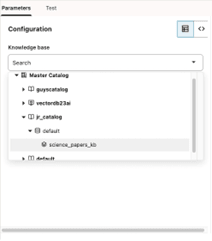
- 知识库:一个存储在 Oracle AI Data Platform 目录中的知识库。
座席将根据与最终用户的对话设置查询字段的值。此查询字段采用自然语言查询。
限制是希望工具从向量存储中检索的文档块数。此值由代理开发人员而不是代理本身设置。
您也可以通过单击 RAG 的测试选项卡来模拟代理发出的查询:
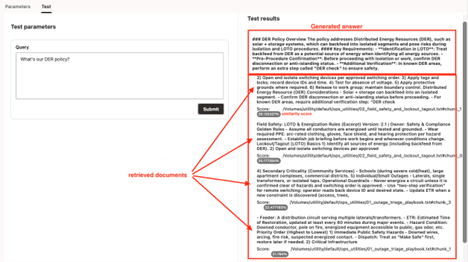
通过 LangGraph 代码的 RAG 工具
通过代码在代理中构建 RAG 工具需要配置与可视流相同的设置和参数。例如,您可以按如下方式设置 RAG 参数:
rag_params = [ { "name" : "query",
    "type" : "string",
    "description" : "<insert a description>",
    "defaultValue" : "<empty>”} ]
然后,设置 RAG 配置:
rag_config = { "catalog": "<catalog>",
		  "schema": "<schema>",
		  "knowledgeBase": "<knowledge-base-name>",
		  "top_k": <number-of-documents-retrieved>,
		  "llm": {
			    "model_id" : "<model-name>",
			    "model_provider" : "<model-provider>",
			    "compartment_id" : "<your-compartment-OCID>",
			    "endpoint" : "https://inference.generativeai.<oci-region>.oci.oraclecloud.com" }
}
最后,使用辅助工具中的 create_langgraph_tool() 实用程序函数创建 LangGraph 兼容工具:
from aidputils.agents.toolkit.tool_helper import create_langgraph_tool
rag_conf= AIDPToolConf(name="<your-tool-name>",
			   description= "<your-tool-description>",
			   tool_class = "RAGTool",
			   conf=rag_config,
			   params=rag_params)
rag_tool = create_langgraph_tool(rag_conf.model_dump())
表 18-2 RAG 工具配置属性
| 属性 | 类型 | 说明 |
|---|---|---|
| LLM | 对象 | LLM 连接详细信息 |
| catalog | string | 数据目录标识符 |
| schema | string | 目录中的方案 |
| 知识基础 | string | 要搜索的知识库的名称或关键字 |
| 前 _K 个 | 整数 | 要检索的顶级匹配文档数 |
测试代理 RAG 工具
将代理连接到 AI 计算集群后,可以从测试选项卡测试 RAG 工具。有关更多信息,请参见 Attach an Existing AI Cluster to an Agent 。
将 RAG 工具添加到代理
您可以向代理添加检索增强生成 (RAG) 工具,以允许代理在生成响应时提取相关的外部知识。
- 导航到您的代理。
- 从工具模板中,将 RAG 工具拖放到画布中。
- 在“配置”选项卡中,选择 RAG 工具从中提取信息的知识库,并提供用于定义要提取的信息的提示。单击代码 以将配置作为 JSON 代码提供。
- 单击应用 。
- 为在配置中建立的任何参数提供定义。单击代码 以将配置作为 JSON 代码提供。
- 单击 应用。
- 可选:单击测试选项卡。提供测试参数,然后单击提交。在测试结果窗格中查看测试结果。
SQL 工具
SQL 工具允许代理开发人员针对在 Oracle AI Data Platform 目录中注册的表运行预定义的 SQL 查询。
在设计时编写查询并定义所需的任何运行时变量。代理在调用工具时为这些变量提供值,结果将以结构化行形式返回,代理可以汇总或传递到下游节点。
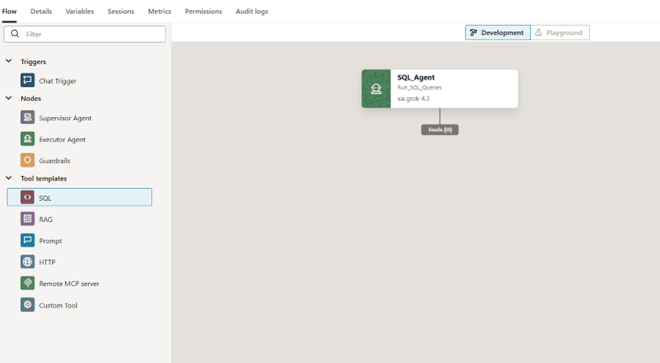
SQL 工具支持两种查询方言。Spark SQL 针对 AI Data Platform 中存储的标准目录表运行,需要 Spark 集群。Oracle SQL 针对外部数据库(例如 Oracle Autonomous AI Database )运行。您可以选择每个工具的方言,其余的配置是相同的。
注意:
SQL 工具用于读取查询。典型的工具运行 SELECT 语句并返回行。您配置的目录、方案和查询对该工具是专用的,不会向代理公开。只有工具名称、说明和 AI 工具定义(运行时变量)对代理可见。注意:
SQL 查询工具不会自动启动停止的集群。因此,用于 Spark SQL 查询工具的 Spark 集群的持续时间应为 Forever 。如果允许集群在空闲超时时向下旋转,则 Spark SQL 查询会在集群停止后在生产环境中停止工作。静态和动态查询
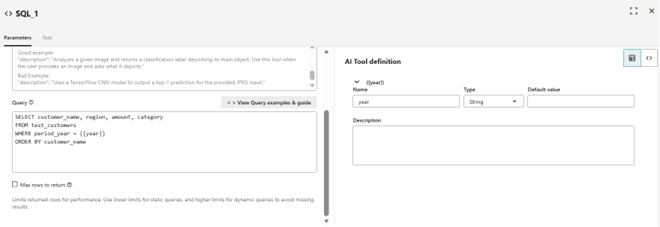
静态查询完全返回您指定的内容,没有代理的运行时决策。动态查询包括一个或多个 {{variable}} 占位符,这些占位符向代理发出在运行时设置值的信号。对于每个占位符,您需要提供名称、类型、可选默认值和代理用于选择值的说明。
SELECT customer_name, region, amount, category
FROM test_customers
WHERE period_year = 2025
ORDER BY customer_name {{year}} 占位符会将其变成代理可以参数化的动态查询: SELECT customer_name, region, amount, category
FROM test_customers
WHERE period_year = {{year}}
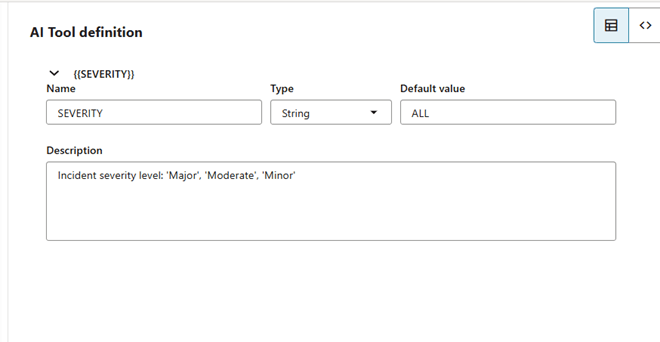
ORDER BY customer_name 在添加占位符时,AI 工具定义窗格会填充每个变量,以便您可以设置其类型、默认值和说明。
SELECT incident_id, project_id, incident_date, incident_type,
       severity, description, workers_involved, days_lost,
       root_cause, corrective_action, reported_by, status
FROM safety_incidents
WHERE LOWER(severity) = LOWER('{{SEVERITY}}')
为每个变量提供清晰的描述和合理的默认值。说明告诉座席哪些值有效,在座席未提供默认值时使用默认值。
注意:
占位符名称区分大小写。写为{{SEVERITY}} 的占位符和写为 {{severity}} 的占位符被视为两个不同的变量,除非您在整个过程中始终使用小写。
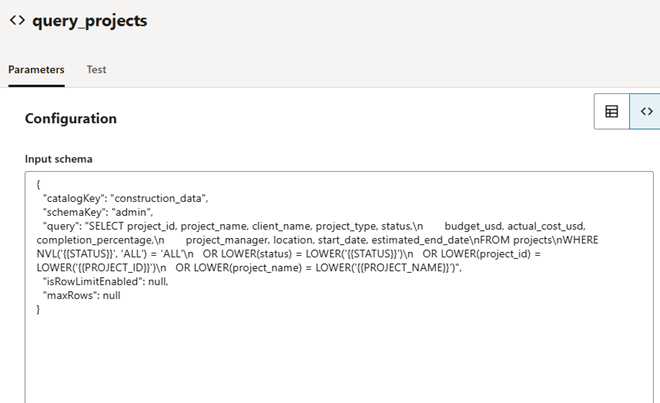
将配置编辑为 JSON
{
  "catalogKey": "construction_data",
  "schemaKey": "admin",
  "query": "SELECT project_id, project_name, client_name, ...",
  "isRowLimitEnabled": null,
  "maxRows": null
}
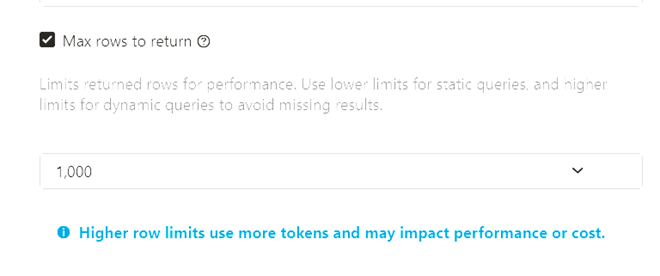
行限额
您可以通过选择要返回的最大行数并输入限制值来限制工具返回的行数。行限制可保护性能并控制向代理发送多少数据。
将此值设置为相对于代理使用的模型。如果查询返回较大的行或具有较大文本值的列,则较大的值可能会导致代理失败。
注意:
如果您看到意外的代理错误,请首先减少 maxRows。在运行查询之前,行限制将应用于 SQL 查询本身。大多数模型都会检测极限并将其呈现给最终用户。对于静态查询,该限制将返回前 n 个可用行。
注意:
如果不希望为最终用户显示行限制,请在代理的说明中相应地指示该代理。查询示例
您可以从查看查询示例和指南按钮中查看查询示例和编写 SQL 工具查询的指南。
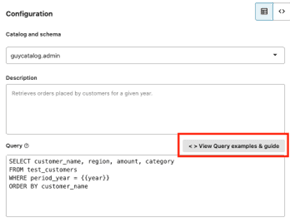
本指南展示了不同的查询模式,并提供了不同的查询参数建议。
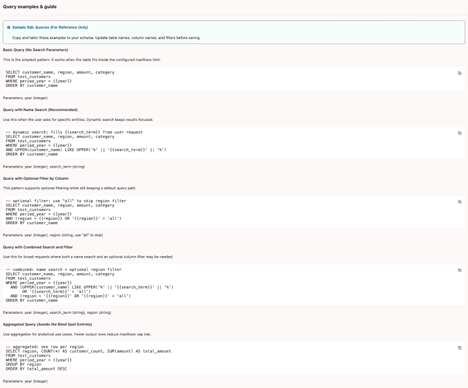
通过 LangGraph 代码执行 SQL 工具
与可视化流一样,您也可以通过 LangGraph 代码为代理创建 SQL 工具,方法是创建查询:
sql_config = { "catalogKey": "adw23ai_phx",
	  "schemaKey": "gold",
	  "query": """Select ... from ... limit {{max_number}}""" }
可以在 params 参数中记录 SQL 查询中的每个参数,其中包含名称、类型、说明以及可选的 defaultValue。
sql_params = [ {  "name" : "max_number",
		    "type" : "string",
		    "description" : "<your-description>",
		    "defaultValue" : "<your-default-value>" } ]
最后,使用辅助工具中的 create_langgraph_tool() 实用程序函数创建 LangGraph 兼容工具:
from aidputils.agents.toolkit.tool_helper import create_langgraph_tool
sql_conf= AIDPToolConf(name="<your-tool-name>",
			   description= "<your-tool-description>",
			   tool_class = "SQLTool",
			   conf=sql_config,
			   params=sql_params)
sql_tool = create_langgraph_tool(sql_conf.model_dump())
表 18-3 SQL 工具配置属性
| 属性 | 类型 | 说明 |
|---|---|---|
| 目录关键字 | string | 目录或数据库连接的标识符 |
| 方案关键字 | string | 目录/数据库中的方案名称 |
| 查询 | string | SQL 查询字符串,可能包含 {{}} 中的占位符 |
测试代理 SQL 工具
"Test" 选项卡自行运行该工具,而无需执行完整代理。这两种方言的测试方式相同。打开“测试”选项卡,为每个运行时参数提供一个值(或使用默认值),然后单击“提交”以运行查询并查看响应。
注意:
测试工具需要将代理连接到 AI 计算。如果 AI 计算标签为绿色且所选 AI 计算处于 ACTIVE 状态,则会连接 AI 计算。SQL 命令参考
SQL 工具查询是从标准 SQL 子句构建的读取查询。Oracle SQL 方言针对外部数据库遵循 Oracle SQL。Spark SQL 方言的目标是标准目录表,即 Delta Lake 表;标准目录当前使用 Delta Lake 3.2.0 运行 Spark 3.5。大多数子句在两个方言中的编写方式相同,因为两个子句都遵循标准 SQL。主要的区别在于每个方言如何限制行数。下表列出了 SQL 工具查询中最常用的子句和关键字,以及每个方言的表单。
| 关键字或子句 | 用途 | Oracle SQL | Spark SQL |
|---|---|---|---|
| SELECT | 选择要返回的列 | SELECT col1, col2 |
|
| DISTINCT | 仅返回唯一行 | SELECT DISTINCT col |
SELECT DISTINCT col |
| FROM | 为源表命名 | FROM table_name |
FROM table_name |
| WHERE | 按条件筛选行 | WHERE col = value |
WHERE col = value |
| 和/或 | 组合条件或否定条件 | a AND b OR NOT c |
a AND b OR NOT c |
| IN | 匹配列表中的任何值 | col IN (a, b, c) |
col IN (a, b, c) |
| BETWEEN | 匹配包含范围 | col BETWEEN x AND y |
col BETWEEN x AND y |
| LIKE | 匹配文本模式 | col LIKE 'A%' |
col LIKE 'A%' |
| IS NULL | 测试缺少的值 | col IS NULL |
col IS NULL |
| ORDER BY | 对结果排序 | ORDER BY col DESC |
ORDER BY col DESC |
| 分组依据 | 对行进行分组以进行聚合 | GROUP BY col |
GROUP BY col |
| HAVING | 筛选分组行 | HAVING COUNT(*) > 1 |
HAVING COUNT(*) > 1 |
| 加入 | 组合两个表中的行 | a JOIN b ON a.id = b.id |
a JOIN b ON a.id = b.id |
| AS | 别名是列或表 | col AS name |
col AS name |
| UNION ALL | 组合两个结果集 | q1 UNION ALL q2 |
q1 UNION ALL q2 |
| CASE | 有条件地返回值 | CASE WHEN c THEN x END |
CASE WHEN c THEN x END |
| 汇总 | 对行进行汇总 | COUNT SUM AVG MIN MAX |
COUNT SUM AVG MIN MAX |
| 行限制 | 限制行数 | FETCH FIRST n ROWS ONLY |
LIMIT n |
注意:
您通常不会自己编写行限制。要返回的最大行数设置将应用于您。FETCH FIRST 和 LIMIT 表单仅在需要查询内部显式限制时才有用。有关完整的 SQL 语法和每个方言背后的查询引擎,请参见以下引用:
Spark SQL 和 Delta 数据湖(标准目录)
- Apache Spark SQL 语法:DML 语句 Spark SQL 查询和 DML 语句语法。
- Delta 数据湖:表删除、更新和合并对 Delta 表执行 DELETE、UPDATE 和 MERGE 操作。
- Delta Lake:Table 实用程序命令 实用程序操作,例如 OPTIMIZE 和 VACUUM。
- Delta Lake:将液体群集用于 Delta 表 Liquid 集群用于 Delta 表布局。
将 SQL 工具添加到代理
您可以向代理添加 SQL 工具,以允许代理对注册的外部目录中的结构化数据源执行 SQL 查询。
- 单击并拖动代理上的连接器句柄以连接到工具节点。
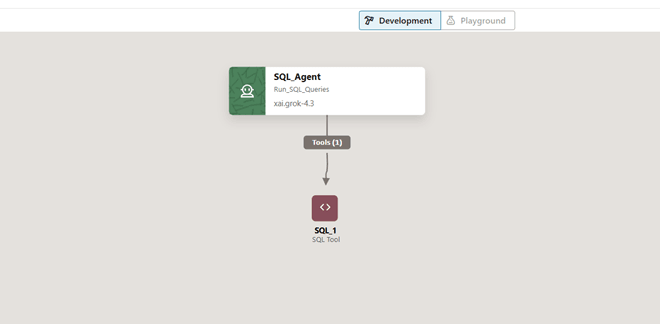
- 选择查询方言:
- Spark SQL 针对标准 AI 数据平台目录编写查询。
- Oracle SQL 针对外部 AI 数据平台目录编写查询。
注意:
Spark SQL 需要在 Oracle AI Data Platform 工作区中运行 Spark 集群。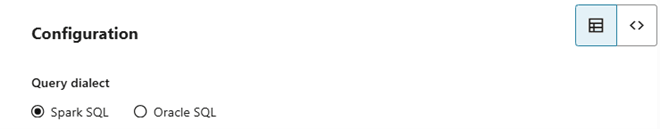
- 从 Cluster(集群)下拉列表中,选择正在运行的 Spark 集群。单击创建集群以预配新的 Spark 集群。有关创建新群集的指导,请参见 Create a Custom Cluster 。
注意:
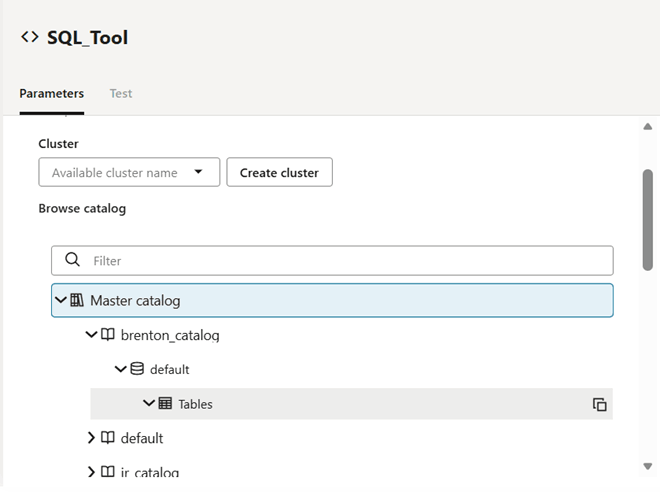
SQL 查询工具不会自动启动停止的集群。因此,用于 Spark SQL 查询工具的 Spark 集群的持续时间应为 Forever 。如果允许集群在空闲超时时向下旋转,则 Spark SQL 查询会在集群停止后在生产环境中停止工作。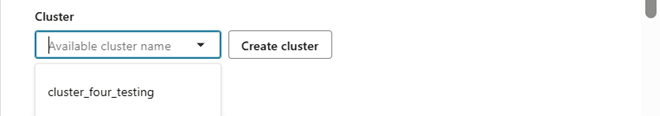
- 在浏览目录下,使用搜索字段按名称查找目录,或单击目录管理器以查找目录。
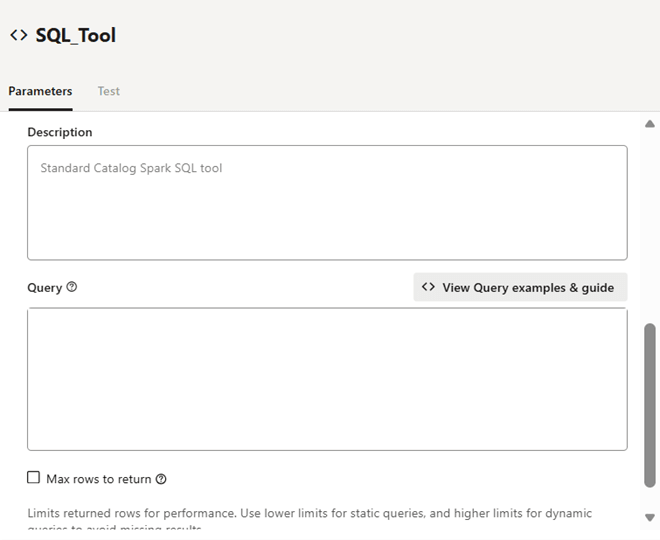
- 在查询字段中,输入查询。单击查看查询示例和指南以打开一个面板,其中包含您可以复制或调整的现成模式。
- 在 AI 工具定义窗格中,为查询中设置的变量设置类型、默认值和说明。
- 可选:单击测试选项卡。提供测试参数,然后单击提交。在测试结果窗格中查看测试结果。