關於配對的常見問題
- 如何計算配對分數,以及如何使用?
- 我應該在載入檔案中使用代碼還是資料來源名稱?
- 建立配對規則時,最好是將多個準則新增至規則,還是建立個別規則?
- 我不小心接受了不想接受的配對結果。我是否可以複查先前接受的配對結果並加以復原?
- 節點之間何時會建立節點連結?
如何計算配對分數,以及如何使用?
計算配對分數的具體機制取決於多個因素,例如資料類型 (字串、整數、日期等)、配對類型 (包含、類似、介於) 以及是否組合配對作業。但一般而言,配對分數越高表示候選項目符合的配對準則越多。
讓我們來看一些範例,以更清楚瞭解如何計算配對分數。
範例 1
在此範例中,配對規則配對的是字串類型的「名稱」特性:
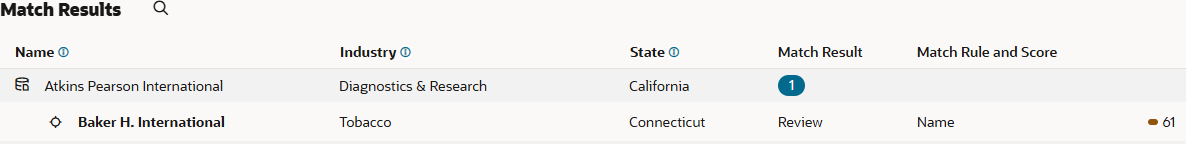
我們要配對的目標名稱是 "Atkins Pearson International",而嘗試配對的來源名稱是 "Baker H. International"。
在此範例中,目標名稱有 28 個字元,而來源名稱符合其中 17 個字元 ("a"、"k"、兩個空格和 "International" 的所有字元)。因此,約有 61% (28 個中的 17 個) 的字元相符,相符分數為 61。
範例 2
在第二個範例中,我們要配對名稱和產業這兩個字串特性:
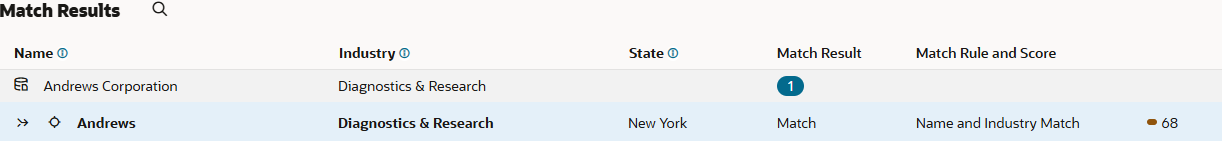
我們要配對的目標名稱是 "Andrews Corporation",目標產業是 "Diagnostics & Research"。來源名稱是 "Andrews",來源產業是 "Diagnostics & Research"。
在此案例中,來源名稱與目標名稱有 37% (19 個中的 7 個) 的字元相符,而來源產業與目標產業則 100% 相符。由於這是組合配對,因此取平均值 (37+100)/2,得出配對分數為 68。
其他資料類型和配對運算子會執行類似的計算,來決定配對分數。
Note:
如果已針對要配對之節點類型中的特性設定停用字,則在計算配對分數時會排除這些停用字。請參閱設定配對停用字。我應該在載入檔案中使用代碼還是資料來源名稱?
處理包含資料來源資訊的要求檔案時,會以兩種方式識別每個節點的資料來源:
- 如果已為資料來源設定代碼,則會使用該代碼。請參閱建立、編輯及刪除資料來源。
- 如果未為資料來源設定代碼,則會使用資料來源名稱。
由於資料來源名稱可能會隨時間改變,最佳作法是一律為資料來源設定代碼,並在要求檔案中使用該代碼,而非資料來源名稱。
建立配對規則時,最好是將多個準則新增至規則,還是建立個別規則?
至於是針對特定識別特性使用個別的配對規則,還是在單一規則中使用多個準則,最好由實作組織自行嘗試決定。在測試環境中調整規則時,管理者可能會評估哪個規則在產生較少誤判方面表現較佳。
原則上,在單一配對規則中組合識別特性會執行 "AND" 作業,而針對特定識別特性使用個別規則,則會單獨評估其作為配對決定因素的值,因此在針對節點類型及資料來源的單一組合評估多個規則時,可能會在多個規則中執行 "OR" 作業。
當您設定自動接受高於特定配對分數臨界值的配對規則,且預期某些準則能達到該臨界值,而其他準則可能無法達到時,在此情況下,與其在單一組合規則中加入多個準則,不如建立多個個別的配對規則會更合理。
例如,假設您設定自動接受高於 90% 的配對結果,且有兩個配對準則,其中一個相符度為 100%,另一個為 50%:
- 如果您有兩個個別的配對規則,相符度為 100% 的配對規則將被自動接受。
- 如果您有一個包含這兩個準則的配對規則,平均配對分數為 75%,低於您自動接受配對結果的 90% 臨界值。配對結果不會被自動接受。
因此,在此範例中,決定要組合準則還是建立個別的配對規則,將取決於您是否希望自動接受高於特定臨界值的某些配對結果。
我不小心接受了不想接受的配對結果。我是否可以複查先前接受的配對結果並加以復原?
完成並關閉有配對並合併項目的要求之後,就無法復原現有節點的配對並合併作業。完成並關閉要求之前,可透過下列方式復原現有節點的配對:
- 套用變更之前 (按一下配對工作台中的「拒絕」或「跳過」)
- 已套用變更但要求未完成時 (刪除要求項目,然後分別重新建立)
但要求完成並關閉之後,就無法再復原該配對。您必須刪除現有的目標節點並再次新增,才能刪除已儲存的配對資訊。
節點之間何時會建立節點連結?
當有已定義資料來源的傳入來源節點更新了現有目標節點時,便會在來源節點與目標節點之間建立節點連結。如需詳細資料,請參閱瞭解節點連結和資料來源。