Concepts relatifs aux développeurs de bases de données
Le développeur Oracle Database crée et gère une application de base de données. Cette section présente brièvement le rôle d'un développeur de base de données et les outils de développement disponibles.
-
Duties of Database Developers Un développeur Oracle est responsable de la création ou de la maintenance des composants de base de données d'une application qui utilise la pile technologique Oracle.
-
Outils pour les développeurs de base de données Oracle fournit plusieurs outils à utiliser pour le développement d'applications de base de données. Cette section décrit certains outils de développement couramment utilisés.
-
Thèmes pour les développeurs de base de données Cette section traite des sujets les plus essentiels pour les développeurs de base de données et qui n'ont pas été abordés ailleurs dans le manuel.
Fonctions des développeurs de base de données
Le développeur Oracle est chargé de créer ou de gérer les composants de base de données d'une application qui utilise la pile technologique Oracle.
Les développeurs Oracle développent de nouvelles applications ou convertissent des applications existantes à exécuter dans un environnement Oracle Database. Pour cette raison, les développeurs travaillent en étroite collaboration avec les administrateurs de base de données, en partageant des connaissances et des informations.
Les développeurs de bases de données Oracle peuvent s'attendre à participer aux tâches suivantes :
-
Implémenter le modèle de données requis par l'application
-
Créer des objets de schéma
-
Implémenter des règles pour l'intégrité des données
-
Choisir un environnement de programmation pour un nouveau projet de développement
-
Ecrire des sous-programmes PL/SQL ou Java côté serveur et du code procédural côté client qui utilisent des instructions SQL
-
Créer l'interface de l'application avec l'outil de développement choisi
-
Créer un environnement de soutien à la mondialisation pour le développement d'applications mondialisées
-
Instancier des applications dans différentes bases de données pour le développement, les tests, la formation et le déploiement dans un environnement de production
Voir aussi :
-
Oracle AI Database - Introduction au développement d'Oracle AI Database pour une introduction et des tutoriels basés sur l'interface graphique dans le développement d'Oracle Database
-
Oracle AI Database Development Guide pour des discussions approfondies sur des sujets tels que la conception de bases de données, le langage SQL pour les développeurs et le langage PL/SQL pour les développeurs
Outils pour les développeurs de bases de données
Oracle fournit plusieurs outils à utiliser pour développer des applications de base de données. Cette section décrit certains outils de développement couramment utilisés.
-
SQL Developer est un moyen pratique pour les développeurs de bases de données de modifier et de développer des tâches de base à l'aide de SQL*Plus.
-
Oracle APEX AI Application Generator Oracle APEX AI Application Generator est un outil de développement d'applications Web pour Oracle Database. Oracle APEX AI Application Generator utilise des fonctionnalités intégrées telles que des thèmes d'interface utilisateur, des contrôles de navigation, des gestionnaires de formulaires et des rapports flexibles pour accélérer le développement d'applications.
-
Oracle JDeveloper est un environnement de développement intégré (IDE) qui permet de créer des applications orientées service à l'aide des dernières normes du secteur pour Java, XML, les services Web et SQL.
-
Oracle Developer Tools for Visual Studio .NET
Oracle Developer Tools for Visual Studio .NET est un ensemble d'outils d'application intégrés à l'environnement Visual Studio .NET.
SQL Developer
SQL Developer est un moyen pratique pour les développeurs de bases de données de modifier et de développer des tâches de base à l'aide de SQL*Plus. SQL Developer est une version graphique de SQL*Plus, écrite en langage Java, qui prend en charge le développement en langage SQL et PL/SQL. Vous pouvez vous connecter à n'importe quel schéma de base de données Oracle à l'aide de l'authentification de base de données standard. SQL Developer permet d'effectuer les opérations suivantes :
-
Parcourir, créer, modifier et supprimer des objets de schéma
-
Exécuter des instructions SQL
-
Modifier et déboguer des programmes PL/SQL
-
Manipuler et exporter des données
-
Créer et afficher des rapports
SQL Developer est disponible dans l'installation par défaut d'Oracle Database et en téléchargement gratuit.
Voir aussi : Oracle AI Database - Introduction à Oracle AI Database Development et Guide de l'utilisateur Oracle SQL Developer pour découvrir comment utiliser SQL Developer
Générateur d'applications AI Oracle APEX
Oracle APEX AI Application Generator est un outil de développement d'applications Web pour Oracle Database. Oracle APEX AI Application Generator utilise des fonctionnalités intégrées telles que des thèmes d'interface utilisateur, des contrôles de navigation, des gestionnaires de formulaires et des rapports flexibles pour accélérer le développement d'applications.
Oracle APEX s'installe avec la base de données et se compose de données dans des tables et de code PL/SQL. Lorsque vous exécutez une application, votre navigateur envoie une demande d'URL convertie en appel PL/SQL Oracle APEX. Une fois que la base de données a traité le code PL/SQL, les résultats sont renvoyés au navigateur au format HTML. Ce cycle se produit chaque fois que vous demandez ou soumettez une page.
Vous pouvez utiliser Oracle APEX avec la passerelle PL/SQL intégrée. La passerelle s'exécute sur le serveur HTTP Oracle XML DB dans la base de données et fournit l'infrastructure nécessaire pour créer des applications dynamiques. Comme le montre la figure 23-1, la passerelle PL/SQL intégrée simplifie l'architecture de l'application en éliminant le niveau intermédiaire.
Figure 1 : APEX avec passerelle PL/SQL intégrée
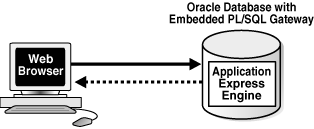
Description de l'image cncpt317.gif
Oracle JDeveloper
Oracle JDeveloper est un environnement de développement intégré (IDE) qui permet de créer des applications orientées service à l'aide des dernières normes du secteur pour Java, XML, les services Web et SQL. Oracle JDeveloper prend en charge le cycle de vie complet du développement logiciel, avec des fonctionnalités intégrées de modélisation, de codage, de débogage, de test, de profilage, de réglage et de déploiement d'applications.
Oracle JDeveloper utilise des fenêtres pour divers outils de développement d'applications. Par exemple, lors de la création d'une application Java, vous pouvez utiliser des outils tels que l'éditeur visuel Java et la palette de composants. En plus de ces outils, Oracle JDeveloper fournit toute une gamme de navigateurs pour vous aider à organiser et à visualiser le contenu de vos projets.
Voir aussi :
-
Oracle AI Database - Introduction au développement Java pour découvrir comment utiliser JDeveloper
-
Vous pouvez télécharger JDeveloper à l'adresse URL suivante : http://www.oracle.com/technetwork/developer-tools/jdev/downloads/
Oracle Developer Tools for Visual Studio .NET
Oracle Developer Tools for Visual Studio .NET est un ensemble d'outils d'application intégrés à l'environnement Visual Studio .NET. Les outils fournissant un accès à la fonction Oracle Developer Tools for Visual Studio .NET par le biais d'une interface utilisateur permettent à l'utilisateur d'effectuer un large éventail de tâches de développement d'applications et d'améliorer la productivité et la facilité d'utilisation du développement.
Les outils Oracle Developer prennent en charge la programmation et l'implémentation de procédures stockées .NET utilisant Visual Basic, C# et d'autres langages .NET. Ces procédures sont écrites dans un langage .NET et contiennent des instructions SQL ou PL/SQL.
Sujets relatifs aux développeurs de bases de données
Cette section couvre les sujets qui sont les plus essentiels pour les développeurs de bases de données et qui n'ont pas été abordés ailleurs dans le manuel.
-
Principes de conception et de réglage des applications Les développeurs Oracle doivent concevoir, créer et régler des applications de base de données afin d'atteindre leurs objectifs de sécurité et de performances.
-
Principes des requêtes correctes Les requêtes d'application du monde réel peuvent être très complexes, avec de nombreuses jointures, et elles ne sont souvent pas correctes dans tous les cas d'angle, en spécifiant explicitement le retour d'un résultat erroné, même dans les instructions SQL exécutées dans les systèmes de production sur de longues périodes, produisant des erreurs non détectées. Cette section explique comment analyser systématiquement et éviter les erreurs SQL les plus importantes.
-
Programmation de base de données côté client Vous pouvez utiliser des précompilateurs ou des traducteurs Java pour placer des instructions SQL dans le code source, ou vous pouvez utiliser des API pour permettre aux applications d'interagir avec la base de données.
-
Support de la mondialisation La prise en charge de la mondialisation d'Oracle Database vous permet de stocker, de traiter et d'extraire des données dans des langues natives.
-
Données non structurées Les données non structurées sont des données qui ne sont pas décomposées en structures logiques plus petites.
Principes de conception et de réglage des applications
Les développeurs Oracle doivent concevoir, créer et régler des applications de base de données afin d'atteindre leurs objectifs en matière de sécurité et de performances.
Les principes suivants de conception et de réglage des applications sont utiles :
-
Découvrir le fonctionnement d'Oracle Database
En tant que développeur, vous souhaitez développer des applications dans un laps de temps minimal par rapport à une base de données Oracle, ce qui nécessite d'exploiter l'architecture et les fonctionnalités de la base de données. Par exemple, ne pas comprendre les contrôles de simultanéité d'accès aux données d'Oracle Database et la cohérence en lecture multiversion peut endommager l'intégrité des données, ralentir l'exécution et réduire l'évolutivité d'une application. Le fonctionnement de Transaction Guard et de la continuité des applications vous permet d'éviter d'écrire du code de gestion des exceptions inutile.
-
Utiliser des variables attachées, sauf si vous avez de bonnes raisons de ne pas les utiliser
Lorsqu'une requête utilise des variables attachées, la base de données peut la compiler une seule fois et stocker le plan d'interrogation dans le pool partagé. Si la même instruction est exécutée à nouveau, la base de données peut effectuer une analyse partielle et réutiliser le plan. En revanche, une analyse complète prend plus de temps et utilise plus de ressources. L'utilisation de variables attachées (bind variables) pour permettre l'analyse partielle (soft parse) est très efficace et constitue la façon dont la base de données entend travailler pour les développeurs.
-
Implémenter des contraintes d'intégrité dans le serveur de base de données plutôt que dans le client
L'utilisation de clés primaires et étrangères permet de réutiliser les données dans plusieurs applications. Le codage des règles dans un client signifie que les autres clients n'ont pas accès à ces règles lorsqu'ils s'exécutent sur les bases de données.
-
Créer un environnement de test avec des données représentatives et une activité de session
Un environnement de test qui simule votre environnement de production en direct présente plusieurs avantages. Par exemple, vous pouvez tester l'application pour vous assurer qu'elle évolue et fonctionne correctement. Vous pouvez également utiliser un environnement de test pour mesurer l'impact des modifications apportées à la base de données sur les performances et vous assurer que les mises à niveau et les patches fonctionnent correctement.
-
Concevoir le modèle de données dans le but d'obtenir de bonnes performances
En général, les tentatives d'utilisation de modèles de données génériques entraînent des performances médiocres. Un modèle de données bien conçu répond aussi efficacement que possible aux requêtes les plus courantes. Par exemple, le modèle de données doit utiliser le type d'index qui fournit les meilleures performances. Le réglage après déploiement n'est pas souhaitable car les modifications apportées aux structures logiques et physiques peuvent être difficiles ou impossibles.
-
Définir des objectifs de performance clairs et conserver des enregistrements historiques des mesures
Un aspect important du développement consiste à déterminer exactement comment l'application est censée fonctionner et évoluer. Par exemple, utilisez des mesures qui incluent la charge attendue des utilisateurs, les transactions par seconde, les temps de réponse acceptables, etc. Selon les bonnes pratiques, vous devez tenir à jour les enregistrements historiques des mesures de performances. De cette façon, vous pouvez surveiller les performances de manière proactive et réactive.
-
Instrumenter le code de demande
Les bonnes pratiques de développement consistent à ajouter du code de débogage à votre application. La possibilité de générer des fichiers trace est utile pour déboguer et diagnostiquer les problèmes de performances.
Voir aussi :
-
"Introduction à la simultanéité et à la cohérence des données"
-
Oracle AI Database - Prise en main du développement Oracle AI Database pour prendre en compte lors de la conception d'applications de base de données
-
Guide de réglage SQL Oracle AI Database pour apprendre à concevoir des applications pour les performances
Principes des requêtes correctes
Les requêtes d'application du monde réel peuvent être très complexes, avec de nombreuses jointures, et celles-ci sont très souvent incorrectes dans tous les cas d'angle, en spécifiant explicitement le retour d'un résultat erroné, même dans les instructions SQL exécutées dans les systèmes de production sur de longues périodes, produisant des erreurs non détectées. Cette section explique comment analyser systématiquement et éviter les erreurs SQL les plus importantes.
Les requêtes peuvent sembler très complexes. Ils peuvent référencer des dizaines de tables, inclure des vues construites sur d'autres vues et utiliser des sous-interrogations dans les clauses WITH, la liste SELECT et la clause WHERE. Sous cette complexité, une bonne requête répond toujours à une question claire. Cette question reflète généralement un besoin de données sur un ensemble d'un type particulier d'entités métier. Chaque ligne renvoyée par l'interrogation doit représenter une instance de cette entité. Pour les requêtes GROUP BY, chaque ligne doit représenter une agrégation sur les instances de la même entité.
Dans la plupart des systèmes, chaque type d'entité métier suffisamment important pour être interrogé a une table correspondante dont les lignes représentent cette entité. En ce sens, de nombreuses requêtes bien écrites, quelle que soit leur complexité, sont en fin de compte des questions sur les lignes d'une seule table. La complexité environnante existe généralement car les bases de données normalisées stockent les attributs d'une entité dans les tables associées, telles que les tables parent, les tables grand-parentes, etc.
Par exemple, une conception normalisée stocke généralement le nom d'un client une seule fois dans une table CUSTOMERS. Une table ORDERS stocke uniquement CUSTOMER_ID afin de pouvoir la joindre à CUSTOMERS. Une table ORDER_ITEMS stocke ORDER_ID afin qu'elle puisse se joindre à ORDERS et ne répète pas CUSTOMER_ID. Pour répertorier un sous-ensemble de ORDER_ITEMS avec le nom de client de chaque élément, nous avons besoin d'une séquence de jointures uniques, d'abord vers ORDERS (le parent), puis vers CUSTOMERS (le grand-parent). Dans les systèmes OLTP bien normalisés, les requêtes peuvent nécessiter de nombreuses jointures de ce type pour extraire des informations détaillées sur un seul type d'entité, même si l'ensemble de résultats met toujours en correspondance un à un avec un sous-ensemble de lignes d'une table "principale".
Nous appelons cette table primaire la table élargie de lignes (RWT). Dans une requête correcte, les autres jointures doivent généralement "élargir" chaque ligne RWT en ajoutant des données de recherche mises en correspondance de manière unique à partir de tables parent, de tables grand-parentes, etc. Ces jointures ne doivent pas multiplier le nombre de lignes RWT. Les requêtes avec cette structure pour toutes les jointures démarrant logiquement à partir du jeton RWT sont des requêtes d'élargissement de ligne uniquement (RWOQ). Remarque : Le filtrage peut supprimer les lignes RWT. Les jointures internes et les prédicats WHERE peuvent enlever des lignes du jeton RWT. "Row-widened" ne signifie pas que l'interrogation conserve toutes les lignes RWT. Cela signifie qu'après filtrage et avant toute agrégation, chaque ligne de résultat de requête correspond strictement une à une aux lignes restantes du RWT.
Si toutes les autres tables de la requête sont accessibles via une chaîne de jointures uniques provenant d'une seule table qui représente les entités renvoyées ou agrégées par la requête, cette table de départ est le jeton RWT et la requête est un RWOQ. Si aucune table ne peut être garantie, via des clés uniques, pour mettre en correspondance un à un avec les lignes de résultat de pré-agrégation, la requête n'est pas RWOQ. En pratique, la plupart des non-RWOQ produisent des résultats qui ne peuvent pas être interprétés correctement par l'application car l'interrogation ne met pas correctement en correspondance les lignes de résultat avec une entité bien définie et significative pour l'entreprise. L'addition de valeurs à partir de ces lignes, par exemple, ajouterait la même valeur pour la même entité plusieurs fois, laissant un total absurde.
A partir d'Oracle Database version 26ai, la fonctionnalité JOIN TO ONE facilite grandement l'écriture de RWOQ corrects. Lorsque vous utilisez JOIN TO ONE pour toutes les jointures, la base de données vérifie au moment de l'analyse que la requête est un RWOQ, en traitant la table la plus à gauche dans la clause FROM comme le RWT, en supposant que l'objet est une table de base plutôt qu'une vue qui pourrait masquer un comportement non RWOQ. Si la base de données ne peut pas prouver l'unicité des jointures JOIN TO ONE au moment de l'analyse, elle effectue des vérifications d'exécution pour vérifier que chaque jointure du jeton RWT présumé reste unique pour les données rencontrées au moment de l'exécution. S'il détecte une jointure non unique dans les résultats réels, il génère une erreur d'exécution. La plupart des RWOQ peuvent être convertis au format JOIN TO ONE. Les requêtes qui ne peuvent pas être converties au format JOIN TO ONE révèlent généralement des jointures irrégulières lors de la tentative de conversion. Lorsque la requête convertie s'exécute sans erreur d'exécution, ce résultat fournit une confirmation forte que la requête possède la propriété "une ligne par entité" souhaitée.
Pour plus de détails sur les RWOQ, les raisons pour lesquelles ils aident à prévenir les problèmes de correction subtils en SQL et la façon dont JOIN TO ONE les applique, reportez-vous au Guide de développement Oracle AI Database.
Programmation de base de données côté client
Vous pouvez utiliser des précompilateurs ou des traducteurs Java pour placer des instructions SQL dans le code source, ou vous pouvez utiliser des API pour permettre aux applications d'interagir avec la base de données.
Il existe deux techniques de base permettant aux applications de base de données procédurales d'utiliser le langage SQL : la programmation côté serveur avec PL/SQL et Java, et la programmation côté client avec des précompilateurs et des API telles que JDBC (Java Database Connectivity) ou OCI (Oracle Call Interface).
-
SQL incorporé Historiquement, les programmes client/serveur ont utilisé le langage SQL intégré pour interagir avec la base de données.
-
API côté client La plupart des développeurs utilisent aujourd'hui une API pour intégrer du code SQL dans leurs applications de base de données.
Voir aussi :
Guide de développement Oracle AI Database pour découvrir comment choisir un environnement de programmation
Programmation côté serveur : PL/SQL et Java à vérifier
SQL intégré
Historiquement, les programmes client/serveur ont utilisé le langage SQL intégré pour interagir avec la base de données.
- Les programmes client/serveur Oracle Precompilers sont généralement écrits à l'aide d'un pré-compilateur Oracle, qui est un outil de programmation qui vous permet d'intégrer des instructions SQL dans des programmes de haut niveau.
Précompilateurs Oracle
Les programmes client/serveur sont généralement écrits à l'aide d'un pré-compilateur Oracle, qui est un outil de programmation qui vous permet d'intégrer des instructions SQL dans des programmes de haut niveau.
Par exemple, le précompilateur Oracle Pro*C/C++ vous permet d'intégrer des instructions SQL dans un fichier source C ou C++. Les précompilateurs Oracle sont également disponibles pour COBOL et FORTRAN.
Un précompilateur offre plusieurs avantages, notamment :
-
Augmente la productivité car vous écrivez généralement moins de code que les applications OCI équivalentes
-
Permet de créer des applications hautement personnalisées
-
Permet une surveillance étroite de l'utilisation des ressources, de l'exécution des instructions SQL et de divers indicateurs d'exécution
-
Gain de temps car le précompilateur, et non vous, traduit chaque instruction SQL intégrée en appels vers la bibliothèque d'exécution d'Oracle Database
-
Utilise le convertisseur de type d'objet pour mettre en correspondance les types d'objet et les collections Oracle Database avec les types de données C à utiliser dans l'application Pro*C/C++.
-
Fournit la vérification du type de temps de compilation des types d'objet et des collections, ainsi que la conversion automatique des types de base de données en types de données C
L'application client contenant les instructions SQL est le programme hôte. Ce programme est écrit en langue d'accueil. Dans le programme hôte, vous pouvez combiner des instructions SQL complètes avec des instructions C complètes et utiliser des variables ou des structures C dans les instructions SQL. Lorsque vous incorporez des instructions SQL, vous devez commencer par les mots-clés EXEC SQL et les terminer par un point-virgule. Pro*C/C++ convertit les instructions EXEC SQL en appels vers la bibliothèque d'exécution SQLLIB.
De nombreuses instructions SQL intégrées diffèrent de leurs homologues interactives uniquement par l'ajout d'une nouvelle clause ou l'utilisation de variables de programme. L'exemple suivant compare les instructions ROLLBACK interactives et imbriquées :
ROLLBACK;           -- interactive
EXEC SQL ROLLBACK;  -- embedded
Les instructions ont le même effet, mais vous devez utiliser la première dans un environnement SQL interactif (tel que SQL Developer) et la seconde dans un programme Pro*C/C++.
Il accepte le programme hôte en entrée, traduit les instructions SQL imbriquées dans l'appel de bibliothèque d'exécution de base de données standard, puis génère un programme origine que vous pouvez compiler, lier et exécuter de la manière habituelle. La Figure 23-2 illustre les étapes classiques de développement de programmes qui utilisent des précompilateurs.
Figure 2 : Développement de programmes avec des précompilateurs
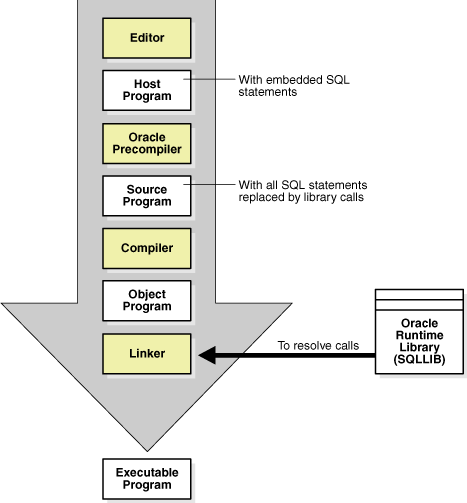
Description de l'image cncpt253.gif
Voir aussi : Guide du développeur Pro*C/C++ pour une description complète du précompilateur Pro*C/C++
API côté client
La plupart des développeurs utilisent aujourd'hui une API pour intégrer SQL dans leurs applications de base de données.
Par exemple, deux API populaires pour permettre aux programmes de communiquer avec Oracle Database sont Open Database Connectivity (ODBC) et JDBC. Oracle Call Interface (OCI) et Oracle C++ Call Interface (OCCI) sont deux autres API courantes pour la programmation côté client.
-
OCI et OCCI Au lieu de précompilateurs, Oracle fournit les API OCI et OCCI.
-
ODBC ODBC et JDBC est une API standard qui permet aux applications de se connecter à une base de données, puis de préparer et d'exécuter des instructions SQL.
OCI et OCCI
Au lieu de précompilateurs, Oracle fournit les API OCI et OCCI.
OCI vous permet de manipuler des données et des schémas dans une base de données à l'aide d'un langage de programmation hôte tel que C. OCCI est une interface orientée objet qui peut être utilisée avec C++. Les deux API permettent aux développeurs d'utiliser des appels de sous-programmes natifs pour accéder à Oracle Database et contrôler l'exécution SQL.
Dans certains cas, OCI offre de meilleures performances ou plus de fonctionnalités que les interfaces de niveau supérieur. OCI et OCCI fournissent de nombreuses fonctionnalités, notamment les suivantes :
-
Prise en charge de toutes les fonctionnalités SQL de DDL, DML, de requête et de contrôle des transactions disponibles via Oracle Database
-
Instant client, un moyen de déployer des applications lorsque l'espace disque est un problème
-
Gestion des threads, regroupement des connexions, fonctions de globalisation et chargement direct des données à partir d'une application C
OCI et OCCI fournissent une bibliothèque de fonctions d'accès et d'extraction de base de données standard sous la forme d'une bibliothèque d'exécution dynamique (OCILIB). Cette bibliothèque peut être liée dans une application lors de l'exécution. Ainsi, vous pouvez compiler et lier un programme OCI ou OCCI de la même manière qu'une application sans base de données, en évitant une étape distincte de prétraitement ou de précompilation. La figure 23-3 illustre le processus de développement.
Figure 3 : Processus de développement à l'aide d'OCI ou d'OCCI
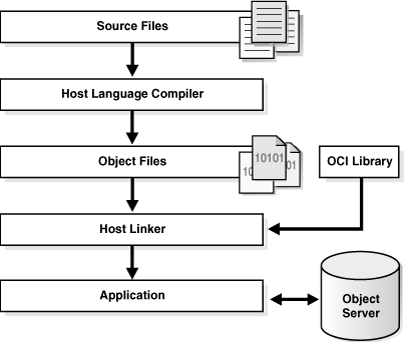
Description de l'image cncpt307.gif
Voir aussi :
ODBC et JDBC
ODBC est une API standard qui permet aux applications de se connecter à une base de données, puis de préparer et d'exécuter des instructions SQL.
ODBC est indépendant du langage de programmation, de la base de données et du système d'exploitation. L'objectif d'ODBC est de permettre à toute application d'accéder aux données contenues dans n'importe quelle base de données.
Un pilote de base de données est un logiciel qui se trouve entre une application et la base de données. Le pilote traduit les appels d'API effectués par l'application en commandes que la base de données peut traiter. En utilisant un pilote ODBC, une application peut accéder à n'importe quelle source de données, y compris les données stockées dans des feuilles de calcul. Le pilote ODBC effectue tous les mappages entre la norme ODBC et la base de données.
Le pilote Oracle ODBC fourni par Oracle permet aux applications compatibles ODBC d'accéder à Oracle Database. Par exemple, une application écrite dans Visual Basic peut utiliser ODBC pour interroger et mettre à jour des tables dans une base de données Oracle.
JDBC est une interface Java de bas niveau qui permet aux applications Java d'interagir avec la base de données Oracle. Comme ODBC, JDBC est une API indépendante du fournisseur. La norme JDBC est définie par Sun Microsystems et implémentée via les interfaces java.sql.
La norme JDBC permet à chaque fournisseur d'implémenter et d'étendre la norme avec ses propres pilotes JDBC. Oracle fournit les pilotes JDBC suivants pour la programmation côté client :
-
Pilote JDBC ThIN
Ce pilote Java pur réside côté client sans installation de client Oracle. Il est indépendant de la plate-forme et utilisable avec les applets et les applications.
-
Pilote OCI JDBC
Ce pilote réside côté client avec une installation de client Oracle. Il n'est utilisable qu'avec des applications. Le pilote OCI JDBC, écrit en C et en Java, convertit les appels JDBC en appels OCI.
Les fragments de code suivants proviennent d'un programme Java qui utilise le pilote JDBC OCI pour créer un objet Statement et interroger la table dual :
// Create a statement
Statement stmt = conn.createStatement();

// Query dual table
ResultSet rset = stmt.executeQuery("SELECT 'Hello World' FROM DUAL");
Voir aussi : Guide de développement Oracle AI Database et Oracle AI Database - Introduction au développement Java pour en savoir plus sur JDBC
Prise en charge de la globalisation
La prise en charge de la mondialisation d'Oracle Database vous permet de stocker, de traiter et d'extraire des données dans des langues natives.
La prise en charge de la mondialisation vous permet de développer simultanément des applications et des logiciels multilingues accessibles et exécutables depuis n'importe où dans le monde.
Les développeurs qui écrivent une application de base de données globalisée doivent effectuer les opérations suivantes :
-
Comprendre l'architecture de prise en charge de la mondialisation d'Oracle Database, y compris les propriétés des différents jeux de caractères, territoires, langues et définitions de tri linguistique
-
Comprendre la fonctionnalité de globalisation de leur environnement de programmation de niveau intermédiaire, y compris la façon dont il peut interagir et se synchroniser avec le modèle d'environnement local de la base de données
-
Concevoir et écrire du code capable de prendre en charge simultanément plusieurs clients s'exécutant sur différents systèmes d'exploitation, avec des jeux de caractères et des paramètres régionaux différents
Par exemple, une application peut être requise pour afficher le contenu de l'interface utilisateur et traiter les données dans les langues et les préférences locales des utilisateurs natifs. Par exemple, l'application doit traiter les données Kanji multioctets, afficher les messages et les dates dans le format régional approprié et traiter les données ASCII 7 bits sans que les utilisateurs aient à modifier les paramètres.
-
Environnement de Support à la Mondialisation L'environnement de Support à la Mondialisation inclut l'application client et la base de données. Vous pouvez contrôler les opérations dépendantes de la langue en définissant des paramètres et des variables d'environnement sur le client et le serveur, qui peuvent exister à des emplacements distincts.
-
Oracle Globalization Development Kit Oracle Globalization Development Kit (GDK) inclut des API de programmation complètes. Voir aussi : Guide de support Oracle AI Database Globalization pour plus d'informations sur la mondialisation
Environnement d'appui à la mondialisation
L'environnement de prise en charge de la globalisation inclut l'application client et la base de données. Vous pouvez contrôler les opérations dépendantes de la langue en définissant des paramètres et des variables d'environnement sur le client et le serveur, qui peuvent exister à des emplacements distincts. Remarque : dans les versions précédentes, Oracle faisait référence aux fonctionnalités de prise en charge de la mondialisation en tant que fonctionnalités NLS (National Language Support). NLS est en fait un sous-ensemble de la prise en charge de la mondialisation et permet de choisir une langue nationale et de stocker des données dans un jeu de caractères spécifique.
Oracle Database prend en charge la globalisation pour des fonctionnalités telles que :
-
Langues et territoires natifs
-
Formats locaux pour la date, l'heure, les nombres et la devise
-
Systèmes de calendrier (grégorien, impérial japonais, bouddha thaïlandais, etc.)
-
Plusieurs jeux de caractères, dont Unicode
-
Sémantique
-
Jeux de caractères Un composant clé de la prise en charge de la globalisation est un jeu de caractères, qui est un schéma de codage utilisé pour afficher les caractères sur un écran d'ordinateur.
-
Paramètres propres à l'environnement local Un environnement local est un environnement linguistique et culturel dans lequel un système ou un programme est exécuté. Les paramètres NLS déterminent le comportement propre à l'environnement linguistique sur le client et la base de données.
Jeux de caractères
Un composant clé de la prise en charge de la globalisation est un jeu de caractères, qui est un schéma de codage utilisé pour afficher les caractères sur un écran d'ordinateur.
La distinction suivante est importante dans le développement d'applications :
-
Un jeu de caractères de base de données détermine les langues qui peuvent être représentées dans une base de données. Le jeu de caractères est indiqué lors de la création de la base de données.
Remarque : une fois la base de données créée, la modification du jeu de caractères est généralement très coûteuse en matière de temps et des ressources. Cette opération peut nécessiter la conversion de toutes les données alphanumériques à l'export de l'intégralité de la base de données et en réimportant.
-
Un jeu de caractères client est le jeu de caractères des données saisies ou affichées par une application client. Le jeu de caractères du client et de la base de données peut être différent.
Un groupe de caractères (par exemple, des caractères alphabétiques, des idéogrammes, des symboles, des signes de ponctuation et des caractères de contrôle) peut être codé en tant que jeu de caractères. Un jeu de caractères encodé attribue un code numérique unique, appelé point de code ou valeur encodée, à chaque caractère du jeu. Les points de code sont importants dans un environnement global en raison de la nécessité potentielle de convertir des données entre différents jeux de caractères.
L'industrie informatique utilise de nombreux jeux de caractères codés. Ces ensembles diffèrent par le nombre de caractères disponibles, les caractères disponibles, les points de code attribués à chaque caractère, etc. Oracle Database prend en charge la plupart de jeux de caractères codés nationaux, internationaux et propres à une société.
Oracle Database prend en charge les classes de jeux de caractères codés suivantes :
-
Jeux de caractères mono-octets
Chaque caractère occupe un octet. US7ASCII est un exemple de jeu de caractères 7 bits. WE8DEC est un exemple de jeu de caractères 8 bits.
-
Jeux de caractères multioctets
Chaque caractère occupe plusieurs octets. Les ensembles multioctets sont couramment utilisés pour les langues asiatiques.
-
Unicode
Le jeu de caractères encodé universel vous permet de stocker des informations dans n'importe quelle langue à l'aide d'un seul jeu de caractères. Unicode fournit une valeur de code unique pour chaque caractère, quelle que soit la plate-forme, le programme ou la langue.
Voir aussi : Oracle AI Database Globalization Support Guide pour en savoir plus sur la migration des jeux de caractères
Paramètres propres aux paramètres régionaux
Un environnement local est un environnement linguistique et culturel dans lequel un système ou un programme est exécuté. Les paramètres NLS déterminent le comportement propre à l'environnement linguistique sur le client et la base de données.
Une session de base de données utilise les paramètres NLS lors de l'exécution d'instructions pour le compte d'un client. Par exemple, la base de données utilise correctement le séparateur des milliers pour un client. En général, la variable d'environnement NLS_LANG sur l'hôte client spécifie l'environnement linguistique de la session serveur et de l'application client. Le processus est le suivant :
-
Lorsqu'une application client démarre, elle initialise l'environnement NLS client à partir des paramètres d'environnement.
Toutes les opérations NLS effectuées localement, telles que l'affichage du formatage dans les applications Oracle Developer, utilisent ces paramètres.
-
Le client communique les informations définies par
NLS_LANGà la base de données lorsqu'il se connecte. -
La session de base de données initialise son environnement NLS en fonction des paramètres communiqués par le client.
Si le client n'a pas spécifié de paramètres, la session utilise les paramètres du fichier de paramètres d'initialisation. La base de données utilise les paramètres d'initialisation uniquement si le client n'a spécifié aucun paramètre NLS. Si le client a spécifié certains paramètres NLS, les paramètres NLS restants sont définis par défaut.
Chaque session démarrée pour le compte d'une application client peut s'exécuter dans le même environnement linguistique ou dans un environnement linguistique différent des autres sessions. Par exemple, une session peut utiliser l'environnement linguistique allemand tandis qu'une autre utilise l'environnement linguistique français. En outre, chaque session peut avoir les mêmes exigences linguistiques ou différentes spécifiées.
Le tableau suivant présente deux clients utilisant des paramètres NLS_LANG différents. Un utilisateur démarre SQL*Plus sur chaque hôte, se connecte à la même base de données que hr et exécute la même requête simultanément. Le résultat de chaque session diffère en raison du paramètre NLS propre à l'environnement linguistique pour les nombres à virgule flottante.
Tableau 1 Paramètres NLS propres aux paramètres régionaux
| t | Hôte client 1 | Hôte client 2 |
|---|---|---|
| t0 | |
|
| t1 | |
|
Voir aussi : Guide de prise en charge de la globalisation d'Oracle AI Database pour en savoir plus sur les paramètres NLS
Oracle Globalization Development Kit
Le kit Oracle Globalization Development Kit (GDK) inclut des API de programmation complètes.
Les API sont disponibles pour Java et PL/SQL, et incluent des exemples de code et une documentation qui traite de nombreux problèmes de conception, de développement et de déploiement rencontrés lors de la création d'applications globales. Le GDK simplifie le processus de développement et réduit le coût de développement des applications Internet utilisées pour prendre en charge un environnement mondial.
Le GDK se compose principalement de deux parties : GDK pour Java et GDK pour PL/SQL. GDK pour Java fournit une prise en charge de la mondialisation aux applications Java. GDK for PL/SQL prend en charge la globalisation dans l'environnement de programmation PL/SQL. Les caractéristiques offertes dans les deux parties ne sont pas identiques.
Voir aussi : Guide de prise en charge de la globalisation d'Oracle AI Database
Données non structurées
Les données non structurées sont des données qui ne sont pas décomposées en structures logiques plus petites.
Le modèle relationnel traditionnel traite des données structurées simples qui s'intègrent dans des tables simples. Oracle Database prend également en charge les données non structurées, qui ne peuvent pas être décomposées en composants standard. Les données non structurées incluent du texte, des images graphiques, des clips vidéo et des formes d'onde sonore.
Oracle Database inclut des types de données pour gérer le contenu non structuré. Ces types de données apparaissent en tant que types natifs dans la base de données et peuvent être interrogés à l'aide de SQL.
-
Présentation de XML dans Oracle Database Oracle XML DB est un ensemble de technologies Oracle Database liées à la manipulation, au stockage et à l'extraction XML hautes performances. Oracle XML DB fournit une prise en charge XML native en englobant les modèles de données SQL et XML de manière interopérable.
-
Présentation de JSON dans Oracle Database Oracle Database fournit une prise en charge native des données JSON (JavaScript Object Notation), y compris l'interrogation et l'indexation.
-
Les types de données LOB (Large Object) présentation des objets LOB vous permettent de stocker et de manipuler des blocs volumineux de données non structurées au format binaire ou alphanumérique.
-
Présentation d'Oracle Text Oracle Text (Text) est une technologie d'extraction de texte intégral intégrée à Oracle Database. Oracle Text indexe tout document ou contenu textuel stocké dans des systèmes de fichiers, des bases de données ou sur le Web. Ces documents peuvent être recherchés en fonction de leur contenu textuel, de leurs métadonnées ou de leurs attributs.
-
Présentation d'Oracle Spatial and Graph Oracle Spatial and Graph (Spatial and Graph) inclut des fonctionnalités avancées pour les données et analyses spatiales, ainsi que pour les applications graphiques physiques, logiques, réseau et sociales et sémantiques.
-
Présentation des graphiques de propriétés SQL La fonctionnalité de graphique de propriétés d'Oracle Database offre une prise en charge puissante des graphiques pour Oracle Database.
Présentation de XML dans Oracle Database
Oracle XML DB est un ensemble de technologies Oracle Database liées à la manipulation, au stockage et à l'extraction XML hautes performances. Oracle XML DB fournit une prise en charge XML native en englobant les modèles de données SQL et XML de manière interopérable.
Oracle XML DB convient à toute application Java ou PL/SQL dans laquelle une partie ou la totalité des données traitées par l'application sont représentées au format XML. Par exemple, l'application peut comporter un grand nombre de documents XML qui doivent être ingérés, générés, validés et recherchés.
Oracle XML DB offre de nombreuses fonctionnalités, notamment :
-
Type de données
XMLTypenatif, qui peut représenter un document XML dans la base de données afin qu'il soit accessible par SQL. -
Prise en charge des normes XML telles que les schémas XML, XPath, XQuery, XSLT et DOM
-
XMLIndex, qui prend en charge toutes les formes de données XML, de très structuré à complètement non structuré
L'exemple suivant crée une table orders de type XMLType :
CREATE TABLE orders OF XMLType;
CREATE DIRECTORY xmldir AS path_to_folder_containing_XML_file;
INSERT INTO orders
  VALUES (XMLType(BFILENAME('XMLDIR','purOrder.xml'),NLS_CHARSET_ID('AL32UTF8')));
L'exemple précédent crée également un objet répertoire SQL, qui est un nom logique dans la base de données pour un répertoire physique sur l'ordinateur hôte. Ce répertoire contient des fichiers XML. L'exemple insère le contenu XML du fichier purOrder.xml dans la table orders.
Oracle XML Developer's Kit (XDK) contient les blocs de construction de base permettant de lire, manipuler, transformer et afficher des documents XML, que ce soit sur un système de fichiers ou dans une base de données. Des API et des outils sont disponibles pour Java, C et C++. La production Oracle XDK est fournie avec une licence de redistribution commerciale.
Exemple 23-1 XMLType
CREATE TABLE orders OF XMLType;
CREATE DIRECTORY xmldir AS path_to_folder_containing_XML_file;
INSERT INTO orders
VALUES (XMLType(BFILENAME('XMLDIR','purOrder.xml'),NLS_CHARSET_ID('AL32UTF8')));Présentation de JSON dans Oracle Database
Oracle Database fournit une prise en charge native des données JavaScript Object Notation (JSON), y compris l'interrogation et l'indexation.
Cette section comprend les rubriques suivantes :
-
Qu'est-ce que JSON ? JavaScript Object Notation (JSON) est un format de données textuel indépendant de la langue qui peut représenter des objets, des tableaux et des données scalaires. Divers langages de programmation peuvent analyser et générer des données JSON.
-
JSON et XML Les langages JSON et XML sont couramment utilisés comme langages d'échange de données. Contrairement aux données relationnelles, les données JSON et XML peuvent être stockées, indexées et interrogées dans la base de données sans schéma définissant les données.
-
La prise en charge des bases de données natives pour JSON JSON est largement stockée dans les bases de données noSQL qui ne disposent pas de fonctionnalités de base de données relationnelle. En revanche, Oracle Database prend en charge JSON nativement avec des fonctionnalités telles que les transactions, l'indexation, l'interrogation déclarative et les vues.
Qu'est-ce que JSON ?
JavaScript Object Notation (JSON) est un format de données textuel indépendant de la langue qui peut représenter des objets, des tableaux et des données scalaires. Divers langages de programmation peuvent analyser et générer des données JSON.
Le format JSON sert généralement de langage d'échange de données. Il est souvent utilisé pour sérialiser des données structurées et les échanger sur un réseau, généralement entre un serveur et des applications Web. JSON est le format de données dominant dans les navigateurs Web qui exécutent des applications écrites dans JavaScript intégré au HTML.
Un objet JavaScript est un tableau associatif de zéro ou plusieurs paires de noms de propriété et de valeurs JSON associées. Un objet JSON est un littéral d'objet JavaScript, qui est écrit sous la forme d'une liste de propriétés entre accolades, avec des paires nom-valeur séparées par des virgules, et avec le nom et la valeur de chaque paire séparés par des deux-points. Une propriété d'objet est parfois appelée clé. Une paire nom-valeur de propriété d'objet est parfois appelée membre d'objet.
Exemple 23-2 Objet JSON
Cet exemple montre un objet JSON qui représente un bon de commande, avec les noms de propriété de niveau supérieur PONumber, Reference, Requestor, User, Costcenter, ShippingInstruction, Special Instructions, AllowPartialShipment et LineItems.
{ "PONumber"             : 1600,
  "Reference"            : "ABULL-20140421",
  "Requestor"            : "Alexis Bull",
  "User"                 : "ABULL",
  "CostCenter"           : "A50",
  "ShippingInstructions" : { "name"   : "Alexis Bull",
                             "Address": { "street"  : "200 Sporting Green",
                                          "city"    : "South San Francisco",
                                          "state"   : "CA",
                                          "zipCode" : 99236,
                                          "country" : "United States of America" },
                             "Phone" : [ { "type" : "Office", "number" : "909-555-7307" },
                                         { "type" : "Mobile", "number" : "415-555-1234" } ] },
  "Special Instructions" : null,
  "AllowPartialShipment" : false,
  "LineItems"            : [ { "ItemNumber" : 1,
                               "Part"       : { "Description" : "One Magic Christmas",
                                                "UnitPrice"   : 19.95,
                                                "UPCCode"     : 13131092899 },
                               "Quantity"   : 9.0 },
                             { "ItemNumber" : 2,
                               "Part"       : { "Description" : "Lethal Weapon",
                                                "UnitPrice"   : 19.95,
                                                "UPCCode"     : 85391628927 },
                               "Quantity"   : 5.0 } ] }
Dans l'exemple précédent, la plupart des propriétés ont des valeurs de chaîne. PONumber, zipCode, ItemNumber et Quantity ont des valeurs numériques. Les valeurs Shipping Instructions et Address ont des objets. La valeur de LineItems est un tableau.
Remarque : Guide du développeur Oracle XML DB pour une présentation plus complète de JSON
JSON et XML
JSON et XML sont couramment utilisés en tant que langages d'échange de données. Contrairement aux données relationnelles, les données JSON et XML peuvent être stockées, indexées et interrogées dans la base de données sans schéma définissant les données.
En raison de sa définition et de ses fonctionnalités simples, les données JSON sont généralement plus faciles à générer, analyser et traiter que les données XML. Il est également plus facile pour les êtres humains d'apprendre et d'utiliser. Le tableau suivant décrit d'autres différences entre JSON et XML.
Tableau 2 Différences entre JSON et XML
| Fonction | JSON | XML |
|---|---|---|
| Utile pour des données simples et structurées | Oui | Oui, mais prend également en charge les données semi-structurées et les données structurées complexes |
| Utile pour le contenu mixte | Non | Oui |
| Absence d'attributs, d'espaces de noms, d'héritage et de substitution | Oui | Non |
| L'importance de la commande | Non | Oui |
| Principalement destiné aux documents plutôt qu'aux données | Non | Oui |
| Inclut un type de données de date | Non | Oui |
Remarque : Guide du développeur Oracle AI Database JSON pour une comparaison plus complète des formats XML et JSON
Prise en charge de la base de données native pour JSON
JSON est largement stocké dans les bases de données noSQL qui ne disposent pas de fonctionnalités de base de données relationnelle. En revanche, Oracle Database prend en charge JSON nativement avec des fonctionnalités telles que les transactions, l'indexation, l'interrogation déclarative et les vues.
Vous pouvez accéder aux données JSON stockées dans la base de données de la même manière que vous accédez à d'autres données de base de données, notamment à l'aide d'OCI, de .NET et de JDBC. La méthode préférée pour stocker les données JSON consiste à utiliser le type de données JSON, qui est un format binaire propriétaire optimisé pour le traitement des requêtes et des instructions LMD. Vous pouvez utiliser le type de données JSON à la plupart des endroits où un type de données SQL est autorisé, y compris un type de colonne ou de paramètre pour une unité de programme PL/SQL.
En utilisant Oracle SQL, vous pouvez effectuer les opérations suivantes sur les données JSON :
-
Joignez des données JSON à des données relationnelles non JSON.
-
Générez un document JSON à partir de données relationnelles à l'aide des fonctions SQL
json_objectetjson_array. -
Projeter les données JSON dans un format relationnel à l'aide de la fonction SQL
json_table. -
Créez une contrainte CHECK avec
is_jsonpour appliquer les données JSON dans une colonne. La base de données utilise la contrainte de vérification pour confirmer que la colonne est au format JSON pour les opérations propres à JSON, telles que la syntaxe simplifiée. -
Manipulez les documents JSON en tant qu'objets PL/SQL.
-
Utilisez les fonctions SQL
json_queryetjson_valuepour accepter une expression de chemin JSON Oracle comme argument et la mettre en correspondance avec les données JSON cible. -
Indexer les données JSON.
-
Interrogez les données JSON stockées dans une table externe.
-
Répliquez des tables avec des colonnes contenant des données JSON à l'aide d'Oracle GoldenGate.
Les données JSON textuelles utilisent toujours le jeu de caractères Unicode, UTF8 ou UTF16. Oracle Database utilise UTF8 en interne lorsqu'il analyse et interroge les données JSON. Si les données d'entrée ou de sortie d'un tel traitement doivent se trouver dans un jeu de caractères différent de UTF8, la conversion de jeu de caractères appropriée est effectuée automatiquement. Remarque : Guide du développeur Oracle AI Database JSON pour une présentation plus complète de la prise en charge de JSON dans Oracle Database
Présentation des objets LOB
Les types de données LOB (Large Object) permettent de stocker et de manipuler des blocs volumineux de données non structurées au format binaire ou alphanumérique.
Le type de données LOB (large object) fournit un accès efficace, aléatoire et par morceaux aux données.
-
LOB internes Un LOB interne stocke les données dans la base de données elle-même plutôt que dans des fichiers externes.
-
LOB externes Un objet
BFILE(objet volumineux de fichier binaire ou LOB) est un objet volumineux externe. -
Le stockage LOB SecureFiles SecureFiles est l'un des deux types de stockage ; l'autre type est le stockage LOB BasicFiles.
LOB internes
Un objet LOB interne stocke les données dans la base elle-même plutôt que dans des fichiers externes.
Les LOBS internes incluent les éléments suivants :
-
CLOB(objet LOB de type caractère), qui stocke de grandes quantités de texte, telles que du texte ou des fichiers XML, dans le jeu de caractères de la base de données -
NCLOB(LOB de jeu de caractères national), qui stocke les données Unicode -
BLOB(objet LOB binaire), qui stocke de grandes quantités d'informations binaires sous forme de flux de bits et n'est pas soumis à la conversion de jeu de caractères
La base stocke les objets LOB différemment des autres types de données. La création d'une colonne LOB crée implicitement un segment LOB et un index LOB. Le tablespace contenant le segment LOB et l'index LOB, qui sont toujours stockés ensemble, peut être différent du tablespace contenant la table.
Remarque : la base de données peut parfois stocker de petites quantités de données LOB dans la table elle-même plutôt que dans un segment LOB distinct.
Le segment LOB stocke les données en morceaux appelés parties. Un bloc est un ensemble logique de blocs de données contigus. Il s'agit de la plus petite unité d'allocation pour un objet LOB. Une ligne de la table stocke un pointeur appelé localisateur de LOB, qui pointe vers l'index LOB. Lorsque la table est interrogée, la base de données utilise l'index LOB pour localiser rapidement les blocs LOB.
La base de données gère la cohérence en lecture pour les segments LOB différemment des autres données. Au lieu d'utiliser les données d'annulation pour enregistrer les modifications, la base de données stocke les images "avant" dans le segment lui-même. Lorsqu'une transaction modifie un LOB, la base de données alloue un nouveau bloc et laisse les anciennes données en place. Si la transaction est annulée, la base de données annule les modifications apportées à l'index, ce qui pointe vers l'ancien bloc.
LOB externes
Un objet LOB (Large Object) BFILE (objet LOB) est un objet LOB externe.
Un objet BFILE est un objet LOB externe car la base de données stocke un pointeur vers un fichier dans le système d'exploitation. Les données externes sont en lecture seule.
Un objet BFILE utilise un objet répertoire pour localiser les données. La quantité d'espace consommée dépend de la longueur du nom de l'objet répertoire et du nom du fichier.
Un élément BFILE n'utilise pas le même mécanisme de cohérence en lecture que le LOBS interne car le fichier binaire est externe à la base de données. Si les données du fichier changent, les lectures répétées à partir du même fichier binaire peuvent produire des résultats différents.
SecureFiles
Le stockage LOB SecureFiles est l'un des deux types de stockage ; l'autre type est le stockage LOB BasicFiles.
Le paramètre LOB SECUREFILE active des fonctionnalités avancées, notamment la compression et la déduplication (partie de l'option de compression avancée) et le cryptage (partie de l'option de sécurité avancée). A partir d'Oracle Database 12c, SecureFiles est le mécanisme de stockage par défaut pour les objets LOB.
Voir aussi :
-
Guide du développeur Oracle AI Database SecureFiles et LOB pour en savoir plus sur les types de données LOB
Présentation d'Oracle Text
Oracle Text (texte) est une technologie d'extraction de texte intégral intégrée à Oracle Database. Oracle Text indexe tout document ou contenu textuel stocké dans des systèmes de fichiers, des bases de données ou sur le Web. Ces documents peuvent être recherchés en fonction de leur contenu textuel, de leurs métadonnées ou de leurs attributs.
Oracle Text offre les avantages suivants :
-
Oracle Text permet de combiner des recherches de texte avec des recherches de base de données régulières dans une seule instruction SQL. L'index de texte se trouve dans la base de données et les requêtes de texte sont exécutées dans le processus Oracle Database. L'optimiseur peut choisir le meilleur plan d'exécution pour n'importe quelle requête, ce qui offre les meilleures performances pour les requêtes ad hoc impliquant du texte et des critères structurés.
-
Vous pouvez utiliser Oracle Text avec des données XML. En particulier, vous pouvez combiner
XMLIndexavec l'indexation Oracle Text, en tirant parti du langage XML et d'un index en texte intégral. -
L'API SQL Oracle Text simplifie et rend intuitive la création et la maintenance des index Oracle Text et l'exécution des recherches.
Pour un cas d'emploi, supposons que vous devez créer un index de catalogue pour un site d'enchères qui vend du matériel électronique. Un nouvel inventaire est ajouté chaque jour. Les descriptions d'article, les dates d'offre et les prix doivent être stockés ensemble. L'application requiert un bon temps de réponse pour les requêtes mixtes. Vous commencez par créer et remplir une table catalog. Vous utilisez ensuite Oracle Text pour créer un index CTXCAT que vous pouvez interroger avec l'opérateur CATSEARCH dans une instruction SELECT ... WHERE CATSEARCH. La figure 23-4 illustre la relation entre la table de catalogue, son index CTXCAT et l'application de catalogue qui utilise l'opérateur CATSEARCH pour interroger l'index.
Figure 4 : Application de requête de catalogue
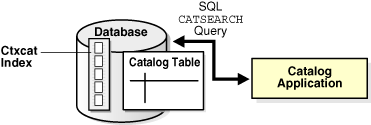
Description de l'image ccapp017.gif
Voir aussi :
-
Guide du développeur Oracle Text Application et Référence Oracle Text
-
Guide du développeur Oracle XML DB pour découvrir comment effectuer une recherche de texte intégral sur des données XML
Présentation d'Oracle Spatial and Graph
Oracle Spatial and Graph (Spatial and Graph) inclut des fonctionnalités avancées pour les analyses et les données spatiales, ainsi que pour les applications graphiques physiques, logiques, réseau et sociales et sémantiques.
Les fonctionnalités spatiales fournissent un schéma et des fonctions qui facilitent le stockage, l'extraction, la mise à jour et l'interrogation des ensembles de fonctionnalités spatiales dans une base de données Oracle. Un exemple de données spatiales est une carte routière. Les données spatiales indiquent l'emplacement de la Terre (comme la longitude et la latitude) des objets sur la carte. Lorsque la carte est rendue, ces données spatiales peuvent projeter les emplacements des objets sur un morceau de papier bidimensionnel. Un système d'information géographique (SIG) peut stocker, récupérer et rendre ces données spatiales relatives à la Terre. Lorsqu'une base de données Oracle stocke ces données spatiales, vous pouvez utiliser Spatial and Graph pour manipuler et extraire ces données, et les associer à d'autres données.
Voir aussi : Guide du développeur Oracle Spatial
Présentation des graphiques de propriétés SQL
La fonctionnalité Property Graph d'Oracle Database offre une prise en charge puissante des graphes pour Oracle Database.
La fonctionnalité Graphique des propriétés vous permet d'explorer et de découvrir des relations complexes dans des ensembles de données tels que les données client, les réseaux sociaux et les transactions financières, pour les applications de recommandation de produits, de détection des fraudes, d'analyse des risques, de marketing ciblé, etc. Cette fonctionnalité de graphe hautes performances offre une prise en charge avancée du langage de requête de graphe, des API de développeur et des fonctionnalités d'analyse avec près de 60 algorithmes prédéfinis.
Les fonctionnalités Property Graph, y compris la prise en charge de PGQL (Property Graph Query Language), sont disponibles à partir d'Oracle Database 12.2. A partir d'Oracle Database version 26ai, vous pouvez également créer et interroger des graphiques de propriétés à l'aide du langage SQL, tel que défini dans la norme SQL:2023.
Oracle Graph Server and Client est un package logiciel qui fonctionne avec la fonctionnalité Property Graph d'Oracle Database. Il inclut des outils de graphes, des bibliothèques client et Oracle Graph Server pour exécuter des algorithmes d'analyse de graphes.
Rubriques connexes