Extractの追加
Extractを追加するための前提条件および考慮事項について学習します。
Extractの追加を開始する前に、次の設定が構成されていることを確認してください。
これで、デプロイメント用にExtractを追加する準備ができました。
以前のExtract証跡ファイルが存在する場合のExtractの作成に関する考慮事項
-
孤立した証跡ファイルが以前の構成からすでに存在する場合にExtractを作成すると、プロセスが失敗する可能性があります。たとえば、
north/ea00000000が以前の構成から残り、削除されていない場合、Extractの作成が失敗する可能性があります。 -
前の証跡順序が存在している間に、上位の順序番号から始まるExtractを再追加すると、Extract構成が同期していないか、正しくない可能性があります。たとえば、
north/ea00002261が存在し、north/ea00002262から始まるExtractを再作成した場合、Extract構成が正しくない可能性があります。このような場合は、既存の証跡ファイルを削除するか、参照されていない場所に移動する必要があります。
抽出情報画面
マイクロサービスのホーム・ページにログインした後、「作成」列の+記号をクリックして、Extractの追加ウィザードを開きます。
「Extractの情報」画面で、Extractのタイプを選択します。データベース・プラットフォームに応じて、使用可能なExtractのタイプは、「統合Extract」、「チェンジ・データ・キャプチャExtract」および「初期ロードExtract」です。
Oracle AI DatabaseにダウンストリームExtractを設定する必要がある場合は、ダウンストリームExtractトグル・スイッチを有効にします。
作成するExtractのタイプを選択し、次を指定します。
-
プロセス名: Extractプロセスの名前です。Extractプロセスの名前は最大8文字です。
-
説明: 作成するExtractプロセスの説明
ノート:初期ロードExtractの作成について学習するには、インスタンス化を参照してください。
「次」をクリックします。
「Extractの登録」画面- PostgreSQLおよびYugabyte Database
ノート: Oracle GoldenGate Extract for Oracle、異なるPostgreSQLフレーバおよびYugabyte Databaseを登録する必要があります。ただし、Extractを追加すると、Extractを登録するための構成オプションが様々な画面に表示されます。
注意: 「PGOUTPUTプラグイン・タイプのガイドラインと制限」も参照してください。
「Register Extract」画面で、次のオプションを構成し、「Register」をクリックします。
-
ソース資格証明: データベースのドメインを指定してください。
-
別名: ソース・ログインのデータベース接続として使用するユーザーID別名を指定するか、表示されたオプションから選択します。
-
(すべてのPostgreSQLフレーバ)プラグイン・タイプ: 論理デコード・プラグイン・タイプpgoutputを選択します。pgoutputは、すべての PostgreSQLフレーバのデフォルトです。
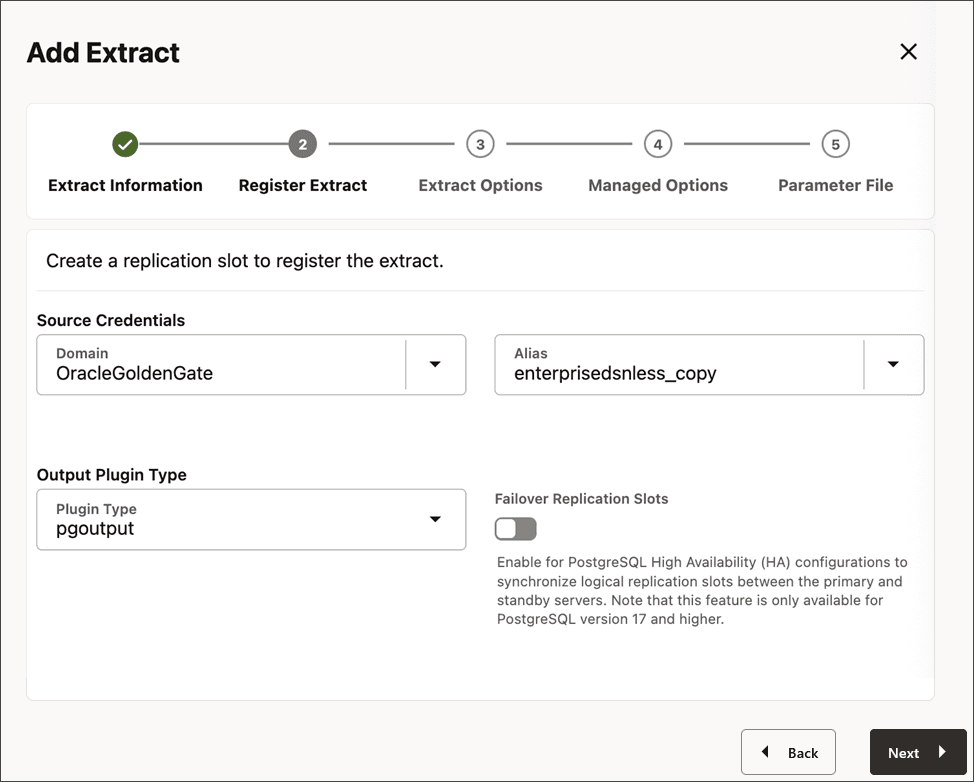
PostgreSQL 17以上のフェイルオーバー・レプリケーション・スロット構成の詳細は、PostgreSQL 17以上のOracle GoldenGateのフェイルオーバー・サポートを参照してください。
-
(Yugabyte Databaseのみ)プラグイン・タイプ: 論理デコード・プラグイン・タイプyboutputを選択します。YBOUTPUTは、Yugabyte Databaseのデフォルトです。
Extractの登録が成功したら、「次へ」をクリックします。
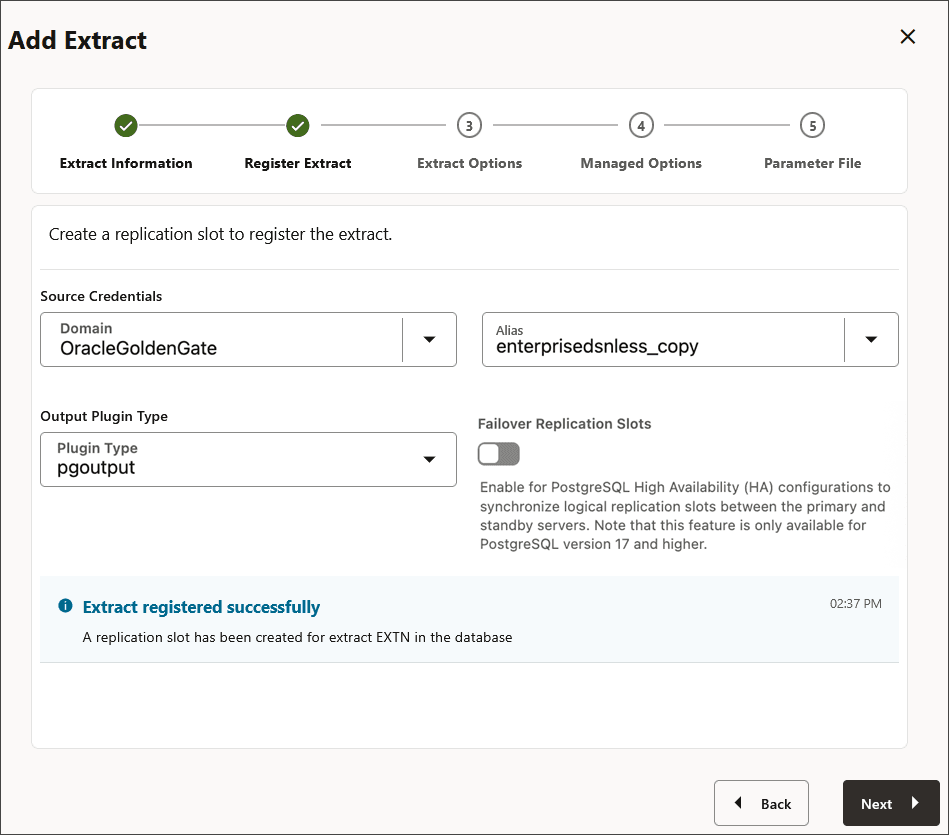
「次」をクリックします。
管理クライアントからのPostgreSQLおよびYugabyteデータベースのExtractの登録
PostgreSQLのExtractは、データベースに登録して、予約済レプリケーション・スロットを付与する必要があります。レプリケーション・スロットは、データベース構成設定max_replication_slotsを介して割り当てられ、データベース構成の説明に従って構成できます。
次の手順に従って、Extractを登録します。Extractの登録は、Extractを作成する前に実行する必要があります。詳細は、Oracle GoldenGateコマンド・ライン・インタフェース・リファレンスのREGISTER EXTRACTを参照してください。
-
デプロイメントに接続してから、ソース・データベースと資格証明別名に接続してください。
CONNECT http*s*://*remotehost*:*srvmgrport* DEPLOYMENT

          *deployment_name* AS *deployment_user* PASSWORD *deployment_password*
OGG (https://*remotehost*:*16000**postgresql_source*)> DBLOGIN USERIDALIAS *alias* -
Extractを登録します。これにより、Extractのレプリケーション・スロットが内部的に作成されます。Extract名は、8文字以内の英数字にする必要があります。
REGISTER EXTRACT *extname*Extractを
pgoutputプラグインに明示的に登録するには、pgoutputプラグイン・タイプを指定する必要があります。REGISTER EXTRACT *extname* PGPLUGINTYPE pgoutput;
Oracle GoldenGate MA WebインタフェースからExtractを登録することもできます。「Extractの追加」を参照してください。
PGOUTPUTプラグイン・タイプのガイドラインおよび制限事項
PGOUTPUTプラグインタイプを構成する際のガイドライン
PostgreSQLのプラグイン・タイプを設定する場合は、次のガイドラインに従います。
-
Extractプロセスを登録する前に、パブリケーションを作成する必要があります。
-
パブリケーション名に、カンマ(、)、一重引用符(')および二重引用符(")の特殊文字を含めることはできません。
-
publication_names内のカンマ区切りリストとして、複数のパブリケーション名を指定できます。たとえば:TRANLOGOPTIONS STREAMINGOPTIONS (publication_names="my*123,my_publication2,123 pub,my_publication";)詳細は、
TRANLOGOPTIONS STREAMINGOPTIONSパラメータを参照してください。 -
リストの最後のパブリケーション名は、セミコロン(;)で終わる必要があります。
制限事項
PostgreSQLのプラグイン・タイプを選択する際には、次の制限が適用されます。
-
タイムゾーン(TZ)環境変数:
WALセンダー・プロセスは常に、OGGセッション・タイムゾーンがUTCと異なるUTC.Ifのコミット・タイムスタンプを送信するため、CDC Extractプロセスのタイムスタンプによる位置決め時に不一致が発生する可能性があります。この問題を回避するには、デプロイメント・レイヤーで環境変数TZ=UTCを設定する必要があります。この制限は、特にpgoutputプラグインに適用されます。 -
複数の切捨て: 複数の切捨て操作は、
pgoutputプラグインでのみサポートされます。test_decodingプラグイン・タイプでは、複数の切捨ては許可されません。 -
一意索引があるが主キーがない表: 表に主キーがなく、一意索引が含まれている場合、レプリカ・アイデンティティは索引を使用するか、
FULLに設定する必要があります。 -
CDC Extractに対するパブリケーション削除の影響: CDC Extractの実行中にパブリケーションが削除された場合、レプリケーション・スロットが破損し、機能が停止するリスクがあります。このような場合、影響を受けるレプリケーションスロットは使用できず、同じパブリケーションを再作成しても問題は解決しません。推奨される解決策は、新しいパブリケーションを作成し、それを新しいレプリケーション・スロットに関連付けてCDC機能をリストアすることです。
-
公開可能な表: パブリケーションに含めることができるのは、永続ベース表およびパーティション表のみです。次のオブジェクト・タイプは公開の一部にできません:
-
一時表
-
ログに記録されていない表
-
外部テーブル
-
マテリアライズド・ビュー
-
通常のビュー
-
-
pgoutputプラグインを使用した双方向レプリケーション・サポート: 双方向レプリケーションに
pgoutputプラグインを使用する場合、CDC Extractプロセスを開始する前に、チェックポイント表を作成して公開リストに含める必要があります。また、レプリケーション・スロットは、チェックポイント表が作成されて公開に追加された後にのみ作成する必要があります。 -
列レベルのパブリケーション制限: パブリケーション内の表の列のサブセットを指定することは、CDCレプリケーションではサポートされていません。パブリケーションにはテーブル全体を含める必要があります。部分列のみを追加しようとすると、CDCストリームでエラーまたはデータの不一致が発生する可能性があります。
「抽出オプション」画面
ノート:この画面には、Extract for Oracle AI Databaseを登録するためのオプションが表示されます。PostgreSQLのExtractを追加する場合、Extractの登録は「Extractの登録」画面で完了します。
「Extractオプション」画面で、次の設定を構成します。
-
Extract証跡:
-
名前: Extract証跡ファイルの名前。証跡ファイルの名前は最大2文字です。
-
サブディレクトリ: Extract証跡が格納されるサブディレクトリのディレクトリ名。
-
トレイル・シーケンス: トレイルの順序番号。
-
トレイル・サイズ: 証跡ファイルの最大サイズ。
-
暗号化プロファイル: 暗号化プロファイルの説明。暗号化プロファイルを作成していない場合は、デフォルトでLocal Walletプロファイルが選択されます。暗号化プロファイルの作成および適用の詳細は、Apply the OKV Encryption Profileを参照してください。
-
暗号化アルゴリズム: Extract証跡ファイルで使用可能な暗号化アルゴリズムのリスト。
ノート:証跡ファイルの暗号化の詳細は、「証跡ファイル暗号化」および「証跡ファイルの暗号化」を参照してください。
-
(Oracleのみ)登録オプション: Oracle AI DatabaseのExtractを登録するには、次のオプションを指定します。
CSN: コミット順序番号(CSN)値。
-
共有: このドロップダウンは、LogMinerデータ・ディクショナリの共有方法を定義するために使用されます。使用可能なオプションは、「自動」、「なし」および「Extract名」です。「自動」は、共有するExtractがシステムで決定されることを意味します。「なし」は、LogMinerデータ・ディクショナリが共有されないことを意味します。「Extract名」は、LogMinerデータ・ディクショナリが指定されたExtractと共有されていることを意味します。
-
最適化済: Extract登録を最適化するには、このオプションを有効にします。
-
管理クライアントからのOracleのExtractの登録
次の手順に従って、Extractを登録します。Extractの登録は、Extractを作成する前に実行する必要があります。
DBLOGINコマンドを使用して、データベースに接続していることを確認します。
詳細は、Oracle GoldenGateコマンドライン・インタフェース・リファレンスの[REGISTER EXTRACT](/pls/topic/lookup?ctx=en/database/goldengate/core/26/coredoc&id=GCLIR-GUID-5E42DB9E-EFDF-40C0-89D7-88413496B8A3)を参照してください。
-
管理クライアントを使用してデプロイメントに接続してから、ソース・データベースの資格証明別名に接続します。
OGG> CONNECT https://*remotehost*:*srvmgrport* DEPLOYMENT *deployment_name* AS *deployment_user* PASSWORD *deployment_password*CONNECTコマンドを実行すると、次の例に示すように、コマンド・プロンプトがnot connectからhttps://servername:port deployment_nameに変わります:OGG (https://*pdbeast.vcn.oracle.com*:*16000**depl_east*)> -
DBLOGINコマンドを使用してデータベースに接続します。OGG (https://*remotehost*:*port**oracle_source*)> DBLOGIN USERIDALIAS *alias* -
Extractを登録します。Extract名は、8文字以内の英数字にする必要があります。
OGG (https://*remotehost*:*port**oracle_source*)> REGISTER EXTRACT *extname* DATABASE
Oracle GoldenGate MA WebインタフェースからExtractを作成するときに、バックグラウンドで抽出を登録することもできます。詳細は、Extractの追加を参照してください。
ダウンストリーム取得画面
Oracleでのみ有効です。
Extractの情報画面で「ダウンストリーム取得」を選択した場合は、「ダウンストリーム取得」オプション画面が表示されます。この画面を使用して、ダウンストリームExtractのダウンストリーム・マイニング・データベース接続を構成します。
-
マイニング資格証明: 「ドメイン」および「別名」ボックスにドメインとユーザーID別名の値を指定します。
-
ユーザーIDなし/ソースDB接続がありません: Active Data Guard (ADG)を使用してマイニング・データベース接続を設定するには、このトグル・スイッチを有効にします。ADGフェッチ資格証明を入力するオプションが表示されます。
-
ドメイン: ADGフェッチ・データベースのドメイン名。
-
別名: ADGフェッチ・データベースのドメイン別名。
-
ノート: ADGによるダウンストリーム取得では、PDBごとのExtractはサポートされていません。
「次」をクリックします。
「管理対象オプション」画面
「管理対象オプション」画面で、Extractプロセスの自動開始および自動再起動オプションを構成します。次の表に、これらのオプションを示します:
次の表に、これらのオプションを示します:
| オプション | 摘要 |
|---|---|
| プロファイル名 | 自動開始および自動再起動プロファイルの名前を指定します。デフォルトまたはカスタムのオプションを選択できます。 すでにプロファイルを作成している場合は、そのプロファイルも選択できます。「カスタム」オプションを選択した場合は、このセクション自体から新しいプロファイルを設定できます。 |
| デプロイメントのヘルスに不可欠 | (Oracleのみ)プロファイルがデプロイメントのヘルスにとってクリティカルな場合、このオプションを有効にします。
ノート: このオプションは、ExtractまたはReplicatの作成時にのみ表示され、「プロファイル」ページで管理対象プロセスを設定するときには表示されません。 |
| 自動開始 | プロセスの自動開始を有効にします。 |
| 開始の遅延 | プロセスの開始まで待機する時間(秒単位) |
| 自動再起動 | プロセスが終了した場合にプロセスを再起動する方法を構成します |
| 最大再試行回数 | プロセスの開始の再試行の最大数を指定します |
| 再試行の遅延 | プロセスの開始を試行する際の遅延時間 |
| 再試行期間 | プロセスの開始を試行する間隔 |
| 失敗時にのみ再起動 | trueの場合、タスクは失敗したときにのみ再開されます。 |
| 試行回数に達したらタスクを無効化 | trueの場合、プロセスの再起動の最大試行回数に達すると、タスクが無効化されます。 |
「次」をクリックします。
「Extractパラメータ・ファイル」画面
「パラメータ・ファイル」画面で、テキスト領域でパラメータ・ファイルを編集して、取得を試行している表詳細をリストできます。Extractパラメータ・ファイルのサンプルを次に示します。
EXTRACT exte
USERIDALIAS ggeast DOMAIN OracleGoldenGate
EXTTRAIL east/ea
DDL INCLUDE MAPPED
TABLE hr.*;「作成および実行」をクリックして、Extractを作成および起動します。「作成」を選択した場合、Extractは作成されますが、Extractのオプションを使用して起動する必要があります。
管理サービスのホームページまたは作成したすべてのExtractがリストされる「Extract」ページに戻ります。
Extract用のパラメータ・ファイルの作成
次の手順に従って、Extractのパラメータ・ファイルを作成します。
-
(MySQLのみ) Windowsサーバーおよびリモート・ホスト上にあるLinuxサーバー(23.10.xより前のOGGバージョン)でMySQL用のOracle GoldenGateを実行する場合データベース・サーバーでは、タイムゾーンが同じであることを確認し、同じでない場合はExtract内の
SETENV(TZ)パラメータを使用して、データベース・サーバーのタイムゾーンに設定します。TZ形式および詳細は、『パラメータおよびファンクション・リファレンス・ガイド』のSETENVパラメータに関する項を参照してください。
参照情報については、次のリンクを参照してください。
https://learn.microsoft.com/en-us/cpp/c-runtime-library/reference/tzset?view=msvc-170#remarks
https://www.gnu.org/software/libc/manual/html_node/TZ-Variable.html
-
ソース・システムで、次のコマンドを発行します。
EDIT PARAMS extract_nameここで:
extract_nameは、ADD EXTRACTコマンドで作成したExtractの名前か、または、グループの作成時に代替の場所を定義した場合は、パラメータ・ファイルの完全修飾名になります。 -
次の表に表示されている順序でパラメータを入力します。パラメータ文ごとに新規行を開始します。一部のパラメータは、特定の構成にのみ適用されます。
パラメータ 摘要 EXTRACT group- groupは、
ADD EXTRACTコマンドで作成したExtractグループの名前です。
Extractをチェックポイント付きのオンライン・プロセスとして構成します。 [, USERIDALIAS alias options ]データベース資格証明を指定するには、 [USERIDALIAS](/pls/topic/lookup?ctx=en/database/goldengate/core/26/coredoc&id=GWURF-GUID-530D7773-B66D-4499-A509-EF5BB9CE9B05)を参照してください。ENCRYPTTRAIL algorithmこのエントリの後に指定した証跡がすべて暗号化されます。 SOURCECATALOGOracleマルチテナント・コンテナ・データベース内のデフォルト・コンテナを SEQUENCE文に指定します。それらのデータベースに対して3つの部分からなる名前が必要であるとされる場合に、2つの部分からなる名前(schema.object)を使用できるようにします。このパラメータのインスタンスを複数使用すると、TABLEまたはSEQUENCEのパラメータの異なる組合せに対して、異なるデフォルト・コンテナまたはカタログを指定できます。TABLE [container. \| catalog.]owner.object \| schema.object \| library/file \| library/file(member);オブジェクトの完全修飾名(複数オブジェクトの場合は完全修飾ワイルドカード表記)を指定します。データベースがOracleマルチテナント・コンテナ・データベースの場合は、
SOURCECATALOGが使用されていないかぎり、オブジェクト名にコンテナまたはカタログの名前を含める必要があります。schemaは、スキーマ名またはスキーマのワイルドカード・セットです。objectは表名またはワイルドカードを使用した表のセットです。libraryは、IBM iライブラリ名またはワイルドカードを使用したライブラリのセットです。fileは、IBM i物理ファイル名またはワイルドカードを使用した物理ファイルのセットです。memberは、IBM i物理ファイル・メンバー名またはワイルドカードを使用したメンバー名のセットです。IBM iネイティブ名の形式(オプション・メンバーを含むライブラリ/ファイル)を使用する場合、有効なワイルドカードは、少なくとも1つの有効な文字の後に末尾のアスタリスト(*)または*ALLが続く名前のみです。
ノート:
メンバー名はオプションであり、オブジェクト名の一部として証跡にメンバー名を書き込む必要がある場合に指定する必要があります。メンバー名を指定しない場合、物理ファイル内のすべてのメンバーは、証跡内の単一のオブジェクトとして暗黙的にマージされます。パラメータ・ファイル内のオブジェクト名を指定するためのガイドラインは、「Oracle GoldenGateの入力におけるオブジェクト名の指定」を参照してください。
SCHEMAEXCLUDETABLEEXCLUDEEXCLUDEWILDCARDOBJECTSONLY関連付けられた TABLE文のワイルドカード表記から特定のオブジェクトを除外するために、互いに組み合せて使用できるパラメータ。 - groupは、
-
Oracle GoldenGateパラメータにリストされている適切なオプションのExtractパラメータを入力します。
-
パラメータ・ファイルを保存して閉じます。
次のExtractパラメータ・ファイルのサンプルでは、Extractの様々な構成パラメータおよびオプションについて説明します。
ADD EXTRACT *extract_name*
{, datasource}
{, BEGIN start_point} | {position_point}
[, PARAMS pathname]
[, REPORT pathname]
[, DESC 'description']-
extract_nameは、Extractグループの名前です。グループ名は必須です。 -
datasourceは、抽出するデータのソースを指定する場合に必要です。次のいずれかを使用します。-
TRANLOGでは、データソースとしてトランザクション・ログを指定します。Oracle Enterprise Editionでこのオプションを使用する場合は、ADD EXTRACTを使用する前に(かつ、DELETE EXTRACTを発行してExtractグループを削除する前に)、Extractデータベース・ユーザー(または同じ権限を持つユーザー)としてDBLOGINコマンドを発行する必要があります。Db2 z/OSのbsdsオプションを使用して、トランザクション・ログのブートストラップ・データセットのファイル名を指定します。
-
INTEGRATED TRANLOGでは、このExtractが統合キャプチャ・モードで動作して、Oracle AI Databaseのログマイニング・サーバーから論理変更レコード(LCR)を受信することを指定します。このパラメータは、Oracleデータベースにのみ適用されます。 -
EXTTRAILSOURCE trail_nameでは、ローカル証跡の相対名または完全修飾名を指定します。
-
-
BEGIN start_pointでは、処理のための初期チェックポイントおよび開始ポイントを確定してオンラインExtractグループを定義します。このポイントより前に開始されたトランザクションは、破棄されます。次のいずれかを使用します。 -
NOWは、グループを作成するために
ADD EXTRACTコマンドが実行された時点(統合モードのExtractの場合は、REGISTER EXTRACTコマンドでグループが登録された時点から)のタイムスタンプが与えられた変更の抽出を開始します。Extractは、OracleおよびPostgreSQLデータベースにのみ登録する必要があります。Timestamp: 開始ポイントとして正確なタイムスタンプを指定するための書式です。レプリケーションまたはロギングが有効化された時点より後の開始ポイントを使用してください。
次の例は、特定のタイムスタンプを使用したExtractの再配置を示しています。
<pre class="copy"><code>OGG (http://localhost:11000 ggeast as pdb1@east.oracle.com) 95> dblogin useridalias ggma Successfully logged into database PDB1.</code></pre> <pre class="copy"><code>OGG (http://localhost:11000 ggeast as ggma@ggeast/PDB1) 96> alter extract exte , begin 2024-05-03T03:48:00Z 2024-05-03T03:50:49Z INFO OGG-08100 Extract exte I/O position is altered and reposition to older date and time position 2024-05-03 03:48:00.000000 current date and time position 2024-05-03 03:49:04.000000. Duplicate transactions are filtered out. Perform output trail ETROLLOVER if duplicate transaction output is desired, or Extract configuration was updated. 2024-05-03T03:50:49Z INFO OGG-08100 Extract altered.</code></pre> -
position_pointは、特定のトランザクション・ログ・ファイル内で処理を開始する位置を指定します。データベースで使用する特定の構文。 -
PARAMSpathnameは、このグループのパラメータ・ファイルをOracle GoldenGateディレクトリのdirprmサブディレクトリ以外の場所に格納する場合に必要です。完全修飾名を指定します。デフォルトの場所をお薦めします。 -
REPORT pathnameは、このグループのプロセス・レポートをOracle GoldenGateディレクトリのdirrptサブディレクトリ以外の場所に格納する場合に必要です。完全修飾名を指定します。デフォルトの場所をお薦めします。 -
DESC 'description'では、グループの説明を指定します。
Extract用のその他のパラメータ・オプション
Extract構成に必要なその他のパラメータについて学習します。
Extractでは、マイニング・データベースのデータベース・ログマイニング・サーバーを使用して、ソース・データベースのREDOストリームをマイニングします。Extractパラメータ・ファイルでINTEGRATEDPARAMSオプションを指定してTRANLOGOPTIONSパラメータを使用することで、ログ・マイニング・サーバーに固有のパラメータを設定できます。
ノート:これらのパラメータの詳細情報および使用方法の詳細は、『Oracle AI Database PL/SQLパッケージおよびタイプ・リファレンス』のDBMS_CAPTURE_ADMに関する項を参照してください。
INTEGRATEDPARAMSとともに設定できるパラメータは、次のとおりです。
-
CAPTURE_IDKEY_OBJECTS:FETCHでサポートされるオブジェクトのキャプチャを制御します。Oracle GoldenGateのデフォルトはYです(キャプチャIDキーの論理変更レコード)。 -
DOWNSTREAM_REAL_TIME_MINE: ログマイニング・サーバーが、リアルタイムのダウンストリーム・キャプチャ・プロセスとして動作するか、アーカイブ・ログのダウンストリーム・キャプチャ・プロセスとして動作するかを制御します。デフォルトはNです(アーカイブ・ログ・モード)。ダウンストリーム・ログマイニング・サーバー構成でリアルタイム・キャプチャを使用するには、このパラメータを指定します。ダウンストリーム・マイニング構成の設定の詳細は、「Oracle GoldenGateデプロイメントでのダウンストリームExtract」を参照してください。 -
INLINE_LOB_OPTIMIZATION: LOBチャンクLCRを送信するかわりに、インラインで処理できるLOB (小さいLOBなど)をLCRに直接含めるかどうかを制御します。Oracle GoldenGateのデフォルトはYです(はい)。 -
MAX_SGA_SIZE: ログマイニング・サーバーで使用される共有メモリーの量を制御します。共有メモリーはSGAのStreamsプールから取得されます。デフォルトは1 GBです。 -
PARALLELISM: ログマイニング・サーバーで使用されるプロセスの数を制御します。デフォルトは2です。Oracle Standard Editionの場合は、1に設定する必要があります。 -
TRACE_LEVEL: Extractログマイニング・サーバーのトレース・レベルを制御します。Oracleサポートの指示を受ける場合のみ使用します。Oracle GoldenGateのデフォルトは0です(トレースなし)。 -
WRITE_ALERT_LOG: Extractログマイニング・サーバーがOracleアラート・ログにメッセージを書き込むかどうかを制御します。Oracle GoldenGateのデフォルトはYです(はい)。
「サーバー・リソースの管理」を参照してください。