인덱스 및 인덱스 구성 테이블
인덱스는 테이블 행에 대한 액세스 속도를 높이는 스키마 객체입니다. 인덱스 구성 테이블은 인덱스 구조에 저장된 테이블입니다.
-
인덱스 소개 인덱스는 때때로 데이터 액세스 속도를 높일 수 있는 테이블 또는 테이블 클러스터와 연관된 선택적 구조입니다.
-
균형이 조정된 트리의 약어인 B 트리 인덱스 개요 B 트리는 가장 일반적인 데이터베이스 인덱스 유형입니다. B 트리 인덱스는 범위로 나눈 정렬된 값 목록입니다. B 트리는 키를 행 또는 행 범위와 연관시켜 정확한 일치 및 범위 검색을 포함하여 광범위한 질의에 대해 뛰어난 검색 성능을 제공합니다.
-
비트맵 인덱스 개요 비트맵 인덱스에서 데이터베이스는 각 인덱스 키에 대한 비트맵을 저장합니다. 기존의 B 트리 인덱스에서 하나의 인덱스 항목이 단일 행을 가리킵니다. 비트맵 인덱스에서 각 인덱스 키는 여러 행에 대한 포인터를 저장합니다.
-
함수 기반 인덱스 개요 함수 기반 인덱스는 하나 이상의 열을 포함하는 함수 또는 표현식의 값을 계산하여 인덱스에 저장합니다. 함수 기반 인덱스는 B 트리 또는 비트맵 인덱스일 수 있습니다.
-
응용 프로그램 도메인 인덱스 개요 응용 프로그램 도메인 인덱스는 응용 프로그램과 관련된 사용자 정의된 인덱스입니다.
-
스칼라 수량화된 HNSW 인덱스 개요 스칼라 수량화된 HNSW(Hierarchical Navigable Small World) 인덱스를 사용하여 메모리 요구 사항을 줄이고 유사성 검색을 가속화할 수 있습니다.
-
인덱스 구성 테이블 개요 인덱스 구성 테이블은 B 트리 인덱스 구조의 변형에 저장된 테이블입니다. 반면, 힙 구성 테이블은 적합한 위치에 행을 삽입합니다.
인덱스 소개
인덱스는 때때로 데이터 액세스 속도를 높일 수 있는 테이블 또는 테이블 클러스터와 연관된 선택적 구조입니다.
인덱스는 연관된 객체의 데이터와 논리적으로 또는 물리적으로 독립적인 스키마 객체입니다. 따라서 인덱스화된 테이블에 물리적으로 영향을 주지 않고 인덱스를 삭제하거나 생성할 수 있습니다.
주: 인덱스를 삭제해도 응용 프로그램은 계속 작동합니다. 그러나 이전에 인덱스화된 데이터에 대한 액세스가 느려질 수 있습니다.
예를 들어 HR 관리자에게 골판지 상자 선반이 있다고 가정해 보겠습니다. 사원 정보가 포함된 폴더는 상자에 무작위로 삽입됩니다. 직원 Whalen(ID 200)의 폴더는 상자 1의 맨 아래에서 위로 10개의 폴더이고 King의 폴더(ID 100)는 상자 3의 맨 아래에 있습니다. 폴더를 찾기 위해 관리자는 상자 1의 모든 폴더를 아래에서 위로 찾은 다음 폴더가 발견될 때까지 상자에서 상자로 이동합니다. 관리자는 액세스 속도를 높이기 위해 폴더 위치를 사용하여 모든 사원 ID를 순차적으로 나열하는 인덱스를 생성할 수 있습니다.
ID 100: Box 3, position 1 (bottom)
ID 101: Box 7, position 8
ID 200: Box 1, position 10
.
.
.
마찬가지로 관리자는 사원의 성, 부서 ID 등에 대해 별도의 인덱스를 생성할 수 있습니다.
이 단원에서는 다음 항목을 다룹니다.
-
인덱스의 장점 및 단점 인덱스가 없거나 존재하는 경우 SQL 문의 표현을 변경할 필요가 없습니다.
-
인덱스 사용성 및 가시성 인덱스는 사용 가능(기본값) 또는 사용 불가능, 표시(기본값) 또는 보이지 않음입니다.
-
키 및 열 키는 인덱스를 작성할 수 있는 열 또는 표현식 세트입니다.
-
조합 인덱스 조합 인덱스는 연결된 인덱스라고도 하며 테이블의 여러 열에 대한 인덱스입니다.
-
고유 및 비고유 인덱스 인덱스는 고유하거나 고유하지 않을 수 있습니다. 고유 인덱스는 테이블의 두 행이 키 열에서 중복된 값을 가지지 않도록 보장합니다.
-
인덱스 유형 Oracle AI Database는 상호 보완적인 성능 기능을 제공하는 여러 인덱스화 체계를 제공합니다.
-
데이터베이스에서 인덱스를 유지 관리하는 방법 데이터베이스는 인덱스가 생성된 후 자동으로 인덱스를 유지 관리하고 사용합니다.
-
인덱스 스토리지 Oracle AI Database는 인덱스 세그먼트에 인덱스 데이터를 저장합니다.
인덱스의 장점과 단점
인덱스가 없거나 존재하는 경우 SQL 문의 표현을 변경할 필요가 없습니다.
인덱스는 단일 데이터 행에 대한 빠른 액세스 경로입니다. 이는 실행 속도에만 영향을 줍니다. 인덱스화된 데이터 값이 제공된 경우 인덱스는 해당 값을 포함하는 행의 위치를 직접 가리킵니다.
테이블의 하나 이상의 열에 인덱스가 있는 경우 데이터베이스는 경우에 따라 테이블에서 임의로 분산된 작은 행 집합을 검색할 수 있습니다. 인덱스는 디스크 I/O를 줄이는 여러 가지 방법 중 하나입니다. 힙 구성 테이블에 인덱스가 없는 경우 데이터베이스는 전체 테이블 스캔을 수행하여 값을 찾아야 합니다. 예를 들어, 인덱스화되지 않은 hr.departments 테이블에 있는 2700 위치의 질의를 사용하려면 데이터베이스가 모든 블록의 모든 행을 검색해야 합니다. 이 접근 방식은 데이터 볼륨이 증가할 뿐 아니라 확장되지도 않습니다.
인덱스의 단점은 다음과 같습니다.
-
인덱스를 수동으로 생성하려면 데이터 모델, 응용 프로그램 및 데이터 분산에 대한 깊은 지식이 필요한 경우가 많습니다.
-
데이터가 변경되면 인덱스에 대한 이전 결정 사항을 다시 확인해야 합니다. 인덱스의 유용성이 중지되거나 새 인덱스가 필요할 수 있습니다.
-
인덱스는 디스크 공간을 차지합니다.
-
데이터베이스는 인덱스화된 데이터에서 DML이 발생할 때 인덱스를 갱신해야 하므로 성능 오버헤드가 발생합니다. 주: Oracle Database 19c부터 Oracle 데이터베이스는 응용 프로그램 작업 로드를 지속적으로 모니터하여 인덱스를 자동으로 생성하고 관리할 수 있습니다. 자동화된 인덱스화는 고정된 간격으로 실행되는 데이터베이스 작업으로 구현됩니다.
다음과 같은 경우에 인덱스를 생성해 보십시오.
-
인덱스화된 열은 자주 질의되며 테이블에 있는 전체 행 수의 작은 비율을 반환합니다.
-
참조 무결성 제약 조건은 인덱스화된 열에 존재합니다. 인덱스는 상위 테이블 기본 키를 업데이트하거나 상위 테이블로 병합하거나 상위 테이블에서 삭제하는 경우 필요한 전체 테이블 잠금을 방지하기 위한 수단입니다.
-
테이블에 unique key 제약 조건이 지정되고 인덱스 및 모든 인덱스 옵션을 수동으로 지정하려는 경우
참조:
-
자동 인덱싱에 대해 자세히 알아보려면 Oracle AI Database Administrator's Guide를 참조하십시오.
-
다양한 에디션 및 서비스에 지원되는 기능에 대한 자세한 내용은 Oracle AI Database Licensing Information User Manual을 참조하십시오.
인덱스 사용성 및 가시성
인덱스는 사용 가능(기본값)하거나 사용할 수 없음, 표시(기본값) 또는 보이지 않음으로 표시됩니다.
이러한 등록 정보는 다음과 같이 정의됩니다.
-
유용성
옵티마이저에서 무시되는 사용할 수 없는 인덱스는 DML 작업에 의해 유지 관리되지 않습니다. 사용할 수 없는 인덱스는 대량 로드 성능을 향상시킬 수 있습니다. 인덱스를 삭제하고 나중에 재생성하는 대신 인덱스를 사용할 수 없게 만든 다음 재구축할 수 있습니다. 사용할 수 없는 인덱스 및 인덱스 분할 영역은 공간을 소비하지 않습니다. 사용 가능한 인덱스를 사용할 수 없게 만들면 데이터베이스는 해당 인덱스 세그먼트를 삭제합니다.
-
가시성
보이지 않는 인덱스는 DML 작업에 의해 유지 관리되지만 옵티마이저에 의해 기본적으로 사용되지 않습니다. 인덱스를 사용할 수 없게 만들거나 삭제하는 대신 보이지 않게 만들 수 있습니다. 보이지 않는 인덱스는 인덱스를 삭제하기 전에 또는 전체 응용 프로그램에 영향을 주지 않고 인덱스를 일시적으로 사용하는 경우에 특히 유용합니다.
참조: 최적기가 실행 계획을 선택하는 방법에 대한 자세한 내용은 "최적기 개요"를 참조하십시오.
키 및 열
키는 인덱스를 작성할 수 있는 열 또는 표현식 집합입니다.
용어가 서로 바꿔서 사용되는 경우가 많지만 인덱스와 키는 다릅니다. 인덱스는 사용자가 SQL 문을 사용하여 관리하는 데이터베이스에 저장된 구조입니다. 키는 엄격하게 논리적 개념입니다.
다음 명령문은 샘플 테이블 oe.orders의 customer_id 열에 인덱스를 생성합니다.
CREATE INDEX ord_customer_ix ON orders (customer_id);앞의 명령문에서 customer_id 열은 인덱스 키입니다. 인덱스 자체의 이름은 ord_customer_ix입니다.
주: 기본 키와 고유 키는 자동으로 인덱스를 가지지만 외래 키에서 인덱스를 생성할 수 있습니다.
참조:
-
"데이터 무결성 "
-
Oracle AI Database SQL Language Reference
CREATE INDEX구문 및 의미
조합 색인
조합 인덱스는 연결된 인덱스라고도 하며 테이블의 여러 열에 대한 인덱스입니다.
데이터를 검색할 query에 가장 적합한 순서로 열을 조합 인덱스에 배치합니다. 열은 테이블에서 인접할 필요가 없습니다.
조합 인덱스는 WHERE 절이 조합 인덱스에 있는 열의 전체 또는 선행 부분을 참조하는 SELECT 문의 데이터 검색 속도를 높일 수 있습니다. 따라서 정의에 사용되는 열의 순서가 중요합니다. 일반적으로 가장 일반적으로 액세스하는 열이 우선합니다.
예를 들어, 애플리케이션이 employees 테이블의 last_name, job_id 및 salary 열을 자주 질의한다고 가정합니다. 또한 last_name에 높은 기수가 있다고 가정합니다. 즉, 구분 값 수가 테이블 행 수에 비해 큽니다. 다음 열 순서로 인덱스를 생성합니다.
CREATE INDEX employees_ix
   ON employees (last_name, job_id, salary);
세 개의 열, last_name 열 또는 last_name 및 job_id 열에만 액세스하는 질의는 이 인덱스를 사용합니다. 이 예제에서 last_name 열에 액세스하지 않는 질의는 인덱스를 사용하지 않습니다.
주: 선행 열의 기수가 매우 낮은 경우와 같이 데이터베이스에서 이 인덱스의 스캔 건너뛰기를 사용할 수 있습니다("인덱스 스캔 건너뛰기 참조).
다음 조건 중 하나를 충족하는 경우 동일한 열 순서로 동일한 테이블에 다중 인덱스가 존재할 수 있습니다.
-
인덱스의 유형은 서로 다릅니다.
예를 들어, 동일한 열에 비트맵 인덱스와 B 트리 인덱스를 생성할 수 있습니다.
-
인덱스는 서로 다른 Partitioning 방식을 사용합니다.
예를 들어, 로컬로 분할된 인덱스와 전역적으로 분할된 인덱스를 생성할 수 있습니다.
-
인덱스는 서로 다른 고유성 속성을 가집니다.
예를 들어, 동일한 열 집합에 고유 인덱스와 비고유 인덱스를 모두 생성할 수 있습니다.
예를 들어, 분할되지 않은 인덱스, Global Partition 인덱스 및 로컬 Partition 인덱스는 동일한 테이블 열에 대해 동일한 순서로 존재할 수 있습니다. 동일한 순서의 열 수가 동일한 인덱스는 한 번에 하나만 볼 수 있습니다.
이 기능을 사용하면 기존 인덱스를 삭제한 후 다른 속성으로 재생성하지 않고도 응용 프로그램을 이전할 수 있습니다. 또한 이 기능은 인덱스 키가 계속 증가하여 데이터베이스가 동일한 인덱스 블록 집합에 새 항목을 삽입하도록 하는 OLTP 데이터베이스에서 유용합니다. 이러한 "핫 스팟"을 완화하려면 분할되지 않은 인덱스에서 글로벌 분할 인덱스로 인덱스를 전개할 수 있습니다.
동일한 열 집합의 인덱스가 유형 또는 Partitioning 스키마에서 다르지 않으면 이러한 인덱스는 서로 다른 열 순열을 사용해야 합니다. 예를 들어, 다음 SQL 문은 유효한 열 순열을 지정합니다.
CREATE INDEX employee_idx1 ON employees (last_name, job_id);
CREATE INDEX employee_idx2 ON employees (job_id, last_name);
참조: Oracle AI Database SQL Tuning Guide에서 동일한 열 집합에 다중 인덱스를 생성하는 방법에 대해 자세히 알아봅니다.
고유 및 Nonunique 인덱스
인덱스는 고유할 수도 있고 고유하지 않을 수도 있습니다. 고유 인덱스는 테이블의 두 행이 키 열에서 중복된 값을 가지지 않도록 보장합니다.
예를 들어, 응용 프로그램에서 동일한 사원 ID를 가진 두 명의 사원이 없도록 요구할 수 있습니다. 고유 인덱스에서는 각 데이터 값에 대해 하나의 rowid가 존재합니다. 최하위 블록의 데이터는 키별로만 정렬됩니다.
비고유 인덱스는 인덱스화된 열에서 중복 값을 허용합니다. 예를 들어, employees 테이블의 first_name 열은 여러 개의 Mike 값을 포함할 수 있습니다. 비고유 인덱스의 경우 rowid는 정렬된 순서대로 키에 포함되므로 비고유 인덱스는 인덱스 키와 rowid(오름차순)를 기준으로 정렬됩니다.
Oracle AI Database는 비트맵 인덱스를 제외하고 또는 클러스터 키 열 값이 널인 경우를 제외하고 모든 키 열이 null인 테이블 행을 인덱스화하지 않습니다.
인덱스 유형입니다.
Oracle AI Database는 보완적인 성능 기능을 제공하는 여러 인덱스화 체계를 제공합니다.
B 트리 인덱스는 표준 인덱스 유형입니다. 고선택적 인덱스(각 인덱스 항목에 해당하는 행은 거의 없음) 및 Primary Key 인덱스에 적합합니다. 연결된 인덱스로 사용되는 B 트리 인덱스는 인덱스화된 열을 기준으로 정렬된 데이터를 검색할 수 있습니다. B 트리 인덱스는 다음 표에 나오는 서브타입을 가집니다.
표 1 B 트리 인덱스 하위 유형
| B 트리 색인 하위 유형 | 설명 | 자세히 알아보기 |
|---|---|---|
| 인덱스 구성 테이블 | 인덱스 구성 테이블은 데이터 자체가 인덱스이므로 힙 구성 테이블과 다릅니다. | "인덱스 구성 테이블 개요" |
| 역방향 키 인덱스 | 이 유형의 인덱스에서는 인덱스 키의 바이트가 반전됩니다. 예를 들어, 103은 301로 저장됩니다. 바이트의 반전은 여러 블록에 걸쳐 인덱스에 삽입을 분산시킵니다. | "역방향 키 인덱스" |
| 내림차순 인덱스 | 이 유형의 인덱스는 특정 열의 데이터를 내림차순으로 저장합니다. | "오름차순 및 내림차순 인덱스" |
| B 트리 클러스터 인덱스 | 이 유형의 인덱스는 특정 열의 데이터를 내림차순으로 저장합니다. | "오름차순 및 내림차순 인덱스" |
다음 표에서는 B 트리 구조를 사용하지 않는 인덱스 유형을 보여줍니다.
테이블 2 인덱스가 B 트리 구조를 사용하지 않음
| 유형 | 설명 | 자세히 알아보기 |
|---|---|---|
| 비트맵 및 비트맵 조인 인덱스 | 비트맵 인덱스에서 인덱스 항목은 비트맵을 사용하여 여러 행을 가리킵니다. 반대로 B 트리 인덱스 항목은 단일 행을 가리킵니다. 비트맵 조인 인덱스는 둘 이상의 테이블 조인을 위한 비트맵 인덱스입니다. | "비트맵 인덱스 개요" |
| 함수 기반의 인덱스 | 이 유형의 인덱스에는 UPPER 함수와 같은 함수에 의해 변환되거나 표현식에 포함된 열이 포함됩니다. B 트리 또는 비트맵 인덱스는 함수 기반 인덱스일 수 있습니다. |
"함수 기반 인덱스 개요" |
| 응용 프로그램 도메인 인덱스 | 유저는 응용 프로그램 특정 도메인의 데이터에 대해 이 유형의 인덱스를 생성합니다. 물리적 인덱스는 기존의 인덱스 구조를 사용할 필요가 없으며 Oracle 데이터베이스에 테이블로 저장하거나 외부에 파일로 저장할 수 있습니다. | "응용 프로그램 도메인 인덱스 개요" |
참조:
-
Oracle AI Database Administrator's Guide - 인덱스 관리 방법 학습
-
다양한 인덱스 액세스 경로에 대해 알아보려면 Oracle AI Database SQL Tuning Guide를 참조하십시오.
데이터베이스에서 인덱스를 유지하는 방법
데이터베이스는 인덱스가 생성된 후 자동으로 유지 관리 및 사용됩니다.
인덱스는 기본 테이블에 대한 데이터 변경 사항을 자동으로 반영합니다. 변경의 예로는 행 추가, 갱신 및 삭제가 있습니다. 사용자 작업이 필요하지 않습니다.
인덱스화된 데이터의 검색 성능은 행이 삽입되더라도 거의 일정하게 유지됩니다. 그러나 데이터베이스에 인덱스도 갱신해야 하므로 테이블에 인덱스가 많으면 DML 성능이 저하됩니다.
참조:
-
자동 인덱싱에 대해 자세히 알아보려면 Oracle AI Database Administrator's Guide를 참조하십시오.
-
다양한 에디션 및 서비스에 지원되는 기능에 대한 자세한 내용은 Oracle AI Database Licensing Information User Manual을 참조하십시오.
인덱스 저장 영역
Oracle AI Database는 인덱스 세그먼트에 인덱스 데이터를 저장합니다.
데이터 블록의 인덱스 데이터에 사용할 수 있는 공간은 데이터 블록 크기에서 블록 오버헤드, 입력 오버헤드, rowid 및 인덱스화된 각 값에 대해 한 길이의 바이트를 뺀 값입니다.
인덱스 세그먼트의 테이블스페이스는 소유자의 기본 테이블스페이스이거나 CREATE INDEX 문에서 특별히 이름이 지정된 테이블스페이스입니다. 손쉬운 관리를 위해 인덱스를 테이블과 다른 별도의 테이블스페이스에 저장할 수 있습니다. 예를 들어, 재구축할 수 있는 인덱스만 포함하는 테이블스페이스는 백업하지 않도록 선택할 수 있으므로 백업에 필요한 시간과 저장 영역을 줄일 수 있습니다.
참조: 인덱스 블록 유형(루트, 분기 및 최하위) 및 인덱스 항목이 블록 내에 저장되는 방법에 대한 자세한 내용은 "인덱스 블록 개요"를 참조하십시오.
B 트리 인덱스 개요
균형이 조정된 트리의 약어인 B 트리는 가장 일반적인 데이터베이스 인덱스 유형입니다. B 트리 인덱스는 범위로 나눈 정렬된 값 목록입니다. B 트리는 키를 행 또는 행 범위와 연관시켜 정확한 일치 및 범위 검색을 포함하여 광범위한 질의에 대해 뛰어난 검색 성능을 제공합니다.
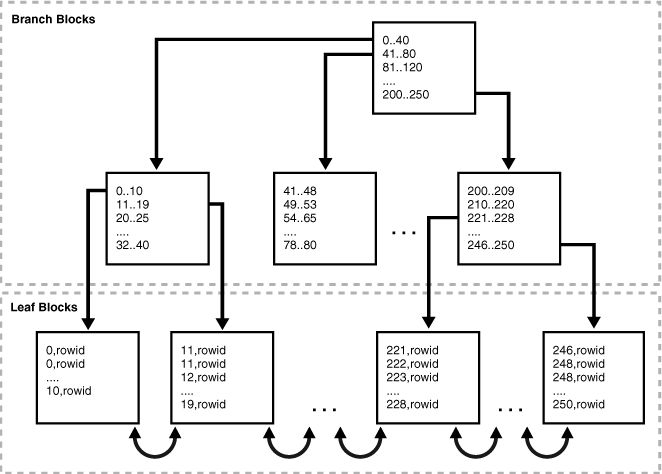
다음 그림은 B 트리 인덱스의 구조를 보여줍니다. 예제에서는 employees 테이블의 외래 키 열인 department_id 열에 대한 인덱스를 보여줍니다.
그림 1: B 트리 인덱스의 내부 구조
이 단원에서는 다음 항목을 다룹니다.
-
지점 블록 및 최하위 블록 B 트리 인덱스에는 검색용 지점 블록과 키 값 저장용 리프 블록의 두 가지 유형의 블록이 있습니다. B 트리 인덱스의 상위 레벨 분기 블록은 하위 레벨 인덱스 블록을 가리키는 인덱스 데이터를 포함합니다.
-
인덱스 스캔 인덱스 스캔에서 데이터베이스는 명령문에 의해 지정된 인덱스화된 열 값을 사용하여 인덱스를 순회하여 행을 검색합니다. 데이터베이스가 인덱스에서 값을 스캔하면 n I/O에서 이 값을 찾을 수 있습니다. 여기서 n은 B 트리 인덱스의 높이입니다. 이는 Oracle AI Database 인덱스의 기본 원칙입니다.
-
역방향 키 인덱스 역방향 키 인덱스는 열 순서를 유지하면서 각 인덱스 키의 바이트를 물리적으로 반전하는 B 트리 인덱스 유형입니다.
-
오름차순 및 내림차순 인덱스 오름차순 인덱스에서 Oracle AI Database는 데이터를 오름차순으로 저장합니다. 기본적으로 문자 데이터는 값의 각 바이트에 포함된 이진 값, 가장 작은 숫자에서 가장 큰 숫자의 숫자 데이터, 가장 이른 값에서 가장 늦은 값으로의 날짜 순으로 정렬됩니다.
-
인덱스 압축 인덱스의 공간을 줄이기 위해 Oracle AI Database는 다양한 압축 알고리즘을 사용할 수 있습니다.
분기 블록 및 리프 블록
B 트리 인덱스에는 검색용 분기 블록과 키 값 저장용 리프 블록의 두 가지 유형의 블록이 있습니다. B 트리 인덱스의 상위 레벨 분기 블록은 하위 레벨 인덱스 블록을 가리키는 인덱스 데이터를 포함합니다.
그림 5-1에서 루트 분기 블록에는 다음 분기 레벨에서 가장 왼쪽 블록을 가리키는 0-40 항목이 있습니다. 이 분기 블록은 0-10 및 11-19 등의 항목을 포함합니다. 이러한 각 항목은 해당 범위에 속하는 키 값을 포함하는 최하위 블록을 가리킵니다.
모든 최하위 블록은 자동으로 동일한 깊이에 있기 때문에 B 트리 인덱스의 균형이 조정됩니다. 따라서 인덱스의 임의 위치에서 레코드를 검색하는 데는 거의 동일한 시간이 걸립니다. 인덱스의 높이는 루트 블록에서 최하위 블록으로 이동하는 데 필요한 블록 수입니다. 분기 레벨은 높이에서 1을 뺀 값입니다. 그림 5-1에서 인덱스의 높이는 3이고 분기 레벨은 2입니다.
분기 블록은 두 키 간에 분기 결정을 내리는 데 필요한 최소 키 접두어를 저장합니다. 이 기술을 사용하면 데이터베이스가 각 분기 블록에 대해 가능한 많은 데이터에 맞출 수 있습니다. 분기 블록은 키를 포함하는 하위 블록에 대한 포인터를 포함합니다. 키 및 포인터의 수는 블록 크기에 의해 제한됩니다.
최하위 블록에는 모든 인덱스화된 데이터 값과 실제 행을 찾는 데 사용되는 해당 rowid가 포함됩니다. 각 항목은 (key, rowid)별로 정렬됩니다. 최하위 블록 내에서 키와 rowid는 왼쪽과 오른쪽 동위 항목에 연결됩니다. 잎 블록 자체도 두 배로 연결됩니다. 그림 5-1에서 가장 왼쪽 최하위 블록(0-10)은 두번째 최하위 블록(11-19)에 연결됩니다. 주: 문자 데이터가 있는 열의 인덱스는 데이터베이스 문자 집합에 있는 문자의 이진 값을 기반으로 합니다.
인덱스 검색
인덱스 스캔에서 데이터베이스는 명령문에 의해 지정된 인덱스화된 열 값을 사용하여 인덱스를 순회하여 행을 검색합니다. 데이터베이스가 인덱스에서 값을 스캔하면 n I/O에서 이 값을 찾을 수 있습니다. 여기서 n은 B 트리 인덱스의 높이입니다. 이는 Oracle AI Database 인덱스의 기본 원칙입니다.
SQL 문이 인덱스화된 열에만 액세스하는 경우 데이터베이스는 테이블이 아닌 인덱스에서 직접 값을 읽습니다. 명령문이 인덱스화된 열 외에 인덱스화되지 않은 열에 액세스하는 경우 데이터베이스는 rowids를 사용하여 테이블에서 행을 찾습니다. 일반적으로 데이터베이스는 인덱스 블록과 테이블 블록을 차례로 읽어들여 테이블 데이터를 검색합니다.
-
전체 인덱스 스캔 전체 인덱스 스캔에서 데이터베이스는 전체 인덱스를 순서대로 읽습니다. 전체 인덱스 스캔은 SQL 문의 predicate(
WHERE절)가 인덱스의 열을 참조하는 경우와 특정 상황에서 술어가 지정되지 않은 경우에 사용할 수 있습니다. 전체 스캔은 데이터가 인덱스 키별로 정렬되기 때문에 정렬을 제거할 수 있습니다. -
빠른 전체 인덱스 스캔 빠른 전체 인덱스 스캔은 데이터베이스가 테이블에 액세스하지 않고 인덱스 자체의 데이터에 액세스하는 전체 인덱스 스캔이며, 데이터베이스는 특정 순서 없이 인덱스 블록을 읽습니다.
-
인덱스 범위 스캔 인덱스 범위 스캔은 인덱스 중 하나 이상의 선행 열이 조건에 지정되고 인덱스 키에 대해 0, 1 또는 그 이상의 값을 사용할 수 있는 인덱스의 순서가 지정된 스캔입니다.
-
인덱스 고유 스캔 인덱스 범위 스캔과 달리 인덱스 고유 스캔에는 인덱스 키와 연관된 rowid가 0개 또는 1개 있어야 합니다.
-
인덱스 건너뛰기 스캔 인덱스 건너뛰기 스캔은 조합 인덱스의 논리적 하위 인덱스를 사용합니다. 데이터베이스는 마치 별도의 인덱스를 검색하는 것처럼 단일 인덱스를 건너뜁니다.
-
인덱스 클러스터링 요소 인덱스 클러스터링 요소는 사원 성과 같은 인덱스화된 값과 관련하여 행 순서를 측정합니다. 순서 정도가 증가하면 클러스터링 계수가 감소합니다. 참조: 인덱스 스캔에 대한 자세한 내용은 Oracle AI Database SQL Tuning Guide를 참조하십시오.
전체 인덱스 스캔
전체 인덱스 스캔에서 데이터베이스는 전체 인덱스를 순서대로 읽습니다. 전체 인덱스 스캔은 SQL 문의 predicate(WHERE 절)가 인덱스의 열을 참조하는 경우와 특정 상황에서 술어가 지정되지 않은 경우에 사용할 수 있습니다. 전체 스캔은 데이터가 인덱스 키별로 정렬되기 때문에 정렬을 제거할 수 있습니다.
예제 5-1 전체 인덱스 스캔
응용 프로그램이 다음 query를 실행한다고 가정합니다.
SELECT department_id, last_name, salary
FROM   employees
WHERE  salary > 5000
ORDER BY department_id, last_name;
이 예에서 department_id, last_name 및 salary는 인덱스의 조합 키입니다. Oracle AI Database는 인덱스 전체 스캔을 수행하여 정렬된 순서(부서 ID 및 성에 따라 정렬됨)로 읽고 급여 속성을 필터링합니다. 이러한 방식으로 데이터베이스는 질의에 포함된 것보다 많은 열을 포함하는 employees 테이블보다 작은 데이터 집합을 스캔하여 데이터 정렬을 방지합니다.
전체 스캔은 다음과 같이 인덱스 항목을 읽을 수 있습니다.
50,Atkinson,2800,rowid
60,Austin,4800,rowid
70,Baer,10000,rowid
80,Abel,11000,rowid
80,Ande,6400,rowid
110,Austin,7200,rowid
.
.
.
빠른 전체 인덱스 검사
빠른 전체 인덱스 스캔은 데이터베이스에 테이블에 액세스하지 않고 인덱스 자체의 데이터에 액세스하는 전체 인덱스 스캔이며, 데이터베이스는 특정 순서 없이 인덱스 블록을 읽습니다.
다음 두 조건이 모두 충족되는 경우 빠른 전체 인덱스 스캔은 전체 테이블 스캔 대신 사용할 수 있습니다.
-
인덱스는 query에 필요한 모든 열을 포함해야 합니다.
-
모든 null을 포함하는 행이 query 결과 집합에 나타나면 안됩니다. 이 결과를 보장하려면 인덱스에 있는 하나 이상의 열에 다음이 있어야 합니다.
-
NOT NULL제약 조건 -
Query 결과 집합에서 null을 고려하지 못하도록 하는 열에 적용되는 술어
-
예제 5-2 빠른 전체 인덱스 스캔
응용 프로그램이 ORDER BY 절을 포함하지 않는 다음 query를 실행한다고 가정합니다.
SELECT last_name, salary
FROM   employees;
last_name 열에 널이 아닌 제약 조건이 있습니다. 성 및 급여가 인덱스의 조합 키인 경우 빠른 전체 인덱스 스캔은 인덱스 항목을 읽어 요청된 정보를 얻을 수 있습니다.
Baida,2900,rowid
Atkinson,2800,rowid
Zlotkey,10500,rowid
Austin,7200,rowid
Baer,10000,rowid
Austin,4800,rowid
.
.
.
인덱스 범위 스캔
인덱스 범위 스캔은 조건에서 하나 이상의 선행 열이 지정되고 인덱스 키에 대해 0, 1 또는 그 이상의 값이 가능한 인덱스의 순서가 지정된 스캔입니다.
조건은 하나 이상의 표현식과 논리(부울) 연산자의 조합을 지정합니다. 이 함수는 TRUE, FALSE 또는 UNKNOWN 값을 반환합니다.
데이터베이스는 일반적으로 인덱스 범위 스캔을 사용하여 선택적 데이터에 액세스합니다. 선택성은 질의가 선택하는 테이블의 행 백분율로, 0은 행 없음을 의미하고 1은 모든 행을 의미합니다. 선택성은 질의 predicate(예: WHERE last_name LIKE 'A%') 또는 술어 조합에 연결됩니다. 값이 1에 가까워질 때 값이 0에 가까워지고 선택성이 낮아지거나 선택성이 떨어지면 술어가 더 선택적입니다.
예를 들어, 유저는 성이 A로 시작하는 사원을 query합니다. 다음과 같은 항목을 사용하여 last_name 열이 인덱스화되었다고 가정합니다.
Abel,rowid
Ande,rowid
Atkinson,rowid
Austin,rowid
Austin,rowid
Baer,rowid
.
.
.
last_name 열이 술어에 지정되고 각 인덱스 키에 대해 여러 rowids가 가능하기 때문에 데이터베이스에서 범위 스캔을 사용할 수 있습니다. 예를 들어, 두 명의 사원 이름이 Austin이므로 두 개의 rowids가 Austin 키와 연관됩니다.
인덱스 범위 스캔은 ID가 10에서 40 사이인 부서에 대한 query에서와 같이 양쪽에서 제한되거나 ID가 40을 초과하는 query에서와 같이 한쪽 면에서만 제한될 수 있습니다. 인덱스를 스캔하기 위해 데이터베이스는 최하위 블록을 통해 뒤로 또는 앞으로 이동합니다. 예를 들어, 10에서 40 사이의 ID 스캔은 10 이상의 가장 낮은 키 값을 포함하는 첫번째 인덱스 최하위 블록을 찾습니다. 그런 다음 스캔은 40보다 큰 값을 찾을 때까지 연결된 리프 노드 목록을 가로로 진행합니다.
인덱스 고유 스캔
인덱스 범위 스캔과 달리 인덱스 고유 스캔에는 인덱스 키와 연관된 rowid가 0개 또는 1개 있어야 합니다.
데이터베이스는 술어가 등호 연산자를 사용하여 UNIQUE 인덱스의 키에 있는 모든 열을 참조하는 경우 고유 스캔을 수행합니다. 인덱스 고유 스캔은 두번째 레코드를 찾을 수 없으므로 첫번째 레코드를 찾는 즉시 처리를 정지합니다.
예를 들어, 유저가 다음 query를 실행한다고 가정합니다.
SELECT *
FROM   employees
WHERE  employee_id = 5;
employee_id 열이 기본 키이며 다음과 같은 항목으로 인덱스화되었다고 가정합니다.
1,rowid
2,rowid
4,rowid
5,rowid
6,rowid
.
.
.
이 경우 데이터베이스는 인덱스 고유 스캔을 사용하여 ID가 5인 사원의 rowid를 찾을 수 있습니다.
인덱스 Skip Scan
인덱스 건너뛰기 스캔은 조합 인덱스의 논리적 하위 인덱스를 사용합니다. 데이터베이스는 마치 별도의 인덱스를 검색하는 것처럼 단일 인덱스를 건너뜁니다.
조합 인덱스의 선행 열에 구분 값이 거의 없고 인덱스의 선행 키에 구분 값이 많은 경우 Skip Scanning이 유용합니다. 데이터베이스는 조합 인덱스의 선행 열이 질의 술어에 지정되지 않은 경우 인덱스 건너뛰기 스캔을 선택할 수 있습니다.
예 5-3 조합 인덱스 스캔 건너뛰기
sh.customers 테이블에서 고객에 대해 다음 질의를 실행한다고 가정합니다.
SELECT * FROM sh.customers WHERE cust_email = 'Abbey@company.example.com';customers 테이블에는 값이 M 또는 F인 cust_gender 열이 있습니다. 조합 인덱스가 열(cust_gender, cust_email)에 있다고 가정합니다. 다음 예제는 인덱스 항목의 일부를 보여줍니다.
F,Wolf@company.example.com,rowid
F,Wolsey@company.example.com,rowid
F,Wood@company.example.com,rowid
F,Woodman@company.example.com,rowid
F,Yang@company.example.com,rowid
F,Zimmerman@company.example.com,rowid
M,Abbassi@company.example.com,rowid
M,Abbey@company.example.com,rowidcust_gender가 WHERE 절에 지정되지 않은 경우에도 데이터베이스는 이 인덱스의 스캔 건너뛰기를 사용할 수 있습니다.
스캔 건너뛰기에서 논리적 하위 인덱스의 수는 선행 열의 구분 값 수에 따라 결정됩니다. 앞의 예제에서 선행 열은 두 개의 가능한 값을 가집니다. 데이터베이스는 F 키를 사용하여 인덱스를 하나의 하위 인덱스로 논리적으로 분할하고 M 키를 사용하여 두번째 하위 인덱스를 분할합니다.
전자메일이 Abbey@company.example.com인 고객에 대한 레코드를 검색할 때 데이터베이스는 먼저 값이 F인 하위 인덱스를 검색한 다음 값이 M인 하위 인덱스를 검색합니다. 개념적으로 데이터베이스는 다음과 같이 query를 처리합니다.
SELECT * FROM sh.customers WHERE cust_gender = 'F'
  AND cust_email = 'Abbey@company.example.com'
UNION ALL
SELECT * FROM sh.customers WHERE cust_gender = 'M'
  AND cust_email = 'Abbey@company.example.com';
참조: 스캔 건너뛰기에 대한 자세한 내용은 Oracle AI Database SQL Tuning Guide를 참조하십시오.
인덱스 클러스터링 요소
인덱스 클러스터링 요소는 사원 성과 같은 인덱스화된 값과 관련하여 행 순서를 측정합니다. 순서 정도가 증가하면 클러스터링 계수가 감소합니다.
클러스터링 요소는 인덱스를 사용하여 전체 테이블을 읽는 데 필요한 I/O 수를 대략적으로 측정할 때 유용합니다.
-
클러스터링 요소가 높으면 Oracle AI Database는 큰 인덱스 범위 스캔 중에 상대적으로 많은 수의 I/O를 수행합니다. 인덱스 항목은 임의 테이블 블록을 가리키므로 데이터베이스에서 인덱스가 가리키는 데이터를 검색하기 위해 동일한 블록을 여러 번 읽고 다시 읽어야 할 수 있습니다.
-
클러스터링 계수가 낮은 경우 Oracle AI Database는 큰 인덱스 범위 스캔 중에 상대적으로 적은 수의 I/O를 수행합니다. 범위에 있는 인덱스 키는 동일한 데이터 블록을 가리키는 경향이 있으므로 데이터베이스에서 동일한 블록을 읽고 다시 읽을 필요가 없습니다.
클러스터화 요소는 다음을 나타낼 수 있으므로 인덱스 스캔과 관련이 있습니다.
-
데이터베이스에서 대규모 범위 스캔을 위해 인덱스를 사용할지 여부
-
인덱스 키와 관련된 테이블 구성 정도
-
인덱스 구성 테이블(Index-organized Table), Partitioning 또는 테이블 클러스터 중에서 인덱스 키를 기준으로 행을 정렬해야 하는 경우 사용 고려
예 5-4 클러스터링 요소
employees 테이블이 두 개의 데이터 블록에 적합하다고 가정합니다. 표 5-3은 두 데이터 블록의 행을 나타냅니다. 줄임표는 표시되지 않은 데이터를 나타냅니다.
표 3 직원 테이블의 두 데이터 블록 내용
| 데이터 블록 1 | 데이터 블록 2 |
|---|---|
|
|
행은 성(굵게 표시) 순서로 블록에 저장됩니다. 예를 들어, 데이터 블록 1의 아래쪽 행은 Abel을 설명하고, 다음 위쪽 행은 Ande를 설명하며, Steven King의 블록 1에 있는 위쪽 행까지 알파벳순으로 표시됩니다. 블록 2의 아래쪽 행은 Kochar에 대해 설명하고, 다음 위쪽 행은 Kumar에 대해 설명하고, Zlotkey의 블록에서 마지막 행까지 문자순으로 정렬합니다.
성 열에 인덱스가 존재한다고 가정합니다. 각 이름 항목은 rowid에 해당합니다. 개념적으로 인덱스 항목은 다음과 같습니다.
Abel,block1row1
Ande,block1row2
Atkinson,block1row3
Austin,block1row4
Baer,block1row5
.
.
.
employee ID 열에 별도의 인덱스가 있다고 가정합니다. 개념적으로 인덱스 항목은 다음과 같을 수 있으며 사원 ID는 두 블록에 걸쳐 거의 임의의 위치에 분산됩니다.
100,block1row50
101,block2row1
102,block1row9
103,block2row19
104,block2row39
105,block1row4
.
.
.
다음 명령문은 이러한 두 인덱스에 대한 클러스터링 요소에 대해 ALL_INDEXES 뷰를 질의합니다.
SQL> SELECT INDEX_NAME, CLUSTERING_FACTOR
  2  FROM ALL_INDEXES
  3  WHERE INDEX_NAME IN ('EMP_NAME_IX','EMP_EMP_ID_PK');

INDEX_NAME           CLUSTERING_FACTOR
-------------------- -----------------
EMP_EMP_ID_PK                       19
EMP_NAME_IX 2EMP_NAME_IX의 클러스터링 요소가 낮습니다. 즉, 단일 최하위 블록의 인접한 인덱스 항목은 동일한 데이터 블록의 행을 가리키는 경향이 있습니다. EMP_EMP_ID_PK의 클러스터링 요소가 높습니다. 즉, 동일한 최하위 블록에 있는 인접한 인덱스 항목이 동일한 데이터 블록에 있는 행을 가리킬 가능성이 훨씬 적습니다.
참조: ALL_INDEXES에 대한 자세한 내용은 Oracle AI Database Reference를 참조하십시오.
역방향 키 인덱스
역방향 키 인덱스는 열 순서를 유지하면서 각 인덱스 키의 바이트를 물리적으로 반전하는 B 트리 인덱스 유형입니다.
예를 들어, 인덱스 키가 20이고 이 키에 대해 16진수로 저장된 2바이트가 표준 B 트리 인덱스의 C1,15인 경우 역방향 키 인덱스는 바이트를 15,C1로 저장합니다.
키를 반대로 하면 B 트리 인덱스 오른쪽에 있는 최하위 블록 경합 문제가 해결됩니다. 이 문제는 여러 Instance가 동일한 블록을 반복적으로 수정하는 Oracle RAC(Oracle Real Application Clusters) 데이터베이스에서 특히 심각한 문제일 수 있습니다. 예를 들어, orders 테이블에서 주문에 대한 기본 키는 순차적입니다. 클러스터의 한 Instance는 순서 20을 추가하고, 다른 Instance는 순서 21을 추가하며, 각 Instance는 인덱스의 오른쪽에 있는 동일한 최하위 블록에 키를 기록합니다.
역방향 키 인덱스에서 바이트 순서의 역방향은 인덱스의 모든 최하위 키에 삽입을 분산합니다. 예를 들어, 표준 키 인덱스에서 인접한 20 및 21과 같은 키는 이제 별도 블록에서 멀리 떨어져 저장됩니다. 따라서 순차 키를 삽입하기 위한 I/O가 더 균등하게 분산됩니다.
인덱스의 데이터는 저장 시 열 키별로 정렬되지 않으므로 역방향 키 배열을 사용하면 경우에 따라 인덱스 범위 스캔 query를 실행할 수 없습니다. 예를 들어, 사용자가 20보다 큰 주문 ID에 대한 질의를 실행하는 경우 데이터베이스는 이 ID가 포함된 블록으로 시작하고 최하위 블록을 가로로 진행할 수 없습니다.
오름차순 및 내림차순 인덱스
오름차순 인덱스에서 Oracle AI Database는 데이터를 오름차순으로 저장합니다. 기본적으로 문자 데이터는 값의 각 바이트에 포함된 이진 값, 가장 작은 숫자에서 가장 큰 숫자의 숫자 데이터, 가장 이른 값에서 가장 늦은 값으로의 날짜 순으로 정렬됩니다.
오름차순 인덱스의 예제는 다음 SQL 문을 고려하십시오.
CREATE INDEX emp_deptid_ix ON hr.employees(department_id);Oracle AI Database는 department_id 열에서 hr.employees 테이블을 정렬합니다. department_id를 사용하여 오름차순 인덱스를 로드하고 0부터 오름차순으로 해당 rowid 값을 로드합니다. 인덱스를 사용하는 경우 Oracle AI Database는 정렬된 department_id 값을 검색하고 연관된 rowids를 사용하여 요청된 department_id 값을 가진 행을 찾습니다.
CREATE INDEX 문에 DESC 키워드를 지정하여 내림차순 인덱스를 생성할 수 있습니다. 이 경우 인덱스는 지정된 열의 데이터를 내림차순으로 저장합니다. employees.department_id 열의 표 5-3에 있는 인덱스가 내림차순인 경우 250를 포함하는 최하위 차단은 트리 왼쪽에 있고 블록은 오른쪽에 0가 있습니다. 내림차순 인덱스를 통한 기본 검색은 가장 높은 값에서 가장 낮은 값으로 수행됩니다.
내림차순 인덱스는 query에서 일부 열을 오름차순 및 다른 열을 내림차순으로 정렬할 때 유용합니다. 예를 들어, 다음과 같이 last_name 및 department_id 열에 조합 인덱스를 생성한다고 가정합니다.
CREATE INDEX emp_name_dpt_ix ON hr.employees(last_name ASC, department_id DESC);유저가 오름차순(A~Z)으로 성에 대해 hr.employees을 query하고 내림차순(높음~낮음)으로 부서 ID를 query하는 경우 데이터베이스는 이 인덱스를 사용하여 데이터를 검색하고 추가 정렬 단계를 피할 수 있습니다.
참조:
-
오름차순 및 내림차순 인덱스 검색에 대해 자세히 알아보려면 Oracle AI Database SQL Tuning Guide를 참조하십시오.
-
CREATE INDEX의ASC및DESC옵션에 대한 설명은 Oracle AI Database SQL Language Reference를 참조하십시오.
인덱스 압축
인덱스의 공간을 줄이기 위해 Oracle AI Database는 다양한 압축 알고리즘을 사용할 수 있습니다.
-
접두어 압축 Oracle AI Database는 접두어 압축(키 압축이라고도 함)을 사용하여 B 트리 인덱스 또는 인덱스 구성 테이블에서 기본 키 열 값의 일부를 압축할 수 있습니다. 접두어 압축은 인덱스가 사용하는 공간을 크게 줄일 수 있습니다.
-
고급 인덱스 압축 Oracle Database 12c 릴리스 1(12.1.0.2)부터 고급 인덱스 압축은 힙 구성 테이블에서 지원되는 인덱스에 대한 기존 접두어 압축을 개선합니다.
접두어 압축
Oracle AI Database는 접두어 압축(키 압축이라고도 함)을 사용하여 기본 키 열 값의 일부를 B 트리 인덱스 또는 인덱스 구성 테이블에서 압축할 수 있습니다. 접두어 압축은 인덱스가 사용하는 공간을 크게 줄일 수 있습니다.
압축되지 않은 인덱스 항목은 한 조각을 가집니다. 접두어 압축을 사용하는 인덱스 항목에는 두 조각(그룹화 피스인 접두어 항목)과 고유하거나 거의 고유한 피스인 접미어 항목이 있습니다. 데이터베이스는 인덱스 블록의 접미어 항목 간에 접두어 항목을 공유하여 압축을 수행합니다. 주: 고유한 피스를 가지도록 키가 정의되지 않은 경우 데이터베이스는 그룹화 피스에 rowid를 추가하여 키를 제공합니다.
기본적으로 고유 인덱스의 접두어는 마지막 열을 제외한 모든 키 열로 구성되지만 비고유 인덱스의 접두어는 모든 키 열로 구성됩니다. 다음과 같이 oe.orders 테이블의 두 열에 조합 고유 인덱스를 생성한다고 가정합니다.
CREATE UNIQUE INDEX orders_mod_stat_ix ON orders ( order_mode, order_status );앞의 예에서 인덱스 키는 online,0일 수 있습니다. rowid는 항목의 키 데이터 부분에 저장되며 키 자체의 일부가 아닙니다.
주: 단일 열에서 고유 인덱스를 생성하는 경우 공통 접두어가 없으므로 Oracle AI Database에서 접두어 키 압축을 사용할 수 없습니다.
또는 동일한 열에 비고유 인덱스를 생성한다고 가정해 보겠습니다.
CREATE INDEX orders_mod_stat_ix ON orders ( order_mode, order_status );또한 order_mode 및 order_status 열에서 반복되는 값이 발생한다고 가정합니다. 인덱스 블록은 다음 예제와 같이 항목을 가질 수 있습니다.
online,0,AAAPvCAAFAAAAFaAAa
online,0,AAAPvCAAFAAAAFaAAg
online,0,AAAPvCAAFAAAAFaAAl
online,2,AAAPvCAAFAAAAFaAAm
online,3,AAAPvCAAFAAAAFaAAq
online,3,AAAPvCAAFAAAAFaAAt
앞의 예에서 키 접두어는 online,0에서와 같이 order_mode 및 order_status 값의 연결로 구성됩니다. 접미어는 AAAPvCAAFAAAAFaAAa에서와 같이 rowid로 구성됩니다. rowid는 데이터베이스에서 rowid 자체가 고유하기 때문에 전체 인덱스 항목을 고유하게 만듭니다.
앞의 예제에서 인덱스가 기본 접두어 압축(COMPRESS 키워드로 지정됨)으로 생성된 경우 online,0 및 online와 같은 중복 키 접두어가 압축됩니다.3 개념적으로 데이터베이스는 다음과 같이 압축을 수행합니다.
online,0
AAAPvCAAFAAAAFaAAa
AAAPvCAAFAAAAFaAAg
AAAPvCAAFAAAAFaAAl
online,2
AAAPvCAAFAAAAFaAAm
online,3
AAAPvCAAFAAAAFaAAq
AAAPvCAAFAAAAFaAAt
접미어 항목(rowids)은 인덱스 행의 압축된 버전을 형성합니다. 각 접미어 항목은 접미어와 동일한 인덱스 블록에 저장되는 접두어 항목을 참조합니다.
또는 접두어 압축을 사용하는 인덱스를 생성할 때 접두어 길이를 지정할 수 있습니다. 예를 들어, COMPRESS 1를 지정한 경우 접두어는 order_mode이고 접미어는 order_status,rowid입니다. 인덱스 블록 예제의 값에 대해 인덱스는 다음과 같이 개념적으로 표현될 수 있는 접두어 online의 중복 발생을 고려합니다.
online
0,AAAPvCAAFAAAAFaAAa
0,AAAPvCAAFAAAAFaAAg
0,AAAPvCAAFAAAAFaAAl
2,AAAPvCAAFAAAAFaAAm
3,AAAPvCAAFAAAAFaAAq
3,AAAPvCAAFAAAAFaAAt
인덱스는 최하위 블록당 한 번씩 특정 접두어를 최대 저장합니다. B 트리 인덱스의 최하위 블록에 있는 키만 압축됩니다. 분기 블록에서 키 접미어는 잘릴 수 있지만 키가 압축되지 않습니다.
참조:
-
압축된 인덱스를 사용하는 방법을 알아보려면 Oracle AI Database Administrator's Guide를 참조하십시오.
-
Oracle AI Database VLDB and Partitioning Guide - 분할된 인덱스에 접두어 압축을 사용하는 방법 학습
-
CREATE INDEX의 key_compression 절에 대한 설명은 Oracle AI Database SQL Language Reference를 참조하십시오.
고급 인덱스 압축
Oracle Database 12c 릴리스 1(12.1.0.2)부터 고급 인덱스 압축은 힙 구성 테이블에서 지원되는 인덱스에 대한 기존 접두어 압축을 개선합니다.
고급 인덱스 압축의 이점
접두어 압축에는 지원되는 인덱스 유형, 압축 비율 및 사용 편의성에 대한 제한이 있습니다. 모든 블록에 대해 고정된 중복 키 제거를 사용하는 접두어 압축과 달리 고급 인덱스 압축은 블록 단위로 Adaptive 중복 키 제거를 사용합니다. 고급 인덱스 압축의 주요 이점은 다음과 같습니다.
-
데이터베이스는 열 내 레벨 접두어, 중복 키 제거 및 rowid 압축과 같은 다양한 내부 알고리즘을 사용하여 각 블록에 대해 가장 적합한 압축을 자동으로 선택합니다. 접두어 압축과 달리 고급 인덱스 압축에서는 유저가 데이터 특성을 알 필요가 없습니다.
-
고급 압축은 고유하지 않은 및 고유 인덱스에서 모두 작동합니다. 접두어 압축은 일부 비고유 인덱스에서 잘 작동하지만 선행 열에 반복이 많지 않은 인덱스의 비율이 낮습니다.
-
압축된 인덱스는 압축되지 않은 인덱스와 동일한 방식으로 사용할 수 있습니다. 인덱스는 동일한 액세스 경로(고유 키 조회, 범위 스캔 및 빠른 전체 스캔)를 지원합니다.
-
인덱스는 상위 테이블 또는 테이블스페이스를 포함하는 고급 압축을 상속할 수 있습니다.
-
인덱스 구성 테이블 및 함수 기반 인덱스는 고급 인덱스 압축을 지원합니다. 인덱스 구성 테이블은 낮은 압축을 지원합니다. 함수 기반 인덱스는 낮은 압축과 높은 압축을 모두 지원합니다.
고급 인덱스 압축 작동 방식
고급 인덱스 압축은 블록 레벨에서 작동하여 각 블록에 가장 적합한 압축을 제공합니다. 데이터베이스는 다음 기법을 사용합니다.
-
인덱스를 생성하는 동안 최하위 블록이 꽉 차면 데이터베이스는 해당 블록을 최적 레벨로 자동으로 압축합니다.
-
DML의 결과로 인덱스 블록을 재구성할 때 데이터베이스가 들어오는 인덱스 항목을 위한 충분한 공간을 생성할 수 있으면 블록 분할이 발생하지 않습니다. 그러나 고급 인덱스 압축을 사용하지 않는 DML 동안에는 블록이 가득 차면 인덱스 블록 분할이 항상 발생합니다.
고급 인덱스 압축 높음
Oracle Database 12c 릴리스 2(12.2) 이전 릴리스에서는 고급 인덱스 압축의 유일한 형식이 낮은 압축(COMPRESS ADVANCED LOW)이었습니다. 이제 기본값인 높은 압축(COMPRESS ADVANCED HIGH)을 지정할 수도 있습니다. HIGH 옵션을 사용한 고급 인덱스 압축은 다음과 같은 이점을 제공합니다.
-
대부분의 경우 압축률이 높아지면서 인덱스에 액세스하는 query의 성능도 향상됩니다.
-
고급 낮음보다 복잡한 압축 알고리즘 사용
-
특수 온디스크 형식인 압축 단위로 데이터를 저장합니다. 주:
HIGH압축을 적용하면 모든 블록이 압축됩니다.LOW압축을 적용할 때 데이터베이스는 일부 블록을 압축되지 않은 상태로 유지할 수 있습니다. 통계를 사용하여 압축을 풀지 않은 상태로 남아 있는 블록 수를 확인할 수 있습니다.
예제 5-5 고급 압축으로 인덱스 생성
이 예에서는 hr.employees 테이블의 인덱스에 대해 고급 인덱스 압축을 사용으로 설정합니다.
CREATE INDEX hr.emp_mndp_ix
  ON hr.employees(manager_id, department_id)
  COMPRESS ADVANCED;
다음 query는 압축 유형을 보여줍니다.
SELECT COMPRESSION FROM DBA_INDEXES WHERE INDEX_NAME ='EMP_MNDP_IX';

COMPRESSION
-------------
ADVANCED HIGH
참조:
-
고급 인덱스 압축을 사용으로 설정하는 방법은 Oracle AI Database Administrator's Guide를 참조하십시오.
-
CREATE INDEX의 key_compression 절에 대한 설명은 Oracle AI Database SQL Language Reference를 참조하십시오. -
ALL_INDEXES에 대한 자세한 내용은 Oracle AI Database Reference를 참조하십시오.
비트맵 인덱스 개요
비트맵 인덱스에서 데이터베이스는 각 인덱스 키에 대한 비트맵을 저장합니다. 기존의 B 트리 인덱스에서 하나의 인덱스 항목이 단일 행을 가리킵니다. 비트맵 인덱스에서 각 인덱스 키는 여러 행에 대한 포인터를 저장합니다.
비트맵 인덱스는 주로 질의가 특정 방식으로 많은 열을 참조하는 데이터 웨어하우징 또는 환경을 위해 설계되었습니다. 비트맵 인덱스를 호출할 수 있는 상황은 다음과 같습니다.
-
인덱스화된 열에는 낮은 기수가 있습니다. 즉, 테이블 행 수에 비해 구분 값 수가 적습니다.
-
인덱스화된 테이블은 읽기 전용이거나 DML 문에 의해 크게 수정될 수 없습니다.
데이터 웨어하우스 예제의 경우 sh.customers 테이블에는 두 개의 가능한 값 M 및 F만 있는 cust_gender 열이 있습니다. 특정 성별의 고객 수에 대한 질의가 일반적이라고 가정합니다. 이 경우 customers.cust_gender 열은 비트맵 인덱스에 대한 후보가 됩니다.
비트맵 내의 각 비트는 가능한 rowid에 해당합니다. 비트가 설정된 경우 해당 rowid의 행에 키 값이 포함됩니다. 매핑 함수는 비트 위치를 실제 rowid로 변환하므로 비트맵 인덱스는 다른 내부 표현을 사용하지만 B 트리 인덱스와 동일한 기능을 제공합니다.
단일 행에서 인덱스화된 열이 갱신되면 데이터베이스는 갱신된 행에 매핑된 개별 비트가 아닌 인덱스 키 항목(예: M 또는 F)을 잠급니다. 키가 여러 행을 가리키므로 인덱스화된 데이터에 대한 DML은 일반적으로 이러한 모든 행을 잠급니다. 이러한 이유로 비트맵 인덱스는 많은 OLTP 응용 프로그램에 적합하지 않습니다.
-
예: 단일 테이블에 대한 비트맵 인덱스 이 예에서는
sh.customers테이블의 일부 열이 비트맵 인덱스에 대한 후보입니다. -
비트맵 조인 인덱스 비트맵 조인 인덱스는 둘 이상의 테이블에 대한 조인의 비트맵 인덱스입니다.
-
비트맵 저장 영역 구조 Oracle AI Database는 B 트리 인덱스 구조를 사용하여 인덱스화된 각 키에 대한 비트맵을 저장합니다.
참조:
-
비트맵 인덱스에 대한 자세한 내용은 Oracle AI Database SQL Tuning Guide를 참조하십시오.
-
Oracle AI Database Data Warehousing Guide: 데이터 웨어하우스에서 비트맵 인덱스를 사용하는 방법 학습
예제: 단일 테이블에 대한 비트맵 인덱스
이 예제에서 sh.customers 테이블의 일부 열은 비트맵 인덱스에 대한 후보입니다.
다음 질의를 고려하십시오.
SQL> SELECT cust_id, cust_last_name, cust_marital_status, cust_gender
  2  FROM   sh.customers
  3  WHERE  ROWNUM < 8 ORDER BY cust_id;

   CUST_ID CUST_LAST_ CUST_MAR C
---------- ---------- -------- -
         1 Kessel              M
         2 Koch                F
         3 Emmerson            M
         4 Hardy               M
         5 Gowen               M
         6 Charles    single   F
         7 Ingram     single   F

7 rows selected.
cust_marital_status 및 cust_gender 열은 낮은 기수를 가지지만 cust_id 및 cust_last_name는 그렇지 않습니다. 따라서 비트맵 인덱스는 cust_marital_status 및 cust_gender에 적합할 수 있습니다. 비트맵 인덱스는 다른 열에 유용하지 않을 수 있습니다. 대신 이러한 열의 고유한 B 트리 인덱스가 가장 효율적인 표현 및 검색을 제공합니다. 표 5-4는 앞의 예제에 표시된 cust_gender 열 출력에 대한 비트맵 인덱스를 보여줍니다. 두 개의 개별 비트맵(각 성별에 하나씩)으로 구성됩니다.
표 4 열 하나에 대한 샘플 비트맵
| 값 | 행 1 | 행 2 | 행 3 | 행 4 | 행 5 | 행 6 | 행 7 |
|---|---|---|---|---|---|---|---|
M |
1 | 0 | 1 | 1 | 1 | 0 | 0 |
F |
0 | 1 | 0 | 0 | 0 | 1 | 1 |
매핑 함수는 비트맵의 각 비트를 customers 테이블의 rowid로 변환합니다. 각 비트 값은 테이블의 해당 행 값에 따라 다릅니다. 예를 들어, customers 테이블의 첫번째 행에서 성별이 M이기 때문에 M 값에 대한 비트맵은 첫번째 비트로 1를 포함합니다. 비트맵 cust_gender='M'에는 행 2, 6, 7의 비트에 대한 0가 있습니다. 이러한 행에는 해당 값으로 M가 포함되어 있지 않기 때문입니다.
주: 비트맵 인덱스는 B 트리 인덱스와 달리 완전히 널 값으로 구성된 키를 포함할 수 있습니다. 인덱스 널은 집계 함수가 COUNT인 질의와 같은 일부 SQL 문에 유용할 수 있습니다.
고객의 인구 통계 추세를 조사하는 분석가는 "여성 고객 중 얼마나 많은 고객이 싱글 또는 이혼합니까?"라고 묻습니다. 이 질문은 다음 SQL query에 해당합니다.
SELECT COUNT(*)
FROM   customers
WHERE  cust_gender = 'F'
AND    cust_marital_status IN ('single', 'divorced');
비트맵 인덱스는 표 5-5에 설명된 대로 결과 비트맵에서 1 값 수를 계산하여 이 질의를 효율적으로 처리할 수 있습니다. 조건을 충족하는 고객을 식별하기 위해 Oracle AI Database는 결과 비트맵을 사용하여 테이블에 액세스할 수 있습니다.
표 5 열 2개에 대한 샘플 비트맵
| 값 | 행 1 | 행 2 | 행 3 | 행 4 | 행 5 | 행 6 | 행 7 |
|---|---|---|---|---|---|---|---|
M |
1 | 0 | 1 | 1 | 1 | 0 | 0 |
F |
0 | 1 | 0 | 0 | 0 | 1 | 1 |
single |
0 | 0 | 0 | 0 | 0 | 1 | 1 |
divorced |
0 | 0 | 0 | 0 | 0 | 0 | 0 |
single 또는 divorced 및 F |
0 | 0 | 0 | 0 | 0 | 1 | 1 |
비트맵 인덱싱은 WHERE 절의 여러 조건에 해당하는 인덱스를 효율적으로 병합합니다. 일부만 만족하는 행은 테이블 자체에 액세스하기 전에 필터링됩니다. 이 기술은 종종 극적으로 응답 시간을 향상시킵니다.
비트맵 조인 인덱스
비트맵 조인 인덱스는 둘 이상의 테이블의 조인에 대한 비트맵 인덱스입니다.
테이블 열의 각 값에 대해 인덱스는 인덱스화된 테이블에 해당 행의 rowid를 저장합니다. 반면, 표준 비트맵 인덱스는 단일 테이블에 생성됩니다.
비트맵 조인 인덱스는 미리 제한 사항을 수행하여 조인해야 하는 데이터 볼륨을 줄이는 효율적인 방법입니다. 예를 들어, 비트맵 조인 인덱스가 유용한 경우 유저는 종종 특정 작업 유형을 가진 사원 수를 query한다고 가정합니다. 일반적인 질의는 다음과 같습니다.
SELECT COUNT(*)
FROM   employees, jobs
WHERE  employees.job_id = jobs.job_id
AND    jobs.job_title = 'Accountant';
앞의 질의는 일반적으로 jobs.job_title의 인덱스를 사용하여 Accountant에 대한 행을 검색한 다음 작업 ID를 검색하고 employees.job_id에 대한 인덱스를 사용하여 일치하는 행을 찾습니다. 테이블 스캔이 아닌 인덱스 자체에서 데이터를 검색하려면 다음과 같이 비트맵 조인 인덱스를 생성할 수 있습니다.
CREATE BITMAP INDEX employees_bm_idx
ON     employees (jobs.job_title)
FROM   employees, jobs
WHERE  employees.job_id = jobs.job_id;
다음 그림에 표시된 것처럼 인덱스 키는 jobs.job_title이고 인덱스화된 테이블은 employees입니다.
그림 2: 비트맵 조인 인덱스
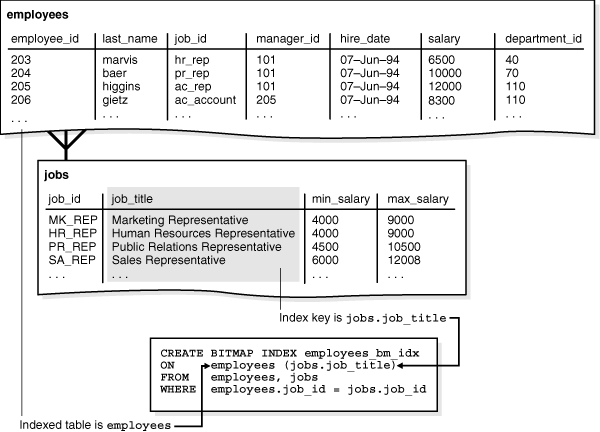
개념적으로 employees_bm_idx는 다음 질의에 표시된 SQL 질의에서 jobs.title 열의 인덱스입니다(샘플 출력 포함). 인덱스의 job_title 키는 employees 테이블의 행을 가리킵니다. 인덱스 자체에 요청된 정보가 포함되어 있으므로 회계사 수에 대한 질의는 인덱스를 사용하여 employees 및 jobs 테이블에 액세스하지 않도록 할 수 있습니다.
SELECT jobs.job_title AS "jobs.job_title", employees.rowid AS "employees.rowid"
FROM   employees, jobs
WHERE  employees.job_id = jobs.job_id
ORDER BY job_title;

jobs.job_title                      employees.rowid
----------------------------------- ------------------
Accountant                          AAAQNKAAFAAAABSAAL
Accountant                          AAAQNKAAFAAAABSAAN
Accountant                          AAAQNKAAFAAAABSAAM
Accountant                          AAAQNKAAFAAAABSAAJ
Accountant                          AAAQNKAAFAAAABSAAK
Accounting Manager                  AAAQNKAAFAAAABTAAH
Administration Assistant            AAAQNKAAFAAAABTAAC
Administration Vice President       AAAQNKAAFAAAABSAAC
Administration Vice President       AAAQNKAAFAAAABSAAB
.
.
.
데이터 웨어하우스에서 조인 조건은 차원 테이블의 기본 키 열과 사실 값 테이블의 외래 키 열 사이의 등가 조인(등가 연산자 사용)입니다. 조인을 미리 구체화하기 위한 대안으로, 비트맵 조인 인덱스가 구체화된 조인 뷰보다 저장 영역에서 훨씬 효율적인 경우가 있습니다.
참조: 비트맵 조인 인덱스에 대한 자세한 내용은 Oracle AI Database Data Warehousing Guide를 참조하십시오.
비트맵 저장 영역 구조
Oracle AI Database는 B 트리 인덱스 구조를 사용하여 인덱스화된 각 키에 대한 비트맵을 저장합니다.
예를 들어, jobs.job_title가 비트맵 인덱스의 키 열인 경우 하나의 B 트리는 인덱스 데이터를 저장합니다. 최하위 블록은 개별 비트맵을 저장합니다.
예제 5-6 비트맵 저장 영역 예제
jobs.job_title 열에 고유한 값 Shipping Clerk, Stock Clerk 및 기타 여러 가지가 있다고 가정합니다. 이 인덱스에 대한 비트맵 인덱스 항목은 다음 구성 요소를 가집니다.
-
인덱스 키로서의 직책
-
rowids 범위에 대한 하위 rowid 및 상위 rowid
-
범위에 있는 특정 rowids에 대한 비트맵
개념적으로 이 인덱스의 인덱스 최하위 블록은 다음과 같은 항목을 포함할 수 있습니다.
Shipping Clerk,AAAPzRAAFAAAABSABQ,AAAPzRAAFAAAABSABZ,0010000100
Shipping Clerk,AAAPzRAAFAAAABSABa,AAAPzRAAFAAAABSABh,010010
Stock Clerk,AAAPzRAAFAAAABSAAa,AAAPzRAAFAAAABSAAc,1001001100
Stock Clerk,AAAPzRAAFAAAABSAAd,AAAPzRAAFAAAABSAAt,0101001001
Stock Clerk,AAAPzRAAFAAAABSAAu,AAAPzRAAFAAAABSABz,100001
.
.
.
rowid 범위가 다르기 때문에 동일한 직책이 여러 항목에 나타납니다.
세션은 한 사원의 직무 ID를 Shipping Clerk에서 Stock Clerk로 갱신합니다. 이 경우 세션은 이전 값(Shipping Clerk) 및 새 값(Stock Clerk)에 대한 인덱스 키 항목에 배타적으로 액세스해야 합니다. Oracle AI Database는 이러한 두 항목이 가리키는 행을 잠급니다. 단, Accountant가 가리키는 행이나 UPDATE가 커밋될 때까지 다른 키가 가리키는 행은 잠기지 않습니다.
비트맵 인덱스에 대한 데이터는 하나의 세그먼트에 저장됩니다. Oracle AI Database는 각 비트맵을 하나 이상의 조각으로 저장합니다. 각 피스는 단일 데이터 블록의 일부를 차지합니다.
참조: "사용자 세그먼트"에서는 다양한 유형의 세그먼트와 세그먼트 생성 방법에 대해 설명합니다.
함수 기반 인덱스 개요
함수 기반 인덱스는 하나 이상의 열이 포함된 함수 또는 표현식의 값을 계산하여 인덱스에 저장합니다. 함수 기반 인덱스는 B 트리 또는 비트맵 인덱스일 수 있습니다.
인덱스화된 함수는 산술식이거나 SQL 함수, 유저 정의 PL/SQL 함수, 패키지 함수 또는 C 콜아웃을 포함하는 표현식일 수 있습니다. 예를 들어, 함수는 두 열의 값을 추가할 수 있습니다.
-
함수 기반 인덱스 사용 함수 기반 인덱스는
WHERE절에 함수가 포함된 명령문을 평가하는 데 효율적입니다. 데이터베이스는 함수가 query에 포함된 경우에만 함수 기반 인덱스를 사용합니다. 그러나 데이터베이스가INSERT및UPDATE문을 처리하는 경우에도 명령문을 처리하는 함수를 평가해야 합니다. -
함수 기반 인덱스를 통한 최적화
WHERE절에 표현식이 있는 질의의 경우 옵티마이저는 함수 기반 인덱스에 대한 인덱스 범위 스캔을 사용할 수 있습니다.
참조:
-
함수 기반 인덱스를 생성하는 방법을 알아보려면 Oracle AI Database Administrator's Guide를 참조하십시오.
-
함수 기반 인덱스 사용에 대한 자세한 내용은 Oracle AI Database Development Guide를 참조하십시오.
-
함수 기반 인덱스에 대한 제한 및 사용 노트의 경우 Oracle AI Database SQL Language Reference
함수 기반 인덱스 사용
함수 기반 인덱스는 WHERE 절에 함수가 포함된 명령문을 평가하는 데 효율적입니다. 데이터베이스는 함수가 query에 포함된 경우에만 함수 기반 인덱스를 사용합니다. 그러나 데이터베이스가 INSERT 및 UPDATE 문을 처리하는 경우에도 명령문을 처리하는 함수를 평가해야 합니다.
산술 표현식을 기반으로 하는 예제 5-7 인덱스
예를 들어, 다음 함수 기반 인덱스를 생성한다고 가정해 보겠습니다.
CREATE INDEX emp_total_sal_idx
  ON employees (12 * salary * commission_pct, salary, commission_pct);
데이터베이스는 다음과 같은 query를 처리할 때 앞의 인덱스를 사용할 수 있습니다(부분 예제 출력 포함).
SELECT   employee_id, last_name, first_name,
         12*salary*commission_pct AS "ANNUAL SAL"
FROM     employees
WHERE    (12 * salary * commission_pct) < 30000
ORDER BY "ANNUAL SAL" DESC;

EMPLOYEE_ID LAST_NAME                 FIRST_NAME           ANNUAL SAL
----------- ------------------------- -------------------- ----------
        159 Smith                     Lindsey                   28800
        151 Bernstein                 David                     28500
        152 Hall                      Peter                     27000
        160 Doran                     Louise                    27000
        175 Hutton                    Alyssa                    26400
        149 Zlotkey                   Eleni                     25200
        169 Bloom                     Harrison                  24000
UPPER 함수를 기반으로 한 예제 5-8 인덱스
SQL 함수 UPPER(column_name) 또는 LOWER(column_name)에 정의된 함수 기반 인덱스를 사용하면 대소문자를 구분하지 않고 쉽게 검색할 수 있습니다. 예를 들어, employees의 first_name 열에 대소문자가 혼합되어 있다고 가정합니다. hr.employees 테이블에 다음 함수 기반 인덱스를 생성합니다.
CREATE INDEX emp_fname_uppercase_idx
ON employees ( UPPER(first_name) );
emp_fname_uppercase_idx 인덱스는 다음과 같은 질의를 용이하게 할 수 있습니다.
SELECT *
FROM   employees
WHERE  UPPER(first_name) = 'AUDREY';
예제 5-9 테이블에서 특정 행 인덱스화
함수 기반 인덱스는 테이블의 특정 행만 인덱스화하는 데도 유용합니다. 예를 들어, sh.customers 테이블의 cust_valid 열에는 I 또는 A가 값으로 포함됩니다. A 행만 인덱스화하기 위해 A 행 이외의 행에 대해 null 값을 반환하는 함수를 작성할 수 있습니다. 다음과 같이 인덱스를 생성할 수 있습니다.
CREATE INDEX cust_valid_idx
ON customers ( CASE cust_valid WHEN 'A' THEN 'A' END );
참조:
-
언어 인덱스에 대한 정보는 Oracle AI Database Globalization Support Guide를 참조하십시오.
-
SQL 함수에 대한 자세한 내용은 Oracle AI Database SQL Language Reference를 참조하십시오.
함수 기반 인덱스로 최적화
WHERE 절에 표현식이 있는 질의의 경우 옵티마이저는 함수 기반 인덱스에 대한 인덱스 범위 스캔을 사용할 수 있습니다.
범위 스캔 액세스 경로는 술어가 매우 선택적인 경우, 즉 상대적으로 적은 행을 선택하는 경우에 특히 유용합니다. 예 5-7에서 인덱스가 12*salary*commission_pct 표현식에 구축된 경우 옵티마이저는 인덱스 범위 스캔을 사용할 수 있습니다.
또한 가상 열은 표현식에서 파생된 데이터에 대한 액세스 속도를 높이는 데 유용합니다. 예를 들어, 가상 열 annual_sal를 12*salary*commission_pct로 정의하고 annual_sal에 함수 기반 인덱스를 생성할 수 있습니다.
옵티마이저는 SQL 문의 표현식을 구문 분석한 다음 명령문의 표현식 트리와 함수 기반 인덱스를 비교하여 표현식 일치를 수행합니다. 이 비교는 대소문자를 구분하지 않으며 공백을 무시합니다.
질의마다 인덱스 스캔 유형이 다를 수 있습니다.
참조:
-
"최적기 개요"
-
통계 수집에 대해 자세히 알아보려면 Oracle AI Database SQL Tuning Guide를 참조하십시오.
-
테이블에 가상 열을 추가하는 방법은 Oracle AI Database Administrator's Guide를 참조하십시오.
응용 프로그램 도메인 인덱스 개요
응용 프로그램 도메인 인덱스는 응용 프로그램과 관련된 사용자 정의된 인덱스입니다.
광범위한 인덱스화는 다음 작업을 수행할 수 있습니다.
-
문서, 공간 데이터, 이미지 및 비디오 클립과 같이 사용자 정의되고 복잡한 데이터 유형에 대한 인덱스를 수용합니다( 참조).
-
특수 인덱스화 기법 사용
응용 프로그램 특정 인덱스 관리 루틴을 인덱스 유형 스키마 객체로 캡슐화한 다음 테이블 열이나 객체 유형의 속성에 도메인 인덱스를 정의할 수 있습니다. 확장 가능한 인덱싱은 응용 프로그램 특정 연산자를 효율적으로 처리할 수 있습니다.
카트리지라고 하는 응용 프로그램 소프트웨어는 도메인 인덱스의 구조 및 컨텐츠를 제어합니다. 데이터베이스는 응용 프로그램과 상호 작용하여 도메인 인덱스를 작성, 유지 관리 및 검색합니다. 인덱스 구조 자체는 데이터베이스에 인덱스 구성 테이블(Index-organized Table) 또는 외부적으로 파일로 저장할 수 있습니다.
참조:
-
복잡한 데이터 유형에 대한 자세한 내용은 Oracle AI Database Development Guide를 참조하십시오.
-
Oracle AI Database 확장성 아키텍처 내에서 데이터 카트리지 사용에 대한 자세한 내용은 Oracle AI Database Data Cartridge Developer's Guide를 참조하십시오.
스칼라 양자화된 HNSW 인덱스 개요
스칼라 정량화 HNSW(Hierarchical Navigable Small World) 인덱스를 사용하여 메모리 요구 사항을 줄이고 유사성 검색을 가속화할 수 있습니다.
벡터 데이터베이스의 맥락에서 스칼라 양자화는 벡터의 각 차원(또는 스칼라 구성요소)을 독립적으로 수량화하여 고차원 데이터 벡터를 압축하거나 근사화하는 방법입니다. 이 접근 방식은 유사성 검색과 같은 작업에 대한 데이터의 필수 구조를 유지하면서 벡터 데이터베이스의 저장 요구 사항을 줄이는 데 사용됩니다. 스칼라 정량화는 단순성과 낮은 스토리지 요구 사항이 높은 우선 순위일 때 특히 유용합니다.
부동 소수점 숫자로 저장된 고차원 벡터에는 상당한 저장 공간이 필요합니다. 스칼라 양자화는 벡터를 압축하여 메모리를 절약합니다. 예를 들어, 차원당 8비트(INT8)에 저장된 128차원 벡터에는 128바이트의 메모리만 필요하며, 32비트 부동 소수점 저장 영역(Float32)에는 512바이트가 필요하고 64비트 이중 저장 영역(Float64)에는 1024바이트가 필요합니다. 이러한 스토리지 요구 사항 감소로 인해 스칼라 양자화를 통해 벡터 데이터베이스는 수십억 개의 벡터로 구성된 매우 큰 데이터 세트를 처리할 수 있습니다. 그렇지 않으면 스토리지 제약으로 인해 비실용적입니다.
스칼라 양자화의 또 다른 이점은 검색 속도가 향상되었습니다. 대략적으로 가장 가까운 이웃(ANN) 검색 방법은 정수 또는 이진 코드에 대한 작업이 부동 소수점 계산보다 빠르므로 양자화된 데이터를 활용하여 더 빠르게 비교할 수 있습니다.
Oracle AI Database를 사용하면 균일한 스칼라 양자화가 구현된 압축 방법입니다. 즉, 입력 범위가 동일한 크기의 간격으로 나뉩니다. 각 간격은 단일 양자화 레벨(일반적으로 중간점)로 표시됩니다. 각 차원의 범위는 동일한 간격으로 2b로 나뉩니다. 여기서 b는 비트 수입니다(예: int8의 경우 8비트). 각 부동 값은 가장 가까운 양자화 레벨에 매핑됩니다.
참조:
-
HNSW 인덱스 구문 및 매개변수에 대한 Oracle AI Database AI Vector Search User's Guide
-
CREATE VECTOR INDEX문의 경우 Oracle AI Database SQL Language Reference
인덱스 구성 테이블 개요
인덱스 구성 테이블은 B 트리 인덱스 구조의 변형에 저장된 테이블입니다. 반면, 힙 구성 테이블은 적합한 위치에 행을 삽입합니다.
인덱스 구성 테이블에서는 행이 테이블의 Primary Key에 정의된 인덱스에 저장됩니다. B 트리의 각 인덱스 항목은 키가 아닌 열 값도 저장합니다. 따라서 인덱스는 데이터이고 데이터는 인덱스입니다. 응용 프로그램은 SQL 문을 사용하여 힙 구성 테이블처럼 인덱스 구성 테이블을 조작합니다.
인덱스 구성 테이블(Index-organized Table)을 비유하기 위해 인적 자원 관리자에 마분지 상자의 책상이 있다고 가정합니다. 각 상자에는 숫자 1, 2, 3, 4 등이 표시되지만 상자는 순차적으로 선반에 놓이지 않습니다. 대신 각 상자에는 시퀀스의 다음 상자의 선반 위치에 대한 포인터가 포함됩니다.
직원 레코드가 포함된 폴더는 각 상자에 저장됩니다. 폴더는 사원 ID별로 정렬됩니다. 사원 King의 ID는 가장 낮은 ID인 100이므로 그의 폴더는 상자 1의 맨 아래에 있습니다. 직원 101의 폴더는 맨 위에 100, 102는 맨 위에 101, 그리고 상자 1이 가득 찰 때까지 계속됩니다. 시퀀스의 다음 폴더는 상자 2의 맨 아래에 있습니다.
이와 유사하게 직원 ID별로 폴더를 정렬하면 별도의 인덱스를 유지 관리하지 않고도 폴더를 효율적으로 검색할 수 있습니다. 유저가 사원 107, 120 및 122에 대한 레코드를 요청한다고 가정합시다. 관리자는 한 단계에서 인덱스를 검색하고 별도의 단계에서 폴더를 검색하는 대신 폴더를 순차적으로 검색하여 찾은 대로 각 폴더를 검색할 수 있습니다.
인덱스 구성 테이블은 기본 키나 키의 유효한 접두어인 임의의 테이블 행에 보다 빠르게 액세스할 수 있도록 해줍니다. 최하위 블록에 있는 행의 키가 아닌 열이 있으면 추가 데이터 블록 I/O가 발생하지 않습니다. 예를 들어, 사원 100의 급여는 인덱스 행 자체에 저장됩니다. 또한 행이 Primary Key 순서로 저장되기 때문에 Primary Key 또는 접두어에 의한 범위 액세스는 최소 블록 I/O를 포함합니다. 또 다른 이점은 별도의 Primary Key 인덱스에 대한 공간 오버헤드를 피할 수 있다는 것입니다.
인덱스 구성 테이블은 관련 데이터 조각을 함께 저장하거나 데이터를 특정 순서로 물리적으로 저장해야 하는 경우에 유용합니다. 이러한 유형의 테이블은 일반적으로 정보 검색, 공간 데이터 및 OLAP 응용 프로그램에 사용됩니다.
-
인덱스 구성 테이블 특성 데이터베이스 시스템은 B 트리 인덱스 구조를 조작하여 인덱스 구성 테이블에 대한 모든 작업을 수행합니다.
-
행 오버플로우 영역이 있는 인덱스 구성 테이블 인덱스 구성 테이블을 생성할 때 별도의 세그먼트를 행 오버플로우 영역으로 지정할 수 있습니다.
-
인덱스 구성 테이블에 대한 2차 인덱스 2차 인덱스는 인덱스 구성 테이블에 대한 인덱스입니다.
참조:
-
Oracle Spatial and Graph 개요는 Oracle Spatial Developer's Guide를 참조하십시오.
-
인덱스 구성 테이블을 관리하는 방법을 알아보려면 Oracle AI Database Administrator's Guide를 참조하십시오.
-
CREATE TABLE ... ORGANIZATION INDEX구문 및 의미에 대한 Oracle AI Database SQL Language Reference
인덱스 구성 테이블의 특성
데이터베이스 시스템은 B 트리 인덱스 구조를 조작하여 인덱스 구성 테이블에 대한 모든 작업을 수행합니다.
다음 표에는 인덱스 구성 테이블과 힙 구성 테이블 간의 차이점이 요약되어 있습니다.
표 6 인덱스 구성 테이블과 힙 구성 테이블 비교
| 힙 구성 테이블 | 인덱스 구성 테이블 |
|---|---|
| rowid는 행을 고유하게 식별합니다. 기본 키 제약 조건을 선택적으로 정의할 수 있습니다. | Primary Key는 행을 고유하게 식별합니다. 기본 키 제약 조건을 정의해야 합니다. |
ROWID pseudocolumn의 물리적 rowid는 보조 인덱스를 작성할 수 있습니다. |
ROWID pseudocolumn의 논리적 rowid는 보조 인덱스를 작성할 수 있습니다. |
| 개별 행은 rowid에 의해 직접 액세스할 수 있습니다. | 개별 행에 대한 액세스는 기본 키에 의해 간접적으로 수행될 수 있습니다. |
| 순차적 전체 테이블 스캔은 모든 행을 순서대로 반환합니다. | 전체 인덱스 스캔 또는 빠른 전체 인덱스 스캔은 모든 행을 어떤 순서로 반환합니다. |
| 다른 테이블과 함께 테이블 클러스터에 저장할 수 있습니다. | 테이블 클러스터에 저장할 수 없습니다. |
LONG 데이터 유형의 열과 LOB 데이터 유형의 열을 포함할 수 있습니다. |
LOB 열은 포함할 수 있지만 LONG 열은 포함할 수 없습니다. |
| 가상 열을 포함할 수 있습니다(관계형 힙 테이블만 지원됨). | 가상 열을 포함할 수 없습니다. |
인덱스 구성 테이블은 CREATE TABLE 문에 COMPRESS ADVANCED LOW 절을 추가하여 Advanced Low 압축을 사용하여 압축할 수 있습니다. 고급 하한 압축은 모든 최하위 블록에 대해 최적의 접두어 열 수를 자율적으로 계산하는 적응형 형식의 접두어 압축으로, 유저 개입 없이 블록 레벨에서 최적 압축을 수행합니다. 여기에는 해당하는 경우 압축되지 않을 가능성이 포함됩니다. 이렇게 하면 음수 압축이 불가능합니다. 전체 오버헤드는 무시할 수 있으므로 압축률이 더 높습니다.
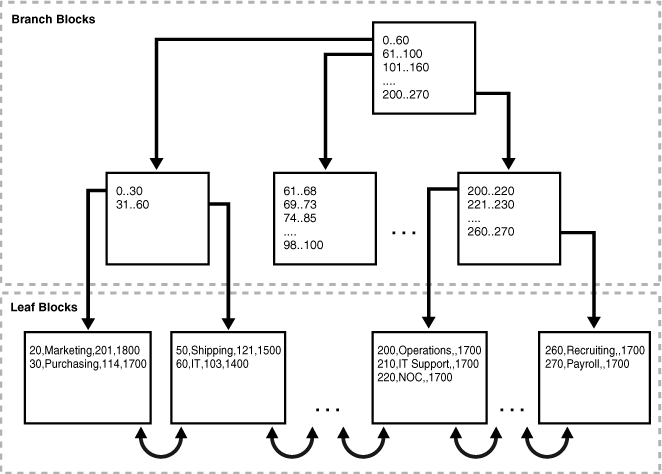
인덱스 구성 테이블에 대한 스캔은 최적기가 질의를 빠른 전체 스캔으로 실행할 수 있다고 간주한 Exadata Smart Scan으로 오프로드될 수 있습니다. 따라서 유저의 개입이 필요하지 않습니다. 전체 셀측 처리는 관심 있는 모든 열이 최하위 블록에 상주하는 인덱스 구성 테이블 최하위 블록에서 지원됩니다. 일부 열이 오버플로우 세그먼트에 상주하는 경우 스마트 스캔은 이러한 열을 처리하지 않으며 데이터베이스가 스캔을 완료합니다. 그림 5-3은 인덱스 구성 departments 테이블의 구조를 보여줍니다. 최하위 블록은 테이블의 행을 포함하며 기본 키를 기준으로 순차적으로 정렬됩니다. 예를 들어, 첫번째 최하위 블록의 첫번째 값은 20의 부서 ID, Marketing의 부서 이름, 201의 관리자 ID 및 1800의 위치 ID를 보여줍니다.
그림 3: 인덱스 구성 테이블
예제 5-10 인덱스 구성 테이블 스캔
인덱스 구성 테이블은 모든 데이터를 동일한 구조에 저장하며 rowid를 저장할 필요는 없습니다. 그림 5-3에 표시된 것처럼 인덱스 구성 테이블의 최하위 블록 1에는 다음과 같이 기본 키별로 정렬된 항목이 포함될 수 있습니다.
20,Marketing,201,1800
30,Purchasing,114,1700
인덱스 구성 테이블의 최하위 블록 2에는 다음과 같은 항목이 포함될 수 있습니다.
50,Shipping,121,1500
60,IT,103,1400
기본 키 순서로 인덱스 구성 테이블 행을 스캔하면 다음 순서로 블록이 읽힙니다.
-
블록 1
-
블록 2
예제 5-11 힙 구성 테이블 스캔
힙 구성 테이블의 데이터 액세스를 인덱스 구성 테이블과 대조하려면 힙 구성 departments 테이블 세그먼트의 블록 1에 다음과 같은 행이 포함되어 있다고 가정합니다.
50,Shipping,121,1500
20,Marketing,201,1800
블록 2는 다음과 같이 동일한 테이블에 대한 행을 포함합니다.
30,Purchasing,114,1700
60,IT,103,1400
이 힙 구성 테이블에 대한 B 트리 인덱스 최하위 블록에는 다음 항목이 포함됩니다. 첫번째 값은 기본 키이고 두번째 항목은 ROWID입니다.
20,AAAPeXAAFAAAAAyAAD
30,AAAPeXAAFAAAAAyAAA
50,AAAPeXAAFAAAAAyAAC
60,AAAPeXAAFAAAAAyAAB
기본 키 순서의 테이블 행 스캔은 다음 순서로 테이블 세그먼트 블록을 읽습니다.
-
블록 1
-
블록 2
-
블록 1
-
블록 2
따라서 이 예제의 블록 I/O 수는 인덱스 구성 예제의 숫자의 두 배입니다.
행 오버플로우 영역이 있는 인덱스 구성 테이블
인덱스 구성 테이블을 생성할 때 별도의 세그먼트를 행 오버플로우 영역으로 지정할 수 있습니다.
인덱스 구성 테이블에서는 전체 행을 포함하므로 B 트리 인덱스 항목이 클 수 있으므로 해당 항목을 포함할 별도의 세그먼트가 유용합니다. 반대로 B 트리 항목은 대개 키와 rowid로 구성되어 있으므로 작습니다.
행 오버플로우 영역을 지정할 경우 데이터베이스는 인덱스 구성 테이블의 행을 다음 부분으로 나눌 수 있습니다.
-
인덱스 항목
이 부분에는 모든 Primary Key 열에 대한 열 값, 행의 오버플로우 부분을 가리키는 물리적 rowid 및 선택적으로 키가 아닌 일부 열이 포함됩니다. 이 부분은 인덱스 세그먼트에 저장됩니다.
-
오버플로우 부분
이 부분에는 나머지 키가 아닌 열에 대한 열 값이 포함되어 있습니다. 이 부분은 오버플로우 저장 영역 세그먼트에 저장됩니다.
참조:
-
CREATE TABLE의OVERFLOW절을 사용하여 행 오버플로우 영역을 설정하는 방법을 알아보려면 Oracle AI Database Administrator's Guide를 참조하십시오. -
CREATE TABLE ... OVERFLOW구문 및 의미에 대한 Oracle AI Database SQL Language Reference
인덱스 구성 테이블의 보조 인덱스
보조 인덱스는 인덱스 구성 테이블에 대한 인덱스입니다.
어떤 의미에서 보조 인덱스는 인덱스의 인덱스입니다. 이것은 독립적인 스키마 객체이며 인덱스 구성 테이블과 별도로 저장됩니다.
Oracle AI Database는 인덱스 구성 테이블에 논리적 rowids라는 행 식별자를 사용합니다. 논리적 rowid는 테이블 기본 키의 base64 인코딩 표현입니다. 논리적 rowid 길이는 기본 키 길이에 따라 달라집니다.
인덱스 최하위 블록의 행은 삽입으로 인해 블록 내에서 또는 블록 간에 이동할 수 있습니다. 인덱스 구성 테이블의 행은 힙 구성 행이 이동할 때 이전되지 않습니다. 인덱스 구성 테이블의 행에는 영구적인 물리적 주소가 없으므로 데이터베이스는 기본 키를 기반으로 하는 논리적 rowids를 사용합니다.
예를 들어, departments 테이블이 인덱스 구성이라고 가정합니다. location_id 열은 각 부서의 ID를 저장합니다. 테이블에는 다음과 같이 행이 저장되며 마지막 값은 위치 ID입니다.
10,Administration,200,1700
20,Marketing,201,1800
30,Purchasing,114,1700
40,Human Resources,203,2400
location_id 열의 보조 인덱스는 다음과 같이 인덱스 항목을 가질 수 있습니다. 여기서 쉼표 다음에 오는 값은 논리적 rowid입니다.
1700,*BAFAJqoCwR/+
1700,*BAFAJqoCwQv+
1800,*BAFAJqoCwRX+
2400,*BAFAJqoCwSn+
보조 인덱스는 기본 키나 기본 키 접두어가 아닌 열을 사용하여 인덱스 구성 테이블에 빠르고 효율적으로 액세스할 수 있도록 합니다. 예를 들어, ID가 1700보다 큰 부서의 이름을 query하면 보조 인덱스를 사용하여 데이터 액세스 속도를 높일 수 있습니다.
-
논리적 행 ID 및 물리적 추측 보조 인덱스는 논리적 행 ID를 사용하여 테이블 행을 찾습니다.
-
인덱스 구성 테이블에 대한 비트맵 인덱스 인덱스 구성 테이블에 대한 보조 인덱스는 비트맵 인덱스일 수 있습니다. 비트맵 인덱스는 각 인덱스 키에 대한 비트맵을 저장합니다.
참조:
-
rowids 및
ROWIDpseudocolumn 사용에 대한 자세한 내용은 "Rowid 데이터 유형"을 참조하십시오. -
"체인 및 이전된 행"을 통해 행이 이전되는 이유와 이전이 I/O 수를 늘리는 이유를 알아봅니다.
-
인덱스 구성 테이블에 보조 인덱스를 생성하는 방법을 알아보려면 Oracle AI Database Administrator's Guide를 참조하십시오.
-
Oracle AI Database VLDB and Partitioning Guide - 인덱스화된 구성 테이블 분할 영역에 보조 인덱스를 생성하는 방법 학습
논리적 Rowids 및 물리적 Guess
보조 인덱스는 논리적 rowids를 사용하여 테이블 행을 찾습니다.
논리적 rowid에는 인덱스 항목이 처음 생성될 때의 물리적 rowid인 물리적 추측이 포함됩니다. Oracle AI Database는 물리적 추측을 사용하여 기본 키 검색을 우회하여 인덱스 구성 테이블의 최하위 블록으로 직접 프로브할 수 있습니다. 행의 물리적 위치가 변경되면 논리적 rowid는 오래된 물리적 추측을 포함하더라도 유효한 상태로 유지됩니다.
힙 구성 테이블의 경우 보조 인덱스에 의한 액세스에는 보조 인덱스를 스캔하고 행을 포함하는 데이터 블록을 패치(fetch)하기 위한 추가 I/O가 포함됩니다. 인덱스 구성 테이블의 경우 물리적 추측의 사용 및 정확성에 따라 보조 인덱스에 의한 액세스가 달라집니다.
-
물리적 추측이 없는 액세스에는 보조 인덱스를 스캔한 후 기본 키 인덱스를 스캔한 두 가지 인덱스 스캔이 포함됩니다.
-
물리적 추측을 통해 액세스는 정확성에 따라 달라집니다.
-
정확한 물리적 추측을 통해 액세스에는 보조 인덱스 스캔과 행을 포함하는 데이터 블록을 패치(fetch)하는 추가 I/O가 포함됩니다.
-
부정확한 물리적 추측을 사용할 경우 액세스에는 잘못된 데이터 블록을 패치(fetch)하는 보조 인덱스 스캔과 I/O가 포함되며, 이어서 인덱스 구성 테이블의 인덱스 고유 스캔이 기본 키 값으로 수행됩니다.
-
인덱스 구성 테이블에 대한 비트맵 인덱스
인덱스 구성 테이블의 보조 인덱스는 비트맵 인덱스일 수 있습니다. 비트맵 인덱스는 각 인덱스 키에 대한 비트맵을 저장합니다.
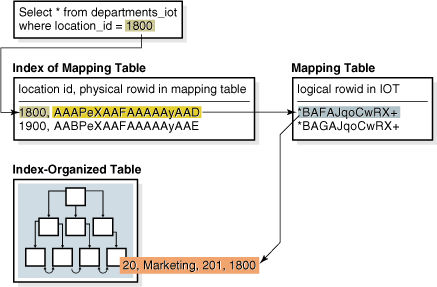
인덱스 구성 테이블에 비트맵 인덱스가 있으면 모든 비트맵 인덱스는 힙 구성 매핑 테이블을 사용합니다. 매핑 테이블은 인덱스 구성 테이블의 논리적 rowids를 저장합니다. 각 매핑 테이블 행은 해당 인덱스 구성 테이블 행에 대해 하나의 논리적 rowid를 저장합니다.
데이터베이스는 검색 키를 사용하여 비트맵 인덱스에 액세스합니다. 데이터베이스에서 키를 찾으면 비트맵 항목이 물리적 rowid로 변환됩니다. 힙 구성 테이블을 사용하는 경우 데이터베이스는 물리적 rowid를 사용하여 기본 테이블에 액세스합니다. 인덱스 구성 테이블(Index-organized Table)을 사용할 경우 데이터베이스에서는 물리적 rowid를 사용하여 매핑 테이블에 액세스합니다. 이렇게 하면 데이터베이스에서 인덱스 구성 테이블에 액세스하는 데 사용하는 논리적 rowids가 생성됩니다. 다음 그림은 departments_iot 테이블 질의에 대한 인덱스 액세스를 보여줍니다.
그림 4: 인덱스 구성 테이블에 대한 비트맵 인덱스
주: 인덱스 구성 테이블의 행을 이동해도 해당 인덱스 구성 테이블에 구축된 비트맵 인덱스는 사용할 수 없는 상태로 유지되지 않습니다.
참조: 물리적 rowids와 논리적 rowids의 차이점에 대해 알아보려면 "행 조각의 행 ID"를 참조하십시오.