논리적 저장 영역 구조
이 장에서는 논리적 저장 영역 구조 간의 특성 및 관계에 대해 설명합니다. 이러한 구조는 Oracle AI Database에 의해 생성되고 인식되며 운영 체제에 알려지지 않습니다.
-
논리적 저장 영역 구조 소개 Oracle AI Database는 데이터베이스의 모든 데이터에 대해 논리적 공간을 할당합니다.
-
데이터 블록 개요 Oracle AI Database는 데이터 블록(Oracle 블록 또는 페이지라고도 함)이라는 단위로 데이터베이스의 데이터 파일에 있는 논리적 저장 공간을 관리합니다. 데이터 블록은 데이터베이스 I/O의 최소 단위입니다.
-
확장 영역 개요 확장 영역은 논리적으로 연속된 데이터 블록으로 구성된 데이터베이스 저장 영역 단위입니다. RAID 스트라이핑 및 파일 시스템 구현으로 인해 데이터 블록이 디스크에 물리적으로 분산되어 있을 수 있습니다.
-
세그먼트 개요 세그먼트는 테이블스페이스 내의 논리적 저장 영역 구조에 대한 모든 데이터를 포함하는 확장 영역의 집합입니다.
-
테이블스페이스 개요 테이블스페이스는 세그먼트에 대한 논리적 스토리지 컨테이너입니다.
논리적 저장 영역 구조 소개
Oracle AI Database는 데이터베이스의 모든 데이터에 논리적 공간을 할당합니다.
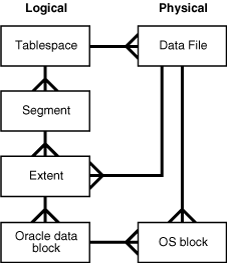
데이터베이스 공간 할당의 논리적 단위는 데이터 블록, Extent, 세그먼트 및 테이블스페이스입니다. 물리적 레벨에서는 데이터가 디스크의 데이터 파일에 저장됩니다. 데이터 파일의 데이터는 운영 체제 블록에 저장됩니다.
다음 그림은 물리적 및 논리적 스토리지에 대한 엔티티 관계 다이어그램입니다. 새 발 모양 표기는 일 대 다 관계를 나타냅니다.
그림 1: 논리적 및 물리적 스토리지
-
논리적 저장 영역 계층 세그먼트는 각각 여러 데이터 블록을 포함하는 하나 이상의 확장 영역을 포함합니다.
-
논리적 공간 관리 Oracle AI Database는 논리적 공간 관리를 사용하여 테이블스페이스의 확장 영역을 추적하고 할당해야 합니다. 참조: "물리적 저장 영역 구조"
논리적 저장 계층
세그먼트는 각각 여러 데이터 블록을 포함하는 하나 이상의 Extent를 포함합니다.
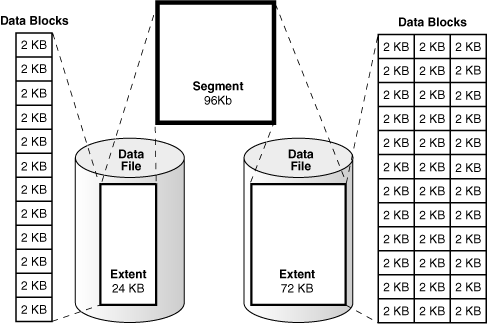
다음 그림은 테이블스페이스 내의 데이터 블록, Extent 및 세그먼트 간의 관계를 보여줍니다. 이 예제에서 세그먼트는 서로 다른 데이터 파일에 저장된 두 개의 Extent를 가집니다.
그림 2: 테이블스페이스 내의 세그먼트, Extent 및 데이터 블록
Oracle AI Database는 가장 낮은 수준의 세분성에서 가장 높은 수준까지 데이터를 다음과 같이 저장합니다.
-
데이터 블록은 Oracle AI Database에서 가장 작은 논리적 데이터 스토리지 단위입니다.
하나의 논리적 데이터 블록은 특정 바이트 수의 영구 저장 영역(예: 2KB)에 해당합니다. 데이터 블록은 Oracle AI Database가 사용 또는 할당할 수 있는 가장 작은 스토리지 단위입니다.
전통적으로 데이터 파일은 자기 디스크 또는 SSD(Solid State Disk)에 저장되었습니다. 또한 Oracle AI Database는 데이터베이스 파일 저장을 위해 PMEM(영구 메모리)을 지원합니다. 기본 데이터가 물리적으로 저장되는 방식에 관계없이 Oracle 프로세스는 항상 논리적 데이터 블록을 읽고 씁니다.
-
extent는 특정 유형의 정보를 저장하기 위해 할당되는 논리적으로 연속된 데이터 블록 세트입니다.
앞의 그림에서 24KB Extent에는 12개의 데이터 블록이 있고 72KB Extent에는 36개의 데이터 블록이 있습니다.
-
세그먼트는 테이블과 같은 특정 데이터베이스 객체에 할당된 일련의 확장 영역입니다.
예를 들어,
employees테이블의 데이터는 자체 데이터 세그먼트에 저장되고,employees의 각 인덱스는 자체 인덱스 세그먼트에 저장됩니다. 저장 영역을 사용하는 모든 데이터베이스 객체는 단일 세그먼트로 구성됩니다. -
테이블스페이스는 하나 이상의 세그먼트를 포함하는 데이터베이스 저장 장치입니다.
각 세그먼트는 하나의 테이블스페이스에만 속합니다. 따라서 세그먼트에 대한 모든 Extent는 동일한 테이블스페이스에 저장됩니다. 앞의 그림과 같이 테이블스페이스 내에서 세그먼트는 여러 데이터 파일의 Extent를 포함할 수 있습니다. 예를 들어, 세그먼트의 한 확장 영역은
users01.dbf에 저장되고 다른 확장 영역은users02.dbf에 저장될 수 있습니다. 단일 Extent는 데이터 파일에 확장될 수 없습니다.
참조: "물리적 저장 영역 구조 소개"
논리적 공간 관리
Oracle AI Database는 논리적 공간 관리를 사용하여 테이블스페이스의 Extent를 추적 및 할당해야 합니다.
데이터베이스 객체에 Extent가 필요한 경우 데이터베이스에는 Extent를 찾아 제공하는 방법이 있어야 합니다. 마찬가지로 객체에 더 이상 Extent가 필요하지 않으면 데이터베이스에 사용 가능한 Extent를 만드는 방법이 있어야 합니다.
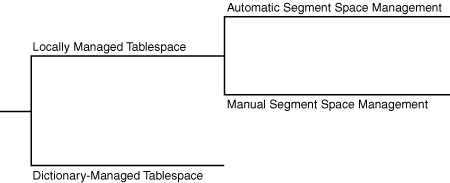
Oracle AI Database는 생성한 유형을 기반으로 테이블스페이스 내의 공간을 관리합니다. 다음 유형의 테이블스페이스 중 하나를 생성할 수 있습니다.
-
로컬관리방식 테이블스페이스(기본값)
데이터베이스는 테이블스페이스 자체의 비트맵을 사용하여 Extent를 관리합니다. 따라서 로컬에서 관리되는 테이블스페이스는 비트맵용으로 남겨두며 테이블스페이스의 일부를 남겨두습니다. 데이터베이스는 테이블스페이스 내에서 자동 세그먼트 공간 관리(ASSM) 또는 수동 세그먼트 공간 관리(MSSM)를 사용하여 세그먼트를 관리할 수 있습니다.
-
딕셔너리관리방식의 테이블스페이스
데이터베이스는 데이터 딕셔너리를 사용하여 확장 영역을 관리합니다.
그림 15-3에서는 테이블스페이스의 논리적 공간 관리에 대한 대안을 보여줍니다.
그림 3: 논리적 공간 관리
-
로컬 관리 테이블스페이스 로컬 관리 테이블스페이스는 데이터 파일 본문에서 사용 가능한 공간과 사용된 공간을 추적하기 위해 데이터 파일 헤더에 비트맵을 유지 관리합니다.
-
딕셔너리 관리 테이블스페이스 딕셔너리 관리 테이블스페이스는 데이터 딕셔너리를 사용하여 확장 영역을 관리합니다. 참조: "데이터 딕셔너리 개요"
로컬에서 관리되는 테이블스페이스
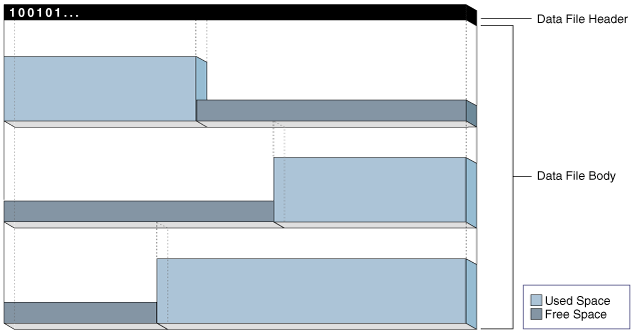
로컬관리방식 테이블스페이스는 데이터 파일 본문에서 사용 가능한 공간과 사용된 공간을 추적하기 위해 데이터 파일 헤더에 비트맵을 유지 관리합니다.
각 비트는 블록 그룹에 해당합니다. 공간이 할당되거나 해제되면 Oracle AI Database는 비트맵 값을 변경하여 블록의 새 상태를 반영합니다.
다음 그림은 비트맵 관리 저장 영역의 개념 표현입니다. 헤더의 1는 사용된 공간을 나타내고, 0는 사용 가능한 공간을 나타냅니다.
그림 4: 비트맵 관리 스토리지
로컬관리방식 테이블스페이스의 이점은 다음과 같습니다.
-
데이터 딕셔너리를 사용하여 Extent 관리 방지
딕셔너리관리방식의 테이블스페이스에서는 딕셔너리관리방식의 테이블스페이스에서 공간을 사용하거나 해제하면 데이터 딕셔너리 테이블이나 데이터 딕셔너리에서 공간을 사용하거나 해제 하는 다른 작업이 발생합니다
-
인접한 사용 가능 공간 자동 추적
이러한 방식으로 데이터베이스는 사용 가능한 Extent를 병합할 필요가 없습니다.
-
로컬로 관리되는 Extent의 크기를 자동으로 결정합니다.
또는 모든 Extent는 지역적으로 관리되는 테이블스페이스에서 동일한 크기를 가지며 객체 저장 영역 옵션을 재정의할 수 있습니다. 주: Oracle은 자동 세그먼트 공간 관리와 함께 로컬관리방식 테이블스페이스를 사용할 것을 적극 권장합니다.
세그먼트 공간 관리는 세그먼트를 포함하는 테이블스페이스에서 상속된 속성입니다. 로컬관리방식의 테이블스페이스 내에서 데이터베이스는 세그먼트를 자동으로 또는 수동으로 관리할 수 있습니다. 예를 들어, users 테이블스페이스의 세그먼트는 자동으로 관리되고 tools 테이블스페이스의 세그먼트는 수동으로 관리됩니다.
-
자동 세그먼트 공간 관리 자동 세그먼트 공간 관리(ASSM) 방법은 비트맵을 사용하여 테이블스페이스의 공간을 관리합니다.
-
수동 세그먼트 공간 관리 레거시 MSSM(수동 세그먼트 공간 관리) 방법은 사용 가능한 목록이라는 링크된 목록을 사용하여 세그먼트의 사용 가능한 공간을 관리합니다.
자동 세그먼트 공간 관리
ASSM(자동 세그먼트 공간 관리) 방법은 비트맵을 사용하여 테이블스페이스의 공간을 관리합니다.
비트맵은 다음과 같은 이점을 제공합니다.
-
간소화된 관리
ASSM을 사용하면 많은 저장 영역 파라미터에 대해 올바른 설정을 수동으로 결정할 필요가 없습니다. 중요한 SQL 매개변수는
PCTFREE중 하나만 공간 할당을 제어합니다. 이 매개변수는 이후 업데이트를 위해 블록에 예약할 공간의 백분율을 지정합니다("데이터 블록의 사용 가능 공간 백분율 참조). -
동시성 증가
다중 트랜잭션에서 별도의 사용 가능한 데이터 블록 리스트를 검색할 수 있으므로 경합과 대기 시간이 줄어듭니다. 많은 표준 작업 로드의 경우 ASSM을 사용하는 응용 프로그램 성능이 MSSM을 사용하는 올바르게 튜닝된 응용 프로그램의 성능보다 낫습니다.
-
Oracle RAC(Oracle Real Application Clusters) 환경에서 Instance에 대한 공간의 동적 유사성
ASSM은 더 효율적이며 영구적인 로컬관리방식 테이블스페이스의 기본값입니다.
주: 이 장에서는 논리적 저장 공간에 대한 모든 토론에서 ASSM을 사용한다고 가정합니다.
수동 세그먼트 공간 관리
레거시 MSSM(수동 세그먼트 공간 관리) 방법은 사용 가능한 목록이라는 링크된 목록을 사용하여 세그먼트의 사용 가능한 공간을 관리합니다.
사용 가능 공간이 있는 데이터베이스 객체의 경우 Free List는 사용된 세그먼트 공간과 아직 사용되지 않은 세그먼트 공간 사이의 구분선인 HWM(고수위)(HWM) 아래에서 블록을 추적합니다. 블록이 사용되면 데이터베이스는 필요에 따라 Free List에 블록을 넣거나 Free List에서 블록을 제거합니다.
PCTFREE 외에도 MSSM에서는 PCTUSED, FREELISTS 및 FREELIST GROUPS와 같은 SQL 매개변수를 사용하여 공간 할당을 제어해야 합니다. PCTUSED는 데이터베이스가 사용 가능 목록에 배치하기 위해 현재 사용된 블록에 존재해야 하는 사용 가능 공간의 백분율을 설정합니다. 예를 들어, CREATE TABLE 문에서 PCTUSED를 40로 설정하면 블록 공간의 40% 미만이 사용될 때까지 세그먼트의 블록에 행을 삽입할 수 없습니다.
예를 들어, 테이블에 행을 삽입한다고 가정합니다. 데이터베이스는 테이블의 Free List를 검사하여 사용 가능한 첫번째 블록을 찾습니다. 행이 블록에 맞지 않고 블록에서 사용된 공간이 PCTUSED보다 크거나 같은 경우 데이터베이스는 목록에서 블록을 제거하고 다른 블록을 검색합니다. 블록에서 행을 삭제하면 데이터베이스는 블록에서 사용된 공간이 PCTUSED보다 작은지 확인합니다. 이 경우 데이터베이스는 해당 블록을 Free List의 맨 앞에 둡니다.
객체에는 여러 Free List가 있을 수 있습니다. 이렇게 하면 테이블에서 DML을 수행하는 여러 세션이 서로 다른 리스트를 사용하여 경합을 줄일 수 있습니다. 각 데이터베이스 세션은 해당 세션 동안 하나의 Free List만 사용합니다.
그림 15-5에 표시된 것처럼 사용 가능한 목록 모음인 사용 가능한 목록 그룹이 하나 이상 있는 객체를 만들 수도 있습니다. 각 그룹에는 그룹의 개별 프로세스 사용 가능 목록을 관리하는 마스터 사용 가능 목록이 있습니다. Free List에 대한 공간 오버헤드, 특히 Free List 그룹에 대한 공간 오버헤드가 중요할 수 있습니다.
그림 5: Free List 그룹
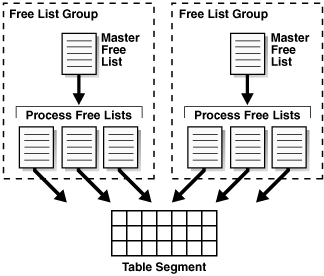
수동으로 세그먼트 공간 관리는 복잡할 수 있습니다. 행 이전을 줄이고 공간 낭비를 방지하려면 PCTFREE 및 PCTUSED를 조정해야 합니다. 예를 들어, 세그먼트에서 사용된 모든 블록이 1/2 찼고 PCTUSED가 40이면 데이터베이스에서는 이러한 블록에 대한 삽입을 허용하지 않습니다. 공간 할당 매개변수 미세 조정의 어려움 때문에 Oracle은 ASSM을 강력히 권장합니다. ASSM에서 PCTFREE는 새 행을 블록에 삽입할 수 있는지 여부를 결정하지만 Free List를 사용하지 않고 PCTUSED를 무시합니다.
참조:
-
로컬로 관리되는 테이블스페이스에 대해 알아보려면 Oracle AI Database Administrator's Guide를 참조하십시오.
-
자동 세그먼트 공간 관리에 대한 자세한 내용은 Oracle AI Database Administrator's Guide를 참조하십시오.
-
PCTFREE및PCTUSED와 같은 저장 영역 매개변수에 대해 알아보려면 Oracle AI Database SQL Language Reference를 참조하십시오.
딕셔너리 관리 테이블스페이스
딕셔너리관리방식의 테이블스페이스는 데이터 딕셔너리를 사용하여 해당 Extent를 관리합니다.
Oracle AI Database는 확장 영역을 재사용하기 위해 비워지거나 할당될 때마다 데이터 딕셔너리의 테이블을 업데이트합니다. 예를 들어, 테이블에 Extent가 필요한 경우 데이터베이스는 데이터 딕셔너리 테이블을 query하고 사용 가능한 Extent를 검색합니다. 데이터베이스가 공간을 찾으면 한 데이터 딕셔너리 테이블을 수정하고 다른 데이터 딕셔너리 테이블에 행을 삽입합니다. 이러한 방식으로 데이터베이스는 데이터를 수정 및 이동하여 공간을 관리합니다.
데이터베이스가 백그라운드에서 실행하여 데이터베이스 객체에 대한 공간을 확보하는 SQL은 반복적 SQL입니다. 데이터 딕셔너리에 대한 갱신을 직렬화해야 하므로 Recursive SQL을 자주 사용하면 성능에 부정적인 영향을 줄 수 있습니다. 로컬로 관리되는 테이블스페이스(기본값)는 이러한 성능 문제를 방지합니다.
참조: Oracle AI Database Administrator's Guide에서 테이블스페이스를 딕셔너리 관리에서 로컬 관리로 이전하는 방법을 알아봅니다.
데이터 블록 개요
Oracle AI Database는 데이터 블록(Oracle 블록 또는 페이지라고도 함)이라는 단위로 데이터베이스의 데이터 파일에 있는 논리적 저장 공간을 관리합니다. 데이터 블록은 데이터베이스 I/O의 최소 단위입니다.
-
데이터 블록 및 운영체제 블록 물리적 레벨에서 데이터베이스 데이터는 운영체제 블록으로 구성된 디스크 파일에 저장됩니다.
-
데이터 블록 형식 모든 데이터 블록에는 데이터베이스가 블록의 데이터 및 사용 가능 공간을 추적할 수 있는 형식 또는 내부 구조가 있습니다. 이 형식은 데이터 블록에 테이블, 인덱스 또는 테이블 클러스터 데이터가 포함되는지 여부와 유사합니다.
-
데이터 블록 압축 데이터베이스는 테이블 압축을 사용하여 데이터 블록에서 중복 값을 제거할 수 있습니다. 이 절에서는 압축을 사용하는 데이터 블록의 형식에 대해 설명합니다.
-
데이터 블록의 공간 관리 데이터베이스가 상향식으로 데이터 블록을 채우면 행 데이터와 블록 헤더 사이의 사용 가능 공간이 줄어듭니다.
-
인덱스 블록 개요 인덱스 블록은 테이블 블록과 공간을 다르게 관리하는 특수 유형의 데이터 블록입니다. Oracle AI Database는 인덱스 블록을 사용하여 인덱스의 논리적 저장 공간을 관리합니다.
데이터 블록 및 운영체제 블록
물리적 레벨에서 데이터베이스 데이터는 운영 체제 블록으로 구성된 디스크 파일에 저장됩니다.
운영 체제 블록은 운영 체제에서 읽거나 쓸 수 있는 최소 데이터 단위입니다. 반대로 Oracle 블록은 운영 체제에 알 수 없는 크기와 구조를 가진 논리적 저장 영역 구조입니다.
다음 그림은 운영 체제 블록의 크기가 데이터 블록과 다를 수 있음을 보여줍니다. 데이터베이스는 운영 체제 블록이 아닌 데이터 블록의 배수로 데이터를 요청합니다.
그림 6: 데이터 블록 및 운영 체제 블록
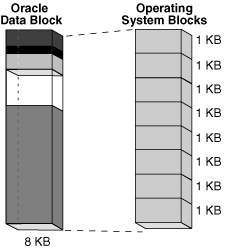
데이터베이스가 데이터 블록을 요청하면 운영 체제는 이 작업을 영구 저장 영역의 데이터 요청으로 변환합니다. 운영 체제 블록과 데이터 블록을 논리적으로 분리하는 것은 다음과 같은 의미를 갖습니다.
-
응용 프로그램은 디스크에 있는 데이터의 물리적 주소를 확인할 필요가 없습니다.
-
데이터베이스 데이터는 여러 물리적 디스크에 스트라이프되거나 Mirroring될 수 있습니다.
-
데이터베이스 블록 크기 모든 데이터베이스에는 데이터베이스 블록 크기가 있습니다.
-
테이블스페이스 블록 크기 블록 크기가
DB_BLOCK_SIZE설정과 다른 개별 테이블스페이스를 생성할 수 있습니다.
데이터베이스 블록 크기
모든 데이터베이스에는 데이터베이스 블록 크기가 있습니다.
DB_BLOCK_SIZE 초기화 매개변수는 데이터베이스 생성 시 데이터베이스의 데이터 블록 크기를 설정합니다. 크기는 SYSTEM 및 SYSAUX 테이블스페이스에 대해 설정되며 다른 모든 테이블스페이스에 대한 기본값입니다. 데이터베이스 블록 크기는 데이터베이스를 재생성하는 것 외에는 변경할 수 없습니다.
DB_BLOCK_SIZE가 설정되지 않은 경우 기본 데이터 블록 크기는 운영 체제에 따라 다릅니다. 데이터베이스의 표준 데이터 블록 크기는 4KB 또는 8KB입니다. 데이터 블록과 운영 체제 블록의 크기가 다르면 데이터 블록 크기는 운영 체제 블록 크기의 배수여야 합니다.
참조:
-
DB_BLOCK_SIZE초기화 매개변수에 대해 알아보려면 Oracle AI Database Reference를 참조하십시오. -
블록 크기를 선택하는 방법을 알아보려면 Oracle AI Database Administrator's Guide 및 Oracle AI Database Performance Tuning Guide를 참조하십시오.
테이블스페이스 블록 크기
블록 크기가 DB_BLOCK_SIZE 설정과 다른 개별 테이블스페이스를 생성할 수 있습니다.
비표준 블록 크기는 전송 가능한 테이블스페이스를 다른 플랫폼으로 이동할 때 유용할 수 있습니다.
참조: Oracle AI Database Administrator's Guide에서 테이블스페이스에 대한 비표준 블록 크기를 지정하는 방법을 알아봅니다.
데이터 블록 형식
모든 데이터 블록에는 데이터베이스가 블록의 데이터와 사용 가능 공간을 추적할 수 있는 형식이나 내부 구조가 있습니다. 이 형식은 데이터 블록에 테이블, 인덱스 또는 테이블 클러스터 데이터가 포함되는지 여부와 유사합니다.
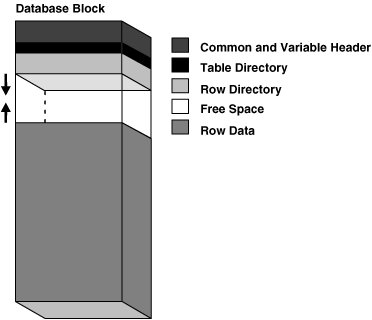
다음 그림은 압축되지 않은 데이터 블록의 형식을 보여줍니다.
그림 7: 데이터 블록 형식
-
데이터 블록 오버헤드 Oracle AI Database는 블록 오버헤드를 사용하여 블록 자체를 관리합니다. 사용자 데이터를 저장하는 데 블록 오버헤드를 사용할 수 없습니다.
-
행 형식 블록의 행 데이터 부분에는 테이블 행 또는 인덱스 키 항목과 같은 실제 데이터가 포함됩니다. 모든 데이터 블록에 내부 형식이 있는 것처럼 모든 행에는 데이터베이스가 행의 데이터를 추적할 수 있는 행 형식이 있습니다. 참조: 압축된 블록에 대한 자세한 내용은 "데이터 블록 압축"을 참조하십시오.
데이터 블록 오버헤드
Oracle AI Database는 블록 오버헤드를 사용하여 블록 자체를 관리합니다. 사용자 데이터를 저장하는 데 블록 오버헤드를 사용할 수 없습니다.
"데이터 블록 형식"에 표시된 것처럼 블록 오버헤드에는 다음 부분이 포함됩니다.
-
블록 헤더
이 부분에는 디스크 주소 및 세그먼트 유형을 포함하여 블록에 대한 일반 정보가 포함되어 있습니다. 트랜잭션이 관리되는 블록의 경우 블록 헤더에는 활성 및 과거 트랜잭션 정보가 포함됩니다.
블록을 업데이트하는 모든 트랜잭션에 대해 트랜잭션 입력이 필요합니다. Oracle AI Database는 처음에 트랜잭션 항목을 위해 블록 헤더에 공간을 예약합니다. 트랜잭션 변경 사항을 지원하는 세그먼트에 할당된 데이터 블록에서 사용 가능 공간은 헤더 공간이 고갈될 때 트랜잭션 항목을 보유할 수도 있습니다. 트랜잭션 항목에 필요한 공간은 운영 체제에 따라 다릅니다. 그러나 대부분의 운영 체제에서 트랜잭션 항목은 약 23바이트가 필요합니다.
-
테이블 디렉토리
힙 구성 테이블의 경우 이 디렉토리에는 이 블록에 저장된 행이 포함된 테이블에 대한 메타 데이터가 포함됩니다. 테이블 클러스터에서는 여러 테이블이 동일한 블록에 행을 저장할 수 있습니다.
-
행 디렉토리
힙 구성 테이블의 경우 이 디렉토리는 블록의 데이터 부분에 있는 행의 위치를 설명합니다. 데이터베이스는 블록의 맨 아래 위치에 행을 배치할 수 있습니다. 행 주소는 행 디렉토리 벡터의 슬롯 중 하나에 기록됩니다.
rowid는 특정 파일, 블록 및 행 번호를 가리킵니다. 예를 들어, rowid
AAAPecAAFAAAABSAAA에서 마지막AAA는 행 번호를 나타냅니다. 행 번호는 행 디렉토리의 항목에 대한 인덱스입니다. 행 디렉토리 항목은 데이터 블록의 행 위치에 대한 포인터를 포함합니다. 데이터베이스가 블록 내에서 행을 이동하는 경우 데이터베이스는 행 디렉토리 항목을 갱신하여 포인터를 수정합니다. rowid는 일정하게 유지됩니다.데이터베이스가 행 디렉토리의 공간을 할당한 후에는 데이터베이스가 행을 삭제한 후 이 공간을 회수하지 않습니다. 따라서 현재 비어 있지만 이전에 최대 50개의 행을 가진 블록은 행 디렉토리에 대해 100바이트가 할당됩니다. 데이터베이스는 세션이 블록에 새 행을 삽입할 때만 이 영역을 재사용합니다.
블록 오버헤드의 일부 부분은 크기가 고정되어 있지만 전체 크기는 다양합니다. 평균적으로 블록 오버헤드는 총 84-107바이트입니다.
행 형식
블록의 행 데이터 부분은 테이블 행이나 인덱스 키 입력과 같은 실제 데이터를 포함합니다. 모든 데이터 블록에 내부 형식이 있는 것처럼 모든 행에는 데이터베이스에서 행의 데이터를 추적할 수 있는 행 형식이 있습니다.
Oracle AI Database는 행을 가변 길이 레코드로 저장합니다. 행은 하나 이상의 섹션에 포함됩니다. 각 섹션을 행 조각이라고 합니다. 각 행 피스에는 행 헤더 및 열 데이터가 있습니다.
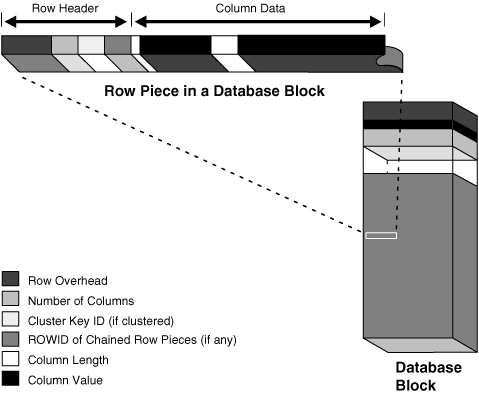
다음 그림은 행의 형식을 보여줍니다.
그림 8: 행 조각의 형식
-
행 헤더 Oracle AI Database는 행 헤더를 사용하여 블록에 저장된 행 조각을 관리합니다.
-
열 데이터 행 헤더 뒤에 열 데이터 섹션이 실제 데이터를 행에 저장합니다. 행 피스는 일반적으로
CREATE TABLE문에 나열된 순서로 열을 저장하지만 이 순서는 보장되지 않습니다. 예를 들어,LONG유형의 열이 마지막으로 생성됩니다. -
Rowid Format Oracle AI Database는 rowid를 사용하여 행을 고유하게 식별합니다. 내부적으로 rowid는 데이터베이스가 행에 액세스해야 하는 정보를 보관하는 구조입니다. rowid는 데이터베이스에 물리적으로 저장되지 않지만 데이터가 저장되는 파일과 블록에서 추론됩니다.
행 머리글
Oracle AI Database는 행 헤더를 사용하여 블록에 저장된 행 피스를 관리합니다.
행 헤더에는 다음과 같은 정보가 포함됩니다.
-
행 피스의 열
-
다른 데이터 블록에 있는 행의 조각
전체 행을 단일 데이터 블록에 삽입할 수 있는 경우 Oracle AI Database는 행을 하나의 행 피스로 저장합니다. 그러나 모든 행 데이터를 단일 블록에 삽입할 수 없거나 기존 행이 해당 블록보다 커지면 데이터베이스는 행을 여러 행 피스에 저장합니다. 데이터 블록은 대개 행당 하나의 행 피스만 포함합니다.
-
테이블 클러스터에 대한 클러스터 키
한 블록에 완전히 포함된 행에는 3바이트 이상의 행 헤더가 있습니다.
참조:
열 데이터
행 헤더 뒤에 열 데이터 섹션이 실제 데이터를 행에 저장합니다. 행 피스는 일반적으로 CREATE TABLE 문에 나열된 순서로 열을 저장하지만 이 순서는 보장되지 않습니다. 예를 들어, LONG 유형의 열이 마지막으로 생성됩니다.
"행 형식"의 그림에 표시된 것처럼 행 조각의 각 열에 대해 Oracle AI Database는 열 길이와 데이터를 별도로 저장합니다. 필요한 공간은 데이터 유형에 따라 다릅니다. 열의 데이터 유형이 가변 길이인 경우 값을 보유하는 데 필요한 공간이 늘어나고 데이터가 갱신되면서 축소될 수 있습니다.
각 행에는 데이터 블록 헤더의 행 디렉토리에 슬롯이 있습니다. 슬롯은 행의 시작을 가리킵니다.
Rowid 형식
Oracle AI Database는 rowid를 사용하여 행을 고유하게 식별합니다. 내부적으로 rowid는 데이터베이스가 행에 액세스해야 하는 정보를 보관하는 구조입니다. rowid는 데이터베이스에 물리적으로 저장되지 않지만 데이터가 저장되는 파일과 블록에서 추론됩니다.
확장 rowid에는 데이터 객체 번호가 포함됩니다. 이 rowid 유형은 각 행에 대한 물리적 주소의 기본 64 인코딩을 사용합니다. 인코딩 문자는 A-Z, a-z, 0-9, +, /입니다.
예제 15-1 ROWID 의사 열
다음 예제는 ROWID 의사 열을 질의하여 사원 100에 대한 employees 테이블에서 행의 확장된 rowid를 표시합니다.
SQL> SELECT ROWID FROM employees WHERE employee_id = 100;

ROWID
------------------
AAAPecAAFAAAABSAAA
다음 그림은 확장된 rowid의 형식을 보여줍니다.
그림 9: ROWID 형식
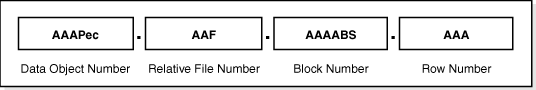
확장 rowid는 네 조각 형식인 OOOOOOFFFBBBBBBRRR로 표시되며 형식은 다음 구성 요소로 나뉩니다.
-
OOOOOO데이터 객체 번호는 세그먼트를 식별합니다(샘플 질의의 데이터 객체
AAAPec). 데이터 객체 번호는 모든 데이터베이스 세그먼트에 지정됩니다. 동일한 세그먼트의 스키마 객체(예: 테이블 클러스터)는 동일한 데이터 객체 번호를 가집니다. -
FFF테이블스페이스 상대 데이터 파일 번호는 행을 포함하는 데이터 파일을 식별합니다(샘플 질의의 파일
AAF). -
BBBBBB데이터 블록 번호는 행을 포함하는 블록을 식별합니다(샘플 질의의 블록
AAAABS). 블록 번호는 테이블스페이스가 아니라 데이터 파일에 대해 상대적입니다. 따라서 블록 번호가 동일한 두 행이 동일한 테이블스페이스의 다른 데이터 파일에 상주할 수 있습니다. -
RRR행 번호는 블록의 행을 식별합니다(샘플 질의의 행
AAA).
rowid가 행 피스에 할당되면 특수한 상황에서 rowid가 변경될 수 있습니다. 예를 들어, 행 이동이 활성화된 경우 분할 영역 키 갱신, Flashback Table 작업, 테이블 축소 작업 등으로 인해 rowid가 변경될 수 있습니다. 행 이동이 사용 안함으로 설정된 경우 Oracle AI Database 유틸리티를 사용하여 행을 익스포트하고 임포트하면 rowid가 변경될 수 있습니다. 주: 내부적으로 데이터베이스는 행이 물리적으로 삭제 및 재삽입된 것처럼 행 이동을 수행합니다. 그러나 행 이동은 트리거에 영향을 주는 갱신으로 간주됩니다.
참조:
-
rowids에 대한 자세한 내용은 Oracle AI Database SQL Language Reference를 참조하십시오.
데이터 블록 압축
데이터베이스는 테이블 압축을 사용하여 데이터 블록에서 중복 값을 제거할 수 있으며, 이 절에서는 압축을 사용하는 데이터 블록의 형식에 대해 설명합니다.
기본 테이블 및 고급 행 압축을 사용하는 데이터 블록의 형식은 기본적으로 압축이 풀린 블록과 동일합니다. 차이점은 블록 시작 부분의 기호 테이블이 행과 열의 중복 값을 저장한다는 점입니다. 데이터베이스는 이러한 값의 발생을 기호 테이블에 대한 짧은 참조로 바꿉니다.
예제 15-2 압축된 데이터 블록 형식
다음 행이 7열 sales 테이블에 대한 데이터 블록에 저장되었다고 가정합니다.
2190,13770,25-NOV-00,S,9999,23,161
2225,15720,28-NOV-00,S,9999,25,1450
34005,120760,29-NOV-00,P,9999,44,2376
9425,4750,29-NOV-00,I,9999,11,979
1675,46750,29-NOV-00,S,9999,19,1121
이 테이블에 기본 테이블 또는 고급 행 압축이 적용되는 경우 데이터베이스는 중복 값을 기호 참조로 바꿉니다. 압축의 다음 개념적 표현은 9999를 대체하는 29-NOV-00 및 % 기호 *를 보여줍니다.
2190,13770,25-NOV-00,S,%,23,161
2225,15720,28-NOV-00,S,%,25,1450
34005,120760,*,P,%,44,2376
9425,4750,*,I,%,11,979
1675,46750,*,S,%,19,1121
표 15-1은 개념적으로 기호를 값에 매핑하는 기호 테이블을 나타냅니다.
표 1 기호 테이블
| 기호 | 값 | 열 | 행 |
|---|---|---|---|
| * | 29-NOV-00 | 3 | 958-960 |
| % | 9999 | 5 | 956-960 |
참조: "테이블 압축"
데이터 블록의 공간 관리
데이터베이스에서 상향식으로 데이터 블록을 채우면 행 데이터와 블록 헤더 사이의 사용 가능 공간이 줄어듭니다.
후행 null 값을 null이 아닌 값으로 변경하는 경우와 같이 데이터 블록의 사용 가능 공간은 갱신 중에 축소될 수도 있습니다. 데이터베이스는 성능을 최적화하고 공간 낭비를 방지하기 위해 데이터 블록의 사용 가능 공간을 관리합니다.
주: 이 섹션에서는 자동 세그먼트 공간 관리를 사용하는 것으로 가정합니다.
-
데이터 블록의 사용 가능 공간 백분율
PCTFREESQL 매개변수는 기존 행 업데이트를 위해 사용 가능 공간으로 예약된 데이터 블록의 최소 백분율을 설정합니다.PCTFREE는 행 이전을 방지하고 낭비되는 공간을 피하는 데 중요합니다. -
데이터 블록의 사용 가능한 공간 최적화 사용 가능한 공간의 백분율은
PCTFREE보다 낮을 수 없지만 사용 가능한 공간의 양은 더 클 수 있습니다. 예를 들어,PCTFREE를 20%로 설정하면 총 사용 가능 공간이 블록의 5%로 줄어들지 않지만 블록의 50%를 사용할 수 있습니다. -
체인 및 마이그레이션된 행 Oracle AI Database는 체인화 및 마이그레이션을 사용하여 너무 큰 행이 단일 블록에 들어가지 않도록 관리합니다.
데이터 블록의 사용 가능 공간 백분율
PCTFREE SQL 매개변수는 기존 행 업데이트를 위해 사용 가능한 공간으로 예약된 데이터 블록의 최소 백분율을 설정합니다. PCTFREE는 행 이전을 방지하고 낭비되는 공간을 피하는 데 중요합니다.
예를 들어, 가끔씩만 업데이트가 필요한 테이블을 만들면 대부분 기존 데이터의 크기가 증가하지 않습니다. CREATE TABLE 문 내에서 다음과 같이 PCTFREE 매개변수를 지정합니다.
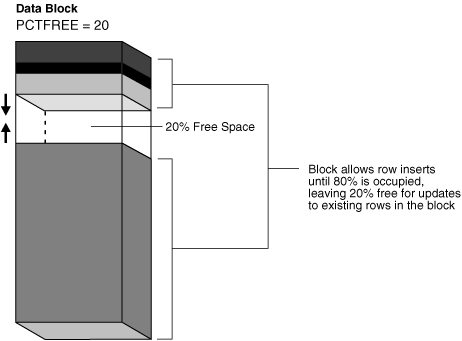
CREATE TABLE test_table (n NUMBER) PCTFREE 20;그림 15-10에서는 20의 PCTFREE 설정이 공간 관리에 미치는 영향을 보여줍니다. 데이터베이스는 시간이 지남에 따라 블록에 행을 추가하여 행 데이터가 블록 헤더 쪽으로 커지도록 하고 그 자체가 행 데이터를 향해 아래쪽으로 확장됩니다. PCTFREE 설정은 데이터 블록의 최소 20%가 사용 가능하도록 합니다. 예를 들어, 데이터베이스는 행 데이터와 헤더가 전체 블록 공간의 결합된 90%를 차지하도록 INSERT 문이 블록을 채우지 못하도록 하여 사용 가능 공간은 10%만 남게 합니다.
그림 10: PCTFREE
주: 이 설명은 PCTFREE 저장 영역 매개변수 또는 사용 가능한 목록을 사용하지 않는 LOB 데이터 유형에는 적용되지 않습니다.
참조:
-
PCTFREE매개변수의 구문 및 의미에 대한 Oracle AI Database SQL Language Reference
데이터 블록의 사용 가능 공간 최적화
사용 가능 공간의 백분율은 PCTFREE보다 작게될 수 없지만 사용 가능 공간의 양은 크게될 수 있습니다. 예를 들어, PCTFREE를 20%로 설정하면 총 사용 가능 공간이 블록의 5%로 줄어들지 않지만 블록의 50%를 사용할 수 있습니다.
-
사용 가능 공간을 늘려 최적화 일부 DML 문은 데이터 블록의 사용 가능 공간을 늘릴 수 있습니다.
-
단편화된 공간 병합을 통한 최적화 릴리스된 공간은 데이터 블록의 사용 가능 공간의 기본 영역과 연속되거나 연속되지 않을 수 있습니다. 연속되지 않은 사용 가능 공간을 분리된 공간이라고 합니다.
사용 가능 공간 증가로 최적화
일부 DML 문은 데이터 블록의 사용 가능 공간을 늘릴 수 있습니다.
다음 명령문은 공간을 늘릴 수 있습니다.
-
DELETE문 -
기존 값을 더 작은 값으로 업데이트하거나 기존 값을 늘리고 행을 강제로 이전하는
UPDATE문 -
고급 행 압축을 사용하는 테이블의
INSERT문INSERT문이 데이터로 블록을 채우면 데이터베이스는 블록 압축을 호출하므로 블록에 더 많은 사용 가능 공간이 생길 수 있습니다.
해제된 공간은 다음 조건에서 INSERT 문에 사용할 수 있습니다.
-
INSERT문이 동일한 트랜잭션에 있고 공간이 확보된 명령문 뒤에 있는 경우 명령문은 공간을 사용할 수 있습니다. -
INSERT문이 공간을 비우는 명령문(다른 유저가 실행할 수 있음)과 별개의 트랜잭션에 있고 공간이 필요한 경우 명령문은 다른 트랜잭션이 커밋된 후에만 사용 가능한 공간을 사용할 수 있습니다.
참조: 고급 행 압축에 대한 자세한 내용은 Oracle AI Database Administrator's Guide를 참조하십시오.
단편화된 공간 병합으로 최적화
해제된 공간은 데이터 블록에 있는 사용 가능 공간의 기본 영역과 인접해 있을 수도 있고 그렇지 않을 수도 있습니다. 연속되지 않은 사용 가능 공간을 분리된 공간이라고 합니다.
다음 그림은 불연속 사용 가능 공간이 있는 데이터 블록을 보여줍니다.
그림 11: 단편화된 공간이 있는 데이터 블록
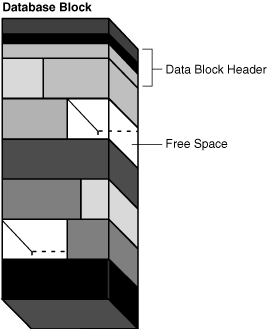
Oracle AI Database는 다음 조건에 해당하는 경우에만 데이터 블록의 사용 가능 공간을 자동으로 투명하게 병합합니다.
-
INSERT또는UPDATE문이 새 행 조각을 포함할 수 있을 만큼 충분한 크기의 사용 가능한 공간을 포함하는 블록을 사용하려고 시도하는 경우 -
사용 가능한 공간이 단편화되어 있어서 행 조각이 블록의 연속 부분에 삽입될 수 없는 경우
병합 후 사용 가능 공간의 크기는 작업 전과 같지만 공간이 이제 연속적입니다. 그림 15-12는 공간이 병합된 후의 데이터 블록을 보여줍니다.
그림 12: 사용 가능 공간 병합 후 데이터 블록
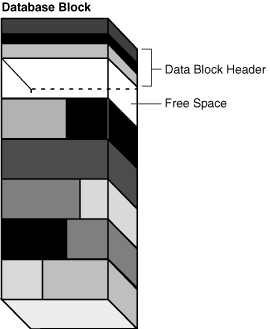
Oracle AI Database는 이전 상황에서만 병합을 수행합니다. 그렇지 않으면 데이터 블록의 사용 가능 공간을 지속적으로 병합하기 때문에 성능이 저하됩니다.
체인화된 행 및 이전된 행
Oracle AI Database는 체인화 및 마이그레이션을 사용하여 너무 커서 단일 블록에 들어가지 않는 행을 관리합니다. 참고: 표준 테이블의 체인화된 행은 블록체인 테이블의 행 체인과 다릅니다. Oracle AI Database는 다양한 기술을 사용하여 블록체인 테이블의 행을 관리합니다.
가능한 상황은 다음과 같습니다.
-
행이 너무 커서 데이터 블록을 처음 삽입할 때 하나의 데이터 블록에 들어가는 경우입니다.
행 체인화에서 Oracle AI Database는 해당 세그먼트를 위해 예약된 하나 이상의 데이터 블록 체인에 행 데이터를 저장합니다. 행 체인화는 대개 큰 행에서 발생합니다. 예를 들어,
LONG또는LONG RAW데이터 유형의 열을 포함하는 행 또는 열 수가 많은 행이 있습니다. 이러한 경우에 행 체인화는 불가피한 선택입니다. -
원래 하나의 데이터 블록에 들어가는 행은 갱신되므로 전체 행 길이는 늘어나지만 갱신된 행을 보유할 여유 공간이 부족합니다.
행 마이그레이션에서 Oracle AI Database는 행이 새 블록에 들어갈 수 있다고 가정하여 전체 행을 새 데이터 블록으로 이동합니다. 이전된 행의 원본 행 피스는 이전된 행을 포함하는 새 블록에 대한 포인터 또는 "전달 주소"를 포함합니다. 이전된 행의 rowid는 변경되지 않습니다.
-
행에 열이 255개를 초과합니다.
Oracle AI Database는 행 조각에 255개의 열만 저장할 수 있습니다. 따라서 1000개의 열이 있는 테이블에 행을 삽입하면 데이터베이스는 일반적으로 여러 블록에 대해 체인화된 네 개의 행 피스를 생성합니다.
그림 15-13에서는 데이터 블록에 큰 행을 삽입하는 방법을 보여 줍니다. 행이 너무 커서 왼쪽 블록에 맞지 않으므로 첫번째 행 조각은 왼쪽 블록에, 두번째 행 조각은 오른쪽 블록에 배치하면 데이터베이스가 행을 체인화합니다.
그림 13: 행 체인화
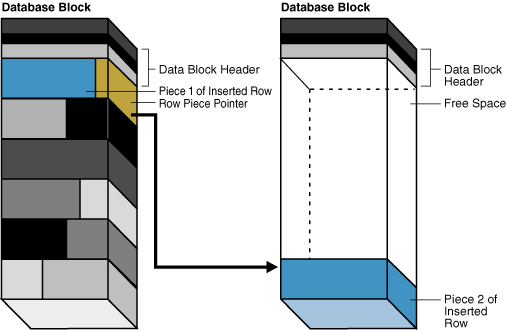
그림 15-14의 왼쪽 블록에는 행이 블록에 비해 너무 커지도록 업데이트된 행이 포함되어 있습니다. 데이터베이스는 전체 행을 오른쪽 블록으로 이동하고 왼쪽 블록에 있는 이전된 행에 대한 포인터를 둡니다.
그림 14: 행 이전
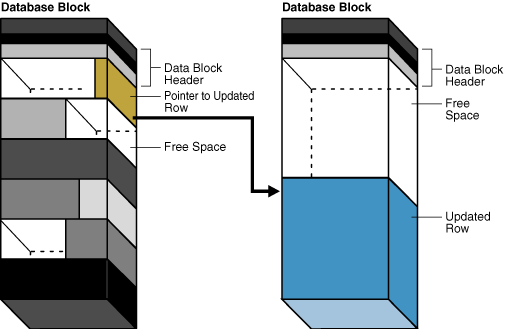
행이 체인화되거나 이전되면 데이터 검색에 필요한 I/O가 증가합니다. 이러한 상황은 Oracle AI Database가 행에 대한 정보를 검색하기 위해 여러 블록을 스캔해야 하기 때문에 발생합니다. 예를 들어, 데이터베이스가 인덱스를 읽기 위해 한 번의 I/O를 수행하고 이전되지 않은 테이블 행을 읽기 위해 한 번의 I/O를 수행하는 경우 이전된 행에 대한 데이터를 얻으려면 추가 I/O가 필요합니다.
Segment Advisor는 수동 및 자동으로 모두 실행할 수 있는 Oracle AI Database 구성 요소로, 회수 가능한 공간이 있는 세그먼트를 식별합니다. Advisor는 사용 가능 공간이 많거나 체인화된 행이 너무 많은 객체에 대한 조언을 제공할 수 있습니다.
참조:
-
"행 저장" 및 "행 조각의 행 ID"
-
Oracle AI Database Administrator's Guide에서 낭비된 공간을 회수하는 방법 알아보기
-
체인화된 행과 이전된 행을 줄이는 방법은 Oracle AI Database Performance Tuning Guide를 참조하십시오.
인덱스 블록 개요
인덱스 블록은 테이블 블록과는 다르게 공간을 관리하는 특수 유형의 데이터 블록입니다. Oracle AI Database는 인덱스 블록을 사용하여 인덱스의 논리적 저장 공간을 관리합니다.
-
인덱스 블록 유형 인덱스는 루트 블록, 분기 블록 및 최하위 블록을 포함합니다.
-
인덱스 항목 저장 인덱스 항목은 데이터 블록의 테이블 행과 동일한 방식으로 인덱스 블록에 저장됩니다. 블록 부분의 인덱스 항목은 이진 순서로 저장되지 않고 힙에 저장됩니다.
-
인덱스 블록에서 슬롯 재사용 데이터베이스는 인덱스 블록 내의 공간을 재사용할 수 있습니다.
-
인덱스 블록 병합 인덱스 병합은 기존 인덱스 데이터를 제자리에 압축하고, 재구성이 블록을 비우면 인덱스 구조에 사용 가능한 블록이 남습니다. 따라서 병합으로 인해 인덱스 블록이 다른 용도로 릴리스되지 않거나 인덱스가 블록을 재할당하게 됩니다.
인덱스 블록 유형
인덱스는 루트 블록, 분기 블록 및 최하위 블록을 포함합니다.
블록 유형은 다음과 같이 정의됩니다.
-
루트 차단
이 블록은 인덱스에 대한 시작점을 식별합니다.
-
분기 블록
데이터베이스는 인덱스 키를 검색할 때 분기 블록을 탐색합니다.
-
최하위 블록
이러한 블록에는 연관된 행을 가리키는 인덱스화된 키 값 rowids가 포함되어 있습니다. 최하위 블록은 데이터베이스가 키 값 범위의 모든 행을 효율적으로 검색할 수 있도록 키 값을 정렬된 순서로 저장합니다.
인덱스 항목 저장 영역
인덱스 항목은 데이터 블록의 테이블 행과 동일한 방식으로 인덱스 블록에 저장됩니다. 블록 부분에 있는 인덱스 항목은 이진 순서가 아니라 힙에 저장됩니다.
데이터베이스는 인덱스 블록의 행 디렉토리를 데이터 블록의 디렉토리와 다르게 관리합니다. 행 디렉토리의 항목(인덱스 블록 본문의 항목이 아님)은 키 값에 따라 정렬됩니다. 예를 들어, 행 디렉토리에서 인덱스 키 000000에 대한 디렉토리 항목은 인덱스 키 111111에 대한 디렉토리 항목보다 우선합니다.
행 디렉토리의 항목을 정렬하면 인덱스 스캔의 효율성이 향상됩니다. 범위 스캔에서 데이터베이스는 범위에 지정된 모든 인덱스 키를 읽어야 합니다. 데이터베이스는 분기 블록을 순회하여 첫번째 키를 포함하는 최하위 블록을 식별합니다. 행 디렉토리의 항목이 정렬되므로 데이터베이스는 이진 검색을 사용하여 범위에서 첫번째 인덱스 키를 찾은 다음 마지막 키를 찾을 때까지 행 디렉토리의 항목을 순차적으로 진행할 수 있습니다. 이러한 방식으로 데이터베이스는 최하위 블록 본문에 있는 모든 키를 읽지 않도록 합니다.
참조: "데이터 블록 오버헤드"
인덱스 블록에서 슬롯 재사용
데이터베이스는 인덱스 블록 내의 공간을 재사용할 수 있습니다.
예를 들어, 응용 프로그램이 열에 값을 삽입한 다음 해당 값을 삭제할 수 있습니다. 행에 공간이 필요한 경우 데이터베이스는 이전에 삭제된 값이 차지했던 인덱스 슬롯을 재사용할 수 있습니다.
인덱스 블록은 대개 힙 구성 테이블 블록보다 많은 행을 가집니다. 단일 인덱스 블록에 많은 행을 저장하는 기능을 사용하면 새 데이터를 저장하는 블록의 빈번한 분할을 방지할 수 있으므로 데이터베이스가 인덱스를 쉽게 유지 관리할 수 있습니다.
인덱스는 REBUILD 또는 COALESCE 옵션을 사용하여 ALTER INDEX 문과 수동으로 병합할 수 있지만 자체적으로 병합할 수는 없습니다. 예를 들어, 1 - 500000 값으로 열을 채우고 짝수 숫자가 포함된 행을 삭제하면 인덱스에 250,000개의 빈 슬롯이 포함됩니다. 데이터베이스는 빈 슬롯을 포함하는 인덱스 블록에 맞는 데이터를 삽입할 수 있는 경우에만 슬롯을 재사용합니다.
인덱스 블록 병합
인덱스 병합은 기존 인덱스 데이터를 제자리에 압축하며, 재구성이 블록을 비우면 인덱스 구조에 사용 가능한 블록이 남습니다. 따라서 병합으로 인해 인덱스 블록이 다른 용도로 릴리스되지 않거나 인덱스가 블록을 재할당하게 됩니다.
Oracle AI Database는 자동으로 인덱스를 압축하지 않습니다. REBUILD 또는 COALESCE 옵션을 사용하여 ALTER INDEX 문을 실행해야 합니다. 그림 15-15는 인덱스가 병합되기 전의 employees.department_id 열 인덱스를 보여줍니다. 처음 세 개의 최하위 블록은 회색 채우기 선으로 표시된 대로 부분적으로만 채워집니다.
그림 15: 병합 전 인덱스
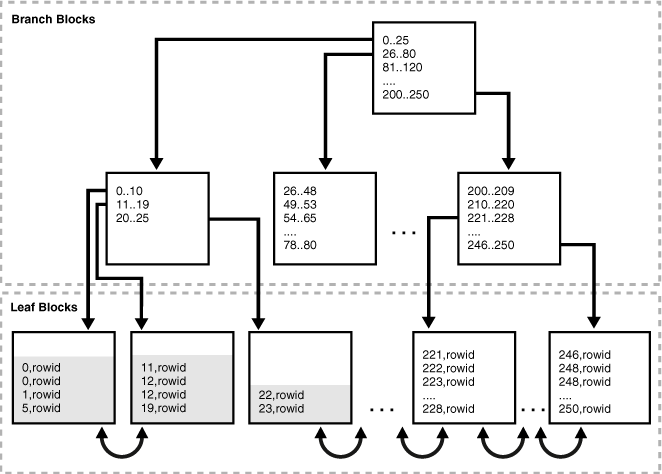
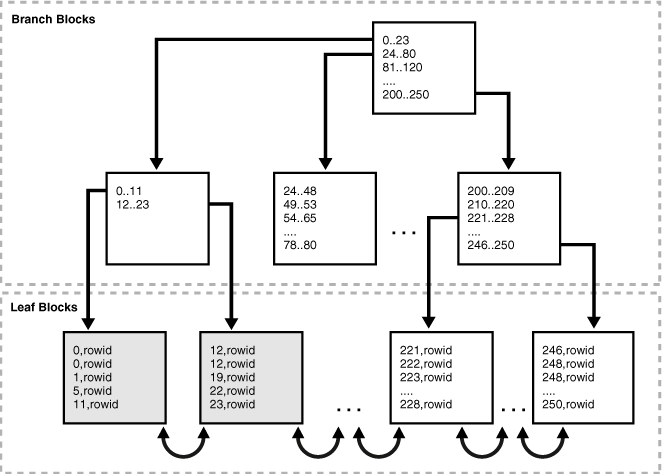
그림 15-16은 인덱스가 병합된 후의 그림 15-15에 있는 인덱스를 보여줍니다. 이제 처음 두 개의 최하위 블록이 회색 채우기 선으로 표시된 것처럼 가득 차고 세번째 최하위 블록이 해제되었습니다.
그림 16: 병합 후 인덱스
참조:
-
인덱스 병합 및 재구축 방법에 대한 자세한 내용은 Oracle AI Database Administrator's Guide를 참조하십시오.
-
COALESCE문에 대한 자세한 내용은 Oracle AI Database SQL Language Reference를 참조하십시오.
Extent 개요
Extent는 논리적으로 연속된 데이터 블록으로 구성된 데이터베이스 저장 영역의 단위입니다. RAID 스트라이핑 및 파일 시스템 구현으로 인해 데이터 블록이 디스크에 물리적으로 분산되어 있을 수 있습니다.
-
확장 영역 할당 기본적으로 데이터베이스는 세그먼트가 생성될 때 데이터 세그먼트에 대한 초기 확장 영역을 할당합니다. Extent는 항상 하나의 데이터 파일에 포함되어 있습니다.
-
확장 영역 할당 해제 일반적으로 사용자 세그먼트의 확장 영역은
DROP문을 사용하여 객체를 삭제하지 않는 한 테이블스페이스로 반환되지 않습니다. -
Storage Parameters for Extents 모든 세그먼트는 확장 영역으로 표현된 저장 영역 매개변수로 정의됩니다. 이러한 매개변수는 Oracle AI Database가 세그먼트에 사용 가능한 공간을 할당하는 방법을 제어합니다.
Extent 할당
기본적으로 데이터베이스는 세그먼트가 생성될 때 데이터 세그먼트에 대해 초기 Extent를 할당합니다. Extent는 항상 하나의 데이터 파일에 포함되어 있습니다.
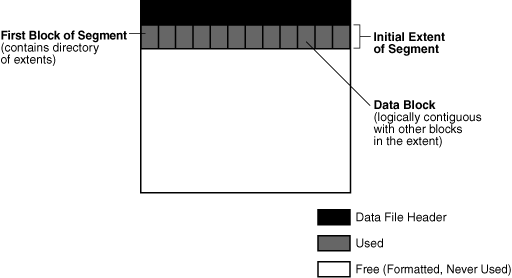
세그먼트에 추가된 데이터는 없지만 초기 Extent의 데이터 블록은 이 세그먼트에 대해서만 예약됩니다. 모든 세그먼트의 첫번째 데이터 블록은 세그먼트에 있는 Extent의 디렉토리를 포함합니다. 그림 15-17에서는 이전에 데이터가 포함되지 않은 데이터 파일의 세그먼트에 있는 초기 확장 영역을 보여줍니다.
그림 17: 세그먼트의 초기 확장 영역
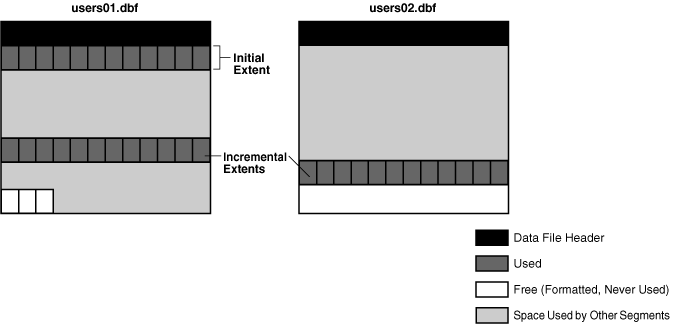
초기 Extent가 가득 차서 공간이 더 필요한 경우 데이터베이스는 자동으로 이 세그먼트에 대해 Incremental Extent를 할당합니다. Incremental Extent는 세그먼트에 대해 생성되는 후속 Extent입니다.
할당 알고리즘은 테이블스페이스가 로컬관리방식인지 딕셔너리관리방식인지에 따라 다릅니다. 로컬관리방식의 경우 데이터베이스는 데이터 파일의 비트맵에서 인접한 사용 가능 블록을 검색합니다. 데이터 파일의 공간이 부족하면 데이터베이스는 다른 데이터 파일에서 찾습니다. 세그먼트의 Extent는 항상 동일한 테이블스페이스에 있지만 다른 데이터 파일에 있을 수 있습니다. 그림 15-18은 데이터베이스가 테이블스페이스의 모든 데이터 파일에 세그먼트에 대한 확장 영역을 할당할 수 있음을 보여줍니다. 예를 들어, 세그먼트는 users01.dbf에 초기 확장 영역을 할당하고, users02.dbf에 첫번째 증분 확장 영역을 할당한 다음, users01.dbf에 다음 확장 영역을 할당할 수 있습니다.
그림 18: 세그먼트의 증분 확장 영역
새로 할당된 Extent의 블록은 사용 가능하지만 이전 데이터로 인해 비어 있지 않을 수 있습니다. ASSM에서 Oracle AI Database는 Extent를 사용할 때 새로 할당된 Extent의 블록의 형식을 지정하지만 필요에 따라 형식을 지정합니다. 주: 이 섹션은 한 서버 프로세스가 명령문을 구문 분석하고 실행하는 직렬 작업에 적용됩니다. 데이터베이스는 여러 서버 프로세스가 포함된 병렬 SQL 문에서 Extent를 다르게 할당합니다.
참조:
-
확장 영역을 수동으로 할당하는 방법을 알아보려면 Oracle AI Database Administrator's Guide를 참조하십시오.
Extent 할당 해제
일반적으로 유저 세그먼트의 Extent는 DROP 문을 사용하여 객체를 삭제하지 않는 한 테이블스페이스로 반환되지 않습니다.
예를 들어, 테이블의 모든 행을 삭제해도 데이터베이스는 테이블스페이스의 다른 객체가 사용할 수 있도록 데이터 블록을 회수하지 않습니다. DBMS_SPACE_ADMIN 패키지를 사용하여 세그먼트를 삭제할 수도 있습니다.
주: 실행 취소 세그먼트에서 Oracle AI Database는 지정된 OPTIMAL 크기가 있거나 데이터베이스가 자동 실행 취소 관리 모드인 경우 하나 이상의 확장 영역을 주기적으로 할당 해제합니다.
일부 경우에는 공간 할당을 수동으로 해제할 수 있습니다. Oracle Segment Advisor는 객체의 단편화 레벨을 기반으로 객체에 회수 가능한 공간이 있는지 여부를 확인할 수 있습니다. 다음 기법으로 Extent를 해제할 수 있습니다.
-
온라인 세그먼트 축소(shrink)를 사용하여 세그먼트에서 단편화된 공간을 회수합니다. 세그먼트 축소는 현재 위치에서 온라인 작업입니다. 일반적으로 데이터 압축은 캐시 활용률을 높이고 전체 테이블 스캔에서 읽을 블록 수를 줄여야 합니다.
-
Partition되지 않은 테이블 또는 테이블 partition의 데이터를 새 세그먼트로 이동하고, 선택적으로 할당량이 있는 다른 테이블스페이스로 이동합니다.
-
인덱스를 재구축하거나 병합할 것
-
모든 행을 제거하는 테이블 또는 테이블 클러스터를 자릅니다. 기본적으로 Oracle AI Database는
MINEXTENTS저장 영역 매개변수로 지정된 경우를 제외하고 제거된 행에서 사용된 모든 공간을 할당 해제합니다. Oracle Database 11g Release 2(11.2.0.2)부터는TRUNCATE를DROP ALL STORAGE옵션과 함께 사용하여 전체 세그먼트를 삭제할 수도 있습니다. -
사용되지 않은 공간을 할당 해제합니다. 이렇게 하면 데이터베이스 세그먼트의 고수위 끝에 사용되지 않은 공간이 확보되고 테이블스페이스의 다른 세그먼트에 해당 공간을 사용할 수 있게 됩니다.
Extent가 해제되면 Oracle AI Database는 로컬관리방식 테이블스페이스에 대한 데이터 파일의 비트맵을 수정하여 복원된 Extent를 사용 가능한 공간으로 반영합니다. 해제된 Extent 블록에 있는 모든 데이터에 액세스할 수 없게 됩니다.
참조:
-
세그먼트 공간을 회수하는 방법을 알아보려면 Oracle AI Database Administrator's Guide를 참조하십시오.
Extent의 저장 영역 파라미터
모든 세그먼트는 Extent로 표현된 저장 영역 매개변수로 정의됩니다. 이러한 매개변수는 Oracle AI Database가 세그먼트에 사용 가능한 공간을 할당하는 방법을 제어합니다.
저장소 설정은 다음과 같은 우선 순위 순서로 결정되며 목록에서 더 높은 설정은 목록의 아래쪽에 있는 설정을 대체합니다.
-
세그먼트 저장 영역 절
-
테이블스페이스 저장 영역 절
-
Oracle AI Database 기본값
로컬관리방식 테이블스페이스는 시스템에 의해 자동으로 결정되는 동일한 Extent 크기 또는 가변 Extent 크기를 가질 수 있습니다.
-
균일한 Extent의 경우 Extent 크기를 지정하거나 기본 크기인 1MB를 사용할 수 있습니다. 테이블스페이스의 모든 Extent는 이 크기입니다. 로컬관리방식의 임시 테이블스페이스는 이러한 유형의 할당만 사용할 수 있습니다.
-
자동으로 할당된 Extent의 경우 Oracle AI Database는 추가 Extent의 최적 크기를 결정합니다.
로컬관리방식 테이블스페이스의 경우 일부 저장 영역 파라미터는 테이블스페이스 레벨에서 지정할 수 없습니다. 그러나 세그먼트 레벨에서 이러한 파라미터를 지정할 수 있습니다. 이 경우 데이터베이스는 모든 파라미터를 함께 사용하여 세그먼트의 초기 크기를 계산합니다. 내부 알고리즘은 각 Extent의 후속 크기를 결정합니다.
참조:
-
로컬에서 관리되는 테이블스페이스를 생성할 때 확장 영역 관리 고려 사항에 대해 알아보려면 Oracle AI Database Administrator's Guide를 참조하십시오.
-
저장 영역 절의 옵션에 대해 알아보려면 Oracle AI Database SQL Language Reference를 참조하십시오.
세그먼트 개요입니다.
세그먼트는 테이블스페이스 내의 논리적 저장 영역 구조에 대한 모든 데이터를 포함하는 확장 영역의 집합입니다.
예를 들어, Oracle AI Database는 하나 이상의 Extent를 할당하여 테이블에 대한 데이터 세그먼트를 구성합니다. 또한 데이터베이스는 하나 이상의 Extent를 할당하여 테이블에 있는 인덱스에 대한 인덱스 세그먼트를 형성합니다.
Oracle AI Database는 자동으로 또는 수동으로 세그먼트 공간을 관리합니다. 이 절에서는 ASSM을 사용한다고 가정합니다.
-
사용자 세그먼트 데이터베이스의 단일 데이터 세그먼트는 하나의 사용자 객체에 대한 데이터를 저장합니다.
-
임시 세그먼트 쿼리를 처리할 때 Oracle AI Database에는 SQL 문 실행의 중간 단계에 대한 임시 작업영역이 필요한 경우가 많습니다.
-
실행 취소 세그먼트 Oracle AI Database는 총체적으로 실행 취소 데이터라고 하는 트랜잭션 작업의 레코드를 유지 관리합니다.
-
세그먼트 공간 및 고수위 공간을 관리하기 위해 Oracle AI Database는 세그먼트에 있는 블록의 상태를 추적합니다. HWM(고수위)은 세그먼트에서 데이터 블록의 형식이 지정되지 않고 사용된 적이 없는 지점입니다. 참조: ASSM에 대한 자세한 내용은 "논리적 공간 관리"를 참조하십시오.
사용자 세그먼트
데이터베이스의 단일 데이터 세그먼트는 하나의 유저 객체에 대한 데이터를 저장합니다.
다음은 다양한 유형의 세그먼트입니다. 유저 세그먼트의 예는 다음과 같습니다.
-
테이블, 테이블 partition 또는 테이블 클러스터
-
LOB 또는 LOB 분할 영역
-
인덱스 또는 인덱스 분할 영역
Partition되지 않은 각 객체 및 객체 partition은 자체 세그먼트에 저장됩니다. 예를 들어, 인덱스에 5개의 partition이 있는 경우 5개의 세그먼트에는 인덱스 데이터가 포함됩니다.
- 사용자 세그먼트 생성 기본적으로 데이터베이스는 지연된 세그먼트 생성을 사용하여 테이블, 인덱스 및 분할 영역을 생성할 때 데이터베이스 메타데이터만 업데이트합니다.
사용자 세그먼트 생성
기본적으로 데이터베이스는 Deferred 세그먼트 생성을 사용하여 테이블, 인덱스 및 Partition을 생성할 때 데이터베이스 메타 데이터만 갱신합니다.
사용자가 테이블이나 분할 영역에 첫번째 행을 삽입하면 데이터베이스는 테이블이나 분할 영역에 대한 세그먼트, 해당 LOB 열 및 인덱스를 생성합니다. Deferred 세그먼트 생성을 사용하면 데이터베이스 리소스를 불필요하게 사용하지 않아도 됩니다. 예를 들어, 응용 프로그램을 설치하면 수천 개의 객체가 생성되어 상당한 디스크 공간을 소비할 수 있습니다. 이러한 객체 중 대부분은 결코 사용되지 않을 수 있습니다.
DBMS_SPACE_ADMIN 패키지는 빈 객체에 대한 세그먼트를 관리합니다. 이 PL/SQL 패키지를 사용하여 다음을 수행할 수 있습니다.
-
빈 테이블 또는 세그먼트가 생성되지 않은 분할 영역에 대해 수동으로 세그먼트 구체화
-
현재 빈 세그먼트가 할당된 빈 테이블 또는 Partition에서 세그먼트 제거
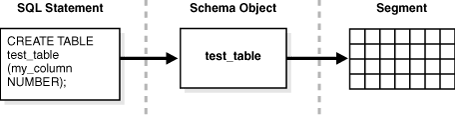
객체 생성과 세그먼트 생성 간의 관계를 가장 잘 설명하기 위해 지연된 세그먼트 생성이 사용 안함으로 설정되었다고 가정합니다. 테이블은 다음과 같은 방식으로 생성합니다.
CREATE TABLE test_table (my_column NUMBER);그림 15-19에 표시된 것처럼 데이터베이스는 테이블에 대해 하나의 세그먼트를 만듭니다.
그림 19: 사용자 세그먼트 만들기
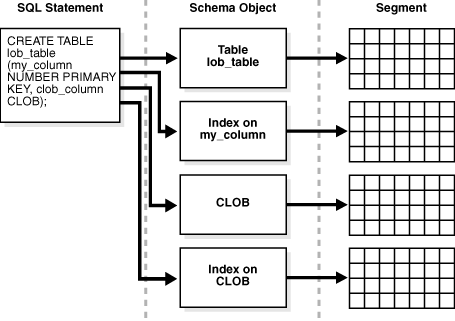
기본 키 또는 고유 키로 테이블을 생성하는 경우 Oracle AI Database에서 이 키에 대한 인덱스를 자동으로 생성합니다. 또한 Deferred 세그먼트 생성이 비활성화된다고 가정합니다. 테이블은 다음과 같은 방식으로 생성합니다.
CREATE TABLE lob_table (my_column NUMBER PRIMARY KEY, clob_column CLOB);그림 15-20은 lob_table에 대한 데이터가 한 세그먼트에 저장되고 암시적으로 생성된 인덱스는 다른 세그먼트에 있음을 보여줍니다. 또한 CLOB 데이터는 연관된 CLOB 인덱스와 마찬가지로 자체 세그먼트에 저장됩니다. 따라서 CREATE TABLE 문은 4개의 서로 다른 세그먼트를 만듭니다.
그림 20: 다중 세그먼트
주: 테이블의 세그먼트와 이 테이블의 인덱스는 동일한 테이블스페이스를 차지할 필요가 없습니다.
데이터베이스는 세그먼트가 생성될 때 하나 이상의 Extent를 할당합니다. 객체에 대한 저장 영역 매개변수는 각 세그먼트에 대한 확장 영역이 할당되는 방식을 결정합니다. 이 매개변수는 객체와 연관된 데이터 세그먼트의 데이터 검색 및 저장 효율성에 영향을 줍니다.
참조:
-
내부 LOB에 대한 자세한 내용은 Oracle AI Database SecureFiles and Large Objects Developer's Guide를 참조하십시오.
-
Oracle AI Database Administrator's Guide - 지연된 세그먼트 생성을 관리하는 방법 학습
-
CREATE TABLE구문의 경우 Oracle AI Database SQL Language Reference
임시 세그먼트
쿼리를 처리할 때 Oracle AI Database는 종종 SQL 문 실행의 중간 단계를 위한 임시 작업 공간을 필요로 합니다.
임시 세그먼트가 필요할 수 있는 일반적인 작업에는 정렬, 해싱 및 비트맵 병합이 포함됩니다. 또한 인덱스를 생성하는 동안 Oracle AI Database는 인덱스 세그먼트를 임시 세그먼트에 배치한 다음 인덱스가 완료되면 이를 영구 세그먼트로 변환합니다.
메모리에서 작업을 수행할 수 있는 경우 Oracle AI Database는 임시 세그먼트를 생성하지 않습니다. 그러나 메모리 사용이 불가능한 경우에는 데이터베이스가 디스크에 임시 세그먼트를 자동으로 할당합니다.
-
질의에 대한 임시 세그먼트 할당 Oracle AI Database는 사용자 세션 중 필요에 따라 질의에 대한 임시 세그먼트를 할당하고 질의가 완료되면 삭제합니다. 임시 세그먼트에 대한 공간 관리 작업을 제외하고 임시 세그먼트에 대한 변경 사항은 온라인 리두 로그에 기록되지 않습니다.
-
임시 테이블 및 인덱스에 대한 세그먼트 할당 Oracle AI Database는 임시 테이블 및 해당 인덱스에 대한 임시 세그먼트를 할당할 수 있습니다.
Query에 임시 세그먼트 할당
Oracle AI Database는 사용자 세션 중 필요에 따라 질의에 임시 세그먼트를 할당하고 질의가 완료되면 삭제합니다. 임시 세그먼트에 대한 공간 관리 작업을 제외하고 임시 세그먼트에 대한 변경 사항은 온라인 리두 로그에 기록되지 않습니다.
데이터베이스는 유저에게 할당된 임시 테이블스페이스에 임시 세그먼트를 생성합니다. 테이블스페이스의 기본 저장 영역 특성에 따라 임시 세그먼트에 있는 Extent의 특성이 결정됩니다. 임시 세그먼트의 할당과 할당 해제가 자주 발생하므로 가장 좋은 방법은 임시 세그먼트를 위한 특수 테이블스페이스를 하나 이상 생성하는 것입니다. 데이터베이스는 디스크 전체에 I/O를 분산하여 SYSTEM 및 임시 세그먼트가 있는 다른 테이블스페이스의 단편화를 방지합니다.
주: SYSTEM가 로컬에서 관리되는 경우 데이터베이스 생성 시 기본 임시 테이블스페이스를 정의해야 합니다. 로컬에서 관리되는 SYSTEM 테이블스페이스는 기본 임시 저장 영역에 사용할 수 없습니다.
참조:
-
임시 테이블스페이스 생성 방법에 대한 자세한 내용은 Oracle AI Database Administrator's Guide를 참조하십시오.
-
CREATE TEMPORARY TABLESPACE구문 및 의미에 대한 Oracle AI Database SQL Language Reference
임시 테이블 및 인덱스에 대한 세그먼트 할당
Oracle AI Database는 임시 테이블 및 해당 인덱스에 임시 세그먼트를 할당할 수 있습니다.
임시 테이블은 트랜잭션 또는 회의 기간 동안에만 존재하는 데이터를 보유합니다. 각 세션은 자체적으로 할당된 Extent에만 액세스하며 다른 세션에 할당된 Extent에 액세스할 수 없습니다.
Oracle AI Database는 테이블에 처음 INSERT이 발생할 때 전역 임시 테이블에 대한 세그먼트를 할당하고, 필요할 때만 전용 임시 테이블에 대한 세그먼트를 할당합니다. 삽입은 명시적으로 또는 CREATE TABLE AS SELECT로 인해 발생할 수 있습니다. 데이터베이스는 테이블 및 해당 인덱스에 대한 세그먼트를 할당하고, 인덱스에 대한 루트 페이지를 생성하고, LOB 세그먼트를 할당합니다.
현재 사용자의 임시 테이블스페이스는 임시 테이블에 세그먼트를 할당합니다. 예를 들어, user1에 지정된 임시 테이블스페이스는 temp1이고 user2에 지정된 임시 테이블스페이스는 temp2입니다. 이 경우 user1는 temp1 세그먼트에 임시 데이터를 저장하고, user2는 temp2 세그먼트에 임시 데이터를 저장합니다.
참조:
-
임시 테이블을 생성하는 방법을 알아보려면 Oracle AI Database Administrator's Guide를 참조하십시오.
실행 취소 세그먼트
Oracle AI Database는 트랜잭션 작업 기록을 총체적으로 실행 취소 데이터라고 합니다.
Oracle AI Database는 언두 데이터를 사용하여 다음을 수행합니다.
Oracle AI Database는 외부 로그가 아닌 데이터베이스 내에 언두 데이터를 저장합니다. 언두 데이터는 데이터 블록처럼 갱신되는 블록에 저장되며 이러한 블록에 대한 변경 사항이 리두 레코드를 생성합니다. 이러한 방식으로 Oracle AI Database는 외부 로그를 읽을 필요 없이 언두 데이터에 효율적으로 액세스할 수 있습니다.
영구 객체에 대한 실행 취소 데이터는 실행 취소 테이블스페이스에 저장됩니다. Oracle AI Database는 언두 테이블스페이스에서 언두 세그먼트 및 공간을 관리하기 위한 완전 자동화된 메커니즘(자동 언두 관리 모드)을 제공합니다.
데이터베이스는 언두 데이터를 두 개의 스트림으로 구분합니다. 임시 언두 스트림은 임시 객체의 변경으로 인해 생성된 언두 레코드만 캡슐화하는 반면 영구 언두 스트림은 영구 객체에 대한 언두 레코드만 캡슐화합니다. 데이터베이스는 임시 언두와 영구 언두를 독립적으로 관리합니다. 언두 구분은 다음을 수행하여 저장 영역을 줄이고 성능을 향상시킵니다.
-
영구 및 임시 테이블의 작업 로드에 가장 적합한 영구 및 언두 테이블스페이스 크기를 구성할 수 있습니다.
-
온라인 리두 로그에 기록되는 리두의 크기 감소
-
임시 언두 데이터를 백업할 필요 없음
Active Data Guard Instance에서 Global 임시 테이블의 DML을 사용하려면 임시 언두 세그먼트에 언두가 생성되어야 합니다.
-
실행 취소 세그먼트 및 트랜잭션 트랜잭션이 시작되면 데이터베이스는 트랜잭션을 실행 취소 세그먼트와 현재 실행 취소 테이블스페이스의 트랜잭션 테이블에 바인드(지정)합니다. 드문 경우지만 데이터베이스 Instance에 지정된 언두 테이블스페이스가 없으면 트랜잭션이 시스템 언두 세그먼트에 바인드됩니다.
-
트랜잭션 롤백
ROLLBACK문이 실행되면 데이터베이스는 언두 레코드를 사용하여 커밋되지 않은 트랜잭션으로 데이터베이스의 변경사항을 롤백합니다. -
임시 실행 취소 세그먼트 임시 실행 취소 세그먼트는 임시 실행 취소 데이터 전용의 선택적 공간 관리 컨테이너입니다.
참조:
-
임시 언두 세그먼트에 대한 자세한 내용은 Oracle AI Database Administrator's Guide를 참조하십시오.
-
TEMP_UNDO_ENABLED초기화 매개변수에 대해 알아보려면 Oracle AI Database Reference를 참조하십시오.
언두 세그먼트 및 트랜잭션
트랜잭션이 시작되면 데이터베이스는 트랜잭션을 언두 세그먼트로 바인드(할당)하여 현재 언두 테이블스페이스의 트랜잭션 테이블에 바인드합니다. 드문 경우지만 데이터베이스 Instance에 지정된 언두 테이블스페이스가 없으면 트랜잭션이 시스템 언두 세그먼트에 바인드됩니다.
다중 활성 트랜잭션은 동일한 언두 세그먼트 또는 다른 세그먼트에 동시에 기록할 수 있습니다. 예를 들어, T1 및 T2 트랜잭션은 모두 실행 취소 세그먼트 U1에 쓸 수 있고, T1는 U1에 쓸 수 있고, T2는 실행 취소 세그먼트 U 2에 쓸 수 있습니다.
개념적으로 언두 세그먼트의 Extent는 링을 형성합니다. 트랜잭션은 한 개의 언두 Extent에 쓰고 그 다음에는 링의 다음 Extent에 쓰는 방식으로 반복됩니다. 그림 15-21에서는 두 개의 트랜잭션(T1 및 T2)을 보여줍니다. 이 트랜잭션은 언두 세그먼트의 세번째 확장 영역(E3)에서 쓰기를 시작하고 계속해서 네번째 확장 영역(E4)에 쓰기를 수행합니다.
그림 21: 언두 세그먼트의 할당된 Extent 링
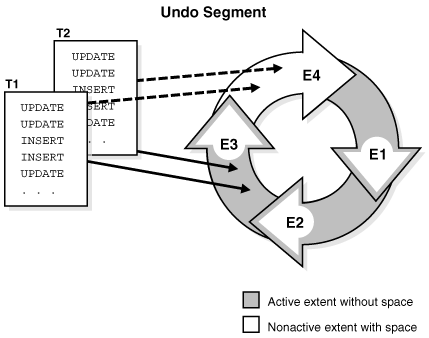
특정 시간에 트랜잭션은 트랜잭션에 대해 현재 Extent라고 하는 언두 세그먼트의 한 Extent에만 순차적으로 씁니다. 다중 활성 트랜잭션은 동일한 현재 Extent 또는 다른 현재 Extent에 동시에 쓸 수 있습니다. 그림 15-21에서는 T1 및 T2 트랜잭션이 E3 범위로 동시에 쓰는 것을 보여줍니다. 언두 Extent 내에서 데이터 블록은 하나의 트랜잭션에 대한 데이터만 포함합니다.
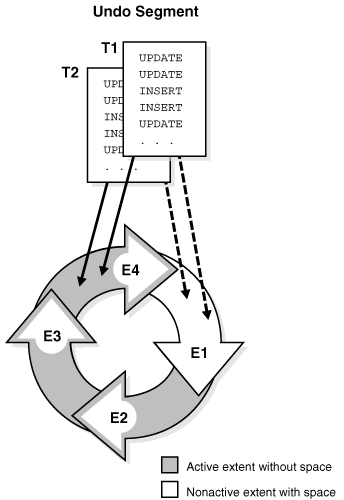
현재 언두 Extent가 가득 차면 공간이 필요한 첫번째 트랜잭션은 링에서 다음으로 할당된 Extent의 가용성을 검사합니다. 다음 확장 영역에 활성 트랜잭션의 데이터가 포함되지 않은 경우 이 확장 영역이 현재 확장 영역이 됩니다. 이제 공간이 필요한 모든 트랜잭션은 새 현재 Extent에 쓸 수 있습니다. 그림 15-22에서 E4가 가득 차면 T1 및 T2가 E1에 계속 쓰면서 E1의 비활성 언두 데이터를 덮어씁니다.
그림 22: 언두 세그먼트에서 할당된 Extent의 순환 사용
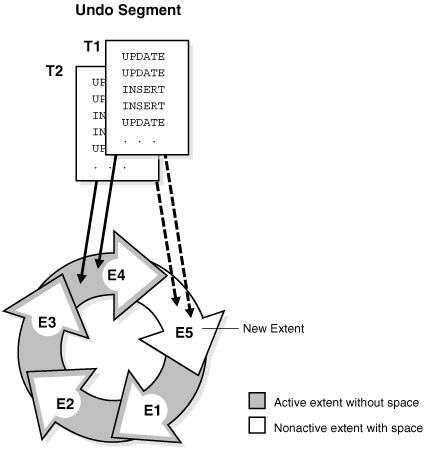
다음 확장 영역이 활성 트랜잭션의 데이터를 포함하는 경우 데이터베이스는 새 확장 영역을 할당해야 합니다. 그림 15-23은 T1 및 T2가 E4에 쓰는 시나리오를 보여줍니다. E4가 채워지면 E1에 활성 실행 취소 항목이 포함되어 있으므로 트랜잭션이 E1에 계속 기록할 수 없습니다. 따라서 데이터베이스는 이 언두 세그먼트에 대해 새 Extent(E5)를 할당합니다. 트랜잭션은 계속 E5에 기록됩니다.
그림 23: 언두 세그먼트에 대한 새 Extent 할당
참조: Oracle AI Database Administrator's Guide에서 언두 세그먼트 관리 방법 알아보기
트랜잭션 롤백
ROLLBACK 문이 실행되면 데이터베이스는 언두 레코드를 사용하여 커밋되지 않은 트랜잭션에 의해 데이터베이스의 변경 사항을 롤백합니다.
복구 중 데이터베이스는 온라인 리두 로그에서 적용된 커밋되지 않은 모든 변경 사항을 데이터 파일로 롤백합니다. 언두 레코드는 다른 사용자가 변경하는 동시에 데이터에 액세스하는 사용자를 위해 데이터의 이전 이미지를 유지 관리하여 읽기 일관성을 제공합니다.
임시 언두 세그먼트
임시 언두 세그먼트는 임시 언두 데이터 전용의 선택적 공간 관리 컨테이너입니다.
임시 테이블 변경에 대한 언두 레코드는 세션마다 다르며 읽기 일관성 및 트랜잭션 롤백에만 유용합니다. Oracle Database 12c 이전 버전에서는 데이터베이스가 항상 이러한 레코드를 온라인 리두 로그에 저장했습니다. 임시 객체의 변경 사항은 온라인 리두 로그에 기록되지 않으므로 임시 객체에 대한 언두를 임시 언두 세그먼트에 기록하면 온라인 리두 로그 및 아카이브된 리두 로그 파일에 공간이 절약됩니다. 데이터베이스는 언두에 대한 변경 사항이나 임시 테이블의 변경 사항을 기록하지 않으므로 성능이 향상됩니다.
임시 테이블이 임시 언두 세그먼트에 언두 데이터를 저장하도록 TEMP_UNDO_ENABLED 초기화 매개변수를 설정할 수 있습니다. 이 매개변수가 TRUE인 경우 데이터베이스는 임시 테이블스페이스에서 임시 언두 세그먼트를 할당합니다.
참조:
-
임시 언두 세그먼트에 대한 자세한 내용은 Oracle AI Database Administrator's Guide를 참조하십시오.
-
TEMP_UNDO_ENABLED초기화 매개변수에 대해 알아보려면 Oracle AI Database Reference를 참조하십시오.
세그먼트 공간 및 고수위
공간을 관리하기 위해 Oracle AI Database는 세그먼트의 블록 상태를 추적합니다. HWM(고수위)은 세그먼트에서 데이터 블록의 형식이 지정되지 않고 사용된 적이 없는 지점입니다.
MSSM은 Free List를 사용하여 세그먼트 공간을 관리합니다. 테이블 생성 시 세그먼트에 있는 블록의 형식은 지정되지 않습니다. 세션이 처음으로 테이블에 행을 삽입하면 데이터베이스는 Free List에서 사용 가능한 블록을 검색합니다. 데이터베이스에서 사용할 수 있는 블록을 찾지 못하면 블록 그룹의 형식이 지정되고 블록이 Free List에 배치되고 블록에 데이터 삽입이 시작됩니다. MSSM에서 전체 테이블 스캔은 HWM 아래의 모든 블록을 읽습니다.
ASSM은 Free List를 사용하지 않으므로 공간을 다르게 관리해야 합니다. 세션이 처음으로 테이블에 데이터를 삽입하면 데이터베이스는 MSSM에서와 같이 블록 그룹의 형식을 미리 지정하는 대신 단일 비트맵 블록의 형식을 지정합니다. 비트맵은 Free List를 대신하는 세그먼트의 블록 상태를 추적합니다. 데이터베이스는 비트맵을 사용하여 사용 가능한 블록을 찾은 다음 데이터로 채우기 전에 각 블록의 형식을 지정합니다. ASSM은 동시성 문제를 방지하기 위해 블록 사이에 삽입을 분산시킵니다.
ASSM 세그먼트의 모든 데이터 블록은 다음 상태 중 하나입니다.
-
HWM 위
이러한 블록은 형식이 지정되지 않았으며 사용된 적이 없습니다.
-
HWM 아래
이러한 블록은 다음 상태 중 하나입니다.
-
할당되었지만 현재 형식이 지정되지 않았으며 사용되지 않음
-
형식 지정 및 데이터 포함
-
데이터가 삭제되었으므로 형식이 지정되고 비어 있습니다.
-
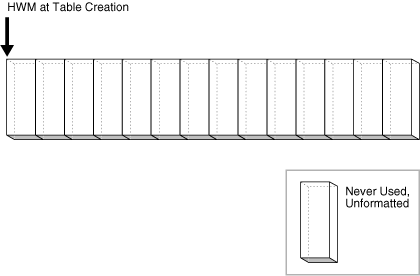
그림 15-24는 ASSM 세그먼트를 수평 블록 시리즈로 나타냅니다. 테이블 생성 시 HWM은 왼쪽의 세그먼트 시작 부분에 있습니다. 아직 삽입된 데이터가 없으므로 세그먼트의 모든 블록은 형식이 지정되지 않고 사용되지 않습니다.
그림 24: 테이블 생성 시 HWM
트랜잭션이 세그먼트에 행을 삽입한다고 가정합시다. 데이터베이스는 행을 보유할 블록 그룹을 할당해야 합니다. 할당된 블록은 HWM 아래로 떨어집니다. 데이터베이스는 메타 데이터를 보유하기 위해 이 그룹의 비트맵 블록 형식을 지정하지만 그룹의 나머지 블록의 형식은 지정하지 않습니다.
그림 15-25에서는 HWM 아래의 블록이 할당되는 반면, HWM 위의 블록은 할당되거나 형식이 지정되지 않습니다. 삽입이 수행되면 데이터베이스는 사용 가능한 공간이 있는 모든 블록에 쓸 수 있습니다. 낮은 고수위(낮은 HWM)는 모든 블록이 데이터를 포함하거나 이전에 포함된 데이터를 포함하기 때문에 형식이 지정된 것으로 알려진 지점을 표시합니다.
그림 25: HWM 및 Low HWM
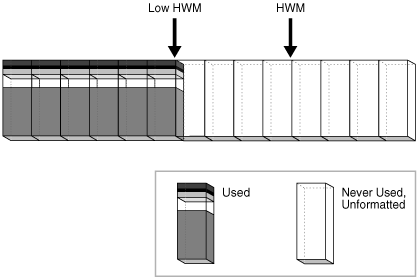
그림 15-26에서 데이터베이스는 HWM과 낮은 HWM 사이의 블록을 선택하여 해당 블록에 씁니다. 데이터베이스는 HWM과 낮은 HWM 사이의 다른 블록이나 사용 가능한 공간이 있는 낮은 HWM 아래의 모든 블록을 쉽게 선택할 수 있습니다. 그림 15-26에서는 새로 채워진 블록의 양쪽에 있는 블록의 형식이 지정되지 않습니다.
그림 26: HWM 및 Low HWM
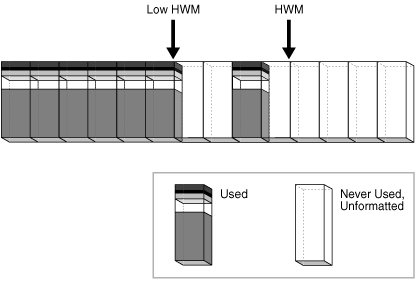
낮은 HWM은 전체 테이블 스캔에서 중요합니다. HWM 아래의 블록은 사용될 때만 형식이 지정되므로 그림 15-26과 같이 일부 블록의 형식이 지정되지 않을 수 있습니다. 이러한 이유로 데이터베이스는 비트맵 블록을 읽어 낮은 HWM의 위치를 얻습니다. 데이터베이스는 형식이 지정된 것으로 알려져 있으므로 HWM이 낮을 때까지 모든 블록을 읽은 다음, HWM이 낮을 때와 HWM 사이의 형식이 지정된 블록만 주의 깊게 읽습니다.
새 트랜잭션이 테이블에 행을 삽입하지만 비트맵이 HWM 아래에 사용 가능 공간이 부족함을 나타낸다고 가정합니다. 그림 15-27에서 데이터베이스는 포맷되지 않은 블록의 새 그룹을 할당하여 HWM을 오른쪽으로 진행합니다.
그림 27: HWM 및 낮은 HWM 향상
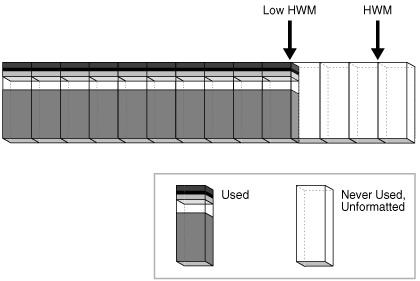
HWM과 낮은 HWM 사이의 블록이 가득 차면 HWM은 오른쪽으로 전진하고 낮은 HWM은 이전 HWM의 위치로 전진합니다. 데이터베이스가 시간이 지남에 따라 데이터를 삽입함에 따라 HWM은 계속해서 오른쪽으로 전진하며, 낮은 HWM은 항상 뒤에서 후행합니다. 수동으로 객체를 재구축, 자르기 또는 축소하지 않는 한 HWM은 다시 처리되지 않습니다.
참조:
-
온라인으로 세그먼트를 축소하는 방법을 알아보려면 Oracle AI Database Administrator's Guide를 참조하십시오.
-
TRUNCATE TABLE구문 및 의미에 대한 Oracle AI Database SQL Language Reference
테이블스페이스 개요입니다.
테이블스페이스는 세그먼트에 대한 논리적 스토리지 컨테이너입니다.
세그먼트는 저장 공간을 사용하는 테이블 및 인덱스와 같은 데이터베이스 객체입니다. 물리적 레벨에서 테이블스페이스는 하나 이상의 데이터 파일 또는 임시 파일에 데이터를 저장합니다.
-
다중 테넌트 환경의 테이블 공간 CDB에서 각 PDB 및 응용 프로그램 루트는 고유한 테이블스페이스 집합을 가집니다.
-
영구 테이블스페이스 영구 테이블스페이스는 영구 스키마 객체를 그룹화합니다. 테이블스페이스의 객체에 대한 세그먼트는 데이터 파일에 물리적으로 저장됩니다.
-
임시 테이블스페이스 임시 테이블스페이스에는 세션 기간 동안만 지속되는 임시 데이터가 포함됩니다. 임시 테이블스페이스에는 영구 스키마 객체가 상주할 수 없습니다. 임시 파일은 임시 테이블스페이스 데이터를 저장합니다.
-
테이블스페이스 모드 테이블스페이스 모드는 테이블스페이스의 접근성을 결정합니다.
-
테이블스페이스 파일 크기 테이블스페이스는 빅파일 테이블스페이스 또는 작은 파일 테이블스페이스입니다. 이러한 테이블스페이스는 데이터 파일이나 임시 파일을 명시적으로 참조하지 않는 SQL 문의 실행과 구별할 수 없습니다.
다중 테넌트 환경의 테이블스페이스
CDB에서는 각 PDB 및 응용 프로그램 루트에 고유한 테이블스페이스 집합이 있습니다.
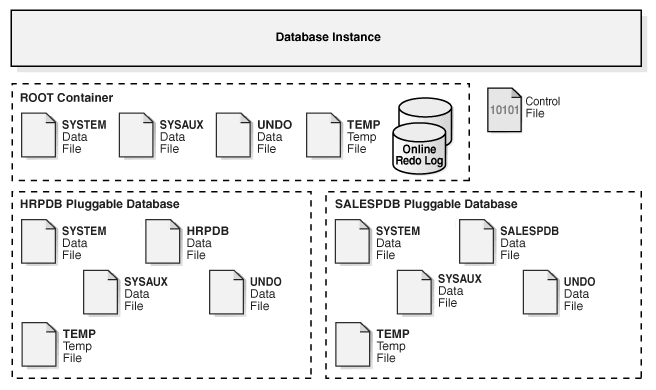
모든 CDB 루트, PDB 및 애플리케이션 루트는 SYSTEM 및 SYSAUX 테이블스페이스를 가져야 합니다. 다음 그림은 일반적인 컨테이너의 테이블스페이스를 보여줍니다.
그림 28: 테이블스페이스
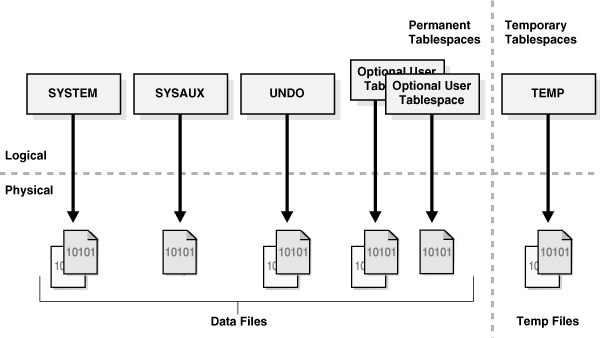
CDB에는 다음이 포함됩니다.
-
하나의 콘트롤 파일
-
하나의 온라인 리두 로그
-
하나 이상의 언두 테이블스페이스
적절한 권한이 있고 현재 컨테이너가 CDB 루트인 일반 사용자만 언두 테이블스페이스를 생성할 수 있습니다. 특정 시점에 CDB는 다음 언두 모드 중 하나입니다.
-
로컬 언두 모드
이 경우 각 PDB에는 고유한 언두 테이블스페이스가 있습니다. CDB가 로컬 언두 모드를 사용하는 경우 데이터베이스는 모든 PDB에 언두 테이블스페이스를 자동으로 생성합니다. 로컬 언두는 PDB의 핫 복제(hot clone)를 수행하고 PDB를 신속하게 재배치하는 기능과 같은 이점을 제공합니다. 또한 로컬 언두는 격리 수준을 제공하며 언플러그 및 적시 복구 작업을 더 빠르게 수행할 수 있습니다.
PDB가 열려 있는 Oracle Real Application Clusters(RAC) 클러스터의 각 노드에 대해 로컬 언두 테이블스페이스가 필요합니다. 예를 들어, PDB를 2노드 클러스터에서 4노드 클러스터로 이동하고 PDB가 모든 노드에서 열려 있는 경우 데이터베이스는 필요한 추가 언두 테이블스페이스를 자동으로 생성합니다. PDB를 다시 이동할 경우 중복 언두 테이블스페이스를 삭제할 수 있습니다.
주: 기본적으로 DBCA(Database Configuration Assistant)는 로컬 언두가 사용으로 설정된 새 CDB를 생성합니다.
-
공유 언두 모드
단일 Instance CDB에는 하나의 활성 언두 테이블스페이스만 존재합니다. Oracle RAC CDB의 경우 모든 Instance에 대해 하나의 활성 언두 테이블스페이스가 존재합니다. 모든 언두 테이블스페이스는 모든 컨테이너의 데이터 딕셔너리 및 관련 뷰에 표시됩니다.
언두 모드는 전체 CDB에 적용됩니다. 즉, 모든 컨테이너가 공유 언두를 사용하거나 모든 컨테이너가 로컬 언두를 사용합니다. 데이터베이스를 다시 시작해야 하는 CDB의 언두 모드 간에 전환할 수 있습니다.
-
-
모든 컨테이너에 대한
SYSTEM및SYSAUX테이블스페이스CDB 루트, 각 응용 프로그램 루트 및 각 PDB에는 고유한
SYSTEM및SYSAUX테이블스페이스가 있습니다. 또한 각 컨테이너에는 컨테이너에 상주하는 객체를 설명하는 자체 데이터 딕셔너리 테이블 집합이 있습니다. -
0개 이상의 유저 생성 테이블스페이스
일반적인 사용 사례에서는 각 PDB에 고유한 비시스템 테이블스페이스 집합이 있습니다. 이러한 테이블스페이스에는 PDB의 유저 정의 스키마 및 객체에 대한 데이터가 포함됩니다.
CREATE PLUGGABLE DATABASE또는ALTER PLUGGABLE DATABASE문에서STORAGE절을 사용하여 PDB에 대한 데이터 파일에서 사용되는 저장 영역 양을 제한할 수 있습니다.PDB 내의 데이터 딕셔너리 저장 영역을 이식성할 수 있습니다. CDB에서 PDB를 언플러그하고 다른 CDB에 플러그인할 수 있습니다.
-
모든 컨테이너에 대한 임시 파일 세트
CDB 루트에 대해 하나의 기본 임시 테이블스페이스가 있고, 각 응용 프로그램 루트, 응용 프로그램 PDB 및 PDB에 대해 하나씩 있습니다.
로컬 언두 모드의 예제 15-3 CDB
이 예에서는 두 개의 PDB(hrpdb 및 salespdb)가 있는 CDB의 물리적 저장 영역 구조의 측면을 보여줍니다. 이 예제에서 데이터베이스는 로컬 언두 모드를 사용하므로 CDB 루트, hrpdb 및 salespdb에 언두 데이터 파일이 있습니다.
그림 29: 로컬 언두 모드에서 CDB의 물리적 구조
참조: "CDB에서 데이터 딕셔너리 구분"
영구 테이블스페이스
영구 테이블스페이스는 영구 스키마 객체를 그룹화합니다. 테이블스페이스의 객체에 대한 세그먼트는 데이터 파일에 물리적으로 저장됩니다.
각 데이터베이스 유저에게 기본 영구 테이블스페이스가 할당됩니다. 아주 작은 데이터베이스에는 기본 SYSTEM 및 SYSAUX 테이블스페이스만 필요할 수 있습니다. 그러나 Oracle은 유저 및 응용 프로그램 데이터를 저장할 테이블스페이스를 하나 이상 생성할 것을 권장합니다. 테이블스페이스를 사용하여 다음 목표를 달성할 수 있습니다.
-
데이터베이스 데이터에 대한 디스크 공간 할당 제어
-
데이터베이스 유저에게 할당량(공간 허용량 또는 제한) 할당
-
전체 데이터베이스의 가용성에 영향을 주지 않고 개별 테이블스페이스를 온라인 또는 오프라인으로 전환
-
개별 테이블스페이스의 백업 및 Recovery 수행
-
Oracle Data Pump 유틸리티를 사용하여 응용 프로그램 데이터 임포트 또는 엑스포트
-
플랫폼 간에도 데이터베이스 간에 복사하거나 이동할 수 있는 전송 가능한 테이블스페이스를 생성합니다.
테이블스페이스를 전송하여 데이터를 이동하는 것은 데이터 파일을 복사하고 테이블스페이스 메타 데이터를 통합하는 작업만 포함되기 때문에 동일한 데이터의 엑스포트/임포트 또는 언로드/로드보다 훨씬 빠릅니다. 테이블스페이스를 전송할 때 인덱스 데이터도 이동할 수 있습니다.
-
SYSTEM 테이블스페이스
SYSTEM테이블스페이스는 생성 시 데이터베이스에 포함된 필수 관리 테이블스페이스입니다. Oracle AI Database는SYSTEM를 사용하여 데이터베이스를 관리합니다. -
SYSAUX 테이블스페이스
SYSAUX테이블스페이스는SYSTEM테이블스페이스에 대한 보조 테이블스페이스입니다. -
실행 취소 테이블스페이스 실행 취소 테이블스페이스는 시스템 관리 언두 데이터용으로 예약된 로컬 관리 테이블스페이스입니다.
-
섀도우 테이블스페이스 섀도우 테이블스페이스는 섀도우 손실 쓰기 보호를 위한 Big File 테이블스페이스입니다.
참조:
-
테이블스페이스 전송 방법에 대한 자세한 내용은 Oracle AI Database Administrator's Guide를 참조하십시오.
-
Oracle AI Database Utilities - Oracle Data Pump에 대해 알아보기
SYSTEM 테이블스페이스
SYSTEM 테이블스페이스는 생성 시 데이터베이스에 포함되는 필수 관리 테이블스페이스입니다. Oracle AI Database는 SYSTEM를 사용하여 데이터베이스를 관리합니다.
SYSTEM 테이블스페이스에는 모두 SYS 사용자가 소유한 다음 정보가 포함됩니다.
-
데이터 딕셔너리
-
데이터베이스에 대한 관리 정보를 포함하는 테이블 및 뷰
-
트리거, 프로시저, 패키지와 같은 컴파일된 내장 객체
SYSTEM 테이블스페이스는 다른 테이블스페이스로 관리되지만 더 높은 레벨의 권한이 필요하며 어떤 방식으로든 제한됩니다. 예를 들어, SYSTEM 테이블스페이스의 이름을 바꾸거나 삭제할 수 없습니다.
기본적으로 Oracle AI Database는 새로 생성된 모든 사용자 테이블스페이스를 로컬로 관리되도록 설정합니다. 로컬관리방식의 SYSTEM 테이블스페이스가 있는 데이터베이스에서는 딕셔너리관리방식의 테이블스페이스(사용되지 않음)를 생성할 수 없습니다. 그러나 CREATE DATABASE 문을 수동으로 실행하고 기본값을 적용할 경우 SYSTEM 테이블스페이스는 딕셔너리 관리 테이블스페이스입니다. 기존 딕셔너리 관리방식의 SYSTEM 테이블스페이스를 로컬관리방식으로 이전할 수 있습니다. 주: Oracle은 SYSTEM를 비롯한 모든 테이블스페이스가 기본적으로 로컬에서 관리되도록 DBCA(Database Configuration Assistant)를 사용하여 새 데이터베이스를 생성할 것을 강력히 권장합니다.
참조:
-
SYSTEM테이블스페이스의 영구 온라인 조건에 대한 자세한 내용은 "온라인 및 오프라인 테이블스페이스"를 참조하십시오. -
Oracle AI Database Administrator's Guide - 로컬에서 관리되는
SYSTEM테이블스페이스를 생성하거나 이전하는 방법 학습 -
CREATE DATABASE구문 및 의미에 대한 Oracle AI Database SQL Language Reference
SYSAUX 테이블스페이스
SYSAUX 테이블스페이스는 SYSTEM 테이블스페이스에 대한 보조 테이블스페이스입니다.
SYSAUX는 이전에 자체 테이블스페이스가 필요했던 많은 Oracle AI Database 기능 및 제품에 대한 기본 테이블스페이스이므로, 데이터베이스에 필요한 테이블스페이스 수를 줄였습니다. 또한 SYSTEM 테이블스페이스의 로드가 줄어듭니다.
데이터베이스 생성 또는 업그레이드는 SYSAUX 테이블스페이스를 자동으로 생성합니다. 일반 데이터베이스 작업 중에 데이터베이스에서는 SYSAUX 테이블스페이스를 삭제하거나 이름을 바꿀 수 없습니다. SYSAUX 테이블스페이스를 사용할 수 없게 되면 핵심 데이터베이스 기능이 계속 작동합니다. SYSAUX 테이블스페이스를 사용하는 데이터베이스 기능은 실패하거나 제한된 기능으로 작동할 수 있습니다.
참조: SYSAUX 테이블스페이스에 대한 자세한 내용은 Oracle AI Database Administrator's Guide를 참조하십시오.
언두 테이블스페이스
실행 취소 테이블스페이스는 시스템 관리 언두 데이터용으로 예약된 로컬 관리 테이블스페이스입니다.
다른 영구 테이블스페이스와 마찬가지로 언두 테이블스페이스에도 데이터 파일이 포함됩니다. 이러한 파일의 언두 블록은 Extent로 그룹화됩니다.
-
자동 실행 취소 관리 모드 실행 취소 테이블스페이스의 경우 데이터베이스가 기본 자동 실행 취소 모드여야 합니다.
-
자동 실행 취소 보존 기간 실행 취소 보존 기간은 Oracle AI Database가 이전 실행 취소 데이터를 덮어쓰기 전에 보존하려고 시도하는 최소 시간입니다. 참조: "실행 취소 세그먼트"
자동 언두 관리 모드
언두 테이블스페이스의 경우 데이터베이스가 기본 자동 언두 모드여야 합니다.
자동 모드는 언두 세그먼트를 수동으로 관리하는 데 따르는 복잡성을 해소합니다. 데이터베이스는 자동으로 자체 튜닝되어 이 데이터가 필요할 수 있는 장기 실행 query를 충족하도록 언두 데이터의 Retention을 최적화합니다.
Oracle AI Database를 새로 설치하면 자동으로 언두 테이블스페이스가 생성됩니다. 이전 버전의 Oracle AI Database에는 실행 취소 테이블스페이스가 포함되지 않을 수 있으며 대신 수동 실행 취소 관리 모드라고 하는 레거시 롤백 세그먼트를 사용할 수 있습니다. Oracle AI Database에는 언두 환경에 대한 조언을 제공하고 언두 환경을 자동화하는 데 도움이 되는 언두 권고자가 포함되어 있습니다.
데이터베이스에는 여러 언두 테이블스페이스가 포함될 수 있지만 한 번에 하나만 사용할 수 있습니다. 인스턴스가 데이터베이스를 열려고 시도할 때 Oracle AI Database는 사용 가능한 첫번째 언두 테이블스페이스를 자동으로 선택합니다. 사용 가능한 언두 테이블스페이스가 없는 경우 인스턴스는 언두 테이블스페이스 없이 시작되어 SYSTEM 테이블스페이스에 언두 데이터를 저장합니다. SYSTEM에 언두 데이터를 저장하지 않는 것이 좋습니다.
참조:
-
자동 실행 취소 관리에 대해 알아보려면 Oracle AI Database Administrator's Guide를 참조하십시오.
-
Oracle AI Database Upgrade Guide - 자동 언두 관리 모드로 이전하는 방법 알아보기
자동 실행 취소 보존 기간
실행 취소 보존 기간은 Oracle AI Database가 이전 실행 취소 데이터를 덮어쓰기 전에 보존하려고 시도하는 최소 시간입니다.
장기 실행 질의의 경우 읽기 일관성을 제공하기 위해 이전 블록 이미지가 필요할 수 있으므로 언두 보존이 중요합니다. 또한 일부 Oracle Flashback 기능은 언두 가용성에 종속될 수 있습니다.
일반적으로 이전 언두 데이터를 최대한 보유하는 것이 좋습니다. 트랜잭션 커밋 후 롤백 또는 트랜잭션 Recovery에 언두 데이터가 더 이상 필요하지 않습니다. 언두 테이블스페이스에 새 트랜잭션에 대한 공간이 있는 경우 데이터베이스는 이전 언두 데이터를 보유할 수 있습니다. 사용 가능한 공간이 부족하면 데이터베이스가 커밋된 트랜잭션의 이전 언두 데이터를 겹쳐쓰기 시작합니다.
Oracle AI Database는 현재 언두 테이블스페이스에 가능한 최상의 언두 Retention을 자동으로 제공합니다. 데이터베이스는 사용 통계를 수집하여 이러한 통계 및 언두 테이블스페이스 크기에 준하여 보존 기간을 튜닝합니다. 언두 테이블스페이스가 AUTOEXTEND 옵션으로 구성되어 있고 최대 크기를 지정하지 않은 경우 언두 Retention 튜닝이 다릅니다. 이 경우 데이터베이스는 공간이 허용되면 언두 Retention 기간을 가장 길게 실행되는 Query보다 약간 길게 튜닝합니다.
참조: 언두 보존 자동 튜닝에 대한 자세한 내용은 Oracle AI Database Administrator's Guide를 참조하십시오.
섀도우 테이블스페이스
섀도우 테이블스페이스는 섀도우 손실 쓰기 보호를 위한 Big File 테이블스페이스입니다.
주: 섀도우 손실 쓰기 보호는 DB_LOST_WRITE_PROTECT 초기화 매개변수 및 대기 데이터베이스로 구성된 손실된 쓰기 보호와 관련이 없습니다.
-
섀도우 테이블스페이스의 목적 섀도우 손실된 쓰기 보호는 빠른 감지와 손실된 쓰기에 대한 즉각적인 응답을 제공합니다.
-
섀도우 테이블스페이스 작동 방식 쓰기 보호 손실 시에는 섀도우 테이블스페이스와 해당 블록이 섀도우 테이블스페이스에 의해 추적되는 비섀도우 테이블스페이스의 두 테이블스페이스가 필요합니다.
-
섀도우 테이블스페이스에 대한 사용자 인터페이스
ALTER PLUGGABLE DATABASE명령을 사용하여 섀도우 손실 쓰기 보호를 사용 및 사용 안함으로 설정합니다. -
예: 손실된 쓰기 보호 구성 이 예에서는 테이블스페이스 집합에 대해 섀도우 손실된 쓰기 추적을 사용으로 설정합니다.
섀도우 테이블스페이스의 목적
섀도우 손실된 쓰기 보호는 손실된 쓰기에 대한 빠른 감지 및 즉각적인 응답을 제공합니다.
쓰기 작업이 수행되지 않았거나 블록의 이전 이미지가 현재 이미지를 덮어쓰는 경우에도 I/O 서브 시스템이 블록 쓰기 완료를 확인하면 데이터 블록 쓰기 손실이 발생합니다.
다른 DML 트랜잭션에서는 잘못된 데이터를 사용할 수 있으므로 감지되지 않은 쓰기 손실로 인해 데이터가 손상될 수 있습니다. 예를 들어, 트랜잭션은 한 테이블에서 이전 데이터와 잘못된 데이터를 읽은 다음 이 데이터를 기반으로 수백 개의 다른 테이블을 갱신할 수 있습니다. 이러한 방식으로 데이터 손상이 데이터베이스 전체에 분산될 수 있습니다.
섀도우 손실 쓰기 보호 기능은 다음과 같은 이점을 제공합니다.
-
표준 DML, SQL*Loader 기본 경로 로드, 직접 경로 로드 및 RMAN 백업에 사용되기 전에 손실된 쓰기를 감지합니다.
-
특정 테이블스페이스 및 데이터 파일에 대해 섀도우 손실 쓰기 보호를 활성화할 수 있습니다. 모든 데이터를 추적할 필요는 없습니다.
-
한 섀도우 테이블스페이스를 다른 섀도우 테이블스페이스로 바꾸어 구성 또는 위치를 변경할 수 있습니다.
-
테이블스페이스 또는 데이터 파일에 대해 손실된 섀도우 쓰기 보호를 일시 중지했다가 재개할 수 있습니다.
-
단일
ALTER DATABASE ... LOST WRITE PROTECTION문을 사용하여 PDB에 대해 PDB를 사용 또는 사용 안함으로 설정할 수 있습니다.PROP$테이블은 PDB에 대해 추적이 사용으로 설정되었는지 여부를 나타냅니다.
참조: LOST WRITE PROTECTION 절에 대한 자세한 내용은 Oracle AI Database SQL Language Reference
섀도우 테이블스페이스의 작동 방식
손실된 쓰기 보호에는 두 개의 테이블스페이스, 즉 섀도우 테이블스페이스와 해당 블록이 섀도우 테이블스페이스에 의해 추적되는 비섀도우 테이블스페이스가 필요합니다.
다음 그림은 샘플 시나리오를 제공합니다. TBS1 및 TBS2 테이블스페이스의 데이터 파일은 섀도우 테이블스페이스에 의해 추적됩니다. TBS3 테이블스페이스의 데이터 파일 DBF6만 섀도우 테이블스페이스에 의해 추적됩니다.
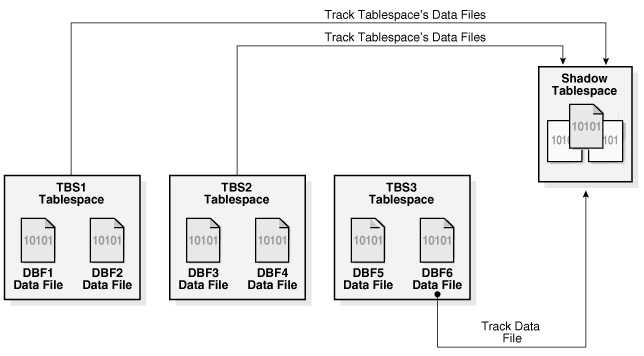
하나의 추적된 데이터 파일은 섀도우 테이블스페이스에 있는 하나의 섀도우 확장 영역으로 매핑됩니다. 추적된 데이터 파일의 모든 데이터 블록에는 섀도우 블록의 해당 항목이 있습니다. 이 항목은 추적된 데이터 블록의 SCN을 포함합니다. 추적된 데이터 블록이 디스크에서 읽혀지면 섀도우 손실 쓰기 보호는 섀도우 테이블스페이스의 블록에 대한 SCN을 추적된 데이터 블록에 있는 가장 최근 쓰기의 SCN과 비교합니다. 섀도우 항목의 SCN이 읽기 중인 데이터 블록보다 크면 쓰기 손실이 발생하여 오류가 발생합니다.
섀도우 Extent의 크기는 데이터 파일의 자동 크기 조정으로 인해 섀도우 Extent의 크기가 너무 커지지 않도록 상당한 추가 공간으로 지정됩니다. 추적된 데이터 파일의 크기가 수동 또는 자동으로 조정되고 섀도우 Extent의 크기가 증가해야 하는 경우 데이터베이스는 추적 데이터의 크기를 조정하려고 시도합니다. 섀도우 테이블스페이스에 충분한 공간이 없으면 데이터베이스는 Alert Log에 경고를 기록하고 가능한 많은 데이터 블록을 추적합니다.
참조: Oracle AI Database Administrator's Guide에서 섀도우 손실 쓰기 보호를 관리하는 방법을 알아봅니다.
섀도우 테이블스페이스에 대한 유저 인터페이스
ALTER PLUGGABLE DATABASE 명령을 사용하여 섀도우 손실 쓰기 보호를 사용 및 사용 안함으로 설정합니다.
특정 테이블스페이스 또는 데이터 파일을 보호하기 위한 섀도우 손실 쓰기 보호의 경우 다음 조건을 충족해야 합니다.
-
ALTER PLUGGABLE DATABASE ENABLE LOST WRITE PROTECTION문을 사용하여 전체 PDB에 대해 섀도우 손실 쓰기 보호를 사용으로 설정해야 합니다.주: CDB에서 루트에서 섀도우 손실 쓰기 보호를 사용으로 설정하면 PDB가 이를 상속하지 않습니다. 보호하려는 모든 PDB에 대해 섀도우 손실 쓰기 보호를 사용으로 설정해야 합니다.
-
테이블스페이스 또는 데이터 파일이
ENABLE LOST WRITE PROTECTION절을 사용하여 보호되도록 하려면 섀도우 손실 쓰기 보호를 사용으로 설정해야 합니다.테이블스페이스에 대해 섀도우 손실 쓰기 보호를 활성화하면 테이블스페이스의 모든 데이터 파일이 보호되고 테이블스페이스에 추가된 모든 데이터 파일도 보호됩니다. 임시 테이블스페이스나 다른 손실된 쓰기 테이블스페이스에서 손실된 쓰기 보호를 활성화할 수는 없습니다.
-
CREATE BIGFILE TABLESPACE문을LOST WRITE PROTECTION절과 함께 사용하여 하나 이상의 섀도우 테이블스페이스를 생성했어야 합니다.
Oracle AI Database는 추적된 데이터 파일을 특정 섀도우 테이블스페이스에 자동으로 할당합니다. 특정 데이터 파일에 사용할 섀도우 테이블스페이스는 지정할 수 없습니다.
다음 데이터 딕셔너리 뷰는 섀도우 테이블스페이스를 모니터합니다.
-
DBA_TABLESPACESquery하여 섀도우 테이블스페이스인 테이블스페이스를 보여줍니다.
-
DBA_DATA_FILES.LOST_WRITE_PROTECT손실된 쓰기 보호가 데이터 파일에 대해 활성화되었는지 여부를 보여줍니다.
-
USER_TABLESPACES.LOST_WRITE_PROTECT특정 테이블스페이스에 대해 손실된 쓰기 보호가 설정되어 있는지 여부를 표시합니다.
DBA_DATA_FILES는 테이블스페이스에 대한 쓰기 손실이 설정되어 있는지 여부를 나타내지 않습니다. 대신USER_TABLESPACES를 확인해야 합니다.
참조:
-
Oracle AI Database Administrator's Guide - 섀도우 테이블스페이스로 손실된 쓰기 보호를 관리하는 방법
-
CREATE TABLESPACE문에 대한 자세한 내용은 Oracle AI Database SQL Language Reference를 참조하십시오. -
DBA_TABLESPACES에 대한 자세한 내용은 Oracle AI Database Reference를 참조하십시오.
예: 손실된 쓰기 보호 구성
이 예제에서는 테이블스페이스 집합에 대해 섀도우 손실 쓰기 추적을 활성화합니다.
이 예제에서 목표는 PDB 내의 salestbs 및 hrtbs 테이블스페이스를 보호하는 것입니다. 또한 oetbs 테이블스페이스 내에서 oetbs01.dbf 데이터 파일과 이 데이터 파일만 보호하려고 합니다. 다음 작업을 수행합니다.
-
관리자로 PDB에 로그인합니다.
-
다음과 같이 단일 shadow 테이블스페이스를 생성합니다.
CREATE BIGFILE TABLESPACE shadow_lwp1 DATAFILE 'shadow_lwp1_df' SIZE 10M LOST WRITE PROTECTION; -
다음과 같이 PDB에 대해 손실된 쓰기 보호를 사용으로 설정합니다.
ALTER DATABASE ENABLE LOST WRITE PROTECTION; -
다음과 같이
salestbs및hrtbs테이블스페이스에 대해 섀도우 손실 쓰기 보호를 사용으로 설정합니다.ALTER TABLESPACE salestbs ENABLE LOST WRITE PROTECTION; ALTER TABLESPACE hrtbs ENABLE LOST WRITE PROTECTION; -
다음과 같이
oetbs01.dbf데이터 파일에 대해 섀도우 손실 쓰기 보호를 사용으로 설정합니다.ALTER DATABASE DATAFILE 'oetbs01.dbf' ENABLE LOST WRITE PROTECTION;
참조:
-
Oracle AI Database Administrator's Guide - 섀도우 테이블스페이스 관리 방법 학습
-
CREATE TABLESPACE문에 대한 자세한 내용은 Oracle AI Database SQL Language Reference를 참조하십시오.
임시 테이블스페이스
임시 테이블스페이스에는 세션 기간 동안만 지속되는 임시 데이터가 포함됩니다. 임시 테이블스페이스에는 영구 스키마 객체가 상주할 수 없습니다. 임시 파일은 임시 테이블스페이스 데이터를 저장합니다.
임시 테이블스페이스는 메모리에 맞지 않는 여러 정렬 작업의 동시성을 향상시킬 수 있습니다. 또한 이러한 테이블스페이스는 정렬 중에 공간 관리 작업의 효율성을 향상시킵니다.
-
공유 및 로컬 임시 테이블스페이스 임시 테이블스페이스는 공유 또는 로컬입니다.
-
기본 임시 테이블스페이스 모든 데이터베이스 사용자 계정에는 기본 공유 임시 테이블스페이스가 지정됩니다. 데이터베이스에 로컬 임시 테이블스페이스가 포함된 경우 모든 유저 계정에도 기본 로컬 임시 저장 영역이 할당됩니다.
공유 및 로컬 임시 테이블스페이스
임시 테이블스페이스는 공유되거나 로컬입니다.
공유 임시 테이블스페이스는 임시 파일을 공유 디스크에 저장하므로 모든 데이터베이스 인스턴스에서 임시 공간에 액세스할 수 있습니다. 반면, 로컬 임시 테이블스페이스는 모든 데이터베이스 인스턴스에 대해 공유되지 않는 별도의 임시 파일을 저장합니다. 로컬 임시 테이블스페이스는 Oracle Real Application Clusters 또는 Oracle Flex Clusters에 유용합니다.
읽기 전용 및 읽기/쓰기 데이터베이스 인스턴스에 대한 로컬 임시 테이블스페이스를 생성할 수 있습니다. 많은 읽기 전용 Instance가 단일 데이터베이스에 액세스하는 경우 로컬 임시 테이블스페이스는 정렬, 해시 집계 및 조인이 포함된 Query의 성능을 향상시킬 수 있습니다. 장점은 다음과 같습니다.
-
공유 디스크 저장 영역 대신 로컬을 사용하여 I/O 성능 향상
-
비용이 많이 드는 교차 Instance 임시 공간 관리 방지
-
온디스크 공간 메타 데이터 관리를 제거하여 Instance 시작 성능 향상
다음 표에서는 공유 및 로컬 임시 테이블스페이스의 특성을 비교합니다.
테이블 2 공유 및 지역 임시 테이블스페이스
| 공유 임시 테이블스페이스 | 로컬 임시 데이터베이스 |
|---|---|
CREATE TEMPORARY TABLESPACE 문을 사용하여 생성됩니다. |
주: 로컬 임시 테이블스페이스는 항상 bigfile 테이블스페이스이지만 |
| 데이터베이스에 대한 단일 임시 테이블스페이스를 생성합니다. | 모든 데이터베이스 Instance에 대해 별도의 임시 테이블스페이스를 생성합니다. FOR LEAF 옵션은 읽기 전용 인스턴스에 대해서만 테이블스페이스를 생성합니다. FOR ALL 옵션은 읽기 전용 및 읽기/쓰기로 모든 인스턴스에 대한 테이블스페이스를 생성합니다. |
| 테이블스페이스 그룹을 지원합니다. | 테이블스페이스 그룹을 지원하지 않습니다. |
| 임시 파일 메타 데이터를 콘트롤 파일에 저장합니다. | Control File의 모든 Instance에 공통되는 임시 파일 메타 데이터와 SGA의 Instance별 메타 데이터(예: 할당에 대한 비트맵, 현재 임시 파일 크기 및 파일 상태)를 저장합니다. |
참조: "Oracle AI Database 인스턴스 소개"
기본 임시직 테이블스페이스
모든 데이터베이스 유저 계정에는 기본 공유 임시 테이블스페이스가 할당됩니다. 데이터베이스에 로컬 임시 테이블스페이스가 포함된 경우 모든 유저 계정에도 기본 로컬 임시 저장 영역이 할당됩니다.
CREATE USER 또는 ALTER USER 문을 사용하여 사용자 계정에 대해 다른 임시 테이블스페이스를 지정할 수 있습니다. Oracle AI Database는 다른 임시 테이블스페이스를 지정하지 않은 사용자에 대해 시스템 레벨의 기본 임시 테이블스페이스를 사용합니다.
-
기본 임시 테이블스페이스 생성 데이터베이스 생성 시 기본 임시 저장 영역은
SYSTEM테이블스페이스가 로컬에서 관리되는지 여부에 따라 달라집니다. -
임시 저장 영역에 대한 액세스 사용자에게 임시 테이블스페이스가 지정된 경우 데이터베이스가 먼저 액세스합니다. 그렇지 않으면 데이터베이스가 기본 임시 테이블스페이스에 액세스합니다. 데이터베이스가 query를 위해 임시 테이블스페이스에 액세스한 후에는 다른 테이블스페이스로 전환되지 않습니다. 참조:
CREATE USER문에 대한 자세한 내용은 Oracle AI Database SQL Language Reference를 참조하십시오.
기본 임시 테이블스페이스 생성
데이터베이스를 생성할 때 기본 임시 저장 영역은 SYSTEM 테이블스페이스가 로컬에서 관리되는지 여부에 따라 달라집니다.
다음 표는 Oracle AI Database가 데이터베이스 생성 시 기본 임시 테이블스페이스를 선택하는 방법을 보여줍니다.
표 3: 기본 임시 테이블스페이스 생성
| SYSTEM 테이블스페이스는 로컬에서 관리됩니까? | CREATE DATABASE 문이 기본 임시 테이블스페이스를 지정합니까? | 그런 다음 데이터베이스 ... |
|---|---|---|
| 예. | 예. | 지정된 테이블스페이스를 기본값으로 사용합니다. |
| 예. | 아니요 | 임시 테이블스페이스를 생성합니다. |
| 아니요 | 예. | 지정된 테이블스페이스를 기본값으로 사용합니다. |
| 아니요 | 아니요 | 기본 임시 저장 영역에 SYSTEM를 사용합니다. 데이터베이스는 기본 임시 테이블스페이스가 권장된다는 경고를 경보 로그에 기록합니다. |
데이터베이스 생성 후에는 ALTER DATABASE DEFAULT TEMPORARY TABLESPACE 문을 사용하여 데이터베이스의 기본 임시 테이블스페이스를 변경할 수 있습니다. 주: 기본 임시 테이블스페이스를 영구적으로 만들 수는 없습니다.
참조:
-
기본 임시 테이블스페이스를 생성하는 방법을 알아보려면 Oracle AI Database Administrator's Guide를 참조하십시오.
-
CREATE DATABASE및ALTER DATABASE의DEFAULT TEMPORARY TABLESPACE절 구문에 대한 Oracle AI Database SQL Language Reference
임시 저장 영역에 액세스
유저에게 임시 테이블스페이스가 할당된 경우 데이터베이스가 먼저 임시 테이블스페이스에 액세스하거나 기본 임시 테이블스페이스에 액세스합니다. 데이터베이스가 query를 위해 임시 테이블스페이스에 액세스한 후에는 다른 테이블스페이스로 전환되지 않습니다.
유저 query는 공유 또는 로컬 임시 저장 영역에 액세스할 수 있습니다. 또한 유저는 읽기 전용 Instance에 대해 하나의 기본 로컬 임시 테이블스페이스를 할당하고 읽기/쓰기 Instance에 대해 다른 기본 로컬 임시 테이블스페이스를 할당할 수 있습니다.
읽기/쓰기 인스턴스의 경우 데이터베이스는 공유 임시 테이블스페이스의 우선 순위를 높입니다. 읽기 전용 Instance의 경우 데이터베이스는 로컬 임시 테이블스페이스의 우선 순위를 높입니다. 데이터베이스 Instance가 읽기/쓰기인 경우 데이터베이스는 다음 순서로 공간을 검색합니다.
-
유저에게 공유 임시 테이블스페이스가 할당되어 있습니까?
-
로컬 임시 테이블스페이스가 유저에게 할당되어 있습니까?
-
데이터베이스 기본 임시 테이블스페이스에 공간이 있습니까?
앞의 질문에 대한 답이 yes인 경우 데이터베이스는 검색을 정지하고 지정된 테이블스페이스에서 공간을 할당합니다. 그렇지 않은 경우 데이터베이스 기본 로컬 임시 테이블스페이스에서 공간이 할당됩니다.
데이터베이스 Instance가 읽기 전용이면 데이터베이스는 다음 순서로 공간을 검색합니다.
-
로컬 임시 테이블스페이스가 유저에게 할당되어 있습니까?
-
할당된 데이터베이스 기본 로컬 임시 테이블스페이스에 공간이 있습니까?
-
유저에게 공유 임시 테이블스페이스가 할당되어 있습니까?
앞의 질문에 대한 답이 yes인 경우 데이터베이스는 검색을 정지하고 지정된 테이블스페이스에서 공간을 할당합니다. 그렇지 않은 경우 데이터베이스 기본 공유 임시 테이블스페이스에서 공간이 할당됩니다.
테이블스페이스 모드
테이블스페이스 모드는 테이블스페이스의 액세스 가능성을 결정합니다.
-
읽기/쓰기 및 읽기 전용 테이블스페이스 모든 테이블스페이스는 쓰기 가능 여부를 지정하는 쓰기 모드입니다.
-
온라인 및 오프라인 테이블스페이스 데이터베이스가 열려 있을 때마다 테이블스페이스는 온라인(액세스 가능) 상태이거나 오프라인(액세스 불가) 상태일 수 있습니다.
읽기/쓰기 및 읽기 전용 테이블스페이스
모든 테이블스페이스는 쓰기 가능 여부를 지정하는 쓰기 모드에 있습니다.
상호 배타적 모드는 다음과 같습니다.
-
Read/write 모드
유저가 테이블스페이스를 읽고 쓸 수 있습니다. 모든 테이블스페이스는 처음에 읽기/쓰기로 생성됩니다.
SYSTEM및SYSAUX테이블스페이스와 임시 테이블스페이스는 영구적으로 읽기/쓰기되므로 읽기 전용으로 설정할 수 없습니다. -
Read-only 모드
테이블스페이스의 데이터 파일에 대한 쓰기 작업은 금지됩니다. 읽기 전용 테이블스페이스는 DVD 또는 WORM 드라이브와 같은 읽기 전용 매체에 상주할 수 있습니다.
읽기 전용 테이블스페이스를 사용하면 데이터베이스의 큰 정적 부분에 대해 백업 및 Recovery를 수행할 필요가 없습니다. 읽기 전용 테이블스페이스는 변경되지 않으므로 반복되는 백업이 필요하지 않습니다. Media Failure 이후 데이터베이스를 Recovery하는 경우 읽기 전용 테이블스페이스를 Recovery할 필요가 없습니다.
참조:
-
Oracle AI Database Administrator's Guide - 테이블스페이스를 읽기 전용 또는 읽기/쓰기 모드로 변경하는 방법을 학습합니다.
-
ALTER TABLESPACE구문 및 의미에 대한 Oracle AI Database SQL Language Reference -
복구에 대한 자세한 내용은 Oracle AI Database Backup and Recovery User's Guide를 참조하십시오.
온라인 및 Offline 테이블스페이스
테이블스페이스는 데이터베이스가 열려 있을 때마다 온라인(액세스 가능) 또는 오프라인(액세스 불가) 상태일 수 있습니다.
테이블스페이스는 유저가 데이터를 사용할 수 있도록 대개 온라인 상태입니다. SYSTEM 테이블스페이스 및 임시 테이블스페이스는 오프라인으로 설정할 수 없습니다.
테이블스페이스는 자동 또는 수동으로 오프라인으로 전환할 수 있습니다. 예를 들어 유지 관리나 백업 및 Recovery를 위해 테이블스페이스를 오프라인으로 설정할 수 있습니다. 데이터베이스 기록자(DBW) 프로세스가 여러 번 데이터 파일에 쓰지 못하는 경우와 같이 특정 오류가 발생하면 데이터베이스는 자동으로 테이블스페이스를 오프라인으로 전환합니다. 오프라인 테이블스페이스에 있는 테이블에 액세스하려는 유저에게 오류가 표시됩니다.
테이블스페이스가 오프라인 상태가 되면 데이터베이스는 다음을 수행합니다.
-
데이터베이스는 후속 DML 문이 오프라인 테이블스페이스의 객체를 참조하도록 허용하지 않습니다. 오프라인 테이블스페이스는 Oracle AI Database 이외의 유틸리티에서 읽거나 편집할 수 없습니다.
-
해당 테이블스페이스의 데이터를 참조하는 완료된 명령문이 있는 활성 트랜잭션은 트랜잭션 레벨에서 영향을 받지 않습니다.
-
데이터베이스는
SYSTEM테이블스페이스의 지연된 언두 세그먼트에 완료된 명령문에 해당하는 언두 데이터를 저장합니다. 테이블스페이스가 온라인 상태가 되면 데이터베이스는 필요한 경우 테이블스페이스에 언두 데이터를 적용합니다.
참조:
-
Oracle AI Database Administrator's Guide에서 테이블스페이스 가용성을 변경하는 방법 알아보기
테이블스페이스 파일 크기
테이블스페이스는 큰 파일 테이블스페이스 또는 작은 파일 테이블스페이스입니다. 이러한 테이블스페이스는 데이터 파일이나 임시 파일을 명시적으로 참조하지 않는 SQL 문의 실행과 구별할 수 없습니다.
차이점은 다음과 같습니다.
-
Smallfile 테이블스페이스는 여러 데이터 파일 또는 임시 파일을 포함할 수 있지만 Big File 테이블스페이스만큼 큰 파일은 포함할 수 없습니다. 기본 테이블스페이스 유형입니다.
-
Big File 테이블스페이스에는 매우 큰 데이터 파일 또는 임시 파일이 하나 포함되어 있습니다. 이 유형의 테이블스페이스는 다음을 수행할 수 있습니다.
-
데이터베이스의 저장 영역 용량 증가
데이터베이스의 최대 데이터 파일 수가 제한되므로 각 데이터 파일의 크기를 늘리면 전체 저장 영역이 늘어납니다.
-
많은 데이터 파일 및 임시 파일 관리 부담 감소
Bigfile 테이블스페이스는 새 파일을 추가하고 여러 파일을 처리할 필요가 없어 Oracle Managed Files 및 Oracle ASM(Automatic Storage Management)으로 파일 관리를 단순화합니다.
-
개별 파일이 아닌 테이블스페이스에서 작업 수행
Big File 테이블스페이스는 테이블스페이스를 디스크 공간 관리, 백업 및 Recovery 등의 기본 단위로 만듭니다.
Big File 테이블스페이스는 ASSM을 사용하는 로컬관리방식의 테이블스페이스에만 지원됩니다. 그러나 세그먼트가 수동으로 관리되는 경우에도 로컬관리방식의 언두 및 임시 테이블스페이스는 Big File 테이블스페이스가 될 수 있습니다.
Oracle AI Database 26ai부터 SYSTEM, SYSAUX 및 USER 테이블스페이스는 기본적으로 Big File 테이블스페이스로 생성됩니다. 이전 릴리스에서 업그레이드된 데이터베이스는 해당 테이블스페이스 유형을 보유합니다.
-
참조:
-
백업 및 복구에 대한 자세한 내용은 Oracle AI Database Backup and Recovery User's Guide를 참조하십시오.
-
Oracle AI Database Administrator's Guide - Bigfile 테이블스페이스 관리 방법 학습