테이블 및 테이블 클러스터
이 장에서는 스키마 객체를 소개하고 스키마 객체의 가장 일반적인 유형인 테이블에 대해 설명합니다.
-
스키마 객체 소개 데이터베이스 스키마는 스키마 객체라고 하는 데이터 구조에 대한 논리적 컨테이너입니다. 스키마 객체의 예로는 테이블 및 인덱스가 있습니다. SQL을 사용하여 스키마 객체를 생성하고 조작하는 경우
-
테이블 개요 테이블은 Oracle 데이터베이스에서 데이터 조직의 기본 단위입니다.
-
테이블 클러스터 개요 테이블 클러스터는 공통 열을 공유하고 관련 데이터를 동일한 블록에 저장하는 테이블 그룹입니다.
-
속성 클러스터화된 테이블 개요 속성 클러스터화된 테이블은 사용자가 지정한 클러스터링 지시어를 기반으로 디스크에 가까운 근접도로 데이터를 저장하는 힙 구성 테이블입니다. 이 지시어는 열을 단일 테이블이나 다중 테이블에 지정합니다.
-
임시 테이블 개요 임시 테이블에는 트랜잭션 또는 세션 기간 동안에만 존재하는 데이터가 포함됩니다.
-
외부 테이블 개요 외부 테이블은 이 데이터가 데이터베이스의 테이블에 있는 것처럼 외부 소스의 데이터에 액세스합니다.
-
블록체인 테이블 개요 블록체인 테이블은 중앙 집중식 블록체인 애플리케이션을 위해 설계된 추가 전용 테이블입니다.
-
변경할 수 없는 테이블 개요 변경할 수 없는 테이블은 내부자의 무단 데이터 수정 및 인적 오류로 인한 실수로 인한 데이터 수정을 방지하는 추가 전용 테이블입니다.
-
객체 테이블 개요 객체 테이블은 각 행이 객체를 나타내는 특수한 종류의 테이블입니다.
스키마 객체 소개
데이터베이스 스키마는 스키마 객체라고 하는 데이터 구조에 대한 논리적 컨테이너입니다. 스키마 객체의 예로는 테이블 및 인덱스가 있습니다. SQL을 사용하여 스키마 객체를 생성하고 조작하는 경우
이 단원에서는 다음 항목을 다룹니다.
-
일반 및 로컬 사용자 계정 정보 데이터베이스 사용자 계정에는 암호와 특정 데이터베이스 권한이 있습니다.
-
공통 및 로컬 객체 공통 객체는 CDB 루트 또는 응용 프로그램 루트에 정의되며 메타데이터 링크 또는 객체 링크를 사용하여 참조할 수 있습니다. 로컬 객체는 공통 객체가 아닌 모든 객체입니다.
-
스키마 객체 유형 Oracle SQL을 사용하면 다른 여러 유형의 스키마 객체를 생성하고 조작할 수 있습니다.
-
스키마 객체 스토리지 일부 스키마 객체는 세그먼트라는 논리적 스토리지 구조 유형으로 데이터를 저장합니다. 예를 들어, 분할되지 않은 힙 구성 테이블이나 인덱스는 세그먼트를 생성합니다.
-
스키마 객체 종속성 일부 스키마 객체는 스키마 객체 종속성을 생성하여 다른 객체를 참조합니다.
-
샘플 스키마 Oracle 데이터베이스에는 상호 연결된 스키마 집합인 샘플 스키마가 포함되어 있으며, 이를 통해 Oracle 설명서 및 Oracle 지침 자료에서 공통 데이터베이스 작업을 보여주도록 합니다. 참조: 사용자 및 권한에 대한 자세한 내용은 Oracle AI Database Security Guide를 참조하십시오.
일반 및 로컬 사용자 계정 정보
데이터베이스 유저 계정에는 암호와 특정 데이터베이스 권한이 있습니다.
유저 계정 및 스키마
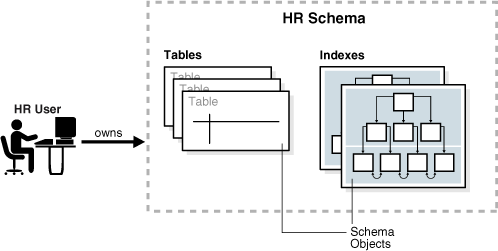
각 유저 계정은 유저와 동일한 이름을 가진 단일 스키마를 소유합니다. 스키마는 스키마를 소유하는 유저의 데이터를 포함합니다. 예를 들어, hr 사용자 계정은 employees 테이블과 같은 스키마 객체를 포함하는 hr 스키마를 소유합니다. 일반적으로 운용 중인 데이터베이스에서 스키마 소유자는 유저가 아닌 데이터베이스 응용 프로그램을 나타냅니다.
스키마 내에서 특정 유형의 각 스키마 객체는 고유한 이름을 가집니다. 예를 들어, hr.employees는 hr 스키마에 있는 employees라는 테이블을 나타내며 다음 그림은 hr라는 스키마 소유자 및 hr 스키마 내의 스키마 객체를 보여줍니다.
그림 1: HR 스키마
일반 및 로컬 사용자 계정
유저 계정이 데이터베이스를 정의하는 객체를 소유하는 경우 이 유저 계정은 일반적입니다. Oracle이 제공하지 않은 사용자 계정은 로컬 계정이거나 공통 계정입니다. CDB 공통 사용자는 CDB 루트에서 생성되는 공통 사용자입니다. 응용 프로그램 공통 사용자는 응용 프로그램 루트에 생성되며 이 응용 프로그램 컨테이너 내에서만 공통됩니다.
다음 그림은 CDB에서 가능한 사용자 계정 유형을 보여줍니다.
그림 2: CDB의 사용자 계정
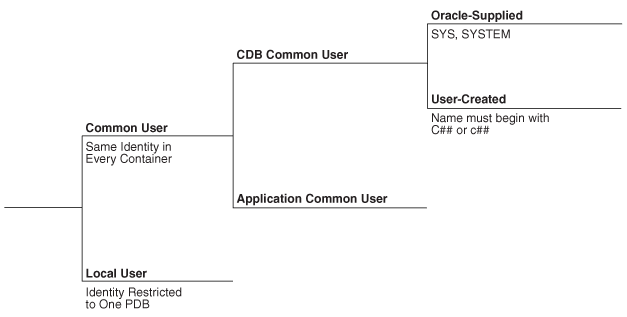
CDB 일반 사용자는 충분한 권한이 있는 CDB의 모든 컨테이너에 연결할 수 있습니다. 반대로 응용 프로그램 일반 사용자는 응용 프로그램 루트가 생성된 응용 프로그램 루트 또는 해당 권한에 따라 이 응용 프로그램 루트에 플러그인된 PDB에만 연결할 수 있습니다.
-
공통 사용자 계정 CDB(시스템 컨테이너) 또는 애플리케이션 컨테이너의 컨텍스트 내에서 공통 사용자는 루트와 이 컨테이너 내의 모든 기존 및 미래 PDB에 동일한 ID를 가진 데이터베이스 사용자입니다.
-
로컬 사용자 계정 로컬 사용자는 일반적이지 않으며 단일 PDB 내에서만 작동할 수 있는 데이터베이스 사용자입니다.
공통 사용자 계정
공통 사용자는 시스템 컨테이너(CDB) 또는 애플리케이션 컨테이너의 컨텍스트 내에서 루트와 이 컨테이너 내의 모든 기존 및 미래 PDB에 동일한 ID를 가진 데이터베이스 사용자입니다.
모든 공통 사용자는 컨테이너 루트 및 충분한 권한이 있는 모든 PDB 내에서 해당 컨테이너 루트에 연결하고 작업을 수행할 수 있습니다. 일부 관리 작업은 공통 사용자가 수행해야 합니다. 예를 들어, PDB 생성 및 PDB 언플러그가 있습니다.
예를 들어, SYSTEM는 DBA 권한을 가진 CDB 일반 사용자입니다. 따라서 SYSTEM는 데이터베이스의 CDB 루트 및 PDB에 연결할 수 있습니다. saas_sales 애플리케이션 컨테이너에 공통 사용자 saas_sales_admin를 생성할 수 있습니다. 이 경우 saas_sales_admin 사용자는 saas_sales 애플리케이션 루트 또는 saas_sales 애플리케이션 컨테이너 내의 애플리케이션 PDB에만 접속할 수 있습니다.
모든 공통 유저는 Oracle 제공 유저 또는 유저 생성 유저입니다. Oracle에서 제공하는 일반 사용자의 예로는 SYS 및 SYSTEM가 있습니다. 유저가 생성한 모든 공통 유저는 CDB 일반 유저 또는 응용 프로그램 일반 유저입니다.
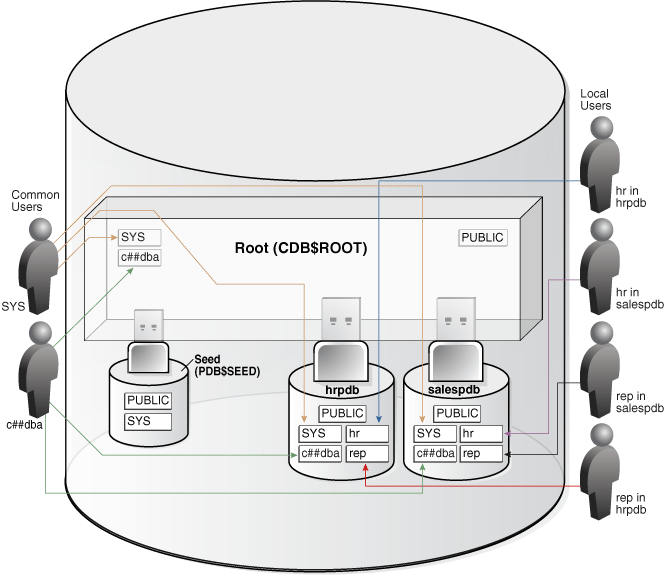
다음 그림은 hrpdb 및 salespdb의 두 PDB에 있는 샘플 사용자 및 스키마를 보여줍니다. SYS 및 c##dba는 CDB$ROOT, hrpdb 및 salespdb에 스키마가 있는 CDB 일반 사용자입니다. 로컬 사용자 hr 및 rep는 hrpdb에 존재합니다. 로컬 사용자 hr 및 rep도 salespdb에 존재합니다.
그림 3: CDB의 사용자 및 스키마
일반 사용자는 다음과 같은 특성을 가집니다.
-
일반 사용자는
CREATE SESSION권한이 있는 모든 컨테이너(CDB$ROOT포함)에 로그인할 수 있습니다.공통 사용자가 모든 컨테이너에서 동일한 권한을 가질 필요는 없습니다. 예를 들어,
c##dba사용자는hrpdb및 루트에서 세션을 생성할 수 있지만salespdb에서 세션을 생성할 수 없습니다. 적절한 권한을 가진 일반 유저는 컨테이너 간에 전환할 수 있으므로 루트의 일반 유저는 PDB를 관리할 수 있습니다. -
애플리케이션 공통 사용자는 자체 애플리케이션 컨테이너 외부의 컨테이너에
CREATE SESSION권한이 없습니다.따라서 응용 프로그램 공통 사용자는 자체 응용 프로그램 컨테이너로 제한됩니다. 예를 들어,
saas_sales애플리케이션에서 생성된 애플리케이션 일반 사용자는 애플리케이션 루트와saas_sales애플리케이션 컨테이너의 PDB에만 연결할 수 있습니다. -
유저가 생성한 CDB 일반 유저의 이름은 다른 데이터베이스 유저의 이름 지정 규칙을 따라야 합니다. 또한 이름은 기본적으로
c##또는C##인COMMON_USER_PREFIX초기화 매개변수로 지정된 문자로 시작해야 합니다. Oracle에서 제공하는 공통 사용자 이름과 사용자 생성 응용 프로그램 공통 사용자 이름은 이러한 제한이 없습니다.로컬 사용자 이름은
c##또는C##문자로 시작할 수 없습니다. -
모든 공통 사용자는 생성된 컨테이너(시스템 컨테이너 또는 특정 애플리케이션 컨테이너) 내의 모든 PDB에서 고유하게 이름이 지정됩니다.
CDB 공통 사용자는 CDB 루트에 정의되지만 동일한 ID를 가진 모든 PDB에 연결할 수 있어야 합니다. 애플리케이션 일반 사용자는 애플리케이션 루트에 상주하며 동일한 ID를 사용하여 컨테이너의 모든 애플리케이션 PDB에 접속할 수 있습니다.
-
일반 사용자의 특성 모든 공통 사용자는 Oracle 제공 또는 사용자 생성입니다.
-
SYS 및 SYSTEM 계정 모든 Oracle 데이터베이스에는 관리 권한이 있는 기본 공통 사용자 계정이 포함됩니다.
일반 사용자의 특성
모든 공통 유저는 Oracle 제공 유저 또는 유저 생성 유저입니다.
공통 사용자 계정에는 다음과 같은 특성이 있습니다.
-
일반 사용자는
CREATE SESSION권한이 있는 모든 컨테이너(CDB$ROOT포함)에 로그인할 수 있습니다.공통 사용자는 모든 컨테이너에서 동일한 권한을 가질 필요가 없습니다. 예를 들어,
c##dba사용자는hrpdb및 루트에서 세션을 생성할 수 있지만salespdb에서 세션을 생성할 수 없습니다. 적절한 권한을 가진 일반 유저는 컨테이너 간에 전환할 수 있으므로 루트의 일반 유저는 PDB를 관리할 수 있습니다. -
애플리케이션 공통 사용자는 자체 애플리케이션 컨테이너 외부의 컨테이너에
CREATE SESSION권한이 없습니다.따라서 응용 프로그램 공통 사용자는 자체 응용 프로그램 컨테이너로 제한됩니다. 예를 들어,
saas_sales애플리케이션에서 생성된 애플리케이션 일반 사용자는 애플리케이션 루트와saas_sales애플리케이션 컨테이너의 PDB에만 연결할 수 있습니다. -
유저가 생성한 CDB 일반 유저의 이름은 다른 데이터베이스 유저의 이름 지정 규칙을 따라야 합니다. 또한 이름은 기본적으로
c##또는C##인COMMON_USER_PREFIX초기화 매개변수로 지정된 문자로 시작해야 합니다. Oracle에서 제공하는 공통 사용자 이름과 사용자 생성 응용 프로그램 공통 사용자 이름은 이러한 제한이 없습니다.로컬 사용자 이름은
c##또는C##문자로 시작할 수 없습니다. -
모든 공통 사용자는 생성된 컨테이너(시스템 컨테이너 또는 특정 애플리케이션 컨테이너) 내의 모든 PDB에서 고유하게 이름이 지정됩니다.
CDB 공통 사용자는 CDB 루트에 정의되지만 동일한 ID를 가진 모든 PDB에 연결할 수 있어야 합니다. 애플리케이션 일반 사용자는 애플리케이션 루트에 상주하며 동일한 ID를 사용하여 컨테이너의 모든 애플리케이션 PDB에 접속할 수 있습니다.
다음 그림은 hrpdb 및 salespdb의 두 PDB에 있는 샘플 사용자 및 스키마를 보여줍니다. SYS 및 c##dba는 CDB$ROOT, hrpdb 및 salespdb에 스키마가 있는 CDB 일반 사용자입니다. 로컬 사용자 hr 및 rep는 hrpdb에 존재합니다. 로컬 사용자 hr 및 rep도 salespdb에 존재합니다.
그림 4: CDB의 사용자 및 스키마
참조:
-
일반 사용자 계정에 대해 알아보려면 Oracle AI Database Security Guide를 참조하십시오.
-
COMMON_USER_PREFIX에 대한 자세한 내용은 Oracle AI Database Reference를 참조하십시오.
SYS 및 SYSTEM 계정
모든 Oracle 데이터베이스에는 관리 권한이 있는 기본 공통 사용자 계정이 포함됩니다.
관리 계정은 권한이 높은 계정이며, 데이터베이스 시작/중지, 메모리/저장소 관리, 데이터베이스 사용자 생성/관리 등과 같은 관리 작업을 수행할 수있는 권한이 있는 DBA만 사용해야 합니다.
SYS 공통 사용자 계정은 데이터베이스가 생성될 때 자동으로 생성됩니다. 이 계정은 모든 데이터베이스 관리 기능을 수행할 수 있습니다. SYS 스키마는 데이터 딕셔너리의 기본 테이블 및 뷰를 저장합니다. 이러한 기본 테이블 및 뷰는 Oracle AI Database 작업에 반드시 필요합니다. SYS 스키마의 테이블은 데이터베이스에 의해서만 조작되며 어떤 유저도 수정할 수 없습니다.
SYSTEM 관리 계정도 데이터베이스가 생성될 때 자동으로 생성됩니다. SYSTEM 스키마는 관리 정보를 표시하는 추가 테이블 및 뷰와 다양한 Oracle AI Database 옵션 및 툴이 사용하는 내부 테이블 및 뷰를 저장합니다. SYSTEM 스키마를 사용하여 비관리 유저에게 관심이 있는 테이블을 저장하지 마십시오.
참조:
-
사용자 계정에 대한 자세한 내용은 Oracle AI Database Security Guide를 참조하십시오.
-
SYS,SYSTEM및 기타 관리 계정에 대해 알아보려면 Oracle AI Database Administrator's Guide를 참조하십시오.
로컬 사용자 계정
로컬 사용자는 일반적이지 않으며 단일 PDB 내에서만 작동할 수 있는 데이터베이스 사용자입니다.
로컬 사용자는 다음과 같은 특성을 가집니다.
-
로컬 사용자는 PDB와 관련되며 이 PDB에서 스키마를 소유할 수 있습니다.
"공통 사용자의 특성"에 표시된 예에서
hrpdb의 로컬 사용자hr은hr스키마를 소유합니다.salespdb에서 로컬 사용자rep는rep스키마를 소유하고 로컬 사용자hr는hr스키마를 소유합니다. -
로컬 사용자는 PDB 열기 및 닫기를 포함하여 PDB를 관리할 수 있습니다.
SYSDBA권한을 가진 일반 사용자는 로컬 사용자에게SYSDBA권한을 부여할 수 있습니다. 이 경우 권한 있는 사용자는 로컬로 유지됩니다. -
한 PDB의 로컬 사용자는 다른 PDB 또는 CDB 루트에 로그인할 수 없습니다.
예를 들어, 로컬 사용자
hr가hrpdb에 접속하는 경우hr는 데이터베이스 링크를 사용하지 않고salespdb데이터베이스에 상주하는sh스키마의 객체에 액세스할 수 없습니다. 동일한 방식으로 로컬 사용자sh가salespdbPDB에 접속할 때sh는 데이터베이스 링크를 사용하지 않고hrpdb에 상주하는hr스키마의 객체에 액세스할 수 없습니다. -
로컬 사용자의 이름은
c##또는C##문자로 시작하면 안됩니다. -
로컬 사용자의 이름은 해당 PDB 내에서만 고유해야 합니다.
사용자 이름과 해당 사용자 스키마가 포함된 PDB는 고유한 로컬 사용자를 결정합니다. "일반 사용자의 특성"은
rep이라는 로컬 사용자 및 스키마가hrpdb에 있음을 보여줍니다.rep라는 완전히 독립적인 로컬 사용자 및 스키마가salespdbPDB에 존재합니다.
다음 표에서는 "일반 사용자의 특성"에 CDB가 포함된 시나리오를 설명합니다. 각 행은 이전 행의 작업 이후에 발생하는 작업을 설명합니다. 공통 사용자 SYSTEM는 두 PDB에 로컬 사용자를 생성합니다.
테이블 1 CDB의 로컬 사용자
| 작업 | 설명 |
|---|---|
|
SYSTEM는 서비스 이름 hrpdb를 사용하여 hrpdb 컨테이너에 접속합니다. |
|
SYSTEM는 이제 로컬 사용자 rep을 생성하고 이 사용자에게 이 PDB의 CREATE SESSION 권한을 부여합니다. 공통 사용자는 루트에 연결된 공통 사용자만 생성할 수 있으므로 사용자는 로컬입니다. |
|
hrpdb에 대한 로컬 rep 사용자는 salespdb에 대한 연결을 시도합니다. rep가 PDB salespdb에 존재하지 않으므로 시도가 실패합니다. |
|
SYSTEM는 서비스 이름 salespdb를 사용하여 salespdb 컨테이너에 접속합니다. |
|
SYSTEM는 salespdb에 로컬 사용자 rep를 생성하고 이 PDB의 CREATE SESSION 권한을 이 사용자에게 부여합니다. 로컬 사용자의 이름은 해당 PDB 내에서만 고유해야 하므로 rep라는 사용자가 salespdb 및 hrpdb 모두에 존재할 수 있습니다. |
|
rep 사용자가 salespdb에 성공적으로 로그인합니다. |
참조: 로컬 사용자 계정에 대한 자세한 내용은 Oracle AI Database Security Guide를 참조하십시오.
공통 및 로컬 객체
공통 객체는 CDB 루트 또는 응용 프로그램 루트에 정의되며 메타 데이터 링크나 객체 링크를 사용하여 참조할 수 있습니다. 로컬 객체는 공통 객체가 아닌 모든 객체입니다.
데이터베이스 제공 공통 객체는 CDB$ROOT에 정의되어 있으며 변경할 수 없습니다. Oracle Database는 CDB$ROOT에서 공통 객체 생성을 지원하지 않습니다.
응용 프로그램 루트에서 테이블, 뷰, PL/SQL 및 Java 프로그램 단위, 시퀀스 등과 같은 대부분의 스키마 객체를 일반 객체로 생성할 수 있습니다. 객체가 응용 프로그램 루트에 있는 경우 이를 응용 프로그램 공통 객체라고 합니다.
로컬 사용자는 공통 객체를 소유할 수 있습니다. 또한 공통 사용자는 로컬 객체를 소유할 수 있지만 객체가 데이터 링크 또는 메타데이터 링크되지 않고 메타데이터 링크나 데이터 링크도 아닌 경우에만 소유할 수 있습니다.
참조: 공통 객체에 대한 권한 관리에 대해 자세히 알아보려면 Oracle AI Database Security Guide를 참조하십시오.
스키마 객체 유형
Oracle SQL을 사용하면 다른 여러 유형의 스키마 객체를 생성하고 조작할 수 있습니다.
스키마 객체의 기본 유형은 다음 표에 나와 있습니다.
테이블 2 스키마 객체
| 객체 | 설명 | 자세히 알아보기 |
|---|---|---|
| 테이블 | 테이블은 데이터를 행에 저장합니다. 테이블은 관계형 데이터베이스에서 가장 중요한 스키마 객체입니다. | "테이블 개요" |
| 인덱스 | 인덱스는 테이블 또는 테이블 클러스터의 인덱스화된 각 행에 대한 항목을 포함하고 행에 대한 빠른 직접 액세스를 제공하는 스키마 객체입니다. Oracle AI Database는 다양한 유형의 인덱스를 지원합니다. 인덱스 구성 테이블은 데이터가 인덱스 구조에 저장되는 테이블입니다. | "인덱스 및 인덱스 구성 테이블" |
| 파티션 | 분할 영역은 대형 테이블 및 인덱스의 조각입니다. 각 분할 영역은 자체 이름을 가지며 선택적으로 자체 저장 영역 특성을 가질 수 있습니다. | "분할 영역 개요" |
| 조회 수 | 뷰는 하나 이상의 테이블이나 다른 뷰에 있는 사용자정의된 데이터 표현입니다. 뷰를 저장된 질의로 간주할 수 있습니다. 뷰는 실제로 데이터를 포함하지 않습니다. | "뷰 개요" |
| 시퀀스 | 시퀀스는 정수를 생성하기 위해 여러 유저가 공유할 수 있는 유저 생성 객체입니다. 일반적으로 시퀀스를 사용하여 기본 키 값을 생성합니다. | "시퀀스 개요" |
| 차원 | 차원은 열 집합 쌍 간의 상위-하위 관계를 정의합니다. 이 경우 열 집합의 모든 열은 동일한 테이블에서 가져와야 합니다. 차원은 일반적으로 고객, 제품 및 시간과 같은 데이터를 분류하는 데 사용됩니다. | "차원 개요" |
| 동의어 | 동의어는 다른 스키마 객체의 별칭입니다. 동의어가 단순히 별칭이므로 데이터 딕셔너리에 있는 해당 정의 외에 저장 영역은 필요하지 않습니다. | "동의어 개요" |
| PL/SQL 서브 프로그램 및 패키지 | PL/SQL은 SQL의 Oracle 프로시저 확장입니다. PL/SQL 하위 프로그램은 매개변수 세트로 호출할 수 있는 명명된 PL/SQL 블록입니다. PL/SQL 패키지는 논리적으로 관련된 PL/SQL 유형, 변수 및 서브 프로그램을 그룹화합니다. | "PL/SQL 서브 프로그램" |
다른 유형의 객체도 데이터베이스에 저장되며 SQL 문을 사용하여 생성 및 조작할 수 있지만 스키마에는 포함되지 않습니다. 이러한 객체에는 데이터베이스 유저 계정, 롤, 컨텍스트 및 딕셔너리 객체가 포함됩니다.
참조:
-
Oracle AI Database Administrator's Guide에서 스키마 객체 관리 방법 학습
-
스키마 객체 및 데이터베이스 객체에 대한 자세한 내용은 Oracle AI Database SQL Language Reference를 참조하십시오.
스키마 오브젝트 스토리지
일부 스키마 객체는 세그먼트라는 논리적 저장 영역 구조의 유형에 데이터를 저장합니다. 예를 들어, 분할되지 않은 힙 구성 테이블이나 인덱스는 세그먼트를 생성합니다.
뷰 및 시퀀스와 같은 다른 스키마 객체는 메타 데이터로만 구성됩니다. 이 항목에서는 세그먼트가 있는 스키마 객체만 설명합니다.
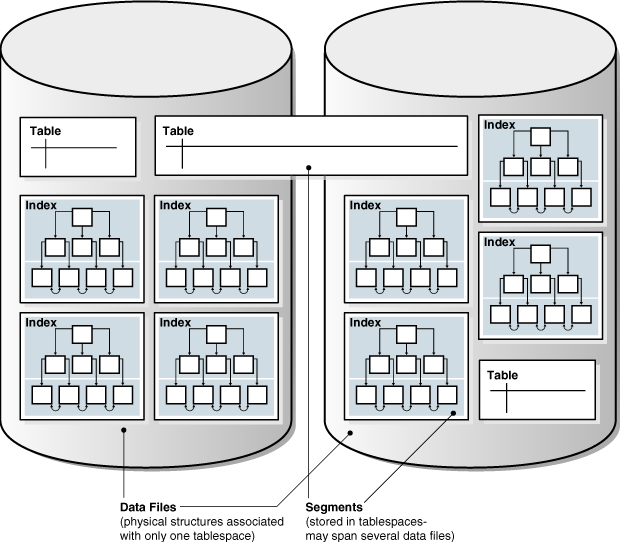
Oracle AI Database는 스키마 객체를 테이블스페이스 내에 논리적으로 저장합니다. 스키마와 테이블스페이스 간에는 관계가 없습니다. 테이블스페이스는 다른 스키마의 객체를 포함할 수 있고 스키마의 객체는 다른 테이블스페이스에 포함될 수 있습니다. 각 객체의 데이터는 하나 이상의 데이터 파일에 물리적으로 포함됩니다.
다음 그림은 테이블 및 인덱스 세그먼트, 테이블스페이스 및 데이터 파일의 가능한 구성을 보여줍니다. 한 테이블의 데이터 세그먼트는 둘 다 동일한 테이블스페이스의 일부인 두 개의 데이터 파일에 걸쳐 있습니다. 세그먼트는 여러 테이블스페이스로 확장될 수 없습니다.
그림 5: 세그먼트, 테이블스페이스 및 데이터 파일
참조:
-
"논리적 저장 영역 구조"에서 테이블스페이스 및 세그먼트에 대해 알아보기
-
Oracle AI Database Administrator's Guide - 스키마 객체에 대한 저장소 관리 방법 학습
스키마 객체 종속성
일부 스키마 객체는 다른 객체를 참조하여 스키마 객체 종속성을 생성합니다.
예를 들어, 뷰는 테이블 또는 뷰를 참조하는 query를 포함하고 PL/SQL 서브 프로그램은 다른 서브 프로그램을 호출합니다. 객체 A의 정의가 객체 B을 참조하면 A는 B에서 종속 객체이고 B는 A에 대해 참조된 객체입니다.
Oracle AI Database는 참조된 객체와 관련하여 종속 객체가 항상 최신 상태인지 확인하는 자동 방식을 제공합니다. 종속 객체를 생성할 때 데이터베이스는 종속 객체와 참조된 객체 간의 종속성을 추적합니다. 참조된 객체가 종속 객체에 영향을 줄 수 있는 방식으로 변경되면 데이터베이스는 종속 객체를 잘못 표시합니다. 예를 들어, 유저가 테이블을 삭제한 경우에는 삭제된 테이블을 기반으로 하는 뷰를 사용할 수 없습니다.
종속 객체를 사용하기 전에 참조된 객체의 새 정의에 대해 부적합한 종속 객체를 재컴파일해야 합니다. 재컴파일은 잘못된 종속 객체가 참조될 때 자동으로 발생합니다.
스키마 객체가 종속성을 생성할 수 있는 방법에 대한 그림으로, 다음 샘플 스크립트는 test_table 테이블을 생성한 다음 이 테이블을 질의하는 프로시저를 생성합니다.
CREATE TABLE test_table ( col1 INTEGER, col2 INTEGER );

CREATE OR REPLACE PROCEDURE test_proc
AS
BEGIN
 FOR x IN ( SELECT col1, col2 FROM test_table )
 LOOP
   -- process data
   NULL;
 END LOOP;
END;
/
test_proc 프로시저의 상태에 대한 다음 질의는 적합함을 보여줍니다.
SQL> SELECT OBJECT_NAME, STATUS FROM USER_OBJECTS WHERE OBJECT_NAME = 'TEST_PROC';

OBJECT_NAME STATUS
----------- -------
TEST_PROC   VALID
col3 열을 test_table에 추가한 후에도 프로시저에 이 열에 대한 종속성이 없기 때문에 프로시저가 여전히 유효합니다.
SQL> ALTER TABLE test_table ADD col3 NUMBER;

Table altered.

SQL> SELECT OBJECT_NAME, STATUS FROM USER_OBJECTS WHERE OBJECT_NAME = 'TEST_PROC';

OBJECT_NAME STATUS
----------- -------
TEST_PROC   VALID
그러나 test_proc 프로시저가 종속된 col1 열의 데이터 유형을 변경하면 프로시저가 무효화됩니다.
SQL> ALTER TABLE test_table MODIFY col1 VARCHAR2(20);

Table altered.

SQL> SELECT OBJECT_NAME, STATUS FROM USER_OBJECTS WHERE OBJECT_NAME = 'TEST_PROC';

OBJECT_NAME STATUS
----------- -------
TEST_PROC   INVALID
다음 예제에 표시된 것처럼 프로시저를 실행하거나 재컴파일하면 프로시저가 다시 유효합니다.
SQL> EXECUTE test_proc

PL/SQL procedure successfully completed.

SQL> SELECT OBJECT_NAME, STATUS FROM USER_OBJECTS WHERE OBJECT_NAME = 'TEST_PROC';

OBJECT_NAME STATUS
----------- -------
TEST_PROC   VALID
참조: 스키마 객체 종속성을 관리하는 방법을 알아보려면 Oracle AI Database Administrator's Guide 및 Oracle AI Database Development Guide를 참조하십시오.
샘플 스키마
Oracle 데이터베이스에는 상호 연결된 스키마 세트인 샘플 스키마가 포함되어 있으며 이를 통해 Oracle 설명서 및 Oracle 지침 자료에서 공통 데이터베이스 작업을 보여주도록 합니다.
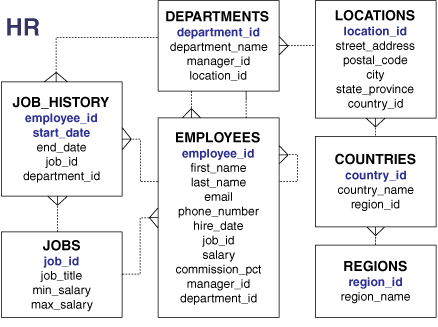
hr 샘플 스키마에는 사원, 부서 및 위치, 작업 이력 등에 대한 정보가 포함되어 있습니다. 다음 그림은 hr에 있는 테이블의 엔티티 관계 다이어그램을 보여줍니다. 이 설명서의 대부분의 예에서는 이 스키마의 객체를 사용합니다.
그림 6: HR 스키마
참조: Oracle AI Database 샘플 스키마 샘플 스키마 설치 방법
테이블 개요
테이블은 Oracle 데이터베이스에서 데이터 조직의 기본 단위입니다.
표에서는 엔티티를 설명합니다. 이 엔티티는 어떤 정보를 기록해야 하는지에 대한 의미입니다. 예를 들어, 사원은 엔티티일 수 있습니다.
Oracle AI Database 테이블은 다음과 같은 기본 범주로 구분됩니다.
-
관계형 테이블의 경우
관계형 테이블은 간단한 열을 가지며 가장 일반적인 테이블 유형입니다. 예 4-1은 관계형 테이블에 대한
CREATE TABLE문을 보여줍니다. -
객체 표
다음과 같은 조직적 특성을 사용하여 관계형 테이블을 생성할 수 있습니다.
-
힙 구성 테이블은 행을 특정 순서로 저장하지 않습니다.
CREATE TABLE문은 기본적으로 힙 구성 테이블을 생성합니다. -
인덱스 구성 테이블은 기본 키 값에 따라 행을 정렬합니다. 일부 응용 프로그램의 경우 인덱스 구성 테이블(Index-organized Table)은 성능을 향상시키고 디스크 공간을 보다 효율적으로 사용합니다. "인덱스 구성 테이블 개요"를 참조하십시오.
-
외부 테이블은 메타데이터가 데이터베이스에 저장되지만 데이터가 데이터베이스 외부에 저장되는 읽기 전용 테이블입니다. "외부 테이블 개요"를 참조하십시오.
테이블은 영구적이거나 임시적입니다. 영구적인 테이블 정의와 데이터는 세션 간에 유지됩니다. 임시 테이블 정의는 영구 테이블 정의와 동일한 방식으로 유지되지만 데이터는 트랜잭션 또는 세션 기간 동안에만 존재합니다. 임시 테이블은 여러 작업을 실행하여 결과 집합을 임시로 보유해야 하는 응용 프로그램에 유용합니다.
-
열 테이블 정의에는 테이블 이름과 열 집합이 포함됩니다.
-
행 행은 테이블의 레코드에 해당하는 열 정보의 모음입니다.
-
예제: CREATE TABLE 및 ALTER TABLE 문 테이블을 생성하는 Oracle SQL 문은
CREATE TABLE입니다. -
Oracle 데이터 유형 각 열에는 특정 저장 형식, 제약 조건 및 적합한 값 범위와 연관된 데이터 유형이 있습니다. 값의 데이터 유형은 고정된 특성 세트를 값과 연관시킵니다.
-
무결성 제약 조건 무결성 제약 조건은 테이블에 있는 하나 이상의 열에 대한 값을 제한하는 명명된 규칙입니다.
-
테이블 스토리지 Oracle AI Database는 테이블스페이스의 데이터 세그먼트를 사용하여 테이블 데이터를 보유합니다.
-
테이블 압축 데이터베이스는 테이블 압축을 사용하여 테이블에 필요한 저장 영역 양을 줄일 수 있습니다. 참조: Oracle AI Database Administrator's Guide에서 테이블 관리 방법 알아보기
열
테이블 정의에는 테이블 이름과 열 집합이 포함됩니다.
열은 테이블에 설명된 엔티티의 속성을 식별합니다. 예를 들어, employees 테이블의 employee_id 열은 사원 엔티티의 사원 ID 속성을 참조합니다.
일반적으로 테이블을 생성할 때 각 열에 열 이름, 데이터 유형 및 너비를 지정합니다. 예를 들어, employee_id의 데이터 유형은 NUMBER(6)이며, 이 열은 너비가 최대 6자리인 숫자 데이터만 포함할 수 있음을 나타냅니다. 너비는 DATE와 같이 데이터 유형에 의해 미리 결정될 수 있습니다.
-
가상 열 테이블에는 표현식 열이라고도 하는 가상 열이 포함될 수 있습니다. 표현식 열은 가상(디스크에 저장되지 않음) 또는 구체화된(디스크에 저장됨) 열일 수 있습니다.
-
표시되지 않는 열 표시되지 않는 열은 열이 명시적으로 이름으로 지정된 경우에만 값이 표시되는 사용자 지정 열입니다. 기존 응용 프로그램에 영향을 주지 않고 테이블에 보이지 않는 열을 추가하고 필요한 경우 열을 표시할 수 있습니다.
-
잠금 없는 예약 잠금 없는 예약을 사용하면 열 값을 추가하거나 뺄 때 커밋되지 않은 업데이트로 차단되지 않고 숫자 열 값에 대한 다중 동시 업데이트를 계속할 수 있습니다.
가상 열
테이블에는 표현식 열이라고도 하는 가상 열이 포함될 수 있습니다. 표현식 열은 가상(디스크에 저장되지 않음) 또는 구체화된(디스크에 저장됨) 열일 수 있습니다.
표현식 열이라고도 하는 가상 열은 유저가 지정한 표현식이나 함수 집합을 계산하여 값을 파생합니다. 테이블에는 이러한 열이 여러 개 포함될 수 있지만 항상 하나의 정규 열이 있어야 합니다. 예를 들어, 아래 EMP 테이블 정의에는 사원의 급여를 기준으로 계산된 시간당 요율을 연간 2080시간으로 나눈 값이 포함됩니다.
CREATE TABLE emp
(
   emp_id           NUMBER(9)     CONSTRAINT emp_pk PRIMARY KEY,
   emp_last_name    VARCHAR2(30)  CONSTRAINT emp_last_name_nn NOT NULL,
   emp_first_name   VARCHAR2(30)  CONSTRAINT emp_first_name_nn NOT NULL,
   emp_salary       NUMBER(9,2),
   emp_hourly_rate  NUMBER(7,2)   GENERATED ALWAYS AS (emp_salary/2080) VIRTUAL,
   emp_phone_no     VARCHAR2(10)
);
그런 다음 가상이 아닌 열에 값을 삽입합니다.
INSERT INTO emp (emp_id, emp_last_name, emp_first_name, emp_salary, emp_phone_no)
VALUES (8291, 'Patel', 'Siddharth', 60000, '6505551234');
테이블을 query하면 이제 표현식 열로 반환되는 계산된 값이 표시됩니다.
SELECT * FROM emp;

 EMP_ID EMP_LAST_NAME  EMP_FIRST_NAME     EMP_SALARY  EMP_HOURLY_RATE EMP_PHONE_NO
_______ ______________ _______________ _____________ ________________ _____________
   8291 Patel          Siddharth               60000            28.85 6505551234
이러한 표현식 열은 가상 열이거나 디스크에서 구체화될 수 있습니다. 순수 가상(표현식) 열의 경우 열 값은 디스크 공간을 소비하지 않으며 액세스 시 요청 시 계산됩니다. 구체화된 표현식 열의 경우 값은 DML 시에 계산되어 디스크에 저장됩니다.
참조: Oracle AI Database Administrator's Guide에서 가상 열 관리 방법 알아보기
보이지 않는 열
표시되지 않는 열은 열이 명시적으로 이름으로 지정된 경우에만 값이 표시되는 사용자 지정 열입니다. 기존 응용 프로그램에 영향을 주지 않고 테이블에 보이지 않는 열을 추가하고 필요한 경우 열을 표시할 수 있습니다.
일반적으로 보이지 않는 열은 온라인 애플리케이션을 마이그레이션하고 발전시키는 데 도움이 됩니다. 사용 사례는 SELECT * 문을 사용하여 3열 테이블을 질의하는 응용 프로그램일 수 있습니다. 테이블에 네번째 열을 추가하면 응용 프로그램이 손상되어 세 개의 데이터 열이 예상됩니다. 네번째 보이지 않는 열을 추가하면 응용 프로그램이 정상적으로 작동합니다. 그런 다음 개발자는 응용 프로그램을 변경하여 네번째 열을 처리하고 응용 프로그램이 활성화될 때 열을 볼 수 있도록 할 수 있습니다.
다음 예제에서는 보이지 않는 열이 count인 products 테이블을 생성한 다음 보이지 않는 열을 표시합니다.
CREATE TABLE products ( prod_id INT, count INT INVISIBLE );
ALTER TABLE products MODIFY ( count VISIBLE );
참조:
-
보이지 않는 열을 관리하는 방법을 알아보려면 Oracle AI Database Administrator's Guide를 참조하십시오.
-
보이지 않는 열에 대한 자세한 내용은 Oracle AI Database SQL Language Reference를 참조하십시오.
잠금 없는 예약
잠금 없는 예약을 사용하면 열 값을 더하거나 뺄 때 커밋되지 않은 업데이트에 의해 차단되지 않고 숫자 열 값에 대한 다중 동시 업데이트를 계속할 수 있습니다.
이 기능을 사용하면 업데이트 중에 일반적인 잠금 방식을 피할 수 있으므로 예약 가능한 열에 대한 동시 업데이트가 자주 발생하는 경우 차단을 줄여 사용자 환경을 크게 향상시킬 수 있습니다. 이전 릴리스에서는 행의 열 값을 더하거나 빼서 갱신하는 경우 트랜잭션이 커밋될 때까지 해당 행에 대한 다른 모든 갱신 사항이 차단됩니다. Oracle AI Database 26ai에 Lock-Free Reservation 기능이 도입되면서 업데이트가 진행될 수 있는 조건을 지정하여 트랜잭션이 서로 차단하지 않고 동일한 행의 예약 가능 열에서 동시에 추가 또는 차감되도록 할 수 있습니다. 이렇게 하려면 숫자 열이 RESERVABLE 열로 지정하고 열에 대해 CHECK 제약 조건을 생성합니다. 예약 가능한 열 갱신이 행을 잠그지 않기 때문에 다른 트랜잭션이 동일한 행의 예약 불가능 열을 동시에 갱신하지 못하도록 차단하지 않기 때문에 추가 처리 능력 향상도 달성할 수 있습니다.
예를 들어 현재고 수량이 요청에 충분하고 100개 품목에 대한 재고 공간을 초과하지 않는 경우 재고 수량에 대한 더하기 및 빼기 작업이 성공하도록 허용할 수 있습니다. 수량 값이 0보다 크고 100보다 작거나 같은 경우 커밋되지 않은 업데이트에 의해 차단되지 않고 수량 값에 대한 업데이트를 계속할 수 있습니다. 추가되거나 차감되는 금액은 내부 예약 메커니즘을 통해 예약 및 보장되므로 동일한 행의 예약 가능 열에 대해 이전에 예약한 다른 트랜잭션이 커밋되기를 기다리지 않고도 트랜잭션이 진행될 수 있습니다.
테이블 레벨 CHECK 제약 조건은 예약 가능한 열과 예약 불가능 열을 모두 포함할 수 있습니다. 갱신이 실행될 때 승인된 Lock-free 보류 예약은 나중에 트랜잭션의 커밋 시에 이러한 제약 조건을 위반할 수 있습니다. 이러한 상황은 현재 값이 CHECK 제약 조건을 위반할 수 있도록 예약이 수행된 이후에 제약 조건의 예약 불가능한 열이 갱신된 경우에 발생할 수 있습니다. 제약 조건을 위반하면 트랜잭션이 종료되어야 합니다. 그러나 테이블 레벨 제약 조건에서 예약할 수 없는 열은 일반적으로 자주 수정되지 않는 임계값입니다. 선반 공간, 계정의 필요한 잔액 및 지출 한도는 이러한 임계값의 예입니다.
다음 예에서는 예약 가능 열이 qty_on_hand인 inventory 테이블을 생성합니다. qty_on_hand의 CHECK 제약 조건은 다른 업데이트를 차단하지 않고 계속하려면 qty_on_hand에서 업데이트가 진행되도록 재고가 0개 이상이고 이 품목에 대한 선반 용량보다 크지 않아야 함을 지정합니다. 아래 예제에서는 적절한 제약 조건을 사용하여 inventory 테이블을 생성하고, 여러 행의 데이터가 삽입되고, inventory 테이블의 데이터 딕셔너리를 질의합니다.
CREATE TABLE inventory
( item_id            NUMBER          CONSTRAINT inv_pk PRIMARY KEY,
  item_display_name  VARCHAR2(100)   NOT NULL,
  item_desc          VARCHAR2(2000),
  qty_on_hand        NUMBER          RESERVABLE CONSTRAINT qty_ck CHECK
                                        (qty_on_hand >= 0) NOT NULL,
  shelf_capacity     NUMBER          NOT NULL,
    CONSTRAINT shelf_ck CHECK (qty_on_hand <= shelf_capacity)
);

-- Insert a few rows in the inventory table
INSERT INTO inventory VALUES (123, 'Milk', 'Lowfat 2%', 100, 120);
INSERT INTO inventory VALUES (456, 'Bread', 'Multigrain', 50, 100);
INSERT INTO inventory VALUES (789, 'Eggs', 'Organic', 50, 75);

COMMIT;

SELECT * FROM inventory;

-- Check views user_tab_cols and user_tables to check
-- if the table is a reservable table and the names of the reservable columns

SELECT table_name, has_reservable_column
FROM   user_tables
WHERE  table_name = 'INVENTORY';

SELECT column_name, reservable_column
FROM   user_tab_cols
WHERE  table_name = 'INVENTORY'
  AND  reservable_column = 'YES';
예약 가능 열에 대한 여러 동시 갱신 예제:
-
트랜잭션 1:
UPDATE inventory SET qty_on_hand = qty_on_hand - 10 WHERE item_id = 123; -
트랜잭션 2:
UPDATE inventory SET qty_on_hand = qty_on_hand + 20 WHERE item_id = 123; -
트랜잭션 3:
UPDATE inventory SET qty_on_hand = qty_on_hand - 30 WHERE item_id = 123; -
트랜잭션 2:
commit; -
트랜잭션 3:
commit; -
트랜잭션 1:
commit;
선택적 CHECK 제약 조건을 지정하는 ALTER TABLE 명령을 사용하여 예약 가능한 열을 테이블에 추가할 수 있습니다. 예를 들어, 다음과 같습니다.
ALTER TABLE inventory ADD
(qty_on_hold NUMBER RESERVABLE DEFAULT 0
 CONSTRAINT qty_hold CHECK (qty_on_hold >= 0 and qty_on_hold <= 25));
예약 가능한 열은 다음 ALTER TABLE 명령을 사용하여 예약할 수 없는 열로 변환할 수 있습니다. 예약 가능 예약이 비활성화되어 있어도 응용 프로그램에서 제약 조건을 적용하도록 선택할 수 있으므로 열이 예약 불가능 열로 변환될 때 제약 조건이 자동으로 삭제되지 않습니다. 요구 사항에 따라 제약 조건 삭제는 선택 사항입니다. 예:
ALTER TABLE inventory MODIFY (qty_on_hand NOT RESERVABLE);
ALTER TABLE inventory DROP CONSTRAINT qty_ck;
예약할 수 없는 열은 ALTER TABLE 명령을 사용하여 예약 가능한 열로 변환할 수 있습니다. 예를 들어, 다음과 같습니다.
ALTER TABLE inventory MODIFY
(qty_on_hand RESERVABLE
 CONSTRAINT qty_ck CHECK (qty_on_hand >= 0 and qty_on_hand <= 100));
행
행은 테이블의 레코드에 해당하는 열 정보의 모음입니다.
예를 들어, employees 테이블의 행은 특정 사원의 속성(사원 ID, 성, 이름 등)을 설명합니다. 테이블을 생성한 후 SQL을 사용하여 행을 삽입, query, 삭제 및 갱신할 수 있습니다.
예제: CREATE TABLE 및 ALTER TABLE 문
테이블을 생성하기 위한 Oracle SQL 문은 CREATE TABLE입니다.
예제 4-1 CREATE TABLE 사원
다음 예에서는 hr 샘플 스키마의 employees 테이블에 대한 CREATE TABLE 문을 보여줍니다. 이 명령문은 각 열에 대해 NUMBER 또는 DATE와 같은 데이터 유형을 지정하여 employee_id, first_name 등과 같은 열을 지정합니다.
CREATE TABLE employees
    ( employee_id    NUMBER(6),
      first_name     VARCHAR2(20),
      last_name      VARCHAR2(25)   CONSTRAINT emp_last_name_nn  NOT NULL,
      email          VARCHAR2(25)   CONSTRAINT emp_email_nn      NOT NULL,
      phone_number   VARCHAR2(20),
      hire_date      DATE           CONSTRAINT emp_hire_date_nn  NOT NULL,
      job_id         VARCHAR2(10)   CONSTRAINT emp_job_nn        NOT NULL,
      salary         NUMBER(8,2),
      commission_pct NUMBER(2,2),
      manager_id     NUMBER(6),
      department_id  NUMBER(4),
      CONSTRAINT     emp_salary_min CHECK (salary > 0),
      CONSTRAINT     emp_email_uk   UNIQUE (email)
    ) ;
예제 4-2 ALTER TABLE 사원
다음 예제는 무결성 제약 조건을 employees 테이블에 추가하는 ALTER TABLE 문을 보여줍니다. 무결성 제약 조건은 업무 규칙을 시행하고 부적합한 정보를 테이블에 입력하지 못하도록 합니다.
ALTER TABLE employees
ADD ( CONSTRAINT emp_emp_id_pk   PRIMARY KEY (employee_id),
      CONSTRAINT emp_dept_fk     FOREIGN KEY (department_id)
                                   REFERENCES departments,
      CONSTRAINT emp_job_fk      FOREIGN KEY (job_id)
                                   REFERENCES jobs (job_id),
      CONSTRAINT emp_manager_fk  FOREIGN KEY (manager_id)
                                   REFERENCES employees
    ) ;
예제 4-3 employees 테이블의 행
다음 샘플 출력은 hr.employees 테이블의 8개 행과 6개 열을 보여줍니다.
EMPLOYEE_ID FIRST_NAME  LAST_NAME      SALARY COMMISSION_PCT DEPARTMENT_ID
----------- ----------- ------------- ------- -------------- -------------
        100 Steven      King            24000                           90
        101 Neena       Kochhar         17000                           90
        102 Lex         De Haan         17000                           90
        103 Alexander   Hunold           9000                           60
        107 Diana       Lorentz          4200                           60
        149 Eleni       Zlotkey         10500             .2            80
        174 Ellen       Abel            11000             .3            80
        178 Kimberely   Grant            7000            .15
앞의 출력에서는 테이블, 열 및 행의 몇 가지 중요한 특성을 보여줍니다.
-
이 테이블의 행은 한 사원의 속성(이름, 급여, 부서 등)을 설명합니다. 예를 들어, 출력의 첫번째 행은 Steven King이라는 사원의 레코드를 보여줍니다.
-
열은 사원의 속성을 설명합니다. 예제에서
employee_id열은 기본 키입니다. 즉, 모든 사원이 사원 ID로 고유하게 식별됩니다. 두 명의 사원이 동일한 사원 ID를 갖지 않도록 보장됩니다. -
키가 아닌 열은 동일한 값을 가진 행을 포함할 수 있습니다. 예제에서 사원 101과 102의 급여 값은
17000와 동일합니다. -
외래 키 열은 동일한 테이블 또는 다른 테이블의 기본 또는 고유 키를 나타냅니다. 이 예에서
department_id의90값은departments테이블의department_id열에 해당합니다. -
필드는 행과 열의 교차입니다. 하나의 값만 포함할 수 있습니다. 예를 들어, 사원 103의 부서 ID 필드에
60값이 포함되어 있습니다. -
필드에 값이 부족할 수 있습니다. 이 경우 필드는 null 값을 포함한다고 합니다. 사원 100에 대한
commission_pct열의 값은 null이지만 사원 149에 대한 필드의 값은.2입니다. 이 열에NOTNULL또는 기본 키 무결성 제약 조건이 정의되지 않은 경우 열은 널을 허용합니다. 이 경우 이 열에 대한 값 없이 행을 삽입할 수 없습니다.
참조: CREATE TABLE 구문 및 의미에 대한 Oracle AI Database SQL Language Reference
Oracle 데이터 유형입니다.
각 열에는 특정 저장 형식, 제약 조건 및 유효한 값 범위와 연관된 데이터 유형이 있습니다. 값의 데이터 유형은 고정된 특성 세트를 값과 연관시킵니다.
이러한 등록 정보로 인해 Oracle AI Database는 한 데이터 유형의 값을 다른 데이터 유형 값과 다르게 처리합니다. 예를 들어, RAW 데이터 유형의 값이 아닌 NUMBER 데이터 유형의 값을 곱할 수 있습니다.
테이블을 생성할 때 각 열에 대한 데이터 유형을 지정해야 합니다. 이후에 열에 삽입된 각 값은 열 데이터 유형으로 간주됩니다.
Oracle AI Database는 다양한 기본 제공 데이터 유형을 제공합니다. 가장 일반적으로 사용되는 데이터 유형은 이 절에 설명된 범주에 속합니다.
기본 제공 유형의 다른 중요한 범주로는 raw, LOB(대형 객체) 및 컬렉션이 있습니다. PL/SQL에는 BOOLEAN, 참조 유형, 조합 유형(레코드) 및 유저 정의 유형이 포함된 상수 및 변수에 대한 데이터 유형이 있습니다.
-
문자 데이터 유형 문자 데이터 유형은 문자열에 영숫자 데이터를 저장합니다. 가장 일반적인 문자 데이터 유형은 문자 데이터를 저장하는 가장 효율적인 옵션인
VARCHAR2입니다. -
숫자 데이터 유형 Oracle AI Database 숫자 데이터 유형은 고정 및 부동 소수점 숫자, 0 및 무한대를 저장합니다. 일부 숫자 유형에는 "숫자가 아님" 또는
NaN으로 알려진 작업의 정의되지 않은 결과인 값도 저장됩니다. -
날짜시간 데이터 유형 날짜시간 데이터 유형은
DATE및TIMESTAMP입니다. Oracle AI Database는 시간 기록에 대한 포괄적인 시간대 지원을 제공합니다. -
Rowid 데이터 유형 데이터베이스에 저장된 모든 행에는 데이터베이스 내에서 해당 행을 찾기 위한 내부 표현인 주소가 있습니다. Oracle AI Database는
ROWID데이터 유형을 사용하여 데이터베이스의 모든 행에 대한 주소(rowid)를 저장합니다. -
부울 데이터 유형 BOOLEAN 데이터 유형은 고유 진리 값
True및False로 구성됩니다. -
형식 모델 및 데이터 유형 형식 모델은 문자열로 저장되는 날짜 시간 또는 숫자 데이터의 형식을 설명하는 문자 리터럴입니다. 형식 모델은 데이터베이스의 값에 대한 내부 표현을 변경하지 않습니다.
참조:
-
내장 SQL 데이터 유형에 대한 자세한 내용은 Oracle AI Database SQL Language Reference를 참조하십시오.
-
PL/SQL 데이터 유형에 대해 알아보려면 Oracle AI Database PL/SQL Packages and Types Reference를 참조하십시오.
-
Oracle AI Database Development Guide에서 내장 데이터 유형 사용 방법 학습
문자 데이터 유형
문자 데이터 유형은 문자열에 영숫자 데이터를 저장합니다. 가장 일반적인 문자 데이터 유형은 문자 데이터를 저장하는 가장 효율적인 옵션인 VARCHAR2입니다.
바이트 값은 일반적으로 문자 세트라고 하는 문자 인코딩 체계에 해당합니다. 데이터베이스 Character Set은 데이터베이스 생성 시 설정됩니다. 문자 집합의 예로는 7비트 ASCII, EBCDIC 및 유니코드 UTF-8이 있습니다.
문자 데이터 유형의 길이 의미는 바이트 또는 문자로 측정할 수 있습니다. 문자열을 바이트 시퀀스로 처리하는 것을 바이트 의미라고 합니다. 문자 데이터 유형의 기본값입니다. 문자열을 일련의 문자로 처리하는 것을 문자 의미라고 합니다. 문자는 데이터베이스 Character Set의 코드 지점입니다.
-
VARCHAR2 및 CHAR 데이터 유형
VARCHAR2데이터 유형은 가변 길이 문자 리터럴을 저장합니다. 리터럴은 고정된 데이터 값입니다. -
NCHAR 및 NVARCHAR2 데이터 유형
NCHAR및NVARCHAR2데이터 유형은 유니코드 문자 데이터를 저장합니다.
참조:
-
문자 집합에 대한 자세한 내용은 Oracle AI Database Globalization Support Guide를 참조하십시오.
-
Oracle AI Database Get Started with Oracle AI Database Development에서 데이터 유형에 대한 간략한 소개
-
문자 데이터 유형을 선택하는 방법은 Oracle AI Database Development Guide를 참조하십시오.
VARCHAR2 및 CHAR 데이터 유형
VARCHAR2 데이터 유형은 가변 길이 문자 리터럴을 저장합니다. 리터럴은 고정된 데이터 값입니다.
예를 들어, 'LILA', 'St. George Island' 및 '101'는 모두 문자 리터럴이고 5001는 숫자 리터럴입니다. 데이터베이스에서 스키마 객체 이름과 구분할 수 있도록 문자 리터럴은 작은 따옴표로 묶습니다. 주: 이 설명서에서는 텍스트 리터럴, 문자 리터럴 및 문자열이라는 용어를 서로 바꿔서 사용합니다.
VARCHAR2 열로 테이블을 생성하는 경우 최대 문자열 길이를 지정합니다. 예 4-1에서 last_name 열의 데이터 유형은 VARCHAR2(25)입니다. 즉, 열에 저장된 이름이 최대 25바이트입니다.
각 행에 대해 Oracle AI Database는 값이 최대 길이를 초과하지 않는 한 열의 각 값을 가변 길이 필드로 저장합니다. 이 경우 데이터베이스가 오류를 반환합니다. 예를 들어, 단일 바이트 문자 집합에서 행의 last_name 열 값에 대해 10자를 입력하면 행 조각의 열은 25가 아닌 10자(10바이트)만 저장합니다. VARCHAR2를 사용하면 공간 소비가 줄어듭니다.
VARCHAR2와 달리 CHAR는 고정 길이 문자열을 저장합니다. CHAR 열로 테이블을 생성하는 경우 열에 문자열 길이가 필요합니다. 기본값은 1바이트입니다. 데이터베이스는 공백을 사용하여 값을 지정된 길이로 채웁니다.
Oracle AI Database는 채워지지 않은 비교 의미를 사용하여 VARCHAR2 값을 비교하고 공백으로 채워진 비교 의미를 사용하여 CHAR 값을 비교합니다.
참조: 공백으로 채워진 비교 의미와 채워지지 않은 비교 의미에 대한 자세한 내용은 Oracle AI Database SQL Language Reference를 참조하십시오.
NCHAR 및 NVARCHAR2 데이터 유형
NCHAR 및 NVARCHAR2 데이터 유형은 유니코드 문자 데이터를 저장합니다.
유니코드는 단일 문자 집합을 사용하여 모든 언어로 정보를 저장할 수 있는 범용 인코딩 문자 집합입니다. NCHAR는 국가별 문자 집합에 해당하는 고정 길이 문자열을 저장하는 반면, NVARCHAR2는 가변 길이 문자열을 저장합니다.
National Character Set는 데이터베이스 생성 시 지정합니다. NCHAR 및 NVARCHAR2 데이터 유형의 문자 집합은 AL16UTF16 또는 UTF8여야 합니다. 두 Character Set 모두 유니코드 인코딩을 사용합니다.
NCHAR 또는 NVARCHAR2 열로 테이블을 생성하는 경우 최대 크기는 항상 문자 길이 의미입니다. 문자 길이 의미는 NCHAR 또는 NVARCHAR2에 대한 기본 및 유일한 길이 의미입니다.
참조: Oracle의 세계화 지원 기능에 대한 자세한 내용은 Oracle AI Database Globalization Support Guide를 참조하십시오.
숫자 데이터 유형
Oracle AI Database 숫자 데이터 유형은 고정 및 부동 소수점 수, 0 및 무한대를 저장합니다. 일부 숫자 유형에는 "숫자가 아님" 또는 NaN으로 알려진 작업의 정의되지 않은 결과인 값도 저장됩니다.
Oracle AI Database는 숫자 데이터를 가변 길이 형식으로 저장합니다. 각 값은 과학적 표기법으로 저장되며 지수를 저장하는 데 1바이트가 사용됩니다. 데이터베이스는 최대 20바이트를 사용하여 유효 자릿수를 포함하는 부동 소수점 수의 일부인 mantissa를 저장합니다. Oracle AI Database는 선행 및 후행 0을 저장하지 않습니다.
-
NUMBER 데이터 유형
NUMBER데이터 유형은 고정 및 부동 소수점 숫자를 저장합니다. 데이터베이스는 거의 모든 크기의 숫자를 저장할 수 있습니다. 이 데이터는 Oracle AI Database를 실행하는 다양한 운영체제 간 이식성이 보장됩니다.NUMBER데이터 유형은 숫자 데이터를 저장해야 하는 대부분의 경우 권장됩니다. -
Floating-Point Numbers Oracle AI Database는 부동 소수점 숫자 전용으로
BINARY_FLOAT및BINARY_DOUBLE의 두 가지 숫자 데이터 유형을 제공합니다.
NUMBER 데이터 유형
NUMBER 데이터 유형은 고정 및 부동 소수점 숫자를 저장합니다. 데이터베이스는 거의 모든 크기의 숫자를 저장할 수 있습니다. 이 데이터는 Oracle AI Database를 실행하는 다양한 운영체제 간 이식성이 보장됩니다. NUMBER 데이터 유형은 숫자 데이터를 저장해야 하는 대부분의 경우 권장됩니다.
고정점 번호는 NUMBER(p,s) 형식으로 지정합니다. 여기서 p 및 s는 다음 특성을 나타냅니다.
-
정밀도
precision은 총 자릿수를 지정합니다. 소수점 이하 자릿수가 지정되지 않은 경우 열은 반올림 없이 애플리케이션에서 제공한 대로 정확하게 값을 저장합니다.
-
배율
scale은 소수점부터 최하위까지 유효 숫자까지의 자릿수를 지정합니다. 소수점 이하 자릿수를 포함하여 소수점 오른쪽의 자릿수를 양수 배율로 계산합니다. 음수 배율은 소수점 왼쪽의 자릿수를 최대로 계산하지만 중요도가 가장 낮은 자릿수는 포함하지 않습니다.
NUMBER(6)에서와 같이 소수점 이하 자릿수를 소수점 이하 자릿수로 지정할 경우 소수점 이하 자릿수는 0입니다.
예 4-1에서 salary 열은 NUMBER(8,2) 유형이므로 소수점 이하 자릿수는 8이고 소수점 이하 자릿수는 2입니다. 따라서 데이터베이스는 급여 100,000을 100000.00로 저장합니다.
부동 소수점 수
Oracle AI Database는 부동 소수점 숫자 전용으로 BINARY_FLOAT 및 BINARY_DOUBLE의 두 가지 숫자 데이터 유형을 제공합니다.
이러한 유형은 NUMBER 데이터 유형에서 제공하는 모든 기본 기능을 지원합니다. 그러나 NUMBER는 소수점 이하 자릿수를 사용하지만 BINARY_FLOAT 및 BINARY_DOUBLE는 이진 자릿수를 사용하므로 산술 계산 속도가 빨라지고 일반적으로 저장 영역 요구 사항이 줄어듭니다.
BINARY_FLOAT 및 BINARY_DOUBLE는 대략적인 숫자 데이터 유형입니다. 정확한 표현이 아닌 십진수 값의 대략적인 표현을 저장합니다. 예를 들어, 값 0.1은 BINARY_DOUBLE 또는 BINARY_FLOAT로 정확하게 표현할 수 없습니다. 그들은 종종 과학적 계산에 사용됩니다. 동작은 Java 및 XMLSchema의 데이터 유형 FLOAT 및 DOUBLE와 유사합니다.
참조: 숫자 유형의 정밀도, 배율 및 기타 특성에 대해 알아보려면 Oracle AI Database SQL Language Reference를 참조하십시오.
Datetime 데이터 유형
datetime 데이터 유형은 DATE 및 TIMESTAMP입니다. Oracle AI Database는 시간 기록에 대한 포괄적인 시간대 지원을 제공합니다.
-
DATE 데이터 유형
DATE데이터 유형은 날짜 및 시간을 저장합니다. 데이터 시간은 문자 또는 숫자 데이터 유형으로 표현될 수 있지만DATE에는 특수 연관된 속성이 있습니다. -
TIMESTAMP 데이터 유형
TIMESTAMP데이터 유형은DATE데이터 유형의 확장입니다.
DATE 데이터 유형
DATE 데이터 유형은 날짜 및 시간을 저장합니다. 데이터 시간은 문자 또는 숫자 데이터 유형으로 표현될 수 있지만 DATE에는 특수 연관된 속성이 있습니다.
데이터베이스는 내부적으로 날짜를 숫자로 저장합니다. 날짜는 세기, 년, 월, 일, 시, 분 및 초와 일치하는 7바이트의 고정 길이 필드에 저장됩니다. 주: 날짜는 산술 연산을 완전히 지원하므로 숫자와 마찬가지로 날짜에서 더하고 빼는 것이 좋습니다.
데이터베이스는 지정된 형식 모델에 따라 날짜를 표시합니다. 형식 모델은 문자열로 날짜시간의 형식을 설명하는 문자 리터럴입니다. 표준 날짜 형식은 DD-MON-RR이며 01-JAN-11 형식으로 날짜를 표시합니다.
RR는 YY(연도의 마지막 2자리)과 유사하지만 반환 값의 세기는 지정된 2자리 연도 및 현재 연도의 마지막 2자리에 따라 다릅니다. 1999년 데이터베이스는 01-JAN-11를 표시한다고 가정합니다. 날짜 형식이 RR를 사용하는 경우 11는 2011를 지정하는 반면, 형식이 YY를 사용하는 경우 11는 1911를 지정합니다. 데이터베이스 instance와 세션 레벨에서 기본 날짜 형식을 변경할 수 있습니다.
Oracle AI Database는 시간을 24시간 형식으로 저장합니다. HH:MI:SS 시간 부분을 입력하지 않으면 기본적으로 일자 필드의 시간은 00:00:00 A.M입니다. 시간 전용 항목에서 일자 부분은 기본적으로 현재 월의 첫날로 설정됩니다.
참조:
-
수세기 및 날짜 형식 마스크에 대한 자세한 내용은 Oracle AI Database Development Guide를 참조하십시오.
-
날짜시간 형식 코드에 대한 자세한 내용은 Oracle AI Database SQL Language Reference를 참조하십시오.
-
Oracle AI Database Development Guide - datetime 데이터 유형으로 산술 연산을 수행하는 방법 학습
TIMESTAMP 데이터 유형
TIMESTAMP 데이터 유형은 DATE 데이터 유형의 확장입니다.
TIMESTAMP는 DATE 데이터 유형에 저장된 정보와 함께 소수 표시 초를 저장합니다. TIMESTAMP 데이터 유형은 이벤트 순서를 추적해야 하는 응용 프로그램과 같이 정확한 시간 값을 저장하는 데 유용합니다.
DATETIME 데이터 유형 TIMESTAMP WITH TIME ZONE 및 TIMESTAMP WITH LOCAL TIME ZONE는 시간대를 인식합니다. 사용자가 데이터를 선택하면 값이 사용자 세션의 시간대로 조정됩니다. 이 데이터 유형은 지리적 영역에서 날짜 정보를 수집하고 평가하는 데 유용합니다.
참조: 시간 기록 열에 데이터를 생성하고 입력하는 구문에 대한 자세한 내용은 Oracle AI Database SQL Language Reference를 참조하십시오.
Rowid 데이터 유형
데이터베이스에 저장된 모든 행에는 데이터베이스 내에서 해당 행을 찾기 위한 내부 표현인 주소가 있습니다. Oracle AI Database는 ROWID 데이터 유형을 사용하여 데이터베이스의 모든 행에 대한 주소(rowid)를 저장합니다.
행 ID는 다음 범주에 속합니다.
-
물리적 rowids는 힙 구성 테이블, 테이블 클러스터, 테이블 및 인덱스 분할 영역에 행 주소를 저장합니다.
-
논리적 rowids는 인덱스 구성 테이블에 행 주소를 저장합니다.
-
외래 rowids는 게이트웨이를 통해 액세스되는 DB2 테이블과 같은 외래 테이블의 식별자입니다. 표준 Oracle AI Database rowids가 아닙니다.
범용 rowid 또는 urowid라는 데이터 유형은 모든 유형의 rowid를 지원합니다.
-
행 ID 사용 Oracle AI Database는 인덱스 구성을 위해 내부적으로 행 ID를 사용합니다.
-
ROWID 의사 열 Oracle 데이터베이스의 모든 테이블에는
ROWID라는 의사 열이 있습니다.
Rowids 사용
Oracle AI Database는 인덱스 구성을 위해 내부적으로 rowids를 사용합니다.
가장 일반적인 유형인 B 트리 인덱스에는 범위로 나눈 정렬된 키 목록이 포함됩니다. 각 키는 빠른 액세스를 위해 연관된 행의 주소를 가리키는 rowid와 연관됩니다.
일반 유저와 응용 프로그램 개발자는 다음과 같은 몇 가지 중요한 기능에 rowids를 사용할 수도 있습니다.
-
Rowids는
rowid가 이전에 SELECT 문을 사용하여 검색된 경우 빠르게 행에 재액세스할 수 있는 수단입니다. -
Rowids는 테이블이 구성되는 방식을 확인하는 기능을 제공합니다.
ROWID 데이터 유형을 사용하여 정의된 열이 있는 테이블을 생성할 수 있지만 이후 단계에서 데이터에 액세스하는 데 행 ID를 사용하려는 의도로 행 ID를 저장해서는 안됩니다. 이러한 방식으로 rowids를 사용하면 예측할 수 없거나 잘못된 결과가 발생할 수 있습니다. 행에 대한 rowid는 사용자가 데이터베이스 엔진에 의해 시작되거나 내부적으로 시작될 수 있는 여러 가지 이유로 변경될 수 있습니다. 이러한 작업이 발생한 후에는 rowid가 동일한 행 또는 적합한 행을 가리키도록 종속할 수 없습니다.
ROWID 의사 열
Oracle 데이터베이스의 모든 테이블에는 ROWID라는 pseudocolumn이 있습니다.
의사 열은 테이블 열처럼 작동하지만 실제로 테이블에 저장되지 않습니다. 값을 의사 열에서 선택할 수 있지만 해당 값을 삽입, 갱신 또는 삭제할 수는 없습니다. 또한 의사 열은 인수 없는 SQL 함수와 유사합니다. 인수 없이 실행되는 함수는 일반적으로 결과 집합의 모든 행에 대해 동일한 값을 반환하지만, 의사 열은 대개의 각 행에 대해 다른 값을 반환합니다.
ROWID 의사 열의 값은 각 행의 주소를 나타내는 문자열입니다. 이러한 문자열의 데이터 유형은 ROWID입니다. 이 pseudocolumn은 SELECT 또는 DESCRIBE을 실행하여 테이블의 구조를 나열할 때와 pseudocolumn이 공간을 소비하지 않을 때 명확하지 않습니다. 그러나 예약어 ROWID를 열 이름으로 사용하여 SQL 질의를 통해 각 행의 rowid를 검색할 수 있습니다.
다음 예제는 ROWID pseudocolumn을 query하여 사원 100에 대한 employees 테이블에서 행의 rowid를 표시합니다.
SQL> SELECT ROWID FROM employees WHERE employee_id = 100;

ROWID
------------------
AAAPecAAFAAAABSAAA
참조:
-
주소별로 행을 식별하는 방법은 Oracle AI Database Development Guide를 참조하십시오.
-
ROWID 유형에 대한 자세한 내용은 Oracle AI Database SQL Language Reference를 참조하십시오.
부울 데이터 유형
BOOLEAN 데이터 유형은 고유한 진리 값 True 및 False로 구성됩니다.
NOT NULL 제약 조건에서 금지하지 않는 한 부울 데이터 유형은 진리 값 UNKNOWN도 널 값으로 지원합니다. 데이터 유형이 Oracle SQL 구문에 나타나는 모든 위치에서 부울 데이터 유형을 사용할 수 있습니다.
참조:
- 부울 데이터 유형에 대한 자세한 내용은 Oracle AI Database SQL Language Quick Reference를 참조하십시오.
형식 모델 및 데이터 유형
형식 모델은 문자열로 저장되는 날짜 시간 또는 숫자 데이터의 형식을 설명하는 문자 리터럴입니다. 형식 모델은 데이터베이스의 값에 대한 내부 표현을 변경하지 않습니다.
문자열을 날짜나 숫자로 변환할 때 형식 모델은 데이터베이스에서 문자열을 해석하는 방식을 결정합니다. SQL에서 형식 모델을 TO_CHAR 및 TO_DATE 함수의 인수로 사용하여 데이터베이스에서 반환될 값의 형식을 지정하거나 데이터베이스에 저장될 값의 형식을 지정할 수 있습니다.
다음 명령문은 부서 80에 있는 사원의 급여를 선택하고 TO_CHAR 함수를 사용하여 이러한 급여를 숫자 형식 모델 '$99,990.99'에 지정된 형식의 문자 값으로 변환합니다.
SQL> SELECT last_name employee, TO_CHAR(salary, '$99,990.99') AS "SALARY"
  2  FROM   employees
  3  WHERE  department_id = 80 AND last_name = 'Russell';

EMPLOYEE                  SALARY
------------------------- -----------
Russell                    $14,000.00
다음 예제는 '1998 05 20' 문자열을 DATE 값으로 변환하기 위해 TO_DATE 함수를 형식 마스크 'YYYY MM DD'와 함께 사용하여 채용 날짜를 업데이트합니다.
SQL> UPDATE employees
  2  SET hire_date = TO_DATE('1998 05 20','YYYY MM DD')
  3  WHERE last_name = 'Hunold';
참조: 형식 모델에 대해 자세히 알아보려면 Oracle AI Database SQL Language Reference를 참조하십시오.
무결성 제약 조건
무결성 제약 조건은 테이블에 있는 하나 이상의 열에 대한 값을 제한하는 명명된 규칙입니다.
데이터 무결성 규칙은 테이블에 부적합한 데이터 입력을 방지합니다. 또한 제약 조건은 특정 종속성이 존재할 때 테이블을 삭제하지 못하도록 할 수 있습니다.
제약 조건이 활성화된 경우 데이터베이스는 입력 또는 갱신될 때 데이터를 검사합니다. Oracle AI Database는 제약 조건을 준수하지 않는 데이터가 입력되지 않도록 합니다. 제약 조건이 사용 안함으로 설정된 경우 Oracle AI Database는 제약 조건을 준수하지 않는 데이터를 데이터베이스에 입력할 수 있도록 허용합니다.
예 4-1에서 CREATE TABLE 문은 last_name, email, hire_date 및 job_id 열에 대해 NOT NULL 제약 조건을 지정합니다. 제약 조건 절은 제약 조건의 열과 조건을 식별합니다. 이러한 제약 조건은 지정된 열에 null 값이 없는지 확인합니다. 예를 들어, 직무 ID 없이 신입 사원을 삽입하려고 하면 오류가 발생합니다.
테이블을 생성할 때나 생성한 후에 제약 조건을 생성할 수 있습니다. 필요한 경우 제약 조건을 일시적으로 비활성화할 수 있습니다. 데이터베이스는 데이터 딕셔너리에 제약 조건을 저장합니다.
참조:
-
무결성 제약 조건에 대한 자세한 내용은 "데이터 무결성"을 참조하십시오.
-
데이터 딕셔너리에 대한 자세한 내용은 "데이터 딕셔너리 개요"를 참조하십시오.
-
SQL 제약 조건 절에 대한 자세한 내용은 Oracle AI Database SQL Language Reference를 참조하십시오.
테이블 저장소
Oracle AI Database는 테이블스페이스의 데이터 세그먼트를 사용하여 테이블 데이터를 보관합니다.
세그먼트는 데이터 블록으로 구성된 Extent를 포함합니다. 테이블(또는 테이블 클러스터의 클러스터 데이터 세그먼트)의 데이터 세그먼트는 테이블 소유자의 기본 테이블스페이스 또는 CREATE TABLE 문에 이름이 지정된 테이블스페이스에 있습니다.
-
테이블 구성 기본적으로 테이블은 힙으로 구성됩니다. 즉, 데이터베이스는 사용자가 지정한 순서가 아닌 가장 적합한 위치에 행을 배치합니다. 따라서 힙 구성 테이블은 순서가 지정되지 않은 행 모음입니다.
-
행 저장 영역 데이터베이스는 행을 데이터 블록에 저장합니다. 256개 미만의 열에 대한 데이터를 포함하는 테이블의 각 행은 하나 이상의 행 피스에 포함됩니다.
-
행 조각의 행 rowid는 실제로 행의 10바이트 물리적 주소입니다.
-
널 값의 저장 영역 널은 열에 값이 없는 것입니다. 널은 누락, 알 수 없음 또는 적용할 수 없는 데이터를 나타냅니다. 참조: "사용자 세그먼트"에서 세그먼트 유형 및 세그먼트 생성 방법에 대해 알아봅니다.
테이블 구성
기본적으로 테이블은 힙으로 구성되어 있습니다. 즉, 데이터베이스는 유저가 지정한 순서가 아닌 가장 적합한 위치에 행을 배치합니다. 따라서 힙 구성 테이블은 순서가 지정되지 않은 행 모음입니다. 주: 인덱스 구성 테이블은 다른 구성 원칙을 사용합니다.
유저가 행을 추가하면 데이터베이스가 데이터 세그먼트의 첫번째 사용 가능한 공간에 행을 배치합니다. 행은 삽입된 순서대로 검색되지 않습니다.
hr.departments 테이블은 힙 구성 테이블입니다. 부서 ID, 이름, 관리자 ID 및 위치 ID에 대한 열이 있습니다. 행이 삽입되면 데이터베이스는 행이 들어가는 곳에 행을 저장합니다. 테이블 세그먼트의 데이터 블록에는 다음 예제에 표시된 순서가 지정되지 않은 행이 포함될 수 있습니다.
50,Shipping,121,1500
120,Treasury,,1700
70,Public Relations,204,2700
30,Purchasing,114,1700
130,Corporate Tax,,1700
10,Administration,200,1700
110,Accounting,205,1700
열 순서는 테이블의 모든 행에 대해 동일합니다. 데이터베이스는 일반적으로 열을 CREATE TABLE 문에 나열된 순서로 저장하지만 이 순서는 보장되지 않습니다. 예를 들어, 테이블에 LONG 유형의 열이 있는 경우 Oracle AI Database는 항상 이 열을 행의 마지막에 저장합니다. 또한 테이블에 새 열을 추가하면 새 열이 마지막으로 저장된 열이 됩니다.
테이블에는 일반 열과 달리 디스크 공간을 소비하지 않는 가상 열이 포함될 수 있습니다. 데이터베이스는 사용자 지정 표현식 또는 함수 집합을 계산하여 요청 시 가상 열의 값을 파생합니다. 가상 열을 인덱스화하고, 가상 열에 대한 통계를 수집하고, 무결성 제약 조건을 생성할 수 있습니다. 따라서 가상 열은 가상 열이 아닌 열과 비슷합니다.
참조:
-
Oracle AI Database SQL Language Reference - 가상 열에 대해 알아보기
행 저장 영역
데이터베이스는 행을 데이터 블록에 저장합니다. 256개 미만의 열에 대한 데이터를 포함하는 테이블의 각 행은 하나 이상의 행 피스에 포함됩니다.
가능한 경우 Oracle AI Database는 각 행을 하나의 행 피스로 저장합니다. 그러나 모든 행 데이터를 단일 데이터 블록에 삽입할 수 없거나 기존 행을 갱신하면 행이 해당 데이터 블록보다 커지는 경우 데이터베이스는 여러 행 피스를 사용하여 행을 저장합니다.
테이블 클러스터의 행은 클러스터화되지 않은 테이블의 행과 동일한 정보를 포함합니다. 또한 테이블 클러스터의 행에는 해당 행이 속한 클러스터 키를 참조하는 정보가 포함됩니다.
참조: 데이터 블록의 구성요소에 대해 알아보려면 "데이터 블록 형식"을 참조하십시오.
행 조각의 행 ID
rowid는 실제로 행의 10바이트 물리적 주소입니다.
힙 구성 테이블의 모든 행에는 행 피스의 물리적 주소에 해당하는 이 테이블 고유의 rowid가 있습니다. 테이블 클러스터의 경우 동일한 데이터 블록에 있는 다른 테이블의 행은 동일한 rowid를 가질 수 있습니다.
Oracle AI Database는 인덱스 구성을 위해 내부적으로 rowids를 사용합니다. 예를 들어, B 트리 인덱스의 각 키는 빠른 액세스를 위해 연관된 행의 주소를 가리키는 rowid와 연관됩니다. 물리적 rowids를 사용하여 테이블 행에 대한 가장 빠른 액세스를 제공하므로 데이터베이스는 최소한 단일 I/O로 행을 검색할 수 있습니다.
참조:
-
rowid 구조에 대해 알아보려면 "Rowid 형식"을 사용합니다.
-
B 트리 인덱스의 유형 및 구조에 대해 알아보려면 "B 트리 인덱스 개요"를 참조하십시오.
Null 값 저장
널은 열에 값이 없는 경우입니다. 널은 누락, 알 수 없음 또는 적용할 수 없는 데이터를 나타냅니다.
널은 데이터 값이 있는 열 사이에 있는 경우 데이터베이스에 저장됩니다. 이 경우 열의 길이를 저장하려면 1바이트가 필요합니다. 행의 후행 널은 저장 영역이 필요하지 않습니다. 새 행 헤더는 이전 행의 나머지 열이 널임을 알리기 때문입니다. 예를 들어, 테이블의 마지막 세 열이 null인 경우 이러한 열에 대한 데이터는 저장되지 않습니다.
참조: 널 값에 대한 자세한 내용은 Oracle AI Database SQL Language Reference를 참조하십시오.
테이블 압축
데이터베이스는 테이블 압축을 사용하여 테이블에 필요한 스토리지 양을 줄일 수 있습니다.
압축은 디스크 공간을 절약하고 데이터베이스 버퍼 캐시의 메모리 사용을 줄이며 경우에 따라 query 실행 속도를 높입니다. 테이블 압축은 데이터베이스 응용 프로그램에 투명합니다.
-
기본 테이블 압축 및 고급 행 압축 딕셔너리 기반 테이블 압축은 힙 구성 테이블에 적합한 압축 비율을 제공합니다.
-
하이브리드 열 형식 압축 하이브리드 열 형식 압축을 사용하면 데이터베이스는 행 그룹에 대해 동일한 열을 함께 저장합니다. 데이터 블록은 행 주요 형식으로 데이터를 저장하지 않지만 행 및 열 메소드 조합을 사용합니다.
-
Memory Speed Hybrid Columnar Compression Memory Speed Hybrid Columnar Compression에는 메모리 속도로 처리할 수 있는 온디스크 압축 장치 형식이 도입되었습니다.
기본 테이블 압축 및 고급 행 압축
딕셔너리 기반 테이블 압축은 힙 구성 테이블에 적합한 압축률을 제공합니다.
Oracle AI Database는 다음과 같은 유형의 딕셔너리 기반 테이블 압축을 지원합니다.
-
기본 테이블 압축
이 유형의 압축은 대량 로드 작업에 사용됩니다. 데이터베이스는 기본 DML을 사용하여 수정된 데이터를 압축하지 않습니다. 기본 테이블 압축을 수행하려면 직접 경로 INSERT 작업,
ALTER TABLE . . . MOVE작업 또는 온라인 테이블 재정의를 사용해야 합니다. -
고급 행 압축
이러한 유형의 압축은 OLTP 응용 프로그램에 사용되며 SQL 작업으로 조작되는 데이터를 압축합니다. 데이터베이스는 압축률이 경쟁력을 높이는 동시에 응용 프로그램이 압축되지 않은 테이블에서 DML과 대략 동일한 시간에 DML을 수행할 수 있도록 합니다.
이전 압축 유형의 경우 데이터베이스는 압축된 행을 행 주 형식으로 저장합니다. 한 행의 모든 열이 함께 저장되고 그 뒤에 다음 행의 모든 열이 저장됩니다. 데이터베이스는 중복된 값을 블록 시작 부분에 저장된 기호 테이블에 대한 짧은 참조로 바꿉니다. 따라서 압축되지 않은 데이터를 재생성하는 데 필요한 정보는 데이터 블록 자체에 저장됩니다.
압축된 데이터 블록은 일반 데이터 블록과 비슷합니다. 일반 데이터 블록에서 작동하는 대부분의 데이터베이스 기능 및 함수는 압축된 블록에서도 작동합니다.
테이블스페이스, 테이블, 분할 영역 또는 서브 분할 영역 레벨에서 압축을 선언할 수 있습니다. 테이블스페이스 레벨에서 지정된 경우 기본적으로 테이블스페이스에 생성된 모든 테이블은 압축됩니다.
예제 4-4 테이블 레벨 압축
다음 명령문은 orders 테이블에 고급 행 압축을 적용합니다.
ALTER TABLE oe.orders ROW STORE COMPRESS ADVANCED;예제 4-5 분할 영역 레벨 압축
다음 부분 CREATE TABLE 문의 예제는 한 분할 영역에 대한 고급 행 압축과 다른 분할 영역에 대한 기본 테이블 압축을 지정합니다.
CREATE TABLE sales (
    prod_id     NUMBER     NOT NULL,
    cust_id     NUMBER     NOT NULL, ... )
 PCTFREE 5 NOLOGGING NOCOMPRESS
 PARTITION BY RANGE (time_id)
 ( partition sales_2013 VALUES LESS THAN(TO_DATE(...)) ROW STORE COMPRESS BASIC,
   partition sales_2014 VALUES LESS THAN (MAXVALUE) ROW STORE COMPRESS ADVANCED );
참조:
-
"행 형식" - 행에 값이 저장되는 방법을 알아봅니다.
-
압축된 데이터 블록의 형식에 대해 알아보려면 "데이터 블록 압축"을 누르십시오.
-
Oracle AI Database Utilities - 직접 경로 로드에 SQL*Loader를 사용하는 방법에 대해 알아보기
-
테이블 압축에 대한 자세한 내용은 Oracle AI Database Administrator's Guide 및 Oracle AI Database Performance Tuning Guide를 참조하십시오.
하이브리드 컬럼 형식 압축
Hybrid Columnar Compression을 사용하면 데이터베이스는 행 그룹에 대해 동일한 열을 함께 저장합니다. 데이터 블록은 행 주요 형식으로 데이터를 저장하지 않지만 행 및 열 메소드의 조합을 사용합니다.
동일한 데이터 유형 및 유사한 특성을 사용하여 열 데이터를 함께 저장하면 압축으로 인한 저장 영역 절약 효과가 크게 향상됩니다. 데이터베이스는 직접 경로 로드의 경우 압축 레벨이 더 높지만 SQL 작업으로 조작되는 데이터를 압축합니다. 데이터베이스 작업은 압축된 객체에 대해 투명하게 작동하므로 응용 프로그램을 변경할 필요가 없습니다.
주: 하이브리드 열 압축 및 IM 열 저장소(In-Memory Column Store)는 밀접한 관련이 있습니다. 주요 차이점은 Hybrid Column Compression이 디스크 저장 영역을 최적화하는 반면 IM 열 저장소는 메모리 저장 영역을 최적화한다는 것입니다.
-
하이브리드 열 압축 유형 기본 스토리지가 하이브리드 열 압축을 지원하는 경우 요구사항에 따라 다른 유형의 압축을 지정할 수 있습니다.
-
압축 단위 하이브리드 열 압축은 압축 단위라는 논리적 구성을 사용하여 행 집합을 저장합니다.
-
DML 및 Hybrid Columnar Compression Hybrid Columnar Compression은 다양한 유형의 DML 작업에서의 행 잠금과 관련이 있습니다. 참조: IM 열 저장소에 대한 자세한 내용은 "인메모리 영역"을 참조하십시오.
하이브리드 열 압축 유형
기본 스토리지가 Hybrid Columnar Compression을 지원하는 경우 요구사항에 따라 다른 유형의 압축을 지정할 수 있습니다.
압축 옵션은 다음과 같습니다.
-
창고 압축
이러한 유형의 압축은 저장 공간 절약에 최적화되어 있으며 데이터 웨어하우스 응용 프로그램에 적합합니다.
-
압축 아카이브
이 압축 유형은 최대 압축 레벨에 맞게 최적화되며 변경되지 않는 기록 데이터 및 데이터에 사용됩니다.
Hybrid Columnar Compression은 Oracle Exadata 스토리지의 데이터 웨어하우징 및 의사 결정 지원 애플리케이션에 최적화되어 있습니다. Oracle Exadata는 Oracle Exadata 스토리지 서버에 통합된 처리 성능, 메모리 및 Infiniband 네트워크 대역폭을 활용하여 Hybrid Columnar Compression을 통해 압축된 테이블의 쿼리 성능을 극대화합니다.
다른 Oracle 스토리지 시스템은 Hybrid Columnar Compression을 지원하며 Oracle Exadata 스토리지와 동일한 공간 절약을 제공하지만 동일한 수준의 쿼리 성능을 제공하지는 않습니다. 이러한 스토리지 시스템의 경우 Hybrid Columnar Compression은 자주 액세스하지 않는 이전 데이터의 데이터베이스 내 아카이빙에 이상적입니다.
압축 단위
Hybrid Columnar Compression은 압축 단위라는 논리적 구성을 사용하여 행 집합을 저장합니다.
데이터를 테이블로 로드하면 데이터베이스는 행 그룹을 열 형식으로 저장하며 각 열의 값은 함께 저장되고 압축됩니다. 데이터베이스가 행 집합에 대한 열 데이터를 압축한 후에는 해당 데이터가 압축 단위에 맞춰집니다.
예를 들어, daily_sales 테이블에 Hybrid Columnar Compression을 적용합니다. 매일 마지막에 품목 및 판매된 번호로 테이블을 채우고 품목 ID 및 복합 기본 키를 형성하는 일자를 사용합니다. 다음 표에서는 daily_sales에 있는 행의 하위 세트를 보여줍니다.
표 3 샘플 표 daily_sales
| Item_ID | 일자 | Num_Sold | Shipped_From | 재보충 |
|---|---|---|---|---|
| 1000 | 01-JUN-18 | 2 | WAREHOUSE1 | Y |
| 1001 | 01-JUN-18 | 0 | WAREHOUSE3 | N |
| 1002 | 01-JUN-18 | 1 | WAREHOUSE3 | N |
| 1003 | 01-JUN-14 | 0 | WAREHOUSE2 | N |
| 1004 | 01-JUN-18 | 2 | WAREHOUSE1 | N |
| 1005 | 01-JUN-18 | 1 | WAREHOUSE2 | N |
이 행 부분 집합은 하나의 압축 단위로 저장되어 있다고 가정합니다. Hybrid Columnar Compression은 각 열의 값을 함께 저장한 다음 여러 알고리즘을 사용하여 각 열을 압축합니다. 데이터베이스는 열의 데이터 유형, 열의 실제 값 기수 및 사용자가 선택한 압축 레벨을 포함하여 다양한 요소를 기반으로 알고리즘을 선택합니다.
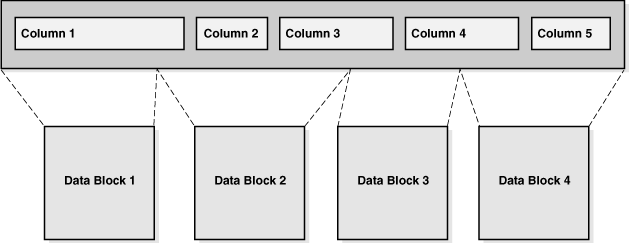
다음 그림과 같이 각 압축 단위는 여러 데이터 블록에 걸쳐 있을 수 있습니다. 특정 열의 값은 여러 블록에 걸쳐 있을 수도 있고 포함되지 않을 수도 있습니다.
그림 7: 압축 장치
Hybrid Columnar Compression으로 공간 절약이 발생하지 않는 경우 데이터베이스는 데이터를 DBMS_COMPRESSION.COMP_BLOCK 형식으로 저장합니다. 이 경우 데이터베이스는 Hybrid Columnar Compression 세그먼트에 상주하는 블록에 OLTP 압축을 적용합니다.
참조:
-
"행 잠금(TX)"
-
Oracle AI Database Licensing Information User Manual - Hybrid Columnar Compression의 라이센스 요구 사항 살펴보기
-
Oracle AI Database Administrator's Guide에서 Hybrid Columnar Compression 사용 방법 학습
-
CREATE TABLE구문 및 의미에 대한 Oracle AI Database SQL Language Reference -
DBMS_COMPRESSION패키지에 대해 알아보려면 Oracle AI Database PL/SQL 패키지 및 유형 참조를 참조하십시오.
DML 및 하이브리드 열 압축
Hybrid Columnar Compression은 다양한 유형의 DML 작업에서 행 잠금과 관련이 있습니다.
직접 경로 로드 및 기본 삽입
Hybrid Columnar Compression을 사용하는 테이블로 데이터를 로드할 때 기본 삽입 또는 직접 경로 로드를 사용할 수 있습니다. 직접 경로 로드는 전체 테이블을 잠그므로 동시성이 줄어듭니다.
Oracle Database 12c 릴리스 2(12.2)부터는 Hybrid Columnar Compression 형식에 기존의 배열 삽입에 대한 지원이 추가되었습니다. 기본 배열 삽입의 이점은 다음과 같습니다.
-
삽입된 행은 행 레벨 Lock을 사용하므로 동시성이 증가합니다.
-
ADO(자동 데이터 최적화) 및 히트맵은 행 레벨 정책에 대해 Hybrid Columnar Compression을 지원합니다. 따라서 데이터베이스는 세그먼트의 다른 부분에서 DML 작업이 발생하더라도 적격한 블록에 대해 Hybrid Columnar Compression을 사용할 수 있습니다.
응용 프로그램에서 기본 배열 삽입을 사용하는 경우 다음 조건이 충족되면 Oracle AI Database는 행을 압축 단위로 저장합니다.
-
테이블은 ASSM 테이블스페이스에 저장됩니다.
-
호환성 레벨은 12.2.0.1 이상입니다.
-
테이블 정의는
LONG유형의 열이 없고 행 종속성이 없는 기존 Hybrid Columnar Compression 테이블 제약 조건을 충족합니다.
기본 삽입은 리두 및 언두를 생성합니다. 따라서 기본 DML 문에 의해 생성된 압축 단위는 DML과 함께 롤백되거나 커밋됩니다. 데이터베이스는 일반 데이터 블록에 저장된 행과 마찬가지로 인덱스 유지 관리를 자동으로 수행합니다.
Oracle AI Database 26ai부터 Automatic Storage Compression을 통해 Oracle AI Database는 처음에 데이터를 압축되지 않은 형식으로 직접 로드한 다음 점차적으로 행을 백그라운드에서 Hybrid Columnar Compression 형식으로 이동할 수 있습니다. 이는 ETL 성능을 개선하고 빠른 질의 성능을 유지하면서 사용자에게 투명합니다.
업데이트 및 삭제
갱신 또는 삭제가 단위의 임의의 행에 적용될 경우 기본적으로 데이터베이스는 압축 단위의 모든 행을 잠급니다. 이 문제를 방지하려면 테이블에 대해 행 레벨 잠금을 활성화하도록 선택할 수 있습니다. 이 경우 데이터베이스는 갱신 또는 삭제 작업의 영향을 받는 행만 잠급니다.
참조:
-
Oracle AI Database Administrator's Guide에서 일반 삽입을 수행하는 방법을 알아봅니다.
-
INSERT문에 대한 자세한 내용은 Oracle AI Database SQL Language Reference를 참조하십시오. -
COMPRESS_IMMEDIATE힌트 사용에 대한 자세한 내용은 Oracle AI Database SQL Language Reference를 참조하십시오. -
자동 저장 영역 압축 사용에 대한 자세한 내용은 Oracle AI Database VLDB and Partitioning Guide를 참조하십시오.
메모리 속도 하이브리드 컬럼 형식 압축
Memory Speed Hybrid Columnar Compression은 메모리 속도로 처리할 수 있는 온디스크 압축 장치 형식을 도입했습니다.
Hybrid Columnar Compression과 마찬가지로 Memory Speed Hybrid Columnar Compression은 데이터 웨어하우징 환경에 적합합니다. 이 메소드는 데이터를 열 지향 형식으로 변환하고 데이터 로드 중에 압축합니다. 주요 차이점은 Memory Speed Hybrid Columnar Compression이 인메모리 열 저장소 및 Exadata 플래시 캐시의 CELLMEMORY와 동일한 특수 열 형식을 사용하므로 모든 스토리지 계층에서 고속 열 스캔 및 효율적인 열 캐싱을 달성한다는 것입니다. 또한 Memory Speed Hybrid Columnar Compression 단위는 하이브리드 컬럼 형식 압축 단위보다 훨씬 크기 때문에 디스크에서 인메모리 컬럼 형식이 효과적으로 사용될 수 있습니다.
MEMSPEED 키워드를 추가하여 CREATE TABLE 명령을 사용하여 Hybrid Columnar Compression의 확장으로 Memory Speed Hybrid Columnar Compression이 사용으로 설정됩니다.
예 4-6 메모리 속도 하이브리드 열 압축
다음 예에서는 메모리 속도 하이브리드 열 압축이 사용으로 설정된 orders 테이블을 만듭니다.
CREATE TABLE orders COLUMN STORE COMPRESS FOR MEMSPEED QUERY;주: 자세한 내용은 Oracle AI Database SQL Language Reference를 참조하십시오.
테이블 클러스터 개요
테이블 클러스터는 공통 열을 공유하고 관련 데이터를 동일한 블록에 저장하는 테이블 그룹입니다.
테이블이 클러스터화되면 단일 데이터 블록에 여러 테이블의 행이 포함될 수 있습니다. 예를 들어, 블록은 단일 테이블이 아닌 employees 및 departments 테이블의 행을 모두 저장할 수 있습니다.
클러스터 키는 클러스터화된 테이블이 공통적으로 가지는 열입니다. 예를 들어, employees 및 departments 테이블은 department_id 열을 공유합니다. 테이블 클러스터를 생성할 때와 테이블 클러스터에 추가된 모든 테이블을 생성할 때 클러스터 키를 지정합니다.
클러스터 키 값은 특정 행 집합에 대한 클러스터 키 열의 값입니다. 동일한 클러스터 키 값을 포함하는 모든 데이터(예: department_id=20)는 물리적으로 함께 저장됩니다. 각 클러스터 키 값은 값을 포함하는 여러 테이블의 행 수에 관계없이 클러스터 및 클러스터 인덱스에 한 번만 저장됩니다.
예를 들어, HR 관리자에게 두 가지 장부 사례가 있다고 가정합니다. 하나는 사원 폴더 상자가 있고 다른 하나는 부서 폴더 상자가 있습니다. 유저는 종종 특정 부서의 모든 사원에 대해 폴더를 요청합니다. 검색을 쉽게 하기 위해 관리자는 모든 상자를 단일 장부 케이스로 재배열합니다. 그녀는 상자를 부서 ID별로 나눕니다. 따라서 부서 20의 사원과 부서 20의 폴더 자체에 대한 모든 폴더는 하나의 상자에 있고, 부서 100의 사원과 부서 100의 폴더는 다른 상자에 있습니다.
테이블이 주로 질의(수정되지 않음)되고 테이블의 레코드가 자주 함께 질의 또는 조인되는 경우 클러스터화를 고려하십시오. 테이블 클러스터는 서로 다른 테이블의 관련 행을 동일한 데이터 블록에 저장하기 때문에 제대로 사용된 테이블 클러스터는 클러스터화되지 않은 테이블에 대해 다음과 같은 이점을 제공합니다.
-
클러스터화된 테이블의 조인에 대한 디스크 I/O가 줄어듭니다.
-
클러스터화된 테이블의 조인에 대한 액세스 시간이 향상됩니다.
-
클러스터 키 값이 각 행에 대해 반복적으로 저장되지 않으므로 관련 테이블 및 인덱스 데이터를 저장하는 데 필요한 저장 영역이 적습니다.
일반적으로 다음과 같은 경우에는 테이블 클러스터화가 적합하지 않습니다.
-
테이블은 자주 갱신됩니다.
-
테이블에는 전체 테이블 스캔이 자주 필요합니다.
-
테이블을 잘라야 합니다.
-
인덱스화된 클러스터 개요 인덱스 클러스터는 인덱스를 사용하여 데이터를 찾는 테이블 클러스터입니다. 클러스터 인덱스는 클러스터 키의 B 트리 인덱스입니다. 클러스터화된 테이블에 행을 삽입하려면 먼저 클러스터 인덱스를 생성해야 합니다.
-
해시 클러스터 개요 해시 클러스터는 인덱스 키가 해시 함수로 대체된다는 점을 제외하고 인덱스화된 클러스터와 같습니다. 별도의 클러스터 인덱스가 존재하지 않습니다. 해시 클러스터에서 데이터는 인덱스입니다.
인덱스화된 클러스터 개요
인덱스 클러스터는 인덱스를 사용하여 데이터를 찾는 테이블 클러스터입니다. 클러스터 인덱스는 클러스터 키의 B 트리 인덱스입니다. 클러스터화된 테이블에 행을 삽입하려면 먼저 클러스터 인덱스를 생성해야 합니다.
예 4-7 테이블 클러스터 및 연관된 인덱스 생성
다음 예와 같이 클러스터 키가 department_id인 employees_departments_cluster 클러스터를 만든다고 가정합니다.
CREATE CLUSTER employees_departments_cluster
   (department_id NUMBER(4))
SIZE 512;

CREATE INDEX idx_emp_dept_cluster
   ON CLUSTER employees_departments_cluster;
HASHKEYS 절이 지정되지 않았기 때문에 employees_departments_cluster는 인덱스화된 클러스터입니다. 앞의 예제에서는 클러스터 키 department_id에 idx_emp_dept_cluster라는 인덱스를 생성합니다.
예제 4-8 인덱스화된 클러스터에서 테이블 생성
다음과 같이 department_id 열을 클러스터 키로 지정하여 클러스터에 employees 및 departments 테이블을 생성합니다. 줄임표는 열 지정이 진행되는 위치를 표시합니다.
CREATE TABLE employees ( ... )
   CLUSTER employees_departments_cluster (department_id);

CREATE TABLE departments ( ... )
   CLUSTER employees_departments_cluster (department_id);
employees 및 departments 테이블에 행을 추가한다고 가정합니다. 데이터베이스는 employees 및 departments 테이블의 각 부서에 대한 모든 행을 동일한 데이터 블록에 물리적으로 저장합니다. 데이터베이스는 행을 힙에 저장하고 인덱스로 찾습니다. 그림 4-8은 employees 및 departments를 포함하는 employees_departments_cluster 테이블 클러스터를 보여줍니다. 데이터베이스는 부서 20의 사원 행과 부서 110의 행을 함께 저장합니다. 테이블이 클러스터화되지 않은 경우 데이터베이스는 관련 행이 함께 저장되도록 보장하지 않습니다.
그림 8: 클러스터화된 테이블 데이터
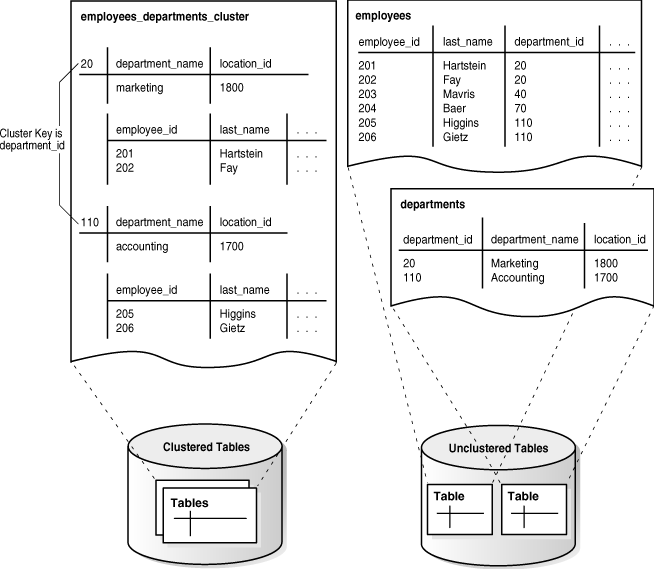
B 트리 클러스터 인덱스는 클러스터 키 값을 데이터를 포함하는 블록의 DBA(데이터베이스 블록 주소)와 연관시킵니다. 예를 들어, 키 20의 인덱스 항목은 부서 20의 사원에 대한 데이터를 포함하는 블록의 주소를 보여줍니다.
20,AADAAAA9d클러스터 인덱스는 클러스터화되지 않은 테이블의 인덱스처럼 별도로 관리되며 테이블 클러스터와는 다른 테이블스페이스에 존재할 수 있습니다.
참조:
-
"인덱스 소개"
-
인덱스화된 클러스터를 생성 및 관리하는 방법을 알아보려면 Oracle AI Database Administrator's Guide를 참조하십시오.
-
CREATE CLUSTER구문 및 의미에 대한 Oracle AI Database SQL Language Reference
해시 클러스터 개요
해시 클러스터는 인덱스 키가 해시 함수로 대체된다는 점을 제외하면 인덱스화된 클러스터와 같습니다. 별도의 클러스터 인덱스가 존재하지 않습니다. 해시 클러스터에서 데이터는 인덱스입니다.
인덱스화된 테이블 또는 인덱스화된 클러스터를 사용하는 Oracle AI Database는 별도의 인덱스에 저장된 키 값을 사용하여 테이블 행을 찾습니다. 인덱스화된 테이블이나 테이블 클러스터에서 행을 찾거나 저장하려면 데이터베이스에서 두 개 이상의 I/O를 수행해야 합니다.
-
인덱스에서 키 값을 찾거나 저장하기 위한 하나 이상의 I/O
-
테이블 또는 테이블 클러스터에서 행을 읽거나 쓰는 또 다른 I/O
해시 클러스터에서 행을 찾거나 저장하기 위해 Oracle AI Database는 행의 클러스터 키 값에 해시 함수를 적용합니다. 결과 해시 값은 실행된 명령문을 대신하여 데이터베이스가 읽거나 쓰는 클러스터의 데이터 블록에 해당합니다.
해싱은 데이터 검색 성능을 향상시키기 위해 테이블 데이터를 저장하는 선택적 방법입니다. 다음 조건이 충족되면 해시 클러스터가 유용할 수 있습니다.
-
테이블은 수정되는 것보다 자주 query됩니다.
-
해시 키 열은 동등 조건(예:
WHERE department_id=20)을 사용하여 자주 질의됩니다. 이러한 질의의 경우 클러스터 키 값이 해시됩니다. 해시 키 값은 행을 저장하는 디스크 영역을 직접 가리킵니다. -
각 키 값으로 저장된 데이터의 크기와 해시 키의 수를 합리적으로 추측할 수 있습니다.
-
해시 클러스터 만들기 해시 클러스터를 만들려면 해시 키를 추가하여 인덱스화된 클러스터와 동일한
CREATE CLUSTER문을 사용합니다. 클러스터의 해시 값 수는 해시 키에 따라 다릅니다. -
해시 클러스터 질의 해시 클러스터 질의에서 데이터베이스는 사용자가 입력한 키 값을 해시하는 방법을 결정합니다.
-
해시 클러스터 변형 단일 테이블 해시 클러스터는 한 번에 하나의 테이블만 지원하는 해시 클러스터의 최적화된 버전입니다. 해시 키와 행 사이에 일대일 매핑이 있습니다.
-
해시 클러스터 스토리지 Oracle AI Database는 해시 클러스터에 대한 공간을 인덱스화된 클러스터와 다르게 할당합니다.
해시 클러스터 생성
해시 클러스터를 생성하려면 인덱스화된 클러스터와 동일한 CREATE CLUSTER 문을 해시 키를 추가하여 사용합니다. 클러스터의 해시 값 수는 해시 키에 따라 다릅니다.
인덱스화된 클러스터의 키와 마찬가지로 클러스터 키는 클러스터의 테이블에서 공유하는 단일 열 또는 조합 키입니다. 해시 키 값은 클러스터 키 열에 삽입된 실제 값 또는 가능한 값입니다. 예를 들어, 클러스터 키가 department_id인 경우 해시 키 값은 10, 20, 30 등이 될 수 있습니다.
Oracle AI Database는 무한히 많은 해시 키 값을 입력으로 받아들이고 한정된 수의 버킷으로 정렬하는 해시 함수를 사용합니다. 각 버킷에는 해시 값이라는 고유한 숫자 ID가 있습니다. 각 해시 값은 해시 키 값(부서 10, 20, 30 등)에 해당하는 행을 저장하는 블록의 데이터베이스 블록 주소에 매핑됩니다.
다음 예에서 존재할 수 있는 부서 수는 100이므로 HASHKEYS는 100로 설정됩니다.
CREATE CLUSTER employees_departments_cluster
   (department_id NUMBER(4))
SIZE 8192 HASHKEYS 100;employees_departments_cluster를 생성한 후 클러스터에 employees 및 departments 테이블을 생성할 수 있습니다. 그런 다음 인덱스화된 클러스터에서와 마찬가지로 해시 클러스터로 데이터를 로드할 수 있습니다.
참조:
-
Oracle AI Database Administrator's Guide - 해시 클러스터 생성 및 관리 방법 학습
해시 클러스터 질의
해시 클러스터의 query에서 데이터베이스는 유저가 입력한 키 값을 해시하는 방법을 결정합니다.
예를 들어, 사용자는 p_id에 대해 다른 부서 ID 번호를 입력하여 다음과 같은 질의를 자주 실행합니다.
SELECT *
FROM   employees
WHERE  department_id = :p_id;

SELECT *
FROM   departments
WHERE  department_id = :p_id;

SELECT *
FROM   employees e, departments d
WHERE  e.department_id = d.department_id
AND    d.department_id = :p_id;
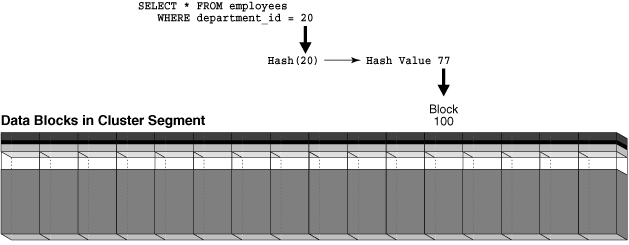
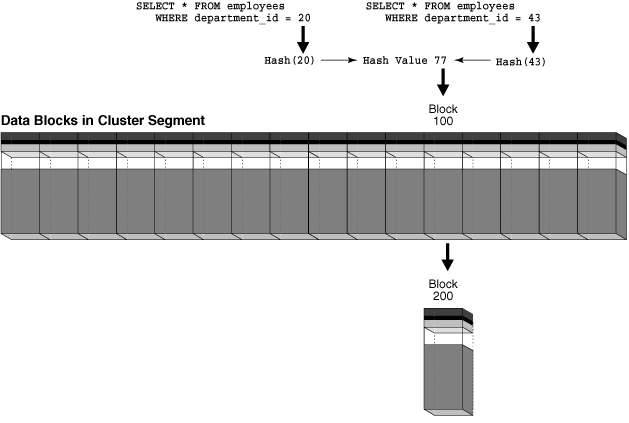
사용자가 department_id=20에서 직원을 질의하는 경우 데이터베이스는 이 값을 버킷 77로 해시할 수 있습니다. 사용자가 department_id=10에서 직원을 질의하는 경우 데이터베이스가 이 값을 버킷 15로 해시할 수 있습니다. 데이터베이스는 내부에서 생성된 해시 값을 사용하여 요청된 부서의 사원 행을 포함하는 블록을 찾습니다.
다음 그림은 해시 클러스터 세그먼트를 블록의 가로 행으로 나타냅니다. 그림에 나오는 것처럼 query는 단일 I/O로 데이터를 검색할 수 있습니다.
그림 9: 해시 클러스터에서 데이터 검색
해시 클러스터의 제한은 인덱스화되지 않은 클러스터 키에 대한 범위 스캔을 사용할 수 없다는 것입니다. 해시 클러스터 생성에서 생성된 해시 클러스터에 대해 별도의 인덱스가 없다고 가정합니다. ID가 20에서 100 사이인 부서에 대한 질의는 20에서 100 사이의 가능한 모든 값을 해시할 수 없으므로 해싱 알고리즘을 사용할 수 없습니다. 인덱스가 없으므로 데이터베이스는 전체 스캔을 수행해야 합니다.
참조: "인덱스 범위 스캔"
해시 클러스터 변형
단일 테이블 해시 클러스터는 한 번에 하나의 테이블만 지원하는 해시 클러스터의 최적화된 버전입니다. 해시 키와 행 사이에 일대일 매핑이 있습니다.
단일 테이블 해시 클러스터는 유저가 Primary Key로 테이블에 신속하게 액세스해야 하는 경우에 유용합니다. 예를 들어, 사용자는 employees 테이블에서 employee_id로 사원 레코드를 조회하는 경우가 많습니다.
정렬된 해시 클러스터는 해시 함수의 각 값에 해당하는 행을 데이터베이스는 정렬된 순서로 효율적으로 반환할 수 있도록 저장합니다. 데이터베이스가 내부적으로 최적화된 정렬을 수행합니다. 항상 정렬된 순서로 데이터를 사용하는 응용 프로그램의 경우 이 기법은 데이터를 더 빠르게 검색할 수 있습니다. 예를 들어, 응용 프로그램은 항상 orders 테이블의 order_date 열을 기준으로 정렬할 수 있습니다.
참조: Oracle AI Database Administrator's Guide에서 단일 테이블 및 정렬된 해시 클러스터를 생성하는 방법을 알아봅니다.
해시 클러스터 저장 영역
Oracle AI Database는 해시 클러스터에 대한 공간을 인덱스화된 클러스터와 다르게 할당합니다.
해시 클러스터 생성의 예에서 HASHKEYS은 존재할 수 있는 부서 수를 지정하고, SIZE은 각 부서와 연관된 데이터의 크기를 지정합니다. 데이터베이스는 다음 공식을 기반으로 저장 영역 공간 값을 계산합니다.
HASHKEYS * SIZE / database_block_size따라서 Hash Cluster Creation에 표시된 예제에서 블록 크기가 4096바이트인 경우 데이터베이스는 해시 클러스터에 최소 200개의 블록을 할당합니다.
Oracle AI Database는 클러스터에 삽입할 수 있는 해시 키 값의 수를 제한하지 않습니다. 예를 들어, HASHKEYS가 100인 경우에도 departments 테이블에 200개의 고유한 부서를 삽입할 수 있는 것은 없습니다. 그러나 해시 값 수가 해시 키 수를 초과하면 해시 클러스터 검색의 효율성이 떨어집니다.
검색 문제를 설명하기 위해 그림 4-9의 블록 100이 부서 20에 대한 행으로 완전히 가득 찼다고 가정합니다. 유저가 department_id 43을 사용하여 departments 테이블에 새 부서를 삽입합니다. 부서 수가 HASHKEYS 값을 초과하므로 데이터베이스는 department_id 43을 해시 값 77로 해시합니다. 해시 값은 department_id 20에 사용된 해시 값과 동일합니다. 여러 입력 값을 동일한 출력 값으로 해시하는 것을 해시 충돌이라고 합니다.
유저가 부서 43의 클러스터에 행을 삽입하면 데이터베이스는 이러한 행을 전체 블록 100에 저장할 수 없습니다. 데이터베이스는 블록 100을 새로운 오버플로우 블록(예: 블록 200)에 연결하고 삽입된 행을 새 블록에 저장합니다. 블록(100)과 200(200) 모두 이제 두 부서에 대한 데이터를 저장할 수 있다. 그림 4-10과 같이 부서 20 또는 43의 질의는 이제 데이터를 검색하기 위해 두개의 I/O(블록 100 및 연관된 블록 200)가 필요합니다. 다른 HASHKEYS 값으로 클러스터를 재생성하여 이 문제를 해결할 수 있습니다.
그림 10: 해시 충돌이 발생할 때 해시 클러스터에서 데이터 검색
참조: Oracle AI Database Administrator's Guide에서 해시 클러스터의 공간을 관리하는 방법을 알아봅니다.
속성 클러스터화된 테이블 개요
속성 클러스터화 테이블은 사용자 지정 클러스터화 지시어를 기반으로 디스크에 가까운 근접도로 데이터를 저장하는 힙 구성 테이블입니다. 이 지시어는 열을 단일 테이블이나 다중 테이블에 지정합니다.
지시어는 다음과 같습니다.
-
CLUSTERING ... BY LINEAR ORDER지시어는 지정된 열에 따라 테이블의 데이터를 정렬합니다.질의가 클러스터링 절에 지정된 열의 접두어를 한정하는 경우 기본값인
BY LINEAR ORDER클러스터링을 사용하는 것이 좋습니다. 예를 들어,sh.sales질의에서 고객 ID 또는 고객 ID와 제품 ID를 모두 지정하는 경우 선형 열 순서cust_id,prod_id를 사용하여 테이블의 데이터를 클러스터화할 수 있습니다. -
CLUSTERING ... BY INTERLEAVED ORDER지시어는 다중 열 I/O 감소를 허용하는 Z 순서 함수와 유사한 특수 알고리즘을 사용하여 하나 이상의 테이블에서 데이터를 정렬합니다.질의가 다양한 열 조합을 지정하는 경우
BY INTERLEAVED ORDER클러스터화를 사용하는 것이 좋습니다. 예를 들어,sh.sales의 질의가 서로 다른 순서로 다른 차원을 지정하는 경우 이러한 차원의 열에 따라sales테이블의 데이터를 클러스터화할 수 있습니다.
속성 클러스터화는 직접 경로 INSERT 작업에만 사용할 수 있습니다. 일반 DML의 경우 무시됩니다.
이 단원에서는 다음 항목을 다룹니다.
-
속성 클러스터화된 테이블의 장점 속성 클러스터화된 테이블의 주요 이점은 I/O 감소로, 테이블 스캔의 I/O 비용과 CPU 비용을 크게 줄일 수 있습니다. I/O 감소는 영역에서 발생하거나 클러스터화된 값에 대해 디스크에서 더 가까운 물리적 근접성을 통해 물리적 I/O를 줄임으로써 발생합니다.
-
조인 속성 클러스터화된 테이블 조인된 열을 기반으로 하는 속성 클러스터링을 조인 속성 클러스터링이라고 합니다. 테이블 클러스터와 달리, 조인 속성 클러스터화된 테이블은 테이블 그룹의 데이터를 동일한 데이터베이스 블록에 저장하지 않습니다.
-
영역을 사용한 I/O 감소 영역은 관련 열의 최소값과 최대값을 저장하는 연속 데이터 블록 세트입니다.
-
선형 정렬이 있는 속성 클러스터 테이블 테이블에 대한 선형 순서 지정 체계는 특정 순서의 사용자 지정 속성을 기반으로 행을 범위로 나눕니다. Oracle AI Database는 기본-외래 키 관계를 통해 연결된 단일 또는 다중 테이블에 대한 선형 주문을 지원합니다.
-
Interleaved Ordering을 사용한 속성 클러스터화된 테이블 순서 지정은 Z-order와 유사한 기법을 사용합니다.
속성 클러스터화된 테이블의 이점
속성 클러스터화된 테이블의 주요 이점은 I/O 감소로, 테이블 스캔 시 I/O 비용과 CPU 비용을 크게 줄일 수 있다는 것입니다. I/O 감소는 영역에서 발생하거나 클러스터화된 값에 대해 디스크에서 더 가까운 물리적 근접성을 통해 물리적 I/O를 줄임으로써 발생합니다.
속성 클러스터화된 테이블에는 다음과 같은 이점이 있습니다.
-
스타 스키마의 차원 열을 기반으로 사실값(fact) 테이블을 클러스터화할 수 있습니다.
스타 스키마에서는 대부분의 query가 사실값(fact) 테이블이 아닌 차원 테이블을 한정하므로 사실값(fact) 테이블 열별 클러스터화는 효과적이지 않습니다. Oracle AI Database는 차원 테이블의 열에 대한 클러스터링을 지원합니다.
-
I/O 감소는 다음과 같은 여러 시나리오에서 발생할 수 있습니다.
-
Oracle Exadata 스토리지 인덱스, Oracle In-Memory 최소/최대 제거 또는 영역 맵과 함께 사용할 경우
-
접두어를 한정하고 속성 클러스터화를 선형 순서로 사용하는 query용 OLTP 응용 프로그램
-
BY INTERLEAVED ORDER클러스터링에 대한 클러스터링 열의 하위 집합
-
-
속성 클러스터화는 데이터 압축을 향상시킬 수 있으며 이러한 방식으로 간접적으로 테이블 스캔 비용을 향상시킬 수 있습니다.
디스크에서 동일한 값이 서로 가까워지면 데이터베이스가 해당 값을 더 쉽게 압축할 수 있습니다.
-
Oracle AI Database는 인덱스의 스토리지 및 유지 관리 비용을 초래하지 않습니다.
참조: Oracle AI Database Data Warehousing Guide(속성 클러스터 테이블의 추가 이점)
조인 속성 클러스터화된 테이블
조인된 열을 기반으로 하는 속성 클러스터링을 조인 속성 클러스터링이라고 합니다. 테이블 클러스터와 달리, 조인 속성 클러스터화된 테이블은 테이블 그룹의 데이터를 동일한 데이터베이스 블록에 저장하지 않습니다.
예를 들어, 차원 테이블 products와 조인된 속성 클러스터 테이블 sales을 고려해 보십시오. sales 테이블은 sales 테이블의 행만 포함하지만 행 순서는 products 테이블에서 조인된 열의 값을 기반으로 합니다. 적합한 조인은 데이터 이동, 직접 경로 삽입 및 CREATE TABLE AS SELECT 작업 중에 실행됩니다. 반대로, sales 및 products가 표준 테이블 클러스터에 있는 경우 데이터 블록은 두 테이블의 행을 포함합니다.
참조: 조인 속성 클러스터링에 대한 자세한 내용은 Oracle AI Database Data Warehousing Guide를 참조하십시오.
영역을 사용한 I/O 감소
영역은 관련 열의 최소값과 최대값을 저장하는 연속 데이터 블록 세트입니다.
SQL 문에 영역에 저장된 열에 대한 술어가 포함된 경우 데이터베이스는 술어 값을 영역에 저장된 최소값 및 최대값과 비교합니다. 이러한 방식으로 데이터베이스는 SQL 실행 중 읽을 영역을 결정합니다.
I/O 감소는 데이터베이스에서 질의를 만족시키는 데 필요한 데이터를 포함하지 않는 테이블이나 인덱스 블록을 건너뛰는 기능입니다. 이렇게 줄이면 테이블 스캔의 I/O 및 CPU 비용이 크게 절감될 수 있습니다.
-
영역의 목적 영역을 느슨하게 비둘기 구멍의 책장을 사용하는 영업 관리자의 경우 데이터 블록과 유사합니다.
-
영역 맵 영역 맵은 데이터 블록을 영역으로 나누는 독립적인 액세스 구조입니다. Oracle AI Database는 각 영역 맵을 구체화된 뷰 유형으로 구현합니다.
-
영역 맵 만들기 기본 영역 맵은 수동 또는 자동으로 만들어집니다.
-
영역 맵 작동 방식: 예 이 예에서는 영역 맵이 술어에 상수가 포함된 질의에서 데이터를 정리하는 방법을 보여줍니다.
영역의 목적
영역을 느슨하게 분석하려면 데이터 블록과 유사한 비둘기 구멍 책장을 사용하는 영업 관리자를 고려하십시오.
각 비둘기 구멍에는 고객에게 판매된 셔츠를 설명하는 영수증(행)이 있으며 배송 일자별로 주문됩니다. 이 비유에서 영역 맵은 인덱스 카드 스택과 같습니다. 각 카드는 비둘기 구멍 1-10과 같은 비둘기 구멍의 "영역"(연속 범위)에 해당합니다. 각 구역에 대해 카드에는 구역에 저장된 입고의 최소 및 최대 출하 일자가 나열됩니다.
누군가가 특정 날짜에 배송 된 셔츠를 알고 싶어 할 때, 관리자는 요청 날짜가 포함 된 날짜 범위에 올 때까지 카드를 뒤집고, 비둘기 구멍 영역을 메모 한 다음이 영역의 비둘기 구멍에서만 요청 된 영수증을 검색합니다. 이 방법으로 관리자는 영수증에 대한 책장의 모든 비둘기 구멍을 검색하지 않습니다.
영역 맵
영역 맵은 데이터 블록을 영역으로 나누는 독립적인 액세스 구조입니다. Oracle AI Database는 각 영역 맵을 구체화된 뷰 유형으로 구현합니다.
인덱스처럼 영역 맵도 테이블 스캔의 I/O 및 CPU 비용을 줄일 수 있습니다. SQL 문에 영역 맵의 열에 대한 술어가 포함된 경우 데이터베이스는 술어 값을 각 영역에 저장된 최소 및 최대 테이블 열 값과 비교하여 SQL 실행 중 읽을 영역을 결정합니다.
기본 영역 맵은 단일 테이블에 정의되며 이 테이블의 일부 열에 대한 최소값과 최대값을 유지 관리합니다. 조인 영역 맵은 하나 이상의 다른 테이블에 대한 포괄 조인이 있고 다른 테이블에 있는 일부 열의 최소값 및 최대값을 유지 관리하는 테이블에 정의됩니다. Oracle AI Database는 두 가지 유형의 영역 맵을 자동으로 유지 관리합니다.
테이블에는 최대 하나의 영역 맵이 존재할 수 있습니다. 분할된 테이블의 경우 모든 분할 영역과 서브 분할 영역에 대해 하나의 영역 맵이 존재합니다. 또한 분할된 테이블의 영역 맵은 영역당, 분할 영역당 및 서브 분할 영역당 최소값과 최대값을 추적합니다. 테이블에 차원 테이블과 포괄 조인이 있는 경우 구역 맵 정의에는 차원 열의 최소값 및 최대값이 포함될 수 있습니다. 주: 분할 영역 또는 하위 분할 영역 레벨 영역만 포함하는 영역 맵을 생성할 수 있습니다. 이러한 영역 맵을 만들면 분할 영역 제거 기능이 분할 영역 메타데이터 이상으로 확장됩니다.
참조: 영역 맵에 대한 개요는 Oracle AI Database Data Warehousing Guide
영역 맵 만들기
기본 영역 맵은 수동 또는 자동으로 만들어집니다.
-
수동 영역 맵 DDL 문을 사용하여 영역 맵을 만들고, 삭제하고, 유지 관리할 수 있습니다.
-
자동 영역 맵 Oracle AI Database는 기본 영역 맵을 자동으로 만들 수 있습니다. 이를 자동 영역 맵이라고 합니다.
수동 영역 맵
DDL 문을 사용하여 영역 맵을 생성, 삭제 및 유지 관리할 수 있습니다.
CREATE TABLE 또는 ALTER TABLE 문에 CLUSTERING 절을 지정할 때마다 데이터베이스는 지정된 클러스터링 열에 영역 맵을 자동으로 생성합니다. 영역 맵은 열의 최소값과 최대값을 속성 클러스터 테이블의 연속 데이터 블록과 상관시킵니다. 속성 클러스터화된 테이블은 영역 맵을 사용하여 I/O 감소를 수행합니다.
CREATE MATERIALIZED ZONEMAP 문을 사용하여 영역 맵을 명시적으로 만들 수도 있습니다. 이 경우 속성 클러스터링과 함께 또는 속성 클러스터링 없이 사용할 영역 맵을 만들 수 있습니다. 예를 들어, 거래가 시간별로 정렬되는 주식 거래 테이블과 같이 열 집합에서 행이 자연스럽게 정렬되는 테이블에 영역 맵을 생성할 수 있습니다.
참조:
-
영역 맵 생성 방법에 대해 자세히 알아보려면 Oracle AI Database Data Warehousing Guide를 참조하십시오.
자동 영역 맵
Oracle AI Database는 기본 영역 맵을 자동으로 만들 수 있습니다. 이를 자동 영역 맵이라고 합니다.
Oracle AI Database는 분할된 테이블과 분할되지 않은 테이블에 대한 기본 영역 맵을 자동으로 생성할 수 있습니다. 백그라운드 프로세스는 이러한 방식으로 생성된 영역 맵을 자동으로 유지 관리합니다.
DBMS_AUTO_ZONEMAP 절차를 사용하여 자동 영역 맵을 사용으로 설정합니다.
EXEC DBMS_AUTO_ZONEMAP.CONFIGURE('AUTO_ZONEMAP_MODE','ON')참조:
-
DBMS_AUTO_ZONEMAP패키지를 사용하여 자동 영역 맵 관리에 대해 자세히 알아보려면 Oracle AI Database Data Warehousing Guide를 참조하십시오. -
DBMS_AUTO_ZONEMAP패키지에 대한 자세한 내용은 Oracle AI Database PL/SQL 패키지 및 유형 참조를 참조하십시오. -
다양한 에디션 및 서비스에 지원되는 기능에 대한 자세한 내용은 Oracle AI Database Licensing Information User Manual을 참조하십시오.
영역 맵 작동 방식: 예
이 예제는 영역 맵에서 해당 술어가 상수를 포함하는 질의에서 데이터를 정리하는 방법을 보여줍니다.
다음 lineitem 테이블을 생성한다고 가정합니다.
CREATE TABLE lineitem
  ( orderkey      NUMBER        ,
    shipdate      DATE          ,
    receiptdate   DATE          ,
    destination   VARCHAR2(50)  ,
    quantity      NUMBER        );
lineitem 테이블에는 블록당 2개의 행이 있는 4개의 데이터 블록이 포함됩니다. 표 4-4는 테이블의 8개 행을 보여줍니다.
테이블 4 lineitem 테이블에 대한 데이터 블록
| 블록 | 주문키 | 출하 일자 | 입고 일자 | 대상 | quantity |
|---|---|---|---|---|---|
| 1 | 1 | 1-1-2014 | 1-10-2014 | San_Fran | 100 |
| 1 | 2 | 1-2-2014 | 1-10-2014 | San_Fran | 200 |
| 2 | 3 | 1-3-2014 | 1-9-2014 | San_Fran | 100 |
| 2 | 4 | 1-5-2014 | 1-10-2014 | San_Diego | 100 |
| 3 | 5 | 1-10-2014 | 1-15-2014 | San_Fran | 100 |
| 3 | 6 | 1-12-2014 | 1-16-2014 | San_Fran | 200 |
| 4 | 7 | 1-13-2014 | 1-20-2014 | San_Fran | 100 |
| 4 | 8 | 1-15-2014 | 1-30-2014 | San_Jose | 100 |
CREATE MATERIALIZED ZONEMAP 문을 사용하여 lineitem 테이블에 영역 맵을 만들 수 있습니다. 각 영역은 2개의 블록을 포함하며 orderkey, shipdate 및 receiptdate 열의 최소값과 최대값을 저장합니다. 표 4-5는 영역 맵을 보여줍니다.
표 5 lineitem 테이블에 대한 영역 맵
| 블록 범위 | 최소 주문 키 | 최대 주문 키 | 최소 출하 일자 | 최대 출하 일자 | 최소 입고 일자 | 최대 입고 일자 |
|---|---|---|---|---|---|---|
| 1-2 | 1 | 4 | 1-1-2014 | 1-5-2014 | 1-9-2014 | 1-10-2014 |
| 3-4 | 5 | 8 | 1-10-2014 | 1-15-2014 | 1-15-2014 | 1-30-2014 |
다음 질의를 실행할 때 데이터베이스는 영역 맵을 읽은 다음 블록 1과 2만 스캔할 수 있으므로 1-3-2014 날짜가 최소 날짜와 최대 날짜 사이에 있기 때문에 블록 3과 4를 건너뛸 수 있습니다.
SELECT * FROM lineitem WHERE shipdate = '1-3-2014';참조:
-
Oracle AI Database Data Warehousing Guide: 영역 맵 사용 방법 학습
-
CREATE MATERIALIZED ZONEMAP문의 구문 및 의미에 대한 Oracle AI Database SQL Language Reference
선형 정렬이 있는 속성 클러스터화된 테이블
테이블에 대한 선형 순서 지정 체계는 특정 순서의 사용자 지정 속성을 기반으로 행을 범위로 나눕니다. Oracle AI Database는 기본-외래 키 관계를 통해 연결된 단일 또는 다중 테이블에 대한 선형 주문을 지원합니다.
예를 들어, sales 테이블은 cust_id 및 prod_id 열을 범위로 나누고 이러한 범위를 디스크에서 함께 클러스터화합니다. 테이블에 대해 BY LINEAR ORDER 지시어를 지정하면 술어가 지시어의 접두어 열 또는 모든 열을 지정할 때 상당한 I/O 감소가 발생할 수 있습니다.
sales 질의가 종종 고객 ID 또는 고객 ID와 제품 ID의 조합을 지정한다고 가정합니다. 속성 클러스터화된 테이블을 생성하여 이러한 query가 I/O 감소를 활용할 수 있도록 합니다.
CREATE TABLE sales
(
   prod_id     NOT NULL NUMBER
,  cust_id     NOT NULL NUMBER
,  amount_sold NUMBER(10,2) ...
)
CLUSTERING
  BY LINEAR ORDER (cust_id, prod_id)
  YES ON LOAD YES ON DATA MOVEMENT
  WITH MATERIALIZED ZONEMAP;
열 cust_id 및 prod_id 또는 접두어 cust_id를 한정하는 질의는 I/O 감소를 경험합니다. prod_id를 한정하는 질의는 prod_id가 BY LINEAR ORDER 절의 접미어이므로 상당한 I/O 감소만 경험하지 않습니다. 다음 예제는 테이블 스캔 중 데이터베이스에서 I/O를 줄이는 방법을 보여줍니다.
예제 4-9 cust_id만 지정
응용 프로그램이 다음 query를 실행합니다.
SELECT * FROM sales WHERE cust_id = 100;sales 테이블은 BY LINEAR ORDER 클러스터이므로 데이터베이스는 100의 cust_id 값을 포함하는 영역만 읽어야 합니다.
예제 4-10 prod_id 및 cust_id 지정
응용 프로그램이 다음 query를 실행합니다.
SELECT * FROM sales WHERE cust_id = 100 AND prod_id = 2300;sales 테이블은 BY LINEAR ORDER 클러스터이므로 데이터베이스는 100의 cust_id 값과 2300의 prod_id 값을 포함하는 영역만 읽어야 합니다.
참조:
-
Oracle AI Database Data Warehousing Guide: 선형 주문을 사용하여 테이블을 클러스터화하는 방법 학습
-
BY LINEAR ORDER절의 구문 및 의미에 대한 Oracle AI Database SQL Language Reference
인터리브 정렬이 있는 속성 클러스터화된 테이블
인터리브 주문은 Z-order와 유사한 기법을 사용합니다.
데이터베이스가 인터리브된 순서를 사용하면 클러스터링 열에 있는 술어의 하위 집합을 기준으로 I/O를 정리할 수 있습니다. 인터리브된 순서는 데이터 웨어하우스의 차원 계층에 유용합니다.
선형 주문이 포함된 속성 클러스터형 테이블과 마찬가지로 Oracle AI Database는 기본-외래 키 관계를 통해 연결된 단일 또는 다중 테이블에서 인터리브된 주문을 지원합니다. 속성 클러스터 테이블이 아닌 테이블의 열은 외래 키로 연결되고 속성 클러스터 테이블에 조인되어야 합니다.
대형 데이터 웨어하우스는 스타 스키마에서 데이터를 자주 구성합니다. 차원 테이블은 상위-하위 계층을 사용하며 외래 키에 의해 팩트 테이블에 연결됩니다. 사실값(fact) 테이블을 인터리브된 순서로 클러스터화하면 데이터베이스에서 특수 함수를 사용하여 테이블 스캔 중에 차원 열의 값을 건너뛸 수 있습니다.
예제 4-11 인터리브 주문 예제
데이터 웨어하우스에 sales 사실 값 테이블과 두 개의 차원 테이블(customers 및 products)이 포함되어 있다고 가정합니다. 대부분의 질의에는 customers 테이블 계층 (cust_state_province, cust_city) 및 제품 계층 (prod_category, prod_subcategory)에 대한 술어가 있습니다. 다음 예제의 부분 명령문에 표시된 것처럼 sales 테이블에 대해 인터리브된 순서를 사용할 수 있습니다.
CREATE TABLE sales
(
   prod_id NUMBER NOT NULL
,  cust_id NUMBER NOT NULL
,  amount_sold NUMBER(10,2) ...
)
CLUSTERING sales
   JOIN products ON (sales.prod_id = products.prod_id)
   JOIN customers ON (sales.cust_id = customers.cust_id)
   BY INTERLEAVED ORDER
   (
     (  products.prod_category
     ,  products.prod_subcategory
     ),
     (  customers.cust_state_province
     ,  customers.cust_city
     )
   )
WITH MATERIALIZED ZONEMAP;
주: BY INTERLEAVED ORDER 절에 지정된 열은 실제 차원 테이블에 있을 필요는 없지만 기본-외래 키 관계를 통해 연결되어야 합니다.
애플리케이션이 조인의 sales, products 및 customers 테이블을 질의한다고 가정합니다. 질의는 다음과 같이 술어에 customers.prod_category 및 customers_cust_state_province 열을 지정합니다.
SELECT cust_city, prod_sub_category, SUM(amount_sold)
FROM   sales, products, customers
WHERE  sales.prod_id = products.prod_id
AND    sales.cust_id = customers.cust_id
AND    customers.prod_category = 'Boys'
AND    customers.cust_state_province = 'England - Norfolk'
GROUP BY cust_city, prod_sub_category;
앞의 질의에서 prod_category 및 cust_state_province 열은 CREATE TABLE 예제에 표시된 클러스터링 정의의 일부입니다. sales 테이블을 스캔하는 동안 데이터베이스는 영역 맵을 참조하고 이 영역의 rowids에만 액세스할 수 있습니다.
참조:
-
"차원 개요"
-
Oracle AI Database Data Warehousing Guide: 인터리브된 주문을 사용하여 테이블을 클러스터화하는 방법 학습
-
BY INTERLEAVED ORDER절의 구문 및 의미에 대한 Oracle AI Database SQL Language Reference
임시 테이블 개요
임시 테이블은 트랜잭션 또는 세션 기간 동안에만 존재하는 데이터를 보유합니다.
임시 테이블의 데이터는 세션 전용(private)입니다. 각 세션은 자신의 데이터만 보고 수정할 수 있습니다.
전역 임시 테이블 또는 개인 임시 테이블을 생성할 수 있습니다. 다음 표는 이들 간의 근본적인 차이를 보여줍니다.
테이블 6 임시 테이블 특성
| 특성 | 글로벌 | 비공개 |
|---|---|---|
| 이름 지정 규칙에 따라 | 영구 테이블과 동일합니다. | ORA$PTT_ 접두어가 있어야 합니다. |
| 테이블 정의의 가시성 | 모든 세션 | 테이블을 생성한 세션만 |
| 테이블 정의의 저장 영역 | 디스크 | 메모리만 |
| 유형 | 트랜잭션별(ON COMMIT DELETE ROWS) 또는 세션별(ON COMMIT PRESERVE ROWS) |
트랜잭션별(ON COMMIT DROP DEFINITION) 또는 세션별(ON COMMIT PRESERVE DEFINITION) |
커서 기간 임시 테이블이라고 하는 세번째 유형의 임시 테이블은 특정 유형의 질의에 대해 데이터베이스에 의해 자동으로 생성됩니다.
-
임시 테이블 목적 임시 테이블은 결과 집합을 버퍼링해야 하는 응용 프로그램에서 유용합니다.
-
임시 테이블의 세그먼트 할당 영구 테이블과 마찬가지로 전역 임시 테이블은 데이터 딕셔너리에 정적으로 정의된 영구 객체입니다. 전용 임시 테이블의 경우 메타 데이터는 메모리에만 존재하지만 디스크의 임시 테이블스페이스에 상주할 수 있습니다.
-
임시 테이블 생성
CREATE ... TEMPORARY TABLE문은 임시 테이블을 생성합니다. 참조: 커서 기간 임시 테이블에 대한 자세한 내용은 Oracle AI Database SQL Tuning Guide를 참조하십시오.
임시 테이블의 목적
임시 테이블은 결과 집합을 버퍼링해야 하는 응용 프로그램에서 유용합니다.
예를 들어, 스케줄링 애플리케이션을 통해 대학생은 선택적 학기 과정 스케줄을 생성할 수 있습니다. 글로벌 임시 테이블의 행은 각 스케줄을 나타냅니다. 세션 중에 스케줄 데이터는 private입니다. 수강생이 스케줄을 선택하면 응용 프로그램이 선택한 스케줄의 행을 영구 테이블로 이동합니다. 세션이 끝나면 데이터베이스는 Global 임시 테이블에 있던 스케줄 데이터를 자동으로 삭제합니다.
전용 임시 테이블은 동적 보고 응용 프로그램에 유용합니다. 예를 들어, CRM(Customer Resource Management) 응용 프로그램은 여러 세션이 동시에 활성화된 상태에서 동일한 유저로 무기한 연결할 수 있습니다. 각 세션은 새 트랜잭션마다 ORA$PTT_crm라는 전용 임시 테이블을 생성합니다. 응용 프로그램은 모든 세션에 대해 동일한 테이블 이름을 사용할 수 있지만 정의를 변경할 수는 있습니다. 데이터와 정의는 세션에만 표시됩니다. 테이블 정의는 트랜잭션이 종료되거나 테이블이 수동으로 삭제될 때까지 지속됩니다.
임시 테이블의 세그먼트 할당
영구 테이블과 마찬가지로 Global 임시 테이블은 데이터 딕셔너리에 정적으로 정의된 지속 객체입니다. 전용 임시 테이블의 경우 메타 데이터는 메모리에만 존재하지만 디스크의 임시 테이블스페이스에 상주할 수 있습니다.
글로벌 및 전용 임시 테이블의 경우 데이터베이스는 세션에서 데이터를 처음 삽입할 때 임시 세그먼트를 할당합니다. 데이터가 세션에 로드될 때까지 테이블은 비어 있습니다. 트랜잭션 관련 임시 테이블의 경우 데이터베이스는 트랜잭션 종료 시 임시 세그먼트의 할당을 해제합니다. 세션 관련 임시 테이블의 경우 데이터베이스는 세션 종료 시 임시 세그먼트의 할당을 해제합니다.
참조: "임시 세그먼트"
임시 테이블 생성
CREATE ... TEMPORARY TABLE 문은 임시 테이블을 생성합니다.
GLOBAL TEMPORARY TABLE 또는 PRIVATE TEMPORARY TABLE를 지정합니다. 두 경우 모두 ON COMMIT 절은 테이블 데이터가 트랜잭션 특정(기본값) 데이터인지 세션 특정 데이터인지 여부를 지정합니다. 모든 PL/SQL 내장 프로시저가 아닌 데이터베이스 자체에 대한 임시 테이블을 생성합니다.
CREATE INDEX 문을 사용하여 글로벌(전용 아님) 임시 테이블에 대한 인덱스를 생성할 수 있습니다. 이러한 인덱스는 임시 인덱스이기도 합니다. 인덱스의 데이터는 임시 테이블의 데이터와 세션 또는 트랜잭션 범위가 동일합니다. 전역 임시 테이블에서 보기 또는 트리거를 생성할 수도 있습니다.
참조:
-
"뷰 개요"
-
"트리거 개요"
-
임시 테이블을 생성하고 관리하는 방법을 알아보려면 Oracle AI Database Administrator's Guide를 참조하십시오.
-
CREATE ... TEMPORARY TABLE구문 및 의미에 대한 Oracle AI Database SQL Language Reference
외부 테이블 개요
외부 테이블은 마치 이 데이터가 데이터베이스의 테이블에 있는 것처럼 외부 소스의 데이터에 액세스합니다.
데이터는 액세스 드라이버가 제공되는 모든 형식일 수 있습니다. SQL(직렬 또는 병렬), PL/SQL 및 Java를 사용하여 External Table을 query할 수 있습니다.
-
외부 테이블 용도 외부 테이블은 Oracle 데이터베이스 응용 프로그램이 비관계형 데이터에 액세스해야 하는 경우에 유용합니다.
-
객체 저장소의 데이터 외부 테이블을 사용하여 객체 저장소의 데이터에 액세스할 수 있습니다.
-
외부 테이블 액세스 드라이버 액세스 드라이버는 데이터베이스에 대한 외부 데이터를 해석하는 API입니다. 액세스 드라이버는 데이터베이스 내부에서 실행되며 이 드라이버는 External Table의 데이터를 읽습니다. 액세스 드라이버와 External Table 층은 External Table 정의와 일치하도록 데이터 파일의 데이터에 필요한 변형을 수행합니다.
-
외부 테이블 생성 내부적으로 외부 테이블을 생성하는 것은 데이터 딕셔너리에 메타데이터를 생성하는 것을 의미합니다. 일반 테이블과 달리 External Table은 데이터베이스에 저장된 데이터를 설명하지 않으며 데이터가 외부에 저장되는 방식을 설명하지도 않습니다. 대신 외부 테이블 메타 데이터는 외부 테이블 층이 데이터를 데이터베이스에 표시하는 방법을 설명합니다.
-
외부 테이블 데이터의 자동 캐싱 외부 테이블의 데이터는 투명하게 캐시되어 쿼리 성능이 향상됩니다.
External Table의 목적
External Table은 Oracle 데이터베이스 응용 프로그램이 비관계형 데이터에 액세스해야 하는 경우에 유용합니다.
예를 들어, SQL 기반 응용 프로그램이 다음과 같은 형식의 레코드가 있는 텍스트 파일에 액세스해야 할 수 있습니다.
100,Steven,King,SKING,515.123.4567,17-JUN-03,AD_PRES,31944,150,90
101,Neena,Kochhar,NKOCHHAR,515.123.4568,21-SEP-05,AD_VP,17000,100,90
102,Lex,De Haan,LDEHAAN,515.123.4569,13-JAN-01,AD_VP,17000,100,90
External Table을 생성하고 텍스트 파일을 External Table 정의에 지정된 위치로 복사한 다음 SQL을 사용하여 텍스트 파일의 레코드를 query할 수 있습니다. 마찬가지로 외부 테이블을 사용하여 JSON 문서 또는 LOB에 대한 읽기 전용 액세스 권한을 부여할 수 있습니다.
데이터 웨어하우스 환경에서 외부 테이블은 ETL(추출, 변환 및 로드) 작업을 수행하는 데 유용합니다. 예를 들어, External Table을 사용하면 데이터 로드 단계를 변형 단계로 파이프라인할 수 있습니다. 이 기술을 사용하면 데이터베이스 내에서 추가 처리를 준비하기 위해 데이터베이스 내부의 데이터를 스테이지할 필요가 없습니다.
가상 또는 비가상 열의 External Table을 Partition할 수 있습니다. 또한 일부 분할 영역이 내부 및 일부 외부인 하이브리드 분할 테이블을 생성할 수 있습니다. 내부 분할 영역과 마찬가지로 외부 분할 영역은 분할 영역 제거 및 분할 방식 조인과 같은 성능 향상의 이점을 활용합니다. 예를 들어, 분할된 외부 테이블을 사용하여 HDFS(Hadoop 분산 파일 시스템) 또는 NoSQL 데이터베이스에 저장된 대량의 비관계형 데이터를 분석할 수 있습니다.
참조: "분할된 테이블"
객체 저장소의 데이터
External Table은 객체 저장소의 데이터에 액세스하는 데 사용될 수 있습니다.
Oracle은 운영 체제 파일 및 빅데이터 소스에 있는 외부 데이터에 대한 액세스를 지원하는 것 외에도 객체 저장소의 외부 데이터에 대한 액세스를 지원합니다. 객체 스토리지는 클라우드에서 일반적이며, 단순 컨테이너로 그룹화하여 개별 객체, 모든 유형의 비정형 데이터를 메타데이터로 관리할 수 있는 플랫 아키텍처를 제공합니다. 오브젝트 스토리지는 주로 클라우드에서 데이터 스토리지 아키텍처이지만 온프레미스 스토리지 하드웨어로도 사용할 수 있습니다.
DBMS_CLOUD 패키지를 사용하거나 수동으로 외부 테이블을 정의하여 객체 저장소의 데이터에 액세스할 수 있습니다. Oracle은 추가 기능을 제공하고 Oracle Autonomous Database와 완벽하게 호환되므로 DBMS_CLOUD 패키지를 사용할 것을 강력히 권장합니다.
외부 테이블 액세스 드라이버
액세스 드라이버는 데이터베이스의 외부 데이터를 해석하는 API입니다. 액세스 드라이버는 데이터베이스 내부에서 실행되며 이 드라이버는 External Table의 데이터를 읽습니다. 액세스 드라이버와 External Table 층은 External Table 정의와 일치하도록 데이터 파일의 데이터에 필요한 변형을 수행합니다.
다음 그림은 외부 데이터의 SQL 액세스를 나타냅니다.
그림 11: External Table
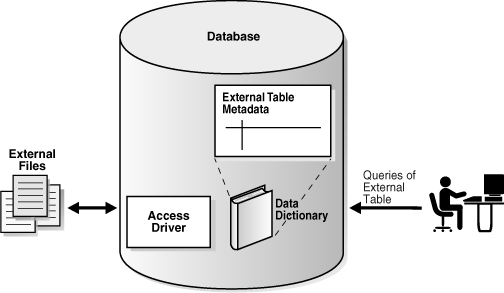
Oracle은 External Table에 대해 다음과 같은 액세스 드라이버를 제공합니다.
-
ORACLE_LOADER(기본값)SQL*Loader에서 지원하는 대부분의 형식을 사용하여 외부 파일에 액세스할 수 있습니다.
ORACLE_LOADER드라이버를 사용하여 외부 파일을 생성, 업데이트 또는 추가할 수 없습니다. -
ORACLE_DATAPUMP외부 데이터를 언로드하거나 로드할 수 있습니다. 언로드 작업은 데이터베이스에서 데이터를 읽고 하나 이상의 External 파일로 표시되는 External Table에 데이터를 삽입합니다. 외부 파일이 생성된 후에는 데이터베이스에서 데이터를 갱신하거나 추가할 수 없습니다. 로드 작업은 External Table을 읽고 해당 데이터를 데이터베이스로 로드합니다.
-
ORACLE_HDFSHDFS(Hadoop 분산 파일 시스템)에 저장된 데이터를 추출할 수 있습니다.
-
ORACLE_HIVEApache Hive 데이터베이스에 저장된 데이터에 액세스할 수 있습니다. 소스 데이터는 HDFS, HBase, Cassandra 또는 기타 시스템에 저장할 수 있습니다. 다른 액세스 드라이버와 달리
ORACLE_HIVE는 외부 메타데이터 저장소에서 위치 정보를 가져오므로 위치를 지정할 수 없습니다. -
ORACLE_BIGDATAApache Parquet, Apache Avro, Apache ORC, Apache Iceberg, Linux Open Project Delta Sharing 프로토콜 및 텍스트 형식을 포함하여 구조화된 형식과 비구조화된 형식으로 저장된 데이터에 대한 읽기 전용 액세스를 지원합니다. 이 드라이버를 사용하여 로컬 데이터를 쿼리할 수도 있습니다. 이는 테스트 및 더 작은 데이터 세트에 유용합니다.
External Table 생성
내부적으로 외부 테이블을 생성하면 데이터 딕셔너리에 메타 데이터가 생성됩니다. 일반 테이블과 달리 External Table은 데이터베이스에 저장된 데이터를 설명하지 않으며 데이터가 외부에 저장되는 방식을 설명하지도 않습니다. 대신 외부 테이블 메타 데이터는 외부 테이블 층이 데이터를 데이터베이스에 표시하는 방법을 설명합니다.
CREATE TABLE ... ORGANIZATION EXTERNAL 문은 두 부분으로 구성됩니다. 외부 테이블 정의는 열 유형을 설명합니다. 이 정의는 SQL이 외부 데이터를 데이터베이스에 로드하지 않고 질의할 수 있도록 하는 뷰와 같습니다. 명령문의 두번째 부분은 외부 데이터를 열에 매핑합니다.
외부 테이블은 ORACLE_DATAPUMP 액세스 드라이버가 있는 CREATE TABLE AS SELECT로 생성되지 않는 한 읽기 전용입니다. External Table에 대한 제한 사항에는 인덱스화된 열 및 열 객체가 지원되지 않습니다.
참조:
-
Oracle AI Database Utilities - 외부 테이블에 대해 알아보기
-
외부 테이블, 외부 연결 및 디렉토리 객체 관리에 대해 알아보려면 Oracle AI Database Administrator's Guide를 참조하십시오.
-
외부 테이블 생성 및 질의에 대한 자세한 내용은 Oracle AI Database SQL Language Reference를 참조하십시오.
External Table 데이터의 자동 캐싱
Query 성능 향상을 위해 External Table의 데이터가 투명하게 캐시됩니다.
객체 스토리지에 완전히 또는 부분적으로 상주하는 External Table에서 자주 액세스하는 데이터는 자동으로 캐시되므로 성능이 향상됩니다. External Table 데이터는 Oracle 데이터베이스에 의해 자동으로 처리되기 때문에 응용 프로그램을 변경할 필요가 없습니다.
블록체인 테이블 개요
블록체인 테이블은 중앙 집중식 블록체인 애플리케이션을 위해 설계된 추가 전용 테이블입니다.
Oracle Blockchain Table에서 피어는 변조 방지 원장을 유지하기 위해 데이터베이스를 신뢰하는 데이터베이스 사용자입니다. 원장은 애플리케이션에 의해 정의되고 관리되는 블록체인 테이블로 구현됩니다. 기존 애플리케이션은 새로운 인프라 또는 프로그래밍 모델 없이도 사기로부터 보호할 수 있습니다. 트랜잭션 처리량은 표준 테이블보다 낮지만 블록체인 테이블의 성능은 분산형 블록체인보다 낫습니다.
블록 체인 테이블은 INSERT 명령만 허용되므로 추가 전용입니다. 이 테이블에서는 UPDATE, DELETE, MERGE, TRUNCATE 및 직접 경로 로드를 허용하지 않습니다. 데이터베이스 트랜잭션은 블록체인 테이블과 표준 테이블에 걸쳐 있을 수 있습니다. 예를 들어 단일 트랜잭션은 표준 테이블과 두 개의 서로 다른 블록체인 테이블에 행을 삽입할 수 있습니다.
블록체인 테이블을 사용하여 Flashback Data Archive 컨텐츠를 보호할 수 있습니다. 이렇게 하면 누구나 테이블의 컨텐트를 조작했는지 확인할 수 있습니다. 블록체인 로그 기록 테이블은 추적된 사용자 테이블의 변경 사항에 대해 암호화 보안 논리적 리두 로그를 유지 관리하는 것으로 간주할 수 있습니다.
버전 2 블록체인 테이블부터 블록체인 테이블에서 사용자 열을 추가하거나 삭제할 수 있습니다. 버전 1 블록체인 테이블에서 사용자 열 추가 또는 삭제는 허용되지 않습니다. 물리적 열과 데이터는 실제로 삭제되지 않지만 표시되지 않는 것으로 표시됩니다.
-
행 체인 블록체인 테이블에서 행 체인은 해싱 체계와 함께 연결된 일련의 행입니다.
-
행 콘텐츠 행 콘텐츠는 행의 열 데이터와 체인에 있는 이전 행의 해시 값을 포함하는 연속된 바이트 시퀀스입니다.
-
블록체인 테이블 사용자 인터페이스 표준 테이블과 마찬가지로 블록체인 테이블은 SQL에 의해 생성되며 스칼라 데이터 유형, LOB, JSON 및 파티션을 지원합니다. 블록체인 테이블에 대한 인덱스 및 트리거를 생성할 수도 있습니다.
행 체인
블록체인 테이블에서 행 체인은 해싱 체계와 함께 연결된 일련의 행입니다.
시스템 행 체인은 버전 1 블록체인 테이블에서 데이터베이스 인스턴스 ID와 체인 ID의 고유한 조합으로 식별됩니다. 버전 2 블록체인 테이블부터 행을 삽입한 데이터베이스의 전역 고유 식별자가 이 두 식별자 외에 필요합니다. 시스템 행 체인은 버전 2 블록체인 테이블에서 플러그 가능한 데이터베이스 전역 고유 ID, 데이터베이스 인스턴스 ID 및 체인 ID의 고유한 조합으로 식별됩니다. 블록체인 테이블의 행은 정확히 하나의 시스템 행 체인에 속합니다. 단일 테이블은 여러 시스템 행 체인을 지원합니다. 참고: 표준 테이블의 체인 행은 블록체인 테이블의 행 체인 직교입니다. "체인"이라는 단어만 동일합니다.
체인의 모든 행에는 고유한 시퀀스 번호가 있습니다. 데이터베이스는 각 체인의 행에 대해 SHA2-512 해시 계산을 사용하여 행의 순서를 지정합니다. 삽입된 모든 행에 대한 해시는 삽입된 행의 행 내용에서 파생됩니다. 이 내용에는 체인에서 이전에 삽입된 행의 해시 값이 포함됩니다.
블록체인 테이블의 모든 행은 정확히 하나의 시스템 체인에 속하지만, 블록체인 테이블이 생성될 때 지정된 사용자 열 집합의 값을 기반으로 사용자 체인에 속할 수도 있습니다.
행 콘텐츠
행 콘텐츠는 행의 열 데이터와 체인에 있는 이전 행의 해시 값을 포함하는 연속된 바이트 시퀀스입니다.
블록체인 테이블을 생성하면 데이터베이스는 여러 개의 숨겨진 열을 생성합니다. 예를 들어, bank 및 deposit 열을 사용하여 블록체인 테이블 bank_ledger을 생성할 수 있습니다.
CREATE BLOCKCHAIN TABLE bank_ledger (bank VARCHAR2 (128), deposit NUMBER)
  NO DROP UNTIL 31 DAYS IDLE
  NO DELETE UNTIL 31 DAYS AFTER INSERT
  HASHING USING "SHA2_512" VERSION "v1";
데이터베이스는 ORABCTAB 접두어(ORABCTAB_INST_ID$, ORABCTAB_CHAIN_ID$, ORABCTAB_SEQ_NUM$ 등)를 사용하여 숨겨진 열을 자동으로 생성합니다. 이러한 숨겨진 열은 대부분 변경하거나 관리할 수 없으므로 변조 방지 알고리즘을 구현합니다. 이 알고리즘은 커밋 시 특정 순서로 고유한 테이블 레벨 체인 잠금을 획득하여 교착 상태를 방지합니다.
참고: 블록체인 테이블의 행 콘텐츠는 표준 데이터 블록에 저장됩니다. 이 Oracle AI Database 릴리스에서는 블록체인 테이블이 테이블 클러스터를 지원하지 않습니다.
인스턴스 ID, 체인 ID 및 순번은 행을 고유하게 식별합니다. 버전 2 블록체인 테이블부터 행을 삽입한 데이터베이스의 전역 고유 식별자가 이 세 값 외에 필요합니다. 각 행에는 숨겨진 열 ORABCTAB_HASH$에 저장된 플랫폼 독립적인 SHA2-512 해시가 있습니다. 해시는 삽입된 행의 내용과 체인에 있는 이전 행의 해시를 기반으로 합니다.
행의 열 값에 대한 데이터 형식은 열 메타 데이터 및 컨텐트의 바이트로 구성됩니다. 열 메타 데이터는 테이블의 위치, 데이터 유형, null 상태 및 바이트 길이와 같은 특성을 설명하는 20바이트 구조입니다. 열 컨텐트는 행의 값을 나타내는 바이트 집합입니다. 예를 들어, Chase 값의 ASCII 표현은 43 68 61 73 65입니다. SQL에서 DUMP 함수를 사용하여 열 메타데이터와 콘텐츠를 모두 가져올 수 있습니다.
해시 계산의 행 컨텐트에는 체인의 이전 행에 있는 해시 값, 유저 정의 열, 고정 개수의 숨겨진 열 등 여러 열의 열 데이터 형식이 포함됩니다.
행 버전이라고 하는 관련 행이 삽입되는 순서는 시스템에서 추적할 수 있으며 행 버전이 정의된 열 집합을 지정하여 기록할 수 있습니다. 또한 행 버전이 지정되면 유저가 지정한 열 집합의 각 값 조합에 대해 삽입된 마지막 행을 보여주는 뷰가 자동으로 생성 및 유지 관리됩니다. 뷰 이름은 이름 지정 규칙 Blockchain_Table_Name_LAST$를 사용합니다.
행에 추가적으로 또는 일반 유저의 대리인이 추가로 서명해야 하는 경우가 많습니다. 한 가지 예로 은행 관리자가 일반 사용자가 삽입한 행에 서명합니다. 위임 서명자는 행의 시스템 암호화 해시를 통해 계산되는 행에 서명을 추가할 수 있는 또 다른 데이터베이스 사용자입니다. 최종 사용자, 위임자 또는 둘 다에 의해 행에 서명할 수 있습니다. 위임자의 서명은 위임자의 인증서를 사용하여 서명을 확인할 수 있고 위임자의 인증서가 데이터베이스 딕셔너리 테이블에 기록된 경우에만 허용됩니다.
최종 사용자나 위임자가 행에 서명한 경우 사용자는 행에 대한 서명 카운터 서명을 조달할 수 있습니다. 카운터 서명은 최종 사용자 또는 대리인이 이미 서명한 행에 대해 특별히 블록체인 테이블 다이제스트로 간주될 수 있습니다. 행이 카운터 서명되면 카운터 서명이 행 서명자에게 반환되고 해당 행에도 저장됩니다. 행에 카운터 서명을 요청하는 사용자는 별도의 데이터 저장소에 비 거부 목적으로 이 정보를 저장할 수 있습니다.
블록체인 테이블에 대한 사용자 인터페이스
표준 테이블과 마찬가지로 블록체인 테이블은 SQL에 의해 생성되며 스칼라 데이터 유형, LOB, JSON 및 파티션을 지원합니다. 블록체인 테이블에 대한 인덱스 및 트리거를 생성할 수도 있습니다.
블록체인 테이블을 생성하려면 CREATE BLOCKCHAIN TABLE 문을 사용합니다. 블록체인 테이블에는 NO DROP UNTIL n DAYS IDLE 절로 지정된 보존 기간이 있습니다. DROP TABLE를 사용하여 테이블을 제거할 수 있습니다.
Oracle Blockchain Table은 다음 인터페이스를 지원합니다.
-
DBMS_BLOCKCHAIN_TABLE패키지를 사용하면 테이블 행에 대해 다양한 작업을 수행할 수 있습니다. 예를 들어, 이전에 삽입된 행의 내용에 서명을 적용하려면SIGN_ROW프로시저를 사용합니다. 행이 변조되지 않았는지 확인하려면VERIFY_ROWS를 사용합니다. 보존 기간(NO DELETE절에 지정됨)이 경과한 후 행을 제거하려면DELETE_EXPIRED_ROWS를 사용합니다. -
DBA_BLOCKCHAIN_TABLES뷰는 테이블 삭제가 허용되기 전의 행 보존 기간, 비활성 기간 및 해시 알고리즘과 같은 테이블 메타데이터를 보여줍니다.
참고:
-
Oracle AI Database Administrator's Guide에서 블록체인 테이블 관리 방법 알아보기
-
DBMS_BLOCKCHAIN_TABLE패키지에 대해 알아보려면 Oracle AI Database PL/SQL 패키지 및 유형 참조를 참조하십시오. -
DBA_BLOCKCHAIN_TABLES뷰에 대한 자세한 내용은 Oracle AI Database Reference를 참조하십시오.
변경할 수 없는 테이블 개요
변경할 수 없는 테이블은 내부자에 의한 무단 데이터 수정 및 인적 오류로 인한 실수로 인한 데이터 수정을 방지하는 추가 전용 테이블입니다.
내부자 인증서에 액세스할 수 있는 손상되거나 허위 사원이 무단 수정을 시도할 수 있습니다.
변경할 수 없는 테이블에 새 행을 추가할 수 있지만 기존 행은 수정할 수 없습니다. 변경할 수 없는 테이블과 변경할 수 없는 테이블 내의 행에 대한 보존 기간을 지정해야 합니다. 지정된 행 retention 기간 후에 행이 불필요해집니다. 불변 테이블에서 폐기된 행만 삭제할 수 있습니다.
변경할 수 없는 테이블에는 시스템 생성 숨겨진 열이 포함됩니다. 열은 블록체인 테이블의 열과 동일합니다. 행이 삽입되면 ORABCTAB_CREATION_TIME$ 및 ORABCTAB_USER_NUMBER$ 열에 대해 NULL이 아닌 값이 설정됩니다. V1 불변 테이블을 제외하고 ORABCTAB_PDB_GUID$ 열에 대해 NULL이 아닌 값이 설정됩니다. 불변 테이블이 행 버전으로 생성된 경우 ORABCTAB_ROW_VERSION$ 및 ORABCTAB_LAST_ROW_VERSION_NUMBER$ 열에 대해 NULL이 아닌 값이 설정됩니다. 나머지 시스템 생성 숨겨진 열의 값은 NULL로 설정됩니다.
변경할 수 없는 테이블을 사용하려면 기존 응용 프로그램을 변경할 필요가 없습니다.
객체 테이블 개요
객체 테이블은 각 행이 객체를 나타내는 특수한 종류의 테이블입니다.
Oracle 객체 유형은 이름, 속성 및 메소드를 포함하는 사용자 정의 유형입니다. 객체 유형을 사용하면 고객 및 구매 주문과 같은 실제 엔티티를 데이터베이스의 객체로 모델링할 수 있습니다.
객체 유형은 논리적 구조를 정의하지만 저장 영역을 생성하지는 않습니다. 다음 예에서는 department_typ라는 객체 유형을 만듭니다.
CREATE TYPE department_typ AS OBJECT
   ( d_name     VARCHAR2(100),
     d_address  VARCHAR2(200) );
/
다음 예제는 객체 유형 department_typ의 departments_obj_t라는 객체 테이블을 생성한 다음 테이블에 행을 삽입합니다. departments_obj_t 테이블의 속성(열)은 객체 유형 정의에서 파생됩니다.
CREATE TABLE departments_obj_t OF department_typ;
INSERT INTO departments_obj_t VALUES ('hr', '10 Main St, Sometown, CA');
관계형 열과 마찬가지로 객체 테이블은 테이블과 선언된 유형이 동일한 객체 인스턴스라는 한 가지 유형의 행만 포함할 수 있습니다. 기본적으로 객체 테이블의 모든 행 객체에는 객체 테이블에서 해당 객체를 고유하게 식별하는 연관된 OID(논리적 객체 식별자)가 있습니다. 객체 테이블의 OID 열은 숨겨진 열입니다.
참조:
-
Oracle AI Database의 객체 관계형 기능에 대한 자세한 내용은 Oracle AI Database Object-Relational Developer's Guide를 참조하십시오.
-
CREATE TYPE구문 및 의미에 대한 Oracle AI Database SQL Language Reference