메모리 구조
이 장에서는 데이터베이스 인스턴스의 메모리 구조에 대해 설명합니다.
-
Oracle AI Database 메모리 구조 소개 인스턴스가 시작되면 Oracle AI Database는 메모리 영역을 할당하고 백그라운드 프로세스를 시작합니다.
-
SGA(시스템 글로벌 영역) 개요 SGA는 Oracle 백그라운드 프로세스와 함께 데이터베이스 인스턴스를 형성하는 읽기/쓰기 메모리 영역입니다.
-
PGA(Program Global Area) 개요 PGA는 시스템의 다른 프로세스나 스레드에서 공유하지 않는 운영 프로세스 또는 스레드에 특정한 메모리입니다. PGA는 프로세스 전용이므로 SGA에 할당되지 않습니다.
-
사용자 글로벌 영역 개요 UGA는 세션 메모리로, 로그온 정보 및 데이터베이스 세션에 필요한 기타 정보와 같은 세션 변수에 할당된 메모리입니다. 기본적으로 UGA는 세션 상태를 저장합니다.
-
MGA(Managed Global Area) 개요 MGA(Managed Global Area)는 신뢰할 수 있는 일련의 Oracle 프로세스에서 메모리를 공유하고 조정할 수 있는 고유한 메모리 프레임워크입니다.
-
소프트웨어 코드 영역 개요 소프트웨어 코드 영역은 실행 중이거나 실행할 수 있는 코드를 저장하는 메모리의 일부입니다. Oracle AI Database 코드는 일반적으로 사용자 프로그램의 위치보다 더 배타적이고 보호되는 소프트웨어 영역에 저장됩니다. 참조: 메모리 구성 및 관리에 대한 지침은 Oracle AI Database Administrator's Guide를 참조하십시오.
Oracle AI Database 메모리 구조 소개
인스턴스가 시작되면 Oracle AI Database는 메모리 영역을 할당하고 백그라운드 프로세스를 시작합니다.
메모리 영역에는 다음과 같은 정보가 저장됩니다.
-
프로그램코드
-
현재 활성 상태가 아닌 경우에도 연결된 각 세션에 대한 정보
-
프로그램 실행 중 필요한 정보(예: 행이 인출되는 query의 현재 상태)
-
프로세스 간에 공유 및 통신되는 잠금 데이터 등의 정보
-
디스크에도 존재하는 데이터 블록 및 리두 레코드와 같은 캐시된 데이터
-
기본 메모리 구조 Oracle AI Database에는 각각 여러 하위 구성 요소를 포함하는 여러 메모리 영역이 포함되어 있습니다.
-
Oracle AI Database 메모리 관리 메모리 관리에서는 데이터베이스의 수요에 따라 Oracle 인스턴스 메모리 구조의 최적 크기를 유지하는 작업이 포함됩니다. Oracle AI Database는 메모리 관련 초기화 매개변수의 설정을 기반으로 메모리를 관리합니다. 참조: "프로세스 아키텍처"
기본 메모리 구조
Oracle AI Database에는 각각 여러 하위 구성 요소를 포함하는 여러 메모리 영역이 포함되어 있습니다.
Oracle AI Database와 연관된 기본 메모리 구조는 다음과 같습니다.
-
SGA(System Global Area)
SGA는 하나의 Oracle AI Database 인스턴스에 대한 데이터 및 제어 정보를 포함하는 공유 메모리 구조(SGA 구성 요소라고 함) 그룹입니다. 모든 서버 프로세스와 백그라운드 프로세스가 SGA를 공유합니다. SGA에 저장된 데이터의 예로는 캐시된 데이터 블록 및 공유 SQL 영역이 있습니다.
-
PGA(Program Global Area)
PGA는 Oracle 프로세스에서만 사용할 수 있는 데이터 및 제어 정보를 포함하는 비공유 메모리 영역입니다. Oracle AI Database는 Oracle 프로세스가 시작될 때 PGA를 생성합니다.
각 서버 프로세스 및 백그라운드 프로세스에 대해 하나의 PGA가 존재합니다. 개별 PGA 모음은 총 인스턴스 PGA 또는 인스턴스 PGA입니다. 데이터베이스 초기화 파라미터는 개별 PGA가 아닌 Instance PGA의 크기를 설정합니다.
-
UGA(사용자 글로벌 영역)
UGA는 유저 세션과 연관된 메모리입니다.
-
MGA(Managed Global Area)
MGA는 Oracle AI Database 인스턴스에서 사용되는 반공유 메모리 구성 요소입니다. 또한 신뢰할 수 있는 소규모 Oracle 프로세스 집합에서 메모리를 공유하고 조정할 수 있습니다. 구성 가능하고 탄력적이며 모듈식이며 온디맨드 방식으로 재사용할 수 있습니다. SGA와 달리 Oracle AI Database 모듈은 이 영역에 연결되는 프로세스를 선택할 수 있으며 이 동작은 동적입니다.
-
소프트웨어 코드 영역
소프트웨어 코드 영역은 실행 중이거나 실행될 수 있는 코드를 저장하는 데 사용되는 메모리의 일부입니다. Oracle AI Database 코드는 일반적으로 사용자 프로그램과는 다른 위치에 있는 소프트웨어 영역에 저장됩니다(보다 배타적이거나 보호된 위치).
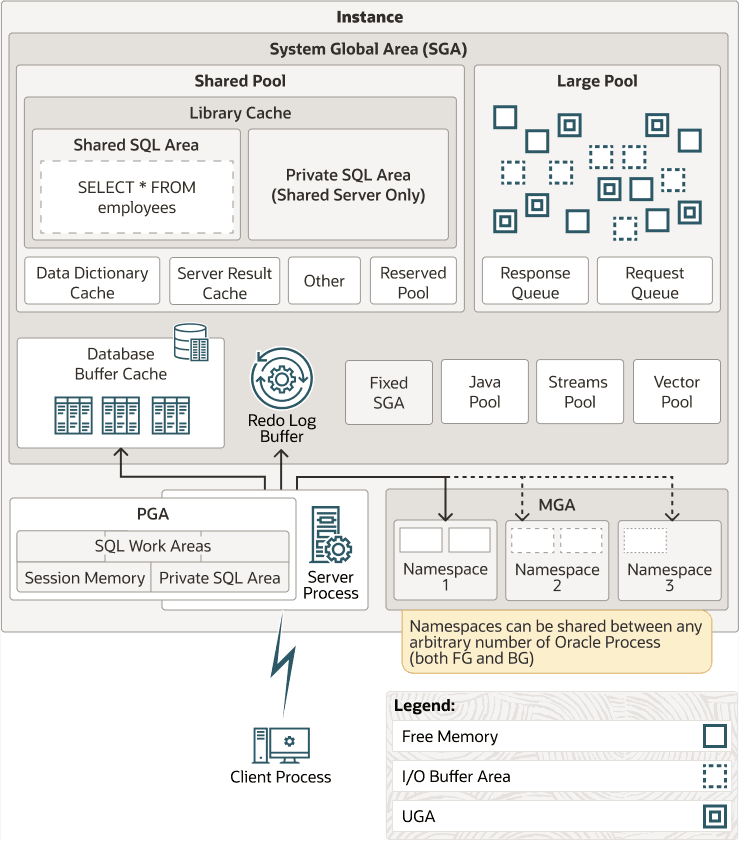
다음 그림은 이러한 메모리 구조 간의 관계를 보여줍니다.
그림 1: Oracle AI Database 메모리 구조
Oracle AI Database 메모리 관리
메모리 관리에서는 데이터베이스에 대한 수요 변화에 따라 Oracle 인스턴스 메모리 구조의 최적 크기를 유지 관리합니다. Oracle AI Database는 메모리 관련 초기화 매개변수의 설정을 기반으로 메모리를 관리합니다.
메모리 관리를 위한 기본 옵션은 다음과 같습니다.
-
통합 메모리 관리
통합 메모리는 데이터베이스 인스턴스 메모리를 단일 매개변수
MEMORY_SIZE로 구성합니다. 데이터베이스는 현재 작업 로드를 기준으로 임의의 SGA, PGA, MGA, UGA 및 기타 메모리 세그먼트 비율에 대해 이 메모리를 동적으로 사용할 수 있습니다. 서로 다른 메모리 세그먼트 간 분할은 CDB에서 현재 열려 있는 PDB의 메모리 크기 조정을 기반으로 합니다. 초대용량 페이지가 구성되면 SGA와 PGA 모두에 사용할 수 있습니다. 통합 메모리는 매우 유연한 메모리 구성을 제공합니다. -
자동 메모리 관리
데이터베이스 Instance 메모리의 대상 크기를 지정합니다. Instance는 자동으로 목표 메모리 크기를 튜닝하여 SGA와 Instance PGA 사이에 필요한 메모리를 재분배합니다.
-
자동 공유 메모리관리
이 관리 모드는 부분적으로 자동화되었습니다. SGA의 대상 크기를 설정한 다음 PGA의 집계 대상 크기를 설정하거나 개별적으로 PGA 작업 영역을 관리할 수 있습니다.
-
수동 메모리 관리
총 메모리 크기를 설정하는 대신 많은 초기화 파라미터를 설정하여 SGA 및 Instance PGA의 구성 요소를 개별적으로 관리합니다.
DBCA(Database Configuration Assistant)를 사용하여 데이터베이스를 생성하고 기본 설치 옵션을 선택하는 경우 자동 메모리 관리가 기본값입니다.
참조:
-
DBA용 메모리 관리 옵션에 대한 자세한 내용은 Oracle AI Database Performance Tuning Guide를 참조하십시오.
-
메모리 관리 옵션에 대해 알아보려면 Oracle AI Database Administrator's Guide를 참조하십시오.
-
초기화 매개변수에 대해 알아보려면 Oracle AI Database Reference를 참조하십시오.
SGA(시스템 전역 영역) 개요
SGA는 Oracle 백그라운드 프로세스와 함께 데이터베이스 인스턴스를 형성하는 읽기/쓰기 메모리 영역입니다. 주: 서버 및 백그라운드 프로세스는 SGA 내부에 상주하지 않지만 별도의 메모리 공간에 존재합니다.
유저를 대신하여 실행되는 모든 서버 프로세스는 Instance SGA의 정보를 읽을 수 있습니다. 데이터베이스 작업 중 일부 프로세스가 SGA에 기록합니다.
각 데이터베이스 Instance에는 고유한 SGA가 있습니다. Oracle AI Database는 인스턴스 시작 시 SGA에 메모리를 자동으로 할당하고 인스턴스 종료 시 메모리를 회수합니다. SQL*Plus 또는 Oracle Enterprise Manager로 Instance를 시작하면 다음 예제와 같이 SGA 크기가 표시됩니다.
SQL> STARTUP
ORACLE instance started.

Total System Global Area  368283648 bytes
Fixed Size                  1300440 bytes
Variable Size             343935016 bytes
Database Buffers           16777216 bytes
Redo Buffers                6270976 bytes
Database mounted.
Database opened.
그림 17-1에 표시된 것처럼 SGA는 특정 클래스의 메모리 할당 요청을 충족시키는 데 사용되는 메모리 풀인 여러 메모리 구성 요소로 구성됩니다. 리두 로그 버퍼를 제외한 모든 SGA 구성 요소는 그래뉼이라는 연속 메모리 단위로 공간을 할당하고 할당 해제합니다. 그래뉼 크기는 플랫폼에 따라 다르며 총 SGA 크기에 따라 결정됩니다.
V$SGASTAT 뷰에서 SGA 구성 요소에 대한 정보를 query할 수 있습니다.
가장 중요한 SGA 구성 요소는 다음과 같습니다.
-
데이터베이스 버퍼 캐시 데이터베이스 버퍼 캐시는 버퍼 캐시라고도 하며 데이터 파일에서 읽은 데이터 블록의 복사본을 저장하는 메모리 영역입니다.
-
리두 로그 버퍼 리두 로그 버퍼는 데이터베이스의 변경 사항을 설명하는 리두 항목을 저장하는 SGA의 순환 버퍼입니다.
-
공유 풀 공유 풀은 다양한 유형의 프로그램 데이터를 캐시합니다.
-
대용량 풀 대용량 풀은 공유 풀에 적합한 것보다 큰 메모리 할당을 위한 선택적 메모리 영역입니다.
-
Java 풀 Java 풀은 JVM(Java Virtual Machine) 내에 모든 세션별 Java 코드와 데이터를 저장하는 메모리 영역입니다. 이 메모리에는 호출 종료 시 Java 세션 공간으로 이전되는 Java 객체가 포함됩니다.
-
고정 SGA 고정 SGA는 내부 정리 영역입니다.
-
선택적 성능 관련 SGA 하위 영역 일부 SGA 하위 영역은 특정 성능 기능에 대해서만 사용으로 설정됩니다.
참조:
-
그래뉼 크기에 대한 자세한 내용은 Oracle AI Database Performance Tuning Guide를 참조하십시오.
데이터베이스 버퍼 캐쉬
데이터베이스 버퍼 캐시(버퍼 캐시라고도 함)는 데이터 파일에서 읽은 데이터 블록의 복사본을 저장하는 메모리 영역입니다.
버퍼는 버퍼 관리자가 현재 또는 최근에 사용된 데이터 블록을 임시로 캐시하는 기본 메모리 주소입니다. 데이터베이스 Instance에 동시에 연결된 모든 유저는 버퍼 캐시에 대한 액세스를 공유합니다.
-
데이터베이스 버퍼 캐시의 목적 Oracle AI Database는 버퍼 캐시를 사용하여 여러 목표를 달성합니다.
-
버퍼 상태 데이터베이스는 내부 알고리즘을 사용하여 캐시의 버퍼를 관리합니다.
-
버퍼 모드 클라이언트가 데이터를 요청할 때 Oracle AI Database는 현재 모드 또는 일관성 있는 모드에서 데이터베이스 버퍼 캐시에서 버퍼를 검색합니다.
-
버퍼 I/O 논리적 I/O는 버퍼 I/O로도 알려져 있으며 버퍼 캐시에서 버퍼의 읽기 및 쓰기를 나타냅니다.
-
버퍼 풀 버퍼 풀은 버퍼 모음입니다.
-
버퍼 및 전체 테이블 스캔 데이터베이스는 복잡한 알고리즘을 사용하여 테이블 스캔을 관리합니다. 기본적으로 데이터베이스는 디스크에서 버퍼를 읽어야 하는 경우 LRU 목록의 가운데에 버퍼를 삽입합니다. 이러한 방식으로 핫 블록은 디스크에서 다시 읽을 필요가 없도록 캐시에 남아 있을 수 있습니다.
-
DRAM 및 PMEM 버퍼 표준(DRAM) 데이터베이스 버퍼는 PMEM 버퍼와 다르지만 특성을 공유합니다.
데이터베이스 버퍼 캐시의 목적
Oracle AI Database는 버퍼 캐시를 사용하여 여러 목표를 달성합니다.
목표는 다음과 같습니다.
-
물리적 I/O 최적화
데이터베이스는 캐시의 데이터 블록을 갱신하고 리두 로그 버퍼의 변경 사항에 대한 메타 데이터를 저장합니다.
COMMIT이후 데이터베이스는 리두 버퍼를 온라인 리두 로그에 기록하지만 데이터 파일에 데이터 블록을 즉시 기록하지는 않습니다. 대신 데이터베이스 기록자(DBW)는 백그라운드에서 지연 쓰기를 수행합니다. -
자주 액세스하는 블록을 버퍼 캐시에 유지하고 자주 액세스하지 않는 블록을 디스크에 기록
데이터베이스 스마트 플래시 캐시(플래시 캐시)가 사용으로 설정된 경우 버퍼 캐시의 일부가 플래시 캐시에 상주할 수 있습니다. 이 버퍼 캐시 확장은 하나 이상의 플래시 장치에 저장됩니다. 데이터베이스는 자기 디스크에서 읽는 대신 플래시 메모리에 버퍼를 캐시하여 성능을 향상시킬 수 있습니다.
DB_FLASH_CACHE_FILE및DB_FLASH_CACHE_SIZE초기화 매개변수를 사용하여 여러 플래시 장치를 구성할 수 있습니다. 버퍼 캐시는 각 장치를 추적하고 균등하게 버퍼를 장치에 분산합니다.주: Database Smart Flash Cache는 Solaris 및 Oracle Linux에서만 사용할 수 있습니다.
-
Oracle 영구 메모리 파일 저장소(PMEM 파일 저장소)의 데이터 파일을 가리키는 버퍼 헤더 관리
PMEM 파일 저장소를 사용으로 설정하면 직접 읽기 전용 액세스를 위해 데이터베이스 파일이 매핑됩니다. Query는 기존의 버퍼 캐시 방식을 사용하지 않을 수 있으므로 불필요한 I/O를 피할 수 있습니다. 이 경우 버퍼 헤더는 PMEM 블록에 해당하는 메타 데이터를 저장해야 합니다. 데이터베이스는 여전히 기존(DRAM) 버퍼 캐시를 사용하여 수정, 읽기 일관성 및 "핫" 데이터 블록에 대한 빠른 액세스를 수행할 수 있습니다.
참조:
-
DB_FLASH_CACHE_FILE초기화 매개변수에 대해 알아보려면 Oracle AI Database Reference를 참조하십시오.
버퍼 상태
데이터베이스는 내부 알고리즘을 사용하여 캐시의 버퍼를 관리합니다.
버퍼는 다음의 상호 배타적 상태일 수 있습니다.
-
사용되지 않음
이 버퍼는 사용된 적이 없거나 현재 사용되지 않았기 때문에 사용할 수 있습니다. 이 유형의 버퍼는 데이터베이스에서 가장 쉽게 사용할 수 있습니다.
-
지우기
이 버퍼는 이전에 사용되었으며 현재 Point-in-time의 읽기 일관성 있는 블록 버전을 포함합니다. 블록은 데이터를 포함하지만 체크포인트할 필요가 없도록 "clean" 상태입니다. 데이터베이스가 블록을 고정하고 재사용할 수 있습니다.
-
더티
버퍼에는 아직 디스크에 기록되지 않은 수정된 데이터가 들어 있습니다. 데이터베이스는 재사용하기 전에 블록을 체크포인트해야 합니다.
모든 버퍼에는 고정되거나 사용 가능한(핀 고정되지 않음) 액세스 모드가 있습니다. 버퍼는 캐시에서 "고정"되어 있으므로 유저 세션이 액세스하는 동안 메모리가 부족해지지 않습니다. 다중 세션에서 고정된 버퍼를 동시에 수정할 수 없습니다.
버퍼 모드로
클라이언트가 데이터를 요청하면 Oracle AI Database는 현재 모드 또는 일관성 있는 모드에서 데이터베이스 버퍼 캐시에서 버퍼를 검색합니다.
모드는 다음과 같이 다릅니다.
-
현재 모드에서
db block get이라고도 하는 current mode get은 현재 버퍼 캐시에 나타나는 블록의 검색입니다. 예를 들어, 커밋되지 않은 트랜잭션이 블록에서 두 행을 갱신한 경우 현재 모드는 이러한 커밋되지 않은 행이 있는 블록을 검색합니다. 데이터베이스는 블록의 현재 버전만 갱신해야 하는 수정 명령문 중에 DB 블록 입수가 가장 자주 사용됩니다.
-
일관성 모드
일관성 있는 읽기 가져오기는 블록의 읽기 일관성 있는 버전을 검색하는 것입니다. 이 검색에서는 언두 데이터를 사용할 수 있습니다. 예를 들어, 커밋되지 않은 트랜잭션이 블록의 두 행을 갱신하고 별도의 세션의 query가 블록을 요청하는 경우 데이터베이스는 언두 데이터를 사용하여 커밋되지 않은 갱신 내용을 포함하지 않는 이 블록의 읽기 일관성 버전(일관성 있는 읽기 복제본이라고 함)을 생성합니다. 일반적으로 query는 일관성 있는 모드에서 블록을 검색합니다.
참조:
-
DB 블록 가져오기 및 일관된 읽기 가져오기와 같은 데이터베이스 통계에 대한 설명은 Oracle AI Database Reference를 참조하십시오.
버퍼 I/O
논리 I/O(버퍼 I/O라고도 함)는 버퍼 캐시에서 버퍼의 읽기 및 쓰기를 참조합니다.
요청된 버퍼를 메모리에서 찾을 수 없는 경우 데이터베이스는 물리적 I/O를 수행하여 버퍼를 플래시 캐시나 디스크에서 메모리로 복사합니다. 그런 다음 데이터베이스는 논리적 I/O를 수행하여 캐시된 버퍼를 읽습니다.
-
버퍼 교체 알고리즘 버퍼 액세스를 효율적으로 수행하려면 데이터베이스가 메모리에 캐시에 저장할 버퍼 및 디스크에서 액세스할 버퍼를 결정해야 합니다.
-
버퍼 쓰기 DBW(데이터베이스 기록자) 프로세스는 콜드 더티 버퍼를 디스크에 주기적으로 기록합니다.
-
버퍼 읽기 사용되지 않은 버퍼 수가 적은 경우 데이터베이스는 버퍼 캐시에서 버퍼를 제거해야 합니다.
-
버퍼 터치 수 데이터베이스는 터치 수를 사용하여 LRU 목록의 버퍼 액세스 빈도를 측정합니다. 이 메커니즘을 통해 데이터베이스는 LRU 리스트에 있는 버퍼를 지속적으로 셔플하는 대신 버퍼가 핀되어 있을 때 카운터를 증분할 수 있습니다.
버퍼 교체 알고리즘
버퍼 액세스를 효율적으로 하려면 데이터베이스가 메모리에 캐시에 저장할 버퍼와 디스크에서 액세스할 버퍼를 결정해야 합니다.
데이터베이스는 다음 알고리즘을 사용합니다.
-
LRU 기반 블록 레벨 대체 알고리즘
이 정교한 알고리즘은 기본적으로 더티 및 비더티 버퍼에 대한 포인터를 포함하는 LRU(Least Recently Used) list를 사용합니다. LRU 목록에는 핫 엔드와 콜드 엔드가 있습니다. 콜드 버퍼는 최근에 사용되지 않은 버퍼입니다. 핫 버퍼는 자주 액세스되며 최근에 사용되었습니다. 개념적으로는 LRU가 하나만 있지만 데이터 동시성의 경우 데이터베이스는 실제로 여러 LRU를 사용합니다.
-
온도 기반 객체 레벨 대체 알고리즘
Oracle Database 12c Release 1(12.1.0.2)부터 자동 대형 테이블 캐시 기능을 통해 테이블 스캔이 다음 시나리오에서 다른 알고리즘을 사용할 수 있습니다.
-
병렬 쿼리
단일 인스턴스 및 Oracle RAC(Oracle Real Applications Cluster) 데이터베이스에서 병렬 질의는
DB_BIG_TABLE_CACHE_PERCENT_TARGET초기화 매개변수가 0이 아닌 값으로 설정되고PARALLEL_DEGREE_POLICY가auto또는adaptive로 설정된 경우 큰 테이블 캐시를 사용할 수 있습니다. -
직렬 질의
단일 인스턴스 구성에서만 직렬 질의는
DB_BIG_TABLE_CACHE_PERCENT_TARGET초기화 매개변수가 0이 아닌 값으로 설정된 경우 큰 테이블 캐시를 사용할 수 있습니다.
테이블이 메모리에 들어가지 않을 경우 데이터베이스는 액세스 패턴에 따라 캐시할 버퍼를 결정합니다. 예를 들어, 인기 있는 테이블의 95%만 메모리에 적합한 경우 데이터베이스는 순환적으로 블록을 메모리에 읽고 블록을 디스크에 쓰는 대신 디스크에 블록의 5%를 남겨 두도록 선택할 수 있습니다. 이러한 현상은 스래싱이라고 합니다. 다중 대형 객체를 캐시할 때 데이터베이스는 캐시되는 블록에 영향을 주는 인기 있는 테이블이 더 뜨거워지고 일반 테이블이 덜 차가워지는 것으로 간주합니다.
DB_BIG_TABLE_CACHE_PERCENT_TARGET초기화 매개변수는 이 알고리즘을 사용하는 버퍼 캐시의 백분율을 설정합니다.주: 이 문서에서는 LRU 기반 블록 레벨 대체 알고리즘에 대해 설명합니다.
-
참조: 온도 기반 알고리즘에 대한 자세한 내용은 Oracle AI Database VLDB and Partitioning Guide를 참조하십시오.
버퍼 쓰기
DBW(데이터베이스 기록자) 프로세스는 콜드 더티 버퍼를 디스크에 주기적으로 기록합니다.
DBW는 다음과 같은 경우에 버퍼를 씁니다.
-
서버 프로세스에서 데이터베이스 버퍼 캐시로 새 블록을 읽기 위한 클린 버퍼를 찾을 수 없습니다.
버퍼가 더티 상태가 되면 사용 가능한 버퍼 수가 줄어듭니다. 숫자가 내부 임계값 아래로 떨어지고 클린 버퍼가 필요한 경우 서버 프로세스는 DBW에 기록하라는 신호를 보냅니다.
데이터베이스는 LRU를 사용하여 기록할 더티 버퍼를 결정합니다. 더티 버퍼가 LRU의 콜드 엔드(cold end)에 도달하면 데이터베이스는 이러한 버퍼를 LRU에서 쓰기 큐로 이동합니다. DBW는 가능하면 다중 블록 쓰기를 사용하여 큐의 버퍼를 디스크에 기록합니다. 이 메커니즘을 사용하면 LRU의 끝이 더티 버퍼로 막히지 않고 클린 버퍼를 찾아 재사용할 수 있습니다.
-
테이블스페이스가 읽기 전용 상태로 변경되거나 오프라인 상태로 변경됩니다.
참조:
-
버퍼 쓰기 문제를 진단하고 조정하는 방법은 Oracle AI Database Performance Tuning Guide를 참조하십시오.
버퍼 읽기
사용되지 않은 버퍼 수가 적을 경우 데이터베이스는 버퍼 캐시에서 버퍼를 제거해야 합니다.
이 알고리즘은 플래시 캐시의 활성화 여부에 따라 달라집니다.
-
플래시 캐시 사용 안함
데이터베이스는 필요에 따라 각 클린 버퍼를 재사용하여 덮어씁니다. 덮어쓴 버퍼가 나중에 필요한 경우 데이터베이스는 자기 디스크에서 읽어야 합니다.
-
플래시 캐시 사용
DBW는 클린 버퍼의 본문을 플래시 캐시에 기록하여 인메모리 버퍼를 재사용할 수 있습니다. 데이터베이스는 플래시 캐시에서 버퍼 본문의 상태와 위치를 추적하기 위해 버퍼 헤더를 기본 메모리에 LRU 목록에 유지합니다. 이 버퍼가 나중에 필요한 경우 데이터베이스는 자기 디스크가 아닌 플래시 캐시에서 읽을 수 있습니다.
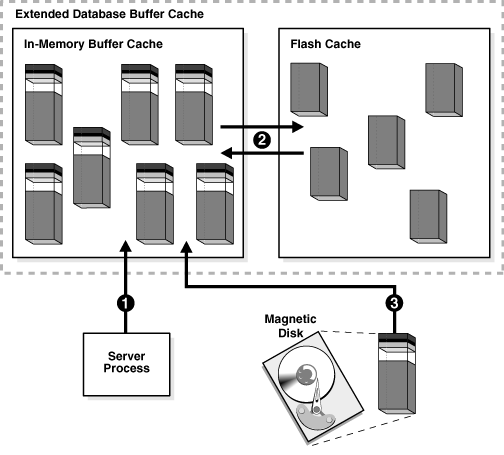
클라이언트 프로세스가 버퍼를 요청하면 서버 프로세스는 버퍼 캐시에서 버퍼를 검색합니다. 데이터베이스에서 메모리의 버퍼를 찾으면 캐시 적중이 발생합니다. 검색 순서는 다음과 같습니다.
-
서버 프로세스는 버퍼 캐시의 전체 버퍼를 검색합니다.
프로세스에서 전체 버퍼를 찾으면 데이터베이스는 이 버퍼를 논리적 읽기로 수행합니다.
-
서버 프로세스는 플래시 캐시 LRU 목록에서 버퍼 헤더를 검색합니다.
프로세스가 버퍼 헤더를 찾으면 데이터베이스는 플래시 캐시에서 인메모리 캐시로 버퍼 본문에 대해 최적화된 물리적 읽기를 수행합니다.
-
프로세스에서 메모리의 버퍼를 찾지 않으면(캐시 실패) 서버 프로세스는 다음 단계를 수행합니다.
-
디스크의 데이터 파일에서 메모리로 블록을 복사합니다(물리적 읽기).
-
메모리로 읽은 버퍼의 논리적 읽기를 수행합니다.
-
그림 17-2에서는 버퍼 검색 순서를 보여줍니다. 확장 버퍼 캐시에는 전체 버퍼를 포함하는 인메모리 버퍼 캐시와 버퍼 본문을 포함하는 플래시 캐시가 모두 포함됩니다. 이 그림에서 데이터베이스는 버퍼 캐시에서 버퍼를 검색하고 버퍼를 찾지 못하면 자기 디스크에서 메모리로 버퍼를 읽습니다.
그림 2: 버퍼 검색
일반적으로 캐시 적중을 통해 데이터에 액세스하면 캐시 실패보다 빠릅니다. 버퍼 캐시 적중률은 데이터베이스에서 디스크에서 읽을 필요 없이 버퍼 캐시에서 요청된 블록을 찾은 빈도를 측정합니다.
데이터베이스는 데이터 파일 또는 임시 파일에서 물리적 읽기를 수행할 수 있습니다. 데이터 파일에서 읽은 다음에는 논리적 I/O가 옵니다. 임시 파일의 읽기는 메모리가 부족하여 데이터베이스가 데이터를 임시 테이블에 강제로 쓰고 나중에 다시 읽어야 하는 경우에 발생합니다. 이러한 물리적 읽기는 버퍼 캐시를 통과하며 논리적 I/O를 유발하지 않습니다.
참조: Oracle AI Database Performance Tuning Guide에서 버퍼 캐시 적중률을 계산하는 방법을 알아봅니다.
버퍼 터치 수
데이터베이스는 터치 수를 사용하여 LRU 목록의 버퍼 액세스 빈도를 측정합니다. 이 메커니즘을 통해 데이터베이스는 LRU 리스트에 있는 버퍼를 지속적으로 셔플하는 대신 버퍼가 핀되어 있을 때 카운터를 증분할 수 있습니다.
주: 데이터베이스는 메모리에서 블록을 물리적으로 이동하지 않습니다. 이동은 목록의 포인터 위치 변경입니다.
버퍼를 핀 고정하면 데이터베이스는 터치 수가 마지막으로 증가한 시기를 결정합니다. 개수가 3초 전에 증분된 경우 개수가 증분되고, 그렇지 않은 경우 개수가 동일하게 유지됩니다. 3초 규칙은 버퍼에서 터치 횟수를 계산하는 핀 버스트를 방지합니다. 예를 들어, 세션이 데이터 블록에 여러 행을 삽입할 수는 있지만 데이터베이스는 이러한 삽입을 한 번의 터치로 간주합니다.
버퍼가 LRU의 콜드 엔드에 있지만 해당 터치 수가 많으면 버퍼가 핫 엔드로 이동합니다. 터치 횟수가 낮으면 버퍼가 캐시에서 삭제됩니다.
버퍼 풀
버퍼 풀은 버퍼 모음입니다.
데이터베이스 버퍼 캐시는 하나 이상의 버퍼 풀로 나뉘어 대부분 동일한 방식으로 블록을 관리합니다. 풀에는 노후화 또는 캐싱 블록에 대해 근본적으로 다른 알고리즘이 없습니다.
데이터를 버퍼 캐시에 보관하거나 데이터 블록을 사용한 직후 새 데이터에 버퍼를 사용할 수 있도록 하는 별도의 버퍼 풀을 수동으로 구성할 수 있습니다. 그런 다음 적절한 버퍼 풀에 특정 스키마 객체를 할당하여 블록이 캐시에서 삭제(age out)되는 방식을 제어할 수 있습니다. 예를 들어 세그먼트를 핫 풀, 웜 풀 및 콜드 버퍼 풀로 분리할 수 있습니다.
가능한 버퍼 풀은 다음과 같습니다.
-
기본 Pool
이 풀은 블록이 일반적으로 캐시되는 위치입니다. 개별 풀을 수동으로 구성하지 않는 한 Default 풀은 유일한 버퍼 풀입니다. 다른 풀의 선택적 구성은 기본 풀에 영향을 주지 않습니다.
큰 테이블 캐시는 온도 기반 객체 레벨 대체 알고리즘을 사용하는 기본 풀의 선택적 섹션입니다. 단일 인스턴스 및 Oracle RAC 데이터베이스에서 병렬 질의는
DB_BIG_TABLE_CACHE_PERCENT_TARGET초기화 매개변수가 0이 아닌 값으로 설정되고PARALLEL_DEGREE_POLICY가auto또는adaptive로 설정된 경우 큰 테이블 캐시를 사용할 수 있습니다. 단일 인스턴스 구성에서만 직렬 질의는DB_BIG_TABLE_CACHE_PERCENT_TARGET가 설정된 경우 큰 테이블 캐시를 사용할 수 있습니다. -
Keep 풀
이 풀은 자주 액세스했지만 공간 부족으로 인해 기본 풀에서 삭제(age out)된 블록을 대상으로 합니다. Keep 버퍼 풀의 목적은 메모리에 객체를 보유하여 I/O 작업을 해결하는 것입니다.
주: Keep 풀은 다른 풀과 동일한 방식으로 버퍼를 관리합니다. 즉, 특수 알고리즘을 사용하여 버퍼를 핀하지 않습니다. "유지"라는 단어는 이름 지정 규칙입니다. 유지하려는 테이블을 더 큰 Keep 풀에 배치하고 유지하지 않을 테이블을 더 작은 Recycle 풀에 배치할 수 있습니다.
-
Recycle 풀
이 풀은 자주 사용되지 않는 블록에 사용됩니다. Recycle 풀은 객체가 캐시의 불필요한 공간을 사용하지 못하도록 합니다.
데이터베이스는 표준 블록 크기를 가집니다. 블록 크기가 표준 크기와 다른 테이블스페이스를 생성할 수 있습니다. 기본 크기가 아닌 각 블록 크기에는 고유한 풀이 있습니다. Oracle AI Database는 기본 풀에서와 동일한 방식으로 이러한 풀의 블록을 관리합니다.
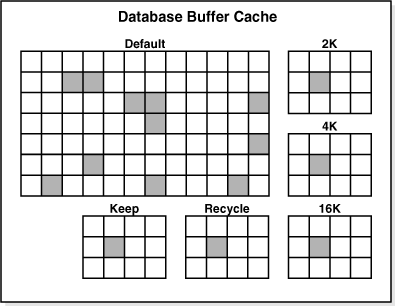
다음 그림은 다중 풀이 사용될 때의 버퍼 캐시 구조를 보여줍니다. 캐시에는 기본, Keep 및 Recycle 풀이 포함되어 있습니다. 기본 블록 크기는 8KB입니다. 캐시에는 2KB, 4KB 및 16KB의 비표준 블록 크기를 사용하는 테이블스페이스에 대해 별도의 풀이 포함되어 있습니다.
그림 3: 데이터베이스 버퍼 캐시
참조:
-
"데이터베이스 블록 크기 "
-
버퍼 풀에 대한 자세한 내용은 Oracle AI Database Administrator's Guide를 참조하십시오.
-
다중 버퍼 풀을 사용하는 방법을 알아보려면 Oracle AI Database Performance Tuning Guide를 참조하십시오.
-
DB_BIG_TABLE_CACHE_PERCENT_TARGET초기화 매개변수에 대해 알아보려면 Oracle AI Database Reference를 참조하십시오.
버퍼 및 전체 테이블 스캔
데이터베이스는 복잡한 알고리즘을 사용하여 테이블 스캔을 관리합니다. 기본적으로 데이터베이스는 디스크에서 버퍼를 읽어야 하는 경우 LRU 목록의 가운데에 버퍼를 삽입합니다. 이러한 방식으로 핫 블록은 디스크에서 다시 읽을 필요가 없도록 캐시에 남아 있을 수 있습니다.
전체 테이블 스캔으로 인해 문제가 발생하여 HWM(고수위) 테이블 아래의 모든 행을 순차적으로 읽습니다. 테이블 세그먼트에 있는 블록의 총 크기가 버퍼 캐시의 크기보다 큽니다. 이 테이블의 전체 스캔은 버퍼 캐시를 정리하여 데이터베이스가 자주 액세스하는 블록의 캐시를 유지 관리하지 못하도록 할 수 있습니다.
-
전체 테이블 스캔의 기본 모드 기본적으로 데이터베이스는 전체 테이블 스캔에 대한 보수적인 접근 방식을 취하여 테이블 크기가 작은 비율의 버퍼 캐시인 경우에만 작은 테이블을 메모리로 로드합니다.
-
병렬 질의 실행 전체 테이블 스캔을 수행할 때 데이터베이스는 때때로 여러 병렬 실행 서버를 사용하여 응답 시간을 향상시킬 수 있습니다.
-
CACHE 속성 기본 캐싱 동작이 필요하지 않은 경우 드물지만
ALTER TABLE ... CACHE를 사용하여 큰 테이블의 블록을 데이터베이스 버퍼 캐시로 읽는 방법을 변경할 수 있습니다. -
KEEP 속성 대형 테이블의 경우
ALTER TABLE ... STORAGE BUFFER_POOL KEEP를 사용하여 스캔을 통해 이러한 테이블의 블록을 KEEP 풀에 로드할 수 있습니다. -
전체 데이터베이스 캐싱 모드 강제 적용 경우에 따라 성능을 향상시키기 위해
ALTER DATABASE ... FORCE FULL DATABASE CACHING문을 명시적으로 실행하여 전체 데이터베이스 캐싱 모드 강제 적용을 사용으로 설정할 수 있습니다. 참조: "세그먼트 공간 및 고수위"
전체 테이블 스캔에 대한 기본 모드
기본적으로 데이터베이스는 전체 테이블 스캔에 대한 보수적인 접근 방식을 취하여 테이블 크기가 버퍼 캐시의 작은 비율일 때만 작은 테이블을 메모리로 로드합니다.
중간 크기의 테이블을 캐시해야 하는지 여부를 확인하기 위해 데이터베이스는 마지막 테이블 스캔 사이의 간격, 버퍼 캐시의 에이징 시간 기록 및 버퍼 캐시에 남아 있는 공간을 통합하는 알고리즘을 사용합니다.
매우 큰 테이블의 경우 데이터베이스에서는 일반적으로 블록을 PGA에 직접 로드하고 SGA를 모두 건너뛰는 직접 경로 읽기를 사용해서 버퍼 캐시를 채우지 않도록 합니다. 중간 크기의 테이블의 경우 데이터베이스는 직접 읽기 또는 캐시 읽기를 사용할 수 있습니다. 캐시 읽기를 사용하기로 결정한 경우 데이터베이스는 스캔이 버퍼 캐시를 효과적으로 정리하지 못하도록 LRU 리스트의 끝에 블록을 둡니다.
Oracle Database 12c Release 1(12.1.0.2)부터 데이터베이스 Instance의 버퍼 캐시는 자동으로 내부 계산을 수행하여 데이터베이스가 Instance SGA에서 완전히 캐시되는 데 충분한지 여부와 액세스 시 테이블을 캐시하면 성능이 향상되는지 여부를 결정합니다. 전체 데이터베이스가 메모리에 완전히 들어갈 수 있고 다른 다양한 내부 조건이 충족되는 경우 Oracle AI Database는 데이터베이스의 모든 테이블을 작은 테이블로 처리하여 캐싱에 적합한 것으로 간주합니다. 그러나 데이터베이스는 NOCACHE 속성으로 표시된 LOB를 캐시에 저장하지 않습니다.
병렬 질의 실행
전체 테이블 스캔을 수행할 때 데이터베이스는 때때로 다중 병렬 실행 서버를 사용하여 응답 시간을 향상시킬 수 있습니다.
데이터베이스에 많은 양의 메모리가 있는 경우와 마찬가지로 데이터베이스는 PGA(Program Global Area)에 직접 경로 읽기를 사용하는 대신 SGA(System Global Area)에 병렬 질의 데이터를 캐시할 수 있습니다. 일반적으로 병렬 질의는 리소스 사용 가능성 때문에 낮은 동시성 데이터 웨어하우스에서 발생합니다.
참조:
-
Oracle AI Database Data Warehousing Guide: 데이터 웨어하우스 소개
-
병렬 실행에 대한 자세한 내용은 Oracle AI Database VLDB and Partitioning Guide를 참조하십시오.
CACHE 속성
드문 경우지만 기본 캐시 동작이 필요하지 않은 경우 ALTER TABLE ... CACHE를 사용하여 대형 테이블의 블록이 데이터베이스 버퍼 캐시로 읽어 들이는 방식을 변경할 수 있습니다.
CACHE 속성이 설정된 테이블의 경우 데이터베이스는 버퍼 캐시에 블록을 강제로 저장하거나 고정하지 않습니다. 대신 데이터베이스는 다른 테이블 블록과 동일한 방식으로 블록을 캐시에서 삭제합니다. 대형 테이블의 전체 스캔은 캐시에서 다른 대부분의 블록을 지울 수 있으므로 이 옵션을 사용할 때는 주의하십시오. 주: ALTER TABLE ... CACHE를 실행해도 테이블이 캐시되지 않습니다.
KEEP 속성
대형 테이블의 경우 ALTER TABLE ... STORAGE BUFFER_POOL KEEP를 사용하여 스캔을 통해 이러한 테이블의 블록을 Keep 풀에 로드할 수 있습니다.
테이블을 Keep 풀에 배치하면 블록이 저장된 버퍼 캐시 부분이 변경됩니다. 기본 버퍼 풀에 블록을 캐시하는 대신 데이터베이스는 블록을 Keep 버퍼 풀에 캐시합니다. 별도의 알고리즘 제어가 풀 캐싱을 유지하지 않습니다.
참조:
-
CACHE절 및KEEP속성에 대한 자세한 내용은 Oracle AI Database SQL Language Reference를 참조하십시오. -
Oracle AI Database Performance Tuning Guide에서 버퍼 캐시 권고 통계를 해석하는 방법 알아보기
강제 전체 데이터베이스 캐싱 모드
일부 상황에서 성능을 향상시키기 위해 ALTER DATABASE ... FORCE FULL DATABASE CACHING 문을 명시적으로 실행하여 전체 데이터베이스 캐싱 모드 강제 적용을 사용으로 설정할 수 있습니다.
자동 기본 모드와 달리 강제 전체 데이터베이스 캐시 모드는 NOCACHE LOB를 포함한 전체 데이터베이스를 데이터베이스 버퍼 캐시에서 캐시에 적합한 것으로 간주합니다. 이 모드는 Oracle Database 12c 릴리스 1(12.1.0.2)부터 사용할 수 있습니다. 주: 강제로 전체 데이터베이스 캐싱 모드를 사용으로 설정해도 데이터베이스가 메모리로 강제로 저장되는 것은 아닙니다. 대신, 전체 데이터베이스를 버퍼 캐시에 캐시할 수 적격합니다. Oracle AI Database는 액세스될 때만 테이블을 캐시에 저장합니다.
Oracle은 각 개별 인스턴스의 버퍼 캐시 크기가 데이터베이스 크기보다 큰 경우에만 전체 데이터베이스 캐시 강제 수행 모드를 활성화할 것을 권장합니다. 이 지침은 단일 인스턴스 및 Oracle RAC 데이터베이스에 모두 적용됩니다. 그러나 Oracle RAC 응용 프로그램이 잘 분할된 경우 Instance 간에 캐시된 중복 블록을 처리하기 위한 추가 공간이 있는 모든 Instance의 결합된 버퍼 캐시가 데이터베이스 크기보다 큰 경우 강제 전체 데이터베이스 캐시 모드를 활성화할 수 있습니다.
참조:
-
Oracle AI Database Administrator's Guide에서 강제 전체 데이터베이스 캐싱 모드를 사용으로 설정하는 방법을 알아봅니다.
-
ALTER DATABASE ... FORCE FULL DATABASE CACHING문에 대한 자세한 내용은 Oracle AI Database SQL Language Reference를 참조하십시오.
DRAM 및 PMEM 버퍼
표준(DRAM) 데이터베이스 버퍼는 PMEM 버퍼와 다르지만 특성을 공유합니다.
Oracle PMEM 파일 저장소(Persistent Memory Filestore)가 구성된 경우 모든 데이터 블록은 DRAM의 버퍼 캐시에 직접 매핑됩니다. DRAM 버퍼와 달리 PMEM 버퍼는 데이터 블록의 내용을 복사하지 않습니다. 대신 PMEM 버퍼 헤더는 PMEM 파일 저장소에 저장된 데이터 블록을 가리킵니다. 대부분의 읽기에 대해 데이터베이스는 컨텐트가 아닌 블록 메타 데이터만 캐시합니다. PMEM 버퍼는 구조가 표준 버퍼 캐시 그래뉼과 다른 특수한 유형의 그래뉼을 사용합니다.
주: 초기화 매개변수 DB_CACHE_SIZE는 DRAM 캐시의 최소 크기를 지정합니다. PMEM 메타 데이터 오버헤드는 이 할당에 포함되지 않습니다.
PMEM 버퍼는 다음 상태일 수 있습니다.
-
현재
PMEM 버퍼의 현재 버전입니다. 파일 저장소에서 직접 액세스할 수 있습니다.
Oracle AI Database는 PMEM 최신 버전을 표준 DRAM 버퍼 현재 버전과 별개로 유지합니다. 이러한 분리는 PMEM 블록 고정, 정리 및 DRAM으로 마이그레이션하는 동안 코드 복잡성을 줄이는 데 도움이 됩니다.
-
일관성
PMEM 버퍼의 일관성 있는 읽기 버전입니다. 데이터베이스가 DRAM에 복제본을 만든 후 생성됩니다. PMEM 버퍼는 파일 저장소에서 직접 액세스할 수 있습니다.
-
사용 가능
사용 가능한 PMEM 버퍼입니다. PMEM 블록에서 재사용할 수 있습니다. Instance 시작 후 모든 PMEM 버퍼는 사용 가능한 상태입니다.
PMEM은 DRAM보다 대기 시간이 높습니다. Oracle AI Database는 내부 워크로드 기반 알고리즘을 사용하여 PMEM에서 DRAM으로 마이그레이션할 블록을 결정합니다.
참조:
-
Oracle AI Database Administrator's Guide에서 PMEM Filestore 설정 방법 학습
리두 로그 Buffer
리두 로그 버퍼는 데이터베이스의 변경 사항을 설명하는 리두 항목을 저장하는 SGA의 순환 버퍼입니다.
리두 레코드는 DML 작업과 DDL 작업을 통한 데이터베이스의 변경 사항을 재구성하거나 재실행하는 데 필요한 정보가 들어 있는 데이터 구조입니다. 데이터베이스 Recovery는 데이터 파일에 리두 항목을 적용하여 손실된 변경 사항을 재구성합니다.
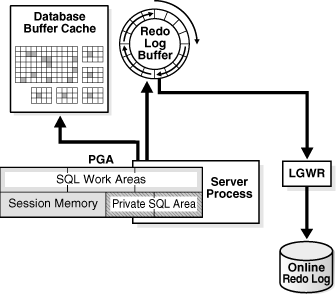
데이터베이스 프로세스는 유저 메모리 공간의 리두 항목을 SGA의 리두 로그 버퍼로 복사합니다. 리두 항목은 버퍼에서 연속되는 순차적 공간을 차지합니다. 백그라운드 프로세스 로그 기록자 프로세스(LGWR)는 리두 로그 버퍼를 디스크의 활성 온라인 리두 로그 그룹에 기록합니다. 그림 17-4에서는 이 리두 버퍼 작업을 보여줍니다.
그림 4: 리두 로그 버퍼
LGWR는 디스크에 리두를 순차적으로 기록하는 반면 DBW는 데이터 블록에 대해 분산된 쓰기를 디스크에 수행합니다. 분산된 쓰기는 순차 쓰기보다 훨씬 느립니다. LGWR를 사용하면 DBW가 느린 쓰기를 완료할 때까지 대기하지 않아도 되므로 데이터베이스는 더 나은 성능을 제공합니다.
LOG_BUFFER 초기화 매개변수는 리두 항목을 버퍼링할 때 Oracle AI Database가 사용하는 메모리의 양을 지정합니다. 다른 SGA 구성 요소와 달리 리두 로그 버퍼 및 고정 SGA 버퍼는 메모리를 그래뉼로 나누지 않습니다.
참조:
-
온라인 리두 로그에 대한 정보는 Oracle AI Database Administrator's Guide를 참조하십시오.
공유 풀
공유 풀은 다양한 유형의 프로그램 데이터를 캐시합니다.
예를 들어, 공유 풀은 구문 분석된 SQL, PL/SQL 코드, 시스템 매개변수 및 데이터 딕셔너리 정보를 저장합니다. 공유 풀은 데이터베이스에서 발생하는 거의 모든 작업에 관여합니다. 예를 들어, 사용자가 SQL 문을 실행하는 경우 Oracle AI Database는 공유 풀에 액세스합니다.
공유 풀은 여러 하위 구성 요소로 구분되며, 그 중 가장 중요한 구성 요소는 그림 17-5에 나와 있습니다.
그림 5: Shared Pool
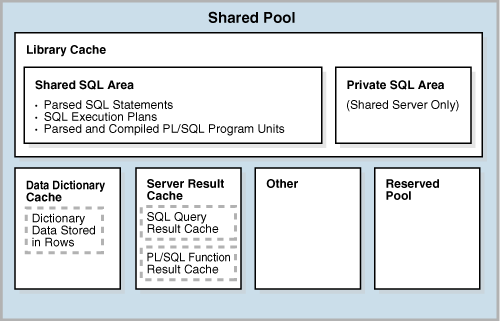
이 섹션에서는 다음 항목을 다룹니다.
-
라이브러리 캐시 라이브러리 캐시는 실행 가능한 SQL 및 PL/SQL 코드를 저장하는 공유 풀 메모리 구조입니다.
-
데이터 딕셔너리 캐시 데이터 딕셔너리는 데이터베이스, 해당 구조 및 유저에 대한 참조 정보를 포함하는 데이터베이스 테이블 및 뷰 모음입니다.
-
서버 결과 캐시 서버 결과 캐시는 공유 풀 내의 메모리 풀입니다. 버퍼 풀과 달리 서버 결과 캐시는 데이터 블록이 아닌 결과 집합을 보유합니다.
-
예약된 풀 예약된 풀은 Oracle AI Database에서 대용량의 연속 메모리 조각(chunks)을 할당할 때 사용할 수 있는 공유 풀의 메모리 영역입니다.
라이브러리 캐쉬
라이브러리 캐시는 실행 가능한 SQL 및 PL/SQL 코드를 저장하는 공유 풀 메모리 구조입니다.
이 캐시에는 공유 SQL 및 PL/SQL 영역과 Lock 및 라이브러리 캐시 핸들과 같은 제어 구조가 포함되어 있습니다. Shared Server 구조에서 라이브러리 캐시는 전용(private) SQL 영역도 포함합니다.
SQL 문이 실행되면 데이터베이스는 이전에 실행된 코드를 재사용하려고 시도합니다. SQL 문의 구문 분석된 표현이 라이브러리 캐시에 존재하고 공유될 수 있는 경우 데이터베이스는 소프트 구문 분석 또는 라이브러리 캐시 적중이라는 코드를 재사용합니다. 그렇지 않으면 데이터베이스가 응용 프로그램 코드의 새 실행 가능 버전(하드 구문 분석 또는 라이브러리 캐시 실패라고 함)을 만들어야 합니다.
-
공유 SQL 영역 데이터베이스는 공유 SQL 영역 및 전용 SQL 영역에서 실행되는 각 SQL 문을 나타냅니다.
-
프로그램 단위 및 라이브러리 캐시 라이브러리 캐시는 PL/SQL 프로그램 및 Java 클래스의 실행 가능한 형식을 보유합니다. 이러한 항목을 총칭하여 프로그램 단위라고 합니다.
-
공유 풀에서 메모리 할당 및 재사용 공유 가능으로 간주되지 않는 DDL 문이 아닌 경우 새 SQL 문이 구문 분석될 때 데이터베이스가 Shared Pool 메모리를 할당합니다. 할당되는 메모리의 크기는 명령문의 복합성에 따라 달라집니다.
공유 SQL 영역
데이터베이스는 공유 SQL 영역 및 전용 SQL 영역에서 실행하는 각 SQL 문을 나타냅니다.
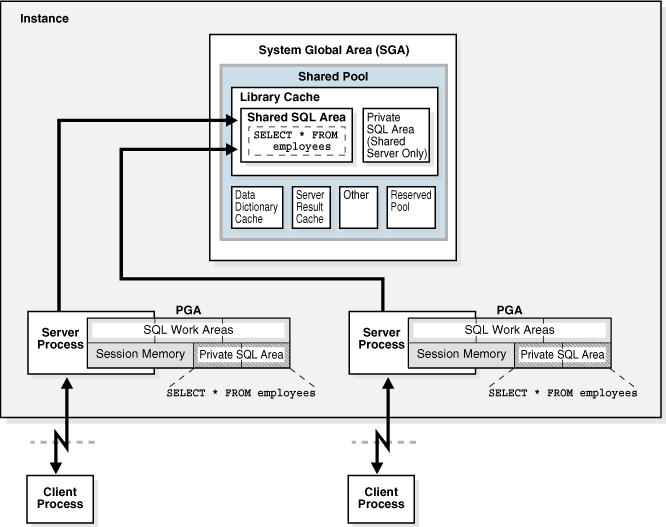
데이터베이스는 공유 SQL 영역을 사용하여 SQL 문의 첫번째 발생을 처리합니다. 이 영역은 모든 사용자가 액세스할 수 있으며 명령문 구문 분석 트리 및 실행 계획을 포함합니다. 고유 명령문에 대해 하나의 공유 SQL 영역만 존재합니다. SQL 문을 실행하는 각 세션에는 해당 PGA에 전용(Private) SQL 영역이 있습니다. 동일한 명령문을 제출하는 각 유저는 동일한 공유 SQL 영역을 가리키는 전용(Private) SQL 영역을 가집니다. 따라서 많은 전용(private) SQL 영역을 동일한 공유 SQL 영역과 연관시킬 수 있습니다.
데이터베이스는 응용 프로그램이 유사한 SQL 문을 제출하는 시기를 자동으로 결정합니다. 데이터베이스는 사용자 및 응용 프로그램에서 직접 실행한 SQL 문과 다른 명령문이 내부적으로 실행한 순환적 SQL 문을 모두 고려합니다.
데이터베이스는 다음 단계를 수행합니다.
-
Shared Pool에서 구문 및 의미상 동일한 명령문에 대해 공유 SQL 영역이 있는지 확인합니다.
-
동일한 명령문이 존재할 경우 데이터베이스는 명령문의 후속 새 Instance 실행을 위해 공유 SQL 영역을 사용하므로 메모리 소모가 줄어듭니다.
-
동일한 명령문이 존재하지 않으면 데이터베이스는 Shared Pool에 새 공유 SQL 영역을 할당합니다. 구문은 동일하지만 의미가 다른 명령문은 하위 커서를 사용합니다.
어느 경우든 유저의 전용(private) SQL 영역은 명령문과 실행 계획을 포함하는 공유 SQL 영역을 가리킵니다.
-
-
세션을 대신하여 전용 SQL 영역 할당
전용 SQL 영역의 위치는 세션에 대해 설정된 연결에 따라 다릅니다. 세션이 공유 서버를 통해 연결되어 있는 경우에는 전용 SQL 영역의 일부가 SGA에 유지됩니다.
그림 17-6은 두 세션이 동일한 SQL 문의 복사본을 자체 PGA에 보관하는 전용 서버 구조를 보여줍니다. Shared Server에서 이 복사본은 MGA에 있는 UGA에 있습니다.
그림 6: 전용 SQL 영역 및 공유 SQL 영역
참조:
-
라이브러리 캐시 관리에 대한 자세한 내용은 Oracle AI Database Performance Tuning Guide를 참조하십시오.
-
공유 SQL에 대한 자세한 내용은 Oracle AI Database Development Guide를 참조하십시오.
프로그램 단위 및 라이브러리 캐시
라이브러리 캐시는 PL/SQL 프로그램 및 Java 클래스의 실행 가능한 형식을 보유합니다. 이러한 항목을 총칭하여 프로그램 단위라고 합니다.
데이터베이스는 SQL 문과 유사한 방식으로 프로그램 단위를 처리합니다. 예를 들어, 데이터베이스는 PL/SQL 프로그램의 구문 분석된 컴파일된 형식을 보관하기 위해 공유 영역을 할당합니다. 데이터베이스는 로컬 변수, Global 및 패키지 변수, SQL 실행 버퍼를 포함하여 프로그램을 실행하는 세션에 관련된 값을 보관하기 위해 전용(private) 영역을 할당합니다. 여러 유저가 동일한 프로그램을 실행하는 경우 각 유저는 세션 특정 값을 보유하는 전용 SQL 영역의 개별 복사본을 유지 관리하고 단일 공유 SQL 영역에 액세스합니다.
데이터베이스는 앞서 설명한 대로 PL/SQL 프로그램 단위 내에서 개별 SQL 문을 처리합니다. PL/SQL 프로그램 단위 내의 원래 값과는 달리 이러한 SQL 문은 공유 영역을 사용하여 구문 분석된 표현을 보관하고 명령문이 실행되는 각 세션에 대해 전용(Private) 영역을 가집니다.
Shared Pool에서 메모리 할당 및 재사용
공유 가능한 명령문으로 간주되지 않는 DDL 문이 아닌 경우 데이터베이스는 새 SQL 문의 구문이 분석될 때 Shared Pool 메모리를 할당합니다. 할당되는 메모리의 크기는 명령문의 복합성에 따라 달라집니다.
일반적으로 공유 풀의 항목은 데이터베이스가 LRU(Least Recently Used) 알고리즘에 따라 제거될 때까지 유지됩니다. 이 데이터베이스를 사용하면 여러 세션에서 사용되는 Shared pool 항목이 해당 항목을 생성한 데이터베이스 프로세스가 종료되어도 항목이 유용한 한 메모리에 유지되도록 할 수 있으며, 이 메커니즘을 사용하면 SQL 문의 오버헤드와 처리가 최소화됩니다. 새 항목에 공간이 필요한 경우 데이터베이스는 자주 사용되지 않는 항목에 의해 소비되는 메모리를 비웁니다.
ALTER SYSTEM FLUSH SHARED_POOL 문은 전역 데이터베이스 이름을 변경하는 것과 마찬가지로 공유 풀의 모든 정보를 제거합니다.
참조:
-
공유 SQL 영역의 수명 주기 개요는 Oracle AI Database SQL Tuning Guide를 참조하십시오.
-
ALTER SYSTEM FLUSH SHARED_POOL사용에 대한 자세한 내용은 Oracle AI Database SQL Language Reference를 참조하십시오. -
V$SQL및V$SQLAREA동적 뷰에 대한 자세한 내용은 Oracle AI Database Reference를 참조하십시오.
데이터 딕셔너리 캐시
데이터 딕셔너리는 데이터베이스, 해당 구조 및 유저에 대한 참조 정보를 포함하는 데이터베이스 테이블 및 뷰 모음입니다.
Oracle AI Database는 SQL 문 구문 분석 중에 데이터 딕셔너리에 자주 액세스합니다. 데이터 딕셔너리는 Oracle AI Database에서 자주 액세스되므로 다음과 같은 특수 메모리 위치가 딕셔너리 데이터를 보관하도록 지정됩니다.
-
데이터 딕셔너리 캐시
이 캐시는 데이터베이스 객체에 대한 정보를 보유합니다. 캐시는 데이터를 버퍼 대신 행으로 보관하므로 행 캐시라고도 합니다.
-
라이브러리 캐시
모든 서버 프로세스는 데이터 딕셔너리 정보에 액세스하기 위해 이러한 캐시를 공유합니다.
참조:
-
데이터 딕셔너리 캐시에 추가 메모리를 할당하는 방법은 Oracle AI Database Performance Tuning Guide를 참조하십시오.
서버 결과 캐시
서버 결과 캐시는 공유 풀 내의 메모리 풀입니다. 버퍼 풀과 달리 서버 결과 캐시는 데이터 블록이 아닌 결과 집합을 보유합니다. 주: 클라이언트 결과 캐시는 서버 결과 캐시와 다릅니다. 클라이언트 캐시는 응용 프로그램 레벨에서 구성되며 데이터베이스 메모리가 아닌 클라이언트 메모리에 있습니다.
-
SQL 질의 결과 캐시 SQL 질의 결과 캐시는 질의 및 질의 부분의 결과를 저장하는 서버 결과 캐시의 하위 집합입니다. 데이터베이스 또는 명령문 레벨에서 결과 캐시를 활성화 또는 비활성화할 수 있습니다.
-
PL/SQL 함수 결과 캐시 PL/SQL 함수 결과 캐시는 함수 결과 집합을 저장하는 서버 결과 캐시의 하위 집합입니다.
-
서버 결과 캐시 기반 구조 질의 결과 캐시와 PL/SQL 함수 결과 캐시는 동일한 기반 구조를 공유합니다.
-
서버 결과 캐시 사용자 인터페이스
RESULT_CACHE_MODE초기화 매개변수는 SQL 질의 결과 캐시가 가능한 모든 질의에 사용되는지 아니면 힌트가 있는 질의에만 사용되는지 결정합니다.
SQL query 결과 캐시
SQL 쿼리 결과 캐시는 쿼리 및 쿼리 부분의 결과를 저장하는 서버 결과 캐시의 하위 집합입니다. 데이터베이스 또는 명령문 레벨에서 결과 캐시를 활성화 또는 비활성화할 수 있습니다.
query가 실행되면 데이터베이스는 query 결과 캐시에 결과가 있는지 여부를 확인합니다. 결과가 캐시되지 않고 query에 대해 캐싱이 활성화된 경우 데이터베이스는 query를 실행하고 결과를 반환한 다음 캐시합니다. 그러나 결과가 존재하면 데이터베이스는 query를 실행하는 대신 캐시에서 해당 결과를 검색합니다.
데이터베이스는 트랜잭션이 결과를 생성하는 데 사용된 데이터베이스 객체의 데이터 또는 메타 데이터를 수정할 때마다 캐시된 결과를 자동으로 무효화합니다. 다음 Query는 캐시된 결과를 사용할 수 없으므로 데이터베이스는 새 결과를 자동으로 계산한 다음 후속 Query에서 사용하도록 캐시합니다. 캐시 새로 고침 프로세스는 응용 프로그램에 투명합니다.
실제로 Query 결과 캐시는 데이터베이스가 필요에 따라 생성하고 유지 관리하는 "Just-in-time" Materialized View로 작동합니다. 캐시를 사용하면 데이터베이스에서 데이터 블록을 다시 읽고 결과를 재계산하는 데 많은 비용이 드는 작업을 피할 수 있습니다. 대부분의 응용 프로그램은 이러한 성능 향상의 이점을 활용합니다.
참조: Oracle AI Database Administrator's Guide에서 질의 결과 캐시를 사용하여 응답 시간을 최적화하는 방법을 알아봅니다.
PL/SQL 함수 결과 캐시
PL/SQL 함수 결과 캐시는 함수 결과 집합을 저장하는 서버 결과 캐시의 하위 집합입니다.
캐시하지 않으면 호출당 1초 동안 PL/SQL 함수를 1000회 호출하는 데 1000초가 걸립니다. 캐싱을 사용하는 경우 동일한 입력을 사용하는 1000개의 함수 호출은 1초 합계를 사용할 수 있습니다. 결과 캐시에 적합한 후보자는 상대적으로 정적 데이터에 종속되는 자주 호출되는 함수입니다.
PL/SQL 함수 코드에는 해당 결과를 캐시하는 요청이 포함될 수 있습니다. 이 함수를 호출하면 시스템이 캐시를 검사합니다. 캐시가 동일한 파라미터 값을 가진 이전 함수 호출의 결과를 포함하는 경우 시스템은 호출자에게 결과를 반환하고 함수 본문을 재실행하지 않습니다. 캐시에 결과가 없으면 시스템은 함수 본문을 실행하고 캐시의 결과(이러한 파라미터 값의 경우)를 추가한 다음 호출자에게 콘트롤을 반환합니다.
주: 캐시된 결과를 계산하는 데 사용되는 데이터베이스 객체를 지정할 수 있습니다. 그러면 해당 데이터베이스가 갱신되는 경우 캐시된 결과가 무효가 되므로 재계산되어야 합니다.
서로 다른 인수로 자주 호출되는 함수는 거의 재사용되지 않는 결과를 생성하여 성능이 저하될 수 있습니다. Oracle AI Database는 RESULT_CACHE 힌트가 있는 최근 사용된 PL/SQL 함수를 추적합니다. 이 내역을 사용하면 데이터베이스는 최근 내역에서 x번 확인된 경우에만 PL/SQL 함수와 인수 쌍을 캐시에 저장합니다. 여기서 x는 내부 임계값에 의해 설정됩니다. 너무 많은 결과가 캐시되어 데이터베이스에 더 많은 메모리가 필요한 경우 하나 이상의 캐시된 결과가 삭제됩니다.
RESULT_CACHE_EXECUTION_THRESHOLD는 캐시될 때까지 함수 및 특정 인수 집합을 확인해야 하는 횟수를 지정합니다. 함수가 서로 다른 인수(예: MYFUNC(1,2) 및 MYFUNC(1,3))를 가진 경우 고유한 것으로 간주됩니다. 이 파라미터는 세션 레벨이 아닌 시스템 레벨에서만 설정할 수 있습니다.
참조:
-
PL/SQL 함수 결과 캐시에 대한 자세한 내용은 Oracle AI Database Development Guide를 참조하십시오.
-
PL/SQL 함수 결과 캐시에 대한 자세한 내용은 Oracle AI Database PL/SQL Language Reference를 참조하십시오.
서버 결과 캐시에 기반 구조
질의 결과 캐시와 PL/SQL 함수 결과 캐시는 동일한 Infrastructure를 공유합니다.
객체 유형: 결과, 종속성 및 임시
서버 결과 캐시 내에서 결과 객체는 질의 또는 PL/SQL 함수에서 반환된 행을 저장하는 데이터 구조입니다. 종속성 객체는 결과 객체로 저장된 질의에서 참조하는 객체에 대한 메타데이터를 저장합니다.
일반적인 쿼리 결과는 규모가 작고 계산 비용이 많이 들며 자주 재사용되고 비휘발성 테이블을 기반으로 합니다. 그러나 결과는 때때로 커질 수 있습니다. 질의 결과가 크기 제한을 통과하면 데이터베이스는 결과의 일부를 임시 객체로 저장하고 일부를 표준 결과 객체로 저장합니다. 임시 객체는 실제 query 결과를 보유하는 임시 테이블스페이스 세그먼트를 가리키는 결과 캐시 메타 데이터의 모음입니다.
결과 하위 캐시
작업 로드에 따라 데이터베이스는 읽기/쓰기 액세스 중 더 높은 동시성을 지원하기 위해 결과 서브 캐시를 생성할 수 있습니다. Oracle AI Database는 내부 알고리즘을 사용하여 하위 캐시를 생성할지 여부와 생성할지 여부를 결정합니다.
서버 결과 캐시 유저 인터페이스
RESULT_CACHE_MODE 초기화 매개변수는 SQL 질의 결과 캐시가 가능한 모든 질의에 사용되는지 아니면 힌트가 있는 질의에만 사용되는지를 결정합니다.
RESULT_CACHE_MAX_TEMP_SIZE 초기화 매개변수는 결과 캐시가 PDB에서 소비할 수 있는 최대 임시 테이블스페이스 메모리를 제어합니다. RESULT_CACHE_MAX_TEMP_RESULT는 하나의 캐시된 질의가 소비할 수 있는 최대 임시 테이블스페이스 메모리를 제어합니다.
RESULT_CACHE_MODE 매개변수 설정을 대체하려면 RESULT_CACHE 힌트를 사용하여 질의 또는 질의 프래그먼트에 주석을 달 수 있습니다. Oracle Database 21c부터 이 힌트는 결과를 임시 테이블스페이스에 저장할 수 있는지 여부를 제어하는 TEMP={TRUE|FALSE} 옵션을 허용합니다.
DBMS_RESULT_CACHE 패키지를 사용하면 SQL 결과 캐시 및 PL/SQL 함수 결과 캐시에서 사용되는 Shared Pool의 해당 부분을 관리할 수 있습니다. 오브젝트, 차단 리스트 쿼리 및 오브젝트를 무효화하고 관련 작업을 수행할 수 있습니다.
V$RESULT_CACHE_OBJECTS.TYPE 열은 캐시의 객체 유형을 나타냅니다. 질의 결과가 임시 테이블스페이스에 저장된 경우 TYPE는 Result 및 Temp의 두 객체를 표시합니다. 하위 캐시 메타데이터는 V$RESULT_SUBCACHE_STATISTICS 및 관련 뷰를 사용하여 액세스할 수 있습니다.
참조:
-
Oracle AI Database Administrator's Guide - 결과 캐시의 동작 크기 조정 및 제어 방법 학습
-
DBMS_RESULT_CACHE패키지에 대한 자세한 내용은 Oracle AI Database PL/SQL 패키지 및 유형 참조를 참조하십시오. -
클라이언트 결과 캐시에 대한 자세한 내용은 Oracle AI Database Performance Tuning Guide를 참조하십시오.
-
RESULT_CACHE_MODE초기화 매개변수에 대해 자세히 알아보려면 Oracle AI Database Reference를 참조하십시오. -
RESULT_CACHE힌트에 대한 자세한 내용은 Oracle AI Database SQL Language Reference를 참조하십시오.
예약 Pool
예약된 풀은 Oracle AI Database에서 대용량의 연속 메모리 조각 할당에 사용할 수 있는 공유 풀의 메모리 영역입니다.
데이터베이스는 공유 풀의 메모리를 청크로 할당합니다. 조각화를 사용하면 연속된 단일 영역 없이도 5KB 이상의 대형 객체를 캐시에 로드할 수 있습니다. 이러한 방식으로 데이터베이스는 단편화로 인해 연속 메모리가 부족할 가능성을 줄입니다.
드물게 Java, PL/SQL 또는 SQL 커서는 5KB보다 큰 Shared Pool에서 할당할 수 있습니다. 이러한 할당이 가장 효율적으로 수행되도록 하기 위해 데이터베이스는 예약된 풀에 대해 소량의 공유 풀을 분리합니다.
참조: Oracle AI Database Performance Tuning Guide에서 예약된 풀 구성 방법 알아보기
대형 풀
대형 풀은 공유 풀에 적합한 것보다 큰 메모리 할당을 위한 선택적 메모리 영역입니다.
Large Pool은 다음에 대해 대용량 메모리 할당을 제공할 수 있습니다.
-
병렬 실행에 사용된 메시지 버퍼
-
RMAN(Recovery Manager) I/O 하위 프로세스의 버퍼
-
지연된 삽입에 대한 버퍼(
MEMOPTIMIZE_WRITE힌트를 사용하여 삽입)
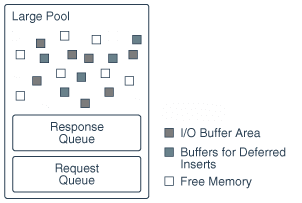
다음 그림은 대용량 풀을 나타냅니다.
그림 7: 대용량 풀
-
대용량 풀 메모리 관리 대용량 풀은 메모리의 일부가 삭제될 수 있도록 LRU 목록을 사용하는 공유 풀과는 다른 방식으로 메모리를 관리합니다.
-
지연 삽입에 대한 큰 풀 버퍼 지연된 삽입이라는 특수 유형의 삽입에 대해 데이터베이스는 대용량 풀에서 버퍼를 할당합니다.
참조:
-
병렬 실행을 위해 메모리 할당에 대한 자세한 내용은 "질의 조정자"를 참조하십시오.
-
"디스패처 요청 및 응답 대기열" - 공유 서버에 대한 세션 메모리 할당에 대해 알아보기
-
Oracle XA에 대한 자세한 내용은 Oracle AI Database Development Guide를 참조하십시오.
-
대용량 풀에 대한 자세한 내용은 Oracle AI Database Performance Tuning Guide를 참조하십시오.
대용량 풀 메모리 관리
Large Pool은 Shared Pool과는 다른 메모리를 관리합니다. Shared Pool은 LRU 리스트를 사용하여 메모리 부분이 삭제(age out)될 수 있도록 합니다.
Large Pool에는 LRU 리스트가 없습니다. 데이터베이스가 대용량 풀 메모리를 데이터베이스 세션에 할당할 때 이 메모리는 해당 세션이 해제하지 않는 한 해제될 수 없습니다. 메모리의 일부가 해제되는 즉시 다른 프로세스에서 사용할 수 있습니다. 대용량 풀에서 세션 메모리를 할당함으로써 데이터베이스는 공유 풀에서 발생할 수 있는 단편화를 방지합니다.
지연된 삽입을 위한 대용량 풀 버퍼
지연된 삽입이라는 특수 유형의 삽입에 대해 데이터베이스는 대용량 풀에서 버퍼를 할당합니다.
Internet of Things(IoT) 응용 프로그램에서 "불타고 잊어버린" 빠른 삽입을 위해 데이터베이스 기반구조는 성능 오버헤드를 만듭니다. 예를 들어, 코드 경로에는 버퍼 캐시 탐색, 버퍼 핀 및 동시성 보호가 포함됩니다. 어레이 삽입은 이러한 비용을 최소화하지만 어레이는 Internet of Things 응용 프로그램에 일반적이지 않은 클라이언트측에 구축되어야 합니다. 이 문제를 해결하기 위해 Oracle 응용 프로그램은 힌트를 사용하여 MEMOPTIMIZE FOR WRITE로 지정된 테이블에 행을 삽입할 수 있습니다.
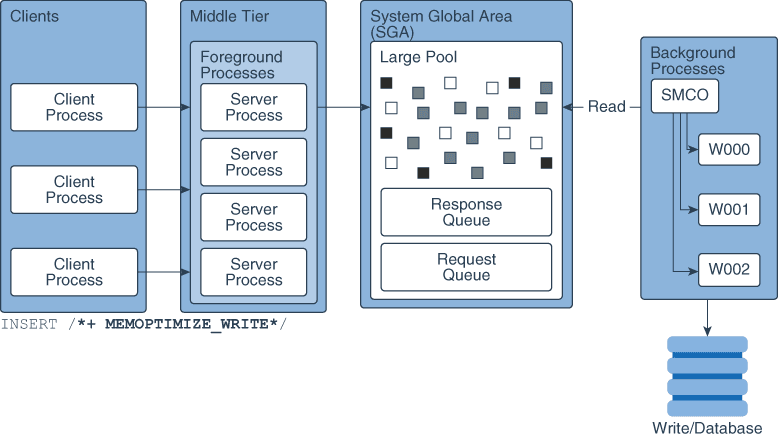
삽입은 대용량 풀에 버퍼링된 다음 나중에 백그라운드 프로세스에 의해 비동기적으로 디스크에 기록되므로 지연됩니다. 데이터베이스는 다음과 같이 지연된 삽입을 처리합니다.
-
응용 프로그램은 데이터를 집계할 수 있는 중간 계층에
MEMOPTIMIZE_WRITE삽입을 보냅니다. IoT 응용 프로그램은 거의 항상 중간 계층에 삽입을 보내지만 데이터베이스에 직접 삽입을 보낼 수도 있습니다. 예를 들어, SQL*Plus를 사용하면 삽입을 데이터베이스로 직접 보낼 수 있습니다. -
중간 계층은 삽입 합계를 데이터베이스 서버에 씁니다.
-
선택적으로 중간 계층 클라이언트는 이전 단계에서 작성한 데이터의 로컬 복사본을 보유합니다.
-
서버 프로세스는 대용량 풀의 버퍼 또는 버퍼에 데이터를 기록합니다.
경합을 피하기 위해 각 버퍼에는 고유한 내부 Lock 메커니즘이 있습니다. 이 Lock 메커니즘은 데이터베이스 버퍼 캐시가 해당 버퍼에 사용하는 Lock 메커니즘과 별개입니다. 기본 쓰기 프로세스는 다음과 같습니다.
-
인스턴스 시작 후 첫번째
MEMOPTIMIZE_WRITE삽입은 Large Pool의 버퍼를 할당합니다. -
기록자는 사용 가능한 버퍼 목록에서 버퍼를 선택합니다.
-
선택한 버퍼가 잠겨 있지 않고 이 버퍼의 사용 가능 공간이 있는 경우 클라이언트는 버퍼에 기록하여 세션 관련 시퀀스 번호를 사용하여 각 버퍼 쓰기를 기록합니다. 그렇지 않은 경우 기록자는 이전 단계로 돌아가며 버퍼를 찾거나 Large Pool에 충분한 공간이 확보될 때까지 이 방식으로 계속됩니다.
-
-
데이터베이스는 버퍼링된 데이터에서 서버측 배열을 생성합니다.
-
SMCO(공간 관리 조정 관리자) 및 해당 도우미 프로세스(Wnnn)는 표준 데이터 블록 형식을 사용하여 어레이를 디스크에 비동기적으로 기록합니다.
표준 삽입과 달리 지연된 삽입은 자동으로 커밋되며 롤백할 수 없습니다. 데이터베이스는 지정된 객체에 대한 삽입을 세션 내에 나타나는 순서대로 커밋합니다. 사이 객체나 세션의 순서를 보장할 수 없습니다.
데이터베이스는 일반 삽입과 마찬가지로 제약 조건 및 인덱스 유지 관리를 지원합니다. 그러나 데이터베이스는 대용량 풀에 쓰지 않고 디스크에 쓰는 동안 평가를 수행합니다.
주: 최상의 성능을 위해 Oracle은 제약 조건을 사용 안함으로 설정할 것을 권장합니다.
다음 그림은 지연된 삽입에 대한 워크플로우를 보여줍니다.
그림 8: 지연 InsertMechanism
참조:
-
테이블을
MEMOPTIMIZE FOR WRITE로 지정하는 방법은 Oracle AI Database Performance Tuning Guide를 참조하십시오. -
INSERT구문 및 의미에 대한 Oracle AI Database SQL Language Reference -
MEMOPTIMIZE_POOL_SIZE에 대한 자세한 내용은 Oracle AI Database Reference를 참조하십시오.
Java 풀
Java 풀은 JVM(Java Virtual Machine) 내에 있는 모든 세션별 Java 코드와 데이터를 저장하는 메모리 영역입니다. 이 메모리에는 호출 종료 시 Java 세션 공간으로 이전되는 Java 객체가 포함됩니다.
Dedicated Server 연결의 경우 Java Pool에는 각 Java 클래스의 공유 부분(메소드 및 코드 벡터와 같은 읽기 전용 메모리 포함)이 포함되지만 각 세션의 세션별 Java 상태는 포함되지 않습니다. Shared Server의 경우 풀에는 각 클래스의 공유 부분과 각 세션의 상태에 사용되는 일부 UGA가 포함됩니다. 각 UGA는 필요에 따라 확장 및 축소되지만 총 UGA 크기는 Java 풀 공간에 적합해야 합니다.
Java Pool Advisor 통계는 Java용으로 사용되는 라이브러리 캐시 메모리에 대한 정보를 제공하며, Java Pool의 크기 변경이 구문 분석 속도에 주는 영향을 예측합니다. statistics_level가 TYPICAL 이상으로 설정된 경우 Java Pool Advisor가 내부적으로 설정됩니다. Advisor가 비활성화되면 이러한 통계는 재설정됩니다.
참조:
-
Java 풀 권고 통계를 포함하는 뷰에 대해 알아보려면 Oracle AI Database Performance Tuning Guide를 참조하십시오.
고정 SGA
고정 SGA는 내부 하우스키핑 영역입니다.
예를 들어, 고정 SGA에는 다음이 포함됩니다.
-
백그라운드 프로세스가 액세스해야 하는 데이터베이스 상태 및 Instance에 대한 일반 정보
-
Lock 정보 등 프로세스 간에 전달되는 정보
고정 SGA의 크기는 Oracle AI Database에 의해 설정되며 수동으로 변경할 수 없습니다. 고정 SGA 크기는 릴리스 간에 변경될 수 있습니다.
참조: "자동 잠금 개요"
성능 관련 SGA 하위 영역(선택 사항)
일부 SGA 하위 영역은 특정 성능 기능에 대해서만 활성화됩니다.
이 단원에서는 다음 항목을 다룹니다.
-
인메모리 영역 인메모리 영역은 인메모리 열 저장소(IM 열 저장소)를 포함하는 선택적 SGA 구성 요소입니다.
-
풀 최적화 memoptimize pool은
MEMOPTIMIZE FOR READ로 지정된 힙 구성 테이블에 대한 버퍼 및 관련 구조를 저장합니다.
인메모리 영역
인메모리 영역은 인메모리 열 저장소(IM 열 저장소)를 포함하는 선택적 SGA 구성 요소입니다.
IM 열 저장소에는 빠른 스캔에 최적화된 열 형식으로 테이블, 분할 영역 및 구체화된 뷰의 복사본이 포함되어 있습니다. IM 열 저장소는 기존 행 형식으로 데이터를 저장하는 데이터베이스 버퍼 캐시를 보완합니다.
주: IM 열 저장소를 사용으로 설정하려면 Oracle AI Database In-Memory 옵션이 있어야 합니다.
참조: In-Memory Area 및 IM 열 저장소에 대한 자세한 내용은 Oracle AI Database In-Memory Guide를 참조하십시오.
풀 최적화
memoptimize pool은 MEMOPTIMIZE FOR READ로 지정된 힙 구성 테이블에 대한 버퍼 및 관련 구조를 저장합니다.
이 구조는 SELECT * FROM cust WHERE cid = 10와 같은 키 기반 질의에 대해 높은 성능 및 확장성을 제공합니다. 엔드 투 엔드 응답 시간을 줄이기 위해 클라이언트는 네트워크를 통해 요청된 버퍼를 SGA에서 직접 끌어와서 CPU 및 운영 체제 오버헤드를 방지합니다. 응용 프로그램은 코드를 변경하지 않고도 memoptimize 풀의 이점을 활용할 수 있습니다.
memoptimize 풀은 다음 두 부분으로 구성됩니다.
-
버퍼 영역 최적화
디스크 I/O를 방지하기 위해 데이터베이스는
NO MEMOPTIMIZE FOR READ로 표시될 때까지 memoptimize 풀에 있는MEMOPTIMIZE FOR READ테이블의 버퍼를 영구적으로 잠급니다. 메모리 최적화 버퍼는 데이터베이스 버퍼 캐시의 버퍼와 동일한 구조를 사용합니다. 그러나 memoptimize 풀의 버퍼는 데이터베이스 버퍼 캐시와 완전히 분리되어 있으며 이들 크기에 포함되지 않습니다. 메모리 최적화 버퍼 영역은 메모리 최적화 풀의 75%를 차지합니다. -
해시 인덱스
해시 인덱스는 비영구적인 세그먼트 데이터 구조입니다. 데이터베이스는 해시 인덱스를 연속되지 않는 여러 메모리 단위로 할당합니다. 각 단위에는 여러 개의 해시 버킷이 포함되어 있습니다. 별도의 맵 구조는 메모리 단위를 기본 키와 상관시킵니다. 해시 인덱스는 메모리 최적화 풀의 25%를 차지합니다. 그림 9: 풀 최적화
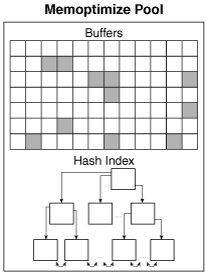
memoptimize 풀을 활성화하려면 MEMOPTIMIZE_POOL_SIZE 초기화 매개변수를 정수 값으로 설정합니다. (풀은 기본적으로 사용 안함으로 설정됩니다.) 이 값은 풀에 할당할 SGA의 양을 지정합니다. The MEMOPTIMIZE_POOL_SIZE value does count toward SGA_TARGET, but the database does not grow and shrink the memoptimize pool automatically. 예를 들어, SGA_TARGET가 10GB이고 MEMOPTIMIZE_POOL_SIZE가 1GB인 경우 memoptimize 풀이 아닌 SGA 메모리에 대해 총 9GB를 사용할 수 있습니다.
memoptimize 풀의 크기를 변경하려면 MEMOPTIMIZE_POOL_SIZE를 수동으로 설정하고 데이터베이스 인스턴스를 재시작해야 합니다. ALTER SYSTEM를 사용하여 풀 크기를 동적으로 변경할 수 없습니다.
DBMS_MEMOPTIMIZE 패키지를 사용하면 memoptimize 풀에 테이블을 명시적으로 채울 수 있습니다.
참조:
-
Oracle AI Database Performance Tuning Guide를 통해 memoptimize 풀을 활성화하여 쿼리 성능을 향상시키는 방법 학습
-
DBMS_MEMOPTIMIZE패키지에 대한 자세한 내용은 Oracle AI Database PL/SQL 패키지 및 유형 참조를 참조하십시오. -
CREATE TABLE ... MEMOPTIMIZE FOR READ에 대한 자세한 내용은 Oracle AI Database SQL Language Reference를 참조하십시오. -
MEMOPTIMIZE_POOL_SIZE에 대한 자세한 내용은 Oracle AI Database Reference를 참조하십시오.
PGA(프로그램 전역 영역) 개요
PGA는 시스템의 다른 프로세스나 스레드에 의해 공유되지 않는 운영 프로세스나 스레드에 특정한 메모리입니다. PGA는 프로세스 전용이므로 SGA에 할당되지 않습니다.
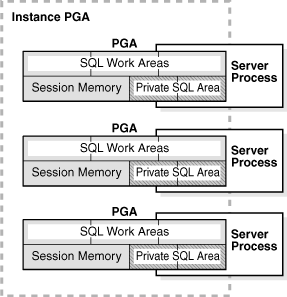
PGA는 Dedicated Server 프로세스 또는 Shared Server 프로세스에서 요구하는 세션 종속 변수를 포함하는 메모리 힙입니다. 서버 프로세스는 PGA에 필요한 메모리 구조를 할당합니다.
PGA에 대한 비유는 파일 직원이 사용하는 임시 싱크대 작업 공간입니다. 이 비유에서 파일 담당자는 고객(클라이언트 프로세스)을 대신하여 작업을 수행하는 서버 프로세스입니다. 담당자는 싱크대 섹션을 지우고, 작업 영역을 사용하여 고객 요청에 대한 세부 정보를 저장하고, 고객이 요청한 폴더를 정렬한 다음, 작업이 완료되면 공간을 확보합니다.
다음 그림은 공유 서버에 대해 구성되지 않은 인스턴스에 대한 인스턴스 PGA(모든 PGA 모음)를 보여줍니다. 초기화 파라미터를 사용하여 Instance PGA의 목표 최대 크기를 설정할 수 있습니다. 필요에 따라 이 대상 크기까지 개별 PGA가 늘어날 수 있습니다.
그림 10: 인스턴스 PGA
주: 백그라운드 프로세스도 자체 PGA를 할당합니다. 이 설명에서는 서버 프로세스 PGA에만 중점을 둡니다.
-
PGA의 내용 PGA는 각각 다른 용도의 서로 다른 영역으로 나뉩니다.
-
전용 및 공유 서버 모드에서 PGA 사용 PGA 메모리 할당은 데이터베이스가 전용 또는 공유 서버 연결을 사용하는지 여부에 따라 달라집니다. 참조: PGA 메모리 관리에 대한 개요는 Oracle AI Database Performance Tuning Guide를 참조하십시오.
PGA의 내용
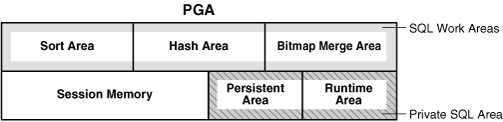
PGA는 각각 다른 목적을 가진 여러 영역으로 나뉩니다.
다음 그림은 Dedicated Server 세션에 사용할 수 있는 PGA의 내용을 보여줍니다. 모든 경우에 모든 PGA 영역이 있는 것은 아닙니다.
그림 11: PGA 내용
-
전용 SQL 영역 전용 SQL 영역은 구문 분석된 SQL 문 및 처리를 위한 기타 세션별 정보에 대한 정보를 보유합니다.
-
SQL 작업 영역 작업 영역은 메모리 사용량이 많은 작업에 사용되는 PGA 메모리의 전용 할당입니다.
전용 SQL 영역
전용 SQL 영역은 구문 분석된 SQL 문 및 처리를 위한 기타 세션별 정보에 대한 정보를 보유합니다.
서버 프로세스가 SQL 또는 PL/SQL 코드를 실행할 때 프로세스는 전용 SQL 영역을 사용하여 바인드 변수 값, 질의 실행 상태 정보 및 질의 실행 작업 영역을 저장합니다.
PGA에 있는 전용 SQL 영역과 SGA에 실행 계획을 저장하는 공유 SQL 영역을 혼동하지 마십시오. 동일한 세션 또는 다른 세션의 여러 전용(Private) SQL 영역은 SGA의 단일 실행 계획을 가리킬 수 있습니다. 예를 들어, 한 세션에서 SELECT * FROM sales를 20회 실행하고 다른 세션에서 동일한 질의를 10회 실행하면 동일한 계획을 공유할 수 있습니다. 각 실행에 대한 전용(Private) SQL 영역은 공유되지 않으며 서로 다른 값과 데이터를 포함할 수 있습니다.
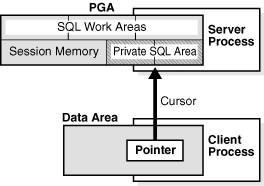
커서는 특정 전용 SQL 영역에 대한 이름 또는 핸들입니다. 다음 그림에 표시된 것처럼 커서를 클라이언트측의 포인터로 간주하고 서버측의 상태로 간주할 수 있습니다. 커서는 전용(private) SQL 영역과 밀접하게 연관되어 있으므로 용어를 서로 바꿔서 사용하는 경우가 있습니다.
그림 12: 커서
전용 SQL 영역은 다음 영역으로 구분됩니다.
-
런타임 영역
이 영역에는 질의 실행 상태 정보가 포함되어 있습니다. 예를 들어, 런타임 영역은 전체 테이블 스캔에서 지금까지 검색된 행 수를 추적합니다.
Oracle AI Database는 실행 요청의 첫 번째 단계로 런타임 영역을 생성합니다. DML 문의 경우 SQL 문이 닫히면 런타임 영역이 해제됩니다.
-
지속 영역
이 영역에는 바인드 변수 값이 포함되어 있습니다. 바인드 변수 값은 명령문이 실행될 때 런타임 시 SQL 문에 제공됩니다. 지속 영역은 커서가 닫힐 때만 해제됩니다.
클라이언트 프로세스는 전용(private) SQL 영역을 관리합니다. 클라이언트 프로세스가 할당할 수 있는 전용 SQL 영역의 수는 초기화 매개변수 OPEN_CURSORS에 의해 제한되지만 전용 SQL 영역의 할당 및 할당 해제는 주로 응용 프로그램에 따라 달라집니다.
대부분의 유저는 데이터베이스 유틸리티의 자동 커서 처리에 의존하지만 Oracle AI Database 프로그래밍 방식 인터페이스는 개발자가 커서를 보다 효과적으로 제어할 수 있도록 합니다. 일반적으로 응용 프로그램은 영구 영역을 해제하고 응용 프로그램 사용자에게 필요한 메모리를 최소화하기 위해 다시 사용하지 않을 열려 있는 모든 커서를 닫아야 합니다.
참조:
SQL 작업 영역
작업 영역은 메모리 사용량이 많은 작업에 사용되는 PGA 메모리의 개인 할당입니다.
예를 들어 정렬 연산자는 정렬 영역을 사용하여 행 집합을 정렬합니다. 마찬가지로 해시 조인 연산자는 해시 영역을 사용하여 왼쪽 입력에서 해시 테이블을 작성하는 반면, 비트맵 병합은 비트맵 병합 영역을 사용하여 여러 비트맵 인덱스의 스캔에서 검색된 데이터를 병합합니다.
다음 예에서는 employees 및 departments의 조인과 질의 계획을 보여줍니다.
SQL> SELECT *
  2  FROM   employees e JOIN departments d
  3  ON     e.department_id=d.department_id
  4  ORDER BY last_name;
.
.
.
--------------------------------------------------------------------------------
| Id| Operation           | Name        | Rows  | Bytes | Cost (%CPU)| Time    |
--------------------------------------------------------------------------------
| 0 | SELECT STATEMENT    |             |   106 |  9328 |    7  (29)| 00:00:01 |
| 1 |  SORT ORDER BY      |             |   106 |  9328 |    7  (29)| 00:00:01 |
|*2 |   HASH JOIN         |             |   106 |  9328 |    6  (17)| 00:00:01 |
| 3 |    TABLE ACCESS FULL| DEPARTMENTS |    27 |   540 |    2   (0)| 00:00:01 |
| 4 |    TABLE ACCESS FULL| EMPLOYEES   |   107 |  7276 |    3   (0)| 00:00:01 |
--------------------------------------------------------------------------------
앞의 예제에서 런타임 영역은 전체 테이블 스캔의 진행 상황을 추적합니다. 세션은 해시 영역에서 해시 조인을 수행하여 두 테이블의 행과 일치시킵니다. ORDER BY 정렬은 정렬 영역에서 발생합니다.
연산자가 처리하는 데이터의 양이 작업 영역에 적합하지 않은 경우 Oracle AI Database는 입력 데이터를 더 작은 피스로 나눕니다. 이러한 방식으로 데이터베이스는 나중에 처리할 수 있도록 임시 디스크 저장 영역에 나머지를 기록하는 동안 메모리에 있는 일부 데이터 피스를 처리합니다.
데이터베이스는 자동 PGA 메모리 관리가 활성화되어 있을 때 작업 영역 크기를 자동으로 튜닝합니다. 작업 영역의 크기를 수동으로 제어하고 튜닝할 수도 있습니다.
일반적으로 작업 영역을 늘리면 연산자의 성능이 크게 향상되지만 메모리 소모량이 많아집니다. 이상적으로 작업 영역의 크기는 입력 데이터 및 해당 연관 SQL 연산자에 의해 할당된 보조 메모리 구조를 수용할 수 있을 만큼 충분합니다. 그렇지 않으면 입력 데이터의 일부가 디스크에 캐시되어야 하므로 응답 시간이 길어집니다. 극단적인 경우 작업 영역의 크기가 입력 데이터 크기에 비해 너무 작으면 데이터베이스는 데이터 피스에 대해 여러 패스를 수행하여 응답 시간을 크게 늘려야 합니다.
참조:
-
Oracle AI Database Administrator's Guide에서 자동 PGA 관리 사용 방법 알아보기
-
Oracle AI Database Performance Tuning Guide에서 PGA 메모리를 튜닝하는 방법 알아보기
전용 및 공유 서버 모드에서 PGA 사용
PGA 메모리 할당은 데이터베이스에서 전용 또는 공유 서버 연결을 사용하는지 여부에 따라 달라집니다.
다음 표에서는 차이점을 보여 줍니다.
표 1 전용 서버와 공유 서버 간의 메모리 할당 차이점
| 메모리 영역 | 전용 서버 | 공유 서버 |
|---|---|---|
| 세션 메모리의 특성 | 비공개 | 공유 |
| 지속 영역의 위치 | PGA | SGA |
| DML 및 DDL 문의 런타임 영역 위치 | PGA | PGA |
참조: Oracle AI Database Administrator's Guide에서 Shared Server용 데이터베이스를 구성하는 방법을 알아봅니다.
사용자 글로벌 영역 개요
UGA는 세션 메모리로, 로그온 정보와 같은 세션 변수에 할당된 메모리 및 데이터베이스 세션에 필요한 기타 정보입니다. 기본적으로 UGA는 세션 상태를 저장합니다.
다음 그림은 UGA를 나타냅니다.
그림 13: UGA(User Global Area)
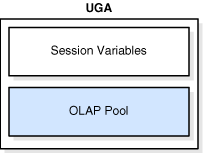
세션이 PL/SQL 패키지를 메모리에 로드하면 UGA에는 특정 시간에 모든 패키지 변수에 저장된 값 집합인 패키지 상태가 포함됩니다. 패키지 서브 프로그램이 변수를 변경하면 패키지 상태가 변경됩니다. 기본적으로 패키지 변수는 세션 기간 동안 고유하며 유지됩니다.
OLAP 페이지 풀도 UGA에 저장됩니다. 이 풀은 데이터 블록과 동일한 OLAP 데이터 페이지를 관리합니다. 페이지 풀은 OLAP 세션 시작 시 할당되고 세션 종료 시 해제됩니다. OLAP 세션은 사용자가 큐브와 같은 차원 객체를 질의할 때마다 자동으로 열립니다.
세션이 지속되는 동안에는 데이터베이스 세션이 UGA를 사용할 수 있어야 합니다. 따라서 공유 서버 연결을 사용할 때는 PGA가 단일 프로세스에만 해당되므로 UGA를 PGA에 저장할 수 없습니다. 따라서 UGA는 Shared Server 연결을 사용할 때 MGA에 저장되므로 Shared Server 프로세스에서 액세스할 수 있습니다. 전용 서버 연결을 사용하는 경우 UGA는 PGA에 저장됩니다.
참조:
-
"연결 및 세션"
-
공유 서버 연결에 대한 자세한 내용은 Oracle AI Database Net Services Administrator's Guide를 참조하십시오.
MGA(Managed Global Area) 개요
MGA(Managed Global Area)는 신뢰할 수 있는 Oracle 프로세스 집합에 걸쳐 메모리를 공유하고 조정할 수 있는 고유한 메모리 프레임워크입니다.
구성 가능하고 탄력적이며 모듈식이며 요청 시 복구 가능한 공유 메모리 영역이 될 수 있습니다. MGA는 데이터베이스에서 여러 유형의 공유 메모리 영역을 활용할 수 있는 방법을 제공합니다. 이 테이블스페이스는 각각 하나에만 속하는 내부 데이터베이스 계층에 대한 네임스페이스로 표시됩니다. 네임스페이스는 주로 공유 메모리 세그먼트와 함께 사용되는 메타 데이터 집합으로 구성됩니다.
데이터베이스의 계층은 네임스페이스의 특성, 범위, 수명 및 내부 세그먼트 크기를 정의할 수 있습니다. 모든 MGA는 PGA 합계 제한 아래로 계산됩니다.
Linux에서 MGA에는 /dev/shm에 마운트된 tempfs가 필요하며 최소한 PGA 집계 제한 크기로 구성됩니다. 여러 인스턴스가 동일한 시스템에서 실행 중인 경우 /dev/shm의 크기는 모든 인스턴스에서 sum(PGA_AGGREGATE_LIMIT) 이상이어야 합니다.
참조:
-
그래뉼 크기에 대한 자세한 내용은 Oracle AI Database Performance Tuning Guide를 참조하십시오.
소프트웨어 코드 영역 개요
소프트웨어 코드 영역은 실행 중이거나 실행할 수 있는 코드를 저장하는 메모리의 일부입니다. Oracle AI Database 코드는 일반적으로 사용자 프로그램의 위치보다 더 배타적이고 보호되는 소프트웨어 영역에 저장됩니다.
소프트웨어 영역은 일반적으로 크기가 정적이며 소프트웨어가 업데이트되거나 재설치될 때만 변경됩니다. 이러한 영역의 필요한 크기는 운영 체제에 따라 다릅니다.
소프트웨어 영역은 읽기 전용이며 공유 또는 비공유로 설치할 수 있습니다. Oracle Forms 및 SQL*Plus와 같은 일부 데이터베이스 툴과 유틸리티는 공유 방식으로 설치할 수 있지만 설치하지 못할 수도 있습니다. 가능한 경우 데이터베이스 코드가 공유되므로 모든 사용자가 메모리에 여러 개의 복사본을 두지 않고도 액세스할 수 있으므로 주 메모리가 줄어들고 전반적인 성능이 향상됩니다. 동일한 컴퓨터에서 실행되는 경우 데이터베이스의 여러 Instance가 서로 다른 데이터베이스와 동일한 데이터베이스 코드 영역을 사용할 수 있습니다. 주: 공유된 소프트웨어를 설치하는 옵션은 일부 운영 체제(예: Microsoft Windows를 운영하는 PC)에서 사용할 수 없습니다. 자세한 내용은 운영 체제별 설명서를 참조하십시오.