서버측 프로그래밍: PL/SQL, Java 및 JavaScript
SQL은 SQL(구조적 질의 언어) 언어와 데이터베이스가 SQL 문을 처리하는 방법을 설명합니다. 이 장에서는 데이터베이스에 저장된 PL/SQL(프로시저 언어/SQL) 또는 Java 프로그램에서 SQL을 사용하는 방법에 대해 설명합니다.
-
서버측 프로그래밍 소개 SQL과 같은 비프로시저 언어에서는 작업할 데이터 집합이 지정되지만 수행할 작업이나 작업 수행 방식은 지정되지 않습니다.
-
PL/SQL 개요 PL/SQL은 사용이 간편하고 SQL, 견고성, 이식성, 보안성이 뛰어난 서버측 저장 프로시저 언어를 제공합니다. PL/SQL 단위라는 절차 객체를 사용하여 데이터베이스 데이터에 액세스하고 데이터베이스 데이터를 조작할 수 있습니다.
-
Oracle AI Database의 Java 개요 Java는 선택한 객체 지향 프로그래밍 언어로 등장했습니다.
-
Oracle AI Database의 JavaScript 개요 JavaScript는 오늘날 가장 널리 사용되는 프로그래밍 언어 중 하나입니다. Linux x86-64 또는 Linux aarch64에 배포된 Oracle AI Database는 서버측 개발을 위해 지원되는 언어 목록에 JavaScript를 추가합니다.
-
트리거 개요 데이터베이스 트리거는 특정 상황에서 Oracle Database가 자동으로 호출("실행")하도록 PL/SQL, Java 또는 JavaScript로 작성된 컴파일된 내장 프로그램 단위입니다. 참조: SQL 언어에 대한 개요는 SQL을 참조하십시오.
서버측 프로그래밍 소개
SQL과 같은 비프로시저 언어에서는 작업할 데이터 집합이 지정되지만 수행할 작업이나 작업 수행 방식은 지정되지 않습니다.
프로시저 언어 프로그램에서 대부분의 명령문 실행은 이전 또는 이후의 명령문과 SQL에서 사용할 수 없는 루프 또는 조건부 분기와 같은 제어 구조에 따라 달라집니다. 프로시저 언어와 비프로시저 언어의 차이에 대한 설명을 보려면 다음 SQL 문이 employees 테이블을 질의한다고 가정해 보겠습니다.
SELECT employee_id, department_id, last_name, salary FROM employees;앞의 명령문은 데이터를 요청하지만 데이터에 논리는 적용되지 않습니다. 그러나 응용 프로그램에서 데이터 집합의 각 사원이 급여 및 부서 성과를 기준으로 인상받을 자격이 있는지 여부를 결정하려고 한다고 가정해 보겠습니다. 급여 인상에 필요한 조건은 사원이 지난 5년 동안 세 번 이상 급여 인상을 받지 못했다는 것입니다. 인상이 요청되면 응용 프로그램은 급여를 조정하고 관리자에게 전자 메일을 보내야 합니다. 그렇지 않으면 응용 프로그램이 보고서를 갱신해야 합니다.
문제는 조건부 논리 및 프로그램 흐름 제어가 필요한 프로시저 데이터베이스 응용 프로그램에서 SQL을 사용하는 방법입니다. 기본 개발 방식은 다음과 같습니다.
-
클라이언트측 프로그래밍을 사용하여 C, C++ 또는 Java와 같은 프로시저 언어로 작성된 응용 프로그램에 SQL 문을 포함시킵니다.
SQL 문을 컴파일하기 전에 소스 코드에 배치하여 precompiler 또는 Java 변환기에 제출할 수 있습니다. 또는 사전 컴파일 단계를 제거하고 응용 프로그램이 데이터베이스와 상호 작용할 수 있도록 JDBC(Java Database Connectivity) 또는 OCI(Oracle Call Interface)와 같은 API를 사용할 수 있습니다.
-
서버측 프로그래밍을 사용하여 데이터베이스에 상주하는 데이터 로직 개발
응용 프로그램은 PL/SQL(P L 속편으로 발음됨) Java 또는 JavaScript로 작성된 내장 서브 프로그램(프로시저 및 함수)을 명시적으로 호출할 수 있습니다. 또한 데이터베이스에 저장되고 지정된 이벤트에 대한 응답으로 호출되는 명명된 프로그램 단위인 트리거를 만들 수 있습니다.
이 장에서는 두 번째 접근 방법에 대해 설명합니다. 서버측 프로그래밍의 주요 이점은 데이터베이스에 내장된 기능을 어디에나 배치할 수 있다는 것입니다. 응용 프로그램이 아닌 데이터베이스가 특정 운영 체제에서 작업을 수행하는 가장 좋은 방법을 결정합니다. 또한 서브 프로그램은 서버에서 응용 프로그램 처리를 중앙 집중화하여 확장성을 높여 클라이언트가 코드를 재사용할 수 있도록 합니다. 서브 프로그램 호출은 빠르고 효율적이므로 단일 호출을 통해 컴퓨팅 집약적인 내장 서브 프로그램을 시작하여 네트워크 트래픽을 줄일 수 있습니다.
다음 언어를 사용하여 Oracle AI Database에 데이터 로직을 저장할 수 있습니다.
-
PL/SQL
PL/SQL은 SQL에 대한 Oracle AI Database 프로시저 확장입니다. PL/SQL은 데이터베이스와 통합되어 모든 Oracle SQL 문, 함수 및 데이터 유형을 지원합니다. 데이터베이스 API로 작성된 응용 프로그램은 PL/SQL 내장 서브 프로그램을 호출하고 실행을 위해 PL/SQL 코드 블록을 데이터베이스로 보낼 수 있습니다.
-
Java
또한 Oracle AI Database는 Java 애플리케이션 개발, 저장, 배포를 지원합니다. Java 내장 서브 프로그램은 데이터베이스에서 실행되며 중간 계층에서 실행되는 프로그램과는 독립적입니다. Java 내장 서브 프로그램은 PL/SQL과 유사한 실행 모델을 사용하여 SQL과 인터페이스됩니다.
-
JavaScript
Linux x86-64 또는 Linux aarch64에 배포된 Oracle AI Database는 개발자가 JavaScript에서 비즈니스 로직을 표현할 수 있도록 지원합니다. JavaScript의 임시 실행은 DBMS_MLE PL/SQL 패키지 및 해당 서브 루틴을 통해 가능합니다. 업무 논리를 JavaScript 스키마 객체로 저장하면 보다 복잡한 응용 프로그램을 작성할 수 있습니다. 호출 사양은 SQL 및 PL/SQL의 데이터베이스에 저장된 JavaScript 코드를 Java 내장 프로시저와 유사한 방식으로 표시합니다.
참조:
-
선행 컴파일러 및 API와 SQL 임베딩에 대해 알아보려면 Oracle AI Database Development Guide를 참조하십시오.
-
Oracle AI Database 시작하기 Oracle AI Database 개발 - Oracle AI Database 애플리케이션 개발 소개
-
Oracle AI Database Development Guide - 프로그래밍 환경 선택 방법 학습
-
Oracle AI Database의 JavaScript 지원에 대해 자세히 알아보려면 Oracle AI Database JavaScript Developer's Guide를 참조하십시오.
PL/SQL 개요
PL/SQL은 사용하기 쉽고 SQL과 원활하며 강력하고 이식 가능하며 안전한 서버측 저장 프로시저 언어를 제공합니다. PL/SQL 단위라는 절차 객체를 사용하여 데이터베이스 데이터에 액세스하고 데이터베이스 데이터를 조작할 수 있습니다.
PL/SQL 단위는 일반적으로 다음과 같이 분류됩니다.
-
PL/SQL 하위 프로그램은 데이터베이스에 저장되고 응용 프로그램에서 이름으로 호출될 수 있는 PL/SQL 블록입니다. 서브 프로그램을 생성하면 데이터베이스가 서브 프로그램을 구문 분석하고 해당 서브 프로그램의 구문 분석된 표현을 데이터베이스에 저장합니다. 서브 프로그램을 프로시저 또는 함수로 선언할 수 있습니다.
-
PL/SQL 익명 블록은 응용 프로그램에 나타나며 데이터베이스에 이름이 지정되거나 저장되지 않는 PL/SQL 블록입니다. 많은 응용 프로그램에서는 SQL 문이 나타날 수 있는 모든 위치에 PL/SQL 블록이 나타날 수 있습니다.
PL/SQL 컴파일러와 인터프리터는 Oracle SQL Developer에 내장되어 개발자에게 클라이언트와 서버 모두에서 일관되고 활용되는 개발 모델을 제공합니다. 또한 PL/SQL 내장 프로시저는 Pro*C, JDBC, ODBC 또는 OCI와 같은 여러 데이터베이스 클라이언트와 Oracle Reports 및 Oracle Forms에서 호출할 수 있습니다.
-
PL/SQL 서브 프로그램 PL/SQL 서브 프로그램은 호출자가 입력 전용, 출력 전용 또는 입력 및 출력 값일 수 있는 파라미터를 제공할 수 있도록 허용하는 명명된 PL/SQL 블록입니다.
-
PL/SQL 패키지 PL/SQL 패키지는 관련된 하위 프로그램과 이들 프로그램에서 사용하는 커서 및 변수로 구성되며, 연속된 사용을 위해 데이터베이스에서 하나의 단위로서 저장됩니다. 패키지화된 서브 프로그램은 응용 프로그램이나 유저가 명시적으로 호출할 수 있습니다.
-
PL/SQL 익명 블록 PL/SQL 익명 블록은 이름이 지정되지 않고 비영구적인 PL/SQL 단위입니다.
-
PL/SQL 언어 생성자 PL/SQL 블록에는 다양한 PL/SQL 언어 생성자가 포함될 수 있습니다.
-
PL/SQL 컬렉션 및 레코드 많은 프로그래밍 기법에서는 배열, 백, 리스트, 중첩 테이블, 집합 및 트리와 같은 컬렉션 유형을 사용합니다.
-
PL/SQL 실행 방법 PL/SQL은 해석된 실행과 고유 실행을 모두 지원합니다.
참조:
-
패키지를 비롯하여 PL/ SQL에 대한 자세한 내용은 Oracle AI Database PL/ SQL Language Reference를 참조하십시오
PL/SQL 서브 프로그램
PL/SQL 서브 프로그램은 호출자가 입력 전용, 출력 전용 또는 입력 및 출력 값일 수 있는 파라미터를 제공할 수 있도록 하는 명명된 PL/SQL 블록입니다.
서브 프로그램은 특정 문제를 해결하거나 관련 작업을 수행하며 모듈식의 유지 관리 가능한 데이터베이스 응용 프로그램의 구성 요소 역할을 합니다. 서브 프로그램은 PL/SQL 프로시저 또는 PL/SQL 함수입니다. 함수가 항상 단일 값을 호출자에게 반환하고 프로시저는 그렇지 않다는 점을 제외하면 프로시저와 함수는 동일합니다. 이 장의 PL/SQL 프로시저라는 용어는 프로시저 또는 함수를 가리킵니다.
-
PL/SQL 서브 프로그램의 장점 서버측 프로그래밍은 클라이언트측 프로그래밍보다 많은 이점이 있습니다.
-
PL/SQL 서브 프로그램 생성 독립형 내장 서브 프로그램은
CREATE PROCEDURE또는CREATE FUNCTION문을 사용하여 스키마 레벨에서 생성되는 서브 프로그램입니다. 패키지에 정의된 서브프로그램을 패키지 서브프로그램이라고 하며 패키지의 일부로 간주됩니다. -
PL/SQL 서브 프로그램 실행 사용자는 여러 가지 방법으로 서브 프로그램을 대화식으로 실행할 수 있습니다.
참조:
-
이러한 언어의 내장 프로시저에 대한 자세한 내용은 Pro*C/C++ Developer's Guide 및 Pro*COBOL Developer's Guide를 참조하십시오.
PL/SQL 서브 프로그램의 이점
서버측 프로그래밍은 클라이언트측 프로그래밍에 비해 많은 장점이 있습니다.
장점은 다음과 같습니다.
-
성능 향상
-
메모리 할당
내장 프로시저는 Oracle AI Database의 공유 메모리 기능을 활용하므로 여러 사용자가 실행할 수 있도록 프로시저의 단일 복사본만 메모리에 로드해야 합니다. 유저 간에 코드를 공유하면 응용 프로그램에 대한 데이터베이스 메모리 요구 사항이 크게 줄어듭니다.
-
생산성 향상
내장 프로시저를 사용하면 개발 생산성이 향상됩니다. 공통 프로시저 집합을 중심으로 응용 프로그램을 설계하면 중복 코딩을 피할 수 있습니다. 예를 들어,
employees테이블의 행을 조작하는 프로시저를 작성할 수 있습니다. 응용 프로그램은 SQL 문을 재작성하지 않고도 이러한 프로시저를 호출할 수 있습니다. 데이터 관리 방법이 변경되는 경우 프로시저를 사용하는 응용 프로그램이 아니라 프로시저만 수정해야 합니다.내장 프로시저는 아마도 코드를 재사용하는 가장 좋은 방법입니다. 데이터베이스에 연결하는 임의의 언어로 작성된 클라이언트 응용 프로그램은 내장 프로시저를 호출할 수 있으므로 모든 환경에서 최대 코드 재사용을 제공합니다.
-
무결성
내장 프로시저는 응용 프로그램의 무결성과 일관성을 향상시킵니다. 일반적인 절차 그룹을 중심으로 응용 프로그램을 개발하면 코딩 오류가 발생할 가능성이 줄어듭니다.
예를 들어, 서브 프로그램을 테스트하여 정확한 결과를 반환하고, 확인된 후에 재테스트 없이 원하는 수의 응용 프로그램에서 재사용할 수 있습니다. 프로시저에서 참조하는 데이터 구조가 변경되는 경우 프로시저만 재컴파일하면 됩니다. 프로시저를 호출하는 응용 프로그램은 반드시 수정할 필요가 없습니다.
-
정의자 권한 프로시저를 사용한 보안
내장 프로시저는 데이터 보안을 강화하는 데 도움이 됩니다. 정의자의 권한 PL/SQL 프로시저는 현재 사용자가 아닌 소유자의 권한을 사용하여 실행됩니다. 따라서 유저가 수행 중인 데이터베이스 작업을 정의자 권한으로 실행되는 프로시저와 함수를 통해서만 데이터에 액세스할 수 있도록 제한할 수 있습니다.
예를 들어, 유저에게 테이블을 갱신하지만 테이블 자체에 대한 액세스 권한은 부여하지 않는 프로시저에 대한 액세스 권한을 부여할 수 있습니다. 유저가 프로시저를 호출하면 해당 소유자의 권한으로 실행됩니다. 기본 테이블에서 query, 갱신 또는 삭제할 수 있는 권한은 없지만 프로시저를 실행할 수 있는 권한만 있는 유저는 프로시저를 호출할 수 있지만 다른 방법으로는 테이블 데이터를 조작할 수 없습니다.
-
호출자의 권한 프로시저를 사용한 상속된 권한 및 스키마 컨텍스트
호출자의 권한 PL/SQL 프로시저는 현재 사용자의 권한으로 현재 사용자의 스키마에서 실행됩니다. 즉, 호출자의 권한 프로시저는 특정 유저나 스키마와 연관되지 않습니다. 호출자의 권한 프로시저를 사용하면 응용 프로그램 개발자가 기본 데이터를 유저 스키마로 구분해도 응용 프로그램 논리를 쉽게 중앙 집중화할 수 있습니다.
예를 들어,
hr.employees테이블에서 갱신 프로시저를 실행하는hr_manager유저는 급여를 갱신할 수 있지만, 동일한 프로시저를 실행하는hr_clerk는 주소 데이터 갱신으로 제한됩니다.
참조:
-
PL/SQL 서브 프로그램 개요는 Oracle AI Database PL/SQL Language Reference를 참조하십시오.
-
정의자 및 호출자 권한에 대해 자세히 알아보려면 Oracle AI Database Security Guide를 참조하십시오.
PL/SQL 서브 프로그램 생성
독립형 내장 서브 프로그램은 CREATE PROCEDURE 또는 CREATE FUNCTION 문을 사용하여 스키마 레벨에서 생성되는 서브 프로그램입니다. 패키지에 정의된 서브프로그램을 패키지 서브프로그램이라고 하며 패키지의 일부로 간주됩니다.
데이터베이스는 서브 프로그램을 데이터 딕셔너리에 스키마 객체로 저장합니다. 서브 프로그램에는 파라미터 및 본문에 대한 설명이 포함된 Spec이 있습니다.
예제 11-1 PL/SQL 프로시저
이 예제는 독립형 PL/SQL 프로시저 hire_employees에 대한 생성 명령문의 일부를 보여줍니다. 이 프로시저는 employees 테이블에 행을 삽입합니다.
CREATE PROCEDURE hire_employees
  (p_last_name VARCHAR2, p_job_id VARCHAR2, p_manager_id NUMBER,
   p_hire_date DATE, p_salary NUMBER, p_commission_pct NUMBER,
   p_department_id NUMBER)
IS
BEGIN
.
.
.
  INSERT INTO employees (employee_id, last_name, job_id, manager_id, hire_date,
    salary, commission_pct, department_id)
  VALUES (emp_sequence.NEXTVAL, p_last_name, p_job_id, p_manager_id,
          p_hire_date, p_salary, p_commission_pct, p_department_id);
.
.
.
END;
참조:
-
Oracle AI Database Get Started with Oracle AI Database Development - 서브프로그램 생성 방법 학습
-
CREATE PROCEDURE문에 대한 자세한 내용은 Oracle AI Database PL/SQL Language Reference를 참조하십시오.
PL/SQL 서브 프로그램 실행
사용자는 여러 가지 방법으로 서브 프로그램을 대화식으로 실행할 수 있습니다.
다음과 같은 옵션이 있습니다.
-
SQL*Plus 또는 SQL Developer 등의 Oracle 도구 사용
-
Oracle Forms 또는 선행 컴파일러 응용 프로그램과 같은 데이터베이스 응용 프로그램의 코드에서 명시적으로 호출
-
다른 프로시저나 트리거의 코드에서 명시적으로 호출
다음 그림은 hire_employees를 호출하는 여러 데이터베이스 응용 프로그램을 보여줍니다.
그림 1: 내장 프로시저의 다중 실행
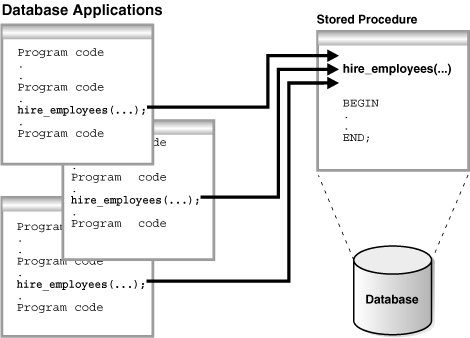
또는 권한 있는 유저가 다음과 같은 명령문을 사용하여 Oracle Enterprise Manager 또는 SQL*Plus를 사용하여 hire_employees 프로시저를 실행할 수 있습니다.
EXECUTE hire_employees ('TSMITH', 'CLERK', 1037, SYSDATE, 500, NULL, 20);앞의 명령문은 employees 테이블에 TSMITH에 대한 새 레코드를 삽입합니다.
내장 프로시저는 본문에서 참조되는 객체에 따라 달라집니다. 데이터베이스는 이러한 종속성을 자동으로 추적하고 관리합니다. 예를 들어, 이 프로시저에 영향을 주는 방식으로 hire_employees 프로시저에서 참조하는 employees 테이블의 정의를 변경하는 경우 프로시저를 재컴파일하여 해당 테이블이 여전히 설계된 대로 작동하는지 검증해야 합니다. 일반적으로 데이터베이스는 이러한 종속성 관리를 자동으로 관리합니다.
참조:
-
SQL*Plus 및 SQL Developer에 대한 자세한 내용은 Oracle AI Database Get Started with Oracle AI Database Development를 참조하십시오.
-
선행 컴파일러에 대한 자세한 내용은 Oracle AI Database Development Guide를 참조하십시오.
-
Oracle AI Database PL/SQL Language Reference를 통해 PL/SQL 서브 프로그램 사용 방법 학습
-
EXECUTE명령에 대해 알아보려면 SQL*Plus 사용 설명서 및 참조를 참조하십시오.
PL/SQL 패키지
PL/SQL 패키지는 관련된 하위 프로그램 그룹으로, 사용되는 커서 및 변수로 구성되며, 연속된 사용을 위해 데이터베이스에서 하나의 단위로서 저장됩니다. 패키지화된 서브 프로그램은 응용 프로그램이나 유저가 명시적으로 호출할 수 있습니다.
Oracle AI Database에는 데이터베이스 기능을 확장하고 SQL 기능에 대한 PL/SQL 액세스를 제공하는 다양한 패키지가 포함되어 있습니다. 예를 들어, UTL_HTTP 패키지를 사용하면 PL/SQL 및 SQL의 HTTP 콜아웃이 인터넷의 데이터에 액세스하거나 Oracle Web Server 카트리지를 호출할 수 있습니다. 응용 프로그램을 생성할 때 또는 고유한 내장 프로시저를 생성할 때 제공된 패키지를 아이디어의 소스로 사용할 수 있습니다.
-
PL/SQL 패키지의 장점 PL/SQL 패키지는 응용 프로그램 개발자에게 여러 가지 장점을 제공합니다.
-
PL/SQL 패키지 생성 사양과 본문의 두 부분으로 패키지를 생성합니다. Package Spec은 패키지의 모든 공용(public) 생성자를 선언하는 반면 Package Body는 패키지의 모든 생성자(public 및 private)를 정의합니다.
-
PL/SQL 패키지 서브 프로그램 실행 데이터베이스 트리거, 내장 서브 프로그램, 3GL 응용 프로그램 및 Oracle 도구는 패키지 내용을 참조할 수 있습니다.
PL/SQL 패키지의 이점
PL/SQL 패키지는 응용 프로그램 개발자에게 여러 가지 이점을 제공합니다.
장점은 다음과 같습니다.
-
캡슐화
패키지를 사용하면 명명된 내장 단위에서 내장 프로시저, 변수, 데이터 유형 등을 캡슐화하거나 그룹화할 수 있습니다. 캡슐화는 개발 중에 더 나은 조직과 더 많은 유연성을 제공합니다. Package Body를 실제로 생성하지 않고 사양을 생성하고 공용(public) 프로시저를 참조할 수 있습니다. 캡슐화는 권한 관리를 단순화합니다. 패키지에 대한 권한을 부여하면 피부여자가 패키지 생성자에 액세스할 수 있습니다.
-
데이터 안전성
패키지 정의 메소드를 사용하면 공용(public) 및 전용(private) 변수, 커서 및 프로시저를 지정할 수 있습니다. 공용(public)은 패키지 유저가 직접 액세스할 수 있음을 의미합니다. Private은 패키지 유저로부터 숨겨짐을 의미합니다.
예를 들어, 패키지는 10개의 프로시저를 포함할 수 있습니다. 세 개의 프로시저만 공용(public)이므로 패키지 유저가 실행할 수 있도록 패키지를 정의할 수 있습니다. 나머지 프로시저는 전용(private) 프로시저이며 패키지 내의 프로시저만 액세스할 수 있습니다. 공용(public) 및 전용(private) 패키지 변수와
PUBLIC에 대한 권한 부여를 혼동하지 마십시오. -
성능 향상
패키지의 프로시저가 처음 호출될 때 전체 패키지가 작은 조각으로 메모리에 로드됩니다. 이 로드는 독립형 프로시저에 필요한 별도의 로드와 달리 한 번의 작업으로 완료됩니다. 관련 패키지 프로시저 호출이 발생할 경우 메모리에서 컴파일된 코드를 실행하는 데 디스크 I/O가 필요하지 않습니다.
Package Body는 Spec에 영향을 주지 않고 교체 및 재컴파일할 수 있습니다. 따라서 Package Spec을 대체하지 않은 경우 항상 Spec을 통해 패키지 생성자를 참조하는 스키마 객체를 재컴파일할 필요가 없습니다. 패키지를 사용하면 불필요한 재컴파일을 최소화할 수 있으므로 전체 데이터베이스 성능에 미치는 영향을 줄일 수 있습니다.
PL/SQL 패키지 생성
Spec과 Body의 두 부분으로 패키지를 생성합니다. Package Spec은 패키지의 모든 공용(public) 생성자를 선언하는 반면 Package Body는 패키지의 모든 생성자(public 및 private)를 정의합니다.
다음 예제는 employees_management에 대한 Package Spec을 생성하는 명령문의 일부를 보여줍니다. 이 명령문은 사원 데이터베이스를 관리하는 데 사용되는 여러 서브 프로그램을 캡슐화합니다. 패키지의 각 부분은 다른 명령문을 사용하여 생성됩니다.
CREATE PACKAGE employees_management AS
  FUNCTION hire_employees (last_name VARCHAR2, job_id VARCHAR2, manager_id NUMBER,
    salary NUMBER, commission_pct NUMBER, department_id NUMBER) RETURN NUMBER;
  PROCEDURE fire_employees(employee_id NUMBER);
  PROCEDURE salary_raise(employee_id NUMBER, salary_incr NUMBER);
.
.
.
  no_sal EXCEPTION;
END employees_management;
사양은 함수 hire_employees, 프로시저 fire_employees 및 salary_raise 및 예외 no_sal를 선언합니다. 이러한 모든 공용 프로그램 객체는 패키지에 액세스할 수 있는 유저가 사용할 수 있습니다.
CREATE PACKAGE BODY 문은 사양에 선언된 객체를 정의합니다. Package Body는 패키지와 동일한 스키마에 생성되어야 합니다. 패키지를 생성한 후에는 이러한 공용 프로시저나 함수를 호출하는 응용 프로그램을 개발하거나 패키지의 공용(public) 예외를 발생시킬 수 있습니다.
참조: CREATE PACKAGE 문에 대한 자세한 내용은 Oracle AI Database PL/SQL Language Reference를 참조하십시오.
PL/SQL 패키지 서브 프로그램 실행
데이터베이스 트리거, 내장 서브 프로그램, 3GL 응용 프로그램 및 Oracle 도구는 패키지 내용을 참조할 수 있습니다.
다음 그림은 employees_management 패키지의 프로시저와 함수를 호출하는 데이터베이스 응용 프로그램을 보여줍니다.
그림 2: PL/SQL 패키지에서 서브 프로그램 호출
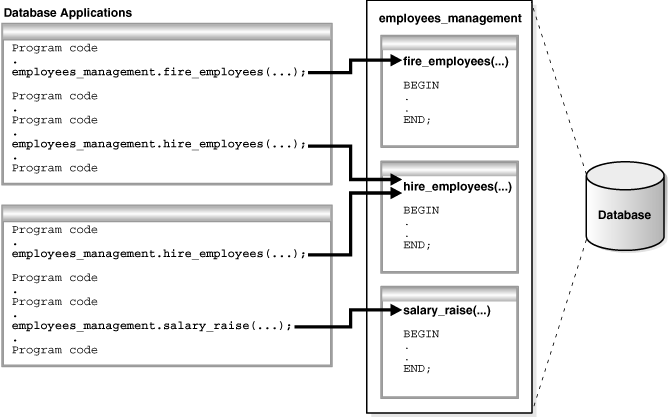
데이터베이스 응용 프로그램은 필요에 따라 명시적으로 패키지 프로시저를 호출합니다. employees_management 패키지에 대한 권한을 부여받은 후 유저는 패키지에 포함된 프로시저를 명시적으로 실행할 수 있습니다. 예를 들어, SQL*Plus는 다음 명령문을 실행하여 hire_employees 패키지 프로시저를 실행할 수 있습니다.
EXECUTE employees_management.hire_employees ('TSMITH', 'CLERK', 1037, SYSDATE, 500, NULL, 20);참조:
-
PL/SQL 패키지 소개를 위한 Oracle AI Database PL/SQL Language Reference
-
PL/SQL 패키지를 코딩하는 방법은 Oracle AI Database Development Guide를 참조하십시오.
PL/SQL 익명의 블록
PL/SQL 익명 블록은 이름이 지정되지 않은 비영구 PL/SQL 단위입니다.
익명 블록의 일반적인 용도는 다음과 같습니다.
-
서브 프로그램 및 패키지 생성자에 대한 호출 시작
-
예외 처리 분리
-
다른 PL/SQL 블록 내에 코드를 중첩하여 제어 관리
익명 블록은 내장 서브 프로그램의 코드 재사용 이점이 없습니다. 표 11-1에는 두 가지 유형의 PL/SQL 단위 간의 차이점이 요약되어 있습니다.
표 1 익명 블록과 서브 프로그램의 차이점
| PL/SQL 단위 ... | 익명의 블록 | 하위 프로그램 |
|---|---|---|
| 이름으로 지정되었습니까? | 아니요 | 예. |
| 모든 재사용으로 컴파일됨 | 아니요 | 아니요 |
| 데이터베이스에 저장되었습니까? | 아니요 | 예. |
| 다른 응용 프로그램에서 호출할 수 있습니까? | 아니요 | 예. |
| 바인드 변수 값을 반환할 수 있습니까? | 예. | 예. |
| 함수 값을 반환할 수 있습니까? | 아니요 | 예. |
| 매개변수를 수락할 수 있습니까? | 아니요 | 예. |
익명 블록은 선택적 선언 부분, 실행 부분 및 하나 이상의 선택적 예외 처리기로 구성됩니다. 다음 예제 익명 블록은 사원의 성을 변수로 선택하고 이름을 출력합니다.
DECLARE
  v_lname VARCHAR2(25);
BEGIN
  SELECT last_name
    INTO v_lname
  FROM employees
  WHERE employee_id = 101;
  DBMS_OUTPUT.PUT_LINE('Employee last name is '||v_lname);
END;
Oracle AI Database는 PL/SQL 블록을 컴파일하여 SGA의 Shared Pool에 배치하지만 현재 Instance 이상으로 재사용할 수 있도록 소스 코드나 컴파일된 버전을 데이터베이스에 저장하지 않습니다. 트리거와 달리 익명 블록은 메모리에 로드될 때마다 컴파일됩니다. 공유 SQL을 사용하면 공유 풀에 있는 익명 PL/SQL 블록이 공유 풀에서 비워질 때까지 재사용 및 공유될 수 있습니다.
참조: 익명 PL/SQL 블록에 대한 자세한 내용은 Oracle AI Database Development Guide를 참조하십시오.
PL/SQL 언어 생성자
PL/SQL 블록에는 다양한 PL/SQL 언어 생성자가 포함될 수 있습니다.
이러한 구성은 다음과 같습니다.
-
변수 및 상수
프로시저, 함수 또는 패키지 내에서 이러한 생성자를 선언할 수 있습니다. SQL 또는 PL/SQL 문에서 변수나 상수를 사용하여 필요할 때 값을 캡처하거나 제공할 수 있습니다.
-
커서
프로시저, 함수 또는 패키지 내에서 명시적으로 커서를 선언하여 Oracle AI Database 데이터의 레코드 지향 처리를 용이하게 할 수 있습니다. PL/SQL 엔진은 커서를 암시적으로 선언할 수도 있습니다.
-
예외
PL/SQL을 사용하면 PL/SQL 코드를 처리하는 동안 발생하는 내부 및 유저 정의 오류 조건(예외)을 명시적으로 처리할 수 있습니다.
PL/SQL은 런타임까지 전체 텍스트를 알 수 없는 동적 SQL 문을 실행할 수 있습니다. 동적 SQL 문은 런타임 시 프로그램에 입력되거나 프로그램에 의해 작성되는 문자열에 저장됩니다. 이 기법을 사용하여 범용 프로시저를 생성할 수 있습니다. 예를 들어, 런타임 시까지 이름을 알 수 없는 테이블에 대해 작동하는 프로시저를 생성할 수 있습니다.
참조:
-
동적 SQL에 대한 자세한 내용은 Oracle AI Database PL/SQL 패키지 및 유형 참조를 참조하십시오.
-
DBMS_SQL패키지에서 동적 SQL을 사용하는 방법을 알아보려면 Oracle AI Database PL/SQL Packages and Types Reference를 참조하십시오.
PL/SQL 컬렉션 및 레코드
많은 프로그래밍 기법은 배열, 백, 리스트, 중첩 테이블, 집합 및 트리와 같은 컬렉션 유형을 사용합니다.
데이터베이스 응용 프로그램에서 수집 기술을 지원하기 위해 PL/SQL은 TABLE 및 VARRAY 데이터 유형을 제공합니다. 이러한 유형을 사용하면 연관 배열, 중첩 테이블 및 가변 크기 배열을 선언할 수 있습니다.
-
수집 PL/SQL 컬렉션은 모두 동일한 유형의 정렬된 요소 그룹입니다.
-
레코드 PL/SQL 레코드는 여러 유형의 데이터 값을 저장할 수 있는 조합 변수로, C, C++ 또는 Java의 struct 유형과 유사합니다. 레코드는 테이블 행에 있는 데이터나 테이블 행에 있는 특정 열의 데이터를 보관하는 데 유용합니다.
수금
PL/SQL 컬렉션은 모두 동일한 유형의 정렬된 요소 그룹입니다.
각 요소에는 모음에서 위치를 결정하는 고유한 하위 스크립트가 있습니다. 컬렉션을 생성하려면 먼저 컬렉션 유형을 정의한 다음 해당 유형의 변수를 선언합니다.
컬렉션은 대부분의 3세대 프로그래밍 언어에서 발견되는 배열처럼 작동합니다. 또한 컬렉션을 파라미터로 전달할 수 있습니다. 따라서 %1$S를 사용하여 데이터베이스 테이블 내/외부 또는 클라이언트측 응용 프로그램과 내장된 서브 프로그램 사이에 데이터 열을 이동할 수 있습니다.
레코드
PL/SQL 레코드는 여러 유형의 데이터 값을 저장할 수 있는 조합 변수로, C, C++ 또는 Java의 struct 유형과 유사합니다. 레코드는 테이블 행에 있는 데이터나 테이블 행에 있는 특정 열의 데이터를 보관하는 데 유용합니다.
이름, 급여 및 채용 날짜와 같은 사원에 대한 데이터가 있다고 가정해 보겠습니다. 이러한 항목은 유형과는 다르지만 논리적으로 관련이 있습니다. 각 항목에 대한 필드가 포함된 레코드를 사용하여 데이터를 논리 단위로 처리할 수 있습니다.
%ROWTYPE 속성을 사용하여 커서에서 패치(fetch)된 테이블 행이나 행을 나타내는 레코드를 선언할 수 있습니다. 사용자 정의 레코드를 사용하여 고유한 필드를 선언할 수 있습니다.
참조: Oracle AI Database PL/SQL Language Reference를 통해 PL/SQL 레코드 사용 방법 학습
PL/SQL 실행 방법
PL/SQL은 해석된 실행과 원시 실행을 모두 지원합니다.
해석된 실행에서 PL/SQL 소스 코드는 소위 바이트 코드 표현으로 컴파일됩니다. Oracle AI Database의 일부로 구현된 이식 가능한 가상 컴퓨터는 이 바이트 코드를 실행합니다.
원시 실행은 계산 집약적인 단위에서 최상의 성능을 제공합니다. 이 경우 PL/SQL 단위의 소스 코드는 주어진 플랫폼에 대한 객체 코드로 직접 컴파일됩니다. 이 객체 코드는 Oracle AI Database에 연결됩니다.
PL/SQL 엔진은 PL/SQL 단위를 정의, 컴파일 및 실행합니다. 이 엔진은 Oracle AI Database를 비롯한 여러 Oracle 제품의 특수 구성요소입니다. 많은 Oracle 제품에 PL/SQL 구성 요소가 있지만, 이 항목에서는 특히 Oracle AI Database에 저장되고 Oracle AI Database PL/SQL 엔진을 사용하여 처리할 수 있는 PL/SQL 단위에 대해 다룹니다. 각 Oracle 툴에 대한 설명서에서는 해당 PL/SQL 기능에 대해 설명합니다.
다음 그림은 Oracle AI Database에 포함된 PL/SQL 엔진을 보여줍니다.
그림 3: PL/SQL 엔진 및 Oracle AI Database
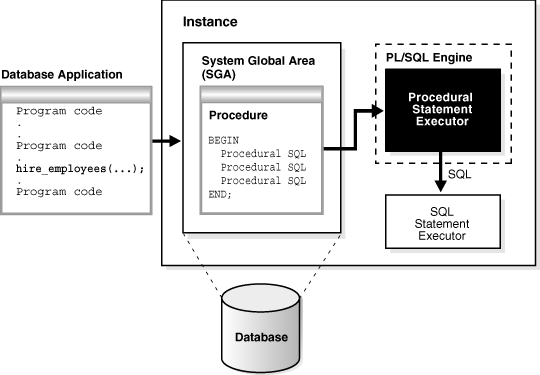
PL/SQL 단위는 데이터베이스에 저장됩니다. 응용 프로그램이 내장 프로시저를 호출하면 데이터베이스는 컴파일된 PL/SQL 단위를 시스템 전역 영역(SGA)의 공유 풀로 로드합니다. PL/SQL 및 SQL 문 실행기는 함께 작동하여 프로시저의 명령문을 처리합니다.
다른 PL/SQL 블록에서 내장 프로시저를 호출할 수 있습니다. 이 블록은 익명 블록이거나 다른 내장 프로시저일 수 있습니다. 예를 들어, Oracle Forms에서 내장 프로시저를 호출할 수 있습니다.
Oracle AI Database에서 실행되는 PL/SQL 프로시저는 C 프로그래밍 언어로 작성되어 공유 라이브러리에 저장된 외부 프로시저나 함수를 호출할 수 있습니다. C 루틴은 Oracle AI Database와는 다른 별도의 주소 공간에서 실행됩니다.
참조:
-
"Shared Pool " - Shared Pool의 목적 및 내용에 대해 자세히 알아보기
-
PL/ SQL 아키텍처에 대한 자세한 내용은 Oracle AI Database PL/ SQL Language Reference를 참조하십시오.
-
외부 절차에 대해 자세히 알아보려면 Oracle AI Database Development Guide를 참조하십시오.
Oracle AI Database의 Java 개요
Java는 선택한 객체 지향 프로그래밍 언어로 등장했습니다.
Java에는 다음 기능이 포함되어 있습니다.
-
플랫폼 독립성을 위한 기반을 제공하는 JVM(Java Virtual Machine)
-
가비지 수집과 같은 자동화된 저장 영역 관리 기술
-
C에서 빌려 강력한 입력을 시행하는 언어 구문 주: 이 장에서는 사용자가 Java 언어에 익숙하다고 가정합니다.
데이터베이스는 Java 프로그램에 복잡한 query 및 다중 데이터 뷰를 지원하는 동적 데이터 처리 엔진을 제공합니다. 클라이언트 요청은 즉각적인 처리를 위한 데이터 쿼리로 어셈블됩니다. Query 결과는 동적으로 생성됩니다.
Java와 Oracle AI Database를 결합하면 비즈니스 요구 사항이 변화함에 따라 쉽게 업데이트할 수 있는 구성요소 기반의 네트워크 중심 애플리케이션을 생성할 수 있습니다. 또한 응용 프로그램 및 데이터 저장소를 데스크탑에서 지능형 네트워크 및 네트워크 중심 서버로 이동할 수 있습니다. 더 중요한 것은 모든 클라이언트 장치에서 이러한 응용 프로그램 및 데이터 저장소에 액세스할 수 있다는 것입니다.
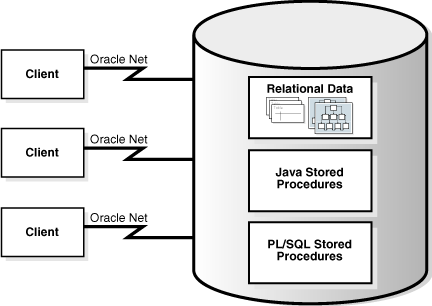
다음 그림은 클라이언트가 PL/SQL 서브 프로그램을 호출하는 것과 동일한 방식으로 Java 내장 프로시저를 호출하는 기존의 2계층 클라이언트/서버 구성을 보여줍니다.
그림 4: 2계층 클라이언트/서버 구성
-
Java Virtual Machine(JVM) 개요 JVM은 컴파일된 Java 코드를 실행하는 가상 프로세서입니다.
-
Java Programming Environment Oracle은 엔터프라이즈 애플리케이션 개발자에게 Java 애플리케이션을 생성, 배포 및 관리할 수 있는 엔드투엔드 Java 솔루션을 제공합니다. 참조: Oracle AI Database Get Started with Java Development에서 Java with Oracle AI Database 사용 소개
JVM(Java Virtual Machine) 개요
JVM은 컴파일된 Java 코드를 실행하는 가상 프로세서입니다.
Java 소스 코드는 플랫폼 독립적인 하위 레벨 기계어 명령(바이트 코드라고 함)으로 컴파일됩니다. Java 바이트 코드는 JVM을 통해 플랫폼 종속 작업으로 해석됩니다.
-
Oracle JVM 개요 Oracle JVM은 모든 순수 Java 애플리케이션을 실행하는 표준 Java 호환 환경입니다. JLS 및 JVM 사양과 호환됩니다.
-
Oracle JVM의 기본 구성요소 Oracle JVM은 메모리 힙을 공유하고 관계형 데이터에 직접 액세스하여 데이터베이스 커널과 동일한 프로세스 공간 및 주소 공간에서 실행됩니다. 이 설계는 메모리 사용을 최적화하고 처리량을 증가시킵니다.
Oracle JVM 개요
Oracle JVM은 모든 순수 Java 애플리케이션을 실행하는 표준 Java 호환 환경입니다. JLS 및 JVM 사양과 호환됩니다.
Oracle JVM은 표준 Java 바이너리 형식 및 API를 지원합니다. 또한 Oracle AI Database는 런타임 시 동적 클래스 로드를 포함하여 표준 Java 언어 의미를 준수합니다.
다음 그림은 Oracle Java 애플리케이션이 Oracle JVM 위에 상주하는 Java 핵심 클래스 라이브러리에 상주하는 방식을 보여줍니다. Oracle Java 지원 시스템은 데이터베이스 내에 있으므로 JVM은 운영 체제와 직접 상호 작용하는 대신 데이터베이스 라이브러리와 상호 작용합니다.
그림 5: Java 구성 요소 구조
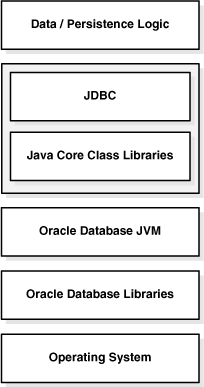
다른 Java 환경과 달리 Oracle JVM은 Oracle AI Database 내에 내장되어 있습니다. Oracle JVM과 일반적인 클라이언트 JVM 간에 중요한 차이점이 있습니다. 예를 들어, 표준 Java 환경에서는 명령행에서 다음 명령을 실행하여 인터프리터를 통해 Java 응용 프로그램을 실행합니다. 여기서 classname은 JVM이 먼저 해석하는 클래스의 이름입니다.
java classname앞의 명령을 실행하면 운영 체제의 프로세스 내에서 응용 프로그램이 실행됩니다. 그러나 명령행 인터페이스를 사용하지 않는 경우 응용 프로그램을 데이터베이스로 로드하고 인터페이스를 게시한 다음 데이터베이스 데이터 딕셔너리 내에서 응용 프로그램을 실행해야 합니다.
참조: Oracle JVM과 일반 클라이언트 JVM 간의 다른 차이점에 대한 설명은 Oracle AI Database Java Developer's Guide를 참조하십시오.
Oracle JVM의 기본 구성요소
Oracle JVM은 메모리 힙을 공유하고 관계형 데이터에 직접 액세스하여 데이터베이스 커널과 동일한 프로세스 공간 및 주소 공간에서 실행됩니다. 이 설계는 메모리 사용을 최적화하고 처리량을 증가시킵니다.
Oracle JVM은 Java 객체에 대한 런타임 환경을 제공합니다. Java 데이터 구조, 메소드 디스패치, 예외 처리 및 언어 레벨 스레드를 완벽하게 지원합니다. 또한 java.lang, java.io, java.net, java.math 및 java.util를 포함한 모든 핵심 Java 클래스 라이브러리를 지원합니다.
다음 그림은 Oracle JVM의 기본 구성 요소를 보여줍니다.
그림 6: Oracle JVM의 주요 구성 요소
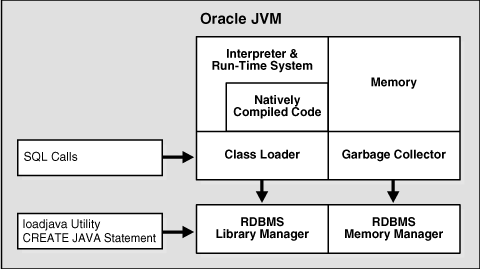
Oracle JVM은 데이터베이스 스키마에 표준 Java 네임스페이스를 포함합니다. 이 기능을 사용하면 Java 프로그램이 전사적으로 Oracle AI Database 및 애플리케이션 서버에 저장된 Java 객체에 액세스할 수 있습니다.
또한 Oracle JVM은 데이터베이스의 확장 가능한 공유 메모리 아키텍처와 긴밀하게 통합되어 있습니다. Java 프로그램은 유저 개입 없이 호출, 세션 및 객체 수명을 효율적으로 사용합니다. 따라서 Oracle JVM 및 중간 계층 Java 비즈니스 객체는 세션이 긴 상태인 경우에도 크기를 조정할 수 있습니다.
참조: Oracle JVM의 기본 구성요소에 대한 설명은 Oracle AI Database Java Developer's Guide를 참조하십시오.
Java 프로그래밍 환경
Oracle은 엔터프라이즈 애플리케이션 개발자에게 Java 애플리케이션을 생성, 배포 및 관리할 수 있는 엔드투엔드 Java 솔루션을 제공합니다.
이 솔루션은 클라이언트측 및 서버측 프로그래밍 인터페이스, Java 개발을 지원하는 도구 및 Oracle AI Database와 통합된 Java Virtual Machine으로 구성됩니다. 이러한 모든 제품은 Java 표준과 호환됩니다.
Java 프로그래밍 환경은 다음과 같은 추가 기능으로 구성됩니다.
-
Java 내장 프로시저는 PL/SQL의 동봉자이며 Java와 동등합니다. Java 내장 프로시저는 PL/SQL과 긴밀하게 통합됩니다. Java 내장 프로시저는 PL/SQL 패키지에서 호출하고 Java 내장 프로시저에서 프로시저를 호출할 수 있습니다.
-
SQL 데이터에 액세스하기 위한 JDBC 및 SQLJ 프로그래밍 인터페이스입니다.
-
클래스 개발, 로드 및 관리를 지원하는 툴 및 스크립트입니다.
-
Java 내장 프로시저 Java 내장 프로시저는 SQL에 게시되고 데이터베이스에 저장되는 Java 메소드입니다.
-
Java 및 PL/SQL 통합 PL/SQL에서 Java 및 Java 프로그램에서 기존 PL/SQL 프로그램을 호출할 수 있습니다. 이 솔루션은 PL/SQL 및 Java 코드를 보호하고 활용합니다.
Java 내장 절차
Java 내장 프로시저는 SQL에 게시되고 데이터베이스에 저장되는 Java 메소드입니다.
PL/SQL 서브 프로그램과 마찬가지로 Java 프로시저는 SQL*Plus와 같은 제품을 사용하여 직접 호출하거나 트리거를 사용하여 간접적으로 호출할 수 있습니다. Oracle Net 클라이언트-OCI, 선행 컴파일러 또는 JDBC에서 이 시스템에 액세스할 수 있습니다.
Java 메소드를 게시하려면 Java 메소드 이름, 파라미터 유형 및 반환 유형을 해당 SQL 상대로 매핑하는 호출 사양을 작성합니다. 클라이언트 응용 프로그램에 의해 호출될 때 Java 내장 프로시저는 인수를 받아들이고 Java 클래스를 참조하며 Java 결과 값을 반환할 수 있습니다.
호출 사양의 이름을 참조하여 Java 메소드를 호출하는 응용 프로그램입니다. 런타임 시스템은 Oracle 데이터 딕셔너리에서 호출 사양 정의를 조회하고 해당 Java 메소드를 실행합니다.
또한 Java를 사용하여 PL/SQL과 독립적으로 강력한 프로그램을 개발할 수 있습니다. Oracle AI Database는 Java 프로그래밍 언어 및 JVM의 완벽하게 호환되는 구현을 제공합니다.
참조: Oracle AI Database Java Developer's Guide에서는 Java에서 내장 프로시저를 작성하는 방법, PL/SQL에서 내장 프로시저에 액세스하는 방법 및 Java에서 PL/SQL 기능에 액세스하는 방법을 설명합니다.
Java 및 PL/SQL 통합
PL/SQL에서 Java 및 Java 프로그램에서 기존 PL/SQL 프로그램을 호출할 수 있습니다. 이 솔루션은 PL/SQL 및 Java 코드를 보호하고 활용합니다.
Oracle AI Database는 클라이언트와 서버 모두에서 Java의 SQL 데이터에 액세스하기 위한 JDBC를 제공합니다.
- JDBC 드라이버 JDBC는 데이터베이스에 접속하고 데이터베이스에 대한 SQL 문 및 질의를 실행할 수 있는 데이터베이스 액세스 프로토콜입니다.
JDBC 드라이버
JDBC는 데이터베이스에 연결하고 SQL 문과 query를 데이터베이스에 실행할 수 있는 데이터베이스 액세스 프로토콜입니다.
핵심 Java 클래스 라이브러리는 하나의 JDBC API java.sql만 제공합니다. 그러나 JDBC는 공급업체가 특정 데이터베이스에 필요한 전문화를 제공하는 드라이버를 제공하도록 설계되었습니다. Oracle은 다음 표에 표시된 고유한 JDBC 드라이버를 제공합니다.
테이블 2 JDBC 드라이버
| 드라이버 | 설명 |
|---|---|
| JDBC Thin 드라이버 | JDBC Thin 드라이버를 사용하여 Oracle SQL 데이터에 액세스하는 순수 Java 응용 프로그램 및 애플릿을 작성할 수 있습니다. JDBC Thin 드라이버는 다른 Java 애플릿과 마찬가지로 웹 페이지에서 동적으로 다운로드할 수 있으므로 웹 기반 응용 프로그램 및 애플릿에 특히 적합합니다. |
| JDBC OCI 드라이브 | JDBC OCI 드라이버는 클라이언트 또는 Middle tier의 Oracle 고유 코드, 즉 비Java 코드 및 라이브러리에 액세스하여 JDBC Thin 드라이버에 비해 훨씬 큰 크기와 클라이언트측 설치 비용으로 성능을 향상시킵니다. |
| JDBC 서버측 내부 드라이버 | Oracle AI Database는 서버에서 Java 코드가 실행될 때 서버측 내부 드라이버를 사용합니다. 이를 통해 서버의 Oracle JVM에서 실행되는 Java 응용 프로그램은 로컬에서 정의된 데이터, 즉 JDBC를 사용하여 동일한 시스템 및 동일한 프로세스의 데이터에 액세스할 수 있습니다. 기본 Oracle RDBMS 라이브러리를 직접 사용할 수 있기 때문에 Java 코드와 SQL 데이터 간의 네트워크 연결에 대한 오버헤드 없이 성능이 향상됩니다. Oracle AI Database는 서버에서 동일한 Java-SQL 인터페이스를 지원하므로 배포 시 코드를 재작업할 필요가 없습니다. |
참조:
Oracle AI Database의 JavaScript 개요
JavaScript는 오늘날 가장 인기있는 프로그래밍 언어 중 하나입니다. Linux x86-64 또는 Linux aarch64에 배포된 Oracle AI Database는 서버측 개발을 위해 지원되는 언어 목록에 JavaScript를 추가합니다.
JavaScript의 모듈을 데이터베이스에 저장하여 클라이언트측 개발 접근 방식보다 잠재적으로 중요한 개선을 제공하는 데이터를 처리할 수 있습니다. JavaScript는 MLE(Multilingual Engine)에 의해 실행됩니다.
개발자는 독립형 JavaScript 코드를 실행하고 데이터베이스에 기본적으로 모듈로 JavaScript 코드를 저장할 수 있습니다.
-
데이터베이스에 비즈니스 로직을 모듈로 저장 클라이언트측 개발 관련 JavaScript과 마찬가지로 코드를 모듈 형식으로 저장할 수 있습니다.
-
JavaScript 코드의 동적 실행 프레임워크 개발자 및 데이터베이스에 코드를 저장하지 않고도 독립형 JavaScript 코드를 실행하려는 모든 사용자가
DBMS_MLE패키지 및 해당 서브루틴을 사용할 수 있습니다. -
인라인 JavaScript 내장 프로시저 인라이닝된 MLE 호출 사양에는
CREATE FUNCTION및CREATE PROCEDUREDDL에 직접 JavaScript 코드가 포함됩니다. 참조: Oracle AI Database JavaScript Developer's Guide에서 Oracle AI Database의 JavaScript 지원에 대해 자세히 알아보십시오.
데이터베이스에 업무 로직을 모듈로 저장
클라이언트측 개발 관련 JavaScript과 마찬가지로 코드를 모듈 형태로 함께 저장할 수 있습니다.
PL/SQL 배경을 가진 개발자는 JavaScript 모듈을 PL/SQL 패키지 본문에 해당하는 것으로 생각할 수 있지만 JavaScript로 작성할 수 있습니다. 모듈에 선언된 함수는 익스포트 또는 비공개로 유지되도록 표시할 수 있습니다.
JavaScript Oracle AI Database는 ECMAScript 2023 표준을 준수하며 개발자에게 데이터베이스 내에 비즈니스 로직을 저장할 수 있는 다양한 가능성을 제공합니다.
참고:
참고 항목:
-
Oracle AI Database JavaScript Developer's Guide 2장에서는 MLE 모듈을 자세히 소개합니다.
-
통화 사양에 대한 자세한 내용은 Oracle AI Database JavaScript Developer's Guide 장 5를 참조하십시오.
다음은 MLE로 JavaScript 모듈을 만드는 예입니다.
create mle module if not exists example_module
language javascript as

export function string2obj(inputString) {
   if ( inputString === undefined ) {
      throw `must provide a string in the form of key1=value1;...;keyN=valueN`;
   }

   let myObject = {};
   if ( inputString.length === 0 ) {
      return myObject;
   }

   const kvPairs = inputString.split(";");
   kvPairs.forEach( pair => {
      const tuple = pair.split("=");
      if ( tuple.length === 1 ) {
          tuple[1] = false;
      } else if ( tuple.length != 2 ) {
          throw "parse error: you need to use exactly one '=' between key and value and not use '=' in either key or value";
      }
      myObject[tuple[0]] = tuple[1];
  });

  return myObject;
}
/
JavaScript 모듈(MLE 모듈이라고도 함)은 이제 사용자의 스키마에 저장됩니다. 이 함수의 유일한 함수인 string2obj()는 호출 사양을 생성하여 SQL 및 PL/SQL에 노출될 수 있습니다. 호출 사양은 SQL 및 PL/SQL이 호출될 수 있는 모든 곳에서 JavaScript 코드를 호출할 수 있는 PL/SQL 프로그램 단위입니다. string2obj()에 대한 호출 사양은 다음과 같이 작성할 수 있습니다.
create function if not exists p_string_to_JSON(p_str varchar2) return JSON
as mle module example_module
   signature 'string2obj(string)';
/
생성된 함수를 SQL에서 호출할 수 있습니다.
declare
   l_json   JSON;
   l_string VARCHAR2(100);
begin
   l_string := 'a=1;b=2;c=3;d';
   l_json := p_string_to_JSON(l_string);
   dbms_output.put_line(json_serialize(l_json PRETTY));
end;
/

{
  "a" : "1",
  "b" : "2",
  "c" : "3",
  "d" : false
}

PL/SQL procedure successfully completed.
JavaScript 코드의 동적 실행
프레임워크 개발자와 데이터베이스에 코드를 저장하지 않고도 독립형 JavaScript 코드를 실행하려는 모든 사용자는 DBMS_MLE 패키지 및 해당 서브 루틴을 사용할 수 있습니다.
예를 들어, Oracle Application Express 및 Database Actions는 DBMS_MLE를 통합하여 커버 아래에서 PL/SQL 패키지가 호출된다는 사실을 숨깁니다.
MLE 모듈에 비해 DBMS_MLE를 사용하면 전체 응용 프로그램을 작성하기가 더 어려워집니다. 예를 들어, 논리적으로 응용 프로그램을 별도의 엔티티로 나누는 것이 더 어렵습니다. 사후 실행 디버깅 기능을 사용하려면 모듈이 필요하므로 코드 조각의 문제 해결이 더 어려워집니다. CI(지속적 통합) 파이프라인은 동일한 파일에 PL/SQL 및 JavaScript 코드를 나열하는 데 어려움을 겪을 수도 있습니다. 마찬가지로 IDE(통합 개발 환경)에도 문제가 발생할 수 있습니다. 대부분의 경우 동일한 창에서 PL/SQL 및 JavaScript를 모두 사용하는 데 어려움을 겪기 때문입니다.
참고:
참고 항목:
-
DBMS_MLE및 해당 서브루틴에 대한 자세한 내용은 Oracle AI Database PL/SQL Packages and Types Reference를 참조하십시오. -
동적 JavaScript 호출에 대한 자세한 내용은 Oracle AI Database JavaScript Developer's Guide 장 3을 참조하십시오.
인라인 JavaScript 내장 프로시저
인라이닝된 MLE 호출 사양에는 CREATE FUNCTION 및 CREATE PROCEDURE DDL에 직접 JavaScript 코드가 포함됩니다.
JavaScript를 사용하여 간단한 기능을 빠르게 구현하려는 경우 인라이닝된 MLE 호출 사양을 선택하는 것이 좋습니다. 이 옵션을 사용하면 JavaScript 코드가 포함된 별도 모듈을 배포할 필요가 없습니다. 대신 JavaScript 함수가 호출 사양 자체의 정의에 내장되어 있습니다.
MLE LANGUAGE 절은 함수가 JavaScript를 사용하여 구현되도록 지정하는 데 사용됩니다. 언어 이름 뒤에 오는 문자열은 호출 사양의 기능을 구현하는 JavaScript 함수의 본문으로 처리됩니다. 코드가 실행될 때 PL/SQL 매개변수는 자동으로 기본 JavaScript 유형으로 변환되고 동일한 이름의 매개변수로 JavaScript 함수에 전달됩니다. 따옴표로 묶이지 않은 매개변수 이름은 모두 대문자 JavaScript 이름에 매핑됩니다. JavaScript 함수에서 반환된 값은 MLE 모듈에 대한 호출 사양과 마찬가지로 PL/SQL 호출 사양의 반환 유형으로 변환됩니다.
참고:
참고 항목:
- 인라인 JavaScript 내장 프로시저에 대한 자세한 내용은 Oracle AI Database JavaScript Developer's Guide 장 5를 참조하십시오.
트리거 개요
데이터베이스 트리거는 특정 상황에서 Oracle Database가 자동으로 호출하는 컴파일된 내장 프로그램 단위로, PL/SQL, Java 또는 JavaScript로 작성됩니다("실행").
트리거는 다음 작업 중 하나가 발생할 때마다 실행됩니다.
-
특정 테이블 또는 뷰의 DML 문(모든 사용자가 실행함)
DML 문은 스키마 객체의 데이터를 수정합니다. 예를 들어, 행 삽입 및 삭제는 DML 작업입니다.
-
DDL 문은 특정 사용자 또는 사용자가 실행합니다.
DDL 문은 스키마 객체를 정의합니다. 예를 들어, 테이블을 생성하고 열을 추가하는 것은 DDL 작업입니다.
-
데이터베이스 행사
유저 로그인 또는 로그오프, 오류, 데이터베이스 시작 또는 종료는 트리거를 호출할 수 있는 이벤트입니다.
트리거는 서브 프로그램과 유사하지만 호출 방식이 다른 스키마 객체입니다. 서브 프로그램은 유저, 응용 프로그램 또는 트리거에 의해 명시적으로 실행됩니다. 트리거는 트리거 이벤트가 발생할 때 데이터베이스에 의해 암시적으로 호출됩니다.
-
트리거의 장점 트리거를 올바르게 사용하면 보다 강력하고 데이터베이스를 보다 효과적으로 사용하는 응용 프로그램을 빌드하고 배치할 수 있습니다.
-
트리거 유형 트리거는 호출 수단 및 해당 트리거가 수행하는 작업 유형에 따라 분류할 수 있습니다.
-
트리거에 대한 타이밍 트리거 작업이 트리거 명령문 전후에 실행될지 여부에 관계없이 트리거 타이밍을 정의할 수 있습니다.
-
트리거 생성
CREATE TRIGGER문은 데이터베이스 트리거를 생성하거나 바꿉니다. -
트리거 실행 Oracle Database는 서브 프로그램 실행과 동일한 단계를 사용하여 내부적으로 트리거를 실행합니다.
-
트리거 저장 Oracle Database는 PL/SQL 내장 프로시저와 마찬가지로 PL/SQL 트리거를 데이터베이스 스키마에 컴파일된 형식으로 저장합니다.
참조:
-
DML 및 DDL에 대한 자세한 내용은 "SQL 문 개요"를 참조하십시오.
트리거의 이점
정확한 트리거 사용을 통해 보다 강력하고 데이터베이스를 보다 효과적으로 사용하는 응용 프로그램을 작성 및 배치할 수 있습니다.
트리거를 사용하여 다음을 수행할 수 있습니다.
-
파생된 열 값 자동 생성
-
부적합한 트랜잭션 방지
-
감사(audit) 및 이벤트 로깅 제공
-
테이블 액세스에 대한 레코드 정보
트리거를 사용하여 모든 클라이언트 응용 프로그램에 공통되는 하위 레벨 업무 규칙을 적용할 수 있습니다. 예를 들어, 여러 응용 프로그램이 employees 테이블에 액세스할 수 있습니다. 이 테이블에 대한 트리거가 삽입된 데이터의 형식을 보장할 경우 이 업무 논리를 모든 클라이언트에서 재생성할 필요는 없습니다. 응용 프로그램에서 트리거를 피할 수 없으므로 트리거의 업무 논리가 자동으로 사용됩니다.
트리거 및 무결성 제약 조건을 모두 사용하여 모든 유형의 무결성 규칙을 정의하고 적용할 수 있습니다. 그러나 Oracle은 무결성 제약 조건을 사용하여 정의할 수 없는 복잡한 비즈니스 규칙을 강제 적용하는 데 트리거만 사용할 것을 강력히 권장합니다.
트리거를 지나치게 많이 사용하면 대규모 응용 프로그램에서 유지 관리하기 어려운 상호 종속성이 복잡해질 수 있습니다. 예를 들어, 트리거가 호출될 때 해당 트리거 작업 내의 SQL 문은 잠재적으로 다른 트리거를 실행할 수 있으므로 의도하지 않은 결과를 초래할 수 있는 계단식 트리거가 생성됩니다.
참조:
-
애플리케이션 트리거를 계획할 때의 지침 및 제한 사항에 대한 Oracle AI Database PL/SQL Language Reference
특정 상황에서 자동으로.]
트리거 유형
트리거는 호출 수단 및 트리거가 수행하는 작업 유형에 따라 분류할 수 있습니다.
Oracle Database는 다음과 같은 유형의 트리거를 지원합니다.
-
행 트리거
행 트리거는 테이블이 트리거 문의 영향을 받을 때마다 실행됩니다. 예를 들어, 명령문이 여러 행을 갱신하는 경우 행 트리거는
UPDATE의 영향을 받는 각 행에 대해 한 번씩 실행됩니다. 트리거 문이 행에 영향을 주지 않으면 행 트리거가 실행되지 않습니다. 행 트리거는 트리거 작업의 코드가 트리거 명령문에서 제공하는 데이터에 종속되거나 영향을 받는 행에 종속되는 경우에 유용합니다. -
명령문 트리거
명령문 트리거는 트리거 명령문의 영향을 받는 행 수에 관계없이 트리거 명령문 대신 한 번 실행됩니다. 예를 들어, 명령문이 테이블에서 100개의 행을 삭제하면 명령문 레벨
DELETE트리거는 한 번만 실행됩니다. 명령문 트리거는 트리거 작업의 코드가 트리거 명령문에서 제공하는 데이터나 영향을 받는 행에 종속되지 않는 경우에 유용합니다. -
INSTEAD OF트리거INSTEAD OF 트리거는 트리거 문을 실행하는 대신 Oracle Database에서 실행됩니다. 이러한 트리거는 DML 문을 통해 직접 수정할 수 없는 뷰를 투명하게 수정하는 데 유용합니다.
-
이벤트 트리거
트리거를 사용하여 가입자에게 데이터베이스 이벤트에 대한 정보를 게시할 수 있습니다. 이벤트 트리거는 다음 범주로 구분됩니다.
-
시스템 이벤트 트리거는 데이터베이스 인스턴스 시작, 종료 또는 오류 메시지와 같은 이벤트로 인해 발생할 수 있습니다.
-
사용자 이벤트 트리거는 사용자 로그온 및 로그오프, DDL 문 및 DML 문과 관련된 이벤트로 인해 실행됩니다.
-
특정 상황에서 자동으로.]
트리거 타이밍
트리거 작업이 트리거 명령문 전후에 실행되는지 여부에 관계없이 트리거 타이밍을 정의할 수 있습니다.
단순 트리거는 다음 타이밍 지점 중 정확히 하나에 대한 작업을 지정할 수 있는 테이블에 대한 단일 트리거입니다.
-
실행 명령문 앞
-
실행 명령문의 영향을 받는 각 행 이전
-
실행 명령문의 영향을 받는 각 행 이후
-
실행 명령문 이후
명령문 및 행 트리거의 경우 BEFORE 트리거를 사용하면 데이터베이스를 변경하기 전에 보안을 강화하고 비즈니스 규칙을 활성화할 수 있습니다. AFTER 트리거는 로깅 작업에 적합합니다.
복합 트리거는 여러 타이밍 지점에서 실행될 수 있습니다. 혼합 트리거는 다양한 타이밍 지점에 대해 구현하는 동작이 공통 데이터를 공유하는 접근 방식을 프로그래밍하는 데 도움이 됩니다.
참조: 복합 트리거에 대해 알아보려면 Oracle AI Database PL/SQL Language Reference를 참조하십시오.
특정 상황에서 자동으로.]
트리거 생성
CREATE TRIGGER 문은 데이터베이스 트리거를 생성하거나 바꿉니다.
PL/SQL 트리거의 일반적인 구문 형식은 다음과 같습니다.
CREATE TRIGGER trigger_name
  triggering_statement
  [trigger_restriction]
BEGIN
 triggered_action;
END;
PL/SQL 트리거에는 다음과 같은 기본 구성 요소가 있습니다.
-
트리거 이름입니다.
이름은 동일한 스키마에 있는 다른 트리거 이름 중에서 고유해야 합니다. 예를 들어, 이름은
part_reorder_trigger일 수 있습니다. -
트리거 이벤트 또는 명령문
트리거 이벤트 또는 명령문은 트리거가 호출되도록 하는 SQL 문, 데이터베이스 이벤트 또는 유저 이벤트입니다. 예를 들어, 유저가 테이블을 갱신하는 경우
-
트리거 제한
트리거 제한은 트리거 실행을 위해
true여야 하는 부울 표현식을 지정합니다. 예를 들어, 사용 가능한 부품 수가 현재 재주문 금액보다 작지 않으면 트리거가 호출되지 않습니다. -
트리거된 작업
트리거된 작업은 트리거 문이 실행되고 트리거 제한 사항이 true로 평가될 때 실행할 SQL 문 및 코드를 포함하는 프로시저입니다. 예를 들어, 유저가 보류 중인 주문 테이블에 행을 삽입합니다.
-
예: CREATE TRIGGER 문 이 예에서는
INSERT,UPDATE또는DELETE문이 라인 항목 테이블에서 실행될 때 실행되는 트리거를 생성합니다. -
예제: 행 레벨 트리거 호출 이 시나리오에서 고객은 두 개의 주문을 시작하고 주문에서 라인 품목을 추가하고 제거합니다.
참조:
-
Oracle AI Database Get Started with Oracle AI Database Development 및 Oracle AI Database PL/SQL Language Reference를 통해 트리거 생성 방법 학습
-
CREATE TRIGGER문에 대한 자세한 내용은 Oracle AI Database SQL Language Reference를 참조하십시오.
특정 상황에서 자동으로.]
예제: CREATE TRIGGER 문
이 예에서는 INSERT, UPDATE 또는 DELETE 문이 라인 항목 테이블에서 실행될 때 실행되는 트리거를 생성합니다.
다음 명령문을 사용하여 orders 및 lineitems 테이블을 생성한다고 가정합니다. orders 테이블에는 각 고유 순서에 대한 행이 포함되는 반면, lineitems 테이블에는 순서의 각 항목에 대한 행이 포함됩니다.
CREATE TABLE orders
( order_id NUMBER PRIMARY KEY,
  /* other attributes */
  line_items_count NUMBER DEFAULT 0 );

CREATE TABLE lineitems
( order_id REFERENCES orders,
  seq_no   NUMBER,
  /* other attributes */
  CONSTRAINT lineitems PRIMARY KEY(order_id,seq_no) );
다음 명령문은 순서대로 항목 수로 orders 테이블을 자동으로 갱신하는 샘플 트리거를 생성합니다.
CREATE OR REPLACE TRIGGER lineitems_trigger
  AFTER INSERT OR UPDATE OR DELETE ON lineitems
  FOR EACH ROW
BEGIN
  IF (INSERTING OR UPDATING)
  THEN
    UPDATE orders SET line_items_count = NVL(line_items_count,0)+1
    WHERE order_id = :new.order_id;
  END IF;
  IF (DELETING OR UPDATING)
  THEN
    UPDATE orders SET line_items_count = NVL(line_items_count,0)-1
    WHERE order_id = :old.order_id;
  END IF;
END;
/lineitems_trigger에서 트리거 문은 lineitems 테이블의 INSERT, UPDATE 또는 DELETE입니다. 트리거 제한이 없습니다. 변경된 각 행에 대해 트리거가 호출됩니다. 트리거는 트리거 문의 영향을 받는 현재 행의 이전 열 값과 새 열 값에 액세스할 수 있습니다. 수정 중인 테이블의 모든 열에 대해 이전 값(:old)과 새 값(:new)의 상관 이름이 두 개 있습니다. 세션이 주문에 대해 lineitems에서 행을 갱신하거나 삽입하는 경우 트리거는 작업 후에 이 주문의 항목 수를 계산하고 orders 테이블을 개수로 갱신합니다.
예제: 행 레벨 트리거 호출
이 시나리오에서 고객은 두 개의 주문을 시작하고 주문에서 라인 품목을 추가 및 제거합니다.
이 시나리오는 예제: CREATE TRIGGER 문에서 생성된 트리거를 기반으로 합니다.
표 3 행 레벨 트리거 시나리오
| SQL 문 | 트리거된 SQL 문 | 설명 |
|---|---|---|
SQL> INSERT INTO orders (order_id) VALUES (78); 1 row created. |
고객은 ID가 78인 주문을 생성합니다. 이때 고객은 주문에 품목이 없습니다.
|
|
SQL> INSERT INTO orders (order_id) VALUES (92); 1 row created. |
고객은 ID가 92인 별도의 주문을 생성합니다. 이때 고객은 주문에 품목이 없습니다.
|
|
SQL> INSERT INTO lineitems (order_id, seq_no) VALUES (78,1); 1 row created. |
UPDATE orders SET line_items_count = NVL(NULL,0)+1 WHERE order_id = 78; |
고객이 주문 78에 품목을 추가합니다.
|
SQL> INSERT INTO lineitems (order_id, seq_no) VALUES (78,2); 1 row created. |
UPDATE orders SET line_items_count = NVL(1,0)+1 WHERE order_id = 78; |
고객이 주문 78에 추가 품목을 추가합니다.
|
SQL> SELECT * FROM orders; ORDER_ID LINE_ITEMS_COUNT --------- ---------------- 78 2 92 0 |
고객은 두 주문의 상태를 질의합니다. 주문 78에는 두 개의 품목이 포함되어 있습니다. 주문 92에 품목이 포함되어 있지 않습니다. | |
SQL> SELECT * FROM lineitems; ORDER_ID SEQ_NO ---------- ---------- 78 1 78 2 |
고객은 라인 품목의 상태를 질의합니다. 각 품목은 주문 ID 및 순번으로 고유하게 식별됩니다. | |
SQL> UPDATE lineitems SET order_id = 92; 2 rows updated. |
UPDATE orders
  SET line_items_count =
  NVL(NULL,0)+1
 WHERE order_id = 92;

  UPDATE orders
  SET line_items_count =
  NVL(2,0)-1
 WHERE order_id = 78;
UPDATE orders SET line_items_count = NVL(1,0)+1 WHERE order_id = 92; UPDATE orders SET line_items_count = NVL(1,0)-1 WHERE order_id = 78; |
고객은 주문 78의 라인 품목을 주문 92로 이동합니다.
트리거가 호출될 때마다 트리거의 두 |
SQL> SELECT * FROM orders; ORDER_ID LINE_ITEMS_COUNT --------- ---------------- 78 0 92 2 |
고객은 두 주문의 상태를 질의합니다. 순 효과는 주문 92의 라인 품목 실사가 0에서 2로 증가한 반면 주문 78의 실사는 2에서 0으로 감소한 것입니다. | |
SQL> SELECT * FROM lineitems; ORDER_ID SEQ_NO ---------- ---------- 92 1 92 2 |
고객은 라인 품목의 상태를 질의합니다. 각 품목은 주문 ID 및 순번으로 고유하게 식별됩니다. | |
SQL> DELETE FROM lineitems; 2 rows deleted. |
UPDATE orders SET line_items_count = NVL(2,0)-1 WHERE order_id = 92; UPDATE orders SET line_items_count = NVL(1,0)-1 WHERE order_id = 92; |
이제 고객은 모든 주문에서 모든 라인 품목을 제거합니다.
|
SQL> SELECT * FROM orders; ORDER_ID LINE_ITEMS_COUNT --------- ---------------- 78 0 92 0 SQL> SELECT * FROM lineitems; no rows selected |
고객은 두 주문의 상태를 질의합니다. 두 주문 모두 라인 품목을 포함하지 않습니다. 또한 고객은 라인 항목의 상태를 쿼리합니다. 품목이 없습니다. |
트리거 실행
Oracle Database는 서브 프로그램 실행과 동일한 단계를 사용하여 내부적으로 트리거를 실행합니다.
유일한 미묘한 차이점은 사용자 계정에 트리거 명령문을 실행할 수 있는 권한이 있는 경우 트리거를 실행할 수 있는 권한이 있다는 것입니다. 이 예외를 사용할 경우 데이터베이스는 내장 서브 프로그램과 동일한 방식으로 트리거를 검증하고 실행합니다.
참조: 트리거 실행에 대한 자세한 내용은 Oracle AI Database PL/SQL Language Reference를 참조하십시오.
특정 상황에서 자동으로.]
트리거 저장 영역
Oracle Database는 PL/SQL 내장 프로시저와 마찬가지로 PL/SQL 트리거를 데이터베이스 스키마에 컴파일된 형태로 저장합니다.
CREATE TRIGGER 문이 커밋되면 컴파일된 PL/SQL 코드가 데이터베이스에 저장됩니다. 공유 풀은 PL/SQL 트리거의 소스 코드를 제거합니다.
다음 그림은 PL/SQL 트리거를 암시적으로 호출하는 SQL 문이 포함된 데이터베이스 응용 프로그램을 보여줍니다. 트리거는 연관된 테이블과 별도로 저장됩니다.
그림 7: 트리거
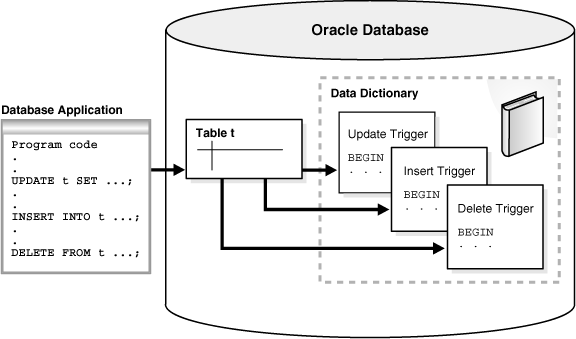
Java 트리거는 PL/SQL 트리거와 동일한 방식으로 저장됩니다. 그러나 Java 트리거는 CALL 문을 사용하여 별도로 컴파일된 Java 코드를 참조합니다. 따라서 Java 트리거 생성에는 Java 코드를 생성하고 이 Java 코드를 참조하는 트리거를 생성하는 과정이 포함됩니다.
참조: Oracle AI Database PL/SQL Language Reference - 트리거 컴파일 및 저장에 대해 알아보기
특정 상황에서 자동으로.]