SQL
이 장에서는 SQL(구조적 질의 언어) 및 Oracle AI Database에서 SQL 문을 처리하는 방법에 대한 개요를 제공합니다.
-
SQL 도입 SQL(시퀀스로 발음함)은 모든 프로그램과 사용자가 오라클 데이터베이스의 데이터에 액세스하는 모든 프로그램과 사용자가 사용하는 설정 기반 고급 컴퓨터 언어입니다.
-
SQL 문 개요 Oracle 데이터베이스의 정보에 대해 수행되는 모든 작업은 SQL 명령문을 사용하여 실행됩니다. SQL 문은 식별자, 매개변수, 변수, 이름, 데이터 유형 및 SQL 예약된 단어로 구성된 컴퓨터 프로그램 또는 명령입니다.
-
최적기 개요 Oracle AI Database가 SQL 문을 처리하는 방식을 이해하려면 최적기(질의 최적기 또는 비용 기반 최적기라고도 함)라는 데이터베이스의 일부를 이해해야 합니다. 모든 SQL 문은 옵티마이저를 사용하여 지정된 데이터에 액세스하는 가장 효율적인 방법을 결정합니다.
-
SQL 처리 개요 이 섹션에서는 Oracle AI Database가 SQL 문을 처리하는 방법에 대해 설명합니다. 특히 이 절에서는 데이터베이스가 DDL 문을 처리하여 객체를 생성하는 방법, 데이터를 수정하는 DML, 데이터를 검색하는 query에 대해 설명합니다.
SQL 소개
SQL(시계로 발음함)은 오라클 데이터베이스의 데이터에 액세스하는 모든 프로그램과 사용자가 사용하는 설정 기반의 고급 선언적 컴퓨터 언어입니다.
일부 Oracle 도구 및 응용 프로그램은 SQL 사용을 마스킹하지만 모든 데이터베이스 작업은 SQL을 사용하여 수행됩니다. 다른 모든 데이터 액세스 방식은 Oracle AI Database에 내장된 보안을 우회하며 잠재적으로 데이터 보안 및 무결성을 손상시킵니다.
SQL은 Oracle AI Database와 같은 관계형 데이터베이스에 대한 인터페이스를 제공합니다. SQL은 다음과 같은 작업을 하나의 일관된 언어로 통합합니다.
-
객체 생성, 대체, 변경 및 삭제
-
테이블 행 삽입, 갱신 및 삭제
-
데이터 Query
-
데이터베이스 및 해당 객체에 대한 액세스 제어
-
데이터베이스 일관성 및 무결성 보장
SQL은 대화식으로 사용할 수 있습니다. 즉, 명령문이 프로그램에 수동으로 입력됩니다. 또한 SQL 문은 C 또는 Java와 같은 다른 언어로 작성된 프로그램에 포함될 수 있습니다.
-
SQL 데이터 액세스 두 가지 광범위한 컴퓨터 언어 제품군이 있습니다. 선언어는 절차가 아니며 수행해야 하는 작업과 C++ 및 Java와 같은 절차 언어는 방법을 설명합니다.
-
SQL 표준 Oracle은 업계에서 인정하는 표준을 따르고 SQL 표준 위원회에 적극적으로 참여하기 위해 노력하고 있습니다.
참조:
-
Oracle AI Database Development Guide - 프로그래밍 환경 선택 방법 학습
-
SQL 소개를 위한 Oracle AI Database SQL Language Reference
SQL 데이터 액세스
There are two broad families of computer languages: declarative languages that are nonprocedural and describe what should be done, and procedural languages such as C++ and Java that describe how things should be done.
SQL은 유저가 원하는 결과를 지정한다는 점에서 SQL을 파생시키는 방법이 아니라 선언적입니다. 예를 들어, 다음 명령문은 성이 K로 시작하는 사원의 레코드를 질의합니다.
데이터베이스는 데이터를 탐색하고 요청된 결과를 검색하는 프로시저 생성 작업을 수행합니다. SQL의 선언적 특성을 사용하면 논리적 레벨에서 데이터 작업을 수행할 수 있습니다. 데이터를 조작할 때만 구현 세부 사항에 주의해야 합니다.
SELECT   last_name, first_name
FROM     hr.employees
WHERE    last_name LIKE 'K%'
ORDER BY last_name, first_name;
데이터베이스는 WHERE 조건(predicate라고도 함)을 충족하는 모든 행을 한 번에 검색합니다. 데이터베이스는 이러한 행을 유저, 다른 SQL 문 또는 응용 프로그램에 하나의 단위로 전달할 수 있습니다. 응용 프로그램은 행을 하나씩 처리할 필요가 없으며 개발자는 행이 물리적으로 저장되거나 검색되는 방식을 알 필요가 없습니다.
모든 SQL 문은 요청된 데이터에 액세스하는 가장 효율적인 방법을 결정하는 데이터베이스의 구성 요소인 옵티마이저를 사용합니다. 또한 Oracle Database는 옵티마이저의 작업 성능을 향상시키는 데 사용할 수 있는 기술을 지원합니다.
참조: SQL 문 및 기타 SQL 부분(예: 연산자, 함수 및 형식 모델)에 대한 자세한 내용은 Oracle AI Database SQL Language Reference를 참조하십시오.
SQL 표준
Oracle은 업계에서 인정하는 표준을 따르고 SQL 표준 위원회에 적극적으로 참여하기 위해 노력하고 있습니다.
업계에서 인정받는 위원회는 ANSI(American National Standards Institute)와 ISO(International Organization for Standardization)입니다. ANSI와 ISO/IEC 모두 SQL을 관계형 데이터베이스의 표준 언어로 받아들였습니다.
SQL 표준은 10개 부분으로 구성됩니다. 한 부분 (SQL / RPR : 2012)은 2012 년에 새로 도입되었습니다. 다섯 가지 다른 부분은 2011 년에 수정되었습니다. 나머지 네 부분의 경우 2008 버전이 그대로 유지됩니다. Oracle SQL에는 ANSI/ISO 표준 SQL 언어에 대한 다양한 확장 기능이 포함되어 있으며, Oracle AI Database 도구 및 애플리케이션은 추가 설명을 제공합니다. SQL*Plus, SQL Developer 및 Oracle Enterprise Manager 도구를 사용하면 Oracle 데이터베이스에 대해 ANSI/ISO 표준 SQL 문을 실행할 수 있으며, 이러한 도구에 사용할 수 있는 추가 명령문이나 함수를 실행할 수 있습니다.
참조:
-
Oracle SQL과 표준 SQL의 차이점에 대한 설명은 Oracle AI Database SQL Language Reference를 참조하십시오.
-
SQL 문과 구별되는 SQL*Plus 명령의 경우 SQL*Plus User's Guide and Reference
SQL 문 개요
Oracle 데이터베이스의 정보에 대해 수행되는 모든 작업은 SQL 명령문을 사용하여 실행됩니다. SQL 문은 식별자, 매개변수, 변수, 이름, 데이터 유형 및 SQL 예약된 단어로 구성된 컴퓨터 프로그램 또는 명령입니다. 주: SQL 예약어는 SQL에서 특별한 의미를 가지며 다른 용도로 사용해서는 안됩니다. 예를 들어, SELECT 및 UPDATE는 예약어이며 테이블 이름으로 사용해서는 안됩니다.
SQL 문은 다음과 같이 완전한 SQL 문장과 동일해야 합니다.
SELECT last_name, department_id FROM employeesOracle AI Database는 완전한 SQL 문만 실행합니다. 다음과 같은 단편은 더 많은 텍스트가 필요함을 나타내는 오류를 생성합니다.
SELECT last_name;Oracle SQL 문은 다음 범주로 구분됩니다.
-
DDL(데이터 정의어) 문 DLL(데이터 정의어) 문은 스키마 객체를 정의, 구조적으로 변경 및 삭제합니다.
-
DML(데이터 조작어) 문 DML(데이터 조작어) 문은 기존 스키마 객체의 데이터를 질의하거나 조작합니다.
-
트랜잭션 제어문 트랜잭션 제어문은 DML 문에 의해 수행된 변경 사항을 관리하고 DML 문을 트랜잭션으로 그룹화합니다.
-
세션 제어문 세션 제어문은 사용자 세션의 등록 정보를 동적으로 관리합니다.
-
시스템 제어문 시스템 제어문은 데이터베이스 인스턴스의 등록 정보를 변경합니다.
-
포함된 SQL 문 내장된 SQL 문은 절차적 언어 프로그램 내에 DDL, DML 및 트랜잭션 제어문을 통합합니다.
DDL(데이터 정의어) 문
DLL(데이터 정의어) 문은 스키마 객체를 정의, 구조적으로 변경 및 삭제합니다.
DDL을 사용하여 객체에 액세스하는 응용 프로그램을 변경하지 않고 객체 속성을 변경할 수 있습니다. 예를 들어, 응용 프로그램을 재작성하지 않고 Human Resources 응용 프로그램에서 액세스하는 테이블에 열을 추가할 수 있습니다. 또한 데이터베이스 유저가 데이터베이스에서 작업을 수행하는 동안 DDL을 사용하여 객체의 구조를 변경할 수 있습니다.
구체적으로 DDL 문을 사용하면 다음을 수행할 수 있습니다.
-
스키마 객체 및 데이터베이스 자체와 데이터베이스 유저를 포함한 기타 데이터베이스 구조를 생성, 변경 및 삭제합니다. 대부분의 DDL 문은 키워드
CREATE,ALTER또는DROP로 시작합니다. -
이러한 객체의 구조를 제거하지 않고 스키마 객체의 모든 데이터를 삭제합니다(
TRUNCATE).주:
DELETE와 달리TRUNCATE는DELETE보다 빠른 실행 취소 데이터를 생성하지 않습니다. 또한TRUNCATE는 삭제 트리거를 호출하지 않습니다. -
권한 및 역할(
GRANT,REVOKE)을 부여하고 취소합니다. -
감사 옵션을 설정 및 해제합니다(
AUDIT,NOAUDIT). -
데이터 딕셔너리(
COMMENT)에 주석을 추가합니다.
예제 10-1 DDL 문
다음 예제는 DDL 문을 사용하여 plants 테이블을 생성한 다음 DML을 사용하여 테이블에 두 개의 행을 삽입합니다. 그런 다음 이 예제에서는 DDL을 사용하여 테이블 구조를 변경하고, 이 테이블에 대한 읽기 권한을 유저에게 부여 및 취소한 다음 테이블을 삭제합니다.
CREATE TABLE plants
    ( plant_id    NUMBER PRIMARY KEY,
      common_name VARCHAR2(15) );

INSERT INTO plants VALUES (1, 'African Violet'); # DML statement

INSERT INTO plants VALUES (2, 'Amaryllis'); # DML statement

ALTER TABLE plants ADD
    ( latin_name VARCHAR2(40) );

GRANT READ ON plants TO scott;

REVOKE READ ON plants FROM scott;

DROP TABLE plants;
암시적 COMMIT는 데이터베이스가 DDL 문을 실행하기 직전에 발생하며 COMMIT 또는 ROLLBACK는 그 직후에 발생합니다. 앞의 예제에서 두 개의 INSERT 문 뒤에 ALTER TABLE 문이 나오므로 데이터베이스가 두 개의 INSERT 문을 커밋합니다. ALTER TABLE 문이 성공하면 데이터베이스가 이 명령문을 커밋하고, 그렇지 않으면 데이터베이스가 이 명령문을 롤백합니다. 두 경우 모두 두 INSERT 문이 이미 커밋되었습니다.
참조:
-
Oracle AI Database Security Guide - 권한 및 롤에 대해 알아보기
-
Oracle AI Database Get Started with Oracle AI Database Development 및 Oracle AI Database Administrator's Guide를 통해 스키마 객체 생성 방법 학습
-
Oracle AI Database Development Guide - DDL 차단 및 비블록화 간의 차이점
-
DDL 문 목록은 Oracle AI Database SQL Language Reference를 참조하십시오.
DML(데이터 조작어) 문
DML(데이터 조작어) 문은 기존 스키마 객체의 데이터를 질의하거나 조작합니다.
DDL 문이 데이터베이스의 구조를 변경하는 반면, DML 문은 내용을 query하거나 변경합니다. 예를 들어, ALTER TABLE는 테이블의 구조를 변경하고 INSERT는 테이블에 하나 이상의 행을 추가합니다.
DML 문은 가장 자주 사용되는 SQL 문이므로 다음을 수행할 수 있습니다.
-
하나 이상의 테이블 또는 뷰(
SELECT)에서 데이터를 검색하거나 인출합니다. -
열 값 목록을 지정하거나 하위 질의를 사용하여 기존 데이터를 선택하고 조작하여 테이블 또는 뷰(
INSERT)에 새 데이터 행을 추가합니다. -
테이블 또는 뷰의 기존 행에서 열 값을 변경합니다(
UPDATE). -
행을 조건부로 테이블 또는 보기(
MERGE)에 업데이트하거나 삽입합니다. -
테이블 또는 뷰에서 행을 제거합니다(
DELETE). -
SQL 문(
EXPLAINPLAN)에 대한 실행 계획을 봅니다. -
테이블 또는 뷰를 잠그고 일시적으로 다른 사용자의 액세스를 제한합니다(
LOCKTABLE).
다음 예제는 DML을 사용하여 employees 테이블을 query합니다. 예제에서는 DML을 사용하여 employees에 행을 삽입하고 이 행을 갱신한 다음 삭제합니다.
SELECT * FROM employees;

INSERT INTO employees (employee_id, last_name, email, job_id, hire_date, salary)
  VALUES (1234, 'Mascis', 'JMASCIS', 'IT_PROG', '14-FEB-2008', 9000);

UPDATE employees SET salary=9100 WHERE employee_id=1234;

DELETE FROM employees WHERE employee_id=1234;
논리적 작업 단위를 형성하는 DML 문의 모음을 트랜잭션이라고 합니다. 예를 들어, 돈을 이체하는 거래에는 저축 예금 계좌 잔액 감소, 당좌 예금 계좌 잔액 증가, 계좌 이체 기록 테이블의 이체 기록이라는 세 가지 개별 작업이 포함될 수 있습니다. DDL 문과 달리 DML 문은 현재 트랜잭션을 암시적으로 커밋하지 않습니다.
-
SELECT 문 질의는 테이블 또는 뷰에서 데이터를 검색하는 작업입니다.
-
조인 조인은 둘 이상의 테이블, 뷰 또는 구체화된 뷰에서 행을 결합하는 질의입니다.
-
하위 질의 하위 질의는 다른 SQL 문 내에 중첩된
SELECT문입니다. subquery는 단일 문제를 해결하기 위해 여러 query를 실행해야 하는 경우에 유용합니다.
참조:
-
Oracle AI Database Get Started with Oracle AI Database Development: 데이터 쿼리 및 조작 방법 학습
-
DML 문 목록은 Oracle AI Database SQL Language Reference를 참조하십시오.
SELECT 명령문
질의는 테이블 또는 뷰에서 데이터를 검색하는 작업입니다.
SELECT는 데이터 질의에 사용할 수 있는 유일한 SQL 문입니다. SELECT 문 실행에서 검색된 데이터 집합을 결과 집합이라고 합니다.
다음 표는 SELECT 문에서 일반적으로 발견되는 하나의 필수 키워드와 세 개의 키워드를 보여줍니다. 또한 이 테이블은 SELECT 문의 기능을 키워드와 연관시킵니다.
SQL 문의 표 1 키워드
| 키워드 | 필수? | 설명 | 기능 |
|---|---|---|---|
SELECT |
예. | 결과에 표시할 열을 지정합니다. 투영은 테이블에 있는 열의 하위 집합을 생성합니다. 표현식은 값으로 분석되는 하나 이상의 값, 연산자 및 SQL 함수의 조합입니다. |
투영 |
FROM |
아니요 | 데이터를 검색할 테이블 또는 뷰를 지정합니다. | 가입 중 |
WHERE |
아니요 | 행을 필터링하여 테이블의 행 부분 집합을 생성하는 조건을 지정합니다. 조건은 하나 이상의 표현식과 논리(부울) 연산자의 조합을 지정하고 TRUE, FALSE 또는 UNKNOWN 값을 반환합니다. |
선택 |
ORDER BY |
아니요 | 행을 표시할 순서를 지정합니다. |
참조: SELECT 구문 및 의미에 대한 Oracle AI Database SQL Language Reference
조인
조인은 두 개 이상의 테이블, 뷰 또는 구체화된 뷰의 행을 결합하는 질의입니다.
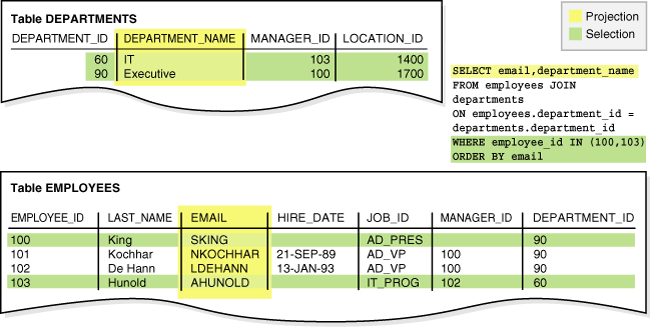
다음 예제는 employees 및 departments 테이블(FROM 절)을 조인하고, 지정된 조건(WHERE 절)을 충족하는 행만 선택하고, 투영을 사용하여 두 열(SELECT)에서 데이터를 검색합니다. 예제 출력은 SQL 문을 따릅니다.
SELECT email, department_name
FROM   employees
JOIN   departments
ON     employees.department_id = departments.department_id
WHERE  employee_id IN (100,103)
ORDER BY email;

EMAIL                     DEPARTMENT_NAME
------------------------- ------------------------------
AHUNOLD                   IT
SKING                     Executive
다음 그림은 앞의 질의에 표시된 조인의 투영 및 선택 작업을 나타냅니다.
그림 1: 투영 및 선택
대부분의 조인에는 FROM 절 또는 WHERE 절에서 서로 다른 테이블의 두 열을 비교하는 조인 조건이 하나 이상 있습니다. 데이터베이스는 행 쌍을 결합합니다. 각 행에는 조인 조건이 TRUE로 평가되는 각 테이블의 한 행이 포함됩니다. 옵티마이저는 조인 조건, 인덱스 및 테이블에 대해 사용 가능한 모든 통계를 기반으로 데이터베이스가 테이블을 조인하는 순서를 결정합니다.
조인 유형은 다음과 같습니다.
-
배타 조인
내부 조인은 조인 조건을 충족하는 행만 반환하는 두 개 이상의 테이블 조인입니다. 예를 들어, 조인 조건이
employees.department_id=departments.department_id이면 이 조건을 충족하지 않는 행은 반환되지 않습니다. -
외부 조인
외부 조인은 조인 조건을 충족하는 모든 행을 반환하고, 특정 테이블에서 다른 테이블의 행이 조건을 충족하는 다른 테이블의 행이 없는 경우도 반환합니다.
A 및 B 테이블에 대한 왼쪽 포괄 조인의 결과는 조인 조건이 오른쪽 테이블 B의 레코드와 일치하지 않더라도 항상 왼쪽 테이블 A의 모든 레코드를 포함합니다. B에서 일치하는 행이 없는 경우 B 열은 B에서 일치하지 않는 행에 대해 널을 포함합니다. 예를 들어, 모든 사원이 부서에 있지 않은 경우
employees(왼쪽 테이블)과departments(오른쪽 테이블)의 왼쪽 포괄 조인은departments의 행이 조인 조건을 충족하지 않는 경우에도employees의 모든 행을 검색합니다(employees.department_id가 널임).A 및 B 테이블에 대한 오른쪽 포괄 조인의 결과는 조인 조건이 왼쪽 테이블 A의 행과 일치하지 않더라도 오른쪽 테이블 B의 모든 레코드를 포함합니다. A에서 일치하는 행이 없는 경우 A 열은 A에서 일치하지 않는 행에 대해 널을 포함합니다. 예를 들어, 모든 부서에 사원이 없는 경우
employees(왼쪽 테이블) 및departments(오른쪽 테이블)의 오른쪽 포괄 조인은employees에 조인 조건을 충족하는 행이 없더라도departments의 모든 행을 검색합니다.전체 포괄 조인은 왼쪽 포괄 조인과 오른쪽 포괄 조인의 조합입니다.
-
Cartesian Products
조인 질의의 두 테이블에 조인 조건이 없는 경우 데이터베이스는 카르테시안 조인을 수행합니다. 한 테이블의 각 행은 다른 테이블의 각 행과 결합됩니다. 예를 들어,
employees에 107개의 행이 있고departments에 27개의 행이 있는 경우 카티션 곱에는 107*27개의 행이 포함됩니다. Cartesian Product는 거의 유용하지 않습니다.
참조:
-
조인에 대한 자세한 내용은 Oracle AI Database SQL Tuning Guide를 참조하십시오.
-
조인에 대한 자세한 설명과 예는 Oracle AI Database SQL Language Reference를 참조하십시오.
하위 쿼리
하위 질의는 다른 SQL 문 내에 중첩된 SELECT 문입니다. subquery는 단일 문제를 해결하기 위해 여러 query를 실행해야 하는 경우에 유용합니다.
명령문의 각 질의 부분을 질의 블록이라고 합니다. 다음 query에서 괄호 안의 subquery는 inner query 블록입니다.
SELECT first_name, last_name
FROM   employees
WHERE  department_id
IN     ( SELECT department_id
         FROM departments
         WHERE location_id = 1800 );
내부 SELECT 문은 위치 ID가 1800인 부서의 ID를 검색합니다. 이러한 부서 ID는 outer query 블록에서 필요로 하며, 이 블록은 subquery에서 ID를 제공한 부서의 사원 이름을 검색합니다.
SQL 문의 구조는 데이터베이스가 inner query를 먼저 실행하도록 강요하지 않습니다. 예를 들어, 데이터베이스가 전체 질의를 employees 및 departments의 조인으로 재작성하여 하위 질의가 자체적으로 실행되지 않도록 할 수 있습니다. 또 다른 예로 VPD(가상 전용 데이터베이스) 기능은 WHERE 절을 사용하여 사원 질의를 제한할 수 있으므로 데이터베이스가 먼저 사원을 query한 다음 부서 ID를 구합니다. 옵티마이저는 요청된 행을 검색하는 최상의 단계 시퀀스를 결정합니다.
참조: VPD에 대한 자세한 내용은 Oracle AI Database Security Guide를 참조하십시오.
트랜잭션 제어문
트랜잭션 제어문은 DML 문에 의해 수행된 변경 사항을 관리하고 DML 문을 트랜잭션으로 그룹화합니다.
이 명령문을 사용하여 다음을 수행할 수 있습니다.
-
트랜잭션을 영구적으로 변경합니다(
COMMIT). -
트랜잭션이 시작된 이후(
ROLLBACK) 또는 저장점 이후(ROLLBACK TO SAVEPOINT) 트랜잭션의 변경 사항을 실행 취소합니다. 저장점은 트랜잭션 컨텍스트 내에서 사용자가 선언한 중간 표시자입니다.주:
ROLLBACK문은 트랜잭션을 종료하지만ROLLBACK TO SAVEPOINT는 종료하지 않습니다. -
롤백할 수 있는 지점(
SAVEPOINT)을 설정합니다. -
트랜잭션에 대한 속성을 설정합니다(
SETTRANSACTION). -
지연 가능한 무결성 제약 조건을 각 DML 문 다음에 검사할지 또는 트랜잭션이 커밋될 때 검사할지(
SET CONSTRAINT) 지정합니다.
다음 예에서는 Update salaries이라는 트랜잭션을 시작합니다. 이 예제에서는 저장점을 생성하고 사원 급여를 갱신한 다음 해당 트랜잭션을 저장점으로 롤백합니다. 이 예제에서는 급여를 다른 값으로 갱신하고 커밋합니다.
SET TRANSACTION NAME 'Update salaries';

SAVEPOINT before_salary_update;

UPDATE employees SET salary=9100 WHERE employee_id=1234 # DML

ROLLBACK TO SAVEPOINT before_salary_update;

UPDATE employees SET salary=9200 WHERE employee_id=1234 # DML

COMMIT COMMENT 'Updated salaries';
참조:
-
트랜잭션 제어문에 대해 알아보려면 Oracle AI Database SQL Language Reference를 참조하십시오.
세션 제어문
세션 제어문은 사용자 세션의 등록 정보를 동적으로 관리합니다.
세션은 데이터베이스에 대한 현재 유저 로그인 상태를 나타내는 데이터베이스 Instance 메모리의 논리적 엔티티입니다. 세션은 유저가 데이터베이스에 의해 인증될 때부터 사용자가 데이터베이스 응용 프로그램을 연결 해제하거나 종료할 때까지 지속됩니다.
세션 제어문을 사용하여 다음을 수행할 수 있습니다.
-
기본 날짜 형식(
ALTER SESSION) 설정과 같은 특수 함수를 수행하여 현재 세션을 변경합니다. -
현재 세션(
SET ROLE)에 대한 권한 그룹인 롤을 사용 및 사용 안함으로 설정합니다.
다음 명령문은 세션의 기본 날짜 형식을 동적으로 'YYYY MM DD-HH24:MI:SS'로 변경합니다.
ALTER SESSION
   SET NLS_DATE_FORMAT = 'YYYY MM DD HH24:MI:SS';
세션 제어문은 현재 트랜잭션을 암시적으로 커밋하지 않으며
참조:
-
ALTER SESSION구문 및 의미에 대한 Oracle AI Database SQL Language Reference
시스템 제어문
시스템 제어문은 데이터베이스 인스턴스의 등록 정보를 변경합니다.
유일한 시스템 제어문은 ALTER SYSTEM입니다. 최소 공유 서버 수와 같은 설정을 변경하고, 세션을 종료하고, 다른 시스템 레벨 작업을 수행할 수 있습니다.
시스템 제어문의 예는 다음과 같습니다.
ALTER SYSTEM SWITCH LOGFILE;

ALTER SYSTEM KILL SESSION '39, 23';
ALTER SYSTEM 문은 현재 트랜잭션을 암시적으로 커밋하지 않습니다.
참조: ALTER SYSTEM 구문 및 의미에 대한 Oracle AI Database SQL Language Reference
포함된 SQL 문
내장된 SQL 문은 프로시저 언어 프로그램 내에 DDL, DML 및 트랜잭션 제어문을 통합합니다.
내장된 명령문은 Oracle 선행 컴파일러와 함께 사용됩니다. 내장된 SQL은 프로시저 언어 응용 프로그램에 SQL을 통합하는 한 가지 방법입니다. 또 다른 접근 방법은 ODBC(Open Database Connectivity) 또는 JDBC(Java Database Connectivity)와 같은 프로시저 API를 사용하는 것입니다.
내장된 SQL 문을 사용하여 다음을 수행할 수 있습니다.
-
커서(
DECLARE CURSOR,OPEN,CLOSE)를 정의, 할당 및 해제합니다. -
데이터베이스를 지정하고 데이터베이스에 접속합니다(
DECLARE DATABASE,CONNECT). -
변수 이름(
DECLARE STATEMENT)을 지정합니다. -
기술자(
DESCRIBE)를 초기화합니다. -
오류 및 경고 조건의 처리 방법을 지정합니다(
WHENEVER). -
SQL 문 구문 분석 및 실행(
PREPARE,EXECUTE,EXECUTE IMMEDIATE) -
데이터베이스에서 데이터를 검색합니다(
FETCH).
옵티마이저 개요
Oracle AI Database가 SQL 문을 처리하는 방식을 이해하려면 최적기(질의 최적기 또는 비용 기반 최적기라고도 함)라는 데이터베이스의 일부를 이해해야 합니다. 모든 SQL 문은 옵티마이저를 사용하여 지정된 데이터에 액세스하는 가장 효율적인 방법을 결정합니다.
-
최적기 사용 최적기는 가능한 실행 방법을 설명하는 실행 계획을 생성합니다.
-
옵티마이저 구성 요소 옵티마이저는 세 가지 주요 구성 요소인 변환기, 예측기 및 계획 생성기를 포함합니다.
-
액세스 경로 액세스 경로는 질의가 행을 검색하는 데 사용하는 기술입니다.
-
최적기 통계 최적기 통계는 데이터베이스 및 데이터베이스의 객체에 대한 세부 정보를 설명하는 데이터 모음입니다. 통계는 액세스 경로를 평가할 때 옵티마이저가 사용할 수 있는 데이터 저장 영역 및 분산에 대한 통계적으로 올바른 그림을 제공합니다.
-
옵티마이저 힌트 힌트는 옵티마이저에 대한 명령으로 사용되는 SQL 문의 주석입니다.
Optimizer 사용
옵티마이저는 가능한 실행 방법을 설명하는 실행 계획을 생성합니다.
옵티마이저는 여러 정보 소스를 고려하여 가장 효율적인 실행 계획을 결정합니다. 예를 들어, 옵티마이저는 Query 조건, 사용 가능한 액세스 경로, 시스템에 대해 수집된 통계 및 힌트를 고려합니다.
DML 문을 실행하기 위해 Oracle AI Database는 여러 단계를 수행해야 할 수 있습니다. 이러한 각 단계에는 명령문을 실행하는 유저를 위해 데이터베이스에서 데이터 행을 물리적으로 검색하거나 명령문을 실행하는 사용자를 위해 특정 방식으로 데이터를 준비합니다. 데이터베이스에서 명령문 실행에 사용하는 단계는 명령문 실행 속도에 큰 영향을 줍니다. DML 문을 처리하는 여러 가지 방법이 있을 수 있습니다. 예를 들어, 테이블 또는 인덱스가 액세스되는 순서는 다를 수 있습니다.
SQL 문에 대한 최상의 실행 계획을 결정할 때 옵티마이저는 다음 작업을 수행합니다.
-
표현식 및 조건 평가
-
무결성 제약 조건을 검사하여 데이터에 대해 자세히 알아보고 이 메타데이터를 기반으로 최적화
-
명령문 변형
-
옵티마이저 목표 선택
-
액세스 경로 선택
-
조인 순서 선택
옵티마이저는 Query 처리 가능한 대부분의 방법을 생성하고 생성된 실행 계획의 각 단계에 비용을 할당합니다. 비용이 가장 낮은 계획이 실행될 질의 계획으로 선택됩니다.
주: 계획을 실행하지 않고 SQL 문에 대한 실행 계획을 얻을 수 있습니다. 데이터베이스가 실제로 query를 실행하는 데 사용하는 실행 계획만 query 계획이라고 합니다.
옵티마이저 목표를 설정하고 옵티마이저에 대한 대표 통계를 수집하여 옵티마이저 선택에 영향을 줄 수 있습니다. 예를 들어, 다음 중 하나로 옵티마이저 목표를 설정할 수 있습니다.
-
총 처리량
ALL_ROWS힌트는 결과의 마지막 행을 클라이언트 응용 프로그램에 최대한 빨리 가져오도록 옵티마이저에 지시합니다. -
초기 응답 시간
FIRST_ROWS힌트는 옵티마이저가 가능한 한 빨리 첫번째 행을 클라이언트로 가져오도록 합니다.
일반적인 일반 유저 대화식 응용 프로그램은 초기 응답 시간 최적화의 이점을 누릴 수 있지만 일괄 처리 모드 비대화식 응용 프로그램은 총 처리량 최적화의 이점을 누릴 수 있습니다.
참조:
-
DBMS_STATS사용에 대한 자세한 내용은 Oracle AI Database PL/SQL Packages and Types Reference를 참조하십시오. -
Oracle AI Database SQL Tuning Guide - 옵티마이저 및 힌트 사용에 대한 자세한 내용
최적기 구성 요소
옵티마이저는 세 가지 주요 구성 요소인 변형기, 예측기 및 계획 생성기를 포함합니다.
다음 다이어그램은 구성 요소를 보여 줍니다.
그림 2: 최적기 구성 요소
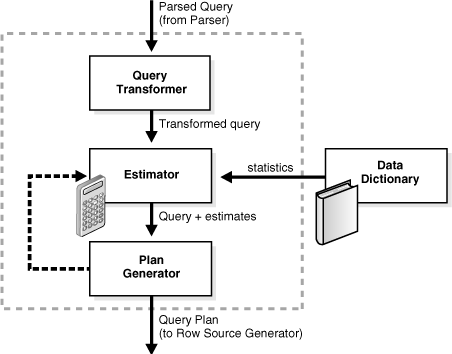
옵티마이저에 대한 입력은 구문 분석된 query입니다. 옵티마이저는 다음 작업을 수행합니다.
-
옵티마이저는 구문 분석된 query를 수신하고 사용 가능한 액세스 경로 및 힌트를 기반으로 SQL 문의 잠재적 계획 집합을 생성합니다.
-
옵티마이저는 데이터 딕셔너리의 통계를 기반으로 각 계획의 비용을 예측합니다. 비용은 특정 계획으로 명령문을 실행하는 데 필요한 예상 리소스 사용에 비례하는 예측 값입니다.
-
옵티마이저는 계획 비용을 비교하고 행 소스 생성기로 전달할 최저 비용 계획(query 계획)을 선택합니다.
-
쿼리 변환기 쿼리 변환기는 최적기가 더 나은 실행 계획을 생성할 수 있도록 쿼리 형식을 변경하는 것이 유용한지 여부를 결정합니다. Query 변형기에 대한 입력은 옵티마이저가 query 블록 집합으로 나타내는 구문 분석된 query입니다.
-
Estimator estimator는 지정된 실행 계획의 전체 비용을 결정합니다.
-
계획 생성기 계획 생성기는 제출된 질의에 대해 서로 다른 계획을 시도합니다. 옵티마이저는 최저 비용의 계획을 선택합니다.
참조:
Query 변환기
질의 변환기는 최적기가 더 나은 실행 계획을 생성할 수 있도록 질의 형식을 변경하는 것이 유용한지 여부를 결정합니다. Query 변형기에 대한 입력은 옵티마이저가 query 블록 집합으로 나타내는 구문 분석된 query입니다.
참조: 질의 재작성
추정자
estimator는 지정된 실행 계획의 전체 비용을 결정합니다.
예측기는 이 목표를 달성하기 위해 다음과 같은 세 가지 유형의 측정을 생성합니다.
-
선택성
이 측정항목은 행 집합에서 행의 비율을 나타냅니다. 선택성은
last_name='Smith'와 같은 query 술어 또는 술어 조합에 연결됩니다. -
기수
이 측정항목은 행 집합의 행 수를 나타냅니다.
-
원가
이 측정은 사용된 작업 또는 자원 단위를 나타냅니다. Query 옵티마이저는 디스크 I/O, CPU 사용량 및 메모리 사용량을 작업 단위로 사용합니다.
통계가 사용 가능한 경우 예측기는 통계를 사용하여 측정 단위를 계산합니다. 통계는 측정 단위의 정확도를 향상시킵니다.
계획 생성기
계획 생성기는 제출된 질의에 대해 서로 다른 계획을 시도합니다. 옵티마이저는 최저 비용의 계획을 선택합니다.
각 중첩된 subquery 및 병합되지 않은 뷰에 대해 옵티마이저는 subplan을 생성합니다. 옵티마이저는 각 하위 계획을 별도의 query block으로 나타냅니다. 계획 생성기는 다양한 액세스 경로, 조인 방법 및 조인 순서를 시도하여 query 블록에 대한 다양한 계획을 탐색합니다.
적응형 질의 최적화 기능은 명령문 실행 중 수집된 통계를 기반으로 계획을 변경합니다. 모든 Adaptive 메커니즘에서는 기본 계획과 다른 명령문에 대해 최종 계획을 실행할 수 있습니다. Adaptive 최적화에서는 명령문 실행 중 sub-plan에서 선택하는 동적 계획이나 현재 실행 후 실행 시 계획을 변경하는 재최적화를 사용합니다.
참조:
-
Oracle AI Database 성능 튜닝 시작하기 - SQL 튜닝 소개
-
Oracle AI Database SQL Tuning Guide - 옵티마이저 구성 요소 및 적응형 최적화에 대해 알아보기
접근 경로
액세스 경로는 질의가 행을 검색하는 데 사용하는 기술입니다.
예를 들어, 인덱스를 사용하는 질의는 그렇지 않은 질의와 다른 액세스 경로를 가집니다. 일반적으로 인덱스 액세스 경로는 테이블 행의 작은 부분 집합을 검색하는 명령문에 가장 적합합니다. 전체 스캔은 테이블의 많은 부분에 액세스하는 데 더 효율적입니다.
데이터베이스는 여러 가지 액세스 경로를 사용하여 테이블에서 데이터를 검색할 수 있습니다. 다음은 대표 리스트입니다.
-
전체 테이블 검색
이 유형의 스캔은 테이블에서 모든 행을 읽고 선택 조건을 충족하지 않는 행을 필터링합니다. 데이터베이스는 사용되지 않은 공간에서 사용되는 것을 구분하는 HWM(고수위) 아래의 데이터 블록을 포함하여 세그먼트의 모든 데이터 블록을 순차적으로 스캔합니다("세그먼트 공간 및 고수위 참조).
-
Rowid 스캔
행의 rowid는 데이터 파일과 데이터 블록을 지정하며, 해당 블록에서 행의 위치와 행을 포함합니다. 데이터베이스는 먼저 명령문
WHERE절 또는 인덱스 스캔을 통해 선택한 행의 rowid를 가져온 다음 해당 rowid를 기반으로 선택한 각 행을 찾습니다. -
인덱스 검색
이 스캔은 인덱스에서 SQL 문이 액세스하는 인덱스화된 열 값을 검색합니다("인덱스 스캔 참조). 명령문이 인덱스의 열만 액세스하는 경우 Oracle AI Database는 인덱스에서 직접 인덱스화된 열 값을 읽습니다.
-
클러스터 스캔
클러스터 스캔은 인덱스화된 테이블 클러스터에 저장된 테이블에서 데이터를 검색합니다. 이 테이블에서는 동일한 클러스터 키 값을 가진 모든 행이 동일한 데이터 블록에 저장됩니다("인덱스화된 클러스터 개요 참조). 데이터베이스는 먼저 클러스터 인덱스를 스캔하여 선택한 행의 rowid를 획득합니다. Oracle AI Database는 이 rowid를 기반으로 행을 찾습니다.
-
해시 검색
해시 스캔은 해시 클러스터에서 동일한 해시 값을 가진 모든 행이 동일한 데이터 블록에 저장되는 행을 찾습니다("해시 클러스터 개요 참조). 데이터베이스는 먼저 명령문에서 지정된 클러스터 키 값에 해시 함수를 적용하여 해시 값을 얻습니다. 그런 다음 Oracle AI Database는 이 해시 값을 가진 행을 포함하는 데이터 블록을 스캔합니다.
옵티마이저는 명령문에 대해 사용 가능한 액세스 경로와 각 액세스 경로 또는 경로 조합을 사용하는 데 드는 예상 비용을 기준으로 액세스 경로를 선택합니다.
참조: 액세스 경로에 대한 자세한 내용은 Oracle AI Database Get Started with Performance Tuning 및 Oracle AI Database SQL Tuning Guide를 참조하십시오.
최적기 통계
최적기 통계는 데이터베이스 및 데이터베이스의 객체에 대한 세부 정보를 설명하는 데이터 모음입니다. 통계는 액세스 경로를 평가할 때 옵티마이저가 사용할 수 있는 데이터 저장 영역 및 분산에 대한 통계적으로 올바른 그림을 제공합니다.
최적기 통계에는 다음이 포함됩니다.
-
테이블 통계
여기에는 행 수, 블록 수 및 평균 행 길이가 포함됩니다.
-
열 통계를 표시합니다.
여기에는 열의 구분 값 및 널 수와 데이터 분산이 포함됩니다.
-
인덱스 통계
여기에는 최하위 블록 수와 인덱스 레벨이 포함됩니다.
-
시스템 통계
여기에는 CPU 및 I/O 성능과 활용률이 포함됩니다.
Oracle AI Database는 모든 데이터베이스 객체에 대한 옵티마이저 통계를 자동으로 수집하고 이러한 통계를 자동화된 유지 관리 작업으로 유지 관리합니다. DBMS_STATS 패키지를 사용하여 통계를 수동으로 수집할 수도 있습니다. 이 PL/SQL 패키지는 통계를 수정, 조회, 엑스포트, 임포트 및 삭제할 수 있습니다. 주: 최적기 통계는 질의 최적화를 위해 생성되며 데이터 딕셔너리에 저장됩니다. 이러한 통계를 동적 성능 뷰를 통해 볼 수 있는 성능 통계와 혼동하지 마십시오.
옵티마이저 통계 Advisor는 현재 통계 수집 방법, 기존 통계 수집 작업의 효율성 및 수집된 통계의 품질을 분석하는 내장 진단 소프트웨어입니다. 옵티마이저 통계 권고자는 현재 기능 집합을 기반으로 Oracle 최적의 사용법을 구현하는 규칙을 유지 관리합니다. 이러한 방식으로 Advisor는 항상 통계 수집을 위한 최신 권장 사항을 제공합니다.
참조:
-
통계 수집 및 관리 방법에 대한 자세한 내용은 Oracle AI Database Get Started with Performance Tuning 및 Oracle AI Database SQL Tuning Guide를 참조하십시오.
-
DBMS_STATS에 대한 자세한 내용은 Oracle AI Database PL/SQL Packages and Types Reference를 참조하십시오.
최적기 힌트
힌트는 옵티마이저에 대한 지침으로 사용되는 SQL 문의 주석입니다.
특정 응용 프로그램의 데이터에 대한 정보가 옵티마이저에서 사용할 수 있는 것보다 많은 응용 프로그램 설계자가 보다 효과적인 SQL 문 실행 방법을 선택할 수 있는 경우가 있습니다. 응용 프로그램 설계자는 SQL 문의 힌트를 사용하여 명령문 실행 방법을 지정할 수 있습니다. 다음 예에서는 힌트 사용을 보여줍니다.
예제 10-2 SELECT에 대한 FIRST_ROWS 힌트 실행 계획
대화식 응용 프로그램에서 50개의 행을 반환하는 query를 실행한다고 가정해 보겠습니다. 이 응용 프로그램은 처음에 일반 유저에게 표시할 query의 처음 25개 행만 패치(fetch)합니다. 옵티마이저가 유저가 강제로 대기하지 않도록 처음 25개의 레코드를 최대한 빨리 가져오는 계획을 생성하도록 하려고 합니다. 다음 예제의 SELECT 문 및 AUTOTRACE 출력에 표시된 것처럼 힌트를 사용하여 이 명령을 옵티마이저에 전달할 수 있습니다.
SELECT /*+ FIRST_ROWS(25) */ employee_id, department_id
FROM   hr.employees
WHERE  department_id > 50;

------------------------------------------------------------------------
| Id | Operation                    | Name              | Rows | Bytes
------------------------------------------------------------------------
|  0 | SELECT STATEMENT             |                   | 26   | 182
|  1 |  TABLE ACCESS BY INDEX ROWID | EMPLOYEES         | 26   | 182
|* 2 |   INDEX RANGE SCAN           | EMP_DEPARTMENT_IX |      |
------------------------------------------------------------------------
이 예제에서 실행 계획은 옵티마이저가 부서 ID가 50을 초과하는 employees의 처음 25개 행을 찾기 위해 employees.department_id 열에서 인덱스를 선택함을 보여줍니다. 옵티마이저는 인덱스에서 검색된 rowid를 사용하여 employees 테이블에서 레코드를 검색하고 클라이언트로 반환합니다. 첫 번째 레코드의 검색은 일반적으로 거의 즉각적입니다.
예제 10-3 힌트가 없는 SELECT에 대한 실행 계획
옵티마이저 힌트 없이 동일한 명령문을 실행한다고 가정합니다.
SELECT employee_id, department_id
FROM   hr.employees
WHERE  department_id > 50;

------------------------------------------------------------------------
| Id | Operation              | Name              | Rows | Bytes | Cos
------------------------------------------------------------------------
|  0 | SELECT STATEMENT       |                   | 50   | 350   |
|* 1 |  VIEW                  | index$_join$_001  | 50   | 350   |
|* 2 |   HASH JOIN            |                   |      |       |
|* 3 |    INDEX RANGE SCAN    | EMP_DEPARTMENT_IX | 50   | 350   |
|  4 |    INDEX FAST FULL SCAN| EMP_EMP_ID_PK     | 50   | 350   |
이 경우 실행 계획은 두 개의 인덱스를 조인하여 요청된 레코드를 최대한 빨리 반환합니다. Example 10-2와 같이 인덱스에서 테이블로 반복적으로 이동하는 대신 옵티마이저는 EMP_DEPARTMENT_IX의 범위 스캔을 선택하여 부서 ID가 50을 초과하는 모든 행을 찾고 이러한 행을 해시 테이블에 배치합니다. 그런 다음 옵티마이저가 EMP_EMP_ID_PK 인덱스를 읽도록 선택합니다. 이 인덱스의 각 행에 대해 해시 테이블을 검사하여 부서 ID를 찾습니다.
이 경우 데이터베이스는 EMP_DEPARTMENT_IX의 인덱스 범위 스캔이 완료될 때까지 첫번째 행을 클라이언트에 반환할 수 없습니다. 따라서 이 생성된 계획은 첫 번째 레코드를 반환하는 데 더 오래 걸립니다. 인덱스 rowid로 테이블에 액세스하는 예 10-2의 계획과 달리 계획은 다중 블록 I/O를 사용하므로 읽기 횟수가 많습니다. 읽기를 사용하면 전체 결과 집합의 마지막 행을 보다 빠르게 반환할 수 있습니다.
참조: Oracle AI Database SQL Tuning Guide에서 옵티마이저 힌트 사용 방법 알아보기
SQL 처리 개요
이 섹션에서는 Oracle AI Database가 SQL 문을 처리하는 방법에 대해 설명합니다. 특히 이 절에서는 데이터베이스가 DDL 문을 처리하여 객체를 생성하는 방법, 데이터를 수정하는 DML, 데이터를 검색하는 query에 대해 설명합니다.
-
SQL 처리 단계 SQL 처리의 일반적인 단계는 구문 분석, 최적화, 행 소스 생성 및 실행입니다. 명령문에 따라 데이터베이스에서 이러한 단계 중 일부를 생략할 수 있습니다.
-
DML과 DDL 처리의 차이점 Oracle AI Database는 DML과 DDL을 다르게 처리합니다.
SQL 처리 단계
SQL 처리의 일반적인 단계는 구문 분석, 최적화, 행 소스 생성 및 실행입니다. 명령문에 따라 데이터베이스에서 이러한 단계 중 일부를 생략할 수 있습니다.
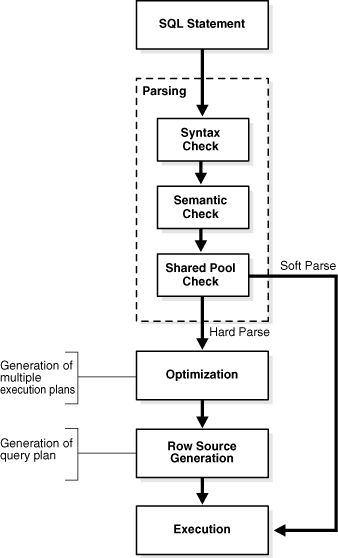
다음 그림은 일반적인 단계를 나타냅니다.
그림 3: SQL 처리 단계
-
SQL 구문 분석 SQL 처리의 첫번째 단계는 SQL 구문 분석입니다. 이 단계에서는 SQL 문의 피스를 다른 루틴에서 처리할 수 있는 데이터 구조로 구분합니다.
-
쿼리 최적화는 SQL 문을 실행하는 가장 효율적인 방법을 선택하는 프로세스입니다.
-
SQL 행 소스 생성 행 소스 생성기는 최적기에서 최적 실행 계획을 수신하고 나머지 데이터베이스에서 사용할 수 있는 질의 계획이라는 반복 계획을 생성하는 소프트웨어입니다.
-
SQL 실행 실행 중 SQL 엔진은 행 소스 생성기에서 생성된 트리의 각 행 소스를 실행합니다. 이 단계는 DML 처리의 유일한 필수 단계입니다.
SQL 구문 분석
SQL 처리의 첫번째 단계는 SQL 구문 분석입니다. 이 단계에서는 SQL 문의 피스를 다른 루틴에서 처리할 수 있는 데이터 구조로 구분합니다.
응용 프로그램이 SQL 문을 실행하면 해당 응용 프로그램은 데이터베이스에 대한 구문 분석 호출을 수행하여 명령문의 실행을 준비합니다. 구문 분석 호출은 구문 분석된 SQL 문 및 기타 처리 정보를 보유하는 세션별 전용 SQL 영역에 대한 핸들인 커서를 열거나 생성합니다. 커서 및 전용 SQL 영역은 PGA에 있습니다.
구문 분석 호출 중 데이터베이스는 다음 검사를 수행합니다.
-
구문 검사
-
의미 검사
-
Shared Pool 검사
앞의 검사는 명령문 실행 전에서 찾을 수 있는 오류를 식별합니다. 일부 오류는 구문 분석으로 감지할 수 없습니다. 예를 들어, 명령문 실행 중에만 데이터베이스에 deadlock 또는 데이터 변환 오류가 발생할 수 있습니다.
데이터베이스는 구문 분석 단계 중 ORA-00600 오류와 함께 실패하는 SQL 문에 대해 자동 오류 완화를 시도합니다. ORA-00600은 심각한 오류입니다. 프로세스에서 예상치 않은 하위 레벨 조건이 발생했음을 나타냅니다. 구문 분석 단계 중 이 오류로 인해 SQL 문이 실패하면 자동 오류 완화로 인해 SQL 문이 트랩되고 조건 해결이 시도됩니다. 해결 방법이 발견되면 데이터베이스는 SQL 실행 계획을 조정하기 위해 SQL 패치를 생성합니다. 이 패치로 인해 구문 분석이 성공적으로 완료될 경우 ORA-00600 오류가 발생하지 않습니다. 응용 프로그램에는 예외가 표시되지 않습니다.
SQL 최적화
쿼리 최적화는 SQL 문을 실행하는 가장 효율적인 방법을 선택하는 프로세스입니다.
데이터베이스는 액세스되는 실제 데이터에 대해 수집된 통계를 기반으로 query를 최적화합니다. 옵티마이저는 행 수, 데이터 집합 크기 및 기타 요소를 사용하여 가능한 실행 계획을 생성하고 각 계획에 숫자 비용을 할당합니다. 데이터베이스는 최저 비용의 계획을 사용합니다.
데이터베이스는 모든 고유 DML 문에 대해 적어도 한 번 하드 구문 분석을 수행하고 이 구문 분석 중에 최적화를 수행해야 합니다. 최적화가 필요한 subquery 등의 DML 구성 요소가 포함되어 있지 않으면 DDL은 최적화되지 않습니다.
참조:
-
질의 최적기에 대한 자세한 내용은 Oracle AI Database SQL Tuning Guide를 참조하십시오.
SQL 행 소스 생성
행 소스 생성기는 최적기에서 최적 실행 계획을 수신하고 나머지 데이터베이스에서 사용할 수 있는 질의 계획이라는 반복 계획을 생성하는 소프트웨어입니다.
query 계획은 일련의 단계를 조합한 형태를 취합니다. 각 단계는 행 세트를 반환합니다. 이 집합의 행은 다음 단계에서 사용하거나 마지막 단계에서 SQL 문을 실행하는 응용 프로그램으로 반환됩니다.
행 소스는 행을 반복적으로 처리할 수 있는 제어 구조와 함께 실행 계획의 단계에서 반환되는 행 집합입니다. 행 소스는 테이블, 뷰 또는 조인이나 그룹화 작업의 결과일 수 있습니다.
SQL 실행
실행 중에 SQL 엔진은 행 소스 생성기에서 생성된 트리의 각 행 소스를 실행합니다. 이 단계는 DML 처리의 유일한 필수 단계입니다.
실행 중에 데이터가 메모리에 없는 경우 데이터베이스는 디스크에서 메모리로 데이터를 읽습니다. 또한 데이터베이스는 데이터 무결성을 보장하는 데 필요한 Lock과 래치를 제거하고 SQL 실행 중에 수행된 모든 변경 사항을 기록합니다. SQL 문 처리의 마지막 단계는 커서를 닫는 것입니다.
데이터베이스가 인메모리 열 저장소(IM 열 저장소)를 사용하도록 구성된 경우 데이터베이스는 가능한 경우 IM 열 저장소로 질의 경로를 투명하게 지정하고 디스크 및 데이터베이스 버퍼 캐시로 경로를 지정합니다. 단일 query는 IM 열 저장소, 디스크 및 버퍼 캐시를 사용할 수도 있습니다. 예를 들어, query는 두 개의 테이블을 조인할 수 있으며 이 중 하나만 IM 열 저장소에서 캐시됩니다.
참조:
-
실행 계획 및
EXPLAIN PLAN문에 대한 자세한 내용은 Oracle AI Database SQL Tuning Guide를 참조하십시오.
DML 처리와 DDL 처리의 차이점
Oracle AI Database는 DML과는 다르게 DDL을 처리합니다.
예를 들어, 테이블을 생성할 때 데이터베이스는 CREATE TABLE 문을 최적화하지 않습니다. 대신 Oracle AI Database는 DDL 문을 구문 분석하고 명령을 실행합니다.
DDL과 달리 대부분의 DML 문에는 query 구성 요소가 있습니다. query에서 커서를 실행하면 query에 의해 생성된 행이 결과 집합에 배치됩니다.
데이터베이스는 한 번에 한 행 또는 그룹으로 결과 집합 행을 패치(fetch)할 수 있습니다. 패치(fetch)에서 데이터베이스는 행을 선택하고 query에 의해 요청된 경우 행을 정렬합니다. 연속되는 각 패치(fetch)는 마지막 행이 패치(fetch)될 때까지 결과의 다른 행을 검색합니다.
참조: Oracle AI Database Development Guide에서 DDL, 트랜잭션 제어 및 기타 유형의 명령문 처리에 대해 알아보기