Partition, 뷰 및 기타 스키마 객체
테이블 및 인덱스가 가장 중요하고 일반적으로 사용되는 스키마 객체이지만 데이터베이스는 다른 여러 유형의 스키마 객체를 지원합니다. 이 중 가장 일반적인 스키마 객체는 이 장에서 설명합니다.
-
분할 영역 개요 Oracle 데이터베이스에서 분할을 사용하면 매우 큰 테이블과 인덱스를 분할 영역이라는 더 작고 관리하기 쉬운 조각으로 분해할 수 있습니다. 각 분할 영역은 자체 이름과 선택적으로 자체 저장 영역 특성을 갖는 독립 객체입니다.
-
샤딩된 테이블 개요 Oracle 데이터베이스에서 Globally Distributed Database 기능을 사용하면 테이블을 여러 데이터베이스에 저장할 수 있는 샤드라는 조각으로 나눌 수 있습니다.
-
뷰 개요 뷰는 하나 이상의 테이블에 대한 논리적 표현입니다. 본질적으로 뷰는 내장 query입니다.
-
구체화된 뷰 개요 구체화된 뷰는 스키마 객체로 미리 저장되거나 "구체화된" 질의 결과입니다. 질의의
FROM절은 테이블, 뷰 또는 구체화된 뷰의 이름을 지정할 수 있습니다. -
시퀀스 개요 시퀀스는 여러 사용자가 고유한 정수를 생성할 수 있는 스키마 객체입니다. 시퀀스 생성기는 숫자 데이터 유형에 대해 대리 키를 생성하는 확장성이 뛰어나고 성능이 뛰어난 방법을 제공합니다.
-
차원 개요 일반적인 데이터 웨어하우스에는 차원과 팩트의 두 가지 중요한 구성요소가 있습니다.
-
동의어 개요 동의어는 스키마 객체의 별칭입니다. 예를 들어, 테이블 또는 뷰, 시퀀스, PL/SQL 프로그램 단위, 유저 정의 객체 유형 또는 다른 동의어에 대한 동의어를 생성할 수 있습니다. 동의어가 단순히 별칭이므로 데이터 딕셔너리에 없는 해당 정의 외에 저장 영역은 필요하지 않습니다.
분할 영역 개요
Oracle 데이터베이스에서 분할을 사용하면 매우 큰 테이블과 인덱스를 분할 영역이라는 더 작고 관리하기 쉬운 조각으로 분해할 수 있습니다. 각 분할 영역은 자체 이름과 선택적으로 자체 저장 영역 특성을 갖는 독립 객체입니다.
Partitioning을 보여주는 비유를 보면 HR 관리자에게 사원 폴더가 포함된 하나의 큰 상자가 있다고 가정합니다. 각 폴더에는 사원 고용 일자가 나열됩니다. 질의는 종종 특정 월에 고용된 사원에 대해 수행됩니다. 이러한 요청을 충족시키는 한 가지 방법은 직원 채용 날짜에 인덱스를 생성하여 상자에 흩어져 있는 폴더의 위치를 지정하는 것입니다. 반대로, 파티셔닝 전략은 여러 개의 작은 상자를 사용하며 각 상자에는 특정 월에 고용된 직원용 폴더가 포함되어 있습니다.
작은 상자를 사용하면 여러 가지 장점이 있습니다. 6월에 채용된 사원의 폴더를 검색할지 묻는 메시지가 나타나면 HR 관리자가 June 상자를 검색할 수 있습니다. 또한 작은 상자가 일시적으로 손상된 경우 다른 작은 상자는 계속 사용할 수 있습니다. 하나의 무거운 상자를 이동하는 대신 관리자가 여러 개의 작은 상자를 이동할 수 있기 때문에 사무실을 이동하는 것도 더 쉬워집니다.
응용 프로그램의 관점에서 하나의 스키마 객체만 존재합니다. 분할된 테이블에 액세스하기 위해 SQL 문을 수정할 필요가 없습니다. 분할은 다양한 유형의 데이터베이스 응용 프로그램, 특히 대용량 데이터를 관리하는 응용 프로그램에 유용합니다. 주요 이점:
-
가용성 향상
분할 영역을 사용할 수 없으면 객체를 사용할 수 없습니다. 질의 옵티마이저는 질의 계획에서 참조되지 않은 분할 영역을 자동으로 제거하므로 분할 영역을 사용할 수 없을 때 질의가 영향을 받지 않습니다.
-
스키마 객체의 관리 용이성
분할된 객체는 집합적으로나 개별적으로 관리할 수 있는 피스를 가집니다. DDL 문은 전체 테이블이나 인덱스가 아닌 분할 영역을 조작할 수 있습니다. 따라서 인덱스나 테이블 재구축과 같은 자원 집약적인 작업을 분석할 수 있습니다. 예를 들어, 한 번에 하나의 테이블 분할 영역을 이동할 수 있습니다. 문제가 발생하면 테이블 이동이 아닌 분할 영역 이동만 다시 실행해야 합니다. 또한 분할 영역을 삭제하면 수많은
DELETE문이 실행되지 않습니다. -
OLTP 시스템에서 공유 리소스에 대한 경합 감소
일부 OLTP 시스템에서는 분할 영역이 공유 리소스에 대한 경합을 줄일 수 있습니다. 예를 들어, DML은 하나의 세그먼트가 아닌 여러 세그먼트에 분산됩니다.
-
데이터 웨어하우스의 쿼리 성능 향상
데이터 웨어하우스에서 파티셔닝은 임시 쿼리의 처리 속도를 높일 수 있습니다. 예를 들어, 백만 개의 행을 포함하는 판매 테이블은 분기별로 분할될 수 있습니다.
-
분할 영역 특성 테이블 또는 인덱스의 각 분할 영역에는 열 이름, 데이터 유형 및 제약 조건과 같은 동일한 논리적 속성이 있어야 합니다.
-
분할된 테이블 분할된 테이블은 개별적으로 관리되며 다른 분할 영역과 독립적으로 작동할 수 있는 하나 이상의 분할 영역으로 구성됩니다.
-
분할된 인덱스 분할된 인덱스는 분할된 테이블과 마찬가지로 더 작고 관리하기 쉬운 조각으로 구분된 인덱스입니다.
-
분할된 테이블에 대한 부분 인덱스 부분 인덱스는 연관된 분할된 테이블의 인덱스화 속성과 상관되는 인덱스입니다.
-
이전 파티션에 객체 저장소 사용 읽기 전용 파티션의 경우 클라우드에서 객체 스토리지와 같은 저비용 스토리지를 사용할 수 있습니다. 참조: 분할 소개는 Oracle AI Database VLDB and Partitioning Guide
분할 영역 특성
테이블 또는 인덱스의 각 분할 영역은 열 이름, 데이터 유형 및 제약 조건과 같은 동일한 논리적 속성을 가져야 합니다.
예를 들어, 테이블의 모든 분할 영역은 동일한 열 및 제약 조건 정의를 공유합니다. 그러나 각 분할 영역은 속성이 속한 테이블스페이스와 같이 별도의 물리적 속성을 가질 수 있습니다.
-
분할 영역 키 분할 영역 키는 분할된 테이블의 각 행이 이동할 분할 영역을 결정하는 하나 이상의 열 집합입니다. 각 행은 단일 분할 영역에 명확하게 할당됩니다.
-
파티셔닝 전략 Oracle Partitioning은 데이터베이스가 데이터를 파티션에 배치하는 방법을 제어하는 여러 가지 파티셔닝 전략을 제공합니다. 기본 전략은 범위, 목록 및 해시(Hash) 분할입니다.
분할 영역 키
분할 영역 키는 분할된 테이블의 각 행이 이동해야 하는 분할 영역을 결정하는 하나 이상의 열 세트입니다. 각 행은 단일 분할 영역에 명확하게 할당됩니다.
sales 테이블에서 time_id 열을 범위 분할 영역의 키로 지정할 수 있습니다. 데이터베이스는 이 열의 날짜가 지정된 범위에 속하는지 여부에 따라 행을 분할 영역에 할당합니다. Oracle AI Database는 파티션 키를 사용하여 적절한 파티션에 삽입, 업데이트 및 삭제 작업을 자동으로 지시합니다.
분할 전략
Oracle Partitioning은 데이터베이스가 데이터를 Partition에 배치하는 방식을 제어하는 여러 Partitioning 전략을 제공합니다. 기본 전략은 범위, 목록 및 해시(Hash) 분할입니다.
단일 레벨 분할은 목록 분할 또는 범위 분할만 등 하나의 데이터 분배 방법만 사용합니다. 조합 분할에서 테이블은 하나의 데이터 분배 방법으로 분할된 다음 각 분할 영역은 두번째 데이터 분배 방법을 사용하여 하위 분할 영역으로 더 나뉩니다. 예를 들어, channel_id에 대한 목록 분할 영역과 time_id에 대한 범위 하위 분할 영역을 사용할 수 있습니다.
예제 6-1 분할된 테이블에 대한 예제 행 집합
이 분할 예제에서는 분할된 테이블 sales를 다음 행으로 채우려고 한다고 가정합니다.
  PROD_ID    CUST_ID TIME_ID   CHANNEL_ID   PROMO_ID QUANTITY_SOLD AMOUNT_SOLD
---------- ---------- --------- ---------- ---------- ------------- -----------
      116      11393 05-JUN-99          2        999             1
12.18
       40     100530 30-NOV-98          9         33             1       44.99
      118        133 06-JUN-01          2        999             1       17.12
      133       9450 01-DEC-00          2        999             1       31.28
       36       4523 27-JAN-99          3        999             1       53.89
      125       9417 04-FEB-98          3        999             1       16.86
       30        170 23-FEB-01          2        999             1         8.8
       24      11899 26-JUN-99          4        999             1       43.04
       35       2606 17-FEB-00          3        999             1       54.94
45 9491 28-AUG-98 4 350 1 47.45-
범위 분할 범위 분할에서 데이터베이스는 분할 키의 값 범위를 기반으로 행을 분할 영역에 매핑합니다. 범위(Range) 분할은 가장 일반적인 분할 유형이며 날짜와 함께 자주 사용됩니다.
-
간격 분할은 범위 분할의 확장입니다.
-
목록 분할 목록 분할에서 데이터베이스는 개별 값 목록을 각 분할 영역에 대한 분할 영역 키로 사용합니다. 분할 키는 하나 이상의 열로 구성됩니다.
-
해시 분할 해시 분할에서 데이터베이스는 데이터베이스가 사용자 지정 분할 키에 적용되는 해싱 알고리즘을 기반으로 행을 분할 영역에 매핑합니다.
-
참조 분할 참조 분할에서 하위 테이블의 분할 전략은 상위 테이블과의 외래 키 관계를 통해서만 정의됩니다. 상위 테이블의 모든 분할 영역에 대해 해당하는 하나의 분할 영역만 하위 테이블에 존재합니다. 상위 테이블은 특정 분할 영역에 상위 레코드를 저장하고 하위 테이블은 해당 분할 영역에 하위 레코드를 저장합니다.
-
조합 분할 조합 분할에서 테이블은 하나의 데이터 분산 방식으로 분할된 다음 각 분할 영역은 두번째 데이터 분산 방식을 사용하여 하위 분할 영역으로 추가로 분할됩니다. 따라서 조합(Composite) 분할은 기본 데이터 분산 방식을 결합합니다. 주어진 분할 영역에 대한 모든 서브 분할 영역은 데이터의 논리적 부분 집합을 나타냅니다.
범위 분할
범위 분할에서 데이터베이스는 분할 키의 값 범위를 기반으로 행을 분할 영역에 매핑합니다. 범위(Range) 분할은 가장 일반적인 분할 유형이며 날짜와 함께 자주 사용됩니다.
다음 SQL 문을 사용하여 time_range_sales를 분할된 테이블로 생성하고 time_id 열을 분할 키로 사용한다고 가정합니다.
CREATE TABLE time_range_sales
   ( prod_id        NUMBER(6)
   , cust_id        NUMBER
   , time_id        DATE
   , channel_id     CHAR(1)
   , promo_id       NUMBER(6)
   , quantity_sold  NUMBER(3)
   , amount_sold    NUMBER(10,2)
   )
PARTITION BY RANGE (time_id)
 (PARTITION SALES_1998 VALUES LESS THAN (TO_DATE('01-JAN-1999','DD-MON-YYYY')),
  PARTITION SALES_1999 VALUES LESS THAN (TO_DATE('01-JAN-2000','DD-MON-YYYY')),
  PARTITION SALES_2000 VALUES LESS THAN (TO_DATE('01-JAN-2001','DD-MON-YYYY')),
  PARTITION SALES_2001 VALUES LESS THAN (MAXVALUE)
 );
그런 다음 예 6-1의 행과 함께 time_range_sales를 로드합니다. 이 코드는 네 개의 분할 영역에 있는 행 분산을 보여줍니다. 데이터베이스는 PARTITION BY RANGE 절에 지정된 규칙에 따라 time_id 값을 기반으로 각 행에 대한 분할 영역을 선택합니다. 범위 분할 영역 키 값은 지정된 분할 영역에 대한 비포함 상한을 결정합니다.
간격 Partitioning
간격 분할은 범위 분할의 확장입니다.
기존 범위 분할 영역을 초과하는 데이터를 삽입하는 경우 Oracle AI Database는 지정된 간격의 분할 영역을 자동으로 생성합니다. 예를 들어, 각 월의 데이터를 별도의 분할 영역에 저장하는 판매 내역 테이블을 생성할 수 있습니다.
간격 Partition을 사용하면 범위 Partition을 명시적으로 생성하지 않아도 됩니다. 범위(Range) 분할된 거의 모든 테이블에 대해 간격 Partitioning을 사용하고 새 Partition에 고정 간격을 사용할 수 있습니다. 간격이 다른 범위 분할 영역을 만들지 않거나 항상 특정 분할 영역 속성을 설정하지 않는 한 간격 분할 영역 사용을 고려하십시오.
간격별로 분할하는 경우 범위 분할 영역을 하나 이상 지정해야 합니다. 범위 분할 키 값은 범위 분할 영역의 높은 값(전환 지점이라고 함)을 결정합니다. 데이터베이스는 변환 지점을 벗어나는 값으로 데이터에 대한 간격 Partition을 자동으로 생성합니다. 모든 간격 분할 영역의 하한은 이전 범위 또는 간격 분할 영역의 포함 상한입니다. 따라서 예 6-2에서 01-JAN-2011 값은 분할 영역 p2에 있습니다.
데이터베이스는 전환 지점을 넘어 데이터에 대한 간격 Partition을 생성합니다. 간격 분할 영역은 데이터베이스에 지정된 범위 또는 간격의 분할 영역을 생성하도록 지시하여 범위 분할을 확장합니다. 데이터베이스는 테이블에 삽입된 데이터가 기존의 모든 범위 분할 영역을 초과할 때 자동으로 분할 영역을 생성합니다. 예 6-2에서 p3 분할 영역은 분할 키 time_id 값이 01-JAN-2013보다 크거나 같은 행을 포함합니다.
예제 6-2 간격 Partitioning
너비가 서로 다른 네 개의 partition으로 구성된 sales 테이블을 생성한다고 가정해 보겠습니다. 전환 지점 2013년 1월 1일 이상에서 데이터베이스가 1개월 간격으로 Partition을 생성하도록 지정합니다. 분할 영역 p3의 상한은 전환점을 나타냅니다. Partition p3 및 그 아래의 모든 Partition이 범위 섹션에 있는 반면 그 위의 모든 Partition은 간격 섹션에 속합니다.
CREATE TABLE interval_sales
    ( prod_id        NUMBER(6)
    , cust_id        NUMBER
    , time_id        DATE
    , channel_id     CHAR(1)
    , promo_id       NUMBER(6)
    , quantity_sold  NUMBER(3)
    , amount_sold    NUMBER(10,2)
    )
  PARTITION BY RANGE (time_id)
  INTERVAL(NUMTOYMINTERVAL(1, 'MONTH'))
    ( PARTITION p0 VALUES LESS THAN (TO_DATE('1-1-2010', 'DD-MM-YYYY'))
    , PARTITION p1 VALUES LESS THAN (TO_DATE('1-1-2011', 'DD-MM-YYYY'))
    , PARTITION p2 VALUES LESS THAN (TO_DATE('1-7-2012', 'DD-MM-YYYY'))
    , PARTITION p3 VALUES LESS THAN (TO_DATE('1-1-2013', 'DD-MM-YYYY')) );
2014년 10월 10일에 만든 판매를 삽입합니다.
SQL> INSERT INTO interval_sales VALUES (39,7602,'10-OCT-14',9,null,1,11.79);

1 row created.
USER_TAB_PARTITIONS 질의는 판매 날짜가 전환 지점보다 이후이므로 데이터베이스가 10월 10일 판매에 대해 새 분할 영역을 생성했음을 보여줍니다.
SQL> COL PNAME FORMAT a9
SQL> COL HIGH_VALUE FORMAT a40
SQL> SELECT PARTITION_NAME AS PNAME, HIGH_VALUE
  2  FROM USER_TAB_PARTITIONS WHERE TABLE_NAME = 'INTERVAL_SALES';

PNAME     HIGH_VALUE
--------- ----------------------------------------
P0        TO_DATE(' 2007-01-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
P1        TO_DATE(' 2008-01-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
P2        TO_DATE(' 2009-07-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
P3        TO_DATE(' 2010-01-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
SYS_P1598 TO_DATE(' 2014-11-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
참조: 간격 분할 영역에 대한 자세한 내용은 Oracle AI Database VLDB and Partitioning Guide를 참조하십시오.
목록 분할
목록 분할에서 데이터베이스는 각 분할 영역에 대한 분할 영역 키로 비연속 값 목록을 사용합니다. 분할 키는 하나 이상의 열로 구성됩니다.
목록(List) 분할을 사용하여 개별 행이 특정 분할 영역에 어떻게 매핑되는지를 제어할 수 있습니다. 목록을 사용하면 식별에 사용되는 키가 편리하게 정렬되지 않을 때 관련 데이터 세트를 그룹화하고 구성할 수 있습니다.
예제 6-3 목록 분할
다음 명령문을 사용하여 목록 분할 테이블로 list_sales를 생성한다고 가정합니다. 여기서 channel_id 열은 분할 영역 키입니다.
CREATE TABLE list_sales
   ( prod_id        NUMBER(6)
   , cust_id        NUMBER
   , time_id        DATE
   , channel_id     CHAR(1)
   , promo_id       NUMBER(6)
   , quantity_sold  NUMBER(3)
   , amount_sold    NUMBER(10,2)
   )
PARTITION BY LIST (channel_id)
 ( PARTITION even_channels VALUES ('2','4'),
   PARTITION odd_channels VALUES ('3','9')
 );
그 후에 Example 6-1의 행을 사용하여 테이블을 로드합니다. 이 코드는 두 분할 영역의 행 분산을 보여줍니다. 데이터베이스는 PARTITION BY LIST 절에 지정된 규칙에 따라 channel_id 값을 기반으로 각 행에 대한 분할 영역을 선택합니다. channel_id 값이 2 또는 4인 행은 EVEN_CHANNELS 분할 영역에 저장되고 channel_id 값이 3 또는 9인 행은 ODD_CHANNELS 분할 영역에 저장됩니다.
해시 분할
해시 분할에서 데이터베이스는 데이터베이스가 사용자 지정 분할 키에 적용되는 해싱 알고리즘을 기반으로 행을 분할 영역에 매핑합니다.
행의 대상은 데이터베이스에 의해 행에 적용된 내부 해시 함수에 의해 결정됩니다. 분할 영역 수가 2의 제곱이면 해싱 알고리즘은 모든 분할 영역에 걸쳐 대략 균등하게 분산된 행을 생성합니다.
해시(Hash) 분할은 관리 효율성을 높이기 위해 대형 테이블을 분할하는 데 유용합니다. 하나의 큰 테이블 대신에 여러 개의 작은 조각이 있습니다. 단일 해시 분할 영역의 손실은 나머지 분할 영역에 영향을 주지 않으며 독립적으로 복구할 수 있습니다. 해시 분할은 업데이트 경합이 높은 OLTP 시스템에서도 유용합니다. 예를 들어, 세그먼트는 경합이 발생하는 단일 세그먼트가 아닌 여러 조각으로 나뉘어 업데이트됩니다.
다음 명령문을 사용하여 분할된 hash_sales 테이블을 생성하고 prod_id 열을 분할 영역 키로 사용한다고 가정합니다.
CREATE TABLE hash_sales
   ( prod_id        NUMBER(6)
   , cust_id        NUMBER
   , time_id        DATE
   , channel_id     CHAR(1)
   , promo_id       NUMBER(6)
   , quantity_sold  NUMBER(3)
   , amount_sold    NUMBER(10,2)
   )
PARTITION BY HASH (prod_id)
PARTITIONS 2;
그 후에 Example 6-1의 행을 사용하여 테이블을 로드합니다. 이 코드는 두 분할 영역에서 가능한 행 분산을 보여줍니다. 이러한 분할 영역의 이름은 시스템에서 생성됩니다.
행을 삽입할 때 데이터베이스는 행을 분할 영역에 무작위로 균등하게 분산하려고 시도합니다. 행이 배치되는 분할 영역은 지정할 수 없습니다. 데이터베이스는 해당 결과가 행을 포함하는 분할 영역을 결정하는 해시 함수를 적용합니다.
참조:
-
Oracle AI Database VLDB and Partitioning Guide - 분할 영역 생성 방법 학습
-
CREATE TABLE ... PARTITION BY예제의 경우 Oracle AI Database SQL Language Reference
참조 분할
참조 분할에서 하위 테이블의 분할 전략은 상위 테이블과의 외래 키 관계를 통해서만 정의됩니다. 상위 테이블의 모든 분할 영역에 대해 해당하는 하나의 분할 영역만 하위 테이블에 존재합니다. 상위 테이블은 특정 분할 영역에 상위 레코드를 저장하고 하위 테이블은 해당 분할 영역에 하위 레코드를 저장합니다.
예를 들어, orders 테이블은 기본 키와 외래 키가 order_id에 정의된 line_items 테이블의 상위입니다. 테이블은 참조에 의해 분할됩니다. 예를 들어, 데이터베이스가 orders의 분할 영역 Q3_2015에 주문 233을 저장하는 경우 데이터베이스는 주문 233에 대한 모든 라인 항목을 line_items의 분할 영역 Q3_2015에 저장합니다. 분할 영역 Q4_2015가 orders에 추가되면 데이터베이스가 자동으로 Q4_2015를 line_items에 추가합니다.
참조 Partitioning의 이점은 다음과 같습니다.
-
상위 테이블과 하위 테이블에 대해 동일한 분할 전략을 사용하면 모든 분할 키 열이 중복되지 않습니다. 이 전략은 비정규화의 수동 오버헤드를 줄이고 공간을 절약합니다.
-
상위 테이블에 대한 유지 관리 작업은 하위 테이블에서 자동으로 수행됩니다. 예를 들어, 기본 테이블에 Partition을 추가하면 데이터베이스가 자동으로 이 추가를 해당 하위 테이블에 전달합니다.
-
데이터베이스는 상위 및 하위 테이블에서 분할 영역의 분할 방식 조인을 자동으로 사용하므로 성능이 향상됩니다.
간격 Partitioning을 포함한 모든 기본 Partitioning 전략에서 참조 Partitioning을 사용할 수 있습니다. 참조 분할 테이블을 조합 분할 테이블로 생성할 수도 있습니다.
예제 6-4 참조 분할 테이블 생성
이 예에서는 order_date에서 범위 분할된 상위 테이블 순서를 생성합니다. 참조 분할된 하위 테이블 order_items는 네 개의 분할 영역 Q1_2015, Q2_2015, Q3_2015 및 Q4_2015로 생성됩니다. 여기서 각 분할 영역은 각 상위 분할 영역의 주문에 해당하는 order_items 행을 포함합니다.
CREATE TABLE orders
    ( order_id           NUMBER(12),
      order_date         DATE,
      order_mode         VARCHAR2(8),
      customer_id        NUMBER(6),
      order_status       NUMBER(2),
      order_total        NUMBER(8,2),
      sales_rep_id       NUMBER(6),
      promotion_id       NUMBER(6),
      CONSTRAINT orders_pk PRIMARY KEY(order_id)
    )
  PARTITION BY RANGE(order_date)
    ( PARTITION Q1_2015 VALUES LESS THAN (TO_DATE('01-APR-2015','DD-MON-YYYY')),
      PARTITION Q2_2015 VALUES LESS THAN (TO_DATE('01-JUL-2015','DD-MON-YYYY')),
      PARTITION Q3_2015 VALUES LESS THAN (TO_DATE('01-OCT-2015','DD-MON-YYYY')),
      PARTITION Q4_2015 VALUES LESS THAN (TO_DATE('01-JAN-2006','DD-MON-YYYY'))
    );

CREATE TABLE order_items
    ( order_id           NUMBER(12) NOT NULL,
      line_item_id       NUMBER(3)  NOT NULL,
      product_id         NUMBER(6)  NOT NULL,
      unit_price         NUMBER(8,2),
      quantity           NUMBER(8),
      CONSTRAINT order_items_fk
      FOREIGN KEY(order_id) REFERENCES orders(order_id)
    )
    PARTITION BY REFERENCE(order_items_fk);
참조: 참조 분할에 대한 개요는 Oracle AI Database VLDB and Partitioning Guide를 참조하십시오.
조합(Composite) 분할
조합 분할에서 테이블은 하나의 데이터 분배 방법으로 분할된 다음 각 분할 영역은 두번째 데이터 분배 방법을 사용하여 하위 분할 영역으로 추가로 분할됩니다. 따라서 조합(Composite) 분할은 기본 데이터 분산 방식을 결합합니다. 주어진 분할 영역에 대한 모든 서브 분할 영역은 데이터의 논리적 부분 집합을 나타냅니다.
조합(Composite) 분할은 다음과 같은 여러 이점을 제공합니다.
-
하나 또는 두 개의 차원에 대해 분할 영역 제거를 수행하면 SQL 문에 따라 성능이 향상될 수 있습니다.
-
질의는 한 차원에서 전체 또는 부분 분할 방식 조인을 사용할 수 있습니다.
-
단일 테이블의 병렬 백업 및 Recovery를 수행할 수 있습니다.
-
분할 영역의 수가 단일 레벨 분할보다 많으므로 병렬 실행에 유용할 수 있습니다.
-
많은 명령문이 분할 영역 제거 또는 분할 방식 조인의 이점을 활용할 수 있는 경우 기록 데이터를 지원하고 다른 차원에 계속 분할되도록 롤링 창을 구현할 수 있습니다.
-
분할 키의 식별에 따라 데이터를 다르게 저장할 수 있습니다. 예를 들어, 특정 제품 유형에 대한 데이터를 읽기 전용의 압축된 형식으로 저장하고 다른 제품 유형 데이터를 압축되지 않은 상태로 유지할 수 있습니다.
범위, 목록 및 해시(Hash) 분할은 조합(Composite) 분할 테이블에 대한 서브 분할 전략으로 사용할 수 있습니다. 다음 그림은 범위-해시 및 범위-목록 조합 Partitioning의 그래픽 뷰를 제공합니다.
그림 1: 복합 범위-목록 분할
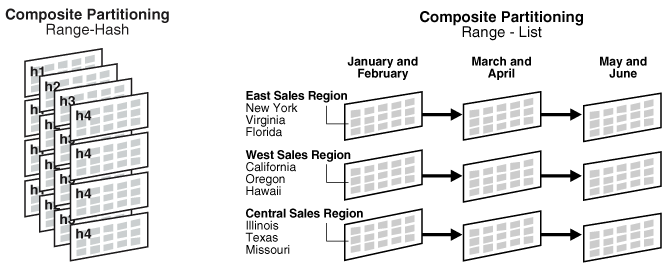
데이터베이스는 모든 하위 분할 영역을 조합 분할된 테이블에 별도의 세그먼트로 저장합니다. 따라서 서브 분할 영역 등록 정보는 테이블의 등록 정보 또는 서브 분할 영역이 속한 분할 영역과 다를 수 있습니다.
참조: 조합 분할에 대한 자세한 내용은 Oracle AI Database VLDB and Partitioning Guide를 참조하십시오.
분할된 테이블
분할된 테이블은 개별적으로 관리되며 다른 분할 영역과 독립적으로 작동할 수 있는 하나 이상의 분할 영역으로 구성됩니다.
테이블은 분할되거나 분할되지 않습니다. 분할된 테이블이 하나의 분할 영역으로만 구성되어 있더라도 이 테이블은 분할되지 않은 테이블과 다르며 분할 영역은 추가될 수 없습니다.
-
분할된 테이블에 대한 세그먼트 분할된 테이블은 하나 이상의 테이블 분할 영역 세그먼트로 구성됩니다.
-
분할된 테이블에 대한 압축 힙 구성 테이블의 일부 또는 모든 분할 영역을 압축된 형식으로 저장할 수 있습니다.
참조:
분할된 테이블의 예에 대한 "Partition Characteristics"
"인덱스 구성 테이블 개요"에서는 향상된 관리 효율성, 가용성 및 성능을 제공하는 분할의 이점을 활용할 수 있는 인덱스 구성 테이블의 목적과 특성에 대해 알아봅니다.
분할된 테이블에 대한 세그먼트
분할된 테이블은 하나 이상의 테이블 분할 영역 세그먼트로 구성됩니다.
hash_products라는 분할된 테이블을 생성하는 경우 이 테이블에 대해 할당된 테이블 세그먼트가 없습니다. 대신 데이터베이스는 각 테이블 Partition에 대한 데이터를 해당 Partition 세그먼트에 저장합니다. 각 테이블 Partition 세그먼트는 테이블 데이터의 일부를 포함합니다.
외부 테이블이 분할되면 모든 분할 영역이 데이터베이스 외부에 상주합니다. 하이브리드 분할 테이블에서는 일부 분할 영역이 세그먼트에 저장되지만 다른 분할 영역은 외부에 저장됩니다. 예를 들어, sales 테이블의 일부 분할 영역은 데이터 파일에 저장되고 다른 분할 영역은 스프레드시트에 저장될 수 있습니다.
분할된 테이블 압축
힙 구성 테이블의 일부 또는 모든 Partition은 압축된 형식으로 저장할 수 있습니다.
압축을 사용하면 공간이 절약되고 query 실행 속도가 빨라집니다. 이러한 이유로, 압축은 데이터 웨어하우스와 같은 환경에서 유용할 수 있습니다. 데이터 웨어하우스는 삽입 작업과 갱신 작업 양이 매우 적은 OLTP 환경과 같은 환경에서 유용합니다.
테이블스페이스, 테이블 또는 테이블 분할 영역에 대한 테이블 압축 속성을 선언할 수 있습니다. 테이블스페이스 레벨에서 선언된 경우 기본적으로 테이블스페이스에 생성된 테이블이 압축됩니다. 테이블의 압축 속성을 변경할 수 있으며 이 경우 변경 사항이 해당 테이블에 추가되는 새 데이터에만 적용됩니다. 따라서 단일 테이블이나 Partition에 압축된 블록과 압축되지 않은 블록이 포함될 수 있으므로 데이터 크기가 증가하지 않습니다. 압축으로 인해 블록 크기가 증가할 수 있는 경우에는 데이터베이스가 블록에 적용되지 않습니다.
참조:
-
"테이블 압축" - 기본, 고급 행 및 Hybrid Columnar 압축을 비롯한 테이블 압축 유형에 대해 알아보기
-
데이터 웨어하우스의 테이블 압축에 대한 자세한 내용은 Oracle AI Database Data Warehousing Guide를 참조하십시오.
분할된 인덱스
분할된 인덱스는 분할된 테이블과 마찬가지로 더 작고 관리하기 쉬운 조각으로 구분된 인덱스입니다.
글로벌 인덱스는 인덱스가 생성된 테이블과 독립적으로 분할되는 반면, 로컬 인덱스는 테이블의 분할 방식에 자동으로 연결됩니다. 분할된 테이블과 마찬가지로 분할된 인덱스는 관리 효율성, 가용성, 성능 및 확장성을 향상시킵니다.
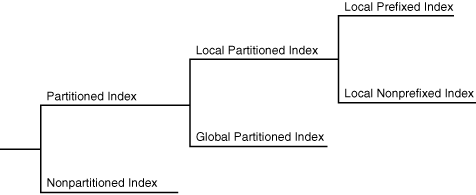
다음 그림은 인덱스 분할 옵션을 보여줍니다.
그림 2: 인덱스 분할 옵션
-
로컬 분할된 인덱스 로컬 분할된 인덱스에서 인덱스는 동일한 열에서 분할되며 분할 영역 수는 동일하고 분할 영역 범위는 테이블과 동일합니다.
-
전역 분할 인덱스 전역 분할 인덱스는 생성된 기본 테이블과 독립적으로 분할되는 B 트리 인덱스입니다. 단일 인덱스 분할 영역은 임의의 테이블 분할 영역이나 모든 테이블 분할 영역을 가리킬 수 있는 반면, 로컬 분할 인덱스에서는 인덱스 분할 영역과 테이블 분할 영역 간에 일대일 패리티가 존재합니다.
참조:
-
"인덱스 소개" - 고유 인덱스 및 비고유 인덱스 간의 차이와 서로 다른 인덱스 유형에 대해 알아보기
-
분할된 인덱스 및 사용할 유형을 결정하는 방법에 대한 자세한 내용은 Oracle AI Database VLDB and Partitioning Guide를 참조하십시오.
분할된 로컬 인덱스
로컬 분할된 인덱스에서 인덱스는 동일한 열에서 분할되며 분할 영역 수와 분할 영역 범위가 테이블과 동일합니다.
각 인덱스 분할 영역은 기본 테이블의 정확히 하나의 분할 영역과 연관되므로 인덱스 분할 영역의 모든 키가 단일 테이블 분할 영역에 저장된 행만 참조합니다. 이러한 방식으로 데이터베이스는 인덱스 분할 영역을 연관된 테이블 분할 영역과 자동으로 동기화하여 각 테이블-인덱스 쌍을 독립적으로 만듭니다.
로컬 분할 인덱스는 데이터 웨어하우징 환경에서 일반적입니다. 로컬 인덱스는 다음과 같은 이점을 제공합니다.
-
분할 영역에서 데이터를 부적합하거나 사용할 수 없게 만드는 작업이 이 분할 영역에만 영향을 주므로 가용성이 향상됩니다.
-
파티션 유지 관리가 간소화됩니다. 테이블 partition을 이동하거나 데이터가 partition에서 삭제되는 경우에는 연관된 로컬 인덱스 partition만 재구축하거나 유지 관리해야 합니다. 글로벌 인덱스에서 모든 인덱스 분할 영역을 재구축하거나 유지 관리해야 합니다.
-
분할 영역의 적시 복구가 발생하면 인덱스를 복구 시간으로 복구할 수 있습니다(Oracle AI Database Backup and Recovery User's Guide 참조). 전체 인덱스를 재구축할 필요는 없습니다.
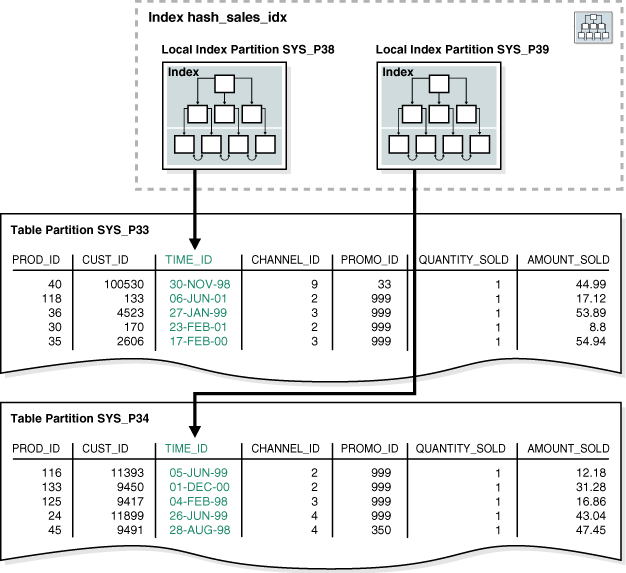
해시 분할의 예에서는 prod_id 열을 분할 영역 키로 사용하여 분할된 hash_sales 테이블에 대한 생성 명령문을 보여줍니다. 다음 예제는 hash_sales 테이블의 time_id 열에 로컬 분할 인덱스를 생성합니다.
CREATE INDEX hash_sales_idx ON hash_sales(time_id) LOCAL;그림 6-3에서 hash_products 테이블에는 두 개의 분할 영역이 있으므로 hash_sales_idx에는 두 개의 분할 영역이 있습니다. 각 인덱스 분할 영역은 다른 테이블 분할 영역과 연관됩니다. 인덱스 분할 영역 SYS_P38는 테이블 분할 영역 SYS_P33의 행을 인덱스화하는 반면 인덱스 분할 영역 SYS_P39는 테이블 분할 영역 SYS_P34의 행을 인덱스화합니다.
그림 3: 로컬 인덱스 파티션
로컬 인덱스에 분할 영역을 명시적으로 추가할 수 없습니다. 대신, 기본 테이블에 분할 영역을 추가할 때만 새 분할 영역이 로컬 인덱스에 추가됩니다. 마찬가지로 로컬 인덱스에서 분할 영역을 명시적으로 삭제할 수 없습니다. 대신 로컬 인덱스 분할 영역은 기본 테이블에서 분할 영역을 삭제할 때만 삭제됩니다.
다른 인덱스와 마찬가지로 분할된 테이블에 비트맵 인덱스를 생성할 수 있습니다. 단, 비트맵 인덱스는 분할된 테이블에 대해 로컬이어야 하며 글로벌 인덱스가 될 수 없다는 제한 사항이 있습니다. 글로벌 비트맵 인덱스는 분할되지 않은 테이블에서만 지원됩니다.
-
로컬 접두어가 있는 인덱스 및 접두어가 없는 인덱스 로컬 분할된 인덱스는 접두어가 있거나 접두어가 없는 인덱스입니다.
-
로컬 분할된 인덱스 저장 영역 테이블 분할 영역과 마찬가지로 로컬 인덱스 분할 영역은 고유 세그먼트에 저장됩니다. 각 세그먼트는 전체 인덱스 데이터의 일부를 포함합니다. 따라서 네 개의 분할 영역으로 구성된 로컬 인덱스는 단일 인덱스 세그먼트에 저장되지 않고 네 개의 개별 세그먼트에 저장됩니다.
로컬 접두어가 붙은 인덱스 및 접두어가 없는 인덱스
로컬 분할 인덱스는 접두어가 지정되거나 접두어가 지정되지 않습니다.
인덱스 하위 유형은 다음과 같이 정의됩니다.
-
로컬이라는 접두어가 붙은 인덱스
이 경우 분할 영역 키는 인덱스 정의의 선행 가장자리에 있습니다. 범위 분할의
time_range_sales예에서는 테이블이time_id의 범위로 분할됩니다. 이 테이블의 로컬 접두어가 붙은 인덱스는 목록의 첫번째 열로time_id를 가집니다. -
로컬 접두어가 없는 인덱스
이 경우 분할 영역 키는 인덱스화된 열 목록의 선행 가장자리에 있지 않으며 목록에 있을 필요가 전혀 없습니다. 로컬 분할된 인덱스의
hash_sales_idx예에서는 분할 영역 키product_id이 선행 가장자리에 없으므로 인덱스에 접두어가 없는 로컬 인덱스가 사용됩니다.
두 유형의 인덱스는 모두 분할 영역 제거(분할 영역 제거라고도 함)를 활용할 수 있습니다. 이는 옵티마이저가 분할 영역을 고려하지 않고 데이터 액세스 속도를 높일 때 발생합니다. query에서 분할 영역을 제거할 수 있는지 여부는 질의 predicate에 따라 다릅니다. 로컬이라는 접두어가 붙은 인덱스를 사용하는 질의는 항상 인덱스 분할 영역 제거를 허용하지만, 로컬이라는 접두어가 붙지 않은 인덱스를 사용하는 질의는 그렇지 않을 수 있습니다.
참조: Oracle AI Database VLDB and Partitioning Guide에서 접두어가 있는 인덱스 및 접두어가 없는 인덱스를 사용하는 방법에 대해 알아봅니다.
분할된 로컬 색인 저장 영역
테이블 Partition과 마찬가지로 로컬 인덱스 Partition이 자체 세그먼트에 저장됩니다. 각 세그먼트는 전체 인덱스 데이터의 일부를 포함합니다. 따라서 네 개의 분할 영역으로 구성된 로컬 인덱스는 단일 인덱스 세그먼트에 저장되지 않고 네 개의 개별 세그먼트에 저장됩니다.
참조: CREATE INDEX ... LOCAL 예제의 경우 Oracle AI Database SQL Language Reference
분할된 글로벌 인덱스
전역 분할 인덱스는 생성된 기본 테이블과 독립적으로 분할되는 B 트리 인덱스입니다. 단일 인덱스 분할 영역은 임의의 테이블 분할 영역이나 모든 테이블 분할 영역을 가리킬 수 있는 반면, 로컬 분할 인덱스에서는 인덱스 분할 영역과 테이블 분할 영역 간에 일대일 패리티가 존재합니다.
일반적으로 글로벌 인덱스는 신속한 액세스, 데이터 무결성 및 가용성이 중요한 OLTP 응용 프로그램에 유용합니다. OLTP 시스템에서 테이블은 하나의 키(예: employees.department_id 열)로 분할될 수 있지만 응용 프로그램이 employee_id 또는 job_id와 같이 서로 다른 여러 키를 사용하여 데이터에 액세스해야 할 수도 있습니다. 글로벌 인덱스는 이 시나리오에서 유용할 수 있습니다.
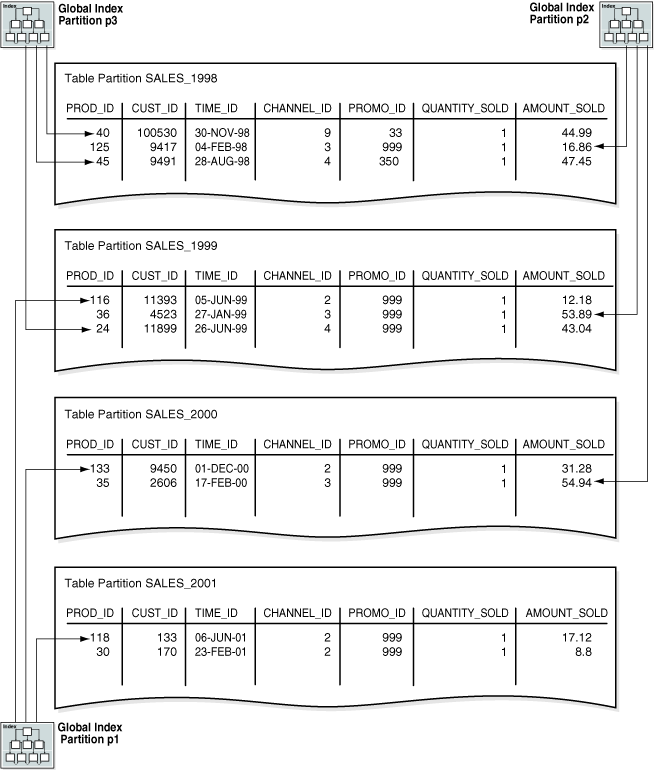
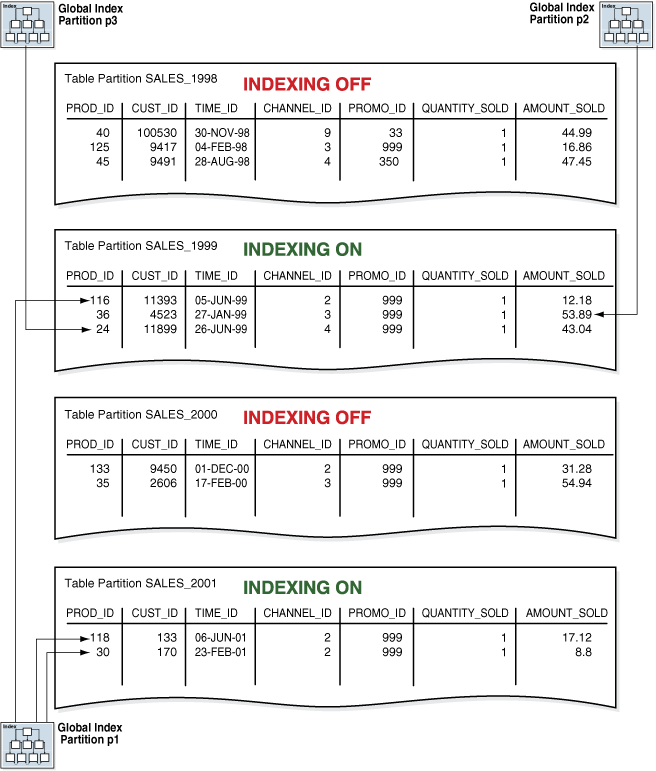
그림으로, "범위 분할"에서 time_range_sales 테이블에 전역 분할 인덱스를 만든다고 가정합니다. 이 테이블에서는 1998년의 판매 행이 한 분할 영역에 저장되고 1999년의 판매 행이 다른 분할 영역에 저장됩니다. 다음 예제는 channel_id 열에 범위로 분할된 글로벌 인덱스를 생성합니다.
CREATE INDEX time_channel_sales_idx ON time_range_sales (channel_id)
   GLOBAL PARTITION BY RANGE (channel_id)
      (PARTITION p1 VALUES LESS THAN (3),
       PARTITION p2 VALUES LESS THAN (4),
       PARTITION p3 VALUES LESS THAN (MAXVALUE));
그림 6-4에 표시된 것처럼 전역 인덱스 분할 영역에는 여러 테이블 분할 영역을 가리키는 항목이 포함될 수 있습니다. 인덱스 분할 영역 p1는 channel_id가 2인 행을 가리키고, 인덱스 분할 영역 p2는 channel_id가 3인 행을 가리키며, 인덱스 분할 영역 p3는 channel_id가 4 또는 9인 행을 가리킵니다.
그림 4: 분할된 전역 인덱스
참조:
-
Oracle AI Database VLDB and Partitioning Guide - 분할된 글로벌 인덱스를 관리하는 방법 학습
-
CREATE INDEX의GLOBAL PARTITION절에 대해 알아보려면 Oracle AI Database SQL Language Reference를 참조하십시오.
분할된 테이블에 대한 부분 인덱스
부분 인덱스는 연관된 분할 테이블의 인덱스화 속성과 상관되는 인덱스입니다.
상관 관계를 사용하면 인덱스화된 테이블 분할 영역을 지정할 수 있습니다. 부분 인덱스는 다음과 같은 이점을 제공합니다.
-
인덱스화되지 않은 테이블 partition은 불필요한 인덱스 저장 공간을 사용하지 않도록 합니다.
-
로드 및 Query의 성능이 향상될 수 있습니다.
Oracle Database 12c 이전에는 교환 분할 작업을 위해 연관된 글로벌 인덱스를 물리적 갱신하여 사용할 수 있도록 보유해야 했습니다. Oracle Database 12c부터는 분할 영역 유지 관리 작업에 관련된 분할 영역이 부분 글로벌 인덱스에 속하지 않는 경우 글로벌 인덱스를 유지 관리할 필요 없이 인덱스를 계속 사용할 수 있습니다.
-
인덱스 생성 시 일부 테이블 partition만 인덱스화하고 나중에 다른 partition을 인덱스화하는 경우 인덱스 생성에 필요한 정렬 공간을 줄일 수 있습니다.
테이블의 개별 분할 영역에 대해 인덱스화를 설정하거나 해제할 수 있습니다. 부분 로컬 인덱스는 인덱스화가 해제된 모든 테이블 partition에 대해 사용 가능한 인덱스 partition이 없습니다. 분할 여부에 관계없이 글로벌 인덱스는 인덱스화가 해제된 모든 분할 영역의 데이터를 제외합니다. 데이터베이스는 고유 제약 조건을 시행하는 인덱스에 대해 부분 인덱스를 지원하지 않습니다. 그림 6-5는 전역 인덱스가 부분적이라는 점을 제외하고 그림 6-4와 동일한 전역 인덱스를 보여줍니다. 테이블 분할 영역 SALES_1998 및 SALES_2000에는 인덱스화 속성이 OFF로 설정되어 있으므로 부분 글로벌 인덱스는 인덱스화하지 않습니다.
그림 5: 부분 전역 분할 인덱스
이전 Partition에 객체 저장소 사용
읽기 전용 파티션의 경우 클라우드에서 오브젝트 스토리지와 같은 저비용 스토리지를 사용할 수 있습니다.
데이터 양은 지난 10년간 엄청나게 증가했습니다. 또한 정부 규정 및 정책은 많은 경우에 매우 오랜 기간 동안 데이터 보존을 요구했습니다. Oracle 데이터베이스 고객은 대용량 데이터베이스에 다양한 데이터 관리 전략을 사용합니다. 고객은 다음과 같은 주요 목표를 달성하고자 합니다.
방대한 양의 데이터를 최저 비용으로 저장하기 데이터 보존 및 보호에 대한 새로운 규제 요건을 충족하기 위해 증가된 양의 데이터를 기반으로 더 나은 분석을 통해 비즈니스 기회를 개선합니다.
온프레미스 고객은 위의 목표를 달성하기 위한 다양한 솔루션을 보유하고 있습니다. Oracle AI Database는 이제 클라우드에서 객체 스토리지와 같은 저비용 스토리지 계층을 활용하여 클라우드 데이터베이스에 대해 유사한 데이터 관리 전략을 개발할 수 있는 기능을 제공합니다.
Oracle 데이터베이스 고객은 데이터 세트가 진화하고 성장함에 따라 다양한 데이터 관리 전략을 수립했습니다. 이러한 모든 전략은 ILM(정보 수명주기 관리)에 속합니다. ILM 솔루션을 구현하는 데 도움이 되는 몇 가지 데이터베이스 기능에는 데이터 분할, 고급 행 압축, 하이브리드 열 압축, 자동 데이터 최적화 등이 있습니다.
ILM 솔루션의 측면 중 하나는 저비용 스토리지 계층을 정의하는 것입니다. 따라서 가능한 최저 비용으로 대량의 데이터를 보존할 수 있습니다. Oracle ILM 전략을 사용하면 저렴한 스토리지 계층으로 자동 데이터 압축 및 데이터 이동이 가능합니다. 온프레미스 오라클 데이터베이스 고객은 Oracle ZFS Storage Appliance 또는 Oracle Exadata Extended(XT) Storage Server와 같은 Oracle 스토리지 솔루션을 자주 액세스하지 않거나 오래된 데이터 또는 규제 데이터에 대한 저렴한 스토리지 옵션으로 사용합니다. 타사 공급업체에서도 비슷한 저비용 스토리지 옵션을 선택할 수 있습니다.
객체 저장소를 사용하면 다음을 수행할 수 있습니다.
-
객체 스토리지에 이전 분할 영역 및 읽기 전용 테이블스페이스를 저장합니다.
-
온라인 방식으로 오브젝트 스토리지 파일의 데이터를 쿼리합니다.
-
다른 PDB에서 PDB가 소유한 오브젝트 스토리지 파일에 대한 무단 액세스를 방지합니다.
-
드물지만 읽기 전용 데이터를 변경하려는 경우 객체 저장소에서 일반 저장소로 데이터를 다시 이동합니다.
-
객체 저장소에 데이터 파일이 있는 테이블스페이스를 삭제합니다.
-
이전 분할 영역 및 읽기 전용 테이블스페이스를 객체 저장소로 이동 시간 기반 분할 전략을 생성하고 읽기 전용 테이블스페이스의 데이터 파일을 객체 스토리지와 같은 저비용 스토리지 계층으로 이동할 수 있습니다.
-
오브젝트 스토리지의 오브젝트 접근 오브젝트 스토리지의 테이블과 파티션에서 데이터에 접근하는 것은 사용자와 SQL 클라이언트에 완전히 투명합니다.
-
객체 저장소 파일의 인증서 관리 오브젝트 스토리지의 파일에 액세스하려면 인증서가 필요합니다.
-
오브젝트 스토리지에서 기존 스토리지로 데이터 파일 다시 이동 객체 저장소 데이터를 업데이트해야 하는 경우 먼저 데이터를 기존 스토리지로 다시 이동해야 합니다.
-
객체 저장소 데이터 파일 삭제 표준
DROP TABLESPACE명령을 사용하여 데이터 파일이 있는 테이블스페이스를 삭제할 수 있습니다.
객체 저장소로 이전 분할 영역 및 읽기 전용 테이블스페이스 이동
시간 기준 Partitioning 전략을 생성하고 읽기 전용 테이블스페이스의 데이터 파일을 객체 저장 영역과 같은 저렴한 저장 영역 계층으로 이동할 수 있습니다.
DATE 열에 범위(Range) 분할된 'orders'라는 테이블이 있다고 가정합니다. 각 분할 영역은 특정 연도에 대한 행을 포함하며 2022년과 2023년에 대한 기존 분할 영역이 있습니다. 새해가 다가오면 데이터베이스 관리자는 2024년 새 파티션을 추가하기로 결정합니다. 동시에 데이터베이스 관리자는 가장 오래된 분할 영역을 저비용 저장 영역 계층으로 이동하려고 합니다.
아래 워크플로우 예제는 테이블스페이스에 단일 테이블에 대한 단일 분할 영역이 있는 시나리오를 나타냅니다. 이는 제한 사항이 아닙니다. 읽기 전용 테이블스페이스에는 하나 이상의 테이블에 대한 분할 영역이 있을 수 있습니다. 또한 테이블스페이스를 읽기 전용으로 만드는 것 외에 분할 영역을 읽기 전용으로 설정하는 옵션도 있습니다. 가장 좋은 방법은 테이블스페이스를 읽기 전용으로 만들고 파일을 객체 저장소로 이동하기 전에 잘 정의된 시간 동안 기다리는 것입니다. 이렇게 하면 읽기 전용 데이터를 업데이트하려고 시도할 때 오류가 반환됩니다. 데이터가 여전히 Exadata 또는 기타 기존 스토리지에 있는 동안 변경 데이터를 다른 테이블스페이스로 이동하는 것이 훨씬 빠릅니다. 이 데이터를 오브젝트 스토리지에서 복사해야 하는 경우 속도가 훨씬 느려집니다.
create tablespace orders_2022 DATAFILE '+DATA_DG/orders_2022.dbf' size 100g;
create tablespace orders_2023 DATAFILE '+DATA_DG/orders_2023.dbf' size 100g;

create table orders
( prod_id         NUMBER NOT NULL,
  time_id         DATE NOT NULL,
  quantity_sold   NUMBER(10,2) NOT NULL,
  amount_sold     NUMBER(10,2) NOT NULL)
    partition by range (time_id)
    ( partition orders_2022 VALUES LESS THAN (TO_DATE('2023-01-01 00:00:00', 'SYYYY-MM-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIAN'))
        TABLESPACE orders_2022,
      partition orders_2023 VALUES LESS THAN (TO_DATE('2024-01-01 00:00:00', 'SYYYY-MM-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIAN'))
        TABLESPACE orders_2023)
  ENABLE ROW MOVEMENT;

create tablespace orders_2024 DATAFILE '+DATA_DG/orders_2024.dbf' size 100g;

alter table orders
  ADD partition orders_2024
  values less than (TO_DATE('2024-01-01 00:00:00', 'SYYYY-MM-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIAN'))
  TABLESPACE orders_2024;

alter tablespace orders_2022 read only;

alter database property set default_credential = 'ADM.DEF_CRED_NAME';

alter database
  move datafile '+DATA_DG/orders_2022.dbf' to
  'https://objectstorage.example.com/oracle/orders_2022.dbf';
객체 스토리지의 객체 액세스
오브젝트 스토리지의 테이블 및 파티션에서 데이터에 액세스하는 것은 사용자와 SQL 클라이언트에 완전히 투명합니다.
데이터베이스 입/출력 하위 시스템은 오브젝트 스토리지에 저장된 파일의 블록을 내부적으로 쿼리하고 제공합니다. 다음 SQL은 이전 예제에서 객체 스토리지로 이동된 읽기 전용 분할 영역 orders_2022의 행을 질의합니다.
select prod_id
from   orders
where  time_id < TO_DATE('2020-01-01 00:00:00', 'SYYYY-MM-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIAN');
글로벌 인덱스와 로컬 인덱스의 기존 인덱스는 투명하게 작동합니다. 하이브리드 열 압축 데이터 및 TDE 암호화된 데이터를 쿼리하는 것은 클라이언트 관점에서도 투명하게 작동합니다.
객체 저장소 파일에 대한 인증서 관리
오브젝트 스토리지의 파일에 액세스하려면 인증서가 필요합니다.
자격 증명은 사용자 이름과 암호를 저장하는 데이터베이스 객체입니다. 인증서 데이터는 암호화되어 생성된 PDB 스키마에 안전하게 저장됩니다.
데이터 파일을 객체 스토리지로 이동하려는 경우 기본 인증서를 정의해야 합니다. 이 기본 인증서는 객체 스토리지의 데이터 파일에 액세스하는 데 사용됩니다.
필요한 최소 권한이 있는 기본 인증서를 선택합니다. 기본 자격 증명이 객체 저장소에 대한 액세스를 사용으로 설정한 후 표준 데이터베이스 인증 및 권한 부여를 통해 해당 데이터 파일에 대해 질의하거나 작업할 수 있는 데이터베이스 사용자가 결정됩니다.
alter database property set default_credential = 'ADM.DEF_CRED_NAME';

alter database move datafile '+DATA_DG/orders_2022.dbf' to
  'https://objectstorage.example.com/oracle/orders_2022.dbf';
객체 스토리지에서 기존 스토리지로 데이터 파일 다시 이동
객체 저장소 데이터를 업데이트해야 하는 경우 먼저 데이터를 기존 스토리지로 다시 이동해야 합니다.
오브젝트 스토리지에 이미 있는 읽기 전용 데이터를 수정해야 하는 경우가 드물지만 데이터를 오브젝트 스토리지에서 기존 스토리지로 다시 이동하는 유일한 옵션입니다. 다음 워크플로우는 객체 저장소에서 다시 ASM 파일 시스템으로 데이터 파일을 이동할 수 있는 방법을 보여줍니다. 오브젝트 스토리지에서 파일을 다시 복사하면 성능에 영향을 줍니다.
alter database move datafile
  'https://objectstorage.example.com/oracle/orders_2022.dbf' to
  '+DATA_DG/orders_2022.dbf';

alter tablespace orders_2022 read write;
객체 저장소 데이터 파일 삭제 중
표준 DROP TABLESPACE 명령을 사용하여 데이터 파일이 있는 테이블스페이스를 삭제할 수 있습니다.
AND DATAFILES 절은 백엔드 스토리지에서 데이터 파일을 삭제하는 데 사용됩니다. 그러면 객체 저장소에서 파일이 삭제됩니다. 객체 저장소 파일에 객체 저장소에 여러 조각이 있는 경우 매니페스트와 함께 모든 조각이 삭제됩니다.
drop tablespace orders_2022 including contents and datafiles;샤딩된 테이블 개요
Oracle 데이터베이스에서는 Globally Distributed Database 기능을 사용하여 테이블을 여러 데이터베이스에 저장할 수 있는 샤드라는 조각으로 나눌 수 있습니다.
수평 분할에는 각 샤드가 동일한 열을 가진 테이블을 포함하지만 행의 하위 집합이 다르도록 데이터베이스 테이블을 샤드 간에 분할하는 작업이 포함됩니다. 이러한 방식으로 분할된 테이블을 샤딩된 테이블이라고도 합니다.
다음 그림은 세 개의 샤드에 가로로 분할된 테이블을 보여줍니다.
그림 6: 샤드 간 테이블 수평 분할
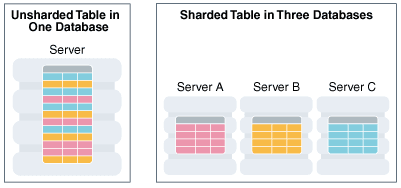
- 샤딩된 테이블 데이터베이스 테이블은 샤드 간에 분할되므로 각 샤드에는 동일한 열이 있지만 행의 다른 부분 집합이 있는 테이블이 포함됩니다. 이러한 방식으로 분할된 테이블을 샤딩된 테이블이라고 합니다. 참조: Oracle Globally Distributed AI Database
샤드된 테이블
데이터베이스 테이블은 샤드 간에 분할되므로 각 샤드에는 열이 동일하지만 행의 하위 집합이 서로 다름이 있는 테이블이 포함됩니다. 이러한 방식으로 분할된 테이블을 샤딩된 테이블이라고 합니다.
다음 그림은 일련의 테이블(테이블 패밀리라고 함)을 일련의 샤드 PDB에서 가로로 분할하여 각 샤드에 빨간색, 노란색 및 파란색 행으로 표시된 데이터의 부분 집합이 포함되도록 하는 방법을 보여줍니다.
그림 7: 샤드 간 테이블 수평 분할
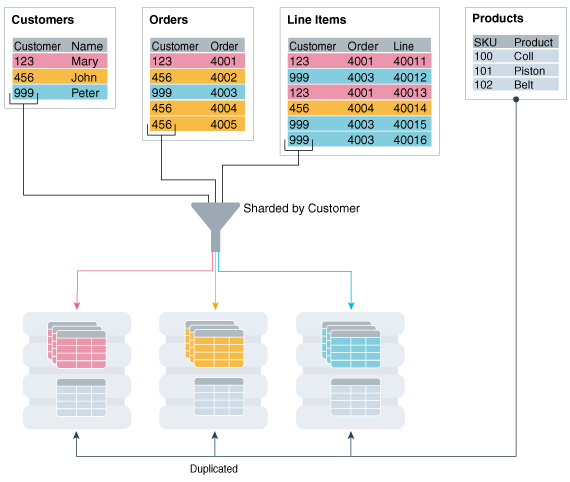
분할 영역은 샤딩 키를 기반으로 테이블스페이스 레벨에서 샤드 간에 분산됩니다. 키의 예로는 고객 ID, 계정 번호 및 국가 ID가 있습니다.
샤딩된 테이블의 각 분할 영역은 별도의 테이블스페이스에 상주하며 각 테이블스페이스는 특정 샤드와 연관됩니다. 샤딩 방법에 따라 연관을 자동으로 설정하거나 관리자가 정의할 수 있습니다.
샤딩된 테이블의 분할 영역은 여러 샤드에 상주하지만 응용 프로그램에서는 테이블이 단일 데이터베이스의 분할된 테이블과 정확히 동일하게 표시되고 동작합니다. 응용 프로그램에서 실행한 SQL 문은 샤드를 참조하거나 샤드 수 및 해당 구성에 따라 달라질 필요가 없습니다.
테이블 분할을 위한 익숙한 SQL 구문은 샤드에서 행을 분할하는 방법을 지정합니다. 예를 들어, 다음 SQL 문은 샤딩된 테이블을 생성하고 샤딩 키 cust_id를 기반으로 샤드 간에 테이블을 수평으로 분할합니다.
CREATE SHARDED TABLE customers
( cust_id     NUMBER NOT NULL,
  name        VARCHAR2(50),
  address     VARCHAR2(250),
  region      VARCHAR2(20),
  class       VARCHAR2(3),
  signup      DATE,
  CONSTRAINT cust_pk PRIMARY KEY(cust_id)
)
PARTITION BY CONSISTENT HASH (cust_id)
PARTITIONS AUTO
TABLESPACE SET ts1;
위의 예제에서 샤딩된 테이블은 확장 가능한 분산 시스템에서 일반적으로 사용되는 특수한 유형의 해시 분할인 일관성 있는 해시로 분할됩니다. 이 기술은 자동으로 테이블스페이스를 샤드로 분산시켜 데이터와 작업 로드를 균등하게 분산시킵니다. 주: 샤딩된 테이블에 대한 전역 인덱스는 지원되지 않지만 로컬 인덱스는 지원됩니다.
뷰 개요
뷰는 하나 이상의 테이블에 대한 논리적 표현입니다. 본질적으로 뷰는 내장 query입니다.
뷰는 기본 테이블이라는 기준이 되는 테이블에서 해당 데이터를 가져옵니다. 기본 테이블은 테이블 또는 다른 뷰일 수 있습니다. 뷰에서 수행한 모든 작업은 실제로 기본 테이블에 영향을 줍니다 테이블이 사용되는 대부분의 위치에서 뷰를 사용할 수 있습니다.
주: 구체화된 뷰는 표준 뷰와 다른 데이터 구조를 사용합니다.
뷰를 사용하면 데이터를 여러 유형의 사용자에 맞게 표시할 수 있습니다. 다음과 같은 경우에 뷰가 많이 사용됩니다.
-
테이블에서 미리 정의된 행 집합 또는 열 집합에 대한 액세스를 제한하여 추가 레벨의 테이블 보안을 제공합니다.
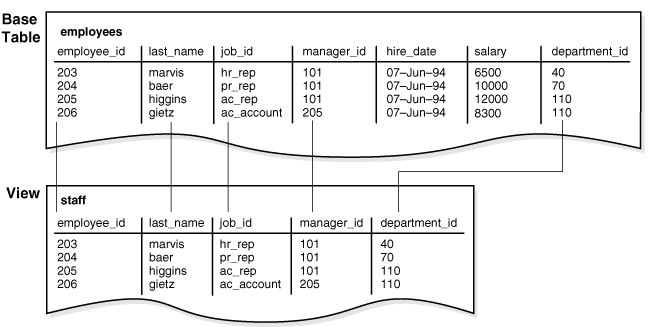
예를 들어, 그림 6-8은
staff뷰에 기본 테이블employees의salary또는commission_pct열이 표시되지 않는 방식을 보여줍니다. -
데이터 복잡성 숨기기
예를 들어, 단일 뷰는 여러 테이블의 관련 열 또는 행 모음인 조인으로 정의할 수 있습니다. 그러나 뷰는 이 정보가 실제로 여러 테이블에서 생성된다는 사실을 숨깁니다. 또한 query는 테이블 정보를 사용하여 광범위한 계산을 수행할 수 있습니다. 따라서 유저는 조인 또는 계산을 수행하는 방법을 몰라도 뷰를 query할 수 있습니다.
-
기본 테이블과 다른 방식으로 데이터를 표시할 경우
예를 들어, 뷰의 기반이 되는 테이블에 영향을 주지 않고 뷰의 열 이름을 바꿀 수 있습니다.
-
기본 테이블 정의의 변경 사항이 응용 프로그램에 적용되지 않도록 할 때
예를 들어, 뷰의 정의 질의가 네 개의 열 테이블에 있는 세 개의 열을 참조하고 다섯번째 열이 테이블에 추가되는 경우 뷰 정의는 영향을 받지 않으며 뷰를 사용하는 모든 응용 프로그램은 영향을 받지 않습니다.
뷰 사용의 예를 들어, 몇 개의 열과 여러 개의 행이 있는 hr.employees 테이블을 고려해 보십시오. 사용자가 이러한 열 중 다섯 개 또는 특정 행만 볼 수 있도록 하려면 다음과 같이 뷰를 생성할 수 있습니다.
CREATE VIEW staff AS
  SELECT employee_id, last_name, job_id, manager_id, department_id
  FROM   employees;
모든 subquery와 마찬가지로 뷰를 정의하는 query는 FOR UPDATE 절을 포함할 수 없습니다. 다음 그림은 이름이 staff인 뷰를 보여줍니다. 뷰는 기본 테이블의 열 중 다섯 개만 표시합니다.
그림 8: 보기
-
뷰 특성 테이블과 달리 뷰에는 저장 공간이 할당되지 않으며 뷰에도 데이터가 포함되어 있지 않습니다. 대신 뷰가 참조하는 기본 테이블에서 데이터를 추출하거나 추출하는 query에 의해 뷰가 정의됩니다. 뷰는 다른 객체를 기반으로 하기 때문에 데이터 딕셔너리의 뷰를 정의하는 query에 대한 저장 영역 외에는 저장 영역이 필요하지 않습니다.
-
업데이트 가능 조인 뷰 조인 뷰에는
FROM절에 여러 테이블 또는 뷰가 있습니다. -
객체 뷰 뷰가 가상 테이블인 것처럼 객체 뷰는 가상 객체 테이블입니다. 뷰의 각 행은 객체 유형의 인스턴스인 객체입니다. 객체 유형은 유저 정의 데이터 유형입니다.
참조:
-
Oracle AI Database Administrator's Guide - 뷰를 관리하는 방법 학습
-
CREATE VIEW구문 및 의미에 대한 Oracle AI Database SQL Language Reference
뷰 특성
테이블과 달리 뷰에는 저장 공간이 할당되지 않으며 뷰에도 데이터가 포함되어 있지 않습니다. 대신 뷰가 참조하는 기본 테이블에서 데이터를 추출하거나 추출하는 query에 의해 뷰가 정의됩니다. 뷰는 다른 객체를 기반으로 하기 때문에 데이터 딕셔너리의 뷰를 정의하는 query에 대한 저장 영역 외에는 저장 영역이 필요하지 않습니다.
뷰는 참조된 객체에 대한 종속성을 가지며 데이터베이스에 의해 자동으로 처리됩니다. 예를 들어, 뷰의 기본 테이블을 삭제하고 재생성하는 경우 데이터베이스는 새 기본 테이블이 뷰 정의에 허용되는지 여부를 결정합니다.
-
뷰의 데이터 조작 뷰는 테이블에서 파생되므로 유사성이 매우 높습니다. 유저는 뷰를 query할 수 있고, 몇 가지 제한 사항을 가지고 뷰에 대해 DML을 수행할 수 있습니다. 뷰에서 수행되는 작업은 뷰의 일부 기본 테이블에 있는 데이터에 영향을 미치며 기본 테이블의 무결성 제약 조건 및 트리거를 따릅니다.
-
뷰에서 데이터에 액세스하는 방법 Oracle AI Database는 뷰 정의를 데이터 딕셔너리에 뷰를 정의하는 쿼리의 텍스트로 저장합니다.
뷰의 데이터 조작
뷰는 테이블에서 파생되기 때문에 여러 유사점이 있습니다. 유저는 뷰를 query할 수 있고, 몇 가지 제한 사항을 가지고 뷰에 대해 DML을 수행할 수 있습니다. 뷰에서 수행되는 작업은 뷰의 일부 기본 테이블에 있는 데이터에 영향을 미치며 기본 테이블의 무결성 제약 조건 및 트리거를 따릅니다.
다음 예에서는 hr.employees 테이블의 뷰를 생성합니다.
CREATE VIEW staff_dept_10 AS
SELECT employee_id, last_name, job_id,
       manager_id, department_id
FROM   employees
WHERE  department_id = 10
WITH CHECK OPTION CONSTRAINT staff_dept_10_cnst;
정의 질의는 부서 10에 대한 행만 참조합니다. CHECK OPTION는 뷰에 대해 실행된 INSERT 및 UPDATE 문으로 인해 뷰에서 선택할 수 없는 행이 발생할 수 없도록 제약 조건이 있는 뷰를 생성합니다. 따라서 부서 10의 사원에 대한 행은 삽입할 수 있지만 부서 30의 행은 삽입할 수 없습니다.
참조: Oracle AI Database SQL Language Reference CREATE VIEW 문의 하위 질의 제한에 대해 알아보기
뷰에서 데이터에 액세스하는 방법
Oracle AI Database는 뷰 정의를 데이터 딕셔너리에 뷰를 정의하는 질의의 텍스트로 저장합니다.
SQL 문에서 뷰를 참조할 때 Oracle AI Database는 다음 작업을 수행합니다.
-
가능한 경우 뷰를 정의하는 질의와 뷰 및 모든 기본 뷰를 병합합니다.
Oracle AI Database는 뷰를 참조하지 않고 쿼리를 실행한 것처럼 병합된 쿼리를 최적화합니다. 따라서 Oracle AI Database는 참조된 기본 테이블 열에서 열이 뷰 정의에서 참조되는지 아니면 뷰에 대한 사용자 질의에서 참조되는지 여부에 관계없이 인덱스를 사용할 수 있습니다.
Oracle AI Database가 뷰 정의를 사용자 질의와 병합할 수 없는 경우도 있습니다. 이 경우 Oracle AI Database는 참조된 열의 모든 인덱스를 사용하지 않을 수 있습니다.
-
공유 SQL 영역에서 병합된 명령문을 구문 분석합니다.
Oracle AI Database는 유사한 명령문을 포함하는 기존 공유 SQL 영역이 없는 경우에만 새 공유 SQL 영역의 뷰를 참조하는 명령문을 구문 분석합니다. 따라서 뷰는 공유 SQL과 관련된 메모리 사용 감소의 이점을 제공합니다.
-
SQL 문을 실행합니다.
다음 예에서는 뷰를 질의할 때의 데이터 액세스를 보여 줍니다. employees 및 departments 테이블을 기반으로 employees_view를 생성한다고 가정합니다.
CREATE VIEW employees_view AS
  SELECT employee_id, last_name, salary, location_id
  FROM   employees JOIN departments USING (department_id)
  WHERE  department_id = 10;
유저는 employees_view의 다음 query를 실행합니다.
SELECT last_name
FROM   employees_view
WHERE  employee_id = 200;
Oracle AI Database는 뷰와 사용자 쿼리를 병합하여 다음 쿼리를 생성한 다음 해당 쿼리를 실행하여 데이터를 검색합니다.
SELECT last_name
FROM   employees, departments
WHERE  employees.department_id = departments.department_id
AND    departments.department_id = 10
AND    employees.employee_id = 200;
참조:
-
"최적기 개요"
-
쿼리 최적화에 대한 자세한 내용은 Oracle AI Database SQL Tuning Guide를 참조하십시오.
갱신 가능한 조인 뷰
조인 뷰에는 FROM 절에 여러 테이블 또는 뷰가 있습니다.
다음 예제에서 staff_dept_10_30 뷰는 부서 10 또는 30의 사원만 포함하여 employees 및 departments 테이블을 조인합니다.
CREATE VIEW staff_dept_10_30 AS
SELECT employee_id, last_name, job_id, e.department_id
FROM   employees e, departments d
WHERE  e.department_id IN (10, 30)
AND    e.department_id = d.department_id;
수정 가능한 조인 뷰라고도 하는 업데이트 가능한 조인 뷰에는 두 개 이상의 기본 테이블 또는 뷰가 포함되며 DML 작업이 허용됩니다. 갱신 가능한 뷰는 SELECT 문의 최상위 레벨 FROM 절에 여러 테이블을 포함하며 WITH READ ONLY 절에 의해 제한되지 않습니다.
기본적으로 갱신할 수 있으려면 뷰가 여러 기준을 충족해야 합니다. 예를 들어, 일반적인 규칙은 조인 뷰에서 INSERT, UPDATE 또는 DELETE 작업이 한 번에 하나의 기본 테이블만 수정할 수 있다는 것입니다. USER_UPDATABLE_COLUMNS 데이터 딕셔너리 뷰의 다음 질의는 staff_dept_10_30 뷰를 갱신할 수 있음을 보여줍니다.
SQL> SELECT TABLE_NAME, COLUMN_NAME, UPDATABLE
  2  FROM   USER_UPDATABLE_COLUMNS
  3  WHERE  TABLE_NAME = 'STAFF_DEPT_10_30';

TABLE_NAME                     COLUMN_NAME                    UPD
------------------------------ ------------------------------ ---
STAFF_DEPT_10_30               EMPLOYEE_ID                    YES
STAFF_DEPT_10_30               LAST_NAME                      YES
STAFF_DEPT_10_30               JOB_ID                         YES
STAFF_DEPT_10_30               DEPARTMENT_ID                  YES
Oracle Database 릴리스 21c부터는 조인 뷰의 모든 업데이트 가능 열이 키 보존 테이블의 열에 매핑되어야 하는 것은 아닙니다. 키로 보존되는 테이블은 기본 테이블의 각 행이 질의 출력에서 최대 한 번 나타나는 테이블입니다. staff_dept_10_30 뷰에서 department_id는 departments 테이블의 기본 키이므로 employees 테이블의 각 행은 결과 집합에서 최대 한 번만 표시되므로 employees 테이블이 키로 보존됩니다. departments 테이블은 각 행이 결과 집합에 여러 번 나타날 수 있으므로 키가 보존되지 않습니다. 키로 보존되지 않는 테이블의 열은 UPDATE 작업이 단일 테이블의 열만 갱신하고 갱신이 결정적이면 갱신될 수 있습니다. 즉, 각 행은 한 번만 갱신됩니다.
참조: 조인 뷰를 업데이트하는 방법을 알아보려면 Oracle AI Database Administrator's Guide를 참조하십시오.
객체 뷰
뷰가 가상 테이블인 것처럼 객체 뷰는 가상 객체 테이블입니다. 뷰의 각 행은 객체 유형의 인스턴스인 객체입니다. 객체 유형은 유저 정의 데이터 유형입니다.
관계형 데이터는 객체 유형으로 저장된 것처럼 검색, 갱신, 삽입 및 삭제할 수 있습니다. 객체, REF 및 모음(중첩 테이블 및 VARRAY)과 같은 객체 데이터 유형의 열을 사용하여 뷰를 정의할 수도 있습니다.
관계형 뷰와 마찬가지로 객체 뷰는 데이터베이스 관리자가 사용자에게 원하는 데이터만 표시할 수 있습니다. 예를 들어 객체 뷰는 IT 프로그래머에 대한 데이터를 표시하지만 급여에 대한 중요한 데이터는 생략할 수 있습니다. 다음 예제는 employee_type 객체를 생성한 다음 이 객체를 기반으로 it_prog_view 뷰를 생성합니다.
CREATE TYPE employee_type AS OBJECT
(
  employee_id  NUMBER (6),
  last_name    VARCHAR2 (25),
  job_id       VARCHAR2 (10)
);
/

CREATE VIEW it_prog_view OF employee_type
  WITH OBJECT IDENTIFIER (employee_id) AS
SELECT  e.employee_id, e.last_name, e.job_id
FROM    employees e
WHERE   job_id = 'IT_PROG';
객체 뷰는 뷰의 데이터를 관계형 테이블에서 가져오고 테이블이 객체 테이블로 정의된 것처럼 액세스할 수 있으므로 객체 지향 응용 프로그램으로의 프로토타입 생성이나 전환에 유용합니다. 기존 테이블을 다른 물리적 구조로 변환하지 않고 객체 지향 응용 프로그램을 실행할 수 있습니다.
참조:
-
객체 유형 및 객체 뷰에 대한 자세한 내용은 Oracle AI Database Object-Relational Developer's Guide를 참조하십시오.
-
CREATE TYPE문에 대해 알아보려면 Oracle AI Database SQL Language Reference를 참조하십시오.
구체화된 뷰 개요
구체화된 뷰는 스키마 객체로 미리 저장되거나 "구체화된" 질의 결과입니다. 질의의 FROM 절은 테이블, 뷰 또는 구체화된 뷰의 이름을 지정할 수 있습니다.
구체화된 뷰는 종종 복제에서 마스터 테이블로, 데이터 웨어하우징에서 팩트 테이블로 사용됩니다. 구체화된 뷰는 데이터를 요약, 계산, 복제 및 배포합니다. 다음과 같은 다양한 컴퓨팅 환경에 적합합니다.
-
데이터 웨어하우스에서 구체화된 뷰는 합계 및 평균과 같은 집계 함수에서 생성된 데이터를 계산하고 저장할 수 있습니다.
요약은 조인 및 집계 작업을 미리 계산하고 결과를 테이블에 저장하여 질의 시간을 줄이는 집계 뷰입니다. Materialized view는 요약과 동일합니다. 또한 Materialized view를 사용하여 합계가 있거나 없는 조인을 계산할 수 있습니다.
-
XStream 및 Oracle GoldenGate를 사용하여 수행되는 구체화된 뷰 복제에서는 뷰에 단일 시점의 테이블 전체 또는 부분 복사본이 포함됩니다. Materialized view는 분산된 사이트에서 데이터를 복제하고 여러 사이트에서 수행되는 갱신을 동기화합니다. 이러한 형태의 복제는 데이터베이스가 네트워크에 항상 연결되어 있지 않은 경우 현장 판매와 같은 환경에 적합합니다.
-
모바일 컴퓨팅 환경에서 구체화된 뷰는 중앙 서버에서 모바일 클라이언트로 데이터 부분 집합을 다운로드할 수 있으며, 중앙 서버에서 주기적으로 새로 고쳐지고 클라이언트에서 중앙 서버로 업데이트가 전달됩니다.
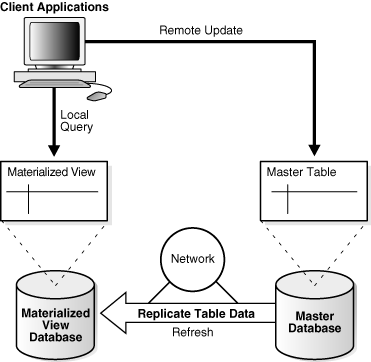
복제 환경에서 구체화된 뷰는 마스터 데이터베이스라고 하는 다른 데이터베이스의 테이블과 데이터를 공유합니다. 마스터 사이트에서 구체화된 뷰와 연결된 테이블은 마스터 테이블입니다. 그림 6-9는 다른 데이터베이스의 마스터 테이블을 기반으로 한 데이터베이스의 구체화된 뷰를 보여줍니다. 마스터 테이블에 대한 갱신은 구체화된 뷰 데이터베이스에 복제됩니다.
그림 9: Materialized View
-
구체화된 뷰의 특성 구체화된 뷰는 인덱스 및 비구체화된 뷰의 일부 특성을 공유합니다.
-
구체화된 뷰에 대한 새로 고침 메소드 데이터베이스는 기본 테이블을 변경한 후 새로 고쳐 구체화된 뷰의 데이터를 유지 관리합니다. Refresh 방식은 증분 또는 전체 Refresh가 될 수 있습니다.
-
자동 구체화된 뷰 Oracle Database 릴리스 21c부터 구체화된 뷰를 자동으로 생성하고 유지 관리할 수 있습니다.
-
질의 재작성은 마스터 테이블을 기반으로 작성된 사용자 요청을 구체화된 뷰가 포함된 의미상 동일한 요청으로 변환하는 기술입니다.
참조:
-
요약에 대한 자세한 내용은 Oracle AI Database Data Warehousing Guide를 참조하십시오.
-
XStream 소개는 Oracle AI Database XStream Guide를 참조하십시오.
-
Oracle GoldenGate에 대한 자세한 내용은 http://www.oracle.com/technetwork/middleware/goldengate/documentation/index.html를 참조하십시오.
-
CREATE MATERIALIZED VIEW문에 대한 자세한 내용은 Oracle AI Database SQL Language Reference를 참조하십시오.
구체화된 뷰의 특성
Materialized view는 인덱스 및 비Materialized view의 일부 특성을 공유합니다.
Materialized View는 다음과 같은 방식으로 인덱스와 유사합니다.
-
실제 데이터를 포함하고 저장 공간을 소비합니다.
-
마스터 테이블의 데이터가 변경되면 새로 고칠 수 있습니다.
-
Query Rewrite 작업에 사용될 때 SQL 실행의 성능을 향상시킬 수 있습니다.
-
SQL 응용 프로그램 및 유저에게 투명합니다.
Materialized View는 다른 테이블과 뷰의 데이터를 나타내므로 Materialized View와 유사합니다. 인덱스와 달리 사용자는 SELECT 문을 사용하여 직접 구체화된 뷰를 질의할 수 있습니다. 필요한 Refresh 유형에 따라 뷰를 DML 문으로 갱신할 수도 있습니다.
다음 예에서는 sh 샘플 스키마의 세 마스터 테이블을 기반으로 구체화된 집계 뷰를 생성하고 채웁니다.
CREATE MATERIALIZED VIEW sales_mv AS
  SELECT t.calendar_year, p.prod_id, SUM(s.amount_sold) AS sum_sales
  FROM   times t, products p, sales s
  WHERE  t.time_id = s.time_id
  AND    p.prod_id = s.prod_id
  GROUP BY t.calendar_year, p.prod_id;
다음 예제는 sales_mv에 대한 마스터 테이블인 sales 테이블을 삭제한 다음 sales_mv를 질의합니다. 행이 마스터 테이블의 데이터와 별도로 저장(구체화된)되므로 query는 데이터를 선택합니다.
SQL> DROP TABLE sales;

Table dropped.

SQL> SELECT * FROM sales_mv WHERE ROWNUM < 4;

CALENDAR_YEAR    PROD_ID  SUM_SALES
------------- ---------- ----------
         1998         13  936197.53
         1998         26  567533.83
         1998         27  107968.24
구체화된 뷰는 분할할 수 있습니다. 분할 테이블에서 구체화된 뷰를 정의하고 구체화된 뷰에서 하나 이상의 인덱스를 정의할 수 있습니다.
참조: Oracle AI Database Data Warehousing Guide에서 데이터 웨어하우스에서 구체화된 뷰를 사용하는 방법 학습
Materialized View에 대한 Refresh 방식
데이터베이스는 기본 테이블이 변경된 후 데이터를 Refresh하여 Materialized view의 데이터를 유지 관리합니다. Refresh 방식은 증분 또는 전체 Refresh가 될 수 있습니다.
-
전체 새로 고침 전체 새로 고침은 구체화된 뷰를 정의하는 질의를 실행합니다. 전체 새로 고침은 구체화된 뷰가 사전 작성된 테이블을 참조하거나 테이블을
BUILD DEFERRED로 정의하지 않는 한 처음에 구체화된 뷰를 생성할 때 발생합니다. -
증분 새로 고침 증분 새로 고침은 빠른 새로 고침이라고도 하며 기존 데이터의 변경 사항만 처리합니다. 이 방법을 사용하면 구체화된 뷰를 처음부터 재구축할 필요가 없습니다. 변경 사항만 처리하면 매우 빠른 새로 고침 시간이 발생할 수 있습니다.
-
In-Place and Out-of-Place Refresh 전체 및 증분 메소드의 경우 데이터베이스는 뷰에서 직접 또는 외부에서 명령문을 새로 고치는 구체화된 뷰를 제자리에 새로 고칠 수 있습니다.
전체 새로고침
완료 새로 고침은 구체화된 뷰를 정의하는 질의를 실행합니다. 전체 새로 고침은 구체화된 뷰가 사전 작성된 테이블을 참조하거나 테이블을 BUILD DEFERRED로 정의하지 않는 한 처음에 구체화된 뷰를 생성할 때 발생합니다.
완전 새로 고침은 특히 데이터베이스가 방대한 양의 데이터를 읽고 처리해야 하는 경우에 느려질 수 있습니다. Materialized View를 생성한 후 언제든지 Complete Refresh를 수행할 수 있습니다.
증분 새로고침
증분 새로 고침은 빠른 새로 고침이라고도 하며 기존 데이터에 대한 변경 사항만 처리합니다. 이 방법을 사용하면 구체화된 뷰를 처음부터 재구축할 필요가 없습니다. 변경 사항만 처리하면 매우 빠른 새로 고침 시간이 발생할 수 있습니다.
요청 시 또는 정기적으로 Materialized View를 Refresh할 수 있습니다. 또는 트랜잭션이 기본 테이블에 대한 변경 사항을 커밋할 때마다 Refresh하도록 동일한 데이터베이스에서 구체화된 뷰를 기본 테이블로 구성할 수 있습니다.
Fast Refresh는 다음 형식 중 하나로 제공됩니다.
-
로그 기반 Refresh
이 Refresh 유형에는 Materialized View 로그 또는 직접 로더 로그가 기본 테이블에 대한 변경 사항 레코드를 보관합니다. 구체화된 뷰 로그는 기본 테이블에 정의된 구체화된 뷰를 증분적으로 새로 고칠 수 있도록 기본 테이블에 대한 변경 사항을 기록하는 스키마 객체입니다. 각 구체화된 뷰 로그는 단일 기본 테이블과 연관됩니다.
-
PCT(분할 영역 변경 사항 추적) Refresh
PCT Refresh는 기본 테이블이 분할된 경우에만 유효합니다. PCT refresh는 영향을 받는 Materialized View Partition이나 영향을 받는 데이터 부분의 모든 데이터를 제거한 다음 재계산합니다. 데이터베이스는 수정된 기본 테이블 Partition을 사용하여 뷰의 영향을 받는 Partition이나 데이터 부분을 식별합니다. 기본 테이블에서 분할 영역 유지 관리 작업이 발생한 경우 PCT Refresh는 사용 가능한 유일한 Incremental Refresh 방식입니다.
내부 및 외부로 새로고침
전체 및 증분 메소드의 경우 데이터베이스는 뷰에서 직접 또는 외부에서 명령문을 새로 고치는 구체화된 뷰를 제자리에 새로 고칠 수 있습니다.
Out-of-place Refresh는 하나 이상의 외부 테이블을 생성하고, 이에 대한 Refresh 문을 실행한 다음 구체화된 뷰 또는 영향을 받는 분할 영역을 외부 테이블로 전환합니다. 이 기법은 refresh 명령문이 완료되는 데 오랜 시간이 걸리는 경우 특히 refresh 중에 고가용성을 구현합니다.
Synchronous refresh는 out-of-place refresh 유형입니다. 동기 Refresh는 기본 테이블의 내용을 수정하지 않지만 동기 Refresh 패키지의 API를 사용하여 기본 테이블 및 구체화된 뷰에 이러한 변경 사항을 동시에 적용함으로써 일관성을 보장합니다. 이 접근 방식을 사용하면 테이블 집합과 테이블에 정의된 Materialized view를 항상 동기화할 수 있습니다. 데이터 웨어하우스에서는 다음과 같은 이유로 동기 Refresh 방식이 적절합니다.
-
증분 데이터의 로드는 엄격하게 제어되며 주기적으로 발생합니다.
-
테이블과 Materialized view는 종종 동일한 방식으로 분할되거나 해당 분할 영역이 기능 종속성에 의해 관련됩니다.
참조: Oracle AI Database Data Warehousing Guide에서 구체화된 뷰를 새로 고치는 방법 학습
자동 Materialized View
Oracle Database 릴리스 21c부터 구체화된 뷰를 자동으로 생성하고 유지 관리할 수 있습니다.
Oracle AI Database는 쿼리 성능을 최적화하기 위해 구체화된 뷰를 자동으로 생성 및 관리할 수 있습니다. 백그라운드 작업은 DBA와의 상호 작용이 거의 없거나 전혀 없는 상태에서 작업 로드 특성을 모니터 및 분석하고 Materialized View가 SQL 성능을 향상시킬 위치를 식별합니다. 후보 Materialized view의 성능 이점은 작업 로드에 표시되기 전에 작업 로드 query를 사용하여 백그라운드에서 측정됩니다.
참조:
-
자세한 내용은 Oracle AI Database Data Warehousing Guide를 참조하십시오.
-
Oracle AI Database PL/SQL Packages and Types Reference,
DBMS_AUTO_MV패키지를 사용하여 자동 구체화된 뷰를 구현하는 방법 학습
질의 재작성
질의 재작성은 마스터 테이블을 기반으로 작성된 사용자 요청을 구체화된 뷰가 포함된 의미상 동일한 요청으로 변환하는 기술입니다.
기본 테이블에 많은 양의 데이터가 포함되어 있으면 집계 또는 조인을 계산하는 데 비용이 많이 들고 시간이 많이 걸립니다. Materialized view에는 미리 계산된 집계 및 조인이 포함되어 있기 때문에 Materialized view를 사용하여 Query Rewrite를 통해 Query에 신속하게 응답할 수 있습니다.
query transformer는 사용자 개입 없이 SQL 문의 Materialized view를 참조할 필요가 없도록 Materialized view를 사용하도록 요청을 투명하게 재작성합니다. 질의 재작성이 투명하므로 응용 프로그램 코드의 SQL을 무효화하지 않고도 구체화된 뷰를 추가하거나 삭제할 수 있습니다.
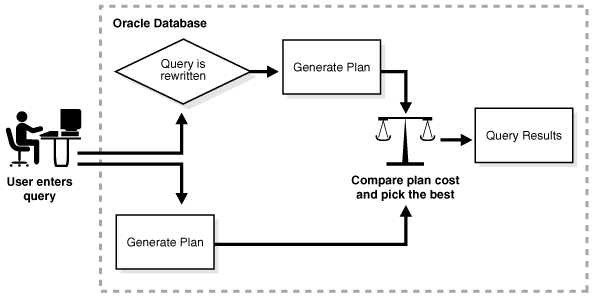
일반적으로 디테일 테이블 대신 Materialized View를 사용하도록 Query를 재작성하면 응답 시간이 향상됩니다. 다음 그림은 원래 질의 및 재작성된 질의에 대한 실행 계획을 생성하고 최저 비용 계획을 선택하는 데이터베이스를 보여줍니다.
그림 10: Query Rewrite
참조:
-
쿼리 변환에 대한 자세한 내용은 "최적기 개요"를 참조하십시오.
-
Oracle AI Database Data Warehousing Guide: Query Rewrite 사용 방법 학습
시퀀스 개요
시퀀스는 여러 사용자가 고유한 정수를 생성할 수 있는 스키마 객체입니다. 시퀀스 생성기는 숫자 데이터 유형에 대해 대리 키를 생성하는 확장성이 뛰어나고 성능이 뛰어난 방법을 제공합니다.
-
순서 특성 시퀀스 정의는 해당 이름 및 시퀀스의 오름차순인지 아니면 내림차순인지 등 시퀀스에 대한 일반 정보를 나타냅니다.
-
시퀀스에 대한 동시 액세스 동일한 시퀀스 생성기는 여러 테이블에 대한 숫자를 생성할 수 있습니다.
순서 특성
시퀀스 정의는 시퀀스의 이름 및 시퀀스의 오름차순인지 아니면 내림차순인지 등 시퀀스에 대한 일반적인 정보를 나타냅니다.
시퀀스 정의는 다음을 나타냅니다.
-
숫자 사이의 간격
-
데이터베이스가 생성된 시퀀스 번호 집합을 메모리에 캐시해야 하는지 여부
-
제한에 도달할 때 시퀀스가 순환되어야 하는지 여부
다음 예에서는 샘플 스키마 oe에 customers_seq 시퀀스를 생성합니다. 응용 프로그램은 이 시퀀스를 사용하여 customers 테이블에 행이 추가될 때 고객 ID 번호를 제공할 수 있습니다.
CREATE SEQUENCE customers_seq
START WITH      1000
INCREMENT BY    1
NOCACHE
NOCYCLE;customers_seq.nextval에 대한 첫번째 참조는 1000를 반환합니다. 두번째는 1001를 반환합니다. 이후의 각 참조는 이전 참조보다 큰 값 1을 반환합니다.
참조:
-
Oracle AI Database Get Started with Oracle AI Database Development - 시퀀스 생성 방법을 보여주는 자습서
-
Oracle AI Database Administrator's Guide - SQL 문에서 시퀀스를 참조하는 방법 학습
-
CREATE SEQUENCE구문 및 의미에 대한 Oracle AI Database SQL Language Reference
시퀀스에 대한 동시 액세스
동일한 시퀀스 생성기가 여러 테이블에 대한 번호를 생성할 수 있습니다.
생성기는 기본 키를 자동으로 생성하고 여러 행 또는 테이블에 걸쳐 키를 조정할 수 있습니다. 예를 들어, 시퀀스는 orders 테이블 및 customers 테이블에 대한 기본 키를 생성할 수 있습니다.
시퀀스 생성기는 디스크 I/O 또는 트랜잭션 잠금에 대한 오버헤드 없이 고유한 숫자 생성을 위해 다중 유저 환경에서 유용합니다. 예를 들어, 두 명의 사용자가 동시에 orders 테이블에 새 행을 삽입합니다. 시퀀스를 사용하여 order_id 열에 대해 고유한 번호를 생성하면 다른 사용자가 사용 가능한 다음 주문 번호를 입력할 때까지 기다릴 필요가 없습니다. 시퀀스는 각 유저에 대해 올바른 값을 자동으로 생성합니다.
시퀀스를 참조하는 각 사용자는 세션에서 마지막으로 생성된 시퀀스인 현재 시퀀스 번호에 액세스할 수 있습니다. 사용자는 명령문을 실행하여 새 시퀀스 번호를 생성하거나 세션에서 마지막으로 생성한 현재 번호를 사용할 수 있습니다. 세션의 명령문이 시퀀스 번호를 생성하면 이 세션에서만 사용할 수 있습니다. 개별 시퀀스 번호는 생성되어 최종적으로 롤백된 트랜잭션에서 사용된 경우 건너뛸 수 있습니다.
경고: 응용 프로그램에서 간격 없는 숫자 집합이 필요한 경우 Oracle 시퀀스를 사용할 수 없습니다. 자체 개발한 코드를 사용하여 데이터베이스의 작업을 직렬화해야 합니다.
참조: "데이터 동시성 및 일관성" 세션이 동시에 데이터에 액세스하는 방법 알아보기
차원 개요
일반적인 데이터 웨어하우스에는 차원과 사실값(fact)이라는 두 가지 중요한 구성 요소가 있습니다.
차원은 시간, 지역, 제품, 부서 및 분배 채널과 같은 비즈니스 질문 지정에 사용되는 범주입니다. 사실은 판매된 단위 또는 수익과 같은 특정 차원 값 세트와 연관된 이벤트 또는 엔티티입니다.
다차원 요청의 예는 다음과 같습니다.
-
2013년과 2014년 주, 국가, 지역 등 지역 차원에 대한 집계 레벨이 증가하면서 모든 제품의 총 매출을 표시합니다.
-
2013년과 2014년 남미의 지역별 비용을 보여주는 운영에 대한 교차 분석 결과를 생성합니다. 가능한 모든 소계를 포함합니다.
-
자동차 제품에 대한 2014년 판매 수익에 따라 아시아의 상위 10대 영업 담당자를 나열하고 커미션 순위를 지정합니다.
다차원적인 질문에는 집계된 데이터와 시간, 지역 또는 예산에 걸친 데이터 집합의 비교가 필요합니다.
차원을 생성하면 질의 재작성 기능을 광범위하게 사용할 수 있습니다. 구체화된 뷰를 사용하도록 질의를 투명하게 재작성하면 데이터베이스가 질의 성능을 향상시킬 수 있습니다.
-
차원 계층 구조 차원 테이블은 열 또는 열 세트 쌍 간의 계층적(상위/하위) 관계를 정의하는 논리적 구조입니다.
-
차원 생성
CREATE DIMENSIONSQL 문을 사용하여 차원을 생성합니다. 참조: 차원에 대한 자세한 내용은 Oracle AI Database Data Warehousing Guide를 참조하십시오.
차원의 계층 구조
차원 테이블은 열 또는 열 세트 쌍 간의 계층적(상위/하위) 관계를 정의하는 논리적 구조입니다.
예를 들어, 차원은 행 내에서 city 열이 state 열의 값을 의미하고 state 열이 country 열의 값을 의미함을 나타낼 수 있습니다.
고객 차원 내에서 고객은 구/군/시, 시/도, 국가, 하위 지역 및 지역으로 롤업할 수 있습니다. 일반적으로 데이터 분석은 차원 계층의 상위 레벨에서 시작하며 상황이 그러한 분석을 보증하는 경우 점차적으로 드릴다운합니다.
하위 레벨의 각 값은 상위 레벨에서 하나의 값에만 연결됩니다. 계층 관계는 계층의 한 레벨에서 계층의 다음 레벨까지의 기능 종속성입니다.
차원에 지정된 데이터 저장 영역이 없습니다. 차원 정보는 차원 테이블에 저장되지만 사실값 정보는 사실값 테이블에 저장됩니다.
참조:
- 차원에 대한 자세한 내용은 Oracle AI Database Data Warehousing Guide를 참조하십시오.
차원 생성
CREATE DIMENSION SQL 문을 사용하여 차원을 생성합니다.
이 명령문은 다음을 지정합니다.
-
각각 차원에서 열 또는 열 집합을 식별하는 여러
LEVEL절 -
인접 레벨 간의 상위/하위 관계를 지정하는 하나 이상의
HIERARCHY절 -
개별 레벨과 연관된 추가 열 또는 열 집합을 식별하는 선택적
ATTRIBUTE절
다음 명령문은 샘플 스키마 sh에서 customers_dim 차원을 생성하는 데 사용되었습니다.
CREATE DIMENSION customers_dim
   LEVEL customer   IS (customers.cust_id)
   LEVEL city       IS (customers.cust_city)
   LEVEL state      IS (customers.cust_state_province)
   LEVEL country    IS (countries.country_id)
   LEVEL subregion  IS (countries.country_subregion)
   LEVEL region     IS (countries.country_region)
   HIERARCHY geog_rollup (
      customer      CHILD OF
      city          CHILD OF
      state         CHILD OF
      country       CHILD OF
      subregion     CHILD OF
      region
   JOIN KEY (customers.country_id) REFERENCES country )
   ATTRIBUTE customer DETERMINES
   (cust_first_name, cust_last_name, cust_gender,
    cust_marital_status, cust_year_of_birth,
    cust_income_level, cust_credit_limit)
   ATTRIBUTE country DETERMINES (countries.country_name);
차원의 열은 동일한 테이블(정규화되지 않음) 또는 여러 테이블(전체 또는 부분 정규화됨)에서 올 수 있습니다. 예를 들어, 정규화된 시간 차원에는 날짜 테이블, 월 테이블 및 연도 테이블이 포함될 수 있으며, 각 날짜 행을 월 행에 연결하는 조인 조건과 각 월 행을 년 행에 연결할 수 있습니다. 완전히 비정규화된 시간 차원에서 날짜, 월 및 년 열은 동일한 테이블에 있습니다. 정규화 또는 비정규화 여부에 관계없이 열 간의 계층적 관계를 CREATE DIMENSION 문에 지정해야 합니다.
참조: CREATE DIMENSION 구문 및 의미에 대한 Oracle AI Database SQL Language Reference
동의어 개요
동의어는 스키마 객체의 별칭입니다. 예를 들어, 테이블 또는 뷰, 시퀀스, PL/SQL 프로그램 단위, 유저 정의 객체 유형 또는 다른 동의어에 대한 동의어를 생성할 수 있습니다. 동의어가 단순히 별칭이므로 데이터 딕셔너리에 없는 해당 정의 외에 저장 영역은 필요하지 않습니다.
동의어는 데이터베이스 유저의 SQL 문을 단순화할 수 있습니다. 동의어는 기본 스키마 객체의 ID 및 위치를 숨기는 데도 유용합니다. 기본 객체의 이름을 바꾸거나 이동해야 하는 경우 동의어만 재정의해야 합니다. 동의어를 기반으로 하는 응용 프로그램은 수정 없이 계속 작동합니다.
전용 동의어와 공용 동의어를 모두 생성할 수 있습니다. 전용 동의어는 다른 사용자의 가용성을 제어하는 특정 사용자의 스키마에 있습니다. 공용 동의어는 PUBLIC라는 사용자 그룹이 소유하며 모든 데이터베이스 사용자가 액세스할 수 있습니다.
예제 6-5 공용 동의어
데이터베이스 관리자가 hr.employees 테이블에 대해 people라는 공용 동의어를 생성한다고 가정합니다. 그런 다음 사용자는 oe 스키마에 연결하고 동의어에서 참조하는 테이블의 행 수를 셉니다.
SQL> CREATE PUBLIC SYNONYM people FOR hr.employees;

Synonym created.

SQL> CONNECT oe
Enter password: password
Connected.

SQL> SELECT COUNT(*) FROM people;

  COUNT(*)
----------
       107
공용(public) 동의어는 데이터베이스 통합을 더욱 어렵게 만들기 때문에 사용하지 마십시오. 다음 예제에 표시된 것처럼 다른 관리자가 공용 동의어 people를 생성하려고 하면 하나의 공용 동의어 people만 데이터베이스에 존재할 수 있으므로 생성이 실패합니다. 공용 동의어를 과도하게 사용하면 응용 프로그램 간에 네임스페이스 충돌이 발생합니다.
SQL> CREATE PUBLIC SYNONYM people FOR oe.customers;
CREATE PUBLIC SYNONYM people FOR oe.customers
                      *
ERROR at line 1:
ORA-00955: name is already used by an existing object

SQL> SELECT OWNER, SYNONYM_NAME, TABLE_OWNER, TABLE_NAME
  2  FROM DBA_SYNONYMS
  3  WHERE SYNONYM_NAME = 'PEOPLE';

OWNER      SYNONYM_NAME TABLE_OWNER TABLE_NAME
---------- ------------ ----------- ----------
PUBLIC     PEOPLE       HR          EMPLOYEES
동의어 자체는 보안이 불가능합니다. 동의어에 대한 객체 권한을 부여하면 실제로 기본 객체에 대한 권한을 부여하게 됩니다. 동의어는 GRANT 문에서 객체의 별칭 역할을 합니다.
참조:
-
동의어를 관리하는 방법을 알아보려면 Oracle AI Database Administrator's Guide를 참조하십시오.
-
CREATE SYNONYM구문 및 의미에 대한 Oracle AI Database SQL Language Reference