프로세스 구조
이 장에서는 Oracle 데이터베이스의 프로세스에 대해 설명합니다.
-
프로세스 소개 프로세스는 일련의 단계를 실행할 수 있는 운영 체제의 방식입니다.
-
클라이언트 프로세스 개요 사용자가 Pro*C 프로그램 또는 SQL*Plus와 같은 응용 프로그램을 실행하면 운영 체제에서는 클라이언트 프로세스(사용자 프로세스라고도 함)를 생성하여 사용자 응용 프로그램을 실행합니다. 클라이언트 애플리케이션에는 데이터베이스와 통신하는 데 필요한 API를 제공하는 Oracle AI Database 라이브러리가 연결되어 있습니다.
-
서버 프로세스 개요 Oracle AI Database는 서버 프로세스를 생성하여 인스턴스에 연결된 클라이언트 프로세스의 요청을 처리합니다. 클라이언트 프로세스는 항상 별도의 서버 프로세스를 통해 데이터베이스와 통신합니다.
-
백그라운드 프로세스 개요 백그라운드 프로세스는 다중 프로세스 Oracle 데이터베이스에서 사용되는 추가 프로세스입니다. 백그라운드 프로세스는 데이터베이스 작동 및 여러 유저의 성능 극대화에 필요한 유지 관리 작업을 수행합니다.
프로세스 소개
프로세스는 운영 체제에서 일련의 단계를 실행할 수 있는 메커니즘입니다.
프로세스 실행 구조는 운영 체제에 따라 다릅니다. 예를 들어, Windows에서 Oracle 백그라운드 프로세스는 프로세스 내의 실행 스레드입니다. Linux 및 UNIX에서는 Oracle 프로세스가 운영 체제 프로세스이거나 운영 체제 프로세스 내의 스레드입니다.
프로세스 실행 코드 모듈 모든 접속된 Oracle AI Database 사용자는 다음 모듈을 실행하여 데이터베이스 인스턴스에 액세스해야 합니다.
-
애플리케이션 또는 Oracle AI Database 유틸리티
데이터베이스 유저는 사전 컴파일러 프로그램과 같은 데이터베이스 응용 프로그램이나 데이터베이스에 SQL 문을 실행하는 SQL*Plus와 같은 데이터베이스 도구를 실행합니다.
-
Oracle 데이터베이스 코드
각 유저는 자신의 대신 응용 프로그램의 SQL 문을 해석하고 처리하는 Oracle 데이터베이스 코드를 실행합니다.
프로세스는 일반적으로 자체 전용(Private) 메모리 영역에서 실행됩니다. 대부분의 프로세스는 연관된 Trace file에 주기적으로 기록할 수 있습니다.
-
프로세스 유형 데이터베이스 인스턴스는 여러 프로세스를 포함하거나 상호 작용합니다.
-
다중 프로세스 및 다중 스레드 Oracle AI Database 시스템 다중 프로세스 Oracle AI Database(다중 사용자 Oracle AI Database라고도 함)는 여러 프로세스를 사용하여 Oracle AI Database 코드의 서로 다른 부분과 사용자를 위한 추가 Oracle 프로세스(연결된 사용자당 하나의 프로세스 또는 여러 사용자가 공유하는 하나 이상의 프로세스)를 실행합니다.
프로세스 유형
데이터베이스 Instance는 여러 프로세스를 포함하거나 상호 작용합니다.
프로세스는 다음 유형으로 구분됩니다.
-
클라이언트 프로세스는 응용 프로그램 또는 Oracle 도구 코드를 실행합니다.
-
Oracle 프로세스는 Oracle 데이터베이스 코드를 실행하는 실행 단위입니다. 다중 스레드 구조에서 Oracle 프로세스는 운영 체제 프로세스이거나 운영 체제 프로세스 내의 스레드일 수 있습니다. Oracle 프로세스에는 다음과 같은 서브타입이 포함됩니다.
-
백그라운드 프로세스는 데이터베이스 인스턴스부터 시작하여 인스턴스 복구 수행, 프로세스 정리, 디스크에 리두 버퍼 쓰기 등의 유지 관리 작업을 수행합니다.
-
서버 프로세스는 클라이언트 요청을 기반으로 작업을 수행합니다.
예를 들어, 이러한 프로세스는 SQL 질의를 구문 분석하고, 공유 풀에 배치하고, 각 질의에 대해 질의 계획을 생성 및 실행하고, 데이터베이스 버퍼 캐시 또는 디스크에서 버퍼를 읽습니다.
주: 서버 프로세스 및 이러한 프로세스에서 할당된 프로세스 메모리는 데이터베이스 인스턴스에서 실행됩니다. 서버 프로세스가 종료되면 인스턴스가 계속 작동합니다.
-
하위 프로세스는 백그라운드 또는 서버 프로세스에 대한 추가 작업을 수행합니다.
-
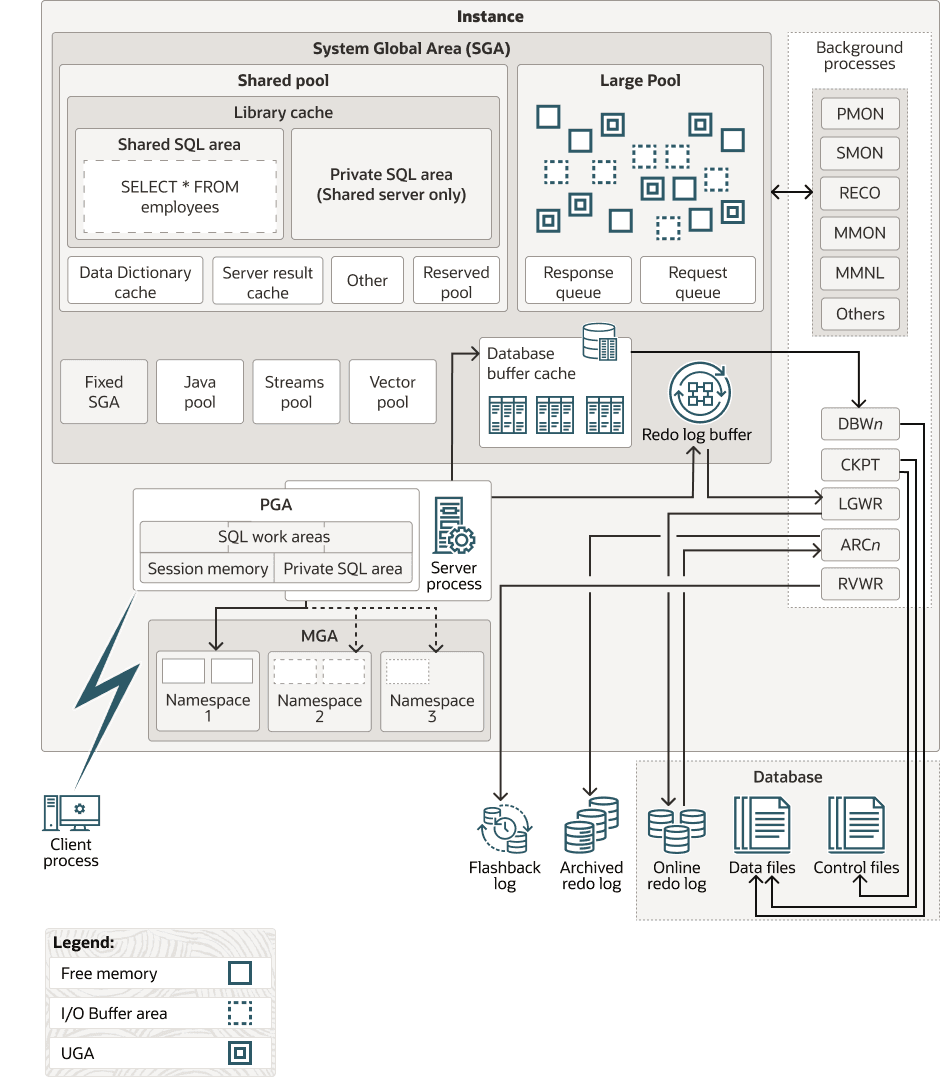
프로세스 구조는 운영 체제와 선택한 Oracle AI Database 옵션에 따라 다릅니다. 예를 들어, 전용 서버 또는 공유 서버 연결에 대해 연결된 사용자에 대한 코드를 구성할 수 있습니다. Shared Server 구조에서 데이터베이스 코드를 실행하는 각 서버 프로세스는 여러 클라이언트 프로세스를 처리할 수 있습니다. 그림 18-1에서는 전용 서버 연결을 사용하는 시스템 전역 영역(SGA) 및 백그라운드 프로세스를 보여줍니다. 각 사용자 연결에 대해 클라이언트 프로세스가 응용 프로그램을 실행합니다. 이 클라이언트 프로세스는 데이터베이스 코드를 실행하는 Dedicated Server 프로세스와 다릅니다. 각 클라이언트 프로세스는 자체 PGA(프로그램 전역 영역)가 있는 자체 서버 프로세스와 연관됩니다.
그림 1: Oracle 프로세스 및 SGA
참조:
-
"전용 서버 아키텍처" 및 "공유 서버 아키텍처"
-
구성 선택 사항에 대한 자세한 내용은 Oracle AI Database 운영 체제별 설명서를 참조하십시오.
-
V$PROCESS뷰에 대한 자세한 내용은 Oracle AI Database Reference를 참조하십시오.
다중 프로세스 및 다중 스레드 Oracle AI Database 시스템
다중 프로세스 Oracle AI Database(다중 사용자 Oracle AI Database라고도 함)는 여러 프로세스를 사용하여 Oracle AI Database 코드의 여러 부분과 사용자를 위한 추가 Oracle 프로세스(연결된 사용자당 하나의 프로세스 또는 여러 사용자가 공유하는 하나 이상의 프로세스)를 실행합니다.
데이터베이스의 주요 이점은 여러 유저가 동시에 필요로 하는 데이터를 관리하는 것이므로 대부분의 데이터베이스는 다중 유저입니다. 데이터베이스 Instance의 각 프로세스는 특정 작업을 수행합니다. 데이터베이스와 응용 프로그램 작업을 여러 프로세스로 나누면 여러 유저와 응용 프로그램이 한 Instance에 동시에 연결할 수 있고 시스템 성능은 향상됩니다.
Oracle Database 12c 이전 릴리스에서는 Oracle 프로세스가 UNIX 및 Linux 시스템에서 스레드로 실행되지 않았습니다. Oracle Database 12c부터 다중 스레드 Oracle AI Database 모델은 Oracle 프로세스가 별도의 주소 공간에서 운영체제 스레드로 실행되도록 합니다. Oracle AI Database가 설치되면 데이터베이스가 프로세스 모드로 실행됩니다. 스레드 모드에서 데이터베이스를 실행하려면 THREADED_EXECUTION 초기화 매개변수를 TRUE로 설정해야 합니다. 스레드 모드에서 UNIX 및 Linux의 일부 백그라운드 프로세스는 프로세스로 실행되는 반면(각 프로세스는 하나의 스레드를 포함함), 나머지 Oracle 프로세스는 프로세스 내의 스레드로 실행됩니다.
스레드 모드에서 실행되는 데이터베이스에서는 PMON 및 DBW가 운영 체제 프로세스로 실행될 수 있지만, LGWR 및 CMON은 단일 프로세스 내에서 스레드로 실행될 수 있습니다. 두 개의 포그라운드 프로세스와 병렬 실행(PX) 서버 프로세스는 두번째 운영 체제 프로세스에서 스레드로 실행될 수 있습니다. 세번째 운영 체제 프로세스에는 여러 포그라운드 스레드가 포함될 수 있습니다. 따라서 "Oracle 프로세스"가 항상 "운영 체제 프로세스"를 의미하지는 않습니다. 주: THREADED_EXECUTION 초기화 매개변수가 TRUE로 설정된 경우 운영체제 인증이 지원되지 않습니다.
예제 18-1 Oracle Process 메타 데이터 보기
V$PROCESS 뷰는 데이터베이스 인스턴스에 연결된 각 Oracle 프로세스에 대해 하나의 행을 포함합니다. 예를 들어, SQL*Plus에서 다음 query를 실행하여 각 프로세스에 대한 운영 체제 프로세스 ID와 운영 체제 스레드 ID를 얻을 수 있습니다.
COL SPID FORMAT a8
COL STID FORMAT a8
SELECT SPID, STID, PROGRAM FROM V$PROCESS ORDER BY SPID;
query는 다음과 같은 부분 샘플 출력을 생성합니다.
SPID   STID   PROGRAM
-----  -----  ---------------------------
7190   7190   oracle@samplehost (PMON)
7192   7192   oracle@samplehost (PSP0)
7194   7194   oracle@samplehost (VKTM)
7198   7198   oracle@samplehost (SCMN)
7198   7200   oracle@samplehost (GEN0)
7202   7202   oracle@samplehost (SCMN)
7202   7204   oracle@samplehost (DIAG)
7198   7205   oracle@samplehost (DBRM)
7202   7206   oracle@samplehost (DIA0)
.
.
.
참조:
-
V$PROCESS뷰를 사용하는 방법에 대한 자세한 내용은 Oracle AI Database Performance Tuning Guide를 참조하십시오. -
THREADED_EXECUTION초기화 매개변수에 대해 알아보려면 Oracle AI Database Reference를 참조하십시오.
클라이언트 프로세스 개요
사용자가 Pro*C 프로그램 또는 SQL*Plus와 같은 응용 프로그램을 실행하면 운영 체제가 클라이언트 프로세스(사용자 프로세스라고도 함)를 생성하여 사용자 응용 프로그램을 실행합니다. 클라이언트 애플리케이션에는 데이터베이스와 통신하는 데 필요한 API를 제공하는 Oracle AI Database 라이브러리가 연결되어 있습니다.
-
클라이언트 및 서버 프로세스 클라이언트 프로세스는 인스턴스와 직접 상호 작용하는 Oracle 프로세스와 중요한 방식으로 다릅니다.
-
연결 및 세션 데이터베이스 연결은 클라이언트 프로세스와 데이터베이스 인스턴스 사이의 물리적 통신 경로입니다.
-
현재 컨테이너 데이터베이스 세션은 데이터베이스에 대한 현재 사용자 로그인 상태를 나타내는 데이터베이스 인스턴스 메모리의 논리적 엔티티입니다.
-
데이터베이스 작업 데이터베이스 모니터링 컨텍스트에서 데이터베이스 작업은 최종 사용자 또는 애플리케이션 코드에 정의된 대로 두 시점 사이의 세션 작업입니다.
클라이언트 및 서버 프로세스
클라이언트 프로세스는 Oracle 프로세스가 인스턴스와 직접 상호 작용하는 것과는 중요한 방식으로 다릅니다.
클라이언트 프로세스를 서비스하는 Oracle 프로세스는 SGA에서 읽고 SGA에 쓸 수 있지만 클라이언트 프로세스는 읽을 수 없습니다. 클라이언트 프로세스는 데이터베이스 호스트가 아닌 다른 호스트에서 실행할 수 있지만 Oracle 프로세스는 실행할 수 없습니다.
예를 들어, 클라이언트 호스트의 유저가 SQL*Plus를 시작한 다음 데이터베이스 Instance가 시작되지 않을 때 네트워크를 통해 다른 호스트의 데이터베이스 sample에 연결합니다.
SQL> CONNECT SYS@inst1 AS SYSDBA
Enter password: *********
Connected to an idle instance.
클라이언트 호스트에서 sqlplus 또는 sample에 대한 프로세스 검색에는 sqlplus 클라이언트 프로세스만 표시됩니다.
% ps -ef | grep -e sample -e sqlplus | grep -v grep
clientuser 29437 29436  0 15:40 pts/1    00:00:00 sqlplus           as sysdba
데이터베이스 호스트에서 sqlplus 또는 sample에 대한 프로세스를 검색하면 로컬이 아닌 연결의 서버 프로세스가 표시되지만 클라이언트 프로세스는 표시되지 않습니다.
% ps -ef | grep -e sample -e sqlplus | grep -v grep
serveruser 29441     1  0 15:40 ?        00:00:00 oraclesample (LOCAL=NO)
참조: "인스턴스 시작 방법"을 참조하여 인스턴스가 시작되지 않을 때 클라이언트가 데이터베이스에 접속할 수 있는 방법을 알아봅니다.
연결 및 세션
데이터베이스 연결은 클라이언트 프로세스와 데이터베이스 인스턴스 사이의 물리적 통신 경로입니다.
연결 중 사용 가능한 프로세스 간 통신 방식 또는 네트워크 소프트웨어를 사용하여 통신 경로가 설정됩니다. 일반적으로 클라이언트 프로세스와 서버 프로세스 또는 디스패처 간에 연결이 발생하지만, 클라이언트 프로세스와 CMAN(Oracle Connection Manager) 간에 연결이 발생할 수도 있습니다.
현재 컨테이너
데이터베이스 세션은 데이터베이스에 대한 현재 유저 로그인 상태를 나타내는 데이터베이스 Instance 메모리의 논리적 엔티티입니다.
예를 들어, 유저가 암호로 데이터베이스에 의해 인증되는 경우 이 유저에 대해 세션이 설정됩니다. 세션은 유저가 데이터베이스에 의해 인증된 시점에서부터 유저가 데이터베이스 응용 프로그램을 연결 해제하거나 종료하는 시점까지 지속됩니다.
세션 및 컨테이너
지정된 세션의 경우 CDB의 현재 컨테이너는 세션이 실행 중인 컨테이너입니다. 현재 컨테이너는 CDB 루트, 응용 프로그램 루트 또는 PDB일 수 있습니다.
각 세션에는 특정 시점에 정확히 하나의 현재 컨테이너가 있습니다. 각 컨테이너의 데이터 딕셔너리는 별개이므로 Oracle AI Database는 이름 분석 및 권한 부여를 위해 현재 컨테이너의 데이터 딕셔너리를 사용합니다.
연결과 세션 간의 관계
단일 연결에는 0개, 1개 이상의 세션이 설정될 수 있습니다. 세션은 독립적입니다. 한 세션의 커밋은 다른 세션의 트랜잭션에 영향을 주지 않습니다.
주: Oracle Net 연결 풀링이 구성된 경우 연결이 끊길 수는 있지만 세션은 그대로 두는 것이 좋습니다.
단일 데이터베이스 유저에 대해 여러 세션이 동시에 존재할 수 있습니다. 다음 그림에 표시된 것처럼 사용자 hr는 데이터베이스에 대해 여러 연결을 가질 수 있습니다. Dedicated Server 연결에서 데이터베이스는 각 연결 대신 서버 프로세스를 생성합니다. Dedicated Server를 생성하게 하는 클라이언트 프로세스만 Dedicated Server를 사용합니다. Shared Server 연결에서는 많은 클라이언트 프로세스가 단일 Shared Server 프로세스에 액세스합니다.
그림 2: 각 연결당 하나의 세션
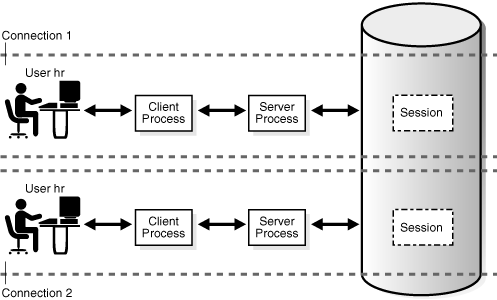
그림 18-3에서는 사용자 hr가 데이터베이스에 대해 단일 연결을 가지지만 이 연결에 두 개의 세션이 있는 경우를 보여 줍니다.
그림 3: 한 연결의 두 세션
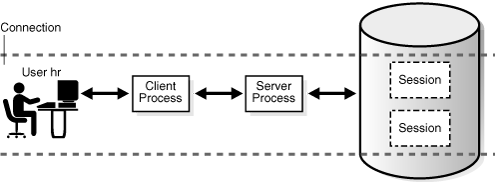
SQL 문 실행 통계에 대한 자동 추적 보고서를 생성하면 그림 18-3에서 시나리오가 재생성됩니다.
Example 18-2의 DISCONNECT 명령은 실제로 연결이 아니라 sessions를 종료합니다.
예제 18-2 연결 및 세션
다음 예제는 SQL*Plus를 SYSTEM 유저로 데이터베이스에 연결하여 추적을 활성화함으로써 새 세션(포함된 예제 출력)을 생성합니다.
SQL> SELECT SID, SERIAL#, PADDR FROM V$SESSION WHERE USERNAME = USER;

SID SERIAL# PADDR
--- ------- --------
 90      91 3BE2E41C

SQL> SET AUTOTRACE ON STATISTICS;
SQL> SELECT SID, SERIAL#, PADDR FROM V$SESSION WHERE USERNAME = USER;

SID SERIAL# PADDR
--- ------- --------
 88      93 3BE2E41C
 90      91 3BE2E41C
...
SQL> DISCONNECT
DISCONNECT 명령은 실제로 연결이 아니라 sessions를 종료합니다. 새 터미널을 열고 다른 유저로 instance에 연결하는 다음 query는 주소 3BE2E41C에 대한 연결이 여전히 활성 상태임을 보여줍니다.
SQL> CONNECT dba1@inst1
Password: ********
Connected.
SQL> SELECT PROGRAM FROM V$PROCESS WHERE ADDR = HEXTORAW('3BE2E41C');

PROGRAM
------------------------------------------------
oracle@stbcs09-1 (TNS V1-V3)
참조: "Shared Server Architecture"
데이터베이스 작업
데이터베이스 모니터링 컨텍스트에서 데이터베이스 작업은 일반 사용자 또는 응용 프로그램 코드에 정의된 대로 두 시점 사이의 세션 작업입니다.
단순 데이터베이스 작업은 단일 SQL 문이거나 단일 PL/SQL 프로시저 또는 함수입니다. 조합 데이터베이스 작업은 단일 또는 조합 작업 집합입니다.
작업을 모니터, 비교 및 튜닝하기 위해 많은 작업 집합을 데이터베이스 작업으로 나누고 작업을 단계로 세분화할 수 있습니다. 사용 사례는 일반 작업보다 느리게 실행되는 PL/SQL 일괄 처리 작업입니다. 작업을 데이터베이스 작업으로 구성하면 비용이 많이 드는 작업을 식별하고 튜닝할 수 있습니다.
데이터베이스 작업의 각 실행은 작업 이름 및 실행 ID 속성 쌍으로 고유하게 식별됩니다. 한 세션은 해당 세션 ID 및 일련 번호를 지정하여 다른 세션에서 데이터베이스 작업을 시작하거나 정지할 수 있습니다.
동일한 데이터베이스 작업이 두 번 발생할 경우 동일한 이름을 사용하되 실행 ID는 다를 수 있습니다. 동일한 이름을 가진 데이터베이스 작업의 실행마다 다른 명령문을 포함할 수 있습니다.
DBMS_SQL_MONITOR PL/SQL 패키지를 사용하여 데이터베이스 작업을 생성하고 관리합니다. V$SQL_MONITOR, V$SQL_PLAN_MONITOR 및 V$SQL_MONITOR_SESSTAT를 사용하여 작업을 모니터할 수 있습니다.
참조:
-
Oracle AI Database SQL Tuning Guide를 통해 데이터베이스 작업 모니터링 방법 학습
-
Oracle AI Database Data Warehousing Guide: 장기 실행 로드를 모니터하는 방법 학습
-
DBMS_SQL_MONITOR에 대한 자세한 내용은 Oracle AI Database PL/SQL 패키지 및 유형 참조를 참조하십시오. -
V$SQL_MONITOR에 대한 자세한 내용은 Oracle AI Database Reference를 참조하십시오.
서버 프로세스 개요
Oracle AI Database는 서버 프로세스를 생성하여 인스턴스에 연결된 클라이언트 프로세스의 요청을 처리합니다. 클라이언트 프로세스는 항상 별도의 서버 프로세스를 통해 데이터베이스와 통신합니다.
데이터베이스 응용 프로그램 대신 생성된 서버 프로세스는 다음 작업 중 하나 이상을 수행할 수 있습니다.
-
query plan 생성 및 실행을 포함하여 응용 프로그램을 통해 실행된 SQL 문 구문 분석 및 실행
-
PL/SQL 코드 실행
-
데이터 파일에서 데이터베이스 버퍼 캐시로 데이터 블록 읽기(DBW 백그라운드 프로세스는 수정된 블록을 디스크에 다시 기록하는 작업을 가짐)
-
응용 프로그램이 정보를 처리할 수 있는 방식으로 결과 반환
-
전용 서버 프로세스 전용 서버 연결에서 클라이언트 연결은 하나의 서버 프로세스와만 연결됩니다.
-
공유 서버 프로세스 공유 서버 연결에서 클라이언트 응용 프로그램은 네트워크를 통해 서버 프로세스가 아닌 디스패처 프로세스에 연결합니다. 예를 들어, 20개의 클라이언트 프로세스가 단일 디스패처 프로세스에 연결할 수 있습니다.
-
Oracle AI Database가 서버 프로세스를 생성하는 방법 데이터베이스는 연결 방법에 따라 다양한 방식으로 서버 프로세스를 생성합니다. 참조: "SQL 처리 단계"
전용 서버 프로세스
Dedicated Server 연결에서는 한 개의 서버 프로세스와만 클라이언트 연결이 연결됩니다.
Linux에서는 20개의 서버 프로세스에서 데이터베이스 Instance에 연결된 20개의 클라이언트 프로세스를 제공합니다. 각 클라이언트 프로세스는 해당 서버 프로세스와 직접 통신합니다. 이 서버 프로세스는 세션이 지속되는 동안 해당 클라이언트 프로세스 전용입니다. 서버 프로세스는 프로세스 특정 정보와 UGA를 해당 PGA에 저장합니다.
참조:
Shared Server 프로세스
공유 서버 연결에서 클라이언트 응용 프로그램은 네트워크를 통해 서버 프로세스가 아닌 디스패처 프로세스에 연결합니다. 예를 들어, 20개의 클라이언트 프로세스가 단일 디스패처 프로세스에 연결할 수 있습니다.
디스패처 프로세스는 연결된 클라이언트로부터 요청을 받아 대용량 풀의 요청 대기열에 넣습니다. 사용 가능한 첫번째 공유 서버 프로세스는 큐에서 요청을 가져와서 처리합니다. 그 후에 공유 서버는 결과를 디스패처 응답 대기열에 넣습니다. 디스패처 프로세스가 이 대기열을 모니터하고 결과를 클라이언트로 전송합니다.
Dedicated Server 프로세스와 마찬가지로 Shared Server 프로세스에도 자체 PGA가 있습니다. 그러나 세션의 UGA는 모든 Shared Server가 세션 데이터에 액세스할 수 있도록 MGA에 있습니다.
참조:
-
"대형 풀"
Oracle AI Database가 서버 프로세스를 생성하는 방법
데이터베이스는 연결 방식에 따라 다양한 방식으로 서버 프로세스를 생성합니다.
연결 방식은 다음과 같습니다.
-
Bequeath
SQL*Plus, OCI 클라이언트 또는 다른 클라이언트 응용 프로그램은 서버 프로세스를 직접 생성합니다.
-
Oracle Net 리스너
클라이언트 응용 프로그램은 리스너를 통해 데이터베이스에 연결합니다.
-
전용 브로커
포그라운드 프로세스를 생성하는 데이터베이스 프로세스입니다. 리스너와 달리 broker는 데이터베이스 instance 내에 상주합니다. 전용 중계자를 사용하는 경우 클라이언트는 리스너에 연결한 다음 전용 중계자에 대한 연결을 해제합니다.
연결이 계승을 사용하지 않으면 데이터베이스는 다음과 같이 서버 프로세스를 생성합니다.
-
클라이언트 응용 프로그램이 리스너 또는 broker로부터 새 연결을 요청합니다.
-
리스너 또는 Broker는 새 프로세스 또는 스레드 생성을 시작합니다.
-
운영 체제가 새 프로세스 또는 스레드를 생성합니다.
-
Oracle AI Database는 다양한 구성요소 및 통지를 초기화합니다.
-
데이터베이스는 연결 및 연결 관련 코드를 대신 사용합니다.
선택적으로 전용 중계자 연결 방식을 사용하는 경우 DBMS_PROCESS 패키지를 사용하여 서버 프로세스 풀을 미리 생성할 수 있습니다. 이 경우 PMAN(Process Manager) 백그라운드 프로세스는 클라이언트 요청과 연관될 때까지 대기하는 미리 생성된 프로세스 풀을 모니터합니다. 연결에 서버 프로세스가 필요한 경우 데이터베이스는 프로세스 생성 2-4단계를 건너뛰고 5단계만 수행합니다. 이 최적화는 성능을 향상시킵니다.
참고:
-
DBMS_PROCESSPL/SQL 패키지에 대해 알아보려면 Oracle AI Database PL/SQL 패키지 및 유형 참조를 참조하십시오. -
Oracle AI Database Reference - PMAN 백그라운드 프로세스에 대해 알아보기
백그라운드 프로세스 개요
백그라운드 프로세스는 다중 프로세스 Oracle 데이터베이스에서 사용되는 추가 프로세스입니다. 백그라운드 프로세스는 데이터베이스 작동 및 여러 유저의 성능 극대화에 필요한 유지 관리 작업을 수행합니다.
각 백그라운드 프로세스에는 별도의 작업이 있지만 다른 프로세스와 함께 작동합니다. 예를 들어, LGWR 프로세스는 리두 로그 버퍼의 데이터를 온라인 리두 로그에 기록합니다. 채워진 리두 로그 파일을 아카이브할 준비가 되면 LGWR는 다른 프로세스에 리두 로그 파일을 아카이브하라는 신호를 보냅니다.
Oracle AI Database는 데이터베이스 인스턴스가 시작될 때 백그라운드 프로세스를 자동으로 생성합니다. Instance에는 모든 데이터베이스 구성에 항상 존재하는 것이 아니라 많은 백그라운드 프로세스가 있을 수 있습니다. 다음 질의는 데이터베이스에서 실행 중인 백그라운드 프로세스를 나열합니다.
SELECT PNAME
FROM   V$PROCESS
WHERE  PNAME IS NOT NULL
ORDER BY PNAME;
이 섹션에서는 다음 항목을 다룹니다.
-
필수 백그라운드 프로세스 필수 백그라운드 프로세스는 모든 일반적인 데이터베이스 구성에 있습니다.
-
선택적 백그라운드 프로세스 선택적 백그라운드 프로세스는 필수로 정의되지 않은 모든 백그라운드 프로세스입니다.
-
보조 프로세스 보조 프로세스는 다른 프로세스 대신 작업을 수행하는 백그라운드 프로세스입니다. 참조: 모든 백그라운드 프로세스에 대한 설명은 Oracle AI Database Reference
필수 백그라운드 프로세스
모든 일반적인 데이터베이스 구성에는 필수 백그라운드 프로세스가 있습니다.
이러한 프로세스는 기본적으로 최소한으로 구성된 초기화 파라미터 파일로 시작된 읽기/쓰기 데이터베이스 Instance에서 실행됩니다. 읽기 전용 데이터베이스 Instance는 이러한 프로세스 중 일부를 비활성화합니다.
이 섹션에서는 다음과 같은 필수 백그라운드 프로세스에 대해 설명합니다.
-
PMON(프로세스 모니터 프로세스) 그룹 PMON 그룹에는 PMON, CLMN(정리 주 프로세스) 및 CLnn(정리 도우미 프로세스)이 포함됩니다. 이러한 프로세스는 다른 프로세스를 모니터하고 정리합니다.
-
PMAN(프로세스 관리자) PMAN(프로세스 관리자)은 공유 서버, 풀링된 서버 및 작업 큐 프로세스를 비롯한 여러 백그라운드 프로세스를 감독합니다.
-
LREG(리스너 등록 프로세스) LREG(리스너 등록 프로세스)는 데이터베이스 Instance 및 디스패처 프로세스에 대한 정보를 Oracle Net Listener에 등록합니다.
-
SMON(시스템 모니터 프로세스) SMON(시스템 모니터 프로세스)은 다양한 시스템 레벨의 정리 작업을 담당합니다.
-
DBW(데이터베이스 기록자 프로세스) DBW(데이터베이스 기록자 프로세스)는 데이터베이스 버퍼의 내용을 데이터 파일에 기록합니다. DBW 프로세스는 데이터베이스 버퍼 캐시의 수정된 버퍼를 디스크에 기록합니다.
-
로그 기록자 처리(LGWR) 로그 기록자 처리(LGWR)는 온라인 리두 로그 버퍼를 관리합니다.
-
CKPT(체크포인트 프로세스) CKPT(체크포인트 프로세스)는 제어 파일 및 데이터 파일 헤더를 체크포인트 정보로 갱신하고 DBW에 블록을 디스크에 기록하라는 신호를 보냅니다. 체크포인트 정보에는 Recovery를 시작할 온라인 리두 로그의 체크포인트 위치, SCN 및 위치가 포함됩니다.
-
MMON 및 MMNL(관리 효율성 모니터 프로세스) MMON(관리 효율성 모니터 프로세스)은 AWR(자동 작업 로드 저장소)과 관련된 여러 작업을 수행합니다.
-
RECO(복구자 프로세스) 분산 데이터베이스에서 RECO(복구자 프로세스)는 분산 트랜잭션의 실패를 자동으로 해결합니다.
-
백그라운드 프로세스(BGnn) 백그라운드 프로세스(BGnn)는 다양한 유지 관리 및 모니터링 작업을 수행하는 Oracle RAC 환경의 표준 백그라운드 프로세스입니다.
-
VOSD(가상 운영 체제 데몬 프로세스) VOSD(가상 운영 체제 데몬 프로세스)는 시간 제한이 있는 Oracle 데이터베이스 서비스 작업을 실행합니다.
-
네트워크 모니터 프로세스(NMON) 네트워크 모니터 프로세스(NMON)는 경량 네트워크 모니터링 서비스입니다.
참조:
-
Oracle AI Database 레퍼런스 - MMAN, DIAG, VKTM, DBRM 및 PSP0를 비롯한 기타 필수 프로세스에 대한 설명
-
Oracle RAC 및 Oracle Clusterware와 관련된 백그라운드 프로세스에 대한 자세한 내용은 Oracle Real Application Clusters Administration and Deployment Guide 및 Oracle Clusterware Administration and Deployment Guide를 참조하십시오.
PMON(프로세스 모니터링 프로세스) 그룹
PMON 그룹에는 PMON, CLMN(Cleanup Main Process) 및 CLnn(Cleanup Helper Processes)이 포함됩니다. 이러한 프로세스는 다른 프로세스를 모니터하고 정리합니다.
PMON 그룹은 버퍼 캐시의 정리 및 클라이언트 프로세스에서 사용하는 자원 릴리스를 감독합니다. 예를 들어, PMON 그룹은 활성 트랜잭션 테이블의 상태를 재설정하고, 더 이상 필요하지 않은 잠금을 해제하고, 활성 프로세스 리스트에서 종료된 프로세스의 프로세스 ID를 제거합니다.
데이터베이스는 종료된 프로세스가 보유한 자원을 해제하여 다른 프로세스에서 사용할 수 있도록 해야 합니다. 그렇지 않으면 프로세스가 차단되거나 경합이 중단될 수 있습니다.
-
PMON(프로세스 모니터 프로세스) PMON(프로세스 모니터)은 다른 백그라운드 프로세스의 종료를 감지합니다. 서버 또는 디스패처 프로세스가 비정상적으로 종료되는 경우 PMON 그룹이 프로세스 Recovery를 수행합니다. 프로세스 종료는 운영 체제 kill 명령 또는
ALTER SYSTEM KILL SESSION문을 포함하여 여러 가지 원인으로 발생할 수 있습니다. -
Cleanup Main Process (CLMN) PMON은 정리 작업을 CLMN(정리 주 프로세스)에 위임합니다. 비정상적인 종료를 감지하는 작업은 PMON에 남아 있습니다.
-
Cleanup Helper Processes(CLnn) CLMN은 CLnn 도우미 프로세스에 정리 작업을 위임합니다.
-
데이터베이스 리소스 격리 프로세스 또는 세션이 종료되면 PMON 그룹이 보유한 리소스를 데이터베이스에 릴리스합니다. 경우에 따라 PMON 그룹이 손상된 복구할 수 없는 리소스를 자동으로 격리하여 데이터베이스 Instance가 즉시 종료되지 않도록 할 수 있습니다.
PMON(프로세스 모니터 프로세스)
PMON(프로세스 모니터)은 다른 백그라운드 프로세스의 종료를 감지합니다. 서버 또는 디스패처 프로세스가 비정상적으로 종료되는 경우 PMON 그룹이 프로세스 Recovery를 수행합니다. 프로세스 종료는 운영 체제 kill 명령 또는 ALTER SYSTEM KILL SESSION 문을 포함하여 여러 가지 원인으로 발생할 수 있습니다.
메인 프로세스 정리(CLMN)
PMON은 정리 작업을 CLMN(정리 주 프로세스)에 위임합니다. 비정상적인 종료를 감지하는 작업은 PMON에 남아 있습니다.
CLMN은 주기적으로 종료된 프로세스, 종료된 세션, 트랜잭션, 네트워크 연결, 유휴 세션, 분리된 트랜잭션 및 유휴 시간 초과를 초과한 분리된 네트워크 연결의 정리를 수행합니다.
도우미 프로세스 정리(CLnn)
CLMN은 정리 작업을 CLnn 도우미 프로세스에 위임합니다.
CLnn 프로세스는 종료된 프로세스 및 세션 정리를 지원합니다. 도우미 프로세스의 수는 수행할 정리 작업의 양과 정리의 현재 효율성에 비례합니다.
정리 프로세스를 차단하면 다른 프로세스 정리를 진행할 수 없게 됩니다. 또한 여러 프로세스를 정리해야 하는 경우 정리 시간이 상당히 오래 걸릴 수 있습니다. 이러한 이유로 Oracle AI Database는 여러 도우미 프로세스를 병렬로 사용하여 정리를 수행할 수 있으므로 성능이 느려집니다.
V$CLEANUP_PROCESS 및 V$DEAD_CLEANUP 뷰에는 CLMN 정리에 대한 메타데이터가 포함되어 있습니다. V$CLEANUP_PROCESS 뷰는 모든 정리 프로세스에 대해 하나의 행을 포함합니다. 예를 들어, V$CLEANUP_PROCESS.STATE가 BUSY인 경우 현재 프로세스가 정리에 관여합니다.
참조: V$CLEANUP_PROCESS에 대한 자세한 내용은 Oracle AI Database Reference를 참조하십시오.
데이터베이스 리소스 격리
프로세스 또는 세션이 종료되면 PMON 그룹이 보유한 자원을 데이터베이스에 릴리스합니다. 경우에 따라 PMON 그룹이 손상된 복구할 수 없는 리소스를 자동으로 격리하여 데이터베이스 Instance가 즉시 종료되지 않도록 할 수 있습니다.
PMON 그룹은 격리된 리소스를 보유하고 있는 프로세스 또는 세션에서 가능한 한 많은 정리를 계속 수행합니다. V$QUARANTINE 뷰에는 리소스 유형, 소비된 메모리 양, 격리를 일으키는 Oracle 오류 등과 같은 메타 데이터가 포함됩니다.
참조: V$QUARANTINE에 대한 자세한 내용은 Oracle AI Database Reference를 참조하십시오.
PMAN(Process Manager)
PMAN(프로세스 관리자)은 공유 서버, 풀링된 서버 및 작업 큐 프로세스를 비롯한 여러 백그라운드 프로세스를 감독합니다.
PMAN은 다음 유형의 프로세스를 모니터, 생성 및 정지합니다.
-
디스패처 및 공유 서버 프로세스
-
데이터베이스에 상주하는 연결 풀에 대한 연결 중계자 및 풀링된 서버 프로세스
-
작업 큐 프로세스
-
재시작 가능한 백그라운드 프로세스
LREG(리스너 등록 프로세스)
LREG(리스너 등록 프로세스)는 데이터베이스 Instance 및 디스패처 프로세스에 대한 정보를 Oracle Net Listener에 등록합니다.
Instance가 시작되면 LREG는 리스너를 폴링하여 실행 중인지 확인합니다. 리스너가 실행 중인 경우 LREG는 관련 파라미터를 전달합니다. 실행 중이 아닌 경우 LREG는 정기적으로 연결을 시도합니다.
주: Oracle Database 12c 이전 릴리스에서는 PMON이 리스너 등록을 수행했습니다.
참조: "Oracle Net Listener"
SMON(시스템 모니터 프로세스)
SMON(시스템 모니터 프로세스)은 다양한 시스템 레벨 정리 작업을 담당합니다.
SMON에 할당되는 업무는 다음과 같습니다.
-
필요한 경우 Instance 시작 시 Instance Recovery를 수행합니다. Oracle RAC 데이터베이스에서는 한 데이터베이스 Instance의 SMON 프로세스가 실패한 Instance에 대해 Instance Recovery를 수행할 수 있습니다.
-
파일 읽기 또는 테이블스페이스 오프라인 오류로 인해 인스턴스 복구 중 건너뛴 종료된 트랜잭션을 복구합니다. 테이블스페이스나 파일이 다시 온라인으로 전환되면 SMON이 트랜잭션을 Recovery합니다.
-
영구 테이블스페이스에서 사용되지 않은 임시 세그먼트 정리 예를 들어, Oracle AI Database는 인덱스를 생성할 때 확장 영역을 할당합니다. 작업이 실패하면 SMON은 임시 공간을 정리합니다.
-
딕셔너리관리방식의 테이블스페이스 내에 연속 사용 가능 Extent 병합
SMON은 정기적으로 프로세스가 필요한지 여부를 확인합니다. SMON이 필요할 경우 다른 프로세스에서 SMON을 호출할 수 있습니다.
DBW(데이터베이스 기록자 프로세서)
DBW(데이터베이스 기록자 프로세스)는 데이터베이스 버퍼의 내용을 데이터 파일에 씁니다. DBW 프로세스는 데이터베이스 버퍼 캐시의 수정된 버퍼를 디스크에 기록합니다.
대부분의 시스템에는 하나의 데이터베이스 기록기 프로세스(DBW0)가 충분하지만 시스템에서 여러 데이터를 수정하는 경우 추가 프로세스(DBW1 - DBW9, DBWa - DBWz 및 BW36 - BW99)를 구성하여 쓰기 성능을 향상시킬 수 있습니다. 단일 프로세서 시스템에서는 이러한 추가 DBW 프로세스를 사용할 필요가 없습니다.
DBW 프로세스는 다음과 같은 경우에 더티 버퍼를 디스크에 기록합니다.
-
서버 프로세스가 임계값 수만큼 버퍼를 스캔한 후에 재사용 가능한 클린 버퍼를 찾지 못하면 DBW에 기록하라는 신호를 보냅니다. DBW는 가능한 경우 다른 처리를 수행하는 동안 더티 버퍼를 디스크에 비동기적으로 기록합니다.
-
DBW는 주기적으로 버퍼를 기록하여 Instance Recovery가 시작되는 리두 스레드의 위치인 체크포인트를 전진시킵니다. 체크포인트의 로그 위치는 완충기 캐시의 가장 오래된 더티 버퍼에 의해 결정됩니다.
대부분의 경우 DBW가 기록하는 블록은 디스크 전체에 분산되어 있습니다. 따라서 쓰기는 LGWR에서 수행하는 순차적 쓰기보다 느린 경향이 있습니다. DBW는 효율성을 개선하기 위해 가능한 경우 다중 블록 쓰기를 수행합니다. 다중 블록 쓰기에서 기록되는 블록 수는 운영 체제에 따라 다릅니다.
참조:
-
"데이터베이스 버퍼 캐시 "
-
"체크포인트 개요"
-
DBW 구성, 모니터링 및 튜닝에 대한 조언은 Oracle AI Database Performance Tuning Guide를 참조하십시오.
LGWR(로그 기록자 프로세스)
로그 기록자 프로세스(LGWR)는 온라인 리두 로그 버퍼를 관리합니다.
LGWR는 버퍼의 한 부분을 온라인 리두 로그에 기록합니다. 데이터베이스 버퍼 수정 작업과 더티 버퍼에 대한 산재된 쓰기 작업을 디스크에 분리하고 디스크에 대한 빠른 순차적 리두 쓰기를 수행함으로써 성능이 향상됩니다.
다음과 같은 경우 LGWR는 마지막으로 기록한 이후 버퍼로 복사된 모든 리두 항목을 기록합니다.
-
유저가 트랜잭션을 커밋하는 경우
-
온라인 리두 로그 스위치가 발생합니다.
-
LGWR가 마지막으로 기록한 지 3초가 지났습니다.
-
리두 로그 버퍼는 1/3 찼거나 1MB의 버퍼된 데이터를 포함합니다.
-
DBW는 수정된 버퍼를 디스크에 기록해야 합니다.
DBW가 더티 버퍼를 기록하려면 먼저 데이터베이스가 버퍼의 변경 사항과 연관된 리두 레코드를 디스크에 기록해야 합니다(먼저 쓰기 프로토콜). DBW는 일부 리두 레코드가 기록되지 않았음을 확인한 경우 LGWR에 레코드를 디스크에 기록하라는 신호를 보내 데이터 버퍼를 디스크에 기록하기 전에 LGWR가 완료될 때까지 기다립니다.
-
LGWR 및 커밋 Oracle AI Database는 빠른 커밋 메커니즘을 사용하여 커밋된 트랜잭션의 성능을 개선합니다.
-
LGWR 및 액세스 불가능한 파일 LGWR은 온라인 리두 로그 파일의 활성 미러링된 그룹에 동기적으로 기록합니다. 참조: "거래 약정"
LGWR 및 커밋
Oracle AI Database는 빠른 커밋 메커니즘을 사용하여 커밋된 트랜잭션의 성능을 개선합니다.
사용자가 COMMIT 문을 실행하면 트랜잭션에 시스템 변경 번호(SCN)가 지정됩니다. LGWR는 리두 로그 버퍼에 커밋 레코드를 배치하고 이를 커밋 SCN 및 트랜잭션의 리두 항목과 함께 즉시 디스크에 기록합니다.
리두 로그 완충제는 일종의 순환이다. LGWR이 리두 로그 버퍼의 리두 항목을 온라인 리두 로그 파일에 기록하면 서버 프로세스가 새 항목을 복사하여 디스크에 기록된 리두 로그 버퍼의 항목에 덮어쓸 수 있습니다. LGWR은 일반적으로 새 항목을 위한 버퍼 공간이 항상 존재할 수 있을 정도로 빠르게 쓰기를 수행합니다. 이 때도 온라인 리두 로그에의 액세스가 많습니다.
트랜잭션의 커밋 레코드를 포함하는 리두 항목의 원자 쓰기는 트랜잭션의 커밋되었는지 확인하는 단일 이벤트입니다. Oracle AI Database는 데이터 버퍼를 아직 디스크에 기록하지 않은 경우에도 커밋 트랜잭션에 대한 성공 코드를 반환합니다. 데이터 블록에 대한 해당하는 변경 사항은 DBW가 데이터 파일에 보다 효율적으로 기록될 수 있을 때까지 지연됩니다.
주: LGWR는 트랜잭션이 커밋되기 전에 리두 로그 항목을 디스크에 기록할 수 있습니다. 나중에 트랜잭션이 커밋되는 경우에만 리두 항목으로 보호되는 변경 사항이 영구적으로 적용됩니다.
작업량이 많으면 LGWR는 그룹 커밋을 사용할 수 있습니다. 예를 들어, 유저가 커밋하여 LGWR가 해당 트랜잭션의 리두 항목을 디스크에 기록하도록 합니다. 이 쓰기 중에 다른 사용자가 커밋합니다. LGWR는 이전 쓰기가 완료되기 전까지는 이러한 트랜잭션을 커밋하기 위해 디스크에 기록할 수 없습니다. 완료되면 LGWR는 대기 중인 트랜잭션(아직 커밋되지 않은 트랜잭션)의 리두 항목 리스트를 한 작업에 기록할 수 있습니다. 이러한 방식으로 데이터베이스는 디스크 I/O를 최소화하고 성능을 최대화합니다. 커밋 요청이 높은 속도로 계속되면 LGWR를 통한 모든 쓰기에 여러 커밋 레코드가 포함될 수 있습니다.
LGWR 및 액세스할 수 없는 파일
LGWR는 온라인 리두 로그 파일의 활성 이중화된 그룹에 동기적으로 기록합니다.
로그 파일에 액세스할 수 없는 경우 LGWR는 그룹의 다른 파일에 계속 기록하고 오류를 LGWR 추적 파일 및 경보 로그에 기록합니다. 그룹의 모든 파일이 손상되었거나 그룹을 아카이브하지 않아 사용할 수 없는 경우에는 LGWR가 계속해서 작동할 수 없습니다.
참조:
-
LGWR의 성능을 모니터하고 조정하는 방법에 대한 자세한 내용은 Oracle AI Database Performance Tuning Guide를 참조하십시오.
CKPT(체크포인트 프로세스)
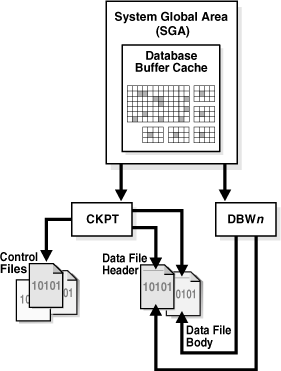
체크포인트 프로세스(CKPT)는 체크포인트 정보로 제어 파일 및 데이터 파일 헤더를 갱신하고 DBW에 블록을 디스크에 기록하라는 신호를 보냅니다. 체크포인트 정보에는 Recovery를 시작할 온라인 리두 로그의 체크포인트 위치, SCN 및 위치가 포함됩니다.
그림 18-4에 표시된 것처럼 CKPT는 데이터 블록을 데이터 파일이나 리두 블록에 온라인 리두 로그 파일에 기록하지 않습니다.
그림 4: 체크포인트 프로세스
참조: "체크포인트 개요"
관리 효율성 모니터 프로세스(MMON 및 MMNL)
MMON(관리 효율성 모니터 프로세스)은 AWR(자동 작업 로드 저장소)과 관련된 여러 작업을 수행합니다.
예를 들어, MMON은 측정 단위가 임계값을 위반하고, 스냅샷을 생성하고, 최근에 수정된 SQL 객체에 대한 통계 값을 캡처할 때 씁니다.
MMNL(관리 효율성 모니터 Lite 프로세스)은 SGA의 ASH(Active Session History) 버퍼에서 디스크에 통계를 기록합니다. ASH 버퍼가 가득 차면 MMNL이 디스크에 기록합니다.
참조: "Oracle AI Database 성능 튜닝 시작하기" 및 "활성 세션 내역 개요"
RECO(복구자 프로세스)
분산 데이터베이스에서 RECO(복구자 프로세스)는 분산 트랜잭션의 실패를 자동으로 해결합니다.
노드의 RECO 프로세스는 in-doubt 분산 트랜잭션과 관련된 다른 데이터베이스에 자동으로 연결됩니다. RECO는 데이터베이스 간의 연결을 재설정할 때 모든 In-Doubt 트랜잭션을 자동으로 해결하여 각 데이터베이스의 보류 트랜잭션 테이블에서 해결된 트랜잭션에 해당하는 모든 행을 제거합니다.
참조: 분산 시스템의 트랜잭션 복구에 대한 자세한 내용은 Oracle AI Database Administrator's Guide를 참조하십시오.
백그라운드 프로세스(BG nn)
백그라운드 프로세스(BGnn)는 다양한 유지 관리 및 모니터링 작업을 수행하는 Oracle RAC 환경의 표준 백그라운드 프로세스입니다.
백그라운드 프로세스는 버퍼 캐시 관리, LGWR(로그 기록자) 프로세스 지원, 체크포인트 조정, 백그라운드 프로세스 모니터 및 통계 수집을 담당합니다.
VOSD(가상 운영 체제 데몬 프로세스)
VOSD(가상 운영 체제 데몬 프로세스)는 시간 제한이 있는 Oracle 데이터베이스 서비스 작업을 실행합니다.
이 프로세스는 Instance 시작 시 생성되며 데이터베이스에 중요한 시스템 서비스 작업을 실행합니다. 이 프로세스는 데이터베이스 Instance, Oracle ASM Instance 및 Oracle RAC에서 사용됩니다.
NMON(네트워크 모니터 프로세스)
NMON(네트워크 모니터 프로세스)은 경량 네트워크 모니터링 서비스입니다.
NMON(네트워크 모니터)은 고급 커널 기능을 활용하여 상시 가동되고 포괄적인 모니터링을 제공하는 오버헤드가 적은 네트워크 모니터링 서비스입니다. 시스템 전체, 인터페이스별, IP별, 플로우별 등 여러 레벨에서 네트워크 통계 및 이벤트를 지속적으로 캡처하여 상위 레벨 서비스에 대한 자세한 측정 단위를 제공합니다. NMON을 기반으로 구축된 Health Score 서비스는 표준화된 0-100 점수로 네트워크 상태 평가를 단순화하고 필요에 따라 진단을 수집하여 문제를 사전에 해결합니다. NMON은 효율적이고 실행 가능한 네트워크 통계를 제공하여 이상 징후를 적시에 감지하고 데이터베이스 작업과의 효과적인 상관 관계를 가능하게 합니다.
선택적 백그라운드 프로세스
선택적 백그라운드 프로세스는 필수로 정의되지 않은 백그라운드 프로세스입니다.
대부분의 선택적인 백그라운드 프로세스는 작업이나 기능에 따라 다릅니다. 예를 들어, Oracle ASM을 지원하는 백그라운드 프로세스는 이 기능이 활성화된 경우에만 사용할 수 있습니다.
이 절에서는 몇 가지 일반적인 선택적 프로세스에 대해 설명합니다.
-
아카이버 프로세스(ARCn) 아카이버 프로세스(ARCn)는 리두 로그 스위치가 발생한 후 온라인 리두 로그 파일을 오프라인 스토리지로 복사합니다.
-
작업 대기열 프로세스(CJQ0 및 Jnnn) 대기열 프로세스는 사용자 작업을 일괄 처리 모드로 실행합니다. 작업은 한 번 이상 실행되도록 일정이 잡힌 사용자 정의 작업입니다.
-
FBDA(Flashback Data Archive Process) FBDA(Flashback Data Archive Process)는 추적된 테이블의 기록 행을 Flashback Data Archive에 아카이브합니다.
-
SMCO(공간 관리 조정자 프로세스) SMCO(공간 관리 조정자 프로세스) 프로세스는 SMON에 의해 시작되고 다양한 공간 관리 관련 작업의 실행을 조정합니다.
참조:
-
Advanced Queuing(AQ)을 소개하는 Oracle AI Database Transactional Event Queues and Advanced Queuing User's Guide
-
AQ 및 Oracle ASM 관련 백그라운드 프로세스에 대한 설명은 Oracle AI Database Reference를 참조하십시오.
아카이버 프로세스(ARC n)
아카이버 프로세스(ARCn)는 리두 로그 스위치가 발생한 후 온라인 리두 로그 파일을 오프라인 스토리지로 복사합니다.
이러한 프로세스는 트랜잭션 리두 데이터를 수집하여 대기 데이터베이스 대상으로 전송할 수도 있습니다. ARCn 프로세스는 ARCHIVELOG 모드이며 자동 아카이브가 활성화되어 있는 경우에만 존재합니다.
참조:
-
아카이버 프로세스 수를 조정하는 방법은 Oracle AI Database Administrator's Guide를 참조하십시오.
-
아카이버 성능 조정 방법에 대한 자세한 내용은 Oracle AI Database Performance Tuning Guide를 참조하십시오.
작업 대기열 프로세스(CJQ0 및 Jnnn)
대기열 프로세스는 사용자 작업을 일괄 처리 모드로 실행하는 경우가 많습니다. 작업은 한 번 이상 실행되도록 일정이 잡힌 사용자 정의 작업입니다.
예를 들어, 작업 큐를 사용하여 백그라운드에서 장기 실행 갱신을 스케줄링할 수 있습니다. 시작 날짜와 시간 간격이 지정된 경우 작업 큐 프로세스는 다음 간격 발생 시 작업을 실행하려고 시도합니다.
Oracle AI Database는 작업 대기열 프로세스를 동적으로 관리하므로 작업 대기열 클라이언트가 필요할 때 더 많은 작업 대기열 프로세스를 사용할 수 있습니다. 데이터베이스는 새 프로세스가 휴지 상태에 있을 때 사용된 리소스를 해제합니다.
동적 작업 큐 프로세스는 지정된 간격으로 여러 작업을 동시에 실행할 수 있습니다. 이벤트 발생 순서는 다음과 같습니다.
-
작업 조정자 프로세스(CJQ0)는 Oracle Scheduler에 의해 필요에 따라 자동으로 시작 및 정지됩니다. 조정자 프로세스에서는 시스템
JOB$테이블에서 실행해야 하는 작업을 주기적으로 선택합니다. 선택한 새 작업은 시간별로 정렬됩니다. -
조정자 프로세스는 작업 큐 하위 프로세스(Jnnn)를 동적으로 생성하여 작업을 실행합니다.
-
작업 큐 프로세스는 실행을 위해 CJQ0 프로세스에서 선택된 작업 중 하나를 실행합니다. 각 작업 큐 프로세스는 완료될 때까지 한 번에 하나의 작업을 실행합니다.
-
프로세스가 단일 작업의 실행을 완료하면 더 많은 작업을 폴링합니다. 실행 일정이 잡힌 작업이 없을 경우 일시 정지 상태로 전환되며, 이 상태에서는 주기적 간격으로 작동하고 추가 작업을 폴링합니다. 프로세스가 새 작업을 찾지 못하면 사전 설정된 간격 후에 종료됩니다.
초기화 매개변수 JOB_QUEUE_PROCESSES는 인스턴스에서 동시에 실행할 수 있는 최대 작업 대기열 프로세스 수를 나타냅니다. 그러나 클라이언트는 모든 작업 큐 프로세스를 작업 실행에 사용할 수 있다고 가정해서는 안됩니다. 주: 초기화 매개변수 JOB_QUEUE_PROCESSES가 0으로 설정된 경우 조정자 프로세스가 시작되지 않습니다.
참조:
-
Oracle Scheduler에 대한 자세한 내용은 Oracle AI Database Administrator's Guide를 참조하십시오.
-
AQ 백그라운드 프로세스에 대한 자세한 내용은 Oracle AI Database Transactional Event Queues and Advanced Queuing User's Guide를 참조하십시오.
FBDA(Flashback Data Archive Process)
FBDA(플래시백 데이터 아카이브 프로세스)는 추적된 테이블의 기록 행을 Flashback Data Archives에 아카이브합니다.
추적된 테이블의 DML을 포함하는 트랜잭션이 커밋되면 이 프로세스는 변경된 행의 이전 이미지를 Flashback Data Archive에 저장합니다. 또한 현재 행에 메타 데이터를 보관합니다.
FBDA는 공간, 구성 및 Retention에 대해 Flashback Data Archive를 자동으로 관리합니다. 또한 추적된 트랜잭션의 아카이브가 발생한 기간을 추적합니다.
공간 관리 조정자 프로세스(SMCO)
SMCO(공간 관리 조정자 프로세스) 프로세스는 SMON에 의해 시작되고 다양한 공간 관리 관련 작업의 실행을 조정합니다.
SMCO 프로세스는 다양한 공간 관리 관련 작업의 실행을 조정합니다.
일반적인 작업에는 사전 공간 할당 및 회수(reclamation)와 임시 테이블스페이스 유지 관리가 포함됩니다. SMCO는 하위 프로세스(Wnnn)를 동적으로 생성하여 작업을 구현합니다.
참조: Flashback Data Archive 및 임시 기록 기능에 대한 자세한 내용은 Oracle AI Database Development Guide를 참조하십시오.
보조 프로세스
보조 프로세스는 다른 프로세스 대신 작업을 수행하는 백그라운드 프로세스입니다.
이 절에서는 Oracle AI Database에서 사용되는 일부 보조 프로세스에 대해 설명합니다.
-
I/O 보조 프로세스 I/O 보조 프로세스(Innn)는 I/O를 지원하지 않는 시스템 및 장치에 대해 비동기 I/O를 시뮬레이션합니다.
-
병렬 실행(PX) 서버 프로세스 병렬 실행에서 여러 프로세스가 동시에 함께 작동하여 단일 SQL 문을 실행합니다. 참조: Oracle AI Database 보조 프로세스에 대한 설명은 Oracle AI Database Reference를 참조하십시오.
I/O 보조 프로세스
I/O 보조 프로세스(Innn)는 I/O를 지원하지 않는 시스템 및 장치에 대해 비동기 I/O를 시뮬레이트합니다.
비동기 I/O에서는 전송에 대한 타이밍 요구 사항이 없으므로 전송이 완료되기 전에 다른 프로세스를 시작할 수 있습니다.
예를 들어, 응용 프로그램이 비동기 I/O를 지원하지 않는 운영 체제의 디스크에 1000개의 블록을 기록한다고 가정합니다. 각 쓰기는 순차적으로 수행되며 쓰기가 성공했다는 확인을 기다립니다. 비동기 디스크를 사용하면 응용 프로그램이 블록을 대량으로 기록하고 모든 블록이 기록된 운영 체제의 응답을 기다리는 동안 다른 작업을 수행할 수 있습니다.
비동기 I/O를 시뮬레이트하기 위해 하나의 프로세스가 여러 보조 프로세스를 감독합니다. 호출자 프로세스는 각 보조 프로세스에 작업을 할당합니다. 이 프로세스는 각 쓰기 작업이 완료될 때까지 기다렸다가 완료되면 호출자에게 다시 보고합니다. 실제 비동기 I/O에서는 운영 체제가 I/O가 완료될 때까지 기다렸다가 다시 프로세스에 보고하는 반면, 시뮬레이트된 비동기 I/O에서는 보조 프로세스가 대기하고 호출자에게 다시 보고합니다.
데이터베이스는 다음을 포함하여 다양한 유형의 I/O 보조 프로세스를 지원합니다.
-
RMAN(Recovery Manager)의 I/O 보조 프로세스
RMAN을 사용하여 데이터를 백업 또는 복원할 때 디스크 및 테이프 장치 모두에 I/O 보조 프로세스를 사용할 수 있습니다.
-
데이터베이스 기록자 보조 프로세스
컴퓨터에 CPU가 하나 있는 경우와 같이 여러 데이터베이스 기록자 프로세스를 사용하는 것이 실용적이지 않은 경우에는 데이터베이스가 여러 보조 프로세스에 I/O를 분산시킬 수 있습니다. DBW는 버퍼 캐시 LRU 목록에서 디스크에 기록되는 블록을 스캔하는 유일한 프로세스입니다. 그러나 I/O 보조 프로세스는 이러한 블록에 대해 I/O를 수행합니다.
참조:
-
백업 및 복원 작업을 위한 I/O 보조 프로세스에 대해 자세히 알아보려면 Oracle AI Database Backup and Recovery User's Guide를 참조하십시오.
-
데이터베이스 기록기 보조 프로세스에 대해 자세히 알아보려면 Oracle AI Database Performance Tuning Guide를 참조하십시오.
PX(병렬 실행) 서버 프로세스
병렬 실행에서 여러 프로세스가 동시에 함께 작동하여 단일 SQL 문을 실행합니다.
Oracle AI Database는 여러 프로세스로 작업을 나누어 보다 신속하게 명세서를 실행할 수 있습니다. 예를 들어 한 프로세스에서 네 개의 사분기를 모두 처리하는 대신 네 개의 프로세스가 연 단위로 네 개의 사분기를 처리합니다.
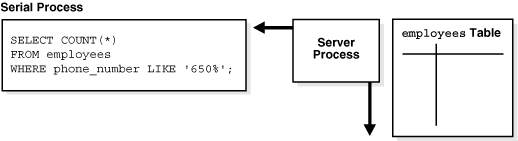
병렬 실행은 단일 서버 프로세스가 SQL 문의 순차적 실행을 위해 필요한 모든 처리를 수행하는 직렬 실행과 대조됩니다. 예를 들어, 전체 테이블 스캔(예: SELECT * FROM employees)을 수행하려면 그림 18-5에 표시된 대로 한 서버 프로세스가 모든 작업을 수행합니다.
그림 5: 직렬 전체 테이블 스캔
병렬 실행은 데이터 웨어하우스와 같은 대용량 데이터베이스에 대한 데이터 집약적 작업의 응답 시간을 줄입니다. SMP(Symmetric Multiprocessing) 및 클러스터화된 시스템은 명령문 처리를 여러 CPU로 분할할 수 있으므로 병렬 실행 시 가장 큰 성능 이점이 있습니다. 병렬 실행은 특정 유형의 OLTP 및 하이브리드 시스템에도 도움이 될 수 있습니다.
Oracle RAC 시스템에서는 특정 서비스의 서비스 배치가 병렬 실행을 제어합니다. 특히 병렬 프로세스는 서비스가 구성된 노드에서 실행됩니다. 기본적으로 Oracle AI Database는 데이터베이스 연결에 사용되는 서비스를 제공하는 인스턴스에서만 병렬 프로세스를 실행합니다. 병렬 복구 또는 GV$ 질의 처리와 같은 다른 병렬 작업에는 영향을 주지 않습니다.
-
질의 조정자 병렬 실행에서 서버 프로세스는 질의 조정자(병렬 실행 조정자라고도 함)로 작동합니다.
-
생산자 및 소비자 병렬 실행 서버는 생산자와 소비자로 나뉩니다. 생산자는 자신의 데이터를 처리 한 다음 필요한 소비자에게 배포 할 책임이 있습니다.
-
그래뉼 병렬 실행에서 테이블은 로드 단위로 동적으로 나뉩니다. 그래뉼이라고 하는 각 단위는 데이터에 액세스할 때 가장 작은 작업 단위입니다.
참조:
-
병렬 실행에 대한 자세한 내용은 Oracle AI Database VLDB and Partitioning Guide를 참조하십시오.
-
Oracle RAC 환경에서의 병렬 실행과 관련된 고려 사항은 Oracle Real Application Clusters Administration and Deployment Guide를 참조하십시오.
질의 조정자
병렬 실행에서 서버 프로세스는 질의 조정자(병렬 실행 조정자라고도 함)로 작동합니다.
query 조정자는 다음 작업을 수행합니다.
-
질의 구문을 분석하는 중
-
병렬 실행 서버 프로세스 할당 및 제어
-
사용자에게 출력 보내기
질의에 대한 질의 계획이 제공될 때 조정자는 SQL 질의의 각 연산자를 병렬 조각으로 분석하고, 질의에 지정된 순서대로 실행하고, 연산자를 실행하는 병렬 실행 서버에서 생성된 부분 결과들을 통합할 수 있습니다.
단일 작업에 할당된 병렬 실행 서버 수는 작업의 병렬도입니다. 동일한 SQL 문 내의 여러 작업은 모두 동일한 병렬도를 가집니다.
생산자 및 소비자
병렬 실행 서버는 생산자와 소비자로 구분됩니다. 생산자는 자신의 데이터를 처리 한 다음 필요한 소비자에게 배포 할 책임이 있습니다.
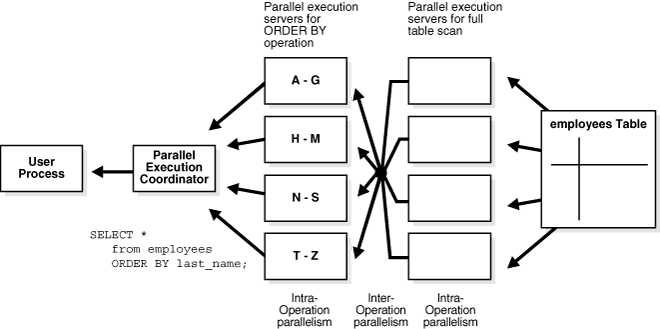
데이터베이스는 다양한 기법을 사용하여 분산을 수행할 수 있습니다. 두 가지 일반적인 기법은 브로드캐스트와 해시입니다. 브로드캐스트에서 각 생산자는 모든 소비자에게 행을 보냅니다. 해시에서 데이터베이스는 일련의 키에 대해 해시 함수를 계산하고 각 소비자가 해시 값의 하위 집합을 담당하도록 합니다. 그림 18-6은 다음 명령문의 병렬 실행에서 생산자와 소비자 간의 상호 작용을 나타냅니다.
SELECT * FROM employees ORDER BY last_name;실행 계획은 employees 테이블의 전체 스캔을 구현합니다. 그런 다음 검색된 행의 정렬이 스캔됩니다. 스캔 작업에 관련된 모든 생산자 프로세스는 정렬을 수행하는 적절한 소비자 프로세스로 행을 전송합니다.
그림 6: 생산자 및 소비자
그래뉼
병렬 실행에서는 테이블이 로드 단위로 동적으로 나뉩니다. 그래뉼이라고 하는 각 단위는 데이터에 액세스할 때 가장 작은 작업 단위입니다.
블록 기반 그래뉼은 Pnnn를 이름 형식으로 사용하는 단일 병렬 실행 서버(PX 서버라고도 함)에서 읽는 테이블의 데이터 블록 범위입니다. 병렬 서버 프로세스 간에 균등한 작업 분산을 얻으려면 그래뉼 수가 항상 요청된 DOP보다 많습니다. 그림 18-7은 employees 테이블의 병렬 스캔을 보여줍니다.
그림 7: 병렬 전체 테이블 스캔
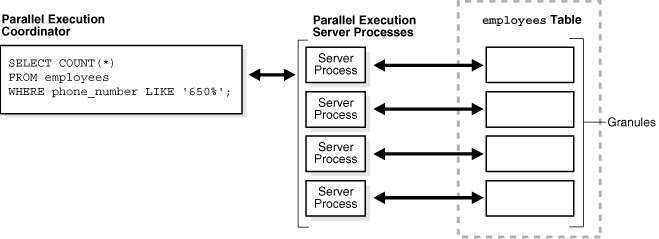
데이터베이스는 실행 시 그래뉼을 병렬 실행 서버에 매핑합니다. 병렬 실행 서버가 그래뉼에 해당하는 행의 읽기를 완료하고 그래뉼이 남아 있는 경우 질의 조정자로부터 다른 그래뉼을 얻습니다. 이 작업은 테이블을 읽을 때까지 계속됩니다. 실행 서버는 결과를 조정자에게 다시 전송하여 원하는 전체 테이블 스캔으로 조각을 어셈블합니다.
참조:
-
Oracle AI Database VLDB and Partitioning Guide - 병렬 실행 사용 방법 학습
-
병렬화를 위한 권장 초기화 매개변수에 대해 알아보려면 Oracle AI Database Data Warehousing Guide를 참조하십시오.