물리적 저장 영역 구조
Oracle 데이터베이스의 물리적 데이터베이스 구조는 운영 체제 레벨에서 볼 수 있습니다.
-
물리적 저장 영역 구조 소개 RDBMS의 한 가지 특징은 테이블, 뷰 및 인덱스와 같은 논리적 데이터 구조와 파일과 같은 물리적 저장 영역 구조의 독립성입니다.
-
데이터 파일 개요 운영 체제 레벨에서 Oracle AI Database는 데이터 파일이라는 구조에 데이터를 저장합니다. 모든 Oracle 데이터베이스(CDB 또는 PDB)에는 데이터 파일이 하나 이상 있어야 합니다.
-
제어 파일 개요 데이터베이스 제어 파일은 하나의 CDB와만 연관된 작은 이진 파일입니다.
-
온라인 리두 로그 개요 복구의 가장 중요한 구조는 온라인 리두 로그입니다. 이 로그는 데이터베이스 변경 사항이 발생할 때 이를 저장하는 미리 할당된 두 개 이상의 파일로 구성됩니다. 온라인 리두 로그는 데이터 파일의 변경 사항을 기록합니다.
물리적 저장 영역 구조 소개
RDBMS의 한 가지 특징은 테이블, 뷰, 인덱스와 같은 논리적 데이터 구조와 파일 같은 물리적 저장 영역 구조의 독립성입니다.
물리적 구조와 논리적 구조는 별개의 구조이므로 논리적 구조에 대한 액세스에 영향을 주지 않고 데이터의 물리적 저장 영역을 관리할 수 있습니다. 예를 들어, 데이터베이스 파일의 이름을 바꾸어도 여기에 저장된 테이블의 이름은 바뀌지 않습니다.
Oracle 데이터베이스는 Oracle 데이터를 영구 저장 영역에 저장하는 파일 집합입니다. Oracle Database 21c부터는 다중 테넌트 컨테이너 데이터베이스(CDB)가 유일하게 지원되는 아키텍처입니다. CDB는 하나 이상의 PDB를 포함합니다.
이 절에서는 CREATE DATABASE 문을 실행하여 CDB를 생성할 때 생성되는 데이터베이스 파일에 대해 설명합니다.
-
데이터 파일 및 임시 파일
데이터 파일은 Oracle AI Database에 의해 생성되고 테이블 및 인덱스와 같은 데이터 구조를 포함하는 영구 저장소의 물리적 파일입니다. 임시 파일은 임시 테이블스페이스에 속하는 데이터 파일입니다. 데이터베이스는 다른 프로그램에서 읽을 수 없는 Oracle 고유 형식으로 이러한 파일에 데이터를 기록합니다.
PDB 내에 PDB를 생성하는 경우 PDB에는 CDB를 구성하는 전체 데이터 파일 집합 내에 고유한 데이터 파일 집합이 있습니다. 예를 들어, 이름이
mycdb인 CDB를 생성한 다음hrpdb및salespdb인 두 개의 PDB를 생성할 수 있습니다. 이 경우mycdb에는hrpdb및salespdb와 같이 자체 데이터 파일 및 임시 파일 세트가 있습니다. -
제어 파일
제어 파일은 CDB의 물리적 구성 요소를 추적하는 루트 파일입니다. PDB에는 고유한 별도 콘트롤 파일이 없습니다.
-
온라인 리두 로그파일
온라인 리두 로그는 CDB 내의 데이터에 대한 변경 사항 레코드를 포함하는 파일 세트입니다. PDB에는 고유한 개별 온라인 리두 로그 파일이 없습니다.
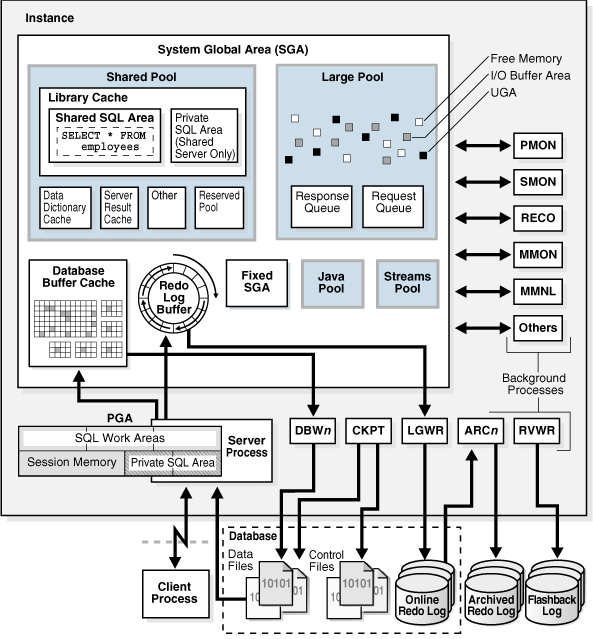
데이터베이스 인스턴스는 CDB의 데이터베이스 파일을 관리하는 메모리 구조 세트입니다. 다음 그림은 인스턴스와 인스턴스에서 관리하는 파일 간의 관계를 보여줍니다.
그림 1: 데이터베이스 인스턴스 및 데이터베이스 파일
-
데이터베이스 파일 저장 방식 이러한 파일의 저장소를 할당하고 관리하는 데 여러 가지 방식을 사용할 수 있습니다.
-
Oracle Managed Files 및 User-Managed Files Oracle Managed Files는 파일 이름이 아닌 데이터베이스 객체 관점에서 작업을 지정할 수 있는 파일 이름 지정 전략입니다. 예를 들어, 데이터 파일의 이름을 지정하지 않고 테이블스페이스를 생성할 수 있습니다.
-
Oracle ASM(Oracle Automatic Storage Management) Oracle ASM은 Oracle AI Database 파일을 위한 관리하기 쉬운 고성능 저장 영역 솔루션입니다. Oracle ASM은 볼륨 관리자이며 데이터베이스에서 독점적으로 사용하도록 설계된 파일 시스템을 제공합니다.
-
Oracle PMEM 파일 저장소(Persistent Memory Filestore) PMEM은 바이트 주소 지정이 가능한 영구 메모리입니다. Oracle PMEM 파일 저장소(Persistent Memory Filestore)는 데이터 파일, 온라인 리두 로그 파일 및 제어 파일을 저장할 수 있습니다.
참조:
-
Oracle AI Database Administrator's Guide에서 데이터베이스 생성 방법 학습
-
CREATE DATABASE의미 및 구문에 대한 Oracle AI Database SQL Language Reference
데이터베이스 파일 저장 방식
이러한 파일의 저장 영역을 할당하고 관리하는 데 여러 가지 방식을 사용할 수 있습니다.
메커니즘에는 다음이 포함됩니다.
-
운영 체제 파일 시스템
대부분의 Oracle 데이터베이스는 데이터를 저장하고 검색하기 위한 구조인 파일 시스템에 파일을 저장합니다.
파일 시스템을 사용하면 응용 프로그램 데이터에 대해 표준적이고 일관된 방식으로 스토리지 공간을 사용할 수 있습니다. 각 파일에는 이름이 있으며 Oracle AI Database와 같은 애플리케이션에 대한 연속 주소 공간으로 나타납니다. 데이터베이스는 파일을 생성, 읽기, 쓰기, 크기 조정 및 삭제할 수 있습니다.
파일 시스템은 일반적으로 논리적 볼륨 관리자(LVM)라는 소프트웨어 패키지로 구성된 논리적 볼륨 위에 구축됩니다. LVM을 사용하면 여러 물리적 디스크 조각을 하나의 연속적인 주소 공간으로 나타나는 디스크로 결합할 수 있습니다.
-
클러스터 파일 시스템입니다.
클러스터 파일 시스템은 클라이언트에 일관성과 고성능을 제공하기 위해 협력하는 서버 클러스터인 분산 파일 시스템입니다. Oracle RAC 환경에서 클러스터 파일 시스템은 공유 저장 영역을 클러스터화된 환경의 여러 컴퓨터에서 공유하는 파일 시스템으로 표시합니다. 클러스터 파일 시스템을 사용할 경우 클러스터에서 컴퓨터가 실패해도 파일 시스템을 사용할 수 없습니다. 그러나 운영 체제 파일 시스템에서는 NFS 또는 다른 방법을 통해 파일을 공유하는 컴퓨터가 실패할 경우 파일 시스템을 사용할 수 없습니다.
-
Oracle PMEM 파일 저장소(Persistent Memory Filestore)
PMEM 파일 저장소는 바이트 주소 지정이 가능한 영구 메모리인 PMEM(영구 메모리)에 데이터베이스 파일을 저장하도록 설계되었습니다.
CREATE PMEM FILESTORE명령을 사용하여 파일 저장소를 만듭니다. Linux 운영 체제 레벨에서 파일 저장소는fsdax모드로 마운트된 큰 ext4 파일 시스템에 데이터를 저장합니다. PMEM Filestore는 Linux에서 Oracle AI Database를 고유 파일 시스템으로 표시합니다.주: POSIX 호환 파일 시스템과 달리 PMEM 파일 저장소는 여러 Oracle 데이터베이스에서 공유할 수 없습니다.
-
Oracle ASM(Oracle Automatic Storage Management)
Oracle ASM에는 Oracle AI Database에서만 사용하도록 설계된 파일 시스템이 포함되어 있습니다.
데이터베이스는 앞서 설명한 저장 영역 방식을 조합하여 사용할 수 있습니다. 예를 들어, 데이터베이스는 서버 파라미터 파일을 기존 파일 시스템에 저장하고 데이터베이스 파일을 PMEM 파일 저장소에 저장한 다음 리두 로그 파일을 클러스터 파일 시스템에 아카이브할 수 있습니다.
참조:
-
Oracle AI Database Administrator's Guide - 데이터베이스 뷰를 질의하여 데이터베이스 저장 영역 구조를 봅니다.
Oracle 관리 파일 및 사용자 관리 파일
Oracle Managed Files는 파일 이름이 아닌 데이터베이스 객체 관점에서 작업을 지정할 수 있는 파일 이름 지정 전략입니다. 예를 들어, 데이터 파일의 이름을 지정하지 않고 테이블스페이스를 생성할 수 있습니다.
관리자가 데이터베이스의 운영 체제 파일을 직접 관리할 필요가 없는 Oracle Managed Files. Oracle ASM에는 Oracle Managed Files가 필요합니다.
주: 이 기능은 추적 파일, 감사 파일 및 경보 로그와 같은 관리 파일의 생성 또는 이름 지정에는 영향을 주지 않습니다.
사용자 관리 파일을 사용하면 데이터베이스의 운영 체제 파일을 직접 관리할 수 있습니다. 파일 구조 및 이름 지정과 관련된 결정을 내려야 합니다. 예를 들어, 테이블스페이스를 생성할 때 테이블스페이스 데이터 파일의 이름과 경로를 설정합니다.
초기화 매개변수를 통해 특정 유형의 파일에 대해 파일 시스템 디렉토리를 지정합니다. OMF(Oracle Managed Files) 기능을 사용하면 데이터베이스에서 고유한 파일을 생성하여 더 이상 필요하지 않은 경우 삭제합니다. 데이터베이스는 내부적으로 표준 파일 시스템 인터페이스를 사용하여 빠른 복구 영역에 저장된 데이터 파일 및 임시 파일, 제어 파일 및 복구 관련 파일에 대한 파일을 만들고 삭제합니다.
OMF(Oracle Managed Files)는 기존 기능을 제거하지 않습니다. 이전 파일을 수동으로 관리하는 동안 새 파일을 만들 수 있습니다. 따라서 데이터베이스에는 Oracle Managed Files와 사용자 관리 파일이 섞여 있을 수 있습니다.
참조:
-
"진단 파일 개요"
-
Oracle AI Database Administrator's Guide에서 Oracle Managed Files 사용 방법 학습
Oracle ASM(Oracle Automatic Storage Management)
Oracle ASM은 Oracle AI Database 파일을 위한 관리가 용이한 고성능 스토리지 솔루션입니다. Oracle ASM은 볼륨 관리자이며 데이터베이스에서 독점적으로 사용하도록 설계된 파일 시스템을 제공합니다.
Oracle ASM은 다음을 포함하여 기존 파일 시스템 및 저장 영역 관리자에 비해 여러 가지 이점을 제공합니다.
-
데이터베이스 생성 및 배치, 디스크 공간 관리와 같은 저장 영역 관련 작업 간소화
-
물리적 디스크에 데이터를 분산하여 핫 스팟을 없애고 디스크 전체에 균일한 성능 제공
-
저장 영역 구성 변경 후 자동으로 데이터 밸런싱 조정
Oracle ASM을 사용하려면 스트라이핑 및 미러링 환경 설정과 함께 Oracle AI Database에 대해 분할된 디스크를 할당합니다. Oracle ASM은 사용 가능한 모든 리소스에 I/I 로드를 분산하여 성능을 최적화하면서 수동 I/O 튜닝의 필요성도 제거합니다. 예를 들어, 데이터베이스를 종료하지 않고도 데이터베이스의 디스크 크기를 늘리거나 데이터베이스의 일부를 새 장치로 이동할 수 있습니다.
-
Oracle ASM 저장 영역 구성 요소 Oracle AI Database는 데이터 파일을 Oracle ASM 디스크 그룹에 Oracle ASM 파일로 저장할 수 있습니다. 디스크 그룹 내에서 Oracle ASM은 데이터베이스 파일에 대한 파일 시스템 인터페이스를 노출합니다.
-
Oracle ASM 인스턴스 Oracle ASM 인스턴스는 Oracle ASM 디스크를 관리하는 특수 Oracle 인스턴스입니다.
Oracle ASM 저장 영역 구성 요소
Oracle AI Database는 데이터 파일을 Oracle ASM 디스크 그룹에 Oracle ASM 파일로 저장할 수 있습니다. 디스크 그룹 내에서 Oracle ASM은 데이터베이스 파일에 대한 파일 시스템 인터페이스를 노출합니다.
다음 그림은 Oracle ASM을 사용하는 데이터베이스의 저장 영역 구성 요소 간 관계를 보여줍니다. 이 다이어그램은 Oracle ASM이 다른 유형의 파일을 저장할 수 있지만 Oracle ASM 파일과 데이터 파일 간의 관계를 나타냅니다. 새 발 모양 표기는 일 대 다 관계를 나타냅니다.
그림 2: Oracle ASM 구성 요소
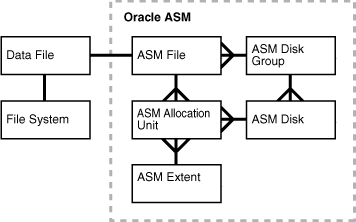
그림 14-2에서는 다음과 같은 Oracle ASM 개념을 보여줍니다.
-
Oracle ASM 디스크
Oracle ASM 디스크는 Oracle ASM 디스크 그룹에 프로비전된 저장 장치입니다. Oracle ASM 디스크는 물리적 디스크 또는 분할 영역, 저장 영역 배열의 LUN(논리 장치 번호), 논리적 볼륨 또는 네트워크 연결 파일일 수 있습니다.
Oracle ASM 디스크는 데이터베이스가 실행 중인 동안 디스크 그룹에서 추가하거나 삭제할 수 있습니다. 디스크 그룹에 디스크를 추가하면 디스크 이름을 지정하거나 디스크에 자동으로 Oracle ASM 디스크 이름이 지정됩니다.
-
Oracle ASM 디스크 그룹
Oracle ASM 디스크 그룹은 논리적 단위로 관리되는 Oracle ASM 디스크의 모음입니다. 디스크 그룹의 데이터 구조는 자체 포함되며 디스크 그룹의 일부 디스크 공간을 소비합니다.
디스크 그룹 내에서 Oracle ASM은 Oracle 데이터베이스 파일에 대한 파일 시스템 인터페이스를 노출합니다. 디스크 그룹에 저장된 파일의 내용은 핫 스팟을 없애고 디스크 전체에 일관된 성능을 제공하기 위해 고르게 분산되거나 스트라이프됩니다.
-
Oracle ASM 파일
Oracle ASM 파일은 Oracle ASM 디스크 그룹에 저장된 파일입니다. Oracle AI Database는 파일 측면에서 Oracle ASM과 통신합니다. 데이터베이스는 데이터 파일, 콘트롤 파일, 온라인 리두 로그 파일 및 기타 유형의 파일을 Oracle ASM 파일로 저장할 수 있습니다. 데이터베이스에서 요청하면 Oracle ASM은 Oracle ASM 파일을 생성하고
+DISK1에서와 같이 더하기 기호(+) 뒤에 디스크 그룹 이름이 오는 이름을 지정합니다.주: Oracle ASM 파일은 타사 파일 시스템과 같은 다른 저장 영역 관리 옵션과 공존할 수 있습니다. 이 기능을 사용하면 Oracle ASM을 기존 환경에 간편하게 통합할 수 있습니다.
-
Oracle ASM Extent
Oracle ASM 확장 영역은 Oracle ASM 파일의 섹션입니다. Oracle ASM 파일은 하나 이상의 파일 확장 영역으로 구성됩니다. 각 Oracle ASM Extent는 특정 디스크에서 하나 이상의 할당 단위로 구성됩니다.
-
Oracle ASM 할당 단위
Oracle ASM 할당 단위는 디스크 그룹 내의 기본 할당 단위입니다. 할당 단위는 Oracle ASM에서 할당하는 가장 작은 연속된 디스크 공간입니다. 하나 이상의 할당 단위는 Oracle ASM Extent를 구성합니다.
참조: Oracle ASM에 대한 자세한 내용은 Oracle Automatic Storage Management Administrator's Guide를 참조하십시오.
Oracle ASM 인스턴스
Oracle ASM 인스턴스는 Oracle ASM 디스크를 관리하는 특수 Oracle 인스턴스입니다.
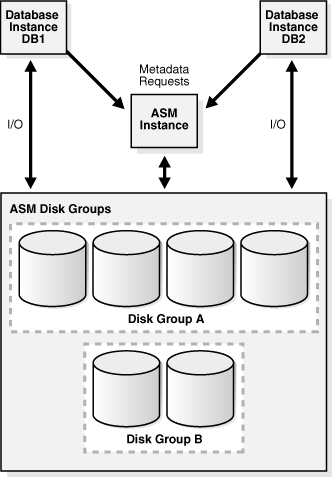
Oracle ASM 및 데이터베이스 Instance 모두 Oracle ASM 디스크 그룹의 디스크에 대한 공유 액세스가 필요합니다. Oracle ASM Instance는 디스크 그룹의 메타 데이터를 관리하고 데이터베이스 Instance에 파일 레이아웃 정보를 제공합니다. 데이터베이스 Instance는 Oracle ASM Instance를 거치지 않고 Oracle ASM 디스크로 I/O를 직접 전달합니다.
Oracle ASM 인스턴스는 데이터베이스 인스턴스와 동일한 기술을 바탕으로 구축됩니다. 예를 들어, Oracle ASM 인스턴스에는 데이터베이스 인스턴스의 SGA(System Global Area)와 유사한 백그라운드 프로세스가 있습니다. 그러나 Oracle ASM Instance는 데이터베이스를 마운트할 수 없으며 데이터베이스 Instance보다 적은 작업을 수행합니다. 그림 14-3에서는 각각 서로 다른 단일 인스턴스 데이터베이스와 연관된 하나의 Oracle ASM 인스턴스와 두 개의 데이터베이스 인스턴스가 있는 단일 노드 구성을 보여줍니다. Oracle ASM 인스턴스는 메타 데이터를 관리하고 두 데이터베이스에 대한 데이터를 저장하는 Oracle ASM 파일에 대한 공간 할당을 제공합니다. 한 Oracle ASM 디스크 그룹에는 네 개의 Oracle ASM 디스크가 있고 다른 디스크에는 두 개의 디스크가 있습니다. 두 데이터베이스 Instance 모두 디스크 그룹에 액세스할 수 있습니다.
그림 3: Oracle ASM 인스턴스 및 데이터베이스 인스턴스
참조: Oracle ASM에 대한 자세한 내용은 Oracle Automatic Storage Management Administrator's Guide를 참조하십시오.
Oracle PMEM 파일 저장소(Persistent Memory Filestore)
PMEM은 바이트 주소 지정이 가능한 영구 메모리입니다. Oracle PMEM 파일 저장소(Persistent Memory Filestore)는 데이터 파일, 온라인 리두 로그 파일 및 제어 파일을 저장할 수 있습니다.
쿼리는 먼저 블록을 데이터베이스 버퍼 캐시로 마이그레이션하지 않고 PMEM에서 직접 바이트를 읽을 수 있습니다. 이 고성능 메커니즘은 데이터 중복성 및 불필요한 I/O를 방지합니다. 주: PMEM 파일 저장소는 추적 파일, 감사 파일 또는 서버 매개변수 파일을 저장할 수 없습니다. PMEM에 대해 지원되는 파일 유형은 Oracle ASM의 유형과 유사합니다.
-
직접 매핑된 버퍼 캐시 기존 저장 영역 피라미드에서 PMEM은 비영구 DRAM과 영구적(비휘발성)인 Flash 사이에 있습니다.
-
PMEM 파일 저장소용 파일 시스템 인터페이스 PMEM 파일 저장소는 사용자 공간(FUSE)에서 파일 시스템이라는 프로토콜을 구현합니다.
-
PMEM 파일 저장소용 사용자 인터페이스 PMEM 파일 저장소를 만들려면
CREATE PMEM FILESTORE명령을 사용합니다.
직접 매핑된 버퍼 캐시
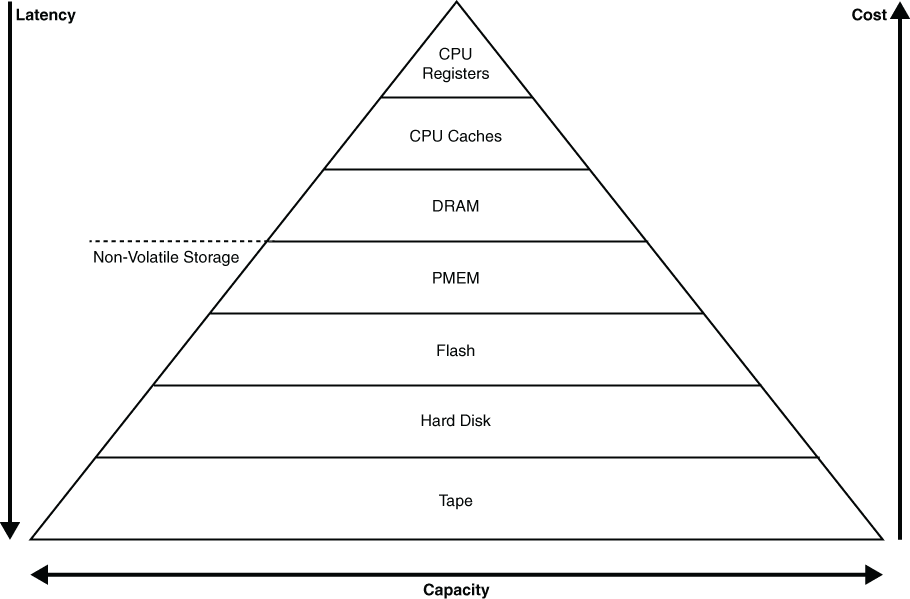
기존 스토리지 피라미드에서 PMEM은 비영구 DRAM과 영구적(비휘발성)인 Flash 사이에 있습니다.
그림 4: 스토리지 피라미드
데이터베이스 버퍼 캐시는 DRAM에 상주합니다. Oracle 프로세스는 데이터베이스 버퍼 캐시에 매핑된 PMEM 파일 저장소의 블록에 대해 바이트를 통해 직접 수신 가능한 액세스 권한을 가집니다. 데이터 파일을 PMEM 파일 저장소에 배치하면 매핑 방식이 자동으로 호출됩니다.
Oracle AI Database는 내부 알고리즘을 사용하여 데이터 블록을 PMEM 파일 저장소에서 DRAM으로 마이그레이션할지 여부를 결정합니다. 마이그레이션의 일반적인 이유로는 DML 수정, 읽기 일관성 및 핫 데이터 블록에 대한 빠른 액세스 등이 있습니다.
참조: "DRAM 및 PMEM 버퍼"
PMEM 파일 저장소용 파일 시스템 인터페이스
PMEM 파일 저장소는 사용자 공간(FUSE)에서 파일 시스템이라는 프로토콜을 구현합니다.
FUSE는 Oracle AI Database 소프트웨어 소유자와 같은 권한이 부여되지 않은 운영 체제 사용자가 파일 시스템 및 파일 시스템 내의 디렉토리와 파일을 만들고 관리할 수 있도록 합니다. 예를 들어, cp, rm 및 ls 명령을 사용할 수 있습니다.
일반적인 파일 시스템은 원시 스토리지를 보조 저장소로 사용하는 반면 PMEM Filestore는 PMEM DAX 파일 시스템의 고유 운영 체제 파일에서 스토리지를 가져옵니다. 이 파일을 백킹 파일이라고 하며 운영 체제에서 파일로 표시됩니다. PMEM 파일 저장소는 보조 파일 내에서 저장소를 세분화하여 로컬 파일 시스템으로 표시합니다.
참조:
- PMEM Filestore에 대한 자세한 내용은 Oracle AI Database Administrator's Guide를 참조하십시오.
PMEM 파일 저장소용 사용자 인터페이스
PMEM 파일 저장소를 만들려면 CREATE PMEM FILESTORE 명령을 사용합니다.
PMEM 파일 저장소는 생성된 후 자동으로 마운트됩니다. PMEM 파일 저장소는 고유 파일 시스템인 것처럼 지정된 마운트 지점 아래에 나타납니다.
PMEM_FILESTORE 초기화 매개변수는 데이터베이스 인스턴스가 시작될 때 자동으로 마운트되는 PMEM 파일 저장소를 지정합니다. 매개변수는 정렬된 문자열 쌍으로 설정됩니다. 매개변수 값 목록의 첫번째 문자열은 PMEM 파일 저장소가 마운트되는 디렉토리입니다. 두번째 문자열은 보조 파일입니다.
V$PMEM_FILESTORE는 PMEM 파일 저장소에 대한 메타데이터를 보여줍니다. 예를 들어, 마운트 지점의 디렉토리 경로, 지원 파일의 파일 경로 및 파일 저장소 크기를 볼 수 있습니다.
참조: Oracle AI Database Administrator's Guide에서 PMEM 파일 저장소 생성 및 관리 방법 학습
데이터 파일 개요
운영 체제 레벨에서 Oracle AI Database는 데이터 파일이라는 구조에 데이터를 저장합니다. 모든 Oracle 데이터베이스(CDB 또는 PDB)에는 데이터 파일이 하나 이상 있어야 합니다.
-
데이터 파일 사용 Oracle AI Database는 테이블스페이스 데이터를 데이터 파일에 물리적으로 저장합니다.
-
영구 및 임시 데이터 파일 영구 테이블스페이스에는 영구 스키마 객체가 포함됩니다. 영구 테이블스페이스의 객체는 데이터 파일에 저장됩니다.
-
온라인 및 오프라인 데이터 파일 모든 데이터 파일은 온라인(사용 가능) 또는 오프라인(사용 불가능)입니다.
-
데이터 파일 구조 Oracle AI Database는 지정된 디스크 공간과 데이터 파일 헤더에 대한 오버헤드를 할당하여 테이블스페이스에 대한 데이터 파일을 생성합니다. Oracle AI Database가 실행되는 운영체제는 데이터베이스에 할당하기 전에 파일에서 이전 정보 및 권한 부여를 지워야 합니다.
데이터 파일 사용
Oracle AI Database는 테이블스페이스 데이터를 데이터 파일에 물리적으로 저장합니다.
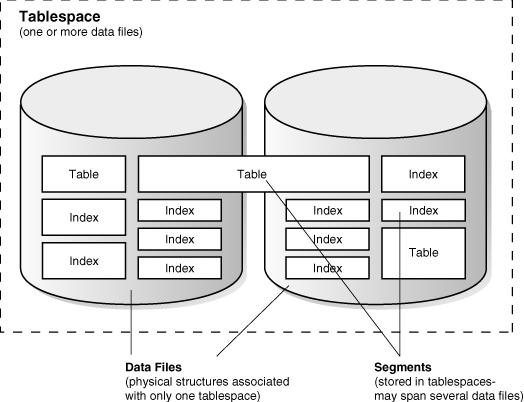
분할되지 않은 각 스키마 객체 및 객체의 각 분할 영역은 하나의 테이블스페이스에만 속하는 고유한 세그먼트에 저장됩니다. 예를 들어, 분할되지 않은 테이블에 대한 데이터는 단일 세그먼트에 저장되며 단일 세그먼트는 하나의 테이블스페이스에 저장됩니다. 테이블스페이스 및 데이터 파일은 밀접하게 연관되어 있지만 중요한 차이점을 가지고 있습니다.
-
각 테이블스페이스는 Oracle AI Database가 실행 중인 운영 체제를 준수하는 하나 이상의 데이터 파일로 구성됩니다.
-
데이터베이스의 데이터는 데이터베이스의 각 테이블스페이스에 있는 데이터 파일에 집합적으로 저장됩니다.
-
세그먼트는 하나 이상의 데이터 파일에 걸쳐 있을 수 있지만 여러 테이블스페이스에 걸쳐 있을 수는 없습니다.
-
CDB에는
SYSTEM및SYSAUX테이블스페이스가 있어야 합니다. CDB 내의 각 PDB에는 고유한SYSTEM및SYSAUX테이블스페이스가 있습니다. Oracle AI Database는 데이터베이스 생성 중SYSTEM테이블스페이스에 대한 데이터베이스의 첫번째 데이터 파일을 자동으로 할당합니다.SYSTEM테이블스페이스에는 데이터베이스 메타데이터를 포함하는 테이블 집합인 데이터 딕셔너리가 포함됩니다. 일반적으로 데이터베이스에는 실행 취소 테이블스페이스 및 임시 테이블스페이스(일반적으로TEMP)도 있습니다.
다음 그림은 테이블스페이스, 데이터 파일 및 세그먼트 간의 관계를 보여줍니다.
그림 5: 데이터 파일 및 테이블스페이스
참조:
-
Oracle AI Database Administrator's Guide에서 데이터 파일 관리 방법 학습
영구 및 임시 데이터 파일
영구 테이블스페이스에는 영구 스키마 객체가 포함됩니다. 영구 테이블스페이스의 객체는 데이터 파일에 저장됩니다.
임시 테이블스페이스에는 세션 기간 동안에만 스키마 객체가 포함됩니다. 로컬관리방식의 임시 테이블스페이스에는 임시 파일(임시 파일)이 있으며 임시 파일은 데이터를 해시, 정렬 및 기타 작업에 저장하도록 설계된 특수 파일입니다. 또한 임시 파일은 메모리에 공간이 부족할 때 결과 집합 데이터를 저장합니다.
임시 파일은 다음과 같은 예외를 제외하고 영구 데이터 파일과 유사합니다.
-
테이블과 같은 영구 데이터베이스 객체는 임시 파일에 저장되지 않습니다.
-
임시 파일은 항상
NOLOGGING모드로 설정됩니다. 즉, 임시 파일에 대해 리두가 생성되지 않습니다. Media Recovery에서는 임시 파일을 인식하지 못합니다. -
임시 파일은 읽기 전용으로 만들 수 없습니다.
-
ALTERDATABASE문을 사용하여 임시 파일을 생성할 수 없습니다. -
임시 파일을 생성하거나 크기를 조정할 때 항상 지정된 파일 크기에 대한 디스크 공간 할당이 보장되는 것은 아닙니다. Linux 및 UNIX와 같은 파일 시스템에서는 임시 파일이 희소 파일로 만들어집니다. 이 경우 디스크 블록은 파일을 생성하거나 크기를 조정할 때가 아니라 블록이 처음으로 액세스될 때 할당됩니다.
주: 희소 파일은 빠른 임시 파일 생성 및 크기 조정을 가능하게 하지만 나중에 임시 파일에 액세스할 때 디스크 공간이 부족해질 수 있습니다.
-
임시 파일 정보는 데이터 딕셔너리 뷰
DBA_TEMP_FILES및 동적 성능 뷰V$TEMPFILE에 표시되지만DBA_DATA_FILES또는V$DATAFILE뷰에는 표시되지 않습니다.
참조:
-
Oracle AI Database Administrator's Guide - 임시 파일 관리 방법 학습
온라인 및 오프라인 데이터 파일
모든 데이터 파일은 온라인(사용 가능) 또는 오프라인(사용할 수 없음) 상태입니다.
개별 데이터 파일 또는 임시 파일의 가용성을 오프라인으로 전환하거나 온라인으로 전환하여 변경할 수 있습니다. 데이터베이스는 온라인 상태가 될 때까지 오프라인 데이터 파일에 액세스할 수 없습니다.
오프라인 백업이나 블록 훼손을 수행하는 등 여러 가지 이유로 데이터 파일을 오프라인으로 설정할 수 있습니다. 데이터베이스는 데이터 파일에 쓸 수 없는 경우 해당 파일을 자동으로 오프라인으로 설정합니다.
데이터 파일과 마찬가지로 테이블스페이스 자체도 오프라인이거나 온라인입니다. 온라인 테이블스페이스에서 데이터 파일을 오프라인으로 설정할 경우 테이블스페이스 자체는 온라인 상태로 유지됩니다. 테이블스페이스 자체를 오프라인으로 설정하여 테이블스페이스의 모든 데이터 파일을 임시로 사용할 수 없게 할 수 있습니다.
Oracle Database 12c부터는 데이터베이스가 열려 있고 파일에 액세스하는 동안 ALTER DATABASE MOVE DATAFILE 문을 사용하여 한 물리적 파일에서 다른 물리적 파일로 온라인 데이터 파일을 이동할 수 있습니다. 이 기법을 사용하여 다음 목표를 달성할 수 있습니다.
-
한 종류의 저장 영역에서 다른 저장 영역으로 테이블스페이스 이동
-
자주 액세스하지 않는 데이터 파일을 저렴한 스토리지로 이동
-
테이블스페이스를 읽기 전용으로 설정하고 해당 데이터 파일을 WORM(Write Once Read Many) 드라이브와 같은 한 번 쓰기 저장 영역으로 이동합니다.
-
Oracle ASM으로 데이터베이스 이동
참조:
-
데이터 파일 가용성을 변경하는 방법은 Oracle AI Database Administrator's Guide를 참조하십시오.
-
Oracle AI Database Administrator's Guide에서 온라인 데이터 파일 이동 방법 학습
-
ALTER DATABASE . . . MOVE DATAFILE에 대한 자세한 내용은 Oracle AI Database SQL Language Reference를 참조하십시오.
데이터 파일 구조
Oracle AI Database는 지정된 디스크 공간과 데이터 파일 헤더에 대한 오버헤드를 할당하여 테이블스페이스에 대한 데이터 파일을 생성합니다. Oracle AI Database가 실행되는 운영체제는 데이터베이스에 할당하기 전에 파일에서 이전 정보 및 권한 부여를 지워야 합니다.
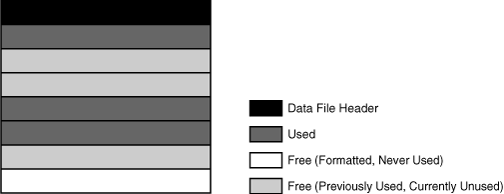
데이터 파일 헤더에는 데이터 파일에 대한 메타데이터(예: 크기 및 체크포인트 SCN)가 포함됩니다. 각 헤더에는 데이터베이스 내에서 데이터 파일을 고유하게 식별하는 절대 파일 번호와 테이블스페이스 내에서 데이터 파일을 고유하게 식별하는 상대 파일 번호가 포함됩니다.
Oracle AI Database가 데이터 파일을 처음 만들 때 할당된 디스크 공간은 포맷되지만 사용자 데이터는 포함되지 않습니다. 그러나 데이터베이스는 연관된 테이블스페이스의 미래 세그먼트를 위한 데이터를 보유할 수 있는 공간을 보유합니다. 데이터가 테이블스페이스에서 증가함에 따라 Oracle AI Database는 데이터 파일의 사용 가능 공간을 사용하여 세그먼트에 대한 확장 영역을 할당합니다.
다음 그림은 데이터 파일의 여러 공간 유형을 보여줍니다. Extent는 세그먼트 데이터를 포함하거나 사용 가능하므로 재사용할 수 있습니다. 시간 경과에 따르면 테이블스페이스 내에서 객체를 업데이트하고 삭제할 경우 개별적으로 새 데이터에 다시 사용할 수 있을 만큼 크지 않은 빈 공간 포켓이 생성될 수 있다. 이러한 유형의 빈 공간을 분할된 사용 가능 공간이라고 합니다.
그림 6: 데이터 파일의 공간
참조: 데이터 파일 정보를 보는 방법은 Oracle AI Database Administrator's Guide를 참조하십시오.
콘트롤 파일 개요
데이터베이스 제어 파일은 하나의 CDB와만 연관된 작은 이진 파일입니다.
동일한 복사본이 여러 개 허용되지만 각 CDB에는 고유한 콘트롤 파일이 하나씩 있습니다. PDB에는 별도의 콘트롤 파일이 없습니다.
-
제어 파일 사용 Oracle AI Database는 제어 파일을 사용하여 데이터베이스 파일을 찾고 일반적으로 데이터베이스의 상태를 관리합니다.
-
다중 제어 파일 Oracle AI Database를 사용하면 동일한 여러 제어 파일을 동시에 열고 동일한 데이터베이스에 기록할 수 있습니다. 서로 다른 디스크에 있는 콘트롤 파일을 다중화하면 데이터베이스가 중복성을 얻을 수 있으므로 단일 Failure 지점이 발생하지 않습니다.
-
제어 파일 구조 데이터베이스에 대한 정보는 제어 파일의 여러 섹션에 저장됩니다. 각 섹션은 데이터베이스의 한 측면에 대한 일련의 레코드입니다.
콘트롤 파일 사용
Oracle AI Database는 제어 파일을 사용하여 데이터베이스 파일을 찾고 일반적으로 데이터베이스 상태를 관리합니다.
콘트롤 파일에는 다음과 같은 정보가 포함됩니다.
-
데이터베이스 이름 및 DBID(데이터베이스 고유 식별자)
-
데이터베이스 생성 시간 기록
-
데이터 파일, 온라인 리두 로그 파일 및 아카이브된 리두 로그 파일에 대한 정보
-
테이블스페이스에 대한 정보
-
RMAN 백업
제어 파일은 다음과 같은 용도로 사용됩니다.
-
데이터베이스 열기에 필요한 데이터 파일, 온라인 리두 로그 파일 등에 대한 정보가 포함되어 있습니다.
콘트롤 파일은 데이터베이스의 구조적 변경 사항을 추적합니다. 예를 들어, 관리자가 데이터 파일이나 온라인 리두 로그 파일을 추가, 이름 변경 또는 삭제하는 경우 데이터베이스는 콘트롤 파일을 갱신하여 이러한 변경 사항을 반영합니다.
-
데이터베이스가 열려 있지 않을 때 액세스할 수 있어야 하는 메타 데이터를 포함합니다.
예를 들어, Control File에는 체크포인트를 포함하여 데이터베이스 Recovery에 필요한 정보가 포함되어 있습니다. 체크포인트는 인스턴스 복구를 시작해야 하는 리두 스트림의 SCN을 나타냅니다. 체크포인트 SCN 전에 커밋된 모든 변경 사항은 데이터 파일의 디스크에 저장됩니다. 체크포인트 프로세스는 3초마다 온라인 리두 로그의 체크포인트 위치에 대한 정보를 콘트롤 파일에 기록합니다.
Oracle AI Database는 데이터베이스 사용 중에 콘트롤 파일을 계속 읽고 쓰므로 데이터베이스가 열려 있을 때마다 쓸 수 있어야 합니다. 예를 들어, 데이터베이스 Recovery에는 데이터베이스에 포함된 모든 데이터 파일의 이름을 콘트롤 파일에서 읽는 작업이 포함됩니다. 데이터 파일 추가와 같은 다른 작업은 콘트롤 파일에 저장된 정보를 갱신합니다.
참조:
-
제어 파일 관리 방법에 대한 자세한 내용은 Oracle AI Database Administrator's Guide를 참조하십시오.
여러 Control File
Oracle AI Database를 사용하면 동일한 여러 콘트롤 파일을 동시에 열고 동일한 데이터베이스에 기록할 수 있습니다. 서로 다른 디스크에 있는 콘트롤 파일을 다중화하면 데이터베이스가 중복성을 얻을 수 있으므로 단일 Failure 지점이 발생하지 않습니다. 주: Oracle은 각각 다른 디스크에 여러 개의 콘트롤 파일 복사본을 유지 관리할 것을 권장합니다.
Control File을 사용할 수 없게 되면 손상된 Control File에 대한 액세스를 시도할 때 데이터베이스 Instance가 실패합니다. 다른 현재 제어 파일 복사본이 있는 경우 매체 복구 없이 데이터베이스를 다시 마운트하고 열 수 있습니다. 그러나 데이터베이스의 모든 제어 파일이 손실된 경우 데이터베이스 인스턴스가 실패하고 매체 복구가 필요합니다. 현재 복사본을 사용할 수 없기 때문에 콘트롤 파일의 이전 백업을 사용해야 하는 경우에는 Media Recovery가 간단하지 않습니다.
참조:
-
Oracle AI Database Administrator's Guide - 여러 콘트롤 파일을 유지 관리하는 방법 학습
-
제어 파일을 백업 및 복원하는 방법은 Oracle AI Database Backup and Recovery User's Guide를 참조하십시오.
제어 파일 구조
데이터베이스에 대한 정보는 콘트롤 파일의 여러 섹션에 저장됩니다. 각 섹션은 데이터베이스의 한 측면에 대한 일련의 레코드입니다.
예를 들어, 콘트롤 파일의 한 섹션은 데이터 파일을 추적하고 각 데이터 파일에 대해 하나씩 일련의 레코드를 포함합니다. 각 섹션은 여러 논리적 콘트롤 파일 블록에 저장됩니다. 레코드는 섹션 내에서 블록을 확장할 수 있습니다.
콘트롤 파일에는 다음 유형의 레코드가 포함됩니다.
-
순환 재사용 레코드
순환 재사용 레코드에는 필요한 경우 덮어쓸 수 있는 중요하지 않은 정보가 포함됩니다. 사용 가능한 모든 레코드 슬롯이 가득 차면 데이터베이스는 제어 파일을 확장하여 새 레코드에 대한 공간을 만들거나 가장 오래된 레코드를 덮어씁니다. 이에 대한 예로는 아카이브된 리두 로그 파일 및 RMAN 백업에 대한 레코드가 있습니다.
-
비순환 재사용 레코드
비순환 재사용 레코드에는 자주 변경되지 않고 덮어쓸 수 없는 중요한 정보가 포함되어 있습니다. 정보의 예로는 테이블스페이스, 데이터 파일, 온라인 리두 로그 파일 및 리두 스레드가 있습니다. Oracle AI Database는 해당 객체가 테이블스페이스에서 삭제되지 않는 한 이러한 레코드를 재사용하지 않습니다.
V$ 뷰라고도 하는 동적 성능 뷰를 질의하여 제어 파일에 저장된 정보를 볼 수 있습니다. 예를 들어, V$DATABASE를 질의하여 데이터베이스 이름 및 DBID를 얻을 수 있습니다. 그러나 데이터베이스만 제어 파일의 정보를 수정할 수 있습니다.
콘트롤 파일 블록 읽기 및 쓰기는 데이터 블록 읽기 및 쓰기와 다릅니다. 제어 파일의 경우 Oracle AI Database는 디스크에서 PGA(프로그램 전역 영역)로 직접 읽고 씁니다. 각 프로세스는 콘트롤 파일 블록에 대해 특정 양의 PGA 메모리를 할당합니다.
참조:
-
V$CONTROLFILE_RECORD_SECTION뷰에 대한 자세한 내용은 Oracle AI Database Reference를 참조하십시오. -
CONTROL_FILE_RECORD_KEEP_TIME초기화 매개변수에 대해 알아보려면 Oracle AI Database Reference를 참조하십시오.
온라인 리두 로그 개요
복구의 가장 중요한 구조는 온라인 리두 로그입니다. 이 로그는 변경 사항이 발생할 때 데이터베이스에 저장되는 두 개 이상의 미리 할당된 파일로 구성됩니다. 온라인 리두 로그는 데이터 파일의 변경 사항을 기록합니다.
-
온라인 리두 로그 사용 데이터베이스는 데이터 손실을 막기 위해 온라인 리두 로그 파일을 유지합니다. 특히 Instance Failure 후에 온라인 리두 로그 파일을 통해 Oracle AI Database는 데이터 파일에 아직 쓰지 않은 커밋된 데이터를 Recovery합니다.
-
Oracle AI Database가 온라인 리두 로그에 기록하는 방법 데이터베이스 인스턴스에 대한 온라인 리두 로그를 리두 스레드라고 합니다.
-
온라인 리두 로그의 구조 온라인 리두 로그 파일에는 리두 레코드가 포함됩니다.
온라인 리두 로그 사용
데이터베이스는 데이터 손실을 막기 위해 온라인 리두 로그 파일을 유지합니다. 특히 Instance Failure 후에 온라인 리두 로그 파일을 통해 Oracle AI Database는 데이터 파일에 아직 쓰지 않은 커밋된 데이터를 Recovery합니다.
서버 프로세스는 모든 트랜잭션을 리두 로그 버퍼에 동기적으로 기록합니다. 그러면 LGWR 프로세스가 해당 트랜잭션을 온라인 리두 로그에 기록합니다. 온라인 리두 로그의 내용에는 커밋되지 않은 트랜잭션 및 스키마/객체 관리 문이 포함됩니다.
데이터베이스가 언두 세그먼트를 변경하면 데이터베이스는 이러한 변경 사항을 온라인 리두 로그에도 기록합니다. 따라서 온라인 리두 로그에는 영구 객체에 대한 언두 데이터가 항상 포함됩니다. 임시 객체에 대한 모든 언두 데이터를 임시 언두 세그먼트에 저장하도록 데이터베이스를 구성하여 공간을 절약하고 성능을 향상시키거나 데이터베이스가 영구 언두 데이터와 임시 언두 데이터를 모두 온라인 리두 로그에 저장하도록 할 수 있습니다.
Oracle AI Database는 온라인 리두 로그만 복구에 사용합니다. 그러나 관리자는 Oracle LogMiner 유틸리티의 SQL 인터페이스를 통해 온라인 리두 로그 파일을 query할 수 있습니다. 리두 로그 파일은 데이터베이스 작업에 대한 기록 정보의 유용한 소스입니다.
참조:
-
Oracle 프로세스에 대해 배우는 "프로세스 아키텍처"
-
임시 언두 세그먼트에 대한 자세한 내용은 Oracle AI Database Administrator's Guide를 참조하십시오.
-
TEMP_UNDO_ENABLED초기화 매개변수에 대해 알아보려면 Oracle AI Database Reference를 참조하십시오.
Oracle AI Database가 온라인 리두 로그에 기록하는 방법
데이터베이스 인스턴스에 대한 온라인 리두 로그를 리두 스레드라고 합니다.
단일 인스턴스 구성에서는 하나의 인스턴스만 데이터베이스에 액세스하므로 하나의 리두 스레드만 존재합니다. 그러나 Oracle RAC(Oracle Real Application Clusters) 구성에서는 여러 Instance가 데이터베이스에 동시에 액세스하여 각 Instance에 고유한 리두 스레드를 가집니다. 각 Instance에 대해 별도의 리두 스레드를 사용하면 단일 온라인 리두 로그 파일 집합에 대한 경합이 발생하지 않습니다.
온라인 리두 로그는 두 개 이상의 온라인 리두 로그 파일로 구성됩니다. Oracle AI Database에는 다른 파일이 지워지거나 아카이브되는 동안 한 파일을 항상 쓰는 데 사용할 수 있도록 보장하기 위해 최소 두 개의 파일이 필요합니다.
-
온라인 리두 로그 스위치 Oracle AI Database는 리두 로그 버퍼에서 기록된 레코드를 저장하기 위해 한 번에 하나의 온라인 리두 로그 파일만 사용합니다.
-
여러 온라인 리두 로그 파일 복사본 Oracle AI Database는 두 개 이상의 동일한 온라인 리두 로그 복사본을 별도의 위치에 자동으로 유지 관리할 수 있습니다.
-
아카이브된 리두 로그 파일 아카이브된 리두 로그 파일은 온라인 리두 로그 그룹의 채워진 멤버의 복사본입니다.
참조: Oracle Real Application Clusters Administration and Deployment Guide에서 Oracle RAC의 온라인 리두 로그 그룹에 대해 알아보기
온라인 리두 Log Switches
Oracle AI Database는 리두 로그 버퍼에서 기록된 레코드를 저장하기 위해 한 번에 하나의 온라인 리두 로그 파일만 사용합니다.
로그 기록자 프로세스(LGWR) 프로세스가 활발히 기록하는 온라인 리두 로그 파일을 현재 온라인 리두 로그 파일이라고 합니다.
로그 스위치는 데이터베이스가 하나의 온라인 리두 로그 파일에 쓰기를 중지하고 다른 리두 로그 파일에 쓰기를 시작할 때 발생합니다. 일반적으로 전환은 현재 온라인 리두 로그 파일이 가득 차서 쓰기가 계속되어야 하는 경우에 발생합니다. 그러나 현재 온라인 리두 로그 파일이 채워졌는지 여부와 관계없이 정기적으로 로그스위치(Log Switch)가 발생하도록 구성하고 수동으로 로그스위치(Log Switch)를 강제 적용할 수 있습니다.
로그 기록자는 온라인 리두 로그 파일에 순환적으로 기록합니다. 로그 기록자가 사용 가능한 마지막 온라인 리두 로그 파일을 채우면 프로세스가 첫번째 로그 파일에 기록되어 주기를 재시작합니다. 그림 14-7에서는 리두 로그의 순환 쓰기를 보여줍니다.
그림 7: 온라인 리두 로그 파일 재사용
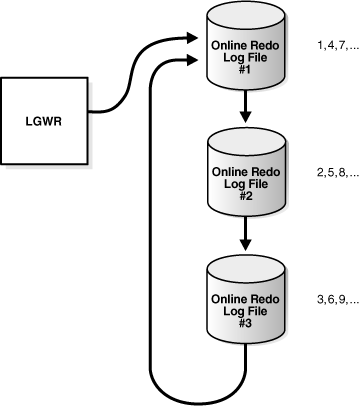
그림 14-7의 숫자는 LGWR가 각 온라인 리두 로그 파일에 기록하는 시퀀스를 보여줍니다. 데이터베이스는 로그 스위치 및 로그 기록자가 기록하기 시작할 때 각 파일에 새 로그 시퀀스 번호를 지정합니다. 데이터베이스가 온라인 리두 로그 파일을 재사용하면 이 파일은 사용 가능한 다음 로그 시퀀스 번호를 받습니다.
채워진 온라인 리두 로그 파일은 아카이브 모드에 따라 재사용할 수 있습니다.
-
아카이브가 사용 안함으로 설정되어 데이터베이스가
NOARCHIVELOG모드인 경우 채워진 온라인 리두 로그 파일은 DBW(데이터베이스 기록자)에 의해 기록된 변경 사항이 디스크에 체크포인트(쓰기)된 후 사용할 수 있습니다. -
아카이브가 사용으로 설정되면 데이터베이스가 ARCHIVELOG 모드인 경우 채워진 온라인 리두 로그 파일을 데이터 파일에 변경 사항이 기록되고 파일이 아카이브된 후 로그 기록자가 사용할 수 있습니다.
경우에 따라 로그 기록자가 기존의 온라인 리두 로그 파일을 재사용하지 못할 수도 있습니다. 인스턴스 복구에는 활성 온라인 리두 로그 파일이 필요하며, 인스턴스 복구에는 비활성 온라인 리두 로그 파일이 필요하지 않습니다. 또한 온라인 리두 로그 파일을 지우는 중일 수 있습니다.
참조:
-
Oracle AI Database Administrator's Guide에서 온라인 리두 로그 관리 방법 알아보기
온라인 리두 로그 파일의 다중 복사본
Oracle AI Database는 두 개 이상의 동일한 온라인 리두 로그 복사본을 별도의 위치에 자동으로 유지 관리할 수 있습니다.
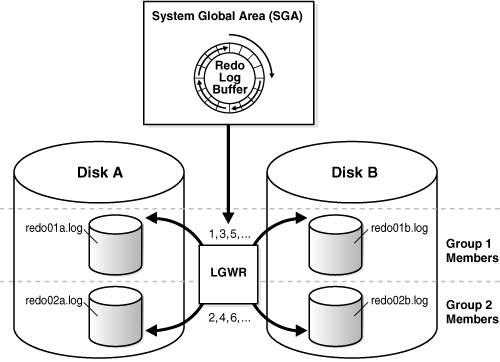
온라인 리두 로그 그룹은 온라인 리두 로그 파일과 중복 복사본으로 구성됩니다. 동일한 각 복사본은 온라인 리두 로그 그룹의 멤버입니다. 각 그룹은 그룹 1, 그룹 2 등과 같이 번호로 정의됩니다.
온라인 리두 로그 그룹의 여러 멤버를 유지 관리하면 리두 로그가 손실되지 않습니다. 이상적으로는 한 디스크가 실패해도 전체 온라인 리두 로그가 손실되지 않도록 멤버의 위치가 별도의 디스크에 있어야 합니다.
그림 14-8에서 A_LOG1 및 B_LOG1는 그룹 1의 동일한 멤버이고 A_LOG2 및 B_LOG2는 그룹 2의 동일한 멤버입니다. 그룹의 각 멤버는 크기가 같아야 합니다. LGWR는 그룹 1(A_LOG1 및 B_LOG1 멤버)에 동시에 기록한 다음 그룹 2(A_LOG2 및 B_LOG2 멤버)에 동시에 기록한 다음 그룹 1 등에 기록합니다. LGWR는 서로 다른 그룹의 멤버에 동시에 기록하지 않습니다.
그림 8: 온라인 리두 로그 파일의 여러 복사본
주: Oracle은 온라인 리두 로그를 다중화할 것을 권장합니다. 복구가 필요한 경우 로그 파일이 손실될 수도 있습니다. 온라인 리두 로그를 다중화하는 경우 데이터베이스는 수행해야 할 I/O의 양을 늘려야 합니다. 시스템에 따라 이 추가 I/O가 전체 데이터베이스 성능에 영향을 줄 수 있습니다.
참조:
-
온라인 리두 로그 파일의 여러 복사본을 유지 관리하는 방법은 Oracle AI Database Administrator's Guide를 참조하십시오.
-
Oracle Data Guard 개념 및 관리 - Data Guard 구성의 멤버 간에 리두 데이터를 자동으로 전송하는 방법 학습
아카이브된 리두 로그 데이터 파일
아카이브된 리두 로그 파일은 온라인 리두 로그 그룹의 채워진 멤버의 복사본입니다.
아카이브된 리두 로그 파일은 데이터베이스의 일부로 간주되지 않습니다. 대신 데이터베이스에 의해 생성되고 유저가 지정한 위치에 기록된 온라인 리두 로그 파일의 오프라인 복사본입니다.
아카이브된 리두 로그 파일은 백업 및 복구 전략의 중요한 부분입니다. 아카이브된 리두 로그 파일을 사용하여 다음 작업을 수행할 수 있습니다.
-
데이터베이스 백업 Recovery
-
대기 데이터베이스 업데이트
-
Oracle LogMiner 유틸리티를 사용하여 데이터베이스 기록에 대한 정보를 얻습니다.
아카이브된 리두 로그 파일 생성 작업을 아카이빙이라고 합니다. 이 작업은 자동 또는 수동입니다. 데이터베이스가 ARCHIVELOG 모드일 때만 가능합니다.
아카이브된 리두 로그 파일에는 온라인 리두 로그 그룹의 동일한 멤버에 대한 리두 항목과 로그 시퀀스 번호가 포함됩니다. "Multiple Copies of Online Redo Log Files"에서 A_LOG1 및 B_LOG1 파일은 그룹 1의 동일한 멤버입니다. 데이터베이스가 ARCHIVELOG 모드이고 자동 아카이브가 사용으로 설정된 경우 아카이버 프로세스(ARCn)는 이러한 파일 중 하나를 아카이브합니다. A_LOG1가 손상된 경우 프로세스는 B_LOG1를 아카이브할 수 있습니다. 아카이브된 리두 로그는 아카이브를 활성화한 시점부터 존재했던 모든 리두 로그 그룹의 복사본을 포함합니다.
참조:
-
Oracle LogMiner에 대한 자세한 내용은 Oracle AI Database Utilities를 참조하십시오.
-
아카이브된 리두 로그를 관리하는 방법은 Oracle AI Database Administrator's Guide를 참조하십시오.
-
대기 리두 로그 아카이브를 구성하는 방법은 Oracle Data Guard Concepts and Administration을 참조하십시오.
온라인 리두 로그의 구조
온라인 리두 로그 파일은 리두 레코드를 포함합니다.
리두 레코드는 각각 데이터 블록에 대한 변경 사항을 설명하는 변경 벡터 그룹으로 구성됩니다. 예를 들어, employees 테이블의 급여를 업데이트하면 테이블에 대한 데이터 세그먼트 블록의 변경 사항, 실행 취소 세그먼트 데이터 블록 및 실행 취소 세그먼트의 트랜잭션 테이블을 설명하는 리두 레코드가 생성됩니다.
리두 레코드는 다음을 포함하여 변경과 관련된 모든 메타 데이터를 포함합니다.
-
변경의 SCN 및 시간 기록
-
변경을 생성한 트랜잭션의 트랜잭션 ID
-
트랜잭션이 커밋된 경우(SCN 및 시간 기록)
-
변경된 작업의 유형
-
수정된 데이터 세그먼트의 이름 및 유형
참조: "데이터 블록 개요"