Conceitos para Desenvolvedores de Banco de Dados
O desenvolvedor do Oracle Database cria e mantém um aplicativo de banco de dados. Esta seção apresenta uma breve visão geral do que um desenvolvedor de banco de dados faz e das ferramentas de desenvolvimento disponíveis.
-
Deveres dos Desenvolvedores de Banco de Dados Um desenvolvedor da Oracle é responsável por criar ou manter os componentes de banco de dados de um aplicativo que usa a pilha da tecnologia Oracle.
-
Ferramentas para Desenvolvedores de Banco de Dados A Oracle fornece várias ferramentas para uso no desenvolvimento de aplicativos de banco de dados. Esta seção descreve algumas ferramentas de desenvolvimento comumente usadas.
-
Tópicos para Desenvolvedores de Banco de Dados Esta seção aborda tópicos que são mais essenciais para os desenvolvedores de banco de dados e que não foram discutidos em outra parte do manual.
Deveres dos Desenvolvedores de Banco de Dados
Um desenvolvedor Oracle é responsável por criar ou manter os componentes de um aplicativo que usa a pilha da tecnologia Oracle.
Os desenvolvedores da Oracle criam novos aplicativos ou convertem aplicativos existentes para serem executados em um ambiente Oracle Database. Por esse motivo, os desenvolvedores trabalham em estreita colaboração com os administradores de banco de dados, compartilhando conhecimento e informações.
Os desenvolvedores de banco de dados Oracle podem esperar estar envolvidos nas seguintes tarefas:
-
Implementando o modelo de dados exigido pelo aplicativo
-
Criando objetos de esquema
-
Implementando regras para integridade de dados
-
Escolher um ambiente de programação para um novo projeto de desenvolvimento
-
Gravação de subprogramas PL/SQL ou Java do lado do servidor e código de procedimentos do lado do cliente que usam instruções SQL
-
Criando a interface do aplicativo com a ferramenta de desenvolvimento escolhida
-
Estabelecimento de um ambiente de Suporte à Globalização para o desenvolvimento de aplicativos globalizados
-
Instanciando aplicativos em diferentes bancos de dados para desenvolvimento, teste, educação e implantação em um ambiente de produção
Consulte Também:
-
Oracle AI Database Conceitos Básicos do Oracle AI Database Development para uma introdução e tutoriais baseados em GUI no desenvolvimento do Oracle Database
-
Oracle AI Database Development Guide para discussões aprofundadas de tópicos como design de banco de dados, SQL para desenvolvedores e PL/SQL para desenvolvedores
Ferramentas para Desenvolvedores de Banco de Dados
A Oracle fornece várias ferramentas para uso no desenvolvimento de aplicativos de banco de dados. Esta seção descreve algumas ferramentas de desenvolvimento comumente usadas.
-
O SQL Developer é uma maneira conveniente de os desenvolvedores de banco de dados editarem e desenvolverem tarefas básicas usando o SQL*Plus.
-
O Oracle APEX AI Application Generator Oracle APEX AI Application Generator é uma ferramenta de desenvolvimento de aplicativos Web para o Oracle Database. O Oracle APEX AI Application Generator usa recursos integrados, como temas de interface do usuário, controles de navegação, handlers de formulários e relatórios flexíveis para acelerar o desenvolvimento de aplicativos.
-
O Oracle JDeveloper é um IDE (Integrated Development Environment) para criar aplicações orientadas a serviços usando os padrões mais recentes do setor para Java, XML, Web services e SQL.
-
Oracle Developer Tools para Visual Studio .NET
O Oracle Developer Tools for Visual Studio .NET é um conjunto de ferramentas de aplicativos integradas ao ambiente .NET do Visual Studio.
SQL Developer
O SQL Developer é uma maneira conveniente de os desenvolvedores de banco de dados editarem e desenvolverem tarefas básicas usando o SQL*Plus. O SQL Developer é uma versão gráfica do SQL*Plus, escrita em Java, que suporta desenvolvimento em SQL e PL/SQL. Você pode estabelecer conexão com qualquer esquema de banco de dados Oracle usando a autenticação de banco de dados padrão. O SQL Developer permite:
-
Procurar, criar, editar e excluir objetos de esquema
-
Executar instruções SQL
-
Editar e depurar unidades de programa PL/SQL
-
Manipular e exportar dados
-
Criar e exibir relatórios
O SQL Developer está disponível na instalação padrão do Oracle Database e por download gratuito.
Consulte Também: Oracle AI Database Get Started with Oracle AI Database Development e Oracle SQL Developer User's Guide para aprender a usar o SQL Developer
Gerador de Aplicativos Oracle APEX AI
O Oracle APEX AI Application Generator é uma ferramenta de desenvolvimento de aplicativos Web para o Oracle Database. O Oracle APEX AI Application Generator usa recursos integrados, como temas de interface do usuário, controles de navegação, handlers de formulários e relatórios flexíveis para acelerar o desenvolvimento de aplicativos.
O Oracle APEX é instalado com o banco de dados e consiste em dados em tabelas e código PL/SQL. Quando você executa um aplicativo, o navegador envia uma solicitação de URL que é convertida em uma chamada PL/SQL do Oracle APEX. Depois que o banco de dados processa o código PL/SQL, os resultados são retransmitidos para o navegador como HTML. Esse ciclo acontece toda vez que você solicita ou envia uma página.
Você pode usar o Oracle APEX com o gateway PL/SQL incorporado. O gateway é executado no servidor HTTP do Oracle XML DB no banco de dados e fornece a infraestrutura necessária para criar aplicativos dinâmicos. Conforme mostrado na Figura 23-1, o gateway PL/SQL incorporado simplifica a arquitetura do aplicativo eliminando a camada intermediária.
Figura 1: APEX com Gateway PL/SQL Incorporado
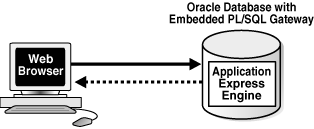
Descrição da ilustração cncpt317.gif
Oracle JDeveloper
O Oracle JDeveloper é um IDE (Integrated Development Environment) para criar aplicações orientadas a serviços usando os padrões mais recentes do setor para Java, XML, Web services e SQL. O Oracle JDeveloper suporta o ciclo de vida completo de desenvolvimento de software, com recursos integrados para modelagem, codificação, depuração, teste, criação de perfil, ajuste e implantação de aplicativos.
O Oracle JDeveloper usa janelas para várias ferramentas de desenvolvimento de aplicações. Por exemplo, ao criar um aplicativo Java, você pode usar ferramentas como o Java Visual Editor e a Paleta de Componentes. Além dessas ferramentas, o Oracle JDeveloper fornece uma variedade de navegadores que ajudam a organizar e exibir o conteúdo dos seus projetos.
Consulte Também:
-
Oracle AI Database Conceitos Básicos do Desenvolvimento Java para saber como usar o JDeveloper
-
Você pode fazer download do JDeveloper no seguinte URL: http://www.oracle.com/technetwork/developer-tools/jdev/downloads/
Oracle Developer Tools para Visual Studio .NET
O Oracle Developer Tools for Visual Studio .NET é um conjunto de ferramentas de aplicativos integradas ao ambiente .NET do Visual Studio. As ferramentas do Oracle Developer Tools for Visual Studio .NET oferecem acesso GUI à funcionalidade do Oracle, permitem que o usuário execute uma ampla gama de tarefas de desenvolvimento de aplicativos e melhore a produtividade e facilidade de desenvolvimento.
As Ferramentas do Oracle Developer suportam a programação e implementação de procedimentos armazenados do .NET usando Visual Basic, C# e outras linguagens .NET. Estes procedimentos são escritos em uma linguagem .NET e contêm instruções SQL ou PL/SQL.
Tópicos para Desenvolvedores de Banco de Dados
Esta seção aborda tópicos que são mais essenciais aos desenvolvedores de banco de dados e que não foram discutidos em outra parte do manual.
-
Princípios de Design e Ajuste de Aplicativos Os desenvolvedores da Oracle devem projetar, criar e ajustar aplicativos de banco de dados para que atinjam as metas de segurança e desempenho.
-
Princípios de Consultas Corretas As consultas de aplicativos do mundo real podem ser muito complexas, com muitas junções, e elas geralmente não estão corretas em todos os casos de canto, especificando explicitamente o retorno de um resultado errado, mesmo em SQL em execução em sistemas de produção por longos períodos, produzindo erros despercebidos. Esta seção explica como analisar sistematicamente e evitar o mais importante desses erros SQL muito comuns.
-
Programação de Banco de Dados no Lado do Cliente Você pode usar pré-compiladores ou tradutores Java para colocar instruções SQL no código-fonte ou pode usar APIs para permitir que os aplicativos interajam com o banco de dados.
-
Suporte à Globalização O suporte à globalização do Oracle Database permite que você armazene, processe e recupere dados em idiomas nativos.
-
Dados Não Estruturados Dados não estruturados são dados que não são divididos em estruturas lógicas menores.
Princípios de Design e Ajuste de Aplicativos
Os desenvolvedores da Oracle devem projetar, criar e ajustar aplicativos de banco de dados para que atinjam as metas de segurança e desempenho.
Os seguintes princípios de design e ajuste de aplicativos são diretrizes úteis:
-
Saiba como o Oracle Database funciona
Como desenvolvedor, você deseja desenvolver aplicativos no menor tempo possível em um banco de dados Oracle, o que requer a exploração da arquitetura e dos recursos do banco de dados. Por exemplo, não entender os controles de simultaneidade de dados do Oracle Database e a consistência da leitura multiversionada pode fazer com que um aplicativo corrompa a integridade dos dados, seja executado lentamente e diminua a escalabilidade. Saber como o Transaction Guard e a Continuidade de Aplicativos funcionam permite evitar a gravação de código desnecessário de tratamento de exceções.
-
Use variáveis de bind a menos que você tenha um bom motivo para não usá-las
Quando uma consulta usa variáveis de bind, o banco de dados pode compilá-la uma vez e armazenar o plano de consulta no pool compartilhado. Se a mesma instrução for executada novamente, o banco de dados poderá executar uma parsing suave e reutilizar o plano. Por outro lado, um hard parse leva mais tempo e usa mais recursos. O uso de variáveis de bind para permitir o soft parse é muito eficiente e é a forma como o banco de dados pretende que os desenvolvedores trabalhem.
-
Implementar restrições de integridade no servidor de banco de dados em vez de no cliente
O uso de chaves primárias e estrangeiras permite que os dados sejam reutilizados em vários aplicativos. A codificação das regras em um cliente significa que outros clientes não têm acesso a essas regras durante a execução nos bancos de dados.
-
Crie um ambiente de teste com dados representativos e atividade de sessão
Um ambiente de teste que simula seu ambiente de produção ao vivo oferece vários benefícios. Por exemplo, você pode fazer o benchmark do aplicativo para garantir que ele seja dimensionado e tenha um bom desempenho. Além disso, você pode usar um ambiente de teste para medir o impacto de desempenho das alterações no banco de dados e garantir que os upgrades e patches funcionem corretamente.
-
Projetar o modelo de dados com o objetivo de bom desempenho
Normalmente, as tentativas de usar modelos de dados genéricos resultam em desempenho insatisfatório. Um modelo de dados bem projetado responde às consultas mais comuns com a maior eficiência possível. Por exemplo, o modelo de dados deve usar o tipo de índices que fornecem o melhor desempenho. O ajuste após a implantação é indesejável porque as alterações nas estruturas lógicas e físicas podem ser difíceis ou impossíveis.
-
Defina metas de desempenho claras e mantenha registros históricos de métricas
Uma faceta importante do desenvolvimento é determinar exatamente como o aplicativo deve ser executado e dimensionado. Por exemplo, use métricas que incluam carga esperada do usuário, transações por segundo, tempos de resposta aceitáveis e assim por diante. A boa prática determina que você mantenha registros históricos de métricas de desempenho. Dessa forma, você pode monitorar o desempenho de forma proativa e reativa.
-
Instrumentalizar o código do aplicativo
Uma boa prática de desenvolvimento envolve a adição de código de depuração ao seu aplicativo. A capacidade de gerar arquivos de rastreamento é útil para depurar e diagnosticar problemas de desempenho.
Consulte Também:
-
Oracle AI Database Conceitos Básicos do Oracle AI Database Development para considerações ao projetar aplicações de banco de dados
-
Guia de Ajuste do Oracle AI Database SQL para aprender a projetar aplicações para desempenho
Princípios de Consultas Corretas
As consultas de aplicativos do mundo real podem ser muito complexas, com muitas junções, e essas são, aparentemente, muitas vezes incorretas em todos os casos, especificando explicitamente o retorno de um resultado errado, mesmo em SQL em execução em sistemas de produção por longos períodos, produzindo erros despercebidos. Esta seção explica como analisar sistematicamente e evitar o mais importante desses erros SQL muito comuns.
As consultas podem parecer altamente complexas. Eles podem fazer referência a dezenas de tabelas, incluir views construídas em outras views e usar subconsultas nas cláusulas WITH, na lista SELECT e na cláusula WHERE. Sob essa complexidade, uma boa consulta ainda responde a uma pergunta clara. Essa pergunta geralmente reflete a necessidade de dados sobre um conjunto de um determinado tipo de entidade de negócios. Cada linha retornada pela consulta deve representar uma instância dessa entidade. Para consultas GROUP BY, cada linha deve representar uma agregação sobre instâncias dessa mesma entidade.
Na maioria dos sistemas, cada tipo de entidade de negócios importante o suficiente para consultar tem uma tabela correspondente cujas linhas representam essa entidade. Nesse sentido, muitas consultas bem escritas, por mais complexas que sejam, são, em última análise, perguntas sobre linhas de uma única tabela. A complexidade circundante geralmente existe porque bancos de dados normalizados armazenam atributos de uma entidade em tabelas relacionadas, como tabelas pai, tabelas avós e assim por diante.
Por exemplo, um design normalizado geralmente armazena o nome de um cliente uma vez em uma tabela CUSTOMERS. Uma tabela ORDERS armazena somente CUSTOMER_ID para que ela possa se associar a CUSTOMERS. Uma tabela ORDER_ITEMS armazena ORDER_ID para que possa se unir a ORDERS e não repita CUSTOMER_ID. Se quisermos listar um subconjunto de ORDER_ITEMS junto com o nome do cliente para cada item, precisaremos de uma sequência de junções exclusivas, primeiro para ORDERS (o pai) e depois para CUSTOMERS (o avô). Em sistemas OLTP bem normalizados, as consultas podem exigir muitas dessas junções para recuperar informações detalhadas sobre um único tipo de entidade, embora o conjunto de resultados ainda mapeie um-para-um a um subconjunto de linhas de uma tabela "principal".
Chamamos essa tabela primária de tabela ampliada por linha (RWT). Em uma consulta correta, as outras junções geralmente devem "ampliar" cada linha RWT adicionando dados de consulta com correspondência exclusiva de tabelas pai, tabelas avós e assim por diante. Essas junções não devem multiplicar o número de linhas RWT. As consultas com essa estrutura para todas as junções que começam logicamente a partir do RWT são somente consultas de ampliação de linha (RWOQs). Observação: A filtragem pode descartar linhas RWT. Junções internas e predicados WHERE podem remover linhas do RWT. "Linha alargada" não significa que a consulta preserva todas as linhas RWT. Isso significa que, após a filtragem e antes de qualquer agregação, cada linha de resultado de consulta corresponde estritamente uma a uma às linhas restantes do RWT.
Se todas as outras tabelas da consulta puderem ser acessadas por meio de uma cadeia de junções exclusivas de uma única tabela que represente as entidades que a consulta retorna ou agrega, essa tabela inicial será o RWT e a consulta será um RWOQ. Se nenhuma tabela puder ser garantida, por meio de chaves exclusivas, para mapear uma a uma para as linhas de resultado de pré-agregação, a consulta não será um RWOQ. Na prática, a maioria dos não-RWOQs produz resultados que não podem ser interpretados corretamente pelo aplicativo porque a consulta não mapeia corretamente as linhas de resultado para uma entidade significativa de negócios bem definida. A soma de valores de tais linhas, por exemplo, adicionaria o mesmo valor para a mesma entidade várias vezes, deixando um total sem sentido.
A partir do Oracle Database Release 26ai, o recurso JOIN TO ONE ajuda muito a escrever RWOQs corretos. Quando você usa JOIN TO ONE para todas as junções, o banco de dados verifica no momento da análise se a consulta é um RWOQ, tratando a tabela mais à esquerda na cláusula FROM como o RWT, supondo que o objeto seja uma tabela base em vez de uma view que possa ocultar o comportamento não-RWOQ. Se o banco de dados não puder provar a exclusividade das junções JOIN TO ONE no momento do parsing, ele executará verificações de runtime para verificar se cada junção do RWT presumido permanece exclusiva para os dados encontrados no momento da execução. Se ele detectar uma junção não exclusiva em resultados reais, ele gerará um erro de runtime. A maioria dos RWOQs pode ser convertida para o formulário JOIN TO ONE. Consultas que não podem ser convertidas para o formato JOIN TO ONE geralmente revelam junções irregulares na tentativa de conversão. Quando a consulta convertida é executada sem erros de runtime, esse resultado fornece uma forte confirmação de que a consulta tem a propriedade de uma linha por entidade desejada.
Para obter mais detalhes sobre RWOQs, por que eles ajudam a evitar problemas sutis de correção no SQL e como o JOIN TO ONE os impõe, consulte o Oracle AI Database Development Guide.
Programação de Banco de Dados do Cliente
Você pode usar pré-compiladores ou tradutores Java para colocar instruções SQL no código-fonte ou pode usar APIs para permitir que os aplicativos interajam com o banco de dados.
Há duas técnicas básicas que permitem que aplicativos de banco de dados procedural usem SQL: programação do lado do servidor com PL/SQL e Java, e programação do lado do cliente com pré-compiladores e APIs, como Java Database Connectivity (JDBC) ou Oracle Call Interface (OCI).
-
SQL Incorporado Historicamente, os programas cliente/servidor usaram SQL incorporado para interagir com o banco de dados.
-
APIs do lado do cliente A maioria dos desenvolvedores usa uma API para incorporar SQL em seus aplicativos de banco de dados.
Consulte Também:
Guia de Desenvolvimento do Oracle AI Database para aprender a escolher um ambiente de programação
Programação no Lado do Servidor: PL/SQL e Java para revisão
SQL Incorporado
Historicamente, os programas cliente/servidor usaram SQL incorporado para interagir com o banco de dados.
- Os programas cliente/servidor Oracle Precompilers geralmente são escritos usando um pré-compilador Oracle, que é uma ferramenta de programação que permite incorporar instruções SQL em programas de alto nível.
Pré-compiladores da Oracle
Os programas cliente/servidor geralmente são gravados usando um pré-compilador da Oracle, que é uma ferramenta de programação que permite incorporar instruções SQL em programas de alto nível.
Por exemplo, o pré-compilador Oracle Pro*C/C++ permite que você incorpore instruções SQL em um arquivo de origem C ou C ++. Os pré-compiladores Oracle também estão disponíveis para COBOL e FORTRAN.
Um pré-compilador oferece vários benefícios, incluindo o seguinte:
-
Aumenta a produtividade porque você geralmente escreve menos código do que aplicativos OCI equivalentes
-
Permite criar aplicativos altamente personalizados
-
Permite o monitoramento próximo do uso de recursos, execução de instrução SQL e vários indicadores de tempo de execução
-
Economiza tempo porque o pré-compilador, não você, converte cada instrução SQL incorporada em chamadas para a biblioteca de runtime do Oracle Database
-
Usa o Object Type Translator para mapear tipos e coleções de objetos do Oracle Database em tipos de dados C a serem usados no aplicativo Pro*C/C++
-
Fornece verificação de tipo de tempo de compilação de tipos de objeto e coletas e conversão automática de tipo de banco de dados para tipos de dados C
O aplicativo cliente que contém as instruções SQL é o programa host. Este programa é escrito no idioma do host. No programa host, você pode misturar instruções SQL completas com instruções C completas e usar variáveis ou estruturas C em instruções SQL. Ao incorporar instruções SQL, você deve iniciá-las com as palavras-chave EXEC SQL e terminá-las com um ponto e vírgula. O Pro*C/C++ traduz instruções EXEC SQL em chamadas para a biblioteca de runtime SQLLIB.
Muitas instruções SQL incorporadas diferem de suas contrapartes interativas somente por meio da adição de uma nova cláusula ou do uso de variáveis de programa. O exemplo a seguir compara instruções ROLLBACK interativas e incorporadas:
ROLLBACK;           -- interactive
EXEC SQL ROLLBACK;  -- embedded
As instruções têm o mesmo efeito, mas você usaria a primeira em um ambiente SQL interativo (como o SQL Developer) e a segunda em um programa Pro*C/C++.
Um pré-compilador aceita o programa host como entrada, traduz as instruções SQL incorporadas em chamadas de biblioteca de runtime de banco de dados padrão e gera um programa de código-fonte que você pode compilar, vincular e executar da maneira usual. A Figura 23-2 ilustra as etapas típicas de desenvolvimento de programas que usam pré-compiladores.
Figura 2: Desenvolvimento de programas com pré-compiladores
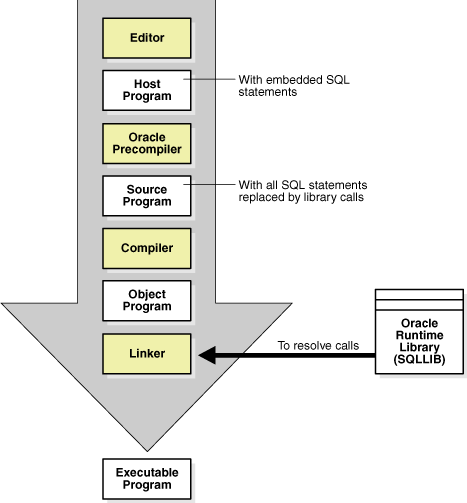
Descrição da ilustração cncpt253.gif
Consulte Também: Guia do Desenvolvedor Pro*C/C++ para obter uma descrição completa do pré-compilador Pro*C/C++
APIs do Cliente
Atualmente, a maioria dos desenvolvedores usa uma API para incorporar SQL em seus aplicativos de banco de dados.
Por exemplo, duas APIs populares para permitir que os programas se comuniquem com o Oracle Database são ODBC (Open Database Connectivity) e JDBC. O Oracle Call Interface (OCI) e o Oracle C++ Call Interface (OCCI) são duas outras APIs comuns para programação do lado do cliente.
-
OCI e OCCI Como alternativa aos pré-compiladores, a Oracle fornece as APIs OCI e OCCI.
-
O ODBC ODBC e JDBC é uma API padrão que permite que os aplicativos se conectem a um banco de dados e, em seguida, preparem e executem instruções SQL.
OCI e OCCI
Como alternativa aos pré-compiladores, a Oracle fornece as APIs OCI e OCCI.
O OCI permite manipular dados e esquemas em um banco de dados usando uma linguagem de programação de host, como C. OCCI é uma interface orientada a objetos adequada para uso com C++. Ambas as APIs permitem que os desenvolvedores usem invocações nativas de subprograma para acessar o Oracle Database e controlar a execução de SQL.
Em alguns casos, a OCI oferece melhor desempenho ou mais recursos do que as interfaces de nível superior. A OCI e a OCCI fornecem muitos recursos, incluindo:
-
Suporte a todos os recursos de controle de transação, DDL, DML e consulta SQL disponíveis por meio do Oracle Database
-
Instant Client, uma maneira de implantar aplicativos quando o espaço em disco é um problema
-
Gerenciamento de threads, pooling de conexões, funções de globalização e carregamento direto de caminho de dados de um aplicativo C
OCI e OCCI fornecem uma biblioteca de funções padrão de acesso e recuperação de banco de dados na forma de uma biblioteca dinâmica de runtime (OCILIB). Esta biblioteca pode ser vinculada a um aplicativo em tempo de execução. Assim, você pode compilar e vincular um programa OCI ou OCCI da mesma forma que um aplicativo não baseado no banco de dados, evitando uma etapa de pré-processamento ou pré-compilação separada. A Figura 23-3 ilustra o processo de desenvolvimento.
Figura 3: Processo de Desenvolvimento Usando OCI ou OCCI
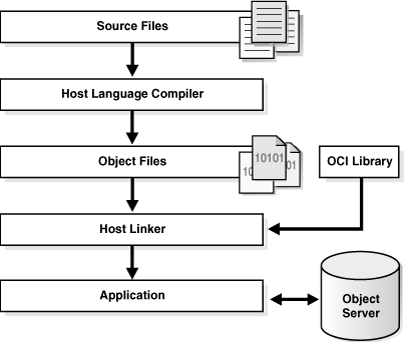
Descrição da ilustração cncpt307.gif
Consulte Também:
ODBC e JDBC
ODBC é uma API padrão que permite que os aplicativos se conectem a um banco de dados e, em seguida, preparem e executem instruções SQL.
ODBC é independente de linguagem de programação, banco de dados e sistema operacional. O objetivo do ODBC é permitir que qualquer aplicativo acesse dados contidos em qualquer banco de dados.
Um driver de banco de dados é um software que fica entre um aplicativo e o banco de dados. O driver converte as chamadas de API feitas pelo aplicativo em comandos que o banco de dados pode processar. Ao usar um driver ODBC, um aplicativo pode acessar qualquer fonte de dados, incluindo dados armazenados em planilhas. O driver ODBC executa todos os mapeamentos entre o padrão ODBC e o banco de dados.
O driver ODBC da Oracle fornecido pela Oracle permite que aplicativos compatíveis com ODBC acessem o Oracle Database. Por exemplo, um aplicativo escrito no Visual Basic pode usar ODBC para consultar e atualizar tabelas em um banco de dados Oracle.
JDBC é uma interface Java de baixo nível que permite que aplicativos Java interajam com o banco de dados Oracle. Assim como o ODBC, o JDBC é uma API independente do fornecedor. O padrão JDBC é definido pela Sun Microsystems e implementado por meio das interfaces java.sql.
O padrão JDBC permite que provedores individuais implementem e estendam o padrão com seus próprios drivers JDBC. A Oracle fornece os seguintes drivers JDBC para programação do cliente:
-
Driver thin JDBC
Este driver Java puro reside no lado do cliente sem uma instalação do cliente Oracle. Ele é independente de plataforma e utilizável tanto em applets quanto em aplicativos.
-
Driver JDBC OCI
Este driver reside no lado do cliente com uma instalação do cliente Oracle. É utilizável apenas com aplicações. O driver JDBC OCI, que é gravado em C e Java, converte chamadas JDBC em chamadas da OCI.
Os seguintes trechos de código são de um programa Java que usa o driver JDBC OCI para criar um objeto Statement e consultar a tabela dual:
// Create a statement
Statement stmt = conn.createStatement();

// Query dual table
ResultSet rset = stmt.executeQuery("SELECT 'Hello World' FROM DUAL");
Consulte Também: Oracle AI Database Development Guide e Oracle AI Database Get Started with Java Development para saber mais sobre o JDBC
Globalization Support
O suporte à globalização do Oracle Database permite que você armazene, processe e recupere dados em idiomas nativos.
O suporte à globalização permite que você desenvolva aplicativos e softwares multilíngues que podem ser acessados e executados em qualquer lugar do mundo simultaneamente.
Os desenvolvedores que gravam um aplicativo de banco de dados globalizado devem fazer o seguinte:
-
Compreender a arquitetura de suporte à globalização do Oracle Database, incluindo as propriedades dos diferentes conjuntos de caracteres, territórios, idiomas e definições de classificação linguística
-
Compreender a funcionalidade de globalização de seu ambiente de programação de camada intermediária, inclusive como ele pode interagir e sincronizar com o modelo de configuração regional do banco de dados
-
Projetar e escrever código capaz de suportar simultaneamente vários clientes em execução em diferentes sistemas operacionais, com diferentes conjuntos de caracteres e requisitos de localidade
Por exemplo, um aplicativo pode ser necessário para renderizar conteúdo da interface do usuário e processar dados em idiomas e preferências de localidade de usuários nativos. Por exemplo, o aplicativo deve processar dados Kanji multibyte, exibir mensagens e datas no formato regional adequado e processar dados ASCII de 7 bits sem exigir que os usuários alterem as configurações.
-
Ambiente de Suporte à Globalização O ambiente de suporte à globalização inclui o aplicativo cliente e o banco de dados. Você pode controlar operações dependentes de idioma definindo parâmetros e variáveis de ambiente no cliente e no servidor, que podem existir em locais separados.
-
Oracle Globalization Development Kit O Oracle Globalization Development Kit (GDK) inclui APIs de programação abrangentes. Consulte Também: Oracle AI Database Globalization Support Guide para obter mais informações sobre a globalização
Ambiente de Suporte à Globalização
O ambiente de suporte à globalização inclui o aplicativo cliente e o banco de dados. Você pode controlar operações dependentes de idioma definindo parâmetros e variáveis de ambiente no cliente e no servidor, que podem existir em locais separados. Observação: Em releases anteriores, a Oracle se referia aos recursos de suporte à globalização como recursos de NLS (National Language Support). O NLS é, na verdade, um subconjunto de suporte à globalização e fornece a capacidade de escolher um idioma nacional e armazenar dados em um conjunto de caracteres específico.
O Oracle Database fornece suporte à globalização para recursos como:
-
Idiomas e territórios nativos
-
Formatos locais para data, hora, números e moeda
-
Sistemas de calendário (Gregoriano, Imperial Japonês, Buda Tailandês e assim por diante)
-
Vários conjuntos de caracteres, incluindo Unicode
-
Semântica de caracteres
-
Conjuntos de Caracteres Um componente-chave do suporte à globalização é um conjunto de caracteres, que é um esquema de codificação usado para exibir caracteres em uma tela de computador.
-
Configurações Específicas de Local Uma configuração regional é um ambiente linguístico e cultural em que um sistema ou programa está em execução. Os parâmetros NLS determinam o comportamento específico de localidade no cliente e no banco de dados.
Conjuntos de Caracteres
Um componente-chave do suporte à globalização é um conjunto de caracteres, que é um esquema de codificação usado para exibir caracteres em uma tela de computador.
A seguinte distinção é importante no desenvolvimento de aplicativos:
-
Um conjunto de caracteres do banco de dados determina quais idiomas podem ser representados em um banco de dados. O conjunto de caracteres é especificado na criação do banco de dados.
Observação: Depois que um banco de dados é criado, a alteração de seu conjunto de caracteres geralmente é muito cara em termos de tempo e recursos. Esta operação pode exigir converter todos os dados de caracteres, exportando todo o banco de dados e importando-o novamente.
-
Um conjunto de caracteres do cliente é o conjunto de caracteres dos dados inseridos ou exibidos por um aplicativo cliente. O conjunto de caracteres para o cliente e o banco de dados pode ser diferente.
Um grupo de caracteres (por exemplo, caracteres alfabéticos, ideografias, símbolos, marcas de pontuação e caracteres de controle) pode ser codificado como um conjunto de caracteres. Um conjunto de caracteres codificados atribui um código numérico exclusivo, chamado de ponto de código ou valor codificado, a cada caractere do conjunto. Os pontos de código são importantes em um ambiente global devido à possível necessidade de converter dados entre diferentes conjuntos de caracteres.
A indústria de computadores usa muitos conjuntos de caracteres codificados. Esses conjuntos diferem no número de caracteres disponíveis, nos caracteres disponíveis para uso, nos pontos de código atribuídos a cada caractere e assim por diante. O Oracle Database suporta a maioria de padrões nacionais, internacionais e de conjuntos de caracteres codificados específicos para fornecedores.
O Oracle Database suporta as seguintes classes de conjuntos de caracteres codificados:
-
Conjuntos de caracteres de Byte Único
Cada caractere ocupa um byte. Um exemplo de conjunto de caracteres de 7 bits é US7ASCII. Um exemplo de conjunto de caracteres de 8 bits é WE8DEC.
-
Conjuntos de caracteres multibyte
Cada caractere ocupa vários bytes. Conjuntos multibyte são comumente usados para idiomas asiáticos.
-
Unicode
O conjunto de caracteres codificados universal permite armazenar informações em qualquer idioma usando um único conjunto de caracteres. O Unicode fornece um valor de código exclusivo para cada caractere, independentemente da plataforma, programa ou idioma.
Consulte Também: Guia de Suporte à Globalização do Oracle AI Database para saber mais sobre a migração de conjuntos de caracteres
Configurações específicas do idioma
Uma configuração regional é um ambiente linguístico e cultural em que um sistema ou programa está em execução. Os parâmetros NLS determinam o comportamento específico de localidade no cliente e no banco de dados.
Uma sessão de banco de dados usa configurações NLS ao executar instruções em nome de um cliente. Por exemplo, o banco de dados faz o uso correto do território do separador de milhares para um cliente. Geralmente, a variável de ambiente NLS_LANG no host do cliente especifica a configuração regional para a sessão do servidor e o aplicativo cliente. O processo é o seguinte:
-
Quando um aplicativo cliente é iniciado, ele inicializa o ambiente NLS do cliente nas configurações do ambiente.
Todas as operações NLS executadas localmente, como exibição de formatação nos aplicativos Oracle Developer, usam essas definições.
-
O cliente comunica as informações definidas pelo
NLS_LANGao banco de dados quando ele se conecta. -
A sessão do banco de dados inicializa seu ambiente NLS com base nas configurações comunicadas pelo cliente.
Se o cliente não especificou as configurações, então a sessão usa as configurações no arquivo de parâmetros de inicialização. O banco de dados usa as configurações do parâmetro de inicialização somente se o cliente não especificou nenhuma configuração NLS. Se o cliente especificou algumas definições NLS, então as definições NLS restantes são padrão.
Cada sessão iniciada em nome de um aplicativo cliente pode ser executada na mesma localidade ou em uma localidade diferente das outras sessões. Por exemplo, uma sessão pode usar a configuração regional da Alemanha, enquanto outra usa a configuração regional da França. Além disso, cada sessão pode ter os mesmos requisitos de idioma ou diferentes especificados.
A tabela a seguir mostra dois clientes usando definições NLS_LANG diferentes. Um usuário inicia o SQL*Plus em cada host, faz log-on no mesmo banco de dados que hr e executa a mesma consulta simultaneamente. O resultado de cada sessão é diferente devido à configuração NLS específica da localidade para números de ponto flutuante.
Tabela 1 Configurações NLS Específicas do Local
| t | Host Cliente 1 | Host Cliente 2 |
|---|---|---|
| t0 | |
|
| t1 | |
|
Consulte Também: Guia de Suporte à Globalização do Oracle AI Database para saber mais sobre as configurações do NLS
Oracle Globalization Development Kit
O Oracle Globalization Development Kit (GDK) inclui APIs de programação abrangentes.
As APIs estão disponíveis para Java e PL/SQL e incluem amostras de código e documentação que abordam muitos dos problemas de design, desenvolvimento e implantação encontrados durante a criação de aplicativos globais. O GDK simplifica o processo de desenvolvimento e reduz o custo de desenvolvimento de aplicações de Internet usadas para suportar um ambiente global.
O GDK consiste principalmente em duas partes: GDK para Java e GDK para PL/SQL. O GDK para Java fornece suporte à globalização para aplicativos Java. O GDK para PL/SQL fornece suporte à globalização para o ambiente de programação PL/SQL. As características oferecidas nas duas partes não são idênticas.
Consulte Também: Guia de Suporte à Globalização do Oracle AI Database
Dados Não Estruturados
Dados não estruturados são dados que não são divididos em estruturas lógicas menores.
O modelo relacional tradicional lida com dados estruturados simples que se enquadram em tabelas simples. O Oracle Database também fornece suporte para dados não estruturados, que não podem ser decompostos em componentes padrão. Dados não estruturados incluem texto, imagens gráficas, videoclipes e formas de onda sonoras.
O Oracle Database inclui tipos de dados para lidar com conteúdo não estruturado. Esses tipos de dados aparecem como tipos nativos no banco de dados e podem ser consultados usando SQL.
-
Visão Geral do XML no Oracle Database O Oracle XML DB é um conjunto de tecnologias do Oracle Database relacionadas à manipulação, armazenamento e recuperação de XML de alto desempenho. O Oracle XML DB oferece suporte nativo a XML, abrangendo modelos de dados SQL e XML de maneira interoperável.
-
Visão Geral do JSON no Oracle Database O Oracle Database fornece suporte nativo para dados JSON (Object Notation) JavaScript, incluindo consulta e indexação.
-
Visão Geral de LOBs Os tipos de dados LOB (Large Object, Objeto grande) permitem armazenar e manipular grandes blocos de dados não estruturados em formato binário ou de caracteres.
-
Visão Geral do Oracle Text Oracle Text (Texto) é uma tecnologia de recuperação de texto completo integrada ao Oracle Database. O Oracle Text indexa qualquer documento ou conteúdo textual armazenado em sistemas de arquivos, bancos de dados ou na Web. Esses documentos podem ser pesquisados com base em seu conteúdo textual, metadados ou atributos.
-
Visão Geral do Oracle Spatial and Graph O Oracle Spatial and Graph (Spatial and Graph) inclui recursos avançados para análise e dados espaciais e para aplicativos gráficos físicos, lógicos, de rede e sociais e semânticos.
-
Visão Geral de Gráficos de Propriedades SQL O recurso Gráfico de Propriedades do Oracle Database oferece suporte avançado a gráficos para o Oracle Database.
Visão Geral do XML no Oracle Database
Oracle XML DB é um conjunto de tecnologias do Oracle Database relacionadas à manipulação, armazenamento e recuperação de XML de alto desempenho. O Oracle XML DB oferece suporte nativo a XML, abrangendo modelos de dados SQL e XML de maneira interoperável.
O Oracle XML DB é adequado para qualquer aplicativo Java ou PL/SQL em que alguns ou todos os dados processados pelo aplicativo são representados usando XML. Por exemplo, o aplicativo pode ter um grande número de documentos XML que devem ser ingeridos, gerados, validados e pesquisados.
O Oracle XML DB fornece muitos recursos, incluindo:
-
O tipo de dados
XMLTypenativo, que pode representar um documento XML no banco de dados para que ele seja acessível por SQL -
Suporte para padrões XML, como Esquema XML, XPath, XQuery, XSLT e DOM
-
XMLIndex, que suporta todas as formas de dados XML, de altamente estruturado a completamente não estruturado
O exemplo a seguir cria uma tabela orders do tipo XMLType:
CREATE TABLE orders OF XMLType;
CREATE DIRECTORY xmldir AS path_to_folder_containing_XML_file;
INSERT INTO orders
  VALUES (XMLType(BFILENAME('XMLDIR','purOrder.xml'),NLS_CHARSET_ID('AL32UTF8')));
O exemplo anterior também cria um objeto de diretório SQL, que é um nome lógico no banco de dados para um diretório físico no computador host. Este diretório contém arquivos XML. O exemplo insere conteúdo XML do arquivo purOrder.xml na tabela orders.
O Oracle XML Developer's Kit (XDK) contém os elementos básicos para leitura, manipulação, transformação e exibição de documentos XML, seja em um sistema de arquivos ou em um banco de dados. APIs e ferramentas estão disponíveis para Java, C e C++. O Oracle XDK de produção vem com uma licença de redistribuição comercial.
Exemplo 23-1 XMLType
CREATE TABLE orders OF XMLType;
CREATE DIRECTORY xmldir AS path_to_folder_containing_XML_file;
INSERT INTO orders
  VALUES (XMLType(BFILENAME('XMLDIR','purOrder.xml'),NLS_CHARSET_ID('AL32UTF8')));
Consulte Também:
Visão Geral do JSON no Oracle Database
O Oracle Database fornece suporte nativo para dados JSON (Object Notation, Notação de objeto) JavaScript, incluindo consulta e indexação.
Essa seção contém os seguintes tópicos:
-
O que é JSON? JavaScript Object Notation (JSON) é um formato de dados baseado em texto independente de idioma que pode representar objetos, arrays e dados escalares. Uma variedade de linguagens de programação pode analisar e gerar dados JSON.
-
JSON e XML JSON e XML são comumente usados como linguagens de intercâmbio de dados. Ao contrário dos dados relacionais, tanto os dados JSON quanto os dados XML podem ser armazenados, indexados e consultados no banco de dados sem qualquer esquema que defina os dados.
-
Suporte ao Banco de Dados Nativo para JSON O JSON é amplamente armazenado em bancos de dados noSQL que não têm recursos de banco de dados relacional. Por outro lado, o Oracle Database suporta JSON nativamente com recursos como transações, indexação, consulta declarativa e views.
O que é JSON?
JavaScript Object Notation (JSON) é um formato de dados baseado em texto independente de idioma que pode representar objetos, arrays e dados escalares. Uma variedade de linguagens de programação pode analisar e gerar dados JSON.
O JSON geralmente serve como uma linguagem de intercâmbio de dados. É frequentemente usado para serializar dados estruturados e trocá-los por uma rede, normalmente entre um servidor e aplicativos da Web. O JSON é o formato de dados dominante em navegadores web que executam aplicativos escritos em JavaScript incorporado em HTML.
Um objeto JavaScript é um array associativo de zero ou mais pares de nomes de propriedades e valores JSON associados. Um objeto JSON é um literal de objeto JavaScript, que é gravado como uma lista de propriedades entre colchetes, com pares nome-valor separados por vírgulas e com o nome e o valor de cada par separado por dois-pontos. Uma propriedade de objeto às vezes é chamada de chave. Um par nome-valor da propriedade do objeto às vezes é chamado de membro do objeto.
Exemplo 23-2 Objeto JSON
Este exemplo mostra um objeto JSON que representa uma ordem de compra, com nomes de propriedade de nível superior PONumber, Reference, Requestor, User, Costcenter, ShippingInstruction, Special Instructions, AllowPartialShipment e LineItems.
{ "PONumber"             : 1600,
  "Reference"            : "ABULL-20140421",
  "Requestor"            : "Alexis Bull",
  "User"                 : "ABULL",
  "CostCenter"           : "A50",
  "ShippingInstructions" : { "name"   : "Alexis Bull",
                             "Address": { "street"  : "200 Sporting Green",
                                          "city"    : "South San Francisco",
                                          "state"   : "CA",
                                          "zipCode" : 99236,
                                          "country" : "United States of America" },
                             "Phone" : [ { "type" : "Office", "number" : "909-555-7307" },
                                         { "type" : "Mobile", "number" : "415-555-1234" } ] },
  "Special Instructions" : null,
  "AllowPartialShipment" : false,
  "LineItems"            : [ { "ItemNumber" : 1,
                               "Part"       : { "Description" : "One Magic Christmas",
                                                "UnitPrice"   : 19.95,
                                                "UPCCode"     : 13131092899 },
                               "Quantity"   : 9.0 },
                             { "ItemNumber" : 2,
                               "Part"       : { "Description" : "Lethal Weapon",
                                                "UnitPrice"   : 19.95,
                                                "UPCCode"     : 85391628927 },
                               "Quantity"   : 5.0 } ] }
No exemplo anterior, a maioria das propriedades tem valores de string. PONumber, zipCode, ItemNumber e Quantity têm valores numéricos. Shipping Instructions e Address têm objetos como valores. LineItems tem uma matriz como um valor.
Observação: Oracle XML DB Developer's Guide para obter uma visão geral mais abrangente do JSON
JSON e XML
Tanto JSON quanto XML são comumente usados como linguagens de intercâmbio de dados. Ao contrário dos dados relacionais, tanto os dados JSON quanto os dados XML podem ser armazenados, indexados e consultados no banco de dados sem qualquer esquema que defina os dados.
Devido à sua definição e recursos simples, os dados JSON geralmente são mais fáceis de gerar, analisar e processar do que os dados XML. Também é mais fácil para os seres humanos aprender e usar. A tabela a seguir descreve outras diferenças entre JSON e XML.
Tabela 2 Diferenças Entre JSON e XML
| Recurso | JSON | XML |
|---|---|---|
| Útil para dados simples e estruturados | Sim | Sim, mas também suporta dados semiestruturados e dados estruturados complexos |
| Útil para conteúdo misto | Não | Sim |
| Falta atributos, namespaces, herança e substituição | Sim | Não |
| Coloca a importância no pedido | Não | Sim |
| Destinado principalmente a documentos em vez de dados | Não | Sim |
| Incluir um tipo de dados de data | Não | Sim |
Observação: Oracle AI Database JSON Developer's Guide para uma comparação mais abrangente de XML e JSON
Suporte ao Banco de Dados Nativo para JSON
O JSON é amplamente armazenado em bancos de dados noSQL que não têm recursos de banco de dados relacional. Por outro lado, o Oracle Database suporta JSON nativamente com recursos como transações, indexação, consulta declarativa e views.
Você pode acessar dados JSON armazenados no banco de dados da mesma forma que acessa outros dados, incluindo o uso de OCI, .NET e JDBC. A forma preferida de armazenar dados JSON é usar o tipo de dados JSON, que é um formato binário proprietário otimizado para consulta e processamento DML. Você pode usar o tipo de dados JSON na maioria dos locais em que um tipo de dados SQL é permitido, incluindo um tipo de coluna ou tipo de parâmetro para uma unidade de programa PL/SQL.
Usando o Oracle SQL, você pode executar as operações como as seguintes nos dados JSON:
-
Una dados JSON com dados relacionais não JSON.
-
Gere documento JSON com base em dados relacionais usando as funções SQL
json_objectejson_array. -
Projete dados JSON em um formato relacional usando a função SQL
json_table. -
Crie uma restrição de verificação com
is_jsonpara impor dados JSON em uma coluna. O banco de dados usa a restrição de verificação para confirmar se a coluna é JSON para operações específicas do JSON, como sintaxe simplificada. -
Manipular documentos JSON como objetos PL/SQL.
-
Use as funções SQL
json_queryejson_valuepara aceitar uma expressão de caminho JSON Oracle como argumento e combiná-la com os dados JSON de destino. -
Indexar dados JSON.
-
Consulte dados JSON armazenados em uma tabela externa.
-
Replique tabelas com colunas que contêm dados JSON usando o Oracle GoldenGate.
Os dados JSON textuais sempre usam o conjunto de caracteres Unicode, UTF8 ou UTF16. O Oracle Database usa o UTF8 internamente quando analisa e consulta dados JSON. Se os dados de entrada ou saída desse processamento precisarem estar em um conjunto de caracteres diferente de UTF8, a conversão apropriada do conjunto de caracteres será realizada automaticamente. Observação: Oracle AI Database JSON Developer's Guide para obter uma visão geral mais abrangente do suporte a JSON no Oracle Database
Visão Geral de LOBs
Os tipos de dados LOB (Large Object) permitem armazenar e manipular grandes blocos de dados não estruturados em formato binário ou de caracteres.
O tipo de dados LOB (large object) fornece acesso eficiente, aleatório e por partes aos dados.
-
LOBs Internos Um LOB interno armazena dados no próprio banco de dados em vez de em arquivos externos.
-
LOBs Externos Um
BFILE(objeto grande de arquivo binário, ou LOB) é um objeto grande externo. -
O armazenamento de LOB SecureFiles SecureFiles é um dos dois tipos de armazenamento; o outro é o armazenamento de LOB BasicFiles.
LOBs internos
Um LOB interno armazena dados no próprio banco de dados em vez de em arquivos externos.
Os LOBS internos incluem o seguinte:
-
CLOB(caractere LOB), que armazena grandes quantidades de texto, como arquivos de texto ou XML, no conjunto de caracteres do banco de dados -
NCLOB(conjunto de caracteres nacionais LOB), que armazena dados Unicode -
BLOB(LOB binário), que armazena grandes quantidades de informações binárias como um fluxo de bits e não está sujeito à tradução de conjuntos de caracteres
O banco de dados armazena LOBs de maneira diferente dos outros tipos de dados. A criação de uma coluna LOB cria implicitamente um segmento LOB e um índice LOB. O tablespace que contém o segmento LOB e o índice LOB, que são sempre armazenados juntos, pode ser diferente do tablespace que contém a tabela.
Observação: Às vezes, o banco de dados pode armazenar pequenas quantidades de dados LOB na própria tabela, em vez de em um segmento LOB separado.
O segmento LOB armazena dados em partes chamadas chunks. Um chunk é um conjunto logicamente contíguo de blocos de dados e é a menor unidade de alocação para um LOB. Uma linha na tabela armazena um ponteiro chamado localizador LOB, que aponta para o índice LOB. Quando a tabela é consultada, o banco de dados usa o índice LOB para localizar rapidamente os blocos LOB.
O banco de dados gerencia a consistência de leitura para segmentos de LOB de maneira diferente dos outros dados. Em vez de usar dados de undo para registrar alterações, o banco de dados armazena as imagens antes no próprio segmento. Quando uma transação altera um LOB, o banco de dados aloca um novo bloco e deixa os dados antigos no lugar. Se a transação fizer rollback, o banco de dados fará rollback das alterações no índice, que aponta para o bloco antigo.
Consulte Também:
LOBs externos
BFILE (arquivo binário grande objeto, ou LOB) é um objeto externo grande.
BFILE é um LOB externo, porque o banco de dados armazena um ponteiro para um arquivo no sistema operacional. Os dados externos são somente leitura.
Um BFILE usa um objeto de diretório para localizar dados. A quantidade de espaço consumida depende do tamanho do nome do objeto de diretório e do tamanho do nome do arquivo.
Um BFILE não usa o mesmo mecanismo de consistência de leitura que o LOBS interno porque o arquivo binário é externo ao banco de dados. Se os dados no arquivo forem alterados, as leituras repetidas do mesmo arquivo binário poderão produzir resultados diferentes.
SecureFiles
O armazenamento de LOB SecureFiles é um dos dois tipos de armazenamento; o outro é o armazenamento de LOB BasicFiles.
O parâmetro LOB SECUREFILE permite recursos avançados, incluindo compactação e desduplicação (parte da Opção de Compactação Avançada) e criptografia (parte da Opção de Segurança Avançada). A partir do Oracle Database 12c, o SecureFiles é o mecanismo de armazenamento padrão para LOBs.
Consulte Também:
-
Oracle AI Database SecureFiles and Large Objects Developer's Guide para saber mais sobre tipos de dados LOB
Visão Geral do Oracle Text
Oracle Text (Texto) é uma tecnologia de recuperação de texto completo integrada ao Oracle Database. O Oracle Text indexa qualquer documento ou conteúdo textual armazenado em sistemas de arquivos, bancos de dados ou na Web. Esses documentos podem ser pesquisados com base em seu conteúdo textual, metadados ou atributos.
O Oracle Text oferece as seguintes vantagens:
-
O Oracle Text permite que pesquisas de texto sejam combinadas com pesquisas regulares em um único comando SQL. O índice de Texto está no banco de dados e as consultas de Texto são executadas no processo do Oracle Database. O otimizador pode escolher o melhor plano de execução para qualquer consulta, fornecendo o melhor desempenho para consultas ad hoc envolvendo critérios estruturados e de Texto.
-
É possível usar o Oracle Text com dados XML. Em particular, é possível combinar
XMLIndexcom a indexação do Oracle Text, aproveitando o XML e um índice de texto completo. -
A API SQL do Oracle Text torna simples e intuitivo criar e manter índices do Oracle Text e executar pesquisas.
Para um caso de uso, suponha que você deva criar um índice de catálogo para um site de leilão que venda equipamentos eletrônicos. Um novo inventário é adicionado todos os dias. As descrições de itens, as datas de lance e os preços devem ser armazenados juntos. O aplicativo requer um bom tempo de resposta para consultas mistas. Primeiro, você cria e preenche uma tabela catalog. Em seguida, use o Oracle Text para criar um índice CTXCAT que você pode consultar com o operador CATSEARCH em uma instrução SELECT ... WHERE CATSEARCH. A Figura 23-4 ilustra a relação da tabela de catálogos, seu índice CTXCAT e a aplicação de catálogo que usa o operador CATSEARCH para consultar o índice.
Figura 4: Aplicativo de Consulta de Catálogo
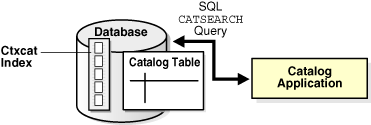
Descrição da ilustração ccapp017.gif
Consulte Também:
-
Guia do Desenvolvedor do Oracle Text Application e Referência do Oracle Text
-
Oracle XML DB Developer's Guide para aprender a executar pesquisa de texto completo em dados XML
Visão Geral do Oracle Spatial and Graph
O Oracle Spatial and Graph (Spatial and Graph) inclui recursos avançados para análise e dados espaciais e para aplicativos gráficos físicos, lógicos, de rede e sociais e semânticos.
Os recursos espaciais fornecem um esquema e funções que facilitam o armazenamento, a recuperação, a atualização e a consulta de conjuntos de recursos espaciais em um banco de dados Oracle. Um exemplo de dados espaciais é um roteiro. Os dados espaciais indicam a localização da Terra (como longitude e latitude) dos objetos no mapa. Quando o mapa é renderizado, esses dados espaciais podem projetar os locais dos objetos em um pedaço de papel bidimensional. Um sistema de informação geográfica (SIG) pode armazenar, recuperar e renderizar esses dados espaciais relativos à Terra. Quando um banco de dados Oracle armazena esses dados espaciais, você pode usar o Spatial and Graph para manipular e recuperar esses dados e relacioná-los a outros dados.
Consulte Também: Guia do Desenvolvedor do Oracle Spatial
Visão Geral de Gráficos de Propriedades SQL
O recurso Property Graph do Oracle Database oferece suporte avançado a gráficos para o Oracle Database.
O recurso Property Graph permite que você explore e descubra relacionamentos complexos em conjuntos de dados, como dados de clientes, redes sociais e transações financeiras, para aplicativos em recomendação de produtos, detecção de fraude, análise de risco, marketing direcionado e muito mais. Esse recurso de gráfico de alto desempenho oferece suporte avançado a linguagens de consulta de gráficos, APIs de desenvolvedor e recursos de análise com quase 60 algoritmos predefinidos.
Os recursos do Property Graph, incluindo o suporte a PGQL (Property Graph Query Language), estão disponíveis no Oracle Database 12.2 em diante. A partir do Oracle Database Release 26ai, você também pode criar e consultar gráficos de propriedades usando SQL, conforme definido no padrão SQL:2023.
O Oracle Graph Server and Client é um pacote de software que funciona com o recurso Property Graph no Oracle Database. Ele inclui ferramentas de gráfico, bibliotecas de clientes e o Oracle Graph Server para executar algoritmos de análise de gráficos.
Tópicos Relacionados