索引表和索引组织表
索引是方案对象,可以加快表行的访问速度。按索引组织的表是存储在索引结构中的表。
-
索引简介 索引是与表或表群集关联的可选结构,有时可以加快数据访问速度。
-
B 树索引概览 B 树,即平衡树,是最常见的数据库索引类型。B 树索引是分成范围的有序值列表。通过将键与行或行范围关联,B 树可为各种查询(包括完全匹配和范围搜索)提供出色的检索性能。
-
位图索引概览 在位图索引中,数据库存储每个索引键的位图。在传统的 B 树索引中,一个索引条目指向一行。在位图索引中,每个索引键存储指向多个行的指针。
-
基于函数的索引概览 基于函数的索引计算涉及一列或多列的函数或表达式的值并将其存储在索引中。基于函数的索引可以是 B 树索引或位图索引。
-
应用程序域索引概览 应用程序域索引是特定于应用程序的定制索引。
-
标量量化 HNSW 索引概述 标量化分层可导航小世界 (HNSW) 索引可用于降低内存要求并加速相似性搜索。
-
索引组织表概览 索引组织表是存储在 B 树索引结构变体中的表。相反,按堆组织的表会插入适合的行。
索引简介
index 是与表或表群集关联的可选结构,有时可以加快数据访问速度。
索引是在逻辑上和物理上都独立于与其关联的对象中的数据的方案对象。因此,可以在不物理影响索引表的情况下删除或创建索引。
注:如果删除索引,则应用程序仍可工作。但是,访问以前索引的数据可能会更慢。
例如,假设 HR 经理有一个纸板箱架。包含员工信息的文件夹将随机插入框中。员工 Whalen 的文件夹 (ID 200) 从框 1 的底部向上是 10 个文件夹,而 King 的文件夹 (ID 100) 位于框 3 的底部。要查找文件夹,经理从下到上查看框 1 中的每个文件夹,然后从一个框移到另一个框,直到找到该文件夹。为了加快访问速度,经理可以创建一个索引,按顺序列出每个员工 ID 及其文件夹位置:
ID 100: Box 3, position 1 (bottom)
ID 101: Box 7, position 8
ID 200: Box 1, position 10
.
.
.
同样,经理可以为雇员的姓氏、部门标识等创建单独的索引。
本部分涵盖以下主题:
-
索引的优点和缺点 索引的缺失或存在不需要更改任何 SQL 语句的措辞。
-
索引可用性和可见性索引可用(默认)或不可用、可见(默认)或不可见。
-
键和列 键是一组列或表达式,您可以在这些列或表达式上构建索引。
-
组合索引 组合索引(也称为级连索引)是一种对表中的多个列的索引。
-
唯一索引和非唯一索引索引可以是唯一的,也可以是非唯一的。唯一索引可以保证表中的任何两行在键列或列中都没有重复的值。
-
索引类型 Oracle AI Database 提供了多种索引方案,可提供互补的性能功能。
-
数据库如何维护索引 数据库在创建索引后会自动维护和使用索引。
-
索引存储 Oracle AI Database 将索引数据存储在索引段中。
索引的优点和缺点
索引的缺失或存在不需要更改任何 SQL 语句的措辞。
索引是单行数据的快速访问路径。它只会影响执行速度。给定已编制索引的数据值,索引将直接指向包含该值的行的位置。
当表的一个或多个列上存在索引时,数据库在某些情况下可以从表中检索一小组随机分布的行。索引是减少磁盘 I/O 的多种方法之一。如果按堆组织的表没有索引,则数据库必须执行全表扫描才能查找值。例如,未编制索引的 hr.departments 表中位置 2700 的 query 要求数据库搜索每个块中的每一行。这种方法不能很好地扩展,因为数据量会增加。
索引的缺点包括:
-
手动创建索引通常需要深入了解数据模型、应用和数据分布。
-
数据发生更改时,必须重新访问以前有关索引的决定。索引可能不再有用,或者可能需要新索引。
-
索引占用磁盘空间。
-
对创建性能开销的已索引数据执行 DML 时,数据库必须更新索引。注:从 Oracle Database 19c 开始,Oracle 数据库可以不断监视应用程序工作量,自动创建和管理索引。自动索引作为在固定时间间隔内运行的数据库任务实现。
请考虑在以下情况下创建索引:
-
索引的列会频繁查询,并且只返回表中行总数的一小部分。
-
索引的列上存在引用完整性约束条件。如果更新父表 primary key 、合并到父表或从父表中删除,则索引是一种避免完整表 lock 的方法。
-
唯一键约束条件将放置在表中,您希望手动指定索引和所有索引选项。
另请参见:
-
Oracle AI Database Administrator’s Guide,了解有关自动索引的更多信息
-
Oracle AI Database Licensing Information User Manual,详细了解不同版本和服务支持哪些功能
索引可用性和可见性
索引可用(默认)、不可用、可见(默认)或不可见。
这些属性按如下方式定义:
-
可用性
DML 操作不会维护由 optimizer 忽略的 unusable index 。不可用的索引可以提高批量加载的性能。您可以使索引不可用,然后重新构建索引,而不必删除索引,然后再重新创建它。不可用的索引和索引分区不会占用空间。使可用索引不可用时,数据库会删除其索引 segment 。
-
可见性
不可见索引由 DML 操作维护,但缺省情况下不会由优化程序使用。使索引不可见是使其不可用或丢弃的替代方法。在删除索引之前或临时使用索引而不影响整个应用程序的情况下,不可见索引对于测试删除索引特别有用。
另请参阅:“优化程序概览”以了解优化程序如何选择执行计划
键和列
键是一组列或表达式,您可以在这些列或表达式上构建索引。
虽然这些术语通常可以互换使用,但索引和键不同。索引是用户使用 SQL 语句管理的数据库中存储的结构。键严格来说是一个逻辑概念。
以下语句会在示例表 oe.orders 的 customer_id 列上创建一个索引:
CREATE INDEX ord_customer_ix ON orders (customer_id);在前面的语句中,customer_id 列是索引键。索引本身名为 ord_customer_ix。
注:主键和唯一键自动具有索引,但您可能希望在外键上创建索引。
另请参见:
-
“数据集成”
-
Oracle AI Database SQL Language Reference
CREATE INDEX语法和语义
组合索引
组合索引(也称为级连索引)是一种对表中的多个列的索引。
按最适合检索数据的查询的顺序将列置于组合索引中。列不需要与表中的列相邻。
组合索引可加快 SELECT 语句中数据的检索速度,条件是这些 WHERE 子句引用组合索引中的所有列或前几列。因此,定义中使用的列的顺序很重要。通常,最常访问的列优先。
例如,假定应用程序经常查询 employees 表中的 last_name、job_id 和 salary 列。还假定 last_name 具有较高的基数,这意味着相较于表行数,相异值的数量较大。创建具有以下列顺序的索引:
CREATE INDEX employees_ix
   ON employees (last_name, job_id, salary);
访问所有这三列的查询,只有 last_name 列,或者只有 last_name 和 job_id 列使用此索引。在此示例中,不访问 last_name 列的查询不使用索引。
注:在某些情况下,例如,当前导列具有非常低的基数时,数据库可能会使用此索引的跳过扫描(请参见“索引跳过扫描”)。
满足以下任一条件时,同一个表上可以存在多个具有相同列顺序的索引:
-
索引类型不同。
例如,可以在相同的列上创建位图和 B 树索引。
-
索引使用不同分区方案。
例如,可以创建本地分区的指数和全局分区的指数。
-
索引具有不同的唯一性属性。
例如,可以在同一组列上创建一个唯一指数和一个不唯一指数。
例如,同一表列可以按相同的顺序存在未分区索引、全局分区索引和本地分区索引。任何时候都只能看到一个列数相同的索引。
使用此功能可以迁移应用程序,而无需删除现有索引并使用不同的属性重新创建索引。此外,当索引键不断增加,导致数据库将新条目插入同一组索引块时,此功能在 OLTP 数据库中很有用。为了缓解这种“热点”,可以将索引从未分区的索引演变成全局分区的索引。
如果同一组列上的索引在类型或分区方案中没有差异,则这些索引必须使用不同的列排列。例如,以下 SQL 语句指定有效的列排列:
CREATE INDEX employee_idx1 ON employees (last_name, job_id);
CREATE INDEX employee_idx2 ON employees (job_id, last_name);另请参阅:Oracle AI Database SQL Tuning Guide,了解有关在同一组列上创建多个索引的更多信息
唯一索引和非唯一索引
索引可以是唯一的,也可以是非唯一的。唯一索引可以保证表中的任何两行在键列或列中都没有重复的值。
例如,您的应用程序可能要求没有两个员工具有相同的员工 ID。在唯一索引中,每个数据值都有一个 rowid 。叶块中的数据仅按键进行排序。
非唯一索引允许在索引列或列中存在重复值。例如,employees 表的 first_name 列可以包含多个 Mike 值。对于非唯一索引,rowid 按排序顺序包含在键中,因此非唯一索引按索引键和 rowid(升序)排序。
Oracle AI Database 不会为所有键列都为 null 的表行编制索引,但位图索引或群集键列值为空时除外。
索引的类型
Oracle AI Database 提供了多种索引方案,可提供互补的性能功能。
B 树索引是标准索引类型。它们非常适合高度选择性索引(每个索引条目对应几行)和主键索引。用作连接索引, B 树索引可以检索按索引列排序的数据。B 树索引具有下表中显示的子类型。
表 1 B 树索引子类型
| B 树索引子类型 | 说明 | 详细了解 |
|---|---|---|
| 按指数组织的表 | 按索引组织的表不同于按堆组织的表,因为数据本身就是索引。 | “ Overview of Index-Organized Tables ” |
| 反向键索引 | 在这种类型的索引中,索引键的字节反转,例如,103 存储为 301。字节反转会将插入到多个块上的索引中。 | " Reverse Key Indexes " |
| 索引降序 | 这种类型的索引按降序对特定列或列的数据进行存储。 | “升序索引和降序索引” |
| B 树集群索引 | 这种类型的索引按降序对特定列或列的数据进行存储。 | “升序和降序索引” |
下表显示了不使用 B 树结构的索引类型。
表 2:不使用 B 树结构的索引
| 类型 | 说明 | 详细了解 |
|---|---|---|
| 位图和位图联接索引 | 在位图索引中,索引条目使用位图指向多个行。相反,B 树索引条目指向单个行。位图联接索引是两个或更多表的联接的位图索引。 | “位图索引概述” |
| 基于功能的索引 | 此类型的索引包括由函数(如 UPPER 函数)转换或包含在表达式中的列。B 树或位图索引可以基于函数。 |
“基于函数的索引概览” |
| 应用程序域索引 | 用户为特定于应用程序的域中的数据创建此类型的索引。物理索引不需要使用传统的索引结构,既可以作为表存储在 Oracle 数据库中,也可以作为文件存储在外部。 | “应用程序域索引概览” |
另请参见:
-
Oracle AI Database SQL Tuning Guide,了解不同的索引访问路径
数据库如何维护索引
创建索引后,数据库会自动维护和使用索引。
索引会自动反映对底层表的数据更改。更改的示例包括添加、更新和删除行。不需要用户操作。
即使在插入行时,索引数据的检索性能也几乎保持不变。但是,表上存在许多索引会降低 DML 性能,因为数据库还必须更新索引。
另请参见:
-
Oracle AI Database Administrator’s Guide,了解有关自动索引的更多信息
-
Oracle AI Database Licensing Information User Manual,详细了解不同版本和服务支持哪些功能
索引存储
Oracle AI Database 将索引数据存储在索引段中。
数据块中可用于索引数据的空间是数据块大小减去块开销、条目开销、rowid 和每个索引值一个长度字节。
索引段的 tablespace 是所有者的默认表空间或 CREATE INDEX 语句中专门指定的表空间。为了便于管理,可以将索引存储在其表中的单独表空间中。例如,您可以选择不备份仅包含可重新构建的索引的表空间,从而减少备份所需的时间和存储。
另请参阅:“索引块概述”以了解索引块的类型(根、分支和叶)以及索引项如何存储在块中
B 树索引概览
B 树,即平衡树,是最常见的数据库索引类型。B 树索引是分成范围的有序值列表。通过将键与行或行范围关联,B 树可为各种查询(包括完全匹配和范围搜索)提供出色的检索性能。
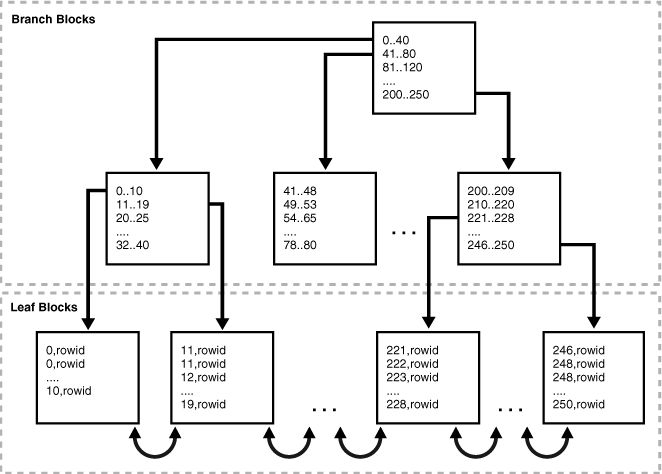
下图说明了 B 树索引的结构。此示例显示了 department_id 列的索引,该索引是 employees 表中的外键列。
图 1:B 树索引的内部结构
本部分涵盖以下主题:
-
分支块和叶块 B 树索引具有两种类型的块:用于搜索的 branch 块和用于存储键值的 leaf 块。B 树索引的上级分支块包含指向下级索引块的索引数据。
-
索引扫描 在索引扫描中,数据库使用语句指定的索引列值遍历索引来检索行。如果数据库扫描索引中的某个值,则会在 n I/O 中找到此值,其中 n 是 B 树索引的高度。这是 Oracle AI Database 索引背后的基本原则。
-
反向键索引 反向键索引是一种 B 树索引类型,在保持列顺序的同时,以物理方式反向每个索引键的字节数。
-
升序和降序索引 在升序索引中,Oracle AI Database 按升序存储数据。默认情况下,字符数据按值的每个字节中包含的二进制值、从最小到大的数字数据以及从最早到最新值的日期进行排序。
-
索引压缩:为了减少索引空间,Oracle AI Database 可以采用不同的压缩算法。
分支块和叶块
B 树索引有两种类型的块:用于搜索的 branch block 和用于存储键值的 leaf block 。B 树索引的上级分支块包含指向下级索引块的索引数据。
在图 5-1 中,根分支块具有一个条目 0-40,该条目指向下一个分支级别的最左侧块。此分支块包含 0-10 和 11-19 等条目。其中每个条目都指向一个叶块,该叶块包含在该范围内的键值。
B 树索引是平衡的,因为所有叶块会自动保持在相同的深度。因此,从索引中的任何位置检索任何记录需要大约相同的时间。索引的高度是从根块到叶块所需的块数。分支级别是高度减去 1。在图 5-1 中,索引的高度为 3,分支级别为 2。
分支块存储了在两个密钥之间做出分支决策所需的最小密钥前缀。此技术使数据库能够在每个分支块上容纳尽可能多的数据。分支块包含指向包含密钥的子块的指针。密钥和指针的数量受块大小限制。
叶块包含每个索引数据值以及用于查找实际行的对应行 ID。每个条目都按键 (key,rowid) 排序。在叶块中,键和 rowid 链接到其左侧和右侧同级条目。叶片本身也具有双重联系。在图 5-1 中,最左侧的叶块 (0-10) 链接到第二个叶块 (11-19)。注:具有字符数据的列中的索引基于数据库字符集中的字符的二进制值。
指数扫描
在 index scan 中,数据库通过使用语句指定的索引列值遍历索引来检索行。如果数据库扫描索引中的某个值,则会在 n I/O 中找到此值,其中 n 是 B 树索引的高度。这是 Oracle AI Database 索引背后的基本原则。
如果 SQL 语句仅访问索引列,则数据库会直接从索引读取值,而不是从表中读取值。如果该语句除了访问索引列之外还访问非索引列,则数据库将使用行 ID 查找表中的行。通常,数据库检索表数据的方式是,先读取索引块,然后再读取表块。
-
完整索引扫描 在完整索引扫描中,数据库按顺序读取整个索引。如果 SQL 语句中的 predicate (
WHERE子句)引用了索引中的列,并且在某些情况下未指定谓词,则可以使用完整索引扫描。完全扫描可以消除排序,因为数据按索引键排序。 -
快速全索引扫描 快速全索引扫描是完全索引扫描,在这种扫描中,数据库在不访问表的情况下访问索引本身中的数据,并且数据库不按特定顺序读取索引块。
-
Index Range Scan(索引范围扫描)index range scan(索引范围扫描)是索引的有序扫描,其中索引的一个或多个前导列在条件中指定,索引键可以有 0、1 或更多值。
-
索引唯一扫描 与索引范围扫描相比,索引唯一扫描必须具有与索引键关联的 0 或 1 行 ID。
-
Index Skip Scan index skip scan 使用组合索引的逻辑子索引。数据库将跳过单个索引,就好像在搜索单独的索引一样。
-
索引聚类系数 索引聚类系数衡量与索引值(如员工姓氏)相关的行顺序。随着顺序的增加,聚类因子会降低。另请参阅: Oracle AI Database SQL Tuning Guide,了解有关索引扫描的详细信息
完整索引扫描
在 full index scan 中,数据库按顺序读取整个索引。如果 SQL 语句中的 predicate (WHERE 子句)引用了索引中的列,并且在某些情况下未指定谓词,则可以使用完整索引扫描。完全扫描可以消除排序,因为数据按索引键排序。
示例 5-1 完整索引扫描
假设应用程序运行以下查询:
SELECT department_id, last_name, salary
FROM   employees
WHERE  salary > 5000
ORDER BY department_id, last_name;在此示例中,department_id、last_name 和 salary 是索引中的组合键。Oracle AI Database 会对索引执行完全扫描,按排序顺序(按部门 ID 和姓氏排序)读取索引并对薪金属性进行筛选。这样,数据库将扫描比 employees 表小的一组数据,其中包含的列多于查询中包含的列,并避免对数据进行排序。
完全扫描可以读取索引条目,如下所示:
50,Atkinson,2800,rowid
60,Austin,4800,rowid
70,Baer,10000,rowid
80,Abel,11000,rowid
80,Ande,6400,rowid
110,Austin,7200,rowid
.
.
.
快速全索引 Scan
快速完整索引扫描是完整索引扫描,在这种扫描中,数据库在不访问表的情况下访问索引本身中的数据,并且数据库不按特定顺序读取索引块。
如果满足以下两个条件,则快速全索引扫描是全表扫描的替代方法:
-
该索引必须包含查询所需的所有列。
-
包含所有空值的行不能出现在查询结果集中。要保证此结果,索引中必须至少有一列具有:
-
NOT NULL约束条件 -
应用于列的谓词,用于防止在查询结果集中考虑 Null 值
-
示例 5-2 快速全索引扫描
假定应用程序发出了以下查询,该查询不包括 ORDER BY 子句:
SELECT last_name, salary
FROM   employees;
last_name 列有一个 Not Null 约束条件。如果姓氏和薪金是索引中的组合键,则快速的全索引扫描可以读取索引条目以获取请求的信息:
Baida,2900,rowid
Atkinson,2800,rowid
Zlotkey,10500,rowid
Austin,7200,rowid
Baer,10000,rowid
Austin,4800,rowid
.
.
.
索引范围 Scan
索引范围扫描是索引的有序扫描,其中索引的一个或多个前导列在条件中指定,索引键可以有 0、1 或更多值。
条件指定一个或多个表达式和逻辑(布尔)运算符的组合。它返回的值为 TRUE、FALSE 或 UNKNOWN。
数据库通常使用索引范围扫描来访问选择性数据。选择性是查询选择的表中的行百分比,其中 0 表示无行,1 表示所有行。选择性与查询谓词(如 WHERE last_name LIKE 'A%')或谓词组合关联。当值接近 0 时,谓词变得更具选择性,当值接近 1 时,其选择性降低(或更无选择性)。
例如,用户查询姓氏以 A 开头的雇员。假定 last_name 列已编制索引,条目如下:
Abel,rowid
Ande,rowid
Atkinson,rowid
Austin,rowid
Austin,rowid
Baer,rowid
.
.
.
数据库可以使用范围扫描,因为在谓词中指定了 last_name 列,并且可以为每个索引键指定多个行 ID。例如,两个雇员命名为 Austin,因此两个行 ID 与关键字 Austin 相关联。
索引范围扫描可以在两端进行界定,例如在查询 ID 介于 10 和 40 之间的部门时,或者仅在一端进行界定,例如在查询 ID 超过 40 的部门时。要扫描索引,数据库将在叶块中向后或向前移动。例如,扫描介于 10 和 40 之间的 ID 会查找包含最低关键字值 10 或更高值的第一个索引叶块。然后,扫描将横向遍历叶节点的链接列表,直到找到大于 40 的值。
索引唯一性扫描
与索引范围扫描相反,索引唯一扫描必须具有与索引键关联的 0 或 1 行 ID。
当谓词使用等号运算符引用 UNIQUE 索引关键字中的所有列时,数据库将执行唯一扫描。索引唯一扫描在找到第一条记录后立即停止处理,因为无法再创建第二条记录。
如图所示,假设用户运行以下查询:
SELECT *
FROM   employees
WHERE  employee_id = 5;
假设 employee_id 列是主键,并按如下所示为条目编制索引:
1,rowid
2,rowid
4,rowid
5,rowid
6,rowid
.
.
.
在这种情况下,数据库可以使用索引唯一扫描来查找 ID 为 5 的员工的行标识。
索引跳过扫描
索引跳过扫描使用组合索引的逻辑子索引。数据库将跳过单个索引,就好像在搜索单独的索引一样。
如果组合索引的前导列中很少有不同的值,并且索引的非前导键中有很多不同的值,则跳过扫描很有用。如果未在查询谓词中指定组合索引的前导列,则数据库可以选择索引跳过扫描。
示例 5-3 跳过组合索引扫描
假设您为 sh.customers 表中的客户运行以下查询:
SELECT * FROM sh.customers WHERE cust_email = 'Abbey@company.example.com';customers 表的 cust_gender 列的值为 M 或 F。假定列(cust_gender、cust_email)上存在组合索引。以下示例显示了部分索引条目:
F,Wolf@company.example.com,rowid
F,Wolsey@company.example.com,rowid
F,Wood@company.example.com,rowid
F,Woodman@company.example.com,rowid
F,Yang@company.example.com,rowid
F,Zimmerman@company.example.com,rowid
M,Abbassi@company.example.com,rowid
M,Abbey@company.example.com,rowid
即使未在 WHERE 子句中指定 cust_gender,数据库也可以使用此索引的跳过扫描。
在跳过扫描中,逻辑子索引数由前导列中的相异值数确定。在前面的示例中,前导列有两个可能的值。数据库以逻辑方式将索引分成一个子索引(关键字为 F),另一个子索引(关键字为 M)。
搜索电子邮件为 Abbey@company.example.com 的客户的记录时,数据库首先搜索值为 F 的子索引,然后搜索值为 M 的子索引。从概念上讲,数据库按如下方式处理查询:
SELECT * FROM sh.customers WHERE cust_gender = 'F'
  AND cust_email = 'Abbey@company.example.com'
UNION ALL
SELECT * FROM sh.customers WHERE cust_gender = 'M'
AND cust_email = 'Abbey@company.example.com';另请参阅:Oracle AI Database SQL Tuning Guide 以了解有关跳过扫描的更多信息
索引聚类因子
索引聚类系数衡量与索引值(如员工姓氏)相关的行顺序。随着顺序的增加,聚类因子会降低。
聚类因子可用于粗略测量使用索引读取整个表所需的 I/O 数:
-
如果群集系数较高,则 Oracle AI Database 在大型索引范围扫描期间会执行相对较高的 I/O 数。索引条目指向随机表块,因此数据库可能必须一遍又一遍地读取和重新读取相同的块来检索索引指向的数据。
-
如果群集因子较低,则 Oracle AI Database 在大型索引范围扫描期间会执行相对较少的 I/O。范围中的索引键往往指向相同的数据块,因此数据库不必一遍又一遍地读取和重新读取相同的块。
聚类因子与索引扫描相关,因为它可以显示:
-
数据库是否使用索引进行大范围扫描
-
与索引键相关的表组织程度
-
如果必须按索引键对行进行排序,是否应考虑使用按索引组织的表、分区或表群集
示例 5-4 群集因子
假设 employees 表可分为两个数据块。表 5-3 描述了两个数据块中的行(省略号指示未显示的数据)。
表 3 员工表中两个数据块的内容
| 数据块 1 | 数据块 2 |
|---|---|
|
|
行按姓氏的顺序存储在块中(以粗体显示)。例如,数据块 1 中的底部行描述 Abel,向上下一行描述 Ande,依此类推,直到块 1 中 Steven King 的顶部行按字母顺序排列。块 2 中的底部行描述 Kochar,向上下一行描述 Kumar,依此类推,直到 Zlotkey 块中的最后一行按字母顺序排列。
假设姓氏列上存在索引。每个名称条目都对应于一个 rowid。从概念上讲,索引条目如下所示:
Abel,block1row1
Ande,block1row2
Atkinson,block1row3
Austin,block1row4
Baer,block1row5
.
.
.
假设员工 ID 列上存在单独的索引。从概念上讲,索引条目可能如下所示,员工 ID 在几乎随机的位置分布在两个块中:
100,block1row50
101,block2row1
102,block1row9
103,block2row19
104,block2row39
105,block1row4
.
.
.
以下语句查询 ALL_INDEXES 视图以获取这两个索引的群集系数:
SQL> SELECT INDEX_NAME, CLUSTERING_FACTOR
  2  FROM ALL_INDEXES
  3  WHERE INDEX_NAME IN ('EMP_NAME_IX','EMP_EMP_ID_PK');

INDEX_NAME           CLUSTERING_FACTOR
-------------------- -----------------
EMP_EMP_ID_PK                       19
EMP_NAME_IX                          2
EMP_NAME_IX 的聚类因子较低,这意味着单个叶块中的相邻索引条目往往指向同一数据块中的行。EMP_EMP_ID_PK 的聚类因子很高,这意味着同一叶块中的相邻索引条目指向同一数据块中的行的可能性要小得多。
另请参阅:Oracle AI Database Reference 以了解 ALL_INDEXES
逆序键索引
反向键索引是一种 B 树索引类型,在保持列顺序的同时,以物理方式反转每个索引键的字节数。
例如,如果索引键为 20,并且此键在十六进制中存储的两个字节在标准 B 树索引中为 C1,15,则反向键索引会将字节存储为 15,C1。
反转密钥可解决 B 树索引右侧的叶块争用问题。在多个实例重复修改同一块的 Oracle Real Application Clusters (Oracle RAC) 数据库中,此问题可能特别严重。例如,在 orders 表中,订单的主键是连续的。集群中的一个实例添加了顺序 20,而另一个实例添加了 21,每个实例将其密钥写入索引右侧的同一叶块。
在反向键索引中,字节顺序反转会在索引中的所有叶键之间分配插入。例如,标准键索引中相邻的键(如 20 和 21)现在存储在单独的块中相隔很远。因此,用于插入顺序键的 I/O 分布更为均匀。
由于索引中的数据在存储时不是按列键排序的,因此反向键排列在某些情况下会消除运行索引范围扫描查询的能力。例如,如果用户对大于 20 的订单 ID 发出查询,则数据库无法从包含此 ID 的块开始,并水平通过叶块进行。
升序索引和降序索引
在升序索引中,Oracle AI Database 按升序存储数据。默认情况下,字符数据按值的每个字节中包含的二进制值、从最小到大的数字数据以及从最早到最新值的日期进行排序。
有关升序索引的示例,请考虑以下 SQL 语句:
CREATE INDEX emp_deptid_ix ON hr.employees(department_id);Oracle AI Database 将对 department_id 列上的 hr.employees 表进行排序。它以升序(从 0 开始)加载具有 department_id 和对应行 ID 值的升序索引。当它使用索引时,Oracle AI Database 会搜索排序的 department_id 值并使用关联的行 ID 来查找具有所请求 department_id 值的行。
通过在 CREATE INDEX 语句中指定 DESC 关键字,可以创建降序索引。在这种情况下,索引按降序对指定列或列存储数据。如果 employees.department_id 列的 Table 5-3 中的索引是降序的,则包含 250 的叶块将位于树的左侧,块的右侧为 0。通过降序索引进行的默认搜索从高到低。
当查询按升序对某些列和按降序对其他列进行排序时,降序索引非常有用。例如,假定您按如下方式对 last_name 列和 department_id 列创建组合索引:
CREATE INDEX emp_name_dpt_ix ON hr.employees(last_name ASC, department_id DESC);如果用户按升序(A 到 Z)查询 hr.employees 以查找姓氏,按降序(从高到低)查询部门 ID,则数据库可以使用此索引检索数据并避免执行额外的排序步骤。
另请参见:
-
Oracle AI Database SQL Tuning Guide,了解有关索引搜索升序和降序的更多信息
-
Oracle AI Database SQL Language Reference(了解
CREATE INDEX的ASC和DESC选项的说明)
索引压缩
为了减少索引空间,Oracle AI Database 可以采用不同的压缩算法。
-
前缀压缩 Oracle AI Database 可以使用 prefix compression (也称为 key compression )压缩 B 树索引或索引组织表中的主键列值的部分。前缀压缩可以大大减少索引占用的空间。
-
从 Oracle Database 12c 发行版 1 (12.1.0.2) 开始,高级索引压缩改进了按堆组织的表上支持的索引的传统前缀压缩。高级索引压缩
前缀压缩
Oracle AI Database 可以使用前缀压缩(也称为键压缩)压缩 B 树索引或按索引组织的表中的主键列值的部分。前缀压缩可以大大减少索引占用的空间。
未压缩的索引条目包含一个片段。使用前缀压缩的索引条目有两个部分:前缀条目(即分组片段)和后缀条目(即唯一或几乎唯一的片段)。数据库通过在索引块中的后缀条目之间共享前缀条目来实现压缩。注:如果未将关键字定义为具有唯一片段,则数据库通过将行 ID 附加到分组片段来提供该关键字。
默认情况下,唯一索引的前缀由除最后一个键列之外的所有键列组成,而非唯一索引的前缀由所有键列组成。假设对 oe.orders 表的两个列创建一个组合唯一索引,如下所示:
CREATE UNIQUE INDEX orders_mod_stat_ix ON orders ( order_mode, order_status );在前面的示例中,索引键可能是 online,0。rowid 存储在条目的关键字数据部分,并且不属于关键字本身。
注:如果对单个列创建唯一索引,则 Oracle AI Database 无法使用前缀键压缩,因为不存在公用前缀。
或者,假设您在相同的列上创建非唯一索引:
CREATE INDEX orders_mod_stat_ix ON orders ( order_mode, order_status );还假定重复值出现在 order_mode 和 order_status 列中。索引块可以具有以下示例中所示的条目:
online,0,AAAPvCAAFAAAAFaAAa
online,0,AAAPvCAAFAAAAFaAAg
online,0,AAAPvCAAFAAAAFaAAl
online,2,AAAPvCAAFAAAAFaAAm
online,3,AAAPvCAAFAAAAFaAAq
online,3,AAAPvCAAFAAAAFaAAt
在前面的示例中,关键字前缀将由 order_mode 和 order_status 值的串联组成,如 online,0 中所示。后缀包含在 rowid 中,如 AAAPvCAAFAAAAFaAAa 中。rowid 可以使整个索引条目唯一,因为 rowid 本身在数据库中唯一。
如果以上示例中的索引是使用缺省前缀压缩(由 COMPRESS 关键字指定)创建的,则将压缩重复的关键字前缀(如 online、0 和 online、3)。从概念上讲,数据库按如下方式实现压缩:
online,0
AAAPvCAAFAAAAFaAAa
AAAPvCAAFAAAAFaAAg
AAAPvCAAFAAAAFaAAl
online,2
AAAPvCAAFAAAAFaAAm
online,3
AAAPvCAAFAAAAFaAAq
AAAPvCAAFAAAAFaAAt
后缀条目(行 ID)构成索引行的压缩版本。每个后缀条目都引用一个前缀条目,该条目与后缀存储在同一索引块中。
或者,可以在创建使用前缀压缩的索引时指定前缀长度。例如,如果指定了 COMPRESS 1,则前缀为 order_mode,后缀为 order_status,rowid。对于索引块示例中的值,该索引将排除前缀 online 的重复出现次数,可从概念上表示如下:
online
0,AAAPvCAAFAAAAFaAAa
0,AAAPvCAAFAAAAFaAAg
0,AAAPvCAAFAAAAFaAAl
2,AAAPvCAAFAAAAFaAAm
3,AAAPvCAAFAAAAFaAAq
3,AAAPvCAAFAAAAFaAAt
索引最多为每个叶块存储一次特定前缀。仅压缩 B 树索引叶块中的键。在分支块中,可以截断密钥后缀,但不会压缩密钥。
另请参见:
-
Oracle AI Database Administrator’s Guide,了解如何使用压缩索引
-
Oracle AI Database VLDB and Partitioning Guide,了解如何对分区索引使用前缀压缩
-
Oracle AI Database SQL Language Reference(了解
CREATE INDEX的 key_compression 子句的说明)
高级索引压缩
从 Oracle Database 12c 发行版 1 (12.1.0.2) 开始,高级索引压缩改进了按堆组织的表上支持的索引的传统前缀压缩。
高级索引压缩的优势
前缀压缩对支持的索引类型、压缩率和易用性具有限制。与每个块使用固定重复键消除的前缀压缩不同,高级索引压缩基于每个块使用自适应重复键消除。高级索引压缩的主要优点是:
-
数据库会自动为每个块选择最佳压缩,并使用许多内部算法,例如列内级别前缀、重复的键消除和行 ID 压缩。与前缀压缩不同,高级索引压缩不需要用户知道数据特征。
-
高级压缩适用于不唯一的索引和唯一索引。前缀压缩在某些非唯一索引上效果良好,但前导列没有多次重复的索引的比率较低。
-
压缩索引的使用方式与未压缩索引相同。该索引支持相同的访问路径:唯一键查找、范围扫描和快速完全扫描。
-
索引可以从父表或包含表空间继承高级压缩。
-
按索引组织的表和基于函数的索引支持高级索引压缩。按索引组织的表支持低压缩。基于函数的索引支持低压缩和高压缩。
高级索引压缩的工作原理
高级索引压缩在块级别工作,可为每个块提供最佳压缩。数据库使用以下技术:
-
在创建索引期间,当叶块已满时,数据库会自动将该块压缩到最佳级别。
-
由于 DML 而重组索引块时,如果数据库可以为传入的索引条目创建足够的空间,则不会发生块拆分。但是,在不进行高级索引压缩的 DML 期间,当块已满时,总会出现索引块拆分。
高级索引压缩 HIGH
在 Oracle Database 12c 发行版 2 (12.2) 之前的发行版中,唯一的高级索引压缩形式是低压缩 (COMPRESS ADVANCED LOW)。现在,您还可以指定高压缩 (COMPRESS ADVANCED HIGH),这是缺省设置。带有 HIGH 选项的高级索引压缩具有以下优点:
-
在大多数情况下提供更高的压缩率,同时还提高了访问索引的查询的性能
-
采用比高级低级更复杂的压缩算法
-
将数据存储在压缩单元中,这是一种特殊的磁盘上格式 注:应用
HIGH压缩时,所有块都具有压缩。应用LOW压缩时,数据库可能会使某些块保持未压缩状态。可以使用统计信息来确定保留了多少块未压缩。
示例 5-5 创建具有高级高压缩的索引
以下示例为 hr.employees 表上的索引启用高级索引压缩:
CREATE INDEX hr.emp_mndp_ix
  ON hr.employees(manager_id, department_id)
  COMPRESS ADVANCED;
以下查询显示了压缩类型:
SELECT COMPRESSION FROM DBA_INDEXES WHERE INDEX_NAME ='EMP_MNDP_IX';

COMPRESSION
-------------
ADVANCED HIGH
另请参见:
-
Oracle AI Database Administrator’s Guide,了解如何启用高级索引压缩
-
Oracle AI Database SQL Language Reference(了解
CREATE INDEX的 key_compression 子句的说明) -
Oracle AI Database Reference(了解
ALL_INDEXES)
位图索引概览
在 bitmap index 中,数据库存储每个索引键的位图。在传统的 B 树索引中,一个索引条目指向一行。在位图索引中,每个索引键存储指向多个行的指针。
位图索引主要用于数据仓库或环境,其中查询以即席方式引用许多列。可能调用位图索引的情况包括:
-
索引列具有较低的基数,即相较于表行数,相异值的数量较少。
-
已索引的表要么是只读的,要么不受 DML 语句进行重大修改。
对于数据仓库示例,sh.customers 表的 cust_gender 列中仅包含两个可能的值:M 和 F。假设查询特定性别的客户数是常见的。在这种情况下,customers.cust_gender 列将成为位图索引的候选项。
位图中的每个位都对应一个可能的 rowid。如果设置了位,则具有相应行 ID 的行包含关键字值。映射函数将位位置转换为实际的 rowid,因此位图索引提供与 B 树索引相同的功能,尽管它使用不同的内部表示形式。
如果单个行中的索引列已更新,则数据库会锁定索引键条目(例如 M 或 F),而不是映射到已更新行的单个位。由于键指向多个行,因此对已索引数据的 DML 通常会锁定所有这些行。因此,位图索引不适用于许多 OLTP 应用程序。
-
示例:单个表中的位图索引在此示例中,
sh.customers表的某些列是位图索引的候选项。 -
位图联接索引 位图联接索引是两个或更多表的联接的位图索引。
-
位图存储结构 Oracle AI Database 使用 B 树索引结构来存储每个索引键的位图。
另请参见:
-
Oracle AI Database SQL Tuning Guide(了解有关位图索引的更多信息)
-
Oracle AI Database Data Warehousing Guide,了解如何在数据仓库中使用位图索引
示例:单个表中的位图索引
在此示例中,sh.customers 表的某些列是位图索引的候选项。
请考虑以下查询:
SQL> SELECT cust_id, cust_last_name, cust_marital_status, cust_gender
  2  FROM   sh.customers
  3  WHERE  ROWNUM < 8 ORDER BY cust_id;

   CUST_ID CUST_LAST_ CUST_MAR C
---------- ---------- -------- -
         1 Kessel              M
         2 Koch                F
         3 Emmerson            M
         4 Hardy               M
         5 Gowen               M
         6 Charles    single   F
         7 Ingram     single   F

7 rows selected.
cust_marital_status 和 cust_gender 列具有低基数,而 cust_id 和 cust_last_name 则没有。因此,位图索引可能适用于 cust_marital_status 和 cust_gender。位图索引可能对其他列没有用处。相反,这些列上的唯一 B 树索引可能会提供最有效的表示和检索。表 5-4 说明了上例中所示 cust_gender 列输出的位图索引。它由两个单独的位图组成,每个性别一个。
表 4 一列位图样例
| 值 | 第 1 行 | 第 2 行 | 第 3 行 | 第 4 行 | 第 5 行 | 第 6 行 | 第 7 行 |
|---|---|---|---|---|---|---|---|
M |
1 | 0 | 1 | 1 | 1 | 0 | 0 |
F |
0 | 1 | 0 | 0 | 0 | 1 | 1 |
映射函数将位图中的每个位转换为 customers 表的行 ID。每个位值都取决于表中对应行的值。例如,M 值的位图包含 1 作为其第一个位,因为 customers 表的第一行中的性别为 M。对于行 2、6 和 7 中的位,位图 cust_gender='M' 具有 0,因为这些行不包含 M 作为其值。
注:位图索引可以包含完全由空值组成的键,这与 B 树索引不同。索引 null 对于某些 SQL 语句很有用,例如使用聚合函数 COUNT 的查询。
调查客户人口趋势的分析师可能会问:“我们的女性客户中有多少是单身或离婚?此问题对应于以下 SQL 查询:
SELECT COUNT(*)
FROM   customers
WHERE  cust_gender = 'F'
AND    cust_marital_status IN ('single', 'divorced');
位图索引可以通过在生成的位图中计算 1 值的数量来高效处理此查询,如 Table 5-5 中所示。要确定满足条件的客户,Oracle AI Database 可以使用生成的位图访问该表。
表 5 两个列的位图样例
| 值 | 第 1 行 | 第 2 行 | 第 3 行 | 第 4 行 | 第 5 行 | 第 6 行 | 第 7 行 |
|---|---|---|---|---|---|---|---|
M |
1 | 0 | 1 | 1 | 1 | 0 | 0 |
F |
0 | 1 | 0 | 0 | 0 | 1 | 1 |
single |
0 | 0 | 0 | 0 | 0 | 1 | 1 |
divorced |
0 | 0 | 0 | 0 | 0 | 0 | 0 |
single 或 divorced 和 F |
0 | 0 | 0 | 0 | 0 | 1 | 1 |
位图索引可有效地合并与 WHERE 子句中的多个条件对应的索引。满足部分(但不是全部)条件的行会在访问表本身之前进行筛选。这种技术可以缩短响应时间,通常非常显著。
位图联接索引
位图联接索引是两个或更多表的联接的位图索引。
对于表列中的每个值,索引将对应行的行标识存储在索引表中。相反,标准位图索引是在单个表上创建的。
位图联接索引是减少必须通过提前执行限制来联接的数据量的有效方法。例如,当位图联接索引有用时,假设用户经常查询具有特定职务类型的雇员的数量。典型的查询可能如下所示:
SELECT COUNT(*)
FROM   employees, jobs
WHERE  employees.job_id = jobs.job_id
AND    jobs.job_title = 'Accountant';
上述查询通常使用 jobs.job_title 上的索引检索 Accountant 的行,然后检索作业 ID,使用 employees.job_id 上的索引查找匹配行。要从索引本身而不是从表的扫描中检索数据,可以按如下方式创建位图联接索引:
CREATE BITMAP INDEX employees_bm_idx
ON     employees (jobs.job_title)
FROM   employees, jobs
WHERE  employees.job_id = jobs.job_id;
如下图所示,索引键为 jobs.job_title,索引表为 employees。
图 2:位图联接索引
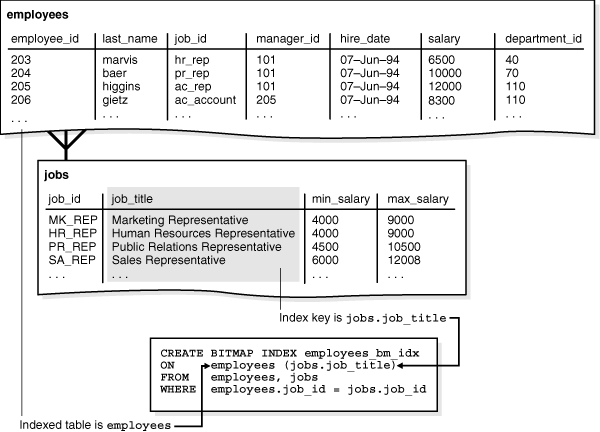
从概念上讲,employees_bm_idx 是 SQL 查询中 jobs.title 列的索引,如下查询所示(包括示例输出)。索引中的 job_title 键指向 employees 表中的行。查询会计师人数时,可以使用索引来避免访问 employees 和 jobs 表,因为索引本身包含请求的信息。
SELECT jobs.job_title AS "jobs.job_title", employees.rowid AS "employees.rowid"
FROM   employees, jobs
WHERE  employees.job_id = jobs.job_id
ORDER BY job_title;

jobs.job_title                      employees.rowid
----------------------------------- ------------------
Accountant                          AAAQNKAAFAAAABSAAL
Accountant                          AAAQNKAAFAAAABSAAN
Accountant                          AAAQNKAAFAAAABSAAM
Accountant                          AAAQNKAAFAAAABSAAJ
Accountant                          AAAQNKAAFAAAABSAAK
Accounting Manager                  AAAQNKAAFAAAABTAAH
Administration Assistant            AAAQNKAAFAAAABTAAC
Administration Vice President       AAAQNKAAFAAAABSAAC
Administration Vice President       AAAQNKAAFAAAABSAAB
.
.
.在数据仓库中,联接条件是维表的主键列与事实表中的外键列之间的等值联接(它使用等值运算符)。位图联接索引在存储方面的效率有时比实体化联接视图要高得多,而实体化联接是提前实现联接的替代方法。
另请参阅:Oracle AI Database Data Warehousing Guide,了解有关位图联接索引的更多信息
位图存储结构
Oracle AI Database 使用 B 树索引结构来存储每个索引键的位图。
例如,如果 jobs.job_title 是位图索引的键列,则一个 B 树存储索引数据。叶块存储各个位图。
示例 5-6 位图存储示例
假设 jobs.job_title 列具有唯一值 Shipping Clerk、Stock Clerk 和其他几个。此索引的位图索引条目包含以下组件:
-
职称作为索引键
-
行 ID 范围的低行 ID 和高行 ID
-
范围内特定行 ID 的位图
从概念上讲,此索引中的索引叶块可以包含如下条目:
Shipping Clerk,AAAPzRAAFAAAABSABQ,AAAPzRAAFAAAABSABZ,0010000100
Shipping Clerk,AAAPzRAAFAAAABSABa,AAAPzRAAFAAAABSABh,010010
Stock Clerk,AAAPzRAAFAAAABSAAa,AAAPzRAAFAAAABSAAc,1001001100
Stock Clerk,AAAPzRAAFAAAABSAAd,AAAPzRAAFAAAABSAAt,0101001001
Stock Clerk,AAAPzRAAFAAAABSAAu,AAAPzRAAFAAAABSABz,100001
.
.
.
相同的职称出现在多个条目中,因为行 ID 范围不同。
会话会将一个员工的职务 ID 从 Shipping Clerk 更新为 Stock Clerk。在这种情况下,会话需要独占访问旧值 (Shipping Clerk) 和新值 (Stock Clerk) 的索引键条目。Oracle AI Database 会锁定这两个条目指向的行,但不会锁定 Accountant 或任何其他关键字指向的行,直到 UPDATE 提交。
位图索引的数据存储在一个段中。Oracle AI Database 将每个位图存储在一个或多个部分。每个块占用单个数据块的一部分。
另请参阅:“用户段”介绍了不同类型的段以及段的创建方式
基于函数的索引概览
基于函数的索引计算涉及一列或多列的函数或表达式的值并将其存储在索引中。基于函数的索引可以是 B 树索引或位图索引。
索引函数可以是算术表达式,也可以是包含 SQL 函数、用户定义的 PL/SQL 函数、程序包函数或 C 调用的表达式。例如,一个函数可以在两列中添加值。
-
基于函数的索引使用 基于函数的索引可以高效地评估在其
WHERE子句中包含函数的语句。仅当查询中包含函数时,数据库才会使用基于函数的索引。但是,当数据库处理INSERT和UPDATE语句时,它仍必须评估函数来处理该语句。 -
使用基于函数的索引进行优化对于在
WHERE子句中使用表达式的查询,优化程序可能会对基于函数的索引使用索引范围扫描。
另请参见:
-
Oracle AI Database Administrator’s Guide,了解如何创建基于函数的索引
-
Oracle AI Database Development Guide,了解有关使用基于函数的索引的更多信息
-
Oracle AI Database SQL Language Reference,了解基于函数的索引的限制和使用说明
使用基于函数的索引
基于函数的索引可以高效地评估在其 WHERE 子句中包含函数的语句。仅当查询中包含函数时,数据库才会使用基于函数的索引。但是,当数据库处理 INSERT 和 UPDATE 语句时,它仍必须评估函数来处理该语句。
基于算术表达式的示例 5-7 索引
例如,假定您创建了以下基于函数的索引:
CREATE INDEX emp_total_sal_idx
  ON employees (12 * salary * commission_pct, salary, commission_pct);
在处理如下查询时,数据库可以使用前面的索引(包括部分示例输出):
SELECT   employee_id, last_name, first_name,
         12*salary*commission_pct AS "ANNUAL SAL"
FROM     employees
WHERE    (12 * salary * commission_pct) < 30000
ORDER BY "ANNUAL SAL" DESC;

EMPLOYEE_ID LAST_NAME                 FIRST_NAME           ANNUAL SAL
----------- ------------------------- -------------------- ----------
        159 Smith                     Lindsey                   28800
        151 Bernstein                 David                     28500
        152 Hall                      Peter                     27000
        160 Doran                     Louise                    27000
        175 Hutton                    Alyssa                    26400
        149 Zlotkey                   Eleni                     25200
        169 Bloom                     Harrison                  24000
基于 UPPER 函数的示例 5-8 索引
在 SQL 函数 UPPER(column_name) 或 LOWER(column_name) 上定义的基于函数的索引有助于进行不区分大小写的搜索。例如,假定 employees 中的 first_name 列包含混合大小写字符。可以对 hr.employees 表创建以下基于函数的索引:
CREATE INDEX emp_fname_uppercase_idx
ON employees ( UPPER(first_name) );
emp_fname_uppercase_idx 索引可以简化如下查询:
SELECT *
FROM   employees
WHERE  UPPER(first_name) = 'AUDREY';
示例 5-9 为表中的特定行编制索引
基于函数的索引也可用于仅为表中的特定行编制索引。例如,sh.customers 表中的 cust_valid 列将 I 或 A 作为值。要仅为 A 行编制索引,可以编写一个函数,为除 A 行以外的任何行返回 NULL 值。可以按如下方式创建索引:
CREATE INDEX cust_valid_idx
ON customers ( CASE cust_valid WHEN 'A' THEN 'A' END );
另请参见:
-
Oracle AI Database Globalization Support Guide(了解有关语言索引的信息)
-
Oracle AI Database SQL Language Reference 了解有关 SQL 函数的更多信息
使用基于函数的索引进行优化
对于在 WHERE 子句中使用表达式的查询,优化程序可能会对基于函数的索引使用索引范围扫描。
范围扫描访问路径在谓词具有高度选择性(即选择相对较少的行)时尤其有用。在示例 5-7 中,如果在表达式 12*salary*commission_pct 上构建了索引,则 optimizer 可以使用索引范围扫描。
虚拟列也可用于加快对从表达式派生的数据的访问。例如,可以将虚拟列 annual_sal 定义为 12*salary*commission_pct,并在 annual_sal 上创建基于函数的索引。
优化程序通过对 SQL 语句中的表达式进行语法分析,然后比较语句的表达式树和基于函数的索引来执行表达式匹配。此比较不区分大小写,并且忽略空格。
不同的查询可以使用不同类型的索引扫描。
另请参见:
-
“优化程序概览”
-
Oracle AI Database SQL Tuning Guide(了解有关收集统计信息的更多信息)
-
Oracle AI Database Administrator’s Guide,了解如何向表中添加虚拟列
应用程序域索引概览
应用程序域索引是特定于应用程序的定制索引。
广泛的索引可以:
-
适应自定义、复杂的数据类型(如文档、空间数据、图像和视频剪辑)的索引(见 )
-
利用专门的索引技术
可以将特定于应用程序的索引管理例程封装为索引类型方案对象,然后在表列或对象类型的属性上定义域索引。可扩展索引可以高效地处理特定于应用程序的运算符。
应用程序软件称为 cartridge ,用于控制域索引的结构和内容。数据库与应用程序进行交互以构建、维护和搜索域索引。索引结构本身可以作为索引组织的表或外部文件存储在数据库中。
另请参见:
-
Oracle AI Database Development Guide,了解有关复杂数据类型的更多信息
-
Oracle AI Database Data Cartridge Developer’s Guide,了解有关在 Oracle AI Database 可扩展性体系结构中使用数据磁带的信息
标量量化 HNSW 索引概览
标量化的分层可导航小世界 (HNSW) 索引可用于降低内存要求并加速相似性搜索。
在向量数据库的上下文中,标量化是通过独立量化向量的每个维(或标量组件)来压缩或近似高维数据向量的一种方法。此方法用于降低向量数据库的存储需求,同时保留相似性搜索等任务的数据的基本结构。当简单性和低存储要求是高优先级时,标量量量化尤其有益。
存储为浮点数的高维向量需要大量存储空间。标量量化通过压缩向量来节省内存。例如,每个维以 8 位 (INT8) 存储的 128 维向量仅需要 128 字节的内存,而 32 位浮点存储 (Float32) 需要 512 字节,64 位双存储 (Float64) 需要 1024 字节。由于存储需求的减少,标量量化可以使向量数据库处理非常大的数据集,包括数十亿个向量,否则由于存储限制,这将是不切实际的。
标量化的另一个好处是提高了搜索速度。近似近邻 (ANN) 搜索方法可以利用量化数据进行更快的比较,因为对整数或二进制代码的操作比浮点计算更快。
使用 Oracle AI Database,统一标量化是实现的压缩方法,这意味着输入范围划分为相等大小的间隔。每个时间间隔由单个量化级别表示,通常是其中点。每个维的范围分为 2b 相等间隔,其中 b 是位数(例如 int8 的 8 位)。每个浮点值都映射到最接近的量化级别。
另请参见:
-
Oracle AI Database AI Vector Search 用户指南了解 HNSW 索引语法和参数
-
Oracle AI Database SQL Language Reference(适用于
CREATE VECTOR INDEX语句)
索引组织表概览
按索引组织的表是存储在 B 树索引结构变体中的表。相反,按堆组织的表会插入适合的行。
在按索引组织的表中,行存储在表的主键上定义的索引中。B 树中的每个索引条目也存储非键列值。因此,索引是数据,数据是索引。应用程序使用 SQL 语句处理按索引组织的表,就像处理按堆组织的表一样。
类似于按索引组织的表,假设人力资源经理有一个纸板箱的书箱。每个框都标有数字 1、2、3、4 等,但这些框不会按顺序放在货架上。相反,每个框都包含一个指向序列中下一个框的机框位置的指针。
包含员工记录的文件夹存储在每个框中。文件夹按员工 ID 排序。雇员 King 的 ID 为 100,这是最低 ID,因此他的文件夹位于框 1 的底部。员工 101 的文件夹位于 100 的顶部,102 位于 101 的顶部,依此类推,直到框 1 已满。序列中的下一个文件夹位于框 2 的底部。
在此类比中,按员工 ID 对文件夹进行排序可以有效地搜索文件夹,而无需维护单独的索引。假设用户请求雇员 107、120 和 122 的记录。经理不必在一个步骤中搜索索引并在单独的步骤中检索文件夹,而是可以按顺序搜索文件夹并检索找到的每个文件夹。
通过按指数组织的表,可以利用主键或作为主键的有效前缀来提供对表行的更快的访问。叶块中存在行的非键列可避免其他数据块 I/O。例如,雇员 100 的薪金存储在索引行本身中。此外,由于行以主键顺序存储,因此由主键或前缀进行的范围访问所涉及的块 I/O 最少。另一个好处是避免了单独的主键索引的空间开销。
当相关数据块必须一起存储或者数据必须以特定顺序以物理方式存储时,按索引组织的表非常有用。此类型表的典型用途是用于信息检索、空间数据和 OLAP 应用程序。
-
索引组织的表特征 数据库系统通过处理 B 树索引结构对索引组织的表执行所有操作。
-
带有行溢出区域的索引组织表创建按索引组织的表时,可以将单独的段指定为行溢出区域。
-
索引表的辅助索引 辅助索引是按索引组织的表的索引。
另请参见:
-
Oracle Spatial Developer’s Guide,概述 Oracle Spatial and Graph
-
Oracle AI Database Administrator’s Guide,了解如何管理按索引组织的表
-
Oracle AI Database SQL Language Reference(了解
CREATE TABLE ... ORGANIZATION INDEX语法和语义)
索引组织的表特性
数据库系统通过操纵 B 树索引结构对按索引组织的表执行所有操作。
下表汇总了按索引组织的表与按堆组织的表之间的差异。
表 6 按堆组织的表和按索引组织的表的比较
| 按堆组织的表 | 索引组织的表 |
|---|---|
| rowid 唯一地标识行。可以根据需要定义主键约束条件。 | 主键用于唯一标识行。必须定义主键约束条件。 |
ROWID pseudocolumn 中的物理 rowid 允许生成辅助索引。 |
ROWID 伪列中的逻辑 rowid 允许构建辅助索引。 |
| 各个行可以直接通过 rowid 进行访问。 | 可以通过主键间接访问各个行。 |
| 顺序全表扫描按某种顺序返回所有行。 | 完整索引扫描或快速完整索引扫描将按某种顺序返回所有行。 |
| 可以与其他表一起存储在表集群中。 | 不能存储在表集群中。 |
可以包含 LONG 数据类型的列和 LOB 数据类型的列。 |
可以包含 LOB 列,但不能包含 LONG 列。 |
| 可以包含虚拟列(仅支持关系堆表)。 | 不能包含虚拟列。 |
通过将 COMPRESS ADVANCED LOW 子句添加到 CREATE TABLE 语句,可以使用高级低压缩来压缩索引组织表。高级低压缩是一种自适应的前缀压缩形式,可自动计算每个叶块的最优前缀列数,从而在块级别实现最佳压缩,而无需任何用户干预。这包括完全不压缩的可能性(如果适用)。这就保证了负压缩是不可能的。观察到更大的压缩率,总体开销可以忽略不计。
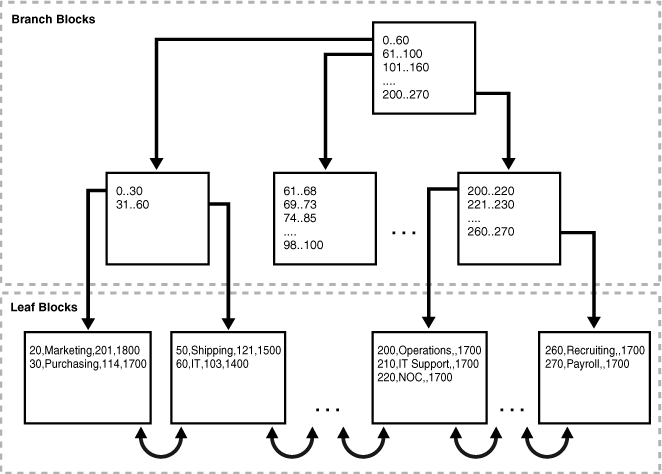
对按索引组织的表的扫描可能会卸载到 Exadata Smart Scan,优化程序认为查询可以作为快速完全扫描执行。这不需要任何用户干预。对于按索引组织的表叶块(所有相关列都位于叶块中),将支持全单元端处理。如果某些列位于溢出段中,则智能扫描不会处理此类列,数据库将完成扫描。图 5-3 说明按索引组织的 departments 表的结构。叶块包含表的行,这些行按主键按顺序排序。例如,第一个叶块中的第一个值显示部门 ID 20、部门名称 Marketing、经理 ID 201 和位置 ID 1800。
图 3:按索引组织的表
索引组织表的示例 5-10 扫描
按索引组织的表将所有数据存储在同一结构中,且不需要存储 rowid。如图 5-3 中所示,按索引组织的表中的叶块 1 可能包含按主键排序的如下条目:
20,Marketing,201,1800
30,Purchasing,114,1700
按索引组织的表中的叶块 2 可能包含如下条目:
50,Shipping,121,1500
60,IT,103,1400
扫描按主键顺序排列的按索引组织的表行会按以下顺序读取块:
-
街区 1
-
街区 2
示例 5-11 堆组织表的扫描
要将按堆组织的表中的数据访问与按索引组织的表进行比较,假设按堆组织的 departments 表段的块 1 包含如下行:
50,Shipping,121,1500
20,Marketing,201,1800
块 2 包含同一表的行,如下所示:
30,Purchasing,114,1700
60,IT,103,1400
此按堆组织的表的 B 树索引叶块包含以下条目,其中第一个值是主键,第二个值是 rowid:
20,AAAPeXAAFAAAAAyAAD
30,AAAPeXAAFAAAAAyAAA
50,AAAPeXAAFAAAAAyAAC
60,AAAPeXAAFAAAAAyAAB
扫描表行时,按主键顺序将按以下顺序读取表段块:
-
街区 1
-
街区 2
-
街区 1
-
街区 2
因此,此示例中的块 I/O 数量是按索引组织的示例中的数字的两倍。
具有行溢出区域的索引组织表
创建按索引组织的表时,可以将单独的段指定为行溢出区域。
在按索引组织的表中,B 树索引条目可能很大,因为它们包含整个行,因此包含条目的单独段非常有用。相比之下,B 树条目通常很小,因为它们由键和 rowid 组成。
如果指定了行溢出区域,则数据库可以将按索引组织的表中的行分为以下部分:
-
索引条目
此部分包含所有主键列的列值、指向该行的溢出部分的物理行 ID 以及一些非键列(可选)。此部分存储在索引段中。
-
溢出部分
此部分包含其余非键列的列值。此部件存储在溢出存储区域段中。
另请参见:
-
Oracle AI Database Administrator’s Guide,了解如何使用
CREATE TABLE的OVERFLOW子句设置行溢出区域 -
Oracle AI Database SQL Language Reference(了解
CREATE TABLE ... OVERFLOW语法和语义)
索引组织表上的辅助索引
辅助索引是按索引组织的表的索引。
从某种意义上说,二级索引是索引上的索引。它是独立的方案对象,与按索引组织的表分开存储。
Oracle AI Database 将名为逻辑行 ID 的行标识符用于按索引组织的表。逻辑 rowid 是表主键的 base64 编码表示形式。逻辑行 ID 长度取决于主键长度。
由于插入,索引叶块中的行可以在块内或块之间移动。按索引组织的表中的行不会像按堆组织的行那样迁移。由于索引组织的表中的行没有永久的物理地址,因此数据库会基于主键使用逻辑行 ID。
例如,假定 departments 表按索引组织。location_id 列存储每个部门的 ID。该表按如下方式存储行,最后一个值作为位置 ID:
10,Administration,200,1700
20,Marketing,201,1800
30,Purchasing,114,1700
40,Human Resources,203,2400
location_id 列上的辅助索引可能具有如下索引条目,其中逗号后面的值是逻辑行 ID:
1700,*BAFAJqoCwR/+
1700,*BAFAJqoCwQv+
1800,*BAFAJqoCwRX+
2400,*BAFAJqoCwSn+
辅助索引使用既不是主键也不是主键前缀的列,可以快速高效地访问按索引组织的表。例如,如果查询 ID 大于 1700 的部门的名称,可以使用辅助索引来加快数据访问速度。
-
逻辑行 ID 和物理猜测辅助索引使用逻辑行 ID 来查找表行。
-
索引组织表上的位图索引 索引组织表上的辅助索引可以是位图索引。位图索引存储每个索引键的位图。
另请参见:
-
“行 ID 数据类型”可详细了解行 ID 和
ROWID伪列的使用 -
Chained and Migrated Rows(链行和迁移行),了解为什么会迁移行以及迁移会增加 I/O 数量
-
Oracle AI Database Administrator’s Guide,了解如何对按索引组织的表创建辅助索引
-
Oracle AI Database VLDB and Partitioning Guide,了解如何在按索引组织的表分区上创建辅助索引
逻辑行 ID 和物理猜测
辅助索引使用逻辑行 ID 来查找表行。
逻辑 rowid 包括一个 physical guess ,它是首次创建索引条目的物理 rowid。Oracle AI Database 可以使用物理猜测直接探测到按索引组织的表的叶块,从而绕过主键搜索。当行的物理位置发生更改时,即使逻辑 rowid 包含过时的物理猜测,该逻辑 rowid 仍然有效。
对于按堆组织的表,辅助索引的访问涉及扫描辅助索引和附加 I/O 以提取包含该行的数据块。对于按索引组织的表,辅助索引的访问因物理猜测的使用和准确性而异:
-
如果没有物理猜测,访问涉及两个索引扫描:扫描次要索引,然后扫描主键索引。
-
通过物理猜测,访问取决于其准确性:
-
通过准确的物理猜测,访问涉及辅助索引扫描和附加 I/O 来提取包含该行的数据块。
-
对于不准确的物理猜测,访问涉及辅助索引扫描和 I/O 来提取错误的数据块(如猜测所示),然后按主键值对按索引组织的表进行索引唯一扫描。
-
索引组织表上的位图索引
按索引组织的表上的辅助索引可以是 bitmap index 。位图索引存储每个索引键的位图。
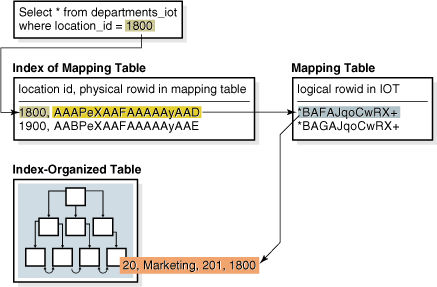
如果按索引组织的表上存在位图索引,则所有位图索引都使用按堆组织的映射表。映射表存储按索引组织的表的逻辑行 ID。每个映射表行都为对应的按索引组织的表行存储一个逻辑行 ID。
数据库使用搜索键访问位图索引。如果数据库找到该键,则位图条目将转换为物理 rowid。对于按堆组织的表,数据库使用物理行 ID 访问基表。对于按索引组织的表,数据库使用物理行 ID 访问映射表,这反过来会产生数据库用于访问按索引组织的表的逻辑行 ID。下图说明了对 departments_iot 表的查询的索引访问。
图 4:按索引组织的表的位图索引
注:按索引组织的表中的行移动不会使基于按索引组织的表构建的位图索引不可用。
另请参阅:“行段的行 ID ”以了解物理行 ID 和逻辑行 ID 之间的差异