SQL
本章概述了结构化查询语言 (SQL) 以及 Oracle AI Database 如何处理 SQL 语句。
-
SQL 简介 SQL(发音为 sequel )是一种基于集的高级声明式计算机语言,所有程序和用户均可使用该语言访问 Oracle 数据库中的数据。
-
SQL 语句概览:对 Oracle 数据库中的信息执行的所有操作都使用 SQL 语句运行。SQL 语句是由标识符、参数、变量、名称、数据类型和 SQL 保留字组成的计算机程序或指令。
-
优化程序概览要了解 Oracle AI Database 如何处理 SQL 语句,必须了解名为 optimizer 的数据库部分(也称为查询优化程序或基于成本的优化程序)。所有 SQL 语句都使用优化程序来确定访问指定数据的最有效方法。
-
SQL 处理概览 本部分介绍 Oracle AI Database 如何处理 SQL 语句。具体而言,本部分将说明数据库处理 DDL 语句创建对象的方式、修改数据的 DML 以及检索数据的查询。
SQL 简介
SQL(发音为 sequel )是一种基于集的高级声明式计算机语言,所有程序和用户都使用它访问 Oracle 数据库中的数据。
虽然某些 Oracle 工具和应用程序会屏蔽 SQL 使用,但所有数据库任务都是使用 SQL 执行的。任何其他数据访问方法都会绕过 Oracle AI Database 内置的安全性,并可能危及数据安全性和完整性。
SQL 提供了与关系数据库(例如 Oracle AI Database)的接口。SQL 以一种一致的语言统一以下任务:
-
创建、替换、变更和删除对象
-
插入、更新和删除表行
-
查询数据
-
控制对数据库及其对象的访问
-
保证数据库的一致性和完整性
SQL 可以以交互方式使用,这意味着语句是手动输入到程序中的。SQL 语句也可以嵌入到以其他语言(如 C 或 Java)编写的程序中。
-
SQL Data Access 有两大系列计算机语言:非过程语言的声明语言,用于描述应执行的操作;过程语言,例如 C++ 和 Java,用于描述如何应执行的操作。
-
SQL 标准 Oracle 致力于遵循业界认可的标准并积极参与 SQL 标准委员会。
另请参见:
-
Oracle AI Database Development Guide,了解如何选择编程环境
-
Oracle AI Database SQL Language Reference(了解 SQL 简介)
SQL 数据访问
有两大类计算机语言:非过程语言的声明语言,描述应执行的操作;过程语言,如 C++ 和 Java,描述应执行的操作方式。
SQL 是声明性的,因为用户指定他们想要的结果,而不是如何推导它。例如,以下语句查询姓氏以 K 开头的员工的记录:
数据库将执行生成过程的工作,以导航数据并检索请求的结果。SQL 的声明性特性使您能够在逻辑级别处理数据。只有在处理数据时,才需要关注实施详细信息。
SELECT   last_name, first_name
FROM     hr.employees
WHERE    last_name LIKE 'K%'
ORDER BY last_name, first_name;
数据库在一个步骤中检索满足 WHERE condition (也称为 predicate )的所有行。数据库可以将这些行作为单元传递给用户、其他 SQL 语句或应用程序。应用程序不需要逐一处理这些行,开发人员也不需要知道这些行的物理存储或检索方式。
所有 SQL 语句都使用优化程序,优化程序是数据库的一个组件,用于确定访问所请求数据的最有效方法。Oracle Database 还支持可用于使优化程序更好地执行其任务的技术。
另请参阅:Oracle AI Database SQL Language Reference,了解有关 SQL 语句和 SQL 的其他部分(例如运算符、函数和格式模型)的详细信息
SQL 标准
Oracle 致力于遵循业界认可的标准,并积极参与 SQL 标准委员会。
业内认可的委员会包括美国国家标准协会 (ANSI) 和国际标准化组织 (ISO)。ANSI 和 ISO/IEC 都接受 SQL 作为关系数据库的标准语言。
SQL 标准由十个部分组成。其中一个部分 (SQL/RPR:2012) 在 2012 年是新的。2011 年对其他五个部分进行了修订。对于其他四个部分,2008 年版本仍然存在。Oracle SQL 包含对 ANSI/ISO 标准 SQL 语言的许多扩展,而 Oracle AI Database 工具和应用提供了其他语句。借助 SQL*Plus、SQL Developer 和 Oracle Enterprise Manager 工具,您可以针对 Oracle 数据库运行任何 ANSI/ISO 标准 SQL 语句,以及可用于这些工具的任何其他语句或函数。
另请参见:
-
Oracle AI Database SQL Language Reference,了解 Oracle SQL 与标准 SQL 之间的差异说明
-
适用于 SQL*Plus 命令的 SQL*Plus 用户指南和参考,包括其与 SQL 语句的区别
SQL 语句概览
对 Oracle 数据库中的信息执行的所有操作都使用 SQL 语句运行。SQL 语句是由标识符、参数、变量、名称、数据类型和 SQL 保留字组成的计算机程序或指令。注: SQL 保留字在 SQL 中具有特殊含义,不应用于任何其他用途。例如,SELECT 和 UPDATE 是保留字,不应用作表名。
SQL 语句必须等效于完整的 SQL 句子,例如:
SELECT last_name, department_id FROM employeesOracle AI Database 仅运行完整的 SQL 语句。诸如以下之类的片段将生成错误,指示需要更多文本:
SELECT last_name;Oracle SQL 语句分为以下类别:
-
数据定义语言 (Data Definition Language,DDL) 语句数据定义语言 (Data Definition Language, DLL ) 语句定义、在结构上更改和删除方案对象。
-
数据操纵语言 (Data Manipulation Language,DML) 语句数据操纵语言 (Data Manipulation Language, DML ) 语句查询或操纵现有方案对象中的数据。
-
事务处理控制语句 事务处理控制语句管理 DML 语句所做的更改,并将 DML 语句分组到事务处理中。
-
Session Control Statements 会话控制语句可动态管理用户 session 的属性。
-
System Control Statement(系统控制语句)。系统控制语句更改 database instance 的属性。
-
嵌入式 SQL 语句 嵌入式 SQL 语句在过程语言程序中包含 DDL、DML 和事务处理控制语句。
Data Definition Language (DDL) Statements - 数据定义语言 (DDL) 语句
数据定义语言 (Data Definition Language, DLL ) 语句定义、结构更改和删除方案对象。
使用 DDL,不必更改访问对象的应用程序,即可更改该对象的属性。例如,可以将一列添加到人力资源应用程序访问的表中,而无需重写该应用程序。还可以在数据库用户正在数据库中工作的同时,使用 DDL 更改对象的结构。
更具体地说,使用 DDL 语句可以:
-
创建、更改和删除方案对象及其他数据库结构,包括数据库本身和数据库用户。大多数 DDL 语句以关键字
CREATE、ALTER或DROP开头。 -
删除方案对象中的所有数据,但不删除这些对象的结构 (
TRUNCATE)。注:与
DELETE不同,TRUNCATE不生成撤消数据,这使得它比DELETE快。此外,TRUNCATE不调用删除触发器 -
授予和撤消权限及角色(
GRANT、REVOKE)。 -
打开和关闭审计选项(
AUDIT、NOAUDIT)。 -
将注释添加到数据字典 (
COMMENT)。
示例 10-1 DDL 语句
以下示例使用 DDL 语句创建 plants 表,然后使用 DML 在表中插入两行。此示例随后使用 DDL 更改表结构,向用户授予并撤消对该表的读取权限,然后删除该表。
CREATE TABLE plants
    ( plant_id    NUMBER PRIMARY KEY,
      common_name VARCHAR2(15) );

INSERT INTO plants VALUES (1, 'African Violet'); # DML statement

INSERT INTO plants VALUES (2, 'Amaryllis'); # DML statement

ALTER TABLE plants ADD
    ( latin_name VARCHAR2(40) );

GRANT READ ON plants TO scott;

REVOKE READ ON plants FROM scott;

DROP TABLE plants;
在数据库执行 DDL 语句之前会立即出现隐式 COMMIT,之后会立即出现 COMMIT 或 ROLLBACK。在前面的示例中,两个 INSERT 语句后跟一个 ALTER TABLE 语句,因此数据库提交两个 INSERT 语句。如果 ALTER TABLE 语句成功,则数据库提交此语句;否则,数据库将回退此语句。在任何一种情况下,两个 INSERT 语句都已提交。
另请参见:
-
Oracle AI Database 入门 Oracle AI Database Development 和 Oracle AI Database Administrator’s Guide,了解如何创建方案对象
-
Oracle AI Database Development Guide,了解阻塞与非阻塞 DDL 之间的区别
-
Oracle AI Database SQL Language Reference(了解 DDL 语句列表)
Data Manipulation Language (DML) Statements - 数据操纵语言 (DML) 语句
数据操纵语言 (Data manipulation language, DML ) 语句查询或操纵现有方案对象中的数据。
而 DDL 语句可以更改数据库的结构,而 DML 语句可以查询或更改内容。例如,ALTER TABLE 更改表的结构,而 INSERT 将向表中添加一行或多行。
DML 语句是最常用的 SQL 语句,可用于:
-
从一个或多个表或视图 (
SELECT) 检索或提取数据。 -
通过指定列值列表或者通过使用子查询来选择和操纵现有数据,向表或视图 (
INSERT) 添加新的数据行。 -
更改表或视图 (
UPDATE) 中现有行的列值。 -
有条件地在表或视图 (
MERGE) 中更新或插入行。 -
删除表或视图中的行 (
DELETE)。 -
查看 SQL 语句的执行计划 (
EXPLAINPLAN)。 -
锁定表或视图,以临时限制其他用户的访问 (
LOCKTABLE)。
以下示例使用 DML 查询 employees 表。本示例使用 DML 将行插入到 employees 中,更新此行,然后将其删除:
SELECT * FROM employees;

INSERT INTO employees (employee_id, last_name, email, job_id, hire_date, salary)
  VALUES (1234, 'Mascis', 'JMASCIS', 'IT_PROG', '14-FEB-2008', 9000);

UPDATE employees SET salary=9100 WHERE employee_id=1234;

DELETE FROM employees WHERE employee_id=1234;
构成逻辑工作单元的一组 DML 语句被称为事务处理。例如,转账事务处理可能涉及三个离散操作:减少储蓄账户余额、增加支票账户余额以及在账户历史记录表中记录转账。与 DDL 语句不同,DML 语句不隐式提交当前事务处理。
-
SELECT 语句 查询是从表或视图中检索数据的操作。
-
联接 联接是将两个或多个表、视图或实体化视图的行组合在一起的查询。
-
子查询 子查询是嵌套在另一个 SQL 语句中的
SELECT语句。当必须执行多个查询才能解决单个问题时,子查询非常有用。
另请参见:
-
Oracle AI Database 快速入门 Oracle AI Database 开发,了解如何查询和处理数据
-
Oracle AI Database SQL Language Reference(了解 DML 语句的列表)
SELECT 语句
查询是从表或视图中检索数据的操作。
SELECT 是可用于查询数据的唯一 SQL 语句。从执行 SELECT 语句中检索到的数据集称为结果集。
下表显示了 SELECT 语句中常见的必需关键字和三个关键字。该表还将 SELECT 语句的功能与关键字相关联。
SQL 语句中的表 1 关键字
| 关键字 | 是否必需? | 说明 | 能力 |
|---|---|---|---|
SELECT |
是 | 指定结果中应显示的列。映射将生成表中列的一个子集。 表达式是解析为值的一个或多个值、运算符和 SQL 函数的组合。在 |
投影 |
FROM |
否 | 指定应从中检索数据的表或视图。 | 联接 |
WHERE |
否 | 指定筛选行的条件,从而生成表中行的子集。条件指定一个或多个表达式和逻辑(布尔)运算符的组合,并返回值 TRUE、FALSE 或 UNKNOWN。 |
选择 |
ORDER BY |
否 | 指定行时应该使用的顺序。 |
另请参见: Oracle AI Database SQL Language Reference,了解 SELECT 语法和语义
联接
联接是将两个或多个表、视图或实体化视图的行组合在一起的查询。
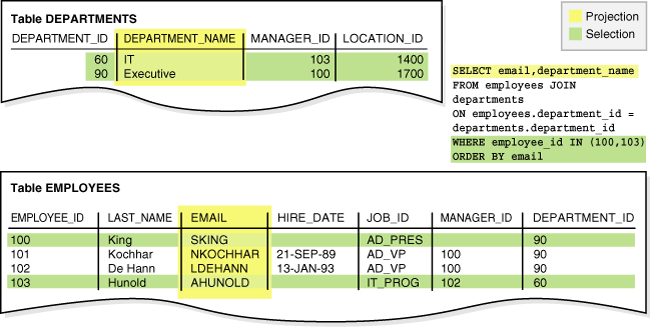
以下示例联接 employees 表和 departments 表(FROM 子句),仅选择符合指定条件的行(WHERE 子句),并使用预测从两列 (SELECT) 检索数据。SQL 语句后跟示例输出。
SELECT email, department_name
FROM   employees
JOIN   departments
ON     employees.department_id = departments.department_id
WHERE  employee_id IN (100,103)
ORDER BY email;

EMAIL                     DEPARTMENT_NAME
------------------------- ------------------------------
AHUNOLD                   IT
SKING                     Executive
下图显示了在前面的查询中所示的联接中映射和选择的操作。
图 1:映射和选择
大多数联接至少有一个 join condition (在 FROM 子句或 WHERE 子句中),用于比较两个列,每个列来自不同的表。数据库将行对组合在一起,每个行包含每个表中的一行,其联接条件的计算结果为 TRUE。优化程序根据表的联接条件、索引和任何可用统计信息来确定数据库联接表的顺序。
联接类型包括以下各项:
-
内部连接
内部联接是两个或更多表的联接,仅返回满足联接条件的行。例如,如果联接条件为
employees.department_id=departments.department_id,则不会返回不满足此条件的行。 -
外部连接
外部联接将返回满足链接条件的所有行,还会返回一个表中没有其他表中的行满足该条件行的行。
表 A 和 B 的左外部联接的结果始终包含左表 A 的所有记录,即使联接条件与右表 B 中的记录不匹配也是如此。如果不存在来自 B 的匹配行,则对于在 B 中没有匹配行的 B 列包含空值。例如,如果不是所有雇员都属于部门,则
employees(左表)和departments(右表)的左外部联接将检索employees中的所有行,即使departments中的任何行都不满足联接条件(employees.department_id为空值)。表 A 和 B 的右外部联接的结果包含右表 B 的所有记录,即使联接条件与左表 A 中的行不匹配也是如此。如果不存在来自 A 的匹配行,则对于在 A 中没有匹配行的 A 列包含空值。例如,如果不是所有部门都有雇员,则
employees(左表)和departments(右表)的右外部联接将检索departments中的所有行,即使employees中的任何行都不满足联接条件也是如此。完整外部联接是左外部联接和右外部联接的组合。
-
笛卡尔积
如果联接查询中的两个表没有联接条件,则数据库将执行笛卡尔联接。一个表的每一行与另一个表的每一行组合。例如,如果
employees包含 107 行,而departments包含 27 行,则笛卡尔积包含 107*27 行。笛卡尔积很少有用。
另请参见:
-
Oracle AI Database SQL Language Reference(了解联接的详细说明和示例)
子查询
子查询是嵌套在另一个 SQL 语句中的 SELECT 语句。当必须执行多个查询才能解决单个问题时,子查询非常有用。
语句的每个查询部分称为查询块。在以下查询中,括号中的子查询是内部查询块:
SELECT first_name, last_name
FROM   employees
WHERE  department_id
IN     ( SELECT department_id
         FROM departments
         WHERE location_id = 1800 );
内部 SELECT 语句检索位置 ID 为 1800 的部门的 ID。外部查询块需要这些部门标识,该查询块检索子查询提供标识的部门中雇员的姓名。
SQL 语句的结构不会强制数据库先执行内部查询。例如,数据库可以将整个查询重写为 employees 和 departments 的联接,这样子查询就不会自行执行。另一个示例是,虚拟专用数据库 (Virtual Private Database,VPD) 功能可以使用 WHERE 子句限制雇员的查询,以便数据库首先查询雇员,然后获取部门 ID。优化程序确定检索所请求行的最佳步骤顺序。
另请参阅:Oracle AI Database Security Guide 以了解有关 VPD 的更多信息
事务处理控制语句
事务处理控制语句用于管理 DML 语句所做的更改并将 DML 语句分组到事务处理中。
这些语句使您能够:
-
对事务处理进行永久性更改 (
COMMIT)。 -
撤消事务处理中自事务处理启动 (
ROLLBACK) 或自保存点 (ROLLBACK TO SAVEPOINT) 以来的更改。savepoint 是事务处理上下文中用户声明的中间标记。注:
ROLLBACK语句结束事务处理,但ROLLBACK TO SAVEPOINT不结束。 -
设置可回退到的点 (
SAVEPOINT)。 -
建立事务处理的属性 (
SETTRANSACTION)。 -
指定在每个 DML 语句之后还是提交事务处理 (
SET CONSTRAINT) 时检查可延迟的完整性约束条件。
以下示例启动名为 Update salaries 的事务处理。此示例创建保存点,更新员工薪金,然后将事务处理回退到保存点。此示例将薪金更新为不同的值并提交。
SET TRANSACTION NAME 'Update salaries';

SAVEPOINT before_salary_update;

UPDATE employees SET salary=9100 WHERE employee_id=1234 # DML

ROLLBACK TO SAVEPOINT before_salary_update;

UPDATE employees SET salary=9200 WHERE employee_id=1234 # DML

COMMIT COMMENT 'Updated salaries';
另请参见:
会话控制语句
会话控制语句动态管理用户 session 的属性。
会话是数据库实例内存中的逻辑实体,表示当前用户登录到数据库的状态。会话从数据库通过用户的验证开始,持续至用户断开连接或退出了该数据库应用程序。
会话控制语句使您能够:
-
通过执行专用函数(例如设置默认日期格式 (
ALTER SESSION))来更改当前会话。 -
为当前会话 (
SET ROLE) 启用和禁用作为特权组的角色。
以下语句会将会话的默认日期格式动态更改为 'YYYY MM DD-HH24:MI:SS':
ALTER SESSION
   SET NLS_DATE_FORMAT = 'YYYY MM DD HH24:MI:SS';
会话控制语句不会隐式提交当前事务处理。
另请参见:
-
Oracle AI Database SQL Language Reference(了解
ALTER SESSION语法和语义)
系统控制语句
系统控制语句将更改数据库实例的属性。
唯一的系统控制语句是 ALTER SYSTEM。它允许您更改设置,例如最小数量的共享服务器,终止会话,以及执行其他系统级任务。
系统控制语句的示例包括:
ALTER SYSTEM SWITCH LOGFILE;

ALTER SYSTEM KILL SESSION '39, 23';
ALTER SYSTEM 语句不会隐式提交当前事务处理。
另请参见: Oracle AI Database SQL Language Reference,了解 ALTER SYSTEM 语法和语义
嵌入的 SQL 语句
嵌入式 SQL 语句将 DDL、DML 和事务处理控制语句包含在过程语言程序中。
嵌入式语句与 Oracle 预编译器一起使用。嵌入式 SQL 是将 SQL 纳入过程语言应用程序的一种方法。另一种方法是使用过程 API,例如 Open Database Connectivity (ODBC) 或 Java Database Connectivity (JDBC)。
通过嵌入式 SQL 语句,您可以:
-
定义、分配和释放 cursor (
DECLARE CURSOR、OPEN、CLOSE)。 -
指定数据库并连接到它(
DECLARE DATABASE、CONNECT)。 -
指定变量名称 (
DECLARE STATEMENT)。 -
初始化描述符 (
DESCRIBE)。 -
指定如何处理错误和警告条件 (
WHENEVER)。 -
解析并运行 SQL 语句(
PREPARE、EXECUTE、EXECUTE IMMEDIATE)。 -
从数据库 (
FETCH) 检索数据。
优化程序概览
要了解 Oracle AI Database 如何处理 SQL 语句,需要了解名为 optimizer (也称为查询优化程序或基于成本的优化程序)的数据库部分。所有 SQL 语句都使用优化程序来确定访问指定数据的最有效方法。
-
使用优化程序 优化程序生成描述可能执行方法的执行计划。
-
优化程序组件 优化程序包含三个主要组件:变压器、估算器和计划生成器。
-
访问路径 访问路径是查询用于检索行的技术。
-
优化程序统计信息 优化程序统计信息是介绍有关数据库和数据库中对象的详细信息的数据集合。统计信息提供了优化程序在评估访问路径时可用的数据存储和分发的统计正确图片。
-
优化程序提示 提示是 SQL 语句中的注释,用作优化程序的指令。
使用优化器
优化程序会生成描述可能执行方法的执行计划。
优化程序通过考虑多个信息源来确定哪个执行计划最有效。例如,优化程序会考虑查询条件、可用访问路径、为系统收集的统计信息以及提示。
要执行 DML 语句,Oracle AI Database 可能需要执行许多步骤。每一步骤要么从数据库物理检索数据行,要么为执行该语句的用户准备这些数据行。数据库用于执行语句的步骤会极大地影响语句的运行速度。通常可以通过多种不同的方式处理 DML 语句。例如,表或索引的访问顺序可能会有所不同。
为 SQL 语句确定最佳执行计划时,优化程序执行以下操作:
-
评估表达式和条件
-
检查完整性约束条件,以了解有关数据的更多信息并基于此元数据进行优化
-
语句转换
-
可选择优化程序目标
-
可选访问路径
-
选择联接顺序
优化程序会生成处理查询的大多数可能方法,并为生成的执行计划中的每个步骤分配成本。成本最低的计划将被选作要执行的查询计划。
注:无需执行该计划即可获取 SQL 语句的执行计划。只有数据库实际用于执行查询的执行计划才正确地称为查询计划。
您可以通过设置优化程序目标和收集优化程序的代表性统计信息来影响优化程序选择。例如,可以将优化程序目标设置为以下任一目标:
-
总吞吐量
ALL_ROWS提示指示优化程序尽快将结果的最后一行获取到客户机应用程序。 -
初次答复时间
FIRST_ROWS提示指示优化程序尽快将第一行发送给客户机。
典型的最终用户交互式应用程序将受益于初始响应时间优化,而批处理模式的非交互式应用程序将从总吞吐量优化中受益。
另请参见:
-
Oracle AI Database PL/SQL Packages and Types Reference(了解有关使用
DBMS_STATS的信息) -
Oracle AI Database SQL Tuning Guide(了解有关优化程序和使用提示的详细信息)
优化程序组件
优化程序包含三个主要组件:变压器、估算器和计划生成器。
下图描述了各个组成部分:
图 2:优化程序组件
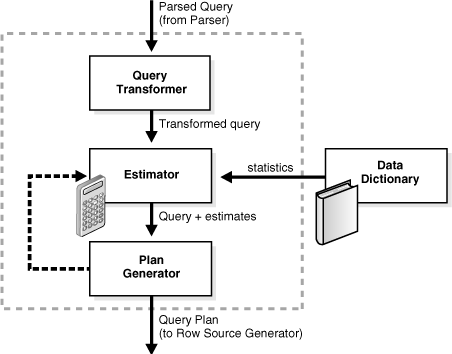
优化程序的输入是一个经过语法分析的查询。优化程序执行以下操作:
-
优化程序将接收已解析的查询,并根据可用的访问路径和提示为 SQL 语句生成一组潜在计划。
-
优化程序根据数据字典中的统计信息估计每个计划的成本。成本是一个估计值,与执行具有特定计划的语句所需的预期资源使用量成比例。
-
优化程序比较计划的成本,并选择要传递到行源生成器的成本最低的计划(称为查询计划)。
-
查询转换器 查询转换器确定是否有助于更改查询形式,以便优化器可以生成更好的执行计划。查询转换器的输入是一个经过语法分析的查询,优化程序将其表示为一组查询块。
-
估算器 估算器确定给定执行计划的整体成本。
-
计划生成器 计划生成器针对提交的查询尝试不同的计划。优化程序选择成本最低的计划。
查询转换器
query transformer 确定是否有助于更改查询形式,以便优化程序可以生成更好的执行计划。查询转换器的输入是一个经过语法分析的查询,优化程序将其表示为一组查询块。
另请参阅:查询重写
估算器
估计器确定给定执行计划的整体成本。
估计器生成三种不同类型的度量来实现此目标:
-
选择性
此度量表示行集中的一小部分行。选择性与查询谓词(如
last_name='Smith')或谓词组合关联。 -
基数
此度量表示行集中的行数。
-
成本
此度量表示所用的工作单位或资源。查询优化程序使用磁盘 I/O、CPU 占用率和内存使用量作为工作单元。
如果有统计信息可用,则评估器使用它们来计算度量。统计数字提高了措施的准确度。
计划生成器
计划生成器针对提交的查询尝试不同的计划。优化程序选择成本最低的计划。
对于每个嵌套子查询和未合并视图,优化程序将生成一个子计划。优化程序将每个子计划表示为单独的 query block 。计划生成器通过测试不同的访问路径、联接方法和联接订单来为查询块探索各种计划。
自适应查询优化功能根据语句执行期间收集的统计信息更改计划。所有自适应机制都可以对与默认计划不同的语句执行最终计划。自适应优化使用动态计划(在语句执行期间在子计划中进行选择)或重新优化(在当前执行后更改执行计划)。
另请参见:
-
Oracle AI Database 性能优化入门,了解 SQL 优化简介
-
Oracle AI Database SQL Tuning Guide,了解优化程序组件和自适应优化
访问途径
访问路径是查询用于检索行的技术。
例如,使用索引的查询与不使用索引的查询具有不同的访问路径。通常,索引访问路径最适合检索表行的一小部分语句。完全扫描对于访问表的很大一部分更为有效。
数据库可以使用多个不同的访问路径从表中检索数据。以下是代表性列表:
-
完整表扫描
此类扫描会从表中读取所有行,然后筛选掉那些不符合选择标准的行。数据库将按顺序扫描段中的所有数据块,包括高水位标记 (HWM) 下将已用空间与未用空间分开的数据块(请参见 Segment Space and the High Water Mark )。
-
行 ID 扫描
行的 rowid 指定了包含行的数据文件和数据块,以及行在该块中的位置。数据库首先从语句
WHERE子句或通过索引扫描获取所选行的行 ID,然后根据其行 ID 查找每个选定的行。 -
索引搜索
此扫描在索引中搜索 SQL 语句访问的索引列值(请参阅“索引扫描”)。如果该语句只访问索引列,Oracle AI Database 将直接从索引中读取已编入索引的列值。
-
集群扫描
群集扫描从存储在索引表群集中的表中检索数据,其中具有相同群集键值的所有行都存储在同一数据块中(请参阅“索引群集概述”)。数据库首先通过扫描群集索引来获取所选行的 rowid。Oracle AI Database 基于此行 ID 查找行。
-
散列 SCAN
散列扫描将查找散列群集中的行,其中具有相同散列值的所有行都存储在同一数据块中(请参见 Overview of Hash Clusters )。数据库首先通过将散列函数应用到该语句所指定的簇关键字值来获得散列的值。然后,Oracle AI Database 将使用该散列表值扫描包含行的数据块。
优化程序会根据语句的可用访问路径和使用每个访问路径或路径组合的估计成本选择访问路径。
另请参见:Oracle AI Database Get Started with Performance Tuning 和 Oracle AI Database SQL Tuning Guide,了解访问路径
优化程序统计信息
优化程序统计信息是用于描述有关数据库和数据库中对象的详细信息的数据集合。统计信息提供了优化程序在评估访问路径时可用的数据存储和分发的统计正确图片。
优化程序统计信息包括以下内容:
-
表统计信息
其中包括行数、块数和平均行长度。
-
列统计数据
其中包括一个列中的相异值和 Null 值的数量以及数据的分布。
-
索引统计数据
其中包括叶块数和索引级别。
-
系统统计信息
其中包括 CPU 和 I/O 性能以及占用率。
Oracle AI Database 会自动收集所有数据库对象的优化程序统计信息,并将这些统计信息作为自动维护任务进行维护。还可以使用 DBMS_STATS 软件包手动收集统计信息。此 PL/SQL 程序包可以修改、查看、导出、导入和删除统计信息。注:优化程序统计信息是为查询优化而创建的,并存储在数据字典中。请勿将这些统计信息与通过动态性能视图可见的性能统计信息混淆。
Optimizer Statistics Advisor 是内置的诊断软件,用于分析您当前如何收集统计信息、现有统计信息收集作业的有效性以及收集的统计信息的质量。优化程序统计信息指导维护基于当前功能集的 Oracle 优秀实践的规则。通过这种方式,指导始终为统计信息收集提供最新的建议。
另请参见:
优化程序提示
hint 是 SQL 语句中的注释,用作优化程序的指令。
有时,应用程序设计者对特定应用程序的数据的信息比优化程序可用的信息多,可以选择更有效的方法来运行 SQL 语句。应用程序设计者可以使用 SQL 语句中的提示来指定该语句的运行方式。以下示例说明如何使用提示。
示例 10-2 带 FIRST_ROWS 提示的 SELECT 执行计划
假设交互式应用程序运行一个返回 50 行的查询。此应用程序最初仅提取要提供给最终用户的查询的前 25 行。您希望优化程序生成一个计划,以尽快获取前 25 条记录,从而不强制用户等待。可以使用提示将此指令传递给优化程序,如以下示例中的 SELECT 语句和 AUTOTRACE 输出中所示:
SELECT /*+ FIRST_ROWS(25) */ employee_id, department_id
FROM   hr.employees
WHERE  department_id > 50;

------------------------------------------------------------------------
| Id | Operation                    | Name              | Rows | Bytes
------------------------------------------------------------------------
|  0 | SELECT STATEMENT             |                   | 26   | 182
|  1 |  TABLE ACCESS BY INDEX ROWID | EMPLOYEES         | 26   | 182
|* 2 |   INDEX RANGE SCAN           | EMP_DEPARTMENT_IX |      |
------------------------------------------------------------------------
在此示例中,执行计划显示优化程序在 employees.department_id 列上选择一个索引,以查找部门 ID 超过 50 的 employees 的前 25 行。优化程序使用从索引中检索到的 rowid 从 employees 表中检索记录并将其返回给客户机。第一个记录的检索通常几乎是瞬时的。
示例 10-3 无提示的 SELECT 执行计划
假设您执行了相同的语句,但没有优化程序提示:
SELECT employee_id, department_id
FROM   hr.employees
WHERE  department_id > 50;

------------------------------------------------------------------------
| Id | Operation              | Name              | Rows | Bytes | Cos
------------------------------------------------------------------------
|  0 | SELECT STATEMENT       |                   | 50   | 350   |
|* 1 |  VIEW                  | index$_join$_001  | 50   | 350   |
|* 2 |   HASH JOIN            |                   |      |       |
|* 3 |    INDEX RANGE SCAN    | EMP_DEPARTMENT_IX | 50   | 350   |
| 4 | INDEX FAST FULL SCAN| EMP_EMP_ID_PK | 50 | 350 |在这种情况下,执行计划将联接两个索引,以尽快返回请求的记录。优化程序不像示例 10-2 中那样反复从索引转为表,而是选择范围扫描 EMP_DEPARTMENT_IX 以查找部门 ID 超过 50 的所有行,并将这些行放置在散列表中。然后,优化程序选择读取 EMP_EMP_ID_PK 索引。对于该索引中的每一行,都会对散列表进行探测以查找部门标识。
在这种情况下,在 EMP_DEPARTMENT_IX 的索引范围扫描完成之前,数据库无法将第一行返回到客户机。因此,此生成的计划需要更长的时间才能返回第一个记录。与 Example 10-2 中的计划(该计划按索引 rowid 访问表)不同,该计划使用多块 I/O,导致大量读取。通过读取,可以更快地返回整个结果集的最后一行。
另请参阅:Oracle AI Database SQL Tuning Guide,了解如何使用优化程序提示
SQL 处理概览
本节介绍 Oracle AI Database 如何处理 SQL 语句。具体而言,本部分将说明数据库处理 DDL 语句创建对象的方式、修改数据的 DML 以及检索数据的查询。
-
SQL 处理阶段:SQL 处理的一般阶段包括语法分析、优化、行源生成和执行。根据该语句,数据库可能会省略其中一些步骤。
-
DML 和 DDL 处理之间的差异 Oracle AI Database 处理 DDL 的方式与 DML 不同。
SQL 处理的各个阶段
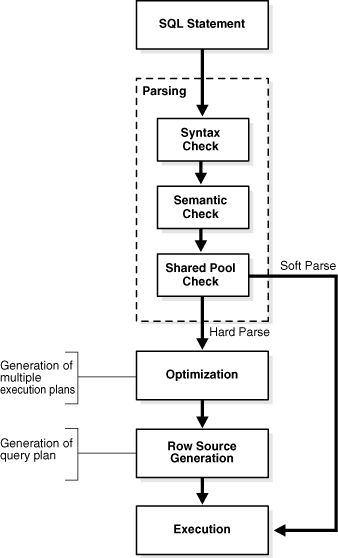
SQL 处理的一般阶段包括:语法分析、优化、行源生成和执行。根据该语句,数据库可能会省略其中一些步骤。
下图描述了一般阶段:
图 3:SQL 处理的各个阶段
-
SQL 语法分析 SQL 处理的第一个阶段是 SQL 分析。此阶段涉及将 SQL 语句的各个部分分隔成可由其他例程处理的数据结构。
-
查询优化是选择最有效的 SQL 语句执行方法的过程。
-
SQL 行源生成器 行源生成器是一个用于从优化程序接收最佳执行计划并生成迭代计划(称为查询计划,可供数据库的其余部分使用)的软件。
-
SQL 执行 在执行过程中,SQL 引擎执行树中由行源生成器生成的每个行源。这是 DML 处理中唯一的必需步骤。
SQL 语法分析
SQL 处理的第一个阶段是 SQL 分析。此阶段涉及将 SQL 语句的各个部分分隔成可由其他例程处理的数据结构。
当应用程序发出 SQL 语句时,应用程序会对数据库进行语法分析调用,以准备语句以供执行。解析调用将打开或创建游标,这是针对会话特定的专用 SQL 区域的句柄,用于保存已解析的 SQL 语句和其他处理信息。游标和专用 SQL 区域位于 PGA 中。
在语法分析调用期间,数据库执行以下检查:
-
语法验证
-
语义检查
-
共享池检查
前面的检查标识在语句执行之前可以找到的错误。某些错误无法通过语法分析捕获。例如,数据库可能会遇到 deadlock 或仅在语句执行期间发生数据转换错误。
对于在语法分析阶段失败并出现 ORA-00600 错误的 SQL 语句,数据库将尝试自动缓解错误。ORA-00600 是一个严重错误。它指示进程遇到了低级的意外情况。当 SQL 语句在语法分析阶段失败并出现此错误时,自动错误缓解会将其捕获并尝试解决该条件。如果找到解决方案,数据库将生成 SQL 补丁程序以调整 SQL 执行计划。如果此修补程序允许解析成功完成,则不会引发 ORA-00600 错误。应用程序未发现异常错误。
另请参阅:锁定和死锁关于自动 SQL 错误缓解
SQL 优化
查询优化是选择最有效的 SQL 语句执行方法的过程。
数据库根据针对当前访问的实际数据收集的统计信息优化查询。优化程序使用行数、数据集大小和其他因素生成可能的执行计划,以便为每个计划分配数字成本。数据库将使用成本最低的计划。
数据库必须对每个唯一的 DML 语句至少执行一次硬性语法分析,并在此语法分析期间执行优化。DDL 永远不会优化,除非它包含 DML 组件(例如需要优化的子查询)。
另请参见:
-
Oracle AI Database SQL Tuning Guide(了解有关查询优化程序的详细信息)
SQL 行源生成
行源生成器是一个用于从优化程序接收最佳执行计划并生成迭代计划(称为查询计划),可供数据库的其余部分使用。
查询计划采用步骤组合的形式。每个步骤均返回一个行集。此集中的各行供下一步使用,或者,在最后一步中,被返回到发出 SQL 语句的应用程序。
行源是执行计划中某个步骤返回的行集,以及可迭代处理行的控制结构。行源可以是表、视图,或者是联接或分组运算的结果。
SQL 执行
在执行过程中,SQL 引擎执行树中由行源生成器生成的每个行源。这是 DML 处理中唯一的必需步骤。
在执行期间,如果数据不在内存中,则数据库会将数据从磁盘读取到内存中。数据库还会断开确保数据完整性所需的任何锁和锁,并记录在 SQL 执行期间所做的任何更改。处理 SQL 语句的最后一个阶段是关闭游标。
如果数据库配置为使用内存中列存储(IM 列存储),则数据库会尽可能透明地将查询路由到 IM 列存储,否则路由到磁盘和数据库缓冲区高速缓存。单个查询还可以使用 IM 列存储、磁盘和缓冲区高速缓存。例如,一个查询可以联接两个表,其中只有一个被缓存到 IM 列存储中。
另请参见:
-
Oracle AI Database SQL Tuning Guide(了解有关执行计划和
EXPLAIN PLAN语句的详细信息)
DML 和 DDL 处理之间的区别
Oracle AI Database 处理 DDL 的方式与 DML 不同。
例如,创建表时,数据库不会优化 CREATE TABLE 语句。而是 Oracle AI Database 解析 DDL 语句并执行该命令。
与 DDL 不同,大多数 DML 语句都具有查询组件。在查询中,执行游标会将查询生成的行放置到结果集中。
数据库可以一次一行或组中提取结果集行。在提取中,数据库选择行,如果查询请求,则对行进行排序。每次连续提取都会检索结果的另一行,直到提取最后一行。
另请参阅:Oracle AI Database Development Guide 以了解如何处理 DDL、事务处理控制和其他类型的语句