数据并发性和一致性
此页上的脚本内容仅用于导航目的,不会以任何方式变更该内容。
本章介绍 Oracle AI Database 如何在多用户数据库环境中维护一致的数据。
-
数据并发性和一致性简介在单用户数据库中,用户可以修改数据,而无需担心其他用户同时修改相同数据。但是,在多用户数据库中,多个同时事务处理中的语句可能会更新相同的数据。同时执行的事务处理必须产生有意义且一致的结果。
-
Oracle AI Database Transaction Isolation Level 概览 事务处理隔离级别的 ANSI 标准根据每个隔离级别允许或阻止的现象来定义。
-
Oracle AI Database Locking Mechanism 概述 锁是一种防止破坏性交互的机制。
-
自动锁定概览 Oracle AI Database 会自动代表事务处理锁定资源,以防止其他事务处理执行需要对同一资源进行独占访问的任务。
-
手动数据锁概览 您可以手动覆盖 Oracle AI Database 默认锁定机制。
-
User-Defined Locks(用户定义的锁概览)使用 Oracle AI Database Lock Management 服务,可以为特定应用程序定义自己的锁。
数据并发性和一致性简介
在单用户数据库中,用户可以修改数据,而无需担心其他用户同时修改相同的数据。但是,在多用户数据库中,多个同时事务处理中的语句可能会更新相同的数据。同时执行的事务处理必须产生有意义且一致的结果。
多用户数据库必须提供以下内容:
为了描述同时运行事务时的一致事务行为,数据库研究人员定义了一个称为序列化的事务隔离模型。可序列化事务处理在环境中运行,使该事务处理显示为没有其他用户在修改数据库中的数据。
虽然事务之间的这种隔离程度通常是可取的,但以可串行化模式运行许多应用程序可能会严重影响应用程序吞吐量。完全隔离并发运行的事务可能意味着一个事务无法执行插入到另一个事务所查询的表中的操作。简而言之,现实世界的考虑通常需要在完美的事务隔离和性能之间达成妥协。
Oracle AI Database 使用多版本一致性模型以及各种类型的锁定和事务来保持数据一致性。通过这种方式,数据库可以将数据视图呈现给多个并发用户,每个视图都与某个时间点一致。由于数据块的不同版本可以同时存在,因此事务处理可以读取在 query 所需的时间点提交的数据版本,并返回与单个时间点一致的结果。
-
多版本读取一致性在 Oracle AI Database 中,多版本是同时实现多个版本数据的能力。Oracle AI Database 可保持多版本读一致性。
-
锁定机制一般来说,多用户数据库使用某种形式的数据锁定来解决与数据并发性、一致性和完整性相关的问题。
-
ANSI/ISO Transaction Isolation Levels ANSI 和 ISO/IEC 都采用的 SQL 标准定义了四种级别的事务隔离。这些级别对事务处理吞吐量有不同程度的影响。另请参阅:“数据完整性”和“交易”
多版本读取一致性
在 Oracle AI Database 中,多版本化可以同时实现多个版本的数据。Oracle AI Database 可保持多版本读一致性。
Oracle 数据库的查询具有以下特征:
-
读一致性查询
查询返回的数据在单个时间点内提交且保持一致。
注:Oracle AI Database 绝不允许脏读取,当事务处理读取其他事务处理中的未提交数据时会出现这种情况。
为了说明脏读数的问题,假设一个事务在不提交的情况下更新列值。第二个事务处理读取更新的脏(未提交)值。第一个会话回退事务处理,以便列具有其旧值,但第二个事务处理使用更新的值继续,从而损坏数据库。脏读取会破坏数据完整性,违反外键并忽略唯一约束条件。
-
非阻塞查询
数据的读取者和写入者不会互相阻止。
-
语句级读取一致性 Oracle AI Database 始终实施语句级读取一致性,可确保单个查询返回的数据在单个时间点内提交且一致。
-
事务级读一致性 Oracle AI Database 还可以为事务中的所有查询(称为事务级读一致性)提供读一致性。
-
读一致性和还原段要管理多版本读一致性模型,数据库必须在同时查询和更新表时创建读一致性数据集。
-
读取一致性和延迟插入 称为延迟插入的特殊插入类型不使用标准读取一致性机制。另请参见:“锁定行为概要”
语句级读一致性
Oracle AI Database 始终实施语句级读取一致性,确保单个查询返回的数据在单个时间点内提交且一致。
单个 SQL 语句的一致性时间点取决于事务处理隔离级别和查询的性质:
-
在已提交的读取隔离级别中,此时间点是打开 statement 的时间。例如,如果
SELECT语句在 SCN 1000 打开,则此语句与 SCN 1000 保持一致。 -
在可序列化或只读事务处理中,此时间点是事务处理开始的时间。例如,如果一个事务从 SCN 1000 开始,并且此事务中发生了多个
SELECT语句,则每个语句都与 SCN 1000 保持一致。 -
在闪回查询操作 (
SELECT ... AS OF) 中,SELECT语句显式指定时间点。例如,可以查询上星期四下午 2 点显示的表。
另请参阅:Oracle AI Database Development Guide 以了解闪回查询
事务处理级别读一致性
Oracle AI Database 还可以为事务处理中的所有查询提供读一致性,称为事务处理级读一致性。
在这种情况下,事务处理中的每个语句都会看到来自相同时间点的数据。这是事务处理开始的时间。
可序列化事务处理进行的查询可以查看事务处理本身所做的更改。例如,更新 employees,然后查询 employees 的事务处理将看到更新。事务处理级读一致性可生成可重复读数,并且不会向虚拟读取公开查询。
读取一致性和还原段
要管理多版本读一致性模型,数据库必须在同时查询和更新表时创建读一致性数据集。
Oracle AI Database 通过撤消数据实现读取一致性。
每当用户修改数据时,Oracle AI Database 都会创建还原条目,该条目将写入还原段。还原段包含未提交或最近提交的事务处理更改的数据的旧值。因此,同一数据的多个版本(所有版本都位于不同的时间点)可以存在于数据库中。数据库可以使用不同时间点的数据快照来提供数据的读一致性视图并启用非阻塞查询。
在单实例和 Oracle Real Application Clusters (Oracle RAC) 环境中保证读一致性。Oracle RAC 使用高速缓存到高速缓存的块传输机制(称为高速缓存融合)将数据块的读一致性映像从一个数据库实例传输到另一个数据库实例。
-
读取一致性:示例此示例显示了一个查询,该查询使用还原数据在读取提交的隔离级别提供语句级读取一致性。
-
读取一致性和相关事务处理列表 每个段块的块标题都包含相关事务处理列表 (interested transaction list,ITL) 。
另请参见:
-
“还原段”了解还原存储
-
Oracle AI Database SecureFiles and Large Objects Developer’s Guide,了解 LOB 的读一致性机制
读一致性:示例
此示例显示了使用还原数据在读取提交的隔离级别提供语句级读取一致性的查询。
图 1:已提交的读取隔离级别中的读取一致性
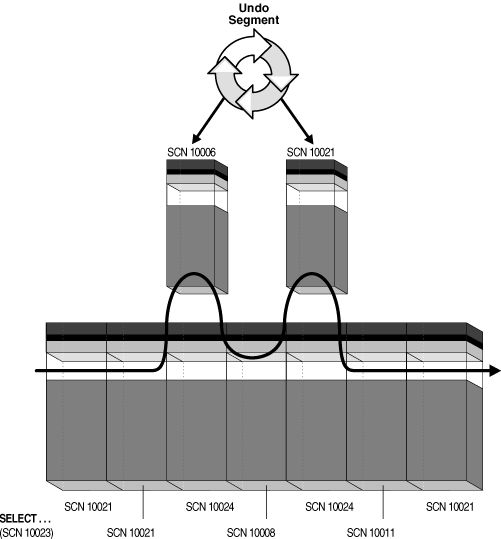
当数据库代表查询检索数据块时,数据库会确保每个块中的数据在查询开始时反映块的内容。数据库会根据需要回滚对块的更改,以将块重构到查询开始处理的时间点。
数据库使用称为 SCN 的内部排序机制来保证事务处理的顺序。当 SELECT 语句进入执行阶段时,数据库将确定在查询开始执行时记录的 SCN。在图 12-1 中,此 SCN 为 10023。该查询仅看到与 SCN 10023 相关的已提交数据。
In Figure 12-1, blocks with SCNs after 10023 indicate changed data, as shown by the two blocks with SCN 10024. SELECT 语句需要与已提交更改一致的块版本。数据库将当前数据块复制到新的缓冲区,并应用还原数据来重建先前版本的块。这些重构的数据块称为一致读取 (CR) 克隆。
在图 12-1 中,数据库创建两个 CR 克隆:一个块与 SCN 10006 一致,另一个块与 SCN 10021 一致。数据库将返回查询的重建数据。通过这种方式,Oracle AI Database 可以防止脏读取。
另请参见:“数据库缓冲区高速缓存”和“系统更改号 (System Change Numbers,SCN) ”
读取一致性和感兴趣的事务处理列表
每个段块的块标头都包含一个相关事务处理列表 (interested transaction list,ITL) 。
数据库使用 ITL 来确定数据库开始修改块时事务处理是否未提交。
ITL 中的条目描述了哪些事务处理已锁定行,块中的哪些行包含已提交和未提交的更改。ITL 指向还原段中的事务处理表,该表提供有关对数据库所做的更改的时间安排的信息。
从某种意义上说,块头包含影响块中每一行的事务处理的最近历史记录。CREATE TABLE 和 ALTER TABLE 语句的 INITRANS 参数控制保留的事务处理历史记录量。
另请参阅:Oracle AI Database SQL Language Reference 以了解 INITRANS 参数
读取一致性和延迟插入
称为延迟插入的特殊插入类型不使用标准读一致性机制。
延迟插入使用 MEMOPTIMIZE_WRITE 提示插入指定为 MEMOPTIMIZE FOR WRITE 的表中。数据库将这些插入缓冲在大型池中,而不是缓冲区高速缓存中。数据库不会使用重做和还原来跟踪更改。相反,当空间管理协调员 (SMCO) 将缓冲区写入磁盘时,数据库会自动提交更改。无法回退更改。
延迟插入与传统插入在重要方面有所不同:
-
驻留在大型池中(应用程序假定已提交)的数据可能会丢失。例如,在将更改保存到磁盘之前,数据库实例可能会失败,即使应用程序报告已保存更改也是如此。
-
不允许直接从内存读取数据。在后台进程将其写入磁盘之前,写入者无法读取其自己的更改。在将已提交的更改写入磁盘之前,任何读取器都无法看到这些更改。
必须避免数据丢失的客户机应用程序在写入大型池后应保留数据的本地副本。客户机可以使用 DBMS_MEMOPTIMIZE 软件包跟踪写入内存的持久性,使用 DBMS_MEMOPTIMIZE_ADMIN 软件包强制数据库写入磁盘。
另请参见:
-
Oracle AI Database SQL Language Reference,详细了解
MEMOPTIMIZE FOR WRITE提示
锁定机制
通常,多用户数据库使用某种形式的数据锁定来解决与数据并发性、一致性和完整性相关的问题。
锁是一种机制,可防止访问同一资源的事务之间的破坏性交互。
另请参阅:“Oracle AI Database Locking Mechanism 概述”
ANSI/ISO 事务处理隔离级别
ANSI 和 ISO/IEC 都采用的 SQL 标准定义了四个级别的事务隔离。这些级别对事务处理吞吐量有不同程度的影响。
这些隔离级别是根据在并发执行事务之间必须防止的现象定义的。可预防的现象包括:
-
脏读取
事务处理读取其他事务处理已写入但尚未提交的数据。
-
不可重复(模糊)读数
事务处理会重新读取之前读取的数据,并发现另一个已提交的事务处理修改或删除了数据。例如,用户查询一行,然后查询同一行,仅为了发现数据已更改。
-
虚拟读取
事务处理会重新运行查询,返回满足搜索条件的一组行,并发现另一个已提交的事务处理插入了满足该条件的其他行。
例如,事务处理会查询员工数。五分钟后,它执行相同的查询,但现在数量增加了一个,因为另一个用户为新雇员插入了记录。满足查询条件的数据比以前多,但与模糊读取不同的是,以前读取的数据保持不变。
SQL 标准根据允许在特定隔离级别运行的事务处理所经历的现象定义了四个隔离级别。表 12-1 显示级别。
表 1 按隔离级别列出的可预防读取现象
| 隔离级别 | 脏读取 | 不可重复读取 | 虚读 |
|---|---|---|---|
| 读数未提交 | 可能的 | 可能的 | 可能的 |
| 已承诺读取 | 不可以 | 可能的 | 可能的 |
| 可重复读取 | 不可以 | 不可以 | 可能的 |
| 可串行化 | 不可以 | 不可以 | 不可以 |
Oracle AI Database 提供读取已提交(默认)和可串行化隔离级别。此外,数据库还提供了只读模式。
另请参见:
-
Oracle AI Database Transaction Isolation Levels 概述,了解读提交、可串行化和只读隔离级别
-
Oracle AI Database SQL Language Reference,介绍 Oracle AI Database 符合 SQL 标准的情况
Oracle AI Database Transaction Isolation Level 概览
事务隔离级别的 ANSI 标准根据每个隔离级别允许或阻止的现象来定义。
Oracle AI Database 提供了事务处理隔离级别:
-
读取提交的隔离级别在读取提交的隔离级别中,由事务处理执行的每个查询只能看到在查询开始之前提交的数据(而不是事务处理)。
-
Serializable Isolation Level(串行化隔离级别)在串行化隔离级别中,事务处理仅看到在事务处理开始时提交的更改(而不是查询),以及事务处理本身所做的更改。
-
只读隔离级别 只读隔离级别与可序列化隔离级别类似,但只读事务处理不允许在事务处理中修改数据,除非用户是
SYS。
另请参见:
-
Oracle AI Database Development Guide,了解有关事务处理隔离级别的详细信息
-
Oracle AI Database SQL Language Reference 和 Oracle AI Database PL/SQL Language Reference 可了解
SET TRANSACTION ISOLATION LEVEL
读取承诺隔离级别
在读取提交的隔离级别中,事务处理执行的每个查询只能看到在查询之前提交的数据,不能看到事务处理开始之前提交的数据。
此隔离级别是默认值。它适用于很少有事务处理可能发生冲突的数据库环境。
读取已提交事务处理中的查询可避免读取在查询进行期间提交的数据。例如,如果查询正在进行百万行表的扫描,并且其他事务处理提交了对行 950,000 的更新,则查询在读取行 950,000 时不会看到此更改。但是,由于数据库不会阻止其他事务处理修改查询读取的数据,因此其他事务处理可能会在介于查询执行之间更改数据。因此,运行同一查询两次的事务处理可能会遇到模糊读取和幻象。
-
读取承诺隔离级别中的一致性 数据库为每个查询提供一致的结果集,确保数据一致性,用户无需执行任何操作。
-
读取已提交事务处理中的冲突写入 在读取已提交事务处理中,当事务处理尝试更改由未提交的并发事务处理更新的行时,将发生冲突写入。
读取承诺隔离级别中的读取一致性
数据库为每个查询提供一致的结果集,确保数据一致性,用户无需执行任何操作。
隐式查询(如 UPDATE 语句中的 WHERE 子句隐含的查询)可以保证结果集的一致性。但是,隐式查询中的每个语句都看不到 DML 语句本身所做的更改,而是看到在进行更改之前存在的数据。
如果 SELECT 列表包含 PL/SQL 函数,则数据库将在语句级别为 PL/SQL 函数代码内的 SQL 运行应用语句级读一致性,而不是在父 SQL 级别应用语句级读一致性。例如,一个函数可以访问一个表,该表的数据由另一个用户更改和提交。在函数中每次执行 SELECT 时,都会建立新的读一致性快照。
另请参阅:“子查询”
读取的已提交事务处理中的写入冲突
在已提交的读取事务中,当事务尝试更改由未提交的并发事务更新的行时,会出现冲突写入。
阻止行修改的事务处理有时称为阻止事务处理。读取的已提交事务处理等待阻止事务处理结束并释放其行锁定。
这些选项如下所示:
-
如果阻塞事务处理回退,则等待事务处理继续更改以前锁定的行,就像从未存在其他事务处理一样。
-
如果阻塞事务处理提交并释放其锁,则等待事务处理继续将其预期更新到新更改的行。
下表显示了事务处理 1(可以是可序列化事务处理还是可读取提交的事务处理)如何与读取提交的事务处理 2 交互。它显示了称为丢失的更新的传统情况。即使事务处理 1 已将其提交,事务处理 1 所做的更新也不在表中。制定策略来处理丢失的更新是应用程序开发的重要组成部分。
表 2 READ COMMITTED 事务处理中出现冲突的写入和丢失的更新
| 会话 1 | 会话 2 | 说明 |
|---|---|---|
SQL> SELECT last_name,
  salary FROM employees
  WHERE last_name IN
  ('Banda', 'Greene',
 'Hintz');

  LAST_NAME SALARY
 ------------- ----------
 Banda 6200
Greene 9500 |
无操作。 | 环节 1 查询 Banda、Greene 和 Hintz 的薪金。未找到名为 Hintz 的员工。 |
SQL> UPDATE employees SET salary = 7000 WHERE last_name = 'Banda'; |
无操作。 | 期次 1 通过更新 Banda 薪资开始交易。事务处理 1 的默认隔离级别为 READ COMMITTED。 |
| 无操作。 | SQL> SET TRANSACTION ISOLATION LEVEL READ COMMITTED; |
会话 2 将启动事务 2,并将隔离级别显式设置为 READ COMMITTED。 |
| 无操作。 | SQL> SELECT last_name,
salary FROM employees
WHERE last_name IN
('Banda', 'Greene',
'Hintz');
LAST_NAME SALARY
------------- ----------
Banda 6200
Greene 9500 |
事务处理 2 查询 Banda、Greene 和 Hintz 的薪金。Oracle AI Database 使用读一致性在事务处理 1 进行未提交的更新之前显示 Banda 的薪金。 |
| 无操作。 | SQL> UPDATE employees SET salary = 9900 WHERE last_name='Greene'; |
事务处理 2 已成功更新 Greene 的薪金,因为事务处理 1 仅锁定了“班达”行。 |
SQL> INSERT INTO employees (employee_id, last_name, email, hire_date, job_id) VALUES (210, 'Hintz', 'JHINTZ', SYSDATE, 'SH_CLERK'); |
无操作。 | 事务处理 1 为员工 Hintz 插入一行,但不会提交。 |
| 无操作。 | SQL> SELECT last_name,
salary FROM employees
WHERE last_name IN
('Banda', 'Greene',
'Hintz');
LAST_NAME SALARY
------------- ----------
Banda 6200
Greene 9900 |
事务处理 2 查询员工 Banda、Greene 和 Hintz 的薪金。 事务处理 2 看到了自己对 Greene 薪金的更新。事务处理 2 没有看到未提交的 Banda 薪金更新或事务处理 1 插入的 Hintz。 |
| 无操作。 | SQL> UPDATE employees SET salary = 6300 WHERE last_name = 'Banda'; -- prompt does not return |
事务处理 2 尝试更新 Banda 的行,该行当前被事务处理 1 锁定,导致写入冲突。事务处理 2 等待事务处理 1 结束。 |
SQL> COMMIT; |
无操作。 | 事务处理 1 提交其工作,结束事务处理。 |
| 无操作。 | 1 row updated. SQL> |
现在释放了 Banda 行上的锁定,因此事务处理 2 继续更新 Banda 的薪金。 |
| 无操作。 | SQL> SELECT last_name,
salary FROM employees
WHERE last_name IN
('Banda', 'Greene',
'Hintz');
LAST_NAME SALARY
------------- ----------
Banda 6300
Greene 9900
Hintz |
事务处理 2 查询员工 Banda、Greene 和 Hintz 的薪金。事务处理 1 提交的 Hintz 插入现在对事务处理 2 可见。事务处理 2 看到了自己对班达薪金的更新。 |
| 无操作。 | COMMIT; |
事务处理 2 提交其工作,结束事务处理。 |
SQL> SELECT last_name,
  salary FROM employees
  WHERE last_name IN
 ('Banda', 'Greene',
  'Hintz');

  LAST_NAME SALARY
 ------------- ----------
 Banda 6300
 Greene 9900
Hintz |
无操作。 | Session 1 查询 Banda、Greene 和 Hintz 的行。Banda 的薪金为 6300,这是事务处理 2 所做的更新。交易 1 将 Banda 的薪金更新为 7000,现在“丢失”。 |
可序列化隔离级别
在串行化隔离级别中,事务处理只能看到在事务处理开始时提交的更改(而不是查询开始时提交的更改)以及事务处理本身所做的更改。
可序列化事务处理在环境中运行,使该事务处理显示为没有其他用户在修改数据库中的数据。可串行化隔离适用于以下环境:
-
具有仅更新几行的大型数据库和短事务处理
-
两个并发事务处理修改相同行的可能性相对较低
-
其中,相对较长的事务处理主要为只读
在可序列化隔离中,通常在语句级别获得的读取一致性扩展到整个事务。保证事务处理读取的任何行在重新读取时都是相同的。任何查询都保证在事务处理的持续时间内返回相同的结果,因此其他事务处理所做的更改对查询不可见,无论该查询运行了多长时间。可序列化事务不会经历脏读取、模糊读取或虚拟读取。
只有在可序列化事务处理开始时已提交了对其他事务处理所进行行的更改时,Oracle AI Database 才允许可序列化事务处理修改行。当可序列化事务处理尝试在可序列化事务处理开始后更新或删除由其他事务处理更改的数据时,数据库将生成错误:
ORA-08177: Cannot serialize access for this transaction当可序列化事务处理失败并出现 ORA-08177 错误时,应用程序可以执行多个操作,包括:
-
将执行的工作提交到该点
-
执行其他(但不同)语句,可能是在回退到事务处理中较早建立的 savepoint 之后
-
回退整个事务
下表显示了可序列化事务处理与其他事务处理的交互方式。如果可序列化事务处理未尝试在可序列化事务处理开始后更改另一个事务处理提交的行,则可避免序列化访问问题。
表 3 可序列化事务处理
| 会话 1 | 会话 2 | 说明 |
|---|---|---|
|
无操作。 | 环节 1 查询 Banda、Greene 和 Hintz 的薪金。未找到名为 Hintz 的员工。 |
|
无操作。 | 期次 1 通过更新 Banda 薪资开始交易 1。默认隔离级别为 READ COMMITTED。 |
| 无操作。 | |
会话 2 将启动事务 2 并将其设置为 SERIALIZABLE 隔离级别。 |
| 无操作。 | |
事务处理 2 查询 Banda、Greene 和 Hintz 的薪金。Oracle AI Database 使用读一致性在事务处理 1 进行未提交的更新之前显示 Banda 的薪金。 |
| 无操作。 | |
事务处理 2 已成功更新 Greene 薪金,因为只有班达行被锁定。 |
|
无操作。 | 事务处理 1 为员工提示插入一行。 |
|
无操作。 | 事务处理 1 提交其工作,结束事务处理。 |
|
|
会话 1 查询员工 Banda、Greene 和 Hintz 的薪金,并查看事务处理 1 提交的更改。会话 1 没有看到交易 2 所进行的未提交的 Greene 更新。 事务处理 2 查询员工 Banda、Greene 和 Hintz 的薪金。Oracle AI Database 读一致性可确保事务 1 提交的 Hintz 插入和 Banda 更新不对事务 2 可见。事务处理 2 看到了自己的 Greene 薪金更新。 |
| 无操作。 | |
事务处理 2 提交其工作,结束事务处理。 |
|
|
这两个期次都查询 Banda、Greene 和 Hintz 的薪金。每个会话均可看到事务处理 1 和事务处理 2 所提交的所有更改。 |
|
无操作。 | 期次 1 通过更新 Hintz 薪资开始交易 3。事务处理 3 的默认隔离级别为 READ COMMITTED。 |
| 无操作。 | |
会话 2 将启动事务 4 并将其设置为 SERIALIZABLE 隔离级别。 |
| 无操作。 | |
事务处理 4 尝试更新 Hintz 的薪金,但由于事务处理 3 锁定了 Hintz 行而被阻止。事务处理 4 队列落后于事务处理 3。 |
|
无操作。 | 事务处理 3 提交其 Hintz 薪金更新,结束事务处理。 |
| 无操作。 | |
结束事务 3 的提交将导致事务 4 中的 Hintz 更新失败,并出现 ORA-08177 错误。出现问题错误是因为事务 3 在事务 4 开始之后提交了 Hintz 更新。 |
| 无操作。 | |
会话 2 回退事务处理 4,该事务处理结束。 |
| 无操作。 | |
会话 2 将启动事务 5 并将其设置为 SERIALIZABLE 隔离级别。 |
| 无操作。 | |
事务处理 5 查询 Banda、Greene 和 Hintz 的薪金。事务处理 3 提交的 Hintz 薪金更新可见。 |
| 无操作。 | |
事务处理 5 将 Hintz 薪金更新为其他值。由于事务处理 3 在事务处理 5 开始之前提交了 Hintz 更新,因此可以避免序列化访问问题。 注:如果在事务处理 5 开始后更新并提交了其他事务处理 Hintz 行,则会再次出现序列化访问问题。 |
| 无操作。 | |
会话 2 提交更新时没有任何问题,从而结束事务处理。 |
只读隔离级别
只读隔离级别与可序列化隔离级别类似,但只读事务不允许在事务中修改数据,除非用户是 SYS。
只读事务处理不易受 ORA-08177 错误的影响。只读事务处理可用于生成报表,其中内容必须与事务处理开始时间一致。
Oracle AI Database 可根据需要从还原段重建数据,从而实现读取一致性。由于还原段以循环方式使用,因此数据库可以覆盖还原数据。长时间运行的报表存在以下风险:读取一致性所需的还原数据可能已被其他事务处理重用,从而引发 snapshot too old 错误。设置 undo retention period(还原保留期),这是数据库在覆盖旧还原数据之前尝试保留的最短时间,可以适当地避免此问题。
另请参见:
-
“撤消段”
-
Oracle AI Database Administrator’s Guide,了解如何设置还原保留期
Oracle AI Database 锁定机制概述
锁是一种防止破坏性交互的机制。
当交互错误地更新数据或错误地更改底层数据结构时,访问共享数据的事务处理之间的交互具有破坏性。锁在维护数据库并发性和一致性方面发挥着至关重要的作用。
-
Summary of Locking Behavior(锁定行为概要)数据库维护多种不同类型的锁定,具体取决于获取锁的操作。
-
使用锁 在单用户数据库中,锁不是必需的,因为只有一个用户正在修改信息。但是,当多个用户访问和修改数据时,数据库必须提供一种防止同时修改相同数据的方法。
-
锁定模式 Oracle AI Database 自动使用最低适用级别的限制来提供最高程度的数据并行操作,同时也提供可靠的数据完整性。
-
锁定转换和升级 Oracle AI Database 可根据需要执行锁定转换。
-
锁定持续时间 Oracle AI Database 在发生某些事件时自动释放锁定,以便事务处理不再需要资源。
-
Locks and Deadlocks 死锁是指两个或多个用户正在等待彼此锁定的数据的情况。死锁可防止某些事务处理继续工作。
锁定行为概要
数据库会维护几种不同类型的锁,具体取决于获取锁的操作。
通常,数据库使用两种类型的锁:独占锁和共享锁。只能在某个资源(如行或表)上获取一个独占锁,但可以在单个资源上获取多个共享锁。
锁会影响读者和写者的交互。读取器是对资源的查询,而写入器是修改资源的语句。以下规则汇总了面向读者和写者的 Oracle AI Database 锁定行为:
-
仅当写入器修改行时,才会锁定行。
当语句更新一行时,事务处理仅获取此行的锁。通过在行级别锁定表数据,数据库可以最大程度地减少对相同数据的争用。在正常情况下,脚注 1 数据库不会将行锁定升级到块或表级别。
-
行的写入器会阻止同一行的并发写入器。
如果一个事务处理正在修改行,则行锁定会阻止另一个事务处理同时修改同一行。
-
读者永远不会阻止作家。
由于行的读取器不锁定该行,因此写入器可以修改该行。唯一的例外是
SELECT ... FOR UPDATE语句,它是SELECT语句的特殊类型,会锁定它正在读取的行。 -
作家从不阻挡读者。
当写入者正在更改行时,数据库会使用还原数据向读取者提供一致的行视图。
注:在暂挂分布式事务处理的特殊情况下,数据读取者可能需要等待相同数据块的写入者。
另请参见:
-
Oracle AI Database SQL Language Reference(了解
SELECT ... FOR UPDATE) -
Oracle AI Database Administrator’s Guide,了解与不确定的分布式事务处理关联的等待
使用锁
在单用户数据库中,锁定不是必需的,因为只有一个用户正在修改信息。但是,当多个用户访问和修改数据时,数据库必须提供一种防止同时修改相同数据的方法。
锁可满足以下重要的数据库要求:
-
一致性
在用户完成之前,会话正在查看或更改的数据不能由其他会话更改。
-
完整性
数据和结构必须以正确的顺序反映对它们所做的所有更改。
Oracle AI Database 通过其锁定机制在事务之间提供数据并发性、一致性和完整性。自动执行锁定,无需用户操作。
可以通过同时更新单个行来说明锁定需求。在以下示例中,基于 Web 的简单应用程序向最终用户提供员工电子邮件和电话号码。应用程序使用 UPDATE 语句(例如以下语句)修改数据:
UPDATE employees
SET    email = ?, phone_number = ?
WHERE  employee_id = ?
AND    email = ?
AND    phone_number = ?
在前面的 UPDATE 语句中,WHERE 子句中的电子邮件和电话号码值是指定员工的原始未修改值。此更新可确保应用程序修改的行在应用程序上次读取后不会更改,并向用户显示。通过这种方式,应用程序可以避免丢失的更新问题,即一个用户覆盖另一个用户所做的更改,从而有效地丢失第二个用户的更新(表 12-2 显示了丢失的更新的示例)。表 12-4 显示当两个会话尝试大致同时修改 employees 表中的同一行时,事件的顺序。
表 4 行锁定示例
| T | 会话 1 | 会话 2 | 说明 |
|---|---|---|---|
| t0 | |
在会话 1 中,hr1 用户查询 hr.employees 以获取 Himuro 记录,并显示 employee_id (118)、电子邮件 (GHIMURO) 和电话号码 (515.127.4565) 属性。 |
|
| t1 | |
在会话 2 中,hr2 用户查询 hr.employees 以获取 Himuro 记录,并显示 employee_id (118)、电子邮件 (GHIMURO) 和电话号码 (515.127.4565) 属性。 |
|
| t2 | |
在会话 1 中,hr1 用户将行中的电话号码更新为 515.555.1234,这将获取对 GHIMURO 行的锁定。 |
|
| t3 | |
在会话 2 中,
|
|
| t4 | |
在会话 1 中, 该承诺使 Himuro 的改变成为永久性的,并取消了会议 2,该会议一直在等待。 |
|
| t5 | |
在会话 2 中, 由于谓词不匹配,因此会话 2 不会更新任何记录。 |
|
| t6 | |
在会话 1 中,hr1 用户意识到它使用错误的电话号码更新了 GHIMURO 行。用户将启动新事务,并将行中的电话号码更新为 515.555.1235,这将锁定 GHIMURO 行。 |
|
| t7 | |
在会话 2 中,hr2 用户查询 hr.employees 以获取 Himuro 记录。该记录显示由会话 1 在 t4 提交的电话号码更新。Oracle AI Database 读一致性可确保会话 2 在 t6 上不会看到未提交的更改。 |
|
| t8 | |
在会话 2 中,hr2 用户尝试更新同一行,但由于 hr1 当前正在处理该行而被阻止。 |
|
| t9 | |
在会话 1 中,hr1 用户回退事务处理,该事务处理将结束。 |
|
| t10 | |
在期次 2 中,由于期次 1 更新被回退,因此电话号码更新成功。GHIMURO 行与其谓词匹配,因此更新成功。 |
|
| t11 | |
会话 2 提交更新,结束事务处理。 |
执行 SQL 语句时,Oracle AI Database 会自动获取必要的锁定。例如,在数据库允许会话修改数据之前,会话必须首先锁定数据。锁定赋予会话对数据的独占控制权,以便在释放锁定之前,其他事务处理都无法修改锁定的数据。
由于 Oracle AI Database 的锁定机制与事务处理控制紧密相关,因此应用程序设计人员只需正确定义事务处理,而 Oracle AI Database 会自动管理锁定。用户无需显式锁定任何资源,尽管 Oracle AI Database 还允许用户手动锁定数据。
以下各节介绍了对于了解 Oracle AI Database 如何实现数据并发性的重要概念。
另请参阅:Oracle AI Database PL/SQL Packages and Types Reference,以了解 OWA_OPT_LOCK 软件包,其中包含有助于防止丢失更新的子程序
锁定方式
Oracle AI Database 自动使用最低适用级别的限制来提供最高程度的数据并行操作,同时也提供可靠的数据完整性。
级别限制越小,其他用户访问的数据就越可用。相反,级别限制越大,其他事务处理就越局限于它们可以获得的锁类型。
Oracle AI Database 在多用户数据库中使用两种锁定模式:
-
独占锁定模式
此模式可防止共享关联的资源。事务处理在修改数据时将获取独占锁定。独占锁定资源的第一个事务处理是唯一可以在释放独占锁定之前更改资源的事务处理。
-
共享锁定模式
此模式允许共享关联的资源,具体取决于所涉及的操作。读取数据的多个用户可以共享数据,每个用户持有 share lock 以防止需要独占锁的写入者同时访问数据。多个事务处理可以在同一资源上获取共享资源锁定。
假设事务处理使用 SELECT ... FOR UPDATE 语句选择单个表行。事务处理将获取独占行锁定和行共享表锁定。行锁定允许其他会话修改锁定的行除外的任何行,而表锁定阻止会话更改表的结构。因此,数据库允许执行尽可能多的语句。
锁定转换和升级
Oracle AI Database 可根据需要执行锁定转换。
在锁转换中,数据库会自动将限制性较低的表锁转换为限制性较高的表锁。例如,假设事务处理为员工发出 SELECT ... FOR UPDATE,然后更新锁定的行。在这种情况下,数据库会自动将行共享表锁定转换为行独占表锁定。事务处理为在事务处理中插入、更新或删除的所有行保留排他行锁。由于行锁定是以最高限制度获取的,因此不需要或执行锁定转换。
锁定转换与锁定升级不同,当在一个粒度级别(例如,行)持有大量锁定并且数据库将锁定提升到更高粒度级别(例如,表)时,会发生锁定转换。如果会话锁定表中的多个行,则某些数据库会自动将行锁定升级到单个表。锁定数量会减少,但锁定的限制性会增加。
Oracle AI Database 永远不会升级锁。 锁定升级会大大增加死锁的概率。假设系统尝试代表事务处理 1 升级锁定,但由于事务处理 2 持有的锁定而无法升级锁定。如果事务处理 2 还需要对相同数据进行锁定升级才能继续,则会创建死锁。
锁定持续时间
发生某些事件时,Oracle AI Database 会自动释放锁,以便事务处理不再需要资源。
通常,数据库保存事务处理期间由语句获取的锁。这些锁可防止并发事务的破坏性干扰,例如脏读取、丢失的更新和破坏性 DDL 。注:由于未编制索引的外键而对子表执行的表锁定在语句的持续时间内,而不是事务处理。此外,通过 DBMS_LOCK 软件包,可以随意释放和分配用户定义的锁,甚至可以保留在事务边界之外。
Oracle AI Database 在提交或回退时释放事务处理内语句获取的所有锁。Oracle AI Database 还会在回退到保存点时释放在保存点后获得的锁。但是,只有未等待以前锁定的资源的事务处理才能获取当前可用资源的锁。正在等待的事务处理将继续等待,直到原始事务处理提交或完全回退之后。
锁数和死锁数
死锁是指两个或多个用户正在等待彼此锁定的数据。死锁可防止某些事务处理继续工作。
Oracle AI Database 会自动检测死锁,并通过回退死锁中涉及的一个语句来解析死锁,从而释放一组冲突的行锁。数据库将返回对进行 statement-level rollback 的事务处理的相应消息。回退的语句属于检测死锁的事务处理。通常,应该显式回退信号事务处理,但可以在等待后重试回退语句。表 12-5 说明死锁中的两个事务。
表 5 死锁事务处理
| T | 会话 1 | 会话 2 | 说明 |
|---|---|---|---|
| t0 | |
|
期次 1 将启动事务处理 1 并更新员工 100 的薪金。期次 2 将启动事务处理 2 并更新员工 200 的薪金。不存在问题,因为每个事务处理仅锁定其尝试更新的行。 |
| t1 | |
|
事务处理 1 尝试更新当前被事务处理 2 锁定的员工 200 行。事务处理 2 尝试更新当前被事务处理 1 锁定的员工 100 行。 死锁导致,因为任何事务处理都无法获取其需要继续或终止的资源。无论每个事务处理等待多长时间,都会保留冲突的锁。 |
| t2 | |
事务处理 1 发出死锁信号并回退在 t1 上发出的 注:死锁中只有一个会话实际会收到死锁错误,但任一会话都可能会收到错误。 |
|
| t3 | |
会话 1 提交在 t0 上进行的更新,结束事务处理 1。未成功尝试对 t1 执行更新。 | |
| t4 | |
将执行事务处理 2 中 t1 的更新,该更新被事务处理 1 阻止。将返回提示。 | |
| t5 | |
会话 2 提交在 t0 和 t1 上进行的更新,该更新结束交易 2。 |
当事务显式覆盖 Oracle AI Database 的默认锁定时,最常发生死锁。由于 Oracle AI Database 不会升级锁,也不会对查询使用读取锁,而是使用行级别(而不是页级别)锁定,因此死锁很少发生。
另请参见:
-
“手动数据锁概述”
-
Oracle AI Database Development Guide,了解显式锁定表时如何处理死锁
自动锁定概览
Oracle AI Database 会自动代表事务处理锁定资源,以防止其他事务处理执行需要对同一资源进行独占访问的任务。
根据所执行的资源和操作,数据库会在不同限制级别自动获取不同类型的锁。注:执行简单读取时,数据库从不锁定行。
Oracle AI Database 锁定分为下表中显示的类别。
表 6 锁定类别
| 锁定 | 说明 | 详细了解 |
|---|---|---|
| DML 锁 | 保护数据。例如,表锁定会锁定整个表,而行锁定会锁定选定的行。 | “ DML 锁” |
| DDL 锁定 | 保护方案对象的结构,例如表和视图的字典定义。 | “ DDL 锁” |
| 系统锁定 | 保护内部数据库结构,例如数据文件。闩锁、互斥和内部锁是完全自动的。 | “系统锁” |
-
DML 锁 DML 锁也称为数据锁,可确保多个用户同时访问的数据的完整性。
-
DDL 锁 数据字典 (DDL) 锁可保护方案对象的定义,而正在进行的 DDL 操作将对该对象执行操作或引用该对象。
-
系统锁 Oracle AI Database 使用各种类型的系统锁来保护内部数据库和内存结构。用户无法访问这些机制,因为用户无法控制它们的出现或持续时间。
DML 锁
DML 锁定(也称为数据锁定)可确保多个用户同时访问的数据的完整性。
例如,DML 锁可防止两个客户购买在线书店提供的书籍的最后一份副本。DML 锁可防止同时发生冲突的 DML 或 DDL 操作的破坏性干扰。
DML 语句自动获取以下类型的锁:
在以下各节中,每种锁定或锁定模式后括号中的首字母缩写是 Oracle Enterprise Manager 的锁监视器 (Enterprise Manager) 中使用的缩写。Enterprise Manager 可能会显示任何表锁的 TM,而不是指示表锁的模式(如 RS 或 SRX)。
-
行锁 (TX) 行锁(也称为 TX 锁)是单行表的锁。对于由
INSERT、UPDATE、DELETE、MERGE或SELECT... FORUPDATE语句修改的每一行,事务处理都会获取行锁定。在事务处理提交或回退之前,行锁定一直存在。 -
Table Locks (TM) 表锁也称为 TM lock ,在通过
INSERT、UPDATE、DELETE、MERGE、SELECT以及FOR UPDATE子句或LOCK TABLE语句修改表时,事务处理将获取表锁。 -
Locks and Foreign Keys Oracle AI Database 可最大限度地提高父键相对于相关外键的并发控制。
行锁 (TX)
行锁也称为 TX 锁,是单行表的锁。对于由 INSERT、UPDATE、DELETE、MERGE 或 SELECT ... FOR UPDATE 语句修改的每一行,事务处理都会获取行锁定。在事务处理提交或回退之前,行锁定一直存在。
行锁定主要用作排队机制,以防止两个事务处理修改同一行。数据库始终以独占模式锁定修改后的行,以便其他事务处理在保留锁的事务处理提交或回退之前无法修改该行。行锁定可提供最好的晶粒锁定,从而提供最佳的并发性和吞吐量。
注:如果事务处理因数据库实例失败而终止,则块级恢复会在恢复整个事务处理之前使行可用。
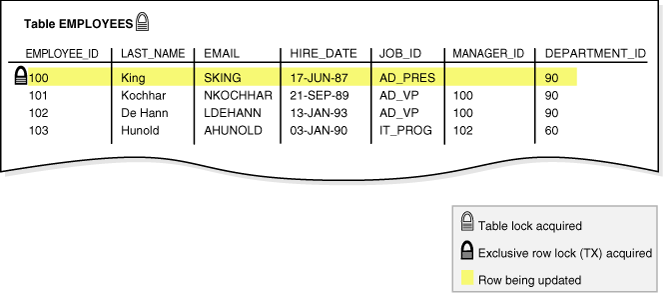
如果事务处理获取了某行的锁定,则该事务处理还会获取包含该行的表的锁定。表锁定可防止将覆盖当前事务处理中的数据更改的冲突 DDL 操作。图 12-2 说明了表中第三行的更新。Oracle AI Database 会自动将独占锁定放在更新的行上,将子独占锁定放在表中。
图 2:行锁和表锁
-
行锁和并发此方案说明 Oracle AI Database 如何使用行锁进行并发。
-
存储行锁 与使用锁定管理器维护内存中锁列表的某些数据库不同,Oracle AI Database 将锁信息存储在包含锁定行的数据块中。
行锁和并发
此方案说明 Oracle AI Database 如何使用行锁进行并发。
三个会话同时查询相同的行。会话 1 和会话 2 继续对不同行进行未提交的更新,而会话 3 不进行更新。每个会话都会看到其自己的未提交更新,但不会看到任何其他会话的未提交更新。
表 7 数据并发性示例
| T | 会话 1 | 会话 2 | 会话 3 | 说明 |
|---|---|---|---|---|
| t0 | |
|
|
三个不同的期次同时查询雇员 100 和 101 的标识和薪金。每个查询返回的结果是相同的。 |
| t1 | |
期次 1 更新员工 100 的薪金,但不提交。在更新中,写入者仅为更新的行获取行级别锁定,从而阻止其他写入者修改此行。 | ||
| t2 | |
|
|
每个会话同时发出原始查询。会话 1 显示 t1 更新产生的薪金为 612。会话 2 和 3 中的读取器会立即返回行,并且不会等待会话 1 结束其事务处理。数据库使用多版本读一致性来显示期次 1 中更新之前存在的薪资。 |
| t3 | |
期次 2 更新员工 101 的薪金,但不提交事务处理。在更新中,写入者仅为更新的行获取行级别锁定,从而阻止其他写入者修改此行。 | ||
| t4 | |
|
|
每个会话同时发出原始查询。期次 1 显示由于 t1 更新而产生的薪金 612,而不是在期次 2 中进行的员工 101 的薪金更新。期次 2 中的读者显示期次 2 中进行的薪资更新,但不显示期次 1 中进行的薪资更新。期次 3 中的读者使用读一致性来显示薪资,然后按期次 1 和 2 进行修改。 |
另请参见:
行锁的存储
与使用锁定管理器维护内存中锁定列表的某些数据库不同,Oracle AI Database 将锁定信息存储在包含锁定行的数据块中。
数据库使用排队机制来获取行锁。如果事务处理需要对未锁定行进行锁定,则该事务处理会将锁置于数据块中。此事务处理修改的每个行都指向块标题中存储的事务处理 ID 的副本。
事务处理结束时,事务处理 ID 将保留在块标题中。如果其他事务处理想要修改行,则使用事务处理 ID 来确定锁定是否有效。如果锁定处于活动状态,则会话要求在释放锁定时收到通知。否则,事务处理将获取锁。
另请参见:
-
“数据块概述”以详细了解数据块标头
-
Oracle AI Database Reference(了解
V$TRANSACTION)
表锁 (TM)
表锁(也称为 TM lock )在通过 INSERT、UPDATE、DELETE、MERGE、SELECT 以及 FOR UPDATE 子句或 LOCK TABLE 语句修改表时由事务获取。
DML 操作需要表锁定来代表事务处理保留对表的 DML 访问权限,并防止执行与事务处理冲突的 DDL 操作。
表锁可以在以下任一模式下保持:
-
行共享 (RS)
此锁(也称为子共享资源表锁 (subshare table lock,SSL) )指示持有表锁的事务处理在表中已锁定行并打算更新这些行。行共享锁是表锁的最小限制模式,为表提供最高程度的并发性。
-
行独占表锁定 (RX)
此锁(也称为子排他表锁 (subexclusive table lock,SX) )通常表示持有锁的事务已更新表行或发出了
SELECT ... FOR UPDATE。SX 锁定允许其他事务处理在同一个表中同时查询、插入、更新、删除或锁定行。因此,SX 锁允许多个事务获取同一表的同时 SX 和子共享表锁。 -
共享表锁定 (S)
事务持有的共享表锁允许其他事务查询该表(不使用
SELECT ... FOR UPDATE),但仅当单个事务持有共享表锁时才允许更新。由于多个事务可能同时持有共享表锁定,因此持有此锁定不足以确保事务可以修改该表。 -
共享行独占表锁定 (SRX)
此锁(也称为 share-subexclusive table lock,SSLX) ) 比共享表锁更具限制性。一次只能有一个事务处理可以获取给定表的 SSX 锁。事务处理持有的 SSX 锁允许其他事务处理查询该表(
SELECT ... FOR UPDATE除外),但不能更新该表。 -
独占表锁定 (X)
此锁定是最严格的,禁止其他事务处理执行任何类型的 DML 语句或将任何类型的锁定放在表中。
另请参见:
锁和外键
Oracle AI Database 可最大限度地实现父键与相关外键的并发控制。
锁定行为取决于外键列是否已编制索引。如果没有为外键编制索引,则子表可能会更频繁地锁定,出现死锁,并降低并发性。因此,外键几乎总是应被索引。唯一的例外是从未更新或删除匹配的唯一键或主键。
-
锁定和取消索引的外键 如果子表的外键列上不存在索引,并且会话修改父表中的主键(例如,删除行或修改主键属性)或将行合并到父表中,则数据库会获取子表的完整表锁定。
-
Locks and Indexed Foreign Keys(锁定和索引外键):当子表中的外键列已编制索引时,数据库不会获取子表的完整表锁定,会话会修改父表中的主键(例如,删除行或修改主键属性)或将行合并到父表中。
锁和未索引外键
当子表的外键列上不存在索引时,数据库将获取子表的完整表锁定,会话将修改父表中的主键(例如,删除行或修改主键属性)或将行合并到父表中。
当满足以下两个条件时,数据库将获取子表的全表锁定:
-
子表的外键列上不存在索引。
-
会话修改父表中的主键(例如,删除行或修改主键属性)或将行合并到父表中。注:插入到父表中不会获取阻止子表上 DML 的块表锁。在插入的情况下,数据库会获取子表的锁,以防止结构性更改,但不会修改现有行或新添加的行。
假设 hr.departments 表是 hr.employees 的父表,其中包含未索引的外键 employees.department_id。下图显示了修改 departments 表中部门 60 的主键属性的会话。
图 3:具有未索引外键的锁定机制
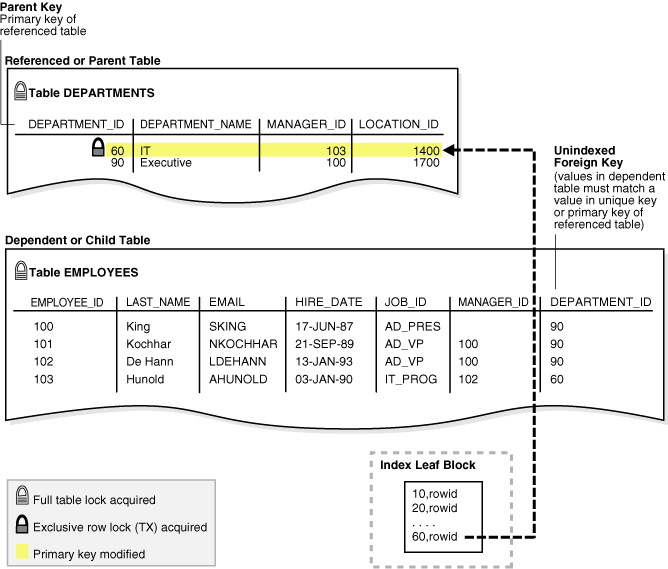
在图 12-3 中,数据库在部门 60 的主键修改期间在 employees 上获取全表锁定。此锁定使其他会话可以查询但不更新 employees 表。例如,期次不能更新员工电话号码。在对 departments 表进行主键修改完成后,立即对 employees 发行版执行表锁定。如果 departments 中的多个行进行了主键修改,则对于在 departments 中修改的每一行,将获取并释放 employees 上的表锁定。注:子表的 DML 不会获取父表的表锁定。
锁和索引外键
当子表中的外键列已编制索引,并且会话修改父表中的主键(例如,删除行或修改主键属性)或将行合并到父表中时,数据库不会获取子表的完整表锁定。
对父表的锁定可防止事务处理获取独占表锁定,但不会阻止在主键修改期间对父或子表执行 DML 操作。如果主键修改发生在父表上,而更新发生在子表上,则最好出现这种情况。图 12-4 显示了带有索引 department_id 列的子表 employees。事务处理从 departments 删除部门 280。此删除不会导致数据库在 employees 表上获取全表锁定,如“ Locks and Unindexed Foreign Keys ”中所述。
图 4:具有索引外键的锁定机制
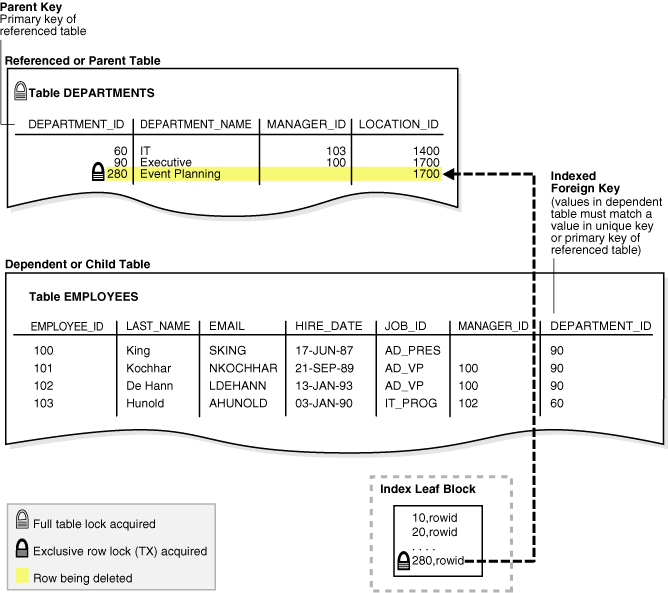
如果子表指定了 ON DELETE CASCADE,则从父表进行删除可能会导致从子表进行删除。例如,删除部门 280 会导致删除已删除部门中员工的 employees 中的记录。在这种情况下,等待和锁定规则与从父表中删除行后从子表中删除行时相同。
另请参见:
-
“索引简介”
DDL 锁定
数据字典 (DDL) 锁可保护方案对象的定义,而正在进行的 DDL 操作将对该对象执行或引用该对象。
在 DDL 操作期间,仅锁定修改或引用的各个方案对象。数据库从不锁定整个数据字典。
Oracle AI Database 会代表需要 DDL 锁的任何 DDL 事务自动获取 DDL 锁。用户无法显式请求 DDL 锁定。例如,如果用户创建了存储过程,则 Oracle AI Database 会自动获取过程定义中引用的所有方案对象的 DDL 锁定。DDL 锁定可以防止在过程编译完成之前对这些对象进行更改或删除。
-
独占 DDL 锁 独占 DDL 锁会阻止其他会话获取 DDL 或 DML 锁。
-
Share DDL Locks(共享 DDL 锁)资源的共享 DDL 锁可防止与冲突的 DDL 操作发生破坏性干扰,但允许对类似的 DDL 操作进行数据并发。
-
可中断语法分析锁 语法分析锁由 SQL 语句或 PL/SQL 程序单元为其引用的每个方案对象保留。
独占 DDL 锁
独占 DDL 锁可防止其他会话获取 DDL 或 DML 锁。
大多数 DDL 操作都需要资源的独占 DDL 锁,以防止对可能修改或引用同一方案对象的其他 DDL 操作造成破坏性干扰。例如,ALTER TABLE 正在向表添加列时,不允许 DROP TABLE 删除表,反之亦然。
独占 DDL 锁定在执行 DDL 语句和自动提交期间的最后一次。在获取独占 DDL 锁期间,如果另一个操作将另一个 DDL 锁保留在方案对象上,则获取将等待,直到释放较旧的 DDL 锁,然后继续。
另请参见:Share DDL Locks 介绍了不需要独占锁定来防止破坏性干扰的情况
共享 DDL 锁
资源的共享资源 DDL 锁可防止与 DDL 操作冲突的破坏性干扰,但允许对类似的 DDL 操作进行数据并发。
例如,当运行 CREATE PROCEDURE 语句时,包含的事务处理会获取所有引用的表的共享 DDL 锁。其他事务处理可以同时创建引用相同表的过程并获取同一表的并发共享 DDL 锁,但任何事务处理都不能获取任何引用的表的独占 DDL 锁。
共享资源 DDL 锁在 DDL 语句执行和自动提交期间持续存在。因此,持有共享资源 DDL 锁的事务处理可以保证在事务处理期间所引用的方案对象的定义保持不变。
可断开的语法分析锁
parse lock 由 SQL 语句或 PL/SQL 程序单元保留,用于其引用的每个方案对象。
获取语法分析锁,以便在引用的对象发生更改或删除时使关联的共享 SQL 区域失效。语法分析锁称为可中断的语法分析锁,因为它不禁止任何 DDL 操作,并且可以中断以允许冲突的 DDL 操作。
在 SQL 语句执行的语法分析阶段,将在共享池中获取语法分析锁。只要该语句的共享 SQL 区域仍位于共享池中,就会保留该锁。
另请参见:“共享池”
系统锁定
Oracle AI Database 使用各种类型的系统锁来保护内部数据库和内存结构。用户无法访问这些机制,因为用户无法控制它们的出现或持续时间。
-
闩锁 闩锁是一种简单的低级序列化机制,可协调多用户对共享数据结构、对象和文件的访问。
-
互斥 互斥对象 (mutex) 是一种低级机制,可防止内存中的对象在并发进程访问时过期或损坏。互斥体与闩锁类似,但闩锁通常保护一组对象,而互斥保护单个对象。
-
内部锁 内部锁是比闩锁和互斥更高级别、更复杂的机制,用于各种用途。
闩锁
闩锁是一种简单的低级串行化机制,可协调多用户对共享数据结构、对象和文件的访问。
闩锁可保护共享内存资源免受多个进程访问时的损坏。具体而言,闩锁可保护数据结构免受以下情况的影响:
-
多个会话的并发修改
-
由一个会话读取,同时由另一个会话修改
-
访问时内存的取消分配(超时)
通常,单个闩锁会保护 SGA 中的多个对象。例如,DBW 和 LGWR 等后台进程从共享池分配内存以创建数据结构。要分配此内存,这些进程使用串行化访问的共享池锁存器,以防止两个进程尝试同时检查或修改共享池。分配内存后,其他进程可能需要访问共享池区域,例如解析所需的 library cache 。在这种情况下,进程仅锁定库高速缓存,而不锁定整个共享池。
与行锁定等入队闩锁不同,闩锁不允许会话排队。当锁存器可用时,请求锁存器的第一个会话将获得对锁存器的独占访问权限。当进程在循环中重复请求锁存器时,会发生 latch spinning 现象,而当进程在续订锁存器请求之前释放 CPU 时,会发生 latch sleeping 。
通常,Oracle 进程在处理或查看数据结构时会获取锁存器很短的时间。例如,在处理单个员工的薪资更新时,数据库可能会获取并释放数千个闩锁。闩锁的实现与操作系统有关,特别是在进程是否等待闩锁以及等待多长时间方面。
锁定增加意味着并发性降低。例如,过多的 hard parse 操作会为库高速缓存闩锁创建争用。V$LATCH 视图包含每个闩锁的详细闩锁使用情况统计信息,包括每个闩锁被请求和等待的次数。
另请参见:
-
“ SQL 语法分析”
-
Oracle AI Database Reference(了解
V$LATCH) -
Oracle AI Database Performance Tuning Guide,了解等待事件统计信息
互斥数
互斥目标文件(mutual exclusion object,互斥目标文件)是一种低级机制,可防止内存中的目标文件在并发进程访问时过期或被损坏。互斥体与闩锁类似,但闩锁通常保护一组对象,而互斥保护单个对象。
互斥具有以下几个优点:
-
互斥可以减少争用的可能性。
由于锁存器可以保护多个对象,因此当进程尝试同时访问其中的任何对象时,锁存器可能会成为瓶颈。通过串行化对单个对象(而非组)的访问,互斥可提高可用性。
-
互斥锁比闩锁消耗的内存少。
-
处于共享模式时,互斥体允许多个会话进行并发引用。
内部锁
内部锁是比闩锁和互斥更高级别、更复杂的机制,用于各种用途。
数据库使用以下类型的内部锁:
-
字典高速缓存锁定
这些锁的持续时间非常短,并且在修改或使用条目时保留在字典高速缓存中的条目上。它们保证被解析的语句不会看到不一致的对象定义。字典高速缓存锁可以共享或独占。共享锁定在语法分析完成时释放,而独占锁定在 DDL 操作完成时释放。
-
文件和日志管理锁定
这些锁可保护各种文件。例如,内部锁可保护 control file ,以便一次只能更改一个进程。另一个锁用于协调联机重做日志文件的使用和归档。数据文件将被锁定,以确保多个实例以共享模式挂载数据库,或者一个实例以独占模式挂载数据库。由于文件和日志锁定指示文件的状态,因此这些锁定必然会保留很长时间。
-
表空间和还原段锁定
这些锁可保护表空间和还原段。例如,访问数据库的所有实例都必须就表空间是联机还是脱机达成一致。还原段被锁定,因此只有一个数据库实例可以写入段。
另请参阅:“数据字典高速缓存”
手动数据锁概述
可以手动覆盖 Oracle AI Database 默认锁定机制。
Oracle AI Database 会自动执行锁定,以确保数据并发性、数据完整性和语句级读取一致性。但是,在以下情况下,覆盖缺省锁定非常有用:
-
应用程序需要事务级读取一致性或可重复读取。
在这种情况下,查询必须在事务处理的持续时间内生成一致的数据,而不反映其他事务处理的更改。通过使用显式锁定、只读事务处理、可序列化事务处理或覆盖默认锁定,可以实现事务处理级别的读取一致性。
-
应用程序要求事务处理对资源具有独占访问权限,以便事务处理不必等待其他事务处理完成。
您可以在会话或事务处理级别覆盖 Oracle AI Database 自动锁定。在会话级别,会话可以使用 ALTER SESSION 语句设置所需的事务隔离级别。在事务处理级别,包含以下 SQL 语句的事务处理将覆盖 Oracle AI Database 默认锁定:
-
SET TRANSACTION ISOLATION LEVEL语句 -
LOCK TABLE语句(用于锁定表,或者用于视图时锁定基表) -
SELECT ... FOR UPDATE语句
上述语句获取的锁将在事务处理结束后释放,或者回退以保存点释放它们。
如果在任何级别覆盖了 Oracle AI Database 默认锁定,则数据库管理员或应用程序开发人员应确保覆盖锁定过程正确运行。锁定过程必须满足以下标准:保证数据完整性、可接受数据并发性以及无法正常处理死锁。
另请参见:
-
Oracle AI Database SQL Language Reference(了解
LOCK TABLE和SELECT的说明) -
Oracle AI Database Development Guide,了解如何手动锁定表
用户定义的锁概览
借助 Oracle AI Database Lock Management 服务,您可以为特定应用程序定义自己的锁。
例如,您可以创建一个锁来序列化对文件系统上消息日志的访问。由于保留的用户锁定与 Oracle AI Database 锁定相同,因此它具有所有 Oracle AI Database 锁定功能,包括死锁检测。用户锁定从不与 Oracle AI Database 锁定冲突,因为它们用前缀 UL 标识。
Oracle AI Database Lock Management 服务可通过 DBMS_LOCK 软件包中的过程获得。可以在 PL/SQL 块中包含以下语句:
-
请求锁定特定类型
-
为锁指定在同一实例或其他实例中的其他过程中可识别的唯一名称
-
更改锁定类型
-
释放锁定
另请参见:
-
Oracle AI Database Development Guide,了解有关 Oracle AI Database Lock Management 服务的更多信息
-
Oracle AI Database PL/SQL Packages and Types Reference(了解有关
DBMS_LOCK的信息)
脚注图例
脚注 1:
处理分布式两阶段提交时,数据库可能会在特殊情况下短暂阻止读取访问。具体而言,如果查询在准备阶段和提交阶段之间开始,并且尝试在提交之前读取数据,则数据库可能会将锁从行级别升级到块级别,以确保读取一致性。