分区、视图和其他方案对象
尽管表和索引是最重要且最常用的方案对象,但数据库支持许多其他类型的方案对象,其中最常见的方案对象将在本章中进行讨论。
-
分区概述 在 Oracle 数据库中,使用分区可以将非常大的表和索引分解为更小、更易于管理的段,称为分区。每个分区都是独立对象,具有自己的名称和(可选)自己的存储特征。
-
分片表概览在 Oracle 数据库中,“全局分布式数据库”功能使您可以将任何表分成称为分片的部分,这些分片可以存储在多个数据库中。
-
视图概览 视图是一个或多个表的逻辑表示形式。从本质上讲,视图是一种存储的查询。
-
实体化视图概览 实体化视图是预先存储或作为方案对象“实体化”的查询结果。查询的
FROM子句可以命名表、视图或实体化视图。 -
序列概览 序列是多个用户可以从中生成唯一整数的方案对象。序列生成器提供了一种高度可扩展且性能良好的方法,用于为数字数据类型生成代理密钥。
-
维概览典型的数据仓库具有两个重要组成部分:维和事实。
-
同义词概览 同义词是方案对象的别名。例如,可以为表或视图、序列、PL/SQL 程序单元、用户定义的对象类型或其他同义语创建同义词。由于同义词只是别名,因此除数据字典中的定义之外,它不需要任何存储。
分区概览
在 Oracle 数据库中,通过 partitioning ,可以将非常大的表和索引分解为更小、更易于管理的段,称为分区。每个分区都是独立对象,具有自己的名称和(可选)自己的存储特征。
对于说明分区的类比,假设人力资源经理有一个包含员工文件夹的大框。每个文件夹都列出雇员的聘用日期。查询通常针对特定月份聘用的员工。满足此类请求的一种方法是创建员工雇用日期的索引,该索引指定整个框中分散的文件夹的位置。相比之下,分区策略使用许多较小的框,每个框都包含给定月份雇用的员工的文件夹。
使用较小的盒子有几个优点。当要求检索 6 月聘用员工的文件夹时,人力资源经理可以检索 6 月框。此外,如果任何小盒子暂时损坏,其他小盒子仍然可用。移动办公室也变得更容易,因为经理可以移动几个小盒子,而不是移动一个沉重的盒子。
从应用程序的角度来看,仅存在一个方案对象。SQL 语句无需修改即可访问分区表。分区对于许多不同类型的数据库应用程序非常有用,尤其是那些管理大量数据的数据库应用程序。优势包括:
-
提高可用性
分区的不可用不意味着该对象不可用。查询 optimizer 会自动从 query plan 中删除未引用的分区,以便在分区不可用时不会影响查询。
-
更轻松地管理方案对象
分区对象具有可以集体或单独管理的片段。DDL 语句可以处理分区,而不是整个表或索引。因此,可以分解资源密集型任务,例如重建索引或表。例如,一次可以移动一个表分区。如果出现问题,则只有分区移动必须重做,而不是表移动。此外,删除分区可避免执行大量
DELETE语句。 -
减少 OLTP 系统中共享资源的争用
在某些 OLTP 系统中,分区可以减少共享资源的争用。例如,DML 分布在多个段而不是一个段上。
-
提高数据仓库中的查询性能
在数据仓库中,分区可以加快即席查询的处理速度。例如,可以按季度对包含一百万行的销售表进行分区。
-
分区特性表或索引的每个分区必须具有相同的逻辑属性,例如列名、数据类型和约束条件。
-
分区表 分区表由一个或多个分区组成,这些分区是单独管理的,可以独立于其他分区运行。
-
分区索引 分区索引是一个索引,它与分区表一样,被划分为更小、更易于管理的部分。
-
Partial Indexes for Partitioned Tables(分区表的部分索引)partial index(部分索引)是与关联分区表的索引属性相关的索引。
-
将对象存储用于较旧的分区对于只读分区,您可以使用低成本存储,例如云中的对象存储。另请参阅:Oracle AI Database VLDB and Partitioning Guide,了解分区简介
分区特性
表或索引的每个分区必须具有相同的逻辑属性,例如列名、数据类型和约束条件。
例如,表中的所有分区都具有相同的列和约束条件定义。但是,每个分区可以具有单独的物理属性,例如它所属的表空间。
-
Partition Key(分区关键字)partition key(分区关键字)是确定每行分区的一组列(一列或多列)。明确地将每一行分配给一个分区。
-
分区策略 Oracle Partitioning 提供了多种分区策略,可控制数据库将数据放置到分区中的方式。基本策略包括范围、列表和散列分区。
分区关键字
分区关键字是确定每行分区的一组列(一行或多列)的一组。明确地将每一行分配给一个分区。
在 sales 表中,可以指定 time_id 列作为范围分区的键。数据库根据此列中的日期是否在指定范围内为分区分配行。Oracle AI Database 使用分区键自动将插入、更新和删除操作定向到相应的分区。
分区策略
Oracle Partitioning 提供了多种分区策略来控制数据库将数据放置到分区中的方式。基本策略包括范围、列表和散列分区。
单级分区仅使用一种数据分配方法,例如,仅使用列表分区或仅使用范围分区。在复合分区中,表按一种数据分配方法进行分区,然后使用另一种数据分配方法将每个分区进一步划分为子分区。例如,可以将列表分区用于 channel_id,将范围子分区用于 time_id。
示例 6-1 分区表的示例行集
此分区示例假定您要使用以下行填充分区表 sales:
  PROD_ID    CUST_ID TIME_ID   CHANNEL_ID   PROMO_ID QUANTITY_SOLD AMOUNT_SOLD
---------- ---------- --------- ---------- ---------- ------------- -----------
      116      11393 05-JUN-99          2        999             1
12.18
       40     100530 30-NOV-98          9         33             1       44.99
      118        133 06-JUN-01          2        999             1       17.12
      133       9450 01-DEC-00          2        999             1       31.28
       36       4523 27-JAN-99          3        999             1       53.89
      125       9417 04-FEB-98          3        999             1       16.86
       30        170 23-FEB-01          2        999             1         8.8
       24      11899 26-JUN-99          4        999             1       43.04
       35       2606 17-FEB-00          3        999             1       54.94
45 9491 28-AUG-98 4 350 1 47.45-
Range Partitioning 在范围分区中,数据库根据分区键的值范围将行映射到分区。范围分区是最常见的分区类型,通常与日期一起使用。
-
间隔分区是范围分区的扩展。
-
List Partitioning 在列表分区中,数据库使用离散值列表作为每个分区的分区关键字。分区键由一个或多个列组成。
-
散列分区 在散列分区中,数据库根据数据库应用于用户指定的分区关键字的散列算法将行映射到分区。
-
引用分区 在引用分区中,子表的分区策略仅通过与父表的外键关系进行定义。对于父表中的每个分区,子表中只存在一个对应的分区。父表将父记录存储在特定分区中,子表将子记录存储在相应分区中。
-
复合分区 在复合分区中,表按一种数据分配方法进行分区,然后使用另一种数据分配方法将每个分区进一步细分为多个子分区。因此,组合分区结合了基本的数据分配方法。给定分区的所有子分区表示数据的逻辑子集。
范围分区
在 range partitioning 中,数据库根据分区键的值范围将行映射到分区。范围分区是最常见的分区类型,通常与日期一起使用。
假定您使用以下 SQL 语句将 time_range_sales 创建为分区表,并将 time_id 列作为分区键:
CREATE TABLE time_range_sales
   ( prod_id        NUMBER(6)
   , cust_id        NUMBER
   , time_id        DATE
   , channel_id     CHAR(1)
   , promo_id       NUMBER(6)
   , quantity_sold  NUMBER(3)
   , amount_sold    NUMBER(10,2)
   )
PARTITION BY RANGE (time_id)
 (PARTITION SALES_1998 VALUES LESS THAN (TO_DATE('01-JAN-1999','DD-MON-YYYY')),
  PARTITION SALES_1999 VALUES LESS THAN (TO_DATE('01-JAN-2000','DD-MON-YYYY')),
  PARTITION SALES_2000 VALUES LESS THAN (TO_DATE('01-JAN-2001','DD-MON-YYYY')),
  PARTITION SALES_2001 VALUES LESS THAN (MAXVALUE)
 );
之后,使用 Example 6-1 中的行装入 time_range_sales。该代码显示四个分区中的行分布。数据库根据 PARTITION BY RANGE 子句中指定的规则,根据 time_id 值为每个行选择分区。范围分区键值确定指定分区的非包含上限。
间隔分区
间隔分区是范围分区的扩展。
如果插入的数据超过了现有范围分区,则 Oracle AI Database 会自动创建指定间隔的分区。例如,可以创建一个销售历史记录表,将每个月的数据存储在单独的分区中。
通过间隔分区,可以避免显式创建范围分区。您可以对几乎每个已进行范围分区的表使用间隔分区,并对新分区使用固定间隔。除非创建具有不同间隔的范围分区,或者除非始终设置特定的分区属性,否则请考虑使用间隔分区。
按间隔进行分区时,必须至少指定一个范围分区。范围分区键值确定范围分区的高值,称为转换点。数据库会自动为值超过转换点的数据创建间隔分区。每个间隔分区的下边界是上一个范围或间隔分区的包含上限。因此,在 Example 6-2 中,值 01-JAN-2011 位于分区 p2 中。
数据库为超出转换点的数据创建间隔分区。间隔分区通过指示数据库创建指定范围或间隔的分区来扩展范围分区。当插入到表中的数据超过所有现有范围分区时,数据库将自动创建分区。在示例 6-2 中,p3 分区包含分区关键字 time_id 值大于或等于 01-JAN-2013 的行。
示例 6-2 间隔分区
假设您创建了一个具有四个不同宽度的分区的销售表。您指定在 2013 年 1 月 1 日的转换点上方,数据库应以一个月的时间间隔创建分区。分区 p3 的上限表示转换点。分区 p3 及其下方的所有分区都位于范围节中,而其上方的所有分区都位于间隔节中。
CREATE TABLE interval_sales
    ( prod_id        NUMBER(6)
    , cust_id        NUMBER
    , time_id        DATE
    , channel_id     CHAR(1)
    , promo_id       NUMBER(6)
    , quantity_sold  NUMBER(3)
    , amount_sold    NUMBER(10,2)
    )
  PARTITION BY RANGE (time_id)
  INTERVAL(NUMTOYMINTERVAL(1, 'MONTH'))
    ( PARTITION p0 VALUES LESS THAN (TO_DATE('1-1-2010', 'DD-MM-YYYY'))
    , PARTITION p1 VALUES LESS THAN (TO_DATE('1-1-2011', 'DD-MM-YYYY'))
    , PARTITION p2 VALUES LESS THAN (TO_DATE('1-7-2012', 'DD-MM-YYYY'))
    , PARTITION p3 VALUES LESS THAN (TO_DATE('1-1-2013', 'DD-MM-YYYY')) );
您插入日期为 2014 年 10 月 10 日的销售:
SQL> INSERT INTO interval_sales VALUES (39,7602,'10-OCT-14',9,null,1,11.79);

1 row created.
查询 USER_TAB_PARTITIONS 将显示数据库为 10 月 10 日的销售创建了一个新分区,因为销售日期晚于转换点:
SQL> COL PNAME FORMAT a9
SQL> COL HIGH_VALUE FORMAT a40
SQL> SELECT PARTITION_NAME AS PNAME, HIGH_VALUE
  2  FROM USER_TAB_PARTITIONS WHERE TABLE_NAME = 'INTERVAL_SALES';

PNAME     HIGH_VALUE
--------- ----------------------------------------
P0        TO_DATE(' 2007-01-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
P1        TO_DATE(' 2008-01-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
P2        TO_DATE(' 2009-07-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
P3        TO_DATE(' 2010-01-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
SYS_P1598 TO_DATE(' 2014-11-01 00:00:00', 'SYYYY-M
M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA另请参阅:Oracle AI Database VLDB and Partitioning Guide 以了解有关间隔分区的更多信息
列表分区
在 list partitioning 中,数据库使用离散值列表作为每个分区的分区键。分区键由一个或多个列组成。
可以使用列表分区控制各个行映射到特定分区的方式。通过使用列表,您可以在标识相关数据集的关键字顺序不便时对相关数据集进行分组和组织。
示例 6-3 列表分区
假设使用以下语句创建 list_sales 作为列表分区表,其中 channel_id 列是分区键:
CREATE TABLE list_sales
   ( prod_id        NUMBER(6)
   , cust_id        NUMBER
   , time_id        DATE
   , channel_id     CHAR(1)
   , promo_id       NUMBER(6)
   , quantity_sold  NUMBER(3)
   , amount_sold    NUMBER(10,2)
   )
PARTITION BY LIST (channel_id)
 ( PARTITION even_channels VALUES ('2','4'),
   PARTITION odd_channels VALUES ('3','9')
 );
然后,使用 Example 6-1 中的行加载表。该代码显示了两个分区中的行分布。数据库根据 PARTITION BY LIST 子句中指定的规则,根据 channel_id 值为每个行选择分区。channel_id 值为 2 或 4 的行存储在 EVEN_CHANNELS 分区中,而 channel_id 值为 3 或 9 的行存储在 ODD_CHANNELS 分区中。
散列分区
在 hash partitioning 中,数据库根据数据库应用于用户指定的分区键的散列算法将行映射到分区。
行的目标由数据库应用于该行的内部 hash function 确定。当分区数为 2 的幂时,散列算法会在所有分区中创建行的大致均匀分布。
散列分区用于划分大型表以提高可管理性。您没有要管理的大表,而是要管理几个较小的部分。单个散列分区的丢失不会影响其余分区,并且可以独立恢复。在具有高更新争用的 OLTP 系统中,散列分区也非常有用。例如,一个段被分成多个段,每个段都会更新,而不是经历争用的单个段。
假定您使用以下语句创建分区的 hash_sales 表,并将 prod_id 列作为分区键:
CREATE TABLE hash_sales
   ( prod_id        NUMBER(6)
   , cust_id        NUMBER
   , time_id        DATE
   , channel_id     CHAR(1)
   , promo_id       NUMBER(6)
   , quantity_sold  NUMBER(3)
   , amount_sold    NUMBER(10,2)
   )
PARTITION BY HASH (prod_id)
PARTITIONS 2;
然后,使用 Example 6-1 中的行加载表。该代码显示了两个分区中可能的行分布。这些分区的名称是系统生成的。
插入行时,数据库会尝试在各个分区之间随机、均匀地分配行。不能指定行所在的分区。数据库应用散列函数,其结果决定了哪个分区包含该行。
另请参见:
-
Oracle AI Database SQL Language Reference(了解
CREATE TABLE ... PARTITION BY示例)
引用分区
在引用分区中,子表的分区策略仅通过与父表的外键关系进行定义。对于父表中的每个分区,子表中只存在一个对应的分区。父表将父记录存储在特定分区中,子表将子记录存储在相应分区中。
例如,orders 表是 line_items 表的父表,在 order_id 上定义了主键和外键。表通过引用进行分区。例如,如果数据库将订单 233 存储在 orders 的分区 Q3_2015 中,则数据库将订单 233 的所有行项目存储在 line_items 的分区 Q3_2015 中。如果将分区 Q4_2015 添加到 orders,则数据库会自动将 Q4_2015 添加到 line_items。
引用分区的优点是:
-
通过对父表和子表使用相同的分区策略,可以避免复制所有分区关键字列。此策略可减少非规范化的手动开销,并节省空间。
-
对父表的维护操作会自动对子表执行。例如,将分区添加到主表时,数据库会自动将此添加项传播到其后代。
-
数据库会自动使用父表和子表中的分区联接,从而提高性能。
可以将引用分区与所有基本分区策略(包括间隔分区)一起使用。还可以将引用分区表创建为组合分区表。
示例 6-4 创建引用分区的表
此示例创建在 order_date 上进行范围分区的父表顺序。创建了引用分区的子表 order_items,其中包含四个分区:Q1_2015、Q2_2015、Q3_2015 和 Q4_2015,其中每个分区包含对应于相应父分区中顺序的 order_items 行。
CREATE TABLE orders
    ( order_id           NUMBER(12),
      order_date         DATE,
      order_mode         VARCHAR2(8),
      customer_id        NUMBER(6),
      order_status       NUMBER(2),
      order_total        NUMBER(8,2),
      sales_rep_id       NUMBER(6),
      promotion_id       NUMBER(6),
      CONSTRAINT orders_pk PRIMARY KEY(order_id)
    )
  PARTITION BY RANGE(order_date)
    ( PARTITION Q1_2015 VALUES LESS THAN (TO_DATE('01-APR-2015','DD-MON-YYYY')),
      PARTITION Q2_2015 VALUES LESS THAN (TO_DATE('01-JUL-2015','DD-MON-YYYY')),
      PARTITION Q3_2015 VALUES LESS THAN (TO_DATE('01-OCT-2015','DD-MON-YYYY')),
      PARTITION Q4_2015 VALUES LESS THAN (TO_DATE('01-JAN-2006','DD-MON-YYYY'))
    );

CREATE TABLE order_items
    ( order_id           NUMBER(12) NOT NULL,
      line_item_id       NUMBER(3)  NOT NULL,
      product_id         NUMBER(6)  NOT NULL,
      unit_price         NUMBER(8,2),
      quantity           NUMBER(8),
      CONSTRAINT order_items_fk
      FOREIGN KEY(order_id) REFERENCES orders(order_id)
    )
PARTITION BY REFERENCE(order_items_fk);另请参阅:Oracle AI Database VLDB and Partitioning Guide,了解参考分区概述
组合分段
在复合分区中,表按一种数据分配方法进行分区,然后使用另一种数据分配方法将每个分区进一步细分为子分区。因此,组合分区结合了基本的数据分配方法。给定分区的所有子分区表示数据的逻辑子集。
组合分区具有以下几个优点:
-
根据 SQL 语句,对一个或两个维进行分区修剪可能会提高性能。
-
查询可以对任一维使用完全或部分分区联接。
-
您可以对单个表执行并行备份和恢复。
-
分区数大于单级分区中的分区数,这可能有利于并行执行。
-
您可以实施滚动窗口来支持历史数据,如果许多语句可以从分区修剪或分区联接中受益,则仍可以在其他维上进行分区。
-
您可以根据分区键的标识以不同的方式存储数据。例如,您可以决定以只读、压缩格式存储特定产品类型的数据,并将其他产品类型的数据保持未压缩状态。
范围、列表和散列分区可作为组合分区表的子分区策略。下图提供了范围散列和范围列表组合分区的图形视图。
图 1:复合范围列表分区
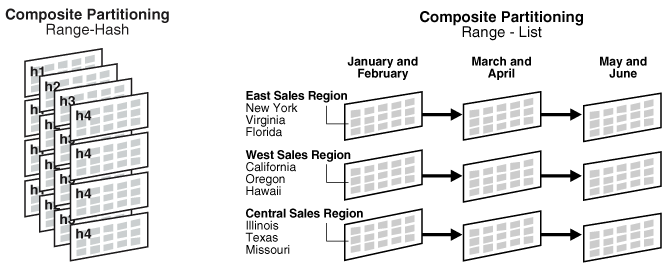
数据库将组合分区表中的每个子分区存储为单独的段。因此,子分区属性可能与表的属性或子分区所属的分区不同。
另请参阅:Oracle AI Database VLDB and Partitioning Guide 以了解有关组合分区的更多信息
分区表
分区表由一个或多个分区组成,这些分区是单独管理的,可以独立于其他分区运行。
表已分区或未分区。即使分区表仅包含一个分区,该表也不同于未分区表,该表不能添加分区。
-
Segments for Partitioned Tables(分区表的段)分区表由一个或多个表分区段组成。
-
对分区表的压缩 按堆组织的表的部分或所有分区可以采用压缩格式存储。
分区表的段
分区表由一个或多个表分区段组成。
如果创建名为 hash_products 的分区表,则不会为此表分配表 segment 。而是,数据库将每个表分区的数据存储在自己的分区段中。每个表分区段都包含部分表数据。
对 external table 进行分区时,所有分区都位于数据库外部。在混合分区表中,某些分区存储在段中,而其他分区存储在外部。例如,sales 表的某些分区可能存储在数据文件中,其他分区存储在电子表格中。
分区表的压缩
按堆组织的表的部分或所有分区可以采用压缩格式进行存储。
压缩可节省空间并加快查询执行速度。因此,压缩在诸如数据仓库、插入和更新操作量较小的环境中以及 OLTP 环境中可能非常有用。
可以为表空间、表或表分区声明 table compression 的属性。如果在表空间级别声明,则默认情况下,在表空间中创建的表将被压缩。您可以变更表的压缩属性,但此更改只应用于进入该表中的新数据。因此,单个表或分区可能包含压缩块和未压缩块,这可确保数据大小不会因压缩而增加。如果压缩可以增加块的大小,则数据库不会将其应用于块。
另请参见:
-
表压缩:了解表压缩的类型,包括基本、高级行和混合列压缩
-
Oracle AI Database Data Warehousing Guide,了解数据仓库中的表压缩
已分区的索引
分区索引是一个索引,它与分区表一样,被划分为更小、更易于管理的部分。
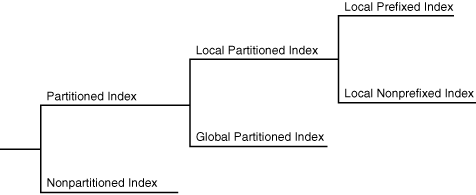
全局索引独立于创建它们的表进行分区,而本地索引会自动链接到表的分区方法。与分区表一样,分区索引可以提高可管理性、可用性、性能和可扩展性。
下图显示了索引分区选项。
图 2:索引分区选项
-
本地分区索引 在本地分区索引中,索引在相同的列上进行分区,具有相同的分区数和与其表相同的分区界限。
-
全局分区索引 全局分区索引是一个 B 树索引,独立于创建该索引的底层表进行分区。单个索引分区可以指向任何或所有表分区,而在本地分区的索引中,索引分区和表分区之间存在一对一奇偶校验。
另请参见:
-
索引简介:了解唯一索引与非唯一索引以及不同索引类型之间的区别
-
Oracle AI Database VLDB and Partitioning Guide(了解有关分区索引的更多信息以及如何确定要使用的类型)
本地分区索引
在 local partitioned index 中,索引在相同的列上进行分区,分区数与其表相同,分区边界相同。
每个索引分区只与底层表的一个分区关联,因此索引分区中的所有键仅引用存储在单个表分区中的行。这样,数据库会自动将索引分区与其关联的表分区同步,从而使每个表 - 索引对相互独立。
本地分区索引在数据仓库环境中很常见。本地索引具有以下优点:
-
可用性会增加,因为使数据在分区中无效或不可用的活动仅影响此分区。
-
简化了分区维护。移动表分区时,或者当数据从分区中老化时,只能重建或维护关联的本地索引分区。在全局索引中,必须重建或维护所有索引分区。
-
如果发生分区的时间点恢复,则可以将索引恢复到恢复时间(请参阅 Oracle AI Database Backup and Recovery User’s Guide)。不需要重新构建整个索引。
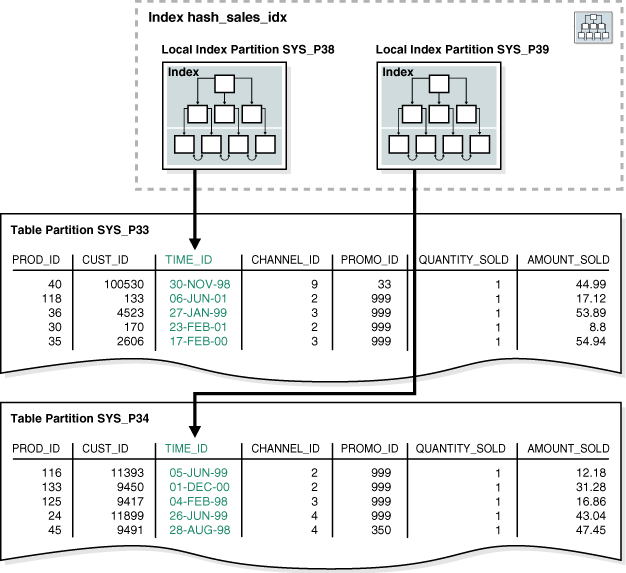
Hash Partitioning 中的示例显示了分区 hash_sales 表的创建语句,该表使用 prod_id 列作为分区键。以下示例在 hash_sales 表的 time_id 列上创建本地分区索引:
CREATE INDEX hash_sales_idx ON hash_sales(time_id) LOCAL;在图 6-3 中,hash_products 表具有两个分区,因此 hash_sales_idx 具有两个分区。每个索引分区都与一个不同的表分区相关联。索引分区 SYS_P38 为表分区 SYS_P33 中的行编制索引,而索引分区 SYS_P39 为表分区 SYS_P34 中的行编制索引。
图 3:本地索引分区
无法将分区显式添加到本地索引。仅当向底层表添加分区时,才会向本地索引添加新分区。同样,您无法显式从本地索引中删除分区。而是仅当从底层表中删除分区时,才会删除本地索引分区。
与其他索引一样,可以在分区表上创建 bitmap index 。唯一的限制是位图索引必须是分区表的本地索引,它们不能是全局索引。全局位图索引仅在未分区的表上受支持。
-
本地前缀索引和非前缀索引 本地分区索引为前缀或非前缀。
-
本地分区索引存储与表分区一样,本地索引分区存储在自己的段中。每个段包含总索引数据的一部分。因此,由四个分区组成的本地索引不会存储在单个索引段中,而是存储在四个单独的段中。
本地前缀索引和非前缀索引
本地分区索引为前缀或非前缀。
索引子类型的定义如下:
-
本地前缀索引
在这种情况下,分区键位于索引定义的前沿。在 Range Partitioning 中的
time_range_sales示例中,表按time_id上的范围进行分区。此表上的本地前缀索引会将time_id作为其列表中的第一列。 -
本地非前缀索引
在这种情况下,分区键不在索引列列表的前沿,并且根本不需要在列表中。在 Local Partitioned Indexes 中的
hash_sales_idx示例中,索引为本地非前缀,因为分区键product_id不在前沿。
这两种类型的索引都可以利用分区删除(也称为分区修剪),当优化程序通过排除分区来加快数据访问时会出现这种情况。query 是否可以消除分区取决于查询 predicate 。使用本地前缀索引的查询始终允许删除索引分区,而使用本地非前缀索引的查询可能不允许。
另请参阅:Oracle AI Database VLDB and Partitioning Guide 以了解如何使用前缀索引和非前缀索引
本地分区索引存储
与表分区类似,本地索引分区存储在自己的段中。每个段包含总索引数据的一部分。因此,由四个分区组成的本地索引不会存储在单个索引段中,而是存储在四个单独的段中。
另请参阅: Oracle AI Database SQL Language Reference(了解 CREATE INDEX ... LOCAL 示例)
全局分区索引
全局分区索引是一个 B 树索引,独立于创建该索引的底层表进行分区。单个索引分区可以指向任何或所有表分区,而在本地分区的索引中,索引分区和表分区之间存在一对一奇偶校验。
通常,全局索引对于 OLTP 应用程序非常有用,在这些应用程序中,快速访问、数据完整性和可用性非常重要。在 OLTP 系统中,表可以按一个键(例如 employees.department_id 列)进行分区,但应用程序可能需要使用许多不同的键(例如 employee_id 或 job_id)访问数据。在此方案中,全局索引可能很有用。
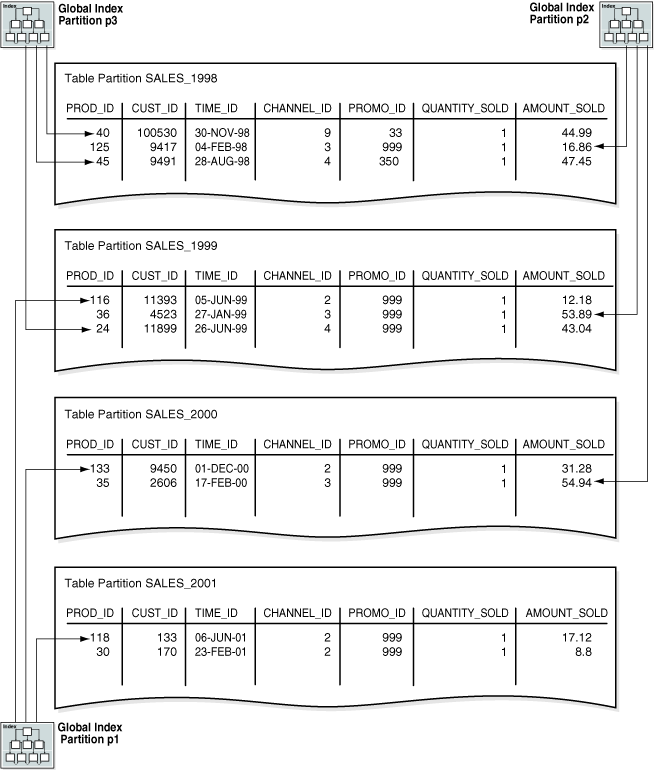
如图所示,假设您在 time_range_sales 表上从“ Range Partitioning ”创建全局分区索引。在此表中,1998 年销售量的行存储在一个分区中,1999 年销售量的行存储在另一个分区中,依此类推。以下示例在 channel_id 列上创建按范围分区的全局索引:
CREATE INDEX time_channel_sales_idx ON time_range_sales (channel_id)
   GLOBAL PARTITION BY RANGE (channel_id)
      (PARTITION p1 VALUES LESS THAN (3),
       PARTITION p2 VALUES LESS THAN (4),
       PARTITION p3 VALUES LESS THAN (MAXVALUE));
如 Figure 6-4 所示,全局索引分区可以包含指向多个表分区的条目。索引分区 p1 指向 channel_id 为 2 的行,索引分区 p2 指向 channel_id 为 3 的行,索引分区 p3 指向 channel_id 为 4 或 9 的行。
图 4:全局分区索引
另请参见:
-
Oracle AI Database VLDB and Partitioning Guide 了解如何管理全局分区索引
-
Oracle AI Database SQL Language Reference,了解
CREATE INDEX的GLOBAL PARTITION子句
分区表的部分索引
部分索引是与关联分区表的索引属性相关联的索引。
通过相关性,可以指定索引哪些表分区。部分索引具有以下优点:
-
未编入索引的表分区可避免占用不必要的索引存储空间。
-
可以提高加载和查询的性能。
在 Oracle Database 12c 之前,交换分区操作需要对关联的全局索引进行物理更新以使其保持可用。从 Oracle Database 12c 开始,如果分区维护操作中涉及的分区不是部分全局索引的一部分,则该索引将保持可用状态,而无需进行任何全局索引维护。
-
如果在创建索引时仅为某些表分区编制索引,如果以后为其他分区编制索引,则可以减少创建索引所需的排序空间。
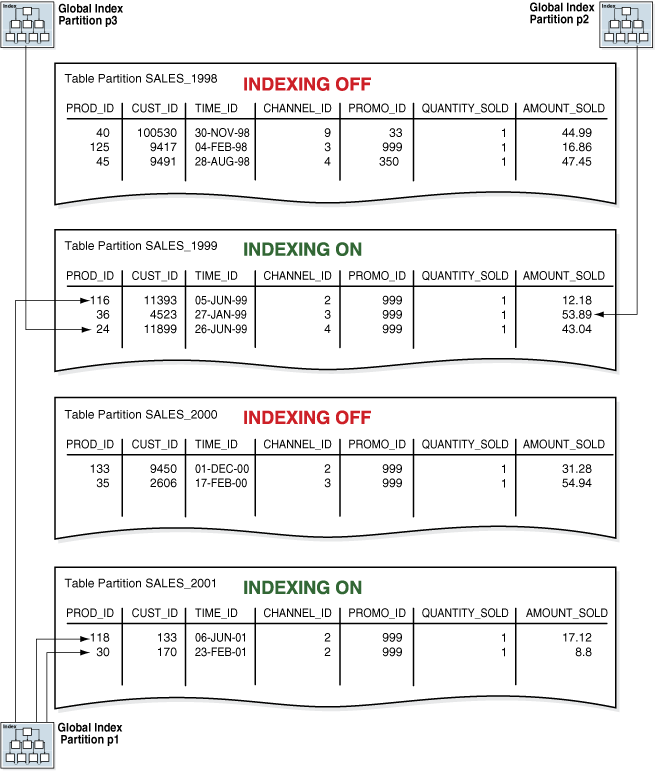
可以为表的各个分区打开或关闭索引。部分本地索引没有可用于已关闭索引的所有表分区的索引分区。无论是否已分区,全局索引都会从已关闭索引的所有分区中排除数据。数据库不支持对强制实施唯一约束的索引使用部分索引。图 6-5 显示的全局索引与图 6-4 中的全局索引相同,只是全局索引是部分索引。表分区 SALES_1998 和 SALES_2000 的索引属性设置为 OFF,因此全局部分索引不会为其编制索引。
图 5:部分全局分区索引
将对象存储用于较旧的分区
对于只读分区,您可以使用低成本存储,例如云中的对象存储。
在过去十年中,数据量大幅增长。此外,政府法规和政策规定,在许多情况下,数据保留时间非常长。Oracle 数据库客户针对大型数据库使用各种数据管理策略。客户有以下主要目标,他们正在努力满足。
以尽可能低的成本存储大量数据满足新的数据保留和保护法规要求通过基于增加的数据量进行更好的分析来改善商机。
本地客户有各种解决方案来实现上述目标。Oracle AI Database 现在为您提供了此功能,支持您利用云端对象存储等低成本存储层,为您的云数据库制定类似的数据管理策略。
随着数据集的不断发展和壮大,Oracle 数据库客户提出了各种数据管理策略。所有这些策略都属于信息生命周期管理 (Information Lifecycle Management,ILM)。有助于实施 ILM 解决方案的一些数据库功能包括数据分区、高级行压缩、混合列压缩、自动数据优化等。
ILM 解决方案的一个方面是定义低成本的存储层。这样,您可以以尽可能低的成本保留大量数据。Oracle ILM 策略支持将数据自动压缩和数据移动到更低成本的存储层。本地部署 Oracle 数据库客户使用 Oracle 存储解决方案(例如 Oracle ZFS Storage Appliance 或 Oracle Exadata Extended (XT) Storage Server)作为低成本存储选项,适用于不经常访问、旧数据或监管数据。您还可以从第三方供应商处选择类似的低成本存储选项。
使用对象存储,您可以:
-
在对象存储中存储较早的分区和只读表空间。
-
以联机方式查询对象存储文件中的数据。
-
防止从另一 PDB 对 PDB 拥有的对象存储文件进行未经授权的访问。
-
在极少数情况下,您希望更改只读数据,请将数据从对象存储移回常规存储。
-
删除对象存储中具有数据文件的表空间。
-
将较早的分区和只读表空间移至对象存储 您可以创建基于时间的分区策略,并将只读表空间的数据文件移至成本较低的存储层(如对象存储)。
-
访问对象存储中的对象访问对象存储中表和分区中的数据对用户和 SQL 客户机是完全透明的。
-
对象存储文件的身份证明管理 访问对象存储中的文件需要身份证明。
-
将数据文件从对象存储移回传统存储 如果必须更新对象存储数据,则必须先将数据移回传统存储。
-
删除对象存储数据文件您可以使用标准
DROP TABLESPACE命令删除包含数据文件的表空间。
将较旧的分区和只读表空间移至对象存储
您可以创建基于时间的分区策略,并将只读表空间的数据文件移动到成本较低的存储层,例如对象存储。
假设您有一个名为“订单”的表,该表在 DATE 列上进行了范围分区。每个分区都包含特定年份的行,并且存在 2022 年和 2023 年的现有分区。随着新的一年临近,数据库管理员决定为 2024 年添加新分区。同时,数据库管理员决定要将最早的分区移动到低成本的存储层。
下面的工作流示例表示一个方案,其中表空间对于单个表具有单个分区。这不是一个限制。只读表空间可以有一个或多个表的分区。除了将表空间设为只读之外,您还可以选择将分区设为只读。最佳做法是,可以将表空间设为只读,并等待一段时间后再将文件移动到对象存储中。这将确保捕获任何更新只读数据的尝试,并返回错误。当数据仍位于 Exadata 或其他传统存储中时,将突变数据移动到其他表空间的速度要快得多。如果需要从对象存储中复制这些数据,速度会慢得多。
create tablespace orders_2022 DATAFILE '+DATA_DG/orders_2022.dbf' size 100g;
create tablespace orders_2023 DATAFILE '+DATA_DG/orders_2023.dbf' size 100g;

create table orders
( prod_id         NUMBER NOT NULL,
  time_id         DATE NOT NULL,
  quantity_sold   NUMBER(10,2) NOT NULL,
  amount_sold     NUMBER(10,2) NOT NULL)
    partition by range (time_id)
    ( partition orders_2022 VALUES LESS THAN (TO_DATE('2023-01-01 00:00:00', 'SYYYY-MM-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIAN'))
        TABLESPACE orders_2022,
      partition orders_2023 VALUES LESS THAN (TO_DATE('2024-01-01 00:00:00', 'SYYYY-MM-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIAN'))
        TABLESPACE orders_2023)
  ENABLE ROW MOVEMENT;

create tablespace orders_2024 DATAFILE '+DATA_DG/orders_2024.dbf' size 100g;

alter table orders
  ADD partition orders_2024
  values less than (TO_DATE('2024-01-01 00:00:00', 'SYYYY-MM-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIAN'))
  TABLESPACE orders_2024;

alter tablespace orders_2022 read only;

alter database property set default_credential = 'ADM.DEF_CRED_NAME';

alter database
  move datafile '+DATA_DG/orders_2022.dbf' to
  'https://objectstorage.example.com/oracle/orders_2022.dbf';
访问对象存储中的对象
从对象存储中的表和分区访问数据对用户和 SQL 客户机是完全透明的。
数据库输入/输出子系统将在内部查询和提供对象存储中存储的文件中的块。以下 SQL 将从在上一个示例中移动到对象存储的只读分区 orders_2022 查询行。
select prod_id
from   orders
where  time_id < TO_DATE('2020-01-01 00:00:00', 'SYYYY-MM-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIAN');
现有索引(包括全局索引和本地索引)可以透明地工作。从客户端的角度来看,查询混合列式压缩数据和 TDE 加密数据可以透明地工作。
对象存储文件的身份证明管理
访问对象存储中的文件需要身份证明。
身份证明是用于存储用户名和口令的数据库对象。身份证明数据将被加密并安全地存储在创建该数据的 PDB 方案中。
计划将数据文件移动到对象存储时,必须定义默认身份证明。此默认身份证明用于访问对象存储中的数据文件。
选择具有最少必要权限的默认身份证明。在默认身份证明允许访问对象存储之后,标准数据库验证和授权将确定哪些数据库用户可以查询或对这些数据文件进行操作。
alter database property set default_credential = 'ADM.DEF_CRED_NAME';

alter database move datafile '+DATA_DG/orders_2022.dbf' to
  'https://objectstorage.example.com/oracle/orders_2022.dbf';
将数据文件从对象存储移回传统存储
如果必须更新对象存储数据,则必须首先将数据移回传统存储。
在极少数情况下,您需要修改对象存储中已有的只读数据,唯一的选择是将数据从对象存储移回传统存储。以下工作流显示如何将数据文件从对象存储移回 ASM 文件系统。将文件从对象存储复制回会对性能产生影响。
alter database move datafile
  'https://objectstorage.example.com/oracle/orders_2022.dbf' to
  '+DATA_DG/orders_2022.dbf';

alter tablespace orders_2022 read write;
删除对象存储数据文件
可以使用标准 DROP TABLESPACE 命令删除具有数据文件的表空间。
子句 AND DATAFILES 用于从后端存储中删除数据文件。这将从对象存储中删除文件。如果对象存储文件在对象存储中有多个块,则所有块都将被删除以及清单。
drop tablespace orders_2022 including contents and datafiles;分片表概览
在 Oracle 数据库中,使用 Globally Distributed Database 功能,可以将任何表拆分成称为分片的片段,这些分片可以存储在多个数据库中。
水平分区涉及拆分数据库表并分配给分片,以使每个分片中都包含该表,并且这些表的列相同,但包含的行不同。以这种方式拆分的表也称为分片表。
下图显示了在三个分片之间水平分区的表。
图 6:跨分片的表的水平分区
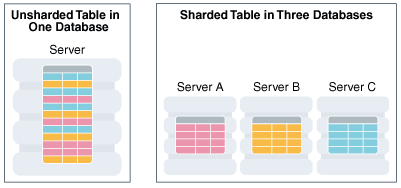
- 分片表 数据库表在分片之间拆分,以便每个分片都包含具有相同列的表,但包含不同的行子集。以这种方式拆分的表称为分片表。另请参阅:Oracle 全局分布式 AI 数据库
分片式表
数据库表将在分片之间拆分,以便每个分片都包含具有相同列的表,但包含不同的行子集。以这种方式拆分的表称为分片表。
下图显示了如何在一组分片 PDB 中水平分区一组表(称为表系列),以便每个分片包含以红色、黄色和蓝色行表示的数据子集。
图 7:跨分片的表的水平分区
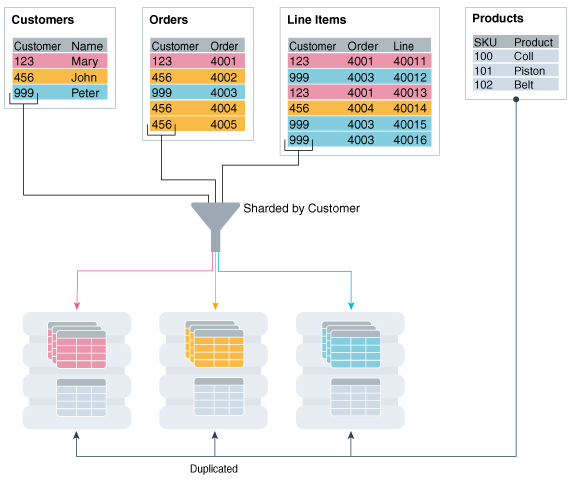
分区基于分片键在表空间级别跨分片进行分布。关键字的示例包括客户 ID、帐号和国家/地区 ID。
分片表的每个分区都位于单独的表空间中,并且每个表空间都与特定的分片关联。根据分片方法,可以自动建立或由管理员定义关联。
尽管分片表的分区位于多个分片中,但对于应用程序而言,该表的外观和行为与单个数据库中的分区表完全相同。应用程序发出的 SQL 语句不必引用分片,也不必依赖于分片的数量及其配置。
熟悉的表分区 SQL 语法指定如何跨分片对行进行分区。例如,以下 SQL 语句创建一个分片表,根据分片键 cust_id 在分片之间水平分区表。
CREATE SHARDED TABLE customers
( cust_id     NUMBER NOT NULL,
  name        VARCHAR2(50),
  address     VARCHAR2(250),
  region      VARCHAR2(20),
  class       VARCHAR2(3),
  signup      DATE,
  CONSTRAINT cust_pk PRIMARY KEY(cust_id)
)
PARTITION BY CONSISTENT HASH (cust_id)
PARTITIONS AUTO
TABLESPACE SET ts1;上例中的分片表按一致的散列进行分区,散列是一种特殊类型的散列分区,常用于可扩展的分布式系统。此技术自动将表空间分布在分片中,以提供数据和工作负载的均匀分布。注:不支持分片表上的全局索引,但支持本地索引。
视图概览
视图是一个或多个表的逻辑表示形式。从本质上讲,视图是一种存储的查询。
视图从它所基于的表(称为基表)派生数据。基表可以是表或其他视图。对视图执行的所有操作实际上影响的是该基表。可以在使用表的大多数位置使用视图。
注:实体化视图使用与标准视图不同的数据结构。
利用视图可以定制对不同类型用户的数据显示方法。视图常常用于:
-
通过限制对表中一组预先设定的行或列的访问权限,提供额外的表安全性级别
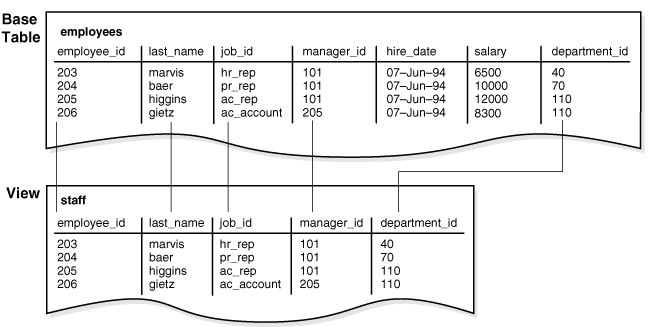
例如,图 6-8 显示了
staff视图如何不显示基表employees的salary或commission_pct列。 -
隐藏数据复杂性
For example, a single view can be defined with a join, which is a collection of related columns or rows in multiple tables. 但是,视图会隐藏这样一个事实,即这些信息实际上来自多个表。查询还可以对表信息执行大量计算。因此,用户可以在不了解如何执行联接或计算的情况下查询视图。
-
以不同于基表的不同视角显示数据
例如,可以在不影响视图所基于的表的情况下重命名视图的列。
-
使应用程序从基表定义的更改中隔离
例如,如果视图的定义查询引用了四个列表的三列,并且向表中添加了第五列,则视图的定义不受影响,并且使用该视图的所有应用程序不受影响。
有关视图使用的示例,请考虑 hr.employees 表,该表包含多个列和多个行。要允许用户仅查看其中的五列或仅查看特定行,可以按如下方式创建视图:
CREATE VIEW staff AS
  SELECT employee_id, last_name, job_id, manager_id, department_id
  FROM   employees;
与所有子查询一样,定义视图的查询不能包含 FOR UPDATE 子句。下图显示了名为 staff 的视图。请注意,该视图仅显示基表中的五列。
视图 8
-
视图的特性 与表不同,视图既不分配存储空间,也不包含数据。视图是由查询定义的,该查询从视图引用的基表中提取或衍生数据。由于视图基于其他对象,因此除了用于在数据字典中定义视图的查询的存储之外,不需要其他存储。
-
可更新联接视图 联接视图在其
FROM子句中具有多个表或视图。 -
对象视图 与视图是虚拟表一样,对象视图是虚拟对象表。视图中的每一行都是一个对象,它是对象类型的实例。对象类型是用户定义的数据类型。
另请参见:
-
“实体化视图概述”
-
Oracle AI Database SQL Language Reference(了解
CREATE VIEW语法和语义)
视图的特征
与表不同,视图既不分配存储空间,视图也不包含数据。视图是由查询定义的,该查询从视图引用的基表中提取或衍生数据。由于视图基于其他对象,因此除了用于在数据字典中定义视图的查询的存储之外,不需要其他存储。
视图与其引用的对象具有相关性,这些对象由数据库自动处理。例如,如果删除并重新创建视图的基表,则数据库将确定视图定义是否可以接受新基表。
-
视图中的数据处理由于视图派生自表,因此它们有许多相似之处。用户可以查询视图,并受一些限制,可以对视图执行 DML。对视图执行的操作会影响视图的某些基表中的数据,并受制于基表的完整性约束条件和触发器。
-
如何在视图中访问数据 Oracle AI Database 将数据字典中的视图定义存储为定义视图的查询文本。
视图中的数据处理
因为视图派生自表,所以它们有许多相似之处。用户可以查询视图,并受一些限制,可以对视图执行 DML。对视图执行的操作会影响视图的某些基表中的数据,并受制于基表的完整性约束条件和触发器。
以下示例创建 hr.employees 表的视图:
CREATE VIEW staff_dept_10 AS
SELECT employee_id, last_name, job_id,
       manager_id, department_id
FROM   employees
WHERE  department_id = 10
WITH CHECK OPTION CONSTRAINT staff_dept_10_cnst;
定义查询仅引用部门 10 的行。CHECK OPTION 创建具有约束条件的视图,以便对视图发出的 INSERT 和 UPDATE 语句不会导致视图无法选择的行。因此,可以插入部门 10 中雇员的行,但不能插入部门 30 的行。
另请参阅:Oracle AI Database SQL Language Reference 以了解 CREATE VIEW 语句中的子查询限制
如何在视图中访问数据
Oracle AI Database 将数据字典中的视图定义存储为定义视图的查询文本。
在 SQL 语句中引用视图时,Oracle AI Database 将执行以下任务:
-
将查询(如果可能)与定义视图和任何基础视图的查询合并
Oracle AI Database 优化合并的查询,就像您发出查询时未引用视图一样。因此,Oracle AI Database 可以对任何引用的基表列使用索引,无论这些列在视图定义中引用还是用户对视图的查询中引用。
有时,Oracle AI Database 无法将视图定义与用户查询合并。在这种情况下,Oracle AI Database 不能对引用的列使用所有索引。
-
解析共享 SQL 区域中的合并语句
Oracle AI Database 仅当现有共享 SQL 区域不包含类似语句时,才会解析引用新共享 SQL 区域中的视图的语句。 因此,视图可以减少与共享 SQL 关联的内存使用。
-
执行 SQL 语句
以下示例说明了查询视图时的数据访问。假定您基于 employees 和 departments 表创建 employees_view:
CREATE VIEW employees_view AS
  SELECT employee_id, last_name, salary, location_id
  FROM   employees JOIN departments USING (department_id)
  WHERE  department_id = 10;
用户对 employees_view 执行以下查询:
SELECT last_name
FROM   employees_view
WHERE  employee_id = 200;
Oracle AI Database 会合并视图和用户查询来构建以下查询,然后执行该查询来检索数据:
SELECT last_name
FROM   employees, departments
WHERE  employees.department_id = departments.department_id
AND    departments.department_id = 10
AND    employees.employee_id = 200;
另请参见:
-
“优化程序概览”
可更新的联接视图
联接视图的 FROM 子句中有多个表或视图。
在以下示例中,staff_dept_10_30 视图联接 employees 表和 departments 表,包括部门 10 或 30 中的雇员:
CREATE VIEW staff_dept_10_30 AS
SELECT employee_id, last_name, job_id, e.department_id
FROM   employees e, departments d
WHERE  e.department_id IN (10, 30)
AND e.department_id = d.department_id;可更新的联接视图(也称为可修改的联接视图)涉及两个或多个基表或视图并允许 DML 操作。可更新视图在 SELECT 语句的顶层 FROM 子句中包含多个表,不受 WITH READ ONLY 子句的限制。
要从本质上可更新,视图必须满足多个标准。例如,一般规则是,一个联接视图上的 INSERT、UPDATE 或 DELETE 操作一次只能修改一个基表。以下 USER_UPDATABLE_COLUMNS 数据字典视图的查询显示 staff_dept_10_30 视图可更新:
SQL> SELECT TABLE_NAME, COLUMN_NAME, UPDATABLE
  2  FROM   USER_UPDATABLE_COLUMNS
  3  WHERE  TABLE_NAME = 'STAFF_DEPT_10_30';

TABLE_NAME                     COLUMN_NAME                    UPD
------------------------------ ------------------------------ ---
STAFF_DEPT_10_30               EMPLOYEE_ID                    YES
STAFF_DEPT_10_30               LAST_NAME                      YES
STAFF_DEPT_10_30               JOB_ID                         YES
STAFF_DEPT_10_30               DEPARTMENT_ID                  YES
从 Oracle Database 发行版 21c 开始,联接视图中的所有可更新列都不必映射到密钥保留表的列。键保留表是一个表,其中底层表的每一行最多在查询输出中显示一次。在 staff_dept_10_30 视图中,department_id 是 departments 表的主键,因此 employees 表中的每一行最多在结果集中显示一次,从而使 employees 表得以按键保留。departments 表未按键保留,因为其每一行在结果集中可能多次出现。如果 UPDATE 操作仅更新单个表中的列,且更新确定,即仅更新每一行一次,则可以更新非键保留表中的列。
另请参阅:Oracle AI Database Administrator’s Guide,了解如何更新联接视图
对象视图
正如视图是虚拟表一样,对象视图是虚拟对象表。视图中的每一行都是一个对象,它是对象类型的实例。对象类型是用户定义的数据类型。
您可以检索、更新、插入和删除关系数据,就像将其存储为对象类型一样。还可以使用属于对象数据类型(例如对象、REF 和集合)的列(嵌套表和 VARRAY)定义视图。
与关系视图一样,对象视图只能呈现数据库管理员希望用户看到的数据。例如,对象视图可以显示有关 IT 程序员的数据,但可以省略有关薪金的敏感数据。以下示例将创建一个 employee_type 对象,然后基于此对象创建视图 it_prog_view:
CREATE TYPE employee_type AS OBJECT
(
  employee_id  NUMBER (6),
  last_name    VARCHAR2 (25),
  job_id       VARCHAR2 (10)
);
/

CREATE VIEW it_prog_view OF employee_type
  WITH OBJECT IDENTIFIER (employee_id) AS
SELECT  e.employee_id, e.last_name, e.job_id
FROM    employees e
WHERE   job_id = 'IT_PROG';
对象视图在原型设计或转换为面向对象的应用程序时非常有用,因为视图中的数据可以从关系表中获取,并且访问时就像将表定义为对象表一样。可以运行面向对象的应用程序,而无需将现有表转换为不同的物理结构。
另请参见:
-
Oracle AI Database Object-Relational Developer’s Guide,了解对象类型和对象视图
-
Oracle AI Database SQL Language Reference,了解
CREATE TYPE语句
实体化视图概览
实体化视图是预先存储或“实体化”为方案对象的查询结果。查询的 FROM 子句可以命名表、视图或实体化视图。
实体化视图通常用作复制中的主表和数据仓库中的事实表。实体化视图汇总、计算、复制和分发数据。它们适用于各种计算环境,例如:
-
在数据仓库中,实体化视图可以计算和存储从聚合函数(如总和和平均值)生成的数据。
摘要是一种聚合视图,它通过预计算联接和聚合操作并将结果存储在表中来缩短查询时间。实体化视图等效于汇总。还可以使用实体化视图计算具有或不具有聚合的联接。
-
在使用 XStream 和 Oracle GoldenGate 实现的实体化视图复制中,该视图包含单个时间点的表的完整或部分副本。实体化视图在分布式站点复制数据,并同步在多个站点执行的更新。这种形式的复制适用于数据库并不总是连接到网络时的现场销售等环境。
-
在移动计算环境中,实体化视图可以将数据子集从中央服务器下载到移动客户端,从中央服务器定期刷新并将客户端的更新传播到中央服务器。
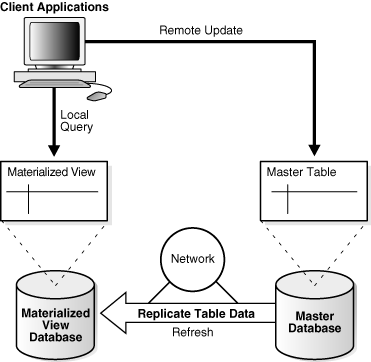
在复制环境中,实体化视图与一个称作主体数据库的不同数据库中的表共享数据。主体站点中与该实体化视图关联的表是主表。图 6-9 说明了一个数据库中的实体化视图,该视图基于另一个数据库中的主表。对主表的更新将复制到实体化视图数据库。
图 9:实体化视图
-
实体化视图的特征实体化视图具有索引和非实体化视图的一些特征。
-
刷新实体化视图的方法 数据库通过在更改基表后刷新实体化视图来维护这些视图中的数据。刷新方法可以是增量刷新,也可以是完全刷新。
-
自动实体化视图 从 Oracle Database 发行版 21c 开始,可以自动创建和维护实体化视图。
-
查询重写可以将按照主表写入的用户请求转换为在语义上相当的请求(其中包括实体化视图)。
另请参见:
-
Oracle AI Database Data Warehousing Guide,了解有关摘要的更多信息
-
Oracle AI Database XStream Guide(介绍 XStream)
-
http://www.oracle.com/technetwork/middleware/goldengate/documentation/index.html 了解有关 Oracle GoldenGate 的更多信息
-
Oracle AI Database SQL Language Reference,了解
CREATE MATERIALIZED VIEW语句
实体化视图的特性
实体化视图具有索引和非实体化视图的某些特征。
实体化视图通过以下方式类似于索引:
-
它们包含实际数据并占用存储空间。
-
当主表中的数据发生更改时,可以刷新它们。
-
当用于查询重写操作时,它们可以提高 SQL 执行的性能。
-
SQL 应用程序和用户的存在是透明的。
实体化视图与非实体化视图类似,因为它表示其他表和视图中的数据。与索引不同,用户可以使用 SELECT 语句直接查询实体化视图。还可以使用 DML 语句更新视图,具体取决于所需的刷新类型。
以下示例根据 sh 示例方案中的三个主表创建并填充实体化聚合视图:
CREATE MATERIALIZED VIEW sales_mv AS
  SELECT t.calendar_year, p.prod_id, SUM(s.amount_sold) AS sum_sales
  FROM   times t, products p, sales s
  WHERE  t.time_id = s.time_id
  AND    p.prod_id = s.prod_id
  GROUP BY t.calendar_year, p.prod_id;
以下示例删除表 sales(这是 sales_mv 的主表),然后查询 sales_mv。该查询选择数据,因为行与主表中的数据分开存储(实体化)。
SQL> DROP TABLE sales;

Table dropped.

SQL> SELECT * FROM sales_mv WHERE ROWNUM < 4;

CALENDAR_YEAR    PROD_ID  SUM_SALES
------------- ---------- ----------
         1998         13  936197.53
         1998         26  567533.83
         1998         27  107968.24
可将实体化视图分区。您可在分区表上定义实体化视图,在实体化视图上定义一个或多个索引。
另请参阅:Oracle AI Database Data Warehousing Guide 以了解如何在数据仓库中使用实体化视图
刷新实体化视图的方法
数据库通过在更改基表后刷新实体化视图中的数据来维护这些数据。刷新方法可以是增量刷新或完全刷新。
-
完成刷新 完成刷新将执行定义实体化视图的查询。最初创建实体化视图时,将发生完全刷新,除非实体化视图引用预生成表,或者将表定义为
BUILD DEFERRED。 -
增量刷新 增量刷新也称为快速刷新,仅处理对现有数据的更改。此方法无需从头重新构建实体化视图。仅处理更改可能会导致非常快的刷新时间。
-
就地和就地刷新 对于完整和增量方法,数据库可以原地刷新实体化视图,从而直接在视图上刷新语句,或刷新不适当的位置。
完全刷新
完全刷新将执行定义实体化视图的查询。最初创建实体化视图时,将发生完全刷新,除非实体化视图引用预生成表,或者将表定义为 BUILD DEFERRED。
完全刷新可能会很慢,特别是当数据库必须读取和处理大量数据时。创建实体化视图后,可以随时执行完全刷新。
递增刷新
增量刷新也称为快速刷新,仅处理对现有数据的更改。此方法无需从头重新构建实体化视图。仅处理更改可能会导致非常快的刷新时间。
您可以按需或按固定时间间隔刷新实体化视图。或者,您可以在与基表相同的数据库中配置实体化视图,以便在事务处理提交更改基表时刷新。
快速刷新有以下两种形式:
-
基于日志的刷新
在此类型的刷新中,实体化视图日志或直接加载程序日志将保留对基表的更改记录。实体化视图日志是一个方案对象,用于记录对基表的更改,以便可以增量刷新基表中定义的实体化视图。每个实体化视图日志都与单个基表关联。
-
分区更改跟踪 (PCT) 刷新
仅当对基表进行分区时,PCT 刷新才有效。PCT 刷新将删除受影响的实体化视图分区或受影响的数据部分中的所有数据,然后重新计算这些数据。数据库使用修改后的基表分区来标识视图中受影响的分区或部分数据。对基表执行分区维护操作时,PCT 刷新是唯一可用的增量刷新方法。
异地和异地刷新
对于完整和增量方法,数据库可以原地刷新实体化视图,从而直接刷新视图上的语句,或者刷新不合适的位置。
异地刷新会创建一个或多个外部表,对它们执行刷新语句,然后将实体化视图或受影响的分区与外部表切换。此技术在刷新期间实现高可用性,尤其是在刷新语句需要很长时间才能完成时。
同步刷新是异地刷新的一种类型。同步刷新不会修改基表的内容,而是使用同步刷新包中的 API,这可通过同时将这些更改应用于基表和实体化视图来确保一致性。通过此方法,可以始终同步一组表及其上定义的实体化视图。在数据仓库中,同步刷新方法非常适合,原因如下:
-
增量数据的加载受到严格控制,并定期进行。
-
表及其实体化视图通常以相同的方式进行分区,或者它们的分区与功能依赖性相关。
另请参阅:Oracle AI Database Data Warehousing Guide 以了解如何刷新实体化视图
自动实体化视图
从 Oracle Database 发行版 21c 开始,可以自动创建和维护实体化视图。
Oracle AI Database 可以自动创建和管理实体化视图,从而优化查询性能。由于很少或根本没有与 DBA 交互,后台任务可以监视和分析工作量特征,并确定实体化视图将提高 SQL 性能的位置。候选实体化视图的性能优势在后台(使用工作量查询)进行衡量,然后才能使其对工作量可见。
另请参见:
-
Oracle AI Database PL/SQL Packages and Types Reference,了解如何使用
DBMS_AUTO_MV程序包实现自动实体化视图
查询重写
查询重写可以将按照主表写入的用户请求转换为在语义上相当的请求(其中包括实体化视图)。
当基表包含大量数据时,计算聚合或联接既昂贵又耗时。由于实体化视图包含预计算的聚合和联接,因此查询重写可以使用实体化视图快速回答查询。
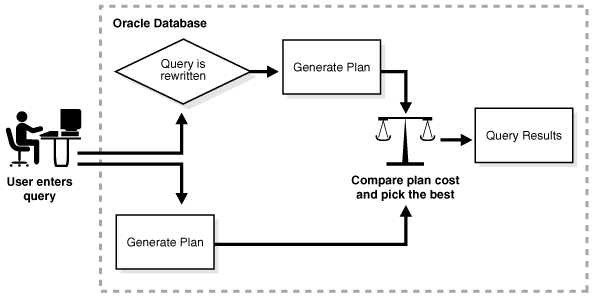
查询转换器透明地重写请求以使用实体化视图,无需用户干预,也无需引用 SQL 语句中的实体化视图。因为查询重写是透明的,所以实体化视图可以添加或删除,而不会使应用程序代码中的 SQL 失效。
通常,重写查询以使用实体化视图而不是详细信息表可以缩短响应时间。下图显示了为原始查询和重写查询生成执行计划并选择最低成本计划的数据库。
图 10:查询重写
另请参见:
-
“优化程序概览”了解有关查询转换的更多信息
-
Oracle AI Database Data Warehousing Guide,了解如何使用查询重写
序列概览
序列是多个用户可以从中生成唯一整数的方案对象。序列生成器提供了一种高度可扩展且性能良好的方法,用于为数字数据类型生成代理密钥。
序列特性
序列定义指示有关序列的一般信息,包括其名称以及序列升序还是降序。
序列定义还指示:
-
数字之间的间隔
-
数据库是否应在内存中缓存生成的序列号集
-
达到限制时序列是否应循环
以下示例在示例方案 oe 中创建序列 customers_seq。将行添加到 customers 表时,应用程序可以使用此序列提供客户 ID 号。
CREATE SEQUENCE customers_seq
START WITH      1000
INCREMENT BY    1
NOCACHE
NOCYCLE;
对 customers_seq.nextval 的第一个引用将返回 1000。第二个返回 1001。每个后续引用返回的值 1 大于上一个引用。
另请参见:
-
Oracle AI Database Get Started with Oracle AI Database Development,介绍如何创建序列
-
Oracle AI Database Administrator’s Guide,了解如何在 SQL 语句中引用序列
-
Oracle AI Database SQL Language Reference(了解
CREATE SEQUENCE语法和语义)
对序列的并发访问
相同的序列生成器可以为多个表生成编号。
生成器可以自动创建主键并协调多个行或表中的键。例如,序列可以为 orders 表和 customers 表生成主键。
序列生成器在多用户环境中尤其有用,可以生成唯一的序列号,而没有磁盘 I/O 或事务处理锁定开销。例如,两个用户同时向 orders 表中插入新行。通过使用序列为 order_id 列生成唯一编号,两个用户都不必等待另一个用户输入下一个可用的订单编号。序列会自动为每个用户生成正确的值。
引用序列的每个用户都可以访问其当前序列号,这是在会话中生成的最后一个序列。用户可以发出语句来生成新的序列号或使用会话最后生成的当前编号。期次中的语句生成序号后,该序号仅可供此期次使用。如果生成单个序号并将其用于最终回退的事务处理,则可以跳过这些序号。
警告:如果您的应用需要一组无间断的数字,则无法使用 Oracle 序列。您必须使用自己开发的代码序列化数据库中的活动。
另请参阅:“数据并发性和一致性”以了解会话如何同时访问数据
维概览
典型的数据仓库有两个重要组成部分:维和事实。
维是用于指定业务问题(例如时间、地理位置、产品、部门和分配渠道)的任何类别。事实是与特定维值集(例如销售件数或利润)关联的事件或实体。
多维请求的示例包括:
-
在 2013 年和 2014 年,按地理位置维度(从省/自治区到国家/地区到区域)的递增汇总级别显示所有产品的总销售额。
-
对我们的运营进行跨表格分析,显示 2013 年和 2014 年南美地区的费用。包括所有可能的小计。
-
根据 2014 年汽车产品销售收入,列出亚洲前 10 位销售代表,并对其佣金进行排名。
许多多维问题需要汇总数据和数据集比较,通常跨时间、地理位置或预算。
创建维允许更广泛地使用查询重写功能。通过透明地重写查询以使用实体化视图,数据库可以提高查询性能。
-
维的层次结构 维表是定义列或列集对之间的分层(父/子)关系的逻辑结构。
-
创建维您可以使用
CREATE DIMENSIONSQL 语句创建维。另请参阅:Oracle AI Database Data Warehousing Guide 以了解有关维的更多信息
维的层次结构
维表是定义列或列集对之间的分层(父/子)关系的逻辑结构。
例如,维可以指示 city 列在一行中表示 state 列的值,state 列表示 country 列的值。
在客户维度内,客户可以累计到城市、州/省、国家/地区、子区域和区域。数据分析通常从维层次结构中的更高级别开始,如果情况需要这样的分析,则逐渐向下钻取。
子层上的每个值都与父层上的一个且仅一个值关联。分层关系是从层次结构的一个层到层次结构中的下一层的功能相关性。
维没有为其分配数据存储。维信息存储在维表中,而事实信息存储在事实表中。
创建维
可以使用 CREATE DIMENSION SQL 语句创建维。
此语句指定:
-
多个
LEVEL子句,每个子句标识维中的列或列集 -
指定相邻级别之间的父/子关系的一个或多个
HIERARCHY子句 -
可选
ATTRIBUTE子句,每个子句标识与单个级别关联的附加列或列集
以下语句用于在示例方案 sh 中创建 customers_dim 维:
CREATE DIMENSION customers_dim
   LEVEL customer   IS (customers.cust_id)
   LEVEL city       IS (customers.cust_city)
   LEVEL state      IS (customers.cust_state_province)
   LEVEL country    IS (countries.country_id)
   LEVEL subregion  IS (countries.country_subregion)
   LEVEL region     IS (countries.country_region)
   HIERARCHY geog_rollup (
      customer      CHILD OF
      city          CHILD OF
      state         CHILD OF
      country       CHILD OF
      subregion     CHILD OF
      region
   JOIN KEY (customers.country_id) REFERENCES country )
   ATTRIBUTE customer DETERMINES
   (cust_first_name, cust_last_name, cust_gender,
    cust_marital_status, cust_year_of_birth,
    cust_income_level, cust_credit_limit)
   ATTRIBUTE country DETERMINES (countries.country_name);
维中的列可以来自同一个表(非规范化),也可以来自多个表(完全或部分规范化)。例如,标准化时间维可以包括日期表、月表和年表,联接条件可将每个日期行连接到一个月行,将每个月行连接到一个年行。在完全非规范化的时间维中,日期、月份和年份列位于同一个表中。无论是规范化还是非规范化,必须在 CREATE DIMENSION 语句中指定列之间的分层关系。
另请参见: Oracle AI Database SQL Language Reference,了解 CREATE DIMENSION 语法和语义
同义语概览
同义词是方案对象的别名。例如,可以为表或视图、序列、PL/SQL 程序单元、用户定义的对象类型或其他同义语创建同义词。由于同义词只是别名,因此除数据字典中的定义之外,它不需要任何存储。
同义词可以简化数据库用户的 SQL 语句。对于隐藏基础方案对象的标识和位置,同义词也非常有用。如果必须重命名或移动基础对象,则必须仅重新定义同义词。基于同义词的应用程序继续工作而不进行修改。
可以创建专用和公共同义词。专用同义词位于控制着专用同义词对其他用户的可用性的特定用户的方案中。公共同义词归名为 PUBLIC 的用户组所有,并且可供每个数据库用户访问。
示例 6-5 公共同义词
假设数据库管理员为 hr.employees 表创建名为 people 的公共同义词。然后,用户连接到 oe 方案并计算同义词所引用的表中的行数。
SQL> CREATE PUBLIC SYNONYM people FOR hr.employees;

Synonym created.

SQL> CONNECT oe
Enter password: password
Connected.

SQL> SELECT COUNT(*) FROM people;

  COUNT(*)
----------
       107
请谨慎使用公共同义词,因为这会使数据库合并变得更加困难。如以下示例中所示,如果另一位管理员尝试创建公共同义词 people,则创建失败,因为数据库中只能存在一个公共同义词 people。过度使用公共同义词会导致应用程序之间的名称空间冲突。
SQL> CREATE PUBLIC SYNONYM people FOR oe.customers;
CREATE PUBLIC SYNONYM people FOR oe.customers
                      *
ERROR at line 1:
ORA-00955: name is already used by an existing object

SQL> SELECT OWNER, SYNONYM_NAME, TABLE_OWNER, TABLE_NAME
  2  FROM DBA_SYNONYMS
  3  WHERE SYNONYM_NAME = 'PEOPLE';

OWNER      SYNONYM_NAME TABLE_OWNER TABLE_NAME
---------- ------------ ----------- ----------
PUBLIC     PEOPLE       HR          EMPLOYEES
同义词本身不可保护。对同义词授予对象权限时,实际上是在授予对底层对象的权限。在 GRANT 语句中,该同义词仅充当对象的别名。
另请参见:
-
Oracle AI Database Administrator’s Guide,了解如何管理同义词
-
Oracle AI Database SQL Language Reference(了解
CREATE SYNONYM语法和语义)