表和表集群
本章介绍方案对象并讨论表,这些表是最常见的方案对象类型。
-
方案对象简介 数据库方案是数据结构的逻辑容器,称为方案对象。方案对象的示例有表和索引。使用 SQL 创建和处理方案对象。
-
表概览 表是 Oracle 数据库中数据组织的基本单位。
-
表集群概览 表集群是一组表,它们共享公用列并将相关数据存储在相同的块中。
-
属性群集表概述 属性群集表是按堆组织的表,它根据用户指定的群集指令在磁盘上以近距离方式存储数据。这些指令用于指定单个或多个表中的列。
-
临时表概览 临时表保存仅存在于事务处理或会话期间的数据。
-
外部表概览 外部表访问外部源中的数据,就像这些数据位于数据库中的表中一样。
-
区块链表概述 区块链表是专为集中式区块链应用设计的仅附加表。
-
不可变表概览不可变表是仅附加表,可防止内部人员进行未经授权的数据修改和人为错误导致的意外数据修改。
-
对象表概览 对象表是每行表示一个对象的特殊表类型。
方案对象简介
数据库 schema 是数据结构的逻辑容器,称为方案对象。方案对象的示例有表和索引。使用 SQL 创建和处理方案对象。
本部分涵盖以下主题:
-
关于公用和本地用户帐户 数据库用户帐户具有口令和特定的数据库权限。
-
公用和本地对象 公用对象在 CDB 根或应用程序根中定义,可以使用元数据链接或对象链接进行引用。本地对象是不是公用对象的每个对象。
-
方案对象类型 Oracle SQL 允许您创建和处理许多其他类型的方案对象。
-
方案对象存储 某些方案对象将数据存储在称为段的逻辑存储结构类型中。例如,按堆组织的未分区表或索引将创建一个段。
-
方案对象相关性 某些方案对象引用其他对象,从而创建方案对象相关性。
-
示例方案 Oracle 数据库可能包括示例方案,示例方案是使 Oracle 文档和 Oracle 教材可以举例说明常用数据库任务的一组相互链接方案。另请参阅:Oracle AI Database Security Guide 以了解有关用户和权限的更多信息
关于公用和本地用户帐户
数据库用户帐户具有口令和特定的数据库权限。
用户帐户和方案
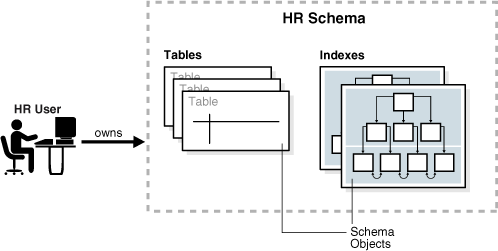
每个用户帐户都拥有一个方案,该方案与用户具有相同的名称。方案包含拥有方案的用户的数据。例如,hr 用户帐户拥有 hr 方案,其中包含方案对象,例如 employees 表。在生产数据库中,方案所有者通常表示数据库应用程序,而不是人员。
在方案内,特定类型的每个方案对象都具有唯一的名称。例如,hr.employees 是指 hr 方案中 employees 的表。下图描述了名为 hr 的方案所有者以及 hr 方案中的方案对象。
图 1:HR 方案
公用和本地用户帐户
如果用户帐户拥有定义数据库的对象,则此用户帐户是公用帐户。Oracle 未提供的用户帐户是本地帐户或公用帐户。CDB 公用用户是在 CDB 根中创建的公用用户。应用程序公用用户是在应用程序根中创建的用户,并且仅在此应用程序容器中公用。
下图显示了 CDB 中可能的用户帐户类型。
图 2:CDB 中的用户帐户
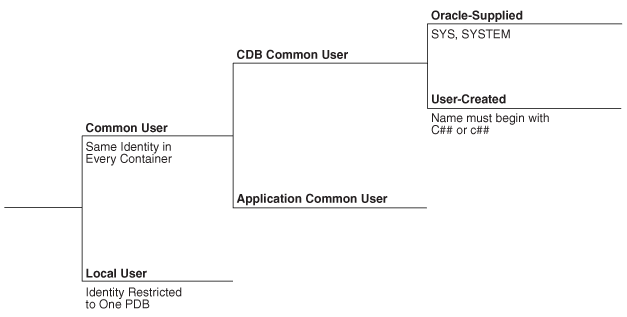
CDB 公用用户可以连接到 CDB 中具有足够权限的任何容器。相反,应用程序公用用户只能连接到创建该应用程序的应用程序根,或者只能连接到插入到此应用程序根的 PDB,具体取决于其权限。
-
公用用户帐户在系统容器 (CDB) 或应用程序容器的上下文中,公用用户是根和此容器内的每个现有和将来 PDB 中具有相同标识的数据库用户。
-
本地用户帐户 本地用户是不通用的数据库用户,只能在单个 PDB 中运行。
公用用户账户
在系统容器 (System Container,CDB) 或应用程序容器的上下文中,公用用户是根和此容器内每个现有和将来 PDB 中具有相同标识的数据库用户。
每个公用用户都可以在其容器的根以及其具有足够权限的任何 PDB 内连接到并执行操作。某些管理任务必须由公用用户执行。示例包括创建 PDB 和断开 PDB。
例如,SYSTEM 是具有 DBA 权限的 CDB 公用用户。因此,SYSTEM 可以连接到 CDB 根和数据库中的任何 PDB。您可以在 saas_sales 应用程序容器中创建公用用户 saas_sales_admin。在这种情况下,saas_sales_admin 用户只能连接到 saas_sales 应用程序根或 saas_sales 应用程序容器内的应用程序 PDB。
每个公用用户要么由 Oracle 提供,要么由用户创建。Oracle 提供的公用用户的示例包括 SYS 和 SYSTEM。每个用户创建的公用用户要么是 CDB 公用用户,要么是应用程序公用用户。
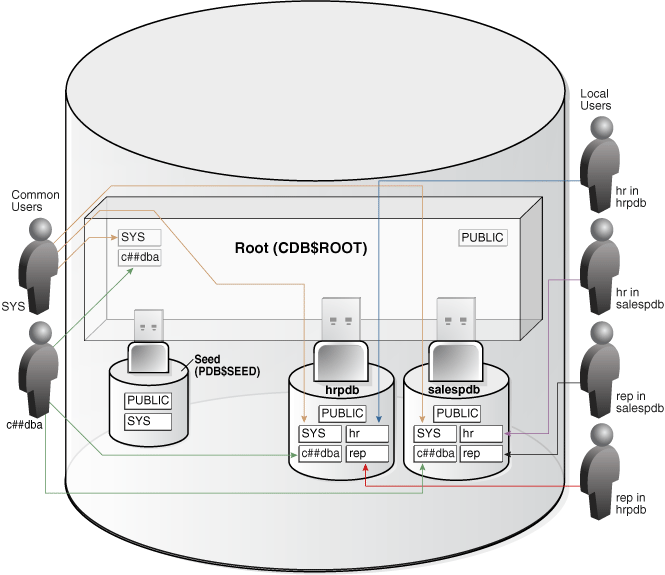
下图显示了两个 PDB 中的样例用户和方案:hrpdb 和 salespdb。SYS 和 c##dba 是 CDB 公用用户,它们在 CDB$ROOT、hrpdb 和 salespdb 中具有方案。hrpdb 中存在本地用户 hr 和 rep。salespdb 中也存在本地用户 hr 和 rep。
图 3:CDB 中的用户和方案
公用用户具有以下特征:
-
公用用户可以登录其具有
CREATE SESSION权限的任何容器(包括CDB$ROOT)。公用用户不必在每个容器中具有相同的权限。例如,
c##dba用户可能有权在hrpdb和根中创建会话,但不能在salespdb中创建会话。由于具有相应权限的公用用户可以在容器之间切换,因此根中的公用用户可以管理 PDB -
应用程序公用用户在其自己的应用程序容器之外的任何容器中都没有
CREATE SESSION权限。因此,应用程序公用用户仅限于自己的应用程序容器。例如,在
saas_sales应用程序中创建的应用程序公用用户只能连接到saas_sales应用程序容器中的应用程序根和 PDB。 -
用户创建的 CDB 公用用户的名称必须遵循其他数据库用户的命名规则。此外,名称必须以
COMMON_USER_PREFIX初始化参数(缺省情况下为c##或C##)指定的字符开头。Oracle 提供的公用用户名和由用户创建的应用程序公用用户名没有此限制。本地用户名不能以字符
c##或C##开头。 -
在创建公用用户的容器(系统容器或特定应用程序容器)内的所有 PDB 中唯一地命名每个公用用户。
CDB 公用用户在 CDB 根中定义,但必须能够连接到具有相同身份的每个 PDB。应用程序公用用户位于应用程序根中,并且可以用相同身份连接到其容器中的每个应用程序 PDB。
-
公用用户的特性 每个公用用户均由 Oracle 提供或由用户创建。
-
SYS 和 SYSTEM 帐户 所有 Oracle 数据库都包含具有管理权限的默认公用用户帐户。
公用用户的特性
每个公用用户要么由 Oracle 提供,要么由用户创建。
公用用户帐户具有以下特征:
-
公用用户可以登录其具有
CREATE SESSION权限的任何容器(包括CDB$ROOT)。公用用户不必在每个容器中具有相同的权限。例如,
c##dba用户可能有权在hrpdb和根中创建会话,但不能在salespdb中创建会话。由于具有相应权限的公用用户可以在容器之间切换,因此根中的公用用户可以管理 PDB。 -
应用程序公用用户在其自己的应用程序容器之外的任何容器中都没有
CREATE SESSION权限。因此,应用程序公用用户仅限于自己的应用程序容器。例如,在
saas_sales应用程序中创建的应用程序公用用户只能连接到saas_sales应用程序容器中的应用程序根和 PDB。 -
用户创建的 CDB 公用用户的名称必须遵循其他数据库用户的命名规则。此外,名称必须以
COMMON_USER_PREFIX初始化参数(缺省情况下为c##或C##)指定的字符开头。Oracle 提供的公用用户名和由用户创建的应用程序公用用户名没有此限制。本地用户名不能以字符
c##或C##开头。 -
在创建公用用户的容器(系统容器或特定应用程序容器)内的所有 PDB 中唯一地命名每个公用用户。
CDB 公用用户在 CDB 根中定义,但必须能够连接到具有相同身份的每个 PDB。应用程序公用用户位于应用程序根中,并且可以使用相同身份连接到其容器中的每个应用程序 PDB。
下图显示了两个 PDB 中的样例用户和方案:hrpdb 和 salespdb。SYS 和 c##dba 是 CDB 公用用户,它们在 CDB$ROOT、hrpdb 和 salespdb 中具有方案。hrpdb 中存在本地用户 hr 和 rep。salespdb 中也存在本地用户 hr 和 rep。
图 4:CDB 中的用户和方案
另请参见:
-
Oracle AI Database Security Guide,了解公用用户帐户
-
Oracle AI Database Reference(了解
COMMON_USER_PREFIX)
SYS 和 SYSTEM 帐户
所有 Oracle 数据库都包含具有管理特权的默认公用用户帐户。
管理帐户是高权限帐户,并且只有经授权执行任务(如启动和停止数据库,管理内存和存储,创建和管理数据库用户等)的 DBA 才需要此帐户。
创建数据库时会自动创建 SYS 公用用户帐户。此帐户可以执行所有数据库管理功能。SYS 方案存储数据字典的基表和视图。这些基表和视图对于 Oracle AI Database 的运行至关重要。SYS 方案中的表仅由数据库处理,决不能由任何用户修改。
创建数据库时,也会自动创建 SYSTEM 管理帐户。SYSTEM 方案用于存储显示管理信息的其他表和视图,以及各种 Oracle AI Database 选配件和工具使用的内部表和视图。切勿使用 SYSTEM 方案来存储非管理用户感兴趣的表。
另请参见:
-
Oracle AI Database Administrator’s Guide,了解
SYS、SYSTEM和其他管理帐户
本地用户帐户
本地用户是不通用的数据库用户,只能在单个 PDB 中运行。
本地用户具有以下特征:
-
本地用户特定于 PDB,在该 PDB 中拥有方案。
在“公用用户的特征”中显示的示例中,
hrpdb上的本地用户hr拥有hr方案。在salespdb上,本地用户rep拥有rep方案,本地用户hr拥有hr方案。 -
本地用户可以管理 PDB,包括打开和关闭 PDB。
具有
SYSDBA权限的公用用户可以向本地用户授予SYSDBA权限。在这种情况下,特权用户仍为本地用户。 -
一个 PDB 中的本地用户无法登录到另一个 PDB 或 CDB 根。
例如,当本地用户
hr连接到hrpdb时,hr无法在不使用数据库链接的情况下访问sh方案中位于salespdb数据库中的对象。同样,当本地用户sh连接到salespdbPDB 时,sh无法在不使用数据库链接的情况下访问hr方案中位于hrpdb中的对象。 -
本地用户的名称不能以字符
c##或C##开头。 -
本地用户的名称在其 PDB 内必须唯一。
用户名和包含该用户方案的 PDB 确定唯一的本地用户。“公用用户的特征”显示
hrpdb上存在名为rep的本地用户和方案。salespdbPDB 上存在一个完全独立的本地用户和名为rep的方案。
下表描述了涉及 CDB 的“公用用户的特征”方案。每一行描述在前一行中的操作之后发生的操作。公用用户 SYSTEM 在两个 PDB 中创建本地用户。
表 1 CDB 中的本地用户
| 操作 | 说明 |
|---|---|
|
SYSTEM 使用服务名称 hrpdb 连接到 hrpdb 容器。 |
|
SYSTEM 现在创建本地用户 rep 并将此 PDB 中的 CREATE SESSION 权限授予此用户。用户是本地用户,因为公用用户只能由连接到根的公用用户创建。 |
|
rep 用户(是 hrpdb 的本地用户)尝试连接到 salespdb。尝试失败,因为 PDB salespdb 中不存在 rep。 |
|
SYSTEM 使用服务名称 salespdb 连接到 salespdb 容器。 |
|
SYSTEM 在 salespdb 中创建本地用户 rep,并将此 PDB 中的 CREATE SESSION 权限授予此用户。由于本地用户的名称在其 PDB 内必须唯一,因此名为 rep 的用户可以同时存在于 salespdb 和 hrpdb 中。 |
|
rep 用户成功登录到 salespdb。 |
另请参阅:Oracle AI Database Security Guide 以了解本地用户帐户
公用对象和本地对象
公用对象在 CDB 根或应用程序根中定义,可以使用元数据链接或对象链接进行引用。本地对象是不是公用对象的每个对象。
数据库提供的公用对象在 CDB$ROOT 中定义,无法更改。Oracle Database 不支持在 CDB$ROOT 中创建公用对象。
可以创建大多数方案对象,例如表、视图、PL/SQL 和 Java 程序单元、序列等,这些都是应用程序根中的公用对象。如果对象存在于应用程序根中,则将其称为应用程序公用对象。
本地用户可以拥有公用对象。此外,公用用户可以拥有本地对象,但仅当该对象不是数据链接或元数据链接,并且既不是元数据链接也不是数据链接时。
另请参阅:Oracle AI Database Security Guide 以了解有关公用对象的权限管理的更多信息
方案对象类型
Oracle SQL 允许您创建和处理许多其他类型的方案对象。
下表中显示了方案对象的主体类型。
表 2:方案对象
| 对象 | 说明 | 详细了解 |
|---|---|---|
| 表 | 表将数据存储在行中。表是关系数据库中最重要的方案对象。 | “表概览” |
| 索引 | 索引是方案对象,它包含表或表集群中每个索引行的条目,并提供对行的直接、快速访问。Oracle AI Database 支持多种类型的索引。按索引组织的表是将数据存储在索引结构中的表。 | “索引和索引组织表” |
| 分区 | 分区是大型表和索引的片段。每个分区都有自己的名称,并且可以有自己的存储特征。 | “分区概述” |
| 视图 | 视图是一个或多个表或其他视图中的数据的定制表示方式。可以将视图看作存储的查询。视图实际上并不包含数据。 | “视图概述” |
| 序列 | 序列是用户创建的对象,可由多个用户共享以生成整数。通常,使用序列生成主键值。 | “序列概述” |
| 维 | 维定义列集对之间的父子关系,其中列集的所有列必须来自同一个表。维通常用于对客户、产品和时间等数据进行分类。 | “维概览” |
| 同义词 | 同义词是其他方案对象的别名。由于同义词只是别名,因此除了在数据字典中的定义之外,它不需要任何存储。 | “同义词概览” |
| PL/SQL 子程序和程序包 | PL/SQL 是 SQL 的 Oracle 过程性扩展。PL/SQL 子程序是指定的 PL/SQL 块,可以使用一组参数进行调用。PL/SQL 程序包对逻辑上相关的 PL/SQL 类型、变量和子程序进行分组。 | “PL/SQL 子程序” |
其他类型的对象也存储在数据库中,可以使用 SQL 语句创建和处理,但是不包含在方案中。这些对象包括数据库用户帐户、角色、上下文和字典对象。
另请参见:
-
Oracle AI Database Administrator’s Guide,了解如何管理方案对象
-
Oracle AI Database SQL Language Reference(了解有关方案对象和数据库对象的更多信息)
方案对象存储
某些方案对象将数据存储在称为段的逻辑存储结构类型中。例如,按堆组织的未分区表或索引将创建一个段。
其他方案对象(例如视图和序列)仅包含元数据。本主题仅介绍具有段的方案对象。
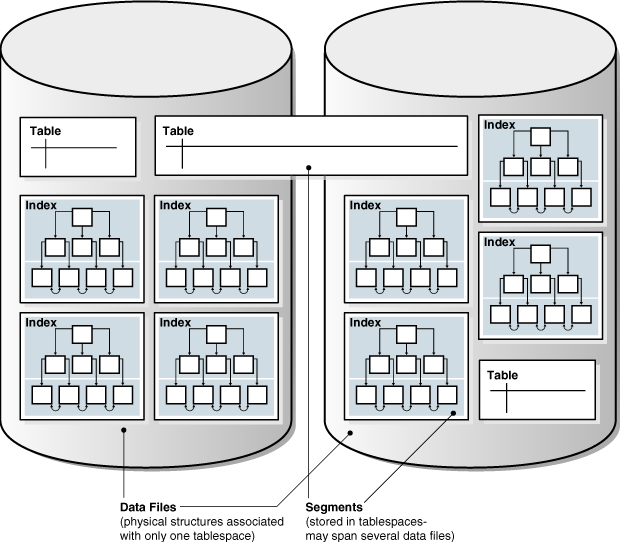
Oracle AI Database 以逻辑方式将方案对象存储在表空间中。方案和表空间之间不存在任何关系:表空间可以包含来自不同方案的对象,并且方案的对象可以包含在不同的表空间中。每个对象的数据以物理方式包含在一个或多个数据文件中。
下图显示了表段和索引段、表空间和数据文件的可能配置。一个表的数据段跨两个数据文件,这两个文件都属于同一表空间。一个段不能跨多个表空间。
图 5:段、表空间和数据文件
另请参见:
-
“逻辑存储结构”了解表空间和段
-
Oracle AI Database Administrator’s Guide,了解如何管理方案对象的存储
方案对象相关性
某些方案对象引用其他对象,从而创建方案对象相关性。
例如,视图包含引用表或视图的查询,而 PL/SQL 子程序调用其他子程序。如果对象 A 的定义引用对象 B,则 A 是 B 上的相关对象,B 是 A 的引用对象。
Oracle AI Database 提供了一种自动机制来确保从属对象始终更新其引用的对象。创建从属对象时,数据库会跟踪从属对象与其引用的对象之间的相关性。当引用的对象以可能影响从属对象的方式更改时,数据库会将从属对象标记为无效。例如,如果用户删除了表,则任何基于已删除表的视图都不可用。
在从属对象可用之前,必须根据所引用对象的新定义重新编译无效的从属对象。引用了无效的从属对象时,将自动进行重新编译。
下面的示例脚本将创建一个表 test_table,然后创建一个查询此表的过程,以说明方案对象如何创建相关项:
CREATE TABLE test_table ( col1 INTEGER, col2 INTEGER );

CREATE OR REPLACE PROCEDURE test_proc
AS
BEGIN
 FOR x IN ( SELECT col1, col2 FROM test_table )
 LOOP
   -- process data
   NULL;
 END LOOP;
END;
/
以下对过程 test_proc 状态的查询显示该过程有效:
SQL> SELECT OBJECT_NAME, STATUS FROM USER_OBJECTS WHERE OBJECT_NAME = 'TEST_PROC';

OBJECT_NAME STATUS
----------- -------
TEST_PROC   VALID
将 col3 列添加到 test_table 之后,该过程仍然有效,因为该过程与此列没有相关性:
SQL> ALTER TABLE test_table ADD col3 NUMBER;

Table altered.

SQL> SELECT OBJECT_NAME, STATUS FROM USER_OBJECTS WHERE OBJECT_NAME = 'TEST_PROC';

OBJECT_NAME STATUS
----------- -------
TEST_PROC   VALID
但是,更改 test_proc 过程所依赖的 col1 列的数据类型会使该过程无效:
SQL> ALTER TABLE test_table MODIFY col1 VARCHAR2(20);

Table altered.

SQL> SELECT OBJECT_NAME, STATUS FROM USER_OBJECTS WHERE OBJECT_NAME = 'TEST_PROC';

OBJECT_NAME STATUS
----------- -------
TEST_PROC   INVALID
运行或重新编译过程会使其再次有效,如以下示例中所示:
SQL> EXECUTE test_proc

PL/SQL procedure successfully completed.

SQL> SELECT OBJECT_NAME, STATUS FROM USER_OBJECTS WHERE OBJECT_NAME = 'TEST_PROC';

OBJECT_NAME STATUS
----------- -------
TEST_PROC VALID另请参阅:Oracle AI Database Administrator’s Guide 和 Oracle AI Database Development Guide,以了解如何管理方案对象相关性
示例方案
Oracle 数据库可能包括示例方案,示例方案是使 Oracle 文档和的 Oracle 教材可以举例说明常用数据库任务的一组相互链接方案。
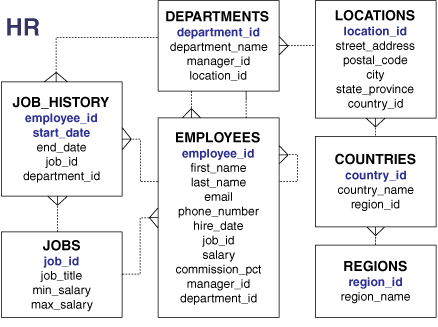
hr 示例方案包含有关雇员、部门和位置、工作历史记录等的信息。下图描述了 hr 中表的实体关系图。本手册中的大多数示例都使用此方案中的对象。
图 6:HR 方案
另请参阅:Oracle AI Database 示例方案以了解如何安装示例方案
表概览
表是 Oracle 数据库中数据组织的基本单元。
表中描述了实体,这是必须记录哪些信息的重要内容。例如,雇员可以是实体。
Oracle AI Database 表分为以下基本类别:
-
关系表格
关系表具有简单的列,是最常见的表类型。Example 4-1 显示了关系表的
CREATE TABLE语句。 -
对象表格
可以创建具有以下组织特征的关系表:
-
按堆组织的表不按任何特定顺序存储行。默认情况下,
CREATE TABLE语句会创建一个按堆组织的表。 -
按索引组织的表根据主键值对行进行排序。对于某些应用程序,按索引组织的表可提高性能并更有效地使用磁盘空间。请参阅“索引组织表概览”。
表可以是永久性的,也可以是临时性的。永久表定义和数据会跨会话保留。临时表定义与永久表定义保持相同,但这些数据仅存在于事务处理或会话的持续时间内。临时表在必须临时保存结果集的应用程序中很有用,这可能是因为结果是通过运行多个操作来构建的。
-
列 表定义包括表名和列集。
-
行 行是与表中的记录对应的列信息的集合。
-
示例:CREATE TABLE 和 ALTER TABLE 语句用于创建表的 Oracle SQL 语句为
CREATE TABLE。 -
Oracle 数据类型 每一列都有一个数据类型,该数据类型与特定的存储格式、约束条件和有效值范围关联。值的数据类型与该值的一组固定属性相关联。
-
完整性约束条件 完整性约束条件是一个命名规则,用于限制表中一个或多个列的值。
-
表存储 Oracle AI Database 使用表空间中的数据段来存储表数据。
-
表压缩 数据库可以使用表压缩来减少表所需的存储量。另请参阅:Oracle AI Database Administrator’s Guide 以了解如何管理表
列
表定义包含表名和一组列。
列标识表所描述的实体的属性。例如,employees 表中的 employee_id 列引用了雇员实体的雇员标识属性。
通常,在创建表时会为每个列指定一个列名、一个数据类型和一个宽度。例如,employee_id 的数据类型是 NUMBER(6),表示此列只能包含宽度不超过 6 位的数字数据。宽度可以由数据类型预先确定,如 DATE。
-
虚拟列 表可以包含一个虚拟列,也称为表达式列。表达式列可以是虚拟的,表示不存储在磁盘上,或实体化,表示存储在磁盘上。
-
不可见列 不可见列是用户指定的列,其值仅在按名称显式指定该列时才可见。可以在不影响现有应用程序的情况下向表中添加不可见列,并在必要时使该列可见。
-
无锁保留 无锁保留允许对数值列值进行多个并发更新,而不会在从列值添加或减去时被未提交的更新阻止。
虚拟列
表可以包含一个虚拟列,也称为表达式列。表达式列可以是虚拟的,表示不存储在磁盘上,或实体化,表示存储在磁盘上。
虚拟列(也称为表达式列)通过计算一组用户指定的表达式或函数来派生值。一个表可以包含多个此类列之一,但必须始终有一个常规列。例如,下面的 EMP 表定义包含基于员工的薪金除以每年 2080 小时计算的时薪。
CREATE TABLE emp
(
   emp_id           NUMBER(9)     CONSTRAINT emp_pk PRIMARY KEY,
   emp_last_name    VARCHAR2(30)  CONSTRAINT emp_last_name_nn NOT NULL,
   emp_first_name   VARCHAR2(30)  CONSTRAINT emp_first_name_nn NOT NULL,
   emp_salary       NUMBER(9,2),
   emp_hourly_rate  NUMBER(7,2)   GENERATED ALWAYS AS (emp_salary/2080) VIRTUAL,
   emp_phone_no     VARCHAR2(10)
);
接下来,向非虚拟列插入值。
INSERT INTO emp (emp_id, emp_last_name, emp_first_name, emp_salary, emp_phone_no)
VALUES (8291, 'Patel', 'Siddharth', 60000, '6505551234');
现在,查询表时,您会看到计算值作为表达式列返回。
SELECT * FROM emp;

 EMP_ID EMP_LAST_NAME  EMP_FIRST_NAME     EMP_SALARY  EMP_HOURLY_RATE EMP_PHONE_NO
_______ ______________ _______________ _____________ ________________ _____________
   8291 Patel          Siddharth               60000            28.85 6505551234
此类表达式列可以在磁盘上虚拟或实体化。如果是纯虚拟(表达式)列,则列值不会占用磁盘空间,并在访问时按需计算。对于实体化表达式列,这些值将在 DML 时间计算并存储在磁盘上。
另请参阅:Oracle AI Database Administrator’s Guide,了解如何管理虚拟列
隐形列
不可见列是用户指定的列,其值仅在按名称显式指定该列时才可见。可以在不影响现有应用程序的情况下向表中添加不可见列,并在必要时使该列可见。
通常,不可见列有助于迁移和发展联机应用程序。用例可以是使用 SELECT * 语句查询三列表的应用程序。向表中添加第四个列会破坏应用程序,该应用程序需要三列数据。添加第四个不可见列可使应用程序正常运行。然后,开发人员可以更改应用程序以处理第四个列,并使该列在应用程序生效时可见。
以下示例创建一个表 products,其中包含不可见的列 count,然后使不可见的列可见:
CREATE TABLE products ( prod_id INT, count INT INVISIBLE );
ALTER TABLE products MODIFY ( count VISIBLE );
另请参见:
-
Oracle AI Database Administrator’s Guide,了解如何管理不可见列
-
Oracle AI Database SQL Language Reference(了解有关不可见列的更多信息)
无锁预订
无锁保留允许对数值列值进行多个并发更新,而不会在从列值添加或减去时被未提交的更新阻止。
通过在更新期间避免传统的锁定机制,此功能允许您在频繁同时更新可保留列的情况下,通过减少阻塞来大大改善用户体验。在以前的发行版中,如果通过添加或减去行来更新行的列值,则在提交事务处理之前会阻止对该行的所有其他更新。在 Oracle AI Database 26ai 中引入了“无锁定预留”功能后,您可以允许事务处理从同一行的可保留列中同时添加或减去,而无需通过指定可能继续更新的条件来相互阻止。这是通过指定数字列为 RESERVABLE 列并为该列创建 CHECK 约束条件来实现的。也可以提高吞吐量,因为可保留列更新不会锁定行,因此不会阻止另一个事务处理同时更新同一行的不可保留列。
例如,如果现有数量足以满足请求且不超过 100 个货品的货架空间,则可以允许对库存数量执行添加和减法运算以成功。只要数量值大于零且小于或等于 100,就允许继续对数量值进行任何此类更新,而不会被未提交的更新阻止。要添加或减去的金额将通过内部保留机制进行保留和保证,以便事务处理可以继续进行,而无需等待在同一行的可保留列上先前进行保留的其他事务处理提交。
允许表级 CHECK 约束条件同时包括可保留列和不可保留列。在发布更新时批准的待处理无锁保留稍后可能会违反事务处理提交时的此类约束。如果在进行保留之后的时间更新了约束的不可保留列,以便其当前值可能违反 CHECK 约束条件,则可能会发生这种情况。如果违反了约束条件,则必须终止事务处理。但是,表级约束条件中的不可保留列通常是极少修改的阈值。货架空间、账户中的必需余额以及支出限制就是此类阈值的示例。
以下示例创建一个表 inventory,其中包含可保留列 qty_on_hand。qty_on_hand 上的 CHECK 约束条件指定必须有零个或多个库存货品,且不得超过此货品的货架容量,才能在 qty_on_hand 上进行更新而不阻止其他更新。在下面的示例中,创建 inventory 表时使用了适当的约束条件,插入了多行数据,并查询了 inventory 表的数据字典。
CREATE TABLE inventory
( item_id            NUMBER          CONSTRAINT inv_pk PRIMARY KEY,
  item_display_name  VARCHAR2(100)   NOT NULL,
  item_desc          VARCHAR2(2000),
  qty_on_hand        NUMBER          RESERVABLE CONSTRAINT qty_ck CHECK
                                        (qty_on_hand >= 0) NOT NULL,
  shelf_capacity     NUMBER          NOT NULL,
    CONSTRAINT shelf_ck CHECK (qty_on_hand <= shelf_capacity)
);

-- Insert a few rows in the inventory table
INSERT INTO inventory VALUES (123, 'Milk', 'Lowfat 2%', 100, 120);
INSERT INTO inventory VALUES (456, 'Bread', 'Multigrain', 50, 100);
INSERT INTO inventory VALUES (789, 'Eggs', 'Organic', 50, 75);

COMMIT;

SELECT * FROM inventory;

-- Check views user_tab_cols and user_tables to check
-- if the table is a reservable table and the names of the reservable columns

SELECT table_name, has_reservable_column
FROM   user_tables
WHERE  table_name = 'INVENTORY';

SELECT column_name, reservable_column
FROM   user_tab_cols
WHERE  table_name = 'INVENTORY'
  AND  reservable_column = 'YES';
可保留列的多个并发更新示例:
-
事务处理 1:
UPDATE inventory SET qty_on_hand = qty_on_hand - 10 WHERE item_id = 123; -
事务处理 2:
UPDATE inventory SET qty_on_hand = qty_on_hand + 20 WHERE item_id = 123; -
事务处理 3:
UPDATE inventory SET qty_on_hand = qty_on_hand - 30 WHERE item_id = 123; -
事务处理 2:
commit; -
事务处理 3:
commit; -
事务处理 1:
commit;
可以使用指定可选 CHECK 约束条件的 ALTER TABLE 命令将可保留列添加到表中。例如:
ALTER TABLE inventory ADD
(qty_on_hold NUMBER RESERVABLE DEFAULT 0
 CONSTRAINT qty_hold CHECK (qty_on_hold >= 0 and qty_on_hold <= 25));
可以使用以下 ALTER TABLE 命令将可保留列转换为不可保留列。尽管禁用了可保留预留空间,但应用程序可以选择强制实施约束条件,因此,将列转换为不可保留列时不会自动删除约束条件。根据您的要求,删除约束条件是可选的。例如:
ALTER TABLE inventory MODIFY (qty_on_hand NOT RESERVABLE);
ALTER TABLE inventory DROP CONSTRAINT qty_ck;
可以使用 ALTER TABLE 命令将不可保留列转换为可保留列。例如:
ALTER TABLE inventory MODIFY
(qty_on_hand RESERVABLE
 CONSTRAINT qty_ck CHECK (qty_on_hand >= 0 and qty_on_hand <= 100));
行
行是与表中的记录相对应的列信息的集合。
例如,employees 表中的一行描述特定雇员的属性:雇员标识、姓氏、名字等。创建表后,可以使用 SQL 插入、查询、删除和更新行。
示例:CREATE TABLE 和 ALTER TABLE 语句
用于创建表的 Oracle SQL 语句为 CREATE TABLE。
示例 4-1 CREATE TABLE 雇员
以下示例显示了 hr 示例方案中 employees 表的 CREATE TABLE 语句。该语句指定列(如 employee_id、first_name 等),并为每个列指定数据类型(如 NUMBER 或 DATE)。
CREATE TABLE employees
    ( employee_id    NUMBER(6),
      first_name     VARCHAR2(20),
      last_name      VARCHAR2(25)   CONSTRAINT emp_last_name_nn  NOT NULL,
      email          VARCHAR2(25)   CONSTRAINT emp_email_nn      NOT NULL,
      phone_number   VARCHAR2(20),
      hire_date      DATE           CONSTRAINT emp_hire_date_nn  NOT NULL,
      job_id         VARCHAR2(10)   CONSTRAINT emp_job_nn        NOT NULL,
      salary         NUMBER(8,2),
      commission_pct NUMBER(2,2),
      manager_id     NUMBER(6),
      department_id  NUMBER(4),
      CONSTRAINT     emp_salary_min CHECK (salary > 0),
      CONSTRAINT     emp_email_uk   UNIQUE (email)
    ) ;
示例 4-2 ALTER TABLE 雇员
以下示例显示了向 employees 表添加完整性约束的 ALTER TABLE 语句。完整性约束条件可以强制实施业务规则,并防止在表中输入无效信息。
ALTER TABLE employees
ADD ( CONSTRAINT emp_emp_id_pk   PRIMARY KEY (employee_id),
      CONSTRAINT emp_dept_fk     FOREIGN KEY (department_id)
                                   REFERENCES departments,
      CONSTRAINT emp_job_fk      FOREIGN KEY (job_id)
                                   REFERENCES jobs (job_id),
      CONSTRAINT emp_manager_fk  FOREIGN KEY (manager_id)
                                   REFERENCES employees
    ) ;
示例 4-3 雇员表中的行
以下样例输出显示了 hr.employees 表的 8 行 6 列。
EMPLOYEE_ID FIRST_NAME  LAST_NAME      SALARY COMMISSION_PCT DEPARTMENT_ID
----------- ----------- ------------- ------- -------------- -------------
        100 Steven      King            24000                           90
        101 Neena       Kochhar         17000                           90
        102 Lex         De Haan         17000                           90
        103 Alexander   Hunold           9000                           60
        107 Diana       Lorentz          4200                           60
        149 Eleni       Zlotkey         10500             .2            80
        174 Ellen       Abel            11000             .3            80
        178 Kimberely   Grant            7000            .15
上面的输出说明了表、列和行的一些以下重要特征:
-
表中的一行描述了某个雇员的属性:姓名、薪金、部门等。例如,输出中的第一行显示名为 Steven King 的雇员的记录。
-
列中描述了雇员的一个属性。在本示例中,
employee_id列是主键,这意味着每个雇员都由雇员标识唯一标识。保证任何两名员工都不能具有相同的员工 ID。 -
非键列可以包含具有相同值的行。在本例中,雇员 101 和 102 的薪金值相同:
17000。 -
外键列引用同一个表或另一个表中的主键或唯一键。在此示例中,
department_id中90的值对应于departments表的department_id列。 -
字段是行和列的交叉处。它只能包含一个值。例如,员工 103 的部门 ID 字段包含值
60。 -
字段可能缺少值。在这种情况下,该字段称为包含 null 值。雇员 100 的
commission_pct列的值为 Null,而雇员 149 的字段的值为.2。除非已在此列中定义了NOTNULL或主键完整性约束条件,否则列将接受 Null 值;在这种情况下,不能插入没有此列值的行。
另请参见: Oracle AI Database SQL Language Reference,了解 CREATE TABLE 语法和语义
Oracle 数据类型
每个列都有一个数据类型,该数据类型与特定存储格式、约束条件和有效值范围相关联。值的数据类型与该值的一组固定属性相关联。
根据这些属性,Oracle AI Database 会对各种数据类型的值做不同于其他数据类型的值。例如,可以乘以 NUMBER 数据类型的值,但不能乘以 RAW 数据类型的值。
在创建表时,必须为其每个列指定一个数据类型。后续被插入列中的每个值将采用该列的数据类型。
Oracle AI Database 提供了多种内置数据类型。最常用的数据类型属于本节中详述的类别。
其他重要的内置类型类别包括原始对象、大型对象 (LOB) 和集合。PL/SQL 具有常量和变量的数据类型,其中包括 BOOLEAN、引用类型、组合类型(记录)和用户定义的类型。
-
字符数据类型 字符数据类型在字符串中存储字母数字数据。最常见的字符数据类型是
VARCHAR2,它是存储字符数据的最有效选项。 -
数字数据类型 Oracle AI Database 数字数据类型存储固定和浮点数字、零和无穷大。某些数字类型还会存储操作(称为“非数字”或
NaN)的未定义结果的值。 -
日期时间数据类型 日期时间数据类型是
DATE和TIMESTAMP。Oracle AI Database 为时间戳提供全面的时区支持。 -
Rowid Data Types(行 ID 数据类型)数据库中存储的每一行都有一个地址,即用于在数据库中定位该行的内部表示形式。Oracle AI Database 使用
ROWID数据类型存储数据库中每行的地址(行 ID)。 -
布尔数据类型 BOOLEAN 数据类型包含不同的真值
True和False。 -
格式模型和数据类型 格式模型是用于描述存储在字符串中的日期时间或数字数据的格式的字符文字。格式样式不会更改数据库中值的内部表达形式。
另请参见:
字符数据类型
字符数据类型在字符串中存储字母数字数据。最常见的字符数据类型是 VARCHAR2,它是存储字符数据的最有效选项。
字节值对应于字符编码方案,通常称为字符集。数据库字符集是在创建数据库时建立的。字符集的示例包括 7 位 ASCII、EBCDIC 和 Unicode UTF-8。
字符数据类型的长度语义可以用字节或字符来衡量。将字符串作为字节序列进行处理称为字节语义。这是字符数据类型的默认值。将字符串作为字符序列进行处理称为字符语义。字符是数据库字符集的代码点。
-
VARCHAR2 和 CHAR 数据类型
VARCHAR2数据类型存储可变长度的字符文字。literal 是固定数据值。 -
NCHAR 和 NVARCHAR2 数据类型
NCHAR和NVARCHAR2数据类型存储 Unicode 字符数据。
另请参见:
-
Oracle AI Database Globalization Support Guide,了解有关字符集的更多信息
-
Oracle AI Database Development Guide,了解如何选择字符数据类型
VARCHAR2 和 CHAR 数据类型
VARCHAR2 数据类型存储可变长度的字符文字。literal 是固定数据值。
例如,'LILA'、'St. George Island' 和 '101' 都是字符文字;5001 是数字文字。字符文字值将用单引号引起来,以便数据库能够将其与方案对象名称区分开来。注:本手册以互换方式使用术语文本文字、字符文字和字符串。
创建包含 VARCHAR2 列的表时,应指定最大字符串长度。在示例 4-1 中,last_name 列的数据类型为 VARCHAR2(25),这意味着该列中存储的任何名称最多包含 25 个字节。
对于每行,Oracle AI Database 将列中的每个值存储为可变长度字段,除非值超过最大长度,在这种情况下,数据库将返回错误。例如,在单字节字符集中,如果为行中的 last_name 列值输入 10 个字符,则行片段中的列仅存储 10 个字符(10 个字节),不存储 25 个字符。使用 VARCHAR2 可减少空间消耗。
与 VARCHAR2 相比,CHAR 存储固定长度的字符串。创建包含 CHAR 列的表时,该列需要字符串长度。缺省值为 1 个字节。数据库使用空格将值填充到指定的长度。
Oracle AI Database 使用未填充的比较语义比较 VARCHAR2 值,并使用空白填充的比较语义比较 CHAR 值。
另请参阅: Oracle AI Database SQL Language Reference,了解有关空白填充和非填充的比较语义的详细信息
NCHAR 和 NVARCHAR2 数据类型
NCHAR 和 NVARCHAR2 数据类型存储 Unicode 字符数据。
Unicode 是通用编码字符集,可以使用单个字符集以任何语言存储信息。NCHAR 存储与国家字符集相对应的固定长度字符串,而 NVARCHAR2 存储可变长度字符串。
在创建数据库时指定国家字符集。NCHAR 和 NVARCHAR2 数据类型的字符集必须为 AL16UTF16 或 UTF8。这两个字符集都使用 Unicode 编码。
创建包含 NCHAR 或 NVARCHAR2 列的表时,最大大小始终为字符长度语义。字符长度语义是 NCHAR 或 NVARCHAR2 的缺省且唯一长度语义。
另请参阅: Oracle AI Database Globalization Support Guide,了解有关 Oracle 全球化支持功能的信息
数字数据类型
Oracle AI Database 数字数据类型存储固定和浮点数字、零和无穷大。某些数字类型还存储的是操作(称为“非数字”)未定义结果的值或 NaN。
Oracle AI Database 以可变长度格式存储数字数据。每个值都以科学表示法存储,1 个字节用于存储指数。数据库最多使用 20 个字节来存储 mantissa ,这是包含其有效数字的浮点数的一部分。Oracle AI Database 不存储前导零和尾随零。
-
NUMBER 数据类型
NUMBER数据类型存储固定和浮点数。数据库可以存储几乎任何数量级的数字。保证这些数据可以在运行 Oracle AI Database 的不同操作系统之间移植。对于必须存储数字数据的大多数情况,建议使用NUMBER数据类型。 -
浮点数 Oracle AI Database 专门为浮点数提供两种数字数据类型:
BINARY_FLOAT和BINARY_DOUBLE。
NUMBER 数据类型
NUMBER 数据类型存储固定和浮点数。数据库可以存储几乎任何数量级的数字。保证这些数据可以在运行 Oracle AI Database 的不同操作系统之间移植。对于必须存储数字数据的大多数情况,建议使用 NUMBER 数据类型。
可以采用 NUMBER( p, s) 格式指定固定点编号,其中 p 和 s 引用以下特征:
-
精确度
precision 指定数字的总数。如果未指定精度,则该列存储的值与应用程序提供的值完全相同,没有任何舍入。
-
缩放
scale 指定小数点到最低有意义数字的位数字数。正小数位数计算小数点右侧的位数,直至和包括最小有效位数。负小数位数计算小数点左边的位数,但不包括最小有效位数。如果指定不带小数的精度(如
NUMBER(6)),则小数位数为 0。
在示例 4-1 中,salary 列的类型为 NUMBER(8,2),因此精度为 8,小数位数为 2。因此,数据库将薪金 100,000 存储为 100000.00。
浮点数
Oracle AI Database 专门为浮点数提供了两种数字数据类型:BINARY_FLOAT 和 BINARY_DOUBLE。
这些类型支持 NUMBER 数据类型提供的所有基本功能。但是,虽然 NUMBER 使用十进制精度,但 BINARY_FLOAT 和 BINARY_DOUBLE 使用二进制精度,这可以加快算术计算速度,并且通常会降低存储要求。
BINARY_FLOAT 和 BINARY_DOUBLE 是近似数字数据类型。它们存储小数值的近似表示,而不是精确表示。例如,值 0.1 不能由 BINARY_DOUBLE 或 BINARY_FLOAT 精确表示。它们经常用于科学计算。其行为与 Java 和 XMLSchema 中的数据类型 FLOAT 和 DOUBLE 类似。
另请参阅:Oracle AI Database SQL Language Reference 以了解数字类型的精度、比例和其他特征
日期时间数据类型
datetime 数据类型为 DATE 和 TIMESTAMP。Oracle AI Database 为时间戳提供全面的时区支持。
-
DATE 数据类型
DATE数据类型存储日期和时间。虽然日期时间可以用字符或数字数据类型表示,但DATE具有特殊的关联属性。 -
TIMESTAMP 数据类型
TIMESTAMP数据类型是DATE数据类型的扩展。
DATE 数据类型
DATE 数据类型存储日期和时间。虽然日期时间可以用字符或数字数据类型表示,但 DATE 具有特殊的关联属性。
数据库在内部将日期存储为数字。日期存储在 7 个字节的固定长度字段中,分别对应于世纪、年、月、日、小时、分钟和秒。注:日期完全支持算术运算,因此您可以像对数字一样,对日期进行加减。
数据库根据指定的格式样式显示日期。格式模型是用于描述字符串中日期时间格式的字符文字。标准日期格式为 DD-MON-RR,日期格式为 01-JAN-11。
RR 与 YY(年份的最后两位数字)类似,但返回值的世纪将根据指定的两位数年份和当前年份的最后两位数字而不同。假设在 1999 年,数据库显示 01-JAN-11。如果日期格式使用 RR,则 11 指定 2011,而如果格式使用 YY,则 11 指定 1911。您可以在数据库实例和会话级别更改默认日期格式。
Oracle AI Database 以 24 小时格式 (HH:MI:SS) 存储时间。如果未输入时间部分,则默认情况下日期字段中的时间为 00:00:00 A.M。在仅时间条目中,日期部分默认为当月的第一天。
另请参见:
-
Oracle AI Database Development Guide,了解有关世纪和日期格式掩码的更多信息
-
Oracle AI Database SQL Language Reference,了解有关日期时间格式代码的信息
-
Oracle AI Database Development Guide,了解如何使用日期时间数据类型执行算术运算
TIMESTAMP 数据类型
TIMESTAMP 数据类型是 DATE 数据类型的扩展。
除了存储在 DATE 数据类型中的信息外,TIMESTAMP 还存储小数秒。TIMESTAMP 数据类型可用于存储精确的时间值,例如在必须跟踪事件顺序的应用程序中。
DATETIME 数据类型 TIMESTAMP WITH TIME ZONE 和 TIMESTAMP WITH LOCAL TIME ZONE 可识别时区。当用户选择数据时,该值将调整为用户会话的时区。此数据类型可用于跨地理区域收集和评估日期信息。
另请参阅: Oracle AI Database SQL Language Reference,了解有关在时间戳列中创建和输入数据的语法的详细信息
行 ID 数据类型
存储在数据库中的每一行都有一个地址 - 一个内部表示形式,用于在数据库中定位该行。Oracle AI Database 使用 ROWID 数据类型存储数据库中每行的地址(行 ID)。
行 ID 属于以下类别:
-
物理行 ID 将行的地址存储在按堆组织的表、表集群以及表和索引分区中。
-
逻辑行 ID 将行的地址存储在按索引组织的表中。
-
外部行 ID 是外部表中的标识符,例如通过网关访问的 DB2 表。它们不是标准的 Oracle AI Database 行 ID。
名为 universal rowid 或 urowid 的数据类型支持所有类型的行 ID。
使用行 ID
Oracle AI Database 在内部使用行 ID 来构建索引。
B 树索引是最常见的类型,其中包含按范围划分的键的有序列表。每个关键字都与一个行 ID 关联,该行 ID 指向关联行的地址以进行快速访问。
最终用户和应用程序开发人员还可以将 rowid 用于以下几个重要功能:
-
如果之前使用 SELECT 语句检索了行的
rowid,则 Rowid 是重新访问行的快速方法。 -
通过行 ID,可以查看表的组织方式。
虽然可以使用 ROWID 数据类型定义的列创建表,但不应存储行 ID,以使用它们在以后的阶段访问数据。以这种方式使用行 ID 可能会产生不可预测或不正确的结果。行的 rowid 可能由于一些原因而发生更改,这些原因可能是用户启动的,也可能是数据库引擎内部启动的。在执行了上述任何操作后,您不能依赖于 rowid 来指向同一行或有效行。
ROWID 伪列
Oracle 数据库中的每个表都有一个名为 ROWID 的伪列。
伪列的行为像表列,但并不实际存储在表中。可以从伪列中选择值,但不能插入、更新或删除它们的值。伪列也类似于不带参数的 SQL function 。不带参数的函数通常为结果集中的每一行返回同样的值,而伪列通常为每一行返回不同的值。
ROWID 伪列的值是表示每行的地址的字符串。这些字符串的数据类型为 ROWID。通过执行 SELECT 或 DESCRIBE 列出表的结构时,此伪列并不明显,伪列也不会占用空间。但是,可以使用 SQL 查询来检索每行的行标识,并使用保留字 ROWID 作为列名。
以下示例查询 ROWID 伪列,以显示员工 100 的 employees 表中行的行标识:
SQL> SELECT ROWID FROM employees WHERE employee_id = 100;

ROWID
------------------
AAAPecAAFAAAABSAAA
另请参见:
-
“行 ID 格式”
-
Oracle AI Database Development Guide,了解如何按地址标识行
布尔数据类型
BOOLEAN 数据类型包含不同的真值 True 和 False。
除非 NOT NULL 约束条件禁止,否则布尔数据类型还支持真值 UNKNOWN 作为空值。在 Oracle SQL 语法中显示数据类型时,可以使用布尔数据类型。
另请参见:
- Oracle AI Database SQL Language Quick Reference,了解有关布尔数据类型的信息。
格式化模型和数据类型
格式样式是用于说明存储在字符串中的日期时间或数字数据的格式的字符文字。格式样式不会更改数据库中值的内部表达形式。
将字符串转换为日期或数字时,格式样式将确定数据库如何解释字符串。在 SQL 中,可以使用格式模型作为 TO_CHAR 和 TO_DATE 函数的参数来设置要从数据库返回的值的格式,或者设置要存储在数据库中的值的格式。
以下语句选择部门 80 中雇员的薪金,并使用 TO_CHAR 函数使用数字格式样式 '$99,990.99' 指定的格式将这些薪金转换为字符值:
SQL> SELECT last_name employee, TO_CHAR(salary, '$99,990.99') AS "SALARY"
  2  FROM   employees
  3  WHERE  department_id = 80 AND last_name = 'Russell';

EMPLOYEE                  SALARY
------------------------- -----------
Russell                    $14,000.00
以下示例使用格式为掩码 'YYYY MM DD' 的 TO_DATE 函数更新聘用日期,以将字符串 '1998 05 20' 转换为 DATE 值:
SQL> UPDATE employees
  2  SET hire_date = TO_DATE('1998 05 20','YYYY MM DD')
3 WHERE last_name = 'Hunold';另请参阅:Oracle AI Database SQL Language Reference 以了解有关格式模型的更多信息
完整性约束条件
完整性约束条件是一个命名规则,用于限制表中一个或多个列的值。
数据完整性规则可防止在表中输入无效的数据。此外,约束条件可以防止在存在某些相关性时删除表。
如果启用了约束条件,则数据库将在输入或更新数据时对其进行检查。Oracle AI Database 可防止输入不符合约束条件的数据。如果禁用了某个约束条件,则 Oracle AI Database 允许不符合该约束条件的数据进入数据库。
在示例 4-1 中,CREATE TABLE 语句为 last_name、email、hire_date 和 job_id 列指定 NOT NULL 约束条件。约束条件子句可以标识约束条件列和条件。这些约束条件可以确保指定的列不包含 Null 值。例如,尝试插入没有职务 ID 的新员工会生成错误。
可以在创建表时或之后创建约束条件。如果需要,可以临时禁用约束条件。数据库将约束条件存储在数据字典中。
另请参见:
-
“数据完整性”了解完整性约束条件
-
“数据字典概览”以了解数据字典
-
Oracle AI Database SQL Language Reference,了解 SQL 约束条件子句
表存储
Oracle AI Database 使用表空间中的数据段来存储表数据。
段包含由数据块组成的区。表(或表群集的群集数据段)的数据段位于表所有者的默认表空间或 CREATE TABLE 语句中指定的表空间中。
-
表组织默认情况下,表组织为堆,这意味着数据库将行放置在最适合的位置,而不是按用户指定的顺序放置。因此,按堆组织的表是行的无序集合。
-
行存储 数据库将行存储在数据块中。包含少于 256 列数据的表的每一行都包含在一个或多个行片段中。
-
行件的行 ID rowid 实际上是行的 10 字节物理地址。
-
NULL 值的存储 NULL 是列中缺少值。NULL 表示缺少数据、未知数据或不适用数据。另请参阅:“用户段”以了解段的类型及其创建方式
表组织
默认情况下,表以堆形式进行组织,这意味着数据库会将行放置在最合适的位置,而不是按用户指定的顺序排列。因此,按堆组织的表是行的无序集合。注:按索引组织的表使用不同的组织原则。
用户添加行时,数据库会将行放置在数据段中的第一个可用空闲空间中。不能保证按行插入的顺序检索行。
hr.departments 表是按堆组织的表。它包含部门标识、名称、经理标识和地点标识的列。插入行时,数据库会将其存储在合适的位置。表段中的数据块可能包含以下示例中所示的未排序行:
50,Shipping,121,1500
120,Treasury,,1700
70,Public Relations,204,2700
30,Purchasing,114,1700
130,Corporate Tax,,1700
10,Administration,200,1700
110,Accounting,205,1700
表中所有行的列顺序相同。数据库通常按列在 CREATE TABLE 语句中的列出顺序存储列,但不能保证此顺序。例如,如果表具有 LONG 类型的列,则 Oracle AI Database 始终将此列存储在行的最后。此外,如果向表中添加新列,则新列将成为存储的最后一列。
表可以包含虚拟列,这与普通列不同,不会占用磁盘空间。数据库通过计算一组用户指定的表达式或函数按需派生虚拟列中的值。您可以为虚拟列编制索引、收集有关这些列的统计信息,以及创建完整性约束条件。因此,虚拟列与非虚拟列非常相似。
行存储
数据库将行存储在数据块中。包含少于 256 列数据的表的每一行都包含在一个或多个行片段中。
如果可能,Oracle AI Database 会将每一行存储为一个行片段。但是,如果无法将所有行数据插入到单个数据块中,或者对现有行的更新导致该行超出其数据块,则数据库会使用多个行片段存储该行。
表集群中的行与非集群表中的行包含相同的信息。此外,表集群中的行包含引用它们所属集群键的信息。
另请参阅:“数据块格式”以了解数据块的组件
行件的行 ID
rowid 实际上是行的 10 字节物理地址。
按堆组织的表中的每一行都有一个对此表唯一的行标识,该行标识对应于行片段的物理地址。对于表群集,位于同一数据块中的不同表中的行可以具有相同的行 ID。
Oracle AI Database 在内部使用行 ID 来构建索引。例如, B 树索引中的每个关键字都与指向关联行的地址以进行快速访问的行 ID 关联。物理行 ID 提供了对表行的尽可能快访问,使数据库能够以最少的单个 I/O 检索行。
存储 NULL 值
null 是列中缺少值。NULL 表示缺少数据、未知数据或不适用数据。
如果 Null 值位于具有数据值的列之间,则存储在数据库中。在这些情况下,它们需要 1 个字节来存储列的长度(零)。行中结尾的 Null 值无需存储,因为新的行标题指示前一行中的其余列为 Null。例如,如果表中的最后三列为空,则不会为这些列存储任何数据。
另请参阅:Oracle AI Database SQL Language Reference 以了解有关空值的更多信息
表压缩
数据库可以使用表压缩来减少表所需的存储量。
压缩可节省磁盘空间,减少数据库缓冲区高速缓存中的内存使用,在某些情况下可加快查询执行速度。表压缩对数据库应用程序是透明的。
-
基本表压缩和高级行压缩 基于字典的表压缩可为按堆组织的表提供良好的压缩率。
-
混合列式压缩 使用混合列式压缩,数据库将一组行的同一列存储在一起。数据块不以行主格式存储数据,而是使用行方法和列方法的组合。
-
Memory Speed Hybrid Columnar Compression 内存速度混合列式压缩引入了可以以内存速度处理的磁盘上压缩单元格式。
基本表压缩和高级行压缩
基于字典的表压缩可为按堆组织的表提供良好的压缩率。
Oracle AI Database 支持以下类型的基于字典的表压缩:
-
基本表压缩
此类型的压缩适用于批量加载操作。数据库不会压缩使用常规 DML 修改的数据。必须使用直接路径 INSERT 操作、
ALTER TABLE . . . MOVE操作或联机表重新定义才能实现基本表压缩。 -
高级行压缩
此类型的压缩适用于 OLTP 应用程序并压缩由任何 SQL 操作处理的数据。数据库实现了竞争性压缩比率,同时使应用程序能够在与未压缩表上的 DML 大约相同的时间内执行 DML。
对于上述类型的压缩,数据库以行主格式存储压缩行。一行的所有列都存储在一起,后跟下一行的所有列,依此类推。数据库使用对块开头存储的符号表的简短引用替换重复值。因此,数据库需要重新创建未压缩数据的信息存储在数据块本身中。
压缩数据块与普通数据块非常相似。对常规数据块起作用的大多数数据库特性和函数也适用于压缩块。
可以在表空间、表、分区或子分区级别声明压缩。如果在表空间级别指定,则默认情况下,在表空间中创建的所有表空间都将被压缩。
示例 4-4 表级压缩
以下语句将高级行压缩应用于 orders 表:
ALTER TABLE oe.orders ROW STORE COMPRESS ADVANCED;示例 4-5 分区级别压缩
以下 CREATE TABLE 语句部分示例指定一个分区的高级行压缩,其他分区的基本表压缩:
CREATE TABLE sales (
    prod_id     NUMBER     NOT NULL,
    cust_id     NUMBER     NOT NULL, ... )
 PCTFREE 5 NOLOGGING NOCOMPRESS
 PARTITION BY RANGE (time_id)
 ( partition sales_2013 VALUES LESS THAN(TO_DATE(...)) ROW STORE COMPRESS BASIC,
   partition sales_2014 VALUES LESS THAN (MAXVALUE) ROW STORE COMPRESS ADVANCED );
另请参见:
-
行格式:了解如何将值存储在行中
-
数据块压缩:了解压缩数据块的格式
-
Oracle AI Database Utilities,了解如何使用 SQL*Loader 进行直接路径加载
-
Oracle AI Database Administrator’s Guide 和 Oracle AI Database Performance Tuning Guide 可了解表压缩
Hybrid Columnar 压缩
使用混合列压缩时,数据库将一组行的同一列存储在一起。数据块不以行主格式存储数据,而是使用行方法和列方法的组合。
将列数据存储在一起,具有相同的数据类型和相似的特征,可以显著提高压缩带来的存储节省。数据库会压缩由任何 SQL 操作处理的数据,尽管直接路径加载的压缩级别较高。数据库操作对压缩对象透明地工作,因此无需更改应用程序。
注:混合列压缩和内存中列存储(IM 列存储)密切相关。主要区别在于混合列压缩优化磁盘存储,而 IM 列存储优化内存存储。
-
混合列压缩的类型 如果底层存储支持混合列压缩,则可以根据您的要求指定不同类型的压缩。
-
压缩单元 混合列压缩使用称为压缩单元的逻辑构造来存储一组行。
-
DML 和混合列压缩 混合列压缩对不同类型的 DML 操作中的行锁定有一定影响。另请参阅:“内存中区域”以了解有关 IM 列存储的更多信息
混合列式压缩的类型
如果底层存储支持混合列压缩,则可以根据您的要求指定不同类型的压缩。
压缩选项包括:
-
仓库压缩
此类压缩经过优化,可节省存储空间,适用于数据仓库应用。
-
存档压缩
此类型的压缩针对最大压缩级别进行了优化,并且适用于不更改的历史数据和数据。
混合列式压缩针对 Oracle Exadata 存储上的数据仓库和决策支持应用程序进行了优化。Oracle Exadata 利用 Oracle Exadata 存储服务器不可或缺的处理能力、内存和 Infiniband 网络带宽,最大限度地提高对使用混合列压缩的表的查询性能。
其他 Oracle 存储系统支持混合列式压缩,并像在 Oracle Exadata 存储上一样节省空间,但不会提供相同级别的查询性能。对于这些存储系统,混合列式压缩非常适合对不经常访问的旧数据进行数据库内归档。
压缩单元
混合列压缩使用称为压缩单元的逻辑结构来存储一组行。
将数据加载到表中时,数据库以列格式存储行组,并将每个列的值一起存储和压缩。在数据库压缩一组行的列数据之后,数据库会将数据放入压缩单元中。
例如,将混合列压缩应用于 daily_sales 表。在每一天结束时,使用商品 ID 和日期填充表,并生成组合主键。下表显示了 daily_sales 中行的子集。
表 3 示例表 daily_sales
| Item_ID | 日期 | Num_Sold | Shipped_From | 重新入库 |
|---|---|---|---|---|
| 1000 | 01-JUN-18 | 2 | WAREHOUSE1 | 是 |
| 1001 | 01-JUN-18 | 0 | WAREHOUSE3 | N |
| 1002 | 01-JUN-18 | 1 | WAREHOUSE3 | N |
| 1003 | 01-JUN-14 | 0 | WAREHOUSE2 | N |
| 1004 | 01-JUN-18 | 2 | WAREHOUSE1 | N |
| 1005 | 01-JUN-18 | 1 | WAREHOUSE2 | N |
假设此行子集存储在一个压缩单元中。混合列压缩将每个列的值存储在一起,然后使用多个算法压缩每个列。数据库根据各种因素选择算法,包括列的数据类型、列中实际值的基数以及用户选择的压缩级别。
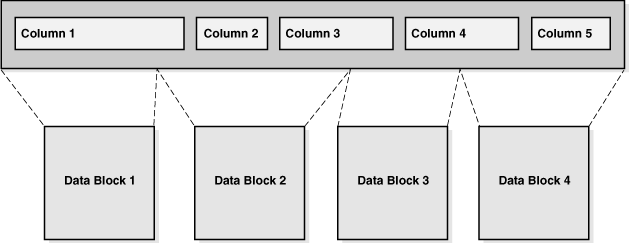
如下图所示,每个压缩单元可以跨多个数据块。特定列的值可以跨多个块,也可以不跨多个块。
图 7:压缩单元
如果混合列式压缩不会节省空间,则数据库会以 DBMS_COMPRESSION.COMP_BLOCK 格式存储数据。在这种情况下,数据库会将 OLTP 压缩应用于位于混合列压缩段中的块。
另请参见:
-
“行锁 (TX) ”
-
Oracle AI Database Licensing Information User Manual,了解混合列压缩的许可要求
-
Oracle AI Database Administrator’s Guide,了解如何使用混合列压缩
-
Oracle AI Database SQL Language Reference(了解
CREATE TABLE语法和语义) -
《Oracle AI Database PL/SQL Packages and Types Reference 》,了解
DBMS_COMPRESSION程序包
DML 和混合列式压缩
混合列式压缩对不同类型的 DML 操作中的行锁定具有影响。
直接路径加载和常规插入
将数据加载到使用混合列压缩的表时,可以使用常规插入或直接路径加载。直接路径加载会锁定整个表,从而减少并发。
从 Oracle Database 12c 发行版 2 (12.2) 开始,增加了对采用混合列压缩格式的常规阵列插入的支持。常规阵列插入的优点是:
-
插入的行使用行级别锁定,这会增加并发性。
-
自动数据优化 (Automatic Data Optimization,ADO) 和热图支持行级别策略的混合列压缩。因此,即使 DML 活动发生在段的其他部分,数据库也可以对符合条件的块使用混合列压缩。
当应用程序使用常规数组插入时,当满足以下条件时,Oracle AI Database 将行以压缩单位存储:
-
该表存储在 ASSM 表空间中。
-
兼容性级别为 12.2.0.1 或更高版本。
-
表定义满足现有的 Hybrid Columnar Compression 表约束条件(不包含
LONG类型的列),也不满足行相关性。
常规插入会生成重做和还原。因此,常规 DML 语句创建的压缩单元会与 DML 一起回退或提交。数据库会自动执行索引维护,就像对于存储在传统数据块中的行一样。
从 Oracle AI Database 26ai 开始,Automatic Storage Compression 使 Oracle AI Database 最初可以将数据直接加载到未压缩的格式中,然后在后台逐步将行移动到混合列压缩格式中。这对用户是透明的,同时可以提高 ETL 性能并保持快速的查询性能。
更新和删除
默认情况下,如果对单元中的任何行应用了更新或删除,则数据库会锁定压缩单元中的所有行。要避免此问题,可以选择为表启用行级锁定。在这种情况下,数据库仅锁定受更新或删除操作影响的行。
另请参见:
-
Oracle AI Database Administrator’s Guide,了解如何执行常规插入
-
Oracle AI Database SQL Language Reference,了解
INSERT语句 -
Oracle AI Database SQL Language Reference(了解有关使用
COMPRESS_IMMEDIATE提示的信息) -
Oracle AI Database VLDB and Partitioning Guide,了解有关使用自动存储压缩的信息
内存速度混合列式压缩
Memory Speed Hybrid Columnar Compression 引入了可以以内存速度处理的磁盘上压缩单元格式。
与混合列式压缩类似,Memory Speed Hybrid Columnar Compression 适用于数据仓库环境。它将数据转换为面向列的格式,并在数据加载期间对其进行压缩。关键区别在于,Memory Speed Hybrid Columnar Compression 在 Exadata 闪存缓存中使用与内存中列存储和 CELLMEMORY 相同的特殊列格式,从而在所有存储层实现高速列式扫描和高效列式缓存。此外,内存速度混合列压缩单元比混合列压缩单元大得多,这允许在磁盘上有效使用内存中列格式。
"Memory Speed Hybrid Columnar Compression"(内存速度混合列压缩)通过添加关键字 MEMSPEED 来使用 CREATE TABLE 命令作为混合列压缩的扩展启用。
示例 4-6 内存速度混合列式压缩
以下示例创建启用了内存速度混合列式压缩的 orders 表:
CREATE TABLE orders COLUMN STORE COMPRESS FOR MEMSPEED QUERY;注:有关详情,请参阅 Oracle AI Database SQL Language Reference。
表集群概览
表集群是一组表,它们共享公用列并将相关数据存储在相同的块中。
对表进行集群时,单个数据块可以包含多个表中的行。例如,块可以存储 employees 和 departments 表中的行,而不仅仅是单个表中的行。
cluster key 是群集表共有的列。例如,employees 和 departments 表共享 department_id 列。在创建表集群以及创建添加到表集群的每个表时,可以指定集群关键字。
群集关键字值是特定一组行的群集关键字列的值。包含相同群集关键字值的所有数据(如 department_id=20)以物理方式一起存储。每个群集键值在群集和群集索引中仅存储一次,而不管不同表中有多少行包含该值。
假设 HR 经理有两个工作簿案例:一个具有员工文件夹框,另一个具有部门文件夹框。用户经常要求特定部门中所有员工的文件夹。为了简化检索,经理将所有框重新排列在一个工作簿案例中。她将方框除以部门 ID。因此,部门 20 中员工的所有文件夹和部门 20 本身的文件夹都位于一个框中;部门 100 中员工的文件夹和部门 100 的文件夹位于另一个框中,依此类推。
主要查询(但未修改)群集表,并且经常对表中的记录进行查询或联接。由于表群集将不同表的相关行存储在同一数据块中,因此正确使用的表群集比非群集表具有以下优点:
-
群集表的联接会减少磁盘 I/O。
-
通过访问时间缩短了集群表的联接。
-
存储相关表和索引数据所需的存储较少,因为不会针对每行重复存储群集键值。
通常,群集表在以下情况下不适用:
-
表会频繁更新。
-
表通常需要进行全表扫描。
-
表需要截断。
-
索引集群概览 索引集群是使用索引来查找数据的表集群。cluster index 是群集键上的 B 树索引。必须先创建群集索引,然后才能将任何行插入到群集表中。
-
散列群集概述 散列群集类似于索引群集,但索引键将替换为 hash function 。不存在单独的群集索引。在散列群集中,数据是索引。
索引集群概览
索引群集是使用索引查找数据的表群集。cluster index 是群集键上的 B 树索引。必须先创建群集索引,然后才能将任何行插入到群集表中。
示例 4-7 创建表集群和关联索引
假定您使用群集关键字 department_id 创建群集 employees_departments_cluster,如下例所示:
CREATE CLUSTER employees_departments_cluster
   (department_id NUMBER(4))
SIZE 512;

CREATE INDEX idx_emp_dept_cluster
   ON CLUSTER employees_departments_cluster;
由于未指定 HASHKEYS 子句,因此 employees_departments_cluster 是一个带索引的群集。上面的示例在群集关键字 department_id 上创建一个名为 idx_emp_dept_cluster 的索引。
示例 4-8 在索引群集中创建表
您可以在群集中创建 employees 和 departments 表,将 department_id 列指定为群集关键字,如下所示(省略号将标记列规范的位置):
CREATE TABLE employees ( ... )
   CLUSTER employees_departments_cluster (department_id);

CREATE TABLE departments ( ... )
   CLUSTER employees_departments_cluster (department_id);
假设向 employees 和 departments 表添加行。数据库以物理方式将 employees 和 departments 表中每个部门的所有行存储在相同的数据块中。数据库将行存储在堆中,并使用索引对其进行定位。图 4-8 显示了 employees_departments_cluster 表群集,其中包含 employees 和 departments。数据库将部门 20 中雇员的行一起存储,部门 110 一起存储,以此类推。如果表未成簇,则数据库不会确保相关行一起存储。
图 8:群集表数据
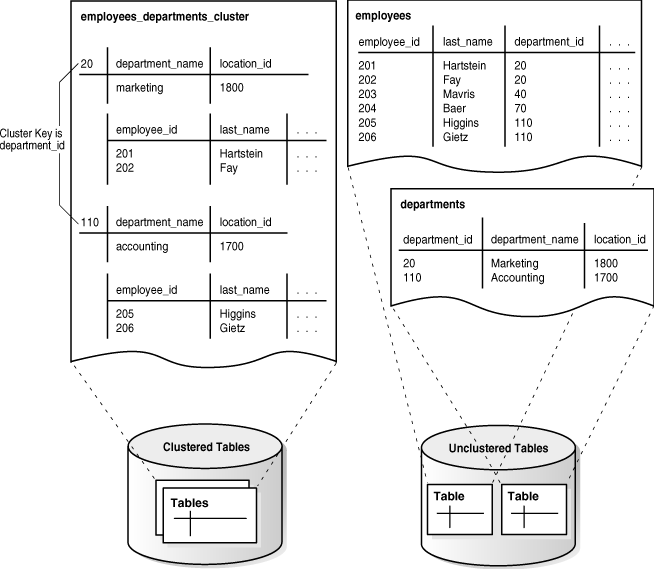
B 树集群索引将集群键值与包含数据的块的数据库块地址 (DBA) 关联。例如,键 20 的索引条目显示包含部门 20 中员工数据的块的地址:
20,AADAAAA9d集群索引是单独管理的,就像非集群表上的索引一样,可以存在于表集群中的单独表空间中。
另请参见:
-
“索引简介”
-
Oracle AI Database Administrator’s Guide,了解如何创建和管理索引集群
-
Oracle AI Database SQL Language Reference(了解
CREATE CLUSTER语法和语义)
散列群集概述
散列群集类似于带索引的群集,但是索引键将替换为 hash function 。不存在单独的群集索引。在散列群集中,数据是索引。
对于带索引的表或带索引的集群,Oracle AI Database 使用存储在单独索引中的键值来查找表行。要在索引表或表集群中查找或存储行,数据库必须至少执行两个 I/O:
-
一个或多个 I/O,用于在索引中查找或存储键值
-
用于读取或写入表或表集群中的行的另一个 I/O
要在散列群集中查找或存储行,Oracle AI Database 会将散列函数应用于该行的群集关键字值。生成的散列值对应于集群中的数据块,数据库代表发出的语句进行读取或写入。
散列是存储表数据以提高数据检索性能的可选方法。满足以下条件时,散列群集可能很有用:
-
对表的查询频率远高于对表的修改频率。
-
在等号条件(例如
WHERE department_id=20)下,会频繁查询散列键列。对于此类查询,将散列集群关键字值。散列键值直接指向存储行的磁盘区域。 -
您可以合理地猜测散列键的数量和与每个键值一起存储的数据的大小。
-
创建散列集群要创建散列集群,请使用与索引集群相同的
CREATE CLUSTER语句,并添加散列关键字。群集的散列值数量取决于散列关键字。 -
散列集群查询 在散列集群的查询中,数据库确定如何散列用户输入的键值。
-
散列集群变体单表散列集群是一次仅支持一个表的散列集群的优化版本。散列键和行之间存在一对一映射。
-
散列集群存储 Oracle AI Database 为散列集群分配空间的方式与索引集群不同。
散列集群创建
要创建散列集群,请使用与索引集群相同的 CREATE CLUSTER 语句,并添加散列关键字。群集的散列值数量取决于散列关键字。
群集键与索引群集的键一样,是群集中的表共享的单个列或组合键。散列键值是插入到群集键列中的实际值或可能值。例如,如果群集关键字为 department_id,则散列关键字值可以是 10、20、30 等。
Oracle AI Database 使用散列函数接受无限数量的散列键值作为输入,并将其排序为有限数量的存储桶。每个存储桶都有一个唯一的数字 ID,称为散列值。每个散列值都映射到块的数据库块地址,该块存储与散列键值(部门 10、20、30 等)对应的行。
在以下示例中,可能存在的部门数为 100,因此 HASHKEYS 设置为 100:
CREATE CLUSTER employees_departments_cluster
   (department_id NUMBER(4))
SIZE 8192 HASHKEYS 100;
创建 employees_departments_cluster 后,可以在群集中创建 employees 和 departments 表。然后,您可以将数据加载到散列集群中,就像在索引集群中一样。
另请参见:
-
“索引集群概览”
-
Oracle AI Database Administrator’s Guide,了解如何创建和管理散列集群
散列集群查询
在散列集群的查询中,数据库确定如何散列用户输入的键值。
例如,用户经常执行如下查询,为 p_id 输入不同的部门标识号:
SELECT *
FROM   employees
WHERE  department_id = :p_id;

SELECT *
FROM   departments
WHERE  department_id = :p_id;

SELECT *
FROM   employees e, departments d
WHERE  e.department_id = d.department_id
AND    d.department_id = :p_id;
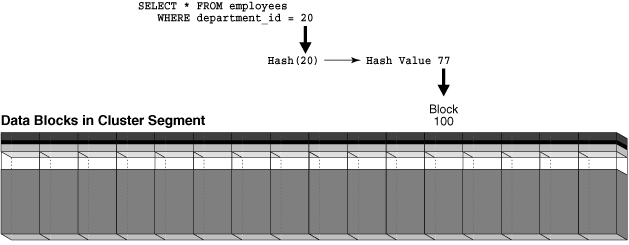
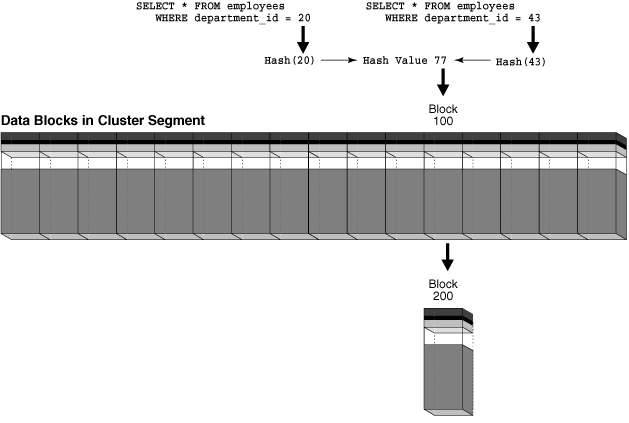
如果用户在 department_id=20 中查询雇员,则数据库可能会将此值散列到存储桶 77。如果用户在 department_id=10 中查询雇员,则数据库可能会将此值散列到存储桶 15。数据库使用内部生成的散列值来查找包含所请求部门员工行的块。
下图将散列群集段描述为块的水平行。如图中所示,查询可以在单个 I/O 中检索数据。
图 9:从散列集群检索信息
散列集群的限制是无法对非索引集群密钥进行范围扫描。假定在创建散列集群中创建的散列集群不存在单独的索引。对于 ID 介于 20 和 100 之间的部门,查询无法使用散列算法,因为它无法散列介于 20 和 100 之间的每个可能值。由于不存在索引,因此数据库必须执行完全扫描。
另请参见:“索引范围扫描”
散列集群变体
单表散列集群是一次仅支持一个表的散列集群的优化版本。散列键和行之间存在一对一映射。
当用户需要按主键快速访问表时,单表散列集群可能会很有用。例如,用户通常通过 employee_id 查找 employees 表中的雇员记录。
排序的散列集群以这样一种方式存储与散列函数的每个值对应的行,以便数据库可以有效地按排序顺序返回这些行。数据库在内部执行优化排序。对于始终按排序顺序使用数据的应用程序,此技术意味着可以更快地检索数据。例如,应用程序可能始终按 orders 表的 order_date 列排序。
另请参阅:Oracle AI Database Administrator’s Guide,了解如何创建单表和已排序散列集群
散列集群存储
Oracle AI Database 为散列集群分配空间的方式与索引集群不同。
在创建散列集群的示例中,HASHKEYS 指定可能存在的部门数,而 SIZE 指定与每个部门关联的数据的大小。数据库根据以下公式计算存储空间值:
HASHKEYS * SIZE / database_block_size因此,如果在 Hash Cluster Creation 中显示的示例中块大小为 4096 字节,则数据库将向散列集群分配至少 200 个块。
Oracle AI Database 不会限制您可以插入到集群中的散列关键字值的数量。例如,即使 HASHKEYS 是 100,也无法阻止您在 departments 表中插入 200 个唯一部门。但是,当散列值数超过散列键数时,散列群集检索的效率会降低。
为了说明检索问题,假定图 4-9 中的块 100 完全填充了部门 20 的行。用户将具有 department_id 43 的新部门插入到 departments 表中。部门数超过 HASHKEYS 值,因此数据库将 department_id 43 散列值 77,该散列值与用于 department_id 20 的散列值相同。将多个输入值散列到同一输出值称为散列碰撞。
当用户在部门 43 的群集中插入行时,数据库无法将这些行存储在块 100 中,该块已满。数据库将块 100 链接到新的溢出块(如块 200),并将插入的行存储在新块中。块 100 和块 200 现在都可用于存储任一部门的数据。如图 4-10 中所示,对部门 20 或 43 的查询现在需要 two 个 I/O 来检索数据:块 100 及其关联的块 200。您可以通过使用不同的 HASHKEYS 值重新创建群集来解决此问题。
图 10:在发生散列冲突时从散列群集中检索数据
另请参阅:Oracle AI Database Administrator’s Guide,了解如何管理散列集群中的空间
属性群集表概览
属性群集表是按堆组织的表,它根据用户指定的群集指令在磁盘上以近距离方式存储数据。这些指令用于指定单个或多个表中的列。
指令如下所示:
-
CLUSTERING ... BY LINEAR ORDER指令根据指定的列对表中的数据进行排序。当查询限定群集子句中指定的列的前缀时,请考虑使用
BY LINEAR ORDER群集(默认设置)。例如,如果sh.sales的查询通常指定客户 ID 或同时指定客户 ID 和产品 ID,则可以使用线性列顺序cust_id、prod_id将表中的数据聚集在一起。 -
CLUSTERING ... BY INTERLEAVED ORDER指令使用特殊算法(类似于 Z 阶函数)对一个或多个表中的数据进行排序,该算法允许缩减多列 I/O。当查询指定各种列组合时,请考虑使用
BY INTERLEAVED ORDER群集。例如,如果sh.sales的查询以不同的顺序指定不同的维,则可以根据这些维中的列将sales表中的数据聚类。
属性群集仅可用于 direct path INSERT 操作。对于常规 DML,它将被忽略。
本部分涵盖以下主题:
-
属性群集表的优点属性群集表的主要优点是 I/O 减少,这可以显著降低表扫描的 I/O 成本和 CPU 成本。I/O 减少发生在区域中,或者通过在磁盘上更接近群集值的物理距离来减少物理 I/O。
-
基于联接列的 Join Attribute Clustered Tables(联接属性群集表)属性群集称为联接属性群集。与表集群不同,联接属性集群表不会将一组表的数据存储在同一数据库块中。
-
I/O Reduction Using Zones zone 是一组连续数据块,用于存储相关列的最小值和最大值。
-
具有线性排序的属性群集表表的线性排序方案根据用户指定的属性按特定顺序将行划分为多个范围。Oracle AI Database 支持对通过主 - 外键关系连接的单个或多个表进行线性排序。
-
具有交错排序的属性群集表交错排序使用类似于 Z-order 的技术。
属性群集表的优点
属性群集表的主要优点是 I/O 减少,这可以显著降低表扫描的 I/O 成本和 CPU 成本。I/O 减少发生在区域中,或者通过在磁盘上更接近群集值的物理距离来减少物理 I/O。
属性群集表具有以下优点:
-
可以根据星型方案中的维列将事实表聚类。
在星型方案中,大多数查询限定维表,而不是事实表,因此按事实表列进行聚类不是有效的。Oracle AI Database 支持对维表中的列进行集群。
-
I/O 减少可能发生在几种不同的场景中:
-
与 Oracle Exadata 存储索引、Oracle In-Memory 最小/最大修剪或区域映射一起使用时
-
在 OLTP 应用程序中,查找限定前缀并使用具有线性顺序的属性群集的查询
-
在
BY INTERLEAVED ORDER群集的群集列的一个子集上
-
-
属性聚类可以改善数据压缩,从而间接提高表扫描成本。
当磁盘上的相同值彼此接近时,数据库可以更轻松地压缩它们。
-
Oracle AI Database 不会产生索引的存储和维护成本。
另请参阅:Oracle AI Database Data Warehousing Guide,了解属性群集表的更多优势
联接属性群集表
基于联接列的属性聚类称为联接属性聚类。与表集群不同,联接属性集群表不会将一组表的数据存储在同一数据库块中。
例如,考虑使用维表 products 联接的属性群集表 sales。sales 表仅包含 sales 表中的行,但行的排序基于从 products 表联接的列的值。在数据移动、直接路径插入和 CREATE TABLE AS SELECT 操作期间执行相应的联接。相反,如果 sales 和 products 位于标准表群集中,则数据块将包含两个表中的行。
另请参阅:Oracle AI Database Data Warehousing Guide 以了解有关联接属性群集的更多信息
使用区域的 I/O 减少
区域是一组连续数据块,用于存储相关列的最小值和最大值。
当 SQL 语句包含区域中存储的列的谓词时,数据库会将谓词值与区域中存储的最小值和最大值进行比较。通过这种方式,数据库确定在 SQL 执行期间要读取哪些区域。
I/O 减少是跳过不包含数据库满足查询所需的数据的表或索引块的功能。这种减少可以显著降低表扫描的 I/O 和 CPU 成本。
-
区域的用途对于区域的一个松散类比,请考虑使用鸽孔书架的销售经理,该书架类似于数据块。
-
区域映射 区域映射是将数据块划分为区域的独立访问结构。Oracle AI Database 将每个区域映射实施为实体化视图类型。
-
创建区域映射 手动或自动创建基本区域映射。
-
区域映射的工作方式:示例此示例说明区域映射如何修剪其谓词包含常量的查询中的数据。
区域用途
对于松散的区域类比,请考虑使用鸽子孔书架的销售经理,该书架类似于数据块。
每个鸽子洞都有收据(行),描述按发运日期订购的向客户销售的衬衫。在此类比中,区域映射就像一堆索引卡。每张牌对应于鸽孔的“区域”(连续范围),例如鸽孔 1-10。对于每个区域,此卡将列出该区域中存储的收据的最小和最大发运日期。
当有人想知道在某个日期发货的衬衫时,经理会翻转卡片,直到她到达包含请求日期的日期范围,记录赛鸽区,然后仅在此区域搜索赛鸽孔以查找请求的收据。通过这种方式,经理可以避免在书架上的每个鸽子洞中搜索收据。
区域映射
区域映射是将数据块划分为区域的独立访问结构。Oracle AI Database 将每个区域映射实施为实体化视图类型。
与索引类似,区域映射可以降低表扫描的 I/O 和 CPU 成本。当 SQL 语句在区域映射的列上包含谓词时,数据库会将谓词值与每个区域中存储的最小和最大表列值进行比较,以确定在 SQL 执行期间要读取哪些区域。
基本区域映射在单个表中定义,并维护此表中某些列的最小值和最大值。联接区域映射是在具有与一个或多个其他表的外部联接的表上定义的,它维护其他表中某些列的最小值和最大值。Oracle AI Database 会自动维护这两种类型的区域映射。
表上最多可以存在一个区域映射。对于分区表,所有分区和子分区都存在一个区域映射。分区表的区域映射还可跟踪每个区域、每个分区以及每个子分区的最小值和最大值。区域映射定义可以包括维列的最小值和最大值,前提是该表具有与维表的外部联接。注:您可以创建仅包含分区或子分区级别区域的区域映射。创建这样的区域映射将分区修剪功能扩展到分区元数据之外。
另请参阅:Oracle AI Database Data Warehousing Guide(了解区域映射概述)
区域映射创建
基本区域映射是手动或自动创建的。
-
Manual Zone Maps(手动区域映射)您可以使用 DDL 语句创建、删除和维护区域映射。
-
自动区域映射 Oracle AI Database 可以自动创建基本区域映射。这些限制称为自动区域映射。
手动区域映射
可以使用 DDL 语句创建、删除和维护区域映射。
每当在 CREATE TABLE 或 ALTER TABLE 语句中指定 CLUSTERING 子句时,数据库都会自动在指定的群集列上创建区域映射。区域映射将列的最小值和最大值与属性群集表中的连续数据块相关联。属性群集表使用区域映射执行 I/O 缩减。
还可以使用 CREATE MATERIALIZED ZONEMAP 语句显式创建区域映射。在这种情况下,您可以创建区域映射以用于或不用于属性群集。例如,您可以在一个表上创建区域映射,该表的行自然在一组列上排序,例如股票交易表,其交易按时间排序。
另请参见:
-
“实体化视图概述”
-
Oracle AI Database Data Warehousing Guide,详细了解如何创建区域映射
自动区域映射
Oracle AI Database 可以自动创建基本区域映射。这些限制称为自动区域映射。
Oracle AI Database 可以自动为分区表和非分区表创建基本区域映射。后台进程会自动维护以这种方式创建的区域映射。
使用 DBMS_AUTO_ZONEMAP 过程启用自动区域映射:
EXEC DBMS_AUTO_ZONEMAP.CONFIGURE('AUTO_ZONEMAP_MODE','ON')另请参见:
-
Oracle AI Database Data Warehousing Guide,了解有关使用
DBMS_AUTO_ZONEMAP软件包管理自动区域映射的更多信息 -
Oracle AI Database PL/SQL Packages and Types Reference(了解有关
DBMS_AUTO_ZONEMAP程序包的更多信息) -
Oracle AI Database Licensing Information User Manual ,详细了解不同版本和服务支持哪些功能
区域映射的工作方式:示例
此示例说明区域映射如何修剪其谓词包含常量的查询中的数据。
假设您创建了以下 lineitem 表:
CREATE TABLE lineitem
  ( orderkey      NUMBER        ,
    shipdate      DATE          ,
    receiptdate   DATE          ,
    destination   VARCHAR2(50)  ,
    quantity      NUMBER        );
表 lineitem 包含 4 个数据块,每个块 2 行。表 4-4 显示了表的 8 行。
行项目表 4 的数据块
| 阻止 | 点球 | 发运日期 | 收据日期 | 目的地 | 数量 |
|---|---|---|---|---|---|
| 1 | 1 | 1-1-2014 | 1-10-2014 | San_Fran | 100 |
| 1 | 2 | 1-2-2014 | 1-10-2014 | San_Fran | 200 |
| 2 | 3 | 1-3-2014 | 1-9-2014 | San_Fran | 100 |
| 2 | 4 | 1-5-2014 | 1-10-2014 | San_Diego | 100 |
| 3 | 5 | 1-10-2014 | 1-15-2014 | San_Fran | 100 |
| 3 | 6 | 1-12-2014 | 1-16-2014 | San_Fran | 200 |
| 4 | 7 | 1-13-2014 | 1-20-2014 | San_Fran | 100 |
| 4 | 8 | 1-15-2014 | 1-30-2014 | San_Jose | 100 |
可以使用 CREATE MATERIALIZED ZONEMAP 语句在 lineitem 表上创建区域映射。每个区域包含 2 个块,并存储 orderkey、shipdate 和 receiptdate 列的最小值和最大值。Table 4-5 显示了区域映射。
行项目表表 5 的区域映射
| 块范围 | 最小订单量 | 最大订单关键字 | 最小发运日期 | 最大发运日期 | 最小收据日期 | 最大收据日期 |
|---|---|---|---|---|---|---|
| 1-2 | 1 | 4 | 1-1-2014 | 1-5-2014 | 1-9-2014 | 1-10-2014 |
| 3-4 | 5 | 8 | 1-10-2014 | 1-15-2014 | 1-15-2014 | 1-30-2014 |
执行以下查询时,数据库可以读取区域映射,然后仅扫描块 1 和块 2,从而跳过块 3 和块 4,因为日期 1-3-2014 介于最小日期和最大日期之间:
SELECT * FROM lineitem WHERE shipdate = '1-3-2014';另请参见:
-
Oracle AI Database Data Warehousing Guide,了解如何使用区域映射
-
Oracle AI Database SQL Language Reference(了解
CREATE MATERIALIZED ZONEMAP语句的语法和语义)
具有线性排序的属性 - 群集表
表的线性排序方案根据用户指定的属性按特定顺序将行划分为多个范围。Oracle AI Database 支持对通过主 - 外键关系连接的单个或多个表进行线性排序。
例如,sales 表将 cust_id 和 prod_id 列划分为多个范围,然后将这些范围分组到磁盘上。为表指定 BY LINEAR ORDER 指令时,当谓词指定前缀列或指令中的所有列时,可能会发生显著的 I/O 减少。
假定查询 sales 通常指定客户 ID 或客户 ID 和产品 ID 的组合。可以创建属性群集表,以便此类查询从 I/O 减少中受益:
CREATE TABLE sales
(
   prod_id     NOT NULL NUMBER
,  cust_id     NOT NULL NUMBER
,  amount_sold NUMBER(10,2) ...
)
CLUSTERING
  BY LINEAR ORDER (cust_id, prod_id)
  YES ON LOAD YES ON DATA MOVEMENT
  WITH MATERIALIZED ZONEMAP;
限定列 cust_id 和 prod_id 或前缀 cust_id 的查询会减少 I/O。限定 prod_id 的查询不会显著减少 I/O,因为 prod_id 是 BY LINEAR ORDER 子句的后缀。以下示例说明数据库如何在表扫描期间减少 I/O。
示例 4-9 仅指定 cust_id
应用程序发出以下查询:
SELECT * FROM sales WHERE cust_id = 100;由于 sales 表是 BY LINEAR ORDER 群集,因此数据库必须仅读取包含 cust_id 值 100 的区域。
示例 4-10 指定 prod_id 和 cust_id
应用程序发出以下查询:
SELECT * FROM sales WHERE cust_id = 100 AND prod_id = 2300;Because the sales table is a BY LINEAR ORDER cluster, the database must only read the zones that include the cust_id value of 100 and prod_id value of 2300.
另请参见:
-
Oracle AI Database Data Warehousing Guide,了解如何使用线性排序对表进行集群
-
Oracle AI Database SQL Language Reference(了解
BY LINEAR ORDER子句的语法和语义)
具有交错排序的属性 - 群集表
交错排序使用一种类似于 Z-order 的技术。
通过交错排序,数据库可以根据群集列中谓词的任何子集修剪 I/O。交错排序对于数据仓库中的维层次非常有用。
与具有线性排序的属性群集表一样,Oracle AI Database 支持在通过主 - 外键关系连接的单个或多个表上进行交错排序。表中非属性群集表中的列必须通过外键进行链接并联接到属性群集表。
大型数据仓库经常以星型模式组织数据。维表使用父子层次,并通过外键连接到事实表。通过按交错顺序对事实表进行聚类,数据库可以使用特殊函数在表扫描期间跳过维列中的值。
示例 4-11 交错排序示例
假设数据仓库包含 sales 事实表及其两个维表:customers 和 products。大多数查询对 customers 表层次 (cust_state_province, cust_city) 和产品层次 (prod_category, prod_subcategory) 具有谓词。可以对 sales 表使用交错排序,如以下示例中的部分语句所示:
CREATE TABLE sales
(
   prod_id NUMBER NOT NULL
,  cust_id NUMBER NOT NULL
,  amount_sold NUMBER(10,2) ...
)
CLUSTERING sales
   JOIN products ON (sales.prod_id = products.prod_id)
   JOIN customers ON (sales.cust_id = customers.cust_id)
   BY INTERLEAVED ORDER
   (
     (  products.prod_category
     ,  products.prod_subcategory
     ),
     (  customers.cust_state_province
     ,  customers.cust_city
     )
   )
WITH MATERIALIZED ZONEMAP;注:BY INTERLEAVED ORDER 子句中指定的列不需要在实际维表中,但必须通过主 - 外键关系来连接这些列。
假设应用程序在联接中查询 sales、products 和 customers 表。该查询指定谓词中的 customers.prod_category 和 customers_cust_state_province 列,如下所示:
SELECT cust_city, prod_sub_category, SUM(amount_sold)
FROM   sales, products, customers
WHERE  sales.prod_id = products.prod_id
AND    sales.cust_id = customers.cust_id
AND    customers.prod_category = 'Boys'
AND    customers.cust_state_province = 'England - Norfolk'
GROUP BY cust_city, prod_sub_category;在前面的查询中,prod_category 和 cust_state_province 列是 CREATE TABLE 示例中显示的群集定义的一部分。在扫描 sales 表期间,数据库可以查阅区域映射并仅访问此区域中的行 ID。
另请参见:
-
“维概览”
-
Oracle AI Database Data Warehousing Guide,了解如何使用交错排序对表进行集群
-
Oracle AI Database SQL Language Reference(了解
BY INTERLEAVED ORDER子句的语法和语义)
临时表概览
临时表保存仅在事务处理或会话持续期间存在的数据。
临时表中的数据是会话的专用数据。每个会话只能查看和修改自己的数据。
可以创建全局临时表或专用临时表。下表显示了它们之间的基本差异。
表 6 临时表特征
| 特性 | 全局 | 专用 |
|---|---|---|
| 命名规则 | 与永久表相同 | 必须以 ORA$PTT_ 为前缀 |
| 表定义的可见性 | 所有会话 | 仅用于创建表的会话 |
| 表定义的存储 | 磁盘 | 仅内存 |
| 类型 | 特定于事务处理 (ON COMMIT DELETE ROWS) 或特定于会话 (ON COMMIT PRESERVE ROWS) |
特定于事务处理 (ON COMMIT DROP DEFINITION) 或特定于会话 (ON COMMIT PRESERVE DEFINITION) |
第三种类型的临时表(称为游标持续时间临时表)由数据库自动为某些类型的查询创建。
-
临时表的用途 在必须缓冲结果集的应用中,临时表非常有用。
-
临时表中的段分配与永久表一样,全局临时表也是数据字典中静态定义的持久性对象。对于专用临时表,元数据仅存在于内存中,但可以驻留在磁盘上的临时表空间中。
-
临时表创建
CREATE ... TEMPORARY TABLE语句将创建一个临时表。另请参阅:Oracle AI Database SQL Tuning Guide 以了解有关游标持续时间临时表的更多信息
临时表的用途
在必须缓冲结果集的应用中,临时表非常有用。
例如,通过计划应用程序,大学生可以创建可选的学期课程计划。全局临时表中的一行表示每个计划。在会话期间,调度数据是专用的。当学生选择计划时,应用程序会将所选计划的行移动到永久表。在会话结束时,数据库会自动删除全局临时表中的调度数据。
专用临时表对于动态报告应用程序非常有用。例如,客户资源管理 (CRM) 应用程序可以无限期地以同一用户身份连接,同时多个会话处于活动状态。每个会话为每个新 transaction 创建一个名为 ORA$PTT_crm 的专用临时表。应用程序可以对每个会话使用相同的表名,但可以更改定义。数据和定义仅对会话可见。表定义会一直存在,直到事务处理结束或手动删除表。
临时表中的段分配
与永久表一样,全局临时表也是数据字典中静态定义的持久性对象。对于专用临时表,元数据仅存在于内存中,但可以驻留在磁盘上的临时表空间中。
对于全局和专用临时表,当会话首次插入数据时,数据库将分配临时段。在会话中加载数据之前,表显示为空。对于特定于事务处理的临时表,数据库将在事务处理结束时取消分配临时段。对于特定于会话的临时表,数据库将在会话结束时取消分配临时段。
另请参见:“临时段”
临时表创建
CREATE ... TEMPORARY TABLE 语句将创建一个临时表。
指定 GLOBAL TEMPORARY TABLE 或 PRIVATE TEMPORARY TABLE。在这两种情况下,ON COMMIT 子句都指定表数据是特定于事务处理(默认)还是特定于会话。可以为数据库本身(而不是每个 PL/SQL 存储过程)创建临时表。
可以使用 CREATE INDEX 语句为全局(非专用)临时表创建索引。这些索引也是暂时的。索引中的数据与临时表中的数据具有相同的会话或事务处理范围。还可以对全局临时表创建视图或触发器。
另请参见:
-
“视图概述”
-
“触发器概览”
-
Oracle AI Database Administrator’s Guide,了解如何创建和管理临时表
-
Oracle AI Database SQL Language Reference(了解
CREATE ... TEMPORARY TABLE语法和语义)
外部表概览
外部表访问外部源中的数据,就像这些数据位于数据库中的表中一样。
数据可以采用提供访问驱动程序的任何格式。可以使用 SQL(串行或并行)、PL/SQL 和 Java 来查询外部表。
-
当 Oracle 数据库应用程序必须访问非关系数据时,外部表的用途外部表非常有用。
-
对象存储中的数据 外部表可用于访问对象存储中的数据。
-
外部表访问驱动程序 访问驱动程序是解释数据库的外部数据的 API。访问驱动程序在数据库内运行,数据库使用该驱动程序读取外部表中的数据。访问驱动程序和外部表层负责对数据文件中的数据执行所需的转换,以便与外部表定义匹配。
-
外部表创建:在内部创建外部表意味着在数据字典中创建元数据。与普通表不同,外部表不描述数据库中存储的数据,也不描述数据在外部存储的方式。相反,外部表元数据描述了外部表层必须如何将数据呈现到数据库。
-
透明地缓存外部表中的外部表数据的自动缓存数据,以提高查询性能。
外部表的用途
当 Oracle 数据库应用程序必须访问非关系数据时,外部表非常有用。
例如,基于 SQL 的应用程序可能需要访问其记录采用以下格式的文本文件:
100,Steven,King,SKING,515.123.4567,17-JUN-03,AD_PRES,31944,150,90
101,Neena,Kochhar,NKOCHHAR,515.123.4568,21-SEP-05,AD_VP,17000,100,90
102,Lex,De Haan,LDEHAAN,515.123.4569,13-JAN-01,AD_VP,17000,100,90
您可以创建一个外部表,将文本文件复制到外部表定义中指定的位置,然后使用 SQL 查询文本文件中的记录。同样,您可以使用外部表为 JSON 文档或 LOB 提供只读访问权限。
在数据仓库环境中,外部表对于执行提取、转换和加载 (ETL) 任务非常有用。例如,使用外部表可以将数据加载阶段与转换阶段连接起来。此技术消除了将数据暂存到数据库中以备在数据库中进一步处理的需要。
可以对虚拟或非虚拟列上的外部表进行分区。此外,还可以创建混合分区表,其中一些分区是内部分区,一些分区是外部分区。与内部分区一样,外部分区也受益于性能增强,例如分区修剪和分区联接。例如,您可以使用分区的外部表来分析存储在 Hadoop 分布式文件系统 (HDFS) 或 NoSQL 数据库上的大量非关系数据。
另请参阅:“分区表”
对象存储中的数据
外部表可用于访问对象存储中的数据。
除了支持访问位于操作系统文件和大数据源中的外部数据外,Oracle 还支持访问对象存储中的外部数据。对象存储在云中很常见,它提供了一个平面架构来管理单个对象、任何类型的非结构化数据以及元数据,方法是将它们分组到简单的容器中。虽然对象存储主要是云中的数据存储架构,但它也可以作为内部部署存储硬件提供。
您可以使用 DBMS_CLOUD 程序包或手动定义外部表来访问对象存储中的数据。Oracle 强烈建议使用 DBMS_CLOUD 程序包,因为它提供了附加功能并且与 Oracle Autonomous Database 完全兼容。
外部表访问驱动程序
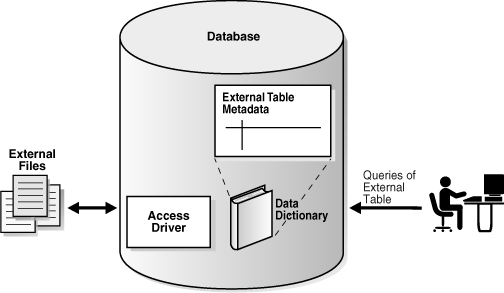
访问驱动程序是为数据库解释外部数据的 API。访问驱动程序在数据库内运行,数据库使用该驱动程序读取外部表中的数据。访问驱动程序和外部表层负责对数据文件中的数据执行所需的转换,以便与外部表定义匹配。
下图显示了对外部数据的 SQL 访问。
图 11:外部表
Oracle 为外部表提供了以下访问驱动程序:
-
ORACLE_LOADER(默认值)允许使用 SQL*Loader 支持的大多数格式访问外部文件。不能使用
ORACLE_LOADER驱动程序创建、更新或附加到外部文件。 -
ORACLE_DATAPUMP可用于卸载或加载外部数据。卸载操作从数据库读取数据,并将数据插入外部表(由一个或多个外部文件表示)。创建外部文件后,数据库无法更新数据或向其附加数据。加载操作读取外部表并将其数据加载到数据库中。
-
ORACLE_HDFS允许提取存储在 Hadoop 分布式文件系统 (HDFS) 中的数据。
-
ORACLE_HIVE允许访问存储在 Apache Hive 数据库中的数据。源数据可以存储在 HDFS、HBase、Cassandra 或其他系统中。与其他访问驱动程序不同,无法指定位置,因为
ORACLE_HIVE从外部元数据存储获取位置信息。 -
ORACLE_BIGDATA支持对以结构化和非结构化格式存储的数据进行只读访问,包括 Apache Parquet、Apache Avro、Apache ORC、Apache Iceberg、Linux Open Project Delta Sharing 协议以及文本格式。您还可以使用此驱动程序查询本地数据,这对于测试和更小的数据集非常有用。
外部表创建
在内部,创建外部表意味着在数据字典中创建元数据。与普通表不同,外部表不描述数据库中存储的数据,也不描述数据在外部存储的方式。相反,外部表元数据描述了外部表层必须如何将数据呈现到数据库。
CREATE TABLE ... ORGANIZATION EXTERNAL 语句由两部分组成。外部表定义描述了列类型。此定义类似于一个视图,允许 SQL 查询外部数据而不将其加载到数据库中。语句的第二部分将外部数据映射到列。
外部表是只读的,除非使用带有 ORACLE_DATAPUMP 访问驱动程序的 CREATE TABLE AS SELECT 创建。外部表的限制包括不支持索引列和列对象。
另请参见:
-
Oracle AI Database Administrator’s Guide,了解如何管理外部表、外部连接和目录对象
-
Oracle AI Database SQL Language Reference,了解有关创建和查询外部表的信息
自动缓存外部表数据
以透明方式缓存外部表中的数据,从而提高查询性能。
经常从外部表访问的数据(完全或部分驻留在对象存储中)会自动缓存以提高性能。外部表数据的高速缓存不需要更改应用程序,因为它由 Oracle 数据库自动处理。
区块链表概览
区块链表是专为集中式区块链应用设计的仅附加表。
在 Oracle Blockchain Table 中,对等数据库用户信任数据库来维护防篡改的分类账。分类账作为区块链表实施,该表由应用定义和管理。现有应用可以防范欺诈,而无需新的基础设施或编程模型。虽然交易吞吐量低于标准表,但区块链表的性能优于去中心化区块链。
区块链表是仅附加的,因为唯一允许的 DML 是 INSERT 命令。该表不允许 UPDATE、DELETE、MERGE、TRUNCATE 和直接路径加载。数据库事务处理可以跨区块链表和标准表。例如,单个事务处理可以将行插入标准表和两个不同的区块链表。
区块链表可用于保护闪回数据归档内容。这样,您可以确定是否有人篡改了表的内容。可以将区块链日志历史记录表视为维护加密安全的逻辑重做日志,以更改跟踪的用户表。
可以从第 2 版区块链表开始的区块链表中添加或删除用户列。不允许从版本 1 区块链表中添加或删除用户列。物理列和数据实际上不会被删除,而是标记为不可见。
-
行链 在区块链表中,行链是与散列方案链接的一系列行。
-
行内容 行内容是包含行列数据和链中上一行的散列值的连续字节序列。
-
区块链表的用户界面与标准表一样,区块链表由 SQL 创建,并支持标量数据类型、LOB、JSON 和分区。您还可以为区块链表创建索引和触发器。
行链
在区块链表中,行链是与散列方案链接的一系列行。
系统行链由版本 1 区块链表中的数据库实例 ID 和链 ID 的唯一组合标识。从版本 2 区块链表开始,除了这两个标识符之外,还需要插入该行的数据库的全局唯一标识符。系统行链由版本 2 区块链表中的可插入数据库全局唯一 ID、数据库实例 ID 和链 ID 的唯一组合标识。区块链表中的一行只属于一个系统行链。一个表支持多个系统行链。注:标准表中的链接行与区块链表中的行链正交。只有“链”这个词是一样的。
链中的每一行都有一个唯一的序号。数据库使用对每个链行进行的 SHA2-512 散列计算对行进行排序。每个插入行的散列派生自插入行的行内容,其中包括链中先前插入行的散列值。
虽然区块链表中的每一行都只属于一个系统链,但它也可以根据创建区块链表时指定的一组用户列中的值属于一个用户链。
行内容
行内容是包含行列数据和链中上一行的散列值的连续字节序列。
创建区块链表时,数据库将创建多个隐藏列。例如,您可以创建区块链表 bank_ledger,其中包含列 bank 和 deposit:
CREATE BLOCKCHAIN TABLE bank_ledger (bank VARCHAR2 (128), deposit NUMBER)
  NO DROP UNTIL 31 DAYS IDLE
  NO DELETE UNTIL 31 DAYS AFTER INSERT
  HASHING USING "SHA2_512" VERSION "v1";
数据库会自动创建前缀为 ORABCTAB 的隐藏列:ORABCTAB_INST_ID$、ORABCTAB_CHAIN_ID$、ORABCTAB_SEQ_NUM$ 及其他。这些隐藏列(其中大多数无法更改或管理)实施了防篡改算法。此算法可通过在提交时按特定顺序获取唯一的表级链锁来避免死锁。
注:区块链表的行内容存储在标准数据块中。在此 Oracle AI Database 发行版中,区块链表不支持表集群。
实例 ID、链 ID 和序号唯一地标识行。从版本 2 区块链表开始,除了这三个值之外,还需要插入该行的数据库的全局唯一标识符。每一行都有一个独立于平台的 SHA2-512 散列,该散列存储在隐藏的列 ORABCTAB_HASH$ 中。散列基于所插入行的内容和链中上一行的散列。
行的列值的数据格式由列元数据和内容中的字节组成。列元数据是一个 20 字节的结构,用于描述表中的位置、数据类型、NULL 状态和字节长度等特征。列内容是一组表示行中值的字节。例如,值 Chase 的 ASCII 表示形式为 43 68 61 73 65。可以在 SQL 中使用 DUMP 函数来获取列元数据和内容。
散列计算的行内容包括来自多个列的列数据格式:链中前一行的散列值、用户定义的列和固定数量的隐藏列。
系统可以跟踪相关行的插入顺序(称为行版本),并通过指定一组定义行版本的列来记录这些行。此外,如果指定了行版本,则会自动创建和维护视图,其中显示为用户指定的列集中的每个值组合插入的最后一行。视图名称使用命名约定 Blockchain_Table_Name_LAST$。
在许多情况下,行需要由最终用户的代表进行额外签名或替代签名。一个示例是银行经理对最终用户插入的行进行签名。委派签名者是另一个数据库用户,可以在通过行的系统加密散列计算的行上添加其签名。行可以由最终用户和/或委托人签名。仅当可以使用委派的证书来验证签名,并且委派的证书记录在数据库字典表中时,才接受委派的签名。
当最终用户或委派对行进行签名时,用户可能希望为该行获取计数器签名。计数器签名可以被视为区块链表摘要,专门用于最终用户或委派已签名的行。对行进行计数时,会将计数器签名返回给行签名者,并保存在该行中。请求行上的计数器签名的用户可以将此信息保存到单独的数据存储中以供不否认。
区块链表的用户界面
与标准表一样,区块链表由 SQL 创建,并支持标量数据类型、LOB、JSON 和分区。您还可以为区块链表创建索引和触发器。
要创建区块链表,请使用 CREATE BLOCKCHAIN TABLE 语句。区块链表具有 NO DROP UNTIL n DAYS IDLE 子句指定的保留期。可以使用 DROP TABLE 删除表。
Oracle Blockchain Table 支持以下接口:
-
使用
DBMS_BLOCKCHAIN_TABLE软件包可以对表行执行各种操作。例如,要将签名应用于以前插入的行内容,请使用SIGN_ROW过程。要验证行是否未被篡改,请使用VERIFY_ROWS。要在保留期(由NO DELETE子句指定)之后删除行,请使用DELETE_EXPIRED_ROWS。 -
DBA_BLOCKCHAIN_TABLES视图显示表元数据,例如行保留期、允许删除表之前的不活动期以及散列算法。
注意:
-
Oracle AI Database Administrator’s Guide,了解如何管理区块链表
-
《Oracle AI Database PL/SQL Packages and Types Reference 》,了解
DBMS_BLOCKCHAIN_TABLE程序包 -
Oracle AI Database Reference,了解
DBA_BLOCKCHAIN_TABLES视图
不可变表概览
不可变表是仅附加表,可防止内部人员进行未经授权的数据修改和人为错误导致的意外数据修改。
有权访问内部凭证的被盗或流氓员工可以尝试未经授权的修改。
可以将新行添加到不可变表中,但无法修改现有行。必须为不可变表和不可变表中的行指定保留期。在指定的行保留期之后,行将过时。只能从不可变表中删除过时的行。
不可变表包含系统生成的隐藏列。这些列与区块链表的列相同。插入行时,会为 ORABCTAB_CREATION_TIME$ 和 ORABCTAB_USER_NUMBER$ 列设置非 NULL 值。除了 V1 不可变表外,还会为 ORABCTAB_PDB_GUID$ 列设置非 NULL 值。如果使用行版本创建了不可变表,则会为 ORABCTAB_ROW_VERSION$ 和 ORABCTAB_LAST_ROW_VERSION_NUMBER$ 列设置非 NULL 值。剩余的系统生成的隐藏列的值设置为 NULL。
使用不可变表不需要更改现有应用程序。
对象表概览
对象表是每行表示一个对象的特殊类型的表。
Oracle 对象类型是具有名称、属性和方法的用户定义类型。通过对象类型,可以将真实世界的实体(如客户和采购订单)建模为数据库中的对象。
对象类型定义逻辑结构,但不创建存储。以下示例创建一个名为 department_typ 的对象类型:
CREATE TYPE department_typ AS OBJECT
   ( d_name     VARCHAR2(100),
     d_address  VARCHAR2(200) );
/
以下示例创建一个对象类型为 department_typ 的名为 departments_obj_t 的对象表,然后在表中插入一行。departments_obj_t 表的属性(列)源自对象类型的定义。
CREATE TABLE departments_obj_t OF department_typ;
INSERT INTO departments_obj_t VALUES ('hr', '10 Main St, Sometown, CA');
与关系列一样,对象表可以只包含一种类型的对象行,即与表具有相同声明类型的对象实例。默认情况下,对象表中的每个行对象都有一个关联的逻辑对象标识符 (OID),用于在对象表中唯一地标识该对象。对象表的 OID 列是一个隐藏列。
另请参见:
-
Oracle AI Database Object-Relational Developer’s Guide,了解 Oracle AI Database 中的对象关系特性
-
Oracle AI Database SQL Language Reference(了解
CREATE TYPE语法和语义)