索引與索引組織表格
索引是可以加快表格資料列存取速度的綱要物件。索引組織表格是以索引結構儲存的表格。
-
索引簡介:索引是與表格或表格叢集相關聯的選擇性結構,有時可以加速資料存取。
-
B-Tree 索引簡介 B- 樹狀結構 ( 平衡樹狀結構簡稱) 是最常見的資料庫索引類型。B-tree 索引是分割為範圍的有序值清單。透過將關鍵碼與列或列範圍建立關聯,B 樹狀目錄可為廣泛的查詢 (包括完全相符與範圍搜尋) 提供絕佳的擷取效能。
-
點陣圖索引簡介:在點陣圖索引中,資料庫會儲存每個索引索引鍵的點陣圖。在傳統的 B-tree 索引中,一個索引項目指向單一資料列。在位元映射索引中,每個索引索引鍵都會將指標儲存到多個資料列。
-
以函數為基礎的索引簡介:以函數為基礎的索引會計算涉及一或多個資料欄的函數或表示式值,並將它儲存在索引中。函數型索引可以是 B-tree 或位元映射索引。
-
應用程式網域索引簡介:應用程式網域索引是應用程式特定的自訂索引。
-
定量量化 HNSW 索引概要 定量量化可瀏覽小型世界 (HNSW) 索引可用於減少記憶體需求,並加速相似性搜尋。
-
索引組織表格簡介:索引組織表格是儲存在 B-tree 索引結構變化的表格。相反地,堆集組織表格會插入符合的資料列。
索引簡介
索引是與表格或表格叢集相關聯的選擇性結構,有時可以加速資料存取。
索引是邏輯和實體上與關聯之物件中的資料無關的綱要物件。因此,您可以刪除或建立索引,而不會實際影響索引表格。
注意:如果您刪除索引,應用程式仍然可以運作。不過,存取先前編製索引的資料可能會比較慢。
例如,假設 HR 經理有紙箱的貨架。包含員工資訊的資料夾會隨機插入方塊中。員工 Whalen (ID 200) 的資料夾是方塊 1 底部的 10 個資料夾,而 King (ID 100) 的資料夾位於方塊 3 的底部。若要尋找資料夾,管理員會從底部到頂端查看方塊 1 中的每個資料夾,然後從方塊移至方塊,直到找到資料夾為止。為了加快存取速度,經理人員可以建立索引,依序列出每個員工 ID 及其資料夾位置:
ID 100: Box 3, position 1 (bottom)
ID 101: Box 7, position 8
ID 200: Box 1, position 10
.
.
.
同樣地,經理人員可以為員工姓氏、部門 ID 等等建立個別的索引。
本節包含下列主題:
-
索引的優點與缺點:沒有索引或存在索引就不需要變更任何 SQL 敘述句的用詞。
-
索引可用性和可見性索引可以使用 (預設) 或無法使用、可見 (預設) 或不顯示。
-
索引鍵和資料欄:索引鍵是一組可以建立索引的資料欄或表示式。
-
複合索引:複合索引 (也稱為串連的索引 ) 是表格中多個資料欄的索引。
-
唯一與非唯一索引索引可以是唯一的或非唯一索引。唯一索引可保證表格的兩個資料列在索引鍵資料欄或資料欄中不會有重複的值。
-
索引類型 Oracle AI Database 提供數種索引配置,提供互補的效能功能。
-
資料庫如何維護索引:資料庫會在建立索引後自動維護和使用索引。
-
索引儲存 Oracle AI Database 將索引資料儲存在索引區段中。
索引的優點與缺點
缺少索引或存在索引時,不需要變更任何 SQL 敘述句的用詞。
索引是單一資料列的快速存取路徑。它只會影響執行速度。如果某個資料值已經編製索引,則索引會直接指向包含該值之資料列的位置。
當索引存在於表格的一或多個資料欄上時,資料庫在某些情況下會從表格擷取一組小型隨機分配的資料列。索引是磁碟 I/O 減少的多種方法之一。如果堆集組織的表格沒有索引,資料庫就必須執行完整表格掃描來尋找值。例如,未編製索引之 hr.departments 表格中位置 2700 的查詢要求資料庫搜尋每個區塊中的每一列。此方法不會擴展,也不會增加資料量。
索引的缺點如下:
-
手動建立索引通常需要深入瞭解資料模型、應用程式和資料分佈。
-
當資料變更時,您必須重新審視先前的索引相關決策。索引可能會停止使用,或可能需要新的索引。
-
索引佔用磁碟空間。
-
當已編製索引的資料發生 DML,而該資料會造成效能超載時,資料庫就必須更新索引。注意:從 Oracle Database 19c 開始,Oracle 資料庫可以持續監督應用程式工作負載、自動建立及管理索引。自動編製索引會作為在固定間隔執行的資料庫作業實行。
請考慮在下列情況下建立索引:
-
索引資料欄會經常查詢,而且會傳回佔表格中資料列總數的一小百分比。
-
已編製索引的資料欄中存在參照完整性限制條件。索引是一種方法,可避免在更新父項表格主索引鍵、合併至父項表格或從父項表格刪除時,需要完整的表格鎖定。
-
表格上將會放置一個唯一索引鍵限制條件,而您想要手動指定索引和所有索引選項。
另請參閱:
-
Oracle AI Database Administrator's Guide,瞭解有關自動編製索引的詳細資訊
-
Oracle AI Database 授權資訊使用手冊,瞭解不同版本和服務支援哪些功能的詳細資訊
索引可用性與可見性
索引可使用 (預設) 或無法使用、可見 (預設) 或不顯示。
這些屬性的定義如下:
-
可行性
最佳化處理程式忽略的無法使用的索引不是由 DML 作業所維護。無法使用的索引可以改善大量載入的效能。您可以讓索引變成無法使用,然後重新建立索引,而不用刪除索引。無法使用的索引與索引分割區不會使用空間。當您讓可用的索引無法使用時,資料庫會刪除其索引區段。
-
可見性
隱形索引是由 DML 作業所維護,但最佳化處理程式預設不會使用。讓索引變成不顯示,是讓索引無法使用或刪除索引的替代方法。不顯示的索引對於在刪除索引前或暫時使用索引,而不影響整體應用程式,測試移除索引特別有用。
另請參閱:「最佳化處理程式簡介」以瞭解最佳化處理程式如何選取執行計畫
索引鍵與資料欄
索引鍵是一組資料欄或表示式,您可以在其中建立索引。
雖然字詞通常可以交替使用,但索引與關鍵碼卻有所不同。索引是儲存在資料庫中的結構,使用者可以使用 SQL 敘述句來管理。關鍵碼是嚴格的邏輯概念。
下列敘述句會在範例表格 oe.orders 的 customer_id 資料欄上建立索引:
CREATE INDEX ord_customer_ix ON orders (customer_id);在先前的敘述句中,customer_id 資料欄是索引索引鍵。索引本身的名稱是 ord_customer_ix。
注意:主索引鍵和唯一索引鍵會自動有索引,但您可能想要在外來索引鍵上建立索引。
另請參閱:
-
「資料完整性」
-
Oracle AI Database SQL Language Reference
CREATE INDEX語法和語意
複合項目索引
複合索引 (也稱為串連索引 ) 是表格中多個資料欄的索引。
將資料欄放在複合索引中,以對擷取資料的查詢而言最有意義的順序。表格中的資料欄不需要相鄰。
複合索引可以加速擷取 SELECT 敘述句的資料,其中 WHERE 子句參照複合索引中所有或前導部分的資料。因此,定義中使用之欄的順序非常重要。一般而言,最常存取的資料欄會先執行。
例如,假設應用程式經常查詢 employees 表格中的 last_name、job_id 和 salary 資料欄。同時也假設 last_name 具有高基數,這表示相異值的數目會比表格資料列的數目大。您將使用以下資料欄順序建立索引:
CREATE INDEX employees_ix
   ON employees (last_name, job_id, salary);
僅存取 last_name 資料欄或僅存取 last_name 和 job_id 資料欄的查詢會使用此索引。在此範例中,無法存取 last_name 資料欄的查詢不會使用索引。
注意:在某些情況下 (例如前導資料欄的基數非常低時),資料庫可能會使用此索引的略過掃描 (請參閱索引略過掃描 )。
當多個索引符合下列任一條件時,便可使用相同的資料欄順序存在於相同表格上:
-
索引的類型不同。
例如,您可以在相同資料欄上建立位元映射與 B-tree 索引。
-
索引使用不同的分割配置。
例如,您可以建立在本機分割的索引,以及在全域分割的索引。
-
索引具有不同的唯一性特性。
例如,您可以在同一組資料欄上同時建立唯一和非唯一的索引。
例如,同一個表格資料欄可以有未分割的索引、全域分割索引以及本機分割索引等順序。您一次只能看到順序相同的資料欄數目相同的一個索引。
此功能可讓您在不刪除現有索引的情況下移轉應用程式,並以不同的屬性重新建立該索引。此外,當索引索引鍵持續增加,導致資料庫將新項目插入同一組索引區塊時,此功能在 OLTP 資料庫中十分有用。為了減輕這類「熱點」,您可以將索引從未分割的索引發展成全域分割索引。
如果類型或分割配置中同一組資料欄的索引不同,則這些索引必須使用不同的資料欄排列。例如,下列 SQL 敘述句會指定有效的資料欄排列:
CREATE INDEX employee_idx1 ON employees (last_name, job_id);
CREATE INDEX employee_idx2 ON employees (job_id, last_name);另請參閱:Oracle AI Database SQL Tuning Guide 以深入瞭解如何在同一組資料欄上建立多個索引
唯一與非唯一索引
索引可以是唯一的或非唯一的。唯一索引可保證表格的兩個資料列在索引鍵資料欄或資料欄中不會有重複的值。
例如,您的應用程式可能需要兩個員工都沒有相同的員工 ID。在唯一的索引中,每個資料值都有一個 rowid 。分葉區塊中的資料僅依索引鍵排序。
非唯一索引允許在已編製索引的資料欄中複製值。例如,employees 表格的 first_name 資料欄可能包含多個 Mike 值。對於非唯一索引,列 ID 會依排序順序包含在關鍵碼中,因此非唯一索引會依索引關鍵碼與列 ID (遞增) 排序。
Oracle AI Database 不會編製所有索引鍵資料欄為空值的表格資料列索引,但點陣圖索引或叢集索引鍵資料欄值為空值時除外。
索引的類型
Oracle AI Database 提供數個索引配置,提供互補的效能功能。
B-tree 索引是標準索引類型。對於高度選擇性索引 (有幾個資料列對應至每個索引項目) 和主索引鍵索引,它們是絕佳的。作為串連索引使用, B-tree 索引可擷取依索引資料欄排序的資料。B-tree 索引的子類型如下表所示。
表格 1 B-Tree 索引子類型
| B- 樹狀結構索引子類型 | 說明 | 深入瞭解 |
|---|---|---|
| 索引組織表 | 索引組織的表格與堆集組織不同,因為資料本身就是索引。 | 「索引組織表格概要」 |
| 反轉金鑰索引 | 在此類型的索引中,會反轉索引索引鍵的位元組,例如,103 會儲存為 301。反轉的位元組會將插入索引分散到多個區塊。 | 「逆索引鍵索引」 |
| 遞減索引 | 此類型的索引會以遞減順序儲存特定資料欄或資料欄的資料。 | 「遞增與遞減索引」 |
| B-tree 叢集索引 | 此類型的索引會以遞減順序儲存特定資料欄或資料欄的資料。 | 「遞增與遞減索引」 |
下表顯示未使用 B-tree 結構的索引類型。
表格 2 未使用 B-Tree 結構的索引
| 類型 | 說明 | 深入瞭解 |
|---|---|---|
| 位元映射和位元映射結合索引 | 在位元映射索引中,索引項目使用位元映射來指向多個資料列。相反地,B-tree 索引項目會指向單一資料列。位元映射結合索引是位元映射索引,用於結合兩個或更多表格。 | 「點陣圖索引概要」 |
| 函數型索引 | 此類型的索引包含由函數轉換的資料欄,例如 UPPER 函數或包含在表示式中的資料欄。B-tree 或位元映射索引可以基於函數。 |
「以函數為基礎的索引簡介」 |
| 應用程式網域索引 | 使用者會為應用程式特定網域中的資料建立此類型的索引。實體索引不需要使用傳統的索引結構,而且可以以表格形式儲存在 Oracle 資料庫中,也可以以檔案形式從外部儲存。 | 「應用程式網域索引簡介」 |
另請參閱:
-
Oracle AI Database SQL Tuning Guide,瞭解不同的索引存取路徑
資料庫維護索引的方式
資料庫會在建立索引後自動維護和使用索引。
索引會自動反映其相關表格的資料變更。變更的範例包括新增、更新與刪除列。不需要使用者動作。
即使插入資料列,已編製索引資料的擷取效能仍幾乎不變。不過,表格上存在許多索引會降低 DML 效能,因為資料庫也必須更新索引。
另請參閱:
-
Oracle AI Database Administrator's Guide,瞭解有關自動編製索引的詳細資訊
-
Oracle AI Database 授權資訊使用手冊,瞭解不同版本和服務支援哪些功能的詳細資訊
索引儲存體
Oracle AI Database 將索引資料儲存在索引區段中。
資料區塊中索引資料的可用空間,是資料區塊大小減去區塊超載、項目超載、資料列 ID,以及每個已編製索引值的一個長度位元組。
索引區段的表格空間是擁有者的預設表格空間,或是 CREATE INDEX 敘述句中特別指定的表格空間。為了簡化管理,您可以將索引與其表格儲存在不同的表格空間中。例如,您可以選擇不要備份只包含可重建索引的表格空間,進而減少備份所需的時間和儲存空間。
另請參閱:「索引區塊簡介」瞭解索引區塊類型 (根、分支和葉),以及索引項目儲存在區塊中的方式
B-Tree 索引總覽
平衡樹狀結構的 B 樹狀結構是最常見的資料庫索引類型。B-tree 索引是分割為範圍的有序值清單。透過將關鍵碼與列或列範圍建立關聯,B 樹狀目錄可為廣泛的查詢 (包括完全相符與範圍搜尋) 提供絕佳的擷取效能。
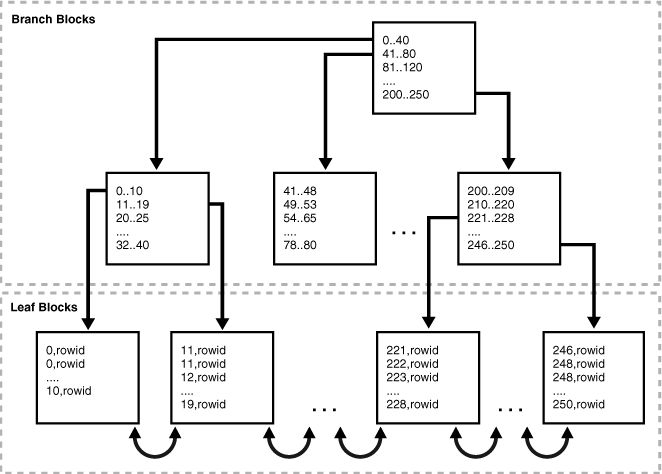
下圖說明 B-tree 索引的結構。範例顯示 department_id 資料欄上的索引,這是 employees 表格中的外來索引鍵資料欄。
圖 1:B-tree 索引的內部結構
本節包含下列主題:
-
分支區塊和分支終端區塊:B-tree 索引有兩種類型的區塊:用於搜尋的分支區塊,以及用於儲存索引鍵值的分葉區塊。B-tree 索引的上層分支區塊包含指向較低層次索引區塊的索引資料。
-
索引掃描:在索引掃描中,資料庫會使用敘述句指定的索引資料欄值來周遊索引,以擷取資料列。如果資料庫掃描某個值的索引,就會在 n I/O 中找到這個值,其中 n 是 B-tree 索引的高度。這是 Oracle AI Database 索引的基本原則。
-
逆向索引鍵索引:逆向索引鍵索引是一種 B-tree 索引,實際上會在保持資料欄順序時反轉每個索引索引鍵的位元組。
-
遞增與遞減索引:在遞增索引中,Oracle AI Database 會以遞增順序儲存資料。依照預設,字元資料會依值每個位元組中所含的二進位值、從最小到最大數字的數值資料,以及從最早到最新值的日期來排序。
-
索引壓縮為了減少索引空間,Oracle AI Database 可以採用不同的壓縮演算法。
分支區塊和分支終端區塊
B-tree 索引有兩種類型的區塊:用於搜尋的分支區塊,以及用於儲存索引鍵值的分葉區塊。B-tree 索引的上層分支區塊包含指向較低層次索引區塊的索引資料。
在圖 5-1 中,根分支區塊有一個項目 0-40,指向下一個分支層次最左邊的區塊。此分支區塊包含 0-10 和 11-19 之類的項目。每個項目都會指向一個分葉區塊,其中包含範圍內的關鍵碼值。
B-tree 索引會平衡,因為所有分支終端區塊都會自動保持相同的深度。因此,從索引中的任何位置擷取任何記錄大約需要相同的時間。索引的高度是從根區塊移至分支終端區塊所需的區塊數目。分支層級為高度減 1。在圖 5-1 中,索引的高度為 3,分支層次為 2。
分支區塊儲存兩個索引鍵之間進行分支決策所需的最小索引鍵前置碼。這項技術可以讓資料庫根據每個分支區塊的資料量需求。分支區塊包含指向包含索引鍵之子項區塊的指標。關鍵碼與指標的數目受區塊大小限制。
分葉區塊包含每個已編製索引的資料值,以及用來尋找實際資料列的對應資料列 ID。每個項目都會依 (關鍵碼、列 ID) 排序。在分葉區塊中,索引鍵與資料列 ID 連結至其左側與右側同階項目。分葉區塊本身也互相連結。在圖 5-1 中,最左邊的分支終端區塊 (0-10) 會連結至第二個分支終端區塊 (11-19)。注意:含有字元資料之資料欄中的索引是以資料庫字元集中的字元二進位值為基礎。
索引掃瞄
在索引掃描中,資料庫會使用敘述句指定的索引資料欄值來周遊索引,以擷取資料列。如果資料庫掃描某個值的索引,就會在 n I/O 中找到這個值,其中 n 是 B-tree 索引的高度。這是 Oracle AI Database 索引的基本原則。
如果 SQL 敘述句只存取已編製索引的資料欄,則資料庫會直接從索引而非從表格讀取值。如果敘述句除了已編製索引的資料欄之外,還存取未編製索引的資料欄,則資料庫會使用資料列 ID 來尋找表格中的資料列。通常,資料庫會先讀取索引區塊,然後再讀取表格區塊,來擷取表格資料。
-
完整索引掃描:在完整索引掃描中,資料庫會依序讀取整個索引。如果 SQL 敘述句中的述詞 (
WHERE子句) 參照索引中的資料欄,且在某些情況下未指定述詞,則可以使用完整的索引掃描。完整掃描可以去除排序,因為資料是依索引索引鍵排序。 -
快速完整索引掃描:快速完整索引掃描是一個完整的索引掃描,資料庫無需存取表格即可存取索引本身中的資料,而資料庫則會以無特定順序讀取索引區塊。
-
索引範圍掃描:索引範圍掃描是索引的排序掃描,其中一或多個索引的前置資料欄是在條件中指定,而索引索引鍵可以有 0、1 或更多的值。
-
索引唯一掃描:與索引範圍掃描相反,索引唯一掃描必須有 0 或 1 個資料列 ID 與索引索引鍵關聯。
-
索引略過掃描:索引略過掃描會使用複合索引的邏輯子索引。資料庫會透過單一索引「略過」,就像搜尋個別的索引一樣。
-
索引叢集係數:索引叢集係數會測量與索引值 (例如員工姓氏) 有關的資料列順序。隨著順序的程度增加,叢集係數也會減少。另請參閱:Oracle AI Database SQL Tuning Guide,瞭解有關索引掃描的詳細資訊
完整索引掃描
在完整索引掃描中,資料庫會依順序讀取整個索引。如果 SQL 敘述句中的述詞 (WHERE 子句) 參照索引中的資料欄,且在某些情況下未指定述詞,則可以使用完整的索引掃描。完整掃描可以去除排序,因為資料是依索引索引鍵排序。
範例 5-1 完整索引掃描
假設應用程式執行下列查詢:
SELECT department_id, last_name, salary
FROM   employees
WHERE  salary > 5000
ORDER BY department_id, last_name;在此範例中,department_id、last_name 和 salary 是索引中的複合索引鍵。Oracle AI Database 會執行索引的完整掃描、依排序順序讀取索引 (依部門 ID 和姓氏排序),以及篩選薪資屬性。如此一來,資料庫會掃描一組小於 employees 表格的資料,其中包含的資料欄數超過查詢所包含的資料欄數,並避免排序資料。
完整掃描可能會讀取索引項目,如下所示:
50,Atkinson,2800,rowid
60,Austin,4800,rowid
70,Baer,10000,rowid
80,Abel,11000,rowid
80,Ande,6400,rowid
110,Austin,7200,rowid
.
.
.
快速完整索引掃瞄
快速完整索引掃描是一個完整的索引掃描,資料庫無需存取表格即可存取索引本身中的資料,而資料庫則會以無特定順序讀取索引區塊。
當符合下列兩項條件時,快速完整索引掃描是完整表格掃描的替代方案:
-
索引必須包含查詢所需的所有資料欄。
-
查詢結果集中不能顯示包含所有空值的資料列。如果要保證這個結果,索引中至少必須有一個資料欄:
-
NOT NULL限制條件 -
套用至資料欄的述詞,防止在查詢結果集中使用空值
-
範例 5-2 快速完整索引掃描
假設應用程式發出下列查詢,其中不包含 ORDER BY 子句:
SELECT last_name, salary
FROM   employees;
last_name 資料欄沒有空值限制條件。如果姓氏與薪資是索引中的複合鍵,則快速完整索引掃描可以讀取索引項目,以取得要求的資訊:
Baida,2900,rowid
Atkinson,2800,rowid
Zlotkey,10500,rowid
Austin,7200,rowid
Baer,10000,rowid
Austin,4800,rowid
.
.
.
索引範圍掃描
索引範圍掃描是索引的排序掃描,索引的一或多個前導資料欄在條件中指定,而索引索引鍵可以有 0、1 或更多的值。
condition 會指定一或多個表示式與邏輯 (布林) 運算子的組合。它會傳回 TRUE、FALSE 或 UNKNOWN 的值。
資料庫通常使用索引範圍掃描來存取選擇性資料。選擇性是查詢選取之表格中的資料列百分比,0 代表無資料列,1 代表所有資料列。選擇性會繫結至查詢述詞 (例如 WHERE last_name LIKE 'A%') 或述詞組合。當值接近 1 時,述詞會變得更有選擇性,因為值會接近 0 且較不選擇性 (或更不選取)。
例如,使用者會查詢姓氏開頭為 A 的員工。假設已編製 last_name 資料欄的索引,項目如下:
Abel,rowid
Ande,rowid
Atkinson,rowid
Austin,rowid
Austin,rowid
Baer,rowid
.
.
.
資料庫可以使用範圍掃描,因為在述詞中指定了 last_name 資料欄,而每個索引索引鍵可以有多個資料列 ID。例如,兩個員工的名稱為 Austin,因此兩個資料列 ID 與索引鍵 Austin 相關聯。
索引範圍掃描可以兩邊繫結,如查詢 ID 介於 10 到 40 之間的部門,或僅繫結於一邊 (如查詢 ID 超過 40)。為了掃描索引,資料庫會向後或向前移動分支終端區塊。例如,掃描 10 到 40 之間的 ID 會找出第一個索引分支區塊,其中包含 10 或更大的最低索引鍵值。然後掃描會透過連結的分支終端節點清單進行水平掃描,直到找到大於 40 的值為止。
索引唯一掃描
與索引範圍掃描相反,索引唯一掃描必須有 0 或 1 個資料列 ID 與索引索引鍵關聯。
當述詞使用相等運算子參照 UNIQUE 索引之索引鍵中的所有資料欄時,資料庫會執行唯一的掃描。索引唯一掃描會在找到第一筆記錄後立即停止處理,因為無法進行第二筆記錄。
如圖所示,假設使用者執行下列查詢:
SELECT *
FROM   employees
WHERE  employee_id = 5;
假設 employee_id 資料欄是主索引鍵,並以下列項目編製索引:
1,rowid
2,rowid
4,rowid
5,rowid
6,rowid
.
.
.
在此情況下,資料庫可以使用索引唯一掃描來尋找 ID 為 5 之員工的資料列 ID。
索引 略過掃描
索引略過掃描使用複合索引的邏輯子索引。資料庫會透過單一索引「略過」,就像搜尋個別的索引一樣。
如果複合索引的前置資料欄中有少數不同的值,以及索引的非前置索引鍵中有許多不同的值,則略過掃描會很有幫助。查詢述詞中未指定複合索引的前置資料欄時,資料庫可以選擇略過索引掃描。
範例 5-3 略過複合項目索引的掃描
假設您對 sh.customers 表格中的客戶執行下列查詢:
SELECT * FROM sh.customers WHERE cust_email = 'Abbey@company.example.com';customers 表格具有資料欄 cust_gender,其值為 M 或 F。假設複合索引存在於資料欄 (cust_gender、cust_email)。下列範例顯示部分索引項目:
F,Wolf@company.example.com,rowid
F,Wolsey@company.example.com,rowid
F,Wood@company.example.com,rowid
F,Woodman@company.example.com,rowid
F,Yang@company.example.com,rowid
F,Zimmerman@company.example.com,rowid
M,Abbassi@company.example.com,rowid
M,Abbey@company.example.com,rowid
即使 WHERE 子句中未指定 cust_gender,資料庫還是可以使用此索引的略過掃描。
在略過掃描中,邏輯子索引數目是由前導資料欄中的相異值數目所決定。在前面的範例中,前導資料欄有兩個可能的值。資料庫會以邏輯方式將索引分割成一個子索引,索引鍵為 F,另一個子索引則為索引鍵為 M。
搜尋電子郵件為 Abbey@company.example.com 的客戶記錄時,資料庫會先搜尋值為 F 的子索引,然後再搜尋值為 M 的子索引。在概念上,資料庫會以下列方式處理查詢:
SELECT * FROM sh.customers WHERE cust_gender = 'F'
  AND cust_email = 'Abbey@company.example.com'
UNION ALL
SELECT * FROM sh.customers WHERE cust_gender = 'M'
AND cust_email = 'Abbey@company.example.com';另請參閱:Oracle AI Database SQL Tuning Guide 以深入瞭解略過掃描
索引叢集係數
索引叢集係數會測量與索引值 (例如員工姓氏) 有關的資料列順序。隨著順序的程度增加,叢集係數也會減少。
叢集係數可用來粗略地測量使用索引讀取整個表格所需的 I/O 數目:
-
如果叢集係數很高,則 Oracle AI Database 會在進行大量索引範圍掃描時,執行相對較高的 I/O。索引項目會指向隨機表格區塊,因此資料庫可能需要讀取和重新重新讀取相同的區塊,才能擷取索引所指向的資料。
-
如果叢集因子很低,則 Oracle AI Database 會在進行大量索引範圍掃描時執行相對較低的 I/O。範圍內的索引索引鍵往往會指向相同的資料區塊,因此資料庫不需要讀取和重新讀取相同的區塊。
叢集因子與索引掃描相關,因為它可以顯示:
-
資料庫是否將使用索引進行大型範圍掃描
-
與索引索引鍵相關的表格組織程度
-
如果必須依索引索引鍵排序資料列,您是否應該考慮使用索引組織表格、分割或表格叢集
範例 5-4 叢集係數
假設 employees 表格符合兩個資料區塊。表格 5-3 說明兩個資料區塊中的資料列 (省略符號代表未顯示的資料)。
表 3 員工表中兩個資料區塊的內容
| 資料區塊 1 | 資料區塊 2 |
|---|---|
|
|
資料列會以姓氏 (以粗體顯示) 的順序儲存在區塊中。例如,資料區塊 1 的底端資料列說明 Abel,下一列向上描述 Ande,依字母順序排列,直到 Steven King 區塊 1 的頂端資料列為止。區塊 2 的底端資料列描述 Kochar,下一列向上則描述 Kumar,依字母順序排列,直到 Zlotkey 區塊中的最後一列為止。
假設索引存在於姓氏欄。每個名稱項目都會對應一個 rowid。在概念上,索引項目看起來如下:
Abel,block1row1
Ande,block1row2
Atkinson,block1row3
Austin,block1row4
Baer,block1row5
.
.
.
假設員工 ID 資料欄上有個別的索引。在概念上,索引項目看起來可能如下,員工 ID 在兩個區塊的幾乎隨機位置中分配:
100,block1row50
101,block2row1
102,block1row9
103,block2row19
104,block2row39
105,block1row4
.
.
.
下列敘述句會查詢這兩個索引之叢集化因子的 ALL_INDEXES 檢視:
SQL> SELECT INDEX_NAME, CLUSTERING_FACTOR
  2  FROM ALL_INDEXES
  3  WHERE INDEX_NAME IN ('EMP_NAME_IX','EMP_EMP_ID_PK');

INDEX_NAME           CLUSTERING_FACTOR
-------------------- -----------------
EMP_EMP_ID_PK                       19
EMP_NAME_IX                          2
EMP_NAME_IX 的叢集因子很低,這表示單一分支終端區塊中相鄰的索引項目往往指向相同資料區塊中的資料列。EMP_EMP_ID_PK 的叢集係數很高,這表示相同分支終端區塊中相鄰的索引項目,較不可能指向相同資料區塊中的資料列。
另請參閱:Oracle AI Database Reference,瞭解 ALL_INDEXES
逆向索引鍵索引
逆向索引鍵索引是一種 B-tree 索引,它會實際反轉每個索引索引鍵的位元組,同時保持資料欄順序。
例如,如果索引索引鍵是 20,而以十六進位儲存此索引鍵的兩個位元組在標準 B-tree 索引中為 C1,15,則反向索引鍵索引會將位元組儲存為 15,C1。
逆轉索引鍵可解決 B-tree 索引右側分支終端區塊的競爭問題。在 Oracle Real Application Clusters (Oracle RAC) 資料庫中,這個問題尤其嚴重,因為多個執行處理會重複修改相同的區塊。例如,在 orders 表格中,訂單的主索引鍵是連續的。叢集中的一個執行處理會新增順序 20,而另一個執行處理則新增 21,每個執行處理會將其金鑰寫入索引右邊的相同分支終端區塊。
在反向索引鍵索引中,反轉位元組順序會將插入分散到索引中的所有分支索引鍵。例如,標準金鑰索引中相鄰的金鑰 (例如 20 和 21) 現在會儲存在個別的區塊中。因此,順序關鍵碼插入的 I/O 更會平均分配。
由於索引中的資料在儲存時不是依資料欄索引鍵排序,因此反向索引鍵安排在某些情況下無法執行索引範圍掃描查詢。例如,如果使用者發出大於 20 之訂單 ID 的查詢,則資料庫無法從包含此 ID 的區塊開始,並透過分葉區塊進行水平處理。
遞增及遞減指數
在遞增索引中,Oracle AI Database 會以遞增順序儲存資料。依照預設,字元資料會依值每個位元組中所含的二進位值、從最小到最大數字的數值資料,以及從最早到最新值的日期來排序。
如需遞增索引的範例,請考慮下列 SQL 敘述句:
CREATE INDEX emp_deptid_ix ON hr.employees(department_id);Oracle AI Database 會排序 department_id 資料欄上的 hr.employees 表格。它會以 department_id 載入遞增索引,並以遞增順序載入對應的 rowid 值,從 0 開始。當它使用索引時,Oracle AI Database 會搜尋已排序的 department_id 值,並使用相關聯的資料列 ID 來尋找具有要求之 department_id 值的資料列。
在 CREATE INDEX 陳述式中指定 DESC 關鍵字,即可建立遞減索引。在此情況下,索引會以遞減順序儲存指定欄或欄上的資料。如果 employees.department_id 資料欄上表格 5-3 中的索引是遞減的,則包含 250 的分支終端封鎖會位於樹狀結構的左側,並在右側使用 0 的區塊。透過遞減索引進行的預設搜尋是從最高到最低的值。
當查詢以遞增方式排序部分資料欄,而其他以遞減方式排序時,遞減索引相當有用。例如,假設您在 last_name 和 department_id 資料欄上建立複合索引,如下所示:
CREATE INDEX emp_name_dpt_ix ON hr.employees(last_name ASC, department_id DESC);如果使用者以遞增順序 (A 到 Z) 查詢姓氏的 hr.employees,並以遞減順序 (從高到低) 查詢部門 ID,則資料庫可以使用此索引來擷取資料,並避免進行額外的排序步驟。
另請參閱:
-
Oracle AI Database SQL Tuning Guide,瞭解有關索引搜尋的遞增和遞減資訊
-
Oracle AI Database SQL Language Reference,瞭解
CREATE INDEX的ASC和DESC選項的說明
索引壓縮
為了減少索引空間,Oracle AI Database 可以採用不同的壓縮演算法。
-
前置碼壓縮:Oracle AI Database 可以使用前置碼壓縮 (亦稱為索引鍵壓縮 ) 來壓縮 B-tree 索引或索引組織表格中主索引鍵資料欄值的部分。前置碼壓縮可大幅減少索引使用的空間。
-
進階索引壓縮從 Oracle Database 12c 版本 1 (12.1.0.2) 開始,針對堆集組織表格上的支援索引,進階索引壓縮可改善傳統前置碼壓縮。
前置碼壓縮
Oracle AI Database 可以使用前置碼壓縮 (亦稱為索引鍵壓縮 ),以壓縮 B-tree 索引或索引組織表格中主索引鍵資料欄值的部分。前置碼壓縮可大幅減少索引使用的空間。
未壓縮的索引項目有一個片段。使用字首壓縮的索引項目有兩個片段:一個字首項目 (即分組片段) 和一個字尾項目 (即唯一或幾乎唯一的片段)。資料庫會在索引區塊中的字尾項目之間共用字首項目,以達到壓縮的目的。注意:如果未將索引鍵定義為具有唯一片段,則資料庫會附加資料列 ID 至群組片段來提供該索引鍵。
依照預設,唯一索引的前置碼會包含所有索引鍵資料欄 (不包括最後一個資料欄),而非唯一索引的前置碼則由所有索引鍵資料欄組成。假設您在 oe.orders 表格的兩個資料欄上建立複合的唯一索引,如下所示:
CREATE UNIQUE INDEX orders_mod_stat_ix ON orders ( order_mode, order_status );在前面的範例中,索引索引鍵可能是 online,0。列 ID 儲存在項目的關鍵資料部分,且不是關鍵碼本身的一部分。
注意:如果您在單一資料欄上建立唯一的索引,則 Oracle AI Database 無法使用前置碼索引鍵壓縮,因為沒有通用前置碼。
或者,假設您在相同的資料欄上建立非唯一的索引:
CREATE INDEX orders_mod_stat_ix ON orders ( order_mode, order_status );同時假設重複的值發生在 order_mode 和 order_status 資料欄中。索引區塊可以具有項目,如下列範例所示:
online,0,AAAPvCAAFAAAAFaAAa
online,0,AAAPvCAAFAAAAFaAAg
online,0,AAAPvCAAFAAAAFaAAl
online,2,AAAPvCAAFAAAAFaAAm
online,3,AAAPvCAAFAAAAFaAAq
online,3,AAAPvCAAFAAAAFaAAt
在前面的範例中,索引鍵前置碼會包含 order_mode 和 order_status 值的串連,如 online,0 中所示。字尾由列 ID 組成,如 AAAPvCAAFAAAAFaAAa。資料列 ID 會使整個索引項目成為唯一項目,因為資料列 ID 在資料庫中是唯一的。
如果先前範例中的索引是以預設前置碼壓縮 (由 COMPRESS 關鍵字指定) 建立,則會壓縮重複的關鍵字前置碼,例如 online、0 和 online,3。在概念上,資料庫按下列方式實現壓縮:
online,0
AAAPvCAAFAAAAFaAAa
AAAPvCAAFAAAAFaAAg
AAAPvCAAFAAAAFaAAl
online,2
AAAPvCAAFAAAAFaAAm
online,3
AAAPvCAAFAAAAFaAAq
AAAPvCAAFAAAAFaAAt
字尾項目 (資料列 ID) 構成索引資料列的壓縮版本。每個字尾項目都會參照一個字首項目,該項目與字尾儲存在相同的索引區塊中。
或者,您也可以在建立使用前置碼壓縮的索引時指定前置碼長度。例如,如果您指定 COMPRESS 1,則字首會是 order_mode,字尾會是 order_status,rowid。對於索引區塊範例中的值,索引會使前置碼 online 出現重複項目,其概念上可以如下所示:
online
0,AAAPvCAAFAAAAFaAAa
0,AAAPvCAAFAAAAFaAAg
0,AAAPvCAAFAAAAFaAAl
2,AAAPvCAAFAAAAFaAAm
3,AAAPvCAAFAAAAFaAAq
3,AAAPvCAAFAAAAFaAAt
索引每一個分支終端區塊最多可儲存一次特定的前置碼。只有 B-tree 索引之分支終端區塊中的金鑰會被壓縮。在分支區塊中,索引鍵尾碼可被截斷,但不會壓縮索引鍵。
另請參閱:
-
Oracle AI Database Administrator's Guide,瞭解如何使用壓縮的索引
-
Oracle AI Database VLDB and Partitioning Guide,瞭解如何對分割的索引使用前置碼壓縮
-
Oracle AI Database SQL Language Reference,瞭解
CREATE INDEXkey_compression 子句的說明
進階索引壓縮
從 Oracle Database 12c 版本 1 (12.1.0.2) 開始,進階索引壓縮可針對堆集組織表格上的支援索引改善傳統前置碼壓縮。
進階索引壓縮的優點
前置碼壓縮對支援的索引類型、壓縮率及易用性有限制。與前置碼壓縮不同 (針對每個區塊使用固定的重複金鑰排除),進階索引壓縮則會以每個區塊為基礎使用調適性重複金鑰排除。進階索引壓縮的主要優點如下:
-
資料庫會使用許多內部演算法 (例如資料欄內層次前置碼、去除重複的索引鍵,以及 rowid 壓縮),自動選擇每個區塊的最佳壓縮。與前置碼壓縮不同,進階索引壓縮不需要使用者知道資料特性。
-
進階壓縮可在非唯一的與唯一索引上使用。前置碼壓縮適用於某些非唯一索引,但前導資料欄不多重複的索引比例較低。
-
壓縮的索引可使用與未壓縮索引相同的方式。索引支援相同的存取路徑:唯一索引鍵查詢、範圍掃描,以及快速完整掃描。
-
索引可以從父項表格或包含表格空間的進階壓縮。
-
索引組織表格與函數式索引支援進階索引壓縮。索引組織表格支援低壓縮。函數式索引支援低壓縮和高壓縮。
進階索引壓縮的運作方式
進階索引壓縮在區塊層次運作,以便為每個區塊提供最佳壓縮。資料庫會使用下列技術:
-
在建立索引期間,分支終端區塊已滿,資料庫會自動將區塊壓縮成最佳層次。
-
當因 DML 而重組索引區塊時,如果資料庫可以為內送索引項目建立足夠的空間,則不會分割區塊。不過,在沒有進階索引壓縮的 DML 期間,區塊填滿時,一律會分割索引區塊。
進階索引壓縮 (高)
在 Oracle Database 12c 版本 2 (12.2) 之前的版本中,唯一形式的進階索引壓縮是低壓縮 (COMPRESS ADVANCED LOW)。現在您也可以指定高壓縮 (COMPRESS ADVANCED HIGH),這是預設值。使用 HIGH 選項的進階索引壓縮提供下列優點:
-
在大多數情況下提供更高的壓縮率,同時也提升存取索引之查詢的效能
-
使用比進階低程式碼更複雜的壓縮演算法
-
將資料儲存在壓縮單位中,這是特殊的磁碟格式注意:套用
HIGH壓縮時,所有區塊都會有壓縮。當您套用LOW壓縮時,資料庫可能會讓某些區塊保持未壓縮。您可以使用統計資料來判斷有多少區塊未壓縮。
範例 5-5 使用進階高壓縮建立索引
此範例為 hr.employees 表格上的索引啟用進階索引壓縮:
CREATE INDEX hr.emp_mndp_ix
  ON hr.employees(manager_id, department_id)
  COMPRESS ADVANCED;
下列查詢顯示壓縮類型:
SELECT COMPRESSION FROM DBA_INDEXES WHERE INDEX_NAME ='EMP_MNDP_IX';

COMPRESSION
-------------
ADVANCED HIGH
另請參閱:
-
Oracle AI Database Administrator's Guide,瞭解如何啟用進階索引壓縮
-
Oracle AI Database SQL Language Reference,瞭解
CREATE INDEXkey_compression 子句的說明 -
Oracle AI Database Reference,瞭解
ALL_INDEXES
點陣圖索引總覽
在點陣圖索引中,資料庫會儲存每個索引索引鍵的點陣圖。在傳統的 B-tree 索引中,一個索引項目指向單一資料列。在位元映射索引中,每個索引索引鍵都會將指標儲存到多個資料列。
位元映射索引主要是針對資料倉儲或查詢以特別方式參照許多資料欄的環境所設計。可能會呼叫點陣圖索引的情況包括:
-
編製索引的資料欄具有較低的基數,亦即相較於表格資料列數目,相異值的數目較小。
-
已編製索引的表格為唯讀,或不受 DML 敘述句重大修改。
對於資料倉儲範例,sh.customers 表格有一個只有兩個可能值的 cust_gender 資料欄:M 和 F。假設查詢特定性別的客戶數很常見。在此情況下,customers.cust_gender 資料欄會是點陣圖索引的候選項目。
位元映射中的每個位元都對應至可能的列 ID。如果設定位元,則具有對應列 ID 的列會包含關鍵碼值。對應函數會將位元位置轉換成實際的 rowid,因此位元映射索引提供與 B-tree 索引相同的功能,雖然它使用不同的內部表示法。
如果更新單一資料列中已編製索引的資料欄,則資料庫會鎖定索引索引鍵項目 (例如,M 或 F),而不是對應至已更新資料列的個別位元。因為索引鍵指向許多資料列,所以已編製索引之資料的 DML 通常會鎖定這些資料列。因此,許多 OLTP 應用程式都不適用位元映射索引。
-
範例:單一表格上的點陣圖索引在此範例中,
sh.customers表格的某些資料欄是點陣圖索引的候選項目。 -
位元映射結合索引:位元映射結合索引是兩個或更多表格之結合的位元映射索引。
-
點陣圖儲存結構 Oracle AI Database 使用 B-tree 索引結構來儲存每個已編製索引金鑰的位元映射。
另請參閱:
-
Oracle AI Database SQL Tuning Guide,深入瞭解位元映射索引
-
Oracle AI Database Data Warehousing Guide,瞭解如何在資料倉儲中使用位元映射索引
範例:單一表格的點陣圖索引
在此範例中,sh.customers 表格的某些資料欄是位元映射索引的候選項目。
請考慮下列查詢:
SQL> SELECT cust_id, cust_last_name, cust_marital_status, cust_gender
  2  FROM   sh.customers
  3  WHERE  ROWNUM < 8 ORDER BY cust_id;

   CUST_ID CUST_LAST_ CUST_MAR C
---------- ---------- -------- -
         1 Kessel              M
         2 Koch                F
         3 Emmerson            M
         4 Hardy               M
         5 Gowen               M
         6 Charles    single   F
         7 Ingram     single   F

7 rows selected.
cust_marital_status 和 cust_gender 資料欄的基數很低,而 cust_id 和 cust_last_name 則不是。因此,位元映射索引可能適用於 cust_marital_status 和 cust_gender。位元映射索引對於其他資料欄可能無效。相反地,這些資料欄上的唯一 B-tree 索引可能會提供最有效率的表示和擷取。表格 5-4 說明先前範例中所顯示之 cust_gender 資料欄輸出的位元映射索引。它包含兩個不同的位元映射,每個性別各一個。
表格 4 一個資料欄的範例點陣圖
| 值 | 列 1 | 列 2 | 列 3 | 第 4 列 | 第 5 列 | 列 6 | 第 7 列 |
|---|---|---|---|---|---|---|---|
M |
1 | 0 | 1 | 1 | 1 | 0 | 0 |
F |
0 | 1 | 0 | 0 | 0 | 1 | 1 |
對應函數會將位元映射中的每個位元轉換成 customers 表格的資料列 ID。每個位元值取決於表格中對應資料列的值。例如,M 值的點陣圖包含 1 作為其第一個位元,因為性別是 customers 表格第一列中的 M。位元映射 cust_gender='M' 在資料列 2、6 及 7 中具有位元的 0,因為這些資料列不包含 M 作為其值。
注意:位元映射索引可以包含完全由空值組成的索引鍵,與 B-tree 索引不同。對某些 SQL 敘述句 (例如具有聚總函數 COUNT 的查詢) 來說,編製空值索引很有用。
調查客戶人口統計趨勢的分析師可能會問:「我們有多少女性客戶是單身或離婚?」此問題對應至下列 SQL 查詢:
SELECT COUNT(*)
FROM   customers
WHERE  cust_gender = 'F'
AND    cust_marital_status IN ('single', 'divorced');
位元映射索引可以藉由計算產生之位元映射中的 1 值數目,有效率地處理此查詢,如表格 5-5 所示。為了識別符合準則的客戶,Oracle AI Database 可以使用產生的點陣圖來存取表格。
表格 5 兩個資料欄的範例點陣圖
| 值 | 列 1 | 列 2 | 列 3 | 第 4 列 | 第 5 列 | 列 6 | 第 7 列 |
|---|---|---|---|---|---|---|---|
M |
1 | 0 | 1 | 1 | 1 | 0 | 0 |
F |
0 | 1 | 0 | 0 | 0 | 1 | 1 |
single |
0 | 0 | 0 | 0 | 0 | 1 | 1 |
divorced |
0 | 0 | 0 | 0 | 0 | 0 | 0 |
single 或 divorced 和 F |
0 | 0 | 0 | 0 | 0 | 1 | 1 |
位元映射編製索引可有效率地合併與 WHERE 子句中數個條件對應的索引。滿足部分 (但非全部) 條件的資料列會在存取表格本身之前篩除。此技術通常會大幅縮短回應時間。
位元映射結合索引
位元映射結合索引是兩個或兩個以上之表格之結合的位元映射索引。
對於表格資料欄中的每個值,索引會將對應資料列的資料列 ID 儲存在索引表格中。相較之下,會在單一表格上建立標準位元映射索引。
位元映射結合索引是一種有效方法,可以透過事先執行限制來減少必須結合的資料量。例如,當位元映射結合索引很有用時,假設使用者經常查詢具有特定工作類型的員工人數。一般查詢的外觀如下:
SELECT COUNT(*)
FROM   employees, jobs
WHERE  employees.job_id = jobs.job_id
AND    jobs.job_title = 'Accountant';
上述查詢通常會使用 jobs.job_title 上的索引來擷取 Accountant 的資料列、工作 ID,以及 employees.job_id 上的索引來尋找相符的資料列。若要從索引本身擷取資料,而不是從表格掃描擷取資料,您可以建立位元映射結合索引,如下所示:
CREATE BITMAP INDEX employees_bm_idx
ON     employees (jobs.job_title)
FROM   employees, jobs
WHERE  employees.job_id = jobs.job_id;
如下圖所示,索引索引鍵為 jobs.job_title,索引表格為 employees。
圖 2:點陣圖結合索引
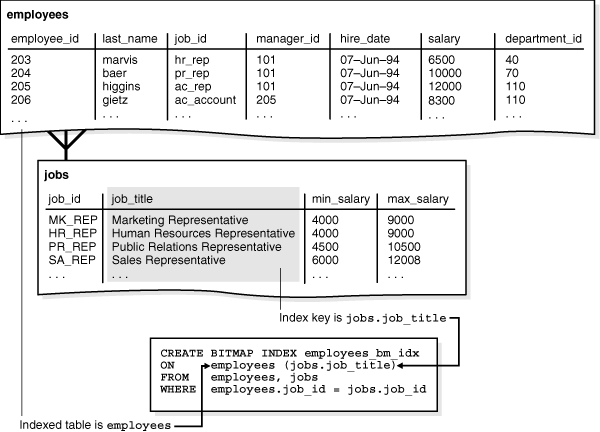
在概念上,employees_bm_idx 是下列查詢中顯示之 SQL 查詢中 jobs.title 資料欄的索引 (包括範例輸出)。索引中的 job_title 索引鍵指向 employees 表格中的資料列。會計師數的查詢可以使用索引來避免存取 employees 和 jobs 表格,因為索引本身包含要求的資訊。
SELECT jobs.job_title AS "jobs.job_title", employees.rowid AS "employees.rowid"
FROM   employees, jobs
WHERE  employees.job_id = jobs.job_id
ORDER BY job_title;

jobs.job_title                      employees.rowid
----------------------------------- ------------------
Accountant                          AAAQNKAAFAAAABSAAL
Accountant                          AAAQNKAAFAAAABSAAN
Accountant                          AAAQNKAAFAAAABSAAM
Accountant                          AAAQNKAAFAAAABSAAJ
Accountant                          AAAQNKAAFAAAABSAAK
Accounting Manager                  AAAQNKAAFAAAABTAAH
Administration Assistant            AAAQNKAAFAAAABTAAC
Administration Vice President       AAAQNKAAFAAAABSAAC
Administration Vice President       AAAQNKAAFAAAABSAAB
.
.
.在資料倉儲中,結合條件是維度表格主索引鍵資料欄與事實表格中外來索引鍵資料欄之間的等式 (使用等式運算子)。相較於具體化結合視觀表,儲存體中的位元映射結合索引有時會比具體化結合視觀表更有效率,這是預先具體化結合的替代方法。
另請參閱:Oracle AI Database Data Warehousing Guide,瞭解有關位元映射結合索引的詳細資訊
點陣圖儲存結構
Oracle AI Database 使用 B-tree 索引結構來儲存每個已編製索引之金鑰的位元映射。
例如,如果 jobs.job_title 是位元映射索引的索引鍵資料欄,則一個 B-tree 會儲存索引資料。分葉區塊儲存個別位元映射。
範例 5-6 點陣圖儲存範例
假設 jobs.job_title 資料欄具有唯一值 Shipping Clerk、Stock Clerk 及其他數個值。此索引的位元映射索引項目具有下列元件:
-
作為索引鍵的職稱
-
一段資料列識別碼範圍的低資料列識別碼與高資料列識別碼
-
範圍中特定資料列 ID 的位元映射
在概念上,此索引中的索引分支終端區塊可能包含以下項目:
Shipping Clerk,AAAPzRAAFAAAABSABQ,AAAPzRAAFAAAABSABZ,0010000100
Shipping Clerk,AAAPzRAAFAAAABSABa,AAAPzRAAFAAAABSABh,010010
Stock Clerk,AAAPzRAAFAAAABSAAa,AAAPzRAAFAAAABSAAc,1001001100
Stock Clerk,AAAPzRAAFAAAABSAAd,AAAPzRAAFAAAABSAAt,0101001001
Stock Clerk,AAAPzRAAFAAAABSAAu,AAAPzRAAFAAAABSABz,100001
.
.
.
相同的職稱會出現在多個項目中,因為列 ID 範圍不同。
階段作業會將一個員工的工作 ID 從 Shipping Clerk 更新為 Stock Clerk。在此情況下,階段作業需要對舊值 (Shipping Clerk) 和新值 (Stock Clerk) 的索引索引鍵項目進行獨佔存取。Oracle AI Database 會鎖定這兩個項目所指向的資料列,但在 UPDATE 確認之前,不會鎖定 Accountant 或任何其他索引鍵所指向的資料列。
位元映射索引的資料會儲存在一個區段中。Oracle AI Database 將每個點陣圖儲存在一或多個部分中。每個片段都屬於單一資料區塊的一部分。
另請參閱:「使用者區隔」說明不同類型的區隔,以及如何建立區隔
以函數為基礎的索引總覽
函數式索引會計算涉及一或多個資料欄的函數或表示式值,並將它儲存在索引中。函數型索引可以是 B-tree 或位元映射索引。
索引函數可以是算術表示式,或是包含 SQL 函數、使用者定義的 PL/SQL 函數、套裝程式函數或 C 註標的表示式。例如,函數可以在兩個資料欄中新增值。
-
以函數為基礎的索引使用以函數為基礎的索引有效評估其
WHERE子句中包含函數的敘述句。當查詢中包含函數時,資料庫只會使用以函數為基礎的索引。不過,當資料庫處理INSERT和UPDATE陳述式時,它仍必須評估函數以處理陳述式。 -
使用以函數為基礎的索引最佳化:對於在
WHERE子句中使用表示式的查詢,最佳化處理程式可能會在以函數為基礎的索引使用索引範圍掃描。
另請參閱:
-
Oracle AI Database Administrator's Guide,瞭解如何建立以函數為基礎的索引
-
Oracle AI Database Development Guide,瞭解有關使用函數型索引的詳細資訊
-
Oracle AI Database SQL Language Reference,瞭解函數型索引的限制和使用注意事項
以函數為基礎的索引使用
以函數為基礎的索引適用於評估其 WHERE 子句中包含函數的敘述句。當查詢中包含函數時,資料庫只會使用以函數為基礎的索引。不過,當資料庫處理 INSERT 和 UPDATE 陳述式時,它仍必須評估函數以處理陳述式。
範例 5-7 以算術表示式為基礎的索引
例如,假設您建立下列以函數為基礎的索引:
CREATE INDEX emp_total_sal_idx
  ON employees (12 * salary * commission_pct, salary, commission_pct);
當處理下列查詢時,資料庫可以使用先前的索引 (包括部分範例輸出):
SELECT   employee_id, last_name, first_name,
         12*salary*commission_pct AS "ANNUAL SAL"
FROM     employees
WHERE    (12 * salary * commission_pct) < 30000
ORDER BY "ANNUAL SAL" DESC;

EMPLOYEE_ID LAST_NAME                 FIRST_NAME           ANNUAL SAL
----------- ------------------------- -------------------- ----------
        159 Smith                     Lindsey                   28800
        151 Bernstein                 David                     28500
        152 Hall                      Peter                     27000
        160 Doran                     Louise                    27000
        175 Hutton                    Alyssa                    26400
        149 Zlotkey                   Eleni                     25200
        169 Bloom                     Harrison                  24000
以 UPPER 函數為基礎的範例 5-8 索引
在 SQL 函數 UPPER(column_name) 或 LOWER(column_name) 上定義的以函數為基礎的索引有助於不區分大小寫的搜尋。例如,假設 employees 中的 first_name 資料欄包含混合大小寫字元。您可以在 hr.employees 表格上建立下列以函數為基礎的索引:
CREATE INDEX emp_fname_uppercase_idx
ON employees ( UPPER(first_name) );
emp_fname_uppercase_idx 索引可以協助查詢,如下所示:
SELECT *
FROM   employees
WHERE  UPPER(first_name) = 'AUDREY';
範例 5-9 編製表格中特定資料列的索引
對於僅編製表格中特定資料列的索引,函數型索引也非常有用。例如,sh.customers 表格中 cust_valid 資料欄的值為 I 或 A。若要僅編製 A 資料列的索引,您可以撰寫函數,為 A 資料列以外的任何資料列傳回空值。您可以依照以下方式建立索引:
CREATE INDEX cust_valid_idx
ON customers ( CASE cust_valid WHEN 'A' THEN 'A' END );
另請參閱:
-
Oracle AI Database Globalization Support Guide,瞭解語言索引的相關資訊
-
Oracle AI Database SQL Language Reference,瞭解 SQL 函數的詳細資訊
使用以函數為基礎的索引進行最佳化
對於在 WHERE 子句中含有表示式的查詢,最佳化處理程式可能會在函數型索引上使用索引範圍掃描。
範圍掃描存取路徑在述詞具有高度選擇性時 (亦即當選擇相對較少的資料列時) 特別有用。在範例 5-7 中,如果索引是建立在表示式 12*salary*commission_pct 上,則最佳化處理程式可以使用索引範圍掃描。
虛擬資料欄也有助於加速存取從表示式衍生的資料。例如,您可以將虛擬資料欄 annual_sal 定義為 12*salary*commission_pct,並在 annual_sal 上建立以函數為基礎的索引。
最佳化處理程式會先剖析 SQL 敘述句中的表示式,然後比較敘述句的表示式樹狀結構以及函數式索引,來執行表示式比對。此比較不區分大小寫,會忽略空白。
不同的查詢可能會使用不同類型的索引掃描。
另請參閱:
-
Oracle AI Database SQL Tuning Guide,深入瞭解如何收集統計資料
-
Oracle AI Database Administrator's Guide,瞭解如何將虛擬資料欄新增至表格
應用程式網域索引總覽
應用程式網域索引是應用程式特定的自訂索引。
廣泛的索引可以:
-
可容納自訂、複雜資料類型的索引,例如文件、空間資料、影像和視訊片段 (請參閱)
-
利用專門的索引技術
您可以將應用程式特定的索引管理常式封裝為索引類型綱要物件,然後在表格資料欄或物件類型的屬性上定義網域索引。可擴充的索引功能可以有效率地處理應用程式特定的運算子。
應用程式軟體 (稱為磁帶匣 ) 可控制網域索引的結構和內容。資料庫會與應用程式互動,以建立、維護和搜尋網域索引。索引結構本身可以用索引組織的表格方式儲存在資料庫中,也可以用外部的方式儲存在資料庫中。
另請參閱:
-
Oracle AI Database 開發指南,深入瞭解複雜資料類型
-
Oracle AI Database Data Cartridge Developer's Guide,瞭解有關在 Oracle AI Database 擴充性架構中使用資料卡匣的資訊
定量量化 HNSW 索引總覽
定量量化階層式可瀏覽小型世界 (HNSW) 索引可用於降低記憶體需求,並加速相似性搜尋。
在向量資料庫的脈絡中,純量量化是一種透過獨立量化向量的每個尺寸 (或純量元件) 來壓縮或近似高維資料向量的方法。此方法用於降低向量資料庫的儲存需求,同時保留相似性搜尋等任務資料的基本結構。當簡單性和低儲存需求很高時,定量量化會特別有用。
儲存為浮點數的高維度向量需要大量的儲存空間。純量量化透過壓縮向量來節省記憶體。例如,每個維度以 8 位元 (INT8) 儲存的 128 維度向量只需要 128 個位元組的記憶體,而 32 位元浮點儲存 (Float32) 則需要 512 個位元組,而 64 位元的雙倍儲存 (Float64) 則需要 1024 個位元組。由於如此降低的儲存需求,定量量化可讓向量資料庫處理非常大型的資料集,包括甚至數十億個向量,否則會因為儲存限制而變得不切實際。
定量量化另一項優點可提高搜尋速度。近似鄰近 (ANN) 的搜尋方法可以利用量化資料來加快比較速度,因為整數或二進位程式碼的作業比浮點運算快。
在 Oracle AI Database 中,統一定量量化是實施的壓縮方法,也就是將輸入範圍劃分為等大小間隔。每個間隔都以單一量化層次表示,通常是它的中點。每個維度的範圍分為 2b 等等的間隔,其中 b 是位元數 (例如,int8 的 8 位元)。每個浮點值都會對應至最接近的量化層次。
另請參閱:
-
Oracle AI Database AI Vector Search User's Guide,瞭解 HNSW 索引語法和參數
-
CREATE VECTOR INDEX敘述句的 Oracle AI Database SQL Language Reference
索引組織表格總覽
索引組織表格是儲存在 B-tree 索引結構變化的表格。相反地,堆集組織表格會插入符合的資料列。
在索引組織的表格中,資料列會儲存在表格主索引鍵上定義的索引中。B-tree 中的每個索引項目也會儲存非索引鍵資料欄值。因此,索引為資料,而資料為索引。應用程式會使用 SQL 敘述句來處理索引組織表格,就像堆集組織表格一樣。
對於索引組織表格的類比,假設人力資源經理有一個紙箱的書本案例。每個方塊的標籤均為數字 1、2、3、4,依此類推,但方塊不會依序位於貨架上。相反地,每個方塊都包含一個指向順序中下一個方塊之貨架位置的指標。
包含員工記錄的資料夾會儲存在每個方塊中。資料夾會依員工 ID 排序。員工王擁有 ID 100,這是最低的 ID,因此其資料夾位於方塊 1 的底部。員工 101 的資料夾位於 100 上方,102 位於 101 上方,依此類推,直到方塊 1 已滿為止。序列中的下一個資料夾位於方塊 2 的底端。
在此類比中,依員工 ID 排序資料夾,不需維護個別的索引即可有效率地搜尋資料夾。假設使用者要求員工 107、120 與 122 的記錄。管理者不需在單一步驟中搜尋索引並在個別步驟中擷取資料夾,而是可以依序搜尋資料夾,並擷取找到的每個資料夾。
索引組織表格會依主索引鍵或金鑰的有效前置碼,快速存取表格資料列。分葉區塊中有資料列的非索引鍵資料欄,可避免產生額外的資料區塊 I/O。例如,員工 100 的薪資都儲存在索引資料列本身。此外,因為列是以主索引鍵順序儲存,所以主索引鍵或前置碼的範圍存取牽涉到最小的區塊 I/O。另一個優點是避免個別主索引鍵索引的空間負荷。
當相關資料片段必須一起儲存,或資料必須以特定順序實體儲存時,索引組織表格就很有用。此類型表格的一般用途是供資訊擷取、空間資料以及 OLAP 應用程式使用。
-
索引組織表格特性:資料庫系統會透過操控 B-tree 索引結構,在索引組織表格上執行所有作業。
-
具有資料列溢位區域的索引組織表格:建立索引組織表格時,您可以指定個別區段作為資料列溢位區域。
-
索引組織表格的次要索引:次要索引是索引組織表格的索引。
另請參閱:
-
Oracle Spatial Developer's Guide,瞭解 Oracle Spatial and Graph 的簡介
-
Oracle AI Database Administrator's Guide,瞭解如何管理索引組織表格
-
Oracle AI Database SQL Language Reference,瞭解
CREATE TABLE ... ORGANIZATION INDEX的語法和語意
索引組織表格特性
資料庫系統會透過操控 B-tree 索引結構,在索引組織表格上執行所有作業。
下表摘要列出索引組織表格與堆集組織表格之間的差異。
表格 6 與索引組織表格之堆集組織表格的比較
| 堆集組織表格 | 索引組織表格 |
|---|---|
| 資料列 ID 可唯一識別資料列。您可以選擇性地定義主索引鍵限制條件。 | 主鍵可唯一識別資料列。必須定義主索引鍵限制條件。 |
ROWID 虛擬資料欄中的實體 rowid 可建立次要索引。 |
ROWID 虛擬資料欄中的邏輯 rowid 可建立次要索引。 |
| 個別列可以由列 ID 直接存取。 | 可透過主索引鍵間接存取個別資料列。 |
| 循序完整表格掃描會以某種順序傳回所有資料列。 | 完整索引掃描或快速完整索引掃描會以某種順序傳回所有資料列。 |
| 可與其他表格一起儲存在表格叢集中。 | 無法儲存在表格叢集中。 |
可以包含 LONG 資料類型的資料欄,以及 LOB 資料類型的資料欄。 |
可以包含 LOB 資料欄,但不能包含 LONG 資料欄。 |
| 可以包含虛擬資料欄 (僅支援關聯式堆集表格)。 | 不能包含虛擬資料欄。 |
將 COMPRESS ADVANCED LOW 子句新增至 CREATE TABLE 敘述句,即可使用「進階低」壓縮來壓縮「索引組織表格」。「進階低壓縮」是一種調適型前置碼壓縮形式,可自動計算每個葉區塊的最佳前置碼資料欄數目,進而讓區塊層次的壓縮達到最佳狀態,無須使用者介入。這包括完全無法壓縮的可能性 (如果適用的話)。這可以保證不會進行負面的壓縮。觀察到較大的壓縮率,整體的負荷極低。
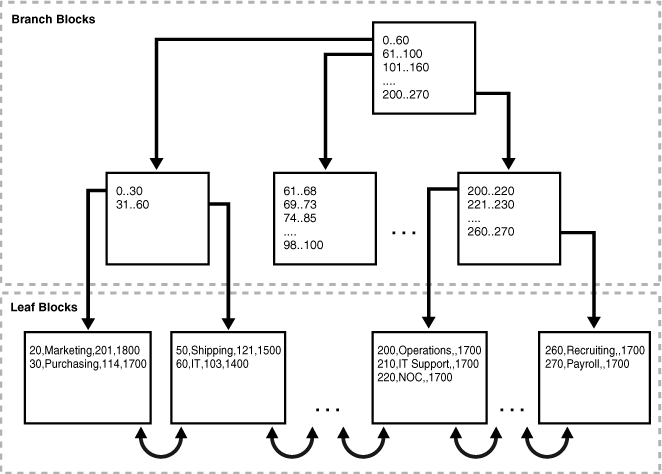
索引組織表格上的掃描可能會卸載至「Exadata 智慧型掃描」,最佳化處理程式會將查詢視為可快速完整掃描執行。這並不需要使用者介入。所有相關資料欄都位於分葉區塊的索引組織表格分葉區塊上,將支援完整儲存格端處理。如果部分資料欄位於溢位區段中,智慧型掃描將不會處理這類資料欄,而資料庫將會完成掃描。圖 5-3 說明索引組織之 departments 表格的結構。分葉區塊包含表格的資料列,依主索引鍵排序。例如,第一個分葉區塊中的第一個值顯示 20 的部門 ID、Marketing 的部門名稱、201 的經理人員 ID,以及 1800 的地點 ID。
圖 3:索引組織表格
範例 5-10 索引組織表格掃描
索引組織的表格會以相同的結構儲存所有資料,因此不需要儲存 rowid。如圖 5-3 所示,索引組織表格中的分支終端區塊 1 可能包含下列項目,依主索引鍵排序:
20,Marketing,201,1800
30,Purchasing,114,1700
索引組織表格中的分葉區塊 2 可能包含以下項目:
50,Shipping,121,1500
60,IT,103,1400
按主索引鍵順序掃描索引組織表格資料列,會依下列順序讀取區塊:
-
區塊 1
-
區塊 2
範例 5-11 堆集組織表格掃描
若要對照堆集組織表格中的資料存取與索引組織表格,假設堆集組織之 departments 表格區段的區塊 1 包含下列資料列:
50,Shipping,121,1500
20,Marketing,201,1800
區塊 2 包含與下列相同表格相同的資料列:
30,Purchasing,114,1700
60,IT,103,1400
此堆集組織表格的 B-tree 索引分支終端區塊包含下列項目,其中第一個值是主索引鍵,第二個是 rowid:
20,AAAPeXAAFAAAAAyAAD
30,AAAPeXAAFAAAAAyAAA
50,AAAPeXAAFAAAAAyAAC
60,AAAPeXAAFAAAAAyAAB
按主索引鍵順序掃描表格資料列時,會依下列順序讀取表格區段區塊:
-
區塊 1
-
區塊 2
-
區塊 1
-
區塊 2
因此,這個範例中的區塊 I/O 數目會倍增索引組織範例中的數字。
具有資料列溢位區域的索引組織表格
建立索引組織表格時,您可以將個別區段指定為資料列溢位區域。
在索引組織表格中,B-tree 索引項目可能會很大,因為它們包含整個資料列,所以個別的區段可以包含項目。相反地,B-tree 項目通常較小,因為它們是由索引鍵與 rowid 所組成。
如果指定資料列溢位區域,資料庫就可以將索引組織表格中的資料列劃分為下列幾個部分:
-
索引項目
此部分包含所有主索引鍵資料欄的資料欄值、指向資料列溢位部分的實體資料列 ID,以及部分非索引鍵資料欄 (選擇性)。此部分儲存在索引區段中。
-
溢位部分
此部分包含其餘非索引鍵資料欄的資料欄值。此部分儲存在溢位儲存區域區段中。
另請參閱:
-
Oracle AI Database Administrator's Guide,瞭解如何使用
CREATE TABLE的OVERFLOW子句來設定資料列溢位區域 -
Oracle AI Database SQL Language Reference,瞭解
CREATE TABLE ... OVERFLOW的語法和語意
索引組織表格的次要索引
次要索引是索引組織表格中的索引。
有意義的是,次要索引是索引上的索引。它是獨立的綱要物件,並且與索引組織的表格分開儲存。
Oracle AI Database 針對索引組織表格使用稱為邏輯列 ID 的列 ID。邏輯 rowid 是以 base64 編碼表示的表格主索引鍵。邏輯列 ID 長度取決於主索引鍵長度。
由於插入,索引葉區塊中的資料列可以在區塊內外移動,或在區塊之間移動。索引組織表格中的資料列不會隨著堆集組織的資料列進行移轉。因為索引組織表格中的資料列沒有永久實體位址,所以資料庫會使用以主索引鍵為基礎的邏輯資料列 ID。
例如,假設 departments 表格是由索引組織而成。location_id 資料欄儲存每個部門的 ID。表格會以下列方式儲存資料列,最後一個值作為地點 ID:
10,Administration,200,1700
20,Marketing,201,1800
30,Purchasing,114,1700
40,Human Resources,203,2400
location_id 資料欄上的次要索引可能會有下列索引項目,其中逗號之後的值為邏輯資料列 ID:
1700,*BAFAJqoCwR/+
1700,*BAFAJqoCwQv+
1800,*BAFAJqoCwRX+
2400,*BAFAJqoCwSn+
次要索引使用不是主索引鍵或主索引鍵前置碼的資料欄,可快速且有效率地存取索引組織表格。例如,查詢 ID 大於 1700 的部門名稱時,可以使用次要索引來加速資料存取。
-
邏輯列 ID 和實體猜測次要索引使用邏輯列 ID 尋找表格列。
-
索引組織表格上的位元映射索引:索引組織表格上的次要索引可以是位元映射索引。位元映射索引會為每個索引索引鍵儲存位元映射。
另請參閱:
-
「 Rowid 資料類型」可進一步瞭解資料列 ID 的使用方式,以及
ROWID虛擬資料欄 -
「鏈結與移轉的資料列」可瞭解資料列移轉的原因,以及移轉為何會增加 I/O 數目
-
Oracle AI Database Administrator's Guide,瞭解如何在索引組織表格上建立次要索引
-
Oracle AI Database VLDB and Partitioning Guide,瞭解如何在已編製索引的組織表格分割區上建立次要索引
邏輯資料列 ID 與實體猜測
次要索引使用邏輯資料列 ID 來尋找表格資料列。
邏輯 rowid 包含一個實體猜測,這是第一次建立索引項目的實體 rowid。Oracle AI Database 可以使用實體猜測,直接探測到索引組織表格的分支終端區塊中,略過主索引鍵搜尋。當資料列的實體位置變更時,即使邏輯 rowid 包含一個過時的實體猜測,其仍會維持有效。
對於堆集組織的表格,依次要索引存取涉及掃描次要索引,另一個 I/O 則是擷取包含該資料列的資料區塊。對於索引組織表格,依次要索引的存取會視實體猜測的使用和準確性而有所不同:
-
如果沒有實體猜測,存取會涉及兩個索引掃描:掃描次要索引後接著掃描主索引鍵索引。
-
透過實際猜測,存取取決於其準確性:
-
藉由準確的實體猜測,存取會涉及次要索引掃描,以及一個額外 I/O 來擷取包含該資料列的資料區塊。
-
對於不正確的實體猜測,存取會涉及次要索引掃描,以及擷取錯誤資料區塊 (如猜測指示) 的 I/O,後面接著依主索引鍵值對索引組織表格進行索引唯一掃描。
-
索引組織表格的位元映射索引
索引組織表格上的次要索引可以是 bitmap index 。位元映射索引會為每個索引索引鍵儲存位元映射。
當位元映射索引存在於索引組織表格中時,所有位元映射索引都會使用堆集組織對應表格。對應表格儲存索引組織表格的邏輯資料列 ID。每個對應表格資料列會為對應的索引組織表格資料列儲存一個邏輯資料列 ID。
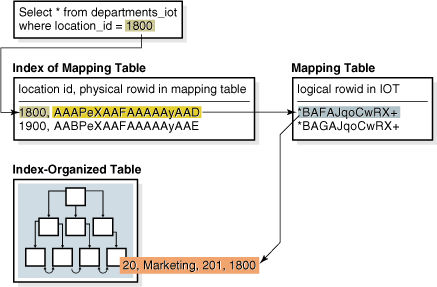
資料庫使用搜尋鍵存取點陣圖索引。如果資料庫找到鍵值,則點陣圖項目會轉換成實體列 ID。使用堆集組織表格時,資料庫會使用實體資料列 ID 來存取基本表格。透過索引組織表格,資料庫會使用實體資料列 ID 來存取對應表格,進而產生資料庫用來存取索引組織表格的邏輯資料列 ID。下圖說明 departments_iot 表格查詢的索引存取。
圖 4:索引組織表格上的點陣圖索引
注意:在索引組織表格中移動資料列並不會讓建立在該索引組織表格上的位元映射索引無法使用。
另請參閱:「列段的列數」以瞭解實體與邏輯列 ID 之間的差異