表格與表格叢集
本章提供綱要物件的簡介,並探討最常見的綱要物件類型之表格。
-
綱要物件簡介:資料庫綱要是資料結構的邏輯容器,稱為綱要物件。綱要物件的範例包括表格和索引。您可以使用 SQL 來建立和操控綱要物件。
-
表格總覽:表格是 Oracle 資料庫中的基本資料單位。
-
表格叢集簡介:表格叢集是共用通用資料欄的表格群組,並將相關資料儲存在同一個區塊中。
-
屬性叢集表格簡介 屬性叢集表格是一種堆集組織表格,可根據使用者指定的叢集指令,以接近磁碟的方式儲存資料。指令會在單一或多個表格中指定資料欄。
-
暫時表格總覽:暫時表格會保留只存在於交易或階段作業期間的資料。
-
外部表格簡介:外部表格會存取外部來源中的資料,就像此資料位於資料庫中的表格一樣。
-
區塊鏈資料表概要 區塊鏈資料表是專為集中式區塊鏈應用程式設計的附加資料表。
-
不可變表格總覽不可變表格是僅附加的表格,可防止內部人員和因人為錯誤而意外修改資料而導致未經授權的資料。
-
物件表格總覽:物件表格是一種特殊的表格,其中每一列代表一個物件。
綱要物件簡介
資料庫綱要是資料結構的邏輯容器,稱為綱要物件。綱要物件的範例包括表格和索引。您可以使用 SQL 來建立和操控綱要物件。
本節包含下列主題:
-
關於通用與本機使用者帳戶:資料庫使用者帳戶具有密碼和特定資料庫權限。
-
通用物件與本機物件:通用物件定義於 CDB 根或應用程式根目錄中,且可使用描述資料連結或物件連結來參照。本機物件是不是共同物件的每個物件。
-
綱要物件類型 - Oracle SQL 可讓您建立和操控許多其他類型的綱要物件。
-
綱要物件儲存體:某些綱要物件會以稱為區段的邏輯儲存體結構類型儲存資料。例如,非分割堆集組織表格或索引會建立區段。
-
綱要物件相依性:部分綱要物件會參照其他物件,建立綱要物件相依性。
-
範例綱要:Oracle 資料庫可能包含範例綱要,這是一組連結的綱要,可讓 Oracle 文件和說明一般資料庫工作的 Oracle 說明資料。另請參閱:Oracle AI Database Security Guide 以進一步瞭解使用者和權限
關於通用與本機使用者帳戶
資料庫使用者帳戶具有密碼和特定資料庫權限。
使用者帳戶和綱要
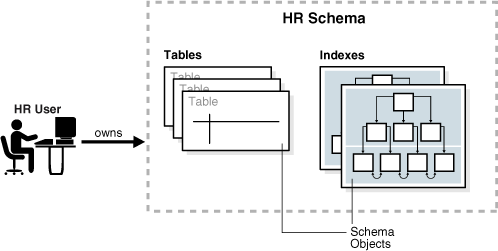
每個使用者帳戶都擁有一個與使用者相同名稱的單一綱要。綱要包含擁有綱要之使用者的資料。例如,hr 使用者帳戶擁有包含綱要物件 (例如 employees 表格) 的 hr 綱要。在實際執行資料庫中,綱要擁有者通常代表資料庫應用程式,而非人員。
在綱要內,特定類型的每個綱要物件都有唯一的名稱。例如,hr.employees 會參照 hr 綱要中的表格 employees。下圖說明名為 hr 的綱要擁有者,以及 hr 綱要內的綱要物件。
圖 1:HR 綱要
通用使用者帳戶與本機使用者帳戶
如果使用者帳戶擁有定義資料庫的物件,則此使用者帳戶是通用的。不 Oracle 提供的使用者帳戶為本機帳戶或通用帳戶。CDB 通用使用者是在 CDB root 中建立的通用使用者。應用程式通用使用者是在應用程式 root 中建立的使用者,而且僅在此應用程式容器中為通用使用者。
下圖顯示 CDB 中可能的使用者帳戶類型。
圖 2:CDB 中的使用者帳戶
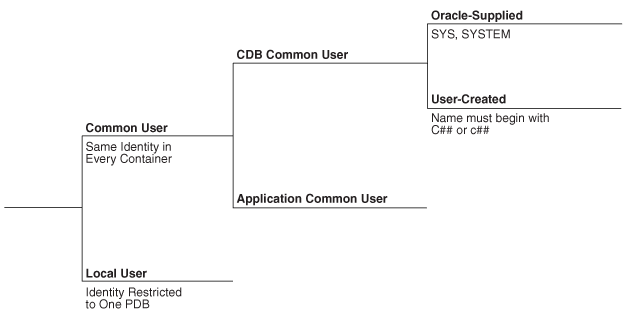
CDB 通用使用者可以連線到具有足夠權限之 CDB 中的任何容器。相反地,應用程式通用使用者只能根據其權限連線到建立它的應用程式 root,或插入到此應用程式 root 的 PDB。
-
一般使用者帳戶:在系統容器 (CDB) 或應用程式容器的相關資訊環境中,通用使用者是在此容器內每個現有和未來 PDB 中都具有相同識別的資料庫使用者。
-
本機使用者帳戶本機使用者是非通用資料庫使用者,只能在單一 PDB 中運作。
一般使用者帳戶
在系統容器 (CDB) 或應用程式容器的相關資訊環境中,通用使用者是 root 中具有相同識別的資料庫使用者,以及此容器內每個現有與未來 PDB 中皆有相同的識別。
每個通用使用者都可以在其容器的 root 內,以及在其中具備足夠權限的任何 PDB 內連線到該 PDB 並執行作業。部分管理作業必須由一般使用者執行。範例包括建立 PDB 及拔除 PDB。
例如,SYSTEM 是具備 DBA 權限的 CDB 通用使用者。因此,SYSTEM 可以連線到資料庫中的 CDB 根目錄與任何 PDB。您可以在 saas_sales 應用程式容器中建立通用使用者 saas_sales_admin。在此情況下,saas_sales_admin 使用者只能連線到 saas_sales 應用程式根目錄,或連線到 saas_sales 應用程式容器內的應用程式 PDB。
每位通用使用者都是由 Oracle 提供或使用者建立。Oracle 提供的通用使用者範例為 SYS 和 SYSTEM。每位使用者建立的通用使用者都是 CDB 通用使用者或應用程式通用使用者。
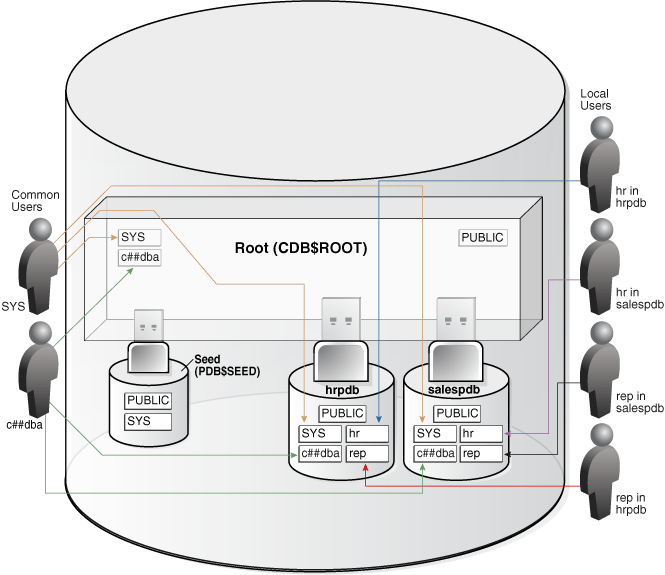
下圖顯示兩個 PDB 中的範例使用者和綱要:hrpdb 和 salespdb。SYS 和 c##dba 是 CDB 通用使用者,其綱要位於 CDB$ROOT、hrpdb 和 salespdb。本機使用者 hr 和 rep 存在於 hrpdb。本機使用者 hr 和 rep 也存在於 salespdb 中。
圖 3:CDB 中的使用者與綱要
通用使用者具有下列特性:
-
通用使用者可以登入任何具有
CREATE SESSION權限的容器 (包括CDB$ROOT)。通用使用者不需要在每個容器中都具備相同的權限。例如,
c##dba使用者可能具有在hrpdb和 root 中建立階段作業的權限,但無法在salespdb中建立階段作業。因為具備適當權限的通用使用者可以在容器之間切換,所以 root 中的通用使用者可以管理 PDB。 -
應用程式通用使用者在其本身應用程式容器以外的任何容器中都沒有
CREATE SESSION權限。因此,應用程式通用使用者只能使用自己的應用程式容器。例如,在
saas_sales應用程式中建立的應用程式通用使用者只能連線到應用程式 root 以及saas_sales應用程式容器中的 PDB。 -
使用者建立之 CDB 通用使用者的名稱必須遵循其他資料庫使用者的命名規則。此外,名稱必須以
COMMON_USER_PREFIX初始化參數所指定的字元為開頭,預設為c##或C##。Oracle 提供的通用使用者名稱與使用者建立的應用程式通用使用者名稱並沒有此限制。本機使用者名稱不能以
c##或C##字元為開頭。 -
每個通用使用者在建立它的容器 (系統容器或特定應用程式容器) 中的所有 PDB 中都是唯一的命名。
CDB 通用使用者是在 CDB 根目錄中定義,但是必須能夠以相同的識別來連線到每個 PDB。應用程式通用使用者位於應用程式 root 中,並且可能以相同的識別連線到容器中的每個應用程式 PDB。
-
通用使用者的特性:每位通用使用者都是由 Oracle 提供或使用者建立的。
-
SYS 和 SYSTEM 帳戶所有 Oracle 資料庫都包括預設的一般使用者帳戶,以及具有管理權限。
通用使用者特性
每位通用使用者都是由 Oracle 提供或使用者建立。
一般使用者帳戶具有下列特性:
-
通用使用者可以登入任何具有
CREATE SESSION權限的容器 (包括CDB$ROOT)。通用使用者不需要在每個容器中都具備相同的權限。例如,
c##dba使用者可能具有在hrpdb和 root 中建立階段作業的權限,但不在salespdb中建立階段作業。因為具備適當權限的通用使用者可以在容器之間切換,所以 root 中的通用使用者可以管理 PDB。 -
應用程式通用使用者在其本身應用程式容器以外的任何容器中都沒有
CREATE SESSION權限。因此,應用程式通用使用者只能使用自己的應用程式容器。例如,在
saas_sales應用程式中建立的應用程式通用使用者只能連線到應用程式 root 以及saas_sales應用程式容器中的 PDB。 -
使用者建立之 CDB 通用使用者的名稱必須遵循其他資料庫使用者的命名規則。此外,名稱必須以
COMMON_USER_PREFIX初始化參數所指定的字元為開頭,預設為c##或C##。Oracle 提供的通用使用者名稱與使用者建立的應用程式通用使用者名稱並沒有此限制。本機使用者名稱不能以
c##或C##字元為開頭。 -
每個通用使用者在建立它的容器 (系統容器或特定應用程式容器) 中的所有 PDB 中都是唯一的命名。
CDB 通用使用者是在 CDB 根目錄中定義,但是必須能夠以相同的識別來連線到每個 PDB。應用程式通用使用者位於應用程式 root 中,而且可以連線到其容器中內具有相同識別的每個應用程式 PDB。
下圖顯示兩個 PDB 中的範例使用者和綱要:hrpdb 和 salespdb。SYS 和 c##dba 是 CDB 通用使用者,其綱要位於 CDB$ROOT、hrpdb 和 salespdb。本機使用者 hr 和 rep 存在於 hrpdb。本機使用者 hr 和 rep 也存在於 salespdb 中。
圖 4:CDB 中的使用者與綱要
另請參閱:
-
Oracle AI Database Security Guide,瞭解一般使用者帳戶
-
Oracle AI Database Reference,瞭解
COMMON_USER_PREFIX
SYS 與 SYSTEM 帳戶
所有 Oracle 資料庫都包含預設的一般使用者帳戶與管理權限。
管理帳戶具有高度的權限,僅供授權執行工作 (例如啟動和停止資料庫、管理記憶體和儲存、建立和管理資料庫使用者等) 的 DBA 使用。
SYS 一般使用者帳戶會在建立資料庫時自動建立。此帳戶可執行所有資料庫管理功能。SYS 綱要會儲存資料說明的基礎表格和視觀表。這些基礎表格和視觀表對於 Oracle AI Database 的運作至關重要。SYS 綱要中的表格僅由資料庫操控,且絕對不能由任何使用者修改。
SYSTEM 管理帳戶也會在建立資料庫時自動建立。SYSTEM 綱要會儲存顯示管理資訊的其他表格和視觀表,以及各種 Oracle AI Database 選項和工具所使用的內部表格和視觀表。絕對不要使用 SYSTEM 綱要來儲存對非管理使用者感興趣的表格。
另請參閱:
-
Oracle AI Database Administrator's Guide,瞭解
SYS、SYSTEM及其他管理帳戶
本機使用者帳號
本機使用者是非通用使用者,只能在單一 PDB 內運作的資料庫使用者。
本機使用者具有下列特性:
-
本機使用者專屬於 PDB,並在此 PDB 中可擁有綱要。
在「通用使用者特性」中顯示的範例中,
hrpdb上的本機使用者hr擁有hr綱要。在salespdb上,本機使用者rep擁有rep綱要,而本機使用者hr擁有hr綱要。 -
本機使用者可以管理一個 PDB,包括開啟和關閉該 PDB。
具有
SYSDBA權限的通用使用者可以將SYSDBA權限授予本機使用者。在此情況下,授權的使用者會維持本機權限。 -
一個 PDB 中的本機使用者無法登入另一個 PDB 或 CDB 根目錄。
例如,當本機使用者
hr連線至hrpdb時,hr無法存取位於salespdb資料庫之sh綱要中的物件,而不需要使用資料庫連結。同樣地,當本機使用者sh連線至salespdbPDB 時,sh無法存取位於hrpdb之hr綱要中的物件,而不需要使用資料庫連結。 -
本機使用者的名稱不得以
c##或C##字元為開頭。 -
本機使用者的名稱在其 PDB 中必須是唯一的。
包含該使用者綱要的使用者名稱與 PDB,會決定唯一的本機使用者。「通用使用者的特性」顯示
hrpdb上有名為rep的本機使用者和綱要。salespdbPDB 中有名稱為rep的完全獨立本機使用者和綱要。
下表說明涉及 CDB 在「通用使用者特性」中的案例。每一列都描述在前一列的動作後所發生的動作。通用使用者 SYSTEM 會在兩個 PDB 中建立本機使用者。
表格 1 CDB 中的本機使用者
| 作業 | 說明 |
|---|---|
|
SYSTEM 會使用服務名稱 hrpdb 連線至 hrpdb 容器。 |
|
SYSTEM 現在會建立本機使用者 rep,並將此 PDB 中的 CREATE SESSION 權限授予此使用者。使用者是本機使用者,因為通用使用者只能由連線至 root 的通用使用者建立。 |
|
rep 使用者 (hrpdb 本機使用者) 會嘗試連線至 salespdb。嘗試失敗,因為 PDB salespdb 中沒有 rep。 |
|
SYSTEM 會使用服務名稱 salespdb 連線至 salespdb 容器。 |
|
SYSTEM 會在 salespdb 中建立本機使用者 rep,並將此 PDB 中的 CREATE SESSION 權限授予此使用者。由於本機使用者的名稱在其 PDB 中必須是唯一的,因此名為 rep 的使用者可以同時存在於 salespdb 和 hrpdb 中。 |
|
rep 使用者已順利登入 salespdb。 |
另請參閱:Oracle AI Database Security Guide 以瞭解本機使用者帳戶
通用物件與本機物件
通用物件是定義在 CDB 根或應用程式根目錄中,而且可以使用描述資料連結或物件連結來參照。本機物件是不是共同物件的每個物件。
資料庫提供的通用物件定義於 CDB$ROOT 中,且無法變更。Oracle Database 不支援在 CDB$ROOT 中建立通用物件。
您可以在應用程式根目錄中建立大多數的綱要物件,例如表格、視觀表、PL/SQL 與 Java 程式單位、序列等等。如果物件存在於應用程式根目錄中,則稱為應用程式通用物件。
本機使用者可以擁有通用物件。而且,通用使用者可以擁有本機物件,但只有在物件不是資料連結或描述資料連結時,而且也不是描述資料連結也不是資料連結。
另請參閱:Oracle AI Database Security Guide 以進一步瞭解通用物件的權限管理
綱要物件類型
Oracle SQL 可讓您建立和操控許多其他類型的綱要物件。
綱要物件的主要類型如下表所示。
表格 2 綱要物件
| 物件 | 說明 | 深入瞭解 |
|---|---|---|
| 表格 | 表格會將資料儲存在資料列中。表格是關聯式資料庫中最重要的綱要物件。 | 「表格總覽」 |
| 索引 | 索引是綱要物件,包含表格或表格叢集中每個已編製索引之資料列的項目,並提供直接、快速存取資料列。Oracle AI Database 支援數種類型的索引。索引組織表格是在此表格中儲存資料的索引結構。 | 「索引和索引組織表格」 |
| 分割區 | 分割區是大型表格與索引片段。每個分割區都有自己的名稱,而且可以選擇性地擁有自己的儲存特性。 | 分割區簡介 |
| 檢視 | 檢視是一或多個表格或其他檢視中資料的自訂簡報。您可以將它們視為儲存的查詢。檢視實際上並未包含資料。 | 「檢視概要」 |
| 順序 | 序列是使用者建立的物件,可以由多位使用者共用以產生整數。一般而言,您會使用順序來產生主索引鍵值。 | 「順序概要」 |
| 尺寸 | 維度會定義資料欄集配對之間的父項與子項關係,其中資料欄集的所有資料欄都必須來自相同的表格。維度通常用來分類資料,例如客戶、產品和時間。 | 「維度總覽」 |
| 同義字 | 同義字是另一個結構物件的別名。由於同義字只是一個別名,因此除了在資料字典中的定義之外,它不需要儲存。 | 「同義字簡介」 |
| PL/SQL 子程式和套裝程式 | PL/SQL 是 SQL 的 Oracle 程序擴充。PL/SQL 子程式是具名的 PL/SQL 區塊,可以使用一組參數來呼叫。PL/SQL 套裝程式可群組邏輯上相關的 PL/SQL 類型、變數以及子程式。 | 「PL/SQL 子程式」 |
其他類型的物件也會儲存在資料庫中,並可使用 SQL 敘述句來建立與操控,但不會包含在綱要中。這些物件包括資料庫使用者帳戶、角色、相關資訊環境以及說明物件。
另請參閱:
-
Oracle AI Database Administrator's Guide,瞭解如何管理綱要物件
-
Oracle AI Database SQL Language Reference,瞭解綱要物件和資料庫物件的詳細資訊
綱要物件儲存體
某些綱要物件會將資料儲存在稱為區段的邏輯儲存體結構類型中。例如,非分割堆集組織表格或索引會建立區段。
其他綱要物件 (例如視觀表和序列) 只會包含描述資料。本主題僅說明具有區隔的綱要物件。
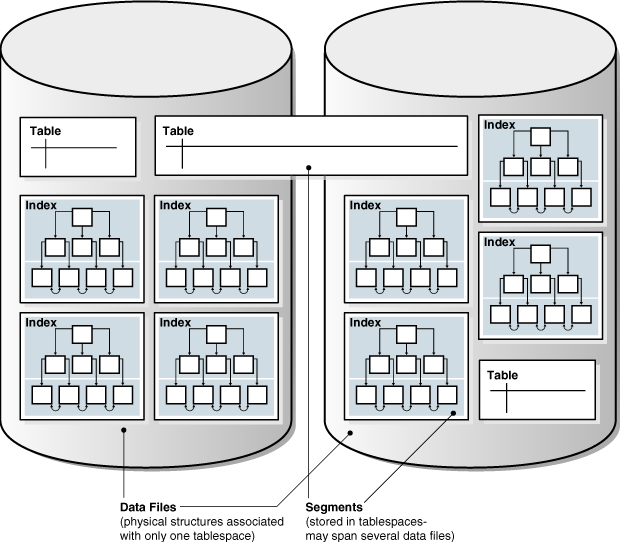
Oracle AI Database 會以邏輯方式將綱要物件儲存在表格空間中。綱要與表格空間之間沒有關係:表格空間可以包含來自不同綱要的物件,而綱要的物件可以包含在不同的表格空間中。每個物件的資料都會實際包含在一或多個資料檔中。
下圖顯示表格與索引區段、表格空間以及資料檔的可能組態。一個表格的資料區段會跨兩個資料檔,這兩個資料檔都是相同表格空間的一部分。區段不能跨多個表格空間。
圖 5:區段、表格空間以及資料檔
另請參閱:
-
「邏輯儲存體結構」以瞭解表格空間和區段
-
Oracle AI Database Administrator's Guide,瞭解如何管理綱要物件的儲存體
綱要物件相依性
某些綱要物件會參照其他物件,以建立綱要物件相依性。
例如,視觀表包含參照表格或視觀表的查詢,而 PL/SQL 子程式呼叫其他子程式。如果物件 A 的定義參考物件 B,則 A 是 B 上的相依物件,而 B 是 A 的參考物件。
Oracle AI Database 提供了自動機制,可確保相依物件在其參考物件方面永遠是最新的。當您建立相依物件時,資料庫會追蹤相依物件與其參照物件之間的相依性。當參照的物件以可能影響相依物件的方式變更時,資料庫會將相依物件標示為無效。例如,如果使用者刪除表格,則根據刪除的表格沒有任何視觀表可以使用。
無效的相依物件必須先依據參照物件的新定義重新編譯,才能使用相依物件。參照無效的相依物件時,會自動進行重新編譯。
如圖解說明綱要物件如何建立相依性,下列範例命令檔會建立表格 test_table,然後查詢此表格的程序:
CREATE TABLE test_table ( col1 INTEGER, col2 INTEGER );

CREATE OR REPLACE PROCEDURE test_proc
AS
BEGIN
 FOR x IN ( SELECT col1, col2 FROM test_table )
 LOOP
   -- process data
   NULL;
 END LOOP;
END;
/
程序 test_proc 狀態的下列查詢顯示它有效:
SQL> SELECT OBJECT_NAME, STATUS FROM USER_OBJECTS WHERE OBJECT_NAME = 'TEST_PROC';

OBJECT_NAME STATUS
----------- -------
TEST_PROC   VALID
將 col3 資料欄新增至 test_table 之後,程序仍然有效,因為程序沒有此資料欄的相依性:
SQL> ALTER TABLE test_table ADD col3 NUMBER;

Table altered.

SQL> SELECT OBJECT_NAME, STATUS FROM USER_OBJECTS WHERE OBJECT_NAME = 'TEST_PROC';

OBJECT_NAME STATUS
----------- -------
TEST_PROC   VALID
不過,變更 col1 資料欄 (test_proc 程序相依) 的資料類型會使程序失效:
SQL> ALTER TABLE test_table MODIFY col1 VARCHAR2(20);

Table altered.

SQL> SELECT OBJECT_NAME, STATUS FROM USER_OBJECTS WHERE OBJECT_NAME = 'TEST_PROC';

OBJECT_NAME STATUS
----------- -------
TEST_PROC   INVALID
執行或重新編譯程序會使其再次有效,如下列範例所示:
SQL> EXECUTE test_proc

PL/SQL procedure successfully completed.

SQL> SELECT OBJECT_NAME, STATUS FROM USER_OBJECTS WHERE OBJECT_NAME = 'TEST_PROC';

OBJECT_NAME STATUS
----------- -------
TEST_PROC VALID另請參閱:Oracle AI Database Administrator's Guide 和 Oracle AI Database Development Guide,瞭解如何管理綱要物件相依性
範例綱要
Oracle 資料庫可能包括範例綱要,它們是一組啟用 Oracle 文件的相互連結綱要,以及說明一般資料庫工作的 Oracle 說明資料。
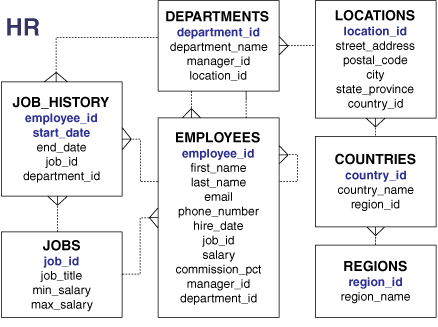
hr 範例綱要包含員工、部門和位置、工作歷史記錄等等的相關資訊。下圖說明 hr 中表格的實體關係圖。本手冊中的大部分範例都使用此綱要中的物件。
圖 6:HR 綱要
另請參閱:Oracle AI Database 範例綱要以瞭解如何安裝範例綱要
表格總覽
表格是 Oracle 資料庫中的基本資料單位。
表格說明實體,這是必須記錄哪些資訊的重要性。例如,員工可以是實體。
Oracle AI Database 表格分為下列基本類別:
您可以建立具有下列組織特性的關聯式表格:
-
堆集組織表格不會以任何特定順序儲存資料列。
CREATE TABLE敘述句預設會建立堆集組織的表格。 -
索引組織表格會根據主索引鍵值排列資料列。對某些應用程式而言,索引組織表格可以更有效率地增強效能和使用磁碟空間。請參閱索引組織表格總覽。
表格是永久表格或暫時表格。永久表格定義與資料會保留在階段作業之間。暫時表格定義會維持與永久表格定義相同的方式,但資料只存在於交易或階段作業的持續時間。暫時表格對於必須暫時保留結果集的應用程式很有用,也許是因為結果是透過執行多個作業來建構。
-
資料欄:表格定義包含表格名稱和資料欄集。
-
資料列:資料列是對應至表格中記錄的資料欄資訊集合。
-
範例:CREATE TABLE 和 ALTER TABLE 敘述句:建立表格的 Oracle SQL 敘述句為
CREATE TABLE。 -
Oracle 資料類型:每個資料欄都有一個資料類型,它與特定的儲存格式、限制條件以及有效的值範圍相關聯。值的資料類型會將一組固定的特性與值建立關聯。
-
完整性限制條件:完整性限制條件是具名規則,可限制表格中一或多個資料欄的值。
-
表格儲存體:Oracle AI Database 使用表格空間中的資料區段來保存表格資料。
-
表格壓縮資料庫可以使用表格壓縮來減少表格所需的儲存體量。另請參閱:Oracle AI Database Administrator's Guide,瞭解如何管理表格
欄
表格定義包含表格名稱與資料欄集合。
資料欄可識別表格所描述之實體的屬性。例如,employees 表格中的資料欄 employee_id 是指員工實體的員工 ID 屬性。
一般而言,您會在建立表格時為每個資料欄指定資料欄名稱、資料類型以及寬度。例如,employee_id 的資料類型為 NUMBER(6),表示此資料欄只能包含寬度最多 6 位數的數值資料。寬度可以依照資料類型預先決定,例如 DATE。
-
虛擬資料欄:表格可以包含虛擬資料欄,也稱為表示式資料欄。表示式資料欄可以是虛擬資料欄,亦即不會儲存在磁碟上,也不會具體化視觀表,這表示會儲存在磁碟上。
-
不顯示的資料欄:不顯示的資料欄是使用者指定的資料欄,只有在依名稱明確指定資料欄時,才會顯示其值。您可以在不影響現有應用程式的情況下,將不顯示的資料欄新增至表格,並視需要將資料欄設為顯示。
-
無鎖定預留:無鎖定預留可讓多個數值資料欄值的並行更新繼續進行,而不會被資料欄值加減時未確認的更新阻擋。
虛擬資料欄
表格可以包含虛擬資料欄,也稱為表示式資料欄。表示式資料欄可以是虛擬資料欄,亦即不會儲存在磁碟上,也不會具體化視觀表,這表示會儲存在磁碟上。
虛擬資料欄 (也稱為表示式資料欄) 會透過計算一組使用者指定的表示式或函數來衍生值。表格可以包含多個這類資料欄的其中之一,但一律必須有一個一般資料欄。例如,以下 EMP 表格定義包含以員工薪資除以每年 2080 小時為基礎的計算時薪。
CREATE TABLE emp
(
   emp_id           NUMBER(9)     CONSTRAINT emp_pk PRIMARY KEY,
   emp_last_name    VARCHAR2(30)  CONSTRAINT emp_last_name_nn NOT NULL,
   emp_first_name   VARCHAR2(30)  CONSTRAINT emp_first_name_nn NOT NULL,
   emp_salary       NUMBER(9,2),
   emp_hourly_rate  NUMBER(7,2)   GENERATED ALWAYS AS (emp_salary/2080) VIRTUAL,
   emp_phone_no     VARCHAR2(10)
);
接下來,將值插入非虛擬資料欄。
INSERT INTO emp (emp_id, emp_last_name, emp_first_name, emp_salary, emp_phone_no)
VALUES (8291, 'Patel', 'Siddharth', 60000, '6505551234');
當您查詢表格時,現在會看到以表示式資料欄傳回的計算值。
SELECT * FROM emp;

 EMP_ID EMP_LAST_NAME  EMP_FIRST_NAME     EMP_SALARY  EMP_HOURLY_RATE EMP_PHONE_NO
_______ ______________ _______________ _____________ ________________ _____________
   8291 Patel          Siddharth               60000            28.85 6505551234
這類表示式資料欄可以在磁碟上進行虛擬或具體化。對於純虛擬 (表示式) 資料欄,資料欄值不會使用磁碟空間,且會在存取時視需要計算。如果是具體化表示式資料欄,系統會在 DML 時間計算值並儲存在磁碟上。
另請參閱:Oracle AI Database Administrator's Guide,瞭解如何管理虛擬欄
不顯示的資料欄
不顯示的資料欄是使用者指定的資料欄,只有在按照名稱明確指定資料欄時,才會顯示其值。您可以在不影響現有應用程式的情況下,將不顯示的資料欄新增至表格,並視需要將資料欄設為顯示。
一般而言,不顯示的資料欄有助於移轉及發展線上應用程式。使用案例可能是查詢含有 SELECT * 敘述句之三欄表格的應用程式。將第四個資料欄加到表格中將會中斷應用程式,這預期會有三個資料資料欄。新增第四個不顯示的資料欄,讓應用程式能夠正常運作。開發人員接著可以更改應用程式來處理第四個資料欄,然後讓資料欄在應用程式正式上線時顯示。
下列範例會建立一個表格 products,其中包含不顯示的資料欄 count,然後顯示不顯示的資料欄:
CREATE TABLE products ( prod_id INT, count INT INVISIBLE );
ALTER TABLE products MODIFY ( count VISIBLE );
另請參閱:
-
Oracle AI Database Administrator's Guide,瞭解如何管理不顯示的資料欄
-
Oracle AI Database SQL Language Reference,瞭解不顯示資料欄的詳細資訊
無鎖定預訂
無鎖定預留允許對數值資料欄值進行多次並行更新,不讓未確認的更新在新增或減去資料欄值時遭到封鎖。
藉由在更新期間避免使用傳統的鎖定機制,此功能可在發生可保留資料欄的頻繁並行更新時,大幅改善使用者體驗。在舊版中,當透過增加或減去資料列的某個資料欄值進行更新時,該資料列的所有其他更新都會被封鎖,直到交易確認為止。藉由在 Oracle AI Database 26ai 中導入無鎖定保留功能,您可以指定可繼續更新的條件,允許交易同時從相同資料列的可保留資料欄進行新增或減去,而不會互相封鎖。這是透過指定數值資料欄是 RESERVABLE 資料欄以及建立資料欄的 CHECK 限制來完成。也可能實現額外的傳輸量改善,因為可保留的資料欄更新不會鎖定資料列,因此也不會封鎖其他交易來同時更新相同資料列的不可保留資料欄。
例如,如果庫存量足以用於要求,而且不超過 100 個料品的貨架空間,您可以允許對庫存量進行加減作業以成功。只要數量值大於零且小於或等於 100,則允許對數量值進行任何此類更新,而不被未確認的更新封鎖。新增或減去的金額會透過內部預留機制預留並保證,以便在不等待先前在相同資料列之可預留資料欄上預留的其他交易的情況下,繼續進行交易。
表格層次 CHECK 限制條件可同時包含可保留和不可保留的資料欄。在發出更新時核准的擱置中無鎖定保留,之後可能會在交易的確認時間違反這類限制。如果限制條件的不可保留資料欄在進行保留之後更新,讓其目前的值可能違反 CHECK 限制條件,就會發生這種情況。如果違反限制,則交易必須終止。不過,表格層次限制中不可保留的資料欄通常是非常不常修改的臨界值。例如貨架空間、帳戶中的必要餘額,以及支出限制。
下列範例使用可保留的資料欄 qty_on_hand 建立表格 inventory。qty_on_hand 上的 CHECK 限制條件指定庫存中必須有零或多個項目,且不得超過此項目的貨架容量,才能在 qty_on_hand 上進行更新,而不封鎖其他更新。在下面的範例中,使用適當的限制條件建立 inventory 表格、插入數個資料列,然後查詢 inventory 表格的資料說明。
CREATE TABLE inventory
( item_id            NUMBER          CONSTRAINT inv_pk PRIMARY KEY,
  item_display_name  VARCHAR2(100)   NOT NULL,
  item_desc          VARCHAR2(2000),
  qty_on_hand        NUMBER          RESERVABLE CONSTRAINT qty_ck CHECK
                                        (qty_on_hand >= 0) NOT NULL,
  shelf_capacity     NUMBER          NOT NULL,
    CONSTRAINT shelf_ck CHECK (qty_on_hand <= shelf_capacity)
);

-- Insert a few rows in the inventory table
INSERT INTO inventory VALUES (123, 'Milk', 'Lowfat 2%', 100, 120);
INSERT INTO inventory VALUES (456, 'Bread', 'Multigrain', 50, 100);
INSERT INTO inventory VALUES (789, 'Eggs', 'Organic', 50, 75);

COMMIT;

SELECT * FROM inventory;

-- Check views user_tab_cols and user_tables to check
-- if the table is a reservable table and the names of the reservable columns

SELECT table_name, has_reservable_column
FROM   user_tables
WHERE  table_name = 'INVENTORY';

SELECT column_name, reservable_column
FROM   user_tab_cols
WHERE  table_name = 'INVENTORY'
  AND  reservable_column = 'YES';
可預留資料欄的多個並行更新範例:
-
交易 1:
UPDATE inventory SET qty_on_hand = qty_on_hand - 10 WHERE item_id = 123; -
交易 2:
UPDATE inventory SET qty_on_hand = qty_on_hand + 20 WHERE item_id = 123; -
交易 3:
UPDATE inventory SET qty_on_hand = qty_on_hand - 30 WHERE item_id = 123; -
交易 2:
commit; -
交易 3:
commit; -
交易 1:
commit;
您可以使用 ALTER TABLE 命令指定選擇性的 CHECK 限制條件,將可保留的資料欄新增至表格。例如:
ALTER TABLE inventory ADD
(qty_on_hold NUMBER RESERVABLE DEFAULT 0
 CONSTRAINT qty_hold CHECK (qty_on_hold >= 0 and qty_on_hold <= 25));
您可以使用下列 ALTER TABLE 命令,將可保留的資料欄轉換成不可保留的資料欄。應用程式可以選擇在停用可保留的保留時強制實行限制條件,因此當資料欄轉換成不可保留的資料欄時,不會自動刪除限制條件。視您的需求而定,可以選擇是否刪除限制。舉例而言:
ALTER TABLE inventory MODIFY (qty_on_hand NOT RESERVABLE);
ALTER TABLE inventory DROP CONSTRAINT qty_ck;
不可保留的資料欄可以使用 ALTER TABLE 命令轉換成可保留的資料欄。例如:
ALTER TABLE inventory MODIFY
(qty_on_hand RESERVABLE
 CONSTRAINT qty_ck CHECK (qty_on_hand >= 0 and qty_on_hand <= 100));
資料列
資料列是對應至表格中記錄的資料欄資訊集合。
例如,employees 表格中的資料列描述特定員工的屬性:員工 ID、姓氏、名字等等。建立表格後,您可以使用 SQL 來插入、查詢、刪除和更新列。
範例:CREATE TABLE 和 ALTER TABLE 敘述句
建立表格的 Oracle SQL 敘述句為 CREATE TABLE。
範例 4-1 CREATE TABLE 員工
下列範例顯示 hr 範例綱要中 employees 表格的 CREATE TABLE 敘述句。敘述句會指定資料欄,例如 employee_id、first_name 等,為每個資料欄指定資料類型,例如 NUMBER 或 DATE。
CREATE TABLE employees
    ( employee_id    NUMBER(6),
      first_name     VARCHAR2(20),
      last_name      VARCHAR2(25)   CONSTRAINT emp_last_name_nn  NOT NULL,
      email          VARCHAR2(25)   CONSTRAINT emp_email_nn      NOT NULL,
      phone_number   VARCHAR2(20),
      hire_date      DATE           CONSTRAINT emp_hire_date_nn  NOT NULL,
      job_id         VARCHAR2(10)   CONSTRAINT emp_job_nn        NOT NULL,
      salary         NUMBER(8,2),
      commission_pct NUMBER(2,2),
      manager_id     NUMBER(6),
      department_id  NUMBER(4),
      CONSTRAINT     emp_salary_min CHECK (salary > 0),
      CONSTRAINT     emp_email_uk   UNIQUE (email)
    ) ;
範例 4-2 ALTER TABLE 員工
下列範例顯示將完整性限制新增至 employees 表格的 ALTER TABLE 陳述式。完整性限制會強制執行業務規則,並防止在表格中輸入無效的資訊。
ALTER TABLE employees
ADD ( CONSTRAINT emp_emp_id_pk   PRIMARY KEY (employee_id),
      CONSTRAINT emp_dept_fk     FOREIGN KEY (department_id)
                                   REFERENCES departments,
      CONSTRAINT emp_job_fk      FOREIGN KEY (job_id)
                                   REFERENCES jobs (job_id),
      CONSTRAINT emp_manager_fk  FOREIGN KEY (manager_id)
                                   REFERENCES employees
    ) ;
範例 4-3 員工表格中的資料列
下列範例輸出顯示 hr.employees 表格的 8 個資料列和 6 個資料欄。
EMPLOYEE_ID FIRST_NAME  LAST_NAME      SALARY COMMISSION_PCT DEPARTMENT_ID
----------- ----------- ------------- ------- -------------- -------------
        100 Steven      King            24000                           90
        101 Neena       Kochhar         17000                           90
        102 Lex         De Haan         17000                           90
        103 Alexander   Hunold           9000                           60
        107 Diana       Lorentz          4200                           60
        149 Eleni       Zlotkey         10500             .2            80
        174 Ellen       Abel            11000             .3            80
        178 Kimberely   Grant            7000            .15
上述輸出說明表格、資料欄以及資料列的下列部分重要特性:
-
表格的資料列描述一位員工的屬性:姓名、薪資、部門等等。例如,輸出中的第一列顯示名為 Steven King 之員工的記錄。
-
描述員工屬性的資料欄。在範例中,
employee_id資料欄是主索引鍵,這表示每個員工都是由員工 ID 唯一識別。任何兩名員工都保證不會擁有相同的員工 ID。 -
非索引鍵資料欄可以包含相同值的資料列。在範例中,員工 101 與 102 的薪資值相同:
17000。 -
外來索引鍵資料欄指的是相同表格或其他表格中的主索引鍵或唯一索引鍵。在此範例中,
department_id中的90值對應至departments表格的department_id資料欄。 -
欄位是列與欄的交集。只能包含一個值。例如,員工 103 之部門 ID 的欄位包含值
60。 -
欄位可能缺少值。在此情況下,欄位會包含 null 值。員工 100 的
commission_pct資料欄值為空值,而員工 149 的欄位值為.2。除非已在此資料欄定義NOTNULL或主索引鍵完整性限制條件,否則資料欄允許空值,在此情況下,無法插入沒有此資料欄值的資料列。
另請參閱:Oracle AI Database SQL Language Reference,瞭解 CREATE TABLE 語法和語意
Oracle 資料型態
每個資料欄都有與特定儲存格式、限制條件及有效範圍值關聯的資料類型。值的資料類型會將一組固定的特性與值建立關聯。
這些特性會導致 Oracle AI Database 將一個資料類型的值與另一個資料類型的值不同。例如,您可以乘以 NUMBER 資料類型的值,但不能乘以 RAW 資料類型的值。
建立表格後,您必須為每個表格的資料欄指定資料類型。後續插入資料欄中的每個值均假設為該資料欄資料類型。
Oracle AI Database 提供多種內建資料類型。最常使用的資料類型屬於本節詳述的類別。
其他重要類別的內建類型包括原始物件、大型物件 (LOB) 以及集合。PL/SQL 具有常數和變數的資料類型,包括 BOOLEAN、參照類型、複合類型 (記錄) 以及使用者定義的類型。
-
字元資料類型字元資料類型會將英數字元資料儲存在字串中。最常見的字元資料類型是
VARCHAR2,這是最有效率的儲存字元資料選項。 -
數值資料類型 Oracle AI Database 數值資料類型儲存固定和浮點數、零和無限大。某些數值類型也會儲存未定義之作業結果的值,也就是「不是數字」或
NaN。 -
日期時間資料類型:日期時間資料類型為
DATE和TIMESTAMP。Oracle AI Database 為時戳提供全面的時區支援。 -
資料列 ID 資料類型:儲存在資料庫中的每個資料列都有一個位址,這是一個內部表示法,用來尋找資料庫中的該資料列。Oracle AI Database 使用
ROWID資料類型來儲存資料庫中每個資料列的地址 (rowid)。 -
布林值資料類型 BOOLEAN 資料類型包含不同的真值
True和False。 -
格式模型和資料類型:格式模型是一個字元文字,描述儲存在字元字串中的日期時間或數值資料的格式。格式模型不會變更資料庫中數值的內部表示。
另請參閱:
-
Oracle AI Database SQL Language Reference,瞭解內建的 SQL 資料類型
-
Oracle AI Database PL/SQL Packages and Types Reference,瞭解 PL/SQL 資料類型
-
Oracle AI Database Development Guide,瞭解如何使用內建資料類型
字元資料類型
字元資料類型會將英數字元資料儲存在字串中。最常見的字元資料類型是 VARCHAR2,這是最有效率的儲存字元資料選項。
位元組值對應至字元編碼配置,通常稱為字元集。資料庫字元集會在建立資料庫時建立。字元集的範例有 7 位元 ASCII、EBCDIC 及 Unicode UTF-8。
字元資料類型的長度語意可測量為位元組或字元。將字串當作位元組順序處理稱為位元組語意。這是字元資料類型的預設值。將字串處理為一系列字元,稱為字元語意。字元是資料庫字元集的代碼點。
-
VARCHAR2 和 CHAR 資料類型
VARCHAR2資料類型會儲存變數長度字元文字。常值是固定的資料值。 -
NCHAR 和 NVARCHAR2 資料類型
NCHAR和NVARCHAR2資料類型會儲存 Unicode 字元資料。
另請參閱:
-
Oracle AI Database 全球化支援指南,深入瞭解字元集
-
Oracle AI Database Development Guide,瞭解如何選擇字元資料類型
VARCHAR2 與 CHAR 資料類型
VARCHAR2 資料類型會儲存變數長度字元文字。常值是固定的資料值。
例如,'LILA'、'St. George Island' 和 '101' 都是所有字元文字;5001 是數值文字。字元文字會以單引號括住,以便資料庫可以區分綱要物件名稱。備註:本手冊可交替使用文字文字、字元文字及字串等詞彙。
當您建立包含 VARCHAR2 資料欄的表格時,可以指定字串長度上限。在範例 4-1 中,last_name 資料欄的資料類型為 VARCHAR2(25),這表示儲存在資料欄中的任何名稱最多有 25 個位元組。
對於每個資料列,Oracle AI Database 會將資料欄中的每個值儲存為變數長度欄位,除非值超過長度上限,在此情況下,資料庫會傳回錯誤。例如,在單一位元組字元集中,如果您在資料列中輸入 last_name 資料欄值的 10 個字元,則資料列片段中的資料欄只會儲存 10 個字元 (10 個位元組),不會儲存 25 個字元。使用 VARCHAR2 可減少空間使用量。
相較於 VARCHAR2,CHAR 會儲存固定長度的字元字串。當您建立包含 CHAR 資料欄的表格時,該資料欄需要字串長度。預設值為 1 個位元組。資料庫使用空白將值填補至指定的長度。
Oracle AI Database 會使用未填補的比較語意來比較 VARCHAR2 值,並使用空白填補的比較語意來比較 CHAR 值。
另請參閱:Oracle AI Database SQL Language Reference,瞭解空白填補與未填補比較語意的詳細資訊
NCHAR 和 NVARCHAR2 資料類型
NCHAR 和 NVARCHAR2 資料類型會儲存 Unicode 字元資料。
Unicode 是通用編碼的字元集,可使用單一字元集以任何語言儲存資訊。NCHAR 會儲存與本國字元集對應的固定長度字元字串,而 NVARCHAR2 則會儲存變數長度字元字串。
您可以在建立資料庫時指定本國字元集。NCHAR 和 NVARCHAR2 資料類型的字元集必須是 AL16UTF16 或 UTF8。兩個字元集都使用 Unicode 編碼。
當您建立包含 NCHAR 或 NVARCHAR2 資料欄的表格時,大小上限一律為字元長度語意。字元長度語意為 NCHAR 或 NVARCHAR2 的預設且唯一的長度語意。
另請參閱:Oracle AI Database Globalization Support Guide,瞭解 Oracle 全球化支援功能的相關資訊
數值資料類型
Oracle AI Database 數值資料類型儲存固定和浮點數、零和無限大。某些數值類型也會儲存未定義之作業結果的值,也就是「不是數字」或 NaN。
Oracle AI Database 以可變長度格式儲存數值資料。每個值都以科學表示法儲存,並使用 1 個位元組來儲存指數。資料庫最多會使用 20 個位元組來儲存 mantissa ,這是浮點數的一部分,其中包含它的有效數字。Oracle AI Database 不會儲存開頭和結尾零。
-
NUMBER 資料類型
NUMBER資料類型會儲存固定與浮點數。資料庫幾乎可以儲存任何大小的數目。此資料保證可攜至執行 Oracle AI Database 的不同作業系統中。對於大多數必須儲存數值資料的情況,建議使用NUMBER資料類型。 -
浮點數 Oracle AI Database 為浮點數提供兩種數值資料類型:
BINARY_FLOAT和BINARY_DOUBLE。
數字資料型態
NUMBER 資料類型儲存固定和浮點數。資料庫幾乎可以儲存任何大小的數目。此資料保證可攜至執行 Oracle AI Database 的不同作業系統中。對於大多數必須儲存數值資料的情況,建議使用 NUMBER 資料類型。
您以 NUMBER( p, s) 格式指定固定點編號,其中 p 與 s 是指下列特性:
-
精確度
小數位數可指定位數的總數。如果未指定小數位數,則資料欄會完全依照應用程式所提供的值來儲存值,而不會進行任何捨入。
-
縮放
小數位數指定從小數點到最小有效數字的位數。正刻度會將小數點右邊的位數計算至 (含) 最小有效位數。負比例會將小數點左邊的數字計算到 (但不包括最小有效數字)。如果您指定不含小數位數的小數位數,如
NUMBER(6)中所示,小數位數為 0。
在範例 4-1 中,salary 資料欄的類型為 NUMBER(8,2),因此精確度為 8,小數位數為 2。因此,資料庫將 100,000 的薪資儲存為 100000.00。
浮點數
Oracle AI Database 為浮點數提供兩種數值資料類型:BINARY_FLOAT 和 BINARY_DOUBLE。
這些類型支援 NUMBER 資料類型提供的所有基本功能。不過,NUMBER 使用小數精確度,而 BINARY_FLOAT 和 BINARY_DOUBLE 使用二進位精確度,可加快算術計算速度,且通常會降低儲存需求。
BINARY_FLOAT 和 BINARY_DOUBLE 是概略數值資料類型。它們會儲存小數值的概略表示法,而不是精確的表示法。例如,值 0.1 不能完全以 BINARY_DOUBLE 或 BINARY_FLOAT 表示。它們常用於科學計算。它們的行為類似於 Java 和 XMLSchema 中的資料類型 FLOAT 和 DOUBLE。
另請參閱:Oracle AI Database SQL Language Reference,瞭解數值類型的精確度、規模和其他特性
日期時間資料類型
日期時間資料類型為 DATE 和 TIMESTAMP。Oracle AI Database 為時戳提供全面的時區支援。
-
DATE 資料類型
DATE資料類型會儲存日期與時間。雖然資料時間可以字元或數字資料類型表示,但DATE具有特殊的相關特性。 -
TIMESTAMP 資料類型
TIMESTAMP資料類型是DATE資料類型的延伸。
日期資料型態
DATE 資料類型會儲存日期與時間。雖然資料時間可以字元或數字資料類型表示,但 DATE 具有特殊的相關特性。
資料庫會將日期內部儲存為數字。日期會以每 7 個位元組的固定長度欄位儲存,相對應於世紀、年、月、日、小時、分鐘和秒。備註:日期完全支援算術運算,因此您可以新增和減去日期,就像使用數字一樣。
資料庫會根據指定的格式模型顯示日期。格式模型是一種字元文字,可描述字元字串中的日期時間格式。標準日期格式為 DD-MON-RR,以 01-JAN-11 格式顯示日期。
RR 與 YY (年度的最後兩位數) 相似,但傳回值的世紀會根據指定的兩位數年度和目前年度的最後兩位數而有所不同。假設在 1999 年,資料庫會顯示 01-JAN-11。如果日期格式使用 RR,則 11 會指定 2011,如果格式使用 YY,則 11 會指定 1911。您可以同時變更資料庫執行處理與階段作業層次的預設日期格式。
Oracle AI Database 將時間儲存為 24 小時格式 - HH:MI:SS。若未輸入時間部分,則日期欄位中的時間預設為 00:00:00 A.M。在僅時間項目中,日期部分會預設為目前月份的第一天。
另請參閱:
-
Oracle AI Database Development Guide,瞭解有關數世紀和日期格式遮罩的詳細資訊
-
Oracle AI Database SQL Language Reference,瞭解日期時間格式代碼的相關資訊
-
Oracle AI Database Development Guide,瞭解如何執行日期時間資料類型的算術運算
TIMESTAMP 資料類型
TIMESTAMP 資料類型是 DATE 資料類型的副檔名。
除了儲存在 DATE 資料類型中的資訊外,TIMESTAMP 還會儲存分數秒數。TIMESTAMP 資料類型有助於儲存精確的時間值,例如在必須追蹤事件順序的應用程式中。
DATETIME 資料類型 TIMESTAMP WITH TIME ZONE 和 TIMESTAMP WITH LOCAL TIME ZONE 需要時區。當使用者選取資料時,該值會調整為使用者階段作業的時區。此資料類型有助於收集和評估跨地理區域的日期資訊。
另請參閱:Oracle AI Database SQL Language Reference,瞭解在時戳資料欄中建立和輸入資料語法的詳細資訊
Rowid 資料類型
儲存在資料庫中的每個資料列都有一個位址 (內部表示法),用來在資料庫內尋找該資料列。Oracle AI Database 使用 ROWID 資料類型來儲存資料庫中每個資料列的地址 (rowid)。
列 ID 屬於下列種類:
-
實體資料列 ID 會將資料列位址儲存在堆集組織表格、表格叢集以及表格與索引分割區中。
-
邏輯資料列 ID 會將資料列位址儲存在索引組織表格中。
-
外部資料列 ID 是外部表格中的識別碼,例如透過閘道存取的 DB2 表格。它們不是標準的 Oracle AI Database 資料列 ID。
名為 universal rowid 或 urowid 的資料類型,支援所有類型的列 ID。
-
使用 Rowids - Oracle AI Database 在內部使用 Rowids 來建構索引。
-
ROWID Pseudocolumn Oracle 資料庫中的每個表格都有名為
ROWID的虛擬資料欄。
使用列 ID
Oracle AI Database 在內部使用列 ID 來建構索引。
B-tree 索引是最常見的類型,包含依序分為範圍的索引鍵清單。每個關鍵碼都與一個列 ID 相關聯,以指向關聯列的地址以供快速存取。
一般使用者和應用程式開發人員也可以將列 ID 用於幾個重要功能:
-
如果先前已使用 SELECT 敘述句擷取資料列的
rowid,則資料列 ID 是重新存取資料列的快速方法。 -
資料列 ID 可讓您查看表格的組織方式。
雖然您可以建立具有使用 ROWID 資料類型定義之資料欄的表格,但您不應該儲存有意在以後階段存取資料的資料列 ID。以此方式使用列 ID 可能會產生無法預測或不正確的結果。資料列的 rowid 可能因為一些原因而變更,這些原因可能是使用者由資料庫引擎起始或內部起始。在這些作業發生之後,您完全無法依存於要指向相同資料列或有效資料列的 rowid。
ROWID 虛擬秋季
Oracle 資料庫中的每個表格都有一個名為 ROWID 的虛擬資料欄。
虛擬資料欄的作用與表格資料欄相同,但實際上不會儲存在表格中。您可以從虛擬資料欄中選取,但無法插入、更新或刪除其值。虛擬資料欄也類似於沒有引數的 SQL 函數。無引數的函式通常會針對結果集中的每一列傳回相同的值,而虛擬通訊欄通常會針對每一列傳回不同的值。
ROWID 虛擬資料欄的值是代表每個資料列位址的字串。這些字串的資料類型為 ROWID。透過執行 SELECT 或 DESCRIBE 來列出表格的結構時,此虛擬資料欄並不明顯,也沒有虛擬資料欄使用空間。不過,可以使用保留字 ROWID 作為資料欄名稱,使用 SQL 查詢擷取每個資料列的資料列 ID。
下列範例會查詢 ROWID 虛擬資料欄,以顯示員工 100 之 employees 表格中資料列的 rowid:
SQL> SELECT ROWID FROM employees WHERE employee_id = 100;

ROWID
------------------
AAAPecAAFAAAABSAAA
另請參閱:
-
Oracle AI Database Development Guide,瞭解如何依地址識別資料列
-
Oracle AI Database SQL Language Reference,瞭解 rowid 類型
布林資料類型
BOOLEAN 資料類型包含不同的真值 True 和 False。
除非 NOT NULL 限制條件禁止,否則布林資料類型也支援真值 UNKNOWN 作為空值。您可以在 Oracle SQL 語法中顯示資料類型的位置使用布林值資料類型。
另請參閱:
- Oracle AI Database SQL Language Quick Reference,瞭解布林資料類型的相關資訊。
格式化模型與資料類型
格式模型是一個字元文字,描述儲存在字元字串中的日期時間格式或數值資料。格式模型不會變更資料庫中數值的內部表示。
將字元字串轉換成日期或數字後,格式模型會決定資料庫解譯字串的方式。在 SQL 中,您可以使用格式模型作為 TO_CHAR 和 TO_DATE 函數的引數,以格式化要從資料庫傳回的值,或格式化要儲存在資料庫中的值。
下列陳述式會選取「部門 80」中員工的薪資,並使用 TO_CHAR 函數,將這些薪資轉換為具有數字格式模型 '$99,990.99' 所指定格式的字元值:
SQL> SELECT last_name employee, TO_CHAR(salary, '$99,990.99') AS "SALARY"
  2  FROM   employees
  3  WHERE  department_id = 80 AND last_name = 'Russell';

EMPLOYEE                  SALARY
------------------------- -----------
Russell                    $14,000.00
下列範例使用格式遮罩 'YYYY MM DD' 的 TO_DATE 函數更新僱用日期,以將字串 '1998 05 20' 轉換成 DATE 值:
SQL> UPDATE employees
  2  SET hire_date = TO_DATE('1998 05 20','YYYY MM DD')
3 WHERE last_name = 'Hunold';另請參閱:Oracle AI Database SQL Language Reference,瞭解格式模型的詳細資訊
完整性限制
完整性限制條件是具名規則,可限制表格中一或多個資料欄的值。
資料完整性規則可防止在表格中輸入無效的資料。此外,限制條件也可在有特定相依性存在時,防止刪除表格。
如果啟用了限制,則資料庫會在輸入或更新資料時檢查資料。Oracle AI Database 可防止輸入不符合限制條件的資料。如果停用限制條件,則 Oracle AI Database 會允許不符合限制條件的資料進入資料庫。
在範例 4-1 中,CREATE TABLE 敘述句會指定 last_name、email、hire_date 和 job_id 資料欄的 NOT NULL 限制條件。限制條件子句可識別資料欄與限制條件。這些限制條件可確保指定的資料欄不包含空值。例如,嘗試插入沒有職務 ID 的新員工會產生錯誤。
您可以在建立表格時或之後建立限制條件。您可以視需要暫時停用限制條件。資料庫會將限制條件儲存在資料說明中。
另請參閱:
-
「資料完整性」以瞭解完整性限制
-
「資料說明簡介」以瞭解資料說明
-
Oracle AI Database SQL Language Reference,瞭解 SQL 限制條件子句
表格儲存
Oracle AI Database 在表格空間中使用資料區段來保存表格資料。
區段包含由資料區塊組成的擴充區塊。表格 (或表格叢集的叢集資料區段) 的資料區段位於表格擁有者的預設表格空間中,或位於 CREATE TABLE 敘述句中指定的表格空間中。
-
表格組織 依照預設,表格會組織為堆集,這表示資料庫會放置最適合的資料列,而不是依照使用者指定的順序。因此,堆集組織的表格會是一個未排序的資料列集合。
-
資料列儲存體:資料庫會將資料列儲存在資料區塊中。表格的每個資料列包含少於 256 個資料欄的資料,都包含在一或多個資料列片段中。
-
資料列部分的資料列: rowid 有效是資料列的 10 位元組實體位址。
表格組織
依照預設,表格會組織成堆集,這表示資料庫會將資料列放置在最適合的位置,而非依使用者指定的順序排列。因此,堆集組織的表格會是一個未排序的資料列集合。注意:索引組織表格使用不同的組織原則。
當使用者新增資料列時,資料庫會將資料列放置在資料區段中第一個可用的可用空間。不保證擷取列的順序與插入列的順序相同。
hr.departments 表格是一個堆集組織的表格。它具有部門 ID、名稱、經理人員 ID 和地點 ID 的欄。當插入列時,資料庫會將其儲存在符合的位置。表格區段中的資料區塊可能包含未排序資料列,如下列範例所示:
50,Shipping,121,1500
120,Treasury,,1700
70,Public Relations,204,2700
30,Purchasing,114,1700
130,Corporate Tax,,1700
10,Administration,200,1700
110,Accounting,205,1700
表格中所有資料列的資料欄順序相同。資料庫通常會以資料欄在 CREATE TABLE 敘述句中的列示順序儲存資料欄,但無法保證此順序。例如,如果表格的資料欄類型為 LONG,則 Oracle AI Database 一律會將此資料欄儲存在資料列的最後面。此外,如果您將新資料欄新增至表格,則新資料欄會成為最後儲存的資料欄。
表格可以包含虛擬資料欄,這與一般資料欄不同,並不會佔用磁碟空間。資料庫會透過計算一組使用者指定的表示式或函數,來視需要衍生虛擬資料欄中的值。您可以編製虛擬資料欄索引、收集虛擬資料欄的統計資料,以及建立完整性限制條件。因此,虛擬資料欄與非虛擬資料欄非常相似。
另請參閱:
資料列儲存
資料庫會將資料列儲存在資料區塊中。表格的每個資料列包含少於 256 個資料欄的資料,都包含在一或多個資料列片段中。
如果可能的話,Oracle AI Database 會將每個資料列儲存成一個資料列片段。不過,如果無法將所有資料列資料插入單一資料區塊,或者如果更新現有資料列導致資料列超出其資料區塊,則資料庫會使用多個資料列片段來儲存資料列。
表格叢集中的資料列與非叢集表格中的資料列包含相同的資訊。此外,表格叢集中的資料列包含參照其所屬叢集索引鍵的資訊。
另請參閱:「資料區塊格式」以瞭解資料區塊的元件
列數的列 ID
rowid 是一個資料列的 10 位元組實體位址。
堆集組織表格中的每個資料列都有一個唯一的 rowid,此表格對應至資料列片段的實體位址。對於表格叢集,相同資料區塊中不同表格的資料列可以有相同的資料列 ID。
Oracle AI Database 在內部使用列 ID 來建構索引。例如, B-tree 索引中的每個索引鍵都與一個資料列 ID 關聯,此資料列 ID 指向關聯的資料列位址以供快速存取。實體資料列 ID 提供表格資料列的最快存取速度,讓資料庫以最少的單一 I/O 擷取資料列。
另請參閱:
-
資料列 ID 格式,瞭解資料列 ID 的結構
-
「 B-Tree 索引簡介」可瞭解 B-tree 索引的類型和結構
空值儲存
空值是資料欄中沒有值。空值表示遺漏、不明或不適用的資料。
如果空值位於具有資料值的資料欄之間,就會儲存在資料庫中。在這些情況下,它們需要 1 個位元組來儲存欄的長度 (零)。資料列中的尾端空值不需要儲存,因為新的資料列標頭表示上一個資料列中的其餘資料欄為空值。例如,如果表格的最後三個資料欄是空值,則不會儲存這些資料欄的資料。
另請參閱:Oracle AI Database SQL Language Reference,瞭解空值的詳細資訊
表格壓縮
資料庫可以使用表格壓縮來減少表格所需的儲存體量。
壓縮可節省磁碟空間、減少資料庫緩衝區快取中的記憶體使用量,在某些情況下則可加速查詢執行。資料庫應用程式可以辨識表格壓縮。
-
基本表格壓縮與進階資料列壓縮:以字典為基礎的表格壓縮為堆集組織表格提供良好的壓縮率。
-
混合分欄壓縮使用「混合分欄壓縮」,資料庫會同時儲存一組資料列的相同資料欄。資料區塊不會以列主要格式儲存資料,而是使用列與分欄方法的組合。
-
記憶體速度混合分欄壓縮「記憶體速度混合分欄壓縮」引進可按記憶體速度處理的磁碟壓縮單位格式。
基本表格壓縮和進階資料列壓縮
堆集組織表格壓縮提供良好的壓縮率。
Oracle AI Database 支援下列類型的字典式表格壓縮:
-
基本表格壓縮
此類型的壓縮適用於大量載入作業。資料庫不會使用傳統 DML 來壓縮修改的資料。您必須使用直接路徑 INSERT 作業、
ALTER TABLE . . . MOVE作業或線上表格重新定義,才能實現基本表格壓縮。 -
進階資料列壓縮
這種壓縮類型適用於 OLTP 應用程式,並壓縮由任何 SQL 作業所控制的資料。資料庫會獲得競爭的壓縮率,並可讓應用程式在未壓縮的表格上執行 DML 的時間大約與 DML 的時間量相同。
對於先前的壓縮類型,資料庫會將壓縮的資料列儲存為資料列的主要格式。一個資料列的所有資料欄都會一起儲存,接著是下一個資料列的所有資料欄,依此類推。資料庫會以儲存在區塊開頭處之符號表格的簡短參照來取代重複值。因此,資料庫需要重新建立未壓縮資料的資訊會儲存在資料區塊本身。
壓縮資料區塊看起來就像一般資料區塊。大多數資料庫特色與處理一般資料區塊的功能,也都可用於壓縮的區塊。
您可以在表格空間、表格、分割區或子分割區層次宣告壓縮。如果在表格空間層次指定,則預設會壓縮在表格空間中建立的所有資料表。
範例 4-4 表格層次壓縮
下列敘述句會將進階資料列壓縮套用至 orders 表格:
ALTER TABLE oe.orders ROW STORE COMPRESS ADVANCED;範例 4-5 分割區層次壓縮
以下部分 CREATE TABLE 敘述句的範例指定某個分割區的進階資料列壓縮,另一個分割區的基本表格壓縮:
CREATE TABLE sales (
    prod_id     NUMBER     NOT NULL,
    cust_id     NUMBER     NOT NULL, ... )
 PCTFREE 5 NOLOGGING NOCOMPRESS
 PARTITION BY RANGE (time_id)
 ( partition sales_2013 VALUES LESS THAN(TO_DATE(...)) ROW STORE COMPRESS BASIC,
   partition sales_2014 VALUES LESS THAN (MAXVALUE) ROW STORE COMPRESS ADVANCED );
另請參閱:
-
資料列格式,瞭解如何將值儲存在資料列中
-
「資料區塊壓縮」可瞭解壓縮資料區塊的格式
-
Oracle AI Database Utilities 瞭解如何使用 SQL*Loader 載入直接路徑
-
Oracle AI Database Administrator's Guide 和 Oracle AI Database Performance Tuning Guide 以瞭解表格壓縮
混合分欄壓縮
使用「混合分欄壓縮」,資料庫會同時針對一組資料列儲存相同的資料欄。資料區塊不會以列主要格式儲存資料,而是使用列與分欄方法的組合。
將資料欄資料與相同的資料類型和相似特性一起儲存,可大幅增加壓縮所節省的儲存空間。資料庫會壓縮由任何 SQL 作業處理的資料,但直接路徑載入的壓縮層次較高。資料庫作業可以針對壓縮的物件通透地運作,因此不需要任何應用程式變更。
注意:「混合資料欄壓縮」與「記憶體內資料欄存放區」(IM 資料欄存放區) 是密切相關的。主要差異在於「混合資料欄壓縮」可最佳化磁碟儲存體,而 IM 資料欄存放區則可最佳化記憶體儲存體。
-
混合分欄壓縮類型:如果您的基礎儲存體支援「混合分欄壓縮」,您可以根據需求指定不同類型的壓縮。
-
壓縮單位「混合分欄壓縮」使用稱為壓縮單位的邏輯建構來儲存一組資料列。
-
DML 和混合分欄壓縮「混合分欄壓縮」對於不同類型 DML 作業中的資料列鎖定有意義。另請參閱:「記憶體內區域」以進一步瞭解 IM 資料欄存放區
混合分欄壓縮類型
如果您的基礎儲存體支援「混合分欄壓縮」,則您可以根據需求指定不同類型的壓縮。
壓縮選項如下:
-
倉庫壓縮
此類型的壓縮經過最佳化,可節省儲存空間,適用於資料倉儲應用程式。
-
封存壓縮
此類型的壓縮已針對最大壓縮層次進行最佳化,適用於不變更的歷史資料與資料。
「混合分欄壓縮」已針對 Oracle Exadata 儲存體上的資料倉儲和決策支援應用程式最佳化。Oracle Exadata 可利用與 Oracle Exadata 儲存體伺服器整合的處理能力、記憶體和 Infiniband 網路頻寬,大幅提升使用「混合分欄壓縮」壓縮之表格的查詢效能。
其他 Oracle 儲存系統支援「混合分欄壓縮」,並提供與 Oracle Exadata 儲存體相同的節省空間,但無法提供相同的查詢效能層次。對於這些儲存系統,「混合分欄壓縮」非常適合在資料庫內存檔不常存取的舊資料。
壓縮單位
「混合分欄壓縮」使用稱為壓縮單位的邏輯建構來儲存一組資料列。
當您將資料載入表格中時,資料庫會以分欄格式儲存資料列群組,每個資料欄的值都會儲存並壓縮在一起。資料庫將資料欄資料壓縮了一組資料列之後,就可以將資料轉換成壓縮單位。
例如,您可以將「混合分欄壓縮」套用至 daily_sales 表格。每天結束時,您會在表格中植入料號與銷售編號,而料號 ID 與日期會形成複合主索引鍵。下表顯示 daily_sales 中資料列的子集。
表格 3 範例表格 daily_sales
| Item_ID | 日期 | Num_Sold | Shipped_From | 重新入庫 |
|---|---|---|---|---|
| 1000 | 01-JUN-18 | 2 | WAREHOUSE1 | Y |
| 1001 | 01-JUN-18 | 0 | WAREHOUSE3 | N 項 |
| 1002 | 01-JUN-18 | 1 | WAREHOUSE3 | N 項 |
| 1003 | 01-JUN-14 | 0 | WAREHOUSE2 | N 項 |
| 1004 | 01-JUN-18 | 2 | WAREHOUSE1 | N 項 |
| 1005 | 01-JUN-18 | 1 | WAREHOUSE2 | N 項 |
假設此資料列子集儲存在一個壓縮單位中。「混合分欄壓縮」會將每個資料欄的值儲存在一起,然後使用多個演算法來壓縮每個資料欄。資料庫會根據各種因素選擇演算法,包括資料欄的資料類型、資料欄中實際值的基數,以及使用者選擇的壓縮層次。
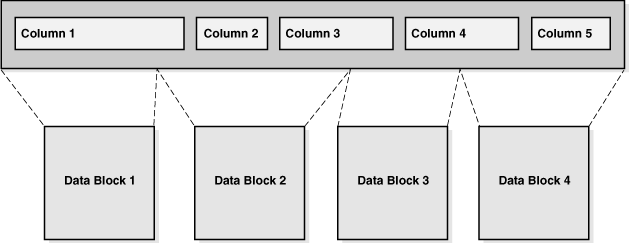
如下圖所示,每個壓縮單元都可以跨多個資料區塊,特定資料欄的值則不一定會跨多個區塊,
圖 7:壓縮單元
如果「混合分欄壓縮」不會導致節省空間,則資料庫會以 DBMS_COMPRESSION.COMP_BLOCK 格式儲存資料。在此情況下,資料庫會將 OLTP 壓縮套用至位於「混合分欄壓縮」區段中的區塊。
另請參閱:
-
「列鎖定 (TX) 」
-
Oracle AI Database 授權資訊使用手冊,瞭解混合分欄壓縮的授權需求
-
Oracle AI Database Administrator's Guide,瞭解如何使用「混合分欄壓縮」
-
Oracle AI Database SQL Language Reference,瞭解
CREATE TABLE的語法和語意 -
Oracle AI Database PL/SQL Packages and Types Reference,瞭解
DBMS_COMPRESSION套裝程式
DML 和混合分欄壓縮
「混合分欄壓縮」會影響不同類型 DML 作業中的資料列鎖定。
直接路徑載入和傳統插入
將資料載入使用「混合分欄壓縮」的表格時,您可以使用傳統的插入或直接路徑載入。直接路徑載入會鎖定整個表格,以減少並行作業。
從 Oracle Database 12c 版本 2 (12.2) 開始,支援傳統陣列插入「混合分欄壓縮」格式。傳統陣列插入的優點如下:
-
插入的資料列會使用資料列層次的鎖定來增加並行。
-
「自動資料最佳化 (ADO)」與「熱力圖」支援資料列層次原則的「混合分欄壓縮」。因此,即使在區段的其他部分發生 DML 活動,資料庫還是可以使用「混合分欄壓縮」作為適用的區塊。
當應用程式使用傳統的陣列插入時,當符合下列條件時,Oracle AI Database 會將資料列以壓縮單位儲存:
-
表格儲存在 ASSM 表格空間中。
-
相容性層次為 12.2.0.1 或更新版本。
-
表格定義符合現有的「混合分欄壓縮」表格限制條件,包括沒有類型
LONG的資料欄,以及沒有資料列相依性。
傳統插入會產生重做與還原。因此,由傳統 DML 敘述句建立的壓縮單位會與 DML 敘述句一起倒回或確認。如同儲存在傳統資料區塊中的資料列一樣,資料庫會自動執行索引維護。
從 Oracle AI Database 26ai 開始,「自動儲存壓縮」可讓 Oracle AI Database 一開始將資料導向未壓縮的格式,然後逐步在背景中將資料列移入「混合分欄壓縮」格式。這對使用者來說是透明的,同時提高 ETL 效能和維持快速查詢效能。
更新與刪除
如果更新或刪除是套用至單位中的任何資料列,資料庫預設會鎖定壓縮單位中的所有資料列。為了避免這個問題,您可以選擇啟用表格的資料列層次鎖定。在此情況下,資料庫只會鎖定受更新或刪除作業影響的資料列。
另請參閱:
-
Oracle AI Database Administrator's Guide,瞭解如何執行傳統的插入
-
Oracle AI Database SQL Language Reference,瞭解
INSERT陳述式 -
Oracle AI Database SQL Language Reference,瞭解使用
COMPRESS_IMMEDIATE提示的相關資訊 -
Oracle AI Database VLDB and Partitioning Guide,瞭解有關使用自動儲存壓縮的資訊
記憶體速度混合分欄壓縮
「記憶體速度混合分欄壓縮」引進可在記憶體速度處理的磁碟壓縮單位格式。
與「混合分欄壓縮」類似,「記憶體速度混合分欄壓縮」適用於資料倉儲環境。它會將資料轉換成資料欄導向格式,並在資料載入期間進行壓縮。關鍵差別在於「記憶體速度混合分欄壓縮」使用與 Exadata 快閃快取中的記憶體內資料欄存放區和 CELLMEMORY 相同的特殊分欄格式,因此可達成所有儲存層的高速分欄掃描和有效率的分欄快取。此外,「記憶體速度混合分欄壓縮」單元比混合分欄壓縮單元大,可有效使用磁碟上的記憶體內分欄格式。
「記憶體速度混合分欄壓縮」可使用 CREATE TABLE 命令新增關鍵字 MEMSPEED,作為「混合分欄壓縮」的副檔名。
範例 4-6 記憶體速度混合分欄壓縮
下列範例會建立已啟用記憶體速度混合分欄壓縮的 orders 表格:
CREATE TABLE orders COLUMN STORE COMPRESS FOR MEMSPEED QUERY;注意:如需詳細資訊,請參閱 Oracle AI Database SQL Language Reference。
表格叢集總覽
表格叢集是共用通用資料欄的一組表格,並將相關資料儲存在相同的區塊中。
將表格叢集化時,單一資料區塊可以包含多個表格的資料列。例如,區塊可以同時儲存 employees 和 departments 表格的資料列,而不是只儲存單一表格的資料列。
叢集索引鍵是叢集化表格共同的一或多個資料欄。例如,employees 和 departments 表格會共用 department_id 資料欄。您可以在建立表格叢集時,以及建立新增至表格叢集的每個表格時,指定叢集索引鍵。
叢集索引鍵值是特定資料列集的叢集索引鍵資料欄值。所有包含相同叢集金鑰值的資料 (例如 department_id=20) 都會實體儲存在一起。每個叢集索引鍵值只會在叢集和叢集索引中儲存一次,不論不同表格的資料列有多少包含該值。
例如,假設 HR 經理人員有兩個書寫案例:一個有員工資料夾方塊,另一個有部門資料夾方塊。使用者通常會要求特定部門中所有員工的資料夾。為了讓擷取更容易,經理人員會以單一書冊大小寫重新排列所有方塊。她將方塊除以部門 ID。因此,部門 20 中員工的所有資料夾,以及部門 20 本身的資料夾都位於一個方塊中;部門 100 中員工的資料夾與部門 100 的資料夾則位於另一個方塊中,依此類推。
當叢集表格主要查詢 (但未修改) 而表格中的記錄經常查詢或結合時,請考慮叢集表格。因為表格叢集會將不同表格的相關資料列都儲存在相同的資料區塊中,所以正確使用的表格叢集會對非叢集表格提供下列優點:
-
減少叢集表格結合的磁碟 I/O。
-
叢集化表格結合的存取時間改進。
-
儲存相關表格和索引資料需要較少的儲存體,因為不會重複儲存每個資料列的叢集索引鍵值。
一般而言,叢集表格不適用於下列情況:
-
表格會經常更新。
-
表格經常需要完整表格掃描。
-
表格需要截斷。
-
索引叢集簡介:索引叢集是使用索引來尋找資料的表格叢集。cluster index 是叢集金鑰上的 B-tree 索引。必須先建立叢集索引,才能將任何資料列插入叢集表格。
-
雜湊叢集簡介:雜湊叢集就像是已編製索引的叢集,但索引索引鍵會取代為雜湊函數。沒有個別的叢集索引。在雜湊叢集中,資料是索引。
索引叢集總覽
索引叢集是使用索引來尋找資料的表格叢集。cluster index 是叢集金鑰上的 B-tree 索引。必須先建立叢集索引,才能將任何資料列插入叢集表格。
範例 4-7 建立表格叢集和關聯的索引
假設您使用叢集金鑰 department_id 建立叢集 employees_departments_cluster,如下列範例所示:
CREATE CLUSTER employees_departments_cluster
   (department_id NUMBER(4))
SIZE 512;

CREATE INDEX idx_emp_dept_cluster
   ON CLUSTER employees_departments_cluster;
因為未指定 HASHKEYS 子句,所以 employees_departments_cluster 是一個已編製索引的叢集。上述範例會在叢集索引鍵 department_id 上建立名為 idx_emp_dept_cluster 的索引。
範例 4-8 在索引叢集中建立表格
您可以在叢集中建立 employees 和 departments 表格,將 department_id 資料欄指定為叢集索引鍵,如下所示 (省略符號會標示資料欄規格所在的位置):
CREATE TABLE employees ( ... )
   CLUSTER employees_departments_cluster (department_id);

CREATE TABLE departments ( ... )
   CLUSTER employees_departments_cluster (department_id);
假設您新增列至 employees 和 departments 表格。資料庫會實際將 employees 和 departments 表格中每個部門的所有列儲存在相同的資料區塊中。資料庫會將資料列儲存在堆集中,並使用索引加以尋找。圖 4-8 顯示 employees_departments_cluster 表格叢集,其中包含 employees 和 departments。資料庫會將部門 20 中員工的列儲存在一起、部門 110 等等。如果表格未叢集化,則資料庫無法確定相關資料列會一起儲存。
圖 8:叢集化表格資料
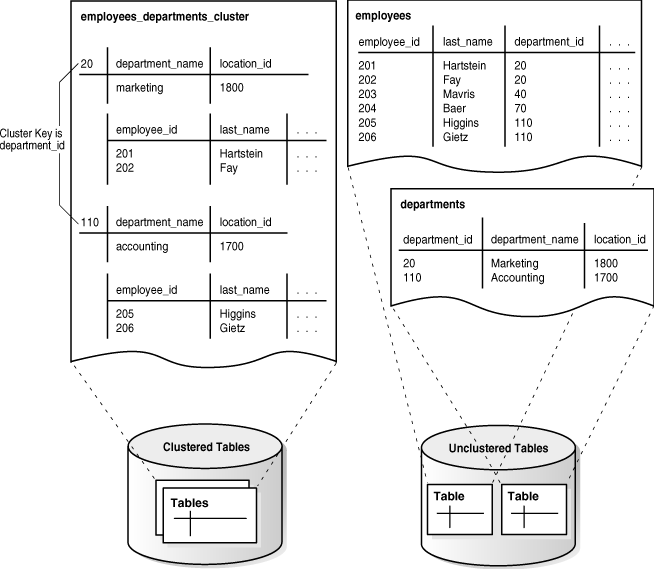
B-tree 叢集索引會將叢集索引鍵值與包含資料之區塊的資料庫區塊位址 (DBA) 建立關聯。例如,關鍵碼 20 的索引項目顯示區塊的地址,該區塊包含部門 20 中員工的資料:
20,AADAAAA9d叢集索引會個別管理,就像非叢集化表格上的索引一樣,而且可以存在於與表格叢集不同的表格空間中。
另請參閱:
-
「索引簡介」
-
Oracle AI Database Administrator's Guide,瞭解如何建立及管理編製索引的叢集
-
Oracle AI Database SQL Language Reference,瞭解
CREATE CLUSTER的語法和語意
雜湊叢集總覽
雜湊叢集就像是已編製索引的叢集,但索引索引鍵會取代為雜湊函數。沒有個別的叢集索引。在雜湊叢集中,資料是索引。
透過已編製索引的表格或已編製索引的叢集,Oracle AI Database 會使用儲存在個別索引中的索引鍵值來尋找表格資料列。如果要在已編製索引的表格或表格叢集中尋找或儲存資料列,資料庫必須至少執行兩個 I/O:
-
要在索引中尋找或儲存金鑰值的一或多個 I/O
-
讀取或寫入表格叢集中資料列的其他 I/O
若要尋找或儲存雜湊叢集中的資料列,Oracle AI Database 會將雜湊函數套用至資料列的叢集索引鍵值。產生的雜湊值對應叢集中的資料區塊,資料庫代表發出的敘述句讀取或寫入。
雜湊是一種選擇性儲存表格資料的方式,可改善資料擷取的效能。符合下列條件時,雜湊叢集可能會有益處:
-
表格的查詢頻率比修改的頻率還要高。
-
雜湊索引鍵資料欄會以相等條件經常查詢,例如
WHERE department_id=20。對於這類查詢,會雜湊叢集索引鍵值。雜湊關鍵值直接指向儲存列的磁碟區域。 -
您可以合理地猜測雜湊關鍵碼的數量,以及每個關鍵碼值所儲存資料的大小。
-
建立雜湊叢集:若要建立雜湊叢集,您可以新增雜湊金鑰,使用與已編製索引之叢集相同的
CREATE CLUSTER敘述句。叢集的雜湊值數目取決於雜湊索引鍵。 -
雜湊叢集查詢在雜湊叢集的查詢中,資料庫會決定如何雜湊使用者輸入的索引鍵值。
-
雜湊叢集變化:單一表格雜湊叢集是最佳化的雜湊叢集版本,一次僅支援一個表格。雜湊關鍵碼與列之間存在一對一對應。
-
雜湊叢集儲存體 Oracle AI Database 為雜湊叢集配置空間,與已編製索引的叢集不同。
建立雜湊叢集
若要建立雜湊叢集,您可以使用與已編製索引叢集相同的 CREATE CLUSTER 敘述句,並新增雜湊金鑰。叢集的雜湊值數目取決於雜湊索引鍵。
叢集索引鍵 (例如已編製索引之叢集的索引鍵) 是叢集中表格共用的單一資料欄或複合索引鍵。雜湊索引鍵值是插入叢集索引鍵資料欄中的實際或可能值。例如,如果叢集索引鍵是 department_id,則雜湊索引鍵值可以是 10、20、30 等等。
Oracle AI Database 使用雜湊函數,接受不限數目的雜湊索引鍵值作為輸入,並將其排序為有限數目的儲存桶。每個儲存桶都有一個唯一的數值 ID,稱為雜湊值。每個雜湊值都會對應至區塊的資料庫區塊位址,該區塊會儲存與雜湊索引鍵值對應的資料列 (部門 10、20、30 等等)。
在下列範例中,可能存在的部門數為 100,因此 HASHKEYS 設為 100:
CREATE CLUSTER employees_departments_cluster
   (department_id NUMBER(4))
SIZE 8192 HASHKEYS 100;
建立 employees_departments_cluster 之後,您可以在叢集中建立 employees 和 departments 表格。接著,您可以將資料載入雜湊叢集,就像在已編製索引的叢集中一樣。
另請參閱:
-
「索引叢集簡介」
-
Oracle AI Database Administrator's Guide,瞭解如何建立和管理雜湊叢集
雜湊叢集查詢
在雜湊叢集的查詢中,資料庫會決定如何雜湊使用者輸入的索引鍵值。
例如,使用者經常執行如下查詢,為 p_id 輸入不同的部門 ID 號碼:
SELECT *
FROM   employees
WHERE  department_id = :p_id;

SELECT *
FROM   departments
WHERE  department_id = :p_id;

SELECT *
FROM   employees e, departments d
WHERE  e.department_id = d.department_id
AND    d.department_id = :p_id;
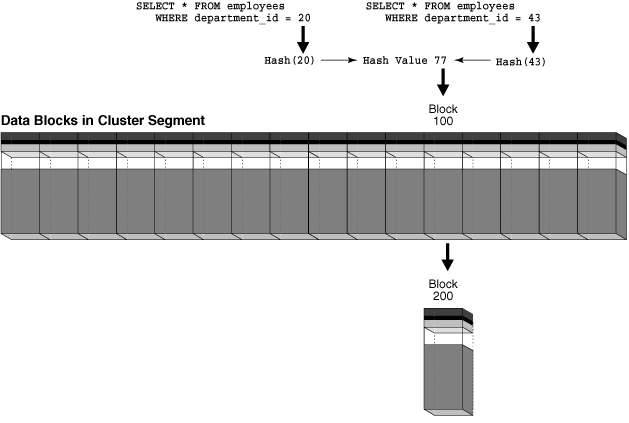
如果使用者查詢 department_id=20 中的員工,則資料庫可能會將此值雜湊至分組 77。如果使用者查詢 department_id=10 中的員工,則資料庫可能會將此值雜湊至分組 15。資料庫使用內部產生的雜湊值來尋找包含所要求部門之員工列的區塊。
下圖將雜湊叢集區段描述為區塊的水平資料列。如圖所示,查詢可以擷取單一 I/O 中的資料。
圖 9:從雜湊叢集擷取數據
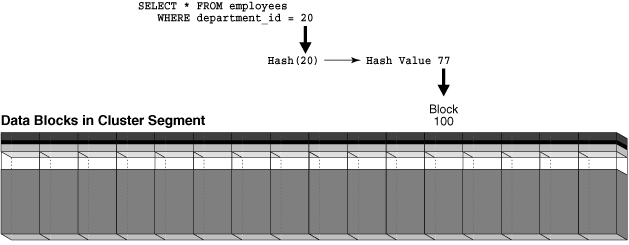
雜湊叢集的限制是無法在非索引叢集金鑰上進行範圍掃描。假設在建立雜湊叢集中建立的雜湊叢集沒有獨立的索引。ID 介於 20 與 100 之間的部門查詢無法使用雜湊演算法,因為其無法雜湊 20 與 100 之間的每個可能值。因為沒有索引,所以資料庫必須執行完整掃描。
另請參閱:「索引範圍掃描」
雜湊叢集變化
單一表格雜湊叢集是最佳化的雜湊叢集版本,一次僅支援一個表格。雜湊關鍵碼與列之間存在一對一對應。
當使用者需要依主索引鍵快速存取表格時,單一表格雜湊叢集會很有幫助。例如,使用者通常會以 employee_id 查詢 employees 表格中的員工記錄。
排序的雜湊叢集會儲存與雜湊函數之每個值對應的資料列,如此一來,資料庫便可有效率地依排序順序傳回它們。資料庫會在內部執行最佳化排序。對於始終以排序順序使用資料的應用程式,此技術可能意味著更快地擷取資料。例如,應用程式可能一律會排序 orders 表格的 order_date 資料欄。
另請參閱:Oracle AI Database Administrator's Guide,瞭解如何建立單一表格和已排序的雜湊叢集
雜湊叢集儲存
Oracle AI Database 為雜湊叢集配置空間的方式與索引叢集不同。
在建立雜湊叢集的範例中,HASHKEYS 指定可能存在的部門數目,而 SIZE 則指定與每個部門相關的資料大小。資料庫會根據下列公式計算儲存體空間值:
HASHKEYS * SIZE / database_block_size因此,如果在建立雜湊叢集顯示的範例中,區塊大小為 4096 個位元組,則資料庫將至少 200 個區塊配置給雜湊叢集。
Oracle AI Database 不會限制您可插入叢集中的雜湊索引鍵值數目。例如,即使 HASHKEYS 為 100,您也無法在 departments 表格中插入 200 個唯一的部門。不過,雜湊值數目超過雜湊索引鍵數目時,雜湊叢集擷取的效率就會降低。
為了說明擷取問題,假設圖 4-9 中的區塊 100 已完全填滿部門 20 的資料列。使用者將 department_id 43 的新部門插入 departments 表格中。部門數目超過 HASHKEYS 值,因此資料庫會將 department_id 43 雜湊值 77 雜湊,此雜湊值與用於 department_id 20 的雜湊值相同。將多個輸入值雜湊至相同的輸出值稱為雜湊衝突。
當使用者在部門 43 的叢集中插入列時,資料庫無法將這些列儲存在已滿的區塊 100 中。資料庫會將區塊 100 連結至新的溢位區塊 (例如區塊 200),並將插入的資料列儲存在新的區塊中。區塊 100 與 200 現在都可儲存任一部門的資料。如圖 4-10 所示,部門 20 或 43 的查詢現在需要兩個 I/O 來擷取資料:區塊 100 與其關聯的區塊 200。您可以使用不同的 HASHKEYS 值重新建立叢集,以解決此問題。
圖 10:發生雜湊衝突時從雜湊叢集擷取資料
另請參閱:Oracle AI Database Administrator's Guide,瞭解如何管理雜湊叢集中的空間
屬性叢集表格概要
屬性叢集表格是一個堆集組織的表格,根據使用者指定的叢集指令,將資料儲存在磁碟上相鄰的位置。指令會在單一或多個表格中指定資料欄。
指令如下:
-
CLUSTERING ... BY LINEAR ORDER指令會根據指定的資料欄來排序表格中的資料。當查詢符合叢集子句中指定之資料欄的前置碼時,請考慮使用
BY LINEAR ORDER叢集 (此為預設值)。例如,如果查詢sh.sales通常會指定客戶 ID 或客戶 ID 與產品 ID,則您可以使用線性資料欄順序cust_id、prod_id來叢集表格中的資料。 -
CLUSTERING ... BY INTERLEAVED ORDER指令使用特殊演算法 (類似 Z 順序函數) 來排序一或多個表格中的資料,這些演算法允許縮減多重資料欄 I/O。查詢指定各種資料欄組合時,請考慮使用
BY INTERLEAVED ORDER叢集。例如,如果sh.sales的查詢以不同的順序指定不同的維度,則您可以根據這些維度中的欄,將sales表格中的資料叢集化。
屬性叢集僅適用於直接路徑 INSERT 作業。而傳統 DML 也會被忽略。
本節包含下列主題:
-
屬性叢集表格的優點:屬性叢集表格的主要優點是縮減 I/O,可大幅降低表格掃描的 I/O 成本和 CPU 成本。減少 I/O 是發生在區域,或是透過更接近叢集值之磁碟的實體鄰近來減少實體 I/O。
-
以結合資料欄為基礎的結合屬性叢集化表格屬性叢集化稱為結合屬性叢集化。與表格叢集相反,結合屬性叢集表格並不會將來自一組表格的資料儲存在相同的資料庫區塊中。
-
使用區域的 I/O 減少:區域是一組連續資料區塊,用於儲存相關資料欄的最小值與最大值。
-
具有線性排序的屬性叢集表格:表格的線性排序配置,會根據使用者指定的屬性,以特定順序將資料列分割成範圍。Oracle AI Database 支援在透過主要外來索引鍵關係連接的單一或多個資料表上進行線性排序。
-
屬性叢集表格與交插式排序交插式排序使用類似於 Z-order 的技術。
屬性叢集表格的優點
屬性叢集表格的主要優點是縮減 I/O,可大幅降低表格掃描的 I/O 成本與 CPU 成本。減少 I/O 是發生在區域,或是透過更接近叢集值之磁碟的實體鄰近來減少實體 I/O。
屬性叢集表格具有下列優點:
-
您可以根據星狀綱要中的維度資料欄來叢集事實表格。
在星狀綱要中,大多數的查詢會限定維度表格而非事實表格,因此依事實表格資料欄進行叢集化並不會有效。Oracle AI Database 支援在維度表格的資料欄上進行叢集。
-
I/O 減少可能發生在幾種不同的情況:
-
與 Oracle Exadata 儲存索引搭配使用時,Oracle In-Memory 最小 / 最大刪除或區域對應
-
在符合前置碼的查詢 OLTP 應用程式中,使用具有線性順序的屬性叢集
-
在
BY INTERLEAVED ORDER叢集的叢集資料欄子集上
-
-
屬性叢集可以改善資料壓縮,並間接改善表格掃描成本。
當同一個值接近磁碟中的彼此時,資料庫就可以輕鬆地將它們壓縮。
-
Oracle AI Database 不會產生索引的儲存和維護成本。
另請參閱:Oracle AI Database Data Warehousing Guide,瞭解屬性叢集化表格的更多優點
結合屬性叢集表格
以結合資料欄為基礎的屬性叢集稱為結合屬性叢集。與表格叢集相反,結合屬性叢集表格並不會將來自一組表格的資料儲存在相同的資料庫區塊中。
例如,假設屬性叢集表格 sales 與維度表格 products 結合。sales 表格僅包含來自 sales 表格的資料列,但資料列的順序是根據從 products 表格結合的資料欄值。適當的結合會在資料移動、直接路徑插入以及 CREATE TABLE AS SELECT 作業期間執行。相反地,如果 sales 和 products 在標準表格叢集中,則資料區塊會包含兩個表格的資料列。
另請參閱:Oracle AI Database Data Warehousing Guide,進一步瞭解結合屬性叢集功能
使用區域的 I/O 減少
區域是一組連續資料區塊,可儲存相關資料欄的最小值與最大值。
當 SQL 陳述式在區域中儲存的資料欄上包含述詞時,資料庫會將述詞值與區域中儲存的最小和最大值進行比較。如此一來,資料庫就會決定 SQL 執行期間要讀取哪些區域。
減少 I/O 是能夠略過表格或索引區塊,這些表格或索引區塊不包含資料庫需要滿足查詢的資料。此減少可大幅降低表格掃描的 I/O 與 CPU 成本。
-
區域用途對於區域的鬆散類比,請考慮使用與資料區塊類似之 Pigeonholes 書籍的銷售經理。
-
區域對應:區域對應是獨立的存取結構,可將資料區塊劃分為區域。Oracle AI Database 將每個區域對應導入為具體化視觀表類型。
-
區域對應建立:手動或自動建立基本區域對應。
-
區域對應如何運作:範例此範例說明區域對應如何在述詞包含常數的查詢中刪除資料。
區域用途
對於區域鬆散的類比,請考慮使用與資料區塊類似之 Pigeonholes 書籍的銷售經理。
每個鴿子都有收據,描述向客戶銷售的襯衫,並按出貨日期排序。在此類比中,區域對應就像是索引卡的堆疊。每張卡相對應於鴿洞的「區域」(連續範圍),如鴿洞 1-10。針對每個區域,卡片會列出區域中儲存之收貨的出貨日期下限與上限。
當有人想知道在特定日期出貨的襯衫時,經理會翻轉卡片,直到她到達包含要求日期的日期範圍為止,記下佩貢洞區,然後只在此區域搜尋佩貢洞,以取得要求的收據。如此一來,經理便可避免在書架中搜尋每一張鴿子,以尋找收據。
區域對應
區域圖是獨立的存取結構,可將資料區塊劃分為區域。Oracle AI Database 將每個區域對應導入為具體化視觀表類型。
與索引相同,區域對應可降低表格掃描的 I/O 與 CPU 成本。當 SQL 陳述式包含區域對應中資料欄的述詞時,資料庫會將述詞值與每個區域中儲存的最小和最大表格資料欄值進行比較,以決定在 SQL 執行期間要讀取哪些區域。
基本區域對應是在單一資料表中定義,並維護此資料表中某些資料欄的最小值和最大值。結合區域對應是在具有外部結合至一或多個其他表格的表格上定義,並維持其他表格中某些資料欄的最小值與最大值。Oracle AI Database 會自動維護兩種類型的區域對應。
表格上最多只能有一個區域對應。在分割的表格中,所有分割區與子分割區都有一個區域對應。分割表格的區域對應也會追蹤每個區域、每個分割區和每個子分割區的最小值與最大值。如果表格與維度表格有外部結合,則區域對應定義可包含維度資料欄的最小值與最大值。備註:您可以建立僅包含分割區或子分割區層級區域的區域對應。建立這類區域對應會在分割區中繼資料之外擴充分割區刪減功能。
另請參閱:Oracle AI Database Data Warehousing Guide,瞭解區域地圖的簡介
區域對應建立
基本區域對應是手動或自動建立的。
手動區域對應
您可以使用 DDL 陳述式來建立、刪除及維護區域對應。
每當您在 CREATE TABLE 或 ALTER TABLE 敘述句中指定 CLUSTERING 子句時,資料庫就會自動在指定的叢集資料欄上建立區域對應。區域對應會將資料欄的最小值和最大值與屬性叢集表格中的連續資料區塊相關聯。屬性叢集表格使用區域對應來執行 I/O 簡化。
您也可以使用 CREATE MATERIALIZED ZONEMAP 敘述句明確地建立區域對應。在此情況下,您可以建立與屬性叢集搭配使用的區域對應。例如,您可以在表格上建立區域對應,其資料列在一組資料欄上自然排序,例如依時間排序其交易的股票交易表格。
另請參閱:
-
「具體化視觀表簡介」
-
Oracle AI Database Data Warehousing Guide,深入瞭解如何建立區域對應
自動區域對應
Oracle AI Database 可以自動建立基本區域對應。這些稱為自動區域對應。
Oracle AI Database 可以自動為已分割和未分割的表格建立基本區域對應。背景處理會自動維護以此方式建立的區域對應。
使用 DBMS_AUTO_ZONEMAP 程序來啟用自動區域對應:
EXEC DBMS_AUTO_ZONEMAP.CONFIGURE('AUTO_ZONEMAP_MODE','ON')另請參閱:
-
Oracle AI Database Data Warehousing Guide,瞭解有關使用
DBMS_AUTO_ZONEMAP套裝軟體管理自動區域對映的詳細資訊 -
Oracle AI Database PL/SQL Packages and Types Reference,瞭解
DBMS_AUTO_ZONEMAP套裝程式的詳細資訊 -
Oracle AI Database 授權資訊使用手冊,瞭解不同版本和服務支援哪些功能的詳細資訊
區域對應運作方式:範例
此範例說明區域對應如何在述詞包含常數的查詢中刪除資料。
假設您建立下列 lineitem 表格:
CREATE TABLE lineitem
  ( orderkey      NUMBER        ,
    shipdate      DATE          ,
    receiptdate   DATE          ,
    destination   VARCHAR2(50)  ,
    quantity      NUMBER        );
表格 lineitem 包含 4 個資料區塊,每個區塊有 2 個資料列。表格 4-4 顯示表格的 8 個資料列。
表格 4 明細行項目表格的資料區塊
| 封鎖 | 順序鍵 | 出貨日期 | 收據日期 | 目的地 | quantity |
|---|---|---|---|---|---|
| 1 | 1 | 1-1-2014 | 1-10-2014 | San_Fran | 100 |
| 1 | 2 | 1-2-2014 | 1-10-2014 | San_Fran | 200 |
| 2 | 3 | 1-3-2014 | 1-9-2014 | San_Fran | 100 |
| 2 | 4 | 1-5-2014 | 1-10-2014 | San_Diego | 100 |
| 3 | 5 | 1-10-2014 | 1-15-2014 | San_Fran | 100 |
| 3 | 6 | 1-12-2014 | 1-16-2014 | San_Fran | 200 |
| 4 | 7 | 1-13-2014 | 1-20-2014 | San_Fran | 100 |
| 4 | 8 | 1-15-2014 | 1-30-2014 | San_Jose | 100 |
您可以使用 CREATE MATERIALIZED ZONEMAP 陳述式在 lineitem 表格上建立區域對映。每個區域包含 2 個區塊,並儲存 orderkey、shipdate 和 receiptdate 資料欄的最小和最大值。表格 4-5 顯示區域對應。
表格 5 明細行項目表格的區域對應
| 區塊範圍 | 最小順序鍵 | 最大 orderkey | 最小出貨日期 | 最大出貨日期 | 最小收款日期 | 最大收貨日期 |
|---|---|---|---|---|---|---|
| 1-2 | 1 | 4 | 1-1-2014 | 1-5-2014 | 1-9-2014 | 1-10-2014 |
| 3-4 | 5 | 8 | 1-10-2014 | 1-15-2014 | 1-15-2014 | 1-30-2014 |
當您執行下列查詢時,資料庫可以讀取區域對應,然後只掃描區塊 1 與區塊 2,因此略過區塊 3 與區塊 4,因為日期 1-3-2014 落在最早與最晚日期之間:
SELECT * FROM lineitem WHERE shipdate = '1-3-2014';另請參閱:
-
Oracle AI Database Data Warehousing Guide,瞭解如何使用區域對應
-
Oracle AI Database SQL Language Reference,瞭解
CREATE MATERIALIZED ZONEMAP敘述句的語法和語意
含線性排序的屬性叢集表格
表格的線性排序機制會根據使用者指定的屬性,以特定順序將資料列分成範圍。Oracle AI Database 支援在透過主要外來索引鍵關係連接的單一或多個資料表上進行線性排序。
例如,sales 表格會將 cust_id 和 prod_id 資料欄分成範圍,然後將這些範圍聚集在磁碟上。當您為表格指定 BY LINEAR ORDER 指令時,當述詞指定前置碼資料欄或指令中的所有資料欄時,可能會大幅減少 I/O。
假設查詢 sales 通常會指定客戶 ID 或客戶 ID 與產品 ID 的組合。您可以建立屬性叢集表格,讓這類查詢可以從減少 I/O 中獲益:
CREATE TABLE sales
(
   prod_id     NOT NULL NUMBER
,  cust_id     NOT NULL NUMBER
,  amount_sold NUMBER(10,2) ...
)
CLUSTERING
  BY LINEAR ORDER (cust_id, prod_id)
  YES ON LOAD YES ON DATA MOVEMENT
  WITH MATERIALIZED ZONEMAP;
符合 cust_id 和 prod_id 資料欄或 cust_id 前置碼的查詢會減少 I/O。符合 prod_id 資格的查詢不會發生重大 I/O 減少,因為 prod_id 是 BY LINEAR ORDER 子句的字尾。下列範例顯示資料庫在表格掃描時如何減少 I/O。
範例 4-9 僅指定 cust_id
應用程式會發出下列查詢:
SELECT * FROM sales WHERE cust_id = 100;因為 sales 表格是 BY LINEAR ORDER 叢集,所以資料庫必須只讀取包含 cust_id 值 100 的區域。
範例 4-10 指定 prod_id 和 cust_id
應用程式會發出下列查詢:
SELECT * FROM sales WHERE cust_id = 100 AND prod_id = 2300;由於 sales 表格是 BY LINEAR ORDER 叢集,因此資料庫只能讀取包含 cust_id 值 100 和 prod_id 值 2300 的區域。
另請參閱:
-
Oracle AI Database Data Warehousing Guide,瞭解如何使用線性排序來叢集表格
-
Oracle AI Database SQL Language Reference,瞭解
BY LINEAR ORDER子句的語法和語意
具有交錯式排序的屬性叢集表格
交插排序使用的技術類似於 Z-order 。
交錯排序可讓資料庫根據叢集資料欄中的任何述詞子集來刪除 I/O。交錯式排序對於資料倉儲中的維度階層非常有用。
如同具有線性順序的屬性叢集表格一樣,Oracle AI Database 支援在透過主要外來索引鍵關係連線的單一或多個表格上進行交錯排序。除了屬性叢集表格以外,表格中的資料欄必須依外來索引鍵連結,並結合至屬性叢集表格。
大型資料倉儲經常以星狀綱要組織資料。維度表格使用父項 - 子項階層,並以外來索引鍵連線至事實表格。依交插順序將事實表格叢集化,可讓資料庫在表格掃描期間使用特殊函數來略過維度資料欄中的值。
範例 4-11 Interleaved Ordering 範例
假設您的資料倉儲包含 sales 事實表格及其兩個維度表格:customers 和 products。大多數查詢在 customers 表格階層 (cust_state_province, cust_city) 和產品階層 (prod_category, prod_subcategory) 上都有述詞。您可以對 sales 表格使用交錯排序,如下列範例中的部分敘述句所示:
CREATE TABLE sales
(
   prod_id NUMBER NOT NULL
,  cust_id NUMBER NOT NULL
,  amount_sold NUMBER(10,2) ...
)
CLUSTERING sales
   JOIN products ON (sales.prod_id = products.prod_id)
   JOIN customers ON (sales.cust_id = customers.cust_id)
   BY INTERLEAVED ORDER
   (
     (  products.prod_category
     ,  products.prod_subcategory
     ),
     (  customers.cust_state_province
     ,  customers.cust_city
     )
   )
WITH MATERIALIZED ZONEMAP;注意:在 BY INTERLEAVED ORDER 子句中指定的資料欄不需要在實際維度表格中,但必須透過主要外來索引鍵關係來連線。
假設應用程式查詢結合中的 sales、products 和 customers 表格。查詢指定述詞中的 customers.prod_category 和 customers_cust_state_province 資料欄,如下所示:
SELECT cust_city, prod_sub_category, SUM(amount_sold)
FROM   sales, products, customers
WHERE  sales.prod_id = products.prod_id
AND    sales.cust_id = customers.cust_id
AND    customers.prod_category = 'Boys'
AND    customers.cust_state_province = 'England - Norfolk'
GROUP BY cust_city, prod_sub_category;在前面的查詢中,prod_category 和 cust_state_province 資料欄是叢集定義的一部分,如 CREATE TABLE 範例所示。在掃描 sales 表格期間,資料庫可參考區域對應,並僅存取此區域中的資料列 ID。
另請參閱:
-
「維度總覽」
-
Oracle AI Database Data Warehousing Guide,瞭解如何使用交錯排序來叢集表格
-
Oracle AI Database SQL Language Reference,瞭解
BY INTERLEAVED ORDER子句的語法和語意
暫時表格概要
暫時表格會保留只存在於交易或階段作業期間的資料。
暫時表格中的資料是階段作業專用的。每個階段作業只能看到和修改自己的資料。
您可以建立全域暫時表格或專用暫時表格。下表顯示它們之間的基本差異。
表 6 暫存表特性
| 特性 | 全域 | 私人 |
|---|---|---|
| 命名的規則 | 與永久表格相同 | 必須在前面加上 ORA$PTT_ |
| 表格定義的可見性 | 所有階段作業 | 只有建立表格的階段作業 |
| 表格定義的儲存 | 磁碟 | 僅限記憶體 |
| 類型 | 特定交易 (ON COMMIT DELETE ROWS) 或特定階段作業 (ON COMMIT PRESERVE ROWS) |
特定交易 (ON COMMIT DROP DEFINITION) 或特定階段作業 (ON COMMIT PRESERVE DEFINITION) |
第三種類型的暫時表格 (稱為游標持續時間暫時表格 ) 會由資料庫自動針對特定類型的查詢建立。
-
暫時表格的用途暫時表格對於必須緩衝處理結果集的應用程式非常有用。
-
暫時表格中的區段配置與永久表格一樣,全域暫時表格是資料說明中靜態定義的永久物件。若為專用暫時表格,描述資料只存在於記憶體中,但可以位於磁碟的暫時表格空間中。
-
建立暫時表格
CREATE ... TEMPORARY TABLE敘述句會建立暫時表格。另請參閱:Oracle AI Database SQL Tuning Guide 以深入瞭解游標持續時間的暫時表格
暫時表格的用途
暫時表格對於必須緩衝處理結果集的應用程式非常有用。
例如,排程應用程式可讓大學生建立選用的學期課程表。全域暫時表格中的資料列代表每個排程。在階段作業期間,排程資料是專用的。當學生選擇排程時,應用程式會將所選排程的列移至永久表格。階段作業結束時,資料庫會自動刪除全域暫時表格中的排程資料。
私人暫存表對於動態報告應用程式很有用。例如,客戶資源管理 (CRM) 應用程式可能會無限期地連線到相同使用者,並同時啟用多個階段作業。每個階段作業都會為每個新的交易建立一個名為 ORA$PTT_crm 的專用暫時表格。應用程式可以在每個階段作業使用相同的表格名稱,但可以變更定義。資料與定義僅供梯次檢視。表格定義會一直保留到交易結束或手動刪除表格為止。
暫時表格中的區段配置
就像永久表格一樣,全域暫時表格也是資料說明中靜態定義的永久物件。若為專用暫時表格,描述資料只存在於記憶體中,但可以位於磁碟的暫時表格空間中。
如果是全域與專用暫時表格,當階段作業首次插入資料時,資料庫會配置暫時區段。在階段作業中載入資料之前,表格會顯示為空白。對於交易特定的暫時表格,資料庫會在交易結束時取消配置暫時區段。如果是階段作業特定的暫時表格,資料庫就會在階段作業結束時取消配置暫時區段。
另請參閱:「暫時區段」
建立暫時表格
CREATE ... TEMPORARY TABLE 敘述句會建立暫時表格。
指定 GLOBAL TEMPORARY TABLE 或 PRIVATE TEMPORARY TABLE。在這兩種情況下,ON COMMIT 子句會指定表格資料是交易特定 (預設) 或階段作業特定。您會為資料庫本身建立暫時表格,而不是為每個 PL/SQL 預存程序建立暫時表格。
您可以使用 CREATE INDEX 敘述句來建立全域 (非專用) 暫時表格的索引。這些索引也是暫時的。索引中的資料與暫時表格中的資料具有相同的階段作業或交易範圍。您也可以在全域暫時表格上建立檢視或觸發程式。
另請參閱:
-
「檢視概要」
-
「觸發程式概要」
-
Oracle AI Database Administrator's Guide,瞭解如何建立及管理暫時表格
-
Oracle AI Database SQL Language Reference,瞭解
CREATE ... TEMPORARY TABLE的語法和語意
外部表格概要
外部表格會存取外部來源中的資料,就像此資料位於資料庫中的表格一樣。
資料可以是任何提供存取驅動程式的格式。您可以使用 SQL (序列或平行)、PL/SQL 以及 Java 來查詢外部表格。
-
當 Oracle 資料庫應用程式必須存取非關聯式資料時,外部表格的用途外部表格非常有用。
-
物件存放區中的資料外部表格可用來存取物件存放區中的資料。
-
外部表格存取驅動程式:存取驅動程式是解譯資料庫外部資料的 API。存取驅動程式會在資料庫內執行,此資料庫會使用驅動程式來讀取外部表格中的資料。存取驅動程式和外部表格層負責執行資料檔中資料所需的轉換,使其符合外部表格定義。
-
外部表格建立:在內部建立外部表格代表在資料說明中建立描述資料。與一般表格不同,外部表格不會描述儲存在資料庫中的資料,也不會描述資料在外部的儲存方式。外部表格描述資料則說明外部表格層如何現在資料至資料庫。
-
自動快取外部表格資料是通透地快取外部表格的資料,以提升查詢效能。
外部表格的用途
當 Oracle 資料庫應用程式必須存取非關聯式資料時,外部表格十分有用。
例如,以 SQL 為基礎的應用程式可能需要存取其記錄格式如下的文字檔:
100,Steven,King,SKING,515.123.4567,17-JUN-03,AD_PRES,31944,150,90
101,Neena,Kochhar,NKOCHHAR,515.123.4568,21-SEP-05,AD_VP,17000,100,90
102,Lex,De Haan,LDEHAAN,515.123.4569,13-JAN-01,AD_VP,17000,100,90
您可以建立外部表格,將文字檔複製到外部表格定義中指定的位置,然後使用 SQL 來查詢文字檔中的記錄。同樣地,您可以使用外部表格提供 JSON 文件或 LOB 的唯讀存取權。
在資料倉儲環境中,外部表格對於執行擷取、轉換及載入 (ETL) 作業相當有價值。例如,外部表格可讓您管線資料載入階段與轉換階段。此技術不需要在資料庫內部暫存資料,即可在資料庫內部進行進一步處理。
您可以分割虛擬或非虛擬資料欄上的外部表格。此外,您可以建立混合分割表格,其中部分分割區是內部分割區和部分外部分割區。與內部分割區相同,外部分割區也受惠於效能增強功能,例如分割區刪除和分割區相關結合。例如,您可以使用分割的外部表格來分析儲存在 Hadoop 分散式檔案系統 (HDFS) 或 NoSQL 資料庫中的大量非關聯式資料。
另請參閱:「已分割的表格」
物件存放區中的資料
外部表格可用於存取物件儲存中的資料。
除了支援存取作業系統檔案和大數據來源中的外部資料之外,Oracle 也支援存取物件存放區中的外部資料。物件儲存體在雲端很常見,並且提供平面架構來管理個別物件 (任何類型的非結構化資料與中繼資料),方法是在簡單的容器中加以分組。雖然物件儲存主要是雲端中的資料儲存架構,但也可以作為內部部署儲存硬體使用。
您可以使用 DBMS_CLOUD 套裝程式或手動定義外部表格,來存取物件存放區中的資料。Oracle 強烈建議您使用 DBMS_CLOUD 套裝程式,因為它提供其他功能,並且與 Oracle Autonomous Database 完全相容。
外部表格存取動因
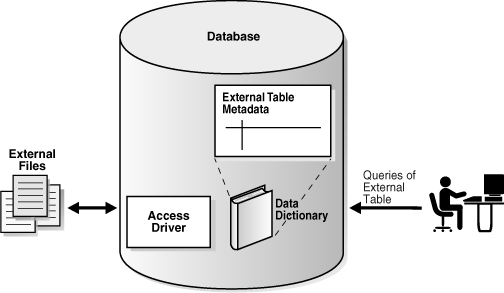
存取驅動程式是解譯資料庫外部資料的 API。存取驅動程式會在資料庫內執行,此資料庫會使用驅動程式來讀取外部表格中的資料。存取驅動程式和外部表格層負責執行資料檔中資料所需的轉換,使其符合外部表格定義。
下圖表示外部資料的 SQL 存取。
圖 11:外部表格
Oracle 針對外部表格提供下列存取驅動程式:
-
ORACLE_LOADER(預設)可使用 SQL*Loader 支援的大部分格式來存取外部檔案。您無法使用
ORACLE_LOADER驅動程式建立、更新或附加至外部檔案。 -
ORACLE_DATAPUMP可讓您卸載或載入外部資料。卸載作業會從資料庫讀取資料,並將資料插入外部表格 (由一或多個外部檔案表示)。外部檔案建立後,資料庫便無法更新或附加資料。載入作業會讀取外部表格,並將其資料載入資料庫。
-
ORACLE_HDFS啟用擷取儲存在 Hadoop 分散式檔案系統 (HDFS) 中的資料。
-
ORACLE_HIVE允許存取儲存在 Apache Hive 資料庫中的資料。來源資料可以儲存在 HDFS、HBase、Cassandra 或其他系統中。與其他存取驅動程式不同,您無法指定位置,因為
ORACLE_HIVE會從外部描述資料存放區取得位置資訊。 -
ORACLE_BIGDATA啟用以結構化和非結構化格式儲存資料的唯讀存取權,包括 Apache Parquet、Apache Avro、Apache ORC、Apache Iceberg、Linux Open Project Delta Sharing 協定和文字格式。您也可以使用此驅動程式來查詢本機資料,這對於測試和較小的資料集非常有用。
外部表格建立
在內部建立外部表格則表示在資料說明中建立描述資料。與一般表格不同,外部表格並不會描述儲存在資料庫中的資料,也不會描述資料在外部儲存的方式。外部表格描述資料則說明外部表格層如何現在資料至資料庫。
CREATE TABLE ... ORGANIZATION EXTERNAL 敘述句有兩個部分。外部表格定義描述資料欄類型。此定義就像是讓 SQL 查詢外部資料的檢視,而不將其載入資料庫中。敘述句的第二個部分會將外部資料對應至資料欄。
除非使用 CREATE TABLE AS SELECT 搭配 ORACLE_DATAPUMP 存取驅動程式建立,否則外部表格都是唯讀的。外部表格的限制包括不支援已編製索引的資料欄和資料欄物件。
另請參閱:
-
Oracle AI Database 公用程式,瞭解外部表格
-
Oracle AI Database Administrator's Guide,瞭解如何管理外部表格、外部連線和目錄物件
-
Oracle AI Database SQL Language Reference,瞭解有關建立和查詢外部表格的資訊
自動快取外部表格資料
外部表格的資料會通透地快取,以提升查詢效能。
系統會自動快取經常從外部表格存取的資料 (位於物件儲存中的完整或部分表格),以提升效能。快取外部表格資料不需要變更應用程式,因為 Oracle 資料庫會自動處理該資料。
區塊鏈表格概要
區塊鏈資料表是專為集中式區塊鏈應用程式設計的附加資料表。
在 Oracle Blockchain 表格中,對等是信任資料庫維護防竄改分類帳的資料庫使用者。分類帳導入為區塊鏈資料表,由應用程式定義及管理。現有的應用程式不需要新的基礎架構或程式設計模型,即可防止詐騙。雖然交易傳輸量低於標準資料表,但區塊鏈資料表的效能比分散式區塊鏈的效能好。
區塊鏈表格僅會附加,因為唯一允許的 DML 是 INSERT 命令。表格不允許 UPDATE、DELETE、MERGE、TRUNCATE 以及直接路徑載入。資料庫交易可以跨區塊鏈表格和標準表格。例如,單一交易可以將資料列插入標準表格和兩個不同的區塊鏈表格。
區塊鏈表格可用來保護「倒溯資料存檔」內容。這可讓您判斷是否有任何人竄改了表格的內容。區塊鏈日誌歷史記錄表格可被視為維護以加密方式保護的邏輯重做日誌,以變更追蹤的使用者表格。
您可以從第 2 版區塊鏈表格開始的區塊鏈表格新增或刪除使用者資料欄。不允許從版本 1 的區塊鏈表格新增或刪除使用者資料欄。實際不會刪除實體資料欄與資料,但會標示為不顯示。
-
資料列鏈結:在區塊鏈表格中,資料列鏈結是一系列與雜湊配置連結的資料列。
-
資料列內容:資料列內容是連續的位元組序列,其中包含資料列的資料欄資料,以及鏈結中上一個資料列的雜湊值。
-
區塊鏈表格的使用者介面與標準表格一樣,區塊鏈表格是由 SQL 建立,並支援純量資料類型、LOB、JSON 及分割區。您也可以建立區塊鏈表格的索引和觸發程式。
資料列鏈
在區塊鏈表格中,資料列鏈是一系列資料列,這些資料列會與雜湊配置連結。
系統資料列鏈是由版本 1 區塊鏈表格中資料庫執行處理 ID 與鏈 ID 的唯一組合來識別。從第 2 版區塊鏈資料表開始,除了這兩個識別碼之外,還需要插入資料列之資料庫的全域唯一識別碼。系統資料列鏈是由第 2 版區塊鏈表格中可插拔資料庫全域唯一 ID、資料庫執行處理 ID 及鏈結 ID 的唯一組合所識別。區塊鏈表格中的資料列僅屬於一個系統資料列鏈。單一表格支援多個系統資料列鏈結。注意:標準表格中的鏈結資料列與區塊鏈表格中的資料列鏈結垂直。只有「鏈」一詞相同。
鏈結中的每一列都有唯一的序號。資料庫會在每個鏈結的資料列上使用 SHA2-512 雜湊計算來排序資料列。每個插入之列的雜湊是從插入之列的列內容衍生而來,其中包含之前在鏈結中插入之列的雜湊值。
雖然區塊鏈表格中的每個資料列都只屬於一個系統鏈結,但它也可以根據建立區塊鏈表格時所指定的一組使用者資料欄值屬於一個使用者鏈結。
列內容
資料列內容是連續的位元組順序,其中包含資料列的資料欄資料,以及鏈結中上一個資料列的雜湊值。
當您建立區塊鏈表格時,資料庫會建立數個隱藏的資料欄。例如,您可以建立含有資料欄 bank 和 deposit 的區塊鏈表格 bank_ledger:
CREATE BLOCKCHAIN TABLE bank_ledger (bank VARCHAR2 (128), deposit NUMBER)
  NO DROP UNTIL 31 DAYS IDLE
  NO DELETE UNTIL 31 DAYS AFTER INSERT
  HASHING USING "SHA2_512" VERSION "v1";
資料庫會自動建立前置碼為 ORABCTAB 的隱藏資料欄:ORABCTAB_INST_ID$、ORABCTAB_CHAIN_ID$、ORABCTAB_SEQ_NUM$ 等。這些隱藏的資料欄大部分無法更改或管理,都會實作反竄改演算法。此演算法會在確認時依特定順序取得唯一的資料表層級鏈結鎖定,以避免鎖死。
注意:區塊鏈表格的資料列內容儲存在標準資料區塊中。在此版本的 Oracle AI Database 中,區塊鏈表格不支援表格叢集。
實例 ID、鏈結 ID 和序號可唯一識別資料列。從第 2 版區塊鏈資料表開始,除了這三個值之外,還需要插入資料列之資料庫的全域唯一識別碼。每個資料列都有一個不受平台影響的 SHA2-512 雜湊,此雜湊儲存在隱藏的資料欄 ORABCTAB_HASH$ 中。雜湊是根據所插入列的內容以及鏈結中上一列的雜湊而定。
資料列之資料欄值的資料格式是由資料欄描述資料和內容的位元組所組成。資料欄描述資料是一個描述特性的 20 位元組結構,例如表格中的位置、資料類型、空值狀態以及位元組長度。資料欄內容是代表資料列值的一組位元組。例如,值 Chase 的 ASCII 表示法為 43 68 61 73 65。您可以使用 SQL 中的 DUMP 函數來取得資料欄描述資料和內容。
雜湊計算的資料列內容包括來自多個資料欄的資料欄資料格式:鏈結中上一列的雜湊值、使用者定義的資料欄,以及固定數目的隱藏資料欄。
系統可追蹤相關列的插入順序 (稱為列版本),並藉由指定定義列版本的欄集合來記錄。此外,如果已指定資料列版本,則會自動建立並維護檢視,以顯示針對使用者指定之資料欄集中每個值組合所插入的最後一個資料列。檢視名稱使用命名慣例 Blockchain_Table_Name_LAST$。
在許多情況下,必須由一般使用者的委派人員另外或替代簽署資料列。其中一個範例是,銀行經理簽署一般使用者插入的列。委派簽署者是另一個資料庫使用者,可以在透過列的系統加密雜湊計算的列上新增其簽章。一般使用者、委派者或兩者都可以簽署資料列。只有在使用委派者的憑證來驗證簽章,且委派者的憑證記錄在資料庫說明表格中時,才會接受委派者的簽章。
當一般使用者或委派者簽署資料列時,使用者可能會想要為該資料列採購計數器簽名。對於已由一般使用者或委派人員簽署的資料列,可以特別將計數器簽名視為區塊鏈資料表摘要。當資料列經過計數器簽署時,會將計數器簽章傳回資料列簽章,並儲存在該資料列中。在資料列上要求計數器簽名的使用者可以將此資訊儲存於個別資料儲存中,以供非可否認之之用。
區塊鏈表格的使用者介面
就像標準表格一樣,區塊鏈表格是由 SQL 建立,並支援純量資料類型、LOB、JSON 及分割區。您也可以建立區塊鏈表格的索引和觸發程式。
若要建立區塊鏈表格,請使用 CREATE BLOCKCHAIN TABLE 敘述句。區塊鏈表格具有 NO DROP UNTIL n DAYS IDLE 子句所指定的保留期間。您可以使用 DROP TABLE 移除表格。
Oracle Blockchain 表格支援下列介面:
-
DBMS_BLOCKCHAIN_TABLE套裝軟體可讓您在表格資料列上執行各種作業。例如,若要將簽名套用至先前插入的資料列內容,請使用SIGN_ROW程序。若要驗證資料列尚未被竄改,請使用VERIFY_ROWS。若要在保留期間 (由NO DELETE子句指定) 通過後移除列,請使用DELETE_EXPIRED_ROWS。 -
DBA_BLOCKCHAIN_TABLES檢視會顯示表格描述資料,例如資料列保留期間、允許刪除表格之前的無活動期間,以及雜湊演算法。
備註:
-
Oracle AI Database Administrator's Guide,瞭解如何管理區塊鏈資料表
-
Oracle AI Database PL/SQL Packages and Types Reference,瞭解
DBMS_BLOCKCHAIN_TABLE套裝程式 -
Oracle AI Database Reference,瞭解
DBA_BLOCKCHAIN_TABLES檢視
不可變表格概要
不可變表格是僅附加的表格,可防止因人為錯誤而造成的內部人員和意外資料修改而導致未經授權的資料修改。
有權存取內部認證的員工可能會嘗試未經授權的修改。
您可以將新資料列新增至不可變的表格,但不能修改現有資料列。您必須同時為不可變表格與不可變表格內的資料列指定保留期間。資料列在指定的資料列保留期間之後變成過時。只能從不可變表格刪除過時的資料列。
不可變表格包含系統產生的隱藏資料欄。資料欄與區塊鏈表格的資料欄相同。插入資料列時,會為 ORABCTAB_CREATION_TIME$ 和 ORABCTAB_USER_NUMBER$ 資料欄設定非空值值。除了 V1 不可變表格之外,會為 ORABCTAB_PDB_GUID$ 資料欄設定非空值的值。如果使用資料列版本建立不可變的表格,則會為 ORABCTAB_ROW_VERSION$ 和 ORABCTAB_LAST_ROW_VERSION_NUMBER$ 資料欄設定非空值值。其餘系統產生的隱藏資料欄值會設為 NULL。
使用不可變的表格時,不需要變更現有的應用程式。
物件表格概要
物件表格是一種特殊的表格,其中每一列都代表一個物件。
Oracle 物件類型是使用者定義的類型,包含名稱、屬性和方法。物件類型可讓您將真實世界的實體 (例如客戶和採購單) 建模為資料庫中的物件。
物件類型定義邏輯結構,但不會建立儲存。下列範例會建立名為 department_typ 的物件類型:
CREATE TYPE department_typ AS OBJECT
   ( d_name     VARCHAR2(100),
     d_address  VARCHAR2(200) );
/
下列範例會建立名為 departments_obj_t 的物件表格,其物件類型為 department_typ,然後在表格中插入資料列。departments_obj_t 表格的屬性 (資料欄) 是衍生自物件類型的定義。
CREATE TABLE departments_obj_t OF department_typ;
INSERT INTO departments_obj_t VALUES ('hr', '10 Main St, Sometown, CA');
就像關聯式資料欄一樣,物件表格只能包含一種類型的資料列,也就是與表格相同宣告類型的物件執行處理。依照預設,物件表格中的每個資料列物件都有相關聯的邏輯物件 ID (OID),可在物件表格中唯一識別它。物件表格的 OID 資料欄是隱藏的資料欄。
另請參閱:
-
Oracle AI Database Object-Relational Developer's Guide,瞭解 Oracle AI Database 中的物件關聯功能
-
Oracle AI Database SQL Language Reference,瞭解
CREATE TYPE的語法和語意