資料並行與一致性
此頁面上的命令檔內容僅適用於瀏覽用途,而且無法利用任何方式來更改內容。
本章說明 Oracle AI Database 如何在多使用者資料庫環境中維持一致的資料。
-
資料並行與一致性簡介:在單一使用者資料庫中,使用者可以修改資料,而不需擔心其他使用者會同時修改相同的資料。不過,在多重使用者資料庫中,多重同時異動內的陳述式可能會更新相同的資料。同時執行的交易必須產生有意義且一致的結果。
-
Oracle AI Database Transaction Isolation Level 簡介:交易隔離層級的 ANSI 標準是以每個隔離層級均允許或禁止的現象為定義。
-
Oracle AI Database 鎖定機制簡介:鎖定是一種防止破壞性互動的機制。
-
自動鎖定簡介 Oracle AI Database 會代表交易自動鎖定資源,以防止其他交易執行需要獨佔存取相同資源的動作。
-
手動資料鎖定簡介:您可以手動覆寫 Oracle AI Database 預設鎖定機制。
-
使用 Oracle AI Database Lock Management 服務使用者定義鎖定的簡介,您可以為特定應用程式定義自己的鎖定。
資料並行和一致性簡介
在單一使用者資料庫中,使用者可以修改資料,而不需擔心會讓其他使用者同時修改相同的資料。不過,在多重使用者資料庫中,多重同時異動內的陳述式可能會更新相同的資料。同時執行的交易必須產生有意義且一致的結果。
多使用者資料庫必須提供下列項目:
為了描述並行執行交易時的一致交易行為,資料庫研究人員定義了稱為序列化性的交易隔離模型。可序列化的交易會在一個環境中運作,讓它看起來就像沒有其他使用者正在修改資料庫中的資料一樣。
雖然交易間的隔離程度通常很適合,但以可序列化模式執行許多應用程式可能會嚴重危害應用程式的傳輸量。並行執行交易的完整隔離,這表示一個交易無法執行被另一個交易查詢之表格中的插入。簡而言之,實際考量通常需要完美交易隔離與效能之間的妥協。
Oracle AI Database 使用多重轉移一致性模型和各種類型的鎖定和交易來維持資料一致性。如此一來,資料庫就可以將資料檢視呈現給多個並行使用者,每個檢視皆一致至一個時間點。因為資料區塊的不同版本可以同時存在,所以交易可以讀取查詢所需時間點所確認的資料版本,並傳回與單一時間點一致的結果。
-
多重轉移讀取一致性在 Oracle AI Database 中,多重轉移是可以同時具體化多個資料版本。Oracle AI Database 保持多變讀取一致性。
-
鎖定機制一般而言,多使用者資料庫會使用某種形式的資料鎖定來解決與資料並行、一致性及完整性相關的問題。
-
ANSI/ISO 交易隔離層次:ANSI 與 ISO/IEC 皆採用的 SQL 標準定義了四種交易隔離層次。這些階層對異動處理處理量有不同的影響程度。另請參閱:「資料完整性」與「交易」
多重轉移讀取一致性
在 Oracle AI Database 中,多功能可以同時具體化多個版本的資料。Oracle AI Database 保持多變讀取一致性。
Oracle 資料庫查詢的特性如下:
-
讀取一致查詢
查詢傳回的資料會在單一時間點確認並一致。
備註:Oracle AI Database 永不允許已修改讀取,當交易在另一個交易中讀取未確認的資料時會發生此情況。
為了說明已變更抄表值的問題,假設有一個交易在不確認的情況下更新資料欄值。第二個交易會讀取已更新且已修改 (未確認) 的值。第一個階段作業會倒回交易,使資料欄具有舊值,但第二個交易會使用更新的值繼續進行,因為資料庫損毀。已變更讀取會影響資料完整性、違反外來索引鍵,以及忽略唯一限制條件。
-
非封鎖查詢
資料的讀取器和寫入器不會互相封鎖。
-
敘述句層次讀取一致性 Oracle AI Database 一律會強制執行敘述句層次讀取一致性,可確保單一查詢傳回的資料在單一時間點確認並一致。
-
交易層級讀取一致性 Oracle AI Database 還能為交易中的所有查詢提供讀取一致性,稱為交易層級讀取一致性。
-
讀取一致性和還原區段:若要管理多重轉移讀取一致性模型,當同時查詢和更新表格時,資料庫必須建立一組讀取一致性的資料。
-
讀取一致性和延緩的插入一種特殊類型的插入,稱為延緩的插入,並不會使用標準讀取一致性機制。另請參閱:「鎖定行為摘要」
敘述句層次讀取一致性
Oracle AI Database 一律會強制執行敘述句層次讀取一致性,這可確保單一查詢傳回的資料在單一時間點會經過確認且一致。
單一 SQL 敘述句一致的時間點,取決於交易隔離層次與查詢的本質:
-
在讀取確認的隔離層次中,此點是開啟敘述句的時間。例如,如果
SELECT陳述式在 SCN 1000 開啟,則此陳述式會與 SCN 1000 一致。 -
在可序列化或唯讀交易中,此點是交易開始的時間。例如,如果交易從 SCN 1000 開始,且此交易中發生多個
SELECT敘述句,則每個敘述句都會與 SCN 1000 一致。 -
在「倒溯查詢」作業 (
SELECT ... AS OF) 中,SELECT敘述句會明確指定時間點。例如,您可以查詢上星期四下午 2 點出現的表格。
另請參閱:Oracle AI Database Development Guide 瞭解倒溯查詢
交易層級讀取一致性
Oracle AI Database 還可以為交易中的所有查詢提供讀取一致性,稱為交易層級讀取一致性。
在此情況下,交易中的每個敘述句會從相同時間點看到資料。這是交易開始的時間。
由可序列化交易所做的查詢,會看到交易本身所做的變更。例如,更新 employees,然後查詢 employees 的交易將會看到更新。交易層次讀取一致性會產生可重複的讀取,而且不會對虛擬在製品讀取顯示查詢。
讀取一致性與還原區段
若要管理多重空間讀取一致性模型,當同時查詢和更新表格時,資料庫必須建立一組讀取一致的資料。
Oracle AI Database 透過還原資料實現讀取一致性。
每當使用者修改資料時,Oracle AI Database 就會建立還原項目,並將其寫入還原區段。還原區段含有已被未確認或最近確認的交易變更的舊資料值。因此,資料庫中存在相同資料的多個版本 (所有版本都位於不同的時間點)。資料庫可以使用不同時間點的資料快照,提供資料的讀取一致檢視,並啟用非封鎖查詢。
在單一執行處理和 Oracle Real Application Clusters (Oracle RAC) 環境中,保證讀取一致性。Oracle RAC 使用快取到快取的區塊傳輸機制 (稱為快取融合),將資料區塊的讀取一致影像從一個資料庫執行處理傳輸到另一個資料庫執行處理。
-
讀取一致性:範例此範例顯示使用還原資料的查詢,在讀取確認的隔離層次中提供敘述句層次讀取一致性。
-
讀取一致性和感興趣的交易清單:每個區段區塊的區塊標頭都包含感興趣的交易清單 (ITL) 。
另請參閱:
-
「還原區段」可瞭解還原儲存
-
Oracle AI Database SecureFiles and Large Object Developer's Guide,瞭解 LOB 的讀取一致性機制
讀取一致性:範例
此範例顯示的查詢使用還原資料,在讀取確認的隔離層次中提供敘述句層次讀取一致性。
圖 1:讀取確認隔離層次中的讀取一致性
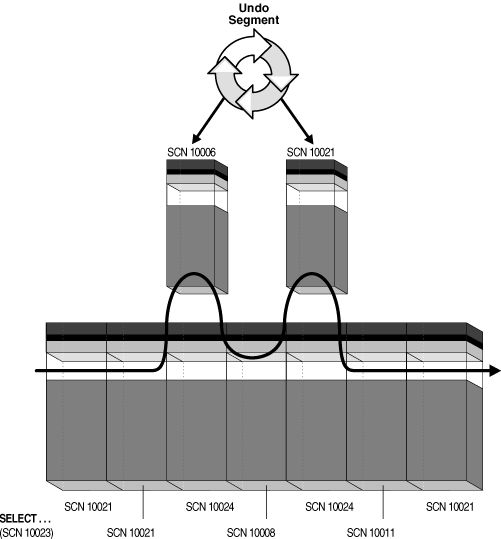
當資料庫代表查詢擷取資料區塊時,資料庫會確保每個區塊中的資料都會在查詢開始時反映區塊的內容。資料庫會視需要將變更倒回至區塊,以將區塊重新建構至查詢開始處理的時間點。
資料庫使用稱為 SCN 的內部排序機制來保證交易的順序。當 SELECT 敘述句進入執行階段時,資料庫會決定查詢開始執行時所記錄的 SCN。在圖 12-1 中,此 SCN 是 10023。此查詢只會看到與 SCN 10023 有關的已確認資料。
在圖 12-1 中,SCN 在 10023 之後的區塊表示資料已變更,如 SCN 10024 的兩個區塊所示。SELECT 敘述句需要一個與確認之變更一致的區塊版本。資料庫會將目前的資料區塊複製到新的緩衝區,並套用還原資料以重新建構先前版本的區塊。這些重新建構的資料區塊稱為一致讀取 (CR) 複製。
在圖 12-1 中,資料庫會建立兩個 CR 複製:一個與 SCN 10006 一致的區塊,另一個與 SCN 10021 一致的區塊。資料庫會傳回查詢的重新建構資料。如此一來,Oracle AI Database 便能防止已修改的讀取。
另請參閱:「資料庫緩衝區快取」與「系統變更編號 (SCN) 」
讀取一致性與感興趣的交易清單
每個區段區塊的區塊標頭都包含一個感興趣的交易清單 (ITL) 。
資料庫會使用 ITL 來判斷當資料庫開始修改區塊時,是否有未確認的交易。
ITL 中的項目說明哪些交易已鎖定資料列,而區塊中的哪些資料列包含已確認與未確認的變更。ITL 指向還原區段中的交易表格,其中提供對資料庫進行變更時機的相關資訊。
有意義的是,區塊標頭會包含影響區塊中每個資料列的最近交易歷史記錄。CREATE TABLE 與 ALTER TABLE 陳述式的 INITRANS 參數會控制要保留的交易歷史記錄數量。
另請參閱:Oracle AI Database SQL Language Reference,瞭解 INITRANS 參數
讀取一致性與延緩的插入
特殊類型的插入稱為延緩插入,並不會使用標準讀取一致性機制。
延遲插入使用 MEMOPTIMIZE_WRITE 提示插入指定為 MEMOPTIMIZE FOR WRITE 的表格中。資料庫會將這些插入緩衝區放在大型集區中,而非緩衝區快取中。資料庫不會使用重做與還原來追蹤變更。而是在「空間管理協調器 (SMCO)」將緩衝區寫入磁碟時,資料庫會自動確認變更。無法倒回變更。
延緩的插入與傳統插入的不同之處如下:
-
應用程式會假設已確認位於大型集區中的資料,可能會遺失。例如,資料庫執行處理在將變更儲存至磁碟之前可能會失敗,即使應用程式回報變更已經儲存。
-
不允許直接從記憶體讀取資料。寫入器必須等到背景處理作業將變更寫入磁碟後,才能讀取自己的變更。在將已確認的變更寫入磁碟之前,任何讀取器都看不到已確認的變更。
必須避免資料遺失的用戶端應用程式,應在寫入大型集區之後,保留資料的本機副本。用戶端可以使用 DBMS_MEMOPTIMIZE 套裝軟體來追蹤寫入記憶體的持久性,以及使用 DBMS_MEMOPTIMIZE_ADMIN 套裝軟體強制資料庫寫入磁碟。
另請參閱:
-
Oracle AI Database SQL Language Reference,瞭解
MEMOPTIMIZE FOR WRITE提示的詳細資訊
鎖定機制
一般而言,多使用者資料庫會使用某種形式的資料鎖定來解決與資料並行、一致性和完整性相關的問題。
鎖定是一種機制,可防止交易在存取相同資源時進行破壞性互動。
另請參閱:「Oracle AI Database 鎖定機制概要」
ANSI/ISO 交易隔離層次
由 ANSI 和 ISO/IEC 採用的 SQL 標準定義了四層交易隔離。這些階層對異動處理處理量有不同的影響程度。
這些隔離層次是定義在必須防止並行執行交易之間的現象。可預防的現象包括:
-
已變更抄表值
交易會讀取被另一個尚未確認的交易所寫入的資料。
-
不可重複的 (模糊) 讀取
一個交易會重新讀取先前已讀取的資料,並發現另一個已確認的交易已修改或刪除資料。例如,使用者先查詢列,之後再查詢相同列,只搜尋已變更的資料。
-
虛擬在製品讀取
交易會重新執行查詢,傳回一組滿足搜尋條件的資料列,並發現另一個確認的交易已插入其他滿足條件的資料列。
例如,異動會查詢員工人數。五分鐘後,它會執行相同的查詢,但現在因為其他使用者插入了新僱用的記錄,所以數字已增加一筆。比以前滿足查詢準則的資料更多,但與模糊讀取不同,先前讀取的資料不會變更。
SQL 標準定義了四種隔離層次,就是在特定隔離層次執行的交易可以體驗的現象而言。表格 12-1 顯示層次。
表格 1 依隔離層次的可預防讀取現象
| 隔離層次 | 已變更讀取 | 不可重複讀取 | 虛擬在製品讀取 |
|---|---|---|---|
| 讀取未確認 | 可能 | 可能 | 可能 |
| 已確認讀取 | 不可能 | 可能 | 可能 |
| 可重複讀取 | 不可能 | 不可能 | 可能 |
| 可序列化 | 不可能 | 不可能 | 不可能 |
Oracle AI Database 提供已確認 (預設) 和可序列化的隔離層級。此外,資料庫也提供唯讀模式。
另請參閱:
-
Oracle AI Database Transaction Isolation Level 簡介,瞭解已確認、可序列化和唯讀的隔離層級
-
Oracle AI Database SQL Language Reference,瞭解 Oracle AI Database 與 SQL 標準是否一致
Oracle AI Database Transaction Isolation Level 概要
交易隔離層次的 ANSI 標準定義於每個隔離層次都允許或防止的現象。
Oracle AI Database 提供交易隔離層次:
-
讀取確認的隔離層次:在讀取確認的隔離層次中,由交易執行的每個查詢只會見到查詢之前確認的資料 (而非交易)。
-
可序列化的隔離層次:在可序列化的隔離層次中,交易只會看到交易時確認的變更 (而非查詢),以及交易本身所做的變更。
-
唯讀隔離層次:唯讀隔離層次與可序列化的隔離層次類似,但是唯讀交易不允許在交易中修改資料,除非使用者為
SYS。
另請參閱:
-
Oracle AI Database Development Guide,瞭解有關交易隔離層級的詳細資訊
-
Oracle AI Database SQL Language Reference 和 Oracle AI Database PL/SQL Language Reference,瞭解
SET TRANSACTION ISOLATION LEVEL
讀取已確認的隔離層次
在讀取確認的隔離層次中,交易所執行的每個查詢只會見到查詢之前確認的資料,而不是交易開始。
此隔離層次為預設層次。這適用於可能會有少數交易發生衝突的資料庫環境。
讀取已確認交易中的查詢可避免在查詢進行時讀取確認的資料。例如,如果查詢正在掃描百萬資料列表格,而其他交易確認資料列 950,000 的更新,則查詢在讀取資料列 950,000 時不會看到此變更。不過,因為資料庫不會讓其他交易無法修改查詢讀取的資料,所以其他交易可能會介於查詢執行之間變更資料。因此,執行相同查詢兩次的交易可能會發生模糊讀取和虛擬的狀況。
-
讀取已確認隔離層級中的一致性:資料庫會為每個查詢提供一致的結果集,保證資料一致性,使用者無需採取任何動作。
-
以讀取確認的交易進行衝突寫入在讀取確認的交易中,當交易嘗試變更由未確認的並行交易更新的資料列時,就會發生衝突寫入。
讀取已確認隔離層次中的讀取一致性
資料庫會為每個查詢提供一致的結果集,保證資料一致性,使用者無需採取任何動作。
隱含查詢 (例如 UPDATE 陳述式中 WHERE 子句隱含的查詢) 可保證一組一致的結果。不過,隱含查詢中的每個敘述句都不會看到 DML 敘述句本身所做的變更,但是會看到資料在進行變更之前即已存在。
如果 SELECT 清單包含 PL/SQL 函數,則資料庫會在敘述句層次套用敘述句層次的敘述句層次讀取一致性,以在 PL/SQL 函數程式碼內執行 SQL,而非在父項 SQL 層次執行。例如,函數可以存取由其他使用者變更和確認其資料的表格。每次在函數中執行 SELECT 時,都會建立一個新的讀取一致快照。
另請參閱:「子查詢」
讀取已確認交易中的衝突寫入
在讀取確認的交易中,當交易嘗試變更由未確認的並行交易更新的資料列時,就會發生衝突寫入。
防止資料列修改的交易有時稱為封鎖交易。讀取確認的交易會等待阻隔交易結束,並釋放其資料列鎖定。
選項如下:
-
如果阻隔交易倒回,則等待交易會繼續變更先前鎖定的資料列,就像其他交易從未存在一樣。
-
如果封鎖交易確認並解除鎖定,則等候交易會繼續進行新變更資料列的預期更新。
下表顯示可序列化或讀取確認的交易 1 如何與讀取確認的交易 2 互動。它會顯示稱為最新更新的傳統情況。即使交易 1 已提交,交易 1 所做的更新也不會出現在表格中。設計策略來處理遺失的更新,是應用程式開發的重要環節。
表格 2 READ COMMITTED 交易中的衝突寫入和遺失更新
| 階段作業 1 | 階段作業 2 | 說明 |
|---|---|---|
SQL> SELECT last_name,
  salary FROM employees
  WHERE last_name IN
  ('Banda', 'Greene',
 'Hintz');

  LAST_NAME SALARY
 ------------- ----------
 Banda 6200
Greene 9500 |
沒有動作。 | 梯次 1 會查詢 Banda、Greene 與 Hintz 的薪資。找不到名為 Hintz 的員工。 |
SQL> UPDATE employees SET salary = 7000 WHERE last_name = 'Banda'; |
沒有動作。 | 梯次 1 會透過更新 Banda 薪資來開始異動。交易 1 的預設隔離層次為 READ COMMITTED。 |
| 沒有動作。 | SQL> SET TRANSACTION ISOLATION LEVEL READ COMMITTED; |
階段作業 2 開始交易 2,並將隔離層次明確設定為 READ COMMITTED。 |
| 沒有動作。 | SQL> SELECT last_name,
salary FROM employees
WHERE last_name IN
('Banda', 'Greene',
'Hintz');
LAST_NAME SALARY
------------- ----------
Banda 6200
Greene 9500 |
Transaction 2 會查詢 Banda、Greene 和 Hintz 的薪資。Oracle AI Database 使用讀取一致性,在交易 1 所進行的未確認更新之前顯示 Banda 的薪資。 |
| 沒有動作。 | SQL> UPDATE employees SET salary = 9900 WHERE last_name='Greene'; |
交易 2 已順利更新 Greene 的薪資,因為交易 1 僅鎖定 Banda 資料列。 |
SQL> INSERT INTO employees (employee_id, last_name, email, hire_date, job_id) VALUES (210, 'Hintz', 'JHINTZ', SYSDATE, 'SH_CLERK'); |
沒有動作。 | 交易 1 會針對員工「提示」插入一列,但不會進行確認。 |
| 沒有動作。 | SQL> SELECT last_name,
salary FROM employees
WHERE last_name IN
('Banda', 'Greene',
'Hintz');
LAST_NAME SALARY
------------- ----------
Banda 6200
Greene 9900 |
Transaction 2 會查詢員工 Banda、Greene 和 Hintz 的薪資。 交易 2 會看到其對 Greene 薪資的更新。交易 2 看不到 Banda 的薪資未確認更新或交易 1 所插入的 Hintz 更新。 |
| 沒有動作。 | SQL> UPDATE employees SET salary = 6300 WHERE last_name = 'Banda'; -- prompt does not return |
Transaction 2 嘗試更新 Banda 的資料列,該資料列目前被交易 1 鎖定,因此建立衝突的寫入。交易 2 會等到交易 1 結束為止。 |
SQL> COMMIT; |
沒有動作。 | 交易 1 確認其工作,結束交易。 |
| 沒有動作。 | 1 row updated. SQL> |
現在解除 Banda 資料列的鎖定,因此交易 2 會繼續更新 Banda 的薪資。 |
| 沒有動作。 | SQL> SELECT last_name,
salary FROM employees
WHERE last_name IN
('Banda', 'Greene',
'Hintz');
LAST_NAME SALARY
------------- ----------
Banda 6300
Greene 9900
Hintz |
Transaction 2 會查詢 Banda、Greene 和 Hintz 員工的薪資。交易 2 現在可以看到由交易 1 確認的 Hintz 插入。交易 2 會看到自己對 Banda 薪資的更新。 |
| 沒有動作。 | COMMIT; |
交易 2 確認其工作,結束交易。 |
SQL> SELECT last_name,
  salary FROM employees
  WHERE last_name IN
 ('Banda', 'Greene',
  'Hintz');

  LAST_NAME SALARY
 ------------- ----------
 Banda 6300
 Greene 9900
Hintz |
沒有動作。 | 階段作業 1 會查詢 Banda、Greene 以及 Hintz 的資料列。Banda 的薪資是 6300,這是交易 2 所做的更新。Banda 的薪資更新為交易 1 所進行的 7000,現在「失落」。 |
另請參閱:
-
「使用鎖定」可瞭解遺失的更新
-
「資料列鎖定 (TX) 」可瞭解資料庫取得資料列鎖定的時機和原因
可序列化的隔離層次
在可序列化的隔離層次中,交易只會見到交易時確認的變更,而不是查詢開始,以及交易本身所做的變更。
可序列化的交易會在一個環境中運作,讓它看起來就像沒有其他使用者正在修改資料庫中的資料一樣。可序列化的隔離適用於下列環境:
-
使用大型資料庫和短交易,僅更新幾個資料列
-
如果兩個並行交易將修改相同資料列的機會相對較低
-
若相對長時間執行的交易主要為唯讀
在可序列化的隔離中,通常是在敘述句層次取得之讀取一致性會延伸至整個交易。重新讀取時,交易所讀取的任何資料列都會確保相同。所有查詢保證會在交易的持續時間內傳回相同的結果,因此無論交易執行多久,查詢都不會看到其他交易所做的變更。可序列化的交易不會發生已變更的讀取、模糊讀取或虛擬在製品讀取。
只有在可序列化交易開始時,已經確認其他交易對資料列所做的變更時,Oracle AI Database 才會允許可序列化交易修改資料列。當可序列化交易在可序列化交易開始之後確認的不同交易嘗試更新或刪除資料時,資料庫會產生錯誤:
ORA-08177: Cannot serialize access for this transaction當可序列化的交易因 ORA-08177 錯誤而失敗時,應用程式可以採取數個動作,包括:
-
將執行的工作確認至該點
-
倒回之前在交易中建立的儲存點之後,執行其他 (但有差異) 敘述句
-
倒回整個異動
下表顯示可序列化交易如何與其他交易互動。如果可序列化的交易在可序列化的交易開始後,沒有嘗試變更另一個交易確認的資料列,則會避免發生序列化的存取問題。
表 3 可序列化交易
| 階段作業 1 | 階段作業 2 | 說明 |
|---|---|---|
|
沒有動作。 | 梯次 1 會查詢 Banda、Greene 與 Hintz 的薪資。找不到名為 Hintz 的員工。 |
|
沒有動作。 | 梯次 1 由更新 Banda 薪資開始異動 1。預設隔離層次為 READ COMMITTED。 |
| 沒有動作。 | |
階段作業 2 會開始交易 2,並將其設為 SERIALIZABLE 隔離層次。 |
| 沒有動作。 | |
Transaction 2 會查詢 Banda、Greene 和 Hintz 的薪資。Oracle AI Database 在交易 1 所進行的未確認更新之前,使用讀取一致性來顯示 Banda 的薪資。 |
| 沒有動作。 | |
交易 2 已順利更新 Greene 薪資,因為只有 Banda 資料列被鎖定。 |
|
沒有動作。 | 「異動 1」會為員工「提示」插入一列。 |
|
沒有動作。 | 交易 1 確認其工作,結束交易。 |
|
|
梯次 1 會查詢員工 Banda、Greene 和 Hintz 的薪資,並查看交易 1 所承諾的變更。階段作業 1 沒有看到交易 2 所進行的未確認 Greene 更新。 Transaction 2 會查詢 Banda、Greene 和 Hintz 員工的薪資。Oracle AI Database 讀取一致性可確保交易 2 看不到由交易 1 確認的 Hintz 插入和 Banda 更新。交易 2 會看到其對 Greene 薪資的更新。 |
| 沒有動作。 | |
交易 2 確認其工作,結束交易。 |
|
|
兩個梯次都會查詢 Banda、Greene 與 Hintz 的薪資。每個階段作業都會看到交易 1 與交易 2 所做的所有確認變更。 |
|
沒有動作。 | 梯次 1 會藉由更新「提示」薪資來開始異動 3。交易 3 的預設隔離層次為 READ COMMITTED。 |
| 沒有動作。 | |
階段作業 2 會開始交易 4,並將其設為 SERIALIZABLE 隔離層次。 |
| 沒有動作。 | |
交易 4 嘗試更新「提示」的薪資,但因為交易 3 鎖定了「提示」列,所以被封鎖。交易 3 背後的交易 4 佇列。 |
|
沒有動作。 | 交易 3 確認其 Hintz 薪資的更新,結束交易。 |
| 沒有動作。 | |
結束交易 3 的確認會導致交易 4 中的 Hintz 更新因 ORA-08177 錯誤而失敗。發生問題,因為交易 3 在交易 4 開始之後確認了 Hintz 更新。 |
| 沒有動作。 | |
階段作業 2 會倒回交易 4,結束交易。 |
| 沒有動作。 | |
階段作業 2 會開始交易 5,並將它設為 SERIALIZABLE 隔離層次。 |
| 沒有動作。 | |
Transaction 5 會查詢 Banda、Greene 和 Hintz 的薪資。可看見由交易 3 確認的提示薪資更新。 |
| 沒有動作。 | |
「異動 5」會將「提示」薪資更新為不同的值。由於交易 3 在交易 5 開始之前,由交易 3 確認的 Hintz 更新,因此可避免序列化存取問題。 備註:如果在交易 5 開始之後更新並確認其他交易的「提示」資料列,則會再次發生序列化存取問題。 |
| 沒有動作。 | |
階段作業 2 會確認更新,不會發生任何問題,因此會結束交易。 |
唯讀隔離層次
唯讀隔離層次與可序列化的隔離層次類似,但唯讀交易不允許在交易中修改資料,除非使用者為 SYS。
唯讀交易不容易發生 ORA-08177 錯誤。唯讀交易可用於產生報表,其內容必須與交易開始的時間一致。
Oracle AI Database 會視需要從還原區段重新建構資料,以實現讀取一致性。因為還原區段會以循環方式使用,所以資料庫可以覆寫還原資料。長時間執行的報表會造成還原讀取一致性所需資料的風險,可能已由不同的交易重複使用,因此會產生 snapshot too old 錯誤。設定還原保留期間,這是資料庫在覆寫之前,嘗試保留舊還原資料的最短時間長度,如此可適當地避免此問題。
另請參閱:
-
Oracle AI Database Administrator's Guide,瞭解如何設定還原保留期間
Oracle AI Database 鎖定機制總覽
鎖定是一種可防止破壞性互動的機制。
當互動在存取共用資料的交易之間不正確地更新資料或不正確地更改基礎資料結構時,互動是破壞性的。鎖定在維護資料庫並行性和一致性方面發揮關鍵作用。
-
鎖定行為摘要:資料庫會根據取得鎖定的作業,維護數種不同類型的鎖定。
-
使用鎖定在單一使用者資料庫中,不需要鎖定,因為只有一位使用者正在修改資訊。不過,當多個使用者正在存取和修改資料時,資料庫必須提供方法以防止相同資料並行修改。
-
鎖定模式:Oracle AI Database 會自動使用最低適用的限制層級來提供最高程度的資料並行,同時提供故障安全防護的資料完整性。
-
鎖定轉換與向上呈報:Oracle AI Database 會視需要執行鎖定轉換。
-
鎖定持續時間:Oracle AI Database 會在發生某些事件時自動解除鎖定,讓交易不再需要資源。
-
鎖定和死鎖:死鎖是指有兩個或更多使用者正在等待彼此鎖定資料時的情況。死鎖可以防止某些交易繼續運作。
鎖定行為摘要
資料庫會根據取得鎖定的作業,維護數種不同類型的鎖定。
一般而言,資料庫使用兩種類型的鎖定:獨佔鎖定與共用鎖定。資源 (例如資料列或表格) 上只能取得一個獨佔鎖定,但是只能在單一資源上取得許多共用鎖定。
鎖定會影響讀取器與寫入器的互動。讀取器是資源的查詢,而寫入器則是修改資源的敘述句。下列規則總結列出 Oracle AI Database 讀取器和寫入器的鎖定行為:
-
只有在寫入器修改資料列時,才會被鎖定。
當敘述句更新一個資料列時,交易只會取得此資料列的鎖定。透過在資料列層次鎖定表格資料,資料庫可將相同資料的競爭降到最低。在一般情況下註腳 1,資料庫不會將資料列鎖定呈報至區塊或表格層次。
-
資料列寫入器會封鎖相同資料列的並行寫入器。
如果某個交易正在修改某個資料列,則資料列鎖定會讓不同的交易無法同時修改相同的資料列。
-
讀取器永遠不會封鎖寫入器。
因為資料列讀取器未鎖定資料列,所以寫入器可以修改此資料列。唯一的例外是
SELECT ... FOR UPDATE陳述式,這是一種特殊類型的SELECT陳述式,執行會鎖定其正在讀取的資料列。 -
寫入器從未封鎖讀取器。
當寫入器變更資料列時,資料庫會使用還原資料,讓讀取器可以一致地檢視資料列。
注意:在非常特殊的待處理分散式交易案例中,資料讀取器可能需要等待相同資料區塊的寫入器。
另請參閱:
-
Oracle AI Database SQL Language Reference,瞭解
SELECT ... FOR UPDATE -
Oracle AI Database Administrator's Guide,瞭解有問題分散式交易的相關等待
使用鎖定
在單一使用者資料庫中,不需要鎖定,因為只有一位使用者正在修改資訊。不過,當多個使用者正在存取和修改資料時,資料庫必須提供方法以防止相同資料並行修改。
鎖定可滿足下列重要的資料庫需求:
-
一致性
階段作業正在檢視或變更的資料,必須等到使用者完成後,其他階段作業才能變更。
-
完整性
資料和結構必須以正確的順序反映對其進行的所有變更。
Oracle AI Database 透過其鎖定機制,提供交易之間的資料並行性、一致性和完整性。鎖定會自動進行,不需要使用者動作。
單一資料列的並行更新可以說明鎖定的需求。在下列範例中,簡單的 Web 應用程式為一般使用者提供員工電子郵件和電話號碼。應用程式會使用 UPDATE 陳述式 (如下所示) 來修改資料:
UPDATE employees
SET    email = ?, phone_number = ?
WHERE  employee_id = ?
AND    email = ?
AND    phone_number = ?
在前面的 UPDATE 陳述式中,WHERE 子句中的電子郵件和電話號碼值是指定員工的原始未修改值。此更新可確保應用程式修改的資料列,在應用程式上次讀取並向使用者顯示之後並未變更。如此一來,應用程式可避免遺失的更新問題,其中一位使用者會覆寫另一位使用者所做的變更,有效地遺失第二位使用者的更新 ( 表 12-2 顯示遺失更新的範例)。表格 12-4 顯示兩個階段作業嘗試在 employees 表格中大致相同時間修改相同資料列時的事件順序。
表格 4 資料列鎖定範例
| T | 階段作業 1 | 階段作業 2 | 說明 |
|---|---|---|---|
| t0 | |
在階段作業 1 中,hr1 使用者會查詢 Himuro 記錄的 hr.employees,並顯示 employee_id (118)、電子郵件 (GHIMURO) 以及電話號碼 (515.127.4565) 屬性。 |
|
| t1 | |
在階段作業 2 中,hr2 使用者會查詢 Himuro 記錄的 hr.employees,並顯示 employee_id (118)、電子郵件 (GHIMURO) 和電話號碼 (515.127.4565) 屬性。 |
|
| t2 | |
在階段作業 1 中,hr1 使用者會將資料列中的電話號碼更新為 515.555.1234,這會取得 GHIMURO 資料列的鎖定。 |
|
| t3 | |
在階段作業 2 中,
|
|
| t4 | |
在階段作業 1 中, 這個承諾會對希姆羅的永久性和解除阻擋已經等待的第 2 階段做出改變。 |
|
| t5 | |
在階段作業 2 中, 因為述詞不相符,所以階段作業 2 不會更新任何記錄。 |
|
| t6 | |
在階段作業 1 中,hr1 使用者知道它使用錯誤的電話號碼更新 GHIMURO 資料列。使用者啟動新交易,並將資料列中的電話號碼更新為 515.555.1235,這會鎖定 GHIMURO 資料列。 |
|
| t7 | |
在階段作業 2 中,hr2 使用者會查詢 Himuro 記錄的 hr.employees。記錄會顯示階段作業 1 在 t4 確認的電話號碼更新。Oracle AI Database 讀取一致性可確保第 2 階段不會看到在 t6 所做的未確認變更。 |
|
| t8 | |
在階段作業 2 中,hr2 使用者嘗試更新相同的資料列,但因為 hr1 目前正在處理該資料列而遭到封鎖。 |
|
| t9 | |
在階段作業 1 中,hr1 使用者會倒回交易,結束交易。 |
|
| t10 | |
在階段作業 2 中,電話號碼更新會成功,因為階段作業 1 更新已回復。GHIMURO 資料列與其述詞相符,因此更新會成功。 |
|
| t11 | |
階段作業 2 會確認更新,結束交易。 |
Oracle AI Database 會在執行 SQL 敘述句時自動取得必要的鎖定。例如,在資料庫允許階段作業修改資料之前,該階段作業必須先鎖定資料。鎖定會讓階段作業對資料擁有獨佔式的控制,因此在釋放鎖定之前,其他任何交易都無法修改鎖定的資料。
由於 Oracle AI Database 的鎖定機制與交易控制密切相關,因此應用程式設計人員只需要正確定義交易,而 Oracle AI Database 會自動管理鎖定。雖然 Oracle AI Database 也可讓使用者手動鎖定資料,但使用者絕不需要明確鎖定任何資源。
下列各節說明瞭解 Oracle AI Database 如何達成資料並行的重要概念。
另請參閱:Oracle AI Database PL/SQL Packages and Types Reference,瞭解 OWA_OPT_LOCK 套裝程式,其中包含可協助防止遺失更新的子程式
鎖定方式
Oracle AI Database 會自動使用最低適用的限制層級,以提供最高程度的資料並行性,同時提供故障安全防護的資料完整性。
層次的限制越少,資料就越多,可供其他使用者存取。相反地,層次的限制越多,其他交易的類型就越有限。
Oracle AI Database 在多使用者資料庫中使用兩種鎖定模式:
-
獨佔鎖定模式
此模式可防止共用相關聯的資源。交易在修改資料時會取得獨佔鎖定。鎖定資源的第一個交易是唯一可以更改資源的交易,直到釋放獨佔鎖定為止。
-
共用鎖定模式
此模式允許根據相關的作業共用關聯的資源。多個讀取資料的使用者可以共用資料,每個使用者都擁有共用鎖定,可防止寫入器需要獨佔鎖定並行存取。多個交易可以取得相同資源的共用鎖定。
假設交易使用 SELECT ... FOR UPDATE 敘述句來選取單一表格資料列。交易會取得獨佔資料列鎖定與資料列共用表格鎖定。資料列鎖定可讓其他階段作業修改除了已鎖定資料列以外的任何資料列,而表格鎖定則可防止階段作業更改表格結構。因此,資料庫會允許盡可能多的敘述句執行。
鎖定轉換與呈報
Oracle AI Database 會視需要執行鎖定轉換。
在鎖定轉換中,資料庫會自動將較低限制的表格鎖定轉換成較高的限制之一。例如,假設交易為員工發出 SELECT ... FOR UPDATE,之後更新鎖定的列。在此情況下,資料庫會自動將資料列共用表格鎖定轉換為資料列獨佔表格鎖定。交易會針對交易內插入、更新或刪除的所有資料列,保留其獨佔資料列鎖定。由於以最高程度的限制取得列鎖定,因此不需要或不執行鎖定轉換。
鎖定轉換與鎖定呈報不同,這會在單一精細度 (例如資料列) 層次保留多個鎖定,而資料庫會將鎖定提升至更高層次的資料值 (例如表格) 時進行。如果階段作業鎖定表格中的多個資料列,則部分資料庫會自動將資料列鎖定呈報至單一表格。鎖定的數目會減少,但鎖定的項目限制會增加。
Oracle AI Database 絕對不會升級鎖定。 鎖定提升可大幅提高死鎖的機率。假設系統嘗試代表交易 1 向上呈報鎖定,但因為交易 2 所保留的鎖定而無法呈報。如果交易 2 也需要鎖定呈報相同的資料,才能繼續進行,就會建立死鎖。
鎖定持續時間
當發生某些事件時,Oracle AI Database 會自動釋放鎖定,讓交易不再需要資源。
通常,資料庫會保留交易期間內敘述句所取得的鎖定。這些鎖定可以防止並行交易中發生破壞性干擾,例如已變更讀取、遺失更新,以及破壞性 DDL 。備註:因為對帳單的持續時間 (而非交易) 中保留未編製索引的外來索引鍵,而對下階表格進行的表格鎖定。此外,DBMS_LOCK 套裝軟體可讓使用者定義的鎖定隨意釋放和配置,甚至保留在交易界限上。
Oracle AI Database 會在交易確認或倒回時,釋放由敘述句所取得的所有鎖定。Oracle AI Database 也會在回復至儲存點時,於儲存點之後釋出取得的鎖定。不過,只有未等待先前鎖定資源的交易,才能鎖定目前可用的資源。等待交易會繼續等待,直到原始交易完全確認或倒回為止。
另請參閱:
-
表格 13-3 顯示交易等待行為
-
「使用者定義的鎖定簡介」可進一步瞭解
DBMS_LOCK
鎖定和死鎖
死鎖是一種狀況,當中有兩位以上的使用者正在等待彼此鎖定資料。死鎖可以防止某些交易繼續運作。
Oracle AI Database 會自動偵測死鎖,並透過倒回死鎖中涉及的一個陳述式來解決死鎖問題,從而釋放一組衝突的資料列鎖定。資料庫會傳回對應訊息給進行敘述句層次倒回的交易。倒回的敘述句屬於偵測死鎖的交易。通常,訊號傳遞的交易應該要明確倒回,但是可以在等待後重試倒回敘述句。表 12-5 說明死鎖中的兩個交易。
表格 5 死鎖的交易
| T | 階段作業 1 | 階段作業 2 | 說明 |
|---|---|---|---|
| t0 | |
|
梯次 1 開始異動 1,並更新員工 100 的薪資。梯次 2 開始異動 2,並更新員工 200 的薪資。沒有問題,因為每個交易只會鎖定嘗試更新的資料列。 |
| t1 | |
|
交易 1 嘗試更新員工 200 列,該列目前被交易 2 鎖定。交易 2 嘗試更新員工 100 列,該列目前被交易 1 鎖定。 因為任何交易都無法取得繼續或終止所需的資源,所以死結結果。無論每個交易等待多久,都會保留衝突的鎖定。 |
| t2 | |
交易 1 指示死鎖並倒回 t1 發出的 注意:死鎖中只有一個階段作業實際上會取得死鎖錯誤,但其中一個階段作業可能會發生錯誤。 |
|
| t3 | |
階段作業 1 會確認在 t0 進行的更新,結束交易 1。未成功嘗試在 t1 進行更新。 | |
| t4 | |
會執行交易 2 (被交易 1 封鎖) 中位於 t1 的更新。就會傳回提示。 | |
| t5 | |
階段作業 2 會確認在 t0 和 t1 進行的更新,這會結束交易 2。 |
交易明確覆寫 Oracle AI Database 的預設鎖定時,最常發生死鎖。因為 Oracle AI Database 不會呈報鎖定,也不會對查詢使用讀取鎖定,而是使用資料列層次 (而非頁面層次) 鎖定,所以死鎖會不常發生。
另請參閱:
-
「手動資料鎖定概要」
-
Oracle AI Database Development Guide,瞭解如何在明確鎖定表格時處理死鎖情況
自動鎖定總覽
Oracle AI Database 會代表交易自動鎖定資源,以防止其他交易執行需要對相同資源進行獨佔存取的動作。
資料庫會根據資源與執行的作業,在不同層次的限制自動取得不同類型的鎖定。注意:執行簡單讀取時,資料庫永遠不會鎖定資料列。
Oracle AI Database 鎖定分為下表顯示的類別。
表格 6 鎖定類別
| 鎖定 | 說明 | 深入瞭解 |
|---|---|---|
| DML 鎖定 | 保護資料。例如,表格鎖定整個表格,而資料列鎖定則是鎖定選取的資料列。 | 「 DML 鎖定」 |
| DDL 鎖定 | 保護綱要物件的結構 - 例如,表格和視觀表的說明定義。 | 「 DDL 鎖定」 |
| 系統鎖 | 保護內部資料庫結構,例如資料檔。閂鎖、互斥鎖和內部鎖都是自動的。 | 「系統鎖定」 |
-
DML 鎖定 DML 鎖定 (也稱為資料鎖定 ),可確保多位使用者並行存取的資料完整性。
-
DDL 鎖定:資料說明 (DDL) 鎖定可保護綱要物件的定義,同時進行中的 DDL 作業會對物件採取動作或參照該物件。
-
系統鎖定 Oracle AI Database 使用各種類型的系統鎖定來保護內部資料庫和記憶體結構。使用者無法存取這些機制,因為使用者無法控制其發生次數或持續時間。
DML 鎖定
DML 鎖定 (亦稱為資料鎖定 ) 可保證多位使用者同時存取的資料完整性。
例如,DML 鎖定可防止兩位客戶向線上書商購買最後一本書。DML 鎖定可防止同時衝突的 DML 或 DDL 作業發生破壞性干擾。
DML 敘述句會自動取得下列類型的鎖定:
在下列各節中,每種鎖定或鎖定模式類型後的首字母縮寫,是 Oracle Enterprise Manager (Enterprise Manager) 的鎖定監督器中使用的縮寫。Enterprise Manager 可能會對任何表格鎖定顯示 TM,而不是表示表格鎖定模式 (例如 RS 或 SRX)。
-
列鎖定 (TX) 列鎖定 (亦稱為 TX 鎖定 ) 是對單一列表格的鎖定。交易會取得
INSERT、UPDATE、DELETE、MERGE或SELECT... FORUPDATE敘述句所修改之每個資料列的資料列鎖定。在交易確認或倒回之前,都會有資料列鎖定。 -
表格鎖定 (TM) 當表格由
INSERT、UPDATE、DELETE、MERGE、SELECT(含FOR UPDATE子句) 或LOCK TABLE敘述句修改時,交易便會取得表格鎖定 (亦稱為 TM 鎖定 )。 -
鎖定和外來索引鍵 Oracle AI Database 可最大化與相依外來索引鍵相關的父項索引鍵並行控制。
資料列鎖定 (TX)
列鎖定 (亦稱為 TX 鎖定 ) 是單一列表格的鎖定。交易會取得 INSERT、UPDATE、DELETE、MERGE 或 SELECT ... FOR UPDATE 敘述句所修改之每個資料列的資料列鎖定。在交易確認或倒回之前,都會有資料列鎖定。
資料列鎖定主要作為佇列機制,以防止兩個交易修改相同的資料列。資料庫一律會以獨佔模式鎖定修改的資料列,如此一來,在保留鎖定的交易確認或倒回之前,其他交易就無法修改資料列。資料列鎖定可提供最細微的鎖定,因此可提供最佳的並行與傳輸量。
注意:如果交易因為資料庫執行處理失敗而終止,則區塊層次復原會在整個交易復原之前,讓資料列可供使用。
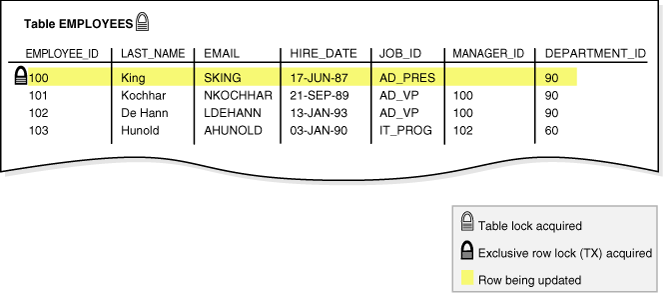
如果交易取得某個資料列的鎖定,則該交易也會取得包含該資料列之表格的鎖定。表格鎖定可防止衝突的 DDL 作業覆寫目前交易中的資料變更。圖 12-2 說明表格中第三個資料列的更新。Oracle AI Database 會自動對更新的資料列加上獨佔式鎖定,並對表格進行獨佔式鎖定。
圖 2:列與表格鎖定
-
資料列鎖定和並行:此案例說明 Oracle AI Database 如何針對並行使用資料列鎖定。
-
儲存資料列鎖定與使用鎖定管理程式來維護記憶體中鎖定清單的某些資料庫不同,Oracle AI Database 會將鎖定資訊儲存在包含鎖定資料列的資料區塊中。
資料列鎖定和並行
此案例說明 Oracle AI Database 如何針對並行使用資料列鎖定。
三個階段作業同時查詢相同的資料列。階段作業 1 與 2 會繼續對不同資料列進行未確認的更新,而階段作業 3 則不會進行任何更新。每個階段作業都會看到自己的未確認更新,但不會看到任何其他階段作業的未確認更新。
表格 7 資料並行範例
| T | 階段作業 1 | 階段作業 2 | 階段作業 3 | 說明 |
|---|---|---|---|---|
| t0 | |
|
|
三個不同的梯次同時查詢員工 100 與 101 的 ID 與薪資。每個查詢傳回的結果都是相同的。 |
| t1 | |
梯次 1 會更新員工 100 的薪資,但不會確認。在更新中,寫入器只會取得已更新列的列階層鎖定,以避免其他寫入器修改此列。 | ||
| t2 | |
|
|
每個階段作業都會同時發出原始查詢。階段作業 1 顯示 t1 更新所產生的薪資為 612。階段作業 2 與 3 中的讀取器會立即傳回資料列,而且不會等待階段作業 1 結束其交易。資料庫使用多重值讀取一致性,在梯次 1 中更新之前顯示其存在的薪資。 |
| t3 | |
梯次 2 會更新員工 101 的薪資,但不會確認異動。在更新中,寫入器只會取得已更新列的列階層鎖定,以防止其他寫入器修改此列。 | ||
| t4 | |
|
|
每個階段作業都會同時發出原始查詢。梯次 1 顯示因 t1 更新而產生的薪資為 612,但不會顯示員工 101 在梯次 2 所做的薪資更新。梯次 2 中的讀取器會顯示在梯次 2 中所做的薪資更新,但不會顯示梯次 1 中所做的薪資更新。梯次 3 中的讀取器會使用讀取一致性,在梯次 1 與 2 修改前先顯示薪資。 |
另請參閱:
資料列鎖定的儲存
不同於使用鎖定管理程式來維護記憶體鎖定清單的某些資料庫,Oracle AI Database 會將鎖定資訊儲存在包含已鎖定資料列的資料區塊中。
資料庫使用佇列機制來取得資料列鎖定。如果交易需要鎖定已解除鎖定資料列,則交易會在資料區塊中鎖定。此交易所修改的每個資料列都會指向儲存在區塊標頭中的交易 ID 副本。
交易結束時,交易 ID 會保留在區塊標頭中。如果不同的交易想要修改某一列,它會使用交易 ID 來判斷鎖定是否作用中。如果鎖定作用中,則階段作業會要求在解除鎖定時收到通知。否則,交易會取得鎖定。
另請參閱:
-
「資料區塊簡介」可進一步瞭解資料區塊標頭
-
Oracle AI Database Reference,瞭解
V$TRANSACTION
表格鎖定 (TM)
當 INSERT、UPDATE、DELETE、MERGE、SELECT (含 FOR UPDATE 子句) 或 LOCK TABLE 敘述句修改表格時,交易會取得表格鎖定 (亦稱為 TM 鎖定 )。
DML 作業需要表格鎖定,才能代表交易保留表格的 DML 存取權,並防止 DDL 作業與交易發生衝突。
表格鎖定可以採用下列任何一種模式:
-
資料列共用 (RS)
這個鎖定 (亦稱為子共用表格鎖定 (SS) ),表示保留表格鎖定的交易,已將表格中的資料列鎖定,並想要更新這些資料列。資料列共用鎖定是表格鎖定的最低限制模式,可提供表格的最高並行程度。
-
資料列專用表格鎖定 (RX)
此鎖定也稱為獨佔式表格鎖定 (SX) ,通常表示保留鎖定的交易已更新表格資料列或發出
SELECT ... FOR UPDATE。SX 鎖定可讓其他交易同時在同一個表格中查詢、插入、更新、刪除或鎖定資料列。因此,SX 鎖定可讓多個交易同時取得相同表格的 SX 與子共用表格鎖定。 -
共用表格鎖定 (S)
交易所保留的共用表格鎖定可讓其他交易查詢表格 (不使用
SELECT ... FOR UPDATE),但只有在單一交易保留共用表格鎖定時,才允許更新。因為多個交易可能會同時保留共用表格鎖定,所以保留此鎖定不足以確定交易可以修改表格。 -
共用資料列專用表格鎖定 (SRX)
這項鎖定 (亦稱為獨佔式共用表格鎖定 (SSX) ) 會比共用表格鎖定更具限制性。一次只有一個交易可以取得指定表格的 SSX 鎖定。交易所保留的 SSX 鎖定可讓其他交易查詢表格 (
SELECT ... FOR UPDATE除外),但不更新表格。 -
專屬桌鎖 (X)
這個鎖定是最具限制性的,會禁止其他交易執行任何類型的 DML 敘述句,或是將任何類型的鎖定置於表格上。
另請參閱:
鎖定和外來索引鍵
Oracle AI Database 可最大化與相依外來索引鍵相關的父項索引鍵並行控制。
鎖定行為取決於是否編製外來索引鍵資料欄的索引。如果未編製外來索引鍵的索引,子項表格可能會更頻繁地被鎖定,就會發生死鎖,並行將會減少。因此,外部索引鍵幾乎一律應該編製索引。唯一的例外是從未更新或刪除相符的唯一或主索引鍵。
-
鎖定和未編製索引的外來索引鍵:當子項表格的外來索引鍵資料欄中沒有索引時,資料庫會取得子項表格的完整表格鎖定,而階段作業會修改父項表格中的主索引鍵 (例如,刪除資料列或修改主索引鍵屬性),或將資料列合併至父項表格。
-
鎖定和已編製索引的外來索引鍵:當子項表格中的外來索引鍵資料欄已編製索引,且階段作業修改父項表格中的主索引鍵 (例如,刪除資料列或修改主索引鍵屬性) 或將資料列合併至父項表格時,資料庫不會取得子項表格的完整表格鎖定。
鎖定和未建立索引的外來索引鍵
當子項表格的外來索引鍵資料欄沒有索引時,資料庫會取得子項表格的完整表格鎖定,而階段作業會修改父項表格中的主索引鍵 (例如,刪除資料列或修改主索引鍵屬性),或將資料列合併至父項表格。
當下列兩種情況均為 true 時,資料庫會取得子項表格的完整表格鎖定:
-
子項表格的外來索引鍵資料欄中沒有索引。
-
階段作業會修改父項表格中的主索引鍵 (例如,刪除資料列或修改主索引鍵屬性),或將資料列合併至父項表格。注意:在父項表格中插入不會取得阻隔表格鎖定,以防止子項表格上的 DML。如果是插入,資料庫會取得子項表格的鎖定,以防止結構變更,但不會修改現有或新新增的資料列。
假設 hr.departments 表格是 hr.employees 的父項,其中包含未編製索引的外來索引鍵 employees.department_id。下圖顯示修改 departments 表格中部門 60 之主索引鍵屬性的階段作業。
圖 3:具有未編製索引外來索引鍵的鎖定機制
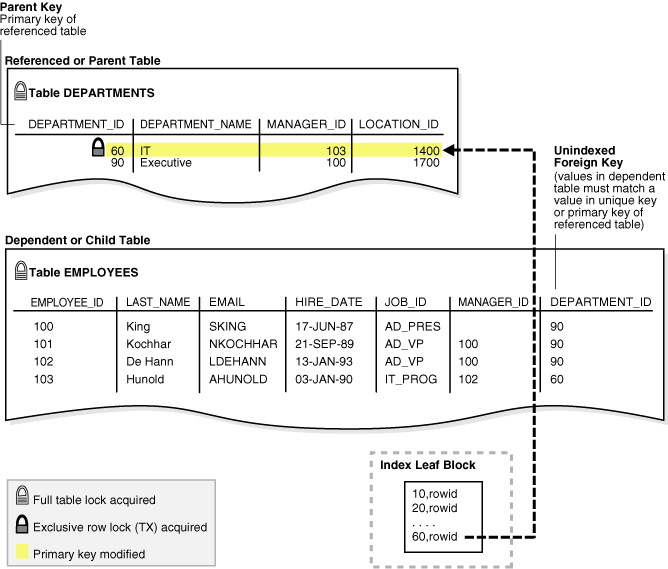
在圖 12-3 中,資料庫會在部門 60 的主索引鍵修改期間取得 employees 的完整表格鎖定。此鎖定可讓其他階段作業查詢,但不更新 employees 表格。例如,梯次無法更新員工電話號碼。departments 表格的主索引鍵修改完成後,會立即鎖定 employees 版次的表格。如果 departments 中的多個資料列修改了主索引鍵,則會為 departments 中修改的每個資料列取得並釋出一次 employees 上的表格鎖定。注意:子項表格上的 DML 不會取得父項表格的表格鎖定。
鎖定和已編製索引的外來索引鍵
當子項表格中的外來索引鍵資料欄已編製索引,且階段作業修改父項表格中的主索引鍵時 (例如,刪除資料列或修改主索引鍵屬性),或將資料列合併至父項表格時,資料庫不會取得子項表格的完整表格鎖定。
父項表格鎖定可防止交易取得獨佔表格鎖定,但不會在主索引鍵修改期間防止父項或子項表格上的 DML。當子項表格發生更新時,如果父項表格發生主索引鍵修改,建議使用此情況。圖 12-4 顯示已編製索引之 department_id 資料欄的子項表格 employees。交易會從 departments 刪除部門 280。此刪除並不會讓資料庫在 employees 表格上取得完整的表格鎖定,如鎖定和未編製索引的外來索引鍵中所述。
圖 4:具有索引外來索引鍵的鎖定機制
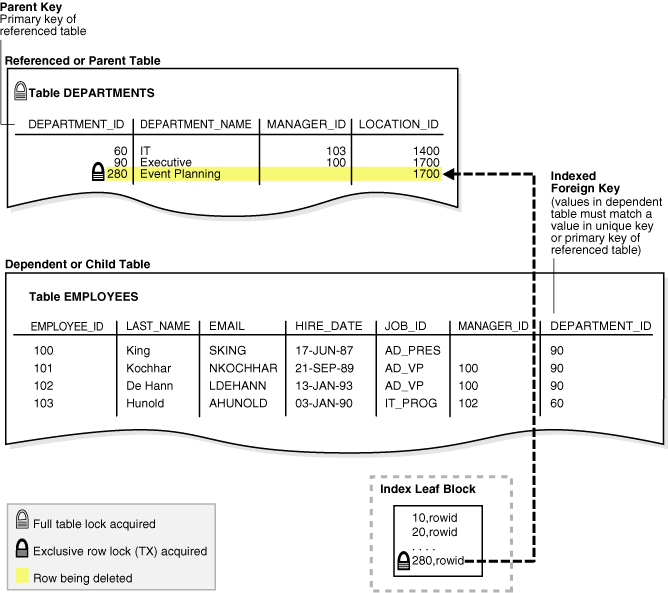
如果子項表格指定 ON DELETE CASCADE,則從父項表格刪除可能會導致子項表格刪除。例如,刪除部門 280 可能會導致刪除部門中員工的記錄從 employees 刪除。在此情況下,等待和鎖定規則與刪除父項表格資料列後,從子項表格刪除資料列的規則相同。
DDL 鎖定
資料說明 (DDL) 鎖定可保護綱要物件的定義,而進行中的 DDL 作業則可處理或參照該物件。
DDL 作業期間,只有修改或參照的個別綱要物件會被鎖定。資料庫絕對不會鎖定整個資料說明。
Oracle AI Database 會代表需要 DDL 交易的任何 DDL 交易自動取得 DDL 鎖定。使用者無法明確要求 DDL 鎖定。例如,如果使用者建立預存程序,則 Oracle AI Database 會自動取得程序定義中參照之所有綱要物件的 DDL 鎖定。DDL 鎖定可防止在完成程序編譯之前更改或刪除這些物件。
-
獨佔 DDL 鎖定:獨佔 DDL 鎖定可防止其他階段作業取得 DDL 或 DML 鎖定。
-
共用 DDL 鎖定:資源的共用 DDL 鎖定可防止發生衝突 DDL 作業的破壞性干擾,但可允許相似 DDL 作業的資料並行處理。
-
可中斷的剖析鎖定:SQL 敘述句或 PL/SQL 程式單位會針對它參照的每個綱要物件,保留剖析鎖定。
獨佔 DDL 鎖定
獨佔的 DDL 鎖定可防止其他階段作業取得 DDL 或 DML 鎖定。
大多數 DDL 作業都需要資源獨佔的 DDL 鎖定,才能防止與其他可能修改或參照相同綱要物件之 DDL 作業的破壞性干擾。例如,在 ALTER TABLE 將資料欄新增至表格時,不允許 DROP TABLE 刪除表格,反之亦然。
DDL 敘述句執行與自動確認期間的獨佔 DDL 鎖定。在取得獨佔 DDL 鎖定期間,如果其他作業在綱要物件上保留另一個 DDL 鎖定,則取得會等待直到釋放較舊的 DDL 鎖定,然後繼續進行。
另請參閱:「共用 DDL 鎖定」說明不需要獨佔鎖定以防止破壞性干擾的情況。
共用 DDL 鎖定
資源的共用 DDL 鎖定可防止 DDL 作業發生破壞性干擾,但可讓相似 DDL 作業的資料並行處理。
例如,執行 CREATE PROCEDURE 敘述句時,包含的交易會取得所有參照之表格的共用 DDL 鎖定。其他交易也可以同時建立參照相同表格的程序,並在相同表格上取得並行共用 DDL 鎖定,但是任何交易都無法針對任何參照的表格取得獨佔 DDL 鎖定。
共用 DDL 鎖定會持續執行 DDL 敘述句與自動確認的持續時間。因此,保留共用 DDL 鎖定的交易,可確保參照綱要物件的定義在交易期間維持不變。
可中斷的剖析鎖定
SQL 敘述句或 PL/SQL 程式單位會針對它參照的每個綱要物件,保留剖析鎖定。
取得剖析鎖定,以便在變更或刪除參照的物件時,讓關聯的共用 SQL 區域變成無效。剖析鎖定稱為可中斷的剖析鎖定,因為此鎖定不允許任何 DDL 作業,而且可以中斷以允許衝突的 DDL 作業。
SQL 敘述句執行剖析階段期間,會在共用集區中取得剖析鎖定。只要該敘述句的共用 SQL 區域仍然存放在共用集區中,就會保留鎖定。
另請參閱:「共用集區」
系統鎖
Oracle AI Database 使用各種類型的系統鎖定來保護內部資料庫和記憶體結構。使用者無法存取這些機制,因為使用者無法控制其發生次數或持續時間。
-
閂鎖 閂鎖是一種簡單、低層次的序列化機制,可以協調對共用資料結構、物件和檔案的多使用者存取。
-
Mutexes - 互斥物件 (mutex) 是一種低階機制,可防止記憶體中的物件因並行程序存取而過時或損毀。mutex 與閂鎖類似,但閂鎖通常會保護一組物件,而 mutex 則會保護單一物件。
-
內部鎖定內部鎖定是比閂鎖和多邊形更高階、更複雜的機制,並且提供各種用途。
閂鎖
閂鎖是一種簡單、低層次的序列化機制,可以協調對共用資料結構、物件及檔案的多使用者存取。
閂鎖可以保護共用記憶體資源,使其在多個處理作業進行存取時免於損毀。具體而言,閂鎖可以保護資料結構免於下列情況:
-
由多個階段作業並行修改
-
由另一個階段作業修改時由一個階段作業讀取
-
被存取時取消配置 (傳出) 記憶體
一般而言,單一閂鎖會保護 SGA 中的多個物件。例如,背景處理作業 (例如 DBW 和 LGWR) 會從共用集區配置記憶體,以建立資料結構。若要配置此記憶體,這些處理作業會使用可序列化存取權的共用集區閂鎖,以防止兩個處理作業同時檢查或修改共用集區。配置記憶體之後,其他處理作業可能需要存取共用集區區域,例如需要剖析的程式庫快取。在此情況下,處理只會閂鎖程式庫快取,而不是整個共用集區。
與排入佇列閂鎖 (例如資料列鎖定) 不同,閂鎖不允許階段作業排入佇列。當閂鎖變成可用時,要求閂鎖的第一個階段作業會取得其獨佔存取權。當處理作業在迴圈中重複要求閂鎖時,就會發生閂鎖旋轉現象,而當處理作業在更新閂鎖要求之前釋出 CPU 時,則會發生閂鎖休眠。
一般而言,Oracle 處理程序在操控或查看資料結構時,會取得極短時間的閂鎖。例如,在處理單一員工的薪資更新時,資料庫可能會取得並釋出數千個閂鎖。閂鎖的實行與作業系統相依,尤其是在處理作業是否等待閂鎖的時間與時間方面。
閂鎖增加表示並行減少。例如,過多的硬剖析作業會建立程式庫快取閂鎖的競爭。V$LATCH 視觀表包含每個閂鎖的詳細閂鎖使用狀況統計資料,包括要求並等待每個閂鎖的次數。
另請參閱:
-
Oracle AI Database Reference,瞭解
V$LATCH -
Oracle AI Database Performance Tuning Guide,瞭解等待事件統計資料
Mutex
互斥物件 (mutex) 是一種低階機制,可防止記憶體中的物件在並行程序進行存取時過時或損毀。mutex 與閂鎖類似,但閂鎖通常會保護一組物件,而 mutex 則會保護單一物件。
Mutexes 提供多種好處:
-
互斥可降低競爭的可能性。
因為閂鎖可以保護多個物件,所以當處理作業嘗試並行存取這些物件時,它可能會成為瓶頸。藉由序列化對個別物件 (而非群組) 的存取,互斥物件可提高可用性。
-
相較於閂鎖,Mutex 會耗用較少的記憶體。
-
在共用模式下,Mutex 會允許多個階段作業並行參照。
內部鎖定
內部鎖是較高階、較閂鎖和互斥較為複雜的機制,並且提供各種用途。
資料庫使用下列類型的內部鎖定:
-
說明快取鎖定
這些鎖定的持續時間非常短,且會在修改或使用項目時保留在字典快取中的項目上。它們保證要剖析的敘述句不會看到不一致的物件定義。說明快取鎖定可以共用或獨佔。剖析完成時會釋放共用鎖定,而 DDL 作業完成時則會釋放專用鎖定。
-
檔案和日誌管理鎖定
這些鎖定可保護各種檔案。例如,內部鎖定會保護控制檔,讓一次只有一個處理作業可以變更它。另一個鎖定則是協調線上重做日誌檔的使用與存檔。資料檔會被鎖定,以確保多個執行處理以共用模式掛載資料庫,或讓一個執行處理以獨佔模式掛載資料庫。因為檔案與記錄鎖定會指出檔案的狀態,所以這些鎖定一定會保留一段時間。
-
表格空間與還原區段鎖定
這些鎖定可保護表格空間與還原區段。例如,存取資料庫的所有執行處理都必須同意表格空間為線上或離線。還原區段是鎖定的,因此只有一個資料庫執行處理能夠寫入區段。
另請參閱:「資料說明快取」
手動資料鎖定總覽
您可以手動覆寫 Oracle AI Database 預設鎖定機制。
Oracle AI Database 會自動執行鎖定,以確保資料並行、資料完整性和對帳單層級讀取一致性。但是,覆寫預設鎖定對於下列情況很有用:
-
應用程式需要交易層次讀取一致性或可重複讀取。
在此情況下,查詢必須在異動期間產生一致的資料,而不會反映其他異動的變更。您可以使用明確鎖定、唯讀交易、可序列化的交易,或是覆寫預設鎖定來達到交易層次讀取一致性。
-
應用程式需要交易具備資源的獨佔存取權,因此交易不需要等待其他交易完成。
您可以在階段作業或交易層次覆寫 Oracle AI Database 自動鎖定。在階段作業層次,階段作業可以使用 ALTER SESSION 敘述句來設定必要的交易隔離層次。在交易層次,包含下列 SQL 敘述句的交易會覆寫 Oracle AI Database 預設鎖定:
-
SET TRANSACTION ISOLATION LEVEL敘述句 -
LOCK TABLE敘述句 (會鎖定表格或與檢視搭配使用時,會鎖定基本表格) -
SELECT ... FOR UPDATE敘述句
前述敘述句所取得的鎖定會在交易結束或倒回以釋出它們。
如果在任何層次覆寫 Oracle AI Database 預設鎖定,則資料庫管理員或應用程式開發人員應確保覆寫鎖定程序正常運作。鎖定程序必須符合下列條件:保證資料完整性、可接受資料並行,以及無法或無法適當地處理死鎖。
另請參閱:
-
Oracle AI Database SQL Language Reference,瞭解
LOCK TABLE和SELECT的說明 -
Oracle AI Database Development Guide,瞭解如何手動鎖定表格
使用者定義的鎖定總覽
您可以使用 Oracle AI Database Lock Management 服務,為特定應用程式定義自己的鎖定。
例如,您可以建立鎖定,將檔案系統上的訊息日誌存取權序列化。由於保留使用者鎖定與 Oracle AI Database 鎖定相同,因此擁有所有 Oracle AI Database 鎖定功能,包括死鎖偵測。使用者鎖定絕對不會與 Oracle AI Database 鎖定發生衝突,因為前綴為 UL。
您可以透過 DBMS_LOCK 套裝程式中的程序使用 Oracle AI Database Lock Management 服務。您可以在 PL/SQL 區塊中包括下列敘述句:
-
要求鎖定特定類型
-
在相同或另一個執行處理的另一個程序中,給予鎖定可辨識的唯一名稱
-
變更鎖定類型
-
釋放鎖定
另請參閱:
-
Oracle AI Database Development Guide,瞭解有關 Oracle AI Database Lock Management 服務的詳細資訊
-
Oracle AI Database PL/SQL Packages and Types Reference,瞭解
DBMS_LOCK的相關資訊
註腳圖例
註腳 1:
處理分散式兩階段確認時,資料庫在特殊情況下可能會短暫地防止讀取存取。特別是,如果查詢在準備並確認階段之間開始,然後嘗試在確認之前讀取資料,則資料庫可能會將鎖定從資料列層次提升至區塊層次,以保證讀取一致性。