記憶體架構
本章探討資料庫執行處理的記憶體架構。
-
Oracle AI Database Memory Structures 簡介啟動執行處理時,Oracle AI Database 會配置記憶體區域並啟動背景處理作業。
-
系統整體區域 (SGA) 簡介 SGA 是一個讀取 / 寫入記憶體區域,以及 Oracle 背景處理作業組成資料庫執行處理。
-
程式整體區域 (PGA) 簡介:PGA 是作業系統或繫線的特定記憶體,但這些處理作業或繫線未由系統上的其他處理作業或繫線共用。因為 PGA 是處理作業特定的,所以它永遠都不會配置在 SGA 中。
-
使用者整體區域簡介 UGA 是階段作業記憶體,也就是配置給階段作業變數的記憶體,例如登入資訊,以及資料庫階段作業所需的其他資訊。基本上,UGA 會儲存階段作業狀態。
-
受管理整體區域 (MGA) 簡介「受管理整體區域 (MGA)」是唯一的記憶體架構,能夠在一組受信任的 Oracle 處理作業之間共用及協調記憶體。
-
軟體程式碼區域簡介 軟體程式碼區域是記憶體的一部分,用來儲存正在執行或可執行的程式碼。Oracle AI Database 程式碼儲存在軟體區域中,通常比使用者程式位置更為專屬且受到保護。另請參閱:Oracle AI Database Administrator's Guide,以取得設定和管理記憶體的指示。
Oracle AI Database 記憶體結構簡介
啟動執行處理時,Oracle AI Database 會配置記憶體區域,並啟動背景處理作業。
記憶體區域會儲存下列資訊:
-
課程代碼
-
每個連線之階段作業的相關資訊,即使目前非作用中
-
程式執行期間所需的資訊,例如,擷取資料列之查詢的目前狀態
-
在處理作業之間共用和通訊的資訊,例如鎖定資料
-
磁碟中也存在的快取資料,例如資料區塊與重做記錄
-
基本記憶體結構 Oracle AI Database 包含數個記憶體區域,每個區域都包含多個子元件。
-
Oracle AI Database Memory Management 記憶體管理涉及在資料庫變更時,維護 Oracle 執行處理記憶體結構最佳大小。Oracle AI Database 會根據記憶體相關初始化參數的設定來管理記憶體。另請參閱:「處理架構」
基本記憶體結構
Oracle AI Database 包含數個記憶體區域,每個區域都包含多個子元件。
與 Oracle AI Database 相關的基本記憶體結構包括:
-
系統總體系統區 (SGA)
SGA 是一組共用記憶體結構 (稱為 SGA 元件 ),其中包含一個 Oracle AI Database 執行處理的資料與控制資訊。所有的伺服器與背景處理作業都共用 SGA。舉例來說,儲存在 SGA 中的資料,包括已快取的資料區塊與共用 SQL 區域。
-
編制整體區域 (PGA)
PGA 是非共用記憶體區域,其中包含專供 Oracle 處理作業使用的資料與控制資訊。Oracle AI Database 會在 Oracle 處理作業啟動時建立 PGA。
每個伺服器處理作業與背景處理作業都有一個 PGA。個別 PGA 的集合是執行處理 PGA 總計,或是實例 PGA 。資料庫初始化參數可設定執行處理 PGA 的大小,而非個別的 PGA。
-
使用者整體區域 (UGA)
UGA 是與使用者階段作業相關聯的記憶體。
-
受管理整體區域 (MGA)
MGA 是 Oracle AI Database 執行處理使用的半共用記憶體元件。它能夠跨一組受信任的小型 Oracle 處理作業共用及協調記憶體。它具備可設定、彈性、模組化、隨選及重複使用的功能。不同於 SGA,Oracle AI Database 模組可以選擇要將哪些處理作業連附至此區域,而且這種行為是動態的。
-
軟體程式碼區域
軟體程式碼區域是用來儲存執行中程式碼或可執行之程式碼的記憶體部分。Oracle AI Database 程式碼儲存在軟體區域中,通常與使用者程式位於不同的位置,也就是更專屬或受保護的位置。
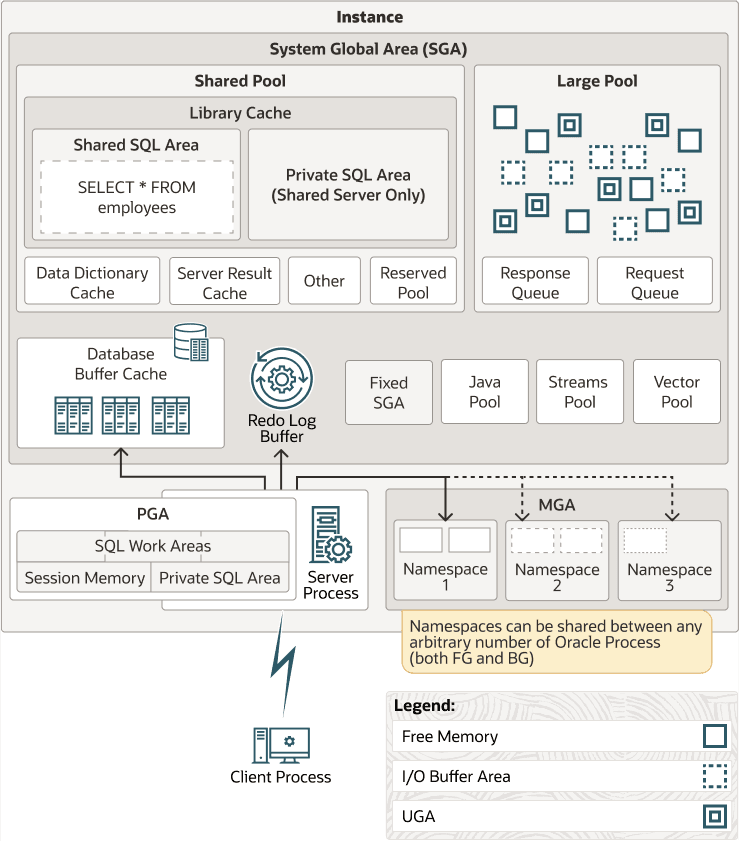
下圖說明這些記憶體結構之間的關係。
圖 1:Oracle AI Database 記憶體結構
Oracle AI Database 記憶體管理
記憶體管理包含維護 Oracle 執行處理記憶體結構最佳大小,以符合資料庫變更的需求。Oracle AI Database 會根據記憶體相關初始化參數的設定來管理記憶體。
記憶體管理的基本選項如下:
-
整合式記憶體管理
「統一記憶體」使用單一參數
MEMORY_SIZE來設定資料庫執行處理記憶體。資料庫可根據目前的工作負載,動態使用此記憶體,表示 SGA、PGA、MGA、UGA 以及其他記憶體區段的任何比例。不同記憶體區段之間的分割是以目前在 CDB 中開啟之 PDB 的記憶體大小為基礎。如果設定了大型頁面,它們就可以同時用於 SGA 與 PGA。「統一記憶體」提供極具彈性的記憶體組態。 -
自動記憶體管理
您可以指定資料庫執行處理記憶體的目標大小。執行處理會自動調整為目標記憶體大小,並視需要在 SGA 與執行處理 PGA 之間重新分配記憶體。
-
自動共享記憶體管理
此管理模式已部分自動化。您可以為 SGA 設定目標大小,然後選擇設定 PGA 的聚總目標大小,或個別管理 PGA 工作區域。
-
手動記憶體管理
您不必設定總記憶體大小,而是設定許多初始化參數以個別管理 SGA 與執行處理 PGA 的元件。
如果您使用「資料庫組態輔助程式 (DBCA)」建立資料庫並選擇基本安裝選項,則預設為自動記憶體管理。
另請參閱:
-
Oracle AI Database Performance Tuning Guide,瞭解有關 DBA 記憶體管理選項的詳細資訊。
-
Oracle AI Database Administrator's Guide,瞭解記憶體管理選項。
-
Oracle AI Database Reference,瞭解初始化參數。
系統整體區域 (SGA) 總覽
SGA 是一個讀取 / 寫入記憶體區域,以及 Oracle 背景處理作業,都會形成一個資料庫執行處理。注意:伺服器和背景處理作業不在 SGA 之中,但存在於個別的記憶體空間中。
代表使用者執行的所有伺服器處理作業都可以讀取執行處理 SGA 中的資訊。在資料庫作業期間,有數個處理作業會寫入 SGA。
每個資料庫執行處理都有自己的 SGA。Oracle AI Database 會在執行處理啟動時自動配置 SGA 的記憶體,並在執行處理關閉時回收記憶體。當您使用 SQL*Plus 或 Oracle Enterprise Manager 啟動執行處理時,會顯示 SGA 的大小,如下列範例所示:
SQL> STARTUP
ORACLE instance started.

Total System Global Area  368283648 bytes
Fixed Size                  1300440 bytes
Variable Size             343935016 bytes
Database Buffers           16777216 bytes
Redo Buffers                6270976 bytes
Database mounted.
Database opened.如圖 17-1 所示,SGA 包含數個記憶體元件,這些元件是用來滿足特定類別之記憶體配置要求的記憶體集區。除了重做日誌緩衝區以外的所有 SGA 元件,都會以稱為 granules 的連續記憶體單位來配置和取消配置空間。顆粒大小是平台特定的大小,由 SGA 總大小決定。
您可以查詢 V$SGASTAT 視觀表,瞭解 SGA 元件的相關資訊。
最重要的 SGA 元件如下:
-
資料庫緩衝區快取:資料庫緩衝區快取 (也稱為緩衝區快取 ) 是儲存從資料檔讀取之資料區塊複本的記憶體區域。
-
重做日誌緩衝區:重做日誌緩衝區是 SGA 中的循環緩衝區,用於儲存描述對資料庫所做之變更的重做項目。
-
共用集區:共用集區會快取各種類型的程式資料。
-
大型集區:大型集區是選擇性記憶體區域,用於大於共用集區的記憶體配置。
-
Java 集區 Java 集區是一個記憶體區域,用於儲存 Java Virtual Machine (JVM) 中的所有階段作業特定 Java 程式碼與資料。此記憶體包含 Java 物件,這些物件會在呼叫結束時移轉至 Java 階段作業空間。
-
固定 SGA :固定 SGA 是內部房務部區域。
-
選擇性效能相關 SGA 子區域:部分 SGA 子區域只針對特定效能功能啟用。
另請參閱:
資料庫緩衝區記憶體快取
資料庫緩衝區快取 (亦稱為緩衝區快取 ) 是儲存從資料檔讀取之資料區塊複本的記憶體區域。
緩衝區是一個主要記憶體位址,緩衝區管理程式會在此暫時快取目前或最近使用的資料區塊。所有同時連線至資料庫執行處理的使用者會共用對緩衝區快取的存取權。
-
資料庫緩衝區快取的用途 Oracle AI Database 使用緩衝區快取來達成多個目標。
-
緩衝區狀態:資料庫使用內部演算法來管理快取中的緩衝區。
-
緩衝區模式:當從屬端要求資料時,Oracle AI Database 會以目前模式或一致模式從資料庫緩衝區快取擷取緩衝區。
-
緩衝區 I/O 邏輯 I/O (又稱為緩衝區 I/O) 是指緩衝區快取中緩衝區的讀取和寫入。
-
緩衝區集區:緩衝區集區是緩衝區的集合。
-
緩衝區和完整表格掃描:資料庫使用複雜的演算法來管理表格掃描。依照預設,當必須從磁碟讀取緩衝區時,資料庫會將緩衝區插入 LRU 清單的中間。如此一來,熱區塊就可以保留在快取中,因此不需要再從磁碟讀取它們。
-
DRAM 與 PMEM 緩衝區標準 (DRAM) 資料庫緩衝區與 PMEM 緩衝區不同,但它們會共用特性。
資料庫緩衝區快取的用途
Oracle AI Database 使用緩衝區快取來達成多個目標。
目標包括:
-
最佳化實體 I/O
資料庫會更新快取中的資料區塊,並儲存重做日誌緩衝區中之變更的相關描述資料。在
COMMIT之後,資料庫會將重做緩衝區寫入線上重做日誌,但是不會立即將資料區塊寫入資料檔。而是資料庫寫入器 (DBW) 會在背景中執行遲緩寫入。 -
將經常存取的區塊保留在緩衝區快取中,並將不常存取的區塊寫入磁碟
啟用「資料庫智慧型快閃快取 (快閃快取)」時,緩衝區快取中的一部分可以位於快閃快取中。此緩衝區快取擴充功能儲存在一或多個快閃裝置上。資料庫可以透過快取快閃記憶體中的緩衝區來改善效能,而不是從磁性磁碟讀取。
您可以使用
DB_FLASH_CACHE_FILE和DB_FLASH_CACHE_SIZE初始化參數來設定多個快閃裝置。緩衝區快取會追蹤每個裝置,並將緩衝區一致地分送至裝置。注意: Database Smart Flash Cache 僅適用於 Solaris 和 Oracle Linux。
-
管理指向 Oracle 永久記憶體檔案存放區中資料檔的緩衝區標頭 (PMEM 檔案存放區)
如果您啟用 PMEM 檔案存放區,則資料庫檔案會對應以供直接唯讀存取。查詢可以略過傳統緩衝區快取機制,以避免不必要的 I/O。在此情況下,緩衝區標頭必須儲存與 PMEM 區塊對應的描述資料。資料庫仍然可以使用傳統 (DRAM) 緩衝區快取進行修改、讀取一致性以及更快速的「熱」資料區塊存取。
另請參閱:
-
Oracle AI Database Reference,瞭解
DB_FLASH_CACHE_FILE初始化參數
緩衝區狀態
資料庫使用內部演算法來管理快取中的緩衝區。
緩衝區可處於下列任何互斥狀態:
-
未使用
此緩衝區從未使用過或目前未使用,因此可供使用。這種緩衝區類型是最容易使用的資料庫。
-
清除
此緩衝區先前已經使用過,現在包含某個區塊在某個時間點的讀取一致版本。區塊包含資料,但為 "clean",因此不需要檢查點。資料庫可以固定區塊並重複使用。
-
已修改
緩衝區包含尚未寫入磁碟的已修改資料。資料庫必須先檢查區塊,再重複使用區塊。
每個緩衝區都有存取模式:已固定或可用 (未固定)。緩衝區在快取中是「固定」,因此在使用者階段作業存取緩衝區時,它不會發生記憶體不足的情況。多個階段作業無法同時修改固定的緩衝區。
緩衝區模式
當從屬端要求資料時,Oracle AI Database 會以目前模式或一致模式從資料庫緩衝區快取擷取緩衝區。
模式有下列不同:
-
目前的模式
目前模式 get (亦稱為資料庫區塊 get) 是區塊在緩衝區快取中目前顯示的擷取。例如,如果未確認的交易在區塊中更新了兩個資料列,則目前的模式就會使用這些未確認的資料列來擷取區塊。資料庫在修改敘述句期間使用資料庫區塊最頻繁,必須只更新目前版本的區塊。
-
一致模式
一致讀取取得是擷取區塊的讀取一致版本。此擷取可以使用還原資料。例如,如果未確認的交易在區塊中更新了兩個資料列,而個別階段作業中的查詢要求區塊,則資料庫會使用還原資料來建立此區塊的讀取一致版本 (稱為一致讀取複製項 ),而此區塊未包含未確認的更新。通常,查詢會以一致模式擷取區塊。
另請參閱:
-
Oracle AI Database Reference,瞭解資料庫統計資料的描述,例如資料庫區塊取得和一致讀取取得
緩衝區 I/O
邏輯 I/O (又稱為緩衝區 I/O) 是指緩衝區快取中緩衝區的讀取和寫入。
在記憶體中找不到要求的緩衝區時,資料庫會執行實體 I/O,將緩衝區從快閃快取或磁碟複製到記憶體中。接著資料庫會執行邏輯 I/O 以讀取快取的緩衝區。
-
緩衝區取代演算法:若要讓緩衝區存取更有效率,資料庫必須決定要快取記憶體中的緩衝區,以及要從磁碟存取的緩衝區。
-
緩衝區寫入 資料庫寫入器 (DBW) 處理作業會定期將冷、已修改的緩衝區寫入磁碟。
-
緩衝區讀取:當未使用的緩衝區數目過低時,資料庫必須從緩衝區快取中移除緩衝區。
-
緩衝區接觸計數:資料庫會使用接觸計數,測量 LRU 清單上緩衝區的存取頻率。此機制可讓資料庫在固定緩衝區時 (而非 LRU 清單上不斷打亂的緩衝區) 遞增計數器。
緩衝區取代演算法
為了讓緩衝區存取更有效率,資料庫必須決定要在記憶體中快取哪些緩衝區,以及要從磁碟存取哪些緩衝區。
資料庫使用下列演算法:
-
以 LRU 為基礎的區塊層級取代演算法
此精密演算法 (預設值) 使用最不常用 (LRU) 清單,該清單包含已修改和未修改的緩衝區指標。LRU 清單具有熱端和冷端。冷緩衝區是最近未使用的緩衝區。經常存取熱機緩衝區,且最近已使用過。在概念上,只有一個 LRU,但對於資料並行,資料庫實際上使用數個 LRU。
-
溫度型物件層級取代演算法
從 Oracle Database 12c 版本 1 (12.1.0.2) 開始,自動大型表格快取功能可讓表格掃描在下列情況下使用不同的演算法:
-
平行查詢
在單一執行處理和 Oracle Real Applications Cluster (Oracle RAC) 資料庫中,當
DB_BIG_TABLE_CACHE_PERCENT_TARGET初始化參數設為非零值,且PARALLEL_DEGREE_POLICY設為auto或adaptive時,平行查詢可以使用大型表格快取。 -
序列查詢
僅在單一執行處理組態中,當
DB_BIG_TABLE_CACHE_PERCENT_TARGET初始化參數設為非零值時,序列查詢可以使用大型表格快取。
當表格不適合記憶體時,資料庫會根據存取樣式來決定要快取的緩衝區。舉例來說,如果只有 95% 的常用表格符合記憶體需求,資料庫就可以選擇將 5% 的區塊保留在磁碟上,而不是以循環方式將區塊讀取到記憶體中,然後將區塊寫入磁碟中,這種現象稱為損毀。當快取多個大型物件時,資料庫會考量較常用的表格較為熱門或較不熱門的表格較冷,而這些表格會影響快取的區塊。
DB_BIG_TABLE_CACHE_PERCENT_TARGET初始化參數會設定使用此演算法的緩衝區快取百分比。備註:本文件說明以 LRU 為基礎的區塊層次取代演算法。
-
另請參閱:Oracle AI Database VLDB and Partitioning Guide,以深入瞭解以溫度為基礎的演算法
緩衝區寫入
資料庫寫入器 (DBW) 處理作業會定期將冷、已修改的緩衝區寫入磁碟。
DBW 會在下列情況下寫入緩衝區:
-
伺服器處理作業找不到將新區塊讀取至資料庫緩衝區快取的乾淨緩衝區。
當緩衝區已損毀時,可用緩衝區的數目會減少。如果數字低於內部臨界值,而且需要乾淨的緩衝區,則伺服器會處理訊號 DBW 以寫入。
資料庫使用 LRU 來判斷要寫入哪些已修改的緩衝區。當修改過的緩衝區到達 LRU 的冷端時,資料庫會將它們從 LRU 移到寫入佇列。DBW 會盡可能使用多重區塊寫入,將佇列中的緩衝區寫入至磁碟。此機制可防止 LRU 被記錄有已修改的緩衝區,並允許找到清理的緩衝區以供重複使用。
-
表格空間會變更為唯讀狀態或離線。
另請參閱:
-
Oracle AI Database Performance Tuning Guide,瞭解如何診斷和調整緩衝區寫入問題
緩衝區讀取
當未使用的緩衝區數目過低時,資料庫必須從緩衝區快取中移除緩衝區。
此演算法取決於是否啟用快閃快取:
-
已停用快閃記憶體快取
資料庫會視需要重新使用每個乾淨的緩衝區,覆寫它。如果稍後需要覆寫的緩衝區,則資料庫必須從磁性磁碟讀取該緩衝區。
-
已啟用快閃記憶體快取
DBW 可以將清除緩衝區的主體寫入快閃快取,以便重複使用其記憶體內緩衝區。資料庫會將緩衝區標頭保留在 LRU 清單中的主記憶體中,以追蹤緩衝區主體在快閃快取中的狀態與位置。如果稍後需要此緩衝區,則資料庫可以從快閃快取而非磁性磁碟來讀取該緩衝區。
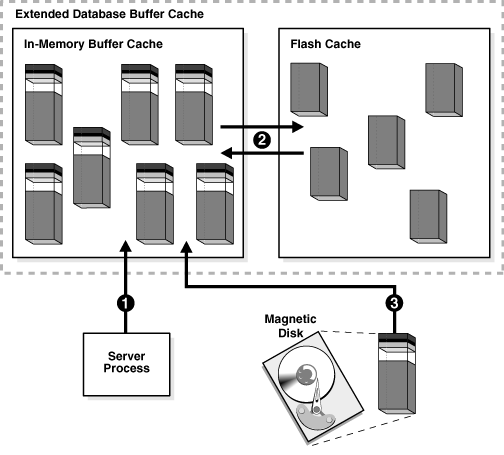
當從屬端處理作業要求緩衝區時,伺服器處理作業會搜尋緩衝區快取中的緩衝區。如果資料庫在記憶體中找到緩衝區,就會發生快取命中。搜尋順序如下:
-
伺服器處理作業會在緩衝區快取中搜尋整個緩衝區。
如果處理作業找到整個緩衝區,則資料庫會執行此緩衝區的邏輯讀取。
-
伺服器處理作業會搜尋快閃快取 LRU 清單中的緩衝區標頭。
如果處理作業找到緩衝區標頭,則資料庫會對緩衝區主體從快閃快取執行最佳化實體讀取至記憶體內快取。
-
如果處理作業未在記憶體中找到緩衝區 (快取遺漏),則伺服器處理作業會執行下列步驟:
-
將區塊從磁碟上的資料檔複製到記憶體 (實體讀取)
-
執行已讀取記憶體中緩衝區的邏輯讀取
-
圖 17-2 說明緩衝區搜尋順序。擴充的緩衝區快取包含了記憶體內的緩衝區快取 (內含整個緩衝區),以及內含緩衝區內容的快閃快取。在圖中,資料庫會搜尋緩衝區快取中的緩衝區,如果沒有找到緩衝區,會從磁性磁碟將它讀取到記憶體中。
圖 2:緩衝區搜尋
一般而言,透過快取命中存取資料會比透過快取遺漏更快。緩衝區快取命中率會測量資料庫在緩衝區快取中找到要求之區塊的頻率,而不需要從磁碟讀取區塊。
資料庫可以從資料檔或 temp 檔案執行實體讀取。資料檔的讀取之後為邏輯 I/O。當記憶體不足,導致資料庫將資料寫入暫時表格,並於稍後重新讀取時,就會發生暫存檔的讀取。這些實體讀取會略過緩衝區快取,不會產生邏輯 I/O。
另請參閱:Oracle AI Database Performance Tuning Guide,瞭解如何計算緩衝區快取命中率
緩衝區接觸計數
資料庫會使用觸控計數,測量 LRU 清單上緩衝區的存取頻率。此機制可讓資料庫在固定緩衝區時 (而非 LRU 清單上不斷打亂的緩衝區) 遞增計數器。
注意:資料庫不會實際移動記憶體中的區塊。移動是指清單中指標的位置變更。
固定緩衝區時,資料庫會決定其接觸計數的上次增量時間。如果計數在三秒前遞增,則計數會遞增;否則,計數會保持不變。3 秒規則可防止緩衝區上的接腳激增次數過多。例如,階段作業可以在資料區塊中插入多個資料列,但資料庫會將這些插入視為一次。
如果緩衝區位於 LRU 的冷端,但其接觸計數很高,則緩衝區會移至熱端。如果接觸計數過低,則緩衝區會過時。
緩衝區儲存池
緩衝區集區是緩衝區的集合。
資料庫緩衝區快取會分割成一或多個緩衝區集區,以大致相同的方式管理區塊。集區對帳齡或快取區塊沒有極為不同的演算法。
您可以手動設定個別的緩衝區集區,以將資料保留在緩衝區快取中,或在使用資料區塊之後立即將緩衝區提供給新資料使用。接著,您可以將特定的綱要物件指派給適當的緩衝區集區,以控制區塊超出快取時的時效。例如,您可以將區段分隔成熱緩衝區、暖緩衝區集區。
可能的緩衝區集區如下:
-
預設人才庫
此集區是區塊一般快取的位置。除非您手動設定個別集區,否則預設集區是唯一的緩衝集區。其他集區的選擇性配置對預設集區沒有影響。
大表格快取是預設集區的選擇性區段,使用以溫度為基礎的物件層級取代演算法。在單一執行處理和 Oracle RAC 資料庫中,當
DB_BIG_TABLE_CACHE_PERCENT_TARGET初始化參數設為非零值,且PARALLEL_DEGREE_POLICY設為auto或adaptive時,平行查詢可以使用大型表格快取。只有在單一執行處理組態中,設定DB_BIG_TABLE_CACHE_PERCENT_TARGET時,序列查詢才能使用大型表格快取。 -
保留池
此集區適用於經常存取的區塊,但因為空間不足而使預設集區失效。保留緩衝區集區的用途是將物件保留在記憶體中,因此避免 I/O 作業。
注意:保留集區管理緩衝區的方式與其他集區相同:它不會使用特殊演算法來固定緩衝區。「保留」這個字是命名慣例。您可以將要保留的表格放在較大的保留集區中,然後將不想保留的表格放置在較小的資源回收集區中。
-
資源回收集區
此集區適用於不常使用的區塊。資源回收集區可防止物件在快取中使用不必要的空間。
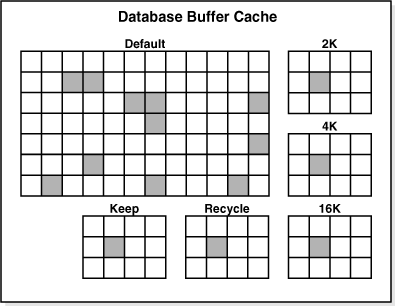
資料庫具有標準區塊大小。您可以建立一個區塊大小與標準大小不同的表格空間。每個非預設區塊大小都有自己的集區。Oracle AI Database 管理這些集區中的區塊的方式與預設集區中的區塊相同。
下圖顯示使用多個集區時,緩衝區快取的結構。快取包含預設、保留及回收集區。預設的區塊大小為 8 KB。此快取包含不同的集區,適用於使用非標準區塊大小為 2 KB、4 KB 以及 16 KB 的表格空間。
圖 3:資料庫緩衝區快取
另請參閱:
-
「資料庫區塊大小」
-
Oracle AI Database Administrator's Guide,瞭解緩衝區集區的詳細資訊
-
Oracle AI Database Performance Tuning Guide,瞭解如何使用多個緩衝區集區
-
Oracle AI Database Reference,瞭解
DB_BIG_TABLE_CACHE_PERCENT_TARGET初始化參數
緩衝區和完整表格掃描
資料庫使用複雜的演算法來管理表格掃描。依照預設,當必須從磁碟讀取緩衝區時,資料庫會將緩衝區插入 LRU 清單的中間。如此一來,熱區塊就可以保留在快取中,因此不需要再從磁碟讀取它們。
問題是由完整表格掃描構成,此掃描會依序讀取高水位標記 (HWM) 表格下的所有資料列。假設表格區段中的區塊大小總計大於緩衝區快取的大小。對此表格進行完整掃描可清除緩衝區快取,防止資料庫維護經常存取之區塊的快取。
-
完整表格掃描的預設模式:資料庫預設會採用保守的方法來完整表格掃描,只有在表格大小佔緩衝區快取的小百分比時,才會將小型表格載入記憶體。
-
平行查詢執行:執行完整表格掃描時,資料庫有時可以使用多個平行執行伺服器來縮短回應時間。
-
CACHE 屬性在罕見的情況下,如果不需要預設快取行為,您可以使用
ALTER TABLE ... CACHE來變更將大型表格的區塊讀取到資料庫緩衝區快取中的方式。 -
KEEP 屬性:對於大型表格,您可以使用
ALTER TABLE ... STORAGE BUFFER_POOL KEEP將這些表格的區塊載入保留集區中。 -
強制完整資料庫快取模式:若要改善某些情況的效能,您可以明確執行
ALTER DATABASE ... FORCE FULL DATABASE CACHING敘述句,以啟用強制完整資料庫快取模式。另請參閱:「區段空間與上限標準」
完整表格掃描的預設模式
依照預設,只有當表格大小佔緩衝區快取的小百分比時,資料庫會採用保守的方法來完整表格掃描,將小型表格載入記憶體。
為了判斷是否應快取中型表格,資料庫會使用包含上次表格掃描之間的間隔、緩衝區快取的時效時戳,以及緩衝區快取中剩餘的空間的演算法。
對於非常大型的表格,資料庫通常會使用直接路徑讀取,此讀取會直接將區塊載入 PGA 並一起略過 SGA,以避免填入緩衝區快取。如果是媒體大小表格,資料庫可能會使用直接讀取或快取讀取。如果資料庫決定使用快取讀取,則會將區塊置於 LRU 清單結尾,以防止掃描有效地清除緩衝區快取。
從 Oracle Database 12c 版本 1 (12.1.0.2) 開始,資料庫執行處理的緩衝區快取會自動執行內部計算,以判斷記憶體是否足以讓資料庫在執行處理 SGA 中完整快取,以及存取時的快取表格是否對效能有幫助。如果整個資料庫可以完全融入記憶體中,且符合各種其他內部條件,則 Oracle AI Database 會將資料庫中的所有表格視為小型表格,並認為它們有資格進行快取。不過,資料庫不會快取以 NOCACHE 屬性標示的 LOB。
平行查詢執行
執行完整表格掃描時,資料庫有時可以使用多個平行執行伺服器來縮短回應時間。
在某些情況下,當資料庫的記憶體量較大時,資料庫可以快取系統整體區域 (SGA) 中的平行查詢資料,而不是使用直接路徑讀取程式整體區域 (PGA)。一般而言,由於可能的資源使用量,平行查詢會發生在低貨幣資料倉儲中。
另請參閱:
CACHE 屬性
在罕見的情況下,如果不需要預設快取行為,您可以使用 ALTER TABLE ... CACHE 變更大型表格的區塊讀取資料庫緩衝區快取的方式。
對於已設定 CACHE 屬性的表格,資料庫不會強制或固定緩衝區快取中的區塊。而是資料庫會依照與任何其他表格區塊相同的方式,將區塊移出快取。練習此選項時請小心,因為對大型表格進行完整掃描可能會將大部分其他區塊從快取中清除。注意:執行 ALTER TABLE ... CACHE 並不會因為要快取的表格。
KEEP 屬性
對於大型表格,您可以使用 ALTER TABLE ... STORAGE BUFFER_POOL KEEP,讓掃描將這些表格的區塊載入保留集區中。
將表格置於保留集區中,會變更儲存區塊的緩衝區快取部分。資料庫會將區塊快取到保留緩衝區集區中,而不是快取預設緩衝區集區中的區塊。沒有個別演算法控制保留集區快取。
另請參閱:
-
Oracle AI Database SQL Language Reference,瞭解
CACHE子句和KEEP屬性的相關資訊 -
Oracle AI Database Performance Tuning Guide,瞭解如何解譯緩衝區快取建議統計資料
強制完整資料庫快取模式
為了改善某些情況的效能,您可以明確執行 ALTER DATABASE ... FORCE FULL DATABASE CACHING 敘述句來啟用強制使用完整資料庫快取模式。
與預設模式 (自動模式) 相較之下,強制完整資料庫快取模式會將整個資料庫 (包括 NOCACHE LOB) 視為適用於資料庫緩衝區快取中的快取。從 Oracle Database 12c 版本 1 (12.1.0.2) 開始,即可使用此模式。注意:啟用強制完整資料庫快取模式時,不會強制資料庫進入記憶體。相反地,整個資料庫適合在緩衝區快取中快取。Oracle AI Database 僅會在存取表格時快取表格。
Oracle 建議您,只有在每個個別執行處理的緩衝區快取大小大於資料庫大小時,才啟用強制完整資料庫快取模式。此準則適用於單一執行處理和 Oracle RAC 資料庫。不過,如果正確分割 Oracle RAC 應用程式,您就可以在所有執行處理的合併緩衝區快取 (使用額外的空間來處理執行處理之間重複的快取區塊) 大於資料庫大小時,啟用強制完整資料庫快取模式。
另請參閱:
-
Oracle AI Database Administrator's Guide,瞭解如何啟用強制完整資料庫快取模式
-
Oracle AI Database SQL Language Reference,瞭解
ALTER DATABASE ... FORCE FULL DATABASE CACHING敘述句的詳細資訊
DRAM 和 PMEM 緩衝區
標準 (DRAM) 資料庫緩衝區與 PMEM 緩衝區不同,但它們會共用特性。
設定「Oracle 永久記憶體檔案存放區 (PMEM 檔案存放區)」時,每個資料區塊都會直接對應至 DRAM 中的緩衝區快取。與 DRAM 緩衝區不同,PMEM 緩衝區不會複製資料區塊的內容。而是 PMEM 緩衝區標頭會指向 PMEM 檔案存放區中儲存的資料區塊。對於大多數的讀取,資料庫只會快取區塊描述資料,不會快取內容。PMEM 緩衝區使用特殊類型的顆粒,其結構與標準緩衝區快取顆粒不同。
注意:初始化參數 DB_CACHE_SIZE 指定 DRAM 快取的大小下限。此分攤不包含 PMEM 中繼資料製造費用。
PMEM 緩衝區可為下列任一狀態:
-
目前
這是目前版本的 PMEM 緩衝區。它可以直接從檔案存放區存取。
Oracle AI Database 會將 PMEM 目前的版本與標準 DRAM 緩衝區目前的版本分開。此分離有助於降低 PMEM 區塊固定、清除及移轉至 DRAM 期間的程式碼複雜性。
-
一致
這是 PMEM 緩衝區的一致讀取版本。它是在資料庫於 DRAM 中建立複製項之後建立的。PMEM 緩衝區可從檔案存放區直接存取。
-
免費
這是可用的 PMEM 緩衝區。它可以由 PMEM 區塊重複使用。執行處理啟動後,所有 PMEM 緩衝區都會處於可用狀態。
PMEM 的延遲比 DRAM 高。Oracle AI Database 使用以工作負載為基礎的內部演算法,來決定要從 PMEM 移轉到 DRAM 的區塊。
另請參閱:
-
Oracle AI Database Administrator's Guide,瞭解如何設定 PMEM 檔案存放區
重做日誌緩衝
重做日誌緩衝區是 SGA 中的循環緩衝區,用於儲存描述對資料庫所做之變更的重做項目。
重做記錄是一種資料結構,包含重新建構或重做 DML 或 DDL 作業對資料庫進行之變更的必要資訊。資料庫復原會將重做項目套用到資料檔,以重新建構遺失的變更。
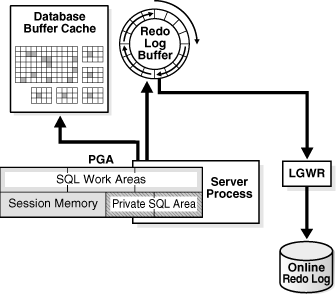
資料庫處理作業會將重做項目從使用者記憶體空間複製到 SGA 中的重做日誌緩衝區。重做項目會在緩衝區中佔用連續的循序空間。背景處理作業日誌寫入器處理作業 (LGWR) 會將重做日誌緩衝區寫入至磁碟上的作用中線上重做日誌群組。圖 17-4 顯示此重做緩衝區活動。
圖 4:重做日誌緩衝區
LGWR 會在 DBW 將分散的資料區塊寫入至磁碟時,依序將重做寫入至磁碟。散佈的寫入比循序寫入慢得多。因為 LGWR 可讓使用者避免等待 DBW 完成其慢速寫入,所以資料庫可提供更佳的效能。
LOG_BUFFER 初始化參數指定 Oracle AI Database 在緩衝重做項目時所使用的記憶體大小。與其他 SGA 元件不同的是,重做日誌緩衝區與固定 SGA 緩衝區不會將記憶體分成其他資料塊。
另請參閱:
-
Oracle AI Database Administrator's Guide,瞭解線上重做日誌的相關資訊
共用集區
共用集區可快取各種類型的程式資料。
例如,共用集區會儲存剖析的 SQL、PL/SQL 程式碼、系統參數以及資料說明資訊。共用集區牽涉到資料庫中幾乎發生的每個作業。例如,如果使用者執行 SQL 陳述式,則 Oracle AI Database 會存取共用集區。
共用集區分為數個子元件,最重要的項目如圖 17-5 所示。
圖 5:共用集區
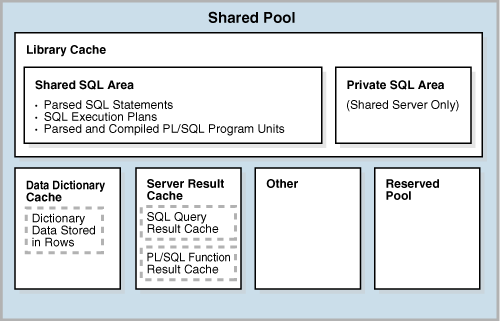
本節包括下列主題:
-
程式庫快取:程式庫快取是儲存可執行 SQL 和 PL/SQL 程式碼的共用集區記憶體結構。
-
資料說明快取:資料說明是資料庫表格和視觀表的集合,其中包含資料庫、結構和使用者的參照資訊。
-
伺服器結果快取:伺服器結果快取是共用集區中的記憶體集區。與緩衝區集區不同,伺服器結果快取保留了結果集,而非資料區塊。
-
保留的集區:保留的集區是共用集區中的記憶體區域,Oracle AI Database 可用來配置大型連續區塊的記憶體。
程式庫緩衝區
程式庫快取是儲存可執行 SQL 和 PL/SQL 程式碼的共用集區記憶體結構。
此快取包含共用的 SQL 和 PL/SQL 區域,以及控制結構 (例如鎖定和程式庫快取處理)。在共用伺服器架構中,程式庫快取也包含專用 SQL 區域。
當執行 SQL 敘述句時,資料庫會嘗試重複使用先前執行的程式碼。如果程式庫快取中存在 SQL 敘述句的剖析表示法,而且可以共用,則資料庫會重複使用該程式碼,稱為軟剖析或程式庫快取命中。否則,資料庫必須建置應用程式程式碼的新可執行版本,稱為硬剖析或程式庫快取遺漏。
-
共用 SQL 區域:資料庫代表它在共用 SQL 區域和專用 SQL 區域中執行的每個 SQL 敘述句。
-
程式單元和程式庫快取:程式庫快取保存 PL/SQL 程式和 Java 類別的可執行形式。這些項目統稱為程式單元。
-
共用集區中的記憶體配置與重複使用:剖析新的 SQL 敘述句時,資料庫會配置共用集區記憶體,除非該敘述句為 DDL,但不會被視為可共用。配置的記憶體大小會取決於敘述句的複雜性。
共用 SQL 區域
資料庫代表 SQL 敘述句在共用 SQL 區域和專用 SQL 區域中執行。
資料庫會使用共用 SQL 區域來處理第一次出現的 SQL 敘述句。所有使用者都可以存取此區域,而且包含敘述句剖析樹狀結構和執行計畫。唯一的敘述句只有一個共用 SQL 區域存在。發出 SQL 敘述句的每個階段作業在其 PGA 中都有專用 SQL 區域。每個提交相同敘述句的使用者都有一個專用 SQL 區域,指向相同的共用 SQL 區域。因此,不同 PGA 中的許多專用 SQL 區域都可以與相同的共用 SQL 區域產生關聯。
資料庫會自動決定應用程式何時提交類似的 SQL 陳述式。資料庫會考慮使用者與應用程式直接發出的 SQL 敘述句,以及由其他敘述句內部發出的遞迴 SQL 敘述句。
資料庫會執行下列步驟:
-
檢查共用集區,以查看語法上和語意上相同的敘述句是否有共用 SQL 區域:
-
如果有相同的敘述句存在,則資料庫會使用共用 SQL 區域來執行敘述句的後續新執行處理,藉此減少記憶體使用量。
-
如果沒有相同的敘述句,資料庫就會在共用集區中配置新的共用 SQL 區域。語法相同但語意不同的敘述句會使用子項游標。
不論是哪一種狀況,使用者的專用 SQL 區域都會指向包含敘述句與執行計畫的共用 SQL 區域。
-
-
代表階段作業配置專用 SQL 區域
專用 SQL 區域的位置取決於為階段作業建立的連線。如果階段作業是透過共用伺服器連線的,則專用 SQL 區域的一部分會保留在 SGA 中。
圖 17-6 顯示專用伺服器架構,其中兩個階段作業會在自己的 PGA 中保留相同 SQL 敘述句的複本。在共用伺服器中,此複本位於 MGA 中的 UGA 中。
圖 6:專用 SQL 區域與共用 SQL 區域
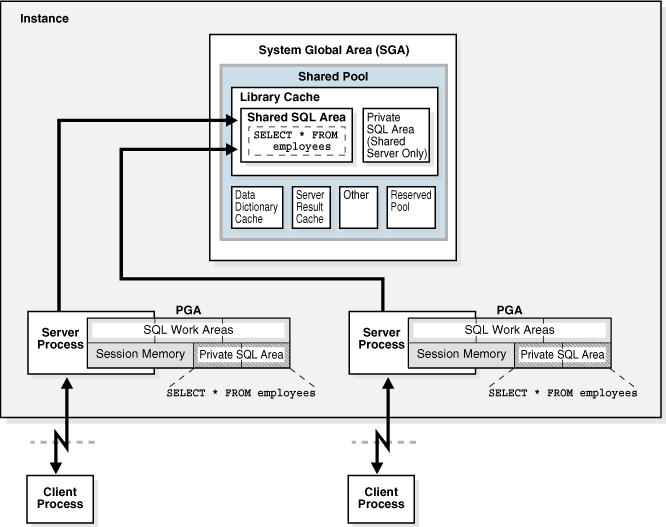
另請參閱:
-
Oracle AI Database Performance Tuning Guide,瞭解有關管理程式庫快取的詳細資訊
-
Oracle AI Database Development Guide,瞭解共用 SQL 的詳細資訊
程式單元和程式庫快取
程式庫快取保存 PL/SQL 程式和 Java 類別的可執行形式。這些項目統稱為程式單元。
資料庫處理程序的程式單元與 SQL 陳述式類似。例如,資料庫會配置共用區域,以保存 PL/SQL 程式的已剖析、編譯形式。資料庫會配置專用區域,以保存執行程式之階段作業的特定值,包括本機、全域與套裝程式變數,以及執行 SQL 的緩衝區。如果多位使用者執行相同的程式,則每位使用者會維護其專用 SQL 區域的複本,此區域保存階段作業特定的值,並存取單一共用 SQL 區域。
資料庫會依照先前所述,處理 PL/SQL 程式單位內的個別 SQL 敘述句。儘管這些 SQL 敘述句的來源為 PL/SQL 程式單元,但是這些 SQL 敘述句還是會使用共用區域來保存它們的已剖析表示法,以及使用一個專用區域來保存每個執行該敘述句的階段作業。
共用集區中的記憶體配置與重複使用
資料庫會在剖析新的 SQL 敘述句時配置共用集區記憶體,除非該敘述句為 DDL,但不會被視為可共用。配置的記憶體大小會取決於敘述句的複雜性。
一般而言,共用集區中的項目會一直存在,直到資料庫根據最不常用 (LRU) 演算法將其移除為止。資料庫允許許多階段作業所使用的共用集區項目,只要它們很有用,即使建立該項目的資料庫處理作業已終止也一樣。此機制可將 SQL 陳述式的負荷與處理降到最低。如果新項目需要空間,則資料庫會釋出不常用項目所使用的記憶體。
ALTER SYSTEM FLUSH SHARED_POOL 陳述式會移除共用集區中的所有資訊,就像變更全域資料庫名稱一樣。
另請參閱:
-
Oracle AI Database SQL Tuning Guide,瞭解共用 SQL 區域的生命週期概要
-
Oracle AI Database SQL Language Reference,瞭解有關使用
ALTER SYSTEM FLUSH SHARED_POOL的資訊 -
Oracle AI Database Reference,瞭解
V$SQL和V$SQLAREA動態檢視的相關資訊
資料字典快取
資料說明是一個資料庫表格與視觀表的集合,其中包含資料庫、結構和使用者的參照資訊。
Oracle AI Database 在 SQL 陳述式剖析期間經常存取資料字典。Oracle AI Database 經常會存取資料字典,指定下列特殊記憶體位置來保留字典資料:
-
資料說明快取
此快取可保存資料庫物件的相關資訊。快取也被稱為資料列快取,因為它會以資料列的形式保存資料,而非緩衝區形式保存。
-
程式櫃快取
所有的伺服器處理作業都會共用這些快取以存取資料說明資訊。
另請參閱:
-
Oracle AI Database Performance Tuning Guide,瞭解如何將額外的記憶體配置給資料說明快取
伺服器結果快取
伺服器結果快取是共用集區中的記憶體集區。與緩衝區集區不同,伺服器結果快取保留了結果集,而非資料區塊。注意:從屬端結果快取與伺服器結果快取不同。用戶端快取是在應用程式層級設定,並位於用戶端記憶體中,而不是在資料庫記憶體中。
-
SQL 查詢結果快取 SQL 查詢結果快取是伺服器結果快取的子集,用來儲存查詢與查詢片段的結果。您可以在資料庫或敘述句層次啟用或停用結果快取。
-
PL/SQL 函數結果快取 PL/SQL 函數結果快取是伺服器結果快取的子集,用於儲存函數結果集。
-
伺服器結果快取基礎架構:查詢結果快取和 PL/SQL 函數結果快取共用相同的基礎架構。
-
伺服器結果快取使用者介面:
RESULT_CACHE_MODE初始化參數會決定 SQL 查詢結果快取是用於所有可能的查詢,還是僅用於提示的查詢。
SQL 查詢結果快取
SQL 查詢結果快取是伺服器結果快取的子集,用來儲存查詢與查詢片段的結果。您可以在資料庫或敘述句層次啟用或停用結果快取。
當查詢執行時,資料庫會決定結果是否存在於查詢結果快取中。如果未快取結果,且已為查詢啟用快取,則資料庫會執行查詢、傳回結果,然後加以快取。不過,如果結果存在,則資料庫會從快取中擷取結果,而非執行查詢。
每當交易修改用來建構結果的資料庫物件資料或描述資料時,資料庫就會自動使快取的結果失效。下一個查詢無法使用快取的結果,因此資料庫會自動計算新的結果,然後將它快取供後續查詢使用。快取重新整理程序對應用程式而言是通透的。
查詢結果快取實際上是作為資料庫視需要建立和維護的「即時調整」具體化視觀表。快取可讓資料庫避免重新讀取資料區塊和重新計算結果的作業太貴。大部分應用程式都可從這項效能提升中獲益。
另請參閱:Oracle AI Database Administrator's Guide,瞭解如何使用查詢結果快取將回應時間最佳化
PL/SQL 函數結果快取
PL/SQL 函數結果快取是伺服器結果快取的子集,用來儲存函數結果集。
如果沒有快取,每次呼叫 1 秒時 1000 次呼叫的 PL/SQL 函數將需要 1000 秒。使用快取時,具有相同輸入值的 1000 個函數呼叫可能需要 1 秒 total 。適合結果快取的候選項目是經常呼叫的函數,這些函數取決於相對靜態資料。
PL/SQL 函數程式碼可以包含快取其結果的要求。呼叫此功能時,系統會檢查快取。如果快取包含先前具有相同參數值之函數呼叫的結果,則系統會將結果傳回給呼叫者,且不會重新執行函數主體。如果快取未包含結果,則系統會先執行函數主體並將結果 (針對這些參數值) 新增至快取,再將控制項傳回給呼叫者。
注意:您可以指定用來計算快取結果的資料庫物件,如此一來,如果更新任何物件,快取的結果就會變成無效,而且必須重新計算。
使用不同引數經常呼叫的函數可能會產生很少重複使用的結果,因而導致效能降低。Oracle AI Database 會追蹤具有 RESULT_CACHE 提示的最近使用 PL/SQL 函數。使用此歷史記錄時,資料庫只有在最近的歷史中見到 PL/SQL 函數與引數組 x 次,其中 x 是由內部臨界值設定的時,才會快取該函數與引數組。如果資料庫因快取過多的結果而需要更多記憶體,則一或多個快取的結果會過時。
RESULT_CACHE_EXECUTION_THRESHOLD 指定函數和一組特定引數必須經過的次數,直到快取為止。請注意,如果函數具有不同的引數 (例如 MYFUNC(1,2) 和 MYFUNC(1,3)),就會被視為唯一函數。您只能在系統層次設定此參數,不能在階段作業層次設定。
另請參閱:
-
Oracle AI Database Development Guide,瞭解有關 PL/SQL 函數結果快取的詳細資訊
-
Oracle AI Database PL/SQL Language Reference,瞭解 PL/SQL 函數結果快取的詳細資訊
伺服器結果快取基礎架構
查詢結果快取與 PL/SQL 函數結果快取共用相同的基礎架構。
物件類型:結果、相依性和暫時性
在伺服器結果快取中,結果物件是資料結構,可儲存查詢或 PL/SQL 函數傳回的資料列。相依性物件會儲存儲存為結果物件之查詢所參照物件的描述資料。
典型的查詢結果很小,運算成本很高,經常重複使用,而且是以非揮發性表格為基礎。不過,結果有時可能會很大。如果查詢結果通過大小限制,則資料庫會將部分結果儲存為 temp 物件,並儲存為標準結果物件。暫時物件是結果快取描述資料集合,這些描述資料會指向保存實際查詢結果的暫時表格空間區段。
結果子快取
視工作負載而定,資料庫可能會在讀取 / 寫入存取期間建立結果子快取,以支援更高的並行性。Oracle AI Database 使用內部演算法來決定是否建立子快取,如果是,還要建立多少子快取。
伺服器結果快取使用者介面
RESULT_CACHE_MODE 初始化參數決定 SQL 查詢結果快取是用於所有可能的查詢,還是僅用於提示的查詢。
RESULT_CACHE_MAX_TEMP_SIZE 初始化參數控制結果快取在 PDB 中可使用的暫時表格空間記憶體大小上限。RESULT_CACHE_MAX_TEMP_RESULT 控制一個快取的查詢所能使用的暫時表格空間記憶體大小上限。
若要覆寫 RESULT_CACHE_MODE 參數設定,您可以使用 RESULT_CACHE 提示加註查詢或查詢片段。從 Oracle Database 21c 開始,提示接受 TEMP={TRUE|FALSE} 選項,控制結果是否可以儲存在暫時表格空間中。
DBMS_RESULT_CACHE 套裝程式可讓您管理 SQL 結果快取和 PL/SQL 函數結果快取所使用之共用集區的該部分。您可以將物件、黑名單查詢和物件失效,以及執行相關作業。
V$RESULT_CACHE_OBJECTS.TYPE 資料欄代表快取中的物件類型。如果查詢結果儲存在暫時表格空間中,TYPE 就會顯示兩個物件:Result 和 Temp。您可以使用 V$RESULT_SUBCACHE_STATISTICS 和相關檢視來存取子快取描述資料。
另請參閱:
-
Oracle AI Database Administrator's Guide,瞭解如何調整結果快取的大小及控制行為
-
Oracle AI Database PL/SQL Packages and Types Reference,瞭解
DBMS_RESULT_CACHE套裝程式的相關資訊 -
Oracle AI Database Performance Tuning Guide,瞭解有關從屬端結果快取的詳細資訊
-
Oracle AI Database Reference,瞭解有關
RESULT_CACHE_MODE初始化參數的詳細資訊 -
Oracle AI Database SQL Language Reference,瞭解
RESULT_CACHE提示
保留集區
保留集區是共用集區中的記憶體區域,Oracle AI Database 可用來配置大型連續區塊的記憶體。
資料庫會以區塊方式從共用集區配置記憶體。分區功能允許將大型物件 (超過 5 KB) 載入快取中,而不需要單一連續區域。如此一來,資料庫就會因為片段化而降低連續記憶體不足執行的可能性。
Java、PL/SQL 或 SQL 游標不常會從超過 5 KB 的共用集區進行配置。為了讓這些配置最有效率地發生,資料庫會為保留集區劃分少量的共用集區。
另請參閱:Oracle AI Database Performance Tuning Guide,瞭解如何設定保留集區
大型集區
大型集區是一種選擇性的記憶體區域,適用於比共用集區更大的記憶體配置。
大型集區可針對下列各項提供大型記憶體配置:
-
平行執行時使用的訊息緩衝區
-
復原管理程式 (RMAN) I/O 子處理作業的緩衝區
-
延緩插入的緩衝區 (插入
MEMOPTIMIZE_WRITE提示)
下圖說明大型集區。
圖 7:大型集區
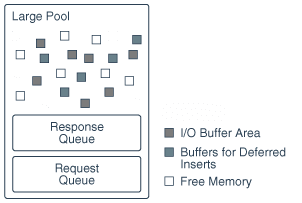
-
大型集區記憶體管理大型集區的記憶體管理方式與共用集區的管理方式不同,而共用集區使用 LRU 清單,因此部分的記憶體可超時。
-
延緩插入的大型集區緩衝區:對於特殊類型的插入 (稱為延緩插入 ),資料庫會從大型集區配置緩衝區。
另請參閱:
-
如需有關為平行執行配置記憶體的資訊,請參閱查詢協調器
-
「分配器要求與回應佇列」瞭解共用伺服器的配置階段作業記憶體
-
Oracle AI Database 開發指南,瞭解 Oracle XA
-
Oracle AI Database Performance Tuning Guide,瞭解有關大型集區的詳細資訊
大型集區記憶體管理
大型集區會與共用集區管理不同的記憶體,而共用集區使用 LRU 清單,因此一部分的記憶體可能會超時。
大型集區沒有 LRU 清單。當資料庫將大型集區記憶體配置給資料庫階段作業時,除非階段作業釋出此記憶體,否則無法釋出此記憶體。只要釋出部分記憶體,其他處理作業就可以使用該記憶體。透過從大型集區配置階段作業記憶體,資料庫可避免在共用集區中可能發生的片段化。
延緩插入的大型集區緩衝區
對於特殊類型的插入 (稱為延緩插入 ),資料庫會從大型集區配置緩衝區。
為了從 Internet of Things (IoT) 應用程式快速插入「火燒」功能,資料庫基礎架構會造成效能負荷。例如,程式碼路徑包括緩衝區快取瀏覽、緩衝區接腳以及並行保護。陣列插入將這些成本降到最低,但陣列必須建立在用戶端上,這不是 Internet of Things 應用程式的典型選擇。若要解決此問題,Oracle 應用程式可以使用提示將資料列插入指定為 MEMOPTIMIZE FOR WRITE 的表格中。
插入是延緩的,因為它們在大型集區中緩衝處理,之後又是由背景處理作業以非同步方式寫入磁碟。資料庫處理作業的延遲插入如下:
-
應用程式會將
MEMOPTIMIZE_WRITE插入傳送至可聚總資料的中間層。雖然 IoT 應用程式幾乎一律會傳送插入至中間層,但也可以直接將插入傳送至資料庫。例如,使用 SQL*Plus 會將插入項目直接傳送到資料庫。 -
中間層會將插入聚總寫入資料庫伺服器。
-
(選擇性) 中間層從屬端會保留其在上一個步驟中所撰寫之資料的本機複本。
-
伺服器處理作業會將資料寫入大型集區中的緩衝區或緩衝區。
為了避免競爭,每個緩衝區都有自己的內部鎖定機制。此鎖定機制與資料庫緩衝區快取用於其緩衝區的鎖定機制不同。基本寫入程序如下:
-
執行處理啟動後,第一個
MEMOPTIMIZE_WRITE插入會從大型集區配置緩衝區。 -
寫入器會從可用緩衝區清單中選擇緩衝區。
-
如果選擇的緩衝區未鎖定,且此緩衝區有可用空間,則從屬端會寫入緩衝區,並以階段作業特定的序號為每個緩衝區寫入加戳記。如果沒有,則寫入器會返回先前的步驟,並以此方式繼續,直到在大型集區中找到緩衝區或已釋出足夠的空間為止。
-
-
資料庫會從緩衝資料建立伺服器端陣列。
-
空間管理協調器 (SMCO) 及其協助程式處理作業 (W nnn) 會使用標準資料區塊格式,以非同步方式將陣列寫入磁碟。
與標準插入不同,延遲插入是自動確認的,無法倒回。資料庫會依照插入項目在階段作業中的顯示順序,將插入項目確認至指定的物件。您不保證能夠訂購 between 物件或階段作業。
資料庫支援限制條件與索引維護,就像一般插入一樣。然而,資料庫在寫入至磁碟期間執行評估,而不是寫入大型集區。
注意:為了獲得最佳效能,Oracle 建議您停用限制條件。
下圖說明延遲插入的工作流程。
圖 8:遞延 InsertMechanism
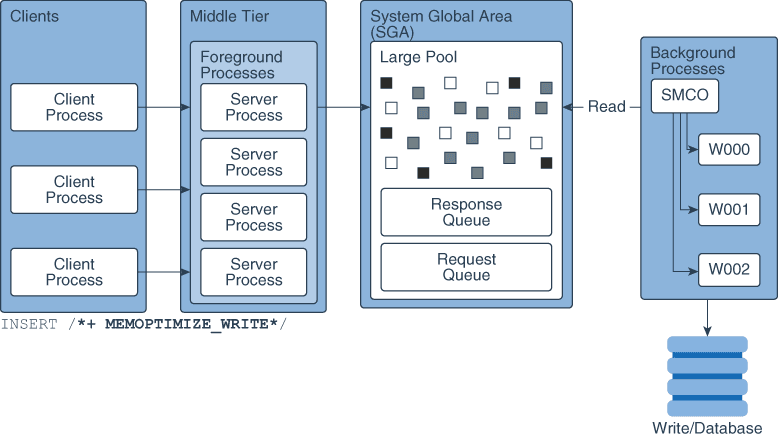
另請參閱:
-
Oracle AI Database Performance Tuning Guide,瞭解如何將表格指定為
MEMOPTIMIZE FOR WRITE -
Oracle AI Database SQL Language Reference,瞭解
INSERT的語法和語意 -
Oracle AI Database Reference,瞭解有關
MEMOPTIMIZE_POOL_SIZE的更多資訊
Java 集區
Java 集區是一個記憶體區域,可將所有階段作業特定的 Java 程式碼與資料儲存在 Java Virtual Machine (JVM) 中。此記憶體包含 Java 物件,這些物件會在呼叫結束時移轉至 Java 階段作業空間。
就專用伺服器連線而言,Java 集區會包含每個 Java 類別的共用部分,包括方法和唯讀記憶體 (例如程式碼向量),但不會包含每個階段作業的每個階段作業 Java 狀態。對於共用伺服器,集區會包含每個類別的共用部分,以及用於每個階段作業狀態的某些 UGA。每個 UGA 會視需要成長與縮小,但是 UGA 總大小必須符合 Java 集區空間。
「Java 集區建議程式」統計資料提供 Java 使用的程式庫快取記憶體資訊,並預測 Java 集區大小的變更如何影響剖析速率。當 statistics_level 設為 TYPICAL 或更新版本時,內部會開啟「Java 集區建議程式」。關閉建議程式時,這些統計資料會重設。
另請參閱:
-
Oracle AI Database Performance Tuning Guide,瞭解包含 Java 集區建議統計資料的檢視
固定的 SGA
固定 SGA 是內部房務部區域。
例如,固定的 SGA 包含:
-
資料庫和執行處理狀態的一般資訊,背景處理作業需要存取這些狀態
-
處理作業之間通訊的資訊,例如鎖定的相關資訊
固定 SGA 的大小是由 Oracle AI Database 所設定,無法手動更改。固定的 SGA 大小可能會從發行版本變更為發行版本。
另請參閱: 「自動鎖定概要」
選擇性效能相關 SGA 子區域
部分 SGA 子區域只針對特定的效能功能啟用。
本節包含下列主題:
-
記憶體內區域「記憶體內區域」是包含記憶體內資料欄存放區 (IM 資料欄存放區) 的選擇性 SGA 元件。
-
記憶體最佳化集區 memoptimize pool 會儲存指定為
MEMOPTIMIZE FOR READ之堆集組織表格的緩衝區和相關結構。
記憶體式區域
「記憶體內區域」是選擇性的 SGA 元件,包含記憶體內資料欄存放區 (IM 資料欄存放區)。
IM 資料欄存放區包含針對快速掃描最佳化的資料欄格式表格、分割區以及具體化視觀表複本。IM 資料欄存放區會補充資料庫緩衝區快取,此快取以傳統資料列格式儲存資料。
注意:若要啟用 IM 資料欄存放區,您必須要有 Oracle AI Database In-Memory 選項。
另請參閱:Oracle AI Database In-Memory Guide,深入瞭解記憶體內區域和 IM 資料欄存放區
重複集區
memoptimize pool 會儲存指定為 MEMOPTIMIZE FOR READ 之堆集組織表格的緩衝區和相關結構。
此結構為關鍵型查詢 (例如 SELECT * FROM cust WHERE cid = 10) 提供高效能和擴展性。為了縮短端對端回應時間,用戶端會透過網路直接從 SGA 提取要求的緩衝區,避免 CPU 與作業系統負荷。應用程式無需變更程式碼,即可受益於記憶體最佳化集區。
memoptimize 集區包含兩個部分:
-
記憶緩衝區
為了避免磁碟 I/O,資料庫會永久鎖定記憶體最佳化集區中
MEMOPTIMIZE FOR READ表格的緩衝區,直到表格標示為NO MEMOPTIMIZE FOR READ為止。memoptimize 緩衝區使用與資料庫緩衝區快取中的緩衝區相同的結構。不過,重複最佳化集區中的緩衝區會與資料庫緩衝區快取完全不同,而且不會計入其大小。memoptimize 緩衝區區域佔用 75% 的 memoptimize 集區。 -
雜湊索引
雜湊索引是非永久的區段資料結構。資料庫會將雜湊索引配置為多個非連續的記憶體單位。每個單位都包含一些雜湊儲存設定 (Bucket)。個別對應結構會將記憶體單元與主索引鍵關聯。雜湊索引佔據了記憶體最佳化集區的 25%。圖 9:集區記憶
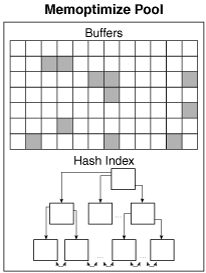
若要啟用 memoptimize 集區,請將 MEMOPTIMIZE_POOL_SIZE 初始化參數設為整數值 (集區預設為停用)。此值指定要配置給集區的 SGA 數量。MEMOPTIMIZE_POOL_SIZE 值會計入 SGA_TARGET,但資料庫不會自動增加和縮小記憶體最佳化集區。例如,如果 SGA_TARGET 為 10 GB,且如果 MEMOPTIMIZE_POOL_SIZE 為 1 GB,則除了 memoptimize 集區之外,SGA 記憶體總計為 9 GB。
若要變更記憶體最佳化集區的大小,您必須手動設定 MEMOPTIMIZE_POOL_SIZE,然後重新啟動資料庫執行處理。您無法使用 ALTER SYSTEM 動態變更集區大小。
DBMS_MEMOPTIMIZE 套裝軟體可讓您將表格明確填入記憶體最佳化集區中。
另請參閱:
-
Oracle AI Database Performance Tuning Guide 透過啟用重複資料集區來瞭解如何提高查詢效能
-
Oracle AI Database PL/SQL Packages and Types Reference,瞭解
DBMS_MEMOPTIMIZE套裝程式的詳細資訊 -
Oracle AI Database SQL Language Reference,瞭解
CREATE TABLE ... MEMOPTIMIZE FOR READ的詳細資訊 -
Oracle AI Database Reference,瞭解有關
MEMOPTIMIZE_POOL_SIZE的更多資訊
方案整體區域總覽 (PGA)
PGA 是系統上其他處理作業或繫線未共用之作業處理作業或繫線的特定記憶體。因為 PGA 是處理作業特定的,所以它永遠都不會配置在 SGA 中。
PGA 是記憶體堆集,其中包含專用或共用伺服器處理作業所需的階段作業相依變數。伺服器處理作業會配置 PGA 中所需的記憶體結構。
與 PGA 一樣,就是檔案工作人員所使用的暫時反彈工作區。在此類比中,檔案管理員是代表客戶 (從屬端處理作業) 執行工作的伺服器處理作業。工作人員會清除反彈的區段,使用工作區來儲存客戶要求的詳細資料,並排序客戶要求的資料夾,然後在工作完成時提供空間。
下圖顯示未針對共用伺服器設定之執行處理的執行處理 PGA (所有 PGA 的集合)。您可以使用初始化參數來設定執行處理 PGA 的目標大小上限。個別 PGA 可視需要成長到這個目標大小。
圖 10:執行處理 PGA
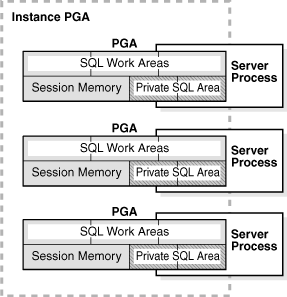
注意:背景處理作業也會配置自己的 PGA。本討論只著重在伺服器處理作業 PGA。
-
PGA 的內容:PGA 會細分為不同區域,每個區域各有不同的用途。
-
專用與共用伺服器模式中的 PGA 使用狀況 PGA 記憶體配置取決於資料庫是使用專用或共用伺服器連線。另請參閱:Oracle AI Database Performance Tuning Guide,瞭解 PGA 記憶體管理簡介
PGA 的內容
PGA 分割成不同的區域,各有不同的用途。
下圖顯示專用伺服器階段作業的可能 PGA 內容。並非所有 PGA 區域都存在於各種情況下。
圖 11:PGA 內容
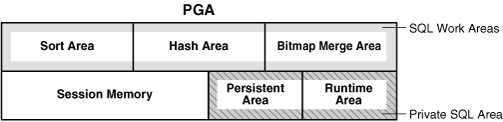
專用 SQL 區域
專用 SQL 區域可保存已剖析之 SQL 敘述句的相關資訊,以及其他階段作業特定資訊以供處理。
當伺服器處理作業執行 SQL 或 PL/SQL 程式碼時,處理作業會使用專用 SQL 區域來儲存連結變數值、查詢執行狀態資訊,以及查詢執行工作區。
請勿混淆位於 PGA 中的專用 SQL 區域與在 SGA 中儲存執行計畫的共用 SQL 區域。同一個或不同階段作業中的多個專用 SQL 區域都可指向 SGA 中的單一執行計畫。例如,在一個階段作業中執行 20 次 SELECT * FROM sales,而在不同階段作業中執行 10 次同一個查詢,則可以共用相同的計畫。每次執行的專用 SQL 區域都不會共用,並可能包含不同的值與資料。
游標是特定專用 SQL 區域的名稱或控點。如下圖所示,您可以將游標視為從屬端上的指標,並視為伺服器端上的狀態。因為游標與專用 SQL 區域密切相關,所以有時術語會交替使用。
圖 12:游標
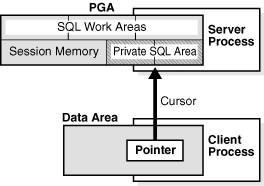
專用 SQL 區域分成下列區域:
-
執行時期區域
此區域包含查詢執行狀態資訊。例如,程式實際執行區域會追蹤到目前為止在完整表格掃描中擷取的資料列數目。
Oracle AI Database 會將執行時期區域建立為執行要求的第一個步驟。對於 DML 敘述句,當 SQL 敘述句關閉時,就會釋放程式實際執行區域。
-
永久區域
此區域包含連結變數值。執行敘述句時,會在程式實際執行時將連結變數值提供給 SQL 敘述句。永久區域只有在游標關閉時才會釋出。
從屬端處理作業負責管理專用 SQL 區域。專用 SQL 區域的配置與取消配置大致取決於應用程式,雖然從屬端處理作業可以配置的專用 SQL 區域數目受初始化參數 OPEN_CURSORS 的限制。
雖然大多數使用者都仰賴資料庫公用程式的自動游標處理,但 Oracle AI Database 程式設計介面可讓開發人員更能掌控游標。一般而言,應用程式應該關閉不會再次使用的所有開啟游標,以釋放永久區域,並儘可能減少應用程式使用者所需的記憶體。
另請參閱:
SQL 工作區
工作區域是用於耗用大量記憶體作業的 PGA 記憶體專用配置。
例如,排序運算子使用排序區域來排序一組資料列。同樣地,雜湊結合運算子使用雜湊區域從其左方輸入建立雜湊表,而位元映射合併則使用位元映射合併區域來合併從多個位元映射索引掃描擷取的資料。
下列範例顯示 employees 和 departments 的結合及其查詢計畫:
SQL> SELECT *
  2  FROM   employees e JOIN departments d
  3  ON     e.department_id=d.department_id
  4  ORDER BY last_name;
.
.
.
--------------------------------------------------------------------------------
| Id| Operation           | Name        | Rows  | Bytes | Cost (%CPU)| Time    |
--------------------------------------------------------------------------------
| 0 | SELECT STATEMENT    |             |   106 |  9328 |    7  (29)| 00:00:01 |
| 1 |  SORT ORDER BY      |             |   106 |  9328 |    7  (29)| 00:00:01 |
|*2 |   HASH JOIN         |             |   106 |  9328 |    6  (17)| 00:00:01 |
| 3 |    TABLE ACCESS FULL| DEPARTMENTS |    27 |   540 |    2   (0)| 00:00:01 |
| 4 |    TABLE ACCESS FULL| EMPLOYEES   |   107 |  7276 |    3   (0)| 00:00:01 |
--------------------------------------------------------------------------------在前面的範例中,程式實際執行區域會追蹤完整表格掃描的進度。階段作業會在雜湊區域中執行雜湊結合,以比對兩個表格的資料列。ORDER BY 排序會出現在排序區域中。
如果操作員要處理的資料量無法放入工作區中,則 Oracle AI Database 會將輸入資料分割成較小的部分。如此一來,資料庫會在將剩餘資料寫入暫存磁碟儲存體以供日後處理時,處理記憶體中的部分資料片段。
啟用自動 PGA 記憶體管理時,資料庫會自動調整工作區大小。您也可以手動控制及調整工作區的大小。
一般而言,較大的工作區可以明顯改善運算子的效能,但代價是會耗用更多的記憶體。最佳化是,工作區的大小足以容納輸入資料,以及由其關聯 SQL 運算子配置的輔助記憶體結構。否則,回應時間會隨著輸入資料的一部分必須快取在磁碟上而增加。在極端情況下,如果工作區的大小與輸入資料大小太小,則資料庫必須對資料片段執行多次傳遞,大幅增加回應時間。
另請參閱:
-
Oracle AI Database Administrator's Guide,瞭解如何使用自動 PGA 管理
-
Oracle AI Database Performance Tuning Guide,瞭解如何調校 PGA 記憶體
專用與共用伺服器模式中的 PGA 使用狀況
PGA 記憶體配置取決於資料庫是使用專用或共用伺服器連線。
下表顯示差異。
表格 1 專用伺服器與共用伺服器之間的記憶體配置差異
| 記憶體區域 | 專用伺服器 | 共用伺服器 |
|---|---|---|
| 工作階段記憶體的性質 | 私人 | 分享 |
| 永久區域的位置 | PGA | SGA |
| DML 和 DDL 敘述句的程式實際執行區域位置 | PGA | PGA |
另請參閱:Oracle AI Database Administrator's Guide,瞭解如何設定共用伺服器的資料庫
使用者整體區域概要
UGA 是階段作業記憶體,也就是配置給階段作業變數的記憶體,例如登入資訊,以及資料庫階段作業所需的其他資訊。基本上,UGA 會儲存階段作業狀態。
下圖說明 UGA。
圖 13:使用者整體區域 (UGA)
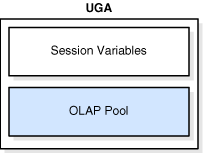
如果階段作業將 PL/SQL 套裝程式載入記憶體,則 UGA 包含套裝程式狀態,這是一組在特定時間儲存在所有套裝程式變數中的值。套裝軟體子程式變更變數時,套裝軟體狀態也會變更。依照預設,套裝程式變數在階段作業期間是唯一的,而且會持續存在。
OLAP 頁面集區也會儲存在 UGA 中。此集區管理 OLAP 資料頁面,等同於資料區塊。頁面集區會在 OLAP 階段作業開始時配置,並在階段作業結束時釋出。每當使用者查詢維度物件 (例如立方體 ) 時,OLAP 階段作業就會自動開啟。
在階段作業的存留期間,UGA 必須可供資料庫階段作業使用。因此,使用共用伺服器連線時,無法將 UGA 儲存在 PGA 中,因為 PGA 是單一處理作業特定的。因此,使用共用伺服器連線時,會將 UGA 儲存在 MGA 中,以便讓任何共用伺服器處理作業都可以存取它。使用專用伺服器連線時,UGA 會儲存在 PGA 中。
另請參閱:
-
「連線與階段作業」
-
Oracle AI Database Net Services 管理員手冊,瞭解共用伺服器連線
受管理全域區域 (MGA) 概要
「受管理整體區域 (MGA)」是唯一的記憶體架構,可跨一組信任的 Oracle 處理作業共用及協調記憶體。
它具有可設定、彈性、模組化、隨選、可復原的共用記憶體區域的功能。MGA 提供一種利用資料庫中不同類型之共用記憶體區域的方式。它被顯示為內部資料庫層的命名空間,而每個命名空間只屬於其中一個。命名空間主要是由一組共用記憶體區段及連同該區段的描述資料所組成。
資料庫中的圖層可以定義命名空間的特性、範圍、使用期限及內部區段大小。所有 MGA 都會列入 PGA 聚總限制之下。
在 Linux 上,MGA 需要掛載於 /dev/shm 的 tempfs,且至少設定為 PGA 聚總限制的大小。在同一部機器上執行多個執行處理時,所有執行處理的 /dev/shm 大小至少必須是 sum(PGA_AGGREGATE_LIMIT) 。
另請參閱:
軟體程式碼區域概要
軟體代碼區域是記憶體的一部分,用於儲存正在執行或可執行的程式碼。Oracle AI Database 程式碼儲存在軟體區域中,通常比使用者程式位置更為專屬且受到保護。
軟體區域的大小通常是靜態的,只有在更新或重新安裝軟體時才會變更。所需的範圍將依作業系統而有所不同。
軟體區域是唯讀的,可以安裝共用或非共用區域。部分資料庫工具和公用程式 (例如 Oracle Forms 與 SQL*Plus) 可以安裝共用,但有些則無法共用。如果可能,會共用資料庫程式碼,讓所有使用者不需要在記憶體中擁有多個複本即可存取資料庫程式碼,進而降低主要記憶體並改善效能。如果在同一部電腦上執行,資料庫的多個執行處理可以將相同的資料庫程式碼區域與不同的資料庫搭配使用。注意:安裝軟體共用的選項不適用於所有作業系統,例如,在操作 Microsoft Windows 的 PC 上。如需詳細資訊,請參閱作業系統特定文件。