處理作業架構
本章探討 Oracle 資料庫中的處理程序。
-
處理簡介 處理是作業系統中可以執行一系列步驟的機制。
-
從屬端處理作業簡介:當使用者執行應用程式 (例如 Pro*C 程式或 SQL*Plus) 時,作業系統會建立從屬端處理作業 (有時稱為使用者處理作業 ) 來執行使用者應用程式。用戶端應用程式中已連結 Oracle AI Database 程式庫,可提供與資料庫通訊所需的 API。
-
伺服器處理作業簡介 Oracle AI Database 會建立伺服器處理作業,以處理連線至執行處理的從屬端處理作業要求。從屬端處理作業一律會透過不同的伺服器處理作業與資料庫通訊。
-
背景處理作業簡介 背景處理作業是多重處理作業 Oracle 資料庫所使用的其他處理作業。背景處理作業會執行操作資料庫所需的維護工作,並將多個使用者的效能發揮到極致。
處理簡介
程序是作業系統中可以執行一系列步驟的機制。
處理作業執行架構取決於作業系統。例如,在 Windows 中,Oracle 背景處理作業是處理作業內的一個執行繫線。在 Linux 與 UNIX 中,Oracle 處理作業可以是作業系統處理作業,或是作業系統處理作業中的繫線。
處理執行程式碼模組。所有連線的 Oracle AI Database 使用者都必須執行下列模組,才能存取資料庫執行處理:
-
應用程式或 Oracle AI Database 公用程式
資料庫使用者會執行向資料庫發出 SQL 敘述句的資料庫應用程式,例如 precompiler 程式或資料庫工具 (例如 SQL*Plus)。
-
Oracle 資料庫代碼
每個使用者都有 Oracle 資料庫程式碼,以代表該程式碼來解譯和處理應用程式的 SQL 敘述句。
處理作業通常會以自己的專用記憶體區域執行。大多數處理作業可以定期寫入至相關聯的追蹤檔。
-
處理作業類型:資料庫執行處理包含多個處理作業或與多個處理作業互動。
-
多程序與多執行緒 Oracle AI Database Systems 多程序 Oracle AI Database (也稱為多使用者 Oracle AI Database) 使用數個流程來執行 Oracle AI Database 程式碼的不同部分,並為使用者執行額外的 Oracle 流程,無論是每個已連線使用者一個流程,還是多位使用者共用的一個或多個流程。
處理類型
資料庫執行處理會包含多個處理作業,或是與多個處理作業互動。
處理作業分為下列類型:
-
從屬端處理作業會執行應用程式或 Oracle 工具程式碼。
-
Oracle 處理作業是執行 Oracle 資料庫程式碼的執行單位。在多重執行緒架構中,Oracle 處理作業可以是作業系統處理作業或作業系統處理作業內的繫線。Oracle 處理作業包含下列子類型:
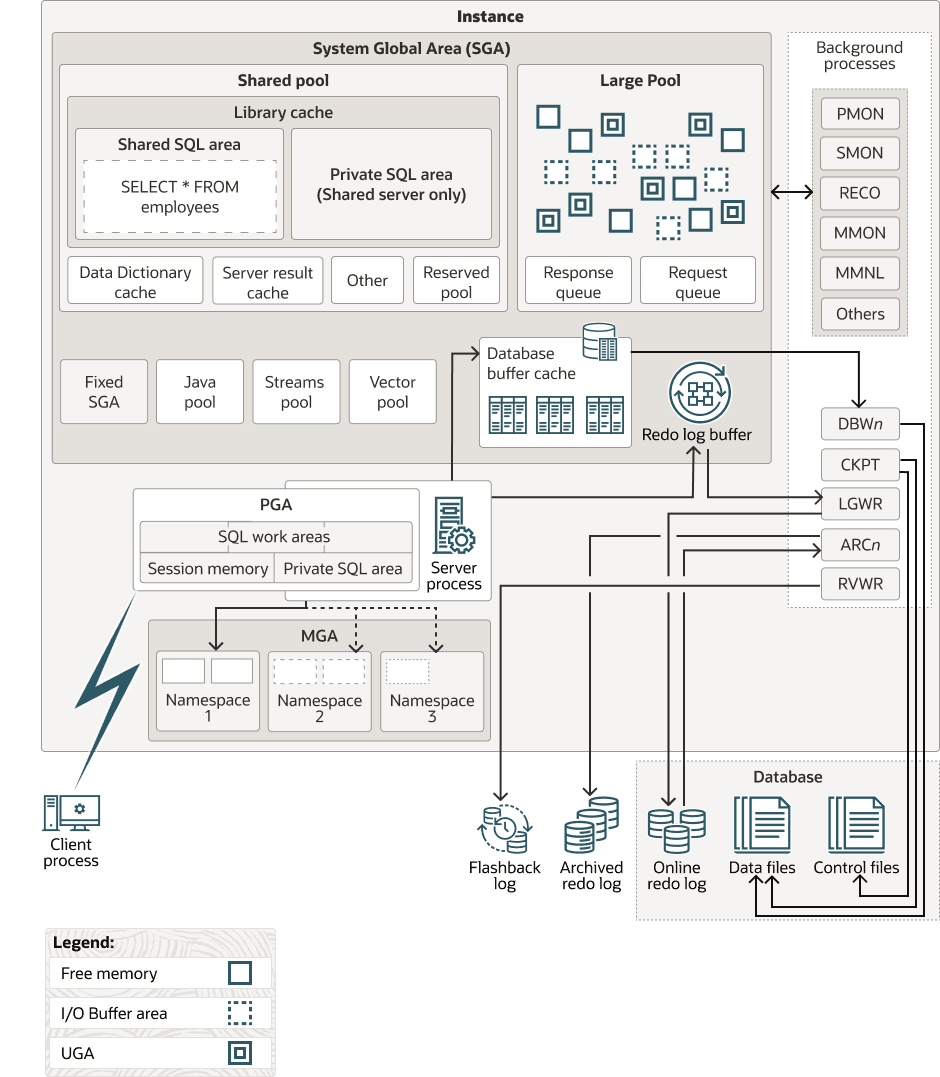
流程結構會因作業系統和 Oracle AI Database 選項的選擇而異。例如,您可以為連線的使用者設定專用伺服器或共用伺服器連線的程式碼。在共用伺服器架構中,執行資料庫程式碼的每個伺服器處理作業都可以服務多個從屬端處理作業。圖 18-1 顯示使用專用伺服器連線的系統全域區域 (SGA) 和背景處理作業。針對每一個使用者連線,從屬端處理作業會執行應用程式。這個從屬端處理作業與執行資料庫程式碼的專用伺服器處理作業不同。每個從屬端處理作業都會與其自己的伺服器處理作業相關聯,這具有自己的程式整體區域 (PGA) 。
圖 1:Oracle 處理作業與 SGA
另請參閱:
-
您的 Oracle AI Database 作業系統特定文件,以取得有關組態選擇的詳細資訊
-
Oracle AI Database Reference,瞭解
V$PROCESS檢視
多程序與多重執行緒 Oracle AI Database 系統
多處理 Oracle AI Database (也稱為多使用者 Oracle AI Database) 使用數個流程來執行 Oracle AI Database 程式碼的不同部分,並為使用者執行額外的 Oracle 流程,可以是每個已連線使用者一個流程,或是多個使用者共用的一個或多個流程。
大多數資料庫都是多使用者,因為資料庫的主要優勢是同時管理多位使用者所需的資料。資料庫執行處理中的每個處理作業都會執行特定的工作。透過將資料庫與應用程式的工作劃分為數個處理作業,多個使用者與應用程式可以同時連線到一個執行處理,而系統可以提供較佳的效能。
在 Oracle Database 12c 之前的版本中,Oracle 處理作業並沒有以 UNIX 與 Linux 系統上的繫線形式執行。從 Oracle Database 12c 開始,多重執行緒 Oracle AI Database 模型可讓 Oracle 處理作業在個別的位址空間中以作業系統繫線的形式執行。安裝 Oracle AI Database 時,資料庫會以處理模式執行。您必須將 THREADED_EXECUTION 初始化參數設為 TRUE,才能以繫線模式執行資料庫。在繫線模式中,UNIX 與 Linux 上的某些背景處理作業會以處理作業 (每個處理作業都包含一個繫線) 的形式執行,其餘的 Oracle 處理作業則會以處理作業內的繫線形式執行。
在以繫線模式執行的資料庫中,PMON 與 DBW 可能會以作業系統處理作業的形式執行,而 LGWR 與 CMON 則可能會在單一處理作業中以繫線的形式執行。有兩個前景處理作業與一個平行執行 (PX) 伺服器處理作業可以在第二個作業系統處理作業中以繫線的形式執行。第三個作業系統處理作業可能包含多個前景繫線。因此,「Oracle 處理作業」不一定代表「作業系統處理作業」。注意:當 THREADED_EXECUTION 初始化參數設為 TRUE 時,不支援作業系統認證。
範例 18-1 檢視 Oracle Process 描述資料
V$PROCESS 視觀表包含每個連線到資料庫執行處理的 Oracle 處理作業一列。例如,您可以在 SQL*Plus 中執行下列查詢,以取得每個處理作業的作業系統處理作業 ID 與作業系統繫線 ID:
COL SPID FORMAT a8
COL STID FORMAT a8
SELECT SPID, STID, PROGRAM FROM V$PROCESS ORDER BY SPID;
查詢會產生下列部分範例輸出:
SPID   STID   PROGRAM
-----  -----  ---------------------------
7190   7190   oracle@samplehost (PMON)
7192   7192   oracle@samplehost (PSP0)
7194   7194   oracle@samplehost (VKTM)
7198   7198   oracle@samplehost (SCMN)
7198   7200   oracle@samplehost (GEN0)
7202   7202   oracle@samplehost (SCMN)
7202   7204   oracle@samplehost (DIAG)
7198   7205   oracle@samplehost (DBRM)
7202   7206   oracle@samplehost (DIA0)
.
.
.
另請參閱:
-
Oracle AI Database Performance Tuning Guide,瞭解如何使用
V$PROCESS視圖 -
Oracle AI Database Reference,瞭解
THREADED_EXECUTION初始化參數
從屬端處理作業總覽
當使用者執行應用程式 (例如 Pro*C 程式或 SQL*Plus) 時,作業系統會建立從屬端處理作業 (有時稱為使用者處理作業 ) 來執行使用者應用程式。用戶端應用程式中已連結 Oracle AI Database 程式庫,可提供與資料庫通訊所需的 API。
-
從屬端和伺服器處理作業從屬端處理作業與 Oracle 處理作業直接與執行處理互動的方式不同。
-
連線與階段作業:資料庫連線是從屬端處理作業與資料庫執行處理之間的實體通訊路徑。
-
目前的容器:資料庫階段作業是資料庫執行處理記憶體中的一個邏輯實體,代表目前使用者登入資料庫的狀態。
-
資料庫作業 在資料庫監督的相關資訊環境中,資料庫作業是兩個時間點之間的階段作業活動,由一般使用者或應用程式程式碼所定義。
用戶端與伺服器處理作業
用戶端處理作業與 Oracle 處理作業直接與執行處理互動的重要方式不同。
服務從屬端處理作業的 Oracle 處理作業可以讀取和寫入 SGA,但從屬端處理作業卻無法。從屬端處理作業可以在資料庫主機以外的主機上執行,但 Oracle 處理作業則無法。
例如,假設從屬端主機上的使用者啟動 SQL*Plus,然後在資料庫執行處理未啟動時,透過網路連線至不同主機上的資料庫 sample:
SQL> CONNECT SYS@inst1 AS SYSDBA
Enter password: *********
Connected to an idle instance.
在用戶端主機上,搜尋 sqlplus 或 sample 的程序只會顯示 sqlplus 用戶端程序:
% ps -ef | grep -e sample -e sqlplus | grep -v grep
clientuser 29437 29436  0 15:40 pts/1    00:00:00 sqlplus           as sysdba
在資料庫主機上,搜尋 sqlplus 或 sample 的處理作業會顯示具有非本機連線的伺服器處理作業,但不會顯示從屬端處理作業:
% ps -ef | grep -e sample -e sqlplus | grep -v grep
serveruser 29441 1 0 15:40 ? 00:00:00 oraclesample (LOCAL=NO)另請參閱:「執行處理的啟動方式」,瞭解從屬端在未啟動執行處理時如何連線至資料庫
連線和階段作業
資料庫連線是從屬端處理作業與資料庫執行處理之間的實體通訊路徑。
連線期間,會使用可用的處理作業間通訊機制或網路軟體來建立通訊路徑。一般而言,連線會在從屬端處理作業與伺服器處理作業或分配器之間發生,但也可能在從屬端處理作業與 Oracle Connection Manager (CMAN) 之間發生。
目前的容器
資料庫階段作業是資料庫執行處理記憶體中的一個邏輯個體,代表目前使用者登入資料庫的狀態。
例如,當資料庫以密碼認證使用者時,就會為此使用者建立階段作業。階段作業的持續時間是從資料庫認證使用者的時間開始,直到使用者中斷連線或結束資料庫應用程式為止。
階段作業和容器
對於指定的階段作業,CDB 中的目前的容器是執行階段作業的容器。目前的容器可以是 CDB 根、應用程式根目錄或 PDB。
每個階段作業在任一時間點只會有一個目前的容器。由於每個容器中的資料說明是分開的,因此 Oracle AI Database 會使用目前容器中的資料說明來解析名稱和授權權限。
連線與階段作業之間的關係
單一連線可以建立 0、1 或多個階段作業。階段作業是獨立的:一個階段作業中的確認不會影響其他階段作業中的交易。
注意:如果已設定 Oracle Net 連線集區,則可以刪除連線,但讓階段作業維持不變。
單一資料庫使用者可以同時存在多個階段作業。如下圖所示,使用者 hr 可以有多個資料庫連線。在專用伺服器連線中,資料庫會代表每個連線建立伺服器處理作業。只有導致建立專用伺服器的從屬端處理作業才會使用它。在共用伺服器連線中,許多從屬端處理作業都可以存取單一共用伺服器處理作業。
圖 2:每個連線一個階段作業
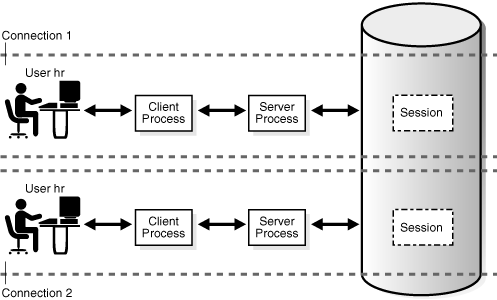
圖 18-3 說明使用者 hr 與資料庫有單一連線,但此連線有兩個階段作業的情況。
圖 3:一個連線中的兩個階段作業
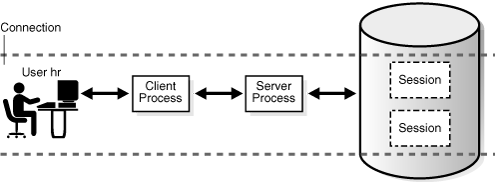
產生 SQL 敘述句執行統計資料的自動追蹤報表,會在圖 18-3 中重新建立分析藍本。
範例 18-2 中的 DISCONNECT 命令實際上會結束階段作業,而非連線。
範例 18-2 連線和階段作業
下列範例會以 SYSTEM 使用者身分將 SQL*Plus 連線至資料庫,並啟用追蹤功能,藉此建立新的階段作業 (包括範例輸出):
SQL> SELECT SID, SERIAL#, PADDR FROM V$SESSION WHERE USERNAME = USER;

SID SERIAL# PADDR
--- ------- --------
 90      91 3BE2E41C

SQL> SET AUTOTRACE ON STATISTICS;
SQL> SELECT SID, SERIAL#, PADDR FROM V$SESSION WHERE USERNAME = USER;

SID SERIAL# PADDR
--- ------- --------
 88      93 3BE2E41C
 90      91 3BE2E41C
...
SQL> DISCONNECT
DISCONNECT 命令實際上會結束階段作業,而非連線。開啟新的終端機,並以不同使用者身分連線至執行處理,下列查詢顯示位址 3BE2E41C 的連線仍在作用中。
SQL> CONNECT dba1@inst1
Password: ********
Connected.
SQL> SELECT PROGRAM FROM V$PROCESS WHERE ADDR = HEXTORAW('3BE2E41C');

PROGRAM
------------------------------------------------
oracle@stbcs09-1 (TNS V1-V3)另請參閱:「共用伺服器架構」
資料庫作業
在資料庫監督的相關資訊環境中,資料庫作業是兩個時間點之間的階段作業活動,由一般使用者或應用程式程式碼所定義。
簡單資料庫作業為單一 SQL 敘述句,或單一 PL/SQL 程序或函數。複合資料庫作業是一組單一或複合作業。
如果要監督、比較以及調整作業,您可以將一組大型作業劃分成資料庫作業,然後將多個作業細分為不同階段。使用案例是一種比一般執行的 PL/SQL 批次工作。透過將工作設定為資料庫作業,您可以識別並調整工作中耗時的步驟。
每次執行資料庫作業時,都是由成對的屬性來唯一識別:作業名稱與執行 ID。一個階段作業可以藉由指定其階段作業 ID 與序號,在不同的階段作業中啟動或停止資料庫作業。
有兩個相同的資料庫作業可以同時使用相同名稱但不同的執行 ID 執行。每次執行相同名稱的資料庫作業都可以包含不同的敘述句。
您可以使用 DBMS_SQL_MONITOR PL/SQL 套裝程式建立及管理資料庫作業。您可以使用 V$SQL_MONITOR、V$SQL_PLAN_MONITOR 和 V$SQL_MONITOR_SESSTAT 來監督作業。
另請參閱:
-
Oracle AI Database SQL Tuning Guide,瞭解如何監控資料庫作業
-
Oracle AI Database Data Warehousing Guide,瞭解如何監控長時間執行的負載
-
Oracle AI Database PL/SQL Packages and Types Reference,瞭解
DBMS_SQL_MONITOR的詳細資訊 -
Oracle AI Database Reference,瞭解有關
V$SQL_MONITOR的更多資訊
伺服器處理作業總覽
Oracle AI Database 會建立伺服器處理作業,以處理連線至執行處理的從屬端處理作業要求。從屬端處理作業一律會透過不同的伺服器處理作業與資料庫通訊。
代表資料庫應用程式建立的伺服器處理作業可以執行下列一或多個作業:
-
剖析和執行透過應用程式發出的 SQL 敘述句,包括建立和執行查詢計畫
-
執行 PL/SQL 程式碼
-
從資料檔將資料區塊讀取至資料庫緩衝區快取 (DBW 背景處理作業具有將修改過的區塊寫回磁碟的工作)
-
以能夠讓應用程式處理資訊的方式來傳回結果
-
專用伺服器處理作業:在專用伺服器連線中,從屬端連線只會與一個伺服器處理作業關聯。
-
共用伺服器處理作業:在共用伺服器連線中,從屬端應用程式會透過網路連線至分配器處理作業,而非伺服器處理作業。例如,20 個從屬端處理作業可以連線至單一分配器處理作業。
-
Oracle AI Database 如何建立伺服器處理作業:資料庫會根據連線方法,以各種方式建立伺服器處理作業。另請參閱:「 SQL 處理階段」
專用伺服器處理作業
在專用伺服器連線中,從屬端連線只會與一個伺服器處理作業關聯。
在 Linux 中,有 20 個連線到資料庫執行處理的從屬端處理作業,會由 20 個伺服器處理作業提供服務。每個用戶端處理作業都會直接與其伺服器處理作業進行通訊。此伺服器處理作業專用於階段作業期間的從屬端處理作業。伺服器處理作業會將處理作業特定資訊與 UGA 儲存在其 PGA 中。
另請參閱:
共用伺服器處理作業
在共用伺服器連線中,從屬端應用程式會透過網路連線至分配器處理作業,而非伺服器處理作業。例如,20 個從屬端處理作業可以連線至單一分配器處理作業。
分配器處理作業會接收來自已連線從屬端的要求,並將它們放入大型集區的要求佇列中。第一個可用的共用伺服器處理作業會從佇列中取得要求,並加以處理。之後,共用伺服器會將結果置於分配器回應佇列中。分配器處理作業會監督此佇列,並將結果傳輸至從屬端。
與專用伺服器處理作業相同,共用伺服器處理作業也有自己的 PGA。不過,階段作業的 UGA 是在 MGA 中,因此任何共用伺服器都可以存取階段作業資料。
Oracle AI Database 如何建立伺服器處理作業
資料庫會根據連線方法,以各種方式建立伺服器處理作業。
連線方法如下:
-
Bequeath
SQL*Plus、OCI 從屬端或其他從屬端應用程式會直接產生伺服器處理作業。
-
Oracle Net 監聽器
用戶端應用程式會透過監聽器連線至資料庫。
-
專用經紀人
這是建立前景處理作業的資料庫處理作業。與監聽器不同,中介位於資料庫執行處理內。使用專用中介時,從屬端會連線至監聽器,然後關閉與專用中介的連線。
當連線未使用 bequeath 時,資料庫會建立伺服器處理作業,如下所示:
-
用戶端應用程式要求來自監聽器或中介的新連線。
-
監聽器或中介會起始建立新處理作業或繫線。
-
作業系統會建立新的處理作業或繫線。
-
Oracle AI Database 會初始化各種元件和通知。
-
資料庫會實際操作連線和連線特定的程式碼。
或者,如果您使用專用中介連線方法,則可以使用 DBMS_PROCESS 套裝程式預先建立伺服器處理作業集區。在此情況下,「程序管理員」(PMAN) 背景處理程序會監視預先建立之處理程序的集區,而該集區會等待與用戶端要求相關聯。當連線需要伺服器處理作業時,資料庫會略過建立處理作業的步驟 2-4,只執行步驟 5。此最佳化可改善效能。
備註:
-
Oracle AI Database PL/SQL Packages and Types Reference,瞭解
DBMS_PROCESSPL/SQL 套件 -
Oracle AI Database Reference,瞭解 PMAN 背景處理作業
背景處理作業總覽
背景處理作業是多重處理作業 Oracle 資料庫使用的額外處理作業。背景處理作業會執行操作資料庫所需的維護工作,並將多個使用者的效能發揮到極致。
每個背景處理都有個別的工作,但可與其他處理搭配使用。例如,LGWR 處理作業會將資料從重做日誌緩衝區寫入線上重做日誌。當已填滿的重做日誌檔可供存檔時,LGWR 會發出另一個處理作業來存檔重做日誌檔。
Oracle AI Database 會在資料庫執行處理啟動時自動建立背景處理作業。執行處理可以有許多背景處理作業,但並非全都存在於每個資料庫組態中。下列查詢列出在您資料庫上執行的背景處理程序:
SELECT PNAME
FROM   V$PROCESS
WHERE  PNAME IS NOT NULL
ORDER BY PNAME;
本節包括下列主題:
-
必要背景處理:所有典型的資料庫組態中都有必要的背景處理。
-
選擇性背景處理:選擇性的背景處理是未定義為必要的任何背景處理。
-
次要處理次要處理是代表其他處理執行工作的背景處理。另請參閱:Oracle AI Database Reference,瞭解所有背景處理作業的描述
必要背景處理
所有典型的資料庫組態中都有必要的背景處理。
這些處理作業在以最少設定之初始化參數檔啟動的讀取 / 寫入資料庫執行處理中預設會執行。唯讀資料庫執行處理會停用其中一些處理作業。
本節描述下列必要背景處理:
-
處理作業監督器處理作業 (PMON) 群組 PMON 群組包括 PMON、「清除主要處理作業 (CLMN)」以及「清除協助程式處理作業 (CL nn)」。這些處理程序負責監視與清除其他處理程序。
-
Process Manager (PMAN) Process Manager (PMAN) 可監督數個背景處理作業,包括共用伺服器、集區伺服器以及工作佇列處理作業。
-
監聽器註冊處理作業 (LREG) 監聽器註冊處理作業 (LREG) 會使用 Oracle Net Listener 註冊有關資料庫執行處理與分配器處理作業的資訊。
-
系統監督器處理作業 (SMON) 系統監督器處理作業 (SMON) 負責各種系統層次的清除工作。
-
資料庫寫入器處理作業 (DBW) :資料庫寫入器處理作業 (DBW) 會將資料庫緩衝區的內容寫入資料檔。DBW 處理作業會將資料庫緩衝區快取中修改過的緩衝區寫入至磁碟。
-
日誌寫入器處理作業 (LGWR) :日誌寫入器處理作業 (LGWR) 可管理線上重做日誌緩衝區。
-
檢查點處理作業 (CKPT) 檢查點處理作業 (CKPT) 會使用檢查點資訊更新控制檔和資料檔標頭,並發出訊號通知 DBW 將區塊寫入磁碟。檢查點資訊包括檢查點位置、SCN 以及開始復原之線上重做日誌中的位置。
-
管理功能監督器處理作業 (MMON 和 MMNL) 管理功能監督器處理作業 (MMON) 會執行許多與自動工作負載儲存區域 (AWR) 相關的工作。
-
復原器處理作業 (RECO) 在分散式資料庫中,復原器處理作業 (RECO) 會自動解決分散式交易中的失敗。
-
背景處理作業 (BGnn) 背景處理作業 (BG nn) 是 Oracle RAC 環境中執行各種維護和監督作業的標準背景處理作業。
-
虛擬作業系統協助程式處理作業 (VOSD) :虛擬作業系統協助程式處理作業 (VOSD) 會執行具時效性的 Oracle 資料庫服務動作。
-
網路監督器處理作業 (NMON) 網路監督器處理作業 (NMON) 是輕量型的網路監督服務。
另請參閱:
-
Oracle AI Database Reference,瞭解其他必要程序的說明,包括 MMAN、DIAG、VKTM、DBRM 和 PSP0
-
Oracle Real Application Clusters Administration and Deployment Guide 和 Oracle Clusterware Administration and Deployment Guide,瞭解有關 Oracle RAC 和 Oracle Clusterware 特定背景處理作業的詳細資訊
處理作業監督器處理作業 (PMON) 群組
PMON 群組包含 PMON、「清除主要處理作業 (CLMN)」以及「清除協助程式處理作業 (CL nn)」。這些處理程序負責監視與清除其他處理程序。
PMON 群組會監督清除緩衝區快取與釋出從屬端處理作業所使用的資源。例如,PMON 群組負責重設作用中交易表格的狀態、釋出不再需要的鎖定,以及從作用中處理作業清單中移除已終止處理作業的處理作業 ID。
資料庫必須確定已終止的處理作業所保留的資源會釋出,其他處理作業才能使用這些資源。否則,程序可能會被封鎖或停滯在競爭狀態。
-
處理作業監督器處理作業 (PMON) :處理作業監督器 (PMON) 會偵測其他背景處理作業的終止。如果伺服器或分配器處理作業異常終止,則 PMON 群組會負責執行處理作業復原。處理作業終止有多種原因,包括作業系統終止命令或
ALTER SYSTEM KILL SESSION敘述句。 -
Cleanup Main Process (CLMN) PMON 會將清除工作委派給清除主要處理作業 (CLMN)。偵測異常終止的工作會與 PMON 一起維持。
-
清除協助程式處理作業 (CLnn) CLMN 會將清除工作委派給 CL nn 協助程式處理作業。
-
資料庫資源隔離:如果處理作業或階段作業終止,則 PMON 群組會將保留的資源釋出給資料庫。在某些情況下,PMON 群組可以自動隔離損毀且無法復原的資源,如此資料庫執行處理就不會立即被強制終止。
處理作業監督器處理作業 (PMON)
處理作業監督器 (PMON) 會偵測其他背景處理作業的終止。如果伺服器或分配器處理作業異常終止,則 PMON 群組會負責執行處理作業復原。處理作業終止有多種原因,包括作業系統終止命令或 ALTER SYSTEM KILL SESSION 敘述句。
清除主要處理作業 (CLMN)
PMON 會將清除工作委派給清除主要處理作業 (CLMN)。偵測異常終止的工作會與 PMON 一起維持。
CLMN 會定期執行清除已終止的處理作業、已終止的階段作業、交易、網路連線、閒置階段作業、已取消連附的交易,以及超過其閒置逾時值的已取消連附網路連線。
清除協助程式處理作業 (CLnn)
CLMN 會將清除工作委派給 CL nn 協助程式處理作業。
CL nn 處理作業可協助清除已終止的處理作業與階段作業。協助程式處理作業的數目與要完成的清除工作量和目前的清除效率成正比。
清除處理作業可能會被封鎖,以防止它繼續清除其他處理作業。此外,如果多個處理程序需要清除,則清除時間可能相當重要。基於這些原因,Oracle AI Database 可以平行使用多個協助程式流程來執行清除,進而降低效能變慢。
V$CLEANUP_PROCESS 和 V$DEAD_CLEANUP 視觀表包含有關 CLMN 清除的描述資料。V$CLEANUP_PROCESS 視觀表包含每個清除處理作業一列。例如,如果 V$CLEANUP_PROCESS.STATE 為 BUSY,則程序目前正在進行清除。
另請參閱:Oracle AI Database Reference,瞭解 V$CLEANUP_PROCESS 的詳細資訊
資料庫資源隔離
如果處理作業或階段作業終止,則 PMON 群組會釋出保留的資源給資料庫。在某些情況下,PMON 群組可以自動隔離損毀且無法復原的資源,如此資料庫執行處理就不會立即被強制終止。
在保留隔離資源的處理作業或階段作業上,PMON 群組會繼續盡可能地執行清除。V$QUARANTINE 視觀表包含描述資料,例如資源類型、使用的記憶體大小、導致隔離的 Oracle 錯誤等等。
另請參閱:Oracle AI Database Reference,瞭解 V$QUARANTINE 的詳細資訊
處理管理程式 (PMAN)
Process Manager (PMAN) 可監督數個背景處理作業,包括共用伺服器、集區伺服器以及工作佇列處理作業。
PMAN 會監督、衍生及停止下列類型的處理作業:
-
分配器與共用伺服器處理作業
-
資料庫常駐連線集區的連線中介和集區化伺服器處理作業
-
工作佇列處理
-
可重新啟動的背景處理作業
監聽器註冊處理作業 (LREG)
監聽器註冊處理作業 (LREG) 會使用 Oracle Net Listener 註冊有關資料庫執行處理與分配器處理作業的資訊。
執行處理啟動時,LREG 會輪詢監聽器以判斷監聽器是否在執行中。如果監聽器正在執行,則 LREG 會傳送其相關參數。如果未執行,則 LREG 會定期嘗試與其聯絡。
注意:在 Oracle Database 12c 之前的版本中,PMON 會執行監聽器註冊。
另請參閱: "Oracle Net Listener "
系統監督器處理作業 (SMON)
系統監督器處理作業 (SMON) 負責各種系統層次的清除工作。
指派給 SMON 的職責包括:
-
視需要在執行處理啟動時執行執行處理復原。在 Oracle RAC 資料庫中,一個資料庫執行處理的 SMON 處理作業可以針對失敗的執行處理執行執行處理復原。
-
復原執行處理復原期間因檔案讀取或表格空間離線錯誤而略過的已終止交易。SMON 會在表格空間或檔案再次回到線上時復原交易。
-
清除永久表格空間中未使用的暫時區段。例如,Oracle AI Database 會在建立索引時配置擴充區塊。如果作業失敗,則 SMON 會清除暫時空間。
-
合併說明管理表格空間內的連續可用擴充區塊。
SMON 會定期確認是否需要檢查。其他處理作業也可以在偵測到需要 SMON 時呼叫 SMON。
資料庫寫入器處理作業 (DBW)
資料庫寫入器處理作業 (DBW) 會將資料庫緩衝區的內容寫入資料檔。DBW 處理作業會將資料庫緩衝區快取中修改過的緩衝區寫入至磁碟。
雖然大部分系統都可以使用一個資料庫寫入器處理作業 (DBW0),但您可以透過 DBW9、DBWa 到 DBWz 以及 BW36 到 BW99 設定其他處理作業,以在系統大量修改資料時改善寫入效能。這些額外的 DBW 處理作業對於單處理器系統並無用。
在下列情況下,DBW 處理作業會將修改過的緩衝區寫入至磁碟:
-
當伺服器處理作業在掃描緩衝區數目臨界值之後找不到乾淨的可重複使用緩衝區時,會發出訊號通知 DBW 進行寫入。DBW 會在執行其他處理時,以非同步方式將修改過的緩衝區寫入磁碟。
-
DBW 會定期寫入緩衝區來將檢查點前進,這是重做繫線中開始進行執行處理復原的位置。檢查點的日誌位置是由緩衝區快取中最舊已修改的緩衝區所決定。
在許多情況下,DBW 寫入的區塊會分散到整個磁碟中。因此,寫入的速度會比 LGWR 執行循序寫入的慢。DBW 會盡可能執行多重區塊寫入來提升效率。多重區塊寫入中所寫入的區塊數目會依作業系統而有所不同。
另請參閱:
-
「檢查站總覽」
-
Oracle AI Database Performance Tuning Guide,瞭解有關設定、監控和調整 DBW 的建議。
日誌寫入器處理作業 (LGWR)
日誌寫入器處理作業 (LGWR) 可管理線上重做日誌緩衝區。
LGWR 會將緩衝區的一個部分寫入至線上重做日誌。透過區隔修改資料庫緩衝區的作業、執行將修改過的緩衝區分散寫入至磁碟,以及執行將重做快速循序寫入磁碟,資料庫就可以提升效能。
在下列情況下,LGWR 會寫入從上一次寫入時至緩衝區的所有重做項目:
-
使用者確認一個交易。
-
會發生線上重做日誌切換。
-
自 LGWR 上次寫入後經過三秒鐘。
-
重做日誌緩衝區三分之一滿或包含 1 MB 的緩衝資料。
-
DBW 必須將修改過的緩衝區寫入磁碟。
資料庫 W 寫入已變更緩衝區之前,資料庫必須先將與緩衝區變更相關聯的重做記錄寫入磁碟 ( 預寫協定 )。如果 DBW 發現尚未寫入某些重做記錄,則會發出訊號通知 LGWR 將記錄寫入至磁碟,並等待 LGWR 完成,再將資料緩衝區寫入至磁碟。
-
LGWR and Commits Oracle AI Database 使用快速確認機制來提升已確認交易的效能。
-
LGWR 與無法存取的檔案 LGWR 會同步寫入至線上重做日誌檔的作用中鏡像群組。另請參閱:「交易確認」
LGWR 與確認
Oracle AI Database 使用快速確認機制來提升已確認交易的效能。
當使用者發出 COMMIT 陳述式時,該交易會被指派系統變更編號 (SCN) 。LGWR 會在重做日誌緩衝區中放入一個確認記錄,並立即將該記錄寫入至磁碟,以及確認 SCN 與交易的重做項目。
重做日誌緩衝區是循環的。LGWR 將重做項目從重做日誌緩衝區寫入至線上重做日誌檔時,伺服器處理作業可以透過重做日誌緩衝區中已寫入至磁碟的項目來複製新項目。LGWR 寫入的速度通常會快到能夠確保緩衝區中一律有空間可放置新的項目,即使線上重做日誌的存取過於頻繁時也是一樣。
包含交易確認記錄之重做項目的單元寫入,是判斷交易已確認的單一事件。雖然尚未將資料緩衝區寫入磁碟,但 Oracle AI Database 會將成功程式碼傳回確認交易。資料區塊的對應變更則會延到比較有效率,讓 DBW 將它們寫入資料檔為止。
注意: LGWR 可以先將重做日誌項目寫入磁碟,再確認交易。受重做項目保護的變更,只有在交易稍後確認時才會變成永久變更。
當活動很高時,LGWR 可以使用群組確認。例如,使用者確認導致 LGWR 將交易重做項目寫入至磁碟。在此寫入期間,確認其他使用者。LGWR 寫入至磁碟以確認這些交易,直到其先前的寫入完成為止。完成時,LGWR 可以使用一個作業來寫入等待中交易 (尚未確認) 的重做項目清單。如此一來,資料庫即可將磁碟 I/O 降到最低並充分發揮效能。如果確認要求以較高的速率繼續,則 LGWR 進行的每一次寫入可以包含多筆確認記錄。
LGWR 與無法存取的檔案
LGWR 會同步地寫入至線上重做日誌檔的作用中鏡像群組。
如果無法存取日誌檔,則 LGWR 會繼續寫入群組中的其他檔案,並將錯誤寫入 LGWR 追蹤檔與警示日誌。如果群組中的所有檔案都損毀,或群組因尚未存檔而無法使用,則 LGWR 將無法繼續運作。
另請參閱:
-
Oracle AI Database Performance Tuning Guide,瞭解如何監控和調整 LGWR 效能的相關資訊
檢查點處理作業 (CKPT)
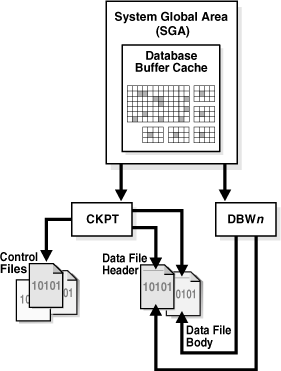
檢查點處理作業 (CKPT) 會使用檢查點資訊更新控制檔和資料檔標頭,並發出訊號通知 DBW 將區塊寫入至磁碟。檢查點資訊包括檢查點位置、SCN 以及開始復原之線上重做日誌中的位置。
如圖 18-4 所示,CKPT 不會將資料區塊寫入資料檔,也不會將重做區塊寫入線上重做日誌檔。
圖 4:檢查點處理作業
另請參閱:「檢查點概要」
管理功能監督器處理作業 (MMON 和 MMNL)
管理功能監督器處理作業 (MMON) 會執行許多與自動工作負載儲存區域 (AWR) 相關的作業。
例如,MMON 會在 metric 違反其臨界值、取得快照,以及擷取最近修改之 SQL 物件的統計資料值時寫入。
管理功能監督器 Lite 處理作業 (MMNL) 會將 SGA 中「作用中階段作業歷史記錄 (ASH)」緩衝區的統計資料寫入磁碟。ASH 緩衝區已滿時,MMNL 會寫入磁碟。
另請參閱:「Oracle AI Database 效能調校入門」和作用中階段作業歷史記錄簡介
復原器處理作業 (RECO)
在分散式資料庫中,復原器處理作業 (RECO) 會自動解決分散式交易中的失敗。
節點的 RECO 處理作業會自動連線至其他進行有問題分散式交易的資料庫。RECO 在資料庫之間重新建立連線時,會自動解決所有的有問題交易,從每個資料庫的擱置中交易表格移除所有與已解析交易對應的資料列。
另請參閱:Oracle AI Database Administrator's Guide,瞭解有關分散式系統中交易復原的詳細資訊
背景處理 (BG nn)
背景處理作業 (BG nn) 是 Oracle RAC 環境中執行各種維護和監督作業的標準背景處理作業。
背景處理作業負責緩衝區快取管理、日誌寫入器 (LGWR) 處理作業支援、檢查點協調、背景處理作業監督以及統計資料收集。
虛擬作業系統協助程式處理作業 (VOSD)
虛擬作業系統常駐程式處理作業 (VOSD) 會執行具時限的 Oracle 資料庫服務動作。
此處理作業會在執行處理啟動時產生,並負責執行對資料庫至關重要的系統服務動作。此處理作業由資料庫執行處理、Oracle ASM 執行處理以及 Oracle RAC 使用。
網路監督器處理作業 (NMON)
網路監督器處理作業 (NMON) 是一種輕量型網路監督服務。
網路監督器 (NMON) 是一種低成本的網路監督服務,運用進階核心功能來提供隨時上線的全方位監督。它會持續擷取多個層級的網路統計資料和事件,包括全系統、每個介面、每個 IP 和每個流程,為更高層級的服務提供詳細的指標。「狀況分數」服務建立在 NMON 上,使用標準化的 0-100 分數簡化網路狀況評估,並視需要收集診斷來主動解決問題。NMON 提供高效率且可操作的網路統計資料,可及時偵測異常情況,並與資料庫活動產生有效的關聯。
選擇性背景處理作業
選擇性的背景處理是任何未定義為必要的背景處理。
大部分可選的背景處理程序都是任務或功能專用的。例如,只有啟用此功能時,才能使用支援 Oracle ASM 的背景處理作業。
本節描述一些常見的選擇性程序:
-
存檔器處理作業 (ARCn) :存檔器處理作業 (ARCn) 會在進行重做日誌切換之後,將線上重做日誌檔複製到離線儲存體。
-
工作佇列處理作業 (CJQ0 和 Jnnn) 佇列處理作業通常是以批次模式執行使用者工作。工作是使用者定義的任務,可排定執行一或多次。
-
倒溯資料存檔處理作業 (FBDA) :倒溯資料存檔處理作業 (FBDA) 會將追蹤之表格的歷史資料列存檔至「倒溯資料存檔」。
-
空間管理協調器處理作業 (SMCO) :空間管理協調器處理作業 (SMCO) 處理作業是由 SMON 啟動,並且協調各種空間管理相關作業的執行。
另請參閱:
-
Oracle AI Database Transactional Event Queues and Advanced Queuing User's Guide,瞭解 Advanced Queuing (AQ) 的簡介
-
Oracle AI Database Reference,瞭解 AQ 和 Oracle ASM 特定的背景處理作業描述
歸檔程式程序 (ARC n)
存檔器處理作業 (ARCn) 會在進行重做日誌切換之後,將線上重做日誌檔複製至離線儲存體。
這些處理作業也可以收集交易重做資料,並將它傳輸至待命資料庫目的地。只有資料庫處於 ARCHIVELOG 模式並啟用自動存檔時,才會存在 ARC n 處理作業。
另請參閱:
-
「封存重做日誌檔」
-
Oracle AI Database Administrator's Guide,瞭解如何調整存檔器處理作業數目
-
Oracle AI Database Performance Tuning Guide,瞭解如何調校存檔器效能
工作佇列處理作業 (CJQ0 和 Jnnn)
佇列處理通常以批次模式執行使用者工作。工作是使用者定義的任務,可排定執行一或多次。
例如,您可以使用工作佇列在背景排定長時間執行的更新。指定開始日期與時間間隔時,工作佇列處理作業會嘗試在下次發生間隔時執行工作。
Oracle AI Database 會動態管理工作佇列處理作業,讓工作佇列從屬端能夠在需要時使用更多的工作佇列處理作業。資料庫會在新處理作業閒置時釋出所使用的資源。
動態工作佇列處理作業可以在指定的間隔同時執行許多工作。事件的順序如下:
-
Oracle Scheduler 會視需要自動啟動和停止工作協調器處理作業 (CJQ0)。協調器處理作業會定期選取需要從系統
JOB$表格執行的工作。選取的新工作會依時間排序。 -
協調器處理作業會動態產生工作佇列子項處理作業 (Jnnn),以執行工作。
-
工作佇列處理作業會執行 CJQ0 處理作業選取要執行的其中一個工作。每個工作佇列處理作業一次會執行一個工作來完成。
-
處理作業完成單一工作的執行之後,就會輪詢更多個工作。如果未排定任何工作來執行,它會進入休眠狀態,它會定期喚醒並輪詢更多工作。如果處理作業未找到任何新工作,則會在預設間隔之後終止。
初始化參數 JOB_QUEUE_PROCESSES 代表可在執行處理上同時執行的工作佇列處理作業數目上限。不過,從屬端不應該假設所有的工作佇列處理作業都可供工作執行。注意:如果初始化參數 JOB_QUEUE_PROCESSES 設為 0,就不會啟動協調器處理作業。
另請參閱:
-
Oracle AI Database Administrator's Guide,瞭解 Oracle Scheduler
-
Oracle AI Database Transactional Event Queues and Advanced Queuing User's Guide,瞭解 AQ 背景處理作業
倒溯資料存檔處理作業 (FBDA)
倒溯資料存檔處理作業 (FBDA) 會將追蹤之表格的歷史資料列存檔到「倒溯資料存檔」。
當追蹤表格上包含 DML 的交易確認時,此處理作業會將變更的資料列預先影像儲存至「倒溯資料存檔」。它也會保留目前資料列的描述資料。
FBDA 會自動管理空間、組織以及保留的「倒溯資料存檔」。此外,此處理會持續追蹤所追蹤交易的封存發生時間。
空間管理協調器處理作業 (SMCO)
SMON 會啟動空間管理協調器處理作業 (SMCO) 處理作業,並且協調各種空間管理相關作業的執行。
SMCO 處理程序會協調各種空間管理相關作業的執行。
一般作業包括主動空間配置與回收,以及暫時表格空間維護。SMCO 會動態產生子項處理作業 (Wnnn) 來實行工作。
另請參閱:Oracle AI Database Development Guide 瞭解「倒溯資料存檔」和「時間歷史記錄」功能
次要處理
次要處理是代表其他處理執行工作的背景處理。
本節描述 Oracle AI Database 所使用的部分次要處理。
-
I/O 次要處理作業 I/O 次要處理作業 (Innn) 會對不支援 I/O 的系統和裝置模擬非同步 I/O。
-
平行執行 (PX) 伺服器處理作業:在平行執行中,多個處理作業會同時運作,以執行單一 SQL 敘述句。另請參閱:Oracle AI Database Reference,以取得 Oracle AI Database 次要處理的描述。
I/O 次要處理作業
I/O 次要處理作業 (Innn) 會對不支援它的系統和裝置模擬非同步 I/O。
在非同步 I/O 中,傳輸不需要計時,讓其他處理可以在傳輸完成之前開始。
例如,假設應用程式將 1000 個區塊寫入作業系統上不支援非同步 I/O 的磁碟。每次寫入都會依序進行,並等待確認寫入成功。使用非同步磁碟時,應用程式可以大量寫入區塊,並在等待來自作業系統的所有區塊都已寫入的回應時執行其他工作。
若要模擬非同步 I/O,一個處理程序會監督數個次要處理程序。呼叫者處理會指派工作給每個次要處理,這些處理會等待每個寫入完成,並在完成時回報給呼叫者。在為 true 非同步 I/O 中,作業系統會等待 I/O 完成並回報給處理作業,在模擬非同步 I/O 中,次要處理作業會等待並回報給呼叫者。
資料庫支援不同類型的 I/O 次要處理作業,包括下列項目:
-
「復原管理程式 (RMAN)」的 I/O 次要處理作業
使用 RMAN 備份或回復資料時,您可以同時對磁碟與磁帶裝置使用 I/O 次要處理作業。
-
資料庫寫入器次要處理作業
如果使用多個資料庫寫入器處理作業 (例如當電腦有一個 CPU) 並不切實際,資料庫就可以將 I/O 分配給多個次要處理作業。DBW 是唯一掃描緩衝區快取 LRU 清單,以找出要寫入磁碟的區塊。不過,I/O 次要處理作業會對這些區塊執行 I/O。
另請參閱:
-
Oracle AI Database Backup and Recovery User's Guide,深入瞭解備份和回復作業的 I/O 次要處理作業
-
Oracle AI Database Performance Tuning Guide,深入瞭解資料庫編寫器次要流程
平行執行 (PX) 伺服器處理作業
在平行執行中,多個處理作業會同時運作以執行單一 SQL 敘述句。
透過將工作分成多個流程,Oracle AI Database 可以更快地執行陳述式。例如,四個處理程序一年處理四個不同的季別,而非處理四個季別的處理程序。
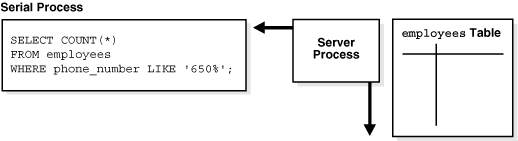
序列執行的平行執行對比,單一伺服器處理作業會在其中執行 SQL 敘述句循序執行的所有必要處理。例如,若要執行完整表格掃描 (例如 SELECT * FROM employees),一個伺服器處理作業會執行所有工作,如圖 18-5 所示。
圖 5:序列完整表格掃描
平行執行可減少對大型資料庫 (例如資料倉儲) 進行大量資料作業的回應時間。對稱式多重處理 (SMP) 與叢集系統從平行執行獲得最大效能優勢,因為敘述句處理可以分割成多個 CPU。平行執行也可以受益於特定類型的 OLTP 和混合系統。
在 Oracle RAC 系統中,特定服務的服務位置會控制平行執行。具體而言,平行處理會在已設定服務的節點上執行。依照預設,Oracle AI Database 只會在提供用於連線資料庫之服務的執行處理上執行平行處理。這不會影響其他平行作業,例如平行復原或 GV$ 查詢的處理。
-
查詢協調器:平行執行時,伺服器處理作業會作為查詢協調器 (也稱為平行執行協調器 )。
-
產生器與用戶平行執行伺服器分為產生器和用戶。產生器負責處理其資料,然後將資料分配給需要資料的用戶。
-
Granules 在平行執行中,會將表格動態分割成載入單位。每個單位 (稱為規則 ) 都是存取資料時的最小工作單位。
另請參閱:
-
Oracle Real Application Clusters Administration and Deployment Guide,瞭解有關在 Oracle RAC 環境中平行執行的考量
查詢協調器
在平行執行中,伺服器處理作業的作用就像查詢協調器 (也稱為平行執行協調器 )。
查詢協調器負責下列工作:
-
剖析查詢
-
配置及控制平行執行伺服器處理作業
-
傳送輸出給使用者
針對查詢指定查詢計畫,協調器會將 SQL 查詢中的每個 operator 分割成平行片段,按照查詢中指定的順序執行它們,並整合執行運算子的平行執行伺服器所產生的部分結果。
指派給單一作業的平行執行伺服器數目是作業的平行程度。同一個 SQL 敘述句內的多個作業,其併行執行程度均相同。
產生器與用戶
平行執行伺服器分為產生器和用戶。產生器負責處理其資料,然後將資料分配給需要資料的用戶。
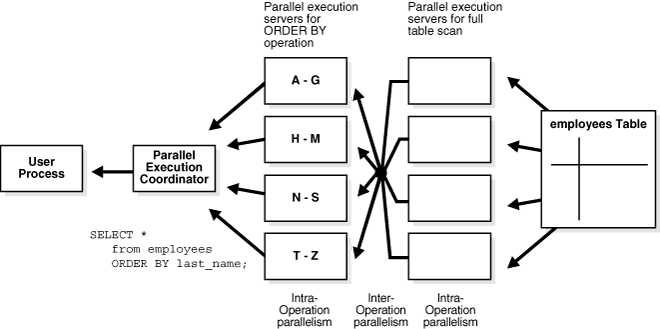
資料庫可以使用多種技術來執行分配。兩種常見的技術是廣播和雜湊。在廣播中,每個產生器都會將資料列傳送給所有用戶。在雜湊中,資料庫會計算一組關鍵碼的雜湊函數,並讓每個用戶對雜湊值的子集負責。圖 18-6 代表以平行方式執行下列敘述句執行產生器與用戶之間的相互作用:
SELECT * FROM employees ORDER BY last_name;執行計畫會實行 employees 表格的完整掃描。掃描後面接著擷取的列排序。掃描作業涉及的所有產生器處理作業都會將資料列傳送給執行排序的適當用戶處理作業。
圖 6:生產者與用戶
公司簡介
在平行執行中,表格會動態分割成載入單位。每個單位 (稱為規則 ) 都是存取資料時的最小工作單位。
區塊型資料塊是單一平行執行伺服器 (也稱為 PX 伺服器 ) 所讀取之表格的一系列資料區塊,該伺服器使用 Pnnn 作為名稱格式。若要在平行伺服器處理作業之間取得平均的工作分配,粒度的數目一律會高於要求的 DOP。圖 18-7 顯示 employees 表格的平行掃描。
圖 7:平行完整表格掃描
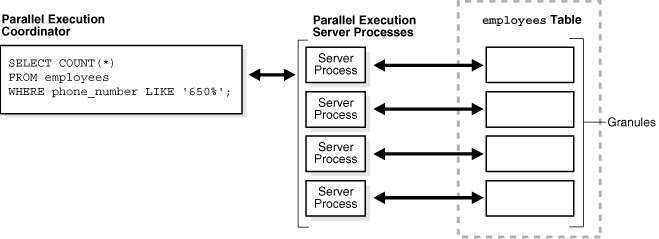
資料庫會在執行期間將資料粒對應至平行執行伺服器。當平行執行伺服器完成讀取與資料塊對應的資料列,而資料粒保留時,會從查詢協調器取得另一個資料粒。此作業會繼續執行,直到讀取表格為止。執行伺服器會將結果傳回協調器,將片段組合成想要的完整表格掃描。
另請參閱:
-
Oracle AI Database Data Warehousing Guide,瞭解建議的平行化參數