SQL
本章提供結構化查詢語言 (SQL) 的概要,以及 Oracle AI Database 如何處理 SQL 陳述式。
-
SQL 簡介 SQL (宣稱序列 ) 是以集合為基礎的高階宣告式電腦語言,所有程式和使用者都可以在其中存取 Oracle 資料庫中的資料。
-
SQL 敘述句簡介:針對 Oracle 資料庫中的資訊執行的所有作業都是使用 SQL 敘述句來執行。SQL 陳述式是由識別碼、參數、變數、名稱、資料類型及 SQL 保留字所組成的電腦程式或指示。
-
最佳化處理程式簡介若要瞭解 Oracle AI Database 如何處理 SQL 敘述句,必須瞭解稱為最佳化處理程式的資料庫部分 (又稱為查詢最佳化處理程式或成本式最佳化處理程式 )。所有 SQL 敘述句都會使用最佳化處理程式來判斷最有效率的存取指定資料方法。
-
SQL 處理簡介本節說明 Oracle AI Database 如何處理 SQL 敘述句。具體而言,本節會說明資料庫處理 DDL 敘述句以建立物件的方式、修改資料的 DML,以及擷取資料的查詢。
SQL 簡介
SQL (發音 sequel) 是以集合為基礎的高階宣告式電腦語言,所有程式與使用者會使用此語言來存取 Oracle 資料庫中的資料。
雖然有些 Oracle 工具與應用程式會遮罩 SQL 使用,但是所有資料庫作業都是使用 SQL 來執行。任何其他資料存取方法都會規避 Oracle AI Database 內建的安全性,並可能危害資料的安全性和完整性。
SQL 提供關聯式資料庫 (例如 Oracle AI Database) 的介面。SQL 以一致的語言統一作業,例如下列各項:
-
建立、取代、更改及刪除物件
-
插入、更新及刪除表格資料列
-
查詢資料
-
控制對資料庫與其物件的存取
-
保證資料庫的一致性和完整性
SQL 可以互動方式使用,也就是說敘述句可以手動輸入程式。SQL 敘述句也可以內嵌在以不同語言 (例如 C 或 Java) 撰寫的程式中。
-
SQL 資料存取有兩種廣泛的電腦語言系列:非程序性的宣告式語言,並描述應該執行什麼,以及程序語言,例如 C++ 和 Java,說明如何事項。
-
SQL 標準 Oracle 致力於遵守業界接受的標準,並積極參與 SQL 標準委員會。
另請參閱:
-
Oracle AI Database Development Guide,瞭解如何選擇程式設計環境
-
Oracle AI Database SQL Language Reference,瞭解 SQL 的簡介
SQL 資料存取
電腦語言有兩種廣泛的系列:非程序性的宣告語言,並描述應該執行什麼,以及程序語言 (例如 C++ 和 Java),這些語言應如何進行。
SQL 是宣告式的,代表使用者指定想要的結果,而非衍生結果。例如,下列陳述式會查詢姓氏開頭為 K 的員工記錄:
資料庫會執行產生程序的工作,以導覽資料並擷取要求的結果。SQL 的宣告性質可讓您使用邏輯層次的資料。只有在您操控資料時,才需要注意實作詳細資料。
SELECT   last_name, first_name
FROM     hr.employees
WHERE    last_name LIKE 'K%'
ORDER BY last_name, first_name;
資料庫會在單一步驟中擷取符合 WHERE 條件的所有資料列,亦稱為述詞。資料庫可以將這些列以單位傳送給使用者、其他 SQL 陳述式,或傳送給應用程式。應用程式不需要逐一處理列,也不需要開發人員知道實際儲存或擷取列的方式。
所有 SQL 敘述句都會使用最佳化處理程式 (資料庫的元件),它可以決定最有效率的方式來存取要求的資料。Oracle Database 也支援可以用來讓最佳化處理程式改善其工作的技術。
另請參閱:Oracle AI Database SQL Language Reference,瞭解 SQL 敘述句和其他 SQL 部分 (例如運算子、函數和格式模型) 的詳細資訊
SQL 標準
Oracle 致力於遵守業界接受的標準,並積極參與 SQL 標準委員會。
業界所接受的委員會包括美國國家標準協會 (American National Standards Institute,ANSI) 與國際標準組織 (International Organization for Standardization,ISO)。ANSI 和 ISO/IEC 都已接受 SQL 作為關聯式資料庫的標準語言。
SQL 標準包含 10 個部分。一部分 (SQL/RPR:2012) 是 2012 年的新功能。其他五部分於二零一一年經修訂。對於其他四個部分,2008 版本將保持原狀。Oracle SQL 包含許多 ANSI/ISO 標準 SQL 語言的擴充功能,Oracle AI Database 工具和應用程式則提供額外的陳述。您可以使用 SQL*Plus、SQL Developer 以及 Oracle Enterprise Manager 工具,針對 Oracle 資料庫執行任何 ANSI/ISO 標準 SQL 敘述句,並針對這些工具執行任何其他可用的敘述句或函數。
另請參閱:
-
Oracle AI Database SQL Language Reference,瞭解 Oracle SQL 與標準 SQL 之間的差異
-
SQL*Plus 命令的 SQL*Plus User's Guide and Reference,包括它們與 SQL 敘述句的區別
SQL 敘述句總覽
在 Oracle 資料庫中對資訊執行的所有作業都是使用 SQL 敘述句來執行。SQL 陳述式是由識別碼、參數、變數、名稱、資料類型及 SQL 保留字組成的電腦程式或指示。注意: SQL 保留字在 SQL 中具有特殊意義,不應用於任何其他用途。例如,SELECT 和 UPDATE 是保留字,不應該用來作為表格名稱。
SQL 陳述式必須等同於完整的 SQL 句子,例如:
SELECT last_name, department_id FROM employeesOracle AI Database 僅執行完整的 SQL 陳述式。片段 (例如下列各項) 會產生錯誤,指出需要更多文字:
SELECT last_name;Oracle SQL 敘述句分為下列類別:
-
資料定義語言 (DDL) 敘述句資料定義語言 ( DLL) 敘述句會定義、結構性變更及刪除綱要物件。
-
資料處理語言 (DML) 敘述句資料處理語言 ( DML) 敘述句可查詢或操控現有綱要物件中的資料。
-
交易控制敘述句交易控制敘述句可管理 DML 敘述句所做的變更,並將 DML 敘述句群組成交易。
-
階段作業控制敘述句階段作業控制敘述句可動態管理使用者階段作業的特性。
-
系統控制敘述句:系統控制敘述句會變更資料庫執行處理的特性。
-
內嵌 SQL 敘述句內嵌 SQL 敘述句會在程序語言程式中結合 DDL、DML 及交易控制敘述句。
資料定義語言 (DDL) 陳述式
資料定義語言 ( DLL) 敘述句會定義、結構化變更以及刪除綱要物件。
DDL 可讓您更改物件的屬性,而不需要更改存取物件的應用程式。例如,您可以新增欄至人力資源應用程式存取的表格,而不需重新編寫應用程式。您也可以在資料庫使用者於資料庫中執行工作時,使用 DDL 更改物件的結構。
更具體的說,DDL 敘述句可以讓您:
-
建立、更改及刪除綱要物件與其他資料庫結構,包括資料庫本身與資料庫使用者。大多數 DDL 敘述句的開頭都是
CREATE、ALTER或DROP關鍵字。 -
刪除綱要物件中的所有資料,而不移除這些物件的結構 (
TRUNCATE)。注意:與
DELETE不同,TRUNCATE不會產生還原資料,因此會比DELETE更快。此外,TRUNCATE不會呼叫刪除觸發程式 -
授與及撤銷權限和角色 (
GRANT、REVOKE)。 -
開啟或關閉稽核選項 (
AUDIT、NOAUDIT)。 -
在資料說明 (
COMMENT) 中新增註解。
範例 10-1 DDL 敘述句
下列範例使用 DDL 敘述句來建立 plants 表格,然後使用 DML 在表格中插入兩個資料列。此範例接著使用 DDL 來更改表格結構、授予使用者此表格的讀取權限,以及刪除表格。
CREATE TABLE plants
    ( plant_id    NUMBER PRIMARY KEY,
      common_name VARCHAR2(15) );

INSERT INTO plants VALUES (1, 'African Violet'); # DML statement

INSERT INTO plants VALUES (2, 'Amaryllis'); # DML statement

ALTER TABLE plants ADD
    ( latin_name VARCHAR2(40) );

GRANT READ ON plants TO scott;

REVOKE READ ON plants FROM scott;

DROP TABLE plants;
隱含 COMMIT 會在資料庫執行 DDL 敘述句之前立即發生,之後會立即發生 COMMIT 或 ROLLBACK。在前面的範例中,兩個 INSERT 陳述式後面跟著一個 ALTER TABLE 陳述式,因此資料庫會確認兩個 INSERT 陳述式。如果 ALTER TABLE 敘述句成功,則資料庫會確認此敘述句;否則,資料庫會倒回此敘述句。無論是哪一種情況,都已經確認兩個 INSERT 敘述句。
另請參閱:
-
Oracle AI Database Oracle AI Database Development 入門和 Oracle AI Database Administrator's Guide,瞭解如何建立綱要物件
-
Oracle AI Database Development Guide,瞭解封鎖和非封鎖 DDL 的差異
-
Oracle AI Database SQL Language Reference,瞭解 DDL 敘述句清單
資料處理語言 (DML) 陳述式
資料處理語言 ( DML) 敘述句可查詢或操控現有綱要物件中的資料。
DDL 敘述句變更資料庫的結構,DML 敘述句會查詢或變更內容。例如,ALTER TABLE 會變更表格的結構,而 INSERT 會新增一或多個資料列至表格。
DML 敘述句是最常使用的 SQL 敘述句,可讓您:
-
從一或多個表格或視觀表 (
SELECT) 擷取或擷取資料。 -
指定資料欄值清單,或使用子查詢來選取和操控現有資料,將資料列新增至表格或視觀表 (
INSERT)。 -
變更表格或視觀表之現有資料列中的資料欄值 (
UPDATE)。 -
依條件更新或插入資料列至表格或檢視 (
MERGE)。 -
從表格或視觀表移除資料列 (
DELETE)。 -
檢視 SQL 敘述句 (
EXPLAINPLAN) 的執行計畫。 -
鎖定表格或檢視,暫時限制其他使用者的存取 (
LOCKTABLE)。
下列範例使用 DML 來查詢 employees 表格。範例使用 DML 將資料列插入 employees、更新此資料列,然後將其刪除:
SELECT * FROM employees;

INSERT INTO employees (employee_id, last_name, email, job_id, hire_date, salary)
  VALUES (1234, 'Mascis', 'JMASCIS', 'IT_PROG', '14-FEB-2008', 9000);

UPDATE employees SET salary=9100 WHERE employee_id=1234;

DELETE FROM employees WHERE employee_id=1234;
構成邏輯工作單位的 DML 敘述句集合稱為交易。例如,移轉資金的交易可能涉及三個分散式作業:減少儲蓄帳戶餘額、增加支票帳戶餘額,以及在帳戶歷史記錄表格中記錄移轉。與 DDL 敘述句不同,DML 敘述句不會隱含地確認目前的交易。
-
SELECT 敘述句:查詢是從表格或視觀表擷取資料的作業。
-
結合:結合是結合兩個或多個表格、視觀表或具體化視觀表之資料列的查詢。
-
子查詢:子查詢是另一個 SQL 敘述句中巢狀的
SELECT敘述句。當您必須執行多個查詢以解決單一問題時,子查詢會很有用。
另請參閱:
SELECT 陳述式
查詢是從表格或視觀表擷取資料的作業。
SELECT 是唯一可用來查詢資料的 SQL 敘述句。從執行 SELECT 陳述式擷取的資料集稱為結果集。
下表顯示常在 SELECT 陳述式中找到的必要關鍵字與三個關鍵字。此表格也會將 SELECT 敘述句的功能與關鍵字建立關聯。
SQL 陳述式中的表格 1 關鍵字
| 關鍵字 | 必要? | 說明 | 功能 |
|---|---|---|---|
SELECT |
是 | 指定應在結果中顯示的資料欄。「預估」會產生表格中資料欄的子集。 表示式是一或多個解析為值之值、運算子及 SQL 函數的組合。顯示在 |
預估 |
FROM |
否 | 指定要從中擷取資料的表格或視觀表。 | 加入 |
WHERE |
否 | 指定篩選資料列的條件,產生表格中資料列的子集。條件可指定一或多個表示式與邏輯 (布林) 運算子的組合,並傳回 TRUE、FALSE 或 UNKNOWN 的值。 |
選擇項目 |
ORDER BY |
否 | 指定資料列的顯示順序。 |
另請參閱:Oracle AI Database SQL Language Reference,瞭解 SELECT 語法和語意
結合
結合是結合兩個或多個表格、視觀表或具體化視觀表之資料列的查詢。
下列範例結合 employees 和 departments 表格 (FROM 子句),僅選取符合指定條件 (WHERE 子句) 的資料列,並使用投影從兩個資料欄 (SELECT) 擷取資料。SQL 敘述句後的範例輸出。
SELECT email, department_name
FROM   employees
JOIN   departments
ON     employees.department_id = departments.department_id
WHERE  employee_id IN (100,103)
ORDER BY email;

EMAIL                     DEPARTMENT_NAME
------------------------- ------------------------------
AHUNOLD                   IT
SKING                     Executive
下圖代表前述查詢中所顯示之結合中的投影和選取項目作業。
圖 1:規劃與選擇
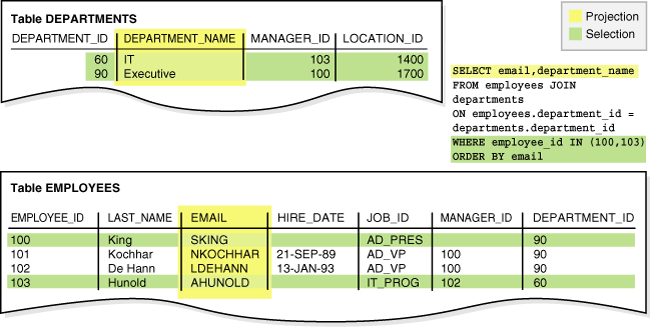
大多數結合在 FROM 子句或 WHERE 子句中至少有一個結合條件,用來比較兩個資料欄,每個資料欄都是來自不同的表格。資料庫會結合資料列組,每個資料列都包含每個表格的一個資料列,結合條件會評估為 TRUE。最佳化處理程式會根據結合條件、索引以及表格的任何可用統計資料,決定資料庫結合表格的順序。
結合類型包括:
-
內部結合
內部結合是兩個或多個表格的結合,只會傳回符合結合條件的資料列。例如,如果結合條件為
employees.department_id=departments.department_id,則不會傳回不滿足此條件的資料列。 -
外部聯結
外部結合會傳回符合結合條件的所有資料列,並傳回來自一個表格的資料列,而其他表格的資料列則不符合條件。
表格 A 與 B 的左外部結合結果一律會包含左側表格 A 的所有記錄,即使結合條件與右側表格 B 中的記錄不相符也一樣。如果 B 中沒有相符的資料列,則 B 資料欄會包含 B 中沒有相符之資料列的空值。例如,如果並非所有員工都位於部門中,則
employees(左側表格) 和departments(右側表格) 的左側外部結合會擷取employees中的所有資料列,即使departments中沒有資料列符合結合條件 (employees.department_id為空值)。表格 A 與 B 的右側外部結合結果會包含右側表格 B 的所有記錄,即使結合條件與左側表格 A 中的資料列不相符也一樣。如果 A 中沒有相符的資料列,則 A 資料欄會包含 A 中沒有相符之資料列的空值。例如,如果並非所有部門都有員工,則
employees(左側表格) 和departments(右側表格) 的右側外部結合會擷取departments中的所有資料列,即使employees中沒有資料列符合結合條件。完整外部結合是左外部結合與右外部結合的組合。
-
笛卡兒乘積
如果結合查詢中的兩個表格沒有結合條件,資料庫就會執行笛卡兒結合。一個表格的每個資料列會與另一個表格的每個資料列合併。例如,如果
employees有 107 列,而departments有 27 列,則笛卡兒乘積會包含 107*27 列。笛卡兒乘積非常有用。
另請參閱:
-
Oracle AI Database SQL Language Reference,瞭解結合的詳細描述和範例
子詢問
子查詢是另一個 SQL 敘述句中巢狀的 SELECT 敘述句。當您必須執行多個查詢以解決單一問題時,子查詢會很有用。
陳述式的每個查詢部分稱為查詢區塊。在下列查詢中,括號中的子查詢是內部查詢區塊:
SELECT first_name, last_name
FROM   employees
WHERE  department_id
IN     ( SELECT department_id
         FROM departments
         WHERE location_id = 1800 );
內部 SELECT 陳述式會擷取地點 ID 為 1800 的部門 ID。外部查詢區塊需要這些部門 ID,該區塊會擷取部門中由子查詢提供 ID 的員工姓名。
SQL 陳述式的結構不會強制資料庫先執行內部查詢。例如,資料庫可以將整個查詢重新寫入為 employees 與 departments 的結合,讓子查詢永遠不會自行執行。另一個範例是,虛擬專用資料庫 (VPD) 功能可以使用 WHERE 子句來限制員工的查詢,讓資料庫先查詢員工,然後再取得部門 ID。最佳化處理程式會決定擷取要求資料列的最佳步驟順序。
另請參閱:Oracle AI Database Security Guide 以深入瞭解 VPD
交易控制對帳單
交易控制敘述句可管理 DML 敘述句所做的變更,並將 DML 敘述句群組成交易。
這些敘述句可讓您:
-
對交易進行永久變更 (
COMMIT)。 -
還原交易中的變更,因為交易已啟動 (
ROLLBACK),或自儲存點 (ROLLBACK TO SAVEPOINT) 起。儲存點是使用者宣告的交易相關資訊環境中的中間標記。注意:
ROLLBACK敘述句會結束交易,但ROLLBACK TO SAVEPOINT不會結束。 -
設定您可以倒回的點 (
SAVEPOINT)。 -
建立交易的特性 (
SETTRANSACTION)。 -
指定是否要在每個 DML 敘述句之後或在確認交易時 (
SET CONSTRAINT),檢查可延緩的完整性限制條件。
下列範例會啟動名為 Update salaries 的交易。此範例會建立儲存點、更新員工薪資,然後將交易倒回至儲存點。此範例會將薪資更新為不同的值並確認。
SET TRANSACTION NAME 'Update salaries';

SAVEPOINT before_salary_update;

UPDATE employees SET salary=9100 WHERE employee_id=1234 # DML

ROLLBACK TO SAVEPOINT before_salary_update;

UPDATE employees SET salary=9200 WHERE employee_id=1234 # DML

COMMIT COMMENT 'Updated salaries';
另請參閱:
階段作業控制敘述句
階段作業控制敘述句會動態管理使用者 session 的特性。
階段作業是資料庫執行處理記憶體中的邏輯個體,代表目前使用者登入資料庫的狀態。階段作業會從資料庫認證使用者的時間開始,直到使用者中斷連線或結束資料庫應用程式為止。
階段作業控制敘述句可讓您:
-
執行特殊功能來變更目前階段作業,例如設定預設日期格式 (
ALTER SESSION)。 -
啟用和停用目前階段作業 (
SET ROLE) 的角色 (權限群組)。
下列敘述句會動態將階段作業的預設日期格式變更為 'YYYY MM DD-HH24:MI:SS':
ALTER SESSION
   SET NLS_DATE_FORMAT = 'YYYY MM DD HH24:MI:SS';
階段作業控制敘述句不會隱含地確認目前的交易。
另請參閱:
-
Oracle AI Database SQL Language Reference,瞭解
ALTER SESSION的語法和語意
系統控制聲明
系統控制敘述句會變更資料庫執行處理的特性。
唯一的系統控制陳述式為 ALTER SYSTEM。它可讓您變更設定值,例如共用伺服器的數目下限、終止階段作業,以及執行其他系統層次作業。
系統控制陳述式的範例包括:
ALTER SYSTEM SWITCH LOGFILE;

ALTER SYSTEM KILL SESSION '39, 23';
ALTER SYSTEM 敘述句不會隱含地確認目前的交易。
另請參閱:Oracle AI Database SQL Language Reference,瞭解 ALTER SYSTEM 語法和語意
內嵌 SQL 敘述句
內嵌的 SQL 敘述句會在程序語言程式中結合 DDL、DML 以及交易控制敘述句。
內嵌陳述式與 Oracle 預先編譯器搭配使用。內嵌 SQL 是將 SQL 併入程序語言應用程式的一種方法。另一種方法是使用程序 API,例如開放式資料庫連線 (ODBC) 或 Java 資料庫連線 (JDBC)。
內嵌的 SQL 敘述句可讓您:
-
定義、配置及釋出游標 (
DECLARE CURSOR、OPEN、CLOSE)。 -
指定資料庫並連線至該資料庫 (
DECLARE DATABASE、CONNECT)。 -
指定變數名稱 (
DECLARE STATEMENT)。 -
初始化描述元 (
DESCRIBE)。 -
指定如何處理錯誤和警告條件 (
WHENEVER)。 -
剖析並執行 SQL 敘述句 (
PREPARE、EXECUTE、EXECUTE IMMEDIATE)。 -
從資料庫擷取資料 (
FETCH)。
最佳化處理程式概要
若要瞭解 Oracle AI Database 如何處理 SQL 敘述句,必須瞭解稱為最佳化處理程式的資料庫部分 (也稱為查詢最佳化處理程式或以成本為基礎的最佳化處理程式 )。所有 SQL 敘述句都會使用最佳化處理程式來判斷最有效率的存取指定資料方法。
-
使用最佳化處理程式:最佳化處理程式會產生描述可能執行方法的執行計畫。
-
最佳化處理程式元件:最佳化處理程式包含三個主要元件:轉換器、預估程式以及計畫產生器。
-
存取路徑:存取路徑是查詢用來擷取資料列的技巧。
-
最佳化處理程式統計資料 最佳化處理程式統計資料是資料的集合,描述資料庫與資料庫中物件的詳細資料。統計資料提供在評估存取路徑時,最佳化處理程式可用之資料儲存和分送的靜態正確圖片。
-
最佳化處理程式提示:提示是 SQL 敘述句中作為最佳化處理程式指示的註解。
使用「最佳化程式」
最佳化處理程式會產生描述可能執行方法的執行計畫。
最佳化處理程式會透過考量數個資訊來源來判斷哪一個執行計畫最有效率。例如,最佳化處理程式會考慮查詢條件、可用的存取路徑、為系統收集的統計資料,以及提示。
若要執行 DML 敘述句,Oracle AI Database 可能需要執行許多步驟。每個步驟都會實際從資料庫擷取資料列,或為發出敘述句的使用者準備資料列。資料庫用來執行陳述式的步驟,會大幅影響陳述式執行的速度。處理 DML 敘述句時常有許多不同的方法。例如,表格或索引的存取順序可能會有所不同。
判斷 SQL 敘述句的最佳執行計畫時,最佳化處理程式會執行下列作業:
-
運算式與條件的評估
-
檢查完整性限制條件以深入瞭解資料,並根據此描述資料進行最佳化
-
敘述句轉換
-
最佳化處理程式目標的選擇
-
選擇存取路徑
-
加入訂單的選擇
最佳化處理程式會產生處理查詢的大多數可能方式,並將成本指派給所產生執行計畫中的每個步驟。成本最低的計畫會被選為要執行的查詢計畫。
注意:您可以在不執行計劃的情況下,取得 SQL 敘述句的執行計劃。只有資料庫實際用來執行查詢的執行計畫,才能正確地稱為查詢計畫。
您可以透過設定最佳化處理程式目標,以及為最佳化處理程式收集代表統計資料,來影響最佳化處理程式選項。例如,您可以將最佳化處理程式目標設為下列其中一項:
-
總傳輸量
ALL_ROWS提示指示最佳化處理程式儘快將結果的最後一個資料列傳送給從屬端應用程式。 -
初始回應時間
FIRST_ROWS提示會指示最佳化處理程式儘快將第一個資料列傳送給從屬端。
典型的終端使用者互動式應用程式會受惠於初始回應時間最佳化,而批次模式的非互動式應用程式則受惠於總輸送量最佳化。
另請參閱:
-
Oracle AI Database PL/SQL Packages and Types Reference,瞭解有關使用
DBMS_STATS的資訊 -
Oracle AI Database SQL Tuning Guide,瞭解有關最佳化處理程式與使用提示的詳細資訊
最佳化處理程式元件
最佳化處理程式包含三個主要元件:轉換器、預估程式以及計畫產生器。
下圖說明元件:
圖 2:最佳化處理程式元件
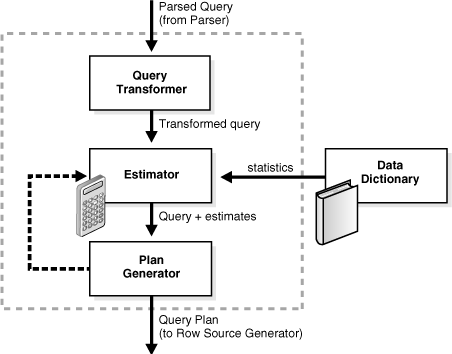
最佳化處理程式的輸入是已剖析的查詢。最佳化處理程式執行下列作業:
-
最佳化處理程式會接收已剖析的查詢,並根據可用的存取路徑與提示,為 SQL 敘述句產生一組可能的計畫。
-
最佳化處理程式會根據資料說明中的統計資料來預估每個計畫的成本。此成本是與以特定計畫執行敘述句時所需之預期資源使用量成比例的預估值。
-
最佳化處理程式會比較計畫的成本,並選擇最下層的計畫 (稱為查詢計畫),以傳送到資料列來源產生器。
-
查詢轉換器:查詢轉換器會決定變更查詢形式是否有幫助,讓最佳化處理程式可以產生更好的執行計畫。查詢轉換器的輸入是已剖析的查詢,最佳化處理程式會將其表示為一組查詢區塊。
-
Estimator : estimator 會決定指定執行計畫的整體成本。
-
計劃產生器:計劃產生器會針對已提交的查詢,嘗試不同的計劃。最佳化處理程式會選擇成本最低的計畫。
另請參閱:
查詢轉換器
查詢轉換器會決定變更查詢的形式是否有幫助,讓最佳化處理程式可以產生較佳的執行計畫。查詢轉換器的輸入是已剖析的查詢,最佳化處理程式會將其表示為一組查詢區塊。
另請參閱:查詢重寫
預估者
estimator 會決定指定執行計畫的整體成本。
預估程式會產生三種不同類型的評量,以達成此目標:
-
選擇性
此計量代表資料列集中資料列的一小部分。選擇性會與查詢述詞 (例如
last_name='Smith') 或述詞的組合連結。 -
基數
此計量代表資料列集中的資料列數目。
-
成本
此度量代表使用的工作單位或資源。查詢最佳化處理程式使用磁碟 I/O、CPU 使用量以及記憶體使用量作為工作單位。
如果有可用的統計資料,則預估程式會使用這些統計資料來計算計量。統計資料可改善測量的準確度。
計畫產生器
計畫產生器會針對已提交的查詢嘗試不同的計畫。最佳化處理程式會選擇成本最低的計畫。
針對每個巢狀子查詢與未合併的視觀表,最佳化處理程式會產生一個子計畫。最佳化處理程式會將每個子計畫以個別的查詢區塊表示。計畫產生器會嘗試不同的存取路徑、結合方法及結合順序,探索查詢區塊的各種計畫。
調適性查詢最佳化功能會根據敘述句執行期間所收集的統計資料來變更計畫。所有調適性機制都可以對不同於預設計畫的敘述句執行最終計畫。調適性最佳化會使用動態計畫 (在敘述句執行期間在子計畫中選擇),或重新最佳化 (在目前執行之後變更執行計畫)。
另請參閱:
-
Oracle AI Database 效能調校入門,瞭解 SQL 調整簡介
-
Oracle AI Database SQL Tuning Guide,瞭解最佳化工具元件和調適型最佳化
存取進程
存取路徑是查詢用來擷取資料列的技巧。
例如,使用索引的查詢有別於查詢的存取路徑。一般而言,索引存取路徑最適合用於擷取小型表格資料列子集的敘述句。完整掃描較有效率地存取大部分的表格。
資料庫可以使用數個不同的存取路徑從表格擷取資料。以下是代表名單:
-
完整表格掃瞄
此類型的掃描會從表格讀取所有資料列,並篩選出不符合選取條件的資料列。資料庫會依序掃描區段中的所有資料區塊,包括高水位標記 (HWM) 底下的資料區塊,這些區塊會與未使用的空間分開使用 (請參閱區段空間和高水位標記 )。
-
Rowid 掃描
資料列的 rowid 會指定資料檔與資料區塊,其中包含資料列與該區塊中資料列的位置。資料庫會先從敘述句
WHERE子句或透過索引掃描取得所選資料列的資料列 ID,然後根據資料列 ID 尋找每個選取的資料列 ID。 -
索引掃瞄
此掃描會搜尋索引,找出由 SQL 敘述句存取的已編製索引資料欄值 (請參閱索引掃描 )。如果敘述句只存取索引的資料欄,則 Oracle AI Database 會直接從索引讀取索引的資料欄值。
-
叢集掃描
叢集掃描會從儲存在已編製索引之表格叢集中的表格擷取資料,其中所有具有相同叢集索引鍵值的資料列都會儲存在相同的資料區塊中 (請參閱已編製索引叢集概要 )。資料庫會先掃描叢集索引,取得所選資料列的資料列 ID。Oracle AI Database 會根據此資料列 ID 尋找資料列。
-
雜湊掃瞄
雜湊掃描會尋找雜湊叢集中的資料列,其中雜湊值相同的所有資料列都會儲存在相同的資料區塊中 (請參閱雜湊叢集簡介 )。資料庫會先將 hash 函數套用到敘述句指定的叢集索引鍵值,以取得雜湊值。接著,Oracle AI Database 會掃描包含具有此雜湊值之資料列的資料區塊。
最佳化處理程式會根據對帳單的可用存取路徑,以及使用每個存取路徑或路徑組合的預估成本,選擇存取路徑。
另請參閱:Oracle AI Database Get Started with Performance Tuning 和 Oracle AI Database SQL Tuning Guide 以瞭解存取路徑
最佳化處理程式統計資料
最佳化處理程式統計資料是資料集合,描述資料庫與資料庫中物件的相關詳細資料。統計資料提供在評估存取路徑時,最佳化處理程式可用之資料儲存和分送的靜態正確圖片。
最佳化處理程式統計資料包含:
-
表格統計資料
這些包括列數、區塊數,以及平均列長度。
-
資料欄統計
這些值包括資料欄中的相異值和空值數目,以及資料分佈。
-
索引統計
包括分葉區塊數目和索引層次。
-
系統統計資料
這些功能包括 CPU 和 I/O 效能和使用率。
Oracle AI Database 會自動收集所有資料庫物件的最佳化處理程式統計資料,並將這些統計資料維持為自動維護作業。您也可以使用 DBMS_STATS 套裝軟體手動收集統計資料。此 PL/SQL 套裝程式可修改、檢視、匯出、匯入以及刪除統計資料。注意:為進行查詢最佳化而建立最佳化處理程式統計資料,並儲存在資料說明中。請勿將這些統計資料與透過動態效能視觀表顯示的效能統計資料混淆。
「最佳化處理程式統計資料建議程式」內建的診斷軟體,可分析您目前如何收集統計資料、現有統計資料收集工作的有效性,以及所收集統計資料的品質。「最佳化處理程式統計資料建議程式」會根據目前的功能集,維護內含 Oracle 最佳實行範例的規則。透過此方式,建議程式一律會針對統計資料收集提供最新的建議事項。
另請參閱:
-
Oracle AI Database 效能調校入門和 Oracle AI Database SQL Tuning Guide,瞭解如何收集和管理統計資料
-
Oracle AI Database PL/SQL Packages and Types Reference,瞭解
DBMS_STATS
最佳化處理程式提示
提示是 SQL 敘述句中作為最佳化處理程式指示的註解。
有時候,應用程式設計人員對特定應用程式資料的相關資訊會比最佳化處理程式還要多,可以選擇更有效的執行 SQL 敘述句方式。應用程式設計人員可以使用 SQL 陳述式中的提示來指定應如何執行陳述式。下列範例說明提示的用法。
範例 10-2 使用 FIRST_ROWS 提示進行 SELECT 的執行計畫
假設您的互動式應用程式執行傳回 50 列的查詢。此應用程式一開始只會擷取向一般使用者顯示之查詢的前 25 個資料列。您想要最佳化處理程式產生一個儘快取得前 25 筆記錄的計畫,不讓使用者被迫等待。您可以使用提示將此指示傳送給最佳化處理程式,如下列範例中的 SELECT 敘述句和 AUTOTRACE 輸出所示:
SELECT /*+ FIRST_ROWS(25) */ employee_id, department_id
FROM   hr.employees
WHERE  department_id > 50;

------------------------------------------------------------------------
| Id | Operation                    | Name              | Rows | Bytes
------------------------------------------------------------------------
|  0 | SELECT STATEMENT             |                   | 26   | 182
|  1 |  TABLE ACCESS BY INDEX ROWID | EMPLOYEES         | 26   | 182
|* 2 |   INDEX RANGE SCAN           | EMP_DEPARTMENT_IX |      |
------------------------------------------------------------------------
在此範例中,執行計畫顯示最佳化處理程式選擇 employees.department_id 資料欄的索引,以尋找 employees 的前 25 個資料列,其部門 ID 超過 50。最佳化處理程式使用從索引擷取的 rowid,從 employees 表格擷取記錄,然後傳回給從屬端。擷取第一筆記錄通常幾乎是即時的。
範例 10-3 無提示之 SELECT 的執行計畫
假設您執行了相同的敘述句,但沒有最佳化處理程式提示:
SELECT employee_id, department_id
FROM   hr.employees
WHERE  department_id > 50;

------------------------------------------------------------------------
| Id | Operation              | Name              | Rows | Bytes | Cos
------------------------------------------------------------------------
|  0 | SELECT STATEMENT       |                   | 50   | 350   |
|* 1 |  VIEW                  | index$_join$_001  | 50   | 350   |
|* 2 |   HASH JOIN            |                   |      |       |
|* 3 |    INDEX RANGE SCAN    | EMP_DEPARTMENT_IX | 50   | 350   |
| 4 | INDEX FAST FULL SCAN| EMP_EMP_ID_PK | 50 | 350 |在此情況下,執行計畫會結合兩個索引,以儘快傳回要求的記錄。最佳化處理程式不像在範例 10-2 中重複從索引移至表格,而是選擇 EMP_DEPARTMENT_IX 的範圍掃描,以尋找部門 ID 超過 50 的所有資料列,並將這些資料列置於雜湊表格。最佳化處理程式接著會選擇讀取 EMP_EMP_ID_PK 索引。對於此索引中的每一列,系統會偵測雜湊表以尋找部門 ID。
在此情況下,在 EMP_DEPARTMENT_IX 的索引範圍掃描完成之前,資料庫無法將第一個資料列傳回從屬端。因此,此產生的計劃會花費較長的時間來傳回第一筆記錄。不同於範例 10-2 中,透過索引 rowid 存取表格的計畫,計畫使用多重區塊 I/O,會產生較大的讀取。讀取可讓整個結果集的最後一個資料列更快速地傳回。
另請參閱:Oracle AI Database SQL Tuning Guide 瞭解如何使用最佳化處理程式提示
SQL 處理概要
本節說明 Oracle AI Database 如何處理 SQL 陳述式。具體而言,本節會說明資料庫處理 DDL 敘述句以建立物件的方式、修改資料的 DML,以及擷取資料的查詢。
-
SQL 處理階段 SQL 處理的一般階段為剖析、最佳化、產生資料列來源以及執行。視敘述句而定,資料庫可能會省略某些步驟。
-
DML 與 DDL 處理之間的差異:Oracle AI Database 會以與 DML 不同的方式處理 DDL。
SQL 處理階段
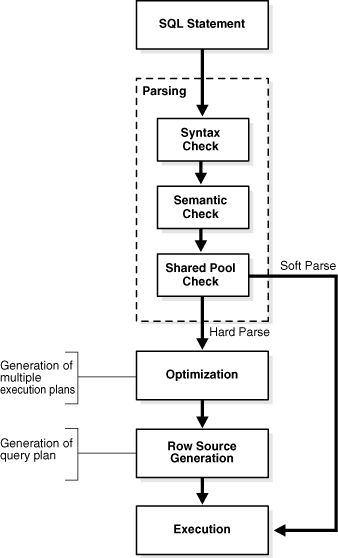
SQL 處理的一般階段為剖析、最佳化、產生資料列來源以及執行。視敘述句而定,資料庫可能會省略某些步驟。
下圖說明一般階段:
圖 3:SQL 處理階段
-
SQL 剖析:SQL 處理的第一階段是 SQL 剖析。此階段涉及將 SQL 陳述式的片段分成可由其他常式處理的資料結構。
-
查詢最佳化是選擇執行 SQL 敘述句最有效率方式的處理作業。
-
產生 SQL 資料列來源:資料列來源產生器是從最佳化處理程式接收最佳執行計畫的軟體,並產生一個稱為查詢計畫的反覆計畫,供資料庫的其餘部分使用。
-
SQL 執行:在執行期間,SQL 引擎會執行資料列來源產生器所產生之樹狀結構中的每個資料列來源。這是 DML 處理中唯一的必要步驟。
SQL 剖析
SQL 處理的第一個階段是 SQL 剖析。此階段涉及將 SQL 陳述式的片段分成可由其他常式處理的資料結構。
當應用程式發出 SQL 敘述句時,應用程式會對資料庫進行剖析呼叫,以準備敘述句以供執行。剖析呼叫會開啟或建立游標,此為階段作業特定專用 SQL 區域的控點,該區域保存已剖析的 SQL 敘述句和其他處理資訊。游標與專用 SQL 區域位於 PGA 中。
在剖析呼叫期間,資料庫會執行下列檢查:
-
語法檢查
-
語意檢查
-
共用集區檢查
前面的檢查是指在敘述句執行之前可找到的錯誤。無法透過剖析抓取某些錯誤。例如,資料庫在敘述句執行期間可能會遇到 deadlock 或資料轉換錯誤。
資料庫會嘗試在剖析階段發生 ORA-00600 錯誤時,自動緩解 SQL 敘述句的錯誤。ORA-00600 為嚴重錯誤。它指出處理程序遇到低階、非預期的情況。當 SQL 敘述句在剖析階段因發生此錯誤而失敗時,自動錯誤緩解會將它設陷並嘗試解決條件。如果找到解決方法,資料庫就會產生一個 SQL 修正程式,以調整 SQL 執行計畫。如果此修正程式讓剖析順利完成,就不會發出 ORA-00600 錯誤。應用程式未見到異常狀況。
另請參閱:鎖定和死鎖關於自動 SQL 錯誤降低
SQL 最佳化
查詢最佳化是選擇執行 SQL 敘述句最有效率方式的處理作業。
資料庫會根據收集的實際存取資料的統計資料來最佳化查詢。最佳化處理程式使用資料列數目、資料集大小以及其他因子來產生可能的執行計畫,並將數值成本指派給每個計畫。資料庫使用成本最低的計畫。
資料庫必須至少為每個唯一的 DML 敘述句執行一次硬剖析,並在此剖析期間執行最佳化。除非 DDL 包含需要最佳化的 DML 元件 (例如子查詢),否則一律不會最佳化。
另請參閱:
-
Oracle AI Database SQL Tuning Guide,瞭解有關查詢最佳化處理程式的詳細資訊
SQL 資料列來源產生
資料列來源產生器是從最佳化處理程式接收最佳執行計畫的軟體,會產生一個稱為查詢計畫的反覆計畫,供資料庫的其餘部分使用。
查詢計畫以步驟組合的形式呈現。每個步驟都會傳回資料列集。此集合中的列為下一個步驟所使用,或最後一個步驟所使用的列,會傳回發佈 SQL 陳述式的應用程式。
資料列來源是由執行計畫中的步驟所傳回的資料列集,以及可反覆處理資料列的控制結構。資料列來源可以是表格、視觀表,或是結合或群組作業的結果。
SQL 執行
執行期間,SQL 引擎會在由列來源產生器所產生的樹狀目錄中執行每個列來源。這是 DML 處理中唯一的必要步驟。
在執行期間,如果資料不在記憶體中,則資料庫會從磁碟將資料讀取至記憶體。資料庫也會進行任何必要的鎖定和閂鎖,以確保資料完整性,並記錄 SQL 執行期間所做的任何變更。處理 SQL 陳述式的最後階段正在關閉游標。
如果資料庫設定為使用記憶體內資料欄存放區 (IM 資料欄存放區),則資料庫會儘可能以通透的方式將查詢遞送至 IM 資料欄存放區,否則會遞送至磁碟和資料庫緩衝區快取。單一查詢也可以使用 IM 資料欄存放區、磁碟以及緩衝區快取。例如,查詢可能會結合兩個表格,而 IM 資料欄存放區中只會快取其中一個表格。
另請參閱:
-
Oracle AI Database SQL Tuning Guide,瞭解有關執行計劃和
EXPLAIN PLAN陳述式的詳細資訊
DML 與 DDL 處理之間的差異
Oracle AI Database 處理 DDL 與 DML 不同。
例如,當您建立表格時,資料庫不會最佳化 CREATE TABLE 敘述句。相反地,Oracle AI Database 會剖析 DDL 陳述式並執行命令。
與 DDL 相較之下,大部分的 DML 敘述句都有查詢元件。在查詢中,執行游標會將查詢產生的資料列放入結果集中。
資料庫一次只能擷取一個資料列或群組的結果集資料列。在擷取中,資料庫會選取列,如果查詢要求,則會排序列。每個連續擷取都會擷取結果的另一個資料列,直到擷取最後一個資料列為止。
另請參閱:Oracle AI Database Development Guide 瞭解如何處理 DDL、交易控制和其他類型的陳述