分割區、視觀表及其他綱要物件
雖然表格與索引是最重要且最常用的綱要物件,但資料庫支援許多其他類型的綱要物件,這是本章討論最常見的綱要物件。
-
分割區簡介在 Oracle 資料庫中,分割可讓您將非常大型的表格和索引分解為較小且更容易管理的片段,稱為分割區。每個分割區都是一個獨立物件,它有自己的名稱和儲存特性 (選擇性)。
-
分區表格簡介:在 Oracle 資料庫中,「全域分散式資料庫」功能可讓您將任何表格分成稱為分區的片段,這些分區可以儲存在多個資料庫中。
-
檢視總覽:檢視是一或多個表格的邏輯表示法。本質上,視觀表是儲存的查詢。
-
具體化視觀表簡介:具體化視觀表是預先儲存或「具體化」作為綱要物件的查詢結果。查詢的
FROM子句可以命名表格、視觀表或具體化視觀表。 -
序列總覽:序列是一個綱要物件,可供多位使用者產生唯一的整數。順序產生器提供可高度擴展且效能良好的方法,以產生數字資料類型的替代索引鍵。
-
維度簡介:一般資料倉儲有兩個重要的元件:維度和事實。
-
同義字簡介:同義字是綱要物件的別名。例如,您可以為表格或視觀表、順序、PL/SQL 程式單位、使用者定義的物件類型或其他同義字建立同義字。由於同義字只是一個別名,因此除了資料字典中的定義之外,它不需要儲存。
分割區簡介
在 Oracle 資料庫中,分割可讓您將非常大的表格與索引分解為較小且更容易管理的片段,稱為分割區。每個分割區都是一個獨立物件,它有自己的名稱和儲存特性 (選擇性)。
對於說明分割的例子,假設 HR 經理人員有一個包含員工資料夾的大方塊。每個資料夾都會列出員工僱用日期。系統通常會對特定月份僱用的員工進行查詢。滿足此類要求的其中一個方法,就是在員工僱用日期上建立索引,此索引指定資料夾在整個方塊中的分散位置。相反地,分割策略使用許多較小的方塊,每個方塊都包含特定月份僱用員工的資料夾。
使用較小的方塊有很多優點。當要求擷取 6 月僱用員工的資料夾時,HR 經理人員可以擷取 6 月方塊。此外,如果任何小箱暫時損壞,其他小箱仍然可以使用。搬家辦公室也變得更加容易,因為主管不必搬搬家一箱重箱就可以搬運數個小箱。
從應用程式的角度來看,只有一個綱要物件存在。SQL 敘述句不需要修改即可存取分割的表格。分割有助於許多不同類型的資料庫應用程式,尤其是管理大量資料的應用程式。優點包括:
-
提升可用性
分割區無法使用不會造成物件無法使用。查詢最佳化處理程式會自動將未參照的分割區自查詢計畫中移除,這樣當分割區無法使用時,查詢便不會受到影響。
-
輕鬆管理綱要物件
分割的物件具有可共同或個別管理的片段。DDL 敘述句可以操控分割區而非整個表格或索引。因此,您可以打破資源密集的工作,例如重建索引或表格。例如,一次只能移動一個表格分割區。如果發生問題,則只有分割區移動必須重新執行,而非表格移動。此外,刪除分割區可避免執行多個
DELETE敘述句。 -
減少 OLTP 系統中共用資源的競爭
在某些 OLTP 系統中,分割區可以減少共用資源的競爭。例如,DML 會分布在多個區段而非一個區段上。
-
增強資料倉儲中的查詢效能
在資料倉儲中,分割可以加速特設查詢的處理。例如,包含百萬列的銷售表格可依季分割。
-
分割特性表格或索引的每個分割區都必須有相同的邏輯屬性,例如資料欄名稱、資料類型以及限制條件。
-
分割的表格:分割的表格是由一或多個分割區所組成,這些分割區是個別管理的,而且可以獨立於其他分割區。
-
分割的索引:分割的索引是一種索引,就像分割的表格一樣,已分割成較小且更容易管理的片段。
-
分割之表格的局部索引:局部索引是與關聯之分割表格的索引特性關聯的索引。
-
使用舊分割區的物件存放區:對於唯讀分割區,您可以使用低成本儲存體 (例如雲端中的物件儲存體)。另請參閱:Oracle AI Database VLDB and Partitioning Guide,瞭解分割簡介
分割區特性
表格或索引的每個分割區都必須具有相同的邏輯屬性,像是資料欄名稱、資料類型以及限制條件。
例如,表格中的所有分割區共用相同的資料欄與限制條件定義。不過,每個分割區都可以有不同的實體屬性,例如它所屬的表格空間。
-
分割區索引鍵:分割區索引鍵是一組一或多個資料欄,決定分割表格中每一列應前往的分割區。每個資料列都會明確地指定給單一分割區。
-
分割策略 Oracle Partitioning 提供數種分割策略,可控制資料庫如何將資料放入分割區中。基本策略包括範圍、清單以及雜湊分割。
分割區索引鍵
分割區索引鍵是一組一或多個資料欄,可決定分割表格中每一列應該要前往的分割區。每個資料列都會明確地指定給單一分割區。
在 sales 表格中,您可以指定 time_id 資料欄作為範圍分割區的索引鍵。資料庫會根據此資料欄中的日期是否落在指定的範圍內,將資料列指派給分割區。Oracle AI Database 會使用分割區索引鍵,自動將插入、更新和刪除作業導向適當的分割區。
分割策略
Oracle Partitioning 提供數種分割策略,可控制資料庫如何將資料放入分割區中。基本策略包括範圍、清單以及雜湊分割。
單一層次分割僅使用一種資料分配方法,例如,僅列出分割或僅使用範圍分割。在複合分割中,表格是以一個資料分配方法來分割,然後使用第二個資料分配方法,將每個分割區進一步分割成子分割區。例如,您可以使用 channel_id 的清單分割區,以及 time_id 的範圍子分割區。
範例 6-1 分割表格的資料列集範例
此分割範例假設您想要將下列資料列填入分割的表格 sales:
  PROD_ID    CUST_ID TIME_ID   CHANNEL_ID   PROMO_ID QUANTITY_SOLD AMOUNT_SOLD
---------- ---------- --------- ---------- ---------- ------------- -----------
      116      11393 05-JUN-99          2        999             1
12.18
       40     100530 30-NOV-98          9         33             1       44.99
      118        133 06-JUN-01          2        999             1       17.12
      133       9450 01-DEC-00          2        999             1       31.28
       36       4523 27-JAN-99          3        999             1       53.89
      125       9417 04-FEB-98          3        999             1       16.86
       30        170 23-FEB-01          2        999             1         8.8
       24      11899 26-JUN-99          4        999             1       43.04
       35       2606 17-FEB-00          3        999             1       54.94
45 9491 28-AUG-98 4 350 1 47.45-
範圍分割:在範圍分割中,資料庫會根據分割索引鍵的值範圍,將資料列對應至分割區。範圍分割是最常見的分割類型,通常與日期搭配使用。
-
區間分割是範圍分割的延伸。
-
清單分割:在清單分割中,資料庫會使用分散式值清單作為每個分割區的分割區索引鍵。分割索引鍵包含一或多個資料欄。
-
雜湊分割:在雜湊分割中,資料庫會根據資料庫套用至使用者指定分割索引鍵的雜湊演算法,將資料列對應至分割區。
-
參照分割:在參照分割中,子項表格的分割策略只能透過與父項表格的外來索引鍵關係來定義。父項表格中的每個分割區,子項表格中只存在一個對應的分割區。父系表格會儲存特定分割區中的父系記錄,子系表格會儲存對應分割區中的子系記錄。
-
複合分割:在複合分割中,表格是以一個資料分配方法來分割,然後使用第二個資料分配方法,將每個分割區進一步細分為子分割區。因此,複合分割會結合基本資料分配方法。指定分割區的所有子分割區代表資料的邏輯子集。
範圍分割
在範圍分割中,資料庫會根據分割索引鍵的值範圍,將資料列對應至分割區。範圍分割是最常見的分割類型,通常與日期搭配使用。
假設您使用下列 SQL 陳述式建立 time_range_sales 作為分割表格,並將 time_id 資料欄作為分割區索引鍵:
CREATE TABLE time_range_sales
   ( prod_id        NUMBER(6)
   , cust_id        NUMBER
   , time_id        DATE
   , channel_id     CHAR(1)
   , promo_id       NUMBER(6)
   , quantity_sold  NUMBER(3)
   , amount_sold    NUMBER(10,2)
   )
PARTITION BY RANGE (time_id)
 (PARTITION SALES_1998 VALUES LESS THAN (TO_DATE('01-JAN-1999','DD-MON-YYYY')),
  PARTITION SALES_1999 VALUES LESS THAN (TO_DATE('01-JAN-2000','DD-MON-YYYY')),
  PARTITION SALES_2000 VALUES LESS THAN (TO_DATE('01-JAN-2001','DD-MON-YYYY')),
  PARTITION SALES_2001 VALUES LESS THAN (MAXVALUE)
);之後,您可以使用範例 6-1 中的資料列載入 time_range_sales。此代碼顯示四個分割區中的列分配。資料庫會根據 PARTITION BY RANGE 子句中指定的規則,根據 time_id 值來選擇每個資料列的分割區。範圍分割區索引鍵值決定指定分割區的非包含上限。
間隔分割
區間分割是範圍分割的延伸。
如果您插入的資料超出現有範圍分割區,Oracle AI Database 會自動建立指定間隔的分割區。例如,您可以建立銷售歷史記錄表格,將每個月的資料儲存在個別分割區中。
您可以利用間隔分割區來避免明確建立範圍分割區。幾乎每一個範圍分割的表格都可以使用間隔分割,並針對新的分割區使用固定間隔。除非您建立具有不同間隔的範圍分割區,或除非您一律設定特定的分割區屬性,否則請考慮使用間隔分割區。
依間隔分割時,您至少必須指定一個範圍分割區。範圍分割索引鍵值決定範圍分割區的高值,亦即稱為轉換點。資料庫會使用超出轉換點的值,自動為資料建立間隔分割區。每個間隔分割區的下限是上一個範圍或間隔分割區的內含上限。因此,在範例 6-2 中,值 01-JAN-2011 位於分割區 p2 中。
資料庫會為超出轉換點的資料建立區間分割區。間隔分割區藉由指示資料庫建立指定範圍或間隔的分割區,來擴充範圍分割。當插入表格的資料超過所有現有的範圍分割區時,資料庫會自動建立分割區。在範例 6-2 中,p3 分割區包含的分割索引鍵為 time_id 值大於或等於 01-JAN-2013 的資料列。
範例 6-2 間隔分割
假設您建立一個銷售表格,其中包含四個不同寬度的分割區。您指定在 2013 年 1 月 1 日的轉換點上方,資料庫應以一個月的間隔建立分割區。分割區 p3 的上限代表轉換點。分割區 p3 及其下的所有分割區都在範圍區段中,而其上的所有分割區都落在間隔區段中。
CREATE TABLE interval_sales
    ( prod_id        NUMBER(6)
    , cust_id        NUMBER
    , time_id        DATE
    , channel_id     CHAR(1)
    , promo_id       NUMBER(6)
    , quantity_sold  NUMBER(3)
    , amount_sold    NUMBER(10,2)
    )
  PARTITION BY RANGE (time_id)
  INTERVAL(NUMTOYMINTERVAL(1, 'MONTH'))
    ( PARTITION p0 VALUES LESS THAN (TO_DATE('1-1-2010', 'DD-MM-YYYY'))
    , PARTITION p1 VALUES LESS THAN (TO_DATE('1-1-2011', 'DD-MM-YYYY'))
    , PARTITION p2 VALUES LESS THAN (TO_DATE('1-7-2012', 'DD-MM-YYYY'))
    , PARTITION p3 VALUES LESS THAN (TO_DATE('1-1-2013', 'DD-MM-YYYY')) );
您插入於 2014 年 10 月 10 日進行的銷售:
SQL> INSERT INTO interval_sales VALUES (39,7602,'10-OCT-14',9,null,1,11.79);

1 row created.
USER_TAB_PARTITIONS 的查詢顯示資料庫已為 10 月 10 日銷售建立新的分割區,因為銷售日期晚於轉換點:
SQL> COL PNAME FORMAT a9
SQL> COL HIGH_VALUE FORMAT a40
SQL> SELECT PARTITION_NAME AS PNAME, HIGH_VALUE
  2  FROM USER_TAB_PARTITIONS WHERE TABLE_NAME = 'INTERVAL_SALES';

PNAME     HIGH_VALUE
--------- ----------------------------------------
P0        TO_DATE(' 2007-01-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
P1        TO_DATE(' 2008-01-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
P2        TO_DATE(' 2009-07-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
P3        TO_DATE(' 2010-01-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
SYS_P1598 TO_DATE(' 2014-11-01 00:00:00', 'SYYYY-M
M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA另請參閱:Oracle AI Database VLDB and Partitioning Guide,以深入瞭解區間分割區
清單分割
在清單分割中,資料庫會使用分散式值清單作為每個分割區的分割區索引鍵。分割索引鍵包含一或多個資料欄。
您可以使用清單分割來控制個別資料列如何對應至特定分割區。透過使用清單,當用來識別相關資料集的關鍵碼未方便排序時,您可以將它們分組並組織。
範例 6-3 清單分割
假設您使用下列敘述句建立 list_sales 作為清單分割表格,其中 channel_id 資料欄是分割區索引鍵:
CREATE TABLE list_sales
   ( prod_id        NUMBER(6)
   , cust_id        NUMBER
   , time_id        DATE
   , channel_id     CHAR(1)
   , promo_id       NUMBER(6)
   , quantity_sold  NUMBER(3)
   , amount_sold    NUMBER(10,2)
   )
PARTITION BY LIST (channel_id)
 ( PARTITION even_channels VALUES ('2','4'),
   PARTITION odd_channels VALUES ('3','9')
);之後,您就會使用範例 6-1 中的資料列來載入表格。此程式碼顯示兩個分割區中的資料列分佈。資料庫會根據 PARTITION BY LIST 子句中指定的規則,根據 channel_id 值來選擇每個資料列的分割區。channel_id 值為 2 或 4 的資料列會儲存在 EVEN_CHANNELS 分割區中,channel_id 值為 3 或 9 的資料列則會儲存在 ODD_CHANNELS 分割區中。
雜湊分割
在雜湊分割中,資料庫會根據資料庫套用至使用者指定分割索引鍵的雜湊演算法,將資料列對應至分割區。
資料列目的地是由資料庫套用至資料列的內部雜湊函數所決定。當分割區數目是 2 的次方時,雜湊演算法會建立所有分割區中大致甚至的資料列分佈。
雜湊分割有助於分割大型表格以增加管理性。有數個較小的片段可供管理,而不是一個大型表格。遺失單一雜湊分割區並不會影響其餘的分割區,而且可以獨立復原。在高更新競爭的 OLTP 系統中,雜湊分割也很有用。例如,區隔會分成數個片段,每個片段都會更新,而不是經歷競爭的單一區隔。
假設您使用下列陳述式建立分割的 hash_sales 表格,並以 prod_id 資料欄作為分割區索引鍵:
CREATE TABLE hash_sales
   ( prod_id        NUMBER(6)
   , cust_id        NUMBER
   , time_id        DATE
   , channel_id     CHAR(1)
   , promo_id       NUMBER(6)
   , quantity_sold  NUMBER(3)
   , amount_sold    NUMBER(10,2)
   )
PARTITION BY HASH (prod_id)
PARTITIONS 2;之後,您就會使用範例 6-1 中的資料列來載入表格。此程式碼顯示兩個分割區中可能的資料列分佈。這些分割區的名稱是由系統產生的。
當您插入資料列時,資料庫會嘗試隨機甚至將它們分配到各個分割區。您無法指定要放置資料列的分割區。資料庫會套用雜湊函數,其結果會決定包含資料列的分割區。
另請參閱:
-
Oracle AI Database SQL Language Reference,瞭解
CREATE TABLE ... PARTITION BY範例
參照分割
在參照分割中,子項表格的分割策略只能透過與父項表格的外來索引鍵關係來定義。父項表格中的每個分割區,子項表格中只存在一個對應的分割區。父系表格會儲存特定分割區中的父系記錄,子系表格會儲存對應分割區中的子系記錄。
例如,orders 表格是 line_items 表格的父項,主索引鍵和外來索引鍵定義在 order_id。表格依參照分割。例如,如果資料庫將訂單 233 儲存在 orders 的分割區 Q3_2015 中,則資料庫會將訂單 233 的所有明細行項目儲存在 line_items 的分割區 Q3_2015 中。如果將分割區 Q4_2015 新增至 orders,則資料庫會自動將 Q4_2015 新增至 line_items。
參照分割的優點如下:
-
透過針對父項和子項表格使用相同的分割策略,您便可以避免重複所有分割索引鍵資料欄。此策略可減少非正規化的手動負荷,並節省空間。
-
父表上的維護作業會自動發生在子表上。例如,當您將分割區新增至主要表格時,資料庫會自動將此新增項目傳輸至其子系。
-
資料庫會自動在父項和子項表格中使用分割區的結合,以提昇效能。
您可以將參照分割與所有基本分割策略搭配使用,包括間隔分割。您也可以將參照分割表格建立為複合分割表格。
範例 6-4 建立參照分割表格
此範例會建立在 order_date 上分割範圍的父項表格順序。參照分割子項表格 order_items 的建立方式有四個分割區:Q1_2015、Q2_2015、Q3_2015 和 Q4_2015,其中每個分割區都包含對應至個別父項分割區中順序的 order_items 資料列。
CREATE TABLE orders
    ( order_id           NUMBER(12),
      order_date         DATE,
      order_mode         VARCHAR2(8),
      customer_id        NUMBER(6),
      order_status       NUMBER(2),
      order_total        NUMBER(8,2),
      sales_rep_id       NUMBER(6),
      promotion_id       NUMBER(6),
      CONSTRAINT orders_pk PRIMARY KEY(order_id)
    )
  PARTITION BY RANGE(order_date)
    ( PARTITION Q1_2015 VALUES LESS THAN (TO_DATE('01-APR-2015','DD-MON-YYYY')),
      PARTITION Q2_2015 VALUES LESS THAN (TO_DATE('01-JUL-2015','DD-MON-YYYY')),
      PARTITION Q3_2015 VALUES LESS THAN (TO_DATE('01-OCT-2015','DD-MON-YYYY')),
      PARTITION Q4_2015 VALUES LESS THAN (TO_DATE('01-JAN-2006','DD-MON-YYYY'))
    );

CREATE TABLE order_items
    ( order_id           NUMBER(12) NOT NULL,
      line_item_id       NUMBER(3)  NOT NULL,
      product_id         NUMBER(6)  NOT NULL,
      unit_price         NUMBER(8,2),
      quantity           NUMBER(8),
      CONSTRAINT order_items_fk
      FOREIGN KEY(order_id) REFERENCES orders(order_id)
    )
PARTITION BY REFERENCE(order_items_fk);另請參閱:Oracle AI Database VLDB and Partitioning Guide,瞭解參照分割的簡介
複合分割
在複合分割中,表格會依一個資料分配方法分割,然後使用第二個資料分配方法,進一步將每個分割區細分為子分割區。因此,複合分割會結合基本資料分配方法。指定分割區的所有子分割區代表資料的邏輯子集。
複合分割提供數種優點:
-
視 SQL 陳述式而定,一或兩個維度的分割刪減可提升效能。
-
查詢可以在任一維度上使用完整或部分分割結合。
-
您可以對單一表格執行平行備份與復原。
-
分割區的數目大於單一層次的分割,這對於平行執行很有幫助。
-
如果許多敘述句可以受益於分割區刪減或分割區結合,您可以實行一個滾動時段來支援歷史資料,並在另一個維度上仍然分割。
-
您可以根據分割索引鍵的識別,以不同的方式儲存資料。例如,您可以決定以唯讀、壓縮格式儲存特定產品類型的資料,並讓其他產品類型資料保持未壓縮。
範圍、清單以及雜湊分割都可以作為複合分割表格的子分割策略。下圖提供範圍雜湊和範圍清單複合分割的圖形化檢視。
圖 1:複合範圍清單分割
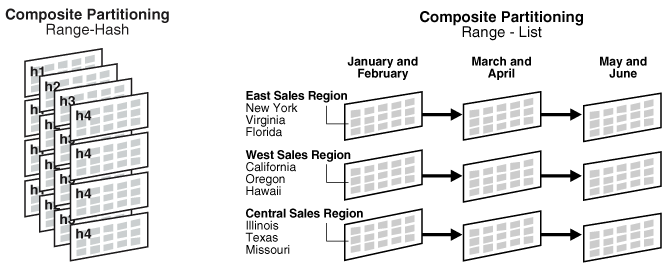
資料庫會將複合分割表格中的每個子分割區儲存為個別的區段。因此,子分割區特性可能會與表格的特性或子分割區所屬的分割區不同。
另請參閱:Oracle AI Database VLDB and Partitioning Guide,以深入瞭解複合分割
已分割的表格
分割表格包含一或多個個別管理的分割區,這些分割區可以獨立於其他分割區來運作。
表格已分割或未分割。即使分割表格只包含一個分割區,這個表格與非分割表格不同,但無法在其中新增分割區。
分割表格的區段
分割表格是由一或多個表格分割區區段所組成。
如果您建立名為 hash_products 的分割表格,則不會為此表格配置任何表格區段。而是資料庫會將每個表格分割區的資料都儲存在自己的分割區區段中。每個表格分割區區段都會包含表格資料的一部分。
分割外部表格時,所有分割區都位於資料庫外部。在混合分割表格中,某些分割區會儲存在區段中,其他分割區則儲存在外部。例如,sales 表格的某些分割區可能會儲存在資料檔中,而其他則儲存在試算表中。
壓縮分割的表格
堆集組織表格的某些或所有分割區都可以用壓縮格式儲存。
壓縮可節省空間並加快查詢執行速度。因此,壓縮在資料倉儲 (其插入與更新作業量較小) 和 OLTP 環境等環境中相當有用。
您可以為表格空間、表格或表格分割區宣告表格壓縮的屬性。如果在表格空間層次宣告,則預設會壓縮在表格空間中建立的表格。您可以更改表格的壓縮屬性,在此情況下,變更只適用於進入該表格的新資料。因此,單一表格或分割區可能會包含壓縮與未壓縮的區塊,以確保資料大小不會因為壓縮而增加。如果壓縮的大小可以增加區塊的大小,則資料庫就不會將它套用到區塊。
另請參閱:
-
「表格壓縮」可瞭解表格壓縮的類型,包括基本、進階資料列以及混合分欄壓縮
-
Oracle AI Database Data Warehousing Guide,瞭解資料倉儲中的表格壓縮
分割的索引
分割索引是一種索引,就像分割的表格一樣,已分割成較小且更容易管理的片段。
全域索引會獨立於建立全域索引的表格之外分割,而區域索引會自動連結至表格的分割方法。如同分割的表格,分割的索引可以提高可管理性、可用性、效能和擴展性。
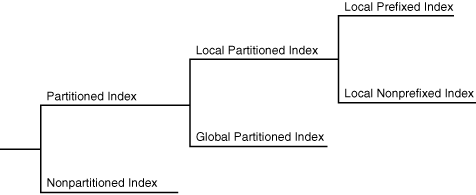
下圖顯示索引分割選項。
圖 2:索引分割選項
-
區域分割索引:在區域分割索引中,索引會在相同的資料欄上分割,而且分割區數目與表格的分割區界限相同。
-
全域分割索引:全域分割索引是一個 B-tree 索引,與建立它的基礎表格無關。單一索引分割區可以指向任何或所有表格分割區,而在本機分割索引中,索引分割區與表格分割區之間存在一對一的同位檢查。
另請參閱:
-
「索引簡介」可瞭解唯一與非唯一索引之間的差異,以及不同的索引類型
-
Oracle AI Database VLDB and Partitioning Guide,瞭解有關分割索引與如何決定要使用哪種類型的詳細資訊
本機分割索引
在本機分割索引中,索引會在相同的資料欄上分割,且分割區數目與表格的分割區界限相同。
每個索引分割區都只與基礎表格的一個分割區關聯,因此索引分割區中的所有索引鍵只會參照單一表格分割區中儲存的資料列。如此一來,資料庫就會自動將索引分割區與其關聯的表格分割區同步,讓每個表格索引組都獨立。
區域分割索引通常在資料倉儲環境中。區域索引提供下列優點:
-
資料無效或無法在分割區中使用的動作只會影響此分割區,因此提高可用性。
-
分割區維護簡化了。當移動表格分割區,或當資料存在分割區時,只能重建或維護關聯的區域索引分割區。在全域索引中,必須重新建立或維護所有索引分割區。
-
如果發生分割區的時間點復原,則可將索引復原至復原時間 (請參閱 Oracle AI Database Backup and Recovery User's Guide)。整個索引不需要重建。
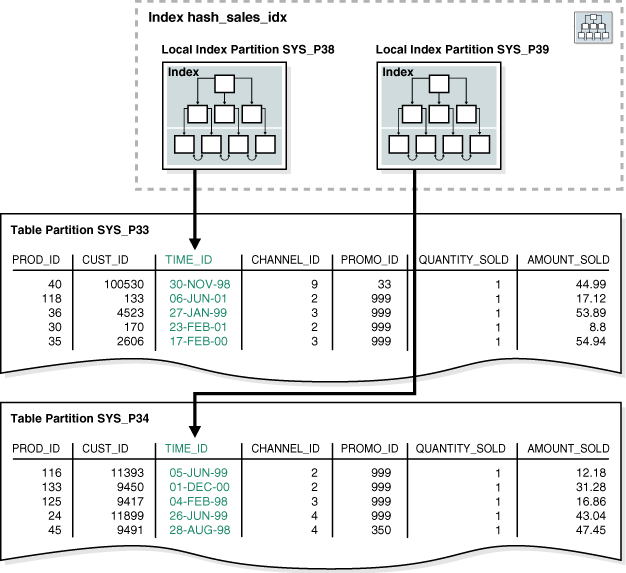
雜湊分割中的範例顯示分割之 hash_sales 表格的建立敘述句,使用 prod_id 資料欄作為分割區索引鍵。下列範例會在 hash_sales 表格的 time_id 資料欄上建立區域分割索引:
CREATE INDEX hash_sales_idx ON hash_sales(time_id) LOCAL;在圖 6-3 中,hash_products 表格有兩個分割區,因此 hash_sales_idx 有兩個分割區。每個索引分割區都會有不同的表格分割區。索引分割區 SYS_P38 會編製表格分割區 SYS_P33 中資料列的索引,而索引分割區 SYS_P39 則會編製表格分割區 SYS_P34 中資料列的索引。
圖 3:區域索引分割區
您無法明確地將分割區新增至區域索引。而只會在您將分割區新增至相關表格時,才會將新分割區新增至區域索引。同樣地,您無法從區域索引明確刪除分割區。而只在從相關表格刪除分割區時,才會刪除區域索引分割區。
就像其他索引一樣,您可以在分割的表格建立位元映射索引。唯一的限制是,位元映射索引必須位於分割之表格的區域,因此不能是全域索引。只有在未分割的表格上才支援全域位元映射索引。
-
區域前綴和非前綴索引 區域分割索引前綴或非前綴。
-
本機分割索引儲存與表格分割區相同,區域索引分割區會儲存在自己的區段中。每個區段都包含一部分的索引資料。因此,由四個分割區組成的區域索引不會儲存在單一索引區段中,而是儲存在四個個別的區段中。
本機前置碼和非前置碼索引
區域分割索引前面加上前置碼或前面不加上前置碼。
索引子類型定義如下:
-
本機前置索引
在此情況下,分割區索引鍵位於索引定義的前緣。在範圍分割的
time_range_sales範例中,表格是依time_id上的範圍來分割。此表格上的區域前置碼索引會有time_id作為其清單中的第一個資料欄。 -
本機非前置碼索引
在此情況下,分割區索引鍵不在已編製索引之資料欄清單的前緣上,且完全不需要在清單中。在本機分割索引的
hash_sales_idx範例中,索引為區域非前置碼,因為分割區索引鍵product_id不在前緣。
這兩種類型的索引都可以利用分割區刪除 (也稱為分割區刪除 ),當最佳化處理程式不考慮分割區而加速資料存取時。查詢是否可以排除分割區,需視查詢述詞而定。使用區域前置碼索引的查詢一律允許排除索引分割區,而使用區域非前置碼索引的查詢則可能不會。
另請參閱:Oracle AI Database VLDB and Partitioning Guide,瞭解如何使用前置碼與非前置碼的索引
本機分割索引儲存
與表格分割區一樣,區域索引分割區也儲存在自己的區段中。每個區段都包含一部分的索引資料。因此,由四個分割區組成的區域索引不會儲存在單一索引區段中,而是儲存在四個個別的區段中。
另請參閱: Oracle AI Database SQL Language Reference,瞭解 CREATE INDEX ... LOCAL 範例
全域分割索引
全域分割索引是一個 B-tree 索引,此索引獨立於建立它的相關表格。單一索引分割區可以指向任何或所有表格分割區,而在本機分割索引中,索引分割區與表格分割區之間存在一對一的同位檢查。
一般而言,全域索引對於快速存取、資料完整性和可用性等方面相當重要的 OLTP 應用程式很有用。在 OLTP 系統中,表格可以用一個索引鍵來分割,例如 employees.department_id 資料欄,但是應用程式可能需要使用許多不同的索引鍵來存取資料,例如 employee_id 或 job_id。全域索引在此案例中很有用。
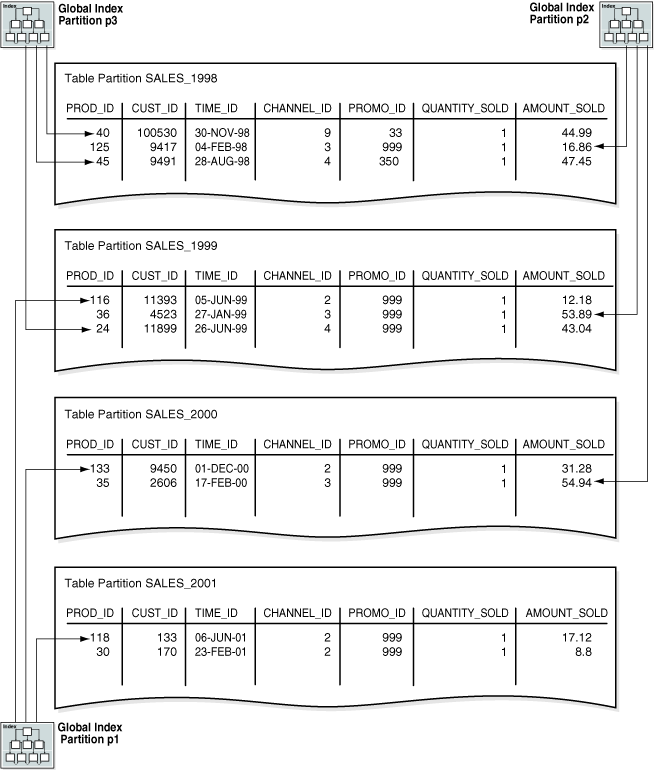
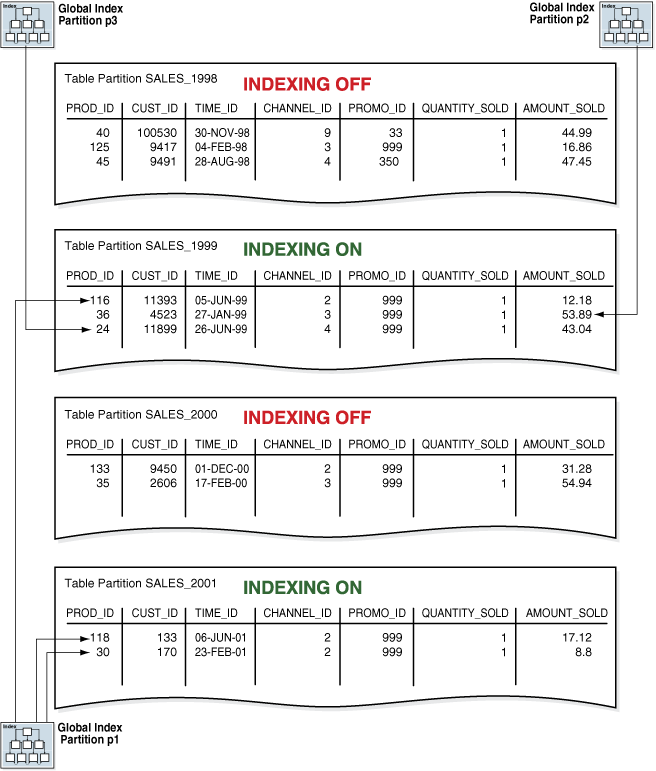
如圖所示,假設您從「範圍分割」在 time_range_sales 表格上建立全域分割索引。在此表格中,1998 年銷售的資料列會儲存在一個分割區中,1999 年銷售的資料列會儲存在另一個分割區中,依此類推。下列範例會在 channel_id 資料欄上建立依範圍分割的全域索引:
CREATE INDEX time_channel_sales_idx ON time_range_sales (channel_id)
   GLOBAL PARTITION BY RANGE (channel_id)
      (PARTITION p1 VALUES LESS THAN (3),
       PARTITION p2 VALUES LESS THAN (4),
PARTITION p3 VALUES LESS THAN (MAXVALUE));如圖 6-4 所示,全域索引分割區可以包含指向多個表格分割區的項目。索引分割區 p1 指向 channel_id 為 2 的資料列,索引分割區 p2 指向 channel_id 為 3 的資料列,索引分割區 p3 指向 channel_id 為 4 或 9 的資料列。
圖 4:全域分割索引
另請參閱:
-
Oracle AI Database VLDB and Partitioning Guide,瞭解如何管理全域分割索引
-
Oracle AI Database SQL Language Reference,瞭解
CREATE INDEX的GLOBAL PARTITION子句
分割之表格的局部索引
局部索引是與關聯之分割表格的索引特性關聯的索引。
關聯可讓您指定要編製索引的表格分割區。局部索引提供下列優點:
-
未編製索引的表格分割區可避免使用不必要的索引儲存空間。
-
載入和查詢的效能可以改進。
在 Oracle Database 12c 之前,交換分割區作業需要對關聯的全域索引進行實體更新,以便讓索引保持在可用狀態。從 Oracle Database 12c 開始,如果涉及分割區維護作業的分割區不是局部全域索引的一部分,則在不進行任何全域索引維護的情況下,該索引仍然可以使用。
-
如果您在建立索引時只編製某些表格分割區的索引,而稍後編製其他分割區的索引,則可以減少建立索引所需的排序空間。
您可以開啟或關閉表格個別分割區的索引。局部區域索引沒有已關閉索引之所有表格分割區的可用索引分割區。全域索引 (無論是否已分割),會排除已關閉索引之所有分割區的資料。資料庫不支援強制實行唯一限制條件之索引的局部索引。圖 6-5 顯示的全域索引與圖 6-4 中的全域索引相同,但全域索引為局部索引除外。表格分割區 SALES_1998 和 SALES_2000 的編製索引特性設為 OFF,因此局部全域索引不會編製索引。
圖 5:局部全域分割索引
使用較舊分割區的物件存放區
對於唯讀分割區,您可以使用低成本儲存體 (例如雲端中的物件儲存體)。
過去十年來,資料量不斷成長。此外,在許多情況下,政府法規和政策規定保留非常大量的資料。Oracle 資料庫客戶對非常大型的資料庫使用各種資料管理策略。客戶有下列他們嘗試滿足的主要目標。
以最低可能成本儲存大量資料。滿足資料保留和保護的新監管要求。根據增加的資料量進行更好的分析,以改善商機。
內部部署客戶有多種解決方案可達成上述目標。Oracle AI Database 現在提供這項功能,可讓您運用低成本儲存層 (例如雲端中的物件儲存),為雲端資料庫開發類似的資料管理策略。
隨著資料集的發展和成長,Oracle 資料庫客戶已有各種資料管理策略。所有這些策略都屬於資訊生命週期管理 (ILM)。有一些協助實行 ILM 解決方案的資料庫功能包括資料分割、進階資料列壓縮、混合分欄壓縮、自動資料最佳化以及其他。
ILM 解決方案的其中一個層面就是定義低成本的儲存層。這可讓您以最低的可能成本保留大量資料。Oracle ILM 策略可以將資料壓縮和資料移到較低成本的儲存層。內部部署 Oracle 資料庫客戶使用 Oracle 儲存解決方案 (例如 Oracle ZFS Storage Appliance 或 Oracle Exadata Extended (XT) Storage Server) 作為不常存取、舊版或監管資料的低成本儲存選項。您也可以從第三方廠商選擇類似的低成本儲存選項。
使用物件存放區可讓您:
-
將舊的分割區和唯讀表格空間儲存在物件儲存中。
-
以線上方式從物件儲存檔案查詢資料。
-
防止未經授權而從另一個 PDB 存取 PDB 擁有的物件儲存體檔案。
-
在極少數的情況下,若要變更唯讀資料,請將資料從物件存放區移回一般儲存體。
-
刪除物件存放區中含有資料檔的表格空間。
-
將較舊的分割區和唯讀表格空間移至物件存放區:您可以建立以時間為基礎的分割策略,並將唯讀表格空間的資料檔移至成本較低的儲存層,例如物件儲存。
-
存取物件儲存中的物件:從物件儲存中的表格和分割區存取資料,將會對使用者和 SQL 從屬端完全通透。
-
物件存放區檔案的證明資料管理:存取物件儲存中的檔案需要證明資料。
-
將資料檔從物件儲存移回傳統儲存:如果必須更新物件儲存資料,必須先將資料移回傳統儲存。
-
刪除物件存放區資料檔:您可以使用標準
DROP TABLESPACE命令,刪除含有資料檔的表格空間。
將較舊的分割區與唯讀表格空間移至物件存放區
您可以建立以時間為基礎的分割策略,將唯讀表格空間的資料檔移到成本較低的儲存層,例如物件儲存體。
假設您有一個名為 'orders' 的表格,該表格範圍已分割至 DATE 資料欄。每個分割區都包含特定年度的資料列,並且 2022 和 2023 年有現有的分割區。作為新的年度方法,資料庫管理員決定為 2024 年新增分割區。資料庫管理員同時會決定將最舊的分割區移到低成本儲存層。
以下工作流程範例代表一個案例,其中表格空間有一個單一表格的分割區。這並不是一項限制。唯讀表格空間可以有一或多個表格的分割區。除了將表格空間設為唯讀之外,您還可以選擇將分割區設為唯讀。最佳做法是,您可以將表格空間設為唯讀,並等待定義完善的一段時間後,再將檔案移入物件存放區。這會確保擷取任何更新唯讀資料的嘗試,並傳回錯誤。當資料仍然位於 Exadata 或其他傳統儲存時,將資料靜音移至另一個表格空間更快。如果需要從物件儲存複製這些資料,會比較慢。
create tablespace orders_2022 DATAFILE '+DATA_DG/orders_2022.dbf' size 100g;
create tablespace orders_2023 DATAFILE '+DATA_DG/orders_2023.dbf' size 100g;

create table orders
( prod_id         NUMBER NOT NULL,
  time_id         DATE NOT NULL,
  quantity_sold   NUMBER(10,2) NOT NULL,
  amount_sold     NUMBER(10,2) NOT NULL)
    partition by range (time_id)
    ( partition orders_2022 VALUES LESS THAN (TO_DATE('2023-01-01 00:00:00', 'SYYYY-MM-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIAN'))
        TABLESPACE orders_2022,
      partition orders_2023 VALUES LESS THAN (TO_DATE('2024-01-01 00:00:00', 'SYYYY-MM-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIAN'))
        TABLESPACE orders_2023)
  ENABLE ROW MOVEMENT;

create tablespace orders_2024 DATAFILE '+DATA_DG/orders_2024.dbf' size 100g;

alter table orders
  ADD partition orders_2024
  values less than (TO_DATE('2024-01-01 00:00:00', 'SYYYY-MM-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIAN'))
  TABLESPACE orders_2024;

alter tablespace orders_2022 read only;

alter database property set default_credential = 'ADM.DEF_CRED_NAME';

alter database
  move datafile '+DATA_DG/orders_2022.dbf' to
  'https://objectstorage.example.com/oracle/orders_2022.dbf';
存取物件儲存中的物件
從物件儲存中的表格和分割區存取資料,將會對使用者和 SQL 從屬端完全通透。
資料庫輸入 / 輸出子系統會在內部查詢及提供儲存於物件儲存之檔案的區塊。下列 SQL 會查詢在上一個範例中已移至物件儲存之唯讀分割區 orders_2022 的資料列。
select prod_id
from   orders
where  time_id < TO_DATE('2020-01-01 00:00:00', 'SYYYY-MM-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIAN');
現有的索引 (全域和本機) 都在透明地工作。從用戶端的角度來看,查詢混合分欄壓縮資料和 TDE 加密資料也可以通透地運作。
物件存放區檔案的證明資料管理
存取物件儲存中的檔案需要證明資料。
證明資料是儲存使用者名稱與密碼的資料庫物件。證明資料會加密並安全地儲存在建立它的 PDB 綱要中。
當您計畫將資料檔移至物件儲存體時,必須定義預設證明資料。此預設證明資料主要用來存取物件儲存中的資料檔。
請選擇最低必要權限的預設證明資料。在預設證明資料能夠存取物件存放區之後,標準資料庫認證與授權就會決定哪些資料庫使用者可以查詢這些資料檔或對這些資料檔進行作業。
alter database property set default_credential = 'ADM.DEF_CRED_NAME';

alter database move datafile '+DATA_DG/orders_2022.dbf' to
  'https://objectstorage.example.com/oracle/orders_2022.dbf';
將資料檔從物件儲存搬回傳統儲存
如果必須更新物件存放區資料,則必須先將資料移回傳統儲存。
在極少數的情況下,您需要修改物件儲存中已有的唯讀資料,唯一的選擇是將資料從物件儲存移回傳統儲存。下列工作流程顯示如何將資料檔從物件存放區移回 ASM 檔案系統。從物件儲存複製檔案會影響效能。
alter database move datafile
  'https://objectstorage.example.com/oracle/orders_2022.dbf' to
  '+DATA_DG/orders_2022.dbf';

alter tablespace orders_2022 read write;
刪除物件存放區資料檔
您可以使用標準的 DROP TABLESPACE 命令來刪除含有資料檔的表格空間。
AND DATAFILES 子句用於從後端儲存刪除資料檔。這會從物件存放區刪除檔案。如果物件存放區檔案在物件存放區中有多個區塊,將會刪除所有區塊以及資訊清單。
drop tablespace orders_2022 including contents and datafiles;分區表格總覽
在 Oracle 資料庫中,「全域分散式資料庫」功能可讓您將任何表格分割成可儲存在多個資料庫中的稱為分區的片段。
水平分割涉及跨分區分割資料庫表格,讓每個分區包含具有相同資料欄但不同資料列子集的表格。以此方式分割的表格也稱為分區表格。
下圖顯示橫跨三個分區的表格水平分割。
圖 6:跨分區的表格水平分割
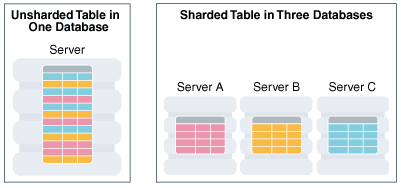
- 分區表格:資料庫表格會分割到分區中,讓每個分區包含具有相同資料欄的表格,但是不同的資料列子集。以此方式分割的表格稱為分區表格。另請參閱: Oracle Globally Distributed AI Database
分區的表格
資料庫表格會跨分區進行分割,讓每個分區包含具有相同資料欄的表格,但是不同的資料列子集。以此方式分割的表格稱為分區表格。
下圖顯示如何跨一組分區 PDB 水平分割一組表格 (稱為表格系列),讓每個分區包含一組資料子集 (以紅色、黃色及藍色資料列表示)。
圖 7:跨分區的表格水平分割
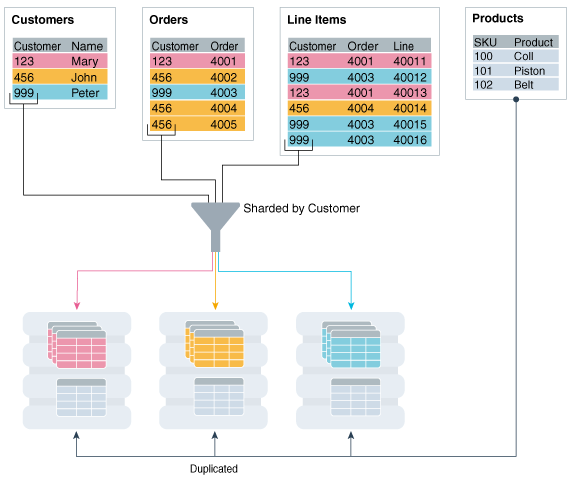
分區會根據分區索引鍵,在表格空間層次分散到分區。關鍵碼的範例包括客戶 ID、帳號與國家 / 地區 ID。
分區表格的每個分割區都位於不同的表格空間,而每個表格空間都與特定的分區相關聯。視分區方法而定,關聯可以由管理員自動建立或定義。
即使分區表格的分割區位於多個分區,但對於應用程式而言,表格的外觀與行為與單一資料庫中分割的表格完全相同。由應用程式發出的 SQL 敘述句絕不需要參照分區或取決於分區數目及其組態。
表格分割的熟悉 SQL 語法指定跨分區分割資料列的方式。例如,下列 SQL 敘述句會建立一個分區表格,並根據分區索引鍵 cust_id 在分區間水平分割表格。
CREATE SHARDED TABLE customers
( cust_id     NUMBER NOT NULL,
  name        VARCHAR2(50),
  address     VARCHAR2(250),
  region      VARCHAR2(20),
  class       VARCHAR2(3),
  signup      DATE,
  CONSTRAINT cust_pk PRIMARY KEY(cust_id)
)
PARTITION BY CONSISTENT HASH (cust_id)
PARTITIONS AUTO
TABLESPACE SET ts1;上述範例中的分區表格使用一致雜湊分割,這是一種經常在可擴展分散式系統中使用的特殊類型雜湊分割。此技術會自動將表格空間分散到分區,以提供甚至的資料與工作負載分配。注意:不支援分區表格上的全域索引,但是支援區域索引。
檢視概要
視觀表是一或多個表格的邏輯表示法。本質上,視觀表是儲存的查詢。
檢視會從其所依據的表格 (稱為基礎表格 ) 衍生其資料。基準表可以是表格或其他檢視。對檢視執行的所有作業實際上會影響基礎表格。您可以在大部分使用表格的位置使用檢視。
注意:具體化視觀表使用與標準視觀表不同的資料結構。
檢視可讓您針對不同類型的使用者量身訂做資料的呈現方式。檢視常用於:
-
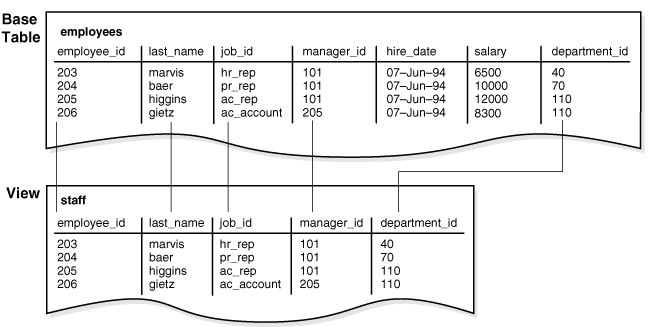
限制對表格一組預先決定的資料列或資料欄的存取,以提供額外的表格安全性層級
例如,圖 6-8 顯示
staff視觀表如何不顯示基礎表格employees的salary或commission_pct資料欄。 -
隱藏資料複雜性
例如,單一檢視可以使用結合來定義,此為多個表格中相關資料欄或資料列的集合。不過,檢視會隱藏此資訊實際上源自數個表格的事實。查詢也可能以表格資訊執行廣泛的計算。因此,使用者無須瞭解如何執行結合或計算,即可查詢檢視。
-
以與基礎表格不同的觀點呈現資料
例如,可以重新命名視觀表的資料欄,而不會影響視觀表所依據的表格。
-
隔離應用模組與基礎表格定義中的變更
例如,如果定義視觀表的查詢參照 4 個資料欄表格的 3 個資料欄,而第 5 個資料欄新增到表格中,則視觀表的定義並不會受到影響,而使用視觀表的所有應用程式則不受影響。
如需使用視觀表的範例,請考慮 hr.employees 表格,此表格具有數個資料欄和許多資料列。若要允許使用者僅查看其中五個資料欄或僅查看特定資料列,您可以建立檢視,如下所示:
CREATE VIEW staff AS
  SELECT employee_id, last_name, job_id, manager_id, department_id
  FROM   employees;
與所有子查詢一樣,定義視觀表的查詢不可包含 FOR UPDATE 子句。下圖說明名為 staff 的檢視。請注意,視觀表只會顯示基本表格中的五個資料欄。
圖 8:檢視
-
視觀表的特性與表格不同的是,視觀表不會配置儲存體空間,也不會包含資料。相反地,檢視是由查詢所定義,該查詢會從檢視所參照的基礎表格擷取或衍生資料。因為視觀表是以其他物件為基礎,所以除了在資料說明中定義視觀表之查詢的儲存之外,它不需要儲存。
-
可更新的結合檢視:結合檢視在其
FROM子句中有多個表格或視觀表。 -
物件視觀表和視觀表一樣,物件視觀表是一個虛擬物件表格。視觀表中的每一列都是一個物件,亦即物件類型的執行處理。物件類型是使用者定義的資料類型。
另請參閱:
-
「具體化視觀表簡介」
-
Oracle AI Database SQL Language Reference,瞭解
CREATE VIEW的語法和語意
視野特性
視觀表與表格不同,不會配置儲存體空間,視觀表也不會包含資料。相反地,檢視是由查詢所定義,該查詢會從檢視所參照的基礎表格擷取或衍生資料。因為視觀表是以其他物件為基礎,所以除了在資料說明中定義視觀表之查詢的儲存之外,它不需要儲存。
視觀表對於其參照物件有相依性,而資料庫會自動處理這類物件。例如,如果您刪除並重新建立視觀表的基礎表格,資料庫就會判斷視觀表定義是否可接受新的基礎表格。
-
檢視中的資料處理:因為檢視是衍生自表格,所以具有許多相似性。使用者可以查詢視觀表,而且有一些限制可以對視觀表執行 DML。在視觀表上執行的作業會影響視觀表之部分基本表格中的資料,並受限於基本表格的完整性限制條件和觸發程式。
-
檢視中的資料存取方式 Oracle AI Database 將檢視定義儲存在資料字典中,作為定義檢視的查詢文字。
檢視中的資料操控
因為視觀表是從表格衍生而來,所以它們有許多相似之處。使用者可以查詢視觀表,而且有一些限制可以對視觀表執行 DML。在視觀表上執行的作業會影響視觀表之部分基本表格中的資料,並受限於基本表格的完整性限制條件和觸發程式。
下列範例會建立 hr.employees 表格的檢視:
CREATE VIEW staff_dept_10 AS
SELECT employee_id, last_name, job_id,
       manager_id, department_id
FROM   employees
WHERE  department_id = 10
WITH CHECK OPTION CONSTRAINT staff_dept_10_cnst;
定義查詢只會參照部門 10 的列。CHECK OPTION 會建立具有限制條件的視觀表,讓針對視觀表發出的 INSERT 和 UPDATE 敘述句無法產生無法選取的資料列。因此,可插入部門 10 中員工的列,但不能插入部門 30 的列。
另請參閱:Oracle AI Database SQL Language Reference,瞭解 CREATE VIEW 敘述句中的子查詢限制
如何在檢視中存取資料
Oracle AI Database 將檢視定義儲存在資料字典中,作為定義檢視的查詢文字。
當您在 SQL 陳述式中參照檢視時,Oracle AI Database 會執行下列作業:
-
將檢視的查詢 (盡可能) 與定義檢視的查詢及任何基礎檢視的查詢合併
Oracle AI Database 將合併的查詢最佳化,就像您發出查詢時未參照檢視一樣。因此,Oracle AI Database 可在任何參照的基礎表格資料欄上使用索引,無論資料欄是在檢視定義中參照,或是在使用者查詢中對視觀表參照。
有時 Oracle AI Database 無法將檢視定義與使用者查詢合併。在這種情況下,Oracle AI Database 可能不會在參考的資料欄上使用所有索引。
-
在共用 SQL 區域中剖析合併的敘述句
只有沒有現有的共用 SQL 區域包含類似的敘述句時,Oracle AI Database 才會剖析參照新共用 SQL 區域中之視觀表的敘述句。因此,視觀表可提供減少與共用 SQL 相關之記憶體使用的優點。
-
執行 SQL 敘述句
下列範例說明查詢檢視時的資料存取。假設您根據 employees 和 departments 表格建立 employees_view:
CREATE VIEW employees_view AS
  SELECT employee_id, last_name, salary, location_id
  FROM   employees JOIN departments USING (department_id)
  WHERE  department_id = 10;
使用者對 employees_view 執行下列查詢:
SELECT last_name
FROM   employees_view
WHERE  employee_id = 200;
Oracle AI Database 會合併檢視與使用者查詢來建構下列查詢,然後執行以擷取資料:
SELECT last_name
FROM   employees, departments
WHERE  employees.department_id = departments.department_id
AND    departments.department_id = 10
AND    employees.employee_id = 200;
另請參閱:
可更新的結合檢視
結合檢視在其 FROM 子句中有多個表格或視觀表。
在下列範例中,staff_dept_10_30 檢視會加入 employees 和 departments 表格,其中只包括部門 10 或 30 中的員工:
CREATE VIEW staff_dept_10_30 AS
SELECT employee_id, last_name, job_id, e.department_id
FROM   employees e, departments d
WHERE  e.department_id IN (10, 30)
AND    e.department_id = d.department_id;
可更新的結合檢視 (亦稱為可修改的結合檢視 ) 涉及兩個或多個基礎表格或檢視,並允許 DML 作業。可更新的視觀表在 SELECT 敘述句的最上層 FROM 子句中包含多個表格,不受 WITH READ ONLY 子句限制。
若要在本質上可更新,檢視必須符合數個條件。例如,一般規則是結合視觀表上的 INSERT、UPDATE 或 DELETE 作業一次只能修改一個基礎表格。USER_UPDATABLE_COLUMNS 資料說明視觀表的下列查詢顯示 staff_dept_10_30 視觀表是可更新的:
SQL> SELECT TABLE_NAME, COLUMN_NAME, UPDATABLE
  2  FROM   USER_UPDATABLE_COLUMNS
  3  WHERE  TABLE_NAME = 'STAFF_DEPT_10_30';

TABLE_NAME                     COLUMN_NAME                    UPD
------------------------------ ------------------------------ ---
STAFF_DEPT_10_30               EMPLOYEE_ID                    YES
STAFF_DEPT_10_30               LAST_NAME                      YES
STAFF_DEPT_10_30               JOB_ID                         YES
STAFF_DEPT_10_30               DEPARTMENT_ID                  YES
從 Oracle Database 版本 21c 開始,結合視觀表中的所有可更新資料欄都不一定要對應至索引鍵保留表格的資料欄。索引鍵保留表格是一個表格,其中基礎表格的每個資料列在查詢輸出中最多出現一次。在 staff_dept_10_30 檢視中,department_id 是 departments 表格的主索引鍵,因此 employees 表格中的每個資料列在結果集中最多出現一次,因此會保留 employees 表格的索引鍵。departments 表格不會保留索引鍵,因為其每個資料列在結果集中可能會出現多次。如果 UPDATE 作業只更新單一表格的資料欄,而且更新確定,就可以更新非索引鍵保留表格中的資料欄。亦即,它只會更新一次每個資料列。
另請參閱:Oracle AI Database Administrator's Guide,瞭解如何更新結合檢視
物件視觀表
就像檢視是虛擬表格一樣,物件檢視是虛擬物件表格。視觀表中的每一列都是一個物件,亦即物件類型的執行處理。物件類型是使用者定義的資料類型。
您可以擷取、更新、插入及刪除關聯式資料,就如同儲存為物件類型。您也可以使用物件資料類型的欄來定義檢視,例如物件、REF 和集合 (巢狀表格和 VARRAYs)。
就像關聯式視觀表一樣,物件視觀表只能呈現資料庫管理員想要讓使用者查看的資料。例如,物件檢視可以呈現關於 IT 程式設計人員的資料,但會省略有關薪資的敏感資料。下列範例會建立 employee_type 物件,然後根據此物件建立檢視 it_prog_view:
CREATE TYPE employee_type AS OBJECT
(
  employee_id  NUMBER (6),
  last_name    VARCHAR2 (25),
  job_id       VARCHAR2 (10)
);
/

CREATE VIEW it_prog_view OF employee_type
  WITH OBJECT IDENTIFIER (employee_id) AS
SELECT  e.employee_id, e.last_name, e.job_id
FROM    employees e
WHERE   job_id = 'IT_PROG';
物件視觀表對於原型設計或轉換至物件導向應用程式非常有用,因為視觀表中的資料可以從關聯式表格取得,而且可以像表格定義為物件表格一樣存取。您不需將現有表格轉換成不同的實體結構,即可執行物件導向的應用程式。
另請參閱:
-
Oracle AI Database Object-Relational Developer's Guide,瞭解物件類型和物件檢視
-
Oracle AI Database SQL Language Reference,瞭解
CREATE TYPE陳述式
具體化視觀表總覽
具體化視觀表是預先儲存或以綱要物件形式「具體化」的查詢結果。查詢的 FROM 子句可以命名表格、視觀表或具體化視觀表。
具體化視觀表在複製中通常是主要表格,在資料倉儲中則是事實表格。具體化視觀表摘要、計算、複製及分送資料。它們適用於各種運算環境,例如:
-
在資料倉儲中,具體化視觀表可以計算和儲存從聚總函數 (例如總和和和平均值) 產生的資料。
摘要是一種聚總檢視,可透過預先計算結合和聚總作業並將結果儲存在表格中,來減少查詢時間。具體化視觀表等同於摘要。您也可以使用具體化視觀表來計算含聚總或不含聚總的結合。
-
在使用 XStream 和 Oracle GoldenGate 進行的具體化視觀表複製中,視觀表會包含從單一時間點開始的完整或部分表格複本。具體化視觀表會複製分散式位置的資料,並同步在數個位置執行的更新。這種複製形式適用於資料庫並非一律連線至網路的環境,例如現場銷售。
-
在行動運算環境中,具體化視觀表可以將資料子集從中央伺服器下載至行動從屬端,並定期從中央伺服器重新整理,以及由從屬端將更新傳輸至中央伺服器。
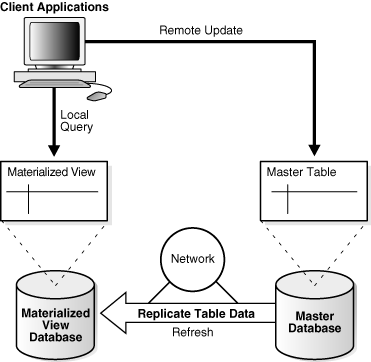
在複製環境中,具體化視觀表會與不同資料庫中的表格 (稱為主要資料庫 ) 共用資料。與主要位置之具體化視觀表格關聯的表格為主要表格。圖 6-9 會根據另一個資料庫中的主要表格,說明一個資料庫中的具體化視觀表。複製到具體化視觀表資料庫之主要表格的更新。
圖 9:具體化視觀表
-
具體化視觀表的特性具體化視觀表會共用索引和非具體化視觀表的某些特性。
-
重新整理具體化視觀表的方法:資料庫會在基本表格變更之後重新整理資料,以維護具體化視觀表中的資料。重新整理方法可以是增量或完整重新整理。
-
自動具體化視觀表從 Oracle Database 版本 21c 開始,可以自動建立和維護具體化視觀表。
-
查詢重新寫入會將以主要表格撰寫的使用者要求,轉換成包含具體化視觀表的語意同等要求。
另請參閱:
-
Oracle AI Database XStream 指南,瞭解 XStream 的簡介
-
http://www.oracle.com/technetwork/middleware/goldengate/documentation/index.html 深入瞭解 Oracle GoldenGate
-
Oracle AI Database SQL Language Reference,瞭解
CREATE MATERIALIZED VIEW陳述式
具體化視觀表的特性
具體化視觀表會共用索引和非具體化視觀表的某些特性。
具體化視觀表與索引類似,如下所示:
-
它們包含實際的資料及使用儲存空間。
-
當主要表格中的資料變更時,可以重新整理它們。
-
它們可以在用於查詢重新寫入作業時,改善 SQL 執行的效能。
-
它們的存在對 SQL 應用程式和使用者來說是通透的。
具體化視觀表與非具體化視觀表類似,因為它代表其他表格和視觀表中的資料。與索引不同,使用者可以使用 SELECT 敘述句直接查詢具體化視觀表。視需要的重新整理類型而定,檢視也可以使用 DML 敘述句更新。
下列範例會根據 sh 範例綱要中的三個主要表格,建立並填入具體化聚總檢視:
CREATE MATERIALIZED VIEW sales_mv AS
  SELECT t.calendar_year, p.prod_id, SUM(s.amount_sold) AS sum_sales
  FROM   times t, products p, sales s
  WHERE  t.time_id = s.time_id
  AND    p.prod_id = s.prod_id
  GROUP BY t.calendar_year, p.prod_id;
下列範例會刪除表格 sales (sales_mv 的主要表格),然後查詢 sales_mv。查詢會選取資料,因為資料列與主要表格中的資料分開儲存 (具體化)。
SQL> DROP TABLE sales;

Table dropped.

SQL> SELECT * FROM sales_mv WHERE ROWNUM < 4;

CALENDAR_YEAR    PROD_ID  SUM_SALES
------------- ---------- ----------
         1998         13  936197.53
         1998         26  567533.83
         1998         27  107968.24
具體化視觀表可以被分割。您可以在分割的表格定義具體化視觀表,並在具體化視觀表定義一或多個索引。
另請參閱:Oracle AI Database Data Warehousing Guide,瞭解如何在資料倉儲中使用具體化視觀表
重新整理具體化視觀表的方法
資料庫會在基本表格變更之後重新整理資料,以維護具體化視觀表中的資料。重新整理方法可以是增量或完整重新整理。
-
完成重新整理:完成重新整理會執行定義具體化視觀表的查詢。當您一開始建立具體化視觀表時,會發生完全重新整理,除非具體化視觀表參照預先建立的表格,或者您將表格定義為
BUILD DEFERRED。 -
增量重新整理:增量重新整理 (亦稱為快速重新整理 ),只會處理對現有資料的變更。此方法不需要從頭重新建立具體化視觀表。只處理變更會造成非常快速的重新整理時間。
-
就地和異地重新整理:對於完整和增量方法,資料庫可以就地重新整理具體化視觀表,直接在視觀表或異地重新整理敘述句。
完整重新整理
完整重新整理會執行定義具體化視觀表的查詢。當您一開始建立具體化視觀表時,除非具體化視觀表參照預先建立的表格,或您將表格定義為 BUILD DEFERRED,否則會進行完整的重新整理。
完整重新整理可能會變慢,尤其是當資料庫必須讀取和處理大量資料時。您可以在建立具體化視觀表之後,隨時執行完整重新整理。
遞增重新整理
增量重新整理 (亦稱為快速重新整理 ) 只會處理現有資料的變更。此方法不需要從頭重新建立具體化視觀表。只處理變更會造成非常快速的重新整理時間。
您可以依需求或定期重新整理具體化視觀表。或者,您也可以在相同資料庫中設定具體化視觀表與其基本表格,以便在交易確認基準表格變更時重新整理。
快速重新整理的格式如下:
-
以日誌為基礎的重新整理
在此類型的重新整理中,具體化視觀表日誌或直接載入器日誌會保留基本表格的變更記錄。具體化視觀表日誌是一個綱要物件,記錄基礎表格的變更,以增量方式重新整理基礎表格上定義的具體化視觀表。每個具體化檢視日誌都與單一基礎表格相關聯。
-
重新整理分割區變更追蹤 (PCT)
只有在分割基準表時,PCT 重新整理才有效。PCT 重新整理會移除受影響具體化視觀表分割區中的所有資料或受影響的資料部分,然後重新計算這些資料。資料庫會使用修改的基礎表格分割區來識別視觀表中受影響的分割區或部分資料。基準資料表發生分割區維護作業時,PCT 重新整理是唯一可用的增量重新整理方法。
就地重新整理和異地重新整理
對於完整和增量方法,資料庫可以就地重新整理具體化視觀表,直接在視觀表上或就地重新整理敘述句。
異位重新整理會建立一或多個外部表格、在這些表格上執行重新整理敘述句,然後使用外部表格切換具體化視觀表或受影響的分割區。此技術在重新整理期間達到高可用性,尤其是在重新整理敘述句需要很長的時間才能完成。
同步重新整理是一種就地重新整理類型。同步重新整理不會修改基礎表格的內容,而是使用同步重新整理套裝程式中的 API,透過將這些變更同時套用至基礎表格和具體化視觀表,確保一致性。此方法可使一組表格與定義於表格上的具體化視觀表一律同步。在資料倉儲中,同步重新整理方法非常適合以下原因:
-
增量資料的載入會受到嚴格控制,並定期進行。
-
表格及其具體化視觀表通常會以相同的方式分割,或者它們的分割區會與功能相依性相關。
另請參閱:Oracle AI Database Data Warehousing Guide,瞭解如何重新整理具體化視觀表
自動具體化視觀表
從 Oracle Database 版本 21c 開始,可以自動建立和維護具體化視觀表。
Oracle AI Database 可以自動建立和管理具體化視觀表,將查詢效能最佳化。背景作業非常少或沒有與 DBA 的互動,可監督和分析工作負載特性,並找出具體化視觀表可改善 SQL 效能的位置。應徵者具體化視觀表的效能效益是在工作負載顯示之前,於背景 (使用工作負載查詢) 中測量。
另請參閱:
-
Oracle AI Database PL/SQL Packages and Types Reference,瞭解如何使用
DBMS_AUTO_MV套裝程式實行自動具體化視觀表
查詢重新寫入
查詢重新寫入會將以主要表格撰寫的使用者要求,轉換成包含具體化視觀表的語意同等要求。
當基礎表格包含大量資料時,計算聚總或結合相當昂貴且耗時。因為具體化視觀表包含預先計算的聚總和結合,所以查詢重新寫入可以使用具體化視觀表快速回答查詢。
查詢轉換器會以通透的方式重寫要求,以使用具體化視觀表,不需要使用者介入,也不需要參照 SQL 敘述句中的具體化視觀表。因為查詢重新寫入是通透的,所以可以新增或刪除具體化視觀表,而不會讓應用程式程式碼中的 SQL 失效。
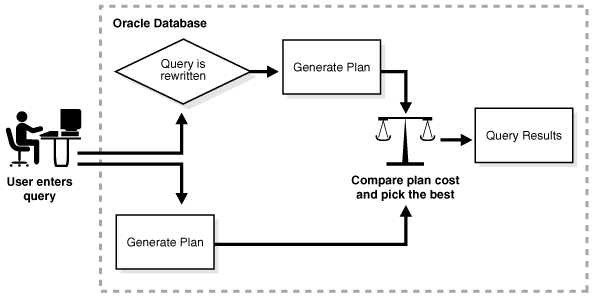
一般而言,重寫查詢以使用具體化視觀表而非明細表格可縮短回應時間。下圖顯示為原始和重寫查詢產生執行計畫的資料庫,以及選擇成本最低的計畫。
圖 10:查詢重新寫入
另請參閱:
-
「最佳化處理程式簡介」可進一步瞭解查詢轉換
-
Oracle AI Database Data Warehousing Guide,瞭解如何使用查詢重新寫入
序號概要
sequence 是一個綱要物件,可供多位使用者從中產生唯一的整數。順序產生器提供可高度擴展且效能良好的方法,以產生數字資料類型的替代索引鍵。
順序特性
順序定義會指出有關順序的一般資訊,包括其名稱,以及順序是遞增還是遞減。
順序定義也會指出:
-
數字之間的間隔
-
資料庫是否應在記憶體中快取一組產生的序號
-
達到限制時序列是否應循環
下列範例會在範例綱要 oe 中建立順序 customers_seq。當資料列新增至 customers 表格時,應用程式可以使用此順序來提供客戶 ID 編號。
CREATE SEQUENCE customers_seq
START WITH      1000
INCREMENT BY    1
NOCACHE
NOCYCLE;
customers_seq.nextval 的第一個參照會傳回 1000。第二個傳回 1001。每個後續參照都會傳回一個大於上一個參照的值 1。
另請參閱:
-
Oracle AI Database Oracle AI Database Development 入門,內含顯示如何建立順序的教學課程
-
Oracle AI Database Administrator's Guide,瞭解如何在 SQL 陳述式中參照序列
-
Oracle AI Database SQL Language Reference,瞭解
CREATE SEQUENCE的語法和語意
並行序號存取
相同的順序產生器可以為多個表格產生號碼。
產生器可以自動建立主索引鍵,並跨多個資料列或表格協調索引鍵。例如,序列可以產生 orders 表格和 customers 表格的主索引鍵。
序列產生器在多重使用者環境中很有用,因為不會造成磁碟 I/O 或交易鎖定負荷而產生唯一的數字。例如,兩個使用者同時將新資料列插入 orders 表格中。透過使用序列來產生 order_id 資料欄的唯一編號,使用者都不需要等待另一個使用者輸入下一個可用的訂單編號。順序會自動為每位使用者產生正確的值。
每個參照序列的使用者都可以存取其目前的序號,這是階段作業中最後產生的序號。使用者可以發出陳述式來產生新的序號,或使用階段作業最後產生的目前號碼。階段作業中的敘述句產生序號之後,此階段作業才可以使用該序號。如果個別序號已產生,且已用於最終倒回的異動中,則可略過這些序號。
警告:如果您的應用程式需要一組無間距的數字,您就無法使用 Oracle 序列。您必須使用自己開發的程式碼,來序列化資料庫中的活動。
另請參閱:「資料並行與一致性」以瞭解階段作業如何同時存取資料
維度總覽
典型的資料倉儲有兩個重要的元件:維度和事實。
維度是用於指定業務問題的任何類別,例如時間、地理區域、產品、部門及分配管道。事實是與特定維度值集相關聯的事件或實體,例如售出單位或利潤。
多維要求的範例包括:
-
顯示 2013 與 2014 年地理區域維度 (從州別到國家 / 地區) 在增加聚總層次的所有產品總銷售量。
-
建立我們營運的跨列表化分析,顯示 2013 年和 2014 年南美洲各地區的支出。包含所有可能的小計。
-
根據 2014 年汽車產品的銷售收入列出亞洲前 10 名銷售代表,並排名其佣金。
許多多維問題都需要聚總的資料和資料集比較,通常需要跨時間、地理區域或預算。
建立維度允許更廣泛地使用查詢重新寫入功能。透過通透地重寫查詢以使用具體化視觀表,資料庫可以提升查詢效能。
-
維度的階層結構:維度表格是邏輯結構,可定義資料欄或資料欄集配對之間的階層式 (父項 / 子項) 關係。
-
建立維度:您可以使用
CREATE DIMENSIONSQL 陳述式建立維度。另請參閱:Oracle AI Database Data Warehousing Guide 以深入瞭解維度
維度的階層結構
維度表格是一種邏輯結構,可定義資料欄或資料欄集配對之間的階層 (父項 / 子項) 關係。
例如,維度可以指示在資料列中,city 資料欄代表 state 資料欄的值,而 state 資料欄代表 country 資料欄的值。
在客戶維度內,客戶可以累計至城市、州別、國家、子區域和區域。資料分析通常從維度階層中的較高層級開始,如果情況保證此類分析,則逐步向下探鑽。
下階層次的每個值在上階層次都只與一個值相關聯。階層關係是從階層的一個層次到階層中下一個層次的功能相依性。
維度沒有指定的資料儲存。維度資訊儲存在維度表格中,而事實資訊則儲存在事實表格中。
另請參閱:
建立維度
您可以使用 CREATE DIMENSION SQL 陳述式建立維度。
此陳述式指定:
-
多個
LEVEL子句,每個子句都可識別維度中的資料欄或資料欄集 -
一或多個
HIERARCHY子句,指定相鄰層次之間的父項 / 子項關係 -
選擇性
ATTRIBUTE子句,每個子句都會識別與個別層次關聯的其他資料欄或資料欄集
下列敘述句是用來在範例綱要 sh 中建立 customers_dim 維度:
CREATE DIMENSION customers_dim
   LEVEL customer   IS (customers.cust_id)
   LEVEL city       IS (customers.cust_city)
   LEVEL state      IS (customers.cust_state_province)
   LEVEL country    IS (countries.country_id)
   LEVEL subregion  IS (countries.country_subregion)
   LEVEL region     IS (countries.country_region)
   HIERARCHY geog_rollup (
      customer      CHILD OF
      city          CHILD OF
      state         CHILD OF
      country       CHILD OF
      subregion     CHILD OF
      region
   JOIN KEY (customers.country_id) REFERENCES country )
   ATTRIBUTE customer DETERMINES
   (cust_first_name, cust_last_name, cust_gender,
    cust_marital_status, cust_year_of_birth,
    cust_income_level, cust_credit_limit)
   ATTRIBUTE country DETERMINES (countries.country_name);
維度中的資料欄可以來自同一個表格 (去標準化) 或來自多個表格 (完全或部分標準化)。例如,標準化時間維度可以包含日期表格、月份表格以及年度表格,以及將每個日期資料列連接至月份資料列的結合條件,以及將每個月份資料列連接至年度資料列。在完全反正規化的時間維度中,日期、月份和年份資料欄都位於相同的表格中。不論是標準化還是非標準化,都必須在 CREATE DIMENSION 敘述句中指定資料欄間的階層關係。
另請參閱:Oracle AI Database SQL Language Reference,瞭解 CREATE DIMENSION 語法和語意
同義字簡介
同義字是結構物件的別名。例如,您可以為表格或視觀表、順序、PL/SQL 程式單位、使用者定義的物件類型或其他同義字建立同義字。由於同義字只是一個別名,因此除了資料字典中的定義之外,它不需要儲存。
同義字可以簡化資料庫使用者的 SQL 陳述式。同義字也有助於隱藏基礎綱要物件的識別和位置。如果必須重新命名或移動基礎物件,則只需要重新定義同義字。以同義字為基礎的應用程式不需要修改即可繼續運作。
您可以建立專用與公用同義字。專用同義字位於特定使用者的綱要中,可控制對其他使用者的可用性。公用同義字是由名為 PUBLIC 的使用者群組所擁有,且可供每個資料庫使用者存取。
範例 6-5 公用同義字
假設資料庫管理員為 hr.employees 表格建立名稱為 people 的公用同義字。然後,使用者會連線至 oe 綱要,並計算同義字所參照之表格中的資料列數目。
SQL> CREATE PUBLIC SYNONYM people FOR hr.employees;

Synonym created.

SQL> CONNECT oe
Enter password: password
Connected.

SQL> SELECT COUNT(*) FROM people;

  COUNT(*)
----------
       107
請謹慎使用公用同義字,因為它們讓資料庫合併變得更加困難。如下列範例所示,如果其他管理員嘗試建立公用同義字 people,則建立作業會失敗,因為資料庫中只能有一個公用同義字 people。過度使用公用同義字會導致應用程式之間發生命名空間衝突。
SQL> CREATE PUBLIC SYNONYM people FOR oe.customers;
CREATE PUBLIC SYNONYM people FOR oe.customers
                      *
ERROR at line 1:
ORA-00955: name is already used by an existing object

SQL> SELECT OWNER, SYNONYM_NAME, TABLE_OWNER, TABLE_NAME
  2  FROM DBA_SYNONYMS
  3  WHERE SYNONYM_NAME = 'PEOPLE';

OWNER      SYNONYM_NAME TABLE_OWNER TABLE_NAME
---------- ------------ ----------- ----------
PUBLIC     PEOPLE       HR          EMPLOYEES
同義字本身無法保護。當您授與同義字的物件權限時,您真的會授與相關物件的權限。同義字僅作為 GRANT 陳述式中物件的別名。
另請參閱:
-
Oracle AI Database Administrator's Guide,瞭解如何管理同義字
-
Oracle AI Database SQL Language Reference,瞭解
CREATE SYNONYM的語法和語意