Konzepte für Datenbankentwickler
Der Oracle Database-Entwickler erstellt und verwaltet eine Datenbankanwendung. In diesem Abschnitt erhalten Sie einen kurzen Überblick über die Funktionen eines Datenbankentwicklers und die verfügbaren Entwicklungstools.
-
Aufgaben von Datenbankentwicklern Ein Oracle-Entwickler ist dafür verantwortlich, die Datenbankkomponenten einer Anwendung zu erstellen oder zu verwalten, die den Oracle-Technologie-Stack verwendet.
-
Tools für Datenbankentwickler Oracle bietet verschiedene Tools für die Entwicklung von Datenbankanwendungen. In diesem Abschnitt werden einige häufig verwendete Entwicklungstools beschrieben.
-
Themen für Datenbankentwickler Dieser Abschnitt behandelt Themen, die für Datenbankentwickler am wichtigsten sind und an anderer Stelle im Handbuch nicht behandelt wurden.
Aufgaben von Datenbankentwicklern
Ein Oracle-Entwickler ist für die Erstellung oder Wartung der Datenbankkomponenten einer Anwendung verantwortlich, die den Oracle-Technologiestack verwendet.
Oracle-Entwickler entwickeln entweder neue Anwendungen oder konvertieren vorhandene Anwendungen, um sie in einer Oracle Database-Umgebung auszuführen. Aus diesem Grund arbeiten Entwickler eng mit den Datenbankadministratoren zusammen und teilen Wissen und Informationen.
Oracle-Datenbankentwickler können mit folgenden Aufgaben rechnen:
-
Implementierung des von der Anwendung benötigten Datenmodells
-
Schemaobjekte werden erstellt
-
Implementierung von Regeln für die Datenintegrität
-
Auswahl einer Programmierumgebung für ein neues Entwicklungsprojekt
-
Server-seitige PL/SQL- oder Java-Unterprogramme und Client-seitigen prozeduralen Code, der SQL-Anweisungen verwendet
-
Anwendungsschnittstelle mit dem gewählten Entwicklungstool erstellen
-
Aufbau einer Globalisierungssupportumgebung für die Entwicklung globalisierter Anwendungen
-
Anwendungen in verschiedenen Datenbanken für Entwicklung, Test, Schulung und Deployment in einer Produktionsumgebung instanziieren
Siehe:
-
Oracle AI Database – Erste Schritte mit Oracle AI Database Development für eine Einführung und GUI-basierte Tutorials in der Oracle Database-Entwicklung
-
Oracle AI Database Development Guide für ausführliche Diskussionen zu Themen wie Datenbankdesign, SQL für Entwickler und PL/SQL für Entwickler
Tools für Datenbankentwickler
Oracle bietet verschiedene Tools für die Entwicklung von Datenbankanwendungen. In diesem Abschnitt werden einige häufig verwendete Entwicklungstools beschrieben.
-
SQL Developer ist eine praktische Möglichkeit für Datenbankentwickler, grundlegende Aufgaben mit SQL*Plus zu bearbeiten und zu entwickeln.
-
Oracle APEX AI Application Generator Oracle APEX AI Application Generator ist ein Tool zur Entwicklung von Webanwendungen für Oracle Database. Oracle APEX AI Application Generator verwendet integrierte Features wie Themen der Benutzeroberfläche, Navigationssteuerelemente, Formular-Handler und flexible Berichte, um die Anwendungsentwicklung zu beschleunigen.
-
Oracle JDeveloper ist eine integrierte Entwicklungsumgebung (IDE) zum Erstellen serviceorientierter Anwendungen mit den neuesten Industriestandards für Java, XML, Webservices und SQL.
-
Oracle Developer Tools for Visual Studio .NET
Oracle Developer Tools for Visual Studio .NET ist eine Gruppe von Anwendungstools, die in die Visual Studio .NET-Umgebung integriert sind.
SQL Developer
SQL Developer ist eine praktische Möglichkeit für Datenbankentwickler, grundlegende Aufgaben mit SQL*Plus zu bearbeiten und zu entwickeln. SQL Developer ist eine grafische Version von SQL*Plus, die in Java geschrieben ist und die Entwicklung in SQL und PL/SQL unterstützt. Sie können sich mit der Standard-Datenbankauthentifizierung bei jedem Oracle-Datenbankschema anmelden. Mit SQL Developer können Sie:
-
Schemaobjekte durchsuchen, erstellen, bearbeiten und löschen
-
SQL-Anweisungen ausführen
-
PL/SQL-Programmeinheiten bearbeiten und debuggen
-
Daten bearbeiten und exportieren
-
Berichte erstellen und anzeigen
SQL Developer ist in der Standardinstallation von Oracle Database verfügbar und kann kostenlos heruntergeladen werden.
Siehe auch: Oracle AI Database – Erste Schritte mit der Oracle AI Database-Entwicklung und Oracle SQL Developer – Benutzerhandbuch, um zu erfahren, wie SQL Developer verwendet wird
Oracle APEX AI-Anwendungsgenerator
Oracle APEX AI Application Generator ist ein Tool zur Entwicklung von Webanwendungen für Oracle Database. Oracle APEX AI Application Generator verwendet integrierte Features wie Themen der Benutzeroberfläche, Navigationssteuerelemente, Formular-Handler und flexible Berichte, um die Anwendungsentwicklung zu beschleunigen.
Oracle APEX wird mit der Datenbank installiert und besteht aus Daten in Tabellen und PL/SQL-Code. Wenn Sie eine Anwendung ausführen, sendet Ihr Browser einen URL-Request, der in einen Oracle APEX-PL/SQL-Aufruf übersetzt wird. Nachdem die Datenbank PL/SQL verarbeitet hat, werden die Ergebnisse als HTML wieder in den Browser übertragen. Dieser Zyklus tritt jedes Mal auf, wenn Sie eine Seite anfordern oder weiterleiten.
Sie können Oracle APEX mit dem eingebetteten PL/SQL-Gateway verwenden. Das Gateway wird auf dem Oracle XML DB-HTTP-Server in der Datenbank ausgeführt und stellt die erforderliche Infrastruktur zum Erstellen dynamischer Anwendungen bereit. Wie in Abbildung 23-1 dargestellt, vereinfacht das eingebettete PL/SQL-Gateway die Anwendungsarchitektur, indem die Middle Tier eliminiert wird.
Abbildung 1: APEX mit eingebettetem PL/SQL-Gateway
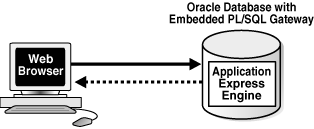
Beschreibung der Abbildung cncpt317.gif
Oracle JDeveloper
Oracle JDeveloper ist eine integrierte Entwicklungsumgebung (IDE) zum Erstellen serviceorientierter Anwendungen mit den neuesten Industriestandards für Java, XML, Webservices und SQL. Oracle JDeveloper unterstützt den gesamten Lebenszyklus der Softwareentwicklung mit integrierten Funktionen für Modellierung, Codierung, Debugging, Tests, Profilerstellung, Optimierung und Deployment von Anwendungen.
Oracle JDeveloper verwendet Fenster für verschiedene Tools zur Anwendungsentwicklung. Beispiel: Beim Erstellen einer Java-Anwendung können Sie Tools wie Java Visual Editor und Component Palette verwenden. Zusätzlich zu diesen Tools bietet Oracle JDeveloper eine Reihe von Navigatoren, mit denen Sie den Inhalt Ihrer Projekte organisieren und anzeigen können.
Siehe:
-
Oracle AI Database – Erste Schritte mit der Java-Entwicklung, um zu erfahren, wie Sie JDeveloper verwenden
-
Sie können JDeveloper von der folgenden URL herunterladen: http://www.oracle.com/technetwork/developer-tools/jdev/downloads/
Oracle Developer Tools for Visual Studio .NET
Oracle Developer Tools for Visual Studio .NET ist eine Gruppe von Anwendungstools, die in die Visual Studio .NET-Umgebung integriert sind. Oracle Developer Tools for Visual Studio .NET-Tools bieten GUI-Zugriff auf Oracle-Funktionen, sodass Benutzer in der Lage sind, eine Vielzahl von Anwendungsentwicklungsaufgaben durchzuführen und die Entwicklungsproduktivität und Benutzerfreundlichkeit zu erhöhen.
Oracle Developer Tools unterstützen die Programmierung und Implementierung von in .NET-Stored Procedures durch Visual Basic, C# und andere .NET-Sprachen. Diese Prozeduren werden in einer .NET-Sprache geschrieben und enthalten SQL- oder PL/SQL-Anweisungen.
Themen für Datenbankentwickler
In diesem Abschnitt werden Themen behandelt, die für Datenbankentwickler am wichtigsten sind und an anderer Stelle im Handbuch nicht behandelt wurden.
-
Principles of Application Design and Tuning Oracle Entwickler müssen Datenbankanwendungen entwerfen, erstellen und optimieren, damit sie Sicherheits- und Performanceziele erreichen.
-
Principles of Correct Queries Real-World-Anwendungsabfragen können sehr komplex sein, mit vielen Joins, und diese sind in allen Eckfällen oft überflüssig. Sie geben explizit die Rückgabe eines fehlerhaften Ergebnisses an, selbst wenn SQL über lange Zeiträume in Produktionssystemen ausgeführt wird und unbemerkte Fehler verursacht. In diesem Abschnitt wird erläutert, wie Sie systematisch die wichtigsten dieser allzu häufigen SQL-Fehler analysieren und vermeiden.
-
Client-seitige Datenbankprogrammierung Sie können Vorkompilierer oder Java-Übersetzer verwenden, um SQL-Anweisungen im Quellcode zu platzieren, oder Sie können APIs verwenden, um Anwendungen die Interaktion mit der Datenbank zu ermöglichen.
-
Globalisierungssupport Mit der Globalisierungsunterstützung von Oracle Database können Sie Daten in nativen Sprachen speichern, verarbeiten und abrufen.
-
Unstrukturierte Daten Unstrukturierte Daten sind Daten, die nicht in kleinere logische Strukturen unterteilt werden.
Prinzipien von Application Design und Tuning
Oracle-Entwickler müssen Datenbankanwendungen entwerfen, erstellen und optimieren, damit sie Sicherheits- und Leistungsziele erreichen.
Die folgenden Prinzipien des Anwendungsdesigns und der Optimierung sind nützliche Richtlinien:
-
Erfahren Sie, wie Oracle Database funktioniert
Als Entwickler möchten Sie Anwendungen in kürzester Zeit für eine Oracle-Datenbank entwickeln, was die Nutzung der Datenbankarchitektur und -features erfordert. Wenn Sie beispielsweise Oracle Database-Datenzugriffskontrollen und Lesekonsistenz bei mehreren Versionen nicht verstehen, kann dies dazu führen, dass eine Anwendung die Integrität der Daten beschädigt, langsam ausgeführt und die Skalierbarkeit verringert. Wenn Sie wissen, wie Transaction Guard und Application Continuity funktionieren, können Sie vermeiden, unnötigen Code für die Exception-Behandlung zu schreiben.
-
Verwenden Sie Bind-Variablen, es sei denn, Sie haben einen guten Grund, sie nicht zu verwenden
Wenn eine Abfrage Bind-Variablen verwendet, kann die Datenbank sie einmal kompilieren und den Abfrageplan im gemeinsam genutzten Pool speichern. Wenn dieselbe Anweisung erneut ausgeführt wird, kann die Datenbank einen Soft Parse ausführen und den Plan wiederverwenden. Im Gegensatz dazu dauert ein Hard Parse länger und verwendet mehr Ressourcen. Die Verwendung von Bind-Variablen, um Soft Parsing zu ermöglichen, ist sehr effizient und die Art und Weise, wie die Datenbank Entwickler arbeiten will.
-
Integritäts-Constraints auf dem Datenbankserver und nicht auf dem Client implementieren
Die Verwendung von Primär- und Fremdschlüsseln ermöglicht die Wiederverwendung von Daten in mehreren Anwendungen. Die Codierung der Regeln in einem Client bedeutet, dass andere Clients keinen Zugriff auf diese Regeln haben, wenn sie für die Datenbanken ausgeführt werden.
-
Testumgebung mit repräsentativen Daten und Sessionaktivität erstellen
Eine Testumgebung, die Ihre Live-Produktionsumgebung simuliert, bietet mehrere Vorteile. Beispiel: Sie können die Anwendung mit Benchmarks versehen, um sicherzustellen, dass sie skaliert und gut funktioniert. Außerdem können Sie mit einer Testumgebung die Performanceauswirkungen von Änderungen an der Datenbank messen und sicherstellen, dass Upgrades und Patches korrekt funktionieren.
-
Entwerfen Sie das Datenmodell mit dem Ziel einer guten Leistung
In der Regel führen Versuche, generische Datenmodelle zu verwenden, zu einer schlechten Performance. Ein gut gestaltetes Datenmodell beantwortet die häufigsten Abfragen so effizient wie möglich. Beispiel: Das Datenmodell sollte den Indextyp verwenden, der die beste Performance bietet. Das Tuning nach dem Deployment ist unerwünscht, da Änderungen an logischen und physischen Strukturen schwierig oder unmöglich sein können.
-
Definieren Sie klare Leistungsziele und bewahren Sie historische Aufzeichnungen von Kennzahlen auf
Ein wichtiger Aspekt der Entwicklung besteht darin, genau zu bestimmen, wie die Anwendung ausgeführt und skaliert werden soll. Verwenden Sie beispielsweise Metriken, die erwartete Benutzerlast, Transaktionen pro Sekunde, akzeptable Antwortzeiten usw. umfassen. Good Practice schreibt vor, dass Sie historische Datensätze von Performancekennzahlen verwalten. Auf diese Weise können Sie die Leistung proaktiv und reaktiv überwachen.
-
Instrumentieren Sie den Anwendungscode
Eine gute Entwicklungspraxis besteht darin, der Anwendung Debugging-Code hinzuzufügen. Die Möglichkeit, Tracedateien zu generieren, ist nützlich, um Performanceprobleme zu debuggen und zu diagnostizieren.
Siehe:
-
Oracle AI Database – Erste Schritte mit der Oracle AI Database-Entwicklung für Überlegungen beim Entwerfen von Datenbankanwendungen
-
SQL Tuning Guide für Oracle AI Database mit Informationen zum Entwerfen von Anwendungen für die Performance
Grundsätze korrekter Abfragen
Real-World-Anwendungsabfragen können sehr komplex sein, mit vielen Joins, und diese sind überzeugend oft nicht in allen Eckfällen korrekt und geben explizit die Rückgabe eines fehlerhaften Ergebnisses an, selbst wenn SQL über lange Zeiträume in Produktionssystemen ausgeführt wird und unbemerkte Fehler verursacht. In diesem Abschnitt wird erläutert, wie Sie systematisch die wichtigsten dieser allzu häufigen SQL-Fehler analysieren und vermeiden.
Abfragen können sehr komplex aussehen. Sie können Dutzende von Tabellen referenzieren, Ansichten einschließen, die auf anderen Ansichten basieren, und Unterabfragen in WITH-Klauseln, der SELECT-Liste und der WHERE-Klausel verwenden. Unter dieser Komplexität beantwortet eine gute Abfrage immer noch eine klare Frage. Diese Frage spiegelt in der Regel den Bedarf an Daten zu einer Gruppe bestimmter Geschäftseinheiten wider. Jede von der Abfrage zurückgegebene Zeile sollte eine Instanz dieser Entity darstellen. Bei GROUP BY-Abfragen muss jede Zeile eine Aggregation über Instanzen derselben Entity darstellen.
In den meisten Systemen hat jeder Geschäftsentitytyp, der für die Abfrage wichtig ist, eine entsprechende Tabelle, deren Zeilen diese Entity darstellen. In diesem Sinne sind viele gut geschriebene Abfragen, egal wie komplex sie aussehen, letztendlich Fragen zu Zeilen aus einer einzelnen Tabelle. Die umgebende Komplexität liegt in der Regel vor, weil normalisierte Datenbanken Attribute einer Entity über verknüpfte Tabellen hinweg speichern, z.B. übergeordnete Tabellen, übergeordnete Tabellen usw.
Beispiel: Bei einem normalisierten Design wird der Name eines Kunden in der Regel einmal in einer CUSTOMERS-Tabelle gespeichert. In einer ORDERS-Tabelle wird nur CUSTOMER_ID gespeichert, damit sie mit CUSTOMERS verknüpft werden kann. In einer ORDER_ITEMS-Tabelle wird ORDER_ID gespeichert, damit sie mit ORDERS verknüpft werden kann, und CUSTOMER_ID wird nicht wiederholt. Wenn wir eine Teilmenge von ORDER_ITEMS zusammen mit dem Kundennamen für jeden Artikel auflisten möchten, benötigen wir eine Folge eindeutiger Joins, zuerst zu ORDERS (übergeordnetes Element) und dann zu CUSTOMERS (übergeordnetes Element). In gut normalisierten OLTP-Systemen können Abfragen viele solcher Joins erfordern, um detaillierte Informationen zu einem einzelnen Entitytyp abzurufen, obwohl die Ergebnismenge immer noch Eins-zu-Eins zu einer Teilmenge von Zeilen aus einer "primären" Tabelle zuordnet.
Wir nennen diese Primärtabelle die Row-Widened Table (RWT). In einer korrekten Abfrage sollten die anderen Joins in der Regel jede RWT-Zeile erweitern, indem eindeutig übereinstimmende Lookup-Daten aus übergeordneten Tabellen, übergeordneten Tabellen usw. hinzugefügt werden. Diese Joins dürfen die Anzahl der RWT-Zeilen nicht multiplizieren. Abfragen mit dieser Struktur für alle Joins, die logisch aus dem RWT starten, sind Zeilen, die nur Abfragen (RWOQs) erweitern. Hinweis: Durch Filtern können RWT-Zeilen verworfen werden. Inner Joins und WHERE-Prädikate können Zeilen aus dem RWT entfernen. "Zeilenverbreitert" bedeutet nicht, dass bei der Abfrage alle RWT-Zeilen beibehalten werden. Das bedeutet, dass jede Zeile mit dem Abfrageergebnis nach dem Filtern und vor jeder Aggregation streng Eins-zu-Eins den verbleibenden RWT-Zeilen entspricht.
Wenn jede andere Tabelle in der Abfrage über eine Kette eindeutiger Joins aus einer einzelnen Tabelle erreichbar ist, die die von der Abfrage zurückgegebenen oder aggregierten Entitys darstellt, ist diese Starttabelle die RWT, und die Abfrage ist eine RWOQ. Wenn keine Tabelle über eindeutige Schlüssel garantiert werden kann, um den Ergebniszeilen vor der Aggregation Eins-zu-Eins zuzuordnen, ist die Abfrage kein RWOQ. In der Praxis produzieren die meisten Nicht-RWOQs Ergebnisse, die von der Anwendung nicht korrekt interpretiert werden können, da die Abfrage Ergebniszeilen nicht eindeutig einer klar definierten, geschäftsrelevanten Entity zuordnet. Wenn Sie beispielsweise Werte aus solchen Zeilen zusammenfassen, wird derselbe Wert für dieselbe Entity mehrmals addiert, sodass eine Summe nicht sinnvoll ist.
Ab Oracle Database Release 26ai unterstützt das Feature JOIN TO ONE das Schreiben korrekter RWOQs erheblich. Wenn Sie JOIN TO ONE für alle Joins verwenden, prüft die Datenbank beim Parsen, ob die Abfrage ein RWOQ ist. Dabei wird die Tabelle ganz links in der FROM-Klausel als RWT behandelt. Dabei wird davon ausgegangen, dass es sich bei dem Objekt um eine Basistabelle und nicht um eine Ansicht handelt, die das Nicht-RWOQ-Verhalten ausblenden könnte. Wenn die Datenbank die Eindeutigkeit der JOIN TO ONE-Joins beim Parsen nicht nachweisen kann, führt sie Laufzeitprüfungen aus, um zu prüfen, ob jeder Join aus dem vorausgesetzten RWT für die zur Ausführungszeit aufgetretenen Daten eindeutig bleibt. Wenn ein nicht eindeutiger Join in den tatsächlichen Ergebnissen erkannt wird, wird ein Laufzeitfehler ausgelöst. Die meisten RWOQs können in das Formular JOIN TO ONE konvertiert werden. Abfragen, die nicht in das JOIN TO ONE-Formular konvertiert werden können, zeigen im Allgemeinen unregelmäßige Joins beim Versuch der Konvertierung. Wenn die konvertierte Abfrage ohne Laufzeitfehler ausgeführt wird, liefert dieses Ergebnis eine starke Bestätigung, dass die Abfrage die gewünschte Einzeileneigenschaft aufweist.
Weitere Informationen zu RWOQs, warum sie dazu beitragen, subtile Korrektheitsprobleme in SQL zu vermeiden, und wie JOIN TO ONE sie durchsetzt, finden Sie im Oracle AI Database Development Guide.
Clientseitige Datenbankprogrammierung
Sie können Vorkompiler oder Java-Übersetzer verwenden, um SQL-Anweisungen in Quellcode zu platzieren, oder Sie können APIs verwenden, um Anwendungen die Interaktion mit der Datenbank zu ermöglichen.
Es gibt zwei grundlegende Techniken, mit denen prozedurale Datenbankanwendungen SQL verwenden können: serverseitige Programmierung mit PL/SQL und Java sowie clientseitige Programmierung mit Precompilern und APIs wie Java Database Connectivity (JDBC) oder Oracle Call Interface (OCI).
-
Eingebettetes SQL In der Vergangenheit haben Client/Server-Programme eingebettete SQL für die Interaktion mit der Datenbank verwendet.
-
Clientseitige APIs Die meisten Entwickler verwenden heute eine API, um SQL in ihre Datenbankanwendungen einzubetten.
Siehe:
Oracle AI Database Development Guide, um zu erfahren, wie Sie eine Programmierumgebung auswählen
Eingebettete SQL
In der Vergangenheit haben Client/Server-Programme Embedded SQL verwendet, um mit der Datenbank zu interagieren.
- Oracle Precompiler-Client/Server-Programme werden in der Regel mit einem Oracle Precompiler geschrieben. Bei diesem Programmiertool können Sie SQL-Anweisungen in übergeordnete Programme einbetten.
Oracle-Precompiler
Client/Server-Programme werden in der Regel mit einem Oracle precompiler geschrieben, einem Programmierungstool, mit dem Sie SQL-Anweisungen in übergeordnete Programme einbetten können.
Beispiel: Mit dem Oracle Pro*C/C++-Precompiler können Sie SQL-Anweisungen in eine C- oder C++-Quelldatei einbetten. Oracle-Precompiler sind auch für COBOL und FORTRAN verfügbar.
Ein Precompiler bietet mehrere Vorteile, darunter:
-
Steigert die Produktivität, da Sie in der Regel weniger Code schreiben als vergleichbare OCI-Anwendungen
-
Ermöglicht die Erstellung hochgradig angepasster Anwendungen
-
Ermöglicht eine enge Überwachung der Ressourcennutzung, der Ausführung von SQL-Anweisungen und verschiedener Laufzeitindikatoren
-
Spart Zeit, da der Precompiler, nicht Sie, jede eingebettete SQL-Anweisung in Aufrufe der Oracle Database Runtime Library übersetzt
-
Ordnet Oracle Database-Objekttypen und -Collections mit dem Object Type Translator C-Datentypen zu, die in der Pro*C/C++-Anwendung verwendet werden sollen
-
Bietet die Prüfung des Kompilierungszeittyps von Objekttypen und Collections und die automatische Typkonvertierung von Datenbanktypen in C-Datentypen
Die Clientanwendung mit den SQL-Anweisungen ist das Hostprogramm. Dieses Programm ist in der Hostsprache geschrieben. Im Hostprogramm können Sie vollständige SQL-Anweisungen mit vollständigen C-Anweisungen mischen und C-Variablen oder -Strukturen in SQL-Anweisungen verwenden. Wenn Sie SQL-Anweisungen einbetten, müssen Sie sie mit den Schlüsselwörtern EXEC SQL beginnen und mit einem Semikolon enden. Pro*C/C++ übersetzt EXEC SQL-Anweisungen in Aufrufe der Laufzeitbibliothek SQLLIB.
Viele eingebettete SQL-Anweisungen unterscheiden sich von ihren interaktiven Gegenstücken nur durch das Hinzufügen einer neuen Klausel oder die Verwendung von Programmvariablen. Im folgenden Beispiel werden interaktive und eingebettete ROLLBACK-Anweisungen verglichen:
ROLLBACK;           -- interactive
EXEC SQL ROLLBACK;  -- embedded
Die Anweisungen haben dieselbe Wirkung, Sie würden jedoch die erste in einer interaktiven SQL-Umgebung (wie SQL Developer) und die zweite in einem Pro*C/C++-Programm verwenden.
Ein Precompiler akzeptiert das Hostprogramm als Eingabe, übersetzt die eingebetteten SQL-Anweisungen in Standard-Library-Aufrufe zur Laufzeit der Datenbank und generiert ein Quellprogramm, das Sie wie gewohnt kompilieren, verknüpfen und ausführen können. In Abbildung 23-2 werden typische Schritte bei der Entwicklung von Programmen dargestellt, die Precompiler verwenden.
Abbildung 2: Programmentwicklung mit Precompilern
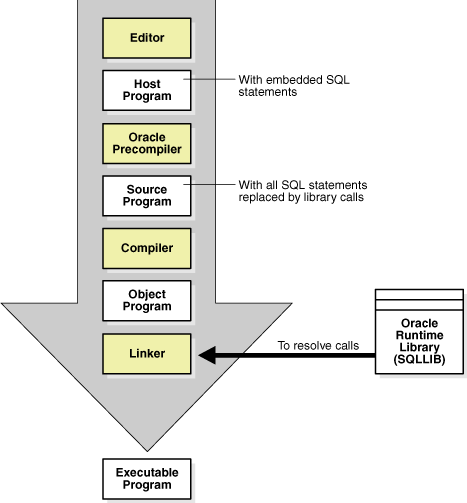
Beschreibung der Abbildung cncpt253.gif
Eine vollständige Beschreibung des Pro*C/C++-Precompilers finden Sie unter: Pro*C/C++ Developer's Guide
Clientseitige APIs
Die meisten Entwickler verwenden heute eine API, um SQL in ihre Datenbankanwendungen einzubetten.
Beispiel: Zwei gängige APIs, mit denen Programme mit Oracle Database kommunizieren können, sind Open Database Connectivity (ODBC) und JDBC. Oracle Call Interface (OCI) und Oracle C++ Call Interface (OCCI) sind zwei weitere gemeinsame APIs für die clientseitige Programmierung.
-
OCI und OCCI Als Alternative zu Precompilern stellt Oracle die OCI- und OCCI-APIs bereit.
-
ODBC und JDBC ODBC ist eine Standard-API, mit der Anwendungen eine Verbindung zu einer Datenbank herstellen und dann SQL-Anweisungen vorbereiten und ausführen können.
OCI und OCCI
Als Alternative zu Precompilern stellt Oracle die OCI- und OCCI-APIs bereit.
Mit OCI können Sie Daten und Schemas in einer Datenbank mit einer Hostprogrammiersprache wie C bearbeiten. OCCI ist eine objektorientierte Schnittstelle, die für den Einsatz mit C++ geeignet ist. Mit beiden APIs können Entwickler native Unterprogrammaufrufe verwenden, um auf Oracle Database zuzugreifen und die SQL-Ausführung zu kontrollieren.
In einigen Fällen bietet OCI eine bessere Performance oder mehr Funktionen als Schnittstellen auf höherer Ebene. OCI und OCCI bieten viele Funktionen, darunter die folgenden:
-
Unterstützung für alle SQL-DDL-, DML-, Abfrage- und Transaktionskontrollfunktionen, die über Oracle Database verfügbar sind
-
Instant Client, eine Möglichkeit, Anwendungen bereitzustellen, wenn Speicherplatz ein Problem ist
-
Thread-Verwaltung, Connection Pooling, Globalisierungsfunktionen und Direct Path-Laden von Daten aus einer C-Anwendung
OCI und OCCI bieten eine Bibliothek mit standardmäßigen Datenbankzugriffs- und -abruffunktionen in Form einer dynamischen Laufzeitbibliothek (OCILIB). Diese Bibliothek kann zur Laufzeit in einer Anwendung verknüpft werden. So können Sie ein OCI- oder OCCI-Programm auf die gleiche Weise kompilieren und verknüpfen wie eine Nicht-Datenbankanwendung, wodurch ein separater Vorverarbeitungs- oder Vorkompilierungsschritt vermieden wird. In Abbildung 23-3 wird der Entwicklungsprozess dargestellt.
Abbildung 3: Entwicklungsprozess mit OCI oder OCCI
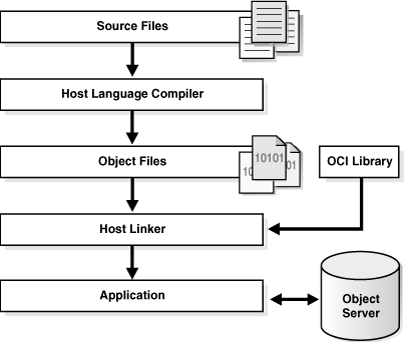
Beschreibung der Abbildung cncpt307.gif
Siehe:
ODBC und JDBC
ODBC ist eine Standard-API, mit der Anwendungen eine Verbindung zu einer Datenbank herstellen und dann SQL-Anweisungen vorbereiten und ausführen können.
ODBC ist unabhängig von Programmiersprache, Datenbank und Betriebssystem. Das Ziel von ODBC ist es, jeder Anwendung den Zugriff auf Daten zu ermöglichen, die in einer Datenbank enthalten sind.
Ein Datenbanktreiber ist eine Software, die zwischen einer Anwendung und der Datenbank sitzt. Der Treiber übersetzt die API-Aufrufe der Anwendung in Befehle, die von der Datenbank verarbeitet werden können. Mit einem ODBC-Treiber kann eine Anwendung auf jede beliebige Datenquelle zugreifen, einschließlich Daten, die in Tabellen gespeichert sind. Der ODBC-Treiber führt alle Zuordnungen zwischen dem ODBC-Standard und der Datenbank aus.
Mit dem von Oracle bereitgestellten Oracle ODBC-Treiber können ODBC-kompatible Anwendungen auf Oracle Database zugreifen. Beispiel: Eine in Visual Basic geschriebene Anwendung kann ODBC verwenden, um Tabellen in einer Oracle-Datenbank abzufragen und zu aktualisieren.
JDBC ist eine Low-Level-Java-Schnittstelle, mit der Java-Anwendungen mit der Oracle-Datenbank interagieren können. Wie ODBC ist JDBC eine herstellerunabhängige API. Der JDBC-Standard wird von Sun Microsystems definiert und über die java.sql-Schnittstellen implementiert.
Mit dem JDBC-Standard können einzelne Provider den Standard mit ihren eigenen JDBC-Treibern implementieren und erweitern. Oracle stellt die folgenden JDBC-Treiber für die clientseitige Programmierung bereit:
-
JDBC-Thin-Treiber
Dieser reine Java-Treiber befindet sich auf der Clientseite ohne Oracle-Clientinstallation. Es ist plattformunabhängig und kann sowohl mit Applets als auch mit Anwendungen verwendet werden.
-
JDBC-OCI-Treiber
Dieser Treiber befindet sich auf der Clientseite mit einer Oracle-Clientinstallation. Es ist nur mit Anwendungen verwendbar. Der JDBC-OCI-Treiber, der sowohl in C als auch in Java geschrieben ist, konvertiert JDBC-Aufrufe in OCI-Aufrufe.
Die folgenden Snippets stammen aus einem Java-Programm, das den JDBC-OCI-Treiber verwendet, um ein Statement-Objekt zu erstellen und die Tabelle dual abzufragen:
// Create a statement
Statement stmt = conn.createStatement();

// Query dual table
ResultSet rset = stmt.executeQuery("SELECT 'Hello World' FROM DUAL");
Siehe auch: Oracle AI Database Development Guide und Oracle AI Database – Erste Schritte mit der Java-Entwicklung, um mehr über JDBC zu erfahren
Globalization-Unterstützung
Mit der Globalisierungsunterstützung von Oracle Database können Daten in verschiedenen Landessprachen gespeichert, verarbeitet und abgerufen werden.
Die Globalisierungsunterstützung ermöglicht es Ihnen, mehrsprachige Anwendungen und Software zu entwickeln, die von überall auf der Welt gleichzeitig aufgerufen und ausgeführt werden können.
Entwickler, die eine globalisierte Datenbankanwendung schreiben, müssen folgende Schritte ausführen:
-
Verständnis der Supportarchitektur der Oracle Database-Globalisierung, einschließlich der Eigenschaften der verschiedenen Zeichensätze, Gebiete, Sprachen und linguistischen Sortierdefinitionen
-
Verständnis der Globalisierungsfunktionalität ihrer Middle Tier-Programmierumgebung, einschließlich der Interaktion und Synchronisierung mit dem Gebietsschemamodell der Datenbank
-
Code entwerfen und schreiben, der mehrere Clients gleichzeitig unterstützt, die auf verschiedenen Betriebssystemen ausgeführt werden, mit unterschiedlichen Zeichensätzen und Gebietsschemaanforderungen
Beispiel: Eine Anwendung kann erforderlich sein, um Inhalte der Benutzeroberfläche wiederzugeben und Daten in Sprachen und Gebietsschemavoreinstellungen von nativen Benutzern zu verarbeiten. Beispiel: Die Anwendung muss Multibyte-Kanji-Daten verarbeiten, Nachrichten und Datumsangaben im richtigen regionalen Format anzeigen und 7-Bit-ASCII-Daten verarbeiten, ohne dass Benutzer die Einstellungen ändern müssen.
-
Globalisierungssupportumgebung Die Globalisierungssupportumgebung umfasst die Clientanwendung und die Datenbank. Sie können sprachabhängige Vorgänge steuern, indem Sie Parameter und Umgebungsvariablen auf dem Client und Server festlegen, die an separaten Speicherorten vorhanden sein können.
-
Oracle Globalization Development Kit Das Oracle Globalization Development Kit (GDK) umfasst umfassende Programmier-APIs. Siehe auch: Oracle AI Database Globalization Support Guide für weitere Informationen zur Globalisierung
Globalisierungssupportumgebung
Die Globalisierungssupportumgebung umfasst die Clientanwendung und die Datenbank. Sie können sprachabhängige Vorgänge steuern, indem Sie Parameter und Umgebungsvariablen auf dem Client und Server festlegen, die an separaten Speicherorten vorhanden sein können. Hinweis: In früheren Releases hat Oracle die Globalisierungssupportfunktionen als National Language Support-(NLS-)Features bezeichnet. NLS ist eigentlich ein Teil der Globalisierungsunterstützung und bietet die Möglichkeit, eine Landessprache auszuwählen und Daten in einem bestimmten Zeichensatz zu speichern.
Oracle Database bietet Globalisierungsunterstützung für folgende Features:
-
Muttersprachen und Territorien
-
Lokale Formate für Datum, Uhrzeit, Zahlen und Währung
-
Kalendersysteme (Gregorianisch, Japanisch Kaiserlich, Thai Buddha usw.)
-
Mehrere Zeichensätze, einschließlich Unicode
-
Zeichensemantik
-
Zeichensätze Eine Schlüsselkomponente der Globalisierungsunterstützung ist ein Zeichensatz, bei dem es sich um ein Codierungsschema handelt, mit dem Zeichen auf einem Computerbildschirm angezeigt werden.
-
Gebietsschemaspezifische Einstellungen Eine Gebietsschema ist eine sprachliche und kulturelle Umgebung, in der ein System oder Programm ausgeführt wird. NLS-Parameter bestimmen das gebietsschemaspezifische Verhalten auf dem Client und der Datenbank.
Zeichensätze
Eine Schlüsselkomponente der Globalisierungsunterstützung ist ein Zeichensatz, bei dem es sich um ein Codierungsschema handelt, mit dem Zeichen auf einem Computerbildschirm angezeigt werden.
Die folgende Unterscheidung ist bei der Anwendungsentwicklung wichtig:
-
Ein Datenbankzeichensatz bestimmt, welche Sprachen in einer Datenbank dargestellt werden können. Der Zeichensatz wird beim Erstellen der Datenbank angegeben.
Hinweis: Nachdem eine Datenbank erstellt wurde, ist die Änderung ihres Zeichensatzes in der Regel sehr zeit- und ressourcenaufwendige. Bei diesem Vorgang müssen möglicherweise alle Zeichendaten konvertiert werden. Dabei wird die gesamte Datenbank exportiert und dann wieder importieren.
-
Ein Client-Zeichensatz ist der Zeichensatz für Daten, die von einer Clientanwendung eingegeben oder angezeigt werden. Der Zeichensatz für den Client und die Datenbank kann unterschiedlich sein.
Eine Gruppe von Zeichen (z.B. alphabetische Zeichen, Ideogramme, Symbole, Satzzeichen und Steuerzeichen) kann als Zeichensatz codiert werden. Ein codierter Zeichensatz weist jedem Zeichen im Satz einen eindeutigen numerischen Code zu, der als Codepunkt oder codierter Wert bezeichnet wird. Codepunkte sind in einer globalen Umgebung wichtig, da Daten möglicherweise zwischen verschiedenen Zeichensätzen konvertiert werden müssen.
Die Computerindustrie verwendet viele verschlüsselte Zeichensätze. Diese Sätze unterscheiden sich in der Anzahl der verfügbaren Zeichen, den zur Verwendung verfügbaren Zeichen, den Codepunkten, die jedem Zeichen zugewiesen sind usw. Oracle Database unterstützt die meisten nationalen, internationalen und herstellerspezifischen codierten Zeichensatz-Standards.
Oracle Database unterstützt die folgenden Klassen von codierten Zeichensätzen:
-
Einzel-Byte-Zeichensätze
Jedes Zeichen nimmt ein Byte ein. Ein Beispiel für einen 7-Bit-Zeichensatz ist US7ASCII. Ein Beispiel für einen 8-Bit-Zeichensatz ist WE8DEC.
-
Multibyte-Zeichensätze
Jedes Zeichen belegt mehrere Byte. Multibyte-Sets werden häufig für asiatische Sprachen verwendet.
-
Unicode
Mit dem universell codierten Zeichensatz können Sie Informationen in jeder Sprache speichern, indem Sie einen einzelnen Zeichensatz verwenden. Unicode bietet einen eindeutigen Codewert für jedes Zeichen, unabhängig von Plattform, Programm oder Sprache.
Siehe auch: Oracle AI Database Globalization Support Guide enthält Informationen zur Zeichensatzmigration
Gebietsschemaspezifische Einstellungen
Eine Gebietsschema ist eine sprachliche und kulturelle Umgebung, in der ein System oder Programm ausgeführt wird. NLS-Parameter bestimmen das gebietsschemaspezifische Verhalten auf dem Client und der Datenbank.
Eine Datenbanksession verwendet NLS-Einstellungen, wenn Anweisungen für einen Client ausgeführt werden. Beispiel: Die Datenbank erstellt die korrekte Gebietsverwendung des Tausendertrennzeichens für einen Client. In der Regel gibt die Umgebungsvariable NLS_LANG auf dem Clienthost das Gebietsschema für die Server-Session und die Clientanwendung an. Folgender Prozess wird verwendet:
-
Wenn eine Clientanwendung gestartet wird, initialisiert sie die Client-NLS-Umgebung aus den Umgebungseinstellungen.
Alle lokal ausgeführten NLS-Vorgänge, wie die Anzeige der Formatierung in Oracle Developer-Anwendungen, verwenden diese Einstellungen.
-
Der Client kommuniziert die von
NLS_LANGdefinierten Informationen bei der Verbindung zur Datenbank. -
Die Datenbanksession initialisiert ihre NLS-Umgebung basierend auf den vom Client kommunizierten Einstellungen.
Wenn der Client keine Einstellungen angegeben hat, verwendet die Session die Einstellungen in der Initialisierungsparameterdatei. Die Datenbank verwendet die Initialisierungsparametereinstellungen nur, wenn der Client keine NLS-Einstellungen angegeben hat. Wenn der Client einige NLS-Einstellungen angegeben hat, werden die übrigen NLS-Einstellungen standardmäßig verwendet.
Jede Session, die im Namen einer Clientanwendung gestartet wurde, kann in demselben oder einem anderen Gebietsschema wie andere Sessions ausgeführt werden. Beispiel: Eine Session verwendet das deutsche Gebietsschema, während eine andere das französische Gebietsschema verwendet. Außerdem können für jede Sitzung dieselben oder unterschiedliche Sprachanforderungen angegeben werden.
In der folgenden Tabelle sind zwei Clients dargestellt, die unterschiedliche NLS_LANG-Einstellungen verwenden. Ein Benutzer startet SQL*Plus auf jedem Host, meldet sich bei derselben Datenbank wie hr an und führt dieselbe Abfrage gleichzeitig aus. Das Ergebnis für jede Session unterscheidet sich aufgrund der gebietsschemaspezifischen NLS-Einstellung für Gleitkommazahlen.
Tabelle 1: Gebietsschemaspezifische NLS-Einstellungen
| t | Clienthost 1 | Clienthost 2 |
|---|---|---|
| t0 | |
|
| t1 | |
|
Siehe auch: Oracle AI Database Globalization Support Guide enthält Informationen zu NLS-Einstellungen
Oracle Globalization Development Kit
Das Oracle Globalization Development Kit (GDK) umfasst umfassende Programmier-APIs.
APIs sind sowohl für Java als auch für PL/SQL verfügbar. Sie enthalten Codebeispiele und Dokumentation, die viele der Design-, Entwicklungs- und Deployment-Probleme beheben, die beim Erstellen globaler Anwendungen auftreten. Die GDK vereinfacht den Entwicklungsprozess und senkt die Kosten für die Entwicklung von Internetanwendungen, die zur Unterstützung einer globalen Umgebung verwendet werden.
Die GDK besteht hauptsächlich aus zwei Teilen: GDK für Java und GDK für PL/SQL. GDK für Java bietet Globalisierungsunterstützung für Java-Anwendungen. GDK für PL/SQL bietet Globalisierungsunterstützung für die PL/SQL-Programmierumgebung. Die in den beiden Teilen angebotenen Merkmale sind nicht identisch.
Siehe auch: Oracle AI Database Globalization Support Guide
Unstrukturierte Daten
Unstrukturierte Daten sind Daten, die nicht in kleinere logische Strukturen unterteilt werden.
Das traditionelle relationale Modell befasst sich mit einfachen strukturierten Daten, die in einfache Tabellen passen. Oracle Database unterstützt auch unstrukturierte Daten, die nicht in Standardkomponenten zerlegt werden können. Unstrukturierte Daten umfassen Text, Grafikbilder, Videoclips und Klangwellenformen.
Oracle Database umfasst Datentypen zur Verarbeitung unstrukturierter Inhalte. Diese Datentypen werden als native Typen in der Datenbank angezeigt und können mit SQL abgefragt werden.
-
Überblick über XML in Oracle Database Oracle XML DB ist eine Gruppe von Oracle Database-Technologien im Zusammenhang mit leistungsstarker XML-Manipulation, -Speicherung und -Abruf. Oracle XML DB bietet native XML-Unterstützung, indem sowohl SQL- als auch XML-Datenmodelle interoperabel integriert werden.
-
Überblick über JSON in Oracle Database Oracle Database bietet native Unterstützung für JavaScript Object Notation-(JSON-)Daten, einschließlich Abfragen und Indexieren.
-
Überblick über LOBs Mit Large Object-(LOB-)Datentypen können Sie große Blöcke unstrukturierter Daten im Binär- oder Zeichenformat speichern und bearbeiten.
-
Überblick über Oracle Text Oracle Text (Text) ist eine Volltextabruftechnologie, die in Oracle Database integriert ist. Oracle Text indiziert alle Dokumente oder Textinhalte, die in Dateisystemen, Datenbanken oder im Web gespeichert sind. Diese Dokumente können anhand ihres Textinhalts, ihrer Metadaten oder Attribute durchsucht werden.
-
Überblick über Oracle Spatial and Graph Oracle Spatial and Graph (Spatial and Graph) umfasst erweiterte Features für räumliche Daten und Analysen sowie für physische, logische, Netzwerk- und Social- und semantische Diagrammanwendungen.
-
Überblick über SQL-Eigenschaftsdiagramme Das Property Graph-Feature von Oracle Database bietet leistungsstarke Diagrammunterstützung für Oracle Database.
XML in Oracle Database - Überblick
Oracle XML DB ist eine Reihe von Oracle Database-Technologien im Zusammenhang mit leistungsstarker XML-Bearbeitung, -Speicherung und -Abruf. Oracle XML DB bietet native XML-Unterstützung, indem sowohl SQL- als auch XML-Datenmodelle interoperabel integriert werden.
Oracle XML DB eignet sich für jede Java- oder PL/SQL-Anwendung, bei der einige oder alle von der Anwendung verarbeiteten Daten mit XML dargestellt werden. Beispiel: Die Anwendung enthält eine große Anzahl von XML-Dokumenten, die aufgenommen, generiert, validiert und durchsucht werden müssen.
Oracle XML DB bietet viele Features, darunter:
-
Der native Datentyp
XMLType, der ein XML-Dokument in der Datenbank darstellen kann, sodass SQL auf das Dokument zugreifen kann -
Unterstützung von XML-Standards wie XML-Schema, XPath, XQuery, XSLT und DOM
-
XMLIndex, das alle Formen von XML-Daten unterstützt, von hochstrukturierten bis hin zu vollständig unstrukturierten
Im folgenden Beispiel wird eine Tabelle orders vom Typ XMLType erstellt:
CREATE TABLE orders OF XMLType;
CREATE DIRECTORY xmldir AS path_to_folder_containing_XML_file;
INSERT INTO orders
  VALUES (XMLType(BFILENAME('XMLDIR','purOrder.xml'),NLS_CHARSET_ID('AL32UTF8')));
Im vorherigen Beispiel wird außerdem ein SQL-Verzeichnisobjekt erstellt, das ein logischer Name in der Datenbank für ein physisches Verzeichnis auf dem Hostcomputer ist. Dieses Verzeichnis enthält XML-Dateien. Im Beispiel wird XML-Inhalt aus der Datei purOrder.xml in die Tabelle orders eingefügt.
Das Oracle XML Developer's Kit (XDK) enthält die grundlegenden Bausteine zum Lesen, Bearbeiten, Transformieren und Anzeigen von XML-Dokumenten, unabhängig davon, ob es sich um ein Dateisystem oder eine Datenbank handelt. APIs und Tools sind für Java, C und C++ verfügbar. Das Oracle XDK für die Produktion verfügt über eine kommerzielle Umverteilungslizenz.
Beispiel 23-1: XMLType
CREATE TABLE orders OF XMLType;
CREATE DIRECTORY xmldir AS path_to_folder_containing_XML_file;
INSERT INTO orders
VALUES (XMLType(BFILENAME('XMLDIR','purOrder.xml'),NLS_CHARSET_ID('AL32UTF8')));Überblick über JSON in Oracle Database
Oracle Database bietet native Unterstützung für JavaScript Object Notation-(JSON-)Daten, einschließlich Abfragen und Indizes.
Der vorliegende Abschnitt umfasst die folgenden Themen:
-
Was ist JSON? JavaScript Object Notation (JSON) ist ein sprachunabhängiges, textbasiertes Datenformat, das Objekte, Arrays und skalare Daten darstellen kann. Eine Vielzahl von Programmiersprachen kann JSON-Daten parsen und generieren.
-
JSON und XML Sowohl JSON als auch XML werden häufig als Datenaustauschsprachen verwendet. Im Gegensatz zu relationalen Daten können sowohl JSON-Daten als auch XML-Daten ohne ein Schema, das die Daten definiert, in der Datenbank gespeichert, indexiert und abgefragt werden.
-
Native Datenbankunterstützung für JSON JSON ist weit verbreitet in noSQL-Datenbanken gespeichert, denen relationale Datenbankfeatures fehlen. Im Gegensatz dazu unterstützt Oracle Database JSON nativ mit Features wie Transaktionen, Indizierung, deklarative Abfragen und Ansichten.
Was ist JSON?
JavaScript Object Notation (JSON) ist ein sprachunabhängiges, textbasiertes Datenformat, das Objekte, Arrays und skalare Daten darstellen kann. Eine Vielzahl von Programmiersprachen kann JSON-Daten parsen und generieren.
JSON dient im Allgemeinen als Datenaustauschsprache. Es wird häufig verwendet, um strukturierte Daten zu serialisieren und über ein Netzwerk auszutauschen, in der Regel zwischen einem Server und Webanwendungen. JSON ist das dominierende Datenformat in Webbrowsern, in denen Anwendungen ausgeführt werden, die in HTML-embedded JavaScript geschrieben sind.
Ein JavaScript-Objekt ist ein assoziatives Array mit null oder mehr Paaren von Eigenschaftsnamen und zugehörigen JSON-Werten. Ein JSON-Objekt ist ein JavaScript-Objektliteral, das als Eigenschaftsliste in Klammern geschrieben wird, wobei Name/Wert-Paare durch Komma getrennt sind und der Name und Wert jedes Paares durch einen Doppelpunkt getrennt sind. Eine Objekteigenschaft wird manchmal als Schlüssel bezeichnet. Ein Name/Wert-Paar einer Objekteigenschaft wird manchmal als ObjektElement bezeichnet.
Beispiel 23-2: JSON-Objekt
Dieses Beispiel zeigt ein JSON-Objekt, das eine Bestellung darstellt, mit den Eigenschaftsnamen der obersten Ebene PONumber, Reference, Requestor, User, Costcenter, ShippingInstruction, Special Instructions, AllowPartialShipment und LineItems.
{ "PONumber"             : 1600,
  "Reference"            : "ABULL-20140421",
  "Requestor"            : "Alexis Bull",
  "User"                 : "ABULL",
  "CostCenter"           : "A50",
  "ShippingInstructions" : { "name"   : "Alexis Bull",
                             "Address": { "street"  : "200 Sporting Green",
                                          "city"    : "South San Francisco",
                                          "state"   : "CA",
                                          "zipCode" : 99236,
                                          "country" : "United States of America" },
                             "Phone" : [ { "type" : "Office", "number" : "909-555-7307" },
                                         { "type" : "Mobile", "number" : "415-555-1234" } ] },
  "Special Instructions" : null,
  "AllowPartialShipment" : false,
  "LineItems"            : [ { "ItemNumber" : 1,
                               "Part"       : { "Description" : "One Magic Christmas",
                                                "UnitPrice"   : 19.95,
                                                "UPCCode"     : 13131092899 },
                               "Quantity"   : 9.0 },
                             { "ItemNumber" : 2,
                               "Part"       : { "Description" : "Lethal Weapon",
                                                "UnitPrice"   : 19.95,
                                                "UPCCode"     : 85391628927 },
                               "Quantity"   : 5.0 } ] }
Im vorherigen Beispiel haben die meisten Eigenschaften Zeichenfolgenwerte. PONumber, zipCode, ItemNumber und Quantity haben numerische Werte. Shipping Instructions und Address haben Objekte als Werte. LineItems hat ein Array als Wert.
Hinweis: Oracle XML DB Developer's Guide für einen umfassenderen Überblick über JSON
JSON und XML
Sowohl JSON als auch XML werden häufig als Datenaustauschsprachen verwendet. Im Gegensatz zu relationalen Daten können sowohl JSON-Daten als auch XML-Daten ohne ein Schema, das die Daten definiert, in der Datenbank gespeichert, indexiert und abgefragt werden.
Aufgrund seiner einfachen Definition und Funktionen sind JSON-Daten im Allgemeinen einfacher zu generieren, zu parsen und zu verarbeiten als XML-Daten. Es ist auch einfacher für den Menschen zu lernen und zu nutzen. In der folgenden Tabelle werden weitere Unterschiede zwischen JSON und XML beschrieben.
Tabelle 2: Unterschiede zwischen JSON und XML
| Feature | JSON | XML |
|---|---|---|
| Nützlich für einfache, strukturierte Daten | Ja | Ja, unterstützt aber auch halbstrukturierte Daten und komplexe strukturierte Daten |
| Nützlich für gemischten Inhalt | Nein | Ja |
| Es fehlen Attribute, Namespaces, Vererbung und Ersetzung | Ja | Nein |
| Platziert Bedeutung bei der Bestellung | Nein | Ja |
| Vorrangig für Dokumente und nicht für Daten | Nein | Ja |
| Enthält einen Datumsdatentyp | Nein | Ja |
Hinweis: Oracle AI Database JSON Developer's Guide für einen umfassenderen Vergleich von XML und JSON
Native Datenbankunterstützung für JSON
JSON ist weit verbreitet in noSQL-Datenbanken gespeichert, denen relationale Datenbankfeatures fehlen. Im Gegensatz dazu unterstützt Oracle Database JSON nativ mit Features wie Transaktionen, Indizierung, deklarative Abfragen und Ansichten.
Sie können auf JSON-Daten zugreifen, die in der Datenbank gespeichert sind, genauso wie auf andere Datenbankdaten, einschließlich OCI, .NET und JDBC. Die bevorzugte Art, JSON-Daten zu speichern, ist die Verwendung des Datentyps JSON, ein proprietäres Binärformat, das für die Abfrage- und DML-Verarbeitung optimiert ist. Sie können den Datentyp JSON an den meisten Stellen verwenden, an denen ein SQL-Datentyp zulässig ist, einschließlich eines Spaltentyps oder Parametertyps für eine PL/SQL-Programmeinheit.
Mit Oracle SQL können Sie die folgenden Vorgänge für JSON-Daten ausführen:
-
Verbinden Sie JSON-Daten mit relationalen Daten, die keine JSON sind.
-
Generieren Sie mit den SQL-Funktionen
json_objectundjson_arrayein JSON-Dokument aus relationalen Daten. -
JSON-Daten mit der SQL-Funktion
json_tablein ein relationales Format projizieren. -
Erstellen Sie ein Check Constraint mit
is_json, um JSON-Daten in einer Spalte durchzusetzen. Die Datenbank verwendet das Check Constraint, um zu bestätigen, dass die Spalte JSON für JSON-spezifische Vorgänge wie vereinfachte Syntax ist. -
JSON-Dokumente als PL/SQL-Objekte bearbeiten
-
Verwenden Sie die SQL-Funktionen
json_queryundjson_value, um einen Oracle-JSON-Pfadausdruck als Argument zu akzeptieren und mit den Ziel-JSON-Daten abzugleichen. -
JSON-Daten indizieren.
-
JSON-Daten abfragen, die in einer externen Tabelle gespeichert sind
-
Mit Oracle GoldenGate Tabellen mit Spalten replizieren, die JSON-Daten enthalten.
Textbezogene JSON-Daten verwenden immer den Unicode-Zeichensatz, entweder UTF8 oder UTF16. Oracle Database verwendet UTF8 intern, wenn JSON-Daten geparst und abgefragt werden. Wenn die Daten, die von einer solchen Verarbeitung eingegeben oder ausgegeben werden, einen anderen Zeichensatz als UTF8 aufweisen müssen, wird automatisch eine entsprechende Zeichensatzkonvertierung durchgeführt. Hinweis: Oracle AI Database JSON Developer's Guide für einen umfassenderen Überblick über die JSON-Unterstützung in Oracle Database
LOBs - Überblick
Mit Large Object-(LOB-)Datentypen können Sie große Blöcke unstrukturierter Daten im Binär- oder Zeichenformat speichern und bearbeiten.
Der Datentyp LOB (Large Object) bietet effizienten, zufälligen, stückweisen Zugriff auf die Daten.
-
Interne LOBs Ein internes LOB speichert Daten in der Datenbank selbst und nicht in externen Dateien.
-
Externe LOBs Ein
BFILE(Binärdatei-Large Object oder LOB) ist ein externes Large Object. -
SecureFiles SecureFiles LOB-Speicher ist einer von zwei Speichertypen, der andere Typ ist BasicFiles LOB-Speicher.
Interne Geschäftsbereiche
Ein internes LOB speichert Daten in der Datenbank selbst und nicht in externen Dateien.
Interne LOBS umfassen:
-
CLOB(Zeichen-LOB), das große Textmengen, wie Text- oder XML-Dateien, im Datenbankzeichensatz speichert -
NCLOB(nationales Zeichensatz-LOB), in dem Unicode-Daten gespeichert werden -
BLOB(binäres LOB), das große Mengen an Binärinformationen als Bitstream speichert und nicht der Zeichensatzübersetzung unterliegt
Die Datenbank speichert LOBs anders als andere Datentypen. Wenn Sie eine LOB-Spalte implizit erstellen, werden ein LOB-Segment und ein LOB-Index erstellt. Der Tablespace, der das LOB-Segment und den LOB-Index enthält, die immer zusammen gespeichert werden, kann sich von dem Tablespace unterscheiden, der die Tabelle enthält.
Hinweis: Manchmal kann die Datenbank kleine Mengen von LOB-Daten in der Tabelle selbst statt in einem separaten LOB-Segment speichern.
Das LOB-Segment speichert Daten in Teilen, die als Chunks bezeichnet werden. Ein Chunk ist eine logisch zusammenhängende Gruppe von Datenblöcken und die kleinste Zuweisungseinheit für ein LOB. In einer Zeile in der Tabelle wird ein Zeiger gespeichert, der als LOB-Positionsanzeiger bezeichnet wird und auf den LOB-Index verweist. Wenn die Tabelle abgefragt wird, verwendet die Datenbank den LOB-Index, um die LOB-Chunks schnell zu finden.
Die Datenbank verwaltet die Lesekonsistenz für LOB-Segmente anders als andere Daten. Anstatt Undo-Daten zum Aufzeichnen von Änderungen zu verwenden, speichert die Datenbank die Before Images im Segment selbst. Wenn eine Transaktion ein LOB ändert, weist die Datenbank einen neuen Chunk zu und behält die alten Daten bei. Wenn die Transaktion zurückgesetzt wird, rollt die Datenbank die Änderungen an dem Index zurück, der auf den alten Block verweist.
Externe Geschäftsbereiche
Ein BFILE (Binary File Large Object, LOB) ist ein externes Large Object.
Eine BFILE ist ein externes LOB, da die Datenbank einen Zeiger auf eine Datei im Betriebssystem speichert. Die externen Daten sind schreibgeschützt.
Eine BFILE verwendet ein Verzeichnisobjekt, um Daten zu suchen. Der belegte Speicherplatz hängt von der Länge des Verzeichnisobjektnamens und der Länge des Dateinamens ab.
Ein BFILE verwendet nicht denselben Lesekonsistenzmechanismus wie ein internes LOBS, da die Binärdatei außerhalb der Datenbank liegt. Wenn sich die Daten in der Datei ändern, können wiederholte Lesevorgänge aus derselben Binärdatei zu unterschiedlichen Ergebnissen führen.
SecureFiles
Der LOB-Speicher SecureFiles ist einer von zwei Speichertypen. Der andere Typ ist der LOB-Speicher BasicFiles.
Der LOB-Parameter SECUREFILE aktiviert erweiterte Features, einschließlich Komprimierung und Deduplizierung (Teil der Option "Erweiterte Komprimierung") und Verschlüsselung (Teil der Option "Erweiterte Sicherheit"). Ab Oracle Database 12c ist SecureFiles der Standardspeichermechanismus für LOBs.
Siehe:
-
Oracle AI Database SecureFiles and Large Objects Developer's Guide, um mehr über LOB-Datentypen zu erfahren
Überblick über Oracle Text
Oracle Text (Text) ist eine Volltextabruftechnologie, die in Oracle Database integriert ist. Oracle Text indiziert alle Dokumente oder Textinhalte, die in Dateisystemen, Datenbanken oder im Web gespeichert sind. Diese Dokumente können basierend auf ihrem Textinhalt, ihren Metadaten oder Attributen durchsucht werden.
Oracle Text bietet die folgenden Vorteile:
-
Mit Oracle Text können Textsuchen mit regulären Datenbanksuchen in einer einzelnen SQL-Anweisung kombiniert werden. Der Textindex befindet sich in der Datenbank, und Textabfragen werden im Oracle Database-Prozess ausgeführt. Der Optimierer kann den besten Ausführungsplan für jede Abfrage auswählen, um die beste Performance für Ad-hoc-Abfragen mit Text- und strukturierten Kriterien zu erzielen.
-
Sie können Oracle Text mit XML-Daten verwenden. Insbesondere können Sie
XMLIndexmit der Oracle Text-Indizierung kombinieren und dabei sowohl XML als auch einen Volltextindex nutzen. -
Die Oracle Text SQL API macht es einfach und intuitiv, Oracle Text-Indizes zu erstellen und zu verwalten und Suchvorgänge auszuführen.
Angenommen, Sie müssen für einen Anwendungsfall einen Katalogindex für einen Auktionsstandort erstellen, der elektronische Geräte verkauft. Täglich wird neues Inventar hinzugefügt. Artikelbeschreibungen, Gebotstermine und Preise müssen zusammen gespeichert werden. Die Anwendung benötigt eine gute Antwortzeit für gemischte Abfragen. Zuerst erstellen und füllen Sie eine catalog-Tabelle. Anschließend erstellen Sie mit Oracle Text einen CTXCAT-Index, den Sie mit dem Operator CATSEARCH in einer SELECT ... WHERE CATSEARCH-Anweisung abfragen können. In Abbildung 23-4 wird die Beziehung der Katalogtabelle, ihres CTXCAT-Indexes und der Kataloganwendung dargestellt, die den Operator CATSEARCH zum Abfragen des Index verwendet.
Abbildung 4: Katalogabfrageanwendung
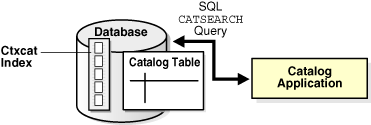
Beschreibung der Abbildung ccapp017.gif
Siehe:
-
Oracle Text Application Developer's Guide und Oracle Text Reference
-
Oracle XML DB Developer's Guide enthält Informationen zur Volltextsuche über XML-Daten
Oracle Spatial and Graph - Überblick
Oracle Spatial and Graph (Spatial and Graph) umfasst erweiterte Features für räumliche Daten und Analysen sowie für physische, logische, Netzwerk-, soziale und semantische Diagrammanwendungen.
Die räumlichen Features bieten ein Schema und Funktionen, die das Speichern, Abrufen, Aktualisieren und Abfragen von Zusammenstellungen räumlicher Features in einer Oracle-Datenbank erleichtern. Ein Beispiel für räumliche Daten ist eine Roadmap. Die räumlichen Daten geben die Position der Erde (wie Längen- und Breitengrad) von Objekten auf der Karte an. Wenn die Karte gerendert wird, können diese räumlichen Daten die Positionen der Objekte auf ein zweidimensionales Blatt Papier projizieren. Ein Geographic Information System (GIS) kann diese erdrelativen räumlichen Daten speichern, abrufen und wiedergeben. Wenn eine Oracle-Datenbank diese räumlichen Daten speichert, können Sie diese Daten mit Spatial and Graph bearbeiten und abrufen und diese Daten mit anderen Daten verknüpfen.
Siehe auch: Oracle Spatial Developer's Guide
Überblick über SQL-Eigenschaftsdiagramme
Die Property Graph-Funktion von Oracle Database bietet leistungsstarke Graph-Unterstützung für Oracle Database.
Mit der Property Graph-Funktion können Sie komplexe Beziehungen in Datasets wie Kundendaten, sozialen Netzwerken und Finanztransaktionen für Anwendungen in Produktempfehlungen, Betrugserkennung, Risikoanalyse, gezieltem Marketing und mehr untersuchen und entdecken. Dieses leistungsstarke Diagrammfeature bietet erweiterte Unterstützung für Diagrammabfragesprachen, Entwickler-APIs und Analysefunktionen mit fast 60 vordefinierten Algorithmen.
Die Property Graph-Features, einschließlich der PGQL-(Property Graph Query Language-)Unterstützung, sind ab Oracle Database 12.2 verfügbar. Ab Oracle Database Release 26ai können Sie auch Eigenschaftsdiagramme mit SQL erstellen und abfragen, wie im SQL:2023-Standard definiert.
Oracle Graph Server and Client ist ein Softwarepackage, das mit der Property Graph-Funktion in Oracle Database zusammenarbeitet. Sie umfasst Diagrammtools, Clientbibliotheken und Oracle Graph Server zur Ausführung von Diagrammanalysealgorithmen.
Verwandte Themen