Adición de un Extract
Obtenga información sobre los requisitos previos y las consideraciones para agregar un Extract.
Antes de comenzar a agregar un Extract, asegúrese de que se han configurado los siguientes valores:
Ahora, ya está listo para agregar un Extract para su despliegue.
Consideraciones para crear una extracción cuando existen archivos de pista de extracción anteriores
-
Si crea un Extract cuando ya existen archivos de pista huérfanos de una configuración anterior, el proceso puede fallar. Por ejemplo, si
north/ea00000000permanece de una configuración anterior y no se ha eliminado, puede que falle la creación de un Extract. -
Si vuelve a agregar un Extract a partir de un número de secuencia superior, mientras exista la secuencia de pista anterior, puede que la configuración de Extract no esté sincronizada o sea incorrecta. Por ejemplo, si
north/ea00002261existe y vuelve a crear el Extract a partir denorth/ea00002262, la configuración de Extract puede ser incorrecta. En estos casos, los archivos de pista existentes se deben eliminar o mover a una ubicación sin referencia.
Pantalla de información de extracción
Después de conectarse a la página inicial de microservicios, haga clic en el signo + en la columna Crear para abrir el asistente Agregar extracciones.
En la pantalla Información de extracción, seleccione el tipo de extracción. Según la plataforma de base de datos, los tipos de extracciones disponibles pueden ser Extracción integrada, Extracción de captura de cambio de datos y Extracción de carga inicial.
Si necesita configurar la Extracción descendente para Oracle AI Database, active el conmutador Extracción descendente.
Seleccione el tipo de extracción que desea crear y especifique lo siguiente:
-
Nombre de proceso: nombre del proceso de Extract. El nombre del proceso de extracción puede tener hasta 8 caracteres.
-
Descripción: descripción del proceso de Extract que se está creando.
Nota: Para obtener más información sobre la creación de Extract de carga inicial, consulte Instanciar.
Haga clic en Siguiente.
Pantalla Register Extract: PostgreSQL y bases de datos de Yugabyte
Nota: Es necesario registrar Oracle GoldenGate Extract para Oracle, diferentes tipos PostgreSQL y la base de datos de Yugabyte. Sin embargo, las opciones de configuración para registrar el Extract se muestran en diferentes pantallas al agregar el Extract.
Nota: Consulte también las Directrices y limitaciones para el tipo de plugin PGOUTPUT.
En la pantalla Registrar extracción, configure las siguientes opciones y haga clic en Registrar:
-
Credenciales de origen: especifique un dominio para la base de datos.
-
Alias: especifique el alias de ID de usuario utilizado como conexión de base de datos para la conexión de origen o seleccione una de las opciones mostradas.
-
(Todos los tipos PostgreSQL) Tipo de plugin: seleccione el tipo de plugin de descodificación lógica pgoutput. pgoutput es el valor predeterminado para todos los tipos PostgreSQL.
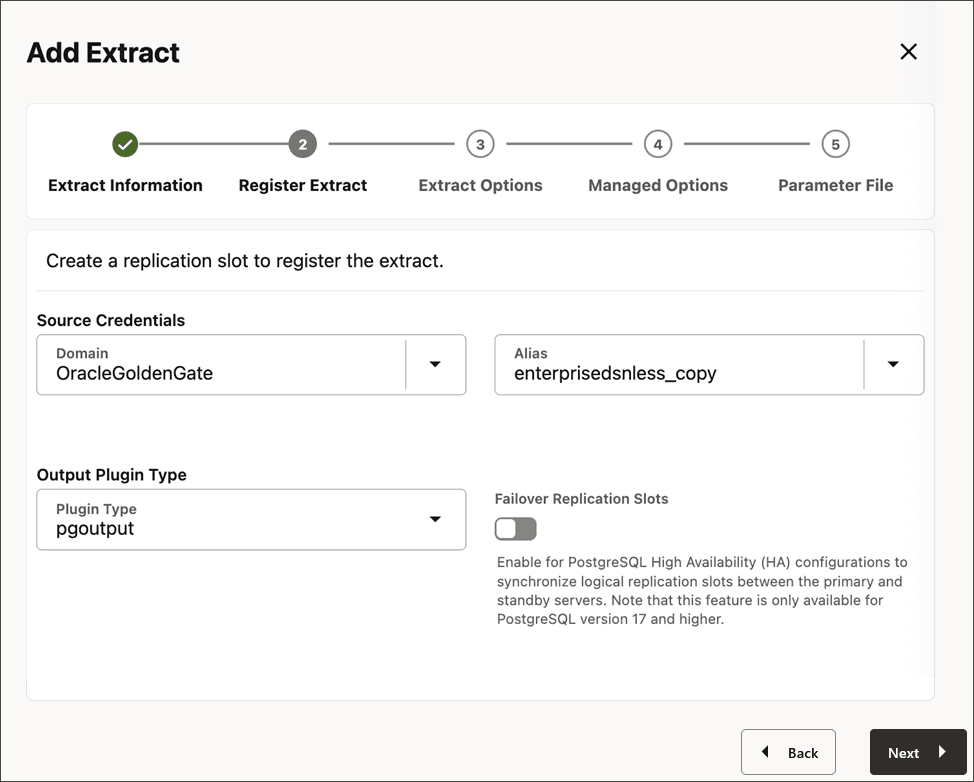
Para obtener detalles sobre la configuración de la ranura de replicación de failover para PostgreSQL 17 y versiones posteriores, consulte Soporte de failover para Oracle GoldenGate con PostgreSQL 17 y versiones posteriores.
-
Tipo de plugin: seleccione el tipo de plugin de descodificación lógica yboutput (solo base de datos de yugabytes). YBOUTPUT es el valor predeterminado para la base de datos de Yugabyte.
Haga clic en Siguiente después de que el registro de Extract se haya realizado correctamente.
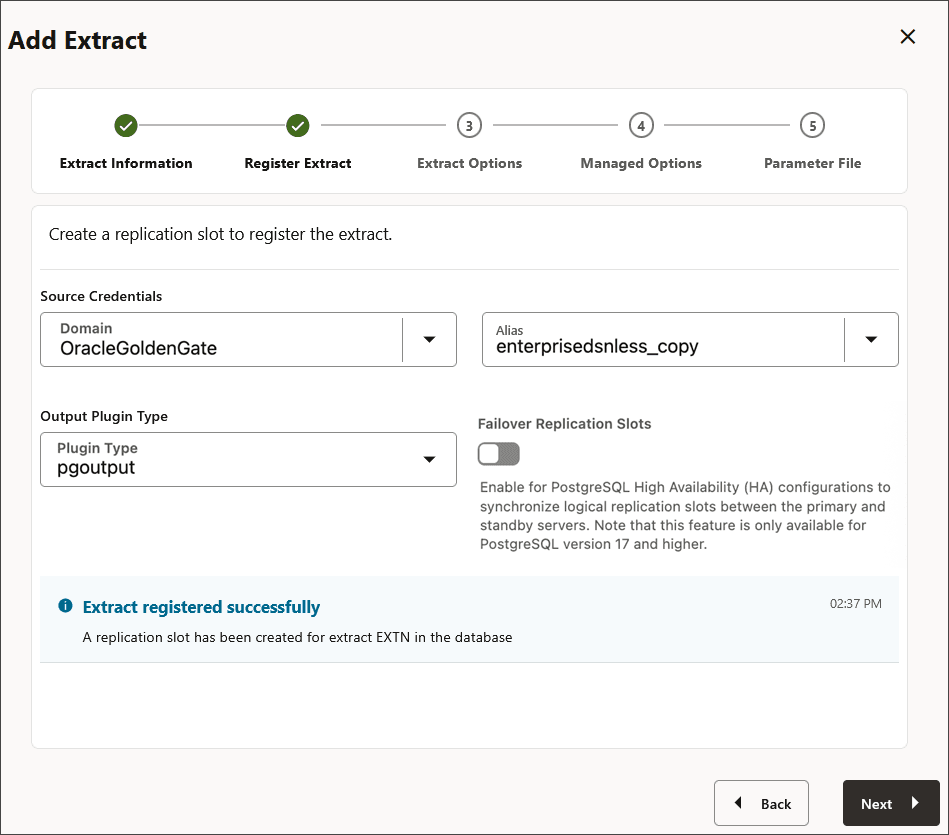
Haga clic en Siguiente.
Registro de Extract para bases de datos PostgreSQL y Yugabyte desde el cliente de administración
Se debe registrar un Extract para PostgreSQL con la base de datos y se le debe otorgar una ranura de replicación reservada. Las ranuras de replicación se asignan mediante el valor de configuración de base de datos max_replication_slots y se pueden configurar como se describe en Configuración de base de datos.
Siga estas instrucciones para registrar un Extract. El registro de extracción se debe realizar antes de crear un Extract. Consulte REGISTER EXTRACT en la Referencia de interfaz de línea de comandos para Oracle GoldenGate para obtener más información.
-
Conéctese al despliegue y, a continuación, conéctese al alias de credencial de la base de datos origen.
CONNECT http*s*://*remotehost*:*srvmgrport* DEPLOYMENT

          *deployment_name* AS *deployment_user* PASSWORD *deployment_password*
OGG (https://*remotehost*:*16000**postgresql_source*)> DBLOGIN USERIDALIAS *alias* -
Registre el Extract, que crea internamente un espacio de replicación para el Extract. Los nombres de extracción no pueden tener más de 8 caracteres alfanuméricos.
REGISTER EXTRACT *extname*Para registrar explícitamente Extract con el plugin
pgoutput, debe especificar el tipo de pluginpgoutput:REGISTER EXTRACT *extname* PGPLUGINTYPE pgoutput;
También puede registrar un Extract desde la interfaz web de Oracle GoldenGate MA. Consulte Adición de un Extract.
Directrices y limitaciones para el tipo de plugin PGOUTPUT
Directrices para configurar el tipo de plugin PGOUTPUT
Siga estas directrices al definir el tipo de plugin para PostgreSQL:
-
Las publicaciones se deben crear antes de registrar el proceso de extracción.
-
Los nombres de publicación no deben contener caracteres especiales: coma (,), comillas simples (') y comillas dobles (").
-
Se pueden especificar varios nombres de publicación como una lista separada por comas en
publication_names. Por ejemplo:TRANLOGOPTIONS STREAMINGOPTIONS (publication_names="my*123,my_publication2,123 pub,my_publication";)Para obtener más información, consulte el parámetro
TRANLOGOPTIONS STREAMINGOPTIONS. -
El nombre de la publicación final de la lista debe terminar con un punto y coma (;).
Limitaciones
Se aplican las siguientes restricciones al seleccionar un tipo de plugin para PostgreSQL:
-
Variable de entorno de zona horaria (TZ): el proceso de remitente
WALsiempre transmite registros de hora de confirmación en UTC.If, la zona horaria de la sesión de OGG difiere de UTC; se pueden producir discrepancias al posicionar por registro de hora en el proceso de extracción de CDC. Para evitar este problema, los usuarios deben definir la variable de entornoTZ=UTCen la capa de despliegue. Esta limitación se aplica específicamente al pluginpgoutput. -
Varios truncados: solo se admiten varias operaciones de truncamiento en el plugin
pgoutput. El tipo de plugintest_decodingno permite varios truncados. -
Tablas con índices únicos pero sin clave primaria: si una tabla no tiene claves primarias pero contiene índices únicos, la identidad de réplica debe utilizar índices o se debe definir en
FULL. -
Impacto de supresión de publicación en el extracto de CDC: si se suprime una publicación mientras el extracto de CDC aún se está ejecutando, existe el riesgo de que se dañe la ranura de replicación, lo que hace que deje de funcionar. En tales casos, la ranura de replicación afectada no se puede utilizar y la recreación de la misma publicación no resolverá el problema. La solución recomendada es crear una nueva publicación y asociarla a una nueva ranura de replicación para restaurar la funcionalidad CDC.
-
Tablas elegibles para publicación: solo las tablas base persistentes y las tablas particionadas se pueden incluir en una publicación. Los siguientes tipos de objetos no pueden formar parte de una publicación:
-
Tablas temporales
-
Tablas sin registrar
-
Tablas ajenas
-
Vistas materializadas
-
Vistas regulares
-
-
Soporte de replicación bidireccional con el plugin pgoutput: al utilizar el plugin
pgoutputpara la replicación bidireccional, se debe crear la tabla de puntos de control e incluirla en la lista de publicación antes de iniciar el proceso de extracción de CDC. Además, la ranura de replicación se debe crear solo después de que la tabla de puntos de control se haya creado y agregado a la publicación. -
Limitación de publicación a nivel de columna: la especificación de un subjuego de columnas para una tabla en una publicación no está soportada para la replicación de CDC. Debe incluir toda la tabla en la publicación. Si se intenta agregar solo columnas parciales, se pueden producir errores o discrepancias de datos en el flujo CDC.
Pantalla Opciones de extracción
Nota: Esta pantalla proporciona opciones para registrar Extract para Oracle AI Database. Si va a agregar un Extract para PostgreSQL, el registro de Extract se completa en la pantalla Registrar Extract.
En la pantalla Extract Options (Opciones de extracción), configure los siguientes valores:
-
Pista de extracción:
-
Nombre: nombre del archivo de pista de Extract. El nombre del archivo de pista puede tener hasta 2 caracteres.
-
Subdirectorio: nombre del directorio del subdirectorio donde se almacena la pista de Extract.
-
Secuencia de pista: número de secuencia de la pista.
-
Tamaño de pista: tamaño máximo del archivo.
-
Perfil de cifrado: descripción del perfil de cifrado. Si no ha creado un perfil de cifrado, el perfil de cartera local se seleccionaría por defecto. Para obtener más información sobre la creación y la aplicación de perfiles de cifrado, consulte Apply the OKV Encryption Profile.
-
Algoritmo de cifrado: lista de algoritmos de cifrado disponibles para el archivo de pista de extracción.
Nota: Para obtener más información sobre el cifrado de archivos de pista, consulte Trail File Encryption y Encrypting Trail Files.
-
(Solo para Oracle)Opciones de registro: especifique las siguientes opciones para registrar un Extract para Oracle AI Database.
CSN: valor de número de secuencia de confirmación (CSN).
-
Compartir: esta lista desplegable se utiliza para definir cómo compartir el diccionario de datos LogMiner. Las opciones disponibles son Automático, Ninguno y Nombre de extracción. Automatic significa que el sistema decide qué Extract compartir. Ninguno significa que el diccionario de datos LogMiner no está compartido. Nombre de extracción significa que el diccionario de datos LogMiner se comparte con el Extract especificado.
-
Optimizado: active esta opción para optimizar el registro de Extract.
-
Registrar extracción para Oracle desde el cliente de administración
Siga estas instrucciones para registrar un Extract. El registro de extracción se debe realizar antes de crear un Extract.
Asegúrese de que está conectado a la base de datos mediante el comando DBLOGIN.
Consulte [REGISTER EXTRACT](/pls/topic/lookup?ctx=en/database/goldengate/core/26/coredoc&id=GCLIR-GUID-5E42DB9E-EFDF-40C0-89D7-88413496B8A3) en la Referencia de interfaz de línea de comandos para Oracle GoldenGate para obtener más información.
-
Mediante el cliente de administración, conéctese al despliegue y, a continuación, conéctese al alias de credencial de la base de datos origen.
OGG> CONNECT https://*remotehost*:*srvmgrport* DEPLOYMENT *deployment_name* AS *deployment_user* PASSWORD *deployment_password*Al ejecutar el comando
CONNECT, el símbolo del sistema cambia de "no conectado" a "https://servername:port deployment_name", como se muestra en el siguiente ejemplo:OGG (https://*pdbeast.vcn.oracle.com*:*16000**depl_east*)> -
Conéctese a la base de datos mediante el comando
DBLOGIN:OGG (https://*remotehost*:*port**oracle_source*)> DBLOGIN USERIDALIAS *alias* -
Registre el Extract. Los nombres de Extract no pueden tener más de 8 caracteres alfanuméricos.
OGG (https://*remotehost*:*port**oracle_source*)> REGISTER EXTRACT *extname* DATABASE
También puede registrar un Extract en segundo plano al crear un Extract desde la interfaz web de Oracle GoldenGate MA. Consulte Agregar un Extract para obtener más información.
Pantalla de captura descendente
Válido solo para Oracle.
Si ha seleccionado la captura descendente en la pantalla Información de extracción, se muestra la pantalla de opciones Captura descendente. Configure la conexión a la base de datos de minería descendente para el Extract descendente mediante esta pantalla.
-
Credenciales de minería: especifique el dominio y el valor de alias de ID de usuario en los cuadros Dominio y Alias.
-
Sin ID de usuario/Sin conexión de base de datos de origen: active este conmutador para configurar la conexión de base de datos de minería mediante Active Data Guard (ADG). Se muestran las opciones para introducir la credencial de recuperación de ADG:
-
Dominio: nombre de dominio para la base de datos para recuperación de ADG.
-
Alias: alias de dominio para la base de datos para recuperación de ADG.
-
Nota: La captura descendente con ADG no soporta la extracción por PDB.
Haga clic en Siguiente.
Pantalla de opciones gestionadas
En la pantalla Opciones Gestionadas, configure las opciones de inicio automático y reinicio automático para el proceso de extracción. En la tabla siguiente se proporcionan estas opciones:
En la tabla siguiente se proporcionan estas opciones:
| Opción | Descripción |
|---|---|
| Nombre del perfil | Proporciona el nombre del perfil de inicio automático y reinicio automático. Puede seleccionar las opciones por defecto o personalizadas. Si ya ha creado un perfil, también puede seleccionarlo. Si selecciona la opción Personalizado, puede configurar un nuevo perfil desde esta sección. |
| Crucial para estado de despliegue | (Solo Oracle) Active esta opción si el perfil es crítico para el estado de despliegue.
Nota: Esta opción solo aparece al crear el Extract o Replicat y no al configurar los procesos gestionados en la página Perfiles. |
| Iniciar automáticamente | Activa el inicio automático para el proceso. |
| Retraso de inicio | Tiempo de espera, en segundos, antes de iniciar el proceso |
| Reinicio automático | Configura cómo reiniciar el proceso si termina. |
| Máximo de Reintentos | Especifique el número máximo de reintentos para iniciar el proceso |
| Retraso de reintento | Tiempo de retraso al intentar iniciar el proceso |
| Período de reintentos | Intervalo de duración para intentar iniciar el proceso |
| Reiniciar solo si hay fallos | Si tiene el valor true la tarea solo se reinicia si falla. |
| Desactivar tarea tras agotar reintentos | Si es true, la tarea se desactiva después de agotar todos los intentos de reinicio del proceso. |
Haga clic en Siguiente.
Pantalla Extraer archivo de parámetros
En la pantalla Archivo de Parámetros, puede editar el archivo de parámetros en el área de texto para mostrar los detalles de la tabla que le interesa capturar. A continuación, se muestra un archivo de parámetros de Extract de ejemplo:
EXTRACT exte
USERIDALIAS ggeast DOMAIN OracleGoldenGate
EXTTRAIL east/ea
DDL INCLUDE MAPPED
TABLE hr.*;
Haga clic en Crear y ejecutar para crear e iniciar el Extract. Si selecciona Crear, se crea el Extract, pero debe iniciarlo mediante las opciones de Extract.
Vuelva a la página inicial del servicio de administración o a la página Extract donde se muestran todas las extracciones creadas.
Creación de un archivo de parámetros para extracción
Siga estas instrucciones para crear un archivo de parámetros para un Extract.
-
(Solo MySQL) Cuando se ejecuta Oracle GoldenGate para MySQL en un servidor Windows y en un servidor Linux (para la versión de OGG inferior a 23.10.x), que está en un host remoto desde el servidor de base de datos, asegúrese de que sus zonas horarias son las mismas y, si no, utilice el parámetro
SETENV(TZ)en Extract y defínalo en la zona horaria del servidor de base de datos.Para obtener más información sobre el formato TZ, consulte el parámetro SETENV en la Guía de referencia de parámetros y funciones.
Consulte los siguientes enlaces como referencia:
https://learn.microsoft.com/en-us/cpp/c-runtime-library/reference/tzset?view=msvc-170#remarks
https://www.gnu.org/software/libc/manual/html_node/TZ-Variable.html
-
En el sistema de origen, ejecute el siguiente comando:
EDIT PARAMS extract_nameDónde:
extract_namees el nombre del Extract que ha creado con el comandoADD EXTRACTo el nombre totalmente cualificado del archivo de parámetros si ha definido una ubicación alternativa al crear el grupo. -
Introduzca los parámetros en el orden que se muestra en la siguiente tabla, iniciando una nueva línea para cada sentencia de parámetro. Algunos parámetros sólo se aplican a determinadas configuraciones.
Parámetro Descripción EXTRACT group- group es el nombre del grupo Extract que ha creado con el comando
ADD EXTRACT.
Permite configurar Extract como un proceso en línea con puntos de control. [, USERIDALIAS alias options ]Consulte [USERIDALIAS](/pls/topic/lookup?ctx=en/database/goldengate/core/26/coredoc&id=GWURF-GUID-530D7773-B66D-4499-A509-EF5BB9CE9B05)para especificar las credenciales de la base de datos.ENCRYPTTRAIL algorithmCifra todas las pistas que se especifican después de esta entrada. SOURCECATALOGEspecifica un contenedor por defecto en una base de datos de contenedor multi-inquilino de Oracle o sentencias SEQUENCE. Permite el uso de nombres de dos partes (schema.object) en los que, de lo contrario, se necesitarían nombres de tres partes para esas bases de datos. Puede utilizar varias instancias de este parámetro para especificar diferentes contenedores o catálogos por defecto para diferentes juegos de parámetrosTABLEoSEQUENCE.TABLE [container. \| catalog.]owner.object \| schema.object \| library/file \| library/file(member);Especifica el nombre completo de un objeto o una especificación comodín totalmente cualificada para varios objetos. Si la base de datos es una base de datos de contenedor multiinquilino de Oracle, el nombre del objeto debe incluir el nombre del contenedor o catálogo, a menos que se utilice
SOURCECATALOG.schemaes el nombre del esquema o un juego de esquemas con comodines.objectes el nombre de la tabla o un juego de tablas con comodines.libraryes el nombre de la biblioteca IBM i o un conjunto de bibliotecas con comodines.filees el nombre de archivo físico de IBM i o un conjunto de archivos físicos con comodines.memberes el nombre del miembro del archivo físico de IBM i o un conjunto comodín de nombres de miembros. Al utilizar el formato de nombre nativo de IBM i (biblioteca/archivo con miembro opcional), los únicos comodines válidos son un nombre con al menos un carácter válido seguido de un asterisco final (*) o*ALLque coincida con cualquier nombre.
Nota:
El nombre de miembro es opcional y se debe proporcionar si los nombres de miembro deben escribirse en la pista como parte del nombre de objeto. Sin nombres de miembros, todos los miembros de un archivo físico se fusionarán implícitamente como un único objeto en la pista.Consulte las directrices de Especificación de nombres de objetos en la entrada de Oracle GoldenGate para especificar nombres de objetos en archivos de parámetros.
SCHEMAEXCLUDETABLEEXCLUDEEXCLUDEWILDCARDOBJECTSONLYParámetros que se pueden utilizar conjuntamente para excluir objetos específicos de una especificación de comodín en la sentencia TABLEasociada. - group es el nombre del grupo Extract que ha creado con el comando
-
Introduzca los parámetros de Extract opcionales adecuados que se muestran en los parámetros de Oracle GoldenGate.
-
Guarde y cierre el archivo de parámetros.
El siguiente archivo de parámetros Extract de ejemplo explica varios parámetros de configuración y opciones para Extract:
ADD EXTRACT *extract_name*
{, datasource}
{, BEGIN start_point} | {position_point}
[, PARAMS pathname]
[, REPORT pathname]
[, DESC 'description']-
extract_namees el nombre del grupo de Extract. Se necesita un nombre de grupo. -
datasourcees necesario para especificar el origen de los datos que se van a extraer. Utilice uno de los siguientes:-
TRANLOGespecifica el log de transacciones como origen de datos. Al utilizar esta opción para Oracle Enterprise Edition, debe emitir el comandoDBLOGINcomo usuario de base de datos de Extract (o un usuario con los mismos privilegios) antes de utilizarADD EXTRACT(y también antes de emitirDELETE EXTRACTpara eliminar un grupo de Extract).Utilice la opción bsds para Db2 z/OS para especificar el nombre de archivo del juego de datos de inicialización de datos del log de transacciones.
-
INTEGRATED TRANLOGespecifica que este Extract funcionará en modo de captura integrada para recibir registros de cambios lógicos (LCR) de un servidor de minería de logs de Oracle AI Database. Este parámetro solo se aplica a las bases de datos Oracle. -
EXTTRAILSOURCE trail_namepara especificar el nombre relativo o totalmente cualificado de una pista local.
-
-
BEGIN start_pointdefine un grupo de extracción en línea mediante el establecimiento de un punto de control inicial y un punto de inicio para el procesamiento. Las transacciones iniciadas antes de este punto se descartan. Utilice uno de los siguientes: -
AHORA para empezar a extraer los cambios con registro de hora en el momento en que se ejecuta el comando
ADD EXTRACTpara crear el grupo o, para Extract en modo integrado, desde el momento en que se registra el grupo con el comandoREGISTER EXTRACT. Extract solo se debe registrar para bases de datos Oracle y PostgreSQL.Registro de hora: formato para especificar un registro de hora exacto como punto de inicio. Utilice un punto de inicio que sea posterior al momento en que se activó la replicación o el registro.
En el siguiente ejemplo se muestra el cambio de posición de Extract mediante un registro de hora específico:
<pre class="copy"><code>OGG (http://localhost:11000 ggeast as pdb1@east.oracle.com) 95> dblogin useridalias ggma Successfully logged into database PDB1.</code></pre> <pre class="copy"><code>OGG (http://localhost:11000 ggeast as ggma@ggeast/PDB1) 96> alter extract exte , begin 2024-05-03T03:48:00Z 2024-05-03T03:50:49Z INFO OGG-08100 Extract exte I/O position is altered and reposition to older date and time position 2024-05-03 03:48:00.000000 current date and time position 2024-05-03 03:49:04.000000. Duplicate transactions are filtered out. Perform output trail ETROLLOVER if duplicate transaction output is desired, or Extract configuration was updated. 2024-05-03T03:50:49Z INFO OGG-08100 Extract altered.</code></pre> -
position_pointespecifica una posición específica dentro de un archivo log de transacciones específico en el que iniciar el procesamiento. Para que la sintaxis específica se utilice para la base de datos. -
El nombre de ruta de acceso
PARAMSes necesario si el archivo de parámetros para este grupo se almacenará en una ubicación distinta del subdirectorio dirprm del directorio de Oracle GoldenGate. Especifique el nombre totalmente cualificado. Se recomienda la ubicación predeterminada. -
REPORT pathnamees necesario si el informe de proceso de este grupo se almacenará en una ubicación distinta del subdirectoriodirrptdel directorio de Oracle GoldenGate. Especifique el nombre totalmente cualificado. Se recomienda la ubicación predeterminada. -
DESC 'description'especifica una descripción del grupo.
Opciones de parámetro adicionales para extracción
Obtenga información sobre los parámetros adicionales que pueden ser necesarios para la configuración de Extract.
Extract utiliza un servidor de logmining de la base de datos de minería para extraer el flujo de redo de la base de datos origen. Puede definir parámetros específicos para el servidor de logmining mediante el parámetro TRANLOGOPTIONS con la opción INTEGRATEDPARAMS en el archivo de parámetros Extract.
Nota: Para obtener información detallada y orientación sobre el uso de estos parámetros, consulte la sección "DBMS_CAPTURE_ADM" en Oracle AI Database PL/SQL Packages and Types Reference.
Los siguientes parámetros se pueden definir con INTEGRATEDPARAMS:
-
CAPTURE_IDKEY_OBJECTS: controla la captura de objetos que puede soportarFETCH. El valor por defecto para Oracle GoldenGate esY(capturar registros de cambio lógico de clave de ID). -
DOWNSTREAM_REAL_TIME_MINE: controla si el servidor de minería de logs funciona como un procedimiento de captura descendente en tiempo real o como un procedimiento de captura descendente de archive log. El valor por defecto esN(modo archive log). Especifique este parámetro para utilizar la captura en tiempo real en una configuración de servidor de logmining descendente. Para obtener más información sobre cómo establecer una configuración de minería descendente, consulte Extracción descendente para el despliegue de Oracle GoldenGate. -
INLINE_LOB_OPTIMIZATION: controla si los LOB que se pueden procesar en línea (como los LOB pequeños) se incluyen directamente en el LCR, en lugar de enviar LCR de fragmentos de LOB. El valor por defecto para Oracle GoldenGate esY(sí). -
MAX_SGA_SIZE: controla la cantidad de memoria compartida que utiliza el servidor de logmining. La memoria compartida se obtiene del pool de flujos de SGA. El valor por defecto es 1 GB. -
PARALLELISM: controla el número de procesos utilizados por el servidor de logmining. El valor por defecto es 2. En el caso de Oracle Standard Edition, este debe estar definido en1. -
TRACE_LEVEL: controla el nivel de rastreo para el servidor de extracción de logmining. Para usar solo con la orientación de los Servicios de Soporte Oracle. El valor por defecto de Oracle GoldenGate es0(sin rastreo). -
WRITE_ALERT_LOG: controla si el servidor de extracción de logmining escribe mensajes en el log de alertas de Oracle. El valor por defecto para Oracle GoldenGate esY(sí).
Consulte Gestión de Recursos del Servidor.