Conceptos para Desarrolladores de Bases de Datos
El desarrollador de Oracle Database crea y mantiene una aplicación de base de datos. En esta sección se presenta una breve visión general de lo que hace un desarrollador de bases de datos y las herramientas de desarrollo disponibles.
-
Derechos de los desarrolladores de bases de datos Un desarrollador Oracle es responsable de crear o mantener los componentes de base de datos de una aplicación que utilice la pila de tecnología de Oracle.
-
Herramientas para desarrolladores de bases de datos Oracle proporciona varias herramientas para su uso en el desarrollo de aplicaciones de bases de datos. En esta sección se describen algunas herramientas de desarrollo de uso común.
-
Temas para desarrolladores de bases de datos En esta sección se tratan temas que son más esenciales para los desarrolladores de bases de datos y que no se han tratado en ningún otro lugar del manual.
Funciones de los desarrolladores de bases de datos
Los desarrolladores de Oracle se encargan de crear o mantener los componentes de base de Datos de una aplicación que utiliza la pila tecnológica Oracle.
Los programadores de Oracle desarrollan aplicaciones nuevas o convierten las aplicaciones existentes para que se ejecuten en un entorno de la Oracle Database. Por este motivo, los desarrolladores trabajan en estrecha colaboración con los administradores de la base de datos, compartiendo conocimientos e información.
Los desarrolladores de bases de datos Oracle pueden esperar participar en las siguientes tareas:
-
Implantación del modelo de datos necesario para la aplicación
-
Creando objetos de esquema
-
Implementación de reglas para la integridad de los datos
-
Elección de un entorno de programación para un nuevo proyecto de desarrollo
-
Escritura de Subprogramas PL/SQL o Java del Servidor y Código de Procedimiento del Cliente que Utilizan Sentencias SQL
-
Creación de la interfaz de aplicación con la herramienta de desarrollo seleccionada
-
Establecimiento de un entorno de soporte de globalización para el desarrollo de aplicaciones globalizadas
-
Creación de instancias de aplicaciones en diferentes bases de datos para su desarrollo, prueba, formación y despliegue en un entorno de producción
Consulte además:
-
Oracle AI Database Introducción a Oracle AI Database Development para obtener una introducción y tutoriales basados en GUI en el desarrollo de Oracle Database
-
Oracle AI Database Development Guide para discusiones en profundidad sobre temas como el diseño de bases de datos, SQL para desarrolladores y PL/SQL para desarrolladores
Herramientas para desarrolladores de bases de datos
Oracle proporciona varias herramientas para su uso en el desarrollo de aplicaciones de base de datos. En esta sección se describen algunas herramientas de desarrollo de uso común.
-
SQL Developer es una forma práctica para que los desarrolladores de bases de datos editen y desarrollen tareas básicas mediante SQL*Plus.
-
Oracle APEX AI Application Generator Oracle APEX AI Application Generator es una herramienta de desarrollo de aplicaciones web para Oracle Database. Oracle APEX AI Application Generator utiliza funciones integradas, como temas de interfaz de usuario, controles de navegación, manejadores de formularios e informes flexibles, para acelerar el desarrollo de aplicaciones.
-
Oracle JDeveloper es un entorno de desarrollo integrado (IDE) para crear aplicaciones orientadas a servicios con los últimos estándares de la industria para Java, XML, servicios web y SQL.
-
Oracle Developer Tools para Visual Studio .NET
Oracle Developer Tools for Visual Studio .NET es un conjunto de herramientas de aplicación integradas con el entorno .NET de Visual Studio.
SQL Developer
SQL Developer es una forma práctica para que los desarrolladores de bases de datos editen y desarrollen tareas básicas mediante SQL*Plus. SQL Developer es una versión gráfica de SQL*Plus, escrita en Java, que soporta el desarrollo en SQL y PL/SQL. Puede conectarse a cualquier esquema de base de datos Oracle mediante la autenticación de base de datos estándar. SQL Developer le permite:
-
Examinar, crear, editar y suprimir objetos de esquema
-
Ejecutar Sentencias SQL
-
Editar y depurar unidades de programa PL/SQL
-
Manipular y exportar datos
-
Crear y mostrar informes
SQL Developer está disponible en la instalación por defecto de Oracle Database y se puede descargar de forma gratuita.
Consulte también: Oracle AI Database Get Started with Oracle AI Database Development y Oracle SQL Developer User's Guide para aprender a utilizar SQL Developer
Generador de aplicaciones Oracle APEX AI
Oracle APEX AI Application Generator es una herramienta de desarrollo de aplicaciones web para Oracle Database. Oracle APEX AI Application Generator utiliza funciones integradas, como temas de interfaz de usuario, controles de navegación, manejadores de formularios e informes flexibles, para acelerar el desarrollo de aplicaciones.
Oracle APEX se instala con la base de datos y consta de datos en tablas y código PL/SQL. Al ejecutar una aplicación, el explorador envía una solicitud de URL que se traduce en una llamada PL/SQL de Oracle APEX. Después de que la base de datos procese el PL/SQL, los resultados se vuelven a transmitir al explorador como HTML. Este ciclo se produce cada vez que se solicita o se envía una página.
Puede utilizar Oracle APEX con el gateway PL/SQL embebido. El gateway se ejecuta en el servidor HTTP de Oracle XML DB de la base de datos y proporciona la infraestructura necesaria para crear aplicaciones dinámicas. Como se muestra en la Figura 23-1, el gateway PL/SQL embebido simplifica la arquitectura de la aplicación al eliminar la capa media.
Figura 1: APEX con gateway PL/SQL incrustado
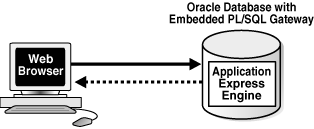
Descripción de la ilustración cncpt317.gif
Oracle JDeveloper
Oracle JDeveloper es un entorno de desarrollo integrado (IDE) para crear aplicaciones orientadas a servicios con los últimos estándares de la industria para Java, XML, servicios web y SQL. Oracle JDeveloper soporta todo el ciclo de vida de desarrollo de software, con funciones integradas para modelar, codificar, depurar, probar, crear perfiles, ajustar y desplegar aplicaciones.
Oracle JDeveloper utiliza ventanas para diversas herramientas de desarrollo de aplicaciones. Por ejemplo, al crear una aplicación Java, puede utilizar herramientas como Java Visual Editor y Component Palette. Además de estas herramientas, Oracle JDeveloper proporciona una serie de navegadores que le ayudarán a organizar y ver el contenido de los proyectos.
Consulte además:
-
Oracle AI Database: introducción al desarrollo de Java para aprender a utilizar JDeveloper
-
Puede descargar JDeveloper desde la siguiente URL: http://www.oracle.com/technetwork/developer-tools/jdev/downloads/
Oracle Developer Tools para Visual Studio .NET
Oracle Developer Tools for Visual Studio .NET es un conjunto de herramientas de aplicación integradas con el entorno .NET de Visual Studio. Las herramientas Oracle Developer Tools for Visual Studio .NET proporcionan acceso de interfaz gráfica de usuario a la función de Oracle, permiten al usuario realizar una amplia gama de tareas del desarrollo y son capaces de mejorar la productividad de desarrollo y facilidad de uso.
Oracle Developer Tools permite la programación e implementación de procedimientos almacenados .NET con Visual Basic, C#, y otros lenguajes .NET. Estos procedimientos se escriben en un lenguaje .NET y contienen sentencias SQL o PL/SQL.
Temas para desarrolladores de bases de datos
En esta sección se tratan los temas que son más esenciales para los desarrolladores de bases de datos y que no se han tratado en ningún otro lugar del manual.
-
Principios de diseño y ajuste de aplicaciones Los desarrolladores de Oracle deben diseñar, crear y ajustar aplicaciones de base de datos para que alcancen los objetivos de seguridad y rendimiento.
-
Principios de consultas correctas Las consultas de aplicaciones del mundo real pueden ser muy complejas, con muchas uniones, y estas suelen no ser correctas en todos los casos de esquina, especificando explícitamente la devolución de un resultado erróneo, incluso en la ejecución de SQL en sistemas de producción durante largos períodos que producen errores inadvertidos. En esta sección se explica cómo analizar sistemáticamente y evitar el más importante de estos errores SQL demasiado comunes.
-
Programación de bases de datos de cliente Puede utilizar precompiladores o traductores de Java para colocar sentencias SQL en el código fuente, o bien puede utilizar API para permitir que las aplicaciones interactúen con la base de datos.
-
Soporte de globalización El soporte de globalización de Oracle Database permite almacenar, procesar y recuperar datos en idiomas nativos.
-
Datos no estructurados Los datos no estructurados son datos que no se dividen en estructuras lógicas más pequeñas.
Principios de Diseño y Ajuste de Aplicaciones
Los desarrolladores de Oracle deben diseñar, crear y ajustar aplicaciones de base de datos para que alcancen los objetivos de seguridad y rendimiento.
Los siguientes principios de diseño y ajuste de aplicaciones son directrices útiles:
-
Descubre cómo funciona Oracle Database
Como desarrollador, desea desarrollar aplicaciones en el menor tiempo posible en una base de datos Oracle, lo que requiere aprovechar la arquitectura y las funciones de la base de datos. Por ejemplo, no entender los controles de simultaneidad de datos de Oracle Database y la consistencia de lectura multiversional puede hacer que una aplicación dañe la integridad de los datos, se ejecute lentamente y disminuya la escalabilidad. Saber cómo funcionan el gestor de transacciones y la continuidad de aplicaciones permite evitar escribir código de manejo de excepciones innecesario.
-
Utilizar variables ligadas a menos que tenga una buena razón para no utilizarlas
Cuando una consulta utiliza variables de enlace, la base de datos puede compilarla una vez y almacenar el plan de consulta en el pool compartido. Si se vuelve a ejecutar la misma sentencia, la base de datos puede realizar un análisis suave y reutilizar el plan. Por el contrario, un análisis pesado tarda más y utiliza más recursos. El uso de variables ligadas para permitir el análisis ligero es muy eficaz y es la forma en que la base de datos pretende que los desarrolladores funcionen.
-
Implementar restricciones de integridad en el servidor de base de datos en lugar de en el cliente
El uso de claves primarias y ajenas permite reutilizar datos en varias aplicaciones. La codificación de las reglas en un cliente significa que otros clientes no tienen acceso a estas reglas cuando se ejecutan en las bases de datos.
-
Crear un entorno de prueba con datos representativos y actividad de sesión
Un entorno de prueba que simule el entorno de producción activo ofrece varias ventajas. Por ejemplo, puede comparar la aplicación para asegurarse de que se amplía y funciona bien. Además, puede utilizar un entorno de prueba para medir el impacto en el rendimiento de los cambios en la base de datos y asegurarse de que las actualizaciones y los parches funcionan correctamente.
-
Diseñar el modelo de datos con el objetivo de un buen rendimiento
Normalmente, los intentos de utilizar modelos de datos genéricos provocan un rendimiento deficiente. Un modelo de datos bien diseñado responde a las consultas más comunes de la forma más eficiente posible. Por ejemplo, el modelo de datos debe utilizar el tipo de índices que proporcionan el mejor rendimiento. No se recomienda realizar ajustes después del despliegue porque los cambios en las estructuras lógicas y físicas pueden ser difíciles o imposibles.
-
Definir objetivos de rendimiento claros y mantener registros históricos de métricas
Una faceta importante del desarrollo es determinar exactamente cómo se espera que se realice y escale la aplicación. Por ejemplo, utilice métricas que incluyan la carga de usuario esperada, las transacciones por segundo, los tiempos de respuesta aceptables, etc. Las buenas prácticas indican que se mantienen registros históricos de métricas de rendimiento. De esta forma, puede supervisar el rendimiento de forma proactiva y reactiva.
-
Instrumentalizar el código de aplicación
Una buena práctica de desarrollo implica agregar código de depuración a la aplicación. La capacidad de generar archivos de rastreo es útil para depurar y diagnosticar problemas de rendimiento.
Consulte además:
-
"Introducción a la Simultaneidad y Consistencia de los Datos"
-
Oracle AI Database Get Started with Oracle AI Database Development para consideraciones al diseñar aplicaciones de base de datos
-
Oracle AI Database SQL Tuning Guide para aprender a diseñar aplicaciones para el rendimiento
Principios de las consultas correctas
Las consultas de aplicaciones reales pueden ser muy complejas, con muchas uniones, y estas suelen no ser correctas en todos los casos de esquina, especificando explícitamente la devolución de un resultado erróneo, incluso en SQL que se ejecuta en sistemas de producción durante largos períodos que producen errores inadvertidos. En esta sección se explica cómo analizar sistemáticamente y evitar el más importante de estos errores SQL demasiado comunes.
Las consultas pueden parecer muy complejas. Pueden hacer referencia a decenas de tablas, incluir vistas creadas a partir de otras vistas y utilizar subconsultas en las cláusulas WITH, la lista SELECT y la cláusula WHERE. Debajo de esa complejidad, una buena consulta todavía responde a una pregunta clara. Esta pregunta suele reflejar la necesidad de datos sobre un juego de un tipo concreto de entidades de negocio. Cada fila devuelta por la consulta debe representar una instancia de esa entidad. Para las consultas GROUP BY, cada fila debe representar una agregación en instancias de la misma entidad.
En la mayoría de los sistemas, cada tipo de entidad de negocio lo suficientemente importante como para consultar tiene una tabla correspondiente cuyas filas representan esa entidad. En ese sentido, muchas consultas bien escritas, sin importar cuán complejas sean, son en última instancia preguntas sobre filas de una sola tabla. La complejidad que la rodea suele existir porque las bases de datos normalizadas almacenan atributos de una entidad en tablas relacionadas, como tablas principales, tablas principales, etc.
Por ejemplo, un diseño normalizado suele almacenar el nombre de un cliente una vez en una tabla CUSTOMERS. Una tabla ORDERS almacena solo CUSTOMER_ID para que se pueda unir a CUSTOMERS. Una tabla ORDER_ITEMS almacena ORDER_ID para que se pueda unir a ORDERS y no repite CUSTOMER_ID. Si queremos mostrar un subjuego de ORDER_ITEMS junto con el nombre de cliente de cada artículo, necesitamos una secuencia de uniones únicas, primero a ORDERS (el principal) y, a continuación, a CUSTOMERS (el abuelo). En sistemas OLTP bien normalizados, las consultas pueden requerir muchas de estas uniones para recuperar información detallada sobre un único tipo de entidad, aunque el juego de resultados aún se asigne de uno a uno a un subjuego de filas de una tabla "principal".
Llamamos a esa tabla primaria la tabla ampliada por filas (RWT). En una consulta correcta, las otras uniones normalmente deben "ampliar" cada fila RWT agregando datos de consulta coincidentes de forma única de las tablas principales, las tablas principales y demás. Esas uniones no deben multiplicar el número de filas de RWT. Las consultas con esta estructura para todas las uniones que comienzan lógicamente desde el RWT son solo consultas de ampliación de filas (RWOQ). Nota: El filtrado puede descartar filas RWT. Las uniones internas y los predicados WHERE pueden eliminar filas del RWT. "Fila ampliada" no significa que la consulta conserve todas las filas de RWT. Significa que, después del filtrado y antes de cualquier agregación, cada fila de resultado de consulta se corresponde estrictamente de uno a uno con las filas de RWT restantes.
Si se puede acceder a todas las demás tablas de la consulta mediante una cadena de uniones únicas de una única tabla que representa las entidades que devuelve o agrega la consulta, esa tabla inicial es el RWT y la consulta es un RWOQ. Si no se puede garantizar que ninguna tabla, a través de claves únicas, se asigne de uno a uno a las filas de resultados anteriores a la agregación, la consulta no es un RWOQ. En la práctica, la mayoría de los no RWOQ producen resultados que la aplicación no puede interpretar correctamente porque la consulta no asigna correctamente las filas de resultados a una entidad bien definida y significativa para el negocio. La suma de valores de dichas filas, por ejemplo, agregaría el mismo valor para la misma entidad varias veces, dejando un total que no tiene sentido.
A partir de la versión 26ai de Oracle Database, la función JOIN TO ONE ayuda mucho a escribir los RWOQ correctos. Al utilizar JOIN TO ONE para todas las uniones, la base de datos comprueba en el momento del análisis que la consulta es un RWOQ, tratando la tabla situada más a la izquierda en la cláusula FROM como el RWT, suponiendo que el objeto es una tabla base en lugar de una vista que puede ocultar el comportamiento que no es de RWOQ. Si la base de datos no puede demostrar la unicidad de las uniones JOIN TO ONE en el momento del análisis, realiza comprobaciones de tiempo de ejecución para verificar que cada unión del RWT supuesto sigue siendo única para los datos encontrados en el momento de la ejecución. Si detecta una unión no única en los resultados reales, genera un error de tiempo de ejecución. La mayoría de los RWOQ se pueden convertir a un formulario JOIN TO ONE. Las consultas que no se pueden convertir al formulario JOIN TO ONE suelen revelar uniones irregulares en el intento de conversión. Cuando la consulta convertida se ejecuta sin errores de tiempo de ejecución, ese resultado proporciona una confirmación sólida de que la consulta tiene la propiedad de una fila por entidad deseada.
Para obtener más información sobre los RWOQ, por qué ayudan a evitar problemas sutiles de corrección en SQL y cómo JOIN TO ONE los aplica, consulte la Guía de desarrollo de Oracle AI Database.
Programación de bases de datos de cliente
Puede utilizar precompiladores o traductores de Java para colocar sentencias SQL en el código fuente, o bien puede utilizar API para permitir que las aplicaciones interactúen con la base de datos.
Existen dos técnicas básicas que permiten a las aplicaciones de bases de datos de procedimiento utilizar SQL: la programación del lado del servidor con PL/SQL y Java, y la programación del lado del cliente con precompiladores y API como Java Database Connectivity (JDBC) u Oracle Call Interface (OCI).
-
SQL embebido Históricamente, los programas cliente/servidor han utilizado SQL embebido para interactuar con la base de datos.
-
API del lado del cliente La mayoría de los desarrolladores utilizan hoy una API para embeber SQL en sus aplicaciones de base de datos.
Consulte además:
Oracle AI Database Development Guide para aprender a elegir un entorno de programación
Programación en el servidor: PL/SQL y Java para revisar
SQL embebido
Históricamente, los programas cliente/servidor han utilizado SQL embebido para interactuar con la base de datos.
- Los programas cliente/servidor de precompiladores de Oracle se escriben normalmente mediante un precompilador de Oracle, que es una herramienta de programación que permite embeber sentencias SQL en programas de alto nivel.
Precompiladores de Oracle
Los programas cliente/servidor se escriben normalmente con un precompilador de Oracle, que es una herramienta de programación que permite embeber sentencias SQL en programas de alto nivel.
Por ejemplo, el precompilador Oracle Pro*C/C++ permite embeber sentencias SQL en un archivo de origen C o C++. Los precompiladores de Oracle también están disponibles para COBOL y FORTRAN.
Un precompilador proporciona varias ventajas, incluidas las siguientes:
-
Aumenta la productividad porque normalmente escribe menos código que las aplicaciones OCI equivalentes
-
Permite crear aplicaciones altamente personalizadas
-
Permite supervisar de cerca el uso de recursos, la ejecución de sentencias SQL y varios indicadores de tiempo de ejecución
-
Ahorra tiempo porque el precompilador, no usted, traduce cada sentencia SQL embebida en llamadas a la biblioteca de tiempo de ejecución de Oracle Database
-
Utiliza Object Type Translator para asignar tipos de objeto y recopilaciones de Oracle Database a tipos de dato C que se utilizarán en la aplicación Pro*C/C++
-
Proporciona la comprobación del tipo de tiempo de compilación de tipos de objeto y recopilaciones y la conversión automática de tipos de base de datos a tipos de dato C
La aplicación cliente que contiene las sentencias SQL es el programa host. Este programa está escrito en el idioma anfitrión. En el programa host, puede combinar sentencias SQL completas con sentencias C completas y utilizar variables o estructuras C en sentencias SQL. Al embeber sentencias SQL, debe comenzarlas con las palabras clave EXEC SQL y terminarlas con un punto y coma. Pro*C/C++ convierte las sentencias EXEC SQL en llamadas a la biblioteca en tiempo de ejecución SQLLIB.
Muchas sentencias SQL embebidas difieren de sus contrapartes interactivas sólo mediante la adición de una nueva cláusula o el uso de variables de programa. En el siguiente ejemplo se comparan las sentencias ROLLBACK interactivas y embebidas:
ROLLBACK;           -- interactive
EXEC SQL ROLLBACK;  -- embedded
Las sentencias tienen el mismo efecto, pero debe utilizar la primera en un entorno SQL interactivo (como SQL Developer) y la segunda en un programa Pro*C/C++.
Un precompilador acepta el programa de host como entrada, traduce las sentencias SQL embebidas en llamadas de biblioteca de tiempo de ejecución de base de datos estándar y genera un programa de fuente que puede compilar, enlazar y ejecutar de la forma habitual. La Figura 23-2 ilustra los pasos típicos del desarrollo de programas que utilizan precompiladores.
Figura 2: Desarrollo de programas con precompiladores
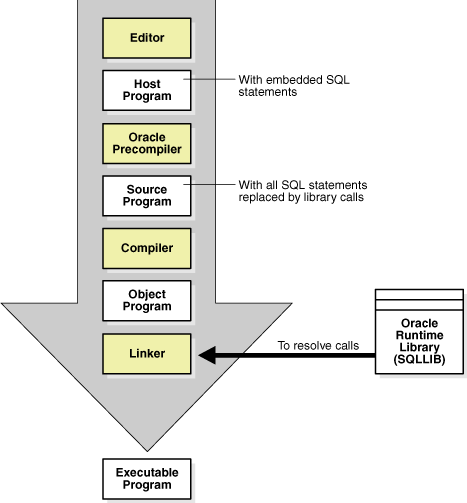
Descripción de la ilustración cncpt253.gif
Consulte también: Guía del desarrollador de Pro*C/C++ para obtener una descripción completa del precompilador de Pro*C/C++
API de cliente
La mayoría de los desarrolladores utilizan hoy en día una API para embeber SQL en sus aplicaciones de base de datos.
Por ejemplo, dos API populares para permitir que los programas se comuniquen con Oracle Database son Open Database Connectivity (ODBC) y JDBC. Oracle Call Interface (OCI) y Oracle C++ Call Interface (OCCI) son otras dos API comunes para la programación del cliente.
-
OCI y OCCI Como alternativa a los precompiladores, Oracle proporciona las API de OCI y OCCI.
-
ODBC ODBC y JDBC es una API estándar que permite a las aplicaciones conectarse a una base de datos y, a continuación, preparar y ejecutar sentencias SQL.
OCI y OCCI
Como alternativa a los precompiladores, Oracle proporciona las API de OCI y OCCI.
OCI permite manipular datos y esquemas en una base de datos mediante un lenguaje de programación de host como C. OCCI es una interfaz orientada a objetos adecuada para su uso con C++. Ambas API permiten a los desarrolladores utilizar llamadas de subprograma nativas para acceder a Oracle Database y controlar la ejecución de SQL.
En algunos casos, OCI proporciona un mejor rendimiento o más funciones que las interfaces de nivel superior. OCI y OCCI proporcionan muchas funciones, incluidas las siguientes:
-
Soporte para todas las utilidades de control de transacciones, consultas, DDL y DML de SQL disponibles a través de Oracle Database
-
Instant Client, una forma de desplegar aplicaciones cuando el espacio en disco es un problema
-
Gestión de threads, pool de conexiones, funciones de globalización y carga de ruta de acceso directa de datos desde una aplicación C
OCI y OCCI proporcionan una biblioteca de funciones de acceso y recuperación de bases de datos estándar en forma de una biblioteca dinámica en tiempo de ejecución (OCILIB). Esta biblioteca se puede enlazar en una aplicación en tiempo de ejecución. Por lo tanto, puede compilar y enlazar un programa OCI u OCCI de la misma forma que una aplicación que no sea de base de datos, evitando un paso de preprocesamiento o precompilación independiente. La Figura 23-3 ilustra el proceso de desarrollo.
Figura 3: Proceso de desarrollo mediante OCI u OCCI
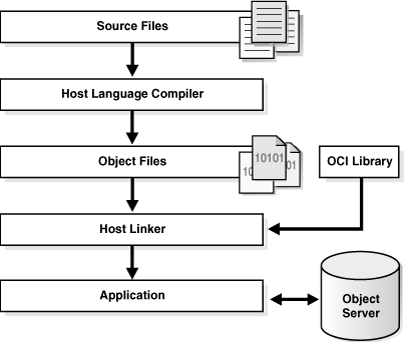
Descripción de la ilustración cncpt307.gif
Consulte además:
ODBC y JDBC
ODBC es una API estándar que permite a las aplicaciones conectarse a una base de datos y, a continuación, preparar y ejecutar sentencias SQL.
ODBC es independiente del lenguaje de programación, la base de datos y el sistema operativo. El objetivo de ODBC es permitir que cualquier aplicación acceda a los datos contenidos en cualquier base de datos.
Un controlador de base de datos es el software que se encuentra entre una aplicación y la base de datos. El controlador traduce las llamadas de API realizadas por la aplicación en comandos que la base de datos puede procesar. Mediante el uso de un controlador ODBC, una aplicación puede acceder a cualquier fuente de datos, incluidos los datos almacenados en hojas de cálculo. El controlador ODBC realiza todas las asignaciones entre el estándar ODBC y la base de datos.
El controlador ODBC de Oracle proporcionado por Oracle permite a las aplicaciones compatibles con ODBC acceder a Oracle Database. Por ejemplo, una aplicación escrita en Visual Basic puede utilizar ODBC para consultar y actualizar tablas en una base de datos Oracle.
JDBC es una interfaz Java de bajo nivel que permite a las aplicaciones Java interactuar con la base de datos Oracle. Al igual que ODBC, JDBC es una API independiente del proveedor. El estándar JDBC es definido por Sun Microsystems e implementado mediante las interfaces java.sql.
El estándar JDBC permite a los proveedores individuales implementar y ampliar el estándar con sus propios controladores JDBC. Oracle proporciona los siguientes controladores JDBC para la programación del cliente:
-
Controlador JDBC Thins
Este controlador Java puro reside en el cliente sin una instalación de cliente de Oracle. Es independiente de la plataforma y se puede utilizar con applets y aplicaciones.
-
Controlador JDBC OCI
Este controlador reside en el cliente con una instalación de cliente de Oracle. Solo se puede utilizar con aplicaciones. El controlador JDBC OCI, que se escribe tanto en C como en Java, convierte las llamadas JDBC en llamadas OCI.
Los siguientes fragmentos proceden de un programa Java que utiliza el controlador JDBC OCI para crear un objeto Statement y consultar la tabla dual:
// Create a statement
Statement stmt = conn.createStatement();

// Query dual table
ResultSet rset = stmt.executeQuery("SELECT 'Hello World' FROM DUAL");
Consulte también: Guía de desarrollo de Oracle AI Database y Oracle AI Database: introducción al desarrollo de Java para obtener más información sobre JDBC
Soporte de Globalización
El soporte de globalización de Oracle Database permite almacenar, procesar y recuperar datos en lenguas maternas.
El soporte de globalización permite desarrollar aplicaciones y software multilingües a los que se puede acceder y ejecutar desde cualquier parte del mundo simultáneamente.
Los desarrolladores que escriben la aplicación de base de datos globalizada deben hacer lo siguiente:
-
Comprender la arquitectura de soporte de globalización de Oracle Database, incluidas las propiedades de los diferentes juegos de caracteres, territorios, idiomas y definiciones de ordenación lingüística
-
Comprender la funcionalidad de globalización de su entorno de programación de capa media, incluida cómo puede interactuar y sincronizarse con el modelo de configuración regional de la base de datos
-
Diseñar y escribir código capaz de soportar simultáneamente varios clientes que se ejecutan en diferentes sistemas operativos, con diferentes juegos de caracteres y requisitos de configuración regional
Por ejemplo, puede ser necesario que una aplicación represente contenido de la interfaz de usuario y procese datos en idiomas y preferencias de configuración regional de usuarios nativos. Por ejemplo, la aplicación debe procesar datos kanji multibyte, mostrar mensajes y fechas en el formato regional adecuado y procesar datos ASCII de 7 bits sin necesidad de que los usuarios cambien la configuración.
-
Entorno de soporte de globalización El entorno de soporte de globalización incluye la aplicación cliente y la base de datos. Puede controlar las operaciones que dependen del idioma definiendo parámetros y variables de entorno en el cliente y el servidor, que pueden existir en ubicaciones separadas.
-
Oracle Globalization Development Kit Oracle Globalization Development Kit (GDK) incluye API de programación completas. Consulte también: Guía de soporte de globalización de Oracle AI Database para obtener más información sobre la globalización
Entorno de Soporte de Globalización
El entorno de soporte de globalización incluye la aplicación cliente y la base de datos. Puede controlar las operaciones que dependen del idioma definiendo parámetros y variables de entorno en el cliente y el servidor, que pueden existir en ubicaciones separadas. Nota: En versiones anteriores, Oracle hacía referencia a las capacidades de soporte de globalización como funciones de soporte de idioma nacional (NLS). NLS es en realidad un subconjunto de apoyo a la globalización y proporciona la capacidad de elegir un idioma nacional y almacenar datos en un juego de caracteres específico.
Oracle Database proporciona soporte de globalización para funciones como:
-
Idiomas y territorios nativos
-
Formatos locales para fecha, hora, números y moneda
-
Sistemas de calendario (gregoriano, imperial japonés, buda tailandés, etc.)
-
Varios juegos de caracteres, incluido Unicode
-
Semántica de caracteres
-
Juegos de caracteres Un componente clave de la compatibilidad con la globalización es un juego de caracteres, que es un esquema de codificación utilizado para mostrar caracteres en una pantalla del equipo.
-
Configuración regional específica Una configuración regional es un entorno lingüístico y cultural en el que se está ejecutando un sistema o programa. Los parámetros NLS determinan el comportamiento específico de la configuración regional tanto en el cliente como en la base de datos.
Juegos de caracteres
Un componente clave de la compatibilidad con la globalización es un conjunto de caracteres, que es un esquema de codificación utilizado para mostrar caracteres en la pantalla de un equipo.
La siguiente distinción es importante en el desarrollo de aplicaciones:
-
Un juego de caracteres de base de datos determina qué idiomas se pueden representar en una base de datos. El juego de caracteres se especifica al crear la base de datos.
Nota: Una vez que se crea una base de datos, cambiar su juego de caracteres suele ser muy costoso en términos de tiempo y recursos. Esta operación puede necesitar la conversión de todos los datos de caracteres exportando la base datos completa e importándola de nuevo.
-
Un juego de caracteres de cliente es el juego de caracteres para los datos introducidos o mostrados por una aplicación cliente. El juego de caracteres para el cliente y la base de datos puede ser diferente.
Un grupo de caracteres (por ejemplo, caracteres alfabéticos, ideogramas, símbolos, signos de puntuación y caracteres de control) se puede codificar como un conjunto de caracteres. Un conjunto de caracteres codificados asigna un código numérico único, denominado punto de código o valor codificado, a cada carácter del conjunto. Los puntos de código son importantes en un entorno global debido a la posible necesidad de convertir datos entre diferentes juegos de caracteres.
La industria informática utiliza muchos conjuntos de caracteres codificados. Estos conjuntos difieren en el número de caracteres disponibles, los caracteres disponibles para su uso, los puntos de código asignados a cada carácter, etc. Oracle Database soporta la mayoría de las normas de juegos de caracteres codificados tanto nacionales, internacionales como específicos de proveedores.
Oracle Database soporta las siguientes clases de juegos de caracteres codificados:
-
Juegos de caracteres de un solo byte
Cada personaje ocupa un byte. Un ejemplo de juego de caracteres de 7 bits es US7ASCII. Un ejemplo de un juego de caracteres de 8 bits es WE8DEC.
-
Juegos de caracteres multibyte
Cada carácter ocupa varios bytes. Los conjuntos multibyte se utilizan comúnmente para las lenguas asiáticas.
-
Unicode
El juego de caracteres codificado universal permite almacenar información en cualquier idioma mediante un único juego de caracteres. Unicode proporciona un code value único para cada carácter, independientemente de la plataforma, el programa o el idioma.
Consulte también: Guía de soporte de globalización de Oracle AI Database para obtener información sobre la migración de juegos de caracteres
Configuración específica de la configuración regional
Una configuración regional es un entorno lingüístico y cultural en el que se está ejecutando un sistema o programa. Los parámetros NLS determinan el comportamiento específico de la configuración regional tanto en el cliente como en la base de datos.
Una sesión de base de datos utiliza valores NLS al ejecutar sentencias en nombre de un cliente. Por ejemplo, la base de datos realiza el uso correcto del territorio del separador de miles para un cliente. Normalmente, la variable de entorno NLS_LANG del host de cliente especifica la configuración regional tanto para la sesión de servidor como para la aplicación de cliente. El proceso es el siguiente:
-
Cuando se inicia una aplicación cliente, se inicializa el entorno NLS del cliente a partir de la configuración del entorno.
Todas las operaciones NLS realizadas localmente, como mostrar el formato en las aplicaciones de Oracle Developer, utilizan esta configuración.
-
El cliente comunica la información definida por
NLS_LANGa la base de datos cuando se conecta. -
La sesión de base de datos inicializa su entorno NLS en función de la configuración comunicada por el cliente.
Si el cliente no ha especificado la configuración, la sesión utiliza la configuración en el archivo de parámetros de inicialización. La base de datos utiliza los valores de los parámetros de inicialización sólo si el cliente no ha especificado ningún valor NLS. Si el cliente especificó algunos valores de NLS, el resto de valores de NLS por defecto.
Cada sesión iniciada en nombre de una aplicación cliente puede ejecutarse en la misma configuración regional o en una diferente que otras sesiones. Por ejemplo, una sesión puede utilizar la configuración regional alemana mientras que otra utiliza la configuración regional francesa. Además, cada sesión puede tener los mismos o diferentes requisitos de idioma especificados.
En la siguiente tabla, se muestran dos clientes que utilizan diferentes valores de NLS_LANG. Un usuario inicia SQL*Plus en cada host, se conecta a la misma base de datos que hr y ejecuta la misma consulta simultáneamente. El resultado de cada sesión difiere debido a la configuración NLS específica de la configuración regional para los números de coma flotante.
Tabla 1 Configuración de NLS específica de la configuración regional
| t | Host del Cliente 1 | Host del Cliente 2 |
|---|---|---|
| t0 | |
|
| t1 | |
|
Consulte también: Guía de soporte de globalización de Oracle AI Database para obtener información sobre la configuración de NLS
Oracle Globalization Development Kit
Oracle Globalization Development Kit (GDK) incluye API de programación completas.
Las API están disponibles tanto para Java como para PL/SQL, e incluyen ejemplos de código y documentación que abordan muchos de los problemas de diseño, desarrollo y despliegue encontrados al crear aplicaciones globales. El GDK simplifica el proceso de desarrollo y reduce el costo del desarrollo de aplicaciones de Internet utilizadas para soportar un entorno global.
El GDK consta principalmente de dos partes: GDK para Java y GDK para PL/SQL. GDK para Java proporciona soporte de globalización para aplicaciones Java. GDK para PL/SQL proporciona soporte de globalización para el entorno de programación PL/SQL. Las características ofrecidas en las dos partes no son idénticas.
Consulte también: Guía de soporte de globalización de Oracle AI Database
Datos no estructurados
Los datos no estructurados son datos que no se dividen en estructuras lógicas más pequeñas.
El modelo relacional tradicional trata de datos estructurados simples que encajan en tablas simples. Oracle Database también proporciona soporte para datos no estructurados, que no se pueden descomponer en componentes estándar. Los datos no estructurados incluyen texto, imágenes gráficas, clips de vídeo y formas de onda de sonido.
Oracle Database incluye tipos de datos para manejar contenido no estructurado. Estos tipos de dato aparecen como tipos nativos en la base de datos y se pueden consultar mediante SQL.
-
Visión general de XML en Oracle Database Oracle XML DB es un juego de tecnologías de Oracle Database relacionadas con la manipulación, el almacenamiento y la recuperación de XML de alto rendimiento. Oracle XML DB proporciona soporte XML nativo mediante la integración de modelos de datos SQL y XML de forma interoperable.
-
Visión general de JSON en Oracle Database Oracle Database proporciona soporte nativo para datos JavaScript de notación de objetos (JSON), incluidas las consultas y la indexación.
-
Visión general de los LOB Los tipos de dato de objetos grandes (LOB) permiten almacenar y manipular grandes bloques de datos no estructurados en formato binario o de caracteres.
-
Descripción general de Oracle Text Oracle Text (texto) es una tecnología de recuperación de texto completo integrada con Oracle Database. Oracle Text indexa cualquier documento o contenido textual almacenado en sistemas de archivos, bases de datos o en la Web. Estos documentos se pueden buscar en función de su contenido textual, metadatos o atributos.
-
Visión general de Oracle Spatial and Graph Oracle Spatial and Graph (Spatial and Graph) incluye funciones avanzadas para datos y análisis espaciales, así como para aplicaciones de gráficos físicos, lógicos, de red y sociales y semánticos.
-
Visión general de los gráficos de propiedades SQL La función Property Graph de Oracle Database ofrece un potente soporte de gráficos para Oracle Database.
Visión General de XML en Oracle Database
Oracle XML DB es un juego de tecnologías de Oracle Database relacionadas con la manipulación, el almacenamiento y la recuperación de XML de alto rendimiento. Oracle XML DB proporciona soporte XML nativo mediante la integración de modelos de datos SQL y XML de forma interoperable.
Oracle XML DB es adecuado para cualquier aplicación Java o PL/SQL en la que algunos o todos los datos procesados por la aplicación se representen mediante XML. Por ejemplo, la aplicación puede tener un gran número de documentos XML que se deben ingerir, generar, validar y buscar.
Oracle XML DB proporciona muchas funciones, entre las que se incluyen las siguientes:
-
Tipo de dato
XMLTypenativo, que puede representar un documento XML en la base de datos para que SQL pueda acceder a él -
Compatibilidad con estándares XML, como XML Schema, XPath, XQuery, XSLT y DOM
-
XMLIndex, que admite todas las formas de datos XML, desde datos altamente estructurados hasta completamente no estructurados
En el siguiente ejemplo se crea una tabla orders de tipo XMLType:
CREATE TABLE orders OF XMLType;
CREATE DIRECTORY xmldir AS path_to_folder_containing_XML_file;
INSERT INTO orders
  VALUES (XMLType(BFILENAME('XMLDIR','purOrder.xml'),NLS_CHARSET_ID('AL32UTF8')));
El ejemplo anterior también crea un objeto de directorio SQL, que es un nombre lógico en la base de datos para un directorio físico en el equipo host. Este directorio contiene archivos XML. En el ejemplo, se inserta contenido XML del archivo purOrder.xml en la tabla orders.
Oracle XML Developer's Kit (XDK) contiene los componentes básicos para leer, manipular, transformar y ver documentos XML, ya sea en un sistema de archivos o en una base de datos. Las API y herramientas están disponibles para Java, C y C++. Oracle XDK de producción incluye una licencia de redistribución comercial.
Ejemplo 23-1 XMLType
CREATE TABLE orders OF XMLType;
CREATE DIRECTORY xmldir AS path_to_folder_containing_XML_file;
INSERT INTO orders
  VALUES (XMLType(BFILENAME('XMLDIR','purOrder.xml'),NLS_CHARSET_ID('AL32UTF8')));
Consulte además:
Visión general de JSON en Oracle Database
Oracle Database proporciona soporte nativo para datos JavaScript de notación de objetos (JSON), incluidas las consultas y la indexación.
Esta sección incluye los siguientes temas:
-
¿Qué es JSON? JavaScript Object Notation (JSON) es un formato de datos basado en texto independiente del lenguaje que puede representar objetos, matrices y datos escalares. Una variedad de lenguajes de programación pueden analizar y generar datos JSON.
-
JSON y XML Tanto JSON como XML se utilizan comúnmente como lenguajes de intercambio de datos. A diferencia de los datos relacionales, tanto los datos JSON como los datos XML se pueden almacenar, indexar y consultar en la base de datos sin ningún esquema que defina los datos.
-
El soporte de base de datos nativa para JSON JSON se almacena ampliamente en bases de datos noSQL que carecen de funciones de base de datos relacional. Por el contrario, Oracle Database soporta JSON de forma nativa con funciones como transacciones, indexación, consultas declarativas y vistas.
¿Qué es JSON?
JavaScript Object Notation (JSON) es un formato de datos basado en texto independiente del lenguaje que puede representar objetos, matrices y datos escalares. Una variedad de lenguajes de programación pueden analizar y generar datos JSON.
JSON suele servir como lenguaje de intercambio de datos. A menudo se utiliza para serializar datos estructurados e intercambiarlos a través de una red, normalmente entre un servidor y aplicaciones web. JSON es el formato de datos dominante en los exploradores web que ejecutan aplicaciones escritas en JavaScript incrustado en HTML.
Un objeto JavaScript es una matriz asociativa de cero o más pares de nombres de propiedades y valores JSON asociados. Un objeto JSON es un literal de objeto JavaScript, que se escribe como una lista de propiedades entre corchetes, con pares nombre-valor separados por comas y con el nombre y el valor de cada par separados por dos puntos. Una propiedad de objeto a veces se denomina clave. Un par nombre-valor de propiedad de objeto a veces se denomina miembro de objeto.
Ejemplo 23-2 Objeto JSON
En este ejemplo se muestra un objeto JSON que representa un pedido, con los nombres de propiedad de nivel superior PONumber, Reference, Requestor, User, Costcenter, ShippingInstruction, Special Instructions, AllowPartialShipment y LineItems.
{ "PONumber"             : 1600,
  "Reference"            : "ABULL-20140421",
  "Requestor"            : "Alexis Bull",
  "User"                 : "ABULL",
  "CostCenter"           : "A50",
  "ShippingInstructions" : { "name"   : "Alexis Bull",
                             "Address": { "street"  : "200 Sporting Green",
                                          "city"    : "South San Francisco",
                                          "state"   : "CA",
                                          "zipCode" : 99236,
                                          "country" : "United States of America" },
                             "Phone" : [ { "type" : "Office", "number" : "909-555-7307" },
                                         { "type" : "Mobile", "number" : "415-555-1234" } ] },
  "Special Instructions" : null,
  "AllowPartialShipment" : false,
  "LineItems"            : [ { "ItemNumber" : 1,
                               "Part"       : { "Description" : "One Magic Christmas",
                                                "UnitPrice"   : 19.95,
                                                "UPCCode"     : 13131092899 },
                               "Quantity"   : 9.0 },
                             { "ItemNumber" : 2,
                               "Part"       : { "Description" : "Lethal Weapon",
                                                "UnitPrice"   : 19.95,
                                                "UPCCode"     : 85391628927 },
                               "Quantity"   : 5.0 } ] }
En el ejemplo anterior, la mayoría de las propiedades tienen valores de cadena. PONumber, zipCode, ItemNumber y Quantity tienen valores numéricos. Shipping Instructions y Address tienen objetos como valores. LineItems tiene una matriz como valor.
Nota: Guía del desarrollador de Oracle XML DB para obtener una visión general más completa de JSON
JSON y XML
Tanto JSON como XML se utilizan comúnmente como lenguajes de intercambio de datos. A diferencia de los datos relacionales, tanto los datos JSON como los datos XML se pueden almacenar, indexar y consultar en la base de datos sin ningún esquema que defina los datos.
Debido a su simple definición y características, los datos JSON generalmente son más fáciles de generar, analizar y procesar que los datos XML. También es más fácil para los seres humanos aprender y usar. En la siguiente tabla, se describen otras diferencias entre JSON y XML.
Tabla 2 Diferencias entre JSON y XML
| Función | JSON | XML |
|---|---|---|
| Útil para datos simples y estructurados | Sí | Sí, pero también soporta datos semiestructurados y datos estructurados complejos |
| Útil para contenido mixto | No | Sí |
| Falta atributos, espacios de nombres, herencia y sustitución | Sí | No |
| Coloca importancia en el pedido | No | Sí |
| Principalmente destinado a documentos en lugar de datos | No | Sí |
| Incluye un tipo de dato de fecha | No | Sí |
Nota: Oracle AI Database JSON Developer's Guide para una comparación más completa de XML y JSON
Soporte de base de datos nativa para JSON
JSON se almacena ampliamente en bases de datos noSQL que carecen de funciones de base de datos relacional. Por el contrario, Oracle Database soporta JSON de forma nativa con funciones como transacciones, indexación, consultas declarativas y vistas.
Puede acceder a los datos JSON almacenados en la base de datos de la misma forma que accede a otros datos de la base de datos, incluido el uso de OCI, .NET y JDBC. La forma preferida de almacenar datos JSON es utilizar el tipo de dato JSON, que es un formato binario propietario optimizado para el procesamiento de consultas y DML. Puede utilizar el tipo de dato JSON en la mayoría de los lugares donde se permite un tipo de dato SQL, incluido un tipo de columna o un tipo de parámetro para una unidad de programa PL/SQL.
Al utilizar Oracle SQL, puede realizar operaciones como las siguientes en datos JSON:
-
Une datos JSON con datos relacionales que no sean JSON.
-
Genere documentos JSON a partir de datos relacionales mediante las funciones SQL
json_objectyjson_array. -
Proyecte los datos JSON en un formato relacional mediante la función SQL
json_table. -
Cree una restricción de control con
is_jsonpara aplicar datos JSON en una columna. La base de datos utiliza la restricción de control para confirmar que la columna es JSON para operaciones específicas de JSON, como la sintaxis simplificada. -
Manipular documentos JSON como objetos PL/SQL.
-
Utilice las funciones SQL
json_queryyjson_valuepara aceptar una expresión de ruta de acceso JSON de Oracle como argumento y hacerla coincidir con los datos JSON de destino. -
Indexar datos JSON.
-
Consulta de datos JSON almacenados en una tabla externa.
-
Replicar tablas con columnas que contengan datos JSON mediante Oracle GoldenGate.
Los datos JSON textuales siempre utilizan el juego de caracteres Unicode, UTF8 o UTF16. Oracle Database utiliza UTF8 internamente cuando analiza y consulta datos JSON. Si los datos que se introducen o salen de dicho procesamiento deben estar en un juego de caracteres diferente de UTF8, la conversión del juego de caracteres adecuada se realiza automáticamente. Nota: Guía para desarrolladores de Oracle AI Database JSON para obtener una visión general más completa del soporte de JSON en Oracle Database
Visión General de LOB
Los tipos de dato de objeto grande (LOB) permiten almacenar y manipular grandes bloques de datos no estructurados en formato binario o de caracteres.
El tipo de dato large object (LOB) proporciona un acceso eficiente, aleatorio y por partes a los datos.
-
LOB internos Un LOB interno almacena datos en la propia base de datos en lugar de en archivos externos.
-
LOB externos Un
BFILE(objeto grande de archivo binario o LOB) es un objeto grande externo. -
El almacenamiento LOB SecureFiles SecureFiles es uno de los dos tipos de almacenamiento; el otro tipo es el almacenamiento LOB BasicFiles.
LOB internos
Un LOB interno almacena datos en la propia base de datos en lugar de en archivos externos.
Los LOB internos incluyen lo siguiente:
-
CLOB(LOB de caracteres), que almacena grandes cantidades de texto, como archivos de texto o XML, en el juego de caracteres de la base de datos -
NCLOB(LOB de juego de caracteres nacional), que almacena datos Unicode -
BLOB(LOB binario), que almacena grandes cantidades de información binaria como un flujo de bits y no está sujeta a la traducción de juegos de caracteres
La base de datos almacena LOB de forma diferente a otros tipos de dato. Al crear una columna LOB, se crea implícitamente un segmento LOB y un índice LOB. El tablespace que contiene el segmento LOB y el índice LOB, que siempre se almacenan juntos, puede ser diferente del tablespace que contiene la tabla.
Nota: En ocasiones, la base de datos puede almacenar pequeñas cantidades de datos LOB en la propia tabla en lugar de en un segmento LOB independiente.
El segmento LOB almacena datos en partes denominadas fragmentos. Un fragmento es un juego lógicamente contiguo de bloques de datos y es la unidad de asignación más pequeña para un LOB. Una fila de la tabla almacena un puntero denominado localizador LOB, que apunta al índice LOB. Cuando se consulta la tabla, la base de datos utiliza el índice LOB para localizar rápidamente los fragmentos LOB.
La base de datos gestiona la consistencia de lectura para los segmentos LOB de forma diferente a la de otros datos. En lugar de utilizar datos de deshacer para registrar cambios, la base de datos almacena las imágenes anteriores en el propio segmento. Cuando una transacción cambia un LOB, la base de datos asigna un nuevo fragmento y deja los datos antiguos en su lugar. Si se realiza un rollback de la transacción, la base de datos realiza un rollback de los cambios en el índice, que apunta al fragmento antiguo.
Consulte además:
LOB externos
Un BFILE (objeto grande de archivo binario o LOB) es un objeto grande externo.
Un BFILE es un LOB externo, porque la base de datos almacena un puntero a un archivo en el sistema operativo. Los datos externos son de solo lectura.
Un archivo BFILE utiliza un objeto de directorio para localizar datos. La cantidad de espacio consumido depende de la longitud del nombre del objeto de directorio y la longitud del nombre de archivo.
Un archivo BFILE no utiliza el mismo mecanismo de consistencia de lectura que el LOB interno porque el archivo binario es externo a la base de datos. Si los datos del archivo cambian, las lecturas repetidas del mismo archivo binario pueden producir resultados diferentes.
SecureFiles
El almacenamiento LOB SecureFiles es uno de los dos tipos de almacenamiento; el otro tipo es el almacenamiento LOB BasicFiles.
El parámetro LOB SECUREFILE permite funciones avanzadas, como la compresión y la desduplicación (parte de la opción de compresión avanzada) y el cifrado (parte de la opción de seguridad avanzada). A partir de Oracle Database 12c, SecureFiles es el mecanismo de almacenamiento por defecto para los LOB.
Consulte además:
-
Guía del desarrollador de Oracle AI Database SecureFiles y objetos grandes para obtener más información sobre los tipos de dato LOB
Visión General de Oracle Text
Oracle Text (texto) es una tecnología de recuperación de texto completo integrada con Oracle Database. Oracle Text indexa cualquier documento o contenido textual almacenado en sistemas de archivos, bases de datos o en la Web. Estos documentos se pueden buscar en función de su contenido textual, metadatos o atributos.
Oracle Text ofrece las siguientes ventajas:
-
Oracle Text permite combinar las búsquedas de texto con las búsquedas de base de datos normales en una sola sentencia SQL. El índice de texto está en la base de datos y las consultas de texto se ejecutan en el proceso de Oracle Database. El optimizador puede elegir el mejor plan de ejecución para cualquier consulta, lo que proporciona el mejor rendimiento para consultas ad hoc que implican criterios estructurados y de texto.
-
Puede utilizar Oracle Text con datos XML. En concreto, puede combinar
XMLIndexcon la indexación de Oracle Text, aprovechando tanto el índice XML como el índice de texto completo. -
La API de Oracle Text SQL facilita e intuitiva la creación y el mantenimiento de índices de Oracle Text y la ejecución de búsquedas.
Para un caso de uso, supongamos que debe crear un índice de catálogo para un sitio de subasta que vende equipos electrónicos. El nuevo inventario se agrega todos los días. Las descripciones de los artículos, las fechas de las ofertas y los precios se deben almacenar juntos. La aplicación requiere un buen tiempo de respuesta para consultas mixtas. En primer lugar, cree y rellene una tabla catalog. A continuación, utilice Oracle Text para crear un índice CTXCAT que pueda consultar con el operador CATSEARCH en una sentencia SELECT ... WHERE CATSEARCH. La Figura 23-4 ilustra la relación de la tabla de catálogo, su índice CTXCAT y la aplicación de catálogo que utiliza el operador CATSEARCH para consultar el índice.
Figura 4: Aplicación de consulta de catálogo
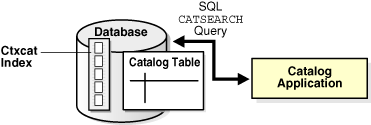
Descripción de la ilustración ccapp017.gif
Consulte además:
-
Guía del desarrollador de aplicaciones de Oracle Text y Referencia de Oracle Text
-
Oracle XML DB Developer's Guide para aprender a realizar búsquedas de texto completo en datos XML.
Visión General de Oracle Spatial and Graph
Oracle Spatial and Graph (Spatial and Graph) incluye funciones avanzadas para análisis y datos espaciales y para aplicaciones de gráficos físicos, lógicos, de red y sociales y semánticos.
Las funciones espaciales proporcionan un esquema y funciones que facilitan el almacenamiento, la recuperación, la actualización y la consulta de recopilaciones de funciones espaciales en una base de datos Oracle. Un ejemplo de datos espaciales es una hoja de ruta. Los datos espaciales indican la ubicación de la Tierra (como longitud y latitud) de los objetos en el mapa. Cuando se presenta el mapa, estos datos espaciales pueden proyectar las ubicaciones de los objetos en un pedazo de papel bidimensional. Un sistema de información geográfica (SIG) puede almacenar, recuperar y renderizar estos datos espaciales relativos a la Tierra. Cuando una base de datos Oracle almacena estos datos espaciales, puede utilizar Spatial y Graph para manipular y recuperar estos datos y relacionarlos con otros.
Consulte también: Guía del desarrollador de Oracle Spatial
Visión General de los Gráficos de Propiedades SQL
La función Property Graph de Oracle Database ofrece un potente soporte de gráficos para Oracle Database.
La función Property Graph le permite explorar y descubrir relaciones complejas en conjuntos de datos como datos de clientes, redes sociales y transacciones financieras, para aplicaciones de recomendación de productos, detección de fraudes, análisis de riesgos, marketing dirigido y mucho más. Esta función de gráficos de alto rendimiento ofrece soporte avanzado del lenguaje de consulta de grafos, API de desarrolladores y capacidades de análisis con casi 60 algoritmos predefinidos.
Las funciones de Property Graph, incluido el soporte de PGQL (Property Graph Query Language), están disponibles en Oracle Database 12.2 en adelante. A partir de Oracle Database versión 26ai, también puede crear y consultar gráficos de propiedades mediante SQL, como se define en el estándar SQL:2023.
Oracle Graph Server and Client es un paquete de software que funciona con la función Property Graph de Oracle Database. Incluye herramientas de grafos, bibliotecas de clientes y Oracle Graph Server para ejecutar algoritmos de análisis de grafos.
Temas relacionados