Concetti per gli sviluppatori di database
Lo sviluppatore di Oracle Database crea e gestisce un'applicazione di database. Questa sezione presenta una breve panoramica di ciò che fa uno sviluppatore di database e degli strumenti di sviluppo disponibili.
-
Prestazioni degli sviluppatori di database Uno sviluppatore Oracle è responsabile della creazione o della gestione dei componenti del database di un'applicazione che utilizza lo stack di tecnologie Oracle.
-
Strumenti per sviluppatori di database Oracle fornisce diversi strumenti da utilizzare per lo sviluppo di applicazioni di database. Questa sezione descrive alcuni strumenti di sviluppo comunemente utilizzati.
-
Argomenti per gli sviluppatori di database In questa sezione vengono trattati gli argomenti più essenziali per gli sviluppatori di database e che non sono stati discussi altrove nel manuale.
Doveri degli sviluppatori di database
Uno sviluppatore Oracle è responsabile della creazione o la gestione dei componenti del database di un'applicazione che utilizza lo stack tecnologico Oracle.
Gli sviluppatori Oracle sviluppano nuove applicazioni o convertono le applicazioni esistenti per l'esecuzione nell'ambiente Oracle Database. Per questo motivo, gli sviluppatori lavorano a stretto contatto con gli amministratori del database, condividendo conoscenze e informazioni.
Gli sviluppatori di database Oracle possono aspettarsi di essere coinvolti nelle seguenti attività:
-
Implementazione del modello dati richiesto dall'applicazione
-
Creazione di oggetti dello schema
-
Implementazione di regole per l'integrità dei dati
-
Scegliere un ambiente di programmazione per un nuovo progetto di sviluppo
-
Scrittura di sottoprogrammi PL/SQL o Java lato server e codice procedurale lato client che utilizzano istruzioni SQL
-
Creazione dell'interfaccia dell'applicazione con lo strumento di sviluppo scelto
-
Creazione di un ambiente di supporto alla globalizzazione per lo sviluppo di applicazioni globalizzate
-
Creazione di istanze di applicazioni in database diversi per lo sviluppo, il test, la formazione e la distribuzione in un ambiente di produzione
Vedere anche:
-
Introduzione a Oracle AI Database Development per un'introduzione e tutorial basati su GUI sullo sviluppo di Oracle Database
-
Oracle AI Database Development Guide per discussioni approfondite su argomenti come la progettazione del database, SQL per gli sviluppatori e PL/SQL per gli sviluppatori
Strumenti per sviluppatori di database
Oracle fornisce diversi strumenti da utilizzare per lo sviluppo di applicazioni di database. Questa sezione descrive alcuni strumenti di sviluppo comunemente utilizzati.
-
SQL Developer è un modo conveniente per gli sviluppatori di database di modificare e sviluppare attività di base utilizzando SQL*Plus.
-
Oracle APEX AI Application Generator Oracle APEX AI Application Generator è uno strumento di sviluppo di applicazioni Web per Oracle Database. Oracle APEX AI Application Generator utilizza funzionalità integrate come temi dell'interfaccia utente, controlli di navigazione, gestori di moduli e report flessibili per accelerare lo sviluppo delle applicazioni.
-
Oracle JDeveloper è un ambiente di sviluppo integrato (IDE, Integrated Development Environment) per la creazione di applicazioni orientate ai servizi che utilizzano gli standard di settore più recenti per Java, XML, Web Services e SQL.
-
Oracle Developer Tools for Visual Studio .NET
Oracle Developer Tools for Visual Studio .NET è un set di strumenti applicativi integrati con l'ambiente Visual Studio .NET.
SQL Developer
SQL Developer è un modo conveniente per gli sviluppatori di database di modificare e sviluppare attività di base utilizzando SQL*Plus. SQL Developer è una versione grafica di SQL*Plus, scritta in Java, che supporta lo sviluppo in SQL e PL/SQL. È possibile connettersi a qualsiasi schema di database Oracle utilizzando l'autenticazione del database standard. SQL Developer consente di:
-
Sfoglia, crea, modifica ed elimina gli oggetti dello schema
-
Esegui istruzioni SQL
-
Modifica ed esegui debug delle program unit PL/SQL
-
Manipolare ed esportare i dati
-
Creare e visualizzare report
SQL Developer è disponibile nell'installazione predefinita di Oracle Database e tramite download gratuito.
Vedere anche: Oracle AI Database Introduzione allo sviluppo di Oracle AI Database e Oracle SQL Developer User's Guide per scoprire come utilizzare SQL Developer
Generatore di applicazioni AI Oracle APEX
Oracle APEX AI Application Generator è uno strumento di sviluppo di applicazioni Web per Oracle Database. Oracle APEX AI Application Generator utilizza funzionalità integrate come temi dell'interfaccia utente, controlli di navigazione, gestori di moduli e report flessibili per accelerare lo sviluppo delle applicazioni.
Oracle APEX viene installato con il database ed è costituito da dati in tabelle e codice PL/SQL. Quando si esegue un'applicazione, il browser invia una richiesta di URL tradotta in una chiamata PL/SQL Oracle APEX. Dopo l'elaborazione del database PL/SQL, i risultati vengono ritrasmessi al browser come HTML. Questo ciclo si verifica ogni volta che si richiede o si sottomette una pagina.
È possibile utilizzare Oracle APEX con il gateway PL/SQL incorporato. Il gateway viene eseguito nel server HTTP Oracle XML DB nel database e fornisce l'infrastruttura necessaria per creare applicazioni dinamiche. Come illustrato nella Figura 23-1, il gateway PL/SQL incorporato semplifica l'architettura dell'applicazione eliminando il livello intermedio.
Figura 1: APEX con gateway PL/SQL incorporato
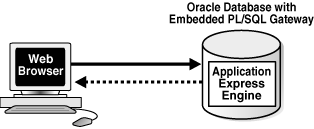
Descrizione dell'illustrazione cncpt317.gif
Oracle JDeveloper
Oracle JDeveloper è un ambiente di sviluppo integrato (IDE, Integrated Development Environment) per la creazione di applicazioni orientate ai servizi che utilizzano gli più recenti standard di settore per Java, XML, Web Services e SQL. Oracle JDeveloper supporta il ciclo di vita completo dello sviluppo software, con funzioni integrate per la modellazione, la codifica, il debug, il test, la profilazione, l'ottimizzazione e la distribuzione delle applicazioni.
Oracle JDeveloper utilizza le finestre per vari strumenti di sviluppo delle applicazioni. Ad esempio, quando si crea un'applicazione Java, è possibile utilizzare strumenti quali l'editor visivo Java e la tavolozza dei componenti. Oltre a questi strumenti, Oracle JDeveloper offre una gamma di navigatori che consentono di organizzare e visualizzare i contenuti dei progetti.
Vedere anche:
-
Inizia a utilizzare Oracle AI Database con Java Development per scoprire come utilizzare JDeveloper
-
È possibile scaricare JDeveloper dal seguente URL: http://www.oracle.com/technetwork/developer-tools/jdev/downloads/
Oracle Developer Tools for Visual Studio .NET
Oracle Developer Tools for Visual Studio .NET è un set di strumenti applicativi integrati con l'ambiente Visual Studio .NET. Gli strumenti Oracle Developer Tools for Visual Studio .NET consentono all'utente di eseguire un'ampia gamma di compiti di sviluppo delle applicazioni e migliorano l'efficienza dello sviluppo e la facilità di utilizzo.
Gli strumenti Oracle Developer supportano la programmazione e l'implementazione di stored procedure .NET mediante l'uso di Visual Basic, C# e altri linguaggi .NET. Queste procedure sono scritte in un linguaggio .NET e contengono istruzioni SQL o PL/SQL.
Argomenti per gli sviluppatori di database
Questa sezione tratta gli argomenti che sono più essenziali per gli sviluppatori di database e che non sono stati discussi altrove nel manuale.
-
Principi di progettazione e ottimizzazione delle applicazioni Gli sviluppatori Oracle devono progettare, creare e ottimizzare le applicazioni di database in modo da raggiungere gli obiettivi di sicurezza e prestazioni.
-
Principi delle query corrette Le query delle applicazioni reali possono essere molto complesse, con molti join, e spesso non sono corrette in tutti i casi angolari, specificando esplicitamente la restituzione di un risultato errato, anche nelle istruzioni SQL in esecuzione nei sistemi di produzione per lunghi periodi che generano errori inosservati. Questa sezione spiega come analizzare sistematicamente e per evitare il più importante di questi errori SQL fin troppo comuni.
-
Programmazione di database lato client Puoi utilizzare precompilatori o traduttori Java per inserire istruzioni SQL nel codice sorgente oppure puoi utilizzare le API per consentire alle applicazioni di interagire con il database.
-
Supporto per la globalizzazione Il supporto per la globalizzazione di Oracle Database consente di memorizzare, elaborare e recuperare i dati nelle lingue native.
-
Dati non strutturati I dati non strutturati sono dati che non sono suddivisi in strutture logiche più piccole.
Principi di Application Design e Tuning
Gli sviluppatori Oracle devono progettare, creare e ottimizzare le applicazioni di database in modo da raggiungere gli obiettivi di sicurezza e prestazioni.
I seguenti principi di progettazione e ottimizzazione delle applicazioni sono linee guida utili:
-
Scopri come funziona Oracle Database
Come sviluppatore, desideri sviluppare applicazioni nel minor tempo possibile rispetto a un database Oracle, che richiede di sfruttare l'architettura e le funzionalità del database. Ad esempio, non comprendere i controlli di concorrenza dei dati di Oracle Database e la coerenza della lettura multiversione può danneggiare l'integrità dei dati, eseguire lentamente e ridurre la scalabilità. Conoscere il funzionamento di Transaction Guard e Application Continuity consente di evitare la scrittura di codice di gestione delle eccezioni non necessario.
-
Utilizzare le bind variable a meno che non si disponga di un motivo valido per non utilizzarle
Quando una query utilizza le bind variable, il database può compilarle una sola volta e memorizzare il piano di query nel pool condiviso. Se la stessa istruzione viene eseguita di nuovo, il database può eseguire un soft parse e riutilizzare il piano. Al contrario, un hard parse richiede più tempo e utilizza più risorse. L'utilizzo di bind variable per consentire l'analisi dettagliata è molto efficiente ed è il modo in cui il database intende far funzionare gli sviluppatori.
-
Implementare vincoli di integrità nel database server anziché nel client
L'utilizzo di chiavi primarie ed estere consente di riutilizzare i dati in più applicazioni. Codificare le regole in un client significa che gli altri client non hanno accesso a queste regole quando vengono eseguiti sui database.
-
Creare un ambiente di test con dati rappresentativi e attività di sessione
Un ambiente di test che simula l'ambiente di produzione attivo offre diversi vantaggi. Ad esempio, è possibile confrontare l'applicazione per assicurarsi che sia scalabile e funzioni correttamente. Inoltre, è possibile utilizzare un ambiente di test per misurare l'impatto delle modifiche sulle prestazioni del database e assicurarsi che gli aggiornamenti e le patch funzionino correttamente.
-
Progettare il modello di dati con l'obiettivo di buone prestazioni
In genere, i tentativi di utilizzare modelli dati generici comportano prestazioni scadenti. Un modello di dati ben progettato risponde alle query più comuni nel modo più efficiente possibile. Ad esempio, il modello dati deve utilizzare il tipo di indici che forniscono le migliori prestazioni. Il tuning dopo la distribuzione è indesiderabile perché le modifiche alle strutture logiche e fisiche possono essere difficili o impossibili.
-
Definisci obiettivi prestazioni chiari e conserva record cronologici delle metriche
Un aspetto importante dello sviluppo è determinare esattamente come l'applicazione si prevede di eseguire e scalare. Ad esempio, utilizzare metriche che includono il carico utente previsto, le transazioni al secondo, i tempi di risposta accettabili e così via. La buona prassi prevede la gestione di record cronologici di metriche delle prestazioni. In questo modo, è possibile monitorare le prestazioni in modo proattivo e reattivo.
-
Strumentare il codice applicazione
Una buona procedura di sviluppo prevede l'aggiunta di codice di debug all'applicazione. La possibilità di generare file di trace è utile per il debug e la diagnosi dei problemi di prestazioni.
Vedere anche:
-
Introduzione a Oracle AI Database Development per considerazioni durante la progettazione delle applicazioni di database
-
Oracle AI Database SQL Tuning Guide per scoprire come progettare applicazioni per le prestazioni
Principi delle query corrette
Le query delle applicazioni del mondo reale possono essere molto complesse, con molti join, e queste sono sorprendentemente spesso non corrette in tutti i casi angolari, specificando esplicitamente il ritorno di un risultato errato, anche nelle istruzioni SQL in esecuzione nei sistemi di produzione per lunghi periodi producendo errori inosservati. Questa sezione spiega come analizzare sistematicamente e per evitare il più importante di questi errori SQL fin troppo comuni.
Le query possono sembrare molto complesse. Possono fare riferimento a decine di tabelle, includere viste create su altre viste e utilizzare subquery nelle clausole WITH, nell'elenco SELECT e nella clausola WHERE. Sotto questa complessità, una buona query risponde ancora a una domanda chiara. Questa domanda di solito riflette la necessità di dati su un insieme di un particolare tipo di entità aziendali. Ogni riga restituita dalla query deve rappresentare un'istanza di tale entità. Per le query GROUP BY, ogni riga deve rappresentare un'aggregazione su istanze della stessa entità.
Nella maggior parte dei sistemi, ogni tipo di entità aziendale abbastanza importante da eseguire una query dispone di una tabella corrispondente le cui righe rappresentano tale entità. In questo senso, molte query ben scritte, indipendentemente dalla complessità dell'aspetto, sono in definitiva domande sulle righe di una singola tabella. La complessità circostante in genere esiste perché i database normalizzati memorizzano gli attributi di un'entità nelle tabelle correlate, ad esempio le tabelle padre, le tabelle padre e così via.
Ad esempio, una progettazione normalizzata in genere memorizza il nome di un cliente una volta in una tabella CUSTOMERS. Una tabella ORDERS memorizza solo CUSTOMER_ID in modo che possa eseguire il join a CUSTOMERS. Una tabella ORDER_ITEMS memorizza ORDER_ID in modo che possa unirsi a ORDERS e non ripetere CUSTOMER_ID. Se vogliamo elencare un sottoinsieme di ORDER_ITEMS insieme al nome del cliente per ogni articolo, abbiamo bisogno di una sequenza di join univoci, prima a ORDERS (il padre) e poi a CUSTOMERS (il nonno). Nei sistemi OLTP ben normalizzati, le query possono richiedere molti join di questo tipo per recuperare informazioni dettagliate su un singolo tipo di entità, anche se il set di risultati mappa ancora uno a uno a un subset di righe da una tabella "primaria".
Chiamiamo questa tabella primaria la tabella allargata a righe (RWT). In una query corretta, gli altri join dovrebbero in genere "allargare" ogni riga RWT aggiungendo dati di lookup corrispondenti in modo univoco da tabelle padre, tabelle nonne e così via. Tali join non devono moltiplicare il numero di righe RWT. Le query con questa struttura per tutti i join che iniziano logicamente dall'RWT sono solo query che allargano le righe (RWOQ). Nota: l'applicazione di filtri può eliminare le righe RWT. I join interni e i predicati WHERE possono rimuovere le righe dall'RWT. "Row-widened" non significa che la query preserva tutte le righe RWT. Ciò significa che, dopo l'applicazione di filtri e prima di qualsiasi aggregazione, ogni riga di risultato della query corrisponde strettamente uno a uno alle righe RWT rimanenti.
Se ogni altra tabella della query è raggiungibile tramite una catena di join univoci da una singola tabella che rappresenta le entità restituite o aggregate dalla query, tale tabella iniziale è l'RWT e la query è un RWOQ. Se non è possibile garantire alcuna tabella tramite chiavi univoche per mappare una a una alle righe dei risultati di preaggregazione, la query non è una RWOQ. In pratica, la maggior parte dei non-RWOQ produce risultati che non possono essere interpretati correttamente dall'applicazione perché la query non mappa in modo pulito le righe dei risultati a un'entità ben definita e significativa per l'azienda. La somma dei valori di tali righe, ad esempio, aggiungerebbe lo stesso valore per la stessa entità più volte, lasciando un totale privo di senso.
A partire da Oracle Database Release 26ai, la funzione JOIN TO ONE facilita notevolmente la scrittura di RWOQ corretti. Quando si utilizza JOIN TO ONE per tutti i join, il database verifica in fase di analisi che la query sia una query RWOQ, trattando la tabella più a sinistra nella clausola FROM come RWT, supponendo che l'oggetto sia una tabella di base anziché una vista che potrebbe nascondere un funzionamento non RWOQ. Se il database non è in grado di dimostrare l'univocità dei join JOIN TO ONE al momento dell'analisi, esegue controlli di runtime per verificare che ogni join del presunto RWT rimanga univoco per i dati rilevati al momento dell'esecuzione. Se rileva un join non univoco nei risultati effettivi, genera un errore di runtime. La maggior parte dei RWOQ può essere convertita in formato JOIN TO ONE. Le query che non possono essere convertite nel modulo JOIN TO ONE in genere rivelano join irregolari nel tentativo di conversione. Quando la query convertita viene eseguita senza errori di runtime, tale risultato fornisce una forte conferma che la query ha la proprietà one-row-per-entity desiderata.
Per ulteriori dettagli sugli RWOQ, sul motivo per cui aiutano a prevenire sottili problemi di correttezza in SQL e sul modo in cui JOIN TO ONE li applica, consulta la Guida allo sviluppo di Oracle AI Database.
Programmazione database lato client
Puoi utilizzare precompilatori o traduttori Java per inserire istruzioni SQL nel codice sorgente, oppure puoi utilizzare le API per consentire alle applicazioni di interagire con il database.
Esistono due tecniche di base che consentono alle applicazioni di database procedurali di utilizzare SQL: la programmazione lato server con PL/SQL e Java, e la programmazione lato client con precompilatori e API come Java Database Connectivity (JDBC) o Oracle Call Interface (OCI).
-
Embedded SQL In passato, i programmi client/server utilizzavano SQL incorporato per interagire con il database.
-
API lato client La maggior parte degli sviluppatori oggi utilizza un'API per incorporare SQL nelle proprie applicazioni di database.
Vedere anche:
Oracle AI Database Development Guide per scoprire come scegliere un ambiente di programmazione
Programmazione lato server: PL/SQL e Java da rivedere
SQL incorporato
In passato, i programmi client/server utilizzavano SQL incorporato per interagire con il database.
- Oracle Precompilers I programmi client/server sono in genere scritti utilizzando un precompiler di Oracle, uno strumento di programmazione che consente di incorporare istruzioni SQL in programmi di alto livello.
Precompilatori Oracle
I programmi client/server vengono in genere scritti utilizzando un precompiler di Oracle, uno strumento di programmazione che consente di incorporare istruzioni SQL in programmi di alto livello.
Ad esempio, il precompilatore Oracle Pro*C/C++ consente di incorporare le istruzioni SQL in un file sorgente C o C++. I precompilatori Oracle sono disponibili anche per COBOL e FORTRAN.
Un precompilatore offre diversi vantaggi, tra cui:
-
Aumenta la produttività perché in genere scrivi meno codice rispetto alle applicazioni OCI equivalenti
-
Consente di creare applicazioni altamente personalizzate
-
Consente il monitoraggio di chiusura dell'uso delle risorse, dell'esecuzione delle istruzioni SQL e di vari indicatori di runtime
-
Risparmia tempo perché il precompilatore, non l'utente corrente, converte ogni istruzione SQL incorporata in chiamate alla libreria runtime di Oracle Database
-
Utilizza Object Type Translator per mappare i tipi di oggetto e le raccolte di Oracle Database nei tipi di dati C da utilizzare nell'applicazione Pro*C/C++
-
Fornisce il controllo del tipo di tempo di compilazione dei tipi di oggetto e delle raccolte e la conversione automatica del tipo dai tipi di database ai tipi di dati C
L'applicazione client che contiene le istruzioni SQL è il programma host. Questo programma è scritto nella lingua ospite. Nel programma host, è possibile combinare istruzioni SQL complete con istruzioni C complete e utilizzare variabili C o strutture nelle istruzioni SQL. Quando si incorporano le istruzioni SQL, è necessario iniziarle con le parole chiave EXEC SQL e terminarle con un punto e virgola. Pro*C/C++ converte le istruzioni EXEC SQL in chiamate alla libreria di runtime SQLLIB.
Molte istruzioni SQL incorporate differiscono dalle loro controparti interattive solo attraverso l'aggiunta di una nuova clausola o l'uso di variabili di programma. Nell'esempio seguente vengono confrontate le istruzioni ROLLBACK interattive e incorporate.
ROLLBACK;           -- interactive
EXEC SQL ROLLBACK;  -- embedded
Le istruzioni hanno lo stesso effetto, ma è possibile utilizzare la prima in un ambiente SQL interattivo (ad esempio SQL Developer) e la seconda in un programma Pro*C/C++.
Il precompilatore accetta il programma host come input, converte le istruzioni SQL incorporate in chiamate standard alla libreria di runtime del database e genera un programma fonte modificato che è possibile compilare, collegare ed eseguire nel modo consueto. La Figura 23-2 illustra i passaggi tipici per lo sviluppo di programmi che utilizzano precompilatori.
Figura 2: Sviluppo del programma con precompilatori
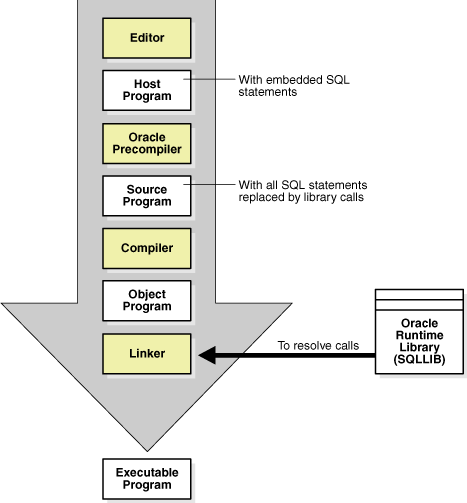
Descrizione dell'illustrazione cncpt253.gif
Vedere anche: Pro*C/C++ Developer's Guide per una descrizione completa del precompilatore Pro*C/C++
API lato client
La maggior parte degli sviluppatori oggi utilizza un'API per incorporare SQL nelle proprie applicazioni di database.
Ad esempio, due API più diffuse per consentire ai programmi di comunicare con Oracle Database sono Open Database Connectivity (ODBC) e JDBC. Oracle Call Interface (OCI) e Oracle C++ Call Interface (OCCI) sono altre due API comuni per la programmazione lato client.
-
OCI e OCCI In alternativa ai precompilatori, Oracle fornisce le API OCI e OCCI.
-
ODBC ODBC e JDBC è un'API standard che consente alle applicazioni di connettersi a un database e quindi di preparare ed eseguire le istruzioni SQL.
OCI e OCCI
In alternativa ai precompilatori, Oracle fornisce le API OCI e OCCI.
OCI consente di manipolare dati e schemi in un database utilizzando un linguaggio di programmazione host come C. OCCI è un'interfaccia orientata agli oggetti adatta per l'uso con C++. Entrambe le API consentono agli sviluppatori di utilizzare i richiami nativi dei sottoprogrammi per accedere a Oracle Database e controllare l'esecuzione SQL.
In alcuni casi, OCI offre prestazioni migliori o più funzioni rispetto a interfacce di livello più elevato. OCI e OCCI forniscono molte funzioni, tra cui:
-
Supporto per tutte le funzionalità SQL DDL, DML, query e controllo delle transazioni disponibili tramite Oracle Database
-
Client istantaneo, un modo per distribuire le applicazioni quando lo spazio su disco è un problema
-
Gestione dei thread, connection pooling, funzioni di globalizzazione e caricamento diretto dei percorsi dei dati da un'applicazione C
OCI e OCCI forniscono una libreria di funzioni standard di accesso al database e recupero sotto forma di libreria runtime dinamica (OCILIB). Questa libreria può essere collegata in un'applicazione in fase di esecuzione. Pertanto, puoi compilare e collegare un programma OCI o OCCI allo stesso modo di un'applicazione non di database, evitando un passo di pre-elaborazione o pre-compilazione separato. La Figura 23-3 illustra il processo di sviluppo.
Figura 3: Processo di sviluppo che utilizza OCI o OCCI
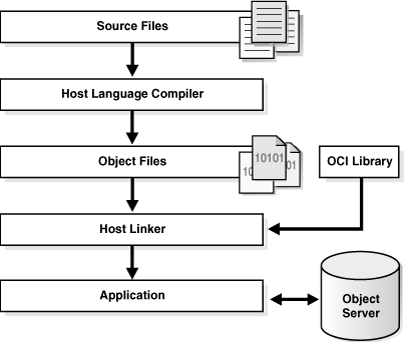
Descrizione dell'illustrazione cncpt307.gif
Vedere anche:
ODBC e JDBC
ODBC è un'API standard che consente alle applicazioni di connettersi a un database e quindi di preparare ed eseguire istruzioni SQL.
ODBC è indipendente da linguaggio di programmazione, database e sistema operativo. L'obiettivo di ODBC è quello di consentire a qualsiasi applicazione di accedere ai dati contenuti in qualsiasi database.
Un driver di database è un software che si trova tra un'applicazione e il database. Il driver traduce le chiamate API effettuate dall'applicazione in comandi che il database può elaborare. Utilizzando un driver ODBC, un'applicazione può accedere a qualsiasi origine dati, inclusi i dati memorizzati in fogli di calcolo. Il driver ODBC esegue tutti i mapping tra lo standard ODBC e il database.
Il driver Oracle ODBC fornito da Oracle consente alle applicazioni conformi a ODBC di accedere a Oracle Database. Ad esempio, un'applicazione scritta in Visual Basic può utilizzare ODBC per eseguire query e aggiornare le tabelle in un database Oracle.
JDBC è un'interfaccia Java di basso livello che consente alle applicazioni Java di interagire con il database Oracle. Come ODBC, JDBC è un'API indipendente dal fornitore. Lo standard JDBC è definito da Sun Microsystems e implementato tramite le interfacce java.sql.
Lo standard JDBC consente ai singoli provider di implementare ed estendere lo standard con i propri driver JDBC. Oracle fornisce i seguenti driver JDBC per la programmazione lato client:
-
Driver thin JDBC
Questo driver Java puro risiede sul lato client senza l'installazione di un client Oracle. È indipendente dalla piattaforma e utilizzabile sia con le applet che con le applicazioni.
-
Driver OCI JDBC
Questo driver si trova sul lato client con un'installazione client Oracle. È utilizzabile solo con applicazioni. Il driver OCI JDBC, scritto sia in C che in Java, converte le chiamate JDBC in chiamate OCI.
Gli snippet riportati di seguito provengono da un programma Java che utilizza il driver OCI JDBC per creare un oggetto Statement ed eseguire una query sulla tabella dual.
// Create a statement
Statement stmt = conn.createStatement();

// Query dual table
ResultSet rset = stmt.executeQuery("SELECT 'Hello World' FROM DUAL");
Vedi anche: Oracle AI Database Development Guide e Oracle AI Database Guida introduttiva allo sviluppo Java per ulteriori informazioni su JDBC
Supporto per la globalizzazione
Il supporto della globalizzazione di Oracle Database consente di memorizzare, elaborare e recuperare i dati nelle lingue di origine.
Il supporto alla globalizzazione consente di sviluppare applicazioni e software multilingue a cui è possibile accedere ed eseguire contemporaneamente da qualsiasi parte del mondo.
Gli sviluppatori che scrivono un'applicazione di database globalizzata devono effettuare le operazioni riportate di seguito.
-
Comprendere l'architettura di supporto della globalizzazione di Oracle Database, incluse le proprietà dei diversi set di caratteri, territori, lingue e definizioni degli ordinamenti linguistici
-
Comprendere la funzionalità di globalizzazione del proprio ambiente di programmazione di livello intermedio, incluso il modo in cui può interagire e sincronizzarsi con il modello locale del database
-
Progettare e scrivere codice in grado di supportare contemporaneamente più client in esecuzione su diversi sistemi operativi, con diversi set di caratteri e requisiti locali
Ad esempio, potrebbe essere necessaria un'applicazione per eseguire il rendering del contenuto dell'interfaccia utente ed elaborare i dati nelle lingue e nelle preferenze locali degli utenti nativi. Ad esempio, l'applicazione deve elaborare dati Kanji multibyte, visualizzare messaggi e date nel formato regionale appropriato ed elaborare dati ASCII a 7 bit senza richiedere agli utenti di modificare le impostazioni.
-
Ambiente di supporto della globalizzazione L'ambiente di supporto della globalizzazione include l'applicazione client e il database. È possibile controllare le operazioni dipendenti dalla lingua impostando i parametri e le variabili di ambiente sul client e sul server, che possono esistere in posizioni separate.
-
Oracle Globalization Development Kit Oracle Globalization Development Kit (GDK) include API di programmazione complete. Vedi anche: Oracle AI Database Globalization Support Guide per ulteriori informazioni sulla globalizzazione
Ambiente di supporto alla globalizzazione
L'ambiente di supporto alla globalizzazione include l'applicazione client e il database. È possibile controllare le operazioni dipendenti dalla lingua impostando i parametri e le variabili di ambiente sul client e sul server, che possono esistere in posizioni separate. Nota: nelle release precedenti, Oracle faceva riferimento alle funzionalità di supporto alla globalizzazione come funzioni del National Language Support (NLS). NLS è in realtà un sottoinsieme del supporto alla globalizzazione e offre la possibilità di scegliere una lingua nazionale e memorizzare i dati in un set di caratteri specifico.
Oracle Database fornisce supporto per la globalizzazione per funzioni quali:
-
Lingue e territori nativi
-
Formati locali per data, ora, numeri e valuta
-
Sistemi di calendario (gregoriano, imperiale giapponese, Buddha tailandese e così via)
-
Set di caratteri multipli, incluso Unicode
-
Semantica dei caratteri
-
Set di caratteri Un componente chiave del supporto della globalizzazione è un set di caratteri, ovvero uno schema di codifica utilizzato per visualizzare i caratteri su uno schermo del computer.
-
Impostazioni nazionali Un'impostazione locale è un ambiente linguistico e culturale in cui viene eseguita un sistema o un'applicazione. I parametri NLS determinano un funzionamento specifico delle impostazioni nazionali sia sul client che sul database.
Set di caratteri
Un componente chiave del supporto della globalizzazione è un set di caratteri, che è uno schema di codifica utilizzato per visualizzare i caratteri su uno schermo del computer.
La seguente distinzione è importante nello sviluppo delle applicazioni:
-
Un set di caratteri del database determina quali lingue possono essere rappresentate in un database. Il set di caratteri viene specificato durante la creazione del database.
Nota: dopo la creazione di un database, la modifica del set di caratteri è in genere molto costosa in termini di tempo e risorse. Questa operazione potrebbe richiedere la conversione di tutti i dati dei caratteri esportando l'intero database e importandolo di nuovo.
-
Un set di caratteri del client è il set di caratteri per i dati immessi o visualizzati da un'applicazione client. Il set di caratteri per il client e il database può essere diverso.
Un gruppo di caratteri (ad esempio, caratteri alfabetici, ideografi, simboli, segni di punteggiatura e caratteri di controllo) può essere codificato come set di caratteri. Un set di caratteri codificato assegna un codice numerico univoco, chiamato code point o valore codificato, a ciascun carattere del set. I punti codice sono importanti in un ambiente globale a causa della potenziale necessità di convertire i dati tra set di caratteri diversi.
L'industria informatica utilizza molti set di caratteri codificati. Questi set differiscono per il numero di caratteri disponibili, i caratteri disponibili per l'uso, i punti di codice assegnati a ciascun carattere e così via. Oracle Database supporta La maggior parte delle norme codificate nazionali, internazionali e specifiche del fornitore.
Oracle Database supporta le seguenti classi di set di caratteri codificati:
-
Set di caratteri a byte singolo
Ogni carattere occupa un byte. Un esempio di set di caratteri a 7 bit è US7ASCII. Un esempio di set di caratteri a 8 bit è WE8DEC.
-
Set di caratteri multibyte
Ogni carattere occupa più byte. I set multibyte sono comunemente utilizzati per le lingue asiatiche.
-
Unicode
Il set di caratteri con codifica universale consente di memorizzare le informazioni in qualsiasi lingua utilizzando un singolo set di caratteri. Unicode fornisce un valore di codice univoco per ogni personaggio, indipendentemente dalla piattaforma, dal programma o dalla lingua.
Vedere anche: Oracle AI Database Globalization Support Guide per ulteriori informazioni sulla migrazione dei set di caratteri
Impostazioni specifiche della versione locale
Un'impostazione locale è un ambiente linguistico e culturale in cui viene eseguita un sistema o un programma. I parametri NLS determinano un funzionamento specifico delle impostazioni nazionali sia sul client che sul database.
Una sessione di database utilizza le impostazioni NLS durante l'esecuzione delle istruzioni per conto di un client. Ad esempio, il database utilizza correttamente il separatore delle migliaia per un client. In genere, la variabile di ambiente NLS_LANG sull'host client specifica le impostazioni nazionali sia per la sessione del server che per l'applicazione client. Il processo viene illustrato di seguito.
-
All'avvio di un'applicazione client, l'ambiente NLS viene inizializzato dalle impostazioni dell'ambiente.
Tutte le operazioni NLS eseguite localmente, ad esempio la visualizzazione della formattazione nelle applicazioni Oracle Developer, utilizzano queste impostazioni.
-
Il client comunica le informazioni definite da
NLS_LANGal database quando si connette. -
La sessione del database inizializza il proprio ambiente NLS in base alle impostazioni comunicate dal client.
Se il client non ha specificato le impostazioni, la sessione utilizza le impostazioni nel file dei parametri di inizializzazione. Il database utilizza le impostazioni dei parametri di inizializzazione solo se il client non ha specificato alcuna impostazione NLS. Se il client ha specificato alcune impostazioni NLS, le impostazioni NLS rimanenti sono predefinite.
Ogni sessione avviata per conto di un'applicazione client può essere eseguita in impostazioni nazionali uguali o diverse rispetto ad altre sessioni. Ad esempio, una sessione può utilizzare la versione locale tedesca mentre un'altra la versione locale francese. Inoltre, ogni sessione può avere gli stessi requisiti linguistici o diversi specificati.
La tabella seguente mostra due client che utilizzano impostazioni NLS_LANG diverse. Un utente avvia SQL*Plus su ciascun host, accede allo stesso database di hr ed esegue la stessa query contemporaneamente. Il risultato per ogni sessione è diverso a causa dell'impostazione NLS specifica per le impostazioni nazionali per i numeri a virgola mobile.
Tabella 1 Impostazioni NLS specifiche delle versioni locali
| t | Host client 1 | Host client 2 |
|---|---|---|
| t0 | |
|
| t1 | |
|
Vedere anche: Oracle AI Database Globalization Support Guide per ulteriori informazioni sulle impostazioni NLS
Oracle Globalization Development Kit
Oracle Globalization Development Kit (GDK) include API di programmazione complete.
Le API sono disponibili sia per Java che per PL/SQL e includono esempi di codice e documentazione che risolvono molti dei problemi di progettazione, sviluppo e distribuzione riscontrati durante la creazione di applicazioni globali. Il GDK semplifica il processo di sviluppo e riduce i costi di sviluppo di applicazioni Internet utilizzate per supportare un ambiente globale.
Il GDK si compone principalmente di due parti: GDK per Java e GDK per PL/SQL. GDK per Java fornisce supporto per la globalizzazione alle applicazioni Java. GDK per PL/SQL fornisce supporto alla globalizzazione per l'ambiente di programmazione PL/SQL. Le caratteristiche offerte nelle due parti non sono identiche.
Vedi anche: Oracle AI Database Globalization Support Guide
Dati non strutturati
I dati non strutturati sono dati che non sono suddivisi in strutture logiche più piccole.
Il modello relazionale tradizionale si occupa di dati strutturati semplici che si adattano a tabelle semplici. Oracle Database fornisce inoltre supporto per i dati non strutturati, che non possono essere scomposti in componenti standard. I dati non strutturati includono testo, immagini grafiche, video clip e forme d'onda sonore.
Oracle Database include tipi di dati per gestire contenuti non strutturati. Questi tipi di dati vengono visualizzati come tipi nativi nel database e possono essere interrogati utilizzando SQL.
-
Panoramica dell'XML in Oracle Database Oracle XML DB è un set di tecnologie Oracle Database correlate alla manipolazione, allo storage e al recupero XML ad alte prestazioni. Oracle XML DB fornisce supporto XML nativo includendo modelli di dati sia SQL che XML in modo interoperabile.
-
Panoramica di JSON in Oracle Database Oracle Database fornisce supporto nativo per i dati JavaScript Object Notation (JSON), tra cui query e indicizzazione.
-
Panoramica dei tipi di dati LOB Large Object (LOB) consente di memorizzare e manipolare grandi blocchi di dati non strutturati in formato binario o a caratteri.
-
Panoramica di Oracle Text Oracle Text (Text) è una tecnologia di recupero full-text integrata con Oracle Database. Oracle Text indicizza qualsiasi documento o contenuto testuale memorizzato in file system, database o sul Web. La ricerca di questi documenti può essere eseguita in base al contenuto testuale, ai metadati o agli attributi.
-
Panoramica di Oracle Spatial and Graph Oracle Spatial and Graph (Spatial and Graph) include funzioni avanzate per l'analisi e i dati spaziali, nonché per applicazioni grafiche fisiche, logiche, di rete e social e semantiche.
-
Panoramica dei grafici delle proprietà SQL La funzione Property Graph di Oracle Database offre un potente supporto grafico per Oracle Database.
Panoramica dell'XML in Oracle Database
Oracle XML DB è un set di tecnologie Oracle Database correlate alla manipolazione, allo storage e al recupero XML ad alte prestazioni. Oracle XML DB fornisce supporto XML nativo includendo modelli di dati sia SQL che XML in modo interoperabile.
Oracle XML DB è adatto a qualsiasi applicazione Java o PL/SQL in cui alcuni o tutti i dati elaborati dall'applicazione vengono rappresentati utilizzando XML. Ad esempio, l'applicazione può avere un numero elevato di documenti XML che devono essere inclusi, generati, convalidati e cercati.
Oracle XML DB offre numerose funzioni, tra cui:
-
Il tipo di dati
XMLTypenativo, che può rappresentare un documento XML nel database in modo che sia accessibile da SQL -
Supporto per standard XML quali schema XML, XPath, XQuery, XSLT e DOM
-
XMLIndex, che supporta tutte le forme di dati XML, da altamente strutturati a completamente non strutturati
L'esempio seguente crea una tabella orders di tipo XMLType:
CREATE TABLE orders OF XMLType;
CREATE DIRECTORY xmldir AS path_to_folder_containing_XML_file;
INSERT INTO orders
  VALUES (XMLType(BFILENAME('XMLDIR','purOrder.xml'),NLS_CHARSET_ID('AL32UTF8')));
Nell'esempio precedente viene inoltre creato un oggetto directory SQL, che è un nome logico nel database per una directory fisica nel computer host. Questa directory contiene file XML. Nell'esempio viene inserito il contenuto XML dal file purOrder.xml nella tabella orders.
Il kit per sviluppatori Oracle XML (XDK) contiene i componenti di base per la lettura, la manipolazione, la trasformazione e la visualizzazione dei documenti XML, sia su un file system che in un database. API e strumenti sono disponibili per Java, C e C++. La produzione di Oracle XDK viene fornita con una licenza di ridistribuzione commerciale.
Esempio 23-1 XMLType
CREATE TABLE orders OF XMLType;
CREATE DIRECTORY xmldir AS path_to_folder_containing_XML_file;
INSERT INTO orders
  VALUES (XMLType(BFILENAME('XMLDIR','purOrder.xml'),NLS_CHARSET_ID('AL32UTF8')));
Vedere anche:
Panoramica di JSON in Oracle Database
Oracle Database fornisce supporto nativo per i dati JavaScript Object Notation (JSON), tra cui l'esecuzione di query e l'indicizzazione.
Questa sezione contiene gli argomenti riportati di seguito.
-
Che cos'è JSON? JavaScript Object Notation (JSON) è un formato di dati basato su testo indipendente dal linguaggio che può rappresentare oggetti, array e dati scalari. Una vasta gamma di linguaggi di programmazione può analizzare e generare dati JSON.
-
JSON e XML Sia JSON che XML sono comunemente utilizzati come linguaggi di interscambio di dati. A differenza dei dati relazionali, sia i dati JSON che quelli XML possono essere memorizzati, indicizzati e sottoposti a query nel database senza alcuno schema che definisca i dati.
-
Native Database Support for JSON JSON è ampiamente memorizzato in database noSQL privi di funzioni di database relazionali. Al contrario, Oracle Database supporta JSON in modo nativo con funzionalità come transazioni, indicizzazione, query dichiarative e viste.
Cos'è JSON?
JavaScript Object Notation (JSON) è un formato di dati basato su testo indipendente dal linguaggio che può rappresentare oggetti, array e dati scalari. Una vasta gamma di linguaggi di programmazione può analizzare e generare dati JSON.
JSON funge in genere da linguaggio di interscambio di dati. Viene spesso utilizzato per serializzare i dati strutturati e scambiarli su una rete, in genere tra un server e applicazioni Web. JSON è il formato di dati dominante nei browser Web che eseguono applicazioni scritte in HTML-embedded JavaScript.
Un oggetto JavaScript è un array associativo di zero o più coppie di nomi di proprietà e valori JSON associati. Un oggetto JSON è un valore di oggetto JavaScript, che viene scritto come lista di proprietà racchiusa tra parentesi graffe, con coppie nome-valore separate da virgole e con il nome e il valore di ogni coppia separati da due punti. Una proprietà oggetto viene talvolta chiamata chiave. Una coppia nome-valore di una proprietà oggetto viene talvolta chiamata membro di un oggetto.
Esempio di oggetto JSON 23-2
Questo esempio mostra un oggetto JSON che rappresenta un ordine di acquisto, con i nomi di proprietà di livello superiore PONumber, Reference, Requestor, User, Costcenter, ShippingInstruction, Special Instructions, AllowPartialShipment e LineItems.
{ "PONumber"             : 1600,
  "Reference"            : "ABULL-20140421",
  "Requestor"            : "Alexis Bull",
  "User"                 : "ABULL",
  "CostCenter"           : "A50",
  "ShippingInstructions" : { "name"   : "Alexis Bull",
                             "Address": { "street"  : "200 Sporting Green",
                                          "city"    : "South San Francisco",
                                          "state"   : "CA",
                                          "zipCode" : 99236,
                                          "country" : "United States of America" },
                             "Phone" : [ { "type" : "Office", "number" : "909-555-7307" },
                                         { "type" : "Mobile", "number" : "415-555-1234" } ] },
  "Special Instructions" : null,
  "AllowPartialShipment" : false,
  "LineItems"            : [ { "ItemNumber" : 1,
                               "Part"       : { "Description" : "One Magic Christmas",
                                                "UnitPrice"   : 19.95,
                                                "UPCCode"     : 13131092899 },
                               "Quantity"   : 9.0 },
                             { "ItemNumber" : 2,
                               "Part"       : { "Description" : "Lethal Weapon",
                                                "UnitPrice"   : 19.95,
                                                "UPCCode"     : 85391628927 },
                               "Quantity"   : 5.0 } ] }
Nell'esempio precedente, la maggior parte delle proprietà contiene valori stringa. I valori numerici sono PONumber, zipCode, ItemNumber e Quantity. Shipping Instructions e Address hanno oggetti come valori. LineItems ha un array come valore.
Nota: Oracle XML DB Developer's Guide per una panoramica più completa di JSON
JSON e XML
Sia JSON che XML sono comunemente utilizzati come linguaggi di interscambio dati. A differenza dei dati relazionali, entrambi i dati JSON e XML possono essere memorizzati, indicizzati e sottoposti a query nel database senza alcuno schema che definisca i dati.
A causa della sua semplice definizione e funzionalità, i dati JSON sono generalmente più facili da generare, analizzare ed elaborare rispetto ai dati XML. È anche più facile per gli esseri umani imparare e usare. Nella tabella seguente vengono descritte ulteriori differenze tra JSON e XML.
Tabella 2 Differenze tra JSON e XML
| Funzione | JSON | XML |
|---|---|---|
| Utile per dati semplici e strutturati | Sì | Sì, ma supporta anche dati semistrutturati e dati strutturati complessi |
| Utile per contenuto misto | N. | Sì |
| Non dispone di attributi, spazi di nomi, eredità e sostituzione | Sì | N. |
| Importanza degli ordini | N. | Sì |
| Principalmente destinato a documenti piuttosto che dati | N. | Sì |
| Include un tipo di dati data | N. | Sì |
Nota: Oracle AI Database JSON Developer's Guide per un confronto più completo di XML e JSON
Supporto database nativo per JSON
JSON è ampiamente memorizzato in database noSQL privi di funzioni di database relazionali. Al contrario, Oracle Database supporta JSON in modo nativo con funzionalità come transazioni, indicizzazione, query dichiarative e viste.
Puoi accedere ai dati JSON memorizzati nel database allo stesso modo in cui accedi ad altri dati del database, tra cui OCI, .NET e JDBC. Il modo preferito per memorizzare i dati JSON è utilizzare il tipo di dati JSON, che è un formato binario proprietario ottimizzato per l'elaborazione di query e DML. È possibile utilizzare il tipo di dati JSON nella maggior parte delle posizioni in cui è consentito un tipo di dati SQL, incluso un tipo di colonna o un tipo di parametro per una program unit PL/SQL.
Utilizzando Oracle SQL, puoi eseguire operazioni quali le seguenti sui dati JSON:
-
Unisci i dati JSON con dati relazionali non JSON.
-
Genera un documento JSON dai dati relazionali utilizzando le funzioni SQL
json_objectejson_array. -
Proietta i dati JSON in un formato relazionale utilizzando la funzione SQL
json_table. -
Creare un vincolo di controllo con
is_jsonper applicare i dati JSON in una colonna. Il database utilizza il vincolo di controllo per confermare che la colonna è JSON per operazioni specifiche di JSON, ad esempio la sintassi semplificata. -
Manipolare i documenti JSON come oggetti PL/SQL.
-
Utilizzare le funzioni SQL
json_queryejson_valueper accettare un'espressione di percorso JSON Oracle come argomento e abbinarla ai dati JSON di destinazione. -
Indicizza dati JSON.
-
Eseguire una query sui dati JSON memorizzati in una tabella esterna.
-
Replica le tabelle con colonne contenenti dati JSON mediante Oracle GoldenGate.
I dati JSON testuali utilizzano sempre il set di caratteri Unicode, UTF8 o UTF16. Oracle Database utilizza UTF8 internamente quando analizza ed esegue query sui dati JSON. Se i dati immessi o generati da tale elaborazione devono trovarsi in un set di caratteri diverso da UTF8, la conversione del set di caratteri appropriata viene eseguita automaticamente. Nota: Oracle AI Database JSON Developer's Guide per una panoramica più completa del supporto JSON in Oracle Database
Panoramica dei LOB
I tipi di dati LOB (Large Object) consentono di memorizzare e manipolare grandi blocchi di dati non strutturati in formato binario o a caratteri.
Il tipo di dati large object (LOB) fornisce un accesso efficiente, casuale e dettagliato ai dati.
-
LOB interni Un LOB interno memorizza i dati nel database stesso anziché in file esterni.
-
LOB esterni Un oggetto
BFILE(oggetto file binario di grandi dimensioni o LOB) è un oggetto esterno di grandi dimensioni. -
SecureFiles SecureFiles Lo storage LOB è uno dei due tipi di storage; l'altro tipo è lo storage LOB BasicFiles.
LOB interni
Un LOB interno memorizza i dati nel database stesso anziché in file esterni.
I LOBS interni includono quanto segue:
-
CLOB(LOB carattere), che memorizza grandi quantità di testo, ad esempio file di testo o XML, nel set di caratteri del database -
NCLOB(National Character Set LOB), che memorizza i dati Unicode -
BLOB(LOB binario), che memorizza grandi quantità di informazioni binarie come flusso di bit e non è soggetto alla traduzione del set di caratteri
Il database memorizza i LOB in modo diverso rispetto ad altri tipi di dati. La creazione di una colonna LOB crea implicitamente un segmento LOB e un indice LOB. La tablespace contenente il segmento LOB e l'indice LOB, sempre memorizzati insieme, può essere diversa dalla tablespace contenente la tabella.
Nota: a volte il database può memorizzare piccole quantità di dati LOB nella tabella stessa anziché in un segmento LOB separato.
Il segmento LOB memorizza i dati in parti denominate chunk. Un chunk è un insieme logicamente contiguo di blocchi di dati ed è l'unità di allocazione più piccola per un LOB. Una riga della tabella memorizza un puntatore denominato locator LOB, che punta all'indice LOB. Quando viene eseguita una query sulla tabella, il database utilizza l'indice LOB per individuare rapidamente i chunk LOB.
Il database gestisce la coerenza delle letture per i segmenti LOB in modo diverso dagli altri dati. Invece di utilizzare i dati di annullamento per registrare le modifiche, il database memorizza le immagini precedenti nel segmento stesso. Quando una transazione cambia un LOB, il database alloca un nuovo chunk e lascia i vecchi dati in posizione. Se viene eseguito il rollback della transazione, il database esegue il rollback delle modifiche apportate all'indice, che punta al vecchio chunk.
Vedere anche:
LOB esterni
Un oggetto BFILE (file binario di grandi dimensioni o LOB) è un oggetto di grandi dimensioni esterno.
Un BFILE è un LOB esterno, poiché il database memorizza un puntatore a un file nel sistema operativo. I dati esterni sono di sola lettura.
Un BFILE utilizza un oggetto directory per individuare i dati. La quantità di spazio consumata dipende dalla lunghezza del nome dell'oggetto directory e dalla lunghezza del nome file.
Un file BFILE non utilizza lo stesso meccanismo di coerenza delle letture di LOBS interno perché il file binario è esterno al database. Se i dati nel file cambiano, le letture ripetute dallo stesso file binario possono produrre risultati diversi.
SecureFiles
SecureFiles LOB storage è uno dei due tipi di archiviazione; l'altro tipo è BasicFiles LOB storage.
Il parametro LOB SECUREFILE consente funzioni avanzate, tra cui compressione e deduplicazione (parte dell'opzione di compressione avanzata) e cifratura (parte dell'opzione di sicurezza avanzata). A partire da Oracle Database 12c, SecureFiles è il meccanismo di storage predefinito per i LOB.
Vedere anche:
-
Oracle AI Database SecureFiles and Large Objects Developer's Guide per saperne di più sui tipi di dati LOB
Panoramica di Oracle Text
Oracle Text (Text) è una tecnologia di recupero full-text integrata con Oracle Database. Oracle Text indicizza qualsiasi documento o contenuto testuale memorizzato in file system, database o sul Web. La ricerca di questi documenti può essere eseguita in base al contenuto testuale, ai metadati o agli attributi.
In Oracle Text sono disponibili i vantaggi riportati di seguito.
-
Oracle Text consente di combinare le ricerche di testo con le normali ricerche di database in una singola istruzione SQL. L'indice di testo si trova nel database e le query di testo vengono eseguite nel processo di Oracle Database. L'ottimizzatore può scegliere il piano di esecuzione migliore per qualsiasi query, offrendo le prestazioni migliori per query ad hoc che coinvolgono testo e criteri strutturati.
-
È possibile utilizzare Oracle Text con dati XML. In particolare, è possibile combinare
XMLIndexcon l'indicizzazione di Oracle Text, sfruttando sia l'XML che un indice full-text. -
L'API SQL di Oracle Text semplifica e rende intuitivo creare e gestire indici Oracle Text ed eseguire ricerche.
Per un caso d'uso, si supponga di dover creare un indice di catalogo per una sede d'asta che vende apparecchiature elettroniche. Il nuovo inventario viene aggiunto ogni giorno. Le descrizioni degli articoli, le date dell'offerta e i prezzi devono essere memorizzati insieme. L'applicazione richiede un buon tempo di risposta per le query miste. In primo luogo, creare e popolare una tabella catalog. Utilizzare quindi Oracle Text per creare un indice CTXCAT che è possibile eseguire una query con l'operatore CATSEARCH in un'istruzione SELECT ... WHERE CATSEARCH. La Figura 23-4 illustra la relazione della tabella del catalogo, il relativo indice CTXCAT e l'applicazione del catalogo che utilizza l'operatore CATSEARCH per eseguire una query sull'indice.
Figura 4: Applicazione query catalogo
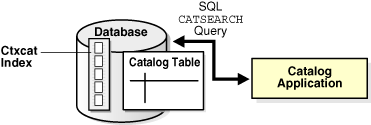
Descrizione dell'illustrazione ccapp017.gif
Vedere anche:
-
Oracle Text Application Developer's Guide e Oracle Text Reference
-
Oracle XML DB Developer's Guide per informazioni su come eseguire la ricerca full-text sui dati XML
Panoramica di Oracle Spatial and Graph
Oracle Spatial and Graph (Spatial and Graph) include funzioni avanzate per l'analisi e i dati spaziali, nonché per applicazioni grafiche fisiche, logiche, di rete, social e semantiche.
Le funzioni spaziali forniscono uno schema e funzioni che facilitano la memorizzazione, il recupero, l'aggiornamento e la query delle raccolte di funzioni spaziali in un database Oracle. Un esempio di dati spaziali è una road map. I dati spaziali indicano la posizione della Terra (come longitudine e latitudine) degli oggetti sulla mappa. Quando la mappa viene visualizzata, questi dati spaziali possono proiettare le posizioni degli oggetti su un foglio di carta bidimensionale. Un sistema di informazione geografica (GIS) può memorizzare, recuperare e rendere questi dati spaziali relativi alla Terra. Quando un database Oracle memorizza questi dati spaziali, è possibile utilizzare Spatial and Graph per manipolare e recuperare questi dati e correlarli ad altri dati.
Vedere anche: Oracle Spatial Developer's Guide
Panoramica dei grafici delle proprietà SQL
La funzione Property Graph di Oracle Database offre un potente supporto grafico per Oracle Database.
La funzione Grafico struttura consente di esplorare e scoprire relazioni complesse in set di dati quali dati dei clienti, social network e transazioni finanziarie, per applicazioni in consigli sui prodotti, rilevamento delle frodi, analisi dei rischi, marketing mirato e altro ancora. Questa funzione di grafico ad alte prestazioni offre supporto avanzato del linguaggio di query dei grafici, API per sviluppatori e funzionalità di analitica con quasi 60 algoritmi predefiniti.
Le funzioni Property Graph, incluso il supporto di PGQL (Property Graph Query Language), sono disponibili da Oracle Database 12.2 in poi. A partire da Oracle Database Release 26ai, è inoltre possibile creare ed eseguire query sui grafici delle proprietà utilizzando SQL, come definito nello standard SQL:2023.
Oracle Graph Server and Client è un pacchetto software che funziona con la funzione Property Graph in Oracle Database. Include strumenti grafici, librerie client e Oracle Graph Server per l'esecuzione di algoritmi di analitica dei grafici.
Argomenti correlati