추출 추가
Extract 추가를 위한 필요 조건 및 고려 사항에 대해 알아봅니다.
Extract를 추가하기 전에 다음 설정이 구성되었는지 확인합니다.
이제 배포에 대한 Extract를 추가할 준비가 되었습니다.
이전 추출 추적 파일이 있는 경우 추출을 생성하기 위한 고려 사항
-
이전 구성에서 고립된 트레일 파일이 존재할 때 Extract를 생성하면 프로세스가 실패할 수 있습니다. 예를 들어,
north/ea00000000가 이전 구성에서 유지되고 제거되지 않은 경우 Extract 생성을 실패할 수 있습니다. -
이전 추적 시퀀스가 있는 동안 상위 시퀀스 번호로 시작하는 Extract를 다시 추가하면 Extract 구성이 동기화되지 않았거나 올바르지 않을 수 있습니다. 예를 들어,
north/ea00002261가 존재하고north/ea00002262부터 Extract를 재생성하는 경우 Extract 구성이 올바르지 않을 수 있습니다. 이러한 경우 기존 트레일 파일을 제거하거나 참조되지 않은 위치로 이동해야 합니다.
정보 추출 화면
마이크로서비스 홈 페이지에 로그인한 후 생성 열에서 + 기호를 눌러 추출 추가 마법사를 엽니다.
추출 정보 화면에서 추출 유형을 선택합니다. 데이터베이스 플랫폼에 따라 사용 가능한 추출 유형은 통합 추출, 데이터 캡처 변경 추출 및 초기 로드 추출일 수 있습니다.
Oracle AI Database에 대해 다운스트림 추출을 설정해야 하는 경우 다운스트림 추출 토글 스위치를 사용으로 설정합니다.
생성할 추출 유형을 선택하고 다음을 지정합니다.
-
프로세스 이름: 추출 프로세스의 이름입니다. 추출 프로세스의 이름은 최대 8자일 수 있습니다.
-
설명: 생성 중인 추출 프로세스에 대한 설명
주: 초기 로드 추출 생성에 대해 알아보려면 인스턴스화를 참조하십시오.
다음을 누릅니다.
추출 등록 화면 - PostgreSQL 및 Yugabyte 데이터베이스
주: Oracle용 Oracle GoldenGate Extract, 서로 다른 PostgreSQL flavor 및 Yugabyte Database를 등록해야 합니다. 그러나 Extract를 등록하는 구성 옵션은 Extract를 추가하는 동안 다른 화면에 표시됩니다.
주: PGOUTPUT 플러그인 유형에 대한 지침 및 제한 사항도 참조하십시오.
추출 등록 화면에서 다음 옵션을 구성하고 등록을 누릅니다.
-
소스 인증서: 데이터베이스에 대한 도메인을 지정합니다.
-
별칭: 소스 로그인에 대한 데이터베이스 연결로 사용되는 사용자 ID 별칭을 지정하거나 표시된 옵션에서 선택합니다.
-
(모든 PostgreSQL flavor) 플러그인 유형: 논리적 디코딩 플러그인 유형 pgoutput을 선택합니다. pgoutput은 모든 PostgreSQL flavor에 대한 기본값입니다.
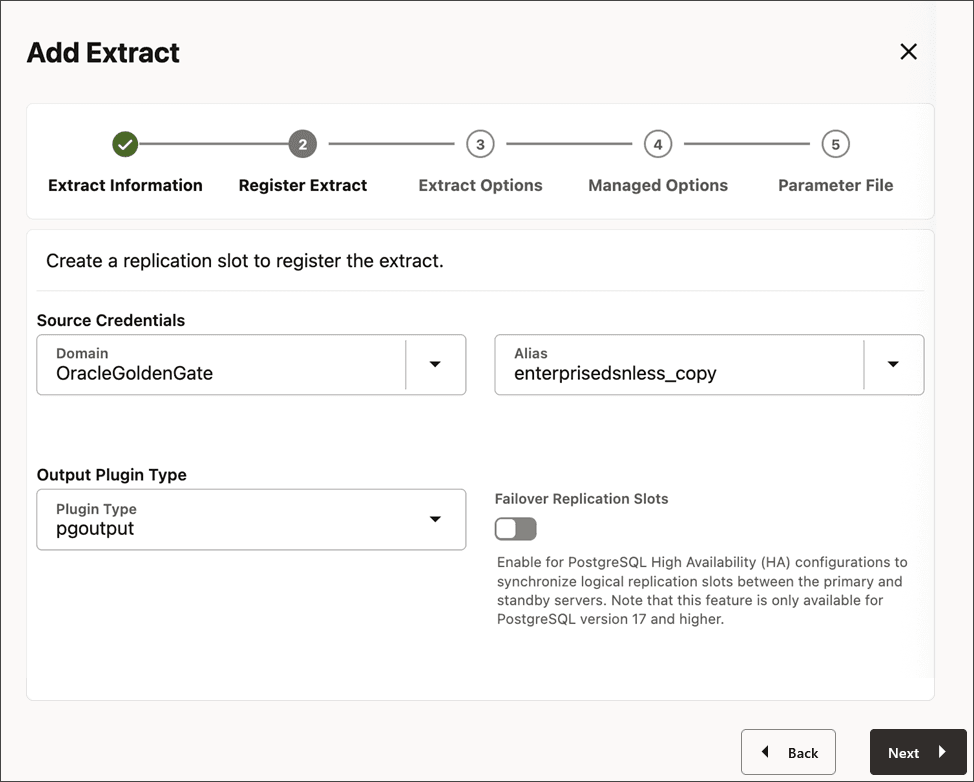
PostgreSQL 17 이상의 페일오버 복제 슬롯 구성에 대한 자세한 내용은 PostgreSQL 17 이상의 Oracle GoldenGate에 대한 페일오버 지원을 참조하십시오.
-
(유가바이트 데이터베이스만 해당) 플러그인 유형: 논리적 디코딩 플러그인 유형 yboutput을 선택합니다. YBOUTPUT은 유가바이트 데이터베이스의 기본값입니다.
추출 등록에 성공한 후 다음을 누릅니다.
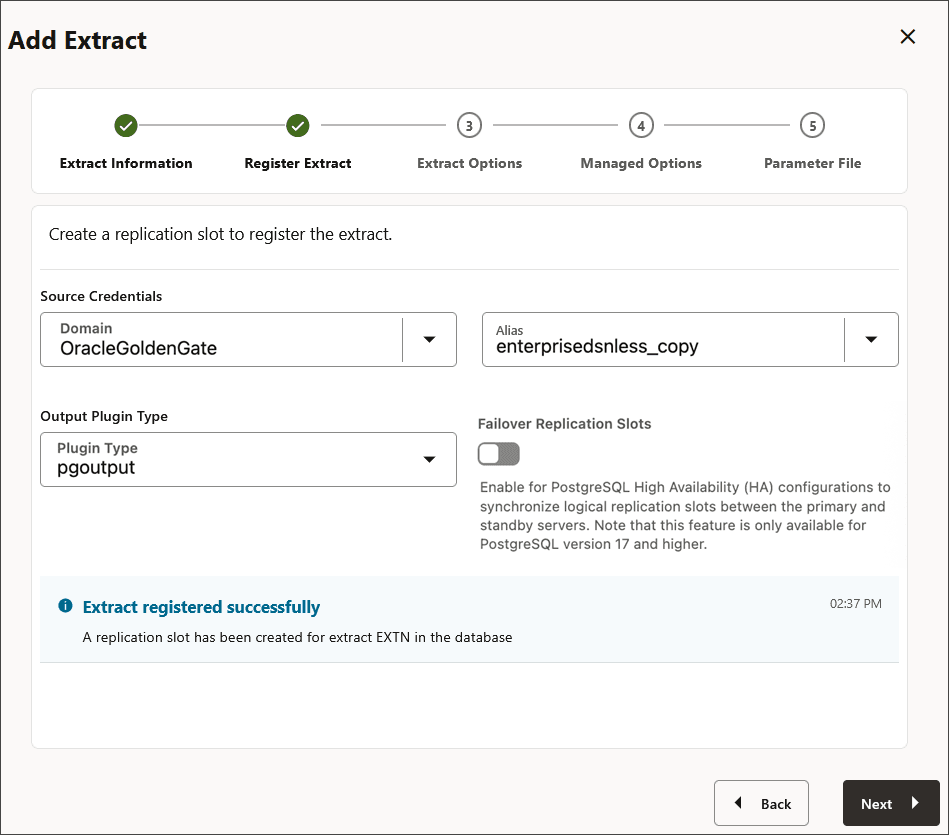
다음을 누릅니다.
관리 클라이언트에서 PostgreSQL 및 Yugabyte 데이터베이스에 대한 Extract 등록
Extract for PostgreSQL는 데이터베이스에 등록되어야 하며 예약된 복제 슬롯이 부여되어야 합니다. 복제 슬롯은 데이터베이스 구성 설정 max_replication_slots을 통해 할당되며 Database Configuration에 설명된 대로 구성할 수 있습니다.
다음 지침에 따라 Extract를 등록하십시오. 추출을 생성하기 전에 추출 등록을 수행해야 합니다. 자세한 내용은 Oracle GoldenGate에 대한 명령행 인터페이스 참조의 REGISTER EXTRACT를 참조하십시오.
-
배치에 접속한 다음 소스 데이터베이스의 인증서 별칭에 접속합니다.
CONNECT http*s*://*remotehost*:*srvmgrport* DEPLOYMENT

          *deployment_name* AS *deployment_user* PASSWORD *deployment_password*
OGG (https://*remotehost*:*16000**postgresql_source*)> DBLOGIN USERIDALIAS *alias* -
Extract에 대한 복제 슬롯을 내부적으로 만드는 Extract를 등록합니다. 추출 이름은 영숫자 8자를 초과할 수 없습니다.
REGISTER EXTRACT *extname*Extract를
pgoutput플러그인에 명시적으로 등록하려면pgoutput플러그인 유형을 지정해야 합니다.REGISTER EXTRACT *extname* PGPLUGINTYPE pgoutput;
Oracle GoldenGate MA 웹 인터페이스에서 Extract를 등록할 수도 있습니다. 추출 추가를 참조하십시오.
PGOUTPUT 플러그인 유형에 대한 지침 및 제한 사항
PGOUTPUT 플러그인 유형을 구성할 때의 지침
PostgreSQL에 대한 플러그인 유형을 설정할 때 다음 지침을 따릅니다.
-
추출 프로세스를 등록하기 전에 게시를 생성해야 합니다.
-
게시 이름에는 쉼표(,), 작은 따옴표('), 큰 따옴표(") 등의 특수 문자가 포함되지 않아야 합니다.
-
여러 등록 이름을
publication_names내에서 콤마로 구분된 목록으로 지정할 수 있습니다. 예:TRANLOGOPTIONS STREAMINGOPTIONS (publication_names="my*123,my_publication2,123 pub,my_publication";)자세한 내용은
TRANLOGOPTIONS STREAMINGOPTIONS매개변수를 참조하십시오. -
목록의 최종 게시 이름은 세미콜론(;)으로 끝나야 합니다.
제한 사항
PostgreSQL에 대한 플러그인 유형을 선택하는 동안 다음 제한 사항이 적용됩니다.
-
시간대(TZ) 환경 변수:
WAL발신자 프로세스는 항상 UTC.If의 커밋 시간기록을 전송하며, OGG 세션 시간대는 UTC와 다르며, CDC Extract 프로세스에서 시간기록별로 배치할 때 불일치가 발생할 수 있습니다. 이 문제를 방지하려면 사용자가 배치 계층에서 환경 변수TZ=UTC을 설정해야 합니다. 이러한 제한은pgoutput플러그인에 특히 적용됩니다. -
다중 자르기: 여러 자르기 작업은
pgoutput플러그인에서만 지원됩니다.test_decoding플러그인 유형은 다중 자르기를 허용하지 않습니다. -
고유 인덱스가 있지만 기본 키가 없는 테이블: 테이블에 기본 키가 없지만 고유 인덱스가 포함된 경우 복제 ID가 인덱스를 사용하거나
FULL로 설정해야 합니다. -
CDC 추출에 대한 등록 삭제 영향: CDC 추출이 계속 실행 중인 동안 게시가 삭제되면 복제 슬롯 손상으로 인해 작동이 중지될 위험이 있습니다. 이러한 경우 영향을 받는 복제 슬롯은 사용할 수 없으며 동일한 게시를 다시 만들면 문제가 해결되지 않습니다. 권장되는 해결 방법은 새 게시를 만들고 새 복제 슬롯과 연관시켜 CDC 기능을 복원하는 것입니다.
-
게시할 수 있는 테이블: 영구 기본 테이블 및 분할된 테이블만 게시에 포함될 수 있습니다. 다음 객체 유형은 게시에 포함될 수 없습니다.
-
임시 테이블
-
기록되지 않은 테이블
-
외래 테이블
-
구체화된 뷰
-
일반 뷰
-
-
ppgoutput 플러그인이 포함된 양방향 복제 지원: 양방향 복제에
pgoutput플러그인을 사용하는 경우 CDC Extract 프로세스를 시작하기 전에 체크포인트 테이블을 생성하여 게시 목록에 포함해야 합니다. 또한 복제 슬롯은 체크포인트 테이블이 만들어지고 게시에 추가된 후에만 만들어야 합니다. -
열 레벨 게시 제한: 게시의 테이블에 대한 열 부분 집합 지정은 CDC 복제에 지원되지 않습니다. 게시에 전체 테이블을 포함해야 합니다. 부분 열만 추가하려고 시도하면 CDC 스트림의 오류 또는 데이터 불일치가 발생할 수 있습니다.
추출 옵션 화면
주: 이 화면에서는 Extract for Oracle AI Database를 등록하는 옵션을 제공합니다. PostgreSQL에 대한 추출을 추가하는 경우 추출 등록이 추출 등록 화면에서 완료됩니다.
추출 옵션 화면에서 다음 설정을 구성합니다.
-
Extract 트레일:
-
이름: 추출 추적 파일의 이름입니다. 추적 파일의 이름은 최대 2자일 수 있습니다.
-
하위 디렉토리: Extract 추적이 저장된 하위 디렉토리의 디렉토리 이름입니다.
-
트레일 시퀀스: 추적의 시퀀스 번호입니다.
-
트레일 크기: 추적 파일의 최대 크기입니다.
-
암호화 프로파일: 암호화 프로파일에 대한 설명입니다. 암호화 프로파일을 생성하지 않은 경우 기본적으로 로컬 전자 지갑 프로파일이 선택됩니다. 암호화 프로파일 만들기 및 적용에 대한 자세한 내용은 Apply the OKV Encryption Profile을 참조하십시오.
-
암호화 알고리즘: 추출 추적 파일에 사용 가능한 암호화 알고리즘 목록입니다.
주: 추적 파일 암호화에 대한 자세한 내용은 트레일 파일 암호화 및 추적 파일 암호화를 참조하십시오.
-
(Oracle만 해당)등록 옵션: Oracle AI Database에 대한 추출을 등록하려면 다음 옵션을 지정합니다.
CSN: 커밋 시퀀스 번호(CSN) 값입니다.
-
공유: 이 드롭다운은 LogMiner 데이터 딕셔너리를 공유하는 방법을 정의하는 데 사용됩니다. 사용 가능한 옵션은 자동, 없음 및 추출 이름입니다. 자동은 시스템에서 공유할 Extract를 결정합니다. 없음은 LogMiner 데이터 딕셔너리가 공유되지 않음을 의미합니다. 추출 이름은 LogMiner 데이터 딕셔너리가 지정된 Extract와 공유됨을 의미합니다.
-
최적화됨: 추출 등록을 최적화하려면 이 옵션을 사용으로 설정합니다.
-
관리 클라이언트에서 Oracle에 대한 추출 등록
다음 지침에 따라 Extract를 등록하십시오. 추출을 생성하기 전에 추출 등록을 수행해야 합니다.
DBLOGIN 명령을 사용하여 데이터베이스와 연결되어 있는지 확인합니다.
자세한 내용은 Oracle GoldenGate에 대한 명령행 인터페이스 참조의 [REGISTER EXTRACT](/pls/topic/lookup?ctx=en/database/goldengate/core/26/coredoc&id=GCLIR-GUID-5E42DB9E-EFDF-40C0-89D7-88413496B8A3)를 참조하십시오.
-
관리 클라이언트를 사용하여 배치에 접속한 다음 소스 데이터베이스의 인증서 별칭에 접속합니다.
OGG> CONNECT https://*remotehost*:*srvmgrport* DEPLOYMENT *deployment_name* AS *deployment_user* PASSWORD *deployment_password*CONNECT명령을 실행할 때 다음 예와 같이 명령 프롬프트가 "not connected"에서 "https://servername:port deployment_name"로 변경됩니다.OGG (https://*pdbeast.vcn.oracle.com*:*16000**depl_east*)> -
DBLOGIN명령을 사용하여 데이터베이스에 연결합니다.OGG (https://*remotehost*:*port**oracle_source*)> DBLOGIN USERIDALIAS *alias* -
Extract 등록 추출 이름은 영숫자 8자를 초과할 수 없습니다.
OGG (https://*remotehost*:*port**oracle_source*)> REGISTER EXTRACT *extname* DATABASE
Oracle GoldenGate MA 웹 인터페이스에서 추출을 생성하는 동안 백그라운드에서 추출을 등록할 수도 있습니다. 자세한 내용은 추출 추가를 참조하십시오.
다운스트림 캡처 화면
Oracle의 경우에만 적합합니다.
정보 추출 화면에서 다운스트림 캡처를 선택한 경우 다운스트림 캡처 옵션 화면이 표시됩니다. 이 화면을 사용하여 다운스트림 Extract에 대한 다운스트림 마이닝 데이터베이스 접속을 구성합니다.
-
인증서 마이닝: 도메인 및 별칭 상자에 도메인 및 사용자 ID 별칭 값을 지정합니다.
-
UserID 없음/소스 DB 접속 없음: ADG(Active Data Guard)를 사용하여 마이닝 데이터베이스 접속을 설정하려면 이 토글 스위치를 사용으로 설정합니다. ADG 인증서 인출을 입력하는 옵션이 표시됩니다.
-
도메인: ADG 인출 데이터베이스에 대한 도메인 이름입니다.
-
별칭: ADG 인출 데이터베이스에 대한 도메인 별칭입니다.
-
주: ADG를 사용한 다운스트림 캡처는 PDB별 추출을 지원하지 않습니다.
다음을 누릅니다.
Managed Options 화면
관리되는 옵션 화면에서 추출 프로세스에 대한 자동 시작 및 자동 재시작 옵션을 구성합니다. 다음 표에서는 다음 옵션을 제공합니다.
다음 표에서는 다음 옵션을 제공합니다.
| 옵션 | 설명 |
|---|---|
| 프로파일 이름 | autostart 및 autorestart 프로파일의 이름을 제공합니다. 기본 또는 사용자 정의 옵션을 선택할 수 있습니다. 이미 프로파일을 만든 경우 해당 프로파일도 선택할 수 있습니다. 사용자정의 옵션을 선택하는 경우 이 섹션 자체에서 새 프로파일을 설정할 수 있습니다. |
| 배치 건전성에 중요 | (Oracle만 해당) 프로파일이 배치 건전성에 중요한 경우 이 옵션을 사용으로 설정합니다.
참고: 이 옵션은 Extract 또는 Replicat를 생성할 때만 나타나며 [프로파일] 페이지에서 관리되는 프로세스를 설정할 때는 나타나지 않습니다. |
| 자동 시작 | 프로세스에 대해 자동 시작을 사용으로 설정합니다. |
| 시작 지연 | 프로세스를 시작하기 전 대기 시간(초)입니다 |
| 자동 재시작 | 프로세스가 종료될 경우 프로세스를 재시작하는 방법을 구성합니다. |
| 최대 재시도 | 프로세스를 시작할 최대 재시도 횟수를 지정합니다. |
| 재시도 지연 | 프로세스를 시작하려는 중 지연 시간 |
| 재시도 창 | 프로세스 시작을 시도하는 기간 간격입니다. |
| 실패 시에만 재시작 | true인 경우, 실패 시점에만 태스크가 재시작됩니다. |
| 재시도가 소진된 후 태스크 사용 안함 | true인 경우 프로세스를 다시 시작하려는 모든 시도가 모두 완료된 후 작업이 사용 안함으로 설정됩니다. |
다음을 누릅니다.
추출 매개변수 파일 화면
매개변수 파일 화면에서 텍스트 영역의 매개변수 파일을 편집하여 캡처하려는 테이블 세부정보를 나열할 수 있습니다. 다음은 샘플 Extract 매개변수 파일입니다.
EXTRACT exte
USERIDALIAS ggeast DOMAIN OracleGoldenGate
EXTTRAIL east/ea
DDL INCLUDE MAPPED
TABLE hr.*;
추출을 생성 및 시작하려면 생성 및 실행을 누릅니다. 생성을 선택하면 추출이 생성되지만 추출 옵션을 사용하여 추출을 시작해야 합니다.
관리 서비스 홈 페이지 또는 생성된 모든 추출이 나열된 추출 페이지로 돌아갑니다.
추출할 매개변수 파일 생성
다음 지침에 따라 Extract에 대한 매개변수 파일을 생성하십시오.
-
(MySQL만 해당) Windows 서버 및 원격 호스트에 있는 Linux 서버(23.10.x보다 작은 OGG 버전의 경우)에서 MySQL용 Oracle GoldenGate를 실행하는 경우 데이터베이스 서버는 해당 시간대가 동일한지 확인하고, 동일하지 않은 경우 Extract 내에서
SETENV(TZ)매개변수를 사용하여 데이터베이스 서버의 시간대로 설정합니다.TZ 형식 및 자세한 내용은 매개변수 및 함수 참조 설명서의 SETENV 매개변수를 참조하십시오.
다음 링크를 참조하십시오.
https://learn.microsoft.com/en-us/cpp/c-runtime-library/reference/tzset?view=msvc-170#remarks
https://www.gnu.org/software/libc/manual/html_node/TZ-Variable.html
-
소스 시스템에서 다음 명령을 실행합니다.
EDIT PARAMS extract_name설명:
extract_name는ADD EXTRACT명령으로 생성한 Extract의 이름 또는 그룹을 생성할 때 대체 위치를 정의한 경우 매개변수 파일의 정규화된 이름입니다. -
다음 표에 나오는 순서대로 파라미터를 입력하고 각 파라미터 문에 대해 새 행을 시작합니다. 일부 매개변수는 특정 구성에만 적용됩니다.
매개변수 설명 EXTRACT group- group은
ADD EXTRACT명령으로 만든 Extract 그룹의 이름입니다.
Extract를 체크포인트가 있는 온라인 프로세스로 구성합니다. [, USERIDALIAS alias options ]데이터베이스 인증서를 지정하려면 [USERIDALIAS](/pls/topic/lookup?ctx=en/database/goldengate/core/26/coredoc&id=GWURF-GUID-530D7773-B66D-4499-A509-EF5BB9CE9B05)를 참조하십시오.ENCRYPTTRAIL algorithm이 항목 다음에 지정된 모든 추적을 암호화합니다. SOURCECATALOGOracle 다중 테넌트 컨테이너 데이터베이스 또는 SEQUENCE문에서 기본 컨테이너를 지정합니다. 두 부분으로 구성된 이름(schema.object)을 사용할 수 있습니다. 여기서 세 부분으로 구성된 이름은 해당 데이터베이스에 필요합니다. 이 매개변수의 여러 인스턴스를 사용하여TABLE또는SEQUENCE매개변수의 서로 다른 세트에 대해 서로 다른 기본 컨테이너 또는 카탈로그를 지정할 수 있습니다.TABLE [container. \| catalog.]owner.object \| schema.object \| library/file \| library/file(member);객체의 전체 이름 또는 여러 객체에 대한 전체 와일드카드 지정을 지정합니다. 데이터베이스가 Oracle 다중 테넌트 컨테이너 데이터베이스인 경우
SOURCECATALOG를 사용하지 않는 한 객체 이름에 컨테이너 또는 카탈로그 이름이 포함되어야 합니다.schema은 스키마 이름 또는 와일드 카드 문자 집합 스키마입니다.object은 테이블 이름 또는 와일드카드 테이블 세트입니다.library는 IBM i 라이브러리 이름 또는 와일드카드 라이브러리 세트입니다.file는 IBM i 물리적 파일 이름 또는 와일드카드 문자 세트의 물리적 파일입니다.member는 IBM i 물리적 파일 멤버 이름 또는 와일드카드 멤버 이름 세트입니다. IBM i 고유 이름 형식(선택적 멤버가 포함된 라이브러리/파일)을 사용할 때 유효한 와일드카드는 하나 이상의 유효한 문자가 포함된 이름이고 뒤에 별표(*) 또는 이름과 일치하는*ALL가 옵니다.
참고:
멤버 이름은 선택 사항이며, 멤버 이름을 객체 이름의 일부로 추적에 기록해야 하는 경우 제공해야 합니다. 멤버 이름이 없으면 물리적 파일의 모든 멤버가 트레일의 단일 객체로 암시적으로 병합됩니다.매개변수 파일에 객체 이름을 지정하려면 Oracle GoldenGate 입력에서 객체 이름 지정 지침을 참조하십시오.
SCHEMAEXCLUDETABLEEXCLUDEEXCLUDEWILDCARDOBJECTSONLY연관된 TABLE문의 와일드카드 사양에서 특정 객체를 제외하기 위해 서로 함께 사용할 수 있는 매개변수입니다. - group은
-
Oracle GoldenGate 매개변수에 나열된 적합한 선택적 Extract 매개변수를 입력합니다.
-
매개변수 파일을 저장한 후 닫습니다.
다음 샘플 Extract 매개변수 파일은 Extract에 대한 다양한 구성 매개변수 및 옵션을 설명합니다.
ADD EXTRACT *extract_name*
{, datasource}
{, BEGIN start_point} | {position_point}
[, PARAMS pathname]
[, REPORT pathname]
[, DESC 'description']-
extract_name은 Extract 그룹의 이름입니다. 그룹 이름이 필요합니다. -
추출할 데이터의 소스를 지정하려면
datasource가 필요합니다. 다음 중 하나를 사용합니다.-
TRANLOG는 트랜잭션 로그를 데이터 소스로 지정합니다. Oracle Enterprise Edition에 이 옵션을 사용하는 경우ADD EXTRACT를 사용하기 전에(및 Extract 그룹을 제거하기 위해DELETE EXTRACT를 실행하기 전에) Extract 데이터베이스 사용자(또는 동일한 권한을 가진 사용자)로DBLOGIN명령을 실행해야 합니다.Db2 z/OS에 대해 bsds 옵션을 사용하여 트랜잭션 로그의 부트스트랩 데이터 세트 파일 이름을 지정합니다.
-
INTEGRATED TRANLOG는 이 Extract가 통합 캡처 모드로 작동하여 Oracle AI Database 로그마이닝 서버에서 LCR(논리적 변경 레코드)을 수신하도록 지정합니다. 이 파라미터는 Oracle 데이터베이스에만 적용됩니다. -
EXTTRAILSOURCE trail_name- 로컬 추적의 상대적 또는 전체 이름을 지정합니다.
-
-
BEGIN start_point는 처리를 위한 초기 체크포인트 및 시작점을 설정하여 온라인 Extract 그룹을 정의합니다. 이 시점 이전에 시작된 트랜잭션은 폐기됩니다. 다음 중 하나를 사용합니다. -
NOW - 그룹을 만들기 위해
ADD EXTRACT명령이 실행될 때 또는 통합 모드에서 Extract의 경우 그룹이REGISTER EXTRACT명령에 등록될 때부터 시간 기록된 변경 사항 추출을 시작합니다. Oracle 및 PostgreSQL 데이터베이스에 대해서만 Extract를 등록해야 합니다.시간 기록: 정확한 시간 기록을 시작점으로 지정하는 형식입니다. 복제 또는 로깅이 사용으로 설정된 시간보다 이후의 시작점을 사용합니다.
다음 예에서는 특정 시간 기록을 사용하여 Extract의 위치를 조정하는 방법을 보여줍니다.
<pre class="copy"><code>OGG (http://localhost:11000 ggeast as pdb1@east.oracle.com) 95> dblogin useridalias ggma Successfully logged into database PDB1.</code></pre> <pre class="copy"><code>OGG (http://localhost:11000 ggeast as ggma@ggeast/PDB1) 96> alter extract exte , begin 2024-05-03T03:48:00Z 2024-05-03T03:50:49Z INFO OGG-08100 Extract exte I/O position is altered and reposition to older date and time position 2024-05-03 03:48:00.000000 current date and time position 2024-05-03 03:49:04.000000. Duplicate transactions are filtered out. Perform output trail ETROLLOVER if duplicate transaction output is desired, or Extract configuration was updated. 2024-05-03T03:50:49Z INFO OGG-08100 Extract altered.</code></pre> -
position_point는 처리를 시작할 특정 트랜잭션 로그 파일 내의 특정 위치를 지정합니다. 데이터베이스에 사용할 특정 구문 -
PARAMS경로 이름은 이 그룹에 대한 매개변수 파일이 Oracle GoldenGate 디렉토리의 dirprm 하위 디렉토리가 아닌 다른 위치에 저장될 경우 필요합니다. 정규화된 이름을 지정하십시오. 기본 위치는 권장됩니다. -
이 그룹에 대한 프로세스 보고서가 Oracle GoldenGate 디렉토리의
dirrpt하위 디렉토리가 아닌 다른 위치에 저장될 경우REPORT pathname가 필요합니다. 정규화된 이름을 지정하십시오. 기본 위치는 권장됩니다. -
DESC 'description'는 그룹에 대한 설명을 나타냅니다.
추출에 대한 추가 매개변수 옵션
Extract 구성에 필요한 추가 매개변수에 대해 알아봅니다.
Extract는 마이닝 데이터베이스의 데이터베이스 로그마이닝 서버를 사용하여 소스 데이터베이스의 리두 스트림을 마이닝합니다. Extract 매개변수 파일의 INTEGRATEDPARAMS 옵션과 함께 TRANLOGOPTIONS 매개변수를 사용하여 로그마이닝 서버와 관련된 매개변수를 설정할 수 있습니다.
주: 이러한 매개변수에 대한 자세한 정보 및 사용 지침은 Oracle AI Database PL/SQL Packages and Types Reference의 "DBMS_CAPTURE_ADM" 절을 참조하십시오.
다음 매개변수는 INTEGRATEDPARAMS로 설정할 수 있습니다.
-
CAPTURE_IDKEY_OBJECTS:FETCH에서 지원할 수 있는 객체 캡처를 제어합니다. Oracle GoldenGate의 기본값은Y입니다(캡처 ID 키 논리적 변경 레코드). -
DOWNSTREAM_REAL_TIME_MINE: 로그 마이닝 서버가 실시간 다운스트림 캡처 프로세스로 작동하는지 아니면 아카이브된 로그 다운스트림 캡처 프로세스로 작동하는지 제어합니다. 기본값은N(아카이브 로그 모드)입니다. 다운스트림 로그 마이닝 서버 구성에서 실시간 캡처를 사용하려면 이 매개변수를 지정합니다. 다운스트림 마이닝 구성 설정에 대한 자세한 내용은 Oracle GoldenGate 배치에 대한 다운스트림 추출을 참조하십시오. -
INLINE_LOB_OPTIMIZATION: LOB 조각 LCR을 전송하는 대신 인라인으로 처리할 수 있는 LOB(예: 작은 LOB)를 LCR에 직접 포함할지 여부를 제어합니다. Oracle GoldenGate의 기본값은Y(예)입니다. -
MAX_SGA_SIZE: 로그 마이닝 서버에서 사용하는 공유 메모리의 양을 제어합니다. 공유 메모리는 SGA의 streams 풀에서 가져옵니다. 기본값은 1GB입니다. -
PARALLELISM: logmining 서버에서 사용되는 프로세스 수를 제어합니다. 기본값은 2입니다. Oracle Standard Edition의 경우1로 설정해야 합니다. -
TRACE_LEVEL: Extract 로그 마이닝 서버에 대한 추적 레벨을 제어합니다. Oracle Support의 지침과 함께만 사용됩니다. Oracle GoldenGate의 기본값은0(추적 안함)입니다. -
WRITE_ALERT_LOG: Extract 로그 마이닝 서버가 Oracle 경보 로그에 메시지를 기록할지 여부를 제어합니다. Oracle GoldenGate의 기본값은Y(예)입니다.
Managing Server Resources를 참조하십시오.