データベース管理者および開発者向けのトピック
このページのスクリプト・コンテンツはナビゲーションのみを目的としており、いかなる方法においても内容を変更するものではありません。
この章では、データベース管理者と開発者にとって重要で一般的なデータベース・トピックを要約し、ここで網羅的にデータベースの機能を説明するかわりに、参照可能な他のマニュアルを紹介します。
-
データベース・セキュリティの概要通常、データベース・セキュリティには、ユーザー認証、暗号化、アクセス制御および監視が含まれます。
-
高可用性の概要可用性とは、アプリケーション、サービスおよび機能が必要な場合にどの程度使用可能であるかということです。
-
グリッドコンピューティングの概要グリッドコンピューティングと呼ばれるコンピューティングアーキテクチャーは、すべてのエンタープライズコンピューティングのニーズに応じて、柔軟なオンデマンドリソースに多くのサーバーおよび記憶域を効果的にプールします。
-
データ・ウェアハウスとビジネス・インテリジェンスの概要 データ・ウェアハウスは、トランザクション処理ではなく問合せおよび分析用に設計されたリレーショナル・データベースである。
-
Oracleにおける情報統合の概要組織の進化に伴い、複数のデータベースおよびアプリケーション間で情報を共有することがますます重要になりました。関連項目: DBAに固有のトピックについては「データベース管理者の概念」を、データベース開発者の固有のトピックについては「データベース開発者の概念」を参照してください。
データベース・セキュリティの概要
通常、データベース・セキュリティには、ユーザー認証、暗号化、アクセス制御および監視が含まれます。
この項では、次のトピックについて説明します:
-
ユーザー・アカウントそれぞれのOracleデータベースには、有効なデータベース・ユーザーのリストがあります
-
データベース認証Oracle AI Databaseのデータベース認証とは、ユーザーが資格証明をデータベースに提示し、この資格証明をデータベースが検証してデータベースへのアクセスを許可するプロセスのことです。
-
暗号化 Oracle AI Database 暗号化は、秘密キーと暗号化アルゴリズムを使用して、データを読取り不可能な形式に変換するプロセスである。
-
Oracle Data Redaction Oracle Data Redactionは、Oracle Advanced Securityの一部であり、これを使用すると、権限の少ないユーザーまたはアプリケーションによって問い合されるデータを隠すことを(リダクションする)できます。このリダクションは、ユーザーがデータを問い合せるときに、リアルタイムで発生します。
-
アクセス制御 Oracle AI Databaseでは、データへのアクセスを制御するための技術が数少なく提供されています。この項では、これらの技術の概要を示します。
-
データ・アクセスの監視 Oracle AI Databaseには、ユーザー・アクティビティを監視するために複数のツールおよび技術が採用されます。監査は、データ・アクセスの監視のために最も重要なメカニズムです。
ユーザー・アカウント
各Oracleデータベースには、有効なデータベース・ユーザーのリストがあります。
データベースには、デフォルトの管理アカウントSYSTEMを含む、複数のデフォルトのアカウントが含まれます。ユーザー・アカウントは必要に応じて作成できます。アプリケーション・ユーザーをOracleデータベースにアクセスするように構成することもできます。
データベースにアクセスするには、有効なユーザー名と認証用の資格証明を提供する必要があります。資格証明には、パスワード、Kerberosチケットまたは公開キー・インフラストラクチャ(PKI)の証明書などがあります。データベース・セキュリティでは、ログオン試行の失敗に基づいてアカウントをロックするよう構成できます。
通常、データベース・アクセス制御には、データ・アクセスおよびデータベース・アクティビティの制限が含まれます。たとえば、指定された表への問合せや指定されたデータベース文の実行を制限できます。
-
権限ユーザー権限とは、特定のSQL文を実行する権利のことです。
-
ロールロールは、関連する権限のグループに名前を付けたもので、ユーザーが他のユーザーまたは他のロールに付与できます。ロールを使用すると、データベース・アプリケーションまたはユーザー・グループの権限の管理が容易になります。
-
権限分析権限分析メカニズムによって、指定した条件に従ってデータベースの権限使用状況を取得できます。
-
ユーザー・プロファイルシステム・リソースのコンテキストにおけるユーザー・プロファイルとは、リソース制限とパスワード・パラメータをセットして名前を付けたもので、ユーザーに対してデータベースの使用およびデータベース・インスタンス・リソースを制限します。
関連情報:
-
管理ユーザー・アカウントについて学習するには、『Oracle AI Database管理者ガイド』を参照してください
-
アプリケーション・ユーザーの構成方法を学習するには、『Oracle AI Database Real Application Security管理者ガイド』を参照してください。
権限
ユーザー権限とは、特定のSQL文を実行する権利のことです。
権限は、次のカテゴリに分類されます。
-
システム権限
これは、データベース内で特定のアクションを実行する権限、または特定のタイプのオブジェクトに対してアクションを実行する権限のことです。たとえば、
CREATE USER、CREATE SESSIONはシステム権限です。 -
スキーマ特権
これは、特定のスキーマ内のすべてのオブジェクトに対してシステム権限を使用する権利です。この権限は、スキーマ内の現在および将来のオブジェクトに適用されます。
-
オブジェクト権限
これは、
employees表への問合せなど、指定されたアクションをオブジェクトに対して実行できる権限のことです。権限のタイプは、データベースによって定義されます。
権限は、他のユーザーの裁量で任意に付与されます。管理者は、ユーザーが業務に必要な作業を実行できるよう、必要な権限をユーザーに付与する必要があります。セキュリティの観点から、権限は必要な作業を行うためにその権限を必要とするユーザーにのみ付与することをお薦めします。
関連情報:
SESSION_PRIVSビューについて学習するには、『Oracle AI Databaseリファレンス』を参照
ロール
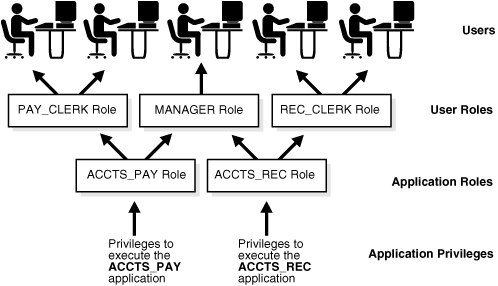
ロールは、関連する権限のグループに名前を付けたもので、ユーザーが他のユーザーまたは他のロールに付与できます。ロールを使用すると、データベース・アプリケーションまたはユーザー・グループの権限の管理が容易になります。図20-1は、ロールの一般的な使用方法を示しています。PAY_CLERK、MANAGER、およびREC_CLERKの各ロールが、異なるユーザーに割り当てられます。ACCTS_PAYアプリケーションを実行する権限を含むACCTS_PAYアプリケーション・ロールが、PAY_CLERKおよびMANAGERロールを持つユーザーに割り当てられます。ACCTS_RECアプリケーションを実行する権限を含むACCTS_RECアプリケーション・ロールが、REC_CLERKおよびMANAGERロールを持つユーザーに割り当てられます。
図1: ロールの一般的な使用方法
関連情報:
-
セキュリティのためのロールの使用方法について学習するには、『Oracle AI Databaseセキュリティ・ガイド』を参照
-
ロールの管理方法を学習するには、Oracle AI Database管理者ガイドを参照
権限分析
権限分析メカニズムによって、指定した条件に従ってデータベースの権限使用状況を取得できます。
こうして、アプリケーション・モジュールの実行または特定のSQL文の実行に必要な権限を取得できます。たとえば、ユーザーが特定のデータベース・セッション中に行使した権限を見つけることができます。
本番データベースでは、権限とロール、ロールとロール、ロールとユーザーの関係は、複雑になる可能性があります。権限分析により、複雑なシステム内で不必要に付与されている権限を特定できます。取得した結果の分析に基づき、不必要な付与を削除することや、権限付与を再構成してデータベースをよりセキュアにすることができます。
関連項目:権限分析について学習するには、『Oracle AI Databaseセキュリティ・ガイド』を参照してください。
ユーザー・プロファイル
システム・リソースのコンテキストにおけるユーザー・プロファイルとは、リソース制限とパスワード・パラメータをセットして名前を付けたものです。これにより、ユーザーに対してデータベースの使用およびデータベース・インスタンス・リソースを制限できます。
プロファイルでは、ユーザーが同時に確立できるセッションの数、各セッションに使用可能なCPU処理時間、および使用可能な論理I/O量を制限できます。たとえば、clerkプロファイルでは、ユーザーのシステム・リソースが事務作業に必要な程度に制限されます。ノート:リソースの制限にはデータベース・リソース・マネージャを使用し、パスワードの管理にプロファイルを使用することをお薦めします。
プロファイルを使用すると、一連の属性を共有する複数のユーザーに対して1つの参照先を指定できます。プロファイルを1つのユーザー・セットに割り当て、デフォルト・プロファイルを他のすべてのユーザーに割り当てることができます。各ユーザーには、任意の時点で最大1つのプロファイルを割り当てることができます。
関連情報:
-
バッファI/Oに関する項
-
プロファイルを使用したリソースの管理方法を学習するには、『Oracle AI Databaseセキュリティ・ガイド』を参照
-
CREATE PROFILEの構文およびセマンティクスについては、『Oracle AI Database SQL言語リファレンス』を参照
データベース認証
Oracle AI Databaseでは、データベース認証は、ユーザーが資格証明をデータベースに提示し、この資格証明をデータベースが検証してデータベースへのアクセスを許可するプロセスである。
アイデンティティを検証することで、その後の対話に関する信頼関係が確立されます。また、認証により、アクセスとアクションを特定のアイデンティティにリンクでき、アカウンティビリティも有効化されます。
Oracle AI Databaseでは、次のような様々な認証方式が提供されています。
-
データベースによる認証
Oracleデータベースは、パスワード、KerberosチケットまたはPKIの証明書を使用してユーザーを認証できます。Oracleでは、生体認証を含む、他の認証方式用のRADIUS準拠のデバイスもサポートしています。認証のタイプは、Oracleデータベースでユーザーを作成する際に指定する必要があります。
-
オペレーティング・システムによる認証
一部のオペレーティング・システムでは、ユーザーが維持している情報を、ユーザーの認証用にOracle AI Databaseで使用できます。オペレーティング・システムから認証を受けたユーザーは、ユーザー名やパスワードを指定することなくデータベースに接続できます。
非管理のデータベース・ユーザー・アカウントは、データベースの停止や起動などのデータベース操作を実行することはできません。これらの操作には、SYSDBA、SYSOPER、SYSBACKUPまたはSYSDG権限が必要です。
関連情報:
-
認証方式について学習するには、『Oracle AI Databaseセキュリティ・ガイド』を参照してください
-
管理認証について学習するには、『Oracle AI Database管理者ガイド』を参照してください
暗号化
Oracle AI Databaseの暗号化とは、秘密キーと暗号化アルゴリズムを使用して、データを読取り不可能な形式に変換するプロセスのことです。
多くの場合、暗号化は、Payment Card Industry Data Security Standard (PCI-DSS)や侵害通知法に関連する要件などの法令遵守要件を満たすために使用されます。たとえば、クレジット・カード番号、社会保障番号、患者の病状に関わる情報などを暗号化する必要があります。
-
ネットワーク暗号化クライアントとサーバー間のネットワーク上移動するデータを暗号化することを、ネットワーク暗号化といいます。
-
Oracle Advanced SecurityのTransparent Data Encryption Oracle Advanced SecurityのTransparent Data Encryptionを使用すると、表の個々の列または表領域を暗号化することができます。
ネットワーク暗号化
クライアントとサーバー間のネットワーク上を移動するデータを暗号化することを、ネットワーク暗号化といいます。
侵入者は、ネットワーク・パケット・スニファを使用することにより、ネットワーク上を移動する情報を取得してファイルにスプールし、悪用できます。ネットワーク上のデータを暗号化することにより、このようなアクティビティを防止できます。
Transparent Data Encryption
Oracle Advanced SecurityのTransparent Data Encryptionを使用すると、表の個々の列または表領域を暗号化することができます。
ユーザーが暗号化された列にデータを挿入すると、データベースによって自動的にデータが暗号化されます。ユーザーが列を選択すると、データは復号化されます。このような形式の暗号化は透過的であり、パフォーマンスが高く、実装が容易です。
Transparent Data Encryptionには、Advanced Encryption Standard (AES)や組込みキー管理などの業界標準の暗号化アルゴリズムが含まれています。
関連項目: 『Oracle AI Database Transparent Data Encryptionガイド』
Oracle Data Redaction
Oracle Advanced Securityの一部のOracle Data Redactionは、Oracle Advanced Securityの一部で、これを使用すると、権限の少ないユーザーまたはアプリケーションによって問い合されるデータを隠すことができます(リダクションします)。このリダクションは、ユーザーがデータを問い合せるときに、リアルタイムで発生します。
データ・リダクションでは次のリダクション機能タイプがサポートされています。
-
完全データ・リダクション
この場合、表またはビューの指定した列の内容全体がリダクションされる。たとえば、姓の
VARCHAR2列には、1つの空白が表示されます。 -
部分データ・リダクション
この場合、表示された出力の一部がリダクションされます。たとえば、アプリケーションでは、
1234で終わるクレジット・カード番号をxxxx-xxxx-xxxx-1234と表示できます。完全と部分のどちらのリダクションにも、正規表現を使用できます。正規表現は、検索パターンに基づいて、データをリダクションできます。たとえば、正規表現を使用して、特定の電話番号または電子メール・アドレスをリダクションできます。 -
ランダム・データ・リダクション
この場合、列のデータ型に応じて、データがランダムに生成された値として表示されます。たとえば、数値
1234567は、83933895として表示される可能性があります。
データ・リダクションは、包括的なセキュリティの解決策ではありません。たとえば、直接接続し権限を付与されたユーザーが、リダクションされたデータに対して推論攻撃を実行することを阻止できません。このような攻撃では、リダクションされた列を識別し、削除の処理で、格納された値を推測するSQL問合せを繰り返すことにより、実際のデータに戻そうとします。権限を持つユーザーからの推論およびその他の攻撃を検出し、阻止するには、Oracle Data Redactionと関連のデータベース・セキュリティ製品(Oracle Audit Vault and Database Firewall、Oracle Database Vaultなど)と組み合せることをお薦めします。
データ・リダクションは、次のように機能します。
-
DBMS_REDACTパッケージを使用して、指定した表のリダクション・ポリシーを作成します。 -
ポリシーで、事前定義のリダクション機能を指定します。
-
データベースで表示される列の値が実際の値かそれともリダクションされた値かは、ポリシーによって決まります。データがリダクションされると、そのリダクションがただちに最上位の選択リストに反映されから、ユーザーに表示されます。
次の例では、hr.employees表の従業員ID(employee_id)列をリダクションする完全データ・リダクション・ポリシーが追加されています。
BEGIN
 DBMS_REDACT.ADD_POLICY(
   object_schema    => 'hr'
,  object_name      => 'employees'
,  column_name      => 'employee_id'
,  policy_name      => 'mask_emp_ids'
,  function_type    => DBMS_REDACT.FULL
,  expression       => '1=1'
);
END;
/この例では、表現の設定(trueと評価)により、EXEMPT REDACTION POLICY権限を付与されていないユーザーに対して、リダクションが適用されます。
関連情報:
-
データのリダクションについて学習するには、『Oracle AI Databaseデータ・リダクション・ガイド』を参照してください。
-
DBMS_REDACTについて学習するには、『Oracle AI Database PL/SQLパッケージおよびタイプ・リファレンス』を参照
アクセス制御
Oracle AI Databaseでは、データへのアクセスを制御するための技術が数少なく提供されています。この項では、これらの技術の概要を示します。
-
Oracle Database Vaultは、権限を持つユーザーによるアクセスをアプリケーション・データに制限する。
-
Oracle Virtual Private Database (VPD)Oracle Virtual Private Database (VPD)を使用すると、行および列レベルでセキュリティを確保することができます。
-
Oracle Label Security (OLS)Oracle Label Security (OLS)では、セキュリティ・ラベルを使用してデータ分類の割当てとアクセスの制御を行うことができます。ラベルは、データまたはユーザーのいずれかに割当て可能です。
Oracle Database Vault
Oracle Database Vaultは、権限を持つユーザーによるアクセスをアプリケーション・データに制限する。
Oracle Database 12cから、Oracle Database Vaultは、Oracle Database Vaultにより、標準データベース監査のデータ構造を拡張します。さらに、統合監査に移行すると、データベースでは監査レコードを、Oracle Secure Filesの統合監査証跡に書き込みます。これにより、Oracle AI Databaseの監査レコードが一元化されます。
Oracle Database Vaultを使用すると、データベース、データおよびアプリケーションに対するアクセスのタイミング、場所および方法を制御できます。このため、法令遵守および責務の分離を実現しながら、関係者による脅威からの保護など、一般的なセキュリティ上の問題にも対応できます。
Oracle Database Vault管理者が責任を果たせるように、データベースではOracle Database Vaultメタデータに行われた構成の変更が強制的に監査されます。これらの変更には、Oracle Database Vault関連の実行の作成、変更および削除、保護されたロールの付与および取消し、Oracle Data PumpやJob Schedulerなどのコンポーネントの認可などが含まれます。
関連情報:
-
OracleデータベースVaultAuditと OracleデータベースNative Auditの統合について学習するには、『Oracle AI Databaseセキュリティ・ガイド』
仮想プライベート・データベース(VPD)
Oracle Virtual Private Database (VPD)を使用すると、行および列レベルでセキュリティを確保することができます。
セキュリティ・ポリシーによって、データを偶発的または悪意のある破壊したり、データベース・インフラストラクチャの破損からデータベースを保護する方法が確立されています。
VPDでは、権限やロールなどのセキュリティ保護では設定できない詳細な設定が可能です。たとえば、すべてのユーザーに対するemployees表へのアクセスを許可する場合は、セキュリティ・ポリシーを作成して、ユーザーが同じ部門の従業員にアクセスすることを禁止できます。
基本的には、Oracle VPDセキュリティ・ポリシーが適用されますが、表、ビューまたはシノニムに対して発行されたSQL文に、動的なWHERE句を追加します。このWHERE句によって、保護データへのアクセスが、セキュリティ・ポリシーに準拠する資格証明を持つユーザーにのみ許可されます。
関連項目: Oracle AI Databaseセキュリティ・ガイド
Oracle Label Security (OLS)
Oracle Label Security (OLS)では、セキュリティ・ラベルを使用してデータ分類の割当てとアクセスの制御を行うことができます。ラベルは、データまたはユーザーのいずれかに割当て可能です。
データに割り当てた場合、ラベルは表に非表示の列として添付でき、SQLに透過性を提供します。たとえば、機密性が高いデータを含む行にはHIGHLY SENSITIVEというラベルを、それほど機密性の高くない行にはSENSITIVEというラベルを付けることができます。ユーザーがデータにアクセスしようとすると、OLSによってユーザー・ラベルがそのデータ・ラベルと比較され、アクセスを許可するかどうかが決定されます。VPDとは異なり、OLSでは、即時利用可能なセキュリティ・ポリシー、およびラベルを定義し格納するためのメタデータ・リポジトリが提供されています。
統合監査が有効である場合、データベースでは、監査オプションの構成および管理のためのポリシーベースのフレームワークが提供されます。OLS操作など、様々なタイプの操作の監査オプションをグループ化し、それらを監査ポリシーとして保存できます。次に、そのポリシーを有効または無効にして、基礎となる監査オプションを実行できます。
OLSポリシーを作成すると必ず、データベースではそのポリシーのラベル列がデータベース監査証跡表に追加されます。OLS監査により、OLS管理者操作のレコードを含む監査レコードを、統合監査証跡に書き込むことができます。
データ・アクセスの監視
Oracle AI Databaseには、ユーザー・アクティビティを監視するために複数のツールおよび技術が採用されている。監査は、データ・アクセスの監視のために最も重要なメカニズムです。
-
データベース監査データベース監査とは、選択したユーザー・データベース・アクションを監視して記録する処理です。
-
統合監査証跡監査レコードは、認可されていないデータ・アクセスの検出および特定に不可欠です。
-
Enterprise Managerの監査サポート Oracle Enterprise Manager (Enterprise Manager)では、ほとんどの監査関連タスクを実行できます。
-
Oracle Audit Vault and Database Firewall Oracle Audit Vault and Database Firewall (Oracle AVDF)は、データベースの最初の防衛線を提供し、データベースの統合監査データ、オペレーティング・システム、ディレクトリに対して第一線の防御を提供します。
データベース監査
データベース監査とは、選択したユーザー・データベース・アクションの監視および記録のことです。
統合監査ポリシーを構成して、次の項目を監査できます。
-
SQL文、システム権限、スキーマ・オブジェクトおよびロール(直接付与されたシステム権限のグループとして)
-
管理および非管理ユーザー
-
アプリケーション・コンテキスト値
アプリケーション・コンテキストとは、指定されたネームスペースでの属性の名前/値ペアです。アプリケーションでは、データベースでアクションを実行する前に、様々なコンテキストを設定します。たとえば、アプリケーションでは、アプリケーション・イベントのステータスを示すモジュール名とクライアントIDなどの情報が格納されます。アプリケーションでコンテキストを構成できるため、それらに関する情報は監査レコードに追加されます。
-
Real Application Security、Oracle Database Vault、Oracle Label Security、Oracle Data PumpおよびOracle SQL*Loaderのダイレクト・パス・イベントのポリシー作成
統合監査証跡では、UNIFIED_AUDIT_TRAILデータ・ディクショナリ・ビューで問い合せることができるRecovery Managerイベントを取得できます。Recovery Managerイベントの統合監査ポリシーは作成しません。
また、ファイングレイン監査を使用して、特定の表の列を監査し、ポリシー作成時にイベント・ハンドラを関連付けることもできます。統合およびファイングレイン監査の場合、表で特定のデータベース・アクション、またはアクティビティが発生する時期を取得する条件の有無を調べるポリシーを作成できます。たとえば、9:00 p.m.以降にアクセスされた表を監査できます。
監査を行う理由は次のとおりです。
-
現在のアクションの今後のアカウンタビリティの有効化
-
アカウンタビリティに基づいた、ユーザー(または侵入者などの非ユーザー)の不適切なアクションの阻止
-
不審なアクティビティの調査、監視および記録
-
コンプライアンスに関する監査要件への対応
Oracle Database 12c以降では、統合監査を使用すると、データベース監査はデフォルトで有効になります。データベース監査は、監査ポリシーを有効にすることにより制御します。ただし、統合監査を使用できるようにするには、自身のデータベースを統合監査に移行する必要があります。
-
監査ポリシー 1つのSQL文を使用して、監査オプションのセットを指定する名前付きの統合監査ポリシーを作成できます。これらのオプションにより、データベース内で監査の対象となるシステム権限、アクションまたはロールを指定できます。
-
監査管理者ロール監査を行うには、適切なシステム権限が付与されている必要があります。
関連情報:
-
統合監査の詳細については、『Oracle AI Databaseセキュリティ・ガイド』を参照してください。
-
統合監査への移行方法を学習するには、『Oracle AI Databaseアップグレード・ガイド』
監査ポリシー
1つのSQL文を使用して、監査オプションのセットを指定する名前付きの統合監査ポリシーを作成できます。これらのオプションにより、データベース内で監査の対象となるシステム権限、アクションまたはロールを指定できます。
監査ポリシーでは、文ごとに評価できる条件を、1セッションに1回、またはそのデータベース・インスタンスに対して1回、オプションで設定できます。イベントの監査は、適用可能な監査ポリシーの条件の評価結果によって決まります。条件がtrueと評価されれば、データベースでは監査レコードが生成されます。
次の例では、信頼できる端末term1およびterm2からユーザーがログインしなければ、hr.employees表でのアクティビティを監査するポリシーを作成します。
CREATE AUDIT POLICY EmployeesTableAudit
  ACTIONS update ON hr.employees, delete ON hr.employees
  WHEN SYS_CONTEXT ("userenv", "hostname") NOT IN
("term1","term2") EVALUATE PER SESSION;次の文により、ユーザーhrおよびhrvpのポリシーが有効になります。
AUDIT POLICY EmployeesTableAudit BY hr, hrvp;統合監査ポリシーは、SYSDBA、SYSOPERなどの管理ユーザーを含む、すべてのデータベース・ユーザーに対して適用できます。ただし、監査ポリシーは、データベースがALTER DATABASE OPEN文によってオープンされて初めて読み取られます。したがって、管理ユーザーからの最上位のアクションは常に、データベースがオープンするまでに監査されます。データベースがオープンされた後に、監査ポリシー構成が有効になります。
統合監査が有効な場合、データベースでは自動的に監査設定に対する変更を監査します。また、データベース・インスタンスの起動および停止も監査されます。
関連項目:監査ポリシーの管理方法を学習するには、『Oracle AI Databaseセキュリティ・ガイド』
監査管理者役割
監査を行うには、適切なシステム権限が付与されている必要があります。
Oracle AI Databaseには、次のシステム提供監査管理者ロールが用意されています。
-
AUDIT_ADMINAUDIT_ADMINロールは、データベースの監査設定を管理します。このロールを持つユーザーには、次のことを行う権限があります。-
監査ポリシー(ファイングレイン監査ポリシーを含む)の作成、変更および削除
-
ビジネス要件ごとの監査ポリシーの有効化または無効化
-
監査レコードの表示
-
監査証跡の管理およびクリーンアップ
-
-
AUDIT_VIEWERAUDIT_VIEWERロールは、データの表示および分析のみを必要とするユーザーのためのものです。このロールを持つユーザーは、監査証跡の内容を表示する権限のみを付与されています。
関連項目:監査についてさらに学習するには、『Oracle AI Databaseセキュリティ・ガイド』を参照してください
統合監査証跡
監査レコードは、認可されていないデータ・アクセスの検出および特定に不可欠です。
Oracle AI Databaseでは、指定したイベントの監査を構成できます。ユーザー・セッション中にイベントが発生した場合、監査レコードが生成されます。
監査証跡は、監査レコードが格納される場所です。統合監査証跡は、Oracle Database 12cで導入されて、すべてのタイプのオーディットから得られる監査レコード用の統合記憶域が用意されています。以前のリリースの従来の監査証跡は、手動で統合監査に移行する必要があります。
監査には、標準およびファイングレイン監査があり、次のイベント(管理ユーザーからのこれらイベントの実行を含む)の監査も含まれます。
-
Oracle Data Pump
-
SQL*Loaderでのダイレクト・パス・ロード
-
Oracle Database Vault
-
Oracle Label Security
-
Recovery Manager
-
Real Application Security
統合監査証跡は、読取り専用で、AUDSYSスキーマに格納されています。デフォルトでは、SYSAUX表領域に、すべてのソースからの監査レコードが格納されます。DBMS_AUDIT_MGMTパッケージを使用して、新規表領域を提供できます。
UNIFIED_AUDIT_TRAILビューでは、監査証跡から監査レコードを取得し、表形式で表示されます。APPLICATION_CONTEXTS列には、構成済のアプリケーション・コンテキスト属性の値が格納されます。AUDIT文を使用して、監査レコード内のコンテキスト属性の値を含めることができます。たとえば、次の文では、userenvネームスペースからMODULEおよびCLIENT_INFO属性を取得します。
AUDIT CONTEXT NAMESPACE userenv ATTRIBUTES MODULE, CLIENT_INFO BY hr;監査対象のコンポーネント(Oracle Database Vaultなど)に応じて、追加の統合監査証跡関連のビューを使用できます。
関連情報:
-
統合監査証跡について学習するには、『Oracle AI Databaseセキュリティ・ガイド』を参照してください
-
統合監査を使用するためのデータベースの移行方法を学習するには、『Oracle AI Databaseアップグレード・ガイド』を参照
-
UNIFIED_AUDIT_TRAILビューについて学習するには、『Oracle AI Databaseリファレンス』を参照
Enterprise Managerの監査サポート
Oracle Enterprise Manager (Enterprise Manager)では、ほとんどの監査関連タスクを実行できます。
タスクは次のとおりです。
-
監査の有効化および無効化
-
文およびスキーマ・オブジェクト監査時のオブジェクトの管理
たとえば、Enterprise Managerを使用して、現行の監査対象の文、権限およびオブジェクトのプロパティを表示および検索することができます。
-
監査関連の初期化パラメータの表示および構成
-
監査レポートの表示
関連項目: Enterprise Managerオンライン・ヘルプ
Oracle Audit Vault and Database Firewall
Oracle Audit Vault and Database Firewall (Oracle AVDF)は、データベースおよびデータベースの統合監査データ、オペレーティング・システム、ディレクトリに対して第一線の防御を提供します。
SQL文法に基づくエンジンは、認可されていなSQLトラフィックがデータベースに到達する前に監視およびブロックします。コンプライアンス・レポートとアラートのために、Oracle AVDFはネットワークからのデータベース・アクティビティ・データを詳細な監査データと統合します。監査および監視制御を調整してエンタープライズ・セキュリティ要件を満たすことができます。
関連項目: Oracle Audit Vault and Database Firewallなどの追加のセキュリティ・リソースについて学習するには、『Oracle AI Databaseセキュリティ・ガイド』を参照
高可用性の概要
可用性とは、アプリケーション、サービスおよび機能が必要なときにどの程度使用可能であるかということです。
たとえば、オンライン書店で使用されるOLTPデータベースには、本を購入する顧客がアクセスできる程レベルの可用性があります。高可用性の主な特徴は、信頼性、リカバリ可能性、タイムリなエラー検出および継続的稼働です。
データベース環境において高可用性が重要である理由は、停止時間のコストに関連するためです(停止時間とは、リソースを使用できない時間のことです)。停止時間は、計画停止時間と計画外停止時間のいずれかに分類されます。高可用性環境を設計する場合の主要な課題は、可能性のある停止時間の原因をすべて調査し、対策を講じることです。
-
高可用性と計画外停止時間 Oracle AI Databaseでは、あらゆるタイプの計画外障害に対して停止時間を防止、許容および短縮する高可用性ソリューションが提供されています。
-
高可用性と計画ダウンタイム特に複数のタイムゾーンのユーザーをサポートしているグローバル・エンタープライズでは、計画ダウンタイムは運用に大きな損害を与える可能性があります。このような場合、ルーチン操作、定期的なメンテナンスおよび新規デプロイメントなどの計画的な中断を最小化するようシステムを設計することが重要です。
高可用性と計画外停止時間
Oracle AI Databaseでは、あらゆるタイプの計画外障害に対して停止時間を防止、許容および短縮する高可用性ソリューションが提供されています。
計画外停止時間は、その原因によって次のように分類されます。
-
サイト障害 サイト障害は、イベントによってアプリケーションのすべてまたは大部分の処理が停止されたか、サービス・レベルが利用できないほど速度が低下した場合に発生します。
-
コンピュータ障害コンピュータ障害によって停止は、データベースを実行しているシステムが停止または アクセス不能になるすることによって、システムが使用不可能な場合に発生します。
-
ストレージ障害 ストレージ障害による停止は、一部またはすべてのデータベース・コンテンツを保持しているストレージが停止または使用不能になり、使用不可になった場合に発生します。ストレージ障害の例には、ディスク・ドライブ障害やストレージ・アレイ障害などがあります。
-
データ破損 データ破損は、ハードウェア、ソフトウェアまたはネットワーク・コンポーネントによって、破損したデータが読み取られた場合、または書き込まれた場合に発生します。
-
人為的なエラー 人為的なエラーによる停止は、過失または悪意による操作がコミットされ、データベース内のデータが 論理的に破損するか、使用不可能な場合に発生します。人為的エラーによる停止のサービス・レベルの影響は、影響を受けたデータの量および重要度によって大きく異なる場合があります。
サイト障害
サイト障害は、イベントによってアプリケーションのすべてまたは大部分の処理が停止されたか、サービス・レベルが利用できないほど速度が低下した場合に発生します。
サイト障害はデータ・センターのすべての処理、またはデータ・センターによってサポートされているアプリケーションのサブセットに影響を及ぼす場合があります。たとえば、サイト全体に拡大した電源障害やネットワーク障害、データ・センターが操作不能になる自然障害、操作またはサイトに対する悪質な攻撃などがあります。
サイト障害に対する最も簡単な保護方法は、RMANを使用してデータベース・バックアップを作成し、オフサイトに保存することです。データベースを別のホストにリストアできます。ただし、この方法は時間がかかる場合があり、バックアップが最新でない可能性もあります。1つ以上のスタンバイ・データベースを持つData Guard環境では、本番サイトに障害が発生した場合でもデータベース・サービスの継続性を維持できます。
関連情報:
-
RMANおよびバックアップおよびリカバリ・ソリューションの詳細は、『Oracle AI Databaseバックアップおよびリカバリ・ユーザーズ・ガイド』を参照してください。
-
スタンバイ・データベースの概要は、Oracle Data Guard概要および管理を参照
コンピュータ障害
コンピュータ障害による停止は、データベースを実行しているシステムが停止またはアクセス不能になることによって、システムが使用不可能になった場合に発生します。
コンピュータ障害の例には、ハードウェア障害やオペレーティング・システム障害などがあります。次の表のOracle機能は、コンピュータ障害を防止、またはコンピュータ障害への対応をサポートします。
表1コンピュータ障害に対する保護
| 機能 | 摘要 | 詳細情報 |
|---|---|---|
| エンタープライズ・グリッド | Oracle Real Applications Cluster(Oracle RAC)環境では、Oracle AI Databaseは1つの共有データベースに同時にアクセスしながら、クラスタ内の2つ以上のシステム上で稼働します。複数のハードウェア・システムにまたがる単一のデータベース・システムが、アプリケーションでは単一のデータベースとして認識されます。 | 「グリッド・コンピューティングの概要」 |
| Oracle Data Guard | Data Guardを使用すると、スタンバイ・データベースと呼ばれる本番データベースの1つ以上のコピーを保持できます。このコピーは、異なる大陸または同じデータ・センターに置くことができます。停止によりプライマリ・データベースが使用できなくなった場合、Data Guardにより任意のスタンバイ・データベースがプライマリ用に切り替えられるため、停止時間が最小限に抑えられます。 | Oracle Data Guard概要および管理 |
| グローバル・データ・サービス | Global Data Servicesフレームワークにより、データベース・クラウドの構成、メンテナンスおよび監視を自動化し、一元化します。Global Data Servicesを使用することで、クラウドで提供されるサービスのロード・バランシングおよびフェイルオーバーが可能になります。基本的に、Global Data Servicesは、Oracle Real Application Clusters (Oracle RAC)が1つのデータベースに提供する利点と同種の利点を一連のデータベースに提供します。 | Oracle AI Database Global Data Services概念および管理ガイド |
| ファスト・スタート・リカバリ | 計画外停止時間の一般的な原因は、システムの故障または障害です。Oracle AI Databaseのファスト・スタート・フォルト・リカバリ・テクノロジでは、データベース・インスタンス・リカバリ時間が自動的に制限されます。 | Oracle AI Databaseパフォーマンス・チューニング・ガイド |
記憶域障害
ストレージ障害による停止は、一部またはすべてのデータベース・コンテンツを保持しているストレージが停止または使用できなくなり、使用できない状態になったときに発生します。ストレージ障害の例には、ディスク・ドライブ障害やストレージ・アレイ障害などがあります。
次の表に、ストレージ障害とOracle Data Guardを示します。
表2ストレージ障害に対するソリューション
| 解決策 | 摘要 | 詳細を表示するには |
|---|---|---|
| Oracle Automatic Storage Management(Oracle ASM) | Oracle ASMは、Oracleデータベース・ファイルのボリューム・マネージャであり、単一インスタンスの1 AI DatabaseおよびOracle RAC構成をサポートするファイル・システムです。Oracle ASMは、従来のボリューム・マネージャおよびファイル・システムの代替となるOracleの推奨ストレージ管理ソリューションです。 | Oracle Automatic Storage Management(Oracle ASM) |
| バックアップとリカバリ | Recovery Manager (RMAN)ユーティリティでは、データのバックアップ、以前のバックアップからのリストア、障害発生時までのデータ変更のリカバリなどを実行できます。 | バックアップとリカバリに関する項 |
関連項目: Oracle ASMについてさらに学習するには、Oracle Automatic Storage Management管理者ガイドを参照してください。
データ破損
データ破損は、ハードウェア、ソフトウェアまたはネットワーク・コンポーネントによって、破損したデータが読み取られた場合、または書き込まれた場合に発生します。
データ破損の例として、不正なディスク読取りまたは書込みの原因となるボリューム・マネージャのエラーがあります。データ破損はほとんどありませんが、発生した場合にはデータベース、つまりビジネスに壊滅的な影響があります。
Oracle AI Databaseでは、Data GuardおよびRecovery Managerに加えて、データ破損に対する次の保護形式をサポートしています。
-
書込み欠落の問題の解決策
書込みの欠落は、I/Oサブシステムでデータ・ブロックの完了は認識されますが、書込みが発生していなかった場合に発生します。後続のブロック読取りでは、失効したデータベース・ブロックがI/Oサブシステムによって戻されます、このデータ・ブロックを使用してデータベースの他のブロックを更新すると、ブロックが破損する場合があります。Oracle AI Databaseソリューションは次のとおりです。
-
スタンバイ・データベースを使用した書込み欠落保護
Oracle Database 11gで導入された標準の消失書込み保護で、プライマリ・データベースとスタンバイ・データベースの両方で
DB_LOST_WRITE_PROTECT初期化パラメータを有効にできます。各データベースは、バッファ・キャッシュ・ブロックの読取りをオンラインREDOログに記録します。スタンバイ・データベースは、管理リカバリ中にREDOを適用する際、対応するブロックを読み取ってSCNをREDOログ内のSCNと比較するため、差異が検出されます。 -
シャドウ表領域を使用した書込み欠落保護
シャドウ書込み損失保護について、シャドウ表領域を作成します。シャドウ表領域には、追跡データファイルのすべてのデータ・ブロックについて、SCNを含む短い説明レコードが含まれます。
シャドウ書込み欠落保護が有効(
ALTER DATABASE ENABLE LOST WRITE TRACKING)で、追跡されたデータ・ブロックがデータベースで更新される場合は、データベースによって対応するシャドウ表領域にSCNが書き込まれます。追跡されたデータ・ブロックを読み取る際、データベースではシャドウ・エントリが確認され、それが追跡されたブロックと比較されます。シャドウ・エントリのSCNが追跡されたブロックを上回る場合は、書込み欠落が発生しています。シャドウ書込み欠落保護には、スタンバイ・データベースを使用せずに、書込み欠落を検出するという利点があります。また、スタンバイ書込み欠落保護に固有の遅延のため、書込み欠落が検出された際には、そのブロックがすでにデータベースの他の部分を破損させている可能性があります。データの破損を防ぐために、シャドウ消失書込み保護は書込みが消費される前にその書込み消失を検出します。
-
-
データ・ブロック破損の検出
ブロック破損とは、認識されているOracle形式ではないデータ・ブロック、または内容の一貫性が内部で保持されていないデータ・ブロックです。RMANなどのいくつかのデータベース・コンポーネントおよびユーティリティでは、破損ブロックを検出し、
V$DATABASE_BLOCK_CORRUPTIONに記録できます。Active Data Guardスタンバイ・データベースを使用する環境であれば、破損は自動的に修復されます。 -
トランザクション・ガードおよびアプリケーション・コンティニュイティ
データベース・セッションの停止が発生すると、それが計画済か計画外かに関係なく、エンド・ユーザーが作業のステータスを把握できないままになる可能性があります。場合によっては、ユーザーがコミット済トランザクションを再送信し、それが論理的なデータ破損につながる可能性があります。トランザクション・ガードは、トランザクションがコミットされ、完了したどうかを示す保証済のコミッション結果をデータベースに保存できるようにするトランザクション冪等性を提供します。アプリケーション・コンティニュイティ(トランザクション・ガードを含む)により、アプリケーションは、リカバリ可能なエラーの後に、データベースに対してトランザクションをリプレイし、トランザクションの中止箇所から続行できるようになります。
関連情報:
-
RMANおよびバックアップおよびリカバリ・ソリューションの詳細は『Oracle AI Databaseバックアップおよびリカバリ・ユーザーズ・ガイド』を参照してください。
人的エラー
人為的エラーによる停止は、意図しないアクションまたは悪意によるアクションによって、データベース内のデータが 論理的に破損するか、使用不可能な場合に発生します。人為的エラーによる停止のサービス・レベルの影響は、影響を受けたデータの量および重要度によって大きく異なる場合があります。
多くの研究で、停止時間の最大の原因は人為的エラーだと指摘されています。Oracle AI Databaseは、管理者がこれらのエラーから迅速に診断およびリカバリできる強力なツールを提供します。また、エンド・ユーザーが、管理者の介入なしで問題からのリカバリを実行できる機能も備えられています。
Oracle AI Databaseでは、次の方法により人的エラーから保護することをお薦めします。
-
ユーザー・アクセスの制限
エラーを回避する最善の方法は、データおよびサービスへのユーザー・アクセスを制限することです。Oracle AI Databaseでは、ユーザー認証によりアプリケーション・データへのアクセスを制御し、管理者は各ユーザーに対し、それぞれの職務の実行に必要な権限のみをユーザーに付与できる多種多様なセキュリティ・ツールが提供されています。
-
Oracle Flashback Technology
Oracle Flashback Technologyは、Oracle AI Databaseの人為的エラー修正機能ファミリです。Oracle Flashbackでは、人為的エラーを迅速に分析して修復するSQLインタフェースを提供しています。たとえば、次の操作を実行できます。
-
部分的な損害を対象としたファイングレイン分析と修復
-
広範囲の損害の迅速な修正
-
行、トランザクション、表、表領域、およびデータベース・レベルでのリカバリ
-
-
Oracle LogMiner
Oracle LogMinerは、SQLを使用してオンライン・ファイルの読取り、分析および解釈を行うことができるリレーショナル・ツールです。
関連情報:
-
データベース・セキュリティの概要に関する項
-
Oracle Flashback機能についてさらに学習するには、Oracle AI Databaseバックアップおよびリカバリ・ユーザーズ・ガイドおよび『Oracle AI Database開発ガイド』を参照してください。
-
Oracle LogMinerについてさらに学習するには、『Oracle AI Databaseユーティリティ』を参照してください
高可用性と計画停止時間
特に複数のタイムゾーンのユーザーをサポートしているグローバル・エンタープライズでは、計画ダウンタイムは運用に大きな損害を与える可能性があります。このような場合、ルーチン操作、定期的なメンテナンスおよび新規デプロイメントなどの計画的な中断を最小化するようシステムを設計することが重要です。
計画停止時間は、その原因によって次のように分類されます。
-
システムおよびデータベースの変更計画的システム変更は、日常的および定期的なメンテナンス操作や新規デプロイメントを実行する場合に発生すると、データベースの組織データ構造の外部で行られる運用環境の計画的変更もその1つになります。
-
データ変更計画的なデータ変更は、Oracle AI Databaseオブジェクトの論理構造または物理的組織に変更があった場合に発生します。この変更は、パフォーマンスまたは管理性の向上を第1の目的としています。例として、表の再定義、表パーティションの追加、および索引の作成または再作成などがあります。
-
アプリケーション変更計画されたアプリケーション変更に、データ、スキーマおよびプログラムの変更が含まれる場合があります。これらの変更を行う主な目的は、パフォーマンス、管理性、および機能を向上させることです。例として、アプリケーションのアップグレードがあります。
システムおよびデータベースの変更
計画的なシステム変更は、日常的および定期的なメンテナンス操作や新規デプロイメントを実行する場合に発生し、データベースの組織データ構造の外部で行われる運用環境の計画的変更もその1つです。
その例としては、CPUやクラスタ・ノード(ノードは、データベース・インスタンスのあるコンピュータ)の追加または削除、システム・ハードウェアまたはソフトウェアのアップグレード、およびシステム・プラットフォームの移行があります。
Oracle AI Databaseでは、計画的なシステムおよびデータベース変更に対するソリューションとして、リソースの動的プロビジョニングを提供しています。
-
データベースの動的再構成
Oracle AI Databaseでは、ハードウェアおよびデータベース構成の様々な変更(SMPサーバーのプロセッサの追加および削除、Oracle ASMを使用したストレージ・アレイの追加および削除など)を動的に実行できます。たとえば、Oracle AI Databaseはオペレーティング・システムを監視して、CPU数の変更を検出する。
CPU_COUNT初期化パラメータがデフォルトに設定されている場合は、データベース・ワークロードで新規に追加されたプロセッサを動的に利用できます。 -
自動調整によるメモリー管理
Oracle AI Databaseでは、非集中型ポリシーを使用して、SGAおよびPGAの各サブコンポーネントのメモリーを解放し、取得する。Oracle AI Databaseは、オペレーティング・システムにメモリーのグラニュルを必要とするコンポーネントへの転送を促すことで、メモリーを自動調整します。
-
データファイル、制御ファイル、およびオンラインREDOログ・ファイルの自動配布
Oracle ASMでは、すべての使用可能なディスクにデータファイル、制御ファイル、およびログ・ファイルが自動配布されるため、それらのファイルのレイアウトが自動化され、簡素化されます。
関連情報:
-
Oracle ASMについてさらに学習するには、Oracle Automatic Storage Management管理者ガイドを参照してください。
データの変更
計画的なデータ変更は、Oracle AI Databaseオブジェクトの論理構造または物理的編成に変更があった場合に発生します。この変更は、パフォーマンスまたは管理性の向上を第1の目的としています。例として、表の再定義、表パーティションの追加、および索引の作成または再作成などがあります。
Oracle AI Databaseは、オンラインでの再編成と再定義を通じて、データ変更のダウンタイムを最小限に抑えます。このアーキテクチャを使用すると、データベースのオープン中に、次のタスクを実行できます。
-
表の可用性に大きな影響を与えることなく表構造を変更できる、オンライン表再定義
-
索引の作成、分析および再編成
-
表パーティションの移動
関連情報:
-
パーティションの概要に関する項
-
オンラインでのデータ構造の変更方法を学習するには、『Oracle AI Database管理者ガイド』
アプリケーション変更
計画的なアプリケーション変更には、データ、スキーマおよびプログラムの変更が含まれる場合があります。この変更を行う主な目的は、パフォーマンス、管理性、および機能を向上させることです。例として、アプリケーションのアップグレードがあります。
Oracle AI Databaseでは、アプリケーション・データベース・オブジェクトの変更に必要なアプリケーションの停止時間を最小限に抑えるために、次のソリューションがサポートされています。
表3停止時間の最小化のためのソリューション
| 解決策 | 摘要 | 詳細を表示するには |
|---|---|---|
| ローリング・データベース・パッチ更新 | Oracle AI Databaseは、ローリング方式によるOracle RACシステムのノードへのパッチの適用をサポートします。 | |
| ローリング・データベース・リリース・アップグレード | Oracle AI Databaseでは、Data Guard SQL Applyおよびロジカル・スタンバイ・データベースを使用して、ローリング方式でデータベース・ソフトウェア・アップグレードのインストールおよびパッチ適用がサポートされており、この方式ではデータベース・ダウンタイムがほぼゼロです。 | Oracle AI Databaseアップグレード・ガイド |
| エディションベース再定義 | エディションベースの再定義を使用すると、アプリケーションの使用中にアプリケーションのデータベース・オブジェクトをアップグレードできるため、停止時間を最小限に抑えることや解消することが可能です。Oracle AI Databaseでは、エディションと呼ばれるプライベート環境でデータベース・オブジェクトを変更(再定義)することにより、このタスクを実行します。 | Oracle AI Database開発ガイド |
デフォルトがWAITオプションのDDL |
DDL文には、内部構造に対する排他ロックが必要です(「DDLロック」を参照)。以前のリリースでは、ロックを取得できない場合、DDL文が失敗しました。この問題は、DDLにWAITオプションを指定することで解決できます。 |
|
| 無効な状態のトリガーの作成 | 無効な状態のトリガーを作成でき、トリガーを有効にする前に、コードが正常にコンパイルされたことを確認できます。 | Oracle AI Database PL/SQL言語リファレンス |
グリッド・コンピューティングの概要
グリッド・コンピューティングとして知られるコンピューティング・アーキテクチャは、すべてのエンタープライズ・コンピューティング・ニーズに応じて、柔軟なオンデマンド・リソースに多くのサーバーおよび記憶域を効果的にプールします。
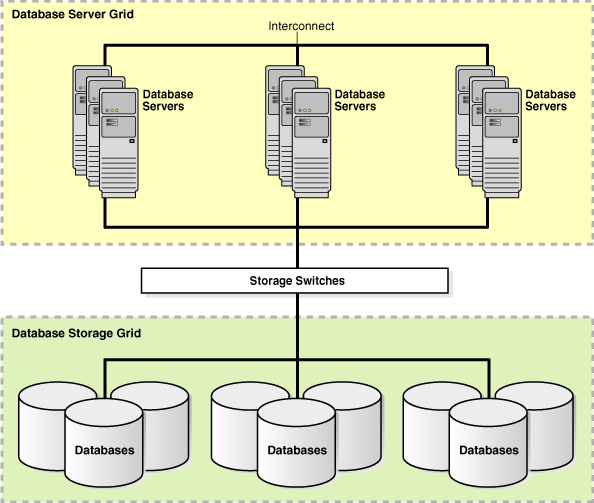
データベース・サーバー・グリッドは、互いに接続されたコモディティ・サーバーのコレクションで、1つ以上のデータベースを実行します。データベース・ストレージ・グリッドは、相互に組み合され、データベース・サーバー・グリッド内のコンピュータからアクセスされる低コストのモジュラ・ストレージ・アレイのコレクションです。
データベース・サーバー・グリッドとデータベース記憶域グリッドにより、システム・リソースのプールを構築できます。これらのシステム・リソースは、業務の優先順位に従って動的に割当ておよび割当解除できます。図20-2に、エンタープライズ・グリッド・コンピューティング環境でのデータベース・サーバー・グリッドおよびデータベース記憶域グリッドを示します。
図2: グリッド・コンピューティング環境
-
データベース・サーバー・グリッド Oracle Real Application Clusters (Oracle RAC)を使用すると、複数のインスタンスでOracleデータベースへのアクセスを共有できます。インスタンスは、インターコネクトを介してリンクされます。
-
Oracle Flex Clusters Starting with Oracle Database 12c, you can configure Oracle Clusterware and Oracle Real Application Clusters in large clusters.
-
データベース記憶域グリッド 関連項目:標準組織グローバル・グリッド・フォーラム(GGF)について学習するには、
http://www.globalgridforum.org/を参照してください
データベース・サーバー・グリッド
Oracle Real Application Clusters (Oracle RAC)では、複数のインスタンス間でOracle Databaseへのアクセスを共有できます。インスタンスは、インターコネクトを介してリンクされます。
Oracle RAC環境では、Oracle AI Databaseはクラスタ内の2つ以上のシステムで実行され、単一の共有データベースに同時にアクセスします。Oracle RACでは、複数の低コストのサーバーにまたがる単一のデータベース(アプリケーションでは単一の統合されたデータベース・システムとして認識される)を提供することによって、データベース・サーバー・グリッドを有効にします。Oracle Clusterwareは、複数のサーバーが1つのサーバーのように操作できるソフトウェアです。各サーバーは、スタンドアロン・サーバーのように見えます。ただし、各サーバーには相互に通信を行うための追加的なプロセスが組み込まれているため、別々のサーバーが1つのサーバーであるかのように連携して動作します。Oracle Clusterwareには、ノード・メンバーシップおよびメッセージ・サービスなど、クラスタの実行に必要なすべての機能が用意されています。
-
スケーラビリティデータベース・サーバー・グリッドでは、Oracle RACを使用すると、容量を増加するためにクラスタにノードを追加できます。
-
フォルト・トレランス高可用性アーキテクチャでは、フォルト・トレランスは、アーキテクチャ内のコンポーネント障害に対して提供される保護です。
-
サービス Oracle RACはサービスをサポートしており、 これによりデータベースのワークロードをグループ化し、サービスを提供するために割り当てられている最適なインスタンスに作業をルーティングできます。
関連情報:
-
Oracle RACデータベース管理方法を学習するには、『Oracle Real Application Clusters管理およびデプロイメント・ガイド』を参照
-
Oracle Clusterwareの管理方法および管理方法を学習するには、『Oracle Clusterware管理およびデプロイメント・ガイド』を参照
スケーラビリティ
データベース・サーバー・グリッドでOracle RACを使用すると、容量を増加するためにクラスタにノードを追加できます。
Oracle RACに実装されているキャッシュ・フュージョン・テクノロジにより、アプリケーションを変更しなくても容量を拡張できます。これにより、システムを段階的に拡張してコストを節約でき、小規模な単一ノード・システムを大規模なシステムに置き換える必要がなくなります。
既存のシステムを大規模なノードに置き換えるかわりに、ノードを段階的にクラスタに追加できます。グリッド・プラグ・アンド・プレイを使用すると、クラスタのノードの追加と削除が簡素化されるため、動的にプロビジョニングされた環境でクラスタをデプロイしやすくなります。また、グリッド・プラグ・アンド・プレイでは、データベースとサービスを位置に依存しない方法で管理することもできます。SCANを使用すると、クライアントはグリッド内の位置とは関係なくデータベース・サービスに接続できるようになります。
関連情報:
- キャッシュ・フュメントについてさらに学習するには、『Oracle Real Application Clusters管理およびデプロイメント・ガイド』を参照してください。
フォルト・トレランス
高可用性アーキテクチャでは、フォルト・トレランスは、アーキテクチャ内のコンポーネント障害に対する保護です。
Oracle RACアーキテクチャの主な利点は、複数のノードによって実現される本質的なフォルト・トレランスです。物理ノードは独立して動作しているため、1つ以上のノードに障害が発生した場合、クラスタ内の他のノードは影響を受けません。
フェイルオーバーはグリッド上の任意のノードで発生します。極端な場合、1つのノードを除くすべてのノードが停止しても、Oracle RACシステムはデータベース・アクセスを提供し続けます。このアーキテクチャでは、メンテナンスのためにノードのグループを透過的にオンラインまたはオフラインにすると同時に、クラスタの残りの部分によってデータベース・アクセスを提供し続けることができます。
Oracle RACには、Oracleクライアントおよび接続プールとの統合が組み込まれています。この機能により、接続を終了する障害がプールを介してアプリケーションに即座に通知されます。アプリケーションは、TCPタイムアウトを待機することなく、適切なリカバリ・アクションを即座に実行できます。Oracle RACでは、リスナーとOracleクライアントおよび接続プールを統合して、最適なアプリケーション・スループットを実現します。Oracle RACは、トランザクション時の負荷に基づいて、クラスタ・ワークロードのバランスを調整します。
関連情報:
-
データベース常駐接続プーリングに関する項
-
自動ワークロードの管理についてさらに学習するには、『Oracle Real Application Clusters管理およびデプロイメント・ガイド』を参照してください。
サービス
Oracle RACはサービスをサポートしており、 これによりデータベースのワークロードをグループ化し、サービスを提供するために割り当てられている最適なインスタンスに作業をルーティングできます。
サービスとは、共通の属性、パフォーマンスしきい値、および優先順位を持つアプリケーションのワークロードです。ビジネス・ポリシーを定義してこれらのサービスに適用し、ピーク処理時用のノードの割当てや、サービス障害の自動処理などのタスクを実行します。サービスを使用してシステム・リソースを必要な場所と時間に応じて適用することにより、ビジネス上の目標を達成します。
サービスがデータベース・リソース・マネージャに統合されており、これによってインスタンス内のサービスが使用できるリソースを制限できます。また、Oracle Schedulerのジョブは、特定のインスタンスではなく、サービスを使用して実行できます。
関連情報:
-
データベース・リソース・マネージャおよびOracle Schedulerについて学習するには、『Oracle AI Database管理者ガイド』を参照
Oracle Flex Cluster
Oracle Database 12c以降では、Oracle ClusterwareおよびOracle Real Application Clustersを大規模クラスタで構成できます。
これらの大規模クラスタは、Oracle Flex Clustersと呼ばれ、ハブ・アンド・スポーク・アーキテクチャに配置された2種類のノード(ハブ・ノードおよびリーフ・ノード)を含んでいます。ハブ・ノードはしっかり接続されていて、共有ストレージに直接アクセスすることができ、1つ以上のリーフ・ノードのアンカーの役割を果たします。リーフ・ノードは、ハブ・ノードにゆるやかに接続され、共有記憶域には直接アクセスできない可能性があります。
関連情報:
-
Oracle Flex Clustersについてさらに学習するには、『Oracle Clusterware管理およびデプロイメント・ガイド』を参照
-
Oracle Flex Clusterのデプロイメントについてさらに学習するには、『Oracle Grid Infrastructureインストレーションおよびアップグレード・ガイド』を参照
データベース・ストレージ・グリッド
DBAまたはストレージ管理者は、Oracle ASMインタフェースを使用してデータベース記憶域グリッド内のディスクを指定できます。このディスクは、Oracle ASMがすべてのサーバーおよび記憶域プラットフォームにわたって管理する必要があります。Oracle ASMは、ディスク領域をパーティションに分散し、データをOracle ASMに提供されたディスク全体に均等に配分します。また、Oracle ASMは、データベース記憶域グリッドのストレージ・アレイのディスクが追加または削除されると、データを自動的に再配分します。
関連情報:
-
クラスタOracle ASMの詳細は、『Oracle Automatic Storage Management管理者ガイド』を参照してください。
データ・ウェアハウスとビジネス・インテリジェンスの概要
データ・ウェアハウスは、トランザクション処理ではなく問合せおよび分析用に設計されたリレーショナル・データベースである。
たとえば、データ・ウェアハウスでは、株価の履歴や所得税の記録を追跡できます。通常、ウェアハウスには履歴トランザクション・データから導出されたデータが格納されますが、他のソースからのデータも格納できます。
データ・ウェアハウス環境には、リレーショナル・データベースの他に、様々なツールがあります。典型的な環境には、ETLソリューション、OLAPエンジン、クライアント分析ツール、データを収集してユーザーに配信するその他のアプリケーションが含まれます。
-
データ・ウェアハウスとOLTPデータ・ウェアハウスを導入する一般的な方法は、William Inmon氏が提唱するデータ・ウェアハウスの特性を十分に理解することです。
-
データ・ウェアハウス・アーキテクチャデータ・ウェアハウスとそのアーキテクチャは、ビジネス要件によって異なります。
-
抽出、変換およびロード(ETL)の概要ソース・システムからデータを抽出してウェアハウスに取り込む処理は、一般にはETLと呼ばれ、抽出、変換、ロードです。ETLは、詳細に定義された3つのステップではなく、広範囲なプロセスを指します。
-
ビジネス・インテリジェンスは、ビジネスにおける意思決定を支援するために組織内で情報を分析することです。
データ・ウェアハウスとOLTP
データ・ウェアハウスを導入する一般的な方法は、William Inmon氏が提唱するデータ・ウェアハウスの特性を十分に理解することです。
特性は次のとおりです。脚注1
-
サブジェクト指向
データ・ウェアハウスでは、売上などの主題別にデータベースを定義できます。
-
統合
データ・ウェアハウスには、異なるソースのデータを、一貫したフォーマットに入れる必要があります。また、ネーミングの競合や単位間の不整合などの問題を解決する必要があります。この目標が達成されて初めて、データ・ウェアハウスは統合されたことになります。
-
恒常的
ウェアハウスの目的は、発生した事柄を分析できるようにすることです。このため、ウェアハウスに格納されたデータは変更されません。
-
時系列
データ・ウェアハウスは時間経過による変化に焦点を当てています。
データ・ウェアハウスとOLTPデータベースでは、要件が異なります。たとえば、データ・ウェアハウスでは、ビジネスの傾向を把握するために、大量のデータを保持する必要があります。それとは対照的に、OLTPシステムでは、パフォーマンスを維持するために、履歴データを定期的にアーカイブに移動する必要があります。表20-4に、データ・ウェアハウスとOLTPの相違点を示します。
表4データ・ウェアハウスとOLTPシステム
| 特性 | データ・ウェアハウス | OLTP |
|---|---|---|
| ワークロード | 非定型問合せに適応するように設計されています。データ・ウェアハウスのワークロードは事前にはわからない場合があり、データ・ウェアハウスは様々な問合せを適切に実行できるように最適化する必要があります。 | 事前定義済の操作のみをサポートします。アプリケーションは、これらの操作のみをサポートするように特別にチューニングまたは設計されている場合があります。 |
| データの変更 | バルク・データ修正テクニックを使用してETLプロセスにより定期的に更新されます。データ・ウェアハウスのエンド・ユーザーがデータベースを直接更新することはありません。 | エンド・ユーザーにより定期的に発行される個々のDML文によって行われます。OLTPデータベースは常に最新であり、各ビジネス・トランザクションの現在の状態が反映されます。 |
| スキーマ設計 | 全体または一部が非正規化されたスキーマ(スター・スキーマなど)を使用して、問合せパフォーマンスが最適化されます。 | 完全に正規化されたスキーマを使用して、DMLパフォーマンスが最適化され、データの整合性が保証されます。 |
| 典型的な操作 | 典型的な問合せでは、数千または数百万の行がスキャンされます。たとえば、すべての顧客についての先月の総売上を要求できます。 | 典型的な操作は、少数のレコードにのみアクセスします。たとえば、1人の顧客の現行の注文を取得できます。 |
| 履歴データ | 履歴分析をサポートするために、数か月または数年分のデータが格納されます。 | 数週間または数か月分のデータしか格納されません。現行のトランザクションの要件を適切に満たすために必要な履歴データが保持されます。 |
関連情報:
-
データベース・ウェアハウスのの詳細は、『Oracle AI Databaseデータ・ウェアハウス・ガイド』を参照してください。
-
OLTPシステムの詳細は、『Oracle AI Database VLDBおよびパーティショニング・ガイド』を参照してください
データ・ウェアハウスのアーキテクチャ
データ・ウェアハウスとそのアーキテクチャは、ビジネス要件によって異なります。
-
データ・ウェアハウスのアーキテクチャ(基本)単純なデータ・ウェアハウスのアーキテクチャでは、エンド・ユーザーは、複数のソース・システムからデータ・ウェアハウスに転送されたデータに直接アクセスできます。
-
データ・ウェアハウスのアーキテクチャ(ステージング領域あり)一部のデータ・ウェアハウスでは、ウェアハウスに入れる前にデータを事前に処理する場所であるステージング領域が使用されます。ステージング領域により、サマリーの作成とウェアハウス管理のタスクが簡素化されます。
-
データ・ウェアハウスのアーキテクチャ(ステージング領域およびデータ・マートあり)ウェアハウス・アーキテクチャを組織内の様々なグループ向けにカスタマイズできます。そのためには、ウェアハウス内のデータを、特定の業務またはプロジェクト用に設計された独立したデータベースであるデータ・マートに転送します。通常、データ・マートには多くのサマリー表が含まれます。
データ・ウェアハウスのアーキテクチャ(基本)
単純なデータ・ウェアハウスのアーキテクチャでは、エンド・ユーザーは、複数のソース・システムからデータ・ウェアハウスに転送されたデータに直接アクセスできます。
次の図は、サンプル・アーキテクチャを示しています。
図3: データ・ウェアハウスのアーキテクチャ
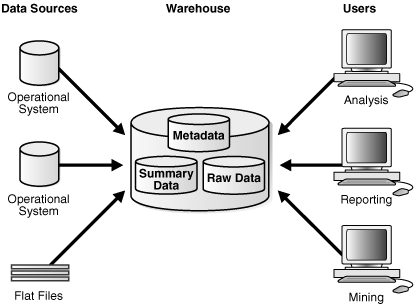
前の図には、従来型OLTPシステムのメタデータと生データの他に、サマリー・データが示されています。サマリーは集計ビューです。集計ビューでは、高コストな結合操作および集計操作が事前に計算されて結果を表に格納することで、問合せのパフォーマンスが向上します。たとえば、サマリー表に地域別、製品別の売上合計を含めることができます。サマリーは、マテリアライズド・ビューとも呼ばれます。
基本マテリアライズド・ビューについて学習するには、『Oracle AI Databaseデータ・ウェアハウス・ガイド』を参照してください。
データ・ウェアハウスのアーキテクチャ(ステージング領域あり)
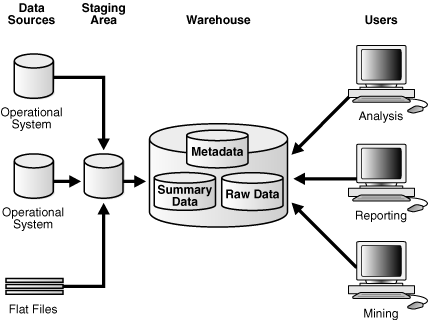
一部のデータ・ウェアハウスでは、ウェアハウスに入れる前にデータを事前に処理する場所であるステージング領域が使用されます。ステージング領域により、サマリーの作成とウェアハウス管理のタスクが簡素化されます。
次の図に、ステージング領域を示します。
図4: データ・ウェアハウス・アーキテクチャ(ステージング・エリアを伴う)
様々な転送メカニズムについて学習するには、関連項目: 『Oracle AI Databaseデータ・ウェアハウス・ガイド』を参照してください。
データ・ウェアハウスのアーキテクチャ(ステージング領域およびデータ・マートあり)
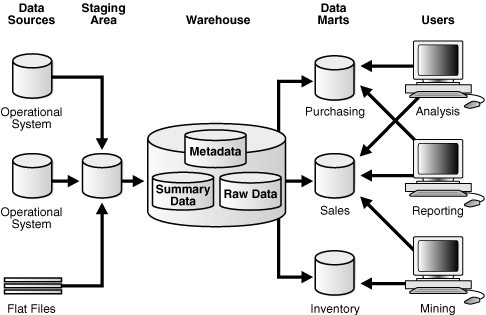
ウェアハウス・アーキテクチャを組織内の様々なグループ向けにカスタマイズできます。そのためには、ウェアハウス内のデータを、特定の業務またはプロジェクト用に設計された独立したデータベースであるデータ・マートに転送します。通常、データ・マートには多くのサマリー表が含まれます。図20-5では、購買、売上および在庫情報が別々のデータ・マートに分離されています。財務アナリストはデータ・マートに対して購買と売上の履歴情報を問い合せることができます。
図5: データ・ウェアハウス・アーキテクチャ(ステージング・エリアおよびデータ・マートあり)
変換メカニズムについて学習するには、関連項目: 『Oracle AI Databaseデータ・ウェアハウス・ガイド』を参照してください。
抽出、変換、ロード(ETL)の概要
一般に、ソース・システムからデータを抽出してウェアハウスに取り込む処理は、ETLと呼ばれ、抽出、変換、ロードです。ETLは、詳細に定義された3つのステップではなく、広範囲なプロセスを指します。
典型的なシナリオでは、1つ以上の業務系システムからデータを抽出し、処理用にターゲット・システムまたは中間システムに物理的に転送します。転送方法によっては、このプロセスでなんらかの変換処理が行われる場合もあります。たとえば、ゲートウェイを介してリモート・ターゲットに直接アクセスするSQL文で、SELECT文の一部として2つの列を連結できます。
Oracle AI Database自体は、ETLツールではありません。ただし、Oracle AI Databaseでは、ETLツールやカスタマイズされたETTLソリューションに使用できる豊富な機能が提供されています。Oracle AI Databaseが提供するETL機能は、次のとおりです。
-
トランスポータブル表領域
異なるコンピュータ・アーキテクチャやオペレーティング・システム間で表領域を転送することもできます。トランスポータブル表領域は、2つのOracleデータベース間で大量のデータを移動する場合に最も高速な方法です。
-
テーブル・ファンクション
テーブル・ファンクションは、行のコレクション(ネストした表またはVARRAY)を戻すユーザー定義PL/SQLファンクションである。テーブル・ファンクションは、出力として行セットを生成でき、行セットを入力として受け入れることができます。テーブル・ファンクションで、PL/SQL、CまたはJavaで実装されている変換のパイプライン実行とパラレル実行がサポートされており、中間のステージング表を使用する必要はありません。
-
外部表
外部表により、最初に外部データをデータベースにロードしなくても、パラレルで直接結合できます。このため、外部表を使用すると、ロード・フェーズと変換フェーズをパイプライン処理できます。
-
表圧縮
ディスク使用量とメモリー使用量を減少させるために、表とパーティション表を圧縮形式で格納できます。通常は、表の圧縮を使用すると、読取り専用操作のスケールアップが向上し、問合せ実行も速くなります。
関連情報:
-
表圧縮に関する項
-
ETLの概要は、『Oracle AI Databaseデータ・ウェアハウス・ガイド』を参照
ビジネス・インテリジェンス
ビジネス・インテリジェンスは、ビジネスにおける意思決定を支援するために組織内で情報を分析することです。
分析アプリケーションおよびビジネス・インテリジェンスは、階層のドリルアップやドリルダウン、および集計値の比較によって占められています。Oracle AI Databaseでは、このような操作をサポートするテクノロジを提供しています。
-
分析SQL Oracle AI Databaseには、分析操作を実行するための多数のSQL操作が導入されました。たとえば、ランキング、移動平均、累計、対比レポート、期間対比などです。
-
分析ビューは、データ・セットの内容を拡張し、ビジネス・インテリジェンス・アプリケーションの開発を容易にします。
-
Oracle Advanced Analytics Oracle Advanced Analyticsオプションでは、Oracle AI Databaseがビッグ・データ・アナリティクス用の包括的な拡張分析プラットフォームにまで拡張されます。
分析SQL
Oracle AI Databaseには、分析操作を実行するための多数のSQL操作が導入されています。たとえば、ランキング、移動平均、累計、対比レポート、期間対比などです。
たとえば、Oracle AI Databaseでは、次の形式による分析SQLがサポートされています。
表5分析SQL
| 分析SQLのタイプ | 摘要 | 詳細を表示するには |
|---|---|---|
| 集計のためのSQL | COUNTなどの集計ファンクションは、行のグループに基づいて、結果行を1つ返します。集計は、データ・ウェアハウスの基盤です。ウェアハウスでの集計パフォーマンスを改善するために、データベースには問合せとレポート作成を容易かつ高速にするGROUP BY句の拡張機能が用意されています。 |
集計について学習するには、Oracle AI Databaseデータ・ウェアハウス・ガイドを参照してください。 |
| 分析用SQL | MAXなどの分析ファンクションは行のグループを集計し(ウィンドウと呼ばれる)、結果セットとして複数の行を返します。Oracleは、分析SQL関数ファミリを使用した拡張SQL分析処理機能を備えています。たとえば、これらの分析関数を使用すると、ランキングやパーセンタイル、変動ウィンドウを計算できます。 |
分析用のSQLおよびレポート用SQLについて学習するには、Oracle AI Databaseデータ・ウェアハウス・ガイドを参照してください |
| モデリングのSQL | MODEL句を使用すると、問合せ結果から多次元配列を作成し、この配列にルールを適用して新規の値を計算できます。たとえば、売上ビューのデータを国別にパーティション化し、複数のルールによって定義されたモデル計算を国別に実行できます。ある製品の2006年と2007年の売上の合計として2008年の売上を計算します。 |
SQLのモデル化について学習するには、Oracle AI Databaseデータ・ウェアハウス・ガイドを参照してください |
SQL関数について学習するには、関連項目: 『Oracle AI Database SQL言語リファレンス』を参照してください。
分析ビュー
分析ビューは、データ・セットの内容を拡張し、ビジネス・インテリジェンス・アプリケーションの開発を容易にします。
分析ビューには、次の特性があります。
-
データは、階層およびディメンションの概念を使用して編成されます。
-
分析ビューには、結合、集計および計測の計算ルールが埋め込まれています。
-
SQL DDLを使用すると、データベース内の既存の表、ビューおよびその他のオブジェクトの上に階層化できます。
-
簡単なSQLを使用して問い合せることができます。
関連項目:分析ビューの概要は、Oracle AI Databaseデータ・ウェアハウス・ガイドを参照してください。
Oracle Advanced Analytics
Oracle Advanced Analyticsオプションは、Oracle AI Databaseをビッグ・データ・アナリティクス用の包括的な高度なアナリティクス・プラットフォームに拡大します。
Oracle Advanced Analyticsでは、予測分析、データ・マイング、テキスト・マイニング、統計分析、拡張数値計算、およびデータベース内の対話型グラフィックを提供します。Oracle Advanced Analyticsには、次のコンポーネントがあります。
-
Oracle Data Miningビジネス・インテリジェンスにおけるデータ・マイニングとは、高度な数学的アルゴリズムを使用してデータをセグメント化し、イベントが将来的に発生する確率を評価することです。
-
Rは、統計計算およびグラフィック用のオープンソース言語および環境である。Oracle Machine Learning for Rにより、Rがエンタープライズ対応およびビッグ・データ対応になります。
Oracle Data Mining
ビジネス・インテリジェンスにおけるデータ・マイニングとは、高度な数学的アルゴリズムを使用してデータをセグメント化し、イベントが将来的に発生する確率を評価することです。
通常、データ・マイニングは、コール・センター、ATM、E-Businessリレーショナル管理(ERM)およびビジネス・プランニングなどで使用されます。Oracle Data Minerを使用すると、データ分析者は、データを迅速に分析し、最良の顧客にターゲットを絞り、不正行為と戦い、ビジネスの競争力向上に役立てられる重要な相互関係やパターンを見つけることができます。
Oracle Data Miningには、高パフォーマンスのインデータベースのモデル作成およびモデル配置用のネイティブSQLファンクションとして実行される、データ・マイニング・アルゴリズムが備わっています。Oracle Data Miningでは、表、ビュー、スター・スキーマ、トランザクション・データおよび非構造化データのマイニングが可能です。
Oracle Data Miningでは、PL/SQL APIおよびモデル・スコアリング用のSQLファンクションがサポートされます。これにより、Oracle AI Databaseはアプリケーション開発者に、データ・マイニングとデータベース・アプリケーションをシームレスに統合するためのインフラストラクチャを提供します。
SQL Developer の拡張機能であるOracle Data Minerには、Oracle Data Mining用のGUIが用意されています。
関連項目: 『Oracle Machine Learning for SQL概要』
Oracle Machine Learning for R
Rは、統計計算およびグラフィック用のオープンソース言語および環境である。Oracle Machine Learning for Rにより、Rがエンタープライズ対応およびビッグ・データ対応になります。
Oracle Machine Learning for Rは大量のデータを処理する問題用に設計されており、RとOracle AI Databaseを統合します。Oracle AI Databaseに格納されたデータでの統計およびグラフィック分析に、Rのコマンドとスクリプトを実行できます。また、データベースの並列性とスケーラビリティを利用してデータ分析を自動化するRスクリプトの開発、改良およびデプロイができます。データ分析者は、Rパッケージを実行し、分析アプリケーション用のRスクリプトは、SQLを学習することなく1回の操作で開発できます。
関連項目: Oracle Machine Learning for Rユーザーズ・ガイド
Oracleにおける情報統合の概要
組織が進化するにつれて、複数のデータベースおよびアプリケーション間で情報を共有できることに対する重要性がますます重要になります。
情報を共有するには、次の基本的な方法があります。
-
連結
情報を1つのデータベースに連結でき、これによって、それ以上の統合は必要なくなります。Oracle RAC、グリッド・コンピューティング、マルチテナント・アーキテクチャおよびOracle VPDにより、情報を1つのデータベースに連結できます。
-
フェデレーション
情報は分散した状態にしておき、この情報を統合するツールを提供できます。これによって、情報が1つの仮想データベース内にあるかのように見せることができます。
-
共有
情報を共有することで、複数のデータ・ストアおよびアプリケーションで情報を保持できます。
この項では、主に情報を統合および共有するためのOracleソリューションについて説明します。
-
フェデレーテッド・アクセス統合されたアクセスの基本となるのは分散環境で、これは、相互にシームレスに通信する異種システムで構成されたネットワークである。
-
情報の共有どのような統合であっても、その中心は社内のアプリケーション間でデータを共有します。
統合されたアクセス
フェデレーテッド・アクセスの基本となるのは分散環境で、これは、相互にシームレスに通信する、相互にシームレスに通信する異なるシステムからなるネットワークである。
環境内の各システムは、ノードと呼ばれます。ユーザーが直接接続するシステムをローカル・システムと呼び、このユーザーがアクセスする他のシステムをリモート・システムと呼びします。
分散環境では、アプリケーションからローカル・システムとリモート・システムのデータにアクセスして相互に交換することができます。すべてのデータに同時にアクセスして変更できます。
-
分散SQL: 分散SQLは、複数のデータベース間に分散したデータに同期的にアクセスおよび更新します。Oracle分散データベース・システムはユーザーに対して透過的であるため、単一のOracle Databaseであるかのように見せることができます。
-
データベース・リンクデータベース・リンクは、2つの物理データベースを結ぶ接続で、これにより、クライアントは1つの論理データベースとしてそれらのデータベースにアクセスできます。
分散SQL
分散SQLを使用すると、複数のデータベース間に分散されたデータに同時にアクセスして更新できます。Oracle分散データベース・システムはユーザーに対して透過的であるため、単一のOracle Databaseであるかのように見せることができます。
分散SQLには、分散問合せおよび分散トランザクションが含まれます。Oracleの分散データベース・アーキテクチャによって、問合せおよびトランザクションが透過的になります。たとえば、標準DML文の動作は、非分散データベース環境の場合と同じです。また、アプリケーションでは標準SQL文COMMIT、SAVEPOINTおよびROLLBACKを使用してトランザクションを制御します。
関連情報:
-
分散トランザクションの管理方法を学習するには、『Oracle AI Database管理者ガイド』を参照
データベース・リンク
データベース・リンクは、2つの物理データベースを結ぶ接続で、これにより、クライアントは1つの論理データベースとしてデータベースにアクセスできます。
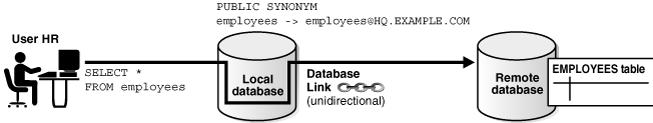
Oracle AI Databaseは、データベース・リンクを使用して、あるデータベース上のユーザーがリモート・データベース内のオブジェクトにアクセスできるようにします。ローカル・ユーザーは、リモート・データベースのユーザーならなくても、リモート・データベースへのリンクにアクセスできます。図20-6の例では、ユーザーhrが、hq.example.comというグローバル名を持つリモート・データベース上にあるemployees表にアクセスしています。employeesシノニムにより、リモート・スキーマ・オブジェクトのアイデンティティおよび位置は意識されなくなります。
図6: データベース・リンク
関連項目:データベース・リンクについて学習するには、『Oracle AI Database管理者ガイド』を参照してください
情報共有
どのような統合であっても、その中心は社内のアプリケーション間でデータを共有することです。
-
Oracle GoldenGate Oracle GoldenGateは、非同期のログベースのリアルタイム・データ・レプリケーション製品である。
-
Oracle AI Database Transactional Event Queues and Advanced Queuing (AQ) Oracle AI Database Transactional Event Queues and Advanced Queuing (AQ)は、Oracle AI Databaseと統合された堅牢で機能豊富なメッセージ・キューイング・システムです。
Oracle GoldenGate
Oracle GoldenGateは、非同期のログベースのリアルタイム・データ・レプリケーション製品です。
Oracle GoldenGateは、異機種間データベース、ハードウェア、オペレーティング・システム環境全体で、大量のトランザクション・データを、影響を最小限に抑えてリアル・タイムで移動します。この製品は、次の理由でリアルタイムの情報アクセスおよび可用性を最適化します。
-
Oracle AI Databaseおよび非Oracleデータベースの異機種混合を含むレプリケーションをサポートします。
-
重要なシステムの継続的な可用性を維持し、その結果、計画メンテナンス中の停止時間を最小限にします。
-
企業内でリアルタイムのデータ統合を可能にします。
-
シャード表でシャード間の双方向レプリケーションを自動的に構成します
典型的な環境として、取得、ポンプおよび配信プロセスがあります。各プロセスは、Oracleデータベースおよび非Oracleデータベースの両方を含む、ほとんどの一般的なオペレーティング・システムおよびデータベースで実行できます。データの一部またはすべてをレプリケートできます。これらのプロセス内のデータは、異機種環境だけでなく、異なるデータベース・スキーマでも操作できます。
Oracle GoldenGateでは、マルチマスター・レプリケーション、ハブ・アンド・スポーク方式のデプロイメント、データ統合およびデータ変換をサポートします。したがって、Oracle GoldenGateにより、クリティカルなシステムの24時間365日の稼働が可能になり、関連データを企業内に分散させて意思決定を最適化できます。
関連情報:
-
Oracle Shardingの使用方法を学習するには、Oracle Globally Distributed AI Databaseを参照してください
-
http://www.oracle.com/technetwork/middleware/goldengate/documentation/index.html
Oracle AI Database Transactional Event QueuesとAdvanced Queuing(AQ)
Oracle AI Database Transactional Event QueuesとAdvanced Queuing(AQ)は、Oracle AI Databaseと統合された堅牢で機能豊富なメッセージ・キューイング・システムです。
組織内の異なるシステム間で通信を行う必要がある場合は、メッセージング環境によって、これらのシステム間で重要な情報を転送する、標準的で信頼性の高い方法が提供されます。
ユースケースの例として、本社のOracleデータベースに注文を入力するとします。注文が入力されると、AQにより、注文IDと注文日がウェアハウスのデータベースに送信されます。これらのメッセージは、倉庫の従業員に注文を通知し、従業員が注文を履行して出荷できるようにします。
-
メッセージ・キューイングとデキューOracle AI Databaseのトランザクション・イベント・キューイングおよびアドバンストなキューイングでは、ユーザー・メッセージがキューと呼ばれる抽象的な記憶単位に保存されます。
-
Oracle AI Database Transactional Event QueuesおよびAdvanced Queuing Advanced Features Oracle AI Database Transactional Event QueuesおよびAdvanced Queuing (AQ)は、メッセージ・キューイング・システムのすべての標準機能をサポートします。
メッセージのキューイングとデキューイング
Oracle AI Database Transactional Event QueuesおよびAdvanced Queuingでは、ユーザー・メッセージがキューと呼ばれる抽象的記憶単位に保存されます。
エンキューは、プロデューサがメッセージをキューに入れるプロセスである。デキューは、コンシューマがキューからメッセージを取得するプロセスです。
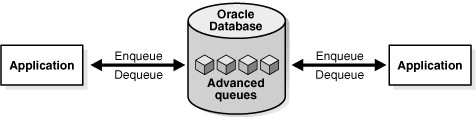
明示的デキューがサポートされるため、開発者はXStreamおよびOracle GoldenGateを使用してメッセージを確実に交換できます。また、Oracle GoldenGateの変更取得および伝播機能を活用することで、変更をアプリケーションに通知できます。図20-7では、サンプル・アプリケーションがアドバンスト・キューイングを介して、明示的にメッセージをエンキューおよびデキューしており、これにより、異なるメッセージ・システムを使用しているパートナとも情報を共有できます。エンキューした後、パートナのアプリケーションに対してデキューされる前に、メッセージを変換および伝播できます。
図7: Oracle Message Queuing
Oracle AI Database Transactional Event QueuesとAdvanced Queuingアドバンスト機能
Oracle AI Database Transactional Event QueuesおよびAdvanced Queuing (AQ)では、メッセージ・キューイング・システムのすべての標準機能がサポートされています。
次の機能を備えています。
-
非同期によるアプリケーションの統合
トランザクション・イベント・キューおよびアドバンスト・キューイングには、メッセージをエンキューするいくつかの方法があります。メッセージは、取得プロセスまたは同期取得が暗黙的に取得するか、アプリケーションやユーザーが明示的に取得できます。
-
拡張可能な統合アーキテクチャ
多くのアプリケーションは、Oracle AI Databaseをハブとして使用する分散ハブアンドスポーク・モデルを使用して統合されます。Oracleデータベース上の分散アプリケーションは、同じハブのキューと通信します。複数のアプリケーションが同じキューを共有できるので、サポートするアプリケーション数を増やすためにキューを追加する必要がありません。
-
異機種間アプリケーションの統合
トランザクション・イベント・キューおよびアドバンスト・キューイングは、アプリケーションにOracleタイプ・システムの全機能を備えています。これには、スカラー・データ型、継承を伴うOracle AI Databaseオブジェクト型、XMLデータ用の追加演算子を持つ
XMLType、およびANYDATAのサポートが含まれます。 -
従来型アプリケーションの統合
Oracle Messaging Gatewayは、Oracle AI DatabaseアプリケーションをWebsphere MQやTibcoなどの他のメッセージ・キューイング・システムと統合します。
-
標準ベースAPIのサポート
トランザクション・イベント・キューおよびアドバンスト・キューイングは、業界標準のAPIであるSQL、JMSおよびSOAPをサポートしています。SQLを使用して行われた変更は、メッセージとして自動的に取得されます。
関連項目: 『Oracle AI Database Transactional Event QueuesおよびAdvanced Queuingユーザーズ・ガイド』
脚注の説明
脚注1:
『Building the Data Warehouse』(1996年John Wiley and Sons社の)