데이터베이스 관리자 및 개발자를 위한 항목
이 페이지의 스크립트 콘텐츠는 탐색 용도로만 사용되며 어떤 방식으로든 콘텐츠를 변경하지 않습니다.
이 장에서는 데이터베이스 관리자와 개발자 모두에게 중요한 일반적인 데이터베이스 항목을 요약하고, 데이터베이스 기능에 대한 전체 계정이 아닌 다른 설명서에 대한 포인터를 제공합니다.
-
데이터베이스 보안 개요 일반적으로 데이터베이스 보안에는 사용자 인증, 암호화, 액세스 제어 및 모니터링이 포함됩니다.
-
고가용성 개요 가용성은 요청 시 애플리케이션, 서비스 또는 기능을 사용할 수 있는 정도입니다.
-
그리드 컴퓨팅 개요 그리드 컴퓨팅이라는 컴퓨팅 아키텍처는 많은 수의 서버와 스토리지를 모든 엔터프라이즈 컴퓨팅 요구 사항에 맞는 유연한 온디맨드 리소스로 효과적으로 풀링합니다.
-
데이터 웨어하우징 및 Business Intelligence 개요 데이터 웨어하우스는 트랜잭션 처리가 아닌 질의 및 분석을 위해 설계된 관계형 데이터베이스입니다.
-
Oracle 정보 통합 개요 조직이 발전함에 따라 여러 데이터베이스와 애플리케이션 간에 정보를 공유할 수 있는 것이 점점 더 중요해지고 있습니다. 참조: DBA와 관련된 항목은 데이터베이스 관리자 개념, 데이터베이스 개발자와 관련된 항목은 데이터베이스 개발자 개념을 참조하십시오.
데이터베이스 보안 개요
일반적으로 데이터베이스 보안에는 사용자 인증, 암호화, 액세스 제어 및 모니터링이 포함됩니다.
이 단원에서는 다음 항목을 다룹니다.
-
사용자 계정 각 Oracle 데이터베이스에는 적합한 데이터베이스 사용자 목록이 있다.
-
데이터베이스 인증 Oracle AI Database에서 데이터베이스 인증은 사용자가 자격 증명을 확인하고 데이터베이스에 대한 액세스를 허용하는 자격 증명을 데이터베이스에 제공하는 프로세스입니다.
-
암호화 Oracle AI Database 암호화는 보안 키 및 암호화 알고리즘을 사용하여 데이터를 읽을 수 없는 형식으로 변환하는 프로세스입니다.
-
Oracle Advanced Security의 일부인 Oracle Data Redaction Oracle Data Redaction을 사용하면 권한이 낮은 사용자 또는 애플리케이션에서 질의한 데이터를 마스킹(재정의)할 수 있습니다. 개정은 사용자가 데이터를 질의할 때 실시간으로 발생합니다.
-
액세스 제어 Oracle AI Database는 데이터에 대한 액세스를 제어하는 다양한 기술을 제공합니다. 이 절에서는 이러한 기술 중 일부를 요약합니다.
-
데이터 액세스 모니터링 Oracle AI Database는 사용자 활동을 모니터링하기 위한 다양한 도구와 기술을 제공합니다. 감사는 데이터 액세스를 모니터하기 위한 기본 메커니즘입니다.
사용자 계정
각 Oracle 데이터베이스에는 적합한 데이터베이스 사용자 목록이 있습니다.
데이터베이스에는 기본 관리 계정 SYSTEM을 비롯한 여러 기본 계정이 포함되어 있습니다. 필요에 따라 사용자 계정을 만들 수 있습니다. 응용 프로그램 유저가 Oracle 데이터베이스에 액세스하도록 구성할 수도 있습니다.
데이터베이스에 액세스하려면 사용자가 적합한 사용자 이름 및 인증 인증서를 제공해야 합니다. 자격 증명은 암호, Kerberos 티켓 또는 PKI(공개 키 기반구조) 인증서일 수 있습니다. 실패한 로그인 시도에 준하여 계정을 잠그도록 데이터베이스 보안을 구성할 수 있습니다.
일반적으로 데이터베이스 액세스 제어에는 데이터 액세스 및 데이터베이스 작업 제한이 포함됩니다. 예를 들어, 유저가 지정된 테이블을 query하거나 지정된 데이터베이스 문을 실행하지 못하도록 제한할 수 있습니다.
-
권한 사용자 권한은 특정 SQL 문을 실행할 수 있는 권한입니다.
-
역할 역할은 사용자가 다른 사용자나 역할에 부여할 수 있는 관련 권한의 명명된 그룹입니다. 롤은 데이터베이스 응용 프로그램 또는 유저 그룹에 대한 권한을 관리하는 데 도움이 됩니다.
-
권한 분석 권한 분석 메커니즘은 지정된 조건에 따라 데이터베이스에 대한 권한 사용을 캡처합니다.
-
사용자 프로파일 시스템 리소스 컨텍스트에서 사용자 프로파일은 사용자에 대한 데이터베이스 사용 및 데이터베이스 인스턴스 리소스를 제한하는 명명된 리소스 제한 및 암호 매개변수 세트입니다.
참조:
-
관리 사용자 계정에 대해 알아보려면 Oracle AI Database Administrator's Guide를 참조하십시오.
-
애플리케이션 사용자를 구성하는 방법을 알아보려면 Oracle AI Database Real Application Security Administrator's and Developer's Guide를 참조하십시오.
권한
사용자 권한은 특정 SQL 문을 실행할 수 있는 권한입니다.
권한은 다음 범주로 구분됩니다.
-
시스템 권한
이것은 데이터베이스에서 특정 작업을 수행하거나 특정 유형의 객체에 대해 작업을 수행할 수 있는 권리입니다. 예를 들어,
CREATE USER및CREATE SESSION는 시스템 권한입니다. -
스키마 특권
이것은 특정 스키마 내의 모든 객체에 대해 시스템 권한을 사용할 수 있는 권리입니다. 이 권한은 스키마의 모든 현재 및 미래 객체에 적용됩니다.
-
객체 권한
이는 객체에 대해 특정 작업을 수행할 수 있는 권한입니다. 예를 들어,
employees테이블을 질의합니다. 권한 유형은 데이터베이스에서 정의합니다.
다른 사용자의 재량에 따라 사용자에게 권한이 부여됩니다. 관리자는 유저가 작업에 필요한 작업을 수행할 수 있도록 권한을 유저에게 부여해야 합니다. 좋은 보안 관행은 필요한 작업을 수행하기 위해 해당 권한을 필요로 하는 유저에게만 권한을 부여하는 것입니다.
참조:
SESSION_PRIVS뷰에 대한 자세한 내용은 Oracle AI Database Reference를 참조하십시오.
역할
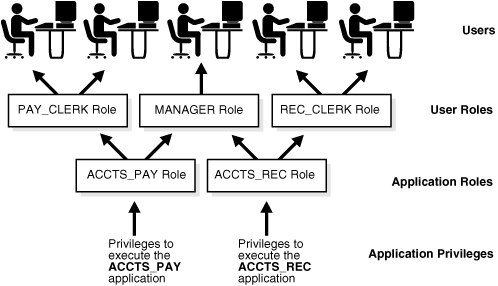
역할은 사용자가 다른 사용자나 롤에 부여할 수 있는 관련 권한의 명명된 그룹입니다. 롤은 데이터베이스 응용 프로그램 또는 유저 그룹에 대한 권한을 관리하는 데 도움이 됩니다. 그림 20-1에서는 역할의 일반적인 용도를 보여줍니다. PAY_CLERK, MANAGER 및 REC_CLERK 롤은 다른 사용자에게 지정됩니다. ACCTS_PAY 응용 프로그램을 실행할 수 있는 권한을 포함하는 응용 프로그램 롤 ACCTS_PAY은 PAY_CLERK 및 MANAGER 롤을 가진 사용자에게 지정됩니다. ACCTS_REC 응용 프로그램을 실행할 수 있는 권한을 포함하는 응용 프로그램 롤 ACCTS_REC은 REC_CLERK 및 MANAGER 롤을 가진 사용자에게 지정됩니다.
그림 1: 역할의 일반적인 용도
참조:
-
Oracle AI Database Security Guide - 보안용 역할 사용에 대해 알아보기
-
Oracle AI Database Administrator's Guide - 롤 관리 방법 학습
권한 분석
권한 분석 방식은 지정된 조건에 따라 데이터베이스에 대한 권한 사용을 캡처합니다.
이러한 방식으로 응용 프로그램 모듈을 실행하거나 특정 SQL 문을 실행하는 데 필요한 권한을 캡처할 수 있습니다. 예를 들어, 특정 데이터베이스 세션 동안 사용자가 행사한 권한을 찾을 수 있습니다.
운용 중인 데이터베이스에서는 권한과 롤, 롤과 롤, 롤과 유저 간의 관계가 복잡할 수 있습니다. 권한 분석을 사용하면 복잡한 시스템에서 불필요하게 부여된 권한을 식별할 수 있습니다. 캡처된 결과의 분석을 기반으로 불필요한 권한 부여를 제거하거나 권한 부여를 재구성하여 데이터베이스의 보안을 강화할 수 있습니다.
참조: 권한 분석에 대한 자세한 내용은 Oracle AI Database Security Guide를 참조하십시오.
사용자 프로파일
시스템 리소스 컨텍스트에서 사용자 프로파일은 사용자에 대한 데이터베이스 사용 및 데이터베이스 인스턴스 리소스를 제한하는 명명된 리소스 제한 및 암호 매개변수 세트입니다.
프로파일은 유저의 동시 세션 수, 각 세션에 사용 가능한 CPU 처리 시간 및 사용 가능한 논리적 I/O 양을 제한할 수 있습니다. 예를 들어, clerk 프로파일은 사용자를 사무 작업에 필요한 시스템 리소스로 제한할 수 있습니다. 주: Database Resource Manager를 사용하여 리소스를 제한하고 프로파일을 사용하여 암호를 관리하는 것이 좋습니다.
프로파일은 속성 세트를 공유하는 사용자에 대한 단일 참조 지점을 제공합니다. 하나의 사용자 세트에 프로필을 할당하고 다른 모든 사용자에게 기본 프로필을 할당할 수 있습니다. 각 사용자에게는 특정 시점에 최대 하나의 프로파일이 지정됩니다.
참조:
-
"버퍼 I/O"
-
Oracle AI Database Security Guide - 프로파일로 리소스를 관리하는 방법 학습
-
CREATE PROFILE구문 및 의미에 대한 Oracle AI Database SQL Language Reference
데이터베이스 인증
Oracle AI Database에서 데이터베이스 인증은 사용자가 데이터베이스에 인증서를 제공하는 프로세스로, 인증서를 확인하고 데이터베이스에 대한 액세스를 허용합니다.
ID를 검증하면 추가 상호 작용을 위한 신뢰 관계가 수립됩니다. 또한 인증을 통해 액세스 권한 및 작업을 특정 ID와 연결할 수 있으므로 책임 소재를 명백히 구분할 수 있습니다.
Oracle AI Database는 다음과 같은 다양한 인증 방법을 제공합니다.
-
데이터베이스에 의한 인증
Oracle 데이터베이스는 암호, Kerberos 티켓 또는 PKI 인증서를 사용하여 사용자를 인증할 수 있습니다. 또한 Oracle은 생체 인식 등 다른 형태의 인증을 위해 RADIUS 호환 장치를 지원합니다. 유저가 Oracle 데이터베이스에 생성될 때 인증 유형을 지정해야 합니다.
-
운영 체제에 의한 인증
일부 운영 체제에서는 Oracle AI Database가 유지 관리하는 정보를 사용하여 사용자를 인증할 수 있습니다. 운영 체제에서 인증한 후에는 유저 이름이나 암호를 지정하지 않고 데이터베이스에 연결할 수 있습니다.
비관리 데이터베이스 사용자 계정은 데이터베이스 종료 또는 시작과 같은 데이터베이스 작업을 수행하지 않아야 합니다. 이러한 작업에는 SYSDBA, SYSOPER, SYSBACKUP 또는 SYSDG 권한이 필요합니다.
참조:
-
인증 방법에 대한 자세한 내용은 Oracle AI Database Security Guide를 참조하십시오.
-
관리 인증에 대해 알아보려면 Oracle AI Database Administrator's Guide를 참조하십시오.
암호화
Oracle AI Database encryption은 보안 키 및 암호화 알고리즘을 사용하여 데이터를 읽을 수 없는 형식으로 변환하는 프로세스입니다.
암호화는 PCI-DSS(Payment Card Industry Data Security Standard) 또는 위반 통지 법률과 같은 규정 준수 요구 사항을 충족하는 데 자주 사용됩니다. 예를 들어, 신용카드 번호, 주민등록번호 또는 환자 건강 정보를 암호화해야 합니다.
-
네트워크 암호화 - 클라이언트와 서버 간에 네트워크를 통해 이동하는 데이터의 암호화를 네트워크 암호화라고 합니다.
-
투명한 데이터 암호화 Oracle Advanced Security 투명한 데이터 암호화를 사용하면 개별 테이블 열 또는 테이블스페이스를 암호화할 수 있으며,
네트워크 암호화
클라이언트와 서버 간에 네트워크를 통해 이동하는 데이터의 암호화를 네트워크 암호화라고 합니다.
침입자는 네트워크 패킷 스니퍼를 사용하여 네트워크에서 이동하는 정보를 캡처하고 이를 악의적인 사용을 위해 파일에 스풀링할 수 있습니다. 네트워크에서 데이터를 암호화하면 이런 종류의 작업을 막을 수 있습니다.
투명한 데이터 암호화
Oracle Advanced Security Transparent Data Encryption에서는 개별 테이블 열 또는 테이블스페이스를 암호화할 수 있도록 합니다.
사용자가 암호화된 열에 데이터를 삽입하면 데이터베이스가 자동으로 해당 데이터를 암호화합니다. 사용자가 열을 선택하면 데이터가 암호 해독됩니다. 이러한 형태의 암호화(encryption)는 투명하고, 고성능을 제공하며, 구현하기 쉽습니다.
투명한 데이터 암호화에는 AES(Advanced Encryption Standard) 및 내장 키 관리와 같은 업계 표준 암호화 알고리즘이 포함됩니다.
참조: Oracle AI Database 투명한 데이터 암호화 가이드
Oracle 데이터 개정
Oracle Advanced Security의 일부인 Oracle Data Redaction을 사용하면 권한이 낮은 사용자 또는 애플리케이션에서 질의한 데이터를 마스킹(재정의)할 수 있습니다. 개정은 사용자가 데이터를 질의할 때 실시간으로 발생합니다.
Data Redaction은 다음 개정 함수 유형을 지원합니다.
-
전체 데이터 개정
이 경우 데이터베이스는 테이블 또는 뷰에서 지정된 열의 전체 내용을 개정합니다. 예를 들어, 성에 대한
VARCHAR2열에는 단일 공백이 표시됩니다. -
부분 데이터 편집
이 경우 데이터베이스는 표시된 출력의 일부를 개정합니다. 예를 들어, 응용 프로그램은
1234로 끝나는 신용 카드 번호를xxxx-xxxx-xxxx-1234로 표시할 수 있습니다. 전체 및 부분 개정 모두에 정규 표현식을 사용할 수 있습니다. 정규식은 검색 패턴을 기반으로 데이터를 개정할 수 있습니다. 예를 들어, 정규식을 사용하여 특정 전화 번호 또는 전자 메일 주소를 개정할 수 있습니다. -
임의 데이터 개정
이 경우 데이터베이스는 열의 데이터 유형에 따라 데이터를 임의로 생성된 값으로 표시합니다. 예를 들어, 숫자
1234567는83933895로 나타날 수 있습니다.
데이터 편집은 포괄적인 보안 솔루션이 아닙니다. 예를 들어, 권한이 있는 직접 연결된 사용자가 개정된 데이터에 대해 추론 공격을 수행하는 것을 방지하지는 않습니다. 이러한 공격은 개정된 열을 식별하고 제거 프로세스를 통해 저장된 값을 추측하는 SQL query를 반복하여 실제 데이터로 돌아가려고 합니다. 권한 있는 사용자의 추론 및 기타 공격을 감지하고 방지하기 위해 Oracle은 Oracle Data Redaction을 Oracle Audit Vault and Database Firewall, Oracle Database Vault와 같은 관련 데이터베이스 보안 제품과 페어링할 것을 권장합니다.
데이터 개정은 다음과 같이 작동합니다.
-
DBMS_REDACT패키지를 사용하여 지정된 테이블에 대한 개정 정책을 생성합니다. -
정책에서 미리 정의된 개정 함수를 지정합니다.
-
데이터베이스에 열의 실제 값 또는 개정된 값이 표시되는지 여부는 정책에 따라 다릅니다. 데이터가 개정되면 사용자에게 표시하기 직전에 최상위 선택 목록에서 개정이 발생합니다.
다음 예제에서는 hr.employees 테이블의 사원 ID(employee_id) 열을 개정하는 전체 데이터 개정 정책을 추가합니다.
BEGIN
 DBMS_REDACT.ADD_POLICY(
   object_schema    => 'hr'
,  object_name      => 'employees'
,  column_name      => 'employee_id'
,  policy_name      => 'mask_emp_ids'
,  function_type    => DBMS_REDACT.FULL
,  expression       => '1=1'
);
END;
/
앞의 예에서 true로 평가되는 표현식 설정은 EXEMPT REDACTION POLICY 권한이 부여되지 않은 사용자에게 편집 내용을 적용합니다.
참조:
-
Oracle AI Database Data Redaction Guide - 데이터 편집에 대해 알아보기
-
DBMS_REDACT에 대한 자세한 내용은 Oracle AI Database PL/SQL Packages and Types Reference를 참조하십시오.
액세스 제어
Oracle AI Database는 데이터 액세스를 제어하는 다양한 기술을 제공합니다. 이 절에서는 이러한 기술 중 일부를 요약합니다.
-
Oracle Database Vault는 애플리케이션 데이터에 대한 권한 있는 사용자 액세스를 제한합니다.
-
VPD(가상 전용 데이터베이스) VPD(Oracle Virtual Private Database)를 사용하면 행 및 열 레벨에서 보안을 적용할 수 있습니다.
-
OLS(Oracle Label Security) OLS(Oracle Label Security)를 사용하면 보안 레이블을 사용하여 데이터 분류를 지정하고 액세스를 제어할 수 있습니다. 데이터 또는 사용자에게 레이블을 지정할 수 있습니다.
Oracle Database Vault
Oracle Database Vault는 애플리케이션 데이터에 대한 권한 있는 사용자 액세스를 제한합니다.
Oracle Database 12c부터 Oracle Database Vault는 표준 데이터베이스 감사 데이터 구조를 확장합니다. 또한 통합 감사로 마이그레이션하는 경우 데이터베이스는 Oracle AI Database에 대한 감사 레코드를 중앙 집중화하는 Oracle Secure Files의 통합 감사 추적에 감사 레코드를 기록합니다.
Oracle Database Vault를 사용하여 데이터베이스, 데이터 및 응용 프로그램의 액세스 시기, 위치 및 방법을 제어할 수 있습니다. 따라서 내부자 위협으로부터 보호하고, 규제 요건을 준수하고, 업무 분리를 적용하는 등 일반적인 보안 문제를 해결할 수 있습니다.
Oracle Database Vault 관리자에게 책임을 부여하기 위해 데이터베이스는 Oracle Database Vault 메타데이터에 대한 구성 변경 사항을 필수적으로 감사합니다. 이러한 변경 사항에는 Oracle Database Vault 관련 강제 수행의 생성, 수정 및 삭제, 보호된 역할의 부여 및 취소, Oracle Data Pump 및 작업 스케줄러와 같은 구성 요소에 대한 권한 부여가 포함됩니다.
참조:
-
Oracle Database Native Audit과 Oracle Database Vault Audit의 통합에 대해 알아보려면 Oracle AI Database Security Guide를 참고하세요.
VPD(가상 프라이빗 데이터베이스)
Oracle Virtual Private Database(VPD)를 사용하면 행 및 열 레벨에서 보안을 적용할 수 있습니다.
보안 정책은 우발적이거나 악의적인 데이터 삭제 또는 데이터베이스 기반구조 손상으로부터 데이터베이스를 보호하는 방법을 설정합니다.
VPD는 권한 및 롤과 같은 보안 보호 기능이 충분히 세분화되지 않은 경우에 유용합니다. 예를 들어, 모든 유저가 employees 테이블에 액세스하도록 허용할 수 있지만 유저와 동일한 부서의 사원에 대한 액세스를 제한하는 보안 정책을 생성할 수 있습니다.
기본적으로 데이터베이스는 Oracle VPD 보안 정책이 적용된 테이블, 보기 또는 동의어에 대해 실행된 SQL 문에 동적 WHERE 절을 추가합니다. WHERE 절은 인증서가 보안 정책을 통과한 사용자만 보호된 데이터에 액세스할 수 있도록 허용합니다.
참조: Oracle AI Database Security Guide
OLS(Oracle Label Security)
OLS(Oracle Label Security)를 사용하면 보안 레이블을 사용하여 데이터 분류를 지정하고 액세스를 제어할 수 있습니다. 데이터 또는 사용자에게 레이블을 지정할 수 있습니다.
데이터에 지정되면 레이블을 테이블에 숨겨진 열로 첨부하여 SQL에 투명성을 제공할 수 있습니다. 예를 들어, 매우 민감한 데이터를 포함하는 행에 HIGHLY SENSITIVE 레이블을 지정하고 덜 민감한 행에 SENSITIVE 레이블을 지정할 수 있습니다. 사용자가 데이터에 액세스하려고 하면 OLS는 사용자 레이블을 데이터 레이블과 비교하고 액세스 권한을 부여할지 여부를 결정합니다. VPD와 달리 OLS는 즉시 사용 가능한 보안 정책과 레이블 정의 및 저장을 위한 메타 데이터 저장소를 제공합니다.
통합 감사가 활성화된 경우 데이터베이스는 감사 옵션을 구성하고 관리하기 위한 정책 기반 프레임워크를 제공합니다. OLS 작업을 비롯한 여러 작업 유형에 대한 감사 옵션을 그룹화하고 감사 정책으로 저장할 수 있습니다. 그런 다음 정책을 사용 또는 사용 안함으로 설정하여 기본 감사 옵션을 적용할 수 있습니다.
OLS 정책이 생성될 때마다 데이터베이스는 정책에 대한 레이블 열을 데이터베이스 감사 추적 테이블에 추가합니다. OLS 감사는 OLS 관리자 작업에 대한 레코드를 비롯한 감사 레코드를 통합 Audit Trail에 기록할 수 있습니다.
데이터 액세스 모니터링
Oracle AI Database는 사용자 활동을 모니터링하기 위한 다양한 도구와 기술을 제공합니다. 감사는 데이터 액세스를 모니터하기 위한 기본 메커니즘입니다.
-
데이터베이스 감사 데이터베이스 감사는 선택된 사용자 데이터베이스 작업의 모니터링 및 기록입니다.
-
통합 감사 추적 감사 레코드는 허용되지 않은 데이터 액세스를 감지하고 식별하는 데 필수적입니다.
-
Enterprise Manager 감사 지원 Oracle Enterprise Manager(Enterprise Manager)에서는 대부분의 감사 관련 작업을 수행할 수 있습니다.
-
Oracle Audit Vault and Database Firewall Oracle AVDF(Oracle Audit Vault and Database Firewall)는 데이터베이스에 대한 첫 번째 방어선을 제공하고 데이터베이스, 운영 체제, 디렉토리의 감사 데이터를 통합합니다.
데이터베이스 감사
데이터베이스 감사는 선택된 사용자 데이터베이스 작업의 모니터링 및 기록입니다.
통합 감사 정책을 구성하여 다음을 감사할 수 있습니다.
-
SQL 문, 시스템 권한, 스키마 객체 및 롤(직접 부여된 시스템 권한 그룹)
-
관리 및 비관리 사용자
-
응용 프로그램 컨텍스트 값
응용 프로그램 컨텍스트는 지정된 네임스페이스의 속성 이름-값 쌍입니다. 응용 프로그램은 데이터베이스에서 작업을 실행하기 전에 다양한 컨텍스트를 설정합니다. 예를 들어, 응용 프로그램은 응용 프로그램 이벤트의 상태를 나타내는 모듈 이름 및 클라이언트 ID와 같은 정보를 저장합니다. 응용 프로그램은 컨텍스트에 대한 정보가 감사 레코드에 추가되도록 컨텍스트를 구성할 수 있습니다.
-
Real Application Security, Oracle Database Vault, Oracle Label Security, Oracle Data Pump 및 Oracle SQL*Loader 직접 경로 이벤트에 대한 정책 생성
통합 Audit Trail은 Recovery Manager 이벤트를 캡처할 수 있으며 UNIFIED_AUDIT_TRAIL 데이터 딕셔너리 뷰에서 Query할 수 있습니다. Recovery Manager 이벤트에 대한 통합 감사 정책은 생성하지 않습니다.
또한 Fine-Grained Auditing을 사용하여 특정 테이블 열을 감사하거나 정책을 생성하는 동안 이벤트 처리기를 연결할 수 있습니다. 통합 감사 및 Fine-Grained Auditing의 경우 테이블에서 특정 데이터베이스 작업을 캡처하는 조건 또는 작업이 발생한 시간을 테스트하는 정책을 생성할 수 있습니다. 예를 들어, 오후 9시 이후에 액세스되는 테이블을 감사할 수 있습니다.
감사 사유는 다음과 같습니다.
-
현재 작업에 대한 향후 책임 부여
-
사용자의 책임에 따라 부적절한 작업으로부터 사용자(또는 침입자와 같은 다른 사용자)를 차단합니다.
-
의심스러운 활동 조사, 모니터 및 기록
-
준수를 위한 감사 요구 사항 해결
Oracle Database 12c부터는 통합 감사를 사용할 때 데이터베이스 감사가 기본적으로 활성화됩니다. 감사 정책을 활성화하여 데이터베이스 감사를 제어합니다. 그러나 통합 감사를 사용하려면 먼저 데이터베이스를 해당 데이터베이스로 이전해야 합니다.
-
감사 정책 단일 SQL 문을 사용하여 감사 옵션 집합을 지정하는 이름이 지정된 통합 감사 정책을 생성할 수 있습니다. 이러한 옵션은 데이터베이스 내에서 감사할 시스템 권한, 작업 또는 롤을 지정할 수 있습니다.
-
감사 관리자 롤 감사를 수행하려면 적합한 시스템 권한을 부여 받아야 합니다.
참조:
-
통합 감사에 대한 자세한 내용은 Oracle AI Database Security Guide를 참조하십시오.
-
통합 감사로 마이그레이션하는 방법을 알아보려면 Oracle AI Database Upgrade Guide를 참조하십시오.
감사 정책
단일 SQL 문을 사용하여 감사 옵션 집합을 지정하는 명명된 통합 감사 정책을 생성할 수 있습니다. 이러한 옵션은 데이터베이스 내에서 감사할 시스템 권한, 작업 또는 롤을 지정할 수 있습니다.
감사 정책에서는 선택적으로 모든 명령문, 세션 또는 데이터베이스 Instance에 대해 한 번씩 평가할 수 있는 조건을 설정할 수 있습니다. 이벤트 감사는 해당 감사 정책에 대한 조건 평가의 결과에 따라 달라집니다. 조건이 true로 평가되면 데이터베이스가 감사 레코드를 생성합니다.
다음 예에서는 사용자가 신뢰할 수 있는 터미널 term1 및 term2에서 로그인하지 않는 한 hr.employees 테이블에서 작업을 감사하는 정책을 만듭니다.
CREATE AUDIT POLICY EmployeesTableAudit
  ACTIONS update ON hr.employees, delete ON hr.employees
  WHEN SYS_CONTEXT ("userenv", "hostname") NOT IN
                   ("term1","term2") EVALUATE PER SESSION;
다음 명령문은 사용자 hr 및 hrvp에 대한 정책을 사용으로 설정합니다.
AUDIT POLICY EmployeesTableAudit BY hr, hrvp;SYSDBA, SYSOPER 등의 관리 유저를 포함하여 모든 데이터베이스 유저에게 통합 감사 정책을 적용할 수 있습니다. 그러나 감사 정책은 ALTER DATABASE OPEN 문을 사용하여 데이터베이스를 연 후에만 읽을 수 있습니다. 따라서 관리 유저의 최상위 레벨 작업은 데이터베이스가 열릴 때까지 항상 감사됩니다. 데이터베이스가 열린 후 감사 정책 구성이 적용됩니다.
통합 감사가 활성화되면 데이터베이스는 감사 설정에 대한 변경 사항을 자동으로 감사합니다. 데이터베이스는 또한 데이터베이스 Instance 시작 및 종료를 감사합니다.
참조: Oracle AI Database Security Guide에서 감사 정책 관리 방법 학습
감사 관리자 역할
감사를 수행하려면 적합한 시스템 권한을 부여 받아야 합니다.
Oracle AI Database는 다음과 같은 시스템 제공 감사 관리자 역할을 제공합니다.
-
AUDIT_ADMINAUDIT_ADMIN역할은 데이터베이스에 대한 감사 설정을 관리합니다. 이 역할을 가진 사용자는 다음을 수행할 수 있는 권한이 있습니다.-
FGA(Fine-Grained Auditing) 정책을 포함한 감사 정책 생성, 변경 및 삭제
-
각 업무 요구 사항에 대한 감사 정책 활성화 또는 비활성화
-
감사 레코드 보기
-
Audit Trail 관리 및 정리
-
-
AUDIT_VIEWERAUDIT_VIEWER롤은 데이터를 보고 분석해야 하는 사용자용입니다. 이 역할을 가진 사용자는 Audit Trail 내용을 볼 수 있는 권한만 있습니다.
참조: 감사에 대한 자세한 내용은 Oracle AI Database Security Guide를 참조하십시오.
통합 감사 추적
감사 레코드는 허용되지 않은 데이터 액세스를 감지하고 식별하는 데 필수적입니다.
Oracle AI Database는 지정된 이벤트에 대한 감사를 구성할 수 있습니다. 유저 세션 중에 이벤트가 발생하면 데이터베이스가 감사 레코드를 생성합니다.
감사 추적은 감사 레코드를 저장하는 위치입니다. Oracle Database 12c의 새로운 통합 감사 추적은 모든 유형의 감사에서 감사 레코드를 위한 통합 스토리지를 제공합니다. 이전 릴리스의 기존 감사 추적에서 통합 감사로 수동으로 마이그레이션해야 합니다.
감사에는 표준 감사와 Fine-Grained Auditing이 포함되며 관리 유저의 이러한 이벤트 실행을 포함하여 다음 이벤트에 대한 감사도 포함됩니다.
-
Oracle Data Pump
-
SQL*Loader 직접 경로 로드
-
Oracle Database Vault
-
Oracle Label Security
-
복구 관리자
-
Real Application Security
통합 Audit Trail은 읽기 전용이며 AUDSYS 스키마에 저장됩니다. 기본적으로 SYSAUX 테이블스페이스는 모든 소스의 감사 레코드를 저장합니다. DBMS_AUDIT_MGMT 패키지를 사용하여 새 테이블스페이스를 제공할 수 있습니다.
UNIFIED_AUDIT_TRAIL 뷰는 감사 추적에서 감사 레코드를 검색하여 표 형식으로 표시합니다. APPLICATION_CONTEXTS 열은 구성된 응용 프로그램 컨텍스트 속성의 값을 저장합니다. AUDIT 문을 사용하여 감사 레코드에 컨텍스트 속성 값을 포함할 수 있습니다. 예를 들어, 다음 명령문은 userenv 네임스페이스에서 MODULE 및 CLIENT_INFO 속성을 캡처합니다.
AUDIT CONTEXT NAMESPACE userenv ATTRIBUTES MODULE, CLIENT_INFO BY hr;Oracle Database Vault와 같은 감사된 구성 요소에 따라 추가적인 통합 Audit Trail 관련 뷰를 사용할 수 있습니다.
참조:
-
통합 감사 추적에 대한 자세한 내용은 Oracle AI Database Security Guide를 참조하십시오.
-
통합 감사를 사용하도록 데이터베이스를 마이그레이션하는 방법에 대한 자세한 내용은 Oracle AI Database Upgrade Guide를 참조하십시오.
-
UNIFIED_AUDIT_TRAIL뷰에 대한 자세한 내용은 Oracle AI Database Reference를 참조하십시오.
Enterprise Manager 감사 지원
Oracle Enterprise Manager(Enterprise Manager)를 사용하면 대부분의 감사 관련 작업을 수행할 수 있습니다.
작업에는 다음이 포함됩니다.
-
감사 활성화 및 비활성화
-
명령문 및 스키마 객체를 감사할 때 객체 관리
예를 들어, Enterprise Manager에서는 현재 감사된 명령문, 권한 및 객체의 속성을 표시하고 검색할 수 있습니다.
-
감사 관련 초기화 파라미터 보기 및 구성
-
감사 보고서 표시
참조: Enterprise Manager 온라인 도움말
Oracle Audit Vault and Database Firewall
Oracle AVDF(Oracle Audit Vault and Database Firewall)는 데이터베이스를 위한 첫 번째 방어선을 제공하고 데이터베이스, 운영 체제, 디렉토리의 감사 데이터를 통합합니다.
SQL 문법 기반 엔진은 무단 SQL 트래픽이 데이터베이스에 도달하기 전에 모니터하고 차단합니다. 규정 준수 보고 및 경고를 위해 Oracle AVDF는 네트워크의 데이터베이스 활동 데이터를 세부적인 감사 데이터와 결합합니다. 엔터프라이즈 보안 요구 사항에 맞게 감사 및 모니터링 제어를 조정할 수 있습니다.
참조: Oracle AI Database Security Guide에서 Oracle Audit Vault and Database Firewall과 같은 추가 보안 리소스에 대해 알아봅니다.
고가용성 개요
가용성은 요청 시 애플리케이션, 서비스 또는 기능을 사용할 수 있는 정도입니다.
예를 들어 온라인 장부 판매자가 사용하는 OLTP 데이터베이스는 고객이 구매할 때 액세스할 수 있는 범위 내에서 사용할 수 있습니다. 신뢰성, 복구 가능성, 시기적절한 오류 감지 및 지속적인 운영은 고가용성의 주요 특성입니다.
데이터베이스 환경에서 고가용성의 중요성은 리소스를 사용할 수 없는 시점인 다운타임 비용과 관련이 있습니다. 작동 중지 시간은 계획됨 또는 계획되지 않음으로 분류될 수 있습니다. 고가용성 환경을 설계할 때의 주요 과제는 다운타임의 가능한 모든 원인을 조사하고 이를 처리할 계획을 개발하는 것입니다.
-
고가용성 및 계획되지 않은 다운타임 Oracle AI Database는 모든 유형의 계획되지 않은 장애에 대한 다운타임을 방지, 허용 및 줄일 수 있는 고가용성 솔루션을 제공합니다.
-
고가용성 및 계획된 작동 중지 시간 계획된 작동 중지 시간은 특히 여러 시간대의 사용자를 지원하는 글로벌 기업에서 운영 중단과 같을 수 있습니다. 이 경우 일상적인 작업, 정기적인 유지 관리 및 새로운 배포와 같은 계획된 중단을 최소화하도록 시스템을 설계하는 것이 중요합니다.
고가용성 및 계획되지 않은 다운타임
Oracle AI Database는 모든 유형의 계획되지 않은 장애에 대한 다운타임을 방지, 허용 및 줄일 수 있는 고가용성 솔루션을 제공합니다.
계획되지 않은 작동 중지 시간은 원인별로 분류할 수 있습니다.
-
사이트 오류 사이트 오류는 이벤트로 인해 응용 프로그램의 전체 또는 중요한 부분이 처리를 중지하거나 사용할 수 없는 서비스 레벨이 느려질 때 발생합니다.
-
컴퓨터 오류 컴퓨터 장애는 데이터베이스가 종료되었거나 더 이상 액세스할 수 없기 때문에 데이터베이스를 실행하는 시스템을 사용할 수 없게 될 때 발생합니다.
-
스토리지 오류 스토리지 오류는 데이터베이스 컨텐츠의 일부 또는 전부를 보유하는 스토리지를 사용할 수 없게 되는 경우 종료되거나 더 이상 액세스할 수 없게 됩니다. 스토리지 오류의 예로는 디스크 드라이브 또는 스토리지 배열 오류 등이 있습니다.
-
데이터 손상 데이터 손상은 하드웨어, 소프트웨어 또는 네트워크 구성 요소로 인해 손상된 데이터를 읽거나 쓸 때 발생합니다.
-
인적 오류 인적 오류 정전은 데이터베이스의 데이터가 논리적으로 손상되거나 사용할 수 없게 만드는 의도하지 않거나 악의적인 작업이 커밋된 경우 발생합니다. 인적 오류 정전의 서비스 수준 영향은 영향을 받는 데이터의 양 및 중요 특성에 따라 크게 다를 수 있습니다.
사이트 오류
사이트 오류는 이벤트로 인해 응용 프로그램의 전체 또는 상당 부분이 처리를 중지하거나 사용할 수 없는 서비스 레벨로 느려질 때 발생합니다.
사이트 장애는 데이터 센터의 모든 처리 또는 데이터 센터에서 지원하는 애플리케이션의 하위 세트에 영향을 줄 수 있습니다. 예를 들어 확장된 사이트 전체의 전원 또는 네트워크 장애, 데이터 센터를 작동하지 않는 자연 재해, 운영 또는 사이트에 대한 악의적인 공격이 있습니다.
사이트 Failure에 대한 가장 간단한 보호 형식은 RMAN을 사용하여 데이터베이스 백업을 생성하고 오프사이트에 저장하는 것입니다. 데이터베이스를 다른 호스트로 복원할 수 있습니다. 그러나 이 기술은 시간이 많이 걸리고 백업이 최신 상태가 아닐 수 있습니다. Data Guard 환경에서 대기 데이터베이스를 하나 이상 유지 관리하면 운용 사이트가 실패할 경우 연속 데이터베이스 서비스를 제공할 수 있습니다.
참조:
-
RMAN 및 백업/복구 솔루션에 대한 자세한 내용은 Oracle AI Database Backup and Recovery User's Guide를 참조하십시오.
-
대기 데이터베이스를 소개하는 Oracle Data Guard 개념 및 관리
컴퓨터 오류
컴퓨터 장애는 데이터베이스가 종료되었거나 더 이상 액세스할 수 없기 때문에 데이터베이스를 실행하는 시스템을 사용할 수 없게 되면 발생합니다.
컴퓨터 고장의 예로는 하드웨어 및 운영 체제 고장이 있습니다. 다음 표의 Oracle 기능은 컴퓨터 고장으로부터 보호하거나 컴퓨터 고장에 대응하는 데 도움이 됩니다.
표 1 컴퓨터 고장 방지
| 기능 | 설명 | 자세히 알아보기 |
|---|---|---|
| 엔터프라이즈 그리드 | Oracle RAC(Oracle Real Applications Cluster) 환경에서 Oracle AI Database는 단일 공유 데이터베이스에 동시에 액세스하는 동안 클러스터 내 둘 이상의 시스템에서 실행됩니다. 단일 데이터베이스 시스템은 여러 하드웨어 시스템에 걸쳐 있지만 응용 프로그램에는 단일 데이터베이스로 나타납니다. | "그리드 컴퓨팅 개요" |
| Oracle Data Guard | Data Guard를 사용하면 서로 다른 대륙이나 동일한 데이터 센터에 상주할 수 있는 대기 데이터베이스라는 운용 중인 데이터베이스의 복사본을 하나 이상 유지 관리할 수 있습니다. 운용중단으로 인해 기본 데이터베이스를 사용할 수 없는 경우 Data Guard는 모든 대기 데이터베이스를 기본 롤로 전환하여 작동 중지 시간을 최소화할 수 있습니다. | Oracle Data Guard 개념 및 관리 |
| 전역 데이터 서비스 | 글로벌 데이터 서비스 프레임워크는 데이터베이스 클라우드의 구성, 유지 관리 및 모니터링을 자동화하고 중앙 집중화합니다. Global Data Services는 클라우드에서 제공하는 서비스에 대해 로드 밸런싱 및 페일오버를 지원합니다. 기본적으로 Global Data Services는 Oracle RAC(Oracle Real Application Clusters)에서 단일 데이터베이스를 제공하는 것과 동일한 종류의 이점을 일련의 데이터베이스에 제공합니다. | Oracle AI Database Global Data Services 개념 및 관리 설명서 |
| 빠른 시작 결함 복구 | 계획되지 않은 다운타임의 일반적인 원인은 시스템 장애 또는 장애입니다. Oracle AI Database의 Fast Start 오류 복구 기술은 데이터베이스 인스턴스 복구 시간을 자동으로 제한합니다. | Oracle AI Database Performance Tuning 가이드 |
저장 영역 실패
스토리지 장애는 데이터베이스 컨텐츠의 일부 또는 전부를 보유하는 스토리지가 종료되었거나 더 이상 액세스할 수 없기 때문에 사용할 수 없게 될 때 발생합니다. 스토리지 오류의 예로는 디스크 드라이브 또는 스토리지 배열 오류 등이 있습니다.
다음 표에서는 Oracle Data Guard 외에 저장 영역 Failure를 보여줍니다.
스토리지 오류에 대한 표 2 솔루션
| 솔루션 | 설명 | 자세히 알아보기 |
|---|---|---|
| Oracle ASM(Oracle Automatic Storage Management) | Oracle ASM은 단일 인스턴스 Oracle AI Database 및 Oracle RAC 구성을 지원하는 Oracle 데이터베이스 파일을 위한 볼륨 관리자이자 파일 시스템입니다. Oracle ASM은 기존 볼륨 관리자 및 파일 시스템을 대체하기 위해 Oracle에서 권장하는 저장 영역 관리 솔루션입니다. | "Oracle ASM(Oracle Automatic Storage Management)" |
| 백업 및 복구 | RMAN(Recovery Manager) 유틸리티는 데이터를 백업하고 이전 백업에서 데이터를 복원하며 failure가 발생하기 전의 시점까지 해당 데이터의 변경 사항을 Recovery할 수 있습니다. | "백업 및 복구 " |
참조: Oracle ASM에 대한 자세한 내용은 Oracle Automatic Storage Management Administrator's Guide를 참조하십시오.
데이터 손상
데이터 손상은 하드웨어, 소프트웨어 또는 네트워크 구성 요소로 인해 손상된 데이터를 읽거나 쓸 때 발생합니다.
데이터 손상의 예로는 잘못된 디스크 읽기 또는 쓰기를 유발하는 볼륨 관리자 오류가 있습니다. 데이터 손상은 드물지만 데이터베이스 및 비즈니스에 심각한 영향을 줄 수 있습니다.
Oracle AI Database는 Data Guard 및 Recovery Manager 외에도 다음과 같은 형태의 데이터 손상 방지 기능을 지원합니다.
-
손실된 쓰기 문제에 대한 해결책
손실된 쓰기는 쓰기가 발생하지 않을 때 I/O 부속 시스템이 데이터 블록의 완료를 확인하면 발생합니다. 후속 블록 읽기에서 I/O 서브 시스템은 데이터베이스의 다른 블록을 갱신하여 손상된 데이터 블록의 오래된 버전을 반환합니다. Oracle AI Database 솔루션은 다음과 같습니다.
-
standby database를 사용한 손실된 쓰기 보호
Oracle Database 11g에 도입된 표준 손실된 쓰기 보호에서는 기본 데이터베이스와 대기 데이터베이스에서
DB_LOST_WRITE_PROTECT초기화 파라미터를 활성화할 수 있습니다. 각 데이터베이스는 온라인 리두 로그에 버퍼 캐시 블록 읽기를 기록합니다. Managed Recovery 중 standby database가 리두를 적용하는 경우 해당 블록을 읽고 리두 로그의 SCN과 SCN을 비교하여 불일치를 감지합니다. -
섀도우 테이블스페이스를 사용한 손실된 쓰기 보호
섀도우 손실 쓰기 보호의 경우 섀도우 테이블스페이스를 생성합니다. 섀도우 테이블스페이스에는 추적된 데이터 파일의 모든 데이터 블록에 대한 SCN을 포함한 간단한 설명 레코드가 포함됩니다.
섀도우 손실 쓰기 보호가 활성화되어 있고(
ALTER DATABASE ENABLE LOST WRITE TRACKING) 데이터베이스가 추적된 데이터 블록을 갱신하는 경우 데이터베이스는 해당 섀도우 테이블스페이스에 SCN을 기록합니다. 추적된 데이터 블록을 읽을 때 데이터베이스는 섀도우 항목을 조회한 다음 추적된 블록과 비교합니다. 섀도우 항목의 SCN이 추적된 블록보다 크면 쓰기 손실이 발생합니다.섀도우 손실 쓰기 보호는 대기 데이터베이스를 사용하지 않고 손실된 쓰기를 감지할 때의 이점이 있습니다. 또한 대기 손실 쓰기 보호에 내재된 지연으로 인해 손실된 쓰기가 감지되면 이 블록이 이미 데이터베이스의 다른 부분을 손상했을 수 있습니다. 데이터 손상을 방지하기 위해 섀도우 손실 쓰기 보호는 소비되기 전에 손실된 쓰기를 감지합니다.
-
-
데이터 블록 훼손 감지
블록 손상은 인식된 Oracle 형식이 아니거나 내용이 내부적으로 일치하지 않는 데이터 블록입니다. RMAN을 비롯한 여러 데이터베이스 구성 요소 및 유틸리티는 손상된 블록을 감지하여
V$DATABASE_BLOCK_CORRUPTION에 기록할 수 있습니다. 환경에서 Active Data Guard 대기 데이터베이스가 사용되는 경우 손상이 자동으로 복구될 수 있습니다. -
Transaction Guard 및 애플리케이션 연속성
계획되거나 계획되지 않은 데이터베이스 세션 중단으로 인해 일반 유저는 작업 상태가 확실하지 않을 수 있습니다. 사용자는 커밋된 트랜잭션을 다시 제출하여 논리적 데이터가 손상되는 경우도 있습니다. Transaction Guard는 트랜잭션 idempotence를 제공합니다. 그러면 데이터베이스에서 트랜잭션이 커밋 및 완료되었는지 여부를 나타내는 보장된 커밋 결과를 보존할 수 있습니다. Transaction Guard를 포함하는 애플리케이션 연속성을 통해 애플리케이션은 복구 가능한 오류 후 데이터베이스에 대해 트랜잭션을 재생하고 트랜잭션이 중단된 위치에서 계속할 수 있습니다.
참조:
-
RMAN 및 백업/복구 솔루션에 대한 자세한 내용은 Oracle AI Database Backup and Recovery User's Guide를 참조하십시오.
사용자 오류
인간 오류 정전은 데이터베이스의 데이터가 논리적으로 손상되거나 사용할 수 없게 만드는 의도하지 않은 또는 악의적인 작업이 커밋될 때 발생합니다. 인적 오류 정전의 서비스 수준 영향은 영향을 받는 데이터의 양 및 중요 특성에 따라 크게 다를 수 있습니다.
많은 연구에 따르면 인적 오류는 다운타임의 가장 큰 원인이라고 합니다. Oracle AI Database는 관리자가 이러한 오류를 신속하게 진단하고 복구할 수 있는 강력한 도구를 제공합니다. 또한 일반 유저가 관리자의 개입 없이 문제를 Recovery할 수 있는 기능도 포함됩니다.
Oracle AI Database는 다음과 같은 형태의 인적 오류 방지 기능을 권장합니다.
-
사용자 액세스 제한
오류를 방지하는 가장 좋은 방법은 데이터 및 서비스에 대한 사용자 액세스를 제한하는 것입니다. Oracle AI Database는 사용자를 인증한 다음 관리자가 사용자에게 업무 수행에 필요한 권한만 부여할 수 있도록 하여 애플리케이션 데이터에 대한 사용자 액세스를 제어하는 다양한 보안 도구를 제공합니다.
-
Oracle Flashback 기술
Oracle Flashback Technology는 Oracle AI Database의 인적 오류 수정 기능 제품군입니다. Oracle Flashback은 Human error를 신속하게 분석 및 복구할 수 있는 SQL 인터페이스를 제공합니다. 예를 들어, 다음을 수행할 수 있습니다.
-
지역화된 손상에 대한 정밀한 수술 분석 및 수리
-
보다 광범위한 손상의 신속한 수정
-
행, 트랜잭션, 테이블, 테이블스페이스 및 데이터베이스 레벨에서 Recovery
-
-
Oracle LogMiner
Oracle LogMiner는 SQL을 사용하여 온라인 파일을 읽고 분석하고 해석할 수 있는 관계형 도구입니다.
참조:
-
Oracle Flashback 기능에 대한 자세한 내용은 Oracle AI Database Backup and Recovery User's Guide 및 Oracle AI Database Development Guide를 참조하십시오.
-
Oracle LogMiner에 대한 자세한 내용은 Oracle AI Database Utilities를 참조하십시오.
고가용성 및 계획된 다운타임
계획된 다운타임은 특히 여러 시간대의 사용자를 지원하는 글로벌 기업에서 운영 중단과 같을 수 있습니다. 이 경우 일상적인 작업, 정기적인 유지 관리 및 새로운 배포와 같은 계획된 중단을 최소화하도록 시스템을 설계하는 것이 중요합니다.
계획된 작동 중지 시간은 원인별로 분류할 수 있습니다.
-
시스템 및 데이터베이스 변경 사항 데이터베이스의 조직 데이터 구조 외부에서 발생하는 운영 환경에 대한 일정이 잡힌 변경 사항을 포함하여 일상적인 유지 관리 작업 및 새 배치를 수행할 때 계획된 시스템 변경 사항이 발생합니다.
-
데이터 변경 계획된 데이터 변경은 Oracle AI Database 객체의 논리적 구조 또는 물리적 조직이 변경될 때 발생합니다. 이러한 변경의 주요 목적은 성능 또는 관리 효율성을 향상시키는 것입니다. 예를 들면 테이블 재정의, 테이블 partition 추가, 인덱스 생성 또는 재구축 등이 있습니다.
-
애플리케이션 변경 계획된 애플리케이션 변경에는 데이터, 스키마 및 프로그램에 대한 변경이 포함될 수 있습니다. 이러한 변경의 주요 목적은 성능, 관리 효율성 및 기능을 향상시키는 것입니다. 애플리케이션 업그레이드를 예로 들 수 있습니다.
시스템 및 데이터베이스 변경 사항
계획된 시스템 변경은 데이터베이스의 조직 데이터 구조 외부에서 발생하는 운영 환경에 대한 일정이 잡힌 변경 사항을 포함하여 일상적인 유지 관리 작업 및 새 배치를 수행할 때 발생합니다.
예를 들어 CPU 및 클러스터 노드 추가/제거(노드는 데이터베이스 인스턴스가 상주하는 컴퓨터), 시스템 하드웨어 또는 소프트웨어 업그레이드, 시스템 플랫폼 마이그레이션 등이 있습니다.
Oracle AI Database는 계획된 시스템 및 데이터베이스 변경에 대한 솔루션으로 동적 리소스 프로비저닝을 제공합니다.
-
데이터베이스의 동적 재구성
Oracle AI Database는 SMP 서버에서 프로세서를 추가/제거하고 Oracle ASM을 사용하여 스토리지 배열을 추가/제거하는 등 하드웨어 및 데이터베이스 구성에 대한 다양한 변경 사항을 동적으로 수용합니다. 예를 들어, Oracle AI Database는 운영 체제를 모니터링하여 CPU 수의 변경 사항을 감지합니다.
CPU_COUNT초기화 매개변수가 기본값으로 설정된 경우 데이터베이스 작업 로드에서 새로 추가된 프로세서를 동적으로 활용할 수 있습니다. -
메모리 관리 자동 튜닝
Oracle AI Database는 비중앙화 정책을 사용하여 SGA 및 PGA의 각 하위 구성 요소에서 메모리를 확보하고 메모리를 확보합니다. Oracle AI Database는 운영체제가 메모리 그래뉼을 필요한 구성 요소로 전송하라는 메시지를 표시하여 메모리를 자동 튜닝합니다.
-
데이터 파일, 콘트롤 파일 및 온라인 리두 로그 파일의 자동 분산
Oracle ASM은 사용 가능한 모든 디스크에 데이터 파일, 콘트롤 파일 및 로그 파일을 자동으로 분산하여 해당 파일의 레이아웃을 자동화하고 단순화합니다.
참조:
-
"메모리 관리"
-
Oracle ASM에 대한 자세한 내용은 Oracle Automatic Storage Management Administrator's Guide를 참조하십시오.
데이터 변경사항
계획된 데이터 변경은 Oracle AI Database 객체의 논리적 구조 또는 물리적 조직이 변경될 때 발생합니다. 이러한 변경의 주요 목적은 성능 또는 관리 효율성을 향상시키는 것입니다. 예를 들어 테이블 재정의, 테이블 partition 추가, 인덱스 생성 또는 재구축이 있습니다.
Oracle AI Database는 온라인 재구성 및 재정의를 통해 데이터 변경에 대한 다운타임을 최소화합니다. 이 구조를 사용하면 데이터베이스가 열려 있을 때 다음 작업을 수행할 수 있습니다.
-
테이블 가용성에 큰 영향을 주지 않고 테이블 구조를 수정할 수 있는 온라인 테이블 재정의 수행
-
인덱스 생성, 분석 및 재구성
-
테이블 Partition 이동
참조:
-
"분할 영역 개요"
-
Oracle AI Database Administrator's Guide에서 온라인으로 데이터 구조를 변경하는 방법 알아보기
애플리케이션 변경사항
계획된 애플리케이션 변경에는 데이터, 스키마 및 프로그램에 대한 변경이 포함될 수 있습니다. 이러한 변경의 주요 목적은 성능, 관리 효율성 및 기능을 향상시키는 것입니다. 애플리케이션 업그레이드를 예로 들 수 있습니다.
Oracle AI Database는 애플리케이션의 데이터베이스 객체 변경에 필요한 애플리케이션 다운타임을 최소화하기 위한 다음과 같은 솔루션을 지원합니다.
다운타임 최소화를 위한 표 3 솔루션
| 솔루션 | 설명 | 자세히 알아보기 |
|---|---|---|
| 데이터베이스 패치 업데이트 롤링 중 | Oracle AI Database는 롤링 방식으로 Oracle RAC 시스템의 노드에 패치를 적용할 수 있도록 지원합니다. | |
| 롤링 데이터베이스 릴리스 업그레이드 | Oracle AI Database는 Data Guard SQL Apply 및 논리적 대기 데이터베이스를 사용하여 데이터베이스 다운타임이 거의 없는 롤링 방식으로 데이터베이스 소프트웨어 업그레이드 설치 및 패치 세트 적용을 지원합니다. | Oracle AI Database 업그레이드 가이드 |
| 에디션 기반 재정의 | 에디션 기반 재정의를 사용하면 응용 프로그램이 사용 중인 동안 응용 프로그램의 데이터베이스 객체를 업그레이드할 수 있으므로 작동 중지 시간을 최소화하거나 제거할 수 있습니다. Oracle AI Database는 편집이라는 개인 환경에서 데이터베이스 객체를 변경(재정의)하여 이 작업을 수행합니다. | Oracle AI Database 개발 가이드 |
기본 WAIT 옵션을 사용하는 DDL |
DDL 문에는 내부 구조에 대한 배타적 잠금이 필요합니다("DDL 잠금 참조). 이전 릴리스에서는 잠금을 획득할 수 없는 경우 DDL 문이 실패합니다. WAIT 옵션과 함께 지정된 DDL은 이 문제를 해결합니다. |
|
| 비활성화된 상태의 트리거 생성 | 트리거를 사용으로 설정하기 전에 코드가 성공적으로 컴파일되는지 확인할 수 있도록 사용 안함으로 설정된 상태에서 트리거를 생성할 수 있습니다. | Oracle AI Database PL/SQL 언어 참조 |
그리드 컴퓨팅 개요
그리드 컴퓨팅이라는 컴퓨팅 아키텍처는 많은 수의 서버와 스토리지를 모든 엔터프라이즈 컴퓨팅 요구 사항에 맞는 유연한 온디맨드 리소스로 효과적으로 풀링합니다.
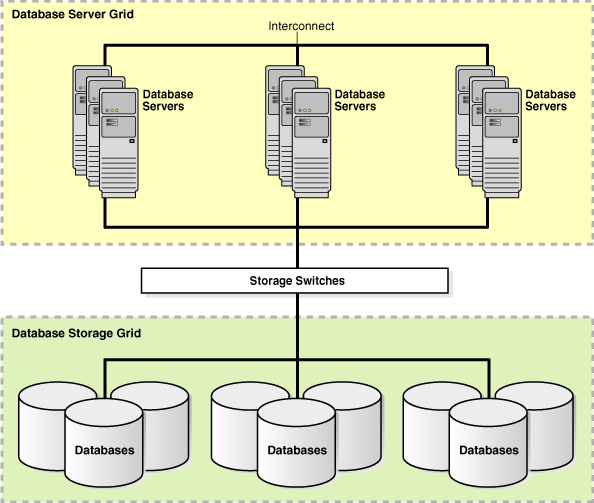
데이터베이스 서버 그리드는 하나 이상의 데이터베이스에서 실행되도록 함께 연결된 상품 서버의 모음입니다. 데이터베이스 스토리지 그리드는 데이터베이스 서버 그리드의 컴퓨터가 함께 결합하고 액세스하는 저비용 모듈식 스토리지 배열의 모음입니다.
데이터베이스 서버 및 스토리지 그리드를 사용하여 시스템 리소스 풀을 구축할 수 있습니다. 비즈니스 우선순위에 따라 이러한 리소스를 동적으로 할당 및 할당 해제할 수 있습니다. 그림 20-2에서는 그리드 엔터프라이즈 컴퓨팅 환경의 데이터베이스 서버 그리드 및 데이터베이스 스토리지 그리드를 보여 줍니다.
그림 2: 그리드 컴퓨팅 환경
-
데이터베이스 서버 그리드 Oracle RAC(Oracle Real Application Clusters)를 사용하면 여러 인스턴스가 Oracle 데이터베이스에 대한 액세스를 공유할 수 있습니다. 인스턴스는 상호 연결을 통해 연결됩니다.
-
Oracle Flex Clusters Oracle Database 12c부터 Oracle Clusterware 및 Oracle Real Application Clusters를 대규모 클러스터로 구성할 수 있습니다.
-
데이터베이스 스토리지 그리드 참조:
http://www.globalgridforum.org/표준 조직인 GGF(Global Grid Forum)에 대해 알아보기
데이터베이스 서버 그리드
Oracle RAC(Oracle Real Application Clusters)를 사용하면 여러 Instance가 Oracle 데이터베이스에 대한 액세스를 공유할 수 있습니다. 인스턴스는 상호 연결을 통해 연결됩니다.
Oracle RAC 환경에서 Oracle AI Database는 클러스터 내 두 개 이상의 시스템에서 실행되며 동시에 단일 공유 데이터베이스에 액세스합니다. Oracle RAC는 여러 저비용 서버에 걸쳐 있지만 응용 프로그램에 단일 통합 데이터베이스 시스템으로 나타나는 단일 데이터베이스를 제공하여 데이터베이스 서버 그리드를 활성화합니다. Oracle Clusterware는 서버가 하나의 서버인 것처럼 함께 작동할 수 있도록 해주는 소프트웨어입니다. 각 서버는 모든 독립형 서버처럼 보입니다. 그러나 각 서버에는 서로 통신하는 추가 프로세스가 있으므로 별도의 서버가 한 서버처럼 함께 작동합니다. Oracle Clusterware는 노드 멤버쉽 및 메시징 서비스를 포함하여 클러스터를 실행하는 데 필요한 모든 기능을 제공합니다.
-
확장성 데이터베이스 서버 그리드에서 Oracle RAC를 사용하면 용량 증가에 대한 수요가 증가함에 따라 클러스터에 노드를 추가할 수 있습니다.
-
결함 허용 한도 고가용성 아키텍처에서 결함 허용 한도는 아키텍처의 구성 요소 실패로부터 제공되는 보호 기능입니다.
-
서비스 Oracle RAC는 데이터베이스 워크로드를 그룹화하고 서비스를 제공하기 위해 할당된 최적의 인스턴스로 작업을 라우팅할 수 있는 서비스를 지원합니다.
참조:
-
Oracle RAC 데이터베이스 관리 방법에 대한 자세한 내용은 Oracle Real Application Clusters Administration and Deployment Guide를 참조하십시오.
-
Oracle Clusterware 관리 및 배치 설명서 - Oracle Clusterware를 관리하고 배치하는 방법 학습
확장성
데이터베이스 서버 그리드에서 Oracle RAC를 사용하면 용량 증가에 대한 요구가 증가함에 따라 클러스터에 노드를 추가할 수 있습니다.
Oracle RAC에 구현된 캐시 결합 기술을 사용하면 응용 프로그램을 변경하지 않고도 용량을 확장할 수 있습니다. 따라서 시스템을 점진적으로 확장하여 비용을 절감하고 작은 단일 노드 시스템을 더 큰 단일 노드 시스템으로 교체할 필요가 없습니다.
기존 시스템을 더 큰 노드로 교체하는 대신 클러스터에 노드를 증분적으로 추가할 수 있습니다. Grid Plug and Play는 클러스터에서 노드 추가 및 제거를 간소화하여 동적으로 프로비저닝된 환경에서 클러스터를 쉽게 배포할 수 있도록 합니다. 또한 Grid Plug and Play를 사용하면 데이터베이스와 서비스를 위치 독립적 방식으로 관리할 수 있습니다. SCAN을 사용하여 클라이언트는 그리드 내의 위치에 관계없이 데이터베이스 서비스에 연결할 수 있습니다.
참조:
- 캐시 결합에 대한 자세한 내용은 Oracle Real Application Clusters Administration and Deployment Guide를 참조하십시오.
내결함성
고가용성 아키텍처에서 결함 허용은 아키텍처의 구성 요소 실패로부터 제공되는 보호 기능입니다.
Oracle RAC 구조의 주요 이점은 여러 노드에서 제공하는 내재된 내결함성입니다. 물리적 노드가 독립적으로 실행되므로 하나 이상의 노드 실패는 클러스터의 다른 노드에 영향을 주지 않습니다.
그리드의 모든 노드에서 페일오버가 발생할 수 있습니다. 극단적인 경우 Oracle RAC 시스템은 노드가 하나만 있는 경우에도 데이터베이스 액세스를 제공합니다. 이 구조를 사용하면 유지 관리를 위해 노드 그룹을 투명하게 온라인화하거나 오프라인으로 전환할 수 있으며 나머지 클러스터는 계속해서 데이터베이스 액세스를 제공합니다.
Oracle RAC는 Oracle 클라이언트 및 연결 풀과의 기본 제공 통합을 제공합니다. 이 기능을 사용하면 응용 프로그램에서 연결을 종료하는 풀을 통한 오류에 대해 즉시 알립니다. 응용 프로그램은 TCP 시간 초과 대기를 피하고 즉시 적절한 복구 작업을 수행할 수 있습니다. Oracle RAC는 리스너를 Oracle 클라이언트 및 연결 풀과 통합하여 최적의 응용 프로그램 처리량을 만듭니다. Oracle RAC는 트랜잭션 시 로드에 따라 클러스터 작업 로드의 균형을 조정할 수 있습니다.
참조:
-
자동 작업 로드 관리에 대해 자세히 알아보려면 Oracle Real Application Clusters Administration and Deployment Guide를 참조하십시오.
서비스
Oracle RAC는 데이터베이스 작업 로드를 그룹화하고 서비스를 제공하기 위해 할당된 최적의 Instance로 작업을 라우팅할 수 있는 서비스를 지원합니다.
서비스는 공통 속성, 성능 임계값 및 우선순위를 포함하는 응용 프로그램의 작업 로드를 나타냅니다. 이러한 서비스에 비즈니스 정책을 정의하고 적용하여 최대 처리 시간에 노드를 할당하거나 서버 Failure를 자동으로 처리하는 등의 작업을 수행합니다. 서비스를 사용하면 비즈니스 목표를 달성하는 데 필요한 장소와 시기에 시스템 리소스를 적용할 수 있습니다.
서비스는 Instance 내의 서비스가 사용할 수 있는 리소스를 제한할 수 있는 Database Resource Manager와 통합됩니다. 또한 특정 인스턴스 사용과는 반대로 서비스를 사용하여 Oracle Scheduler 작업을 실행할 수 있습니다.
참조:
-
Database Resource Manager 및 Oracle Scheduler에 대한 자세한 내용은 Oracle AI Database Administrator's Guide를 참조하십시오.
Oracle Flex 클러스터
Oracle Database 12c부터는 대형 클러스터에 Oracle Clusterware 및 Oracle Real Application Clusters를 구성할 수 있습니다.
이러한 대형 클러스터(Oracle Flex Clusters라고 함)에는 허브 및 스포크 아키텍처(허브 노드 및 리프 노드)로 정렬된 두 가지 유형의 노드가 포함됩니다. 허브 노드는 긴밀하게 연결되고, 공유 스토리지에 직접 액세스할 수 있으며, 하나 이상의 리프 노드에 대한 앵커 역할을 합니다. 리프 노드는 허브 노드와 느슨하게 연결되며 공유 스토리지에 직접 액세스할 수 없습니다.
참조:
-
Oracle Flex Clusters에 대한 자세한 내용은 Oracle Clusterware Administration and Deployment Guide를 참조하십시오.
-
Oracle Flex Cluster 배치에 대해 자세히 알아보려면 Oracle Grid Infrastructure Installation and Upgrade Guide를 참조하십시오.
데이터베이스 저장 영역 그리드
DBA 또는 저장 영역 관리자는 Oracle ASM 인터페이스를 사용하여 Oracle ASM이 모든 서버 및 저장 영역 플랫폼에서 관리해야 하는 데이터베이스 저장 영역 그리드 내의 디스크를 지정할 수 있습니다. Oracle ASM은 디스크 공간을 분할하고 Oracle ASM에 제공된 디스크에 데이터를 균등하게 분산합니다. 또한 데이터베이스 저장 영역 그리드에서 저장 영역 배열의 디스크가 추가되거나 제거되면 Oracle ASM이 자동으로 데이터를 재분배합니다.
참조:
-
클러스터화된 Oracle ASM에 대한 자세한 내용은 Oracle Automatic Storage Management Administrator's Guide를 참조하십시오.
데이터 웨어하우징 및 Business Intelligence 개요
데이터 웨어하우스는 거래 프로세싱이 아닌 질의 및 분석을 위해 설계된 관계형 데이터베이스입니다.
예를 들어, 데이터 웨어하우스는 과거 주가 또는 소득세 레코드를 추적할 수 있습니다. 웨어하우스는 일반적으로 과거 트랜잭션 데이터에서 파생된 데이터를 포함하지만 다른 소스의 데이터를 포함할 수 있습니다.
데이터 웨어하우스 환경에는 관계형 데이터베이스 외에도 여러 가지 도구가 포함되어 있습니다. 일반적인 환경에는 ETL 솔루션, OLAP 엔진, 클라이언트 분석 도구 및 데이터를 수집하여 사용자에게 전달하는 기타 응용 프로그램이 포함됩니다.
-
데이터 웨어하우징 및 OLTP 데이터 웨어하우징을 도입하는 일반적인 방법은 William Inmon이 규정한 데이터 웨어하우스의 특성을 지칭하는 것입니다.
-
데이터 웨어하우스 아키텍처 데이터 웨어하우스 및 해당 아키텍처는 비즈니스 요구 사항에 따라 다릅니다.
-
추출, 변환 및 로드(ETL) 개요 소스 시스템에서 데이터를 추출하여 웨어하우스로 가져오는 프로세스를 일반적으로 ETL(추출, 변환 및 로드)이라고 합니다. ETL은 세 가지 잘 정의된 단계가 아닌 광범위한 프로세스를 나타냅니다.
-
비즈니스 인텔리전스는 비즈니스 의사 결정을 돕기 위해 조직의 정보를 분석하는 것입니다.
데이터 웨어하우징 및 OLTP
데이터 웨어하우징을 도입하는 일반적인 방법은 William Inmon이 규정한 데이터 웨어하우스의 특성을 참조하는 것입니다.
특성은 다음과 같습니다:발 1
-
제목 지향
데이터 웨어하우스를 사용하면 판매와 같은 주제별로 데이터베이스를 정의할 수 있습니다.
-
통합됨
데이터 웨어하우스는 서로 다른 소스의 데이터를 일관된 형식으로 배치해야 합니다. 측정 단위 간의 이름 지정 충돌 및 불일치와 같은 문제를 해결해야 합니다. 이 목표를 달성하면 통합되었다고 합니다.
-
비휘발성
창고의 목적은 발생한 사항을 분석하는 것입니다. 따라서 웨어하우스에 데이터가 입력된 후에는 데이터가 변경되지 않아야 합니다.
-
시간 변동
데이터 웨어하우스의 초점은 시간에 따른 변화에 있습니다.
데이터 웨어하우스와 OLTP 데이터베이스는 요구 사항이 다릅니다. 예를 들어, 비즈니스 추세를 파악하려면 데이터 웨어하우스가 대량의 데이터를 유지 관리해야 합니다. 반대로 좋은 성능을 얻으려면 기록 데이터를 정기적으로 OLTP 시스템에서 아카이브로 이동해야 합니다. 표 20-4는 데이터 웨어하우스와 OLTP 간의 차이를 나열합니다.
표 4 데이터 웨어하우스 및 OLTP 시스템
| 특성 | 데이터 웨어하우스 | OLTP |
|---|---|---|
| 작업 로드 | 임시 쿼리를 수용하도록 설계되었습니다. 데이터 웨어하우스의 작업 로드를 미리 알지 못할 수도 있으므로 다양한 query에 대해 제대로 수행되도록 최적화해야 합니다. | 미리 정의된 작업만 지원합니다. 응용 프로그램은 이러한 작업만 지원하도록 특별히 조정되거나 설계될 수 있습니다. |
| 데이터 변경 | 대량 데이터 수정 기술을 사용하여 ETL 프로세스에 의해 정기적으로 업데이트됩니다. 데이터 웨어하우스의 일반 유저는 데이터베이스를 직접 갱신하지 않습니다. | 최종 사용자가 정기적으로 발행하는 개별 DML 문에 따라 달라집니다. OLTP 데이터베이스는 항상 최신 상태이며 각 업무 트랜잭션의 현재 상태를 반영합니다. |
| 스키마 디자인 | Star 스키마와 같은 비정규화 또는 부분 비정규화 스키마를 사용하여 Query 성능을 최적화합니다. | 완전히 정규화된 스키마를 사용하여 DML 성능을 최적화하고 데이터 일관성을 보장합니다. |
| 일반적인 작업 | 일반적인 질의는 수천 개 또는 수백만 개의 행을 스캔합니다. 예를 들어, 사용자는 지난 달 모든 고객에 대한 총 판매를 요청할 수 있다. | 일반적인 작업은 소수의 레코드만 액세스합니다. 예를 들어, 유저는 단일 고객에 대한 현재 주문을 검색할 수 있습니다. |
| 과거 데이터 | 기록 분석을 지원하기 위해 수개월 또는 수년간의 데이터를 보관합니다. | 몇 주 또는 몇 달의 데이터만 저장합니다. 현재 트랜잭션의 요구사항을 충족하기 위해 필요에 따라 보존된 과거 데이터입니다. |
참조:
-
데이터베이스 웨어하우스에 대한 자세한 설명은 Oracle AI Database Data Warehousing Guide를 참조하십시오.
-
OLTP 시스템에 대한 자세한 설명은 Oracle AI Database VLDB and Partitioning Guide를 참조하십시오.
데이터 웨어하우스 구조
데이터 웨어하우스 및 해당 아키텍처는 비즈니스 요구 사항에 따라 다릅니다.
-
데이터 웨어하우스 아키텍처(기본) 단순 데이터 웨어하우스 아키텍처에서 최종 사용자는 여러 소스 시스템에서 데이터 웨어하우스로 전송된 데이터에 직접 액세스할 수 있습니다.
-
데이터 웨어하우스 아키텍처(스테이징 영역 포함) 일부 데이터 웨어하우스는 웨어하우스에 들어가기 전에 데이터가 선행 처리되는 위치인 스테이징 영역을 사용합니다. 스테이지 영역은 요약 작성 및 웨어하우스 관리 작업을 단순화합니다.
-
데이터 웨어하우스 아키텍처(스테이징 영역 및 데이터 마트 포함) 조직 내 여러 그룹에 맞게 웨어하우스 아키텍처를 사용자정의할 수 있습니다. 웨어하우스의 데이터를 특정 업무 또는 프로젝트를 위해 설계된 독립 데이터베이스인 데이터 마트로 전송함으로써 이러한 목표를 달성할 수 있습니다. 일반적으로 데이터 마트에는 많은 요약 테이블이 포함됩니다.
데이터 웨어하우스 구조(기본)
간단한 데이터 웨어하우스 아키텍처에서 최종 사용자는 여러 소스 시스템에서 데이터 웨어하우스로 전송된 데이터에 직접 액세스할 수 있습니다.
다음 그림에서는 샘플 구조를 보여 줍니다.
그림 3: 데이터 웨어하우스 아키텍처
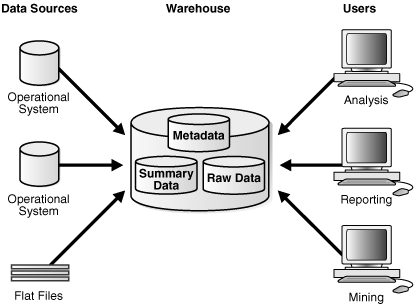
앞의 그림은 기존 OLTP 시스템의 메타 데이터 및 원시 데이터와 요약 데이터를 모두 보여줍니다. 요약은 값비싼 조인 및 집계 작업을 미리 계산하고 결과를 테이블에 저장하여 질의 성능을 향상시키는 집계 뷰입니다. 예를 들어, 요약 테이블에는 지역별 및 제품별 판매 합계가 포함될 수 있습니다. 요약은 구체화된 뷰라고도 합니다.
참조: 기본 구체화된 뷰에 대한 자세한 내용은 Oracle AI Database Data Warehousing Guide를 참조하십시오.
데이터 웨어하우스 구조(스테이징 영역 포함)
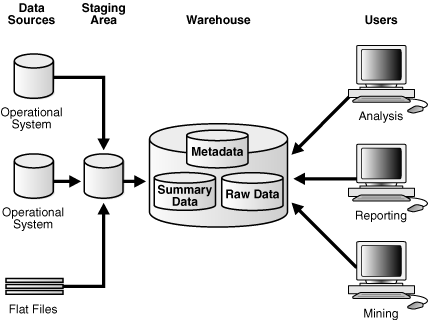
일부 데이터 웨어하우스는 웨어하우스에 들어가기 전에 데이터가 선행 처리되는 곳인 스테이징 영역을 사용합니다. 스테이지 영역은 요약 작성 및 웨어하우스 관리 작업을 단순화합니다.
다음 그림은 스테이지 영역을 보여줍니다.
그림 4: 스테이지 영역이 있는 데이터 웨어하우스 구조
참조: Oracle AI Database Data Warehousing Guide에서 다양한 운송 메커니즘에 대해 알아보기
데이터 웨어하우스 구조(스테이징 영역 및 데이터 마트 포함)
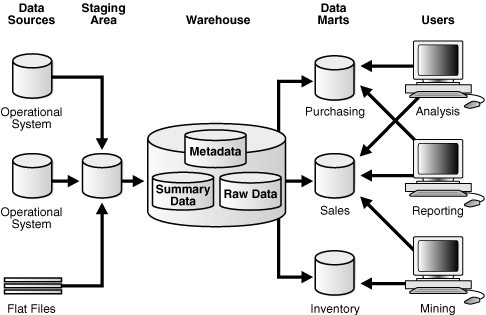
조직 내 여러 그룹에 맞게 창고 구조를 사용자정의할 수 있습니다. 웨어하우스의 데이터를 특정 업무 또는 프로젝트를 위해 설계된 독립 데이터베이스인 데이터 마트로 전송함으로써 이러한 목표를 달성할 수 있습니다. 일반적으로 데이터 마트에는 많은 요약 테이블이 포함됩니다. 그림 20-5는 구매, 판매 및 재고 정보를 독립 데이터 마트로 구분합니다. 재무 분석가는 데이터 마트에서 구매 및 판매에 대한 과거 정보를 쿼리할 수 있습니다.
그림 5: 스테이지 영역 및 데이터 마트를 사용한 데이터 웨어하우스 아키텍처
참조: Oracle AI Database Data Warehousing Guide에서 혁신 메커니즘 학습
ETL(추출, 변형 및 로드) 개요
소스 시스템에서 데이터를 추출하여 웨어하우스로 가져오는 프로세스를 일반적으로 추출, 변형 및 로드라고 합니다. ETL은 세 가지 잘 정의된 단계가 아닌 광범위한 프로세스를 나타냅니다.
일반적인 시나리오에서는 하나 이상의 운영 체제에서 데이터를 추출한 다음 처리를 위해 대상 시스템이나 중간 시스템으로 물리적으로 전송합니다. 전송 방식에 따라 이 프로세스 중에 일부 변형이 발생할 수 있습니다. 예를 들어, 게이트웨이를 통해 원격 대상에 직접 액세스하는 SQL 문은 두 열을 SELECT 문의 일부로 연결할 수 있습니다.
Oracle AI Database 자체는 ETL 도구가 아닙니다. 그러나 Oracle AI Database는 ETL 도구 및 맞춤형 ETL 솔루션에서 사용할 수 있는 다양한 기능을 제공합니다. Oracle AI Database에서 제공하는 ETL 기능은 다음과 같습니다.
-
Transportable 테이블스페이스
여러 컴퓨터 구조와 운영 체제 간에 테이블스페이스를 전송할 수 있습니다. Transportable 테이블스페이스는 두 Oracle 데이터베이스 간에 대용량 데이터를 이동하는 가장 빠른 방법입니다.
-
테이블 함수
테이블 함수는 행 모음(중첩 테이블 또는 varray)을 반환하는 유저 정의 PL/SQL 함수입니다. 테이블 함수는 행 집합을 출력으로 생성할 수 있으며 행 집합을 입력으로 받아들일 수 있습니다. 테이블 함수는 중간 스테이지 테이블 없이도 PL/SQL, C 또는 Java에서 구현되는 변형의 파이프 라인 및 병렬 실행을 지원합니다.
-
외부 테이블
외부 테이블을 사용하면 외부 데이터를 먼저 데이터베이스에 로드하지 않고도 직접 병렬로 조인할 수 있습니다. 따라서 외부 테이블을 사용하여 로드 단계에 변형 단계를 파이프 라인할 수 있습니다.
-
테이블 압축
디스크 사용과 메모리 사용을 줄이기 위해 테이블 및 분할된 테이블을 압축된 형식으로 저장할 수 있습니다. 테이블 압축을 사용하면 읽기 전용 작업에 대한 확장성이 향상되고 쿼리 실행 속도가 빨라지는 경우가 많습니다.
참조:
Business Intelligence
비즈니스 인텔리전스는 비즈니스 의사 결정을 돕기 위해 조직의 정보를 분석하는 것입니다.
분석 애플리케이션 및 비즈니스 인텔리전스는 계층을 드릴 업 및 다운하고 집계 값을 비교하여 지배합니다. Oracle AI Database는 이러한 작업을 지원하는 여러 가지 기술을 제공합니다.
-
Analytic SQL Oracle AI Database는 분석 작업 수행을 위한 다양한 SQL 작업을 도입했습니다. 이러한 작업에는 순위 지정, 이동 평균, 누적 합계, 보고서 대비 비율 및 기간별 비교가 포함됩니다.
-
분석 뷰는 데이터 세트의 콘텐츠를 확장하고 비즈니스 인텔리전스 애플리케이션의 개발을 간소화합니다.
-
Oracle Advanced Analytics Oracle Advanced Analytics Option은 Oracle AI Database를 빅 데이터 분석을 위한 종합적인 고급 분석 플랫폼으로 확장합니다.
분석 SQL
Oracle AI Database는 분석 작업 수행을 위한 다양한 SQL 작업을 도입했습니다. 이러한 작업에는 순위 지정, 이동 평균, 누적 합계, 보고서 대비 비율 및 기간별 비교가 포함됩니다.
예를 들어, Oracle AI Database는 다음과 같은 형태의 분석 SQL을 지원합니다.
표 5 Analytic SQL
| 분석 SQL 유형 | 설명 | 자세히 알아보기 |
|---|---|---|
| 집계용 SQL | 집계 함수는 COUNT와 같이 행 그룹을 기반으로 단일 결과 행을 반환합니다. 집계는 데이터 웨어하우징의 기본 요소입니다. 웨어하우스의 집계 성능을 개선하기 위해 데이터베이스는 질의 및 보고를 더 쉽고 빠르게 수행할 수 있도록 GROUP BY 절의 확장을 제공합니다. |
집계에 대한 자세한 내용은 Oracle AI Database Data Warehousing Guide를 참조하십시오. |
| 분석을 위한 SQL | MAX와 같은 분석 함수는 여러 행을 결과 집합으로 반환하기 위해 행 그룹(창)을 집계합니다. Oracle은 분석 SQL 함수 제품군을 사용하여 SQL 분석 처리 기능을 개선했습니다. 예를 들어, 이러한 분석 함수를 사용하면 순위와 백분위수 및 이동 창을 계산할 수 있습니다. |
Oracle AI Database Data Warehousing Guide: 분석 및 보고를 위한 SQL에 대해 알아보기 |
| 모델링을 위한 SQL | MODEL 절을 사용하면 질의 결과에서 다차원 배열을 생성하고 이 배열에 규칙을 적용하여 새 값을 계산할 수 있습니다. 예를 들어, 국가별로 판매 뷰의 데이터를 분할하고 각 국가에서 여러 규칙에 따라 정의된 모델 계산을 수행할 수 있습니다. 한 가지 규칙은 2008년 제품의 판매를 2006년과 2007년의 판매 합계로 계산할 수 있습니다. |
Oracle AI Database Data Warehousing Guide: SQL 모델링에 대해 알아보기 |
참조: SQL 함수에 대한 자세한 내용은 Oracle AI Database SQL Language Reference
분석 보기
분석 뷰는 데이터 세트의 콘텐츠를 확장하고 비즈니스 인텔리전스 애플리케이션의 개발을 간소화합니다.
분석 뷰의 특성은 다음과 같습니다.
-
데이터는 계층적 개념과 차원적 개념을 사용하여 구성됩니다.
-
조인, 집계 및 측정 계산 규칙은 분석 뷰에 포함됩니다.
-
SQL DDL을 사용하여 데이터베이스의 기존 테이블, 뷰 및 기타 객체에 대해 Layered가 될 수 있습니다.
-
간단한 SQL을 사용하여 query할 수 있습니다.
참조: 분석 뷰 개요는 Oracle AI Database Data Warehousing Guide를 참조하십시오.
Oracle Advanced Analytics
Oracle Advanced Analytics Option은 Oracle AI Database를 빅 데이터 분석을 위한 종합적인 고급 분석 플랫폼으로 확장합니다.
Oracle Advanced Analytics는 데이터베이스 내에서 예측 분석, 데이터 마이닝, 텍스트 마이닝, 통계 분석, 고급 숫자 계산 및 대화식 그래픽을 제공합니다. Oracle Advanced Analytics의 구성 요소는 다음과 같습니다.
-
Oracle Data Mining 비즈니스 인텔리전스에서 데이터 마이닝은 정교한 수학적 알고리즘을 사용하여 데이터를 세분화하고 향후 이벤트의 가능성을 평가하는 것입니다.
-
R은 통계 컴퓨팅 및 그래픽을 위한 오픈 소스 언어 및 환경입니다. Oracle Machine Learning for R을 통해 R은 엔터프라이즈 및 빅데이터에 대비할 수 있습니다.
Oracle Data Mining
비즈니스 인텔리전스에서 데이터 마이닝은 정교한 수학적 알고리즘을 사용하여 데이터를 세분화하고 향후 이벤트의 가능성을 평가합니다.
데이터 마이닝의 일반적인 응용 프로그램에는 콜 센터, ATM, E-Business Relational Management(ERM) 및 비즈니스 계획이 포함됩니다. Oracle Data Miner는 데이터 분석가가 데이터를 신속하게 분석하고, 최고의 고객을 타겟팅하고, 사기에 대처하고, 기업의 경쟁력을 높일 수 있는 중요한 상관관계 및 패턴을 찾을 수 있도록 지원합니다.
Oracle Data Mining은 고성능 데이터베이스 내 모델 구축 및 모델 배포를 위해 고유 SQL 함수로 실행되는 데이터 마이닝 알고리즘을 제공합니다. Oracle Data Mining은 테이블, 뷰, 스타 스키마, 트랜잭션 데이터 및 비구조적 데이터를 마이닝할 수 있습니다.
Oracle Data Mining은 모델 점수부여를 위해 PL/SQL API 및 SQL 함수를 지원합니다. 따라서 Oracle AI Database는 애플리케이션 개발자가 데이터 마이닝을 데이터베이스 애플리케이션과 원활하게 통합할 수 있는 인프라를 제공합니다.
SQL Developer 확장인 Oracle Data Miner는 Oracle Data Mining에 대한 GUI를 제공합니다.
참조: Oracle Machine Learning for SQL Concepts
Oracle Machine Learning for R
R은 통계 컴퓨팅 및 그래픽을 위한 오픈 소스 언어 및 환경입니다. Oracle Machine Learning for R을 통해 R은 엔터프라이즈 및 빅데이터에 대비할 수 있습니다.
대량의 데이터와 관련된 문제를 위해 설계된 Oracle Machine Learning for R은 R을 Oracle AI Database와 통합합니다. Oracle AI Database에 저장된 데이터에 대한 통계 및 그래픽 분석을 위한 R 명령 및 스크립트를 실행할 수 있습니다. 또한 데이터베이스의 병렬화 및 확장성을 활용하여 데이터 분석을 자동화하는 R 스크립트를 개발, 세분화 및 배치할 수 있습니다. 데이터 분석가는 SQL을 배우지 않고도 R 패키지를 실행하고 분석 애플리케이션용 R 스크립트를 한 번에 개발할 수 있습니다.
참조: Oracle Machine Learning for R 사용 설명서
Oracle Information Integration 개요
조직이 발전함에 따라 여러 데이터베이스와 애플리케이션 간에 정보를 공유할 수 있는 것이 점점 더 중요해지고 있습니다.
정보 공유에 대한 기본 접근 방법은 다음과 같습니다.
-
통합
이 정보를 단일 데이터베이스로 통합하면 추가 통합이 필요하지 않습니다. Oracle RAC, 그리드 컴퓨팅, 다중 테넌트 구조 및 Oracle VPD를 사용하면 정보를 단일 데이터베이스로 통합할 수 있습니다.
-
통합
정보를 분산된 상태로 두고 이 정보를 통합하는 도구를 제공하여 단일 가상 데이터베이스에 있는 것처럼 보이게 할 수 있습니다.
-
공유
여러 데이터 저장소 및 응용 프로그램에서 정보를 유지 관리할 수 있는 정보를 공유할 수 있습니다.
이 섹션에서는 정보 통합 및 공유를 위한 Oracle 솔루션에 대해 중점적으로 다룹니다.
통합 액세스
통합 액세스의 기반은 서로 원활하게 통신하는 이기종 시스템의 네트워크인 분산 환경입니다.
환경의 각 시스템을 노드라고 합니다. 사용자가 직접 연결된 시스템을 로컬 시스템이라고 합니다. 이 사용자가 액세스하는 추가 시스템은 원격 시스템입니다.
분산 환경에서는 응용 프로그램이 로컬 및 원격 시스템에서 데이터를 액세스하고 교환할 수 있습니다. 모든 데이터를 동시에 액세스하고 수정할 수 있습니다.
-
분산 SQL 분산 SQL은 여러 데이터베이스 간에 분산된 데이터에 동기적으로 액세스하고 업데이트합니다. Oracle 분산 데이터베이스 시스템은 유저에게 투명할 수 있으므로 단일 Oracle 데이터베이스로 나타납니다.
-
데이터베이스 링크 데이터베이스 링크는 클라이언트가 하나의 논리적 데이터베이스로 액세스할 수 있도록 하는 두 물리적 데이터베이스 간의 연결입니다.
분산 SQL
분산 SQL은 여러 데이터베이스 간에 분산된 데이터에 동기적으로 액세스하고 갱신합니다. Oracle 분산 데이터베이스 시스템은 유저에게 투명할 수 있으므로 단일 Oracle 데이터베이스로 나타납니다.
분산 SQL에는 분산 query 및 분산 트랜잭션이 포함됩니다. Oracle 분산 데이터베이스 구조는 Query와 트랜잭션 투명성을 제공합니다. 예를 들어, 표준 DML 문은 분산되지 않은 데이터베이스 환경에서와 마찬가지로 작동합니다. 또한 응용 프로그램은 표준 SQL 문 COMMIT, SAVEPOINT 및 ROLLBACK를 사용하여 트랜잭션을 제어합니다.
참조:
-
Oracle AI Database Administrator's Guide에서 분산 트랜잭션 관리 방법 학습
데이터베이스 링크
데이터베이스 링크는 클라이언트가 하나의 논리적 데이터베이스로 액세스할 수 있도록 하는 두 물리적 데이터베이스 간의 연결입니다.
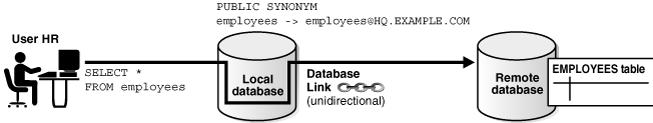
Oracle AI Database는 데이터베이스 링크를 사용하여 한 데이터베이스의 사용자가 원격 데이터베이스의 객체에 액세스할 수 있게 합니다. 로컬 유저는 원격 데이터베이스의 유저가 아니더라도 원격 데이터베이스에 대한 링크에 액세스할 수 있습니다. 그림 20-6에서는 전역 이름이 hq.example.com인 원격 데이터베이스의 employees 테이블에 액세스하는 사용자 hr의 예를 보여줍니다. employees 동의어는 원격 스키마 객체의 ID 및 위치를 숨깁니다.
그림 6: 데이터베이스 링크
참조: 데이터베이스 링크에 대한 자세한 내용은 Oracle AI Database Administrator's Guide를 참조하십시오.
정보 공유
통합의 핵심은 기업 내 애플리케이션 간 데이터 공유입니다.
-
Oracle GoldenGate Oracle GoldenGate는 비동기, 로그 기반의 실시간 데이터 복제 제품입니다.
-
Oracle AI Database Transactional Event Queues and Advanced Queuing(AQ) Oracle AI Database Transactional Event Queues 및 Advanced Queuing(AQ)은 Oracle AI Database와 통합된 강력하고 기능이 풍부한 메시지 대기열 처리 시스템입니다.
Oracle GoldenGate
Oracle GoldenGate는 비동기 로그 기반의 실시간 데이터 복제 제품입니다.
Oracle GoldenGate는 영향을 최소화하면서 이기종 데이터베이스, 하드웨어 및 운영 체제 환경에서 대량의 트랜잭션 데이터를 실시간으로 이동합니다. 다음과 같은 이유로 실시간 정보 액세스 및 가용성을 최적화합니다.
-
Oracle AI Database와 비오라클 데이터베이스의 이기종 조합을 포함하는 복제 지원
-
미션 크리티컬 시스템에 대한 지속적인 가용성을 유지하여 계획된 유지 관리 중 다운타임을 최소화합니다.
-
기업 전반의 실시간 데이터 통합 지원
-
샤딩된 테이블에서 샤드 간 양방향 복제를 자동으로 구성합니다.
일반적인 환경에는 캡처, 펌프 및 전달 프로세스가 포함됩니다. 각 프로세스는 Oracle 데이터베이스 및 비Oracle 데이터베이스를 포함하여 대부분의 인기 있는 운영 체제 및 데이터베이스에서 실행될 수 있습니다. 일부 또는 모든 데이터가 복제될 수 있습니다. 이러한 프로세스 내의 데이터는 이기종 환경과 다른 데이터베이스 스키마에 대해 모두 조작될 수 있습니다.
Oracle GoldenGate는 멀티마스터 복제, 허브 앤 스포크 배포, 데이터 통합 및 데이터 변환을 지원합니다. 따라서 Oracle GoldenGate를 사용하면 중요한 시스템이 연중무휴 24시간 운영되고 관련 데이터가 전사적으로 분산되어 의사 결정을 최적화할 수 있습니다.
참조:
-
Oracle Globally Distributed AI Database에서 Oracle Sharding 사용 방법 알아보기
-
http://www.oracle.com/technetwork/middleware/goldengate/documentation/index.html
Oracle AI Database Transactional Event Queues 및 Advanced Queuing(AQ)
Oracle AI Database Transactional Event Queues 및 Advanced Queuing(AQ)은 Oracle AI Database와 통합된 강력하고 기능이 풍부한 메시지 대기열 처리 시스템입니다.
조직이 서로 통신해야 하는 서로 다른 시스템을 가지고 있는 경우 메시징 환경은 이러한 시스템 간에 중요한 정보를 전송하는 표준적이고 신뢰할 수 있는 방법을 제공할 수 있습니다.
샘플 사용 사례는 본사에서 Oracle 데이터베이스에 주문을 입력하는 비즈니스입니다. 주문을 입력할 때 회사는 AQ를 사용하여 주문 ID 및 주문 날짜를 웨어하우스의 데이터베이스로 전송합니다. 이러한 메시지는 웨어하우스의 직원에게 주문에 대해 알려 직원이 주문 이행 및 선적을 수행할 수 있게 합니다.
-
메시지 대기열에 넣기 및 대기열에서 빼기 Oracle AI Database 트랜잭션 이벤트 대기열 및 고급 대기열에 넣기는 대기열이라는 추상 저장 장치에 사용자 메시지를 저장합니다.
-
Oracle AI Database Transactional Event Queues 및 Advanced Queuing Advanced Features Oracle AI Database Transactional Event Queues 및 Advanced Queuing(AQ)은 메시지 큐 처리 시스템의 모든 표준 기능을 지원합니다.
메시지 큐 대기 및 대기열에서 빼기
Oracle AI Database Transactional Event Queues 및 Advanced Queuing은 사용자 메시지를 대기열이라는 추상 저장 단위로 저장합니다.
대기열에 넣기는 생산자가 메시지를 대기열에 넣는 프로세스입니다. 대기열에서 빼기는 소비자가 대기열에서 메시지를 검색하는 프로세스입니다.
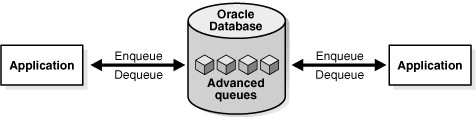
명시적 대기열에서 빼기를 지원하므로 개발자는 XStream 및 Oracle GoldenGate를 사용하여 안정적으로 메시지를 교환할 수 있습니다. 또한 Oracle GoldenGate의 변경 사항 캡처 및 전달 기능을 활용하여 애플리케이션에 변경 사항을 알릴 수 있습니다. 그림 20-7에서는 Advanced Queuing을 통해 메시지를 명시적으로 enqueue 및 dequeue하는 샘플 응용 프로그램을 보여 주므로 여러 메시징 시스템을 사용하는 파트너와 정보를 공유할 수 있습니다. 대기열에 넣은 후 파트너의 응용 프로그램으로 대기열에서 빼기 전에 메시지를 변환하고 전달할 수 있습니다.
그림 7: Oracle Message Queuing
Oracle AI Database 트랜잭션 이벤트 대기열 및 고급 대기열 처리 고급 기능
Oracle AI Database Transactional Event Queues 및 Advanced Queuing(AQ)은 메시지 대기열 처리 시스템의 모든 표준 기능을 지원합니다.
기능에는 다음이 포함됩니다.
-
비동기 애플리케이션 통합
Transactional Event Queues 및 Advanced Queuing은 여러 가지 방법으로 메시지를 enqueue할 수 있습니다. 캡처 프로세스 또는 동기식 캡처는 메시지를 암시적으로 캡처하거나 응용 프로그램과 유저가 메시지를 명시적으로 캡처할 수 있습니다.
-
확장 가능한 통합 아키텍처
많은 애플리케이션이 Oracle AI Database를 허브로 사용하여 분산 허브 앤 스포크 모델과 통합됩니다. Oracle 데이터베이스의 분산 응용 프로그램은 동일한 허브의 큐와 통신합니다. 여러 응용 프로그램이 동일한 대기열을 공유하므로 추가 응용 프로그램을 지원하기 위해 대기열을 추가할 필요가 없습니다.
-
이기종 애플리케이션 통합
Transactional Event Queues 및 Advanced Queuing은 응용 프로그램에 Oracle Type 시스템의 모든 기능을 제공합니다. 스칼라 데이터 유형, 상속이 있는 Oracle AI Database 객체 유형, XML 데이터에 대한 추가 연산자가 있는
XMLType및ANYDATA에 대한 지원이 포함됩니다. -
레거시 애플리케이션 통합
Oracle Messaging Gateway는 Oracle AI Database 애플리케이션을 Websphere MQ 및 Tibco와 같은 다른 메시지 대기열 시스템과 통합합니다.
-
표준 기반 API 지원
트랜잭션 이벤트 대기열 및 고급 대기열 처리는 산업 표준 API(SQL, JMS 및 SOAP)를 지원합니다. SQL을 사용한 변경 사항은 메시지로 자동으로 캡처됩니다.
참조: Oracle AI Database 트랜잭션 이벤트 대기열 및 Advanced Queuing 사용 설명서
각주 범례
각주 1:
Building the Data Warehouse, John Wiley and Sons, 1996년