Conceitos para Administradores de Banco de Dados
O conteúdo do script nesta página é para navegação apenas e não altera o conteúdo de nenhuma forma.
Esta parte descreve as tarefas, as ferramentas e o conhecimento essencial para administradores de banco de dados.
-
Deveres dos Administradores de Banco de Dados A principal responsabilidade de um administrador de banco de dados (DBA) é disponibilizar dados empresariais para seus usuários.
-
Ferramentas para Administradores de Banco de Dados A Oracle fornece várias ferramentas para uso na administração de um banco de dados.
-
Tópicos para Administradores de Banco de Dados Esta seção abrange tópicos que são mais essenciais para DBAs e que não foram discutidos em nenhum outro lugar do manual.
Deveres dos Administradores de Banco de Dados
A principal responsabilidade de um administrador de banco de dados (DBA) é disponibilizar os dados da empresa para seus usuários.
Os DBAs devem trabalhar em estreita colaboração com os desenvolvedores para garantir que seus aplicativos façam uso eficiente do banco de dados e com os administradores do sistema para garantir que os recursos físicos sejam adequados e usados com eficiência.
Os Oracle DBAs são responsáveis por entender a arquitetura do Oracle AI Database e como o banco de dados funciona. Os DBAs podem esperar executar estas tarefas:
-
Instalação, atualização e aplicação de patches do software Oracle AI Database
-
Projetar bancos de dados, incluindo identificação de requisitos, criação de design lógico (modelo conceitual) e design físico de banco de dados
-
Criando bancos de dados Oracle
-
Desenvolver e testar uma estratégia de backup e recuperação, fazer backup de bancos de dados Oracle regularmente e recuperá-los em caso de falhas
-
Configurando o ambiente de rede para permitir que os clientes se conectem a bancos de dados
-
Iniciando e encerrando o banco do dados
-
Gerenciando o armazenamento do banco de dados
-
Gerenciando usuários e segurança
-
Gerenciar objetos de banco de dados, como tabelas, índices e views
-
Monitorando e ajustando o desempenho do banco de dados
-
Investigando, coletando dados e reportando ao Oracle Support Services quaisquer erros críticos no banco de dados
-
Avaliando e testando novos recursos de banco de dados
Os tipos de usuários e suas atribuições e responsabilidades dependem do ambiente de banco de dados. Um banco de dados pequeno pode ter um DBA. Um banco de dados muito grande pode dividir as funções de DBA entre vários especialistas, por exemplo, agentes de segurança, operadores de backup e administradores de aplicativos.
Consulte Também:
-
Oracle AI Database 2 Day DBA para uma introdução às tarefas de DBA
-
Oracle AI Database Administrator's Guide para uma apresentação mais detalhada dos conceitos e tarefas do DBA
Ferramentas para Administradores de Bancos de Dados
A Oracle fornece várias ferramentas para uso na administração de um banco de dados.
Esta seção descreve algumas ferramentas comumente usadas.
-
O Oracle Enterprise Manager (Enterprise Manager) é uma ferramenta de gerenciamento de sistemas baseada na Web que fornece gerenciamento de bancos de dados Oracle, máquina de banco de dados Exadata, Fusion Middleware, aplicativos Oracle, servidores, armazenamento e hardware e software não Oracle.
-
O SQL*Plus é uma ferramenta de consulta interativa e em lote incluída em todas as instalações do Oracle AI Database.
-
Ferramentas para Instalação e Configuração do Banco de Dados A Oracle fornece várias ferramentas para simplificar a tarefa de instalar e configurar o software Oracle AI Database.
-
Ferramentas para Configuração e Administração do Oracle Net Oracle Net Services oferece soluções empresariais de conectividade em ambientes de computação distribuídos e heterogêneos. Oracle Net, um componente do Oracle Net Services, ativa uma sessão de rede de um aplicativo cliente para um banco de dados.
-
Ferramentas para Movimentação e Análise de Dados O Oracle AI Database inclui vários utilitários para auxiliar na movimentação e análise de dados.
Oracle Enterprise Manager
O Oracle Enterprise Manager (Enterprise Manager) é uma ferramenta de gerenciamento de sistemas baseada na Web que fornece gerenciamento de bancos de dados Oracle, máquina de banco de dados Exadata, Fusion Middleware, aplicativos Oracle, servidores, armazenamento e hardware e software não Oracle.
-
Oracle Enterprise Manager Cloud Control O Oracle Enterprise Manager Cloud Control (Cloud Control) é uma interface baseada na Web que fornece ao administrador monitoramento completo em toda a pilha de tecnologia Oracle e componentes não Oracle.
-
Oracle Enterprise Manager Database Express 12c O Oracle Enterprise Manager Database Express (EM Express) é um produto de gerenciamento da Web incorporado ao banco de dados Oracle. Não requer instalação ou gerenciamento especial.
Oracle Enterprise Manager Cloud Control
O Oracle Enterprise Manager Cloud Control (Cloud Control) é uma interface baseada na Web que fornece ao administrador monitoramento completo em toda a pilha de tecnologia Oracle e componentes não Oracle.
Às vezes, um componente de notificação rápida de aplicativo (FAN) pode ficar indisponível ou apresentar problemas de desempenho. Nesse caso, o Cloud Control exibe o alerta gerado automaticamente para que o administrador possa executar a ação de recuperação apropriada.
Os componentes do Cloud Control incluem:
-
OMS (Oracle Management Service)
O recurso OMS é um conjunto de aplicativos J2EE que renderiza a interface para o Cloud Control, trabalha com todos os agentes de gerenciamento da Oracle para processar informações de monitoramento e usa o repositório do Enterprise Manager como seu armazenamento de dados persistente.
-
Agentes de Gerenciamento Oracle
Esses agentes são processos implantados em cada host monitorado para monitorar todos os alvos no host, comunicar essas informações ao OMS e manter o host e seus alvos.
-
Oracle Management Repository
O repositório é um esquema em um banco de dados Oracle que contém todas as informações disponíveis sobre administradores, destinos e aplicativos gerenciados pelo Cloud Control.
Consulte Também:
-
Oracle AI Database Administrator's Guide para saber como usar o Cloud Control para administrar um banco de dados
-
Ajuda On-line do Cloud Control
Oracle Enterprise Manager Database Express 12c
O Oracle Enterprise Manager Database Express (EM Express) é um produto de gerenciamento da Web incorporado ao banco de dados Oracle. Não requer instalação ou gerenciamento especial.
O EM Express contém as principais páginas de gerenciamento de desempenho e administração básica no Cloud Control. Estas páginas incluem as seguintes:
-
Home page do Banco de dados
-
Monitoramento em Tempo Real de SQL
-
Análise ASH
É possível acessar esses recursos on-line por meio do console do EM Express e off-line por meio da tecnologia Active Reports. Do ponto de vista arquitetônico, o EM Express não tem componentes de middleware ou camada intermediária, garantindo que sua sobrecarga no servidor de banco de dados seja insignificante.
Usando o EM Express, você pode executar tarefas administrativas, como gerenciar a segurança do usuário e gerenciar a memória e o armazenamento do banco de dados. Você também pode exibir informações de desempenho e status sobre seu banco de dados.
Consulte Também: Oracle AI Database Get Started with Performance Tuning para saber como administrar o banco de dados com o EM Express
SQL*Plus
O SQL*Plus é uma ferramenta de consulta interativa e em lote incluída em todas as instalações do Oracle AI Database.
Ele possui uma interface com o usuário de linha de comandos que age como o cliente ao estabelecer conexão com o banco de dados. O SQL*Plus possui seus próprios comandos e ambiente. Ele permite que você informe e execute comandos SQL, PL/SQL, SQL*Plus e do sistema operacional para executar tarefas como:
-
Formatando, realizando cálculos, armazenando e imprimindo a partir dos resultados da consulta
-
Examinando Definições de Tabela e de Objeto
-
Desenvolvendo e executando scripts de batch
-
Administrando um banco de dados
É possível usar o SQL*Plus para gerar relatórios de modo interativo, gerar relatórios como processos de batch e gravar os resultados em um arquivo de texto, na tela ou em arquivo HTML para navegação na Internet. Você pode gerar relatórios de modo dinâmico utilizando o recurso de geração HTML.
Consulte Também: SQL*Plus User's Guide and Reference para saber mais sobre o SQL*Plus
Ferramentas para Instalação e Configuração de Bancos de Dados
A Oracle fornece várias ferramentas para simplificar a tarefa de instalar e configurar o software Oracle AI Database.
A tabela a seguir descreve as ferramentas suportadas.
Tabela 1 Ferramentas para Instalação e Configuração do Banco de Dados
| Ferramenta | Descrição | Para Saber Mais |
|---|---|---|
| Oracle Universal Installer (OUI) | OUI é um utilitário GUI que permite exibir, instalar e desinstalar o software Oracle AI Database. A Ajuda on-line está disponível para guiá-lo durante a instalação. | Ajuda on-line para guiá-lo durante a instalação |
| Assistente de Upgrade de Banco de Dados (DBUA) | O DBUA o orienta interativamente por meio de um upgrade do banco de dados e configura o banco de dados para a nova release. O DBUA automatiza o upgrade executando todas as tarefas normalmente executadas manualmente. O DBUA faz recomendações para opções de configuração, como tablespaces e o redo log on-line. | Oracle AI Database 2 Day DBA para saber como fazer upgrade de um banco de dados com DBUA |
| Assistente de Configuração de Banco de Dados (DBCA) | O DBCA fornece uma interface gráfica e um workflow guiado para criar e configurar um banco de dados. Esta ferramenta permite que você crie um banco de dados com base em modelos fornecidos pela Oracle ou crie seu próprio banco de dados e modelos. | Oracle AI Database Administrator's Guide para saber como criar um banco de dados com o DBCA |
Ferramentas para Configuração e Administração do Oracle Net
O Oracle Net Services oferece soluções para conectividade em toda a corporação em ambientes de computação distribuídos e heterogêneos. Oracle Net, um componente do Oracle Net Services, ativa uma sessão de rede de um aplicativo cliente para um banco de dados.
Você pode usar as seguintes ferramentas para configurar e administrar o Oracle Net Services:
-
Oracle Net Manager
Essa ferramenta permite que você configure o Oracle Net Services para um Oracle home em um cliente local ou host do servidor. Você pode usar o Oracle Net Manager para configurar métodos de nomeação, nomeação, perfis e listeners. Você pode iniciar o Oracle Net Manager usando a Console do Oracle Enterprise Manager ou como um aplicativo independente.
-
Assistente de Configuração do Oracle Net
Essas ferramentas são executadas automaticamente durante a instalação do software. O Assistente permite configurar componentes básicos de rede durante a instalação, incluindo nomes de listener e endereços de protocolo, métodos de nomeação, nomes de serviços de rede em um arquivo
tnsnames.orae uso do servidor de diretórios. -
Utilitário de Controle do Listener
O utilitário Listener Control permite que você configure listeners para receber conexões de clientes. Você pode acessar o utilitário por meio do Enterprise Manager ou como um aplicativo de linha de comando independente.
-
Utilitário de Controle do Oracle Connection Manager
Esse utilitário de linha de comando permite administrar um Oracle Connection Manager, que é um roteador por meio do qual uma solicitação de conexão do cliente pode ser enviada para seu próximo hop ou diretamente para o banco de dados. Você pode usar comandos do utilitário para executar funções básicas de gerenciamento em um ou mais Oracle Connection Managers. Além disso, você pode exibir e alterar as definições de parâmetro.
Consulte Também:
-
Oracle AI Database Net Services Administrator's Guide para saber mais sobre as ferramentas do Oracle Net Services
Ferramentas para Movimentação e Análise de Dados
O Oracle AI Database inclui vários utilitários para auxiliar na movimentação e análise de dados.
Por exemplo, é possível usar utilitários de banco de dados para:
Tabela 2 Tarefas de Análise e Movimentação de Dados
| Tarefa | Para Saber Mais |
|---|---|
| Carregar dados nas tabelas do Oracle AI Database a partir de arquivos do sistema operacional | "SQL*Loader" |
| Mover dados e metadados de um banco de dados para outro | "Exportação e Importação do Oracle Data Pump" |
| Consultar arquivos de redo log por meio de uma interface SQL | "Oracle LogMiner" |
| Gerenciar dados do Oracle AI Database | "ADR Command Interpreter (ADRCI)" |
Outras tarefas incluem a execução de verificações de integridade da estrutura física de dados em um banco de dados off-line ou arquivo de dados com DBVERIFY, ou a alteração do identificador do banco de dados (DBID) ou nome do banco de dados para um banco de dados operacional usando o utilitário DBNEWID.
Observação:
-
O SQL*Loader SQL*Loader carrega dados de arquivos externos, chamados arquivos de dados (não devem ser confundidos com os arquivos de dados internos do banco de dados) em tabelas de banco de dados. Ele tem um poderoso mecanismo de parsing de dados que coloca pouca limitação no formato dos dados no arquivo de dados
-
Exportação e Importação do Oracle Data Pump O Oracle Data Pump permite a movimentação de alta velocidade de dados e metadados de um banco de dados para outro.
-
O Oracle LogMiner Oracle LogMiner permite que você consulte arquivos de redo log por meio de uma interface SQL.
-
O ADRCI (Interpretador de Comandos ADRCI) ADRCI é um utilitário de linha de comando que permite investigar problemas, exibir relatórios de verificação de integridade e empacotar e fazer upload de dados de primeira falha para o Suporte Técnico da Oracle.
Consulte Também:
-
"Backup e Recuperação" para saber mais sobre ferramentas relacionadas a backup e recuperação
-
Oracle AI Database Utilities para saber mais sobre DBVERIFY e DBNEWID
SQL*Loader
O SQL*Loader carrega dados de arquivos externos, chamados arquivos de dados (não deve ser confundido com os arquivos de dados internos do banco de dados), em tabelas de banco de dados. Ele tem um poderoso mecanismo de parsing de dados que coloca pouca limitação no formato dos dados no arquivo de dados
Você pode usar o SQL*Loader para fazer o seguinte:
-
Carregar dados de vários arquivos de dados em várias tabelas
Você armazena os dados a serem carregados nos arquivos de dados do SQL*Loader. O arquivo de controle SQL*Loader é um arquivo de texto que contém instruções de DDL que o SQL*Loader usa para determinar onde encontrar os dados, como analisá-los e interpretá-los, onde inseri-los e muito mais.
Observação: Os arquivos de dados e o arquivo de controle do SQL*Loader não estão relacionados aos arquivos de dados e ao arquivo de controle do Oracle AI Database.
-
Controlar vários aspectos da operação de carga
Por exemplo, você pode carregar dados seletivamente, especificar o conjunto de caracteres de dados, manipular os dados com funções SQL, gerar valores de chave sequencial exclusivos em colunas especificadas e assim por diante. Você também pode gerar relatórios de erro sofisticados.
-
Usar caminho convencional, caminho direto ou carregamentos de tabela externa
Um carregamento de caminho convencional executa instruções SQL
INSERTpara preencher tabelas. Por outro lado, uma INSERÇÃO de caminho direto elimina grande parte da sobrecarga do banco de dados formatando blocos de dados e gravando-os diretamente nos arquivos de dados. As gravações diretas operam em blocos acima da marca d'água alta (HWM) e gravam diretamente no disco, ignorando o cache de buffer do banco de dados. Leituras diretas lidas diretamente do disco na PGA, ignorando novamente o buffer cache.Um carregamento de tabela externa cria uma tabela externa para dados contidos em um arquivo de dados. O carregamento executa instruções
INSERTpara inserir os dados do arquivo de dados na tabela de destino.
Uma sessão típica do SQL*Loader utiliza como entrada um arquivo de controle do SQL*Loader e um ou mais arquivos de dados. A saída é um banco de dados Oracle, um arquivo de log, um arquivo inválido e, potencialmente, um arquivo de descarte. A figura a seguir ilustra o fluxo de uma sessão típica do SQL*Loader.
Figura 1: Sessão do SQL*Loader
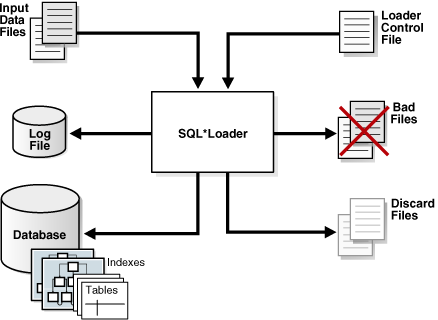
Descrição da ilustração cncpt271.gif
Você também pode usar o modo expresso SQL*Loader, que é ativado quando você especifica o parâmetro table no comando SQL*Loader, como no seguinte exemplo:
% sqlldr hr table=employeesNenhum arquivo de controle é permitido, o que torna o SQL*Loader mais fácil de usar. Em vez de fazer parse de um arquivo de controle, o SQL*Loader usa as definições de coluna da tabela para determinar os tipos de dados de entrada. O SQL*Loader faz várias suposições padrão, incluindo o conjunto de caracteres, os delimitadores de campo e os nomes de dados, log e arquivos inválidos. Você pode substituir muitos dos padrões por parâmetros de linha de comando.
Consulte Também:
-
Oracle AI Database Utilities para saber mais sobre o SQL*Loader
Exportação e Importação do Oracle Data Pump
O Oracle Data Pump permite a movimentação de dados e metadados em alta velocidade de um banco de dados para outro.
Essa tecnologia é a base para os seguintes utilitários de movimentação de dados do Oracle AI Database:
-
Exportação do Data Pump (Exportação)
A exportação é um utilitário para descarregar dados e metadados em um conjunto de arquivos do sistema operacional chamado conjunto de arquivos de dump. O conjunto de arquivos de dump é composto por um ou mais arquivos binários que contêm dados de tabela, metadados de objeto de banco de dados e informações de controle.
-
Importação do Data Pump (Importação)
A importação é um utilitário para carregar um conjunto de arquivos de dump de exportação em um banco de dados. Você também pode usar o recurso Importar para carregar um banco de dados de destino diretamente de um banco de dados de origem sem arquivos intermediários, o que permite que operações de exportação e importação sejam executadas simultaneamente, minimizando o tempo total decorrido.
O Oracle Data Pump é composto pelas seguintes partes distintas:
-
Os clientes de linha de comando
expdpeimpdpEsses clientes fazem chamadas ao pacote
DBMS_DATAPUMPpara executar operações do Oracle Data Pump. -
O pacote PL/SQL
DBMS_DATAPUMP, também conhecido como API do Data PumpEssa API fornece funcionalidade de importação e exportação de alta velocidade.
-
O pacote PL/SQL
DBMS_METADATA, também conhecido como API de MetadadosTodos os processos que carregam e descarregam metadados usam essa API, que armazena definições de objeto em XML.
A figura a seguir mostra como o Oracle Data Pump se integra ao SQL*Loader e a tabelas externas. Conforme mostrado, o SQL*Loader é integrado à API de Tabela Externa e à API do Data Pump para carregar dados em tabelas externas. Clientes como o Oracle Enterprise Manager Cloud Control (Cloud Control) e tablespaces transportáveis podem usar a infraestrutura do Oracle Data Pump.
Figura 2: Arquitetura do Oracle Data Pump
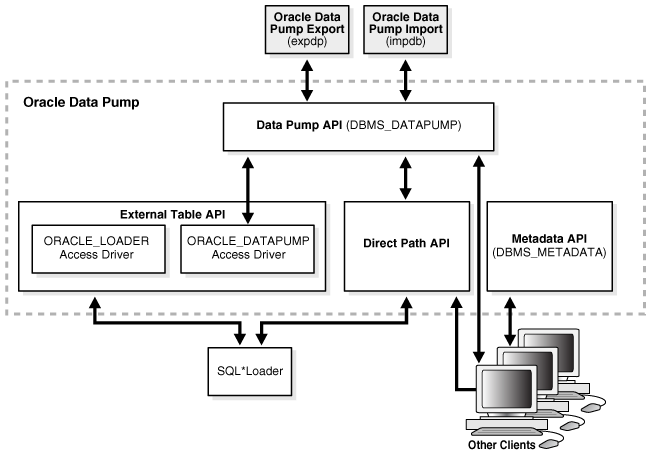
Descrição da ilustração cncpt261.png
Consulte Também:
-
Oracle AI Database Utilities para obter uma visão geral do Oracle Data Pump
-
Referência de Tipos e Pacotes PL/SQL do Oracle AI Database para obter uma descrição de
DBMS_DATAPUMPeDBMS_METADATA
Oracle LogMiner
O Oracle LogMiner permite consultar arquivos de redo log por meio de uma interface SQL.
Os usos potenciais dos dados contidos nos arquivos de redo log incluem:
-
Identificar quando uma corrupção lógica em um banco de dados, como erros feitos no nível do aplicativo, pode ter começado
-
Detectando erro do usuário
-
Determinar quais ações você precisaria executar para executar uma recuperação detalhada no nível da transação
-
Usando a análise de tendências para determinar quais tabelas obtêm mais atualizações e inserções
-
Analisando o comportamento do sistema e o uso do banco de dados de auditoria por meio da interface relacional abrangente LogMiner para arquivos de redo log
LogMiner pode ser acessado por meio de uma interface de linha de comando ou da GUI do Oracle LogMiner Viewer, que faz parte do Enterprise Manager.
Consulte Também: Utilitários do Oracle AI Database para saber mais sobre o LogMiner
ADRCI (Interpretador de Comandos)
ADRCI é um utilitário de linha de comando que permite investigar problemas, exibir relatórios de verificação de integridade e empacotar e fazer upload de dados de primeira falha para o Suporte Técnico da Oracle.
Você também pode usar o utilitário para exibir os nomes dos arquivos de rastreamento no ADR (Automatic Diagnostic Repository) e para exibir o log de alerta. ADRCI tem um rico conjunto de comandos que você pode usar interativamente ou em scripts.
Consulte Também:
-
Para obter mais informações sobre ADR e ADRCI, consulte Oracle AI Database Utilities e Oracle AI Database Administrator's Guide
Tópicos para Administradores de Banco de Dados
Esta seção aborda os tópicos mais essenciais aos DBAs, que não foram abordados em nenhuma outra parte do manual.
-
Backup e Recuperação O backup e a recuperação são o conjunto de conceitos, procedimentos e estratégias envolvidos na proteção do banco de dados contra perda de dados causada por falha de mídia ou erros de usuários.
-
Gerenciamento de Memória O gerenciamento de memória envolve manter tamanhos ideais para as estruturas da memória da instância do Oracle como demandas sobre a alteração do banco de dados. As definições de parâmetro de inicialização determinam como a memória PGA da SGA e da instância é gerenciada.
-
Resource Management e Programação de Tarefas O Oracle AI Database fornece ferramentas para ajudá-lo a gerenciar recursos e programar tarefas para reduzir o impacto nos usuários.
-
Desempenho e Ajuste Como DBA, você é responsável pelo desempenho do banco de dados da Oracle. Normalmente, os problemas de desempenho resultam de um tempo de resposta inaceitável, que é o tempo para concluir uma carga de trabalho especificada, ou throughput, que é a quantidade de trabalho que pode ser concluída em um tempo especificado.
Backup e Recuperação
Backup e recuperação é o conjunto de conceitos, procedimentos e estratégias envolvidos na proteção do banco de dados contra perda de dados causada por falha de mídia ou erros de usuários.
Backup é uma cópia dos dados. Um backup pode incluir partes cruciais do banco de dados, como arquivos de dados, o arquivo de parâmetros do servidor e o arquivo de controle. Um exemplo de cenário de backup e recuperação é uma unidade de disco com falha que causa a perda de um arquivo de dados. Se existir um backup do arquivo perdido, você poderá restaurá-lo e recuperá-lo. As operações envolvidas na restauração de dados para seu estado antes que a perda seja conhecida como recuperação de mídia.
Essa seção contém os seguintes tópicos:
-
Técnicas de Backup e Recuperação Você pode usar o Recovery Manager ou técnicas gerenciadas pelo usuário para fazer backup, restaurar e recuperar um banco de dados Oracle.
-
O RMAN e o Oracle Secure Backup da Arquitetura do Recovery Manager podem ser acessados na linha de comando e no Enterprise Manager Cloud Control (Cloud Control).
-
Os backups do banco de dados Backups do Banco de Dados podem ser físicos ou lógicos.
-
Reparo de Dados Embora vários problemas possam interromper a operação normal de um banco de dados ou afetar as operações de E/S, apenas alguns problemas exigem intervenção do DBA e reparo de dados.
-
Zero Data Loss Recovery Appliance O Zero Data Loss Recovery Appliance em escala de nuvem, comumente conhecido como Recovery Appliance, é um Sistema Projetado que reduz drasticamente a perda de dados e a sobrecarga de backup para todos os bancos de dados Oracle na empresa.
Consulte Também:
-
Oracle AI Database Backup and Recovery User's Guide para conceitos e tarefas de backup e recuperação
-
Oracle AI Database Administrator's Reference for Microsoft Windows para saber como usar aplicativos VSS (Volume Shadow Copy Service) para fazer backup e recuperar bancos de dados no Microsoft Windows
Técnicas de Backup e Recuperação
Você pode usar o Recovery Manager ou técnicas gerenciadas pelo usuário para fazer backup, restaurar e recuperar um banco de dados Oracle.
As principais diferenças entre as duas abordagens são as seguintes:
-
O RMAN é um utilitário do Oracle AI Database que se integra a um banco de dados Oracle para executar atividades de backup e recuperação, incluindo a manutenção de um repositório de metadados de backup históricos no arquivo de controle de cada banco de dados que ele faz backup. O RMAN também pode manter um repositório de backup centralizado chamado catálogo de recuperação em outro banco de dados. O RMAN é um recurso do Oracle AI Database e não requer instalação separada.
O RMAN é integrado ao Oracle Secure Backup, que fornece gerenciamento de backup em fita confiável e centralizado, protegendo os dados do sistema de arquivos e os arquivos do Oracle AI Database. A interface SBT do Oracle Secure Backup permite que você use o RMAN para fazer backup e restaurar arquivos de banco de dados de e para Web Services baseados em fita e Internet, como o Amazon S3. O Oracle Secure Backup suporta quase todas as unidades de fita e bibliotecas de fitas nos ambientes SAN e SCSI.
-
Técnicas gerenciadas pelo usuário
Como alternativa ao RMAN, você pode usar comandos do sistema operacional como o Linux
ddpara fazer backup e restaurar arquivos e o comandoRECOVERdo SQL*Plus para recuperação de mídia. O backup e a recuperação gerenciados pelo usuário são totalmente suportados pela Oracle, embora o RMAN seja recomendado porque está integrado ao Oracle AI Database e simplifica a administração.
Consulte Também:
-
Oracle AI Database Backup and Recovery User's Guide para obter uma visão geral das soluções de backup e recuperação
-
Oracle Secure Backup Administrator's Guide para obter uma visão geral do Oracle Secure Backup
Arquitetura do Recovery Manager
O RMAN e o Oracle Secure Backup podem ser acessados na linha de comando e no Enterprise Manager Cloud Control (Cloud Control).
O Cloud Control fornece um front-end gráfico e um recurso de programação para o RMAN. Você informa parâmetros de job e, em seguida, especifica uma programação de job. O Cloud Control executa o RMAN no horário designado ou no intervalo de repetição designado para conduzir as operações de backup e recuperação. O Cloud Control fornece acesso ao RMAN por meio de um conjunto de assistentes. Esses assistentes conduzem você por uma variedade de procedimentos de recuperação com base em uma análise do seu banco de dados, seus backups disponíveis e seus objetivos de recuperação de dados.
Usando o Cloud Control, você pode executar os cenários mais simples de restauração e recuperação descritos nesta documentação. Você também pode usar técnicas de restauração e recuperação mais sofisticadas, como recuperação pontual e operações do Oracle Flashback, que permitem o reparo eficiente de falhas de mídia e erros do usuário. O uso do Cloud Control geralmente é mais simples do que o cliente de linha de comando do RMAN.
O gráfico a seguir mostra um exemplo de arquitetura RMAN. O cliente RMAN, acessível por meio do Cloud Control, usa sessões do servidor em um banco de dados de destino para fazer backup dos dados em disco ou fita. O RMAN pode atualizar um catálogo de recuperação externo com metadados de backup.
Figura 3: Arquitetura do RMAN
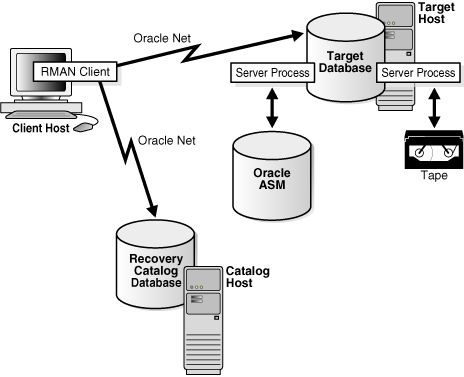
Descrição da ilustração cncpt318.gif
Seja qual for a técnica de backup e recuperação usada, a Oracle recomenda que você configure uma área de recuperação rápida. Esse diretório, sistema de arquivos ou grupo de discos do Oracle ASM gerenciado pelo banco de dados centraliza arquivos de backup e recuperação, incluindo arquivos de controle ativos, arquivos de redo log on-line e arquivados e backups. Os componentes de recuperação do Oracle AI Database interagem com a área de recuperação rápida para garantir a capacidade de recuperação do banco de dados.
Consulte Também:
-
Oracle AI Database 2 Day DBA para aprender a executar backup e recuperação com o Recovery Manager
-
Oracle AI Database Administrator's Guide para obter informações sobre como configurar e administrar a área de recuperação rápida
Backups de Bancos de Dados
Os backups de bancos de dados podem ser físicos ou lógicos.
Backups físicos, que são a principal preocupação em uma estratégia de backup e recuperação, são cópias de arquivos de banco de dados físicos. Você pode fazer backups físicos com utilitários RMAN ou de sistema operacional.
Por outro lado, os backups lógicos contêm tabelas, procedimentos armazenados e outros dados lógicos. Você pode extrair dados lógicos com um utilitário do Oracle AI Database, como o Data Pump Export, e armazená-los em um arquivo binário. Backups lógicos podem complementar backups físicos.
Os backups físicos têm grande granularidade e transportabilidade limitada, mas são muito rápidos. Os backups lógicos têm granularidade fina e transportabilidade completa, mas são mais lentos que os backups físicos.
-
Backups de Banco de Dados Inteiros e Parciais Um backup de banco de dados inteiro é um backup de todos os arquivos de dados no banco de dados, mais o arquivo de controle. Os backups de bancos de dados inteiros são o tipo mais comum de backup.
-
Backups Consistentes e Inconsistentes Um backup de banco de dados inteiro é consistente ou inconsistente.
-
Conjuntos de Backup e Cópias de Imagem O comando
BACKUPdo RMAN gera cópias de imagem ou conjuntos de backup. Consulte Também: Oracle AI Database Backup and Recovery User's Guide para saber mais sobre backups físicos e lógicos
Backups de Banco de Dados Inteiros e Parciais
Um backup de todo o banco de dados é um backup de cada arquivo de dados no banco de dados, mais o arquivo de controle. Os backups de bancos de dados inteiros são o tipo mais comum de backup.
Um backup parcial do banco de dados inclui um subconjunto do banco de dados: tablespaces individuais ou arquivos de dados. Um backup de tablespace é um backup de todos os arquivos de dados em um tablespace ou em vários tablespaces. Os backups de tablespace, sejam consistentes ou inconsistentes, só serão válidos se o banco de dados estiver operando no modo ARCHIVELOG porque é necessário redo para tornar o tablespace restaurado consistente com o restante do banco de dados.
Backups Consistentes e Inconsistentes
Um backup de banco de dados inteiro é consistente ou inconsistente.
Em um backup consistente, todos os arquivos de dados de leitura/gravação e arquivos de controle têm o mesmo SCN ponto de verificação, garantindo que esses arquivos contenham todas as alterações feitas nesse SCN. Este tipo de backup não requer recuperação após ser restaurado.
Um backup consistente do banco de dados só é possível após um shutdown consistente e é a única opção de backup válida para um banco de dados que opera no modo NOARCHIVELOG. Outras opções de backup exigem recuperação de mídia para consistência, o que não é possível sem a aplicação de arquivos de redo log arquivados. Observação: Se você restaurar um backup de banco de dados inteiro consistente sem aplicar redo, perderá todas as transações feitas após o backup.
Em um backup inconsistente, os arquivos de dados de leitura/gravação e os arquivos de controle não têm garantia de ter o mesmo SCN de checkpoint, portanto, as alterações podem estar ausentes. Todos os backups on-line são necessariamente inconsistentes porque os arquivos de dados podem ser modificados enquanto os backups ocorrem.
Backups inconsistentes oferecem disponibilidade superior porque você não precisa fazer shutdown do banco de dados para fazer backups que protejam totalmente o banco de dados. Se o banco de dados for executado no modo ARCHIVELOG e se você fizer backup dos redo logs e arquivos de dados arquivados, os backups inconsistentes poderão ser a base de uma estratégia de backup e recuperação sólida.
Consulte Também:
-
Oracle AI Database Backup and Recovery User's Guide para saber mais sobre backups inconsistentes
Conjuntos de Backup e Cópias-Imagem
O comando BACKUP do RMAN gera cópias de imagem ou conjuntos de backup.
Os tipos de backup diferem da seguinte forma:
-
Cópia da imagem
Uma cópia de imagem é uma duplicação bit a bit em disco de um arquivo de dados, de um arquivo de controle ou de um arquivo de redo log arquivado. Você pode criar cópias de imagem de arquivos físicos com utilitários de sistema operacional ou RMAN e usar qualquer uma das ferramentas para restaurá-los.
Observação: Ao contrário das cópias do sistema operacional, o RMAN valida os blocos no arquivo e registra a cópia da imagem no repositório do RMAN.
-
Conjunto de backup
O RMAN também pode criar backups em um formato proprietário chamado conjunto de backups. Um conjunto de backup contém os dados de um ou mais arquivos de dados, arquivos de redo log arquivados ou arquivos de controle ou arquivo de parâmetros do servidor. A menor unidade de um conjunto de backup é um arquivo binário chamado peça de backup. Os conjuntos de backup são a única forma na qual o RMAN pode gravar backups em dispositivos sequenciais, como unidades de fita.
Os conjuntos de backup permitem que os dispositivos de fita sejam transmitidos continuamente. Por exemplo, o RMAN pode misturar blocos de discos lentos, médios e rápidos em um conjunto de backup para que o dispositivo de fita tenha uma entrada constante de blocos. As cópias de imagem são úteis para o disco porque você pode atualizá-las incrementalmente e também recuperá-las no local.
Consulte Também: Oracle AI Database Backup and Recovery User's Guide para saber mais sobre conjuntos de backup e cópias de imagem
Reparo de Dados
Embora vários problemas possam interromper o funcionamento normal de um banco de dados ou afetar as operações de E/S, apenas alguns problemas exigem intervenção do DBA e reparo de dados.
O reparo de dados geralmente é necessário nos seguintes casos:
-
Falhas na mídia
Uma falha de mídia ocorre quando um problema externo ao banco de dados o impede de ler ou gravar em um arquivo. Falhas de mídia típicas incluem falhas físicas, como falhas no cabeçalho do disco, e a substituição, exclusão ou corrupção de um arquivo de banco de dados. Falhas de mídia são menos comuns do que erros de usuário ou aplicativo, mas uma estratégia de backup e recuperação sólida deve se preparar para elas.
-
Erros do usuário
Um usuário ou aplicativo pode fazer alterações indesejadas no seu banco de dados, como atualizações erradas, exclusão do conteúdo de uma tabela ou eliminação de objetos do banco de dados. Uma boa estratégia de backup e recuperação permite que você retorne seu banco de dados ao estado desejado, com o mínimo possível de impacto sobre a disponibilidade do banco de dados e o mínimo de esforço do DBA.
Normalmente, você tem várias maneiras de resolver os problemas anteriores. Esta seção resume algumas dessas soluções.
-
Tecnologia Oracle Flashback O Oracle AI Database fornece um grupo de recursos conhecidos como Tecnologia Oracle Flashback que suportam a exibição de estados passados de dados e a migração de dados a tempo, sem a necessidade de restaurar backups.
-
Block Media Recovery A recuperação de mídia em bloco é uma técnica para restaurar e recuperar blocos de dados corrompidos enquanto os arquivos de dados estão on-line.
-
Recuperação de Arquivo de Dados A recuperação de arquivo de dados repara um arquivo de dados atual ou de controle perdido ou danificado. Ele também pode recuperar alterações perdidas quando um tablespace ficou off-line sem a opção
OFFLINENORMAL.
Consulte Também:
-
Oracle AI Database Backup and Recovery User's Guide para conceitos de reparo de dados
Tecnologia do Oracle Flashback
O Oracle AI Database fornece um grupo de recursos conhecidos como Tecnologia Oracle Flashback que suportam a visualização de estados anteriores de dados e a sinalização de dados a tempo, sem a necessidade de restaurar backups.
Dependendo das alterações do banco de dados, os recursos de flashback geralmente podem reverter alterações indesejadas mais rapidamente e com menos impacto na disponibilidade do que a recuperação de mídia. Os seguintes recursos de flashback são mais relevantes para backup e recuperação:
-
Flashback de Banco de Dados
Você pode retroceder um CDB ou PDB para um horário anterior para corrigir problemas causados por corrupções lógicas de dados ou erros do usuário. O Flashback Database também pode ser usado para complementar o Data Guard e para sincronizar bancos de dados clone. O Flashback Database não restaura ou executa a recuperação de mídia nos arquivos, portanto não é possível usá-lo para corrigir falhas de mídia, como falhas de disco.
No nível do PDB, você pode criar um ponto de restauração do PDB e rebobinar o PDB para esse ponto de restauração sem afetar outro PDB. No nível do CDB, você pode criar um ponto de restauração do CDB.
-
Flashback Table
Você pode retroceder as tabelas para um ponto específico no tempo com uma única instrução SQL. Você pode restaurar os dados da tabela com índices, triggers e constraints associados, enquanto o banco de dados está on-line, desfazendo alterações apenas nas tabelas especificadas. A Tabela de Flashback não trata de danos físicos, como discos inválidos ou inconsistências de segmento de dados e índice.
-
Flashback Drop
Você pode reverter os efeitos de uma operação
DROP TABLE. O Flashback Drop é substancialmente mais rápido do que os mecanismos de recuperação, como a recuperação pontual, e não leva à perda de transações recentes ou tempo de inatividade.
Consulte Também:
-
Oracle AI Database Backup and Recovery User's Guide para saber mais sobre recursos de flashback
-
Oracle AI Database SQL Language Reference e Oracle AI Database Backup and Recovery Reference para saber mais sobre a instrução
FLASHBACK DATABASE
Recuperação de Mídia em Bloco
Block media recovery é uma técnica para restaurar e recuperar blocos de dados corrompidos enquanto os arquivos de dados estão on-line.
Um corrupção de bloco é um bloco de dados que não está em um formato Oracle reconhecido ou cujo conteúdo não é internamente consistente. Se você detectar corrupções de bloco, e se apenas alguns blocos estão corrompidos, a recuperação de bloco pode ser preferível à recuperação de arquivos de dados.
Consulte Também:
-
Oracle AI Database Backup and Recovery User's Guide para aprender a executar a recuperação de mídia em bloco
Recuperação de Arquivo de Dados
Recuperação de arquivo de dados repara um arquivo de dados atual perdido ou danificado ou arquivo de controle. Ele também pode recuperar alterações perdidas quando um tablespace ficou off-line sem a opção OFFLINE NORMAL.
A recuperação de mídia é necessária se você restaurar um backup de um arquivo de dados ou de controle ou um arquivo de dados for colocado off-line sem a opção OFFLINE NORMAL. O banco de dados não pode ser aberto se os arquivos de dados on-line precisarem de recuperação de mídia, nem um arquivo de dados que precise de recuperação de mídia pode ser colocado on-line até que a recuperação de mídia seja concluída.
Restaurar um backup físico de um arquivo de dados ou arquivo de controle é reconstruí-lo e disponibilizá-lo para o Oracle AI Database. Recuperar um backup é aplicar arquivos de redo log arquivados para reconstruir alterações perdidas. O RMAN também pode recuperar arquivos de dados com backups incrementais, que contêm apenas blocos de dados modificados após um backup anterior.
Ao contrário da recuperação de instância, que aplica automaticamente alterações a arquivos on-line, a recuperação de mídia deve ser chamada por um usuário e aplica arquivos de redo log arquivados a backups restaurados. A recuperação de mídia de arquivo de dados só pode operar em arquivos de dados off-line ou arquivos de dados em um banco de dados que não seja aberto por nenhuma instância do banco de dados.
A recuperação da mídia do arquivo de dados difere, dependendo de todas as alterações serem aplicadas:
-
Recuperação completa
A recuperação completa aplica todas as alterações de redo contidas nos redo logs arquivados e on-line a um backup. Normalmente, você executa a recuperação completa de mídia após uma falha de mídia danificar os arquivos de dados ou o arquivo de controle. Você pode executar a recuperação completa em um banco de dados, tablespace ou arquivo de dados.
-
Recuperação incompleta
A recuperação incompleta, também chamada de recuperação pontual do banco de dados, resulta em uma versão não atual do banco de dados. Nesse caso, você não aplica todos os redo gerados após o backup restaurado. Normalmente, você executa a recuperação pontual do banco de dados para desfazer um erro do usuário quando o Oracle Flashback Database não é possível.
Para executar a recuperação incompleta, você deve restaurar todos os arquivos de dados dos backups criados antes do horário em que deseja recuperar e, em seguida, abrir o banco de dados com a opção
RESETLOGSquando a recuperação for concluída. A redefinição dos logs cria um novo fluxo de números de sequência de log começando com a sequência de log 1.Observação: Se os arquivos de dados atuais estiverem disponíveis, o Banco de Dados de Flashback será uma alternativa ao DBPITR.
O recurso de recuperação point-in-time (TSPITR) do tablespace permite que você recupere um ou mais tablespaces para um ponto no tempo anterior ao restante do banco de dados.
Consulte Também:
-
Oracle AI Database Backup and Recovery User's Guide para conceitos de recuperação de mídia
Zero Data Loss Recovery Appliance
O Zero Data Loss Recovery Appliance em escala de nuvem, comumente conhecido como Recovery Appliance, é um Sistema Projetado que reduz drasticamente a perda de dados e a sobrecarga de backup para todos os bancos de dados Oracle na empresa.
Integrado ao RMAN, o Recovery Appliance implementa uma estratégia centralizada de backup e recuperação para grandes números de bancos de dados, usando hardware e armazenamento tolerantes a falhas em escala de nuvem. O Recovery Appliance valida continuamente os backups para fins de recuperação.
-
Benefícios do Recovery Appliance Um Recovery Appliance centralizado executa a maioria do processamento de backup e restauração do banco de dados, tornando a utilização do armazenamento, o desempenho e a capacidade de gerenciamento dos backups mais eficientes.
-
Ambiente do Recovery Appliance Um banco de dados protegido é um banco de dados cliente que faz backup de dados para um Recovery Appliance.
Benefícios do Recovery Appliance
Um Recovery Appliance centralizado executa a maior parte do processamento de backup e restauração do banco de dados, tornando a utilização do armazenamento, o desempenho e a capacidade de gerenciamento dos backups mais eficientes.
Os principais benefícios são os seguintes:
-
Eliminação de perda de dados
O Recovery Appliance elimina a exposição à perda de dados experimentada pela maioria dos bancos de dados no data center, usando tecnologias como as seguintes:
-
A transferência contínua de alterações de redo da SGA de um banco de dados protegido para um Recovery Appliance, conhecida como transporte de redo em tempo real
-
Replicação em Appliances de Recuperação remotos
-
Backups de fita automatizados feitos pelo Recovery Appliance centralizado
-
Validação de bloco de banco de dados de ponta a ponta
-
-
Custo indireto de backup mínimo
A sobrecarga de backup em servidores de banco de dados é minimizada ao descarregar o trabalho para o Recovery Appliance, que gerencia backups de vários bancos de dados em um pool de discos unificado. A estratégia de backup incremental para sempre do RMAN envolve fazer um backup inicial de nível 0 para o Recovery Appliance, com todos os backups incrementais subsequentes no nível 1. O Recovery Appliance cria um backup completo virtual combinando o nível 0 com backups de nível 1. O Recovery Appliance compacta, desduplica e valida continuamente backups no nível do bloco.
-
Melhor visibilidade da proteção de dados de ponta a ponta
O Cloud Control fornece uma view completa do ciclo de vida de backup gerenciado pelo Recovery Appliance, desde o início do backup do RMAN até o momento em que ele é armazenado em disco, fita ou replicado para um Recovery Appliance downstream. A instalação do plug-in Enterprise Manager for Zero Data Loss Recovery Appliance (plug-in Recovery Appliance) permite o monitoramento e a administração.
-
Proteção em escala de nuvem
O Recovery Appliance é dimensionado para suportar de dezenas a centenas ou milhares de bancos de dados. Os principais componentes da arquitetura são:
-
O Recovery Appliance simplifica o gerenciamento por meio de uma política de proteção, que define uma meta da janela de recuperação imposta para cada banco de dados associado à política. As políticas de proteção melhoram a capacidade de gerenciamento agrupando bancos de dados em camadas com características compartilhadas.
-
Usando políticas de proteção, o Recovery Appliance gerencia o espaço de armazenamento de backup de acordo com a meta da janela de recuperação para cada banco de dados protegido. Essa abordagem granular de gerenciamento de espaço orientada a banco de dados elimina a necessidade de gerenciar o espaço no nível de volume de armazenamento, como fazem os dispositivos de terceiros.
-
O Recovery Appliance pode ser dimensionado para acomodar aumentos no tráfego de backup, no uso de armazenamento e no número de bancos de dados, adicionando recursos de computação e armazenamento de forma simples e modular.
-
Ambiente do Recovery Appliance
Um banco de dados protegido é um banco de dados cliente que faz backup de dados para um Recovery Appliance.
A figura a seguir mostra um ambiente de amostra, que inclui seis bancos de dados protegidos e dois Recovery Appliances. Cada banco de dados usa o Módulo de Backup do Zero Data Loss Recovery Appliance (Módulo de Backup do Recovery Appliance) para seus backups. Este módulo é uma biblioteca SBT fornecida pela Oracle que o RMAN usa para transferir backups pela rede para o Recovery Appliance.
Figura 4: Ambiente do Recovery Appliance
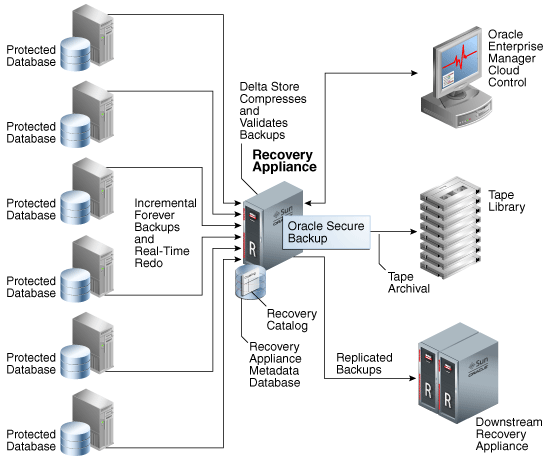
Descrição da ilustração amagd_vm_025.png
O banco de dados de metadados do Recovery Appliance, que reside em cada Recovery Appliance, gerencia os metadados armazenados no catálogo de recuperação. Todos os bancos de dados protegidos que enviam backups para o Recovery Appliance devem usar esse catálogo de recuperação. Os backups estão localizados no local de armazenamento do Recovery Appliance, que é um conjunto de grupos de discos do Oracle ASM. Observação: Os bancos de dados podem usar o Recovery Appliance como seu catálogo de recuperação sem também usá-lo como repositório de backup.
Os administradores usam o Cloud Control para gerenciar e monitorar o ambiente. O Cloud Control fornece uma exibição "única" de todo o ciclo de vida de backup para cada banco de dados, independentemente de os backups residirem em disco, fita ou outro Recovery Appliance.
Gerenciamento de Memória
O gerenciamento da memória envolve manter tamanhos ideais para as estruturas da memória da instância Oracle como demandas sobre a alteração do banco de dados. As definições de parâmetro de inicialização determinam como a memória PGA da SGA e da instância é gerenciada. A Figura 22-5 mostra uma árvore de decisão para opções de gerenciamento de memória. As seções a seguir explicam as opções em detalhes.
Figura 5: Métodos de gerenciamento de memória
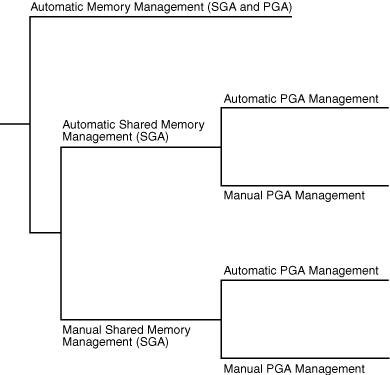
Descrição da ilustração cncpt242.gif
-
Gerenciamento Automático de Memória No gerenciamento automático de memória, o Oracle AI Database gerencia a SGA e a memória PGA da instância completamente automaticamente. Esse método é o mais simples e é altamente recomendado pela Oracle.
-
Gerenciamento de Memória Compartilhada da SGA Você pode controlar o tamanho da SGA manualmente, definindo o tamanho da SGA com gerenciamento automático de memória compartilhada ou ajustando manualmente os componentes da SGA.
-
Gerenciamento de Memória da PGA da Instância Se o gerenciamento automático de memória não estiver ativado, o Oracle AI Database usará o gerenciamento automático ou manual de memória da PGA.
-
Resumo de Métodos de Gerenciamento de Memória O gerenciamento de memória é automático ou manual. Consulte Também: "Arquitetura de Memória" para saber mais sobre a SGA e a PGA
Gerenciamento Automático de Memória
No gerenciamento automático de memória, o Oracle AI Database gerencia a SGA e a memória PGA da instância completamente automaticamente. Esse método é o mais simples e é altamente recomendado pela Oracle.
Os únicos controles especificados pelo usuário são o parâmetro de inicialização do tamanho da memória de destino (MEMORY_TARGET) e o parâmetro opcional de inicialização do tamanho máximo da memória (MEMORY_MAX_TARGET). O Oracle AI Database se ajusta ao tamanho da memória de destino, redistribuindo a memória conforme necessário entre a SGA e a PGA da instância.
A SGA pode conter o Armazenamento de Colunas na Memória (armazenamento de colunas do IM) ou o pool de otimização de memória, ambos opcionais. Não importa qual método de gerenciamento de memória você use, dimensione o armazenamento de colunas do IM com o parâmetro de inicialização INMEMORY_SIZE e o pool de memoptimização com o parâmetro de inicialização MEMOPTIMIZE_POOL_SIZE. O tamanho do armazenamento de colunas do IM são pool de memoptimização incluídos no destino da memória, mas não são gerenciados pelo algoritmo de redimensionamento automático. Por exemplo, se você definir MEMORY_TARGET como 5 GB e INMEMORY_SIZE como 1 GB, o destino geral da memória será 5 GB (não 6 GB) e o INMEMORY_SIZE será sempre 1 GB.
O gráfico a seguir mostra um banco de dados que às vezes processa jobs enviados por usuários on-line e, às vezes, jobs em batch. Usando o gerenciamento automático de memória, o banco de dados ajusta automaticamente o tamanho do grande pool e do cache de buffer do banco de dados, dependendo do tipo de jobs em execução. Observe que o gráfico não representa a área de armazenamento de colunas IM ou memoptimize.
Figura 6: Gerenciamento automático de memória
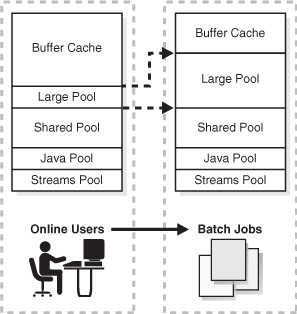
Descrição da ilustração cncpt256.gif
Se você criar um banco de dados com o DBCA e escolher a opção de instalação básica, o Oracle AI Database permitirá o gerenciamento automático da memória por padrão.
Consulte Também:
-
Oracle AI Database Administrator's Guide para aprender sobre o gerenciamento automático de memória
Gerenciamento de Memória Compartilhada da SGA
Você pode controlar o tamanho da SGA manualmente, definindo o tamanho da SGA com gerenciamento automático de memória compartilhada ou ajustando manualmente os componentes da SGA.
Se o gerenciamento automático de memória não estiver ativado, o sistema deverá usar o gerenciamento de memória compartilhada da SGA. O gerenciamento de memória compartilhada é possível em uma das seguintes formas:
-
Gerenciamento automático de memória compartilhada
Este modo permite que você exerça controle mais direto sobre o tamanho da SGA e é o padrão quando o gerenciamento automático de memória está desativado. O banco de dados ajusta a SGA total ao tamanho de destino e ajusta dinamicamente os tamanhos dos componentes da SGA. Se você estiver usando um arquivo de parâmetros do servidor, o Oracle AI Database lembrará os tamanhos dos componentes ajustados automaticamente nos shutdowns da instância do banco de dados.
-
Gerenciamento manual de memória compartilhada
Neste modo, você define os tamanhos de vários componentes SGA individuais e ajusta manualmente componentes SGA individuais de forma contínua. Você tem controle total de tamanhos de componentes SGA individuais. O banco de dados assume este modo como padrão quando o gerenciamento automático de memória e o gerenciamento automático de memória compartilhada estão desativados.
Observação: Quando o gerenciamento automático de memória está desativado, em alguns casos o banco de dados pode ajustar automaticamente os tamanhos relativos do pool compartilhado e do cache de buffer, com base na carga de trabalho do usuário.
Consulte Também:
-
Oracle AI Database Administrator's Guide para aprender sobre o gerenciamento de memória compartilhada
-
Observação KB84770 do My Oracle Support para saber mais sobre redimensionamento automático durante o modo manual:
Gerenciamento de Memória da PGA da Instância
Se o gerenciamento automático de memória não estiver ativado, o Oracle AI Database usará o gerenciamento automático ou manual de memória PGA.
Os seguintes modos são possíveis para o gerenciamento da memória PGA:
-
Gerenciamento automático de memória PGA
Quando o gerenciamento automático de memória (
MEMORY_TARGET) é desativado ePGA_AGGREGATE_TARGETé definido com um valor diferente de zero, o banco de dados usa o gerenciamento automático de memória PGA. Nesse modo,PGA_AGGREGATE_TARGETespecifica um tamanho de destino "suave" para a PGA da instância. O destino é flexível porque só se aplica a tipos específicos de alocações de memória que podem optar por usar espaço temporário em vez do PGA. O banco e dados ajusta o tamanho da PGA de instância a este destino e ajusta dinamicamente os tamanhos de PGAs individuais. Se você não definir explicitamente um tamanho de destino, o banco de dados configurará automaticamente um padrão razoável.O parâmetro de inicialização
PGA_AGGREGATE_LIMITdefine dinamicamente um limite rígido de toda a instância para memória PGA. Como o parâmetro responde à alteração das condições de memória, não é necessário definir o valor do parâmetro explicitamente. Por padrão,PGA_AGGREGATE_LIMITé definido como o maior dos seguintes:-
2 GB
-
200% da definição do parâmetro de inicialização do
PGA_AGGREGATE_TARGET -
(Valor da definição do parâmetro de inicialização
PROCESSES) * 3 MB
Um processo em segundo plano compara periodicamente o tamanho da PGA com o limite definido por
PGA_AGGREGATE_LIMIT. Se o limite for atingido ou excedido, esse processo encerrará as chamadas das sessões usando a memória PGA mais insustentável. Se essas sessões ainda não liberarem memória suficiente, elas também serão encerradas. -
-
Gerenciamento manual de memória PGA
Quando o gerenciamento automático de memória é desativado e
PGA_AGGREGATE_TARGETé definido como0, o banco de dados assume como padrão o gerenciamento manual de PGA. As releases anteriores do Oracle AI Database exigiam que o DBA especificasse manualmente o tamanho máximo da área de trabalho para cada tipo de operador SQL (como uma classificação ou junção de hash). Essa técnica se mostrou muito difícil porque a carga de trabalho está sempre mudando. Embora o Oracle AI Database suporte o método manual de gerenciamento de memória PGA, a Oracle recomenda enfaticamente o gerenciamento automático de memória.
Consulte Também: Guia de Ajuste de Desempenho do Oracle AI Database para saber mais sobre o gerenciamento de memória PGA
Resumo dos Métodos de Gerenciamento de Memória
O gerenciamento de memória é automático ou manual.
Se você não ativar o gerenciamento automático de memória, deverá configurar separadamente um método de gerenciamento de memória para a SGA e outro para a PGA. Observação: Quando o gerenciamento automático de memória é desativado para a instância do banco de dados como um todo, o Oracle Database ativa o gerenciamento automático de memória PGA por padrão.
A tabela a seguir inclui os parâmetros de inicialização INMEMORY_SIZE e de inicialização MEMOPTIMIZE_POOL_SIZE. As duas áreas de memória de controle são opcionais.
Tabela 3 Métodos de Gerenciamento de Memória
| Instância | SGA | PGA | Descrição | Parâmetros de Inicialização |
|---|---|---|---|---|
| Automático | n/a (não aplicável) | n/a (não aplicável) | O banco de dados ajusta o tamanho da instância com base em um tamanho de destino de instância única. | Você define:
|
| n/a (não aplicável) | Automático | Automático | O banco de dados ajusta automaticamente a SGA com base em um destino SGA. O banco de dados ajusta automaticamente a PGA com base em um destino PGA. |
Você define:
O banco de dados configura automaticamente o parâmetro de inicialização |
| n/a (não aplicável) | Automático | Manual | O banco de dados ajusta automaticamente a SGA com base em um destino SGA. Você controla o PGA manualmente, definindo o tamanho máximo da área de trabalho para cada tipo de operador SQL. |
Você define:
|
| n/a (não aplicável) | Manual | Automático | Você controla a SGA manualmente definindo tamanhos de componentes individuais. O banco de dados ajusta automaticamente a PGA com base em um destino PGA. |
Você define:
O banco de dados configura automaticamente o parâmetro de inicialização |
| n/a (não aplicável) | Manual | Manual | Configure manualmente os tamanhos dos componentes SGA. Você controla a PGA manualmente, definindo o tamanho máximo da área de trabalho para cada tipo de operador SQL. |
Configure manualmente os tamanhos dos componentes SGA. Você define:
|
Nota de rodapé 1
O banco de dados configura automaticamente o parâmetro de inicialização PGA_AGGREGATE_LIMIT. Você também opta por definir esse parâmetro manualmente.
Nota de rodapé 2
O banco de dados configura automaticamente o parâmetro de inicialização PGA_AGGREGATE_LIMIT. Você também opta por definir esse parâmetro manualmente.
Consulte Também: Oracle AI Database Administrator's Guide porque o gerenciamento automático de memória não está disponível em todas as plataformas
Resource Management e Programação de Tarefa
O Oracle AI Database fornece ferramentas para ajudá-lo a gerenciar recursos e programar tarefas para reduzir o impacto nos usuários.
Em um banco de dados com muitos usuários ativos, o gerenciamento de recursos é uma parte importante da administração do banco de dados. Sessões que consomem recursos excessivos podem impedir que outras sessões façam seu trabalho. Um problema relacionado é como agendar tarefas para que elas sejam executadas no melhor momento. O Oracle AI Database fornece ferramentas para ajudar a resolver esses problemas.
-
Gerenciador de Recursos de Banco de Dados O Oracle AI Database Resource Manager (o Resource Manager) fornece controle granular de recursos de banco de dados alocados para contas de usuário, aplicativos e serviços. O Resource Manager atua principalmente como um gatekeeper, retardando a execução lenta de alguns jobs para que outros possam ser executados rapidamente.
-
Gerenciamento de CPU A partir do Oracle AI Database 26ai, a Oracle oferece um método alternativo para o gerenciamento de recursos de CPU, que opera em todas as instâncias de banco de dados no servidor.
-
Oracle Scheduler O Oracle Scheduler (o Scheduler) permite que administradores de banco de dados e desenvolvedores de aplicativos controlem quando e onde várias tarefas ocorrem no ambiente de banco de dados.
Gerenciador de Recursos do Banco de Dados
O Oracle AI Database Resource Manager (o Resource Manager) fornece controle granular de recursos de banco de dados alocados para contas de usuário, aplicativos e serviços. O Resource Manager atua principalmente como um gatekeeper, retardando a execução lenta de alguns jobs para que outros possam ser executados rapidamente.
O pacote PL/SQL DBMS_RESOURCE_MANAGER resolve muitos problemas de alocação de recursos que um sistema operacional não gerencia bem, incluindo:
-
Despesas gerais excessivas
-
Programação ineficiente
-
Alocação inadequada de recursos
-
Incapacidade de gerenciar recursos específicos do banco de dados
O Resource Manager ajuda a superar os problemas precedentes, dando ao banco de dados mais controle sobre a alocação de recursos de hardware e priorização do trabalho dentro do banco de dados. Você pode classificar sessões em grupos com base em atributos de sessão e, em seguida, alocar recursos a esses grupos para otimizar a utilização do hardware. Você pode usar o Resource Manager para definir limites para o consumo de memória do PDB.
Recursos são alocados para usuários de acordo com um plano de recursos especificado pelo administrador do banco de dados. O plano especifica como os recursos devem ser distribuídos entre grupos de consumidores de recursos, que são sessões de usuário agrupadas por requisitos de recursos. Uma diretiva de plano de recursos associa um grupo de consumidores de recursos a um plano e especifica como os recursos devem ser alocados ao grupo. A Figura 22-7 mostra um plano de recursos simples para uma organização que executa aplicações OLTP e aplicações de relatórios simultaneamente durante o dia. O plano ativo no momento, DAYTIME, aloca recursos da CPU entre três grupos de consumidores de recursos. Especificamente, OLTP tem 75% do tempo de CPU, REPORTS tem 15% e OTHER_GROUPS recebe os 10% restantes.
Figura 7: Plano de Recursos Simples
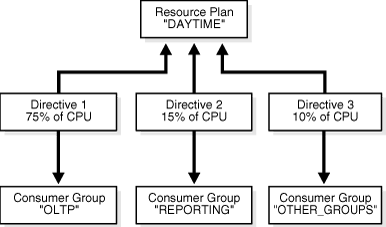
Descrição da ilustração admin078.gif
Um problema que o Resource Manager pode resolver são as consultas descontroladas, que podem ser monitoradas usando o Monitor SQL. O Resource Manager permite que você especifique limites para identificar e responder a instruções SQL descartáveis. Por exemplo, você pode especificar limites para tempo de CPU, tempo decorrido, E/Ss físicas ou lógicas e uso de PGA por cada processo em primeiro plano em um grupo de consumidores. Em resposta, o Resource Manager pode alternar para um grupo de consumidores de prioridade mais baixa, encerrar a instrução SQL ou registrar a violação de limite.
Consulte Também:
-
Oracle AI Database Administrator's Guide para saber como usar o Resource Manager
-
Referência de Tipos e Pacotes PL/SQL do Oracle AI Database para aprender a usar o pacote PL/SQL
DBMS_RESOURCE_MANAGER
Gerenciamento de CPU
A partir do Oracle AI Database 26ai, a Oracle oferece um método alternativo para gerenciamento de recursos de CPU, que opera em todas as instâncias de banco de dados do servidor.
Em versões anteriores, a Oracle oferecia um método de gerenciamento de recursos de CPU, que operava dentro de uma instância de banco de dados. A partir do Oracle AI Database 26ai, você pode definir o RESOURCE_MANAGER_CPU_SCOPE para controlar o escopo do gerenciamento de recursos da CPU. Esse parâmetro permite que você escolha entre os dois métodos de controle.
A definição de RESOURCE_MANAGER_CPU_SCOPE como SERVER_WIDE permite o gerenciamento de recursos de CPU entre instâncias no nível do servidor. Introduzido no Oracle AI Database 26ai, esse método pode ser usado quando várias instâncias de banco de dados compartilham um servidor Linux. Ele permite o gerenciamento de recursos da CPU em todas as instâncias de banco de dados no servidor. Com esse método, a Oracle configura automaticamente grupos de controle do Linux (cgroups) com os limites de compartilhamento de CPU e utilização de CPU desejados e, em seguida, coloca sessões de banco de dados nos cgroups apropriados.
RESOURCE_MANAGER_CPU_SCOPE é definido como INSTANCE_ONLY por padrão.
Consulte Também:
- Oracle AI Database Administrator's Guide para saber mais sobre as opções de gerenciamento de CPU.
Oracle Scheduler
O Oracle Scheduler (o Scheduler) permite que administradores de banco de dados e desenvolvedores de aplicativos controlem quando e onde várias tarefas ocorrem no ambiente de banco de dados.
O Scheduler fornece uma funcionalidade de programação empresarial complexa, que você pode usar para:
-
Programar execução de job com base em tempo ou eventos
-
Programe o processamento de tarefas de forma a modelar seus requisitos de negócios
-
Gerenciar e monitorar jobs
-
Executar e gerenciar jobs em um ambiente clusterizado
Os objetos de programa (programas) contêm metadados sobre o comando que o Scheduler executará, incluindo valores padrão para quaisquer argumentos. Os objetos de programação (programações) contêm informações sobre os padrões de data e hora de execução e recorrência. Os objetos de trabalho (cargos) associam um programa a uma programação. Para definir o que é executado e quando, você atribui relacionamentos entre programas, cronogramas e jobs.
O Scheduler é implementado como um conjunto de funções e procedimentos no pacote PL/SQL DBMS_SCHEDULER. Você cria e manipula objetos do Scheduler com este pacote ou com o Enterprise Manager. Como os objetos do Scheduler são objetos de banco de dados padrão, você pode controlar o acesso a eles com privilégios de sistema e de objeto. A Figura 22-8 mostra a arquitetura básica do Scheduler. A tabela de jobs é um contêiner para todos os jobs, com uma tabela por banco de dados. O processo em segundo plano do coordenador do job é iniciado automaticamente e interrompido conforme necessário. Os processos filhos do job são despertados pelo coordenador quando um job deve ser executado. Os processos filhos coletam metadados da tabela de jobs e executam o job.
Figura 8: Componentes do Scheduler
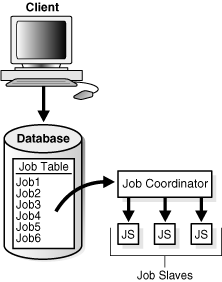
Descrição da ilustração admin062.gif
Consulte Também:
-
Oracle AI Database Administrator's Guide para saber mais sobre o Scheduler
Desempenho e Ajuste
Como um DBA, você é responsável pelo desempenho do banco de dados da Oracle. Normalmente, os problemas de desempenho resultam de um tempo de resposta inaceitável, que é o tempo para concluir uma carga de trabalho especificada, ou throughput, que é a quantidade de trabalho que pode ser concluída em um tempo especificado.
Os problemas típicos incluem:
-
Engarrafamentos da CPU
-
Estruturas de memória pequenas
-
Problemas de capacidade de E/S
-
Instruções SQL ineficientes ou de carga alta
-
Regressão de desempenho inesperada após o ajuste de instruções SQL
-
Problemas de simultaneidade e contenção
-
Problemas de configuração do banco de dados
O objetivo geral do ajuste é geralmente melhorar o tempo de resposta, aumentar o throughput ou ambos. Uma meta específica e mensurável pode ser "Reduzir o tempo de resposta da instrução SELECT especificada para menos de 5 segundos". Se essa meta é alcançável depende de fatores que podem ou não estar sob o controle do DBA. Em geral, o ajuste é o esforço para atingir metas de ajuste específicas, mensuráveis e alcançáveis usando recursos de banco de dados da maneira mais eficiente possível.
O método de desempenho da Oracle se baseia em identificar e eliminar gargalos no banco de dados e desenvolver instruções SQL eficientes. A aplicação do método de desempenho da Oracle envolve as seguintes tarefas:
-
Executando preparações de pré-ajuste
-
Ajustando o Banco de Dados Proativamente em uma Base Regular
-
Ajustando o banco de dados de forma reativa quando os usuários relatam problemas de desempenho
-
Identificando, ajustando e otimizando instruções SQL de alta carga
Esta seção descreve aspectos essenciais do ajuste de desempenho do Oracle AI Database, incluindo o uso de consultores. Os consultores do Oracle AI Database fornecem conselhos específicos sobre como lidar com os principais desafios de gerenciamento de banco de dados, abrangendo uma ampla gama de áreas, incluindo espaço, desempenho e gerenciamento de undo.
-
O automonitoramento do Database Self-Monitoring ocorre à medida que o banco de dados executa sua operação regular, garantindo que o banco de dados esteja ciente dos problemas à medida que eles surgem. O Oracle AI Database pode enviar um alerta gerado pelo servidor para notificá-lo sobre um problema iminente.
-
O Automatic Workload Repository (AWR) Automatic Workload Repository (AWR) é um repositório de dados históricos de desempenho que inclui estatísticas cumulativas para o sistema, sessões, instruções SQL individuais, segmentos e serviços.
-
Monitor de Banco de Dados Automático (ADDM) Usando estatísticas capturadas no AWR (Automatic Workload Repository), o ADDM diagnostica automaticamente e proativamente o desempenho do banco de dados e determina como os problemas identificados podem ser resolvidos. Você também pode executar o ADDM manualmente.
-
O Histórico de Sessões Ativas (ASH) Histórico de Sessões Ativas (ASH) mostra sessões de banco de dados ativas a cada segundo, gravando os dados na memória e no armazenamento persistente. A ASH é parte integrante da estrutura do autogerenciamento do banco de dados e é útil para diagnosticar problemas do desempenho.
-
O Application and SQL Tuning Oracle Database automatiza completamente o processo de ajuste de SQL. Consulte Também: O Oracle AI Database Get Started with Performance Tuning e o Oracle AI Database SQL Tuning Guide fornecem informações sobre como implementar o método de desempenho da Oracle
Monitoramento Automático do Banco de Dados
O automonitoramento ocorre à medida que o banco de dados executa seu funcionamento regular, garantindo que o banco de dados esteja ciente dos problemas à medida que eles surgem. O Oracle AI Database pode enviar um alerta gerado pelo servidor para notificá-lo sobre um problema iminente.
Alertas são gerados automaticamente quando ocorre um problema ou quando os dados não correspondem aos valores esperados para métricas como leituras físicas por segundo ou tempo de resposta SQL. Métrica é a taxa de alteração em uma estatística cumulativa. Os alertas gerados pelo servidor podem ser baseados em níveis de limite especificados pelo usuário ou porque ocorreu um evento.
Alertas gerados pelo servidor não apenas identificam o problema, mas também recomendam como ele pode ser resolvido. Um exemplo é um alerta de que a área de recuperação rápida está ficando sem espaço, com a recomendação de que backups obsoletos devem ser excluídos ou espaço adicional em disco adicionado.
Consulte Também: Oracle AI Database Administrator's Guide
AWR (Automatic Workload Repository)
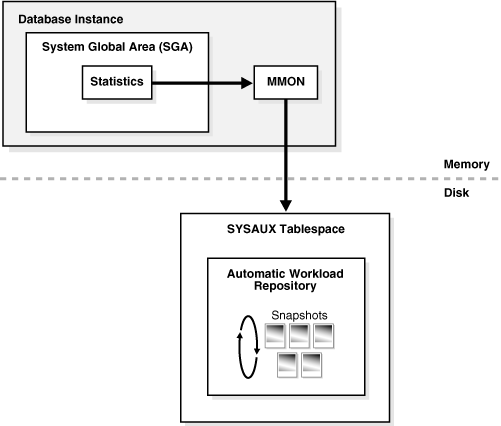
O Automatic Workload Repository (AWR) é um repositório de dados históricos de desempenho que inclui estatísticas cumulativas para o sistema, sessões, instruções SQL individuais, segmentos e serviços.
As estatísticas do AWR são a base do ajuste de desempenho. Ao automatizar a coleta de estatísticas de banco de dados para detecção e ajuste de problemas, o AWR serve como base para o autogerenciamento do banco de dados.
Conforme mostrado no gráfico a seguir, o banco de dados armazena estatísticas recentes do AWR na SGA. Por padrão, o processo MMON coleta estatísticas a cada hora e cria um snapshot do AWR. Um instantâneo AWR é um conjunto de estatísticas de desempenho capturadas em um momento específico. O banco de dados grava snapshots no tablespace SYSAUX. O AWR gerencia o espaço do snapshot, expurgando snapshots mais antigos de acordo com uma política de retenção de snapshot configurável.
Figura 9: AWR (Automatic Workload Repository)
Descrição da ilustração cncpt279.gif
Uma linha de base AWR é um conjunto de taxas de estatísticas geralmente utilizadas durante um período em que o sistema está tendo um bom desempenho na carga de pico. Você pode especificar um par ou uma faixa de snapshots do AWR como uma linha de base. Usando um relatório do AWR para comparar estatísticas capturadas durante um período de desempenho ruim com uma linha de base, você pode diagnosticar problemas.
Uma infraestrutura de manutenção automatizada conhecida como AutoTask ilustra como o Oracle Database usa o AWR para autogerenciamento. Ao analisar dados do AWR, o AutoTask pode determinar a necessidade de tarefas de manutenção e programá-las para execução nas janelas de manutenção do Oracle Scheduler. Exemplos de tarefas incluem a coleta de estatísticas para o otimizador e a execução do Supervisor de Segmento Automático.
Consulte Também:
-
Guia de Ajuste de Desempenho do Oracle AI Database para aprender sobre o AWR
-
Oracle AI Database Administrator's Guide para aprender a gerenciar tarefas de manutenção automática
ADDM (Automatic Database Monitor)
Usando estatísticas capturadas no AWR (Automatic Workload Repository), o ADDM diagnostica automaticamente e proativamente o desempenho do banco de dados e determina como os problemas identificados podem ser resolvidos. Você também pode executar o ADDM manualmente. O Automatic Database Diagnostic Monitor (ADDM) é um autovisor incorporado no Oracle Database.
O ADDM adota uma abordagem holística para o desempenho do sistema, usando o tempo como uma moeda comum entre os componentes. O ADDM identifica áreas do Oracle Database que consomem mais tempo. Por exemplo, o banco de dados pode estar gastando muito tempo aguardando buffers de banco de dados gratuitos. O ADDM faz drill-down para identificar a causa raiz dos problemas, em vez de apenas os sintomas, e relata o efeito do problema no Oracle Database geral. Ocorre uma sobrecarga mínima durante o processo.
Em muitos casos, o ADDM recomenda soluções e quantifica os benefícios de desempenho esperados. Por exemplo, o ADDM pode recomendar alterações no hardware, na configuração do banco de dados, no esquema do banco de dados ou em aplicativos. Se uma recomendação for feita, o ADDM reportará o benefício de tempo. A utilização do tempo como medida permite a comparação de problemas ou recomendações.
Além de relatar possíveis problemas de desempenho, o ADDM documenta áreas do banco de dados que não são problemas. Subcomponentes como E/S e memória que não estão impactando significativamente o desempenho do banco de dados são removidos da árvore de classificação em um estágio inicial. O ADDM lista esses subcomponentes para que você possa ver rapidamente que há pouco benefício em executar ações nessas áreas.
Consulte Também: Oracle AI Database Get Started with Performance Tuning e Oracle AI Database Performance Tuning Guide
Histórico da Sessão Ativa (ASH)
O Histórico de Sessões Ativas (ASH) faz amostra de sessões de banco de dados ativas a cada segundo, gravando os dados na memória e no armazenamento persistente. A ASH é parte integrante da estrutura do autogerenciamento do banco de dados e é útil para diagnosticar problemas do desempenho.
Ao contrário das estatísticas no nível da instância coletadas pelo AWR (Automatic Workload Repository), o banco de dados reúne estatísticas do ASH no nível da sessão. Uma sessão ativa é uma sessão que está usando a CPU e que não está aguardando um evento na classe de espera ociosa.
Você pode usar scripts do Enterprise Manager ou SQL para gerar relatórios ASH que reúnem estatísticas de sessão reunidas em uma duração especificada. Você pode usar relatórios ASH para:
-
Análise de problemas de desempenho de curta duração não identificados pelo Automatic Database Diagnostic Monitor (ADDM)
-
Análise de desempenho com escopo ou meta por várias dimensões ou suas combinações, como tempo, sessão, módulo, ação ou ID SQL
Por exemplo, um usuário notifica que o banco de dados estava lento entre 10:00 e 10:02. No entanto, a degradação de desempenho de 2 minutos representa uma pequena parte do intervalo de snapshot do AWR das 10:00 p.m. e 11:00 p.m. e não aparece nas descobertas do ADDM. Os relatórios ASH podem ajudar a identificar a origem do problema transitório.
Consulte Também: Oracle AI Database Get Started with Performance Tuning e Oracle AI Database Performance Tuning Guide
Ajuste de Aplicativos e SQL
O Oracle Database automatiza completamente o processo de ajuste de SQL.
O ADDM identifica instruções SQL que consomem recursos de sistema excepcionalmente altos e, portanto, causam problemas de desempenho. Além disso, o AWR captura automaticamente as principais instruções SQL em termos de consumo de CPU e memória compartilhada. A identificação de instruções SQL de alta carga acontece automaticamente e não requer intervenção.
-
EXPLAIN PLAN Statement Ferramentas como a instrução
EXPLAIN PLANpermitem exibir planos de execução escolhidos pelo otimizador. -
O Optimizer Statistics Advisor Optimizer Statistics Advisor é um software de diagnóstico que analisa como você está coletando estatísticas no momento, a eficácia dos jobs de coleta de estatísticas existentes e a qualidade das estatísticas coletadas. O Optimizer Statistics Advisor usa a mesma estrutura de consultor que o Automatic Database Diagnostic Monitor (ADDM), o SQL Performance Analyzer e outros consultores.
-
SQL Tuning Advisor A interface para ajuste automático de SQL é o SQL Tuning Advisor, que é executado automaticamente durante as janelas de manutenção do sistema como uma tarefa de manutenção.
-
SQL Access Advisor Use o SQL Access Advisor para ajudá-lo a analisar consultas SQL e determinar maneiras de otimizar objetos de esquema ou ajustar consultas.
-
SQL Plan Management Gerencie planos de execução SQL usando o gerenciamento de planos SQL para realizar apenas planos testados e verificados.
Instrução EXPLAIN PLAN
Ferramentas como a instrução EXPLAIN PLAN permitem exibir planos de execução escolhidos pelo otimizador.
EXPLAIN PLAN mostra o plano de consulta para a consulta SQL especificada se ela tiver sido executada agora na sessão atual. Outras ferramentas são o Oracle Enterprise Manager e o comando AUTOTRACE do SQL*Plus.
Consulte Também: Referência de Linguagem SQL do Oracle AI Database para saber mais sobre EXPLAIN PLAN
Optimizer Statistics Advisor
O Optimizer Statistics Advisor é um software de diagnóstico que analisa como você está coletando estatísticas no momento, a eficácia dos jobs de coleta de estatísticas existentes e a qualidade das estatísticas coletadas. O Optimizer Statistics Advisor usa a mesma estrutura de consultor que o Automatic Database Diagnostic Monitor (ADDM), o SQL Performance Analyzer e outros consultores.
O Optimizer Statistics Advisor oferece as seguintes vantagens em relação à abordagem tradicional, que se baseia nas melhores práticas:
-
Fornece relatórios de fácil compreensão
-
Fornece scripts para implementar as correções necessárias sem exigir alterações no código do aplicativo
-
Executa uma tarefa predefinida chamada
AUTO_STATS_ADVISOR_TASKuma vez por dia na janela de manutenção -
Fornece uma API no pacote
DBMS_STATSque permite criar e executar tarefas manualmente, armazenar descobertas e recomendações em views do dicionário de dados, gerar relatórios para as tarefas e implementar correções quando necessário -
Integra-se com ferramentas existentes, como o Oracle Enterprise Manager (Enterprise Manager)
O Optimizer Statistics Advisor mantém regras, que são padrões fornecidos pela Oracle pelos quais o consultor executa suas verificações. As regras incorporam as melhores práticas da Oracle com base no conjunto de recursos atual. Se as melhores práticas forem alteradas de uma release para outra, as regras do Optimizer Statistics Advisor também serão alteradas. Dessa forma, o consultor sempre fornece as recomendações mais atualizadas.
O Optimizer Statistics Advisor inspeciona o processo de coleta de estatísticas e, em seguida, gera um relatório de descobertas, que são violações das regras. Se o consultor fizer recomendações e se ele propor ações com base nessas recomendações, você poderá implementar as ações automaticamente ou gerar um script PL/SQL editável e executável.
A tarefa do consultor é executada automaticamente na janela de manutenção, mas você também pode executá-la sob demanda.
Consulte Também:
-
Guia de Ajuste do Oracle AI Database SQL para saber mais sobre o Optimizer Statistics Advisor
-
Referência de Tipos e Pacotes PL/SQL do Oracle AI Database para saber mais sobre o pacote
DBMS_STATS
Supervisor de Ajuste SQL
A interface para ajuste automático de SQL é o SQL Tuning Advisor, que é executado automaticamente durante as janelas de manutenção do sistema como uma tarefa de manutenção.
Durante cada execução automática, o consultor seleciona consultas SQL de alta carga no banco de dados e gera recomendações para ajustar essas consultas.
As recomendações do SQL Tuning Advisor se enquadram nas seguintes categorias:
-
Análise estatística
-
Criação de perfil SQL
-
Análise do caminho de acesso
-
Análise da estrutura SQL
Um perfil SQL contém estatísticas adicionais específicas de uma instrução SQL e permite que o otimizador gere um plano de execução melhor. Essencialmente, um perfil SQL é um método para analisar uma consulta. Tanto o caminho de acesso quanto a análise de estrutura SQL são úteis para ajustar um aplicativo em desenvolvimento ou um aplicativo de produção desenvolvido internamente.
Um dos principais benefícios do SQL Tuning Advisor é que as soluções vêm do otimizador em vez de ferramentas externas. Assim, o ajuste é executado pelo componente de banco de dados responsável pelos planos de execução e desempenho de SQL. O processo de ajuste pode considerar estatísticas de execução anteriores de uma instrução SQL e personalizar as definições do otimizador para esta instrução.
Consulte Também:
SQL Access Advisor
Use o Supervisor de Acesso SQL para ajudá-lo a analisar consultas SQL e determinar maneiras de otimizar objetos de esquema ou ajustar consultas.
O Supervisor de Acesso SQL oferece conselhos sobre como otimizar caminhos de acesso a dados. Especificamente, ele recomenda como o desempenho do banco de dados pode ser melhorado por meio de particionamento, views materializadas, índices e logs de view materializada.
Objetos de esquema, como partições e índices, são essenciais para otimizar consultas complexas e com uso intenso de dados. No entanto, a criação e a manutenção desses objetos podem ser demoradas, e os requisitos de espaço podem ser significativos. O Supervisor de Acesso SQL ajuda a atingir as metas de desempenho recomendando estruturas de dados para uma carga de trabalho especificada.
Você pode executar o Supervisor de Acesso SQL no Enterprise Manager usando um assistente ou usando o pacote DBMS_ADVISOR. DBMS_ADVISOR consiste em um conjunto de funções e procedimentos de análise e consultoria que podem ser chamados de qualquer programa PL/SQL.
Consulte Também: Oracle AI Database Get Started with Performance Tuning e Oracle AI Database SQL Tuning Guide
Gerenciamento de Planos SQL
Gerencie planos de execução SQL usando o gerenciamento de planos SQL para realizar apenas planos testados e verificados.
Por padrão, o Supervisor de Evolução do SQL Plan Management (SPM) é executado diariamente na janela de manutenção programada, classifica todos os planos não aceitos e executa execuções de teste do maior número possível de planos. O SPM Evolve Advisor seleciona o plano aceito de menor custo na linha de base do plano SQL para comparação com cada plano não aceito. Se o plano não aceito tiver um desempenho suficientemente melhor do que o plano aceito existente, o consultor o aceitará.
O SPM de alta frequência, quando ativado, executará o Supervisor de Evolução do SPM em uma tarefa em segundo plano periódica fora da janela de manutenção para permitir melhorias de desempenho mais oportunas. A tarefa de alta frequência identificará instruções SQL usando recursos significativos do sistema e verificará se um plano de execução SQL usado anteriormente tem melhor desempenho. Se esse for o caso, uma nova linha de base do plano SQL será criada para impor o plano de execução SQL anterior e reparar a regressão de desempenho SQL.
A partir do Oracle Database 26ai, se ativado, o SPM em tempo real iniciará a análise de desempenho imediatamente se uma instrução SQL usar um novo plano de execução de SQL. Se um plano de execução SQL anteriormente visto funcionar melhor, uma nova linha de base do plano SQL será criada imediatamente sem depender de uma tarefa em segundo plano para fazer isso.
Consulte Também:
-
Guia de Ajuste do Oracle AI Database SQL para saber mais sobre o SQL Plan Management