Concepts pour les administrateurs de base de données
Le contenu du script de cette page a pour seul objectif la navigation et n'altère en rien le contenu.
Cette partie décrit les tâches, les outils et les connaissances essentielles pour les administrateurs de base de données.
-
Duités des administrateurs de base de données La responsabilité principale d'un administrateur de base de données est de mettre les données d'entreprise à la disposition de ses utilisateurs.
-
Outils pour les administrateurs de base de données Oracle fournit plusieurs outils pour l'administration d'une base de données.
-
Sujets relatifs aux administrateurs de base de données Cette section traite des sujets qui sont les plus essentiels pour les administrateurs de base de données et qui n'ont pas été abordés ailleurs dans le manuel.
Fonctions des administrateurs de base de données
La responsabilité principale d'un administrateur de base de données est de mettre les données d'entreprise à la disposition de ses utilisateurs.
Les administrateurs de base de données doivent travailler en étroite collaboration avec les développeurs pour s'assurer que leurs applications utilisent efficacement la base de données et avec les administrateurs système pour s'assurer que les ressources physiques sont adéquates et utilisées efficacement.
Les administrateurs de base de données Oracle sont chargés de comprendre l'architecture d'Oracle AI Database et le fonctionnement de la base de données. Les administrateurs de base de données peuvent s'attendre à effectuer les tâches suivantes :
-
Installation, mise à niveau et application de patches au logiciel Oracle AI Database
-
Concevoir des bases de données, notamment identifier les besoins, créer la conception logique (modèle conceptuel) et la conception de bases de données physiques
-
Créer des bases de données Oracle
-
Développer et tester une stratégie de sauvegarde et de récupération, sauvegarder régulièrement les bases de données Oracle et les récupérer en cas de panne
-
Configuration de l'environnement réseau pour permettre aux clients de se connecter aux bases de données
-
Le démarrage et l'arrêt de la base de données
-
Gestion du stockage pour la base de données
-
Gestion des utilisateurs et de la sécurité
-
Gérer des objets de base de données tels que des tables, des index et des vues
-
Surveillance et réglages des performances des bases de données
-
Examen, collecte de données et signalement à Oracle Support Services de toute erreur de base de données critique
-
Evaluer et tester les nouvelles fonctionnalités de base de données
Les types d'utilisateur et leurs rôles et responsabilités dépendent de l'environnement de base de données. Une petite base de données peut avoir un DBA. Une base de données très volumineuse peut répartir les tâches de l'administrateur de base de données entre plusieurs spécialistes, par exemple les agents de sécurité, les opérateurs de sauvegarde et les administrateurs d'application.
Voir aussi :
-
Oracle AI Database 2 Day DBA pour une introduction aux tâches d'administrateur de base de données
-
Guide de l'administrateur Oracle AI Database pour une présentation plus approfondie des concepts et des tâches liés aux administrateurs de base de données
Outils pour les administrateurs de base de données
Oracle fournit plusieurs outils permettant d'administrer une base de données.
Cette section décrit certains outils couramment utilisés.
-
Oracle Enterprise Manager (OEM)
Oracle Enterprise Manager (Enterprise Manager) est un outil de gestion de système Web qui permet de gérer les bases de données Oracle, la machine de base de données Exadata, Fusion Middleware, les applications Oracle, les serveurs, le stockage et le matériel et les logiciels non Oracle.
-
SQL*Plus est un outil de requête interactif et par lots inclus dans chaque installation d'Oracle AI Database.
-
Outils d'installation et de configuration de la base de données Oracle fournit plusieurs outils pour simplifier la tâche d'installation et de configuration du logiciel Oracle AI Database.
-
Outils de configuration et d'administration d'Oracle Net Oracle Net Services offre des solutions d'entreprise dans des environnements informatiques hétérogènes répartis. Oracle Net, un composant d'Oracle Net Services, permet d'établir une session réseau entre une application client et une base de données.
-
Outils de déplacement et d'analyse des données Oracle AI Database inclut plusieurs utilitaires pour faciliter le déplacement et l'analyse des données.
Oracle Enterprise Manager
Oracle Enterprise Manager (Enterprise Manager) est un outil de gestion de système Web qui permet de gérer les bases de données Oracle, la machine de base de données Exadata, Fusion Middleware, les applications Oracle, les serveurs, le stockage et le matériel et les logiciels non Oracle.
-
Oracle Enterprise Manager Cloud Control Oracle Enterprise Manager Cloud Control (Cloud Control) est une interface Web qui fournit à l'administrateur une surveillance complète de la pile technologique Oracle et des composants non Oracle.
-
Oracle Enterprise Manager Database Express 12c Oracle Enterprise Manager Database Express (EM Express) est un produit de gestion Web intégré à la base de données Oracle. Il ne nécessite aucune installation ou gestion particulière.
Oracle Enterprise Manager Cloud Control
Oracle Enterprise Manager Cloud Control (Cloud Control) est une interface Web qui fournit à l'administrateur une surveillance complète de la pile technologique Oracle et des composants autres qu'Oracle.
Parfois, un composant de notification d'application rapide (FAN) peut devenir indisponible ou rencontrer des problèmes de performances. Dans ce cas, Cloud Control affiche l'alerte générée automatiquement afin que l'administrateur puisse effectuer l'action de récupération appropriée.
Les composants de Cloud Control sont les suivants :
-
Oracle Management Service (OMS)
La fonctionnalité OMS est un ensemble d'applications J2EE qui affiche l'interface de Cloud Control, qui fonctionne avec tous les agents de gestion Oracle pour traiter les informations de surveillance et qui utilise le référentiel Enterprise Manager comme banque de données persistante.
-
Agents de gestion Oracle
Ces agents sont des processus déployés sur chaque hôte surveillé pour surveiller toutes les cibles sur l'hôte, communiquer ces informations au service OMS et gérer l'hôte et ses cibles.
-
Oracle Management Repository
Le référentiel est un schéma d'une base de données Oracle qui contient toutes les informations disponibles sur les administrateurs, les cibles et les applications gérés par Cloud Control.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour découvrir comment utiliser Cloud Control pour administrer une base de données
-
Aide en ligne pour Cloud Control
Oracle Enterprise Manager Database Express 12c
Oracle Enterprise Manager Database Express (EM Express) est un produit de gestion Web intégré à la base de données Oracle. Il ne nécessite aucune installation ou gestion particulière.
EM Express contient les principales pages de gestion des performances et d'administration de base dans Cloud Control. Ces pages sont les suivantes :
-
Base de données - Page d'accueil
-
Surveillance SQL en direct
-
ASH Analytics
Vous pouvez accéder à ces fonctionnalités en ligne via la console EM Express et hors ligne via la technologie Active Reports. D'un point de vue architectural, EM Express ne dispose pas de composants de niveau intermédiaire ou middleware, ce qui garantit que sa surcharge sur le serveur de base de données est négligeable.
EM Express vous permet d'effectuer des tâches d'administration telles que la gestion de la sécurité des utilisateurs et de la mémoire et du stockage de la base de données. Vous pouvez également visualiser les performances et le statut de la base de données.
Voir aussi : Oracle AI Database - Introduction au réglage des performances pour découvrir comment administrer la base de données avec EM Express
SQL*Plus
SQL*Plus est un outil de requête interactif et par lots inclus dans chaque installation d'Oracle AI Database.
Il est doté d'une interface utilisateur de ligne de commande qui agit comme client lors de la connexion à la base de données. SQL*Plus possède son propre environnement et ses propres commandes. Il permet d'entrer et d'exécuter des commandes SQL, PL/SQL, SQL*Plus et du système d'exploitation pour effectuer des tâches telles que :
-
Formatage, exécution de calculs sur, stockage et impression à partir des résultats de requête
-
Examen de tables et définitions d'objets
-
Développement et exécution de scripts de batch
-
Administrer une base de données
Vous pouvez utiliser SQL*Plus pour générer des rapports de façon interactive, pour générer des rapports via des traitements par batch, puis intégrer les résultats dans un fichier texte, les afficher à l'écran ou dans un fichier HTML afin de le parcourir sur internet. Vous pouvez générer des rapports de façon dynamique à l'aide de la fonction de sortie HTML.
Voir aussi : Guide de l'utilisateur et référence SQL*Plus pour en savoir plus sur SQL*Plus
Outils pour l'installation et la configuration de bases de données
Oracle fournit plusieurs outils pour simplifier la tâche d'installation et de configuration du logiciel Oracle AI Database.
Le tableau suivant décrit les outils pris en charge.
Tableau 1 Outils d'installation et de configuration de la base de données
| Outil | Description | Pour en savoir plus |
|---|---|---|
| Oracle Universal Installer (OUI) | OUI est un utilitaire d'interface graphique qui permet d'afficher, d'installer et de désinstaller le logiciel Oracle AI Database. L'aide en ligne est disponible pour vous guider dans l'installation. | Aide en ligne pour vous guider dans l'installation |
| Assistant Mise à niveau (DBUA) de base de données | DBUA vous guide de manière interactive tout au long d'une mise à niveau de base de données et configure la base de données pour la nouvelle version. DBUA automatise la mise à niveau en effectuant toutes les tâches normalement effectuées manuellement. DBUA émet des recommandations pour les options de configuration telles que les tablespaces et le fichier de journalisation en ligne. | Oracle AI Database 2 Day DBA pour apprendre à mettre à niveau une base de données avec DBUA |
| Assistant Configuration de bases de données (DBCA) | L'assistant DBCA fournit une interface graphique et le workflow guidé permettant de créer et de configurer une base de données. Cet outil vous permet de créer une base de données à partir de modèles fournis par Oracle ou de créer votre propre base de données et vos propres modèles. | Guide de l'administrateur Oracle AI Database pour découvrir comment créer une base de données avec DBCA |
Outils de configuration et d'administration d'Oracle Net
Oracle Net Services offre des solutions pour la connectivité à l'échelle de l'entreprise dans les environnements informatiques hétérogènes répartis. Oracle Net, un composant d'Oracle Net Services, permet d'établir une session réseau entre une application client et une base de données.
Vous pouvez utiliser les outils suivants pour configurer et administrer Oracle Net Services :
-
Oracle Net Manager
Cet outil vous permet de configurer Oracle Net Services pour un répertoire de base Oracle sur un client ou un hôte de serveur local. Vous pouvez utiliser Oracle Net Manager pour configurer des méthodes de résolution de noms, des profils et des processus d'écoute. Vous pouvez démarrer Oracle Net Manager à l'aide de la console Oracle Enterprise Manager ou en tant qu'application indépendante.
-
Assistant Configuration Oracle Net
Ces outils s'exécutent automatiquement lors de l'installation du logiciel. L'assistant vous permet de configurer les composants réseau de base au cours de l'installation, notamment les noms de processus d'écoute et les adresses de protocole, les méthodes de résolution de noms, les noms de service réseau dans un fichier
tnsnames.oraet l'utilisation du serveur d'annuaire. -
Utilitaire de contrôle de processus d'écoute
L'utilitaire de contrôle du processus d'écoute permet de configurer les processus d'écoute pour qu'ils reçoivent les connexions client. Vous pouvez accéder à l'utilitaire via Enterprise Manager ou en tant qu'application de ligne de commande autonome.
-
Utilitaire de contrôle d'Oracle Connection Manager
Cet utilitaire de ligne de commande vous permet d'administrer un Oracle Connection Manager, qui est un routeur via lequel une demande de connexion client peut être envoyée à son saut suivant ou directement à la base de données. Vous pouvez utiliser des commandes utilitaires pour exécuter des fonctions de gestion de base sur un ou plusieurs gestionnaires de connexions Oracle. Par ailleurs, vous pouvez visualiser et modifier les paramètres.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database Net Services pour en savoir plus sur les outils Oracle Net Services
Outils de déplacement et d'analyse des données
Oracle AI Database inclut plusieurs utilitaires pour faciliter le déplacement et l'analyse des données.
Par exemple, vous pouvez utiliser des utilitaires de base de données pour :
Tableau 2 : Tâches de déplacement et d'analyse de données
| Tâche | Pour en savoir plus |
|---|---|
| Charger des données dans des tables Oracle AI Database à partir de fichiers du système d'exploitation | SQL*Loader |
| Déplacer des données et des métadonnées d'une base de données vers une autre | "Export et import d'Oracle Data Pump" |
| interroger les fichiers de journalisation via une interface SQL | "Oracle LogMiner" |
| Gérer les données d'Oracle AI Database | "ADR Command Interpreter (ADRCI)" |
D'autres tâches incluent l'exécution de contrôles d'intégrité de structure de données physiques sur une base de données hors ligne ou un fichier de données avec DBVERIFY, ou la modification de l'identificateur de base de données (DBID) ou du nom de base de données pour une base de données opérationnelle à l'aide de l'utilitaire DBNEWID.
Remarque :
-
SQL*Loader SQL*Loader charge les données à partir de fichiers externes, appelés fichiers de données (à ne pas confondre avec les fichiers de données de base de données internes), dans des tables de base de données. Il dispose d'un puissant moteur d'analyse de données qui limite peu le format des données du fichier.
-
Oracle Data Pump Export et import Oracle Data Pump permet de déplacer à grande vitesse les données et les métadonnées d'une base de données vers une autre.
-
Oracle LogMiner Oracle LogMiner vous permet d'interroger les fichiers de journalisation via une interface SQL.
-
ADRCI (ADR Command Interpreter) ADRCI est un utilitaire de ligne de commande qui vous permet d'examiner les problèmes, d'afficher les rapports de vérification de l'état et de packager et de télécharger les données en cas de première défaillance vers le support technique Oracle.
Voir aussi :
-
"Sauvegarde et récupération" pour en savoir plus sur les outils de sauvegarde et de récupération
-
Utilitaires Oracle AI Database pour en savoir plus sur DBVERIFY et DBNEWID
SQL*Loader ;
SQL*Loader charge les données à partir de fichiers externes, appelés fichiers de données (à ne pas confondre avec les fichiers de données de base de données internes), dans des tables de base de données. Il dispose d'un puissant moteur d'analyse de données qui limite peu le format des données du fichier.
Vous pouvez utiliser SQL*Loader pour effectuer les opérations suivantes :
-
Charger les données de plusieurs fichiers de données dans plusieurs tables
Vous stockez les données à charger dans des fichiers de données SQL*Loader. Le fichier de contrôle SQL*Loader est un fichier texte qui contient des instructions DDL que SQL*Loader utilise pour déterminer où trouver les données, comment les analyser et les interpréter, où les insérer, etc.
Remarque : les fichiers de données et de contrôle SQL*Loader ne sont pas liés aux fichiers de données et au fichier de contrôle Oracle AI Database.
-
Contrôle des différents aspects de l'opération de charge
Par exemple, vous pouvez charger des données de manière sélective, indiquer le jeu de caractères de données, manipuler les données à l'aide de fonctions SQL, générer des valeurs de clé séquentielle uniques dans les colonnes indiquées, etc. Vous pouvez également générer des rapports d'erreur sophistiqués.
-
Utiliser des chargements par chemin conventionnel, chemin direct ou table externe
Un chargement par chemin conventionnel exécute des instructions SQL
INSERTpour remplir les tables. En revanche, un chemin d'accès direct INSERT élimine une grande partie de la surcharge de la base de données en formatant les blocs de données et en les écrivant directement dans les fichiers de données. Les écritures directes fonctionnent sur des blocs situés au-dessus de la limite supérieure du contrôle du débit (HWM) et écrivent directement sur le disque, en contournant le cache de tampons de la base de données. Lectures directes directement depuis le disque vers la PGA, en ignorant à nouveau le cache de tampons.Un chargement de table externe crée une table externe pour les données contenues dans un fichier de données. Le chargement exécute des instructions
INSERTpour insérer les données du fichier de données dans la table cible.
Une session SQL*Loader type utilise en entrée un fichier de contrôle SQL*Loader et un ou plusieurs fichiers de données. La sortie est une base de données Oracle, un fichier journal, un fichier incorrect et, éventuellement, un fichier de rebut. La figure suivante illustre le flux d'une session SQL*Loader standard.
Figure 1 : Session SQL*Loader
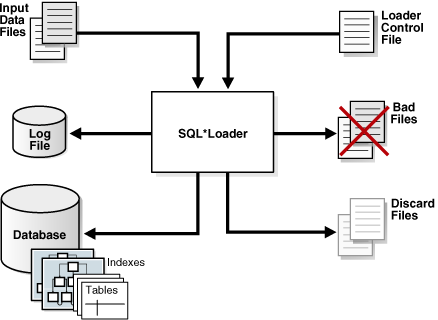
Description de l'image cncpt271.gif
Vous pouvez également utiliser le mode express SQL*Loader, qui est activé lorsque vous indiquez le paramètre table dans la commande SQL*Loader, comme dans l'exemple suivant :
% sqlldr hr table=employeesAucun fichier de contrôle n'est autorisé, ce qui facilite l'utilisation de SQL*Loader. Au lieu d'analyser un fichier de contrôle, SQL*Loader utilise les définitions de colonne de table pour déterminer les types de données d'entrée. SQL*Loader émet plusieurs hypothèses par défaut, notamment le jeu de caractères, les délimiteurs de champ et les noms des données, des journaux et des fichiers incorrects. Vous pouvez remplacer de nombreuses valeurs par défaut par des paramètres de ligne de commande.
Voir aussi :
-
Utilitaires Oracle AI Database pour en savoir plus sur SQL*Loader
Export et import d'Oracle Data Pump
Oracle Data Pump permet de déplacer rapidement des données et des métadonnées d'une base à une autre.
Cette technologie est la base des utilitaires de déplacement de données Oracle AI Database suivants :
-
Export Data Pump (export)
L'export est un utilitaire permettant de décharger des données et des métadonnées dans un ensemble de fichiers du système d'exploitation appelé ensemble de fichiers de vidage. L'ensemble de fichiers dump est composé d'un ou de plusieurs fichiers binaires contenant des données de table, des métadonnées d'objet de base de données et des informations de contrôle.
-
Import Data Pump (import)
L'import est un utilitaire permettant de charger un jeu de fichiers dump d'export dans une base de données. Vous pouvez également utiliser Import pour charger une base de données de destination directement à partir d'une base de données source sans fichier intermédiaire, ce qui permet aux opérations d'export et d'import de s'exécuter simultanément, ce qui réduit le temps total écoulé.
Oracle Data Pump se compose des parties distinctes suivantes :
-
Clients de ligne de commande
expdpetimpdpCes clients effectuent des appels vers le package
DBMS_DATAPUMPpour effectuer des opérations Oracle Data Pump. -
Le package PL/SQL
DBMS_DATAPUMP, également appelé API Data PumpCette API fournit des fonctionnalités d'import et d'export haut débit.
-
Le package PL/SQL
DBMS_METADATA, également appelé API de métadonnéesTous les processus de chargement et de déchargement des métadonnées utilisent cette API, qui stocke les définitions d'objet au format XML.
La figure suivante montre comment Oracle Data Pump s'intègre à SQL*Loader et aux tables externes. Comme indiqué, SQL*Loader est intégré à l'API de table externe et à l'API Data Pump pour charger des données dans des tables externes. Les clients tels qu'Oracle Enterprise Manager Cloud Control (Cloud Control) et les tablespaces transportables peuvent utiliser l'infrastructure Oracle Data Pump.
Figure 2 : Architecture d'Oracle Data Pump
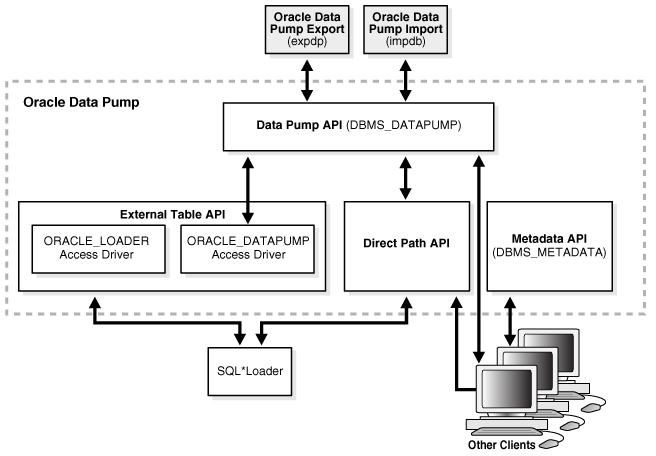
Description de l'image cncpt261.png
Voir aussi :
-
Utilitaires d'Oracle AI Database pour une présentation d'Oracle Data Pump
-
Référence des types et packages PL/SQL d'Oracle AI Database pour une description de
DBMS_DATAPUMPetDBMS_METADATA
Oracle LogMiner
Oracle LogMiner vous permet d'interroger les fichiers de journalisation via une interface SQL.
Les utilisations potentielles des données contenues dans les fichiers de journalisation sont les suivantes :
-
Détection lorsqu'une corruption logique d'une base de données, telle que des erreurs commises au niveau de l'application, peut avoir commencé
-
Détection d'une erreur utilisateur
-
Détermination des actions que vous devez effectuer pour effectuer une récupération détaillée au niveau transaction
-
Utiliser l'analyse des tendances pour déterminer les tables qui obtiennent le plus de mises à jour et d'insertions
-
Analyser le comportement du système et auditer l'utilisation de la base de données via l'interface relationnelle complète LogMiner pour les fichiers de journalisation
LogMiner est accessible via une interface de ligne de commande ou via l'interface graphique du visualiseur Oracle LogMiner, qui fait partie d'Enterprise Manager.
Voir aussi : Utilitaires Oracle AI Database pour en savoir plus sur LogMiner
Interpréteur de commande ADR (ADRCI)
ADRCI est un utilitaire de ligne de commande qui vous permet d'examiner les problèmes, d'afficher les rapports de vérification de l'état, et de packager et de télécharger les données de première défaillance vers le support technique Oracle.
Vous pouvez également utiliser l'utilitaire pour visualiser les noms des fichiers trace dans le référentiel ADR (Automatic Diagnostic Repository) et pour afficher le journal des alertes. ADRCI dispose d'un ensemble de commandes enrichi que vous pouvez utiliser de manière interactive ou dans des scripts.
Voir aussi :
-
Utilitaires Oracle AI Database et Guide de l'administrateur Oracle AI Database pour plus d'informations sur ADR et ADRCI
Sujets relatifs aux administrateurs de base de données
Cette section traite des sujets qui sont les plus essentiels pour les administrateurs de base de données et qui n'ont pas été abordés ailleurs dans le manuel.
-
Sauvegarde et récupération La sauvegarde et la récupération sont l'ensemble des concepts, procédures et stratégies impliqués dans la protection de la base de données contre les pertes de données causées par une défaillance physique ou des erreurs des utilisateurs.
-
Gestion de la mémoire La gestion de la mémoire implique le maintien d'une taille optimale pour les structures mémoire d'instance Oracle au moment de la modification de la base de données. Les paramètres d'initialisation déterminent la façon dont la mémoire SGA et la mémoire PGA de l'instance sont gérées.
-
Resource Management and Task Scheduling Oracle AI Database fournit des outils pour vous aider à gérer les ressources et à planifier des tâches afin de réduire l'impact sur les utilisateurs.
-
Performances et réglage En tant qu'administrateur de base de données, vous êtes responsable des performances de votre base Oracle. En général, les problèmes de performances résultent d'un temps de réponse inacceptable, c'est-à-dire du temps nécessaire à l'exécution d'une charge globale ou d'un débit spécifique, c'est-à-dire de la quantité de travail pouvant être effectuée dans un délai donné.
Sauvegarde et récupération
La sauvegarde et la récupération sont l'ensemble des concepts, procédures et stratégies impliqués dans la protection de la base de données contre la perte de données causée par une défaillance physique ou des erreurs des utilisateurs.
Une sauvegarde est une copie des données. Une sauvegarde peut inclure des éléments essentiels de la base de données tels que les fichiers de données, le fichier de paramètres serveur et le fichier de contrôle. Un exemple de scénario de sauvegarde et de récupération est une unité de disque défaillante qui entraîne la perte d'un fichier de données. S'il existe une sauvegarde du fichier perdu, vous pouvez le restaurer et le récupérer. Les opérations impliquées dans la restauration des données à leur état avant la perte sont appelées récupération de média.
Cette section comprend les rubriques suivantes :
-
Techniques de sauvegarde et de récupération Vous pouvez utiliser Recovery Manager ou des techniques gérées par l'utilisateur pour sauvegarder, restaurer et récupérer une base de données Oracle.
-
Architecture de Recovery Manager RMAN et Oracle Secure Backup sont accessibles à partir de la ligne de commande et d'Enterprise Manager Cloud Control (Cloud Control).
-
Les sauvegardes de base de données de sauvegardes de base de données peuvent être physiques ou logiques.
-
Réparation des données Bien que plusieurs problèmes puissent interrompre le fonctionnement normal d'une base de données ou affecter les opérations d'E/S, seuls certains problèmes nécessitent une intervention de l'administrateur de base de données et une réparation des données.
-
Zero Data Loss Recovery Appliance Zero Data Loss Recovery Appliance à l'échelle du cloud, communément appelé Recovery Appliance, est un système intégré qui réduit considérablement la perte de données et la surcharge de sauvegarde pour toutes les bases de données Oracle de l'entreprise.
Voir aussi :
-
Guide de l'utilisateur Oracle AI Database Backup and Recovery pour les tâches et concepts relatifs à la sauvegarde et à la récupération
-
Référence de l'administrateur Oracle AI Database pour Microsoft Windows afin d'apprendre à utiliser les applications Volume Shadow Copy Service (VSS) pour sauvegarder et récupérer des bases de données sous Microsoft Windows
Techniques de sauvegarde et de récupération
Vous pouvez utiliser Recovery Manager ou des techniques gérées par l'utilisateur pour sauvegarder, restaurer et récupérer une base de données Oracle.
Les principales différences entre les deux approches sont les suivantes :
-
RMAN est un utilitaire Oracle AI Database qui s'intègre à une base de données Oracle pour effectuer des activités de sauvegarde et de récupération, notamment la gestion d'un référentiel de métadonnées de sauvegarde historiques dans le fichier de contrôle de chaque base de données qu'il sauvegarde. RMAN peut également gérer un référentiel de sauvegarde centralisé appelé catalogue de récupération dans une autre base de données. RMAN est une fonctionnalité d'Oracle AI Database et ne nécessite pas d'installation distincte.
RMAN est intégré à Oracle Secure Backup, qui fournit une gestion fiable et centralisée des sauvegardes sur bande, protégeant les données des systèmes de fichiers et les fichiers Oracle AI Database. L'interface SBT d'Oracle Secure Backup vous permet d'utiliser RMAN pour sauvegarder et restaurer des fichiers de base de données sur bande et à partir de services Web Internet tels qu'Amazon S3. Oracle Secure Backup prend en charge presque tous les lecteurs de bande et bibliothèques de bandes dans les environnements SAN et SCSI.
-
Techniques gérées par l'utilisateur
Au lieu de RMAN, vous pouvez utiliser des commandes du système d'exploitation telles que Linux
ddpour sauvegarder et restaurer des fichiers et la commande SQL*PlusRECOVERpour la restauration physique. La sauvegarde et la récupération gérées par l'utilisateur sont entièrement prises en charge par Oracle, bien que RMAN soit recommandé car il est intégré à Oracle AI Database et simplifie l'administration.
Voir aussi :
-
Guide de l'utilisateur Oracle AI Database Backup and Recovery pour un aperçu des solutions de sauvegarde et de récupération
-
Guide de l'administrateur Oracle Secure Backup, pour une présentation d'Oracle Secure Backup
Architecture de Recovery Manager
RMAN et Oracle Secure Backup sont accessibles à partir de la ligne de commande et à partir d'Enterprise Manager Cloud Control (Cloud Control).
Cloud Control fournit une fonctionnalité graphique de front-end et de planification pour RMAN. Vous entrez les paramètres de travail, puis indiquez une programmation de travail. Cloud Control exécute RMAN à l'heure indiquée ou à l'intervalle de répétition indiqué pour effectuer les opérations de sauvegarde et de récupération. Cloud Control permet d'accéder à RMAN via un ensemble d'assistants. Ces assistants vous guident tout au long d'une variété de procédures de récupération basées sur une analyse de votre base de données, de vos sauvegardes disponibles et de vos objectifs de récupération de données.
Grâce à Cloud Control, vous pouvez exécuter les scénarios de restauration et de récupération plus simples décrits dans cette documentation. Vous pouvez également utiliser des techniques de restauration et de récupération plus sophistiquées, telles que la récupération jusqu'à un point dans le temps et les opérations Oracle Flashback, qui permettent de réparer efficacement les défaillances physiques et les erreurs utilisateur. L'utilisation de Cloud Control est souvent plus simple que le client de ligne de commande RMAN.
Le graphique suivant présente un exemple d'architecture RMAN. Le client RMAN, accessible via Cloud Control, utilise des sessions serveur sur une base de données cible pour sauvegarder les données sur disque ou sur bande. RMAN peut mettre à jour un catalogue de restauration externe avec des métadonnées de sauvegarde.
Figure 3 : Architecture RMAN
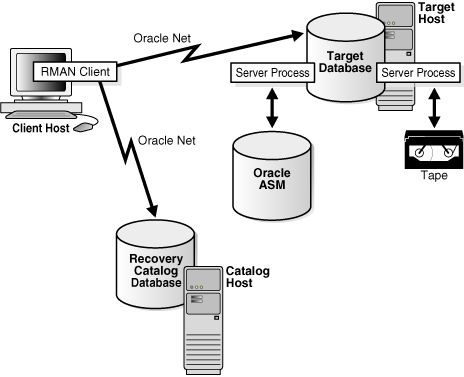
Description de l'image cncpt318.gif
Quelle que soit la technique de sauvegarde et de récupération utilisée, Oracle vous recommande de configurer une zone de récupération rapide. Ce répertoire géré par la base de données, ce système de fichiers ou ce groupe de disques Oracle ASM centralise les fichiers de sauvegarde et de récupération, y compris les fichiers de contrôle actifs, les fichiers de journalisation en ligne et archivés et les sauvegardes. Les composants de récupération d'Oracle AI Database interagissent avec la zone de récupération rapide pour assurer la récupération de la base de données.
Voir aussi :
-
Administrateur de base de données 2 jours d'Oracle AI Database pour apprendre à effectuer des sauvegardes et des récupérations avec Recovery Manager
-
Guide de l'administrateur Oracle AI Database, pour plus d'informations sur la configuration et l'administration de la zone de récupération rapide
Sauvegardes de base de données
Les sauvegardes de base de données peuvent être physiques ou logiques.
Les sauvegardes physiques, qui constituent la principale préoccupation d'une stratégie de sauvegarde et de récupération, sont des copies de fichiers de base de données physiques. Vous pouvez effectuer des sauvegardes physiques à l'aide de RMAN ou des utilitaires du système d'exploitation.
En revanche, les sauvegardes logiques contiennent des tables, des procédures stockées et d'autres données logiques. Vous pouvez extraire des données logiques à l'aide d'un utilitaire Oracle AI Database tel que Data Pump Export et les stocker dans un fichier binaire. Les sauvegardes logiques peuvent compléter les sauvegardes physiques.
Les sauvegardes physiques présentent une granularité élevée et une transportabilité limitée, mais sont très rapides. Les sauvegardes logiques ont une granularité fine et une transportabilité complète, mais sont plus lentes que les sauvegardes physiques.
-
Sauvegardes de base de données complètes et partielles Une sauvegarde de base de données complète est une sauvegarde de tous les fichiers de données de la base de données, plus le fichier de contrôle. Les sauvegardes de l'intégralité d'une base de données sont les plus fréquentes.
-
Sauvegardes cohérentes et incohérentes Une sauvegarde de base de données entière est cohérente ou incohérente.
-
Ensembles de sauvegarde et copies d'image La commande RMAN
BACKUPgénère des copies d'image ou des jeux de sauvegarde. Voir aussi : Guide de l'utilisateur Oracle AI Database Backup and Recovery pour en savoir plus sur les sauvegardes physiques et logiques
Sauvegardes de base de données complètes et partielles
Une sauvegarde de base de données complète est une sauvegarde de tous les fichiers de données de la base de données, plus le fichier de contrôle. Les sauvegardes de l'intégralité d'une base de données sont les plus fréquentes.
Une sauvegarde partielle de la base de données inclut un sous-ensemble de la base : des tablespaces individuels ou des fichiers de données. Une sauvegarde de tablespace est une sauvegarde de tous les fichiers de données d'un tablespace ou de plusieurs tablespaces. Les sauvegardes de tablespace, qu'elles soient cohérentes ou incohérentes, ne sont valides que si la base de données fonctionne en mode ARCHIVELOG car les informations de journalisation sont requises pour que le tablespace restauré soit cohérent avec le reste de la base de données.
Sauvegardes cohérentes et incohérentes
Une sauvegarde complète de la base de données est cohérente ou incohérente.
Dans une sauvegarde cohérente, tous les fichiers de données en lecture/écriture et les fichiers de contrôle ont le même SCN de point de reprise, ce qui garantit que ces fichiers contiennent toutes les modifications jusqu'à ce SCN. Ce type de sauvegarde ne nécessite pas de récupération après sa restauration.
Une sauvegarde cohérente de la base de données n'est possible qu'après un arrêt cohérent et constitue la seule option de sauvegarde valide pour une base de données fonctionnant en mode NOARCHIVELOG. D'autres options de sauvegarde nécessitent une restauration physique pour garantir la cohérence, ce qui n'est pas possible sans l'application de fichiers de journalisation archivés. Remarque : si vous restaurez une sauvegarde cohérente de l'ensemble de la base de données sans appliquer les informations de journalisation, vous perdrez toutes les transactions effectuées après la sauvegarde.
Dans une sauvegarde incohérente, les fichiers de données en lecture/écriture et les fichiers de contrôle ne sont pas garantis d'avoir le même numéro SCN de point de reprise, de sorte que les modifications peuvent être manquantes. Toutes les sauvegardes base ouverte sont nécessairement incohérentes car les fichiers de données peuvent être modifiés pendant les sauvegardes.
Les sauvegardes incohérentes offrent une disponibilité supérieure car vous n'avez pas besoin d'arrêter la base de données pour effectuer des sauvegardes qui protègent entièrement la base de données. Si la base de données est exécutée en mode ARCHIVELOG et que vous sauvegardez les fichiers de journalisation archivés et les fichiers de données, des sauvegardes incohérentes peuvent constituer la base d'une stratégie de sauvegarde et de récupération saines.
Voir aussi :
-
Guide de l'utilisateur Oracle AI Database Backup and Recovery pour en savoir plus sur les sauvegardes incohérentes
Ensembles de sauvegarde et copies d'image
La commande RMAN BACKUP génère des copies d'image ou des jeux de sauvegarde.
Les types de sauvegarde diffèrent comme suit :
-
Copie d'image
Une copie d'image est une copie bit à bit sur disque d'un fichier de données, d'un fichier de contrôle ou d'un fichier de journalisation archivé. Vous pouvez créer des copies d'image de fichiers physiques à l'aide des utilitaires du système d'exploitation ou de RMAN et utiliser l'un ou l'autre des outils pour les restaurer.
Remarque : contrairement aux copies du système d'exploitation, RMAN valide les blocs du fichier et enregistre la copie d'image dans le référentiel RMAN.
-
Ensemble de sauvegarde
RMAN peut également créer des sauvegardes dans un format propriétaire appelé ensemble de sauvegarde. Un jeu de sauvegarde contient les données d'un ou de plusieurs fichiers de données, fichiers de journalisation archivés (archived redo logs), fichiers de contrôle ou fichiers de paramètres serveur. La plus petite unité d'un jeu de sauvegarde est un fichier binaire appelé pièce de sauvegarde. Les jeux de sauvegarde sont la seule forme sous laquelle RMAN peut écrire des sauvegardes sur des périphériques séquentiels tels que des lecteurs de bande.
Les jeux de sauvegarde permettent aux périphériques à bande de diffuser en continu. Par exemple, RMAN peut combiner des blocs de disques lents, moyens et rapides en un seul jeu de sauvegarde afin que le périphérique de bande ait une entrée constante de blocs. Les copies d'image sont utiles pour le disque, car vous pouvez les mettre à jour de manière incrémentielle et les récupérer en place.
Voir aussi : Guide de l'utilisateur Oracle AI Database Backup and Recovery pour en savoir plus sur les jeux de sauvegarde et les copies d'image
Réparation de données
Bien que plusieurs problèmes puissent interrompre le fonctionnement normal d'une base de données ou affecter les opérations d'E/S, seuls certains problèmes nécessitent une intervention de l'administrateur de base de données et une réparation des données.
La réparation des données est généralement requise dans les cas suivants :
-
Echecs de média
Une défaillance physique se produit lorsqu'un problème externe à la base de données l'empêche de lire ou d'écrire dans un fichier. Les défaillances physiques, telles que les pannes de tête de disque, et l'écrasement, la suppression ou la corruption d'un fichier de base de données, sont des défaillances physiques. Les pannes de support sont moins fréquentes que les erreurs d'utilisateur ou d'application, mais une stratégie de sauvegarde et de récupération saine doit les préparer.
-
Erreurs utilisateur
Un utilisateur ou une application peut apporter des modifications indésirables à votre base de données, telles que des mises à jour erronées, la suppression du contenu d'une table ou la suppression d'objets de base de données. Une bonne stratégie de sauvegarde et de récupération vous permet de ramener la base de données à l'état souhaité, avec un impact minimal possible sur la disponibilité de la base de données et un effort minimal de l'administrateur de base de données.
En règle générale, vous disposez de plusieurs moyens de résoudre les problèmes précédents. Cette section résume certaines de ces solutions.
-
Technologie Oracle Flashback Oracle AI Database fournit un groupe de fonctionnalités appelées technologie Oracle Flashback qui prennent en charge l'affichage des états passés des données et l'enroulement des données dans le temps, sans avoir à restaurer les sauvegardes.
-
La restauration physique de bloc Block Media Recovery est une technique permettant de restaurer et de récupérer des blocs de données endommagés lorsque les fichiers de données sont en ligne.
-
Récupération de fichier de données La récupération de fichier de données répare un fichier de données ou de contrôle en cours perdu ou endommagé. Il peut également récupérer les modifications perdues lorsqu'un tablespace est passé hors ligne sans l'option
OFFLINENORMAL.
Voir aussi :
-
Guide de l'utilisateur Oracle AI Database Backup and Recovery pour les concepts de réparation de données
Technologie Oracle Flashback
Oracle AI Database fournit un groupe de fonctionnalités appelé technologie Oracle Flashback qui prennent en charge l'affichage des états passés des données et l'enroulement des données dans le temps, sans avoir à restaurer les sauvegardes.
En fonction des modifications apportées à la base de données, les fonctionnalités Flashback peuvent souvent annuler les modifications indésirables plus rapidement et avec moins d'impact sur la disponibilité que la restauration physique. Les fonctions Flashback suivantes sont les plus pertinentes pour la sauvegarde et la récupération :
-
Flashback Database
Vous pouvez rembobiner une base de données Conteneur ou pluggable jusqu'à une date précédente pour corriger les problèmes causés par des corruptions de données logiques ou des erreurs utilisateur. Flashback Database peut également être utilisé pour compléter Data Guard et pour synchroniser des bases de données clones. Flashback Database ne restaure pas et n'effectue pas de restauration physique sur les fichiers. Vous ne pouvez donc pas l'utiliser pour corriger les pannes de support, telles que les pannes de disque.
Au niveau de la base de données pluggable, vous pouvez créer un point de restauration de la base de données pluggable et rembobiner la base de données pluggable jusqu'à ce point de restauration sans affecter les autres bases de données pluggables. Au niveau de la base de données Conteneur, vous pouvez créer un point de restauration de base de données Conteneur.
-
Flashback Table
Vous pouvez rembobiner des tables jusqu'à un point donné dans le temps avec une seule instruction SQL. Vous pouvez restaurer les données de table avec les index, les déclencheurs et les contraintes associés, tandis que la base de données est en ligne, en annulant les modifications apportées aux tables indiquées uniquement. Flashback Table ne traite pas les corruptions physiques telles que les disques défectueux ou les incohérences de segment de données et d'index.
-
Flashback Drop
Vous pouvez inverser les effets d'une opération
DROP TABLE. Flashback Drop est nettement plus rapide que les mécanismes de récupération tels que la récupération jusqu'à un point dans le temps et n'entraîne pas de perte de transactions récentes ou de temps d'arrêt.
Voir aussi :
-
Guide de l'utilisateur Oracle AI Database Backup and Recovery pour en savoir plus sur les fonctionnalités Flashback
-
Référence du langage SQL Oracle AI Database et Référence de sauvegarde et de récupération d'Oracle AI Database pour en savoir plus sur l'instruction
FLASHBACK DATABASE
Restauration physique de bloc
La restauration physique de bloc est une technique permettant de restaurer et de récupérer des blocs de données endommagés lorsque les fichiers de données sont en ligne.
Une altération de bloc est un bloc de données qui n'est pas au format Oracle reconnu ou dont le contenu n'est pas cohérent en interne. Si vous détectez des corruptions de blocs et que seuls quelques blocs sont endommagés, la récupération de blocs peut être préférable à la récupération de fichiers de données.
Voir aussi :
-
Guide de l'utilisateur Oracle AI Database Backup and Recovery pour apprendre à effectuer une restauration physique de bloc
Récupération de fichiers de données
La récupération de fichiers de données répare un fichier de données ou un fichier de contrôle en cours perdu ou endommagé. Il peut également récupérer les modifications perdues lorsqu'un tablespace est passé hors ligne sans l'option OFFLINE NORMAL.
La restauration physique est nécessaire si vous restaurez une sauvegarde d'un fichier de données ou de contrôle, ou si un fichier de données est mis hors ligne sans l'option OFFLINE NORMAL. La base de données ne peut pas être ouverte si les fichiers de données en ligne nécessitent une restauration physique, et un fichier de données nécessitant une restauration physique ne peut pas être mis en ligne tant que la restauration physique n'est pas terminée.
La restauration d'une sauvegarde physique d'un fichier de données ou d'un fichier de contrôle consiste à le reconstruire et à le rendre disponible pour Oracle AI Database. Pour récupérer une sauvegarde, vous devez appliquer des fichiers de journalisation archivés (archived redo logs) afin de reconstruire les modifications perdues. RMAN peut également récupérer des fichiers de données à l'aide de sauvegardes incrémentielles, qui contiennent uniquement des blocs de données modifiés après une sauvegarde précédente.
Contrairement à la récupération d'instance, qui applique automatiquement les modifications aux fichiers en ligne, la restauration physique doit être appelée par un utilisateur et applique les fichiers de journalisation archivés aux sauvegardes restaurées. La restauration physique des fichiers de données ne peut fonctionner que sur des fichiers de données ou des fichiers de données hors ligne d'une base de données qui n'est ouverte par aucune instance de base de données.
La restauration physique des fichiers de données diffère selon que toutes les modifications sont appliquées :
-
Récupération complète
La récupération complète applique toutes les modifications de journalisation contenues dans les fichiers de journalisation archivés et en ligne à une sauvegarde. En général, vous effectuez une restauration physique complète après une défaillance physique endommage les fichiers de données ou le fichier de contrôle. Vous pouvez effectuer une récupération complète sur une base de données, un tablespace ou un fichier de données.
-
Récupération incomplète
Une récupération incomplète, également appelée récupération à un point dans le temps de la base de données, entraîne une version non actuelle de la base de données. Dans ce cas, vous n'appliquez pas toutes les informations de journalisation générées après la sauvegarde restaurée. En général, vous effectuez une récupération de base de données jusqu'à un point dans le temps pour annuler une erreur utilisateur lorsqu'Oracle Flashback Database n'est pas possible.
Pour effectuer une récupération incomplète, vous devez restaurer tous les fichiers de données à partir des sauvegardes créées avant l'heure de récupération, puis ouvrir la base de données avec l'option
RESETLOGSune fois la récupération terminée. La réinitialisation des journaux crée un flux de numéros de séquence de journal commençant par la séquence de journal 1.Remarque : si les fichiers de données en cours sont disponibles, Flashback Database est une alternative à DBPITR.
La fonctionnalité de récupération de tablespace jusqu'à un point dans le temps (TSPITR) permet de récupérer un ou plusieurs tablespaces jusqu'à un point dans le temps antérieur au reste de la base de données.
Voir aussi :
-
Guide de l'utilisateur Oracle AI Database Backup and Recovery pour les concepts de restauration physique
Zero Data Loss Recovery Appliance
Zero Data Loss Recovery Appliance à l'échelle du cloud, communément appelé Recovery Appliance, est un système intégré qui réduit considérablement la perte de données et la surcharge de sauvegarde pour toutes les bases de données Oracle de l'entreprise.
Intégré à RMAN, Recovery Appliance déploie une stratégie de sauvegarde et de récupération centralisée pour un grand nombre de bases de données, à l'aide d'un stockage et d'un matériel tolérant aux pannes à l'échelle du cloud. Recovery Appliance valide en permanence les sauvegardes à des fins de récupération.
-
Avantages de Recovery Appliance Une instance Recovery Appliance centralisée effectue la plupart des traitements de sauvegarde et de restauration de base de données, ce qui rend l'utilisation du stockage, les performances et la facilité de gestion des sauvegardes plus efficaces.
-
Environnement Recovery Appliance Une base de données protégée est une base de données client qui sauvegarde les données vers une instance Recovery Appliance.
Avantages de Recovery Appliance
Une instance Recovery Appliance centralisée effectue la plupart des traitements de sauvegarde et de restauration de base de données, ce qui rend l'utilisation du stockage, les performances et la facilité de gestion des sauvegardes plus efficaces.
Les principaux avantages sont les suivants :
-
Elimination de la perte de données
Recovery Appliance élimine les risques de perte de données rencontrés par la plupart des bases de données du centre de données, à l'aide de technologies telles que les suivantes :
-
Transfert continu des modifications de journalisation de la mémoire SGA d'une base de données protégée vers une instance Recovery Appliance, appelée transport des informations de journalisation en temps réel
-
Réplication vers des appareils de récupération distants
-
Sauvegardes sur bande automatisées effectuées par Recovery Appliance centralisé
-
Validation de bloc de base de données de bout en bout
-
-
Surcharge de sauvegarde minimale
La surcharge de sauvegarde sur les serveurs de base de données est réduite par le déchargement du travail vers Recovery Appliance, qui gère les sauvegardes de plusieurs bases de données dans un pool de disques unifié. La stratégie de sauvegarde incrémentielle permanente RMAN implique d'effectuer une sauvegarde initiale de niveau 0 sur Recovery Appliance, avec toutes les sauvegardes incrémentielles ultérieures de niveau 1. Recovery Appliance crée une sauvegarde complète virtuelle en combinant le niveau 0 avec les sauvegardes de niveau 1. Recovery Appliance compresse, déduplique et valide en permanence les sauvegardes au niveau des blocs.
-
Amélioration de la visibilité sur la protection des données de bout en bout
Cloud Control fournit une vue complète de bout en bout du cycle de vie des sauvegardes gérées par Recovery Appliance, depuis le lancement de la sauvegarde RMAN jusqu'au stockage sur disque, sur bande ou répliqué vers une instance Recovery Appliance en aval. L'installation du module d'extension Enterprise Manager pour Zero Data Loss Recovery Appliance (module d'extension Recovery Appliance) permet la surveillance et l'administration.
-
Protection à l'échelle du cloud
Recovery Appliance s'adapte pour prendre en charge des dizaines, voire des centaines de milliers de bases de données. Les principaux composants de l'architecture sont les suivants :
-
Recovery Appliance simplifie la gestion grâce à une stratégie de protection, qui définit un objectif de fenêtre de récupération appliqué pour chaque base de données associée à la stratégie. Les stratégies de protection améliorent la facilité de gestion en regroupant les bases de données en niveaux avec des caractéristiques partagées.
-
A l'aide de stratégies de protection, Recovery Appliance gère l'espace de stockage de sauvegarde en fonction de l'objectif de fenêtre de récupération pour chaque base de données protégée. Cette approche granulaire de gestion de l'espace orientée base de données élimine la nécessité de gérer l'espace au niveau du volume de stockage, comme le font les appliances tierces.
-
Recovery Appliance peut évoluer pour s'adapter à l'augmentation du trafic de sauvegarde, de l'utilisation du stockage et du nombre de bases de données en ajoutant des ressources de calcul et de stockage de manière simple et modulaire.
-
Environnement Recovery Appliance
Une base de données protégée est une base de données client qui sauvegarde les données vers une instance Recovery Appliance.
La figure suivante présente un exemple d'environnement, qui inclut six bases de données protégées et deux appliances de récupération. Chaque base de données utilise le module de sauvegarde Zero Data Loss Recovery Appliance (module de sauvegarde Recovery Appliance) pour ses sauvegardes. Ce module est une bibliothèque SBT fournie par Oracle que RMAN utilise pour transférer les sauvegardes sur le réseau vers Recovery Appliance.
Figure 4 : Environnement Recovery Appliance
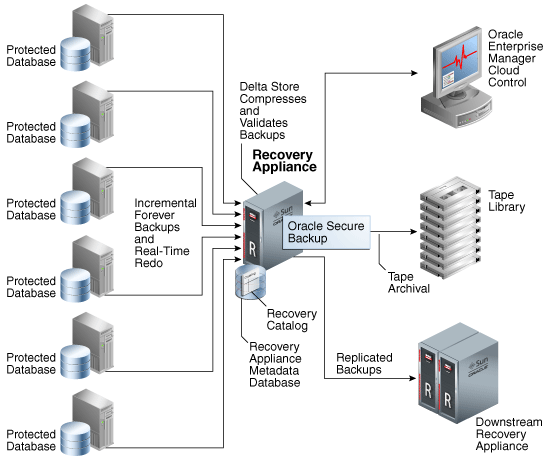
Description de l'illustration amagd_vm_025.png
La base de données de métadonnées Recovery Appliance, qui réside sur chaque instance Recovery Appliance, gère les métadonnées stockées dans le catalogue de restauration. Toutes les bases de données protégées qui envoient des sauvegardes à Recovery Appliance doivent utiliser ce catalogue de restauration. Les sauvegardes se trouvent dans l'emplacement de stockage Recovery Appliance, qui est un ensemble de groupes de disques Oracle ASM. Remarque : les bases de données peuvent utiliser Recovery Appliance comme catalogue de restauration sans également l'utiliser comme référentiel de sauvegarde.
Les administrateurs utilisent Cloud Control pour gérer et surveiller l'environnement. Cloud Control fournit une vue d'ensemble du cycle de vie des sauvegardes pour chaque base de données, que les sauvegardes résident sur disque, sur bande ou sur une autre instance Recovery Appliance.
Gestion de la mémoire
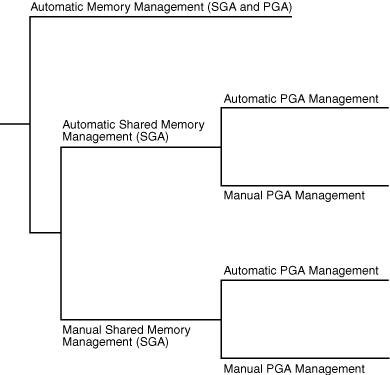
La gestion de la mémoire implique de conserver une taille optimale pour les structures mémoire d'instance Oracle au fil des modifications de la base de données. Les paramètres d'initialisation déterminent la façon dont la mémoire SGA et la mémoire PGA de l'instance sont gérées. La figure 22-5 présente une arborescence de décision pour les options de gestion de la mémoire. Les sections suivantes expliquent les options en détail.
Figure 5 : Méthodes de gestion de la mémoire
Description de l'image cncpt242.gif
-
Gestion automatique de la mémoire Dans le cadre de la gestion automatique de la mémoire, Oracle AI Database gère automatiquement la mémoire SGA et la mémoire PGA de l'instance. Cette méthode est la plus simple et est fortement recommandée par Oracle.
-
Gestion de la mémoire partagée de la mémoire SGA Vous pouvez contrôler la taille de la mémoire SGA manuellement, soit en définissant la taille de la mémoire SGA avec la gestion automatique de la mémoire partagée, soit en réglant manuellement les composants de la mémoire SGA.
-
Gestion de la mémoire de la mémoire PGA d'instance Si la gestion automatique de la mémoire n'est pas activée, Oracle AI Database utilise la gestion automatique ou manuelle de la mémoire PGA.
-
Récapitulatif des méthodes de gestion de la mémoire La gestion de la mémoire est automatique ou manuelle. Voir aussi : "Architecture de mémoire" pour en savoir plus sur la mémoire SGA et la mémoire PGA
Gestion automatique de la mémoire
Dans la gestion automatique de la mémoire, Oracle AI Database gère complètement automatiquement la mémoire SGA et la mémoire PGA d'instance. Cette méthode est la plus simple et est fortement recommandée par Oracle.
Les seuls contrôles spécifiés par l'utilisateur sont le paramètre d'initialisation de la taille de mémoire cible (MEMORY_TARGET) et le paramètre facultatif d'initialisation de la taille de mémoire maximale (MEMORY_MAX_TARGET). Oracle AI Database règle la taille de mémoire cible en redistribuant la mémoire nécessaire entre la mémoire SGA et la mémoire PGA de l'instance.
La mémoire SGA peut contenir le stockage en colonnes en mémoire (stockage en colonnes IM) ou le pool memoptimize, tous deux facultatifs. Quelle que soit la méthode de gestion de la mémoire que vous utilisez, définissez la taille de la banque de colonnes IM avec le paramètre d'initialisation INMEMORY_SIZE et celle du pool memoptimize avec le paramètre d'initialisation MEMOPTIMIZE_POOL_SIZE. La taille du magasin de colonnes IM est un pool memoptimize inclus dans la cible de mémoire, mais n'est pas géré par l'algorithme de redimensionnement automatique. Par exemple, si vous définissez MEMORY_TARGET sur 5 Go et INMEMORY_SIZE sur 1 Go, la cible de mémoire globale est 5 Go (et non 6 Go) et INMEMORY_SIZE est toujours 1 Go.
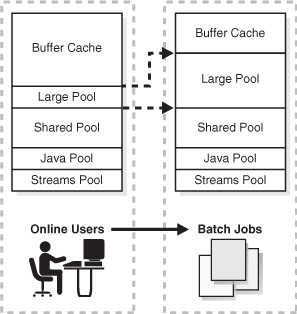
Le graphique suivant illustre une base de données qui traite parfois des travaux soumis par des utilisateurs en ligne et parfois des travaux batch. Grâce à la gestion automatique de la mémoire, la base de données ajuste automatiquement la taille du grand pool et du cache de tampons de la base de données en fonction du type de travail en cours d'exécution. Notez que le graphique ne représente pas le magasin de colonnes IM ou la zone memoptimize.
Figure 6 : Gestion automatique de la mémoire
Description de l'image cncpt256.gif
Si vous créez une base de données avec l'assistant DBCA et choisissez l'option d'installation de base, Oracle AI Database active la gestion automatique de la mémoire par défaut.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour en savoir plus sur la gestion automatique de la mémoire
Gestion de la mémoire partagée de la mémoire SGA
Vous pouvez contrôler la taille de la mémoire SGA manuellement, soit en définissant la taille de la mémoire SGA avec la gestion automatique de la mémoire partagée, soit en réglant manuellement les composants de la mémoire SGA.
Si la gestion automatique de la mémoire n'est pas activée, le système doit utiliser la gestion de la mémoire partagée de la mémoire SGA. La gestion de la mémoire partagée est possible sous l'une des formes suivantes :
-
Gestion automatique de la mémoire partagé
Ce mode vous permet d'exercer un contrôle plus direct sur la taille de la mémoire SGA et est la valeur par défaut lorsque la gestion automatique de la mémoire est désactivée. La base de données règle quant à elle la quantité totale de mémoire SGA sur la dimension cible que vous avez désigné et ajuste dynamiquement la quantité de composants SGA. Si vous utilisez un fichier de paramètres serveur, Oracle AI Database mémorise la taille des composants réglés automatiquement lors de l'arrêt d'une instance de base de données.
-
Gestion manuelle de la mémoire partagé
Dans ce mode, vous définissez la taille de plusieurs composants SGA individuels et vous réglez manuellement les différents composants SGA de manière continue. Vous disposez d'un contrôle complet sur la taille des composants de la mémoire SGA. La base de données utilise par défaut ce mode lorsque la gestion automatique de la mémoire et la gestion automatique de la mémoire partagée sont désactivées.
Remarque : lorsque la gestion automatique de la mémoire est désactivée, la base de données peut ajuster automatiquement la taille relative de la zone de mémoire partagée et du cache de tampons, en fonction de la charge globale utilisateur.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour en savoir plus sur la gestion de la mémoire partagée
-
Pour en savoir plus sur le redimensionnement automatique en mode manuel, consultez la page KB84770 de My Oracle Support :
Gestion de la mémoire PGA de l'instance
Si la gestion automatique de la mémoire n'est pas activée, Oracle AI Database utilise la gestion automatique ou manuelle de la mémoire PGA.
Les modes suivants sont possibles pour la gestion de la mémoire PGA :
-
Gestion automatique de la Mémoire PGA
Lorsque la gestion automatique de la mémoire (
MEMORY_TARGET) est désactivée et que la valeurPGA_AGGREGATE_TARGETest définie sur une valeur différente de zéro, la base de données utilise la gestion automatique de la mémoire PGA. Dans ce mode,PGA_AGGREGATE_TARGETindique une taille cible "soft" pour la mémoire PGA de l'instance. La cible est souple car elle ne s'applique qu'à des types spécifiques d'allocation de mémoire qui peuvent choisir d'utiliser de l'espace temporaire plutôt que la mémoire PGA. La base de données règle quantique à la taille de la PGA d'instance sur la cible et ajuste la taille des mémoires PGA individuelles de façon dynamique. Si vous ne définissez pas explicitement une taille cible, la base de données configure automatiquement une valeur par défaut raisonnable.Le paramètre d'initialisation
PGA_AGGREGATE_LIMITdéfinit dynamiquement une limite stricte à l'échelle de l'instance pour la mémoire PGA. Etant donné que le paramètre répond aux conditions de mémoire changeantes, vous n'avez pas besoin de définir la valeur du paramètre de manière explicite. Par défaut,PGA_AGGREGATE_LIMITest défini sur la plus grande des valeurs suivantes :-
2 Go
-
200 % de la définition des paramètres d'initialisation
PGA_AGGREGATE_TARGET -
(Valeur du paramètre d'initialisation
PROCESSES) * 3 Mo
Un processus en arrière-plan compare périodiquement la taille de la mémoire PGA à la limite définie par
PGA_AGGREGATE_LIMIT. Si la limite est atteinte ou dépassée, ce processus met fin aux appels des sessions qui utilisent la mémoire PGA la plus non réglable. Si ces sessions ne libèrent toujours pas suffisamment de mémoire, elles sont également interrompues. -
-
Gestion manuelle de la mémoire PGA
Lorsque la gestion automatique de la mémoire est désactivée et que
PGA_AGGREGATE_TARGETest défini sur0, la base de données utilise par défaut la gestion manuelle de la mémoire PGA. Dans les versions précédentes d'Oracle AI Database, l'administrateur de base de données devait indiquer manuellement la taille maximale de la zone de travail pour chaque type d'opérateur SQL (par exemple, un tri ou une jointure de hachage). Cette technique s'est avérée très difficile car la charge de travail est en constante évolution. Bien qu'Oracle AI Database prenne en charge la méthode manuelle de gestion de la mémoire PGA, Oracle recommande vivement la gestion automatique de la mémoire.
Voir aussi : Guide de réglage des performances d'Oracle AI Database pour en savoir plus sur la gestion de la mémoire PGA
Récapitulatif des méthodes de gestion de la mémoire
La gestion de la mémoire est automatique ou manuelle.
Si vous n'activez pas la gestion automatique de la mémoire, vous devez configurer séparément une méthode de gestion de la mémoire pour la mémoire SGA et une pour la mémoire PGA. Remarque : lorsque la gestion automatique de la mémoire est désactivée pour l'ensemble de l'instance de base de données, Oracle Database active par défaut la gestion automatique de la mémoire PGA.
Le tableau suivant inclut le paramètre d'initialisation INMEMORY_SIZE et le paramètre d'initialisation MEMOPTIMIZE_POOL_SIZE. Les deux zones de mémoire de contrôle sont facultatives.
Tableau 3 Méthodes de gestion de la mémoire
| Instance | Mémoire SGA | Mémoire PGA | Description | Paramètres d'initialisation |
|---|---|---|---|---|
| Automatique | n/a | n/a | La base de données règle la taille de l'instance en fonction de la taille cible d'une seule instance. | Vous définissez :
|
| n/a | Automatique | Automatique | La base de données règle automatiquement la mémoire SGA en fonction d'une cible SGA. La base de données règle automatiquement la mémoire PGA en fonction d'une cible PGA. |
Vous définissez :
La base de données configure automatiquement le paramètre d'initialisation |
| n/a | Automatique | Manuel | La base de données règle automatiquement la mémoire SGA en fonction d'une cible SGA. Vous contrôlez la mémoire PGA manuellement, en définissant la taille maximale de la zone de travail pour chaque type d'opérateur SQL. |
Vous définissez :
|
| n/a | Manuel | Automatique | Vous pouvez contrôler manuellement la mémoire SGA en définissant la taille de chaque composant. La base de données règle automatiquement la mémoire PGA en fonction d'une cible PGA. |
Vous définissez :
La base de données configure automatiquement le paramètre d'initialisation |
| n/a | Manuel | Manuel | Vous devez configurer manuellement la taille des composants de la mémoire SGA. Vous contrôlez la mémoire PGA manuellement, en définissant la taille maximale de la zone de travail pour chaque type d'opérateur SQL. |
Vous devez configurer manuellement la taille des composants de la mémoire SGA. Vous définissez :
|
Note de bas de page 1
La base de données configure automatiquement le paramètre d'initialisation PGA_AGGREGATE_LIMIT. Vous choisissez également de définir ce paramètre manuellement.
Note de bas de page 2
La base de données configure automatiquement le paramètre d'initialisation PGA_AGGREGATE_LIMIT. Vous choisissez également de définir ce paramètre manuellement.
Voir aussi : Guide de l'administrateur Oracle AI Database car la gestion automatique de la mémoire n'est pas disponible sur toutes les plates-formes
Planification des tâches et Resource Management
Oracle AI Database fournit des outils pour vous aider à gérer les ressources et à planifier des tâches afin de réduire l'impact sur les utilisateurs.
Dans une base de données avec de nombreux utilisateurs actifs, la gestion des ressources est une partie importante de l'administration de la base de données. Les sessions qui consomment trop de ressources peuvent empêcher les autres sessions d'effectuer leur travail. Un problème connexe est de savoir comment planifier des tâches afin qu'elles s'exécutent au meilleur moment. Oracle AI Database fournit des outils pour aider à résoudre ces problèmes.
-
Database Resource Manager Oracle AI Database Resource Manager (Resource Manager) fournit un contrôle affiné des ressources de base de données allouées aux comptes utilisateur, aux applications et aux services. Le gestionnaire de ressources agit principalement en tant que contrôleur d'accès, ce qui ralentit l'exécution de certains travaux afin que d'autres puissent s'exécuter rapidement.
-
Gestion de l'UC A partir d'Oracle AI Database 26ai, Oracle propose une autre méthode de gestion des ressources d'UC, qui fonctionne sur toutes les instances de base de données sur le serveur.
-
Oracle Scheduler Oracle Scheduler (le planificateur) permet aux administrateurs de base de données et aux développeurs d'applications de contrôler où et quand différentes tâches sont effectuées dans l'environnement de base de données.
Gestionnaire de ressources Database Resource Manager
Oracle AI Database Resource Manager (Resource Manager) fournit un contrôle affiné des ressources de base de données allouées aux comptes utilisateur, aux applications et aux services. Le gestionnaire de ressources agit principalement en tant que contrôleur d'accès, ce qui ralentit l'exécution de certains travaux afin que d'autres puissent s'exécuter rapidement.
Le package PL/SQL DBMS_RESOURCE_MANAGER résout de nombreux problèmes d'allocation de ressources qu'un système d'exploitation ne gère pas correctement, notamment :
-
Frais généraux excessifs
-
Planification inefficace
-
Allocation inappropriée de ressources
-
Incapacité à gérer les ressources propres à la base de données
Resource Manager permet de résoudre les problèmes précédents en donnant à la base de données plus de contrôle sur l'allocation des ressources matérielles et sur la hiérarchisation des tâches au sein de la base. Vous pouvez classer les sessions en groupes en fonction des attributs de session, puis allouer des ressources à ces groupes pour optimiser l'utilisation du matériel. Vous pouvez utiliser Resource Manager pour définir des limites d'utilisation de la mémoire des bases pluggables.
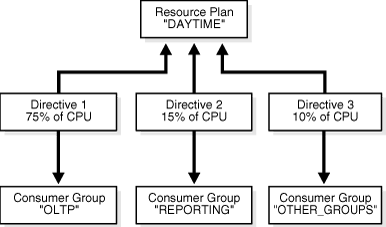
Les ressources sont allouées aux utilisateurs conformément à un plan d'allocation de ressources indiqué par l'administrateur de base de données. Le plan indique comment les ressources doivent être réparties entre les groupes de consommateurs de ressources, qui sont des sessions utilisateur regroupées par besoins en ressources. Une directive de plan de ressources associe un groupe de consommateurs de ressources à un plan et indique comment les ressources doivent être allouées au groupe. La figure 22-7 présente un plan de ressources simple pour une organisation qui exécute simultanément des applications OLTP et des applications de reporting pendant la journée. Le plan actuellement actif, DAYTIME, alloue des ressources CPU à trois groupes de consommateurs de ressources. Plus précisément, OLTP est alloué 75 % du temps CPU, REPORTS est alloué 15 % et OTHER_GROUPS reçoit les 10 % restants.
Figure 7 : Plan de ressources simple
Description de l'image admin078.gif
Un problème que Resource Manager peut résoudre est les requêtes bloquées, qui peuvent être surveillées à l'aide de SQL Monitor. Resource Manager vous permet d'indiquer des seuils pour identifier les instructions SQL bloquées et y répondre. Par exemple, vous pouvez définir des seuils pour le temps CPU, le temps écoulé, les E/S physiques ou logiques et l'utilisation de la mémoire PGA par chaque processus en avant-plan d'un groupe de consommateurs de ressources. En réponse, Resource Manager peut passer à un groupe de consommateurs de ressources de priorité inférieure, mettre fin à l'instruction SQL ou consigner la violation de seuil.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour apprendre à utiliser Resource Manager
-
Référence des types et packages PL/SQL d'Oracle AI Database pour découvrir comment utiliser le package PL/SQL
DBMS_RESOURCE_MANAGER
Gestion de l'UC
A partir d'Oracle AI Database 26ai, Oracle propose une autre méthode de gestion des ressources CPU, qui fonctionne sur toutes les instances de base de données sur le serveur.
Dans les versions précédentes, Oracle offrait une méthode de gestion des ressources CPU, qui fonctionnait au sein d'une instance de base de données. A partir d'Oracle AI Database 26ai, vous pouvez définir RESOURCE_MANAGER_CPU_SCOPE pour contrôler la portée de la gestion des ressources CPU. Ce paramètre vous permet de choisir entre les deux méthodes de contrôle.
La définition de RESOURCE_MANAGER_CPU_SCOPE sur SERVER_WIDE permet la gestion des ressources CPU inter-instances au niveau du serveur. Introduite dans Oracle AI Database 26ai, cette méthode peut être utilisée lorsque plusieurs instances de base de données partagent un serveur Linux. Il permet la gestion des ressources CPU sur toutes les instances de base de données du serveur. Avec cette méthode, Oracle configure automatiquement les groupes de contrôle Linux (cgroups) avec les limites de partage de CPU et d'utilisation de CPU souhaitées, puis place les sessions de base de données dans les cgroups appropriés.
Par défaut, RESOURCE_MANAGER_CPU_SCOPE est défini sur INSTANCE_ONLY.
Voir aussi :
- Guide de l'administrateur Oracle AI Database pour en savoir plus sur les options de gestion de l'UC.
Oracle Scheduler
Oracle Scheduler (le planificateur) permet aux administrateurs de base de données et aux développeurs d'applications de contrôler où et quand différentes tâches sont effectuées dans l'environnement de base de données.
Le planificateur fournit une fonctionnalité de planification d'entreprise complexe, que vous pouvez utiliser pour :
-
Programmer l'exécution du travail en fonction de l'heure ou des événements
-
Planifier le traitement des travaux de manière à modéliser les besoins de votre entreprise
-
Gérer et surveiller les travaux
-
Exécuter et gérer des travaux dans un environnement clusterisé
Les objets programme (programmes) contiennent des métadonnées sur la commande exécutée par le planificateur, y compris les valeurs par défaut pour les arguments. Les objets de planification (programmes) contiennent des informations sur les modèles de date et d'heure d'exécution et de récurrence. Les objets fonctionnels associent un programme à un planning. Pour définir ce qui est exécuté et quand, vous affectez des relations entre les programmes, les plannings et les travaux.
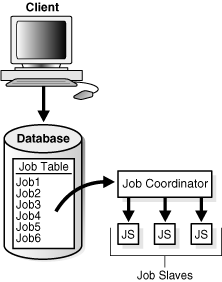
Le planificateur est implémenté en tant qu'ensemble de fonctions et de procédures dans le package PL/SQL DBMS_SCHEDULER. Vous créez et manipulez des objets du planificateur à l'aide de ce package ou d'Enterprise Manager. Les objets du planificateur étant des objets de base de données standard, vous pouvez contrôler leur accès à l'aide de privilèges système et d'objets. La figure 22-8 présente l'architecture de base du planificateur. La table de travaux est un conteneur pour tous les travaux, avec une table par base de données. Le processus en arrière-plan du coordinateur de travaux est automatiquement démarré et arrêté si nécessaire. Les processus enfant de travail sont réveillés par le coordinateur lorsqu'un travail doit être exécuté. Les processus enfant collectent les métadonnées de la table de travail et exécutent le travail.
Figure 8 : Composants du planificateur
Description de l'image admin062.gif
Voir aussi :
-
"Processus de mise en file d'attente des tâches (CJQ0 et Jnnn)"
-
Guide de l'administrateur Oracle AI Database pour en savoir plus sur le planificateur
Performances et réglage
En tant qu'administrateur de base de données (DBA), vous êtes responsable des performances de la base Oracle. En général, les problèmes de performances résultent d'un temps de réponse inacceptable, c'est-à-dire du temps nécessaire à l'exécution d'une charge globale ou d'un débit spécifique, c'est-à-dire de la quantité de travail pouvant être effectuée dans un délai donné.
Les problèmes courants sont les suivants :
-
Goulets d'étranglement d'UC
-
Structures de mémoire trop petites
-
Problèmes de capacité d'E/S
-
Instructions SQL inefficaces ou à forte charge
-
Diminution inattendue des performances après le réglage des instructions SQL
-
Problèmes de concomitance et de contention
-
Problèmes de configuration de la base de données
L'objectif général du réglage est généralement d'améliorer le temps de réponse, d'augmenter le débit ou les deux. Un objectif spécifique et mesurable peut être "Réduire le temps de réponse de l'instruction SELECT spécifiée à moins de 5 secondes". La réalisation de cet objectif dépend de facteurs qui peuvent ou non être sous le contrôle du DBA. En général, le réglage est l'effort visant à atteindre des objectifs de réglage spécifiques, mesurables et réalisables en utilisant les ressources de base de données de la manière la plus efficace possible.
La méthode des performances d'Oracle repose sur l'identification et l'élimination des goulets d'étranglement dans la base de données, ainsi que sur le développement d'instructions SQL efficaces. L'application de la méthode d'amélioration des performances Oracle implique les tâches suivantes :
-
Préparation du pré-réglage
-
Régler la base de données de façon proactive et régulière
-
Régler la base de données de manière réactive lorsque les utilisateurs signalent des problèmes de performances
-
Identifier, régler et optimiser les instructions SQL à forte charge
Cette section décrit les aspects essentiels du réglage des performances d'Oracle AI Database, notamment l'utilisation des fonctions de conseil. Les fonctions de conseil d'Oracle AI Database fournissent des conseils spécifiques vous permettant de répondre aux principaux défis inhérents à La gestion des bases de données, couvrant un large éventail de domaines, notamment la gestion de l'environnement, des performances et des annulations.
-
L'auto-surveillance Database Self-Monitoring a lieu au fur et à mesure que la base de données effectue ses opérations standard, en veillant à ce qu'elle soit consciente des problèmes qui surviennent. Oracle AI Database peut envoyer une alerte générée par le serveur pour vous informer d'un problème imminent.
-
Référentiel de charge globale automatique (AWR) Référentiel de charge globale automatique (AWR) est un référentiel de données de performances historiques qui inclut des statistiques cumulées pour le système, les sessions, les instructions SQL individuelles, les segments et les services.
-
Moniteur de base de données automatique (ADDM) Grâce aux statistiques capturées dans le référentiel AWR (Automatic Workload Repository), le moniteur ADDM diagnostique automatiquement et de manière proactive les performances de la base de données et détermine la manière dont les problèmes identifiés peuvent être résolus. Vous pouvez également exécuter ADDM manuellement.
-
Historique des sessions actives (ASH) Historique des sessions actives (ASH) échantillonne les sessions de base de données actives chaque seconde, en écrivant les données dans la mémoire et le stockage permanent. ASH fait partie intégrante de la structure d'auto-gestion de la base de données et est utile pour diagnostiquer les problèmes de performances.
-
Réglage des applications et des instructions SQL Oracle Database automatise complètement le processus de réglage SQL. Voir aussi : les manuels Oracle AI Database - Introduction au réglage des performances et Oracle AI Database SQL Tuning Guide expliquent comment implémenter la méthode de performances Oracle
Surveillance automatique des bases de données
L'autosurveillance a lieu au fur et à mesure que la base de données effectue son fonctionnement normal, en s'assurant que la base de données est consciente des problèmes qui surviennent. Oracle AI Database peut envoyer une alerte générée par le serveur pour vous informer d'un problème imminent.
Des alertes sont générées automatiquement lorsqu'un problème se produit ou lorsque les données ne correspondent pas aux valeurs attendues pour les mesures telles que les lectures physiques par seconde ou le temps de réponse SQL. Une mesure représente le taux de changement d'une statistique cumulée. Les alertes générées par le serveur peuvent être basées sur des niveaux de seuil définis par l'utilisateur ou parce qu'un événement s'est produit.
Les alertes générées par le serveur identifient non seulement le problème, mais recommandent parfois comment le problème signalé peut être résolu. Par exemple, une alerte indique que la zone de récupération rapide manque d'espace et recommande la suppression des sauvegardes obsolètes ou l'ajout d'espace disque supplémentaire.
Voir aussi : Guide de l'administrateur Oracle AI Database
Référentiel AWR
Le référentiel AWR est un référentiel de données de performances historiques qui inclut des statistiques cumulées pour le système, les sessions, les instructions SQL individuelles, les segments et les services.
Les statistiques AWR constituent la base du réglage des performances. En automatisant la collecte de statistiques de base de données pour la détection et le réglage des problèmes, le référentiel AWR sert de base à l'autogestion de la base de données.
Comme indiqué dans le graphique suivant, la base de données stocke les statistiques AWR récentes dans la mémoire SGA. Par défaut, le processus MMON collecte les statistiques toutes les heures et crée un cliché AWR. Un cliché AWR est un ensemble de statistiques de performances capturées à un moment donné. La base de données écrit des clichés dans le tablespace SYSAUX. Le référentiel AWR gère l'espace des clichés, en purgeant les clichés plus anciens conformément à une stratégie configurable de conservation des clichés.
Figure 9 : Référentiel AWR
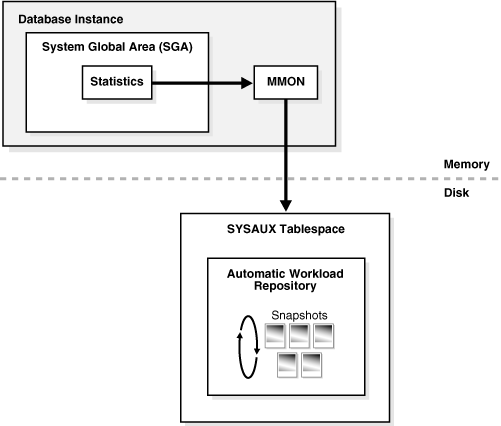
Description de l'image cncpt279.gif
Une ligne de base AWR est un ensemble de taux de statistiques généralement pris sur une période où le système fonctionne bien lors d'un pic de charge. Vous pouvez définir une paire ou une plage de clichés AWR en tant que ligne de base. L'utilisation d'un rapport AWR pour comparer les statistiques capturées pendant une période de mauvaises performances à une ligne de base permet de diagnostiquer les problèmes.
Une infrastructure de maintenance automatisée appelée AutoTask illustre comment Oracle Database utilise le référentiel AWR pour l'autogestion. En analysant les données AWR, AutoTask peut déterminer le besoin de tâches de maintenance et les programmer pour qu'elles s'exécutent dans les fenêtres de maintenance d'Oracle Scheduler. Par exemple, la collecte de statistiques pour l'optimiseur et l'exécution d'Automatic Segment Advisor sont des exemples de tâches.
Voir aussi :
-
Guide de réglage des performances d'Oracle AI Database pour en savoir plus sur le référentiel AWR
-
Guide de l'administrateur Oracle AI Database pour apprendre à gérer les tâches de maintenance automatique
Moniteur de base de données automatique (ADDM)
Grâce aux statistiques capturées dans le référentiel AWR (Automatic Workload Repository), le moniteur ADDM diagnostique automatiquement et de manière proactive les performances de la base de données et détermine la manière dont les problèmes identifiés peuvent être résolus. Vous pouvez également exécuter ADDM manuellement. Automatic Database Diagnostic Monitor (ADDM) est une fonction de conseil automatique intégrée à Oracle Database.
Le moniteur ADDM adopte une approche globale des performances du système, en utilisant le temps comme devise commune entre les composants. Le moniteur ADDM identifie les domaines d'Oracle Database qui consomment le plus de temps. Par exemple, la base de données peut passer un temps excessif à attendre des tampons de base de données gratuits. Le moniteur ADDM (Automatic Database Diagnostic Monitor) effectue une analyse descendante pour identifier la cause première des problèmes, plutôt que les symptômes, et signale l'effet du problème sur Oracle Database dans son ensemble. Un temps système minimal se produit au cours du processus.
Dans de nombreux cas, le moniteur ADDM recommande des solutions et quantifie les avantages attendus en termes de performances. Par exemple, le moniteur ADDM peut recommander des modifications de matériel, de configuration de base de données, de schéma de base de données ou d'applications. Si une recommandation est faite, le moniteur ADDM signale l'avantage temporel. L'utilisation du temps comme mesure permet de comparer des problèmes ou des recommandations.
Outre la génération de rapports sur les problèmes de performances potentiels, le moniteur ADDM documente les zones de la base de données qui ne sont pas des problèmes. Les sous-composants tels que les E/S et la mémoire qui n'ont pas d'impact significatif sur les performances de la base de données sont élagués dès le début de l'arborescence de classification. Le moniteur ADDM (Automatic Database Diagnostic Monitor) répertorie ces sous-composants afin que vous puissiez rapidement constater que l'exécution d'actions dans ces domaines présente peu d'avantages.
Voir aussi : Oracle AI Database - Introduction au réglage des performances et Guide de réglage des performances d'Oracle AI Database
Historique de la session active (ASH)
L'historique des sessions actives (ASH) échantillonne les sessions de base de données actives chaque seconde, en écrivant les données dans la mémoire et le stockage persistant. ASH fait partie intégrante de la structure d'auto-gestion de la base de données et est utile pour diagnostiquer les problèmes de performances.
Contrairement aux statistiques de niveau instance collectées par le référentiel AWR (Automatic Workload Repository), la base de données collecte les statistiques ASH au niveau de la session. Une session active est une session qui utilise la CPU et n'attend pas d'événement dans la classe d'attente inactive.
Vous pouvez utiliser Enterprise Manager ou des scripts SQL pour générer des états ASH qui collectent les statistiques de session collectées sur une durée donnée. Vous pouvez utiliser les états ASH pour :
-
Analyse des problèmes de performances de courte durée non identifiés par le moniteur ADDM (Automatic Database Diagnostic Monitor)
-
Analyse de performances globale ou ciblée par différentes dimensions ou leurs combinaisons, telles que le temps, la session, le module, l'action ou l'ID SQL
Par exemple, un utilisateur vous informe que la base de données a été lente entre 10h00 et 10h02. Toutefois, la dégradation des performances de 2 minutes représente une petite partie de l'intervalle entre les clichés AWR de 10 h 00 et 11 h 00 et n'apparaît pas dans les résultats du moniteur ADDM. Les rapports ASH peuvent aider à identifier la source du problème transitoire.
Voir aussi : Oracle AI Database - Introduction au réglage des performances et Guide de réglage des performances d'Oracle AI Database
Réglage des applications et des instructions SQL
Oracle Database automatise complètement le processus de réglage SQL.
Le moniteur ADDM identifie les instructions SQL qui consomment des ressources système exceptionnellement élevées et causent donc des problèmes de performances. En outre, le référentiel AWR capture automatiquement les instructions SQL les plus consommatrices de CPU et de mémoire partagée. L'identification des instructions SQL à forte consommation de ressources se fait automatiquement et ne nécessite aucune intervention.
-
Instruction EXPLAIN PLAN Les outils tels que l'instruction
EXPLAIN PLANvous permettent de visualiser les plans d'exécution choisis par l'optimiseur. -
Optimizer Statistics Advisor Optimizer Statistics Advisor est un logiciel de diagnostic qui analyse la façon dont vous collectez actuellement des statistiques, l'efficacité des travaux de collecte de statistiques existants et la qualité des statistiques collectées. La fonction de conseil Optimizer Statistics Advisor utilise la même structure de conseil qu'Automatic Database Diagnostic Monitor (ADDM), SQL Performance Analyzer et d'autres fonctions de conseil.
-
SQL Tuning Advisor L'interface pour le réglage automatique des instructions SQL est SQL Tuning Advisor, qui s'exécute automatiquement pendant les fenêtres de maintenance du système en tant que tâche de maintenance.
-
SQL Access Advisor : utilisez SQL Access Advisor pour vous aider à analyser les requêtes SQL et à déterminer les moyens d'optimiser les objets de schéma ou de régler les requêtes.
-
Gestion des plans SQL Gérez les plans d'exécution SQL à l'aide de la gestion des plans SQL pour effectuer uniquement des plans testés et vérifiés.
Instruction EXPLAIN PLAN
Des outils tels que l'instruction EXPLAIN PLAN permettent de visualiser les plans d'exécution choisis par l'optimiseur.
EXPLAIN PLAN affiche le plan de requête pour la requête SQL indiquée si elle a été exécutée maintenant dans la session en cours. Les autres outils sont Oracle Enterprise Manager et la commande SQL*Plus AUTOTRACE.
Voir aussi : Référence du langage SQL d'Oracle AI Database pour en savoir plus sur EXPLAIN PLAN
Fonction de conseil des statistiques de l'optimiseur
Optimizer Statistics Advisor est un logiciel de diagnostic qui analyse la façon dont vous collectez actuellement des statistiques, l'efficacité des travaux de collecte de statistiques existants et la qualité des statistiques collectées. La fonction de conseil Optimizer Statistics Advisor utilise la même structure de conseil qu'Automatic Database Diagnostic Monitor (ADDM), SQL Performance Analyzer et d'autres fonctions de conseil.
La fonction de conseil Optimizer Statistics Advisor offre les avantages suivants par rapport à l'approche traditionnelle, qui repose sur les meilleures pratiques :
-
Fournit des rapports faciles à comprendre
-
Fournit des scripts pour implémenter les corrections nécessaires sans modification du code de l'application
-
Exécute une tâche prédéfinie nommée
AUTO_STATS_ADVISOR_TASKune fois par jour dans la fenêtre de maintenance -
Fournit une API dans le package
DBMS_STATSqui vous permet de créer et d'exécuter des tâches manuellement, de stocker des résultats et des recommandations dans des vues du dictionnaire de données, de générer des rapports pour les tâches et d'implémenter des corrections si nécessaire. -
s'intègre aux outils existants tels qu'Oracle Enterprise Manager (Enterprise Manager)
La fonction de conseil Optimizer Statistics Advisor gère les règles, qui sont des normes fournies par Oracle et qui permettent à la fonction de conseil d'effectuer ses vérifications. Les règles reflètent les meilleures pratiques d'Oracle en fonction de l'ensemble de fonctionnalités actuel. Si les meilleures pratiques changent d'une version à l'autre, les règles de la fonction de conseil Optimizer Statistics Advisor changent également. De cette façon, la fonction de conseil fournit toujours les recommandations les plus récentes.
La fonction de conseil Optimizer Statistics Advisor inspecte le processus de collecte des statistiques, puis génère un état des résultats, qui constituent des violations des règles. Si la fonction de conseil émet des recommandations et propose des actions basées sur ces recommandations, vous pouvez implémenter les actions automatiquement ou générer un script PL/SQL exécutable et modifiable.
La tâche de conseil s'exécute automatiquement dans la fenêtre de maintenance, mais vous pouvez également l'exécuter à la demande.
Voir aussi :
-
Guide de réglage SQL Oracle AI Database pour en savoir plus sur la fonction de conseil Optimizer Statistics Advisor
-
Référence Oracle AI Database PL/SQL Packages and Types pour en savoir plus sur le package
DBMS_STATS
SQL Tuning Advisor
L'interface de réglage automatique des instructions SQL est SQL Tuning Advisor, qui s'exécute automatiquement pendant les fenêtres de maintenance du système en tant que tâche de maintenance.
Lors de chaque exécution automatique, la fonction de conseil sélectionne les requêtes SQL à forte consommation de ressources dans la base de données et génère des recommandations pour le réglage de ces requêtes.
Les recommandations de la fonction de conseil STA se répartissent comme suit :
-
Analyse statistique
-
Profilage SQL
-
Analyse des chemins d'accès
-
Analyse de structure SQL
Un profil SQL contient des statistiques supplémentaires propres à une instruction SQL et permet à l'optimiseur de générer un meilleur plan d'exécution. Essentiellement, un profil SQL est une méthode d'analyse d'une requête. Les analyses de chemin d'accès et de structure SQL sont utiles pour régler une application en cours de développement ou une application de production locale.
L'un des principaux avantages de la fonction de conseil STA est que les solutions proviennent de l'optimiseur plutôt que d'outils externes. Par conséquent, le réglage est effectué par le composant de base de données responsable des plans d'exécution et des performances SQL. Le processus de réglage peut prendre en compte les statistiques d'exécution passées d'une instruction SQL et personnaliser les paramètres de l'optimiseur pour cette instruction.
Voir aussi :
SQL Access Advisor
Utilisez SQL Access Advisor pour analyser les interrogations SQL et déterminer les moyens d'optimiser les objets de schéma ou de régler les interrogations.
SQL Access Advisor fournit des conseils sur l'optimisation des chemins d'accès aux données. Plus précisément, il recommande d'améliorer les performances de la base de données grâce au partitionnement, aux vues matérialisées, aux index et aux journaux de vues matérialisées.
Les objets de schéma tels que les partitions et les index sont essentiels pour optimiser les requêtes complexes et gourmandes en données. Cependant, la création et la maintenance de ces objets peuvent nécessiter beaucoup de temps et les besoins en espace peuvent être importants. SQL Access Advisor permet d'atteindre les objectifs de performances en recommandant des structures de données pour une charge globale donnée.
Vous pouvez exécuter la fonction de conseil SAA à partir d'Enterprise Manager à l'aide d'un assistant ou du package DBMS_ADVISOR. DBMS_ADVISOR est un ensemble de fonctions et de procédures d'analyse et de conseil pouvant être appelées à partir de n'importe quel programme PL/SQL.
Voir aussi : Oracle AI Database - Introduction au réglage des performances et Guide de réglage SQL Oracle AI Database
SQL Plan Management
Gérer les plans d'exécution SQL à l'aide de la gestion des plans SQL pour effectuer uniquement des plans testés et vérifiés.
Par défaut, la fonction de conseil Evolve Advisor de SQL Plan Management (SPM) s'exécute quotidiennement dans la fenêtre de maintenance programmée, classe tous les plans non acceptés et exécute des tests sur le plus grand nombre possible de plans. SPM Evolve Advisor sélectionne le plan accepté le moins coûteux dans la ligne de base du plan SQL à comparer à chaque plan non accepté. Si le plan non accepté est suffisamment performant que le plan accepté existant, la fonction de conseil l'accepte.
Le module SPM haute fréquence, lorsqu'il est activé, exécute SPM Evolve Advisor dans une tâche périodique en arrière-plan en dehors de la fenêtre de maintenance pour permettre des améliorations de performances plus rapides. La tâche à fréquence élevée identifie les instructions SQL à l'aide de ressources système importantes et vérifie si un plan d'exécution SQL précédemment utilisé fonctionne mieux. Dans ce cas, un nouveau SQL Plan Baseline est créé pour appliquer le plan d'exécution SQL précédent et réparer la régression des performances SQL.
A partir d'Oracle Database 26ai, si elle est activée, SPM en temps réel lance l'analyse des performances immédiatement si une instruction SQL utilise un nouveau plan d'exécution SQL. Si un plan d'exécution SQL précédemment vu fonctionne mieux, un nouveau SQL Plan Baseline est créé immédiatement sans s'appuyer sur une tâche en arrière-plan pour ce faire.
Voir aussi :
-
Guide de réglage SQL Oracle AI Database pour en savoir plus sur SQL Plan Management