Sujets relatifs aux administrateurs et développeurs de base de données
Le contenu du script de cette page a pour seul objectif la navigation et n'altère en rien le contenu.
Ce chapitre récapitule les rubriques de base de données courantes qui sont importantes pour les administrateurs et les développeurs de base de données, et fournit des pointeurs vers d'autres manuels, pas un compte rendu exhaustif des fonctionnalités de base de données.
-
Présentation de la sécurité des bases de données En général, la sécurité des bases de données implique l'authentification, le cryptage, le contrôle d'accès et la surveillance des utilisateurs.
-
Présentation de la haute disponibilité La disponibilité est la mesure dans laquelle une application, un service ou une fonctionnalité est disponible à la demande.
-
Présentation de Grid Computing L'architecture informatique appelée grid computing regroupe efficacement un grand nombre de serveurs et de stockage en une ressource flexible à la demande pour tous les besoins informatiques des entreprises.
-
Présentation de l'entreposage de données et de Business Intelligence Un entrepôt de données est une base de données relationnelle conçue pour la requête et l'analyse, plutôt qu'au traitement des transactions.
-
Présentation d'Oracle Information Integration À mesure qu'une entreprise évolue, il devient de plus en plus important pour elle de pouvoir partager des informations entre plusieurs bases de données et applications. Voir aussi : Concepts pour les administrateurs de base de données pour les sujets propres aux administrateurs de base de données, et Concepts pour les développeurs de base de données pour les sujets propres aux développeurs de base de données.
Présentation de la sécurité de la base de données
En général, la sécurité des bases de données implique l'authentification des utilisateurs, le cryptage, le contrôle d'accès et la surveillance.
Cette section comprend les rubriques suivantes :
-
Comptes utilisateur Chaque base de données d'Oracle possède une liste d'utilisateurs de base de données valides.
-
Authentification de base de données Dans Oracle AI Database, l'authentification de base de données est le processus par lequel un utilisateur présente des informations d'identification à la base de données, qui vérifie les informations d'identification et permet l'accès à la base de données.
-
Cryptage Oracle AI Database cryptage est le processus de transformation des données dans un format illisible à l'aide d'une clé secrète et d'un algorithme de cryptage.
-
La protection par occultation Oracle Oracle Data Redaction, qui fait partie d'Oracle Advanced Security, vous permet de masquer (de protéger) les données interrogées par des utilisateurs ou des applications à faible privilège. La protection par occultation se produit en temps réel lorsque les utilisateurs interrogent les données.
-
Contrôle d'accès Oracle AI Database fournit de nombreuses techniques pour contrôler l'accès aux données. Cette section résume certaines de ces techniques.
-
Surveillance de l'accès aux données Oracle AI Database fournit plusieurs outils et techniques pour surveiller l'activité des utilisateurs. L'audit est le principal mécanisme de surveillance de l'accès aux données.
Comptes utilisateur
Chaque base de données Oracle possède une liste d'utilisateurs de base de données valides.
La base de données contient plusieurs comptes par défaut, dont le compte d'administration par défaut SYSTEM. Vous pouvez créer des comptes utilisateur selon vos besoins. Vous pouvez également configurer des utilisateurs d'application pour accéder aux bases de données Oracle.
Pour accéder à une base de données, un utilisateur doit fournir un nom utilisateur et des informations d'identification d'authentification valides. Les informations d'identification peuvent être un mot de passe, un ticket Kerberos ou un certificat d'infrastructure de clé publique (PKI). Vous pouvez configurer la sécurité de la base de données pour verrouiller les comptes en fonction des échecs de connexion.
En général, le contrôle d'accès à la base de données implique de restreindre l'accès aux données et les activités de la base de données. Par exemple, vous pouvez empêcher les utilisateurs d'interroger des tables spécifiques ou d'exécuter des instructions de base de données spécifiques.
-
Privilèges Un privilège utilisateur est le droit d'exécuter des instructions SQL spécifiques.
-
Rôles Un rôle est un groupe nommé de privilèges associés qu'un utilisateur peut accorder à d'autres utilisateurs ou rôles. Un rôle permet de gérer les privilèges d'une application de base de données ou d'un groupe d'utilisateurs.
-
Analyse des privilèges Le mécanisme d'analyse des privilèges capture l'utilisation des privilèges pour une base de données en fonction d'une condition spécifiée.
-
Profils utilisateur Dans le contexte des ressources système, un profil utilisateur est un ensemble nommé de limites de ressources et de paramètres de mot de passe qui limitent l'utilisation de la base de données et les ressources d'instance de base de données pour un utilisateur.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour en savoir plus sur les comptes utilisateur d'administration
-
Guide de l'administrateur et du développeur Oracle AI Database Real Application Security pour apprendre à configurer des utilisateurs d'application
Privilèges
Un privilège utilisateur est le droit d'exécuter des instructions SQL spécifiques.
Les privilèges appartiennent aux catégories suivantes :
-
Privilège système
Il s'agit du droit d'exécuter une action particulière dans la base de données ou d'effectuer une action sur les objets d'un type spécifique. Par exemple,
CREATE USERetCREATE SESSIONsont des privilèges système. -
Privilège de schéma
Il s'agit du droit d'utiliser les privilèges système sur tous les objets d'un schéma spécifique. Ce privilège s'applique à tous les objets actuels et futurs du schéma.
-
Privilège d'objet
Il s'agit du droit d'effectuer une action spécifique sur un objet, par exemple, interroger la table
employees. Les types de privilège sont définis par la base de données.
Les privilèges sont accordés aux utilisateurs à la discrétion des autres utilisateurs. Les administrateurs doivent accorder des privilèges aux utilisateurs afin qu'ils puissent effectuer les tâches requises pour leurs travaux. Les bonnes pratiques de sécurité consistent à accorder un privilège uniquement à un utilisateur qui a besoin de ce privilège pour accomplir le travail nécessaire.
Voir aussi :
- Référence Oracle AI Database pour en savoir plus sur la vue
SESSION_PRIVS
Rôles
Un rôle est un groupe nommé de privilèges associés qu'un utilisateur peut accorder à d'autres utilisateurs ou rôles. Un rôle permet de gérer les privilèges d'une application de base de données ou d'un groupe d'utilisateurs. La figure 20-1 illustre une utilisation commune des rôles. Les rôles PAY_CLERK, MANAGER et REC_CLERK sont affectés à différents utilisateurs. Le rôle d'application ACCTS_PAY, qui inclut le privilège d'exécution de l'application ACCTS_PAY, est affecté aux utilisateurs dotés des rôles PAY_CLERK et MANAGER. Le rôle d'application ACCTS_REC, qui inclut le privilège d'exécution de l'application ACCTS_REC, est affecté aux utilisateurs dotés des rôles REC_CLERK et MANAGER.
Figure 1 : Utilisations communes des rôles
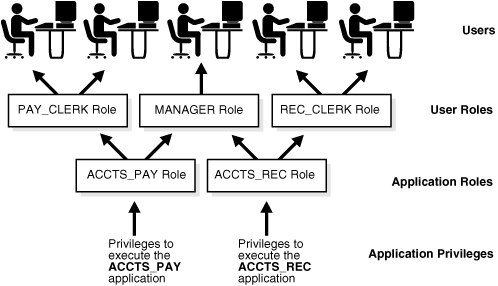
Description de l'image cncpt082.gif
Voir aussi :
-
Guide de sécurité Oracle AI Database pour en savoir plus sur l'utilisation des rôles pour la sécurité
-
Guide de l'administrateur Oracle AI Database pour apprendre à administrer des rôles
Analyse de privilège
Le mécanisme d'analyse des privilèges capture l'utilisation des privilèges pour une base de données en fonction d'une condition spécifiée.
Vous pouvez ainsi capturer les privilèges requis pour exécuter un module applicatif ou exécuter des instructions SQL spécifiques. Par exemple, vous pouvez rechercher les privilèges qu'un utilisateur a exercés au cours d'une session de base de données spécifique.
Dans une base de données de production, les relations entre les privilèges et les rôles, les rôles et les rôles, et les rôles et les utilisateurs peuvent être complexes. L'analyse des privilèges permet d'identifier les privilèges qui sont accordés inutilement dans un système complexe. En fonction de l'analyse des résultats capturés, vous pouvez supprimer les autorisations inutiles ou reconfigurer les autorisations de privilège pour sécuriser les bases de données.
Voir aussi : Guide de sécurité Oracle AI Database pour en savoir plus sur l'analyse des privilèges.
Profils utilisateur
Dans le contexte des ressources système, un profil utilisateur est un ensemble nommé de limites de ressources et de paramètres de mot de passe qui limitent l'utilisation de la base de données et les ressources d'instance de base de données pour un utilisateur.
Les profils peuvent limiter le nombre de sessions simultanées pour un utilisateur, le temps de traitement de la CPU disponible pour chaque session et la quantité d'E/S logiques disponibles. Par exemple, le profil clerk peut limiter un utilisateur aux ressources système requises pour les tâches administratives. Remarque : il est préférable d'utiliser Database Resource Manager pour limiter les ressources et d'utiliser des profils pour gérer les mots de passe.
Les profils constituent un point de référence unique pour les utilisateurs qui partagent un ensemble d'attributs. Vous pouvez affecter un profil à un ensemble d'utilisateurs et un profil par défaut à tous les autres. Chaque utilisateur a au plus un profil affecté à un moment donné.
Voir aussi :
-
Guide de sécurité Oracle AI Database pour découvrir comment gérer des ressources à l'aide de profils
-
Référence du langage SQL Oracle AI Database pour la syntaxe et la sémantique
CREATE PROFILE
Authentification de base de données
Dans Oracle AI Database, l'authentification de base de données est le processus par lequel un utilisateur présente des informations d'identification à la base de données, qui vérifie les informations d'identification et permet l'accès à la base de données.
La validation de l'identité établit une relation de confiance pour d'autres interactions. L'authentification permet également la responsabilisation en permettant de lier l'accès et les actions à des identités spécifiques.
Oracle AI Database fournit différentes méthodes d'authentification, notamment les suivantes :
-
Authentification par la base de données
La base de données Oracle peut authentifier les utilisateurs à l'aide d'un mot de passe, d'un ticket Kerberos ou d'un certificat PKI. Oracle prend également en charge les périphériques conformes à RADIUS pour d'autres formes d'authentification, y compris la biométrie. Le type d'authentification doit être indiqué lorsqu'un utilisateur est créé dans la base de données Oracle.
-
Authentification par le système d'exploitation
Certains systèmes d'exploitation permettent à Oracle AI Database d'utiliser les informations qu'ils conservent pour authentifier les utilisateurs. Après avoir été authentifié par le système d'exploitation, les utilisateurs peuvent se connecter à une base de données sans indiquer de nom utilisateur ni de mot de passe.
Les comptes utilisateur de base de données non administratifs ne doivent pas effectuer d'opérations telles que l'arrêt ou le démarrage de la base de données. Ces opérations nécessitent des privilèges SYSDBA, SYSOPER, SYSBACKUP ou SYSDG.
Voir aussi :
-
Guide de sécurité Oracle AI Database pour en savoir plus sur les méthodes d'authentification
-
Guide de l'administrateur Oracle AI Database pour en savoir plus sur l'authentification administrative
Chiffrement
Oracle AI Database encryption est le processus de transformation des données dans un format illisible à l'aide d'une clé secrète et d'un algorithme de cryptage.
Le cryptage est souvent utilisé pour répondre aux exigences de conformité réglementaire, telles que celles associées à la norme PCI-DSS (Payment Card Industry Data Security Standard) ou aux lois sur les notifications de violation. Ces données confidentielles, par exemple, doivent être cryptées pour les numéros des cartes de crédit, de sécurité sociale ou des dossiers médicaux.
-
Chiffrement du réseau Le cryptage des données au fur et à mesure qu'elles transitent dans le réseau entre un client et un serveur est appelé chiffrement du réseau.
-
Cryptage des données transparent Oracle Advanced Security Cryptage des données transparent permet de crypter les colonnes d'une table ou d'un tablespace.
Cryptage réseau
Le cryptage des données au fur et à mesure qu'elles circulent dans le réseau entre un client et un serveur est appelé chiffrement réseau.
Un intrus peut utiliser un renifleur de paquets pour capturer des informations lorsqu'il se déplace sur le réseau, puis l'envoyer vers un fichier dans un mais malveillant. Ce type d'activité peut être évité grâce au cryptage des données sur le réseau.
Cryptage transparent des données
Oracle Advanced Security Transparent Data Encryption permet de crypter les colonnes d'une table ou d'un tablespace.
Lorsque l'utilisateur insère des données dans une colonne cryptée, la base de données les crypte automatiquement. Lorsque l'utilisateur sélectionne cette colonne, les données sont décryptées. Cette forme de cryptage est transparente, offre des performances élevées et est facile à implémenter.
Transparent Data Encryption inclut des algorithmes de cryptage standard tels que la norme AES (Advanced Encryption Standard) et la gestion des clés intégrée.
Voir aussi : Guide de cryptage transparent des données Oracle AI Database
Protection par occultation Oracle
La protection par occultation Oracle, qui fait partie d'Oracle Advanced Security, vous permet de masquer (redact) les données interrogées par des utilisateurs ou des applications à faible privilège. La protection par occultation se produit en temps réel lorsque les utilisateurs interrogent les données.
La protection par occultation prend en charge les types de fonction de protection par occultation suivants :
-
Protection par occultation complète des données
Dans ce cas, la base de données occulte l'intégralité du contenu des colonnes indiquées dans une table ou une vue. Par exemple, une colonne
VARCHAR2pour un nom de famille affiche un espace unique. -
Protection partielle des données par occultations
Dans ce cas, la base de données occulte des parties de la sortie affichée. Par exemple, une application peut présenter un numéro de carte de crédit se terminant par
1234sous la formexxxx-xxxx-xxxx-1234. Vous pouvez utiliser des expressions régulières pour la protection par occultation complète et partielle. Une expression régulière peut occulter des données selon un modèle de recherche. Par exemple, vous pouvez utiliser des expressions régulières pour occulter des numéros de téléphone ou des adresses électroniques spécifiques. -
Protection par occultation aléatoire des données
Dans ce cas, la base de données affiche les données sous forme de valeurs générées de manière aléatoire, en fonction du type de données de la colonne. Par exemple, le nombre
1234567peut apparaître sous la forme83933895.
La protection par occultation n'est pas une solution de sécurité complète. Par exemple, il n'empêche pas les utilisateurs connectés directement et privilégiés d'effectuer des attaques d'inférence sur les données occultées. Ces attaques identifient les colonnes occultées et, par processus d'élimination, tentent de revenir aux données réelles en répétant des requêtes SQL qui devinent les valeurs stockées. Pour détecter et empêcher l'inférence et les autres attaques des utilisateurs privilégiés, Oracle recommande d'associer la protection par occultation Oracle à des produits de sécurité de base de données associés tels qu'Oracle Audit Vault and Database Firewall et Oracle Database Vault.
La protection par occultation fonctionne comme suit :
-
Utilisez le package
DBMS_REDACTpour créer une stratégie de protection par occultation pour une table spécifiée. -
Dans la stratégie, indiquez une fonction de protection par occultation prédéfinie.
-
Le fait que la base de données affiche la valeur réelle ou occultée d'une colonne dépend de la stratégie. Si les données sont occultées, l'occultation se produit dans la liste de sélection de niveau supérieur immédiatement avant d'être affichée pour l'utilisateur.
L'exemple suivant ajoute une stratégie de protection par occultation complète pour occulter la colonne d'ID d'employé (employee_id) de la table hr.employees :
BEGIN
 DBMS_REDACT.ADD_POLICY(
   object_schema    => 'hr'
,  object_name      => 'employees'
,  column_name      => 'employee_id'
,  policy_name      => 'mask_emp_ids'
,  function_type    => DBMS_REDACT.FULL
,  expression       => '1=1'
);
END;
/
Dans l'exemple précédent, le paramètre d'expression, qui prend la valeur true, applique la protection par occultation aux utilisateurs qui ne disposent pas du privilège EXEMPT REDACTION POLICY.
Voir aussi :
-
Guide de protection par occultation Oracle AI Database pour en savoir plus sur la protection par occultation
-
Référence des types et packages PL/SQL d'Oracle AI Database pour en savoir plus sur
DBMS_REDACT
Contrôle d'accès
Oracle AI Database fournit de nombreuses techniques pour contrôler l'accès aux données. Cette section résume certaines de ces techniques.
-
Oracle Database Vault restreint l'accès des utilisateurs privilégiés aux données d'application.
-
Oracle Virtual Private Database (VPD) Oracle Virtual Private Database (VPD) vous permet d'appliquer la sécurité au niveau ligne et colonne.
-
Oracle Label Security (OLS) Oracle Label Security (OLS) vous permet d'affecter une classification des données et de contrôler l'accès à l'aide de étiquettes de sécurité. Vous pouvez affecter un libellé aux données ou aux utilisateurs.
Oracle Database Vault
Oracle Database Vault restreint l'accès des utilisateurs privilégiés aux données d'application.
A partir d'Oracle Database 12c, Oracle Database Vault étend la structure de données d'audit de base de données standard. En outre, si vous effectuez une migration vers l'audit unifié, la base de données écrit les enregistrements d'audit dans la trace d'audit unifié dans Oracle Secure Files, qui centralise les enregistrements d'audit pour Oracle AI Database.
Vous pouvez utiliser Oracle Database Vault pour contrôler quand, où et comment les bases de données, les données et les applications sont accessibles. Ainsi, vous pouvez résoudre des problèmes de sécurité courants tels que la protection contre les menaces internes, le respect des exigences réglementaires et l'application de la séparation des tâches.
Pour rendre l'administrateur Oracle Database Vault responsable, la base de données effectue un audit obligatoire des modifications apportées à la configuration des métadonnées Oracle Database Vault. Ces modifications incluent la création, la modification et la suppression de toute application liée à Oracle Database Vault, l'octroi et la révocation de rôles protégés, ainsi que les autorisations pour des composants tels qu'Oracle Data Pump et le planificateur de travaux.
Voir aussi :
-
Guide de sécurité Oracle AI Database pour en savoir plus sur l'intégration d'Oracle Database Vault Audit avec Oracle Database Native Audit
Base de données privée virtuelle (VPD)
Oracle Virtual Private Database (VPD) vous permet d'appliquer la sécurité au niveau des lignes et des colonnes.
Une stratégie de sécurité établit des méthodes pour protéger une base de données contre la destruction accidentelle ou malveillante de données ou les dommages causés à l'infrastructure de base de données.
VPD est utile lorsque les protections de sécurité telles que les privilèges et les rôles ne sont pas suffisamment détaillées. Par exemple, vous pouvez autoriser tous les utilisateurs à accéder à la table employees, mais créer des stratégies de sécurité pour restreindre l'accès aux employés du même service que l'utilisateur.
Essentiellement, la base de données ajoute une clause WHERE dynamique à une instruction SQL exécutée sur la table, la vue ou le synonyme auquel une stratégie de sécurité Oracle VPD a été appliquée. La clause WHERE permet uniquement aux utilisateurs dont les informations d'identification passent la stratégie de sécurité d'accéder aux données protégées.
Voir aussi : Guide de sécurité d'Oracle AI Database
Oracle Label Security (OLS)
Oracle Label Security (OLS) vous permet d'affecter la classification des données et de contrôler l'accès à l'aide de étiquettes de sécurité. Vous pouvez affecter un libellé aux données ou aux utilisateurs.
Lorsqu'il est affecté à des données, le libellé peut être associé en tant que colonne masquée aux tables, ce qui garantit la transparence du code SQL. Par exemple, vous pouvez étiqueter les lignes contenant des données hautement sensibles comme HIGHLY SENSITIVE et étiqueter les lignes moins sensibles comme SENSITIVE. Lorsqu'un utilisateur tente d'accéder aux données, OLS compare le libellé utilisateur au libellé de données et détermine s'il doit accorder l'accès. Contrairement à VPD, OLS fournit une stratégie de sécurité prête à l'emploi et un référentiel de métadonnées pour la définition et le stockage des étiquettes.
Si l'audit unifié est activé, la base de données fournit une structure basée sur une stratégie pour configurer et gérer les options d'audit. Vous pouvez regrouper des options d'audit pour différents types d'opération, y compris les opérations OLS, et les enregistrer en tant que stratégie d'audit. Vous pouvez ensuite activer ou désactiver la stratégie pour appliquer les options d'audit sous-jacentes.
Chaque fois qu'une stratégie OLS est créée, la base de données ajoute une colonne de libellé pour la stratégie à la table de trace d'audit de la base de données. L'audit OLS peut écrire des enregistrements d'audit, y compris des enregistrements pour les opérations d'administrateur OLS, dans la piste d'audit unifiée.
Surveillance de l'accès aux données
Oracle AI Database fournit plusieurs outils et techniques pour surveiller l'activité des utilisateurs. L'audit est le principal mécanisme de surveillance de l'accès aux données.
-
L'audit Database Auditing est la surveillance et l'enregistrement des actions d'une base de donnée utilisateur sélectionnées.
-
Les enregistrements d'audit de piste d'audit unifiée sont essentiels pour détecter et identifier les accès non autorisés aux données.
-
Prise en charge de l'audit Enterprise Manager Oracle Enterprise Manager (Enterprise Manager) permet d'effectuer la plupart des tâches liées à l'audit.
-
Oracle Audit Vault and Database Firewall Oracle Audit Vault and Database Firewall (Oracle AVDF) fournit une première ligne de défense pour les bases de données et consolide les données d'audit des bases de données, des systèmes d'exploitation et des répertoires.
Audit de base de données
Il s'agit de surveiller et d'enregistrer les actions d'utilisateur de base de donnée sélectionnées.
Vous pouvez configurer une stratégie d'audit unifié pour auditer les éléments suivants :
-
Instructions SQL, privilèges système, objets de schéma et rôles (en tant que groupe de privilèges système qui leur sont directement accordés)
-
Utilisateurs administratifs et non administratifs
-
Valeurs de contexte d'application
Un contexte d'application est une paire nom-valeur d'attribut dans un espace de noms spécifié. Les applications définissent différents contextes avant d'exécuter des actions sur la base de données. Par exemple, les applications stockent des informations telles que le nom du module et l'ID client qui indiquent le statut d'un événement d'application. Les applications peuvent configurer des contextes de sorte que les informations les concernant soient ajoutées aux enregistrements d'audit.
-
Création de stratégies pour les événements de chemin direct Real Application Security, Oracle Database Vault, Oracle Label Security, Oracle Data Pump et Oracle SQL*Loader
La trace d'audit unifié peut capturer les événements Recovery Manager, que vous pouvez interroger dans la vue du dictionnaire de données UNIFIED_AUDIT_TRAIL. Vous ne créez pas de stratégies d'audit unifié pour les événements Recovery Manager.
Vous pouvez également utiliser l'audit détaillé pour auditer des colonnes de table spécifiques et associer des gestionnaires d'événements lors de la création d'une stratégie. Pour l'audit unifié et détaillé, vous pouvez créer des stratégies qui testent les conditions qui capturent des actions de base de données spécifiques sur une table ou des moments où des activités se produisent. Par exemple, vous pouvez auditer une table à laquelle vous avez accédé après 9h00.
Les raisons de l'audit sont les suivantes :
-
Assurer la responsabilité future des actions en cours
-
Empêcher les utilisateurs (ou d'autres, comme les intrus) d'effectuer des actions inappropriées en fonction de leur responsabilité
-
Examiner, surveiller et enregistrer les activités suspectes
-
Répondre aux exigences d'audit pour des raisons de conformité
A partir d'Oracle Database 12c, lorsque vous utilisez l'audit unifié, l'audit de base de données est activé par défaut. Vous contrôlez l'audit de la base de données en activant les stratégies d'audit. Toutefois, pour pouvoir utiliser l'audit unifié, vous devez y migrer vos bases de données.
-
Stratégies d'audit Vous pouvez utiliser une seule instruction SQL pour créer une stratégie d'audit unifié nommée qui spécifie un ensemble d'options d'audit. Ces options peuvent indiquer les privilèges système, les actions ou les rôles à auditer dans la base de données.
-
Rôles d'administrateur d'audit Pour effectuer l'audit, vous devez disposer des privilèges système appropriés.
Voir aussi :
-
Guide de sécurité Oracle AI Database pour plus d'informations sur l'audit unifié
-
Guide de mise à niveau d'Oracle AI Database pour découvrir comment migrer vers l'audit unifié
Stratégies d'audit
Vous pouvez utiliser une seule instruction SQL pour créer une stratégie d'audit unifié nommée qui spécifie un ensemble d'options d'audit. Ces options peuvent spécifier les privilèges système, les actions ou les rôles à auditer dans la base de données.
Dans une stratégie d'audit, vous pouvez éventuellement définir une condition qui peut être évaluée pour chaque instruction, une fois pour une session ou une fois pour l'instance de base de données. L'audit d'un événement est soumis au résultat de l'évaluation d'une condition pour les stratégies d'audit applicables. Si la condition renvoie la valeur true, la base de données génère l'enregistrement d'audit.
L'exemple suivant crée une stratégie qui audite les activités de la table hr.employees, sauf si un utilisateur se connecte à partir des terminaux sécurisés term1 et term2 :
CREATE AUDIT POLICY EmployeesTableAudit
  ACTIONS update ON hr.employees, delete ON hr.employees
  WHEN SYS_CONTEXT ("userenv", "hostname") NOT IN
                   ("term1","term2") EVALUATE PER SESSION;
L'instruction suivante active la stratégie pour les utilisateurs hr et hrvp :
AUDIT POLICY EmployeesTableAudit BY hr, hrvp;Vous pouvez appliquer des stratégies d'audit unifié à n'importe quel utilisateur de base de données, y compris les administrateurs tels que SYSDBA, SYSOPER, etc. Toutefois, les stratégies d'audit ne peuvent être lues qu'une fois la base de données ouverte à l'aide de l'instruction ALTER DATABASE OPEN. Par conséquent, les actions de niveau supérieur des administrateurs sont toujours auditées jusqu'à l'ouverture de la base de données. Une fois la base de données ouverte, la configuration de la stratégie d'audit est active.
Lorsque l'audit unifié est activé, la base de données audite automatiquement les modifications apportées aux paramètres d'audit. La base de données audite également le démarrage et l'arrêt des instances de base de données.
Voir aussi : Guide de sécurité Oracle AI Database pour apprendre à gérer les stratégies d'audit
Rôles d'administrateur d'audit
Pour effectuer l'audit, vous devez disposer des privilèges système appropriés.
Oracle AI Database fournit les rôles d'administrateur d'audit fournis par le système suivants :
-
AUDIT_ADMINLe rôle
AUDIT_ADMINgère les paramètres d'audit de la base de données. Les utilisateurs dotés de ce rôle disposent des privilèges suivants :-
Créer, modifier et supprimer des stratégies d'audit, y compris des stratégies d'audit détaillées
-
Activer ou désactiver les stratégies d'audit pour chaque besoin métier
-
Afficher les enregistrements d'audit
-
Gérer et nettoyer la piste d'audit
-
-
AUDIT_VIEWERLe rôle
AUDIT_VIEWERest destiné aux utilisateurs qui ont uniquement besoin d'afficher et d'analyser des données. Les utilisateurs dotés de ce rôle sont uniquement autorisés à visualiser le contenu de la piste d'audit.
Voir aussi : Guide de sécurité Oracle AI Database pour en savoir plus sur l'audit
Trace d'audit unifiée
Les enregistrements d'audit sont essentiels pour détecter et identifier les accès non autorisés aux données.
Oracle AI Database peut configurer l'audit pour des événements spécifiés. Si l'événement se produit pendant une session utilisateur, la base de données génère un enregistrement d'audit.
Une piste d'audit est un emplacement qui stocke les enregistrements d'audit. La piste d'audit unifiée, nouvelle dans Oracle Database 12c, fournit un stockage unifié pour les enregistrements d'audit de tous les types d'audit. Vous devez migrer manuellement les traces d'audit traditionnelles des versions précédentes vers l'audit unifié.
L'audit inclut l'audit standard et détaillé, ainsi que l'audit des événements suivants, notamment l'exécution de ces événements par les administrateurs :
-
Oracle Data Pump
-
Chargements de chemin direct SQL*Loader
-
Oracle Database Vault
-
Oracle Label Security
-
Gestionnaire de récupération
-
Real Application Security
La trace d'audit unifié est en lecture seule et stockée dans le schéma AUDSYS. Par défaut, le tablespace SYSAUX stocke les enregistrements d'audit de toutes les sources. Vous pouvez fournir un nouveau tablespace en utilisant le package DBMS_AUDIT_MGMT.
La vue UNIFIED_AUDIT_TRAIL extrait les enregistrements d'audit de la piste d'audit et les affiche sous forme de tableau. La colonne APPLICATION_CONTEXTS stocke les valeurs des attributs de contexte d'application configurés. Vous pouvez utiliser l'instruction AUDIT pour inclure les valeurs des attributs de contexte dans les enregistrements d'audit. Par exemple, l'instruction suivante capture les attributs MODULE et CLIENT_INFO de l'espace de noms userenv :
AUDIT CONTEXT NAMESPACE userenv ATTRIBUTES MODULE, CLIENT_INFO BY hr;Selon le composant audité (tel qu'Oracle Database Vault), des vues supplémentaires liées à la trace d'audit unifié sont disponibles.
Voir aussi :
-
Guide de sécurité Oracle AI Database pour en savoir plus sur la trace d'audit unifié
-
Guide de mise à niveau d'Oracle AI Database pour apprendre à migrer la base de données afin d'utiliser l'audit unifié
-
Référence Oracle AI Database pour en savoir plus sur la vue
UNIFIED_AUDIT_TRAIL
Prise en charge de l'audit Enterprise Manager
Oracle Enterprise Manager (Enterprise Manager) permet d'effectuer la plupart des tâches liées à l'audit.
Les tâches comprennent les éléments suivants :
-
Activer et désactiver l'audit
-
Administrer les objets lors de l'audit des instructions et des objets de schéma
Par exemple, Enterprise Manager vous permet d'afficher et de rechercher les propriétés des instructions, privilèges et objets audités en cours.
-
Afficher et configurer les paramètres d'initialisation liés à l'audit
-
Afficher les rapports d'audit
Voir aussi : Aide en ligne d'Enterprise Manager
Oracle Audit Vault and Database Firewall
Oracle Audit Vault and Database Firewall (Oracle AVDF) fournit une première ligne de défense pour les bases de données et consolide les données d'audit des bases de données, des systèmes d'exploitation et des répertoires.
Un moteur basé sur la grammaire SQL surveille et bloque le trafic SQL non autorisé avant d'atteindre la base de données. Pour les rapports de conformité et les alertes, Oracle AVDF combine les données d'activité de la base de données du réseau avec des données d'audit détaillées. Vous pouvez personnaliser les contrôles d'audit et de surveillance pour répondre aux exigences de sécurité de l'entreprise.
Voir aussi : Guide de sécurité Oracle AI Database pour en savoir plus sur les ressources de sécurité supplémentaires telles qu'Oracle Audit Vault and Database Firewall
Présentation de la haute disponibilité
La disponibilité est la mesure dans laquelle une application, un service ou une fonctionnalité est disponible à la demande.
Par exemple, une base de données OLTP utilisée par un libraire en ligne est disponible dans la mesure où elle est accessible par les clients effectuant des achats. La fiabilité, la capacité de récupération, la détection rapide des erreurs et les opérations continues sont les principales caractéristiques de la haute disponibilité.
L'importance de la haute disponibilité dans un environnement de base de données est liée au coût des temps d'arrêt, c'est-à-dire au temps pendant lequel une ressource n'est pas disponible. Le temps d'arrêt peut être classé comme planifié ou non planifié. Lors de la conception d'un environnement hautement disponible, le principal défi consiste à examiner toutes les causes possibles de temps d'arrêt et à élaborer un plan pour y faire face.
-
Haute disponibilité et temps d'arrêt imprévus Oracle AI Database fournit des solutions de haute disponibilité pour prévenir, tolérer et réduire les temps d'arrêt pour tous les types de pannes imprévues.
-
Haute disponibilité et temps d'arrêt planifiés Les temps d'arrêt planifiés peuvent tout aussi perturber les opérations, en particulier dans les entreprises mondiales qui prennent en charge les utilisateurs dans plusieurs fuseaux horaires. Dans ce cas, il est important de concevoir un système pour minimiser les interruptions planifiées telles que les opérations de routine, la maintenance périodique et les nouveaux déploiements.
Haute disponibilité et temps d'arrêt imprévus
Oracle AI Database fournit des solutions de haute disponibilité pour prévenir, tolérer et réduire les temps d'arrêt pour tous les types d'échecs non planifiés.
Les temps d'arrêt non planifiés peuvent être classés en fonction de leurs causes.
-
Défaillances de site Une défaillance de site se produit lorsqu'un événement entraîne l'arrêt du traitement de tout ou partie d'une application ou un ralentissement jusqu'à un niveau de service inutilisable.
-
Echecs de l'ordinateur Une panne de l'ordinateur se produit lorsque le système exécutant la base de données devient indisponible car il s'est arrêté ou n'est plus accessible.
-
Pannes de stockage Une panne de stockage se produit lorsque le stockage contenant tout ou partie du contenu de la base de données devient indisponible car il est arrêté ou n'est plus accessible. La défaillance d'une unité de disque ou d'une baie de stockage est un exemple de panne de stockage.
-
Corruption des données Un corruption des données survient lorsqu'un composant matériel, logiciel ou réseau entraîne une lecture ou une écriture des données altérées.
-
Erreurs humaines Une incident d'erreur humaine se produit lorsque des actions involontaires ou malveillantes sont validées et que les données de la base de données deviennent logiquement corrompues ou inutilisables. L'impact d'une panne d'erreur humaine sur le niveau de service peut varier considérablement en fonction de la quantité et de la nature critique des données concernées.
Echecs du site
Une défaillance du site se produit lorsqu'un événement entraîne l'arrêt du traitement de tout ou partie d'une application ou un ralentissement jusqu'à un niveau de service inutilisable.
Une panne de site peut affecter tous les traitements dans un centre de données ou un sous-ensemble d'applications prises en charge par un centre de données. Il peut s'agir, par exemple, d'une panne réseau ou d'une alimentation étendue à l'échelle du site, d'une catastrophe naturelle rendant un centre de données inutilisable ou d'une attaque malveillante sur les opérations ou le site.
La forme la plus simple de protection contre les pannes de site consiste à créer des sauvegardes de base de données à l'aide de RMAN et à les stocker hors site. Vous pouvez restaurer la base de données sur un autre hôte. Cependant, cette technique peut prendre du temps et la sauvegarde peut ne pas être à jour. La gestion d'une ou de plusieurs bases de données de secours dans un environnement Data Guard vous permet de fournir un service de base de données continu en cas de panne du site de production.
Voir aussi :
-
Guide de l'utilisateur Oracle AI Database Backup and Recovery pour plus d'informations sur RMAN et les solutions de sauvegarde et de récupération
-
Administration et concepts d'Oracle Data Guard, pour une présentation des bases de données de secours
Echecs de l'ordinateur
Une panne d'ordinateur se produit lorsque le système exécutant la base de données devient indisponible car il s'est arrêté ou n'est plus accessible.
Les pannes de matériel et de système d'exploitation sont des exemples de pannes informatiques. Les fonctionnalités d'Oracle du tableau suivant vous protègent contre les pannes informatiques ou vous aident à y répondre.
Tableau 1 Protection contre les pannes informatiques
| Fonction | Description | Pour en savoir plus |
|---|---|---|
| Grilles d'entreprise | Dans un environnement Oracle Real Applications Cluster (Oracle RAC), Oracle AI Database s'exécute sur deux systèmes ou plus d'un cluster tout en accédant simultanément à une seule base de données partagée. Un système de base de données unique couvre plusieurs systèmes matériels mais apparaît à l'application comme une seule base de données. | "Présentation du grid computing" |
| Oracle Data Guard | Data Guard vous permet de gérer une ou plusieurs copies d'une base de données de production, appelée base de données de secours, qui peuvent résider sur différents continents ou dans le même centre de données. Si la base de données principale n'est pas disponible en raison d'une panne, Data Guard peut basculer n'importe quelle base de données de secours vers le rôle de base principale, ce qui réduit les temps d'arrêt. | Administration et concepts d'Oracle Data Guard |
| Global Data Services | La structure Global Data Services automatise et centralise la configuration, la maintenance et la surveillance d'un cloud de base de données. Global Data Services permet l'équilibrage de charge et le basculement pour les services fournis par le cloud. Globalement, Global Data Services fournit à un ensemble de bases de données les mêmes avantages qu'Oracle Real Application Clusters (Oracle RAC) fournit à une seule base de données. | Guide d'administration et des concepts relatifs aux services de données globaux d'Oracle AI Database |
| Fast Start - Récupération après défaillance | Une cause fréquente de temps d'arrêt imprévu est une panne ou une panne du système. La technologie de récupération rapide des pannes d'Oracle AI Database limite automatiquement la durée de récupération d'instance de la base de données. | Guide de réglage des performances Oracle AI Database |
Echecs du stockage
Une panne de stockage se produit lorsque le stockage contenant tout ou partie du contenu de la base de données devient indisponible car il a été arrêté ou n'est plus accessible. La défaillance d'une unité de disque ou d'une baie de stockage est un exemple de panne de stockage.
Le tableau suivant présente les échecs de stockage en plus d'Oracle Data Guard.
Tableau 2 Solutions pour les défaillances de stockage
| Solution | Description | Pour en savoir plus |
|---|---|---|
| Oracle Automatic Storage Management (Oracle ASM) | Oracle ASM est un gestionnaire de volumes et un système de fichiers pour les fichiers de base de données Oracle qui prend en charge les configurations Oracle AI Database et Oracle RAC à instance unique. Oracle ASM est la solution d'administration de stockage recommandée par Oracle en remplacement des gestionnaires de volumes, systèmes d'exploitation et systèmes d'exploitation classiques. | "Oracle Automatic Storage Management (Oracle ASM)" |
| Sauvegarde et récupération | L'utilitaire Recovery Manager (RMAN) peut sauvegarder des données, restaurer des données à partir d'une sauvegarde précédente et récupérer les modifications apportées à ces données jusqu'au moment où l'échec s'est produit. | Sauvegarde et récupération |
Voir aussi : Guide de l'administrateur Oracle Automatic Storage Management pour en savoir plus sur Oracle ASM
Altération des données
Une altération des données survient lorsqu'un composant matériel, logiciel ou réseau entraîne une lecture ou une écriture des données altérées.
Un exemple d'altération de données est une erreur du gestionnaire de volumes qui entraîne des erreurs de lecture ou d'écriture sur disque. Les corruptions de données sont rares, mais elles peuvent avoir un effet catastrophique sur une base de données et donc sur une entreprise.
Outre Data Guard et Recovery Manager, Oracle AI Database prend en charge les formes de protection suivantes contre l'altération des données :
-
Solutions au problème d'écriture perdue
Une écriture perdue se produit lorsqu'un sous-système d'E/S accuse réception de la fin d'un bloc de données alors que l'écriture n'a pas eu lieu. Lors d'une lecture de bloc ultérieure, le sous-système d'E/S renvoie la version obsolète du bloc de données, qui peut être utilisée pour mettre à jour d'autres blocs de la base de données, ce qui l'endommage. Les solutions Oracle AI Database sont les suivantes :
-
Protection en écriture perdue à l'aide d'une base de données de secours
Dans la protection en écriture perdue standard, qui a été introduite dans Oracle Database 11g, vous pouvez activer le paramètre d'initialisation
DB_LOST_WRITE_PROTECTsur une base de données principale et une base de données de secours. Chaque base de données enregistre les lectures de bloc du cache de tampons dans le fichier de journalisation en ligne. Lorsque la base de données de secours applique les informations de journalisation pendant la récupération gérée, elle lit les blocs correspondants et compare les numéros SCN aux numéros SCN du fichier de journalisation, ce qui détecte les divergences. -
Protection en écriture perdue à l'aide d'un tablespace shadow
Pour la protection contre les pertes d'écriture shadow, vous créez un tablespace shadow. Un tablespace shadow contient un enregistrement de description courte, y compris le numéro SCN, pour chaque bloc de données d'un fichier de données suivi.
Si la protection en écriture shadow lost est activée (
ALTER DATABASE ENABLE LOST WRITE TRACKING) et que la base de données met à jour un bloc de données suivi, la base de données écrit le numéro SCN dans le tablespace shadow correspondant. Lors de la lecture d'un bloc de données suivi, la base de données recherche l'entrée shadow, puis la compare au bloc suivi. Si le numéro SCN de l'entrée shadow est supérieur au bloc suivi, une écriture perdue s'est produite.La protection contre les écritures perdues shadow présente l'avantage de détecter les écritures perdues sans utiliser de base de données de secours. En outre, en raison du délai inhérent à la protection en écriture perdue de la base de données de secours, lorsqu'une écriture perdue est détectée, ce bloc peut avoir déjà endommagé d'autres parties de la base de données. Pour empêcher l'altération des données, la protection en écriture shadow lost détecte une écriture perdue avant qu'elle ne soit consommée.
-
-
Détection de corruption de bloc de données
Une altération de bloc est un bloc de données qui n'est pas au format Oracle reconnu ou dont le contenu n'est pas cohérent en interne. Plusieurs composants et utilitaires de base de données, y compris RMAN, peuvent détecter un bloc endommagé et l'enregistrer dans
V$DATABASE_BLOCK_CORRUPTION. Si l'environnement utilise une base de données de secours Active Data Guard, la corruption peut être réparée automatiquement. -
Transaction Guard et continuité des applications
Les interruptions de session de base de données, qu'elles soient planifiées ou non, peuvent laisser les utilisateurs finaux incertains du statut de leur travail. Dans certains cas, les utilisateurs peuvent soumettre à nouveau les transactions validées, ce qui entraîne une corruption logique des données. Transaction Guard fournit une idémpotence de transaction, qui permet à la base de données de conserver un résultat de validation garanti indiquant si la transaction a été validée et terminée. La continuité des applications, qui inclut Transaction Guard, permet aux applications de réexécuter une transaction par rapport à la base de données après une erreur récupérable et de continuer là où la transaction s'est arrêtée.
Voir aussi :
-
Guide de l'utilisateur Oracle AI Database Backup and Recovery pour plus d'informations sur RMAN et les solutions de sauvegarde et de récupération
Erreurs humaines
Une incident d'erreur humaine se produit lorsque des actions involontaires ou malveillantes sont validées et que les données de la base de données deviennent logiquement corrompues ou inutilisables. L'impact d'une panne d'erreur humaine sur le niveau de service peut varier considérablement en fonction de la quantité et de la nature critique des données concernées.
Beaucoup de recherches citent l'erreur humaine comme la principale cause de temps d'arrêt. Oracle AI Database fournit des outils puissants pour aider les administrateurs à diagnostiquer et à récupérer rapidement de ces erreurs. Il inclut également des fonctionnalités qui permettent aux utilisateurs finaux de se remettre de problèmes sans intervention de l'administrateur.
Oracle AI Database recommande les formes de protection suivantes contre les erreurs humaines :
-
Restriction de l'accès utilisateur
La meilleure façon d'éviter les erreurs est de restreindre l'accès des utilisateurs aux données et aux services. Oracle AI Database fournit un large éventail d'outils de sécurité pour contrôler l'accès des utilisateurs aux données d'application en authentifiant les utilisateurs, puis en permettant aux administrateurs d'accorder aux utilisateurs uniquement les privilèges requis pour effectuer leurs tâches.
-
Technologie Oracle Flashback
La technologie Oracle Flashback est une famille de fonctionnalités de correction d'erreurs humaines dans Oracle AI Database. Oracle Flashback fournit une interface SQL permettant d'analyser et de réparer rapidement les erreurs humaines. Par exemple, vous pouvez effectuer :
-
Analyse chirurgicale fine et réparation des dommages localisés
-
Correction rapide de dommages plus répandus
-
Récupération au niveau ligne, transaction, table, tablespace et base de données
-
-
Oracle LogMiner
Oracle LogMiner est un outil relationnel qui vous permet d'utiliser le langage SQL pour lire, analyser et interpréter des fichiers en ligne.
Voir aussi :
-
Guide de l'utilisateur Oracle AI Database Backup and Recovery et Guide de développement Oracle AI Database pour en savoir plus sur les fonctionnalités d'Oracle Flashback
-
Utilitaires Oracle AI Database pour en savoir plus sur Oracle LogMiner
Haute disponibilité et temps d'arrêt planifiés
Les temps d'arrêt planifiés peuvent être tout aussi perturbateurs pour les opérations, en particulier dans les entreprises internationales qui prennent en charge les utilisateurs de plusieurs fuseaux horaires. Dans ce cas, il est important de concevoir un système pour minimiser les interruptions planifiées telles que les opérations de routine, la maintenance périodique et les nouveaux déploiements.
Les temps d'arrêt planifiés peuvent être classés en fonction de leurs causes.
-
Modifications du système et de la base de données Les modifications planifiées du système se produisent lorsque vous effectuez des opérations de maintenance régulières et périodiques et de nouveaux déploiements, y compris les modifications programmées de l'environnement d'exploitation qui se produisent en dehors de la structure de données organisationnelle dans la base de données.
-
Modifications de données Les modifications de données planifiées surviennent en cas de modification de la structure logique ou de l'organisation physique des objets Oracle AI Database. L'objectif principal de ces changements est d'améliorer les performances ou la facilité de gestion. Par exemple, la redéfinition de table, l'ajout de partitions de table et la création ou la reconstruction d'index.
-
Modifications d'application Les modifications d'application planifiées peuvent inclure des modifications de données, de schémas et de programmes. L'objectif principal de ces modifications est d'améliorer les performances, la facilité de gestion et les fonctionnalités. Par exemple, une mise à niveau d'application.
Modifications du système et de la base de données
Les modifications système planifiées se produisent lorsque vous effectuez des opérations de maintenance régulières et périodiques et de nouveaux déploiements, y compris les modifications programmées de l'environnement d'exploitation qui se produisent en dehors de la structure des données organisationnelles dans la base de données.
Par exemple, l'ajout ou la suppression de CPU et de noeuds de cluster (un noeud est un ordinateur sur lequel réside une instance de base de données), la mise à niveau du matériel ou des logiciels système et la migration de la plate-forme système.
Oracle AI Database fournit un provisionnement dynamique des ressources en tant que solution aux modifications planifiées du système et de la base de données :
-
Reconfiguration dynamique de la base de données
Oracle AI Database prend en charge de manière dynamique diverses modifications apportées aux configurations de matériel et de base de données, notamment l'ajout et la suppression de processeurs sur un serveur SMP et l'ajout et la suppression de baies de stockage à l'aide d'Oracle ASM. Par exemple, Oracle AI Database surveille le système d'exploitation pour détecter les modifications du nombre de CPU. Si le paramètre d'initialisation
CPU_COUNTest défini sur la valeur par défaut, la charge globale de base de données peut tirer parti dynamiquement des nouveaux processeurs ajoutés. -
Gestion de la mémoire à réglage automatique
Oracle AI Database utilise une stratégie non centralisée pour libérer et acquérir de la mémoire dans chaque sous-composant de la SGA et de la PGA. Oracle AI Database règle automatiquement la mémoire en invitant le système d'exploitation à transférer des granules de mémoire vers les composants qui en ont besoin.
-
Distributions automatisées des fichiers de données, des fichiers de contrôle et des fichiers de journalisation en ligne
Oracle ASM automatise et simplifie la disposition des fichiers de données, des fichiers de contrôle et des fichiers journaux en les répartissant automatiquement sur tous les disques disponibles.
Voir aussi :
-
Pour en savoir plus sur Oracle ASM, reportez-vous au Guide de l'administrateur Oracle Automatic Storage Management.
Modifications des données
Les modifications de données planifiées surviennent en cas de modification de la structure logique ou de l'organisation physique des objets Oracle AI Database. L'objectif principal de ces changements est d'améliorer les performances ou la facilité de gestion. Par exemple, la redéfinition de table, l'ajout de partitions de table et la création ou la reconstruction d'index.
Oracle AI Database réduit les temps d'arrêt pour les modifications de données grâce à la réorganisation et à la redéfinition en ligne. Cette architecture vous permet d'effectuer les tâches suivantes lorsque la base de données est ouverte :
-
effectuer une redéfinition de table en ligne, ce qui vous permet d'apporter des modifications à la structure de la table sans affecter de manière significative la disponibilité de la table ;
-
Créer, analyser et réorganiser des index
-
Déplacer les partitions de table
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour découvrir comment modifier des structures de données en ligne
Modifications d'application
Les modifications d'application planifiées peuvent inclure des modifications de données, de schémas et de programmes. L'objectif principal de ces modifications est d'améliorer les performances, la facilité de gestion et les fonctionnalités. Par exemple, une mise à niveau d'application.
Oracle AI Database prend en charge les solutions suivantes pour minimiser le temps d'inactivité des applications requis pour apporter des modifications aux objets de base de données d'une application.
Tableau 3 Solutions pour réduire les temps d'arrêt
| Solution | Description | Pour en savoir plus |
|---|---|---|
| Mises à jour non simultanées des patches de base de données | Oracle AI Database prend en charge l'application de patches aux noeuds d'un système Oracle RAC de manière non simultanée. | |
| Mises à niveau non simultanées des versions de base de données | Oracle AI Database prend en charge l'installation des mises à niveau logicielles de base de données et l'application des ensembles de patches, de manière non simultanée, avec un temps d'inactivité de base de données quasi nul, à l'aide de Data Guard SQL Apply et de bases de données de secours logiques. | Guide de mise à niveau d'Oracle AI Database |
| Redéfinition basée sur l'édition | La redéfinition basée sur l'édition vous permet de mettre à niveau les objets de base de données d'une application pendant son utilisation, ce qui réduit ou élimine les temps d'arrêt. Oracle AI Database accomplit cette tâche en modifiant (définissant) des objets de base de données dans un environnement privé appelé édition. | Guide de développement d'Oracle AI Database |
DDL avec l'option WAIT par défaut |
Les instructions LDD nécessitent des verrous exclusifs sur les structures internes (reportez-vous à la section "Verrous LDD"). Dans les versions précédentes, les instructions LDD échouaient si elles ne pouvaient pas obtenir les verrous. Le DDL indiqué avec l'option WAIT résout ce problème. |
|
| Création de déclencheurs à l'état désactivé | Vous pouvez créer un déclencheur à l'état désactivé afin de vous assurer que la compilation du code a réussi avant d'activer le déclencheur. | Référence du langage PL/SQL d'Oracle AI Database |
Présentation de Grid Computing
L'architecture informatique connue sous le nom de grid computing regroupe efficacement un grand nombre de serveurs et de stockage en une ressource flexible à la demande pour tous les besoins informatiques des entreprises.
Une grille de serveurs de base de données est un ensemble de serveurs standard connectés ensemble pour s'exécuter sur une ou plusieurs bases de données. Une grille de stockage de base de données est un ensemble de baies de stockage modulaires à faible coût combinées et accessibles par les ordinateurs de la grille de serveur de base de données.
Avec Database Server et Storage Grid, vous pouvez créer un pool de ressources système. Vous pouvez allouer et désallouer dynamiquement ces ressources en fonction des priorités de l'entreprise. La figure 20-2 illustre la grille de serveur de base de données et la grille de stockage de base de données dans un environnement d'entreprise Grid.
Figure 2 : Environnement Grid Computing
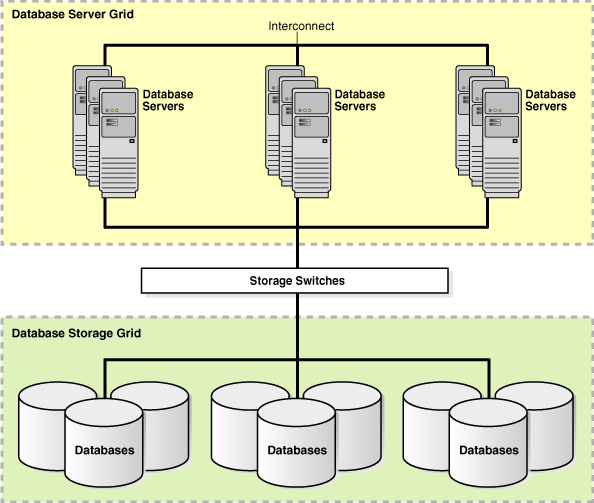
Description de l'image haovw004.gif
-
Oracle Real Application Clusters (Oracle RAC) de grille de serveur de base de données permet à plusieurs instances de partager l'accès à une base de données Oracle. Les instances sont liées via une interconnexion.
-
Oracle Flex Clusters A partir d'Oracle Database 12c, vous pouvez configurer Oracle Clusterware et Oracle Real Application Clusters dans des clusters volumineux.
-
Database Storage Grid Voir aussi :
http://www.globalgridforum.org/pour en savoir plus sur l'organisation de normalisation Global Grid Forum (GGF)
Grille du serveur de base de données
Oracle Real Application Clusters (Oracle RAC) permet à plusieurs instances de partager l'accès à une base de données Oracle. Les instances sont liées via une interconnexion.
Dans un environnement Oracle RAC, Oracle AI Database s'exécute sur plusieurs systèmes d'un cluster tout en accédant simultanément à une seule base de données partagée. Oracle RAC active une grille de serveurs de base de données en fournissant une base de données unique qui couvre plusieurs serveurs à faible coût mais qui apparaît à l'application comme un système de base de données unique et unifié. Oracle Clusterware est un logiciel qui permet aux serveurs de fonctionner ensemble comme s'il s'agissait d'un seul serveur. Chaque serveur ressemble à n'importe quel serveur autonome. Cependant, chaque serveur dispose de processus supplémentaires qui communiquent entre eux afin que des serveurs distincts fonctionnent ensemble comme s'il s'agissait d'un seul serveur. Oracle Clusterware fournit toutes les fonctionnalités requises pour exécuter le cluster, y compris l'appartenance aux noeuds et les services de messagerie.
-
Evolutivité Dans une grille de serveur de base de données, Oracle RAC vous permet d'ajouter des noeuds au cluster à mesure que la demande de capacité augmente.
-
Tolérance aux pannes Dans une architecture haute disponibilité, la tolérance aux pannes est la protection fournie contre la panne d'un composant de l'architecture.
-
Services Oracle RAC prend en charge les services qui peuvent regrouper les charges globales de base de données et acheminer le travail vers les instances optimales affectées pour offrir les services.
Voir aussi :
-
Guide d'administration et de déploiement Oracle Real Application Clusters pour apprendre à gérer une base de données Oracle RAC
-
Guide d'administration et de déploiement Oracle Clusterware pour découvrir comment administrer et déployer Oracle Clusterware
Evolutivité
Dans une grille de serveur de base de données, Oracle RAC vous permet d'ajouter des noeuds au cluster à mesure que la demande en capacité augmente.
La technologie Cache Fusion implémentée dans Oracle RAC vous permet de faire évoluer la capacité sans modifier vos applications. Ainsi, vous pouvez redimensionner le système de manière incrémentielle pour réduire les coûts et éliminer la nécessité de remplacer les systèmes à noeud unique plus petits par des systèmes plus grands.
Vous pouvez ajouter des noeuds de manière incrémentielle à un cluster au lieu de remplacer les systèmes existants par des noeuds plus volumineux. Grid Plug and Play simplifie l'ajout et la suppression de noeuds dans un cluster, ce qui facilite le déploiement de clusters dans un environnement provisionné dynamiquement. Grid Plug and Play permet également de gérer les bases de données et les services de manière indépendante de l'emplacement. Le nom SCAN permet aux clients de se connecter au service de base de données sans tenir compte de son emplacement dans le grid.
Voir aussi :
- Guide d'administration et de déploiement Oracle Real Application Clusters pour en savoir plus sur le mécanisme Cache Fusion
Tolérance aux pannes
Dans une architecture haute disponibilité, la tolérance aux pannes est la protection fournie contre la panne d'un composant de l'architecture.
L'un des principaux avantages de l'architecture Oracle RAC est la tolérance aux pannes inhérente à plusieurs noeuds. Etant donné que les noeuds physiques s'exécutent indépendamment, la défaillance d'un ou de plusieurs noeuds n'affecte pas les autres noeuds du cluster.
Le basculement peut se produire sur n'importe quel noeud de la grille. Dans le cas extrême, un système Oracle RAC fournit un accès à la base de données même lorsque tous les noeuds sauf un sont arrêtés. Cette architecture permet à un groupe de noeuds d'être mis en ligne ou mis hors ligne de manière transparente, à des fins de maintenance, tandis que le reste du cluster continue de fournir un accès à la base de données.
Oracle RAC fournit une intégration intégrée aux clients Oracle et aux pools de connexions. Grâce à cette fonctionnalité, une application est immédiatement informée de toute défaillance du pool qui met fin à la connexion. L'application évite d'attendre un délai d'attente TCP et peut immédiatement effectuer l'action de récupération appropriée. Oracle RAC intègre le processus d'écoute aux clients Oracle et aux pools de connexions pour créer un débit d'application optimal. Oracle RAC peut équilibrer la charge globale du cluster en fonction de la charge au moment de la transaction.
Voir aussi :
-
Guide d'administration et de déploiement Oracle Real Application Clusters pour en savoir plus sur la gestion automatique de la charge globale
Services
Oracle RAC prend en charge les services qui peuvent regrouper les charges de travail de base de données et acheminer le travail vers les instances optimales affectées pour offrir les services.
Un service représente la charge globale des applications ayant des attributs, des seuils de performance et des priorités en commun. Vous définissez et appliquez des stratégies métier à ces services pour effectuer des tâches telles que l'allocation de noeuds en cas de pic de traitement ou la gestion automatique d'une panne de serveur. L'utilisation des services garantit l'application des ressources système où et quand elles sont nécessaires pour atteindre les objectifs de l'entreprise.
Les services s'intègrent à Database Resource Manager, ce qui vous permet de restreindre les ressources qu'un service au sein d'une instance peut utiliser. Par ailleurs, les travaux Oracle Scheduler peuvent être exécutés à l'aide d'un service, et non d'une instance donnée.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database, pour en savoir plus sur Database Resource Manager et Oracle Scheduler
Flex Clusters Oracle
A partir d'Oracle Database 12c, vous pouvez configurer Oracle Clusterware et Oracle Real Application Clusters dans des clusters volumineux.
Ces grands clusters, appelés Oracle Flex Clusters, contiennent deux types de noeud disposés dans une architecture hub-and-spoke : les noeuds hub et les noeuds feuille. Les noeuds hub sont étroitement connectés, ont un accès direct au stockage partagé et servent d'ancres pour un ou plusieurs noeuds feuille. Les noeuds feuille sont faiblement connectés aux noeuds hub et peuvent ne pas disposer d'un accès direct au stockage partagé.
Voir aussi :
-
Guide d'administration et de déploiement Oracle Clusterware pour en savoir plus sur les Flex Clusters Oracle
-
Guide d'installation et de mise à niveau d'Oracle Grid Infrastructure pour en savoir plus sur le déploiement Oracle Flex Cluster
Grille de stockage de base de données
Un administrateur de base de données ou de stockage peut utiliser l'interface Oracle ASM pour indiquer les disques de la grille de stockage de base de données qu'Oracle ASM doit gérer sur toutes les plates-formes de serveur et de stockage. Oracle ASM partitionne l'espace disque et répartit uniformément les données entre les disques fournis à Oracle ASM. En outre, Oracle ASM redistribue automatiquement les données lorsque des disques de baies de stockage sont ajoutés ou supprimés de la grille de stockage de base de données.
Voir aussi :
-
Guide de l'administrateur Oracle Automatic Storage Management, pour plus d'informations sur Oracle ASM en cluster
Présentation de l'entreposage de données et de la Business Intelligence
Un entrepôt de données est une base de données relationnelle conçue pour la requête et l'analyse, plutôt qu'au traitement des transactions.
Par exemple, un data warehouse peut effectuer le suivi des prix des actions historiques ou des enregistrements d'impôt sur le revenu. Un entrepôt contient généralement des données dérivées de données de transaction historiques, mais il peut inclure des données provenant d'autres sources.
Un environnement d'entrepôt de données comprend plusieurs outils en plus d'une base de données relationnelle. Un environnement standard comprend une solution ETL, un moteur OLAP, des outils d'analyse client et d'autres applications qui collectent des données et les fournissent aux utilisateurs.
-
Entreposage de données et OLTP Une façon courante d'introduire l'entreposage de données consiste à faire référence aux caractéristiques d'un entrepôt de données telles qu'elles sont définies par William Inmon.
-
Architecture de data warehouse Les data warehouses et leurs architectures varient en fonction des besoins de l'entreprise.
-
Présentation de l'extraction, de la transformation et du chargement (ETL) Le processus d'extraction des données des systèmes source et de leur introduction dans l'entrepôt est généralement appelé ETL : extraction, transformation et chargement. Le processus ETL se réfère à un processus large plutôt qu'à trois étapes bien définies.
-
Le Business intelligence est l'analyse des informations d'une organisation pour faciliter la prise de décisions commerciales.
Entreposage de données et OLTP
Une façon courante d'introduire l'entreposage de données est de se référer aux caractéristiques d'un entrepôt de données telles qu'énoncées par William Inmon.
Les caractéristiques sont les suivantes:Foot 1
-
Orienté objet
Les data warehouses vous permettent de définir une base de données par sujet, tel que les ventes.
-
Intégré
Les entrepôts de données doivent mettre les données de sources disparates dans un format cohérent. Ils doivent résoudre des problèmes tels que les conflits de dénomination et les incohérences entre les unités de mesure. Lorsqu'ils atteignent cet objectif, on dit qu'ils sont intégrés.
-
Non volatile
Le but d'un entrepôt est de vous permettre d'analyser ce qui s'est passé. Ainsi, une fois que les données sont entrées dans l'entrepôt, elles ne doivent pas changer.
-
Variante de temps
L'accent d'un data warehouse est mis sur le changement dans le temps.
Les data warehouses et la base de données OLTP ont des exigences différentes. Par exemple, pour découvrir les tendances de l'entreprise, les data warehouses doivent gérer de grandes quantités de données. En revanche, pour de bonnes performances, les données historiques doivent être déplacées régulièrement des systèmes OLTP vers une archive. Le tableau 20-4 répertorie les différences entre les data warehouses et OLTP.
Tableau 4 Entrepôts de données et systèmes OLTP
| Caractéristiques | Entrepôt de données | OLTP |
|---|---|---|
| Charge globale | Conçu pour répondre aux requêtes ad hoc. Vous ne connaissez peut-être pas la charge de travail de votre entrepôt de données à l'avance, il doit donc être optimisé pour fonctionner correctement pour une grande variété de requêtes possibles. | Prend en charge uniquement les opérations prédéfinies. Vos applications peuvent être spécialement réglées ou conçues pour prendre uniquement en charge ces opérations. |
| Modifications de données | Mis à jour régulièrement par le processus ETL à l'aide de techniques de modification de données en masse. Les utilisateurs finals d'un data warehouse ne mettent pas directement à jour la base de données. | Soumis à des instructions DML individuelles régulièrement émises par les utilisateurs finaux. La base de données OLTP est toujours à jour et reflète l'état actuel de chaque transaction. |
| Conception de schéma | Utilise des schémas dénormalisés ou partiellement dénormalisés (comme un schéma en étoile) pour optimiser les performances des requêtes. | Utilise des schémas entièrement normalisés pour optimiser les performances des instructions LMD et garantir la cohérence des données. |
| Opérations typiques | Une requête type analyse des milliers ou des millions de lignes. Par exemple, un utilisateur peut demander le total des ventes pour tous les clients le mois dernier. | Une opération classique n'accède qu'à une poignée d'enregistrements. Par exemple, un utilisateur peut extraire la commande en cours pour un seul client. |
| Données historiques | Stockage de nombreux mois ou années de données pour permettre l'analyse historique. | Stocke les données de quelques semaines ou mois seulement. Données historiques conservées selon les besoins pour répondre aux exigences de la transaction en cours. |
Voir aussi :
-
Guide de l'entreposage de données Oracle AI Database pour une description plus détaillée d'un entrepôt de données
-
Oracle AI Database VLDB and Partitioning Guide pour une description plus détaillée d'un système OLTP
Architecture Data Warehouse
Les data warehouses et leurs architectures varient en fonction des besoins de l'entreprise.
-
Architecture d'entrepôt de données (de base) Dans une architecture d'entrepôt de données simple, les utilisateurs finaux accèdent directement aux données qui ont été transférées de plusieurs systèmes source vers l'entrepôt de données.
-
Architecture de l'entrepôt de données (avec une zone intermédiaire) Certains entrepôts de données utilisent une zone intermédiaire, qui est un endroit où les données sont prétraitées avant d'entrer dans l'entrepôt. Une zone intermédiaire simplifie les tâches de création de synthèses et de gestion de l'entrepôt.
-
Architecture de l'entrepôt de données (avec zone intermédiaire et datamarts) Vous pouvez personnaliser l'architecture de l'entrepôt pour différents groupes de votre organisation. Vous pouvez atteindre cet objectif en transférant les données de l'entrepôt vers des datamarts, qui sont des bases de données indépendantes conçues pour une entreprise ou un projet spécifique. En général, les datamarts incluent de nombreuses tables récapitulatives.
Architecture de base de Data Warehouse
Dans une architecture simple d'entrepôt de données, les utilisateurs finaux accèdent directement aux données transférées de plusieurs systèmes source vers l'entrepôt de données.
La figure suivante illustre un exemple d'architecture.
Figure 3 : Architecture d'un data warehouse
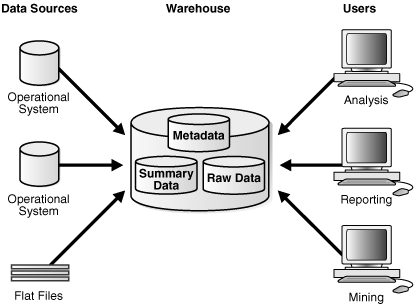
Description de l'image cncpt170.gif
La figure précédente présente à la fois les métadonnées et les données brutes d'un système OLTP traditionnel et les données récapitulatives. Une récapitulatif est une vue agrégée qui améliore les performances des requêtes en précalculant les jointures et les opérations d'agrégation coûteuses et en stockant les résultats dans une table. Par exemple, une table récapitulative peut contenir les sommes des ventes par région et par produit. Les résumés sont également appelés vues matérialisées.
Voir aussi : Guide d'entreposage de données Oracle AI Database pour en savoir plus sur les vues matérialisées de base
Architecture d'entrepôt de données (avec zone intermédiaire)
Certains entrepôts de données utilisent une zone intermédiaire, qui est un endroit où les données sont prétraitées avant d'entrer dans l'entrepôt. Une zone intermédiaire simplifie les tâches de création de synthèses et de gestion de l'entrepôt.
Le graphique suivant représente une zone intermédiaire.
Figure 4 : Architecture d'un entrepôt de données avec une zone intermédiaire
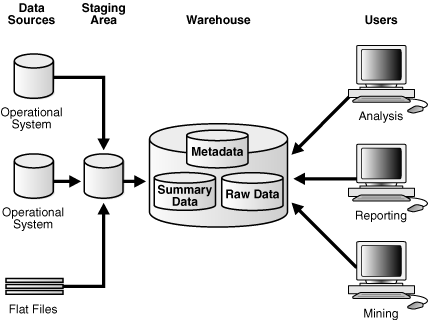
Description de l'image cncpt171.gif
Voir aussi : Guide d'entreposage de données Oracle AI Database pour en savoir plus sur les différents mécanismes de transport
Architecture d'entrepôt de données (avec zone intermédiaire et datamarts)
Vous pouvez personnaliser l'architecture de votre entrepôt pour différents groupes au sein de votre organisation. Vous pouvez atteindre cet objectif en transférant les données de l'entrepôt vers des datamarts, qui sont des bases de données indépendantes conçues pour une entreprise ou un projet spécifique. En général, les datamarts incluent de nombreuses tables récapitulatives. La figure 20-5 sépare les informations sur les achats, les ventes et les stocks en data marts indépendants. Un analyste financier peut interroger les data marts pour obtenir des informations historiques sur les achats et les ventes.
Figure 5 : Architecture d'un entrepôt de données avec une zone intermédiaire et des datamarts
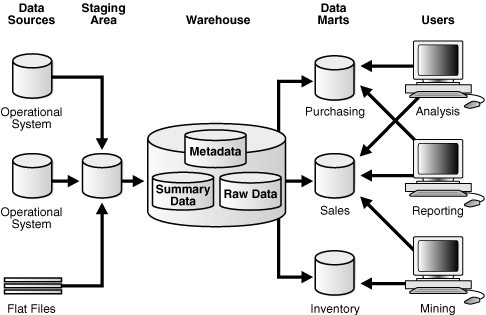
Description de l'image cncpt172.gif
Voir aussi : Guide de l'entreposage de données Oracle AI Database pour en savoir plus sur les mécanismes de transformation
Présentation de l'extraction, de la transformation et du chargement (ETL)
Le processus d'extraction des données des systèmes source et de leur introduction dans l'entrepôt est communément appelé ETL : extraction, transformation et chargement. Le processus ETL se réfère à un processus large plutôt qu'à trois étapes bien définies.
Dans un scénario type, les données d'un ou de plusieurs systèmes opérationnels sont extraites puis transportées physiquement vers le système cible ou un système intermédiaire pour traitement. Selon le mode de transport, certaines transformations peuvent se produire au cours de ce processus. Par exemple, une instruction SQL qui accède directement à une cible distante via une passerelle peut concaténer deux colonnes dans le cadre de l'instruction SELECT.
Oracle AI Database n'est pas lui-même un outil ETL. Cependant, Oracle AI Database fournit un riche ensemble de fonctionnalités utilisables par les outils ETL et les solutions ETL personnalisées. Les fonctionnalités ETL fournies par Oracle AI Database sont les suivantes :
-
Tablespaces transportables
Vous pouvez transporter des tablespaces entre différentes architectures informatiques et différents systèmes d'exploitation. Les tablespaces transportables sont le moyen le plus rapide de déplacer de grands volumes de données entre deux bases Oracle.
-
Fonctions de table
Une fonction de table est une fonction PL/SQL définie par l'utilisateur qui renvoie un ensemble de lignes (table imbriquée ou VARRAY). Les fonctions de table peuvent produire un ensemble de lignes en sortie et accepter un ensemble de lignes en entrée. Les fonctions de table prennent en charge l'exécution en parallèle et en pipeline de transformations implémentées en PL/SQL, C ou Java sans nécessiter de tables intermédiaires.
-
Tables externes
Les tables externes permettent de joindre les données externes directement et en parallèle sans avoir à les charger d'abord dans la base de données. Ainsi, des tables externes permettent la tuyauterie de la phase de chargement avec la phase de transformation.
-
Compression de table
Pour réduire l'utilisation du disque et de la mémoire, vous pouvez stocker les tables et les tables partitionnées dans un format compressé. L'utilisation de la compression de table conduit souvent à une meilleure augmentation pour les opérations en lecture seule et à une exécution plus rapide des requêtes.
Voir aussi :
Business Intelligence
Le Business intelligence est l'analyse des informations d'une organisation pour faciliter la prise de décisions commerciales.
Les applications analytiques et la business intelligence sont dominées par l'exploration des hiérarchies vers le haut et vers le bas et la comparaison des valeurs agrégées. Oracle AI Database fournit plusieurs technologies pour prendre en charge ces opérations.
-
Analytic SQL Oracle AI Database a introduit de nombreuses opérations SQL pour effectuer des opérations analytiques. Ces opérations comprennent le classement, les moyennes mobiles, les sommes cumulées, le ratio par rapport aux rapports et les comparaisons d'une période à l'autre.
-
Les vues analytiques étendent le contenu des ensembles de données et simplifient le développement des applications décisionnelles.
-
Oracle Advanced Analytics L'option Oracle Advanced Analytics étend Oracle AI Database à une plate-forme d'analyse avancée complète pour l'analyse du Big Data.
SQL analytique
Oracle AI Database a introduit de nombreuses opérations SQL pour effectuer des opérations analytiques. Ces opérations comprennent le classement, les moyennes mobiles, les sommes cumulées, le ratio par rapport aux rapports et les comparaisons d'une période à l'autre.
Par exemple, Oracle AI Database prend en charge les formes SQL analytiques suivantes.
Tableau 5 SQL analytique
| Type de SQL analytique | Description | Pour en savoir plus |
|---|---|---|
| SQL pour l'agrégation | Une fonction d'agrégation telle que COUNT renvoie une ligne unique de résultat à partir d'un groupe de lignes. L'agrégation est fondamentale pour l'entreposage de données. Pour améliorer les performances d'agrégation dans un entrepôt, la base de données fournit des extensions de la clause GROUP BY afin de faciliter et d'accélérer l'interrogation et le reporting. |
Guide de l'entreposage de données Oracle AI Database pour en savoir plus sur l'agrégation |
| SQL pour l'analyse | Une fonction analytique telle que MAX agrège un groupe de lignes (appelé fenêtre) pour renvoyer plusieurs lignes en tant qu'ensemble de résultats. Oracle dispose de fonctionnalités avancées de traitement analytique SQL à l'aide d'une famille de fonctions SQL analytiques. Par exemple, ces fonctions analytiques vous permettent de calculer les classements et les centiles et les fenêtres mobiles. |
Guide de l'entreposage de données Oracle AI Database pour en savoir plus sur SQL à des fins d'analyse et de reporting |
| SQL pour la modélisation | Avec la clause MODEL, vous pouvez créer un tableau multidimensionnel à partir des résultats de requête et appliquer des règles à ce tableau pour calculer de nouvelles valeurs. Par exemple, vous pouvez partitionner les données d'une vue des ventes par pays et effectuer un calcul de modèle, tel que défini par plusieurs règles, sur chaque pays. Une règle pourrait calculer les ventes d'un produit en 2008 comme la somme des ventes en 2006 et 2007. |
Guide de l'entreposage de données Oracle AI Database pour en savoir plus sur la modélisation SQL |
Voir aussi : Référence du langage SQL d'Oracle AI Database pour en savoir plus sur les fonctions SQL
Vues analytiques
Les vues analytiques étendent le contenu des ensembles de données et simplifient le développement des applications décisionnelles.
Les vues analytiques présentent les caractéristiques suivantes :
-
Les données sont organisées selon des concepts hiérarchiques et dimensionnels.
-
Les jointures, les agrégations et les règles de calcul de mesure sont intégrées dans la vue analytique.
-
Elles peuvent être superposées à des tables, vues et autres objets existants de la base de données à l'aide de SQL DDL.
-
Peut être interrogé à l'aide d'instructions SQL simples.
Voir aussi : Guide d'entreposage de données Oracle AI Database pour une présentation des vues analytiques
Oracle Advanced Analytics
L'option Oracle Advanced Analytics étend Oracle AI Database à une plate-forme d'analyse avancée complète pour l'analyse du Big Data.
Oracle Advanced Analytics fournit des analyses prédictives, l'exploration de données, l'exploration de texte, l'analyse statistique, des calculs numériques avancés et des graphiques interactifs dans la base de données. Oracle Advanced Analytics comporte les composants suivants :
-
Oracle Data Mining Dans le domaine de la veille économique, l'exploration de données est l'utilisation d'algorithmes mathématiques sophistiqués pour segmenter les données et évaluer la probabilité d'événements futurs.
-
R est un langage et un environnement open source pour le calcul statistique et les graphiques. Oracle Machine Learning for R prépare R à l'entreprise et au Big Data.
Oracle Data Mining
Dans la business intelligence, le data mining est l'utilisation d'algorithmes mathématiques sophistiqués pour segmenter les données et évaluer la probabilité d'événements futurs.
Les applications typiques de l'exploration de données comprennent les centres d'appels, les distributeurs automatiques de billets, la gestion relationnelle des affaires électroniques (ERM) et la planification d'entreprise. Oracle Data Miner permet aux analystes de données d'analyser rapidement les données, de cibler les meilleurs clients, de lutter contre la fraude et de trouver des corrélations et des modèles importants qui peuvent aider leur entreprise à mieux rivaliser.
Oracle Data Mining fournit des algorithmes d'exploration de données qui s'exécutent en tant que fonctions SQL natives pour la création et le déploiement de modèles dans la base de données hautes performances. Oracle Data Mining peut extraire des tables, des vues, des schémas en étoile, des données transactionnelles et des données non structurées.
Oracle Data Mining prend en charge une API PL/SQL et des fonctions SQL pour l'évaluation des modèles. Par conséquent, Oracle AI Database fournit aux développeurs d'applications une infrastructure leur permettant d'intégrer l'exploration de données de manière transparente aux applications de base de données.
Oracle Data Miner, une extension SQL Developer, fournit une interface graphique pour Oracle Data Mining.
Voir aussi : Concepts d'Oracle Machine Learning for SQL
Oracle Machine Learning for R
R est un langage et un environnement open source pour le calcul statistique et les graphiques. Oracle Machine Learning for R prépare R à l'entreprise et au Big Data.
Conçu pour les problèmes impliquant de grandes quantités de données, Oracle Machine Learning for R intègre R à Oracle AI Database. Vous pouvez exécuter des commandes et des scripts R pour des analyses statistiques et graphiques sur les données stockées dans Oracle AI Database. Vous pouvez également développer, affiner et déployer des scripts R qui exploitent le parallélisme et l'évolutivité de la base de données pour automatiser l'analyse des données. Les analystes de données peuvent exécuter des packages R et développer des scripts R pour les applications analytiques en une seule étape, sans avoir à apprendre le langage SQL.
Voir aussi : Guide de l'utilisateur Oracle Machine Learning for R
Présentation d'Oracle Information Integration
À mesure qu'une organisation évolue, il devient de plus en plus important pour elle de pouvoir partager des informations entre plusieurs bases de données et applications.
Les approches de base du partage d'informations sont les suivantes :
-
Consolidation
Vous pouvez consolider les informations dans une base de données unique, ce qui élimine le besoin d'une intégration plus poussée. Oracle RAC, la grille informatique, l'architecture colocative et Oracle VPD peuvent vous permettre de consolider les informations dans une base de données unique.
-
Fédération
Vous pouvez laisser les informations distribuées et fournir des outils pour fédérer ces informations, ce qui les fait apparaître dans une seule base de données virtuelle.
-
Partage
Vous pouvez partager des informations, ce qui vous permet de gérer les informations dans plusieurs banques de données et applications.
Cette section est consacrée aux solutions Oracle de fédération et de partage d'informations.
-
Accès fédéré La base de l'accès fédéré est un environnement distribué, qui est un réseau de systèmes disparates qui communiquent de manière transparente les uns avec les autres.
-
Partage d'informations Le partage de données entre les applications de l'entreprise est au cœur de toute intégration.
Accès fédéré
Le fondement de l'accès fédéré est un environnement distribué, qui est un réseau de systèmes disparates qui communiquent de manière transparente les uns avec les autres.
Chaque système de l'environnement est appelé noeud. Le système auquel un utilisateur est directement connecté est appelé système local. Les autres systèmes auxquels cet utilisateur accède sont les systèmes distants.
Un environnement distribué permet aux applications d'accéder aux données des systèmes locaux et distants et de les échanger. Toutes les données sont accessibles et modifiées simultanément.
-
SQL distribué Distributed SQL accède et met à jour de manière synchrone les données distribuées entre plusieurs bases de données. Un système de base de données distribuée Oracle peut être transparent pour les utilisateurs, ce qui le fait apparaître comme une base de données Oracle unique.
-
Liens de base de données Un lien de base de données est une connexion entre deux bases de données physiques qui permet à un client d'y accéder en tant que base de données logique.
SQL distribué
Le code SQL distribué accède et met à jour de manière synchrone les données distribuées entre plusieurs bases de données. Un système de base de données distribuée Oracle peut être transparent pour les utilisateurs, ce qui le fait apparaître comme une base de données Oracle unique.
Le code SQL distribué comprend des requêtes distribuées et des transactions distribuées. L'architecture de base de données distribuée Oracle assure la transparence des requêtes et des transactions. Par exemple, les instructions LMD standard fonctionnent comme dans un environnement de base de données non distribué. En outre, les applications contrôlent les transactions à l'aide des instructions SQL standard COMMIT, SAVEPOINT et ROLLBACK.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour apprendre à gérer les transactions distribuées
Liens de base de données
Un lien de base de données est une connexion entre deux bases de données physiques qui permet à un client d'y accéder en tant que base de données logique.
Oracle AI Database utilise des liens de bases de données pour permettre aux utilisateurs sur une base de données d'accéder aux objets d'une base de données distante. Un utilisateur local peut accéder à un lien vers une base de données distante sans être utilisateur de la base de données distante. La figure 20-6 présente un exemple d'accès de l'utilisateur hr à la table employees sur la base de données distante avec le nom global hq.example.com. Le synonyme employees masque l'identité et l'emplacement de l'objet de schéma distant.
Figure 6 : Lien de base de données
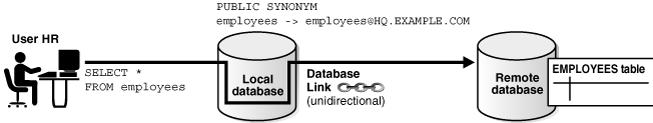
Description de l'image cncpt243.gif
Voir aussi : Guide de l'administrateur Oracle AI Database pour en savoir plus sur les liens de base de données
Partage d'informations
Le partage des données entre les applications de l'entreprise est au cœur de toute intégration.
-
Oracle GoldenGate Oracle GoldenGate est un produit de réplication de données asynchrone, basé sur les journaux et en temps réel.
-
Oracle AI Database Transactional Event Queues et Advanced Queuing (AQ) Oracle AI Database Transactional Event Queues et Advanced Queuing (AQ) est un système de file d'attente de messages robuste et riche en fonctionnalités intégré à Oracle AI Database.
Oracle GoldenGate
Oracle GoldenGate est un produit de réplication de données asynchrone, basé sur les journaux et en temps réel.
Oracle GoldenGate déplace d'importants volumes de données transactionnelles en temps réel dans des environnements de base de données, de matériel et de système d'exploitation hétérogènes avec un impact minimal. Il optimise l'accès et la disponibilité des informations en temps réel car il :
-
Prise en charge de la réplication impliquant un mélange hétérogène de bases de données Oracle AI Database et non Oracle
-
Maintient la disponibilité continue des systèmes stratégiques, ce qui réduit les temps d'arrêt lors de la maintenance planifiée
-
Permet l'intégration des données en temps réel dans toute l'entreprise
-
Configuration automatique de la réplication bidirectionnelle entre les shards dans une table distribuée
Un environnement standard comprend un processus de capture, de pompe et de livraison. Chaque processus peut être exécuté sur la plupart des bases de données et systèmes d'exploitation populaires, y compris les bases de données Oracle et non Oracle. Une partie ou la totalité des données peuvent être répliquées. Les données de l'un de ces processus peuvent être manipulées pour des environnements hétérogènes et des schémas de base de données différents.
Oracle GoldenGate prend en charge la réplication multimaître, le déploiement hub-and-spoke, la consolidation des données et la transformation des données. Par conséquent, Oracle GoldenGate vous permet de vous assurer que vos systèmes critiques sont opérationnels 24/7 et que les données associées sont distribuées dans toute l'entreprise pour optimiser la prise de décision.
Voir aussi :
-
Oracle Globally Distributed AI Database pour découvrir comment utiliser le sharding Oracle
-
http://www.oracle.com/technetwork/middleware/goldengate/documentation/index.html
Files d'attente d'événements transactionnels et file d'attente avancée (AQ) Oracle AI Database
Oracle AI Database Transactional Event Queues and Advanced Queuing (AQ) est un système de file d'attente de messages robuste et riche en fonctionnalités intégré à Oracle AI Database.
Lorsqu'une organisation dispose de systèmes différents qui doivent communiquer entre eux, un environnement de messagerie peut fournir un moyen standard et fiable de transporter des informations critiques entre ces systèmes.
Un exemple de cas d'utilisation est une entreprise qui saisit des commandes dans une base de données Oracle au siège. Lorsqu'une commande est saisie, l'entreprise utilise AQ pour envoyer l'ID et la date de commande vers la base de données d'un entrepôt. Ces messages permettent d'informer les employés de l'entrepôt des commandes passées afin qu'ils puissent les préparer et les envoyer.
-
Mise en file d'attente et retrait de la file d'attente des messages Oracle AI Database Transactional Event Queues et Advanced Queuing stockent les messages utilisateur dans des unités de stockage abstraites appelées file d'attente.
-
Fonctionnalités avancées Oracle AI Database Transactional Event Queues et Advanced Queuing Oracle AI Database Transactional Event Queues et Advanced Queuing (AQ) prennent en charge toutes les fonctionnalités standard des systèmes de mise en file d'attente de messages.
Mise en file d'attente et retrait de la file d'attente des messages
Oracle AI Database Transactional Event Queues et Advanced Queuing stockent les messages utilisateur dans des unités de stockage abstraites appelées file d'attente.
La mise en file d'attente est le processus par lequel les émetteurs placent les messages dans des files d'attente. Le retrait de la file d'attente est le processus par lequel les destinataires extraient les messages des files d'attente.
La prise en charge du retrait explicite de la file d'attente permet aux développeurs d'utiliser XStream et Oracle GoldenGate pour échanger des messages de manière fiable. Ils peuvent également notifier les modifications aux applications en tirant parti des fonctionnalités de capture et de propagation des modifications d'Oracle GoldenGate. La figure 20-7 présente un exemple d'application qui met explicitement en file d'attente et retire des messages via la file d'attente avancée, ce qui lui permet de partager des informations avec des partenaires utilisant différents systèmes de messagerie. Après avoir été mis en file d'attente, les messages peuvent être transformés et propagés avant d'être retirés de la file d'attente dans l'application du partenaire.
Figure 7 : Mise en file d'attente des messages Oracle
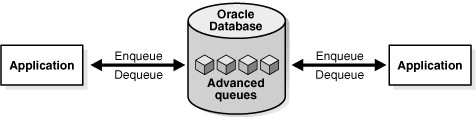
Description de l'image cncpt310.gif
Files d'attente d'événements transactionnels Oracle AI Database et fonctionnalités avancées de file d'attente
Oracle AI Database Transactional Event Queues et Advanced Queuing (AQ) prennent en charge toutes les fonctionnalités standard des systèmes de mise en file d'attente de messages.
Les fonctionnalités sont les suivantes:
-
Intégration d'applications asynchrone
Les files d'attente d'événements transactionnels et la file d'attente avancée offrent plusieurs façons de mettre des messages en file d'attente. Un processus de capture ou un processus de capture synchrone peut capturer les messages implicitement, ou les applications et les utilisateurs peuvent capturer les messages explicitement.
-
Architecture d'intégration extensible
De nombreuses applications sont intégrées à un modèle de hub-and-spoke distribué avec Oracle AI Database en tant que hub. Les applications distribuées d'une base de données Oracle communiquent avec les files d'attente du même hub. Plusieurs applications partagent la même file d'attente, ce qui évite d'avoir à ajouter des files d'attente pour prendre en charge d'autres applications.
-
Intégration hétérogène des applications
Transactional Event Queues et Advanced Queuing fournissent aux applications toute la puissance du système de type Oracle. Il inclut la prise en charge des types de données scalaires, des types d'objet Oracle AI Database avec héritage,
XMLTypeavec des opérateurs supplémentaires pour les données XML etANYDATA. -
Intégration d'applications héritées
Oracle Messaging Gateway intègre les applications Oracle AI Database à d'autres systèmes de mise en file d'attente de messages, tels que Websphere MQ et Tibco.
-
Prise en charge des API standard
Transactional Event Queues et Advanced Queuing prennent en charge les API standard : SQL, JMS et SOAP. Les modifications apportées à l'aide de SQL sont capturées automatiquement en tant que messages.
Voir aussi : Guide de l'utilisateur Oracle AI Database Transactional Event Queues and Advanced Queuing
Note
Note 1 :
Construire l'entrepôt de données, John Wiley and Sons, 1996.