Concetti per gli amministratori del database
I componenti script in questa pagina sono utilizzati solo per scopi di navigazione e non alterano in alcun modo il contenuto.
Questa parte descrive le responsabilità, gli strumenti e le conoscenze essenziali per gli amministratori del database.
-
Responsabilità degli amministratori di database La responsabilità principale di un amministratore di database (DBA) consiste nel rendere disponibili i dati aziendali ai propri utenti.
-
Strumenti per amministratori di database Oracle fornisce diversi strumenti da utilizzare per amministrare un database.
-
Argomenti per gli amministratori di database In questa sezione vengono trattati gli argomenti più importanti per i DBA e che non sono stati discussi altrove nel manuale.
Funzioni degli amministratori di database
La responsabilità principale di un amministratore di database (DBA) è quella di rendere i dati aziendali disponibili ai propri utenti.
I DBA devono lavorare a stretto contatto con gli sviluppatori per garantire che le loro applicazioni utilizzino in modo efficiente il database e con gli amministratori di sistema per garantire che le risorse fisiche siano adeguate e utilizzate in modo efficiente.
Gli Oracle DBA sono responsabili della comprensione dell'architettura di Oracle AI Database e del funzionamento del database. I DBA possono prevedere di eseguire i task riportati di seguito:
-
Installazione, upgrade e applicazione di patch al software Oracle AI Database
-
Progettazione di database, tra cui l'identificazione dei requisiti, la creazione della progettazione logica (modello concettuale) e la progettazione fisica del database
-
Creazione di database Oracle
-
Sviluppo e test di una strategia di backup e ripristino, backup periodico dei database Oracle e loro ripristino in caso di errori
-
Configurazione dell'ambiente di rete per consentire ai client di connettersi ai database
-
Avvio e chiusura del database
-
Gestione dello storage per il database
-
Gestione di utenti e sicurezza
-
Gestione di oggetti di database quali tabelle, indici e viste
-
Monitoraggio e tuning delle prestazioni del database
-
Indagine, raccolta di dati per e segnalazione a Oracle Support Services di eventuali errori critici nel database
-
Valutazione e test delle nuove funzioni del database
I tipi di utenti e i relativi ruoli e responsabilità dipendono dall'ambiente del database. Un database di piccole dimensioni può avere un DBA. Un database di grandi dimensioni può dividere i compiti del DBA tra diversi specialisti, ad esempio funzionari della sicurezza, operatori di backup e amministratori delle applicazioni.
Vedere anche:
-
Oracle AI Database 2 Day DBA per un'introduzione alle attività DBA
-
Oracle AI Database Administrator's Guide per una presentazione più approfondita dei concetti e delle attività DBA
Strumenti per amministratori di database
Oracle fornisce diversi strumenti da utilizzare per amministrare un database.
Questa sezione descrive alcuni strumenti di uso comune.
-
Oracle Enterprise Manager (Enterprise Manager) è uno strumento di gestione di sistemi basato sul Web che fornisce la gestione di database Oracle, database machine Exadata, Fusion Middleware, applicazioni, server, storage e hardware e software Oracle non-Oracle.
-
SQL*Plus è uno strumento di query interattivo e batch incluso in ogni installazione di Oracle AI Database.
-
Strumenti per l'installazione e la configurazione del database Oracle fornisce diversi strumenti per semplificare il task di installazione e configurazione del software Oracle AI Database.
-
Strumenti per la configurazione e l'amministrazione di Oracle Net Oracle Net Services fornisce soluzioni per la connettività a livello aziendale in ambienti informatizzati eterogenei e distribuiti. Oracle Net, un componente di Oracle Net Services, consente di eseguire una sessione della rete da un'applicazione client a una base di dati.
-
Strumenti per lo spostamento e l'analisi dei dati Oracle AI Database include diverse utility che forniscono assistenza nello spostamento e nell'analisi dei dati.
Oracle Enterprise Manager
Oracle Enterprise Manager (Enterprise Manager) è uno strumento di gestione di sistemi basato sul Web che fornisce la gestione di database Oracle, database machine Exadata, Fusion Middleware, applicazioni, server, storage e hardware e software Oracle non-Oracle.
-
Oracle Enterprise Manager Cloud Control Oracle Enterprise Manager Cloud Control (Cloud Control) è un'interfaccia basata sul Web che fornisce all'amministratore un monitoraggio completo dello stack di tecnologie Oracle e dei componenti non Oracle.
-
Oracle Enterprise Manager Database Express 12c Oracle Enterprise Manager Database Express (EM Express) è un prodotto di gestione Web integrato nel database Oracle. Non richiede alcuna installazione o gestione speciale.
Oracle Enterprise Manager Cloud Control
Oracle Enterprise Manager Cloud Control (Cloud Control) è un'interfaccia basata sul Web che fornisce all'amministratore un monitoraggio completo dello stack tecnologico Oracle e dei componenti non Oracle.
A volte un componente della notifica FAN (Fast Application Notification) può diventare non disponibile o si verifica un problema a livello di prestazioni. In questo caso, Cloud Control visualizza l'avviso generato automaticamente in modo che l'amministratore possa eseguire l'azione di recupero appropriata.
Di seguito sono elencati i componenti di Cloud Control.
-
Servizio di gestione Oracle (OMS)
La funzione OMS è un set di applicazioni J2EE che esegue il rendering dell'interfaccia per Cloud Control, utilizza tutti i Management Agent Oracle per elaborare le informazioni di monitoraggio e utilizza il repository di Enterprise Manager come data store persistente.
-
Agenti Oracle Management
Questi agenti sono processi distribuiti su ciascun host monitorato per monitorare tutte le destinazioni sull'host, comunicare queste informazioni all'OMS e gestire l'host e le relative destinazioni.
-
Oracle Management Repository
Il repository è uno schema di un database Oracle che contiene tutte le informazioni disponibili su amministratori, destinazioni e applicazioni gestite da Cloud Control.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come utilizzare Cloud Control per amministrare un database
-
Guida in linea di Cloud Control
Oracle Enterprise Manager Database Express: 12c
Oracle Enterprise Manager Database Express (EM Express) è un prodotto di gestione Web integrato nel database Oracle. Non richiede alcuna installazione o gestione speciale.
EM Express contiene le pagine di gestione delle prestazioni chiave e amministrazione di base in Cloud Control. Queste pagine includono quanto riportato di seguito.
-
Home page del database
-
Monitoraggio SQL in tempo Reale
-
Analitica ASH
È possibile accedere a queste funzioni online tramite la console EM Express e offline tramite la tecnologia Active Reports. Dal punto di vista architettonico, EM Express non ha componenti di livello intermedio o middleware, garantendo che il suo sovraccarico sul database server sia trascurabile.
EM Express consente di eseguire task amministrativi quali la gestione della sicurezza degli utenti e la gestione della memoria e dello storage del database. È inoltre possibile visualizzare le informazioni relative alle prestazioni e allo stato del database.
Vedere anche: Introduzione a Oracle AI Database con il tuning delle prestazioni per scoprire come amministrare il database con EM Express
SQL*Plus
SQL*Plus è uno strumento di query interattivo e batch incluso in ogni installazione di Oracle AI Database.
Ha un'interfaccia utente della riga di comando che funge da client durante la connessione al database. SQL*Plus dispone di un ambiente e di comandi propri. Consente di immettere ed eseguire comandi SQL, PL/SQL, SQL*Plus e del sistema operativo per eseguire task quali:
-
Formattazione, esecuzione di calcoli, memorizzazione e stampa dai risultati della query
-
Esame delle definizioni di tabella e di oggetti
-
Sviluppo ed esecuzione di script batch
-
Amministrazione di un database
È possibile utilizzare SQL*Plus per generare i report in modo interattivo, generare i report come processi batch ed eseguire l'output dei risultati in file di testo, sullo schermo o in un file HTML per l'esplorazione su Internet. È possibile generare i report in modo dinamico utilizzando la funzione per l'output HTML.
Vedere anche: SQL*Plus User's Guide and Reference per ulteriori informazioni su SQL*Plus
Strumenti per l'installazione e la configurazione del database
Oracle fornisce diversi strumenti per semplificare il task di installazione e configurazione del software Oracle AI Database.
Nella tabella seguente vengono descritti gli strumenti supportati.
Tabella 1 Strumenti per l'installazione e la configurazione del database
| Strumento | Descrizione | Per saperne di più |
|---|---|---|
| Oracle Universal Installer (OUI) | OUI è una utility GUI che consente di visualizzare, installare e disinstallare il software Oracle AI Database. Guida in linea disponibile per guidare l'utente durante l'installazione. | Guida in linea per guidarti attraverso l'installazione |
| Assistenza all'aggiornamento del database (DBUA) | DBUA guida in modo interattivo l'utente attraverso un aggiornamento del database e configura il database per la nuova release. DBUA automatizza l'upgrade eseguendo tutti i task normalmente eseguiti manualmente. DBUA fornisce suggerimenti per le opzioni di configurazione, ad esempio le tablespace e il redo log in linea. | Oracle AI Database 2 Day DBA per scoprire come aggiornare un database con DBUA |
| DBCA (Database Configuration Assistant) | DBCA offre un'interfaccia grafica e il workflow guidato per la creazione e la configurazione di un database. Questo strumento consente di creare un database da modelli forniti da Oracle o di creare database e modelli personalizzati. | Oracle AI Database Administrator's Guide per informazioni su come creare un database con DBCA |
Strumenti di configurazione e amministrazione di Oracle Net
Oracle Net Services fornisce soluzioni per la connettività a livello aziendale in ambienti informatizzati eterogenei e distribuiti. Oracle Net, un componente di Oracle Net Services, consente di effettuare una sessione della rete da un'applicazione client a una base di dati.
È possibile utilizzare gli strumenti indicati di seguito per configurare e amministrare Oracle Net Services.
-
Oracle Net Manager
Questo strumento consente di configurare Oracle Net Services per una Oracle home su un client o un host server locale. È possibile utilizzare Oracle Net Manager per configurare la denominazione, i metodi di denominazione, i profili e i listener. È possibile avviare Oracle Net Manager utilizzando Oracle Enterprise Manager Console o come applicazione indipendente.
-
Assistente alla configurazione di Oracle Net
Questi strumenti vengono eseguiti automaticamente durante l'installazione del software. L'Assistente consente di configurare i componenti di rete di base durante l'installazione, inclusi i nomi dei listener e gli indirizzi di protocollo, i metodi di denominazione, i nomi dei servizi di rete in un file
tnsnames.orae l'uso del server delle directory. -
Utility Controllo del listener
La utility Controllo listener consente di configurare i listener per la ricezione delle connessioni client. È possibile accedere alla utility tramite Enterprise Manager o come applicazione standalone della riga di comando.
-
Utility di controllo di Oracle Connection Manager
Questa utility della riga di comando consente di amministrare un Oracle Connection Manager, ovvero un router tramite il quale una richiesta di connessione client può essere inviata all'hop successivo o direttamente al database. È possibile utilizzare i comandi delle utility per eseguire funzioni di gestione di base su uno o più Oracle Connection Manager. Inoltre, è possibile visualizzare e modificare le impostazioni dei parametri.
Vedere anche:
-
Oracle AI Database Net Services Administrator's Guide per ulteriori informazioni sugli strumenti Oracle Net Services
Strumenti per lo spostamento e l'analisi dei dati
Oracle AI Database include diverse utility che forniscono assistenza nello spostamento e nell'analisi dei dati.
Ad esempio, è possibile utilizzare le utility del database per:
Tabella 2 - Spostamento dei dati e task di analisi
| Task | Per saperne di più |
|---|---|
| Caricare i dati nelle tabelle di Oracle AI Database dai file del sistema operativo | "SQL*Loader" |
| Spostare dati e metadati da un database a un altro | "Esportazione e importazione di Oracle Data Pump" |
| Eseguire una query sui redo log file tramite un'interfaccia SQL | "Oracle LogMiner" |
| Gestire i dati di Oracle AI Database | "ADR Command Interpreter (ADRCI)" |
Altri task includono l'esecuzione di controlli di integrità della struttura di dati fisica su un database o un file di dati non in linea con DBVERIFY o la modifica dell'identificativo del database (DBID) o del nome del database per un database operativo utilizzando la utility DBNEWID.
Nota:
-
SQL*Loader SQL*Loader carica i dati da file esterni, denominati file di dati (da non confondere con i file di dati interni del database), nelle tabelle di database. Dispone di un potente motore per l'analisi dei dati che pone pochi limiti al formato dei dati nel file.
-
Esportazione e importazione di Oracle Data Pump Oracle Data Pump consente lo spostamento ad alta velocità di dati e metadati da un database all'altro.
-
Oracle LogMiner Oracle LogMiner consente di eseguire query sui redo log file tramite un'interfaccia SQL.
-
ADRCI (ADR Command Interpreter) ADRCI è una utility della riga di comando che consente di analizzare i problemi, visualizzare i report sul controllo dell'integrità e creare pacchetti e caricare i dati relativi ai primi errori in Oracle Support.
Vedere anche:
-
"Backup e ripristino" per conoscere gli strumenti relativi a backup e ripristino
-
Oracle AI Database Utilities per saperne di più su DBVERIFY e DBNEWID
SQL*Loader:
SQL*Loader carica i dati da file esterni, denominati file di dati (da non confondere con i file di dati di database interni), nelle tabelle di database. Dispone di un potente motore per l'analisi dei dati che pone pochi limiti al formato dei dati nel file.
È possibile utilizzare SQL*Loader per effettuare le operazioni riportate di seguito.
-
Caricare i dati da più file di dati in più tabelle
Memorizzare i dati da caricare nei file di dati SQL*Loader. Il control file SQL*Loader è un file di testo che contiene le istruzioni DDL utilizzate da SQL*Loader per determinare dove trovare i dati, come analizzarli e interpretarli, dove inserirli e altro ancora.
Nota: i file di dati e il control file SQL*Loader non sono correlati ai file di dati e al control file di Oracle AI Database.
-
Controllare vari aspetti dell'operazione di carico
Ad esempio, è possibile caricare i dati in modo selettivo, specificare il set di caratteri dei dati, manipolare i dati con funzioni SQL, generare valori chiave sequenziali univoci nelle colonne specificate e così via. È inoltre possibile generare report di errore sofisticati.
-
Utilizzare percorsi convenzionali, percorsi diretti o carichi di tabelle esterne
Un caricamento di percorso convenzionale esegue le istruzioni SQL
INSERTper popolare le tabelle. Al contrario, un percorso diretto INSERT elimina gran parte del sovraccarico del database formattando i blocchi di dati e scrivendoli direttamente nei file di dati. Le scritture dirette operano su blocchi al di sopra del valore high water mark (HWM) e scrivono direttamente su disco, ignorando la cache del buffer del database. Letture dirette lette direttamente dal disco nella PGA, ignorando di nuovo la buffer cache.Un caricamento di tabelle esterne crea una tabella esterna per i dati contenuti in un file di dati. Il caricamento esegue le istruzioni
INSERTper inserire i dati del file di dati nella tabella di destinazione.
Una sessione SQL*Loader tipica richiede come input un file di controllo SQL*Loader e uno o più file di dati. L'output è un database Oracle, un file di log, un file errato e, potenzialmente, un file eliminato. La figura seguente illustra il flusso di una sessione SQL*Loader tipica.
Figura 1: Sessione SQL*Loader
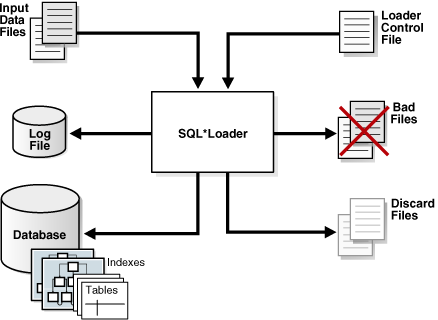
Descrizione dell'illustrazione cncpt271.gif
È inoltre possibile utilizzare la modalità Express di SQL*Loader, che viene attivata quando si specifica il parametro table nel comando SQL*Loader, come nell'esempio riportato di seguito.
% sqlldr hr table=employeesNon è consentito alcun control file, il che rende SQL*Loader più facile da usare. Anziché analizzare un control file, SQL*Loader utilizza le definizioni delle colonne della tabella per determinare i tipi di dati di input. SQL*Loader effettua diverse ipotesi predefinite, tra cui il set di caratteri, i delimitatori di campo e i nomi dei dati, dei log e dei file errati. È possibile sostituire molte delle impostazioni predefinite con parametri della riga di comando.
Vedere anche:
-
Oracle AI Database Utilities per saperne di più su SQL*Loader
Esportazione e importazione di Oracle Data Pump
Oracle Data Pump consente lo spostamento ad alta velocità di dati e metadati da un database all'altro.
Questa tecnologia è la base per le seguenti utility di spostamento dei dati di Oracle AI Database:
-
Esportazione Data Pump (esportazione)
L'esportazione è una utility per lo scaricamento di dati e metadati in un set di file del sistema operativo denominato set di file di dump. Il set di file di dump è costituito da uno o più file binari contenenti dati di tabella, metadati dell'oggetto di database e informazioni di controllo.
-
Importazione Data Pump (importazione)
Import è una utility per il caricamento di un file di dump di esportazione impostato in un database. È inoltre possibile utilizzare Importa per caricare un database di destinazione direttamente da un database di origine senza file intermedi, che consente l'esecuzione contemporanea delle operazioni di esportazione e importazione, riducendo al minimo il tempo trascorso totale.
Oracle Data Pump è composto dalle seguenti parti distinte:
-
Client della riga di comando
expdpeimpdpQuesti client effettuano chiamate al pacchetto
DBMS_DATAPUMPper eseguire le operazioni di Oracle Data Pump. -
Il pacchetto PL/SQL
DBMS_DATAPUMP, noto anche come API Data PumpQuesta API fornisce funzionalità di importazione ed esportazione ad alta velocità.
-
Il package PL/SQL
DBMS_METADATA, noto anche come API MetadataTutti i processi che caricano e scaricano i metadati utilizzano questa API, che memorizza le definizioni degli oggetti in XML.
La figura seguente mostra come Oracle Data Pump si integra con SQL*Loader e tabelle esterne. Come mostrato, SQL*Loader è integrato con l'API tabella esterna e l'API Data Pump per caricare i dati in tabelle esterne. I client, ad esempio Oracle Enterprise Manager Cloud Control (Cloud Control) e le tablespace trasportabili, possono utilizzare l'infrastruttura Oracle Data Pump.
Figura 2: Architettura di Oracle Data Pump
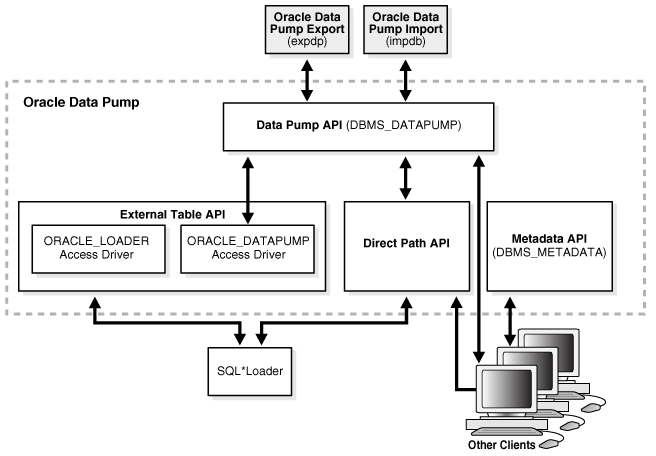
Descrizione dell'illustrazione cncpt261.png
Vedere anche:
-
Oracle AI Database Utilities per una panoramica di Oracle Data Pump
-
Oracle AI Database PL/SQL Packages and Types Reference per una descrizione dei formati
DBMS_DATAPUMPeDBMS_METADATA
Oracle LogMiner
Oracle LogMiner consente di eseguire query sui redo log file tramite un'interfaccia SQL.
I potenziali usi dei dati contenuti nei redo log file includono:
-
Individuazione quando un danneggiamento logico di un database, ad esempio errori eseguiti a livello di applicazione, potrebbe essere iniziato
-
Rilevamento errore utente
-
Determinazione delle azioni da eseguire per eseguire il recupero con filtro a livello di transazione
-
Utilizzo dell'analisi delle tendenze per determinare quali tabelle ottengono il maggior numero di aggiornamenti e inserimenti
-
Analisi del funzionamento del sistema e controllo dell'uso del database tramite l'interfaccia relazionale completa LogMiner per i redo log file
LogMiner è accessibile tramite un'interfaccia a riga di comando o tramite la GUI di Oracle LogMiner Viewer, che fa parte di Enterprise Manager.
Vedi anche: Oracle AI Database Utilities per saperne di più su LogMiner
Interprete comando ADR (ADRCI)
ADRCI è una utility della riga di comando che consente di analizzare i problemi, visualizzare i report sul controllo dell'integrità e caricare i dati relativi ai primi errori nel supporto Oracle.
È inoltre possibile utilizzare la utility per visualizzare i nomi dei file di trace in Automatic Diagnostic Repository (ADR) e per visualizzare il log degli avvisi. ADRCI dispone di un ricco set di comandi che è possibile utilizzare in modo interattivo o in script.
Vedere anche:
-
Oracle AI Database Utilities e Oracle AI Database Administrator's Guide per ulteriori informazioni su ADR e ADRCI
Argomenti per gli amministratori del database
Questa sezione tratta gli argomenti più essenziali per i DBA e che non sono stati discussi altrove nel manuale.
-
Backup e ripristino Backup e ripristino è l'insieme di concetti, procedure e strategie utilizzati per proteggere il database dalla perdita di dati causata da errori dei supporti o degli utenti.
-
La gestione della memoria di Memory Management implica il mantenimento di dimensioni ottimali per la struttura di memoria dell'istanza Oracle al variare delle richieste nel database. Le impostazioni dei parametri di inizializzazione determinano la modalità di gestione della memoria PGA SGA e dell'istanza.
-
Resource Management and Task Scheduling Oracle AI Database fornisce strumenti che ti aiutano a gestire le risorse e a pianificare attività per ridurre l'impatto sugli utenti.
-
Prestazioni e tuning In qualità di DBA, l'utente è responsabile delle prestazioni del database Oracle. In genere, i problemi di prestazioni derivano da un tempo di risposta inaccettabile, ovvero il tempo necessario per completare un carico di lavoro o un throughput specificato, ovvero la quantità di lavoro che è possibile completare in un periodo di tempo specificato.
Backup e recupero
Backup e ripristino è l'insieme di concetti, procedure e strategie coinvolte nella protezione del database dalla perdita di dati causata da errori dei media o degli utenti.
Un backup è una copia di dati. Un backup può includere parti cruciali del database, ad esempio file di dati, file dei parametri del server e control file. Uno scenario di backup e ripristino di esempio è un'unità disco con errori che causa la perdita di un file di dati. Se esiste un backup del file perso, è possibile ripristinarlo e recuperarlo. Le operazioni necessarie per ripristinare i dati allo stato precedente alla perdita sono denominate media recovery.
Questa sezione contiene gli argomenti riportati di seguito.
-
Tecniche di backup e recupero È possibile utilizzare Recovery Manager o tecniche gestite dall'utente per eseguire il backup, il ripristino e il recupero di un database Oracle.
-
Recovery Manager Architecture RMAN e Oracle Secure Backup sono accessibili sia dalla riga di comando che da Enterprise Manager Cloud Control (Cloud Control).
-
Backup database I backup del database possono essere fisici o logici.
-
Riparazione dei dati Sebbene diversi problemi possano interrompere il normale funzionamento di un database o influire sulle operazioni di I/O, solo alcuni problemi richiedono l'intervento del DBA e la riparazione dei dati.
-
Zero Data Loss Recovery Appliance Zero Data Loss Recovery Appliance su scala cloud, comunemente noto come Recovery Appliance, è un sistema di engineering che riduce drasticamente la perdita di dati e il sovraccarico di backup per tutti i database Oracle dell'azienda.
Vedere anche:
-
Guida per l'utente di Oracle AI Database Backup and Recovery per concetti e attività di backup e ripristino
-
Oracle AI Database Administrator's Reference for Microsoft Windows per informazioni su come utilizzare le applicazioni Volume Shadow Copy Service (VSS) per eseguire il backup e il recupero dei database in Microsoft Windows
Tecniche di backup e recupero
Puoi utilizzare Recovery Manager o tecniche gestite dall'utente per eseguire il backup, il ripristino e il recupero di un database Oracle.
Le principali differenze tra i due approcci sono le seguenti:
-
RMAN è una utility di Oracle AI Database che si integra con un database Oracle per eseguire attività di backup e ripristino, inclusa la gestione di un repository di metadati di backup cronologici nel control file di ogni database di cui esegue il backup. RMAN può anche gestire un repository di backup centralizzato denominato catalogo di recupero in un database diverso. RMAN è una funzione di Oracle AI Database e non richiede un'installazione separata.
RMAN è integrato con Oracle Secure Backup, che offre una gestione dei backup su nastro affidabile e centralizzata, proteggendo i dati del file system e i file di Oracle AI Database. L'interfaccia SBT di Oracle Secure Backup consente di utilizzare RMAN per eseguire il backup e il ripristino dei file di database da e verso servizi Web su nastro e basati su Internet, ad esempio Amazon S3. Oracle Secure Backup supporta quasi tutte le unità nastro e le librerie a nastro negli ambienti SAN e SCSI.
-
Tecniche gestite dall'utente
In alternativa a RMAN, è possibile utilizzare i comandi del sistema operativo come Linux
ddper il backup e il ripristino dei file e il comando SQL*PlusRECOVERper il recupero dei supporti. Il backup e il ripristino gestiti dall'utente sono completamente supportati da Oracle, anche se RMAN è consigliato perché è integrato con Oracle AI Database e semplifica l'amministrazione.
Vedere anche:
-
Oracle AI Database Backup and Recovery User's Guide per una panoramica delle soluzioni di backup e ripristino
-
Oracle Secure Backup Administrator's Guide per una panoramica su Oracle Secure Backup
Architettura di Recovery Manager
RMAN e Oracle Secure Backup sono accessibili sia dalla riga di comando che da Enterprise Manager Cloud Control (Cloud Control).
Cloud Control fornisce un front-end grafico e una funzionalità di pianificazione per RMAN. Inserire i parametri del processo, quindi specificare una schedulazione del processo. Cloud Control esegue RMAN all'ora specificata o all'intervallo di ripetizione designato per eseguire le operazioni di backup e ripristino. Cloud Control fornisce l'accesso a RMAN tramite un set di procedure guidate. Queste procedure guidate ti guidano attraverso una varietà di procedure di recupero basate su un'analisi del tuo database, dei tuoi backup disponibili e dei tuoi obiettivi di recupero dati.
Utilizzando Cloud Control, puoi eseguire gli scenari di ripristino e ripristino più semplici descritti in questa documentazione. Puoi anche utilizzare tecniche di ripristino e ripristino più sofisticate, come il ripristino point-in-time e le operazioni Oracle Flashback, che consentono una riparazione efficiente dei guasti dei supporti e degli errori degli utenti. L'uso di Cloud Control è spesso più semplice rispetto al client della riga di comando RMAN.
Il grafico seguente mostra un esempio di architettura RMAN. Il client RMAN, accessibile mediante Cloud Control, utilizza sessioni server in un database di destinazione per eseguire il backup dei dati su disco o nastro. RMAN può aggiornare un Recovery Catalog esterno con metadati di backup.
Figura 3: Architettura RMAN
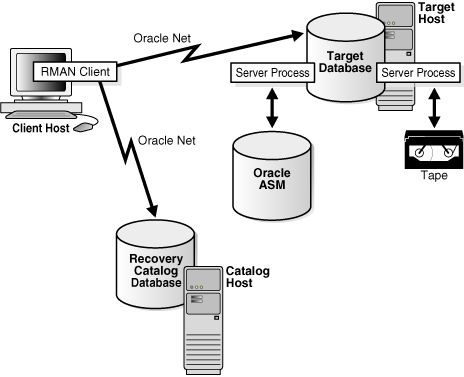
Descrizione dell'illustrazione cncpt318.gif
Indipendentemente dalla tecnica di backup e ripristino utilizzata, Oracle consiglia di configurare un'area di recupero rapido. Questa directory, file system o gruppo di dischi Oracle ASM gestita dal database centralizza i file di backup e ripristino, inclusi i control file attivi, i redo log file in linea e archiviati e i backup. I componenti di ripristino di Oracle AI Database interagiscono con l'area di recupero rapido per garantire la recuperabilità del database.
Vedere anche:
-
Oracle AI Database 2 Day DBA per scoprire come eseguire backup e ripristino con Recovery Manager
-
Oracle AI Database Administrator's Guide per informazioni su come impostare e amministrare l'area di recupero rapido
Backup del database
I backup del database possono essere fisici o logici.
I backup fisici, che sono la preoccupazione principale in una strategia di backup e ripristino, sono copie di file di database fisici. È possibile eseguire backup fisici con le utility RMAN o del sistema operativo.
Al contrario, i backup logici contengono tabelle, stored procedure e altri dati logici. È possibile estrarre dati logici con una utility di Oracle AI Database, ad esempio Esportazione Data Pump, e memorizzarli in un file binario. I backup logici possono integrare i backup fisici.
I backup fisici hanno una grande granularità e una trasportabilità limitata, ma sono molto veloci. I backup logici hanno una granularità fine e una trasportabilità completa, ma sono più lenti dei backup fisici.
-
Backup completi e parziali del database Un backup completo del database è un backup di ogni file di dati nel database, oltre al control file. I backup dell'intero database sono i tipi di backup più comuni.
-
Backup coerenti e incoerenti Un backup dell'intero database è coerente o incoerente.
-
Set di backup e copie di immagini Il comando RMAN
BACKUPgenera copie di immagini o backup set. Vedere anche: Oracle AI Database Backup and Recovery User's Guide per informazioni sui backup fisici e logici
Backup di database interi e parziali
Un backup completo del database è un backup di ogni file di dati nel database, oltre al control file. I backup dell'intero database sono i tipi di backup più comuni.
Un backup parziale del database include un sottoinsieme del database: singole tablespace o file di dati. Il backup di una tablespace è un backup di tutti i file di dati in una tablespace o in più tablespace. I backup delle tablespace, coerenti o incoerenti, sono validi solo se il database funziona in modalità ARCHIVELOG perché è necessario un redo per rendere la tablespace ripristinata coerente con il resto del database.
Backup coerenti e non coerenti
Un backup dell'intero database è coerente o incoerente.
In un backup coerente, tutti i file di dati di lettura/scrittura e i control file hanno lo stesso SCN checkpoint, garantendo che questi file contengano tutte le modifiche fino a questo SCN. Questo tipo di backup non richiede il ripristino dopo il ripristino.
Un backup coerente del database è possibile solo dopo una chiusura coerente ed è l'unica opzione di backup valida per un database che opera in modalità NOARCHIVELOG. Altre opzioni di backup richiedono il recupero dei supporti per garantire la coerenza, il che non è possibile senza applicare i redo log file archiviati. Nota: se si ripristina un backup coerente dell'intero database senza applicare redo, tutte le transazioni effettuate dopo il backup andranno perdute.
In un backup incoerente, non è garantito che i file di dati di lettura/scrittura e i control file abbiano lo stesso SCN del checkpoint, pertanto è possibile che manchino modifiche. Tutti i backup in linea sono necessariamente incoerenti perché i file di dati possono essere modificati durante l'esecuzione dei backup.
I backup incoerenti offrono una disponibilità superiore perché non è necessario arrestare il database per eseguire backup che proteggono completamente il database. Se il database viene eseguito in modalità ARCHIVELOG e se si esegue il backup dei redo log e dei file di dati archiviati, i backup incoerenti possono essere alla base di una strategia di backup e ripristino efficace.
Vedere anche:
-
Oracle AI Database Backup and Recovery User's Guide per ulteriori informazioni sui backup incoerenti
Backup set e copie immagine
Il comando RMAN BACKUP genera copie di immagine o backup set.
I tipi di backup sono diversi come indicato di seguito.
-
Copia immagine
Una copia immagine è una copia bit per bit su disco di un file di dati, di un control file o di un redo log file archiviato. È possibile creare copie di immagini di file fisici con le utility del sistema operativo o RMAN e utilizzare uno degli strumenti per ripristinarli.
Nota: a differenza delle copie del sistema operativo, RMAN convalida i blocchi nel file e registra la copia dell'immagine nel repository RMAN.
-
Backup set
RMAN può anche creare backup in un formato proprietario denominato set di backup. Un backup set contiene i dati di uno o più file di dati, redo log file archiviati o control file o file dei parametri del server. L'unità più piccola di un backup set è un file binario denominato backup piece. I backup set sono l'unica forma in cui RMAN può scrivere i backup su dispositivi sequenziali come le unità nastro.
I set di backup consentono lo streaming continuo dei dispositivi a nastro. Ad esempio, RMAN può combinare blocchi da dischi lenti, medi e veloci in un set di backup in modo che il dispositivo a nastro abbia un input costante di blocchi. Le copie delle immagini sono utili per il disco perché è possibile aggiornarle in modo incrementale e recuperarle in posizione.
Vedere anche: Oracle AI Database Backup and Recovery User's Guide per ulteriori informazioni sui backup set e le copie di immagini
Riparazione dati
Sebbene diversi problemi possano arrestare il normale funzionamento di un database o influire sulle operazioni di I/O, solo alcuni problemi richiedono l'intervento del DBA e la riparazione dei dati.
La riparazione dei dati è in genere necessaria nei seguenti casi:
-
Errori nel supporto
Si verifica un errore del supporto quando un problema esterno al database impedisce la lettura o la scrittura in un file. Gli errori tipici dei supporti includono errori fisici, come crash dell'intestazione del disco e la sovrascrittura, l'eliminazione o il danneggiamento di un file di database. Gli errori dei supporti sono meno comuni degli errori dell'utente o dell'applicazione, ma una solida strategia di backup e ripristino deve prepararsi per loro.
-
Errori utente
Un utente o un'applicazione può apportare modifiche indesiderate al database, ad esempio aggiornamenti errati, eliminazione del contenuto di una tabella o eliminazione di oggetti di database. Una buona strategia di backup e ripristino ti consente di ripristinare lo stato desiderato del database, con il minimo impatto possibile sulla disponibilità del database e il minimo sforzo del DBA.
In genere, sono disponibili diversi modi per risolvere i problemi precedenti. Questa sezione riassume alcune di queste soluzioni.
-
Tecnologia Oracle Flashback Oracle AI Database fornisce un gruppo di funzioni note come Tecnologia Oracle Flashback che supportano la visualizzazione degli stati dei dati passati e la ventilazione dei dati avanti e indietro nel tempo, senza la necessità di ripristinare i backup.
-
Block Media Recovery Il recupero dei supporti a blocchi è una tecnica per il ripristino e il recupero di blocchi di dati danneggiati mentre i file di dati sono online.
-
Recupero file di dati Il recupero file di dati ripristina un file di dati o un control file corrente perso o danneggiato. Può anche recuperare le modifiche perse quando una tablespace è diventata offline senza l'opzione
OFFLINENORMAL.
Vedere anche:
-
Guida per l'utente di Oracle AI Database Backup and Recovery per i concetti relativi alla riparazione dei dati
Tecnologia Oracle Flashback
Oracle AI Database fornisce un gruppo di funzioni note come Oracle Flashback Technology che supportano la visualizzazione degli stati passati dei dati e l'avvolgimento dei dati avanti e indietro nel tempo, senza dover ripristinare i backup.
A seconda delle modifiche al database, le funzionalità di flashback possono spesso invertire le modifiche indesiderate più rapidamente e con meno impatto sulla disponibilità rispetto al recupero dei supporti. Le seguenti funzionalità di flashback sono più rilevanti per il backup e il ripristino:
-
Flashback database
È possibile riavvolgere un CDB o un PDB in un'ora precedente per correggere i problemi causati da danneggiamenti logici dei dati o errori dell'utente. Il database flashback può essere utilizzato anche per completare Data Guard e sincronizzare i database clone. Flashback Database non ripristina o esegue il recupero dei supporti sui file, quindi non è possibile utilizzarlo per correggere errori multimediali come crash del disco.
A livello di PDB, è possibile creare un punto di ripristino PDB e riavvolgere il PDB in questo punto di ripristino senza influire su altri PDB. A livello di CDB, è possibile creare un punto di ripristino CDB.
-
Flashback table
È possibile riavvolgere le tabelle in un point-in-time specificato con una singola istruzione SQL. È possibile ripristinare i dati delle tabelle insieme a indici, trigger e vincoli associati, mentre il database è in linea, annullando le modifiche solo alle tabelle specificate. La tabella di flashback non risolve il danneggiamento fisico, ad esempio dischi danneggiati, segmenti di dati e incoerenze di indice.
-
Flashback Drop
È possibile invertire gli effetti di un'operazione
DROP TABLE. Flashback Drop è sostanzialmente più veloce dei meccanismi di recupero come il recupero point-in-time e non porta alla perdita di transazioni recenti o tempi di inattività.
Vedere anche:
-
Oracle AI Database Backup and Recovery User's Guide per ulteriori informazioni sulle funzioni di flashback
-
Oracle AI Database SQL Language Reference e Oracle AI Database Backup and Recovery Reference per ulteriori informazioni sull'istruzione
FLASHBACK DATABASE
Recupero dei supporti a blocchi
Block media recovery è una tecnica per il ripristino e il recupero di blocchi di dati danneggiati mentre i file di dati sono online.
Un danneggiamento dei blocchi è un blocco di dati non in un formato Oracle riconosciuto o il cui contenuto non è coerente internamente. Se rilevi danneggiamenti dei blocchi e se solo pochi blocchi sono danneggiati, il recupero dei blocchi potrebbe essere preferibile al recupero dei file di dati.
Vedere anche:
-
Oracle AI Database Backup and Recovery User's Guide per informazioni su come eseguire il recupero dei supporti a blocchi
Recupero file di dati
Il recupero dei file di dati ripara un file di dati o un file di controllo corrente perso o danneggiato. Può anche recuperare le modifiche perse quando una tablespace è diventata offline senza l'opzione OFFLINE NORMAL.
Il recupero dei supporti è necessario se si ripristina un backup di un file di dati o di controllo o se un file di dati viene messo offline senza l'opzione OFFLINE NORMAL. Il database non può essere aperto se i file di dati online richiedono il recupero dei supporti, né un file di dati che richiede il recupero dei supporti può essere portato online fino al completamento del recupero dei supporti.
Per ripristinare un backup fisico di un file di dati o di controllo, è necessario ricostruirlo e renderlo disponibile per Oracle AI Database. Per recuperare un backup è necessario applicare i redo log file archiviati per ricostruire le modifiche perse. RMAN può anche recuperare i file di dati con backup incrementali, che contengono solo blocchi di dati modificati dopo un backup precedente.
A differenza del ripristino dell'istanza, che applica automaticamente le modifiche ai file in linea, il recupero dei supporti deve essere richiamato da un utente e applica i redo log file archiviati ai backup ripristinati. Il recupero dei supporti dei file di dati può funzionare solo su file di dati o file di dati offline in un database non aperto da alcuna istanza di database.
Il recupero dei supporti dei file di dati varia a seconda che vengano applicate tutte le modifiche:
-
Completa recupero
Il recupero completo applica a un backup tutte le modifiche di redo contenute nei redo log archiviati e in linea. In genere, si esegue il recupero completo dei supporti dopo che un errore dei supporti danneggia i file di dati o il control file. È possibile eseguire il recupero completo su un database, una tablespace o un file di dati.
-
Recupero incompleto
Il recupero incompleto, chiamato anche recupero point-in-time del database, determina una versione non corrente del database. In questo caso, non si applicano tutti i redo generati dopo il backup ripristinato. In genere, è possibile eseguire il recupero point-in-time del database per annullare un errore utente quando il database Oracle Flashback non è possibile.
Per eseguire il recupero incompleto, è necessario ripristinare tutti i file di dati dai backup creati prima dell'ora in cui si desidera recuperare e quindi aprire il database con l'opzione
RESETLOGSal termine del recupero. La reimpostazione dei log crea un nuovo flusso di numeri di sequenza di log che inizia con la sequenza di log 1.Nota: se sono disponibili i file di dati correnti, Flashback Database è un'alternativa a DBPITR.
La funzione di recupero point-in-time (TSPITR) della tablespace consente di recuperare una o più tablespace in un point-in-time precedente al resto del database.
Vedere anche:
-
Oracle AI Database Backup and Recovery User's Guide per i concetti relativi al recupero dei supporti
Zero Data Loss Recovery Appliance
Zero Data Loss Recovery Appliance su scala cloud, comunemente noto come Recovery Appliance, è un sistema di engineering che riduce drasticamente la perdita di dati e il sovraccarico di backup per tutti i database Oracle nell'azienda.
Integrato con RMAN, Recovery Appliance implementa una strategia di backup e ripristino centralizzata per un numero elevato di database, utilizzando hardware e storage su scala cloud e con tolleranza agli errori. Recovery Appliance convalida continuamente i backup per la recuperabilità.
-
Vantaggi di Recovery Appliance Una Recovery Appliance centralizzata esegue la maggior parte dell'elaborazione di backup e ripristino del database, rendendo più efficiente l'utilizzo dello storage, le prestazioni e la gestibilità dei backup.
-
Ambiente Recovery Appliance Un database protetto è un database client che esegue il backup dei dati in una Recovery Appliance.
Vantaggi di Recovery Appliance
Una Recovery Appliance centralizzata esegue la maggior parte dell'elaborazione di backup e ripristino del database, rendendo più efficiente l'utilizzo dello storage, le prestazioni e la gestibilità dei backup.
I vantaggi principali sono i seguenti:
-
Eliminazione della perdita dei dati
Recovery Appliance elimina l'esposizione alla perdita di dati riscontrata dalla maggior parte dei database nel data center, utilizzando tecnologie come le seguenti:
-
Trasferimento continuo di modifiche di redo dalla SGA di un database protetto a Recovery Appliance, noto come trasporto di redo in tempo reale
-
Replica agli appliance di recupero remoto
-
Backup su nastro automatizzati eseguiti da Recovery Appliance centralizzato
-
Convalida del blocco del database end-to-end
-
-
Overhead di backup minimo
Il sovraccarico di backup sui database server viene ridotto al minimo scaricando il lavoro su Recovery Appliance, che gestisce i backup di più database in un pool di dischi unificato. La strategia di backup incrementale permanente di RMAN prevede l'esecuzione di un backup iniziale di livello 0 su Recovery Appliance, con tutti i backup incrementali successivi al livello 1. Recovery Appliance crea un backup completo virtuale combinando il livello 0 con i backup di livello 1. Recovery Appliance comprime, deduplica e convalida continuamente i backup a livello di blocco.
-
Maggiore visibilità sulla protezione dei dati end-to-end
Cloud Control offre una visione completa e end-to-end del ciclo di vita del backup gestito da Recovery Appliance, dal momento in cui viene avviato il backup RMAN, fino a quando viene memorizzato su disco, nastro o replicato in un Recovery Appliance a valle. L'installazione del plugin Enterprise Manager for Zero Data Loss Recovery Appliance (plugin Recovery Appliance) consente il monitoraggio e l'amministrazione.
-
Protezione su scala cloud
Recovery Appliance si ridimensiona per supportare da decine a centinaia o migliaia di database. I componenti chiave dell'architettura sono i seguenti:
-
Recovery Appliance semplifica la gestione attraverso un criterio di protezione, che definisce un obiettivo della finestra di recupero applicato per ogni database associato al criterio. I criteri di protezione migliorano la gestibilità raggruppando i database in livelli con caratteristiche condivise.
-
Utilizzando i criteri di protezione, Recovery Appliance gestisce lo spazio di storage di backup in base all'obiettivo della finestra di ripristino per ogni database protetto. Questo approccio granulare alla gestione dello spazio orientato al database elimina la necessità di gestire lo spazio a livello di volume di storage, come fanno le appliance di terze parti.
-
Recovery Appliance è in grado di adattarsi agli aumenti del traffico di backup, dell'uso dello storage e del numero di database aggiungendo risorse di computazione e storage in modo semplice e modulare.
-
Ambiente Recovery Appliance
Un database protetto è un database client che esegue il backup dei dati in una Recovery Appliance.
La figura seguente mostra un ambiente di esempio, che include sei database protetti e due Recovery Appliance. Ogni database utilizza il modulo di backup Zero Data Loss Recovery Appliance (Recovery Appliance Backup Module) per i propri backup. Questo modulo è una libreria SBT fornita da Oracle che RMAN utilizza per trasferire i backup sulla rete a Recovery Appliance.
Figura 4: Ambiente Recovery Appliance
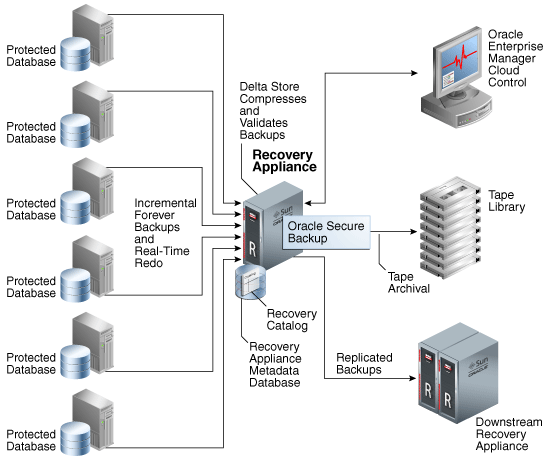
Descrizione dell'immagine amagd_vm_025.png
Il database di metadati Recovery Appliance, che risiede su ogni Recovery Appliance, gestisce i metadati memorizzati nel Recovery Catalog. Tutti i database protetti che inviano backup a Recovery Appliance devono utilizzare questo Recovery Catalog. I backup si trovano nella posizione di storage di Recovery Appliance, che è un set di gruppi di dischi Oracle ASM. Nota: i database possono utilizzare Recovery Appliance come Recovery Catalog senza utilizzarlo anche come repository di backup.
Gli amministratori utilizzano Cloud Control per gestire e monitorare l'ambiente. Cloud Control offre una vista "singola panoramica" dell'intero ciclo di vita del backup per ogni database, indipendentemente dal fatto che i backup risiedano su disco, su nastro o su un'altra Recovery Appliance.
Gestione memoria
La gestione della memoria prevede la conservazione delle dimensioni ottimali per la struttura di memoria dell'istanza Oracle al variare delle richieste nel database. Le impostazioni dei parametri di inizializzazione determinano la modalità di gestione della memoria PGA SGA e dell'istanza. La Figura 22-5 mostra una struttura decisionale per le opzioni di gestione della memoria. Le sezioni seguenti illustrano le opzioni in dettaglio.
Figura 5: Metodi di gestione della memoria
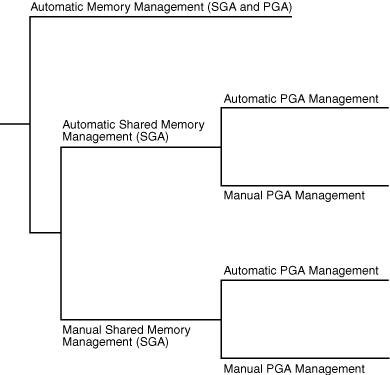
Descrizione dell'illustrazione cncpt242.gif
-
Gestione automatica della memoria Nella gestione automatica della memoria, Oracle AI Database gestisce la memoria SGA e PGA dell'istanza in modo completamente automatico. Questo metodo è il più semplice ed è fortemente consigliato da Oracle.
-
Gestione della memoria condivisa dell'area SGA È possibile controllare manualmente la dimensione dell'area SGA impostando la dimensione dell'area SGA con la gestione automatica della memoria condivisa oppure ottimizzando manualmente i componenti dell'area SGA.
-
Gestione della memoria dell'area PGA dell'istanza Se la gestione automatica della memoria non è abilitata, Oracle AI Database utilizza la gestione automatica o manuale della memoria PGA.
-
Riepilogo dei metodi di gestione della memoria La gestione della memoria è automatica o manuale. Vedi anche: "Architettura della memoria" per ulteriori informazioni su SGA e PGA
Gestione automatica della memoria
Nella gestione automatica della memoria, Oracle AI Database gestisce la memoria SGA e PGA dell'istanza in modo completamente automatico. Questo metodo è il più semplice ed è fortemente consigliato da Oracle.
Gli unici controlli specificati dall'utente sono il parametro di inizializzazione della dimensione della memoria di destinazione (MEMORY_TARGET) e il parametro opzionale di inizializzazione della dimensione massima della memoria (MEMORY_MAX_TARGET). Oracle AI Database esegue il tuning in base alla dimensione della memoria di destinazione, ridistribuendo la memoria in base alle esigenze tra SGA e PGA dell'istanza.
L'area SGA può contenere l'area di memorizzazione colonne in memoria (area di memorizzazione colonne IM) o il pool di memoria, entrambi facoltativi. Indipendentemente dal metodo di gestione della memoria utilizzato, ridimensionare l'area di memorizzazione delle colonne IM con il parametro di inizializzazione INMEMORY_SIZE e il pool memoptimize con il parametro di inizializzazione MEMOPTIMIZE_POOL_SIZE. Le dimensioni dell'area di memorizzazione delle colonne IM sono pool memoptimize inclusi nella destinazione di memoria, ma non gestiti dall'algoritmo di ridimensionamento automatico. Ad esempio, se si imposta MEMORY_TARGET su 5 GB e INMEMORY_SIZE su 1 GB, la destinazione di memoria complessiva è 5 GB (non 6 GB) e INMEMORY_SIZE è sempre 1 GB.
L'immagine riportata di seguito mostra un database che a volte elabora processi sottomessi da utenti in linea e talvolta processi batch. Utilizzando la gestione automatica della memoria, il database regola automaticamente le dimensioni del pool grande e della buffer cache del database a seconda del tipo di job in esecuzione. Si noti che il grafico non rappresenta l'area di memorizzazione delle colonne IM o l'area memoptimize.
Figura 6: Gestione automatica della memoria
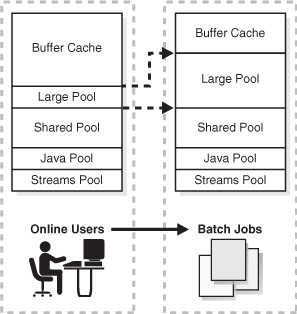
Descrizione dell'illustrazione cncpt256.gif
Se si crea un database con DBCA e si sceglie l'opzione di installazione di base, Oracle AI Database abilita la gestione automatica della memoria per impostazione predefinita.
Vedere anche:
-
Oracle AI Database Administrator's Guide per ulteriori informazioni sulla gestione automatica della memoria
Gestione della memoria condivisa della SGA
È possibile controllare le dimensioni della SGA manualmente, impostando la dimensione SGA con la gestione automatica della memoria condivisa o ottimizzando manualmente i componenti SGA.
Se la gestione automatica della memoria non è abilitata, il sistema deve utilizzare la gestione della memoria condivisa dell'area SGA. La gestione della memoria condivisa è possibile in una delle seguenti forme:
-
Gestione automatica della memoria comune
Questa modalità consente di esercitare un controllo più diretto sulle dimensioni della SGA ed è quella predefinita quando la gestione automatica della memoria è disabilitata. Il database esegue il tuning della SGA totale rispetto alla dimensione di destinazione e, in modo dinamico, esegue il tuning dinamico delle dimensioni dei componenti SGA. Se si utilizza un file dei parametri del server, Oracle AI Database ricorda le dimensioni dei componenti sottoposti a tuning automatico tra le chiusure delle istanze del database.
-
Gestione manuale della memoria comune
In questa modalità, è possibile impostare le dimensioni di diversi singoli componenti SGA e sintonizzare manualmente i singoli componenti SGA su base continuativa. Hai il controllo completo delle dimensioni dei singoli componenti SGA. Per impostazione predefinita, il database utilizza questa modalità quando la gestione automatica della memoria e la gestione automatica della memoria condivisa sono disabilitate.
Nota: quando la gestione automatica della memoria è disabilitata, in alcuni casi il database può regolare automaticamente le dimensioni relative dello shared pool e della buffer cache in base al carico di lavoro dell'utente.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni sulla gestione della memoria condivisa
-
Per ulteriori informazioni sul ridimensionamento automatico in modalità manuale, consultare la nota KB84770 di My Oracle Support:
Gestione della memoria del PGA dell'istanza
Se la gestione automatica della memoria non è abilitata, Oracle AI Database utilizza la gestione automatica o manuale della memoria PGA.
Per la gestione della memoria PGA sono possibili le seguenti modalità:
-
Gestione automatica della memorizzazione PGA
Quando la gestione automatica della memoria (
MEMORY_TARGET) è disabilitata ePGA_AGGREGATE_TARGETè impostato su un valore diverso da zero, il database utilizza la gestione automatica della memoria PGA. In questa modalità,PGA_AGGREGATE_TARGETspecifica una dimensione di destinazione "soft" per la PGA dell'istanza. La destinazione è soft perché si applica solo a tipi specifici di allocazioni di memoria che possono scegliere di utilizzare lo spazio temporaneo anziché il PGA. Il database esegue il tuning della dimensione PGA dell'istanza rispetto a questa destinazione indicata e, dinamicamente, quella delle dimensioni delle singole aree PGA. Se non si imposta esplicitamente una dimensione di destinazione, il database configura automaticamente un valore predefinito ragionevole.Il parametro di inizializzazione
PGA_AGGREGATE_LIMITimposta dinamicamente un limite assoluto a livello di istanza per la memoria PGA. Poiché il parametro risponde alla modifica delle condizioni di memoria, non è necessario impostare il valore del parametro in modo esplicito. Per impostazione predefinita,PGA_AGGREGATE_LIMITè impostato sul valore maggiore tra i seguenti:-
2 GB
-
200% dell'impostazione del parametro di inizializzazione
PGA_AGGREGATE_TARGET -
(Valore dell'impostazione del parametro di inizializzazione
PROCESSES) * 3 MB
Un processo in background confronta periodicamente la dimensione PGA con il limite impostato da
PGA_AGGREGATE_LIMIT. Se il limite viene raggiunto o superato, questo processo interrompe le chiamate per le sessioni utilizzando la memoria PGA più non configurabile. Se queste sessioni non rilasciano ancora abbastanza memoria, vengono interrotte. -
-
Gestione manuale della memoria PGA
Quando la gestione automatica della memoria è disabilitata e
PGA_AGGREGATE_TARGETè impostato su0, per impostazione predefinita il database utilizza la gestione PGA manuale. Le release precedenti di Oracle AI Database richiedevano al DBA di specificare manualmente la dimensione massima dell'area di lavoro per ogni tipo di operatore SQL (ad esempio un ordinamento o un hash join). Questa tecnica si è rivelata molto difficile perché il carico di lavoro è in continua evoluzione. Sebbene Oracle AI Database supporti il metodo manuale di gestione della memoria PGA, Oracle consiglia vivamente la gestione automatica della memoria.
Vedere anche: Oracle AI Database Performance Tuning Guide per ulteriori informazioni sulla gestione della memoria PGA
Riepilogo dei metodi di gestione della memoria
La gestione della memoria è automatica o manuale.
Se non si abilita la gestione automatica della memoria, è necessario configurare separatamente un metodo di gestione della memoria per la SGA e uno per la PGA. Nota: quando la gestione automatica della memoria è disabilitata per l'intera istanza di database, Oracle Database abilita la gestione automatica della memoria PGA per impostazione predefinita.
La tabella seguente include il parametro di inizializzazione INMEMORY_SIZE e il parametro di inizializzazione MEMOPTIMIZE_POOL_SIZE. Entrambe le aree di memoria di controllo sono facoltative.
Tabella 3 Metodi di gestione della memoria
| Istanza | SGA | PGA | Descrizione | Parametri di inizializzazione |
|---|---|---|---|---|
| Automatico | n/d | n/d | Il database ottimizza le dimensioni dell'istanza in base a una dimensione di destinazione a istanza singola. | L'utente ha impostato:
|
| n/d | Automatico | Automatico | Il database ottimizza automaticamente l'SGA in base a una destinazione SGA. Il database ottimizza automaticamente la PGA in base a una destinazione PGA. |
L'utente ha impostato:
Il database configura automaticamente il parametro di inizializzazione |
| n/d | Automatico | Manuale | Il database ottimizza automaticamente l'SGA in base a una destinazione SGA. È possibile controllare manualmente la PGA, impostando la dimensione massima dell'area di lavoro per ogni tipo di operatore SQL. |
L'utente ha impostato:
|
| n/d | Manuale | Automatico | È possibile controllare la SGA manualmente impostando le dimensioni dei singoli componenti. Il database ottimizza automaticamente la PGA in base a una destinazione PGA. |
L'utente ha impostato:
Il database configura automaticamente il parametro di inizializzazione |
| n/d | Manuale | Manuale | È necessario configurare manualmente le dimensioni dei componenti SGA. È possibile controllare manualmente il PGA, impostando la dimensione massima dell'area di lavoro per ogni tipo di operatore SQL. |
È necessario configurare manualmente le dimensioni dei componenti SGA. L'utente ha impostato:
|
Nota a piè di pagina 1
Il database configura automaticamente il parametro di inizializzazione PGA_AGGREGATE_LIMIT. Si sceglie inoltre di impostare questo parametro manualmente.
Nota a piè di pagina 2
Il database configura automaticamente il parametro di inizializzazione PGA_AGGREGATE_LIMIT. Si sceglie inoltre di impostare questo parametro manualmente.
Vedere anche: Oracle AI Database Administrator's Guide perché la gestione automatica della memoria non è disponibile su tutte le piattaforme
Pianificazione di Resource Management e task
Oracle AI Database fornisce strumenti per assisterti nella gestione delle risorse e nella pianificazione delle attività per ridurre l'impatto sugli utenti.
In un database con molti utenti attivi, la gestione delle risorse è una parte importante dell'amministrazione del database. Le sessioni che consumano risorse eccessive possono impedire ad altre sessioni di svolgere il proprio lavoro. Un problema correlato è come pianificare i task in modo che vengano eseguiti al momento migliore. Oracle AI Database fornisce strumenti che aiutano a risolvere questi problemi.
-
Database Resource Manager Oracle AI Database Resource Manager (Resource Manager) fornisce un controllo granulare delle risorse del database allocate agli account utente, alle applicazioni e ai servizi. Resource Manager agisce principalmente come gatekeeper, rallentando l'esecuzione di alcuni job in modo che altri possano essere eseguiti rapidamente.
-
Gestione della CPU A partire da Oracle AI Database 26ai, Oracle offre un metodo alternativo per la gestione delle risorse della CPU, che opera in tutte le istanze di database sul server.
-
Oracle Scheduler Oracle Scheduler (lo scheduler) consente agli amministratori del database e agli sviluppatori di applicazioni di controllare quando e dove vengono eseguiti vari task nell'ambiente di database.
Gestione risorse di database
Oracle AI Database Resource Manager (Resource Manager) fornisce un controllo granulare delle risorse del database allocate agli account utente, alle applicazioni e ai servizi. Resource Manager agisce principalmente come gatekeeper, rallentando l'esecuzione di alcuni job in modo che altri possano essere eseguiti rapidamente.
Il pacchetto PL/SQL DBMS_RESOURCE_MANAGER risolve molti problemi di allocazione delle risorse che un sistema operativo non gestisce bene, tra cui:
-
Sovraccarico eccessivo
-
Pianificazione inefficiente
-
Assegnazione inadeguata delle risorse
-
Incapacità di gestire risorse specifiche del database
Resource Manager aiuta a superare i problemi precedenti offrendo al database un maggiore controllo sull'allocazione delle risorse hardware e sulla definizione delle priorità del lavoro all'interno del database. È possibile classificare le sessioni in gruppi in base agli attributi delle sessioni, quindi allocare le risorse a questi gruppi per ottimizzare l'utilizzo dell'hardware. È possibile utilizzare Resource Manager per impostare i limiti per il consumo di memoria del PDB.
Le risorse vengono allocate agli utenti in base a un piano risorse specificato dall'amministratore del database. Il piano specifica la modalità di distribuzione delle risorse tra i gruppi di consumer di risorse, ovvero le sessioni utente raggruppate in base ai requisiti delle risorse. Una direttiva del piano risorse associa un gruppo di consumer di risorse a un piano e specifica la modalità di allocazione delle risorse al gruppo. La Figura 22-7 mostra un semplice piano delle risorse per un'organizzazione che esegue applicazioni OLTP e applicazioni di reporting contemporaneamente durante il giorno. Il piano attualmente attivo, DAYTIME, alloca le risorse CPU tra tre gruppi di consumer di risorse. In particolare, a OLTP viene assegnato il 75% del tempo CPU, a REPORTS viene assegnato il 15% e a OTHER_GROUPS viene assegnato il restante 10%.
Figura 7: Piano risorse semplice
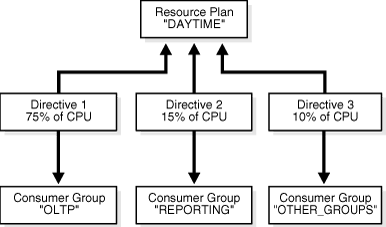
Descrizione dell'illustrazione admin078.gif
Un problema che Resource Manager può risolvere sono le query eseguibili, che possono essere monitorate utilizzando SQL Monitor. Resource Manager consente di specificare le soglie per identificare e rispondere alle istruzioni SQL eseguibili. Ad esempio, è possibile specificare le soglie per il tempo CPU, il tempo trascorso, gli I/O fisici o logici e l'uso PGA in base a ciascun processo in primo piano in un gruppo di consumer. In risposta, Resource Manager può passare a un gruppo di consumer con priorità inferiore, terminare l'istruzione SQL o registrare la violazione della soglia.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come utilizzare Resource Manager
-
Oracle AI Database PL/SQL Packages and Types Reference per informazioni su come utilizzare il package PL/SQL
DBMS_RESOURCE_MANAGER
Gestione CPU
A partire da Oracle AI Database 26ai, Oracle offre un metodo alternativo per la gestione delle risorse CPU, che opera in tutte le istanze di database sul server.
Nelle release precedenti, Oracle offriva un metodo di gestione delle risorse della CPU, che operava all'interno di un'istanza di database. A partire da Oracle AI Database 26ai, è possibile impostare RESOURCE_MANAGER_CPU_SCOPE per controllare l'ambito della gestione delle risorse CPU. Questo parametro consente di scegliere tra i due metodi di controllo.
L'impostazione di RESOURCE_MANAGER_CPU_SCOPE su SERVER_WIDE consente di gestire le risorse CPU tra istanze a livello di server. Introdotto in Oracle AI Database 26ai, questo metodo può essere utilizzato quando più istanze di database condividono un server Linux. Consente la gestione delle risorse CPU in tutte le istanze di database sul server. Con questo metodo, Oracle configura automaticamente i gruppi di controllo (cgroup) Linux con i limiti di condivisione della CPU e di utilizzo della CPU desiderati, quindi inserisce le sessioni di database nei cgroup appropriati.
RESOURCE_MANAGER_CPU_SCOPE è impostato su INSTANCE_ONLY per impostazione predefinita.
Vedere anche:
- Oracle AI Database Administrator's Guide per informazioni sulle opzioni di gestione della CPU.
Oracle Scheduler
Oracle Scheduler (lo scheduler) consente agli amministratori del database e agli sviluppatori di applicazioni di controllare quando e dove vengono eseguiti vari task nell'ambiente di database.
Scheduler fornisce funzionalità di pianificazione aziendale complesse che è possibile utilizzare per:
-
Schedula l'esecuzione del job in base all'ora o agli eventi
-
Pianifica l'elaborazione dei job in modo da modellare i requisiti aziendali
-
Gestire e monitorare i job
-
Eseguire e gestire i job in un ambiente in cluster
Gli oggetti programma (programmi) contengono metadati sul comando che verrà eseguito dallo scheduler, inclusi i valori predefiniti per qualsiasi argomento. Gli oggetti di pianificazione (schedulazioni) contengono informazioni sulla data e l'ora di esecuzione e sui pattern di ricorrenza. Gli oggetti job associano un programma a una pianificazione. Per definire cosa viene eseguito e quando, si assegnano relazioni tra programmi, schedulazioni e job.
Lo scheduler viene implementato come un insieme di funzioni e procedure nel package PL/SQL DBMS_SCHEDULER. È possibile creare e modificare gli oggetti Scheduler con questo package o con Enterprise Manager. Poiché gli oggetti Scheduler sono oggetti di database standard, è possibile controllarne l'accesso con privilegi di sistema e di oggetto. La Figura 22-8 mostra l'architettura di base dello scheduler. La tabella dei job è un contenitore per tutti i job, con una tabella per database. Il processo in background del coordinatore job viene avviato e interrotto automaticamente in base alle esigenze. I processi figlio del job vengono risvegliati dal coordinatore quando è necessario eseguire un job. I processi figlio raccolgono i metadati dalla tabella dei job ed eseguono il job.
Figura 8: Componenti dello scheduler
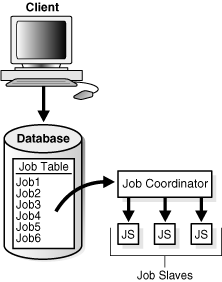
Descrizione dell'illustrazione admin062.gif
Vedere anche:
-
Oracle AI Database Administrator's Guide per ulteriori informazioni sullo scheduler
Prestazioni e tuning
L'amministratore del database Oracle è responsabile delle prestazioni del database. In genere, i problemi di prestazioni derivano da un tempo di risposta inaccettabile, ovvero il tempo necessario per completare un carico di lavoro o un throughput specificato, ovvero la quantità di lavoro che è possibile completare in un periodo di tempo specificato.
I problemi tipici includono:
-
Punti critici della CPU
-
Strutture di memoria sottodimensionate
-
Problemi di capacità di I/O
-
Istruzioni SQL inefficienti o con carichi elevati
-
Imprevista regressione delle prestazioni dopo il tuning delle istruzioni SQL
-
Problemi di concorrenza e conflitti
-
Problemi di configurazione del database
L'obiettivo generale dell'ottimizzazione è di solito quello di migliorare i tempi di risposta, aumentare il throughput o entrambi. Un obiettivo specifico e misurabile potrebbe essere "Ridurre il tempo di risposta dell'istruzione SELECT specificata a meno di 5 secondi". Il fatto che questo obiettivo sia raggiungibile dipende da fattori che possono o meno essere sotto il controllo del DBA. In generale, il tuning è lo sforzo per raggiungere obiettivi di tuning specifici, misurabili e raggiungibili utilizzando le risorse del database nel modo più efficiente possibile.
Il metodo delle prestazioni di Oracle si basa sull'identificazione ed eliminazione dei colli di bottiglia nel database e sullo sviluppo di istruzioni SQL efficienti. L'applicazione del metodo delle prestazioni Oracle prevede quanto riportato di seguito.
-
Esecuzione di preparazioni pre-tuning
-
Tuning proattivo del database su base regolare
-
Ottimizzazione del database in modo reattivo quando gli utenti segnalano problemi di prestazioni
-
Identificazione, ottimizzazione e ottimizzazione di istruzioni SQL ad alto carico
Questa sezione descrive gli aspetti essenziali dell'ottimizzazione delle prestazioni di Oracle AI Database, incluso l'uso di consulenti. I consulenti di Oracle AI Database forniscono suggerimenti specifici per gestire i problemi chiave relativi a numerosi aspetti della gestione del database, quali ad esempio, lo spazio, le prestazioni e gli undo.
-
Auto-monitoraggio del database L'auto-monitoraggio viene eseguito quando il database esegue il suo normale funzionamento, assicurandosi che il database sia a conoscenza dei problemi che si presentano. Oracle AI Database può inviare un avviso generato dal server per avvisarti di un problema imminente.
-
Automatic Workload Repository (AWR) Automatic Workload Repository (AWR) è un repository di dati cronologici sulle prestazioni che include statistiche cumulative per il sistema, le sessioni, le singole istruzioni SQL, i segmenti e i servizi.
-
Automatic Database Monitor (ADDM) Utilizzando le statistiche acquisite in AWR (Automatic Workload Repository), ADDM diagnostica in modo automatico e proattivo le prestazioni del database e determina la modalità di risoluzione dei problemi identificati. È possibile eseguire ADDM anche manualmente.
-
Active Session History (ASH) Active Session History (ASH) analizza le sessioni di database attive ogni secondo, scrivendo i dati in memoria e memorizzazione persistente. ASH è parte integrante della struttura d'autogestione del database ed è molto utile per diagnosticare problemi di prestazioni.
-
Applicazione e SQL Tuning Oracle Database automatizza completamente il processo di SQL Tuning. Vedere anche: Oracle AI Database Introduzione all'ottimizzazione delle prestazioni e Oracle AI Database SQL Tuning Guide forniscono informazioni su come implementare il metodo delle prestazioni Oracle
Monitoraggio automatico del database
L'auto-monitoraggio avviene quando il database esegue il suo normale funzionamento, assicurando che il database sia a conoscenza dei problemi man mano che si presentano. Oracle AI Database può inviare un avviso generato dal server per avvisarti di un problema imminente.
Gli avvisi vengono generati automaticamente quando si verifica un problema o quando i dati non corrispondono ai valori previsti per metriche quali letture fisiche al secondo o tempo di risposta SQL. Una metrica rappresenta la percentuale di modifica in una statistica cumulativa. Gli avvisi generati dal server possono essere basati su livelli di soglia specificati dall'utente o perché si è verificato un evento.
Gli avvisi generati dal server non solo identificano il problema, ma a volte consigliano come il problema segnalato può essere risolto. Un esempio è un avviso che l'area di recupero rapido sta esaurendo lo spazio con il suggerimento che i backup obsoleti dovrebbero essere eliminati o lo spazio su disco aggiuntivo aggiunto.
Vedi anche: Oracle AI Database Administrator's Guide
AWR (Automatic Workload Repository)
Automatic Workload Repository (AWR) è un repository di dati cronologici sulle prestazioni che include statistiche cumulative per il sistema, le sessioni, le singole istruzioni SQL, i segmenti e i servizi.
Le statistiche AWR sono alla base dell'ottimizzazione delle prestazioni. Automatizzando la raccolta delle statistiche del database per il rilevamento e l'ottimizzazione dei problemi, AWR funge da base per l'autogestione del database.
Come mostrato nel grafico seguente, il database memorizza le statistiche AWR recenti nell'area SGA. Per impostazione predefinita, il processo MMON raccoglie le statistiche ogni ora e crea uno snapshot AWR. Per istantanea AWR si intende un set di statistiche delle prestazioni acquisite in un momento specifico. Il database scrive gli snapshot nella tablespace SYSAUX. AWR gestisce lo spazio degli snapshot, rimuovendo gli snapshot meno recenti in base a un criterio di conservazione degli snapshot configurabile.
Figura 9: AWR (Automatic Workload Repository)
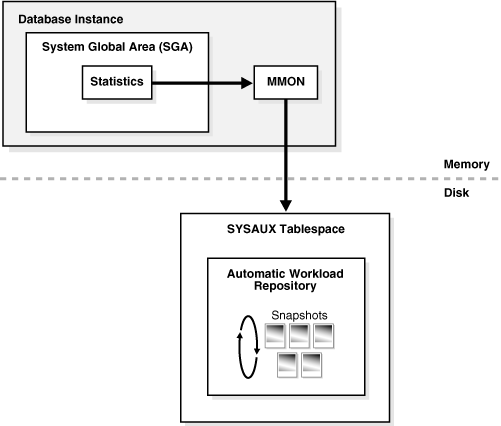
Descrizione dell'illustrazione cncpt279.gif
Una base AWR è una raccolta di tassi di statistica utilizzati in genere in un periodo in cui il sistema si sta comportando bene al massimo carico. È possibile specificare una coppia o un intervallo di snapshot AWR come baseline. Utilizzando un report AWR per confrontare le statistiche acquisite durante un periodo di prestazioni errate con una baseline, è possibile diagnosticare i problemi.
Un'infrastruttura di manutenzione automatica nota come AutoTask illustra in che modo Oracle Database utilizza AWR per l'autogestione. Analizzando i dati AWR, AutoTask può determinare la necessità di task di manutenzione e pianificarne l'esecuzione nelle finestre di manutenzione di Oracle Scheduler. Esempi di task includono la raccolta delle statistiche per l'ottimizzatore e l'esecuzione di Automatic Segment Advisor.
Vedere anche:
-
Oracle AI Database Performance Tuning Guide per ulteriori informazioni su AWR
-
Oracle AI Database Administrator's Guide per informazioni su come gestire i task di manutenzione automatica
ADDM (Automatic Database Monitor)
Utilizzando le statistiche acquisite in AWR (Automatic Workload Repository), ADDM diagnostica in modo automatico e proattivo le prestazioni del database e determina la modalità di risoluzione dei problemi identificati. È possibile eseguire ADDM anche manualmente. ADDM (Automatic Database Diagnostic Monitor) è un motore autodiagnostico integrato in Oracle Database.
ADDM adotta un approccio olistico alle prestazioni del sistema, utilizzando il tempo come valuta comune tra i componenti. ADDM identifica le aree di Oracle Database che richiedono più tempo. Ad esempio, il database potrebbe trascorrere una quantità eccessiva di tempo in attesa di buffer di database gratuiti. ADDM esegue il drill-down per identificare la causa principale dei problemi, anziché solo i sintomi, e segnala l'effetto del problema su Oracle Database in generale. Durante il processo si verifica un sovraccarico minimo.
In molti casi, ADDM consiglia soluzioni e quantifica i benefici attesi delle prestazioni. Ad esempio, ADDM può consigliare modifiche a hardware, configurazione del database, schema di database o applicazioni. Se viene fornito un suggerimento, ADDM segnala il benefit temporale. L'uso del tempo come misura consente confronti di problemi o raccomandazioni.
Oltre a segnalare potenziali problemi di prestazioni, ADDM documenta le aree del database che non rappresentano problemi. Subcomponenti come I/O e memoria che non hanno un impatto significativo sulle prestazioni del database vengono eliminati dalla struttura di classificazione in una fase iniziale. ADDM elenca questi sottocomponenti in modo da poter vedere rapidamente che l'esecuzione di azioni in tali aree presenta pochi vantaggi.
Vedi anche: Oracle AI Database Introduzione al tuning delle prestazioni e Oracle AI Database Performance Tuning Guide
ASH (Active Session History)
Active Session History (ASH) analizza le sessioni di database attive ogni secondo, scrivendo i dati in memoria e storage persistente. ASH è parte integrante della struttura d'autogestione del database ed è molto utile per diagnosticare problemi di prestazioni.
A differenza delle statistiche a livello di istanza raccolte da Automatic Workload Repository (AWR), il database raccoglie le statistiche ASH a livello di sessione. Una sessione attiva è una sessione che utilizza la CPU e non è in attesa di un evento nella classe di attesa inattiva.
È possibile utilizzare gli script Enterprise Manager o SQL per generare report ASH che raccolgono le statistiche delle sessioni raccolte per una durata specificata. È possibile utilizzare i rapporti ASH per:
-
Analisi dei problemi di prestazioni di breve durata non identificati da ADDM (Automatic Database Diagnostic Monitor)
-
Eseguire analisi delle prestazioni definite o specifiche in base alle varie dimensioni o alle loro combinazioni come tempo, sessione, modulo, azione o ID SQL.
Ad esempio, un utente notifica che il database è stato lento tra le 10:00 e le 10:02. Tuttavia, il degrado delle prestazioni di 2 minuti rappresenta una piccola parte dell'intervallo snapshot AWR dalle 10:00 p.m. e dalle 11:00 p.m. e non viene visualizzato nei risultati ADDM. I report ASH possono aiutare a identificare l'origine del problema transitorio.
Vedi anche: Oracle AI Database Introduzione al tuning delle prestazioni e Oracle AI Database Performance Tuning Guide
Tuning delle applicazioni e delle istruzioni SQL
Oracle Database automatizza completamente il processo di SQL tuning.
ADDM identifica le istruzioni SQL che utilizzano risorse di sistema insolitamente elevate e pertanto causano problemi di prestazioni. Inoltre, AWR acquisisce automaticamente le prime istruzioni SQL in termini di consumo di CPU e memoria condivisa. L'identificazione delle istruzioni SQL ad alto carico avviene automaticamente e non richiede alcun intervento.
-
Dichiarazione EXPLAIN PLAN Strumenti quali l'istruzione
EXPLAIN PLANconsentono di visualizzare i piani di esecuzione scelti dall'optimizer. -
Optimizer Statistics Advisor Optimizer Statistics Advisor è un software diagnostico che analizza la modalità di raccolta delle statistiche, l'efficacia dei processi di raccolta delle statistiche esistenti e la qualità delle statistiche raccolte. Optimizer Statistics Advisor utilizza lo stesso framework Advisor di Automatic Database Diagnostic Monitor (ADDM), SQL Performance Analyzer e altri consulenti.
-
SQL Tuning Advisor L'interfaccia per il tuning SQL automatico è SQL Tuning Advisor, che viene eseguito automaticamente durante le finestre di manutenzione del sistema come task di manutenzione.
-
SQL Access Advisor Utilizzare SQL Access Advisor per assistere l'utente nell'analisi delle query SQL e nella determinazione dei modi per ottimizzare gli oggetti dello schema o le query di tuning.
-
SQL Plan Management Gestisci i piani di esecuzione SQL utilizzando la gestione dei piani SQL per eseguire solo piani testati e verificati.
Istruzione EXPLAIN PLAN
Strumenti come l'istruzione EXPLAIN PLAN consentono di visualizzare i piani di esecuzione scelti dall'ottimizzatore.
EXPLAIN PLAN mostra il piano di query per la query SQL specificata se è stata eseguita ora nella sessione corrente. Altri strumenti sono Oracle Enterprise Manager e il comando SQL*Plus AUTOTRACE.
Vedi anche: Oracle AI Database SQL Language Reference per informazioni su EXPLAIN PLAN
Advisor statistiche dell'optimizer
Optimizer Statistics Advisor è un software diagnostico che analizza la modalità di raccolta delle statistiche, l'efficacia dei processi di raccolta delle statistiche esistenti e la qualità delle statistiche raccolte. Optimizer Statistics Advisor utilizza lo stesso framework Advisor di Automatic Database Diagnostic Monitor (ADDM), SQL Performance Analyzer e altri consulenti.
Optimizer Statistics Advisor offre i seguenti vantaggi rispetto all'approccio tradizionale, che si basa sulle best practice:
-
Fornisce report di facile comprensione
-
Fornisce script per implementare le correzioni necessarie senza richiedere modifiche al codice dell'applicazione
-
Esegue un task predefinito denominato
AUTO_STATS_ADVISOR_TASKuna volta al giorno nella finestra di manutenzione -
Fornisce un'API nel package
DBMS_STATSche consente di creare ed eseguire i task manualmente, memorizzare i risultati e i suggerimenti nelle viste del dizionario dati, generare report per i task e implementare le correzioni quando necessario. -
Si integra con strumenti esistenti come Oracle Enterprise Manager (Enterprise Manager)
Optimizer Statistics Advisor gestisce le regole, ovvero gli standard forniti da Oracle in base ai quali l'advisor esegue i controlli. Le regole incorporano le procedure ottimali Oracle in base al set di funzioni corrente. Se le procedure ottimali cambiano da release a release, cambiano anche le regole di Optimizer Statistics Advisor. In questo modo, il consulente fornisce sempre le raccomandazioni più aggiornate.
Optimizer Statistics Advisor ispeziona il processo di raccolta delle statistiche e quindi genera un report dei risultati, ovvero violazioni delle regole. Se l'advisor formula suggerimenti e propone azioni basate su questi suggerimenti, è possibile implementare automaticamente le azioni o generare uno script PL/SQL modificabile ed eseguibile.
Il task Advisor viene eseguito automaticamente nella finestra di manutenzione, ma è anche possibile eseguirlo su richiesta.
Vedere anche:
-
Oracle AI Database SQL Tuning Guide per ulteriori informazioni su Optimizer Statistics Advisor
-
Oracle AI Database PL/SQL Packages and Types Reference per ulteriori informazioni sul package
DBMS_STATS
SQL Tuning Advisor
L'interfaccia per il tuning SQL automatico è SQL Tuning Advisor, che viene eseguito automaticamente durante le finestre di manutenzione del sistema come task di manutenzione.
Durante ogni esecuzione automatica, l'advisor seleziona query SQL ad alto carico nel database e genera suggerimenti per il tuning di queste query.
I suggerimenti di SQL tuning advisor rientrano nelle seguenti categorie:
-
Analisi statistica
-
Profilo SQL
-
Analisi percorso di accesso
-
Analisi della struttura SQL
Un profilo SQL contiene statistiche aggiuntive specifiche di un'istruzione SQL e consente all'ottimizzatore di generare un piano di esecuzione migliore. In sostanza, un profilo SQL è un metodo per analizzare una query. Sia l'analisi del percorso di accesso che quella della struttura SQL sono utili per il tuning di un'applicazione in fase di sviluppo o di produzione interna.
Un vantaggio principale di SQL Tuning Advisor è che le soluzioni provengono dall'ottimizzatore anziché da strumenti esterni. Pertanto, il tuning viene eseguito dal componente di database responsabile dei piani di esecuzione e delle prestazioni SQL. Il processo di tuning può considerare le statistiche di esecuzione passate di un'istruzione SQL e personalizzare le impostazioni dell'ottimizzatore per questa istruzione.
Vedere anche:
SQL Access Advisor
Utilizzare SQL Access Advisor per facilitare l'analisi delle query SQL e determinare i modi per ottimizzare gli oggetti dello schema o le query di tuning.
SQL Access Advisor fornisce suggerimenti su come ottimizzare i percorsi di accesso ai dati. In particolare, è consigliabile migliorare le prestazioni del database mediante il partizionamento, le viste materializzate, gli indici e i log delle viste materializzate.
Gli oggetti dello schema, come partizioni e indici, sono essenziali per ottimizzare query complesse e a uso intensivo di dati. Tuttavia, la creazione e la gestione di questi oggetti possono richiedere molto tempo e i requisiti di spazio possono essere significativi. SQL Access Advisor consente di raggiungere gli obiettivi prestazioni consigliando le strutture di dati per un carico di lavoro specificato.
È possibile eseguire SQL Access Advisor da Enterprise Manager utilizzando una procedura guidata o utilizzando il package DBMS_ADVISOR. DBMS_ADVISOR è costituito da una raccolta di funzioni e procedure di analisi e consulenza richiamabili da qualsiasi programma PL/SQL.
Vedi anche: Oracle AI Database Introduzione al tuning delle prestazioni e Oracle AI Database SQL Tuning Guide
Gestione del piano SQL
Gestisci i piani di esecuzione SQL utilizzando la gestione dei piani SQL per eseguire solo piani testati e verificati.
Per impostazione predefinita, SQL Plan Management (SPM) Evolve Advisor viene eseguito quotidianamente nella finestra di manutenzione pianificata, classifica tutti i piani non accettati ed esegue esecuzioni di test del maggior numero possibile di piani. SPM Evolve Advisor seleziona il piano accettato a costo più basso nella baseline del piano SQL da confrontare con ogni piano non accettato. Se il piano non accettato funziona sufficientemente meglio del piano accettato esistente, il consulente lo accetta.
Se abilitata, SPM ad alta frequenza eseguirà SPM Evolve Advisor in un task periodico in background al di fuori della finestra di manutenzione per consentire miglioramenti delle prestazioni più tempestivi. Il task ad alta frequenza identificherà le istruzioni SQL utilizzando risorse di sistema significative e verificherà se un piano di esecuzione SQL utilizzato in precedenza funziona meglio. In questo caso, verrà creata una nuova baseline del piano SQL per applicare il piano di esecuzione SQL precedente e correggere la regressione delle prestazioni SQL.
A partire da Oracle Database 26ai, se abilitato, l'SPM in tempo reale avvierà immediatamente l'analisi delle prestazioni se un'istruzione SQL utilizza un nuovo piano di esecuzione SQL. Se un piano di esecuzione SQL visualizzato in precedenza funziona meglio, verrà creata immediatamente una nuova baseline del piano SQL senza fare affidamento su un task in background per eseguire questa operazione.
Vedere anche:
-
Oracle AI Database SQL Tuning Guide per ulteriori informazioni su SQL Plan Management