Konzepte für Datenbankadministratoren
Der Skriptcontent auf dieser Seite ist ausschließlich für Navigationszwecke vorgesehen und bewirkt keinerlei Änderung des Contents.
In diesem Teil werden die Aufgaben, Tools und grundlegenden Kenntnisse für Datenbankadministratoren beschrieben.
-
Aufgaben von Datenbankadministratoren Die Hauptverantwortung eines Datenbankadministrators (DBA) besteht darin, Unternehmensdaten für seine Benutzer verfügbar zu machen.
-
Tools für Datenbankadministratoren Oracle bietet mehrere Tools für die Verwaltung einer Datenbank.
-
Themen für Datenbankadministratoren In diesem Abschnitt werden Themen behandelt, die für DBAs am wichtigsten sind und an anderer Stelle im Handbuch nicht behandelt wurden.
Aufgaben von Datenbankadministratoren
Die Hauptverantwortung eines Datenbankadministrators (DBA) besteht darin, den Benutzern Unternehmensdaten zur Verfügung zu stellen.
DBAs müssen eng mit Entwicklern zusammenarbeiten, um sicherzustellen, dass ihre Anwendungen die Datenbank effizient nutzen. Außerdem müssen sie mit Systemadministratoren zusammenarbeiten, um sicherzustellen, dass physische Ressourcen angemessen und effizient genutzt werden.
Oracle DBAs sind dafür verantwortlich, die Oracle AI Database-Architektur und die Funktionsweise der Datenbank zu verstehen. DBAs können die folgenden Aufgaben ausführen:
-
Oracle AI Database-Software installieren, aktualisieren und patchen
-
Entwerfen von Datenbanken, einschließlich der Identifizierung von Anforderungen, Erstellen des logischen Designs (Konzeptmodell) und des physischen Datenbankdesigns
-
Oracle-Datenbanken erstellen
-
Entwicklung und Testen einer Backup- und Recovery-Strategie, regelmäßige Sicherung von Oracle-Datenbanken und Wiederherstellung bei Ausfällen
-
Netzwerkumgebung konfigurieren, damit Clients eine Verbindung zu Datenbanken herstellen können
-
Datenbank hoch- und herunterfahren
-
Speicher für die Datenbank verwalten
-
Verwalten von Benutzern und Sicherheit
-
Datenbankobjekte wie Tabellen, Indizes und Views verwalten
-
Datenbankperformance überwachen und optimieren
-
Untersuchen, Sammeln von Daten für und Melden kritischer Datenbankfehler an Oracle Support Services
-
Evaluieren und Testen neuer Datenbankfunktionen
Die Benutzertypen sowie ihre Rollen und Verantwortlichkeiten hängen von der Datenbankumgebung ab. Eine kleine Datenbank kann über einen DBA verfügen. Eine sehr große Datenbank kann die DBA-Aufgaben auf mehrere Spezialisten aufteilen, z. B. Sicherheitsbeauftragte, Backup-Operatoren und Anwendungsadministratoren.
Siehe:
-
Oracle AI Database 2 Day DBA für eine Einführung in DBA-Aufgaben
-
Oracle AI Database Administrator's Guide für eine ausführlichere Präsentation der DBA-Konzepte und -Aufgaben
Tools für Datenbankadministratoren
Oracle stellt mehrere Tools für die Verwaltung einer Datenbank bereit.
In diesem Abschnitt werden einige häufig verwendete Tools beschrieben.
-
Oracle Enterprise Manager (Enterprise Manager) ist ein webbasiertes Systemverwaltungstool, das die Verwaltung von Oracle-Datenbanken, Exadata-Datenbankmaschinen, Fusion Middleware, Oracle-Anwendungen, Servern, Speicher und nicht von Oracle stammender Hardware und Software bereitstellt.
-
SQL*Plus ist ein interaktives Tool für Batchabfragen, das in jeder Oracle AI Database-Installation enthalten ist.
-
Tools für Datenbankinstallation und -konfiguration Oracle bietet mehrere Tools, um die Installation und Konfiguration von Oracle AI Database-Software zu vereinfachen.
-
Tools for Oracle Net Configuration and Administration Oracle Net Services stellt unternehmensweite Connectivity-Lösungen in verteilten, heterogenen Computing-Umgebungen dar. Mit Oracle Net, einer Komponente von Oracle Net Services, wird eine Netzwerksession von der Clientanwendung zu einer Datenbank ermöglicht.
-
Tools für Data Movement and Analysis Oracle AI Database umfasst mehrere Utilitys zur Unterstützung bei der Datenverschiebung und -analyse.
Oracle Enterprise Manager
Oracle Enterprise Manager (Enterprise Manager) ist ein webbasiertes Systemverwaltungstool, das die Verwaltung von Oracle-Datenbanken, Exadata-Datenbankmaschinen, Fusion Middleware, Oracle-Anwendungen, Servern, Speicher und nicht von Oracle stammender Hardware und Software bereitstellt.
-
Oracle Enterprise Manager Cloud Control Oracle Enterprise Manager Cloud Control (Cloud Control) ist eine webbasierte Schnittstelle, die dem Administrator eine vollständige Überwachung über den Oracle-Technologie-Stack und Nicht-Oracle-Komponenten hinweg bietet.
-
Oracle Enterprise Manager Database Express 12c Oracle Enterprise Manager Database Express (EM Express) ist ein Webmanagementprodukt, das in die Oracle-Datenbank integriert ist. Es erfordert keine spezielle Installation oder Verwaltung.
Oracle Enterprise Manager Cloud Control
Oracle Enterprise Manager Cloud Control (Cloud Control) ist eine webbasierte Schnittstelle, die dem Administrator eine vollständige Überwachung über den gesamten Oracle-Technologie-Stack und Nicht-Oracle-Komponenten bietet.
Manchmal ist eine Komponente der Fast Application Notification (FAN) nicht mehr verfügbar, oder es treten Leistungsprobleme auf. In diesem Fall zeigt Cloud Control den automatisch generierten Alert an, damit der Administrator die entsprechende Wiederherstellungsaktion ausführen kann.
Zu den Komponenten von Cloud Control gehören:
-
Oracle Management Service (OMS)
Das OMS-Feature ist eine Gruppe von J2EE-Anwendungen, die das Interface für Cloud Control wiedergibt, mit allen Oracle-Management-Agents zusammenarbeitet, um Überwachungsinformationen zu verarbeiten, und das Enterprise Manager-Repository als persistenten Datenspeicher verwendet.
-
Oracle-Management-Agents
Diese Agents sind Prozesse, die auf jedem überwachten Host bereitgestellt werden, um alle Ziele auf dem Host zu überwachen, diese Informationen an OMS zu übermitteln und den Host und seine Ziele zu verwalten.
-
Oracle Management Repository
Das Repository ist ein Schema in einer Oracle-Datenbank, das alle verfügbaren Informationen zu Administratoren, Zielen und Anwendungen enthält, die von Cloud Control verwaltet werden.
Siehe:
-
Oracle AI Database Administrator's Guide, in dem Sie erfahren, wie Sie mit Cloud Control eine Datenbank verwalten
-
Onlinehilfe für Cloud Control
Oracle Enterprise Manager Database Express 12c
Oracle Enterprise Manager Database Express (EM Express) ist ein Web-Management-Produkt, das in die Oracle-Datenbank integriert ist. Es erfordert keine spezielle Installation oder Verwaltung.
EM Express enthält die wichtigsten Seiten für das Performance-Management und die grundlegende Administration in Cloud Control. Diese Seiten umfassen:
-
Datenbank-Homepage
-
Echtzeit-SQL-Monitoring
-
ASH-Analyse
Sie können online über die EM Express-Konsole und offline über die Active Reports-Technologie auf diese Features zugreifen. Aus architektonischer Sicht verfügt EM Express über keine Mid-Tier- oder Middleware-Komponenten, wodurch der Overhead auf dem Datenbankserver vernachlässigbar ist.
Mit EM Express können Sie administrative Aufgaben wie die Verwaltung der Benutzersicherheit und die Verwaltung von Datenbankspeicher und -speicher ausführen. Sie können auch Performance- und Statusinformationen zur Datenbank prüfen.
Siehe auch: Unter Oracle AI Database – Erste Schritte mit Performance Tuning erfahren Sie, wie Sie die Datenbank mit EM Express verwalten.
SQL*Plus
SQL*Plus ist ein interaktives Tool für Batchabfragen, das in jeder Oracle AI Database-Installation enthalten ist.
Es verfügt über eine Befehlszeilen-Benutzeroberfläche, die bei der Anmeldung bei der Datenbank als Client agiert. SQL*Plus verfügt über eigene Befehle und eine eigene Umgebung. Sie können SQL-, PL/SQL-, SQL*Plus- und Betriebssystembefehle eingeben und ausführen, um Aufgaben wie die folgenden auszuführen:
-
Formatieren, Berechnungen ausführen, speichern und aus Abfrageergebnissen drucken
-
Tabellen- und Objektdefinitionen untersuchen
-
Batchskripte entwickeln und ausführen
-
Datenbanken verwalten
Sie können SQL*Plus verwenden, um Berichte interaktiv und als Batchprozesse zu generieren. Sie können die Ergebnisse in eine Textdatei, auf dem Bildschirm oder zum Durchsuchen im Internet in eine HTML-Datei ausgeben. Mit der HTML-Ausgabefunktion können Sie Berichte dynamisch generieren.
Siehe auch: SQL*Plus-Benutzerdokumentation und -Referenz, um mehr über SQL*Plus zu erfahren
Tools für Datenbankinstallation und -konfiguration
Oracle stellt mehrere Tools bereit, um die Installation und Konfiguration von Oracle AI Database-Software zu vereinfachen.
In der folgenden Tabelle werden unterstützte Tools beschrieben.
Tabelle 1: Tools für die Datenbankinstallation und -konfiguration
| Tool | Beschreibung | Weitere Infos |
|---|---|---|
| Oracle Universal Installer (OUI) | OUI ist ein GUI-Utility, mit dem Sie Oracle AI Database-Software anzeigen, installieren und deinstallieren können. Die Onlinehilfe führt Sie durch die Installation. | Onlinehilfe, die Sie durch die Installation führt |
| Assistent für Datenbank-Upgrade (DBUA) | DBUA führt Sie interaktiv durch ein Datenbankupgrade und konfiguriert die Datenbank für das neue Release. DBUA automatisiert das Upgrade, indem alle Aufgaben ausgeführt werden, die normalerweise manuell ausgeführt werden. DBUA gibt Empfehlungen für Konfigurationsoptionen wie Tablespaces und das Online-Redo-Log aus. | Oracle AI Database 2 Day DBA, um zu erfahren, wie Sie eine Datenbank mit DBUA upgraden |
| Datenbank-Konfigurationsassistent (DBCA) | DBCA stellt eine grafische Oberfläche und den geführten Workflow zum Erstellen und Konfigurieren einer Datenbank dar. Mit diesem Tool können Sie eine Datenbank aus von Oracle bereitgestellten Templates erstellen oder eine eigene Datenbank und eigene Templates erstellen. | Oracle AI Database - Administratordokumentation, in der Sie erfahren, wie Sie eine Datenbank mit DBCA erstellen |
Tools für Oracle Net-Konfiguration und -Administration
Oracle Net Services stellt unternehmensweite Connectivity-Lösungen in verteilten, heterogenen Computing-Umgebungen dar. Mit Oracle Net, einer Komponente von Oracle Net Services, wird eine Netzwerksession von der Clientanwendung zu einer Datenbank ermöglicht.
Mit den folgenden Tools können Sie Oracle Net Services konfigurieren und verwalten:
-
Oracle Net Manager
Mit diesem Tool können Sie Oracle Net Services für ein Oracle Home auf einem lokalen Client- oder Serverhost konfigurieren. Mit Oracle Net Manager können Sie Benennungs-, Benennungsmethoden, Profile und Listener konfigurieren. Sie können Oracle Net Manager mit der Oracle Enterprise Manager-Konsole oder als unabhängige Anwendung starten.
-
Oracle Net-Konfigurationsassistent
Diese Tools werden während der Softwareinstallation automatisch ausgeführt. Mit dem Assistenten können Sie während der Installation grundlegende Netzwerkkomponenten konfigurieren, einschließlich Listener-Namen und Protokolladressen, Benennungsmethoden, Net Service-Namen in einer
tnsnames.ora-Datei und Directory-Server-Verwendung. -
Listener Control-Utility
Mit dem Utility Listener Control können Sie Listener für den Empfang von Clientverbindungen konfigurieren. Sie können auf das Utility über Enterprise Manager oder als Standalone-Befehlszeilenanwendung zugreifen.
-
Oracle Connection Manager Control-Utility
Mit diesem Befehlszeilenutility können Sie einen Oracle Connection Manager verwalten. Dabei handelt es sich um einen Router, über den eine Clientverbindungsanforderung entweder an den nächsten Hop oder direkt an die Datenbank gesendet werden kann. Mit Utilitybefehlen können Sie grundlegende Verwaltungsfunktionen für einen oder mehrere Oracle Connection Manager ausführen. Außerdem können Sie Parametereinstellungen anzeigen und ändern.
Siehe:
-
Oracle AI Database Net Services Administrator's Guide, um mehr über Oracle Net Services-Tools zu erfahren
Tools für Datenverschiebung und -analyse
Oracle AI Database umfasst mehrere Dienstprogramme zur Unterstützung bei der Datenverschiebung und -analyse.
Beispiel: Mit Datenbankutilitys können Sie:
Tabelle 2: Aufgaben zum Verschieben und Analysieren von Daten
| Aufgabe | Weitere Infos |
|---|---|
| Daten aus Betriebssystemdateien in Oracle AI Database-Tabellen laden | "SQL*Loader" |
| Daten und Metadaten von einer Datenbank in eine andere verschieben | "Oracle Data Pump - Export und Import" |
| Redo Log-Dateien über eine SQL-Schnittstelle abfragen | "Oracle LogMiner" |
| Oracle AI Database-Daten verwalten | "ADR-Befehlsdolmetscher (ADRCI)" |
Weitere Aufgaben umfassen die Durchführung von Integritätsprüfungen der physischen Datenstruktur in einer Offlinedatenbank oder Datendatei mit DBVERIFY oder die Änderung der Datenbank-ID (DBID) oder des Datenbanknamens für eine operative Datenbank mit dem DBNEWID-Utility.
Hinweis:
-
SQL*Loader SQL*Loader lädt Daten aus externen Dateien, den so genannten Datendateien (nicht zu verwechseln mit den internen Datendateien der Datenbank), in Datenbanktabellen. Es verfügt über eine leistungsstarke Datenanalyse-Engine, die kaum Einschränkungen des Formats der Daten in der Datendateien vorgibt.
-
Oracle Data Pump-Export und -Import Oracle Data Pump ermöglicht das schnelle Verschieben von Daten und Metadaten von einer Datenbank in eine andere.
-
Mit Oracle LogMiner Oracle LogMiner können Sie Redo-Logdateien über eine SQL-Schnittstelle abfragen.
-
ADR Command Interpreter (ADRCI) ADRCI ist ein Befehlszeilenutility, mit dem Sie Probleme untersuchen, Health-Check-Berichte anzeigen sowie First-Failure-Daten in ein Package integrieren und in Oracle Support hochladen können.
Siehe:
-
"Backup und Recovery", um mehr über Tools für Backup und Recovery zu erfahren
-
Oracle AI Database-Utilitys, um mehr über DBVERIFY und DBNEWID zu erfahren
SQL*Loader
SQL*Loader lädt Daten aus externen Dateien, die als Datendateien bezeichnet werden (nicht zu verwechseln mit den internen Datendateien der Datenbank), in Datenbanktabellen. Es verfügt über eine leistungsstarke Datenanalyse-Engine, die kaum Einschränkungen des Formats der Daten in der Datendateien vorgibt.
Mit SQL*Loader können Sie:
-
Daten aus mehreren Datendateien in mehrere Tabellen laden
Sie speichern die Daten, die in SQL*Loader-Datendateien geladen werden sollen. Die SQL*Loader-Kontrolldatei ist eine Textdatei, die DDL-Anweisungen enthält, mit denen SQL*Loader bestimmt, wo die Daten zu finden sind, wie sie geparst und interpretiert werden, wo sie eingefügt werden sollen und vieles mehr.
Hinweis: Die SQL*Loader-Datendateien und die Kontrolldatei beziehen sich nicht auf die Oracle AI Database-Datendateien und die Kontrolldatei.
-
Steuerung verschiedener Aspekte des Lastbetriebs
Beispiel: Sie können Daten selektiv laden, den Datenzeichensatz angeben, die Daten mit SQL-Funktionen bearbeiten, eindeutige sequenzielle Schlüsselwerte in angegebenen Spalten generieren usw. Sie können auch komplexe Fehlerberichte generieren.
-
Verwenden Sie herkömmliche Pfad-, Direct Path- oder externe Tabellenladevorgänge
Beim Laden eines herkömmlichen Pfads werden SQL-Anweisungen
INSERTausgeführt, um Tabellen aufzufüllen. Im Gegensatz dazu eliminiert ein Direct Path INSERT einen Großteil des Datenbank-Overheads, indem Datenblöcke formatiert und direkt in die Datendateien geschrieben werden. Direkte Schreibvorgänge werden an Blöcken über der High Water Mark (HWM) ausgeführt und direkt auf den Datenträger geschrieben. Dabei wird der Datenbankpuffercache umgegangen. Direkte Lesevorgänge, die direkt von der Festplatte in die PGA gelesen werden, umgehen erneut den Puffercache.Beim Laden einer externen Tabelle wird eine externe Tabelle für Daten erstellt, die in einer Datendatei enthalten sind. Beim Laden werden
INSERT-Anweisungen ausgeführt, um die Daten aus der Datendatei in die Zieltabelle einzufügen.
Eine typische SQL*Loader-Session übernimmt als Eingabe eine SQL*Loader-Kontrolldatei und eine oder mehrere Datendateien. Die Ausgabe ist eine Oracle-Datenbank, eine Log-Datei, eine fehlerhafte Datei und möglicherweise eine Discard-Datei. Die folgende Abbildung veranschaulicht den Ablauf einer typischen SQL*Loader-Session.
Abbildung 1: SQL*Loader-Session
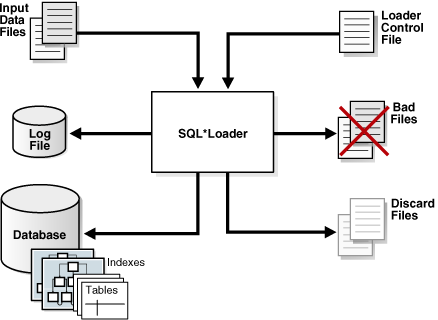
Beschreibung der Abbildung cncpt271.gif
Sie können auch den SQL*Loader-Expressmodus verwenden, der aktiviert wird, wenn Sie den Parameter table im SQL*Loader-Befehl angeben, wie im folgenden Beispiel dargestellt:
% sqlldr hr table=employeesEs ist keine Kontrolldatei zulässig, was die Verwendung von SQL*Loader vereinfacht. Anstatt eine Kontrolldatei zu parsen, verwendet SQL*Loader die Tabellenspaltendefinitionen, um die Eingabedatentypen zu bestimmen. SQL*Loader nimmt mehrere Default-Annahmen vor, einschließlich Zeichensatz, Feldbegrenzungszeichen und Namen von Daten, Log-Dateien und fehlerhaften Dateien. Sie können viele der Standardwerte mit Befehlszeilenparametern überschreiben.
Siehe:
-
Oracle AI Database-Dienstprogramme, um mehr über SQL*Loader zu erfahren
Oracle Data Pump exportieren und importieren
Mit Oracle Data Pump können Daten und Metadaten schnell von einer Datenbank in eine andere verschoben werden.
Diese Technologie ist die Grundlage für die folgenden Oracle AI Database-Dienstprogramme zur Datenverschiebung:
-
Data Pump-Export (Export)
Export ist ein Utility zum Entladen von Daten und Metadaten in eine Gruppe von Betriebssystemdateien, die als Dump File Set bezeichnet werden. Das Dumpdateiset besteht aus einer oder mehreren Binärdateien, die Tabellendaten, Datenbankobjektmetadaten und Kontrollinformationen enthalten.
-
Data Pump-Import (Import)
Import ist ein Utility zum Laden eines Exportdumpdateisets in eine Datenbank. Mit dem Import können Sie auch eine Zieldatenbank direkt aus einer Quelldatenbank ohne zwischengeschaltete Dateien laden. Dadurch können Export- und Importvorgänge gleichzeitig ausgeführt werden, wodurch die gesamte verstrichene Zeit minimiert wird.
Oracle Data Pump besteht aus den folgenden eindeutigen Teilen:
-
Die Befehlszeilenclients
expdpundimpdpDiese Clients rufen das
DBMS_DATAPUMP-Package auf, um Oracle Data Pump-Vorgänge auszuführen. -
Das PL/SQL-Package
DBMS_DATAPUMP, auch als Data Pump-API bezeichnetDiese API bietet schnelle Import- und Exportfunktionen.
-
Das PL/SQL-Package
DBMS_METADATA, auch als Metadaten-API bezeichnetAlle Prozesse, die Metadaten laden und entladen, verwenden diese API, die Objektdefinitionen in XML speichert.
In der folgenden Abbildung wird dargestellt, wie Oracle Data Pump mit SQL*Loader und externen Tabellen integriert wird. Wie gezeigt, ist SQL*Loader in die API für externe Tabellen und die Data Pump-API integriert, um Daten in externe Tabellen zu laden. Clients wie Oracle Enterprise Manager Cloud Control (Cloud Control) und Transportable Tablespaces können die Oracle Data Pump-Infrastruktur verwenden.
Abbildung 2: Oracle Data Pump-Architektur
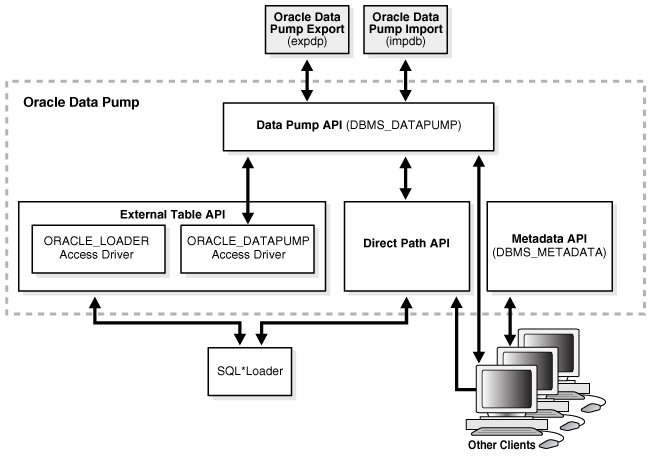
Beschreibung der Abbildung cncpt261.png
Siehe:
-
Oracle AI Database-Utilitys für einen Überblick über Oracle Data Pump
-
Oracle AI Database PL/SQL Packages and Types Reference für eine Beschreibung von
DBMS_DATAPUMPundDBMS_METADATA
Oracle LogMiner
Mit Oracle LogMiner können Sie Redo Log-Dateien über eine SQL-Schnittstelle abfragen.
Mögliche Anwendungen für Daten in Redo Log-Dateien umfassen:
-
Ermitteln, wann eine logische Beschädigung einer Datenbank, z. B. Fehler auf Anwendungsebene, begonnen haben kann
-
Benutzerfehler wird erkannt
-
Festlegen, welche Aktionen Sie ausführen müssen, um ein feingranuliertes Recovery auf Transaktionsebene durchzuführen
-
Mit Trendanalysen bestimmen, welche Tabellen die meisten Aktualisierungen und Einfügungen erhalten
-
Analyse des Systemverhaltens und der Verwendung von Auditingdatenbanken über die umfassende relationale Schnittstelle LogMiner zu Redo-Logdateien
Der Zugriff auf LogMiner erfolgt über eine Befehlszeilenschnittstelle oder über die Oracle LogMiner Viewer-GUI, die Bestandteil von Enterprise Manager ist.
Siehe auch: Oracle AI Database Utilities, um mehr über LogMiner zu erfahren
ADR Command Interpreter (ADRCI)
ADRCI ist ein Befehlszeilenutility, mit dem Sie Probleme untersuchen, Health-Check-Berichte anzeigen sowie First-Failure-Daten in ein Package integrieren und in Oracle Support hochladen können.
Sie können das Utility auch verwenden, um die Namen der Tracedateien im Automatic Diagnostic Repository (ADR) anzuzeigen und das Alertlog anzuzeigen. ADRCI verfügt über einen umfangreichen Befehlssatz, den Sie interaktiv oder in Skripten verwenden können.
Siehe:
-
Oracle AI Database Utilities und Oracle AI Database Administrator's Guide für weitere Informationen zu ADR und ADRCI
Themen für Datenbankadministratoren
In diesem Abschnitt werden Themen behandelt, die für DBAs am wichtigsten sind und an anderer Stelle im Handbuch nicht behandelt wurden.
-
Backup und Recovery von Backup und Recovery sind Konzepte, Prozeduren und Strategien zum Schutz der Datenbank vor Datenverlust, die durch Mediafehler oder Benutzerfehler verursacht werden.
-
Bei der Speicherverwaltung von Memory Management werden optimale Größen für die Speicherstrukturen der Oracle-Instanz beibehalten, während sich Anforderungen an die Datenbank ändern. Initialisierungsparametereinstellungen bestimmen, wie der SGA- und Instanz-PGA-Speicher verwaltet wird.
-
Resource Management und Aufgabenplanung Oracle AI Database bietet Tools, die Sie bei der Verwaltung von Ressourcen und bei der Planung von Aufgaben unterstützen, um die Auswirkungen auf Benutzer zu reduzieren.
-
Performance und Tuning Als DBA sind Sie verantwortlich für die Performance der Oracle-Datenbank. In der Regel resultieren Performanceprobleme aus inakzeptablen Antwortzeiten, d.h. der Zeit bis zum Abschluss einer bestimmten Workload, oder dem Durchsatz, d.h. dem Umfang der Arbeit, die in einer bestimmten Zeit abgeschlossen werden kann.
Backup und Wiederherstellung
Backup und Recovery sind Konzepte, Prozeduren und Strategien zum Schutz der Datenbank vor Datenverlust, die durch Mediafehler oder Benutzerfehler verursacht werden.
Ein Backup ist eine Kopie von Daten. Ein Backup kann wichtige Teile der Datenbank enthalten, wie Datendateien, die Serverparameterdatei und die Kontrolldatei. Ein Beispielszenario für Backup und Recovery ist ein ausgefallenes Festplattenlaufwerk, das den Verlust einer Datendatei verursacht. Wenn ein Backup der verlorenen Datei vorhanden ist, können Sie sie wiederherstellen und wiederherstellen. Die Vorgänge, die an der Wiederherstellung von Daten in den Zustand vor dem Verlust beteiligt sind, werden als Medien-Recovery bezeichnet.
Der vorliegende Abschnitt umfasst die folgenden Themen:
-
Backup- und Recovery-Techniken Sie können entweder Recovery Manager oder vom Benutzer verwaltete Techniken verwenden, um eine Oracle-Datenbank zu sichern, wiederherzustellen und wiederherzustellen.
-
Auf Recovery Manager Architecture RMAN und Oracle Secure Backup kann sowohl über die Befehlszeile als auch über Enterprise Manager Cloud Control (Cloud Control) zugegriffen werden.
-
Datenbankbackups von Datenbankbackups können physisch oder logisch sein.
-
Datenreparatur Während mehrere Probleme den normalen Betrieb einer Datenbank stoppen oder sich auf I/O-Vorgänge auswirken können, erfordern nur einige Probleme einen Eingriff des DBA und eine Datenreparatur.
-
Zero Data Loss Recovery Appliance Die Cloud-basierte Zero Data Loss Recovery Appliance, allgemein bekannt als Recovery Appliance, ist ein Engineered System, das den Datenverlust und den Backup-Overhead für alle Oracle Databases im Unternehmen drastisch reduziert.
Siehe:
-
Oracle AI Database Backup and Recovery - Benutzerhandbuch für Backup- und Recovery-Konzepte und -Aufgaben
-
Oracle AI Database Administrator's Reference for Microsoft Windows, in der beschrieben wird, wie Sie mit Volume Shadow Copy Service-(VSS-)Anwendungen Datenbanken unter Microsoft Windows sichern und wiederherstellen
Backup- und Recovery-Techniken
Mit Recovery Manager oder benutzerverwalteten Techniken können Sie eine Oracle-Datenbank sichern, wiederherstellen und wiederherstellen.
Die Hauptunterschiede zwischen den beiden Ansätzen sind wie folgt:
-
Wiederherstellungsmanager (RMAN)
RMAN ist ein Oracle AI Database-Utility, das in eine Oracle-Datenbank integriert wird, um Backup- und Recovery-Aktivitäten auszuführen. Dazu gehört auch die Verwaltung eines Repositorys historischer Backupmetadaten in der Kontrolldatei jeder Datenbank, die es sichert. RMAN kann auch ein zentrales Backup-Repository verwalten, das als Recovery-Katalog bezeichnet wird, in einer anderen Datenbank. RMAN ist ein Feature von Oracle AI Database und erfordert keine separate Installation.
RMAN ist in Oracle Secure Backup integriert, das eine zuverlässige, zentralisierte Bandbackupverwaltung bietet und Dateisystemdaten und Oracle AI Database-Dateien schützt. Mit der SBT-Schnittstelle von Oracle Secure Backup können Sie mit RMAN Datenbankdateien in und aus band- und internetbasierten Webservices wie Amazon S3 sichern und wiederherstellen. Oracle Secure Backup unterstützt fast jedes Bandlaufwerk und jede Bandbibliothek in SAN- und SCSI-Umgebungen.
-
Benutzerverwaltete Techniken
Alternativ zu RMAN können Sie Betriebssystembefehle wie Linux
ddzum Sichern und Wiederherstellen von Dateien und den SQL*Plus-BefehlRECOVERzum Media Recovery verwenden. Vom Benutzer verwaltetes Backup und Recovery wird von Oracle vollständig unterstützt. RMAN wird jedoch empfohlen, da es in Oracle AI Database integriert ist und die Administration vereinfacht.
Siehe:
-
Oracle AI Database Backup and Recovery - Benutzerhandbuch für einen Überblick über Backup- und Recovery-Lösungen
-
Oracle Secure Backup Administrator's Guide: Überblick über Oracle Secure Backup
Recovery Manager-Architektur
Auf RMAN und Oracle Secure Backup kann sowohl über die Befehlszeile als auch über Enterprise Manager Cloud Control (Cloud Control) zugegriffen werden.
Cloud Control bietet eine grafische Frontend- und Planungsfunktion für RMAN. Sie geben Jobparameter ein und geben dann einen Jobplan an. Cloud Control führt RMAN zum angegebenen Zeitpunkt oder zu dem angegebenen Wiederholungsintervall aus, um die Backup- und Recovery-Vorgänge auszuführen. Cloud Control ermöglicht den Zugriff auf RMAN über eine Reihe von Assistenten. Diese Assistenten führen Sie durch eine Vielzahl von Recovery-Prozeduren, die auf einer Analyse Ihrer Datenbank, Ihrer verfügbaren Backups und Ihrer Daten-Recovery-Ziele basieren.
Mit Cloud Control können Sie die in dieser Dokumentation beschriebenen einfacheren Wiederherstellungs- und Recovery-Szenarios ausführen. Sie können auch anspruchsvollere Wiederherstellungs- und Recovery-Techniken wie Point-in-Time Recovery und Oracle Flashback-Vorgänge verwenden, die eine effiziente Reparatur von Medienfehlern und Benutzerfehlern ermöglichen. Die Verwendung von Cloud Control ist oft einfacher als der RMAN-Befehlszeilenclient.
Die folgende Grafik zeigt eine RMAN-Beispielarchitektur. Der über Cloud Control zugängliche RMAN-Client verwendet Serversessions in einer Zieldatenbank, um Daten auf Datenträger oder Band zu sichern. RMAN kann einen externen Recovery-Katalog mit Backupmetadaten aktualisieren.
Abbildung 3: RMAN-Architektur
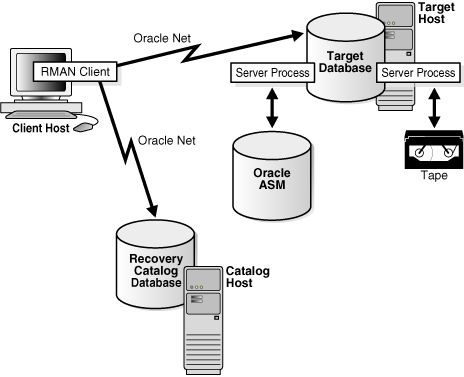
Beschreibung der Abbildung cncpt318.gif
Unabhängig davon, welche Backup- und Recovery-Technik Sie verwenden, empfiehlt Oracle, einen Fast Recovery-Bereich zu konfigurieren. Dieses datenbankverwaltete Verzeichnis, Dateisystem oder Oracle ASM-Datenträgergruppe zentralisiert Backup- und Recovery-Dateien, einschließlich aktiver Kontrolldateien, Online- und archivierter Redo-Logdateien und Backups. Recovery-Komponenten von Oracle AI Database interagieren mit dem Fast Recovery-Bereich, um die Wiederherstellbarkeit der Datenbank sicherzustellen.
Siehe:
-
Oracle AI Database 2 Day DBA, um zu erfahren, wie Sie Backup und Recovery mit Recovery Manager ausführen
-
Oracle AI Database Administrator's Guide für Informationen zum Einrichten und Verwalten des Fast Recovery-Bereichs
Datenbankbackups
Datenbankbackups können physisch oder logisch sein.
Physische Backups, die in einer Backup- und Recovery-Strategie das Hauptanliegen sind, sind Kopien physischer Datenbankdateien. Sie können physische Backups mit RMAN- oder Betriebssystem-Utilitys erstellen.
Im Gegensatz dazu enthalten logische Backups Tabellen, Stored Procedures und andere logische Daten. Sie können logische Daten mit einem Oracle AI Database-Utility wie Data Pump Export extrahieren und in einer Binärdatei speichern. Logische Backups können physische Backups ergänzen.
Physische Backups haben eine große Granularität und eine begrenzte Transportfähigkeit, sind jedoch sehr schnell. Logische Backups haben eine feine Granularität und vollständige Transportierbarkeit, sind jedoch langsamer als physische Backups.
-
Gesamte und teilweise Datenbankbackups Ein gesamtes Datenbankbackup ist ein Backup jeder Datendatei in der Datenbank sowie der Kontrolldatei. Ganze Datenbankbackups sind der häufigste Backup-Typ.
-
Konsistente und inkonsistente Backups Ein Backup der gesamten Datenbank ist entweder konsistent oder inkonsistent.
-
Backupsets und Imagekopien Der RMAN-Befehl
BACKUPgeneriert Imagekopien oder Backupsets. Siehe auch: Oracle AI Database Backup and Recovery - Benutzerhandbuch, um mehr über physische und logische Backups zu erfahren
Vollständige und teilweise Datenbankbackups
Ein gesamtes Datenbankbackup ist ein Backup jeder Datendatei in der Datenbank sowie der Kontrolldatei. Ganze Datenbankbackups sind der häufigste Backup-Typ.
Ein partielles Datenbankbackup enthält eine Teilmenge der Datenbank: einzelne Tablespaces oder Datendateien. Ein Tablespace Backup ist ein Backup aller Datendateien in einem Tablespace oder in mehreren Tablespaces. Tablespace-Backups, unabhängig davon, ob sie konsistent oder inkonsistent sind, sind nur gültig, wenn die Datenbank im ARCHIVELOG-Modus ausgeführt wird, da Redo erforderlich ist, um den wiederhergestellten Tablespace mit dem Rest der Datenbank konsistent zu machen.
Konsistente und inkonsistente Backups
Ein Backup der gesamten Datenbank ist konsistent oder inkonsistent.
In einem konsistenten Backup haben alle Lese-/Schreibdatendateien und Kontrolldateien dieselbe Checkpoint-SCN, sodass sichergestellt ist, dass diese Dateien alle Änderungen bis zu dieser SCN enthalten. Diese Art von Backup erfordert kein Recovery, nachdem es wiederhergestellt wurde.
Ein konsistentes Backup der Datenbank ist nur nach einem konsistenten Herunterfahren möglich und ist die einzige gültige Backupoption für eine Datenbank, die im NOARCHIVELOG-Modus ausgeführt wird. Für andere Backupoptionen ist ein Media Recovery aus Gründen der Konsistenz erforderlich. Dies ist ohne Anwendung archivierter Redo Log-Dateien nicht möglich. Hinweis: Wenn Sie ein konsistentes Backup der gesamten Datenbank wiederherstellen, ohne Redo anzuwenden, gehen alle Transaktionen verloren, die nach dem Backup vorgenommen wurden.
In einem inkonsistenten Backup verfügen Lese-/Schreibdatendateien und Kontrolldateien nicht garantiert über dieselbe Checkpoint-SCN, sodass Änderungen fehlen können. Alle Online-Backups sind notwendigerweise inkonsistent, da Datendateien während der Backups geändert werden können.
Inkonsistente Backups bieten eine überragende Verfügbarkeit, da Sie die Datenbank nicht herunterfahren müssen, um Backups zu erstellen, die die Datenbank vollständig schützen. Wenn die Datenbank im ARCHIVELOG-Modus ausgeführt wird und Sie die archivierten Redo-Logs und Datendateien sichern, können inkonsistente Backups die Grundlage für eine solide Backup- und Recovery-Strategie sein.
Siehe:
-
Oracle AI Database Backup and Recovery - Benutzerdokumentation, um mehr über inkonsistente Backups zu erfahren
Backupsets und Imagekopien
Der RMAN-Befehl BACKUP generiert Imagekopien oder Backupsets.
Die Backup-Typen unterscheiden sich wie folgt:
-
Image-Kopie
Eine Imagekopie ist ein Bit-für-Bit-Duplikat einer Datendatei, einer Kontrolldatei oder einer archivierten Redo-Logdatei auf Datenträger. Sie können Imagekopien physischer Dateien mit Betriebssystem-Utilitys oder RMAN erstellen und diese mit einem der beiden Tools wiederherstellen.
Hinweis: Im Gegensatz zu Betriebssystemkopien validiert RMAN die Blöcke in der Datei und zeichnet die Imagekopie im RMAN-Repository auf.
-
Backup Set
RMAN kann Backups auch in einem proprietären Format erstellen, das als Backupset bezeichnet wird. Ein Backup Set enthält die Daten aus einer oder mehreren Datendateien, archivierten Redo Log-Dateien oder Kontrolldateien oder Server Parameter File. Die kleinste Einheit eines Backupsets ist eine Binärdatei, die als Backup Piece bezeichnet wird. Backupsets sind die einzige Form, in der RMAN Backups auf sequenzielle Devices wie Bandlaufwerke schreiben kann.
Mit Backup Sets können Band-Devices kontinuierlich gestreamt werden. Beispiel: RMAN kann Blöcke von langsamen, mittleren und schnellen Platten in einem Backup-Set mischen, sodass das Band-Device eine konstante Eingabe von Blöcken aufweist. Image-Kopien sind nützlich für Datenträger, da Sie sie inkrementell aktualisieren und auch wiederherstellen können.
Siehe auch: Oracle AI Database Backup and Recovery - Benutzerdokumentation, um mehr über Backupsets und Imagekopien zu erfahren
Datenreparatur
Während mehrere Probleme den normalen Betrieb einer Datenbank stoppen oder I/O-Vorgänge beeinträchtigen können, erfordern nur einige Probleme einen Eingriff des DBA und eine Datenreparatur.
Datenreparatur ist in der Regel in den folgenden Fällen erforderlich:
-
Media-Fehler
Ein Media-Fehler tritt auf, wenn ein Problem außerhalb der Datenbank verhindert, dass es aus einer Datei liest oder in eine Datei schreibt. Typische Mediafehler umfassen physische Fehler, wie Festplattenkopfabstürze und das Überschreiben, Löschen oder Beschädigen einer Datenbankdatei. Medienfehler sind seltener als Benutzer- oder Anwendungsfehler, aber eine solide Backup- und Wiederherstellungsstrategie muss sich darauf vorbereiten.
-
Benutzerfehler
Ein Benutzer oder eine Anwendung kann unerwünschte Änderungen an Ihrer Datenbank vornehmen, z. B. fehlerhafte Aktualisierungen, das Löschen des Inhalts einer Tabelle oder das Löschen von Datenbankobjekten. Mit einer guten Backup- und Recovery-Strategie können Sie die Datenbank wieder in den gewünschten Zustand versetzen, mit minimalen Auswirkungen auf die Datenbankverfügbarkeit und minimalem DBA-Aufwand.
In der Regel haben Sie mehrere Möglichkeiten, die vorhergehenden Probleme zu lösen. In diesem Abschnitt werden einige dieser Lösungen zusammengefasst.
-
Oracle Flashback-Technologie Oracle AI Database bietet eine Gruppe von Features, die als Oracle Flashback-Technologie bekannt sind und die Anzeige früherer Datenstatus sowie die zeitnahe Verarbeitung von Daten unterstützen, ohne Backups wiederherstellen zu müssen.
-
Block Media Recovery Das Block Media Recovery ist eine Methode zum Wiederherstellen und Wiederherstellen beschädigter Datenblöcke, während Datendateien online sind.
-
Bei der Wiederherstellung von Datendateien wird eine verlorene oder beschädigte aktuelle Datendatei oder Kontrolldatei repariert. Es kann auch Änderungen wiederherstellen, die verloren gehen, wenn ein Tablespace ohne die Option
OFFLINENORMALoffline ging.
Siehe:
-
Oracle AI Database Backup and Recovery - Benutzerhandbuch für Datenreparaturkonzepte
Oracle Flashback-Technologie
Oracle AI Database bietet eine Gruppe von Funktionen, die als Oracle Flashback-Technologie bekannt sind und die das Anzeigen früherer Datenstatus und das zeitnahe Aufwickeln von Daten unterstützen, ohne dass Backups wiederhergestellt werden müssen.
Abhängig von den Datenbankänderungen können Flashback-Features unerwünschte Änderungen oft schneller rückgängig machen und weniger Auswirkungen auf die Verfügbarkeit haben als das Media Recovery. Die folgenden Flashback-Features sind am wichtigsten für Backup und Recovery:
-
Flashback Database
Sie können eine CDB oder PDB auf einen früheren Zeitpunkt zurückspulen, um Probleme zu beheben, die durch logische Datenbeschädigungen oder Benutzerfehler verursacht werden. Flashback Database kann auch zur Ergänzung von Data Guard und zum Synchronisieren von Klondatenbanken verwendet werden. Flashback Database stellt keine Dateien wieder her oder führt kein Media Recovery durch. Daher können Sie es nicht verwenden, um Mediafehler wie Datenträgerabstürze zu beheben.
Auf PDB-Ebene können Sie einen PDB-Wiederherstellungspunkt erstellen und die PDB auf diesen Wiederherstellungspunkt zurückspulen, ohne dass sich dies auf andere PDB auswirkt. Auf CDB-Ebene können Sie einen CDB-Restore Point erstellen.
-
Flashback Table
Mit einer einzelnen SQL-Anweisung können Sie Tabellen auf einen bestimmten Zeitpunkt zurückspulen. Sie können Tabellendaten zusammen mit zugehörigen Indizes, Triggern und Constraints wiederherstellen, während die Datenbank online ist, und Änderungen nur an den angegebenen Tabellen rückgängig machen. Flashback Table behandelt keine physischen Beschädigungen wie fehlerhafte Datenträger oder Inkonsistenzen bei Datensegmenten und Indizes.
-
Flashback Drop
Sie können die Auswirkungen eines
DROP TABLE-Vorgangs rückgängig machen. Flashback Drop ist wesentlich schneller als Recovery-Mechanismen wie Point-in-Time Recovery und führt nicht zu einem Verlust der letzten Transaktionen oder Ausfallzeiten.
Siehe:
-
Oracle AI Database Backup and Recovery - Benutzerhandbuch, um mehr über Flashback-Features zu erfahren
-
Oracle AI Database SQL Language Reference und Oracle AI Database Backup and Recovery Reference, um mehr über die
FLASHBACK DATABASE-Anweisung zu erfahren
Block Media-Recovery
Block Media Recovery ist eine Methode zum Wiederherstellen und Wiederherstellen beschädigter Datenblöcke, während Datendateien online sind.
Eine Blockbeschädigung ist ein Datenblock, der sich nicht in einem erkannten Oracle-Format befindet oder dessen Inhalt intern nicht konsistent ist. Wenn Sie Blockbeschädigungen erkennen und nur wenige Blöcke beschädigt sind, ist das Block-Recovery möglicherweise dem Recovery von Datendateien vorzuziehen.
Siehe:
-
Oracle AI Database Backup and Recovery - Benutzerhandbuch zum Ausführen von Block Media Recovery
Wiederherstellung von Datendateien
Die Wiederherstellung von Datendateien repariert eine verlorene oder beschädigte aktuelle Datendatei oder Kontrolldatei. Es kann auch Änderungen wiederherstellen, die verloren gehen, wenn ein Tablespace ohne die Option OFFLINE NORMAL offline ging.
Ein Media Recovery ist erforderlich, wenn Sie ein Backup einer Datendatei oder Kontrolldatei wiederherstellen oder eine Datendatei ohne die Option OFFLINE NORMAL offline gesetzt wird. Die Datenbank kann nicht geöffnet werden, wenn Online-Datendateien ein Media Recovery benötigen. Eine Datendatei, die ein Media Recovery erfordert, kann auch nicht online gesetzt werden, bis das Media Recovery abgeschlossen ist.
Um ein physisches Backup einer Datendatei oder Kontrolldatei wiederherzustellen, müssen Sie sie rekonstruieren und für Oracle AI Database verfügbar machen. Um ein Backup wiederherzustellen, wenden Sie archivierte Redo Log-Dateien an, um verlorene Änderungen wiederherzustellen. RMAN kann Datendateien auch mit inkrementellen Backups wiederherstellen, die nur Datenblöcke enthalten, die nach einem vorherigen Backup geändert wurden.
Im Gegensatz zum Instance Recovery, bei dem Änderungen automatisch auf Onlinedateien angewendet werden, muss das Media Recovery von einem Benutzer aufgerufen werden und archivierte Redo Log-Dateien auf zurückgeschriebene Backups anwenden. Media Recovery von Datendateien kann nur für Offlinedatendateien oder Datendateien in einer Datenbank ausgeführt werden, die nicht von einer Datenbankinstanz geöffnet wird.
Das Recovery von Datendateien unterscheidet sich je nachdem, ob alle Änderungen angewendet werden:
-
Vollständige Wiederherstellung
Bei einem vollständigen Recovery werden alle Redo-Änderungen, die in den archivierten und Online-Redo-Logs enthalten sind, auf ein Backup angewendet. In der Regel führen Sie ein vollständiges Media Recovery durch, nachdem ein Media-Fehler Datendateien oder die Kontrolldatei beschädigt hat. Sie können ein vollständiges Recovery für eine Datenbank, einen Tablespace oder eine Datendatei durchführen.
-
Unvollständiges Recovery
Ein unvollständiges Recovery, auch Datenbank-Point-in-Time Recovery genannt, führt zu einer nicht aktuellen Version der Datenbank. In diesem Fall wenden Sie nicht alle Redo-Daten an, die nach dem zurückgeschriebenen Backup generiert wurden. Normalerweise führen Sie ein Point-in-Time-Datenbank-Recovery aus, um einen Benutzerfehler rückgängig zu machen, wenn Oracle Flashback Database nicht möglich ist.
Um ein unvollständiges Recovery auszuführen, müssen Sie alle Datendateien aus Backups wiederherstellen, die vor dem Zeitpunkt erstellt wurden, zu dem Sie ein Recovery durchführen möchten, und die Datenbank anschließend mit der Option
RESETLOGSöffnen, wenn das Recovery abgeschlossen ist. Durch das Zurücksetzen der Logs wird ein neuer Stream von Logfolgenummern erstellt, der mit der Logsequenz 1 beginnt.Hinweis: Wenn aktuelle Datendateien verfügbar sind, ist Flashback Database eine Alternative zu DBPITR.
Mit dem Tablespace Point-in-Time Recovery-(TSPITR-)Feature können Sie einen oder mehrere Tablespaces bis zu einem Zeitpunkt wiederherstellen, der älter ist als der Rest der Datenbank.
Siehe:
-
Oracle AI Database Backup and Recovery - Benutzerhandbuch für Media Recovery-Konzepte
Zero Data Loss Recovery Appliance
Die Cloud-basierte Zero Data Loss Recovery Appliance, allgemein als Recovery Appliance bekannt, ist ein Engineered System, das Datenverluste und Backup-Overhead für alle Oracle Databases im Unternehmen drastisch reduziert.
Die Recovery Appliance ist in RMAN integriert und stellt eine zentralisierte Backup- und Recovery-Strategie für eine große Anzahl von Datenbanken bereit. Dabei werden Hardware und Speicher in der Cloud verwendet, die fehlertolerant sind. Die Recovery Appliance validiert Backups kontinuierlich auf Wiederherstellbarkeit.
-
Vorteile von Recovery Appliance Eine zentralisierte Recovery Appliance führt die meisten Datenbankbackups und -wiederherstellungsprozesse aus, wodurch die Speicherauslastung, Performance und Verwaltbarkeit von Backups effizienter wird.
-
Recovery Appliance-Umgebung Eine geschützte Datenbank ist eine Clientdatenbank, die Daten in einer Recovery Appliance sichert.
Vorteile von Recovery Appliance
Eine zentralisierte Recovery Appliance führt die meisten Datenbankbackups und -wiederherstellungen durch, wodurch die Speicherauslastung, Performance und Verwaltbarkeit von Backups effizienter wird.
Die Hauptvorteile sind:
-
Eliminierung von Datenverlust
Die Recovery Appliance eliminiert das Risiko von Datenverlusten, das bei den meisten Datenbanken im Rechenzentrum auftritt, indem Technologien wie die folgenden verwendet werden:
-
Die kontinuierliche Übertragung von Redo-Änderungen von der SGA einer geschützten Datenbank in eine Recovery Appliance, die als Echtzeit-Redo-Transport bezeichnet wird
-
Replikation auf Remote Recovery Appliances
-
Automatisierte Bandbackups, die von der zentralen Recovery Appliance erstellt werden
-
End-to-End-Datenbankblockvalidierung
-
-
Minimaler Backup-Overhead
Der Backup-Overhead auf Datenbankservern wird minimiert, indem die Arbeit an die Recovery Appliance ausgelagert wird, die Backups mehrerer Datenbanken in einem einheitlichen Plattenpool verwaltet. Bei der Strategie für inkrementelles Forever-Backup von RMAN wird ein anfängliches Backup der Ebene 0 für die Recovery Appliance erstellt, wobei alle nachfolgenden inkrementellen Backups auf Ebene 1 erstellt werden. Die Recovery Appliance erstellt ein virtuelles vollständiges Backup, indem die Ebene 0 mit Backups der Ebene 1 kombiniert wird. Die Recovery Appliance komprimiert, dedupliziert und validiert Backups kontinuierlich auf Blockebene.
-
Verbesserte End-to-End-Datenschutztransparenz
Cloud Control bietet eine vollständige End-to-End-Ansicht des Backuplebenszyklus, der von der Recovery Appliance verwaltet wird, von der Initiierung des RMAN-Backups bis hin zum Speichern auf Datenträger, Band oder Replikation in einer Downstream Recovery Appliance. Die Installation des Plug-ins Enterprise Manager for Zero Data Loss Recovery Appliance (Recovery Appliance-Plug-in) ermöglicht Überwachung und Verwaltung.
-
Cloud-Skalierungsschutz
Recovery Appliance lässt sich skalieren, um Zehn- bis Hunderttausende von Datenbanken zu unterstützen. Die wichtigsten Komponenten der Architektur:
-
Recovery Appliance vereinfacht die Verwaltung durch eine Schutz-Policy, die ein Recovery-Fensterziel definiert, das für jede mit der Policy verknüpfte Datenbank durchgesetzt wird. Schutz-Policys verbessern die Verwaltbarkeit, indem Datenbanken in Ebenen mit gemeinsamen Merkmalen gruppiert werden.
-
Mithilfe von Schutz-Policys verwaltet die Recovery Appliance den Backup-Speicherplatz gemäß dem Recovery-Fensterziel für jede geschützte Datenbank. Mit diesem granularen, datenbankorientierten Speicherverwaltungsansatz ist es nicht mehr erforderlich, Speicherplatz auf Speichervolumebene zu verwalten, wie es Appliances von Drittanbietern tun.
-
Recovery Appliance kann skaliert werden, um den Anstieg des Backup-Traffics, der Speicherauslastung und der Anzahl der Datenbanken zu bewältigen, indem Compute- und Speicherressourcen auf einfache, modulare Weise hinzugefügt werden.
-
Recovery Appliance-Umgebung
Eine geschützte Datenbank ist eine Clientdatenbank, die Daten in einer Recovery Appliance sichert.
Die folgende Abbildung zeigt eine Beispielumgebung, die sechs geschützte Datenbanken und zwei Recovery Appliances umfasst. Jede Datenbank verwendet das Zero Data Loss Recovery Appliance-Backupmodul (Recovery Appliance-Backupmodul) für ihre Backups. Dieses Modul ist eine von Oracle bereitgestellte SBT-Library, mit der RMAN Backups über das Netzwerk an die Recovery Appliance überträgt.
Abbildung 4: Recovery Appliance-Umgebung
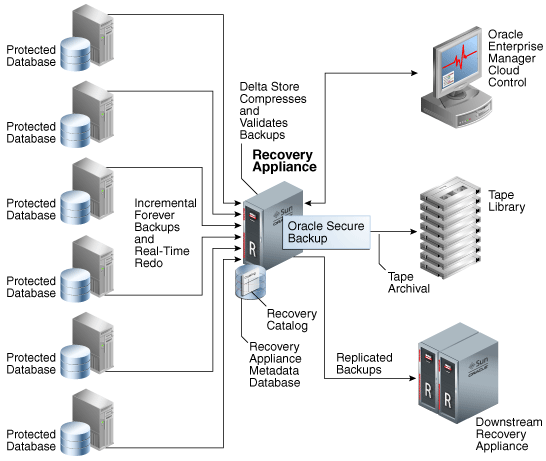
Beschreibung der Abbildung amagd_vm_025.png
Die Recovery Appliance-Metadatendatenbank, die sich auf jeder Recovery Appliance befindet, verwaltet Metadaten, die im Recovery-Katalog gespeichert sind. Alle geschützten Datenbanken, die Backups an Recovery Appliance senden, müssen diesen Recovery-Katalog verwenden. Die Backups befinden sich im Recovery Appliance-Speicherort, einem Set von Oracle ASM-Datenträgergruppen. Hinweis: Datenbanken können Recovery Appliance als Recovery-Katalog verwenden, ohne sie auch als Backup-Repository zu verwenden.
Administratoren verwalten und überwachen die Umgebung mit Cloud Control. Cloud Control bietet eine zentrale Ansicht des gesamten Backup-Lebenszyklus für jede Datenbank, unabhängig davon, ob Backups auf Datenträger, Band oder einer anderen Recovery Appliance gespeichert sind.
Speicherverwaltung
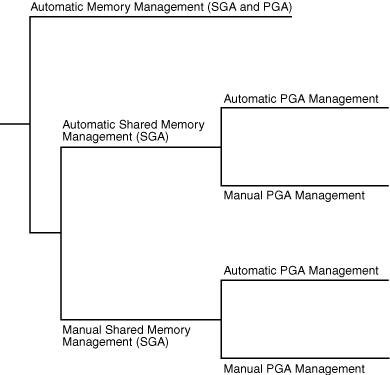
Zur Speicherverwaltung gehört die Verwaltung optimaler Größen für die Speicherstrukturen für die Oracle-Instanzen, während sich der Bedarf an der Datenbank ändert. Initialisierungsparametereinstellungen bestimmen, wie der SGA- und Instanz-PGA-Speicher verwaltet wird. Abbildung 22-5 zeigt einen Entscheidungsbaum für Speicherverwaltungsoptionen. In den folgenden Abschnitten werden die Optionen ausführlich erläutert.
Abbildung 5: Speicherverwaltungsmethoden
Beschreibung der Abbildung cncpt242.gif
-
Automatische Speicherverwaltung Bei der automatischen Speicherverwaltung verwaltet Oracle AI Database den SGA- und Instanz-PGA-Speicher vollständig automatisch. Diese Methode ist die einfachste und wird von Oracle dringend empfohlen.
-
Shared Memory Management der SGA Sie können die Größe der SGA manuell steuern, indem Sie die SGA-Größe mit automatischer Shared Memory-Verwaltung festlegen oder die SGA-Komponenten manuell optimieren.
-
Speicherverwaltung der Instanz-PGA Wenn die automatische Speicherverwaltung nicht aktiviert ist, verwendet Oracle AI Database entweder automatische oder manuelle PGA-Speicherverwaltung.
-
Die Speicherverwaltung Zusammenfassung der Speicherverwaltungsmethoden erfolgt entweder automatisch oder manuell. Siehe auch: "Speicherarchitektur", um mehr über die SGA und PGA zu erfahren
Automatic Memory Management
Bei der automatischen Speicherverwaltung verwaltet Oracle AI Database den SGA- und Instanz-PGA-Speicher vollständig automatisch. Diese Methode ist die einfachste und wird von Oracle dringend empfohlen.
Die einzigen benutzerdefinierten Steuerelemente sind der Initialisierungsparameter für die Zielspeichergröße (MEMORY_TARGET) und der optionale Initialisierungsparameter für die maximale Speichergröße (MEMORY_MAX_TARGET). Oracle AI Database optimiert die Größe des Zielspeichers und verteilt den Speicher nach Bedarf zwischen der SGA und der Instanz-PGA.
Die SGA kann den In-Memory Column Store (IM-Spaltenspeicher) oder den memoptimize pool enthalten, die beide optional sind. Größe des IM-Spaltenspeichers mit dem Initialisierungsparameter INMEMORY_SIZE und des Memoptimize-Pools mit dem Initialisierungsparameter MEMOPTIMIZE_POOL_SIZE unabhängig von der verwendeten Speicherverwaltungsmethode. Die Größe des IM-Spaltenspeichers ist Memoptimize-Pool, der IM Speicherziel enthalten ist, aber nicht vom automatischen Skalierungsalgorithmus verwaltet wird. Beispiel: Wenn Sie MEMORY_TARGET auf 5 GB und INMEMORY_SIZE auf 1 GB setzen, beträgt das Gesamtspeicherziel 5 GB (nicht 6 GB), und INMEMORY_SIZE ist immer 1 GB.
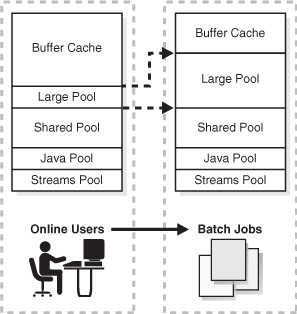
Die folgende Grafik zeigt eine Datenbank, die manchmal Jobs verarbeitet, die von Onlinebenutzern und manchmal von Batchjobs weitergeleitet wurden. Mit der automatischen Speicherverwaltung passt die Datenbank die Größe des Großen Pools und des Datenbankpuffercaches automatisch an, je nachdem, welcher Jobtyp ausgeführt wird. Beachten Sie, dass die Grafik den IM-Spaltenspeicher oder den Memoptimierungsbereich nicht darstellt.
Abbildung 6: Automatic Memory Management
Beschreibung der Abbildung cncpt256.gif
Wenn Sie eine Datenbank mit DBCA erstellen und die grundlegende Installationsoption auswählen, aktiviert Oracle AI Database standardmäßig die automatische Speicherverwaltung.
Siehe:
-
Oracle AI Database Administrator's Guide, um mehr über die automatische Speicherverwaltung zu erfahren
Shared Memory-Verwaltung der SGA
Sie können die Größe der SGA manuell steuern, indem Sie die SGA-Größe mit automatischer Shared Memory-Verwaltung festlegen oder die SGA-Komponenten manuell optimieren.
Wenn die automatische Speicherverwaltung nicht aktiviert ist, muss das System die Shared Memory-Verwaltung der SGA verwenden. Shared Memory Management ist in einer der folgenden Formen möglich:
-
Automatische Shared Memory-Verwaltung
In diesem Modus können Sie die Größe der SGA direkter steuern. Dies ist der Standard, wenn die automatische Speicherverwaltung deaktiviert ist. Die Datenbank optimiert die Gesamtgröße des SGA auf die Zielgröße und optimiert die Größe der SGA-Komponenten dynamisch. Wenn Sie eine Serverparameterdatei verwenden, merkt sich Oracle AI Database die Größe der automatisch optimierten Komponenten beim Herunterfahren der Datenbankinstanz.
-
Manuelle Verwaltung von Shared Memory
In diesem Modus legen Sie die Größe mehrerer einzelner SGA-Komponenten fest und optimieren einzelne SGA-Komponenten fortlaufend manuell. Sie haben die vollständige Kontrolle über die einzelnen SGA-Komponentengrößen. Standardmäßig wird dieser Modus für die Datenbank verwendet, wenn sowohl die automatische Speicherverwaltung als auch die automatische Shared Memory-Verwaltung deaktiviert sind.
Hinweis: Wenn die automatische Speicherverwaltung deaktiviert ist, kann die Datenbank in einigen Fällen die relativen Größen des Shared Pools und des Puffercaches basierend auf der Benutzer-Workload automatisch anpassen.
Siehe:
-
Oracle AI Database Administrator's Guide, um mehr über Shared Memory Management zu erfahren
-
My Oracle Support-Hinweis KB84770, um mehr über die automatische Größenänderung im manuellen Modus zu erfahren:
Speicherverwaltung der Instanz-PGA
Wenn die automatische Speicherverwaltung nicht aktiviert ist, verwendet Oracle AI Database entweder automatische oder manuelle PGA-Speicherverwaltung.
Die folgenden Modi sind für die Verwaltung des PGA-Speichers möglich:
-
Automatische PGA-Speicherverwaltung
Wenn die automatische Speicherverwaltung (
MEMORY_TARGET) deaktiviert ist undPGA_AGGREGATE_TARGETauf einen Wert ungleich Null gesetzt ist, verwendet die Datenbank die automatische PGA-Speicherverwaltung. In diesem Modus gibtPGA_AGGREGATE_TARGETeine "weiche" Zielgröße für die Instanz-PGA an. Das Ziel ist weich, da es nur für bestimmte Arten von Speicherzuweisungen gilt, die temporären Speicherplatz anstelle der PGA verwenden können. Die Datenbank optimiert dann die Größe der Instanz-PGA auf dieses Ziel und optimiert die Größen der einzelnen PGAs dynamisch. Wenn Sie keine explizite Zielgröße festlegen, konfiguriert die Datenbank automatisch einen angemessenen Standardwert.Der Initialisierungsparameter
PGA_AGGREGATE_LIMITlegt dynamisch einen instanzweiten absoluten Grenzwert für den PGA-Speicher fest. Da der Parameter auf sich ändernde Speicherbedingungen reagiert, müssen Sie den Parameterwert nicht explizit festlegen. Standardmäßig istPGA_AGGREGATE_LIMITauf den Größeren der folgenden Werte gesetzt:-
2 GB
-
200% der Initialisierungsparametereinstellung
PGA_AGGREGATE_TARGET -
(Wert der Initialisierungsparametereinstellung
PROCESSES) * 3 MB
Ein Hintergrundprozess vergleicht die PGA-Größe regelmäßig mit dem durch
PGA_AGGREGATE_LIMITfestgelegten Grenzwert. Wenn der Grenzwert erreicht oder überschritten wird, beendet dieser Prozess Aufrufe für die Sessions mit dem nicht optimierbaren PGA-Speicher. Wenn diese Sessions immer noch nicht genügend Speicher freigeben, werden sie ebenfalls beendet. -
-
Manuelle PGA-Speicherverwaltung
Wenn die automatische Speicherverwaltung deaktiviert ist und
PGA_AGGREGATE_TARGETauf0gesetzt ist, wird standardmäßig die manuelle PGA-Verwaltung verwendet. Bei früheren Releases von Oracle AI Database musste der DBA manuell die maximale Arbeitsbereichsgröße für jeden SQL-Operatortyp angeben (z.B. eine Sortierung oder einen Hash Join). Diese Technik erwies sich als sehr schwierig, da sich die Arbeitslast ständig ändert. Obwohl Oracle AI Database die manuelle PGA-Speicherverwaltungsmethode unterstützt, empfiehlt Oracle dringend die automatische Speicherverwaltung.
Siehe auch: Oracle AI Database Performance Tuning Guide enthält Informationen zur PGA-Speicherverwaltung
Zusammenfassung der Speicherverwaltungsmethoden
Die Speicherverwaltung erfolgt entweder automatisch oder manuell.
Wenn Sie die automatische Speicherverwaltung nicht aktivieren, müssen Sie separat eine Speicherverwaltungsmethode für die SGA und eine für die PGA konfigurieren. Hinweis: Wenn die automatische Speicherverwaltung für die Datenbankinstanz als Ganzes deaktiviert ist, aktiviert Oracle Database standardmäßig die automatische PGA-Speicherverwaltung.
Die folgende Tabelle enthält den Initialisierungsparameter INMEMORY_SIZE und den Initialisierungsparameter MEMOPTIMIZE_POOL_SIZE. Beide steuern Speicherbereiche, die optional sind.
Tabelle 3: Speicherverwaltungsmethoden
| Instanz | SGA | PGA | Beschreibung | Initialisierungsparameter |
|---|---|---|---|---|
| Automatisch | n/v | n/v | Die Datenbank optimiert die Größe der Instanz basierend auf einer einzelnen Instanzzielgröße. | Sie legen Folgendes fest:
|
| n/v | Automatisch | Automatisch | Die Datenbank optimiert die SGA automatisch basierend auf einem SGA-Ziel. Die Datenbank optimiert die PGA automatisch basierend auf einem PGA-Ziel. |
Sie legen Folgendes fest:
Die Datenbank konfiguriert den Initialisierungsparameter |
| n/v | Automatisch | Manuell | Die Datenbank optimiert die SGA automatisch basierend auf einem SGA-Ziel. Sie steuern die PGA manuell und legen die maximale Größe des Arbeitsbereichs für jeden SQL-Operatortyp fest. |
Sie legen Folgendes fest:
|
| n/v | Manuell | Automatisch | Sie steuern die SGA manuell, indem Sie einzelne Komponentengrößen festlegen. Die Datenbank optimiert die PGA automatisch basierend auf einem PGA-Ziel. |
Sie legen Folgendes fest:
Die Datenbank konfiguriert den Initialisierungsparameter |
| n/v | Manuell | Manuell | Sie müssen die SGA-Komponentengrößen manuell konfigurieren. Sie steuern die PGA manuell und legen die maximale Größe des Arbeitsbereichs für jeden SQL-Operatortyp fest. |
Sie müssen die SGA-Komponentengrößen manuell konfigurieren. Sie legen Folgendes fest:
|
Fußnote 1
Die Datenbank konfiguriert den Initialisierungsparameter PGA_AGGREGATE_LIMIT automatisch. Sie können diesen Parameter auch manuell festlegen.
Fußnote 2
Die Datenbank konfiguriert den Initialisierungsparameter PGA_AGGREGATE_LIMIT automatisch. Sie können diesen Parameter auch manuell festlegen.
Siehe auch: Oracle AI Database Administrator's Guide, da die automatische Speicherverwaltung nicht auf allen Plattformen verfügbar ist
Resource Management und Aufgabenplanung
Oracle AI Database bietet Tools, die Sie bei der Verwaltung von Ressourcen und bei der Planung von Aufgaben unterstützen, um die Auswirkungen auf Benutzer zu reduzieren.
In einer Datenbank mit vielen aktiven Benutzern ist die RessourcenAdministration ein wichtiger Bestandteil der Datenbankverwaltung. Sessions, die übermäßige Ressourcen verbrauchen, können andere Sessions daran hindern, ihre Arbeit auszuführen. Ein verwandtes Problem ist, wie Aufgaben so geplant werden, dass sie zur besten Zeit ausgeführt werden. Oracle AI Database bietet Tools zur Lösung dieser Probleme.
-
Database Resource Manager Oracle AI Database Resource Manager (der Resource Manager) bietet eine granulare Kontrolle über Datenbankressourcen, die Benutzeraccounts, Anwendungen und Services zugewiesen sind. Der Resource Manager fungiert in erster Linie als Gatekeeper, wodurch einige Jobs langsam ausgeführt werden, sodass andere schnell ausgeführt werden können.
-
CPU-Verwaltung Ab Oracle AI Database 26ai bietet Oracle eine alternative Methode für die CPU-Ressourcenverwaltung, die auf allen Datenbankinstanzen auf dem Server ausgeführt wird.
-
Oracle Scheduler Oracle Scheduler (der Scheduler) ermöglicht es Datenbankadministratoren und Anwendungsentwicklern zu kontrollieren, wann und wo verschiedene Aufgaben in der Datenbankumgebung ausgeführt werden.
Database Resource Manager
Oracle AI Database Resource Manager (der Resource Manager) bietet eine granulare Kontrolle über Datenbankressourcen, die Benutzeraccounts, Anwendungen und Services zugewiesen sind. Der Resource Manager fungiert in erster Linie als Gatekeeper, wodurch einige Jobs langsam ausgeführt werden, sodass andere schnell ausgeführt werden können.
Das PL/SQL-Package DBMS_RESOURCE_MANAGER löst viele Probleme bei der Ressourcenzuweisung, die ein Betriebssystem nicht gut verwaltet, einschließlich:
-
Übermäßiger Overhead
-
Ineffiziente Planung
-
Unangemessene Zuweisung von Ressourcen
-
Unfähigkeit, datenbankspezifische Ressourcen zu verwalten
Der Resource Manager hilft dabei, die vorhergehenden Probleme zu überwinden, indem er der Datenbank mehr Kontrolle über die Zuweisung von Hardwareressourcen und die Priorisierung der Arbeit in der Datenbank gibt. Sie können Sessions basierend auf Sessionattributen in Gruppen klassifizieren und diesen Gruppen dann Ressourcen zuweisen, um die Hardwareauslastung zu optimieren. Mit Resource Manager können Sie Grenzwerte für den PDB-Speicherverbrauch festlegen.
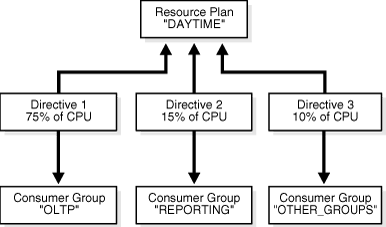
Die Zuteilung von Ressourcen zu Benutzern geschieht nach einem Ressourcenplan, der vom Datenbankadministrator festgelegt wurde. Der Plan gibt an, wie die Ressourcen auf Ressourcen-Nutzungsgruppen verteilt werden sollen. Hierbei handelt es sich um Benutzersessions, die nach Ressourcenanforderungen gruppiert sind. Eine Ressourcenplananweisung verknüpft eine Ressourcen-Nutzungsgruppe mit einem Plan und gibt an, wie Ressourcen der Gruppe zugewiesen werden sollen. Abbildung 22-7 zeigt einen einfachen Ressourcenplan für ein Unternehmen, das OLTP-Anwendungen und Reportinganwendungen tagsüber gleichzeitig ausführt. Der derzeit aktive Plan DAYTIME weist CPU-Ressourcen drei Ressourcennutzungsgruppen zu. Insbesondere wird OLTP 75% der CPU-Zeit zugewiesen, REPORTS 15% und OTHER_GROUPS 10% erhalten.
Abbildung 7: Einfacher Ressourcenplan
Beschreibung der Abbildung admin078.gif
Ein Problem, das Resource Manager lösen kann, sind unkontrollierte Abfragen, die mit SQL Monitor überwacht werden können. Mit Resource Manager können Sie Schwellenwerte zur Identifizierung und Reaktion auf fehlgeleitete SQL-Anweisungen angeben. Beispiel: Sie können Schwellenwerte für CPU-Zeit, verstrichene Zeit, physische oder logische I/Os und PGA-Auslastung durch jeden Vordergrundprozess in einer Nutzungsgruppe angeben. Als Antwort kann Resource Manager zu einer Consumer-Gruppe mit niedrigerer Priorität wechseln, die SQL-Anweisung beenden oder die Schwellenwertverletzung protokollieren.
Siehe:
-
Oracle AI Database - Administratordokumentation zur Verwendung von Resource Manager
-
PL/SQL-Packages und -Typenreferenz für Oracle AI Database mit Informationen zur Verwendung des PL/SQL-Packages
DBMS_RESOURCE_MANAGER
CPU-Management
Ab Oracle AI Database 26ai bietet Oracle eine alternative Methode für die CPU-Ressourcenverwaltung, die auf allen Datenbankinstanzen auf dem Server ausgeführt wird.
In früheren Releases bot Oracle eine Methode der CPU-Ressourcenverwaltung an, die innerhalb einer Datenbankinstanz ausgeführt wurde. Ab Oracle AI Database 26ai können Sie RESOURCE_MANAGER_CPU_SCOPE festlegen, um den Geltungsbereich der CPU-Ressourcenverwaltung zu steuern. Mit diesem Parameter können Sie zwischen den beiden Steuermethoden wählen.
Wenn Sie RESOURCE_MANAGER_CPU_SCOPE auf SERVER_WIDE setzen, wird die instanzübergreifende CPU-Ressourcenverwaltung auf Serverebene aktiviert. Diese Methode wurde in Oracle AI Database 26ai eingeführt und kann verwendet werden, wenn mehrere Datenbankinstanzen einen Linux-Server gemeinsam verwenden. Es ermöglicht die CPU-Ressourcenverwaltung für alle Datenbankinstanzen auf dem Server. Mit dieser Methode konfiguriert Oracle automatisch Linux-Kontrollgruppen (Cgroups) mit den gewünschten CPU-Sharing- und CPU-Auslastungslimits und platziert Datenbanksessions dann in die entsprechenden Cgroups.
RESOURCE_MANAGER_CPU_SCOPE ist standardmäßig auf INSTANCE_ONLY gesetzt.
Siehe:
- Oracle AI Database Administrator's Guide, um mehr über CPU-Managementoptionen zu erfahren.
Oracle Scheduler
Mit Oracle Scheduler (dem Scheduler) können Datenbankadministratoren und Anwendungsentwickler kontrollieren, wann und wo verschiedene Aufgaben in der Datenbankumgebung ausgeführt werden.
Der Scheduler bietet komplexe Funktionen für die Unternehmensplanung, mit denen Sie:
-
Jobausführung basierend auf Zeit oder Ereignissen planen
-
Planen Sie die Jobverarbeitung so, dass sie Ihren Geschäftsanforderungen entspricht
-
Jobs verwalten und überwachen
-
Jobs in einer geclusterten Umgebung ausführen und verwalten
Programmobjekte (Programme) enthalten Metadaten zu dem Befehl, den der Scheduler ausführt, einschließlich der Standardwerte für alle Argumente. Ausführungsplanobjekte (Zeitpläne) enthalten Informationen über Ausführungsdatum und -zeit sowie Wiederholungsmuster. Jobobjekte (Jobs) verknüpfen ein Programm mit einem Zeitplan. Um zu definieren, was wann ausgeführt wird, ordnen Sie Beziehungen zwischen Programmen, Zeitplänen und Jobs zu.
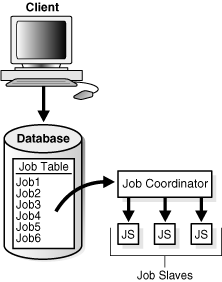
Der Scheduler wird als eine Gruppe von Funktionen und Prozeduren im PL/SQL-Package DBMS_SCHEDULER implementiert. Scheduler-Objekte erstellen und bearbeiten Sie mit diesem Package oder mit Enterprise Manager. Da Scheduler-Objekte Standard-Datenbankobjekte sind, können Sie den Zugriff auf diese Objekte mit System- und Objektberechtigungen steuern. In Abbildung 22-8 wird die grundlegende Architektur des Schedulers dargestellt. Die Job-Tabelle ist ein Container für alle Jobs mit einer Tabelle pro Datenbank. Der Hintergrundprozess des Jobkoordinators wird bei Bedarf automatisch gestartet und gestoppt. Untergeordnete Jobprozesse werden vom Koordinator erweckt, wenn ein Job ausgeführt werden muss. Die untergeordneten Prozesse sammeln Metadaten aus der Jobtabelle und führen den Job aus.
Abbildung 8: Scheduler-Komponenten
Beschreibung der Abbildung admin062.gif
Siehe:
Performance und Optimierung
Als DBA sind Sie verantwortlich für die Performance der Oracle-Datenbank. In der Regel resultieren Performanceprobleme aus inakzeptablen Antwortzeiten, d.h. der Zeit bis zum Abschluss einer bestimmten Workload, oder dem Durchsatz, d.h. dem Umfang der Arbeit, die in einer bestimmten Zeit abgeschlossen werden kann.
Typische Probleme sind:
-
CPU-Engpässe
-
Unterdimensionierte Speicherstruktur
-
I/O-Kapazitätsprobleme
-
Ineffiziente oder High-Load-SQL-Anweisungen
-
Unerwarteter Performancerückgang nach der Optimierung von SQL-Anweisungen
-
Nebenläufigkeits- und Konfliktprobleme
-
Probleme mit der Datenbankkonfiguration
Das allgemeine Ziel der Optimierung besteht in der Regel darin, die Reaktionszeit zu verbessern, den Durchsatz zu erhöhen oder beides. Ein spezifisches und messbares Ziel könnte "die Antwortzeit der angegebenen SELECT-Anweisung auf weniger als 5 Sekunden reduzieren" lauten. Ob dieses Ziel erreicht werden kann, hängt von Faktoren ab, die möglicherweise vom DBA kontrolliert werden. Im Allgemeinen ist das Tuning der Aufwand, spezifische, messbare und erreichbare Optimierungsziele zu erreichen, indem Datenbankressourcen so effizient wie möglich verwendet werden.
Die Performance-Methode von Oracle basiert auf der Identifizierung und Beseitigung von Engpässen in der Datenbank und der Entwicklung effizienter SQL-Anweisungen. Die Anwendung der Oracle-Performancemethode umfasst folgende Aufgaben:
-
Vorbereitende Vorbereitungen durchführen
-
Regelmäßiges proaktives Optimieren der Datenbank
-
Datenbank reaktiv optimieren, wenn Benutzer Performanceprobleme melden
-
Ermitteln, optimieren und optimieren von High-Load-SQL-Anweisungen
In diesem Abschnitt werden wesentliche Aspekte der Leistungsoptimierung von Oracle AI Database beschrieben, einschließlich der Verwendung von Advisorn. Oracle AI Database Advisor geben spezifische Empfehlungen zu wichtigen Fragen des Datenbankmanagements, u.a. zu Speicherplatz, Performance und Undo-Management.
-
Datenbank-Selbstüberwachung Selbstüberwachung erfolgt, wenn die Datenbank ihren regulären Betrieb ausführt und sicherstellt, dass die Datenbank über auftretende Probleme informiert ist. Oracle AI Database kann einen vom Server generierten Alert senden, um Sie über ein bevorstehendes Problem zu informieren.
-
Automatic Workload Repository (AWR) Automatic Workload Repository (AWR) ist ein Repository historischer Performancedaten, das kumulative Statistiken für das System, die Sessions, einzelne SQL-Anweisungen, Segmente und Services enthält.
-
Automatic Database Monitor (ADDM) Mit in AWR (Automatic Workload Repository) erfassten Statistiken diagnostiziert ADDM automatisch und proaktiv die Datenbankperformance und bestimmt, wie identifizierte Probleme gelöst werden können. Sie können ADDM auch manuell ausführen.
-
Aktive Sessionhistorie (ASH) Aktive Sessionhistorie (ASH) erfasst aktive Datenbanksessions jede Sekunde und schreibt die Daten in den Speicher und den persistenten Speicher. ASH ist ein integraler Bestandteil des Datenbank-Selbstverwaltungs-Frameworks und eignet sich besonders zur Diagnose von Performanceproblemen.
-
Application and SQL Tuning Oracle Database automatisiert den SQL-Tuning-Prozess vollständig. Siehe auch: In der Dokumentation Oracle AI Database Get Started with Performance Tuning und im Oracle AI Database SQL Tuning Guide wird beschrieben, wie die Oracle-Performancemethode implementiert wird.
Datenbank-Selbstüberwachung
Die Selbstüberwachung erfolgt, wenn die Datenbank ihren regulären Betrieb ausführt und sicherstellt, dass die Datenbank über auftretende Probleme informiert ist. Oracle AI Database kann einen vom Server generierten Alert senden, um Sie über ein bevorstehendes Problem zu informieren.
Alerts werden automatisch generiert, wenn ein Problem auftritt oder wenn Daten nicht mit erwarteten Werten für Metriken übereinstimmen, wie physische Lesevorgänge pro Sekunde oder SQL-Antwortzeit. Eine Metrik ist die Änderungsrate in einer kumulativen Statistik. Servergenerierte Alerts können auf benutzerdefinierten Schwellenwerten basieren oder weil ein Ereignis aufgetreten ist.
Servergenerierte Alerts identifizieren nicht nur das Problem, sondern empfehlen manchmal, wie das gemeldete Problem gelöst werden kann. Ein Beispiel ist ein Alert, dass der Speicherplatz im Fast Recovery-Bereich knapp wird. Dabei wird empfohlen, veraltete Backups zu löschen oder zusätzlichen Plattenspeicherplatz hinzuzufügen.
Siehe auch: Oracle AI Database Administrator's Guide
Automatic Workload Repository (AWR)
Automatic Workload Repository (AWR) ist ein Repository historischer Performancedaten, das kumulative Statistiken für das System, Sessions, einzelne SQL-Anweisungen, Segmente und Services enthält.
AWR-Statistiken bilden die Grundlage für das Performance Tuning. Durch die Automatisierung der Erfassung von Datenbankstatistiken zur Problemerkennung und -optimierung dient AWR als Grundlage für die Selbstverwaltung der Datenbank.
Wie in der folgenden Grafik dargestellt, speichert die Datenbank die aktuellen AWR-Statistiken in der SGA. Standardmäßig sammelt der MMON-Prozess Statistiken jede Stunde und erstellt einen AWR-Snapshot. Ein AWR-Snapshot ist ein Set von Performancestatistiken, die zu einem bestimmten Zeitpunkt erfasst werden. Die Datenbank schreibt Snapshots in den Tablespace SYSAUX. AWR verwaltet Snapshot-Speicherplatz und löscht ältere Snapshots gemäß einer konfigurierbaren Snapshot-Aufbewahrungs-Policy.
Abbildung 9: Automatic Workload Repository (AWR)
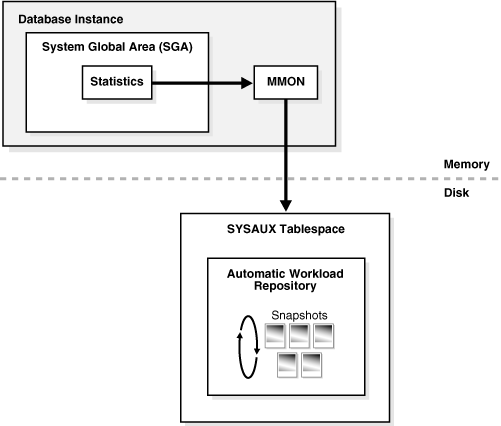
Beschreibung der Abbildung cncpt279.gif
Eine AWR-Baseline ist eine Sammlung von Statistikraten, die in der Regel über einen Zeitraum hinweg verwendet werden, in dem das System bei Spitzenlast gut abschneidet. Sie können ein Paar oder einen Bereich von AWR-Snapshots als Baseline angeben. Wenn Sie mithilfe eines AWR-Berichts Statistiken vergleichen, die während einer Periode schlechter Performance mit einer Baseline erfasst wurden, können Sie Probleme diagnostizieren.
Eine automatisierte Wartungsinfrastruktur namens AutoTask veranschaulicht, wie Oracle Database AWR für die Selbstverwaltung verwendet. Durch die Analyse von AWR-Daten kann AutoTask den Bedarf an Wartungsaufgaben ermitteln und deren Ausführung in Oracle Scheduler-Wartungsfenstern planen. Beispiele für Aufgaben sind das Sammeln von Statistiken für den Optimizer und das Ausführen von Automatic Segment Advisor.
Siehe:
-
Weitere Informationen zu AWR finden Sie im Oracle AI Database Performance Tuning Guide.
-
Oracle AI Database Administrator's Guide zum Verwalten automatischer Wartungsaufgaben
Automatic Database Monitor (ADDM)
Mit in AWR (Automatic Workload Repository) erfassten Statistiken diagnostiziert ADDM automatisch und proaktiv die Datenbankperformance und bestimmt, wie identifizierte Probleme gelöst werden können. Sie können ADDM auch manuell ausführen. Automatic Database Diagnostic Monitor (ADDM) ist ein Selbstdiagnose-Advisor, der in Oracle Database integriert wurde.
ADDM verfolgt einen ganzheitlichen Ansatz für die Systemperformance und verwendet die Zeit als gemeinsame Währung zwischen den Komponenten. ADDM identifiziert Bereiche von Oracle Database, die am meisten Zeit beanspruchen. Beispiel: Die Datenbank verbringt möglicherweise übermäßig viel Zeit mit dem Warten auf freie Datenbankpuffer. ADDM führt einen Drilldown durch, um die Ursache von Problemen und nicht nur die Symptome zu ermitteln, und meldet die Auswirkungen des Problems auf Oracle Database insgesamt. Minimaler Overhead tritt während des Prozesses auf.
In vielen Fällen empfiehlt ADDM Lösungen und quantifiziert die erwarteten Performancevorteile. ADDM kann beispielsweise Änderungen an Hardware, Datenbankkonfiguration, Datenbankschema oder Anwendungen empfehlen. Wenn eine Empfehlung abgegeben wird, meldet ADDM den Zeitvorteil. Die Verwendung von Zeit als Maßnahme ermöglicht Vergleiche von Problemen oder Empfehlungen.
Neben der Meldung potenzieller Performanceprobleme dokumentiert ADDM Bereiche der Datenbank, die keine Probleme darstellen. Unterkomponenten wie I/O und Speicher, die sich nicht wesentlich auf die Datenbankperformance auswirken, werden frühzeitig aus dem Klassifizierungsbaum entfernt. ADDM listet diese Unterkomponenten auf, sodass Sie schnell erkennen können, dass die Ausführung von Aktionen in diesen Bereichen wenig Vorteile bietet.
Siehe auch: Oracle AI Database – Erste Schritte mit Performance Tuning und Oracle AI Database Performance Tuning Guide
Active Session History (ASH)
Active Session History (ASH) erfasst jede Sekunde aktive Datenbanksessions und schreibt die Daten in den Speicher und den persistenten Speicher. ASH ist ein integraler Bestandteil des Datenbank-Selbstverwaltungs-Frameworks und eignet sich besonders zur Diagnose von Performanceproblemen.
Im Gegensatz zu Statistiken auf Instance-Ebene, die von Automatic Workload Repository (AWR) erfasst werden, sammelt die Datenbank ASH-Statistiken auf Session-Ebene. Eine aktive Session ist eine Session, die CPU verwendet und nicht auf ein Ereignis in der Wait-Klasse "inaktiv" wartet.
Mit Enterprise Manager oder SQL-Skripten können Sie ASH-Berichte generieren, die Sessionstatistiken sammeln, die über einen bestimmten Zeitraum gesammelt wurden. Sie können ASH-Berichte für folgende Zwecke verwenden:
-
Analyse von kurzlebigen Performanceproblemen, die nicht durch Automatic Database Diagnostic Monitor (ADDM) identifiziert werden
-
Bereichs- oder Ziel-Performanceanalysen durch verschiedene Dimensionen oder ihre Kombinationen, z.B. Zeit, Session, Modul, Aktion oder SQL-Bezeichner
Beispiel: Ein Benutzer benachrichtigt Sie, dass die Datenbank zwischen 10:00 und 10:02 Uhr langsam war. Die 2-minütige Performancebeeinträchtigung stellt jedoch einen kleinen Teil des AWR-Snapshot-Intervalls von 10:00 Uhr und 11:00 Uhr dar und wird in ADDM-Ergebnissen nicht angezeigt. ASH-Berichte können helfen, die Quelle des vorübergehenden Problems zu identifizieren.
Siehe auch: Oracle AI Database – Erste Schritte mit Performance Tuning und Oracle AI Database Performance Tuning Guide
Anwendungs- und SQL-Tuning
Oracle Database automatisiert den SQL-Tuning-Prozess vollständig.
ADDM identifiziert SQL-Anweisungen, die ungewöhnlich hohe Systemressourcen belegen und daher Performanceprobleme verursachen. Darüber hinaus erfasst AWR automatisch die wichtigsten SQL-Anweisungen in Bezug auf CPU- und Shared Memory-Auslastung. Die Identifizierung von High-Load-SQL-Anweisungen erfolgt automatisch und erfordert keinen Eingriff.
-
EXPLAIN PLAN-Anweisung Mit Tools wie der
EXPLAIN PLAN-Anweisung können Sie die vom Optimizer ausgewählten Ausführungspläne anzeigen. -
Optimizer Statistics Advisor Optimizer Statistics Advisor ist eine Diagnosesoftware, die analysiert, wie Sie derzeit Statistiken erfassen, die Effektivität vorhandener Jobs zur Statistiksammlung und die Qualität der gesammelten Statistiken. Optimizer Statistics Advisor verwendet dasselbe Advisor Framework wie Automatic Database Diagnostic Monitor (ADDM), SQL Performance Analyzer und andere Advisor.
-
SQL Tuning Advisor Die Schnittstelle für das automatische SQL-Tuning ist SQL Tuning Advisor, der automatisch während der Systemwartungsfenster als Wartungsaufgabe ausgeführt wird.
-
SQL Access Advisor Mit SQL Access Advisor können Sie SQL-Abfragen analysieren und Möglichkeiten zur Optimierung von Schemaobjekten oder zur Optimierung von Abfragen festlegen.
-
SQL Plan Management Verwalten Sie SQL-Ausführungspläne, indem Sie SQL Plan Management verwenden, um nur getestete und geprüfte Pläne auszuführen.
EXPLAIN PLAN-Anweisung
Mit Tools wie der Anweisung EXPLAIN PLAN können Sie Ausführungspläne anzeigen, die vom Optimizer ausgewählt wurden.
EXPLAIN PLAN zeigt den Abfrageplan für die angegebene SQL-Abfrage an, wenn sie jetzt in der aktuellen Session ausgeführt wurde. Weitere Tools sind Oracle Enterprise Manager und der SQL*Plus-Befehl AUTOTRACE.
Siehe auch: Oracle AI Database SQL Language Reference, um mehr über EXPLAIN PLAN zu erfahren
Optimizer Statistics Advisor
Optimizer Statistics Advisor ist eine Diagnosesoftware, die analysiert, wie Sie derzeit Statistiken sammeln, die Effektivität vorhandener Statistiksammeljobs und die Qualität der gesammelten Statistiken. Optimizer Statistics Advisor verwendet dasselbe Advisor Framework wie Automatic Database Diagnostic Monitor (ADDM), SQL Performance Analyzer und andere Advisor.
Optimizer Statistics Advisor bietet die folgenden Vorteile gegenüber dem herkömmlichen Ansatz, der auf Best Practices basiert:
-
Bietet leicht verständliche Berichte
-
Stellt Skripte bereit, um erforderliche Korrekturen zu implementieren, ohne Änderungen am Anwendungscode erforderlich zu machen
-
Führt eine vordefinierte Aufgabe namens
AUTO_STATS_ADVISOR_TASKeinmal täglich im Wartungsfenster aus -
Stellt eine API im Package
DBMS_STATSbereit, mit der Sie Aufgaben manuell erstellen und ausführen, Ergebnisse und Empfehlungen in Data Dictionary Views speichern, Berichte für die Aufgaben generieren und bei Bedarf Korrekturen implementieren können -
Integration mit vorhandenen Tools wie Oracle Enterprise Manager (Enterprise Manager)
Optimizer Statistics Advisor verwaltet Regeln, die von Oracle bereitgestellte Standards sind, mit denen der Advisor seine Prüfungen ausführt. Die Regeln enthalten Best Practices von Oracle basierend auf dem aktuellen Featureset. Wenn sich die Best Practices von Release zu Release ändern, ändern sich auch die Optimizer Statistics Advisor-Regeln. Auf diese Weise liefert der Berater immer die aktuellsten Empfehlungen.
Optimizer Statistics Advisor prüft den Prozess zur Erfassung von Statistiken und generiert dann einen Bericht über Ergebnisse, die Verstöße gegen die Regeln darstellen. Wenn der Advisor Empfehlungen ausgibt und Aktionen auf der Grundlage dieser Empfehlungen vorschlägt, können Sie die Aktionen entweder automatisch implementieren oder ein editierbares, ausführbares PL/SQL-Skript generieren.
Die Advisor Task wird automatisch im Wartungsfenster ausgeführt. Sie können sie aber auch bei Bedarf ausführen.
Siehe:
-
SQL Tuning Guide für Oracle AI Database, um mehr über Optimizer Statistics Advisor zu erfahren
-
Oracle AI Database PL/SQL Packages and Types Reference für Informationen zum
DBMS_STATS-Package
SQL Tuning Advisor
Die Schnittstelle für das automatische SQL-Tuning ist SQL Tuning Advisor, der automatisch während der Systemwartungsfenster als Wartungsaufgabe ausgeführt wird.
Während jeder automatischen Ausführung wählt der Advisor High-Load-SQL-Abfragen in der Datenbank und generiert Empfehlungen für das Tuning dieser Abfragen.
SQL Tuning Advisor-Empfehlungen fallen in die folgenden Kategorien:
-
Statistikanalyse
-
SQL-Profilerstellung
-
Zugriffspfadanalyse
-
SQL-Strukturanalyse
Ein SQL-Profil enthält zusätzliche Statistiken, die für eine SQL-Anweisung spezifisch sind, und ermöglicht dem Optimizer, einen besseren Ausführungsplan zu generieren. Im Wesentlichen ist ein SQL-Profil eine Methode zur Analyse einer Abfrage. Sowohl die Zugriffspfad- als auch die SQL-Strukturanalyse sind nützlich, um eine Anwendung zu optimieren, die sich in der Entwicklung befindet, oder eine selbst entwickelte Produktionsanwendung.
Ein Hauptvorteil von SQL Tuning Advisor besteht darin, dass Lösungen vom Optimizer und nicht von externen Tools stammen. Daher wird das Tuning von der Datenbankkomponente durchgeführt, die für die Ausführungspläne und die SQL-Performance verantwortlich ist. Der Tuning-Prozess kann vergangene Ausführungsstatistiken einer SQL-Anweisung berücksichtigen und die Optimizer-Einstellungen für diese Anweisung anpassen.
Siehe:
SQL Access Advisor
Mit SQL Access Advisor können Sie SQL-Abfragen analysieren und Möglichkeiten zur Optimierung von Schemaobjekten oder zur Optimierung von Abfragen festlegen.
SQL Access Advisor bietet Ratschläge zur Optimierung von Datenzugriffspfaden. Insbesondere wird empfohlen, wie die Datenbankperformance durch Partitionierung, Materialized Views, Indizes und Materialized View Logs verbessert werden kann.
Schemaobjekte wie Partitionen und Indizes sind für die Optimierung komplexer, datenintensiver Abfragen unerlässlich. Die Erstellung und Verwaltung dieser Objekte kann jedoch zeitaufwendig sein, und der Speicherplatzbedarf kann erheblich sein. Mit SQL Access Advisor können Sie Leistungsziele erreichen, indem Sie Datenstrukturen für eine angegebene Workload empfehlen.
Sie können SQL Access Advisor in Enterprise Manager mit einem Assistenten oder mit dem Package DBMS_ADVISOR ausführen. DBMS_ADVISOR besteht aus einer Sammlung von Analyse- und Advisory-Funktionen und -Prozeduren, die aus einem beliebigen PL/SQL-Programm aufgerufen werden können.
Siehe auch: Oracle AI Database – Erste Schritte mit Performance Tuning und Oracle AI Database SQL Tuning Guide
SQL-Planmanagement
Verwalten Sie SQL-Ausführungspläne, indem Sie mit SQL Plan Management nur getestete und geprüfte Pläne ausführen.
Standardmäßig wird SQL Plan Management (SPM) Evolve Advisor täglich im geplanten Wartungsfenster ausgeführt, sortiert alle nicht akzeptierten Pläne und führt Testausführungen so vieler Pläne wie möglich durch. SPM Evolve Advisor wählt den kostengünstigsten akzeptierten Plan in der SQL-Planbaseline aus, um ihn mit jedem nicht akzeptierten Plan zu vergleichen. Wenn der nicht akzeptierte Plan ausreichend besser funktioniert als der vorhandene akzeptierte Plan, akzeptiert der Advisor ihn.
Wenn Hochfrequenz-SPM aktiviert ist, wird der SPM Evolve Advisor in einer periodischen Hintergrundaufgabe außerhalb des Wartungsfensters ausgeführt, um zeitnahere Leistungsverbesserungen zu ermöglichen. Die Hochfrequenzaufgabe identifiziert SQL-Anweisungen, die wichtige Systemressourcen verwenden, und prüft, ob ein zuvor verwendeter SQL-Ausführungsplan besser funktioniert. In diesem Fall wird eine neue SQL-Plan-Baseline erstellt, um den früheren SQL-Ausführungsplan durchzusetzen und die SQL-Performance-Regression zu reparieren.
Wenn Oracle Database 26ai aktiviert ist, startet Echtzeit-SPM die Performanceanalyse sofort, wenn eine SQL-Anweisung einen neuen SQL-Ausführungsplan verwendet. Wenn ein vorher erstellter SQL-Ausführungsplan besser funktioniert, wird sofort eine neue SQL-Planbaseline erstellt, ohne dass hierfür eine Hintergrundaufgabe erforderlich ist.
Siehe:
-
SQL-Tuning-Leitfaden für Oracle AI Database zum SQL-Planmanagement