Themen für Datenbankadministratoren und Entwickler
Der Skriptcontent auf dieser Seite ist ausschließlich für Navigationszwecke vorgesehen und bewirkt keinerlei Änderung des Contents.
In diesem Kapitel werden allgemeine Datenbankthemen zusammengefasst, die sowohl für Datenbankadministratoren als auch für Entwickler wichtig sind. Außerdem werden Verweise auf andere Handbücher und nicht auf einen umfassenden Überblick über Datenbankfunktionen bereitgestellt.
-
Überblick über Datenbanksicherheit Im Allgemeinen umfasst die Datenbanksicherheit die Benutzerauthentifizierung, Verschlüsselung, Zugriffskontrolle und Überwachung.
-
Überblick über High Availability: Die Verfügbarkeit ist der Grad, in dem eine Anwendung, ein Service oder eine Funktionalität auf Anforderung verfügbar ist.
-
Überblick über Grid Computing Die Computing-Architektur, die als Grid Computing bekannt ist, bündelt eine große Anzahl von Servern und Speicher effektiv in einer flexiblen On-Demand-Ressource für alle Unternehmens-Computing-Anforderungen.
-
Überblick über Data Warehousing und Business Intelligence Ein Data Warehouse ist eine relationale Datenbank, der eher zur Abfrage und Analyse als zur Transaktionsverarbeitung ausgelegt wird.
-
Überblick über Oracle Information Integration Mit der Weiterentwicklung eines Unternehmens wird es immer wichtiger, Informationen zwischen mehreren Datenbanken und Anwendungen gemeinsam nutzen zu können. Siehe auch: Konzepte für Datenbankadministratoren für Themen speziell für DBAs und Konzepte für Datenbankentwickler für Themen speziell für Datenbankentwickler.
Datenbanksicherheit - Überblick
Im Allgemeinen umfasst die Datenbanksicherheit Benutzerauthentifizierung, Verschlüsselung, Zugriffskontrolle und Überwachung.
Der vorliegende Abschnitt umfasst die folgenden Themen:
-
Benutzeraccounts Jede Oracle-Datenbank hat eine Liste mit gültigen Datenbankbenutzern.
-
Datenbankauthentifizierung In Oracle AI Database ist die Datenbankauthentifizierung der Prozess, bei dem ein Benutzer Zugangsdaten für die Datenbank vorlegt. Dadurch werden die Zugangsdaten geprüft, und der Zugriff auf die Datenbank ist möglich.
-
Verschlüsselung Oracle AI Database Verschlüsselung ist der Prozess der Umwandlung von Daten in ein unlesbares Format mit einem Secret Key und einem Verschlüsselungsalgorithmus.
-
Mit Oracle Data Redaction Oracle Data Redaction, einem Teil von Oracle Advanced Security, können Sie Daten maskieren (redaktieren), die von Benutzern mit geringem Privileg oder Anwendungen abgefragt werden. Die Verdeckung erfolgt in Echtzeit, wenn Benutzer die Daten abfragen.
-
Zugriffskontrolle Oracle AI Database bietet viele Techniken, um den Zugriff auf Daten zu kontrollieren. In diesem Abschnitt werden einige dieser Techniken zusammengefasst.
-
Datenzugriffsüberwachung Oracle AI Database bietet mehrere Tools und Techniken zur Überwachung der Benutzeraktivität. Auditing ist der primäre Mechanismus zur Überwachung des Datenzugriffs.
Benutzeraccounts
Jede Oracle-Datenbank enthält eine Liste von gültigen Datenbankbenutzern.
Die Datenbank enthält mehrere Standardaccounts, einschließlich des Standardadministrationsaccounts SYSTEM. Sie können Benutzeraccounts nach Bedarf erstellen. Sie können auch Anwendungsbenutzer für den Zugriff auf Oracle-Datenbanken konfigurieren.
Um auf eine Datenbank zuzugreifen, muss ein Benutzer einen gültigen Benutzernamen und Authentifizierungszugangsdaten angeben. Die Zugangsdaten können ein Kennwort, ein Kerberos-Ticket oder ein Public Key Infrastructure-(PKI-)Zertifikat sein. Sie können die Datenbanksicherheit so konfigurieren, dass Accounts basierend auf nicht erfolgreichen Anmeldeversuchen gesperrt werden.
Im Allgemeinen umfasst die Datenbankzugriffskontrolle die Einschränkung des Datenzugriffs und der Datenbankaktivitäten. Beispiel: Sie können die Abfrage bestimmter Tabellen oder die Ausführung bestimmter Datenbankanweisungen durch Benutzer einschränken.
-
Berechtigungen Eine Benutzerberechtigung ist das Recht, bestimmte SQL-Anweisungen auszuführen.
-
Rollen Eine Rolle ist eine benannte Gruppe von zugehörigen Berechtigungen, die ein Benutzer anderen Benutzern oder Rollen erteilen kann. Mit einer Rolle können Berechtigungen für eine Datenbankanwendung oder Benutzergruppe verwaltet werden.
-
Berechtigungsanalyse Der Mechanismus der Berechtigungsanalyse erfasst die Berechtigungsverwendung für eine Datenbank gemäß einer angegebenen Bedingung.
-
Benutzerprofile Im Kontext von Systemressourcen ist ein Benutzerprofil eine benannte Gruppe von Ressourcenlimits und Kennwortparametern, die Datenbanknutzung und Datenbankinstanzressourcen für einen Benutzer einschränken.
Siehe:
-
Oracle AI Database Administrator's Guide mit Informationen zu administrativen Benutzeraccounts
-
Oracle AI Database Real Application Security Administrator's and Developer's Guide zum Konfigurieren von Anwendungsbenutzern
Berechtigungen
Eine Benutzerberechtigung ist das Recht, bestimmte SQL-Anweisungen auszuführen.
Berechtigungen fallen in die folgenden Kategorien:
-
Systemberechtigung
Dies ist das Recht, eine bestimmte Aktion in der Datenbank auszuführen oder eine Aktion für Objekte eines bestimmten Typs auszuführen. Beispiel:
CREATE USERundCREATE SESSIONsind Systemberechtigungen. -
Schemaberechtigung
Dies ist das Recht, Systemberechtigungen für alle Objekte in einem bestimmten Schema zu verwenden. Diese Berechtigung gilt für alle aktuellen und zukünftigen Objekte im Schema.
-
Objektberechtigung
Dies ist das Recht, eine bestimmte Aktion für ein Objekt auszuführen, z.B. die Tabelle
employeesabzufragen. Privilegtypen werden von der Datenbank definiert.
Berechtigungen werden Benutzern nach Ermessen anderer Benutzer erteilt. Administratoren sollten Benutzern Berechtigungen erteilen, damit sie die für ihre Tätigkeiten erforderlichen Aufgaben ausführen können. Eine gute Sicherheitspraxis besteht darin, eine Berechtigung nur einem Benutzer zu erteilen, der diese Berechtigung zum Durchführen der erforderlichen Arbeit benötigt.
Siehe:
- Oracle AI Database-Referenz zur
SESSION_PRIVS-Ansicht
Rollen
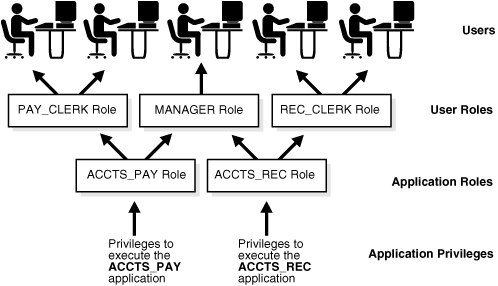
Eine Rolle ist eine benannte Gruppe zugehöriger Berechtigungen, die ein Benutzer anderen Benutzern oder Rollen erteilen kann. Mit einer Rolle können Berechtigungen für eine Datenbankanwendung oder Benutzergruppe verwaltet werden. In Abbildung 20-1 wird eine allgemeine Verwendung für Rollen dargestellt. Die Rollen PAY_CLERK, MANAGER und REC_CLERK werden verschiedenen Benutzern zugewiesen. Die Anwendungsrolle ACCTS_PAY, die die Berechtigung zum Ausführen der Anwendung ACCTS_PAY enthält, wird Benutzern mit der Rolle PAY_CLERK und MANAGER zugewiesen. Die Anwendungsrolle ACCTS_REC, die die Berechtigung zum Ausführen der Anwendung ACCTS_REC enthält, wird Benutzern mit der Rolle REC_CLERK und MANAGER zugewiesen.
Abbildung 1: Allgemeine Verwendungen für Rollen
Beschreibung der Abbildung cncpt082.gif
Siehe:
-
Oracle AI Database - Sicherheitshandbuch, um mehr über die Verwendung von Rollen für die Sicherheit zu erfahren
-
Oracle AI Database Administrator's Guide zum Verwalten von Rollen
Berechtigungsanalyse
Der Mechanismus der Berechtigungsanalyse erfasst die Berechtigungsverwendung für eine Datenbank gemäß einer bestimmten Bedingung.
Auf diese Weise können Sie die Berechtigungen erfassen, die zum Ausführen eines Application Modules oder zum Ausführen bestimmter SQL-Anweisungen erforderlich sind. Beispiel: Sie können die Privilegien ermitteln, die ein Benutzer während einer bestimmten Datenbank-Session ausgeübt hat.
In einer Produktionsdatenbank können die Beziehungen zwischen Berechtigungen und Rollen, Rollen und Rollen sowie Rollen und Benutzern komplex sein. Mit der Berechtigungsanalyse können Sie Berechtigungen identifizieren, die in einem komplexen System unnötig erteilt werden. Basierend auf der Analyse der erfassten Ergebnisse können Sie unnötige Berechtigungen entfernen oder Berechtigungsberechtigungen neu konfigurieren, um die Sicherheit der Datenbanken zu erhöhen.
Siehe auch: Oracle AI Database - Sicherheitshandbuch, um Informationen zur Berechtigungsanalyse zu erhalten.
Benutzerprofile
Im Kontext von Systemressourcen ist ein Benutzerprofil eine benannte Gruppe von Ressourcenlimits und Kennwortparametern, die Datenbanknutzung und Datenbankinstanzressourcen für einen Benutzer einschränken.
Profile können die Anzahl der gleichzeitigen Sessions für einen Benutzer, die für jede Session verfügbare CPU-Verarbeitungszeit und die Anzahl der verfügbaren logischen I/O-Vorgänge begrenzen. Beispiel: Das Profil clerk könnte einen Benutzer auf Systemressourcen beschränken, die für klerikale Aufgaben erforderlich sind. Hinweis: Sie sollten Database Resource Manager verwenden, um Ressourcen zu begrenzen und Profile zum Verwalten von Kennwörtern zu verwenden.
Profile bieten einen einzigen Referenzpunkt für Benutzer, die eine Gruppe von Attributen gemeinsam verwenden. Sie können ein Profil einer Gruppe von Benutzern und ein Standardprofil allen anderen Benutzern zuweisen. Jedem Benutzer kann jeweils maximal ein Profil zugewiesen werden.
Siehe:
-
Oracle AI Database - Sicherheitshandbuch zum Verwalten von Ressourcen mit Profilen
-
Oracle AI Database SQL Language Reference für
CREATE PROFILE-Syntax und Semantik
Datenbankauthentifizierung
In Oracle AI Database ist die Datenbankauthentifizierung der Prozess, bei dem ein Benutzer Zugangsdaten für die Datenbank vorlegt. Damit werden die Zugangsdaten geprüft und der Zugriff auf die Datenbank ermöglicht.
Durch die Validierung der Identität wird eine Vertrauensbeziehung für weitere Interaktionen hergestellt. Die Authentifizierung ermöglicht auch die Verantwortlichkeit, indem der Zugriff und die Aktionen mit bestimmten Identitäten verknüpft werden können.
Oracle AI Database bietet verschiedene Authentifizierungsmethoden, darunter die folgenden:
-
Authentifizierung durch die Datenbank
Die Oracle-Datenbank kann Benutzer mit einem Kennwort, einem Kerberos-Ticket oder einem PKI-Zertifikat authentifizieren. Oracle unterstützt auch RADIUS-konforme Geräte für andere Formen der Authentifizierung, einschließlich Biometrie. Der Authentifizierungstyp muss angegeben werden, wenn ein Benutzer in der Oracle-Datenbank erstellt wird.
-
Authentifizierung durch das Betriebssystem
Einige Betriebssysteme ermöglichen es Oracle AI Database, Informationen zu verwenden, die sie zur Authentifizierung von Benutzern verwalten. Nach der Authentifizierung durch das Betriebssystem können sich Benutzer bei einer Datenbank anmelden, ohne einen Benutzernamen oder ein Kennwort anzugeben.
Nicht-administrative Datenbankbenutzeraccounts dürfen keine Datenbankvorgänge wie das Herunterfahren oder Hochfahren der Datenbank ausführen. Für diese Vorgänge sind die Berechtigungen SYSDBA, SYSOPER, SYSBACKUP oder SYSDG erforderlich.
Siehe:
-
Oracle AI Database - Sicherheitshandbuch für Informationen zu Authentifizierungsmethoden
-
Oracle AI Database - Administratordokumentation mit Informationen zur administrativen Authentifizierung
Verschlüsselung
Oracle AI Database Verschlüsselung ist der Prozess der Umwandlung von Daten in ein unlesbares Format mit einem Secret Key und einem Verschlüsselungsalgorithmus.
Verschlüsselung wird häufig verwendet, um gesetzliche Compliance-Anforderungen zu erfüllen, wie sie mit dem Payment Card Industry Data Security Standard (PCI-DSS) oder den Gesetzen zur Meldung von Verstößen verbunden sind. Beispiel: Kreditkartennummern, Sozialversicherungsnummern oder Patienteninformationen müssen immer verschlüsselt werden.
-
Netzwerkverschlüsselung Die Verschlüsselung von Daten, während sie zwischen einem Client und dem Server über das Netzwerk übertragen werden, wird als Netzwerkverschlüsselung bezeichnet.
-
Transparente Datenverschlüsselung Mit der transparenten Datenverschlüsselung von Oracle Advanced Security können Sie einzelne Tabellenspalten oder einen Tablespace verschlüsseln.
Netzwerkverschlüsselung
Die Verschlüsselung von Daten, während sie zwischen einem Client und einem Server über das Netzwerk übertragen werden, wird als Netzwerkverschlüsselung bezeichnet.
Ein Eindringling kann mit einem Netzwerk-Paketsniffer Informationen erfassen, während er im Netzwerk übertragen wird, und diese dann für bösartige Zwecke in eine Datei puffern. Durch Verschlüsseln der über das Netzwerk übertragenen Daten werden Aktivitäten dieser Art verhindert.
Transparente Datenverschlüsselung
Mit der transparenten Datenverschlüsselung von Oracle Advanced Security können Sie einzelne Tabellenspalten oder einen Tablespace verschlüsseln.
Wenn ein Benutzer Daten in eine verschlüsselte Spalte einfügt, verschlüsselt die Datenbank die Daten automatisch. Wenn Benutzer die Spalte wählen, werden die Daten entschlüsselt. Diese Form der Verschlüsselung ist transparent, bietet eine hohe Leistung und ist einfach zu implementieren.
Transparent Data Encryption umfasst branchenübliche Verschlüsselungsalgorithmen wie den Advanced Encryption Standard (AES) und die integrierte Schlüsselverwaltung.
Siehe auch: Oracle AI Database Transparent Data Encryption Guide
Oracle-Datenverdeckung
Mit Oracle Data Redaction, einem Teil von Oracle Advanced Security, können Sie Daten maskieren (redaktieren), die von Benutzern mit geringem Privileg oder Anwendungen abgefragt werden. Die Verdeckung erfolgt in Echtzeit, wenn Benutzer die Daten abfragen.
Die Datenverdeckung unterstützt die folgenden Verdeckungsfunktionstypen:
-
Vollständige Datenverdeckung
In diesem Fall verdeckt die Datenbank den gesamten Inhalt der angegebenen Spalten in einer Tabelle oder View. Beispiel: In einer Spalte
VARCHAR2für einen Nachnamen wird ein einzelnes Leerzeichen angezeigt. -
Teilweise Verdeckung von Daten
In diesem Fall verdeckt die Datenbank Teile der angezeigten Ausgabe. Beispiel: Eine Anwendung kann eine Kreditkartennummer mit der Endung
1234alsxxxx-xxxx-xxxx-1234vorlegen. Sie können reguläre Ausdrücke für vollständige und teilweise Verdeckung verwenden. Ein regulärer Ausdruck kann Daten basierend auf einem Suchmuster verdecken. Beispiel: Sie können reguläre Ausdrücke verwenden, um bestimmte Telefonnummern oder E-Mail-Adressen zu verdecken. -
Zufällige Datenverdeckung
In diesem Fall zeigt die Datenbank die Daten als zufällig generierte Werte an, abhängig vom Datentyp der Spalte. Beispiel: Die Zahl
1234567kann als83933895angezeigt werden.
Data Redaction ist keine umfassende Sicherheitslösung. Sie verhindert beispielsweise nicht, dass direkt verbundene, privilegierte Benutzer Inferenzangriffe auf verdeckte Daten ausführen. Solche Angriffe identifizieren verdeckte Spalten und versuchen durch Eliminierungsprozess, in tatsächliche Daten zurückzukehren, indem SQL-Abfragen wiederholt werden, die gespeicherte Werte erraten. Um Inferenz- und andere Angriffe privilegierter Benutzer zu erkennen und zu verhindern, empfiehlt Oracle, Oracle Data Redaction mit verwandten Datenbanksicherheitsprodukten wie Oracle Audit Vault and Database Firewall und Oracle Database Vault zu koppeln.
Die Datenverdeckung funktioniert wie folgt:
-
Verwenden Sie das Package
DBMS_REDACT, um eine Verdeckungs-Policy für eine angegebene Tabelle zu erstellen. -
Geben Sie in der Policy eine vordefinierte Verdeckungsfunktion an.
-
Ob die Datenbank den tatsächlichen oder verdeckten Wert einer Spalte anzeigt, hängt von der Policy ab. Wenn die Daten verdeckt werden, erfolgt die Verdeckung unmittelbar vor der Anzeige für den Benutzer in der Auswahlliste der obersten Ebene.
Im folgenden Beispiel wird eine vollständige Datenverdeckungs-Policy hinzugefügt, um die Spalte "Mitarbeiter-ID" (employee_id) der Tabelle hr.employees zu verdecken:
BEGIN
 DBMS_REDACT.ADD_POLICY(
   object_schema    => 'hr'
,  object_name      => 'employees'
,  column_name      => 'employee_id'
,  policy_name      => 'mask_emp_ids'
,  function_type    => DBMS_REDACT.FULL
,  expression       => '1=1'
);
END;
/
Im vorherigen Beispiel wendet die Ausdruckseinstellung, die als true ausgewertet wird, die Verdeckung auf Benutzer an, denen die Berechtigung EXEMPT REDACTION POLICY nicht erteilt wurde.
Siehe:
-
Oracle AI Database Data Redaction Guide für Informationen zur Datenverdeckung
-
Oracle AI Database PL/SQL Packages and Types Reference für Informationen zu
DBMS_REDACT
Zugriffskontrolle
Oracle AI Database bietet viele Techniken, um den Zugriff auf Daten zu kontrollieren. In diesem Abschnitt werden einige dieser Techniken zusammengefasst.
-
Oracle Database Vault schränkt den privilegierten Benutzerzugriff auf Anwendungsdaten ein.
-
Mit Virtual Private Database (VPD) Oracle Virtual Private Database (VPD) können Sie die Sicherheit auf Zeilen- und Spaltenebene durchsetzen.
-
Mit Oracle Label Security (OLS) Oracle Label Security (OLS) können Sie Datenklassifizierung und Zugriffskontrolle mit Sicherheitslabels zuweisen. Sie können Daten oder Benutzern ein Label zuweisen.
Oracle Database Vault
Oracle Database Vault schränkt den privilegierten Benutzerzugriff auf Anwendungsdaten ein.
Ab Oracle Database 12c erweitert Oracle Database Vault die standardmäßige Datenbankauditdatenstruktur. Wenn Sie außerdem zu Unified Auditing migrieren, schreibt die Datenbank Auditdatensätze in den einheitlichen Audittrail in Oracle Secure Files, der Auditdatensätze für Oracle AI Database zentralisiert.
Mit Oracle Database Vault können Sie steuern, wann, wo und wie auf die Datenbanken, Daten und Anwendungen zugegriffen wird. So können Sie gängige Sicherheitsprobleme wie den Schutz vor Insider-Bedrohungen, die Einhaltung gesetzlicher Anforderungen und die Durchsetzung einer Aufgabentrennung beheben.
Damit der Oracle Database Vault-Administrator zur Verantwortung gezogen werden kann, prüft die Datenbank Konfigurationsänderungen, die an den Oracle Database Vault-Metadaten vorgenommen wurden. Diese Änderungen umfassen das Erstellen, Ändern und Löschen von Oracle Database Vault-bezogenen Durchsetzungen, Berechtigungen und den Widerruf geschützter Rollen sowie Autorisierungen für Komponenten wie Oracle Data Pump und den Job Scheduler.
Siehe:
-
Oracle AI Database Database Vault – Administratordokumentation
-
Oracle AI Database - Sicherheitshandbuch, um mehr über die Integration von Oracle Database Vault Audit mit Oracle Database Native Audit zu erfahren
Virtual Private Database (VPD)
Mit Oracle Virtual Private Database (VPD) können Sie die Sicherheit auf Zeilen- und Spaltenebene durchsetzen.
Eine Sicherheitsrichtlinie legt Methoden fest, mit denen eine Datenbank vor versehentlicher oder böswilliger Zerstörung von Daten oder vor Beschädigung der Datenbankinfrastruktur geschützt wird.
VPD ist nützlich, wenn Sicherheitsschutzfunktionen wie Berechtigungen und Rollen nicht ausreichend feingranuliert sind. Beispiel: Sie können allen Benutzern den Zugriff auf die Tabelle employees erlauben, jedoch Sicherheits-Policys erstellen, um den Zugriff auf Mitarbeiter in derselben Abteilung wie der Benutzer einzuschränken.
Im Wesentlichen fügt die Datenbank einer SQL-Anweisung, die für die Tabelle, die Ansicht oder das Synonym abgesetzt wurde, eine dynamische WHERE-Klausel hinzu, auf die eine Oracle VPD-Sicherheits-Policy angewendet wurde. Mit der WHERE-Klausel können nur Benutzer, deren Zugangsdaten die Sicherheits-Policy übergeben, auf die geschützten Daten zugreifen.
Siehe auch: Oracle AI Database - Sicherheitshandbuch
Oracle Label Security (OLS)
Mit Oracle Label Security (OLS) können Sie Datenklassifizierung und Zugriffskontrolle mit Sicherheitslabels zuweisen. Sie können Daten oder Benutzern ein Label zuweisen.
Wenn das Label Daten zugewiesen wird, kann es als ausgeblendete Spalte an Tabellen angehängt werden, um SQL transparent zu machen. Beispiel: Sie können Zeilen, die hochsensible Daten enthalten, als HIGHLY SENSITIVE und weniger sensible Labelzeilen als SENSITIVE labeln. Wenn ein Benutzer versucht, auf Daten zuzugreifen, vergleicht OLS das Benutzerlabel mit dem Datenlabel und legt fest, ob Zugriff gewährt werden soll. Im Gegensatz zu VPD bietet OLS eine Out-of-the-box-Sicherheits-Policy und ein Metadaten-Repository zum Definieren und Speichern von Labels.
Wenn Unified Auditing aktiviert ist, stellt die Datenbank ein Policy-basiertes Framework zur Konfiguration und Verwaltung von Auditoptionen bereit. Sie können Auditoptionen für verschiedene Typen von Vorgängen, einschließlich OLS-Vorgängen, gruppieren und als Audit-Policy speichern. Anschließend können Sie die Policy aktivieren oder deaktivieren, um die zugrunde liegenden Auditingoptionen durchzusetzen.
Wenn eine OLS-Policy erstellt wird, fügt die Datenbank der Datenbank-Audittrailtabelle eine Labelspalte für die Policy hinzu. Beim OLS-Auditing können Auditdatensätze, einschließlich Datensätze für OLS-Administratorvorgänge, in den einheitlichen Audittrail geschrieben werden.
Datenzugriffsüberwachung
Oracle AI Database bietet mehrere Tools und Techniken zur Überwachung der Benutzeraktivität. Auditing ist der primäre Mechanismus zur Überwachung des Datenzugriffs.
-
Das Auditing von Datenbankauditing umfasst das Monitoring und die Aufzeichnung ausgewählter Benutzer-Datenbankaktionen.
-
Unified Audit Trail-Auditdatensätze sind für das Erkennen und Identifizieren nicht autorisierter Datenzugriffe unerlässlich.
-
Mit Enterprise Manager Auditing Support Oracle Enterprise Manager (Enterprise Manager) können Sie die meisten auditierungsbezogenen Aufgaben ausführen.
-
Oracle Audit Vault and Database Firewall Oracle Audit Vault and Database Firewall (Oracle AVDF) bietet eine erste Verteidigungslinie für Datenbanken und konsolidiert Auditdaten aus Datenbanken, Betriebssystemen und Verzeichnissen.
Datenbankauditing
Das Datenbank-Auditing umfasst das Monitoring und die Aufzeichnung ausgewählter Benutzerdatenbankaktionen.
Sie können eine Einheitsaudit-Policy so konfigurieren, dass Folgendes auditiert wird:
-
SQL-Anweisungen, Systemberechtigungen, Schemaobjekte und Rollen (als Gruppe von Systemberechtigungen, die ihnen direkt erteilt wurden)
-
Administrative und nicht-administrative Benutzer
-
Anwendungskontextwerte
Ein Anwendungskontext ist ein Name/Wert-Paar eines Attributs in einem angegebenen Namespace. Anwendungen legen verschiedene Kontexte fest, bevor Aktionen in der Datenbank ausgeführt werden. Beispiel: Anwendungen speichern Informationen wie Modulname und Client-ID, die den Status eines Anwendungsereignisses angeben. Anwendungen können Kontexte so konfigurieren, dass Informationen über sie an Auditdatensätze angehängt werden.
-
Policy-Erstellung für Real Application Security-, Oracle Database Vault-, Oracle Label Security-, Oracle Data Pump- und Oracle SQL*Loader-Direktpfadereignisse
Der einheitliche Audittrail kann Recovery Manager-Ereignisse erfassen, die Sie in der Data Dictionary View UNIFIED_AUDIT_TRAIL abfragen können. Sie erstellen keine einheitlichen Audit-Policys für Recovery Manager-Ereignisse.
Sie können auch fine-grained audititing verwenden, um bestimmte Tabellenspalten zu auditieren und Event Handler während der Policy-Erstellung zu verknüpfen. Für ein einheitliches und feingranuliertes Auditing können Sie Policys erstellen, die auf Bedingungen testen, die bestimmte Datenbankaktionen in einer Tabelle oder Zeiten erfassen, in denen Aktivitäten stattfinden. Beispiel: Sie können eine Tabelle prüfen, auf die nach 9:00 Uhr zugegriffen wird.
Gründe für die Prüfung:
-
zukünftige Verantwortlichkeit für aktuelle Aktionen ermöglichen
-
Entfernen von Benutzern (oder anderen, wie Eindringlingen) von unangemessenen Aktionen basierend auf ihrer Verantwortlichkeit
-
Verdächtige Aktivitäten untersuchen, überwachen und aufzeichnen
-
Erfüllung von Auditinganforderungen für Compliance
Ab Oracle Database 12c ist das Datenbank-Auditing standardmäßig aktiviert, wenn Sie Unified Auditing verwenden. Sie steuern das Datenbankauditing, indem Sie Audit-Policys aktivieren. Bevor Sie jedoch einheitliches Auditing verwenden können, müssen Sie Ihre Datenbanken dorthin migrieren.
-
Audit-Policys Mit einer einzelnen SQL-Anweisung können Sie eine benannte einheitliche Audit-Policy erstellen, die ein Set von Auditoptionen angibt. Diese Optionen können Systemberechtigungen, Aktionen oder Rollen angeben, die in der Datenbank auditiert werden sollen.
-
Auditadministratorrollen Zur Ausführung des Audits benötigen Sie die entsprechenden Systemberechtigungen.
Siehe:
-
Oracle AI Database - Sicherheitshandbuch für detaillierte Informationen über Unified Auditing
-
Oracle AI Database Upgrade Guide, um zu erfahren, wie Sie zu Unified Auditing migrieren
Audit-Policys
Sie können eine einzelne SQL-Anweisung verwenden, um eine benannte einheitliche Audit-Policy zu erstellen, die eine Gruppe von Auditoptionen angibt. Diese Optionen können Systemberechtigungen, Aktionen oder Rollen angeben, die in der Datenbank auditiert werden sollen.
In einer Audit-Policy können Sie optional eine Bedingung festlegen, die für jede Anweisung, einmal für eine Session oder einmal für die Datenbankinstanz ausgewertet werden kann. Die Prüfung eines Ereignisses unterliegt dem Ergebnis der Bewertung einer Bedingung für die geltenden Auditrichtlinien. Wenn die Bedingung als true ausgewertet wird, generiert die Datenbank den Auditdatensatz.
Im folgenden Beispiel wird eine Policy erstellt, die Aktivitäten in der Tabelle hr.employees auditiert, es sei denn, ein Benutzer meldet sich von den vertrauenswürdigen Terminals term1 und term2 an:
CREATE AUDIT POLICY EmployeesTableAudit
  ACTIONS update ON hr.employees, delete ON hr.employees
  WHEN SYS_CONTEXT ("userenv", "hostname") NOT IN
                   ("term1","term2") EVALUATE PER SESSION;
Die folgende Anweisung aktiviert die Policy für die Benutzer hr und hrvp:
AUDIT POLICY EmployeesTableAudit BY hr, hrvp;Sie können einheitliche Audit-Policys auf jeden Datenbankbenutzer anwenden, einschließlich administrativer Benutzer wie SYSDBA, SYSOPER usw. Die Audit-Policys können jedoch nur gelesen werden, nachdem die Datenbank mit der Anweisung ALTER DATABASE OPEN geöffnet wurde. Daher werden die Aktionen der obersten Ebene von Benutzern mit Administratorrechten immer geprüft, bis die Datenbank geöffnet wird. Nachdem die Datenbank geöffnet wurde, ist die Audit-Policy-Konfiguration wirksam.
Wenn das einheitliche Auditing aktiviert ist, prüft die Datenbank automatisch Änderungen an den Auditeinstellungen. Die Datenbank prüft auch das Hoch- und Herunterfahren der Datenbankinstanz.
Siehe auch: Oracle AI Database - Sicherheitshandbuch zum Verwalten von Audit-Policys
Auditadministratorrollen
Zur Ausführung des Auditings benötigen Sie Systemberechtigungen.
Oracle AI Database stellt die folgenden vom System bereitgestellten Auditadministratorrollen bereit:
-
AUDIT_ADMINDie Rolle
AUDIT_ADMINverwaltet Auditeinstellungen für die Datenbank. Benutzer mit dieser Rolle sind berechtigt, Folgendes auszuführen:-
Erstellen, Ändern und Löschen von Audit-Policys, einschließlich feingranulierter Auditing-Policys
-
Audit-Policys für jede Geschäftsanforderung aktivieren oder deaktivieren
-
Auditdatensätze anzeigen
-
Audittrails verwalten und bereinigen
-
-
AUDIT_VIEWERDie Rolle
AUDIT_VIEWERist für Benutzer bestimmt, die nur Daten anzeigen und analysieren müssen. Benutzer mit dieser Rolle sind nur berechtigt, den Inhalt des Audittrails anzuzeigen.
Siehe auch: Oracle AI Database - Sicherheitshandbuch, um mehr über das Auditing zu erfahren
Einheitlicher Audittrail
Auditdatensätze sind für die Erkennung und Identifizierung nicht autorisierter Datenzugriffe unerlässlich.
Oracle AI Database kann das Auditing für angegebene Ereignisse konfigurieren. Wenn das Ereignis während einer Benutzersession auftritt, generiert die Datenbank einen Auditdatensatz.
Ein Audittrail ist ein Speicherort, in dem Auditdatensätze gespeichert werden. Der einheitliche Audittrail, der neu in Oracle Database 12c ist, bietet einheitlichen Speicher für Auditdatensätze aller Audittypen. Sie müssen manuell von den herkömmlichen Audittrails früherer Releases zu einem einheitlichen Auditing migrieren.
Das Auditing umfasst das standardmäßige und feingranulierte Auditing sowie das Auditing der folgenden Ereignisse, einschließlich der Ausführung dieser Ereignisse durch administrative Benutzer:
-
Oracle Data Pump
-
SQL*Loader Direct Path-Ladevorgänge
-
Oracle Database Vault
-
Oracle Label Security
-
Recovery Manager
-
Real Application Security
Der einheitliche Audittrail ist schreibgeschützt und wird im Schema AUDSYS gespeichert. Standardmäßig speichert der Tablespace SYSAUX Auditdatensätze aus allen Quellen. Sie können einen neuen Tablespace mit dem Package DBMS_AUDIT_MGMT bereitstellen.
Die Ansicht UNIFIED_AUDIT_TRAIL ruft die Auditdatensätze aus dem Audittrail ab und zeigt sie in tabellarischer Form an. In der Spalte APPLICATION_CONTEXTS werden die Werte der konfigurierten Anwendungskontextattribute gespeichert. Mit der Anweisung AUDIT können Sie die Werte von Kontextattributen in Auditdatensätze aufnehmen. Beispiel: Die folgende Anweisung erfasst die Attribute MODULE und CLIENT_INFO aus dem Namespace userenv:
AUDIT CONTEXT NAMESPACE userenv ATTRIBUTES MODULE, CLIENT_INFO BY hr;Abhängig von der auditierten Komponente (wie Oracle Database Vault) sind zusätzliche vereinheitlichte Audittrail-bezogene Views verfügbar.
Siehe:
-
Oracle AI Database - Sicherheitshandbuch, um mehr über den einheitlichen Audittrail zu erfahren
-
Oracle AI Database Upgrade Guide, um zu erfahren, wie Sie die Datenbank migrieren, um Unified Auditing zu verwenden
-
Oracle AI Database-Referenz zur
UNIFIED_AUDIT_TRAIL-Ansicht
Auditingunterstützung für Enterprise Manager
Mit Oracle Enterprise Manager (Enterprise Manager) können Sie die meisten auditierungsbezogenen Aufgaben ausführen.
Die Aufgaben umfassen:
-
Auditing aktivieren und deaktivieren
-
Objekte beim Auditing von Anweisungen und Schemaobjekten verwalten
Beispiel: Mit Enterprise Manager können Sie die Eigenschaften aktuell geprüfter Anweisungen, Berechtigungen und Objekte anzeigen und suchen.
-
Auditbezogene Initialisierungsparameter anzeigen und konfigurieren
-
Auditberichte anzeigen
Siehe auch: Onlinehilfe zu Enterprise Manager
Oracle Audit Vault and Database Firewall
Oracle Audit Vault and Database Firewall (Oracle AVDF) bietet eine erste Verteidigungslinie für Datenbanken und konsolidiert Auditdaten aus Datenbanken, Betriebssystemen und Verzeichnissen.
Eine SQL-Grammatik-basierte Engine überwacht und blockiert nicht autorisierten SQL-Datenverkehr, bevor sie die Datenbank erreicht. Für Complianceberichte und -alerts kombiniert Oracle AVDF Datenbankaktivitätsdaten aus dem Netzwerk mit detaillierten Auditdaten. Sie können Auditing- und Überwachungskontrollen an die Sicherheitsanforderungen des Unternehmens anpassen.
Siehe auch: Oracle AI Database - Sicherheitshandbuch enthält Informationen zu zusätzlichen Sicherheitsressourcen wie Oracle Audit Vault and Database Firewall
Überblick über High Availability
Verfügbarkeit ist der Grad, bis zu dem eine Anwendung, ein Service oder eine Funktionalität auf Anforderung verfügbar ist.
Beispiel: Eine OLTP-Datenbank, die von einem Online-Buchhändler verwendet wird, ist so weit verfügbar, wie Kunden, die Einkäufe tätigen, darauf zugreifen können. Zuverlässigkeit, Wiederherstellbarkeit, zeitnahe Fehlererkennung und kontinuierlicher Betrieb sind die Hauptmerkmale von High Availability.
Die Bedeutung von High Availability in einer Datenbankumgebung hängt von den Kosten für Ausfallzeiten ab, d.h. der Zeit, zu der eine Ressource nicht verfügbar ist. Ausfallzeiten können entweder als geplant oder ungeplant kategorisiert werden. Die größte Herausforderung bei der Gestaltung einer hochverfügbaren Umgebung besteht darin, alle möglichen Ursachen von Ausfallzeiten zu untersuchen und einen Plan zu entwickeln, um mit ihnen umzugehen.
-
Hochverfügbarkeit und ungeplante Ausfallzeiten Oracle AI Database bietet Hochverfügbarkeitslösungen, um Ausfallzeiten für alle Arten von ungeplanten Fehlern zu verhindern, zu tolerieren und zu reduzieren.
-
Hochverfügbarkeit und geplante Ausfallzeiten Geplante Ausfallzeiten können ebenso störend für den Betrieb sein, insbesondere in globalen Unternehmen, die Benutzer in mehreren Zeitzonen unterstützen. In diesem Fall ist es wichtig, ein System zu entwerfen, um geplante Unterbrechungen wie Routinevorgänge, regelmäßige Wartung und neue Bereitstellungen zu minimieren.
Hohe Verfügbarkeit und ungeplante Ausfallzeiten
Oracle AI Database bietet Hochverfügbarkeitslösungen, um Ausfallzeiten für alle Arten von ungeplanten Fehlern zu verhindern, zu tolerieren und zu reduzieren.
Ungeplante Ausfallzeiten können nach ihren Ursachen kategorisiert werden.
-
Sitefehler Ein Sitefehler tritt auf, wenn ein Ereignis dazu führt, dass die Verarbeitung oder ein erheblicher Teil einer Anwendung gestoppt oder auf einen nicht verwendbaren Servicegrad verlangsamt wird.
-
Computerfehler Ein Computerausfall tritt auf, wenn das System, auf dem die Datenbank ausgeführt wird, nicht mehr verfügbar ist, weil es heruntergefahren wurde oder nicht mehr zugänglich ist.
-
Speicherfehler Ein Speicherfehler tritt auf, wenn der Speicher, der einen oder alle Datenbankinhalte enthält, nicht mehr verfügbar ist, weil er heruntergefahren wurde oder nicht mehr zugänglich ist. Beispiele für Speicherfehler sind der Ausfall eines Festplattenlaufwerks oder Speicherarrays.
-
Datenbeschädigung Eine Datenbeschädigung tritt auf, wenn eine Hardware-, Software- oder Netzwerkkomponente das Lesen oder Einschreiben fehlerhafter Daten verursacht.
-
Menschliche Fehler Ein menschlicher Fehlerausfall tritt auf, wenn unbeabsichtigte oder böswillige Aktionen festgeschrieben werden, die dazu führen, dass Daten in der Datenbank logisch beschädigt werden oder nicht mehr verwendet werden können. Die Auswirkungen eines menschlichen Fehlerausfalls auf den Servicegrad können je nach Menge und kritischem Charakter der betroffenen Daten erheblich variieren.
Sitefehler
Ein Sitefehler tritt auf, wenn ein Ereignis dazu führt, dass die Verarbeitung einer Anwendung vollständig oder teilweise gestoppt oder auf einen nicht verwendbaren Servicegrad verlangsamt wird.
Ein Standortausfall kann sich auf die gesamte Verarbeitung in einem Data Center oder auf eine Teilmenge von Anwendungen auswirken, die von einem Data Center unterstützt werden. Beispiele hierfür sind ein erweiterter standortweiter Strom- oder Netzwerkausfall, eine Naturkatastrophe, die ein Rechenzentrum funktionsunfähig macht, oder ein böswilliger Angriff auf den Betrieb oder die Website.
Die einfachste Art des Schutzes vor Siteausfällen besteht darin, Datenbankbackups mit RMAN zu erstellen und extern zu speichern. Sie können die Datenbank auf einem anderen Host wiederherstellen. Diese Technik kann jedoch zeitaufwändig sein, und das Backup ist möglicherweise nicht aktuell. Wenn Sie eine oder mehrere Standbydatenbanken in einer Data Guard-Umgebung verwalten, können Sie einen kontinuierlichen Datenbankservice bereitstellen, wenn die Produktions-Site ausfällt.
Siehe:
-
Oracle AI Database Backup and Recovery - Benutzerhandbuch für Informationen zu RMAN- und Backup- und Recovery-Lösungen
-
Oracle Data Guard - Konzepte und Administration für eine Einführung in Standbydatenbanken
Computerfehler
Ein Computerausfall tritt auf, wenn das System, auf dem die Datenbank ausgeführt wird, nicht mehr verfügbar ist, weil es heruntergefahren wurde oder nicht mehr zugänglich ist.
Beispiele für Computerfehler sind Hardware- und Betriebssystemfehler. Die Oracle-Funktionen in der folgenden Tabelle schützen vor Computerfehlern oder helfen bei der Reaktion darauf.
Tabelle 1: Schutz vor Computerfehlern
| Feature | Beschreibung | Weitere Infos |
|---|---|---|
| Unternehmensraster | In einer Oracle Real Applications Cluster-(Oracle RAC-)Umgebung wird Oracle AI Database auf zwei oder mehr Systemen in einem Cluster ausgeführt, während gleichzeitig auf eine einzelne gemeinsame Datenbank zugegriffen wird. Ein einzelnes Datenbanksystem umfasst mehrere Hardwaresysteme, die der Anwendung jedoch als einzelne Datenbank angezeigt werden. | "Überblick über Grid Computing" |
| Oracle Data Guard | Mit Data Guard können Sie eine oder mehrere Kopien einer Produktionsdatenbank verwalten, die als Standbydatenbank bezeichnet wird und sich auf verschiedenen Kontinenten oder im selben Data Center befinden kann. Wenn die Primärdatenbank aufgrund eines Ausfalls nicht verfügbar ist, kann Data Guard jede Standbydatenbank auf die Primärrolle umstellen und so Ausfallzeiten minimieren. | Oracle Data Guard - Konzepte und Administration |
| Global Data Services | Das Global Data Services-Framework automatisiert und zentralisiert Konfiguration, Wartung und Überwachung einer Datenbank-Cloud. Global Data Services ermöglicht Load Balancing und Failover für von der Cloud bereitgestellte Services. Im Wesentlichen bietet Global Data Services eine Reihe von Datenbanken die gleichen Vorteile wie Oracle Real Application Clusters (Oracle RAC) eine einzelne Datenbank. | Oracle AI Database Global Data Services – Leitfaden zu Konzepten und Administration |
| Fast Start Fault Recovery | Eine häufige Ursache für ungeplante Ausfallzeiten ist ein Systemfehler oder -ausfall. Die Fast-Start-Fault-Recovery-Technologie in Oracle AI Database begrenzt automatisch die Instanzwiederherstellungszeit der Datenbank. | Oracle AI Database – Leitfaden zur Optimierung der Datenbankperformance |
Speicherfehler
Ein Speicherausfall tritt auf, wenn der Speicher, der einen oder alle Datenbankinhalte enthält, nicht mehr verfügbar ist, weil er heruntergefahren wurde oder nicht mehr zugänglich ist. Beispiele für Speicherfehler sind der Ausfall eines Festplattenlaufwerks oder Speicherarrays.
In der folgenden Tabelle werden Speicherfehler zusätzlich zu Oracle Data Guard aufgeführt.
Tabelle 2: Lösungen für Speicherfehler
| Lösung | Beschreibung | Weitere Infos |
|---|---|---|
| Oracle Automatic Storage Management (Oracle ASM) | Oracle ASM ist ein Volume Manager und ein Dateisystem für Oracle-Datenbankdateien, das Oracle AI Database- und Oracle RAC-Einzelinstanzkonfigurationen unterstützt. Oracle ASM ist eine von Oracle empfohlene Speicherverwaltungslösung, die eine Alternative zu herkömmlichen Volume Managern und Dateisystemen bietet. | "Oracle Automatic Storage Management (Oracle ASM)" |
| Backup und Wiederherstellung | Das Recovery Manager-(RMAN-)Utility kann Daten sichern, Daten aus einem vorherigen Backup wiederherstellen und Änderungen an diesen Daten bis zu dem Zeitpunkt wiederherstellen, zu dem der Fehler aufgetreten ist. | "Backup und Recovery" |
Siehe auch: Oracle Automatic Storage Management Administrator's Guide, um mehr über Oracle ASM zu erfahren
Datenbeschädigung
Eine Datenbeschädigung tritt auf, wenn eine Hardware-, Software- oder Netzwerkkomponente das Lesen oder Beschreiben fehlerhafter Daten verursacht.
Ein Beispiel für eine Datenbeschädigung ist ein Volume Manager-Fehler, der fehlerhafte Datenträgerlese- oder -schreibvorgänge verursacht. Datenbeschädigungen sind selten, können jedoch katastrophale Auswirkungen auf eine Datenbank und damit auf ein Unternehmen haben.
Zusätzlich zu Data Guard und Recovery Manager unterstützt Oracle AI Database die folgenden Formen des Schutzes vor Datenbeschädigung:
-
Lösungen für das verlorene Schreibproblem
Ein verlorener Schreibvorgang tritt auf, wenn ein I/O-Subsystem den Abschluss eines Datenblocks bestätigt, wenn der Schreibvorgang nicht erfolgt ist. Bei einem nachfolgenden Block-Lesevorgang gibt das I/O-Subsystem die veraltete Version des Datenblocks zurück, mit der andere Blöcke der Datenbank aktualisiert und dadurch beschädigt werden können. Die Oracle AI Database-Lösungen lauten wie folgt:
-
Schutz vor verlorenem Schreibvorgang mit einer Standbydatenbank
Beim Standardschutz für verlorene Schreibvorgänge, der in Oracle Database 11g eingeführt wurde, können Sie den Initialisierungsparameter
DB_LOST_WRITE_PROTECTsowohl für eine Primärdatenbank als auch für eine Standbydatenbank aktivieren. Jede Datenbank zeichnet Buffer Cache Block-Lesevorgänge im Online Redo Log auf. Wenn die Standby-Datenbank während des Managed Recoverys Redo anwendet, liest sie die entsprechenden Blöcke und vergleicht die SCNs mit den SCNs im Redo Log. Dadurch werden Abweichungen erkannt. -
Schreibschutz mit Schatten-Tablespace verloren
Für Schreibschutz bei Schattenverlusten erstellen Sie einen Schatten-Tablespace. Ein Shadow Tablespace enthält einen kurzen Beschreibungsdatensatz, einschließlich der SCN, für jeden Datenblock in einer verfolgten Datendatei.
Wenn der Schattenschutz für verlorene Schreibvorgänge aktiviert ist (
ALTER DATABASE ENABLE LOST WRITE TRACKING), und wenn die Datenbank einen verfolgten Datenblock aktualisiert, schreibt die Datenbank die SCN in den entsprechenden Schatten-Tablespace. Beim Lesen eines verfolgten Datenblocks sucht die Datenbank nach dem Schatteneintrag und vergleicht ihn dann mit dem verfolgten Block. Wenn der Schatteneintrag eine SCN aufweist, die größer als der verfolgte Block ist, ist ein verlorener Schreibvorgang aufgetreten.Der Schutz vor Schattenverlusten hat den Vorteil, verlorene Schreibvorgänge ohne Verwendung einer Standbydatenbank zu erkennen. Aufgrund der Verzögerung, die dem Standby-Schreibschutz innewohnt, kann dieser Block bereits andere Teile der Datenbank beschädigt haben, wenn ein verlorener Schreibvorgang erkannt wird. Um Datenbeschädigung zu verhindern, erkennt der Schatten-Schreibschutz einen verlorenen Schreibvorgang, bevor er verbraucht wird.
-
-
Erkennung von Datenblockfehlern
Eine Blockbeschädigung ist ein Datenblock, der sich nicht in einem erkannten Oracle-Format befindet oder dessen Inhalt intern nicht konsistent ist. Mehrere Datenbankkomponenten und Utilitys, einschließlich RMAN, können einen beschädigten Block erkennen und in
V$DATABASE_BLOCK_CORRUPTIONaufzeichnen. Wenn die Umgebung eine Active Data Guard-Standbydatenbank verwendet, kann die Beschädigung automatisch behoben werden. -
Transaction Guard und Application Continuity
Datenbank-Sessionausfälle, ob geplant oder ungeplant, können Endbenutzer den Status ihrer Arbeit nicht kennen. In einigen Fällen können Benutzer festgeschriebene Transaktionen erneut weiterleiten, was zu einer logischen Datenbeschädigung führt. Transaction Guard stellt die Transaktions-IDempotenz bereit, mit der die Datenbank ein garantiertes Commit-Ergebnis beibehalten kann, das angibt, ob die Transaktion festgeschrieben und abgeschlossen wurde. Application Continuity, einschließlich Transaction Guard, ermöglicht es Anwendungen, eine Transaktion nach einem behebbaren Fehler für die Datenbank wiederzugeben und dort fortzufahren, wo die Transaktion aufgehört hat.
Siehe:
-
Oracle AI Database Backup and Recovery - Benutzerhandbuch für Informationen zu RMAN- und Backup- und Recovery-Lösungen
Menschliche Fehler
Ein Ausfall menschlicher Fehler tritt auf, wenn unbeabsichtigte oder böswillige Aktionen festgeschrieben werden, die dazu führen, dass Daten in der Datenbank logisch beschädigt oder unbrauchbar werden. Die Auswirkungen eines menschlichen Fehlerausfalls auf den Servicegrad können je nach Menge und kritischem Charakter der betroffenen Daten erheblich variieren.
Viele Studien zitieren menschliche Fehler als die größte Ursache für Ausfallzeiten. Oracle AI Database bietet leistungsstarke Tools, mit denen Administratoren diese Fehler schnell diagnostizieren und beheben können. Es enthält auch Funktionen, mit denen Endbenutzer Probleme ohne Administratorbeteiligung beheben können.
Oracle AI Database empfiehlt die folgenden Formen des Schutzes vor menschlichen Fehlern:
-
Einschränkung des Benutzerzugriffs
Der beste Weg, um Fehler zu vermeiden, besteht darin, den Benutzerzugriff auf Daten und Dienste einzuschränken. Oracle AI Database bietet eine breite Palette von Sicherheitstools, um den Benutzerzugriff auf Anwendungsdaten zu kontrollieren, indem Benutzer authentifiziert werden. Administratoren können dann Benutzern nur die Berechtigungen erteilen, die für die Ausführung ihrer Aufgaben erforderlich sind.
-
Oracle Flashback-Technologie
Oracle Flashback Technology ist eine Familie von Funktionen zur Fehlerkorrektur in Oracle AI Database. Oracle Flashback bietet eine SQL-Schnittstelle, mit der Sie menschliche Fehler schnell analysieren und beheben können. Sie können beispielsweise folgende Aufgaben ausführen:
-
Fein granulierte chirurgische Analyse und Reparatur für lokalisierte Schäden
-
Schnelle Korrektur weit verbreiteter Schäden
-
Recovery auf Zeilen-, Transaktions-, Tabellen-, Tablespace- und Datenbankebene
-
-
Oracle LogMiner
Oracle LogMiner ist ein relationales Tool, mit dem Sie mit SQL Online-Dateien lesen, analysieren und interpretieren können.
Siehe:
-
Oracle AI Database Backup and Recovery User's Guide und Oracle AI Database Development Guide, um mehr über die Features von Oracle Flashback zu erfahren
-
Oracle AI Database Utilities, um mehr über Oracle LogMiner zu erfahren
Hohe Verfügbarkeit und geplante Ausfallzeiten
Geplante Ausfallzeiten können den Betrieb ebenso stören, insbesondere in globalen Unternehmen, die Benutzer in mehreren Zeitzonen unterstützen. In diesem Fall ist es wichtig, ein System zu entwerfen, um geplante Unterbrechungen wie Routinevorgänge, regelmäßige Wartung und neue Bereitstellungen zu minimieren.
Geplante Ausfallzeiten können nach ihren Ursachen kategorisiert werden.
-
System- und Datenbankänderungen Geplante Systemänderungen treten auf, wenn Sie routinemäßige und regelmäßige Wartungsvorgänge und neue Deployments ausführen, einschließlich geplanter Änderungen an der Betriebsumgebung, die außerhalb der Organisationsdatenstruktur in der Datenbank auftreten.
-
Datenänderungen Geplante Datenänderungen treten auf, wenn Änderungen an der logischen Struktur oder der physischen Organisation von Oracle AI Database-Objekten auftreten. Das Hauptziel dieser Änderungen ist die Verbesserung der Leistung oder Verwaltbarkeit. Beispiele sind die Neudefinition von Tabellen, das Hinzufügen von Tabellenpartitionen und das Erstellen oder Neuerstellen von Indizes.
-
Anwendungsänderungen Geplante Anwendungsänderungen können Änderungen an Daten, Schemas und Programmen umfassen. Das Hauptziel dieser Änderungen besteht darin, die Leistung, Verwaltbarkeit und Funktionalität zu verbessern. Ein Beispiel ist ein Anwendungsupgrade.
System- und Datenbankänderungen
Geplante Systemänderungen treten auf, wenn Sie routinemäßige und regelmäßige Wartungsvorgänge und neue Deployments ausführen, einschließlich geplanter Änderungen an der Betriebsumgebung, die außerhalb der Organisationsdatenstruktur in der Datenbank auftreten.
Beispiele hierfür sind das Hinzufügen oder Entfernen von CPUs und Clusterknoten (ein Knoten ist ein Computer, auf dem sich eine Datenbankinstanz befindet), das Upgraden von Systemhardware oder -software und das Migrieren der Systemplattform.
Oracle AI Database bietet dynamisches Ressourcen-Provisioning als Lösung für geplante System- und Datenbankänderungen:
-
Dynamische Rekonfiguration der Datenbank
Oracle AI Database berücksichtigt dynamisch verschiedene Änderungen an Hardware- und Datenbankkonfigurationen, darunter das Hinzufügen und Entfernen von Prozessoren von einem SMP-Server sowie das Hinzufügen und Entfernen von Speicherarrays mit Oracle ASM. Beispiel: Oracle AI Database überwacht das Betriebssystem, um Änderungen an der Anzahl der CPUs zu ermitteln. Wenn der Initialisierungsparameter
CPU_COUNTauf den Standardwert gesetzt ist, kann die Datenbank-Workload die neu hinzugefügten Prozessoren dynamisch nutzen. -
Speicherverwaltung automatisch optimieren
Oracle AI Database verwendet eine nicht-zentralisierte Policy, um Speicher in jeder Unterkomponente der SGA und der PGA freizugeben und abzurufen. Oracle AI Database optimiert den Speicher automatisch, indem das Betriebssystem aufgefordert wird, Speichergranulate an Komponenten zu übertragen, die ihn benötigen.
-
Automatische Verteilung von Datendateien, Kontrolldateien und Online Redo Log-Dateien
Oracle ASM automatisiert und vereinfacht das Layout von Datendateien, Kontrolldateien und Logdateien, indem es sie automatisch auf alle verfügbaren Platten verteilt.
Siehe:
-
Weitere Informationen zu Oracle ASM finden Sie im Oracle Automatic Storage Management Administrator's Guide.
Datenänderungen
Geplante Datenänderungen treten auf, wenn Änderungen an der logischen Struktur oder der physischen Organisation von Oracle AI Database-Objekten auftreten. Das Hauptziel dieser Änderungen ist die Verbesserung der Leistung oder Verwaltbarkeit. Beispiele sind die Neudefinition von Tabellen, das Hinzufügen von Tabellenpartitionen und das Erstellen oder Neuerstellen von Indizes.
Oracle AI Database minimiert Ausfallzeiten für Datenänderungen durch Online-Reorganisation und Neudefinition. Mit dieser Architektur können Sie die folgenden Aufgaben ausführen, wenn die Datenbank geöffnet ist:
-
Online-Neudefinition von Tabellen durchführen, mit der Sie Änderungen an der Tabellenstruktur vornehmen können, ohne die Verfügbarkeit der Tabelle erheblich zu beeinträchtigen
-
Indizes erstellen, analysieren und neu organisieren
-
Tabellenpartitionen verschieben
Siehe:
-
Oracle AI Database Administrator's Guide zum Ändern von Datenstrukturen online
Anwendungsänderungen
Geplante Anwendungsänderungen können Änderungen an Daten, Schemas und Programmen umfassen. Das Hauptziel dieser Änderungen besteht darin, die Leistung, Verwaltbarkeit und Funktionalität zu verbessern. Ein Beispiel ist ein Anwendungsupgrade.
Oracle AI Database unterstützt die folgenden Lösungen zur Minimierung von Anwendungsausfallzeiten, die erforderlich sind, um Änderungen an den Datenbankobjekten einer Anwendung vorzunehmen.
Tabelle 3: Lösungen zur Minimierung von Ausfallzeiten
| Lösung | Beschreibung | Weitere Infos |
|---|---|---|
| Rolling-Updates für Datenbankpatches | Oracle AI Database unterstützt die Anwendung von Patches auf den Knoten eines Oracle RAC-Systems im Rolling-Modus. | |
| Rolling-Upgrades von Datenbankreleases | Oracle AI Database unterstützt die Installation von Datenbanksoftwareupgrades und die Anwendung von Patchsets im Rolling-Modus mit nahezu keiner Datenbankausfallzeit, indem Data Guard SQL Apply und logische Standbydatenbanken verwendet werden. | Oracle AI Database-Upgradeanleitung |
| Editionsbasierte Neudefinition | Mit der Editions-basierten Neudefinition können Sie die Datenbankobjekte einer Anwendung aktualisieren, während die Anwendung verwendet wird. Dadurch werden Ausfallzeiten minimiert oder eliminiert. Oracle AI Database erfüllt diese Aufgabe, indem Datenbankobjekte in einer privaten Umgebung, die als Edition bezeichnet wird, geändert (neu definiert) werden. | Oracle AI Database-Entwicklungshandbuch |
DDL mit der Standardoption WAIT |
DDL-Anweisungen erfordern exklusive Sperren für interne Strukturen (siehe "DDL-Sperren"). In früheren Releases waren DDL-Anweisungen nicht erfolgreich, wenn sie die Sperren nicht abrufen konnten. Mit der Option WAIT angegebene DDL löst dieses Problem. |
|
| Erstellung von Triggern mit deaktiviertem Status | Sie können einen Trigger im Status "Deaktiviert" erstellen, damit Sie sicherstellen können, dass der Code erfolgreich kompiliert wird, bevor Sie den Trigger aktivieren. | Oracle AI Database PL/SQL-Sprachreferenz |
Überblick über Grid Computing
Die Computing-Architektur, die als Grid Computing bekannt ist, bündelt eine große Anzahl von Servern und Speicher in einer flexiblen On-Demand-Ressource für alle Unternehmens-Computing-Anforderungen.
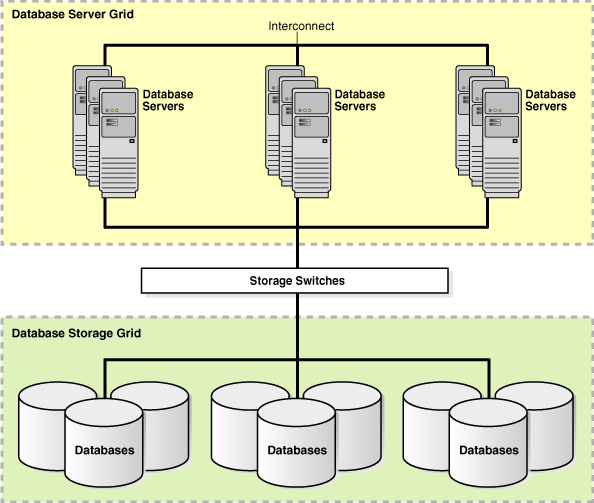
Ein Datenbankserverraster ist eine Sammlung von Commodity-Servern, die miteinander verbunden sind, um in einer oder mehreren Datenbanken ausgeführt zu werden. Ein Database Storage Grid ist eine Sammlung kostengünstiger modularer Speicherarrays, die von den Computern im Database Server Grid kombiniert und aufgerufen werden.
Mit Database Server und Storage Grid können Sie einen Pool von Systemressourcen erstellen. Sie können diese Ressourcen basierend auf den Geschäftsprioritäten dynamisch zuweisen und die Zuweisung aufheben. In Abbildung 20-2 wird das Database Server Grid und das Database Storage Grid in einer Grid Enterprise Computing-Umgebung dargestellt.
Abbildung 2: Grid Computing-Umgebung
Beschreibung der Abbildung haovw004.gif
-
Database Server Grid Oracle Real Application Clusters (Oracle RAC) ermöglicht es mehreren Instanzen, den Zugriff auf eine Oracle-Datenbank gemeinsam zu nutzen. Die Instanzen werden über ein Interconnect verknüpft.
-
Oracle Flex-Cluster Ab Oracle Database 12c können Sie Oracle Clusterware und Oracle Real Application Clusters in großen Clustern konfigurieren.
-
Database Storage Grid Siehe auch:
http://www.globalgridforum.org/, um mehr über das Global Grid Forum (GGF) der Standardorganisation zu erfahren
Datenbankserverraster
Mit Oracle Real Application Clusters (Oracle RAC) können mehrere Instanzen den Zugriff auf eine Oracle-Datenbank freigeben. Die Instanzen werden über ein Interconnect verknüpft.
In einer Oracle RAC-Umgebung wird Oracle AI Database auf zwei oder mehr Systemen in einem Cluster ausgeführt, während gleichzeitig auf eine einzelne gemeinsame Datenbank zugegriffen wird. Oracle RAC ermöglicht ein Database Server Grid, indem eine einzelne Datenbank bereitgestellt wird, die mehrere kostengünstige Server umfasst, die der Anwendung jedoch als einzelnes, einheitliches Datenbanksystem angezeigt werden. Oracle Clusterware ist eine Software, mit der Server wie ein Server zusammenarbeiten können. Jeder Server sieht aus wie ein Standalone-Server. Jeder Server verfügt jedoch über zusätzliche Prozesse, die miteinander kommunizieren, sodass separate Server wie ein Server zusammenarbeiten. Oracle Clusterware bietet alle Features, die zur Ausführung des Clusters erforderlich sind, einschließlich Knotenmitgliedschaft und Messaging Services.
-
Skalierbarkeit In einem Datenbankserver-Grid können Sie mit Oracle RAC Knoten zum Cluster hinzufügen, wenn der Bedarf an Kapazität steigt.
-
Fehlertoleranz In einer High-Availability-Architektur ist die Fehlertoleranz der Schutz, der vor dem Ausfall einer Komponente in der Architektur bereitgestellt wird.
-
Services Oracle RAC unterstützt Services, die Datenbank-Workloads gruppieren und Arbeit an die optimalen Instanzen weiterleiten können, die den Services zugewiesen sind.
Siehe:
-
Oracle Real Application Clusters Administration and Deployment Guide zum Verwalten einer Oracle RAC-Datenbank
-
Oracle Clusterware Administration and Deployment Guide zum Verwalten und Bereitstellen von Oracle Clusterware
Skalierbarkeit
In einem Database Server Grid können Sie mit Oracle RAC Knoten zum Cluster hinzufügen, wenn der Kapazitätsbedarf steigt.
Mit der in Oracle RAC implementierten Cache Fusion-Technologie können Sie die Kapazität skalieren, ohne Ihre Anwendungen zu ändern. So können Sie das System inkrementell skalieren, um Kosten zu sparen und kleinere Ein-Knoten-Systeme durch größere Systeme zu ersetzen.
Sie können einem Cluster inkrementell Knoten hinzufügen, anstatt vorhandene Systeme durch größere Knoten zu ersetzen. Grid Plug and Play vereinfacht das Hinzufügen und Entfernen von Knoten aus einem Cluster und erleichtert das Deployment von Clustern in einer dynamisch bereitgestellten Umgebung. Mit Grid Plug and Play können Datenbanken und Services auch standortunabhängig verwaltet werden. Mit SCAN können Clients eine Verbindung zum Datenbankservice herstellen, ohne den Speicherort im Grid zu berücksichtigen.
Siehe:
- Oracle Real Application Clusters Administration and Deployment Guide, um mehr über Cache Fusion zu erfahren
Fehlertoleranz
In einer High-Availability-Architektur ist die Faulttoleranz der Schutz, der vor dem Ausfall einer Komponente in der Architektur bereitgestellt wird.
Ein wesentlicher Vorteil der Oracle RAC-Architektur ist die inhärente Fehlertoleranz, die von mehreren Knoten bereitgestellt wird. Da die physischen Knoten unabhängig voneinander ausgeführt werden, wirkt sich der Ausfall eines oder mehrerer Knoten nicht auf andere Knoten im Cluster aus.
Ein Failover kann für jeden Knoten im Grid erfolgen. Im Extremfall bietet ein Oracle RAC-System Datenbankzugriff, selbst wenn nur ein Knoten heruntergefahren ist. Diese Architektur ermöglicht es, eine Gruppe von Knoten transparent online zu setzen oder offline zu setzen, um sie zu warten, während der Rest des Clusters weiterhin Datenbankzugriff bietet.
Oracle RAC bietet eine integrierte Integration mit Oracle-Clients und Verbindungspools. Mit dieser Funktion wird eine Anwendung sofort über den Pool benachrichtigt, der die Verbindung beendet. Die Anwendung vermeidet das Warten auf einen TCP-Timeout und kann sofort die entsprechende Wiederherstellungsaktion ausführen. Oracle RAC integriert den Listener mit Oracle-Clients und den Verbindungspools, um einen optimalen Anwendungsdurchsatz zu erstellen. Oracle RAC kann die Cluster-Workload basierend auf der Last zum Zeitpunkt der Transaktion ausgleichen.
Siehe:
-
Oracle Real Application Clusters Administration and Deployment Guide für weitere Informationen zum automatischen Workload-Management
Dienstleistungen
Oracle RAC unterstützt Services, die Datenbank-Workloads gruppieren und Arbeit an die optimalen Instanzen weiterleiten können, die den Services zugewiesen sind.
Ein Service steht für die Workload von Anwendungen mit allgemeinen Attributen, Performanceschwellenwerten und Prioritäten. Sie definieren und wenden Geschäfts-Policys auf diese Services an, um Aufgaben auszuführen, wie die Zuweisung von Knoten für Zeiten der Spitzenverarbeitung oder die automatische Verarbeitung von Serverfehlern. Durch den Einsatz von Services wird die Anwendung von Systemressourcen sichergestellt, wo und wann sie zum Erreichen von Geschäftszielen benötigt werden.
Services werden in Database Resource Manager integriert, sodass Sie die Ressourcen einschränken können, die ein Service in einer Instanz verwenden kann. Zudem können Oracle Scheduler-Aufträge nicht nur über eine spezielle Instanz sondern über einen Service ausgeführt werden.
Siehe:
-
Oracle AI Database Administrator's Guide mit Informationen zu Database Resource Manager und Oracle Scheduler
Oracle Flex-Cluster
Ab Oracle Database 12c können Sie Oracle Clusterware und Oracle Real Application Clusters in großen Clustern konfigurieren.
Diese großen Cluster, die als Oracle Flex-Cluster bezeichnet werden, enthalten zwei Knotentypen, die in einer Hub-and-Spoke-Architektur angeordnet sind: Hubknoten und Blattknoten. Hubknoten sind eng miteinander verbunden, haben direkten Zugriff auf Shared Storage und dienen als Anker für einen oder mehrere Blattknoten. Blattknoten sind lose mit Hubknoten verbunden und haben möglicherweise keinen direkten Zugriff auf Shared Storage.
Siehe:
-
Oracle Clusterware Administration and Deployment Guide, um mehr über Oracle Flex-Cluster zu erfahren
-
Oracle Grid Infrastructure - Installations- und Upgradedokumentation, um mehr über das Oracle Flex Cluster-Deployment zu erfahren
Datenbankspeicher-Grid
Ein DBA oder Speicheradministrator kann die Oracle ASM-Schnittstelle verwenden, um die Datenträger in Database Storage Grid anzugeben, die Oracle ASM auf allen Server- und Speicherplattformen verwalten soll. Oracle ASM partitioniert den Festplattenspeicher und verteilt die Daten gleichmäßig auf die Datenträger, die Oracle ASM bereitgestellt werden. Darüber hinaus verteilt Oracle ASM Daten automatisch neu, wenn Datenträger aus Speicherarrays zum Database Storage Grid hinzugefügt oder daraus entfernt werden.
Siehe:
-
Oracle Automatic Storage Management Administrator's Guide für weitere Informationen zu geclustertem Oracle ASM
Überblick über Data Warehousing und Business Intelligence
Ein Data Warehouse ist eine relationale Datenbank, das eher zur Abfrage und Analyse als zur Transaktionsverarbeitung verwendet wird.
Beispiel: Ein Data Warehouse kann historische Aktienkurse oder Einkommensteuerdatensätze verfolgen. Ein Warehouse enthält in der Regel Daten, die aus historischen Transaktionsdaten abgeleitet werden, kann jedoch Daten aus anderen Quellen enthalten.
Eine Data Warehouse-Umgebung umfasst neben einer relationalen Datenbank mehrere Tools. Eine typische Umgebung umfasst eine ETL-Lösung, eine OLAP-Engine, Clientanalysetools und andere Anwendungen, die Daten erfassen und an Benutzer übermitteln.
-
Data Warehousing und OLTP Eine gängige Art der Einführung von Data Warehousing besteht darin, sich auf die Eigenschaften eines Data Warehouse zu beziehen, wie von William Inmon dargelegt.
-
Data Warehouse Architecture Data Warehouses und ihre Architekturen variieren je nach Geschäftsanforderungen.
-
Überblick über Extraktion, Transformation und Laden (ETL) Der Prozess des Extrahierens von Daten aus Quellsystemen und des Einbringens in das Warehouse wird im Allgemeinen als ETL bezeichnet: Extraktion, Transformation und Laden. ETL bezieht sich auf einen breiten Prozess und nicht auf drei klar definierte Schritte.
-
Business Intelligence ist die Analyse der Informationen einer Organisation, um Geschäftsentscheidungen zu treffen.
Data Warehousing und OLTP
Eine gängige Methode zur Einführung von Data Warehousing besteht darin, sich auf die Eigenschaften eines Data Warehouse zu beziehen, wie sie von William Inmon dargelegt wurden.
Die Eigenschaften sind wie folgt: Fuß 1
-
Themenorientiert
Mit Data Warehouses können Sie eine Datenbank nach Themen wie Vertrieb definieren.
-
Integriert
Data Warehouses müssen Daten aus unterschiedlichen Quellen in ein konsistentes Format aufnehmen. Sie müssen Probleme wie Benennungskonflikte und Inkonsistenzen zwischen Maßeinheiten lösen. Wenn sie dieses Ziel erreichen, sollen sie integriert werden.
-
Nichtflüchtig
Der Zweck eines Lagers besteht darin, Ihnen zu ermöglichen, zu analysieren, was passiert ist. Nachdem Daten in das Warehouse eingegeben wurden, dürfen sich die Daten daher nicht ändern.
-
Zeitvariable
Der Schwerpunkt eines Data Warehouse liegt auf Veränderungen im Zeitverlauf.
Data Warehouses und OLTP-Datenbanken haben unterschiedliche Anforderungen. Um beispielsweise Trends im Geschäft zu erkennen, müssen Data Warehouses große Datenmengen verwalten. Im Gegensatz dazu erfordert eine gute Performance, dass historische Daten regelmäßig von OLTP-Systemen in ein Archiv verschoben werden. In Tabelle 20-4 werden die Unterschiede zwischen Data Warehouses und OLTP aufgeführt.
Tabelle 4: Data Warehouses und OLTP-Systeme
| Eigenschaften | Data Warehouse | OLTP |
|---|---|---|
| Arbeitsauslastung | Konzipiert für Ad-hoc-Abfragen. Möglicherweise kennen Sie die Workload Ihres Data Warehouse nicht im Voraus. Daher sollte es für eine Vielzahl möglicher Abfragen optimiert werden. | Unterstützt nur vordefinierte Vorgänge. Ihre Anwendungen werden möglicherweise speziell optimiert oder so konzipiert, dass sie nur diese Vorgänge unterstützen. |
| Datenänderungen | Regelmäßige Aktualisierung durch den ETL-Prozess mithilfe von Massendatenmodifikationstechniken. Endbenutzer eines Data Warehouse aktualisieren die Datenbank nicht direkt. | Vorbehaltlich einzelner DML-Anweisungen, die routinemäßig von Endbenutzern abgesetzt werden. Die OLTP-Datenbank ist immer auf dem neuesten Stand und spiegelt den aktuellen Status jeder Geschäftstransaktion wider. |
| Schemadesign | Verwendet denormalisierte oder teilweise denormalisierte Schemas (wie ein Star-Schema), um die Abfrageperformance zu optimieren. | Verwendet vollständig normalisierte Schemas zur Optimierung der DML-Performance und zur Gewährleistung der Datenkonsistenz. |
| Typische Vorgänge | Eine typische Abfrage scannt Tausende oder Millionen von Zeilen. Beispiel: Ein Benutzer kann den Gesamtumsatz für alle Kunden im letzten Monat anfordern. | Ein typischer Vorgang greift nur auf eine Handvoll Datensätze zu. Beispiel: Ein Benutzer kann die aktuelle Bestellung für einen einzelnen Kunden abrufen. |
| Historische Daten | Speichert Daten über mehrere Monate oder Jahre, um historische Analysen durchzuführen. | Speichert Daten aus nur wenigen Wochen oder Monaten. Historische Daten, die nach Bedarf gespeichert werden, um die Anforderungen der aktuellen Transaktion zu erfüllen. |
Siehe:
-
Oracle AI Database Data Warehousing Guide für eine detailliertere Beschreibung eines Datenbank-Warehouse
-
Oracle AI Database VLDB and Partitioning Guide für eine ausführlichere Beschreibung eines OLTP-Systems
Data Warehouse-Architektur
Data Warehouses und ihre Architekturen variieren je nach Geschäftsanforderungen.
-
Data Warehouse-Architektur (Basis) In einer einfachen Data Warehouse-Architektur greifen Endbenutzer direkt auf Daten zu, die von mehreren Quellsystemen zum Data Warehouse transportiert wurden.
-
Data Warehouse-Architektur (mit einer Staging Area) Einige Data Warehouses verwenden eine Staging Area, eine Stelle, an der Daten vor dem Eintritt in das Warehouse verarbeitet werden. Eine Staging Area vereinfacht die Erstellung von Summen und die Verwaltung des Warehouse.
-
Data Warehouse-Architektur (mit einer Staging Area und Data Marts) Möglicherweise möchten Sie Ihre Warehouse-Architektur für verschiedene Gruppen in Ihrer Organisation anpassen. Sie können dieses Ziel erreichen, indem Sie Daten im Warehouse zu Data Marts transportieren, bei denen es sich um unabhängige Datenbanken handelt, die für ein bestimmtes Unternehmen oder Projekt entwickelt wurden. In der Regel enthalten Data Marts viele Summentabellen.
Data Warehouse-Architektur (Grundlagen)
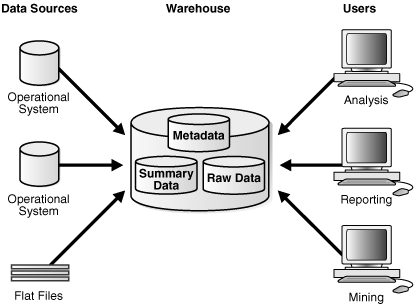
In einer einfachen Data Warehouse-Architektur greifen Endbenutzer direkt auf Daten zu, die von mehreren Quellsystemen in das Data Warehouse transportiert wurden.
Die folgende Abbildung zeigt eine Beispielarchitektur.
Abbildung 3: Architektur eines Data Warehouse
Beschreibung der Abbildung cncpt170.gif
Die obige Abbildung zeigt sowohl die Metadaten als auch die Rohdaten eines herkömmlichen OLTP-Systems und Übersichtsdaten. Eine Zusammenfassung ist eine Aggregatansicht, die die Abfrageperformance verbessert, indem aufwändige Joins und Aggregationsvorgänge vorab berechnet und die Ergebnisse in einer Tabelle gespeichert werden. Beispiel: Eine Übersichtstabelle kann die Umsatzsummen nach Region und Produkt enthalten. Zusammenfassungen werden auch als Materialized Views bezeichnet.
Siehe auch: Oracle AI Database Data Warehousing Guide mit Informationen zu grundlegenden Materialized Views
Data Warehouse-Architektur (mit einer Staging Area)
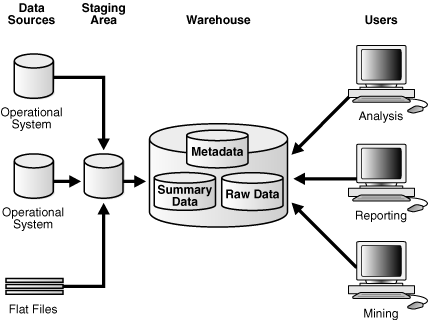
Einige Data Warehouses verwenden eine Staging Area, eine Stelle, an der Daten vor dem Eintritt in das Warehouse verarbeitet werden. Eine Staging Area vereinfacht die Erstellung von Summen und die Verwaltung des Warehouse.
Die folgende Grafik zeigt eine Staging Area.
Abbildung 4: Architektur eines Data Warehouse mit einer Staging Area
Beschreibung der Abbildung cncpt171.gif
Siehe auch: Oracle AI Database Data Warehousing Guide, um mehr über verschiedene Transportmechanismen zu erfahren
Data Warehouse-Architektur (mit Staging Area und Data Marts)
Sie können Ihre Warehouse-Architektur für verschiedene Gruppen in Ihrer Organisation anpassen. Sie können dieses Ziel erreichen, indem Sie Daten im Warehouse zu Data Marts transportieren, bei denen es sich um unabhängige Datenbanken handelt, die für ein bestimmtes Unternehmen oder Projekt entwickelt wurden. In der Regel enthalten Data Marts viele Summentabellen. In Abbildung 20-5 werden Einkaufs-, Vertriebs- und Bestandsinformationen in unabhängige Data Marts unterteilt. Ein Finanzanalyst kann die Data Marts nach historischen Informationen über Käufe und Verkäufe abfragen.
Abbildung 5: Architektur eines Data Warehouse mit Staging Area und Data Marts
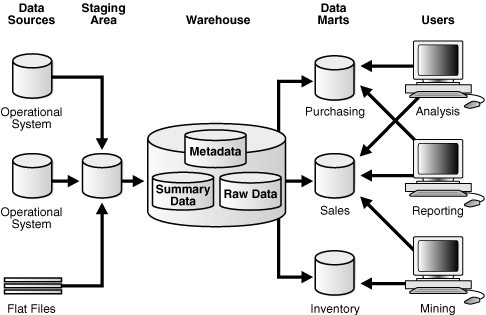
Beschreibung der Abbildung cncpt172.gif
Siehe auch: Oracle AI Database Data Warehousing Guide mit Informationen zu Transformationsmechanismen
Übersicht über Extraktion, Transformation und Laden (ETL)
Der Prozess des Extrahierens von Daten aus Quellsystemen und des Einbringens in das Warehouse wird üblicherweise als ETL bezeichnet: Extrahieren, Transformieren und Laden. ETL bezieht sich auf einen breiten Prozess und nicht auf drei klar definierte Schritte.
In einem typischen Szenario werden Daten aus einem oder mehreren Betriebssystemen extrahiert und dann physisch zum Zielsystem oder einem Zwischensystem zur Verarbeitung transportiert. Abhängig von der Transportmethode können während dieses Prozesses einige Transformationen auftreten. Beispiel: Eine SQL-Anweisung, die direkt über ein Gateway auf ein Remoteziel zugreift, kann zwei Spalten als Teil der SELECT-Anweisung verketten.
Oracle AI Database ist selbst kein ETL-Tool. Oracle AI Database bietet jedoch zahlreiche Funktionen, die von ETL-Tools und benutzerdefinierten ETL-Lösungen verwendet werden können. Zu den von Oracle AI Database bereitgestellten ETL-Funktionen gehören:
-
Transportable Tablespaces
Sie können Tablespaces zwischen verschiedenen Computerarchitekturen und Betriebssystemen übertragen. Transportable Tablespaces sind die schnellste Möglichkeit, große Datenmengen zwischen zwei Oracle-Datenbanken zu verschieben.
-
Table-Funktionen
Eine Tabellenfunktion ist eine benutzerdefinierte PL/SQL-Funktion, die eine Collection von Zeilen (eine verschachtelte Tabelle oder ein Varray) zurückgibt. Tabellenfunktionen können eine Gruppe von Zeilen als Ausgabe erzeugen und eine Gruppe von Zeilen als Eingabe akzeptieren. Tabellenfunktionen unterstützen die Pipeline- und parallele Ausführung von Transformationen, die in PL/SQL, C oder Java implementiert sind, ohne dass Zwischenspeichertabellen erforderlich sind.
-
Externe Tabellen
Mit externen Tabellen können externe Daten direkt und parallel verknüpft werden, ohne dass sie zuerst in die Datenbank geladen werden müssen. So ermöglichen externe Tabellen das Pipelining der Ladephase mit der Transformationsphase.
-
Tabellenkomprimierung
Um die Festplattenbelegung und die Speicherbelegung zu reduzieren, können Sie Tabellen und partitionierte Tabellen in einem komprimierten Format speichern. Die Verwendung der Tabellenkomprimierung führt häufig zu einer besseren Skalierung für schreibgeschützte Vorgänge und einer schnelleren Abfrageausführung.
Siehe:
-
Oracle AI Database Data Warehousing Guide für einen Überblick über ETL
Business Intelligence
Business Intelligence ist die Analyse der Informationen einer Organisation, um Geschäftsentscheidungen zu treffen.
Analytische Anwendungen und Business Intelligence werden durch Drilldowns von Hierarchien und Vergleich von Aggregatwerten dominiert. Oracle AI Database bietet verschiedene Technologien zur Unterstützung solcher Vorgänge.
-
Analytic SQL Oracle AI Database hat viele SQL-Vorgänge zur Ausführung von Analysevorgängen eingeführt. Diese Operationen umfassen Ranking, gleitende Durchschnitte, kumulative Summen, Verhältnis-zu-Berichte und Periodenvergleiche.
-
Analyse-Views erweitern den Inhalt von Datasets und vereinfachen die Entwicklung von Business-Intelligence-Anwendungen.
-
Oracle Advanced Analytics Mit der Oracle Advanced Analytics-Option wird Oracle AI Database zu einer umfassenden erweiterten Analyseplattform für Big-Data-Analysen erweitert.
Analytisches SQL
Oracle AI Database hat viele SQL-Vorgänge zur Ausführung von Analysevorgängen eingeführt. Diese Operationen umfassen Ranking, gleitende Durchschnitte, kumulative Summen, Verhältnis-zu-Berichte und Periodenvergleiche.
Beispiel: Oracle AI Database unterstützt die folgenden Formen von analytischem SQL.
Tabelle 5: Analytisches SQL
| Typ des analytischen SQL | Beschreibung | Weitere Infos |
|---|---|---|
| SQL für Aggregation | Eine Aggregatfunktion, wie COUNT, gibt eine einzelne Ergebniszeile zurück, die auf einer Gruppe von Zeilen basiert. Aggregation ist für Data Warehousing von grundlegender Bedeutung. Um die Aggregationsleistung in einem Warehouse zu verbessern, bietet die Datenbank Erweiterungen für die GROUP BY-Klausel, um Abfragen und Reporting einfacher und schneller zu gestalten. |
Oracle AI Database Data Warehousing Guide für Informationen zur Aggregation |
| SQL für die Analyse | Eine analytische Funktion wie MAX aggregiert eine Gruppe von Zeilen (als Fenster bezeichnet), um mehrere Zeilen als Ergebnismenge zurückzugeben. Oracle verfügt über erweiterte SQL-Analyseverarbeitungsfunktionen mit einer Reihe von analytischen SQL-Funktionen. Mit diesen analytischen Funktionen können Sie beispielsweise Rankings und Perzentile berechnen und Fenster verschieben. |
Oracle AI Database Data Warehousing Guide für Informationen zu SQL für Analysen und Berichte |
| SQL für die Modellierung | Mit der Klausel MODEL können Sie ein mehrdimensionales Array aus Abfrageergebnissen erstellen und Regeln auf dieses Array anwenden, um neue Werte zu berechnen. Beispiel: Sie können Daten in einer Vertriebsansicht nach Land partitionieren und für jedes Land eine Modellberechnung durchführen, die durch mehrere Regeln definiert ist. Eine Regel könnte die Verkäufe eines Produkts im Jahr 2008 als Summe der Verkäufe in den Jahren 2006 und 2007 berechnen. |
Oracle AI Database Data Warehousing Guide für Informationen zur SQL-Modellierung |
Siehe auch: Oracle AI Database SQL Language Reference, um mehr über SQL-Funktionen zu erfahren
Analyse-Views
Analyse-Views erweitern den Inhalt von Datasets und vereinfachen die Entwicklung von Business-Intelligence-Anwendungen.
Analytische Views weisen die folgenden Eigenschaften auf:
-
Die Daten werden mit hierarchischen und dimensionalen Konzepten organisiert.
-
Joins, Aggregationen und Kennzahlenberechnungsregeln sind in die Analyse-View eingebettet.
-
Kann mit SQL DDL über vorhandene Tabellen, Views und andere Objekte in der Datenbank geschichtet werden.
-
Kann mit einfachem SQL abgefragt werden.
Siehe auch: Oracle AI Database Data Warehousing Guide für einen Überblick über Analyseansichten
Oracle Advanced Analytics
Die Oracle Advanced Analytics-Option erweitert Oracle AI Database in eine umfassende erweiterte Analyseplattform für Big-Data-Analysen.
Oracle Advanced Analytics bietet prädiktive Analysen, Data Mining, Text-Mining, statistische Analysen, erweiterte numerische Berechnungen und interaktive Grafiken in der Datenbank. Oracle Advanced Analytics umfasst die folgenden Komponenten:
-
Oracle Data Mining In Business Intelligence ist Data Mining die Verwendung ausgefeilter mathematischer Algorithmen, um Daten zu segmentieren und die Wahrscheinlichkeit zukünftiger Ereignisse zu bewerten.
-
R ist eine Open-Source-Sprache und -Umgebung für statistische Berechnungen und Grafiken. Oracle Machine Learning for R macht R bereit für Unternehmen und Big-Data.
Oracle Data Mining
In Business Intelligence ist Data Mining die Verwendung ausgefeilter mathematischer Algorithmen, um Daten zu segmentieren und die Wahrscheinlichkeit zukünftiger Ereignisse zu bewerten.
Typische Anwendungen des Data Mining sind Call Center, Geldautomaten, E-Business relational Management (ERM) und Geschäftsplanung. Mit Oracle Data Miner können Datenanalysten schnell Daten analysieren, die besten Kunden ansprechen, Betrug bekämpfen und wichtige Korrelationen und Muster finden, die ihren Unternehmen helfen können, besser im Wettbewerb zu bestehen.
Oracle Data Mining bietet Data-Mining-Algorithmen, die als native SQL-Funktionen ausgeführt werden, um datenbankinterne Modellerstellung und Modellbereitstellung mit hoher Performance zu ermöglichen. Oracle Data Mining kann Tabellen, Ansichten, Star-Schemas, Transaktionsdaten und unstrukturierte Daten abbauen.
Oracle Data Mining unterstützt eine PL/SQL-API und SQL-Funktionen für die Modellbewertung. Daher bietet Oracle AI Database eine Infrastruktur für Anwendungsentwickler, mit der Data Mining nahtlos in Datenbankanwendungen integriert werden kann.
Oracle Data Miner, eine SQL Developer-Erweiterung, bietet eine GUI für Oracle Data Mining.
Siehe auch: Oracle Machine Learning for SQL - Konzepte
Oracle Machine Learning for R
R ist eine Open-Source-Sprache und -Umgebung für statistische Berechnungen und Grafiken. Oracle Machine Learning for R macht R bereit für Unternehmen und Big-Data.
Oracle Machine Learning for R wurde für Probleme mit großen Datenmengen entwickelt und integriert R in die Oracle AI Database. Sie können R-Befehle und -Skripte für statistische und grafische Analysen zu Daten ausführen, die in der Oracle AI Database gespeichert sind. Außerdem können Sie R-Skripte entwickeln, verfeinern und bereitstellen, die zur Automatisierung der Datenanalyse die Parallelität und Skalierbarkeit der Datenbank nutzen. Datenanalysten können R-Packages ausführen und R-Skripte für analytische Anwendungen in einem Schritt entwickeln, ohne SQL erlernen zu müssen.
Siehe auch: Oracle Machine Learning for R - Benutzerdokumentation
Überblick über Oracle Information Integration
Wenn sich ein Unternehmen weiterentwickelt, wird es immer wichtiger, Informationen zwischen mehreren Datenbanken und Anwendungen teilen zu können.
Die grundlegenden Ansätze für den Informationsaustausch sind:
-
Konsolidierung
Sie können die Informationen in einer einzigen Datenbank konsolidieren, sodass keine weitere Integration erforderlich ist. Mit Oracle RAC, Grid Computing, der Multi-Tenant-Architektur und Oracle VPD können Sie Informationen in einer einzigen Datenbank konsolidieren.
-
Föderation
Sie können Informationen verteilt lassen und Tools bereitstellen, um diese Informationen zu föderieren, sodass sie sich in einer einzigen virtuellen Datenbank befinden.
-
Teilen
Sie können Informationen freigeben, mit denen Sie die Informationen in mehreren Datenspeichern und Anwendungen verwalten können.
Dieser Abschnitt konzentriert sich auf Oracle-Lösungen zum Föderieren und Teilen von Informationen.
-
Federated Access Die Grundlage des föderierten Zugriffs ist eine verteilte Umgebung, bei der es sich um ein Netzwerk unterschiedlicher Systeme handelt, die nahtlos miteinander kommunizieren.
-
Informationsfreigabe Das Herzstück jeder Integration ist die gemeinsame Nutzung von Daten zwischen Anwendungen im Unternehmen.
Föderierter Zugriff
Die Grundlage des föderierten Zugriffs ist eine verteilte Umgebung, bei der es sich um ein Netzwerk unterschiedlicher Systeme handelt, die nahtlos miteinander kommunizieren.
Jedes System in der Umgebung wird als Knoten bezeichnet. Das System, mit dem ein Benutzer direkt verbunden ist, wird als lokales System bezeichnet. Weitere Systeme, auf die dieser Benutzer zugreift, sind Remote-Systeme.
Eine verteilte Umgebung ermöglicht Anwendungen den Zugriff auf und den Austausch von Daten aus lokalen und Remote-Systemen. Alle Daten können gleichzeitig abgerufen und geändert werden.
-
Distributed SQL Distributed SQL greift synchron auf Daten zu, die auf mehrere Datenbanken verteilt sind, und aktualisiert sie. Ein verteiltes Datenbanksystem von Oracle kann für Benutzer transparent sein, sodass es als eine einzelne Oracle-Datenbank angezeigt wird.
-
Datenbanklinks Ein Datenbanklink ist eine Verbindung zwischen zwei physischen Datenbanken, über die ein Client als eine logische Datenbank auf sie zugreifen kann.
Verteiltes SQL
Distributed SQL greift synchron auf Daten zu, die auf mehrere Datenbanken verteilt sind, und aktualisiert sie. Ein verteiltes Datenbanksystem von Oracle kann für Benutzer transparent sein, sodass es als eine einzelne Oracle-Datenbank angezeigt wird.
Verteiltes SQL umfasst verteilte Abfragen und verteilte Transaktionen. Die verteilte Datenbankarchitektur von Oracle bietet Abfrage- und Transaktionstransparenz. Beispiel: Standard-DML-Anweisungen funktionieren genauso wie in einer nicht verteilten Datenbankumgebung. Darüber hinaus steuern Anwendungen Transaktionen mit den SQL-Standardanweisungen COMMIT, SAVEPOINT und ROLLBACK.
Siehe:
-
Oracle AI Database Administrator's Guide, um zu erfahren, wie verteilte Transaktionen verwaltet werden
Datenbanklinks
Ein Datenbanklink ist eine Verbindung zwischen zwei physischen Datenbanken, über die ein Client als eine logische Datenbank auf sie zugreifen kann.
Oracle AI Database verwendet Datenbanklinks, um Benutzern aus einer Datenbank den Zugriff auf Objekte in einer Remotedatenbank zu ermöglichen. Ein lokaler Benutzer kann auf einen Link zu einer Remotedatenbank zugreifen, ohne ein Benutzer in der Remotedatenbank zu sein. Abbildung 20-6 zeigt ein Beispiel für den Benutzer hr, der auf die Tabelle employees in der Remotedatenbank mit dem globalen Namen hq.example.com zugreift. Das Synonym employees blendet die Identität und den Speicherort des Remote-Schemaobjekts aus.
Abbildung 6: Datenbanklink
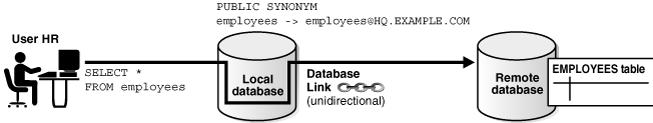
Beschreibung der Abbildung cncpt243.gif
Siehe auch: Oracle AI Database Administrator's Guide, um mehr über Datenbanklinks zu erfahren
Informationen freigeben
Das Herzstück jeder Integration ist die gemeinsame Nutzung von Daten zwischen Anwendungen im Unternehmen.
-
Oracle GoldenGate Oracle GoldenGate ist ein asynchrones, logbasiertes Echtzeit-Datenreplikationsprodukt.
-
Oracle AI Database Transactional Event Queues and Advanced Queuing (AQ) Oracle AI Database Transactional Event Queues and Advanced Queuing (AQ) ist ein robustes und funktionsreiches Message Queuing-System, das in Oracle AI Database integriert ist.
Oracle GoldenGate
Oracle GoldenGate ist ein asynchrones, logbasiertes Echtzeit-Datenreplikationsprodukt.
Oracle GoldenGate verschiebt große Mengen an Transaktionsdaten in Echtzeit in heterogene Datenbank-, Hardware- und Betriebssystemumgebungen mit minimalen Auswirkungen. Es optimiert den Informationszugriff und die Verfügbarkeit in Echtzeit, da es:
-
Unterstützt Replikation mit einer heterogenen Mischung aus Oracle AI Database- und Nicht-Oracle-Datenbanken
-
Behält die kontinuierliche Verfügbarkeit geschäftskritischer Systeme bei und minimiert so Ausfallzeiten während der geplanten Wartung
-
Ermöglicht die Datenintegration in Echtzeit im gesamten Unternehmen
-
Bidirektionale Replikation zwischen Shards in einer gemeinsam verwendeten Tabelle automatisch konfigurieren
Eine typische Umgebung umfasst einen Erfassungs-, Pumpen- und Lieferprozess. Jeder Prozess kann auf den meisten gängigen Betriebssystemen und Datenbanken ausgeführt werden, einschließlich Oracle-Datenbanken und Nicht-Oracle-Datenbanken. Einige oder alle Daten können repliziert werden. Die Daten in einem dieser Prozesse können sowohl für heterogene Umgebungen als auch für verschiedene Datenbankschemas bearbeitet werden.
Oracle GoldenGate unterstützt Multimaster-Replikation, Hub-and-Spoke-Deployment, Datenkonsolidierung und Datentransformation. So können Sie mit Oracle GoldenGate sicherstellen, dass Ihre kritischen Systeme 24/7 betriebsbereit sind und die zugehörigen Daten im gesamten Unternehmen verteilt werden, um die Entscheidungsfindung zu optimieren.
Siehe:
-
Oracle Globally Distributed AI Database, um zu erfahren, wie Oracle Sharding verwendet wird
-
http://www.oracle.com/technetwork/middleware/goldengate/documentation/index.html
Oracle AI Database Transactional Event Queues und Advanced Queuing (AQ)
Oracle AI Database Transactional Event Queues and Advanced Queuing (AQ) ist ein robustes und funktionsreiches Message Queuing-System, das in Oracle AI Database integriert ist.
Wenn eine Organisation über unterschiedliche Systeme verfügt, die miteinander kommunizieren müssen, kann eine Messaging-Umgebung eine standardmäßige, zuverlässige Möglichkeit bieten, kritische Informationen zwischen diesen Systemen zu übertragen.
Ein Beispielanwendungsfall ist ein Unternehmen, das Aufträge in einer Oracle-Datenbank am Hauptsitz eingibt. Bei der Eingabe eines Auftrags werden die Auftrags-ID und das Auftragsdatum über AQ an eine Datenbank in einem Lager gesendet. Anhand dieser Nachrichten sollen die Lagermitarbeiter über die Aufträge informiert werden, damit sie die Aufträge bearbeiten und versenden können.
-
Message Queuing und Dequeuing Oracle AI Database Transactional Event Queues und Advanced Queuing speichern Benutzernachrichten in abstrakten Speichereinheiten, die als Queues bezeichnet werden.
-
Oracle AI Database Transactional Event Queues und Advanced Queuing - Erweiterte Features Oracle AI Database Transactional Event Queues und Advanced Queuing (AQ) unterstützen alle Standardfeatures von Message Queuing-Systemen.
Nachrichtenwarteschlange und -dequeuing
Oracle AI Database Transactional Event Queues und Advanced Queuing speichern Benutzernachrichten in abstrakten Speichereinheiten, die als Queues bezeichnet werden.
Enqueuing ist der Prozess, bei dem Producer Nachrichten in Queues platzieren. Dequeuing ist der Prozess, bei dem Consumer Nachrichten aus Queues abrufen.
Durch die Unterstützung von expliziter Dequeue können Entwickler XStream und Oracle GoldenGate verwenden, um Nachrichten zuverlässig auszutauschen. Sie können Anwendungen auch über Änderungen benachrichtigen, indem sie die Change Capture- und Propagierungsfeatures von Oracle GoldenGate nutzen. Abbildung 20-7 zeigt eine Beispielanwendung, die Nachrichten explizit über Advanced Queuing in die Queue stellt und aus der Queue entfernt, sodass sie Informationen mit Partnern teilen können, die verschiedene Messaging-Systeme verwenden. Nachdem Nachrichten in die Queue gestellt wurden, können sie transformiert und propagiert werden, bevor sie in die Partneranwendung aus der Queue entfernt werden.
Abbildung 7: Oracle Message Queuing
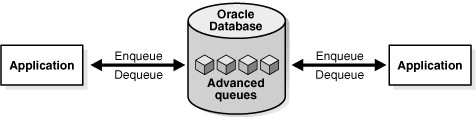
Beschreibung der Abbildung cncpt310.gif
Oracle AI Database Transactional Event Queues und Advanced Queuing - Erweiterte Features
Oracle AI Database Transactional Event Queues und Advanced Queuing (AQ) unterstützen alle Standardfeatures von Message Queuing-Systemen.
Zu den Features gehören:
-
Asynchrone Anwendungsintegration
Transactional Event Queues und Advanced Queuing bieten verschiedene Möglichkeiten zum Enqueue von Nachrichten. Ein Capture-Prozess oder ein synchroner Capture-Prozess kann die Nachrichten implizit erfassen, oder Anwendungen und Benutzer können Nachrichten explizit erfassen.
-
Erweiterbare Integrationsarchitektur
Viele Anwendungen sind in ein verteiltes Hub-and-Spoke-Modell mit Oracle AI Database als Hub integriert. Die verteilten Anwendungen in einer Oracle-Datenbank kommunizieren mit Queues im selben Hub. Mehrere Anwendungen verwenden dieselbe Queue, sodass keine Warteschlangen hinzugefügt werden müssen, um zusätzliche Anwendungen zu unterstützen.
-
Heterogene Anwendungsintegration
Transactional Event Queues und Advanced Queuing bieten Anwendungen die volle Leistungsfähigkeit des Oracle-Systems. Sie umfasst Unterstützung für skalare Datentypen, Oracle AI Database-Objekttypen mit Vererbung,
XMLTypemit zusätzlichen Operatoren für XML-Daten undANYDATA. -
Legacy-Anwendungsintegration
Oracle Messaging Gateway integriert Oracle AI Database-Anwendungen mit anderen Message Queuing-Systemen, wie Websphere MQ und Tibco.
-
Standardbasierte API-Unterstützung
Transactional Event Queues und Advanced Queuing unterstützen branchenübliche APIs: SQL, JMS und SOAP. Mit SQL vorgenommene Änderungen werden automatisch als Nachrichten erfasst.
Siehe auch: Oracle AI Database Transactional Event Queues and Advanced Queuing - Benutzerdokumentation
Fußnotenlegende
Fußnote 1:
Building the Data Warehouse, John Wiley and Sons, 1996.